


Phi-4 Technical Report 요약 설명
12 Dec 2024 | Paper Review Synthetic Training Data LLM Pretraining Direct Preference Optimization목차
이번 글에서는 Phi-4 Technical Report 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 12월 12일(Arxiv)
- Abdin, Marah, Aneja, Jyoti, Behl, Harkirat, Bubeck, Sébastien, Eldan, Ronen, Gunasekar, Suriya, Harrison, Michael, Hewett, Russell J., Javaheripi, Mojan, Kauffmann, Piero, et al.
- Microsoft Research
- 논문 링크
요약
- 소형 언어 모델의 추론 능력을 높이려면 사실 지식을 유지하면서 유용한 풀이 단계를 가르치는 학습 데이터가 필요하다. 프롬프트, 답변 추출 방식, 샘플링 설정을 고정하는 평가 프레임워크인 simple-evals에서 temperature 0.5로 평가했을 때, 14-billion-parameter phi-4는 교사 모델인 GPT-4o를 능가한다. 대학원 수준의 과학 질의응답 벤치마크인 GPQA에서는 56.1 대 50.6, 수학 경시대회 벤치마크인 MATH에서는 80.4 대 74.6을 기록한다.
- 학습 방식은 모델이 생성한 합성 데이터와 필터링한 인간 작성 데이터 또는 그 밖의 비합성 자료를 결합한다. 초기의 광범위한 학습 단계인 사전학습에는 약 10T 토큰을 사용한다. 토큰은 학습 중 처리하는 텍스트 단위다. 이후 입력 문맥을 확장하는 중간학습, 선별한 응답 예시로 학습하는 Supervised Fine-Tuning(SFT), 선호 응답과 비선호 응답으로 학습하는 Direct Preference Optimization(DPO)을 진행한다.
- Pivotal Token Search(PTS)는 선택에 따라 최종 답변의 정답 여부가 크게 달라지는 개별 토큰을 찾아, 첫 DPO 단계에 사용할 선호도 쌍을 제공한다. 새로 공개된 2024년 11월 American Mathematics Competitions(AMC) 시험 결과는 수학 성능을 뒷받침한다. 다만 사실 지식, 엄격한 지시 준수, 일부 긴 문맥 과제는 여전히 약점이다. 보고서는 평가의 모호한 부분과 벤치마크 오염 방지의 한계도 기록한다. 벤치마크 오염은 평가 자료가 학습 데이터에 포함되는 현상이다.
1 Introduction
보고서는 phi-4의 성능 향상이 주로 데이터 생성, 데이터 혼합 설계, 후속학습에서 비롯되며, phi-3-medium과 비교한 아키텍처 변화는 비교적 작다고 설명한다. 개발의 3가지 핵심 요소는 사전학습과 중간학습용 합성 데이터, 고품질 비합성 데이터 선별, 후속학습 데이터셋과 선호도 쌍의 개선이다.
- 합성 데이터 생성에는 여러 모델 역할, 반복적인 비평과 수정, 코드 같은 기존 출력에서 지시문을 만드는 instruction reversal을 사용한다.
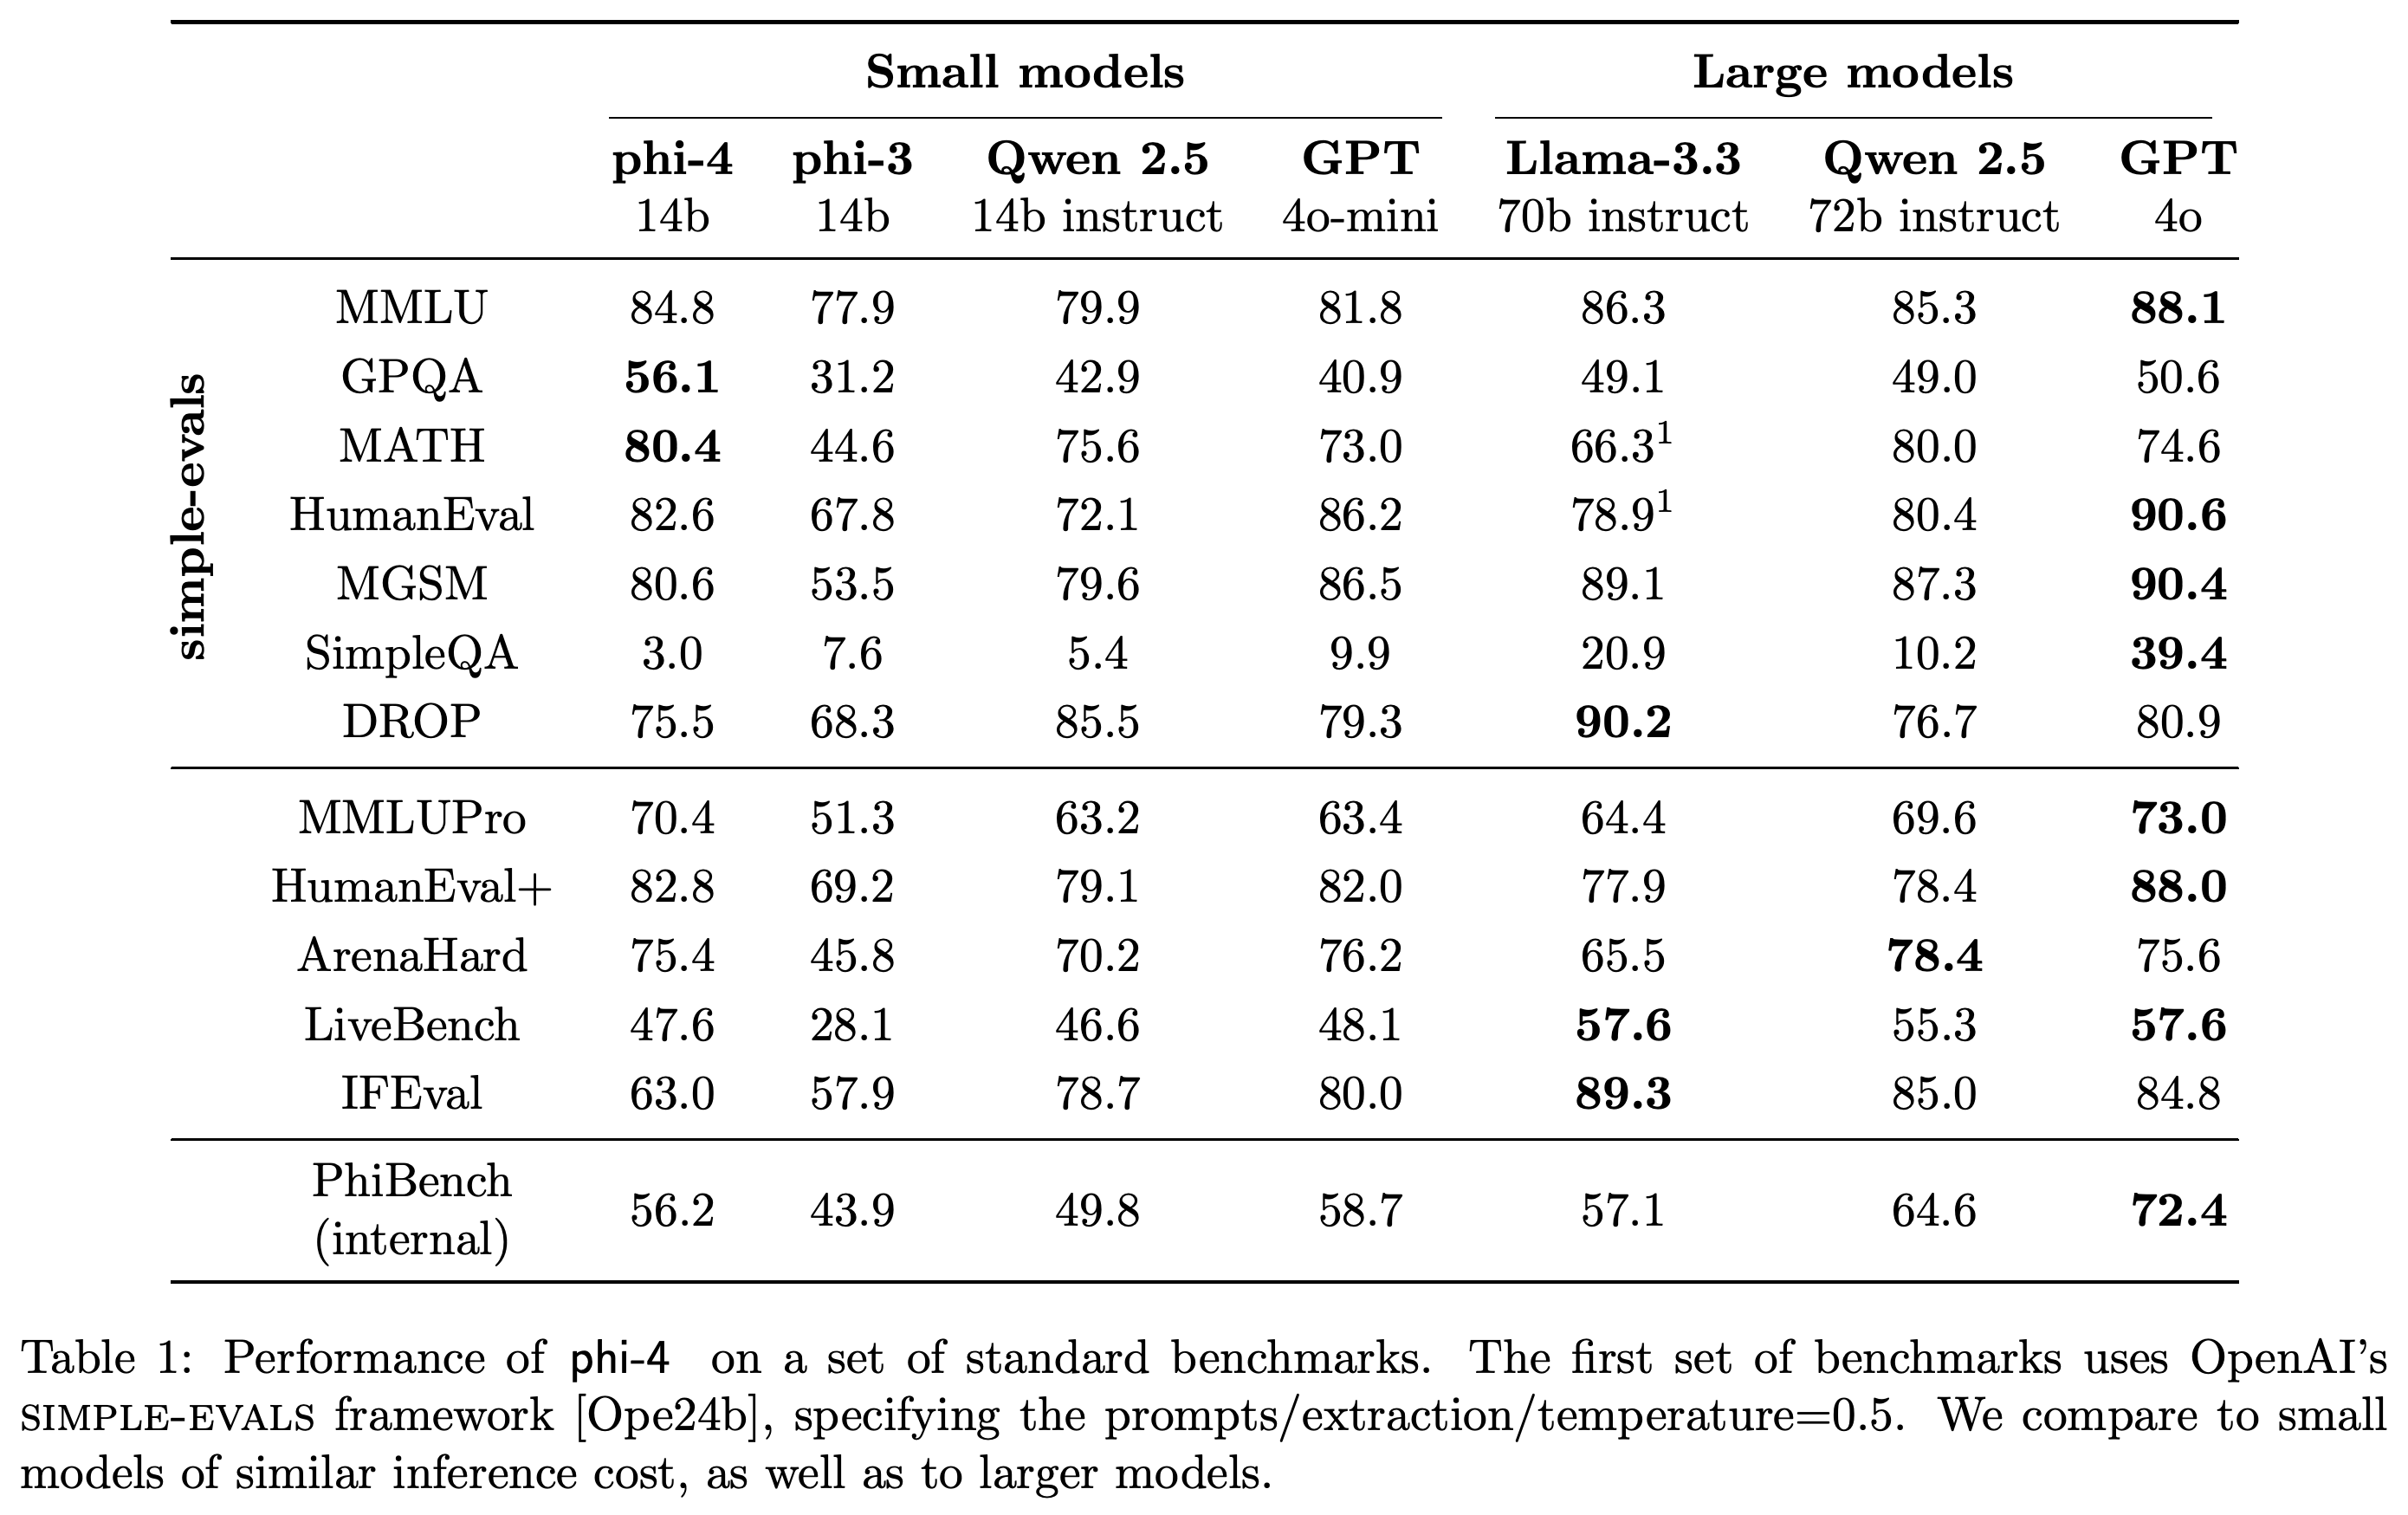
- Table 1은 수학과 과학에서는 강한 성능을 보이지만, 사실 질의응답과 엄격한 지시 준수에서는 상대적으로 약한 결과를 보여 준다.
Phi-4는 나열된 모델 중 GPQA와 MATH에서 앞서지만, 사실 질의응답과 엄격한 지시 준수에서는 크게 뒤처진다. 이 비교는 보고된 평가 절차에서 과제별 강점을 보여 준다. 첫 벤치마크 묶음은 temperature 0.5의 simple-evals를 사용한다.
1.1 Addressing Overfitting and Data Contamination
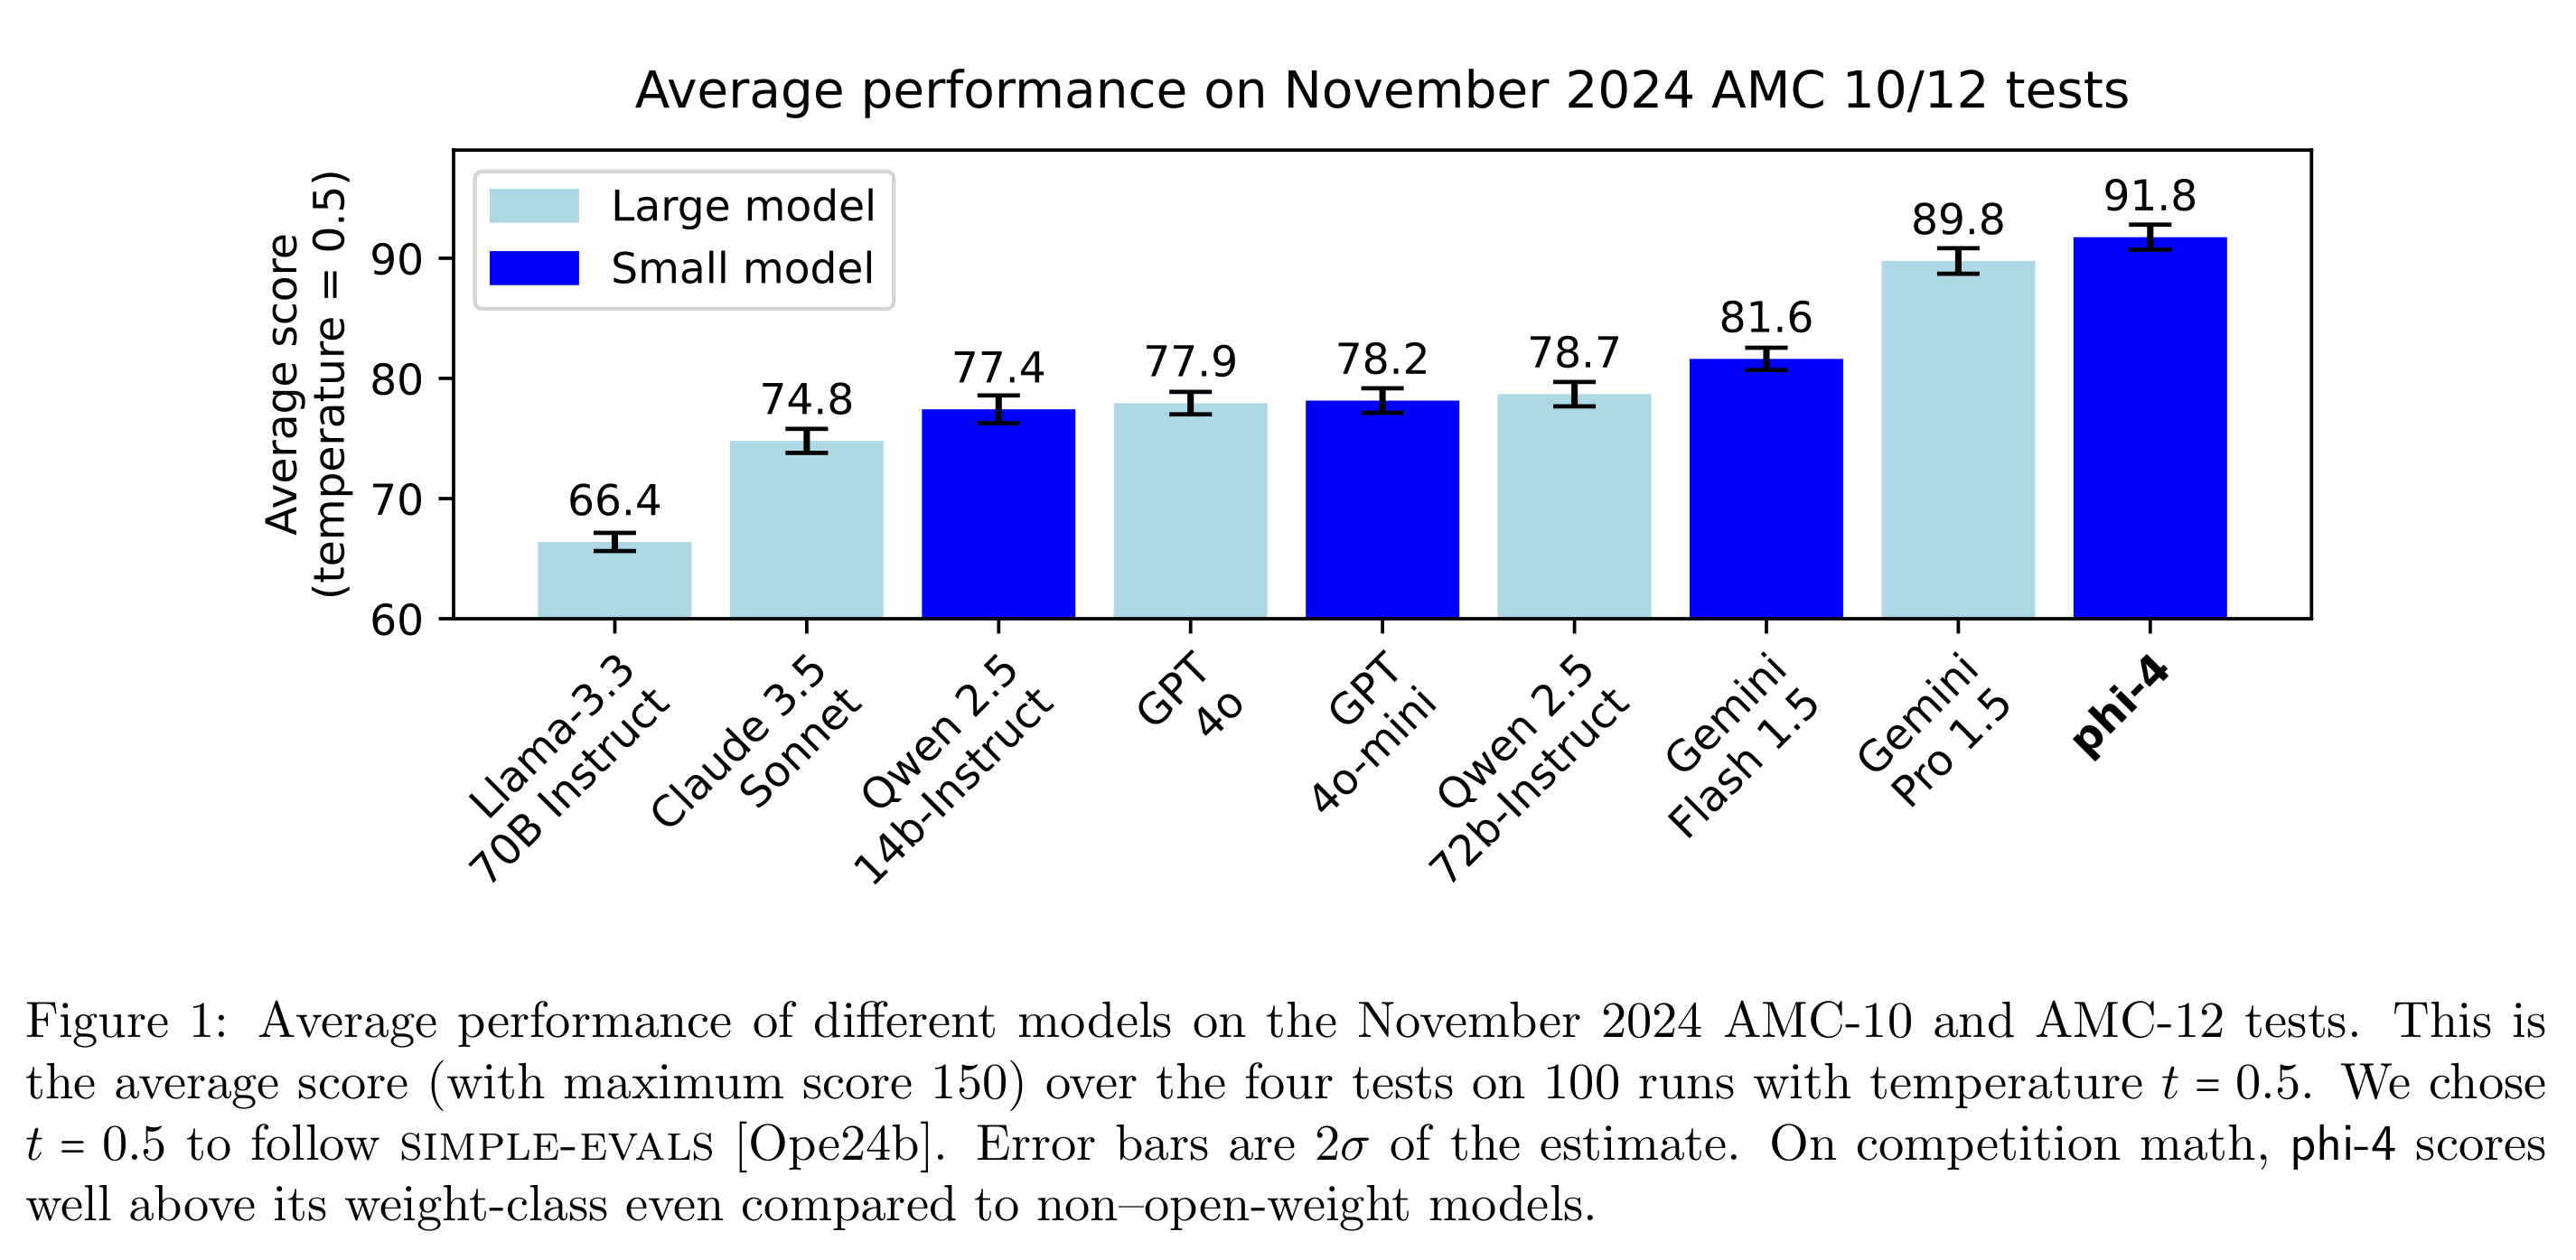
저자들은 필터링 강화, 내부에서 직접 작성한 질문, 학습 데이터 수집 이후 공개된 2024년 11월 AMC-10과 AMC-12 문제 평가로 오염 문제에 대응한다. Figure 1에서 temperature 0.5로 평가한 phi-4는 150점 만점에 91.8점을 기록하며, GPT-4o는 77.9점, Gemini Pro 1.5는 89.8점을 기록한다.
- 그림 캡션은 시험 4개에 대해 100회 실행한 평균을 보고하고, 추정 표준편차의 2배인 2σ 오차 막대를 표시한다고 설명한다. Appendix C는 질문당 독립 생성 10회를 명시하지만, 이 샘플링 설명들이 어떤 관계인지는 설명하지 않는다.
- 추론 시 긴 단계별 풀이를 생성하는 QwQ-32B-Preview는 이 설정에서 124.5를 기록하지만, 토큰을 4X 더 사용하고 파라미터도 두 배를 넘는다. 따라서 보고서는 이 모델을 비용과 지연 시간이 다른 범주로 분류한다.
- 시험 공개 시점은 학습 데이터와 직접 겹치지 않았다는 근거가 된다. 다만 Appendix C는 최종 모델의 점수를 측정하기 전에 다른 최종 후보 2개를 평가했다고 공개한다.
새로 공개된 경시대회 시험에서 phi-4는 150점 만점에 91.8점으로, Gemini Pro 1.5의 89.8점과 GPT-4o의 77.9점보다 높다. 캡션은 100회 실행과 2σ 오차 막대를 명시하지만, Appendix C는 질문당 독립 생성 10회를 명시하며 이 둘의 관계를 설명하지 않는다.
2 Approach to Data
사전학습은 상호 보완적인 여러 기법으로 생성한 합성 데이터셋에 크게 의존한다. 필터링한 비합성 자료는 직접 학습에 사용하면서 합성 생성을 시작하는 시드로도 활용한다. 시드는 생성의 출발점이 되는 원문 구절이나 질문이다.
2.1 Purpose of Synthetic Data
저자들은 합성 텍스트가 중간 단계를 생성 순서대로 제시하므로 다음 토큰 예측을 통해 추론을 더 쉽게 학습할 수 있다고 주장한다. 다음 토큰 예측은 앞선 텍스트 단위로 다음 단위를 예측하는 방식이다. 또한 원문의 지식을 어시스턴트 형식으로 재작성하면 사전학습 예시가 추론 시 접하는 문맥에 가까워진다고 설명한다.
- 제시한 생성 원칙은 다양성, 미묘한 차이와 복잡성, 정확성, 명시적인 단계별 추론인 Chain-of-Thought다.
- 이 절은 데이터 구성 방식이 효과적인 이유를 제안하지만, 각 메커니즘의 효과를 독립적으로 정량화하지는 않는다.
2.2 Synthetic Data for Pretraining and Midtraining
연구팀은 서로 다른 시드와 다단계 프롬프팅 절차를 사용해 합성 데이터셋 유형 50개를 만들었다. 가중치 적용 전의 총 토큰 수는 약 400B 규모다. 생성 과정은 원문 선택, 연습문제나 토론 형식으로 재작성, 자체 수정, instruction reversal, 검증을 결합한다.
- 원문 구절은 먼저 교육적 가치를 기준으로 필터링한 뒤 사실과 추론 내용을 기준으로 다시 필터링한다. 질문 시드는 여러 독립 답변을 통해 선별하며, 답변이 모두 일치하거나 전혀 일관되지 않는 질문은 제외한다. 별도의 파이프라인은 원문에 있는 연역 추론 과정을 질문과 답변 쌍으로 변환한다.
- 참조 정답이 없을 때는 가장 자주 생성된 답변인 최다 빈도 답변을 rejection sampling에 사용한다. 이 과정은 선택한 정답 기준을 충족하는 생성 응답을 남긴다.
- Instruction reversal은 기존 코드에서 과제 프롬프트를 도출하고, 원래 코드와 재생성한 코드의 일치도가 높은 쌍을 유지한다. 적절한 경우에는 실행과 테스트로 합성 코드를 검증한다.
2.3 Curation and Filtering of Web and Q&A Data
저자들은 비합성 문제와 풀이 수천만 건을 수집했으며, ablation 실험에서 원래 질문이 합성 질문보다 훨씬 효과적이었다고 보고한다. 신뢰하기 어려운 원문 답변은 다수결로 뒷받침한 생성 답변으로 대체하고, 질문과 풀이는 평가 세트와 대조해 필터링했다.
- 약 10^6개의 모델 생성 주석으로 학습한 소형 분류기가 고품질 웹 문서를 선별한다. 별도 파이프라인은 초기 필터링에서 부족했던 예술, 역사, 여행, 문화, 엔터테인먼트 분야의 비중을 늘린다.
- 다국어 처리에서는 텍스트 분류 도구인 fastText 기반 언어 식별 모델로 문서를 176개 언어로 분류한 뒤 품질을 필터링한다.
- 맞춤형 추출 과정은 웹페이지와 여러 문서 형식에서 수식, 코드, 표, 포럼 구조를 보존한다. 보고서는 시드 자료의 오류가 합성 문서로 전파될 수 있다고 강조한다.
2.4 Post-Training datasets
후속학습 데이터셋은 공개 프롬프트와 합성 프롬프트에 여러 생성 응답을 결합한다. 모델 기반 평가로 SFT 응답을 선별하고, rejection sampling과 모델 평가로 DPO용 선호 응답과 비선호 응답 쌍을 만든다. 여기에는 pivotal token의 차이만 분리한 쌍도 포함된다.
3 Pretraining details
Phi-4는 앞선 토큰을 바탕으로 텍스트를 생성하는 decoder-only transformer를 사용하며, 파라미터는 14B, 초기 문맥 길이는 4096이다. phi-3-medium과 달리 텍스트를 모델 토큰으로 변환하는 tiktoken tokenizer를 사용하고, 미사용 토큰을 포함해 어휘 크기를 100,352로 패딩한다. 또한 2K sliding window 대신 4K 토큰 전체에 attention을 적용하므로, 각 토큰은 최근의 제한된 부분을 넘어 앞선 문맥 전체를 활용할 수 있다.
- 사전학습에는 약 10T 토큰, 선형 학습률 워밍업과 감소, 최대 학습률 0.0003, weight decay 0.1, 전역 배치 크기 5760을 사용한다.
- 예시 없이 엄격한 답변 형식을 요구하면 사전학습 모델의 능력을 제대로 평가하기 어려우므로, 기본 모델 평가는 후보 답변의 로그우도를 계산하는 내부 평가 방식과 과제 예시를 포함한 few-shot 프롬프트를 사용한다.
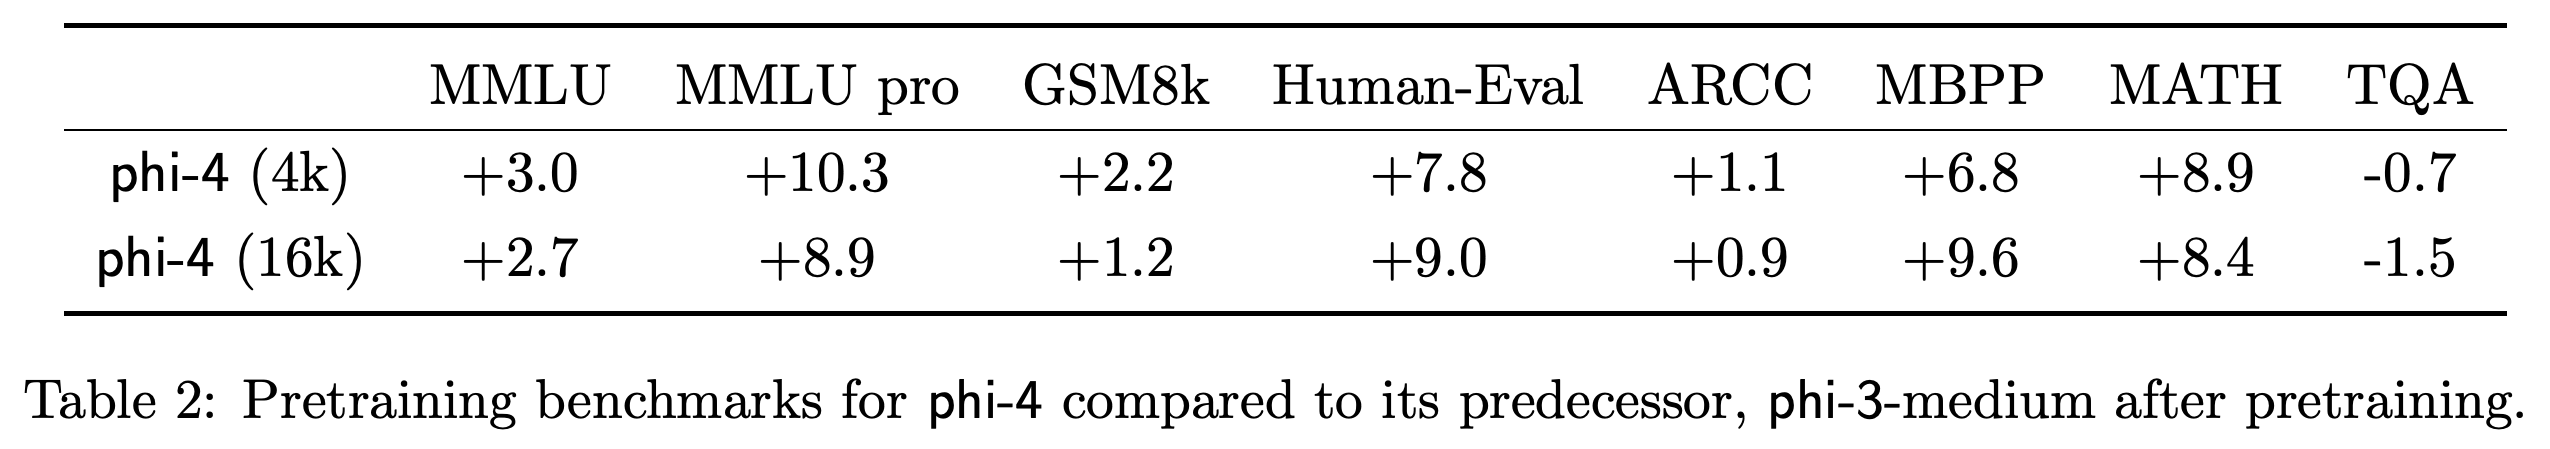
- Table 2는 광범위한 다중 과제 언어 이해 벤치마크인 MMLU, 더 어려운 변형인 MMLU pro, 코드 생성 등 대부분의 평가 과제에서 향상을 보고한다. 표에서 TQA로 줄여 쓴 사실 질의응답 벤치마크 TriviaQA의 성능은 하락한다.
4K와 16K 체크포인트 2개 모두 phi-3-medium 대비 대부분의 기본 모델 평가에서 개선되지만, TriviaQA는 각각 0.7과 1.5 하락한다. 16K 체크포인트는 이전 모델 대비 개선을 유지하지만 4K 체크포인트를 일관되게 능가하지는 않는다.
3.1 Data Composition in Pretraining
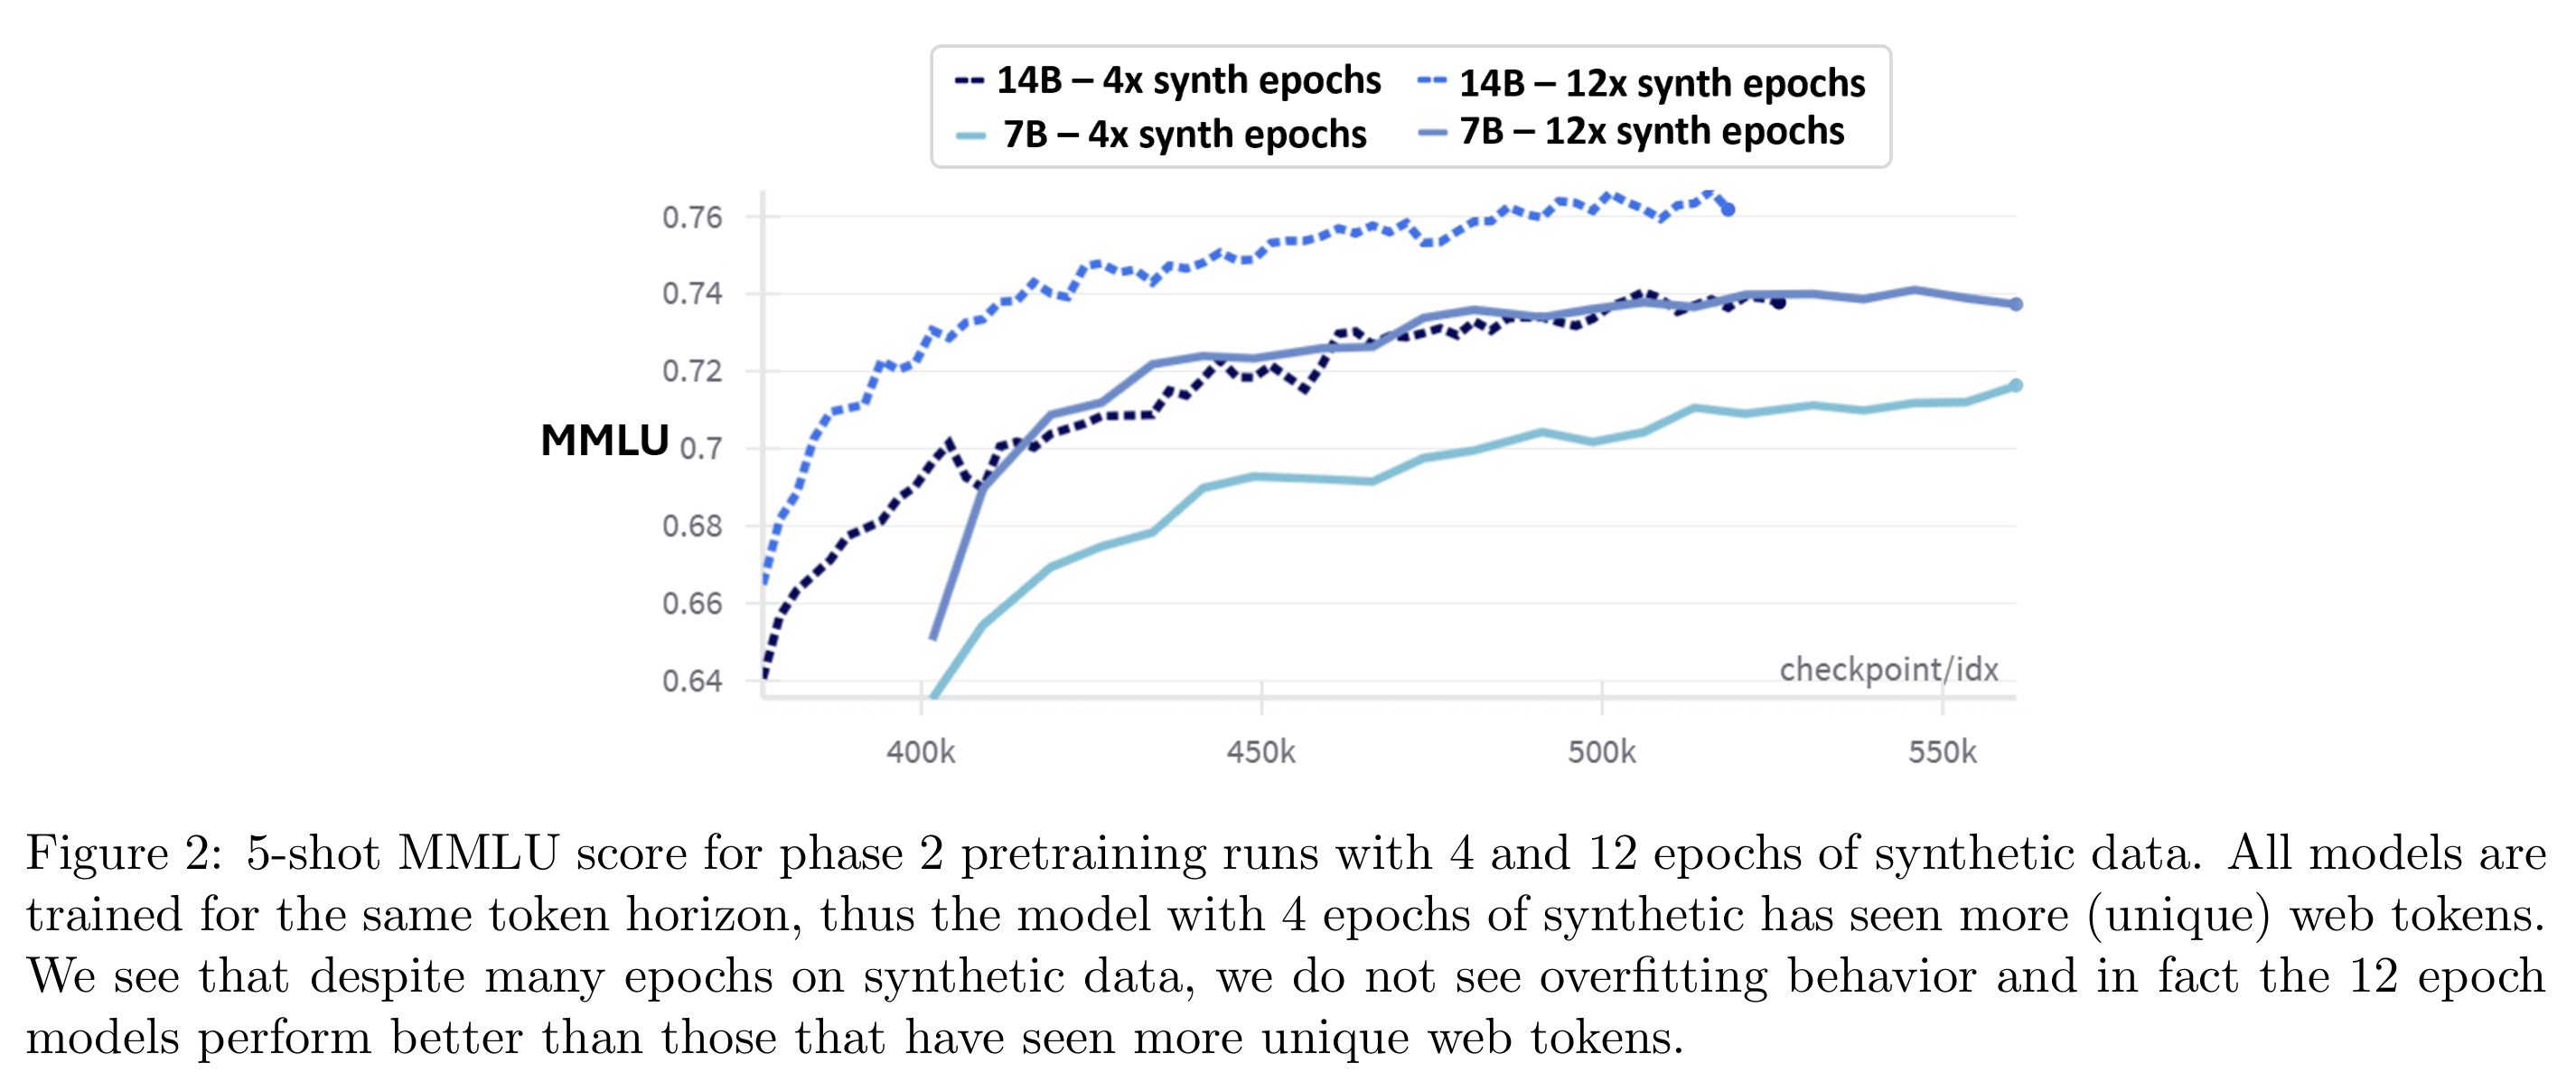
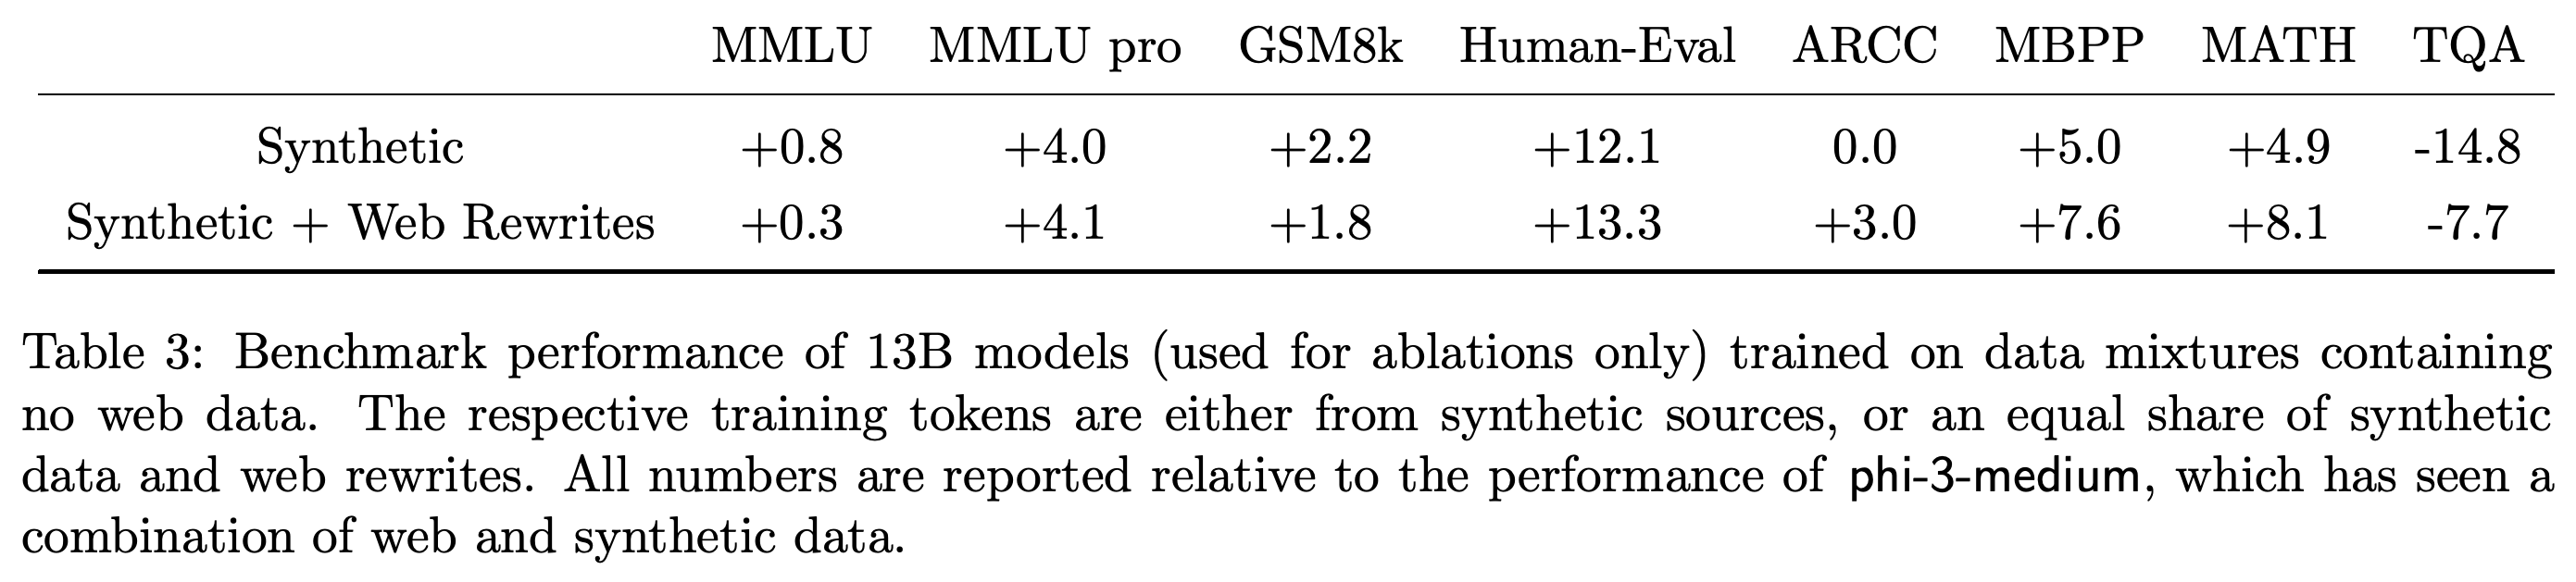
학습 토큰 예산을 고정한 phase 2의 7B 및 14B 모델 실험에서는, 고정된 합성 데이터셋을 12회 반복하는 방식이 4회 반복에 더 많은 고유 웹 토큰을 추가하는 방식보다 유리하다. 그러나 데이터 선택을 비교하는 13B 실험 모델을 원시 웹 데이터 없이 학습하면 여러 추론 및 코딩 점수는 오르지만, 사실 질의응답 성능은 크게 하락한다.
- Figure 2는 프롬프트에 예시 5개를 제공하는 5-shot MMLU에서 합성 데이터 반복의 이점을 보여 준다. 그래프에 제시된 학습 구간에서는 성능 저하가 관찰되지 않는다.
- phi-3-medium 대비 합성 데이터만 사용한 모델은 TriviaQA에서 14.8 하락한다. 합성 데이터와 웹 콘텐츠를 재작성해 생성한 web rewrites를 같은 비율로 섞으면 하락 폭이 7.7로 줄어든다.
- 이 실험들은 검증한 설정 안에서 선별한 합성 데이터를 반복 학습하는 방식을 뒷받침한다. 한편 사실 지식의 부족은 비합성 자료를 유지할 필요성을 보여 준다.
7B와 14B 모델 2개 모두 같은 학습 토큰 예산에서 합성 데이터를 12 epochs 학습한 경우가 4 epochs 학습한 대안보다 높은 MMLU 점수를 얻는다. 이 실험에서는 고유 웹 토큰을 추가하는 대신 고정된 합성 데이터셋의 반복을 늘리면 측정 성능이 개선된다.
합성 데이터만 사용한 13B 모델은 phi-3-medium 대비 Human-Eval에서 12.1 상승하지만 TriviaQA에서 14.8 하락한다. 합성 데이터와 web rewrites를 같은 비율로 사용하면 추론과 코딩의 개선을 유지하면서 사실 지식의 하락 폭을 7.7로 줄인다. 어느 변형에도 원시 웹 데이터는 포함되지 않는다.
3.2 Data Mixture
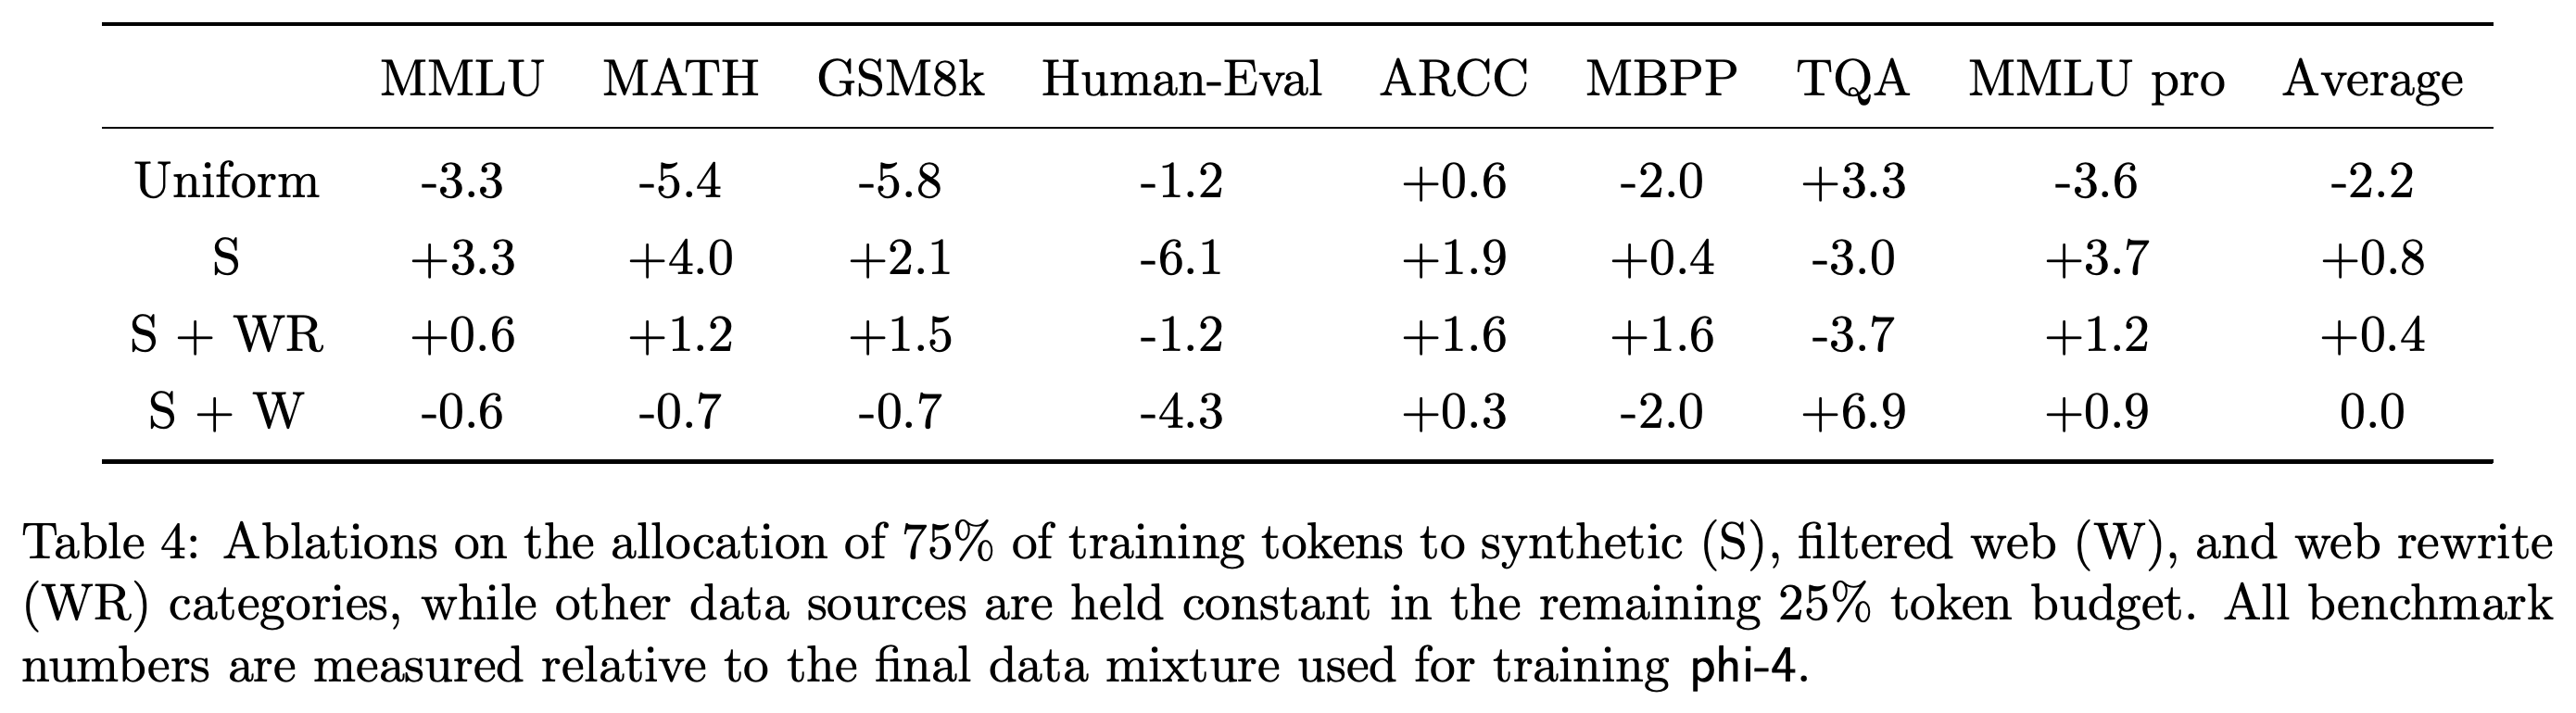
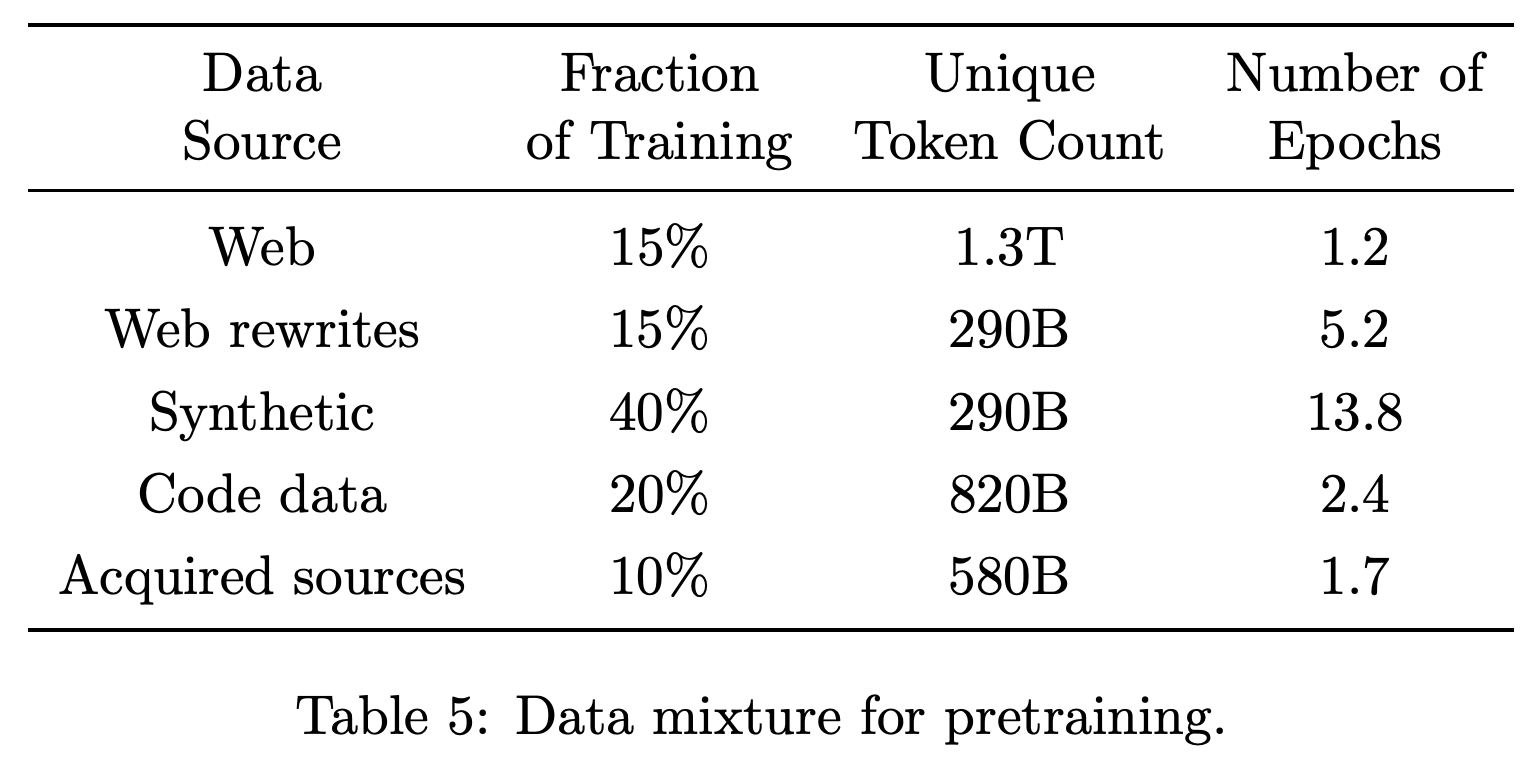
데이터 혼합은 주로 7B 규모의 짧은 1T-token 실험으로 선택한다. 저자들은 혼합 구성이 충분히 다르고 데이터 소스가 포화되지 않았을 때, 학습 길이와 모델 크기가 달라도 성능 순위가 일관된다는 관찰을 근거로 삼는다. 최종 사전학습 비율은 웹 15%, web rewrites 15%, 합성 데이터 40%, 코드 데이터 20%, 확보한 자료 10%다.
- Table 4는 실험 토큰 예산의 75% 안에서 합성 데이터, 필터링한 웹, web rewrites의 배분을 바꾸고 나머지 25%는 고정한다. 균등 배분은 최종 혼합보다 보고된 평균 점수가 2.2 낮다.
- 합성 데이터 비중을 높인 대안은 평균을 0.8 또는 0.4 높이지만, 선택한 혼합은 능력 간 균형을 위해 지식 중심 자료를 유지한다. 저자들은 후속학습 이후 이 격차의 상당 부분이 줄어든다고 보고한다.
- Table 5에서 합성 데이터는 약 290B 고유 토큰을 13.8 epochs 반복하고, 웹 데이터는 1.3T 고유 토큰을 1.2 epochs 반복한다. Epoch는 해당 소스 전체를 한 차례 학습하는 단위다. 코드 데이터에는 합성 코드와 원시 코드가 모두 포함된다.
변경한 범주 3개에 균등하게 배분하면 보고된 평균이 2.2 하락하고, 합성 데이터 비중을 높인 배분은 0.8 또는 0.4 상승한다. 웹 비중을 높이면 TriviaQA에 유리하다. 이는 최종 혼합 선택에서 고려한 추론 성능과 지식 성능의 상충을 보여 준다.
합성 데이터는 고유 토큰이 290B에 불과하지만 학습의 40%를 차지해 13.8 epochs 학습한다. 웹 데이터는 고유 토큰이 1.3T이지만 학습의 15%를 차지하고 1.2 epochs 학습한다. 이는 학습 배분과 각 소스의 고유 코퍼스 크기가 어떻게 다른지 보여 준다.
3.3 Midtraining Details
중간학습은 250B 토큰을 사용해 지원 문맥을 4K에서 16K로 늘린다. 혼합 데이터는 새로 선별한 긴 문맥 자료 30%와 다시 사용하는 사전학습 자료 70%로 구성한다. 최대 학습률은 10배 낮추고, 모델의 위치 표현인 rope position encoding의 기저 주파수는 250K로 높인다.
- 보고된 ablation 실험에서는 본래 긴 문서가 짧은 샘플을 인위적으로 이어 붙인 데이터보다 성능이 좋다. 파이프라인은 8K를 넘는 비합성 샘플을 선택하고, 길이가 16K 이상인 샘플의 가중치를 높이며, 4K보다 긴 합성 시퀀스를 만든다.
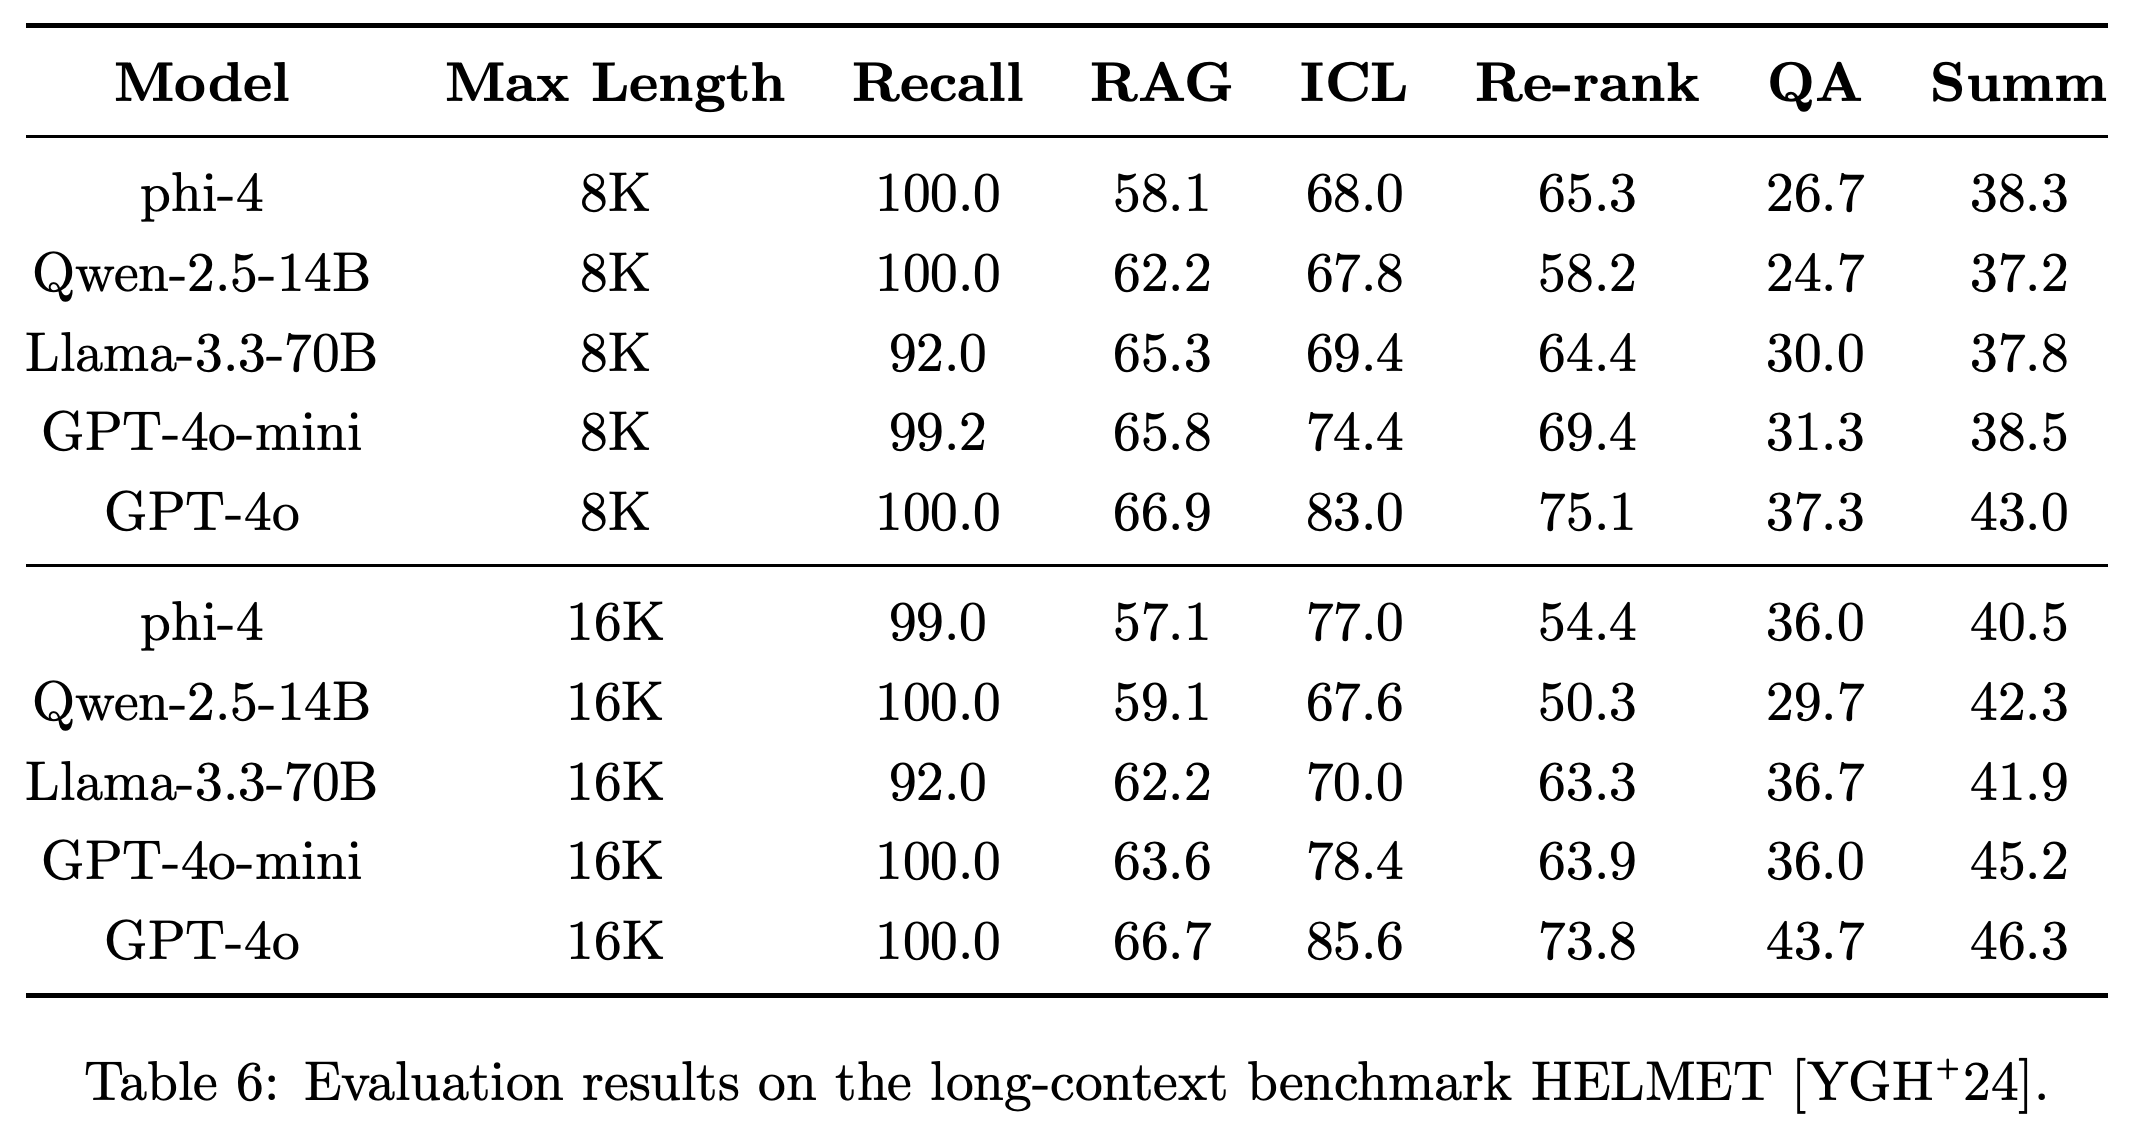
- 여러 긴 문맥 과제를 다루는 평가 도구인 HELMET은 8K와 16K에서 평가하며, 범주별 실행 5회의 결과를 평균한다.
- 16K에서 phi-4는 키가 주어졌을 때 값을 찾는 key-value recall에서 99.0을 기록하지만, 검색한 문서를 바탕으로 답하는 retrieval-augmented question answering에서는 57.1로 GPT-4o의 66.7보다 낮다. 따라서 개별 값을 복원하는 능력과 문서 기반 질의응답 능력은 서로 다른 성능을 보인다.
거의 완벽한 key-value recall과 상대적으로 약한 문서 기반 질의응답 및 요약 성능이 함께 나타난다. 16K에서 phi-4는 프롬프트의 예시로 과제를 학습하는 in-context learning에서 77.0을 기록하지만, 나열된 모든 범주에서 GPT-4o보다 낮다.
4 Post-Training
후속학습은 SFT 1회, pivotal-token 쌍을 사용하는 DPO 1회, 전체 응답 선호도 쌍을 사용하는 DPO 1회를 거쳐 사전학습 모델을 어시스턴트로 전환한다. 대화에는 보고서에 제시된 역할 구분 형식인 chatml을 사용한다.
4.1 Supervised Fine-Tuning
SFT는 학습률 10^−6에서 약 8B 토큰을 사용한다. 학습은 수학, 코딩, 추론, 대화, 모델 정체성, 안전성, 40개 언어의 다국어 데이터를 다루며, 모두 chatml 형식을 사용한다.
4.2 Direct Preference Optimization
첫 DPO는 PTS로 생성한 선호도 쌍을 사용하고, 두 번째 DPO는 GPT-4o가 라벨을 부여한 전체 응답 쌍 약 850k개를 사용한다. 두 번째 단계에서는 GPT-4o, GPT-4t, phi-4의 응답을 정확도 또는 정확도, 문체, 상세함의 평균으로 비교한다.
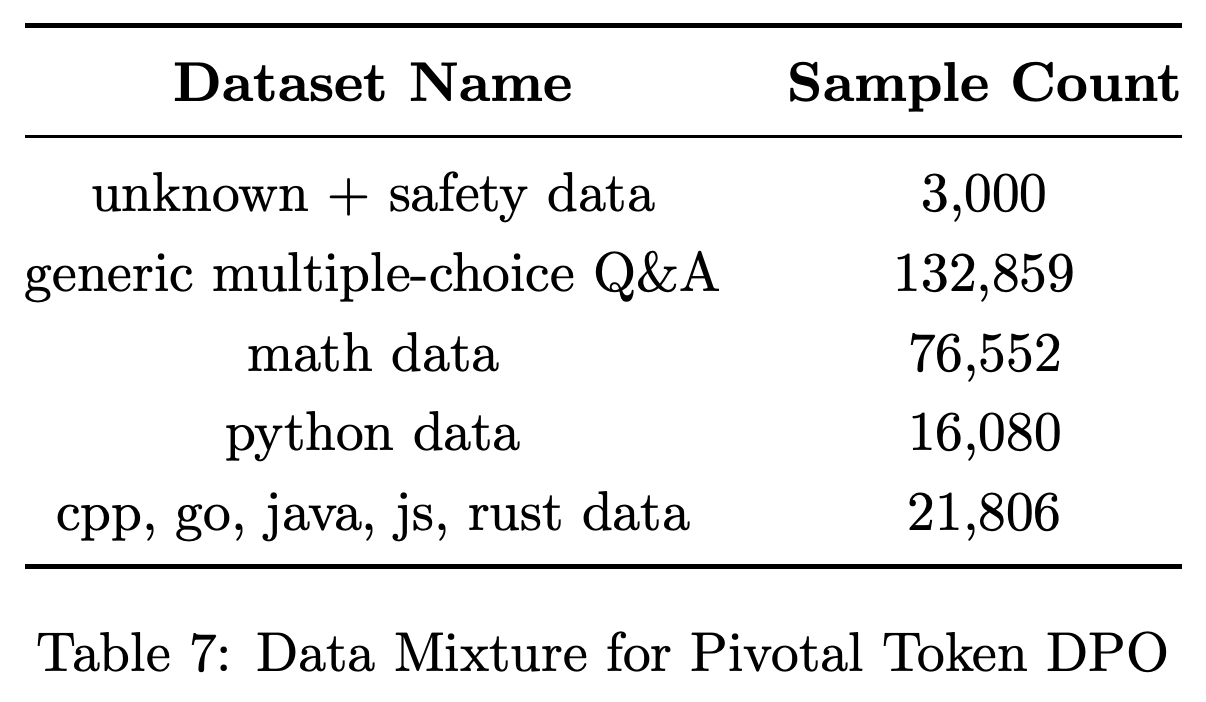
- Table 7은 pivotal-token DPO에 사용하는 일반 객관식 샘플 132,859개, 수학 샘플 76,552개, Python 샘플 16,080개, 다른 프로그래밍 언어 샘플 21,806개, 정답을 모르는 질문 및 안전성 샘플 3,000개를 제시한다.
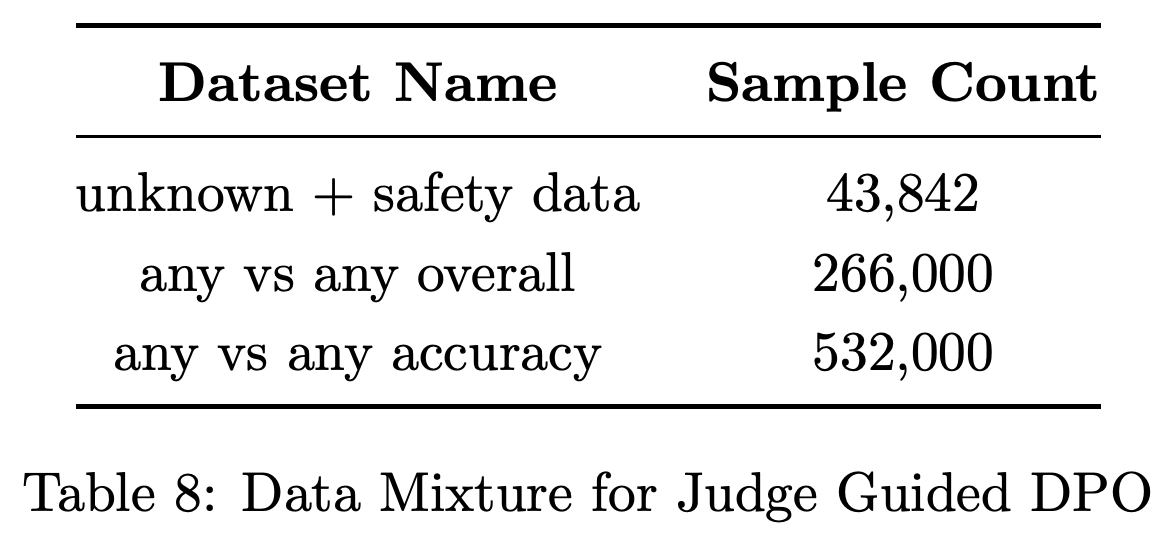
- Table 8은 judge-guided DPO에 사용하는 전반적 선호도 쌍 266,000개, 정확도 선호도 쌍 532,000개, 정답을 모르는 질문 및 안전성 쌍 43,842개를 제시한다.
- 단계 2개 모두 안전하지 않은 행동과 환각을 줄이기 위한 데이터를 포함한다. 환각은 근거가 없거나 지어낸 답변을 뜻한다.
일반 객관식 질문이 132,859개로 pivotal-token 학습에서 가장 큰 범주를 차지하고, 수학이 76,552개로 뒤를 잇는다. 프로그래밍 범주와 함께 이 데이터는 정답 검사가 용이한 과제에 집중하는 방법의 특성과 맞는다.
정확도 기반 쌍은 532,000개로 전반적 선호도 쌍 266,000개의 두 배이며, 정답을 모르는 질문 및 안전성 쌍 43,842개도 포함된다. 2단계는 정확성 중심 감독과 더 넓은 응답 품질 판단을 결합한다.
4.3 Pivotal Token Search
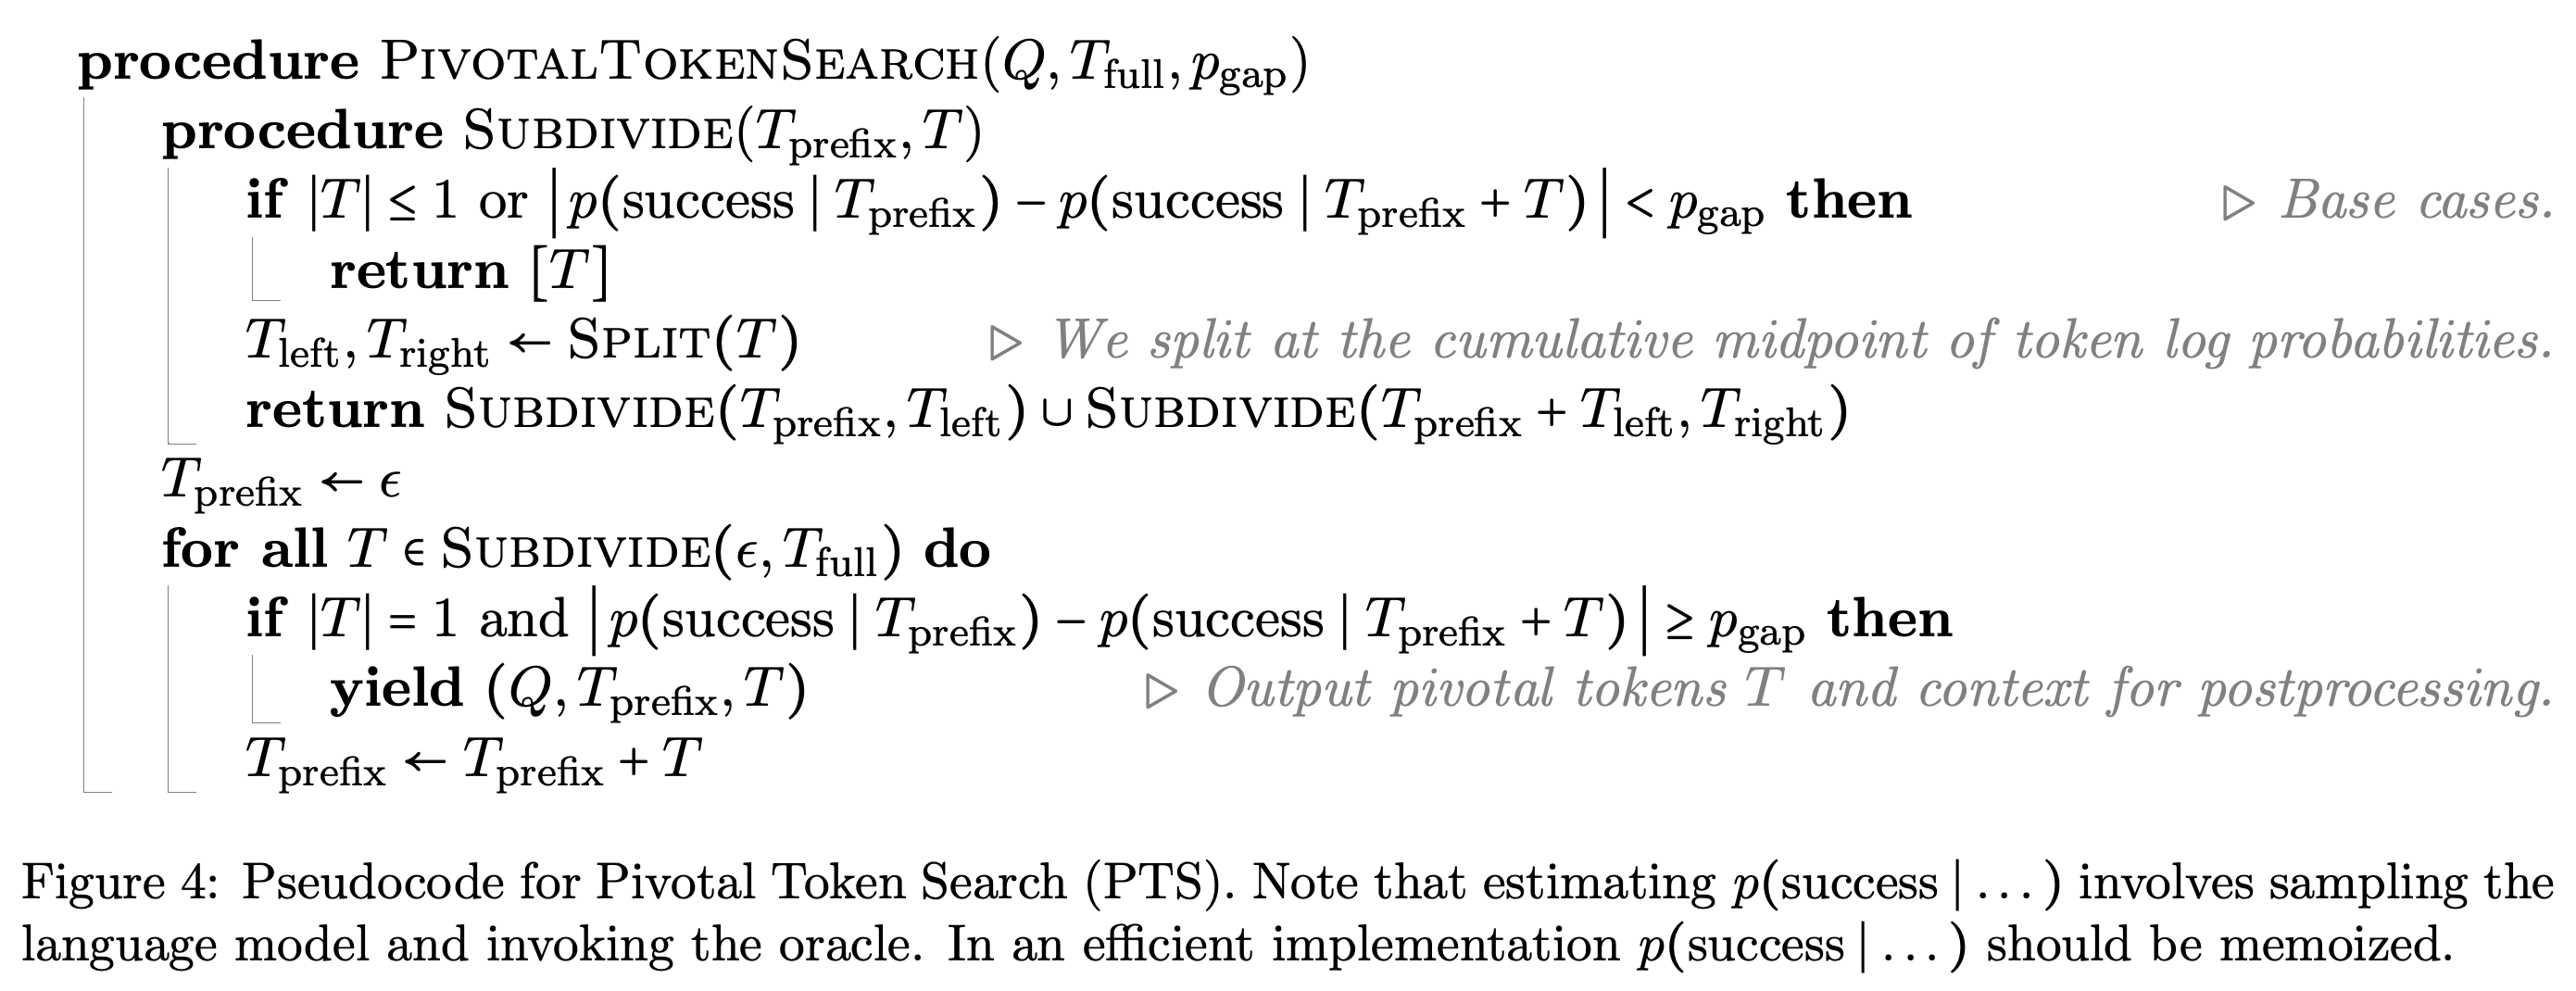
PTS는 응답 접두부에서 이어지는 생성을 샘플링하고 oracle로 검사해 최종 정답 확률을 추정한다. Oracle은 알려진 수학 정답이나 코드 테스트 같은 정답 판별 수단이다. 완성 응답을 재귀적으로 나누어 성공 확률이 급변하는 토큰을 찾고, 같은 접두부를 공유하는 선호 및 비선호 단일 토큰 후속 응답을 구성한다.
- 중간 난도의 과제에 탐색을 집중하도록 질문을 0.2 ≤ p(success) ≤ 0.8로 제한한다. 여기서 p(success)는 정답 확률이다.
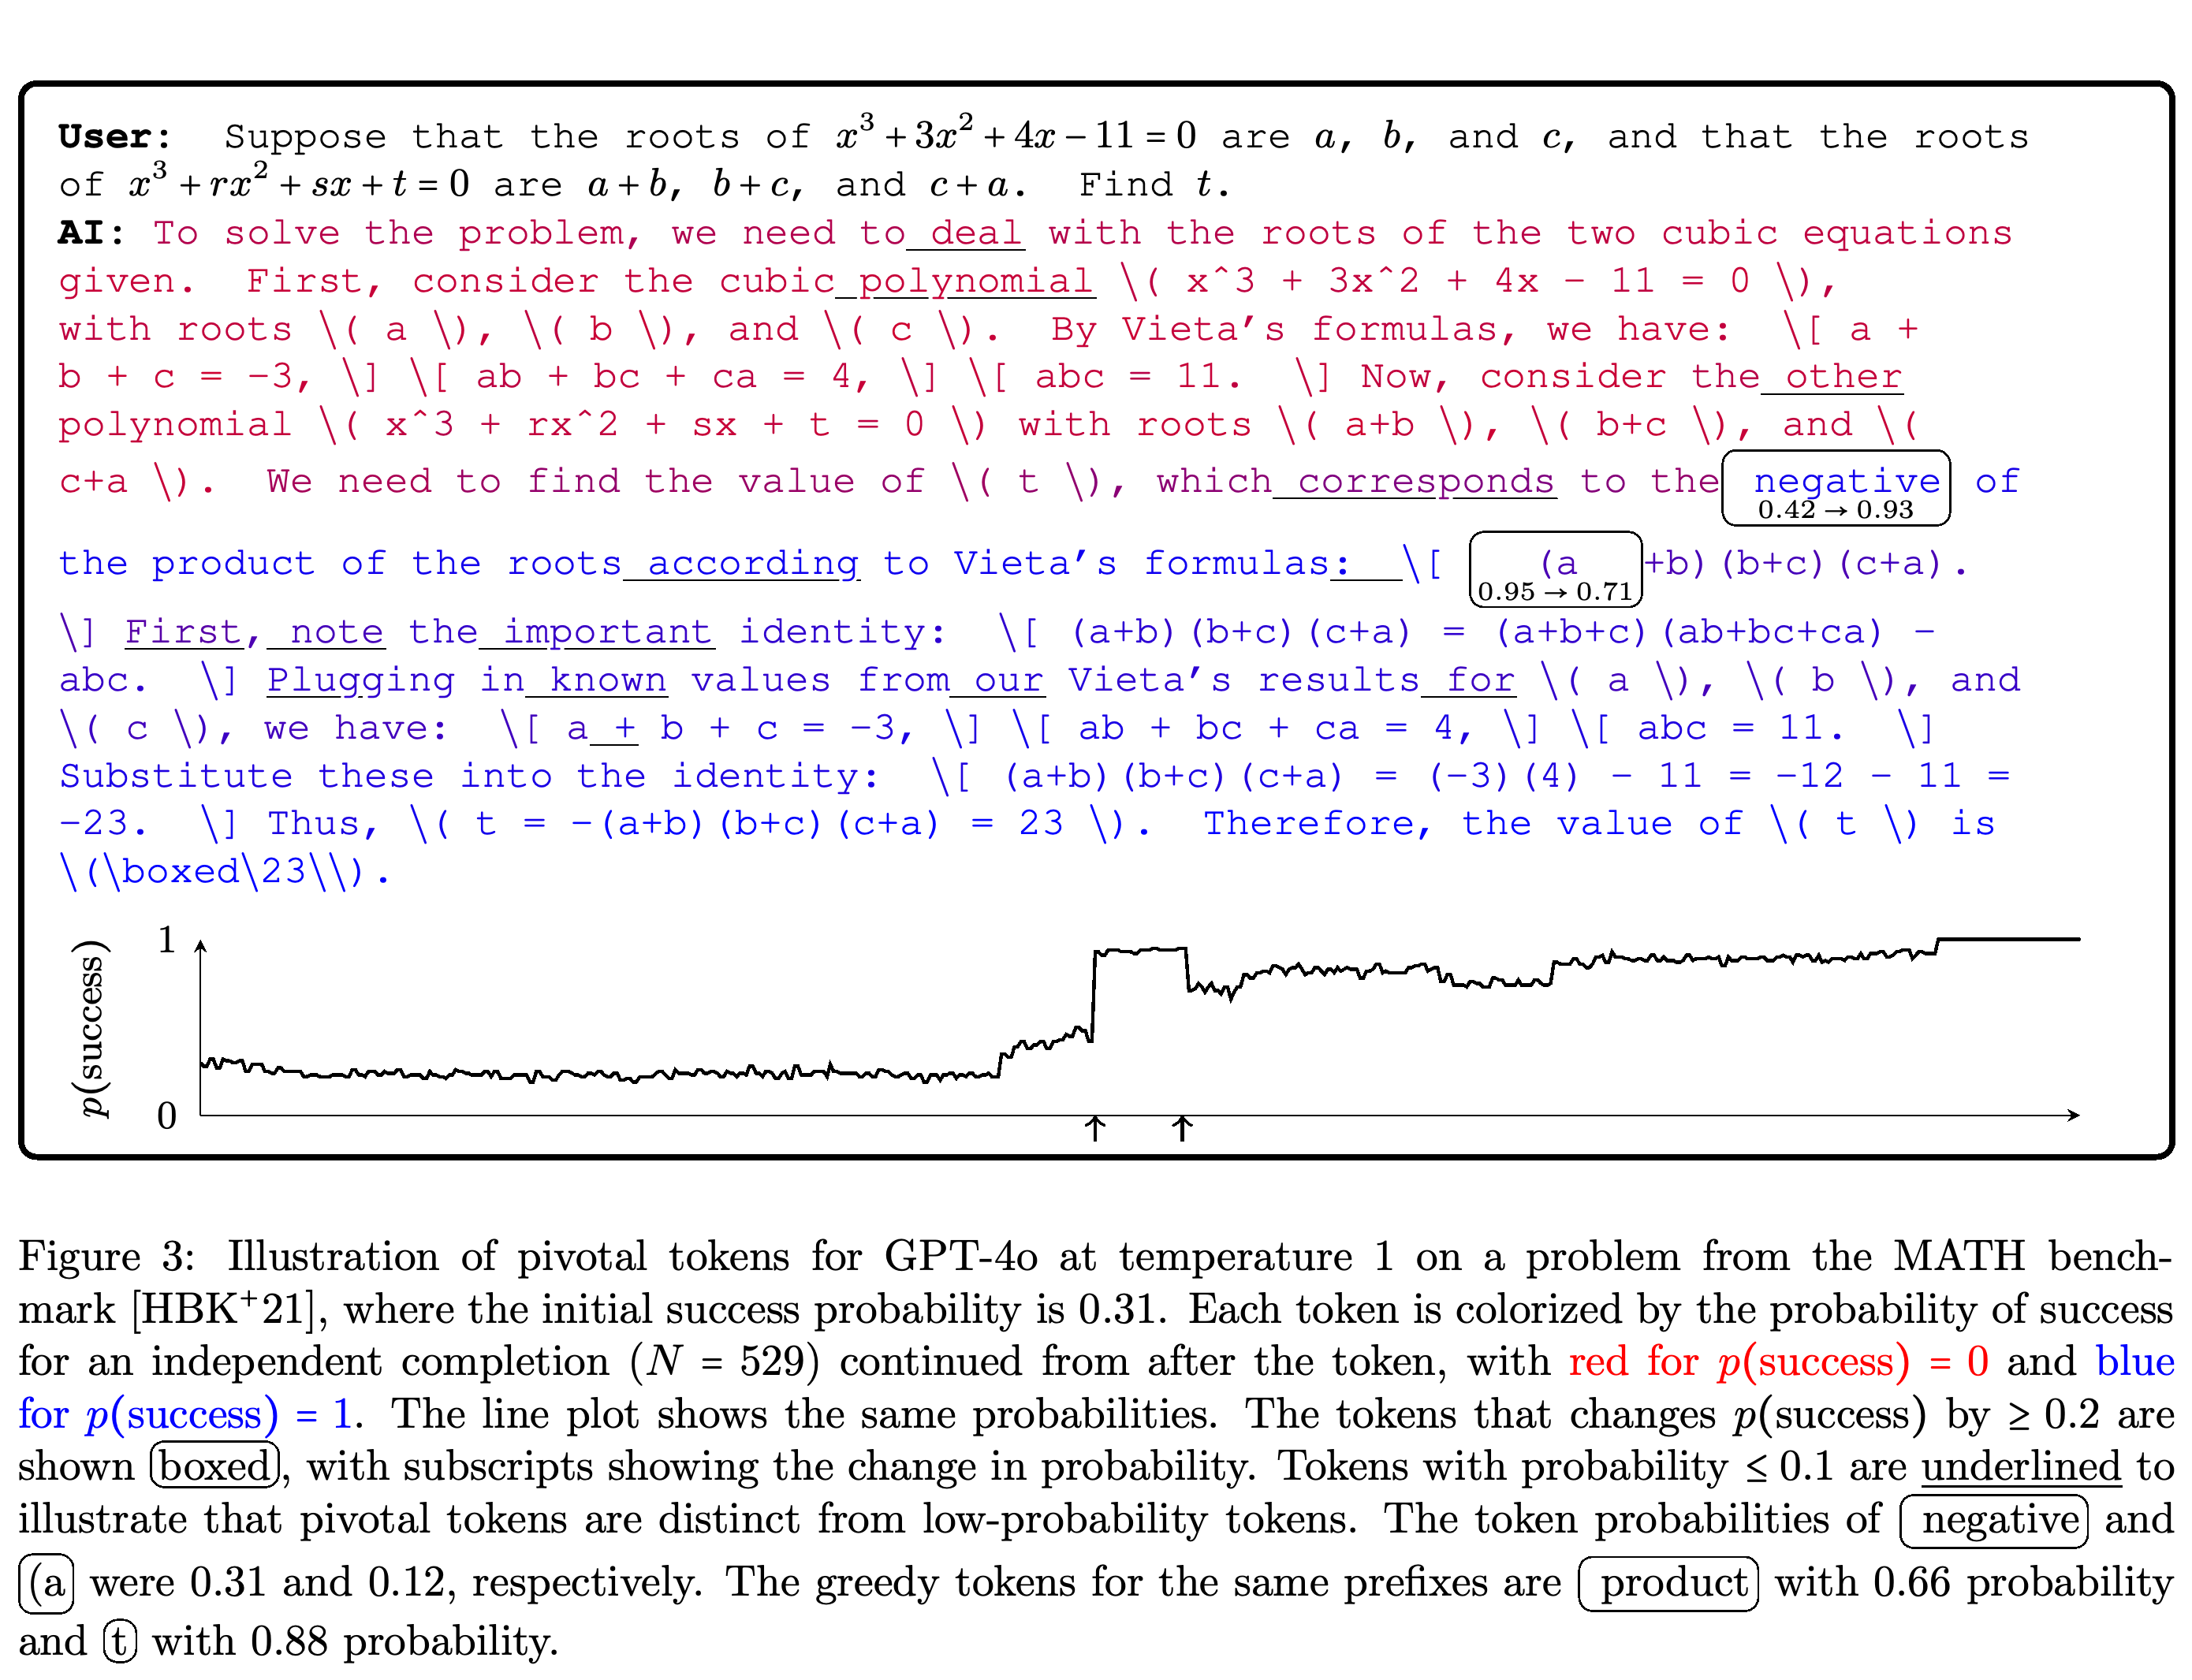
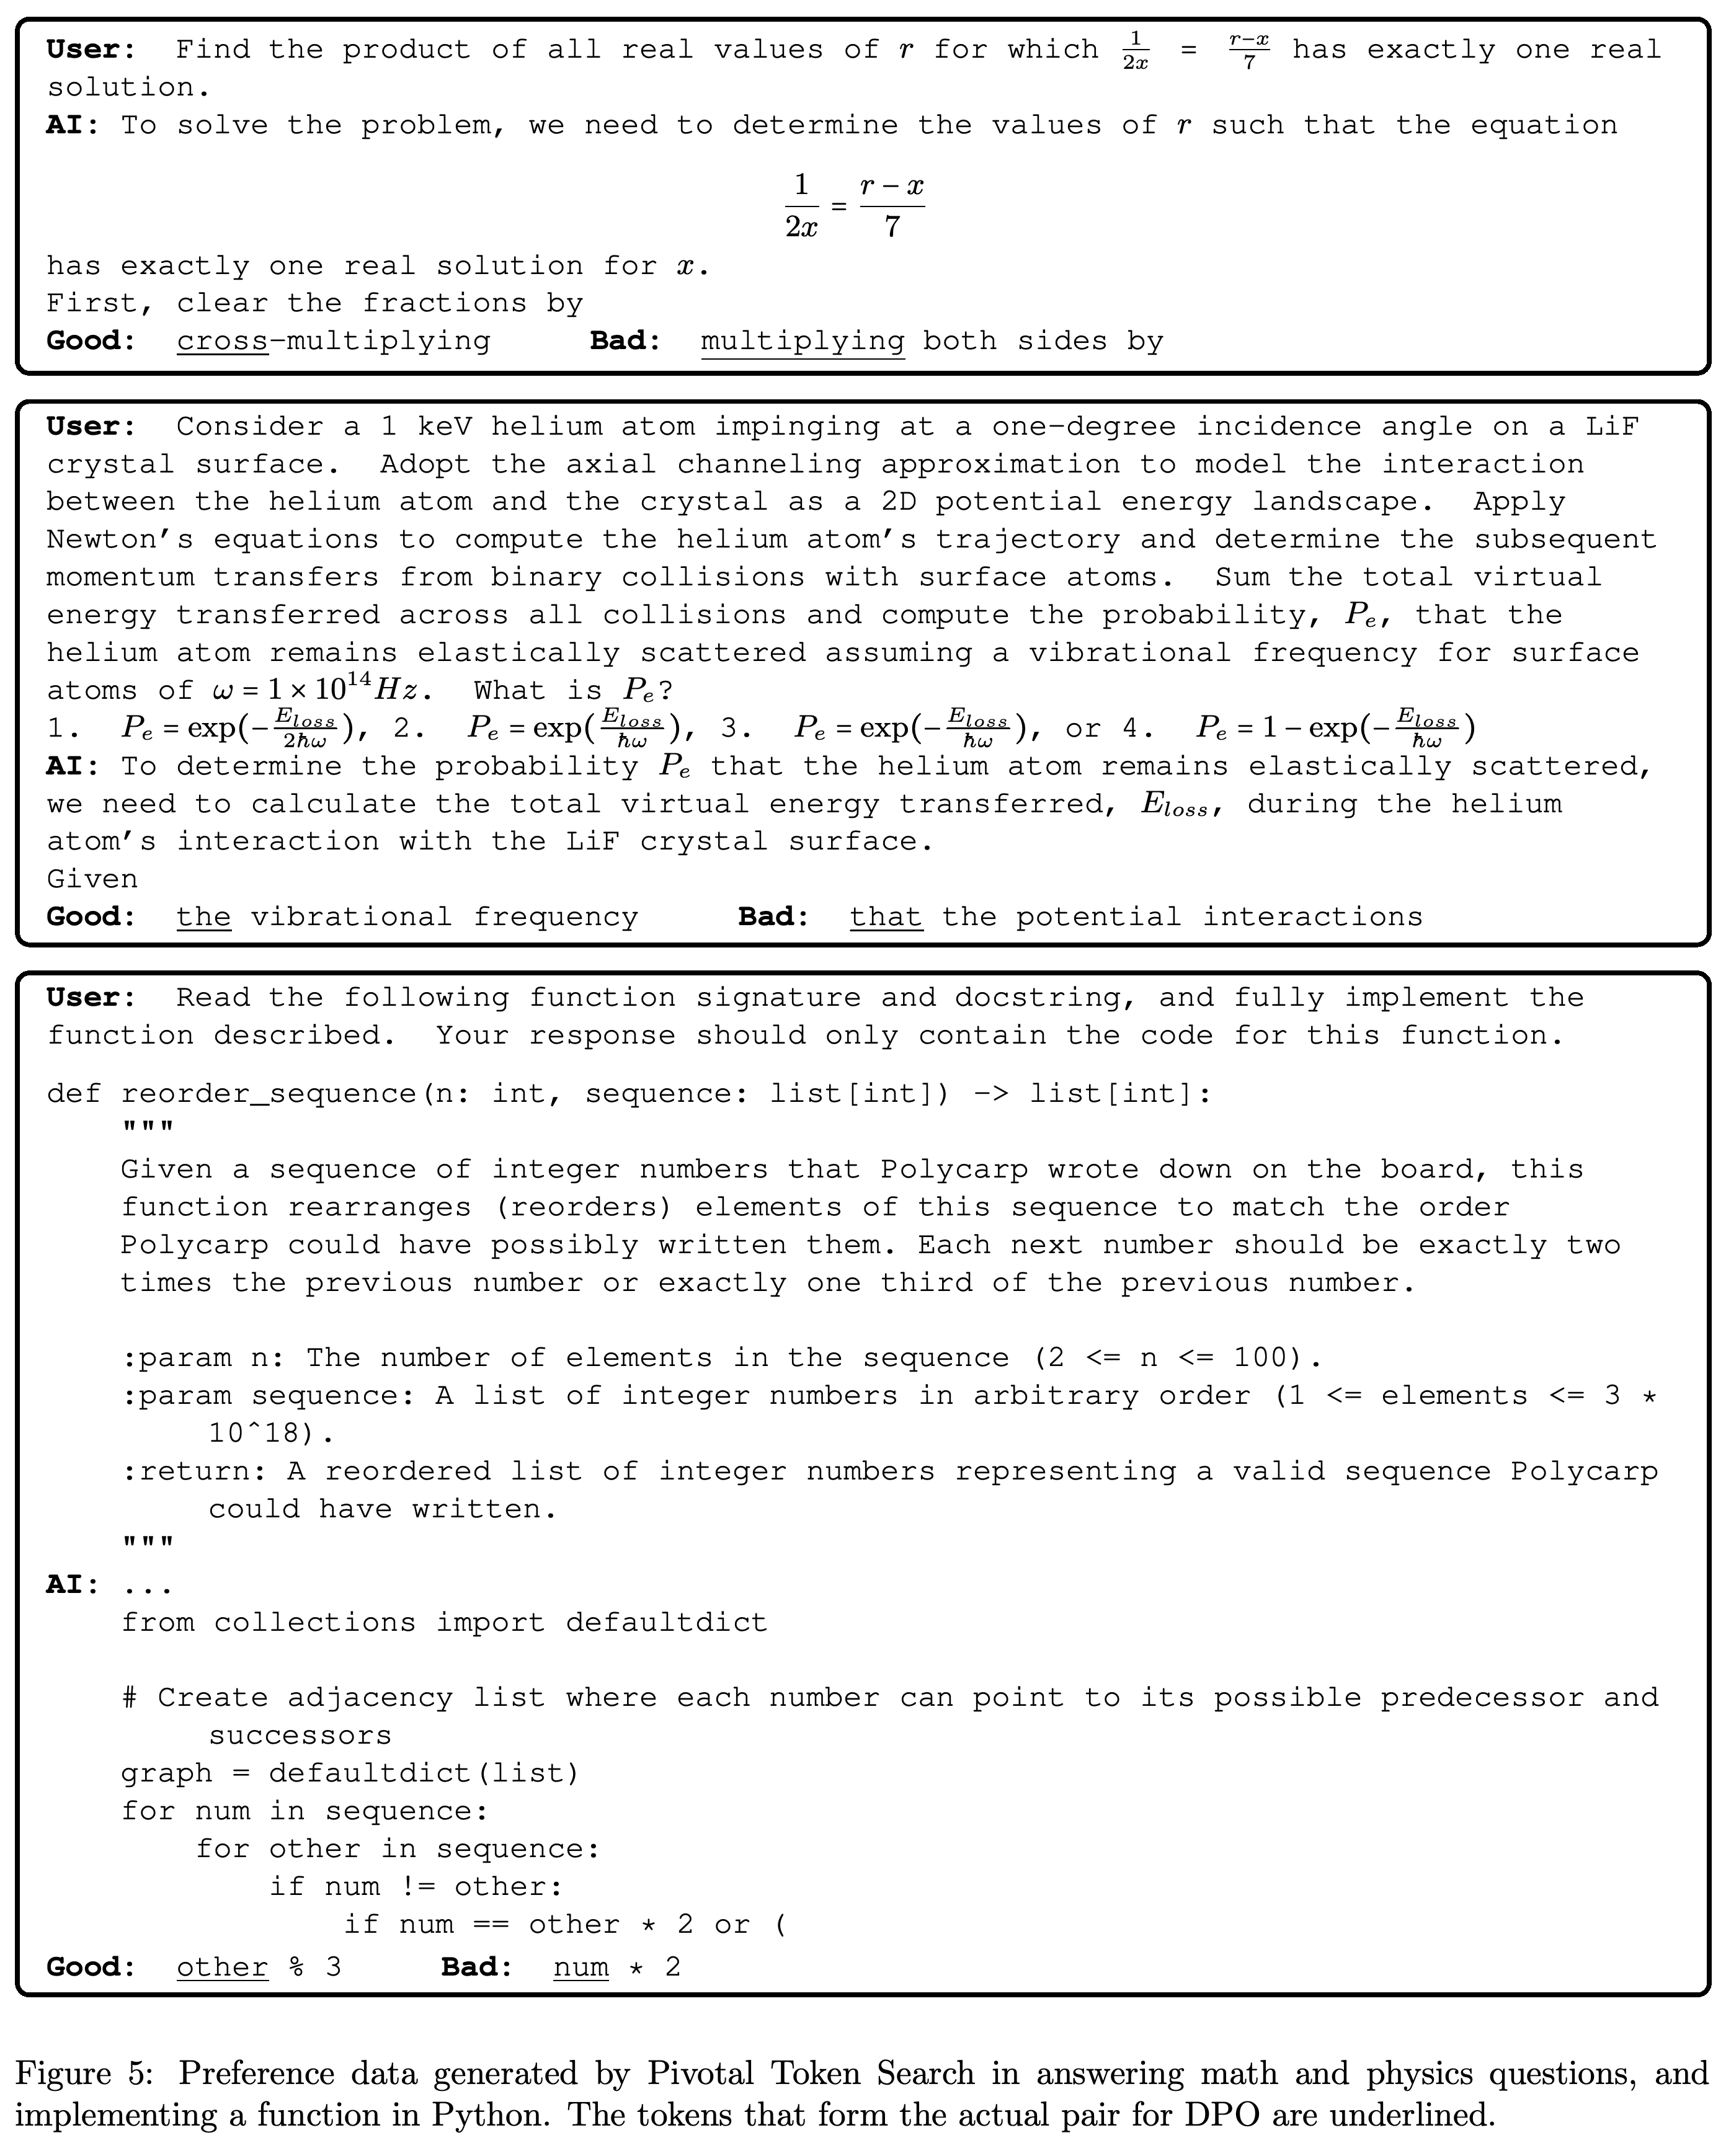
- Figure 3은 pivotal token과 단순히 확률이 낮은 토큰을 구분한다. 제시된 수학 풀이에서 “negative”를 선택하면 추정 성공 확률이 0.42에서 0.93으로 바뀐다.
- Figure 4의 탐색은 구간 안에서 반대 방향의 변화가 상쇄되면 pivotal token을 놓칠 수 있다. 저자들은 성공 확률이 주로 한 방향으로 변하는 준단조 상태라면 모든 pivotal token을 찾는다고 설명한다. Figure 5는 비선호 후속 응답도 수학적으로 타당할 수 있지만, 이후 생성의 신뢰도는 더 낮을 수 있음을 보여 준다.
- 이 방법에는 반복적인 후속 생성 샘플링과 신뢰할 수 있는 정답 검사가 필요하다. 보고서는 이를 중간 풀이 결정에 학습 신호를 주는 자동화된 과정 감독과 연결하지만, 생성 비용을 포괄적으로 비교하지는 않는다.
후속 생성 샘플링에서 “negative”는 추정 성공 확률을 0.42에서 0.93으로 높이지만, 뒤의 다른 토큰은 0.95에서 0.71로 낮춘다. 최종적으로 정답인 응답에도 이후 생성의 신뢰도를 낮추는 선택이 들어갈 수 있으므로, 이 예시는 결과에 영향을 주는 선택을 개별적으로 감독할 근거를 제공한다.
재귀 절차는 구간 경계의 성공 확률을 비교하고, 개별 토큰을 분리하거나 변화가 임계값보다 작아질 때까지 구간을 나눈다. 각 확률 추정에는 후속 생성 샘플링과 정답 검사가 필요하다. 의사코드는 같은 작업을 반복하지 않도록 추정치를 캐싱할 것을 권장한다.
수학, 물리, Python 예시는 각각 같은 응답 접두부에서 이어지는 후속 응답을 비교하며, 밑줄 친 토큰이 선호도 쌍을 이룬다. 수학 예시는 타당한 풀이 방법 사이에서도 이후 생성의 신뢰도를 기준으로 선호도를 구분할 수 있음을 보여 준다.
4.4 Hallucination mitigation
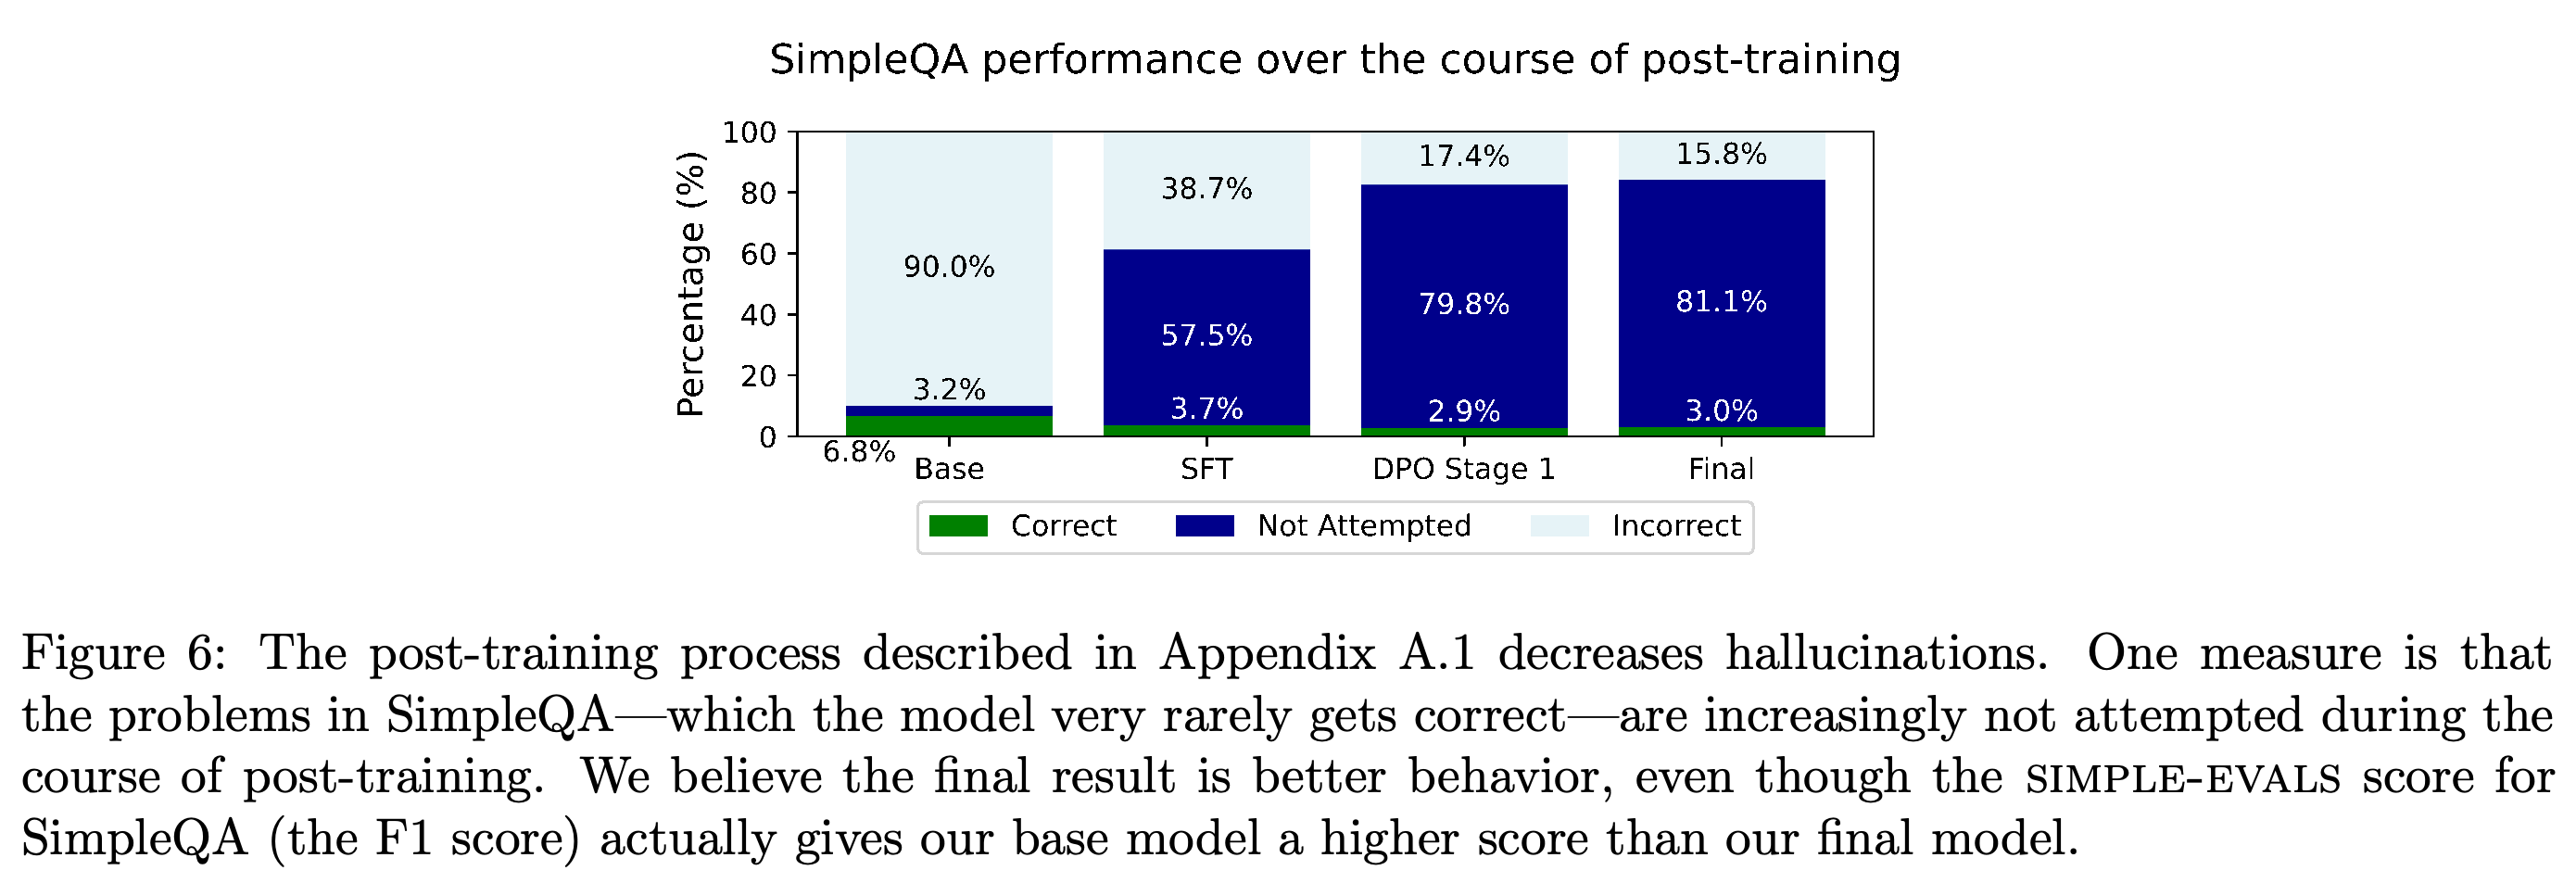
전용 SFT 예시와 DPO 쌍으로 정답을 맞힐 가능성이 낮은 질문에 답변을 거부하도록 학습한다. 짧은 사실 질문 벤치마크인 SimpleQA의 결과를 제시한 Figure 6에서 오답 응답은 기본 모델의 90.0%에서 최종 모델의 15.8%로 줄고, 답변을 시도하지 않은 질문은 3.2%에서 81.1%로 늘어난다.
- 정답 비율도 6.8%에서 3.0%로 줄어든다.
- 이 결과는 해당 벤치마크에서 답변 보류가 늘면서 오답과 정답이 모두 줄었음을 보여 준다. 사실 지식이 증가했음을 보여 주지는 않는다.
SimpleQA 오답은 90.0%에서 15.8%로 줄며, 주로 답변을 시도하지 않은 질문이 3.2%에서 81.1%로 늘어난 결과다. 정답도 6.8%에서 3.0%로 줄어들므로, 오류 감소에는 답변 범위 축소가 동반된다.
4.5 Post-Training Ablation
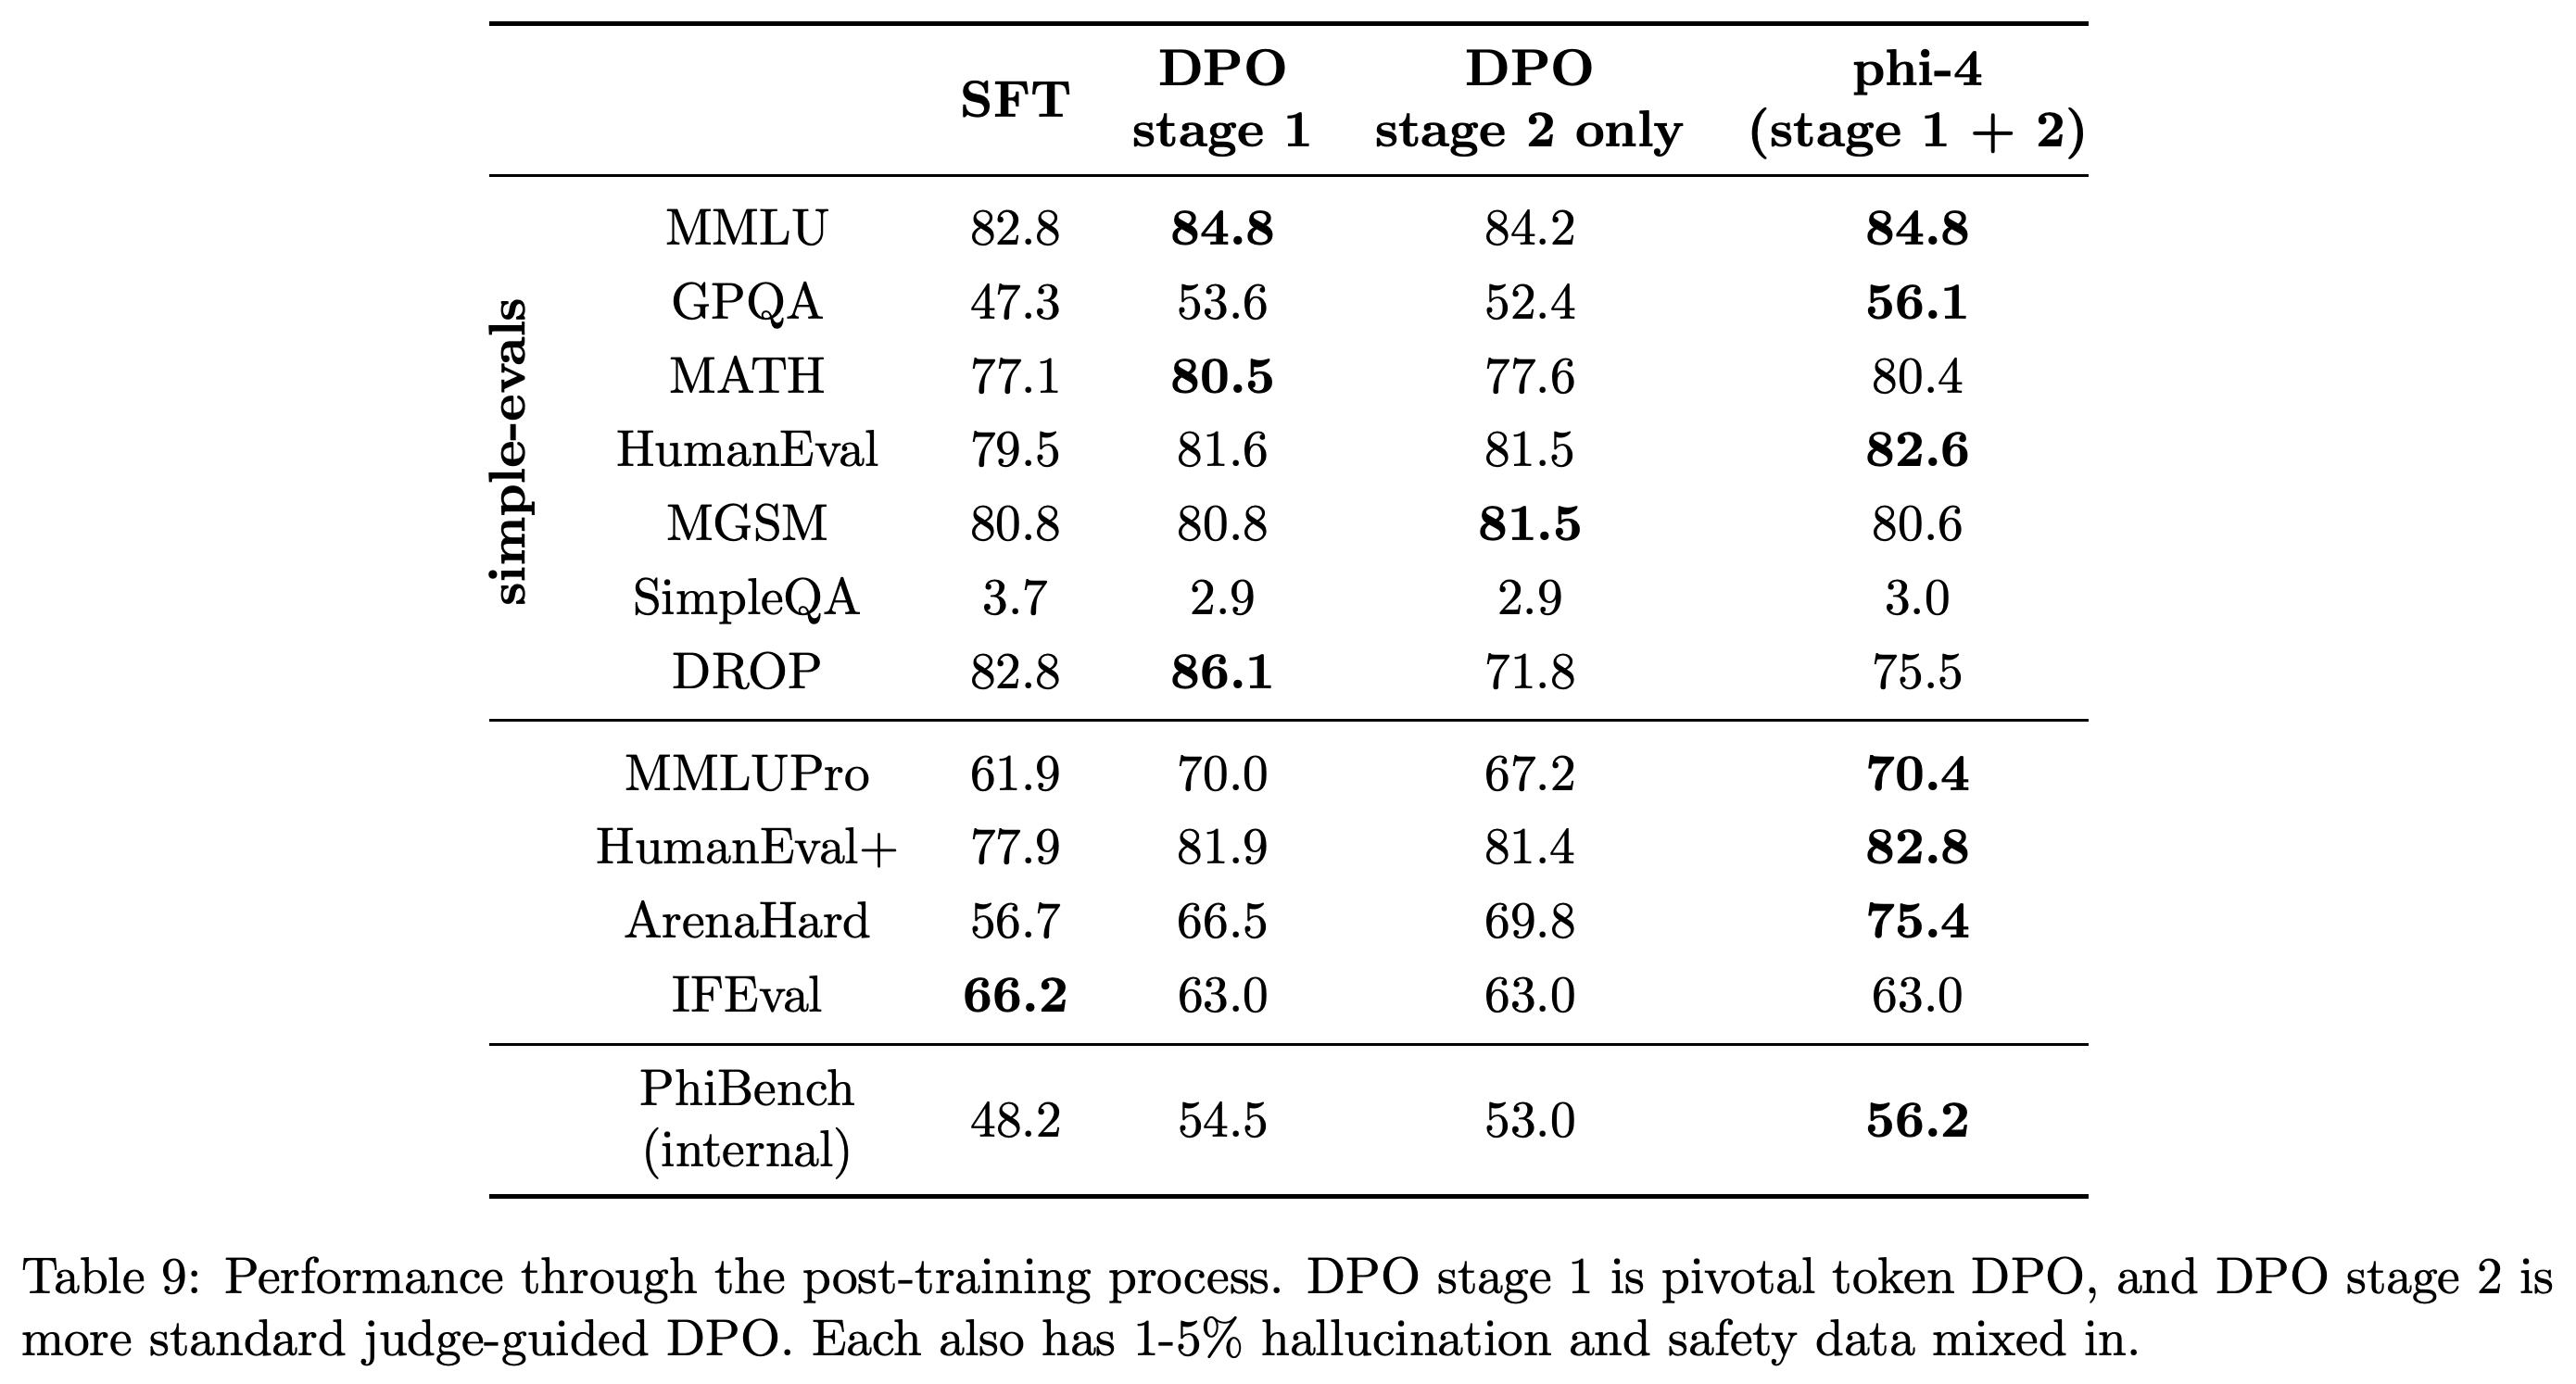
Table 9는 SFT, pivotal-token DPO, judge-guided DPO만 적용한 경우, DPO 단계 2개를 모두 적용한 경우를 비교한다. Pivotal-token DPO는 GPQA를 47.3에서 53.6으로, MATH를 77.1에서 80.5로 높인다. 최종 모델은 각각 56.1과 80.4에 도달한다.
- 모델 심사자가 평가하는 응답 생성 벤치마크 ArenaHard는 SFT 이후 56.7에서 pivotal-token DPO 이후 66.5로 오른다. Judge-guided DPO만 사용하면 69.8, 단계 2개를 모두 사용하면 75.4를 기록한다.
- 이 단계들은 여러 지표에서 상호 보완적이지만 개선 폭은 고르지 않다. 독해 벤치마크 DROP은 1단계 이후 86.1에서 최종 75.5로 하락하고, 엄격한 지시 준수 평가인 IFEval은 SFT 이후 66.2에서 63.0으로 하락한다.
전체 과정을 적용하면 비교한 변형 중 GPQA와 ArenaHard에서 가장 높은 결과를 얻어, DPO 단계 2개의 상호 보완 효과를 뒷받침한다. 두 번째 단계 이후 DROP은 크게 하락하고 IFEval은 SFT 때보다 낮게 유지되어, 과제별 성능 하락도 드러난다.
5 Benchmarking Considerations
보고서는 필터링 이후에도 남는 오염, 좁은 능력 범위, 모델 심사 기반 생성 평가의 문체 편향, 추측이나 패턴 매칭으로 객관식 정답을 맞히는 현상이라는 4가지 평가 문제를 지적한다. 연구팀이 직접 작성한 독창적 프롬프트로 구성된 내부 벤치마크 PhiBench는 디버깅, 코드 설명, 증명 오류 식별 등으로 평가 범위를 넓힌다.
- 상세한 심사 지침은 정확도, 논리적 구조, 과제 요구사항을 강조한다. 저자들은 채점 일관성이 개선됐다고 보고하지만, 이 절에서는 일관성을 정량적으로 분석하지 않는다.
- PhiBench는 데이터 혼합과 후속학습 하이퍼파라미터 선택에 사용되므로, 독창적 질문에 대한 성능 평가이면서 개발 도구이기도 하다.
- 저자들은 연속된 단어열을 대조하는 방식으로는 바꾸어 표현한 벤치마크 자료를 모두 제거하기 어렵다고 인정한다.
6 Performance on Key Benchmarks
저자들은 비교한 벤치마크 12개 중 9개에서 phi-4가 Qwen-2.5-14B-Instruct를 능가하며, 과학, 수학, 코드 생성에서 강한 성능을 보인다고 보고한다. Table 1에서 MATH는 80.4 대 75.6이고, 코드 생성 평가인 HumanEval은 82.6 대 72.1이다.
- 첫 벤치마크 묶음은 simple-evals의 프롬프트, 추출 규칙, temperature 0.5를 사용한다. 추가 벤치마크 일부는 내부 프롬프팅과 추출 방식을 사용한다.
- 약한 결과로는 SimpleQA 3.0, DROP 75.5, IFEval 63.0이 있다. Qwen-2.5-14B-Instruct는 각각 5.4, 85.5, 78.7을 기록한다.
- 논문은 SimpleQA 점수 하락의 일부를 의도적인 답변 보류와 연결하고, 엄격한 지시 준수를 실질적인 약점으로 인정한다. 또한 일부 Llama 점수가 개발사 보고치보다 낮은 원인이 엄격한 출력 형식일 수 있다고 설명한다.
7 Safety
안전성 개발은 원하는 행동을 유도하는 후속학습 정렬, 적대적 테스트, 수십 가지 Responsible AI(RAI) 위해 범주에 대한 자동 평가를 결합한다. 학습에는 유용성과 무해성 선호도 데이터셋, 수정한 안전성 데이터, 내부에서 생성한 안전성 데이터를 사용한다.
7.1 RAI Benchmarks
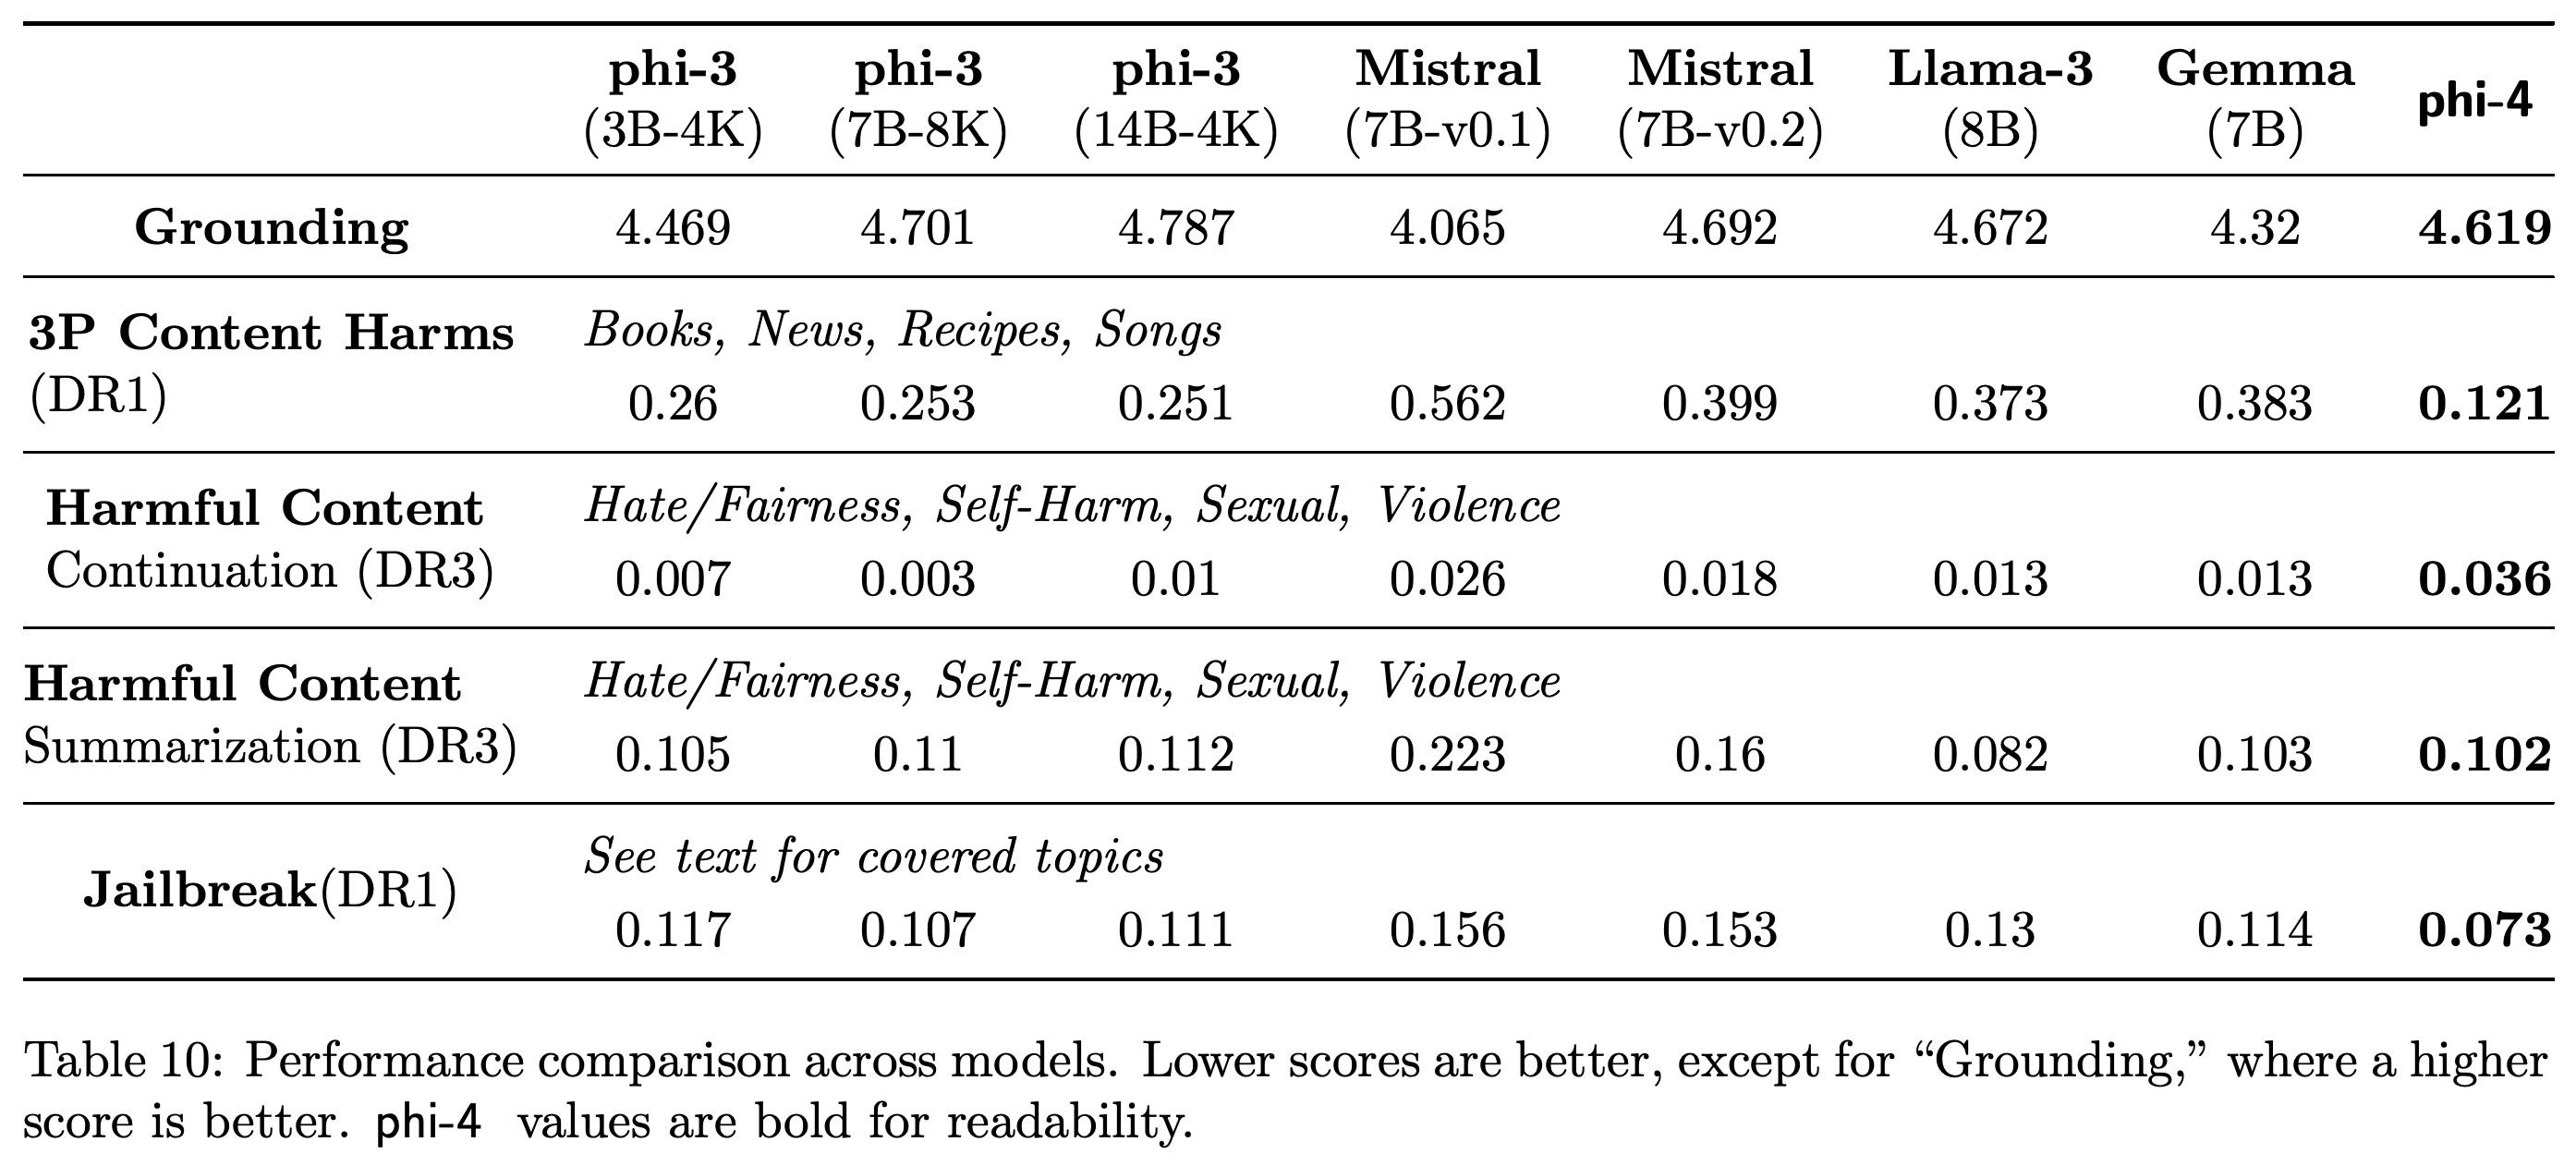
내부 RAI 평가는 GPT-4o로 5개 범주의 다중 턴 대화를 시뮬레이션하고 평가한다. 답변이 프롬프트에 근거하는지를 뜻하는 grounding은 0~5로 평가한다. 다른 범주는 0~7의 위해 심각도와 지정한 심각도 임계값 이상인 샘플의 비율인 결함률을 사용한다.
- Table 10에서 phi-4는 제3자 콘텐츠 위해 0.121, 안전 제한을 우회하려는 시도인 jailbreak 0.073을 기록한다. 이 지표에서는 나열된 모든 비교 모델보다 낮다.
- 범주별 결과는 엇갈린다. 유해 콘텐츠 이어 쓰기는 0.036으로 모든 비교 모델보다 높아 더 나쁘고, grounding은 4.619로 phi-3-medium의 4.787보다 낮다.
- 이 결과는 내부 평가 조건에서 범주별 안전성을 비교하는 근거가 되지만, 모든 지표의 개선을 보여 주지는 않는다.
Phi-4는 나열된 모델 중 제3자 콘텐츠 위해와 jailbreak 결함률이 가장 낮지만, 유해 콘텐츠 이어 쓰기 비율은 0.036으로 가장 높다. 굵은 글씨는 범주별 최고 성능이 아니라 phi-4의 값을 표시한다.
7.2 Red Teaming
Microsoft AI Red Team은 안전성과 보안 실패를 찾는 적대적 테스트인 레드팀 평가를 2주 동안 진행했다. 평가는 단일 턴과 다중 턴 환경에서 일반 사용자와 적대적 사용자를 다뤘다. 발견한 위험 행동을 바탕으로 안전성 후속학습을 추가했으며, 시험한 공격에는 jailbreak, 인코딩한 프롬프트, 여러 대화 턴에 분산한 공격이 포함된다.
- 보고된 실험에서 phi-3-medium을 대상으로 생성한 적대적 접미사는 phi-4에 전이되지 않았다. 적대적 접미사는 원치 않는 행동을 유도하기 위해 프롬프트 뒤에 붙이는 텍스트다.
- 저자들은 추가 시나리오와 위해 범주에 대한 후속 테스트가 필요하다고 설명한다. 이 절은 수치로 표현한 공격 성공률 없이 정성적 결과를 제시한다.
8 Weaknesses
남은 약점에는 사실을 지어낸 인물 소개, 상세한 형식 지시 불이행, 기초 추론 오류, 불필요하게 장황한 응답이 있다. 보고서는 phi-4가 9.9를 9.11보다 작다고 잘못 판단할 수 있으며, 미세조정이 단일 턴 질의에 집중됐다고 설명한다.
- 저자들은 형식 준수의 약점을 엄격한 지시 준수보다 질의응답과 추론을 우선한 학습과 부분적으로 연결한다.
- 완화 조치에도 편향, 부적절한 생성, 안전성 실패는 남아 있다.
부록
- A Post-Training Dataset Details는 모델이 정답을 맞힐 가능성을 추정해 답변이나 거부 응답을 선택하는 SFT와, 정답을 맞히거나 틀리는 경우에 각각 거부보다 정답을, 오답보다 거부를 선호하도록 하는 DPO를 설명한다. 답변 불가능한 합성 질문, 거부 응답과 정답 대조용 프롬프트, judge-guided DPO의 평가 기준도 제공한다.
- B Data Processing은 직접 일치와 중복 비율을 사용하는 n-gram 기반 오염 제거를 설명하며, 불필요한 제거를 줄이려고 흔한 구절은 예외로 둔다. 알고리즘은 중복 임계값을 명시하지 않으며, 단어열 대조만으로는 바꾸어 표현한 벤치마크 자료를 모두 제거하기 어렵다.
- C AMC Evaluation Details는 학습 데이터 수집 이후 공개된 경시대회 문제의 추론과 채점 방식을 설명한다. 최종 모델은 다른 후보들의 성능을 확인한 뒤, 자체 점수를 측정하기 전에 다른 요인을 기준으로 선택됐다. 그림과 부록의 샘플링 설명이 서로 어떻게 연결되는지는 명확히 설명되지 않는다.
- D Synthetic generation examples는 메타데이터에 따른 자료 선별, 자체 수정, 대화 생성, fill-in-the-middle 과제, AgentKit 궤적을 독립적으로 이해할 수 있는 추론 문장으로 재작성하는 방법을 다룬다. 보고서는 AgentKit 데이터가 내부 성능을 높였다고 주장하지만, 이 부록에는 정량적인 ablation 실험이 없다.
짧은 생각
학습 방식의 효과를 가장 명확히 뒷받침하는 근거는 고정 예산 실험에서 선별한 합성 데이터의 반복 학습이 유리했다는 결과와, 후속학습 비교에서 pivotal-token 선호도가 성능을 높였다는 결과다. 합성 데이터만 사용했을 때 나타나는 사실 지식의 부족은 최종 학습 구성에 비합성 자료를 유지한 이유도 설명한다. PTS는 정답 여부를 검사한 후속 생성 결과를 개별 토큰 선호도로 바꾸는 구체적인 방법을 제공한다. 후속 생성 샘플링에 대한 더 상세한 비용 내역이 없어 실제 비용은 평가하기 어렵다. 새로운 AMC 질문은 수학 성능의 근거를 강화한다. 다만 실행 횟수 설명이 서로 어떻게 연결되는지 불분명하고 다른 최종 후보도 사전에 평가했으므로, 이 시험을 얼마나 독립적으로 활용했는지 판단할 때 이를 고려해야 한다. 보고된 결과는 추론, 사실 질문에 대한 답변 범위, 형식 준수, 다중 턴 행동을 따로 평가할 필요성을 뒷받침한다. 한 지표의 개선이 다른 지표의 하락과 함께 나타날 수 있기 때문이다.