


2026년 6월 AI 논문 동향
30 Jun 2026 | Paper Review Monthly Papers Agent Memory Synthetic Training Data Model Architecture목차
이달의 트렌드
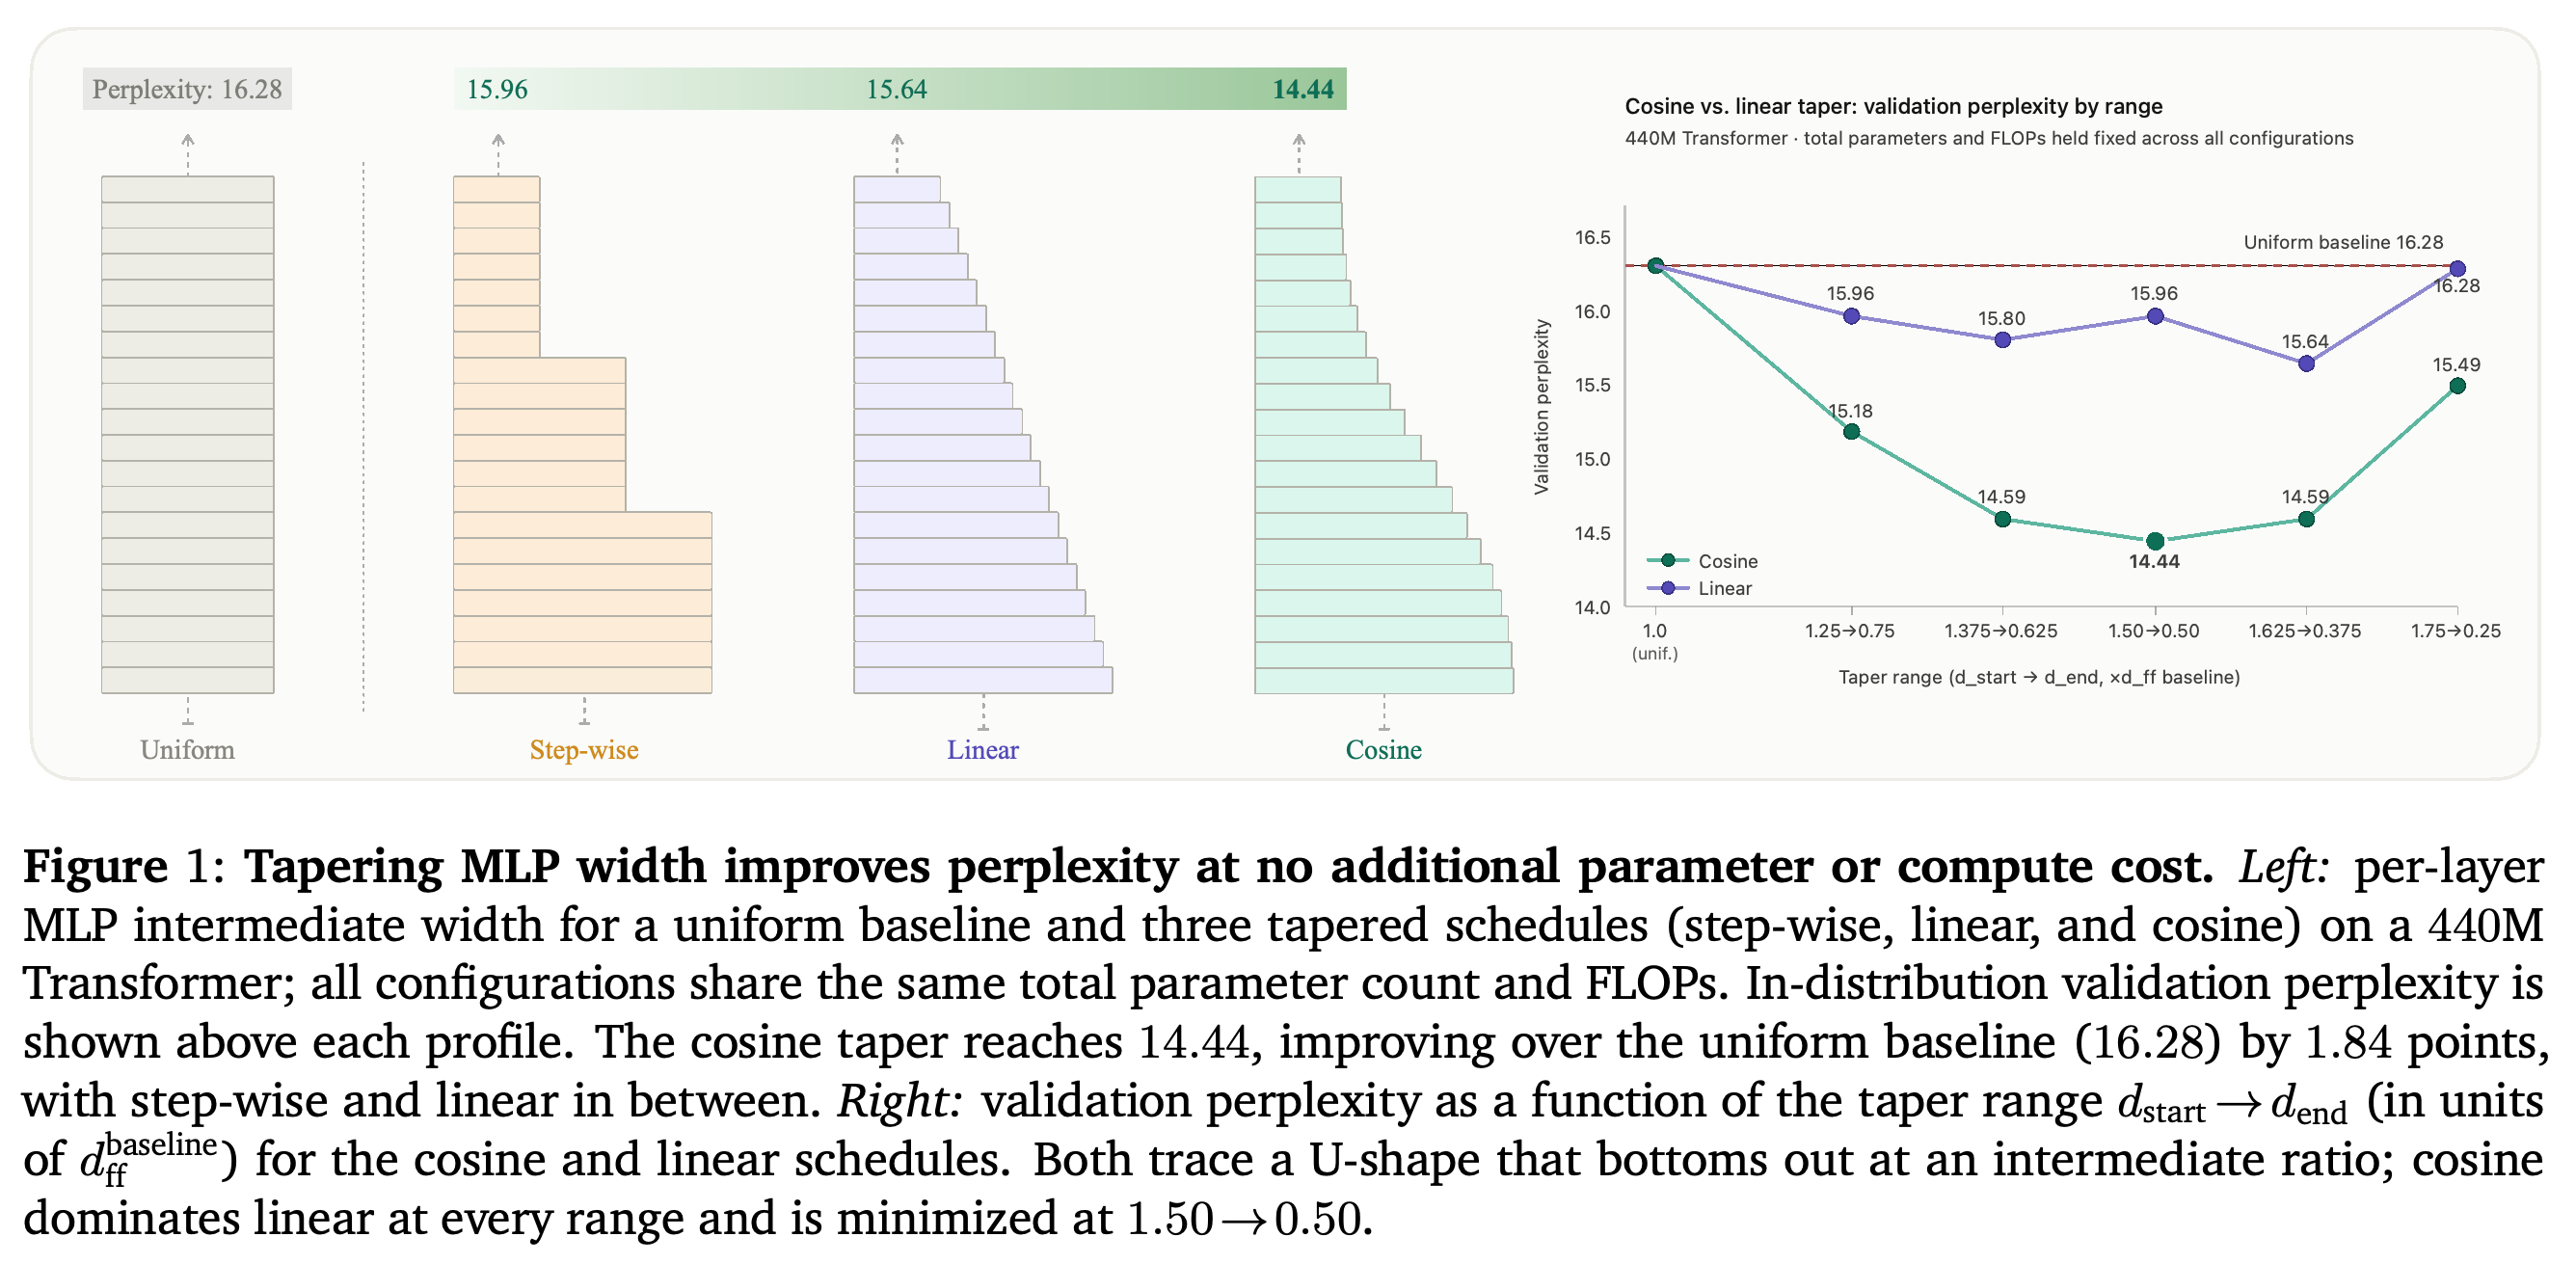
2026년 6월에 선정된 세 논문은 측정으로 확인한 요구에 맞춰 시스템을 설계한다는 공통 주제 아래, 에이전트가 보존할 정보, 목표 모델의 학습에 도움이 되는 생성 예제, 언어 모델의 층별 용량 배분을 살펴본다. 세션을 넘어 보존하고 수정할 수 있는 상태인 에이전트 메모리에서는 이후 질의에 필요한 근거를 유지하는 것이 유리하다. Autodata는 문제를 푸는 모델인 solver의 피드백으로 합성 학습 예제를 조정하며, 컴퓨터 과학과 법률 추론에서 난이도를 서로 다르게 조정한다. Tapered Language Models는 총 파라미터 수와 부동소수점 연산 수를 유지하면서 피드포워드 용량을 앞쪽 층에 더 많이 배분한다. 이 연구들은 구체적인 배분 방식이 워크로드의 요구에 맞는지 검증하는 접근을 뒷받침한다. 1, 2, 3
평가에서는 중간 신호와 실제 성과를 구분한다. 메모리 연구는 답변 품질과 함께 근거 검색과 운영 지연 시간을 측정한다. Autodata는 예제 생성의 성공과 해당 예제로 학습한 뒤의 성능 향상을 구분하며, 외부 과학 추론 평가 결과도 평균 정답률을 측정하는지, 여러 시도 중 적어도 한 번 성공하는지를 측정하는지에 따라 달라진다. Tapering은 파라미터와 연산 예산이 같은 조건에서 과제 종합 점수를 높이지만, 실제 실행 시간의 이점은 측정하지 않는다. 엔지니어링 관점에서는 어떤 성과를 개선했으며 어떤 자원을 실제로 통제했는지 명시해야 한다. 예제 수를 맞췄다고 생성 비용까지 같은 것은 아니며, 연산 수가 같다고 지연 시간까지 같은 것도 아니다.
2026년 6월의 주요 논문
1. Are We Ready For An Agent-Native Memory System?
- https://arxiv.org/abs/2606.24775
- Are We Ready For An Agent-Native Memory System? 요약 설명
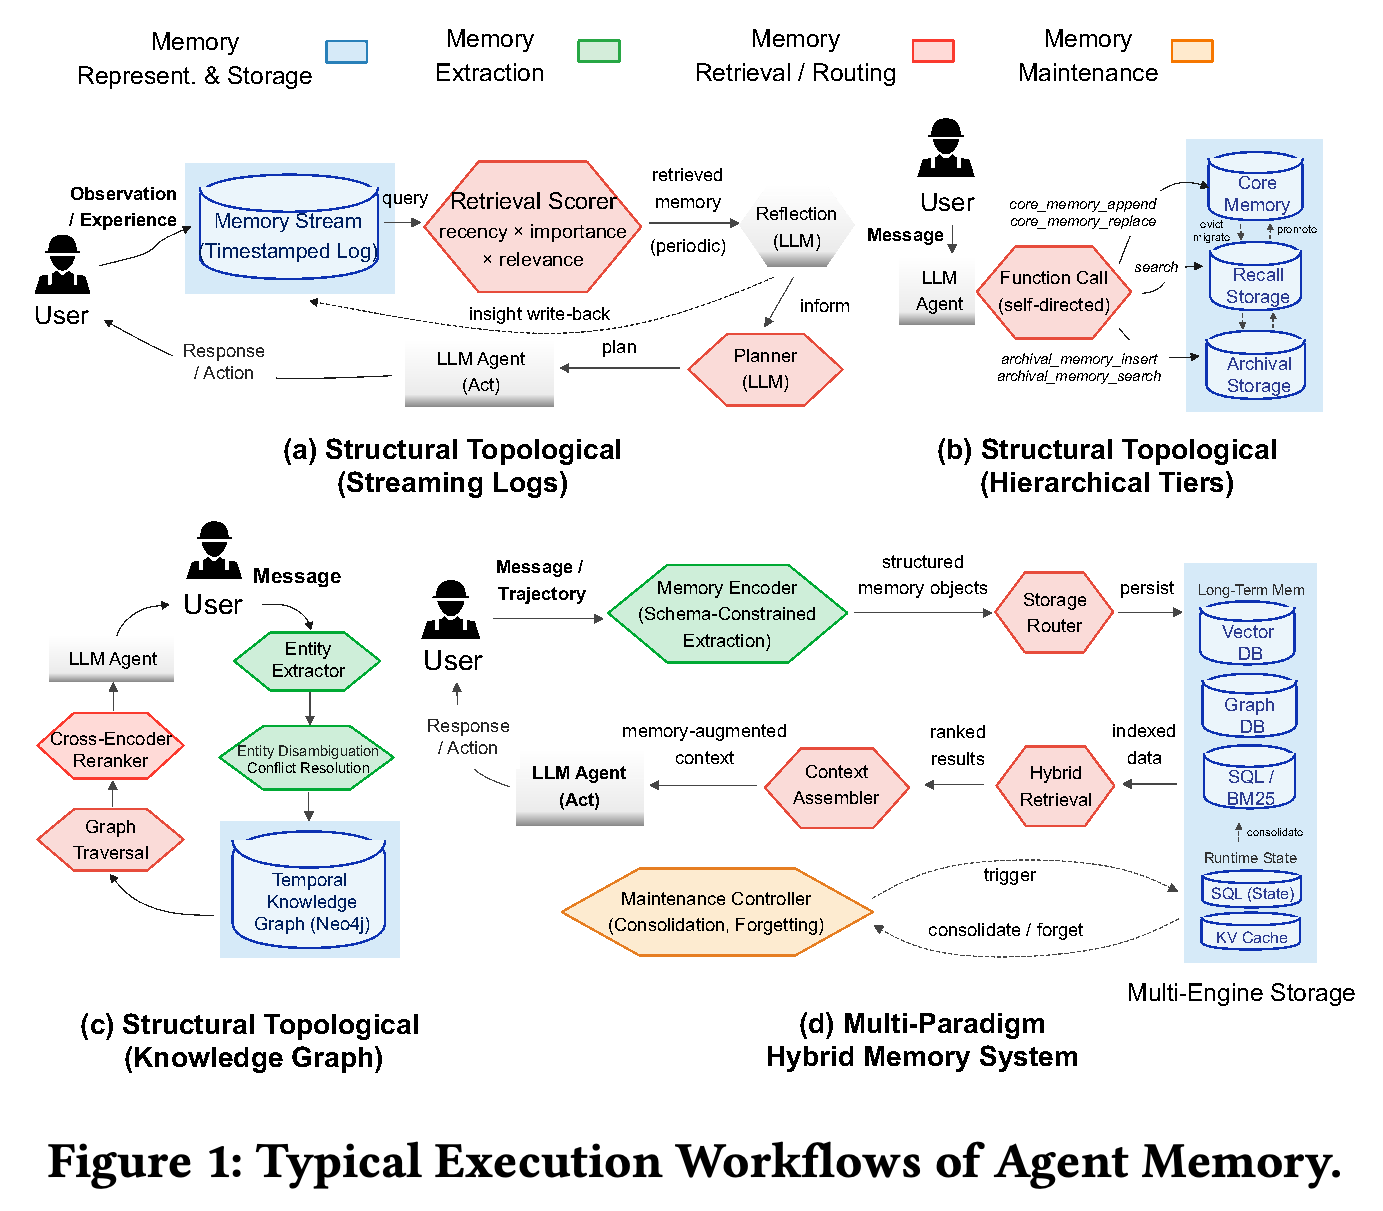
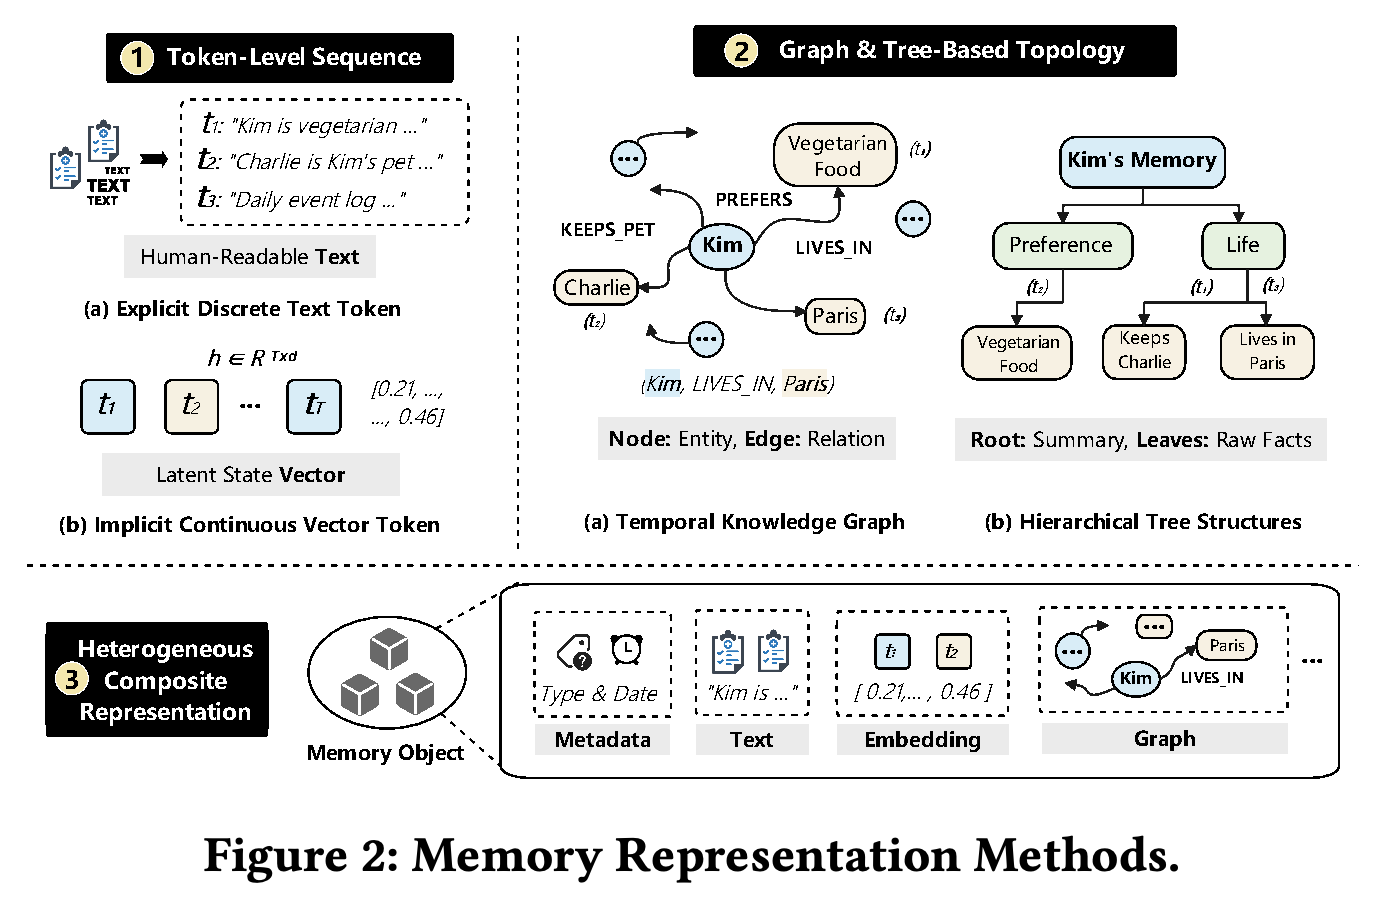
- Are We Ready For An Agent-Native Memory System?은 메모리를 표현과 저장, 추출, 검색과 라우팅, 유지관리로 나눈다. 11개 데이터셋을 포괄하는 5개 벤치마크 워크로드에서 대표 시스템 12개와 참조 베이스라인 2개를 비교하며, 실험마다 포함된 시스템 범위는 다르다.
- 장기 대화 질의응답 벤치마크인 LoCoMo에서 A-MEM은 Recall@10 85.9%를 기록한다. 이 지표는 검색된 상위 10개 source-id 그룹이 주석으로 표시된 정답 근거를 얼마나 포함하는지 측정한다. MemTree는 80.5%, 임베딩 검색을 사용하는 검색 증강 생성 방식인 Embedding RAG는 17.7%를 기록한다. 이 전체 시스템 비교에서는 연결형 또는 계층형 근거 접근이 유리하지만, 표현 방식만을 원인으로 분리하지는 못한다.
- LightMem 구성요소 비교 실험에서는 근거 보존이 큰 영향을 준다. User-Only Raw는 답변의 중첩 정도를 측정하는 LoCoMo Answer F1에서 38.9를 기록하지만, User-Only Summary는 15.6을 기록한다. 운영 성능도 워크로드에 따라 크게 달라진다. LongBench의 컨텍스트 길이 스트레스 테스트에서 이상치를 제외한 질의당 평균 지연 시간은 LightMem이 17.3초, MemTree가 116.7초, Zep Local이 2867초다.
2. Autodata: An agentic data scientist to create high quality synthetic data
- https://arxiv.org/abs/2606.25996
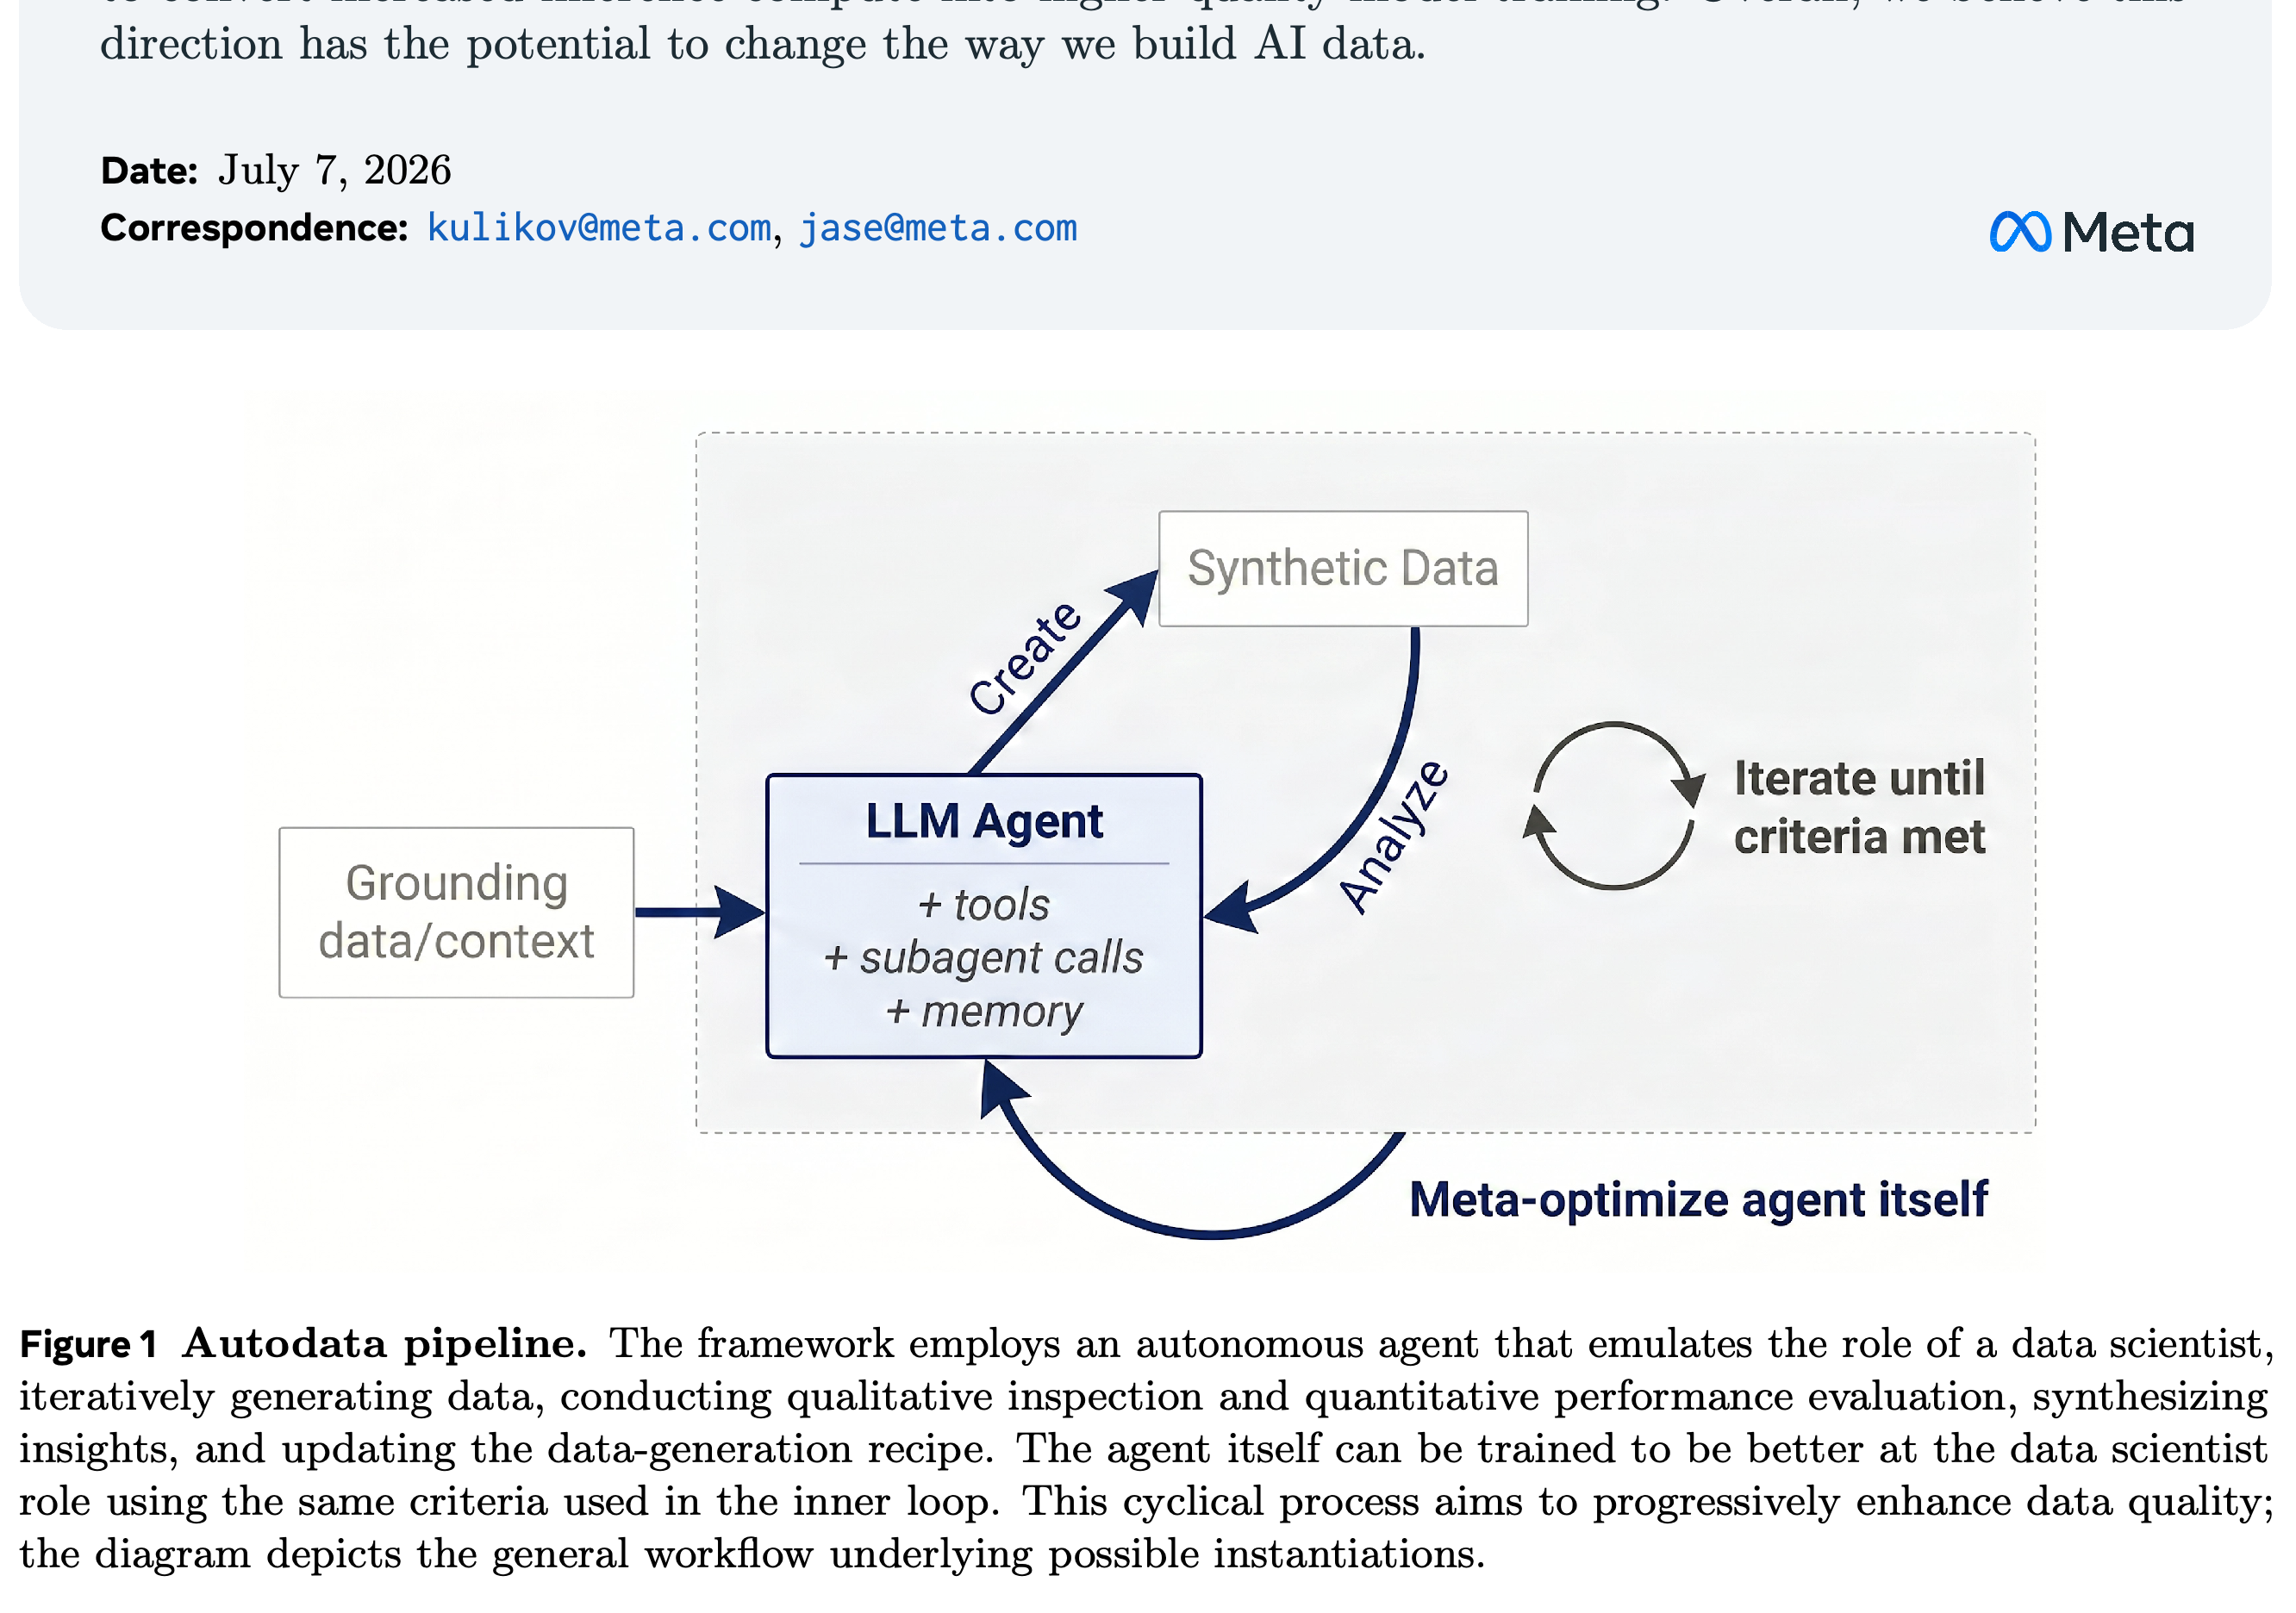
- Autodata: An agentic data scientist to create high quality synthetic data 요약 설명
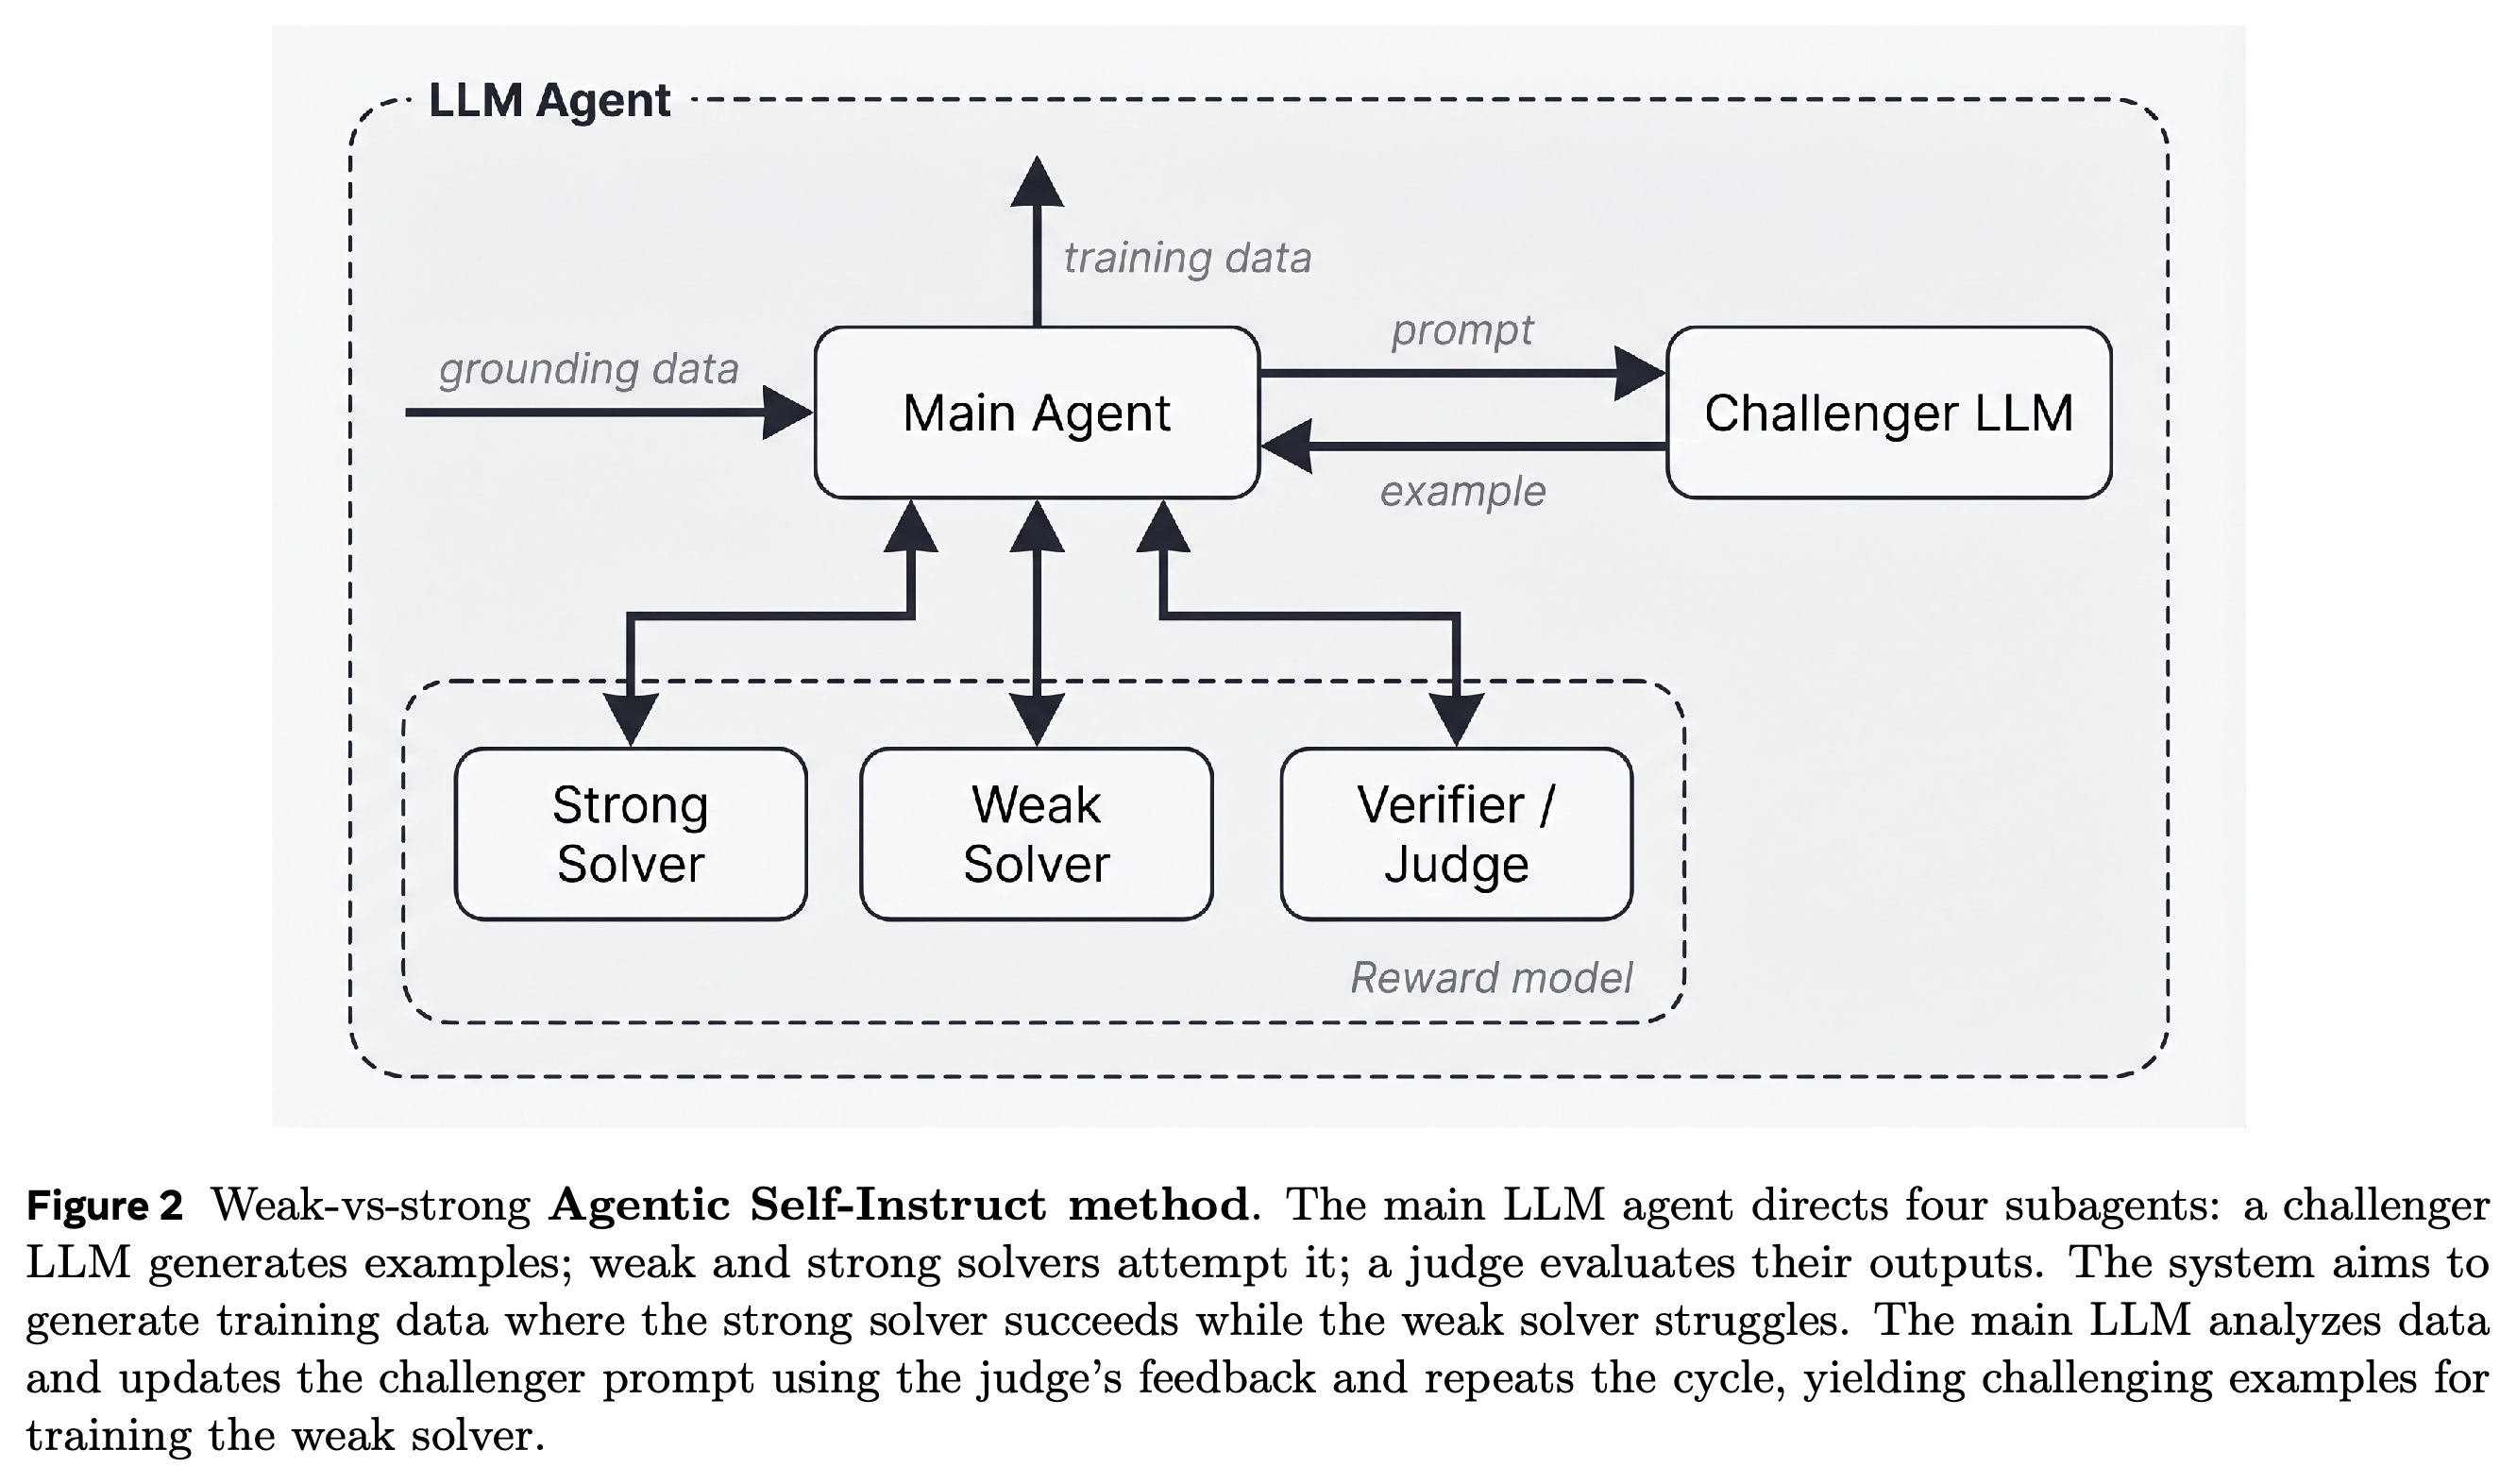
- Autodata: An agentic data scientist to create high quality synthetic data는 문제를 만드는 challenger, weak solver와 strong solver, verifier/judge를 조율하는 생성 루프인 Agentic Self-Instruct를 구현한다. 피드백을 바탕으로 후보 예제를 수정해 특정 모델의 학습에 도움이 되도록 한다. 컴퓨터 과학 질문은 weak solver에게 더 어렵게 만들고, 법률 질문은 더 학습하기 쉽게 만들어 보상이 일괄적으로 0에 가까워지는 상황을 줄인다. judge에 대해서는 J1: Incentivizing Thinking in LLM-as-a-Judge via Reinforcement Learning 요약 설명 글을 참조하라.
- 학습 예제 수를 맞춘 비교에서 에이전트 기반 데이터는 명시적 추론을 포함한 예제를 생성하는 chain-of-thought Self-Instruct보다 Qwen3.5-4B의 성능을 더 높인다. 외부 PRBench-Legal 평가에서 GPT-5로 채점한 점수는 에이전트 기반 데이터와 chain-of-thought 데이터 순으로 Legal에서 0.441과 0.377, Legal-Hard에서 0.315와 0.253이다. Kimi-K2.6로 채점해도 같은 순위가 유지된다. chain-of-thought에 대해서는 Likelihood-Based Reward Designs for General LLM Reasoning 요약 설명 글을 참조하라.
- 외부 과학 추론 과제로의 전이 효과는 작고 지표에 따라 달라진다. 2,113개 항목으로 구성된 Principia 벤치마크에서 8회 시도의 평균 정답률인 avg@8은 에이전트 기반 데이터 학습이 51.47%, 기본 모델이 50.43%, chain-of-thought 데이터 학습이 51.10%다. 8회 중 적어도 한 번 성공하는 비율인 전체 pass@8은 chain-of-thought 데이터 학습이 60.06%로, 에이전트 기반 데이터 학습의 59.91%보다 높다.
3. Tapered Language Models
- https://arxiv.org/abs/2606.23670
- Tapered Language Models 요약 설명
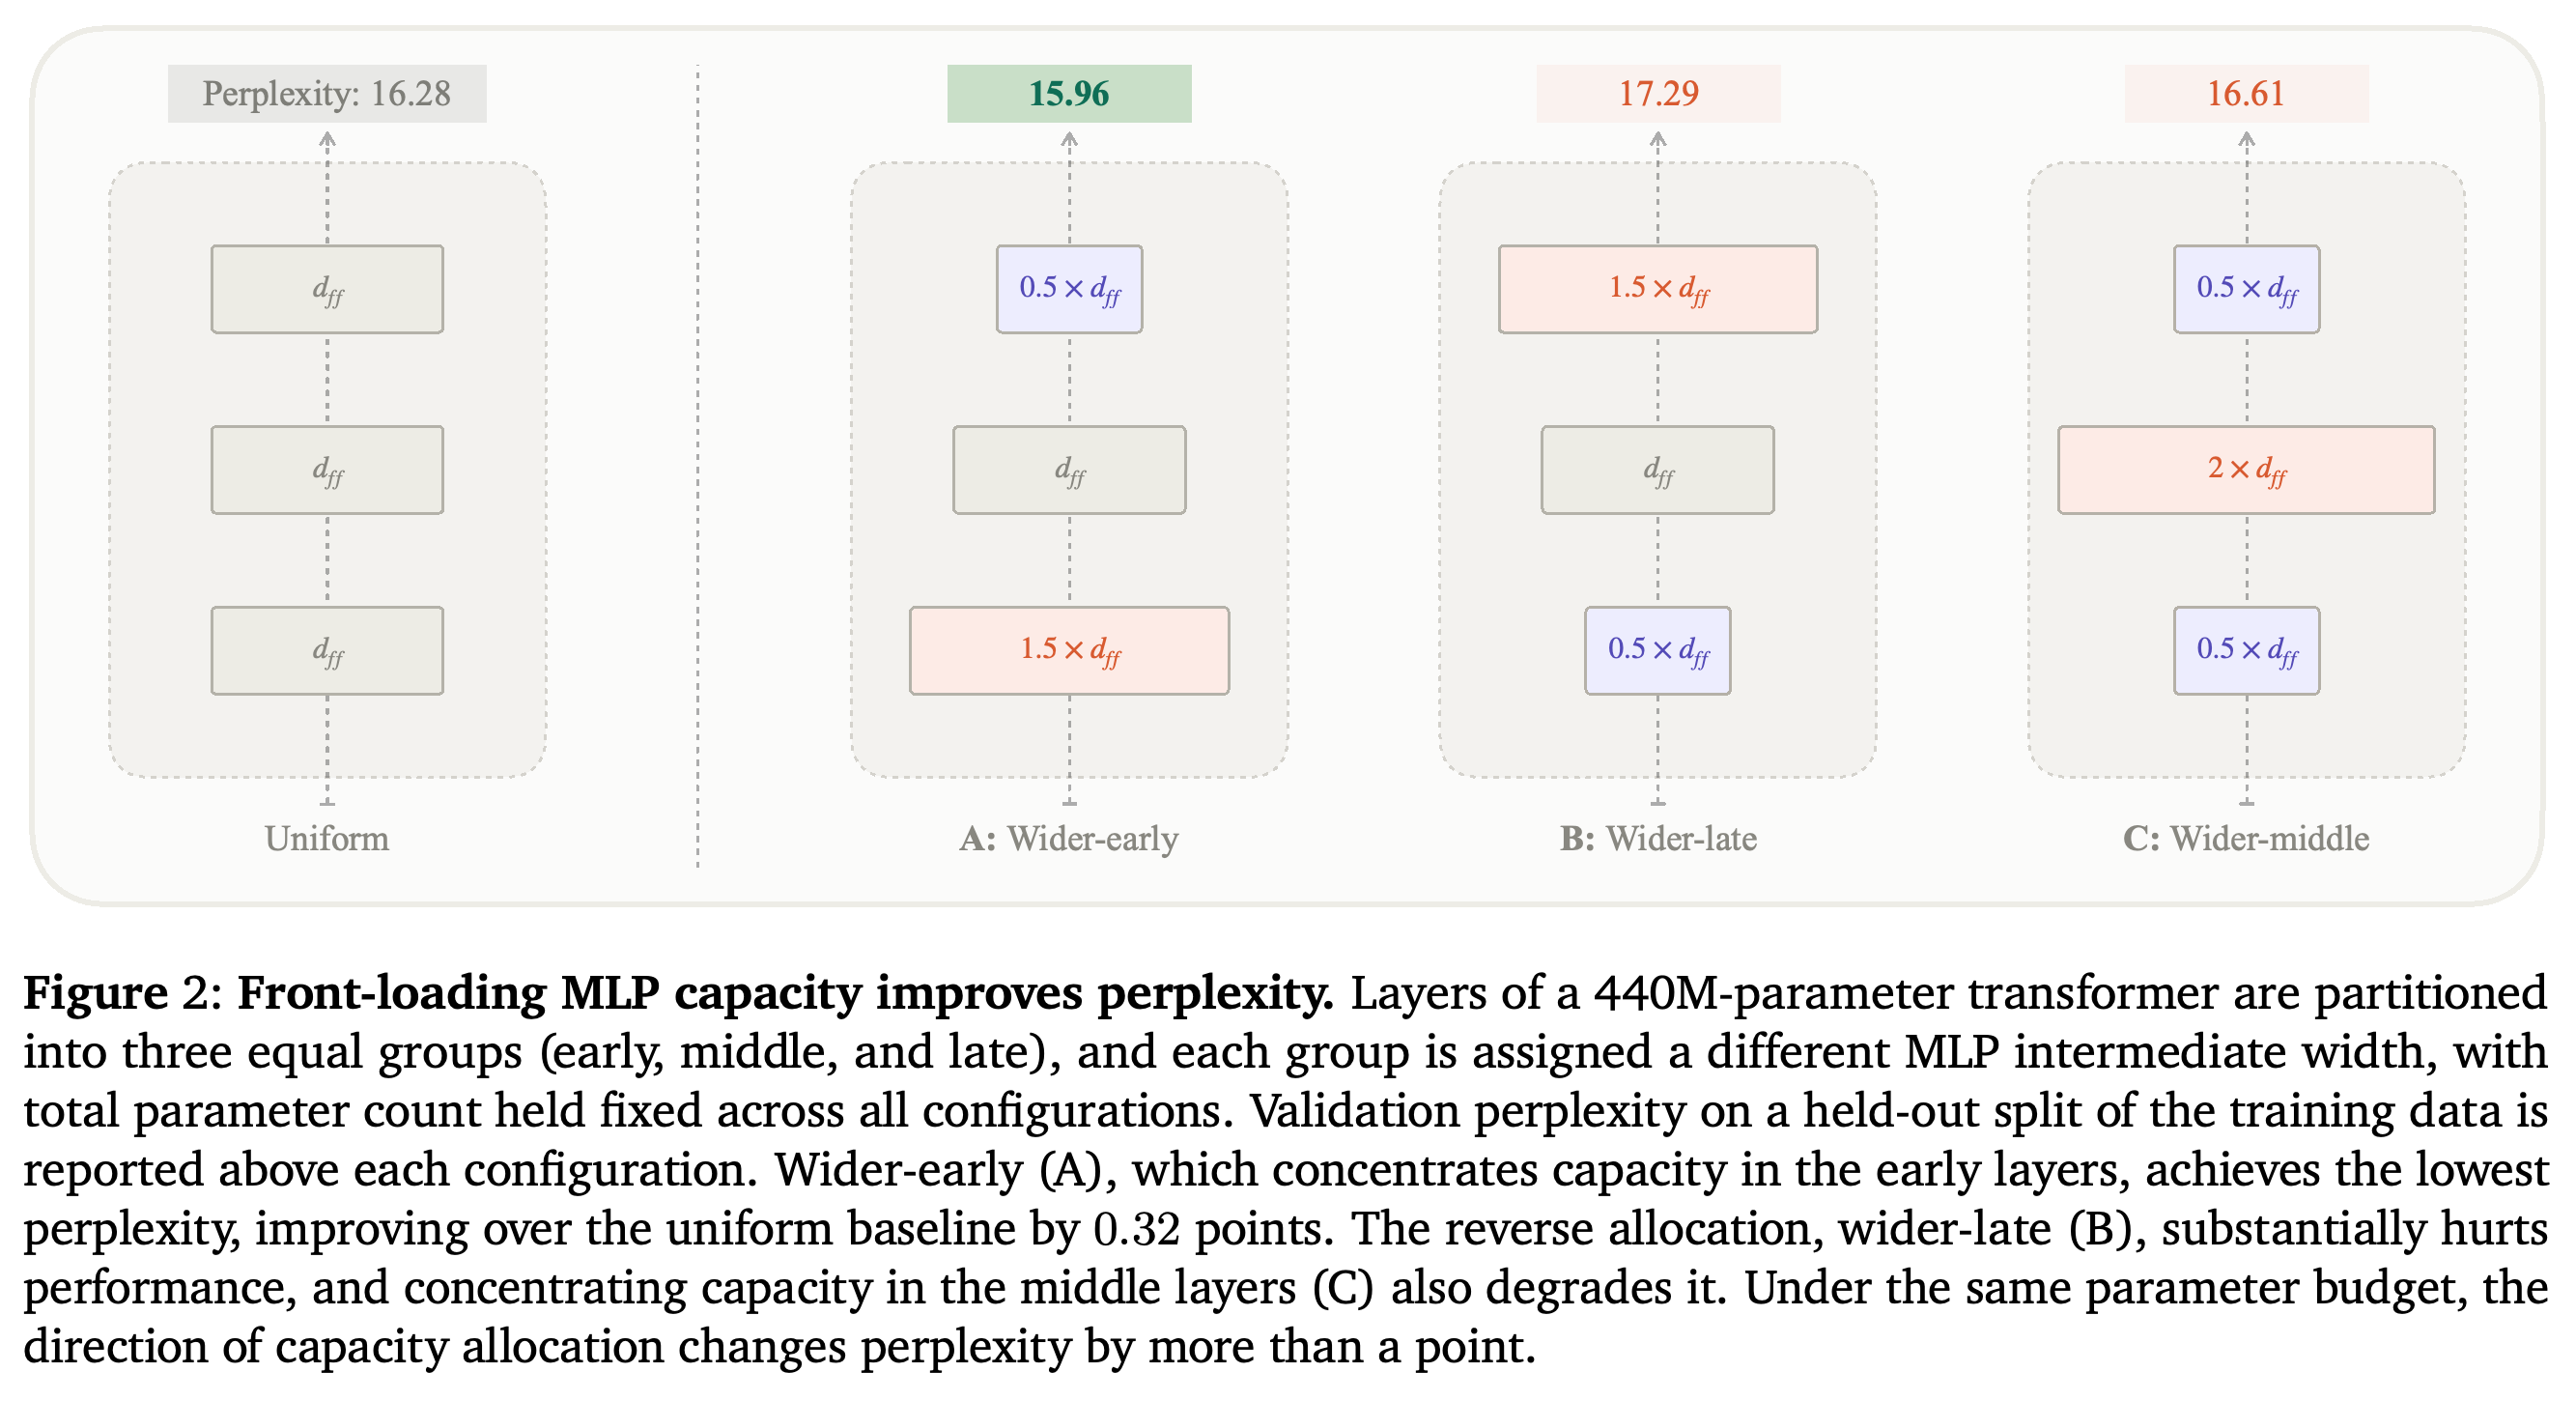
- Tapered Language Models는 피드포워드 모듈인 다층 퍼셉트론(MLP)의 내부 차원을 뜻하는 중간 너비를 층이 깊어질수록 줄이되, 평균 너비는 유지한다. 각 비교에서는 총 파라미터 수, 학습과 추론의 연산 수, 학습 하이퍼파라미터를 고정한다. 440M-parameter Transformer에서 15개 설정을 탐색해 기준 너비에 대한 배율이 1.50에서 0.50 times로 감소하는 cosine taper를 선택한다. 이 설정은 낮을수록 좋은 언어 모델링 지표인 검증 perplexity를 16.28에서 14.44로 낮춘다. perplexity에 대해서는 Multi-Token Attention 요약 설명 글을 참조하라.
- 선택한 배분 형태를 변경하지 않고 760M과 1.3B 파라미터 규모의 4개 아키텍처에 적용하면, 8개 비교 모두에서 보고된 8개 과제의 평균 정확도가 높아진다. LAMBADA perplexity는 8개 비교 모두에서, WikiText perplexity는 7개 비교에서 개선된다. 1.3B Hope-attention의 WikiText perplexity는 15.91에서 15.94로 바뀐다. 개별 과제의 정확도는 낮아지는 경우도 있다.
- 사전 학습된 GPT-2 모델을 측정하면 뒤쪽 층의 MLP 업데이트가 입력 표현과 방향상 더 잘 정렬된다. 이 관측에 기반한 대리 지표는 앞쪽에 용량을 더 배분하는 동기를 제공하지만, 인과적 메커니즘을 입증하지는 않는다. 스케줄 탐색은 440M Transformer에서만 수행하며, seed를 바꾼 반복 실험의 불확실성이나 실제 지연 시간과 처리량은 보고하지 않는다. 따라서 최적성, 신뢰성, 배포 효율에 관한 주장에는 한계가 있다.
출처
[1] Are We Ready For An Agent-Native Memory System?
[2] Autodata: An agentic data scientist to create high quality synthetic data