


RedPajama: an Open Dataset for Training Large Language Models 요약 설명
19 Nov 2024 | Paper Review Data Curation Datasets LLM Pretraining목차
이번 글에서는 RedPajama: an Open Dataset for Training Large Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 11월 19일(Arxiv), 38th Conference on Neural Information Processing Systems (NeurIPS 2024) Track on Datasets and Benchmarks
- Weber, Maurice, Fu, Daniel, Anthony, Quentin, Oren, Yonatan, Adams, Shane, Alexandrov, Anton, Lyu, Xiaozhong, Nguyen, Huu, Yao, Xiaozhe, Adams, Virginia, et al.
- Together AI, Stanford University, University of Chicago, EleutherAI, Ontocord.ai, Princeton University, ETH Zurich, Mila, Montréal, Canada, Université de Montréal, Ohio State University, Caltech
- 논문 링크
- Github
요약
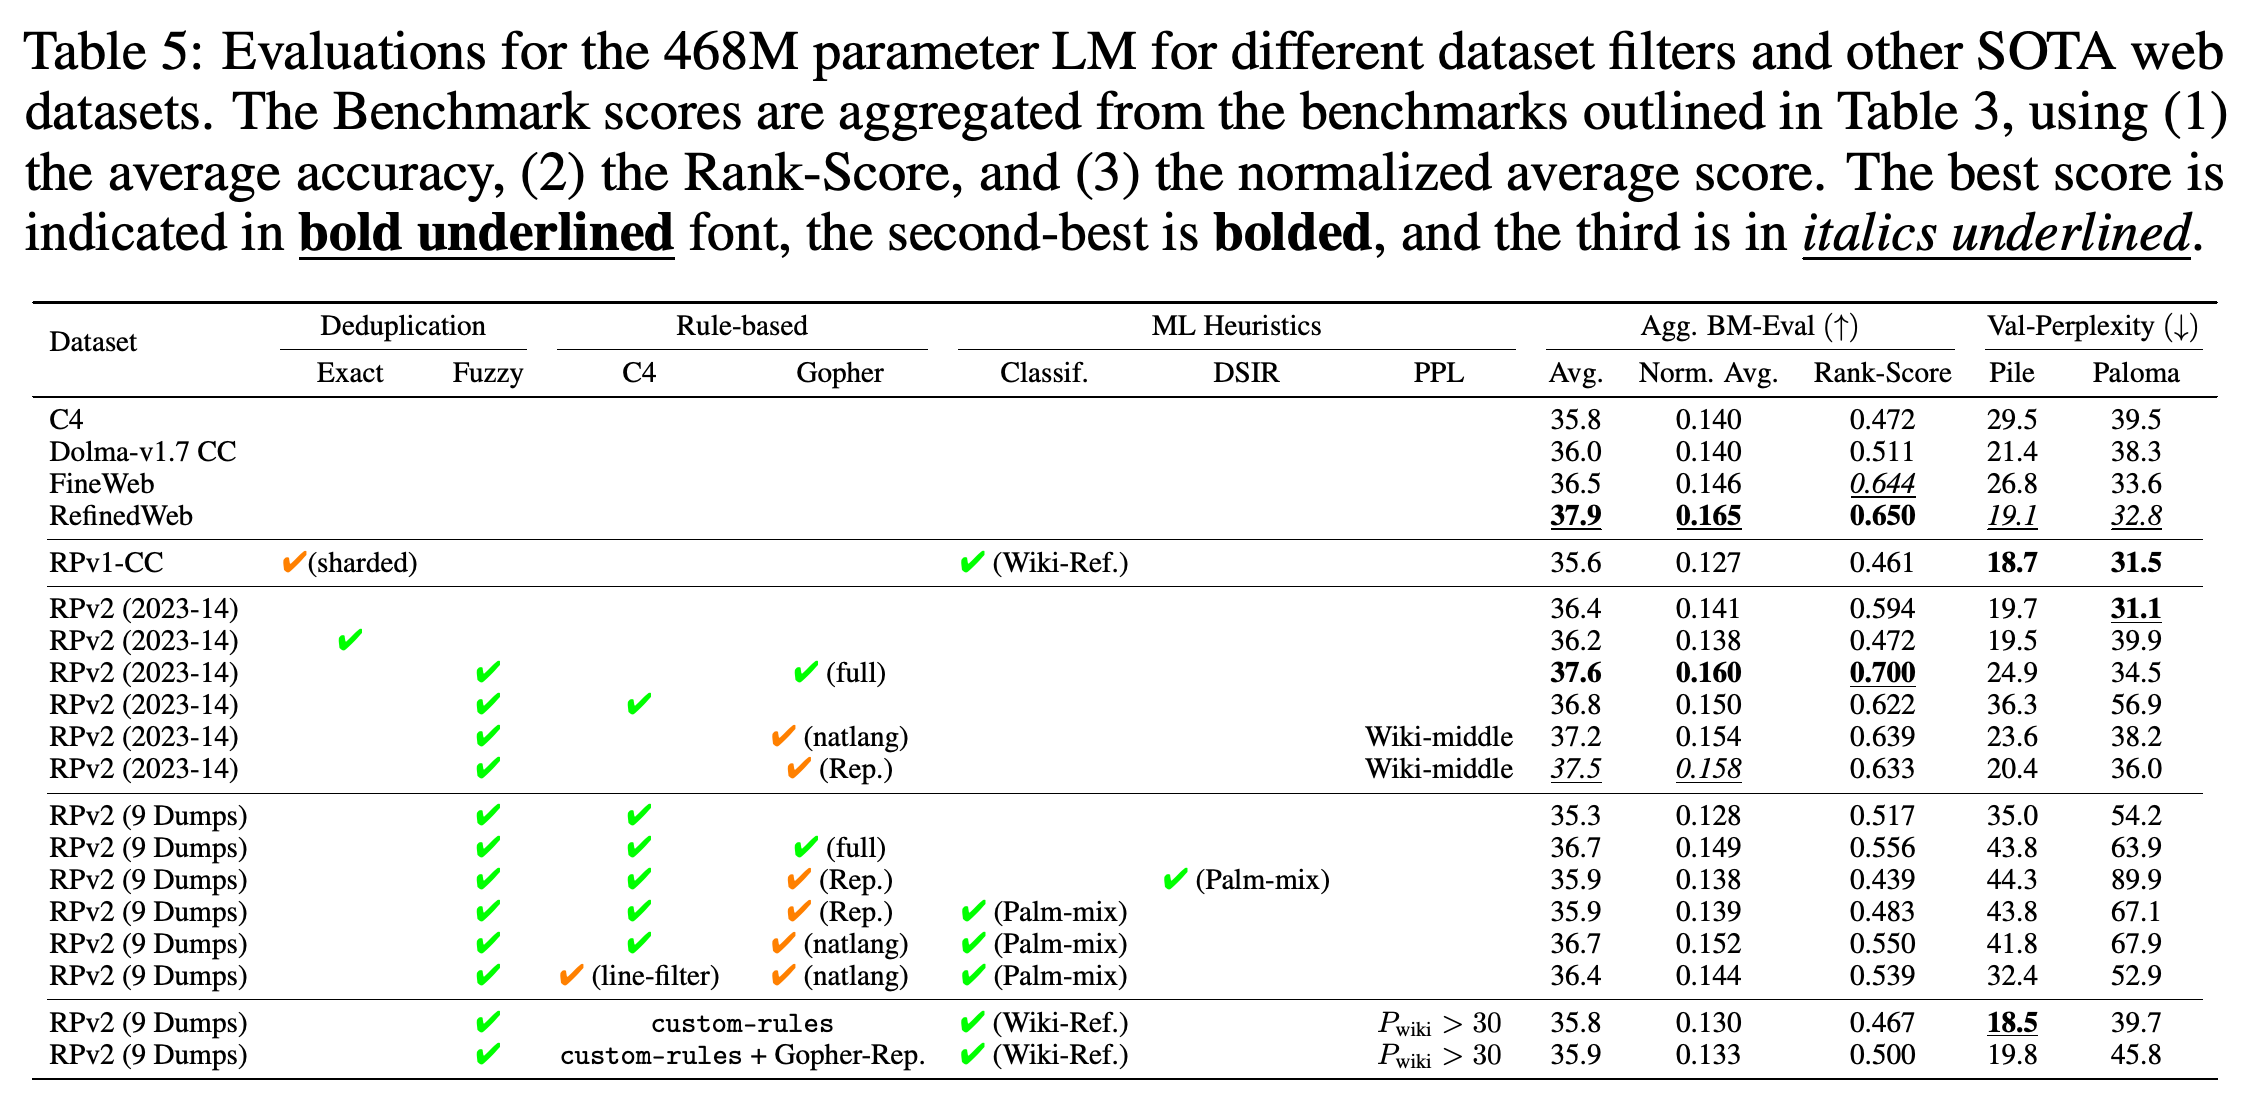
- RedPajama는 문서화된 학습 말뭉치에 접근하기 어렵고 텍스트 필터링이 대규모 언어 모델(LLM)에 미치는 영향을 측정하기 어렵다는 문제를 다룬다. LLM은 대규모 텍스트 모음으로 사전 학습한 모델이다. 학습 중 처리하는 텍스트 단위인 토큰을 100B 토큰씩 학습한 468M-parameter 모델을 비교하면, 필터링한 2023-14 웹 부분집합의 Rank-Score는 0.700으로 필터링된 웹 말뭉치인 RefinedWeb의 0.650보다 높다. Rank-Score는 과제별 순위를 정규화해 종합한 지표다. 반면 평균 벤치마크 점수는 37.6으로 비교 대상의 37.9보다 낮다. 이 RedPajama-V2 구성은 자연어 품질과 반복을 검사하는 휴리스틱인 Gopher 규칙에 유사한 문서를 제거하는 fuzzy deduplication을 결합한다.
- RedPajama-V1은 공개 언어 모델 계열인 LLaMA의 공개된 구성법을 따라 일곱 출처 그룹에서 약 1.2T 토큰을 재구성한다. RedPajama-V2는 공개 웹 아카이브인 Common Crawl의 스냅샷 84개에서 수집한 5개 언어의 텍스트를 제공하며, 토큰 수는 약 123.7T로 추정된다. 품질 지표 46개는 약 50T-token 규모의 head+middle 부분집합에 제공된다. 이 부분집합은 Wikipedia로 학습한 언어 모델이 텍스트를 얼마나 예측하기 어려워하는지 나타내는 perplexity를 기준으로 나눈 세 구간 중 값이 낮은 두 구간의 문서로 구성된다.
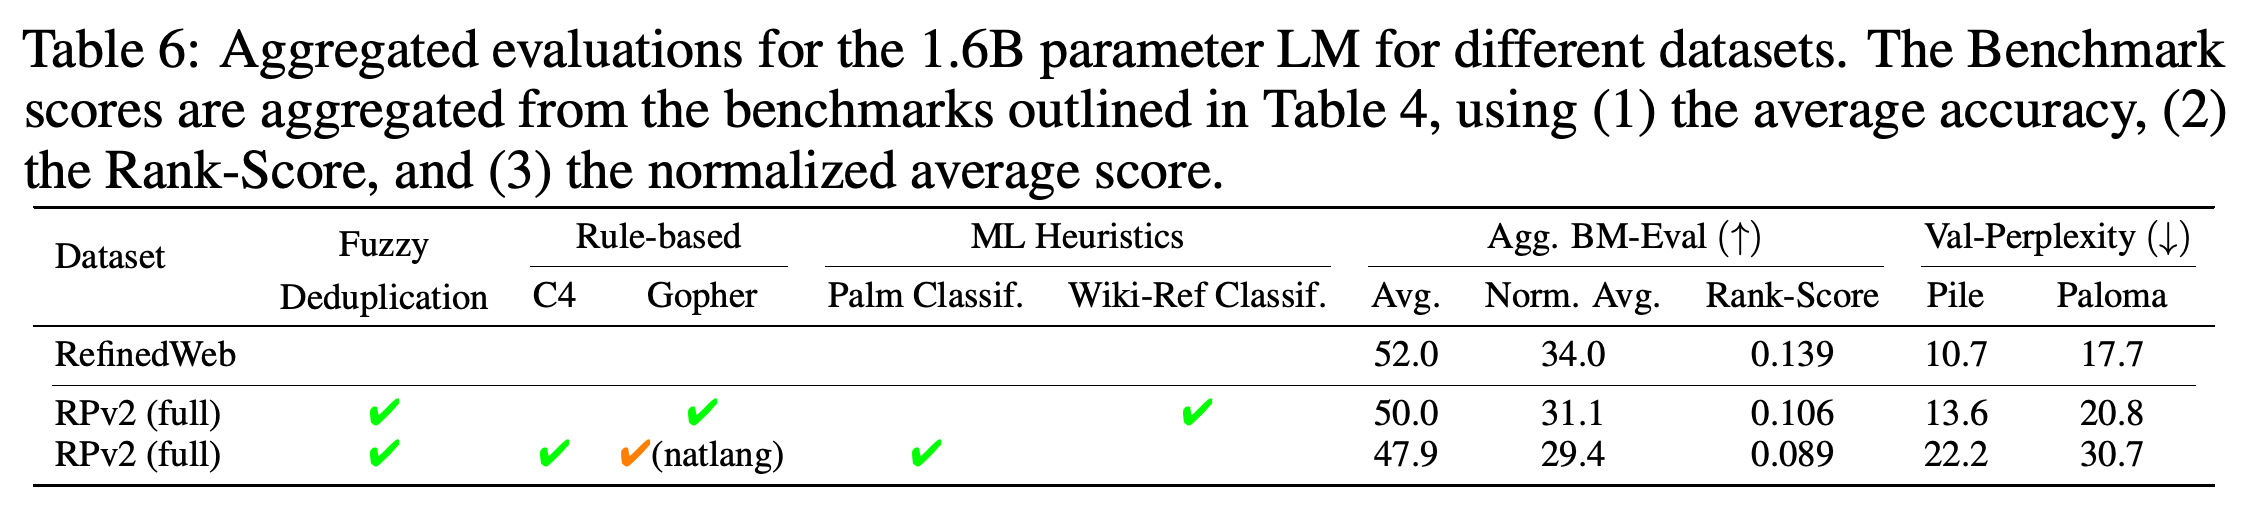
- 필터링 선택은 모델 품질에 영향을 주지만, 실험 결과만으로 모든 상황에서 가장 좋은 구성을 정할 수는 없다. 1.6B 파라미터와 350B 학습 토큰 조건에서 실험한 RedPajama-V2 구성 중 성능이 더 높은 구성의 평균 점수는 50.0으로, RefinedWeb의 52.0보다 낮다. 저자들은 제한된 실험 규모, 학습 말뭉치에 평가 데이터가 포함되었는지 확인하는 철저한 벤치마크 오염 제거와 개인 식별 정보 분석의 부재를 한계로 제시한다.
1 Introduction
서론은 공개 언어 모델 개발의 장애물 3가지를 제시한다. 불투명한 데이터 선별 과정, 대규모 고품질 말뭉치에 대한 제한된 접근, 말뭉치를 분석하고 필터링하는 데 필요한 산출물의 부족이다. RedPajama는 Transparency, Scale, Versatility를 통해 이를 해결하고자 한다. 문서와 코드를 공개하고, 접근 가능한 대규모 데이터 모음을 제공하며, 사용자가 필터링 기준을 선택할 수 있도록 문서에 주석을 제공한다.
- RedPajama-V1은 공개된 학습 데이터 혼합의 재현을 지원하고, RedPajama-V2는 최소한으로 처리한 웹 텍스트와 일부 데이터에 대한 재사용 가능한 품질 메타데이터를 제공한다.
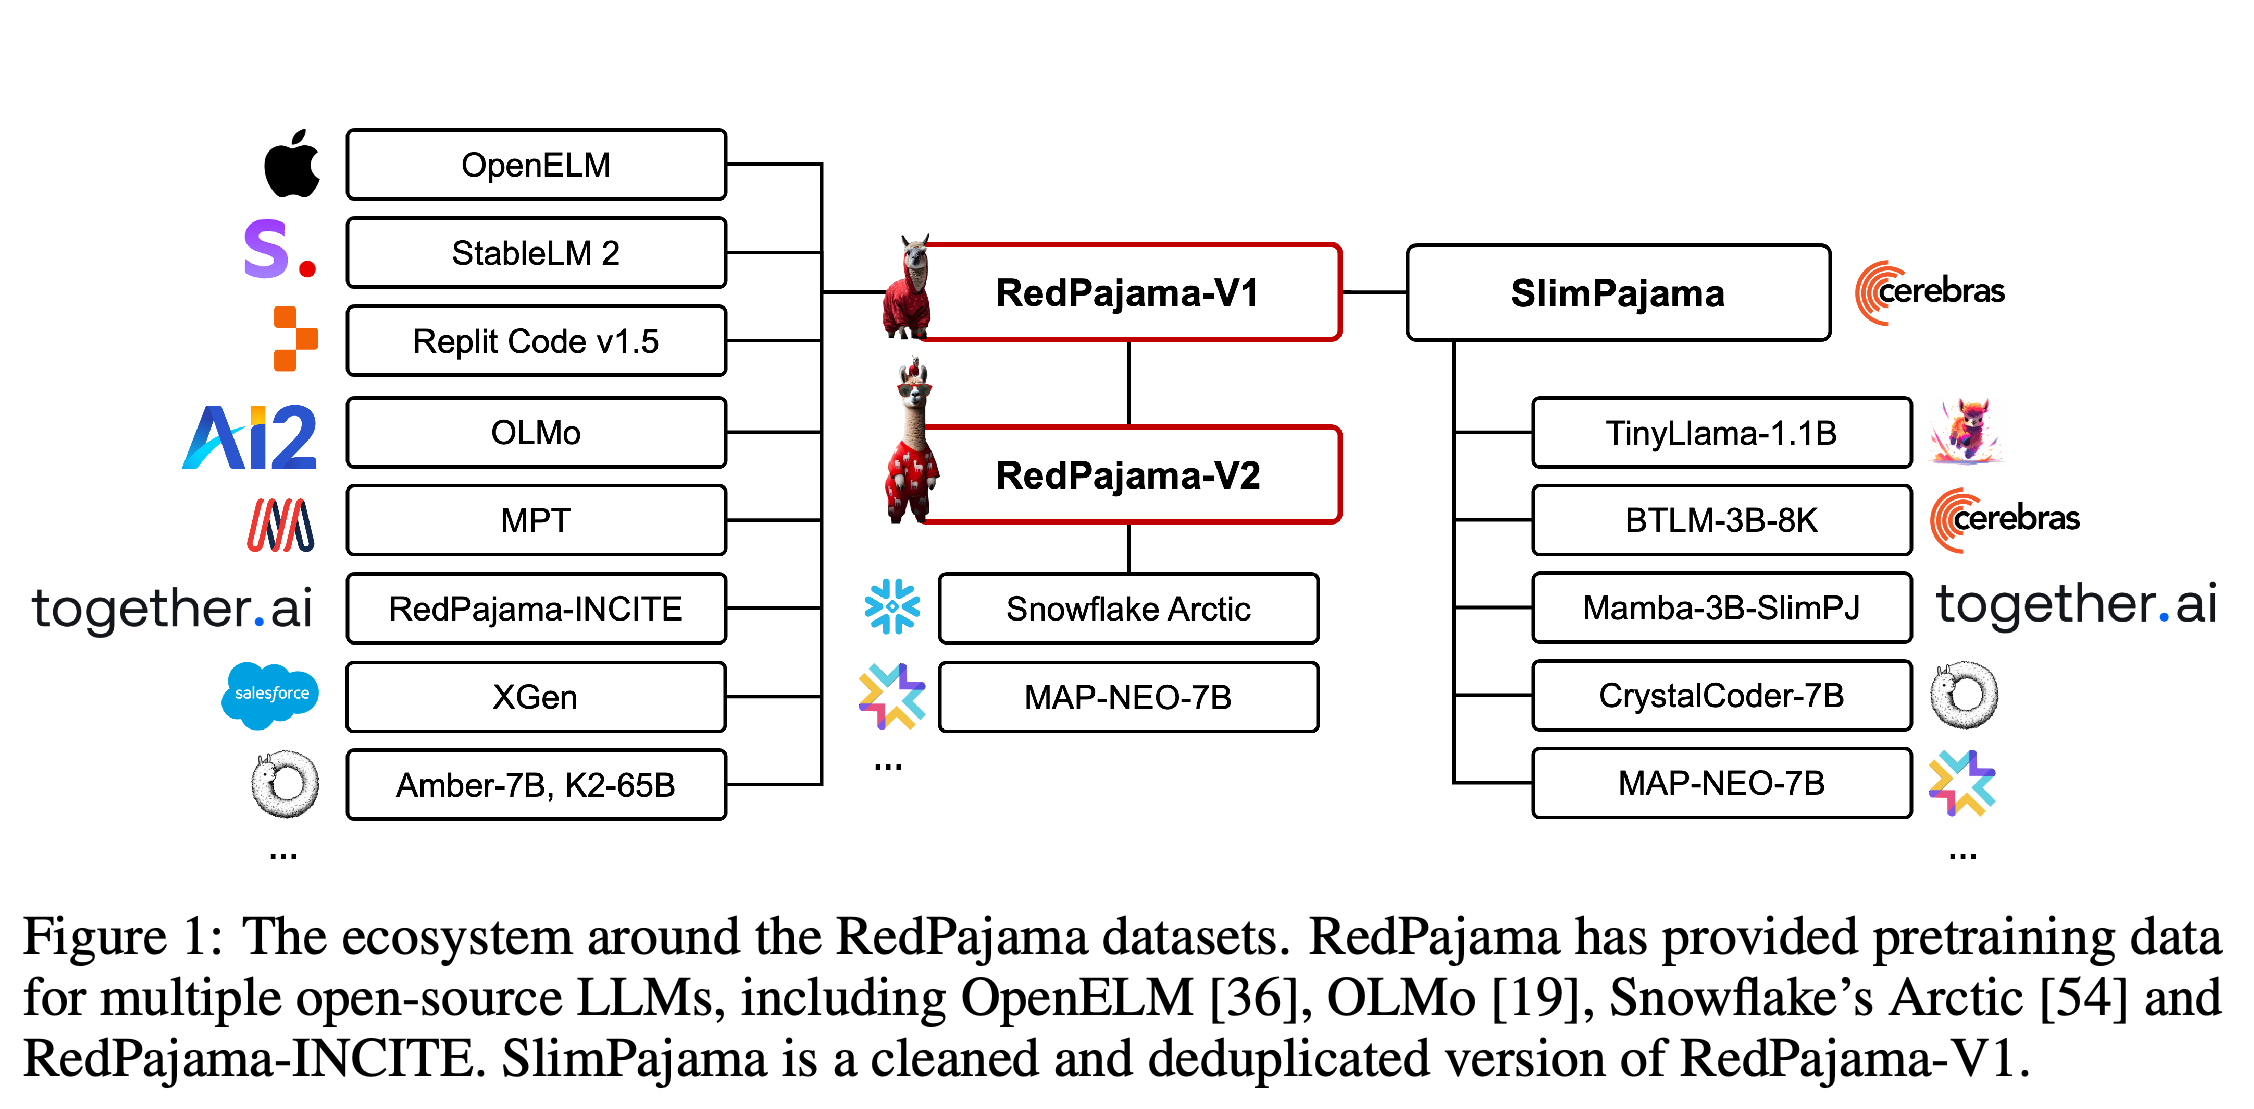
- 논문이 소개하는 생태계에는 RedPajama로 학습한 모델과 이를 가공한 데이터셋이 포함된다. 대표적으로 SlimPajama는 RedPajama-V1을 정제하고 중복을 제거한 데이터셋이다.
이 도식은 RedPajama-V1과 V2를 직접 사용하는 관계와 SlimPajama를 거쳐 사용하는 관계를 구분한다. 활용 사례와 데이터셋 파생 관계를 보여주지만, 모델 성능 중 어느 정도가 RedPajama에 기인하는지는 측정하지 않는다.
2 Related Work
관련 연구는 C4, RefinedWeb, FineWeb처럼 웹 데이터만 사용하는 말뭉치와 Pile, Dolma, ROOTS, RedPajama-V1처럼 여러 도메인을 결합한 복합 말뭉치를 구분한다. RedPajama-V2는 대부분 필터링하지 않은 대규모 데이터 모음과 재사용 가능한 품질 신호를 제공해 다양한 학습 부분집합을 구성하도록 지원한다.
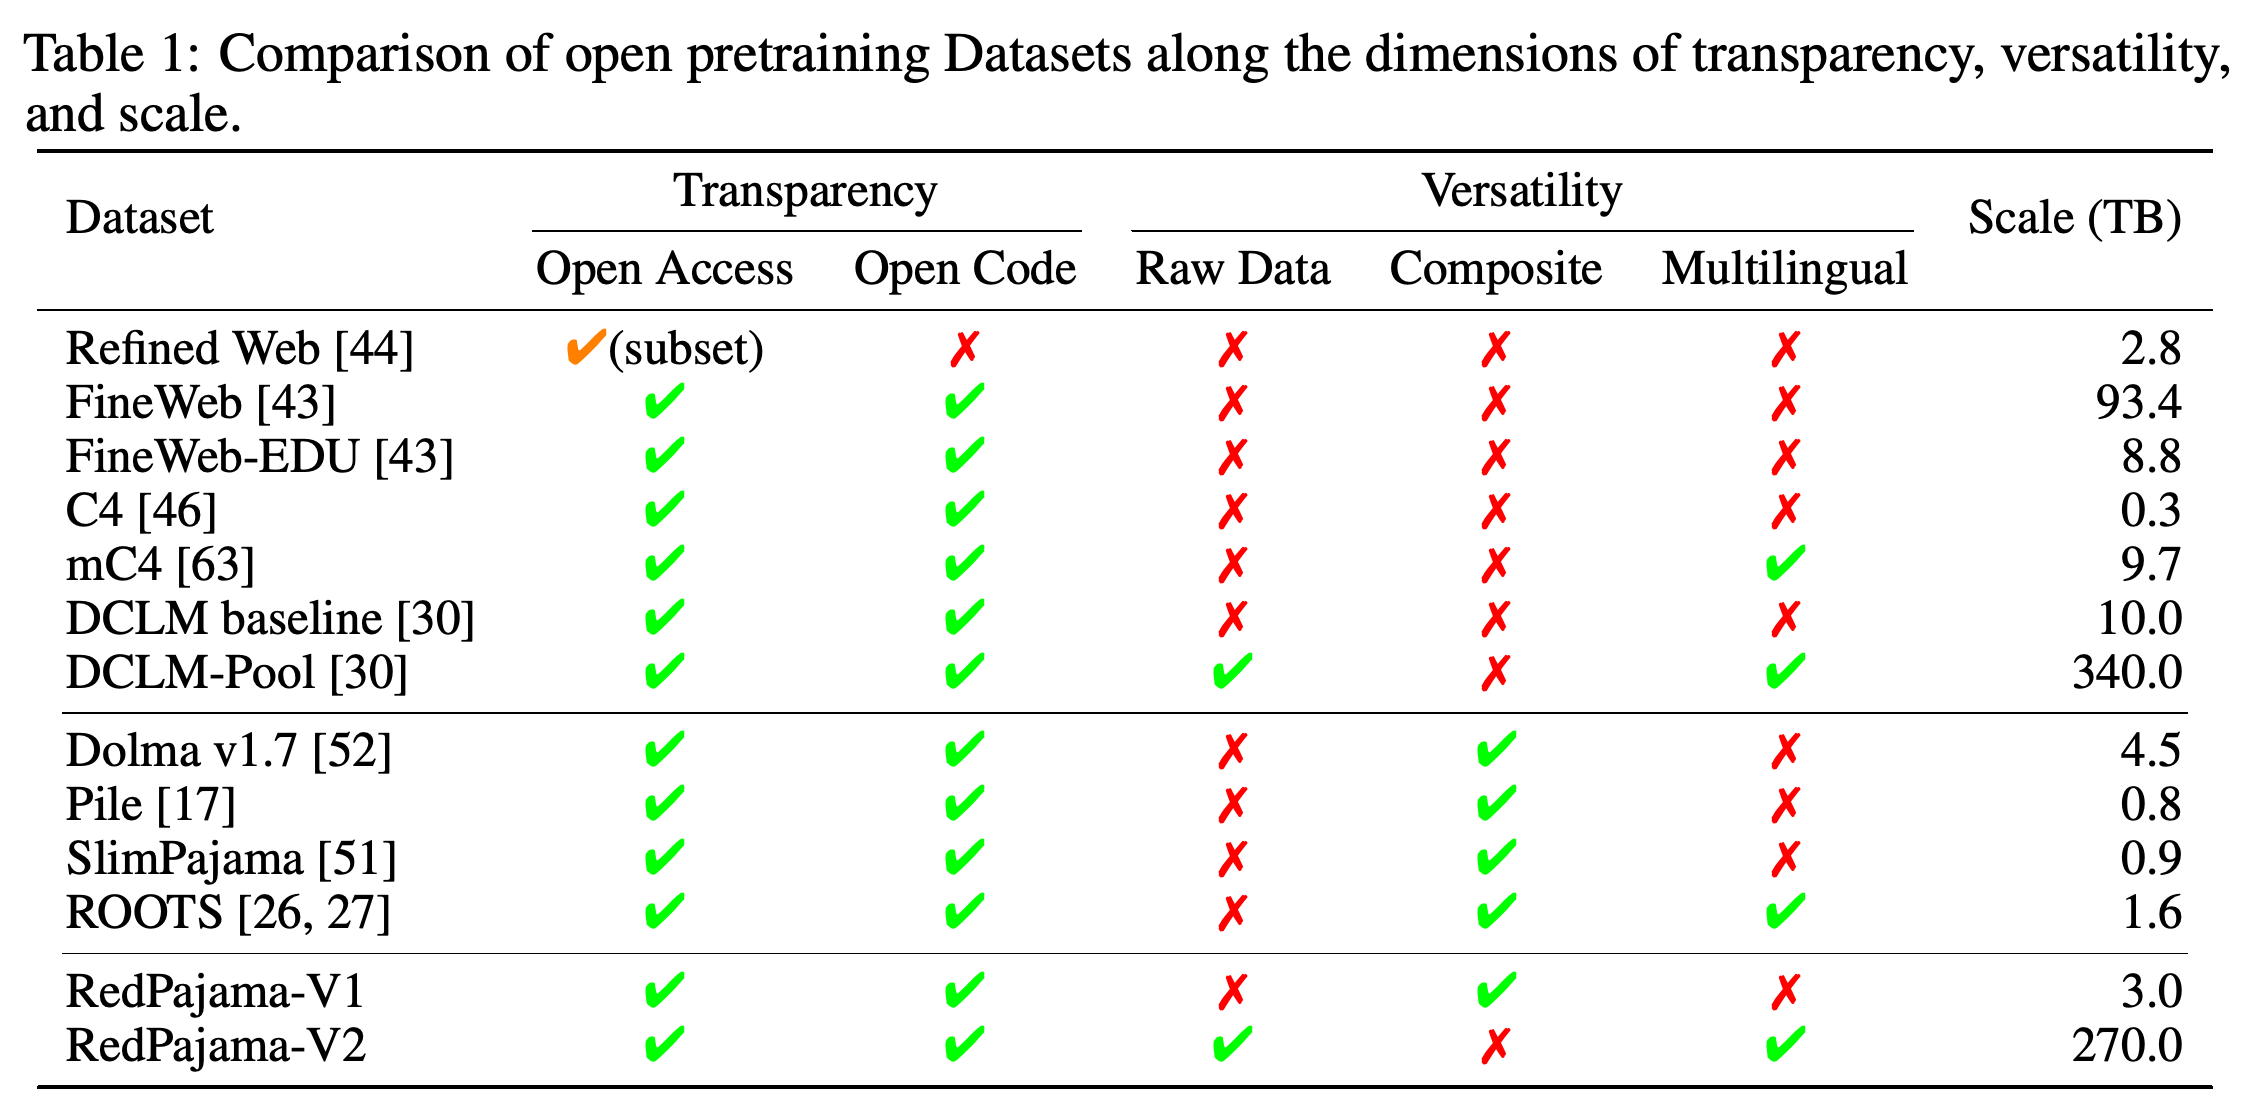
- Table 1은 RedPajama-V1의 크기를 3.0 TB, RedPajama-V2의 크기를 270.0 TB로 보고하며, 데이터셋 2개 모두 데이터와 코드를 공개한다.
- 비교표에는 DCLM-Pool도 340.0 TB로 기재되어 있으므로, RedPajama-V2가 나열된 모든 데이터셋보다 저장 용량이 크다고 단정할 수는 없다.
V1은 여러 도메인을 결합하고, V2는 다국어 원시 웹 데이터를 공개한다. 저장 용량 수치는 논문의 규모에 관한 주장을 해석할 때 고려해야 한다. DCLM-Pool은 340.0 TB로, V2의 270.0 TB보다 크게 기재되어 있다.
3 RedPajama-V1: An open Reproduction of the LLaMA Training Data
RedPajama-V1은 초기 LLaMA 모델의 학습 데이터 설명을 최대한 충실하게 재현하려는 시도다. 저자들은 구성법에서 빠진 세부 사항과 이를 대체하기 위해 내린 결정을 문서화한다. 따라서 약 1.2T 토큰의 결과 말뭉치는 재구성을 시도한 데이터이며, 원본 데이터와의 동등성은 검증되지 않았다.
- 함께 공개한 RedPajama-INCITE 모델로 파라미터 3B와 7B 규모에서 말뭉치를 평가한다.
- 저자들은 7B 모델의 성능 차이에 대한 설명으로 학습 정밀도와 해결되지 않은 데이터 차이를 제시하지만, 각각의 영향을 실험으로 분리하지는 않는다.
3.1 Data Processing Steps
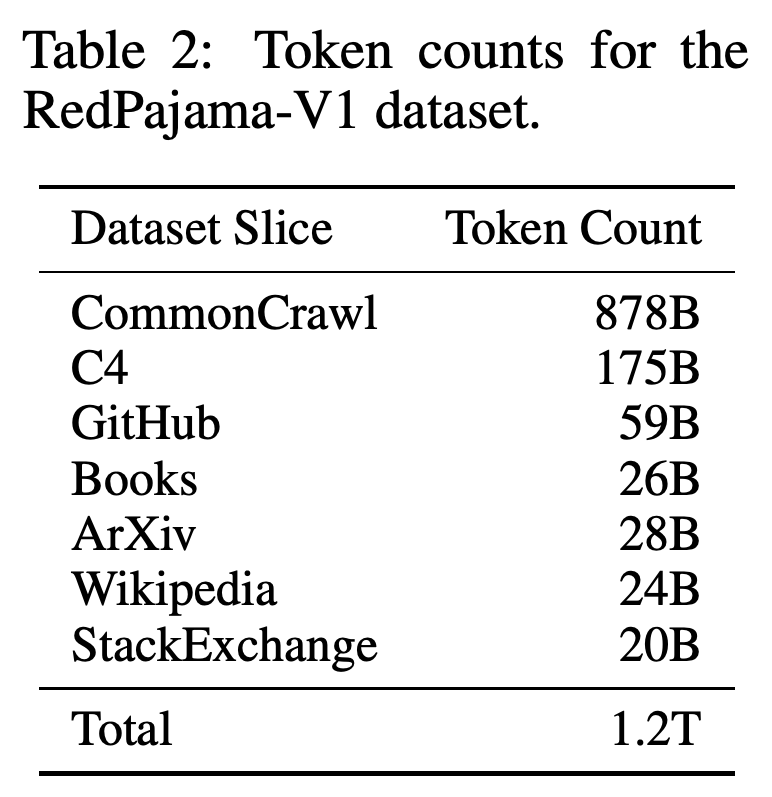
RedPajama-V1의 출처 그룹 7개는 CommonCrawl 878B, C4 175B, GitHub 59B, Books 26B, ArXiv 28B, Wikipedia 24B, StackExchange 20B 토큰으로 구성된다. 공개된 LLaMA 설명을 따라 처리하되, 설명이 불완전한 부분은 구체적인 방식을 선택한다.
- CommonCrawl은 2019-30, 2020-05, 2021-04, 2022-5, 2023-06 스냅샷을 사용한다. 웹 텍스트 처리 파이프라인인 CCNet은 Wikipedia 모델의 perplexity를 기준으로 head, middle, tail 구간을 나누며, V1은 head와 middle을 유지한다.
- 개별 단어 특징을 사용하는 텍스트 분류기인 fastText unigram 분류기는 Wikipedia 참고문헌을 크롤링한 데이터로 학습한다. 저자들은 참고문헌 URL 38M개를 추출하고 페이지 300K개를 크롤링하며, 분류기 점수가 0.25보다 낮은 문서를 제거한다. C4는 c4_en 릴리스를 사용한다.
- GitHub 프로젝트는 Apache, BSD, MIT 라이선스로 제한하고 파일 통계와 확장자로 필터링한다. Wikipedia는 2023-03-20 덤프를 사용한다. Gutenberg는 도서 부분집합인 PG19를 사용하며, 유사 중복을 탐지하는 SimHash를 적용한다. Books3는 처음에 포함했으나 이후 저작권 문제로 제거했다.
- ArXiv는 LaTeX 문서 소스를 유지하고, 전처리부, 주석, 참고문헌을 제거하며 매크로를 확장한다. Stack Exchange는 규모가 가장 큰 사이트 28개를 유지하고, 웹 서식용 HTML 태그를 제거하며, 질문과 답변을 묶고 답변을 점수순으로 정렬한다.
CommonCrawl은 878B 토큰을 제공하고 C4의 기여량은 175B 규모이므로, 약 1.2T 토큰의 재구성 데이터에서 웹 데이터가 가장 큰 비중을 차지한다. 나머지 출처는 코드, 도서, 과학 텍스트, 백과사전 텍스트, 질문과 답변 자료를 더한다. 이 수치는 구축 당시의 집계이며, 이후 제거된 Books3가 현재도 제공된다는 뜻은 아니다.
3.2 The RedPajama-INCITE family of LLMs
3.2.1 Summit Training Setup은 노드당 V100 그래픽 처리 장치(GPU) 6개가 장착된 Summit의 IBM Power9 노드에서 수행한 학습을 설명한다. V100은 참고한 안정적 학습 구성에서 사용하는 16비트 수치 형식인 bf16을 지원하지 않는다. 이에 저자들은 다른 16비트 부동소수점 형식인 fp16을 사용하고, 수치 계산을 안정화하기 위한 loss scaling과 낮춘 학습률을 적용한다.
- 3B 모델은 노드 256개, GPU 1536개, 학습률 1.6 × 10^-4, 학습 토큰 800B를 사용한다. 7B 모델은 노드 512개, GPU 3072개, 학습률 1.2 × 10^-4, 토큰 1.001T를 사용한다. 모델 2개 모두 전역 배치 크기는 4M 토큰이며, warmup 이후 학습률을 선형으로 감소시킨다.
- 학습 환경에서는 모델 학습 프레임워크인 PyTorch를 Power9에 맞게 다시 컴파일해야 했다. 저자들은 모델 단계를 장치에 분산하는 pipeline parallelism을 3B에 6-way, 7B에 12-way로 적용하고, 개별 계층의 계산을 분할하는 tensor parallelism은 모델 2개 모두에 2-way로 적용한다.
3.2.2 Evaluation은 3B base 모델이 비슷한 크기의 GPT-Neo와 Pythia 모델보다 HELM classic과 일부 lm-evaluation-harness 과제에서 높은 성능을 보였다고 보고한다. HELM classic은 핵심 시나리오 16개의 결과를 평균하는 평가 모음이며, lm-evaluation-harness는 별도의 언어 모델 평가 프레임워크다. HELM은 프롬프트에 예시를 제공하는 few-shot 평가를 사용하고, 선택된 harness 비교는 예시를 제공하지 않는 zero-shot 평가를 사용한다. 학습 토큰 예산은 RedPajama가 800B 토큰이며, GPT-Neo는 420B, Pythia-2.8B는 300B로 서로 다르다.
- Table 7에서 3B 모델의 선택 과제 평균은 0.6662, HELM 평균은 0.4060이다. Pythia-2.8B는 각각 0.6451과 0.3770, GPT-Neo는 각각 0.6197과 0.3570이다.
- 7B base 모델의 HELM 점수는 0.431이며, Falcon-7B는 0.441, Llama-7B는 0.472다. 저자들은 답변 확률로 채점하는 과제에서 성능이 낮다고 분석하고, 답변을 직접 생성하는 과제에서는 평균 성능이 비슷하다고 설명한다.
- 지시문으로 표현된 과제로 추가 학습하는 instruction tuning에는 P3와 Natural Instructions 과제 모음을 사용한다. 7B Instruct 모델의 HELM 평균은 0.492에 이른다. 다만 Table 9에서 lm-evaluation-harness 평균은 0.6858로, base 모델의 0.6882보다 개선되지 않는다.
4 RedPajama-V2
RedPajama-V2는 웹 데이터에만 집중하며, 다양한 고품질 부분집합을 구성할 수 있는 말뭉치를 제공한다. 최소한으로 처리한 텍스트를 유지하고 관련 메타데이터를 공개하므로, 사용자는 최초 수집 과정을 반복하지 않고 필터링 구성을 수정할 수 있다.
4.1 Data Processing Steps
4.1.1 Data Acquisition은 2014년부터 2023년 4월까지의 월별 스냅샷 84개 전체에서 Common Crawl .wet 파일을 사용한다. .wet 파일에는 웹 페이지에서 추출한 텍스트가 담겨 있다. CCNet 처리에서는 영어, 프랑스어, 독일어, 이탈리아어, 스페인어 텍스트를 유지하고 perplexity 구간 3개를 모두 보존한다.
- 이 데이터 모음은 이후 품질 필터링을 적용하기 전이라는 의미에서 원시 데이터이며, 웹 텍스트 추출과 CCNet 처리는 이미 거쳤다.
- tail 구간을 유지하면 V1의 구간 선택 규칙이 제거했을 자료도 보존되며, 이후 선택은 데이터셋 사용자에게 맡긴다.
4.1.2 Quality Signals는 주석을 자연어 특성, 반복성, 콘텐츠 지표, 학습된 도메인 유사도 점수, 중복 제거용 산출물로 분류한다. 이 신호들은 필터링 기준을 제공하지만, 문서가 모든 학습 목적에 적합하다는 점을 보장하지는 않는다.
- 자연어 지표에는 대문자 비율, 고유 단어 비율, 문장부호, 행 특성이 포함된다. 반복 지표는 연속된 단어 n개의 나열인 단어 n-gram을 대상으로, n ∈ {2, 3, 4}에서는 가장 자주 나타나는 n-gram의 문자 수를, n ∈ {5, …, 10}에서는 중복된 n-gram의 문자 수를 센다. 겹치는 문자는 중복 계산하지 않는다.
- 콘텐츠 지표는 비속어 차단 목록인 LDNOOBW와 일치하는 항목을 세고, 범주별 도메인 차단 목록인 UT1에 등재된 도메인을 식별한다. 이 지표들은 유해하거나 모욕적인 콘텐츠를 제한적으로 가늠하는 대리 지표다.
- 학습 기반 신호는 fastText 분류기와 DSIR(Data Selection via Importance Resampling) 가중치를 사용한다. DSIR 가중치는 개별 단어와 단어 쌍에 대해 대상 분포와 원본 분포 사이의 로그 우도비를 측정한다. 영어 분류기의 기준 도메인에는 Wikipedia, Wikipedia 참고문헌, 도서, 웹 텍스트 데이터셋인 OpenWebText가 포함된다. 비영어 분류기는 Wikipedia를 사용한다.
- 정확히 중복되는 문서의 식별자는 CCNet 처리 전 .wet 문서 해시에 오류율 1%인 Bloom filter를 적용해 생성한다. Bloom filter는 원소의 포함 여부를 확률적으로 확인하는 자료구조다. 문서 간 근사 유사도를 간결하게 표현하는 MinHash 서명은 fuzzy deduplication을 지원한다. 정확한 중복 제거는 2023-14부터 2014-15까지 역순으로 진행한다.
- 논문은 학습된 품질 필터가 편향을 유발하거나 소수 집단을 충분히 반영하지 못할 수 있음을 인정한다. 공개된 품질 신호는 전체 123.7T 토큰 모음이 아니라 약 50T 토큰의 head+middle 부분집합에 제공된다.
4.2 Dataset Statistics
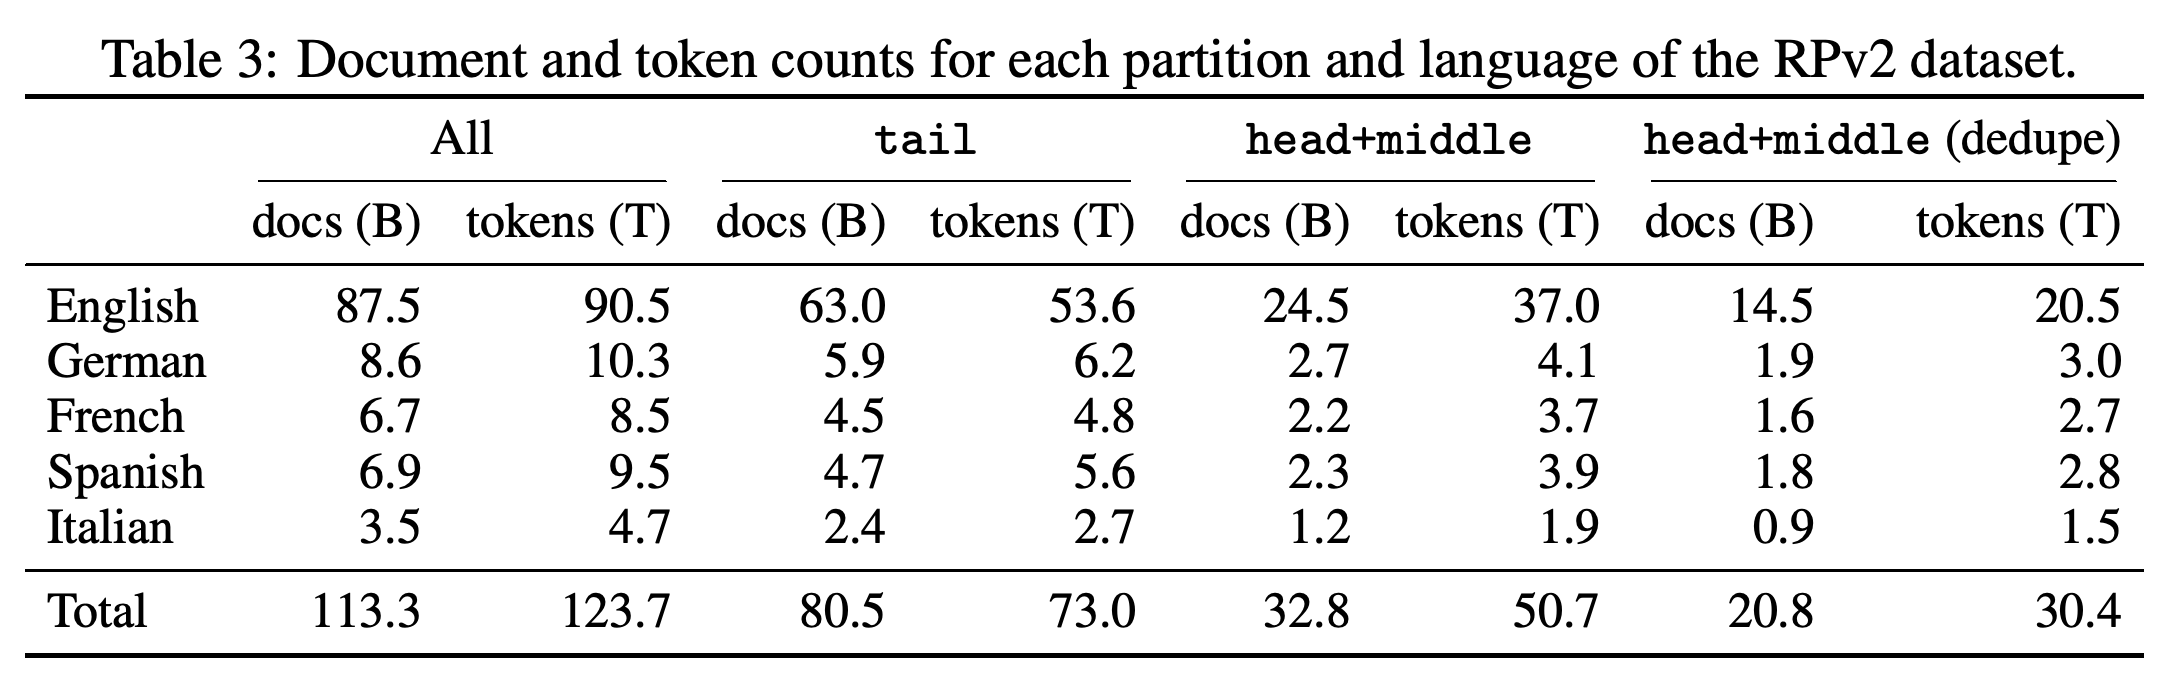
Table 3은 RedPajama-V2의 문서 수를 113.3B개, 추정 토큰 수를 123.7T로 보고한다. 여기에는 영어 문서 87.5B개와 영어 토큰 90.5T가 포함된다. head+middle 분할에는 문서 32.8B개와 토큰 50.7T가 있으며, 보고된 중복 제거 후에는 문서 20.8B개와 토큰 30.4T가 남는다.
- tail 분할에는 문서 80.5B개와 토큰 73.0T가 포함된다. tail 문서는 보통 더 짧아서 약 850 토큰이며, head와 middle 문서는 약 1500 토큰이다.
- 토큰 수는 독립적이고 동일한 분포에서 추출한 문서 100M개의 표본에 Mistral BPE tokenizer를 적용해 추정한다. 이 tokenizer는 byte-pair encoding으로 부분 단어 단위를 병합해 텍스트를 표현한다.
4.3 Dataset Ablations
4.3.1 Setup은 앞선 텍스트로 다음 토큰을 예측하는 decoder-only Llama-2 아키텍처로 필터링 구성을 비교한다. 파라미터 규모로 468M 및 1.6B 모델을 사용하며, 시퀀스 길이는 2048이다. 468M 모델마다 100B 토큰을 학습하고, 1.6B 모델마다 350B 토큰을 학습하므로 같은 모델 크기 내에서는 학습 토큰 예산이 고정된다.
- 아키텍처 2개 모두 계층 24개, 병렬 attention 연산을 수행하는 attention head 16개, feed-forward 확장 비율 4.0을 사용한다. 확장 비율은 hidden dimension 대비 중간 계층의 너비를 뜻하며, hidden dimension은 각각 1024와 2048이다. 학습 optimizer인 AdamW는 weight decay 0.1, 최대 학습률 각각 5e−3과 5e−4, cosine decay, 최초 1% 스텝의 선형 warmup을 사용한다.
- 학습에는 OLMo 언어 모델 학습 프레임워크와 학습 상태를 장치에 분할하는 FSDP(fully sharded data parallelism)를 사용하며, InfiniBand로 연결된 H100 노드를 최대 5개 사용한다.
- 468M 실험은 2023-14 크롤 또는 2021-49부터 2023-14까지의 크롤 9개를 사용한다. Fuzzy deduplication은 유사 문서를 찾는 locality-sensitive hashing인 MinHash LSH를 사용하며, 단어 13-gram에 해시 함수 128개, band 9개, row 13개를 적용한다.
- 1.6B 실험에서는 전체 말뭉치를 필터링하고 약 1T 토큰을 표본 추출한 뒤, 같은 MinHash 설정으로 중복을 제거한다.
- 평가는 평균 벤치마크 점수, 정규화 평균, Rank-Score를 보고한다. 또한 여러 도메인에서 언어 모델의 적합도를 평가하는 Pile과 Paloma 검증 세트에서 perplexity를 측정하며, 값이 낮을수록 적합도가 높다.
전체 123.7T 토큰 모음과 품질 신호가 제공되는 50.7T 토큰의 head+middle 분할은 구분된다. 보고된 중복 제거 후 head+middle 토큰은 30.4T로 줄어들므로, 원시 말뭉치 규모와 중복을 제거한 학습 후보 데이터의 규모는 다르다.
4.3.2 Results에서 fuzzy deduplication과 전체 Gopher 필터링을 적용한 2023-14 부분집합은 실험한 468M 파라미터 RedPajama-V2 구성 중 가장 높은 종합 결과를 보인다. 평균은 37.6, 정규화 평균은 0.160, Rank-Score는 0.700이다. RefinedWeb은 각각 37.9, 0.165, 0.650이므로 어떤 데이터셋이 더 나은지는 종합 지표에 따라 달라진다.
- 필터링하지 않은 2023-14 baseline의 평균 점수는 36.4, Rank-Score는 0.594다. Paloma perplexity는 31.1로 Gopher 필터링 모델의 34.5보다 낮다. 이는 벤치마크 성능 향상이 폭넓은 검증 분포에 대한 적합도 향상과 반드시 일치하지는 않음을 보여준다.
- Wikipedia, OpenWebText, 도서를 혼합해 학습한 Palm-mix 분류기를 사용하는 크롤 9개 구성에서 나머지 조건을 같게 두고 Gopher 반복 필터를 자연어 필터로 바꾸면 평균 점수가 35.9에서 36.7로 오른다. 보고된 비교에서 분류기 기반 변형과 DSIR 기반 변형의 평균 점수는 모두 35.9지만, 이것만으로 통계적 동등성이 성립하지는 않는다.
- 나머지 조건을 맞춘 구성에서 문서 단위 C4 필터링을 행 단위 C4 필터링으로 바꾸면 Pile perplexity는 41.8에서 32.4로, Paloma perplexity는 67.9에서 52.9로 개선된다. 평균 벤치마크 점수는 36.7에서 36.4로 바뀐다.
- 1.6B 파라미터에서 전체 Gopher와 Wikipedia 참고문헌 분류기를 결합한 구성의 평균 점수는 50.0이다. C4, Gopher 자연어 필터, Palm 분류기를 결합한 구성은 47.9이고 RefinedWeb은 52.0이다. V2 구성 2개 사이에는 여러 필터가 달라지므로, 이 비교로 전체 Gopher 필터링의 효과만 분리할 수는 없다.
5 Conclusion
결론은 RedPajama를 말뭉치 필터링, 선별, 혼합을 연구하기 위한 공개 자원으로 제시한다. 공개된 데이터와 산출물, 필터링 구성별로 관찰된 성능 차이가 이를 뒷받침한다. 저자들은 실험 근거가 비교적 작은 모델에 한정된다고 밝히며, 철저한 벤치마크 오염 제거와 개인 식별 정보 분석을 수행하지 않았다고 명시한다.
파라미터 468M, 학습 토큰 100B 조건에서 2023-14에 fuzzy deduplication과 전체 Gopher 필터링을 적용하면 Rank-Score는 0.700으로 RefinedWeb의 0.650보다 높지만, 평균 점수는 37.6으로 37.9보다 낮다. 필터링하지 않은 2023-14 데이터의 Paloma perplexity가 더 낮다는 결과도 어떤 구성이 더 나아 보이는지가 평가 지표에 따라 달라짐을 보여준다.
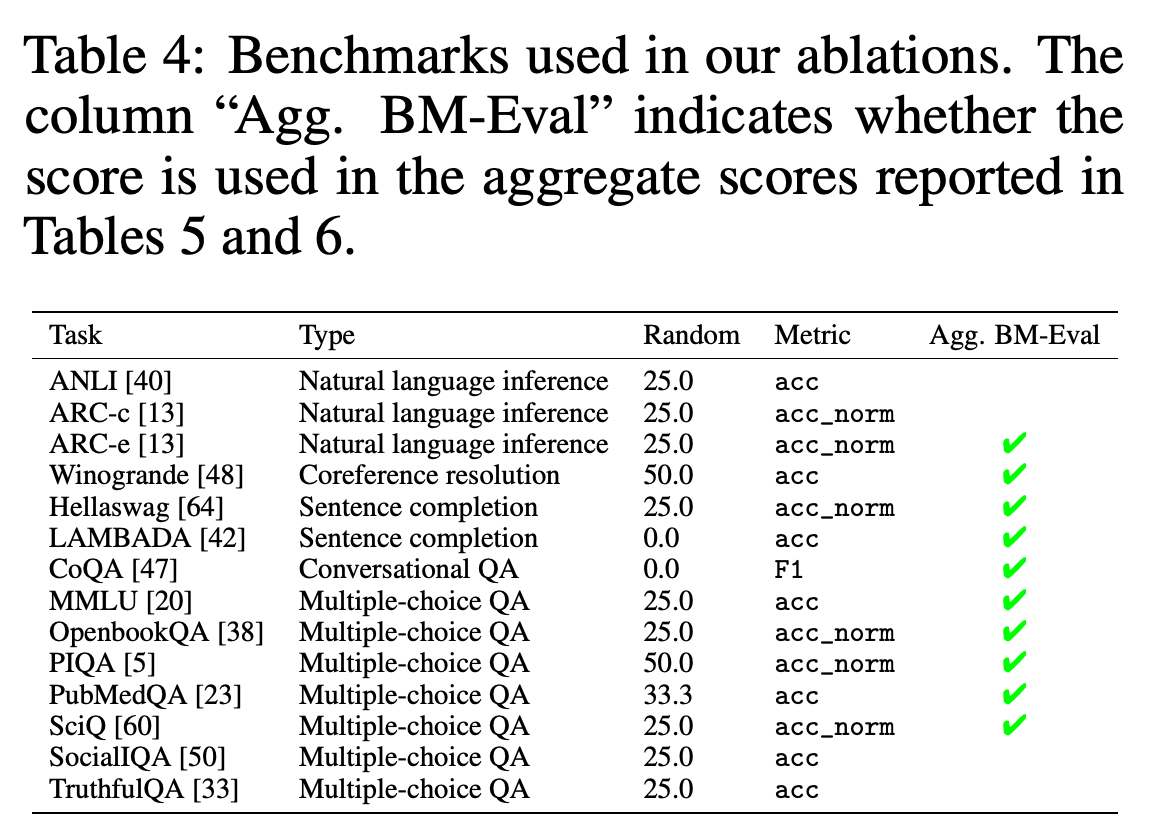
포함 여부 표시는 종합 점수에 반영되는 벤치마크와 추가로 보고하는 과제를 구분한다. 따라서 종합 점수는 논문에 나열된 모든 과제가 아닌, 선택된 평가 집합을 요약한다.
1.6B 파라미터와 350B 학습 토큰 조건에서 성능이 더 높은 V2 구성의 평균 점수는 50.0으로, RefinedWeb의 52.0보다 낮고 다른 V2 구성의 47.9보다 높다. V2 행 사이에는 여러 필터링 요소가 달라지므로, 특정 필터에 성능 차이의 원인을 귀속하기는 어렵다.
부록
- A Intended Uses는 언어 모델 학습을 주된 목적으로 제시한다. V1은 웹 텍스트, 백과사전과 과학 자료, 코드를 결합하고, V2는 필터링 신호가 포함된 웹 텍스트를 제공한다.
- B Dataset Accessibility는 공개 Hugging Face 데이터셋과 HTTPS 다운로드 목록을 제공한다. 데이터를 여러 파일로 나눈 JSON Lines에 텍스트와 메타데이터를 저장하며, V2는 행 단위와 문서 단위 품질 주석을 제공한다. 중복 식별자와 MinHash 서명은 정확한 중복과 유사 문서의 중복 제거를 지원한다. 나열된 정확한 중복 문서를 제거하면 클러스터마다 대표 문서가 남는다.
- C RedPajama-V1은 GitHub 코드 필터링과 3B, 7B 모델의 과제별 평가를 설명한다. 원본 구성법에서 해결되지 않은 세부 사항과 스냅샷, 분류기, 임계값, Wikipedia 덤프, 도서 중복 제거에 관해 저자들이 내린 선택도 기록한다.
- D RedPajama-V2는 중복 제거 통계, 품질 신호 분포, 임베딩 기반 주제 분석, 상세 모델 평가를 제공한다. 최신 데이터부터 중복을 제거하면 오래된 스냅샷일수록 고유 문서가 적으며, 저자들은 크롤링 시작 사이트의 변화가 2014–2017년의 급격한 감소를 설명할 수 있다고 가정한다. 히스토그램은 2023-06 스냅샷의 영어 데이터만 다룬다. 보충 평가는 468M 모델과 각각 350B 토큰을 학습한 1.6B 모델을 포함한다.
- E Author Responsibility Statement는 ODC-By-1.0과 적용 가능한 개별 구성 데이터의 라이선스를 명시한다. 이 규모에서는 완전성과 정확성을 보장할 수 없다고 밝히고, 권리 침해에 대한 책임을 부인한다.
- F License는 저장소 코드에 Apache 2.0, 웹 파생 데이터에 Common Crawl 약관, 그 밖의 출처에 원래 라이선스나 약관이 적용된다고 명시한다. GitHub 부분집합은 MIT, BSD, Apache 라이선스로 제한한다.
짧은 생각
RedPajama의 핵심 기여는 재사용 가능한 말뭉치와 필터링 결정을 분리한 데 있다. 공개된 주석과 중복 제거용 산출물로 대안 구성을 검토할 수 있다. 실험은 고정된 학습 예산에서 구성에 따른 차이를 보여주며, 벤치마크 순위와 검증 perplexity가 일치하지 않는 경우를 포함해 이러한 설계를 뒷받침한다. 실험 근거는 선별 연구에 RedPajama-V2를 활용하는 방안을 뒷받침한다. 모델 크기 2개 모두에서 RefinedWeb의 평균 벤치마크 점수는 실험한 V2 구성보다 높다. V1의 모델 비교는 토큰 예산, 하드웨어 제약을 받은 학습 방식, 말뭉치 구성이 달라 데이터 품질을 판단하는 근거로는 한계가 있다. V2 실험은 각 비교에서 모델 크기와 학습 토큰 예산을 고정하지만, 더 큰 규모의 검증, 반복 실행 간 변동성 추정, 오염 점검, 개인정보 분석은 여전히 남은 과제다.