


Whose Language Counts as High Quality? Measuring Language Ideologies in Text Data Selection 요약 설명
25 Jan 2022 | Paper Review Data Curation Selection Bias LLM Pretraining목차
이번 글에서는 Whose Language Counts as High Quality? Measuring Language Ideologies in Text Data Selection 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 1월 25일(Arxiv)
- Gururangan, Suchin, Card, Dallas, Dreier, Sarah K., Gade, Emily K., Wang, Leroy Z., Wang, Zeyu, Zettlemoyer, Luke, Smith, Noah A..
- University of Washington, University of Michigan, University of New Mexico, Emory University, Allen Institute for AI
- 논문 링크
- 검토한 원문: arXiv v2, 2022-01-26.
요약
- 언어 모델의 학습 데이터는 흔히 품질 필터로 선별하지만, 필터에 반영된 사회적 선호는 거의 검토하지 않는다. 미국 학교 신문의 비대표 표본에서 GPT-3 필터의 재현 모델은 여건이 열악한 지역의 학교보다 부유하고 교육 수준이 높으며 도시화된 지역의 규모가 큰 학교에서 나온 기사에 더 높은 점수를 부여했다.
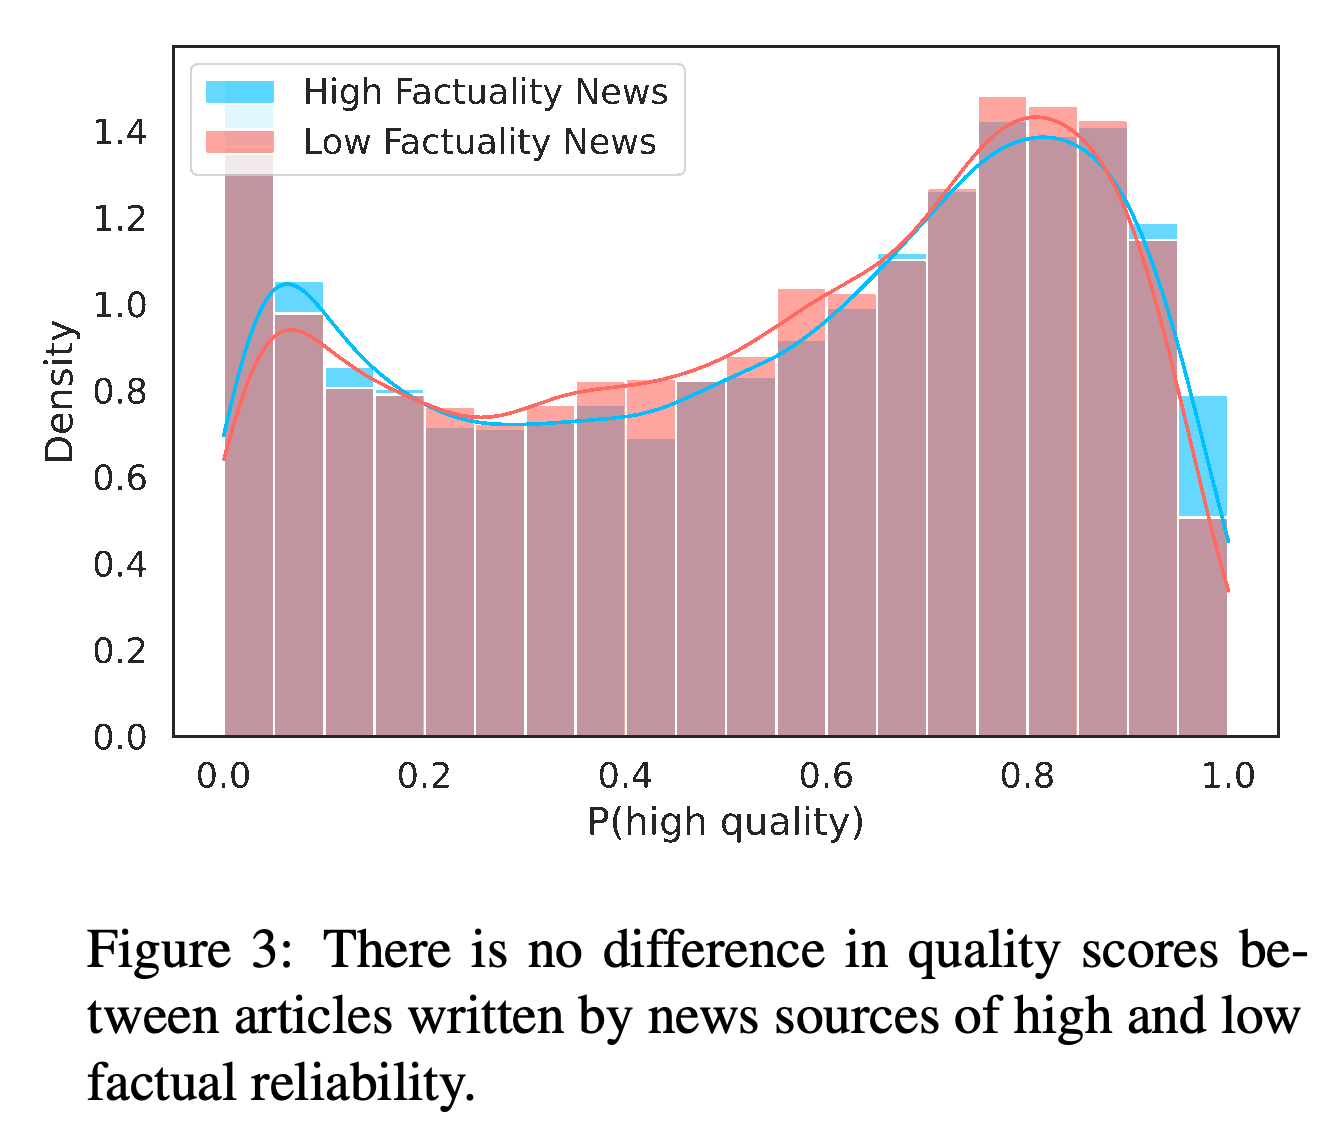
- 저자들은 고등학교 신문 기사 910K개를 분석하고 필터 점수를 뉴스 출처의 사실성, 사람이 매긴 에세이 점수, 문학상 수상 여부와 비교했다. 점수는 주제와 장르에 따라 크게 달랐으며, 뉴스 출처 비교에서는 통계적으로 유의한 분포 차이가 나타나지 않았다(p = 0.085).
- 인구통계 분석은 개별 저자의 속성 대신 학교와 지역의 특성을 대리 지표로 사용한다. 저자들은 선별 기준을 문서화하고 어떤 목소리와 장르가 배제되는지 검증할 것을 권고한다.
1 Introduction
논문은 언어 이데올로기를 언어의 사회적 사용과 구조를 정당화하는 언어에 관한 가정과 믿음으로 정의한다(Craft et al., 2020). 필터에 사용할 참조 텍스트를 선택하면 이러한 가정이 반영되며, 용도에 따라 서로 다른 선별 기준이 필요할 수 있다고 주장한다.
2 Motivation: Data Sources
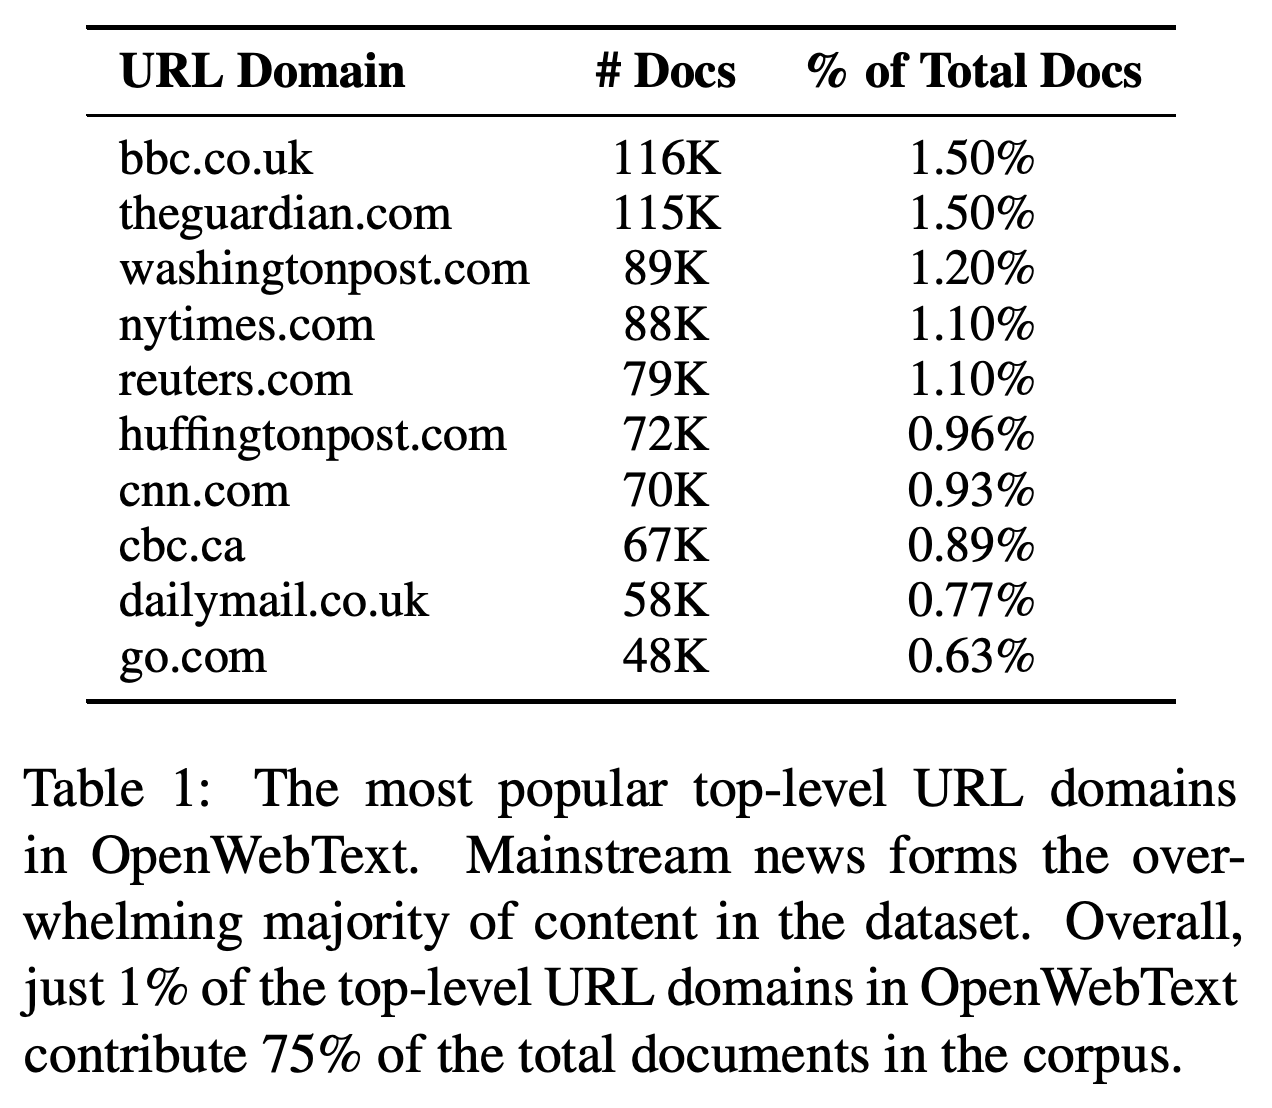
Wikipedia, 책, 인기 온라인 기사는 저자 구성과 수록 범위의 불균형이 확인되었음에도 학습 자료로 반복해서 사용된다. 인기 Reddit 링크를 기반으로 한 코퍼스의 오픈소스 복제본인 OpenWebText에서는(Gokaslan and Cohen, 2019) 고유 최상위 도메인 311K개 중 1%가 문서의 75%를 차지한다.
BBC와 The Guardian은 각각 문서의 약 1.5%를 차지하며, 인기 링크 코퍼스에서 대형 뉴스 도메인이 차지하는 비중을 보여준다.
3 Measuring the Language Ideology of the GPT-3 Quality Filter
대규모 참조 코퍼스에는 포괄적인 저자 메타데이터가 없으므로, 저자들은 신문, ZIP code 또는 카운티 단위의 인구통계 정보와 연결된 별도의 학교 신문 데이터셋을 분석한다. 개별 저자의 정체성을 직접 측정하지 않고 재현한 필터의 작동을 측정한다.
3.1 U.S. School News
저자들은 공통 WordPress 템플릿을 사용하는 학교 2,483곳에서 기사 1.95M개를 수집한 뒤, 2010–2019년에 발행된 기사 910K개를 남겼다. 이 기사들은 ZIP code 1,329개와 카운티 552곳에 걸친 고등학교 1,410곳에서 나왔다. 동영상, 사진, 멀티미디어 범주와 기사 수가 100개 미만인 학교는 제외했으며, 최종 표본은 무작위 표본도 대표 표본도 아니다.
3.2 The GPT-3 Quality Filter
저자들은 연속된 토큰의 나열인 n-gram을 특성으로 사용하는 로지스틱 회귀로 Brown et al. (2020)이 설명한 필터를 재현했다. 이 필터는 Books3, Wikipedia, OpenWebText를 무작위 Common Crawl 표본과 구분한다. 학습에는 각 긍정 출처에서 공백으로 구분한 토큰 80M개와 부정 토큰 240M개를 사용했다. 무작위 하이퍼파라미터 실험 100회 후, 분류기는 별도로 남겨 둔 토큰 60M개에서 정밀도와 재현율을 결합한 지표인 F1 90.4%와 정확도 91.7%를 달성했다.
3.3 Document-Level Analysis
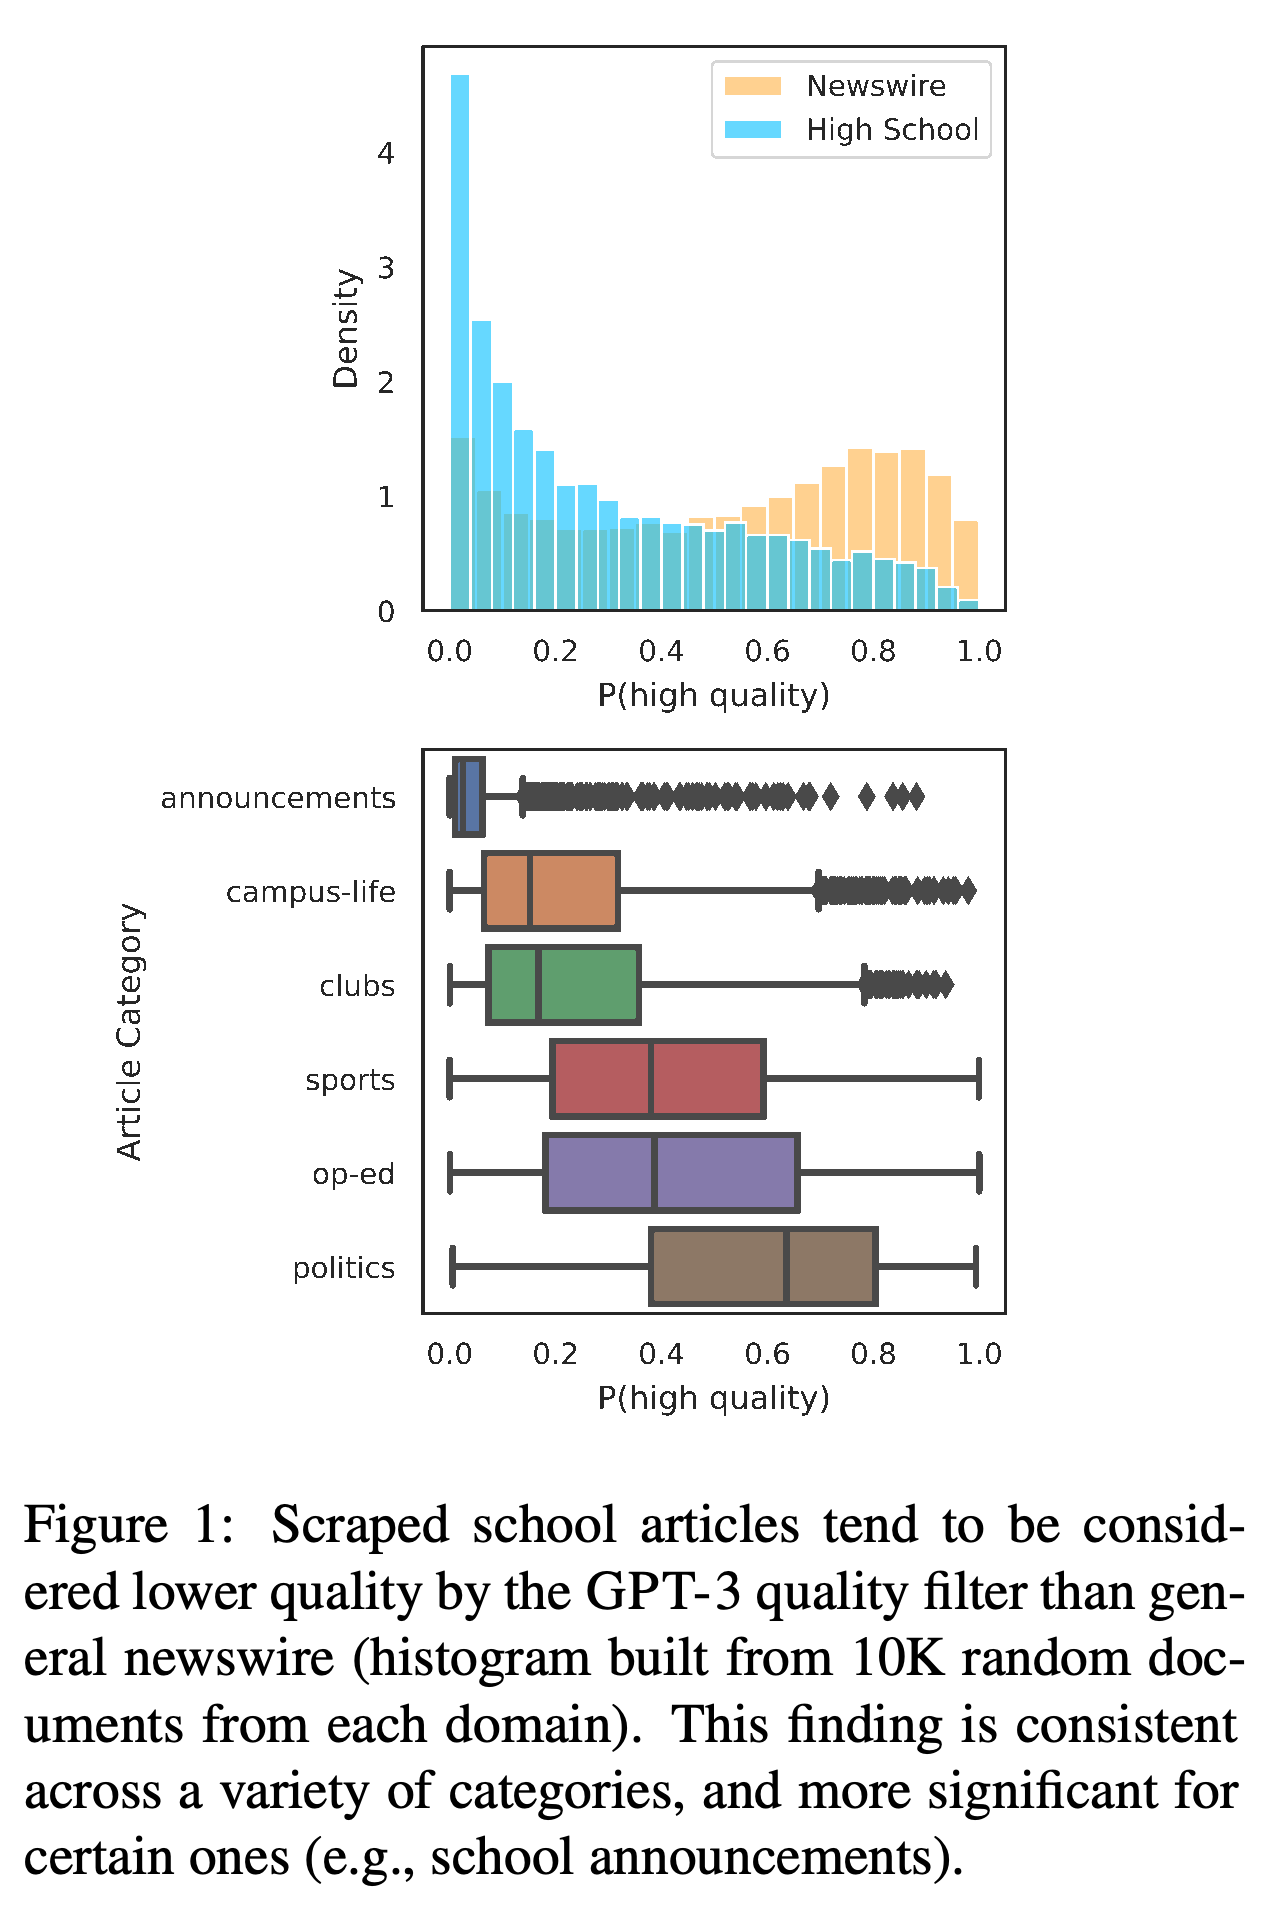
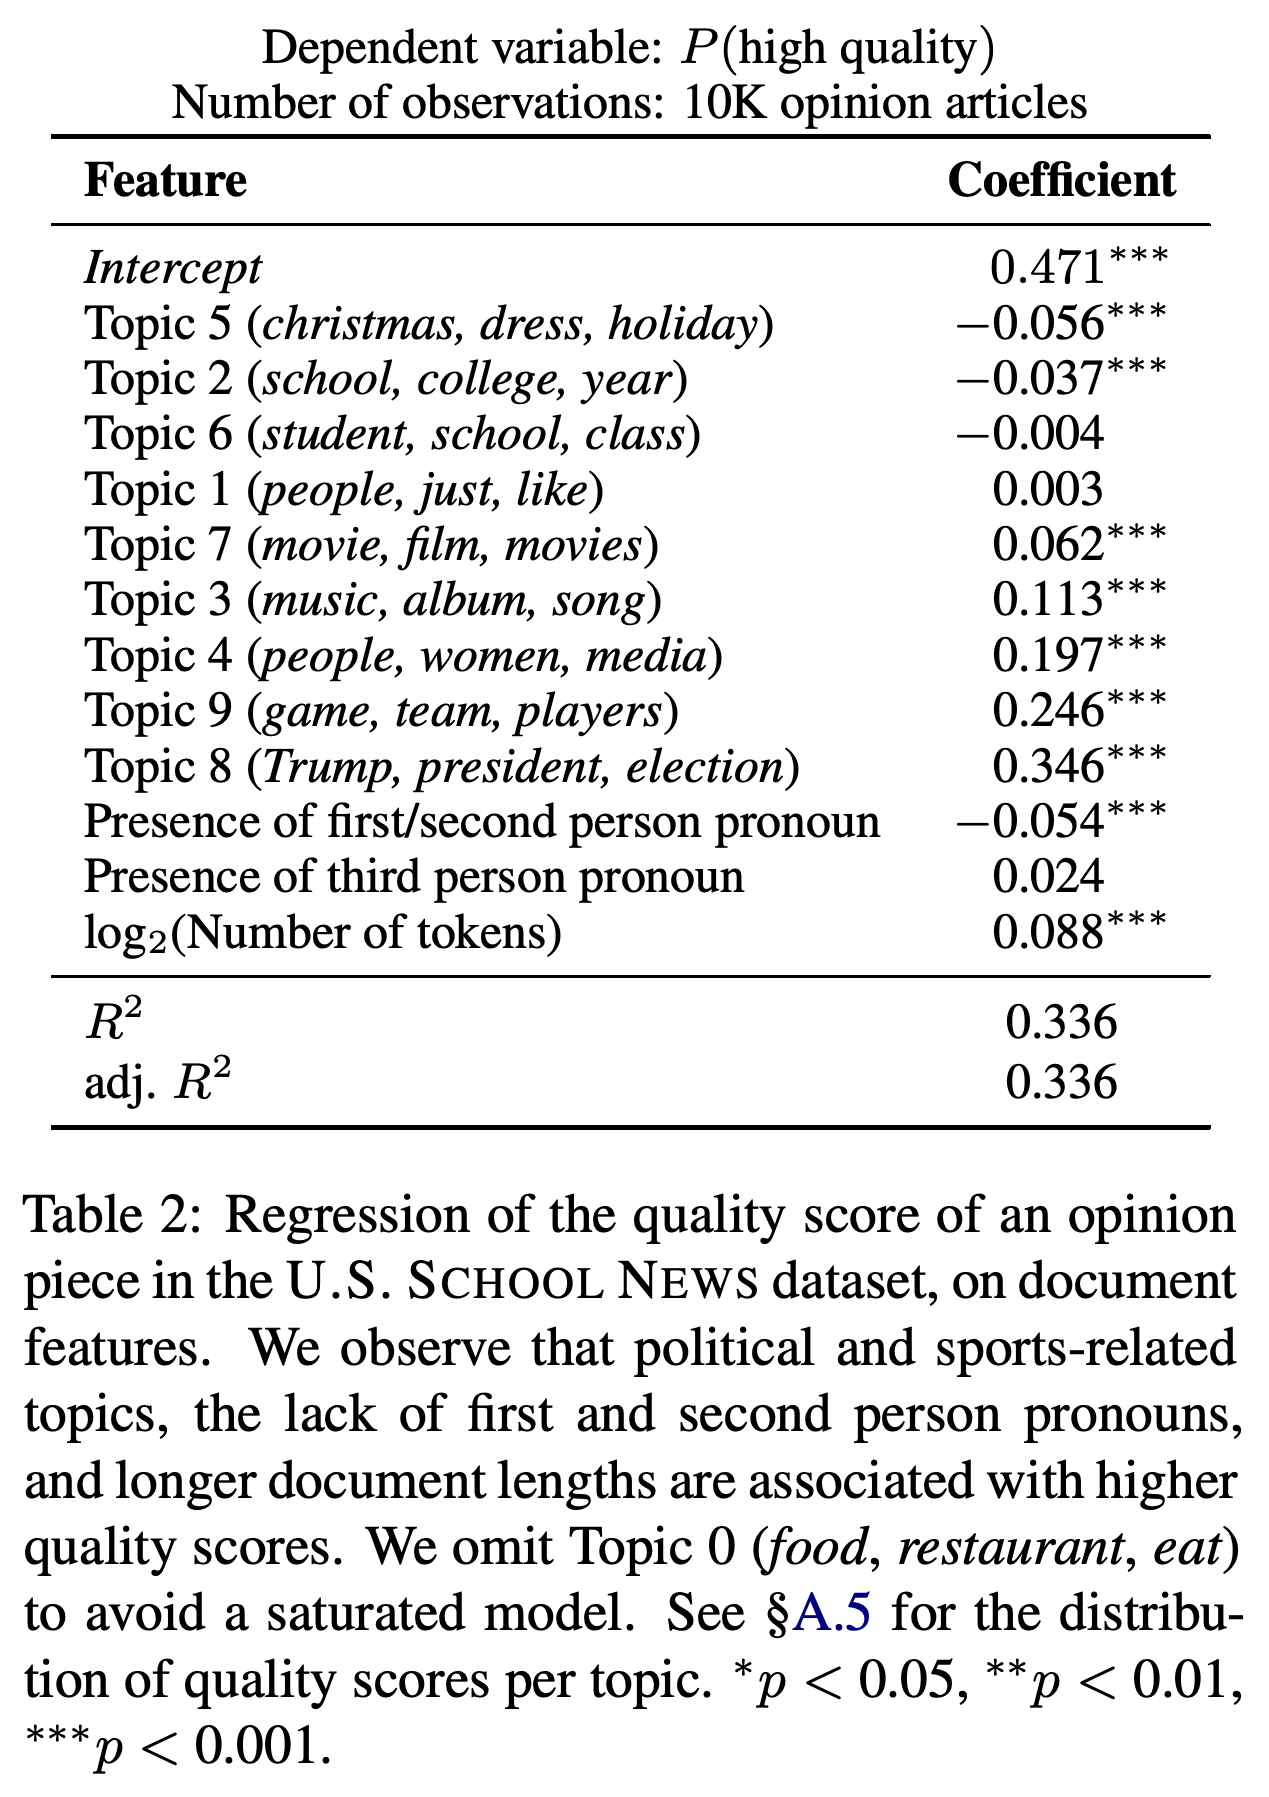
학교 기사는 대체로 통신사 기사보다 낮은 점수를 받았으며, 공지사항의 점수는 특히 낮았다. 의견 기사 10K개를 대상으로 한 회귀 분석에서 생략된 음식 주제 대비 선거와 스포츠 주제의 계수는 각각 0.346과 0.246이었다. 1인칭 또는 2인칭 대명사의 계수는 −0.054였고, 다른 특성을 통제했을 때 토큰 수가 2배가 되면 점수는 0.088 높았다.
히스토그램은 도메인별로 무작위 추출한 문서 10K개를 비교하며, 범주별 그래프에서는 학교 공지사항의 점수가 특히 낮고 정치 기사의 점수가 더 높다.
회귀 분석은 의견 기사에서 주제, 대명사, 길이와 점수의 연관성을 구분한다. R² 0.336은 이 특성들이 점수 변동의 약 3분의 1을 설명함을 나타낸다.
3.4 Demographic Analysis
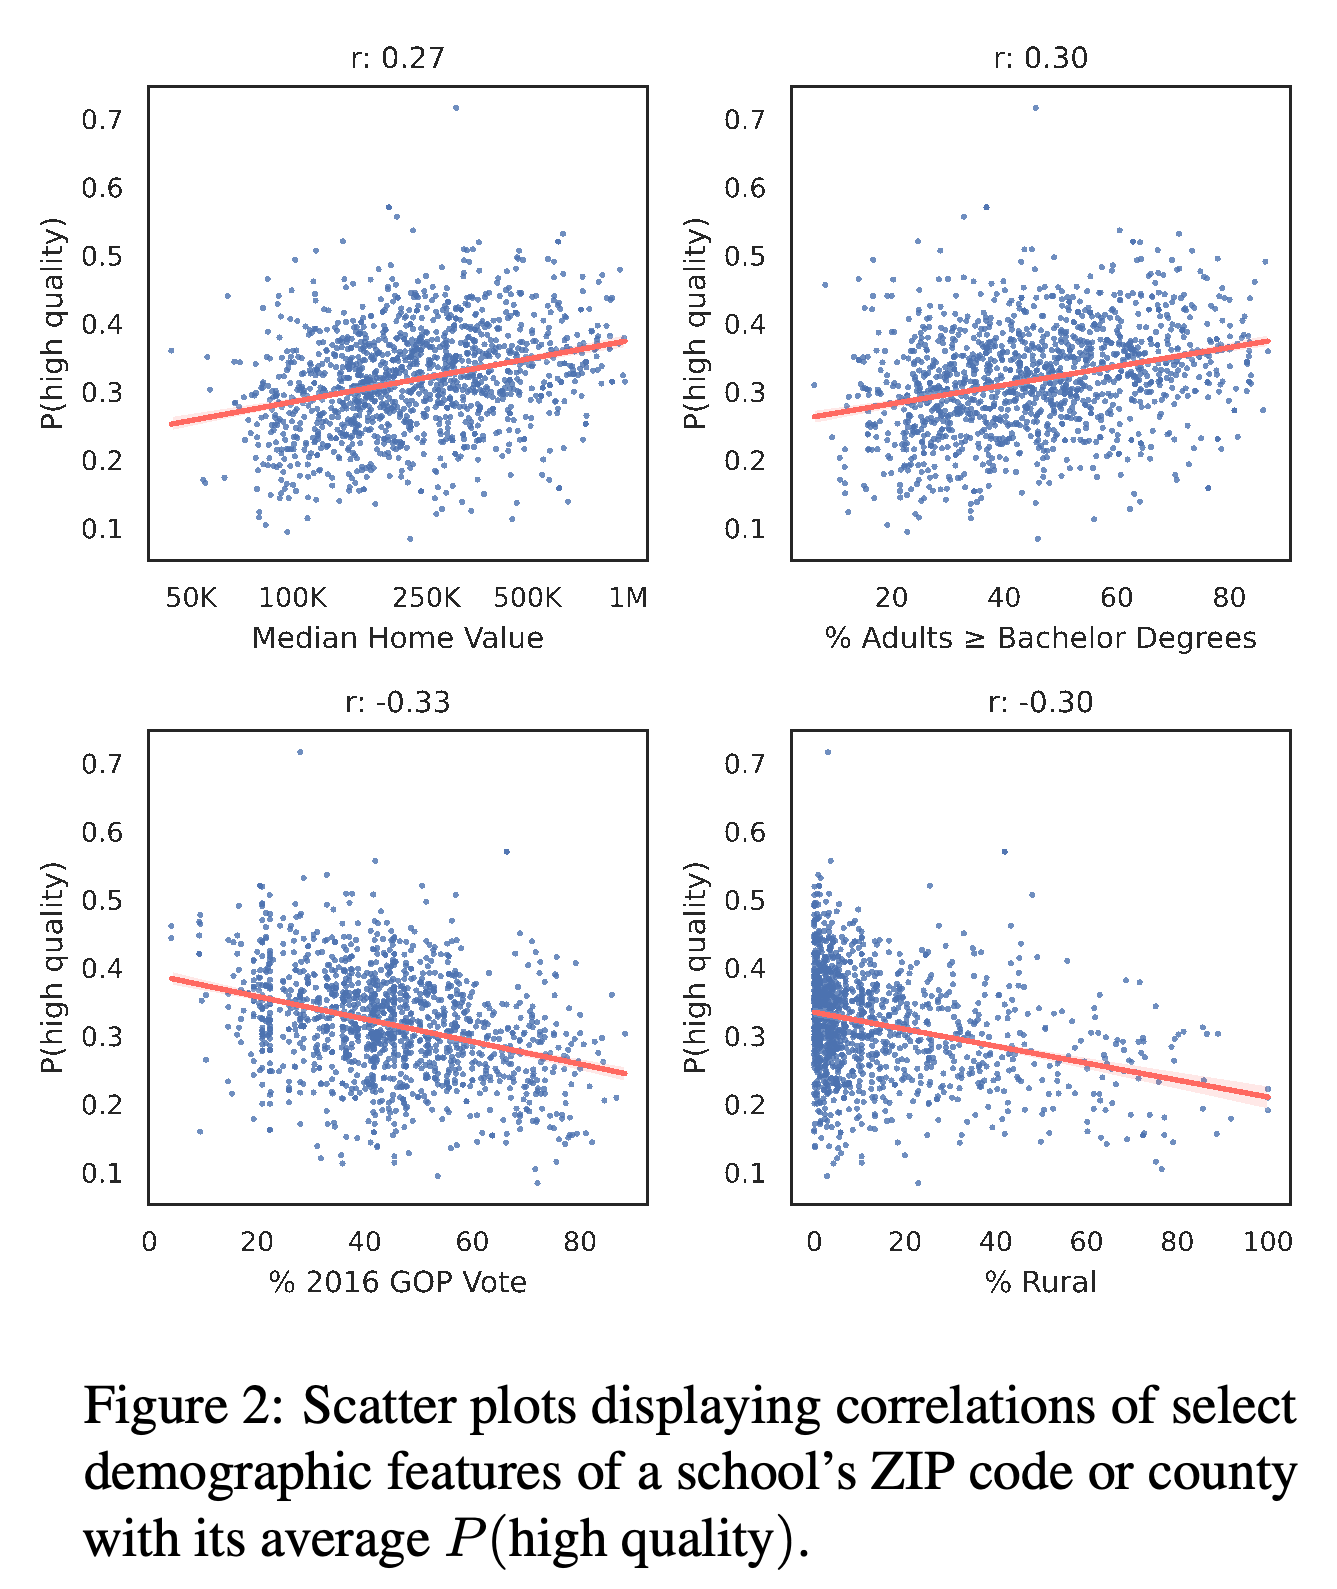
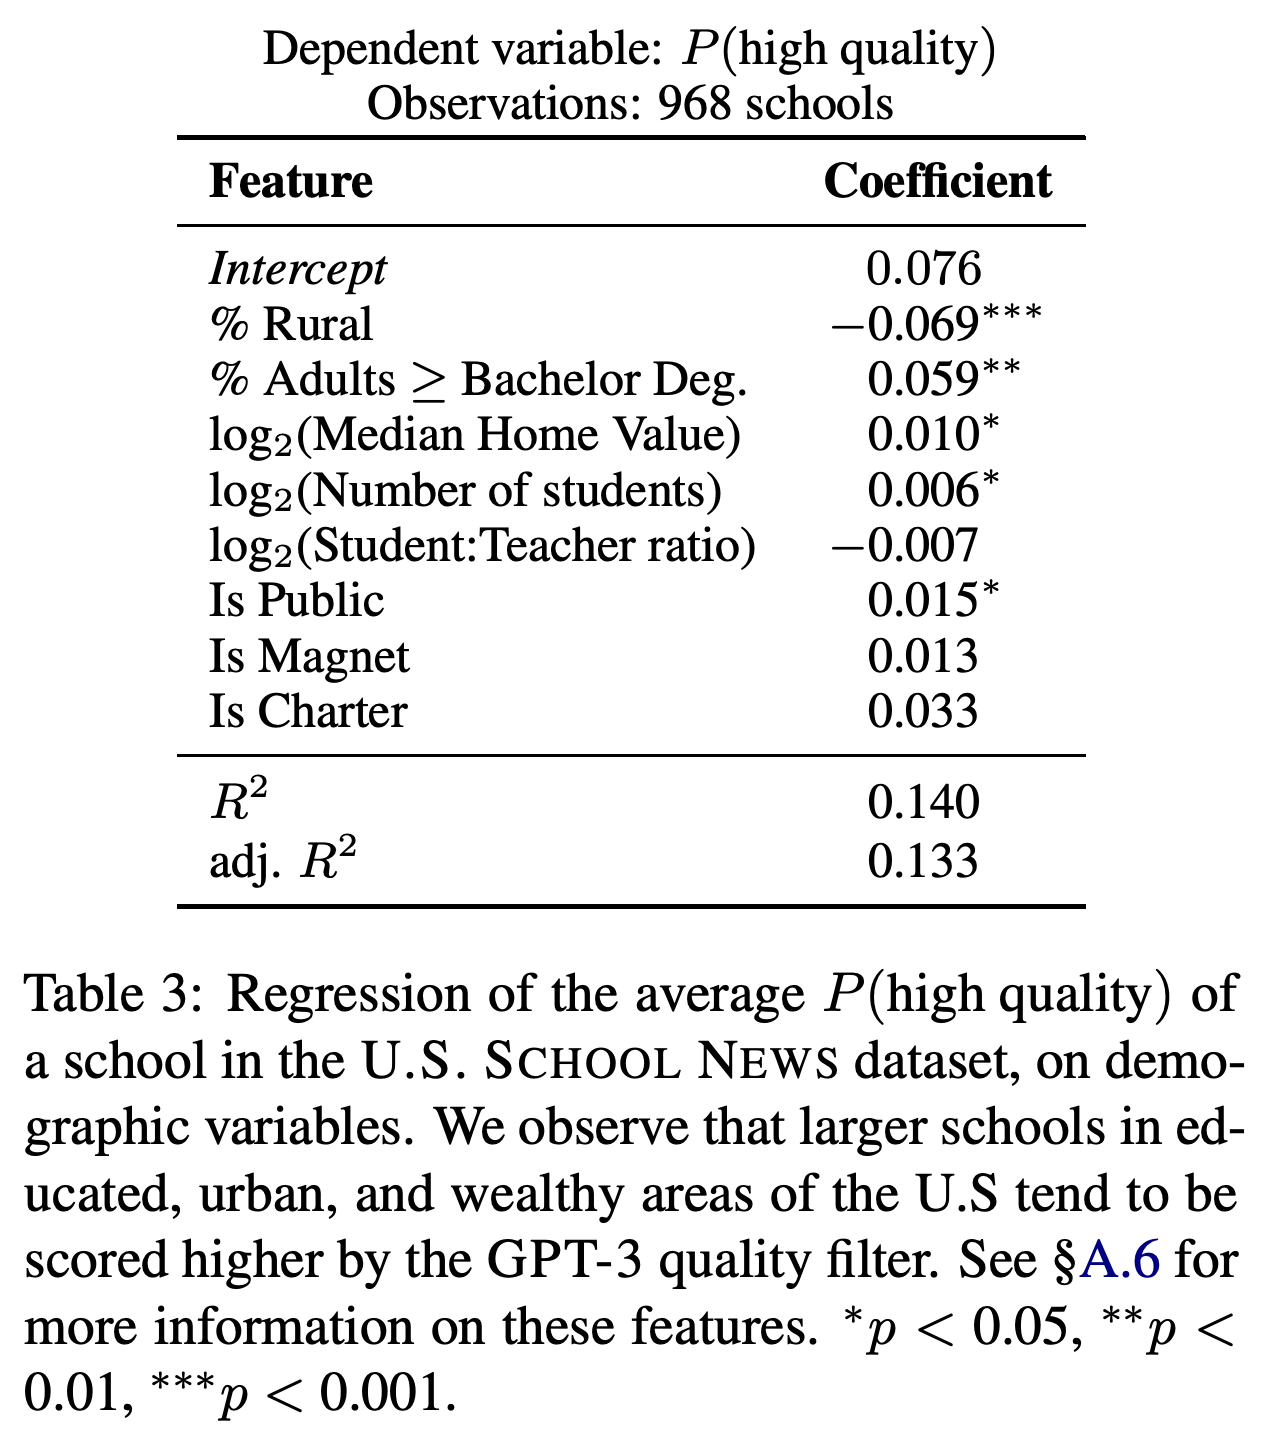
학교 단위 회귀 분석은 ZIP code 926개와 카운티 354곳에 걸친 학교 968곳을 대상으로 학교와 Census 특성을 사용한다. 도시 인구, 성인 교육 수준, 주택 가치, 학교 규모, 공립학교 여부는 평균 점수와 유의한 양의 연관성을 보인다. 점수 변동 중 설명되는 비율인 모델의 R²는 0.140이다.
학교 평균 점수는 주택 가치 및 성인 교육 수준과 양의 상관관계를, 공화당 득표율 및 농촌 인구와 음의 상관관계를 보인다. 이는 다른 변수를 보정하지 않은 관계다.
보정된 농촌 계수는 −0.069이고 공립학교 계수는 0.015다. 이 모델에서 magnet 학교 여부, charter 학교 여부, 학생 대 교사 비율은 유의하지 않다.
4 Alignment with Other Notions of Quality
저자들은 필터 점수를 사람이 정한 3가지 기준인 뉴스 출처의 사실성 평가, 채점된 영어 능력 에세이, Pulitzer Prize와 비교한다. 이 기준에도 기관의 판단과 고유한 언어 이데올로기가 반영된다.
4.1 Data
비교에는 사실성이 높은 매체의 기사 9.9K개와 낮은 매체의 기사 7.7K개, 점수와 문제가 포함된 Test Of English as a Foreign Language (TOEFL) 에세이 12.1K개, Books3와 Gutenberg 코퍼스에 수록된 Pulitzer 수상 도서를 사용한다.
4.2 Results
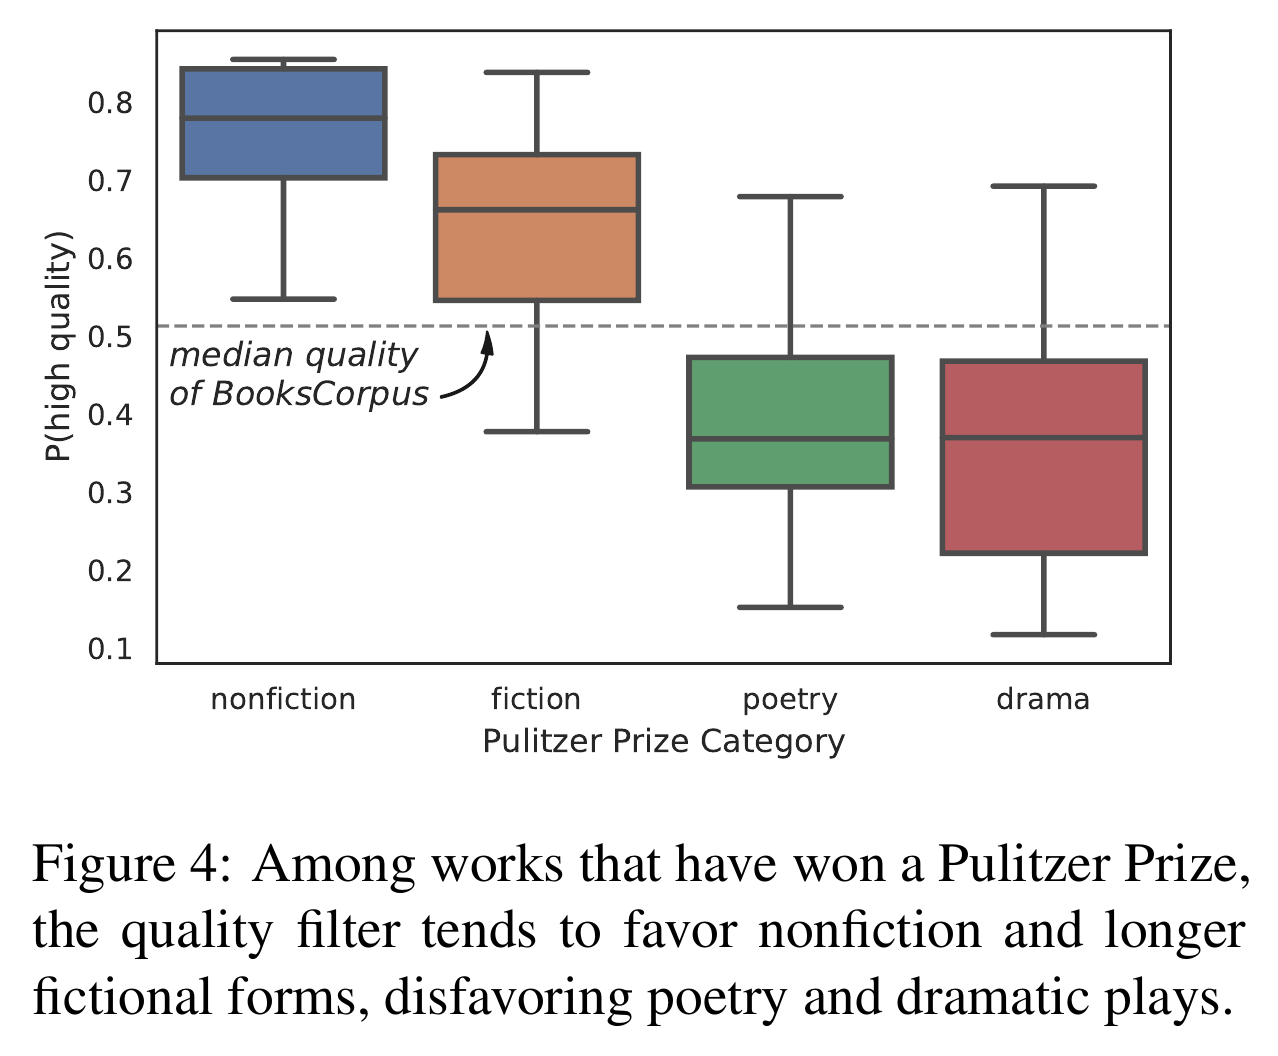
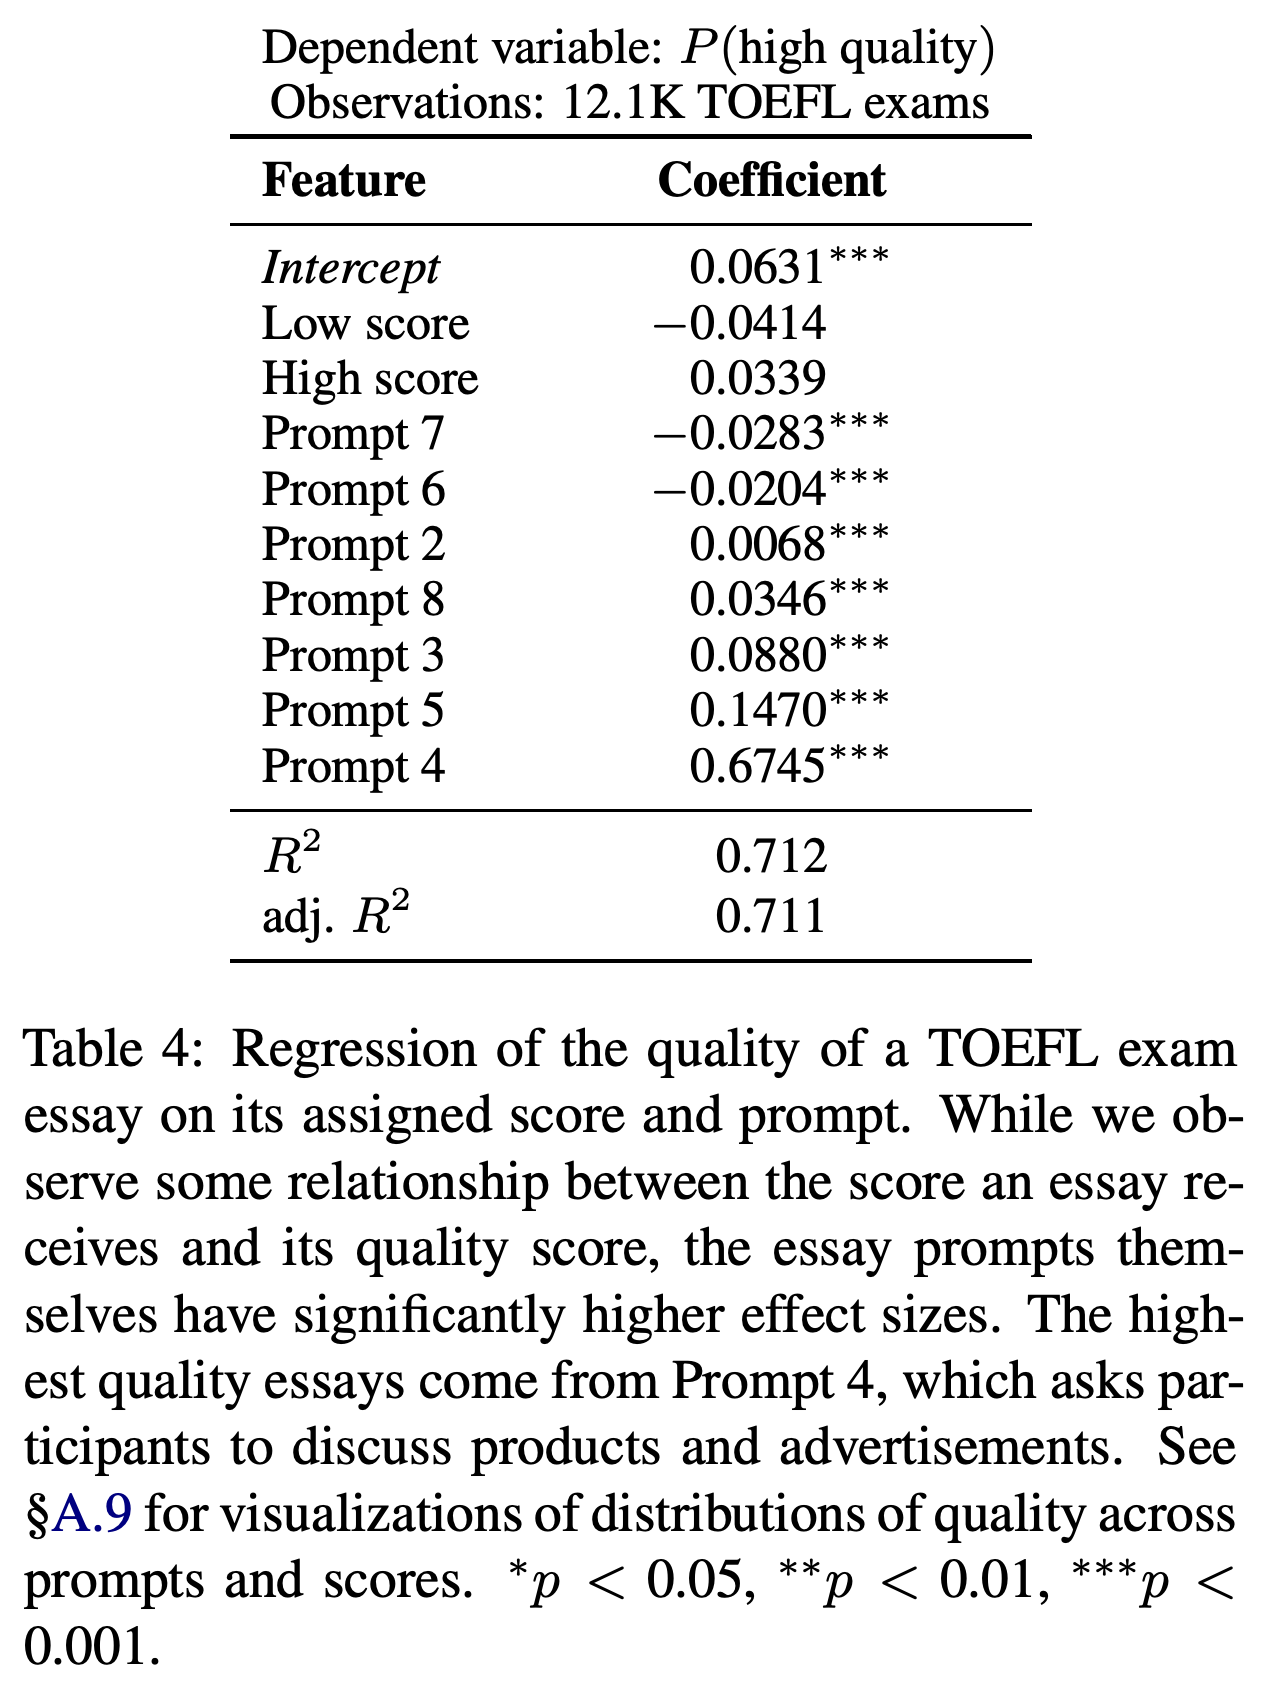
분포를 비교하는 양측 Kolmogorov-Smirnov 검정에서 뉴스 점수 분포는 유의하게 다르지 않았다(p = 0.085). 에세이 점수와 필터 점수의 상관관계는 약했지만(Pearson r = 0.12, p < 0.001), 문제의 영향은 훨씬 컸다. Pulitzer를 수상한 시와 희곡은 논픽션과 소설보다 낮은 점수를 받았다.
점수 분포 2개는 대체로 겹치며, 이는 보고된 p = 0.085 검정 결과와 부합한다. 이 결과가 분포의 동일성을 입증하지는 않는다.
Pulitzer 수상작 중 시와 희곡에 표시된 점수 중앙값은 BookCorpus 중앙값보다 낮지만, 논픽션과 소설은 그렇지 않다.
Prompt 4의 계수는 0.6745로, 낮은 에세이 점수와 높은 에세이 점수의 계수보다 훨씬 크다. 이는 해당 회귀 분석에서 문제에 대한 의존성이 강함을 나타낸다.
5 Discussion
저자들은 포함 및 제외 기준을 문서화하고, 필터의 영향을 검증하며, 과소 대표된 관점과 더 다양한 장르를 의도적으로 수집할 것을 제안한다. 적합한 학습 텍스트는 사용 목적에 따라 달라진다고 주장한다.
6 Ethical Considerations & Limitations
표본은 발행 템플릿과 온라인에 보관된 콘텐츠에 의존하므로 자원이 가장 부족한 학교와 가장 부유한 학교를 모두 누락할 수 있다. ZIP code와 카운티는 학교 상황을 나타내는 불완전한 대리 지표이며, 저자들은 기사 수집에 대한 동의를 구하지 않았다. 저자 중 미성년자가 많으므로 학교 단위 인구통계 변수와 점수는 공개하지만 기사 코퍼스는 공개하지 않는다.
7 Related Work
논문은 이 분석을 언어 차별에 관한 사회언어학 연구, 웹 데이터 수집에 대한 비판, 다른 필터가 소수 집단의 언어를 불균형하게 배제할 수 있다는 증거와 연결한다(Dodge et al., 2021). 후속 분석의 동기로 다운스트림 과제에서 나타나는 격차를 인용하지만, 이 필터와 모델 행동 사이의 인과관계는 입증하지 않는다.
8 Conclusion
저자들은 Wikipedia, 뉴스, 책, 인기 인터넷 콘텐츠를 긍정 참조 자료로 사용하면 이 평가에서 일부 학교 공동체가 유리해진다고 결론짓는다. 데이터 선별 과정과 배제 가능성을 문서화하면서 더 다양한 저자, 장르, 문체를 확보할 것을 권고한다.
부록
- A.1–A.6은 학습 코퍼스를 나열하고 https://bit.ly/3rLrmwV에서 U.S. School News 데이터시트를 제공하며, 필터 설정, 기사 예시, 주제별 점수, 인구통계 특성을 문서화한다. 선택된 필터는 L1 정규화, liblinear, 공백 토큰화, 해싱, unigram과 bigram 특성을 사용한다.
- A.7은 대안적인 회귀 분석을 보고한다. 인종 구성을 추가하면 주택 가치가 유의하지 않게 되며, 2016년 공화당 득표율을 추가하면 주택 가치와 농촌 인구 모두 유의하지 않게 된다. A.8–A.9는 사실성이 낮은 기사가 높은 점수를 받은 사례와 추가 TOEFL 문제 및 점수 비교를 제시한다.
짧은 생각
분류기의 출처 구분 성능과 다른 품질 지표와의 약한 일치도는 필터 점수가 선택된 참조 출처를 반영한다는 점을 보여준다. 인구통계 회귀 분석은 이 표본 내 연관성을 뒷받침하지만, 제한적인 설명력과 지역 단위 대리 지표로 인해 개인 수준의 해석과 인과적 해석은 미해결 상태로 남는다.