


ReST meets ReAct: Self-Improvement for Multi-Step Reasoning LLM Agent 요약 설명
15 Dec 2023 | Paper Review Agent Training Self-Training Knowledge Distillation목차
이번 글에서는 ReST meets ReAct: Self-Improvement for Multi-Step Reasoning LLM Agent 논문의 핵심 포인트만 간단히 정리한다.
- 2023년 12월 15일(Arxiv)
- Aksitov, Renat, Miryoosefi, Sobhan, Li, Zonglin, Li, Daliang, Babayan, Sheila, Kopparapu, Kavya, Fisher, Zachary, Guo, Ruiqi, Prakash, Sushant, Srinivasan, Pranesh, et al.
- Google Research, Google DeepMind, Google
- 논문 링크
요약
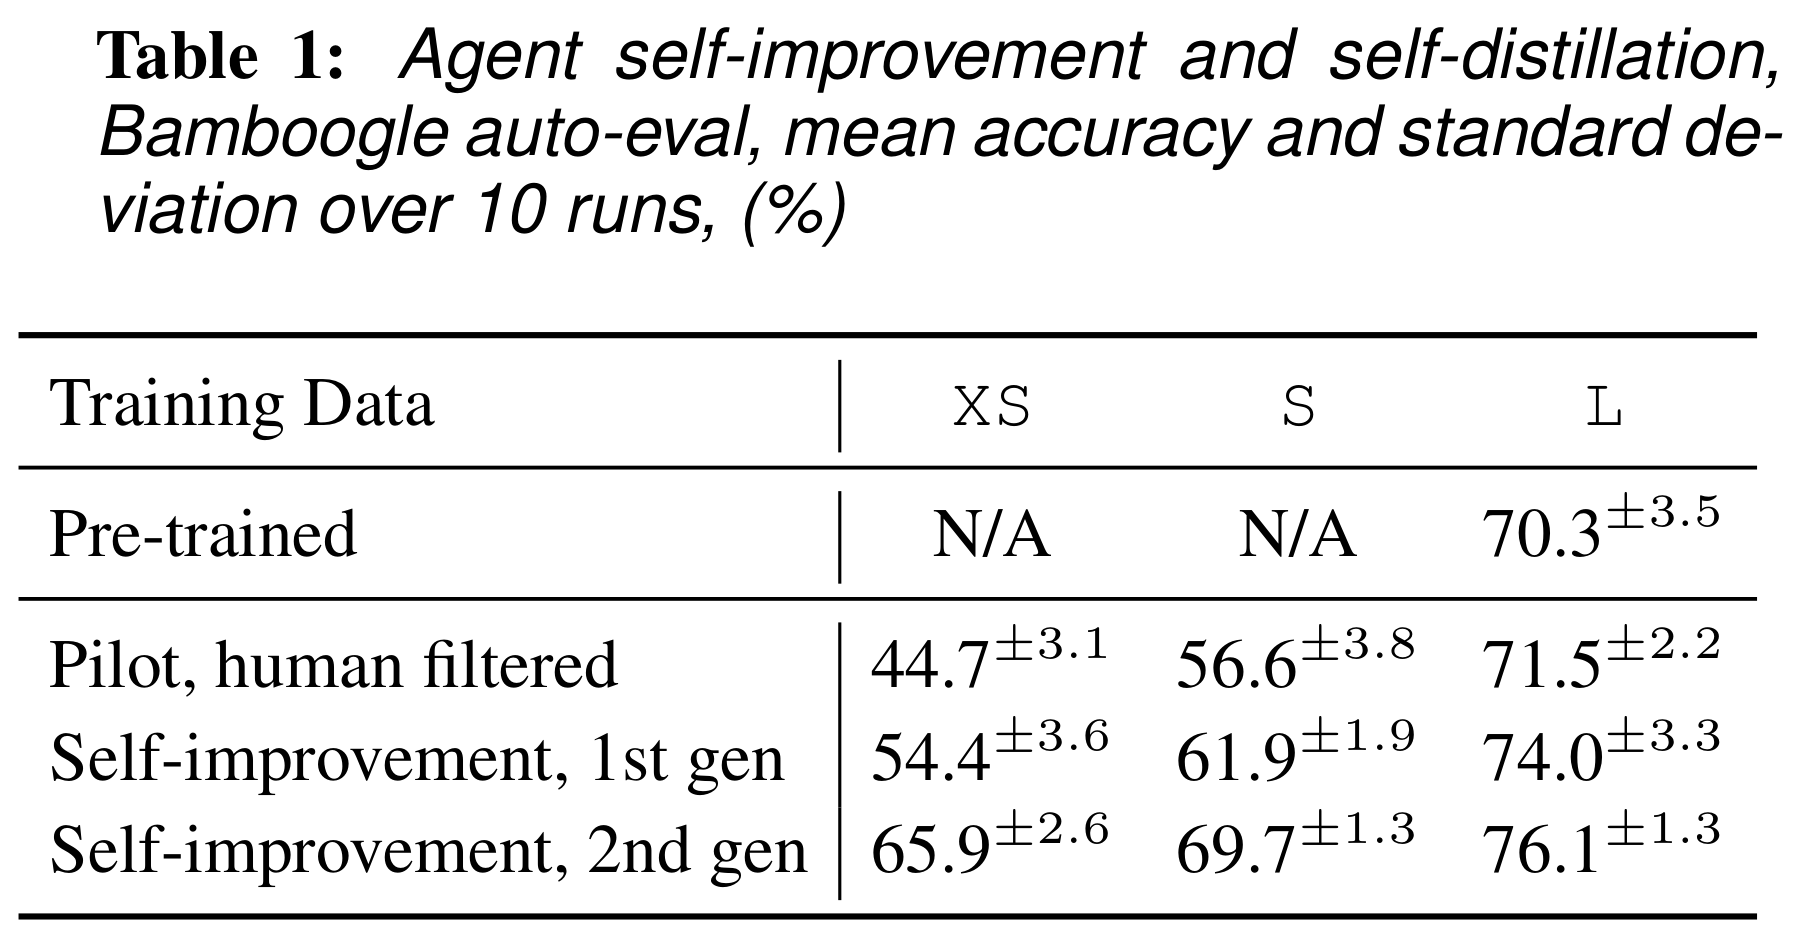
- 대규모 언어 모델(LLM)로 복잡한 질문에 답하려면 검색과 추론 단계를 조율해야 하지만, 외부 검색이 포함되면 미분을 통한 직접적인 종단 간 학습이 불가능하다. 이 논문의 소형 PaLM 2-S 검색 에이전트는 학습을 2회 반복한 뒤 Bamboogle 자동 평가에서 정확도 69.7%를 달성한다. Bamboogle은 서로 연결된 근거 2개가 필요한 벤치마크이며, 프롬프트로 구동한 대형 PaLM 2-L 교사 모델은 70.3%를 기록한다.
- 이 방법은 추론, 행동, 관찰을 번갈아 수행하는 ReAct와 Reinforced Self-Training(ReST)을 결합한다. ReST는 에이전트의 단계별 실행 기록인 궤적을 생성하고, 선택한 단계로 학습하는 과정을 반복한다. 대형 모델이 궤적을 생성하고, 지시 학습을 거친 모델이 후보 행동의 순위를 매긴다. 이후 미세 조정으로 대형 에이전트를 개선하면서 증류를 통해 소형 모델에도 그 행동을 전달한다.
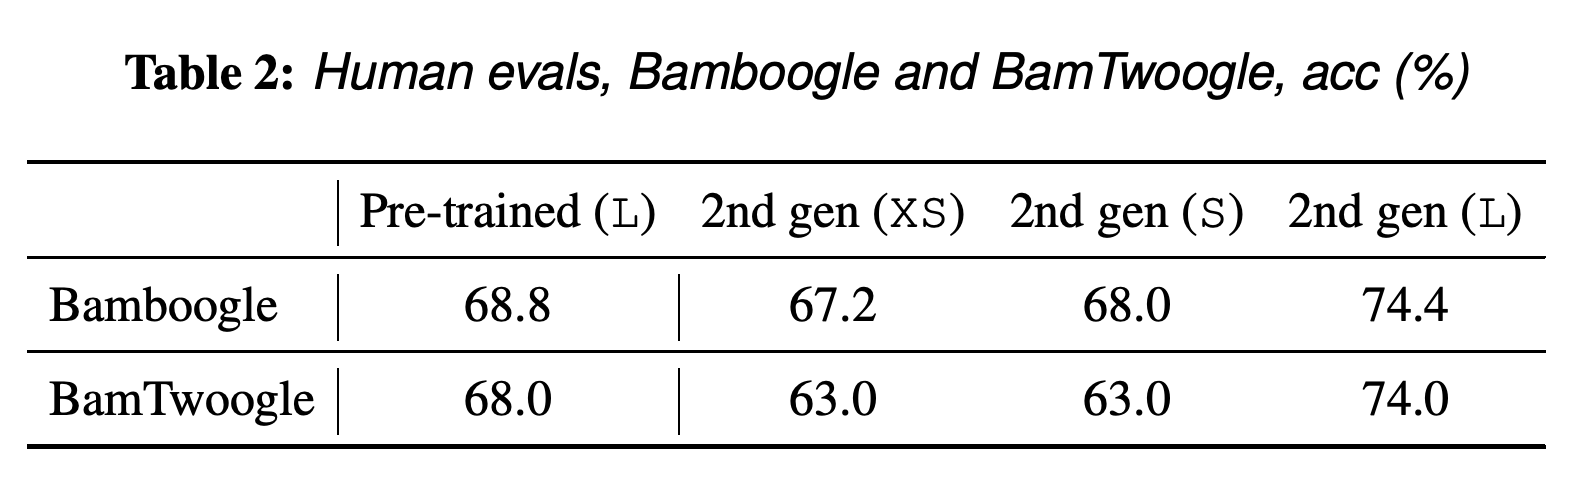
- 별도의 질문 100개로 구성된 테스트 벤치마크 BamTwoogle의 사람 평가에서, 프롬프트로 구동한 PaLM 2-L은 68.0%, 2세대 버전은 74.0%를 기록한다. 소형 버전 2개는 모두 63.0%를 기록한다. 실험 범위는 Bamboogle 질문 125개, BamTwoogle 질문 100개, 모델 크기 3개, 검색 도구 1개, 학습 반복 2회다.
1 Introduction
이 논문은 전체 추론 궤적에 사람이 주석을 다는 데 드는 비용을 다룬다. 궤적 수집이나 학습 데이터 필터링에 질문의 정답 레이블을 사용하지 않고, 합성 궤적과 단계별 AI 피드백으로 검색 에이전트를 개선하는 방법을 제안한다.
- ReST의 “grow” 단계에서는 현재 모델로 궤적을 샘플링하고, “improve” 단계에서는 선택한 데이터로 학습한다. 여기서는 사람의 선호도로 학습한 별도 보상 모델 대신 LLM이 행동의 순위를 직접 매긴다.
- 동일한 대형 모델 궤적으로 소형 에이전트도 학습하므로, 반복적인 성능 개선과 교사 모델의 행동 전달을 모두 살펴볼 수 있다.
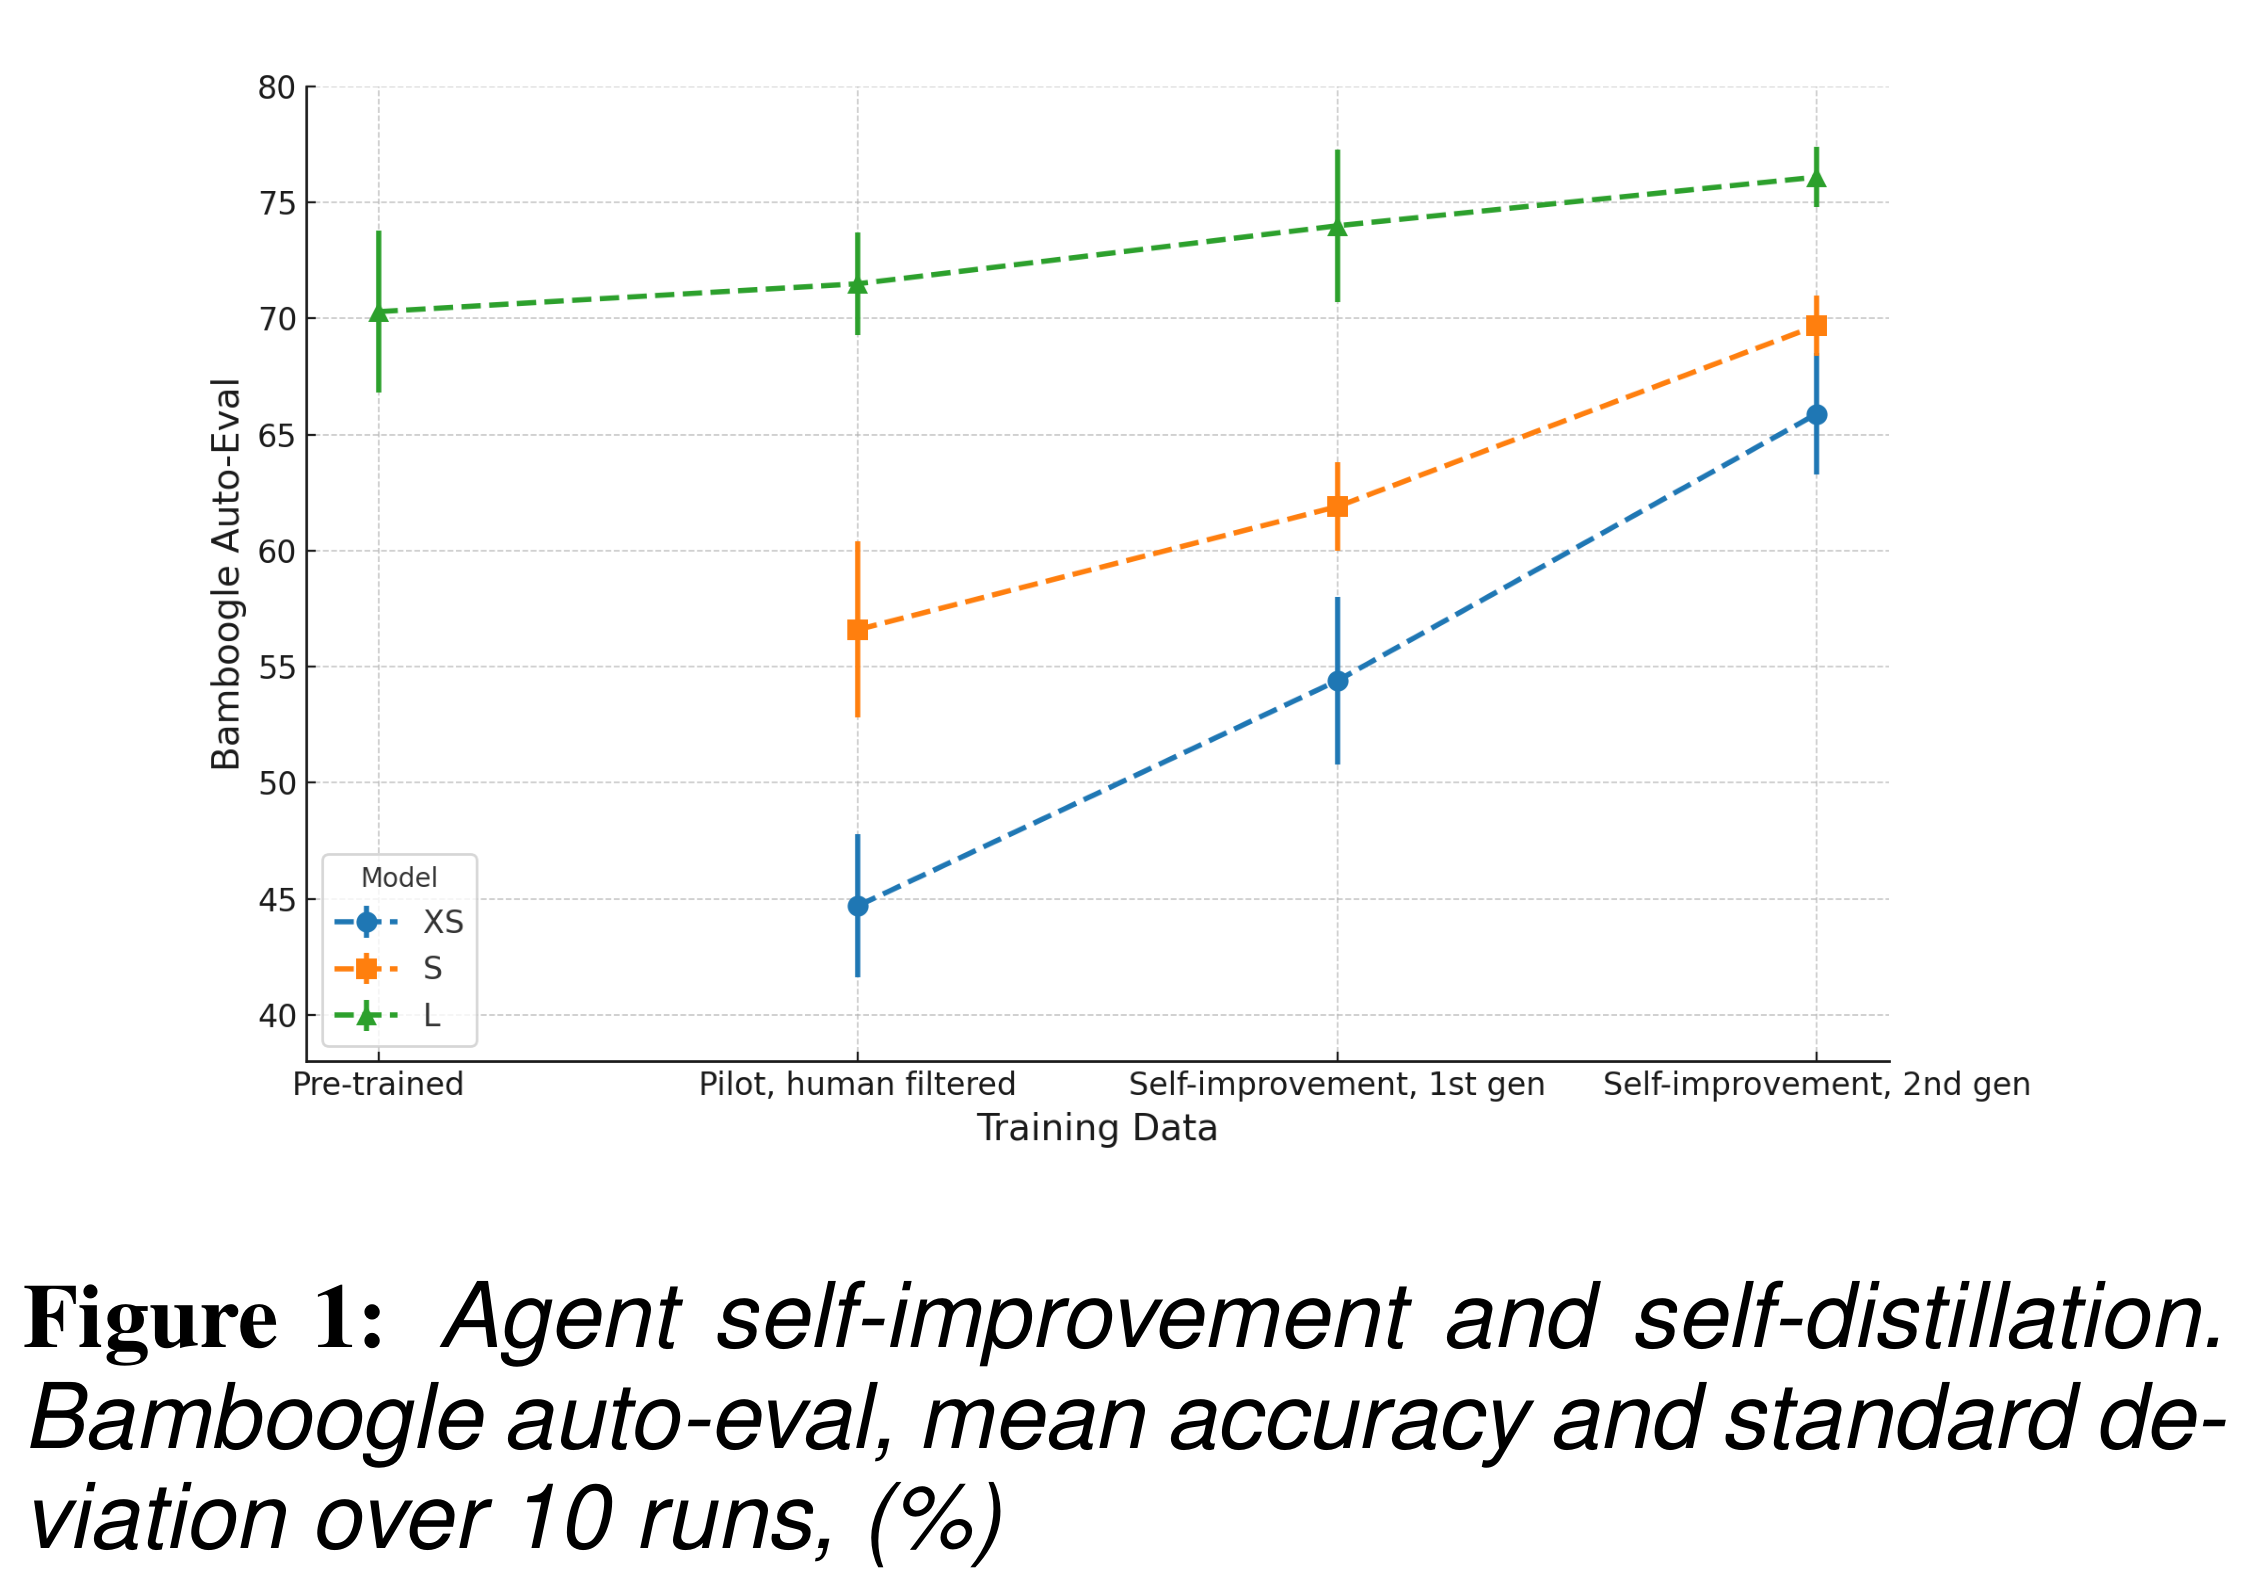
모델 크기 3개 모두 파일럿 베이스라인에서 시작해 생성 데이터의 반복 세대를 거치며 성능이 개선된다. 2세대 S는 69.7%로 프롬프트로 구동한 L의 70.3%에 근접하며, 2세대 L은 76.1%를 기록한다. 소형 모델의 비교 대상은 초기 교사 모델이다.
2 Background: Search Agent
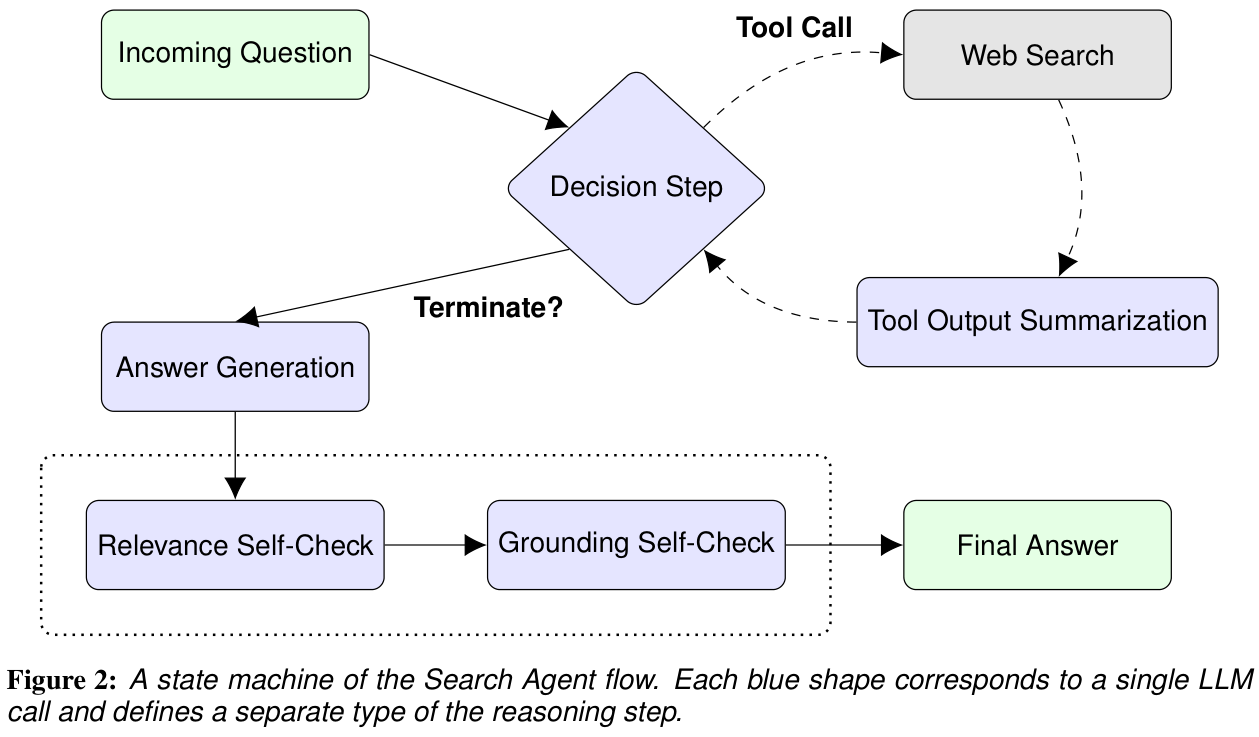
Search Agent는 ReAct 방식의 시스템에 Reflexion을 결합하며, 여기서는 자기 점검과 답변 수정으로 구현한다. 추가 정보가 필요한지 판단하고, 웹을 검색하며, 검색한 스니펫을 요약하는 과정을 반복한다. 검색 반복을 종료하면 답변 초안을 작성한 뒤 관련성과 근거성을 별도로 점검한다. 근거성은 검색한 스니펫이 답변을 뒷받침하는지를 뜻한다.
- 관련성 점검에서는 초안이 원래 질문에 답하는지 확인한다. 근거성 점검에서는 검색한 근거가 답변을 뒷받침하는지 확인한다.
- Figure 2는 전체 과정을 판단, 요약, 답변 생성, 관련성 자기 점검, 근거성 자기 점검이라는 모델 호출 유형 5개로 구분한다.
검색 반복에서는 판단과 웹 검색, 스니펫 요약을 번갈아 수행한다. 반복을 종료하면 답변을 생성하고, 추가 모델 호출 2개로 관련성과 근거의 뒷받침 여부를 점검한다. 이 구조는 학습 예제를 구성하는 데 사용하는 개별 상태를 보여 준다.
3 Methods
이 방법은 완료된 검색 궤적을 수집하고 개별 추론 단계를 학습 예제로 변환한다. 생성, 행동 순위 평가, 미세 조정을 반복해 성능을 개선하며, 동일한 예제로 소형 모델을 학습해 지식을 증류한다.
3.1 Prompting
저자들은 추론 단계 유형 5개 모두에 대해 입력과 출력 예시를 포함한 few-shot 프롬프트를 직접 작성한다. 모델 출력을 파싱하고 검색 과정에 통합할 수 있도록 프롬프트를 Python 코드로 구성한다.
- 모델은 주어진 코드에 구조화된 행동을 이어서 작성한다. 실험한 사전 학습 모델 중 초기 궤적을 생성할 만큼 이 형식을 일관되게 처리한 모델은 PaLM 2-L뿐이다.
- 따라서 소형 에이전트는 프롬프트만으로 전체 수행 방식을 독자적으로 익히는 대신 대형 모델의 궤적으로 학습한다.
3.2 Implementation Details
실험에는 초소형(XS), 소형(S), 대형(L) 크기의 사전 학습 및 미세 조정 PaLM 2 base models를 사용한다. 각 단계에서는 대체로 생성의 무작위성을 조절하는 온도 T = 0.5로 후보를 샘플링하고, 모델이 해당 시퀀스를 얼마나 예측하기 어려워하는지를 나타내는 perplexity가 가장 낮은 후보로 진행한다. L과 S는 후보 네 개를, XS는 16개를 사용한다.
- 검색 도구의 인터페이스인 Google 내부 Q&A API가 스니펫을 제공하며, 보통 쿼리당 상위 3개를 사용한다. 궤적마다 검색은 최대 10회까지 허용한다.
- REMAINING_SEARCHES는 남은 검색 횟수를 추적하고, PAST_ACTIONS는 누적된 궤적을 저장한다.
3.3 Input DATA
초기 질문 집합은 HotpotQA, Eli5, Eli5-askH, Eli5-askS의 학습 질문에서 각각 무작위로 선택한 500개로 구성하며, 총 2000개다. HotpotQA는 여러 문서의 정보를 결합해야 하는 질문을 제공한다. 나머지 데이터셋은 r/explainlikeimfive, r/askhistorians, r/askscience의 개방형 질문을 제공한다.
- 질문만 사용한다. 데이터셋의 정답으로 궤적을 필터링하지 않으며, 이 데이터셋들의 검증 분할도 하이퍼파라미터 선택이나 성능 평가에 사용하지 않는다.
3.4 Fine-Tuning
완료된 궤적을 개별 추론 단계로 나누어 미세 조정용 학습 데이터를 구성한다. 모든 실험에서는 모델의 전체 파라미터를 학습하는 전체 미세 조정을 사용한다. 모델이 클수록 미세 조정 비용이 높아지므로 가능한 한 많은 실험을 XS로 수행한다.
3.5 RANKING ”REWARD” MODEL
지시를 따르도록 학습한 PaLM 2-L에 현재 입력, 후보 출력, 순위 평가 지침을 제공하고, 가장 높은 순위의 행동을 학습 대상으로 선택한다. 이는 원래 ReST에서 사용한 임곗값 기반 필터링을 행동 간 상대 순위로 대체한다.
- 순위 평가는 주로 off-policy 방식으로 이루어진다. 궤적 수집 후 학습 대상으로 사용할 행동을 교체하며, 실제 궤적을 이어갈 때는 여전히 perplexity가 가장 낮은 후보를 사용한다.
- 논문은 이 선택 방식을 보상 순위로 선택한 응답에 대해 미세 조정하는 방법인 RAFT와 연결한다.
3.6 Iterative Self-Improvement
개선 과정은 프롬프트로 구동한 PaLM 2-L에서 시작한다. 고정된 질문 2000개에 대한 궤적을 수집하고, 학습 예제를 구성하면서 행동의 순위를 다시 매긴 뒤 동일한 크기의 모델을 미세 조정한다. 새 모델의 성능이 개선되면 다음 반복의 궤적을 생성하는 데 사용한다. 각 반복에서 얻은 데이터로 소형 모델도 학습할 수 있다.
- 각 외부 반복에서는 개선 단계를 1회 수행한다. 질문 집합은 고정하고 생성하는 궤적을 바꾼다.
4 Evaluation
평가에서는 여러 정보를 결합해야 하는 조합형 질문에 에이전트가 정확히 답하는지 측정한다. Bamboogle은 반복적인 자동 평가와 모델 선택에 사용하고, BamTwoogle은 최종 테스트용으로 남겨 둔다.
4.1 Bamboogle
Bamboogle은 2-hop 질문 125개로 구성된다. 각 질문은 원래 Google 직접 검색만으로 답하기 어렵고, 필요한 근거 2개를 모두 Wikipedia에서 찾을 수 있도록 선정되었다. Search Agent는 출처를 포함한 장문 답변을 생성하므로, 문자열의 정확한 일치 여부 대신 사람이나 별도로 호출한 PaLM 2-L 기본 모델로 정답 여부를 평가한다.
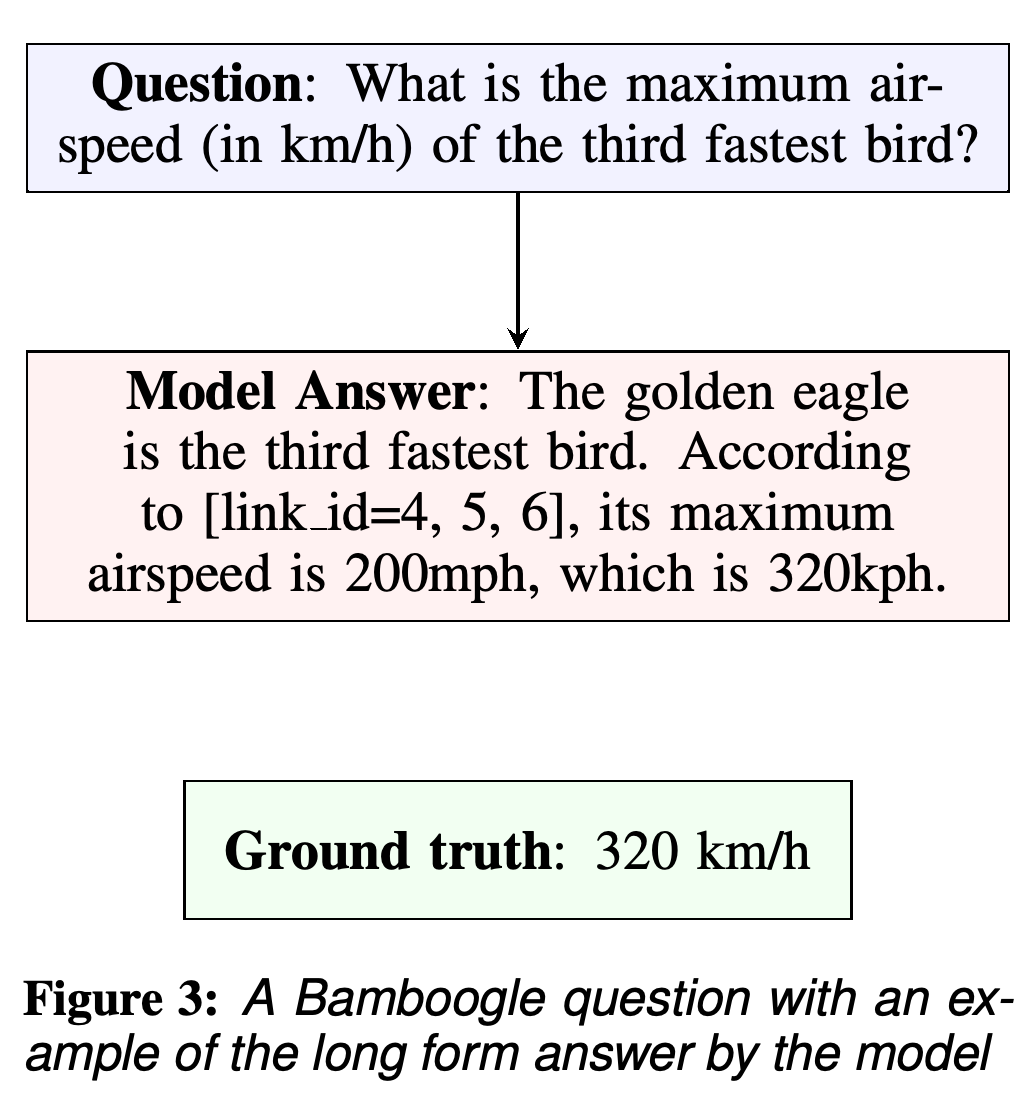
- Figure 3은 평가의 어려움을 보여 준다. 검독수리를 식별하고 속도를 320kph로 제시하는 문단을 짧은 참조 정답인 320 km/h와 비교해야 한다.
생성된 답변은 검독수리를 식별하고 속도를 200mph와 320kph로 표현하지만, 참조 정답에는 320 km/h만 들어 있다. 따라서 정답 평가에서는 긴 문장 안에 포함된 답을 인식해야 한다.
4.2 Auto-Eval
모델로 정답 여부를 판단하는 auto-eval은 생성된 답변이 참조 정답을 함의하는지 묻는다. 평가한 에이전트 전반에서 자동 평가 점수와 사람 평가 점수의 상관관계는 선형 연관성을 나타내는 Pearson 0.98이며 p = 6.6 × 10⁻⁸이다. 순위 일치도를 나타내는 Spearman은 0.83이며 p = 0.0015다. 일반적인 평가에서는 Bamboogle 질문마다 궤적 10개의 결과를 평균한다.
- Bamboogle auto-eval로 온도 T = 0.5를 선택하고, 저장된 학습 상태인 체크포인트를 XS는 9K, S는 5K, L은 3.5K 스텝에서 선택한다. 추가 반복, 궤적 수, 자기 점검에 관한 결정에도 이 평가를 사용한다.
- Bamboogle 질문은 궤적 생성용 학습 데이터에서 제외하며, 해당 질문으로 프롬프트를 조정하지 않는다. 다만 모델 선택에 반복적으로 사용하므로 Bamboogle은 사실상 검증 세트 역할을 한다.
4.3 BamTwoogle
BamTwoogle은 반복적인 Bamboogle 평가에 따른 과적합 우려를 다루기 위해 사람이 직접 만든 질문 100개의 테스트 세트다. 검색 엔진이 바뀌면서 일부 기존 Bamboogle 질문은 검색 1회로 답할 수 있게 되었지만, BamTwoogle 질문은 최소 2단계가 필요하도록 확인했다.
- 질문은 대부분 검색이나 추론 2단계가 필요하며, 일부는 3단계 또는 4단계가 필요하다. 각 질문은 Google 검색 결과의 첫 페이지에 정답이 나타나지 않는지 사람이 직접 확인한다.
- 기대 정답은 모호하지 않고 시간에 따라 변하지 않아야 하며, 고유 명사의 다른 표기도 수용해야 한다. 사실 확인용 참조 자료로는 가능하면 관련 품질 경고가 없는 Wikipedia 문서를 사용한다.
5 Experiments
실험에서는 사람이 필터링한 파일럿 베이스라인, 2세대에 걸친 자기 개선 데이터, XS와 S 에이전트로의 증류를 비교한다. 자동 평가는 Bamboogle 실행 10회의 평균과 표준편차를 보고한다. 최종 사람 평가는 각 벤치마크에서 모델마다 1회 실행한 결과를 대상으로 한다.
5.1 Pilot
파일럿 실험은 HotpotQA와 Eli5 질문에서 생성한 궤적 500개를 사용하며, 모델의 순위 재평가 없이 perplexity가 가장 낮은 행동을 선택한다. 사람 평가자는 도움이 되지 않는 쿼리, 비어 있는 추론, 불완전한 요약 등의 문제가 있는 학습 예제 약 30%를 제거한다. 이렇게 사람이 필터링한 학습 데이터를 미세 조정 베이스라인으로 사용한다.
5.2 Self-Improvement and Self-Distillation
1세대는 프롬프트로 구동한 PaLM 2-L의 궤적 2000개를 사용한다. 2세대는 1세대에서 미세 조정한 L 모델의 궤적 8000개를 사용하며, 동일한 질문 2000개를 각각 4회 반복한다. 각 세대의 학습 데이터로 XS, S, L 모델을 학습한다.
- Table 1에서 1세대 XS, S, L의 Bamboogle 자동 평가 정확도는 각각 54.4 ± 3.6%, 61.9 ± 1.9%, 74.0 ± 3.3%이며, 2세대에서는 65.9 ± 2.6%, 69.7 ± 1.3%, 76.1 ± 1.3%로 높아진다. 프롬프트로 구동한 L은 70.3 ± 3.5%를 기록한다.
- Table 2의 Bamboogle 사람 평가 점수는 프롬프트로 구동한 L이 68.8%이고, 2세대 XS, S, L이 각각 67.2%, 68.0%, 74.4%다. BamTwoogle 점수는 같은 순서로 68.0%, 63.0%, 63.0%, 74.0%다.
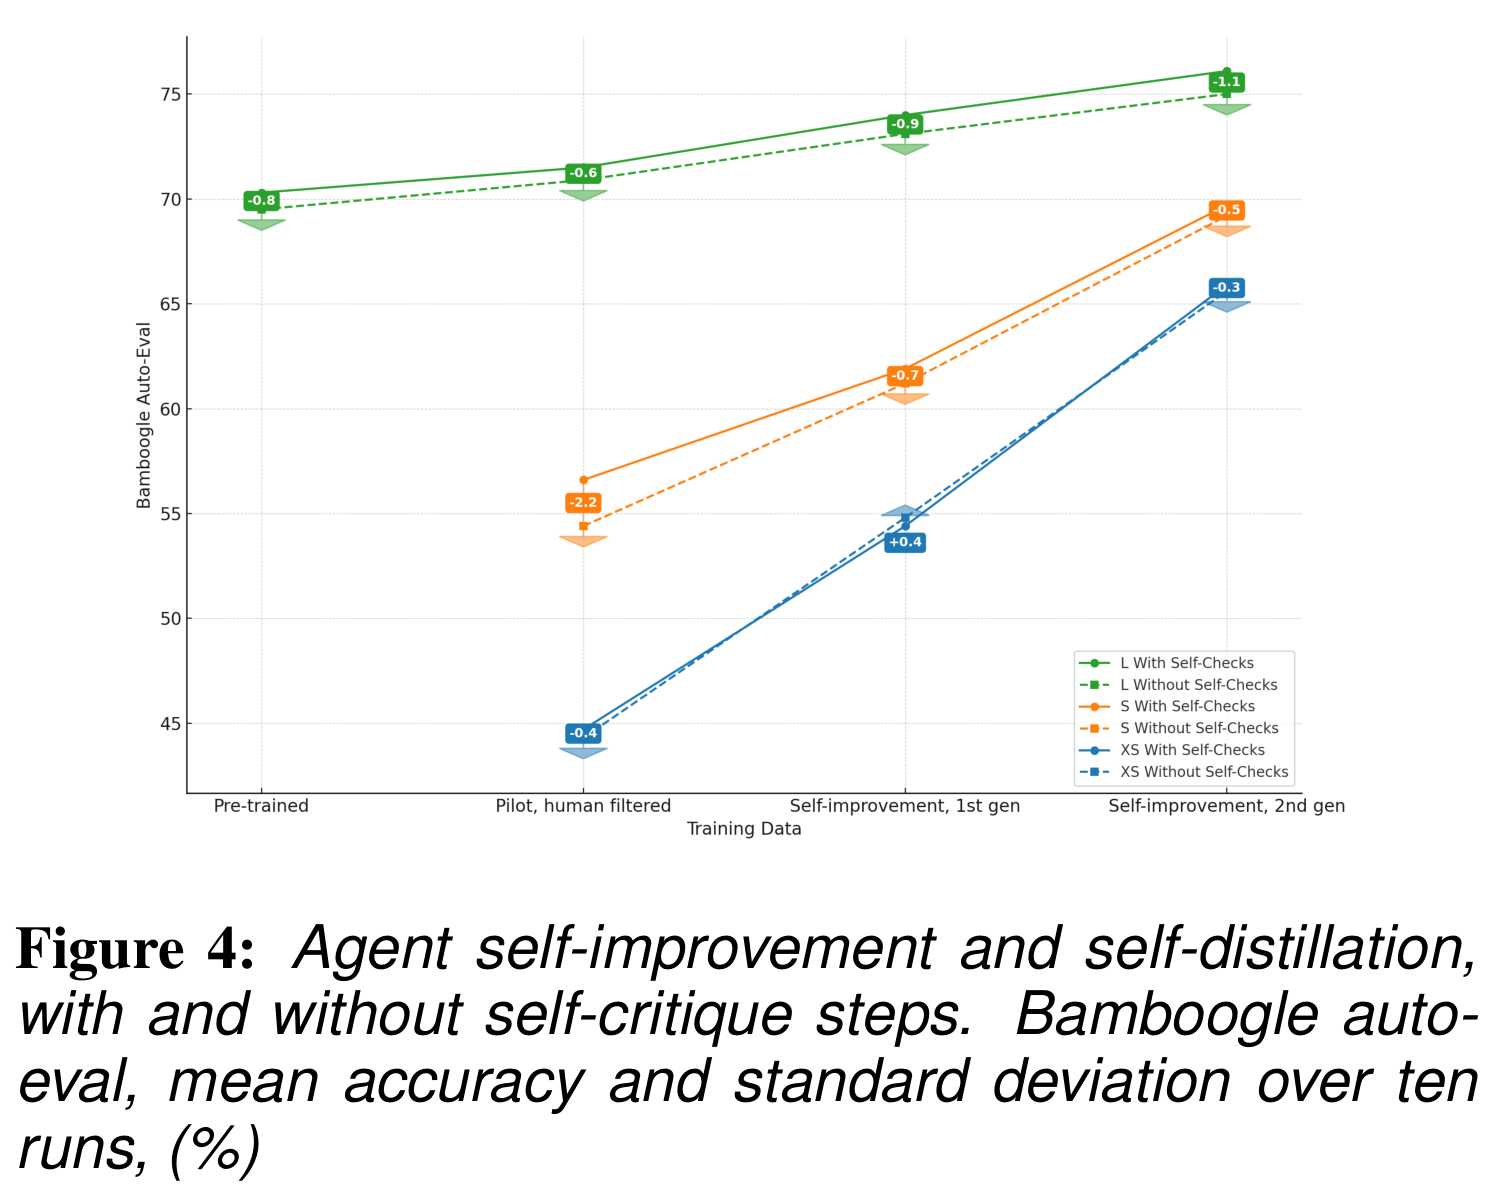
- Figure 4는 자기 점검 전후의 답변을 비교한다. 2개 조건 모두에서 학습 세대가 진행될수록 성능이 개선되는 양상이 나타난다.
초안과 최종 답변의 곡선은 서로 가까우며, 2개 곡선 모두 학습 세대가 진행될수록 개선된다. 학습 단계에 따른 이득은 자기 점검 호출 2회의 기여보다 크다. 자기 점검에 따른 변화는 대체로 작고 모델마다 다르다.
2세대 XS, S, L은 각각 65.9 ± 2.6%, 69.7 ± 1.3%, 76.1 ± 1.3%를 기록하며, 사전 학습 L은 70.3 ± 3.5%를 기록한다. 사전 학습 XS와 S는 N/A로 표시되어 있으므로, 이 표에는 해당 모델들을 프롬프트로 직접 구동한 베이스라인이 없다.
실행 1회의 사람 평가에서 L은 벤치마크 2개 모두에서 개선된다. Bamboogle에서는 68.8%에서 74.4%로, BamTwoogle에서는 68.0%에서 74.0%로 높아진다. 증류한 XS와 S 에이전트는 BamTwoogle에서 63.0%를 기록하며, 별도로 남겨 둔 테스트에서 초기 대형 교사 모델과 5퍼센트포인트의 격차를 보인다.
5.3 Ablations
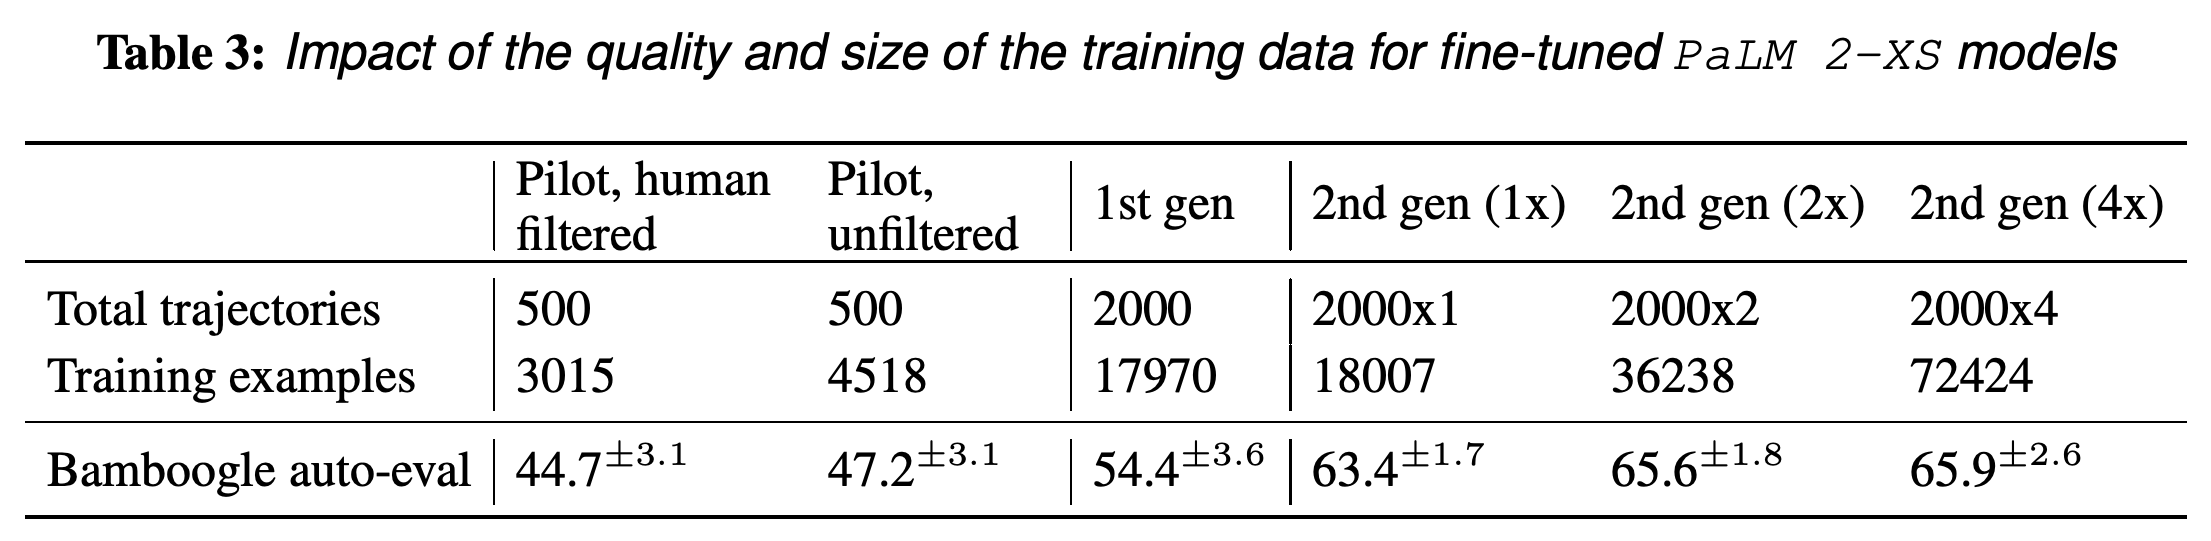
XS를 대상으로 학습 구성의 일부를 바꾸는 ablation 실험을 수행해 데이터 생성 방식, 양, 필터링을 살펴본다. 사람이 필터링한 파일럿 데이터의 점수는 44.7 ± 3.1%로, 필터링하지 않은 파일럿 데이터의 47.2 ± 3.1%보다 2.5퍼센트포인트 낮다. 저자들은 필터링이 프롬프트 형식을 익히는 데 필요한 예제를 줄이는 반면, PAST_ACTIONS 안의 문제가 있는 이전 단계는 그대로 남기기 때문일 수 있다고 추측한다.
- 학습 예제 수가 거의 같은 조건에서, 예제 17970개로 구성된 1세대 데이터는 54.4 ± 3.6%를 기록한다. 질문당 궤적 1개를 사용한 2세대 데이터는 예제 18007개로 63.4 ± 1.7%를 기록한다. 이는 규모가 대략 같은 조건에서 2세대 데이터의 가치를 뒷받침하지만, 개선을 일으킨 개별 원인을 분리하지는 못한다.
- 2세대의 질문당 궤적을 1개에서 2개로 늘리면 정확도가 63.4 ± 1.7%에서 65.6 ± 1.8%로 높아지며, 궤적 4개에서는 65.9 ± 2.6%를 기록한다. 학습 예제 수는 각각 18007개, 36238개, 72424개다.
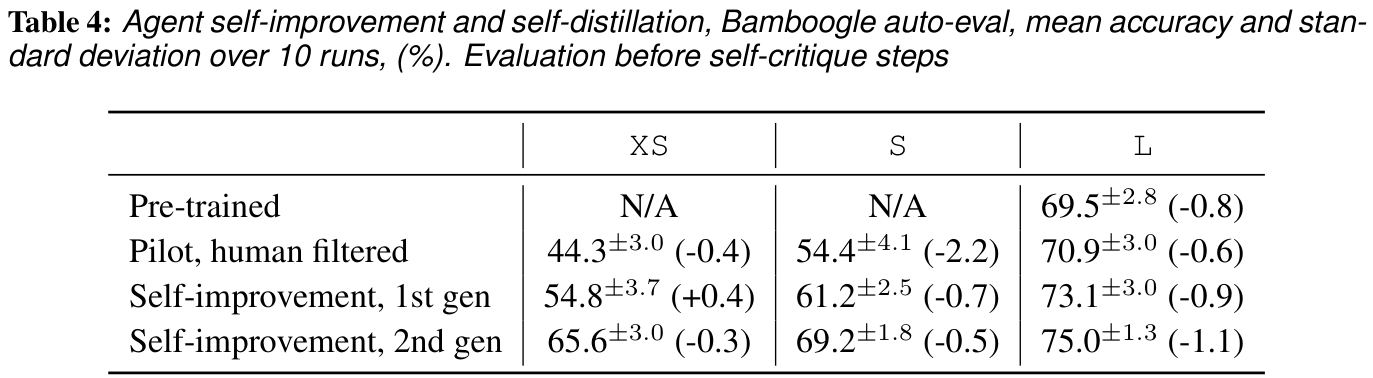
- 초안과 최종 답변을 비교하면 대부분의 모델에서 자기 비평으로 약 0.5–1.0%p의 이득을 얻는다. Table 4에는 예외도 나타난다. 초기 세대 XS에서는 초안 점수가 최종 답변보다 0.4점 높다.
거의 같은 데이터 규모에서 초기 세대 데이터를 후속 세대 데이터로 교체하면 XS 정확도가 54.4%에서 63.4%로 높아진다. 후속 세대 궤적을 배증하면 65.6%, 거기서 다시 배증하면 65.9%에 도달한다. 이 실험에서는 궤적을 추가할수록 관측되는 추가 이득이 줄어든다.
6 Discussion
논의에서는 이 접근법을 개별 작업 상태와 행동으로 학습하는 과정 감독에 탐색과 AI 순위 평가를 결합한 방식으로 설명한다. 학습에 올바른 최종 답변이 필요하지 않으므로, 저자들은 실패한 궤적에서도 유용한 단계를 유지할 수 있고 명확한 단일 정답이 없는 질문에도 이 절차를 적용할 수 있다고 주장한다.
- 무작위로 샘플링한 궤적을 반복 실행하고 대형 모델로 판정하면 평가 비용이 커진다. 자동 평가 덕분에 세부적인 비교가 가능하지만, 여전히 상당한 계산이 필요하다.
- 자기 점검의 이득은 대체로 큰 모델에서 더 크며, 자기 개선을 거치면서 뚜렷하게 커지지는 않는다. 자기 점검 전 2세대 XS, S, L의 점수는 각각 65.6 ± 3.0%, 69.2 ± 1.8%, 75.0 ± 1.3%다.
- 저자들은 수작업 프롬프트, 작은 평가 규모, 제한된 모델, 도구 1개만 사용한 점을 한계로 꼽는다. 여러 도구나 처음 보는 도구로의 일반화, 2회 반복 이후의 추가 개선, 최종적인 성능 포화는 미해결 과제로 남는다.
초안 답변 평가는 자기 점검의 기여가 일정하지 않음을 수치로 보여 준다. 자기 점검 후 후속 세대 L은 1.1%p 높아지며, S와 XS의 상승 폭은 각각 0.5와 0.3이다. 반면 초기 세대 XS는 0.4점 낮아진다.
7 Related Work
논문은 검색 기반 장문 답변이라는 측면에서 사람의 시연과 강화 학습으로 학습하는 WebGPT와 비교하고, 에이전트 미세 조정이라는 측면에서 또 다른 에이전트 미세 조정 방법인 FireAct와 비교한다. 핵심 학습 과정에서 질문의 정답 레이블을 사용하지 않고 AI 피드백으로 학습 단계를 생성하고 선택한다는 점이 특징이다.
- Few-shot 프롬프트 예시, 벤치마크 구성, 평가, 별도의 파일럿 베이스라인에는 여전히 사람이 관여한다. 논문은 레이블이 있는 예제로 프롬프트 예시를 최적화하고 에이전트 구성 요소를 미세 조정할 수 있는 DSP도 논의한다.
- 최종 답변의 정답 여부를 사용하는 자기 학습 방법인 STAR 및 ReSTEM과 달리, 이 방법은 정답 여부를 학습 신호로 사용하지 않는다. ReST 및 RAFT와 비교하면, 사람의 선호도로 학습한 전용 보상 모델 대신 모델에 직접 프롬프트를 주어 순위를 얻는다.
8 Conclusion
이 논문은 다단계 검색 에이전트를 개선하고, 프롬프트로 구동한 대형 교사 모델의 성능을 상당 부분 소형 모델에 전달하는 반복적 합성 데이터 절차를 보여 준다. 실험은 명시된 PaLM 2 검색 과정에서 2회 반복에 걸쳐 이 결과를 확인한다.
부록
- A.1 PROMPTS는 Listings 1–8에 구조화된 프롬프트 인터페이스를 제시한다. 전체 추론 프롬프트에는 판단 예시 9개, 요약 예시 6개, 답변 생성 예시 5개, 관련성 점검 예시 6개, 근거성 점검 예시 5개가 들어간다. Listings 1–6은 첫 예시의 일부와 공통 자기 점검 접두부를 제공한다.
- Listing 7은 ANSWER가 REF_ANSWER를 함의하는지 검사하는 예시 5개를 포함한 전체 auto-eval 프롬프트를 제공한다. Listing 8은 예시가 없는 순위 평가 프롬프트를 제공하며, Python 코드 형식을 사용하지 않는 유일한 프롬프트다. 이 프롬프트는 최소한의 단계로 관련성과 근거성을 갖춘 답변을 만들도록 후보 행동의 순위를 매긴다. A.2 ADDITIONAL DATA에는 자기 비평 전 초안 답변의 점수를 담은 Table 4가 있으며, 자기 점검 효과가 항상 긍정적이지는 않다는 예외도 포함한다.
짧은 생각
질문당 궤적 1개를 사용한 1세대와 2세대 데이터의 비교는 특히 유용하다. 학습 예제 수가 거의 같은데도 XS 성능은 9.0퍼센트포인트 높아진다. 이 실험에서는 생성 데이터를 바꾸는 편이 2세대 궤적 수를 늘리는 것보다 더 큰 이득을 보인다. 다만 이 비교로는 행동 순위 평가의 기여와 궤적 생성기의 변화가 미친 영향을 분리할 수 없다. 소형 모델의 결과는 비교 조건에 따라 달라진다. Bamboogle 자동 평가에서는 S가 프롬프트로 구동한 L에 거의 근접하지만, BamTwoogle 사람 평가에서는 XS와 S 모두 프롬프트로 구동한 L보다 5%p 낮다. 내부 검색 API와 일부만 공개된 추론 프롬프트 때문에 전체 과정을 재현하는 데 제약이 있다. 자동 평가와 사람 평가의 집계 점수가 높은 일치도를 보이더라도 모든 개별 답변이나 인용이 정확히 판정된다는 뜻은 아니다.