


SAND-Math: Using LLMs to Generate Novel, Difficult and Useful Mathematics Questions and Answers 요약 설명
28 Jul 2025 | Paper Review Synthetic Data Mathematical Reasoning Supervised Fine-Tuning목차
이번 글에서는 SAND-Math: Using LLMs to Generate Novel, Difficult and Useful Mathematics Questions and Answers 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 7월 28일(Arxiv), 39th Conference on Neural Information Processing Systems (NeurIPS 2025) Workshop: MATH-AI
- Manem, Chaitanya, Brahma, Pratik Prabhanjan, Mishra, Prakamya, Liu, Zicheng, Barsoum, Emad.
- Advanced Micro Devices, Inc. (AMD)
- 논문 링크
- Github
요약
- 대규모 언어 모델(LLM)이 어려운 수학 문제를 풀도록 학습시키려면 난도가 높고 신뢰할 수 있는 학습 예제가 필요하지만, 이러한 예제는 부족하다. 엄선한 예제 817개로 구성된 학습 코퍼스 LIMO에 SAND-Math 예제 500개를 추가하면 Qwen2.5-32B-Instruct의 AIME25 정확도가 44.50%에서 48.89%로 높아진다. AIME25는 2025 American Invitational Mathematics Examination 벤치마크다. 이 결과는 동일한 학습 설정에서 합성 수학 데이터셋 MetamathQA를 추가했을 때보다 17.85%포인트 높다.
- SAND-Math는 수정할 기존 문제 모음인 시드 데이터셋 없이 문제를 생성한다. 이후 답의 일치 여부, 중복, 벤치마크와의 중첩, 풀이 모델을 기준으로 한 난도, 웹 문서와의 유사도를 기준으로 필터링하여 문제 8,842개를 남긴다. Difficulty Hiking 단계에서는 정리와 보조 개념을 추가하여 문제를 다시 작성한다. 이 과정을 1회 적용하면 모델이 평가한 평균 난도가 5.02에서 5.98로 높아진다.
- LIMO에 예제 1,500개를 추가하는 실험에서 Difficulty Hiking을 적용하면, 적용하지 않은 데이터에 비해 벤치마크 평균 정확도가 72.94%에서 74.39%로 높아지고 AIME25 정확도는 46.38%에서 49.23%로 높아진다. 실험 범위는 미세 조정한 모델 1개, 소규모 학습 부분집합, Difficulty Hiking 1회 적용에 한정된다. 필터링 통계가 서로 일치하지 않고 모델로 풀이의 정확성을 검사하므로, 재현성과 데이터 품질에 관한 의문이 남는다.
1 Introduction
논문은 경시대회 문제를 수작업으로 선별하는 방식의 한계와 기존 벤치마크 문제를 주로 수정하는 합성 방식의 특성을 설명하며, 어려운 수학 데이터를 자동으로 생성할 필요성을 제시한다. 저자들은 강력한 모델이 문제를 어렵게 만드는 요소를 암묵적으로 이해하는 메타인지 능력을 갖추고 있으며, 이를 통해 최소한의 프롬프트만으로 문제를 생성할 수 있다고 가정한다. 실험은 생성한 데이터의 유용성을 검증하지만, 가정한 작동 원리를 직접 입증하지는 않는다.
2 SAND-Math Pipeline
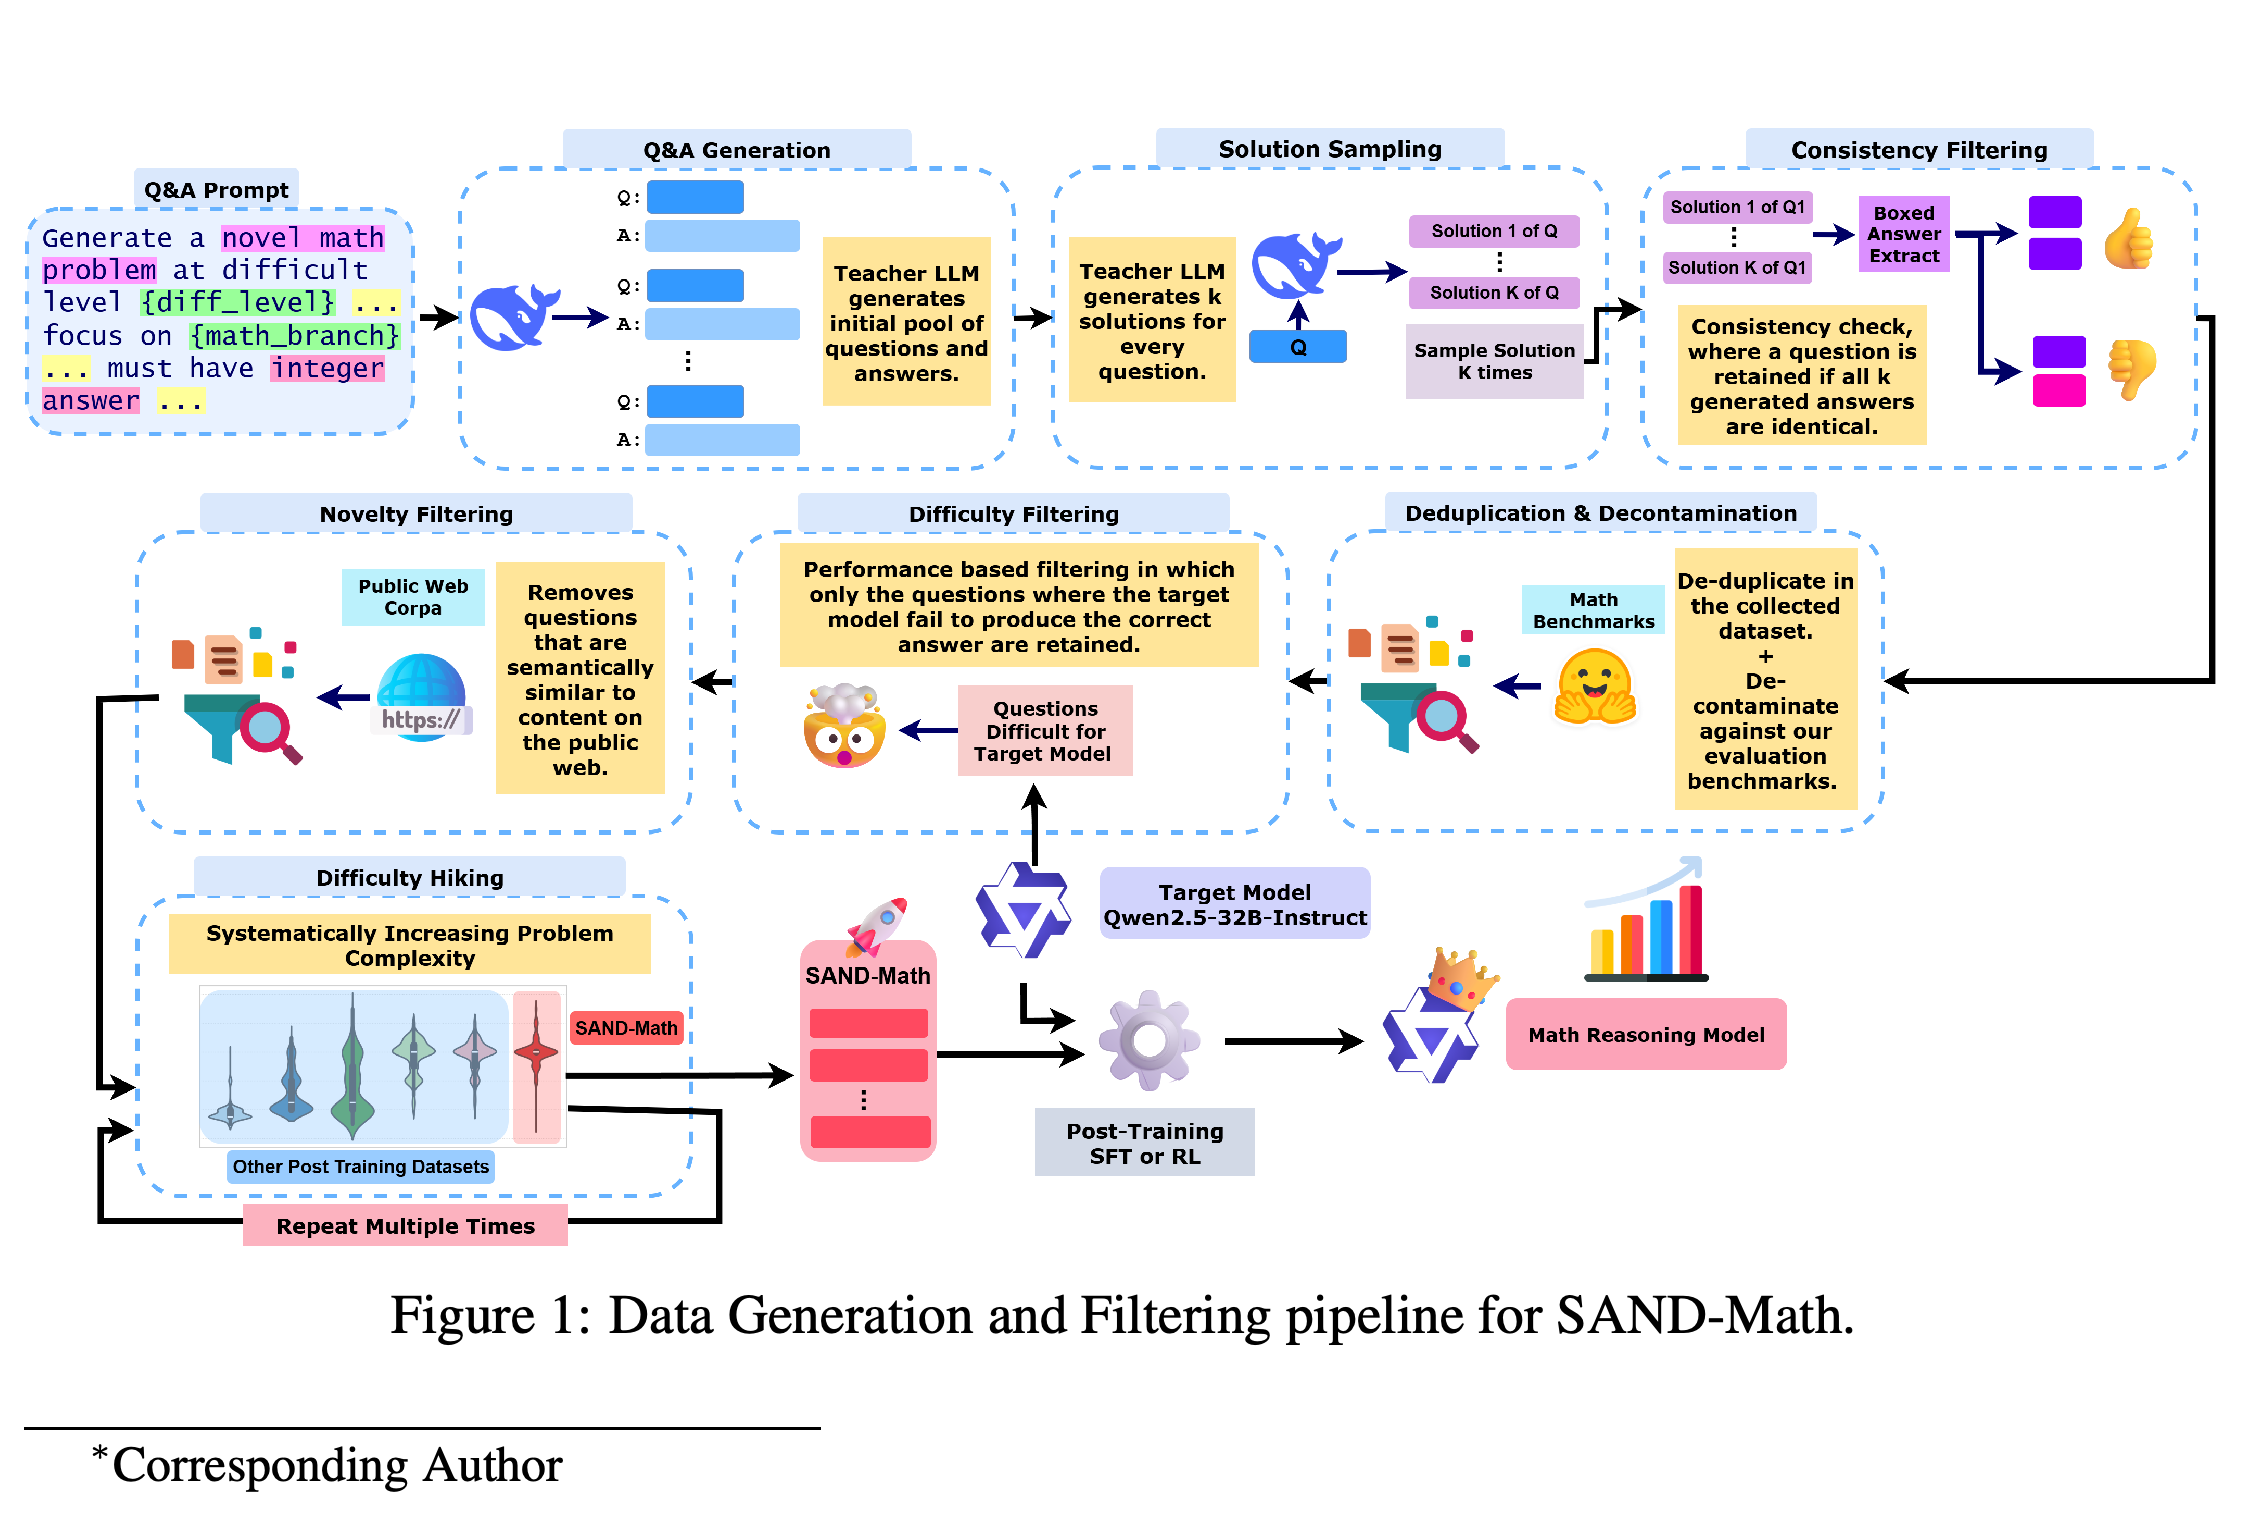
SAND-Math는 Synthetic Augmented Novel and Difficult Mathematics problems and solutions의 약자로, 생성, 순차적 필터링, 문제 재작성을 결합한다. 각 단계에서는 풀이 가능성, 샘플링한 답 사이의 일치 여부, 중복, 평가 데이터와의 중첩, 대상 풀이 모델을 기준으로 한 난도, 공개적으로 검색할 수 있는 콘텐츠와의 유사도를 검사한다.
도식은 교사 모델의 생성, 답의 일치 여부 검사, 중복 제거, 풀이 모델 기반 선별, 웹 기반 신규성 검사, Difficulty Hiking을 구분하여 보여준다. 피드백 경로를 통해 Difficulty Hiking을 반복할 수 있지만, 보고된 실험에서는 이를 1회 적용한 결과를 평가한다.
2.1 Question and Solution Generation
학습 문제와 풀이를 생성하는 교사 모델은 풀이 가능한 문제를 만들도록 먼저 임시 풀이와 함께 문제를 생성한다. 이후 해당 문제에 대해 풀이 \(k\)개를 별도로 샘플링한다. 각 풀이에는 단계별 도출 과정을 담은 추론 과정과 최종 답이 포함된다. 최초 수집 결과는 문제와 풀이로 구성된 세트 23,437개다.
2.2 Solution Correctness Filtering
Self-consistency 필터링은 독립적으로 샘플링한 최종 답이 모두 일치하는 문제만 남긴다. 이 과정에서 예제 수는 17,578개로 줄어들며, 논문은 이를 최초 생성량의 약 74%로 보고한다. 답이 일치하는 추론 과정과 답의 쌍 중 1개를 샘플링하여 학습에 사용한다. 답의 일치는 선별에 유용한 신호지만, 답이나 도출 과정이 정확하다는 사실을 독립적으로 입증하지는 않는다.
2.3 De-duplication and Decontamination
의미가 비슷한 문제를 제거하는 의미 기반 중복 제거에는 semhash 필터링 프레임워크와 minisilab/potion-base-8M을 사용한다. 유사도 임계값을 0.99로 설정하여 예제 1,293개를 제거하며, 논문은 이 비율을 7.3%로 보고한다. 평가 문제와의 중첩을 제거하는 오염 제거 단계에서는 문제마다 벤치마크 후보 top-5를 검색하고 모델 평가자가 이를 판단한다. 이 단계에서 문제 4개를 추가로 제거하여 예제 16,281개가 남는다.
2.4 Difficulty Filtering and Rating
난도 필터링은 풀이 모델 Qwen2.5-32B-Instruct가 틀린 문제만 남긴다. 그 결과 예제 9,211개가 남으며, 보고된 유지율은 56.6%다. 별도로 Llama-3.3-70B-Instruct는 Art of Problem Solving(AoPS) 경시대회 참고 자료를 기준으로 만든 평가 지침에 따라 문제 난도를 1–10 척도로 평가한다. 이 모델 평가 점수는 난도 분포 분석과 Difficulty Hiking에 사용된다.
2.5 Novelty Filtering
남은 각 문제를 웹 검색 질의로 사용하고, 텍스트를 벡터로 변환하여 의미를 비교하는 문장 임베딩 모델로 검색된 스니펫과의 최대 유사도를 측정한다. Section 2.5에서는 top-10 검색 결과를 사용하고 유사도가 \(\tau = 0.85\)를 초과하는 문제를 버린다고 명시한다. 이 과정에서 4%를 제거하여 문제 8,842개가 남는다. 반면 Appendix I에서는 검색 결과 수를 \(K = 20\)으로 명시한다.
2.6 Difficulty Hiking: Systematically Increasing Problem Complexity
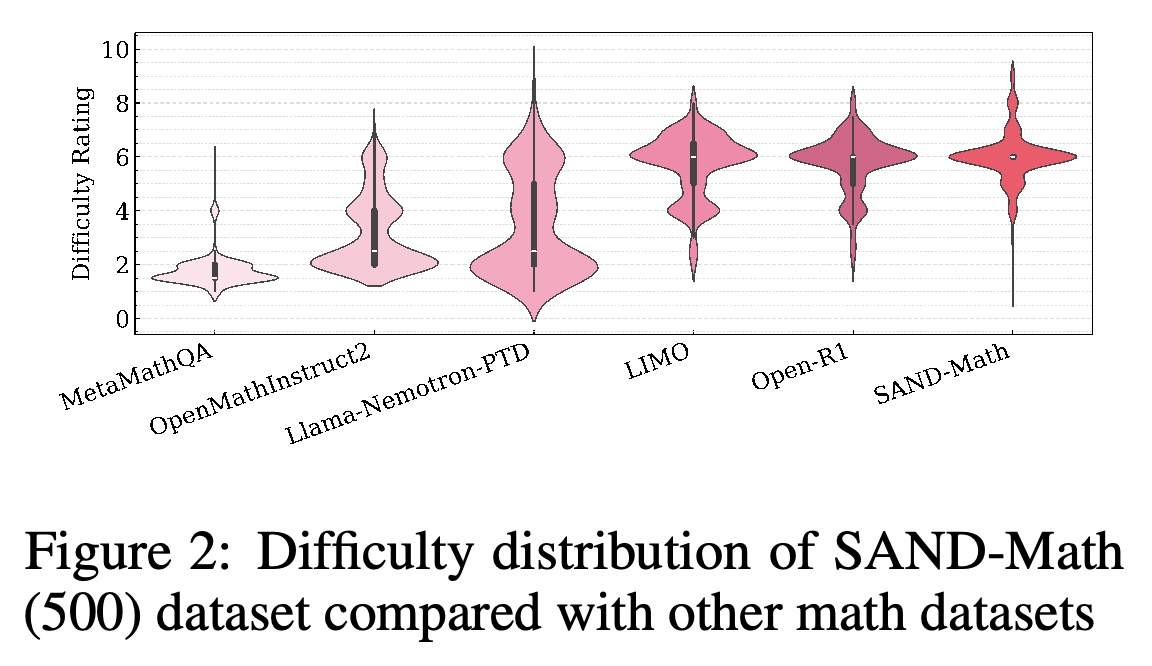
Difficulty Hiking은 교사 모델에 기존 문제의 난도 점수, 같은 수학 분야의 정리, 다른 분야의 개념을 제공하여 문제를 다시 작성하도록 요청한다. 이를 1회 적용하면 평균 난도 점수가 5.02에서 5.98로 높아진다. 모델이 평가한 난도 분포에서 SAND-Math는 비교한 기존 합성 데이터셋보다 높은 난도를 보이며, 엄선한 고난도 코퍼스와도 분포가 겹친다. Appendix K에서는 재작성된 문제가 요청한 변환 중 1개만 반영하는 경우가 많다고 설명한다.
바이올린 플롯은 모델이 부여한 난도 점수의 분포를 보여준다. 예제 500개로 구성된 SAND-Math 부분집합은 MetaMathQA와 OpenMathInstruct-2보다 높은 점수에 집중되며, LIMO 및 Open-R1과도 분포가 겹친다. 이 그래프는 사람이 문제를 풀 때의 난도를 독립적으로 측정한 결과는 아니다.
3 Experiments and Results
구현 세부 사항: DeepSeek-R1은 temperature 0.8로 문제를 생성하고, temperature 0.6으로 \(k = 2\)개의 풀이를 생성하며, Difficulty Hiking도 수행한다. Temperature는 샘플링의 무작위성을 조절한다. Llama-3.3-70B-Instruct는 일관성, 오염 여부, 난도를 판단하며, 난도 점수는 3회 실행한 결과의 평균을 사용한다. 웹 기반 신규성 검사에는 Alibaba-NLP/gte-Qwen2-7B-instruct 임베딩과 LangChain을 통해 접근하는 자체 호스팅 SearXNG 검색 서비스를 사용한다.
실험 설계: 모든 비교에서는 예제 풀이를 사용해 모델의 모든 매개변수를 학습하는 전체 매개변수 지도 미세 조정(SFT)을 Qwen2.5-32B-Instruct에 적용한다. 학습률은 5e-6이며 10 epochs 동안 학습한다. 학습에는 LLaMA-Factory 프레임워크와 메모리 사용량을 줄이는 분산 학습 전략 DeepSpeed ZeRO-3를 사용한다. 8× AMD Instinct MI300X 그래픽 처리 장치(GPU)를 갖춘 노드 1개에서 학습하며, 생성에도 같은 노드 구성을 사용한다.
- 단독 학습 비교에서는 예제 500개를 사용하고, 데이터 추가 비교에서는 예제 817개로 구성된 LIMO 코퍼스에 예제 500개를 추가한다. Difficulty Hiking 효과 분석 실험에서는 예제 1,500개를 추가한다.
- 평가 지표는 샘플링한 답 1개의 정확도인 pass@1이다. AIME 2024/2025와 수학 경시대회 벤치마크 AMC에서는 temperature 0.7로 문제당 답 16개를 샘플링하여 이를 추정한다. 문제 500개로 구성된 수학 벤치마크 MATH500에서는 매번 확률이 가장 높은 다음 토큰을 선택하는 greedy decoding을 temperature 0으로 수행한다.
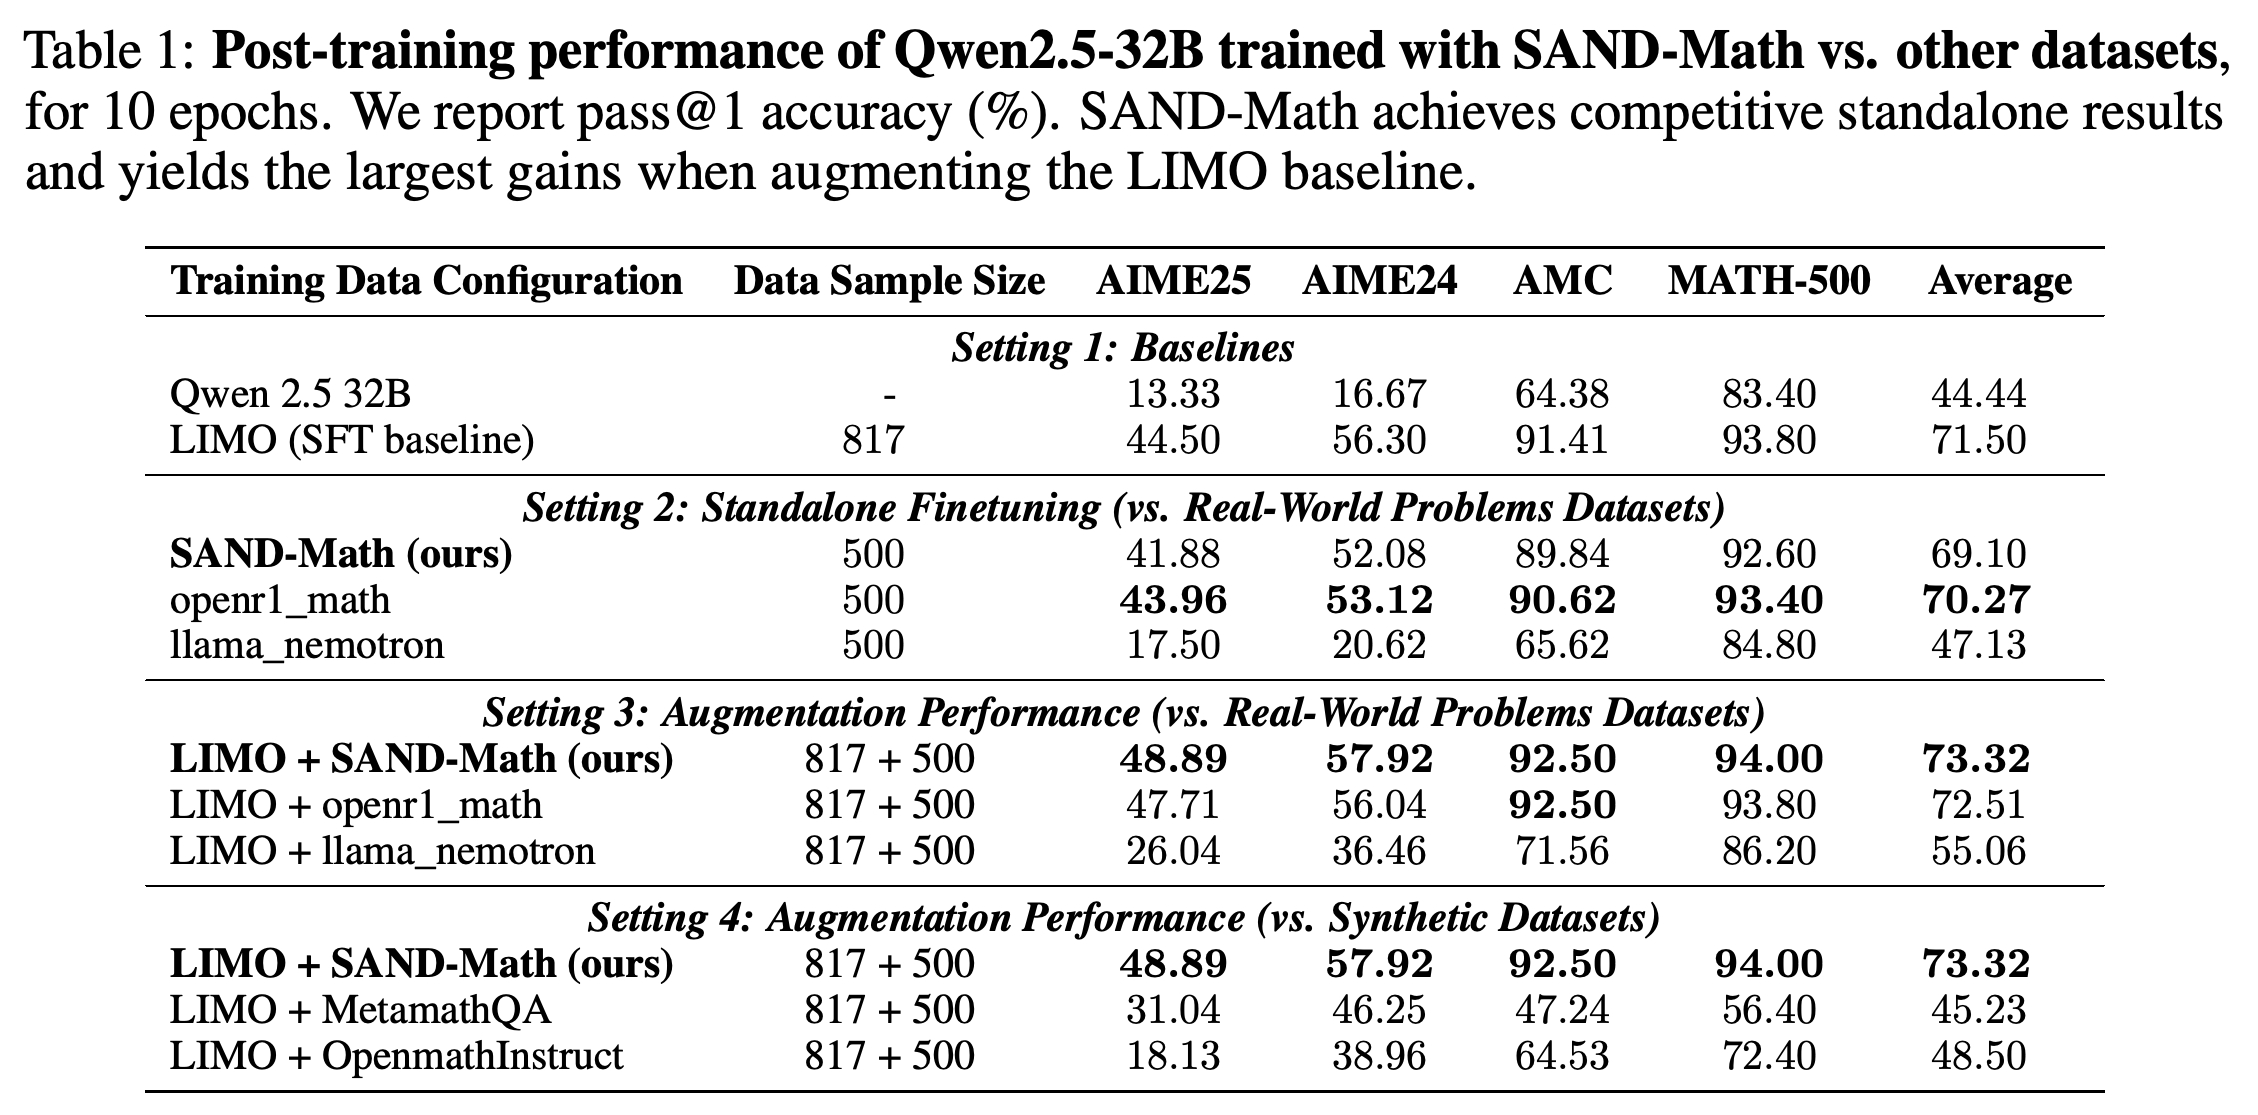
실험 결과: SAND-Math만으로 학습하면 평균 정확도는 69.10%로, OpenR1 수학 데이터에서 비교용으로 추출한 부분집합인 openr1_math의 70.27%보다 낮다. LIMO에 SAND-Math 예제 500개를 추가하면 평균 정확도는 73.32%에 도달한다. 비교 결과는 LIMO 단독 71.50%, LIMO + openr1_math 72.51%, LIMO + MetamathQA 45.23%, 또 다른 합성 수학 데이터셋을 추가한 LIMO + OpenmathInstruct 48.50%다.
- AIME25에서 17.85 point의 우위는 SAND-Math를 추가한 결과인 48.89%와 MetamathQA를 추가한 결과인 31.04%를 비교한 값이다. LIMO 단독 대비 향상 폭은 4.39 point다.
- 이 결과는 보고된 샘플링 및 학습 조건에서 SAND-Math 추가가 유용함을 뒷받침한다. 일부 비교 데이터셋을 추가한 뒤 성능이 크게 하락했지만, 이 결과만으로 다른 학습 설정에서 해당 데이터셋의 유용성을 판단할 수는 없다.
예제 수를 500개로 맞춘 비교에서 SAND-Math는 단독 학습 시 openr1_math보다 낮은 점수를 얻지만, LIMO에 추가하면 보고된 평균 정확도가 가장 높다. AIME25에서 48.89%와 MetamathQA의 31.04%를 비교한 차이가 핵심 수치인 17.85 point다. LIMO 단독과 비교한 향상 폭은 4.39 point다.
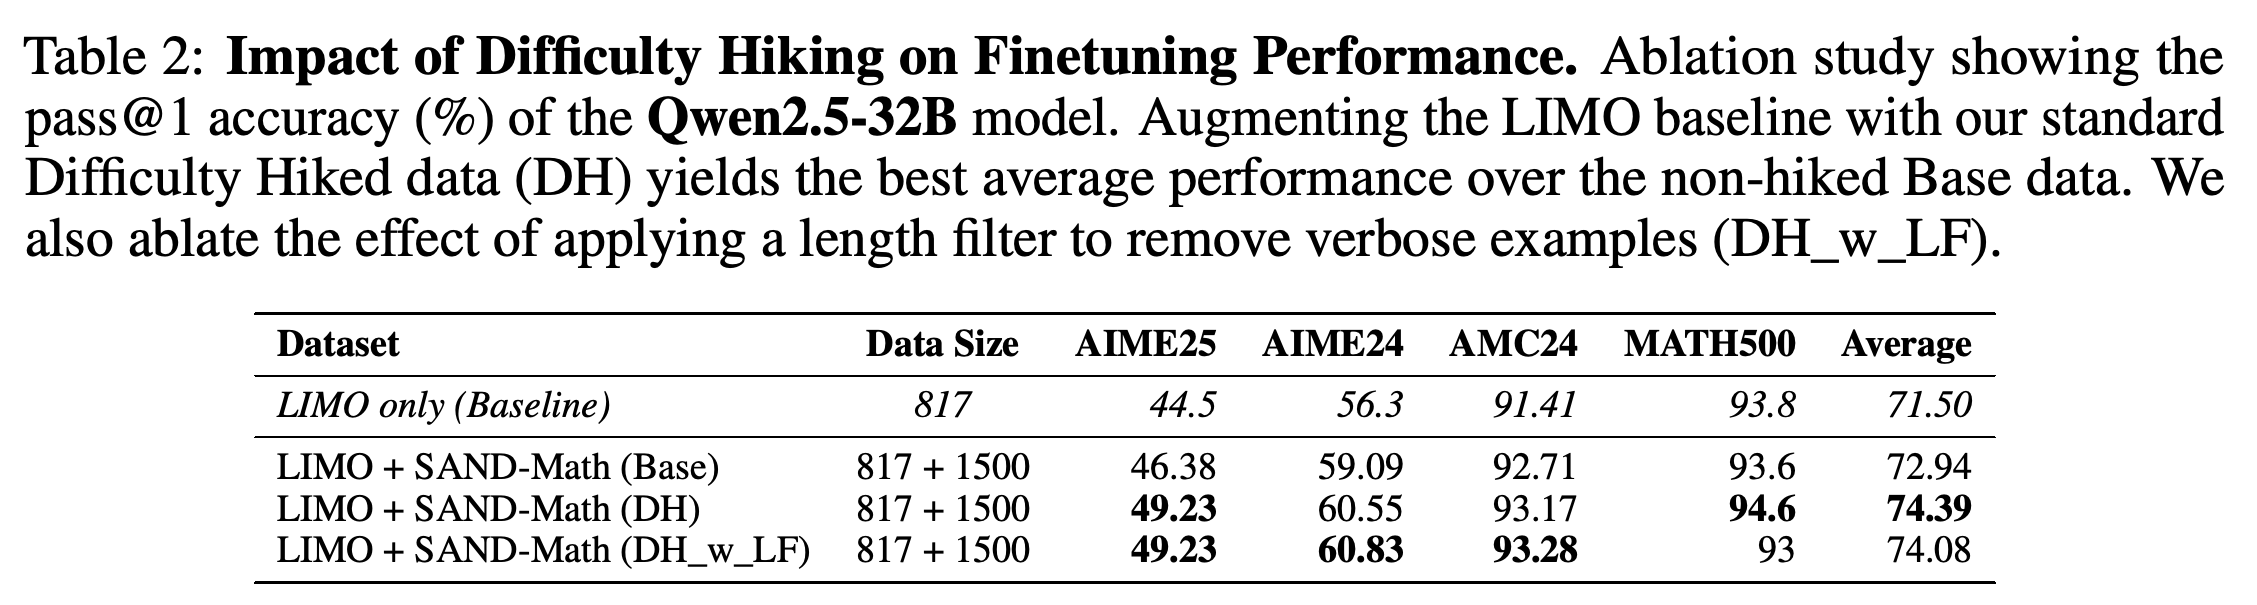
Difficulty Hiking 효과 분석 실험에서는 추가하는 표본 수를 1,500개로 고정한다. 난도를 높이지 않은 데이터인 Base의 평균 정확도는 72.94%, 난도를 높인 버전인 DH는 74.39%, 난도를 높인 뒤 32k 길이 필터를 적용한 DH_w_LF는 74.08%다. DH를 적용하면 AIME25는 46.38%에서 49.23%, AIME24는 59.09%에서 60.55%, AMC24는 92.71%에서 93.17%, MATH500은 93.6%에서 94.6%로 높아진다.
- 길이 필터를 적용한 버전은 AIME25에서 DH와 같은 성능을 보이고 AIME24와 AMC24에서는 소폭 개선되지만, MATH500 정확도는 93%로 낮아진다. 이 버전의 평균 정확도가 더 낮다는 결과만으로 긴 풀이가 모든 과제에 도움이 된다고 볼 수는 없다.
- 부록에는 모델이 평가한 풀이 품질과 데이터 규모 분석이 제시된다. 주요 학습 비교에서는 불확실성 추정치를 보고하지 않는다.
각 데이터 추가 조건에서 LIMO 예제 817개에 예제 1,500개를 추가한 비교에서 Difficulty Hiking은 평균 정확도를 72.94%에서 74.39%로 높인다. 길이 필터를 적용한 버전은 74.08%에 도달한다. 이 버전은 기본 DH보다 AIME24와 AMC24 성능이 소폭 높지만 MATH500 성능은 낮으므로, 효과가 벤치마크마다 다르다.
4 Conclusion
결론에서는 모든 문제를 전문가가 직접 선별하지 않고도 유용한 수학 추론 데이터를 확보하는 방법으로 자동 생성과 Difficulty Hiking의 결합을 제시한다. 데이터 추가 실험과 Difficulty Hiking 효과 분석 실험은 검증한 설정 안에서 이 방법의 유용성을 뒷받침한다. 다른 과학 분야로의 확장을 제안하지만, 이를 실험으로 평가하지는 않는다.
Limitations
저자들은 교사 모델의 능력에 의존한다는 점과 연산 예산 때문에 소규모 학습 부분집합을 사용했다는 점을 한계로 제시한다. DeepSeek-R1의 결합 수율을 41.9%, GPT-OSS 120B의 결합 수율을 74.0%로 보고하며, 후자가 더 어려운 문제를 거의 5.2X 빠르게 생성한다고 설명한다. 부록 표에는 수율이 제시되지만, 추가로 주장한 속도와 난도를 뒷받침할 측정값은 없다.
부록
- A Pipeline Yield and Teacher Model Ablation: DeepSeek-R1의 self-consistency 통과율은 74.0%, 난도 필터 통과율은 56.6%이며, 보고된 결합 수율은 41.9%다. GPT-OSS 120B에서는 이 값이 각각 94.0%, 78.8%, 74.0%로 높아진다. 결합 지표는 이 2개 유지율을 곱한 값이며, 모든 필터를 거친 최종 유지율을 측정한 값은 아니다.
- B Detailed Analysis of Difficulty Hiking: Figure 3은 Base, DH, DH_w_LF의 난도 히스토그램을 비교한다. Difficulty Hiking을 적용하면 점수 4.0–5.0 부근의 문제 수가 줄고 6.0–8.0 부근의 문제 수가 늘어난다. 길이 필터를 적용한 버전에서도 이러한 변화가 상당 부분 유지된다.
- C Deeper Analysis of Reasoning and Model Failures: 모델 평가자가 생성된 풀이 480개를 1–5 척도로 평가한다. LIMO + SAND-Math (DH)는 논리적 타당성을 3.03에서 3.20으로, 근거 없는 내용을 뜻하는 환각의 회피 수준을 3.54에서 3.64로, 명확성을 3.03에서 3.10으로, 간결성을 2.06에서 2.18로 높인다. Table 5의 “Percentage of Failures”에는 추론 오류 35.8%, 문제 해석 오류 11.9%, 계산 오류 5.2%, 환각 오류 4.6%가 제시된다. 이 비율의 합은 100%가 아니므로 전체 오류 구성이 불분명하다.
- D Data Efficiency and Scaling Analysis: Figure 4는 LIMO 단독 학습과 예제 500개 또는 1,500개를 추가한 학습의 AIME24 성능을 나타낸다. 예제 1,500개를 추가했을 때 DH는 60.55%, Base는 59.09%에 도달한다. 이는 실험한 데이터 예산에서 DH의 우위를 뒷받침하지만, 그래프에 제시된 학습 규모 3개만으로 일반적인 스케일링 법칙을 입증할 수는 없다.
- E Sensitivity Analysis for De-duplication Threshold: o4-mini 모델 평가자가 중복 후보로 표시된 쌍의 표본을 평가한다. 임계값 0.99, 0.97, 0.95에서 각각 데이터의 7.4%, 26.7%, 44.5%가 중복 후보로 표시된다. 표시된 쌍 중 실제 중복으로 판단된 비율인 중복 정밀도는 각각 52.0%, 38.0%, 24.0%다. 선택한 임계값은 측정된 정밀도가 가장 높지만, 52.0%라는 값은 실제 중복으로 판단되지 않은 쌍도 상당수 제거된다는 점을 보여준다.
- F Justification for Decontamination Model Choice: 검색용 임베딩 모델 paraphrase-multilingual-MiniLM-L12-v2는 표본 10k개를 4.94s에 인코딩한다. gte-Qwen2-1.5B는 66.54s가 걸리며, 논문은 전자가 13.5× 빠르다고 보고한다. 모델 평가자가 각 모델의 검색 상위 30개 쌍에 부여한 평균 유사도 점수는 각각 0.41과 0.36이다. 이 평가는 검색 순위가 높은 후보를 대상으로 하며, 전체 벤치마크 중첩 중 검색으로 찾아낸 비율인 재현율은 측정하지 않는다.
- G Detailed Training Steps: 부록은 8× AMD Instinct MI300X GPU를 갖춘 노드 1개에서 LLaMA-Factory로 전체 매개변수를 미세 조정하는 절차를 설명한다. 재현을 위한 학습 하이퍼파라미터와 환경 설정 정보도 제공한다.
- G.1 Hyperparameters: Table 9는 학습률 5.0e-6, cosine 학습률 스케줄링, warmup 비율 0.0, 학습 10 epochs, gradient accumulation steps 1, cutoff length 32,768, Flash Attention 구현 fa2, DeepSpeed 전략 ZeRO-3를 명시한다. 이 설정들은 학습률 변화 방식, 매개변수 갱신 빈도, 시퀀스 길이 제한, attention 구현, 분산 학습 전략을 규정한다.
- G.2 Training Setup: 문서에 제시된 환경은 컨테이너 이미지 rocm/pytorch-training:v25.6, LLaMA-Factory, deepspeed==0.16.9를 사용한다. 학습 데이터는 학습 프레임워크가 사용하는 구조화된 예제 형식인 Alpaca-style JSON으로 변환하고 data/dataset_info.json에 등록한다. 데이터 추가 학습에서는 dataset을 limo,sand_math로 설정한다. 실행 설정 파일은 examples/train_full/train_sand_math.yaml이다.
- H Dataset Characteristics: Consistency, Novelty, and Difficulty: 이 부록은 오염률 0.2%, self-consistency 통과율 85%, 난도 필터 유지율 41%, 전체 유지율 약 35%를 보고한다. 본문에 제시된 self-consistency 통과율 약 74%, 난도 필터 유지율 56.6%, 생성 세트 23,437개 중 최종 문제 8,842개라는 값과 이러한 수치가 다른 이유는 설명하지 않는다.
- I Algorithm for Novelty Filtering: Algorithm 1은 문제마다 웹 검색 결과 \(K = 20\)개를 가져와 문제와 각 스니펫을 임베딩한다. 벡터 방향을 비교하는 코사인 유사도의 최댓값이 \(\tau = 0.85\) 이하이면 문제를 유지한다. 검색 결과 수는 Section 2.5에 명시된 top-10과 다르다.
- J Difficulty Hiking Prompt: 템플릿은 이름을 직접 밝히지 않으면서 풀이에 필수적인 핵심 정리, 보조 개념, 자명하지 않은 중간 단계 최소 2–3개, 최종 정수 답 1개를 갖춘 어려운 Olympiad 문제를 요청한다. 추상화 수준을 높이거나 일반화하는 것도 허용하며, 문제와 풀이를 <Q> 및 <S> 태그 안에 작성하도록 요청한다.
- K Difficulty Hiking Examples: 저자들은 핵심 정리 추가, 보조 개념 추가, 추상화 수준 향상, 제약 조건 추가를 변환 전략으로 제시한다. 생성된 재작성 결과에서는 요청한 모든 요소를 결합하지 못하고 전략 1개만 개별적으로 적용하는 경우가 많다고 인정한다. 제시된 예시에서는 목표 점수가 8.0일 때 실제 점수가 1.0 또는 2.0에서 6.0 또는 7.0으로 높아진다.
- L Question Generation Prompt: 템플릿은 음이 아닌 정수 답 1개를 갖는 새로운 국가 또는 국제 Olympiad 수준 문제 1개를 요청한다. 무작위로 선택한 주된 수학 분야와 보조 수학 분야를 결합하고, 최종 답을 상자로 표시한 단계별 풀이를 요청한다.
- M Solution Generation Prompt: 별도의 짧은 템플릿은 기존 수학 문제를 단계별로 풀고 최종 답을 boxed{} 안에 넣도록 모델에 요청한다. 이를 통해 일관성 필터링에 사용할 풀이를 별도로 샘플링한다.
- N Question Difficulty Rating Prompt: 평가 지침은 초급 경시대회 문제부터 역사적으로 어려웠던 Olympiad 문제까지 참고 기준을 제시하고, 1.0부터 10.0까지 0.5 간격으로 점수를 부여한다. 평가자는 문제와 풀이를 모두 검토한 뒤 주제 요약, 점수, 근거를 <S>, <D>, <R> 태그로 반환한다.
- O Question Decontamination Prompt: 템플릿은 합성 문제를 검색된 기존 문제와 비교하여 동일한 문제이거나 바꿔 쓴 문제인지 yes/no로 판단하도록 요청한다. 따라서 검사 범위는 앞선 검색 단계에 좌우된다.
- P Math Theorems and Concepts Taxonomy: 제공된 분류 체계는 수학적 구성 요소를 체계적으로 분류하며, Number Theory, Algebra, Combinatorics, Geometry, Probability에 걸쳐 정리와 보조 도구를 정리한다. 이 체계는 Difficulty Hiking에 사용할 요소를 제공하고, 개념적 도구와 이름이 있는 정리를 구분한다.
짧은 생각
표본 수를 고정한 Difficulty Hiking 효과 분석 실험은 제안한 재작성 단계의 효과를 가장 직접적으로 뒷받침한다. 난도를 높인 예제 1,500개를 사용하면 Base 예제 1,500개를 사용했을 때보다 보고된 모든 벤치마크에서 성능이 높아진다. 예제 500개를 추가한 비교도 유용성을 보여주지만, 핵심 수치인 17.85 point는 합성 데이터 추가 조건을 서로 비교한 값이다. LIMO 단독 대비 AIME25 향상 폭은 4.39 point다.
답의 일치 여부와 검색 기반 신규성 검사만으로는 여러 풀이에 공통된 오류나 탐지하지 못한 중첩이 남을 수 있다. 서로 일치하지 않는 유지율 통계, top-10과 \(K = 20\)으로 다른 신규성 검사 설정, 불확실성 추정치의 부재, 미세 조정한 모델 1개에 한정된 평가는 보고된 향상의 재현성과 일반화 가능성을 제한한다. 데이터셋은 https://huggingface.co/datasets/amd/SAND-MATH 에서 확인할 수 있다.