


Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference 요약 설명
18 Dec 2024 | Paper Review Language Models Efficient Inference Long-Context Models Masked Language Modeling목차
이번 글에서는 Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 12월 18일(Arxiv)
- Warner, Benjamin, Chaffin, Antoine, Clavié, Benjamin, Weller, Orion, Hallström, Oskar, Taghadouini, Said, Gallagher, Alexis, Biswas, Raja, Ladhak, Faisal, Aarsen, Tom, et al.
- Answer.AI, LightOn, Johns Hopkins University, NVIDIA, HuggingFace
- 논문 링크
요약
- ModernBERT는 분류와 검색을 위해 주변 텍스트로 각 토큰을 표현하는 양방향 인코더의 제한된 문맥 길이, 오래된 학습 데이터, 추론 비용 문제를 다룬다. 평가에 포함된 비슷한 크기의 인코더 가운데 짧은 문맥 검색 평균 점수가 가장 높다. NVIDIA RTX 4090 1대에서 길이가 8192토큰으로 고정된 입력을 처리할 때 base는 123.7 thousand tokens/s, large는 46.8 thousand tokens/s의 처리량을 기록한다. 효율적인 transformer 구현을 제공하는 라이브러리인 xformers를 적용한 GTE-en-MLM의 처리량은 각각 47.5와 16.5 thousand tokens/s다.
- 149-million-parameter base 모델과 395-million-parameter large 모델은 하드웨어를 고려한 차원 설계, 인접 토큰에 적용하는 local attention, 시퀀스 전체에 적용하는 global attention, 모델 전반에서 패딩 토큰 연산을 제거하는 unpadding을 결합한다. 각 모델은 코드를 포함한 약 2조 토큰으로 학습하며, 기본적으로 8192토큰 문맥을 지원한다.
- 문장과 문장 쌍의 이해 능력을 평가하는 General Language Understanding Evaluation (GLUE)에서 ModernBERT-base는 88.4점으로 DeBERTaV3-base의 88.1점을 웃돈다. ModernBERT-large는 90.4점으로 DeBERTaV3-large의 91.4점보다 낮다. 긴 문서 검색 벤치마크인 MLDR의 영어 하위 집합에서는 토큰별 표현을 유지하는 multi-vector 검색이 추가 MLDR 미세조정 없이 80.2점과 80.4점을 기록한다. GTE-en-MLM은 69.3점과 71.3점이다.
- 각 문서를 1개의 표현으로 압축하는 single-vector 검색은 긴 문맥 미세조정 없이 평가한 MLDR에서 GTE-en-MLM보다 성능이 낮다. 효율성은 RTX 4090 1대에서 합성 입력으로 측정하며, 길이가 512토큰으로 고정된 입력에서는 기존 BERT가 더 빠르다.
1 Introduction
서론은 인코더 모델이 실제 서비스에서 계속 사용되는 데 비해 현대화는 제한적이라는 문제를 제기한다. 기존 모델은 대체로 입력을 512토큰으로 제한하고, 사전학습에 코드를 포함하지 않으며, 최신 하드웨어를 충분히 활용하지 못하는 아키텍처나 어휘를 사용한다.
- 검색한 문맥을 언어 모델에 제공하는 Retrieval-Augmented Generation은 연구의 동기가 된 활용 사례이며, 분류와 쿼리 라우팅도 활용 사례에 해당한다.
- 저자들은 ModernBERT-base, ModernBERT-large, 아키텍처 실험을 위한 모듈형 FlexBERT 프레임워크, 학습 중간 체크포인트를 https://github.com/AnswerDotAI/ModernBERT 에 공개한다.
2.1 Architectural Improvements
이 방법은 검증된 transformer 개선 기법, 더 효율적인 attention과 입력 처리, 일반적인 그래픽 처리 장치(GPU)에 맞춘 모델 차원을 결합한다. 아키텍처를 선택할 때는 개별 설계 요소를 바꿔 비교하는 ablation 실험을 참고했다. 대부분의 실험은 최종 학습 규모보다 작은 8–20 billion 학습 토큰 규모에서 진행했다.
2.1.1 Modern Transformer
ModernBERT는 최종 토큰 예측 decoder를 제외한 선형 계층의 bias를 제거하고, 은닉 활성값을 정규화하는 LayerNorm에서도 bias를 제거한다. 절대 위치 임베딩은 rotary positional embeddings (RoPE)로 대체한다. RoPE는 성능, 효율적인 구현, 문맥 확장의 용이성을 고려해 선택한 토큰 위치 인코딩 방법이다.
- Pre-normalization은 transformer 하위 계층에 들어가기 전에 LayerNorm을 적용한다. 임베딩 뒤에도 정규화를 추가하되, 중복을 피하기 위해 첫 attention 계층의 정규화는 제거한다.
- Gaussian error linear unit (GeLU)을 기반으로 한 게이트 활성화 함수인 GeGLU가 기존 BERT의 활성화 구성을 대체한다.
2.1.2 Efficiency Improvements
매 3번째 attention 계층에는 global attention을 적용하고, 나머지 계층에는 128토큰 local sliding window를 적용한다. 문맥 확장 이후 global 계층의 위치 주파수 파라미터인 RoPE theta는 160,000을 사용하며, local 계층은 theta 10,000을 유지한다.
- 임베딩 전에 입력의 패딩을 제거하고 모든 계층에서 패딩이 없는 상태를 유지하며, 필요하면 출력에서 패딩을 복원한다. 저자들은 패딩 제거와 복원을 반복하는 방식보다 성능이 10–20퍼센트 개선되었다고 보고한다.
- 메모리와 연산 효율을 높인 attention 커널 계열인 Flash Attention으로 가변 길이 attention을 구현한다. 연구를 시작할 당시 Flash Attention 3가 sliding window를 지원하지 않았기 때문에 global 계층에는 Flash Attention 3를, local 계층에는 Flash Attention 2를 사용한다.
- 호환되는 모듈을 PyTorch의 torch.compile로 컴파일하면 컴파일 오버헤드가 거의 없는 상태에서 학습 처리량이 10퍼센트 개선된다고 보고한다.
2.1.3 Model Design
모델은 추론 속도 저하를 억제하면서 은닉 차원을 줄이고 계층 수를 늘리는 Deep & Narrow 구성을 지향한다. Base는 22개 계층, 은닉 크기 768, 게이트 확장 차원 2304를 사용한다. Large는 28개 계층, 은닉 크기 1024, 게이트 확장 차원 5248을 사용한다. 파라미터 수는 각각 149 million과 395 million이다.
- 차원을 선택할 때 행렬 연산을 하드웨어에 맞는 블록으로 나누는 matrix tiling과 NVIDIA T4, A10, L4, RTX 3090, RTX 4090, A100, H100 GPU의 활용률을 고려하며, 추론용 GPU에 더 큰 비중을 둔다.
2.2 Training
학습에는 더 폭넓은 데이터 구성, 단계적인 문맥 길이 확장, 학습률과 배치 크기 스케줄을 함께 적용한다. Large 모델은 base 모델의 가중치로 초기화한다.
2.2.1 Data
모델 2개 모두 주로 영어 웹 문서, 코드, 과학 문헌으로 구성된 약 2 trillion 토큰으로 학습한다. OLMo 언어 모델의 토크나이저를 수정해 사용하며, 서브워드 토큰화 방법인 byte-pair encoding을 적용한다. 어휘는 미사용 토큰 83개를 포함해 50,368개다.
- 토크나이저는 BERT의 특수 토큰 [CLS]와 [SEP], 입력 템플릿을 유지한다.
- 학습 시퀀스에 예시를 채워 미사용 공간을 줄이는 greedy sequence packing은 99퍼센트를 넘는 패킹 효율을 달성하며, unpadding으로 발생하는 미니배치 크기의 변동을 줄인다.
2.2.2 Training Settings
마스킹한 입력 토큰을 예측하는 Masked Language Modeling (MLM)에 마스킹 비율 30퍼센트를 적용하고, BERT의 문장 쌍 사전학습 목표인 Next-Sentence Prediction은 제외한다. StableAdamW는 가중치 감쇠를 분리한 옵티마이저인 AdamW에 파라미터별 학습률 조정 방식의 update clipping을 추가한다. 저자들은 일반적인 gradient clipping보다 학습이 안정적이고 후속 과제 성능이 높았다고 보고한다.
- 학습률 스케줄은 warmup, 긴 고정 구간, 1 − sqrt 감쇠로 구성한다. Base는 3-billion-token warmup 이후 8e-4를 사용한다. Large는 처음에 2-billion-token warmup 이후 5e-4를 사용하다가 성능이 정체되자, 남은 짧은 문맥 학습 토큰 800 billion에 대해 5e-5로 재시작한다.
- 배치 크기는 base의 경우 50 billion 토큰에 걸쳐 768에서 4608로, large의 경우 10 billion 토큰에 걸쳐 448에서 4928로 늘린다. Large는 초기 학습을 가속하기 위해 base 가중치를 더 큰 행렬에 타일링해 초기화한다.
- 시퀀스 길이 1024로 약 1.7 trillion 토큰을 학습한 뒤, 문맥 확장 과정에서 global RoPE theta를 10,000에서 160,000으로 늘리고 길이 8192로 250 billion 토큰을 추가 학습한다. 이후 고품질 데이터의 샘플링 비중을 높이고 학습률을 감쇠하면서 50 billion 토큰을 학습한다. 문맥 확장 학습률은 base가 3e-4, large가 5e-5다.
3.1 Evaluation Setting
후속 과제 평가에서는 ModernBERT를 BERT, RoBERTa, DeBERTaV3, GTE-en-MLM과 비교하며, base 그룹에는 NomicBERT도 포함한다. 과제별 미세조정을 통해 언어 이해, 짧은 문맥과 긴 문맥의 텍스트 검색, 코드 검색을 평가한다.
- 이는 파라미터 수를 정확히 맞춘 실험이 아니라 크기 그룹별 비교다. 효율성 표에서 ModernBERT-large의 파라미터 수는 395 million이며, GTE-en-MLM-large는 435 million이다.
3.1.1 Natural Language Understanding
언어 이해는 GLUE로 측정하며, 각 하위 과제에서 하이퍼파라미터를 따로 탐색한다. 과제에는 감성 분류와 함의 판단이 포함되며, 함의 판단에서는 한 문장이 다른 문장으로부터 도출되는지 판별한다.
- 기존 모델의 GLUE 점수는 문헌에서 가져온다. GTE-en-MLM은 저자들이 직접 탐색했을 때 결과가 일관되지 않아 기존에 발표된 점수를 사용한다. 따라서 비교 전체에 완전히 동일한 평가 절차를 적용한 것은 아니다.
3.1.2 Text Retrieval
텍스트 검색은 여러 도메인의 검색 데이터셋을 모은 BEIR에서 평가한다. 지표는 상위 10개 검색 결과의 순위 할인 누적 이득을 정규화한 nDCG@10을 사용한다. Dense Passage Retrieval (DPR)은 문서마다 1개 벡터를 사용한다. ColBERT는 토큰 벡터를 유지하고, 각 쿼리 토큰과 가장 유사한 문서 토큰의 유사도를 합산하는 MaxSim을 사용한다.
- Single-vector 학습에는 지문 검색 데이터셋인 MS-MARCO의 샘플 1.25 million개를 사용하며, 난도가 높은 비관련 예시를 선별한 hard negative를 포함한다. 배치 크기는 16, 학습률 warmup 비율은 5퍼센트다. 대조 학습은 관련 쿼리와 문서의 표현을 가깝게 하고 비관련 표현은 멀어지게 한다.
- Multi-vector 학습은 PyLate 검색 라이브러리로 JaColBERTv2.5 학습 절차를 따르며, MS-MARCO 샘플 810k개, 배치 크기 16, warmup 비율 5퍼센트를 사용한다. 지식 증류에서는 정규화된 교사와 학생 점수 분포의 차이를 측정하는 KL-Divergence를 통해 BGE-M3 교사 모델의 점수를 전달한다.
- 학습률은 BEIR 데이터셋 일부에서 선택한다. 부록에는 NFCorpus, SciFact, TREC-Covid, FiQA가 명시되어 있다.
3.1.3 Long-Context Text Retrieval
긴 문맥 검색에는 긴 문서가 200,000개 넘게 포함된 MLDR의 영어 하위 집합을 사용한다. 전이와 적응을 구분하기 위해 3가지 조건을 평가한다. 짧은 문맥으로만 학습한 뒤 single-vector로 평가하는 조건, 추가 MLDR 미세조정 후 single-vector로 평가하는 조건, 추가 MLDR 미세조정 없이 multi-vector로 평가하는 조건이다.
- 논문은 표준화된 긴 문맥 인코더 벤치마크가 부족하다는 점을 인정한다. 이 실험은 긴 문서 검색을 측정하며, 일반적인 긴 문맥 추론 성능을 입증하지는 않는다.
3.1.4 Code Retrieval
코드 검색에는 코드를 관련 docstring이나 주석에 연결하는 CodeSearchNet과, 관련 답변에 자연어와 코드가 섞일 수 있는 StackOverflow-QA를 사용한다. 후자는 쿼리와 문서의 평균 길이가 각각 1400단어와 1200단어이며, 평균 토큰 수는 2000개를 넘는다.
- 벤치마크 2개 모두 코드 정보 검색 평가 프레임워크인 CoIR에서 single-vector 검색 과제로 평가하며, 텍스트 검색에서 선택한 하이퍼파라미터를 재사용한다. 결과 표에서는 벤치마크를 CSN과 SQA로 줄여 쓰고, 후자를 StackQA라고 부른다.
3.2 Downstream Results and Discussion
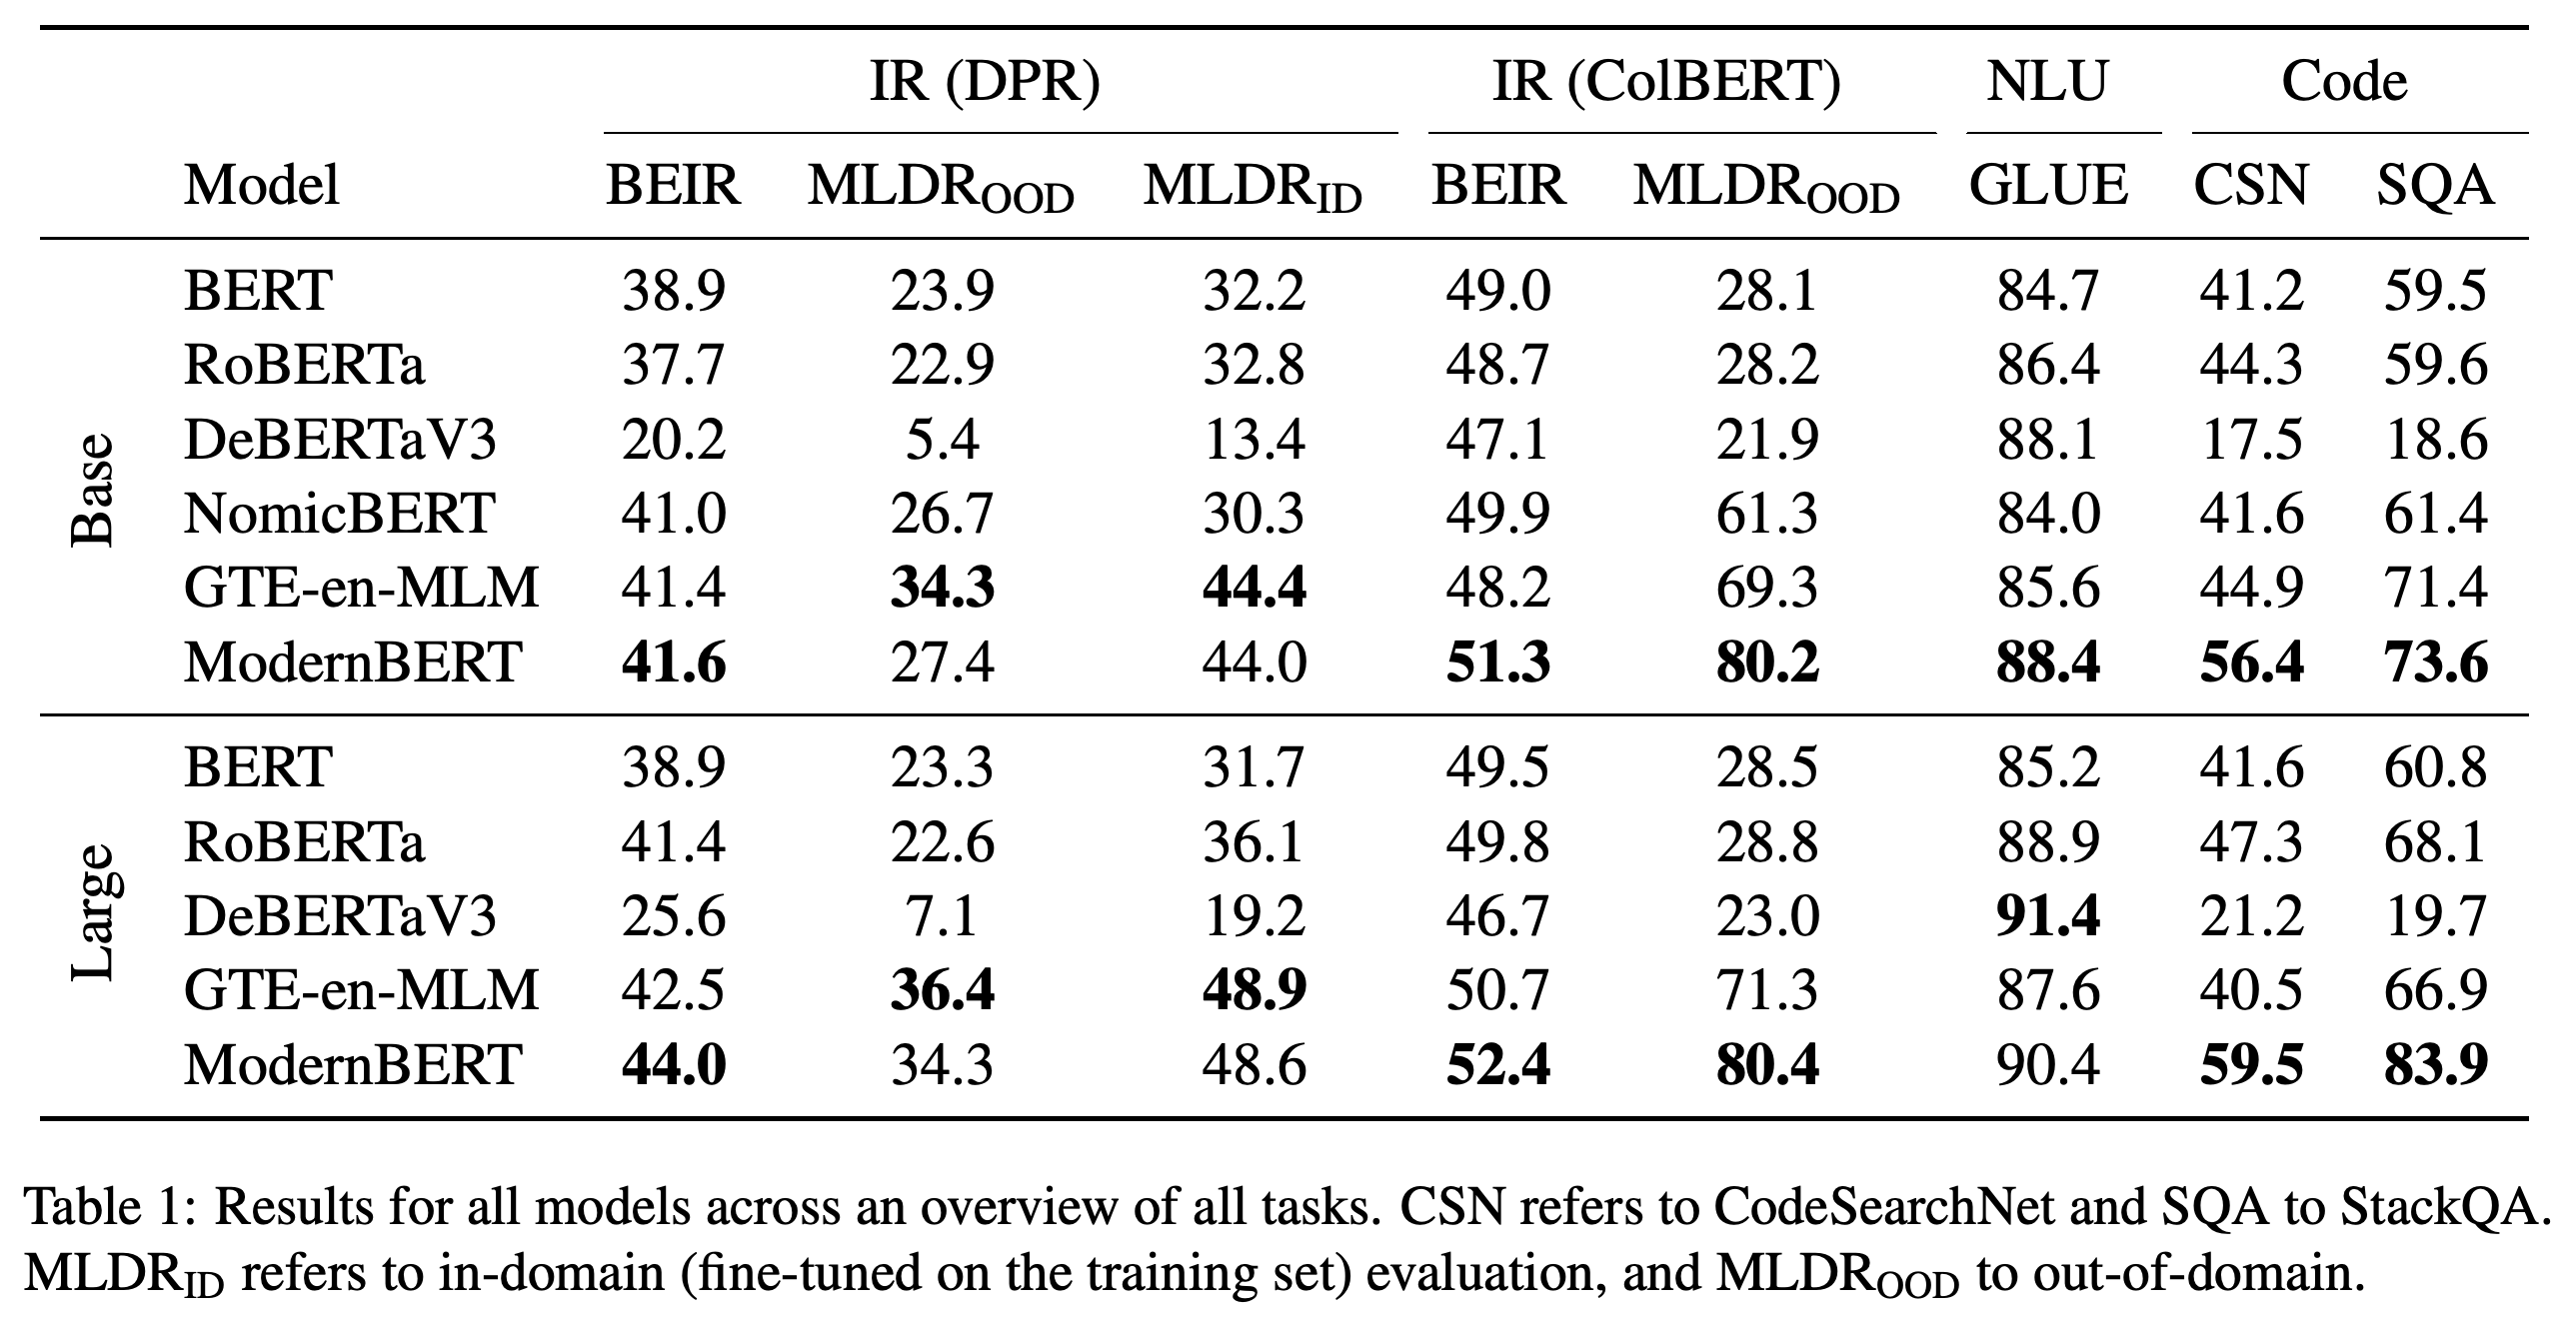
Table 1에서 ModernBERT는 검색 설정 2개 모두 BEIR 평균 점수가 가장 높다. Base는 DPR 41.6점, ColBERT 51.3점이며, large는 44.0점과 52.4점이다. GTE-en-MLM의 대응 점수는 base가 41.4점과 48.2점, large가 42.5점과 50.7점이다.
- MLDR multi-vector 점수는 80.2점과 80.4점으로 GTE-en-MLM의 69.3점과 71.3점을 웃돈다. 저자들은 더 긴 사전학습과 local attention을 이유로 제시하지만, 이는 가설에 머문다.
- Single-vector MLDR 전이 성능은 더 낮다. Base는 27.4점으로 GTE-en-MLM의 34.3점보다 낮고, large는 34.3점으로 36.4점보다 낮다. 추가 MLDR 미세조정 후에는 44.0점 대 44.4점, 48.6점 대 48.9점으로 격차가 줄어든다.
- ModernBERT는 크기 그룹 2개 모두에서 평가 모델 가운데 CodeSearchNet과 StackQA 점수가 가장 높다. Base는 56.4점과 73.6점, large는 59.5점과 83.9점이다. GLUE에서는 base 그룹에서 가장 높으며, large 그룹에서는 DeBERTaV3-large의 점수가 더 높다.
ModernBERT는 크기 그룹 2개 모두에서 BEIR 평균 검색 점수, multi-vector MLDR, 코드 과제 2개의 점수가 가장 높다. Single-vector MLDR에서는 GTE-en-MLM이, large 모델의 GLUE에서는 DeBERTaV3-large가 가장 높다. Base의 multi-vector MLDR 격차인 80.2점 대 69.3점은 DPR BEIR 격차인 41.6점 대 41.4점보다 훨씬 크다. 표에는 이 과제 점수의 불확실성 추정치가 제시되지 않는다.
4 Efficiency
효율성 평가에서는 짧은 입력과 긴 입력의 추론 처리량, 최대 배치 크기를 측정한다. 시퀀스 길이를 달리해 패딩 연산을 생략하는 이점을 확인한다.
4.1 Evaluation Setting
실험에는 각각 문서 8192개로 구성된 합성 데이터셋 4개를 사용한다. 길이가 512토큰 또는 8192토큰으로 고정된 데이터셋과, 256토큰 또는 4096토큰을 중심으로 하는 정규분포에서 길이를 추출한 가변 길이 데이터셋이다. NVIDIA RTX 4090 1대에서 10회 실행한 결과를 평균한다.
- GTE-en-MLM은 기본 상태와 unpadding 등의 최적화를 지원하는 xformers를 적용한 상태를 모두 평가한다.
- 가변 길이의 긴 입력 데이터셋은 분포 중심이 4096토큰이며, 실제 추출된 평균 길이는 4102토큰이다.
4.2 Results
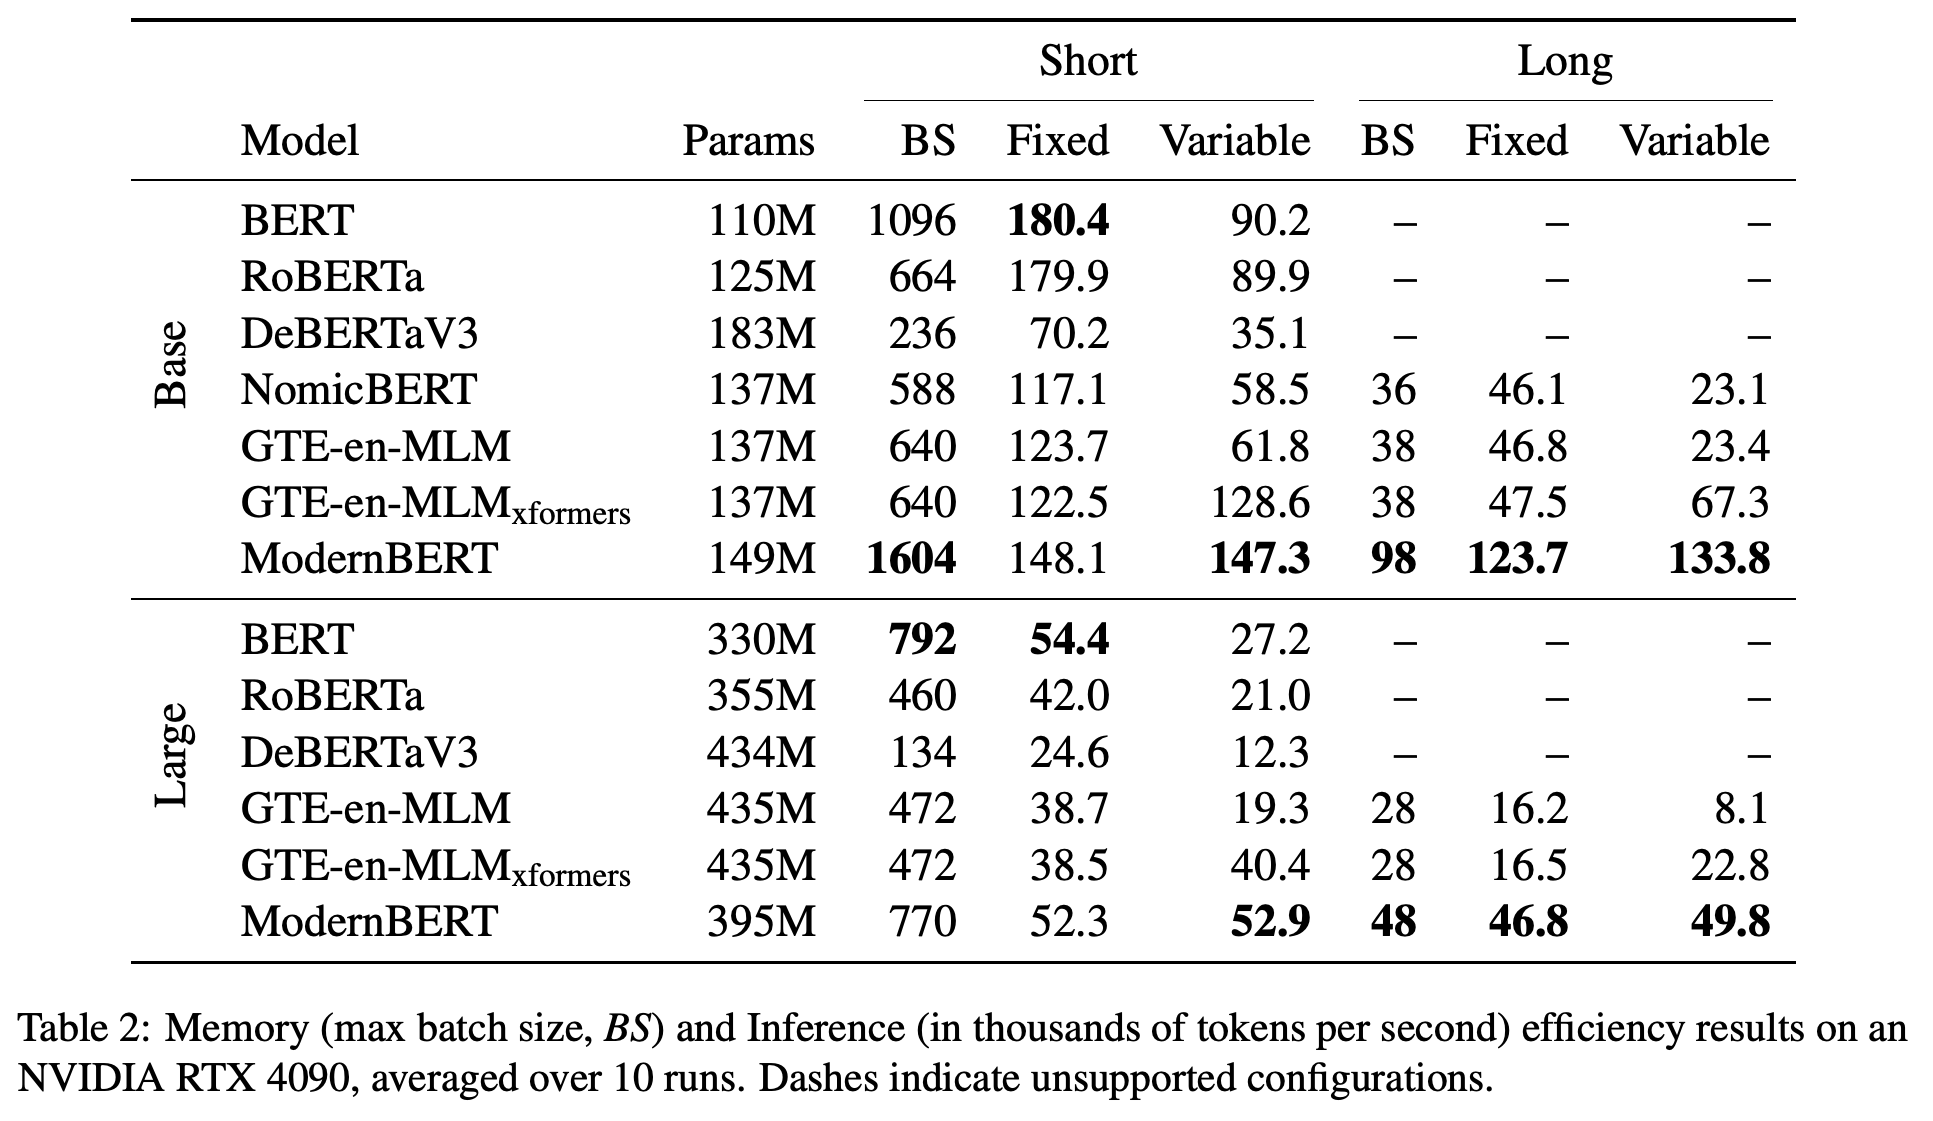
Table 2에서 base의 짧은 고정 길이 입력과 가변 길이 입력 처리량은 각각 148.1과 147.3 thousand tokens/s이며, 긴 고정 길이 입력과 가변 길이 입력에서는 123.7과 133.8 thousand tokens/s다. Large의 처리량은 같은 순서로 52.3, 52.9, 46.8, 49.8 thousand tokens/s다.
- 가변 길이 입력에서 ModernBERT는 xformers를 적용한 GTE-en-MLM보다 짧은 입력의 초당 토큰 처리량이 14.5–30.9퍼센트, 긴 입력은 98.8–118.8퍼센트 높다.
- Base의 최대 배치 크기는 짧은 입력에서 1604, 긴 입력에서 98이며, GTE-en-MLM은 640과 38이다. Large는 770과 48을 지원하며, GTE-en-MLM은 472와 28이다.
- 짧은 고정 길이 입력의 처리량은 BERT의 base 처리량인 180.4 thousand tokens/s와 large 처리량인 54.4 thousand tokens/s보다 낮다. BERT-large는 짧은 입력에서 최대 배치 크기도 792로 조금 더 크다.
측정 결과는 입력 길이 분포에 따라 모델 간 상대 성능이 어떻게 달라지는지 보여준다. ModernBERT-base는 긴 가변 길이 입력에서 133.8 thousand tokens/s의 처리량을 기록하며, xformers를 적용한 GTE-en-MLM은 같은 단위로 67.3을 기록한다. 반면 짧은 고정 길이 입력의 처리량은 같은 단위로 148.1이며, BERT의 180.4보다 낮다. 최대 배치 크기는 이 벤치마크 조건에서의 메모리 수용 능력을 측정하며, 할당된 메모리의 바이트 수를 직접 보고하지 않는다.
5 Conclusion
결론은 ModernBERT를 향상된 후속 과제 성능, 기본 8192토큰 지원, 효율적인 추론을 결합한 공개 인코더 계열로 제시한다. 보고된 평가에서는 후속 과제 범주 전반에서 BERT와 RoBERTa보다 개선된 결과를 보인다. 특히 코드 검색과 multi-vector 긴 문맥 검색에서 강점을 보이지만, 앞서 설명한 과제별 예외도 존재한다.
6 Limitations
연구는 영어에 집중하므로 다른 언어, 특히 저자원 언어에 적용할 수 있는지는 확인되지 않았다. 웹 데이터 중심의 사전학습은 원천 데이터의 편향을 전달할 수 있으며, 마스킹 토큰 예측은 유해한 토큰을 제안할 수 있다. 저자들은 이 기능을 ModernBERT가 학습하지 않은 긴 텍스트 생성과 구분한다.
- 저자들은 MLM만 사용하는 학습 목표를 한계로 보고, 대체된 토큰을 탐지하는 Replaced-Token Detection을 MLM과 결합하는 방안을 제안한다.
- 공개된 모델보다 파라미터 수를 늘리는 방안은 탐구하지 않았다. 최종 비교에서는 아키텍처와 학습 데이터를 함께 바꾸었으므로, 성능 향상을 개별 변경의 효과로 분리하기 어렵다.
8 Contribution Statement
Benjamin Warner, Antoine Chaffin, Benjamin Clavié가 프로젝트를 공동으로 이끌었다. Warner는 모델 설계와 학습을 주도했고, Chaffin은 프로젝트를 조율하며 ablation과 최종 평가를 공동으로 이끌었다. Clavié는 최종 평가를 공동으로 이끌고 논문 작성을 주도했다.
- Orion Weller는 데이터 선택과 처리를 주도했다. Oskar Hallström과 Said Taghadouini는 아키텍처, 학습, ablation, 평가에 기여했다. Hallström은 학습 문제를 조사했고, Taghadouini는 패딩이 제거된 시퀀스에 RoPE를 적용하고 최종 GLUE 벤치마크를 실행했다.
- 다른 저자들은 sequence packing, 초기 평가와 긴 문맥 평가, 코드 데이터 품질, 소프트웨어 통합, 프로젝트 방향 설정에 기여했다.
부록
- A Training Settings는 단계별 학습 절차, 배치 크기 스케줄, base에서 large를 초기화하는 방법, 가중치 감쇠의 제외 대상, 최종 체크포인트 선택을 설명한다. Base는 체크포인트를 평균하고, large는 annealing 중 가장 좋은 체크포인트를 사용한다. 시험한 설정에서는 지수 이동 평균이 성능을 개선하지 못했다.
- B Model Design은 여러 GPU를 고려해 모델 차원을 선택한 방법을 설명한다. 모든 대상 GPU에 구성을 완벽하게 맞출 수 없으므로, 대략적인 하드웨어 활용률을 설계 기준으로 삼는다.
- C Training Log는 초기 base 학습을 발산시킨 샘플링 문제와, large의 성능 정체 후 학습률과 가중치 감쇠를 낮춰 재시작한 사례를 기록한다. 샘플링 문제가 발생하는 임계값은 엄밀히 확인하지 않았다. Base는 완료된 사전학습 과정에서 개선 폭이 줄어들면서도 계속 향상되었다.
- D Architecture ablations는 주로 더 작은 학습 규모에서 활성화 함수, 정규화, 위치 인코딩, attention 구성, 토크나이저를 비교한다. 여러 대안의 성능은 비슷했고, parallel attention은 시험한 모델 크기에서 성능을 떨어뜨렸다. Local attention과 global attention을 번갈아 적용한 구성은 시험한 후속 과제에서 모든 계층에 global attention을 적용한 구성과 성능이 같았다. 최종 선택에는 구현 효율과 소규모 실험 결과의 외삽에 대한 주의도 반영했다.
- E Extended results는 과제별 GLUE와 BEIR 결과 및 튜닝 절차를 제시한다. 여기에는 early stopping, 일부 과제의 MNLI 기반 초기화, BEIR 일부 데이터셋을 통한 검색 모델 선택이 포함된다. 평균 점수가 높다고 모든 데이터셋에서 가장 높은 것은 아니다. 저자들은 TREC-COVID가 성능에 크게 기여한다고 보고, 데이터의 최신성도 가능한 요인으로 보지만 이것만으로 결과를 모두 설명할 수는 없다고 논의한다.
- F Efficiency는 본문의 효율성 평가를 보완하는 합성 데이터 통계, 상세 추론 시간과 변동성, 최대 배치 크기를 제공한다.
- G Licensing은 아키텍처, 모델 가중치, 학습 코드베이스를 Apache 2.0으로 공개한다.
짧은 생각
가장 뚜렷한 결과는 시험한 조건에서 검색 성능과 처리량이 함께 개선되었다는 점이다. Multi-vector MLDR와 코드 검색의 성능 향상은 BEIR에서 base DPR이 보인 0.2점 우위보다 실용적인 품질 개선을 더 강하게 뒷받침한다. 입력 조건에 따라 결과가 달라진다. 길이가 512토큰으로 고정된 입력에서는 기존 BERT 모델이 유리할 수 있으며, 이 실험의 single-vector 긴 문서 전이에서는 GTE-en-MLM이 유리하다. Ablation은 여러 설계 선택을 뒷받침하지만, 대부분 학습 규모가 더 작고 데이터와 아키텍처를 동시에 바꾸었기 때문에 인과관계를 분리하기 어렵다. 보고된 효율성 실험은 실제 말뭉치와 다른 GPU에서의 처리량을 검증하지 않았다.