


START: Self-taught Reasoner with Tools 요약 설명
06 Mar 2025 | Paper Review Tool Use Self-Distillation Test-Time Scaling목차
이번 글에서는 START: Self-taught Reasoner with Tools 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 3월 6일(Arxiv)
- Li, Chengpeng, Xue, Mingfeng, Zhang, Zhenru, Yang, Jiaxi, Zhang, Beichen, Wang, Xiang, Yu, Bowen, Hui, Binyuan, Lin, Junyang, Liu, Dayiheng.
- University of Science and Technology of China, Alibaba Group
- 논문 링크
요약
- START: Self-taught Reasoner with Tools는 긴 중간 추론으로 문제를 푸는 언어 모델의 계산 오류와 부정확한 코드 검증을 다룬다. 가장 확률이 높은 다음 토큰을 선택하는 greedy decoding과 최대 6회의 Python 도구 호출을 사용할 때, START는 기반 모델 QwQ-32B-Preview보다 단일 답변 정확도가 높다. AIME24 경시 수학에서는 50.0%에서 66.7%로, 평가에 사용한 LiveCodeBench 프로그래밍 문제에서는 41.4%에서 47.3%로 향상된다.
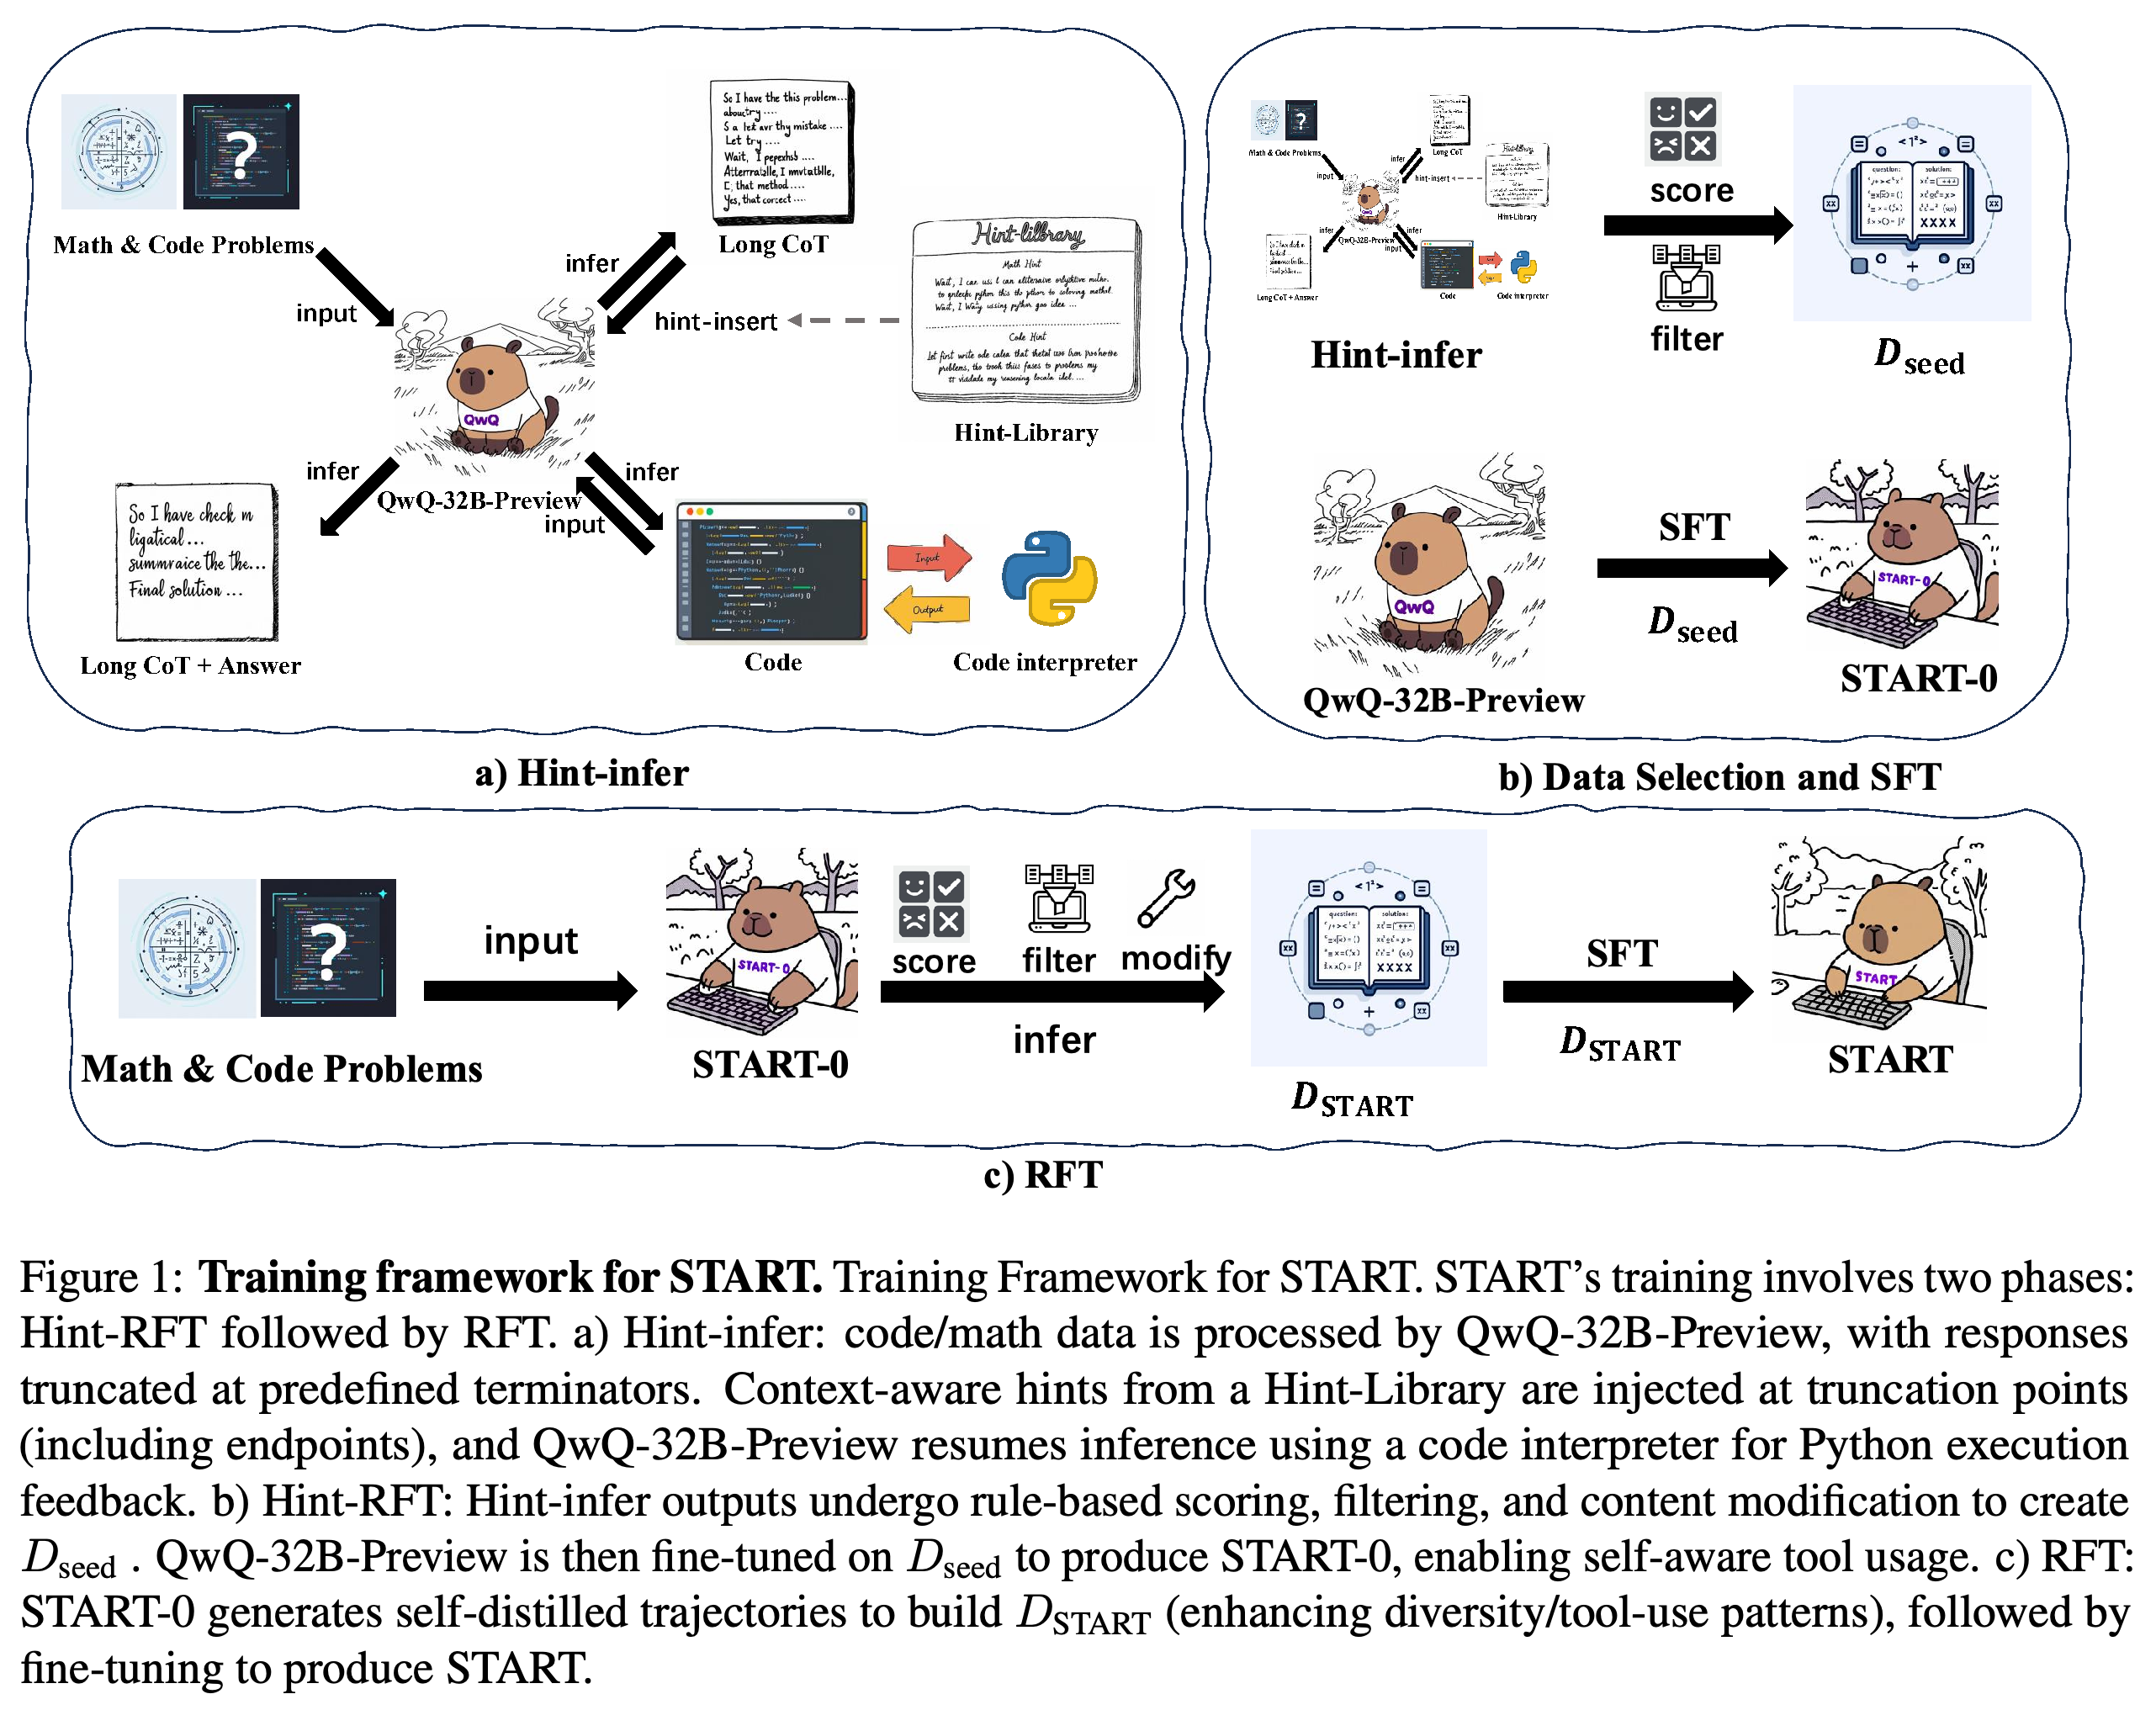
- Hint-infer는 모델이 명시적으로 작성하는 중간 추론인 chain-of-thought(CoT)에 수작업으로 작성한 힌트를 삽입해 Python 실행을 유도한다. 성공한 생성 풀이를 선별해 학습하는 Hint Rejection Sampling Fine-Tuning(Hint-RFT)은 먼저 도구 상호작용 형식을 가르친다. 이후 START-0가 추론 단계와 도구 상호작용으로 구성된 추론 궤적을 생성하고, 이를 사용하는 2번째 학습 단계에서 START를 만든다.
- 동일한 학습 질문을 사용한 비교는 중간 추론과 외부 도구 호출을 결합하는 tool-integrated reasoning(TIR)의 기여를 뒷받침한다. 일반적인 rejection sampling fine-tuning은 개선 폭이 더 작고 AIME25 경시 수학 정확도를 떨어뜨린다. 다만 근거는 기반 모델 1개, 외부 도구 1개, 일부 과학, 수학, 프로그래밍 벤치마크에 한정되며, 힌트를 추가하면 START의 정확도가 낮아지기도 한다.
1 Introduction
서론에서는 긴 추론에 실행 가능한 계산과 피드백을 어떻게 통합할지 묻는다. 저자들은 실험한 설정에서 직접적인 지시, 상세한 도구 지시, 시연 예시로 Python 인터프리터 호출을 유도하지 못했다고 보고한다. 이를 계기로 “Alternatively”, “Wait” 같은 단어 뒤나 추론이 끝나기 직전에 힌트를 삽입하는 Hint-infer를 도입한다.
- START는 생성된 코드를 실행하고 출력을 모델에 반환하는 Python 인터프리터만 사용한다.
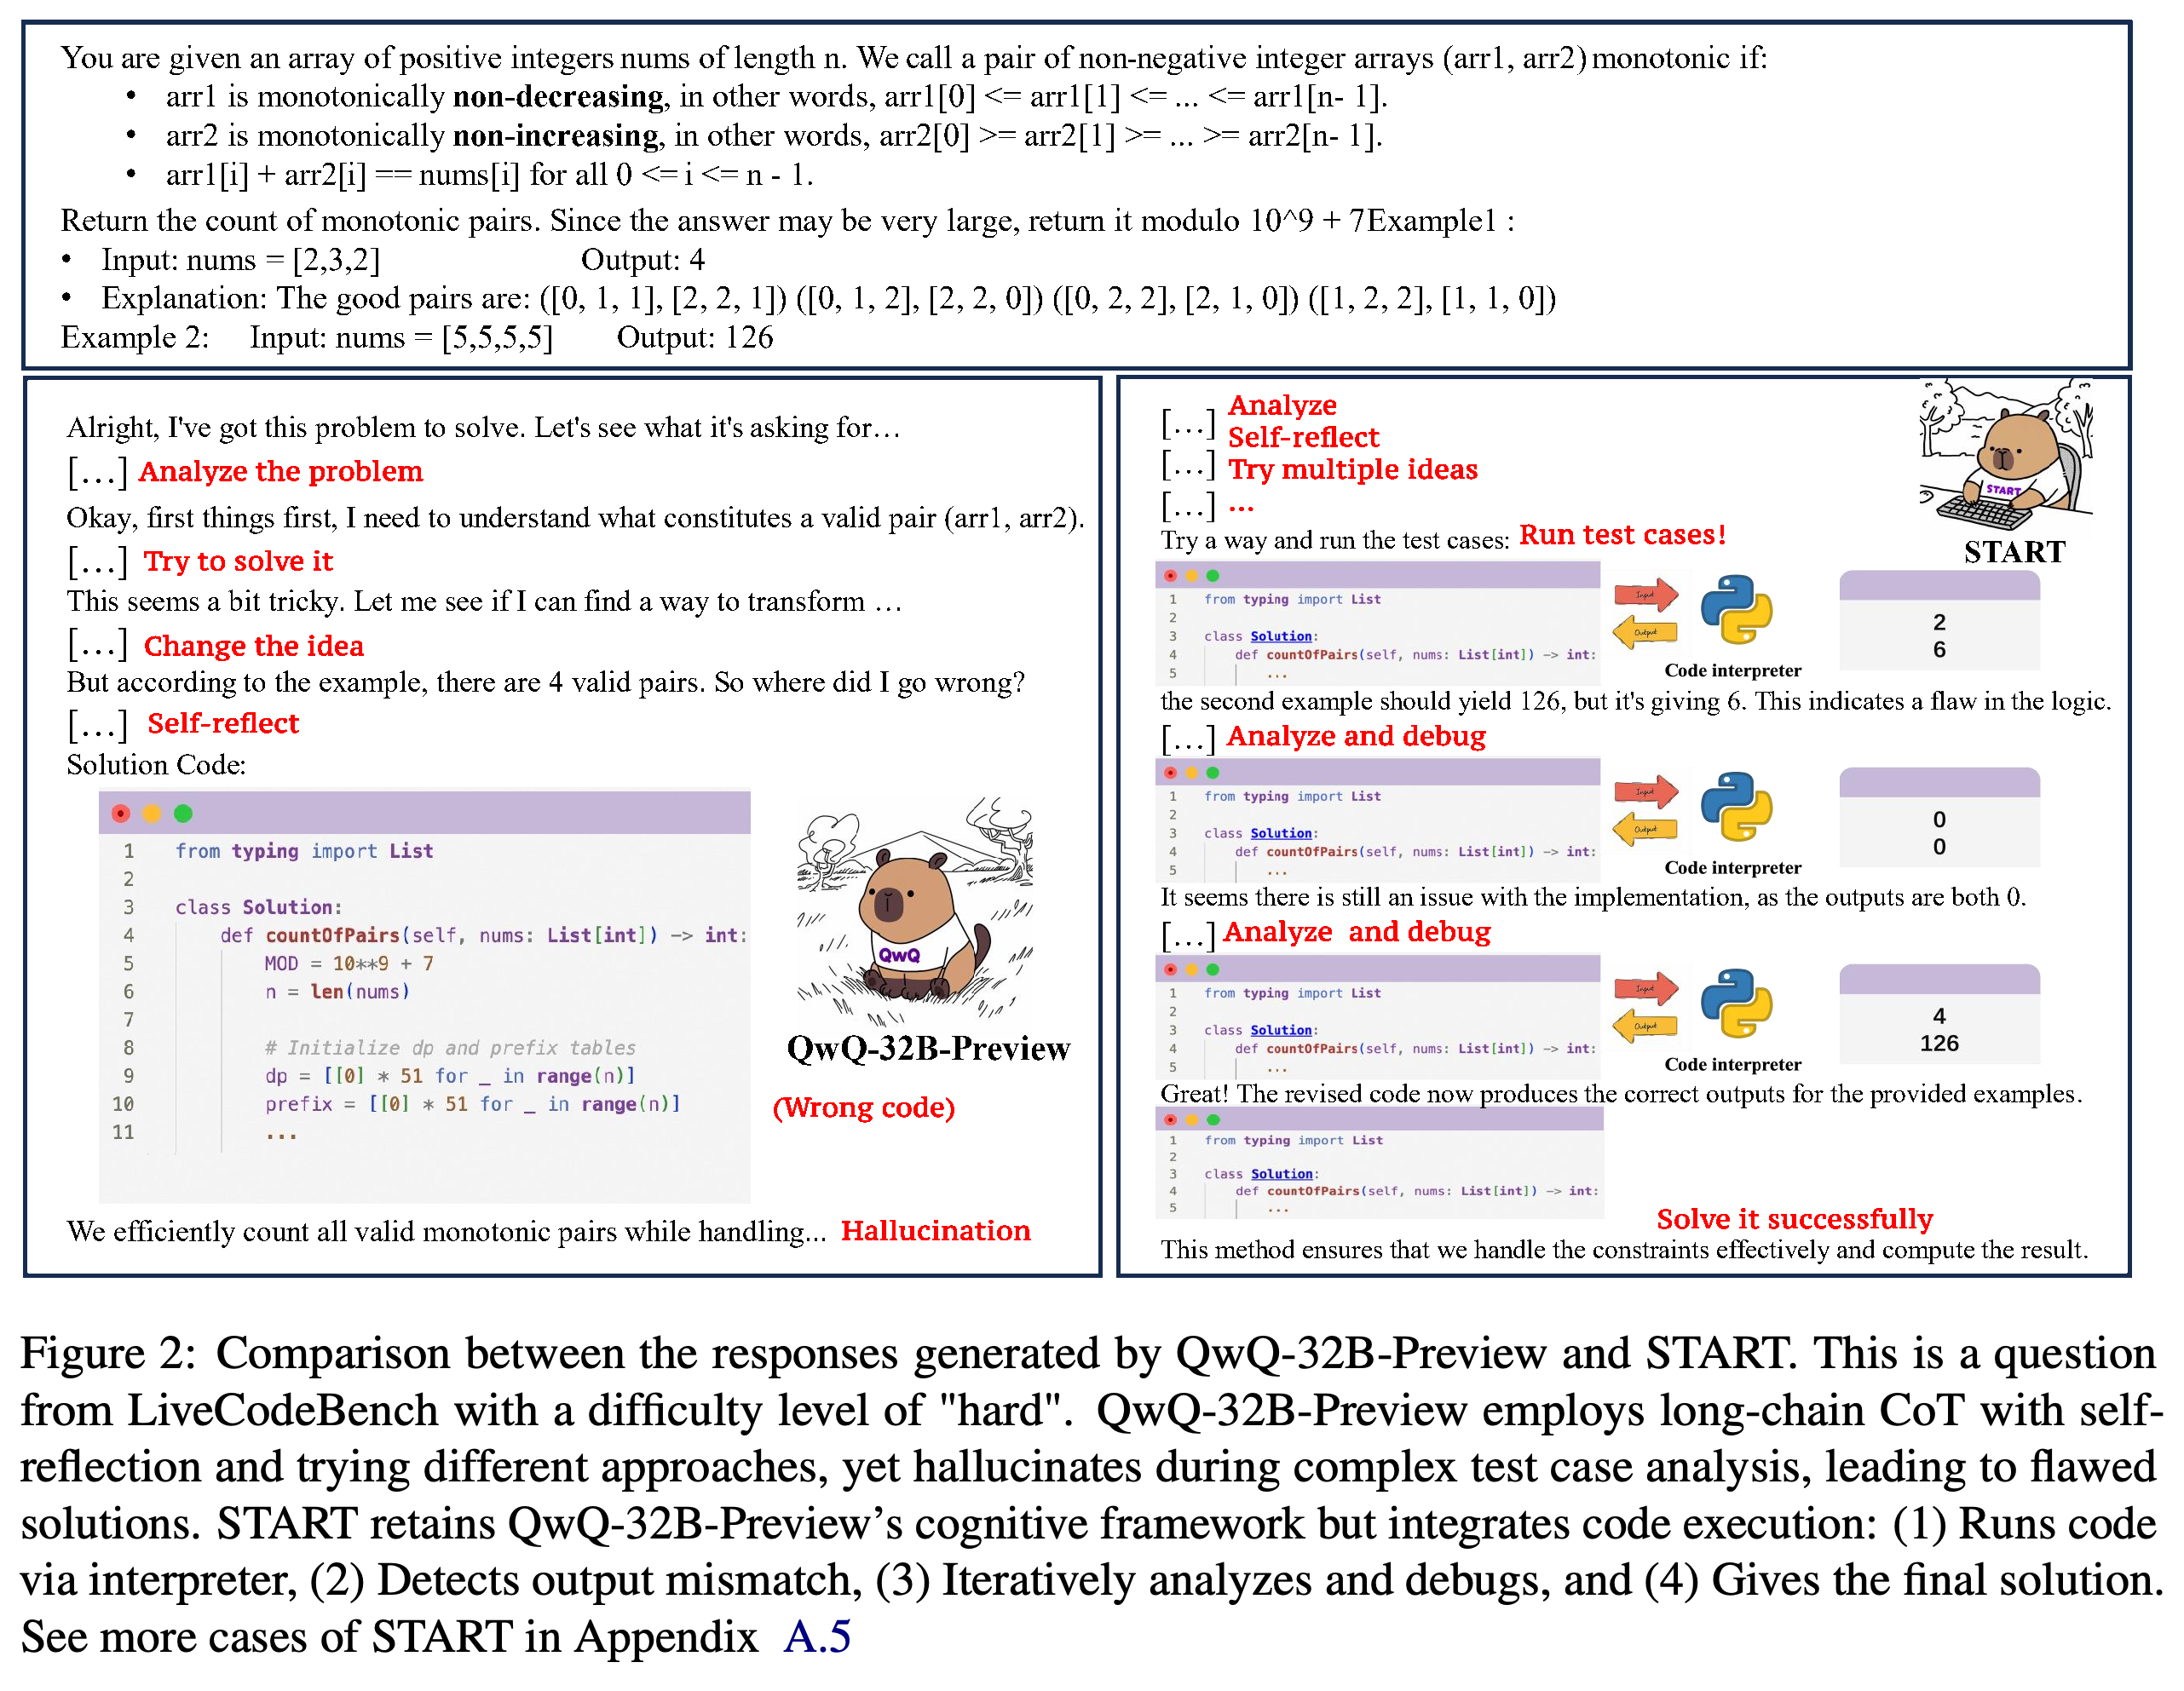
- Figure 2는 의도한 효과를 보여준다. 실제 실행으로 잘못된 예제 출력을 확인하면, 모델은 상상한 테스트 결과에 의존하는 대신 구현을 수정할 수 있다.
2 Related Work
관련 연구에서는 긴 CoT, 다른 모델이 생성한 추론으로 학습하는 distillation, 답변 전에 추론 연산량을 늘리는 test-time scaling을 연결해 설명한다. Python을 활용한 수학 추론과 수학 증명 검증 시스템 Lean도 검토하며, START를 긴 추론과 인터프리터 피드백을 결합하는 방법으로 제시한다.
3 Methodology
방법론은 Figure 1에 제시한 2개의 학습 단계로 구성된다. Hint-infer는 초기 모델 START-0를 학습할 성공적인 도구 활용 궤적을 제공한다. 이후 START-0가 더 폭넓은 궤적을 생성하고, 이를 사용해 QwQ-32B-Preview를 START로 fine-tuning한다.
이 도식은 도구 상호작용 형식을 학습하는 과정과 최종 학습 말뭉치를 생성하는 과정을 구분한다. START-0는 2단계에 사용할 궤적을 제공하며, 최종 fine-tuning은 QwQ-32B-Preview에서 시작한다.
이 예제는 언어적 자기 성찰로 놓친 오류를 실제 실행으로 어떻게 드러낼 수 있는지 보여준다. START는 출력 불일치 이후 프로그램을 수정한다. 이는 전체 프로그래밍 성능 향상을 설명할 수 있는 작동 방식을 보여주지만, 그 빈도를 입증하지는 않는다.
3.1 Training data
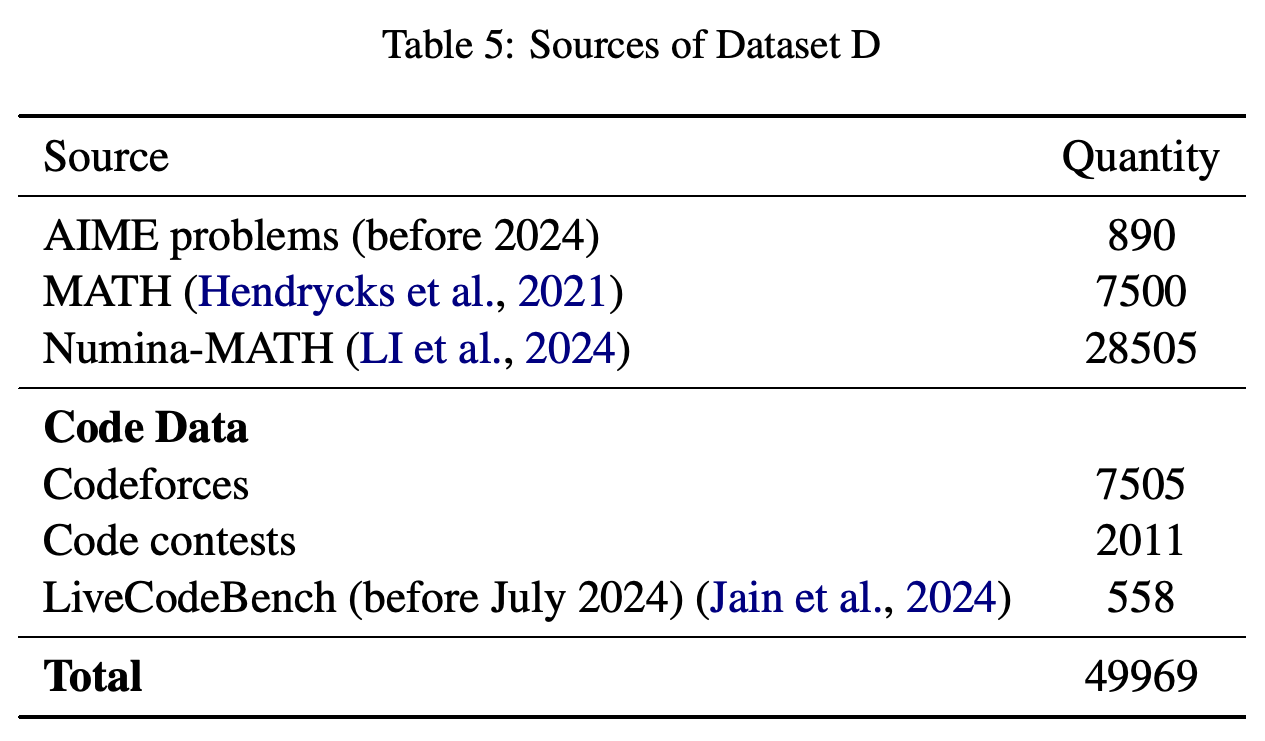
학습 질문은 2024년 이전 AIME 문제, 수학 데이터셋 MATH와 Numina-MATH, Codeforces와 code contests의 프로그래밍 문제, 2024년 7월 이전 LiveCodeBench에서 가져온다. 본문은 수학 문제 약 40K개와 프로그래밍 문제 약 10K개를 사용한다고 설명한다. 평가 데이터와의 중복을 줄이기 위해 Yang et al. (2024)의 decontamination 절차를 적용한다.
- Table 5는 출처별 개수를 제시하지만, 항목의 합은 표에 적힌 총계 49,969개와 다른 46,969개다. 따라서 논문에서 일관된 정확한 학습 데이터셋 크기를 확인할 수 없다.
3.2 Hint-RFT
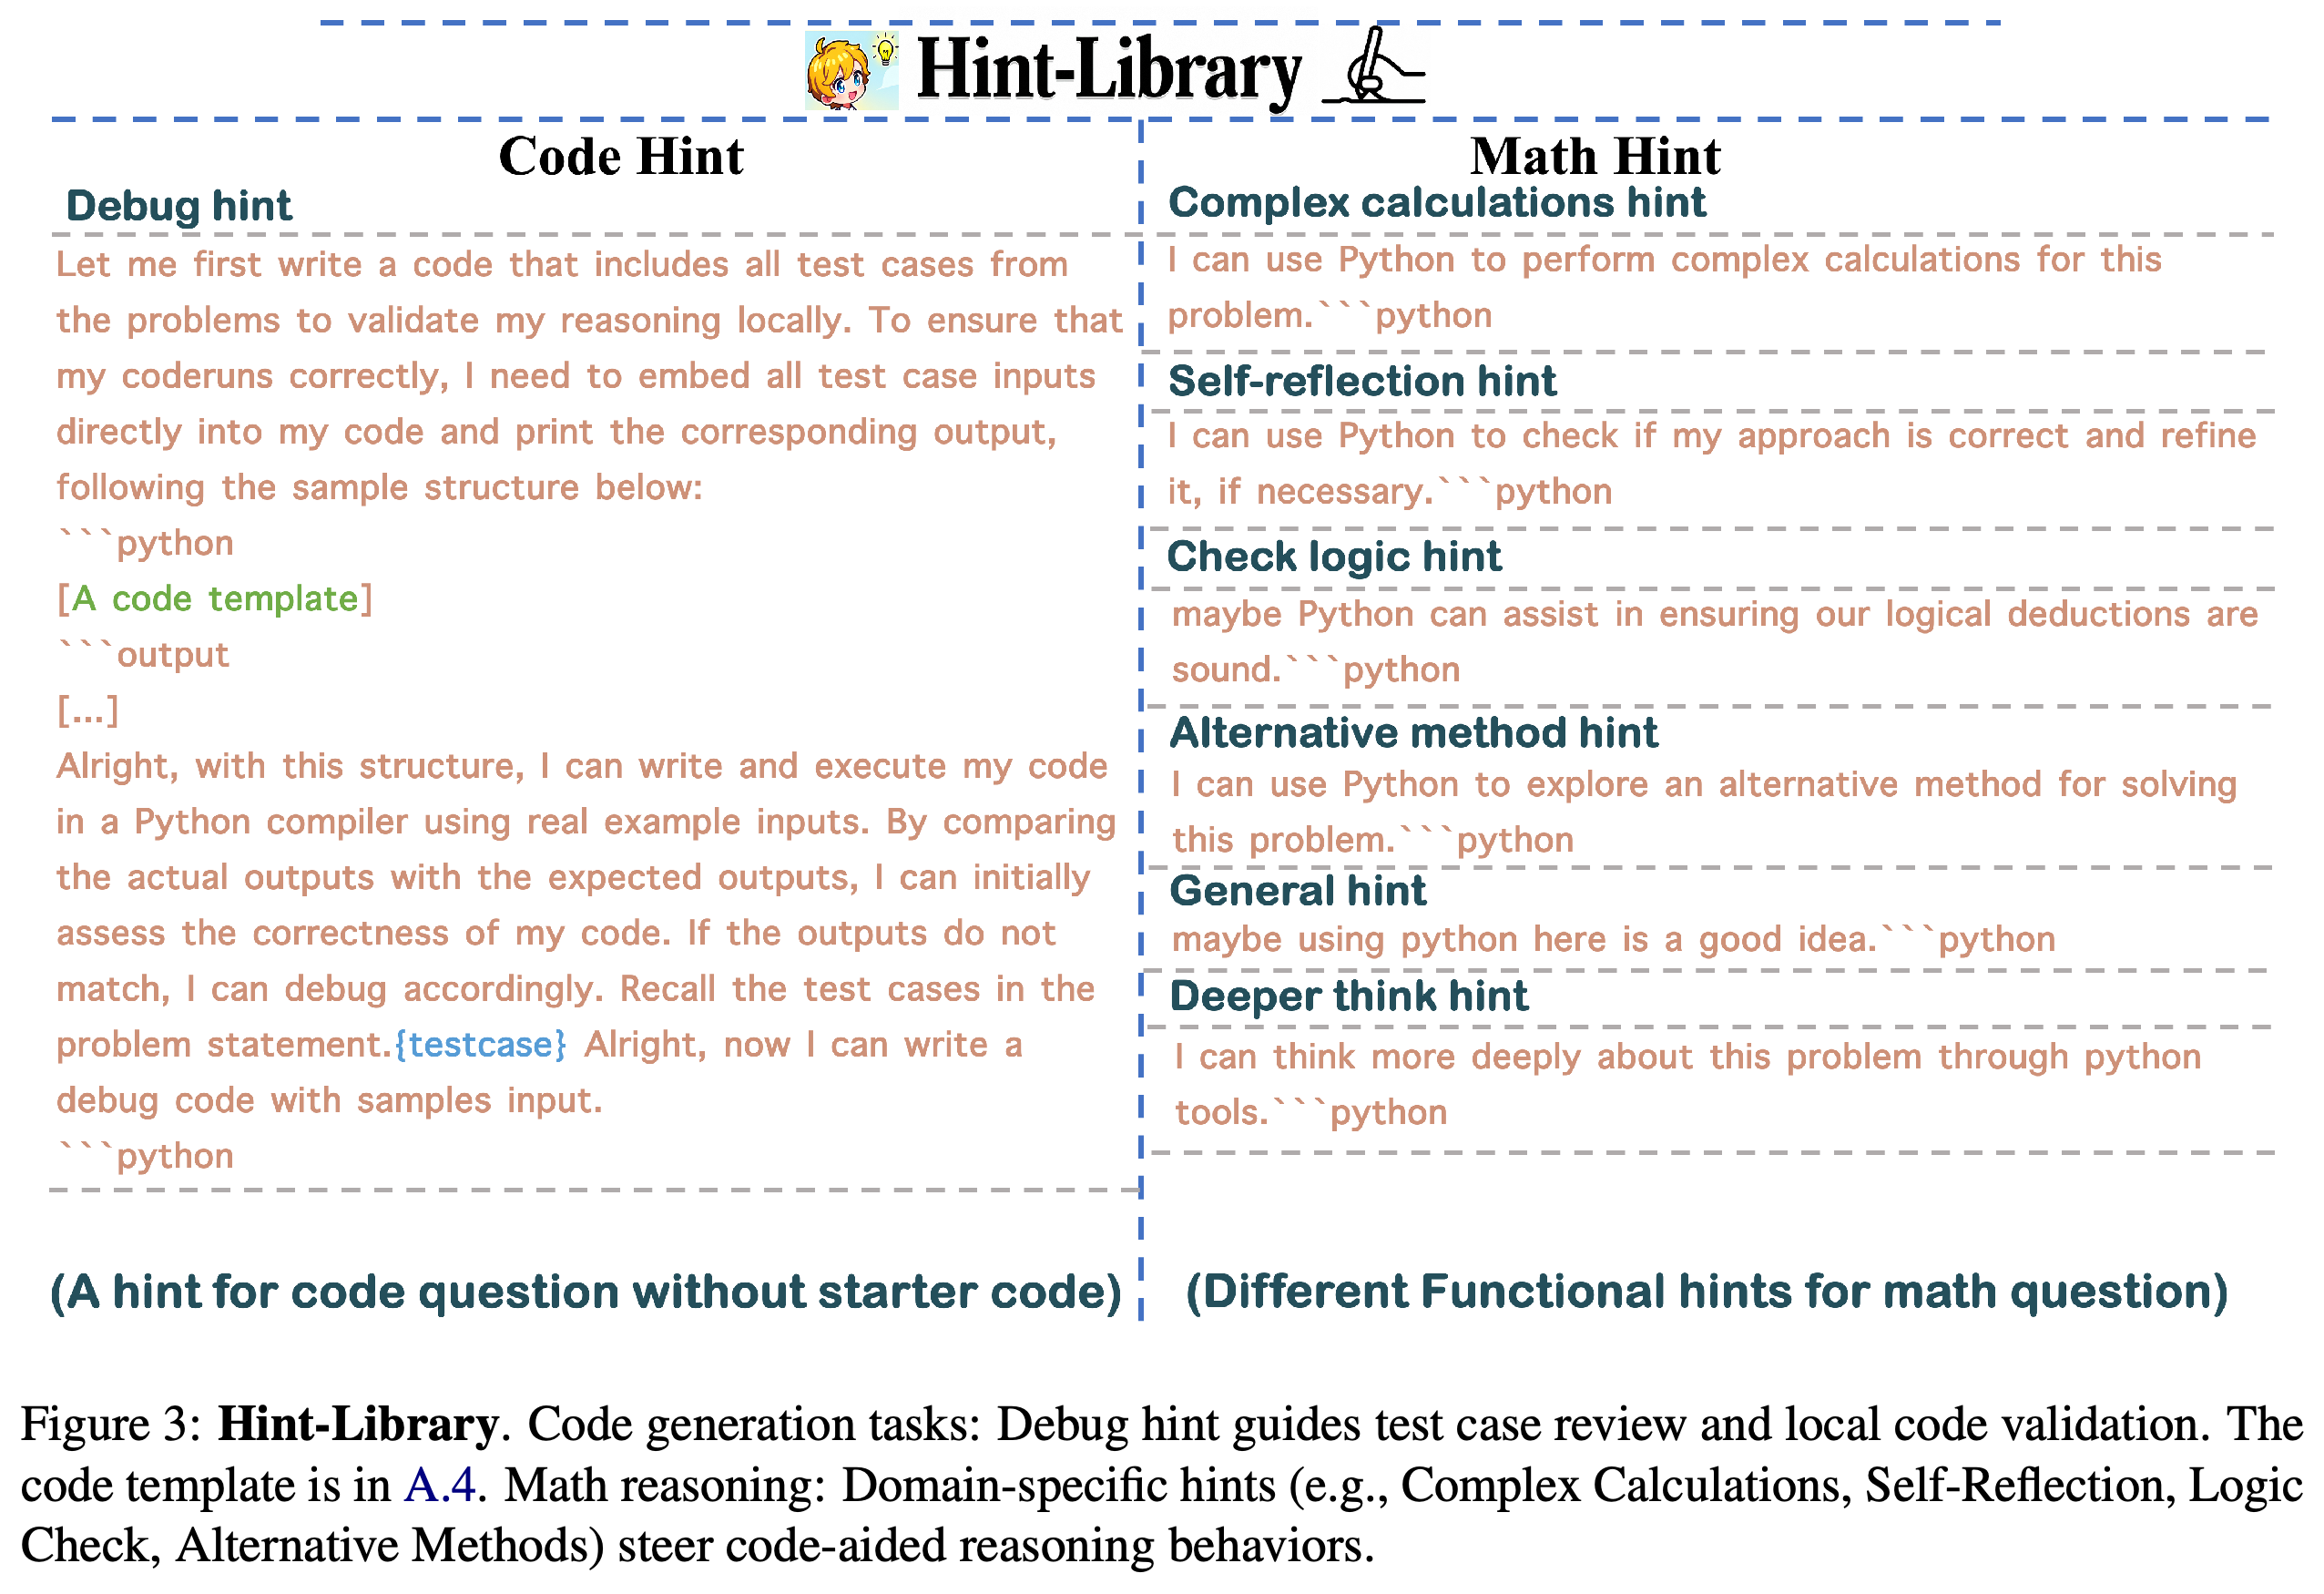
Hint-Library에는 계산, 자기 성찰, 논리 검증, 대안 탐색, 더 깊은 추론을 위한 수학 힌트와 디버깅 템플릿을 포함한 프로그래밍 힌트가 들어 있다. 수학에서는 Hint-infer가 선택한 접속 표현 뒤나 생성을 끝내는 stop token 앞에 힌트를 삽입한다. 프로그래밍에서는 최종 풀이를 제시하기 전에 테스트를 요청하고, 인터프리터 출력을 모델에 반환한다.
- 시드 데이터셋 D_seed는 QwQ-32B-Preview의 greedy 추론으로는 풀지 못하지만 힌트를 사용한 추론으로는 풀 수 있는 질문을 모으며, 수학 예제 10K개와 프로그래밍 예제 2K개로 구성된다.
- 규칙 기반 채점과 반복 필터링으로 궤적을 선별한다. 프로그래밍 궤적에서는 힌트의 Python 식별자를 “Debug Code Template”으로 바꾸고 출력 자리표시자를 제거한다. 이후 선별한 궤적으로 학습하는 supervised fine-tuning을 수행해 START-0를 만든다.
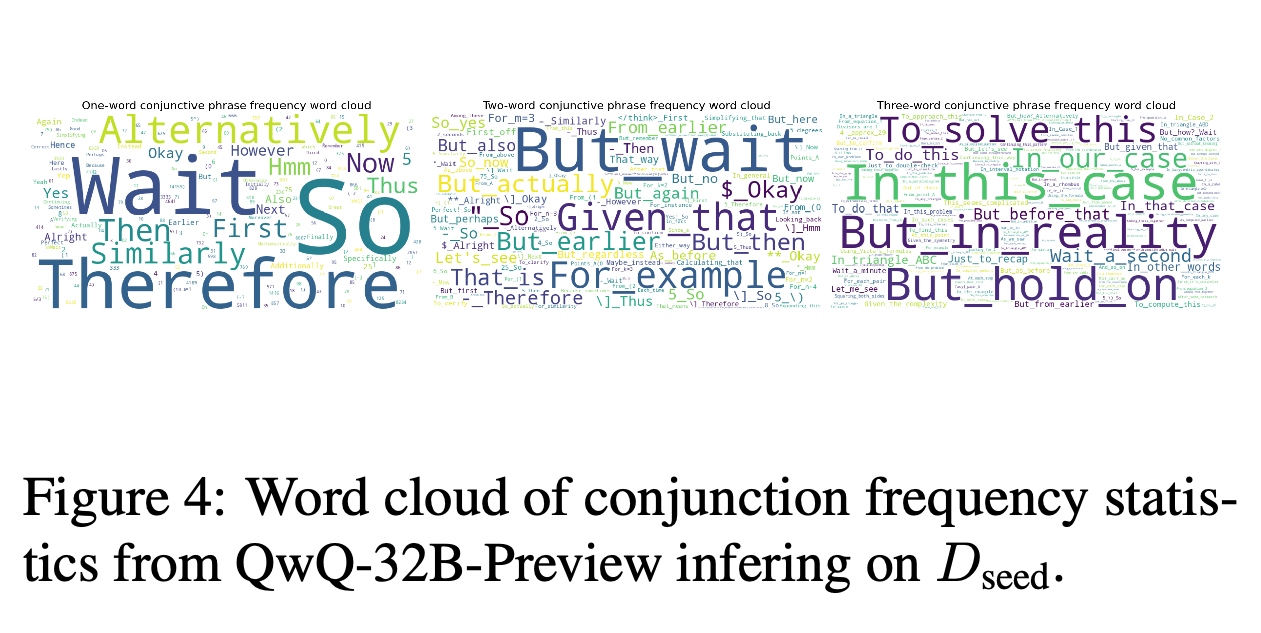
- Figure 4는 힌트 삽입 위치를 정할 때 참고한 빈번한 접속 표현을 보여준다. 해당 위치가 최적이라는 점을 입증하지는 않는다.
수학 힌트는 Python을 사용할 짧은 이유를 제시하고, 프로그래밍 힌트는 더 긴 테스트 및 디버깅 템플릿을 제공한다. 따라서 이 절차를 재현하려면 모델이 생성한 데이터뿐 아니라 과제에 맞는 힌트 작성도 필요하다.
저자들은 “Wait”, “Alternatively”처럼 자주 나타나는 단어를 참고해 생성을 중단하고 힌트를 삽입할 위치를 정한다. 이 워드 클라우드는 기반 모델의 텍스트를 보여주며, 서로 다른 삽입 전략의 효과를 비교하지는 않는다.
3.3 RFT
Rejection sampling fine-tuning(RFT)에서는 START-0로 학습 질문마다 16개의 샘플을 생성한다. 샘플링의 무작위성을 조절하는 temperature는 0.6, 토큰 누적 확률의 임계값인 top-p는 0.95로 설정한다. 저자들은 궤적을 채점하고 반복 응답을 제거하며, 부적절한 내용을 수작업으로 수정한 뒤 질문마다 최대 1개의 응답을 D_START에 남긴다.
- 마지막 학습 단계에서는 수학 항목 40,000개와 프로그래밍 항목 10,000개를 포함한다고 설명한 D_START로 QwQ-32B-Preview를 다시 fine-tuning한다.
- 모델이 스스로 생성한 궤적을 사용하는 방식은 self-distillation이다. 힌트 작성과 내용 수정에 수작업이 남아 있으므로 데이터 처리 과정은 완전히 자동화되어 있지 않다.
4 Experiment
실험에서는 Python을 활용한 추론이 과학 질의응답, 수학 문제 풀이, 코드 생성을 개선하는지 평가한다. START를 기반 모델 및 다른 언어 모델과 비교한 뒤, 도구 없이 추가 학습하는 경우와 추론 중 힌트를 반복해서 삽입하는 경우를 분석한다.
4.1 Benchmarks
GPQA는 전문가가 작성한 대학원 수준의 과학 질의응답 벤치마크로, 생물학, 물리학, 화학을 다룬다. 논문은 객관식 질문 448개로 구성된다고 설명한다. 수학 평가는 고등학교 수학 벤치마크 MATH500과 경시 수학 데이터셋 AMC23, AIME24, AIME25를 사용한다.
- 프로그래밍 평가는 2024년 8월부터 2024년 11월까지의 LiveCodeBench 문제 112개를 사용하며, 쉬움, 중간, 어려움 난이도를 포함한다.
- 학습에 사용한 LiveCodeBench 데이터는 2024년 7월 이전 자료이므로, 선택한 프로그래밍 평가 기간과 시간적으로 구분된다.
4.2 Baselines
일반 모델 베이스라인은 Qwen2.5-32B-Instruct, Qwen2.5-Coder-32B-Instruct, DeepSeek-V3-671B, Llama3.3-70B-Instruct, GPT-4o를 포함한다. 추론 모델은 o1 시리즈, o3-mini(low), R1-Distill-Qwen-32B, s1-32B, Search-o1-32B, QwQ-32B-Preview와 비교한다.
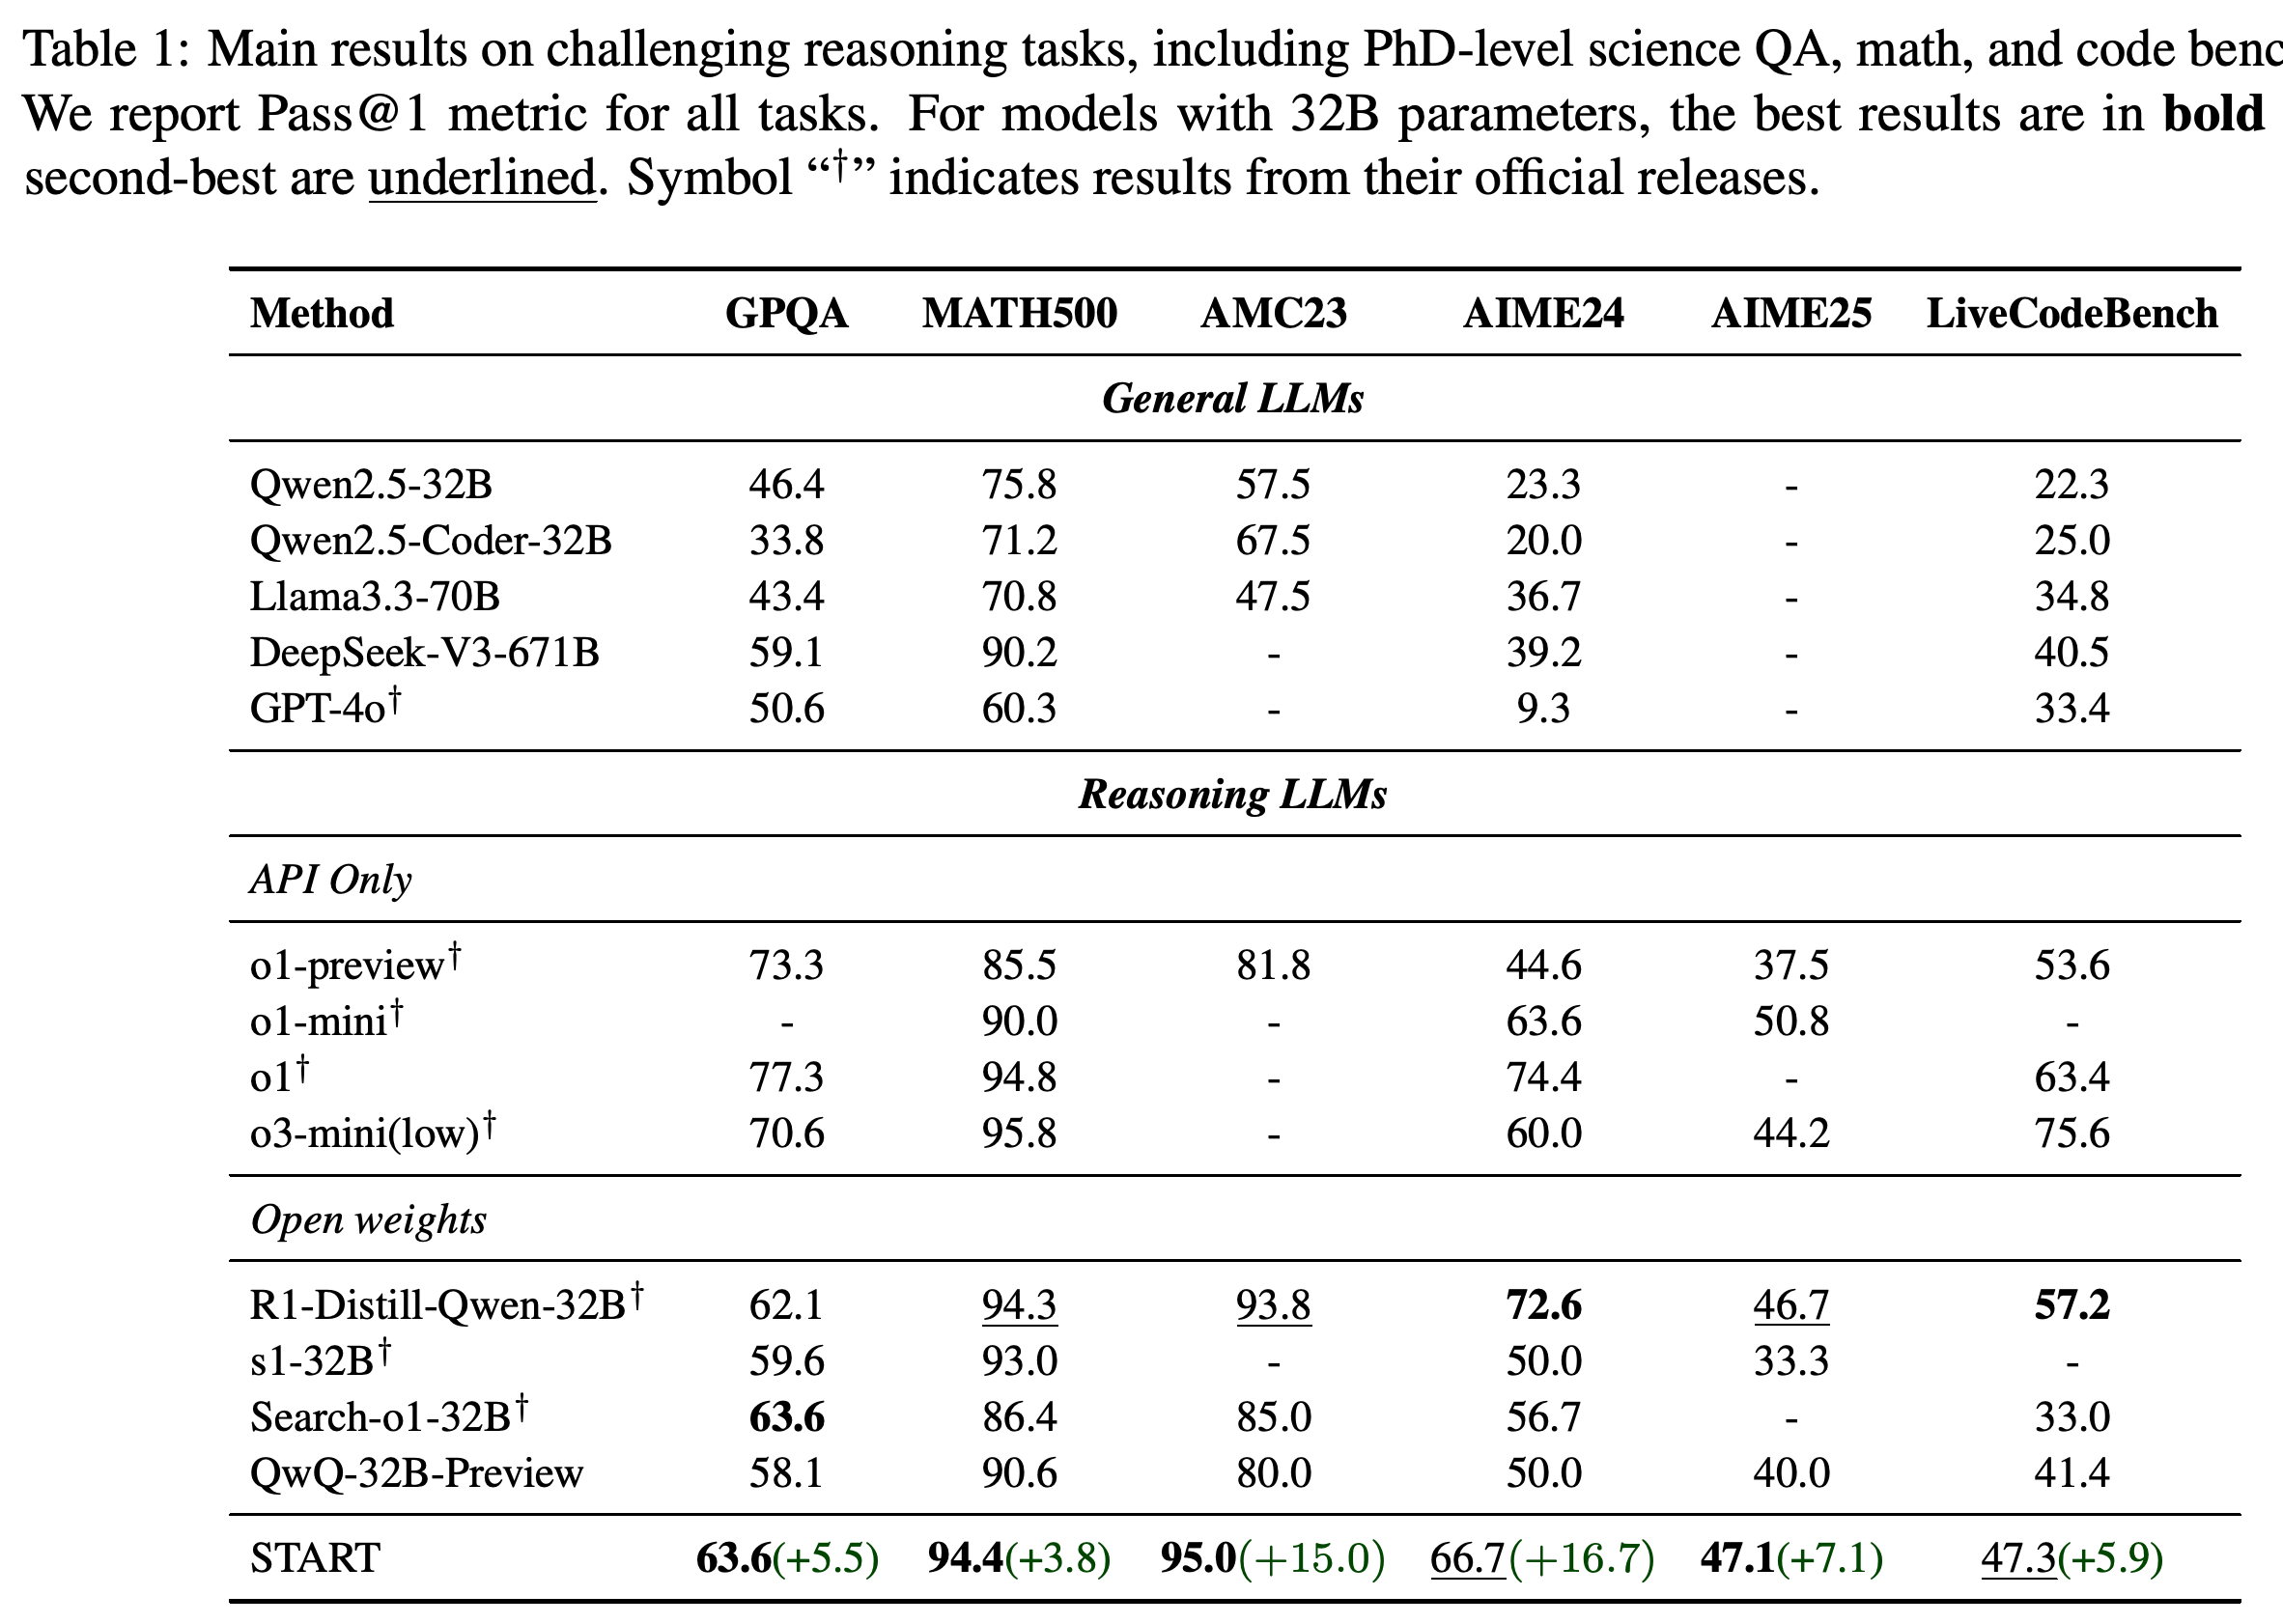
- Table 1은 일부 결과를 모델 공식 발표에서 가져왔다고 표시한다. 따라서 모든 모델에 동일한 추론 연산량이나 도구 접근 예산을 적용한 비교로 볼 수는 없다.
4.3 Implementation Details
모든 모델 파라미터를 갱신하는 full-parameter fine-tuning에는 학습률 7e-6, 전역 배치 크기 128, 3% warm-up을 적용한 cosine schedule, 최대 문맥 길이 16,384토큰, 3 epochs를 사용한다. 조기 종료에 따른 체크포인트 선택은 사용하지 않는다. 학습은 분산 메모리 최적화 기법 DeepSpeed ZeRO-3와 NVIDIA A100 GPU 32개로 수행한다.
- 평가에는 greedy decoding, 최대 시퀀스 길이 32,768, 최대 6회의 도구 사용, QwQ-32B-Preview의 chat template을 적용한다.
- 보고하는 지표는 생성한 답변 1개의 성공 여부를 나타내는 pass@1이며, Yang et al. (2024)의 평가 절차를 사용한다.
4.4 Main Results
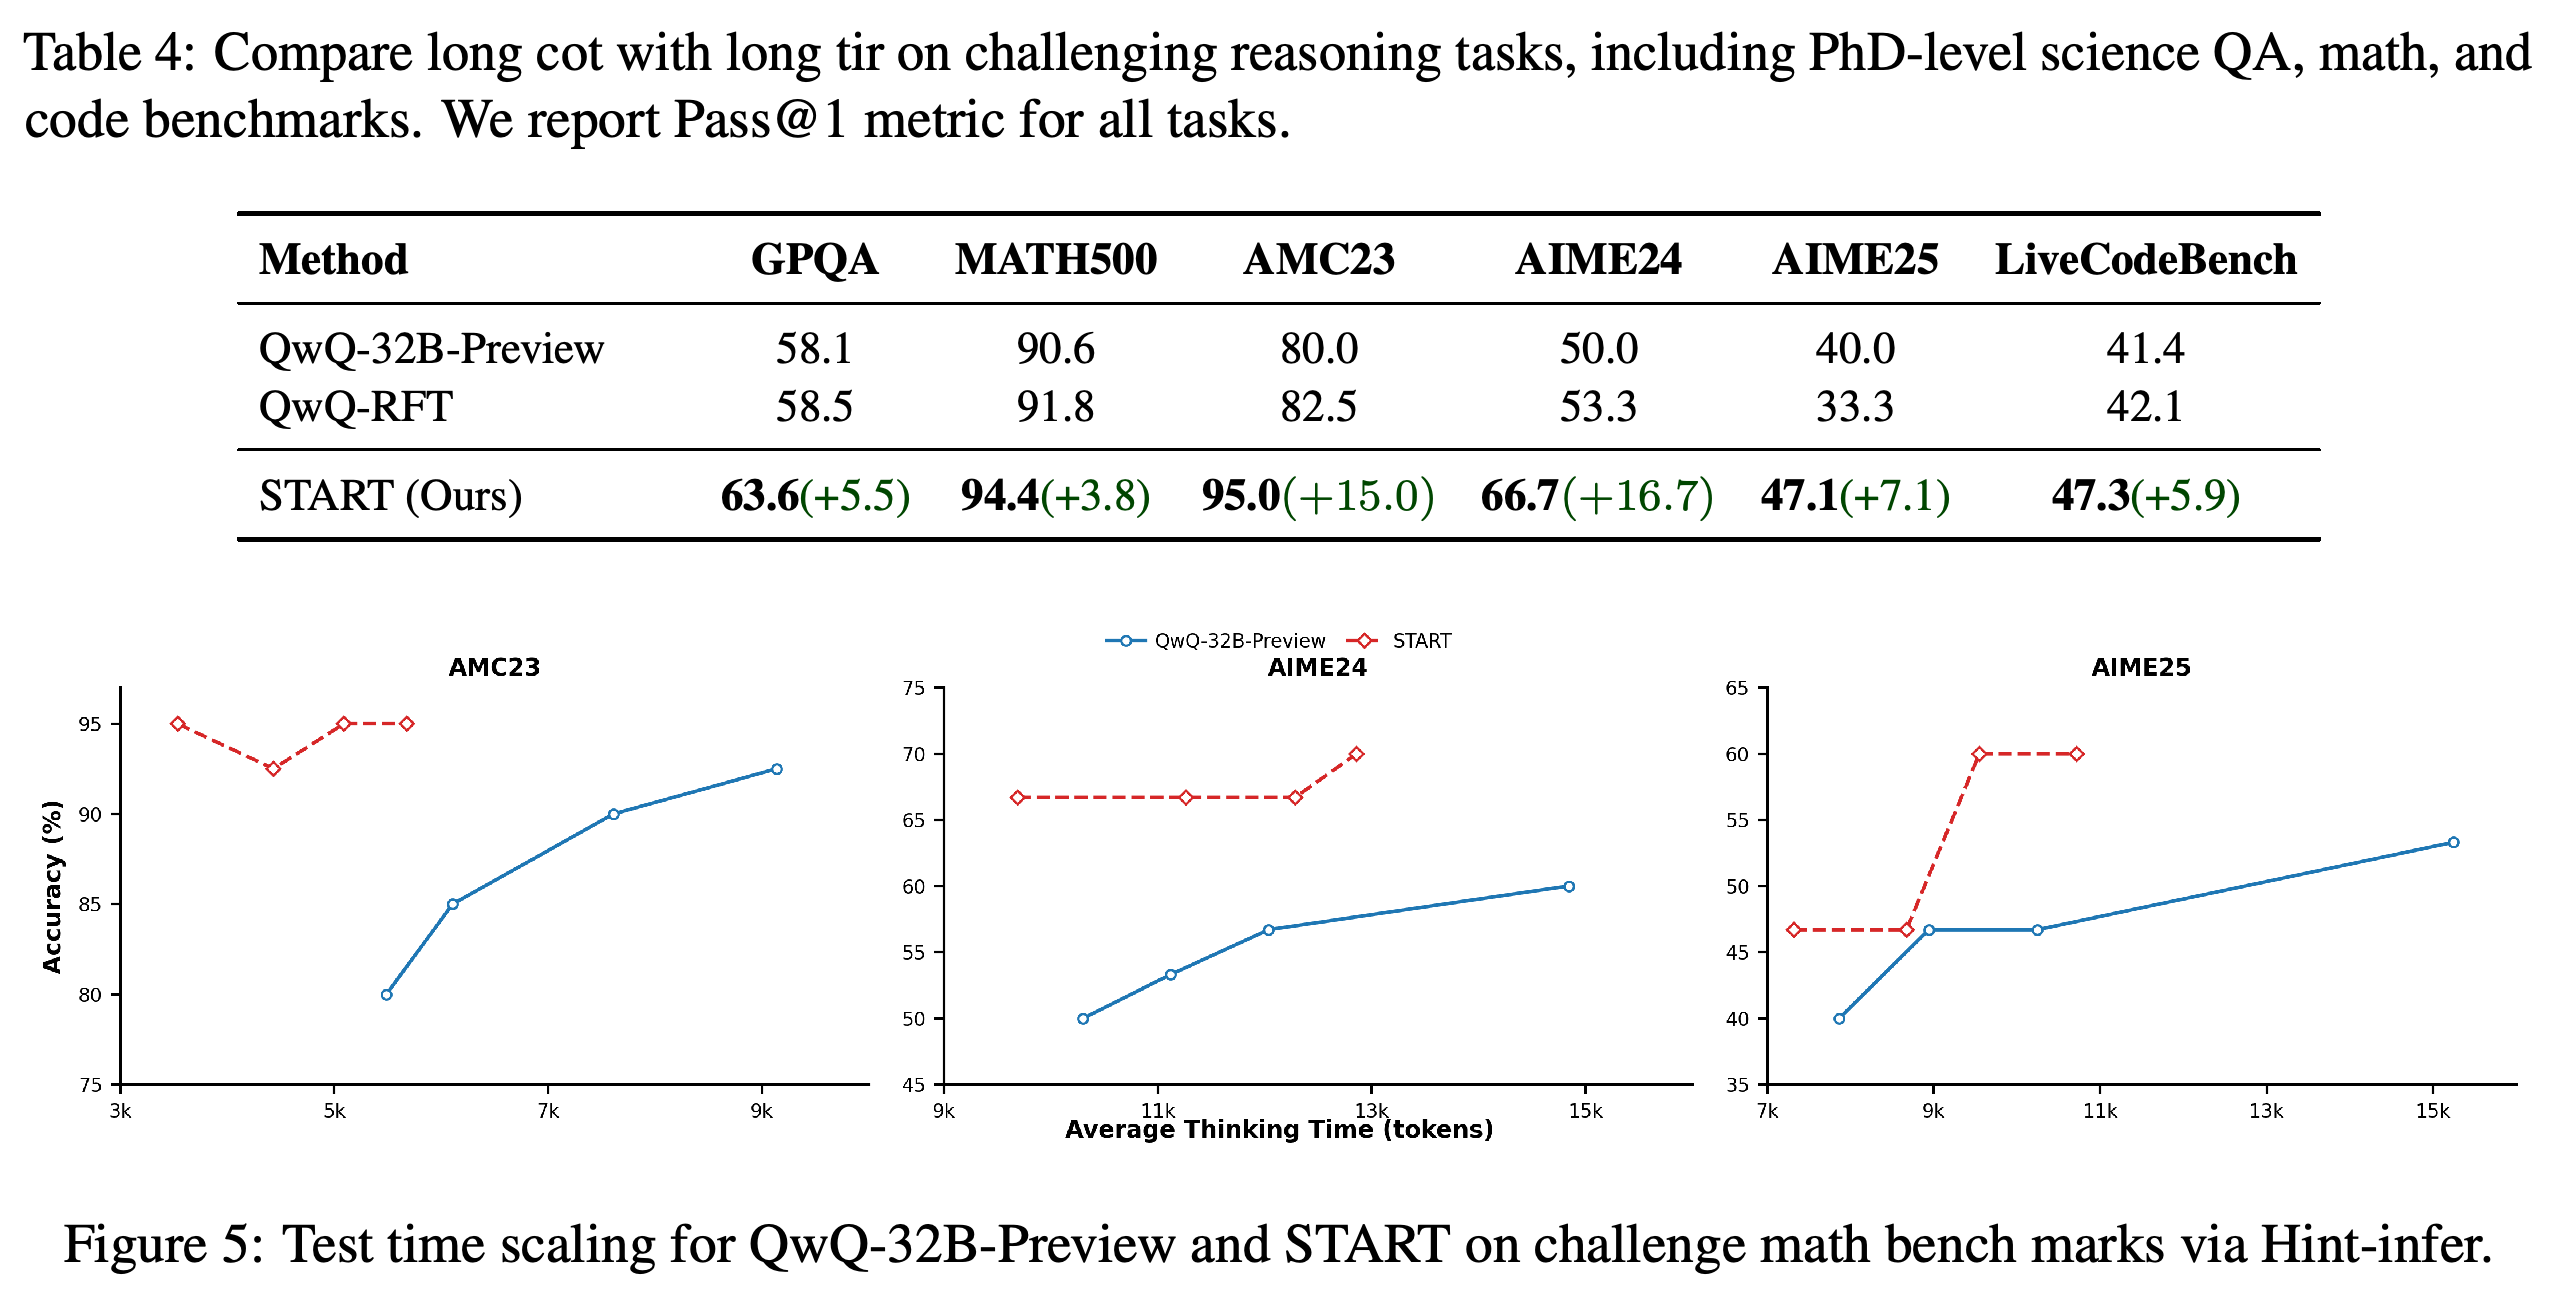
Table 1에서 START는 GPQA 63.6%, MATH500 94.4%, AMC23 95.0%, AIME24 66.7%, AIME25 47.1%, LiveCodeBench 47.3%를 기록한다. QwQ-32B-Preview 대비 개선 폭은 각각 5.5, 3.8, 15.0, 16.7, 7.1, 5.9%p다.
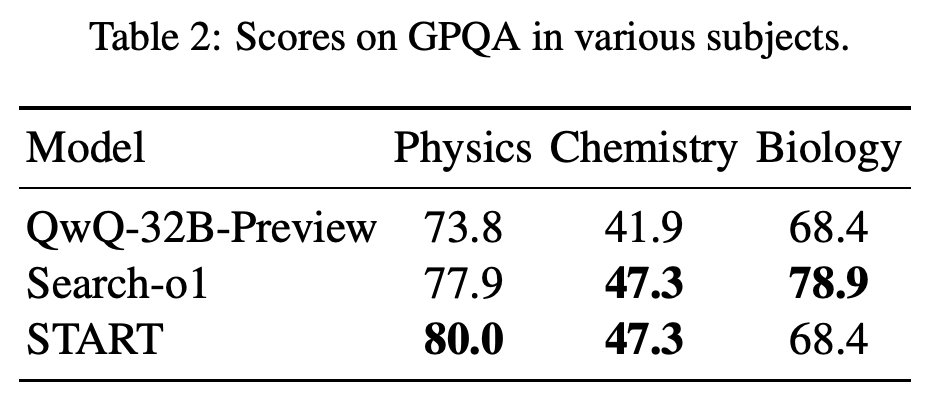
- START는 전체 GPQA 점수에서 Search-o1-32B와 동률이다. Table 2에서는 물리학이 73.8%에서 80.0%로, 화학이 41.9%에서 47.3%로 향상되고 생물학은 68.4%를 유지한다. 저자들은 이를 계산의 유용성으로 설명하지만, 그 설명을 직접 검증하지는 않는다.
- START는 R1-Distill-Qwen-32B보다 GPQA, MATH500, AMC23, AIME25의 보고 점수가 높지만 AIME24와 LiveCodeBench 점수는 낮다. 따라서 우위는 과제에 따라 달라진다.
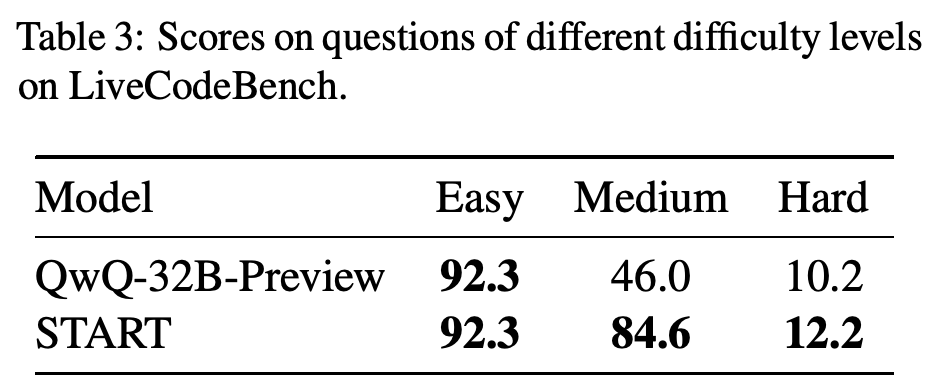
- Table 3에서 쉬운 프로그래밍 문제의 정확도는 92.3%로 유지되고, 중간 난이도는 46.0%에서 84.6%로, 어려운 문제는 10.2%에서 12.2%로 향상된다. 저자들은 쉬운 문제에는 디버깅이 거의 필요하지 않고, 어려운 문제는 주어진 디버깅 예산 안에서도 해결하기 어렵기 때문일 가능성을 제시한다.
START는 보고된 과제 6개 모두에서 기반 모델보다 성능이 높으며, 절대 개선 폭은 AIME24에서 가장 크다. R1-Distill-Qwen-32B와의 비교에서는 우열이 엇갈리고, 일부 비교 모델의 결과는 공식 발표에서 가져왔다.
START의 GPQA 성능은 물리학과 화학에서 향상되지만, 생물학에서는 기반 모델과 동일하다. Search-o1은 생물학에서 더 높은 성능을 보이므로, 전체 GPQA 점수가 같아도 과목별 결과는 다르다.
보고된 개선은 중간 난이도 프로그래밍 문제에 집중되며, 정확도가 46.0%에서 84.6%로 높아진다. 쉬운 문제의 성능은 그대로이고 어려운 문제는 소폭만 향상되므로, 디버깅 효과를 모든 난이도로 일반화하기는 어렵다.
4.5 Analysis
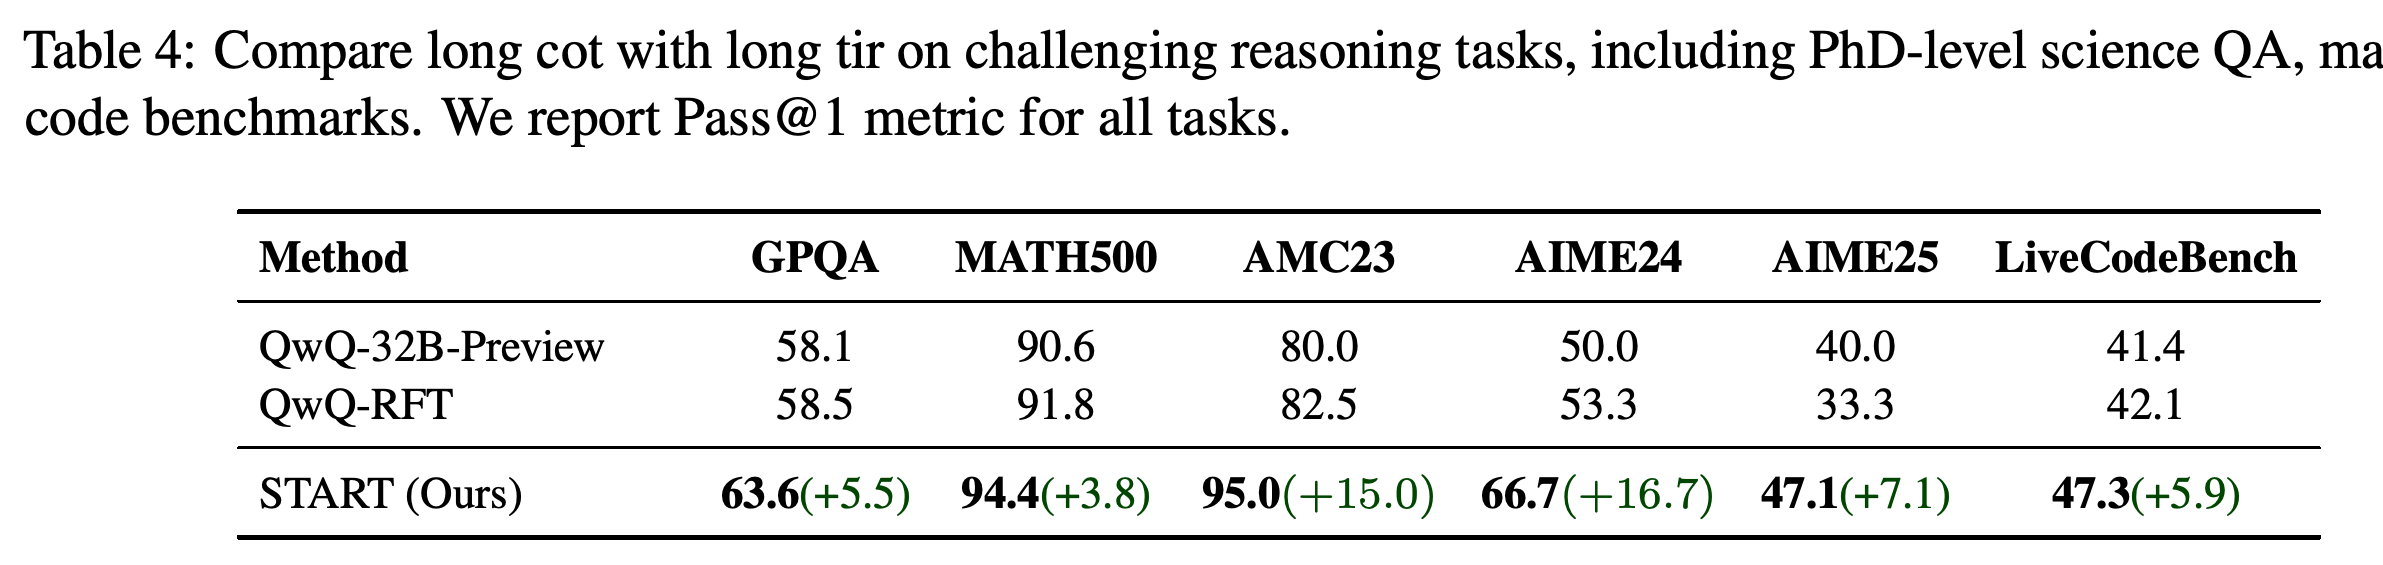
“4.5.1 Long CoT vs Long TIR”에서는 동일한 질문에 대해 질문당 32개의 샘플, temperature 0.7, top-p 0.95로 일반 추론 궤적을 생성한다. 이후 오답과 반복 응답을 걸러내고 질문마다 최대 1개의 응답을 남긴다. 이렇게 학습한 QwQ-RFT는 AIME24에서 53.3%, LiveCodeBench에서 42.1%를 기록하며, START의 66.7%, 47.3%보다 낮다. AIME25 점수는 기반 모델의 40.0%에서 33.3%로 하락한다.
- Table 4는 도구를 활용한 학습 과정이 질문 집합을 재사용하는 것 이상의 이점을 제공함을 뒷받침한다. 다만 궤적 생성 절차와 샘플링 설정도 다르므로, 도구 접근만의 효과를 완전히 분리한 실험으로 볼 수는 없다.
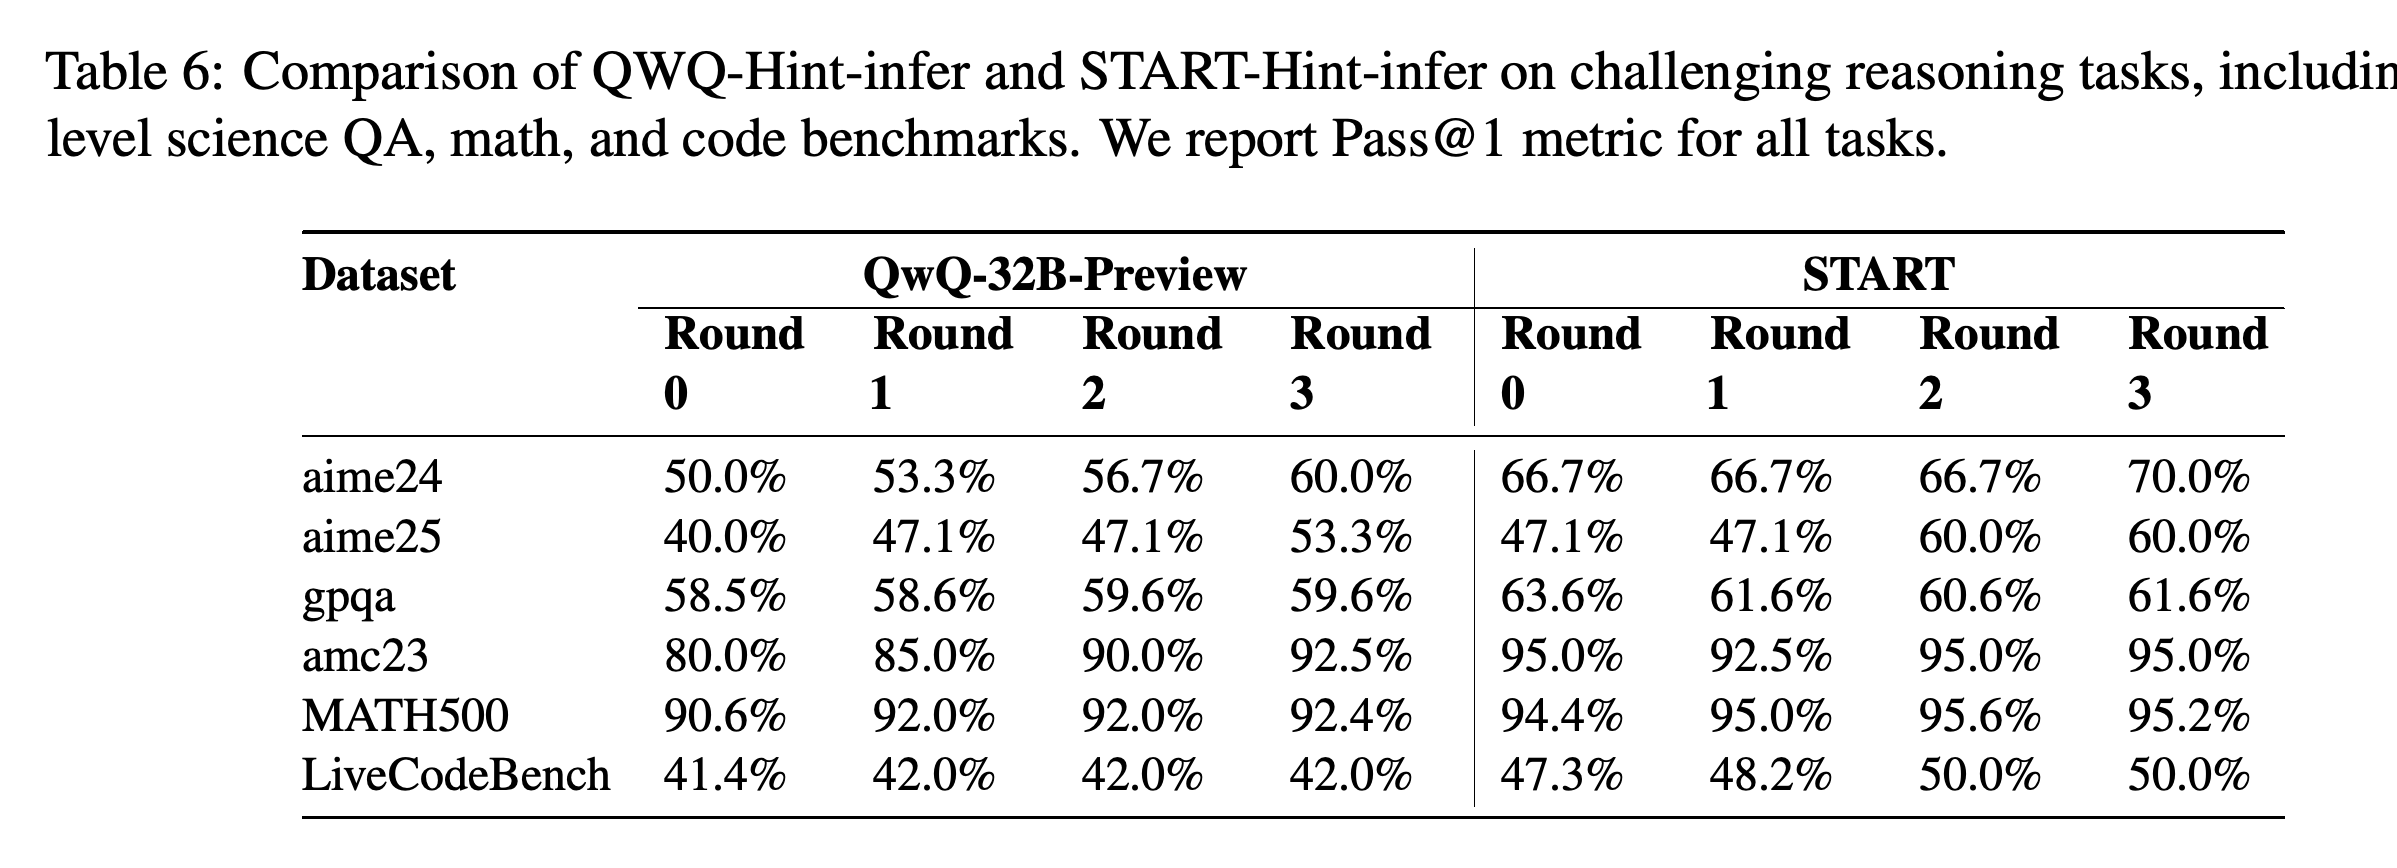
- “4.5.2 Analysis of Hint-infer”에서는 stop token 앞에 힌트를 반복해서 넣어 추론을 연장한다. Figure 5와 Table 6에서 QwQ-32B-Preview는 추가 3개 라운드를 거치며 AIME24 정확도가 50.0%에서 60.0%로, AMC23 정확도가 80.0%에서 92.5%로 향상된다.
- START의 변화는 일정하지 않다. AIME25는 47.1%에서 60.0%로, LiveCodeBench는 47.3%에서 50.0%로 향상되지만, GPQA는 Round 3에 이르러 63.6%에서 61.6%로 하락한다. 또한 Table 6은 기반 모델의 Round 0 GPQA를 58.5%로 기재하지만, Tables 1과 4는 58.1%로 보고한다.
동일한 질문 집합으로 일반적인 rejection sampling fine-tuning을 수행하면 START보다 개선 폭이 작고 AIME25 성능은 악화된다. 이는 도구를 활용한 학습 과정을 뒷받침하지만, 학습 과정 2개는 궤적 생성과 샘플링 설정에서도 차이가 난다.
이 그래프는 힌트로 추론을 연장할 때 생성한 평균 추론 토큰 수와 정확도의 관계를 보여준다. 기반 모델은 그래프에 제시한 수학 과제 전반에서 개선되지만, START의 변화는 벤치마크와 라운드에 따라 다르다. 가로축은 인터프리터 지연 시간이나 전체 실행 비용을 측정하지 않는다.
출처별 개수의 합은 46,969개로, 표에 인쇄된 총계 49,969개 및 본문에 제시된 약 50K개와 다르다. 이 불일치 때문에 논문만으로 학습 말뭉치를 정확히 재구성하기 어렵다.
힌트를 추가하면 일부 수학과 프로그래밍 점수는 향상되지만, START의 GPQA 정확도는 추가된 3개 라운드 모두에서 하락한다. 표의 QwQ-32B-Preview GPQA Round 0 값도 Tables 1과 4의 값과 다르므로, 이 시작값들을 구분해야 한다.
5 Conclusion
결론에서는 Hint-infer와 Hint-RFT를 긴 추론에 인터프리터 사용을 추가하는 방법으로 제시한다. 실험은 QwQ-32B-Preview 대비 벤치마크 정확도 향상을 뒷받침하고 계산, 검증, 디버깅 행동을 보여준다. 다른 모델과 비교한 성능은 과제와 모델에 따라 달라진다.
6 Limitations
논문이 제시한 한계는 외부 도구로 Python만 사용한다는 점, 수작업으로 선택한 힌트와 삽입 위치가 추론을 방해할 가능성, 제한된 벤치마크에서만 평가했다는 점이다. 저자들은 코드 생성과 문제 해결 능력의 오용 가능성도 논의하지만, 실증적인 안전성 평가를 보고하지는 않는다.
- 논문은 반복 실행에 따른 불확실성 추정이나 체계적인 지연 시간 및 실행 비용 비교를 보고하지 않는다. 정확도 결과만으로 모델과 인터프리터를 결합한 전체 시스템의 효율성을 입증할 수는 없다.
부록
- A.1 Training set of START: Table 5는 2024년 이전 AIME 문제 890개, MATH 문제 7,500개, Numina-MATH 문제 28,505개, Codeforces 문제 7,505개, code contests 문제 2,011개, 2024년 7월 이전 LiveCodeBench 문제 558개를 제시한다. 항목의 합은 46,969개지만 표에 인쇄된 총계는 49,969개이며, 본문은 약 50K개로 설명한다.
- A.2 More results about Hint-infer: Table 6은 모델 2개의 라운드 0–3 결과를 기록한다. QwQ-32B-Preview는 Round 3에서 MATH500 92.4%, LiveCodeBench 42.0%에 도달한다. START는 MATH500에서 Round 2에 최고점 95.6%를 기록한 뒤 95.2%로 하락한다. 이는 추론을 추가해도 결과가 일관되게 개선되지는 않음을 보여준다.
- A.3 Prompting Methods for Data annotation은 직접적인 프롬프트, 상세한 프롬프트, 시연 기반 프롬프트를 비교한다. 저자들은 이 방법들로 QwQ-32B-Preview, DeepSeek-R1, o1-mini에서 원하는 인터프리터 호출을 포함한 추론을 생성하지 못한 반면, Hint-infer는 100%의 성공률로 Python 코드 생성을 유도했다고 보고한다. 이는 풀이 정확도가 아니라 코드 생성 유도에 관한 결과이며, 부록에는 성공률의 분모가 명시되어 있지 않다. o1 시리즈에서는 추론 요약에 Python 호출이 포함되었는지만 확인할 수 있었다.
- A.4 Hint-infer for test time scaling은 수학과 GPQA에서 Python으로 추론을 검증하고, 재검증하고, 심화하도록 요청하는 연속된 힌트 3개를 제공한다. 프로그래밍 힌트는 starter code가 있는 경우와 없는 경우에 맞는 디버깅 템플릿을 사용하며, 예제 입력을 넣고 출력을 인쇄해 비교하도록 한다.
- A.5 Case Study For START에는 “A.5.1 A case form AMC23”이 포함된다. 이 사례에서는 6, 10, 15센트 동전 조합을 열거해 만들 수 없는 가장 큰 값 29와 자릿수 합 11을 구한다. “A.5.2 A case form AIME24”에서는 보고된 SyntaxError 이후 코드를 수정해 (17, 110)을 얻는다. “A.5.3 A case form AIME25”에서는 기호 연산과 외적 계산으로 넓이 507√3과 답 510을 구한다. 이들은 설명을 위해 선별한 궤적이며, 각 행동이 얼마나 자주 나타나는지를 추정한 결과는 아니다.
- “A.5.4 A case form MATH500”에서는 소프트웨어로 대수 연산을 수행하는 기호 연산을 함수방정식에 적용해 −2, 1을 반환한다. “A.5.5 A case form GPQA”에서는 수치 계산을 다시 검토하고 변화 배율 4.514를 얻은 뒤 B를 선택한다. “A.5.6 A case form LiveCodeBench”에서는 출력 2와 6이 기대값 4와 126에 맞지 않자 개수를 세는 구현을 수정하고, 이후 예제 출력이 일치한다고 보고한다. 해당 예제의 일치만으로 모든 유효한 입력에 대한 정당성을 증명할 수는 없다.
짧은 생각
가장 뚜렷한 기여는 기존 추론 모델에 실행 피드백 사용을 가르치는 구체적인 데이터 생성 절차다. 동일한 질문을 사용한 QwQ-RFT 비교와 디버깅 예제가 이를 뒷받침한다. 다만 실험에는 도구 사용, 궤적 구성, 데이터 선별의 변화가 함께 포함된다.
결과는 계산이나 실행 가능한 검증으로 오류를 드러낼 수 있는 과제에서 이 접근법을 시험할 근거를 제공한다. Python만 사용한 평가, 추가 힌트에 따른 엇갈린 효과, 보고되지 않은 불확실성과 실행 시간 및 비용, 일관되지 않은 데이터셋 개수 때문에 신뢰성과 배포 비용은 아직 충분히 평가되지 않았다.