


StyleCrafter: Enhancing Stylized Text-to-Video Generation with Style Adapter 요약 설명
01 Dec 2023 | Paper Review Text-to-Video Generation Controllable Video Generation Video Diffusion Models목차
이번 글에서는 StyleCrafter: Enhancing Stylized Text-to-Video Generation with Style Adapter 논문의 핵심 포인트만 간단히 정리한다.
- 2023년 12월 1일(Arxiv), ACM Transactions on Graphics, Vol. 43, No. 6, December 2024
- Liu, Gongye, Xia, Menghan, Zhang, Yong, Chen, Haoxin, Xing, Jinbo, Wang, Yibo, Wang, Xintao, Yang, Yujiu, Shan, Ying.
- Tsinghua University, China, Tencent AI Lab, China, The Chinese University of Hong Kong, China
- 논문 링크
- Github
요약
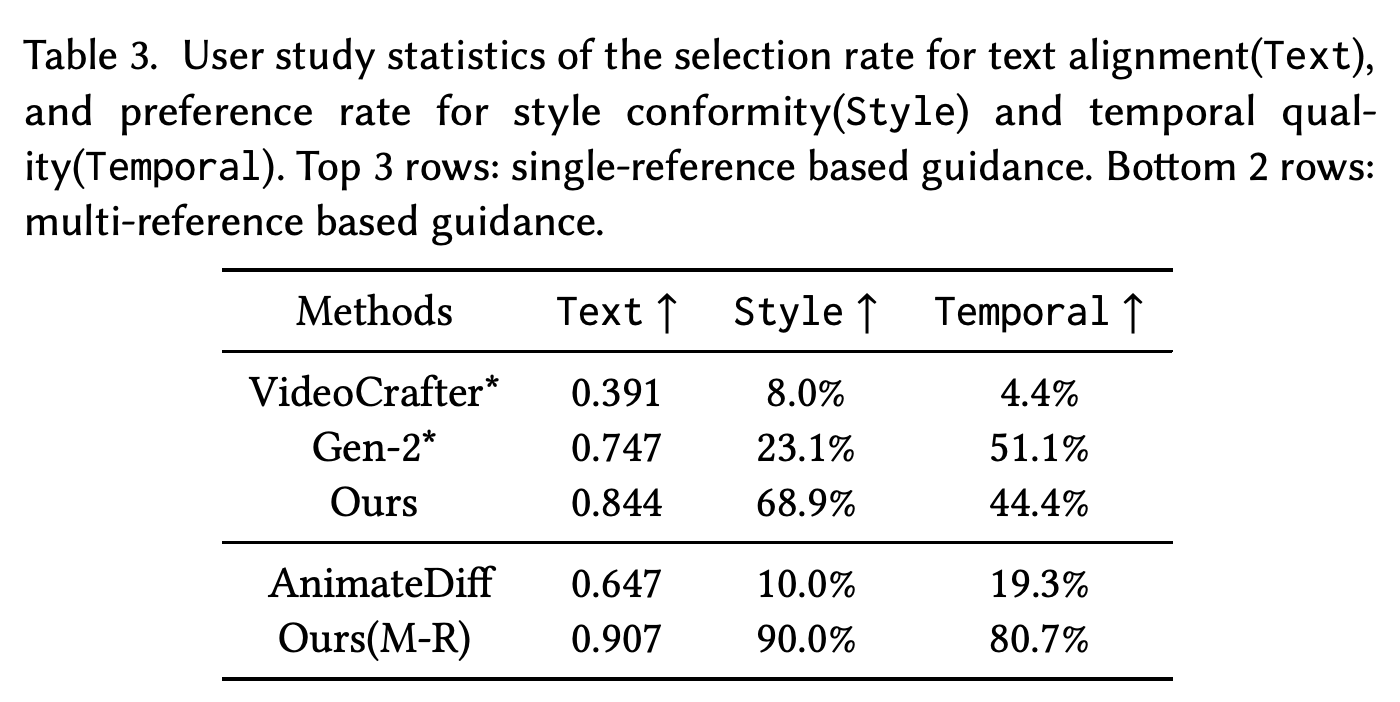
- StyleCrafter는 텍스트 설명을 따르면서 참조 이미지의 예술적 스타일을 반영하는 영상을 생성하는 문제를 다룬다. 단일 참조 생성에 관한 사용자 15명 대상 조사에서 StyleCrafter 영상의 스타일 선호도는 68.9%였고, 참조 스타일을 텍스트로 설명받은 Gen-2*와 VideoCrafter*는 각각 23.1%와 8.0%였다.
- 이 방법은 참조 이미지의 특징을 사전 학습된 생성기에 주입하는 style adapter를 예술 이미지로 학습한 뒤, 이미지와 사실적인 영상을 사용해 비디오 모델의 temporal block을 적응시킨다. 별도의 attention 경로와 문맥에 따른 스케일 조정으로 참조 스타일과 프롬프트 내용의 균형을 맞춘다.
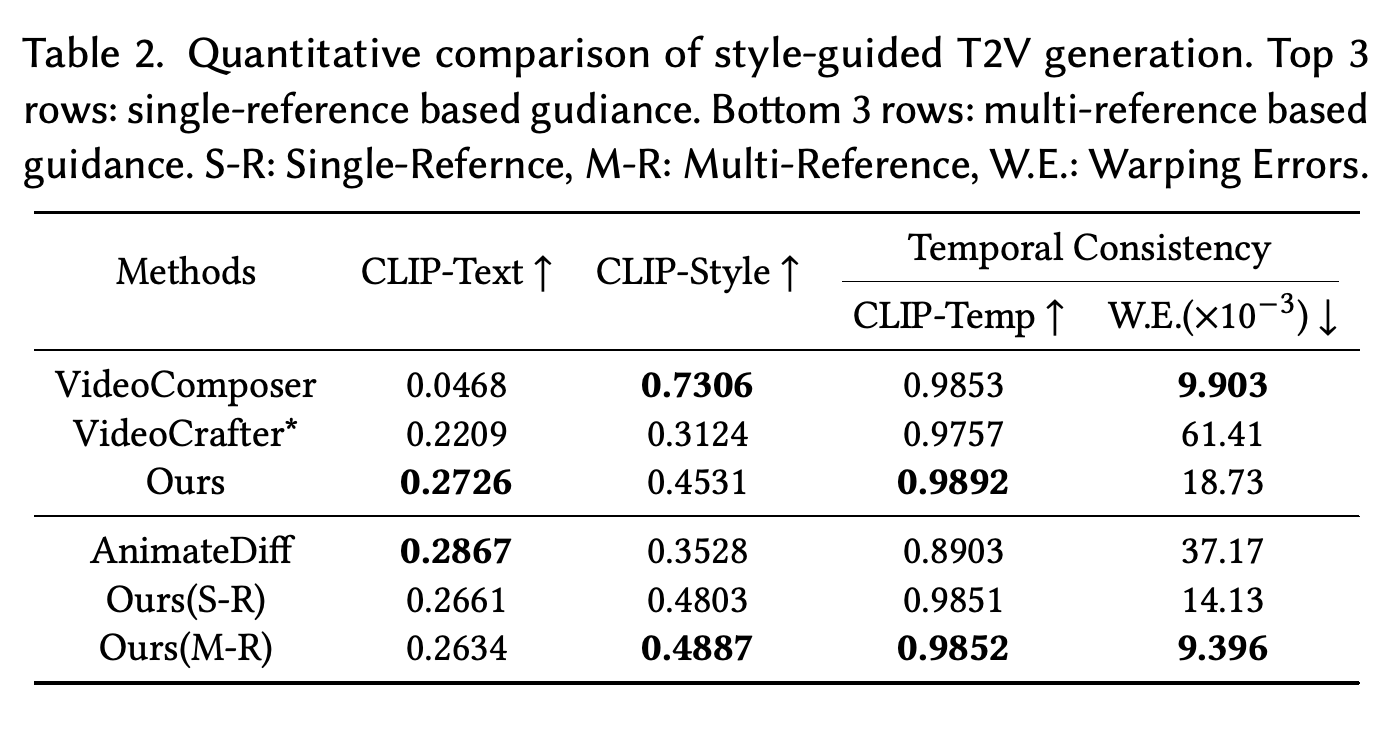
- 단일 참조 영상 쌍 240개에서 StyleCrafter는 텍스트와 이미지의 유사도를 나타내는 CLIP-Text 0.2726, 이미지와 참조 이미지의 유사도를 나타내는 CLIP-Style 0.4531을 기록했다. VideoComposer는 각각 0.0468과 0.7306을 기록했지만 참조 내용을 자주 복사했다. 결과는 기반 비디오 모델의 성능과 목표 스타일을 충분히 표현하지 못하는 참조 이미지에 의해 제한된다.
1 Introduction
논문은 참조 이미지의 내용을 복사하지 않고 스타일을 추출하는 문제와 스타일화된 영상 학습 데이터가 부족한 상황에서 비디오 생성기를 적응시키는 문제를 제시한다. 이를 해결하기 위해 이미지 기반 adapter 학습 후 temporal adaptation을 수행하고, 데이터 증강과 adaptive fusion으로 내용과 스타일의 분리를 유도한다.
2 Related Works
관련 연구는 text-to-video synthesis, stylized image generation, stylized video generation을 다룬다. 논문은 이 분야들이 만나는 지점에 adapter를 제안한다.
2.1 Text to Video Synthesis
기존 text-to-video 시스템은 autoregressive transformer나 diffusion model을 사용하며, 사전 학습된 text-to-image 모델에 temporal block을 추가하는 방법도 있다. VideoCrafter는 후자의 방식을 따르며 이 연구의 기반 모델로 사용된다.
2.2 Stylized Image Generation
Style transfer는 한 이미지의 외형과 다른 이미지의 내용을 결합하며, 예시 기반 이미지 생성기는 참조 이미지에서 스타일을 학습하거나 추출한다. 저자들은 IP-Adapter가 이미지 변형을 생성할 수 있지만 다른 내용을 생성하도록 요청해도 참조 내용이 남을 수 있다고 지적한다.
2.3 Stylized Video Generation
Video style transfer는 주로 원본 영상과 프레임 일관성 제약을 사용한다. VideoComposer는 스타일 참조를 입력받지만 참조 내용을 복사할 수 있으며, AnimateDiff는 개인화된 이미지 모델과 motion module을 결합하고 보통 스타일별 준비가 필요하다.
3 Method
StyleCrafter는 사전 학습된 video diffusion model에 내용은 텍스트 프롬프트로, 스타일은 이미지로 조건을 부여한다. 2단계에 걸쳐 이미지에서 참조 기반 스타일 조절을 학습한 뒤 예술 이미지와 사실적인 영상을 섞어 temporal 처리를 적응시킨다.
참조 이미지 특징이 별도의 스타일 attention 경로로 입력되고, 텍스트와 스타일이 함께 레이어별 융합 스케일을 결정하는 과정을 보여준다.
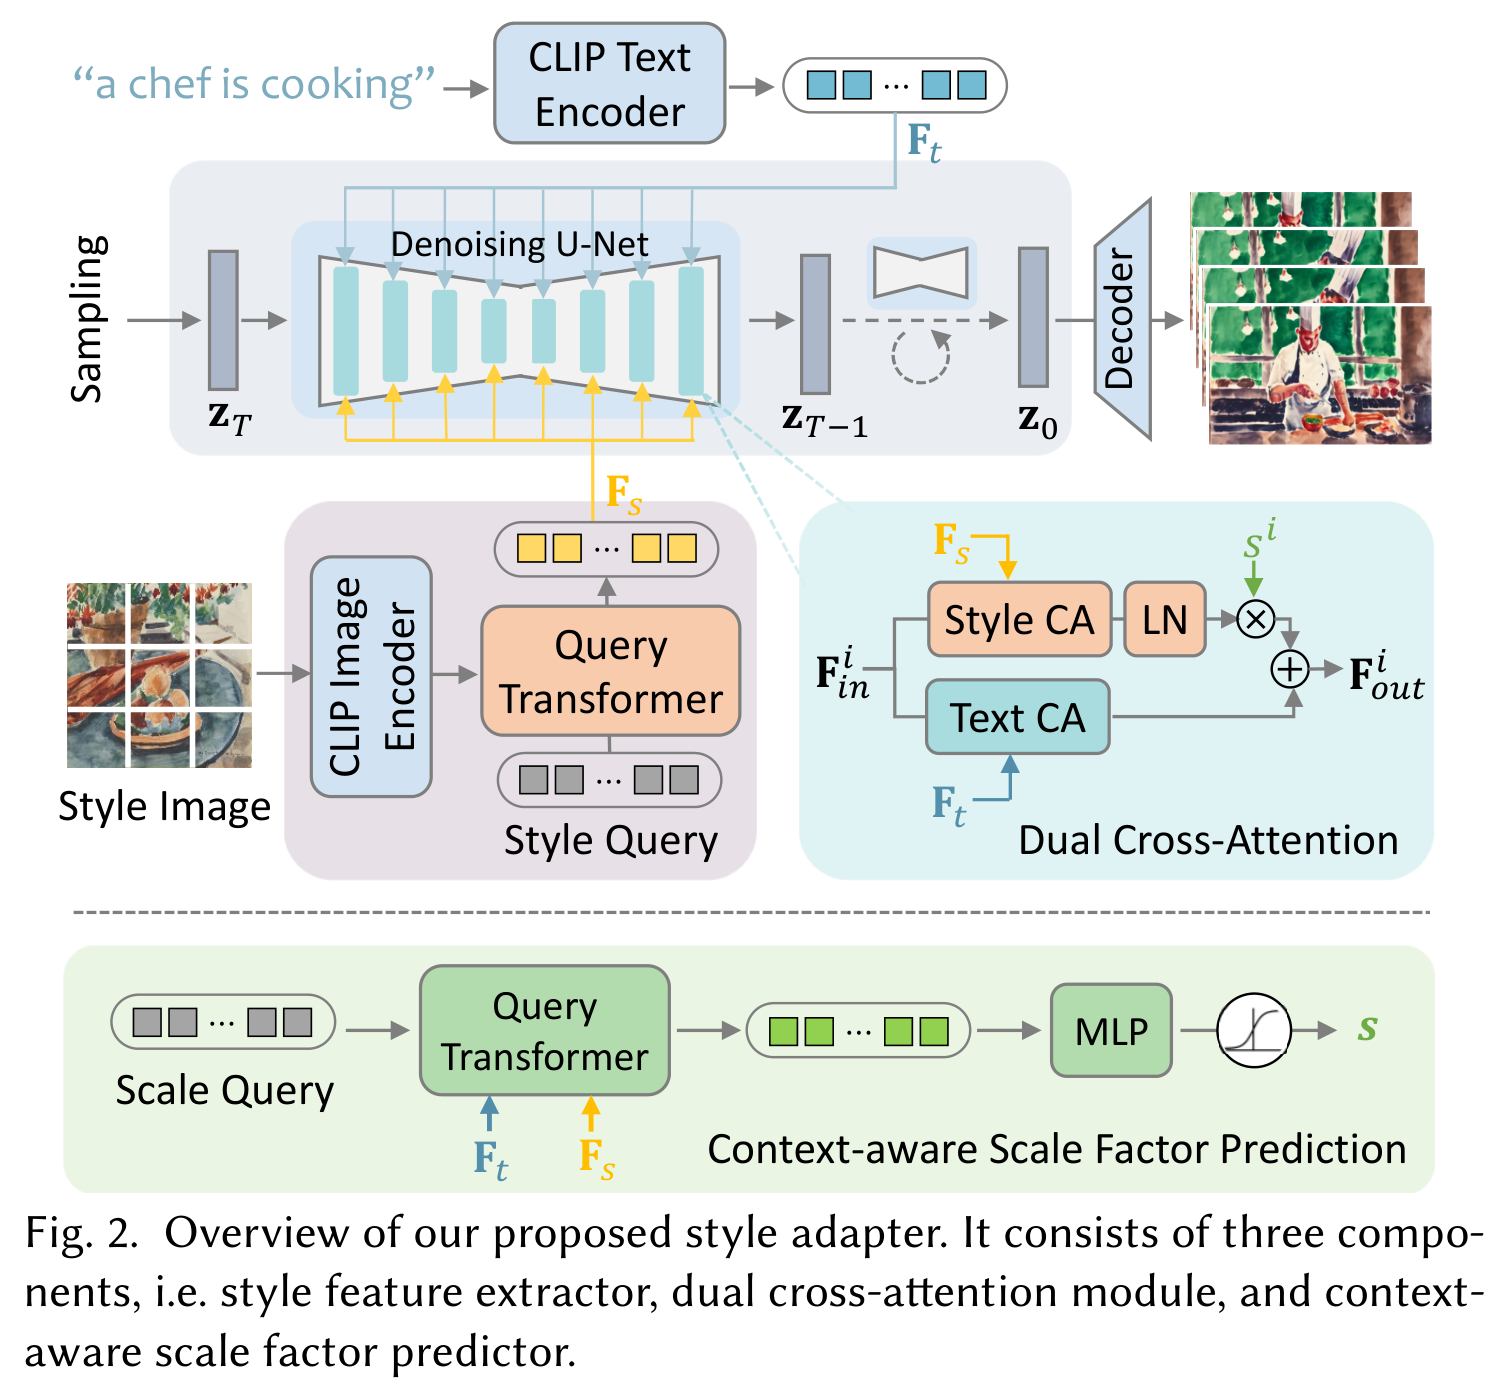
3.1 Reference-Based Style Modulation
학습에는 WikiArt와 점수가 6.5를 초과하는 Laion-Aesthetics 일부를 사용한다. 이미지 언어 모델인 BLIP-2로 캡션을 다시 생성하고 정규 표현식으로 일부 스타일 표현을 제거한다. 타깃 이미지는 짧은 변을 512로 조정한 뒤 중앙을 자르고, 스타일 참조는 짧은 변을 800으로 조정한 뒤 512 × 512 크기로 무작위로 잘라 내용이 겹치는 정도를 줄인다.
사전 학습된 CLIP 이미지 인코더는 전역 토큰과 로컬 토큰 256개를 학습 가능한 Query Transformer(Q-Former)에 전달하며, Q-Former는 스타일 특징을 추출한다. 텍스트와 스타일에 별도로 attention을 적용하는 dual cross-attention은 두 조건에서 예측한 레이어별 스케일 계수 16개를 사용해 특징을 결합한다. CLIP에 대해서는 CLIP 논문 리뷰(Learning Transferable Visual Models From Natural Language Supervision) 글을 참조하라.
3.2 Temporal Adaptation to Stylized Features
이미지로 학습한 adapter만 사용하면 영상에 흔들림과 아티팩트가 생길 수 있다. 따라서 2단계에서는 다른 모듈을 고정하고 스타일화된 이미지와 사실적인 영상으로 temporal block을 미세 조정한다. 생성 과정에서 조건의 강도를 조정하는 classifier-free guidance는 텍스트와 스타일에 별도 가중치를 사용하며, 영상에는 각각 15.0과 7.5, 이미지에는 7.5와 5.0을 적용한다.
4 Experimental Results
실험은 이미지와 영상 생성을 평가하고 단일 참조 및 다중 참조 방법을 비교하며, adapter와 학습 방식의 구성 요소를 제거해 효과를 분석한다. 자동 유사도 및 시간적 일관성 지표와 사용자 조사를 함께 사용한다.
4.1 Experimental settings
1단계는 GPU당 배치 크기 32로 40k 스텝을 학습한다. 2단계는 영상 배치 크기 1, 이미지 배치 크기 16, 이미지 배치 비율 20%로 20k 스텝을 학습한다. 학습에는 A100 GPU 8개를 사용하며 3일 이내에 완료된다.
백본 그룹 2개에서 스타일 지표가 일관되게 개선되지만, Stable Diffusion 2.1 그룹에서는 DreamBooth의 텍스트 점수가 약간 더 높다.
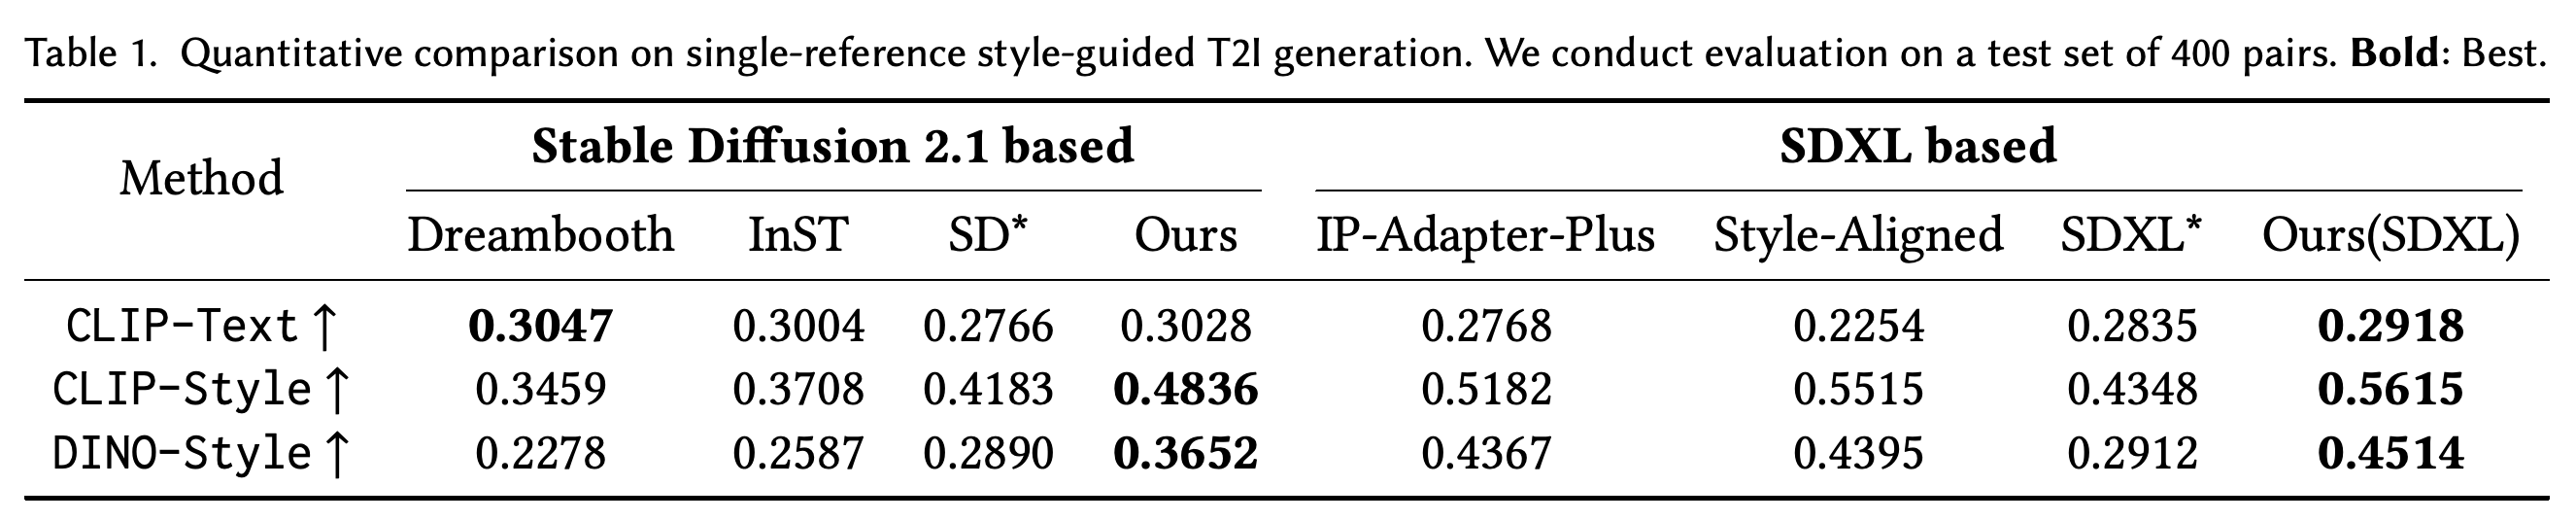
테스트 세트는 이미지 쌍 400개와 영상 쌍 300개로 구성되며, 영상 쌍에는 단일 참조 240개와 다중 참조 60개가 포함된다. 이미지 프롬프트 20개, 영상 프롬프트 12개, 단일 참조 20개, 이미지 5~7개로 구성된 다중 참조 세트 8개를 사용한다. 사용자 조사는 단일 참조 쌍 15개와 다중 참조 쌍 10개를 대상으로 진행하며 사용자 15명에게서 투표 1,125건을 수집한다.
VideoComposer는 스타일 점수가 높지만 텍스트 정합성이 매우 낮다. 이는 참조 이미지와의 유사도만으로 스타일 전이가 성공했다고 판단할 수 없음을 보여준다.
4.2 Style-Guided Text-to-Image Generation
이미지 쌍 400개에서 Stable Diffusion 2.1 기반 StyleCrafter는 CLIP-Style 0.4836과 DINO 시각 특징을 기반으로 한 유사도인 DINO-Style 0.3652를 기록했다. SD*는 각각 0.4183과 0.2890을 기록했다. StyleCrafter의 CLIP-Text는 0.3028로 DreamBooth의 0.3047보다 약간 낮았으며, SDXL 기반 버전은 비교 그룹에서 보고된 점수 3개 모두 가장 높았다.
StyleCrafter는 설정 2개 모두에서 스타일 선호도가 가장 높으며, 단일 참조의 시간적 품질 선호도는 Gen-2*가 가장 높다.
4.3 Style-Guided Text-to-Video Generation
단일 참조 영상에서 StyleCrafter는 CLIP-Text 0.2726과 인접 프레임 간 유사도를 나타내는 CLIP-Temp 0.9892를 기록했으며, VideoCrafter*는 각각 0.2209와 0.9757을 기록했다. VideoComposer는 CLIP-Style이 더 높고 움직임 기반 정렬 후 프레임 차이를 측정하는 warping error가 더 낮았지만, 참조 이미지를 복사하고 정적인 영상을 자주 생성한 점이 결과에 영향을 미쳤다.
사용자 조사에서 StyleCrafter는 단일 참조 스타일 선호도 68.9%를 얻었지만, 시간적 품질 선호도에서는 Gen-2*가 51.1%로 StyleCrafter의 44.4%보다 높았다. 다중 참조 비교에서 StyleCrafter의 스타일 및 시간적 품질 선호도는 각각 90.0%와 80.7%였고, AnimateDiff는 10.0%와 19.3%였다.
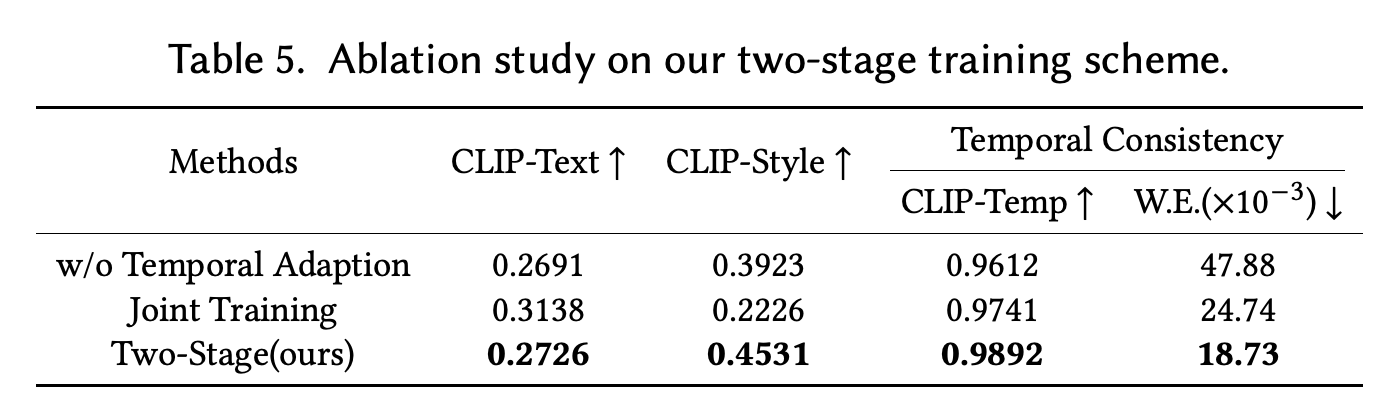
Temporal adaptation은 이미지로 학습한 adapter를 직접 적용한 경우보다 보고된 시간적 지표 2개를 모두 개선한다. 공동 학습은 텍스트 유사도가 더 높지만 스타일 유사도는 더 낮다.
4.4 Ablation Study
데이터 증강을 제거하면 이미지 CLIP-Style이 0.4836에서 0.4005로 낮아진다. Dual cross-attention을 제거하면 스타일 유사도는 0.7332로 높아지지만 CLIP-Text는 0.0983으로 낮아져 참조 내용을 복사하는 현상과 부합한다. Adaptive fusion이 없으면 CLIP-Text는 0.3028에서 0.2807로 낮아진다.
2단계 학습은 CLIP-Temp 0.9892와 warping error 18.73 × 10⁻³을 기록했으며, temporal adaptation을 적용하지 않으면 각각 0.9612와 47.88 × 10⁻³을 기록했다. 공동 학습의 CLIP-Text는 0.3138로 0.2726보다 높았지만, CLIP-Style은 0.2226으로 0.4531보다 낮았다.
5 Conclusion and Limitations
저자들은 참조 이미지가 의도한 스타일을 제대로 표현하지 못하거나 스타일이 매우 낯선 경우 생성에 실패한다고 보고한다. 보충 자료는 기반 모델에서 물려받은 해상도, 영상 길이, 시간적 일관성, 사람 얼굴의 한계와 함께 중국 수묵화의 여백처럼 복잡한 미적 특징을 완벽하게 재현하지 못하는 문제도 지적한다.
부록
- A Implementation Details와 A.1 Comparison methods는 베이스라인 학습 방식을 설명한다. DreamBooth는 단일 참조 스타일에 500 스텝, 다중 참조 스타일에 1,500 스텝을 사용하고, InST는 1,000 스텝을 사용하며 IP-Adapter의 스케일은 0.5로 설정한다. A.2 Testing Datasets는 GPT-4로 프롬프트를 생성하고 사람, 동물, 사물, 풍경 범주에서 수동으로 선별한 과정을 설명한다.
- B Evaluation Details와 B.1 Evaluation Metrics는 CLIP 코사인 유사도와 optical flow 기반 warping error를 정의한다. B.2 User Study는 선택지 순서를 무작위로 바꾸고 워터마크를 가린 뒤 텍스트 정합성, 스타일 부합도, 시간적 품질을 별도로 질문한 과정을 설명한다. VideoComposer는 참조 이미지를 자주 복사하여 조사에서 제외했다.
- C Extended Comparison의 C.1 Multi-reference Stylized Image Generation에서 StyleCrafter의 스타일 점수는 0.5333으로 CustomDiffusion의 0.4441보다 높다. C.2 Comparison with StyleDrop은 비공식 구현을 사용해 각각 0.4836과 0.3962를 보고한다. C.3 Comparison with Style Transfer Methods에서 영상 스타일 점수는 StyleCrafter가 0.4531, MCCNet 기반 비교 방법이 0.2858이다.
- D Extended Ablation Study는 multilayer perceptron(MLP), Transformer, Q-Former 추출기의 스타일 점수를 각각 0.2843, 0.4149, 0.4836으로 보고하며, 텍스트 점수의 순서는 반대다. E Application Extension은 추론 시 독립적으로 학습한 스타일 adapter와 깊이 adapter를 결합한다. F More Results는 추가 예시를 제공하고, G Limitations는 얼굴 아티팩트와 복잡한 스타일을 완전히 재현하지 못하는 문제를 설명한다.
짧은 생각
구성 요소 제거 실험은 스타일과 내용을 분리할 필요성을 뒷받침한다. 특히 높은 스타일 유사도 점수는 참조 이미지를 복사한 결과에도 부여될 수 있다. 선별된 프롬프트와 참조 세트, 15명 대상 조사는 비교 결과를 폭넓게 일반화하는 데 제약이 있으며, 단일 참조의 시간적 품질 선호도에서는 Gen-2*가 앞선다.