


Video Creation by Demonstration 요약 설명
12 Dec 2024 | Paper Review Controllable Video Generation Video Diffusion Models Self-Supervised Learning목차
이번 글에서는 Video Creation by Demonstration 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 12월 12일(Arxiv)
- Sun, Yihong, Zhou, Hao, Yuan, Liangzhe, Sun, Jennifer J., Li, Yandong, Jia, Xuhui, Adam, Hartwig, Hariharan, Bharath, Zhao, Long, Liu, Ting.
- Google DeepMind, Cornell University
- 논문 링크
- Project Page
요약
- Video Creation by Demonstration은 영상에 나온 행동을 초기 이미지로 주어진 다른 장면에서 재현하는 문제를 다룬다. Something-Something v2, Epic Kitchens 100, Fractal에서 행동과 맥락이 호환되도록 선별한 예시를 평가한 결과, 사람 평가자는 WALT와의 행동 전이 비교에서 δ-Diffusion을 각각 77%, 83%, 80%의 비율로 선호했다. WALT는 이미지와 텍스트를 조건으로 영상을 생성하는 모델로, 각 데이터셋에서 미세 조정했으며 정답 행동 캡션을 제공했다.
- 이 방법은 시연 영상에서 행동 잠재 표현을 추출한다. 행동 잠재 표현은 생성할 행동을 제어하도록 학습한 표현이다. 제어 정보에 포함되는 장면 외형 정보를 제한하는 appearance bottleneck은 시간에 걸쳐 집계한 영상 특징에서 개별 프레임만으로 예측할 수 있는 특징을 뺀다. 이를 통해 시연에 등장하는 물체와 배경이 새로운 장면으로 옮겨지는 현상을 줄인다.
- 학습은 자기지도 방식으로 이루어진다. 입력 조건과 복원 목표를 영상 자체에서 얻으며, 행동 라벨로 생성을 지도하지 않는다. 실험 결과는 호환되는 입력을 선별한 조건에서 행동 전이가 개선됨을 뒷받침한다. 다만 생성기는 128×128 해상도로 16프레임 구간을 생성하며, 잘못된 공간 관계, 물체 정체성 변화, 여분의 손 생성 등의 실패가 보고되었다. 자기지도에 대해서는 Self-Supervised Learning(자기지도 학습 설명) 글을 참조하라.
1. Introduction
핵심 과제는 제공된 맥락 이미지에서 자연스럽게 이어지는 영상을 생성하면서, 행위자, 물체, 시점, 환경이 달라져도 행동 개념을 전이하는 것이다. 여기서 행동 개념은 정확한 이동 궤적이 아니라 의도한 상호작용을 뜻한다. 텍스트, 추적점, 장면의 거리를 나타내는 깊이 맵, 이미지 영역을 구분하는 분할 마스크 같은 명시적 제어 정보는 행동의 세부 내용을 빠뜨리거나 확보하는 데 추가 노력이 필요할 수 있다.
- 제안 방법은 사전 학습된 영상 표현, appearance bottleneck, 조건부 후속 프레임 예측을 결합한다. 조건부 후속 프레임 예측은 제공된 이미지와 행동 제어 정보로 이후 프레임을 생성한다.
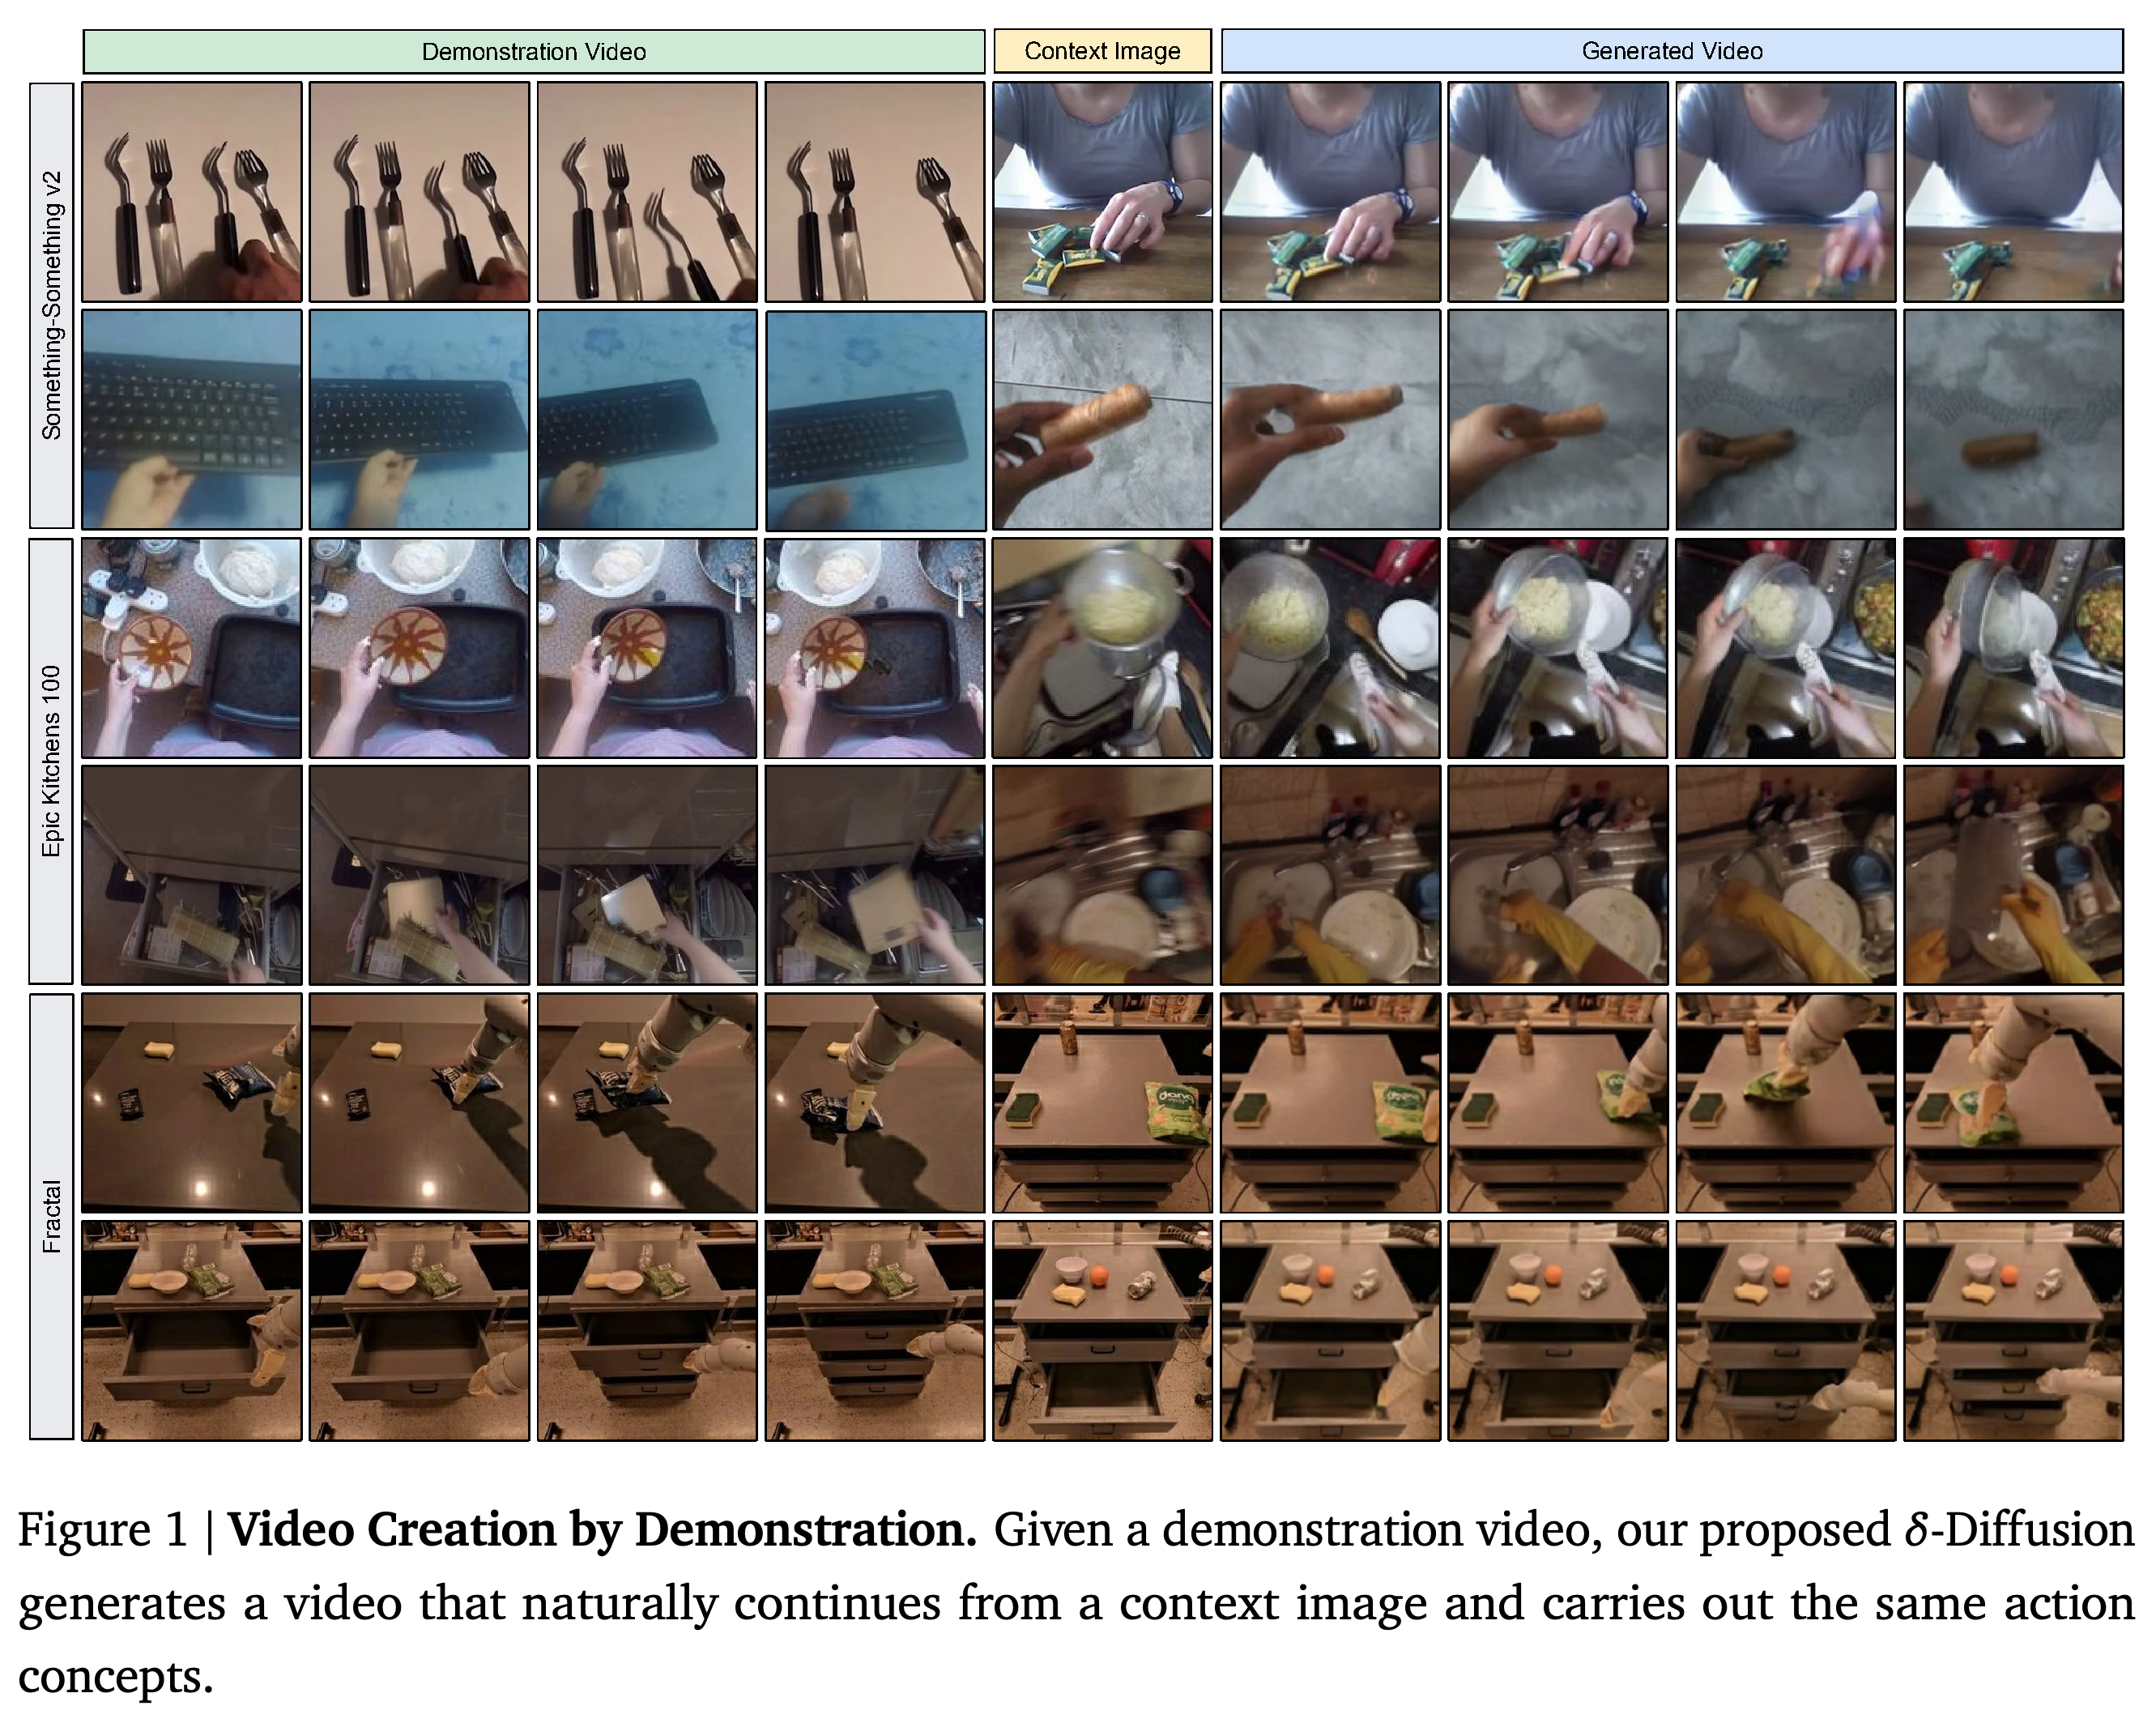
- Figure 1은 일상적인 물체 상호작용, 1인칭 주방 활동, 로봇 조작에서 행동을 전이하는 예시를 보여준다.
이 예시들은 행동 전이와 원본 장면 복사의 차이를 보여준다. 시연과 맥락 이미지에는 서로 다른 물체나 환경이 등장하며, 생성 시퀀스는 맥락을 유지하면서 시연한 행동을 재현하려 한다.
2. Related Works
관련 연구에서는 조건부 영상 생성, 움직임과 외형을 분리하는 방법, 행동과 장면 맥락을 포착하는 사전 학습 영상 인코더를 다룬다.
2.1. Video Generation
이 과제는 다른 영상이나 그 영상에서 추출한 신호를 이용해 초기 이미지에 움직임을 부여하는 image+video-to-video generation (I+V2V)에 속한다. 기존 방법은 명시적 제어 정보를 사용하는 경우가 많지만, δ-Diffusion은 시연에서 직접 추출한 학습된 표현을 생성 조건으로 사용한다.
- MotionDirector는 추론 시 시연마다 영상 확산 모델을 별도로 조정한다. 영상 확산 모델은 반복적으로 노이즈를 제거해 영상을 생성하는 모델이다. δ-Diffusion은 추론 시 최적화가 필요하지 않다.
- Genie는 비디오 게임에서 이산 행동 코드를 학습한다. 이 코드는 유한한 집합에서 선택하는 재사용 가능한 행동 표현이다. 이 논문은 실제 영상의 행동 개념을 대상으로 한다.
2.2. Modeling Motion and Action
기존 행동 전이와 리타기팅 방법은 한 영상의 움직임을 다른 장면이나 대상에 적용한다. 이 방법들은 저수준 움직임이 원하는 행동을 나타낼 수 있도록 대상과 시점이 충분히 정렬되어 있다고 가정하는 경우가 많다. 그러나 같은 행동에도 서로 다른 움직임이 필요할 수 있다. 위쪽 서랍 닫기와 아래쪽 서랍 닫기는 행동 개념은 같지만 궤적은 다르다.
2.3. Video Foundation Models
여러 영상 이해 과제를 지원하도록 사전 학습한 인코더인 영상 파운데이션 모델은 행동과 맥락 정보를 함께 담은 표현을 제공한다. 논문은 VideoPrism을 사용하며, 인코더를 업데이트하지 않고 추출한 특징을 활용한 기존 캡셔닝, 질의응답, 행동 위치 추정 결과를 선택 근거로 제시한다. 행동 위치 추정은 행동이 발생하는 위치나 시점을 찾는 과제다.
3. Methodology
δ-Diffusion은 학습을 행동 잠재 표현 추출과 조건부 영상 생성으로 나눈다. 이 설계는 생성기에 제한 없는 시연 특징을 제공했을 때 맥락 이미지를 무시하고 시연의 외형을 복사할 위험을 줄이기 위한 것이다.
3.1. Task Formulation
맥락 이미지 I와 시연 영상 V가 주어졌을 때, 목표는 I에서 이어지면서 V에 나온 행동 개념을 수행하는 영상을 생성하는 것이다. 이 과제는 시연한 행동과 맥락이 호환된다고 명시적으로 가정한다. 손이 없는 이미지에서 자르는 행동을 생성하는 경우는 논문이 설정한 범위에 포함되지 않는다.
3.2. Method Overview
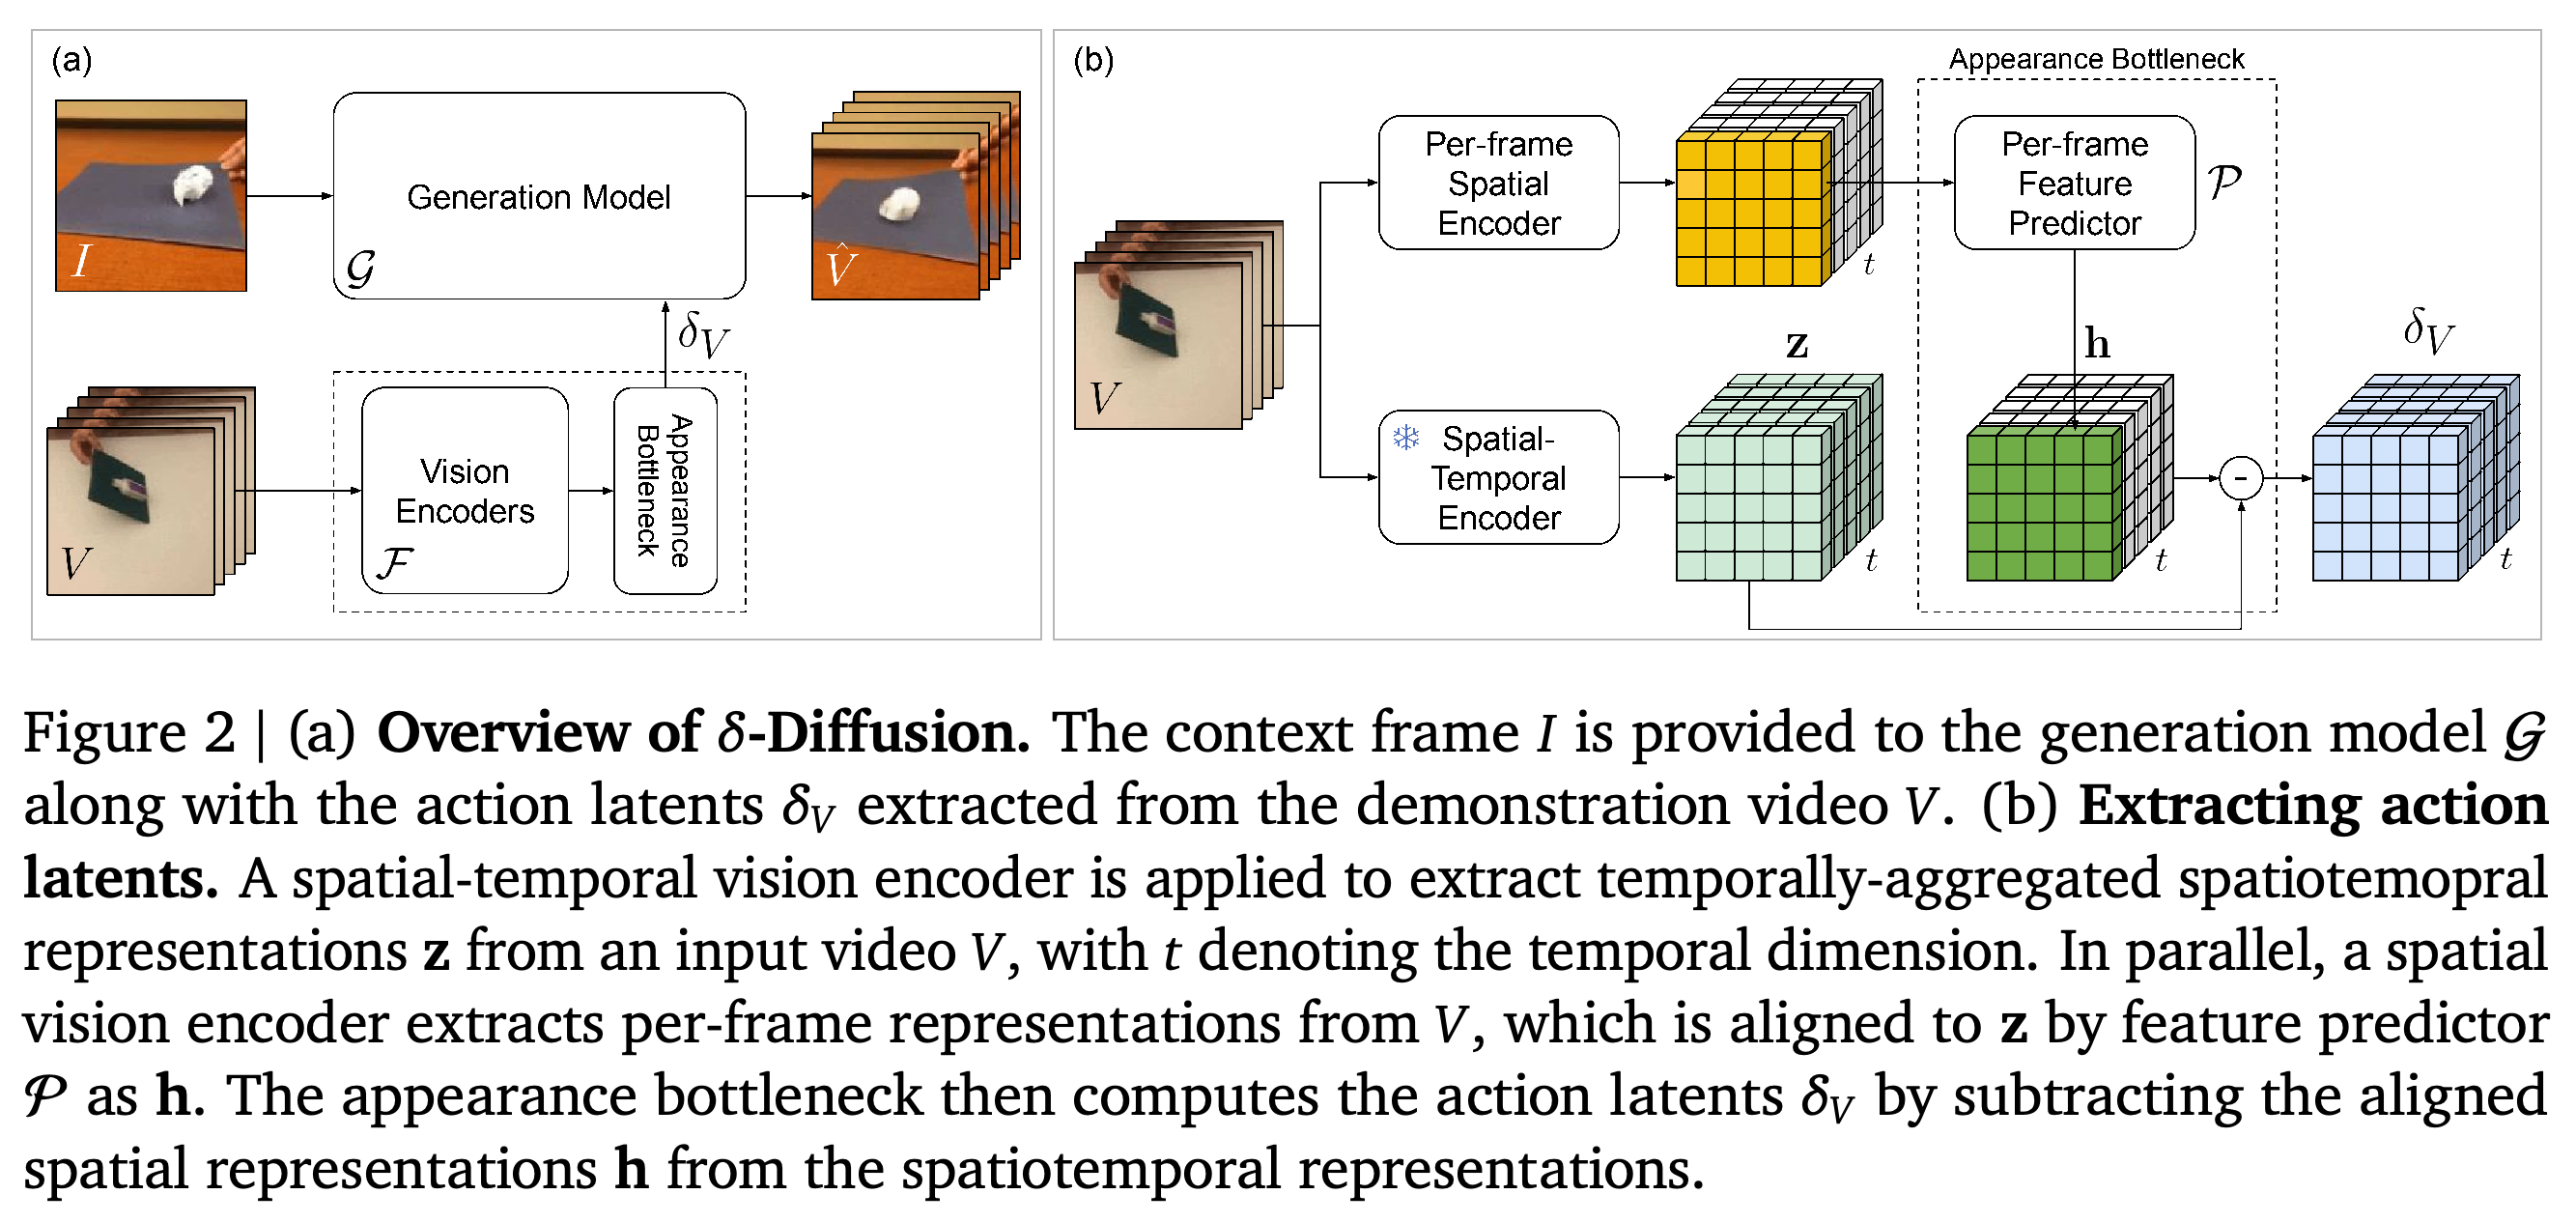
시각 인코더는 시연에서 이미지의 여러 위치와 시간에 걸친 정보를 결합한 시공간 특징을 추출한다. appearance bottleneck은 이 특징을 행동 제어 정보로 변환한다. 생성기는 Figure 2처럼 이 정보와 맥락 이미지를 결합해 후속 프레임을 예측한다.
- 학습 시에는 같은 영상에서 맥락 프레임과 시연을 가져오며, 뒤따르는 클립을 복원 목표로도 사용한다.
- 추론 시에는 서로 다른 장면에서 시연과 맥락을 가져올 수 있다.
도식은 행동 제어 정보를 구성하는 과정을 보여준다. 단일 프레임 예측기가 시간에 걸쳐 집계한 특징 중 외형으로 예측할 수 있는 성분을 추정한다. 이 성분을 빼서 얻은 잔차를 맥락 이미지와 함께 생성기에 제공한다.
3.3. Extracting Action Latents
영상 인코더가 시간에 걸쳐 집계한 표현 z의 형태를 T×N×D라고 하자. T, N, D는 각각 시간, 공간, 특징 차원이다. 프레임별 예측기 P는 해당 프레임의 특징만으로 각 시간 슬라이스 zₜ를 추정해 hₜ를 출력한다. 학습 시에는 특징 차이의 절댓값을 합한 L1 복원 오차 ‖zₜ−hₜ‖₁을 시간에 걸쳐 합산해 최소화한다.
- 행동 표현은 \(\delta_v = z - [h_0, h_1, …, h_{T-1}]\)이며, 대괄호 안의 특징은 시간축으로 이어 붙인다.
- 저자들은 이 잔차를 “temporal surprisal”이라고 부른다. 이는 프레임 시퀀스에는 있지만 단일 프레임 예측기는 복원할 수 없는 정보다.
- 복원 학습은 외형 추정치를 영상 특징 공간에 맞춰, 뺄셈을 정보 제거 연산으로 사용할 수 있게 한다. 이는 외형 정보를 줄이기 위한 설계이며, 완전한 분리를 보장한다는 증거는 아니다.
3.4. Training 𝛿-Diffusion
학습 시 T+1개 프레임을 샘플링하고 첫 프레임을 맥락 이미지로 사용한다. 나머지 T개 프레임은 시연과 예측 목표로 함께 사용한다. 제어 정보를 추출하기 전에 무작위 공간 크롭 등 행동을 보존하는 증강을 시연에 적용해 외형을 그대로 복사하기 어렵게 만든다.
- 생성기는 픽셀 공간에서 직접 작업하는 대신 압축된 표현에서 반복적으로 노이즈를 제거해 영상을 만드는 잠재 확산 모델이다.
- 프레임을 압축된 표현으로 변환하는 구성 요소인 토크나이저가 맥락과 목표 프레임을 인코딩한다. 모델은 기존 확산 연구에서 채택한 속도 예측 목표를 사용하는 노이즈 제거 목적함수로 학습한다(Gupta et al., 2024; Salimans and Ho, 2022).
3.5. Implementation Details
고정된 VideoPrism Base 인코더는 0.1B 파라미터를 가지며, 288×288 해상도의 16프레임을 입력받아 16×16×16×768 특징 텐서를 출력한다. 공간과 시간을 따로 처리하는 분해형 구조로, 시간 집계 이전의 프레임별 공간 특징을 외형 예측기가 재사용할 수 있다.
- 예측기는 어텐션으로 특징을 처리하는 Transformer 인코더 블록 4개로 구성된다. 은닉 차원은 1024이며, 별도의 특징 상호작용을 계산하는 어텐션 헤드는 8개다. L1 손실, 확률적 최적화 알고리즘인 Adam, 기본 학습률 10⁻⁴, 가중치 감쇠 4.5×10⁻²를 사용해 30k회 반복 학습한다.
- 생성기는 0.3B 파라미터를 가진 WALT Large다. image+text-to-video 체크포인트로 초기화한 뒤 데이터셋마다 500k회 반복 미세 조정하며, 128×128 해상도로 16프레임을 생성한다.
- 행동 특징을 2048차원 벡터로 투영해 기존 텍스트 임베딩을 대체한다. 추론 시에는 조건부 예측과 무조건부 예측을 결합해 조건의 강도를 조절하는 classifier-free guidance를 사용하며, 강도는 1.25다.
4. Experiment
실험은 사람과 물체의 상호작용, 로봇 조작에서 생성 충실도, 행동 전이, 맥락 이미지로부터의 연속성을 평가한다. bottleneck 변형에 대한 자동 평가와 WALT, MotionDirector에 대한 사람 비교 평가를 함께 수행한다.
4.1. Datasets
주요 데이터셋은 3개다. Something-Something v2 (SSv2)는 라벨이 있는 일상 행동 범주 174개를 포함한다. Epic Kitchens 100은 논문에서 55시간 분량의 1인칭 주방 영상으로 설명한다. Fractal은 700개 과제에 걸친 약 130k개 로봇 조작 에피소드를 포함한다. 공통 외형 예측기는 이 데이터셋들의 학습 분할과 추가 1인칭 영상 데이터인 Ego4D를 함께 사용해 학습하며, 생성기는 주요 데이터셋별로 따로 학습한다.
- 자동 평가 절차에서는 각 데이터셋에서 가장 빈번한 상위 10개 라벨을 선택하고 라벨마다 영상 쌍 1k개를 샘플링한다고 명시한다. 이를 계산하면 데이터셋마다 10k개 쌍에 해당한다.
- 각 쌍에서 한 영상은 시연을 제공하고 다른 영상은 첫 프레임을 맥락으로, 클립을 참조 영상으로 제공한다. 이는 같은 라벨이 전이 가능한 행동 개념을 나타낸다고 가정한다.
4.2. Evaluation Setup
Fréchet Video Distance (FVD)는 생성 영상과 참조 영상 분포의 차이를 측정하며, 값이 낮을수록 분포가 가깝다. 이 지표만으로 개별 영상의 행동 충실도를 확인할 수는 없다. 따라서 논문은 사전 학습된 영상 특징 추출기인 I3D를 사용해 특징 벡터의 방향을 비교하는 임베딩 코사인 유사도(ES)와 참조 영상 검색 적중률도 계산한다.
- Hit@100, Hit@500, Hit@1k는 대응하는 참조 영상이 각각 상위 100개, 500개, 1000개 후보에 포함되는지를 측정한다. 이는 검색 집합의 1%, 5%, 10%에 해당한다.
- 사람 평가자 5명이 데이터셋마다 20개, 전체 60개 예시에서 시각적 품질(VQ), 행동 전이성(AT), 맥락 일관성(CC)을 기준으로 방법들을 비교한다.
- Table 3은 연속성 평가 기준을 “Frame Continuity”라고 부르며, 생성 영상이 초기 이미지에서 자연스럽게 이어지는지를 묻는다. 행동 평가 기준에는 카메라 움직임도 포함된다.
4.3. Ablation Study
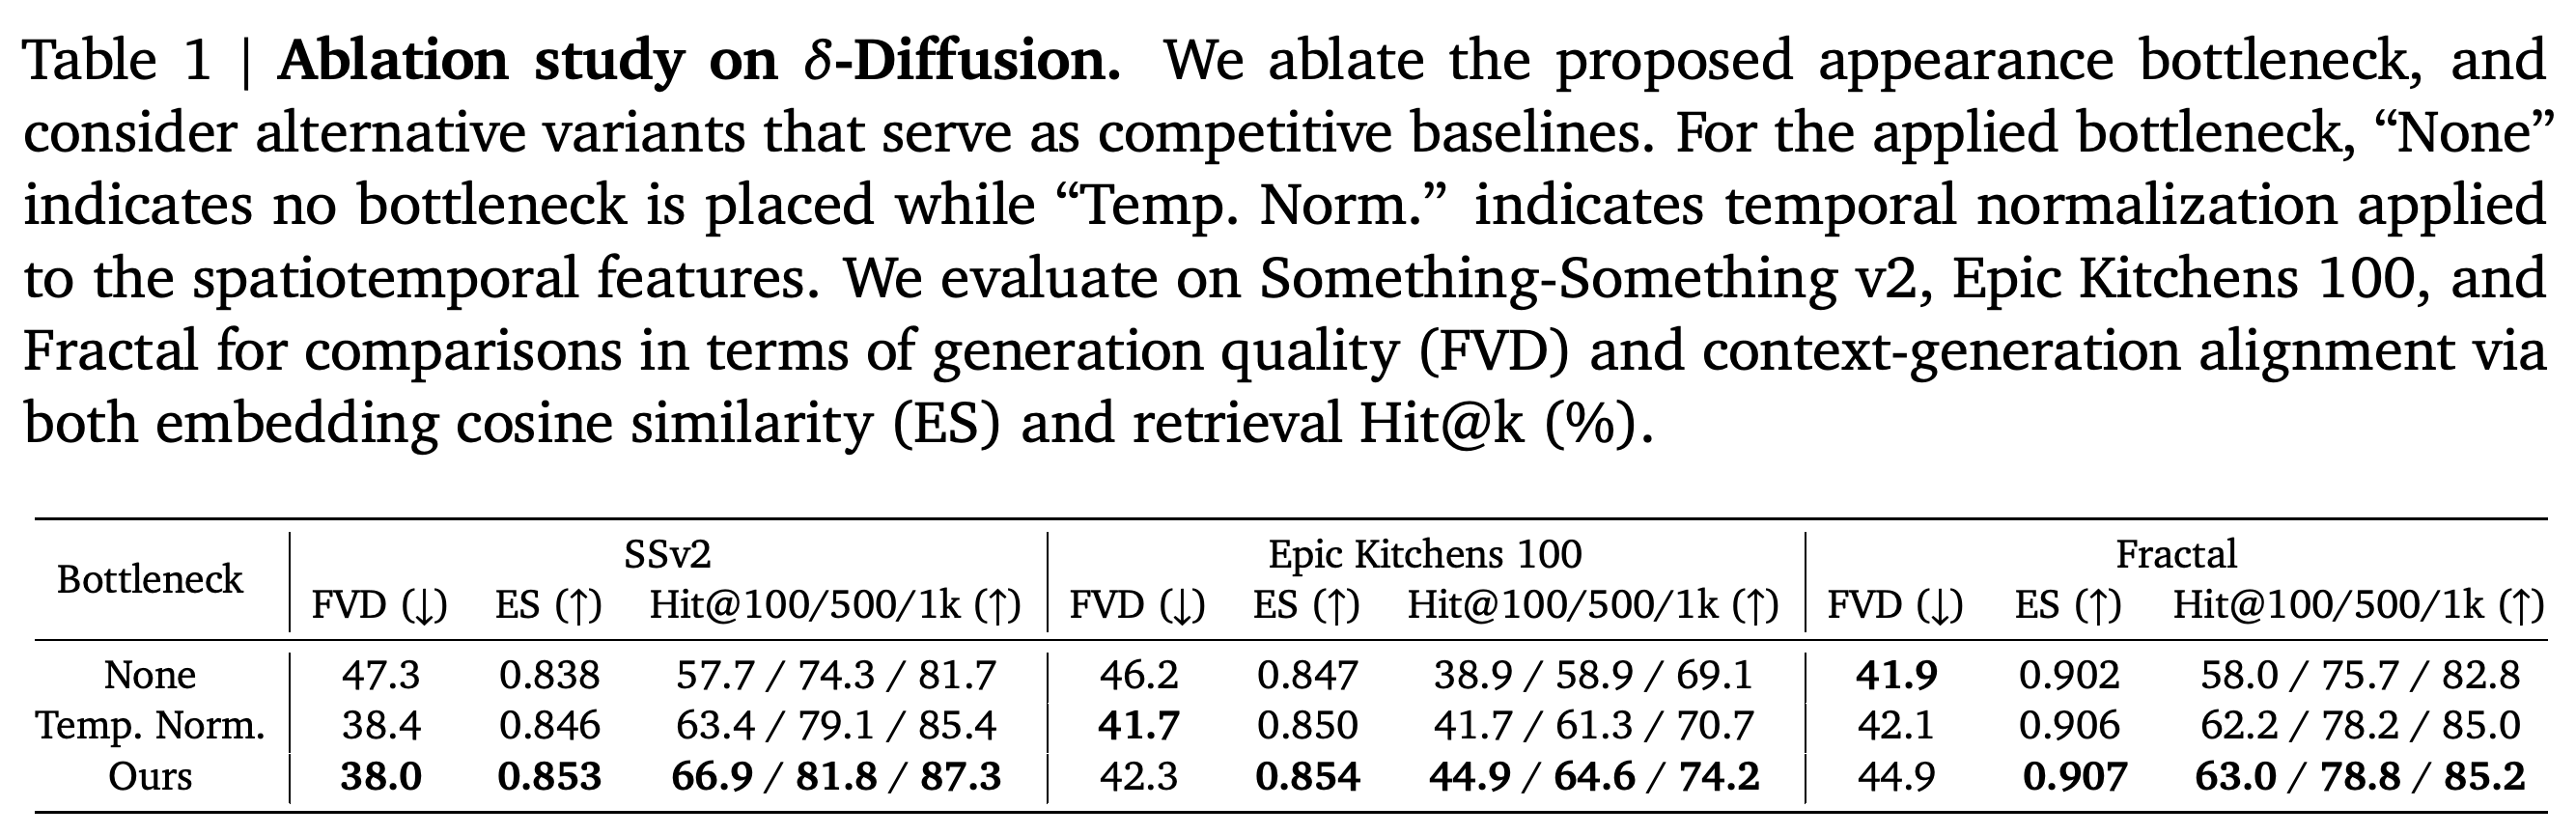
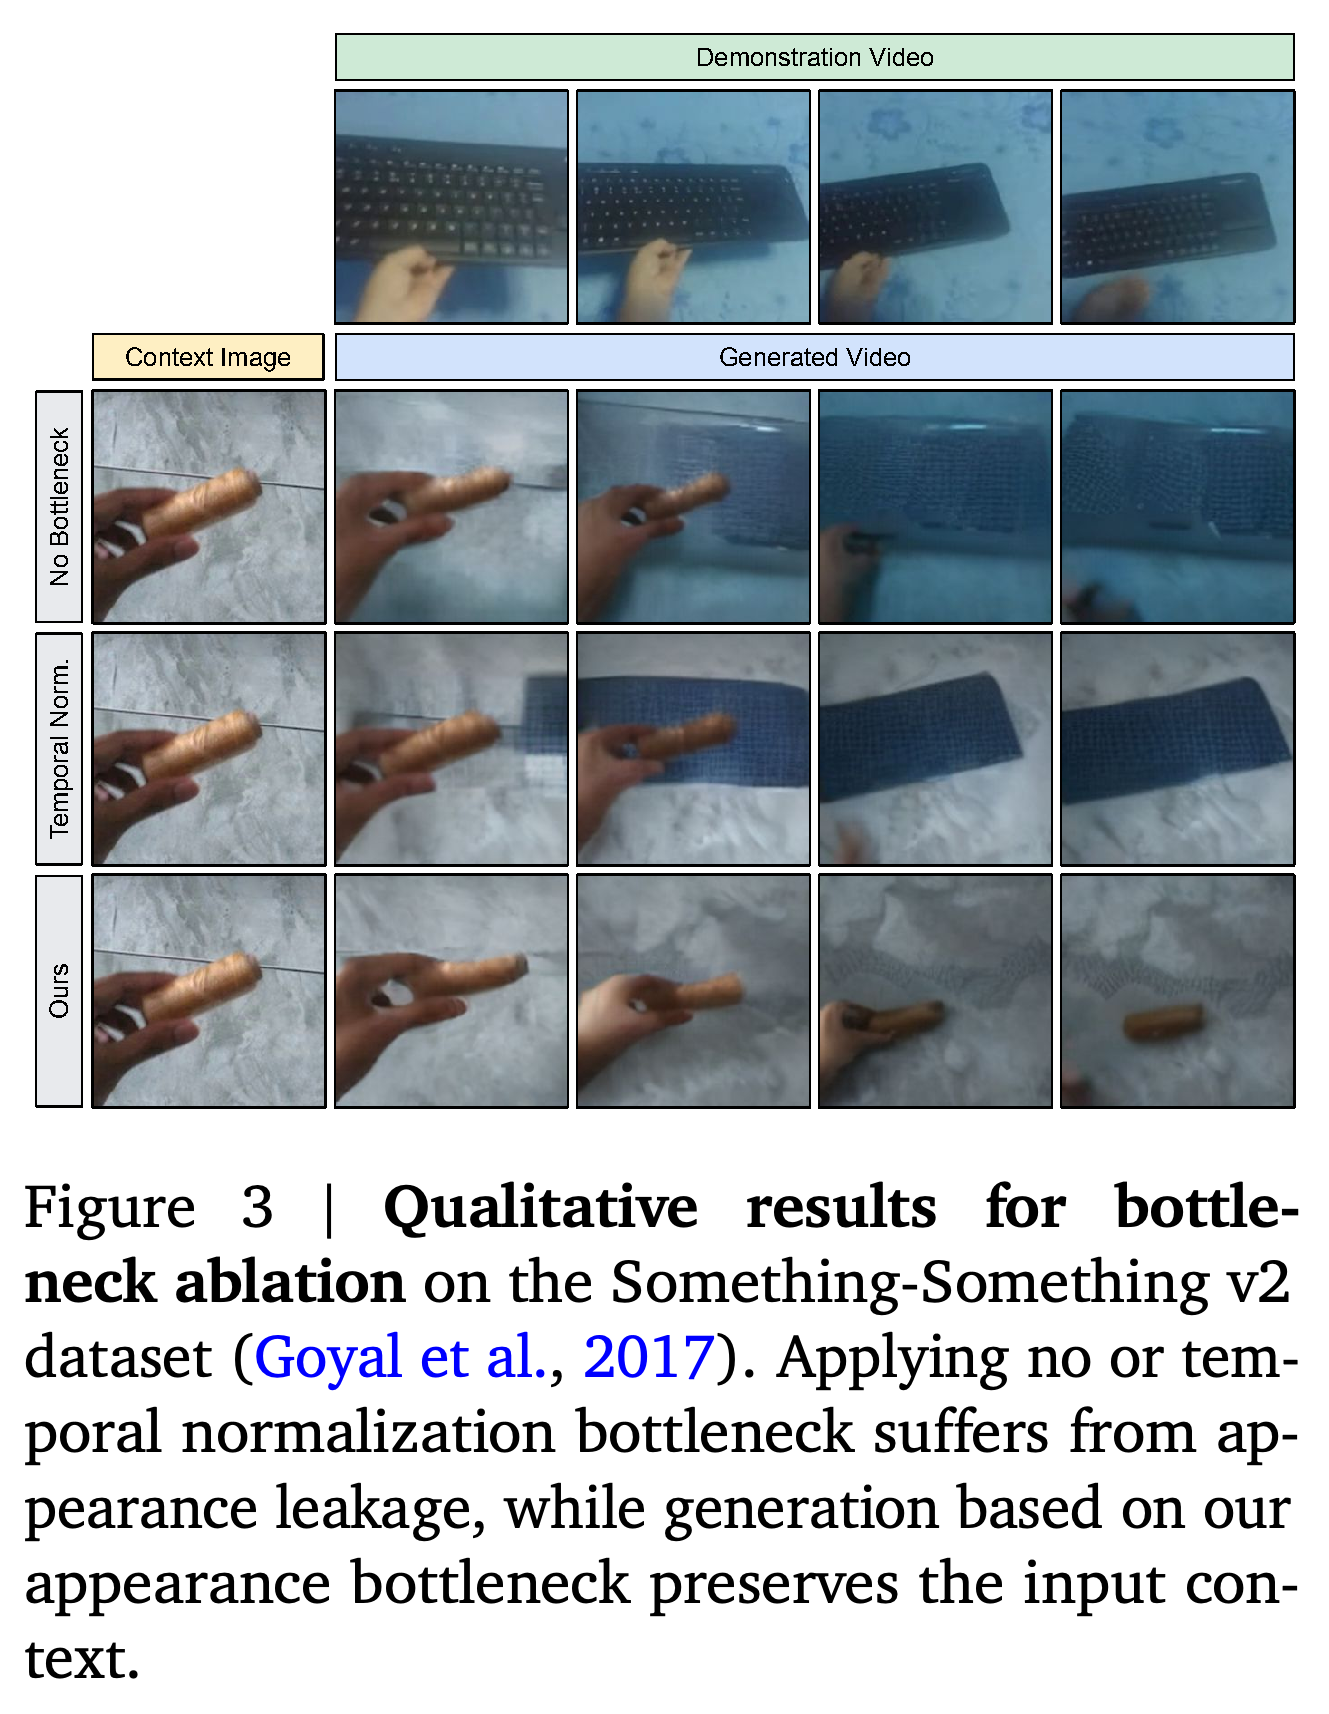
Table 1은 학습된 appearance bottleneck을 제한 없는 영상 특징, 시간 정규화와 비교한다. 시간 정규화는 특징에서 시간 평균을 빼는 방법이다. 학습된 bottleneck은 모든 데이터셋에서 ES와 보고된 모든 검색 적중률이 가장 높지만, FVD가 항상 가장 낮지는 않다.
- SSv2에서 제한 없는 특징, 시간 정규화, 제안 방법의 ES는 각각 0.838, 0.846, 0.853이며, Hit@100은 각각 57.7%, 63.4%, 66.9%다.
- SSv2에서 제안 방법의 FVD는 38.0으로, 비교 방법의 47.3, 38.4보다 낮다. Epic Kitchens 100에서는 42.3으로 시간 정규화의 41.7보다 높고, Fractal에서는 44.9로 제한 없는 특징의 41.9보다 높다.
- Figure 3은 이에 대응하는 시각적 예시를 보여준다. 다른 변형은 시연의 키보드 외형을 가져오지만, 학습된 bottleneck은 목표 장면을 유지한다.
학습된 bottleneck은 3개 데이터셋에서 임베딩 유사도와 모든 검색 적중률을 개선한다. FVD 결과는 데이터셋마다 달라, 이 표는 분포 수준의 생성 충실도 개선보다 개별 영상 수준의 정렬 개선을 더 일관되게 뒷받침한다.
4.4. Main Results
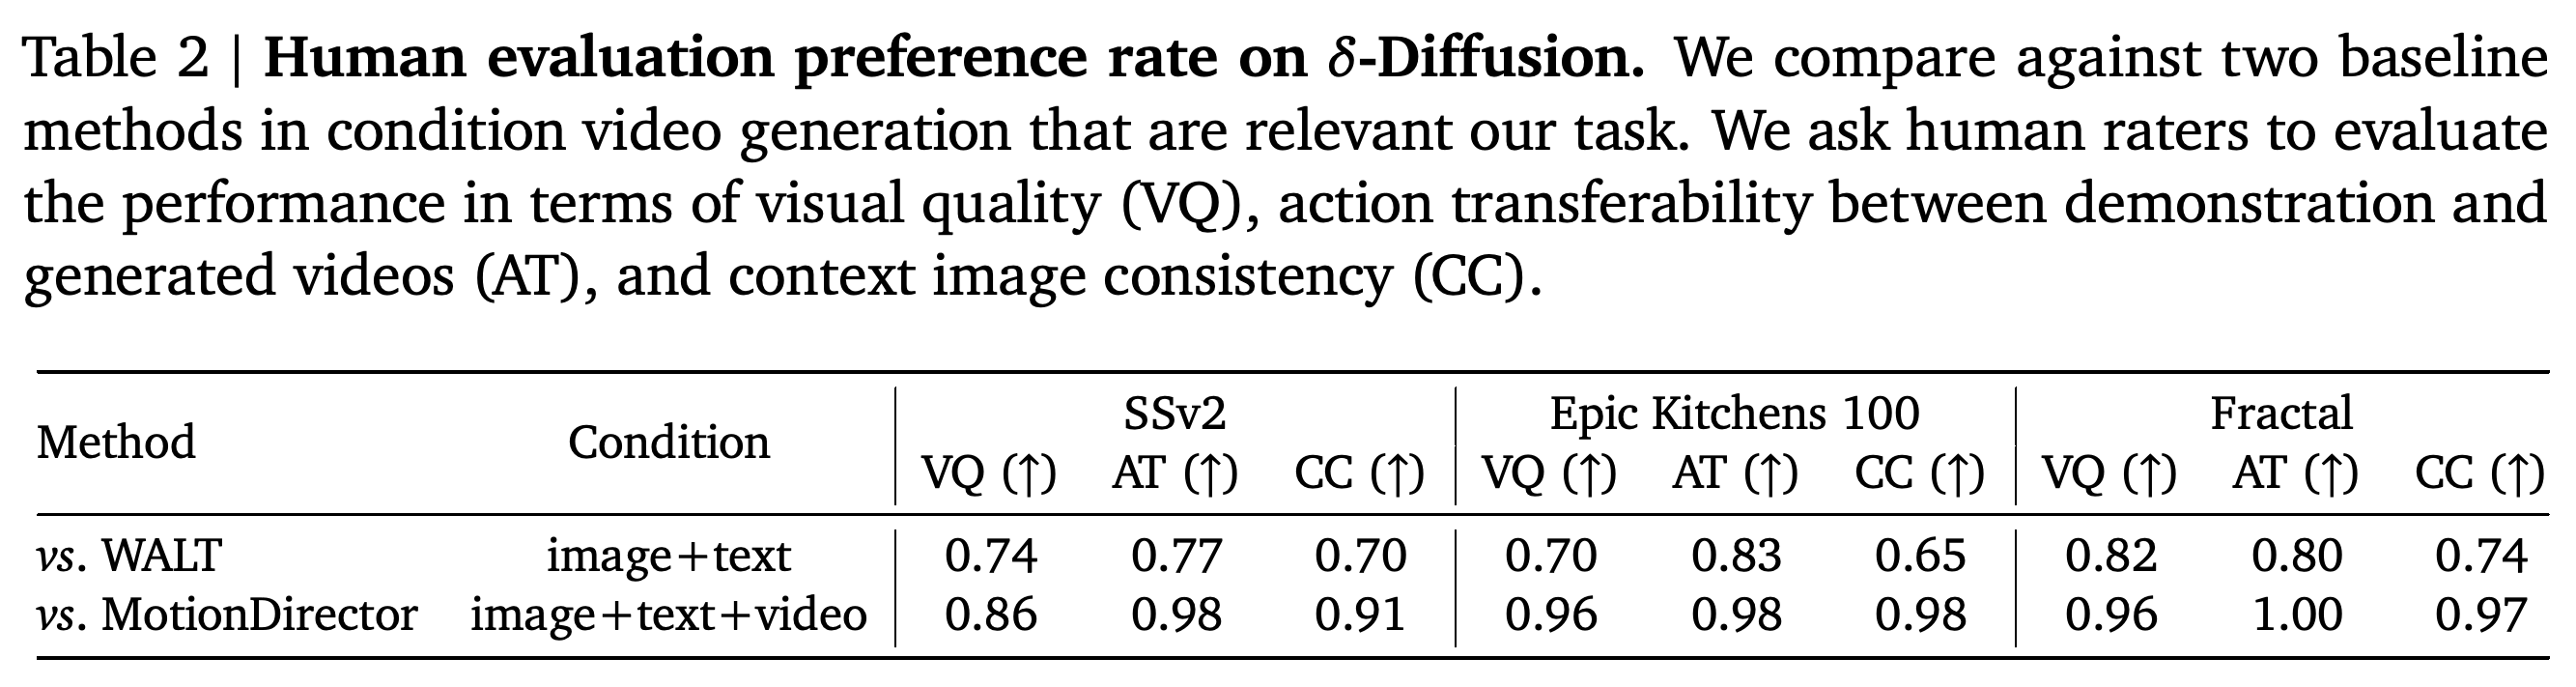
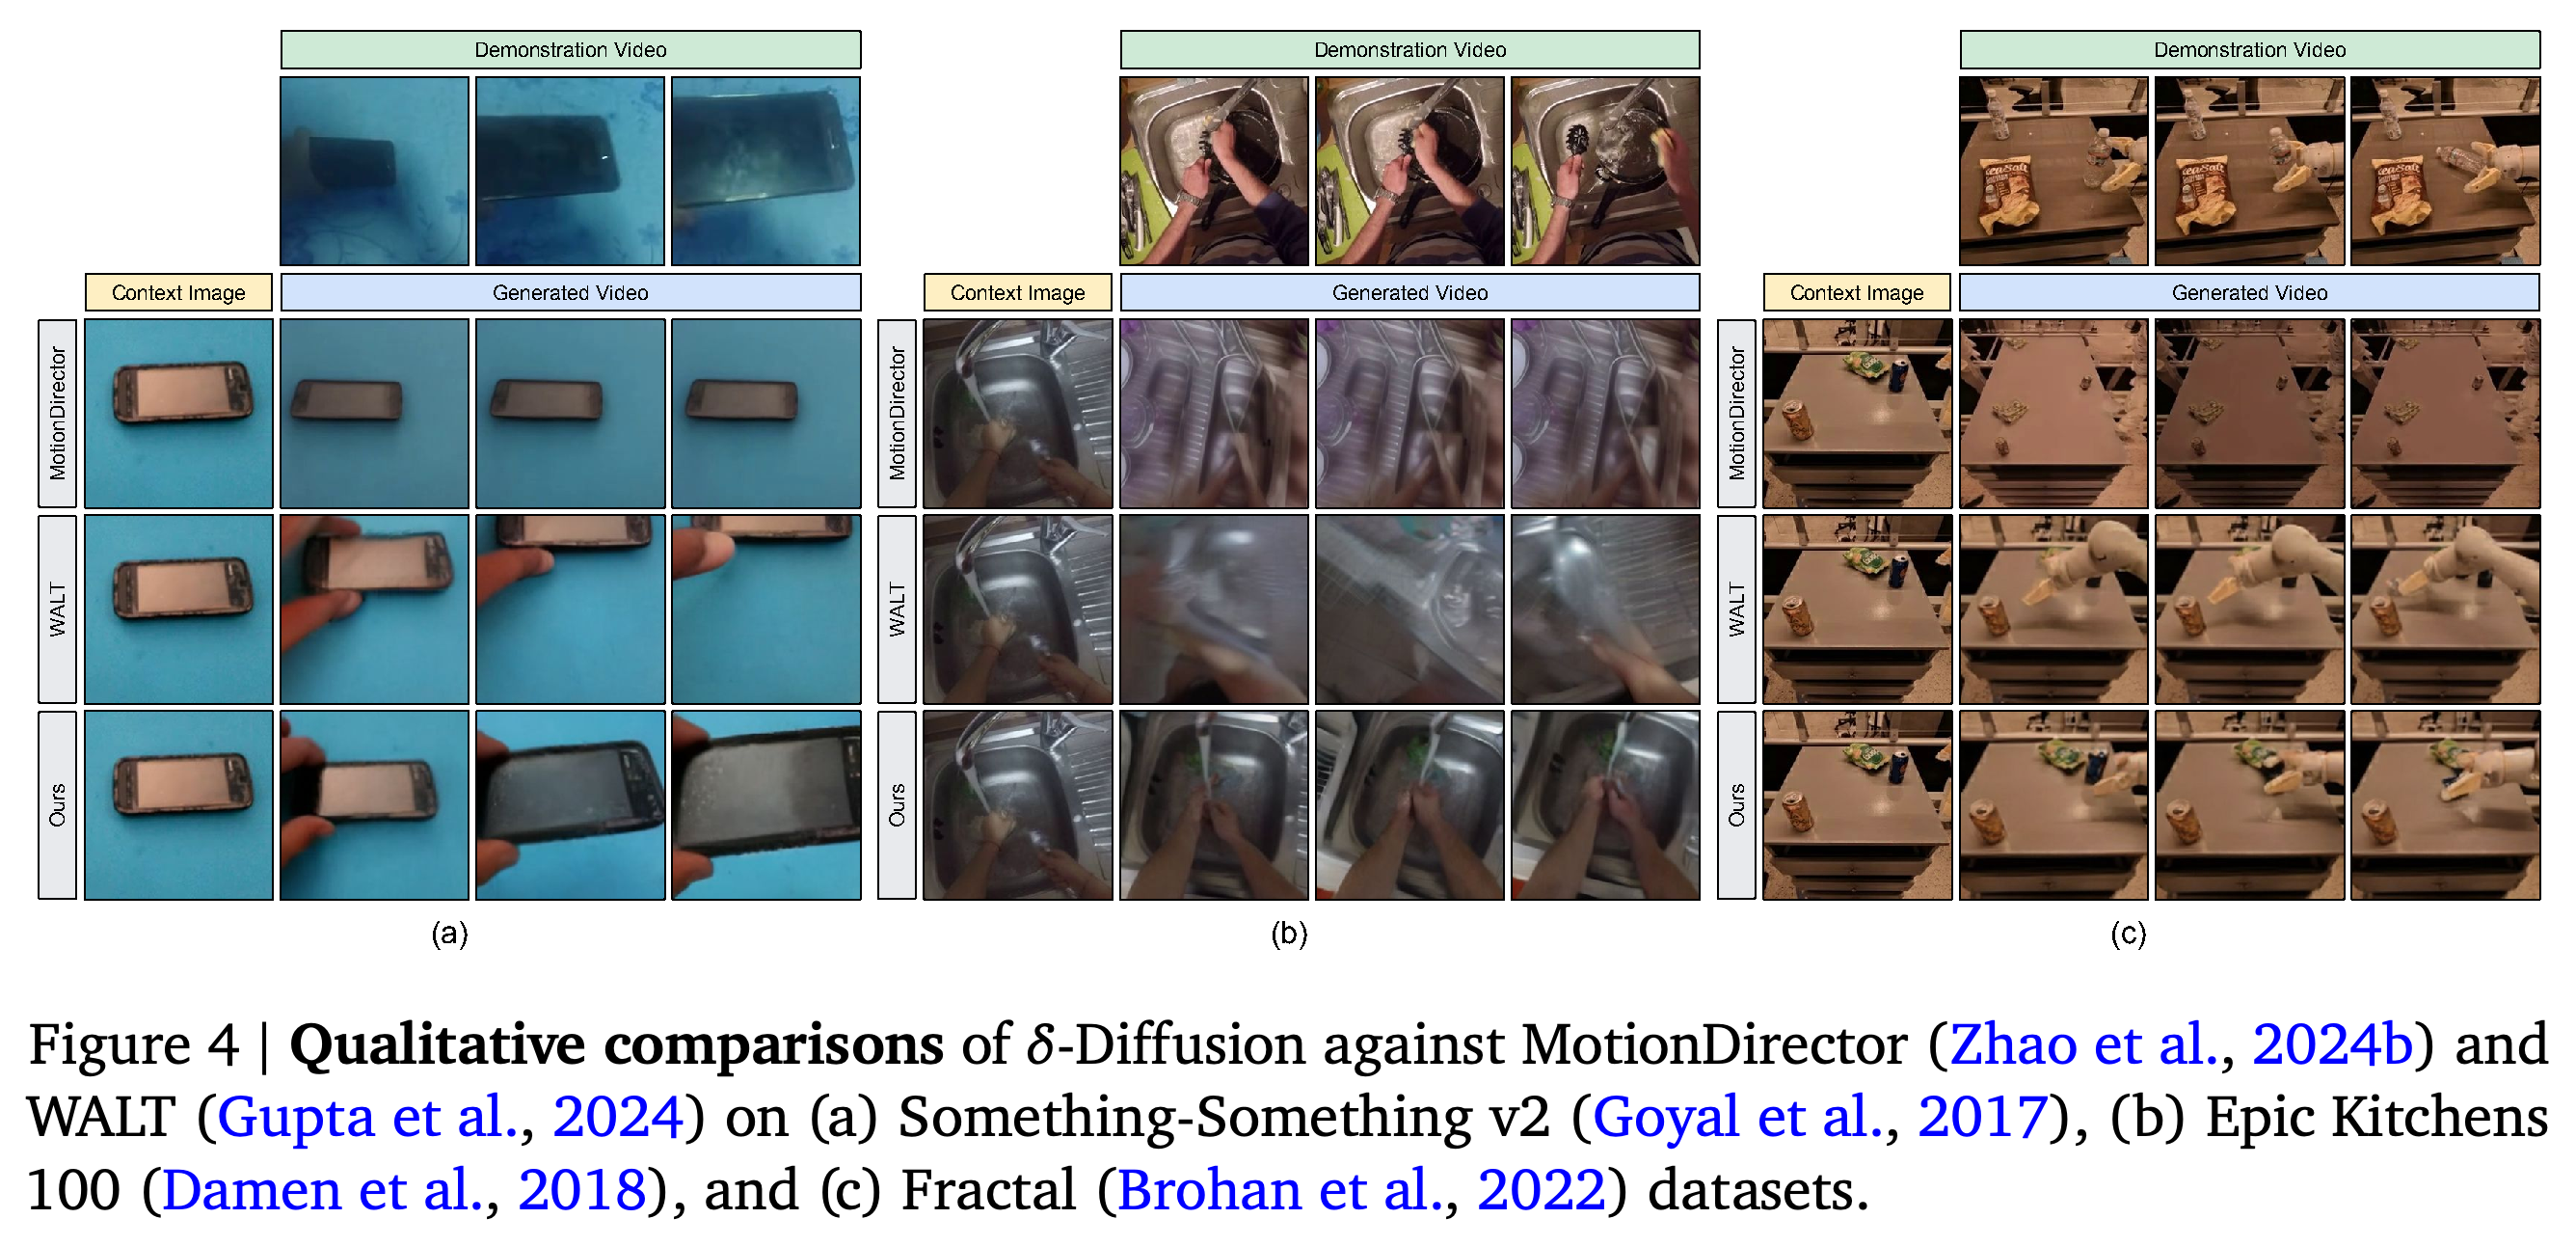
Table 2에서 사람 평가자는 모든 데이터셋과 평가 기준에서 베이스라인 2개보다 δ-Diffusion을 선호한다. WALT 대비 VQ/AT/CC 선호율은 SSv2에서 0.74/0.77/0.70, Epic Kitchens 100에서 0.70/0.83/0.65, Fractal에서 0.82/0.80/0.74다.
- MotionDirector 대비 VQ/AT/CC 선호율은 같은 순서로 0.86/0.98/0.91, 0.96/0.98/0.98, 0.96/1.00/0.97이다.
- 베이스라인 2개 모두 정답 행동 캡션을 제공받는다. WALT는 맥락 이미지와 텍스트를 사용한다. MotionDirector는 시연과 인스턴스별 LoRA도 사용한다. LoRA는 제한된 모델 파라미터 집합을 업데이트해 외형과 움직임을 학습하는 저랭크 적응 방법이다.
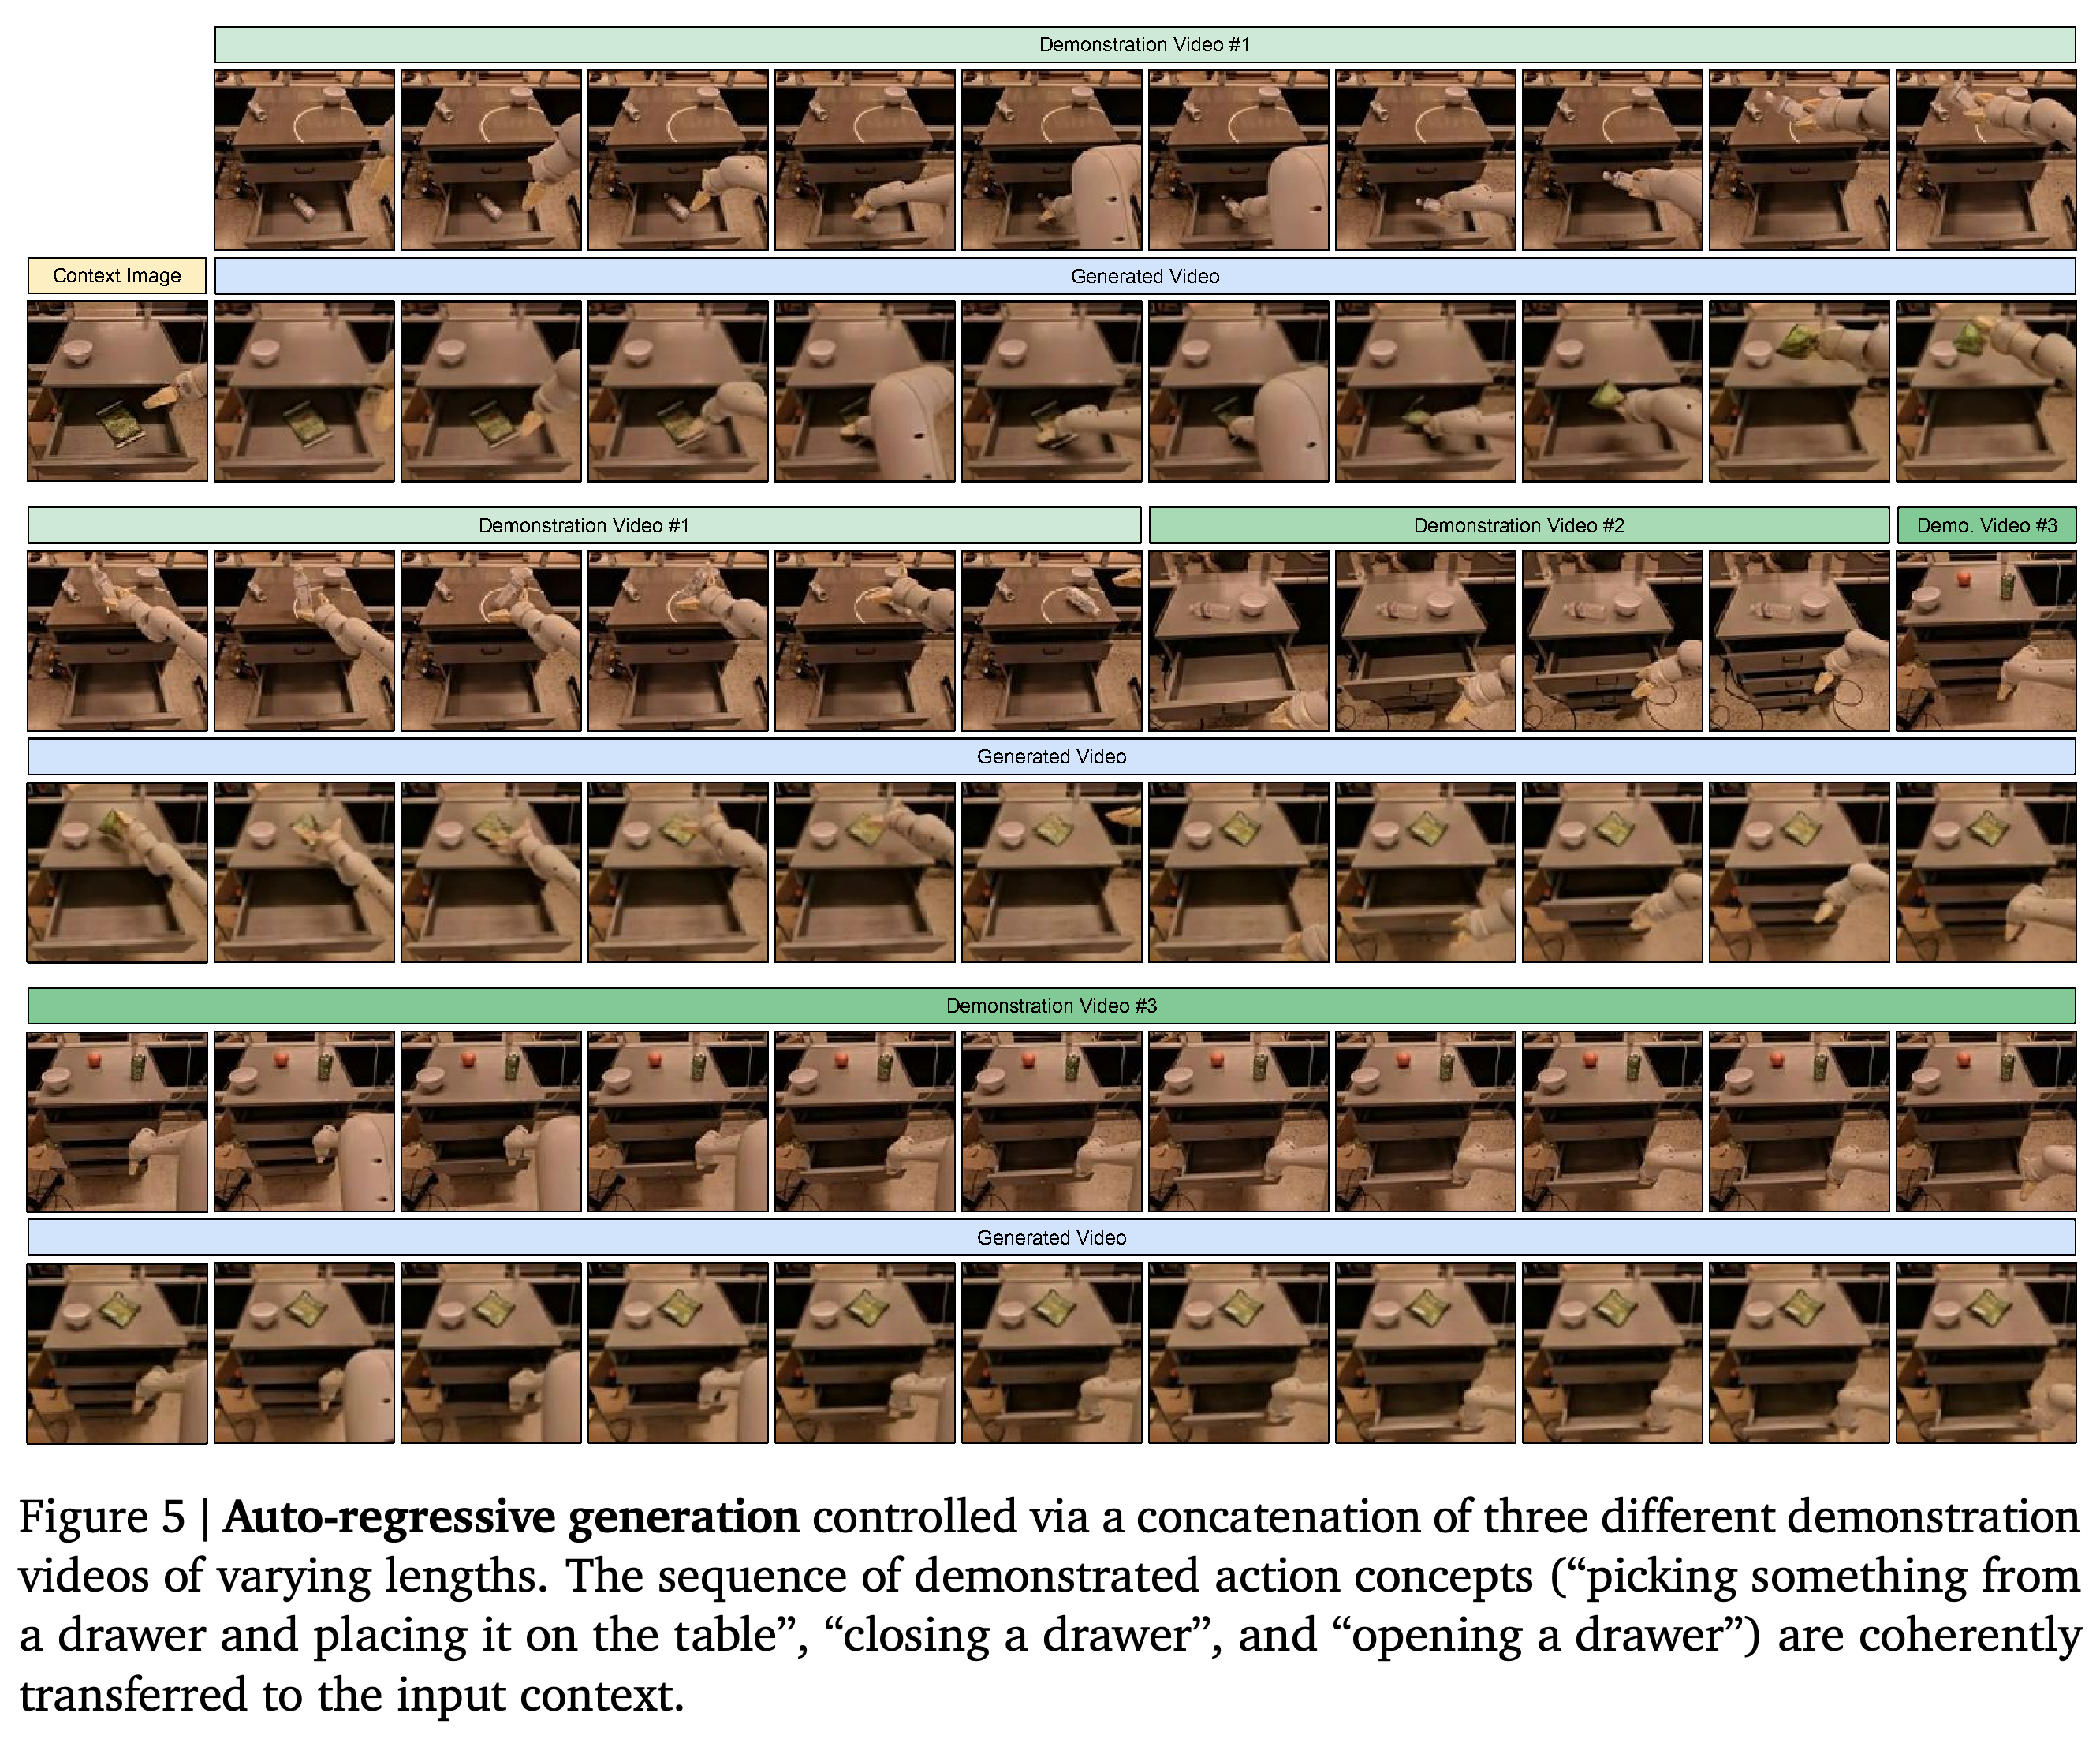
- Figure 4는 3개 데이터셋 모두에서 베이스라인의 차이를 보여준다. Figure 5는 물체를 집어 옮기기, 서랍 닫기, 서랍 열기를 연결해 자기회귀 생성을 보여준다. 자기회귀 생성에서는 생성된 프레임을 다음 구간의 조건으로 사용한다.
- Figures 6–9는 맥락 이미지를 고정하고 시연을 바꿔, 시연한 행동이 생성되는 움직임에 영향을 준다는 정성적 증거를 제시한다.
보고된 모든 선호율이 0.5를 넘는다. 선별된 사람 평가 조건에서 행동 전이 선호율은 WALT 대비 0.77부터 0.83까지, MotionDirector 대비 0.98부터 1.00까지다.
시연에는 키보드가 있고, 목표 맥락에는 손에 든 다른 물체가 있다. 제한 없는 특징이나 시간 정규화를 사용한 생성 결과에는 키보드가 나타난다. 이 예시에서는 학습된 bottleneck이 이러한 외형 누출을 줄인다.
선택된 예시들은 서로 다른 실패 양상을 보여준다. MotionDirector는 유의미한 행동이 거의 없거나 외형이 일관되지 않은 영상을 생성할 수 있다. WALT는 장면을 유지하면서도 시연한 행동을 놓칠 수 있다. 이 예시들에서 δ-Diffusion은 의도한 행동과 주어진 맥락을 더 잘 결합한다.
서로 다른 장면의 시연 3개가 생성된 환경 1개에서 이어지는 로봇 시퀀스를 제어한다. 이 예시는 구간 연결을 통한 행동 제어를 보여주지만, 장기 생성의 신뢰성을 정량화하지는 않는다.
5. Conclusion
논문은 사전 학습된 영상 특징에서 추출한 행동 제어 정보와, 장면 간 대응 예시 없이 학습한 생성 모델을 결합한다. 복잡한 장면에서는 물리적 사실성이 여전히 불안정하다. Figure 10은 잘못된 공간 관계, 빠른 회전 중 발생하는 외형 누출, 시점 불일치와 관련된 여분의 손을 보여준다. 외형 누출은 시연의 시각적 내용이 출력으로 옮겨지는 현상을 뜻한다.
- 저자들은 생성기 규모를 키우면 이런 한계를 완화할 수 있다고 제안하지만, 논문은 그 해결책을 실험으로 입증하지 않는다.
Broader Impact
저자들은 시연을 통한 제어를 세밀한 영상 생성을 쉽게 하고, 시연에 직접 나오지 않은 상호작용까지 시뮬레이션하는 방법으로 제시한다. 또한 다른 제어형 영상 생성 방법과 공통으로 발생할 수 있는 위험으로 데이터셋 편향, 오해를 유발하거나 부적절한 콘텐츠, 당사자의 명시적 동의가 없는 개인정보 문제를 제시한다.
부록
- A Author Contributions는 연구, 인프라, 데이터 선별, 평가, 시연, 기술 또는 전략 자문을 맡은 기여자들의 역할을 설명한다.
- B Improving Generation Quality는 앞서 생성한 프레임을 조건으로 사용해 구간을 이어 영상을 확장하는 방법을 설명한다. 생성 품질을 높이기 위한 self-conditioning과 guidance도 다룬다.
- C Human Evaluation Setup은 호환되는 시연과 맥락의 선별, 표시 순서를 무작위로 정한 나란히 비교 평가, 평가 기준을 설명한다. SSv2의 클래스마다 20개 쌍을 선택한다는 서술과 데이터셋별 최종 예시가 20개라는 보고의 관계는 설명하지 않는다.
- D Details on Baselines는 MotionDirector와 WALT의 구현을 설명한다. WALT는 데이터셋마다 200k스텝 미세 조정하지만 제안 생성기는 500k회 반복 학습하므로, 보고된 학습 기간이 서로 다르다.
- E Qualitative Results는 본문의 예시에 해당하는 영상 링크를 제공한다.
- F Controllability by Demonstration은 고정된 맥락 이미지에서 서로 다른 시연 행동으로 생성을 유도하는 예시와 추가 영상 샘플을 제공한다.
- G Failure Cases는 공간 배치 오류, 외형이 빠르게 변할 때 물체 영속성을 잃는 문제, 시연과 맥락이 크게 다를 때 일관되지 않은 내용을 생성하는 문제를 설명한다.
짧은 생각
가장 명확한 증거는 appearance bottleneck에 관한 것이다. 다른 조건을 통제한 구성 요소 제거 실험에서 3개 데이터셋의 보고된 모든 개별 영상 수준 지표가 개선되었으며, 시각적 예시는 이 방법이 해결하려는 외형 복사 문제를 보여준다. 다만 베이스라인 비교를 해석할 때는 선별된 사람 평가 예시가 60개라는 점, 생성기별로 보고된 미세 조정 횟수가 다르다는 점, 자동 평가 지표가 물리적 정확성을 직접 검증하지 않는다는 점을 고려해야 한다. 자기회귀 예시는 여러 행동 제어 정보를 연결할 수 있음을 보여주지만, 논문은 장기 생성에 대한 정량 평가나 실시간 상호작용의 증거를 제공하지 않는다. 호환성에 따른 선별은 이 과제의 작동 조건에 포함된다. 따라서 이 결과만으로 임의의 시연과 이미지 쌍에서도 행동을 안정적으로 전이한다고 볼 수는 없다.