


SWE-Lancer: Can Frontier LLMs Earn $1 Million from Real-World Freelance Software Engineering? 요약 설명
17 Feb 2025 | Paper Review AI Coding Agents Benchmark LLM Evaluation목차
이번 글에서는 SWE-Lancer: Can Frontier LLMs Earn $1 Million from Real-World Freelance Software Engineering? 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 2월 17일(Arxiv), Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 2025
- Miserendino, Samuel, Wang, Michele, Patwardhan, Tejal, Heidecke, Johannes.
- OpenAI
- 논문 링크
- Github
요약
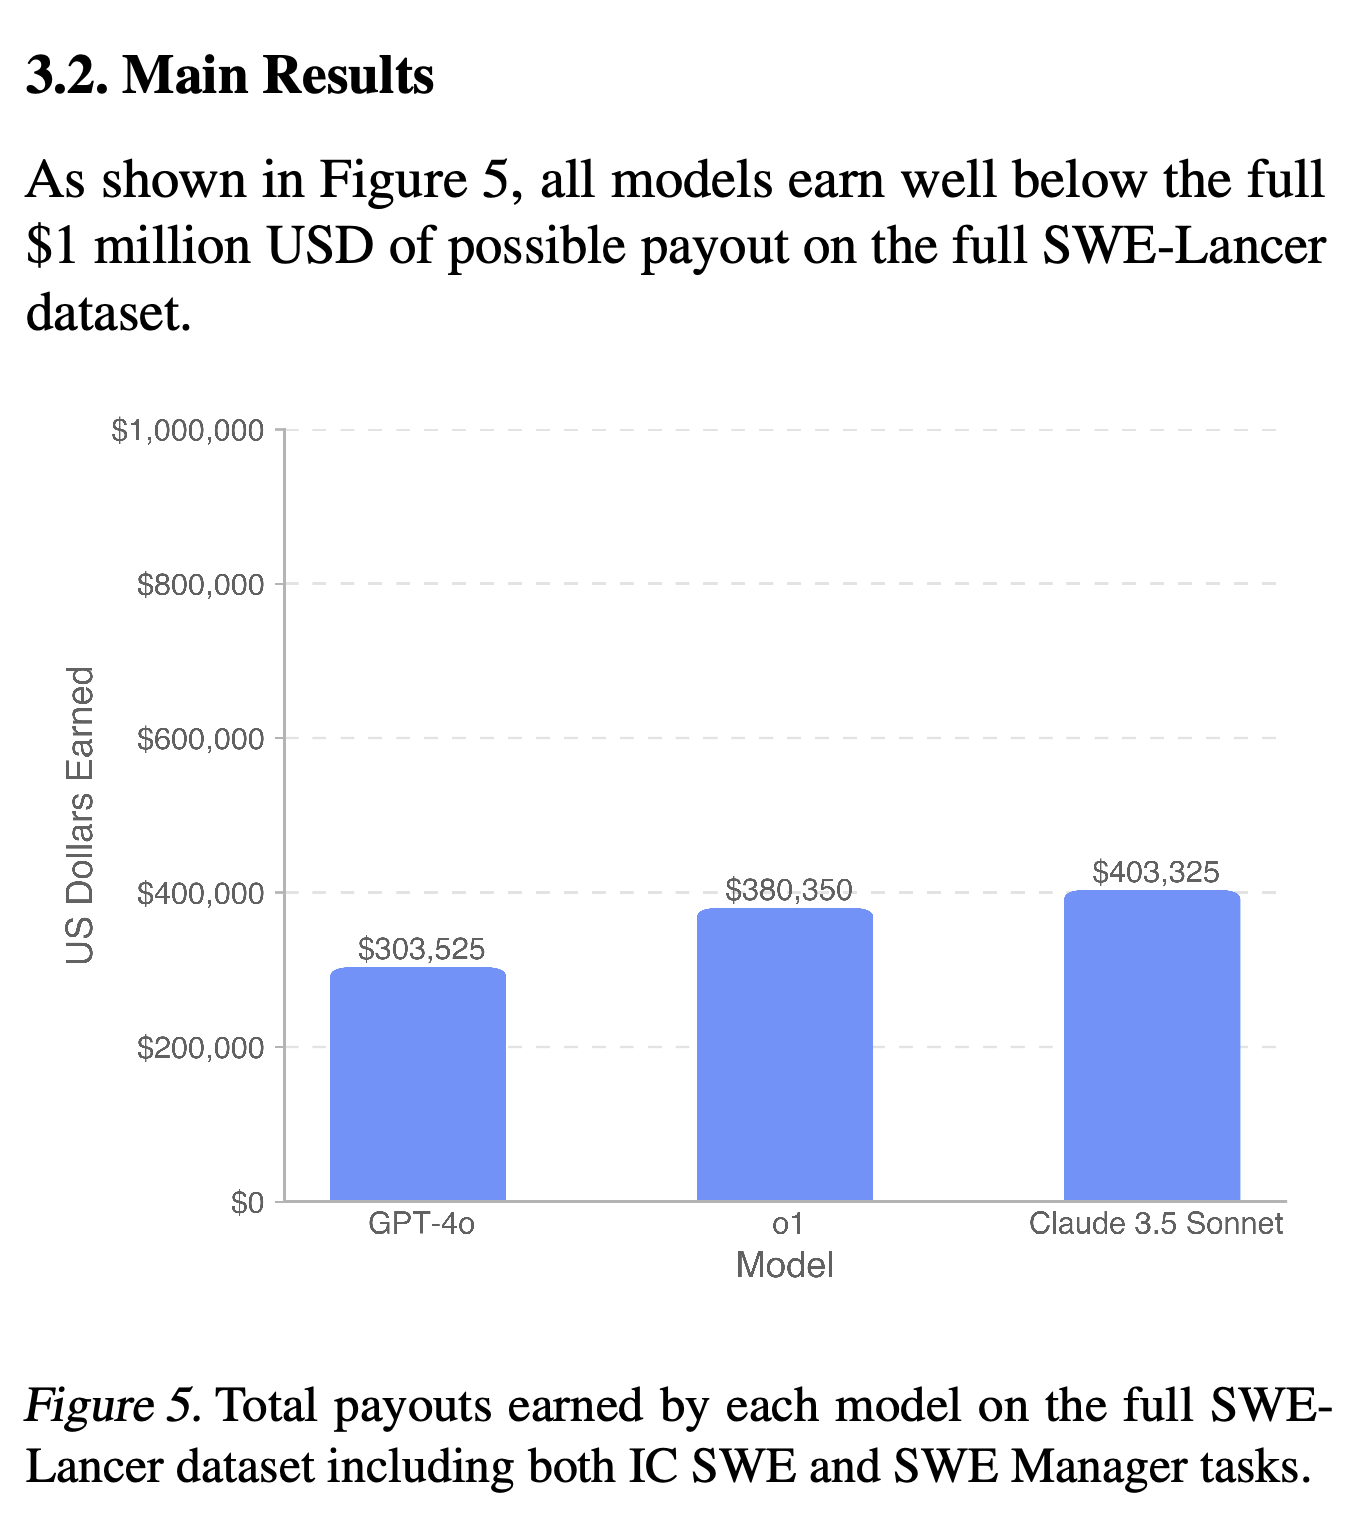
- SWE-Lancer는 텍스트를 생성하는 대규모 언어 모델(LLM)을 코딩 에이전트로 사용해 유료 프리랜서 소프트웨어 엔지니어링 작업을 수행하고 적절한 구현 제안을 선택할 수 있는지 평가한다. 논문의 1회 시도 평가에서 Claude 3.5 Sonnet은 전체 데이터셋의 과거 지급액 $1,000,000 중 $403,325를 획득하며, o1은 $380,350, GPT-4o는 $303,525를 획득한다.
- 벤치마크는 Expensify 저장소와 Upwork 공고에서 수집한 작업 1,488개로 구성된다. 코드 패치를 작성하는 Individual Contributor(IC) 소프트웨어 엔지니어링(SWE) 작업이 764개이며, 구현 제안을 선택하는 SWE Manager 작업이 724개다. 패치는 브라우저에서 애플리케이션의 전체 작업 과정을 확인하는 비공개 end-to-end 테스트로 채점하며, 관리 작업의 선택 결과는 당시 관리자의 결정과 비교한다.
- 공개된 SWE-Lancer Diamond 분할에서 Claude 3.5 Sonnet은 구현 작업의 26.2%를 해결하고, 관리 작업의 44.9%에서 당시 채택된 제안을 선택한다. 시도 횟수와 추론 노력을 늘리면 o1의 성능이 향상된다. 다만 비용 절감 추정치는 해답 검증과 사람의 미해결 작업 완료를 전제로 하며, 데이터셋은 저장소 1개와 프리랜서 플랫폼 1개만 다룬다.
1. Introduction
논문은 코딩 벤치마크 점수가 높아져도 모델에 여전히 어려운 평가가 필요하다는 점에서 SWE-Lancer를 제안한다. 상용 애플리케이션의 구현 작업과 기술 관리 작업이라는 작업 유형 2개에 실제 과거 지급액을 연결해, 작업 완료 여부와 완료한 작업에 책정된 금전적 가치를 함께 측정한다.
- 공개 Diamond 분할에는 총 $500,800에 해당하는 작업 502개가 포함된다. 나머지 $499,200는 별도의 평가용 비공개 홀드아웃으로 유지한다. 공개 평가 환경과 벤치마크는 https://github.com/openai/SWELancer-Benchmark 에서 확인할 수 있다.
- Diamond 작업은 해결까지 평균 약 26일이 걸렸고 댓글이 평균 약 47개 달렸다. 이 통계는 논의와 경과 시간을 포함하므로 엔지니어링 노동 시간을 직접 측정한 값은 아니다.
- 저자들은 기존 테스트가 있는 이슈만 고르는 대신 전문 소프트웨어 엔지니어 100명에게 테스트 개발과 검증을 의뢰했다.
1.1. Related Work
관련 연구에서는 명세에 따른 함수 생성, 경쟁 프로그래밍, 과학 계산 코드 작성, 저장소 코드 완성, 이슈 해결을 다룬다. SWE-bench와 SWE-bench Verified는 실제 저장소 이슈를 평가하고, SWE-bench Multimodal은 시각적 소프트웨어 영역으로 평가를 확장한다. SWE-Lancer는 여기에 과거 지급액, 제안 선택, 전문가가 작성한 애플리케이션 작업 과정 테스트를 추가한다.
- 논문은 개별 함수나 컴포넌트를 확인하는 단위 테스트가 이미 있는 이슈를 선택하면 테스트하기 쉬운 문제에 편중될 수 있다고 지적한다. 대안으로 프리랜서 작업을 먼저 선택한 뒤 테스트를 구성한다.
- 이러한 차이는 평가가 다루는 범위를 설명한다. 인용된 점수는 동일한 모델, 도구, 실행 예산으로 벤치마크 난도를 통제해 비교한 결과가 아니다.
2. SWE-Lancer
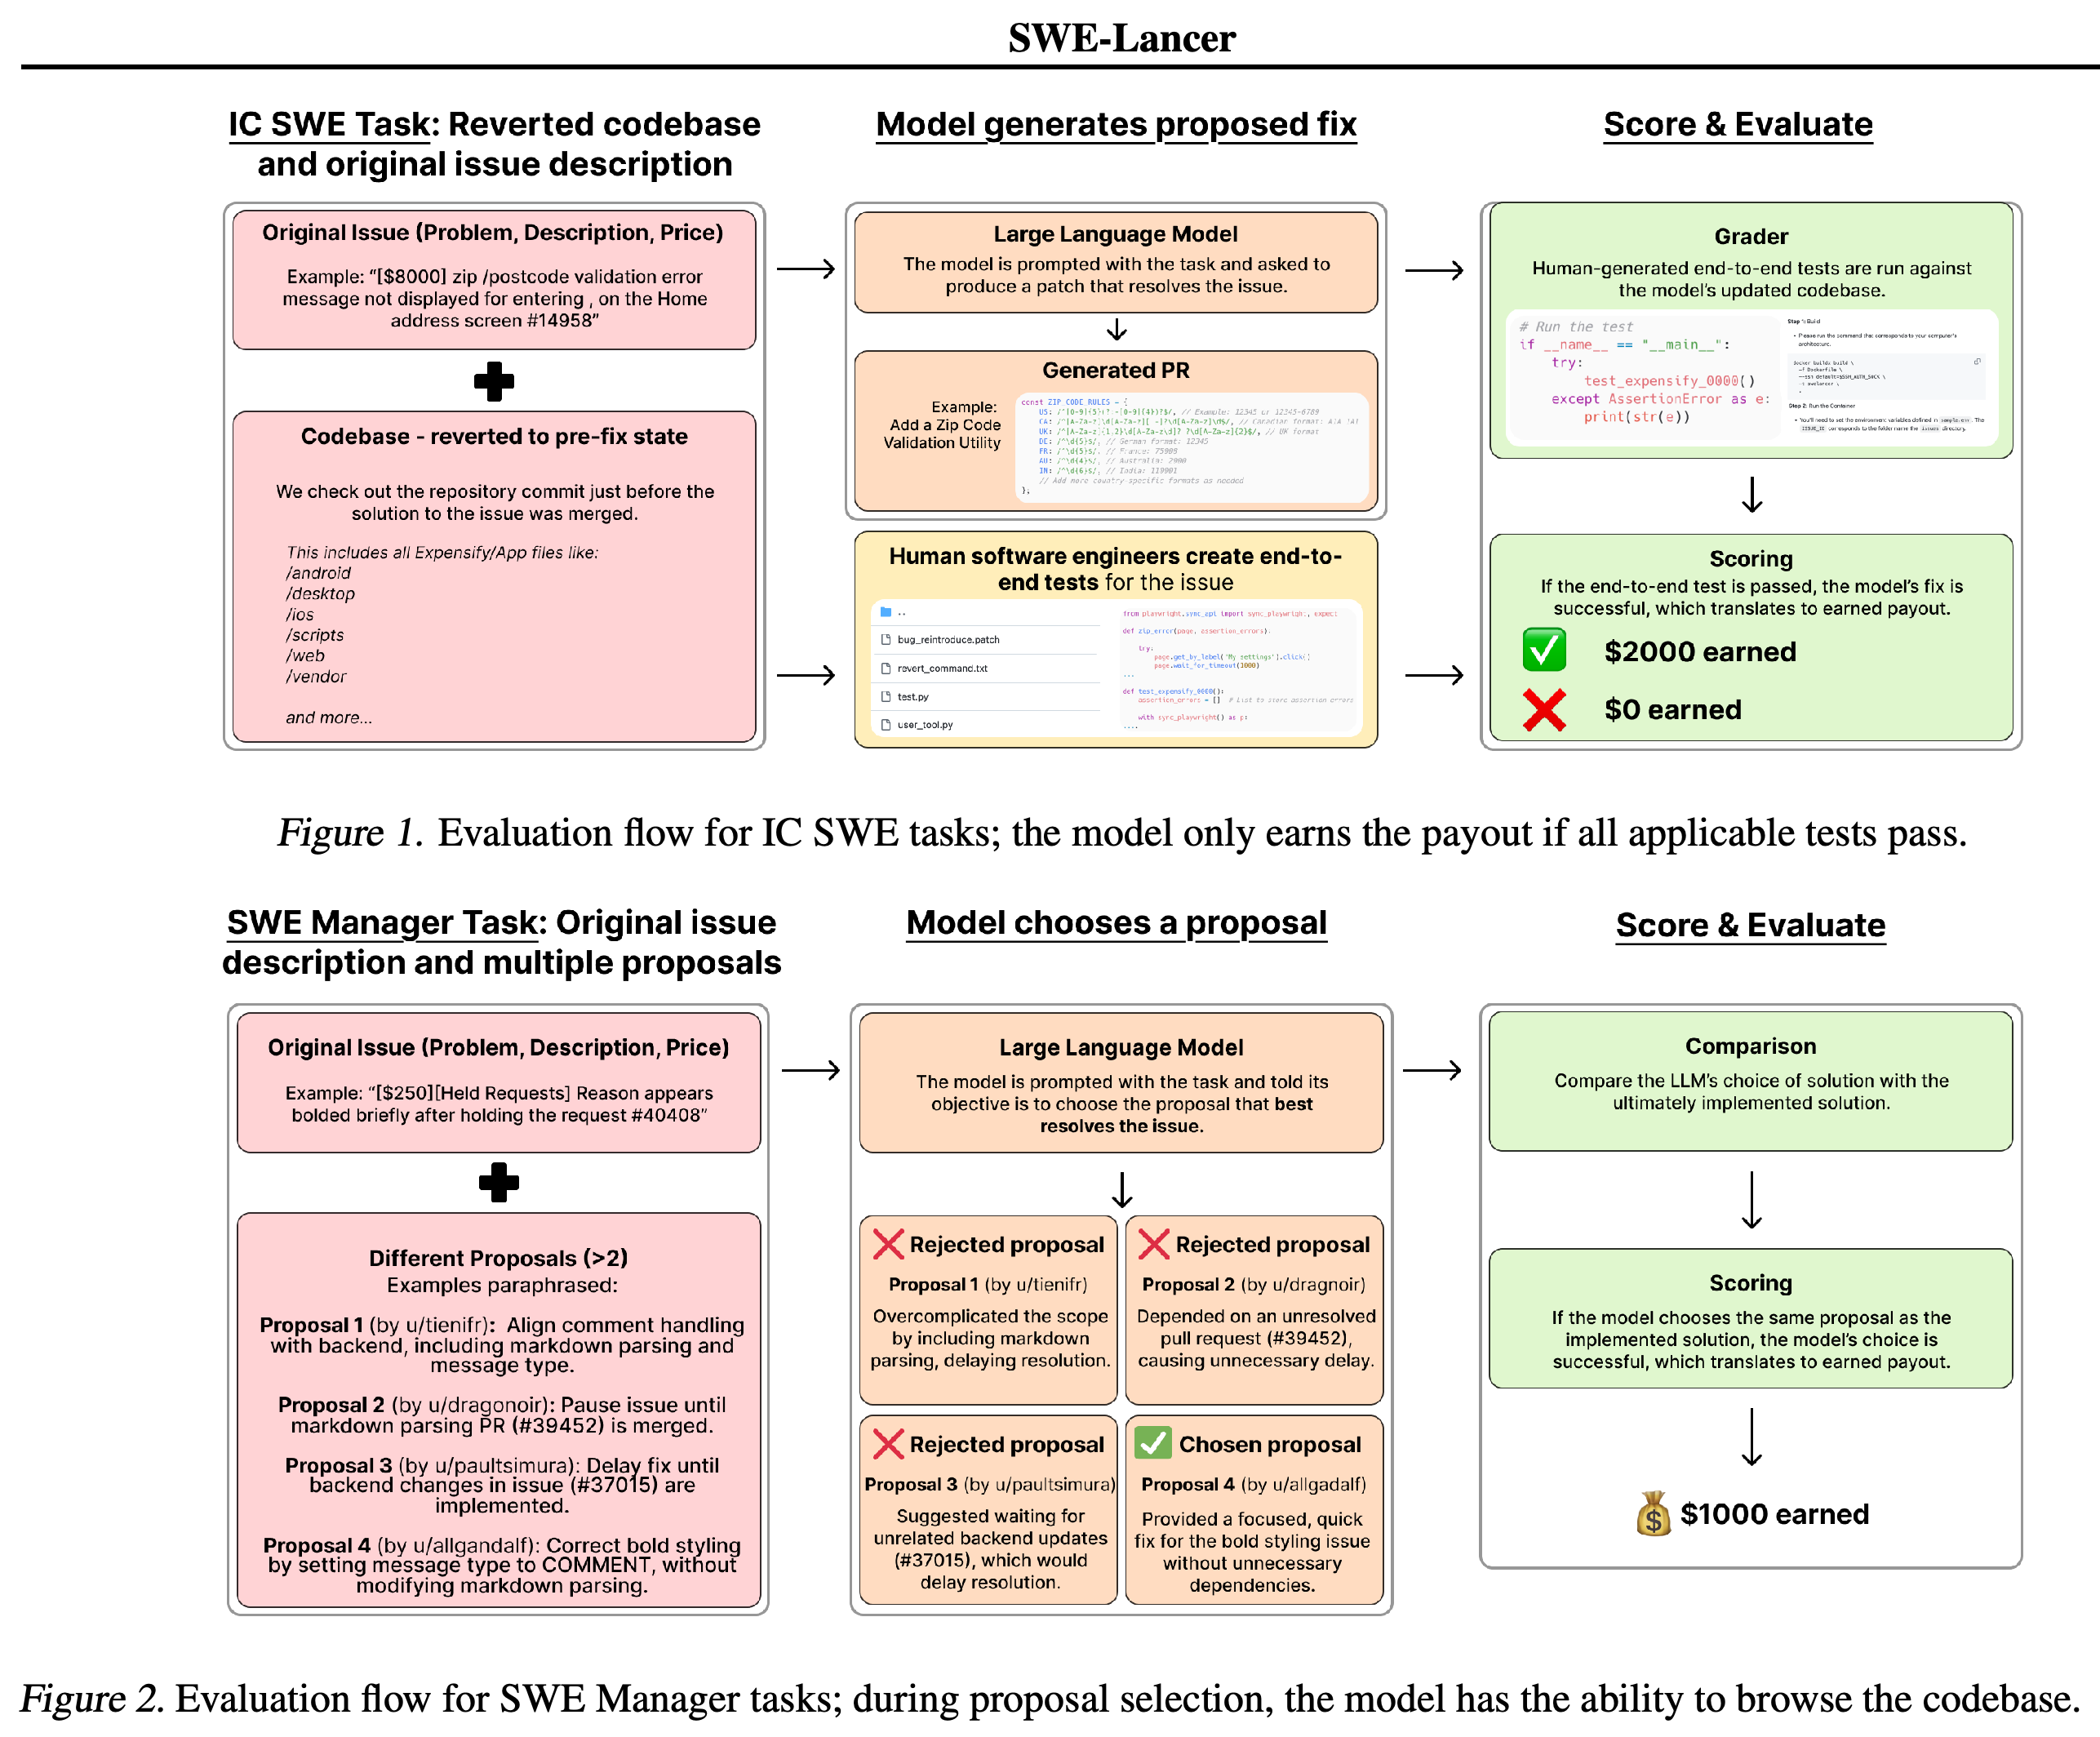
SWE-Lancer는 총 $414,775에 해당하는 IC SWE 작업 764개와 총 $585,225에 해당하는 SWE Management 작업 724개로 구성된다. 구현 작업에는 이슈 설명과 수정 이전의 저장소 스냅샷을 제공한다. 관리 작업에는 이슈, 이전 코드베이스, 원래 논의에서 경쟁했던 제안들을 제공한다.
- 구현 작업은 연결된 비공개 테스트를 모두 통과해야 지급액을 획득한다. 테스트는 브라우저 자동화 라이브러리인 Playwright를 사용하며, 평가 중에는 모델에 공개하지 않는다.
- 관리 작업은 선택한 제안이 당시의 선택과 일치하면 성공으로 판정한다. 숙련된 엔지니어가 추가로 검토한 결과, 원래 선택과 99% 일치했다.
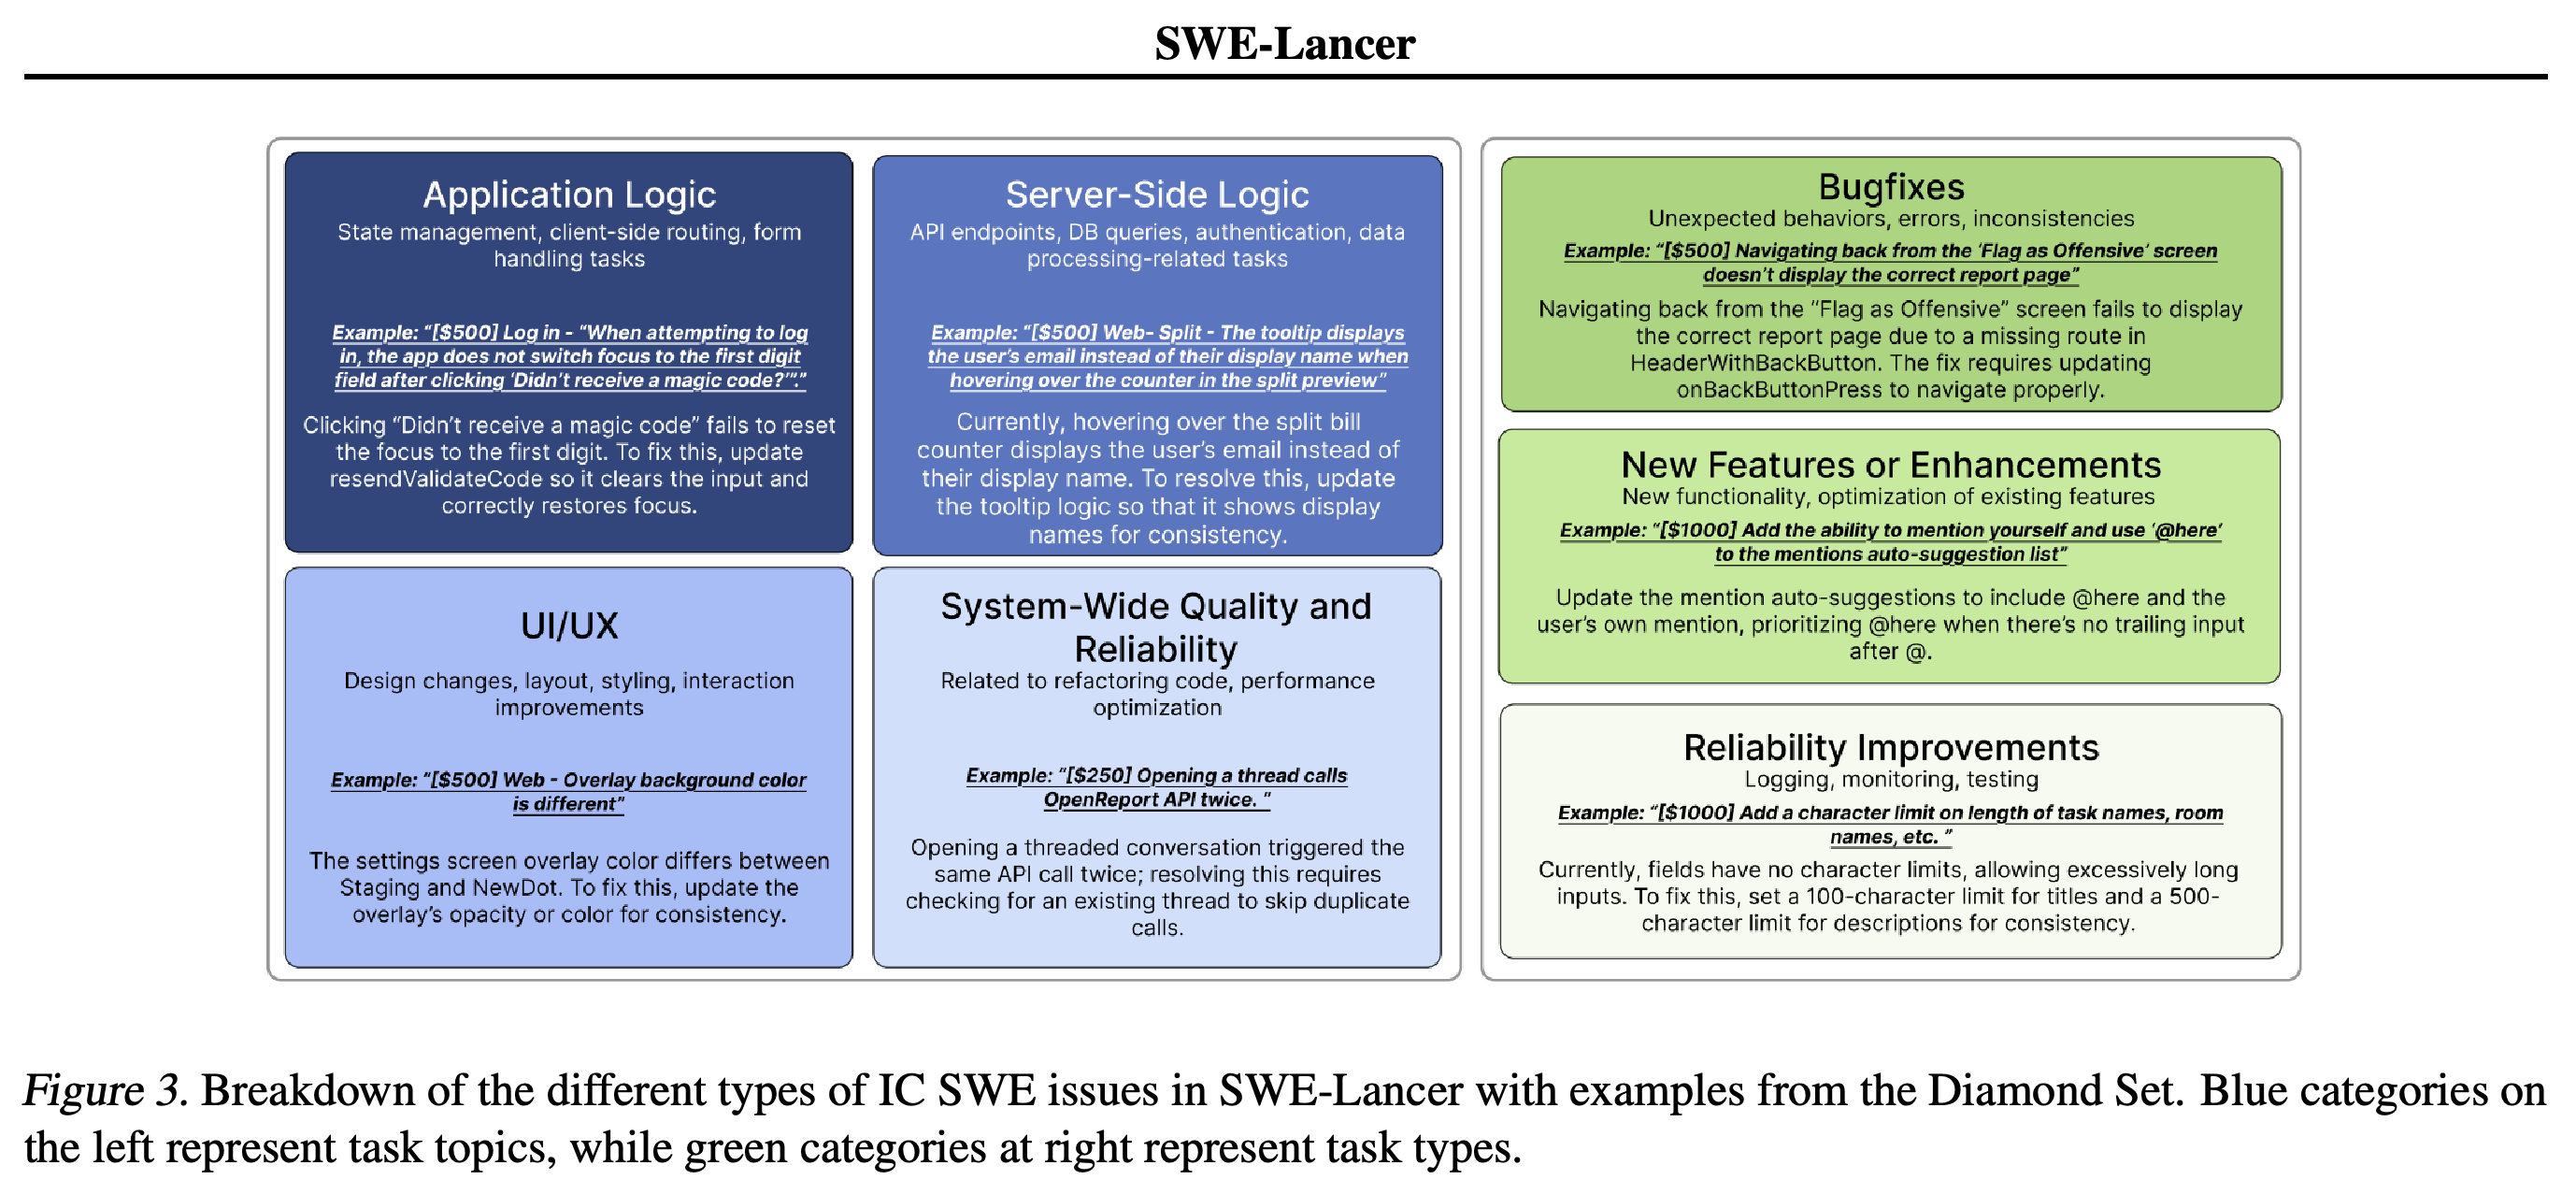
- Figure 3은 작업 주제와 작업 유형을 구분한다. 애플리케이션 로직, 서버 측 로직, 인터페이스 동작, 시스템 품질에 관한 작업은 버그 수정, 기능 추가, 안정성 개선을 포함할 수 있다.
이 과정은 모델에 공개되는 이슈와 수정 이전으로 되돌린 저장소를 사람이 만든 채점기와 구분한다. 모든 테스트를 통과해야 지급액을 획득하므로, 증상 1개만 수정한 패치는 획득액이 0일 수 있다.
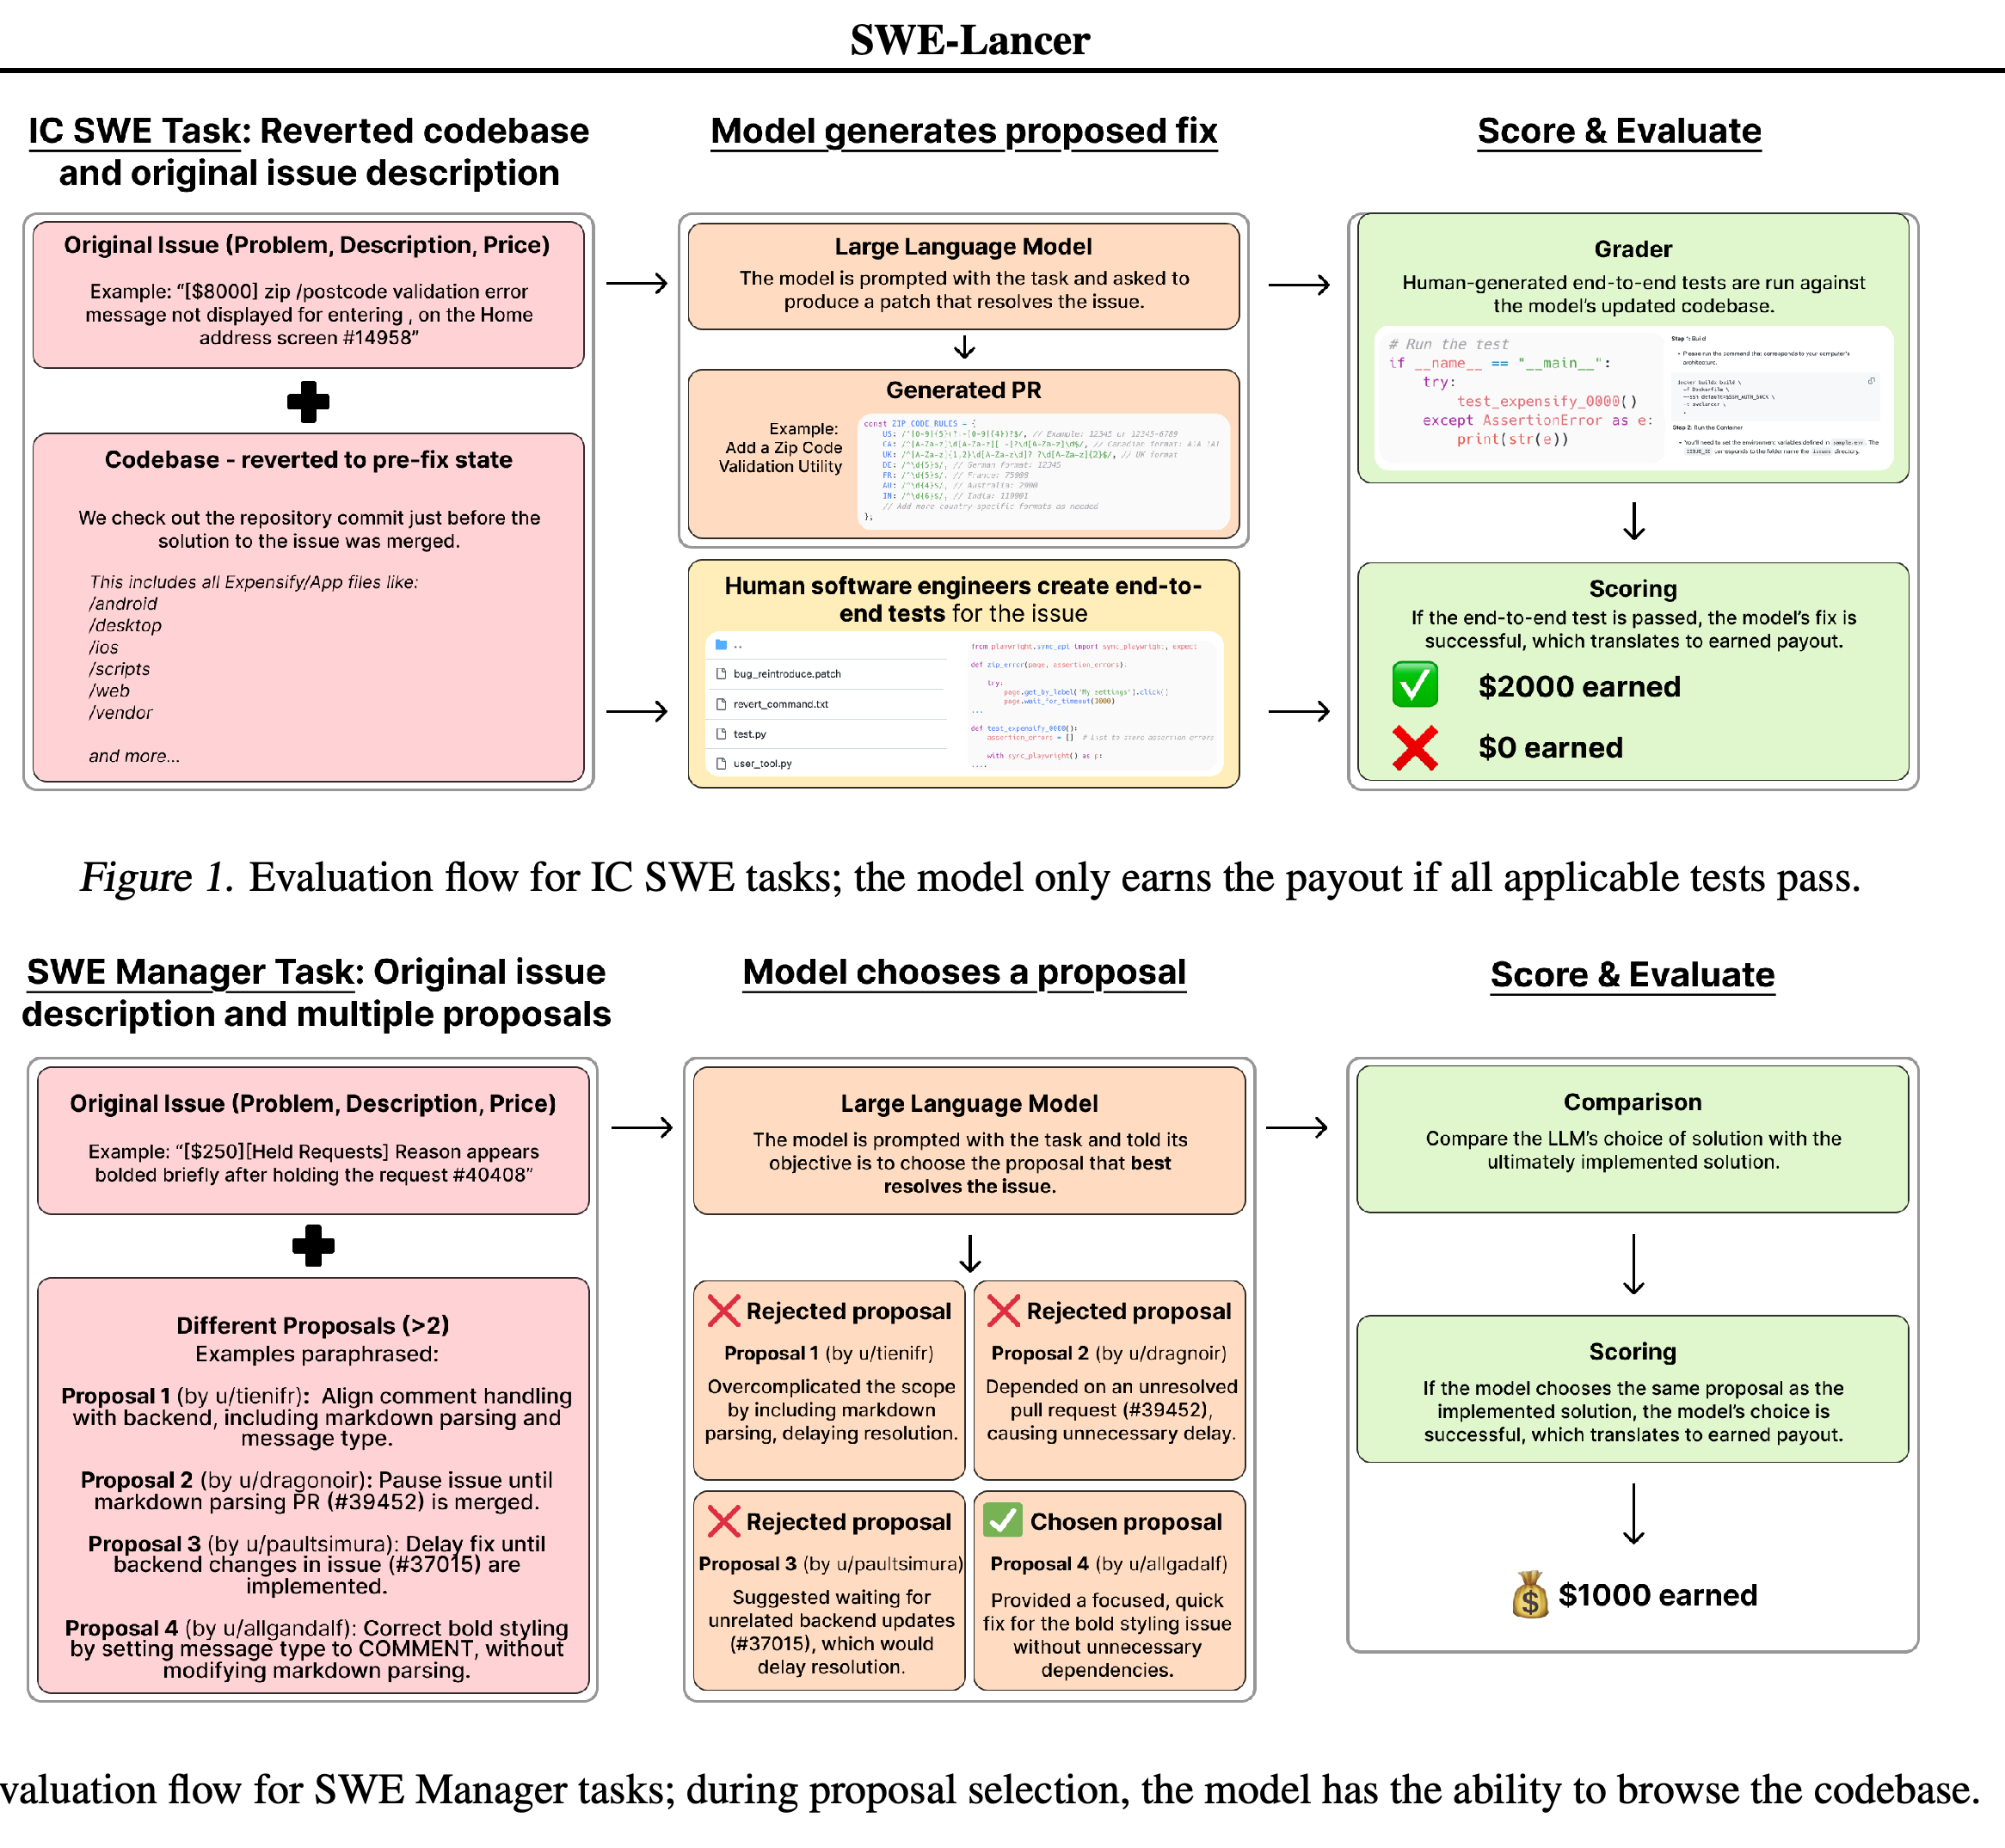
관리 트랙은 로컬 코드베이스 확인을 허용하면서 제공된 제안 중 선택하는 능력을 평가한다. 성공은 당시 실제로 구현한 제안과의 일치를 뜻하므로, 패치를 작성하고 검증하는 능력과는 다른 능력을 측정한다.
분류 2개는 엔지니어링 작업이 이루어지는 영역과 요청된 변경 유형을 구분한다. 애플리케이션 로직이나 인터페이스 작업에는 버그 수정뿐 아니라 기능 추가와 안정성 개선도 포함될 수 있다.
2.1. Evaluation Metrics and Task Types
평가에서는 해결한 작업의 비율과 성공한 작업에 책정된 과거 지급액을 보고한다. Earn rate는 획득한 지급액을 전체 지급 가능액으로 나눈 값이므로 작업 가격에 따라 결과에 가중치를 부여한다.
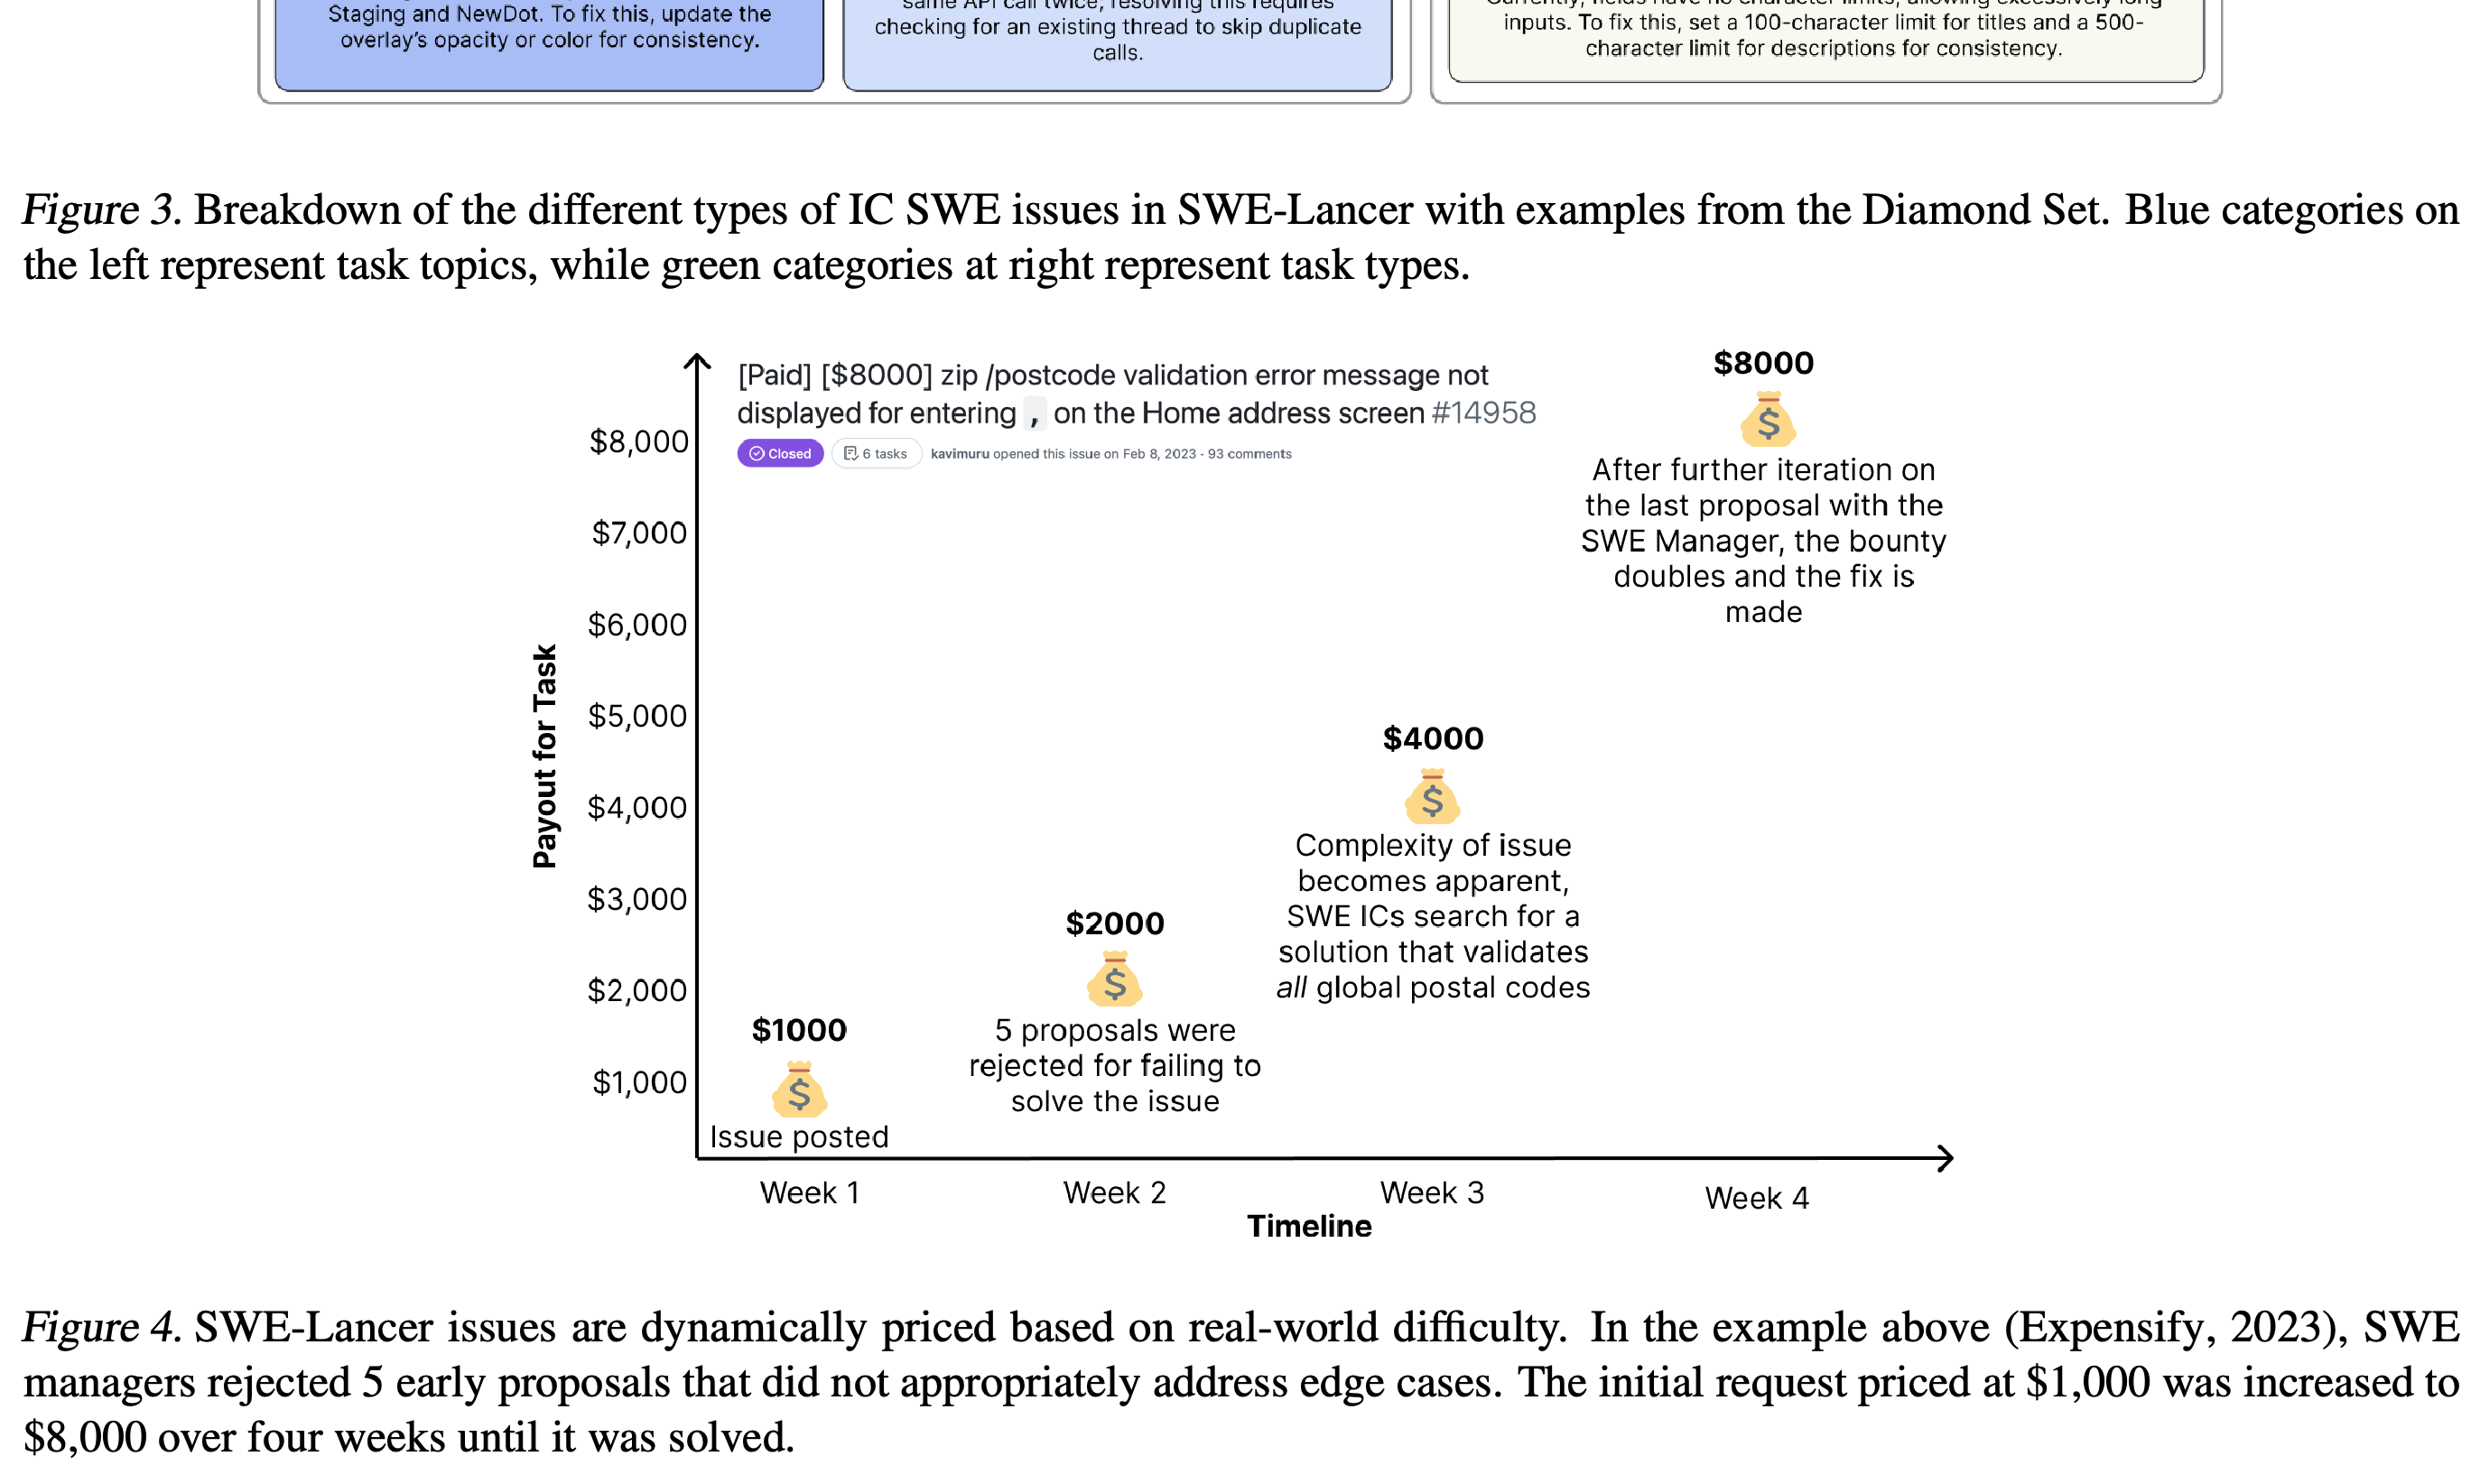
- Figure 4는 초기 제안 5개가 거절된 뒤 4주 동안 현상금이 $1,000에서 $8,000로 오른 우편번호 검증 이슈 1건을 보여준다. 이 사례는 가격을 시장에서 형성된 난도 신호로 해석할 근거를 제공하면서, 가격에 검토 과정의 변화도 반영됨을 보여준다.
우편번호 사례는 실패한 제안과 새롭게 드러난 예외 상황을 현상금 인상과 연결한다. 지급액을 난도 신호로 해석할 근거를 제공하면서, 검토 중에도 가격이 달라짐을 보여준다.
2.2. Benchmark Construction
벤치마크 구성은 저장소 선택, 작업 검토, 작업 생성, end-to-end 테스트 개발, user tool 제공 순서로 진행된다. User tool은 수정된 로컬 애플리케이션에서 이슈에 보고된 사용자 동작을 재현하는 스크립트다. 엔지니어들은 이슈의 명확성, 환경의 실행 가능성, 테스트 범위를 검토했다. Section 2.2는 IC 작업에 3회, 관리 작업에 2회 검토를 적용하고, $5,000를 초과하는 IC 작업은 숙련된 엔지니어 10명이 검증한다고 명시한다.
- User tool은 성공이나 실패를 명시적으로 보고하지 않고, 애플리케이션 동작과 상태를 기록한 텍스트 실행 기록과 스크린샷을 작업 디렉터리에 저장한다. 평가에 사용된 텍스트 전용 설정에서 에이전트는 텍스트 기록을 확인해 수정 결과를 판단한다.
- 테스트는 로그인과 애플리케이션 내 동작 등 전체 작업 과정을 재현한다. 자동 검사는 테스트가 수정된 버전에서는 통과하고 문제가 있는 버전에서는 실패하는지도 확인한다.
3. Experiments and Results
실험은 구현과 제안 선택 성능을 측정한 뒤 시도 횟수, 추론 노력, user tool 접근 여부를 바꾼다. 별도의 가격 분석에서는 모델 실행 비용에 미해결 작업의 과거 프리랜서 비용을 합산한다.
3.1. Experiment Setup
에이전트는 실행 환경을 패키징한 Docker 컨테이너에서 동작한다. 저장소는 미리 설정되어 있으며 인터넷 접근, GitHub 원격 저장소, 이후 커밋은 제공하지 않는다. 베이스라인은 gpt-4o-2024-08-06, High 추론 노력의 o1, claude-3-5-sonnet-20240620을 평가한다. 저장소 탐색, 파일 편집, 터미널 명령을 제공하는 기본 실행 프레임워크인 scaffold를 사용한다.
- 주요 지표는 샘플링한 시도 1회의 성공률인 pass@1이다. 베이스라인 구현 작업에서는 user tool을 활성화한다.
- Appendix A.5는 샘플링 temperature 1.0, 최대 도구 호출 100회, rollout당 최대 3시간을 명시한다. Rollout은 에이전트의 완전한 시도 1회를 뜻한다. 에이전트에는 이미지나 동영상 입력을 제공하지 않는다.
- 저자들은 1회 시도 결과가 실행마다 크게 달라질 수 있다고 언급한다. Claude 3.5 Sonnet은 호출 한도 때문에 전체 데이터셋에서 pass@1만 평가했다.
3.2. Main Results
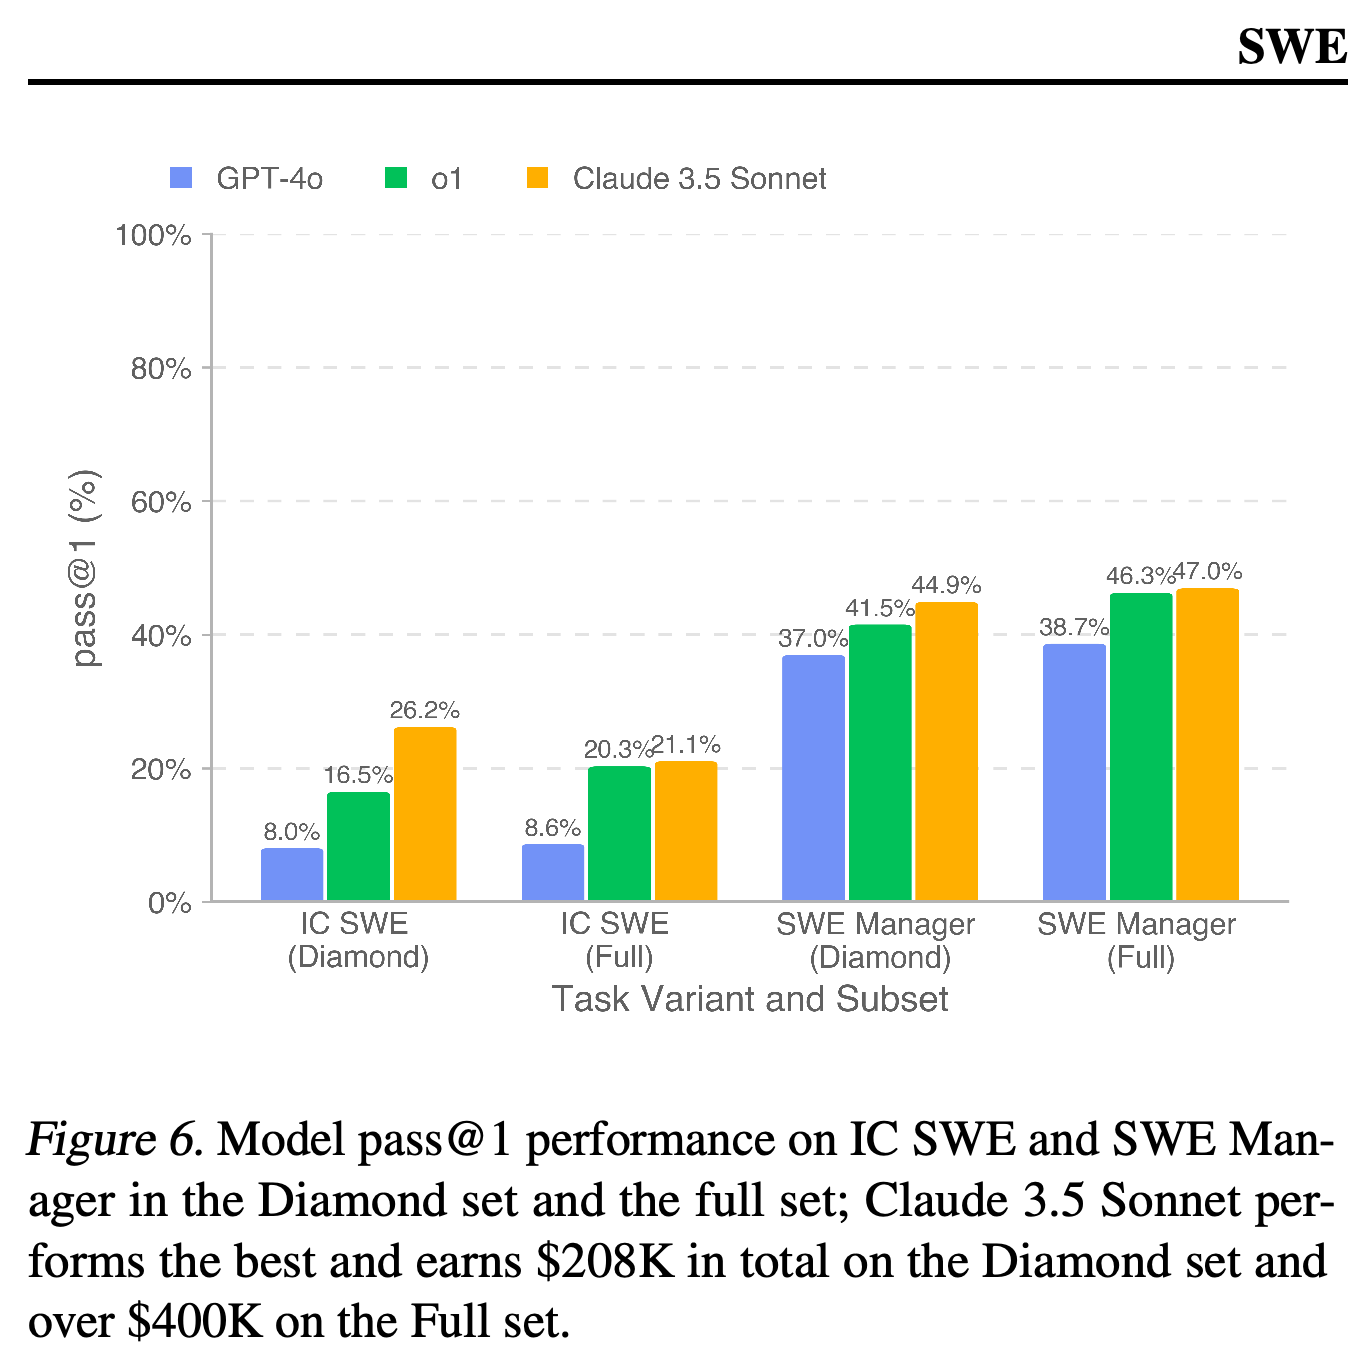
Claude 3.5 Sonnet은 분할 2개 모두에서 베이스라인 중 가장 높은 성능을 보인다. Diamond의 IC SWE와 SWE Manager pass@1은 각각 26.2%, 44.9%이며, o1은 16.5%, 41.5%, GPT-4o는 8.0%, 37.0%다. 획득액은 Diamond에서 $500,800 중 $208,050이며, 전체 데이터셋에서 $1,000,000 중 $403,325다.
- 전체 데이터셋의 IC SWE pass@1은 GPT-4o, o1, Claude 3.5 Sonnet 순서로 8.6%, 20.3%, 21.1%이며, SWE Manager pass@1은 38.7%, 46.3%, 47.0%다.
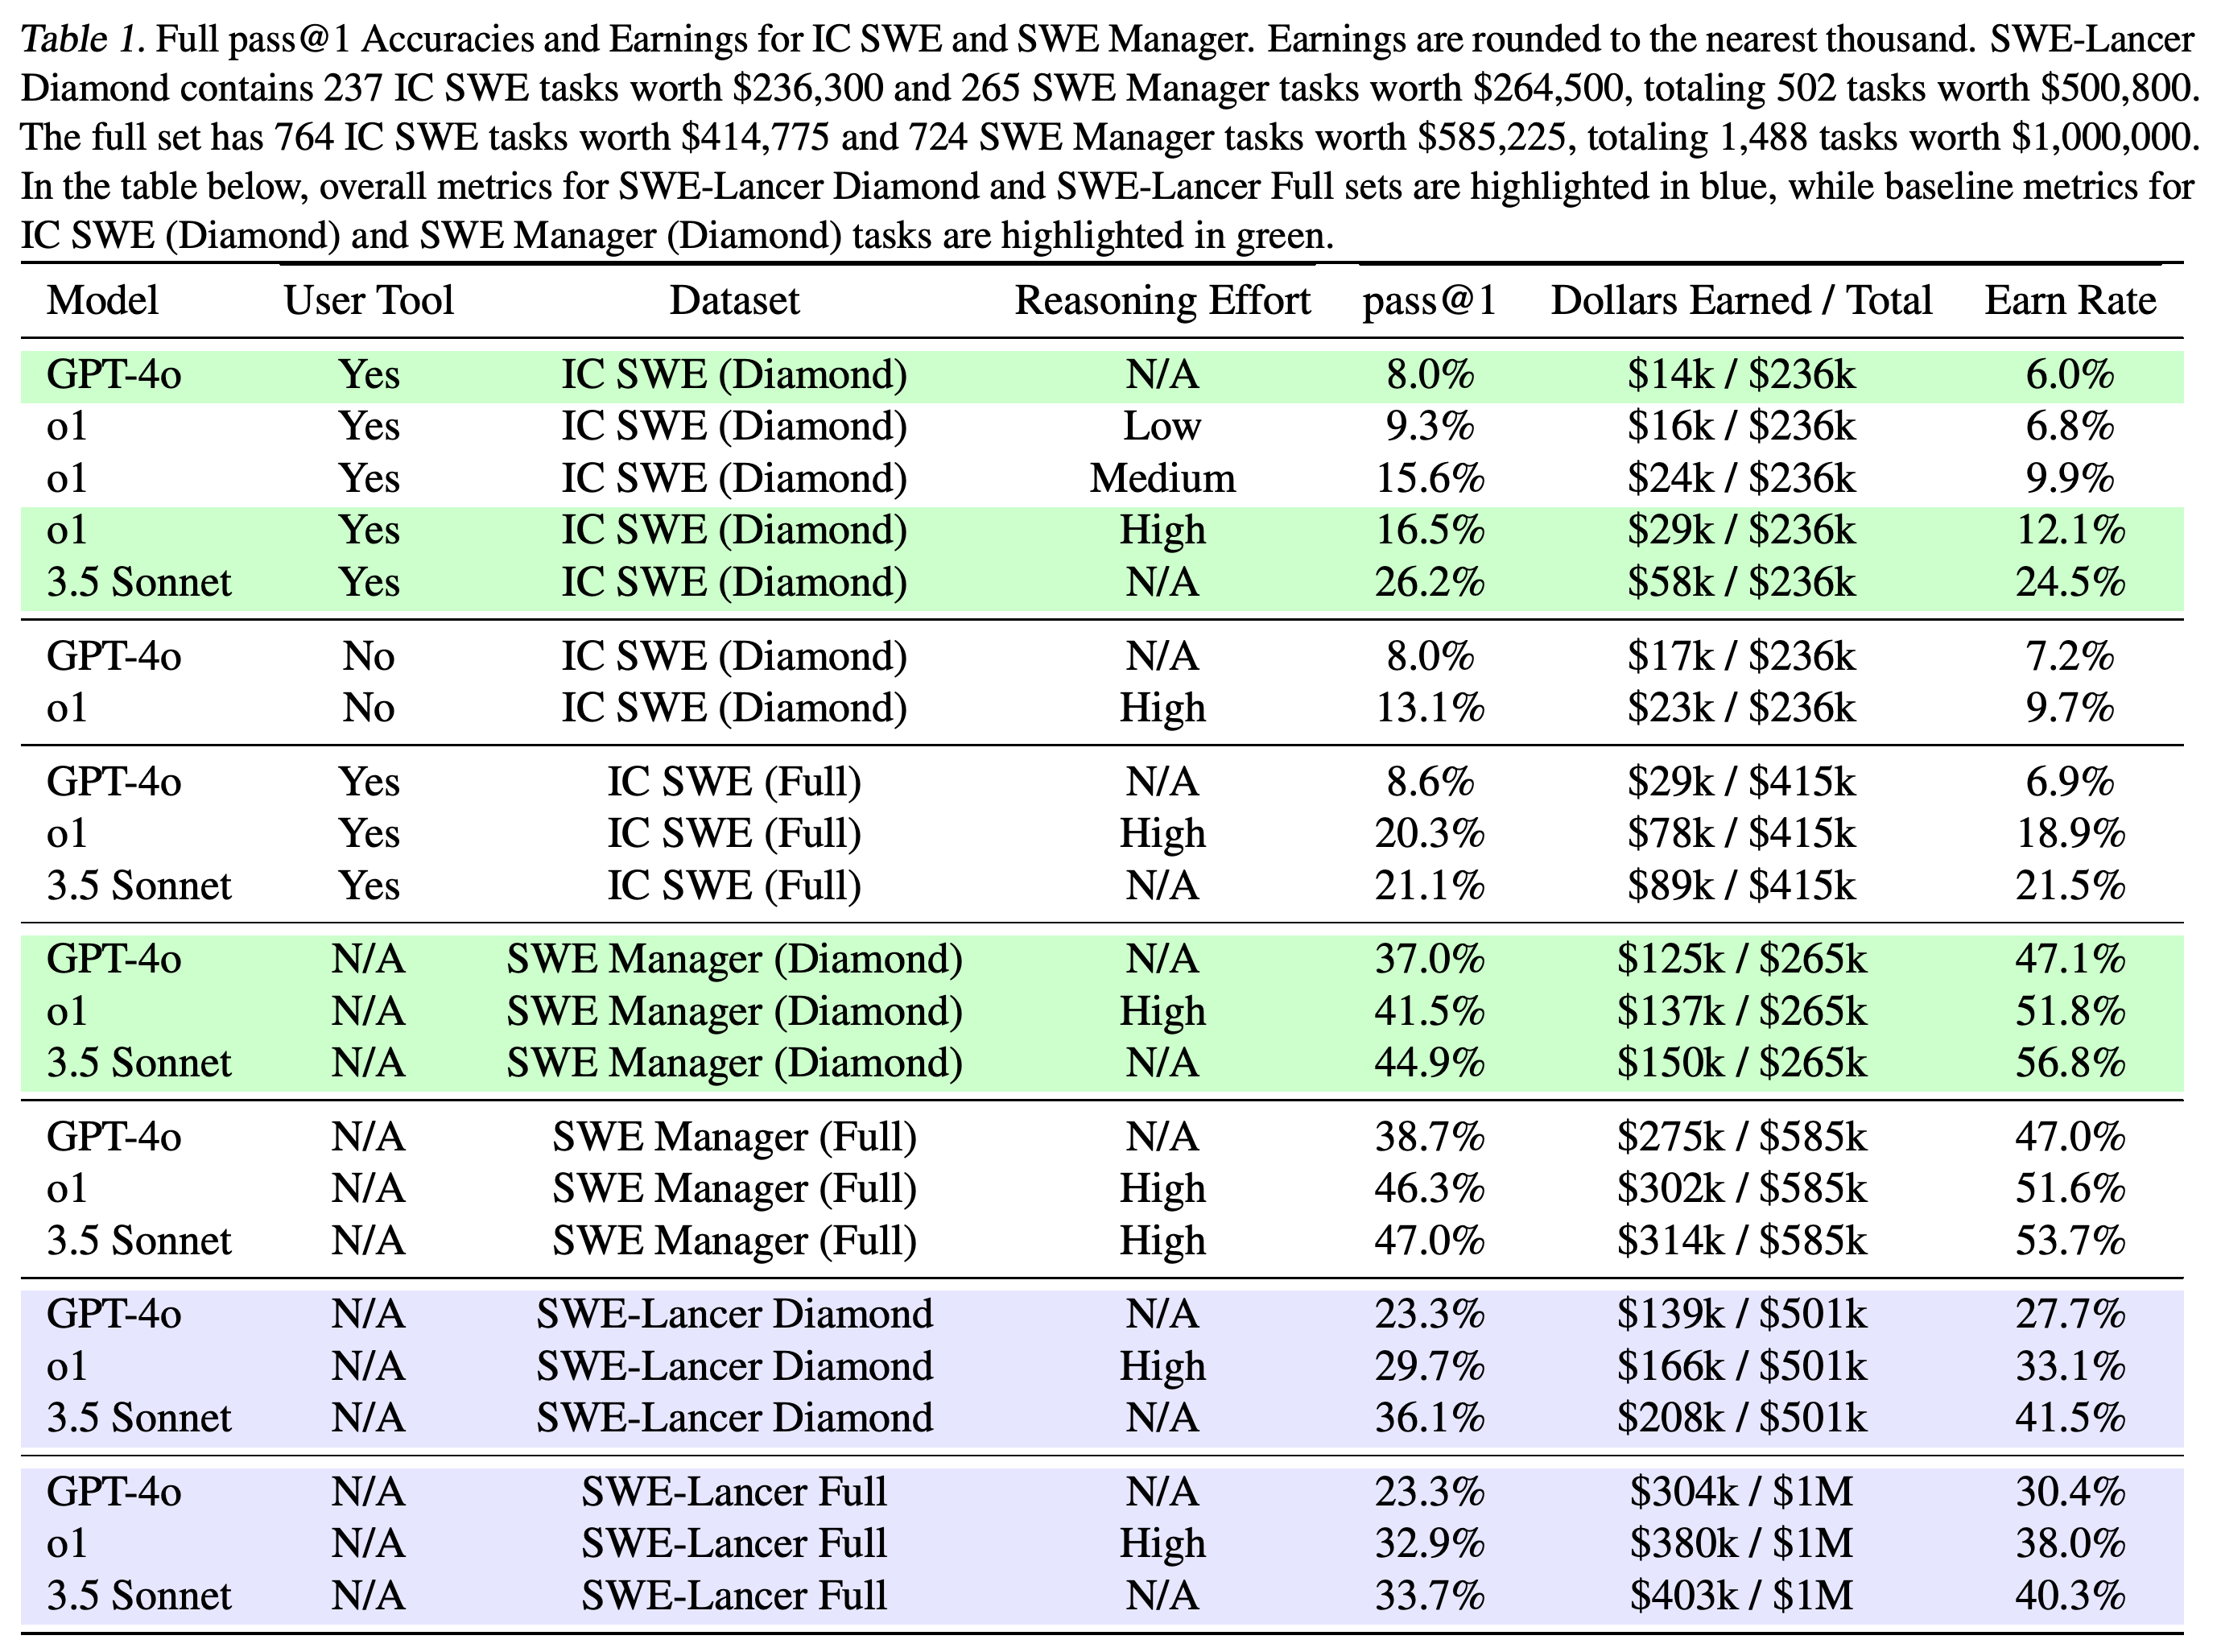
- Table 1은 작업 성공률과 지급액으로 가중한 성능을 구분한다. Claude 3.5 Sonnet의 Diamond 전체 pass@1은 36.1%, earn rate는 41.5%이며, 전체 데이터셋에서는 각각 33.7%, 40.3%다.
- 관리 작업의 결과는 구현 작업보다 일관되게 높다. 다만 이는 제안을 선택할 때 과거 결정과 일치하는지를 측정하며, 선택한 제안을 성공적으로 구현했는지를 측정하지는 않는다.
성공한 작업에 책정된 과거 지급액의 합은 GPT-4o가 $303,525, o1이 $380,350, Claude 3.5 Sonnet이 $403,325다. 가장 높은 베이스라인도 전체 $1,000,000의 절반에 못 미친다. 이는 실제 프리랜서 업무에 투입되어 받은 보수가 아니라 벤치마크의 지급액 합계다.
모델 3개 모두 분할 2개에서 구현보다 제안 선택 점수가 높다. Claude 3.5 Sonnet의 구현 점수는 Diamond에서 26.2%, 전체 데이터셋에서 21.1%다. 이 그림은 서로 다른 작업 집합의 성능을 보고하며 난도 변화를 통제한 비교는 아니다.
이 표는 작업 성공률, 반올림한 획득액, earn rate를 함께 보고해 작업 수 기준과 금전 가중 기준의 차이를 드러낸다. 추론 노력과 도구 열은 베이스라인과 ablation 결과를 비교하는 데 필요한 조건을 명시한다.
3.3. Increasing Number of Attempts
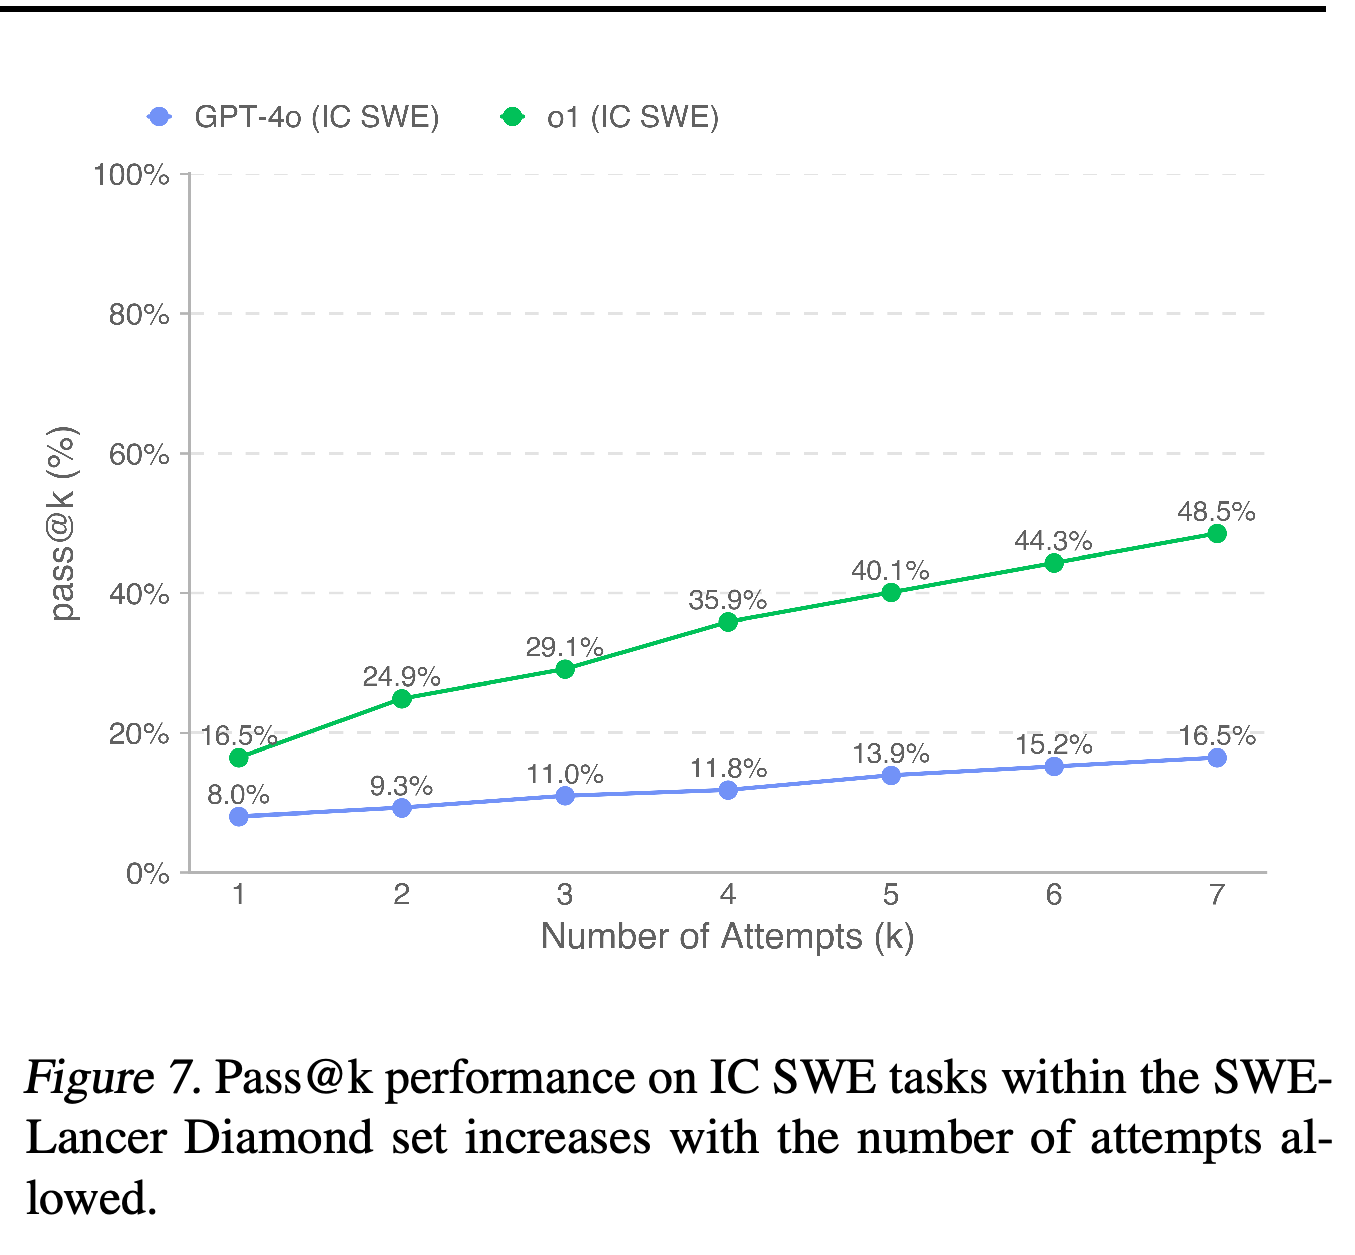
반복 시도 실험은 Diamond IC SWE 작업에서 k를 1부터 7까지 바꾸며 pass@k를 측정한다. Pass@k는 k회 시도 중 적어도 1회 성공할 확률의 추정치다. o1은 1회 시도에서 16.5%, 7회에서 48.5%로 상승하며, GPT-4o는 8.0%에서 16.5%로 상승한다.
- 추정식은 pass@k = E_Problems[1 − C(n − c, k) / C(n, k)]이며, n은 샘플링한 시도 수, c는 정답 시도 수, C는 이항계수를 뜻한다.
- 이 결과는 시도한 후보 중 성공한 후보가 포함되는지를 측정한다. 그 후보를 실제로 사용하려면 성공 여부를 판별해야 하며, 5회 시도의 가격 분석은 이를 빠르게 판별할 수 있다고 가정한다.
- 본문은 GPT-4o가 pass@6에서 16.5%에 도달한다고 설명하지만, Figure 7은 6회에서 15.2%, 7회에서 16.5%로 표시한다. 여기서는 그림의 최종 값을 사용한다.
o1의 성공률 추정치는 1회 시도에서 16.5%, 7회에서 48.5%로 상승하며, GPT-4o는 8.0%에서 16.5%로 상승한다. 그래프의 최종 지점은 GPT-4o의 16.5%를 7회 시도에 표시하며, 6회를 언급하는 본문 설명과 다르다.
3.4. Increasing Test Time Compute
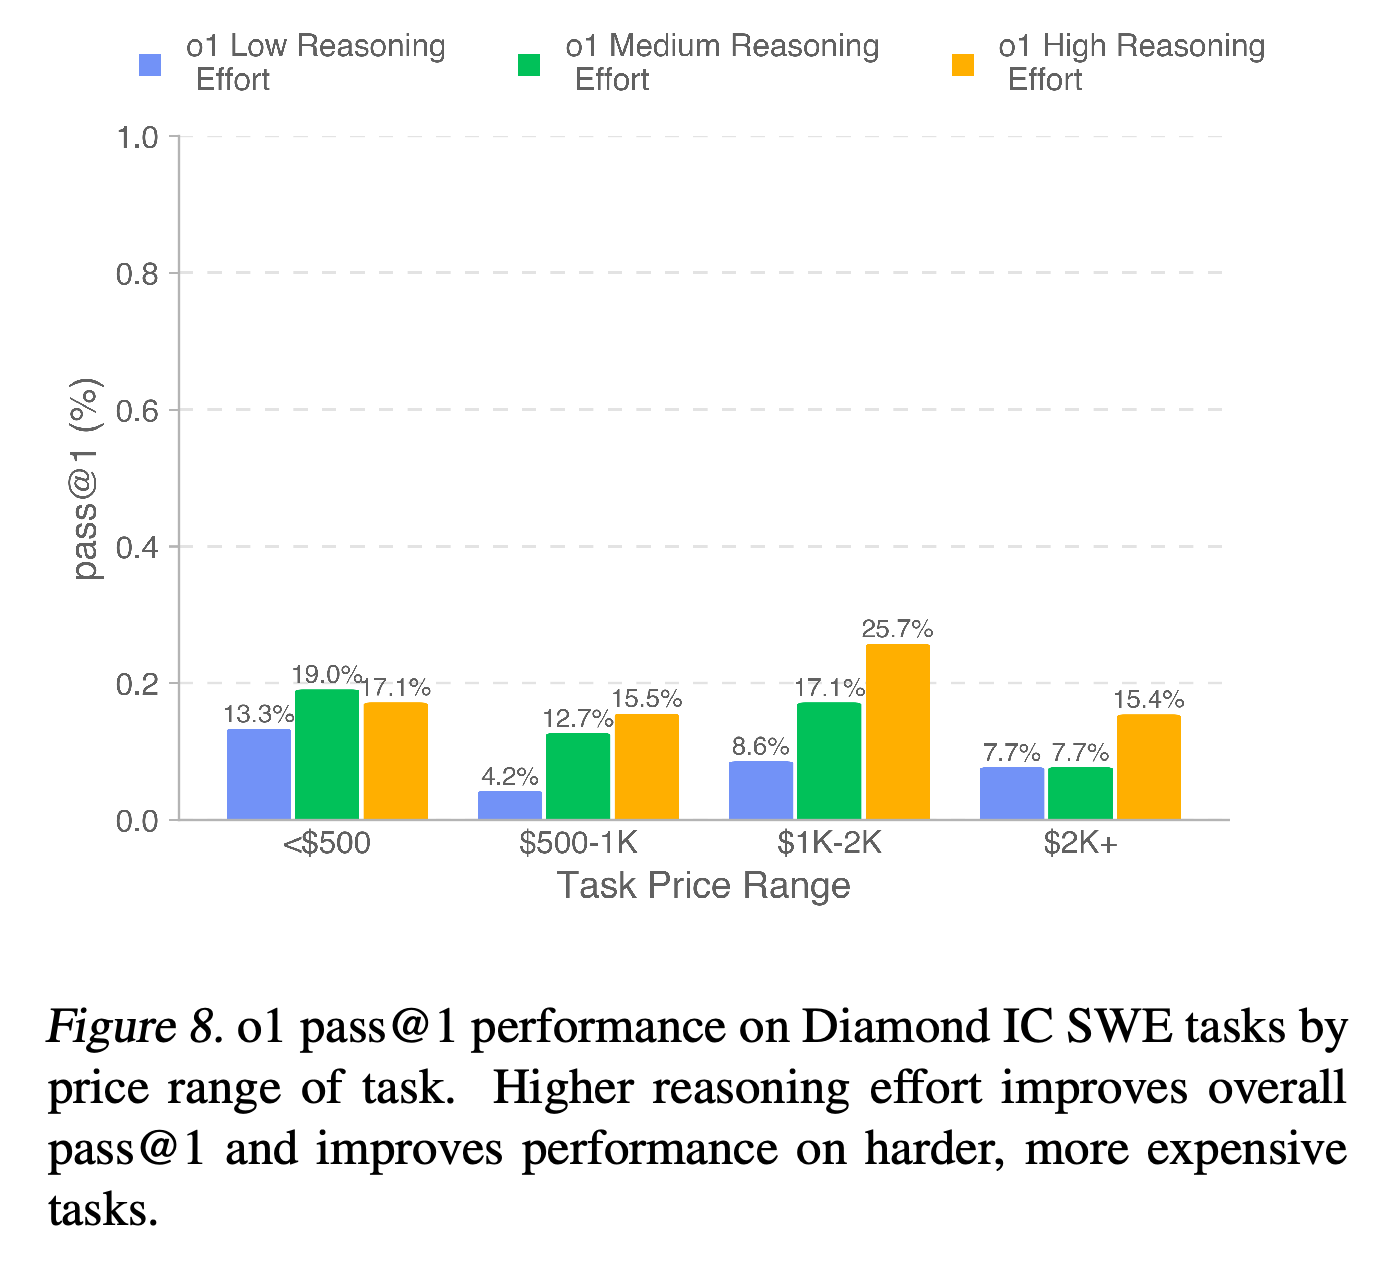
User tool을 활성화한 Diamond IC SWE 작업에서 o1의 추론 시점 연산량 설정인 추론 노력을 Low에서 High로 높이면 pass@1이 9.3%에서 16.5%로 상승한다. 반올림한 획득액은 $16K에서 $29K로, earn rate는 6.8%에서 12.1%로 상승한다. Medium 추론 노력의 pass@1은 15.6%다.
- Figure 8은 가격대에 따라 개선 폭이 다름을 보여준다. $1K–2K 작업의 pass@1은 Low에서 8.6%, High에서 25.7%로 상승하며, $2K+ 작업은 7.7%에서 15.4%로 상승한다.
- $500 미만 그룹의 성능은 단조롭게 증가하지 않는다. Medium은 19.0%, High는 17.1%다. 추론 노력을 늘리면 전체 결과는 개선되지만 모든 가격대가 개선되지는 않는다.
추론 노력을 높였을 때 그래프에서 가장 크게 개선되는 $1K–2K 그룹은 8.6%에서 25.7%로 상승한다. $500 미만 그룹은 Medium에서 가장 높으므로, 전체 성능 향상이 모든 가격대의 단조로운 향상을 뜻하지는 않는다.
3.5. Removing User Tool
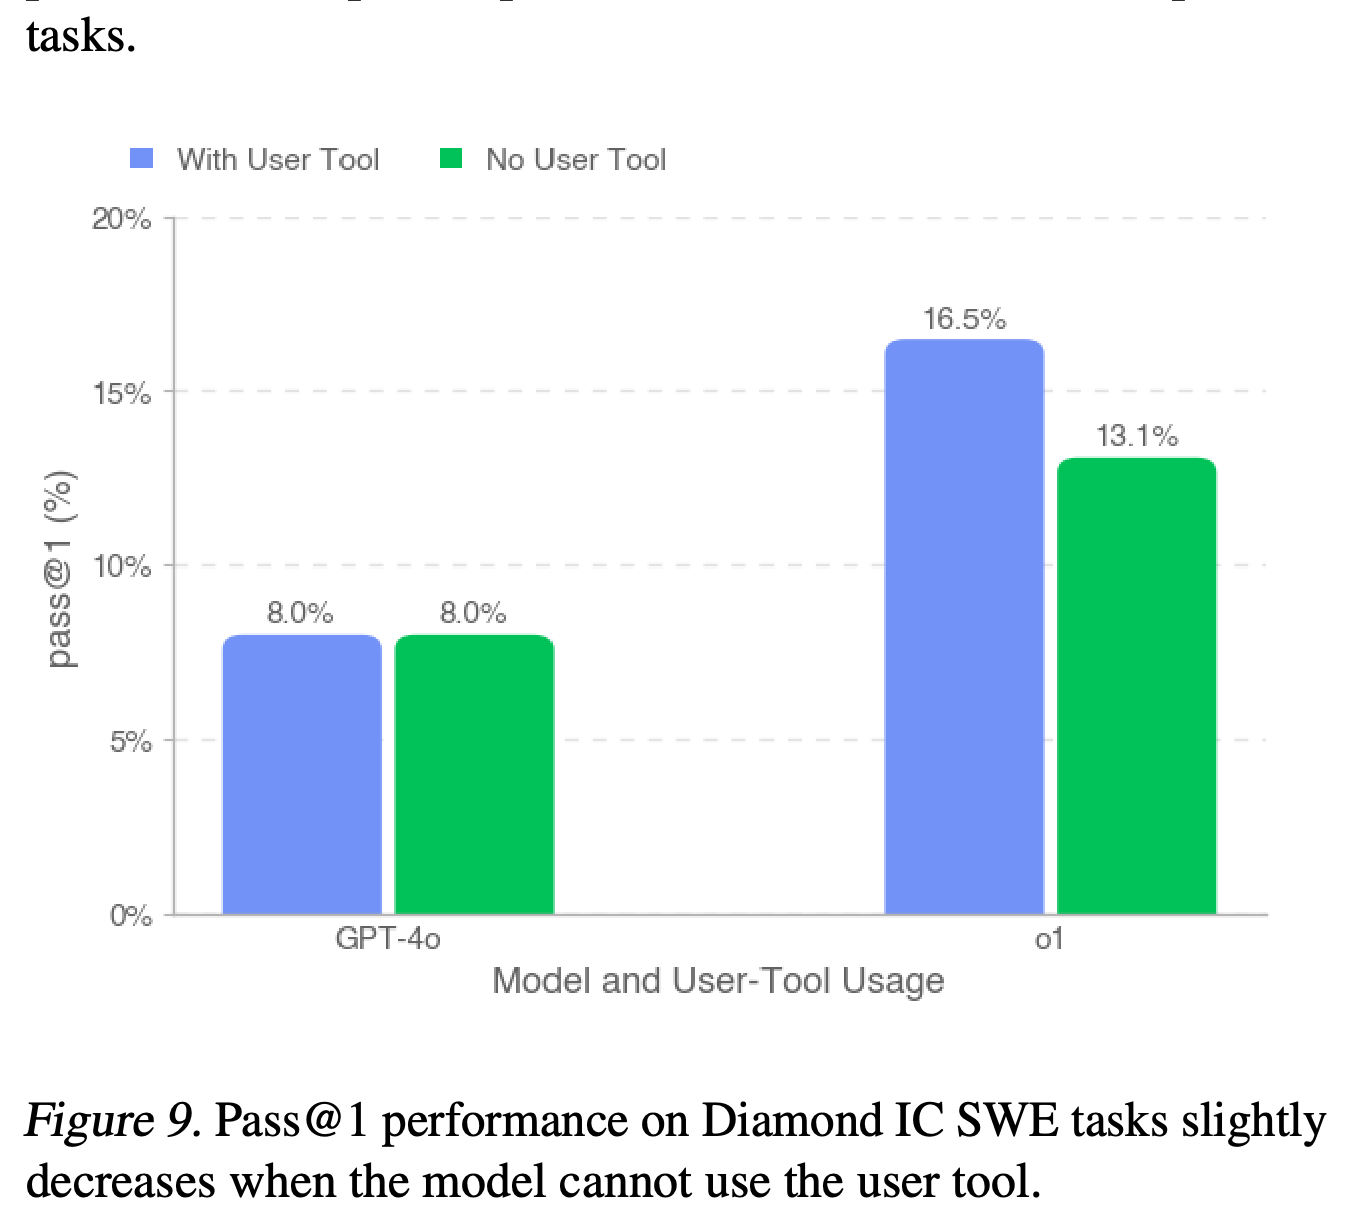
User tool을 제거하면 GPT-4o의 Diamond IC SWE pass@1은 8.0%로 유지되고, o1은 16.5%에서 13.1%로 낮아진다. 구성 요소 1개를 제거하는 이 ablation 실험은 평가에 사용한 scaffold에서 도구가 o1의 작업 성공률에 더 큰 도움을 주었음을 보여준다.
- Table 1에서 GPT-4o는 작업 성공률이 같은데도 도구가 있을 때 earn rate가 6.0%, 없을 때는 7.2%다. 따라서 보고된 도구의 효과는 모델과 지표에 따라 다르다.
도구를 제거하면 o1의 구현 성공률은 16.5%에서 13.1%로 3.4%포인트 낮아지고, GPT-4o는 8.0%로 유지된다. 재현된 사용자 실행 기록에 접근하는 효과가 모델에 따라 다름을 보여준다.
3.6. Price Analysis
가격 분석은 총 $236,300에 해당하는 Diamond IC SWE 작업 237개에서 GPT-4o와 o1을 각각 5회 실행한 결과의 평균을 사용한다. 비용 절감률은 모델 비용과 모델이 실패한 작업의 프리랜서 비용을 합산하고, 이를 모든 작업을 프리랜서가 해결하는 비용으로 나눈 뒤 1에서 뺀 값이다.
- 모델이 1회 시도한 뒤 미해결 작업을 프리랜서가 완료하면 예상 절감률은 GPT-4o가 8.84%, o1이 13.26%다. 프리랜서에게 넘기기 전에 5회 시도를 허용하면 각각 18.6%, 33.5%로 높아진다.
- 모델 기여 비율은 모델이 성공한 작업의 지급액을 모델 비용과 미해결 작업을 완료하는 프리랜서 비용의 합으로 나눈 값이다. 총지출 $1당 기여액은 GPT-4o가 $0.10, o1이 $0.16이다.
- 보고된 평균 실행 비용과 95% 신뢰구간은 GPT-4o가 $194.31 ± $17.31, o1이 $1,623.76 ± $56.68다. 추정에는 고객용 애플리케이션 프로그래밍 인터페이스(API) 가격을 사용하며, 재시도를 포함하고 배치 가격은 제외한다. 또한 과거 현상금에 의존한다. 검증에 24시간 넘게 걸릴 수 있는데도 5회 시도 시나리오는 빠른 검증을 가정한다.
3.7. Discussion
논의에서는 불완전한 원인 진단과 효과적이지 않은 검증을 반복되는 장애 요인으로 지적한다. 에이전트는 관련 파일을 찾고도 컴포넌트 간 상호작용을 고려하지 못해 부분적인 수정안을 제출하는 경우가 많다. 성능이 높은 에이전트는 user tool의 실행을 기다리고, 출력을 해석하며, 디버깅에 활용하는 데 더 능숙하다. 이 도구의 실행에는 보통 90~120초가 걸린다.
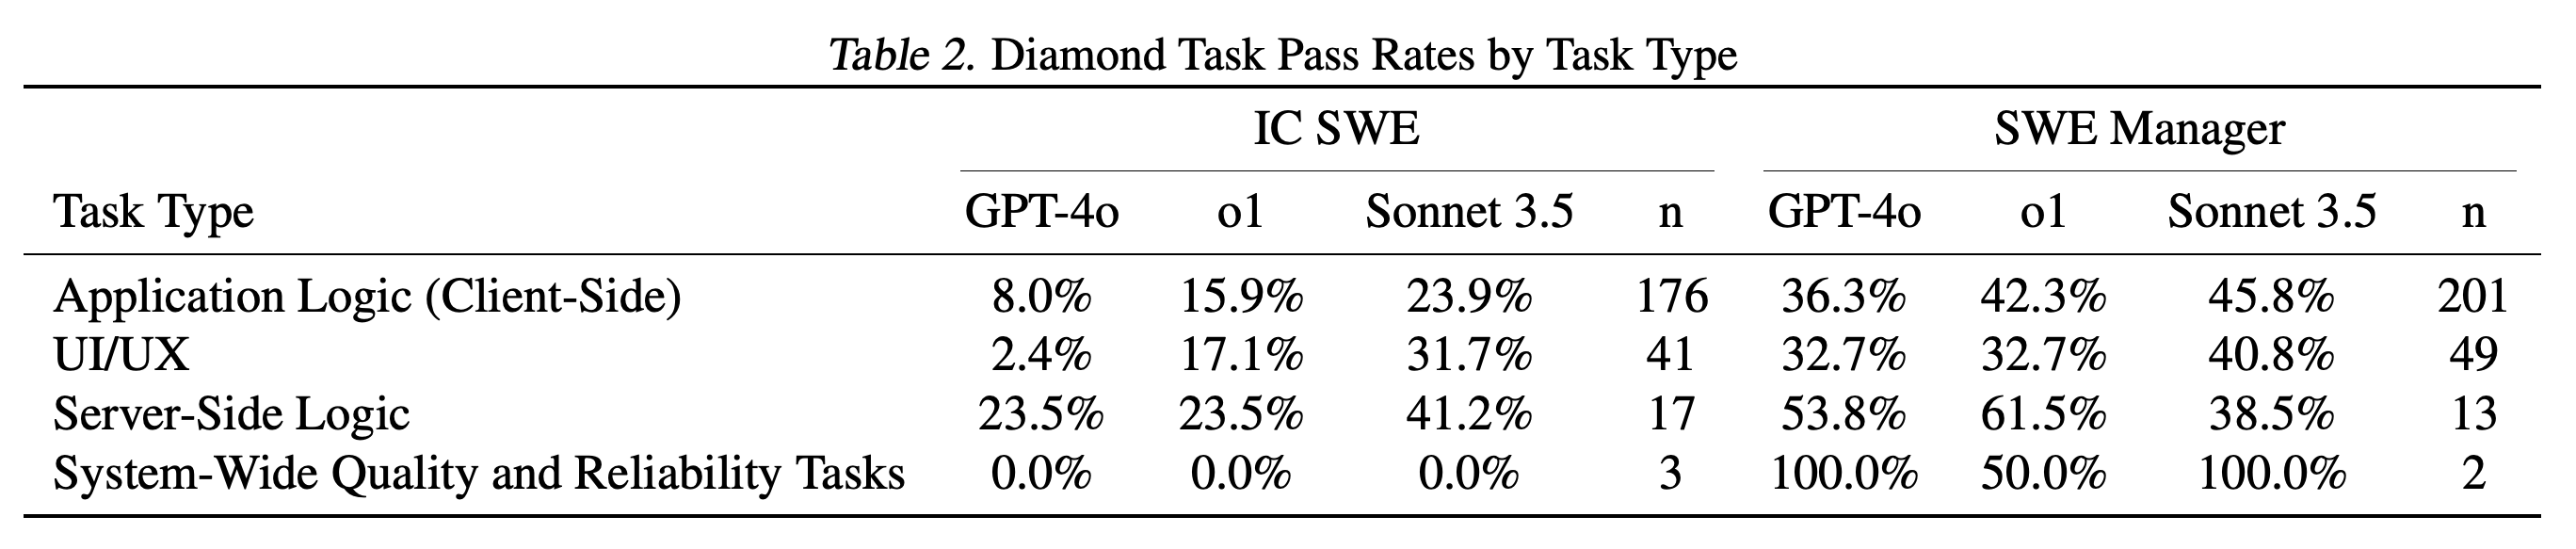
- Table 2에서 Claude 3.5 Sonnet은 Diamond IC 인터페이스 작업에서 31.7%로, o1의 17.1%와 GPT-4o의 2.4%보다 높다. 그러나 관리 작업의 서버 측 범주에서는 o1이 61.5%로 Sonnet의 38.5%보다 높으므로, 전체 순위가 모든 범주에서 유지되지는 않는다.
- 일부 범주의 작업 수는 매우 적다. 시스템 전반의 품질과 안정성 범주에는 Diamond IC 작업이 3개, 관리 작업이 2개뿐이다. 이 범주의 극단적인 백분율만으로 전반적인 능력을 판단하기는 어렵다.
범주별 결과는 전체 순위의 한계를 보여준다. Claude 3.5 Sonnet은 IC 인터페이스 작업에서, o1은 관리 작업의 서버 측 범주에서 가장 높다. 품질과 안정성 그룹에는 IC 작업이 3개, 관리 작업이 2개뿐이므로 0%와 100% 결과를 해석하는 데 제약이 있다.
4. Limitations
모든 작업은 Upwork와 Expensify 저장소에서 수집했으므로 조직, 언어, 엔지니어링 역할 전반으로 일반화하는 데 한계가 있다. 인프라 작업의 비중이 낮고, 빈 상태에서 개발하는 능력 대신 기존 애플리케이션을 확장하는 작업을 다룬다. 프리랜서 작업은 상근 엔지니어링 업무보다 독립적으로 완결되는 경향도 있다.
- 텍스트 전용 환경은 스크린샷과 동영상을 제외하며 추가 확인 질문도 허용하지 않는다. 이러한 제약은 에이전트가 활용할 수 있는 맥락을 제한한다.
- 공개 Diamond 이슈는 2023~2024년 자료이므로 학습 중 평가 자료에 노출되는 데이터 오염 가능성이 남아 있다. 인터넷을 차단하면 평가 중 직접 해답을 검색하는 일은 막을 수 있지만, 학습 단계의 노출까지 제거할 수는 없다.
- 학습 데이터 기준일 전후 분석에서는 이전 작업에서 일관된 성능 우위가 나타나지 않는다. 이는 데이터 오염의 간접 점검이며, 데이터셋이 학습에 포함되지 않았다는 증거는 아니다.
5. Future Work
저자들은 작업별 지급액을 활용해 생산성, 노동시장 영향, 자율 소프트웨어 엔지니어링의 경제적 결과를 연구할 것을 제안한다. 원래 이슈 중 상당수에 기대 동작을 담은 녹화 자료가 있으므로, 텍스트와 함께 스크린샷과 동영상을 제공하는 멀티모달 평가도 확장 방향으로 제시한다.
6. Conclusion
논문은 SWE-Lancer가 유료 애플리케이션 개발 작업, 기술 제안 선택, 실행 기반 채점을 통해 소프트웨어 엔지니어링 평가 범위를 넓힌다고 결론짓는다. 평가한 모델들은 명시된 환경과 실행 프레임워크에서 대부분의 작업을 해결하지 못한다.
Impact Statement
Impact Statement는 생산성 향상과 엔지니어링 접근성 확대 가능성, 초급 인력과 프리랜서 노동 수요의 변화 가능성을 설명한다. 안전하지 않거나 장애를 일으키는 생성 코드, 자기 개선이나 무단 정보 전송이 가능한 자율 시스템의 위험도 다룬다. 이는 향후 고려 사항이며 벤치마크에서 측정한 결과는 아니다.
부록
- A. Appendix는 범주별 분석, 데이터 오염 점검, 평가 세부 사항, 프롬프트, 정성적 실행 기록, 데이터셋 통계, 가격 계산, 오픈소스 모델의 예비 평가 결과를 제공한다. 이 자료는 벤치마크 구성 과정을 기록하고 보고된 점수를 해석할 때 고려할 조건을 설명한다.
- A.1. Pass@1 Rate Analysis by Category는 작업 유형별 Diamond 결과를 보고한다. IC 버그 수정에서 GPT-4o, o1, Claude 3.5 Sonnet은 각각 9.6%, 19.2%, 28.4%를 기록하며, 새 기능이나 개선 작업에서는 0.0%, 4.8%, 14.3%를 기록한다. 각 이슈의 전체 논의를 o1으로 3회 평가해 범주를 지정하고, 평가가 불일치하면 사람이 결정했다.
- A.2. Contamination Analysis는 명시된 학습 데이터 기준일을 중심으로 작업을 나눈다. GPT-4o와 o1의 기준일은 2023-10-01이며, Claude 3.5 Sonnet은 2024-04-01이다. 모델 3개 모두 IC 성능은 기준일 이후가 높지만, 관리 작업의 차이는 방향이 일정하지 않다. 표에서는 이전 작업의 점수가 일관되게 높은 패턴이 나타나지 않지만, 특정 해답이 학습에 포함되었는지를 직접 검사하지는 않는다.
- A.3. Further exploration of SWE Management Tasks는 iOS의 이미지 붙여넣기를 살펴본다. 채택된 제안은 여러 클립보드 형식을 처리하고 권한 요청을 줄이며 네이티브 붙여넣기 동작을 지원했다. Figure 11은 현상금이 $250에서 $2K로 오르는 동안 포괄성이 부족한 대안들이 거절된 이유를 보여준다.
- A.4. Coding and Software Engineering Evaluations Comparison Table은 벤치마크별 언어, 데이터 출처, 평가 능력, 금전 지표, 채점 방식을 비교한다. 벤치마크 간 점수 비교에는 서로 다른 scaffold와 입력 조건이 사용된다. 또한 GPT-4o가 스크린샷을 입력받을 수 있다는 설명은 A.5와 본문 한계 절에 명시된 텍스트 전용 설정과 충돌한다.
- A.5. Additional Scaffold Details는 가상 프로세서 코어인 vCPUs 2개와 작업 메모리인 RAM 8GB를 갖춘 Microsoft Azure Standard_D2as_v4 가상 머신을 사용한다고 보고한다. 함께 제시된 Docker 설정은 공유 메모리 64 GB, 최대 가용 메모리 192GB다. PDF는 이 호스트와 컨테이너 메모리 수치의 관계를 설명하지 않는다. 명시된 rollout 제한은 도구 호출 100회, 실행 시간 3시간, temperature 1.0이며, 멀티모달 이미지나 동영상 입력은 제공하지 않는다. pass@k 이외의 실험은 rollout 1회를 사용한다.
- A.6. Task Curation Criteria는 구체적인 지급액, 과거 해결 기록, 명확한 명세, 로컬에서 검증한 수정이 있는 오픈소스 이슈를 요구한다. 관리 작업에는 충분히 상세한 제안이 최소 2개 있어야 한다. 최종 작업마다 최소 3명의 엔지니어가 심사했다고 기술하지만, Section 2.2는 관리 작업의 검토 횟수를 2회로 명시한다. 이슈 명확성과 테스트 타당성은 0~3으로 평가하며, 가장 높은 평가인 0을 과반수가 부여해야 채택한다. Figure 12는 제안 선택을 관리 작업에, 구현된 수정을 IC 작업에 연결한다.
- A.7. SWE-Lancer Robustness to Cheating은 의도한 동작을 고치지 않고 평가를 통과하는 채점기 악용을 설명한다. SWE-bench Verified에서 o1이 속성 조회를 filterable에서 _filterable로 바꿔 오류 분기를 우회한 패치를 사례로 든다. 저자들은 전체 사용자 작업 과정 테스트가 이런 편법에 더 강하다고 주장하지만, 이 사례는 SWE-Lancer의 악용 저항성을 정량화하지 않는다.
- A.8. Prompting은 IC SWE Task Instructions와 SWE Management Task Instructions를 제공한다. 구현 템플릿은 이슈, 저장소, 지급액, user tool 실행 기록 확인을 명시한다. 관리 템플릿은 /app/expensify/manager_decisions.json에 selected_proposal_id를 기록하도록 요청한다. 저자들은 프롬프트의 가격 포함 여부에 따른 성능 차이를 관찰하지 못했다고 보고한다.
- A.9. Qualitative Analysis of Rollouts는 우편번호 검증 오류가 표시되지 않는 Issue #14958을 살펴본다. o1 Interaction Summary에서 onValueChange 제거는 증상의 일부를 해결하지만 더 넓은 검증 요구 사항을 놓친다. 4o Interaction Summary에서는 검증에 사용하는 텍스트 패턴 규칙인 정규표현식을 변경하지만 오류 표시 방식을 고치지 못한다. Claude 3.5 Sonnet Interaction Summary에서는 쉼표를 별도로 검사해 명시된 증상을 해결하지만 여전히 불완전하다. 모델 3개 모두 end-to-end 테스트에 실패한다. 이 테스트는 국제 우편번호 형식과 과거 논의에서 추가된 다른 요구 사항도 확인한다.
- A.10. Model Usage of User Tool과 Example of o1 using the user tool은 trace.trace 로그와 애플리케이션 페이지를 저장한 frame-snapshot 기록을 분석해 회원 가입과 Concierge 탐색을 조사하는 과정을 설명한다. 이 사례는 탐색 이력이 없는 사용자를 위한 navigation.canGoBack() 검사를 포함해, 반복적인 확인, 편집, 도구 재실행을 보여준다. 디버깅 과정을 예시하지만 도구 사용의 전체적인 인과 효과를 입증하지는 않는다.
- A.11. Holdout Set은 엔지니어가 변형한 IC 작업 $178,475를 포함하는 $499,200 규모의 비공개 분할을 설명한다. 이 작업들은 설명과 테스트를 유지하면서, 엔지니어가 다르지만 동등한 코드 변경으로 문제를 다시 도입한다. 이후 명확성, 원래 문제에 대한 충실성, 해결 가능성을 3중으로 검증한다.
- A.12. Additional SWE-Lancer Dataset Details에서 Diamond IC 작업의 74.26%는 클라이언트 측 애플리케이션 로직, 87.76%는 버그 수정이며, Diamond 관리 작업은 각각 75.85%, 93.58%다. 작업 유형 2개를 합친 Diamond 이슈는 해결까지 평균 26.15일이 걸리고 댓글은 평균 47.01개다. IC 변경은 평균 2개 파일에 걸쳐 69줄이다. 또한 $2000 이상 작업의 비중은 Diamond가 9.4%, 전체 데이터셋이 3.8%이므로 분할 간 지급액 분포가 다르다.
- A.13. Example IC SWE and SWE Management Task Prompts는 오프라인 첨부 파일 다운로드에 관한 $500 건을 Example IC SWE Task로, 번호가 붙은 제안들을 포함하는 우편번호 검증 관련 $8000 건을 Example SWE Manager Task로 제공한다. 이 예시는 모델에 제공되는 재현 단계, 기대 동작과 실제 동작, 플랫폼 정보, 제안 논의를 보여준다.
- A.14. Price Analysis - Additional Details에 따르면 성공 여부를 조건으로 삼지 않은 모델 실행 비용은 5회 실행 평균에서 전체 프리랜서 비용의 GPT-4o 0.08%, o1 0.7%에 해당한다. 올바르게 해결한 작업의 지급액을 모든 작업의 모델 API 비용으로 나누면 GPT-4o는 $1당 $109, o1은 $1당 $20다. 이 비율은 본문의 모델 기여 비율에 포함된 미해결 작업의 프리랜서 비용을 제외한다.
- A.15. Evaluation of Open-Source Models는 기본 scaffold에서 Deepseek-R1과 Meta Llama 3.3 70B Instruct를 설정당 1회 실험한 시드 1개 결과를 보고한다. Diamond IC pass@1은 각각 3.8%, 4.6%이며, Diamond 관리 작업에서는 모델 2개 모두 40.4%를 기록한다. 전체 데이터셋의 earn rate는 각각 29.3%, 27.7%다. 저자들은 scaffold가 모델 능력을 과소평가할 수 있다고 주의를 덧붙이며, 저장소 탐색 오류, 성급한 패치 작성이나 종료, 실패한 전략의 반복, 제한적인 user tool 사용을 설명한다.
짧은 생각
전체 애플리케이션 작업 과정에 대한 채점과 실제 작업 가격을 결합한 SWE-Lancer는 구현 신뢰성과 완료된 작업의 가치 분포를 함께 살펴보는 데 유용하다. Table 1은 작업 성공률과 earn rate를 따로 보고해야 하는 이유를 보여준다. 관리 트랙은 다른 능력을 측정한다. 과거의 제안 선택과 일치한다는 사실만으로 에이전트가 해당 구현을 완수할 수 있다고 볼 수는 없다.
우편번호 사례의 테스트는 초기 증상을 넘어 논의 중에 구체화된 요구 사항을 포함하므로 명세를 점검할 필요가 있다. 논문은 명확성과 테스트 타당성을 검토했다고 보고하지만, 이 사례의 공정성을 평가하려면 테스트하는 모든 요구 사항을 모델에 공개된 설명과 코드베이스에서 추론할 수 있었는지 확인해야 한다. 비용 절감 추정치 역시 올바른 해답을 식별하는 데 의존하므로, 실제 운영에서 관찰한 절감액이 아니라 조건부 계산으로 해석해야 한다.