


SwitchHead: Accelerating Transformers with Mixture-of-Experts Attention 요약 설명
13 Dec 2023 | Paper Review Mixture-of-Experts Efficient Attention Language Models목차
이번 글에서는 SwitchHead: Accelerating Transformers with Mixture-of-Experts Attention 논문의 핵심 포인트만 간단히 정리한다.
- 2023년 12월 13일(Arxiv), 38th Conference on Neural Information Processing Systems (NeurIPS 2024)
- Csordás, Róbert, Piękos, Piotr, Irie, Kazuki, Schmidhuber, Jürgen.
- Stanford University, Stanford, CA, USA, AI Initiative, KAUST, Thuwal, Saudi Arabia, Center for Brain Science, Harvard University, Cambridge, MA, USA, The Swiss AI Lab IDSIA, USI & SUPSI, Lugano, Switzerland
- 논문 링크
- Github
요약
- Transformer 언어 모델은 토큰 사이의 정보를 결합하는 attention에 상당한 연산량과 메모리를 사용하지만, 모델 구성 요소를 선택적으로 활성화하는 방법은 대부분 다른 계층을 대상으로 한다. 언어 모델링 데이터셋인 C4에서 262M-parameter SwitchHead는 파라미터 수가 같은 dense Transformer의 16.28보다 낮은 perplexity 16.23을 달성한다. Perplexity는 낮을수록 좋은 예측 성능 지표다. 이때 attention 계층의 연산량은 베이스라인의 약 44%, 중간 결과를 저장하는 메모리는 27%만 사용한다.
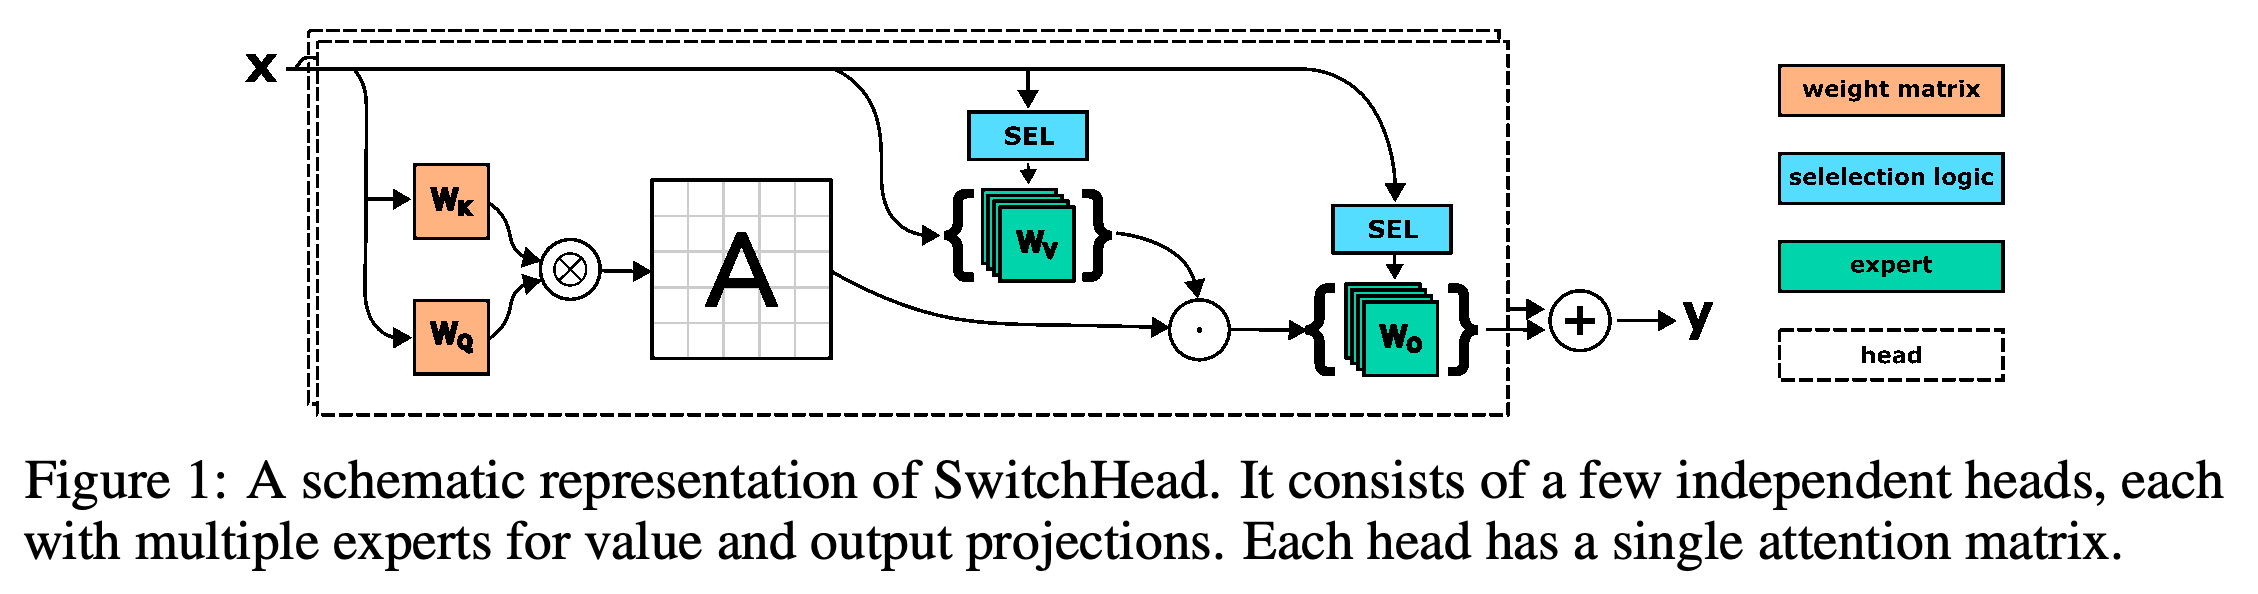
- SwitchHead는 토큰마다 학습된 변환 중 일부를 선택하는 Mixture of Experts(MoE)를 value projection과 output projection에 적용한다. Value projection은 attention이 결합할 정보를 준비하고, output projection은 결합한 정보를 모델의 표현 공간으로 변환한다. 병렬 attention 구성 요소인 각 head 안에서는 expert들이 토큰 간 attention 가중치를 결정하는 key와 query projection을 공유한다. 따라서 여러 expert가 같은 attention 행렬을 사용할 수 있으며, 보고된 비교에서 행렬 수의 감소 비율은 최대 8 times다. Expert 선택을 안정적으로 유지하기 위한 추가 정규화도 필요하지 않다.
- 전체 학습 파이프라인에서 SwitchHead는 각 모델 규모별로 동일한 하드웨어에서 비교했을 때, 학습 반복 시간을 47M 파라미터에서 473에서 342 ms로, 262M 파라미터에서 670에서 442 ms로 줄인다. 여러 데이터셋과 토큰 위치 인코딩 방식에서 결과를 확인했지만, 현재 대규모 언어 모델에 해당하는 규모에서의 성능이나 생성 시 가속 효과는 검증하지 않았다.
1 Introduction
기존 MoE 방법은 주로 Transformer에서 토큰별 변환을 수행하는 feedforward 블록을 가속하므로, attention 비용은 거의 줄이지 못한다. SwitchHead는 attention 연산 밖에서 expert를 선택해 계산하고 저장해야 하는 attention 행렬 수를 줄인다. 또한 각 expert의 선택 점수를 독립적인 sigmoid로 0–1 범위에 매핑하는 feedforward MoE인 σ-MoE와 결합해 SwitchAll을 구성한다.
2 Method
이 방법은 토큰마다 projection expert를 선택하는 routing과 토큰 간 attention 연산을 분리한다. 최종 설계는 일반적인 key와 query projection을 유지하고, value와 output에만 선택한 expert를 활성화한다.
2.1 Background
Multi-head self-attention(MHA)은 여러 토큰 간 가중치 행렬을 병렬로 계산한다. 먼저 입력을 key, query, value로 투영한 뒤 value에 attention을 적용하고, 그 결과를 출력으로 투영한다. 출력은 head별 기여의 합으로도 표현할 수 있으므로 각 head의 연산은 독립적이다.
- 시퀀스 길이가 T, head 수가 n_heads, head 차원이 d_head일 때, attention 행렬 구성과 value readout에는 O(n_heads d_head T²)의 multiply-accumulate operations(MACs)가 필요하다. MAC은 2개의 수를 곱한 결과를 누산기에 더하는 연산이며, 논문은 이 연산 횟수를 하드웨어에 독립적인 연산량 지표로 사용한다.
- 학습 중에는 O(n_heads T²)의 attention 항목과 O(n_heads T d_head)의 projection 중간 결과를 저장하므로, 시퀀스가 길어질수록 attention 비용이 커진다.
2.2 From Dense to SwitchHead Attention Layer
Attention은 정보를 보내는 토큰과 받는 토큰 모두에 의존하므로, 받는 토큰만으로 head 전체를 선택하면 모든 발신 토큰의 projection이 여전히 필요할 수 있어 가속하기 어렵다. SwitchHead는 대신 발신 측 value expert와 수신 측 output expert를 독립적으로 선택한다. Sigmoid 점수를 계산한 뒤 top-k 선택을 적용해 토큰마다 점수가 가장 높은 k개의 expert를 유지한다.
- 각 head는 E개의 expert를 가지지만 attention 행렬은 1개만 계산한다. 선택한 value projection은 attention 전에 결합하고, 선택한 output projection은 attention readout 후에 결합한다.
- 최종 구성에서는 각 head의 expert들이 head 전용 key projection 1개와 query projection 1개를 공유한다. Sigmoid 점수는 expert 사이에서 정규화하지 않고 독립적으로 계산한다. 보고된 학습에서는 routing이 지나치게 적은 expert에 집중되는 expert collapse를 방지하기 위한 추가 정규화가 필요하지 않다.
이 도식은 공유 attention 행렬의 앞뒤에 있는 value와 output 경로에서 expert를 선택하는 구조를 보여준다. 따라서 projection 선택지가 여러 개여도 expert마다 별도의 attention 행렬이 필요하지 않다.
3 Experiments
주요 실험은 전체 파라미터 수를 맞춘 뒤, dense 베이스라인과 비슷한 perplexity를 유지하면서 자원을 최대한 절약하도록 SwitchHead를 구성한다. 이전 문맥 청크를 추가로 활용하는 Transformer XL을 사용하며, 전체 문맥은 현재 청크와 그 길이가 같은 이전 문맥으로 구성된다. 별도 실험에서는 이전 문맥을 저장하는 XL 캐시 없이 RoPE를 사용한다. 이는 query와 key 표현을 회전시켜 토큰 위치를 인코딩하는 rotary position embeddings다.
- n_heads × E가 dense 베이스라인의 head 수와 같도록 설정한다. Head 2개와 활성 expert 2개로 시작하고, 필요하면 활성 expert 수를 늘린다. 활성 expert 4개로도 부족하면 head 4개와 활성 expert 2개로 전환한다. Head 차원과 나머지 feedforward 용량은 파라미터 예산에 맞춰 조정한다.
- 모든 모델은 100k 배치 동안 학습한다. 문자 단위 Enwik8을 제외한 데이터에는 텍스트를 subword 단위로 나누는 tokenizer로 얻은 8k-token SentencePiece 어휘를 사용한다.
- C4와 peS2o는 처음 10⁵ × T × N_batch개의 토큰으로 학습한다. T는 현재 처리하는 청크 길이이고 N_batch는 배치 크기다. 저자들은 주요 자원 절감 비교에서 나타난 소폭의 perplexity 개선을 성능을 완전히 일치시키지 못한 결과로 해석한다.
3.1 Which Projections Require an MoE?
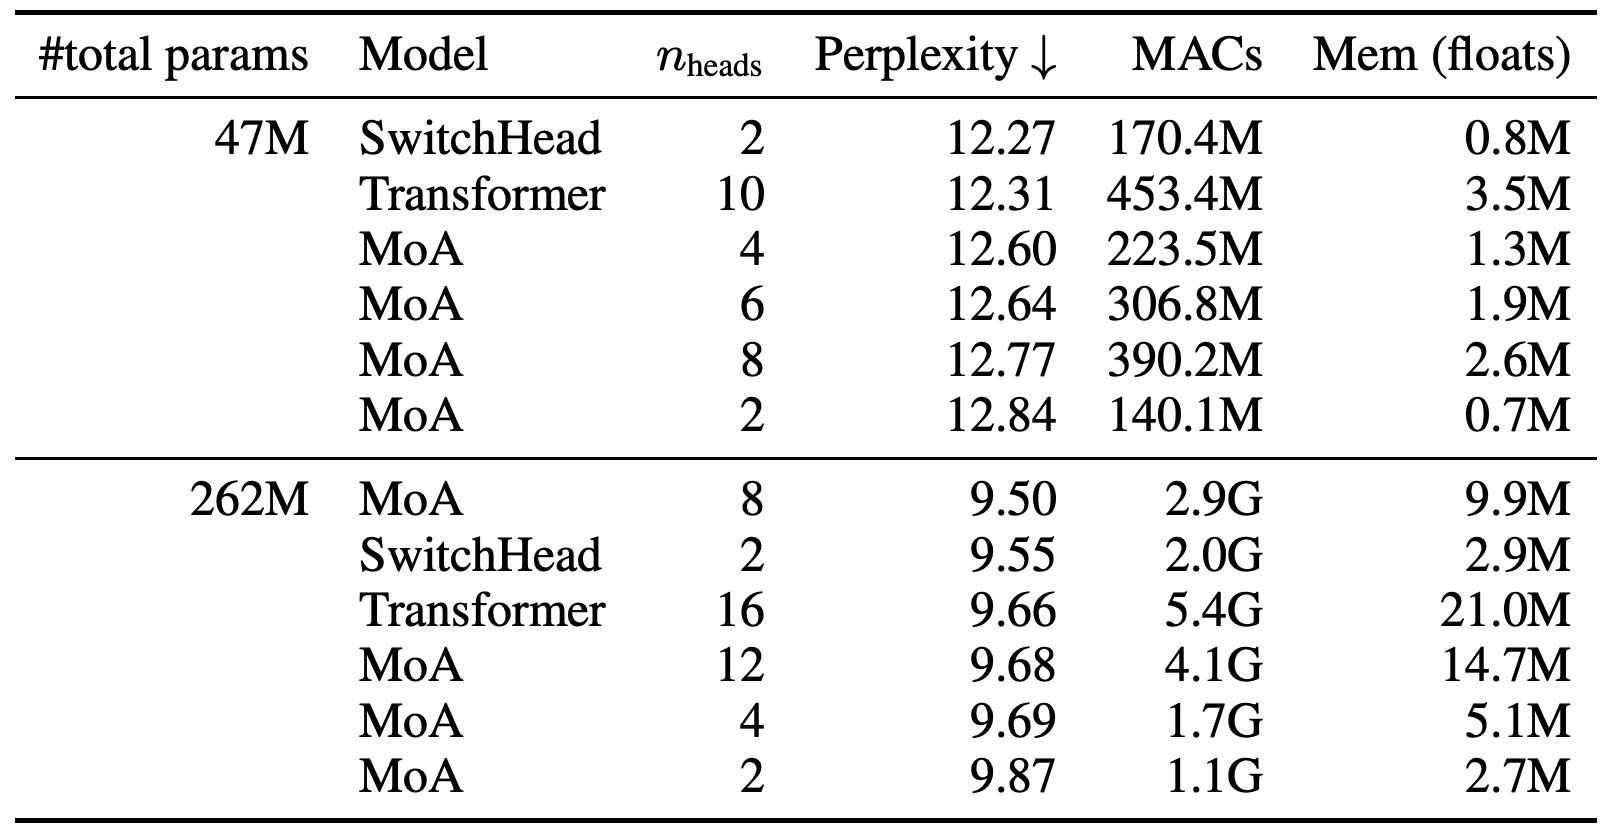
Key, query, value, output projection을 expert 또는 고정 projection으로 구성하는 모든 조합을 비교한 결과, 고정된 파라미터 예산에서는 value와 output에 expert를 적용한 구성이 가장 우수하다. Wikitext 103의 47M 파라미터 모델에서 이 구성은 perplexity 12.27을 달성한다. Head 10개를 사용하는 dense 베이스라인은 12.31이고, projection 4개 모두에 expert를 적용하면 12.57이다.
- Output expert만 사용해도 perplexity 12.30을 달성한다. 모델 구성 요소를 바꿔 비교하는 이 ablation에서는 output routing의 영향이 특히 크다. Key나 query에 expert를 추가하면 더 유용한 구성 요소에 할당할 수 있는 파라미터가 줄어든다.
3.2 Comparison with MoA
가장 가까운 비교 방법인 Mixture of Attention Heads(MoA)는 key와 value projection을 공유하지만, 선택한 query/output expert마다 별도의 attention 행렬을 계산한다. SwitchHead는 더 적은 attention 행렬의 앞뒤에서 expert를 결합하고, 독립적인 sigmoid routing을 사용한다. 반면 MoA는 expert 사이에서 점수를 정규화하는 경쟁적 routing을 사용하며, 정규화 항 3개가 필요하다.
- Wikitext 103의 47M 파라미터 모델에서 SwitchHead는 170.4M MACs와 부동소수점 값 0.8M개를 저장하는 메모리로 perplexity 12.27을 달성한다. Head 4개를 사용하는 MoA는 223.5M MACs와 부동소수점 값 1.3M개를 저장하는 메모리를 사용하며 perplexity는 12.60이다. 이 자원 추정치는 attention 계층 1개가 시퀀스 1개를 처리하는 경우를 나타낸다.
- 262M 파라미터에서는 head 8개를 사용하는 MoA의 perplexity가 9.50으로 SwitchHead의 9.55보다 조금 낮다. 하지만 MACs는 2.9G 대 2.0G, 저장하는 부동소수점 값은 9.9M개 대 2.9M개로 더 많다. 이는 Table 1의 비교이며, Table 2의 Wikitext 103 결과와는 구분해야 한다.
47M 파라미터에서 SwitchHead는 나열된 모든 MoA 변형보다 perplexity가 낮으며, head 4개를 사용하는 MoA 모델보다 자원도 적게 사용한다. 262M 파라미터에서는 head 8개를 사용하는 MoA가 perplexity를 소폭 개선하지만 MACs와 중간 결과 메모리를 더 많이 사용한다. 예측 품질과 자원 사용량 사이의 절충을 보여준다.
3.3 Performance on Different Datasets
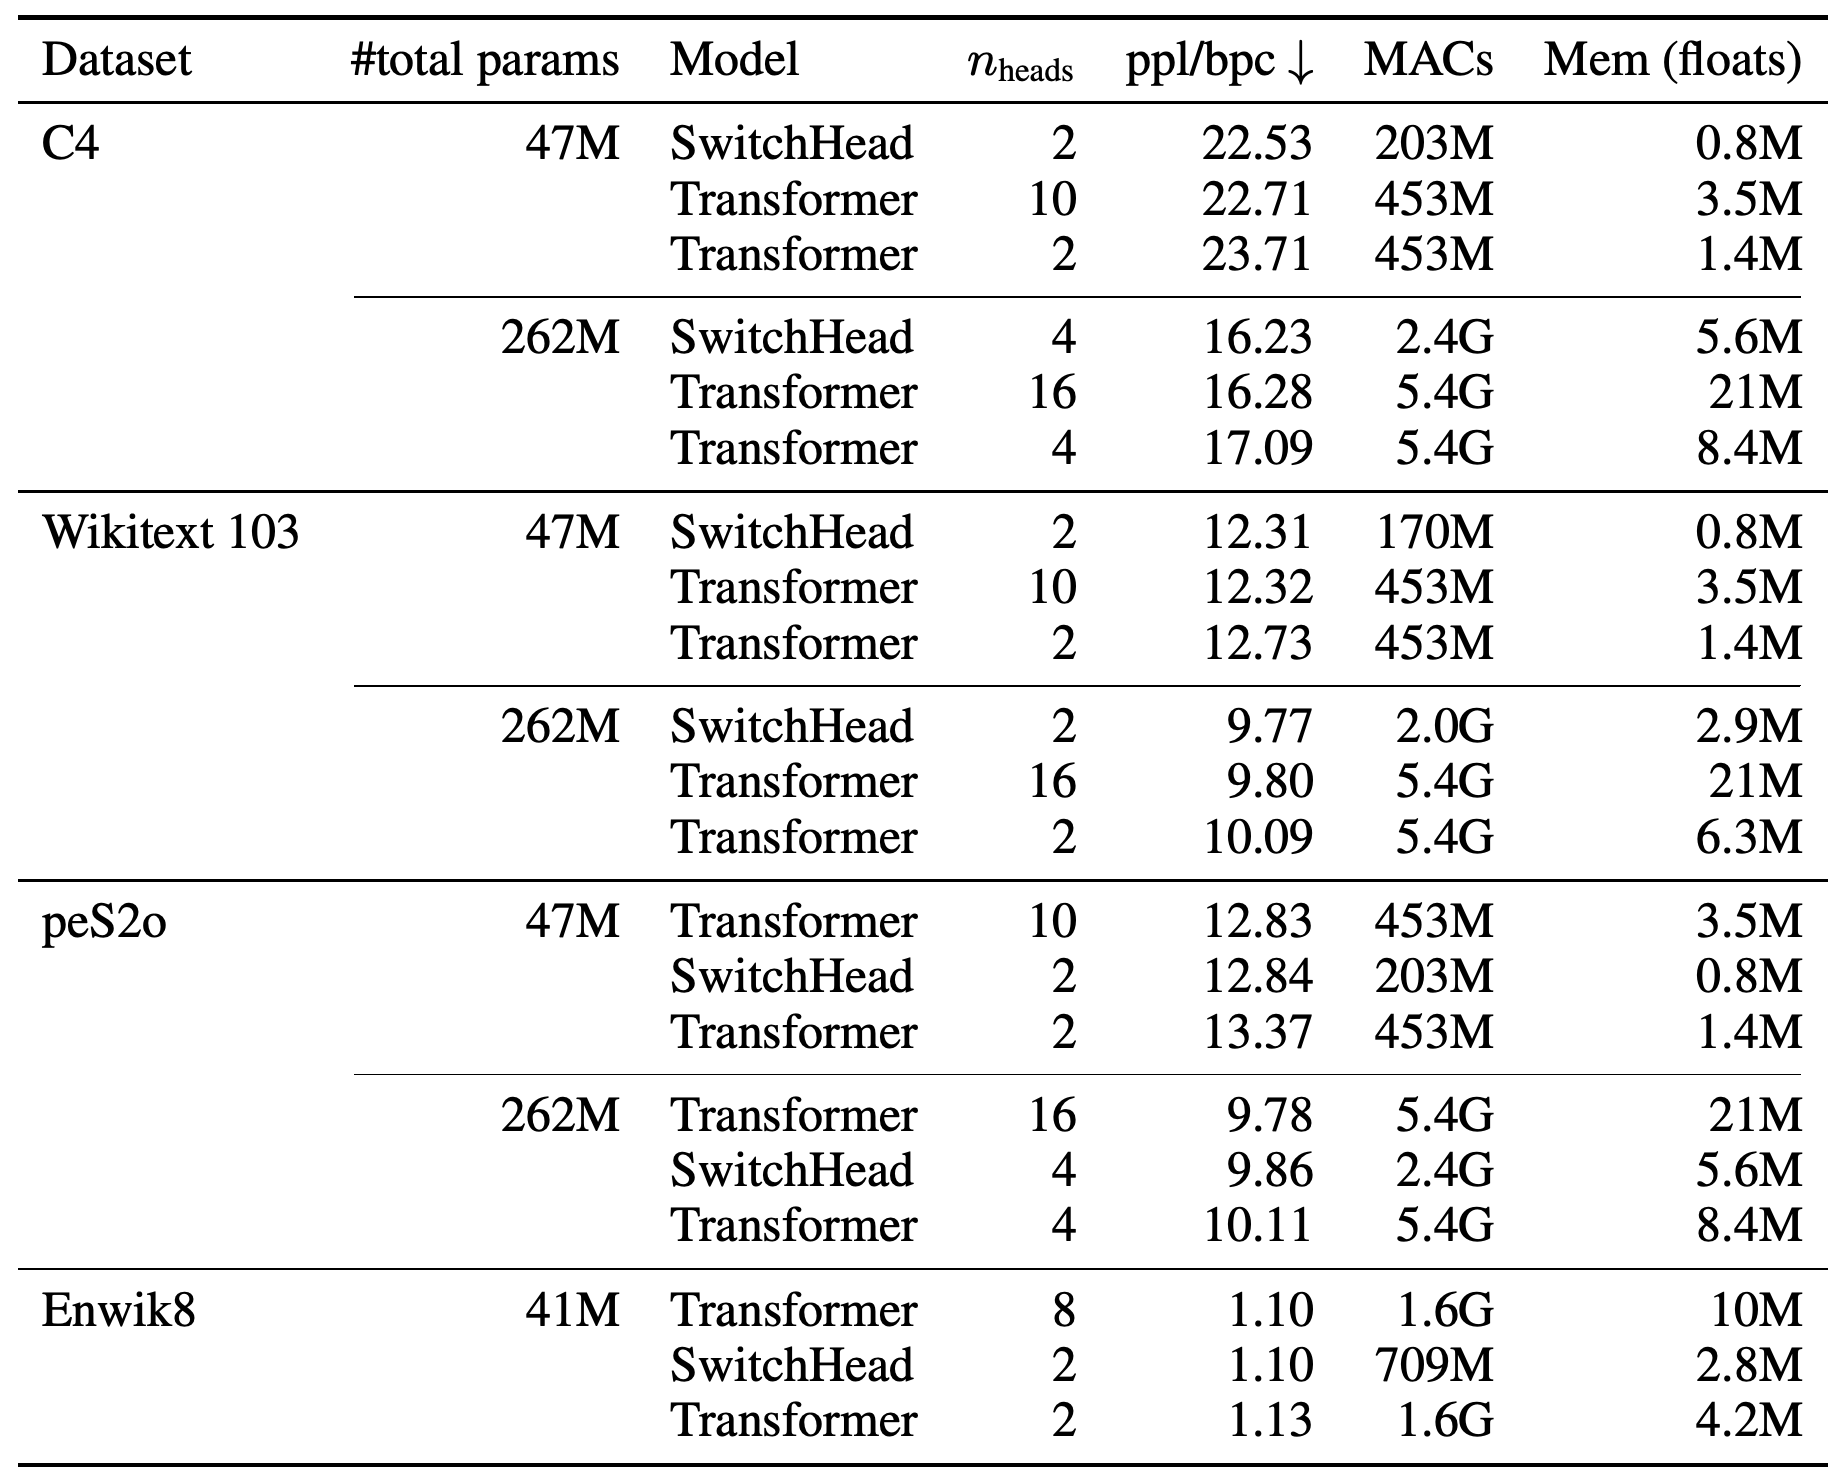
C4, Wikitext 103, peS2o, Enwik8에서 SwitchHead는 head가 많은 dense 베이스라인과 비슷한 성능을 보인다. 또한 파라미터 수를 맞추고 동일하게 줄어든 head 수를 사용한 dense 모델보다 일관되게 우수하다. 예를 들어 262M C4 모델의 perplexity는 head 4개를 사용하는 SwitchHead가 16.23, head 16개를 사용하는 베이스라인이 16.28, head 4개를 사용하는 dense 베이스라인이 17.09다.
- Wikitext 103의 262M 파라미터 모델에서 head 2개를 사용하는 SwitchHead의 perplexity는 9.77이고, head 16개를 사용하는 베이스라인은 9.80이다. MACs는 2.0G 대 5.4G, 저장하는 부동소수점 값은 2.9M개 대 21M개다.
- 성능이 소폭 낮아지는 경우도 있다. 262M 파라미터의 peS2o perplexity는 9.86 대 9.78이다. Enwik8에서는 41M-parameter 모델 2개 모두 문자당 평균 예측 불확실성을 나타내는 bits per character가 1.10이다.
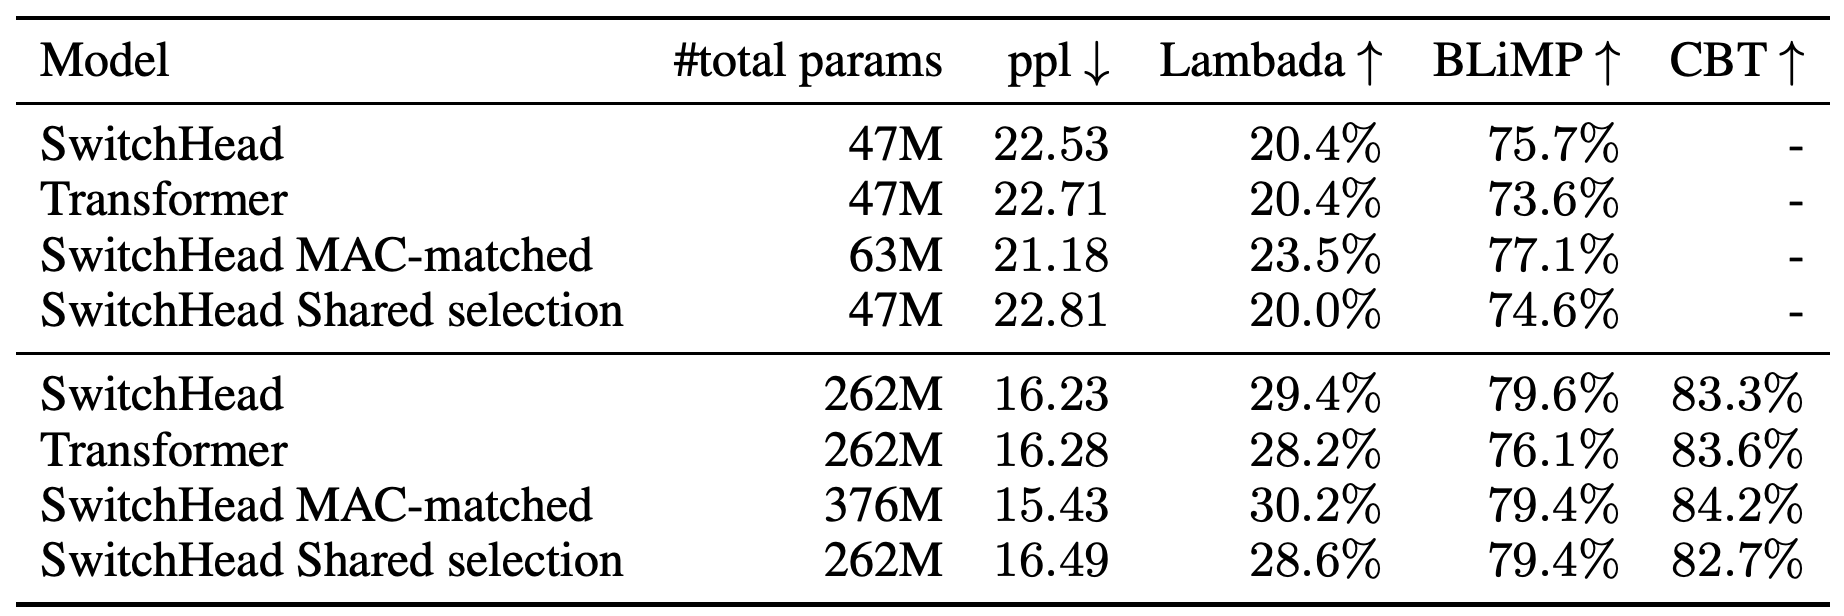
- 과제별 추가 학습 없이 사전 학습 모델을 평가하는 zero-shot 평가에는 문맥 기반 단어 예측을 위한 Lambada, 영어의 언어학적 최소 대립쌍을 평가하는 BLiMP, 책 문맥을 이용한 예측을 위한 Children’s Book Test(CBT)가 포함된다. 262M 파라미터에서 SwitchHead는 Lambada를 28.2%에서 29.4%로, BLiMP를 76.1%에서 79.6%로 개선하지만, CBT는 83.6%에서 83.3%로 낮아진다.
Head 수를 줄인 dense 대조군은 파라미터 수를 맞춰도 성능이 낮다. 이는 head 수 감소 외에도 expert projection이 성능에 기여함을 뒷받침한다. 262M C4 비교에서 나온 약 44%의 연산량과 27%의 중간 결과 메모리 수치는 attention 계층 기준이다.
3.4 SwitchAll
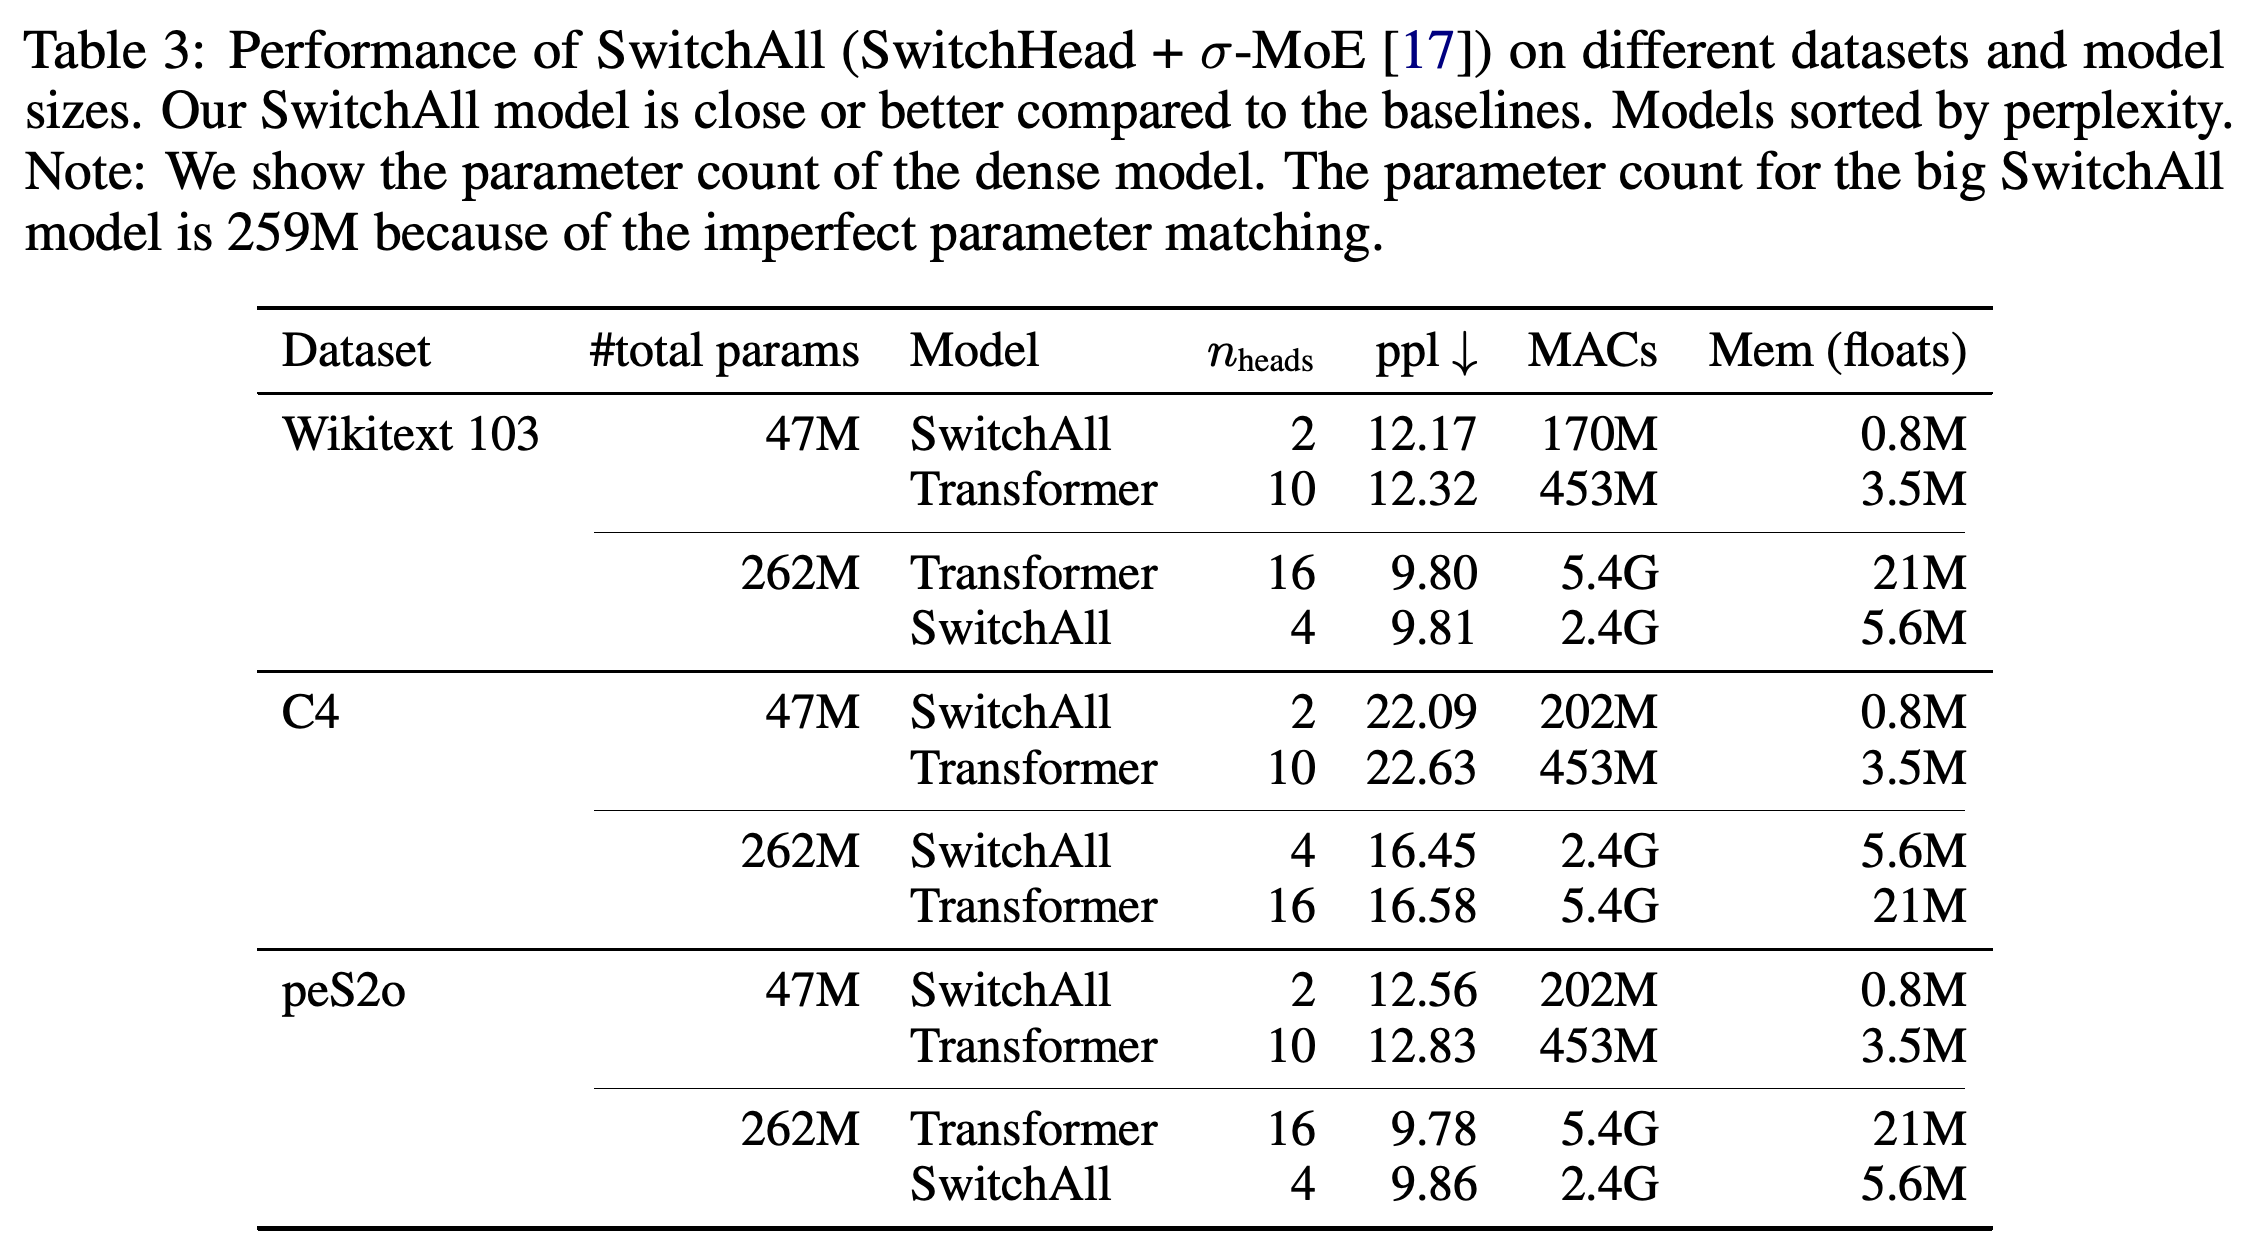
SwitchAll은 기존 feedforward 설정과 주요 실험의 attention 설정을 사용해 SwitchHead attention과 σ-MoE feedforward 계층을 결합한다. Table 3은 두 방법을 함께 사용할 수 있음을 보여준다. 47M 비교 3개에서는 모두 perplexity가 낮아지지만, 더 큰 규모에서는 결과가 엇갈린다.
- 47M 파라미터에서 SwitchAll의 perplexity는 Wikitext 103에서 12.17 대 12.32, C4에서 22.09 대 22.63, peS2o에서 12.56 대 12.83이다.
- 더 큰 SwitchAll 모델의 실제 파라미터 수는 259M이며, 비교 대상 베이스라인의 명목상 규모는 262M이다. Table 3의 perplexity는 Wikitext 103에서 9.81 대 9.80, C4에서 16.45 대 16.58, peS2o에서 9.86 대 9.78이다. 이 수치는 C4를 성능 개선의 예외로 지목한 주변 본문 설명과 충돌한다.
작은 SwitchAll 모델 3개는 모두 표에 제시된 dense 베이스라인보다 perplexity가 낮다. 큰 규모에서는 C4가 개선되지만 Wikitext 103과 peS2o는 조금 나쁘다. 큰 SwitchAll 모델의 실제 파라미터 수는 259M이다.
3.5 MAC-Matched Setup
MAC 수를 맞춘 설정은 SwitchHead로 절약한 연산량을 head 추가와 projection 차원 확대에 사용하므로, dense 베이스라인보다 파라미터가 많다. Transformer XL의 작은 구성에서는 head 차원을 76에서 112로, head 수를 2개에서 3개로 늘린다. 큰 구성에서는 차원을 112에서 168로, head 수를 4개에서 6개로 늘린다.
- C4에서 63M 모델은 47M dense 베이스라인의 22.71보다 낮은 perplexity 21.18을 달성한다. 376M 모델은 262M 베이스라인의 16.28보다 낮은 15.43을 달성한다.
- 376M 모델의 성능은 Lambada 30.2%, BLiMP 79.4%, CBT 84.2%이며, dense 베이스라인은 각각 28.2%, 76.1%, 83.6%다. BLiMP 점수는 파라미터 수를 맞춘 SwitchHead 모델의 79.6%보다 조금 낮다.
3.6 Shared Selection
발신 측과 수신 측에서 expert 선택을 공유하면 정렬과 top-k 연산을 줄일 수 있지만, 대체로 예측 성능이 낮아진다. C4의 262M 파라미터 모델에서 선택을 공유하면 perplexity가 16.23에서 16.49로, Lambada가 29.4%에서 28.6%로, BLiMP가 79.6%에서 79.4%로, CBT가 83.3%에서 82.7%로 바뀐다.
이 표는 파라미터 수를 맞춘 설정, MAC 수를 맞춘 설정, expert 선택을 공유하는 설정을 구분한다. 연산량을 맞추고 파라미터를 늘린 모델은 여러 결과를 개선하지만, 파라미터 수를 맞춘 SwitchHead 모델은 CBT 성능이 소폭 낮아진다.
3.7 Wall-Clock Time and Memory Usage Estimation
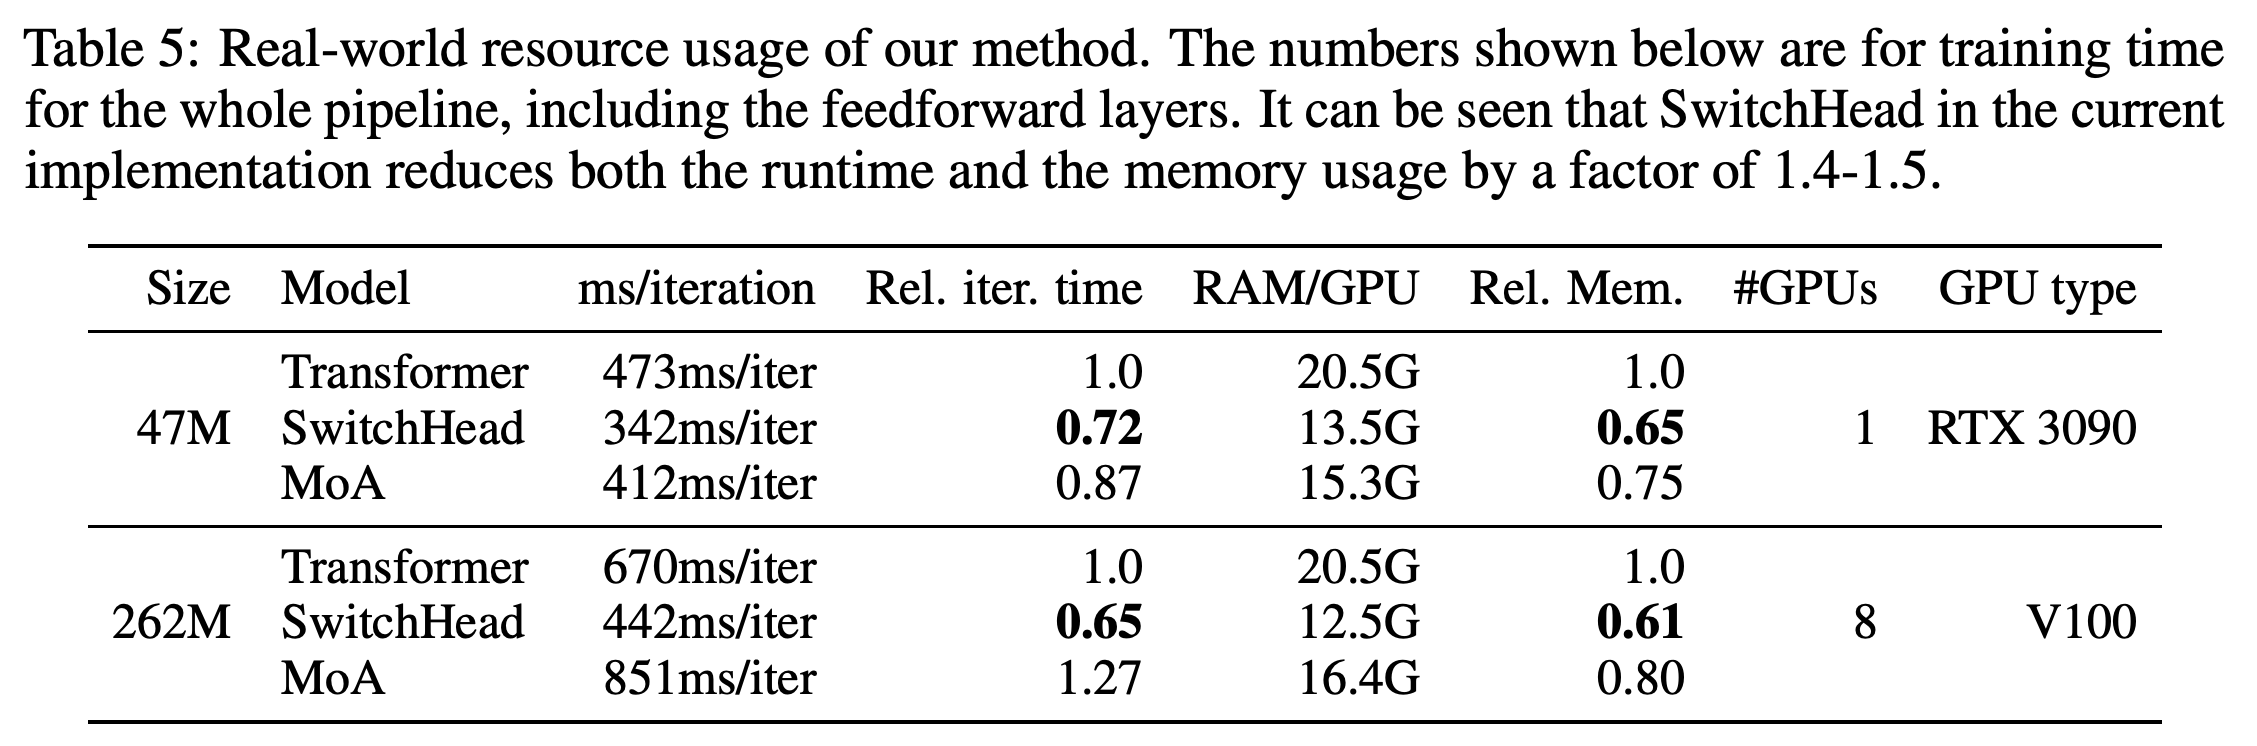
전체 학습 파이프라인 벤치마크는 같은 규모의 비교에서 하드웨어와 attention 핵심 연산 구현을 동일하게 유지하고, attention projection을 변경한다. Feedforward 계층, optimizer, 장치 간 gradient 동기화까지 포함하므로, attention 계층만 분석적으로 추정한 결과보다 절감 폭이 작다.
- RTX 3090 1개에서 47M 모델의 반복 시간은 473에서 342 ms로, 장치당 메모리는 20.5G에서 13.5G로 줄어든다. V100 장치 8개에서 262M 모델의 반복 시간은 670에서 442 ms로, 메모리는 20.5G에서 12.5G로 줄어든다.
- MoA 비교에는 47M 파라미터에서 활성 head 4개, 262M에서 8개를 사용한다. Dense 베이스라인과 성능이 비슷한 모델 중 가장 빠른 모델을 선택하고, 해당 모델이 없으면 성능이 가장 좋은 모델을 선택한다. MoA는 작은 규모에서 412 ms와 15.3G, 큰 규모에서 851 ms와 16.4G를 사용한다. 비교 2개 모두 SwitchHead가 더 빠르고 메모리도 적게 사용한다.
- 이 결과는 측정한 구현에서 학습이 빨라짐을 보여준다. 다른 하드웨어에서의 실제 실행 속도는 MAC 수만으로 결정되지 않는다.
전체 파이프라인 측정은 분석적인 연산 횟수뿐 아니라 실제 학습에서도 자원이 절약됨을 보여준다. SwitchHead는 47M 파라미터에서 RTX 3090 1개, 262M 파라미터에서 V100 장치 8개를 사용할 때 반복 시간과 장치당 메모리를 줄인다. 제시된 MoA 구현보다도 측정 지표 2개 모두 우수하다.
4 Analysis
중첩된 리스트 연산을 다루는 합성 과제 ListOps에서 계층 6개와 head 8개를 사용하는 dense Transformer와 파라미터 수를 맞추고 head 2개를 사용하는 SwitchHead를 비교한다. 모델 2개 모두 학습 분포에서 추출한 별도 평가 예제에서 약 95%의 정확도를 달성하지만, head 2개를 사용하는 dense 모델은 약 80%에서 성능이 포화된다. 이 분류 실험은 언어 모델링에서 미래 토큰을 참조하지 못하도록 제한하는 autoregressive mask를 사용하지 않는다.
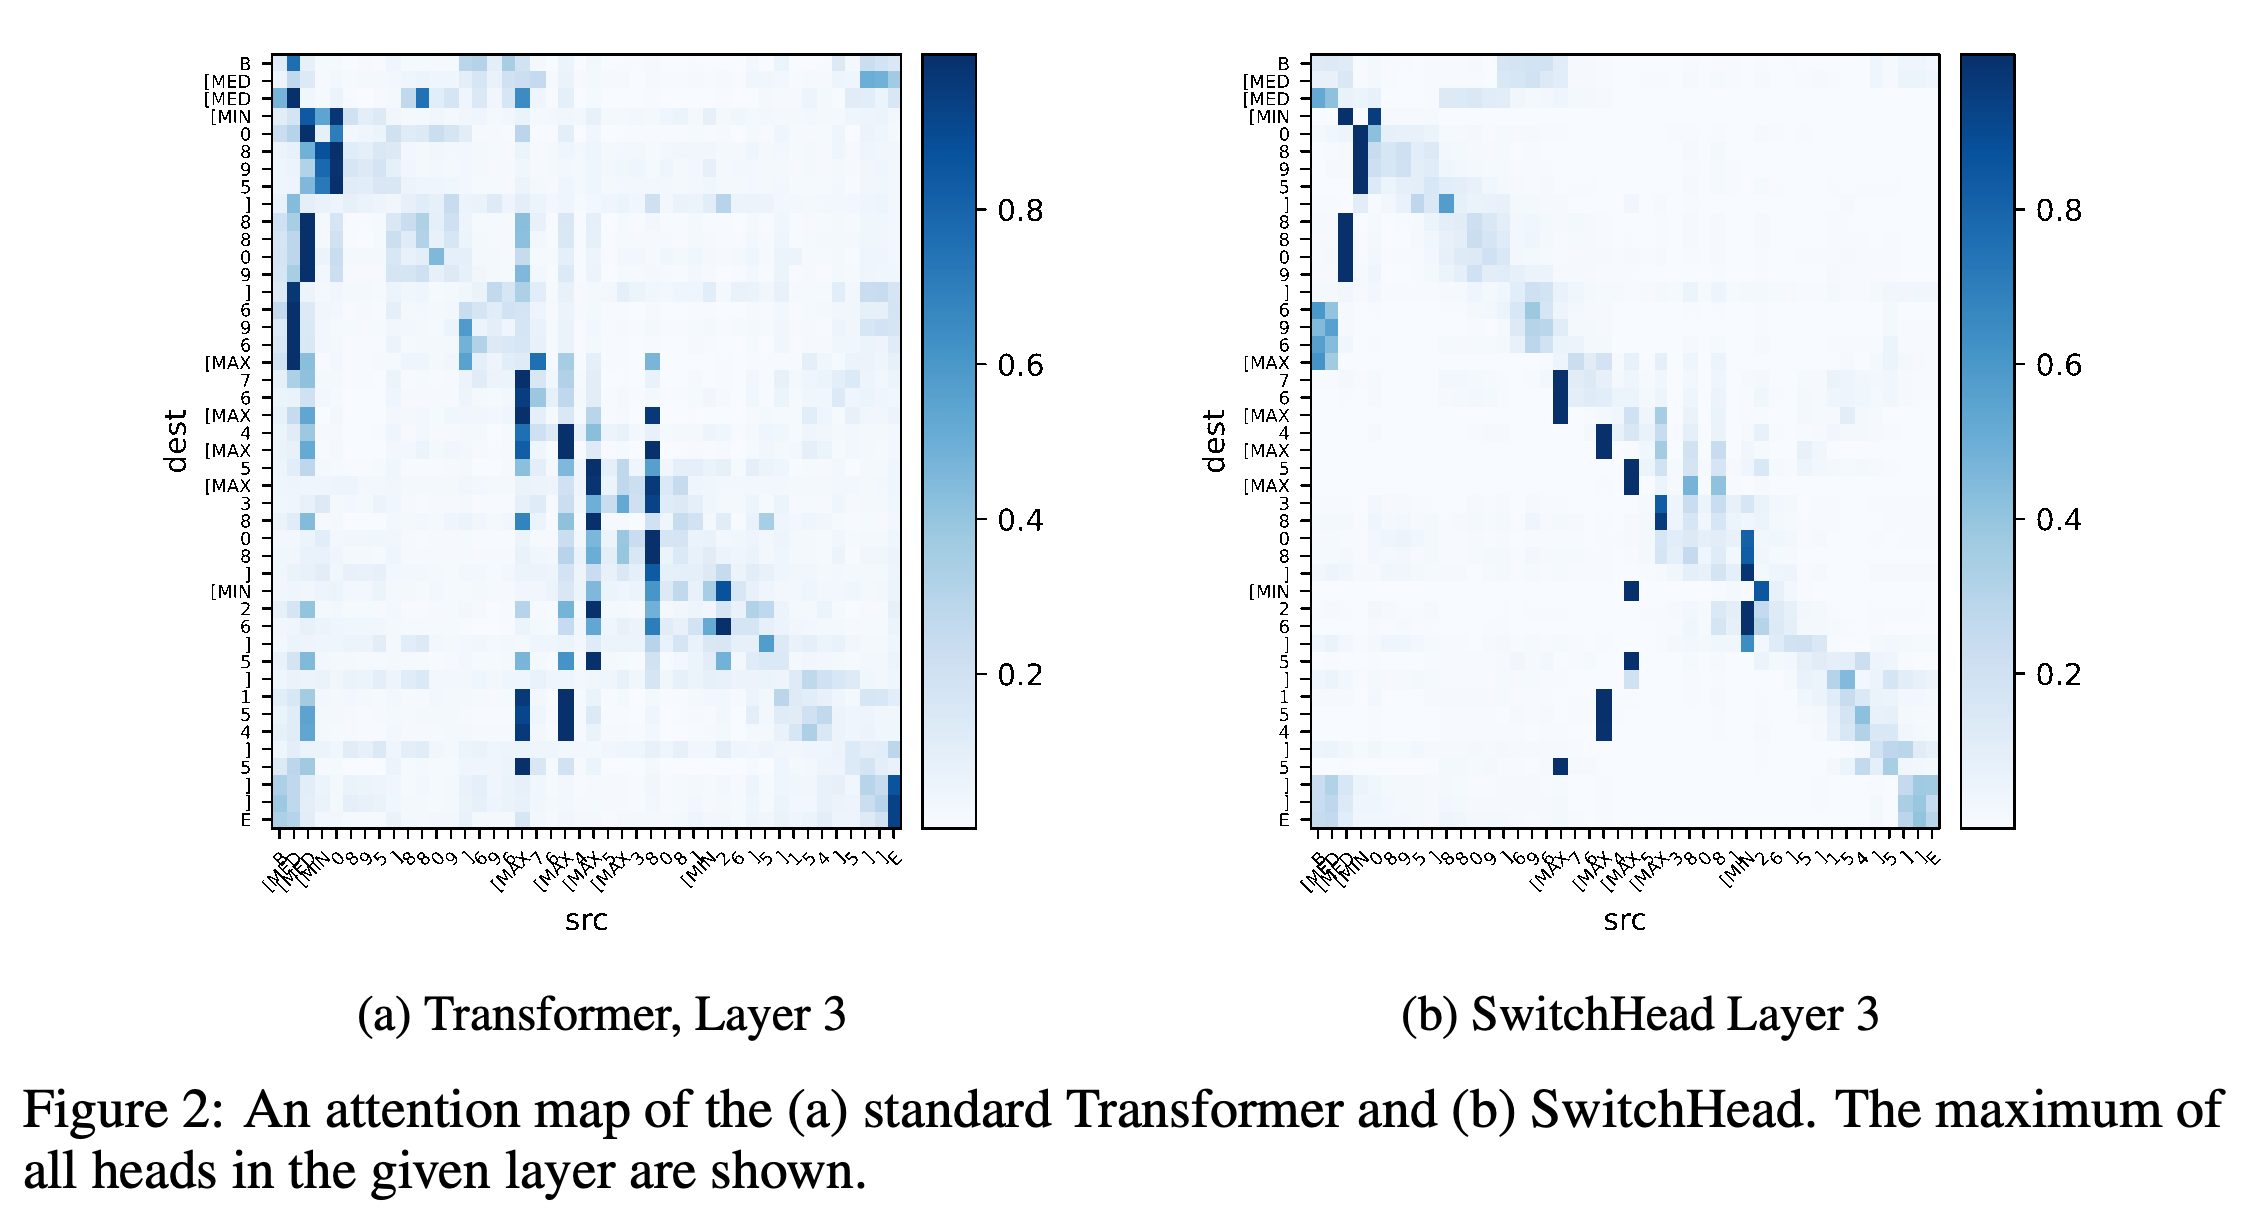
- 각 토큰 쌍에 대해 head 전체에서 가장 큰 가중치를 취한 계층별 최대 attention 맵은 dense 모델과 SwitchHead에서 정성적으로 비슷하다. 개별 routing 시각화에서는 output expert가 연산별로 특화되고, value expert는 숫자와 닫는 괄호를 구분하는 양상이 나타난다.
- 언어 모델 시각화에서도 비슷한 패턴이 나타난다. 앞서 등장한 일치 문맥에서 정보를 복사하는 induction head의 사례로 드문 이름 “Homarus”를 제시하며, 세로줄 형태의 attention 패턴도 보여준다. 이 사례들은 정성적 근거이며, 내부 동작의 동등성을 종합적으로 측정한 결과는 아니다.
계층 3의 attention 맵에서는 SwitchHead가 더 적은 head를 사용해도 주요 attention 구조가 비슷하게 유지된다. 각 패널은 head 전체에서 최댓값을 취하므로, 이 시각화는 정성적 유사성을 뒷받침하지만 head 수준의 표현이 동일함을 입증하지는 않는다.
5 Related Work
관련 연구에서는 attention 행렬 수를 줄이는 방법을 head의 가중치를 다시 조정하거나 attention 정규화 전 점수인 logit을 결합하는 방법과 구분한다. 이러한 대안은 행렬 구성과 readout에 여전히 상당한 비용이 들 수 있지만, SwitchHead에서는 여러 projection expert가 attention 행렬을 공유한다.
- Multi-Query attention은 head 사이에서 key와 value projection을 공유한다. SwitchHead의 ablation에서는 실험한 파라미터 예산 내에서 value와 output projection의 다양성을 유지하는 구성이 유리하다.
- 전체 attention 행렬을 저장하지 않고 정확한 attention을 계산하는 하드웨어 최적화 구현인 FlashAttention은 메모리 접근 비용을 줄이며, SwitchHead의 구조 변경과 함께 사용할 수 있다. 부록은 RoPE 실험에서 두 방법을 결합한 결과를 보고한다.
6 Limitations
실험한 모델의 규모는 비교적 작으며, 최신 대규모 언어 모델에서 결과를 검증하지 않았다. Triton 프로그래밍 시스템으로 구현한 expert 전용 연산 커널의 속도는 NVIDIA의 행렬 연산 라이브러리 cuBLAS를 사용해 단일 expert에 해당하는 크기의 dense 행렬을 곱할 때 속도의 약 60%다. 제안한 목표인 80–90%는 추정치다.
- 모델 구성 요소를 여러 장치에 분산하는 모델 병렬 학습에는 expert를 장치 사이에서 동적으로 이동할 수 있는 부하 분산 시스템이 필요하다.
7 Conclusion
논문은 value와 output projection을 routing하는 SwitchHead가 expert collapse를 막기 위한 추가 정규화 없이도, 더 적은 attention 행렬과 자원으로 파라미터 수가 같은 dense 모델에 가까운 성능을 낼 수 있다고 결론짓는다. 실험은 feedforward MoE 계층과 결합할 수 있음도 보여주지만, SwitchAll의 예측 성능 개선은 데이터셋과 규모에 따라 달라진다.
부록
- A.1 A Comment on Flash Attention: 저자들은 많은 환경에서 FlashAttention만으로 더 큰 자원 절감 효과를 얻을 수 있음을 인정한다. 두 방법은 서로 보완적인 비용을 줄인다고 설명하며, RoPE 실험에서 함께 사용할 수 있음을 보고한다. 해당 하드웨어상의 절충 관계가 성립하지 않을 수 있는 엣지 장치에서의 이점은 조건부 가능성으로 남아 있다.
- A.2 Resource Usage of Different Methods: 자원 계산식과 MAC 및 중간 결과 메모리 열은 attention 계층 1개가 시퀀스 1개를 처리하는 경우를 나타내며, 배치 크기와 계층 수에 비례해 증가한다. 이전 청크 C − 1개를 포함해 문맥 길이가 CT이면, attention 행렬 저장량은 n_heads CT²에, attention 핵심 연산량은 n_heads CT² d_head에 비례한다. SwitchHead는 head 수를 줄이는 대신 선택한 expert의 projection 비용을 추가한다. 메모리 계산식은 활성 expert마다 별도의 중간 결과를 저장하지 않는 커널을 가정하며, 연산량 추정에서는 작은 expert 선택 오버헤드를 제외한다.
- A.3 The Importance of Different Projections: Table 6은 head 2개와 E = 5 expert를 사용하는 47M-parameter Wikitext 103 모델들의 expert와 고정 projection 조합을 모두 비교한다. Value/output expert의 perplexity가 12.27로 보고된 결과 중 가장 낮다. Value/output expert 없이 key/query expert만 사용하면 12.90이므로, 고정된 파라미터 예산을 최종 설계처럼 배분하는 선택을 뒷받침한다.
- A.4 RoPE Positional Encodings: XL 캐시 없이도 SwitchHead는 Wikitext 103과 C4에서 경쟁력 있는 성능을 유지한다. Table 7의 Wikitext 103 perplexity는 작은 규모에서 12.75 대 12.78, 큰 규모에서 10.00 대 10.17이다. 큰 규모의 C4에서는 16.41 대 16.35로 조금 나쁘다. Table 8에서 큰 규모의 파라미터 수를 맞춘 비교는 BLiMP 정확도 79.9% 대 76.1%를 보고한다.
- A.5 Hyperparameters: 학습에는 gradient 기반 optimizer인 Adam, 배치 크기 64, 학습률 0.00025를 사용한다. Gradient 크기를 제한하는 gradient clipping도 적용하며, 최대 norm κ는 Table 9에 명시한다. 본문은 “large models (> 200K parameters)”에 4k-step 학습률 warm-up을 적용한다고 기술하며, 여기서는 PDF에 명시된 기준을 그대로 유지한다. 학습 중 활성값을 무작위로 억제하는 feedforward dropout은 SwitchAll을 제외하고 작은 모델에서 0.1, 큰 모델에서 0.2다. Transformer XL은 학습과 검증에서 추가 문맥 청크 1개를 사용한다.
- A.6 A Note on the Parameter Count of the SwitchAll: σ-MoE의 expert 차원을 바꾸면 모든 expert가 동시에 바뀌고, 커널이 4의 배수 차원만 지원하므로 파라미터 수를 정확히 맞추기 어렵다. 따라서 저자들은 기존 feedforward MoE 설정을 유지하며, 큰 SwitchAll 모델의 파라미터 수는 259M으로 남는다.
- A.7 Visalizing all Attention Heads: Figures 3과 4는 ListOps의 계층별 최대 attention 맵을 보여주고, Figure 5는 head별 value/output 선택 점수를 추가하며, Figure 6은 Wikitext 103에서 선택한 attention 패턴을 제시한다. 선택 점수 시각화는 고정된 0–1 척도를 사용하지만 attention 시각화는 패널마다 척도를 조정하므로, attention 패널 사이에서 색상 강도를 직접 비교할 수 없다.
- A.8 Compute Requirements: Table 10은 학습 하드웨어, 장치 수, 공유 호스트 자원, hh:mm 형식의 소요 시간을 나열한다. 대부분의 실행은 더 빠른 Triton 커널을 도입하기 전에 이루어졌으므로, 이 시간은 조건을 맞춘 속도 비교에 사용할 수 없다. 저자들은 실패한 실험과 예비 실험에 사용한 자원이 논문에 포함된 실험 자원의 약 10 times에 해당한다고 추정한다.
짧은 생각
Projection ablation, head 수를 줄인 dense 대조군, 전체 파이프라인 속도 측정은 attention 행렬 수를 줄이면서 projection의 다양성을 유지하는 설계를 함께 뒷받침한다. 실제 적용을 평가할 때는 attention 계층의 분석적 자원 절감과 측정한 학습 자원 절감을 구분하고, 검증하지 않은 더 큰 규모와 peS2o 및 CBT의 소폭 성능 저하를 고려해야 한다. Table 3에서는 큰 규모의 SwitchAll 결과가 엇갈리며, Table 4에서는 파라미터 수를 맞춘 SwitchHead의 CBT 성능이 소폭 낮아진다. 이 결과 2개는 논문의 포괄적인 성능 주장이 성립하는 범위를 제한한다. 코드는 https://github.com/robertcsordas/switchhead 에 공개되어 있다.