Tina: Tiny Reasoning Models via LoRA | 요약
22 Apr 2025 | Paper Review LoRA Reinforcement Learning With Verifiable Rewards Mathematical Reasoning목차
이 글은 Tina: Tiny Reasoning Models via LoRA의 핵심 내용을 살펴본다.
- 2025-04-22 (arXiv)
- Wang, Shangshang, Asilis, Julian, Akgül, Ömer Faruk, Bilgin, Enes Burak, Liu, Ollie, Neiswanger, Willie.
- University of Southern California
- Paper
- Github
- Project Page
출처 및 라이선스. 이 글은 Shangshang Wang, Julian Asilis, Ömer Faruk Akgül, Enes Burak Bilgin, Ollie Liu, Willie Neiswanger의 Tina: Tiny Reasoning Models via LoRA, arXiv:2504.15777v1를 요약한다. arXiv 레코드에는 이 논문의 라이선스가 CC BY 4.0으로 표시되어 있다. 아래 이미지는 해당 버전 PDF에서 자른 그림과 표다: 그림 1 (PDF 2쪽), 그림 2 (PDF 3쪽), 표 1 (PDF 6쪽), 표 2 (PDF 7쪽), 표 3 (PDF 8쪽), 표 4 (PDF 9쪽), 그림 3 (PDF 10쪽) 및 그림 4 (PDF 11쪽).
요약
- Tina는 파라미터 15억 개인 언어 모델을 추가 학습해 수학과 과학 문제 해결 능력을 얼마나 저렴하게 개선할 수 있는지 살펴본다. 저장된 모델 상태인 최고 체크포인트는 표준화된 평가에서 여섯 벤치마크 평균 50.60%를 기록했다. 모든 파라미터를 업데이트한 Open-RS2의 평균은 41.60%였다. 두 모델은 모두 DeepSeek-R1-Distill-Qwen-1.5B를 기반으로 한다.
- 사전학습 가중치를 고정한 채 작은 행렬 업데이트를 학습하는 저랭크 적응(LoRA)과 보상 신호로 생성 응답을 최적화하는 강화학습(RL)을 결합했다. 두 개의 NVIDIA L40S GPU에서 Group Relative Policy Optimization(GRPO)을 사용한다. GRPO는 기대 보상을 예측하는 별도 네트워크 없이 샘플 답변들의 그룹 내 보상을 비교한다.
- 최고 Tina-Open-RS2 체크포인트는 2024년 American Invitational Mathematics Examination 벤치마크인 AIME24에서 43.33%를 기록했다. 평가는 예시 없이 답변 하나의 정답 여부를 보는 zero-shot pass@1 방식이다. 추정 비용 $9에는 해당 체크포인트까지 학습한 비용 $8과 평가 비용 $1이 포함된다. 보고된 모든 실험을 재현하는 데는 $526이 든다.
- 저자들은 형식 보상과 응답 길이의 변화를 근거로 LoRA가 기존 지식을 보존하면서 추론 출력 형식에 빠르게 적응한다고 가정한다. 형식 보상은 요구한 응답 구조를 따르는 정도를 평가한다. 근거는 간접적이다. 실험에는 더 강한 추론 모델을 모방하도록 증류 학습된 단일 기반 모델을 사용했고, 부록에는 학습 중 변화와 최고 성능의 관계에 대한 예외도 기록되어 있다.
1. Introduction
서론은 추론 능력 향상을 자원 문제로 다룬다. 예시 응답으로 학습하는 지도 미세조정은 더 강한 모델이 생성한 단계별 풀이를 자주 사용하며, 이런 시연을 확보하는 데 비용이 들 수 있다. RL 파이프라인에도 상당한 연산이 들 수 있다. Tina는 이미 증류된 DeepSeek-R1-Distill-Qwen-1.5B에서 출발해 작은 파라미터 업데이트로 얻는 추가 성능 향상을 측정한다.
- 보고된 비용은 추가 학습과 평가에 한정되며 사전학습과 증류로 시작 체크포인트를 만든 비용은 포함하지 않는다.
- 저자들은 재현을 위해 코드, 학습 로그, 평가 스크립트와 체크포인트를 공개했다.
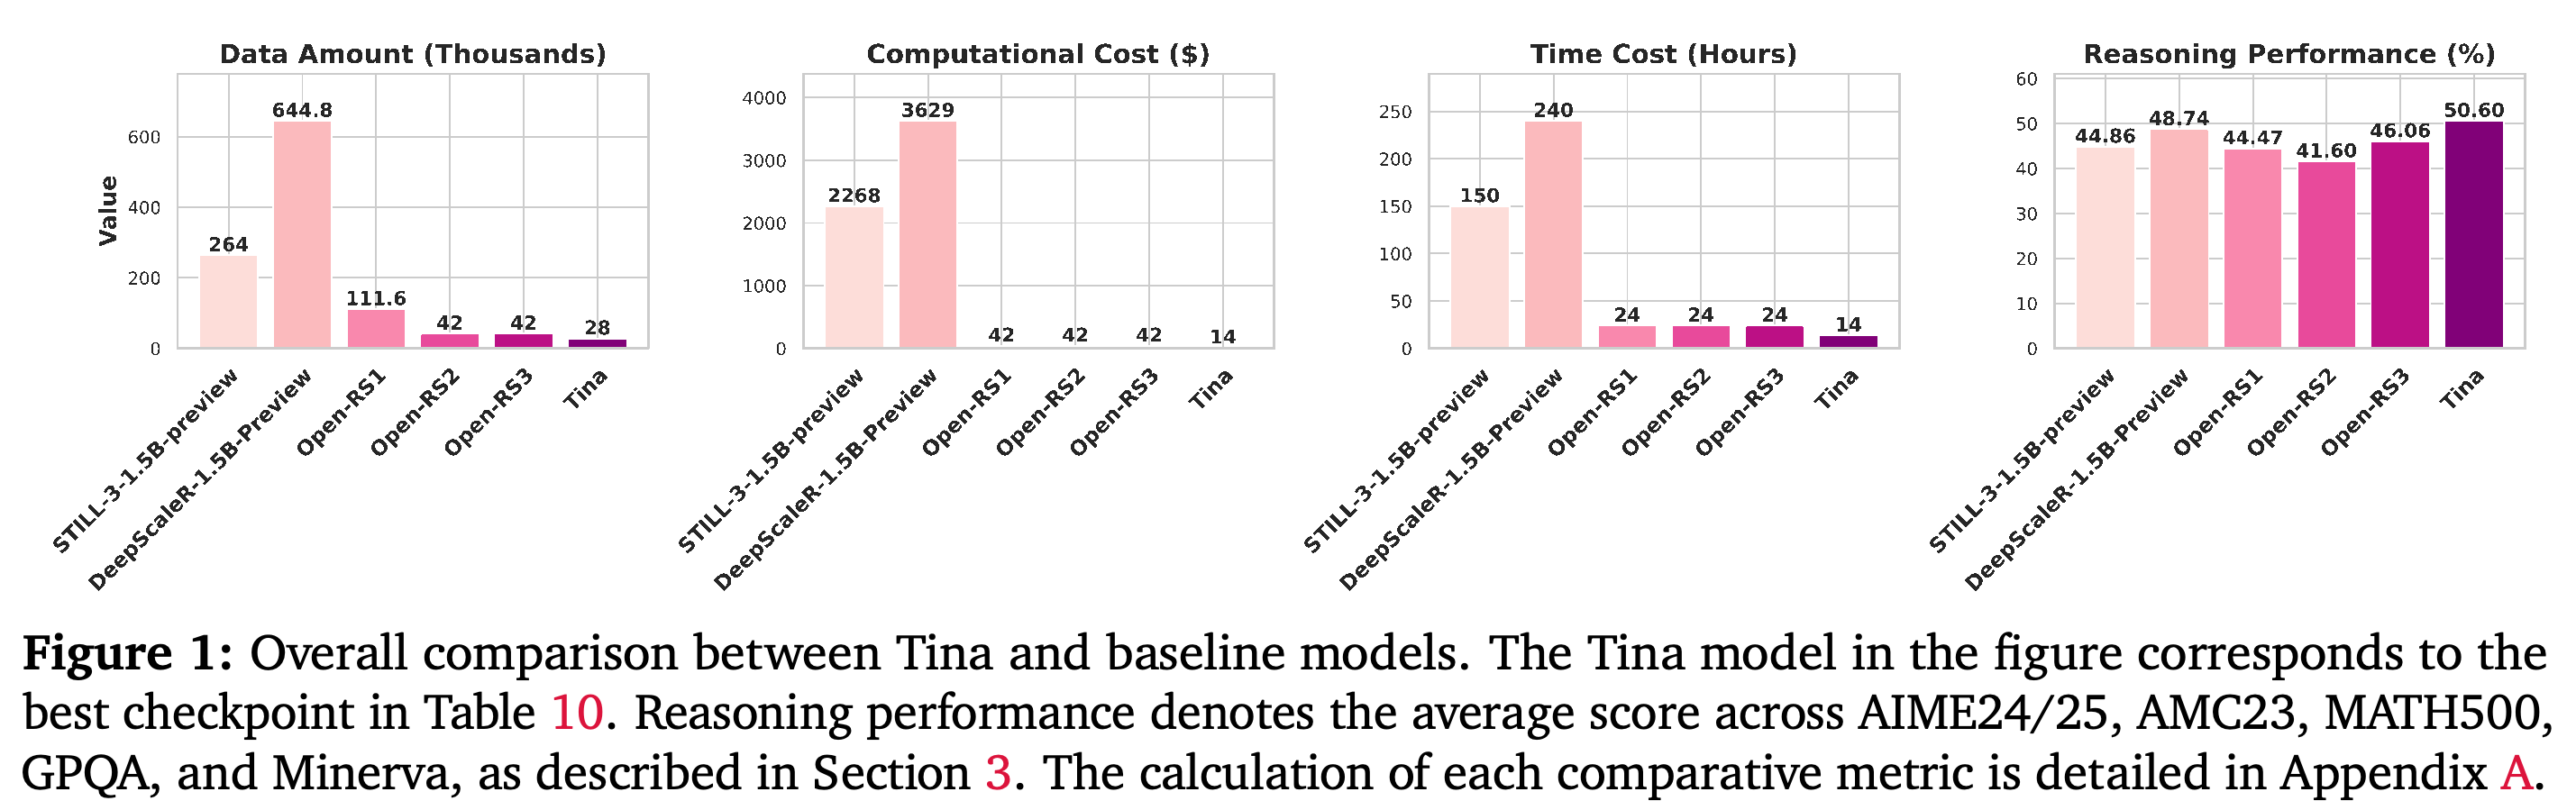
Tina는 표시된 여섯 과제 평균이 50.60%로 가장 높고 추정 학습 비용은 $14다. DeepScaleR은 48.74%, $3629다. 부록 A에 따르면 자원 막대는 전체 실행을 가리키고 평가를 제외하므로 $14와 초록의 체크포인트 추정치 $9은 비용 범위가 다르다.
2. Related Work
관련 연구에서는 공개 추론 모델 재현, 검증 가능한 보상을 쓰는 RL, 일부 파라미터만 학습하는 적응 기법을 살펴본다. 이를 바탕으로 작은 기반 모델, 공개 학습 자원, LoRA 기반 RL을 결합한다.
2.1. Open-Source Reasoning Replicas
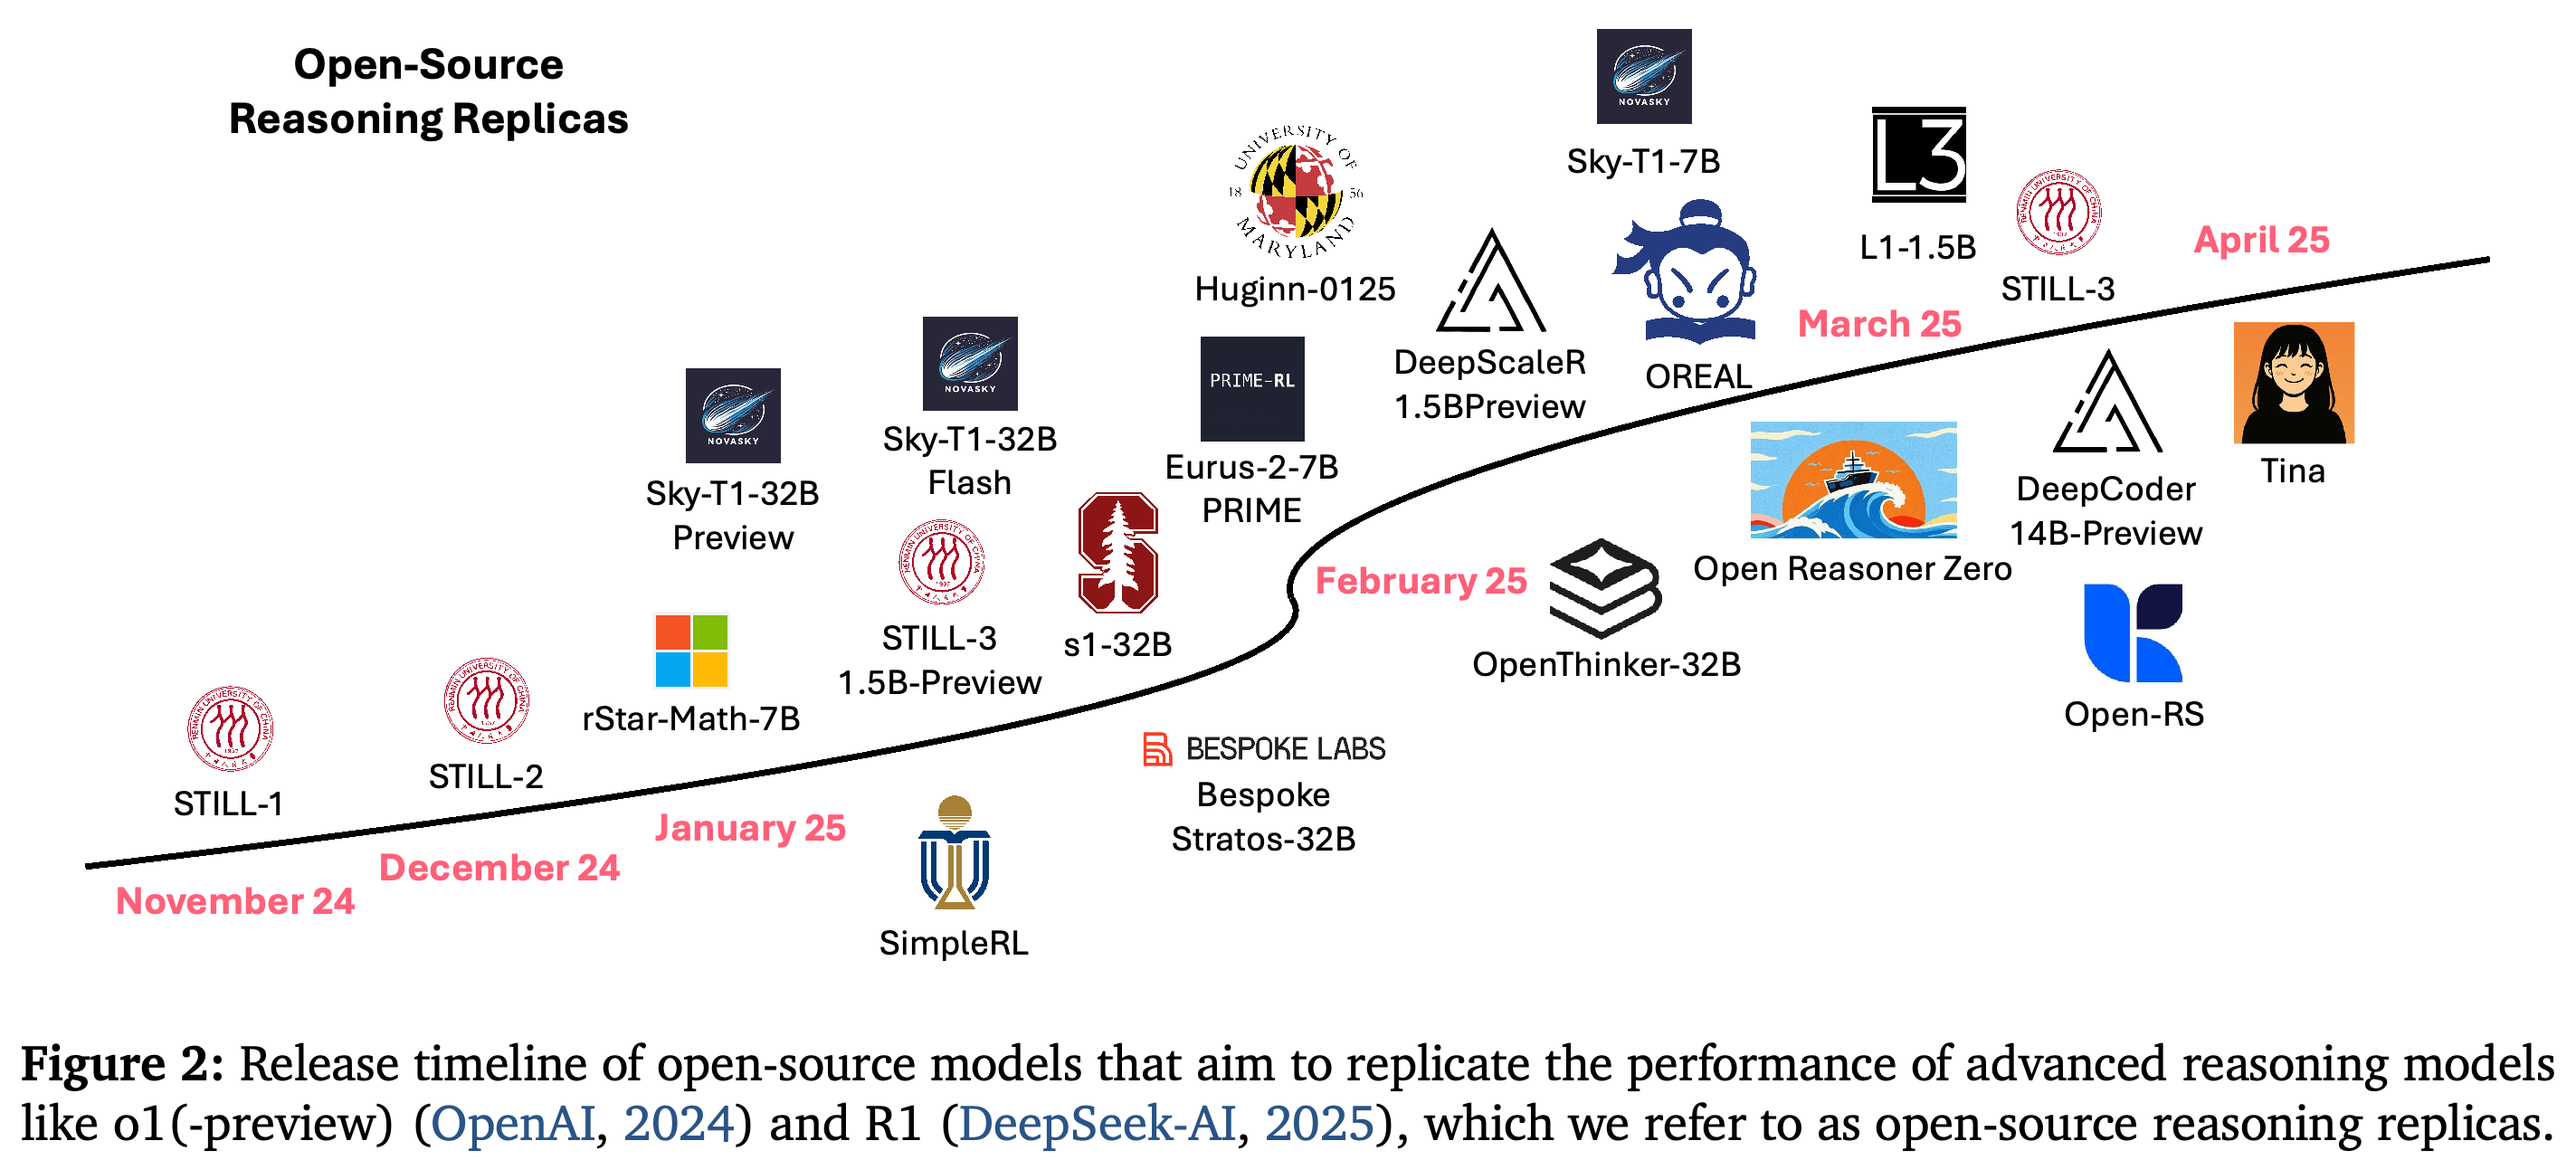
오픈소스 추론 재현 모델은 o1-preview와 DeepSeek-R1 같은 시스템의 추론 성능을 재현하려고 공개한 모델이다. 논문은 정제된 시연 데이터, 경량 RL, 응답 길이 제어와 소형 모델 학습을 다루며 STILL, Sky-T1, SimpleRL, s1, DeepScaleR, Open-RS를 소개한다.
- 인용된 프로젝트는 선행 사례와 공개 자원을 제공하지만 학습 방법은 서로 다르다.
연대표는 2024년 11월부터 2025년 4월까지 공개된 추론 모델 프로젝트 사이에 Tina를 배치한다. 비교 대상의 역사적 맥락을 제공하며 상대 성능이나 학습 효율을 측정하지는 않는다.
2.2. RL with Verifiable Rewards
검증 가능한 보상은 답의 정오나 요구된 응답 구조처럼 확인할 수 있는 속성으로 학습 피드백을 제공한다. 논문은 학습된 보상 평가기, 규칙 기반 검증과 탐색을 장려하는 방법을 소개한 뒤 GRPO를 설명한다.
- GRPO는 같은 질문에 대한 다른 응답을 이용해 각 응답의 그룹 상대 보상, 즉 advantage를 추정한다.
- Dr.GRPO는 긴 응답에 치우치는 GRPO의 편향을 다루도록 수정한 방법이다. Tina는 선택한 설계 요소를 바꾸는 절제 실험에서 이를 평가한다.
2.3. Low-Rank Adaptation
LoRA는 가중치 업데이트를 두 저랭크 행렬의 곱으로 표현한다. 두 행렬의 작은 공통 차원은 학습할 파라미터 수를 제한한다. Tina는 이렇게 제한된 업데이트가 전체 파라미터 학습에 견줄 만한 추론 능력 향상을 낼 수 있는지 시험한다. 별도로 저장하는 업데이트 파라미터인 어댑터를 사용하면 완전한 모델 사본을 여러 개 저장하지 않고도 동작을 바꿀 수 있다.
3. Tina: Tiny Reasoning Models via LoRA
Tina는 DeepSeek-R1-Distill-Qwen-1.5B를 GRPO 방식의 RL에서 LoRA로 추가 학습한 모델군이다. 작은 시작 모델과 제한된 파라미터 업데이트에 공개 데이터셋, 공유 학습 인프라, GPU 두 개와 제한된 실험 예산을 결합한다.
3.1. Training Pipeline: Baselines & Datasets
모든 Tina 모델과 비교 기준은 동일한 1.5B 체크포인트에서 출발한다. Tina 변형은 STILL-3-1.5B-preview, DeepScaleR-1.5B-Preview, Open-RS1/2/3의 데이터셋과 보상 구현을 재사용한다.
- STILL은 수학 문제 데이터셋 MATH, 수학 추론 데이터셋 NuminaMathCoT, 1983–2023년 AIME 문제를 비롯한 경시 수학 자료에서 추론 예제 33k개를 사용한다.
- DeepScaleR은 AIME, American Mathematics Competition인 AMC, 올림피아드 수준 수학 데이터셋 OMNI-MATH와 STILL에서 약 40k개의 문제와 답 쌍을 사용한다. Tina는 데이터셋과 보상 설계를 따른다.
- Open-RS 변형은 s1과 DeepScaleR에서 정제한 데이터셋을 쓰며 Tina는 해당 데이터 분할과 보상 구현을 유지한다.
3.2. Training Setup: Infrastructure & Budget
구현은 DeepSeek-R1의 공개 재현 프레임워크 OpenR1을 기반으로 하며 응답 생성 엔진 vLLM과 함께 NVIDIA L40S GPU 두 개에서 학습한다. 학습 전에 정하는 대부분의 하이퍼파라미터는 기존 권장값을 따라 고정했다. 보상 설정은 과제별로 다르고 절제 실험에서는 개별 요소를 바꾼다.
- 비용은 논문 작성 당시 가격을 기준으로 GPU 시간당 약 $1을 가정하며 저장 공간 300 GB를 포함한다. 일부 실행에는 NVIDIA RTX 6000 Ada GPU를 사용했지만 비용 보고의 기준 하드웨어는 L40S다.
- 학습 한 단계는 보통 1분 이내에 끝나며 체크포인트 하나를 여섯 벤치마크 전체에서 평가하는 데 L40S GPU 약 1시간이 든다.
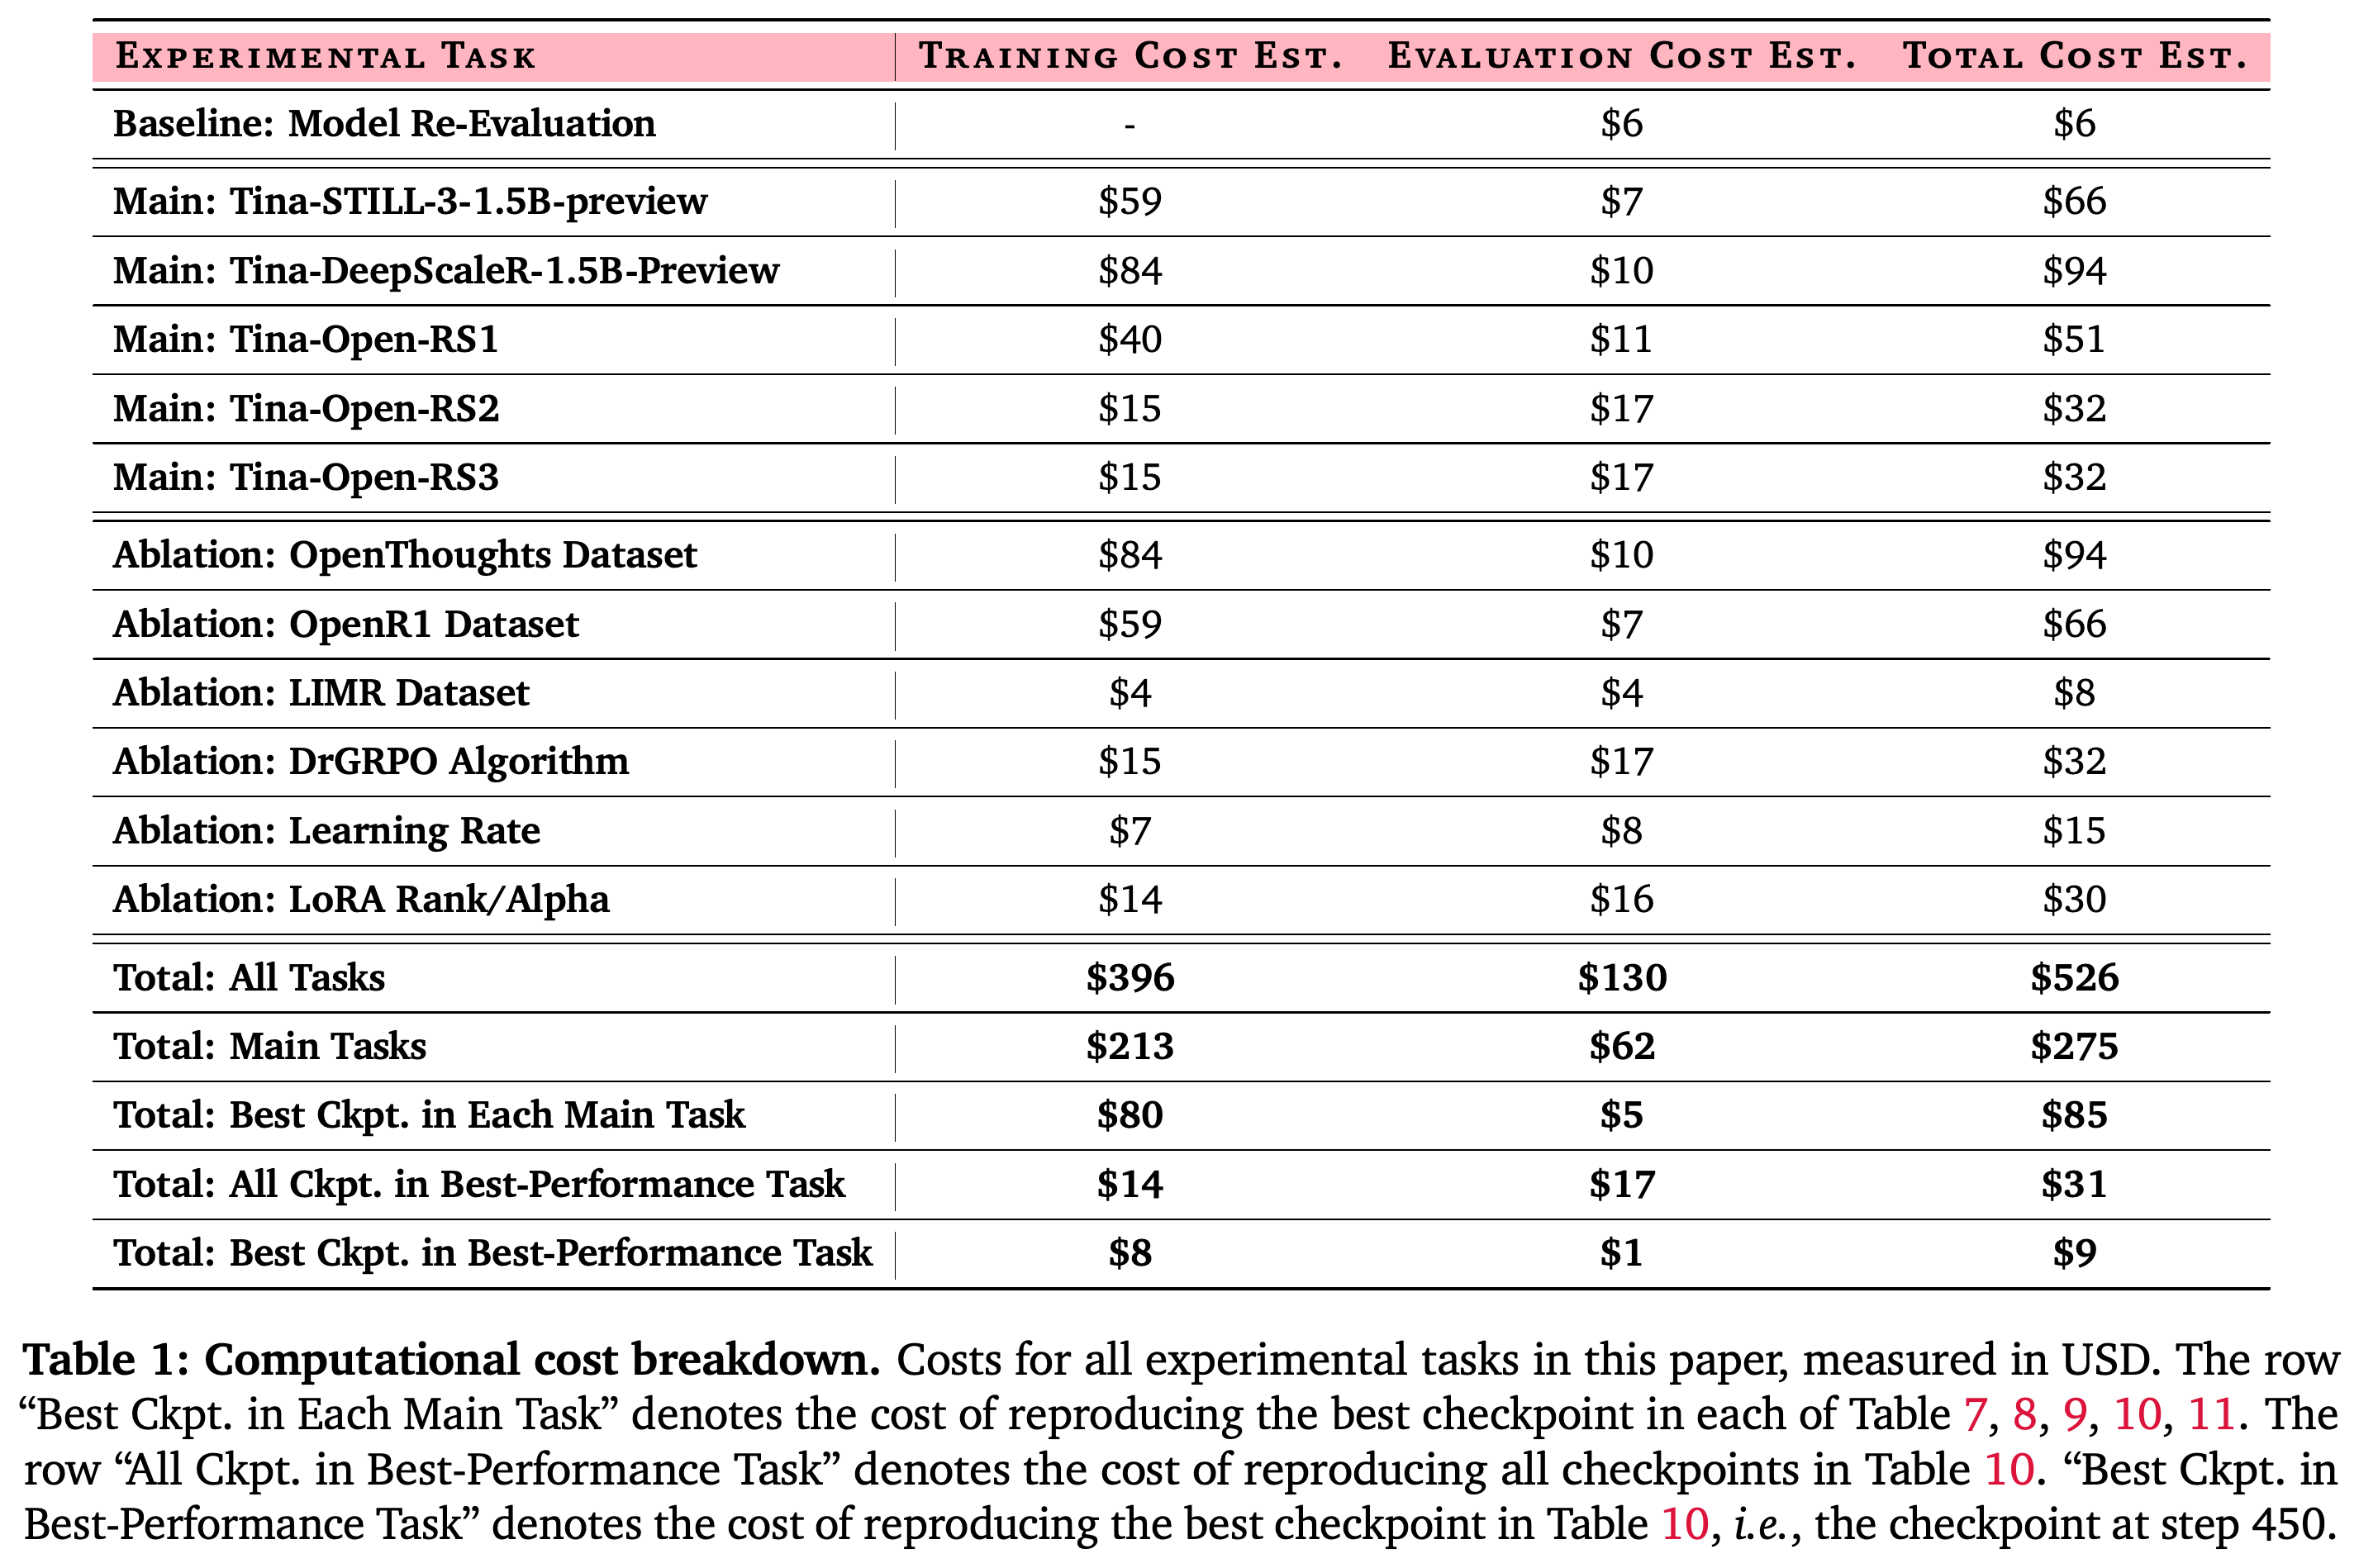
- 표 1은 선택된 최고 체크포인트까지의 $9, 해당 전체 학습과 체크포인트 평가의 $31, 모든 주요 과제의 $275, 전체 실험의 $526을 구분한다.
전체 과제의 학습 비용은 $396, 평가 비용은 $130이다. 선택된 최고 체크포인트에는 각각 $8과 $1이 든다. 최고 성능 과제의 모든 체크포인트 평가 추정치 $17은 학습 추정치 $14보다 높아 체크포인트 선택에 드는 비용을 보여 준다.
4. Surprising Effectiveness of Efficient RL Reasoning via LoRA
실험에서는 먼저 공통 설정으로 비교 기준을 다시 평가하고, Tina 변형 다섯 개를 각각 대응하는 기준과 비교한다. 이후 학습 데이터, 학습률, 어댑터 랭크와 RL 알고리즘을 바꿔 본다. 성능 비교에는 수학 및 과학 추론 벤치마크 여섯 개의 평균 백분율 점수를 사용한다.
4.1. Experiments Stage I: Baseline Model Re-Evaluation
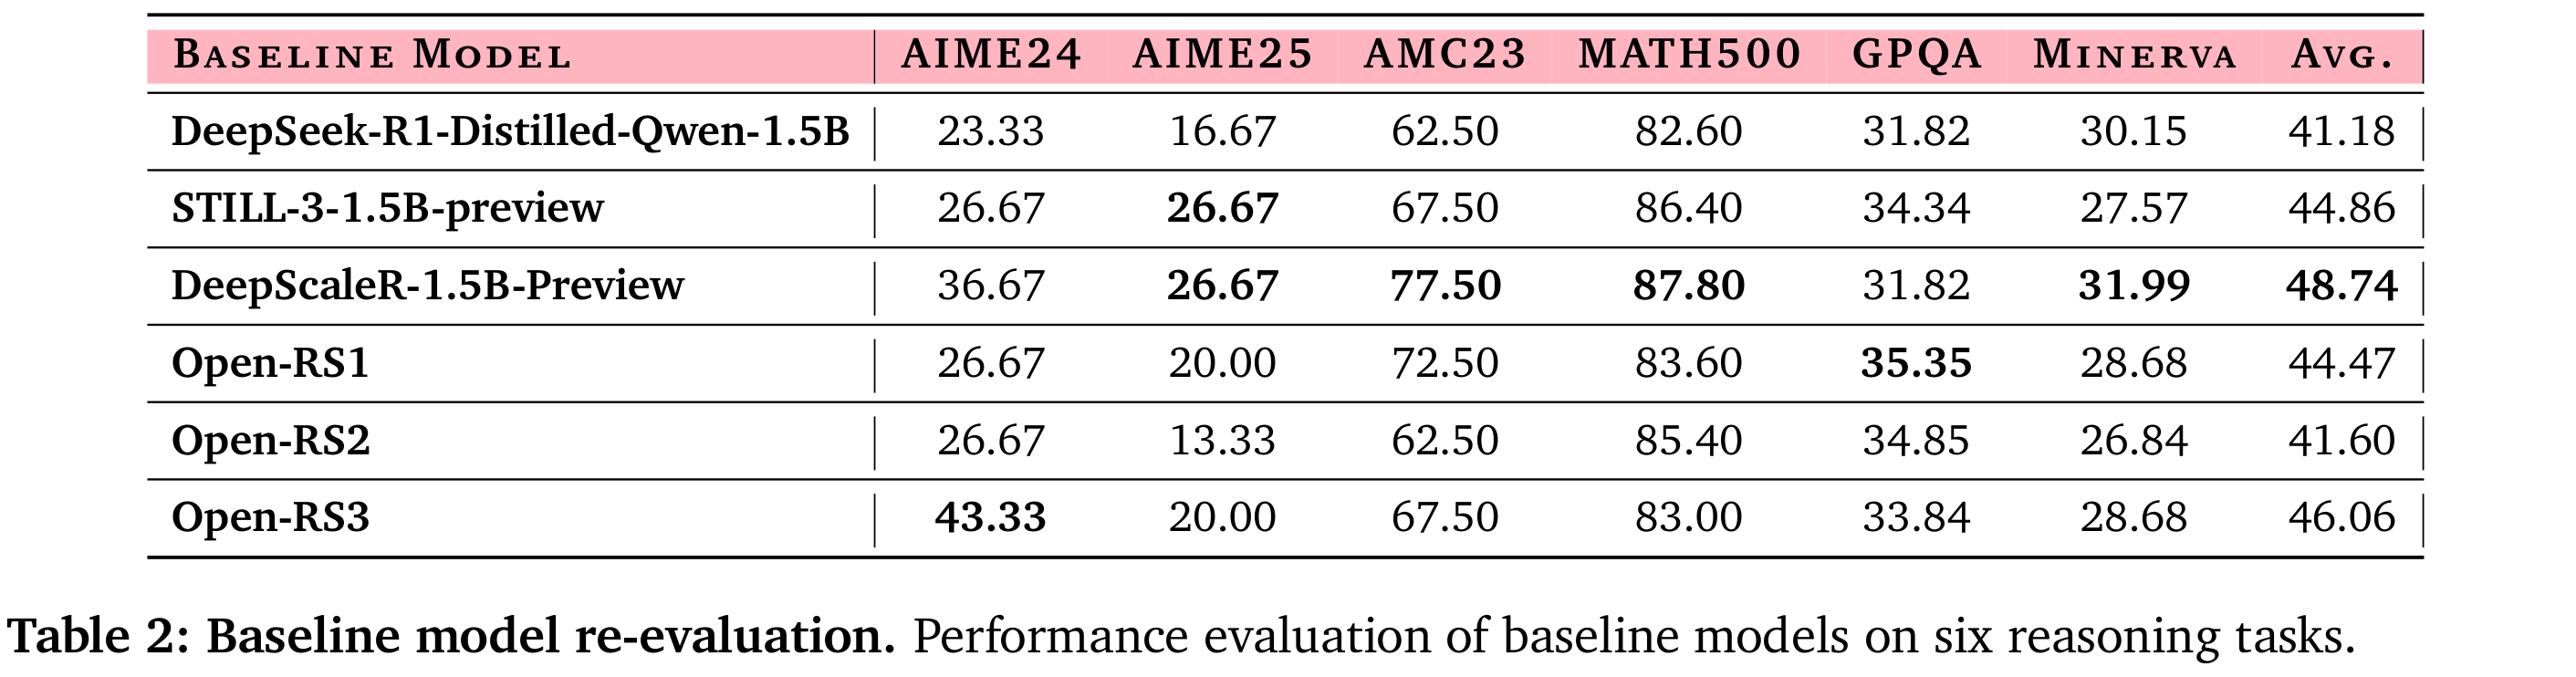
평가 설정 차이의 영향을 줄이기 위해 저자들은 평가 프레임워크 lighteval과 vLLM을 L40S GPU 두 개에서 사용해 모든 기준 모델을 다시 평가한다. 모든 결과는 동일한 생성 설정의 zero-shot pass@1이다.
- 여섯 과제는 각각 경시 수학 문제 30개인 AIME24와 AIME25, 2023년 대회 문제 40개인 AMC23, 경시 문제 500개인 MATH500, 박사 수준 과학 문제 198개인 GPQA Diamond, 정량 추론 문제 272개인 Minerva다.
- 평가에서는 새 토큰 최대 32768개를 허용하고 샘플링의 무작위성을 제어하는 temperature 0.6과 누적 확률에 따라 후보를 제한하는 top_p 0.95를 사용한다. 이 생성 한도는 학습 중 최대 응답 길이인 3584 토큰보다 길다.
- 시작 모델의 평균은 41.18%였다. 다시 평가한 전체 파라미터 기준 모델의 평균은 Open-RS2의 41.60%에서 DeepScaleR-1.5B-Preview의 48.74%까지 분포했다.
공통 평가에서 시작 모델의 평균은 41.18%, 기준 모델 중 최고인 DeepScaleR의 평균은 48.74%다. 과제별 최고 모델은 서로 다르므로 평균 순위만으로 모든 벤치마크를 설명할 수 없다.
4.2. Experiments Stage II: Tina Model Evaluation
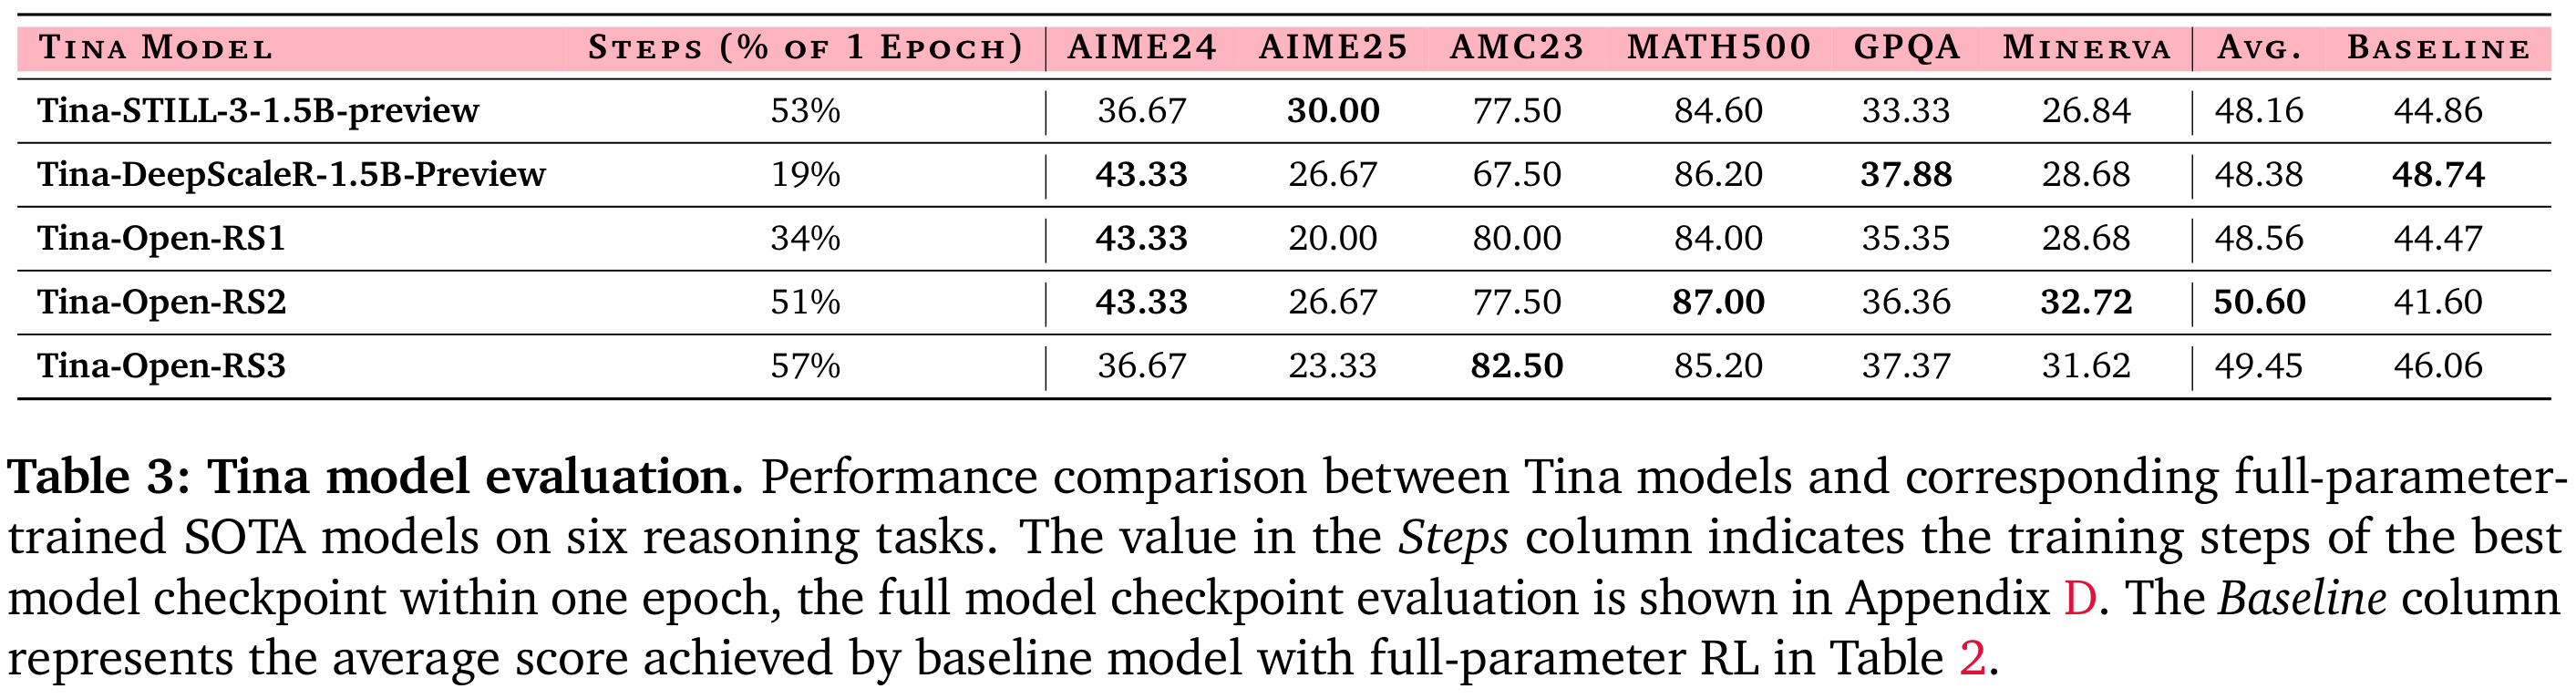
선택된 Tina 체크포인트 다섯 개는 전체 학습 데이터를 한 번 도는 에폭의 19%–57%를 진행한 뒤 여섯 과제 평균 48.16%–50.60%를 기록했다. 네 개는 대응하는 전체 파라미터 기준 모델의 평균을 넘었다. Tina-DeepScaleR-1.5B-Preview는 48.38%로 기준 모델의 48.74%보다 약간 낮았다.
- Tina-Open-RS2의 평균이 50.60%로 가장 높았다. Open-RS2의 41.60%보다 9.00%포인트 높고 상대적으로 20% 넘게 개선됐다.
- 과제별 점수는 AIME24 43.33%, AIME25 26.67%, AMC23 77.50%, MATH500 87.00%, GPQA 36.36%, Minerva 32.72%다.
- 대표 체크포인트는 한 에폭의 약 51% 지점인 450단계다. 비교에는 선택된 체크포인트를 사용했으며 이후 체크포인트의 점수는 크게 변동한다.
다섯 Tina 변형 중 네 개가 대응하는 기준 모델의 평균을 넘는다. Tina-Open-RS2는 에폭의 51% 지점에서 50.60%로 가장 높고 DeepScaleR 대응 모델은 기준보다 약간 낮다.
4.3. Experiments Stage III: Tina Ablation Variants
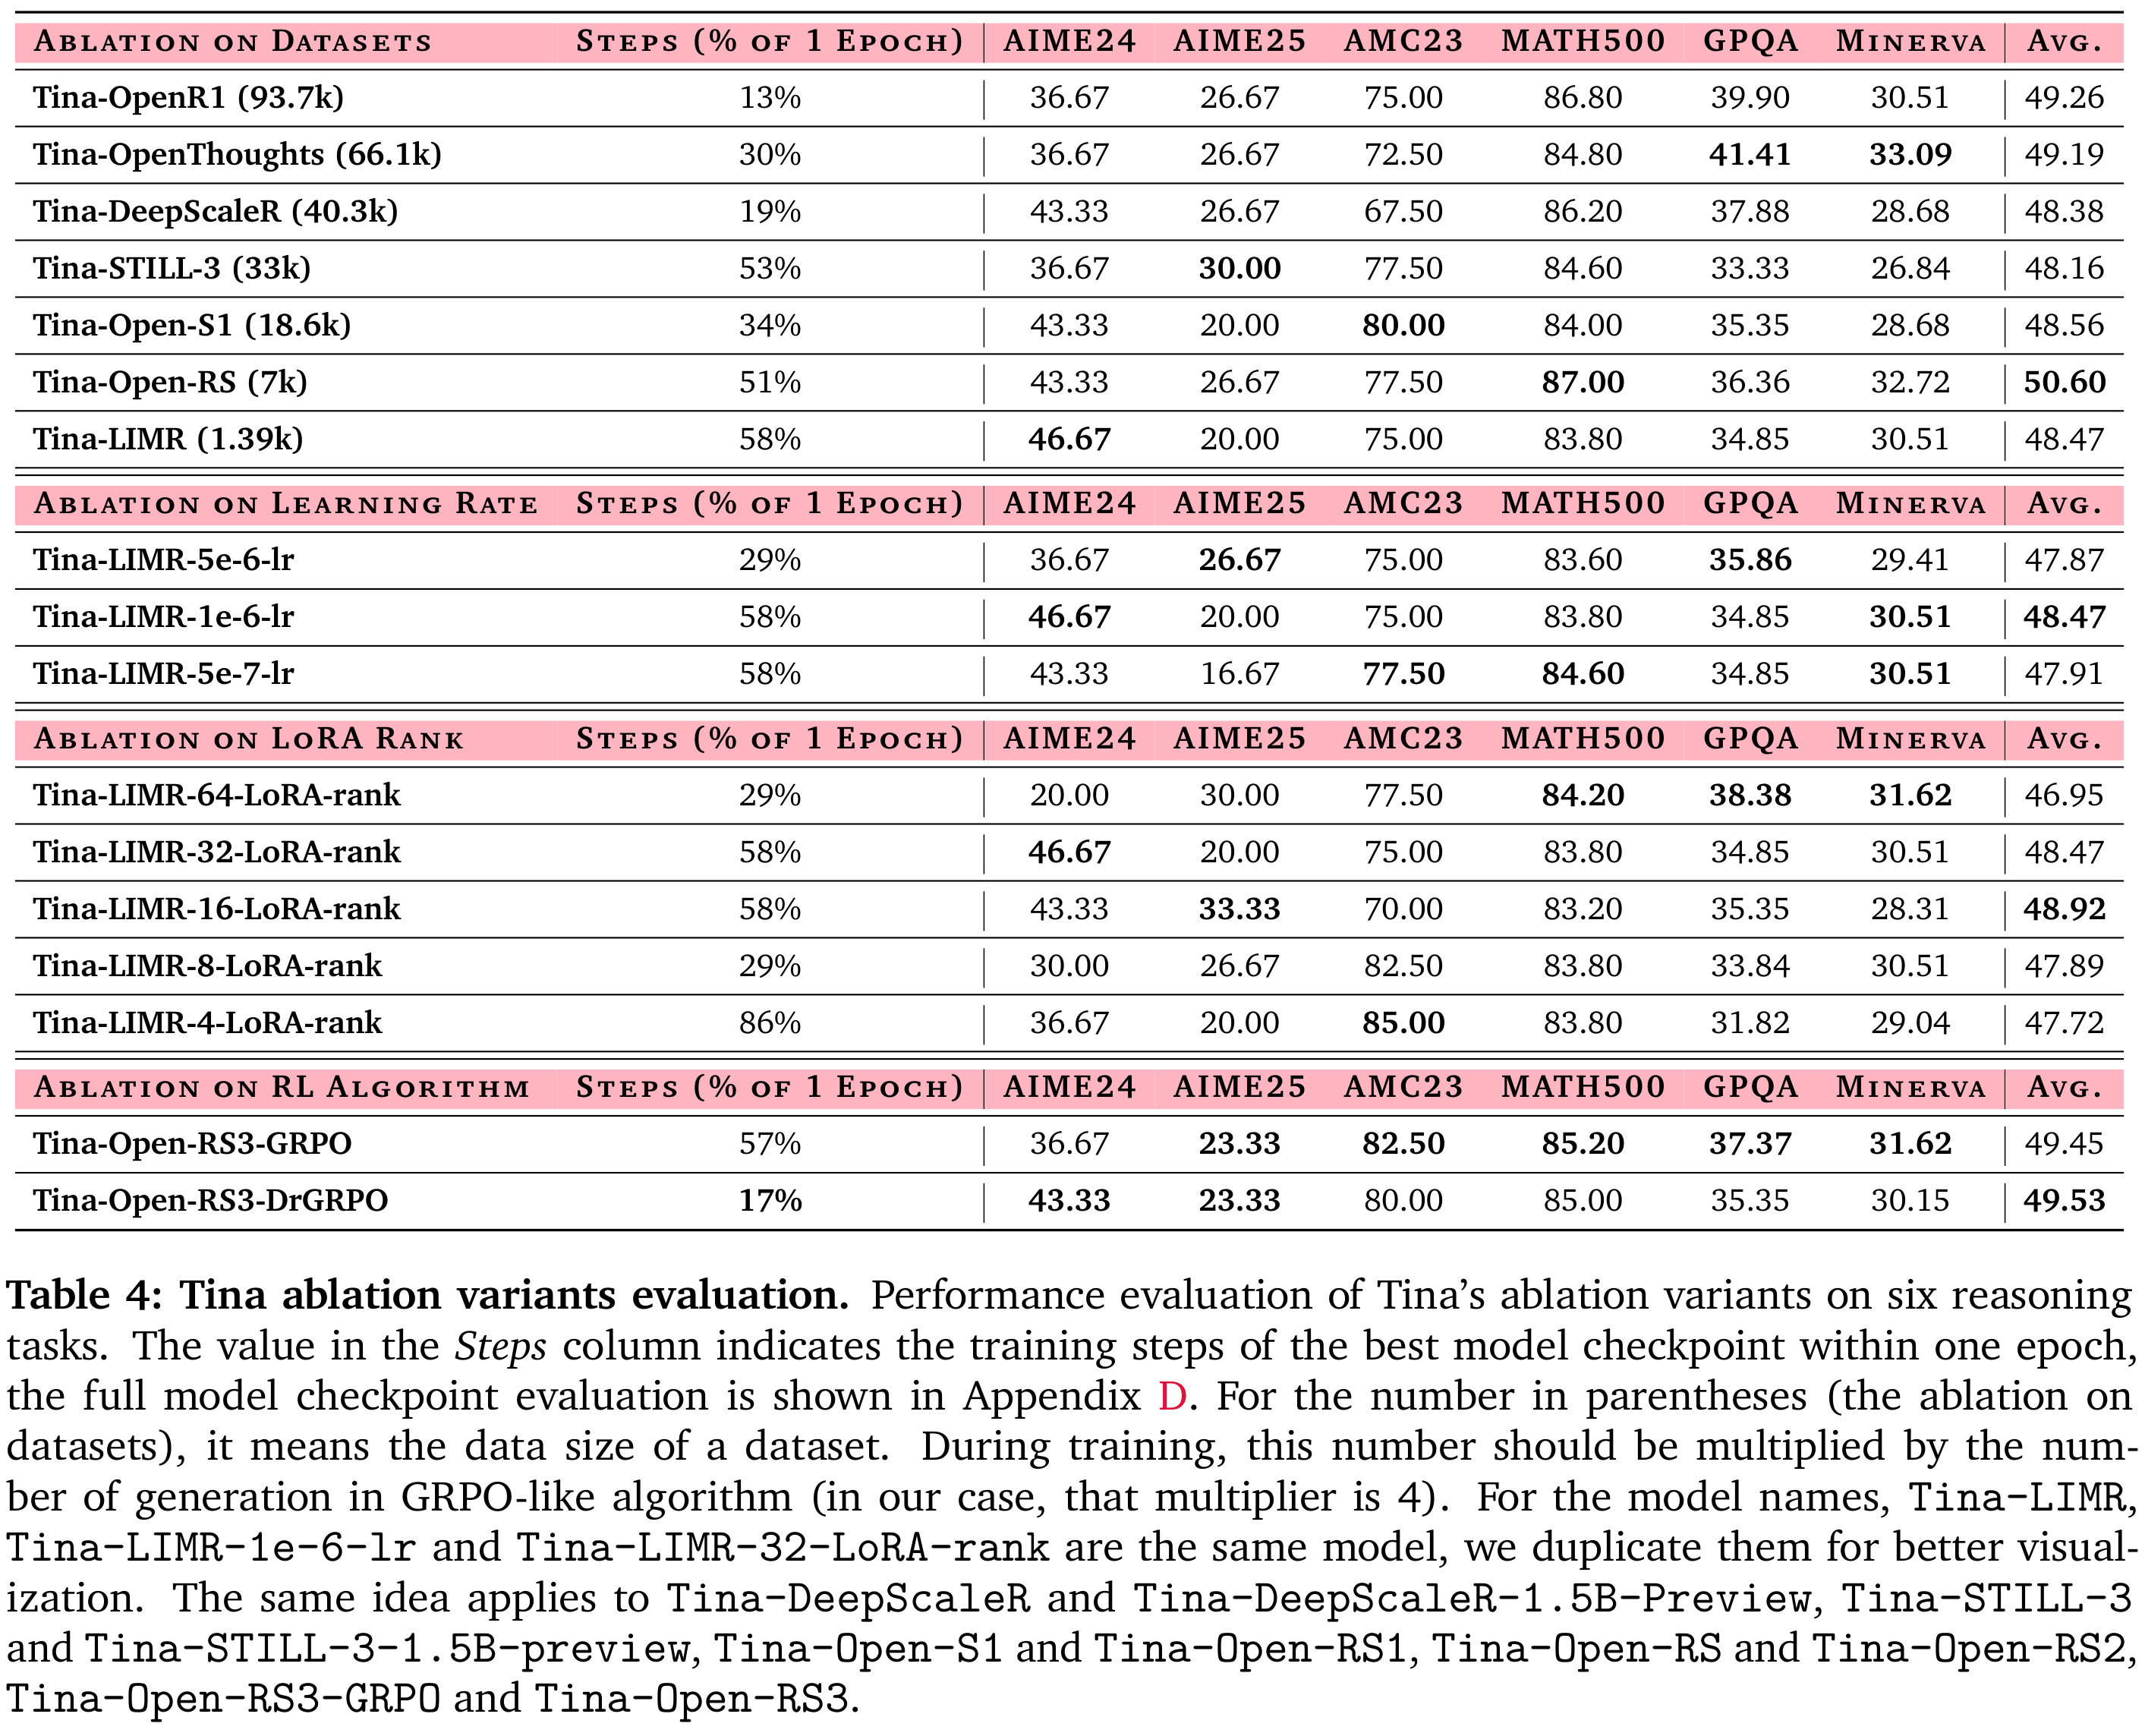
더 큰 데이터셋이나 높은 어댑터 랭크가 선택 체크포인트의 평균을 일관되게 개선하지는 않았다. 알고리즘 비교에서 Dr.GRPO는 GRPO와 비슷한 최고 점수에 더 이른 체크포인트에서 도달했다.
- 일곱 데이터셋 비교에서 예제 7k개인 Open-RS 설정은 50.60%, 예제 93.7k개인 OpenR1은 49.26%, 여러 절제 실험에 사용한 예제 1.39k개인 LIMR은 48.47%를 기록했다. 데이터 크기만으로 순위를 설명할 수 없지만 보상 설정도 다르므로 그 차이를 데이터 품질만으로 돌릴 수 없다.
- LIMR에서 업데이트 크기를 조절하는 학습률 5e-6, 1e-6, 5e-7의 표 4 점수는 각각 47.87%, 48.47%, 47.91%였다. 어댑터 랭크 4, 8, 16, 32, 64의 점수는 각각 47.72%, 47.89%, 48.92%, 48.47%, 46.95%였다. 랭크 실험에서는 어댑터 배율 파라미터 alpha도 바뀌었다.
- Tina-Open-RS3에서 GRPO는 에폭의 57% 지점에 49.45%, Dr.GRPO는 17% 지점에 49.53%를 기록했다. 보고된 설정에서는 Dr.GRPO가 더 일찍 최고 성능에 도달했지만 이 비교만으로 알고리즘의 일반적인 우열을 입증하지는 못한다.
선택된 체크포인트에서 데이터셋 크기나 어댑터 랭크가 커질수록 성능이 일관되게 오르지는 않는다. Dr.GRPO는 에폭 17% 지점에서 49.53%, GRPO는 57% 지점에서 49.45%로 최고점을 기록해 이 설정에서는 Dr.GRPO가 더 이르다.
5. Hypothesis for Effective and Efficient LoRA: Rapid Format Adaptation
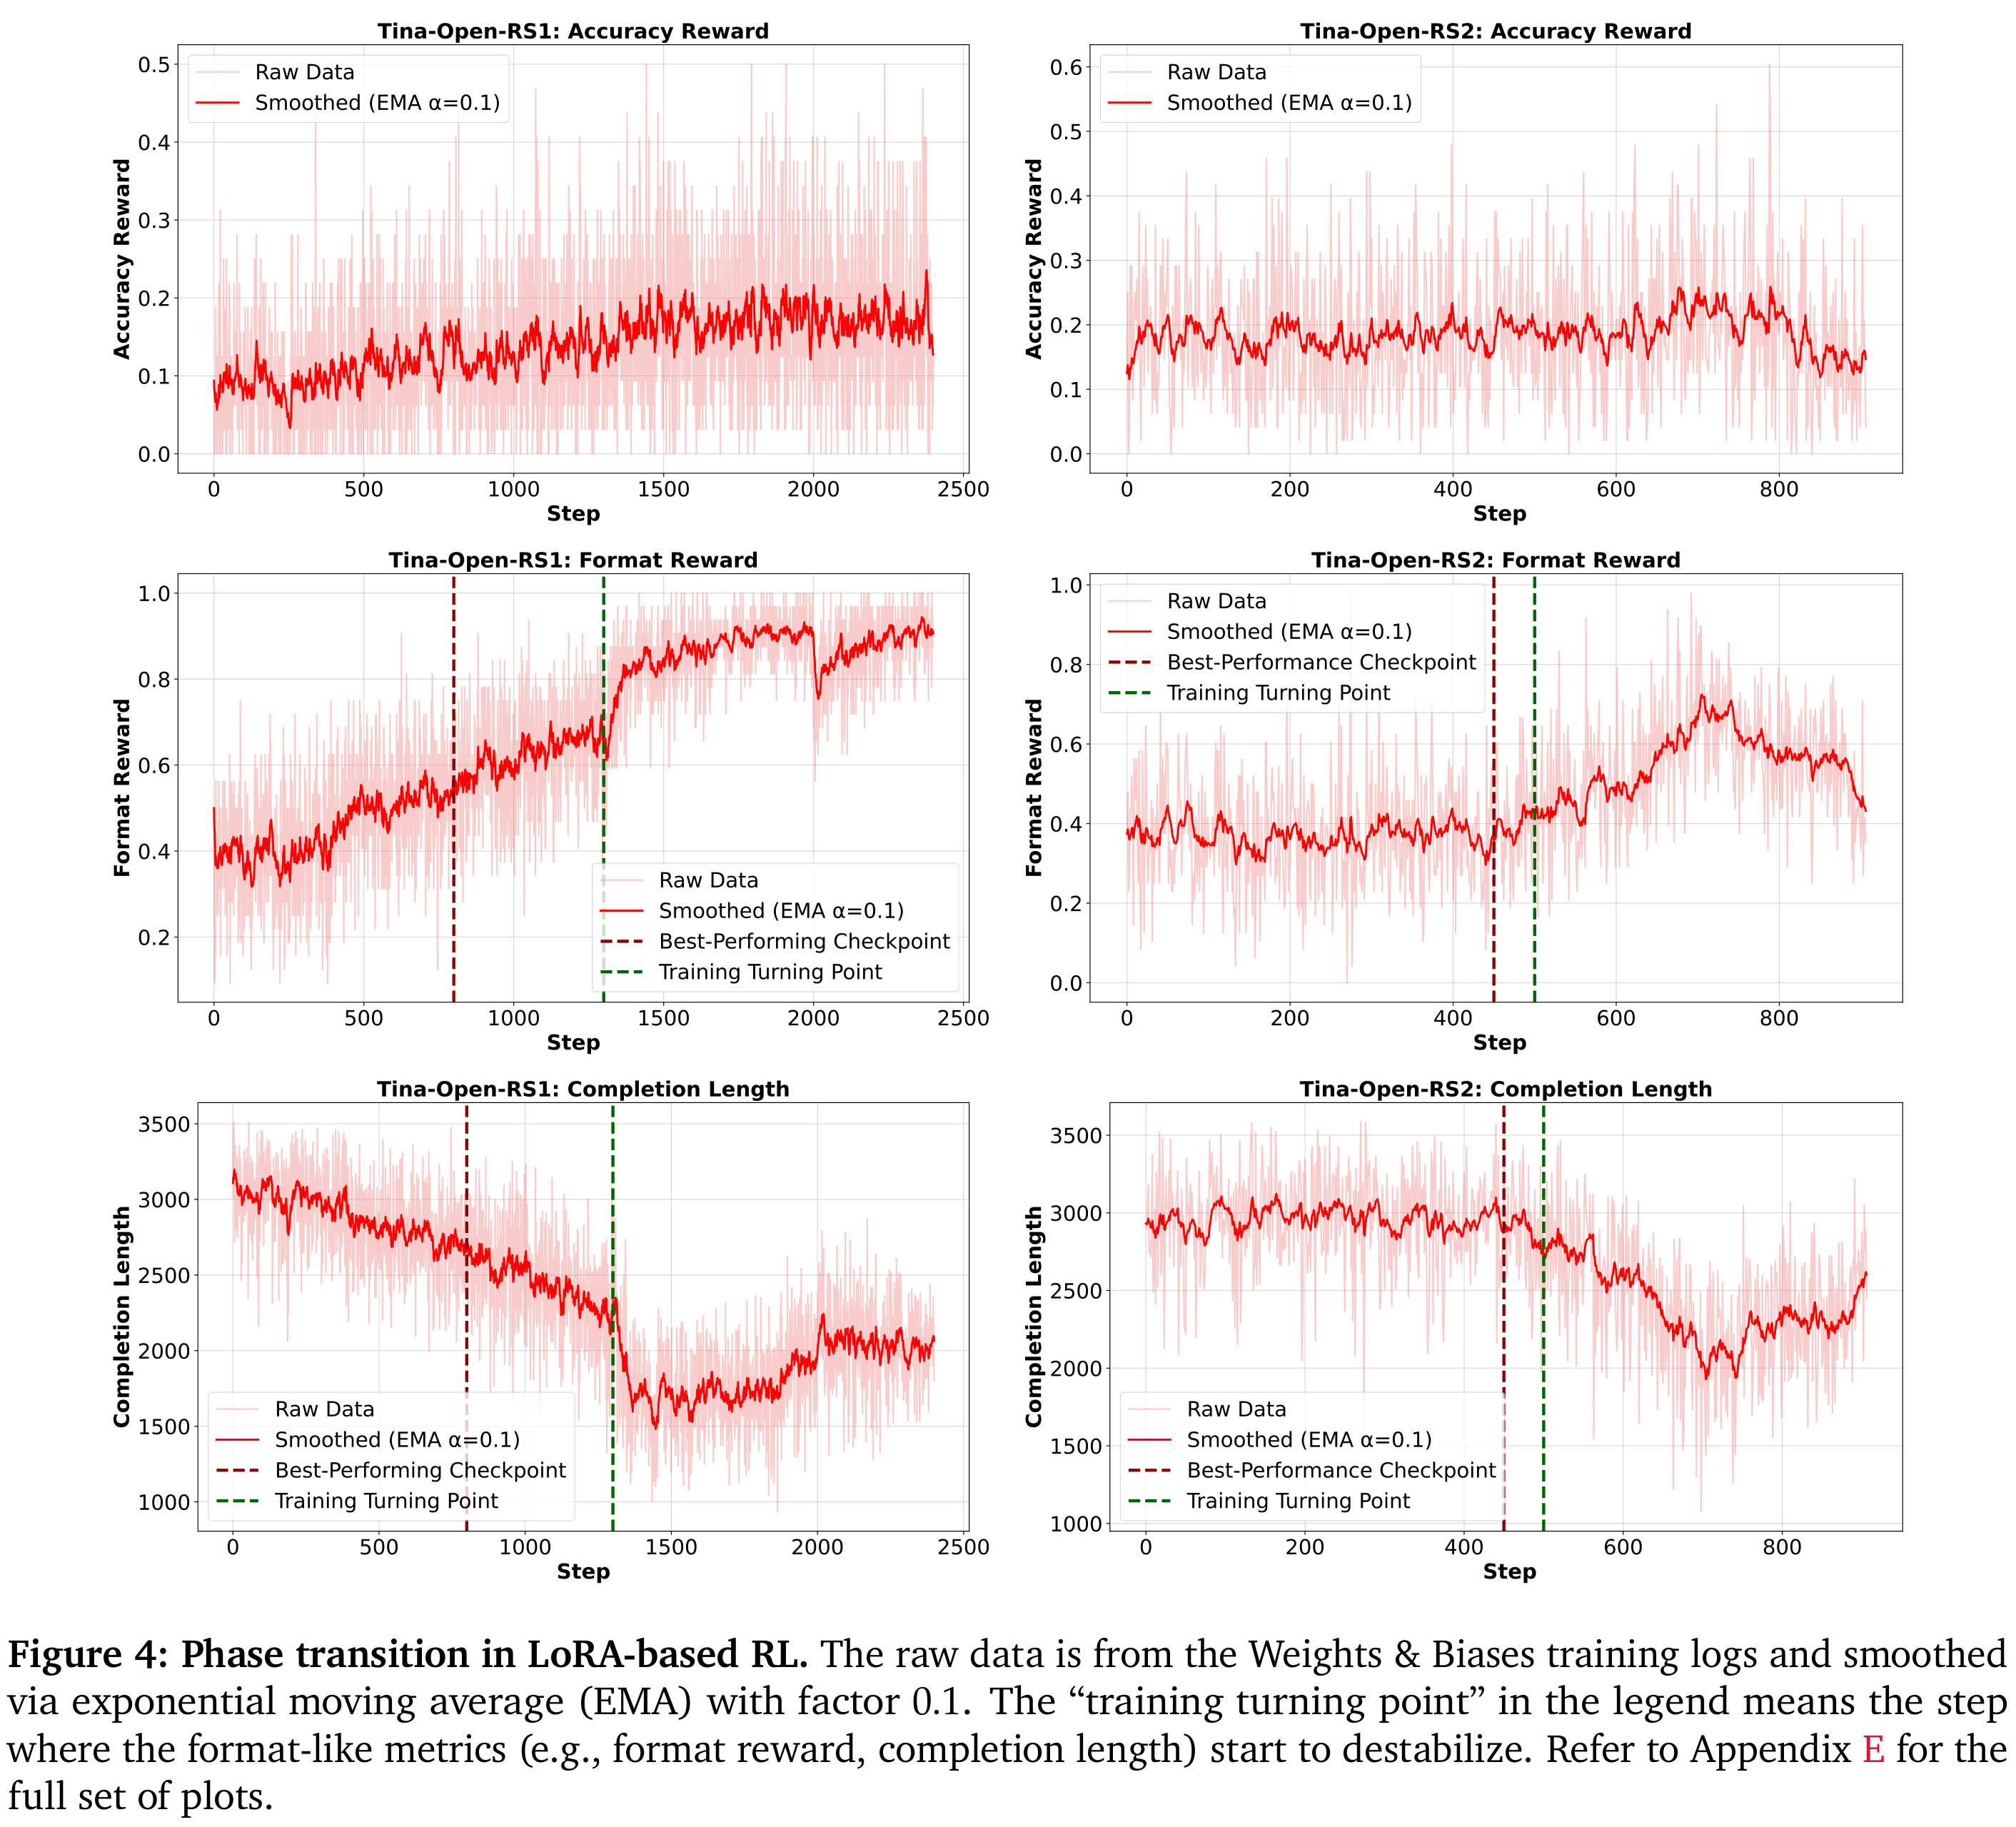
빠른 형식 적응 가설은 작은 업데이트가 기존 지식을 보상받는 추론 형식으로 표현하는 방식을 개선한다고 설명한다. 근거는 대략적인 학습 연산 비교와 형식 보상 및 생성 응답 길이의 변화를 담은 로그다. 정답 여부를 평가하는 보상에서는 변화가 덜 뚜렷했다.
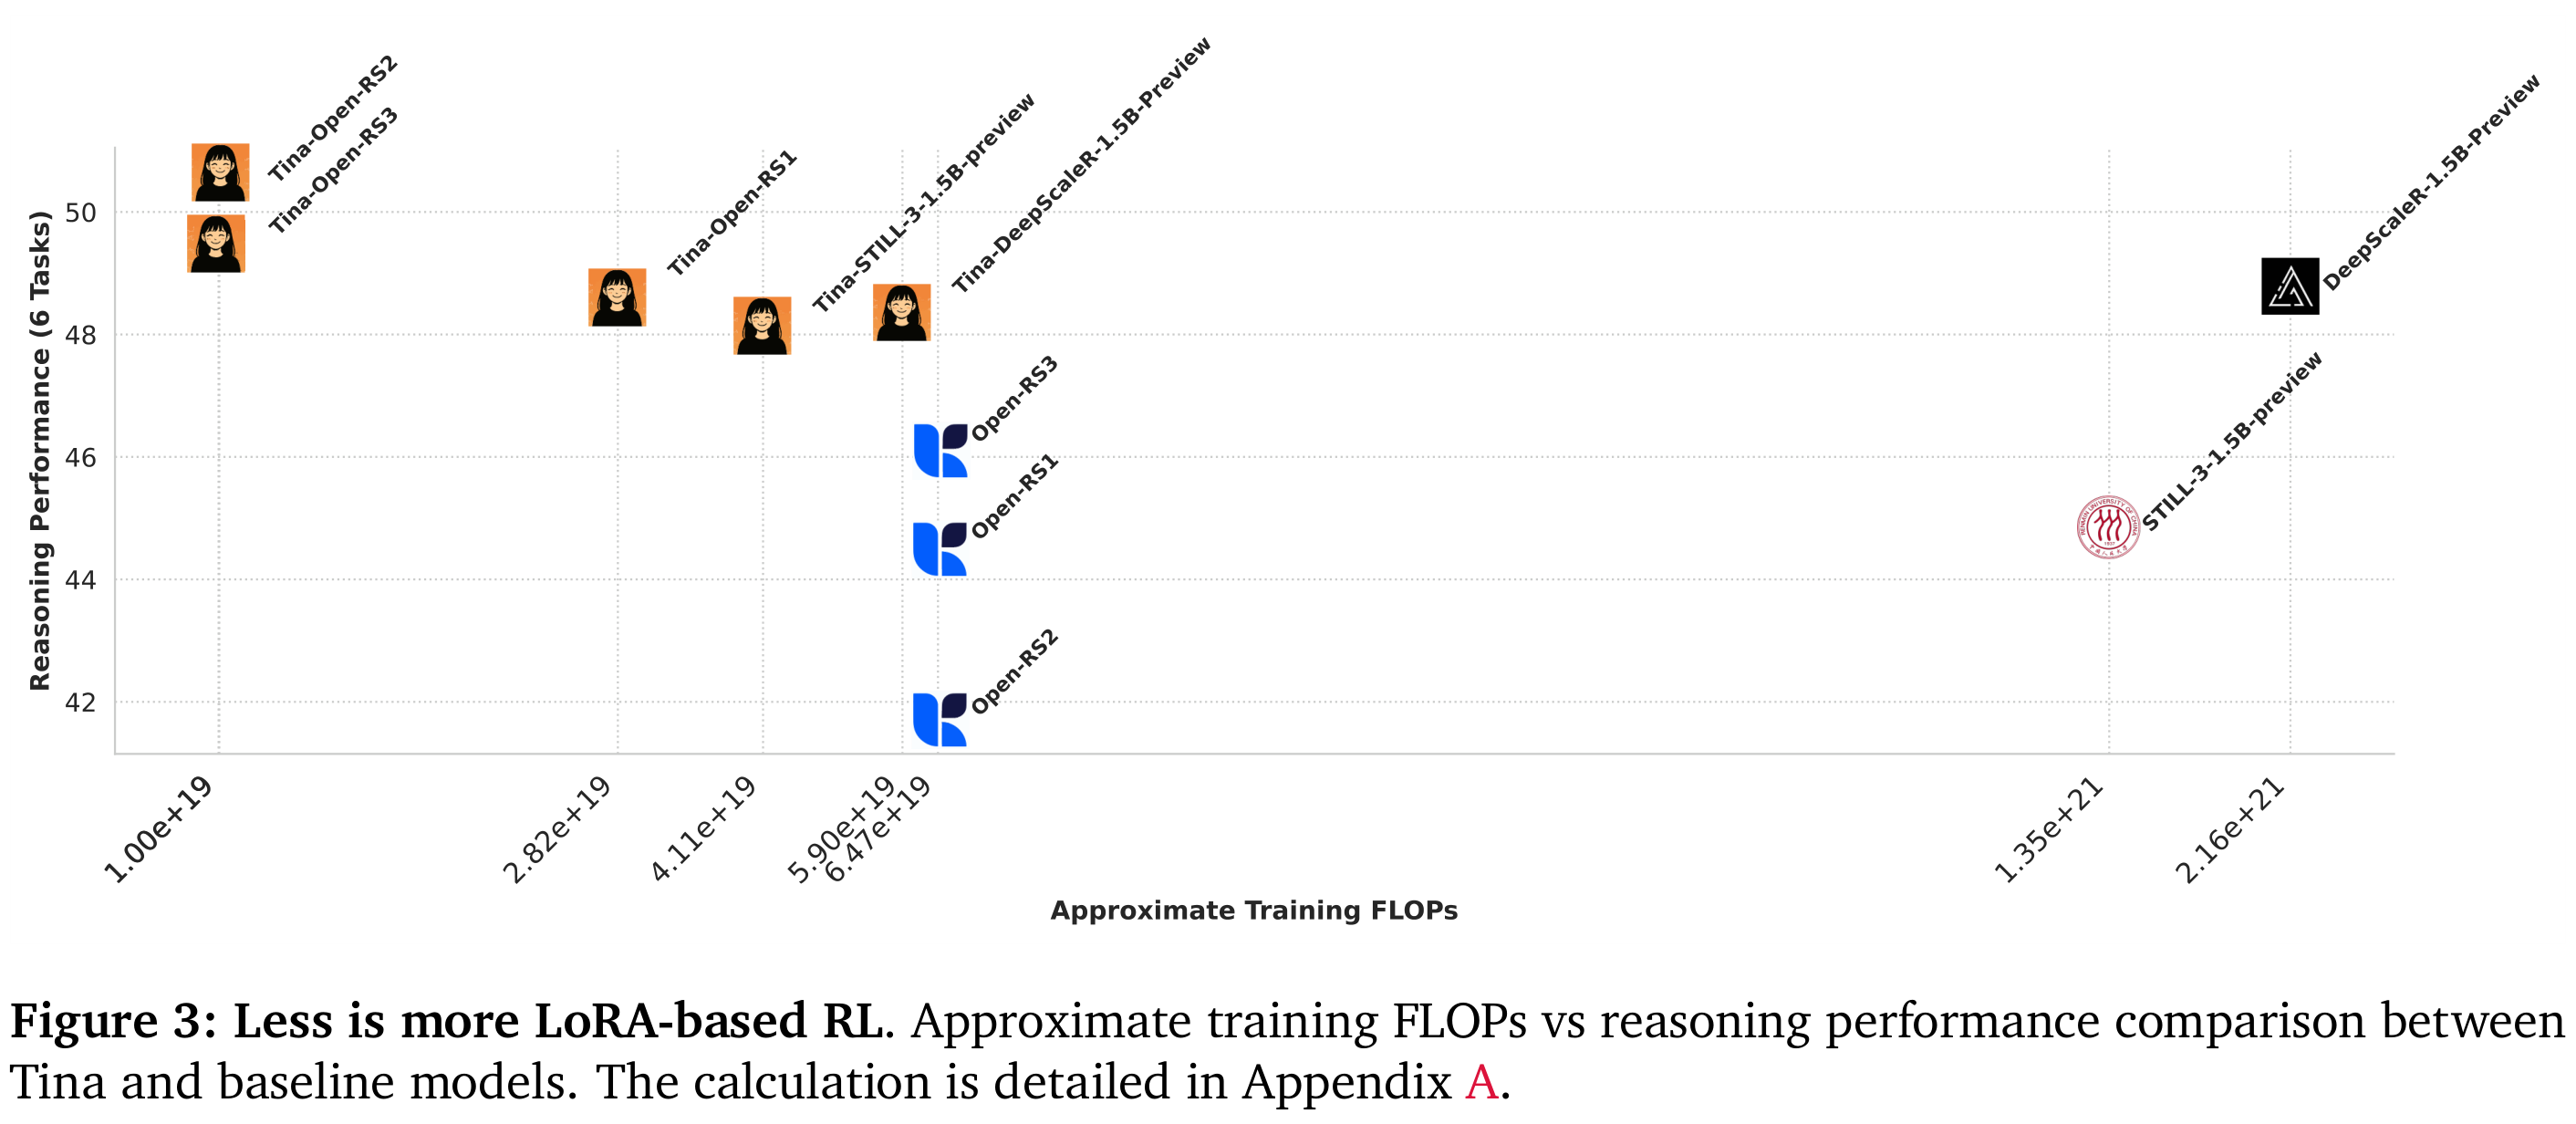
- 그림 3은 추론 점수와 추정 학습 부동소수점 연산량을 비교한다. 연산량은 보고된 하드웨어와 학습 시간을 사용해 추정했으며 연산량만 바꾼 통제 실험은 아니다.
- 그림 4에서 Tina-Open-RS1과 Tina-Open-RS2의 최고 체크포인트는 형식 관련 지표의 뚜렷한 변화보다 앞선다. 곡선에는 관찰값을 시간에 따라 평활화하는 지수이동평균 계수 0.1을 적용했다.
- 이 관찰은 지식 보존을 직접 측정하지 않으며 형식 학습이 벤치마크 향상을 유발했다고 입증하지도 않는다. 부록 E에서는 OpenR1과 OpenThoughts가 변화 지점 뒤에 최고 성능에 도달하고 LIMR 변형에는 비슷하게 뚜렷한 전환이 없는 사례를 보고한다.
여러 Tina 설정은 전체 파라미터 기준 모델보다 추정 학습 연산량이 적고 평균 점수는 높다. 데이터셋, 보상과 학습 조건이 다르므로 이 점들의 배치만으로 연산량 감소 자체가 추론을 개선한다고 볼 수 없다.
표시된 Tina-Open-RS1과 Tina-Open-RS2의 최고 체크포인트는 형식 보상과 응답 길이의 표시된 변화보다 앞서며 정답 보상의 변화는 덜 뚜렷하다. 이 상관관계는 형식 적응 가설의 근거가 되지만 지식 보존을 직접 측정하지는 않는다.
6. Conclusion
결론은 추가 연산 비용을 낮게 유지하면서 LoRA 기반 RL로 추론 성능을 개선한 결과를 강조한다. 저자들이 명시한 한계는 1.5B 규모의 기반 모델 하나만 사용한 점, 평가가 수학과 과학 추론에 집중된 점, 하이퍼파라미터 최적화를 의도적으로 제한한 점이다.
- 코딩과 다른 분야로의 전이는 시험하지 않았다.
- 보고된 실험은 동일한 1.5B 시작 체크포인트를 사용하는 모델을 직접 비교한다. 더 큰 추론 모델과 전반적으로 동등하다는 뜻은 아니다.
부록
- A. Cost Breakdown은 그림 1과 3의 자원 비교가 전체 에폭 또는 사전에 정한 실행을 대상으로 하며 평가 비용은 제외한다고 설명한다. 초록의 $9은 선택된 최고 체크포인트까지의 학습과 해당 평가를 합한 값이다. 부록 A는 대응하는 전체 학습을 $14, 평가 포함 시 약 $31로 제시한다. 기준 모델의 자원 추정치는 선행 기술 보고서에서 가져왔으므로 초록의 추정 260배 절감에는 서로 다른 비용 범위가 결합되어 있다. 표 1의 주요 Tina-Open-RS2 과제 행에는 학습 $15, 총 $32로 적혀 있어 요약 행의 $14, $31과도 다르다.
- B. Background behind Tina Training은 B.1. GRPO Formulation과 B.2. LoRA Formulation을 다룬다. GRPO는 샘플 그룹 내 보상을 정규화하고 응답 확률 비율의 변화를 제한하며 기준 모델의 출력 분포에서 멀어지는 것을 억제하는 Kullback–Leibler 발산 페널티를 적용한다. LoRA는 순전파 계산을 \(\hat{h}(x)=W_0x+ABx\)로 바꾼다. W₀는 고정된 가중치이고 A와 B는 학습 가능한 행렬이며 공통 차원 r은 원래 행렬의 차원보다 훨씬 작다.
- C. Additional Experimental Details의 C.1. Hyperparameters는 기본 LoRA 랭크 32, 업데이트 배율 alpha 128, dropout 0.05, 대상 모듈 query, key, value, dense를 제시한다. 학습에는 모멘텀 계수 0.9와 0.999인 AdamW 최적화기, 학습률 1e-6, 최솟값이 있는 코사인 학습률 일정, warmup 비율 0.1, 혼합 bfloat16 정밀도, 4단계 기울기 누적, 전체 배치 크기 32, 1 에폭을 사용한다. 최대 프롬프트와 응답 길이는 512와 3584이고 질문당 응답 4개를 생성한다. vLLM GPU 메모리 사용률은 0.4, 최대 모델 길이는 4608이다. 표 6은 보상 및 절제 실험의 변경을 기록한다. C.2. Evaluation Command는 dtype=bfloat16, data_parallel_size=2, max_model_length=32768, gpu_memory_utilization=0.5, generation_parameters={max_new_tokens:32768,temperature:0.6,top_p:0.95}를 명시한다. 평가에는 lighteval vllm, 모델 입력 형식을 지정하는 chat template, OpenR1 사용자 정의 과제 스크립트 https://github.com/huggingface/open-r1/blob/4f5b21e21dec473af9729bce8e084deb16223ae4/src/open_r1/evaluate.py를 사용한다.
- D. Full Tina Model Performance Evaluation은 표 7–21에 체크포인트별 결과를 열거하며 큰 변동을 보여 준다. Tina-Open-RS2 평균은 450단계에서 50.60%, 500단계에서 43.05%다. 일부 항목은 본문의 요약과 충돌한다. 표 16은 5e-6 표시에도 표 12의 기본 LIMR 결과를 반복하며 해당 학습률에 대한 표 4의 최고 점수 47.87%와 다르다. 표 18 캡션은 alpha 512라고 하지만 표 6은 랭크 64에서 256을 제시한다.
- E. Full Tina Model Training Phase Transition은 그림 5–12에서 학습 로그 분석을 확장한다. OpenR1과 OpenThoughts의 최고 평가 체크포인트는 표시된 전환점 이후에 나타나며 LIMR 변형에는 비슷하게 명확한 전환이 없다. 저자들은 LIMR의 짧은 실행이 후자의 이유일 수 있다고 제안한다. 이러한 예외는 전환점을 학습 중단의 일반 규칙으로 삼는 근거를 제한한다.
짧은 생각
Tina는 공통 평가 방식에서 다섯 쌍 중 네 쌍의 기준 모델 평균을 LoRA 기반 RL로 개선하면서 추가 학습 비용을 낮게 유지했다. 설명은 아직 충분히 확립되지 않았다. 학습 로그의 상관관계는 형식 적응의 효과를 다른 요인과 분리하지 못하며 부록에는 예외도 있다. $9 추정치는 이미 알려진 최고 체크포인트를 재현하는 비용이다. 반복 평가로 그 체크포인트를 찾는 비용은 다르며 보고된 실행 단위 비용이 이를 더 폭넓게 반영한다. 논문은 이 비교에 대해 시드를 반복한 불확실성 추정치를 제시하지 않는다. 작은 벤치마크, 확률적 생성과 체크포인트 변동을 고려하면 작은 점수 차이를 확신하기 어렵다.