


Token Assorted: Mixing Latent and Text Tokens for Improved Language Model Reasoning 요약 설명
05 Feb 2025 | Paper Review Latent Reasoning Token Compression Supervised Fine-Tuning목차
이번 글에서는 Token Assorted: Mixing Latent and Text Tokens for Improved Language Model Reasoning 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 2월 5일(Arxiv), 42nd International Conference on Machine Learning, PMLR 267, 2025
- Su, DiJia, Zhu, Hanlin, Xu, Yingchen, Jiao, Jiantao, Tian, Yuandong, Zheng, Qinqing.
- Meta AI, UC Berkeley, UCL
- 논문 링크
요약
- Token Assorted는 문제 풀이의 중간 단계를 텍스트로 명시하는 긴 chain-of-thought(CoT) 추론 과정의 연산 비용을 다룬다. 수학 풀이를 생성해 모은 데이터셋인 MetaMathQA에서 전체 텍스트 CoT로 학습한 경우와 비교하면, 잠재 토큰과 텍스트 토큰을 섞어 학습했을 때 수학 벤치마크에서 평균 정확도가 높아진다. 각각 1, 3, 8B 규모의 모델에서 평균 정확도는 14.1에서 17.8로, 25.2에서 28.1로, 33.4에서 37.9로 상승한다. 논문은 생성 응답 길이가 평균 17% 줄었다고 보고한다.
- 이 방법은 압축한 텍스트 청크를 나타내는 어휘 항목인 이산 잠재 토큰을 학습한다. 이를 위해 텍스트를 유한한 학습 벡터 집합에 대응시키는 인코더와 디코더 구조인 vector-quantized variational autoencoder(VQ-VAE)를 사용한다. 각 학습 추론 과정에서 무작위 길이의 접두부를 잠재 토큰으로 바꾸고 나머지 텍스트는 유지한다. 추론 시에는 언어 모델이 토큰 유형 2개를 모두 직접 생성한다. vector-quantized variational autoencoder(VQ-VAE)에 대해서는 VQ-VAE 논문 설명(Neural Discrete Representation Learning) 글을 참조하라.
- 실험은 최대 8B 모델로 경로 계획, 합성 논리 추론, 수학 추론을 평가한다. 치환 방식을 통제해 비교한 실험은 텍스트를 남기고 압축할 접두부 길이를 달리하는 선택을 뒷받침한다. 다만 효율성 평가는 실행 시간이 아니라 응답 토큰 수를 측정한다. 토큰 표현을 결합할 때 모델이 부여하는 가중치인 attention의 분석과 잠재 토큰을 디코딩한 예시는 표현의 작동 방식을 이해하는 데 제한적인 근거를 제공한다.
1 Introduction
Introduction은 텍스트 추론에 과제와 관련된 정보뿐 아니라 언어적 일관성을 유지하는 단어도 포함된다는 관찰에서 압축의 필요성을 설명한다. 핵심 과제는 방대한 텍스트로 사전학습한 대규모 언어 모델(LLM)이 이전에 보지 못한 잠재 어휘 항목을 사용하도록 적응시키는 것이다. 이때 언어 모델 학습을 여러 단계로 나누는 일정은 사용하지 않는다.
2 Related Work
Related Work는 명시적 CoT 프롬프팅, 추론 과정 학습, 잠재 공간 추론을 구분한다. 대안으로는 생성 응답들의 투표로 답을 고르는 self-consistency, 은닉 표현을 모델에 다시 입력하는 연속 잠재 추론, 답변 전에 연산할 수 있도록 제공하는 학습 토큰인 pause token 등이 있다.
- 제안 방법은 학습한 이산 압축 표현과 남겨 둔 텍스트 추론 과정을 결합한다. 반면 여기서 논의하는 연속 잠재 추론 방법은 은닉 표현을 통해 연산을 이어 간다.
- 실험에서는 전체 CoT 학습과 정답만 사용하는 학습에 더해, 텍스트 추론을 점진적으로 제거하는 커리큘럼인 iCoT와 Pause Token을 비교한다.
3 Methodology
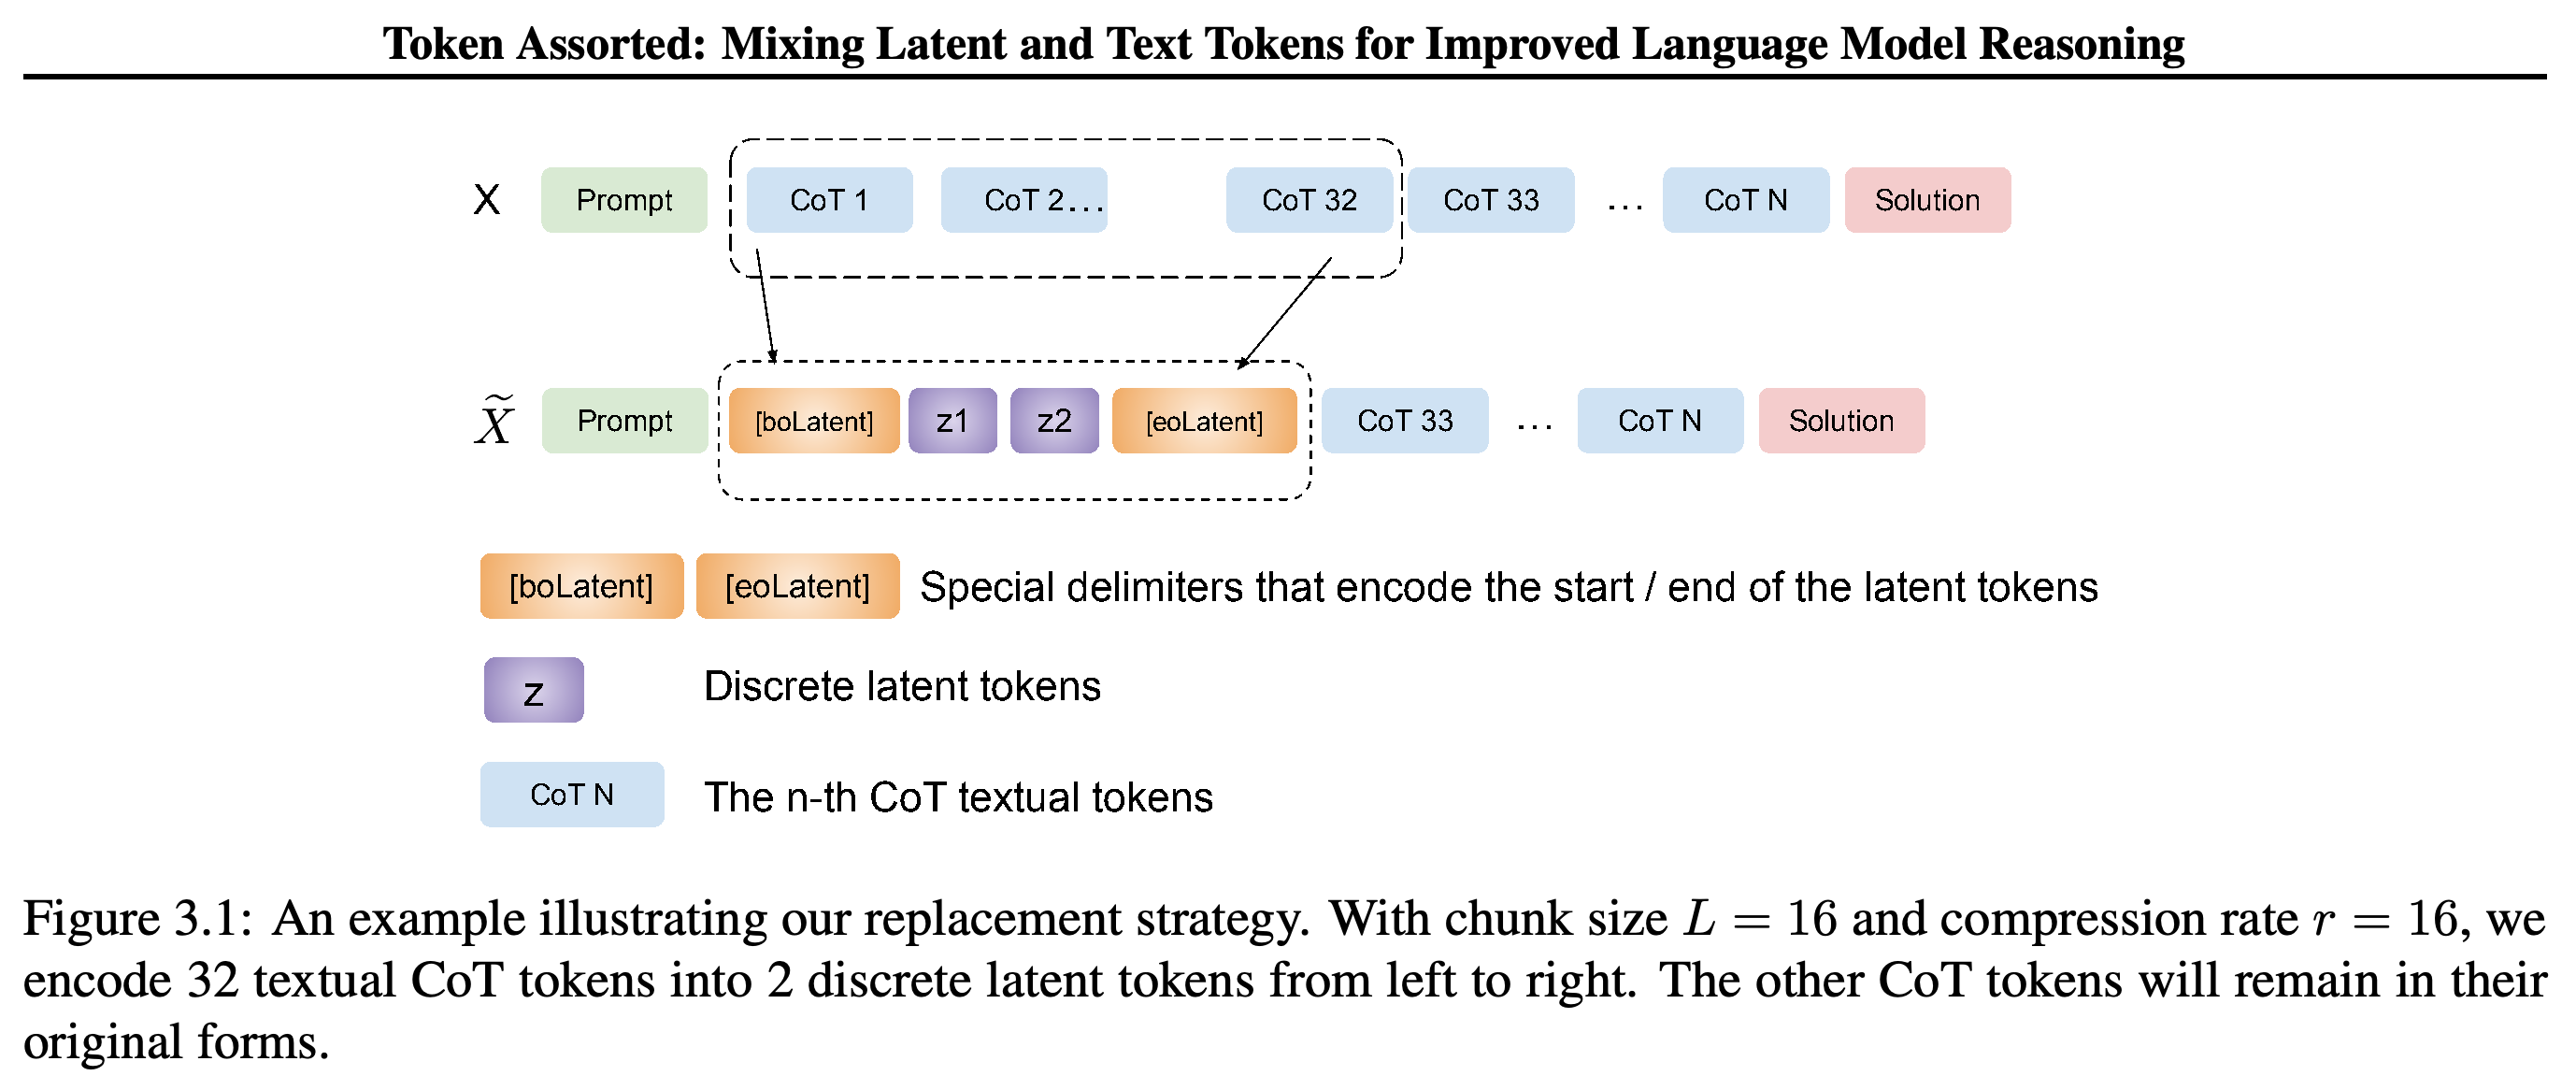
각 예시를 프롬프트 P, 추론 과정 C, 정답 S로 나누고 X = P ⊕ C ⊕ S로 표현한다. 여기서 ⊕는 이어 붙이기를 뜻한다. 압축한 추론 과정 Z를 학습한 뒤, 처음 m개의 텍스트 토큰을 m/r개의 잠재 토큰으로 치환해 X̃ = P ⊕ [z₁, …, zₘ/ᵣ, cₘ₊₁, …, cₜ꜀] ⊕ S를 만든다. r은 텍스트 추론 길이와 잠재 추론 길이의 비율이다.
원문은 이 그림을 Figure 3.1로 표기한다. 처음 32개의 추론 토큰을 잠재 식별자 2개로 압축하면서 프롬프트, 이후의 추론 텍스트, 정답을 유지해 연속된 접두부를 치환하는 설계를 보여 준다.
3.1 Learning Latent Abstractions
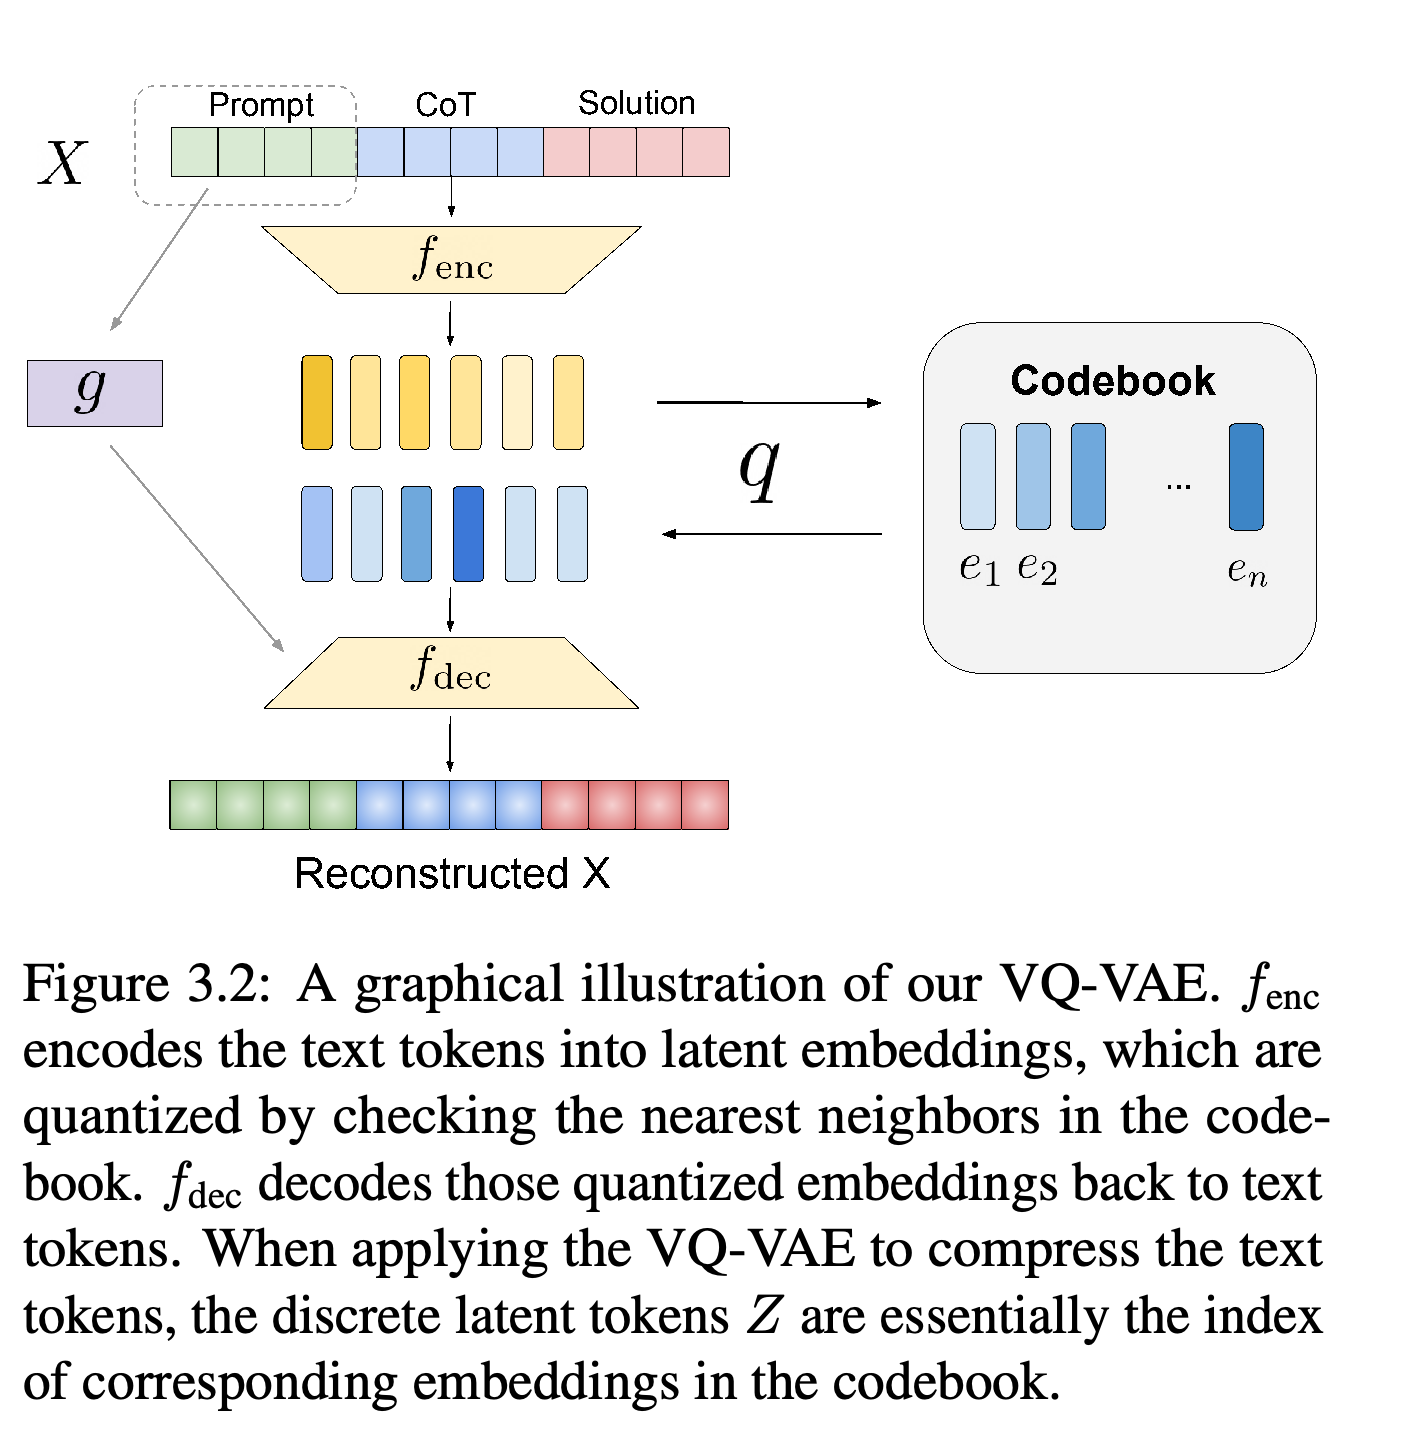
VQ-VAE는 전체 예시로 학습하지만, 이후에는 추론 과정만 압축한다. 인코더는 텍스트 토큰 L개로 이루어진 청크를 L/r개의 벡터로 변환한다. 양자화는 각 벡터를 학습한 유한 벡터 집합인 코드북에서 가장 가까운 벡터로 바꾼다. 프롬프트를 조건으로 받는 디코더는 텍스트를 복원하며, 잠재 토큰은 선택된 코드북 항목을 식별한다.
- 학습 목적함수는 복원 항, 벡터 양자화 항, commitment 항을 결합한다. 각 항은 텍스트 복원을 학습하고, 코드북 항목을 인코더 출력에 가깝게 이동시키며, 인코더 출력이 선택된 항목 근처에 머물도록 유도한다.
- 미분할 수 없는 양자화 연산을 넘어 디코더의 기울기를 전달하는 straight-through gradient로 인코더를 학습한다. 인코더와 디코더 모두 현재 위치와 이전 위치에만 attention을 적용하는 시퀀스 모델인 causal Transformer를 사용한다.
원문은 이 그림을 Figure 3.2로 표기한다. 코드북은 연속적인 인코더 출력을 이산 어휘 식별자에 연결한다. 복원 경로는 언어 모델 학습 전에 압축기를 학습하는 데 사용된다.
3.2 Reasoning with Discrete Latent Tokens
Reasoning with Discrete Latent Tokens에서는 일부를 압축한 예시로 다음 토큰 예측을 학습한다. 절차는 3가지 선택으로 구성된다. 텍스트 접미부를 남기고, 왼쪽부터 연속된 접두부를 치환하며, 예시마다 접두부 길이를 따로 무작위로 정한다.
- <boLatent>와 <eoLatent> 토큰은 잠재 구간의 경계를 표시하며, 언어 모델 어휘에는 학습한 잠재 식별자가 포함된다.
- 논문은 데이터 준비 단계에서 사용하는 50M-parameter VQ-VAE를 설명한다. 언어 모델 학습과 추론에서는 이 보조 모델을 실행하지 않는다. 추론 시에는 잠재 토큰을 직접 생성한 뒤 텍스트를 생성한다.
4 Experiments
실험은 합성 계획과 논리 추론을 평가한 뒤, 수학 추론 데이터로 Llama 언어 모델을 미세조정한다. Sol-Only는 질문과 최종 정답을 사용하고, CoT는 전체 추론 과정을 사용하며, iCoT는 추론 과정을 점진적으로 제거한다. Pause Token은 연산을 위한 학습 토큰을 추가한다.
4.1 Benchmarks
4.1.1 SYNTHETIC BENCHMARKS는 열쇠를 최대 1개만 소지한 채 색깔별로 잠긴 문을 통과하는 Keys-Finding Maze, 정확한 증명 경로가 1개인 논리 문제 9000개로 구성된 ProntoQA, 주의를 분산시키는 추론 경로가 포함된 논리 문제 17,886개로 구성된 ProsQA를 다룬다. ProsQA는 방향 간선이 있고 방향 순환은 없는 directed acyclic graph에서 문제를 생성한다. Maze 학습 데이터는 100k개이며, 휴리스틱 탐색 알고리즘인 nondeterministic A*로 생성한 중간 탐색 과정을 포함한다.
4.1.2 MATHEMATICAL REASONING은 수학 문제 풀이 벤치마크인 Math와 GSM8K에서 가져온 질문으로 학습한다. 학습 데이터로는 MetaMathQA 또는 또 다른 수학 풀이 생성 데이터셋인 Dart-MATH를 사용한다. MetaMathQA는 Math에서 가져온 155k개와 GSM8K에서 가져온 240k개를 합쳐 총 395k개의 예시를 포함한다. 저자들은 Llama-3.1-405B-Inst로 응답을 다시 생성한다.
- Math와 GSM8K는 학습 데이터의 기반이 되는 원본 데이터셋이므로 도메인 내 평가로 취급한다. Dart-MATH는 생성한 학습 응답을 선별하는 difficulty-aware rejection tuning으로 어려운 질문에 중점을 둔다.
- 다른 데이터셋을 사용하는 도메인 외 평가에는 교과서 9권에서 가져온 문제 2818개로 구성된 College-Math, 학교 수준 문제 1000개로 구성된 DeepMind-Math, 영어 텍스트 전용 경시 문제 675개로 구성된 OlympiaBench-Math, 정리 기반 문제 800개로 구성된 TheoremQA, 시험 문제 30개로 구성된 Fresh-Gaokao-Math-2023이 포함된다.
4.2 Main Results
기본 압축기는 파라미터 갱신 최적화 알고리즘인 Adam을 사용해 학습률 10⁻⁵, 배치 크기 32로 100k스텝 동안 학습한다. L = 16과 r = 16을 사용해 잠재 토큰당 텍스트 토큰 16개를 인코딩한다. 무작위 치환을 위해 논문은 M = {0, 72, 128, 160, 192, 224, 256}을 제시한다. 이 집합에서 치환 길이의 상한을 샘플링한 뒤, 명시된 수열 [0, 16, 32, …, m_max]에서 m을 균등하게 샘플링한다.
- 기재된 값 72는 M의 모든 원소가 16의 배수라는 설명과 충돌하므로, 이 샘플링 세부사항은 불명확하다.
- 본문은 코드북 크기를 1024로 명시하지만, Appendix A.1은 과제별로 논리 추론에 64, 미로에 512, 수학에 1024를 지정한다.
4.2.1 SYNTHETIC BENCHMARKS는 사전학습한 언어 모델 GPT-2를 ProntoQA와 ProsQA에서 16k스텝 동안 미세조정한다. 학습률은 10⁻⁴, 학습률을 점진적으로 높이는 warmup은 100스텝, 배치 크기는 128이며, 다음 토큰의 확률이 가장 높은 항목을 고르는 greedy decoding을 사용한다. 미로에서는 T5 인코더와 디코더 모델을 처음부터 학습률 7.5 × 10⁻⁴, 배치 크기 1024로 100k스텝 동안 학습한다. 1-Feasible-10 지표는 확률이 가장 높은 토큰 10개로 선택 범위를 제한하는 top-k decoding으로 응답 10개를 샘플링한 뒤, 그중 하나라도 유효한 경로로 목표에 도달하는지 측정한다.
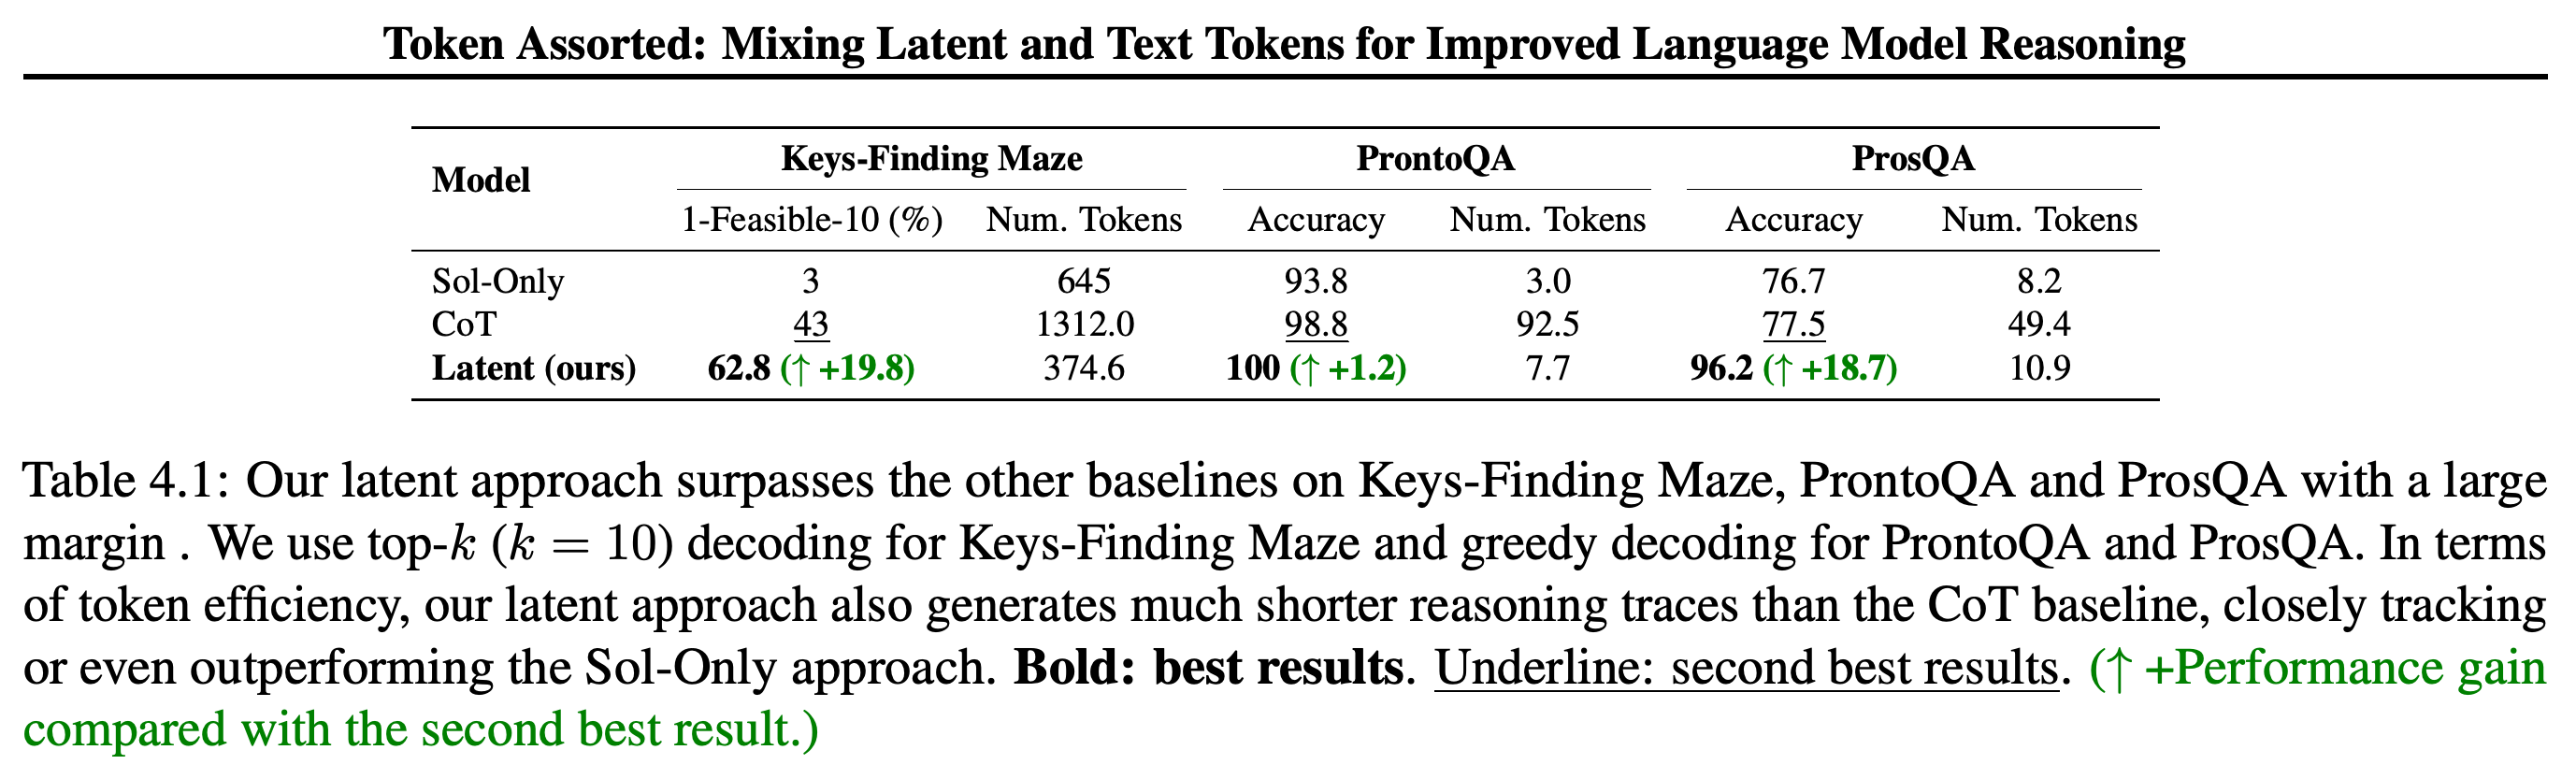
- Table 4.1에서 미로 성공률은 CoT의 43%에 비해 62.8%, ProntoQA 정확도는 98.8%에 비해 100%, ProsQA 정확도는 77.5%에 비해 96.2%다. 각각 19.8, 1.2, 18.7%포인트 상승한 결과다.
- 평균 생성 길이는 미로에서 1312.0에서 374.6토큰으로, ProntoQA에서 92.5에서 7.7토큰으로, ProsQA에서 49.4에서 10.9토큰으로 줄어든다.
원문은 이 표를 Table 4.1로 표기한다. 잠재 토큰 학습은 미로 성공률을 43%에서 62.8%로, ProsQA 정확도를 77.5%에서 96.2%로 높이면서 생성 길이를 줄인다. 미로 성공률은 샘플링한 응답 10개를 사용하며, 논리 정확도는 greedy decoding을 사용한다.
4.2.2 MATHEMATICAL REASONING은 MetaMathQA에서 Llama-3.2-1B, Llama-3.2-3B, Llama-3.1-8B를 배치 크기 32로 1 epoch 동안, 즉 학습 데이터를 1회 순회하며 미세조정한다. Sequence packing은 4096으로 설정해 예시들을 해당 길이의 시퀀스로 묶는다. 검증을 통해 8B의 학습률은 10⁻⁵, 1B와 3B의 학습률은 2.5 × 10⁻⁵로 선택하며, 평가에는 greedy decoding을 사용한다.
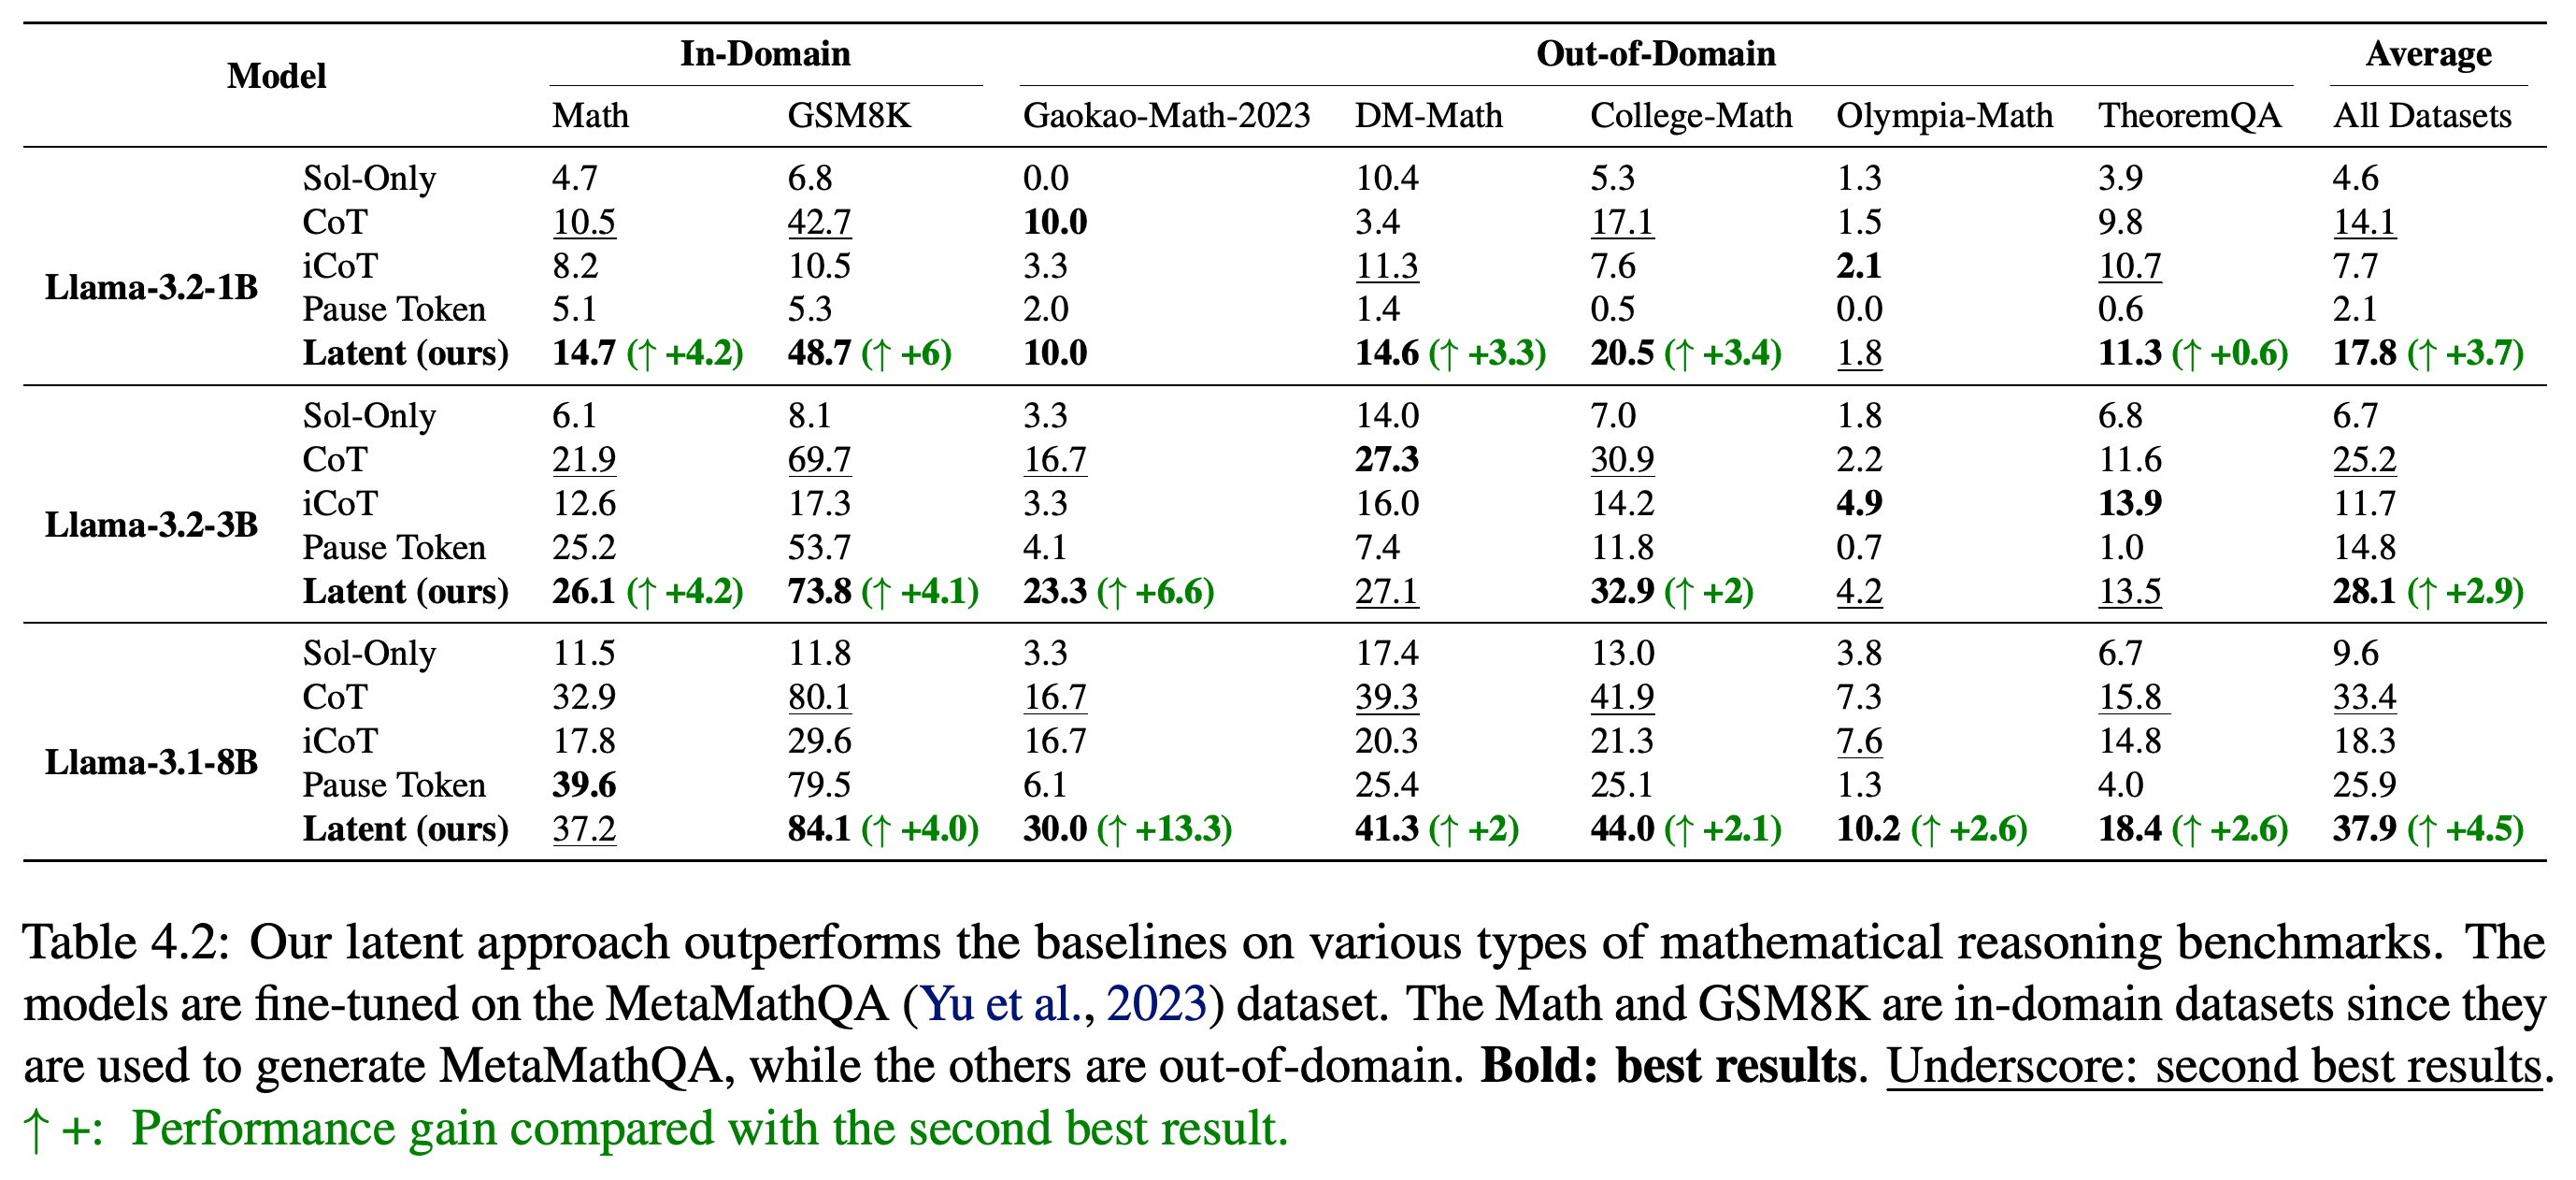
- Table 4.2에서 벤치마크 7개의 평균 정확도는 17.8, 28.1, 37.9이며, CoT의 평균은 14.1, 25.2, 33.4다. 각각 3.7, 2.9, 4.5%포인트 상승한다.
- 예를 들어 1B의 Math 정확도는 10.5에서 14.7로, 3B의 GSM8K 정확도는 69.7에서 73.8로, 8B의 Fresh-Gaokao-Math-2023 정확도는 16.7에서 30.0으로 높아진다. 모든 비교에서 가장 높은 성능을 보이지는 않는다. 8B Pause Token 모델은 Math에서 39.6을 기록해 잠재 모델의 37.2를 앞선다.
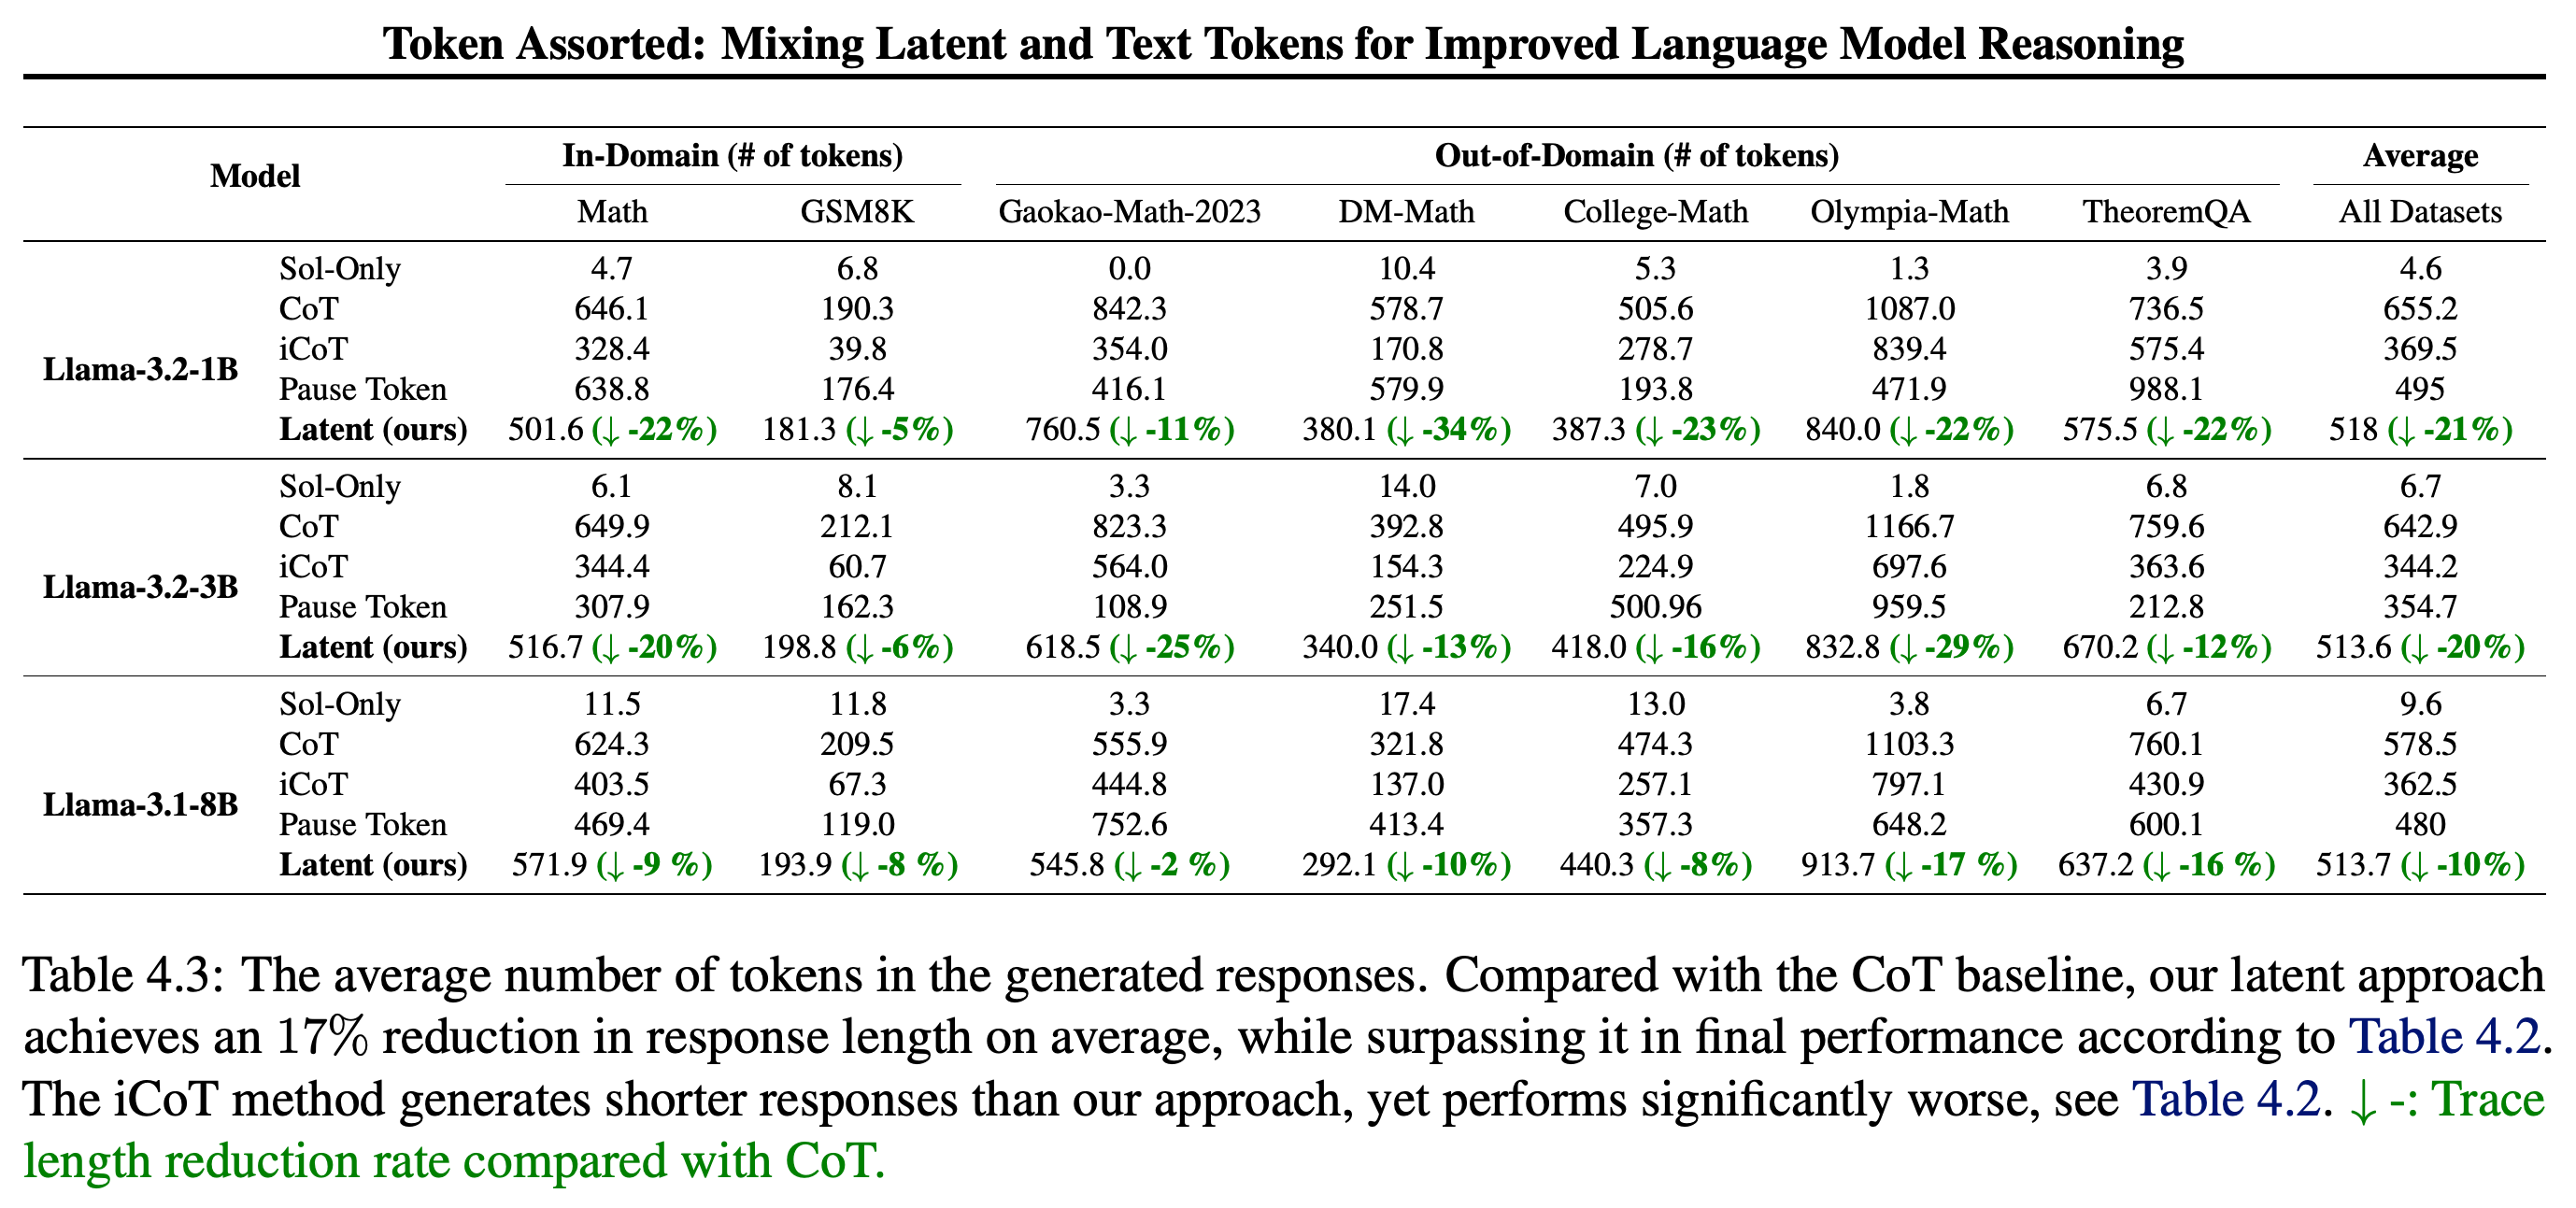
- Table 4.3의 평균 응답 길이는 518, 513.6, 513.7토큰이며, CoT는 655.2, 642.9, 578.5토큰이다. 논문은 이를 평균 17% 감소로 요약한다. iCoT는 더 짧은 응답을 생성하지만 평균 정확도가 상당히 낮다.
원문은 이 표를 Table 4.2로 표기한다. 잠재 모델 3개 모두 데이터셋 7개의 평균 정확도가 CoT보다 높다. 다만 개별 예외가 있으며, 8B의 Math에서는 Pause Token이 39.6, 잠재 모델이 37.2를 기록한다.
원문은 이 표를 Table 4.3으로 표기한다. 잠재 모델의 평균 응답 길이는 1B, 3B, 8B에서 각각 518, 513.6, 513.7토큰으로, 대응하는 CoT 모델보다 짧다. 이보다 더 짧은 iCoT 출력의 성능을 평가하는 데 필요한 정확도 비교는 Table 4.2에 제시되어 있다.
4.3 Ablation & Understanding Studies
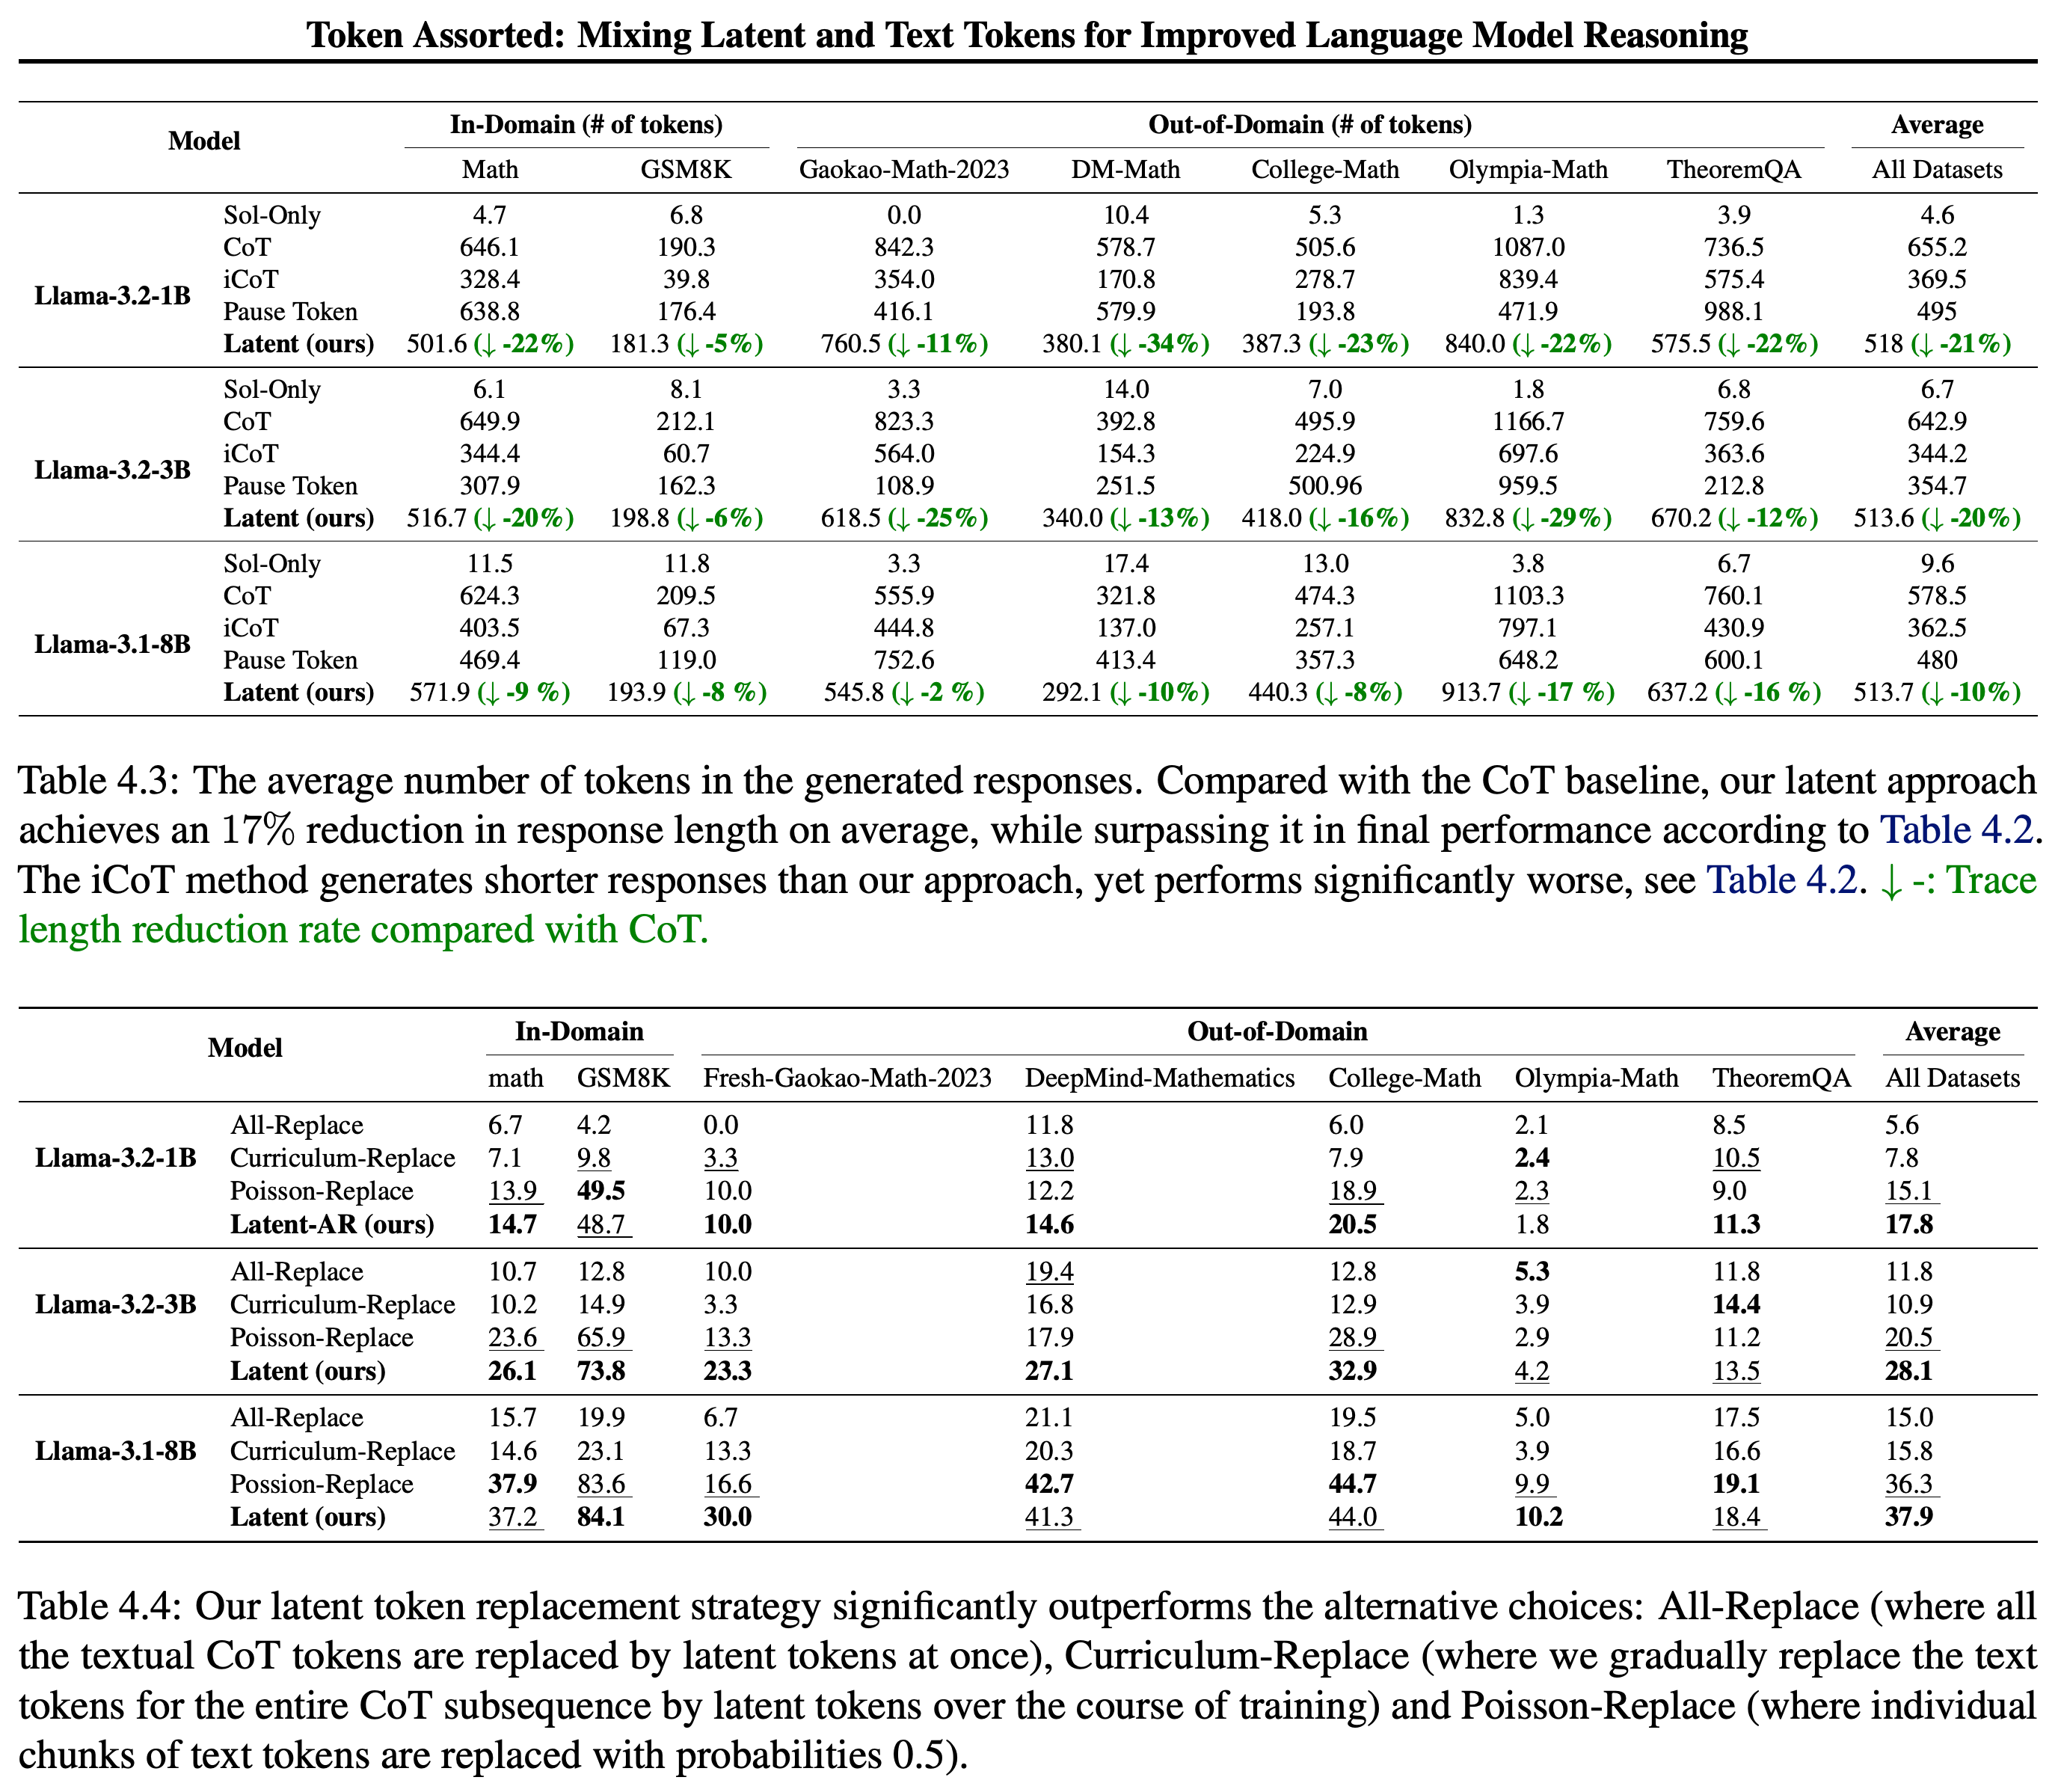
치환 방식 비교 실험은 제안한 무작위 접두부 치환인 AR-Replace를 전체 추론 과정을 치환하는 All-Replace, 8 epochs에 걸쳐 점진적으로 치환하는 Curriculum-Replace, 각 16-token 청크를 확률 0.5로 독립적으로 치환하는 Poisson-Replace와 비교한다. Table 4.4에서 AR-Replace는 시험한 모든 모델 크기에서 가장 높은 평균 정확도인 17.8, 28.1, 37.9를 기록한다. Poisson-Replace는 각각 15.1, 20.5, 36.3이다.
- All-Replace와 Curriculum-Replace는 평균 정확도가 상당히 낮다. 이는 해당 조건에서 혼합 추론 과정의 효과를 뒷받침한다. 남겨 둔 텍스트가 잠재 토큰을 사전학습한 언어 표현에 정렬하는 데 도움이 된다는 설명은 저자들의 해석이다.
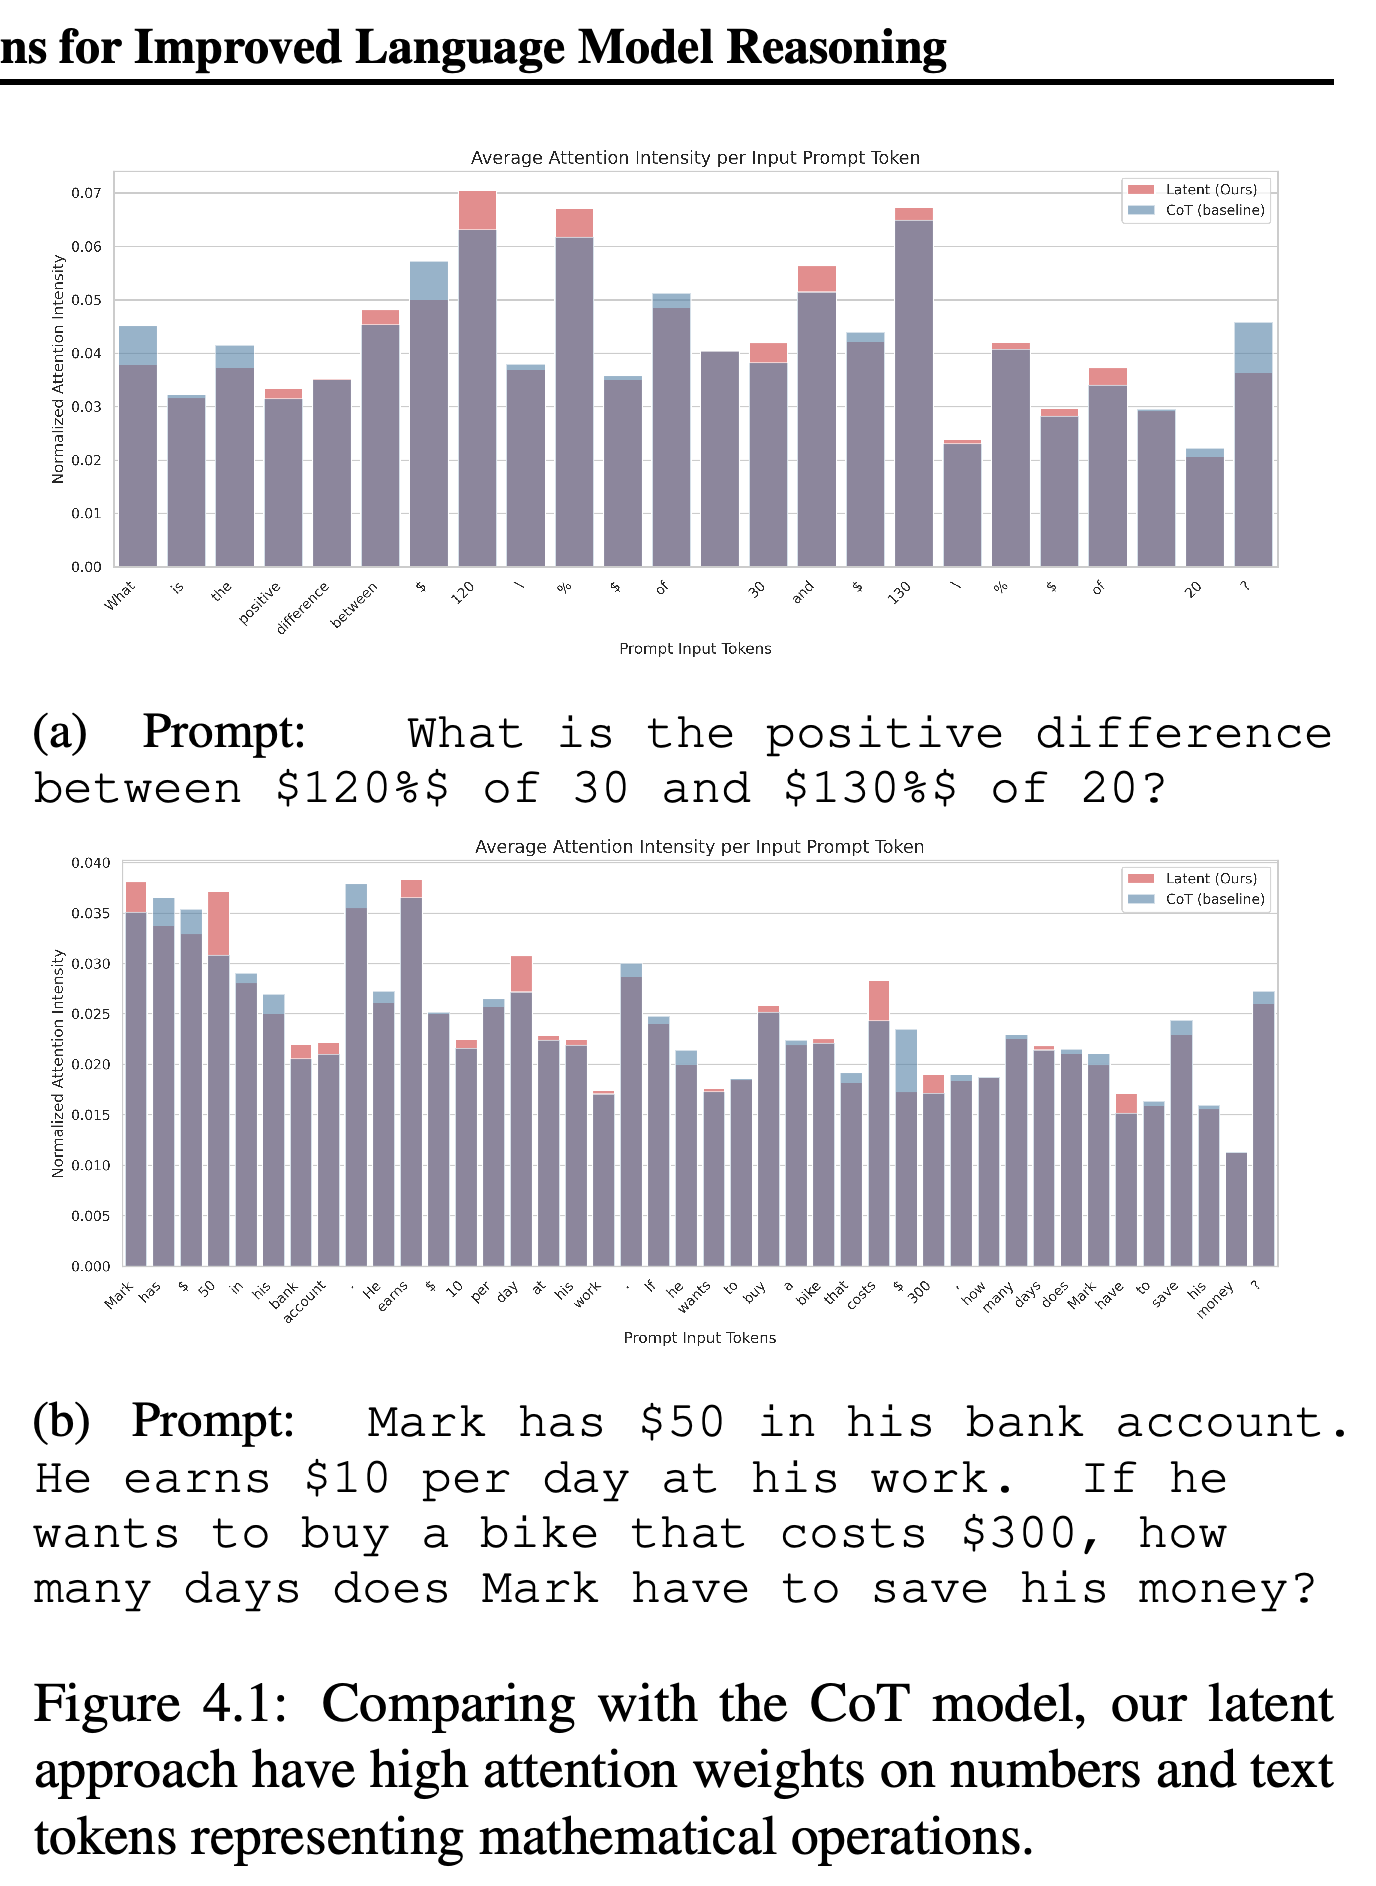
- Attention 분석은 질문 2개에 대해 마지막 attention layer를 살펴본다. 병렬로 attention을 계산하는 head들의 값을 평균한 뒤, 열별로 합산한 attention 가중치를 정규화한다. Figure 4.1은 특정 숫자와 연산 관련 단어에 더 높은 attention이 부여됨을 보여 주지만, 예시 2개만으로 인과적 작동 원리를 입증하지는 못한다.
원문은 이 표를 Table 4.4로 표기한다. 무작위 접두부 치환은 각 모델 크기에서 보고된 평균 정확도가 가장 높다. Poisson-Replace와의 차이는 3B에서 28.1 대 20.5로 가장 크다.
원문은 이 그림을 Figure 4.1로 표기한다. 예시 2개에서 잠재 토큰 학습은 프롬프트의 특정 숫자와 연산 관련 토큰에 더 높은 정규화 attention이 부여되는 현상과 연관된다. 이러한 관찰적 비교만으로 정확도 향상의 원인을 분리해 확인할 수는 없다.
4.4 Ablations on the Latent r parameters
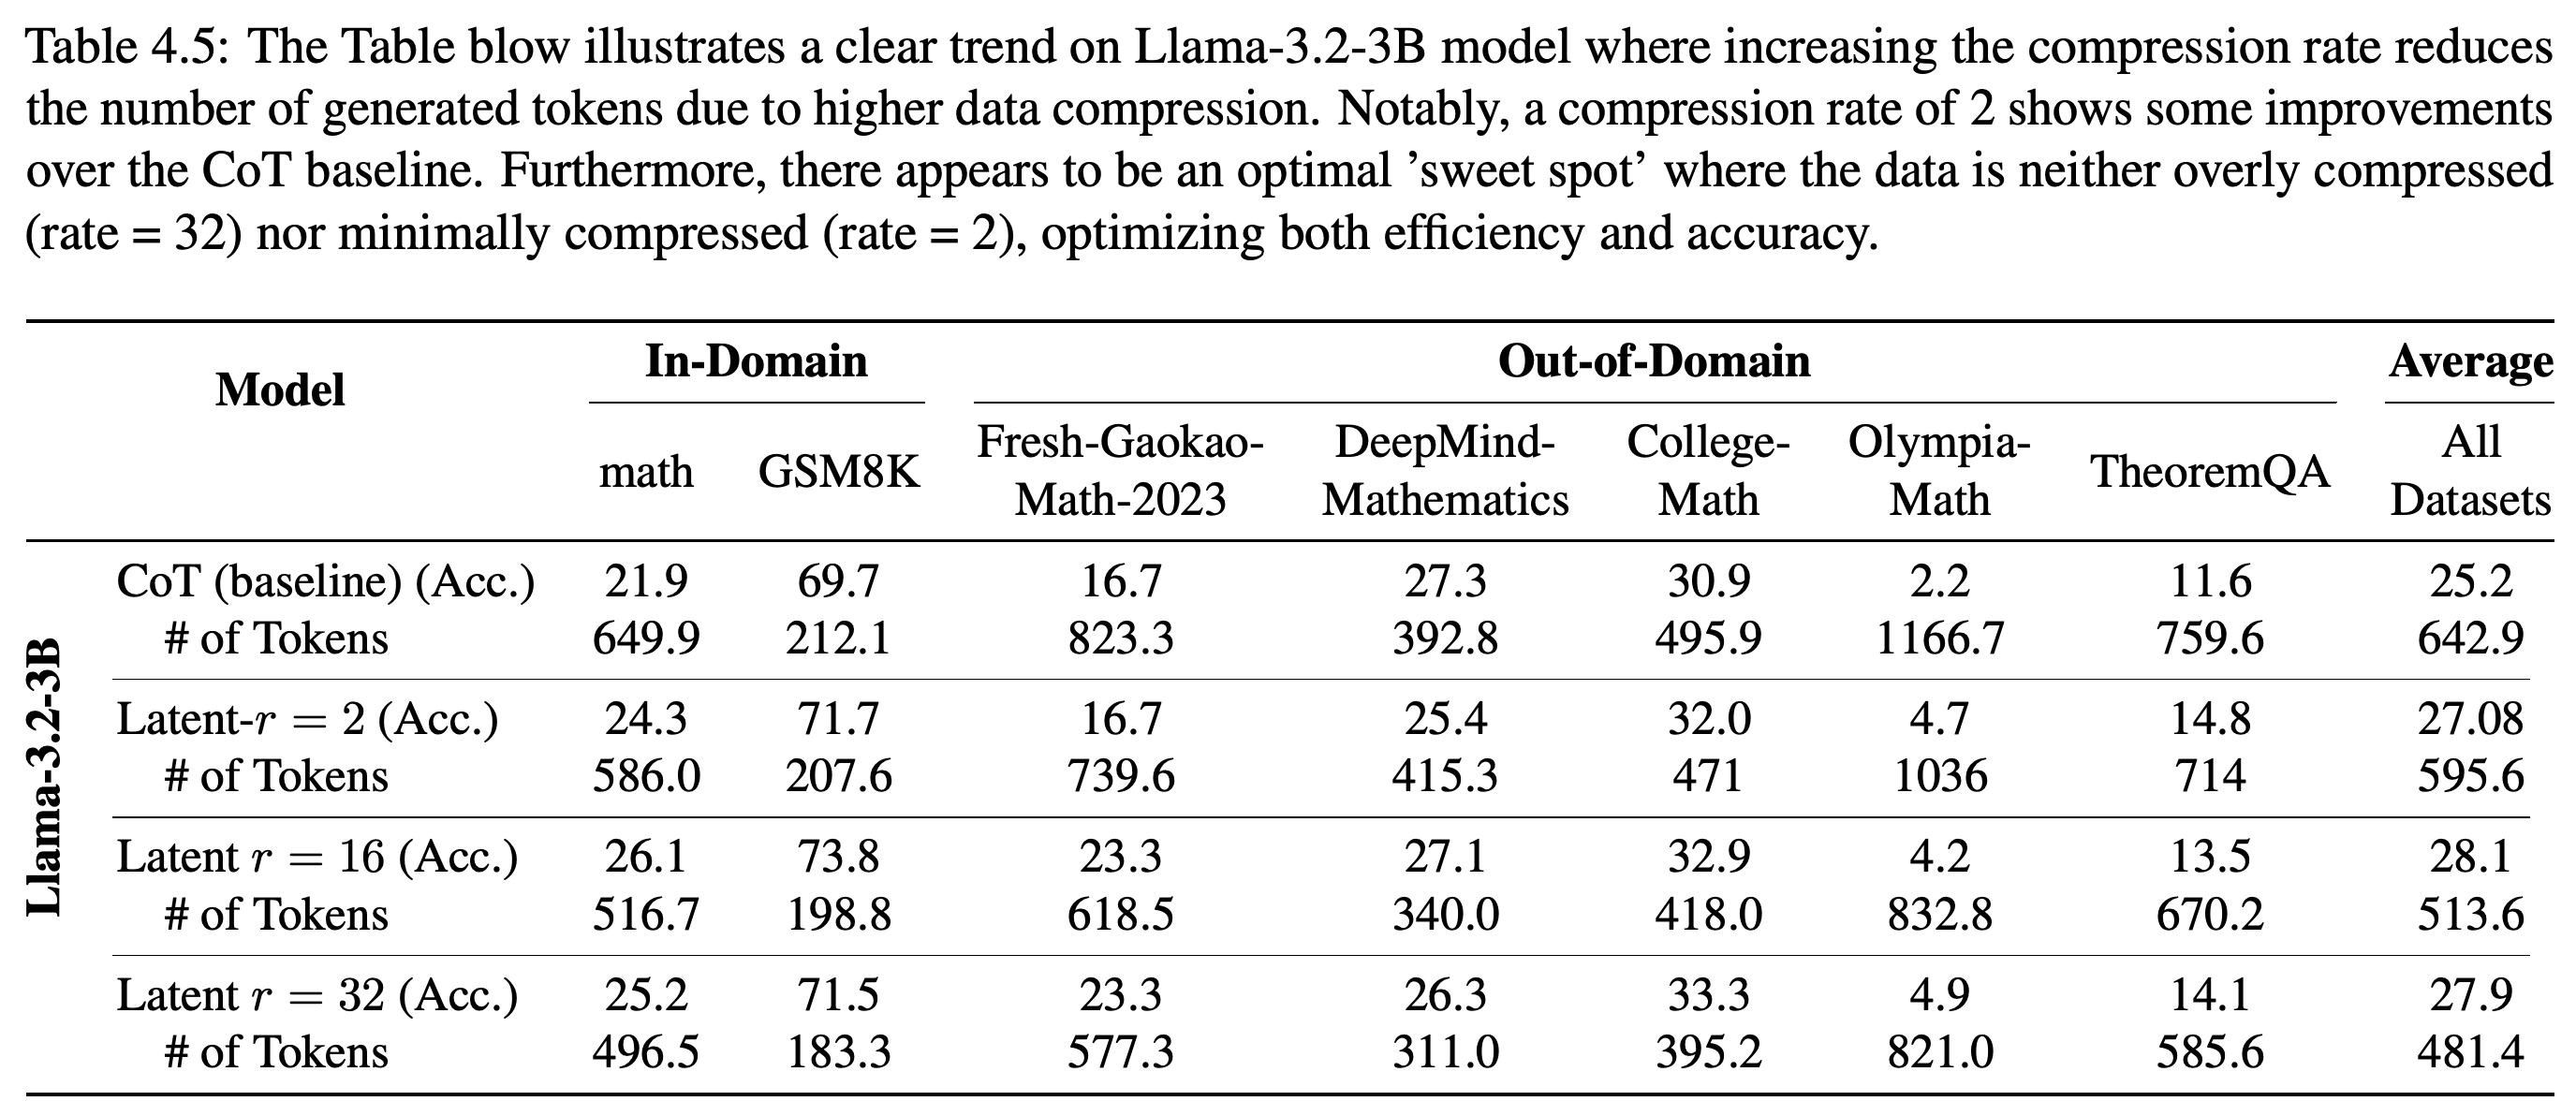
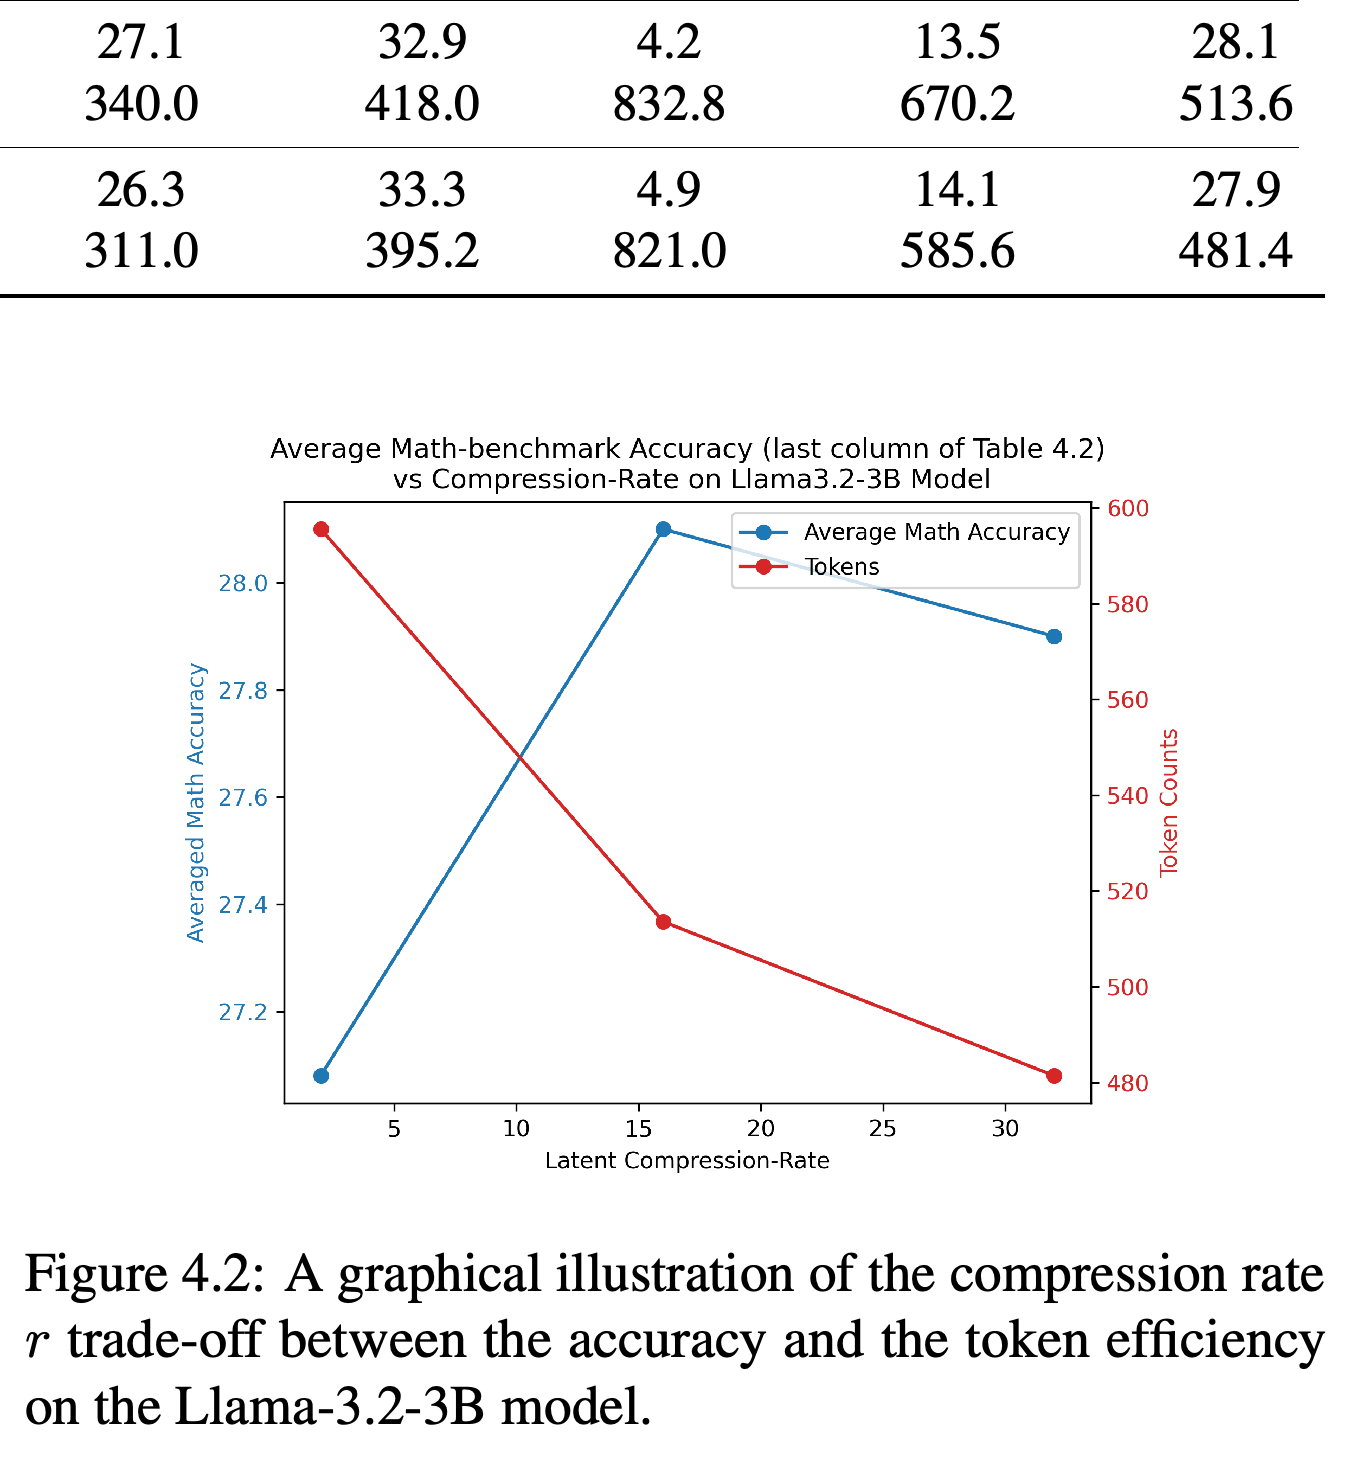
압축률 비교 실험은 Llama-3.2-3B에서 r = 2, 16, 32를 시험한다. Table 4.5의 평균 정확도는 27.08, 28.1, 27.9이며, 평균 응답 길이는 595.6, 513.6, 481.4토큰이다. CoT의 정확도는 25.2, 길이는 642.9토큰이다.
- 압축률이 높아지면 평균 응답 길이가 줄어들며, 이 3개 설정 중 r = 16에서 평균 정확도가 가장 높다.
- 측정한 정확도와 길이의 상충 관계는 이 모델과 학습 설정에 해당한다. 개별 데이터셋에서 일관되게 개선되지는 않는다. DeepMind-Mathematics 정확도는 시험한 모든 압축률에서 CoT 베이스라인보다 낮다.
원문은 이 표를 Table 4.5로 표기한다. r = 2에서 r = 32로 높이면 평균 생성 길이가 595.6토큰에서 481.4토큰으로 줄어든다. 중간 설정인 r = 16에서는 평균 정확도가 28.1로 가장 높다.
원문은 이 그림을 Figure 4.2로 표기한다. 압축률이 높아질수록 토큰 수는 줄어들지만, 정확도는 r = 16에서 가장 높고 r = 32에서 소폭 낮아진다. 시험한 설정 3개 사이의 상충 관계를 요약한다.
4.5 Additional Examples and Interpretability Result
Additional Examples and Interpretability Result는 Appendix D의 생성 응답 4개, Appendix E의 잠재 토큰 디코딩 예시, Appendix F의 Dart-MATH 실험을 안내한다. 보충 자료에서 학습 데이터를 바꿔 비교한 실험에서도 응답이 짧아지지만, CoT 대비 평균 정확도 향상 폭은 MetaMathQA 실험보다 훨씬 작다.
5 Conclusion
Conclusion은 관찰된 정확도 향상과 토큰 수 감소를 초기 추론의 압축, 이후의 상세한 텍스트 추론, 학습 중 무작위 압축을 결합한 결과로 설명한다. 실험은 시험한 계획, 논리, 수학 과제에서 이 조합을 뒷받침하지만, 개별 수학 벤치마크에는 예외가 있다.
Impact Statement
Impact Statement는 잠재 추론의 불투명성을 잠재적인 안전 문제로 지적하고, 잠재 토큰을 읽을 수 있는 텍스트로 디코딩하는 방안을 제안한다. 논문은 정성적인 디코딩 예시를 제공하지만, 안전성에 미치는 영향이나 디코딩한 텍스트가 모델의 연산을 충실하게 설명하는지는 평가하지 않는다.
부록
- A Experiment Details의 A.1 VQ-VAE Model Details는 인코더와 디코더에 2-layer Transformer를 사용하고, attention head 수는 4, 임베딩 크기는 512, 설정된 토큰 블록 길이인 블록 크기는 512로 지정한다. 코드북 크기는 ProntoQA와 ProsQA에서 64, Keys-Finding Maze에서 512, 수학에서 1024다. 최대 시퀀스 길이는 합성 실험에서 2048, 수학에서 256이다. A.2 Keys-Finding Maze는 A.2.1 ENVIRONMENT DETAILS, A.2.2 DATASET DETAILS, A.2.3 MODEL DETAILS를 다룬다. 그림에 제시된 환경은 5 × 5칸으로 된 방을 3 × 3으로 배치한 구조다. 데이터셋은 학습 예시 100k개, 검증 예시 500개, 시험 예시 300개로 구성된다. 구조화된 프롬프트는 벽, 에이전트, 목표, 열쇠, 문을 인코딩하며, 응답은 탐색 노드 기록과 이동 경로를 포함한다. 모델은 layer 6개, attention head 3개, 임베딩 크기 64를 사용한다. 토큰 위치를 인코딩하는 rotary position embedding을 적용하며, 학습 중 활성값을 무작위로 억제하는 dropout은 사용하지 않는다. A.3 ProntoQA and ProsQA는 사전학습한 GPT-2가 layer 12개, 은닉 크기 768, attention head 12개, 어휘 크기 50,257, 파라미터 규모 117 million으로 구성된다고 명시한다. A.4 LLM experiments는 Llama Cookbook 코드베이스를 소개하고 미세조정 설정을 다시 제시한다. 코드베이스 주소는 https://github.com/meta-llama/llama-cookbook 이다. 여기서 사용한 Llama-3.2-8B라는 이름은 본 실험의 Llama-3.1-8B 식별자와 다르다.
- B Notations는 프롬프트, 추론 과정, 정답, 압축, 코드북, 인코더, 양자화기, 디코더의 기호를 모아 정리한다.
- C Details of Attention Weights Analysis와 C.1 Generated Responses는 attention 분석 예시 2개를 제공한다. 백분율 차이 문제에서는 접근법 2개가 모두 정답을 내지만, 저축 문제에서는 잠재 방식이 25일, CoT가 35일로 답한다.
- D Other Text Generation Examples는 지수식 곱셈, 이항계수, 수직 점근선, 방향 순환에 대한 응답을 보여 준다. 이는 종합 평가가 아니라 설명을 위한 사례다.
- E Interpreability Examples는 비례 환산 문제와 최대공약수 문제의 잠재 접두부를 디코딩한다. 디코딩한 조각에는 “We find the greatest of CD of::63 common find,”처럼 문법 오류와 비정상적인 텍스트가 포함된다. 이후 응답은 315와 108의 최대공약수를 9로 정확히 계산한다. 이 예시들은 내용을 살펴볼 수 있는 텍스트 조각을 보여 주지만, 의미를 신뢰성 있게 복원한다는 점까지 입증하지는 못한다.
- F Additional Experiments는 DART-MATH에서 Llama-3.1-8B를 미세조정한다. Table F.1에서 잠재 방식의 평균 정확도는 40.8, CoT는 40.4이며, GSM8K, DeepMind-Mathematics, TheoremQA에서는 잠재 방식의 정확도가 더 낮다. Table F.2의 평균 응답 길이는 452.7토큰과 529.1토큰이다. 표는 감소율을 16%로 표시하지만, 제시된 평균값으로 계산하면 약 14.4%다.
짧은 생각
가장 강한 근거는 벤치마크 정확도와 생성 응답 길이가 함께 개선된 결과이며, 전체 압축의 성능이 낮았던 치환 방식 비교 실험이 이를 뒷받침한다. DART-MATH에서는 평균 정확도가 CoT보다 0.4%포인트만 높아, 정확도 향상 폭이 학습 데이터 조건에 따라 달라짐을 보여 준다.
응답 길이만으로는 지연 시간이나 압축기 학습과 데이터 준비를 포함한 전체 학습 비용을 직접 확인할 수 없다. 결과에는 불확실성 추정치도 보고되지 않는다. 또한 Fresh-Gaokao-Math-2023은 질문이 30개이므로, 눈에 띄는 성능 향상이 소수의 정답 여부에 민감하다.
재현하려면 원문의 불일치를 해소해야 한다. 치환 집합에는 명시된 16-token 정렬과 맞지 않는 72가 포함되어 있으며, 일부 본문 설명과 향상 폭 표기는 표의 값과 다르다. 예를 들어 Table 4.2에서 8B의 CoT 대비 평균 향상 폭은 4.5점이지만, 주변 본문은 5.3이라고 설명한다. 앞서 제시한 수치 비교는 표의 값을 따른다.