


Emergent temporal abstractions in autoregressive models enable hierarchical reinforcement learning 요약 설명
23 Dec 2025 | Paper Review Hierarchical Reinforcement Learning Self-Supervised Learning Activation Steering목차
이번 글에서는 Emergent temporal abstractions in autoregressive models enable hierarchical reinforcement learning 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 23일(Arxiv)
- Kobayashi, Seijin, Schimpf, Yanick, Schlegel, Maximilian, Steger, Angelika, Wolczyk, Maciej, von Oswald, Johannes, Scherrer, Nino, Maile, Kaitlin, Lajoie, Guillaume, Richards, Blake A., et al.
- Google, Paradigms of Intelligence Team, Google
- 논문 링크
요약
- 이 논문은 자기회귀 다음 행동 예측 모델이 여러 타임스텝에 걸쳐 실행되는 재사용 가능한 행동을 학습하고, 이를 활용해 희소 보상으로 학습할 수 있는지 살펴본다. 이산 gridworld 탐색과 연속 MuJoCo ant 제어에서 실험하며, 후속 학습 과제는 이전에 보지 못한 더 긴 하위 목표 조합을 요구한다.
- 이 방법은 자기회귀 행동 모델을 사전 학습한 뒤 고정하고, 미래 정보를 조건으로 사용하는 metacontroller를 학습해 residual stream에 선형 개입을 생성한다. 학습된 switching gate는 여러 타임스텝 동안 controller code를 유지하며, 변분 목적함수는 하위 목표 라벨 없이도 표준 정규 사전분포에서 의미 있는 코드를 샘플링하도록 유도한다.
- Internal RL은 미래 정보를 조건으로 사용하는 code encoder를 인과적 정책으로 대체하고, 학습된 전환 시점의 controller 선택을 강화한다. 실험한 희소 보상 과제를 학습하지만, raw-action RL, 실험 환경에 맞게 수정한 CompILE, 공동 학습, 강제 전환 변형은 이에 견줄 만한 성공률을 달성하지 못한다. 실험에는 작은 모델과 계층적 구조를 의도적으로 갖춘 환경을 사용한다.
Key results
논문은 5가지 결과를 제시한다. 다음 행동 예측을 통해 숨겨진 하위 목표의 표현이 형성되고, 내부 선형 controller가 해당 하위 목표로 행동을 유도한다. Controller를 순서대로 실행하면 길이 일반화와 조합 일반화가 가능하다. Metacontroller는 하위 목표 라벨 없이 controller와 종료 조건을 발견하며, internal RL은 종료 시점의 보상으로 이러한 추상 행동을 조합한다.
- 선형 probing은 하위 목표 정보에 접근할 수 있는지 측정하고, 개입 실험은 controller가 행동을 인과적으로 유도할 수 있는지 확인한다.
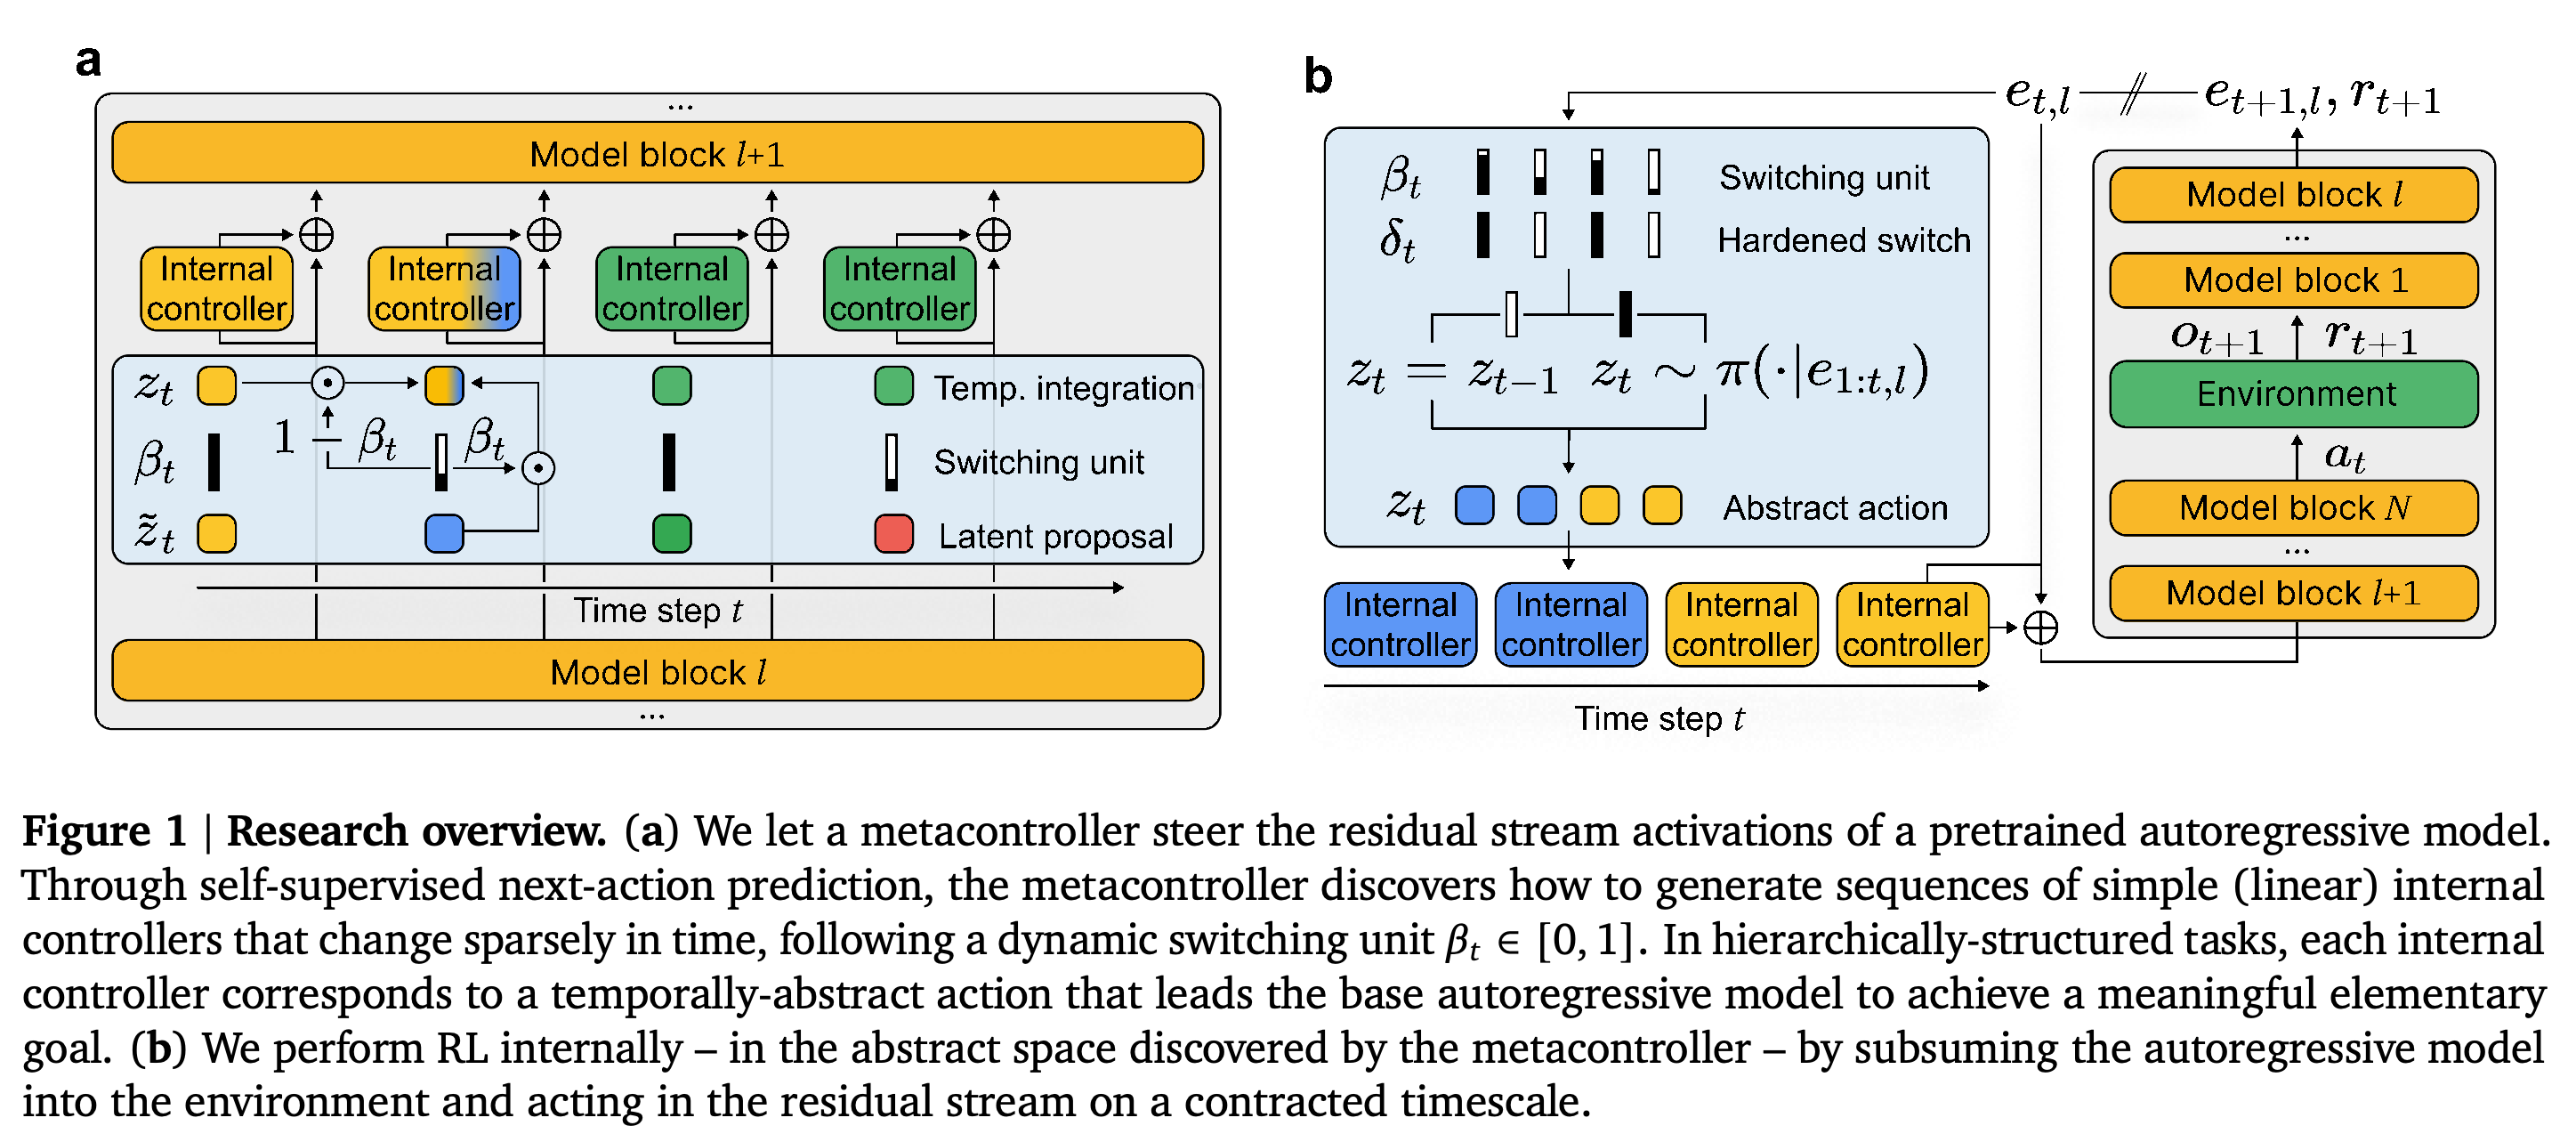
- 비지도 발견 과정은 고정된 사전 학습 모델의 residual stream을 읽고 수정하며, 학습 중에는 미래 정보를 사용한다.
- Internal RL은 residual activation을 관측으로, controller code를 행동으로 사용해 행동 차원과 정책의 의사결정 횟수를 줄인다.
이 도식은 지속되는 내부 controller를 오프라인으로 발견하는 과정과 그 코드를 대상으로 온라인 RL을 수행하는 과정을 구분한다. 고정된 예측 모델, controller decoder, 학습된 전환 메커니즘이 유효 환경의 일부가 되므로, 정책의 각 의사결정을 여러 원시 행동 단계에 걸쳐 실행할 수 있다.
Results
실험에서는 먼저 하위 목표 표현과 그 제어 가능성을 살펴보고, 하위 목표 라벨 없이 metacontroller를 학습한 뒤, 이전에 보지 못한 하위 목표 조합에서 희소 보상 RL을 평가한다.
Linearly controllable abstract action representations emerge in autoregressive models
기본 모델은 보상, 과제 설명, 하위 목표 라벨 없이 전문가의 관측-행동 궤적으로 처음부터 학습한다. 인과적 transformer는 gridworld 행동을 모델링하고, Hawk state-space model은 ant 제어를 모델링한다. 학습에서는 다음 행동의 우도와 가중치 λ ≥ 0을 적용한 보조 다음 관측 예측 목적함수를 결합한다.
- 이산 행동에는 범주형 우도를 사용하고, 연속 행동에는 학습된 대각 공분산을 갖는 Gaussian 우도를 사용한다.
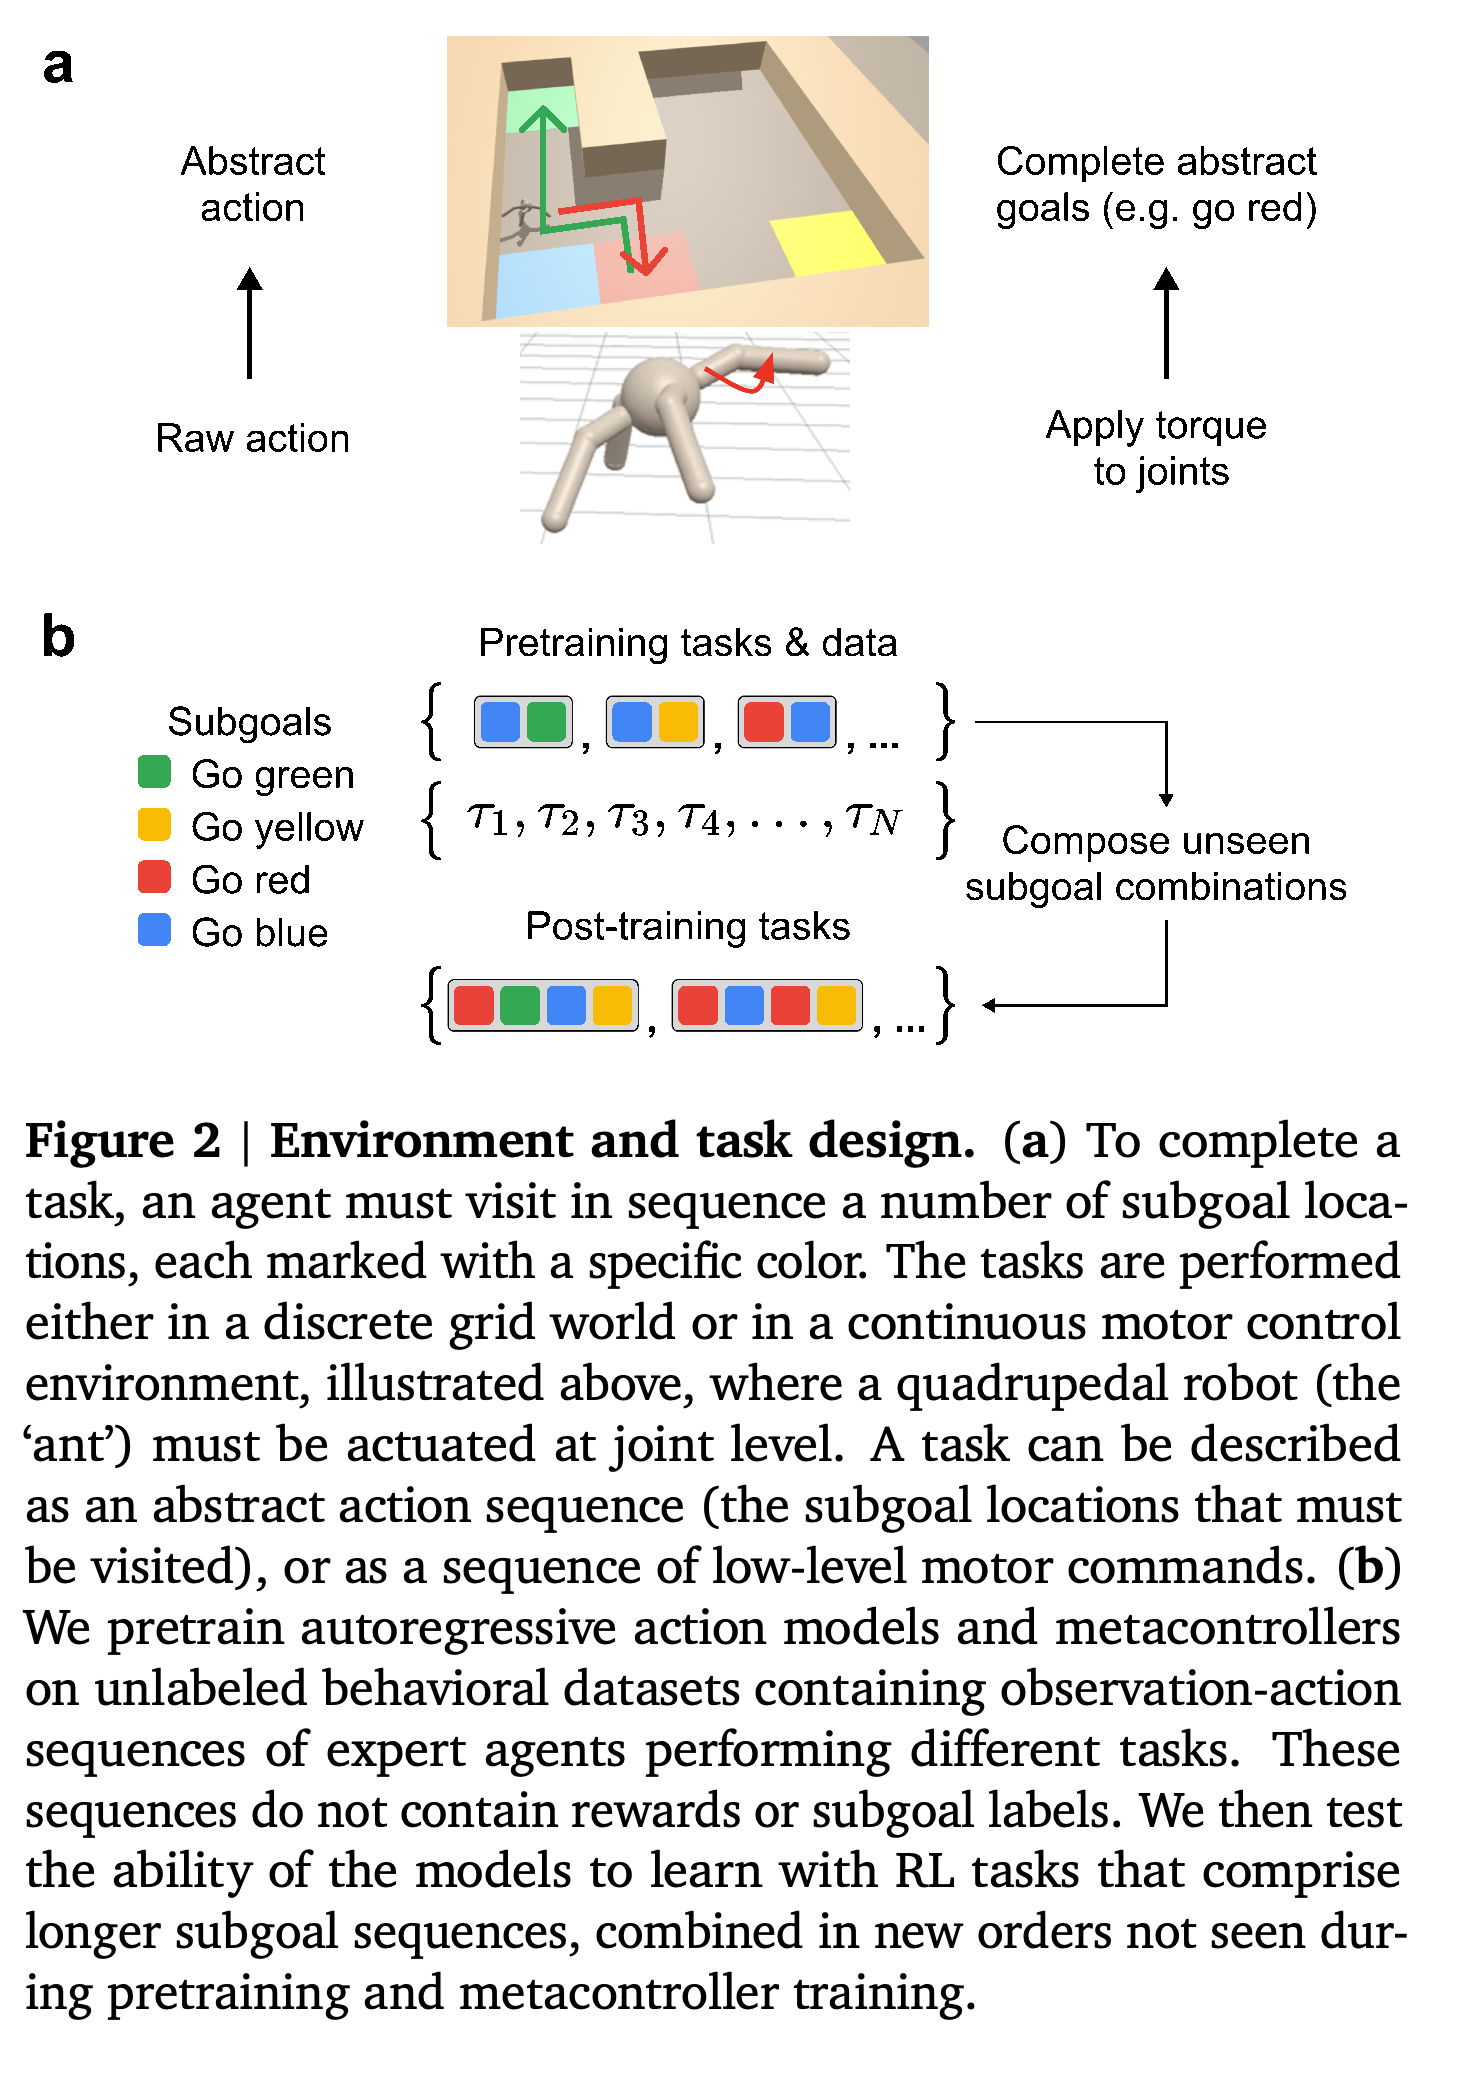
- 과제는 벽과 잘못된 색상의 위치를 피하면서 지정된 순서대로 색상 위치를 방문하도록 요구한다.
- 추상 하위 목표는 gridworld에서는 연속된 색상 위치 2개로, ant 제어에서는 색상 위치 1개로 구성된다.
후속 학습에서는 익숙한 하위 목표의 요구 순서와 길이를 바꾼다. 이를 통해 재사용 가능한 탐색 행동의 조합을 평가하며, ant 제어에서는 연속적인 관절 수준 운동 실행도 요구한다.
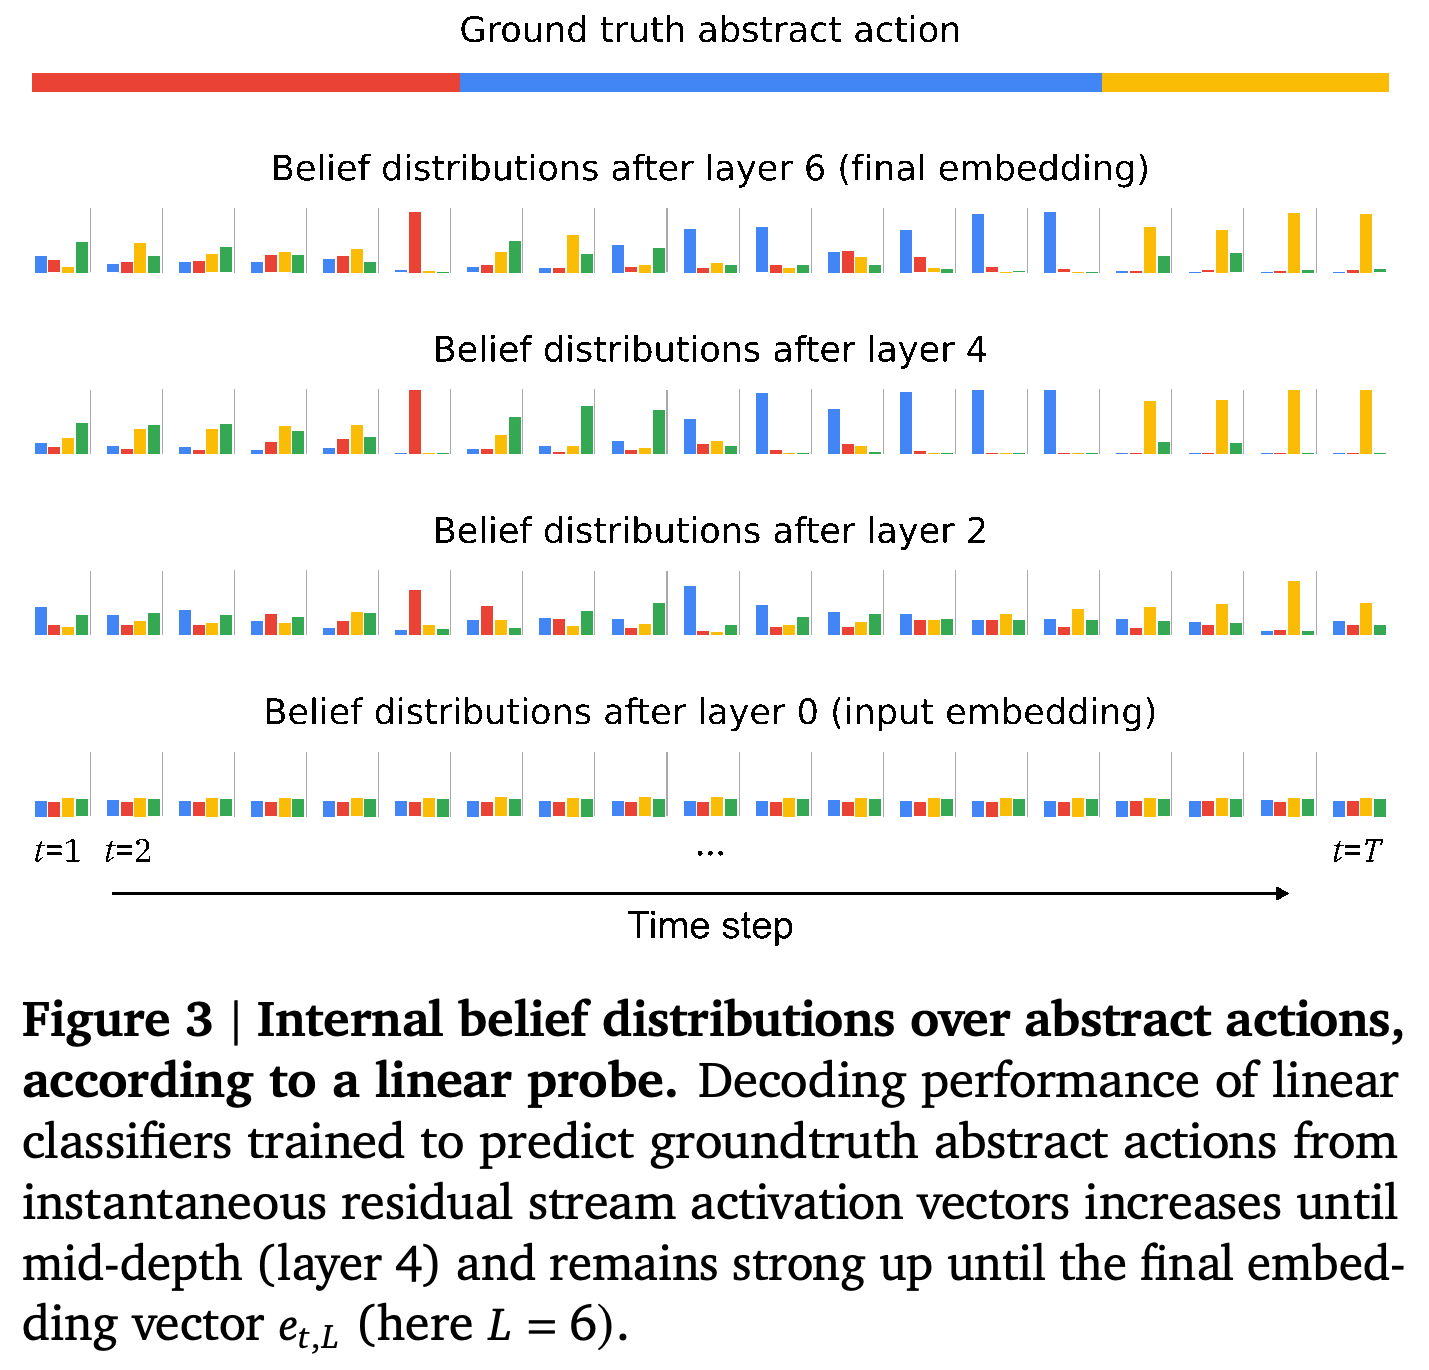
선형 분류기는 gridworld 모델의 각 시점에서 residual-stream activation으로부터 잠재 하위 목표를 디코딩한다. 제시된 6층 transformer에서는 행동을 통해 증거가 쌓일수록 예측이 현재 하위 목표에 집중되며, 입력보다 중간층과 깊은 층에서 디코딩 성능이 높다.
- Probe는 분석을 위해 정답 하위 목표 라벨을 사용하지만, 기본 모델의 사전 학습에는 해당 라벨을 사용하지 않는다.
- 디코딩 가능성은 하위 목표 정보에 접근할 수 있음을 보여주지만, 그 자체로 행동을 제어할 수 있음을 입증하지는 않는다.
궤적에서 현재 목표에 대한 증거가 쌓이면 선형 probe는 중간층과 깊은 층에서 더 뚜렷한 하위 목표 확률을 부여한다. 이 그림은 하위 목표 정보에 접근할 수 있는지를 측정하며, 행동의 제어 가능성은 별도로 검증한다.
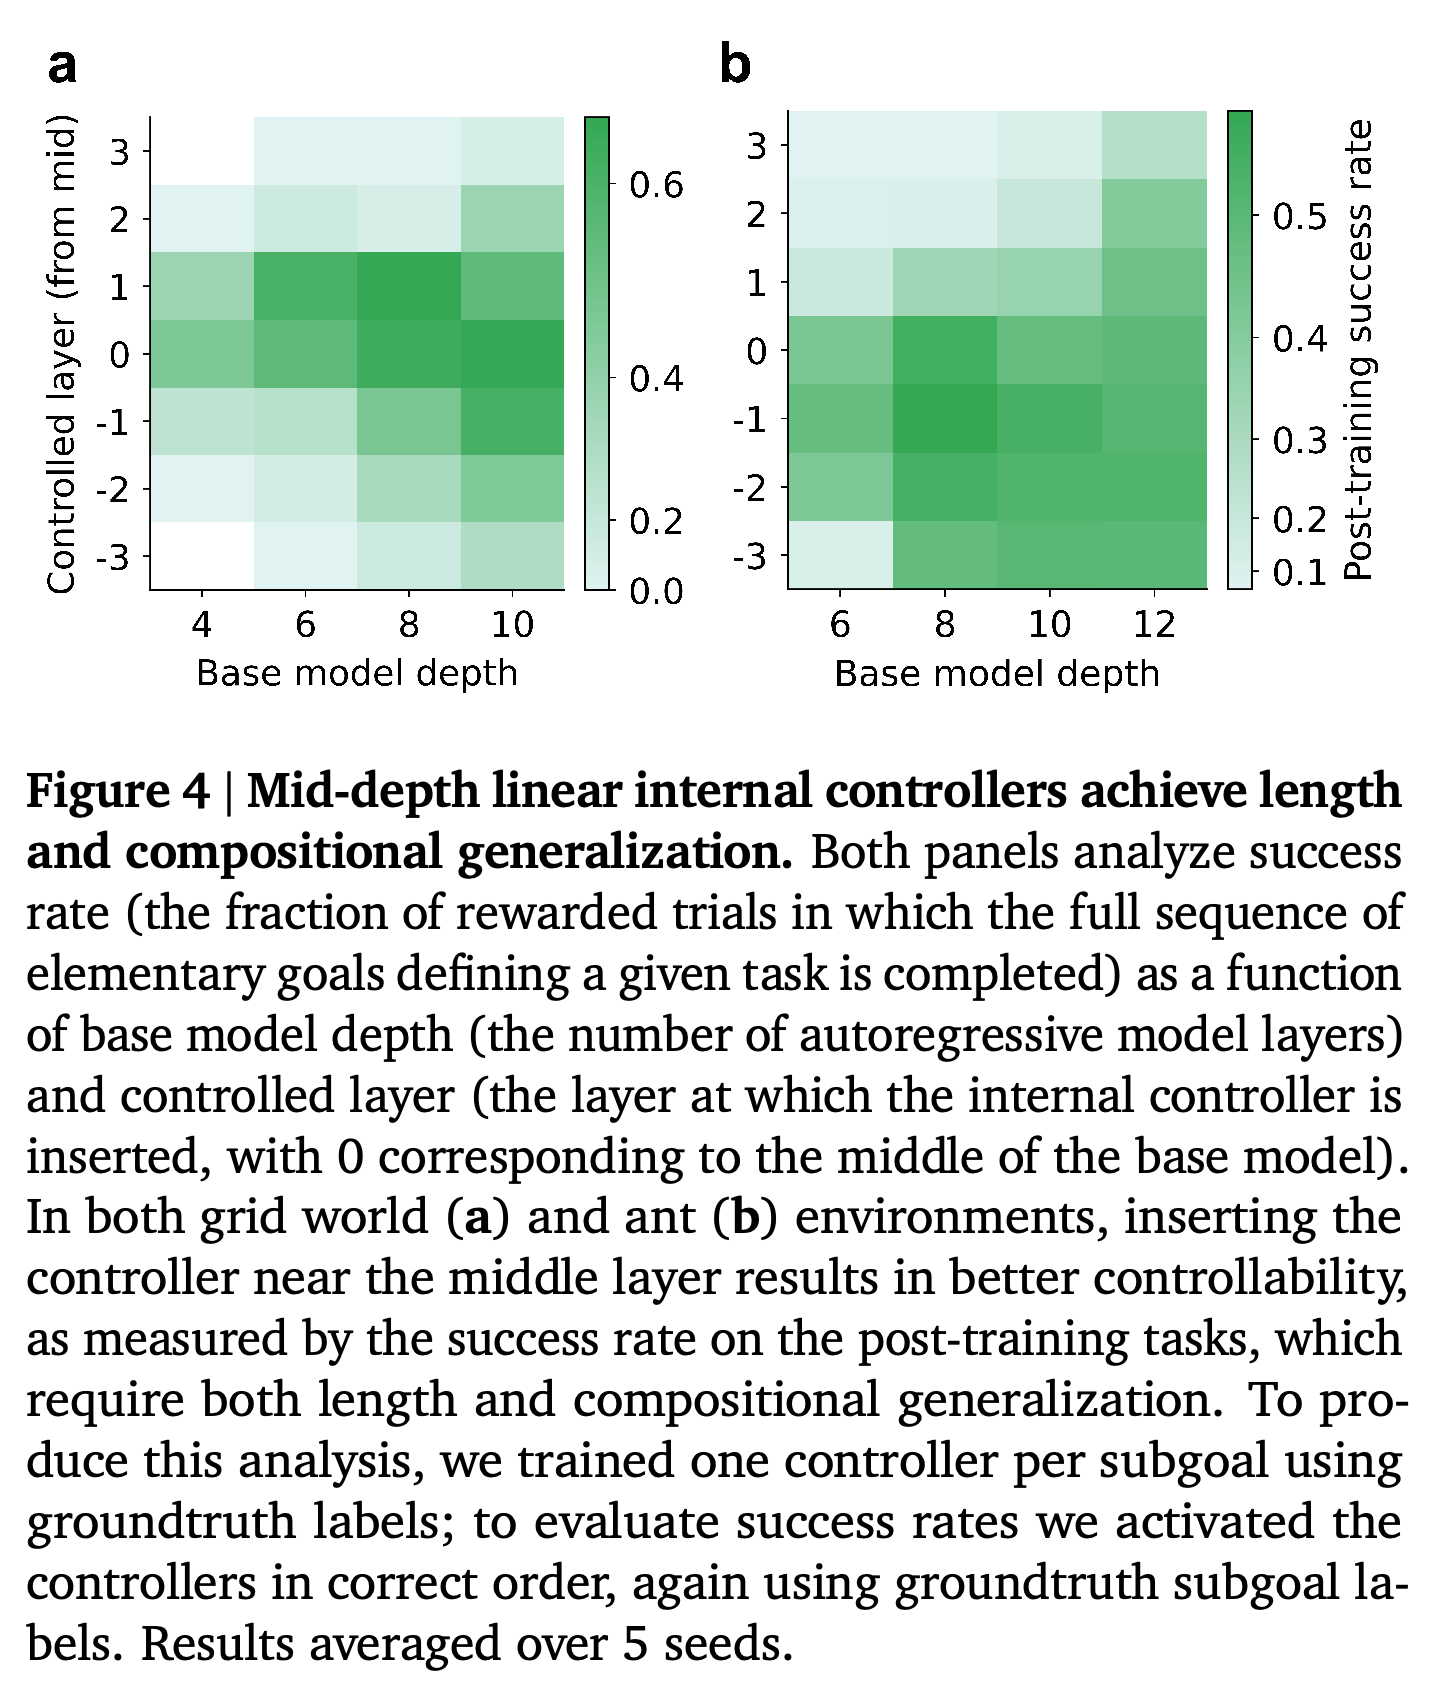
인과적 개입을 위해 선형 controller는 모델 블록 사이에서 \(e_{t,l}\leftarrow e_{t,l}+U_t e_{t,l}\)을 적용한다. 정답 하위 목표 라벨로 학습하고 선택한 controller는 고정된 기본 모델이 이전에 보지 못한 더 긴 하위 목표 조합을 수행하도록 유도한다. Figure 4에서는 실험한 backbone 깊이 전반에서 모델의 중간 깊이 부근에 개입할 때 제어 성능이 더 높다.
- 결과는 5개 seed에 걸쳐 평균하며, 자기회귀 모델은 다시 학습하지 않는다.
- 후반층의 높은 디코딩 성능과 중간 깊이 부근의 높은 제어 성능을 바탕으로, 후속 실험에서는 중간 깊이에 개입한다.
- 이 실험에서는 하위 목표 시퀀스를 외부에서 제공하며, 자율적인 controller 선택은 RL 단계에서 평가한다.
두 heatmap 모두 실험한 backbone 깊이 전반에서 중간 깊이 부근에 controller를 삽입할 때 성능이 높다. Controller 학습과 선택에 정답 라벨을 사용하므로, 이 결과는 원하는 하위 목표 시퀀스를 제공한 상태에서 조합적 제어 가능성을 측정한다.
Unsupervised metacontroller discovers temporally-abstract actions within autoregressive models
비지도 metacontroller는 확률적 순환 hypernetwork다. Encoder는 Gaussian controller code를 제안하고, decoder는 각 코드를 선형 controller 행렬로 변환한다. 학습 중 encoder는 전체 activation 궤적의 embedding을 받아 초기 행동만으로는 모호할 수 있는 목표를 추론하며, switching unit은 인과적으로 작동한다.
- 기본 모델은 고정하며, metacontroller 학습에는 기본 모델의 사전 학습보다 잡음이 적은 시연을 사용한다.
- 미래 정보를 조건으로 사용하는 방식은 오프라인에서 추상 행동을 발견하는 데 활용하며, RL의 행동 정책에서는 제거한다.
- Decoder는 운동 행동 대신 개입 매개변수를 생성한다.
시간적 통합은 Gaussian code 제안을 controller decoder와 연결해 여러 타임스텝 동안 코드를 유지할 수 있게 한다. 전체 시퀀스 embedding은 오프라인 추론을 지원하며, switching unit은 인과적 정보로 controller를 바꿀 시점을 결정한다.
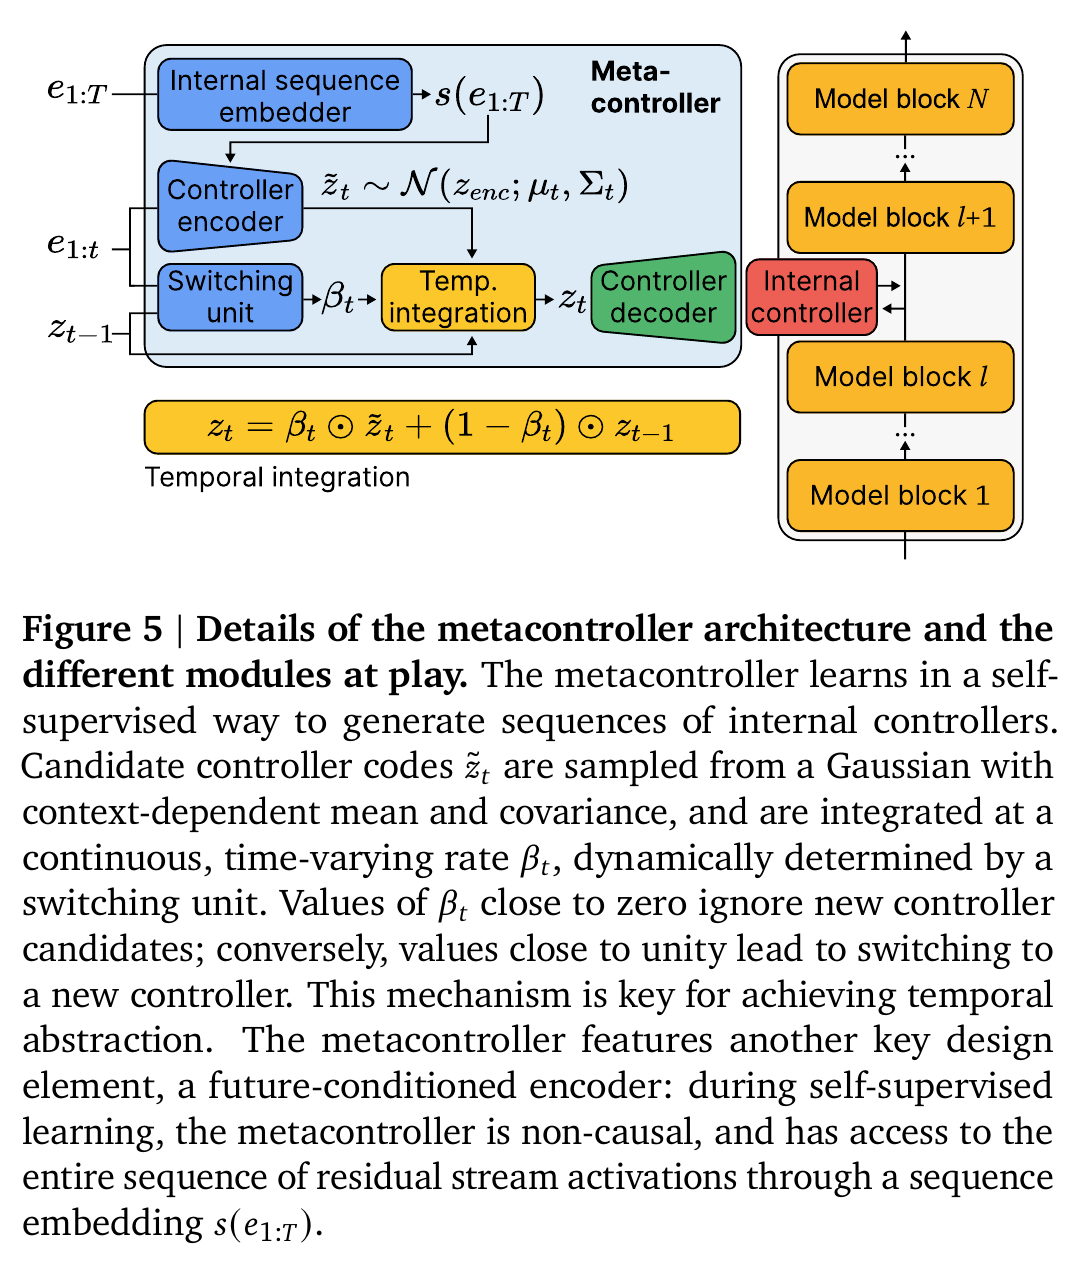
시간적 통합은 zt = βt ⊙ z̃t + (1 − βt) ⊙ zt−1을 따르며, \(\beta_t\in[0,1]\)이다. Gate 값이 작으면 이전 controller code를 유지하고, 값이 1에 가까우면 새로운 제안을 채택한다. 다음 행동 예측과 \(\mathcal N(0,I)\)에 대한 KL 페널티로 명시적인 하위 목표 또는 경계 라벨 없이 metacontroller를 학습한다.
- KL 가중치 α는 정보 병목을 조절하며, 사전분포에서 의미 있는 controller를 샘플링하도록 유도한다.
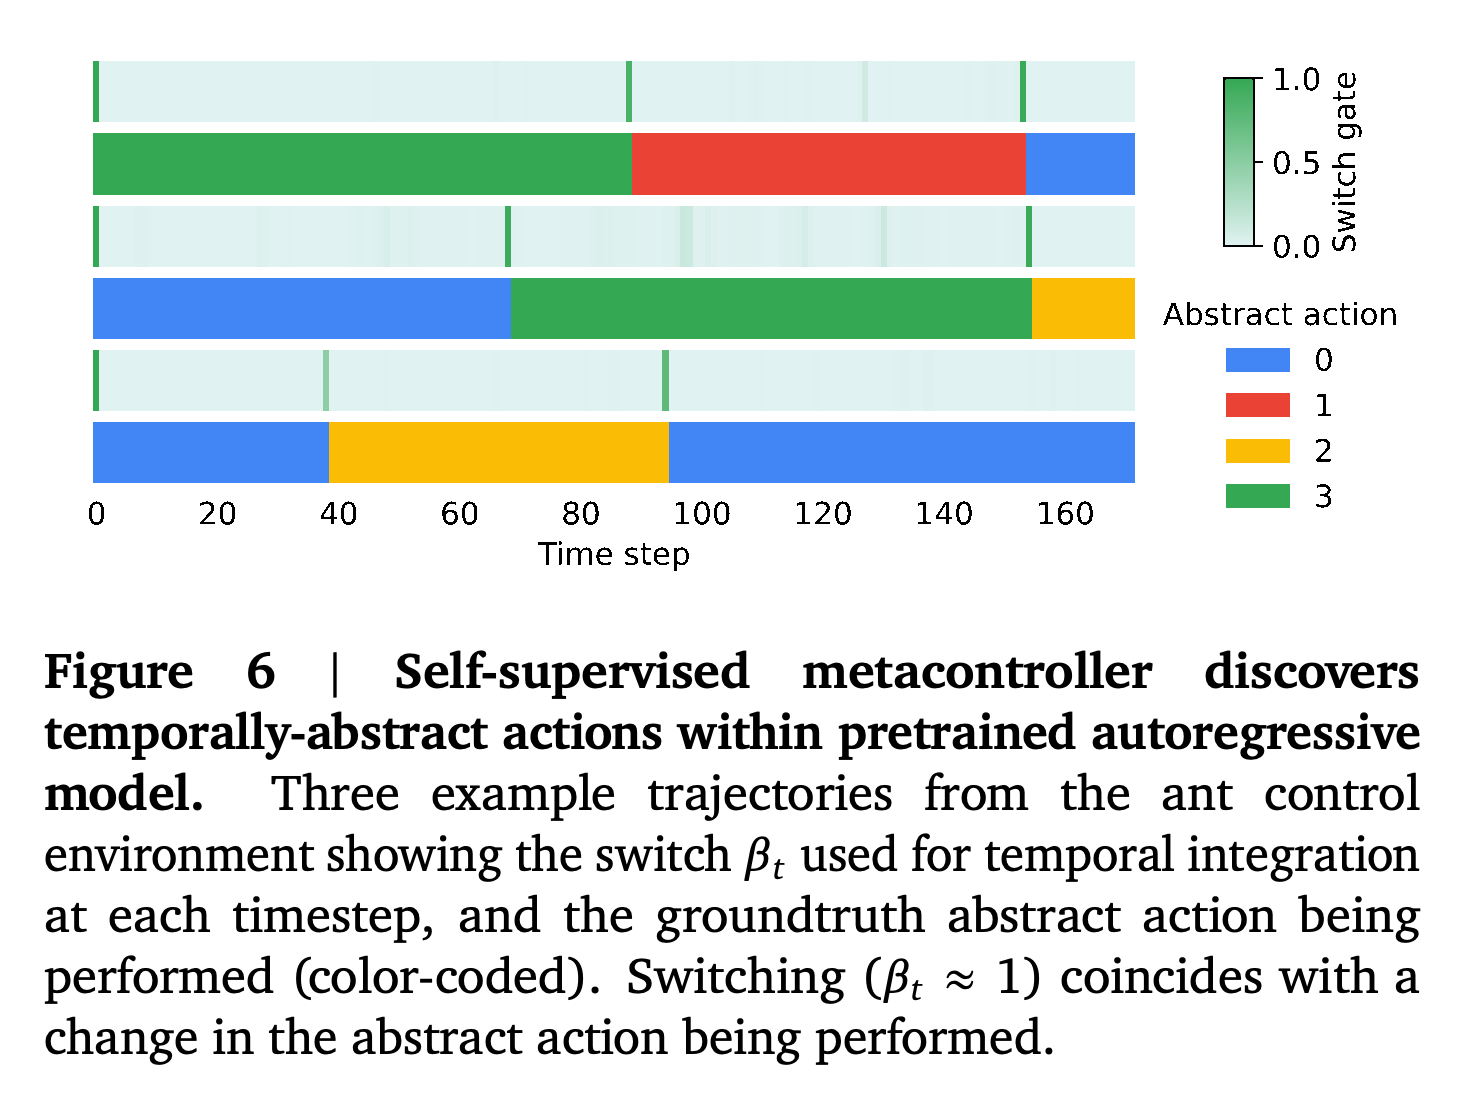
- 학습된 gate는 드물게 전환하며 거의 이진 값을 가진다. 제시된 ant 궤적에서는 전환 시점이 하위 목표의 변화와 일치한다.
- 조건 없는 제안 사전분포를 사용하므로 이전 제안과 독립적으로 새로운 controller code를 샘플링할 수 있다.
Ant 궤적 3개에서는 높은 switching-gate 값이 정답 하위 목표의 변화와 일치하고, 낮은 값은 기존 행동을 계속 실행하는 동안 나타난다. 이 예시는 경계의 일치를 보여주지만, 데이터셋 전체에서 얼마나 일치하는지를 나타내는 지표를 보고하지는 않는다.
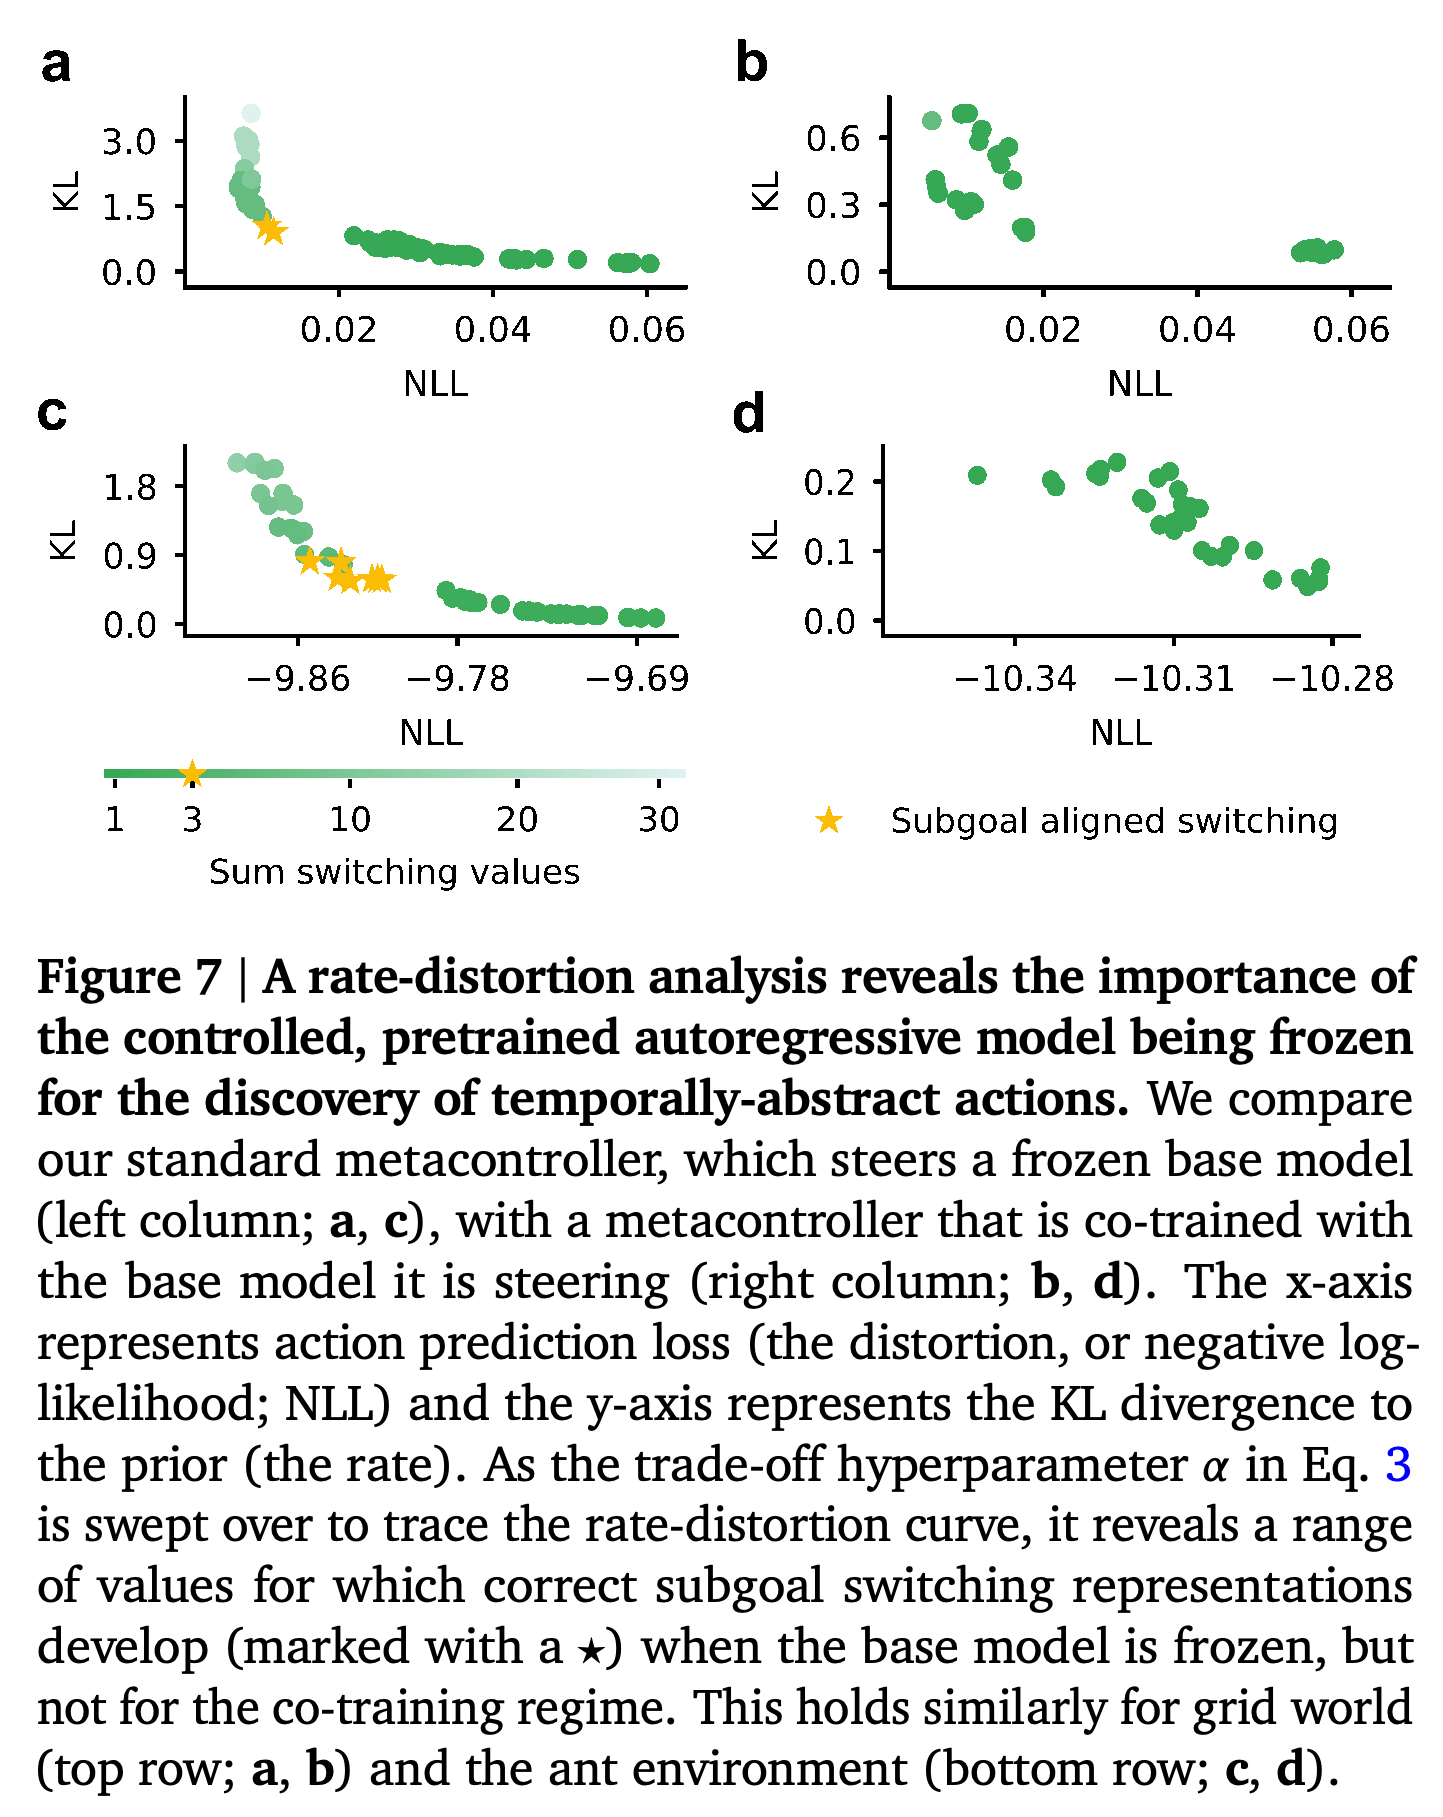
Rate-distortion 실험에서는 α를 변화시키며 행동 예측 손실과 사전분포에 대한 KL divergence를 비교한다. 사전 학습한 기본 모델을 고정하면 여러 설정에서 전환 시점이 하위 목표와 일치한다. 반면 실험한 공동 학습 변형에서는 이러한 구조가 사라지며, 처음에만 1번 전환하는 형태로 붕괴하는 경우가 많다.
- Figure 7에서는 잠재 정보가 조금만 늘어도 예측 오차가 크게 줄어드는 rate-distortion frontier의 간극 부근에서 하위 목표와 일치하는 전환이 나타난다.
- 이 비교는 실험한 학습 절차에서 사전 학습 모델을 고정하는 방식을 뒷받침한다.
- Appendix C.6에서는 무작위로 선택한 backbone 1개와 KL 설정별 metacontroller seed 10개를 사용한다.
Backbone을 고정한 패널에는 하위 목표와 전환 시점이 일치한다고 표시된 설정이 있지만, 공동 학습 패널에는 이러한 표시가 없다. 따라서 예측 손실이 낮다는 사실만으로는 학습된 코드와 전환이 유용한 시간적 추상화를 형성한다고 볼 수 없다.
Internal reinforcement learning
후속 학습에서는 요구한 전체 하위 목표 시퀀스를 완료한 경우에만 보상 1을 제공하고, 그렇지 않으면 보상 0을 제공한다. Raw-action RL은 GRPO와 관련된 critic 없는 PPO 방식의 알고리즘으로 사전 학습한 예측 모델을 미세 조정한다. 그러나 출력 수준의 샘플링으로는 새로운 조합의 성공 사례를 충분히 얻지 못해 뚜렷한 학습이 이루어지지 않는다.
- 논문은 어려운 설정에서 raw-action 샘플링의 성공 빈도가 궤적 백만 개당 약 한 번 수준이라고 설명한다.
- 알고리즘은 배치 전체의 궤적 보상을 정규화해 advantage를 추정하며, GRPO의 그룹화 방식은 사용하지 않는다.
- Raw-action 기준선은 행동 사전 학습을 마친 모델에서 시작한다.
Internal RL은 기본 모델, controller decoder, 전환 메커니즘을 포함한 나머지 모듈을 모두 고정하고, controller code에 대한 인과적 순환 정책을 학습한다. Switching gate는 임계값 0.5로 이진화하므로 선택한 controller가 학습된 전환 시점까지 유지된다. 고정된 모듈과 물리적 환경은 함께 정책이 상호작용하는 유효 환경을 구성한다.
- Controller code의 차원은 8이며, residual stream의 차원은 256이다.
- 1층 SSM 정책은 residual activation을 관측하고 순환 상태를 유지한다. 단일 activation 벡터에는 입력 이력의 일부 정보가 빠질 수 있기 때문이다.
- 전환 시점에만 의사결정을 내리면 정책의 유효 horizon이 짧아진다.
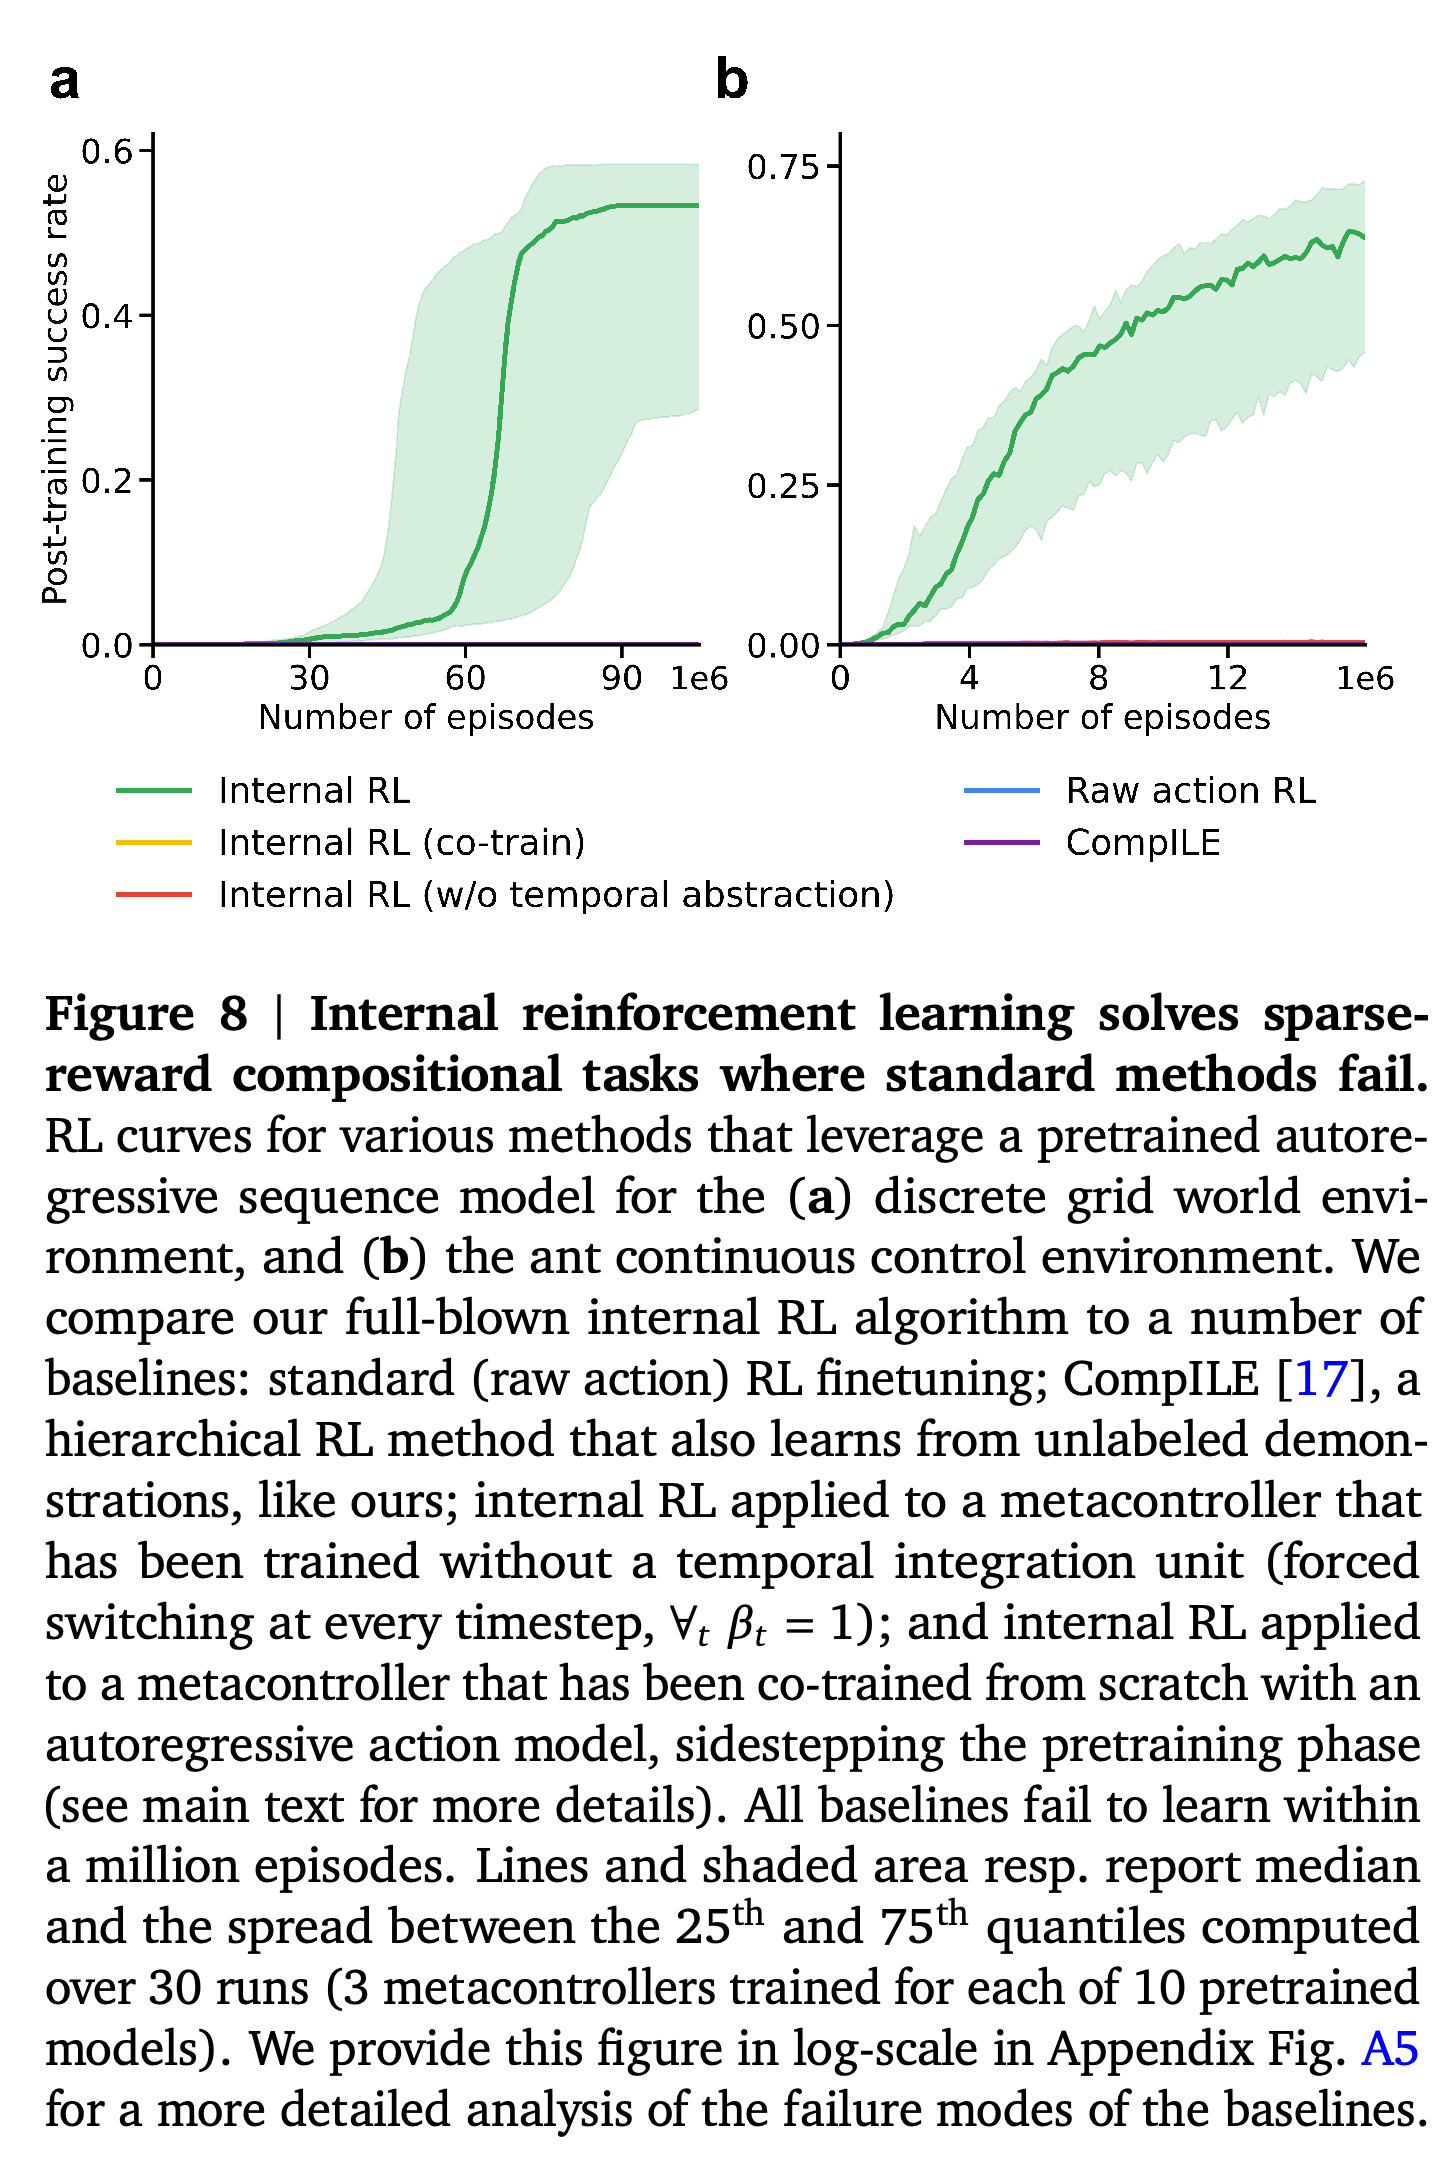
Figure 8에서는 전체 internal RL의 성공률이 두 환경에서 모두 높아지지만, raw-action RL, 실험 환경에 맞게 수정한 CompILE, 공동 학습, 강제 전환은 선형 척도에서 거의 성공하지 못하는 수준에 머문다. 곡선은 사전 학습 모델 10개 각각에 metacontroller seed 3개를 적용한 총 30회 실행의 중앙값과 25–75 분위수 범위를 보여준다.
- 강제 전환 변형은 추상 행동 발견과 RL 모두에서 매 타임스텝에 \(\beta_t=1\)을 사용해 학습 전 과정에서 시간적 지속성을 제거한 효과를 확인한다.
- 로그 척도 결과에서는 일부 기준선이 간헐적으로 성공하지만, 이를 강화해 성공적인 정책으로 발전시키지 못한다.
- Figure 8의 ant 성공률은 전문가의 후속 학습 과제 성공률 0.7로 정규화한다. 따라서 그래프의 ant 점수는 정규화 전의 완료 확률이 아니다.
전체 internal RL은 두 후속 학습 환경에서 모두 높은 성공률을 달성하지만, 비교 방법은 표시된 선형 척도에서 0에 가깝게 유지된다. 강제 전환 ablation은 시간적 지속성을 검증하고, 음영 영역은 30회 실행의 사분위 범위에 따른 변동을 보여준다. Ant 점수는 전문가 성능으로 정규화한다.
Discussion
Discussion에서는 다음 행동 예측을 통해 여러 타임스텝에 걸쳐 실행되는 목표 지향적 행동의 내부 표현이 형성될 수 있다는 근거로 실험 결과를 해석한다. 이 방법은 이러한 표현에서 controller와 종료 조건을 추출하고, RL을 통해 이를 조합하는 방법을 학습한다.
- 저자들은 이 접근법을 자기지도 학습과 RL을 번갈아 수행하는 방식, 그리고 선택한 목표에 맞춰 예측 모델을 조절하는 아키텍처와 연결한다. 자기지도 학습에 대해서는 이 글을 참조하라.
- Metacontroller는 순환 상태를 유지하며 행동 예측을 개선하는 개입을 학습한다. 반면 여기서 논의한 sparse autoencoder는 각 시점의 activation을 복원한다.
저자들은 통제된 실험 환경에서 얻은 결과이므로 더 큰 모델과 실제 과제에 적용하려면 추가 연구가 필요하다고 밝힌다. LLM 추론과 대규모 모델 제어를 향후 방향으로 제안하지만, 이 논문에는 언어 모델 추론 benchmark나 실제 로봇 평가가 없다.
부록
- A. Environment details는 탐색 환경 2개를 설명한다. A.1. Gridworld-pinpad와 A.1.1. Markov decision process specification은 무작위로 배치한 격자에서 상하좌우로 이동하는 방식을 정의하며, 물체, 벽, 에이전트 위치를 one-hot 관측으로 제공한다. 벽이나 격자 밖으로 이동하려는 행동은 상태를 바꾸지 않는다. 잘못된 색상 칸을 방문하거나 제한 시간이 지나면 episode가 종료되며, 전체 과제를 완료해야 보상 1을 얻는다. A.1.2. Task specification and hyperparameters는 7-by-7 격자, 색상 칸 8개, 벽 4개, 최대 episode 길이 100을 설정한다. 추상 하위 목표는 0–1, 2–3, 4–5, 6–7이며, 후속 학습 시퀀스는 0–1–2–3–4–5–6–7–0–1–2–3이다.
- A.2. Ant-pinpad와 A.2.1. Markov decision process specification은 8차원 관절 토크 행동을 사용하는 연속 탐색을 정의한다. 배치, 초기 위치, yaw, 관절 각도, 속도를 무작위화한다. 관측은 symlog로 변환한 고유수용감각 정보, 정규화한 전역 좌표, 물체와 벽의 상대 위치, 국소 좌표를 결합한다. 벽에 진입하거나 잘못된 색상 칸을 방문하거나 제한 시간을 초과하거나 몸통 높이가 [0.2, 1.0] 범위를 벗어나면 episode가 종료된다. 전체 과제를 완료하면 보상 1을 얻는다. A.2.2. Task specification and hyperparameters는 4-by-4 격자, 색상 칸 4개, 벽 1개, 최대 episode 길이 500, 후속 학습 시퀀스 0–1–2–3을 설정한다.
- B. Additional experimental results는 probing, 추상 행동, RL에 대한 추가 분석을 제시한다. B.1. Belief state probing에서는 6층 transformer의 중간층 부근에서 gridworld 하위 목표의 선형 디코딩이 더 잘 이루어지며, 정확도가 30%에서 약 50%로 높아진다고 보고한다. Backbone 학습이 100K steps를 넘으면 출력층 probing 성능이 저하될 수 있다. B.2. Effect of sequence model training hyperparameters on the abstract action representations에서는 더 긴 사전 학습, 적당한 weight decay, 보조 관측 목적함수가 도움이 되지만, 지나친 weight decay나 관측 손실 가중치는 controller의 일반화 성능을 낮춘다고 보고한다. 기본 표현은 실험한 전문가 행동 잡음에도 견고하게 유지된다. 저자들은 관측 손실 가중치가 매우 낮을 때 발생한 실패가 해당 환경의 특성 때문일 수 있다고 제안한다.
- B.3. Unsupervised abstract action discovery와 B.3.1. Temporal abstraction in the gridworld는 학습된 전환 시점이 gridworld 하위 목표와도 일치함을 보여준다. B.3.2. Quality of abstract actions는 사전분포에서 샘플링한 ant rollout에서 수집한 코드를 평가한다. 타임스텝 30에 “go to blue” 코드를 주입하면 목표 도달 성공률이 23%에서 36%로 높아지며, object 0에 도달한 뒤 object-1 코드를 활성화하면 이전에 보지 못한 해당 전환의 성공률이 10%에서 24%로 높아진다. B.4. Internal reinforcement learning은 로그 척도 곡선을 사용해 기준선의 간헐적인 성공과 전체 internal RL의 지속적인 개선을 구분한다.
- C. Experimental details는 학습과 평가 절차를 명시한다. C.1. Pretraining of sequence models와 C.1.1. Expert trajectory generation에서는 gridworld에 동적 계획법 기반 최단 경로 전문가를, ant 제어에 PPO로 학습한 전문가를 사용한다. Ant 전문가는 추가 방향 관측과 속도 방향에 대한 내재적 보상을 받는다. 성공률은 사전 학습 과제에서 0.8, 후속 학습 과제에서 0.7로 보고한다. C.1.2. Sequence model training은 다음 행동과 다음 관측의 우도를 결합하며, C.1.3. Seed는 환경별로 독립적으로 사전 학습한 모델 10개를 명시한다. 제시된 backbone의 embedding 차원은 256이다. Gridworld에서는 6층 transformer를 256000 steps 동안 학습하고, ant-pinpad에서는 8층 SSM을 204800 steps 동안 학습한다.
- C.2. Belief state probing은 고정된 activation으로 지도 학습 선형 분류기를 학습한다. C.3. Controller compositional generalization은 제어 가능성을 분리해 확인하기 위해 매 타임스텝에 one-hot 하위 목표 식별자를 제공하며, gridworld에서는 rank-16 선형 controller를, ant-pinpad에서는 선형 controller를 사용한다. C.4. Unsupervised abstract action discovery는 하위 목표 라벨 없이 KL 정규화로 Gaussian controller code를 학습한다. 제시된 설정은 backbone 깊이의 절반 지점에 개입하며, 코드 차원은 8이다.
- C.4.1. Baseline – forced resets는 매 타임스텝에 switching gate를 1로 설정한다. C.4.2. Baseline – metacontroller cotraining은 backbone과 metacontroller를 공동 학습하며, gridworld에서는 무작위 backbone 매개변수에서 시작하고 ant-pinpad에서는 사전 학습한 매개변수에서 시작한다. C.4.3. Baseline – CompILE은 원시 관측을 입력받고 구간 경계를 추론하도록 latent-code 모듈을 수정하며, 구간 수는 최대 4개로 제한한다. Sequence model은 사전 학습한 상태로 초기화한다. C.4.4. Metacontroller training dataset은 ant 전문가의 평균 행동을 사용하고 gridworld 행동 잡음을 0으로 설정해 잡음이 적은 시연을 얻는다. C.4.5. Seed는 sequence model 10개 각각에 seed 3개를 적용해 각 추상 행동 발견 설정을 반복한다.
- C.5. RL experiments와 C.5.1. Internal RL은 유효 환경 초기화, 추상 행동 실행, 정책 학습 알고리즘을 제시하며, embedding 차원 256의 1층 SSM 정책을 사용한다. C.5.2. RL algorithm details는 clipping을 적용한 PPO 방식의 대리 목적함수와 배치 전체의 궤적 보상을 정규화해 계산한 critic 없는 advantage를 사용한다. C.5.3. Baseline – raw action RL은 사전 학습한 backbone을 미세 조정하며, C.5.4. Baseline – others는 대안적인 추상 행동 모델에 internal RL을 적용한다. C.5.5. Seed and Hyperparameter selection은 학습률 (0.000003, 0.00001, 0.00003, 0.0001, 0.0003)을 탐색하고, 사전 학습 모델 10개와 seed 3개에 걸친 RL 성능 중앙값으로 설정을 선택한다.
- C.6. Rate-distortion curve는 무작위로 선택한 backbone 1개와 KL 설정별 추상 행동 발견 seed 10개를 사용하며, gridworld에는 Gumbel-Sigmoid 전환 변형을 적용한다. 임계값 0.5로 이진화한 뒤 전환 횟수를 세고, 전환 패턴이 하위 목표 변화와 일치하는지 수작업으로 확인한다. 이 분석은 주요 RL 비교보다 적은 backbone seed를 사용한다.
- D. Architecture details와 D.1. Sequence model은 입력을 먼저 정규화하는 residual 아키텍처를 명시한다. D.1.1. SSM은 Hawk recurrence를 사용하고, D.1.2. Transformer는 상대 위치 bias를 적용한 attention을 사용한다. 둘 다 MLP channel mixing을 포함한다. D.2. Metacontroller architecture는 GRU 이력 상태, 전체 궤적의 sequence embedding, Gaussian code encoder, 인과적 switching unit, 시간적 통합, 선형 개입을 위한 hypernetwork decoder를 결합한다. D.3. Internal RL policy architecture는 단일 residual activation에 관측 이력의 일부 정보가 빠질 수 있으므로 순환형 1층 SSM을 사용한다.
- E. Additional discussions는 잠재변수 정식화와 RL gradient 추정기의 비교를 포함한다. E.1. Graphical model and ELBO derivation은 전환 사이에는 controller code를 유지하고 전환 시점에는 표준 정규 사전분포에서 새 코드를 뽑는 과정을 설명한다. 학습에서는 전환을 연속적으로 완화하며, 인과적 residual activation에 미래 정보 없이도 종료 신호를 생성할 만큼 충분한 정보가 있다고 가정한다. E.2. Internal RL vs RL with reparametrization trick은 종료 시점 보상과 고정 분산 추상 정책을 전제로 추정기를 비교하며, 분산 비교에서는 추상 의사결정이 1회라고 추가로 가정한다. 이 분석은 horizon에 따른 잡음이 줄어들 가능성과 함께, 잠재 코드 샘플링에 따른 분산의 상충 관계를 설명한다.
짧은 생각
인과적 controller 개입, 하위 목표와 일치하는 전환, RL ablation은 함께 숨겨진 하위 목표 정보와 재사용 가능한 행동의 관계를 보여준다. 강제 전환 비교는 이 과제들에서 잠재 코드 잡음을 활용한 탐색에 더해 시간적 지속성도 기여한다는 점을 보여준다.
이 방법은 유용한 내부 controller를 형성하는 행동 사전 학습과 추상 행동 발견을 위한 잡음이 적은 시연에 의존한다. 효과는 명시적인 조합 구조를 갖춘 탐색 과제에서 확인되었다. 구조가 덜 명확한 행동, 신뢰하기 어려운 종료 신호, 대규모 언어 모델에도 적용할 수 있는지는 실험으로 확인해야 할 과제로 남아 있다.