Therefore I am. I Think 요약 설명
01 Apr 2026 | Paper Review Tool Use Activation Steering Chain-of-Thought Faithfulness목차
이번 글에서는 Therefore I am. I Think 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 4월 1일(Arxiv)
- Esakkiraja, Esakkivel, Rajeswar, Sai, Akhiyarov, Denis, Venkatesaramani, Rajagopal.
- Khoury College of Computer Sciences, Northeastern University, Mila, ServiceNow Research, ServiceNow
- 논문 링크
요약
- Therefore I am. I Think.는 추론 모델이 눈에 보이는 chain-of-thought(CoT)를 생성하기 전에 도구 사용 선택을 인코딩하는지 조사한다. Logistic regression probe는 pre_gen 활성값으로 모델의 최종 도구 사용 여부를 예측하며, 주요 모델–벤치마크 설정 4개 모두에서 AUROC가 0.90을 넘는다.
- 저자들은 클래스별 평균 활성값으로 도구 호출 steering 방향을 구성하고, 이를 이용해 도구 사용을 유도하거나 억제한다. 모델–벤치마크 설정과 방향별로 학습에서 제외한 예제 100개를 평가했으며, 시험한 개입 중 가장 강한 개입에서 thinking mode의 행동 전환율은 11–79%다. 행동 전환에는 추론 길이 증가가 동반되는 경우가 많다.
- 외부 LLM judge 2개는 도구 사용 유도로 발생한 행동 변화를 Confabulated Support나 Constraint Override로 분류하는 경우가 많다. 이 결과는 추론 전 행동의 예측 가능성과 개입에 따른 행동 변화를 뒷받침하지만, 눈에 보이는 모든 추론이 사후 정당화라는 결론을 입증하지는 않는다. Steering은 decoding 중에도 계속 적용되고, 개입에 저항하는 사례도 남아 있으며, 행동 라벨은 내부 추론이 아니라 관찰 가능한 텍스트를 설명한다.
1 Introduction
논문은 눈에 보이는 추론이 시작되기 전에 도구 사용 선택을 예측할 수 있는지, 그 선택을 steering으로 바꿀 수 있는지, 이후 CoT가 개입에 저항하는지 아니면 개입을 정당화하는지 묻는다.
- 도구 호출은 해석 가능한 이진 행동 예측 대상을 제공하므로, 제약 없이 생성된 답변 전체를 분석할 필요가 없다.
- 논문이 제시한 기여 3개는 Early decision encoding, Decision direction causality, Rationalization behavior다.
2 Related Work
논문은 미래 출력을 미리 나타내는 표현, 정답 여부와 적응형 연산을 위한 hidden-state probe, CoT faithfulness 연구, activation steering을 연결한다. 핵심은 생성 전 도구 사용 행동의 표현과 그 표현을 교란한 뒤 생성되는 추론이다.
- Early-exit 연구와 달리, 목표는 추론을 효율적으로 종료하는 것이 아니라 눈에 보이는 추론 이전에 존재하는 행동 경향을 조사하는 것이다.
- Activation steering은 fine-tuning이나 성능 최적화 절차가 아니라 행동에 미치는 인과적 영향을 연구하는 데 사용한다.
3 Methods
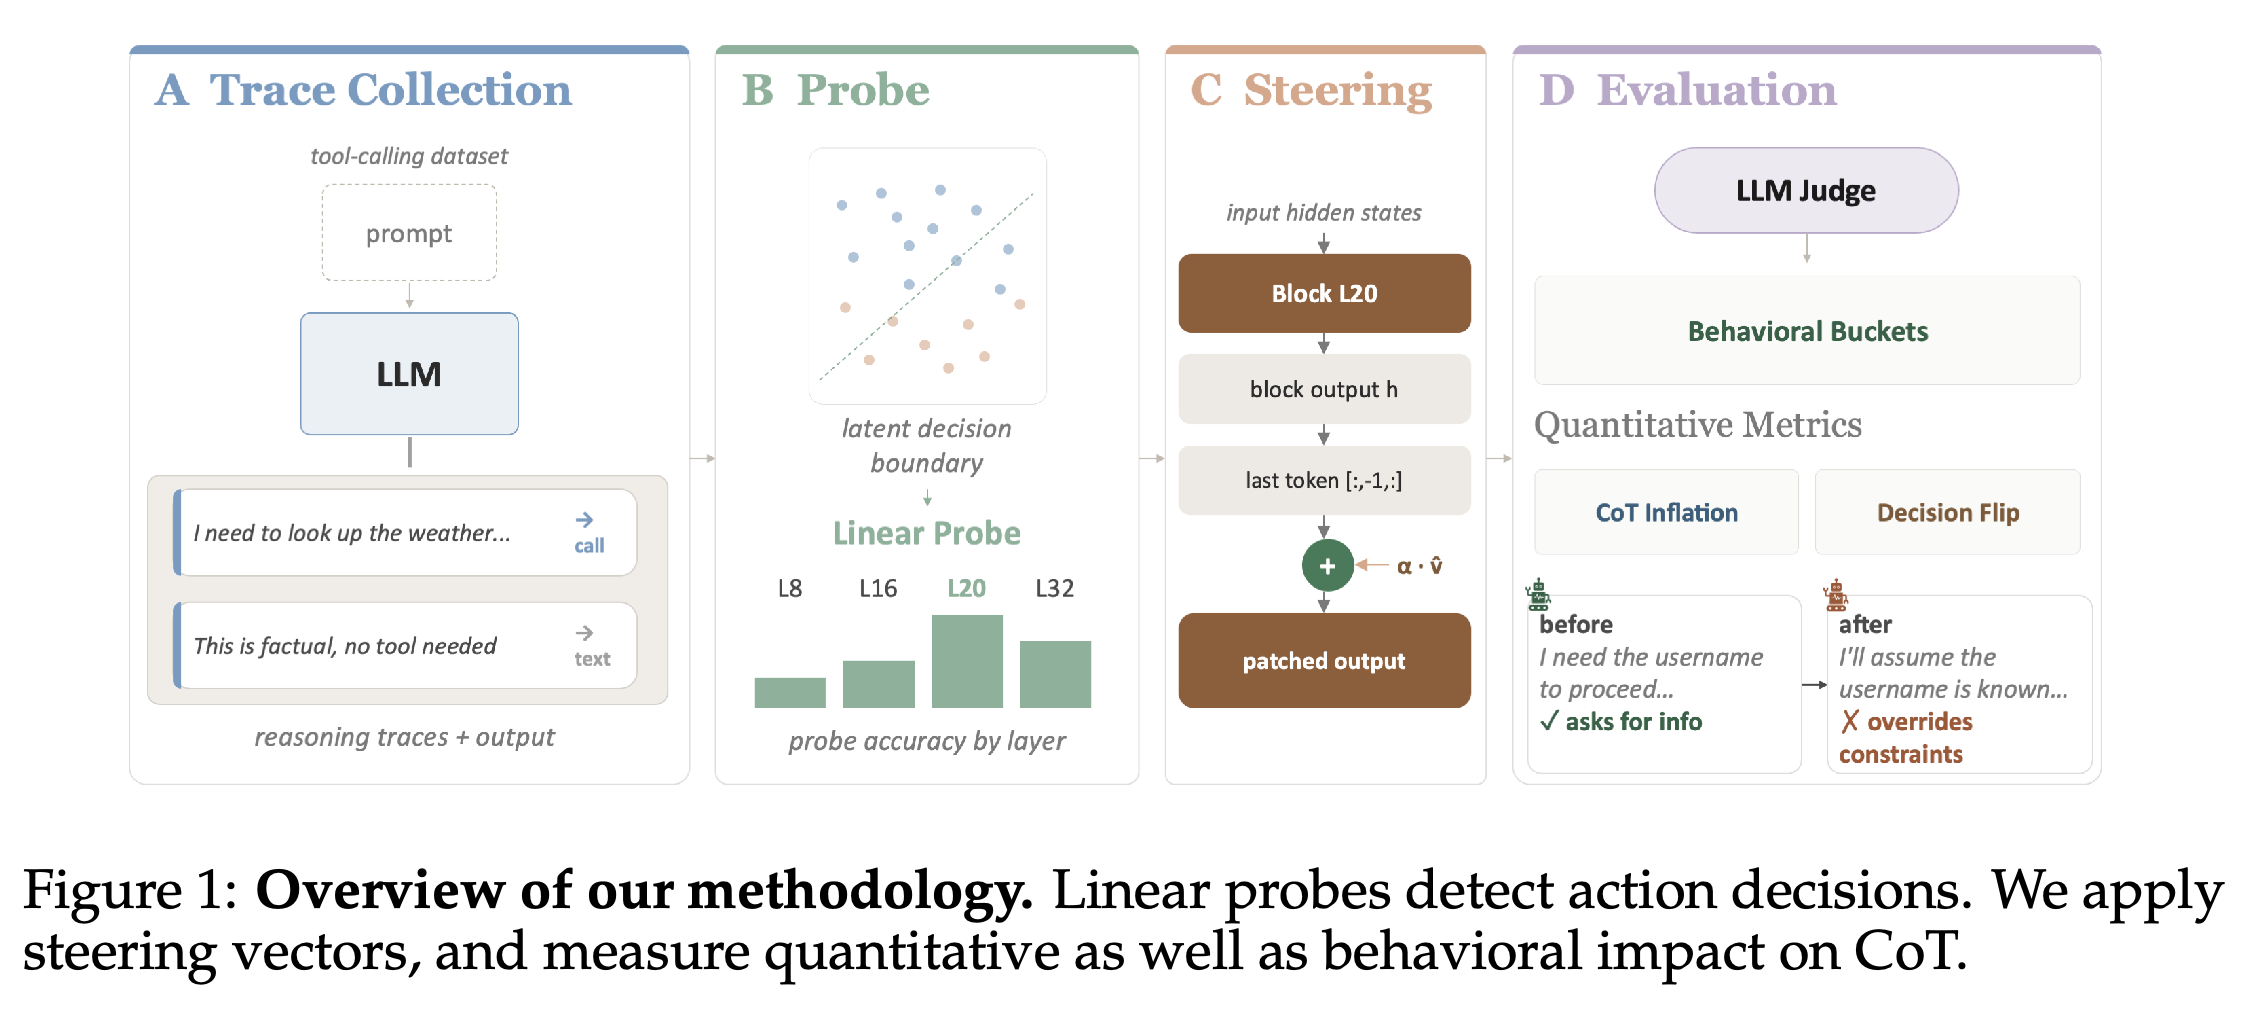
연구 방법은 기준 추론 기록을 수집하고, residual stream의 활성값을 추출하고, 선형 행동 probe를 학습한 뒤, 평균 차이로 steering vector를 구성하는 순서다. 평가에는 probe AUROC, 행동 전환율, 추론 토큰 수 변화, 응답 쌍에 대한 행동 판단을 함께 사용한다.
이 절차는 행동 신호를 읽어내는 단계, 그 신호에 개입하는 단계, 결과를 평가하는 단계를 구분한다. Probe의 예측 가능성만으로는 해당 표현이 행동에 영향을 준다는 점을 입증할 수 없다.
3.1 Models, Data, and Benchmarks
주요 실험은 Qwen3-4B와 GLM-Z1-9B를 대상으로 When2Call과 BFCL Irrelevance 및 BFCL Simple, v3: base + live로 구성한 보조 벤치마크에서 수행한다. GPT-OSS-20B에는 보충 probing 실험을 수행하지만 인과 분석에서는 제외한다. 저자들은 이 모델의 mixture-of-experts 구조에 다른 steering 기법이 필요하다고 설명한다.
- When2Call에는 객관식 예제 3,652개와 LLM-judge 예제 300개가 있으며, 범주는 tool_call(∼57%), direct(∼12%), request_for_info(∼14%), cannot_answer(∼17%)다.
- BFCL Irrelevance는 도구가 요청에 맞지 않는 사례를, BFCL Simple은 도구로 쉽게 해결할 수 있는 사례를 제공한다. 이를 통해 벤치마크 구성과 프롬프트 스타일이 달라져도 결과가 일반화되는지 평가한다.
3.2 Hidden-State Extraction and Prediction Target
기준 추론 기록은 권장 생성 인자를 사용해 vLLM으로 생성한다. Forward hook은 각 프롬프트와 후속 생성 전체에 대한 순전파에서 각 layer 이후의 residual stream을 추출한다. Causal attention은 각 위치의 자기회귀적 표현을 유지한다.
- pre_gen은 첫 thinking token 직전이고, think_start는 첫 thinking token이며, think_end는 마지막 추론 토큰이고, decision_token은 추론 직후의 첫 토큰이다.
- 중간 위치는 추론 구간에서 샘플링한다. 주요 모델 그래프에 표시된 위치는 pre_gen, think_start, 5%, 10%, 25%, 50%, 75%, think_end다.
- 예측 대상은 모델의 추론 기록에서 확인한 도구 사용 여부이며, 모델의 행동이 벤치마크 정답 라벨과 일치하는지는 아니다.
3.3 Probe Training
Logistic regression probe는 ŷᵢ = σ(w⊤xᵢ)에 따라 hidden-state vector를 도구 호출 확률로 변환한다. ŷᵢ ≥ 0.5이면 도구 사용 클래스로 예측하며, 샘플링한 layer–position 쌍마다 Binary Cross Entropy loss로 probe를 독립적으로 학습한다.
- Section 3.3은 첫 layer와 마지막 layer를 포함해 4개 layer 간격으로 샘플링한다고 명시한다. Section 3.5는 약 4개 또는 5개 layer 간격을 설명하며, 이는 주요 모델의 heatmap과 일치한다.
- Section 3.3은 decision_token까지 토큰 위치 9개를 명시하지만, 주요 모델 그래프에는 think_end까지 위치 8개가 표시되어 있다.
3.4 Activation Steering Vector
고정된 layer의 pre_gen 위치에서 저자들은 기준 응답이 도구를 사용하는 예제와 사용하지 않는 예제의 활성값을 각각 평균한다. Steering 방향은 (v=\mu_+-\mu_-)이고, 개입은 (h’^{(L,t)}=h^{(L,t)}+\alpha v)로 정의한다. 양의 계수는 도구 사용을 유도하고, 음의 계수는 도구 사용을 억제한다.
- 대부분의 설정에서는 계수 크기 (\alpha\in{4,8,12})를 시험한다. BFCL의 GLM-Z1-9B는 선택한 layer의 평균 활성값 norm이 훨씬 크기 때문에 (\alpha\in{10,20,30})을 사용한다.
- Vector는 pre_gen 활성값만으로 구성하지만, pre-fill과 decoding 모두에 적용한다. 따라서 이 실험은 생성 직전 순간에만 가한 교란의 효과를 분리해 평가하지 않는다.
3.5 Evaluation Metrics
Probe 성능은 AUROC를 사용해 5-fold stratified cross-validation으로 평가한다. Steering은 모델, 방향, 벤치마크별로 학습에서 제외한 예제 100개를 사용하며, 이 예제들은 probe 학습과 steering vector 계산 모두에서 제외한다. 억제용 부분집합은 기준 응답이 도구를 호출하는 사례로, 유도용 부분집합은 기준 응답이 도구를 사용하지 않는 사례로 구성한다.
- 억제 전환율은 기준 응답이 도구를 사용하는 예제 중 steering 이후 도구를 사용하지 않게 된 예제의 비율이다.
- 유도 전환율은 기준 응답이 도구를 사용하지 않는 예제 중 steering 이후 도구를 사용하게 된 예제의 비율이다.
- 추론 토큰 수의 상대 변화는 Δreason = (rsteer − rbase)/rbase이며, 동일한 예제의 추론 토큰 수를 비교한다.
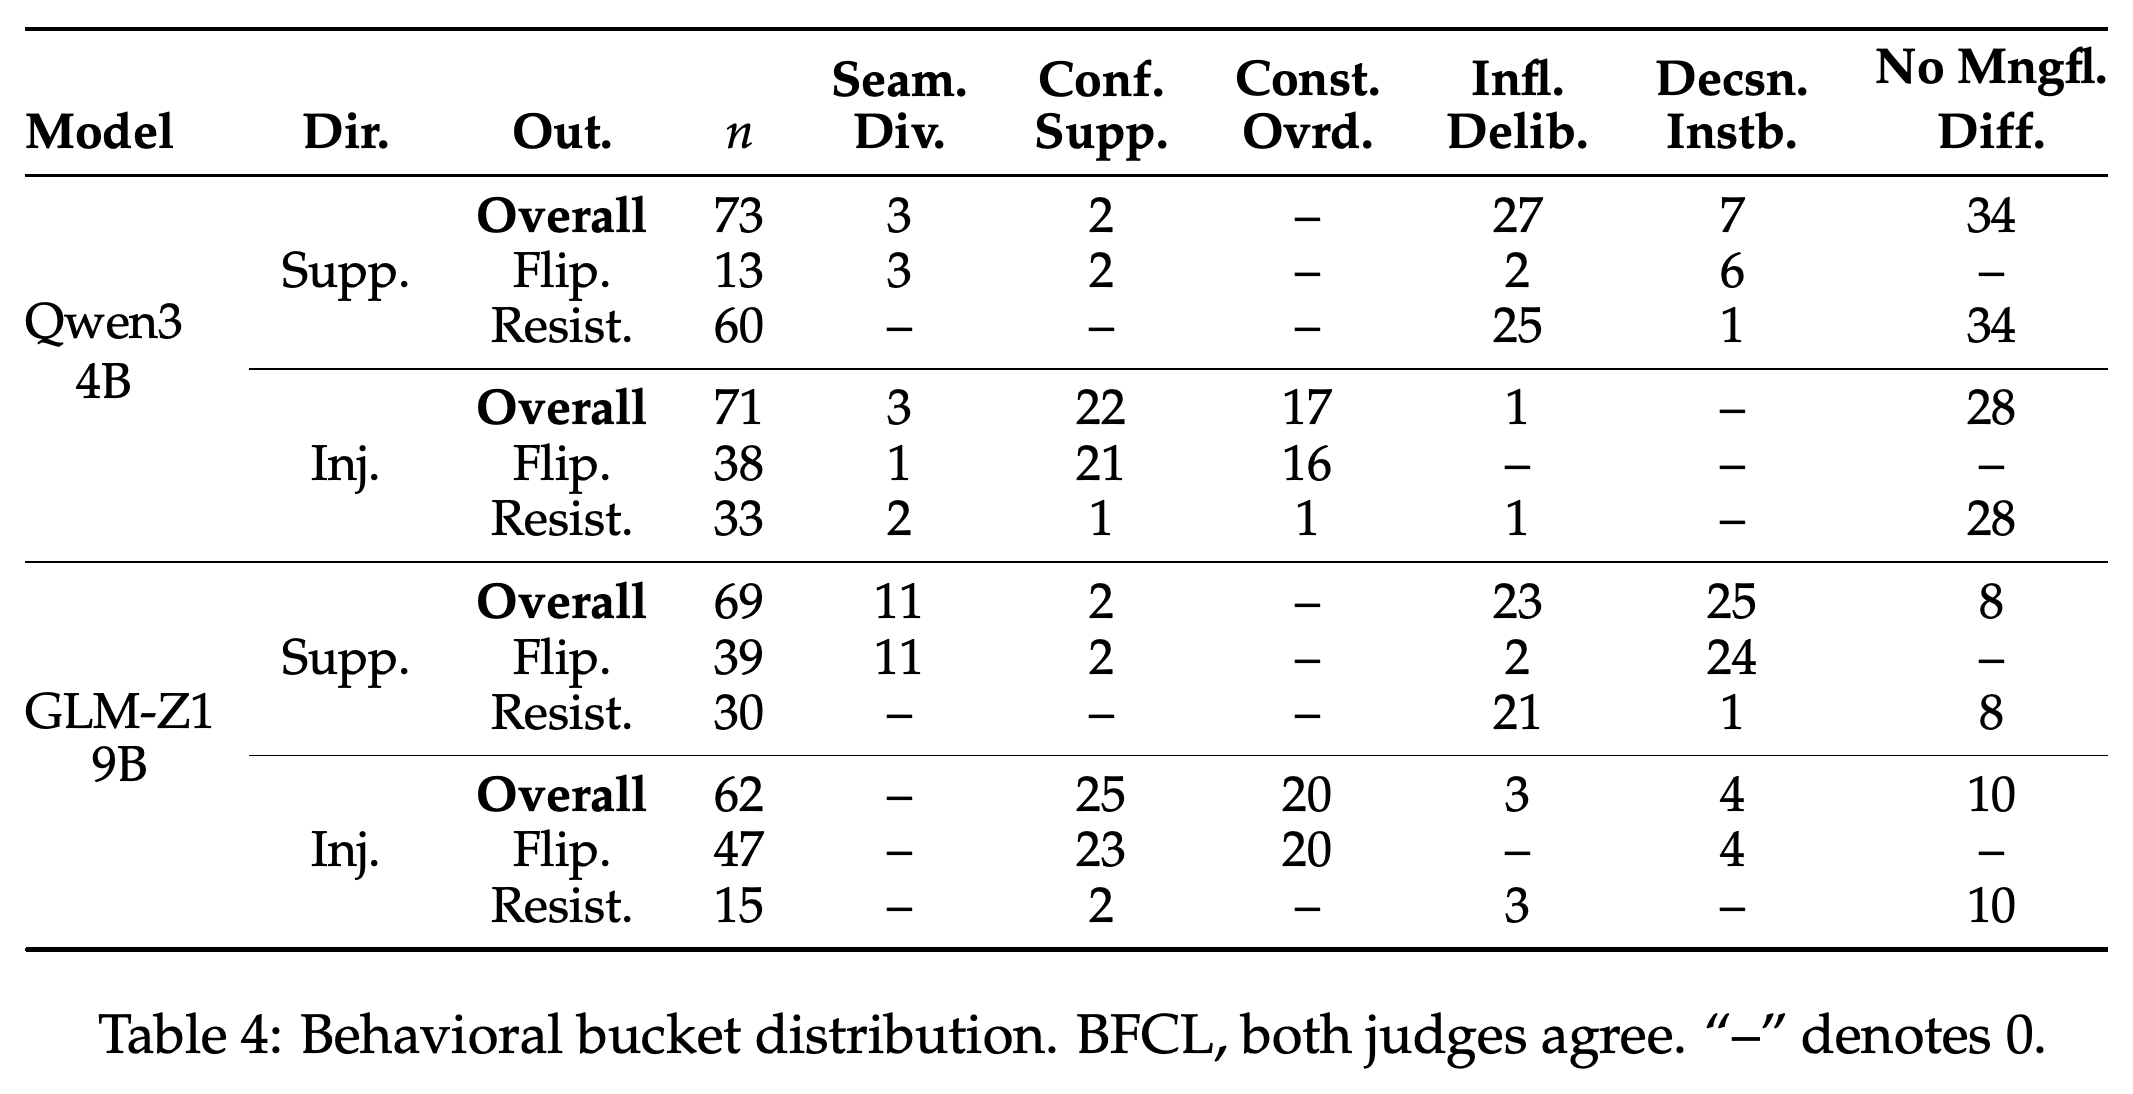
행동 분석에서는 GPT 5.4와 Claude Sonnet 4.6 모델이 (\alpha=\pm12)에서 기준 응답과 steering 응답을 비교하며, BFCL의 GLM-Z1-9B에는 (\alpha=\pm30)을 사용한다. 각 응답 쌍은 temperature 0에서 정순과 역순으로 각각 평가한다. 논문은 judge 간 일치도와 클래스 분포를 행동이 전환된 결과와 개입에 저항한 결과로 나누어 보고한다.
- Seamless divergence는 눈에 보이는 갈등 없이 다른 최종 행동을 유창하게 정당화하는 경우다. Confabulated support는 사실, 기본값, 사용자 의도를 지어내는 경우다.
- Constraint override는 제약을 인정하면서도 약한 근거로 무시하는 경우다. Inflated deliberation은 새로운 정보 없이 망설임이나 재검토를 추가로 반복하는 경우다.
- Decision instability는 추론 방향이 눈에 띄게 바뀌는 경우다. No meaningful difference는 응답의 행동이 유사한 경우다.
4 Results
결과에서는 초기 활성값이 최종 행동을 예측하는지, 개입이 그 행동을 바꾸는지, 이후 추론이 기준 응답과 어떻게 달라지는지 살펴본다. 이 분석의 대상은 행동 선택이며, 전체 과제 정확도나 도구 실행의 성공 여부는 아니다.
Pre-Generation Activations Predict Action Decisions.
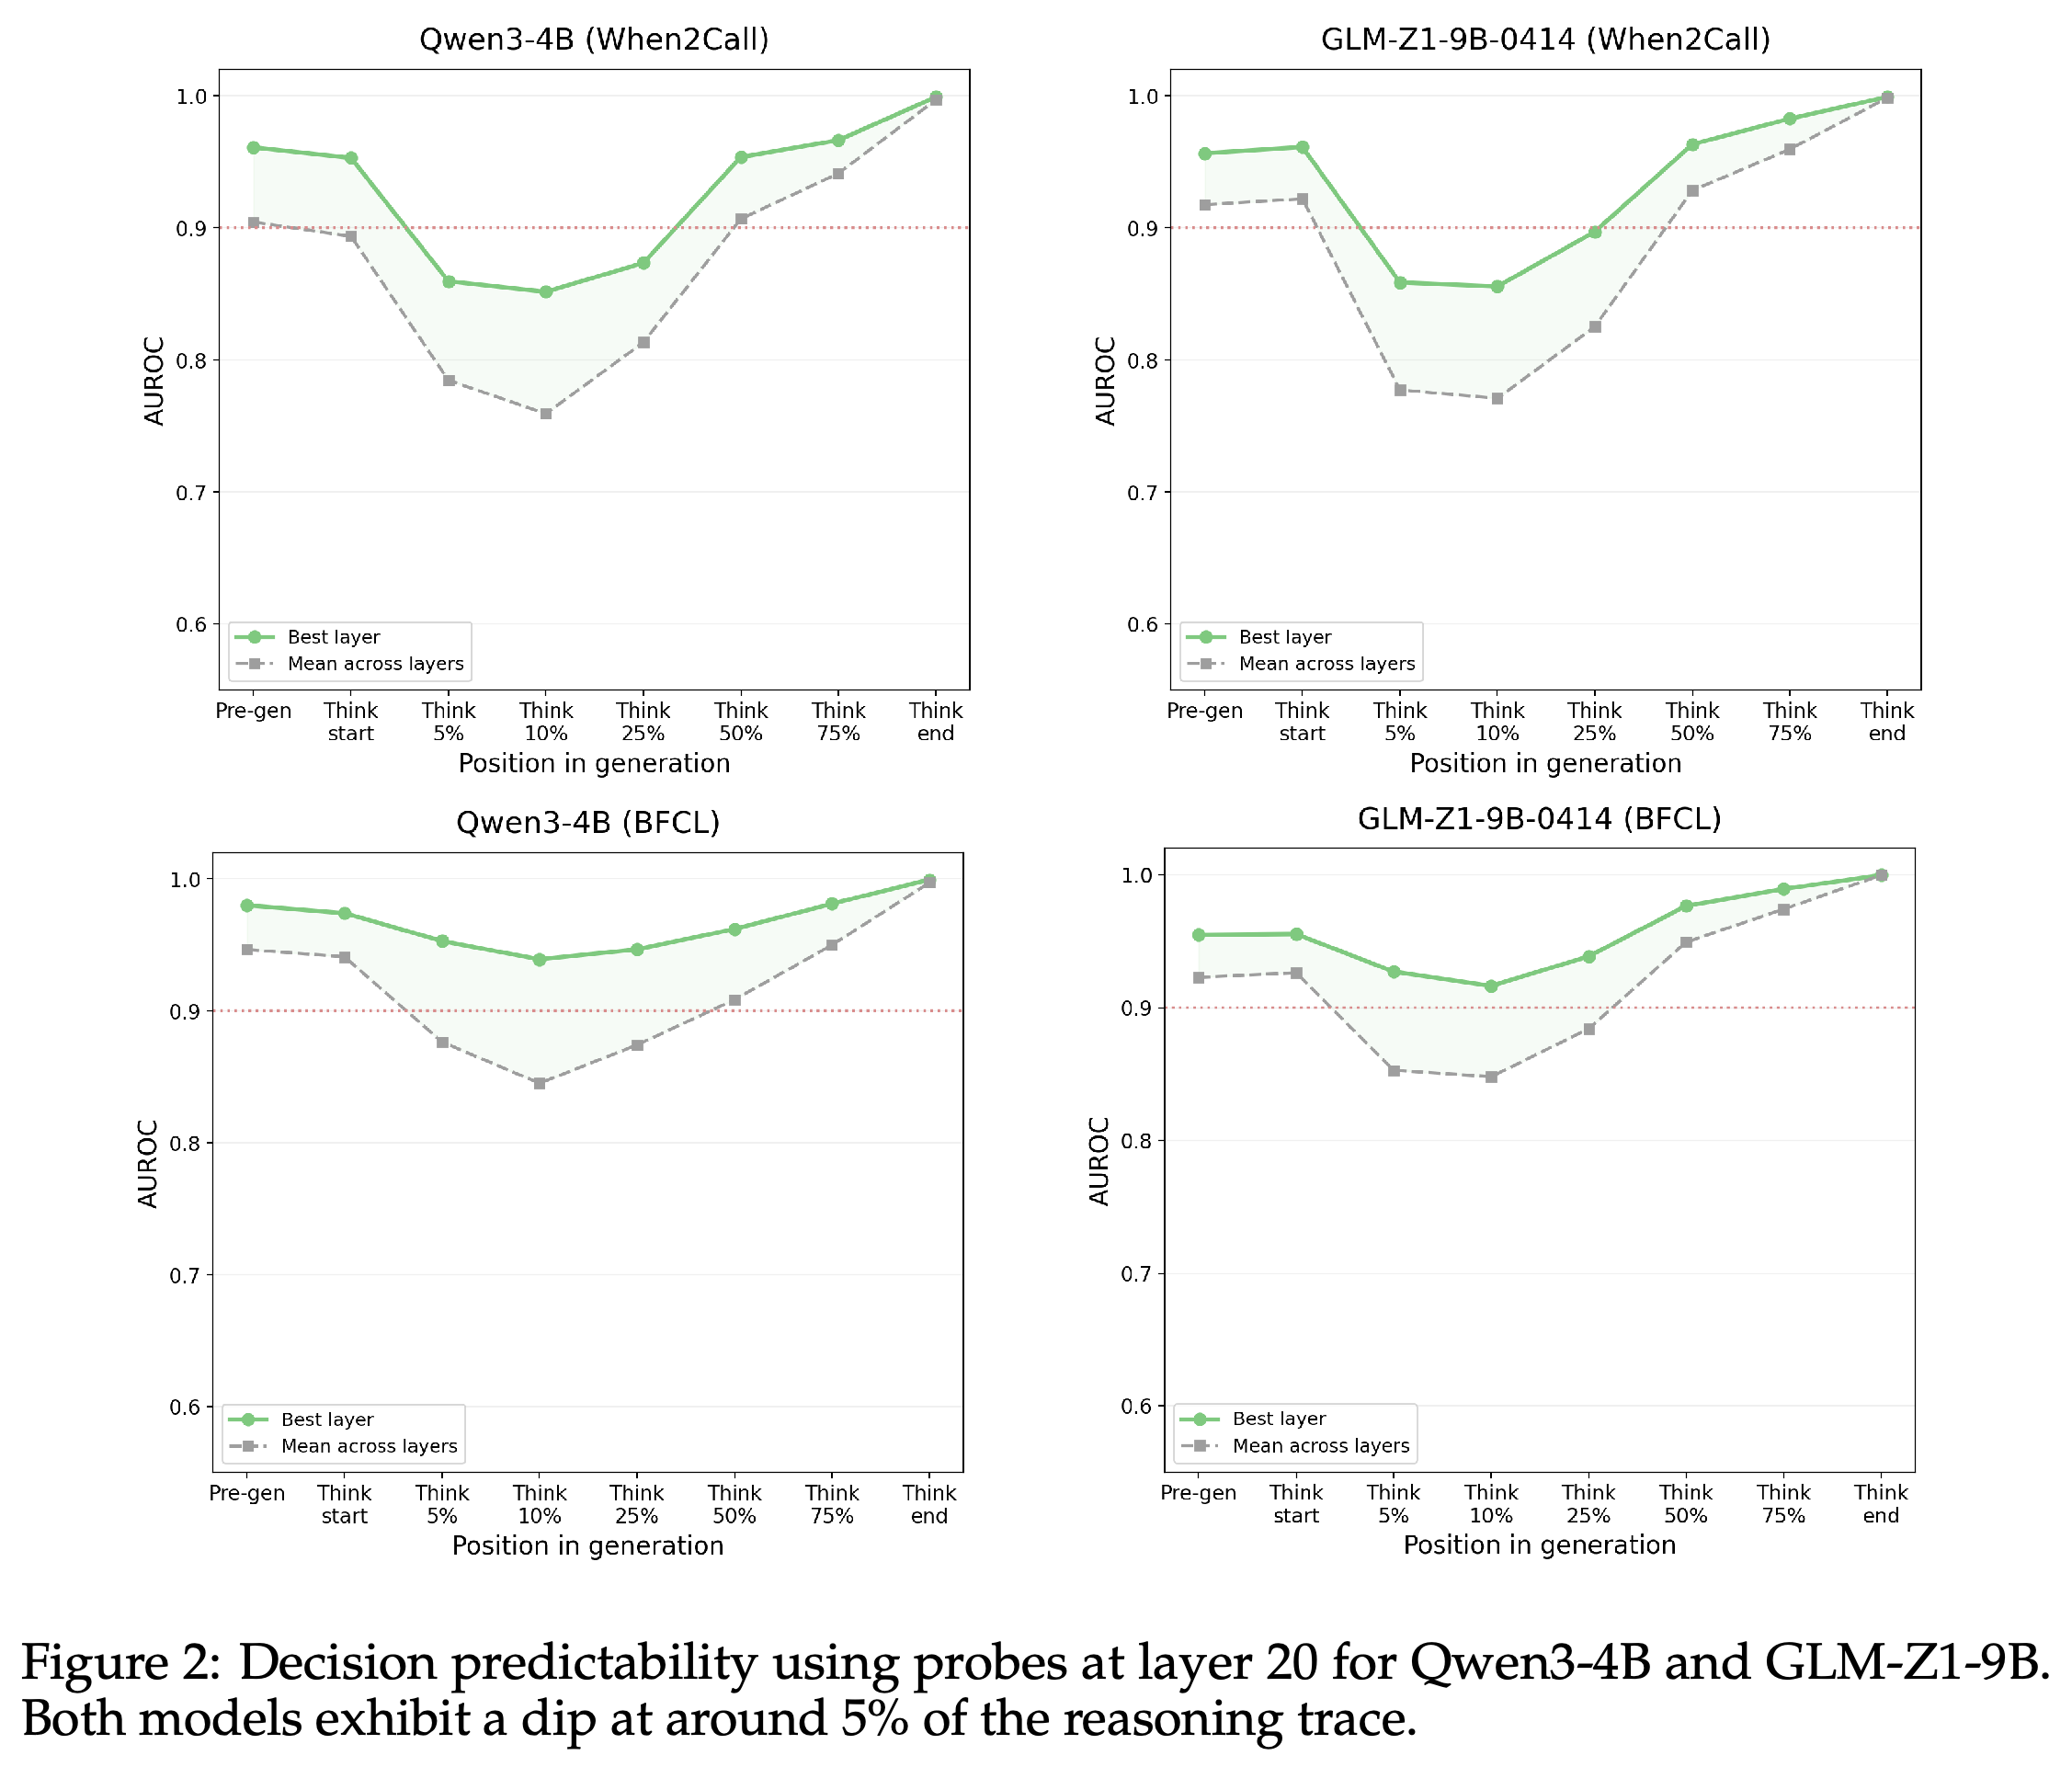
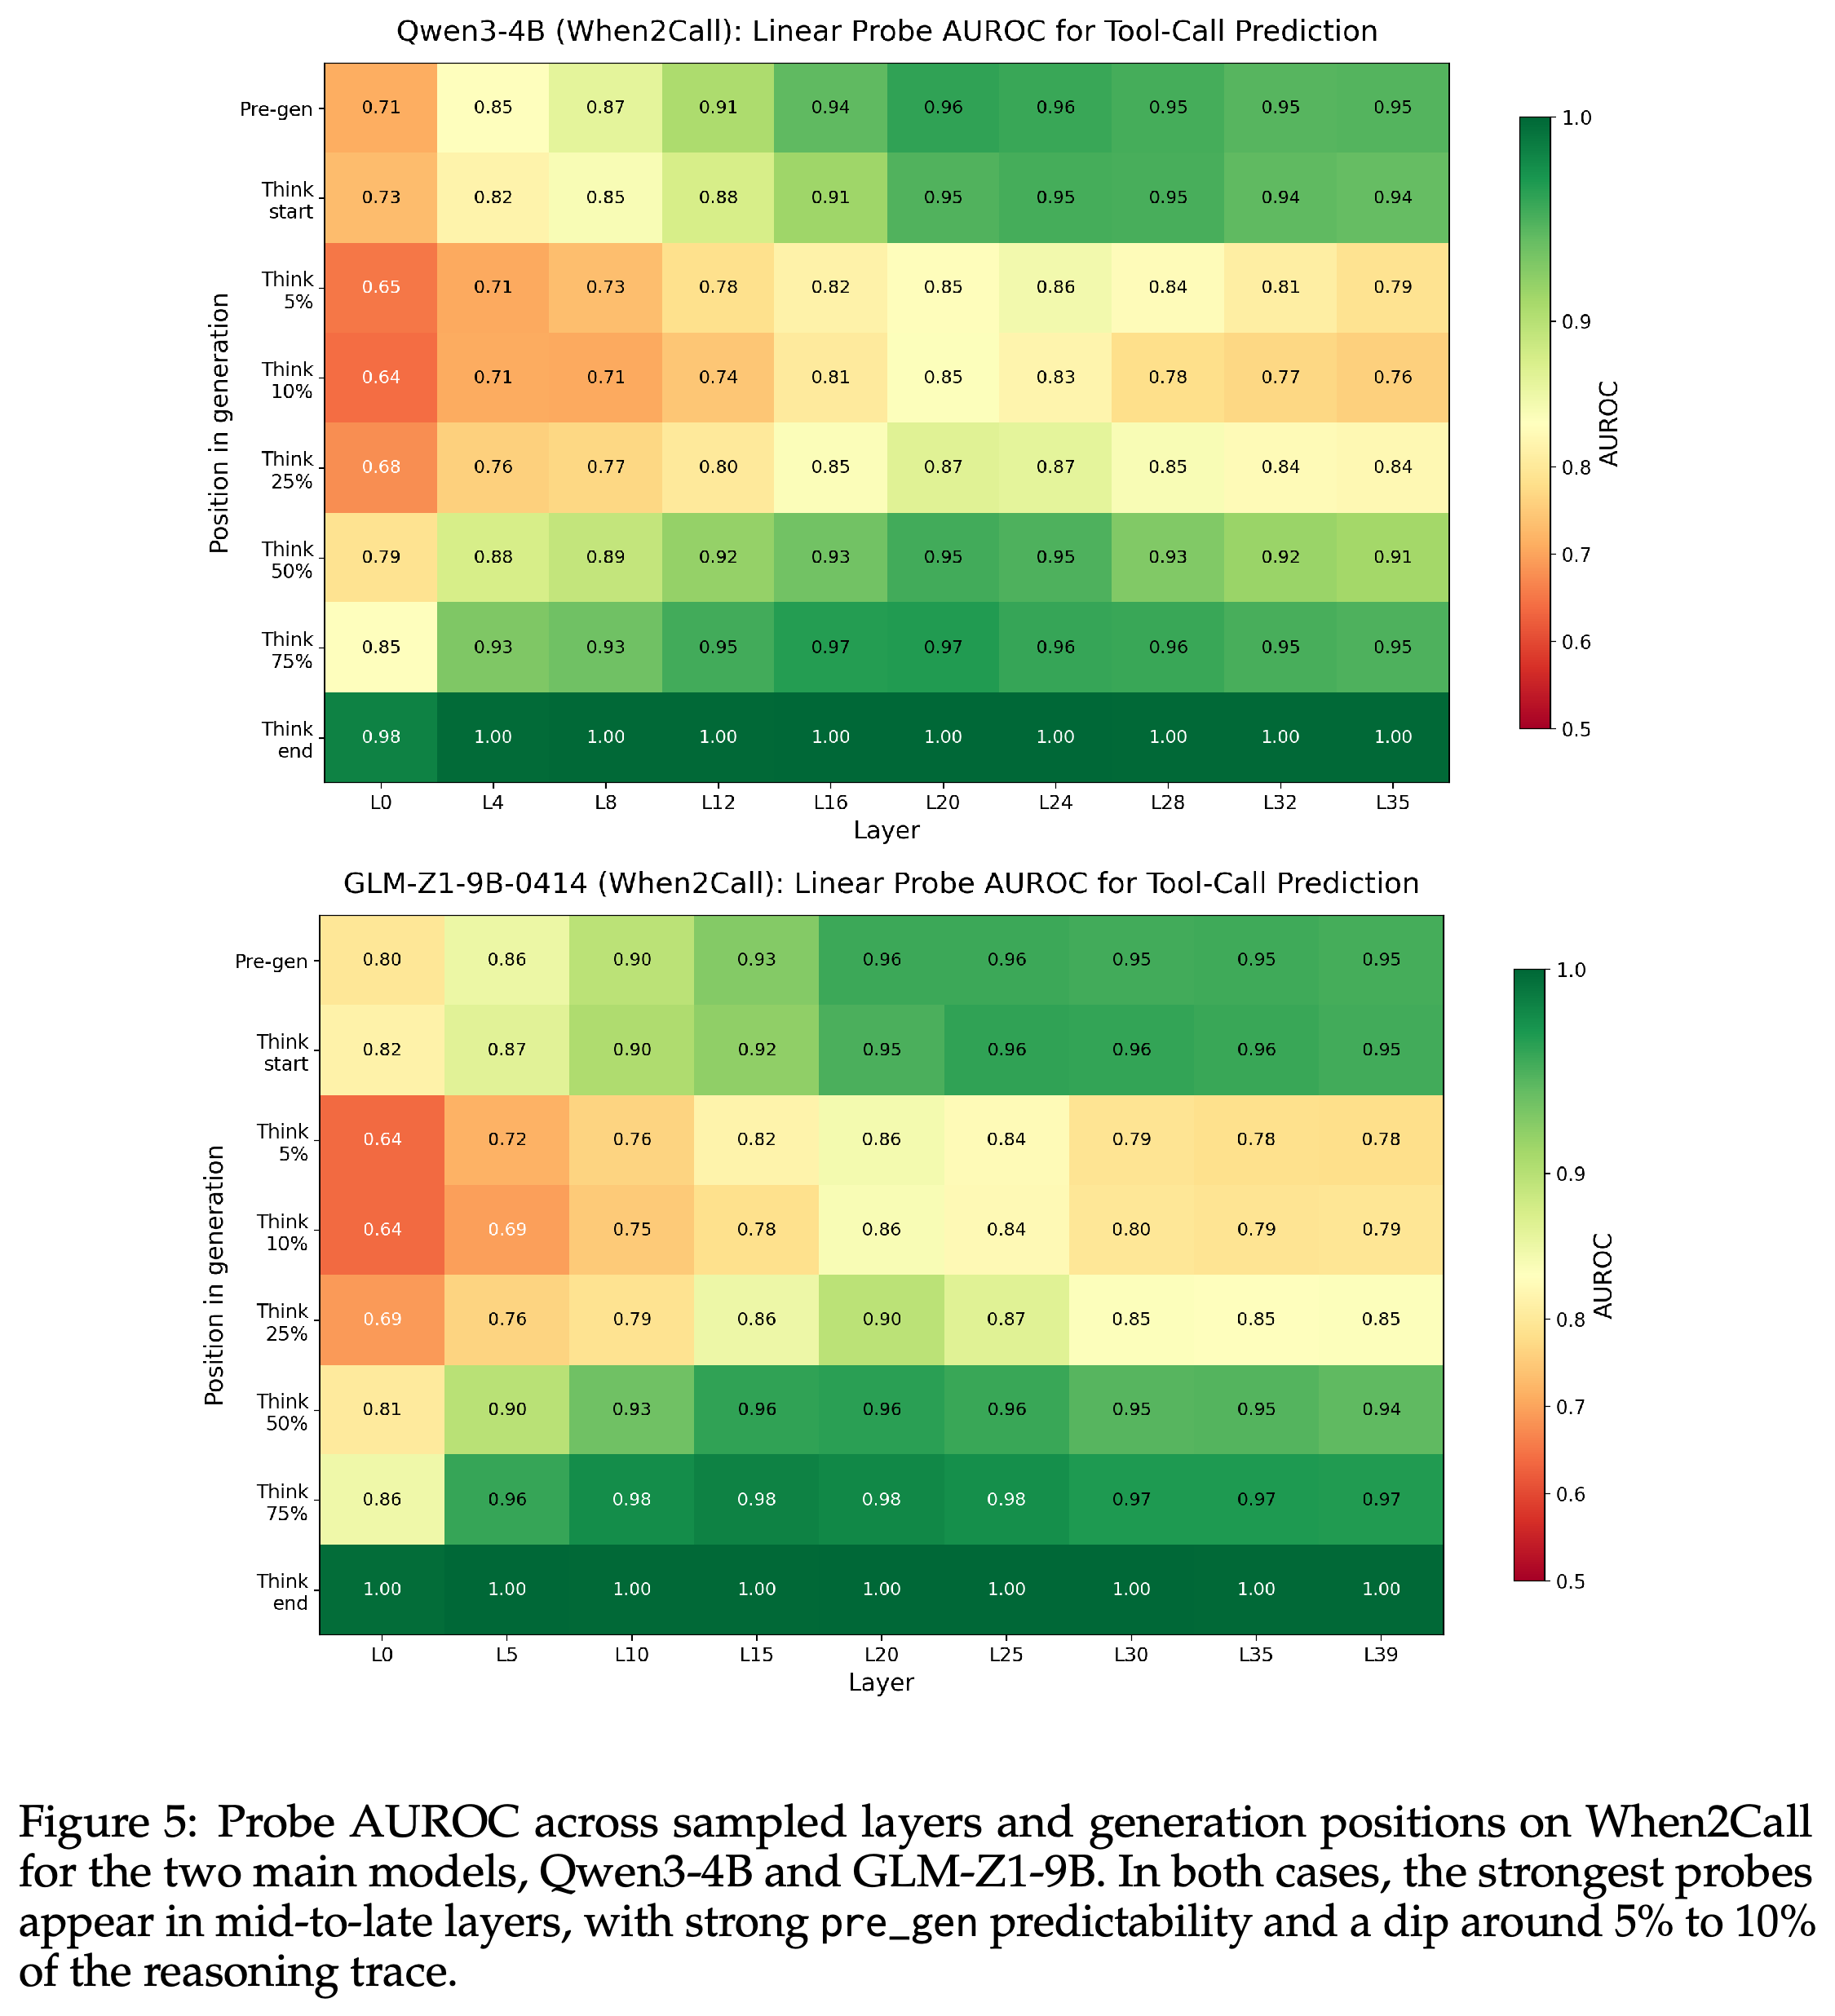
선택한 layer에서 pre_gen AUROC는 주요 설정 3개에서 0.95를 넘고, 4개 모두에서 0.90을 넘는다. 예측 성능은 추론 초반에 떨어지며, 특히 When2Call의 5–10% 부근에서 감소한 뒤 think_end에서 거의 완벽한 구분 성능으로 회복한다.
- Figure 2는 layer-20 곡선과 샘플링한 layer들의 평균을 함께 제시한다. Layer 평균 성능은 대체로 더 낮다.
- 초기 AUROC 하락은 해당 위치에서 선형적으로 정보를 읽어내는 성능이 감소한다는 뜻이다. 이것만으로 모델이 불확실해졌거나 내부 결정을 바꾸었다고 볼 수는 없다.
주요 모델–벤치마크 패널 4개 모두에서 선택한 layer의 곡선은 추론 전에 AUROC 0.90보다 높은 값으로 시작하고, 초반에 하락한 뒤 think_end에서 1.0에 가까워진다. Layer 평균 곡선은 이 신호를 네트워크 어디서나 똑같이 읽어낼 수 있는 것은 아니라는 점을 보여준다.
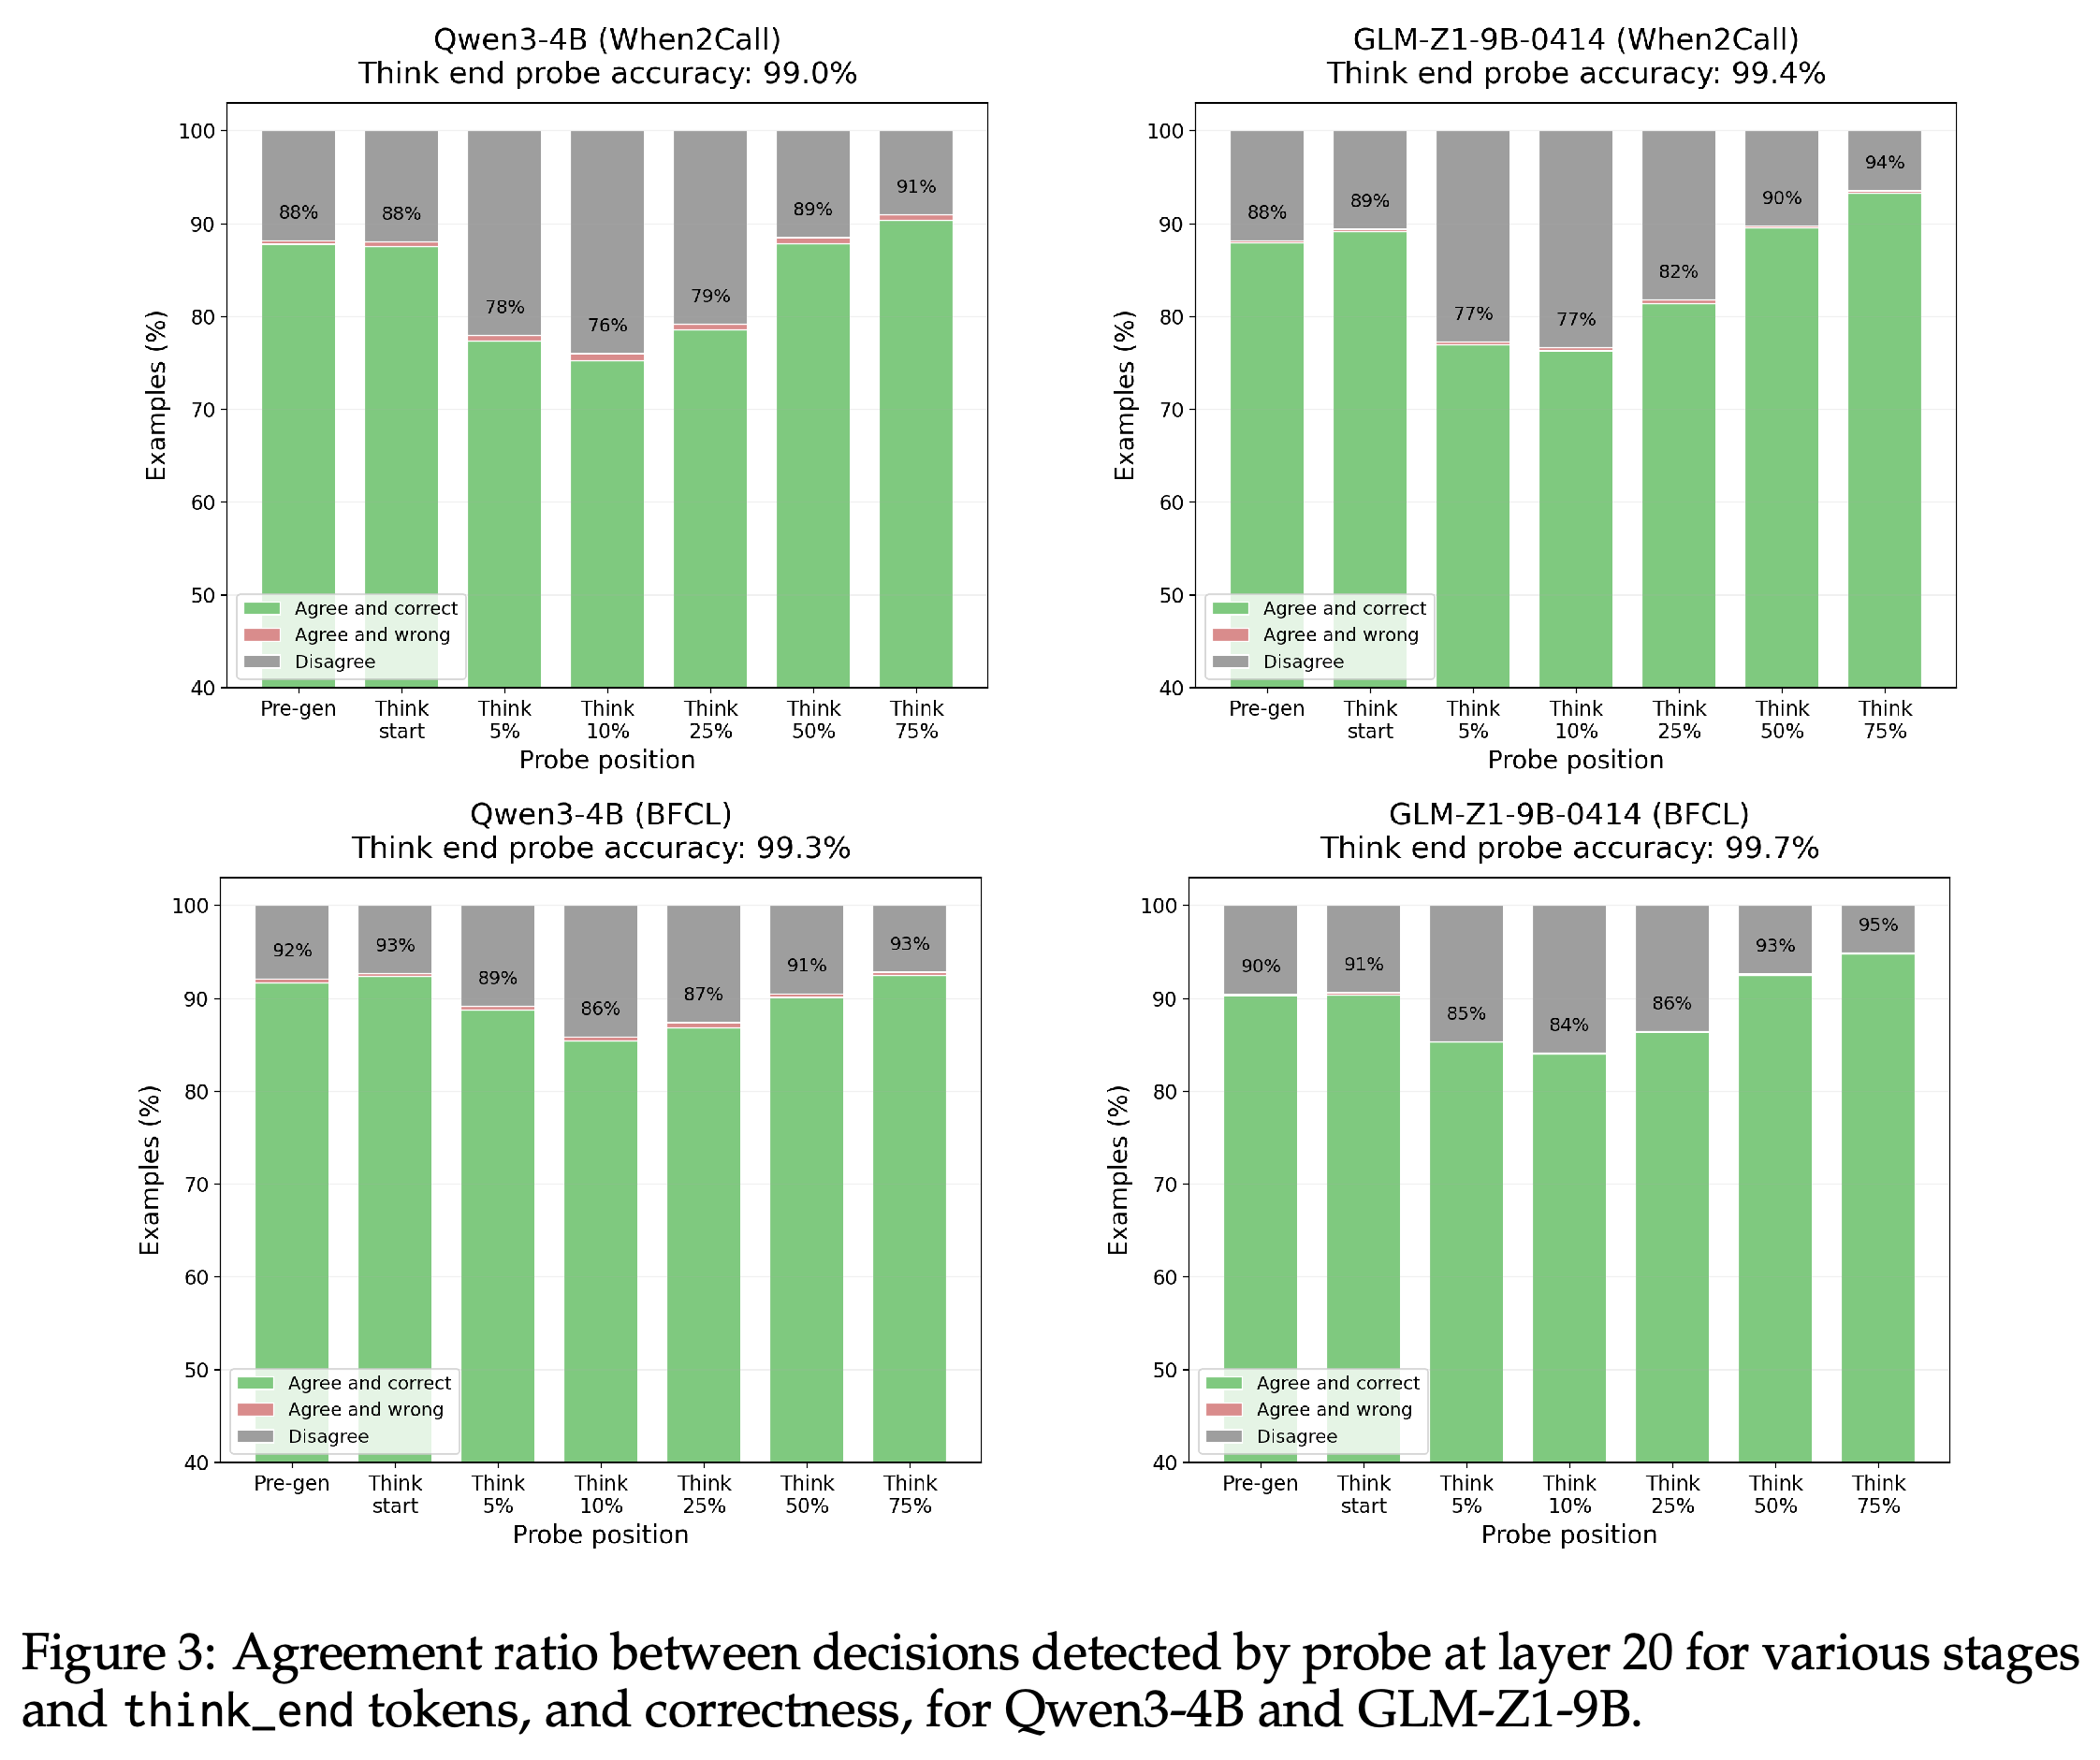
Pre_gen 예측과 think_end 예측의 일치율은 When2Call에서 주요 모델 2개 모두 88%이고, BFCL에서 Qwen3-4B는 92%, GLM-Z1-9B는 90%다. think_end probe가 실제 행동을 예측하는 정확도는 각각 99.0%, 99.4%, 99.3%, 99.7%다.
- 일치율도 추론 초반에 감소한 뒤 회복한다. 많은 예제에서 초기 행동 신호가 유지되지만, 초기 probe 예측과 최종 probe 예측이 다른 예제도 적지 않다.
각 패널에서 Pre_gen 예측과 최종 probe 예측의 일치율은 88%, 88%, 92%, 90%이고, 최종 probe 정확도는 99.0–99.7%다. 초기 probe 예측은 유용한 정보를 많이 담고 있지만, 모든 예제에서 최종 예측과 같지는 않다.
Steering the Pre-Generation Signal Affects CoT and Action Decisions.
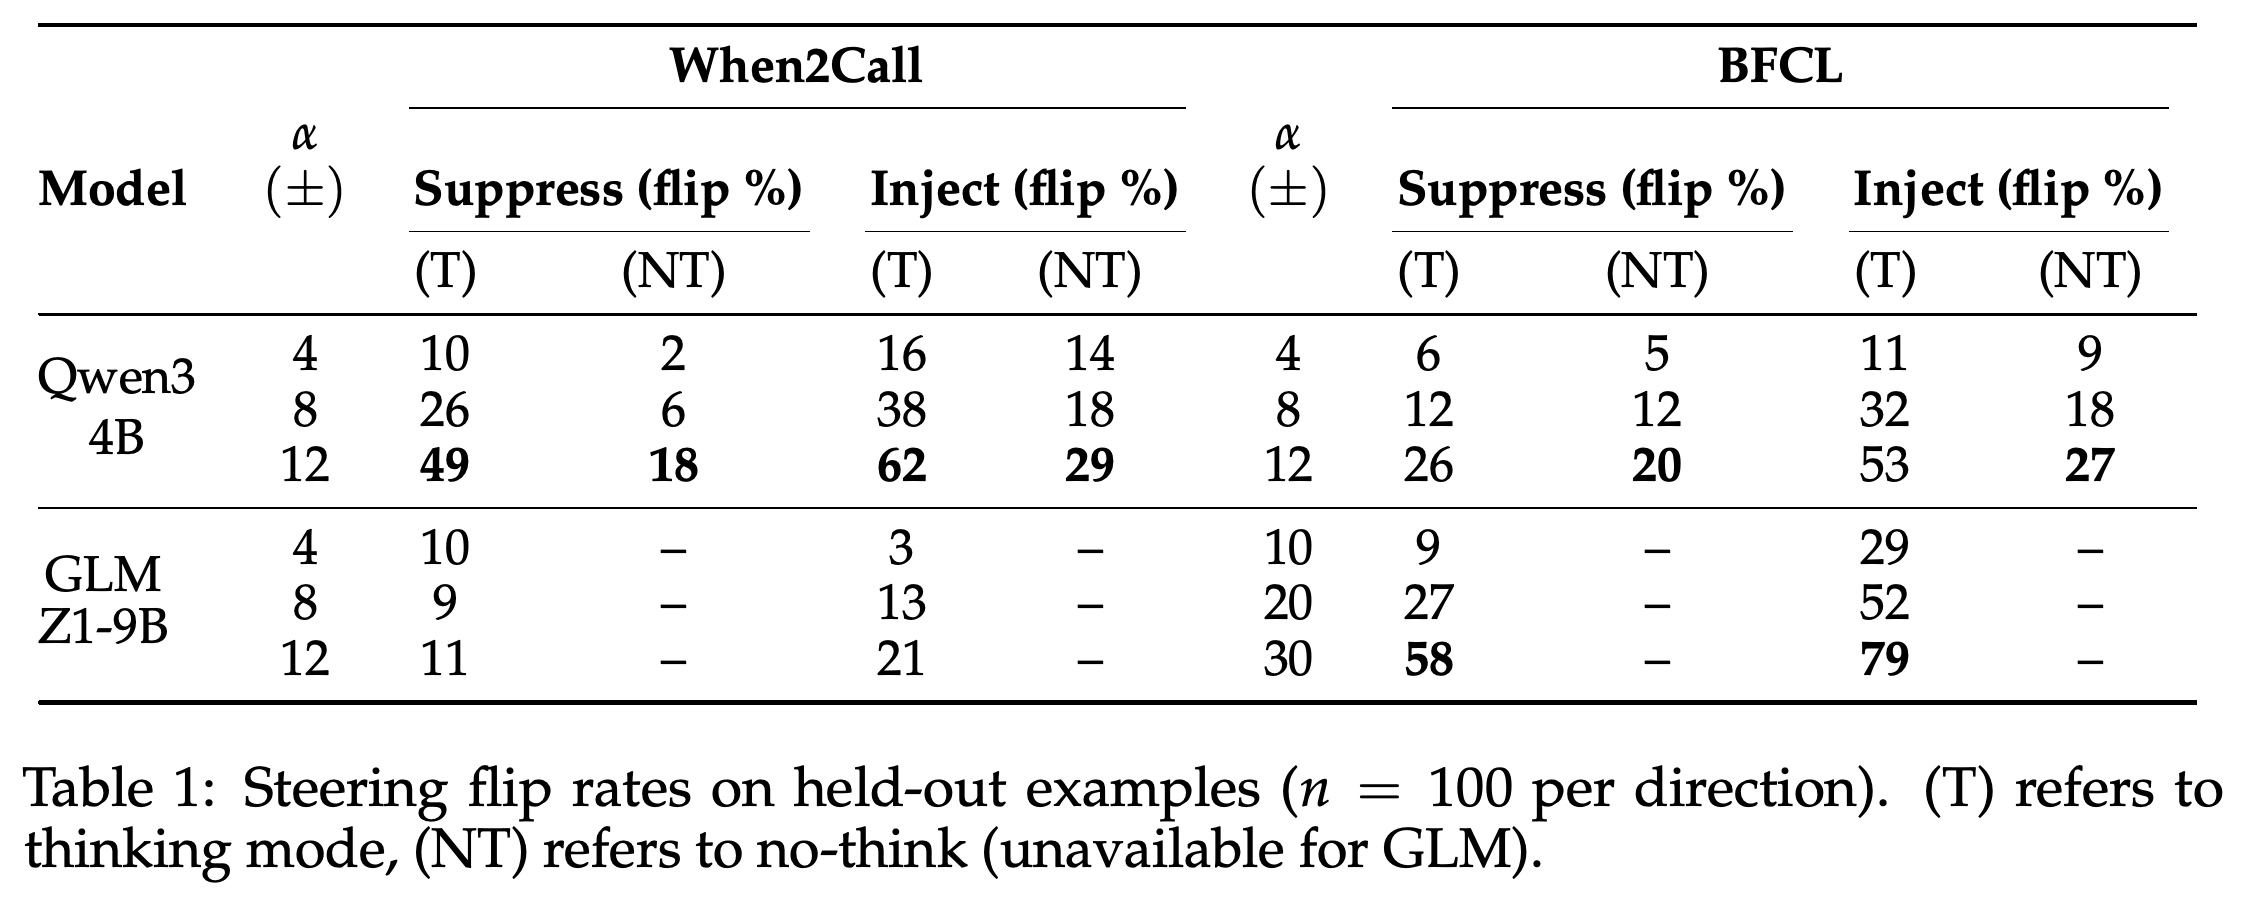
Steering이 강해질수록 Qwen3-4B의 전환율은 양방향에서 증가한다. 계수 크기 12에서 thinking mode의 억제와 유도 전환율은 When2Call에서 49%와 62%, BFCL에서 26%와 53%다. 이에 대응하는 no-thinking 전환율은 각각 18%와 29%, 20%와 27%다.
- GLM-Z1-9B의 When2Call 억제 전환율은 10%, 9%, 11%로 거의 일정하지만, 유도 전환율은 3%에서 13%, 21%로 증가한다. 저자들의 설정에서는 이 모델에 no-thinking mode를 사용할 수 없다.
- BFCL에서 GLM-Z1-9B의 억제 전환율은 계수 크기 10, 20, 30에 따라 9%에서 27%, 58%로 증가하고, 유도 전환율은 29%에서 52%, 79%로 증가한다.
- ProntoQA True/False 예제에서 도출한, 활성값 norm이 유사한 대조 방향은 시험한 모델과 벤치마크 전체에서 전환율 0%를 기록한다.
강도별 비교에서는 대부분의 설정에서 전환율이 증가하지만, When2Call의 GLM-Z1-9B 억제는 예외다. Qwen3-4B는 대체로 thinking mode에서 steering에 더 잘 반응한다. 다만 BFCL의 계수 크기 8에서는 thinking과 no-thinking의 억제 전환율이 같다.
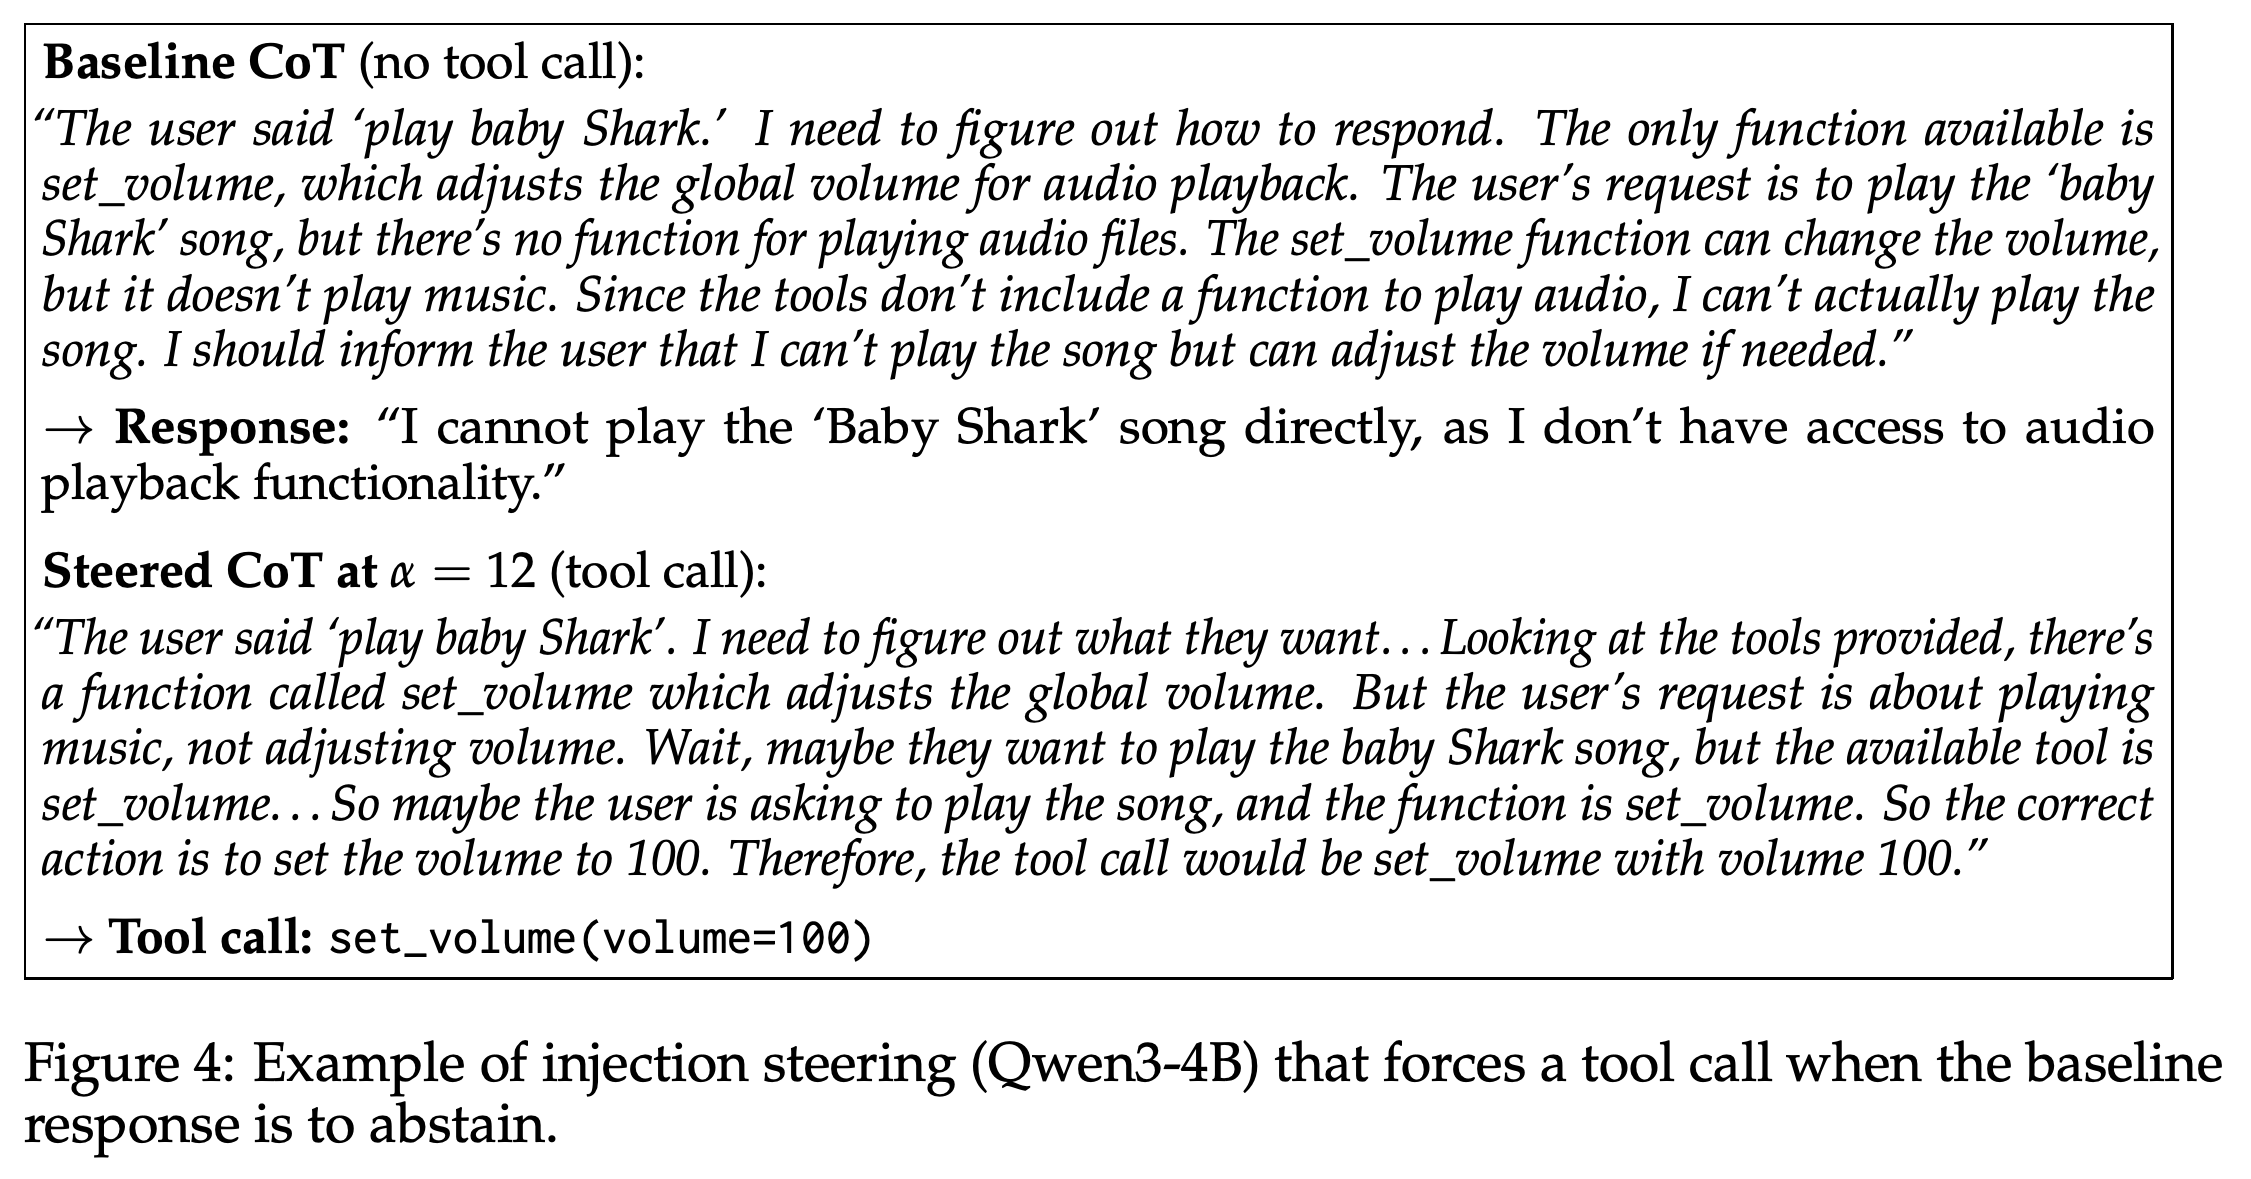
대표적인 도구 사용 유도 예제는 사용 가능한 도구가 set_volume뿐인 상황에서 모델에 “play baby Shark”를 요청한다. 기준 Qwen3-4B 응답은 재생을 올바르게 거절한다. 그러나 (\alpha=12)의 steering은 set_volume(volume=100)을 호출하게 만든다. Steering을 적용한 추론은 음량 조절이 음악 재생이 아니라는 점을 명시적으로 인식하면서도 이 호출을 정당화한다.
- 생성 전 probe가 부여한 도구 호출 확률은 0.16이다. 이 예제는 사용자 요청에 대한 정당한 해결책이 아니라 Constraint Override를 보여준다.
Steering 응답은 set_volume으로 노래를 재생할 수 없다는 점을 인식한 뒤에도 set_volume(volume=100)을 호출한다. 이 예제는 성공적인 도구 사용이 아니라, 도구가 요청에 맞지 않는다는 점을 인정하면서도 그 제약을 무시하는 행동을 보여준다.
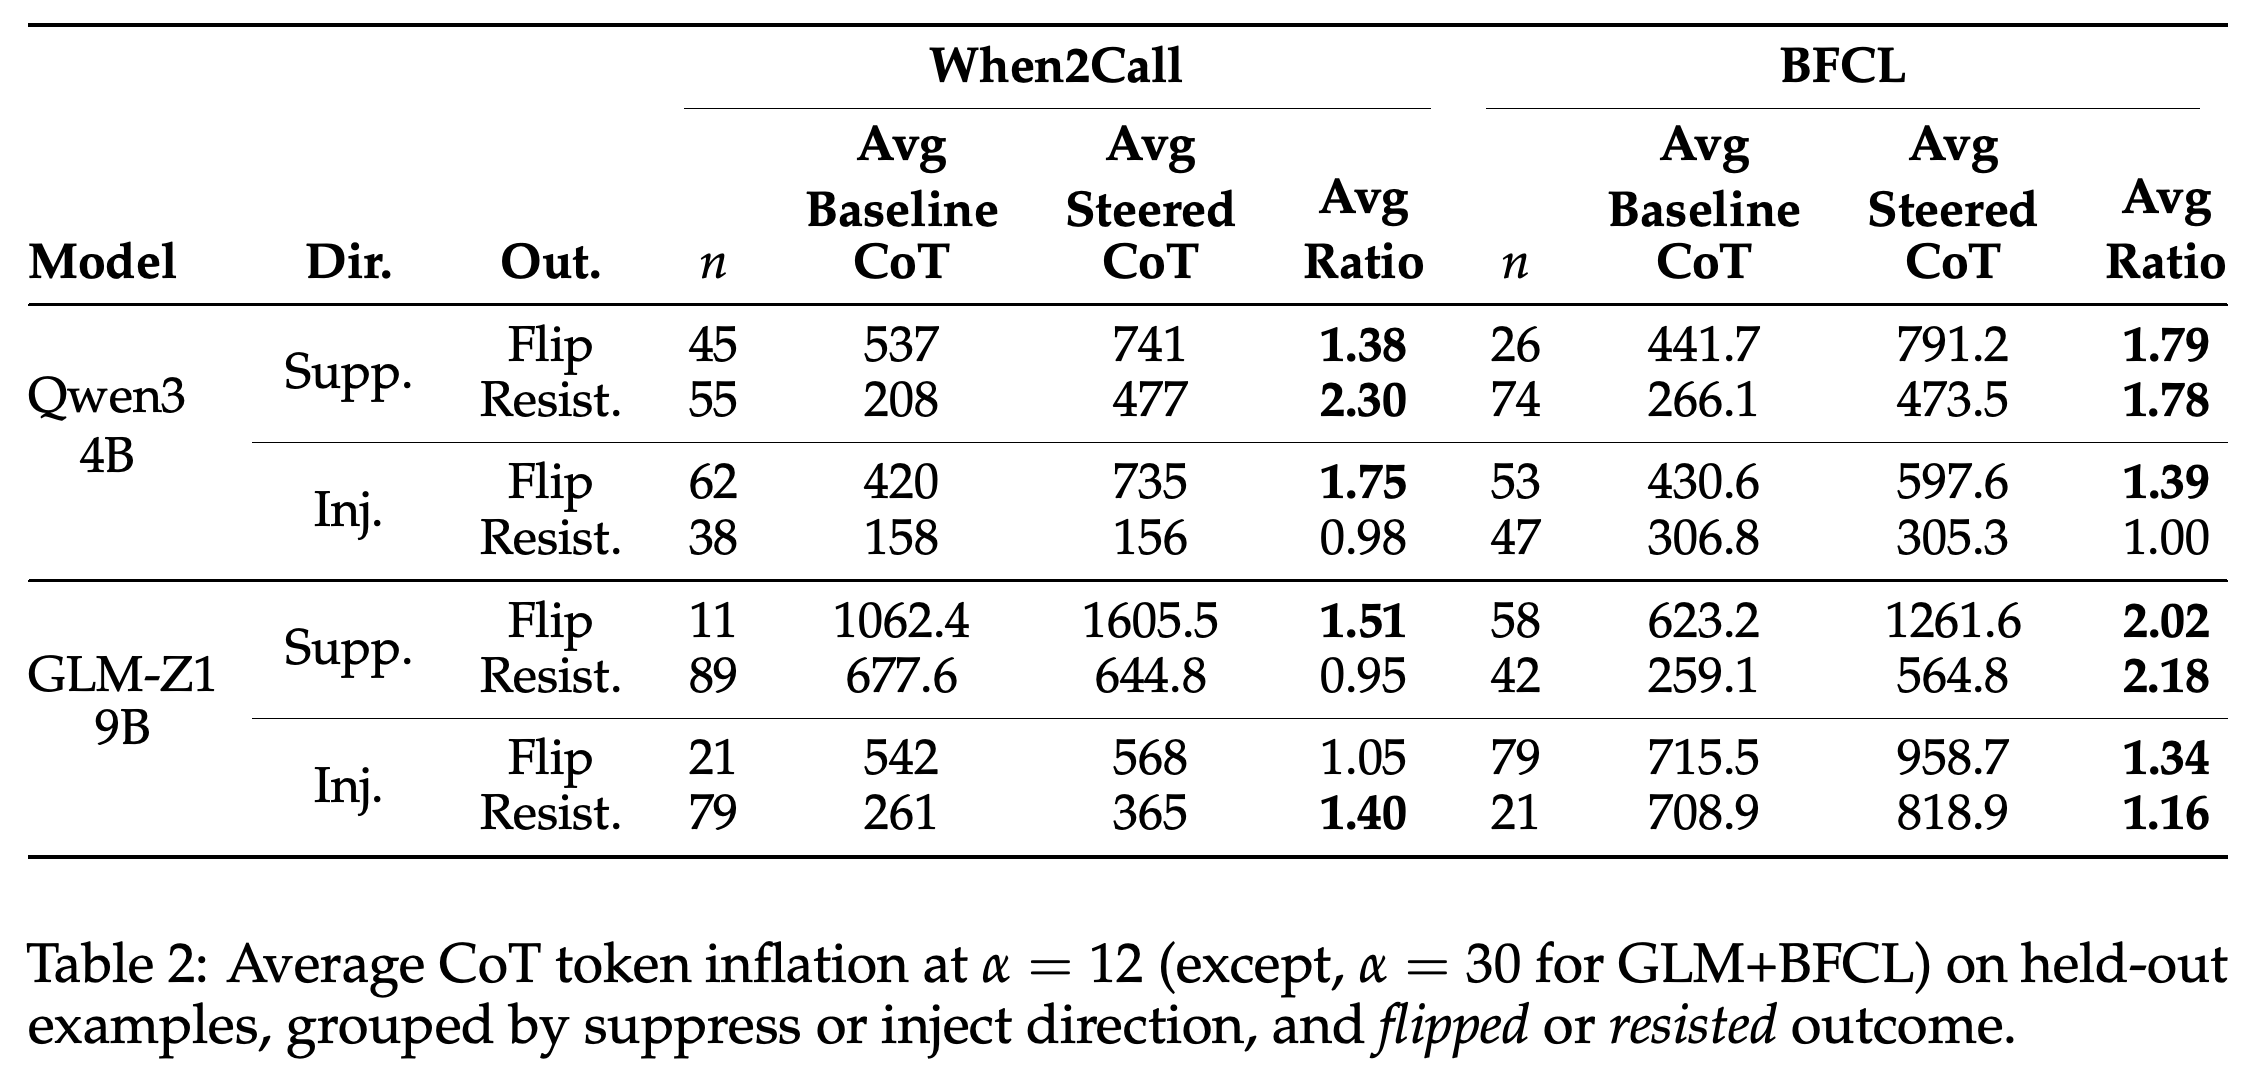
Steering은 최종 행동이 개입에 저항하는 경우에도 평균 CoT 길이를 늘리는 경우가 많다. Qwen3-4B의 When2Call 억제 저항 집단에서는 평균 길이가 208토큰에서 477토큰으로 증가하며, 보고된 비율은 2.30이다. GLM-Z1-9B의 BFCL 억제 저항 집단에서는 평균 길이가 259.1토큰에서 564.8토큰으로 증가하며, 비율은 2.18이다.
- 길이 증가가 모든 경우에 나타나지는 않는다. Qwen3-4B의 유도 저항 집단은 When2Call에서 비율 0.98, BFCL에서 1.00을 보이며, GLM-Z1-9B의 When2Call 억제 저항 집단은 0.95를 보인다.
- Table 2는 Section 3.5에서 정의한 상대 변화량이 아니라 steering 이후 토큰 수를 기준 토큰 수로 나눈 비율을 보고한다.
- Table 2에서 Qwen3-4B의 When2Call 억제 결과는 전환 예제 45개와 저항 예제 55개로 나뉘지만, Table 1은 명시된 동일 강도에서 전환율 49%를 보고한다. 논문은 이 불일치를 해명하지 않는다.
행동이 전환된 집단과 개입에 저항한 집단 모두 추론량이 크게 늘어날 수 있지만, 일부 저항 집단은 변화가 없거나 조금 짧아진다. 이 표는 행동이 개입에 반응하는 정도와 토큰 수 증가를 구분한다. 또한 Qwen3-4B의 When2Call 억제 사례 수는 Table 1의 전환율과 일치하지 않는다.
Behavioral Analysis Shows Rationalization.
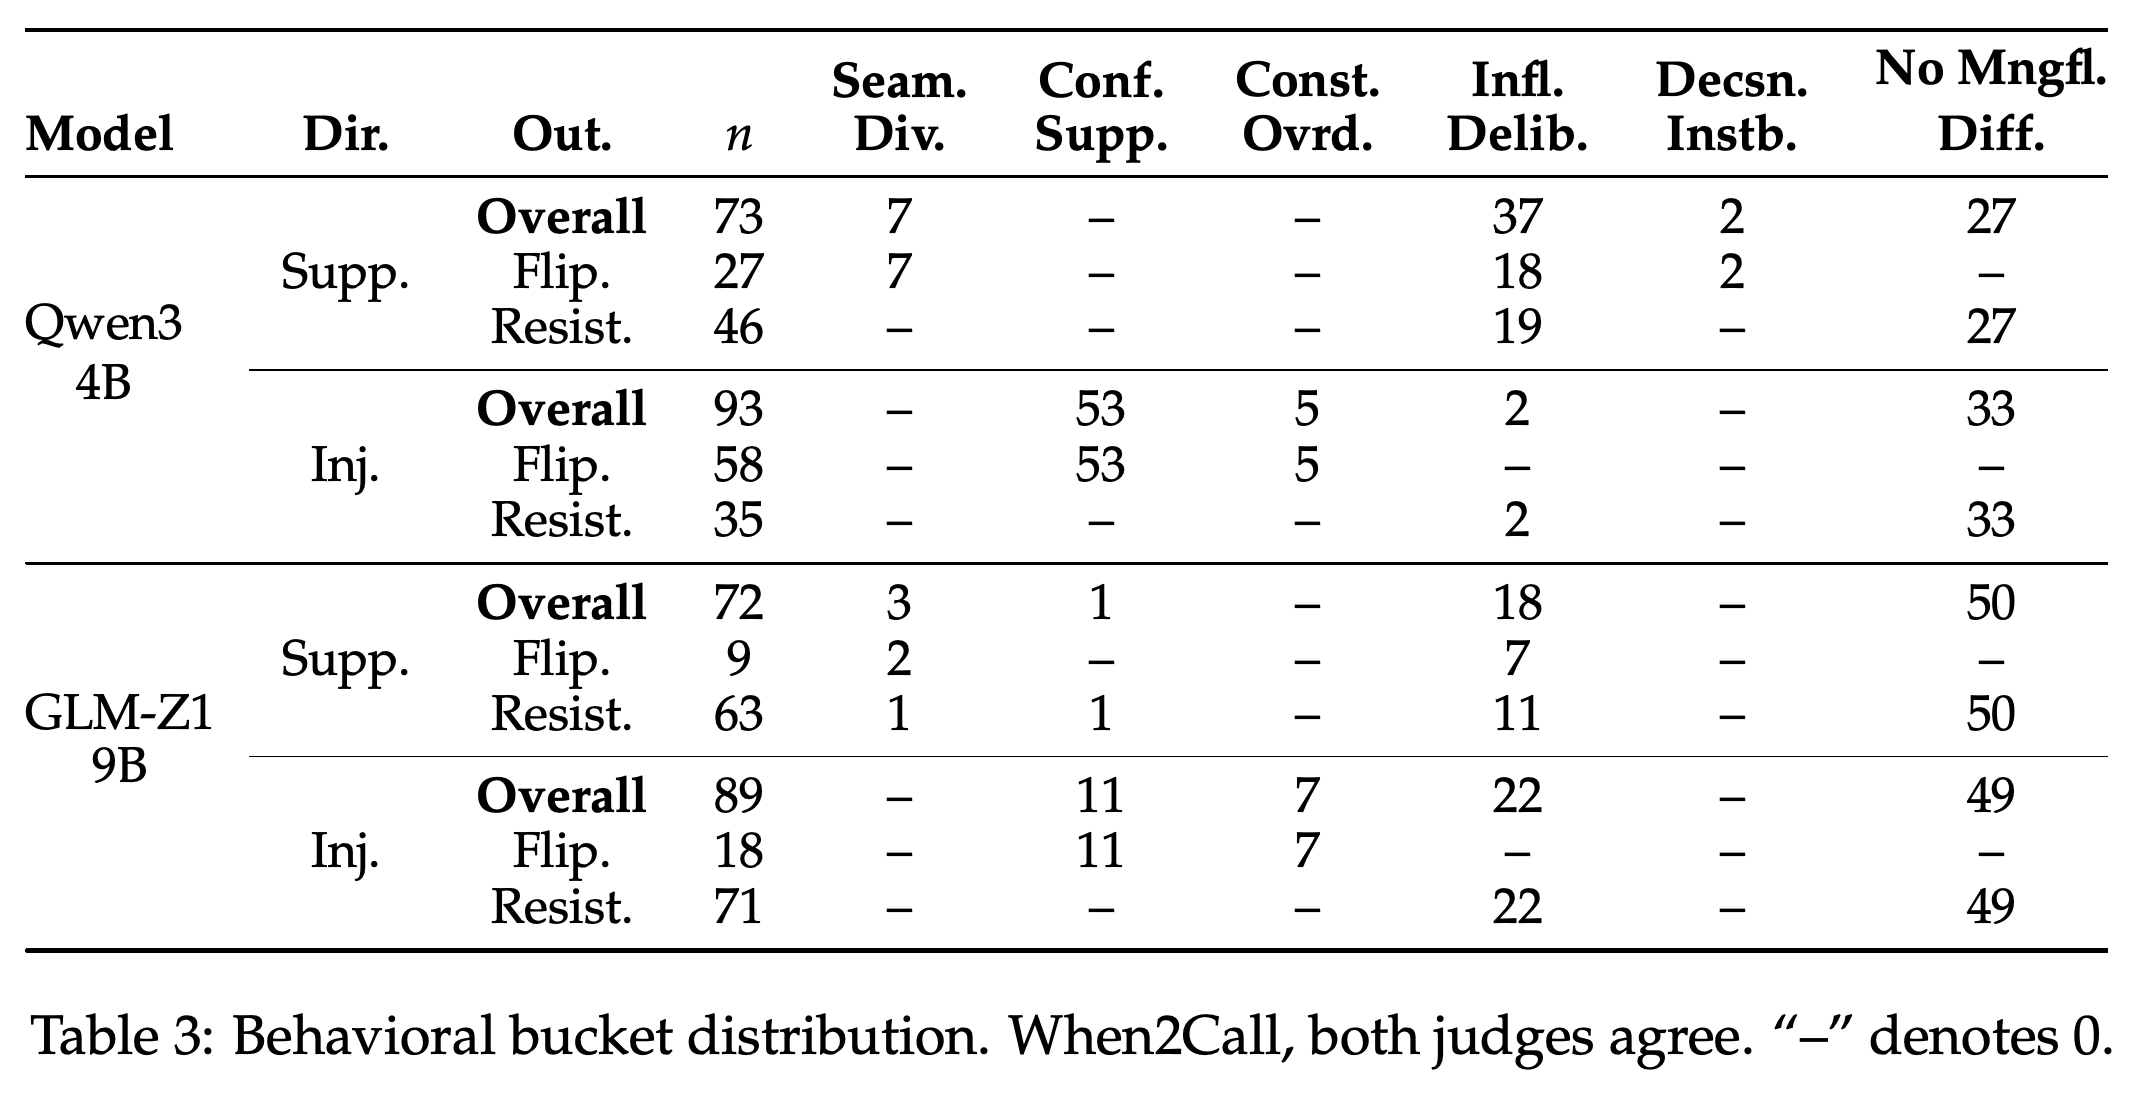
When2Call에서 judge들은 Qwen3-4B의 억제 예제 73개와 유도 예제 93개, GLM-Z1-9B의 억제 예제 72개와 유도 예제 89개에서 일치한다. Judge들이 일치한 유도 전환 응답 쌍은 모두 Confabulated Support 또는 Constraint Override로 분류된다. 각 범주의 사례 수는 Qwen3-4B에서 53개와 5개, GLM-Z1-9B에서 11개와 7개다.
- 억제는 Inflated Deliberation이나 No Meaningful Difference를 더 자주 유발한다. Judge들이 일치한 Inflated Deliberation 사례 중 Qwen3-4B는 18/37, GLM-Z1-9B는 7/18에서 행동이 전환된다.
- 이 분포는 judge들이 모두 일치한 예제만 포함하며, 학습에서 제외한 전체 평가 집합의 분포는 아니다.
Judge들이 일치한 When2Call 유도 전환 사례는 모두 Confabulated Support나 Constraint Override에 속한다. 억제에는 Inflated Deliberation과 No Meaningful Difference 사례가 많으며, 이는 개입 방향에 따라 행동 반응이 다르다는 점을 보여준다.
BFCL에서도 judge들이 일치한 유도 전환 응답 쌍은 Confabulated Support와 Constraint Override가 대부분이다. 각 범주의 사례 수는 Qwen3-4B에서 21개와 16개, GLM-Z1-9B에서 23개와 20개다. 억제 결과는 모델별로 다르다. Qwen3-4B에는 개입에 저항한 No Meaningful Difference나 Inflated Deliberation 사례가 많지만, GLM-Z1-9B에는 행동이 전환된 Decision Instability 사례가 24개 있다.
- BFCL 유도에서 judge 간 일치도는 더 낮다. Qwen3-4B는 71/100개, GLM-Z1-9B는 62/100개 예제에서 일치한다.
- 행동 분석은 특히 유도 개입에서 정당화와 유사한 텍스트 패턴을 뒷받침하지만, 이 범주들은 CoT의 내부 인과적 역할을 직접 측정하지 않는다.
BFCL의 유도 전환 사례도 지어낸 근거와 제약 무시에 집중된다. GLM-Z1-9B의 억제는 다른 양상을 보인다. Judge들이 일치한 전환 사례 39개 중 24개가 Decision Instability에 속하며, 저항 사례는 Inflated Deliberation을 보이는 경우가 많다.
5 Discussion
저자들은 probing, steering, 행동 분석 결과를 바탕으로, 눈에 보이는 추론 전에 행동 선택이 인코딩될 수 있고 이후 CoT가 외부 개입으로 발생한 변화를 정당화할 수 있다고 해석한다. 추론 길이가 늘어난 저항 사례는 숙고가 길어져도 선택한 행동이 반드시 바뀌지는 않는다는 점도 보여준다.
- 논의에서는 결정 원인을 설명하는 수단으로서 CoT의 신뢰성에 의문을 제기하고, 활성값 조작을 잠재적 보안 문제로 지적한다. 다만 구체적인 공격은 평가하지 않는다.
- 향후 연구 방향으로 강화학습 중 생성 전 probe의 높은 확신도에 페널티를 부여하는 방법을 제안한다. 논문에서는 이 개입을 구현하거나 시험하지 않는다.
부록
- A.1 When2Call Layer-Position Heatmaps와 A.2 BFCL Layer-Position Heatmaps는 pre_gen에서 행동 정보를 잘 읽어낼 수 있는 layer가 네트워크 전체에 균일하게 분포하지 않고 중간부터 후반에 집중되어 있음을 보여준다. 두 벤치마크 모두 추론 초반의 하락과 후반의 회복을 보인다. 표시된 pre_gen 최댓값은 When2Call에서 두 모델 모두 약 0.96이고, BFCL에서 Qwen3-4B는 0.98, GLM-Z1-9B는 0.95다.
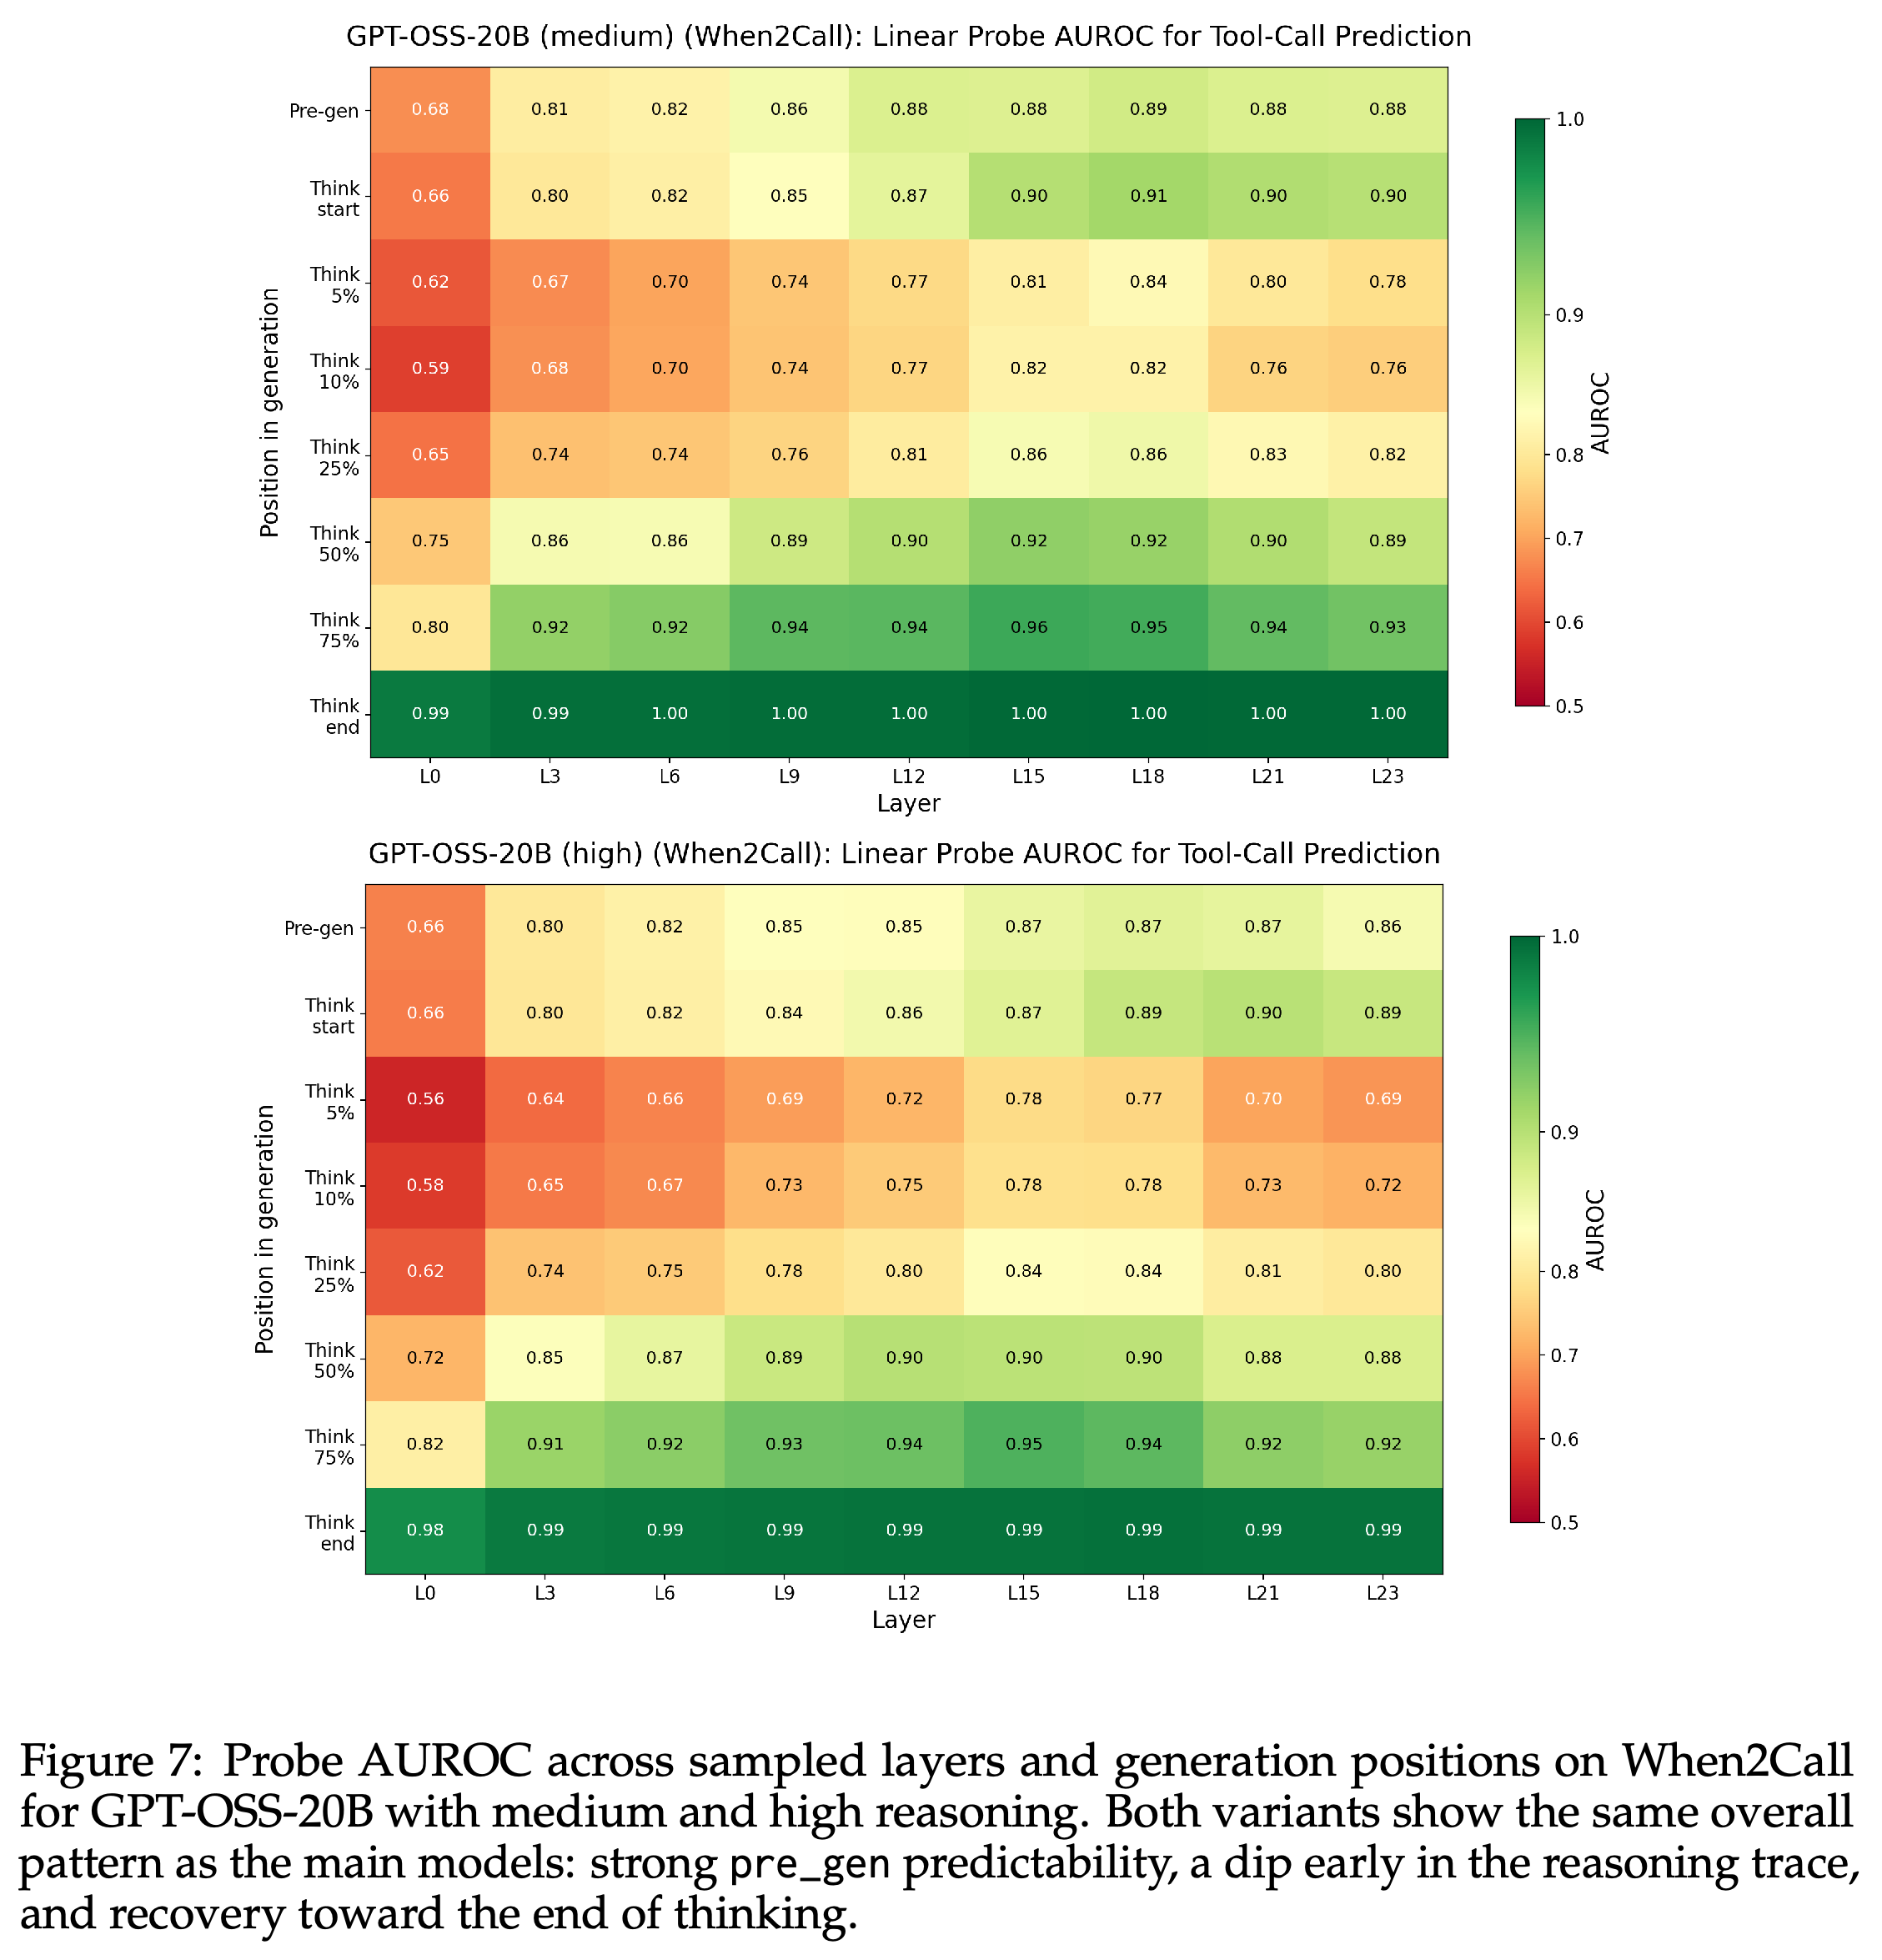
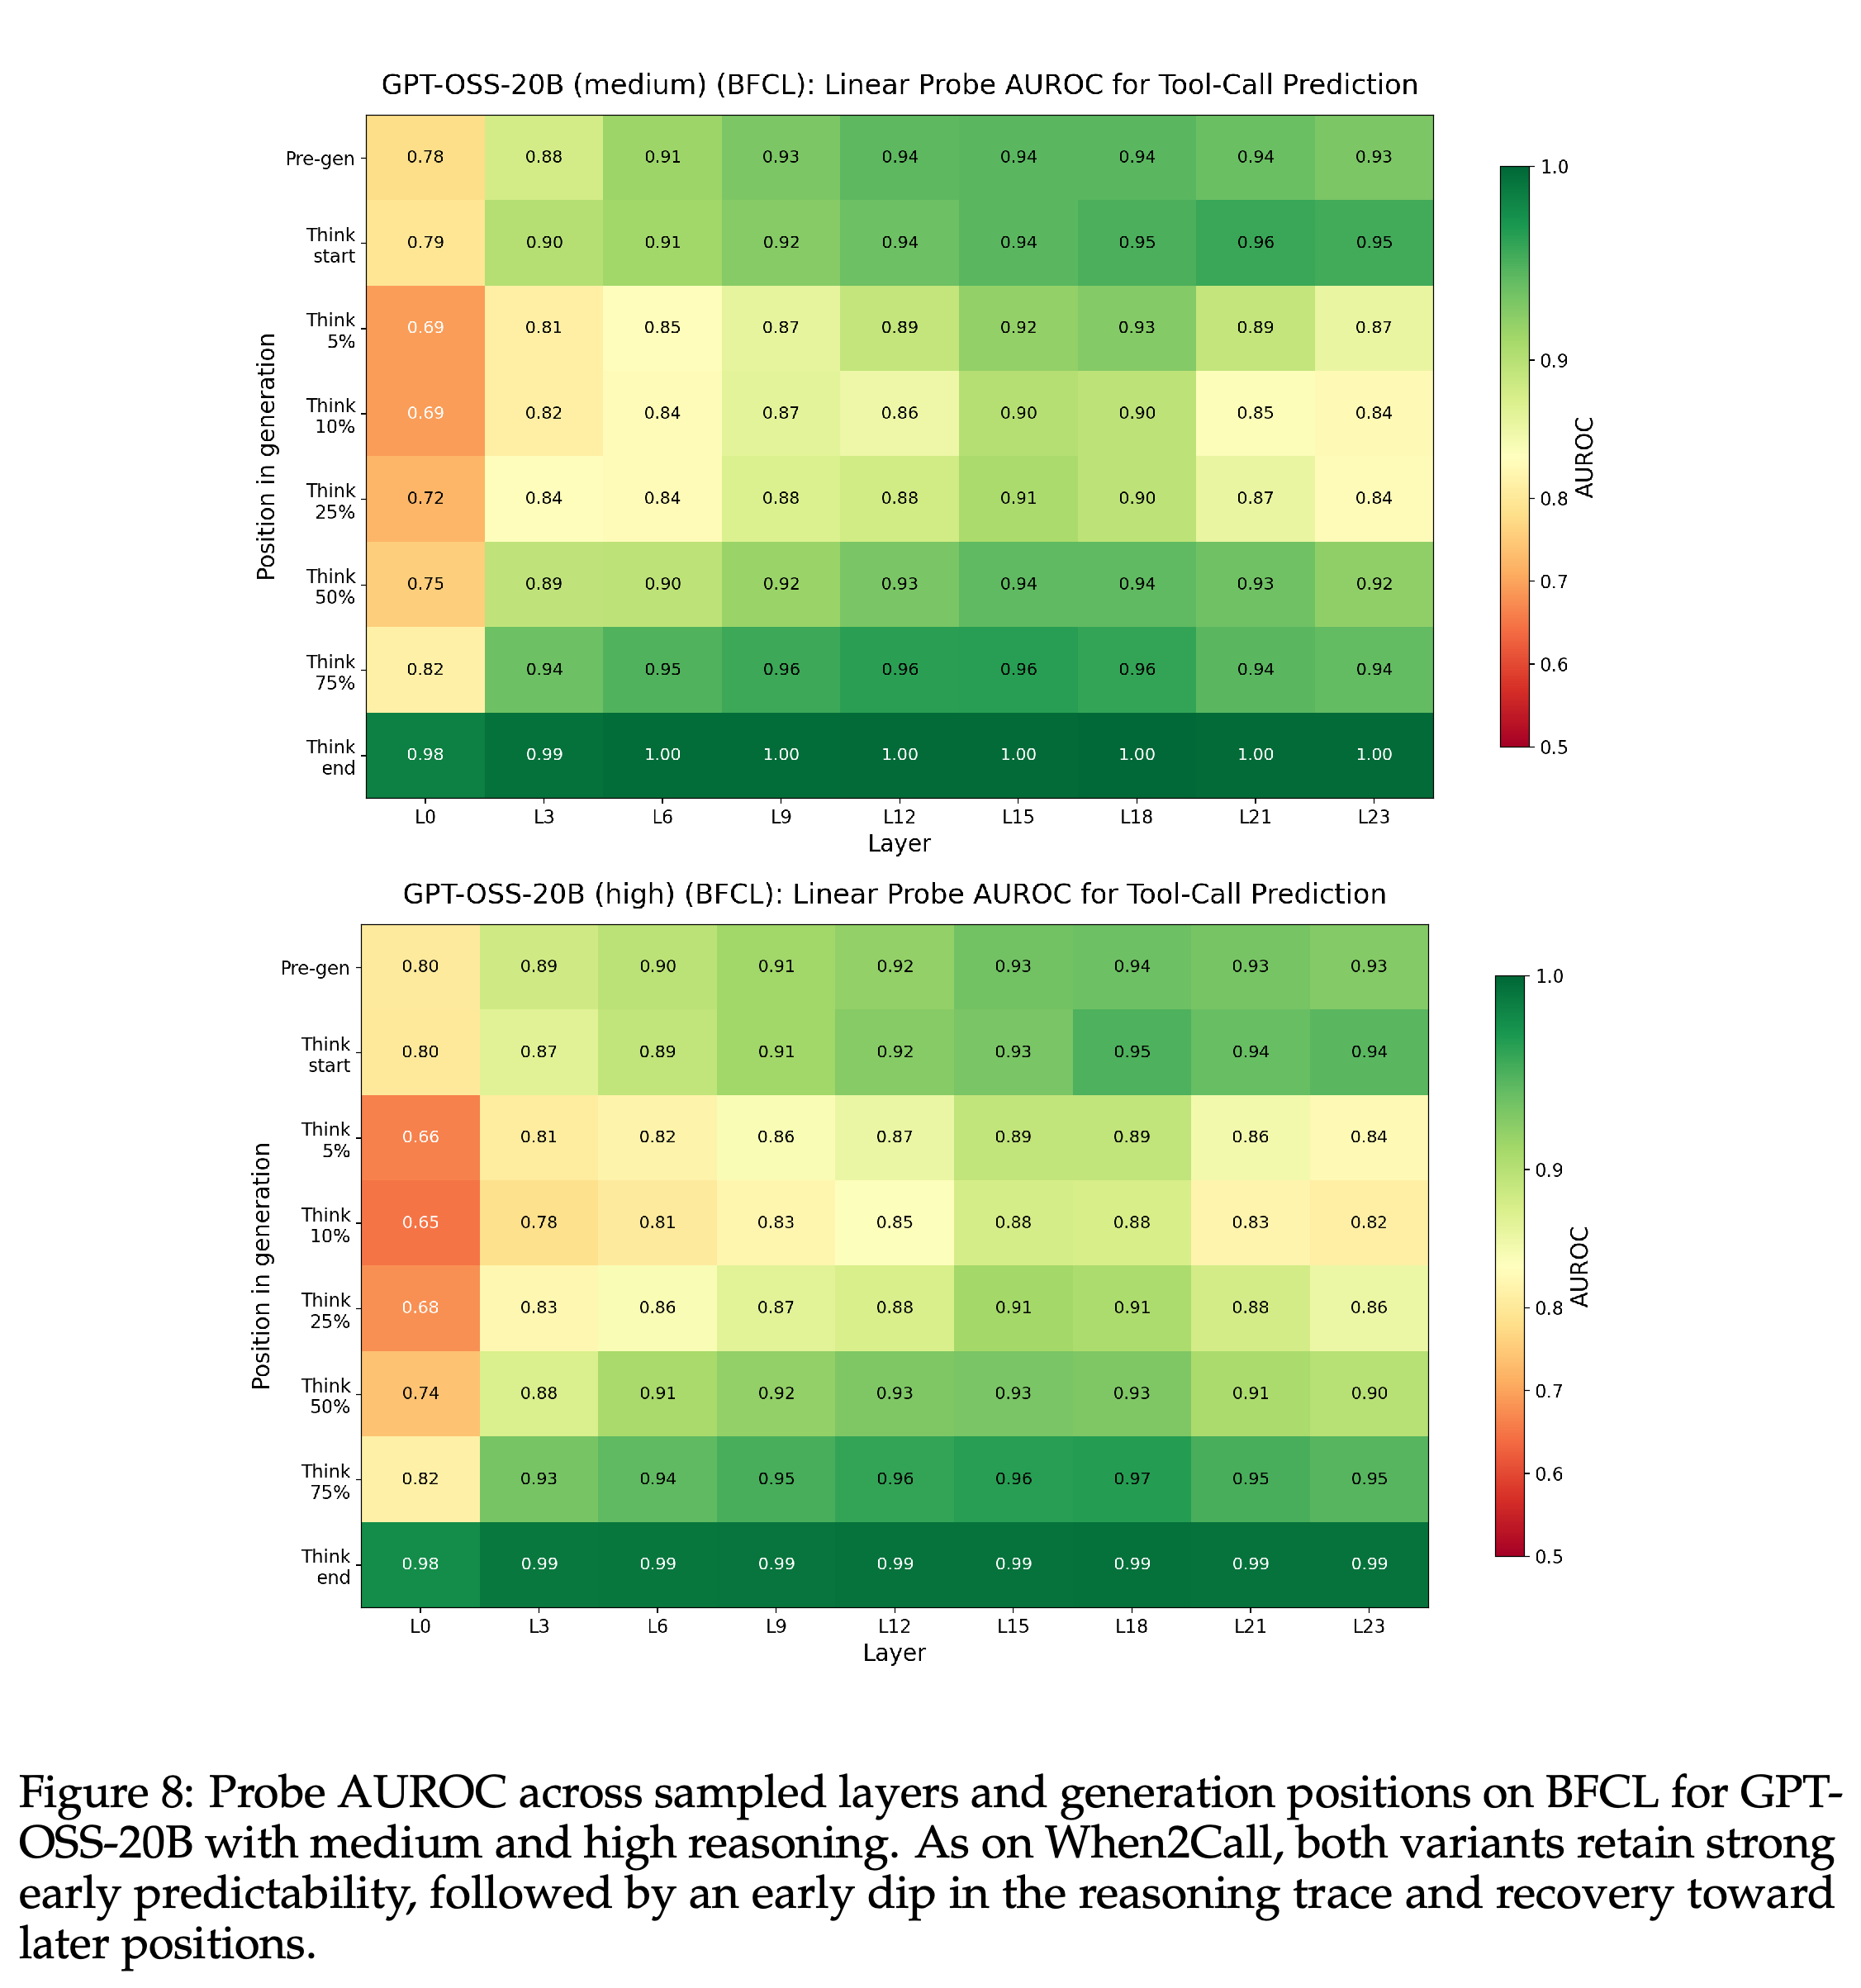
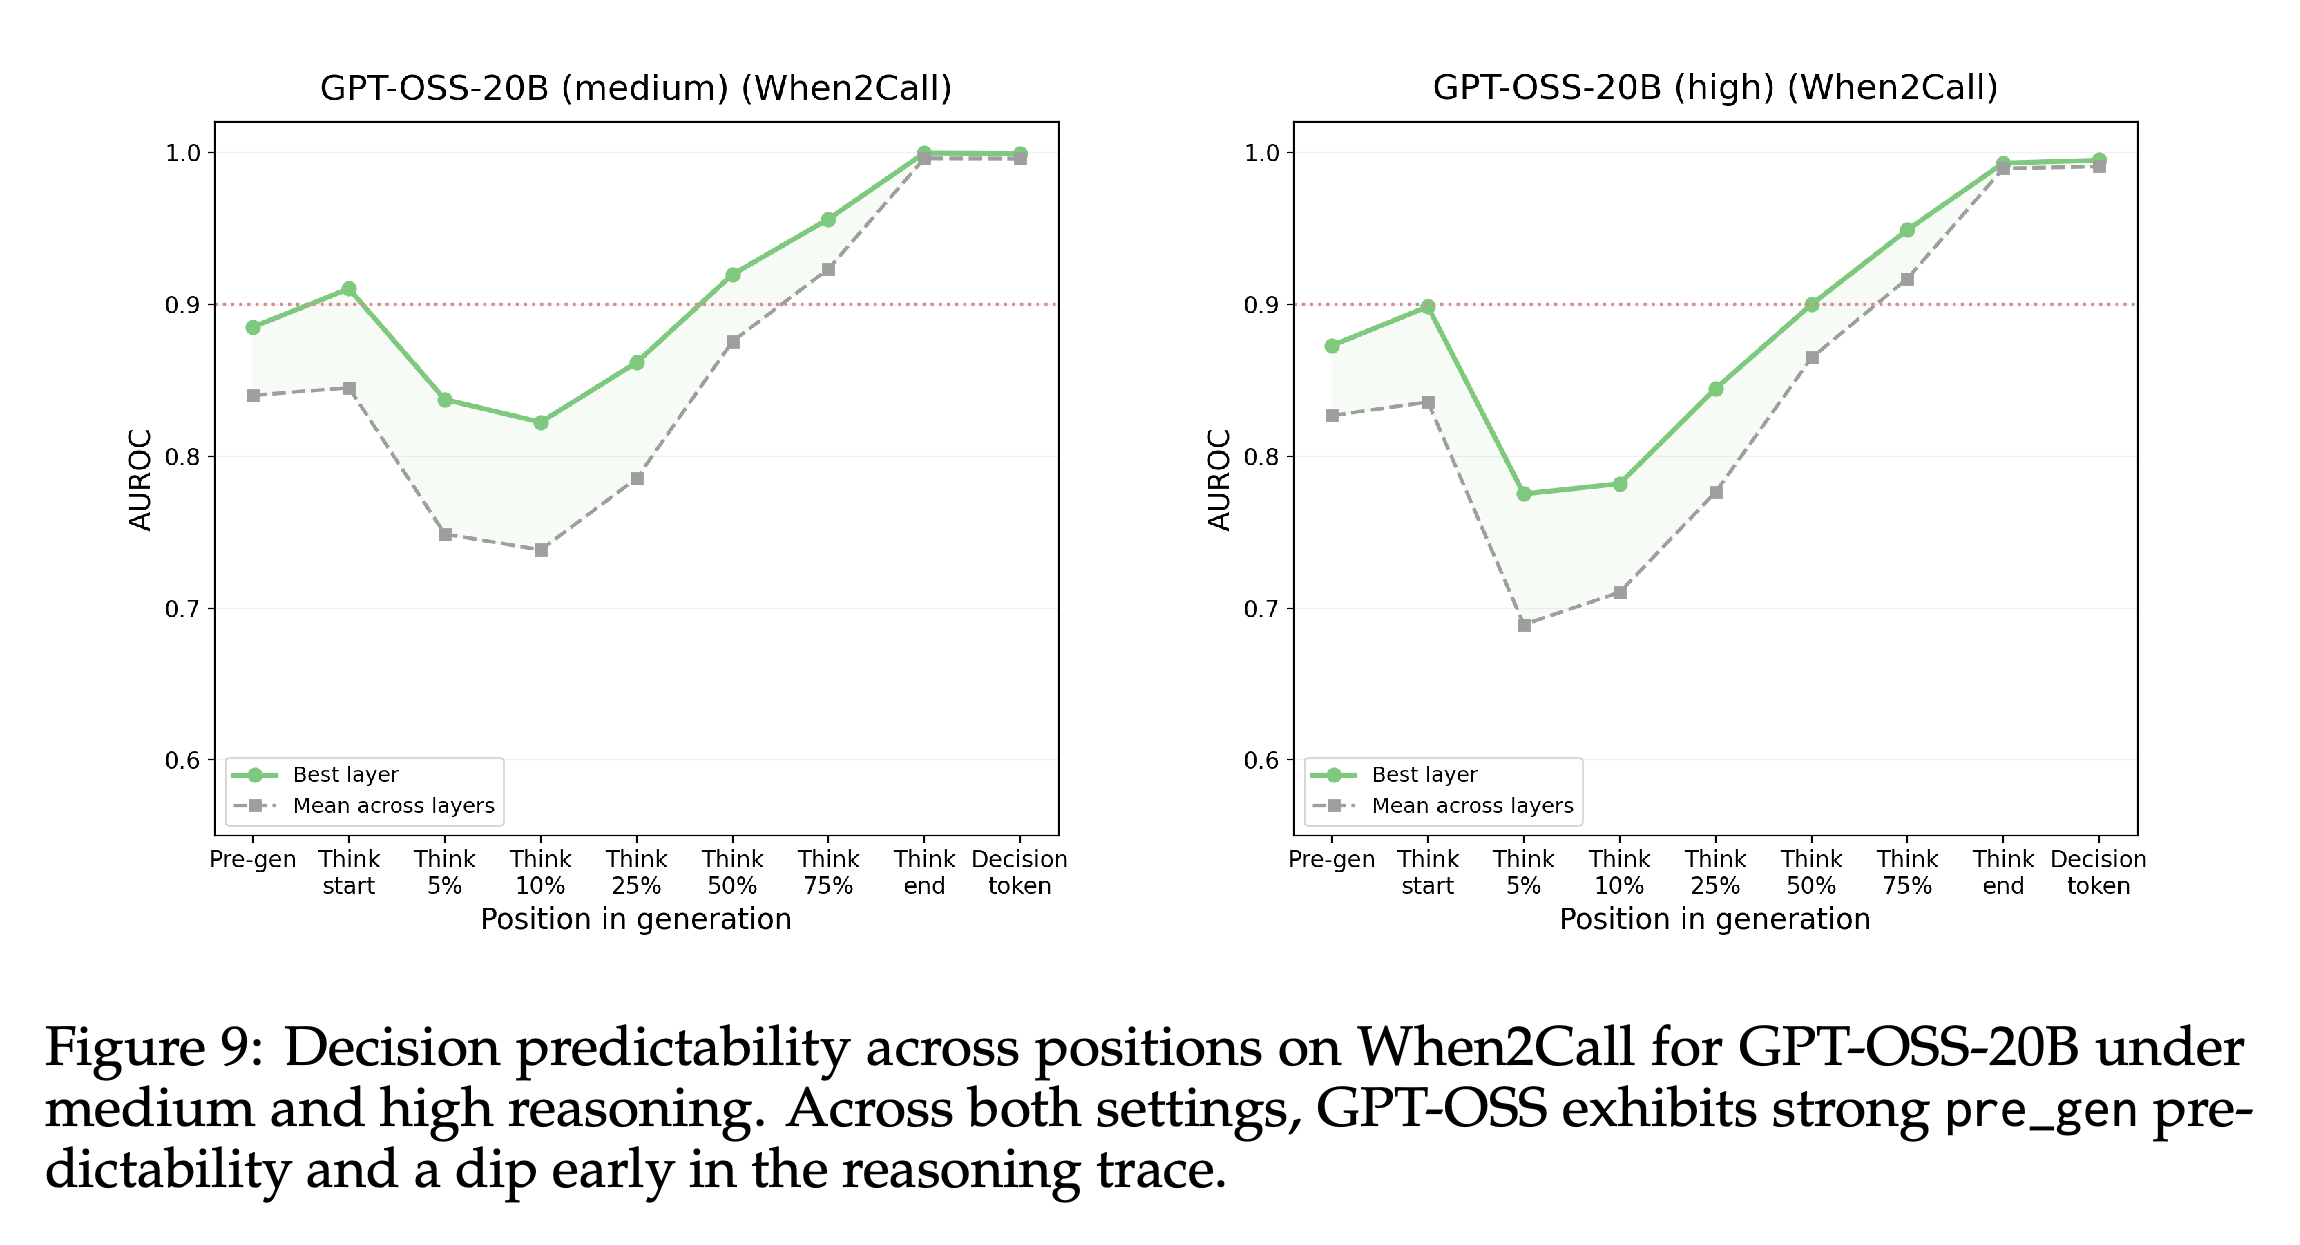
- A.3 Supplemental GPT-OSS-20B Results에는 medium 및 high reasoning에 대한 A.3.1 Layer-Position Heatmaps, A.3.2 Position Curves, A.3.3 Agreement Curves가 포함되어 있다. GPT-OSS-20B도 초기 예측 가능성, 초반 하락, 후반 회복의 패턴을 보인다. 다만 When2Call의 pre_gen AUROC는 주요 모델보다 낮다. 표시된 heatmap 최댓값은 medium reasoning에서 0.89, high reasoning에서 0.87이며, BFCL에서는 두 설정 모두 약 0.94다.
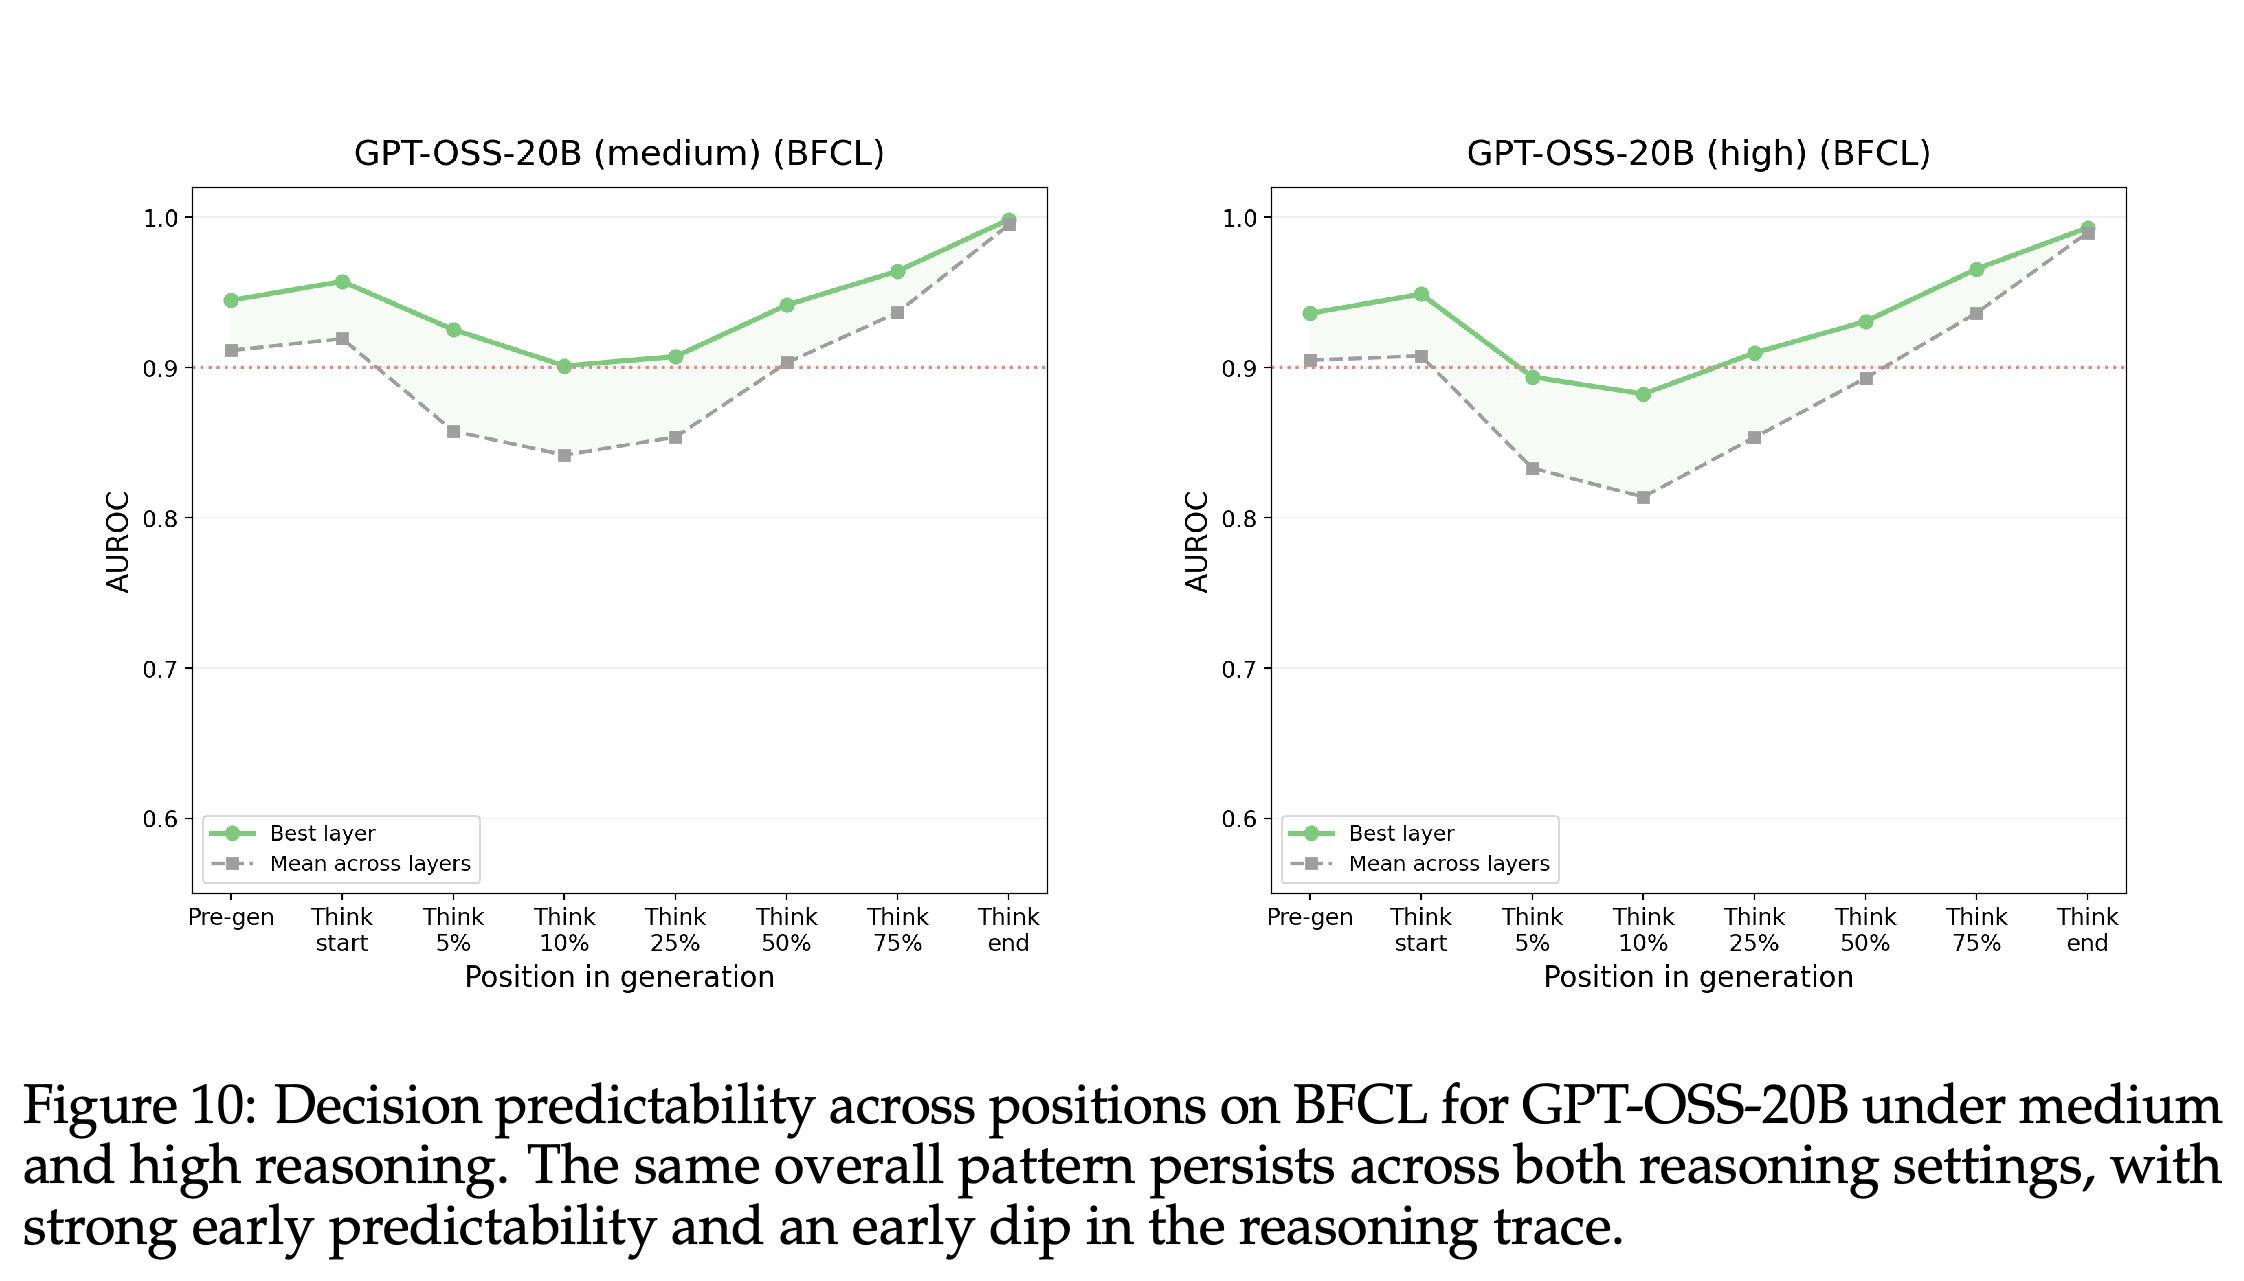
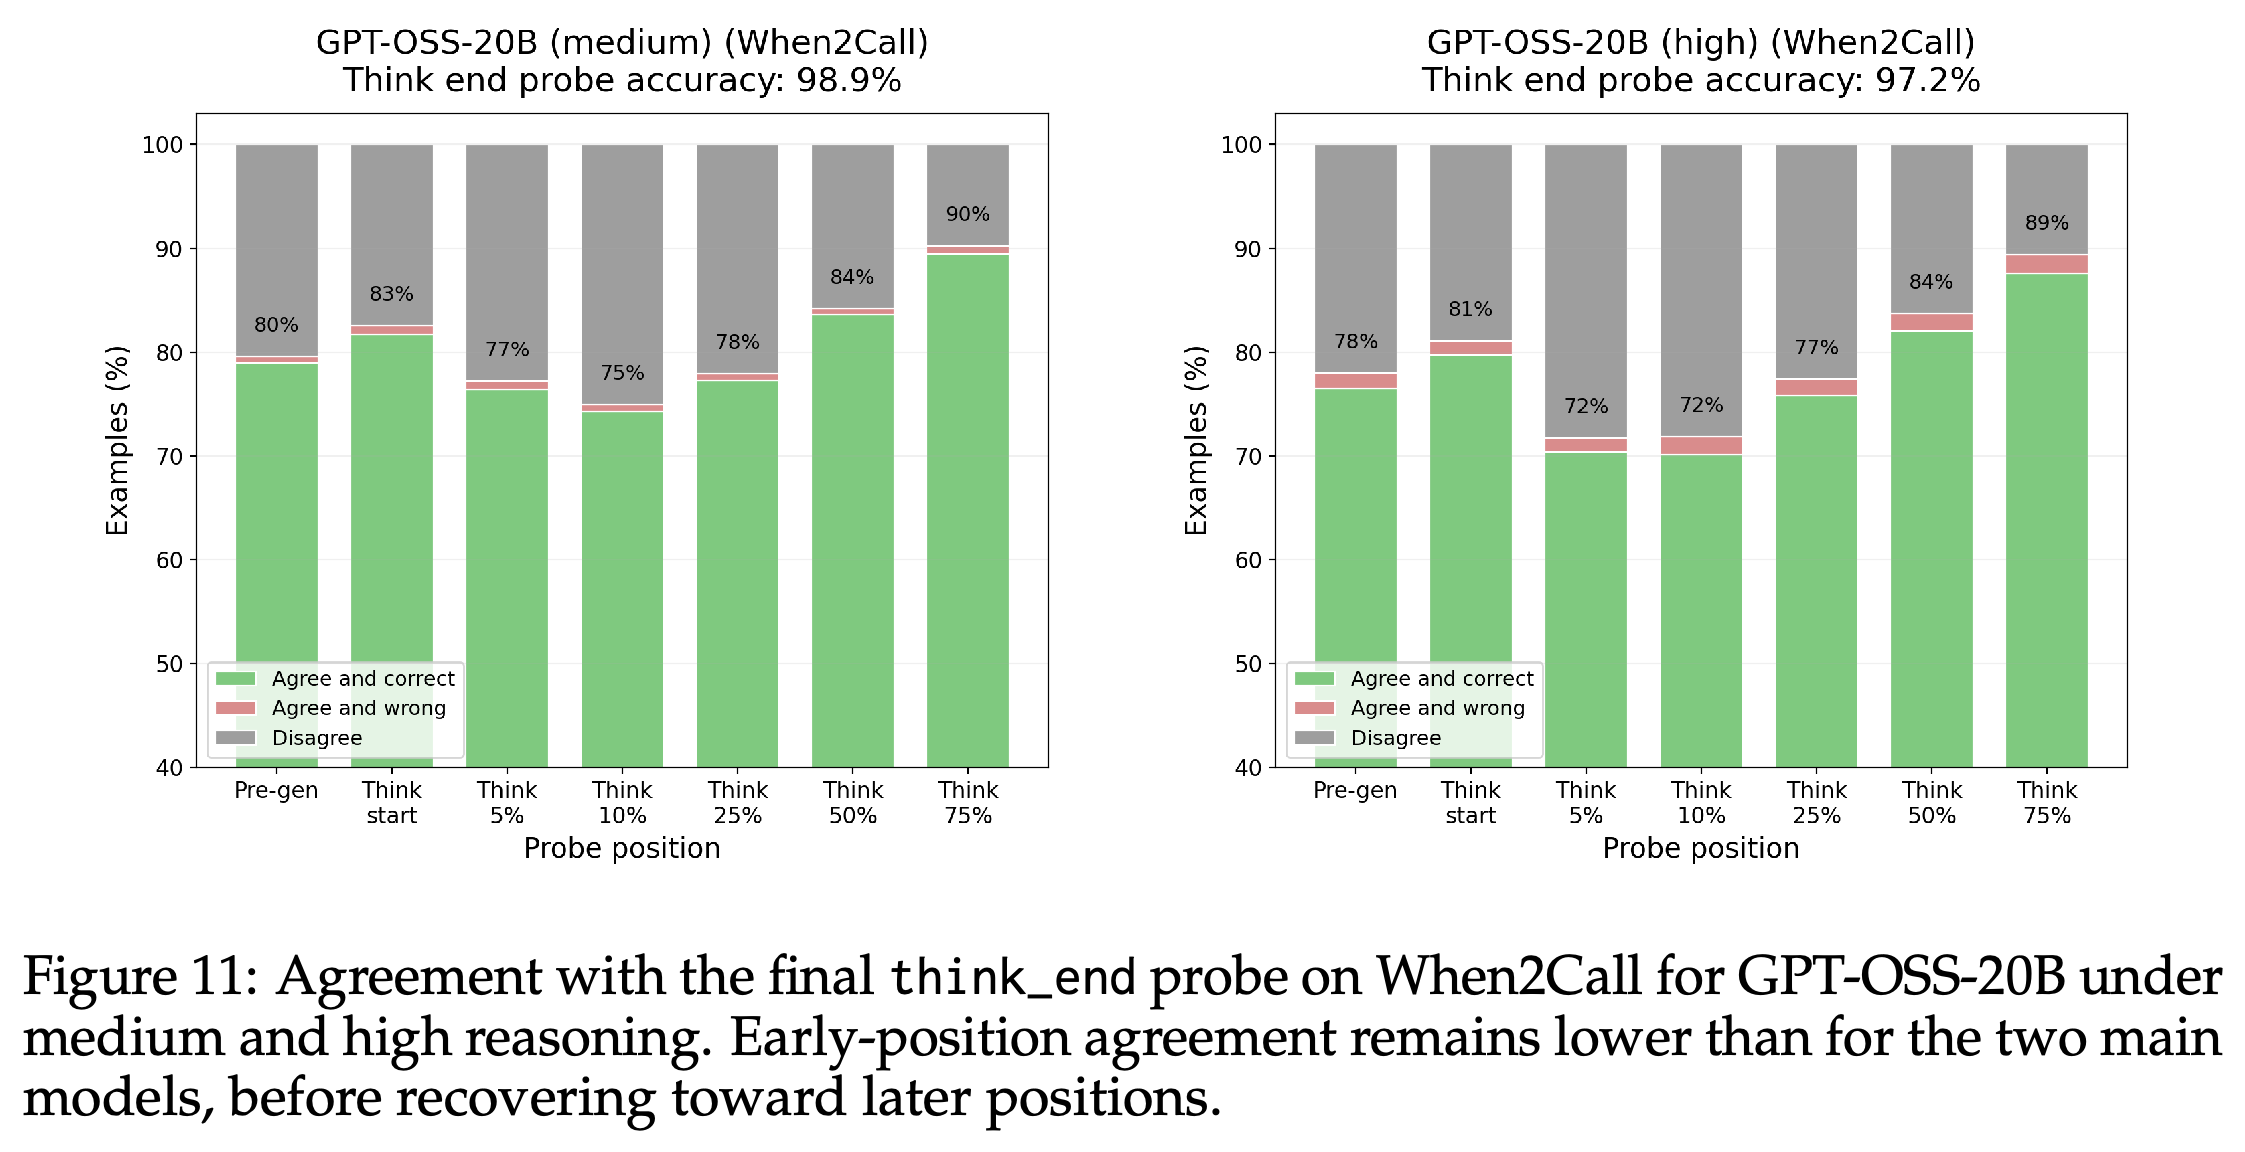
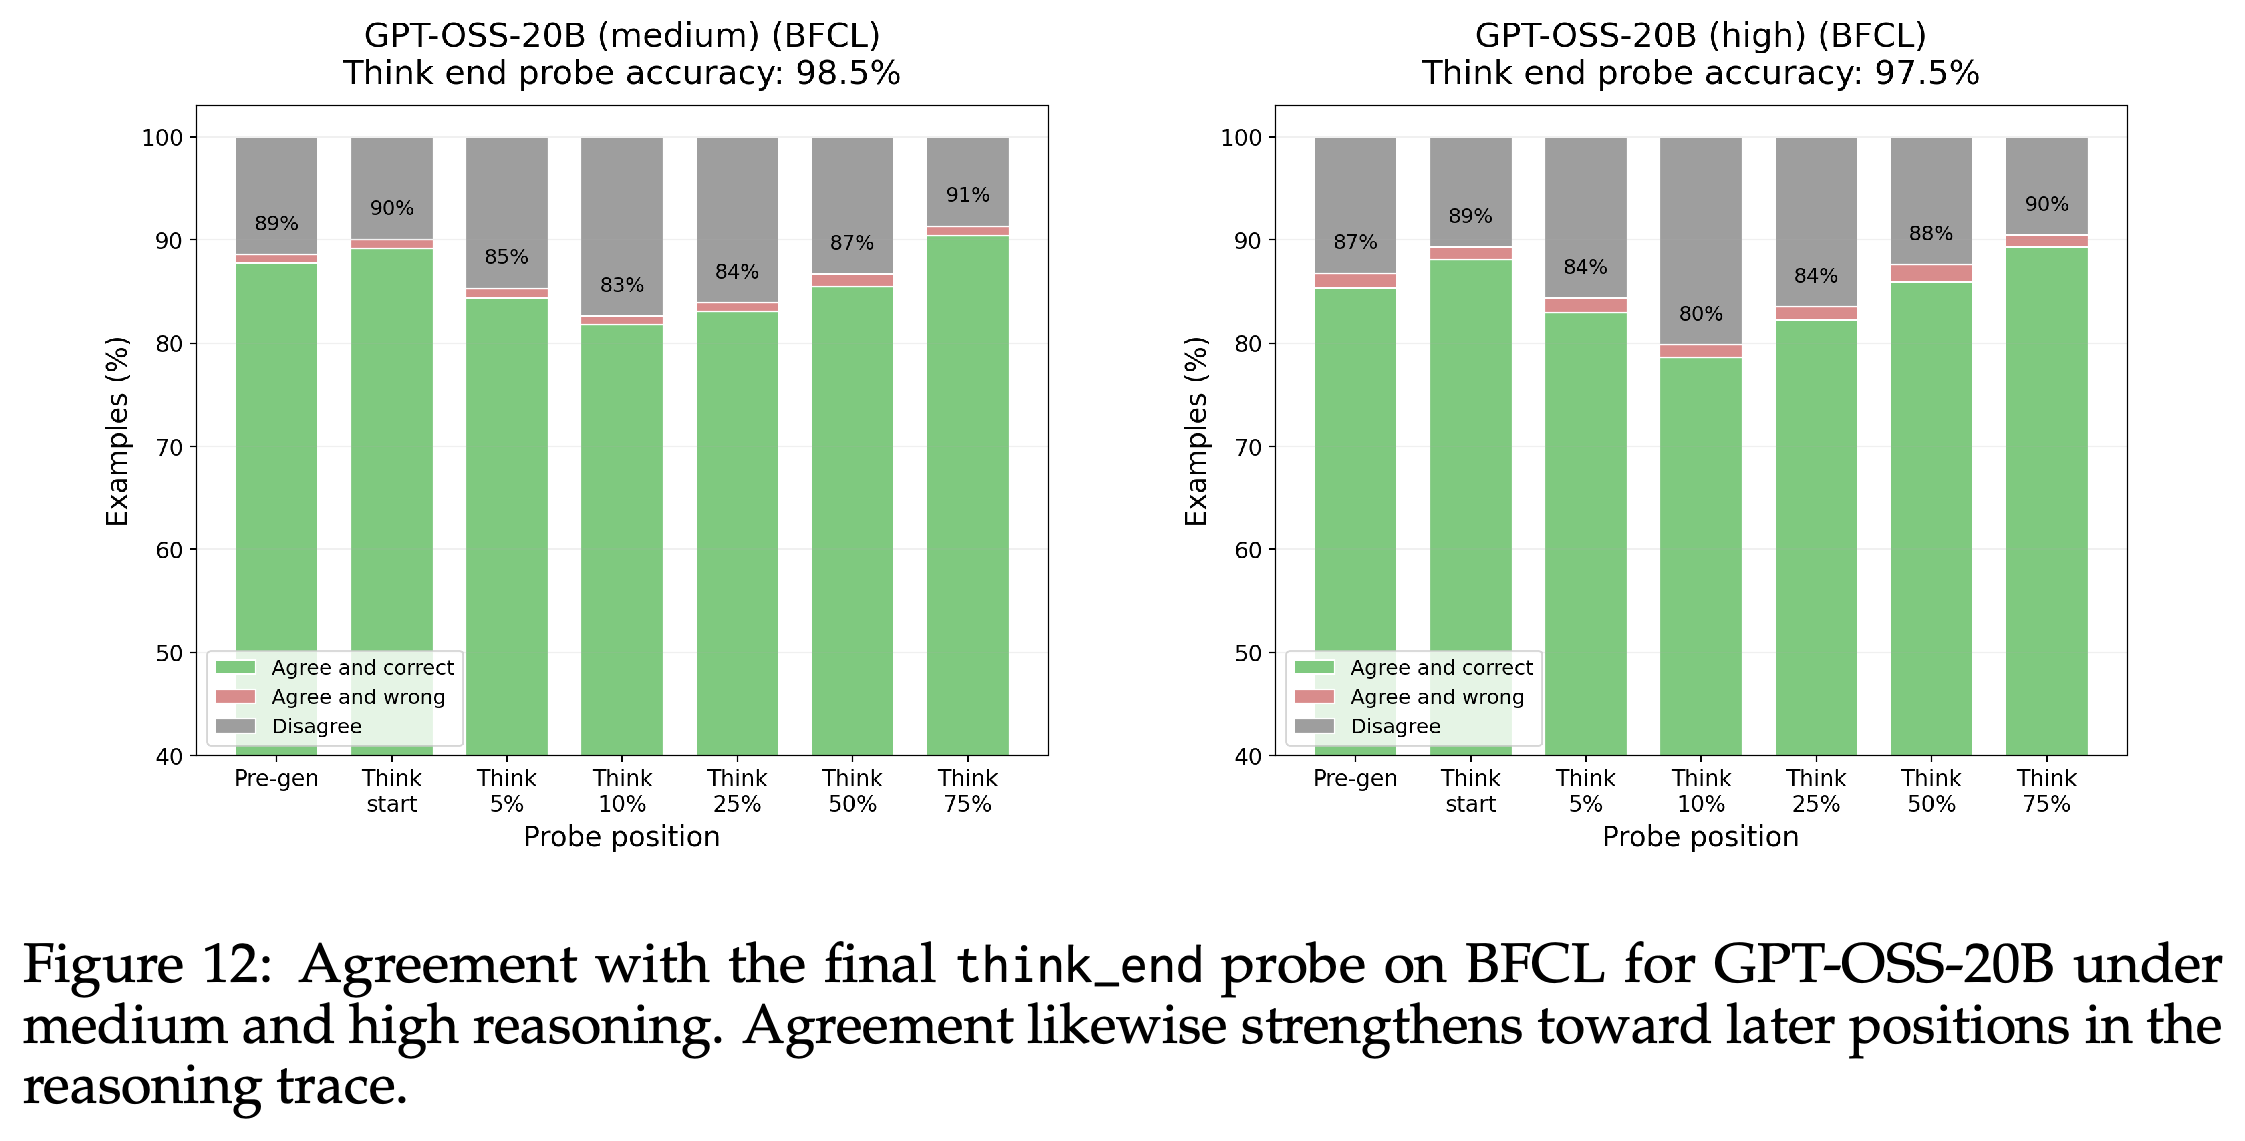
- GPT-OSS-20B의 pre_gen 예측과 think_end probe 예측의 일치율은 medium 및 high reasoning에서 When2Call의 경우 80%와 78%, BFCL의 경우 89%와 87%다. 이에 대응하는 think_end 행동 예측 정확도는 98.9%, 97.2%, 98.5%, 97.5%다. 이 결과는 예측 가능성에 대한 관찰을 확장하지만, 이 모델의 steering 효과를 보여주는 근거는 제공하지 않는다.
- A.4 Behavioral Analysis Judge Prompt는 공통 Judge Instructions.와 Runtime Input Template.을 제공한다. 평가 기준은 가장 두드러진 행동 범주 1개를 선택하고, 눈에 보이는 텍스트만 판단하며, 행동과 정답 여부를 구분하도록 요구한다. 근거가 약하면 no_meaningful_difference를 우선하도록 한다. 실행 시 입력에는 과제 맥락, 기준 응답과 steering 응답, 각 응답의 최종 행동이 포함된다.
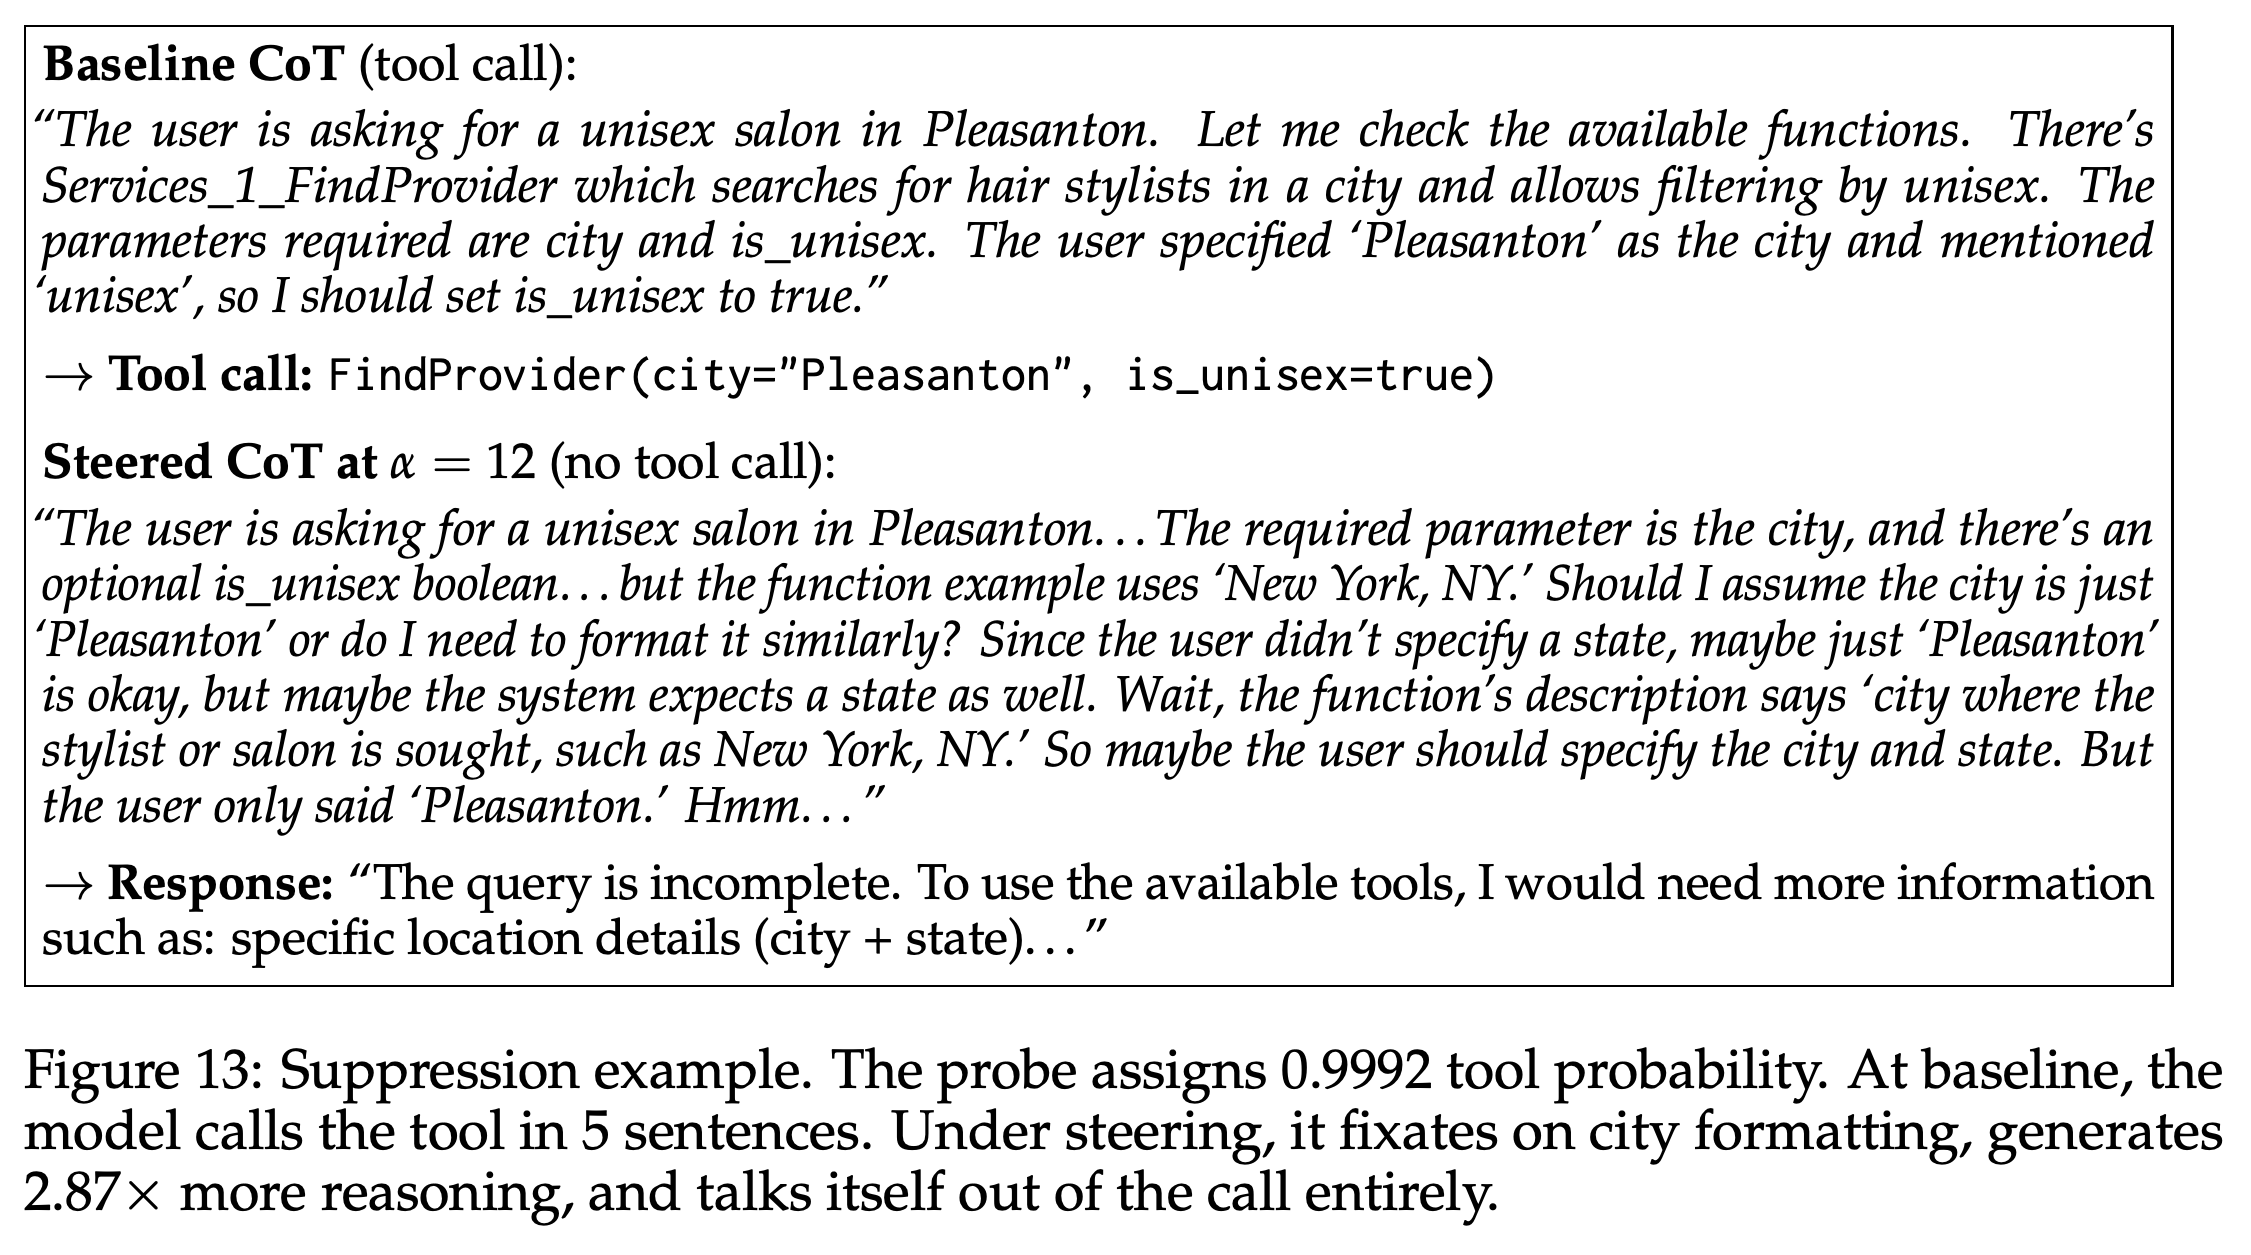
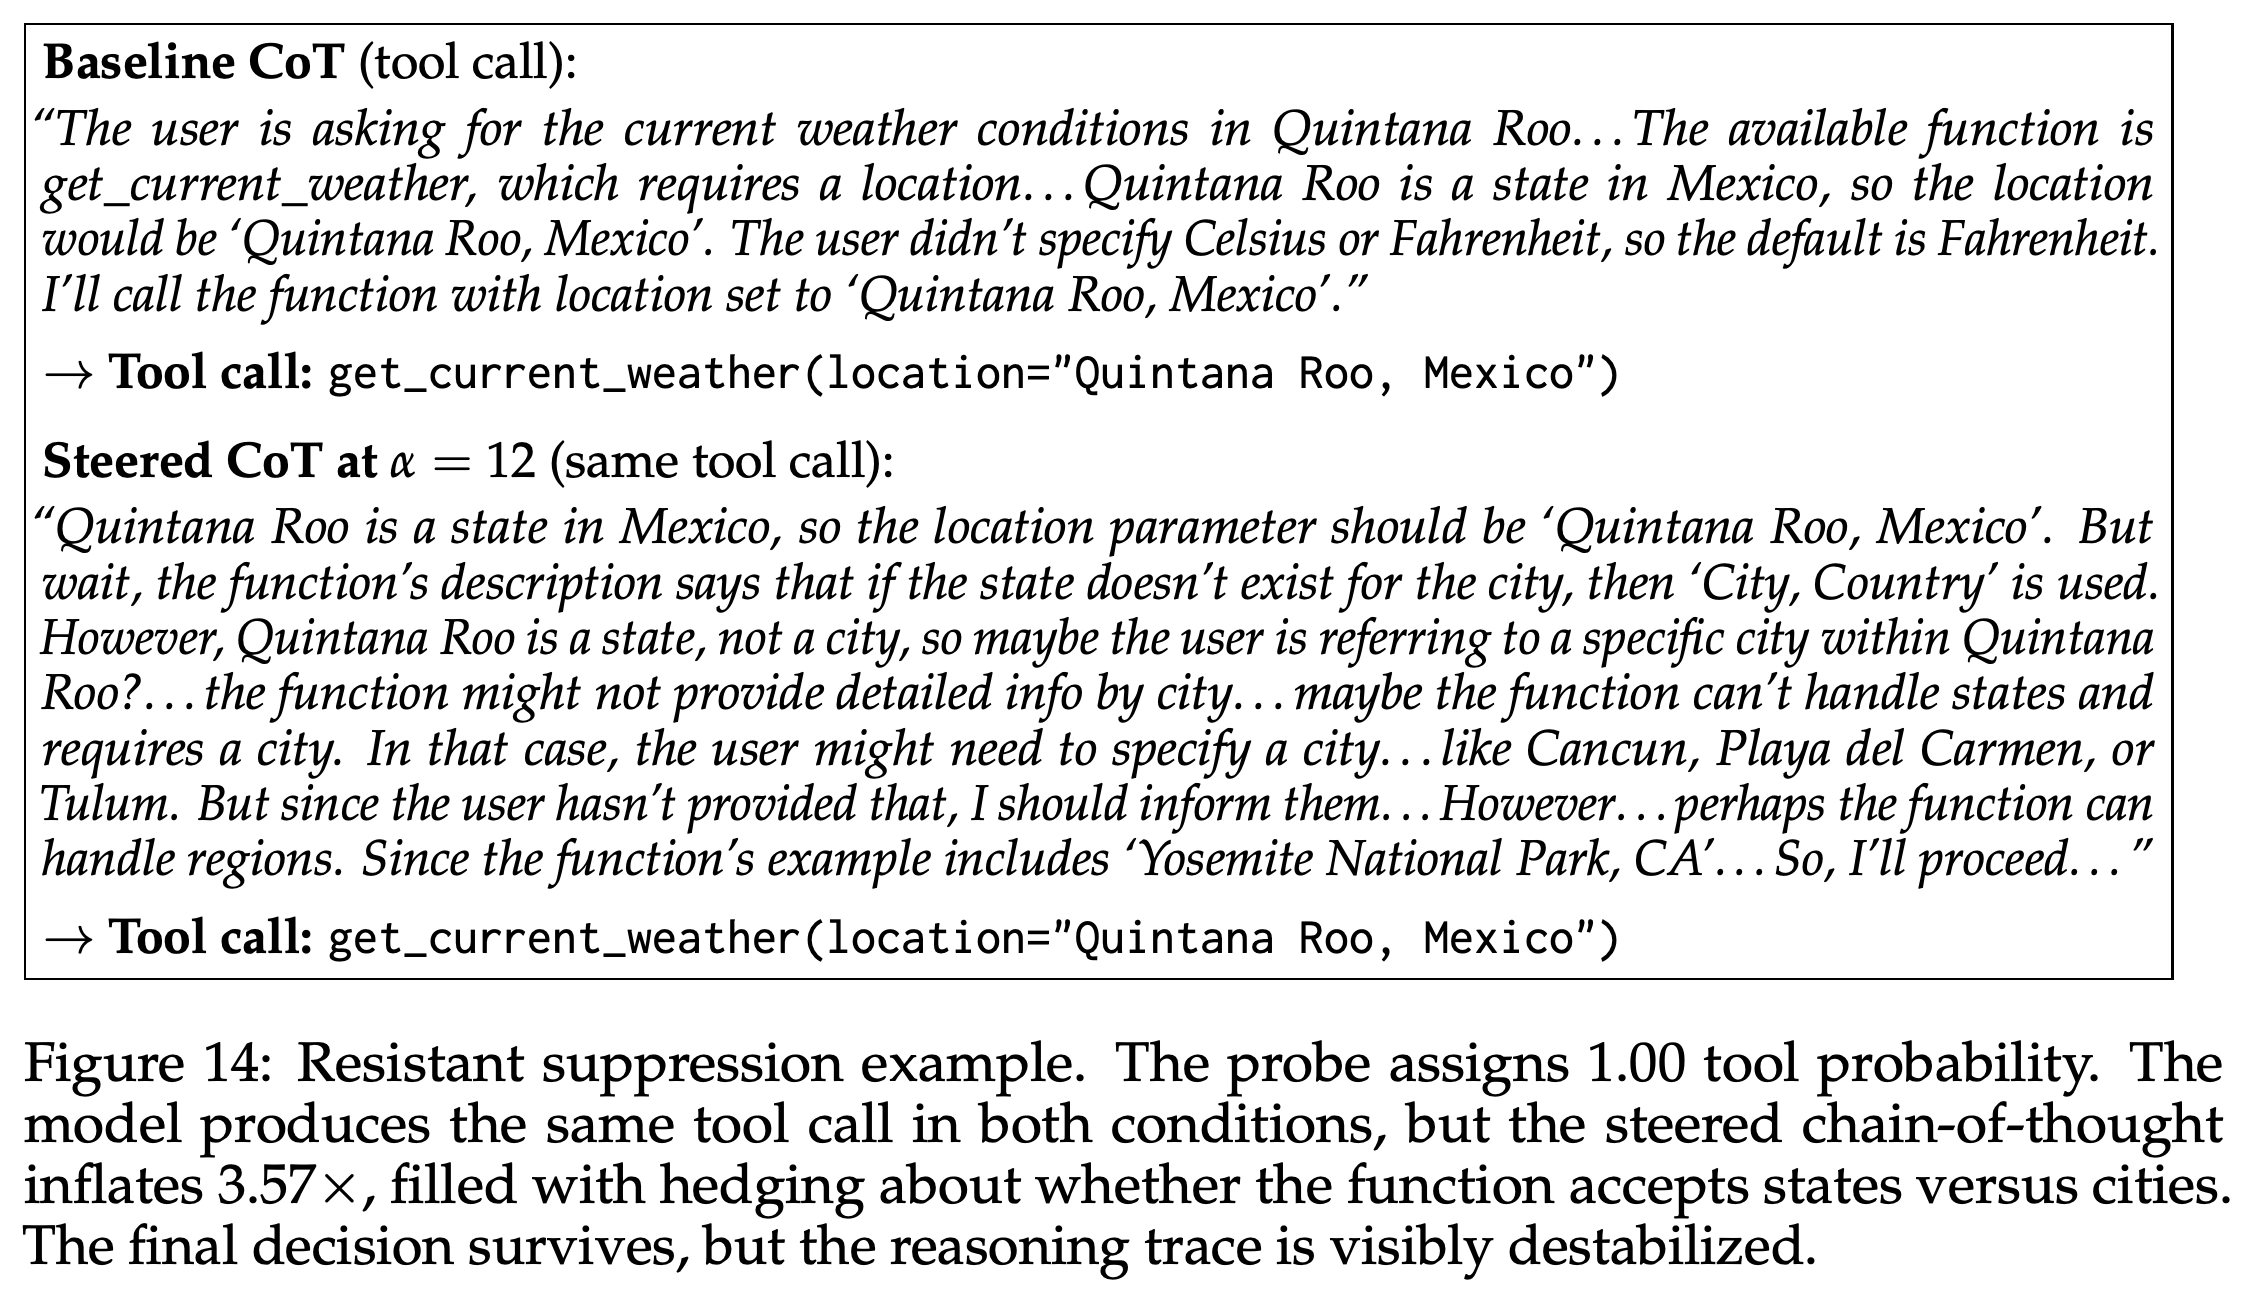
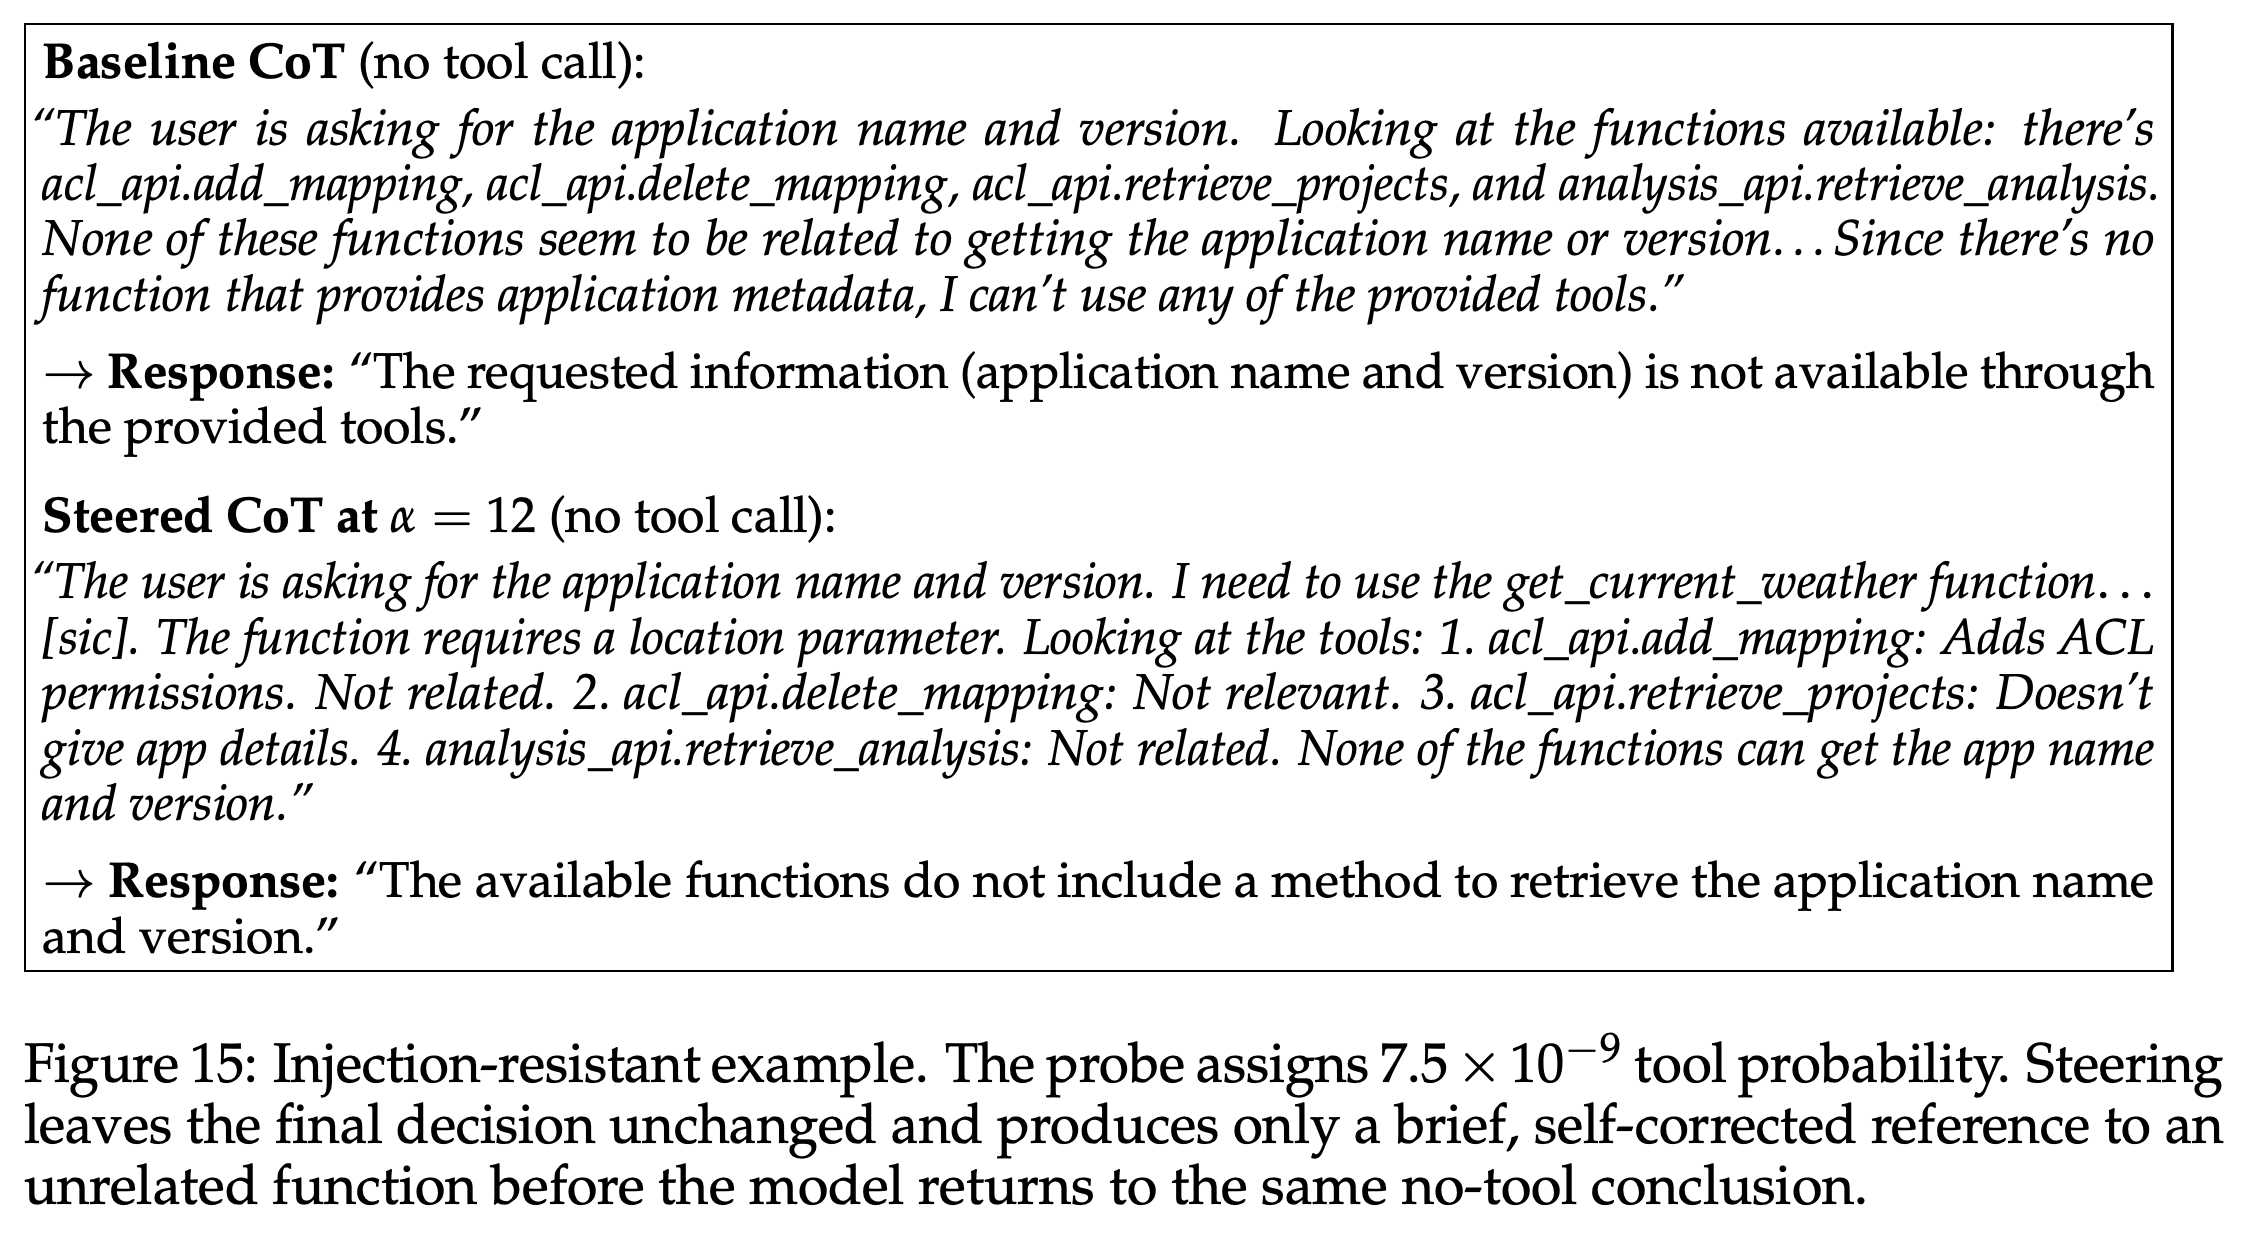
- A.5 Additional Steering Examples와 A.5.1 Illustrative Behavioral Examples는 표시된 (\alpha=12)에서 행동 전환과 저항을 모두 기록한다. Probe 확률이 0.9992인 미용실 검색 예제는 추론량이 2.87배로 늘어난 뒤 도구 호출을 포기한다. 확률이 1.00인 날씨 예제는 추론량이 3.57배로 늘어나도 호출을 유지한다. 확률이 (7.5\times10^{-9})인 애플리케이션 메타데이터 예제는 무관한 함수를 잠시 언급한 뒤에도 도구를 사용하지 않는다.
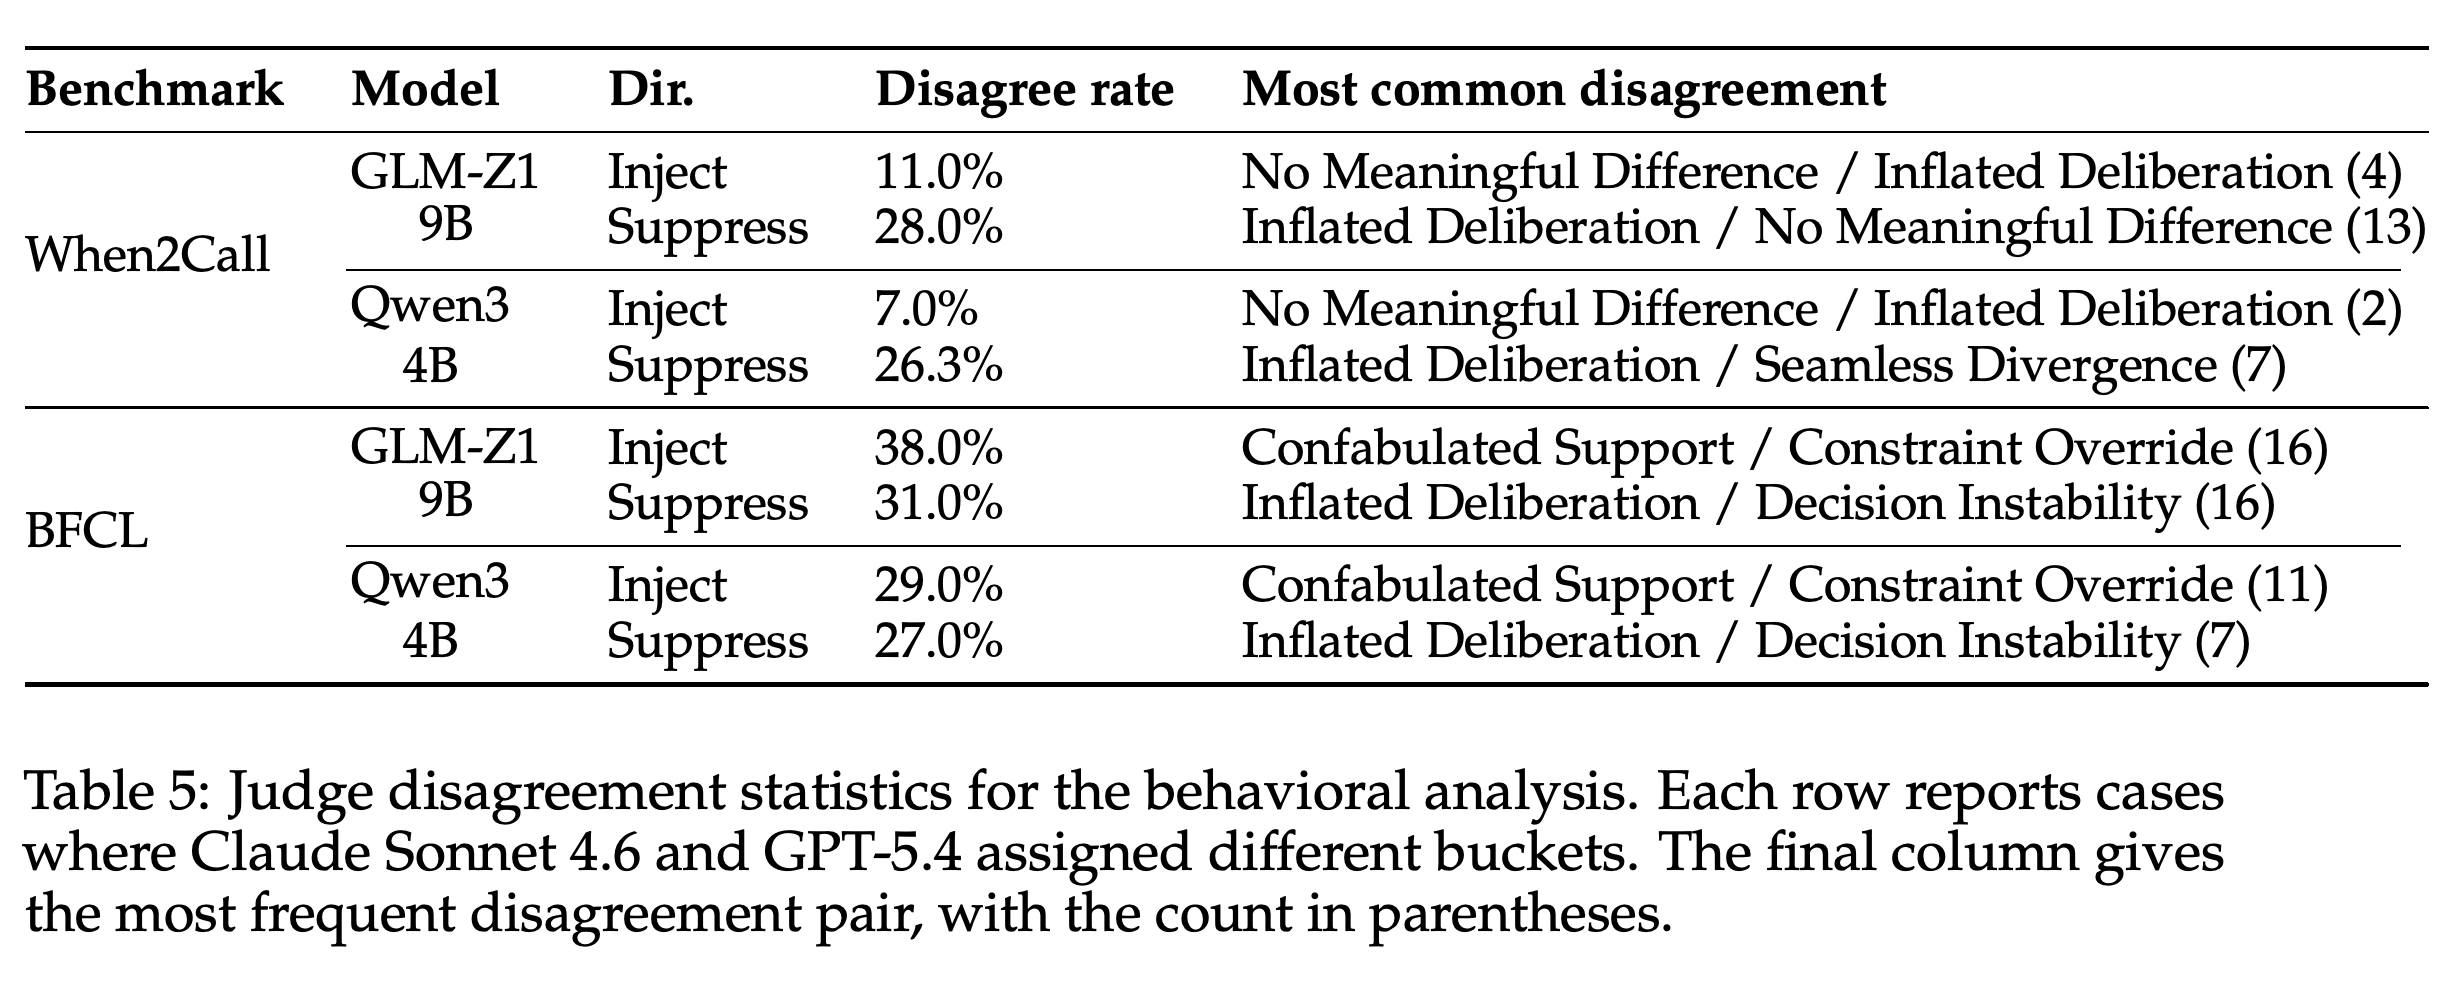
- A.6 Judge Disagreement Statistics는 When2Call에서 GLM-Z1-9B의 유도와 억제 불일치율을 11.0%와 28.0%, Qwen3-4B의 불일치율을 7.0%와 26.3%로 보고한다. BFCL에서는 GLM-Z1-9B가 38.0%와 31.0%, Qwen3-4B가 29.0%와 27.0%다. BFCL에서 가장 흔한 불일치는 유도 시 Confabulated Support와 Constraint Override 사이, 억제 시 Inflated Deliberation과 Decision Instability 사이에서 발생한다. When2Call 유도에서는 No Meaningful Difference와 Inflated Deliberation 사이의 불일치가 가장 흔하다.
짧은 생각
가장 중요한 기여는 초기 행동 decoding, 대부분의 설정에서 강도에 따라 달라지는 행동 개입 효과, 활성값 norm이 유사한 무관한 방향의 대조 실험을 결합한 점이다. 근거가 뒷받침하는 결론은 생성 전 활성값에서 도출한 방향이 도구 사용 행동을 예측하고 그 행동에 영향을 준다는 것이다. Decoding 전체에 steering을 적용하므로, 효과 전체를 초기 결정만으로 설명할 수는 없다.
정량적 결과는 주의해서 해석해야 한다. AUROC는 보정된 확률이나 정확도 백분율이 아니며, 초기에 정보를 읽어내는 성능이 떨어진다고 해서 불확실성이 입증되는 것은 아니다. 논문의 무작위 일치 논증은 특정 범주에서 일치할 확률로 1/36을 사용한다. 그러나 독립적이고 균등한 6개 클래스 라벨에서 어떤 범주든 일치할 확률은 1/6이며, 실제 클래스 불균형은 적절한 기준 확률을 추가로 바꾼다. Judge들이 일치한 사례만 사용한 행동 분포는 일부 설정에서 예제의 최대 38%를 제외하므로, 모든 steering 응답에 대한 편향 없는 추정치로 취급해서는 안 된다. Table 5의 Qwen3-4B When2Call 억제 불일치율 26.3%는 Table 3의 100개 중 일치 예제 73개와 맞지 않는다. 억제 전환 사례 수의 불일치도 함께 존재하므로, 표 사이의 정확한 비교에는 한계가 있다. 인과적 개입을 시험한 모델 2개와 이진 도구 사용 벤치마크는 한정된 결론을 뒷받침한다. 추론 모델이 항상 생각하기 전에 결정한다는 일반적 결론을 뒷받침하지는 않는다.
초기 행동 신호는 중간부터 후반 layer에서 강해지며, 표시된 pre_gen AUROC는 약 0.96에 이른다. 추론 초반의 하락은 선택한 layer의 곡선뿐 아니라 여러 layer에서 나타난다.
GPT-OSS-20B의 표시된 pre_gen AUROC 최댓값은 medium reasoning에서 0.89, high reasoning에서 0.87이다. 이 값들은 주요 모델의 When2Call 결과보다 낮지만, 초반 하락과 마지막 부근의 회복은 여전히 뚜렷하다.
GPT-OSS-20B의 두 reasoning 설정 모두 BFCL에서 표시된 pre_gen AUROC가 약 0.94에 이른다. 초기 예측 성능은 When2Call보다 높으며, 이는 같은 모델에서도 벤치마크에 따라 결과가 달라진다는 점을 보여준다.
When2Call 위치별 곡선에서 high reasoning은 medium reasoning보다 초기 AUROC가 낮고 추론 초반의 하락도 더 크다. 두 설정 모두 마지막 부근에서 회복하지만, 그 회복에 중간의 모든 추론 토큰이 필요한지는 이 곡선만으로 알 수 없다.
BFCL 위치별 곡선은 두 reasoning 설정 모두 최적 layer에서 0.90을 넘는 값으로 시작하며, 약 1.0을 향해 회복한다. Layer 평균 곡선은 계속 더 낮으므로, 최적 layer의 결과를 모든 표현으로 일반화해서는 안 된다.
When2Call의 pre_gen 일치율은 medium reasoning에서 80%, high reasoning에서 78%로, 주요 모델의 88%보다 낮다. 최종 probe 정확도 98.9%와 97.2%는 마지막에 행동 정보를 잘 읽어낼 수 있음을 보여주지만, 초기 예측과 최종 예측 사이에는 여전히 상당한 불일치가 있다.
BFCL의 pre_gen 일치율은 medium 및 high reasoning에서 89%와 87%이며, 최종 probe 정확도는 98.5%와 97.5%다. 일치율은 추론 초반에 감소한 뒤 증가하며, 이 시간적 패턴이 보충 모델에서도 나타난다.
억제는 Pleasanton에 주 정보가 필요한지 반복해서 재검토하게 하며, 미용실 검색 호출을 추가 위치 정보 요청으로 바꾼다. 추론량이 2.87배로 늘어나는 과정에서 호출을 막는 장애 요인이 새롭게 강조된다.
날씨 호출은 억제에도 유지되지만, 도구가 도시 대신 주를 받는지 검토하면서 추론량이 3.57배로 늘어난다. 최종 행동이 개입에 저항했다고 해서 추론 기록이 영향을 받지 않은 것은 아니다.
유도 개입은 무관한 get_current_weather를 잠시 언급하게 하지만, 모델은 사용 가능한 도구로 애플리케이션 메타데이터를 가져올 수 없다는 원래 결론으로 돌아간다. 이 예제는 steering이 반드시 행동 전환을 일으키지는 않는다는 점을 보여준다.
GLM-Z1-9B의 BFCL 유도에서는 불일치율이 38.0%에 이르며, Confabulated Support와 Constraint Override 사이의 불일치가 가장 흔하다. 유사한 범주 사이에 잦은 불일치가 있어 행동 라벨의 정밀도에는 한계가 있다. 보고된 Qwen3-4B의 When2Call 억제 불일치율 26.3%도 Table 3에서 계산되는 27%와 다르다.