


FinMCP-Bench: Benchmarking LLM Agents for Real-World Financial Tool Use under the Model Context Protocol 요약 설명
26 Mar 2026 | Paper Review Tool Use LLM Evaluation Model Context Protocol Synthetic Data목차
이번 글에서는 FinMCP-Bench: Benchmarking LLM Agents for Real-World Financial Tool Use under the Model Context Protocol 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 3월 26일(Arxiv)
- Zhu, Jie, Tian, Yimin, Li, Boyang, Wu, Kehao, Liang, Zhongzhi, Li, Junhui, Zhang, Xianyin, Guo, Lifan, Chen, Feng, Liu, Yong, et al.
- Qwen DianJin Team, Alibaba Cloud Computing, YINGMI Wealth Management, Soochow University
- 논문 링크
- Project Page
요약
- FinMCP-Bench는 LLM 에이전트가 Model Context Protocol(MCP)로 제공되는 금융 도구를 선택하고 실행 구조를 구성하는 능력을 평가한다. 단일 도구, 다중 도구, 다중 턴 과제를 다루며, 샘플 613개, 도구 65개, 주요 시나리오 10개, 세부 시나리오 33개로 구성된다.
- 저자들은 익명화한 운영 로그에 의존성 체인 기반 질의 합성과 페르소나 기반 대화 시뮬레이션을 결합하고, 자동 검증과 전문가 검토를 수행한다. 평가는 도구 precision, recall, F1과 참조 도구 그룹의 정확한 일치 여부를 측정한다. 각 대화 턴에서는 모델이 앞서 생성한 응답이 아니라 정답 대화 이력을 사용해 응답을 생성한다.
- Qwen3-235B-A22B-Thinking은 전체 TF1 64.27%와 EMR 25.92%로 보고된 결과 중 가장 높은 점수를 기록한다. 그러나 다중 도구 EMR이 10.62%를 넘거나 다중 턴 EMR이 4.10%를 넘는 모델은 없다. 이 결과는 참조 도구 워크플로와의 일치도를 측정하며, 금융 조언의 품질, 인자의 정확성, 자율적인 전체 대화 수행의 성공 여부를 측정하지는 않는다.
1 Introduction
금융 에이전트는 사용자 의도를 해석하고, 주가 추세나 펀드 보유 종목 같은 정보를 검색하며, 앞선 결과에 의존하는 도구 호출을 조율해야 한다. 논문은 기존 금융 평가가 대체로 도구 사용을 시험하지 않고 특정 과제만 다루기 때문에 이러한 실행 의존성을 충분히 평가하지 못한다고 주장한다.
- MCP는 여러 서버에서 도구를 호출할 때 사용할 표준화된 스키마를 제공한다. FinMCP-Bench는 이 인터페이스를 사용하는 금융 워크플로를 평가한다.
- 데이터 구축은 시나리오 33개에 걸친 운영 상호작용 기록 10K개에서 시작한다. 서론은 5단계를 초과하는 합성 체인과 선별된 최종 트레이스 10K개를 설명하지만, 이 데이터가 상세 구축 절에서 명시한 샘플 613개의 벤치마크와 어떤 관계인지는 설명하지 않는다.
2 FinMCP-Bench: A Financial MCP Benchmark
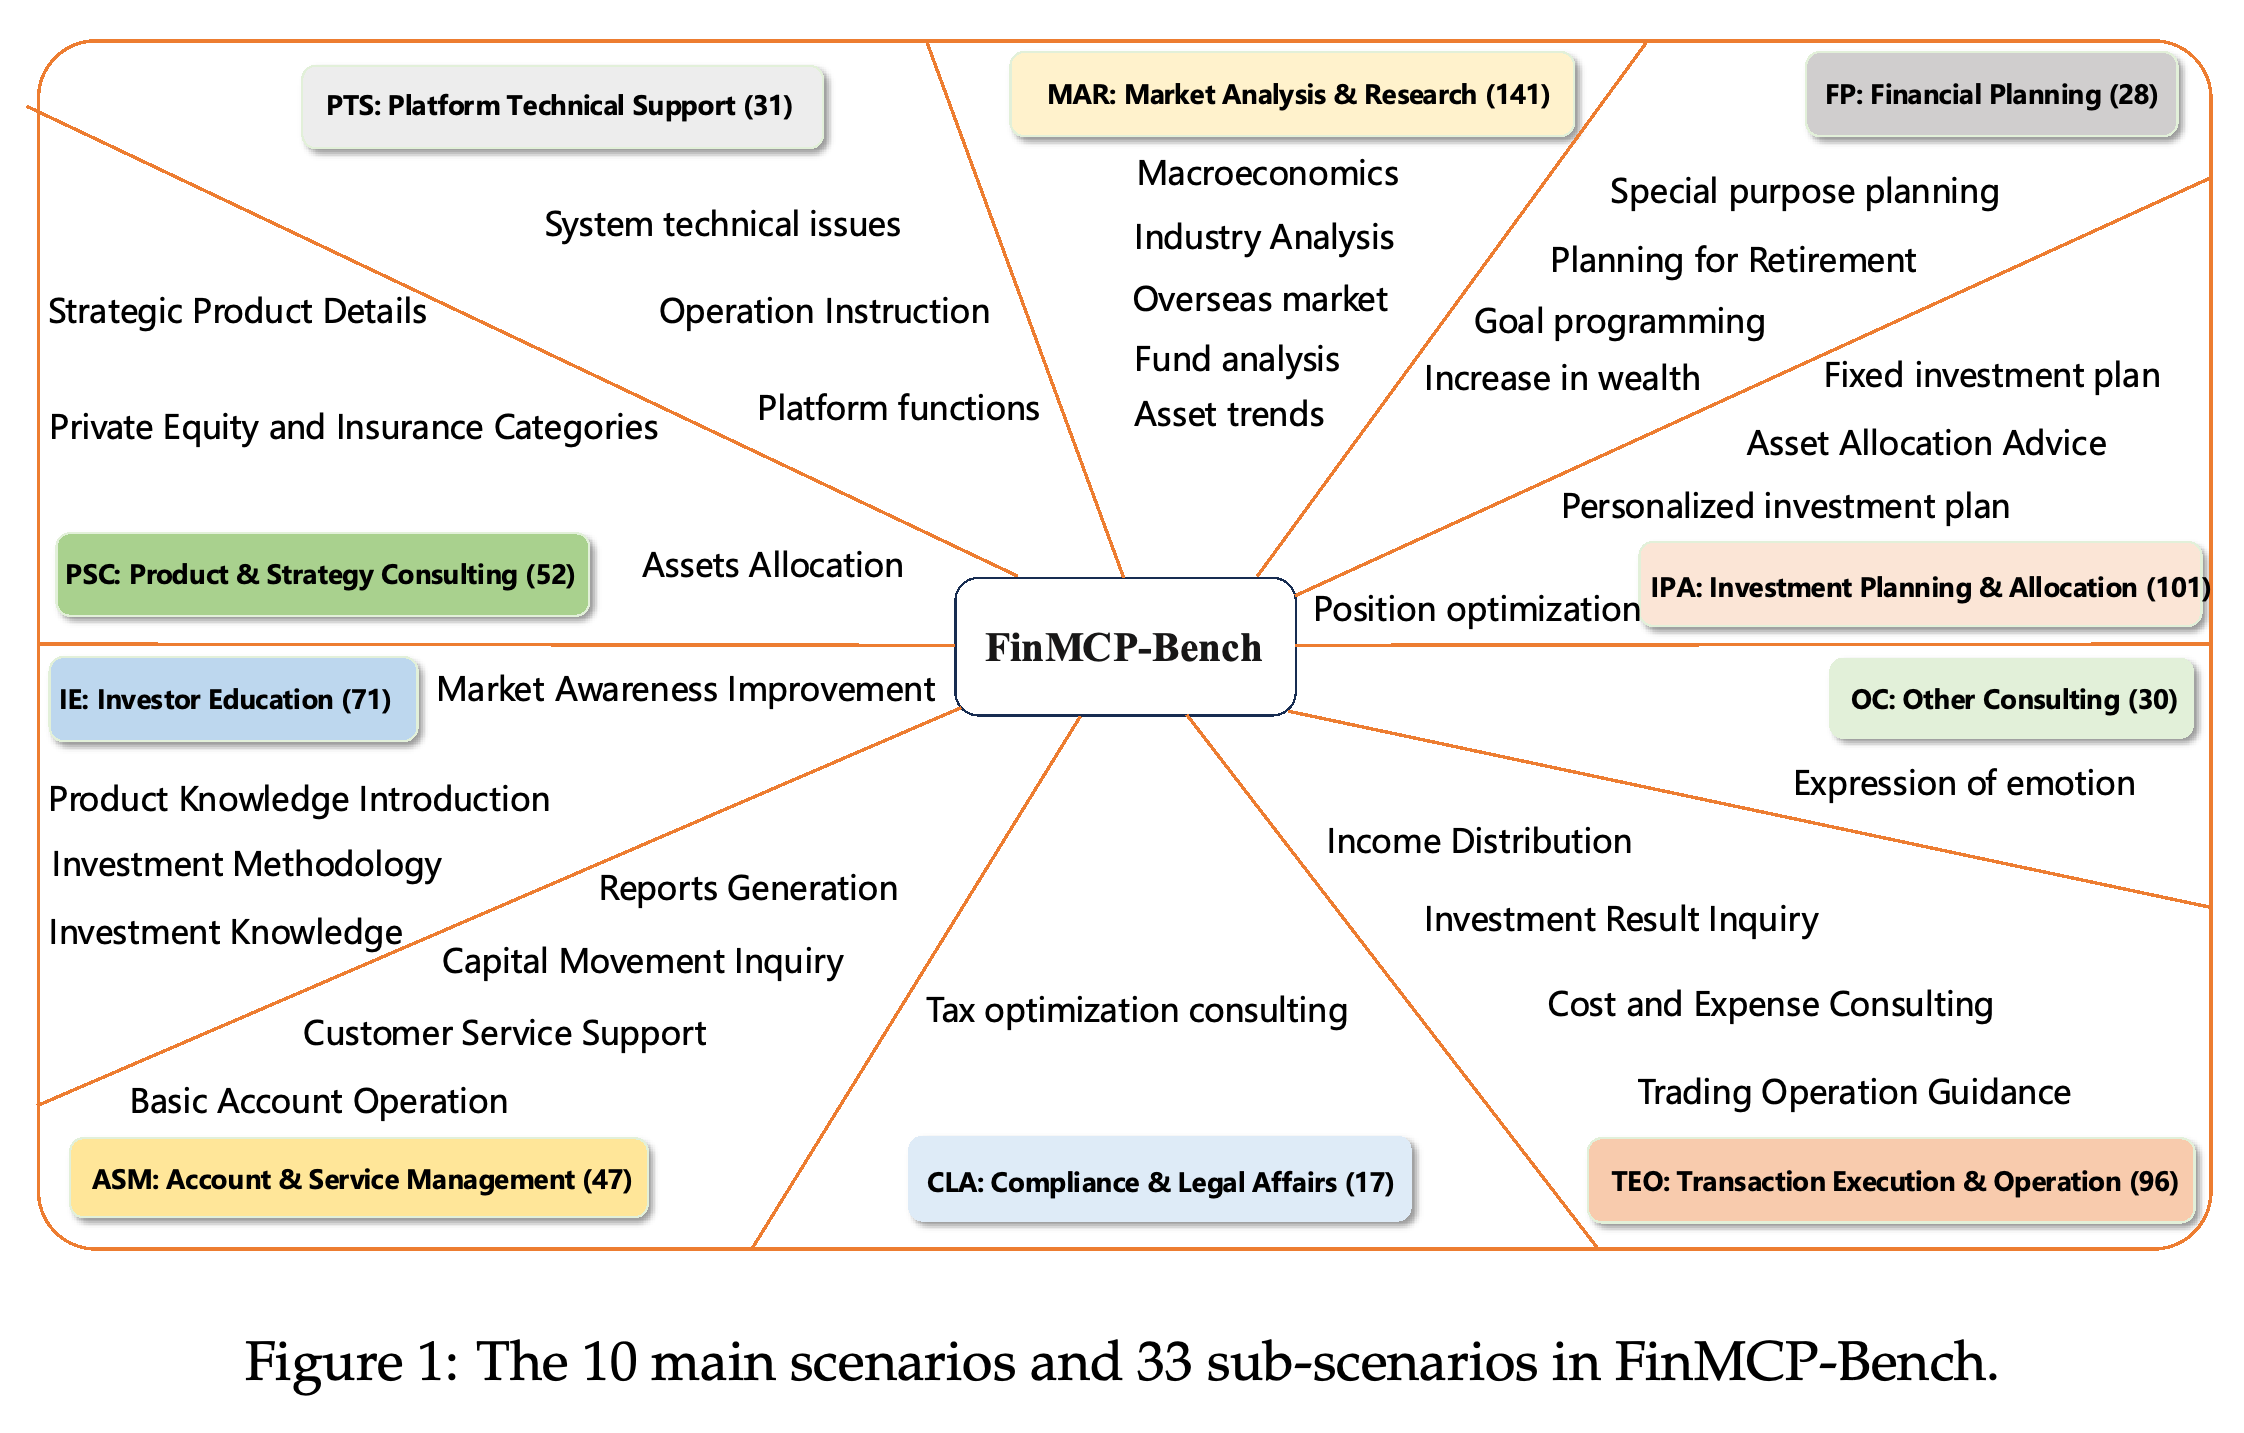
FinMCP-Bench는 단일 도구 샘플 145개, 다중 도구 샘플 249개, 다중 턴 샘플 219개로 구성된다. Figure 1은 시나리오 범위를 보여준다. Market Analysis & Research(MAR)가 샘플 141개로 가장 크고, Investment Planning & Allocation(IPA)이 101개로 그다음이다.
- 단일 도구 과제는 대화 1턴에서 호출 1회를 요구한다. 다중 도구 과제는 1턴 안에서 여러 도구를 순차 또는 병렬로 호출해야 한다.
- 다중 턴 과제는 여러 대화 턴에 걸쳐 진행되며, 각 턴에서 도구 1개 이상이 필요할 수 있다.
- 나머지 범주는 Financial Planning(28), Account & Service Management(47), Transaction Execution & Operation(96), Investor Education(71), Product & Strategy Consulting(52), Compliance & Legal Affairs(17), Platform Technical Support(31), Other Consulting(30)이다.
시나리오 지도는 시장 분석을 넘어 계좌 업무, 교육, 규제 준수, 기술 지원까지 평가 범위를 넓힌다. 시나리오별 규모는 균등하지 않다. MAR은 사례 141개인 반면 CLA는 17개이므로, 종합 평가에 반영되는 사례 수는 금융 시나리오마다 다르다.
2.1 Data Source
원천 데이터는 Yingmi Fund가 운영하는 Qieman APP의 XiaoGu AI assistant에서 수집한 과거 로그 10,000개다. 이 어시스턴트는 전문가가 정의한 SOP와 워크플로 방식의 도구 호출을 따른다. 저자들은 모든 로그에 엄격한 익명화 및 공개 절차를 적용했다고 보고한다.
- 채택할 로그는 실제 금융 수요를 담고, 도구 호출로 문제를 해결하며, 만족스러운 최종 응답을 제공해야 한다.
- 필터링 결과 단일 도구 샘플 1,484개와 다중 도구 샘플 183개가 남는다. 단일 도구 후보군은 무작위로 나누어 700개를 전문가 선별에 사용하고, 784개를 더 복잡한 샘플 합성을 위해 남겨 둔다.
- 전문가 검토에서는 단일 도구 후보 700개 중 145개를 채택한다. Section 2.1은 나머지 784개를 다중 도구 및 다중 턴 합성에 사용하도록 남겨 두지만, Section 2.3은 대화 생성에서 이 샘플들을 어떻게 사용하는지 자세히 설명하지 않는다.
2.2 Chain-based Multi-tool Sample Construction
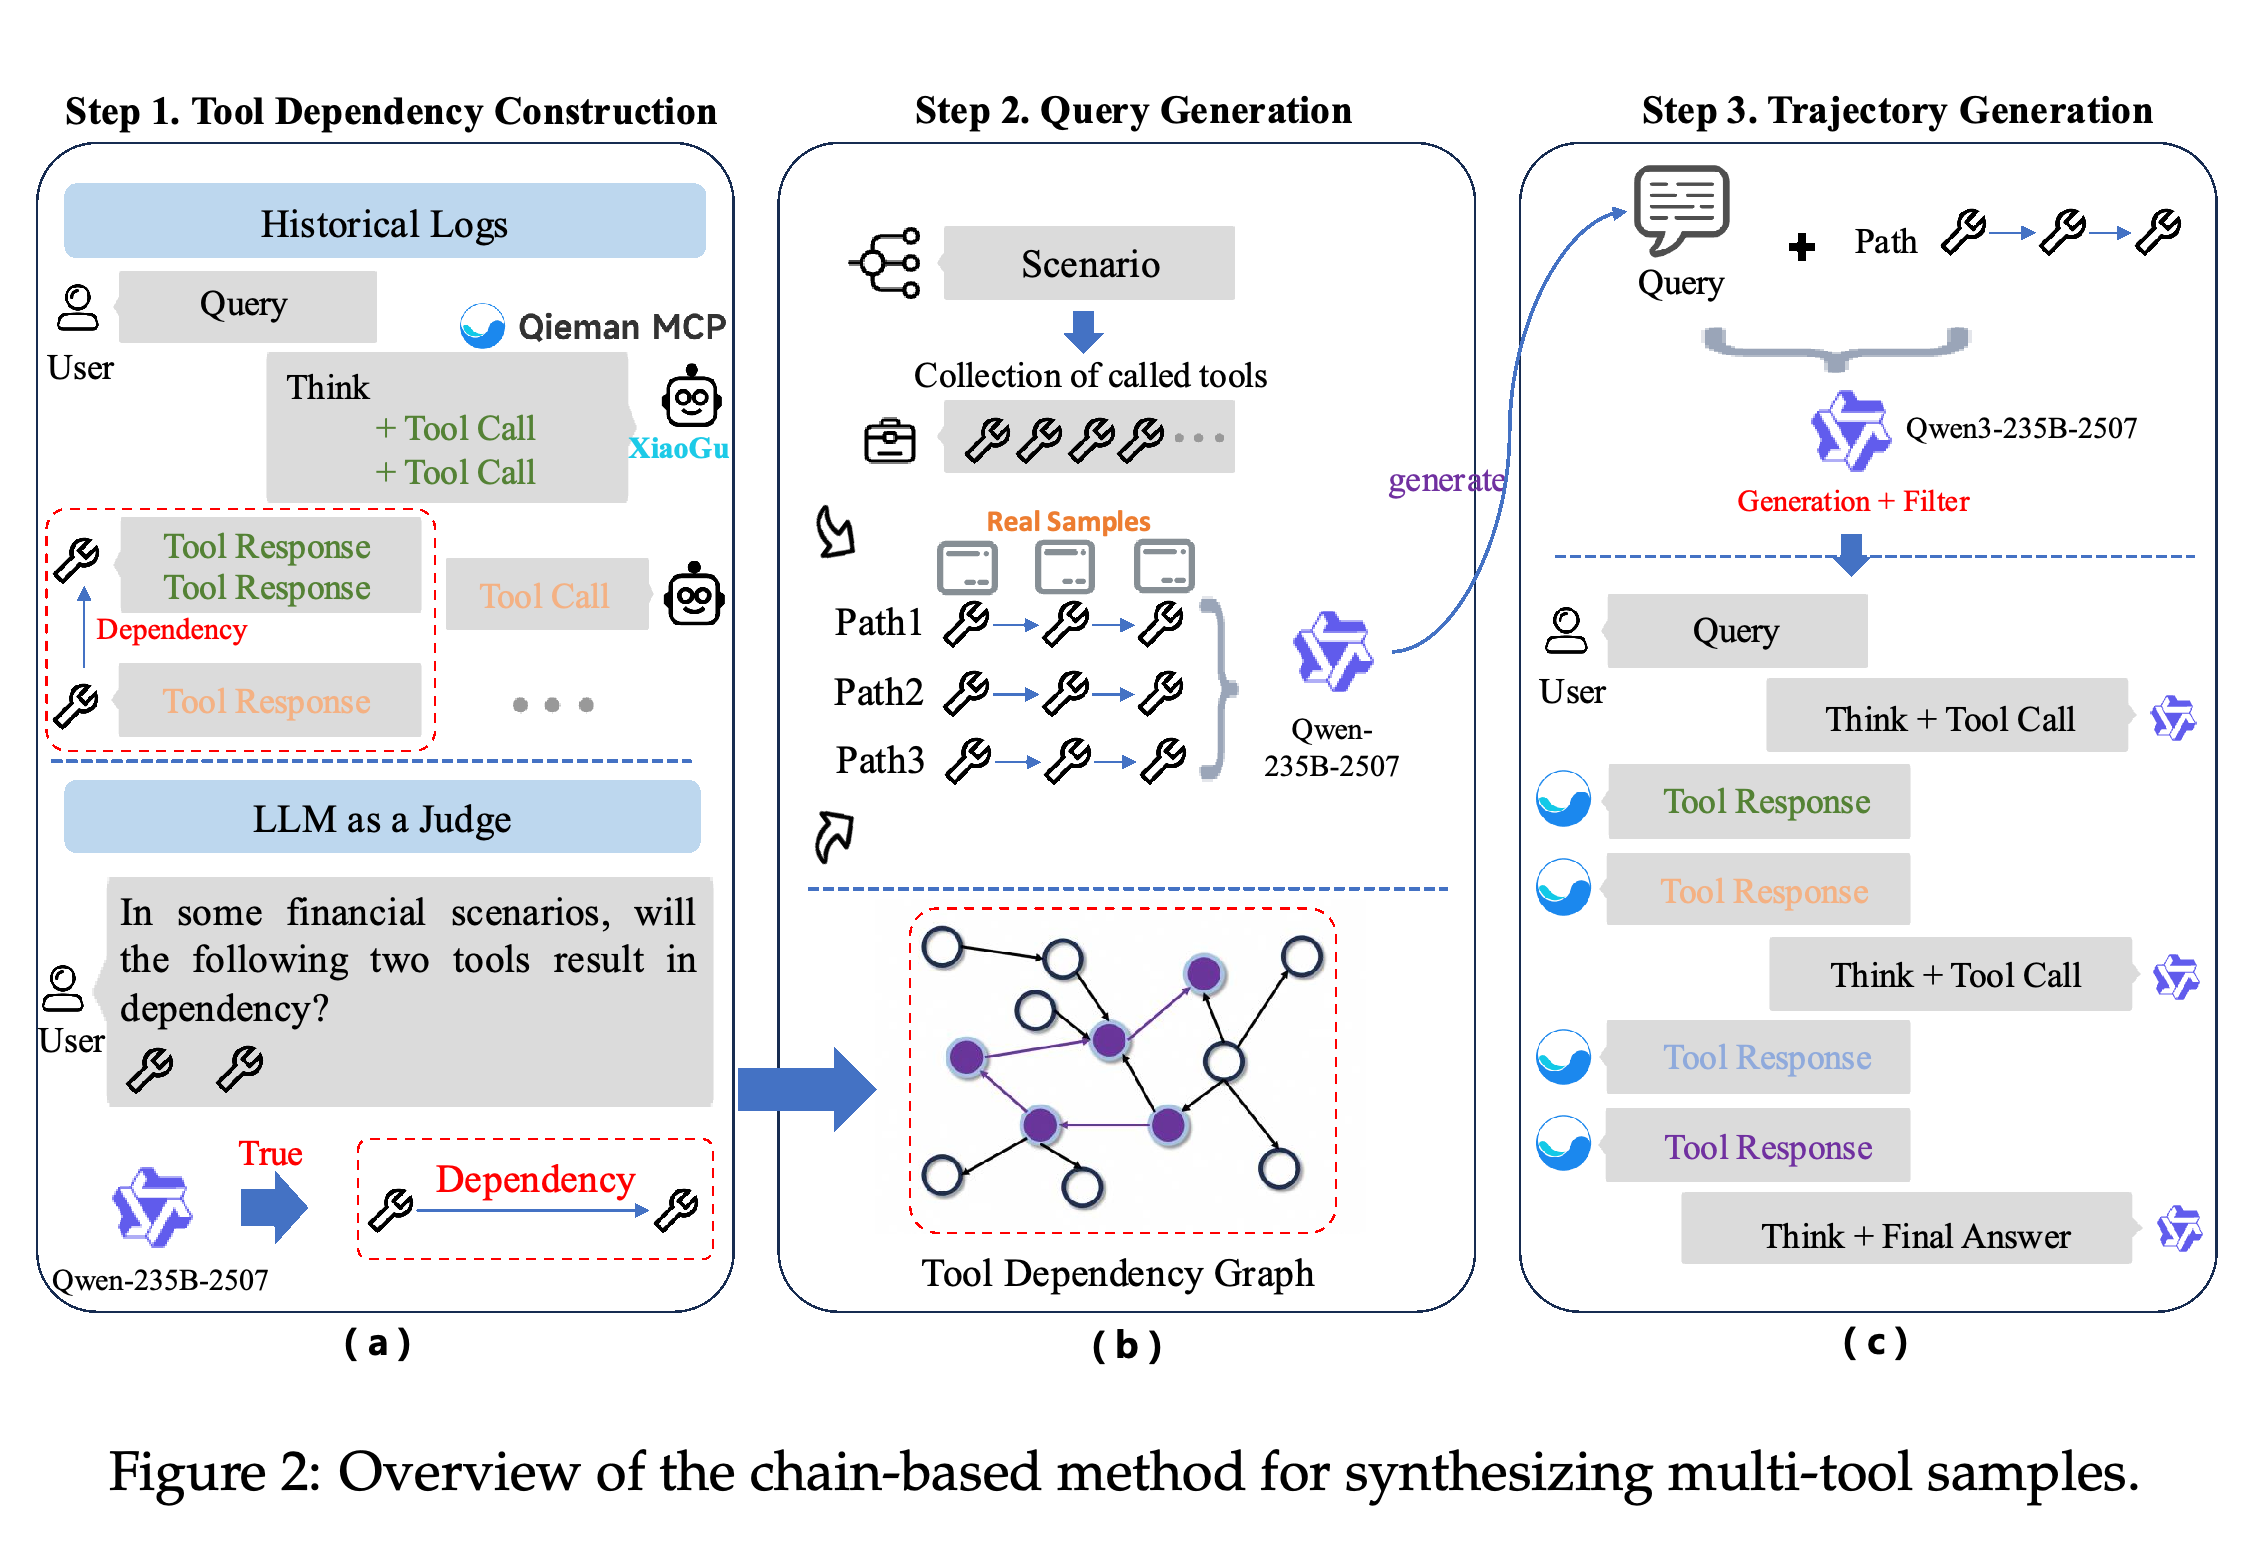
도구 의존성 그래프 구축: Figure 2의 체인 기반 방법은 도구마다 노드 1개를 만들고 간선이 없는 상태에서 시작한 뒤, 실제 다중 도구 샘플을 처리한다. 바로 이어지는 실행 그룹에 속한 도구들 사이에서 의존성 후보를 제안하고, Qwen3-235B-2507이 각 의존성이 금융 시나리오에서 타당한지 판단한다.
- 연속된 그룹이 (t1, t2)와 (t3)이면 후보는 t1 → t3와 t2 → t3이다. 병렬 도구인 t1과 t2 사이의 의존성은 추론하지 않는다.
- 검증된 후보는 방향 간선이 된다. 완성된 그래프에는 노드 65개와 간선 288개가 있다.
사용자 질의 생성: 저자들은 각 시나리오에 해당하는 실제 다중 도구 샘플에 등장하는 도구 2개를 표본 추출하고, 의존성 그래프에서 이들을 연결하는 경로를 선택한다. Qwen3-235B-2507은 남겨 둔 후보군에서 체인에 속한 도구마다 무작위로 선택한 단일 도구 예시 1개를 사용해, 체인에 맞는 질의를 생성한다.
- 표본 추출한 도구들을 연결하는 경로가 여러 개이면 경로 1개를 무작위로 선택한다.
- 따라서 합성 질의는 시나리오와 관련된 도구, 의존성 경로, 개별 도구 사용 예시를 조건으로 생성된다.
실행 궤적 생성: Qieman의 MCP 서버에 연결된 Qwen3-235B-2507이 각 합성 질의에 대한 도구 사용 궤적을 생성한다. 채택할 궤적은 표본 추출한 체인의 의존 관계를 유지해야 하지만, 추가 도구 사용은 허용된다.
- 생성된 질의-궤적 쌍 1K개 중 496개가 초기 구축 필터를 통과한다.
- 이 후보 496개를 실제 다중 도구 샘플 183개와 합쳐 전문가 검토를 수행하고, 다중 도구 샘플 249개를 채택한다. 최종 데이터에서 실제 샘플과 합성 샘플이 각각 얼마나 차지하는지는 보고하지 않는다.
3단계 도식은 운영 환경의 도구 실행 순서에서 검증된 의존성 간선, 표본 추출한 경로, 합성 질의, 생성된 궤적으로 이어지는 과정을 보여준다. 단일 도구 예시는 질의 생성을 제약하고, MCP 서버를 통한 실행과 의존성 보존 필터링은 결과 워크플로를 제약한다.
2.3 Role-Playing-based Multi-turn Sample Construction
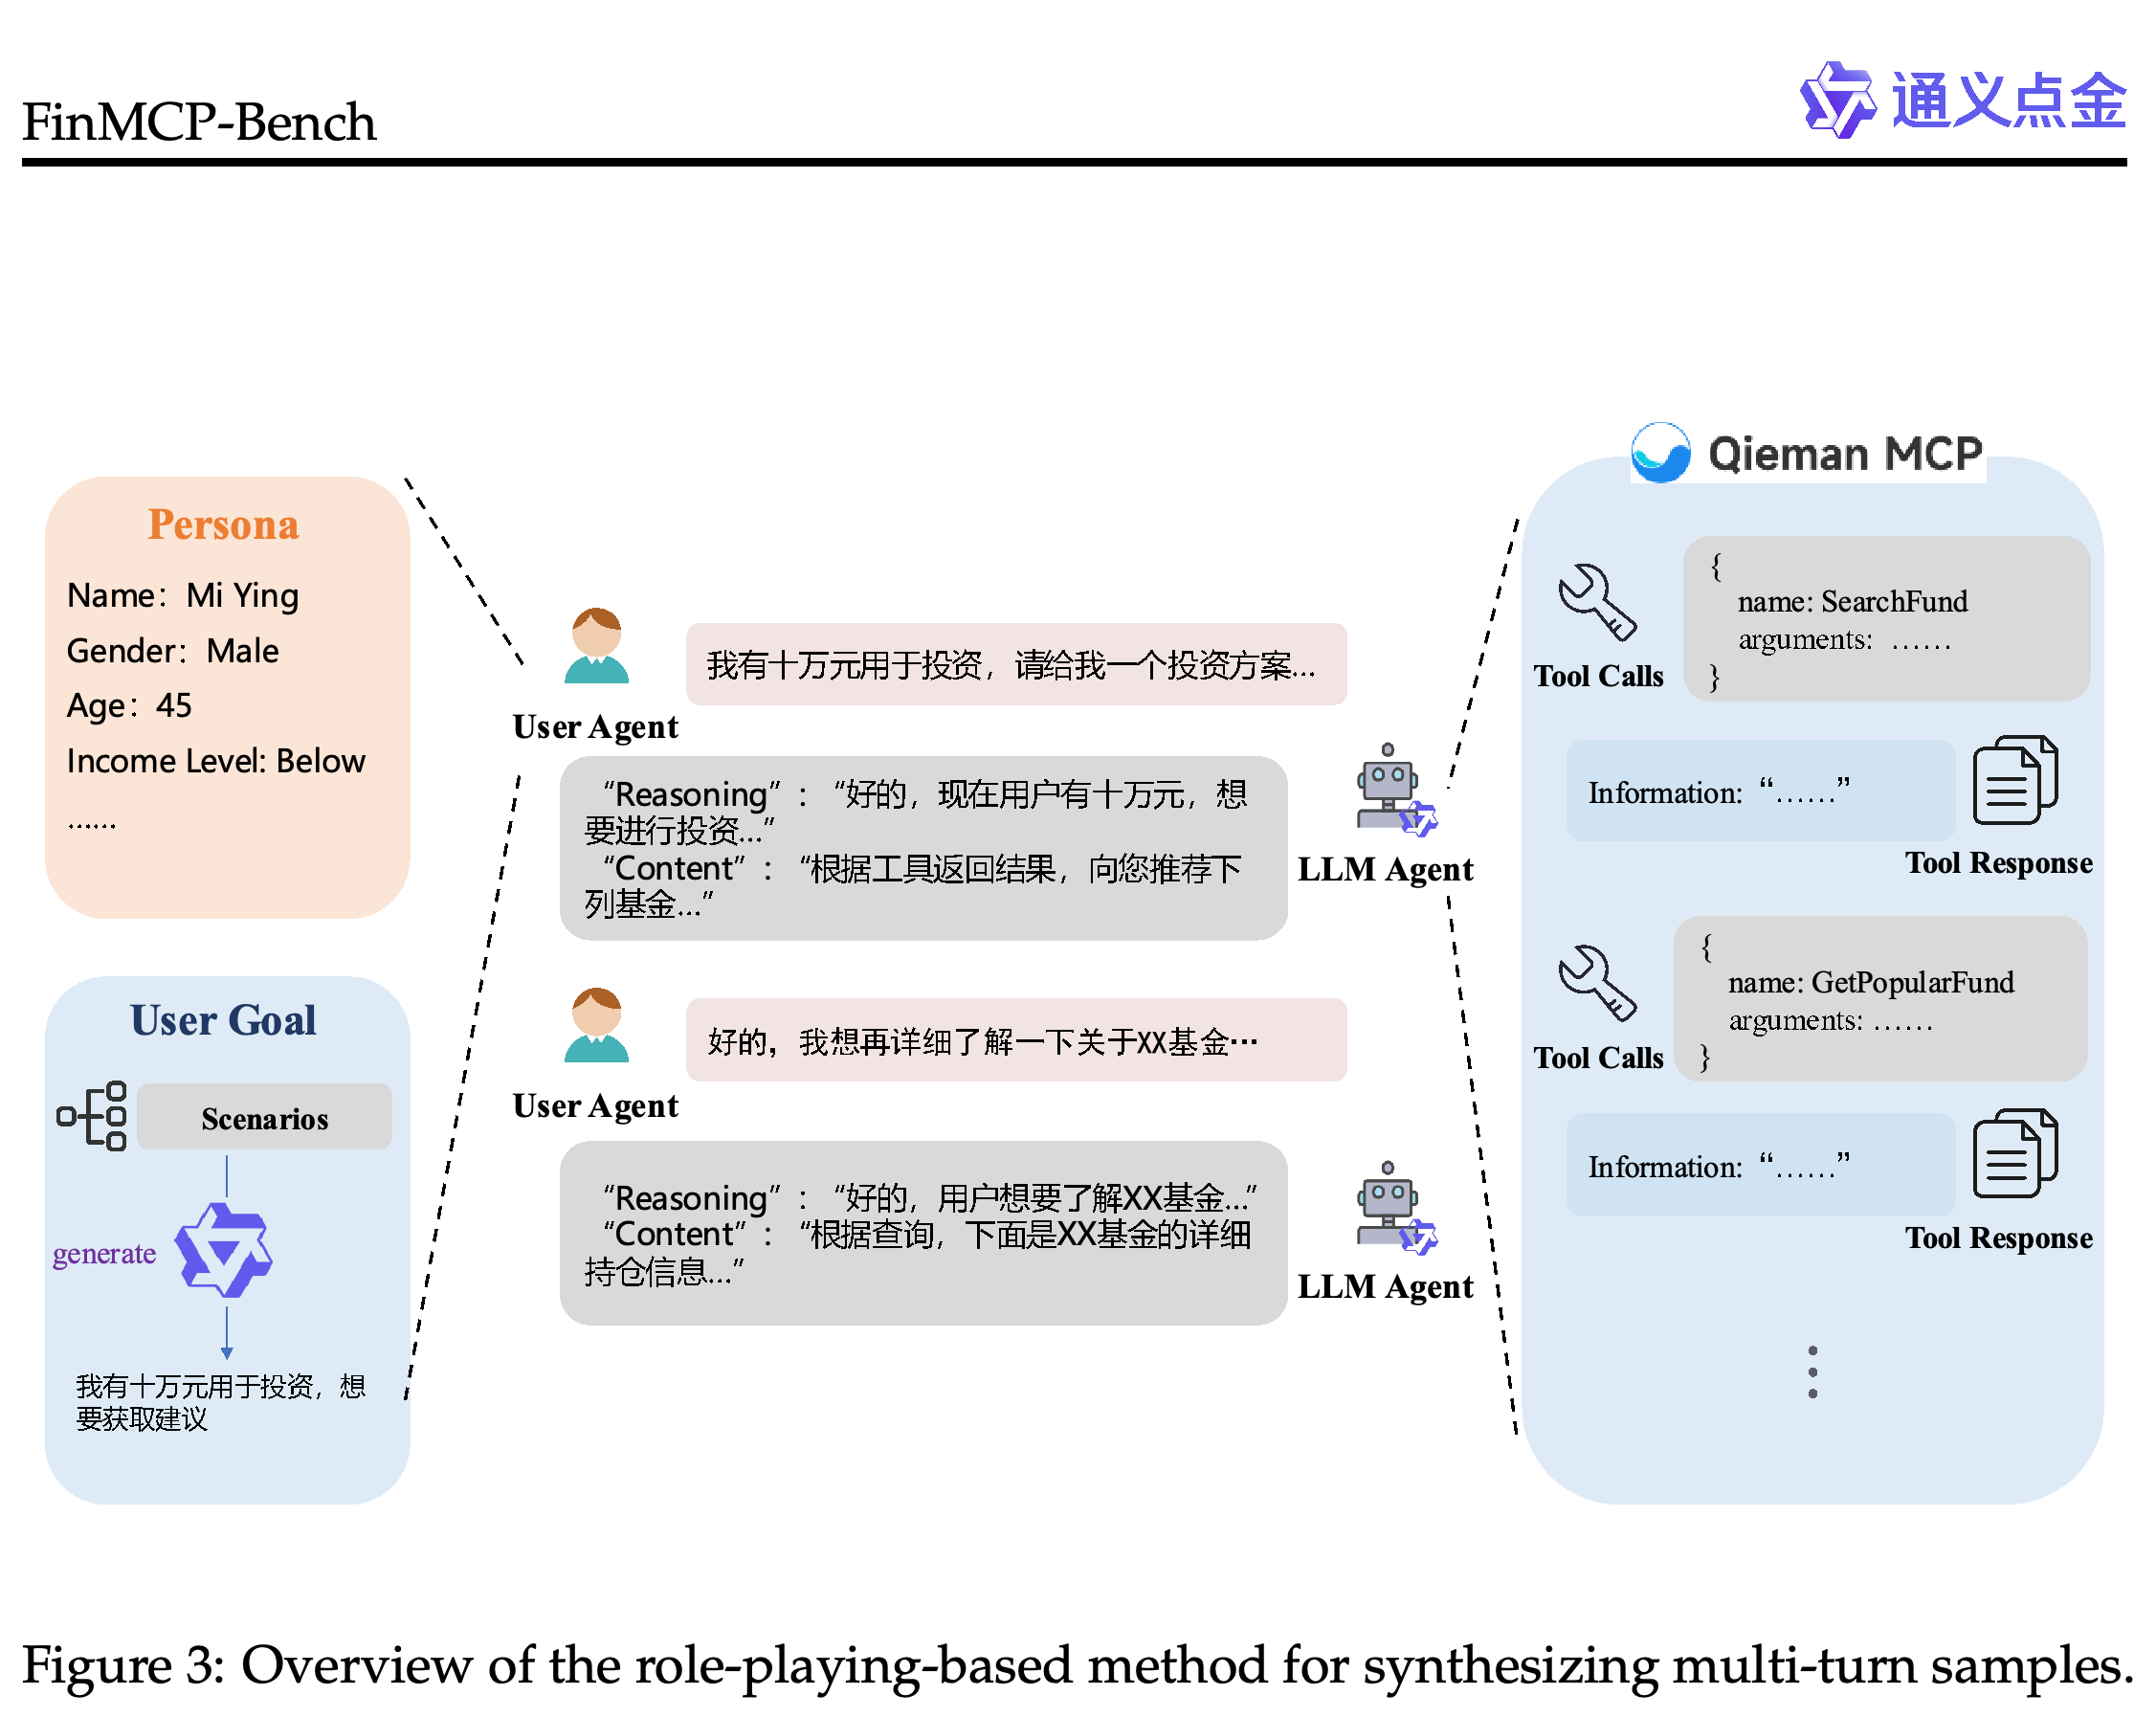
Figure 3은 역할극을 통한 다중 턴 합성을 보여준다. 플래너는 금융 고객 페르소나와 세부 시나리오를 선택하고, 이에 맞는 사용자 목표를 생성한 뒤, Qwen3-235B-2507이 사용자와 어시스턴트 역할을 모두 시뮬레이션하도록 한다.
- 페르소나는 Zhu et al. (2025a)의 프로필 후보군에서 가져오며, 나이, 성별, 소득 수준 등의 속성을 포함한다.
- 시뮬레이션된 사용자가 후속 요청을 제시하는 동안 어시스턴트는 금융 도구와 상호작용한다.
- 저자들은 후보 대화 500개를 생성한다. Qwen3-235B-2507이 모든 사용자 질의가 처리되었는지 확인해 378개를 남기고, 금융 전문가 검토에서 최종적으로 219개를 채택한다.
페르소나와 목표 선택은 시뮬레이션 사용자의 금융 맥락을 설정하고, 후속 요청은 상호작용을 단일 질의보다 길게 이어 간다. 어시스턴트는 이 대화 중 Qieman MCP 도구를 호출한다. 구축 설명에서는 Qwen3-235B-2507이 대화의 양쪽 역할을 모두 수행한다고 명시한다.
2.4 Quality Control
품질 관리는 자동 실행 검사와 금융 분야 전문가 및 숙련 개발자 6명의 검토를 결합한다. 각 샘플은 무작위로 배정된 검토자 2명이 5점 Likert 척도로 독립적으로 평가한다. 모든 평가 차원에서 검토자 모두가 4점 이상을 부여해야 샘플을 채택한다.
- 자동 검증기는 모든 도구가 오류 없이 성공적으로 실행되는지 확인한다.
- 평가 차원 5개는 질문의 관련성, 도구 체인의 완전성, 도구 체인의 논리적 일관성, 답변의 신뢰성과 추적 가능성, 데이터의 최신성이다.
- 검토자 간 의견 차이는 토론으로 해결한다. 논문은 평가자 간 일치도 통계를 보고하지 않는다.
2.5 Dataset Analysis
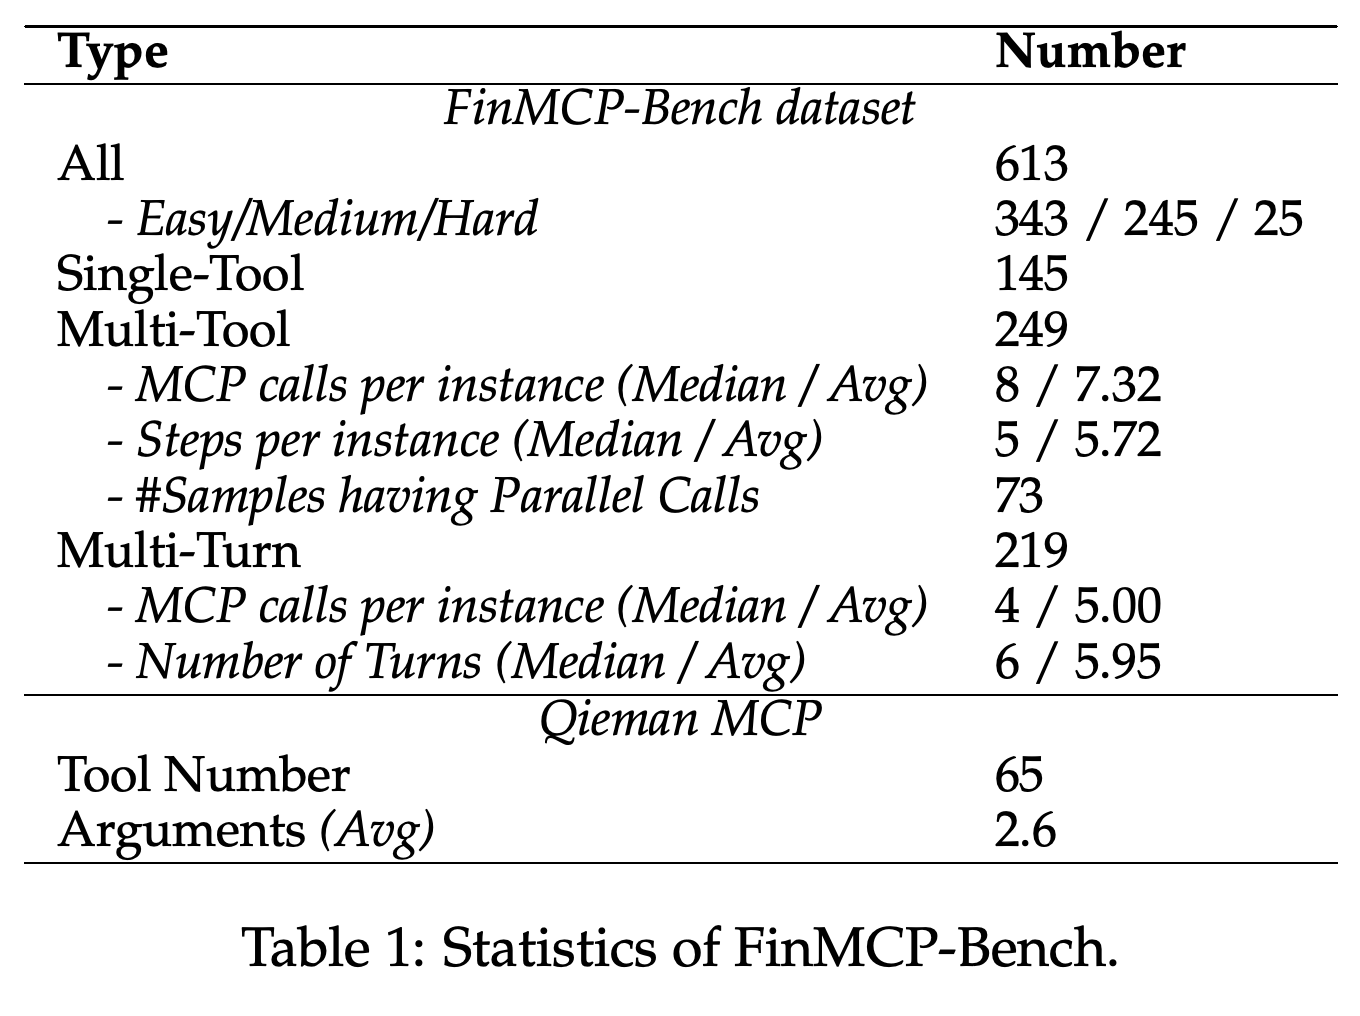
도구 실행 궤적은 연속된 실행 그룹으로 표현한다. 그룹 안의 도구는 병렬로 호출되며, 그룹 내부 순서는 바뀌어도 된다. 난이도는 도구 호출 횟수로 정의한다. Easy는 5회 이하, Medium은 5회 초과 10회 이하, Hard는 10회 초과 호출을 요구한다. Table 1에 따르면 각 난이도의 샘플 수는 순서대로 343개, 245개, 25개다.
- 단일 도구 샘플 145개는 모두 정확히 1단계에서 1회 호출한다.
- 다중 도구 샘플의 호출 횟수 중앙값/평균은 8 / 7.32이고, 단계 수 중앙값/평균은 5 / 5.72다. 샘플 249개 중 73개에서 병렬 호출이 발생한다.
- 다중 턴 샘플의 호출 횟수 중앙값/평균은 4 / 5.00이고, 턴 수 중앙값/평균은 6 / 5.95다. Qieman MCP 도구 65개의 평균 인자 수는 2.6개다.
통계는 도구 호출 횟수, 실행 단계 수, 대화 턴 수를 구분한다. 다중 도구 과제는 평균 5.72단계에서 7.32회 호출하며, 샘플 73개가 병렬 호출을 포함한다. 다중 턴 과제는 평균 5.95턴에 걸쳐 5.00회 호출한다. 전체 샘플 613개 중 Hard 분할에 속하는 샘플은 25개뿐이다.
3 Experimentation
실험은 과제 유형, 금융 시나리오, 도구 수에 따른 난이도별로 LLM 6개를 비교한다. 평가는 도구 선택의 일치도와, 참조의 순차 및 병렬 실행 구조를 재현해야 하는 더 엄격한 요건을 구분한다.
3.1 Experimental Settings
모델: 평가 모델은 Qwen3-4B-Thinking, Qwen3-30B-A3B-Thinking, Qwen3-235B-A22B-Thinking, DeepSeek-R1, GPT-OSS-20B, Seed-OSS-36B다. 추론: 현재 사용자 발화와 정답 대화 이력을 바탕으로 각 응답을 생성하고, 생성된 응답에서 호출한 도구를 추출한다.
- 단일 도구와 다중 도구 사례는 1턴 대화로 취급한다. 다중 턴 사례는 대화 구조를 유지한다.
- 턴 i에서 모델에는 자신이 앞서 생성한 응답이 아니라 이전 턴의 참조 발화-응답 쌍을 제공한다. 이는 Zhu et al. (2025a)의 대화 평가 설정을 따른 것으로, 자율적으로 대화를 진행할 때 누적되는 오류는 제외한다.
- 논문은 디코딩 매개변수, 반복 실행에 따른 변동성, 상세 추론 예산을 명시하지 않는다.
3.2 Evaluation Metrics
Tool Recall(TR): 의존 관계를 무시하고 참조 도구 집합과 예측 도구 집합을 비교한다. recall은 교집합 크기를 참조 집합 크기로 나눈 값이다. Tool Precision(TP): precision은 같은 교집합 크기를 예측 집합 크기로 나눈 값이다. Tool F1(TF1): 두 지표의 조화 평균은 TF1 = 2×TR×TP/(TR+TP)다.
- 집합 기반 비교는 도구 선택을 측정하지만, 실행 그룹이나 반복 호출 횟수는 보존하지 않는다.
- 논문은 금융 리서치와 자문 질문이 개방형이며 표준 최종 답변이 없다는 점을 들어 도구 중심 평가의 필요성을 설명한다.
Exact Match Rate(EMR): 각 병렬 그룹의 내부 순서를 무시했을 때 도구 실행 구조가 참조와 일치해야 예측을 정확한 일치로 인정한다. 따라서 EMR은 TP, TR, TF1보다 실행 구조를 엄격하게 평가한다.
- 지표 정의에서는 인자 값, 수치의 정확성, 최종 금융 응답의 품질을 명시적으로 평가하지 않는다.
- 참조 실행 구조와 정확히 일치한다는 사실만으로는 다른 워크플로도 사용자 요청을 해결할 수 있는지 판단할 수 없다.
3.3 Experimental Results
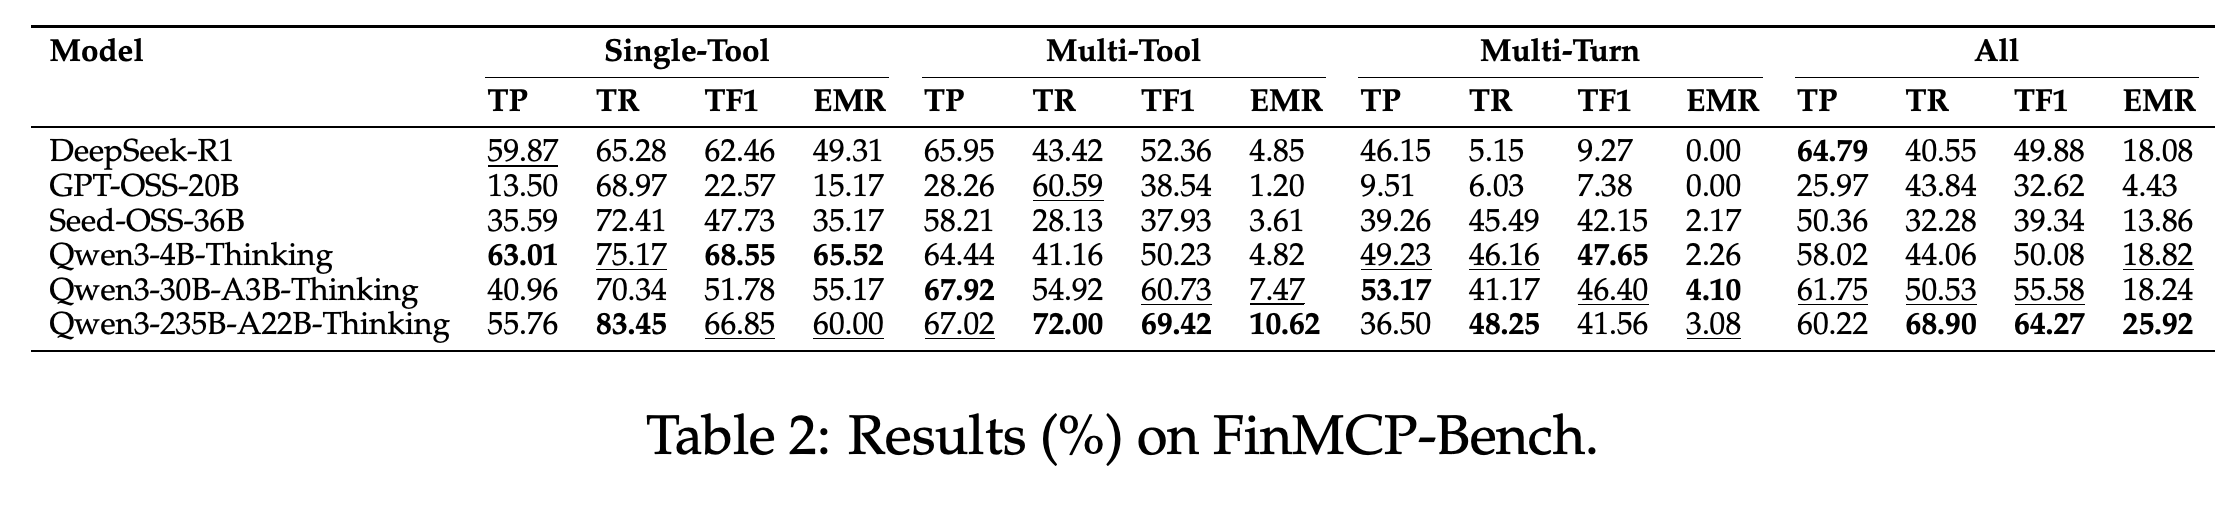
Table 2에서 Qwen3-235B-A22B-Thinking은 TP 60.22%, TR 68.90%, TF1 64.27%, EMR 25.92%를 기록하며 전체 TF1과 EMR에서 가장 높다. 모델 크기에 따라 순위가 일관되게 정해지지는 않는다. Qwen3-4B-Thinking은 Qwen3-30B-A3B-Thinking보다 전체 EMR이 18.82% 대 18.24%로 높지만, TF1은 50.08% 대 55.58%로 낮다.
- 나머지 모델의 전체 TF1 / EMR은 DeepSeek-R1 49.88% / 18.08%, GPT-OSS-20B 32.62% / 4.43%, Seed-OSS-36B 39.34% / 13.86%다.
- Qwen3-4B-Thinking은 단일 도구 TF1과 EMR에서 각각 68.55%와 65.52%로 가장 높다. Qwen3-235B-A22B-Thinking은 다중 도구 TF1과 EMR에서 각각 69.42%와 10.62%로 가장 높다.
다중 턴 EMR은 0.00%부터 4.10%까지이며, Qwen3-30B-A3B-Thinking이 가장 높다. 다중 턴 TF1은 Qwen3-4B-Thinking이 47.65%로 가장 높다. 이는 도구 집합의 일치도와 실행 구조의 정확한 일치도가 서로 다른 순위를 만든다는 점을 보여준다.
- DeepSeek-R1과 GPT-OSS-20B의 다중 턴 TR은 각각 5.15%와 6.03%이며, EMR은 모두 0.00%다.
- 모든 모델은 다중 도구 과제보다 단일 도구 과제에서 recall이 높지만, precision은 단일 도구 과제에서 더 낮다. 저자들은 도구가 1개만 필요한 상황에서 불필요한 도구를 추가로 선택하기 때문에 이러한 precision 양상이 나타난다고 설명한다.
- 다중 도구 TF1과 EMR의 차이는 참조 도구를 많이 찾아내더라도 참조 실행 구조 전체를 복원한 것은 아니라는 점을 보여준다.
다중 도구 과제에서는 도구 집합의 일치도가 실행 구조의 정확한 일치도보다 훨씬 높다. Qwen3-235B-A22B-Thinking은 전체 TF1과 EMR에서 가장 높지만, 다중 도구 EMR은 어느 모델도 10.62%를 넘지 못하고 다중 턴 EMR도 4.10%를 넘지 못한다. 단일 도구 TF1과 EMR에서는 Qwen3-4B-Thinking이 가장 높다.
3.4 Experimental Analysis
시나리오별 결과: Figure 4는 주요 시나리오 10개의 TF1을 비교한다. 저자들은 Qwen3-30B-A3B-Thinking과 Qwen3-235B-A22B-Thinking이 전반적으로 균형 잡힌 성능을 보이는 선두 그룹이며, GPT-OSS-20B는 시나리오 전반에서 뒤처진다고 설명한다.
- 저자들은 다중 도구 계획과 여러 출처의 정보 종합이 필요한 시나리오에서 격차가 크고, 단순한 단일 작업 질의에서는 격차가 작다고 설명한다. 다만 이러한 워크플로 특성의 영향을 분리한 별도 분석은 제공하지 않는다.
- 정확한 시나리오별 수치, 신뢰구간, 유의성 검정을 제공하지 않아 작은 차이를 정밀하게 비교하기 어렵다.
- Figure 4에는 Seed-OSS-32B라고 표시되어 있지만, 실험 설정과 Table 2에는 Seed-OSS-36B로 명시되어 있다. PDF는 이 불일치를 해소하지 않는다.
레이더 차트는 시나리오에 따른 도구 집합의 일치도를 비교한다. 여러 모델의 성능 영역이 상당 부분 겹치며, GPT-OSS-20B는 대체로 가장 작은 영역을 차지한다. 정확한 시나리오 점수는 표로 제공하지 않는다. 범례에는 Seed-OSS-32B라고 표기되어 있어, 실험 설정과 결과 표의 Seed-OSS-36B와 다르다.
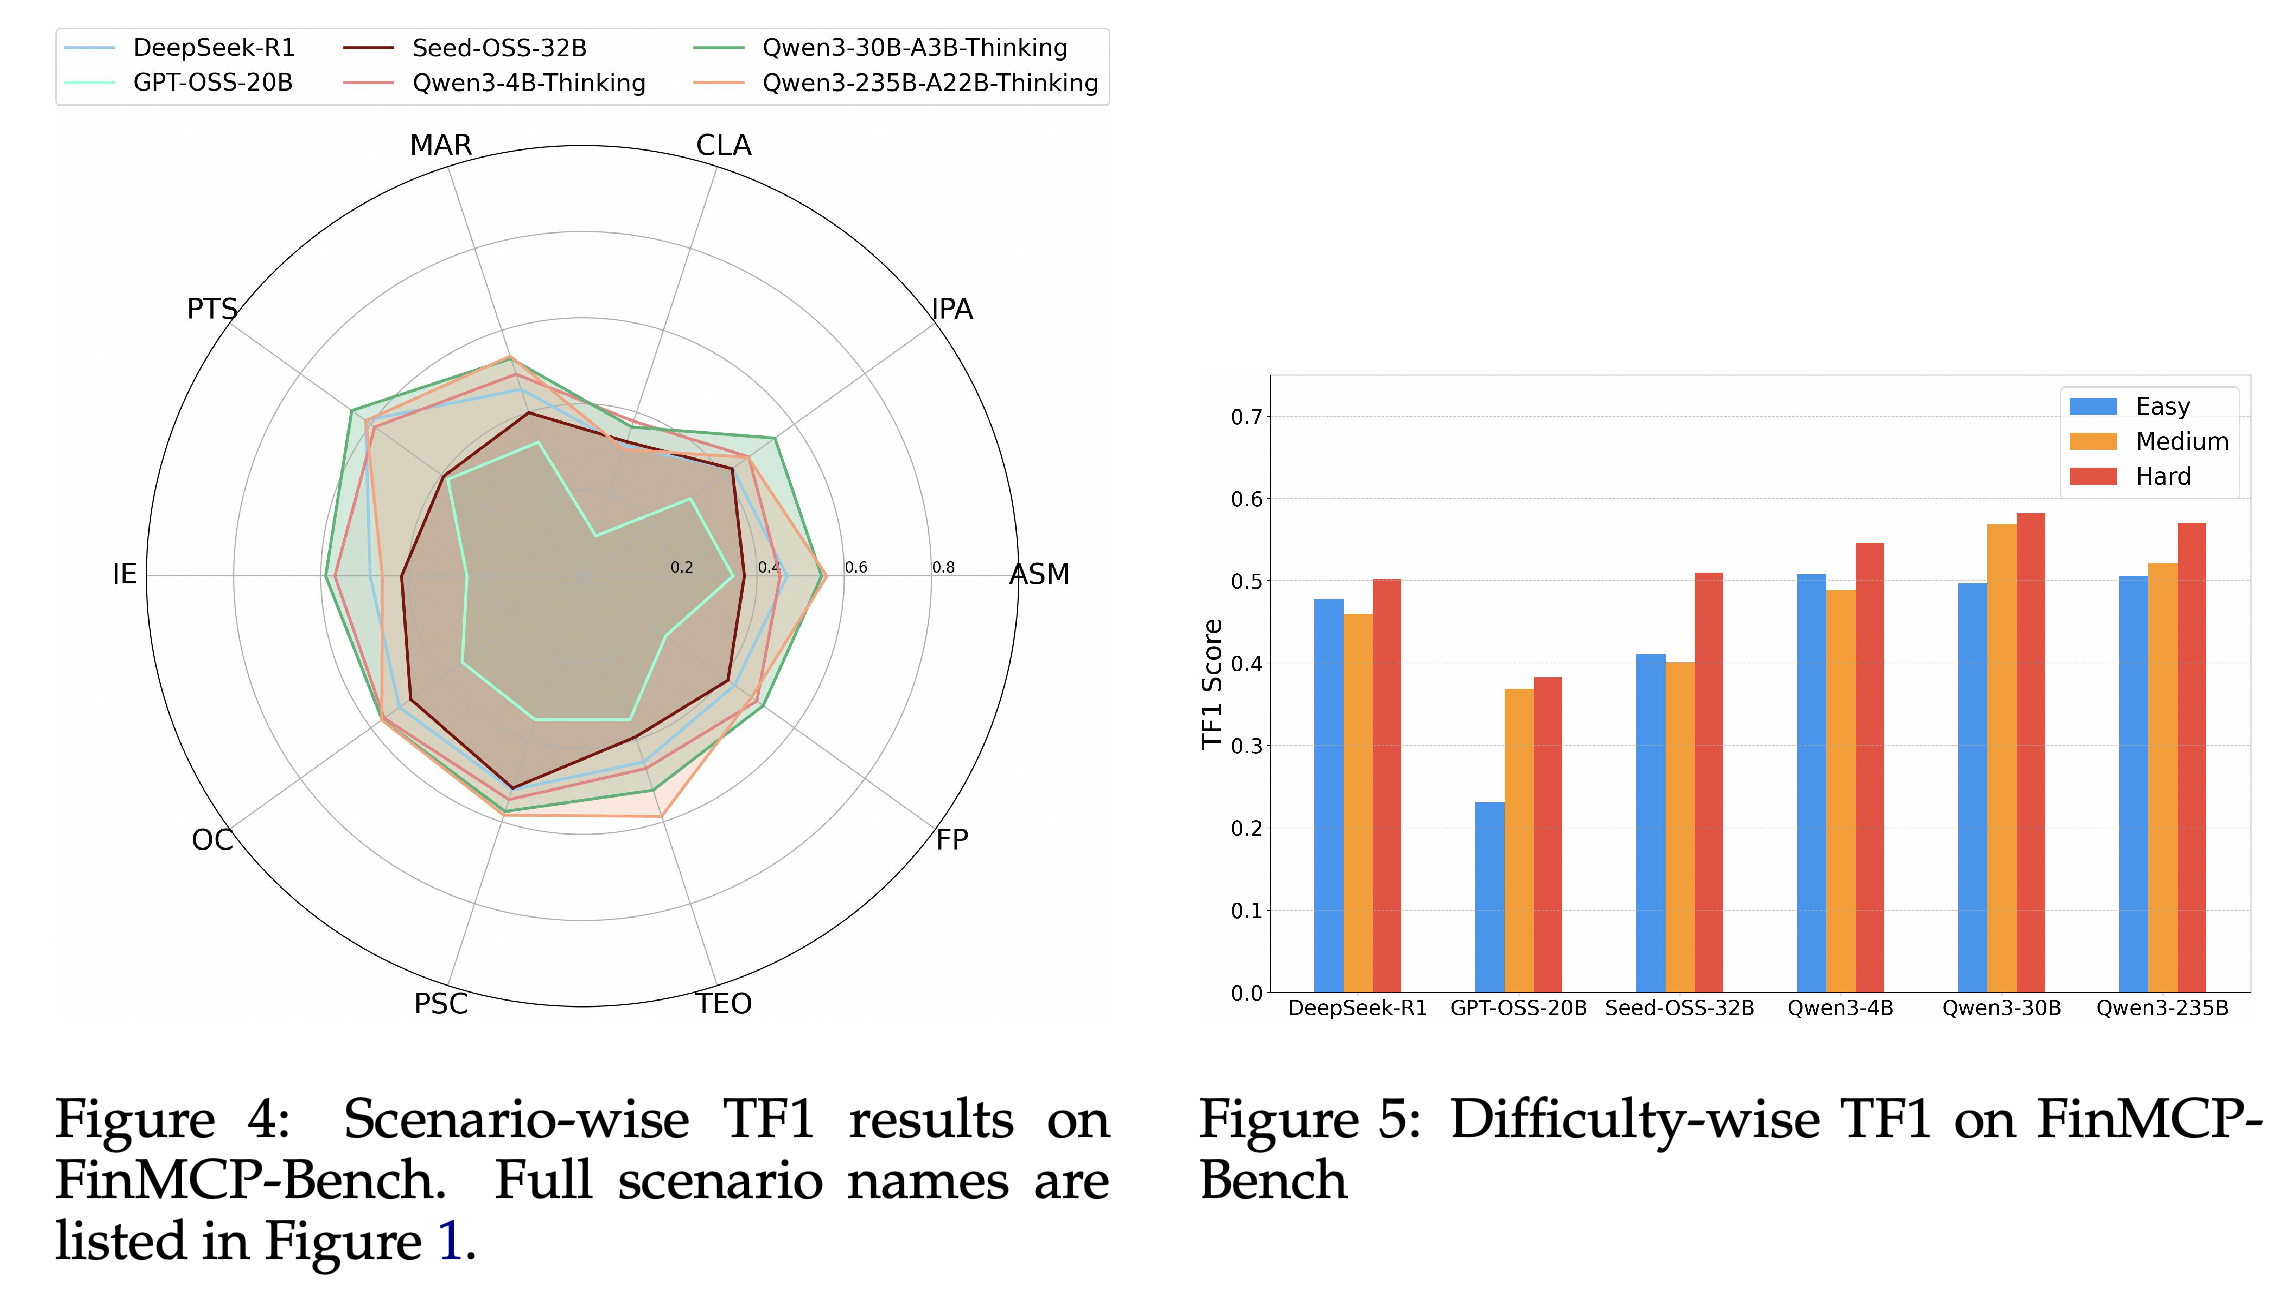
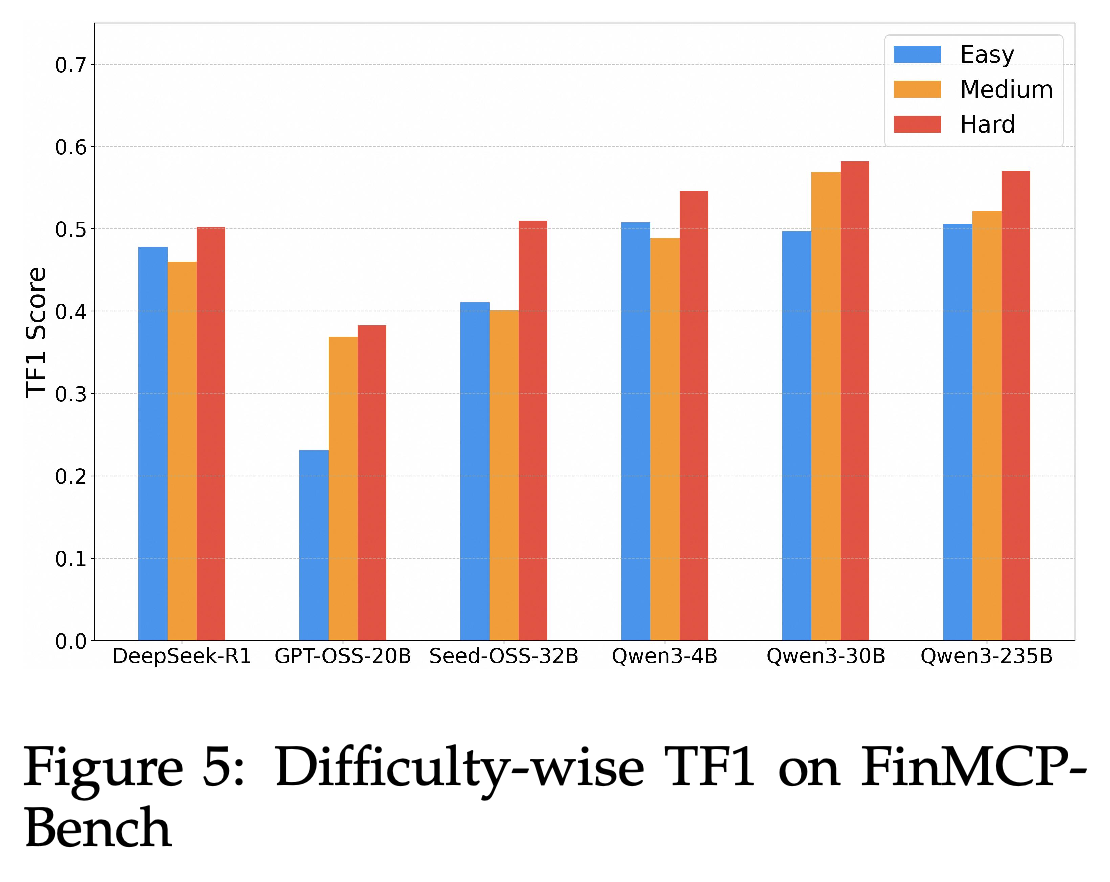
난이도별 결과: Figure 5는 필요한 도구 호출 횟수가 늘어나도 TF1이 단조롭게 감소하지 않음을 보여준다. 저자들은 이를 precision과 recall의 균형으로 해석한다. Easy 과제에서는 과도한 호출이 불이익을 받지만, 참조 도구 집합이 커지면 recall 향상이 점수에 유리하게 작용할 수 있다.
- Qwen3-30B-A3B-Thinking과 Qwen3-235B-A22B-Thinking은 Easy에서 Hard로 갈수록 성능이 높아진다. GPT-OSS-20B는 Easy에서 Medium/Hard로 갈 때 크게 상승하지만 다른 모델보다 낮은 수준에 머문다. Figure 5도 Seed 계열을 Seed-OSS-36B가 아니라 Seed-OSS-32B로 표시한다.
- TF1은 의존 구조를 무시하므로, Hard 분할에서 TF1이 높다는 사실이 정확한 워크플로 성공률도 높다는 뜻은 아니다.
- Hard 분할은 샘플 25개에 불과하며, Easy는 343개, Medium은 245개다. 논문은 이 비교에 대한 불확실성 추정치를 보고하지 않는다.
표시된 모든 모델에서 Hard 분할의 TF1이 Easy 분할의 TF1보다 높지만, 일부 Medium 점수는 Easy보다 낮다. 이 결과는 저자들의 precision과 recall에 관한 설명과 부합한다. 그러나 복잡한 워크플로를 정확하게 실행하기가 더 쉽다는 근거는 아니다. TF1은 의존성을 무시하며, Hard 분할에는 샘플 25개만 있다. Seed 계열은 Seed-OSS-36B가 아니라 Seed-OSS-32B로 표시되어 있다.
4 Conclusion
논문은 금융 MCP 도구 사용, 특히 다중 도구 의존성과 다중 턴 상호작용이 여전히 어렵다고 결론짓는다. 이 연구의 기여는 벤치마크와 도구 사용 비교 평가다. 새로운 에이전트 학습 방법을 제안하거나 금융 의사결정의 품질이 향상되었다는 근거를 제시하는 연구는 아니다.
부록
- 제공된 9페이지 PDF에는 부록이 없으며, 8–9페이지는 참고문헌으로 끝난다. 첫 페이지에는 https://huggingface.co/DianJin, https://modelscope.cn/organization/tongyi_dianjin, https://github.com/aliyun/qwen-dianjin, https://tongyi.aliyun.com/dianjin이 기재되어 있다. IEEE에 게재 심사를 위해 제출했다고 밝히지만, 구체적인 학술지나 학회는 명시하지 않는다.
짧은 생각
이 벤치마크의 유용한 점은 참조 도구 선택과 실행 구조 재현을 구분한다는 데 있다. 실제 운영에서 가져온 도구, 전문가가 검토한 샘플, 병렬 호출을 고려한 EMR은 다중 도구 성능의 격차를 구체적으로 보여준다. Qwen3-235B-A22B-Thinking은 TF1 69.42%에 도달하지만 EMR은 10.62%에 그친다.
이 연구의 근거는 금융 플랫폼 1개 안에서 참조 워크플로와 얼마나 일치하는지에 관한 것이며, 금융 에이전트의 일반적인 신뢰성에 관한 것은 아니다. 정답 이력을 사용하는 추론은 누적 대화 오류를 제외하고, 지표는 인자나 최종 답변을 명시적으로 채점하지 않는다. 또한 Qwen3-235B-2507이 합성 데이터 생성과 자동 판단의 상당 부분을 수행하지만, 생성기 편향 분석은 보고하지 않는다. 다중 도구 샘플 249개에서 실제 샘플과 합성 샘플이 각각 얼마나 차지하는지 보고하지 않아, 공개된 결과만으로 실제 운영 질의의 성능을 따로 평가할 수 없다. 서론의 선별된 트레이스 10K개라는 설명과 상세 절의 샘플 613개 벤치마크 구축 사이의 관계가 해명되지 않는다. 불확실성 추정치의 부재, 작은 Hard 분할, 분석 그림 모두에서 나타나는 Seed-OSS 표기 불일치는 세부 순위의 해석을 제한한다.