


Code-Space Response Oracles: Generating Interpretable Multi-Agent Policies with Large Language Models 요약 설명
10 Mar 2026 | Paper Review Program Synthesis Self-Play Opponent Modeling Evolutionary Search목차
- 요약
- 1. Introduction
- 2. Code Space Response Oracles
- 3. Experiments
- 4. Results
- 5. Related Work
- 6. Conclusion and Discussion
- 부록
- 짧은 생각
이번 글에서는 Code-Space Response Oracles: Generating Interpretable Multi-Agent Policies with Large Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 3월 10일(Arxiv)
- Hennes, Daniel, Li, Zun, Schultz, John, Lanctot, Marc.
- Google DeepMind
- 논문 링크
요약
- Code-Space Response Oracles (CSRO)는 Policy-Space Response Oracles (PSRO)의 강화학습 최적 응답 오라클을 실행 가능한 정책을 생성하는 LLM으로 대체한다. 생성된 전략은 상태를 유지하는 프로그램이며, 의사결정 규칙과 상대 모델을 직접 살펴볼 수 있다.
- CSRO는 상대 정보를 조건으로 코드를 생성하며, ZeroShot, LinearRefinement, AlphaEvolve 중 하나를 오라클로 사용한다. 필요하면 피드백에 따라 후보 정책을 개선한다. 실험에서는 Gemini 2.5 Pro를 사용해 1000라운드 Repeated Rock-Paper-Scissors와 100핸드 repeated Leduc hold’em poker에서 외부 반복을 20회 수행한다.
- Rock-Paper-Scissors에서 상대 코드와 Top 5 필터링을 사용한 LinearRefinement는 Aggregate Score 122.1 ± 9.8을 달성하며, 매 턴 추론하는 Gemma 3 27B 에이전트는 126.0을 기록한다. Leduc에서 AlphaEvolve는 44.9 ± 4.1로 CFR+의 39.8 ± 0.3보다 높지만, 집단 내 exploitability는 0.0 ± 0.0이 아니라 4.4 ± 0.6이다. 이 결과는 평가한 집단에서 경쟁력 있고 내부 로직을 살펴볼 수 있는 정책을 합성한다는 근거다. 일반적인 균형 수렴이나 가능한 모든 상대에 대한 강건성을 입증하지는 않는다.
1. Introduction
표준 PSRO는 현재 균형 혼합 전략에 대한 근사 최적 응답을 학습해 정책 집단을 확장한다. Deep RL 오라클은 내부 로직을 살펴보기 어려운 신경망 정책을 생성하며, 많은 시뮬레이션이 필요할 수 있다. CSRO는 대신 게임 규칙, 환경 API, 상대 혼합 전략 정보를 바탕으로 LLM에 프로그램 합성을 요청한다.
- LLM-PSRO (Bachrach et al., 2025)와 비교하면, 제안하는 확장은 피드백을 반영하는 폐루프 후보 개선과 상대 설명 및 필터링을 통한 컨텍스트 추상화다.
- 논문은 외부 상대 집단과 기존 기준선으로 평가하며, LLM-PSRO에서 사용한 집단 간 평가를 확장한다.
2. Code Space Response Oracles
CSRO는 PSRO의 집단 기반 게임이론 구조를 유지하면서 최적 응답의 표현과 구성 방식을 바꾼다. 경험적 메타게임으로 기존 정책들의 균형 혼합 전략을 구하고, LLM이 그 혼합 전략에 대한 다음 실행 가능한 응답을 생성한다.
2.1. Preliminaries
정식화는 공통 전략 공간을 가진 2인 대칭 제로섬 게임에 초점을 맞춘다. PSRO는 정책 집합 P를 유지하고, 경험적 보수 행렬에서 대칭 균형 혼합 전략 σ를 계산한 뒤, 응답 π* ∈ arg maxπ Eπ′∼σ[u(π, π′)]를 찾는다. 새 응답을 P에 추가한 뒤 이 과정을 반복한다.
- 제로섬 조건은 u(π′, π) = −u(π, π′)다.
- 저자들은 더 일반적인 게임에도 방법론을 적용할 수 있다고 설명하지만, 보고한 실험은 대칭 제로섬 설정에 한정된다.
2.2. Code Policies
코드 정책은 관측을 행동으로 변환하는 상태 유지 프로그램이며, Python 함수나 클래스가 그 예다. 프롬프트는 게임, 실행 인터페이스, 현재 상대 메타전략을 명시한다. 상대 소스 코드를 직접 제공하거나 요약을 덧붙일 수 있으며, LLM이 생성한 자연어 설명으로 대체할 수도 있다.
- 주석과 docstring은 의도한 전략을 설명하고, 실행 코드는 실제 의사결정 로직을 드러낸다.
- 설명과 필터링은 프롬프트 크기를 줄이지만, 오라클의 컨텍스트에 어떤 상대 행동을 포함할지도 결정한다.
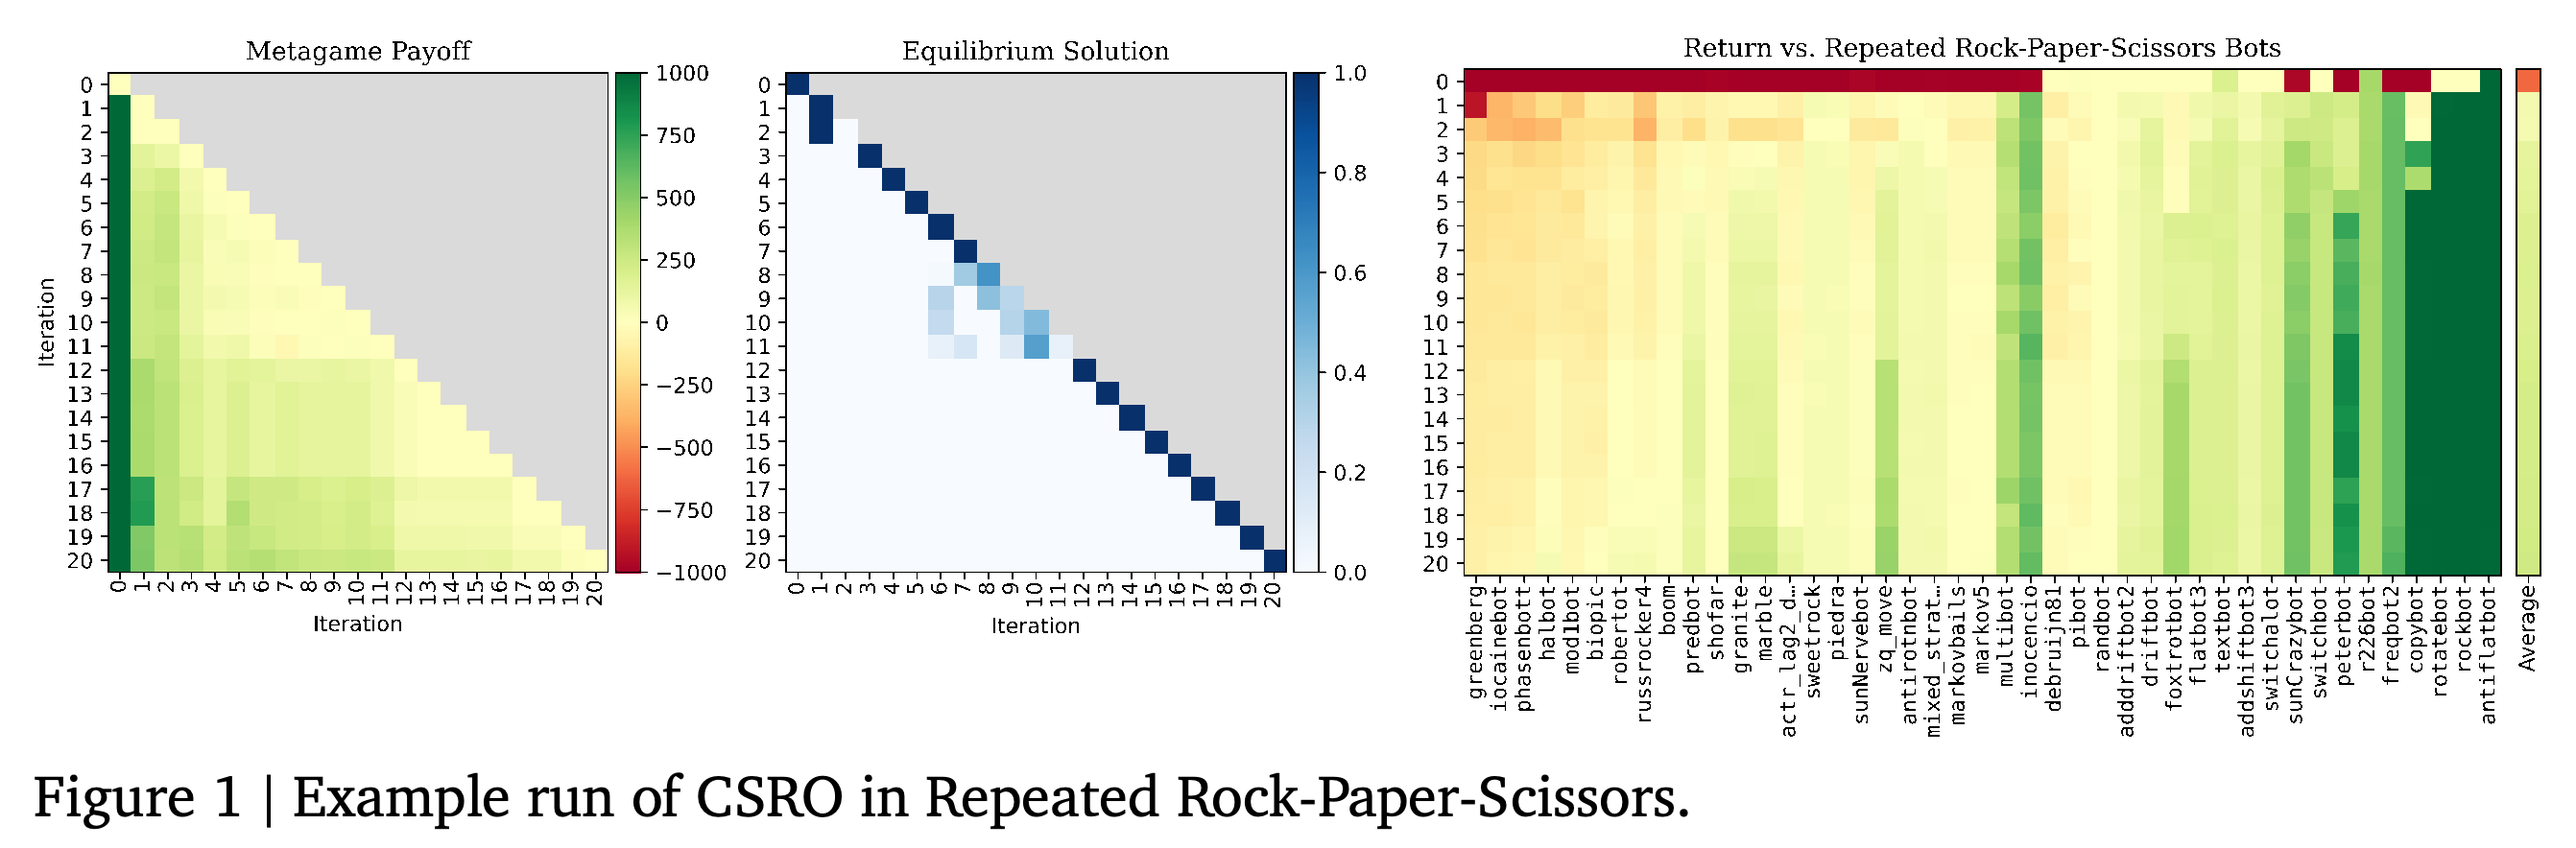
히트맵 3개는 RRPS 실행 1회에서 집단의 성장과 경험적 보수, 균형 가중치, 외부 봇 상대 수익을 연결한다. 균형에서 양의 가중치를 받는 정책은 최근 추가된 정책에 자주 집중되지만, 수익은 외부 상대마다 다르다. 이 사례는 내부 메타게임의 진전을 독립적인 집단으로 점검할 필요성을 보여준다.
2.3. CSRO Algorithm
Algorithm 1은 초기 정책으로 P를 초기화하고, 보수 행렬과 메타균형을 다시 계산한 뒤, 상대 정보를 조건으로 프롬프트를 구성해 후보를 생성하고 평가한다. 선택적인 내부 루프에서는 후보와 측정한 효용을 사용해 프롬프트를 갱신한다. 이후 최종 프로그램을 P에 추가한다. 의사코드는 정책 집단과 메타전략을 반환한다.
- 외부 루프는 집단이 커짐에 따라 전략적 목표를 바꾸고, 내부 루프는 고정된 목표 혼합 전략에 대한 응답을 개선한다.
2.4. Oracle Refinement Mechanisms
2.4.1. Cross-Iteration Strategic Adaptation은 새로운 오라클 호출에 앞서 현재 메타균형으로 전략적 컨텍스트를 구성한다. construct_prompt는 상대 코드나 LLM이 생성한 요약을 포함할 수 있으며, minimum-support 임계값이나 top-k 필터로 입력을 제한할 수 있다. 실험에는 Top 5 필터링이 포함된다.
- 필터링은 컨텍스트 길이를 조절하지만, 균형이 일부 정책에 집중되면 minimum-support 프롬프트에 매우 적은 상대 전략만 남을 수 있다.
2.4.2. Intra-Iteration Policy Refinement는 3가지 오라클 변형을 정의한다. ZeroShot은 개선 없이 후보 1개를 생성한다. LinearRefinement는 후보의 효용이 음수일 때만 수정을 시작하고, 점수가 개선되는 변경만 유지하며, 효용이 비음수가 되거나 예산 M에 도달하면 중단한다. AlphaEvolve는 σ에 대한 추정 기대 효용을 점수로 사용하는 분산 진화 프로그램 탐색을 수행한다.
- LinearRefinement는 단일 스레드에서 갱신을 수행한다.
- AlphaEvolve는 독립적으로 진화하는 하위 집단들을 유지하고, 과거 프로그램을 샘플링해 LLM으로 변이를 생성하면서 여러 수정 경로를 탐색한다 (Novikov et al., 2025; Romera-Paredes et al., 2024).
- 효용이 비음수라는 조건은 중단 기준이지, 후보가 정확한 최적 응답이라는 근거는 아니다.
3. Experiments
실험은 CSRO가 exploitability가 낮은 전략에 도달하는지, LLM 오라클이 적은 과제별 피드백으로 효과적이고 단순하지 않은 정책을 생성하는지, 프로그램이 신경망 정책보다 전략적 로직을 더 명확하게 드러내는지 평가한다. 두 환경 모두 OpenSpiel (Lanctot et al., 2019)을 사용한다. 해석 가능성의 근거는 선택한 소스 프로그램을 살펴본 결과이며, 사람의 이해도를 비교하는 통제 실험은 아니다.
3.1. Environments
Repeated Rock-Paper-Scissors (RRPS)는 한 경기에서 연속으로 1000번의 수를 낸다. Repeated Leduc hold’em poker는 한 경기에서 100핸드를 진행하며, 딜러 역할을 번갈아 맡고 첫 딜러는 무작위로 정한다. 이 과제들은 서로 다른 정보 구조에서 반복해서 만나는 상대에 대한 적응을 평가한다.
- RRPS에서 매번 독립적으로 균등 무작위 행동을 선택하면 착취당하지 않지만, 예측 가능한 상대를 착취하지도 못한다.
- Leduc는 Jack, Queen, King이 각각 2장씩 있는 6장의 카드를 사용한다. 플레이어마다 비공개 카드 1장을 받고, 베팅 라운드 2회와 공개 커뮤니티 카드 1장을 사용한다. 반복 플레이를 통해 정책은 여러 핸드에 걸쳐 상대 성향을 학습할 수 있다.
3.2. Evaluation Population
RRPS 평가는 고정된 수, 주기적 수열, 빈도 분석, Markov 예측, 적응형 예측기 앙상블을 포함한 대회용 수작업 봇 43개를 사용한다. Leduc 평가는 AlwaysCall, AlwaysFold와 함께, CFR+를 10 000회 반복하고 가중 평균해 계산한 단일 핸드 전략을 매 핸드 반복하는 정책을 사용한다. 앙상블에 대해서는 이 글을 참조하라.
- RRPS 집단에는 rockbot과 randbot 같은 단순 전략뿐 아니라 iocainebot과 greenberg 같은 적응형 상대도 포함된다.
- AlwaysFold는 가능하면 폴드하고, 그렇지 않으면 콜한다. 상대가 3개인 Leduc 집단은 균형을 지향하는 플레이와 뚜렷한 행동 패턴 2가지에 대한 착취를 평가한다.
Population Return은 PopReturn(π) = Eπ′∼P[u(π, π′)]이며, Within Population Exploitability는 PopExpl(π) = −minπ′∈P u(π, π′)다. Aggregate Score는 AggScore(π) = PopReturn(π) − PopExpl(π)로 정의하며, 평균 수익과 평가 집단 내 최악의 손실을 함께 반영한다.
- 정책은 평균 수익이 높아도 특정 상대에게 취약할 수 있다. Aggregate Score는 그 취약성에 페널티를 부여한다.
- PopExpl은 평가 집단으로 제한한 지표이며, 제한 없는 최적 응답을 상대로 계산한 exploitability가 아니다.
3.3. Baselines
주요 기준선은 PSRO-IMPALA이며, 최적 응답 오라클이 Importance Weighted Actor-Learner Architecture로 LSTM 정책을 학습한다. RRPS에는 사전학습된 Gemma 3 에이전트도 포함된다. 이 에이전트들은 텍스트 형태의 행동 이력을 받아 다음 행동을 예측하고, 예측한 상대 수를 이기는 수를 낸다.
- 매 턴 행동을 생성하는 LLM 기준선은 플레이 중에 추론하지만, CSRO는 배포 전에 재사용할 수 있는 프로그램을 생성한다.
- 추가 RRPS 비교에는 기존에 보고된 이력 길이 10의 Q-learning, Contextual Regret Minimization (ContRM), Chinchilla 70B LLM 에이전트가 포함된다 (Lanctot et al., 2023).
3.4. Implementation Details
코드 생성 오라클은 Gemini 2.5 Pro다. 실험은 외부 반복 K = 20과 LinearRefinement의 M = 10을 사용하며, 별도 명시가 없으면 시드 5개를 사용한다. Leduc 결과는 시드 3개를 사용한다. 보충 Table 7은 RRPS AlphaEvolve에 시드 3개, 다른 CSRO 변형에 5개를 명시하지만, Table 1의 일반 캡션에는 시드 5개라고 적혀 있다.
- 구현 세부 사항은 공개된 AlphaEvolve 절차를 참조하지만, 진화 탐색 예산을 수치로 명시하지 않는다.
- 보충 자료는 프롬프트, 초기 포커 전략, PSRO-IMPALA 하이퍼파라미터 탐색을 제공한다.
4. Results
정량 결과에서는 K = 20 이후의 최종 메타균형 전략을 평가하고, 이어서 선택한 생성 프로그램을 살펴본다. RRPS에서는 집단 내 exploitability가 가장 낮은 CSRO 변형과 Aggregate Score가 가장 높은 변형이 서로 다르다. Leduc에서는 AlphaEvolve가 3가지 CSRO 변형 중 평균 수익이 가장 높고 집단 내 exploitability가 가장 낮다.
4.1. Repeated Rock-Paper-Scissors
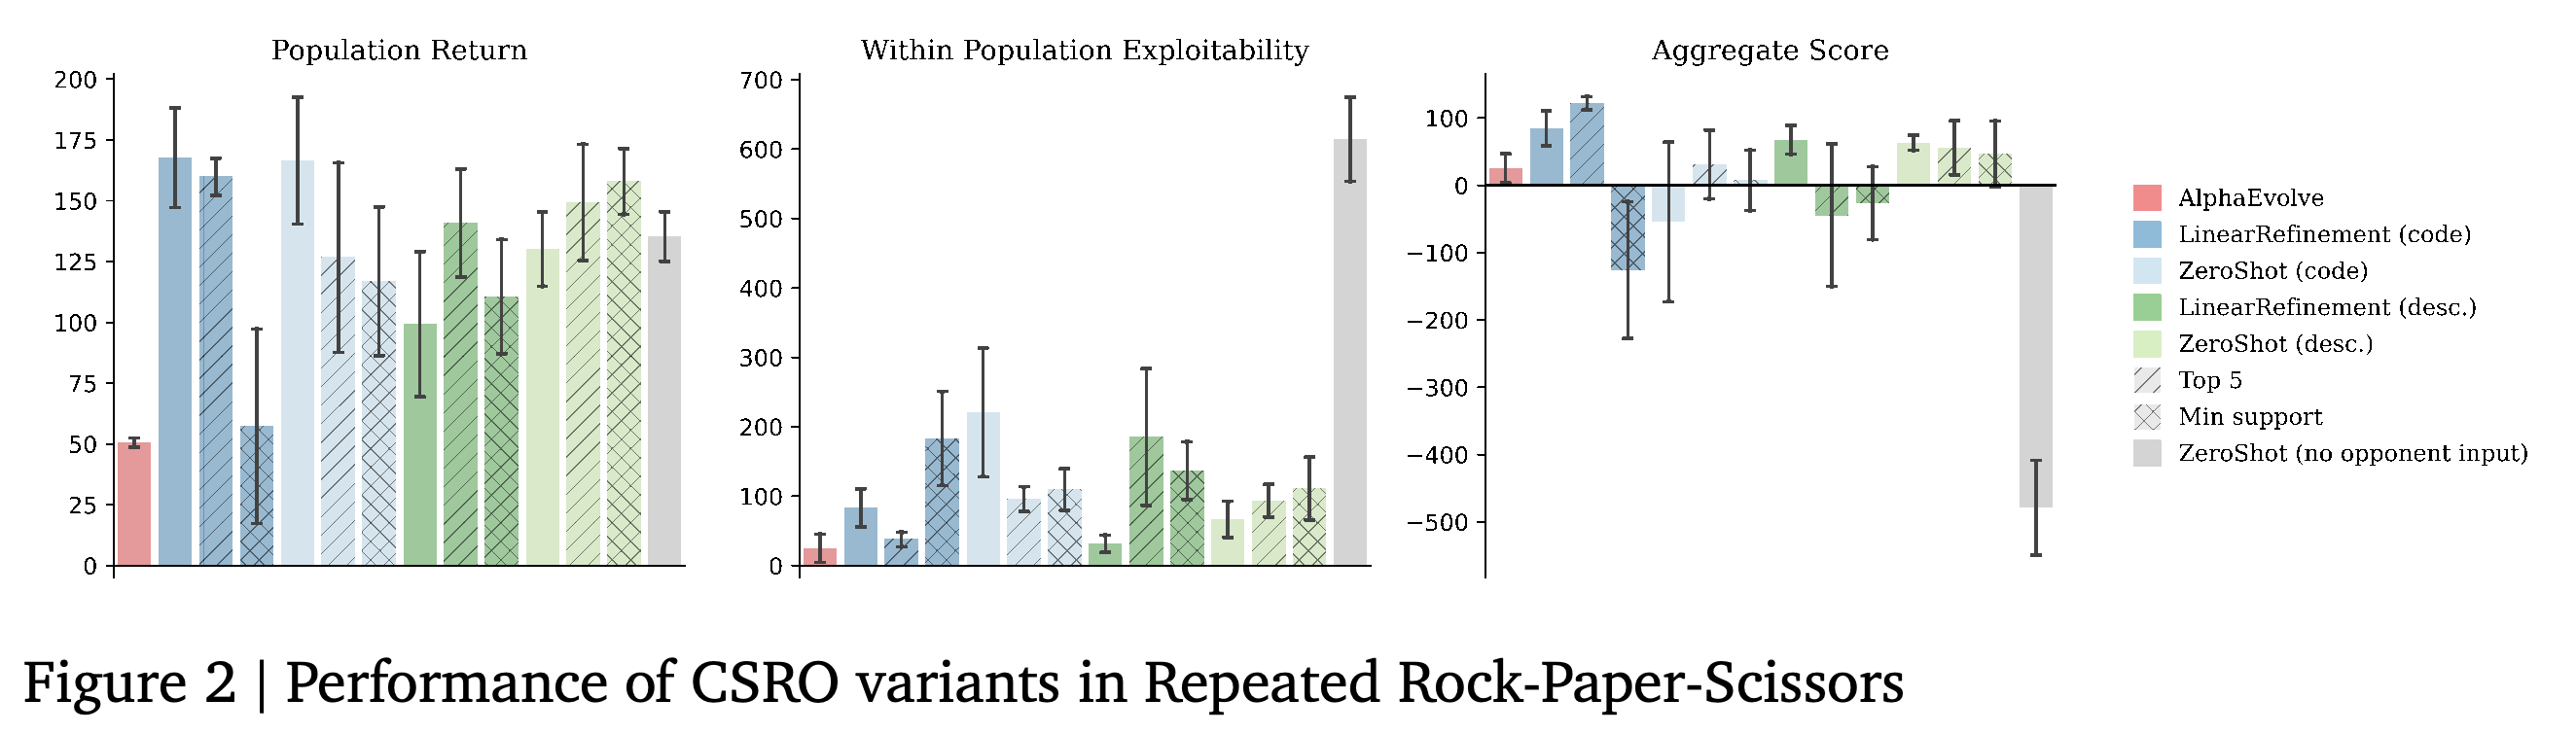
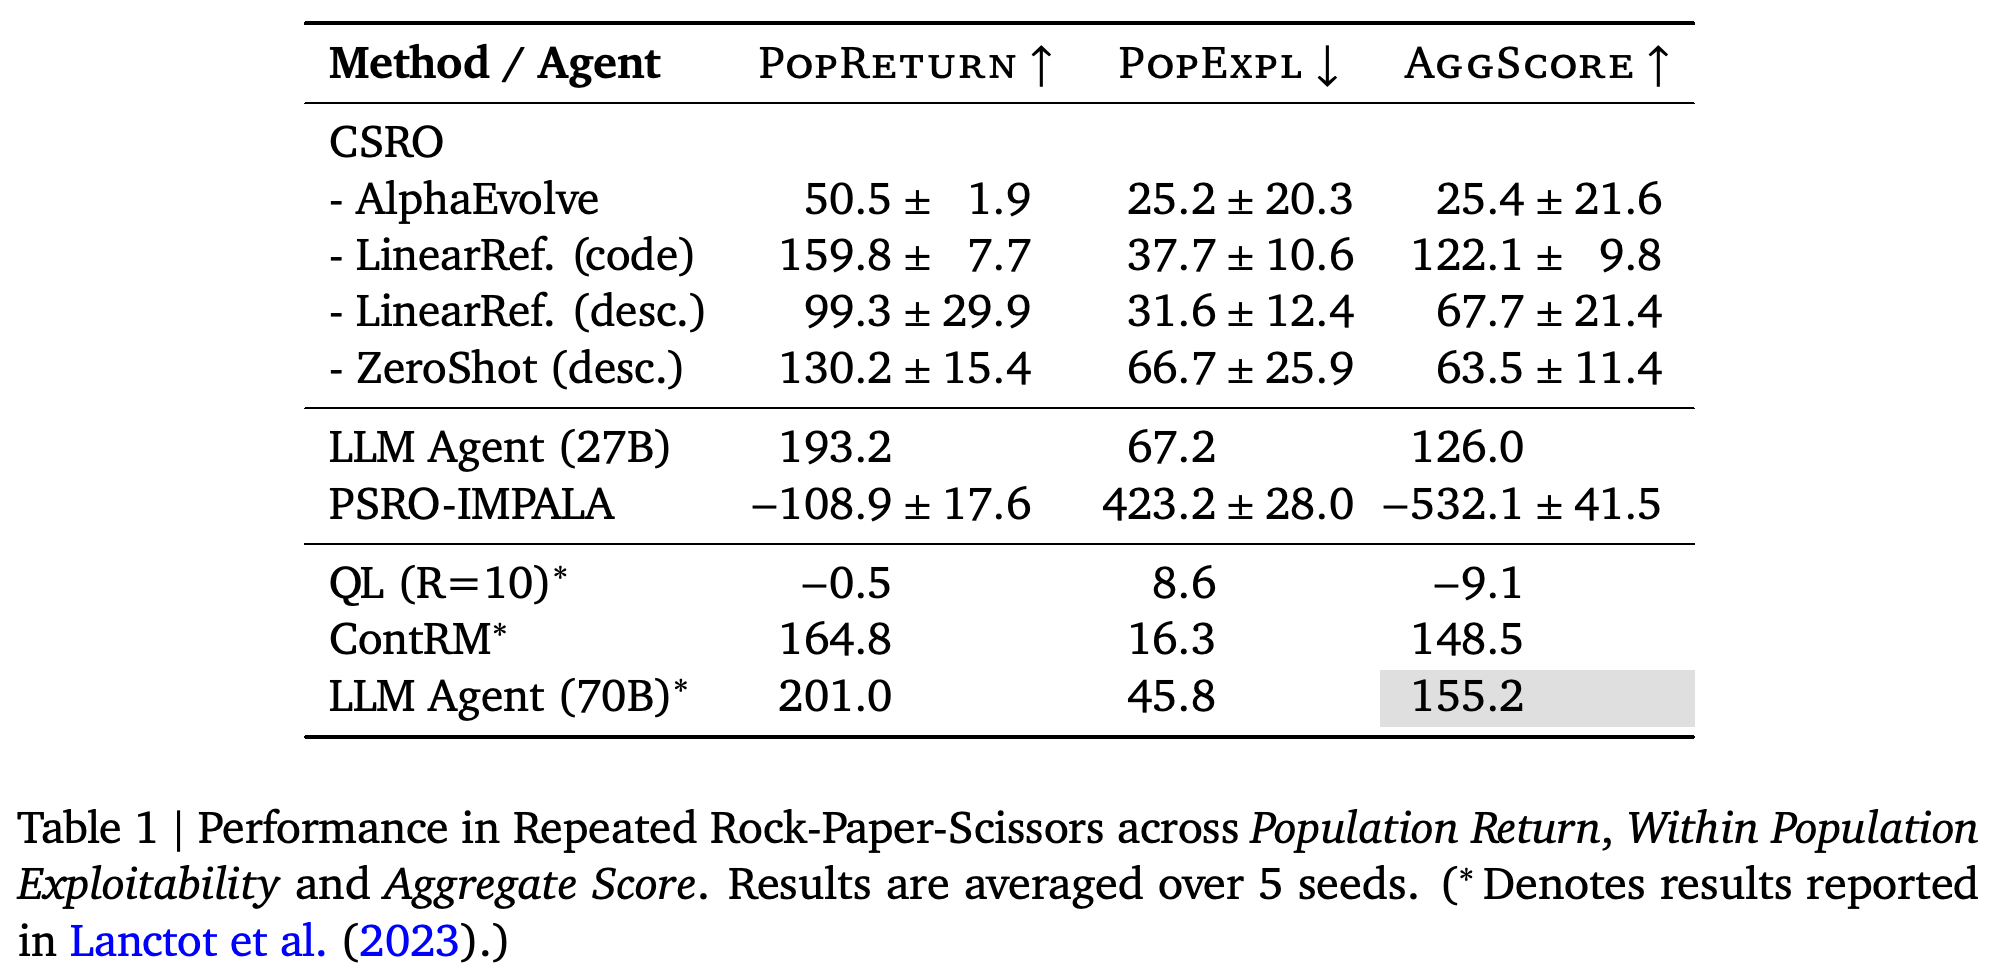
RRPS에서 AlphaEvolve는 평가한 CSRO 변형 중 평균 PopExpl이 25.2 ± 20.3으로 가장 낮지만, PopReturn은 50.5 ± 1.9에 그친다. 코드 입력과 Top 5 필터링을 사용한 LinearRefinement는 CSRO 중 가장 높은 평균 Aggregate Score인 122.1 ± 9.8을 기록하며, PopReturn은 159.8 ± 7.7, PopExpl은 37.7 ± 10.6이다.
- Gemma 3 27B의 Aggregate Score는 126.0이다. 기존에 보고된 ContRM과 Chinchilla 70B 결과는 각각 148.5와 155.2로 더 높다.
- Table 1에서 선택한 CSRO 변형들은 PSRO-IMPALA보다 우수하다. PSRO-IMPALA의 PopReturn은 −108.9 ± 17.6, PopExpl은 423.2 ± 28.0, Aggregate Score는 −532.1 ± 41.5다.
- 오라클은 외부 집단 수익이나 최악의 손실을 직접 줄이는 목적함수가 아니라 현재 균형 혼합 전략에 대한 기대 효용을 최적화한다. 저자들은 균형에서 약한 상대에 배정되는 가중치가 제한적이기 때문에 AlphaEvolve의 외부 평균 수익이 낮다고 설명한다.
3개 패널은 평균적인 착취 수익과 최악의 상대에 대한 취약성을 구분한다. 상대 입력이 없는 변형은 상당한 평균 수익을 얻지만 집단 내 exploitability가 매우 높아 Aggregate Score가 큰 음수가 된다. 입력 표현, 개선, 필터링은 서로 영향을 주며, 모든 변형의 모든 지표를 개선하는 입력 및 필터 선택은 없다.
코드 입력을 사용한 LinearRefinement는 표에 제시된 CSRO 중 가장 높은 Aggregate Score인 122.1 ± 9.8을 기록하며, Gemma 3 27B 에이전트의 126.0에 가깝다. AlphaEvolve는 제시된 CSRO 중 집단 내 exploitability가 25.2 ± 20.3으로 가장 낮고, 기존에 보고된 ContRM과 Chinchilla 70B 결과는 Aggregate Score가 더 높다. 일반 캡션의 시드 5개 표기는 Table 7의 AlphaEvolve 시드 3개 명시와 충돌한다.
상대 입력을 제거하면 PopReturn은 135.3 ± 10.2지만, PopExpl은 614.2 ± 60.8, Aggregate Score는 −478.9 ± 70.2가 된다. 이는 평균적으로 상대를 잘 착취해도 심각한 취약성이 함께 나타날 수 있음을 보여준다. 입력 표현도 중요하다. 필터링하지 않은 ZeroShot 설명 입력의 Aggregate Score는 63.5 ± 11.4인 반면, 필터링하지 않은 ZeroShot 코드 입력은 −54.3 ± 118.7이다.
- 저자들은 많은 소스 프로그램을 처리하는 것보다 텍스트 요약이 한 번의 생성으로 정책을 합성하기 쉽게 만든다고 제안하지만, 이 설명을 직접 검증하지는 않는다.
- 보고한 비교에서는 Top 5 필터링이 대체로 minimum-support 필터링보다 우수하다. 여러 상대를 포함하면 지배적인 균형 정책에만 좁게 적응하는 현상을 줄일 수 있다는 설명을 제시한다.
- 세부 제거 실험의 결과는 입력과 필터링 선택에 따라 크게 달라진다. 모든 설정에서 개선 과정이 강건성을 높이지는 않는다.
4.2. Repeated Leduc Hold’em Poker
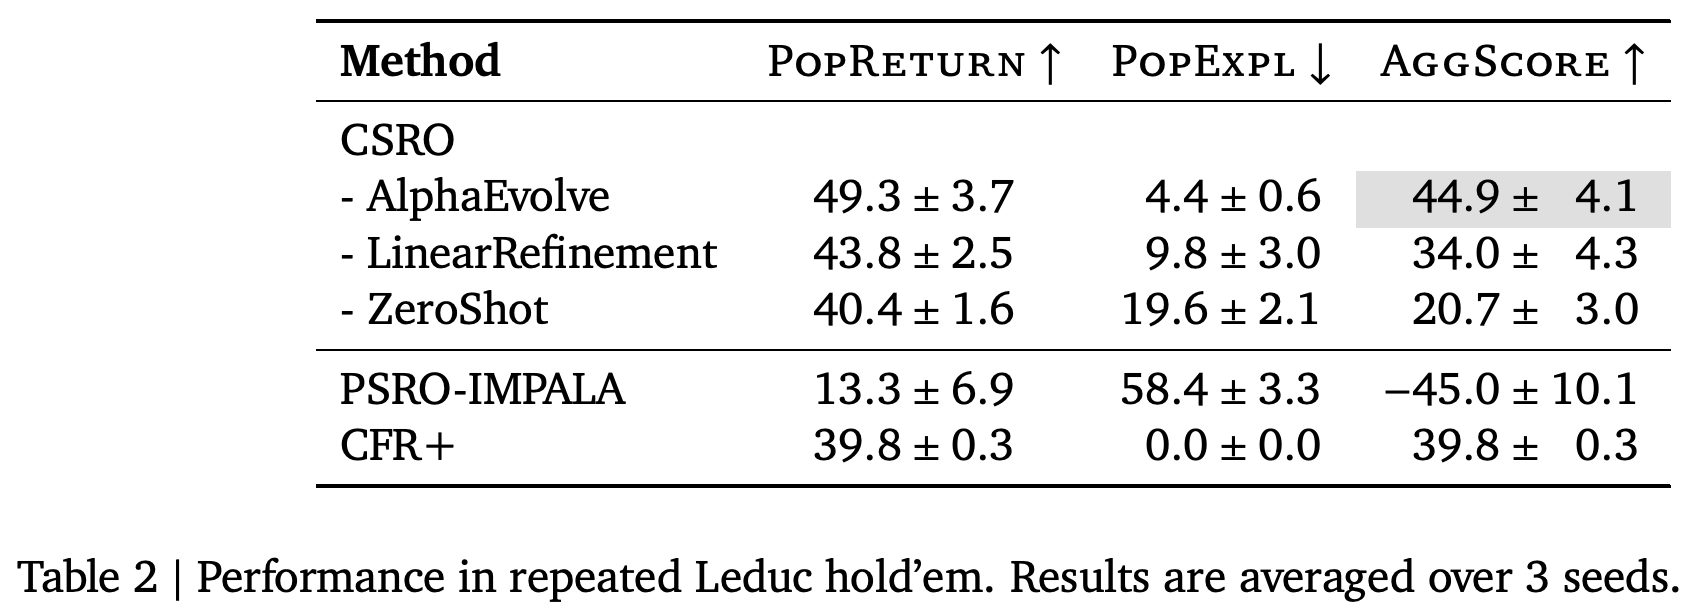
Leduc 실험은 모든 CSRO 오라클에 필터링하지 않은 상대 설명을 사용한다. AlphaEvolve의 PopReturn은 49.3 ± 3.7, PopExpl은 4.4 ± 0.6, Aggregate Score는 44.9 ± 4.1이다. 같은 지표 순서로 LinearRefinement는 43.8 ± 2.5, 9.8 ± 3.0, 34.0 ± 4.3을, ZeroShot은 40.4 ± 1.6, 19.6 ± 2.1, 20.7 ± 3.0을 기록한다.
- CFR+의 PopReturn과 Aggregate Score는 39.8 ± 0.3이며, PopExpl은 0.0 ± 0.0이다. AlphaEvolve는 평균적인 착취 수익이 더 높지만, CFR+에는 여전히 취약하다.
- PSRO-IMPALA의 Aggregate Score는 −45.0 ± 10.1, PopExpl은 58.4 ± 3.3이다.
- 집단 내 최악의 수익은 CFR+를 상대로 나타나며, 더 강한 CSRO 오라클은 이 손실을 줄인다.
Leduc의 3가지 CSRO 변형에서는 더 강한 개선 방식이 더 높은 평균 수익 및 더 낮은 집단 내 exploitability와 관련된다. AlphaEvolve의 Aggregate Score는 44.9 ± 4.1로 CFR+의 39.8 ± 0.3보다 높지만, 집단 내 최악의 손실은 4.4 ± 0.6으로 남아 있다. 반면 CFR+는 0.0 ± 0.0이다. 이 비교는 평가한 휴리스틱에 대한 착취와 균형을 지향하는 상대에 대한 강건성을 구분한다.
상대별 수익은 AlphaEvolve가 Aggregate Score에서 CFR+를 넘어서는 이유를 보여준다. AlwaysCall을 상대로 AlphaEvolve는 110.3 ± 9.7을 얻으며, CFR+는 62.1 ± 0.8, PSRO-IMPALA는 57.7 ± 3.3을 얻는다. AlwaysFold를 상대로 LinearRefinement는 57.3 ± 8.8을 얻어 CFR+의 57.4 ± 0.2와 비슷하고, AlphaEvolve의 42.0 ± 3.2보다 높다.
- 오라클들은 서로 다른 절충 관계를 보이며, 특정 정책이 모든 상대별 비교에서 우세한 것은 아니다.
- 예측 가능한 휴리스틱을 상대로 CFR+보다 높은 수익을 얻는 것은 착취 능력을 보여줄 뿐, 균형 전략보다 강한 최악 상황 보장을 뜻하지 않는다.
4.3. Qualitative Analysis
4.3.1. Repeated Rock-Paper-Scissors는 PopReturn 238.3인 선택 결과와 연결된 앙상블 프로그램을 제시한다. 이는 최종 혼합 전략들의 평균 성능이 아니다. 이 프로그램의 예측기 32개는 Markov 모델, 반응형 모델과 공동 이력 모델, 주기 탐지기, 메타예측기를 결합한다. 각 예측기의 점수를 5제곱한 값으로 투표에 가중치를 부여한다.
- Listing 1에서는 Markov 차수 1부터 8까지, 점수 감쇠 0.985, 무작위 동률 처리, meta_imitation 구성 요소를 확인할 수 있다.
- 메타예측기는 상대가 에이전트의 성공적인 예측기 중 하나와 비슷한 모델을 사용한다고 가정하고, 상대의 대응 수를 추정해 그 예측을 앙상블에 전달한다. 이는 내부 로직을 살펴볼 수 있는 휴리스틱이지, 심리학적 마음 이론 능력을 독립적으로 검증한 근거는 아니다.
- 정성 분석 본문은 설정을 “LinearRefinement (no filter) - Top 5”로 일관되지 않게 표시한다. Table 7은 최대 PopReturn 238.3을 LinearRefinement, 코드 입력, 필터 없음과 연결하지만, 별도로 제시한 코드 자체의 점수를 독립적으로 확정하지는 않는다.
4.3.2. Repeated Leduc hold’em poker는 PopReturn 77.8과 Aggregate Score 69.1을 달성했다고 보고한 선택 정책을 살펴본다. 프로그램은 쇼다운 equity를 추정하고, 공개 베팅 상황별로 상대 행동 빈도를 추적하며, 가능한 행동들의 근사 기대값을 비교한다. 레이즈 계산은 상대가 폴드할 때의 이익과 상대가 계속 플레이할 때의 추정 가치를 결합한다.
- 의도한 적응 방식은 추정 폴드 확률을 바탕으로 AlwaysCall을 상대로 밸류 베팅을 하고, AlwaysFold를 상대로 자주 블러핑하는 것이다.
- Listing 2는 근사 방식을 드러낸다. 상대 핸드 가중치는 행동별 고정 휴리스틱을 사용하고, 레이즈 EV는 상대의 재레이즈를 명시적으로 무시한다.
- 첫 docstring은 연속적인 “bravery” 파라미터를 설명하지만, 실행되는 의사결정 로직은 equity와 EV 계산을 사용한다. 따라서 주석만으로 정책의 행동을 확정할 수는 없다.
5. Related Work
CSRO는 PSRO 메타솔버가 아니라 최적 응답 오라클을 바꾼다. 또한 전략적 프롬프트나 직접 생성한 행동 대신 지속적으로 사용할 수 있는 실행 정책을 생성한다는 점에서, 대화 모델을 게임이론으로 유도하는 접근 및 Game of Thoughts와도 다르다.
- 논문은 오라클을 바꾸는 접근을 alpha-rank 같은 메타솔버 연구 및 Pipeline PSRO 같은 학습 방식과 대비한다.
- 가장 가까운 비교 대상은 LLM-PSRO (Bachrach et al., 2025)이며, 이 연구는 이미 self-play 안에서 코드 정책을 합성한다.
- LLM-PSRO와의 차이로 제시한 것은 반복 내부 피드백, 컨텍스트 추상화, 외부 평가다. self-play에서 코드 정책을 처음 사용했다는 주장은 아니다.
6. Conclusion and Discussion
결론은 배포 방식의 차이를 강조한다. 행동을 생성하는 LLM 기준선은 RRPS 경기마다 1000개의 모델 호출이 필요하지만, 합성된 CSRO 정책은 이후 경기에서 턴별 LLM 추론 없이 플레이할 수 있다. 다만 정책 생성에는 여전히 오라클 호출과 시뮬레이션이 필요하며, 개선과 상대 요약을 사용하는 경우에는 추가 호출이 필요하다.
- 논문은 실제 경과 시간, 금전 비용, 총 시뮬레이션 예산을 맞춘 비교를 보고하지 않는다. 따라서 배포 방식의 차이만으로 전체 과정의 비용 우위가 측정되었다고 볼 수는 없다.
- 저자들은 사전학습을 통해 고전 게임 전략을 이미 알고 있을 가능성을 인정한다. 동적으로 생성되는 상대 혼합 전략에는 맥락에 맞는 응답 합성이 필요하지만, 사전 지식의 기여를 실험적으로 분리하지는 않는다.
명시한 한계는 LLM 역량과 프롬프트 품질에 대한 의존, 유효하지 않은 코드 생성 가능성, 반복적인 API 비용, Stratego나 StarCraft 같은 고차원 게임으로의 확장 문제다. 복잡한 상태와 상대 전략을 모델 컨텍스트 안에 표현하는 일은 여전히 공학적 과제다.
- 해석 가능성은 선택한 정책의 소스를 살펴보며 예시로 보여준다. 통제된 사용자 연구나 형식 검증으로 입증하지는 않는다.
- 실험은 2개의 소규모 도메인과 제한된 평가 집단에서 성능을 확인한다. 일반적인 수렴이나 제한 없는 상대에 대한 낮은 exploitability를 입증하지는 않는다.
부록
- A. Supplementary materials와 A.1. Hyperparameters는 A.1.1. PSRO-IMPALA의 설정을 설명하며, 학습률, 은닉층 크기, unroll 길이, 엔트로피 비용, 배치 크기, 최대 기울기 노름에 대한 탐색을 포함한다. RRPS에서 선택한 설정은 학습률 0.0001, 은닉층 [256, 128], unroll 길이 20, 엔트로피 비용 0.001, 배치 크기 16, 최대 기울기 노름 40이며, observation_tensor()를 사용한다. Leduc에서 선택한 설정은 학습률 0.001, 은닉층 [512, 256], unroll 길이 40, 엔트로피 비용 0.01, 배치 크기 64, 최대 기울기 노름 40이며, infostate_tensor()를 사용한다.
- A.2. Prompts and Initial Strategies에는 Agent.act와 이전 행동 관측을 명시한 A.2.1. Repeated Rock-Paper-Scissors가 포함된다. A.2.2. Repeated Leduc Poker는 receive_outcome, restart, act, JSON 관측, 상대 요약, 코드 수정 템플릿을 명시한다. A.2.3. Repeated Leduc Poker에는 zero-shot 프롬프팅으로 생성한 초기 비학습 휴리스틱 포커 봇이 포함된다. 보충 자료는 선택 정책의 전체 구현, Gemma 3 모델 크기 비교, CSRO 입력 및 필터 제거 실험, 상대별 포커 수익도 제공한다.
짧은 생각
기여는 실행 가능한 정책 합성을 집단 수준의 피드백 및 외부 평가와 결합한 것이다. 상대 입력을 제거한 실험은 강건한 합성에 상대 컨텍스트가 중요하다는 직접적인 근거를 제공한다. 이 컨텍스트를 제거하면 높은 평균 수익과 최악의 상대에 대한 심각한 손실이 함께 나타난다.
근거는 일반적인 균형 계산이나 전체 과정의 계산 효율성보다, 내부 로직을 살펴볼 수 있는 정책 구성 능력을 더 강하게 뒷받침한다. 더 폭넓은 포커 상대 집단, 동일한 탐색 및 시뮬레이션 예산, 사람의 이해도를 평가하는 실험이 장점의 범위를 판단하는 데 도움이 될 것이다. 제공된 코드만으로도 휴리스틱 근사와 문서 설명 및 실행 사이의 불일치를 확인할 수 있다.