


StateAct: Program State, before Pixels, for Long-Horizon Computer-Use Agents 요약 설명
24 Jul 2026 | Paper Review Computer-Use Agents Program State Agent LearningContents
- 요약
- 1 Introduction
- 2 Related Work
- 3 The State-Grounding Principle
- 4 StateAct
- 5 Experiments
- 6 Discussion
- 7 Conclusion
- 부록
- 짧은 생각
이번 글에서는 StateAct: Program State, before Pixels, for Long-Horizon Computer-Use Agents 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 7월 24일(Arxiv)
- Yang, Yan, Jian, Xiangru, Luo, Ziyang, Zhao, Zirui, Dai, Yutong, Shi, Ziji, Yan, Hanshu, Liew, Jun Hao, Savarese, Silvio, Li, Junnan.
- Salesforce AI Research
- 논문 링크
요약
- StateAct는 스크린샷 대신 파일, 애플리케이션 백엔드, DOM 같은 영속 프로그램 상태를 주된 인터페이스로 사용하는 장기 지평 컴퓨터 사용용 코드 우선 멀티 에이전트 하니스다. OSWorld 2.0에서 Claude Opus 4.8의 이진 성공률을 20.6%에서 26.9%로, 평균 부분 성공률을 54.8%에서 61.6%로 높였으며, 보고된 비용은 과제당 약 $72에서 약 $7.8 per task로 감소했다.
1 Introduction
논문은 스크린샷이 과제에 중요한 상태를 손실하는 렌더링이라고 주장한다. 같은 픽셀이라도 수식, 숨겨진 행, 백엔드 값, 저장 위치가 다를 수 있다. 따라서 StateAct는 상태 기반 행동, 독립적인 상태 기반 완료 확인, 긴 의존적 궤적을 위한 컨텍스트 관리를 결합한다.
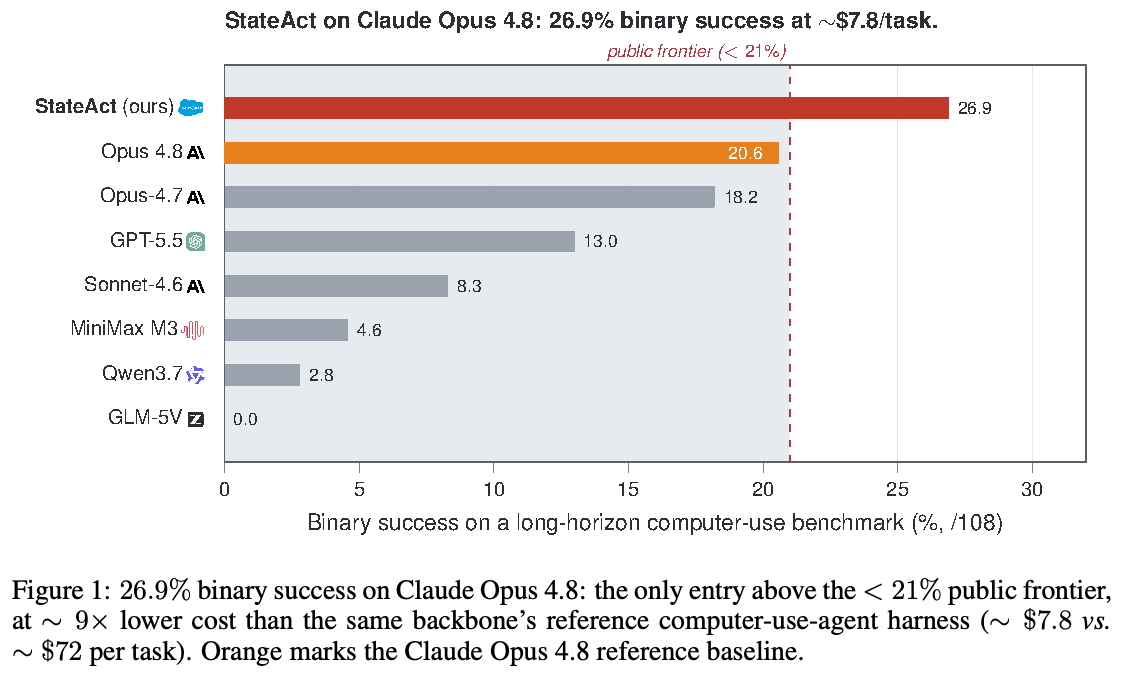
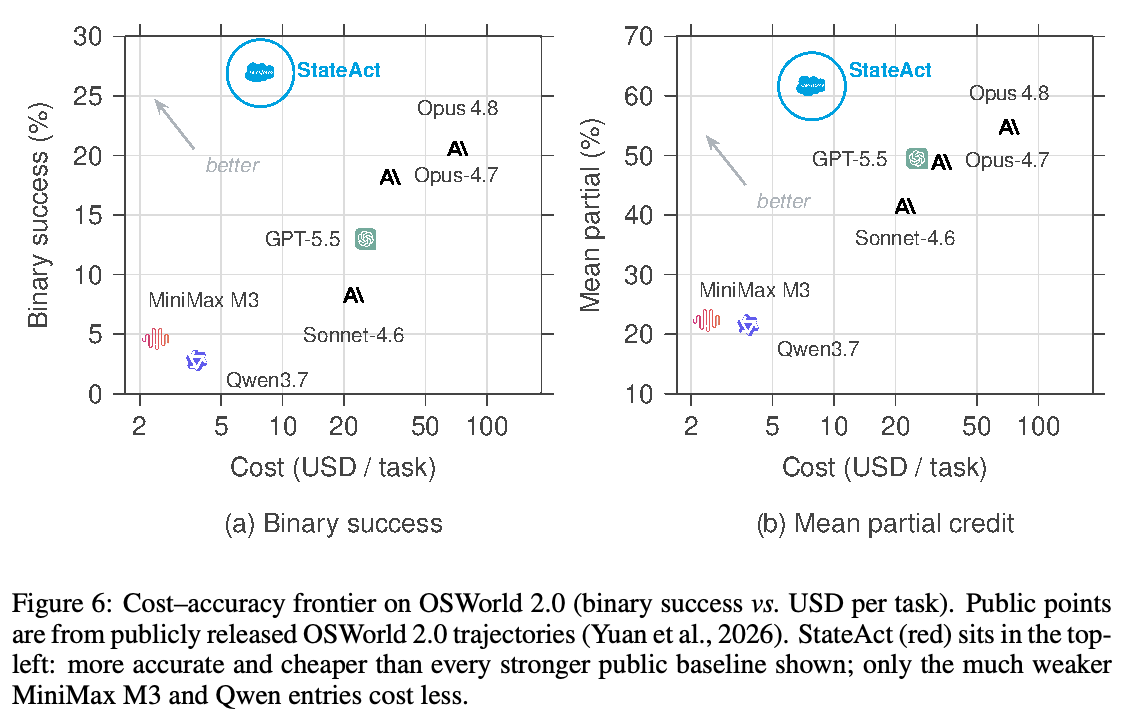
차트는 StateAct의 이진 성공률이 26.9%이며, Claude Opus 4.8 기준 하니스의 20.6% 및 표시된 21% 미만의 공개 최고 성능보다 높다고 보고한다. 또한 기준의 약 $72와 비교한 과제당 약 $7.8의 비용을 제시한다.
2 Related Work
관련 연구는 시각적 grounding, 네이티브 GUI 행동, 테스트 시점 선택, 또는 GUI/API 혼합 제어를 개선한다. 반면 StateAct는 주 에이전트가 코드와 프로그램 상태 연산을 기본으로 사용하고, 필요할 때 직접 GUI 상호작용을 위임하며, 궤적 조건부 자기 성찰 대신 내레이션을 보지 않는 종료 게이트를 사용한다.
3 The State-Grounding Principle
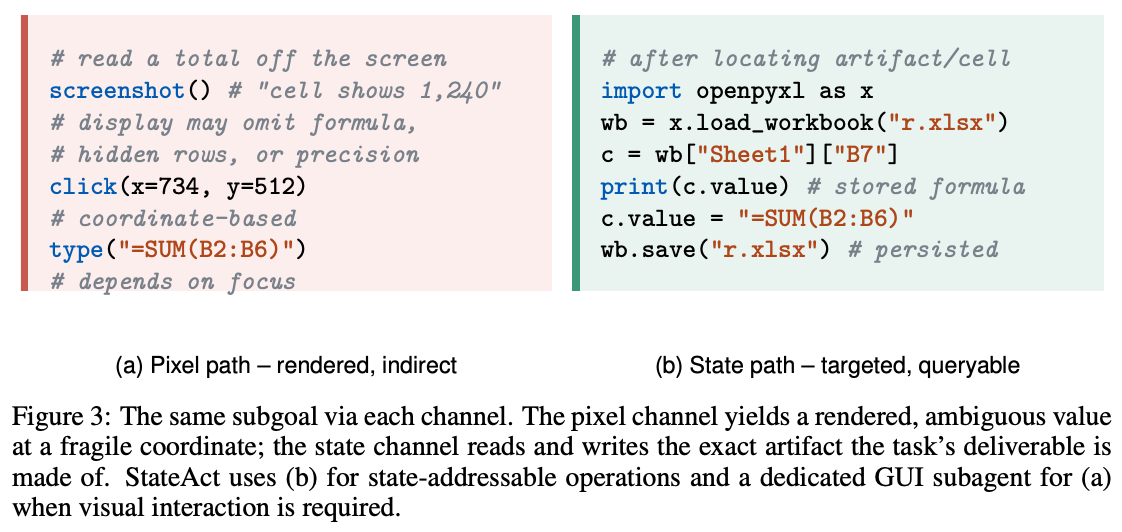
상태 grounding 원칙은 프로그램 상태를 $s$로 두고, 픽셀 관측 채널 $f_{\mathrm{render}}(s)$와 질의 가능한 상태 채널 $g(s)$를 구분한다. 렌더링은 단사 함수가 아니므로 스크린샷만으로는 일반적으로 관련 프로그램 상태 전체를 복원할 수 없다. 상태 질의는 영속 아티팩트를 직접 검사하고 편집할 수 있지만, 렌더링 자체가 목표인 경우에는 여전히 시각적 상호작용이 필요하다.
이 예시는 스크린샷 기반 스프레드시트 상호작용과 코드를 통한 직접적인 워크북 검사 및 수정을 대비한다. 상태 접근이 아티팩트가 상태로 접근 가능할 때 저장된 수식을 복원하고 정확한 편집을 영속화할 수 있음을 보여 준다.
4 StateAct
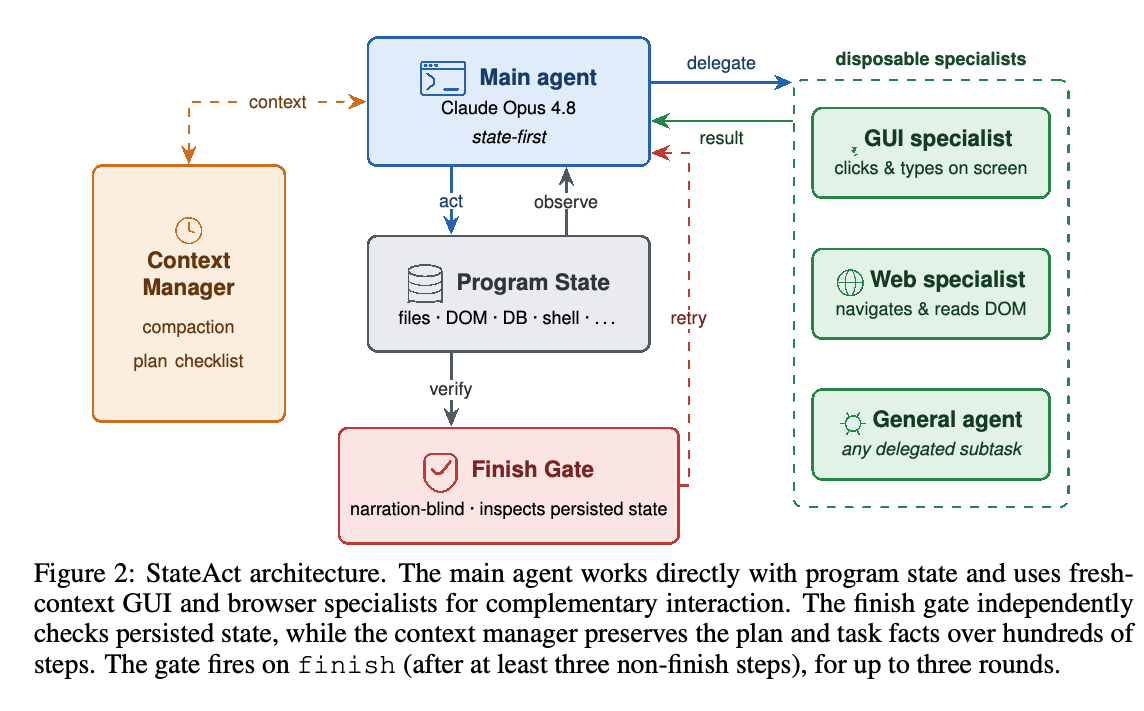
StateAct는 상태 우선 주 에이전트, 독립적인 종료 게이트, 장기 지평 컨텍스트 메커니즘으로 구성된다. 영속 상태는 행동과 검증의 공통 기반이며, 일회용 GUI, 웹, 범용 전문 에이전트가 위임된 하위 목표를 처리한다.
아키텍처는 주 에이전트가 관측과 행동을 위해 프로그램 상태에 접근하고, 좁은 범위의 작업을 새 컨텍스트 전문 에이전트에 위임하며, 별도 종료 게이트가 영속 상태를 검증하는 흐름을 보여 준다. 또한 컨텍스트 관리자의 압축 및 체크리스트 기능과 게이트 거부 뒤의 재시도 경로를 제시한다.
4.1 Act on state
주 에이전트는 영속 bash, 파일 편집기, 읽기 전용 이미지 뷰, 계획 체크리스트, 종료, 위임을 사용하지만 실시간 마우스나 키보드 제어는 하지 않는다. 사전 지식과 탐색으로 저장 위치를 찾으며, 접근할 수 없거나 본질적으로 시각적인 하위 목표에만 GUI 전문 에이전트를 호출한다. 이는 108개 과제 중 28개 과제와 주 에이전트 단계의 1.1%에 해당한다.
4.2 Verify on state
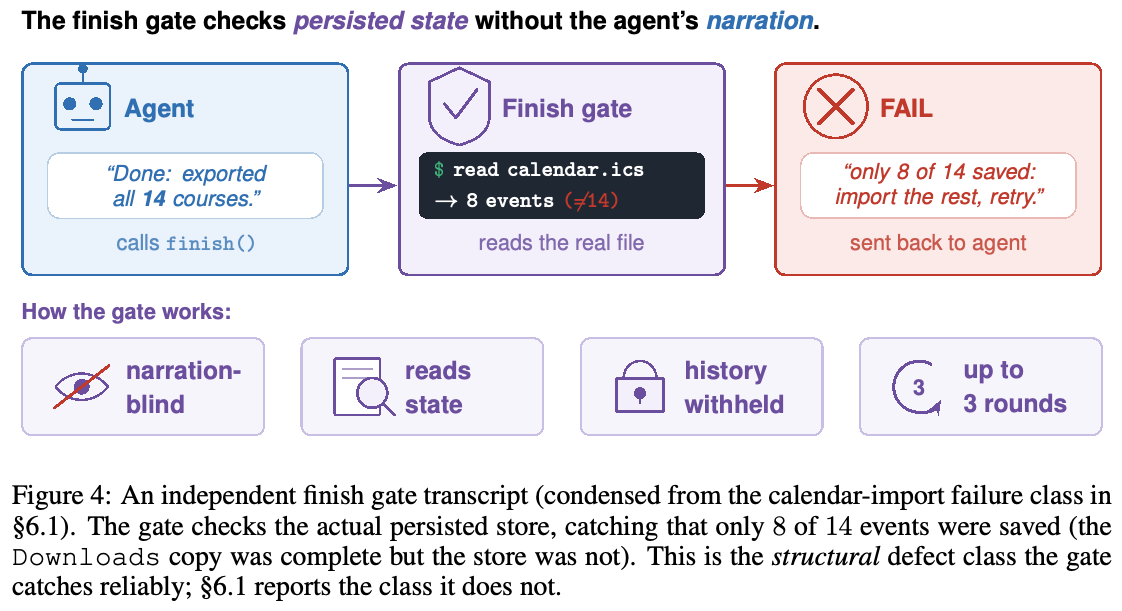
최소 세 번의 비종료 단계를 거친 뒤 종료 호출을 하면, 과제 지시와 읽기 전용 머신 접근만 가진 별도 게이트가 생성된다. 게이트는 주 에이전트의 이력, 계획, 근거, 예상 값을 보지 못한다. 요청된 아티팩트를 독립적으로 찾고, 최대 3 correction rounds 동안 지정된 구조적 결함을 반환할 수 있다.
축약된 기록은 게이트가 영속된 캘린더 파일을 읽고, 14개가 아니라 8개 이벤트만 저장되었음을 감지하는 모습을 보여 준다. 이는 내레이션을 보지 않는 게이트가 식별하고 수정을 요청할 수 있는 구조적 실패를 예시한다.
4.3 Sustain state
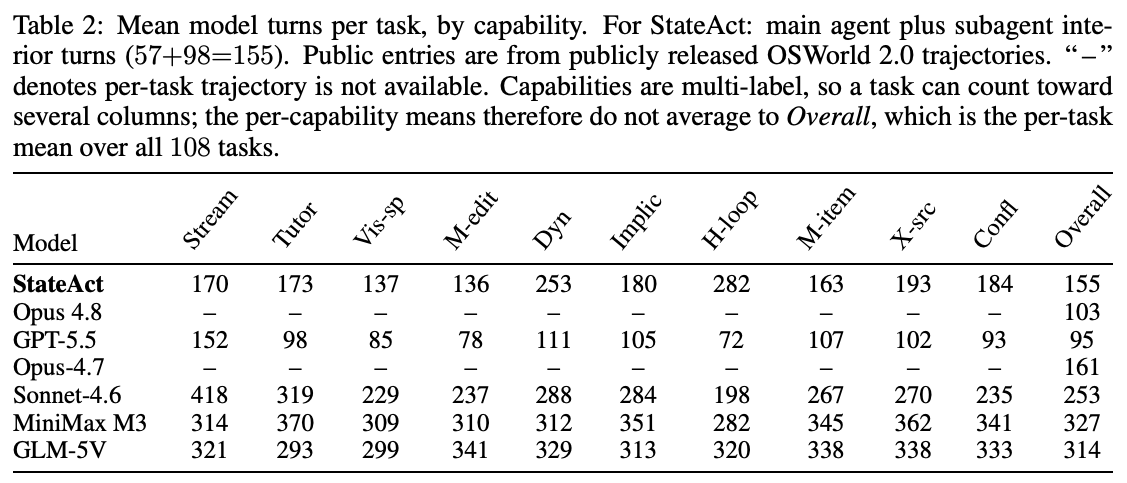
StateAct는 장기 에피소드를 지원하기 위해 집중된 작업을 새 컨텍스트의 전문 에이전트에 위임하고, 이미지를 제거하면서 오래된 컨텍스트를 압축하며, 외부화된 체크리스트를 매 턴 다시 주입한다. 보고된 평균은 주 에이전트 약 57턴과 하위 에이전트 약 98턴으로, 과제당 약 155 model turns다.
5 Experiments
실험은 상태 grounding이 장기 지평 컴퓨터 사용을 개선하는지, 어떤 구성 요소가 기여하는지, 실패가 어디에 남는지를 검증한다. OSWorld 2.0 평가, 구성 요소 및 위임 깊이 ablation, 백본 이전, 단기 지평 비교, 수동 실패 감사, 5개 벤치마크 전반의 GUI 하위 에이전트 대체를 포함한다.
5.1 Experimental setup
주 벤치마크는 108 tasks로 구성된 장기 지평 GUI 과제 집합인 OSWorld 2.0이다. 실행에는 adaptive thinking을 사용하는 Claude Opus 4.8과 200-turn main-agent budget을 사용하며, 이진 성공률, 평균 부분 점수, 과제당 USD 비용을 보고한다.
5.2 Main result
동일한 Claude Opus 4.8 기준 하니스와 비교하면 StateAct는 이진 성공률에서 6.3%p, 평균 부분 점수에서 6.8%p 높으며, 출력 토큰은 224K에서 100K로, 보고된 비용은 과제당 약 $72에서 약 $7.8 per task로 줄인다. 표시된 Opus-4.7 항목보다 이진 성공률이 8.7%p 높고, GPT-5.5보다 13.9%p 높다.
5.3 Ablation
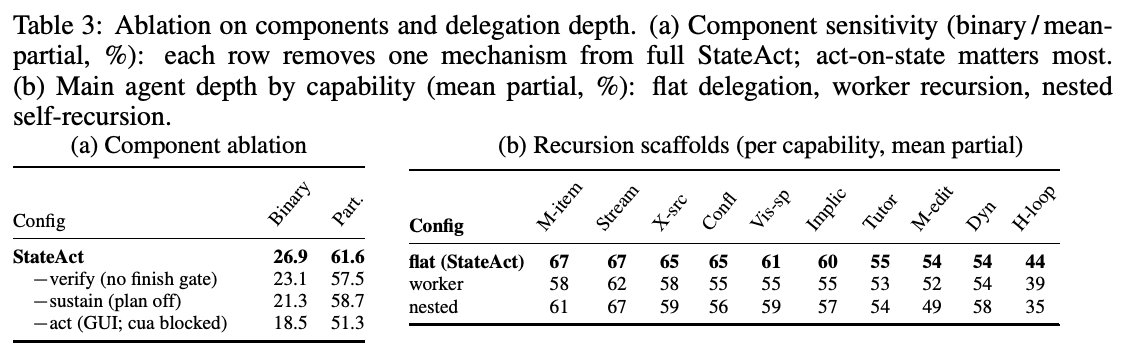
act-on-state를 제거하면 구성 요소 중 가장 큰 성능 저하가 발생하며, 평균 부분 성공률은 61.6%에서 51.3%로 감소한다. 검증 또는 sustain 메커니즘을 제거하면 각각 57.5%와 58.7%가 된다. 평면 위임은 나열된 평균 부분 점수 중 가장 높은 결과를 보였지만, 재귀는 108개 과제 중 7개에서만 실행되었고 중첩된 적은 없다. 따라서 이 비교는 계층 구조 일반에 관한 주장보다 저자들의 평면 설계 선택을 뒷받침한다.
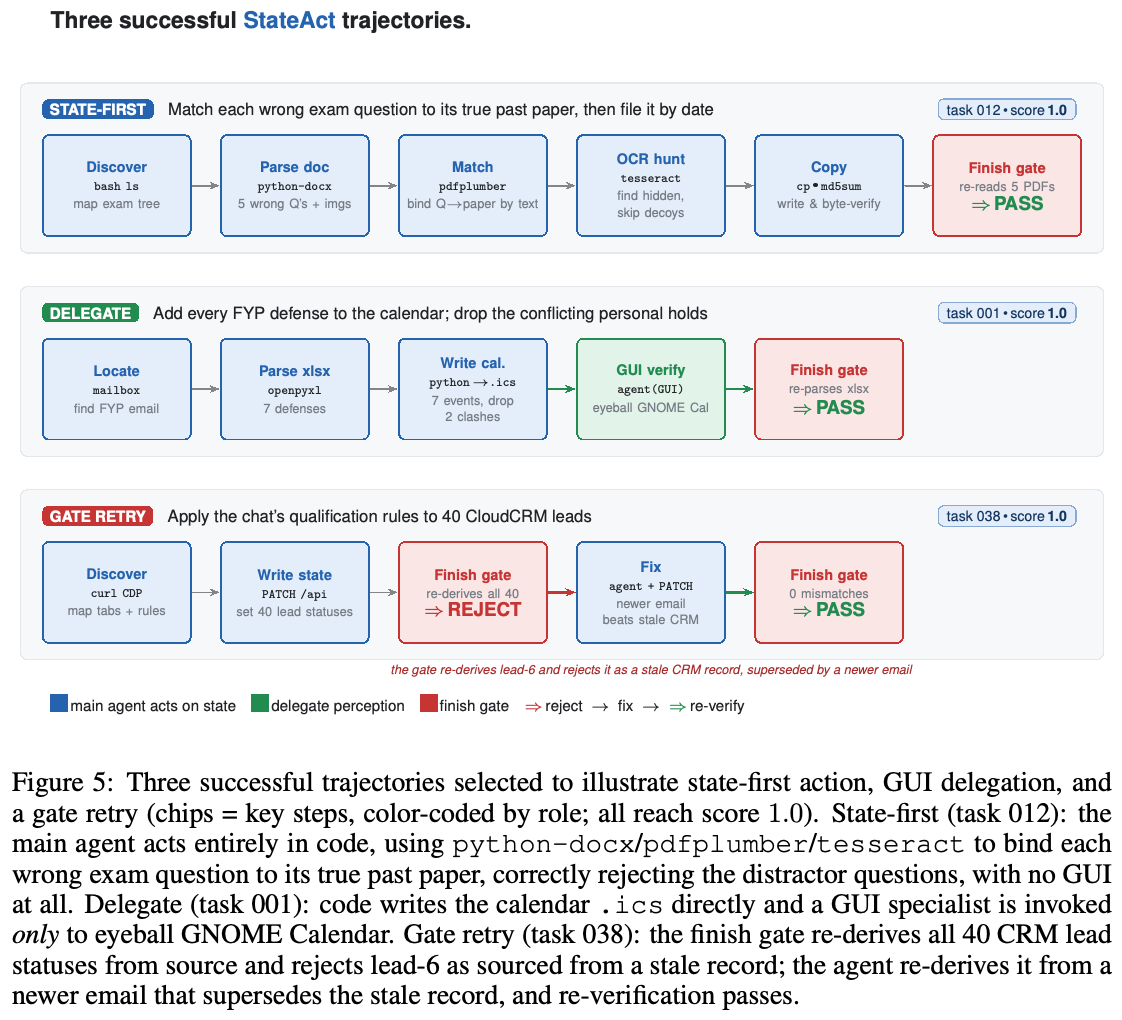
선택된 3개 궤적은 완전히 코드 기반인 문서 매칭, 좁은 범위의 GUI 위임을 포함한 캘린더 생성, 오래된 CRM 레코드에 대한 종료 게이트 재시도를 보여 준다. 모두 점수 1.0으로 끝나지만, 이 그림은 집계 평가가 아니라 예시다.
StateAct는 과제당 평균 155 model turns를 사용하며, 이는 주 에이전트 57턴과 하위 에이전트 내부 98턴으로 분해된다. 이는 기준 Opus 4.8 항목의 보고된 103턴보다 많지만 Sonnet-4.6의 253턴과 GLM-5V의 314턴을 포함한 여러 표시 시스템보다는 적다.
쌍으로 제시된 그래프는 StateAct가 $7.8 per task에서 이진 성공률 26.9%, 평균 부분 점수 61.6%를 기록함을 보여 준다. 더 저렴한 표시 항목인 MiniMax M3와 Qwen3.7은 정확도가 크게 낮다.
Ablation 표는 act-on-state를 제거했을 때 가장 큰 하락이 발생함을 보여 준다. 이진은 18.5%, 부분은 51.3%로, StateAct의 26.9%와 61.6%에 비해 낮다. 위임 패널은 본문에서 논의한 집계 비교에서 평면 위임이 가장 강한 나열 구성임을 보고한다.
5.4 Additional designs
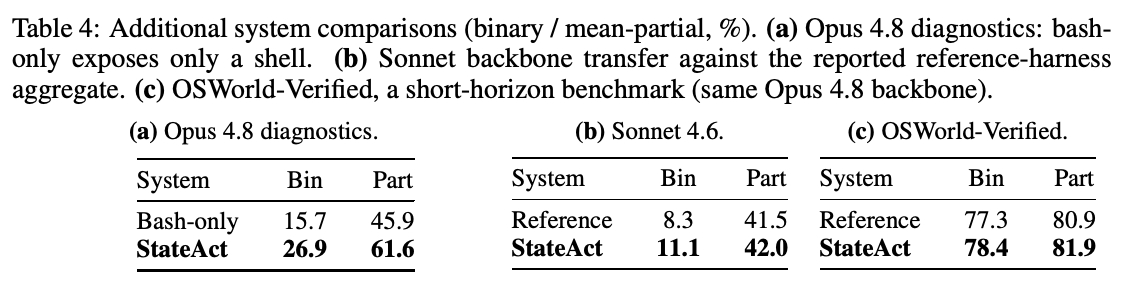
bash 전용 구성은 부분 성공률 45.9%에 도달하며, 54.8%인 기준보다 낮다. 이는 셸 접근만으로는 전체 시스템의 결과를 재현하지 못함을 보여 준다. StateAct는 Claude Sonnet 4.6의 이진 성공률을 8.3%에서 11.1%로 높이며, 단기 지평 OSWorld-Verified에서는 78.4% 대 77.3%로 기준에 가깝다.
표는 Opus 4.8에서 bash 전용 행동이 기준보다 낮고, StateAct가 Sonnet 4.6을 소폭 개선하며, 단기 지평 OSWorld-Verified에서는 기준에 가깝다는 점을 보여 준다. 이 조건들은 코드 접근, 백본 이전, 과제 지평 효과를 분리해 결과를 한정한다.
6 Discussion
논의는 가장 큰 성능 격차를 다중 항목 상태, 교차 소스 추론, 충돌 모호성 해소를 포함한 기계 검증 가능한 능력과 연결한다. 상태 grounding은 지각 및 영속성 오류를 줄이지만, 잘못된 해석이나 값 추론 오류를 독립적으로 해결하지는 못한다.
6.1 Why State-Grounding Helps: A Failure Analysis
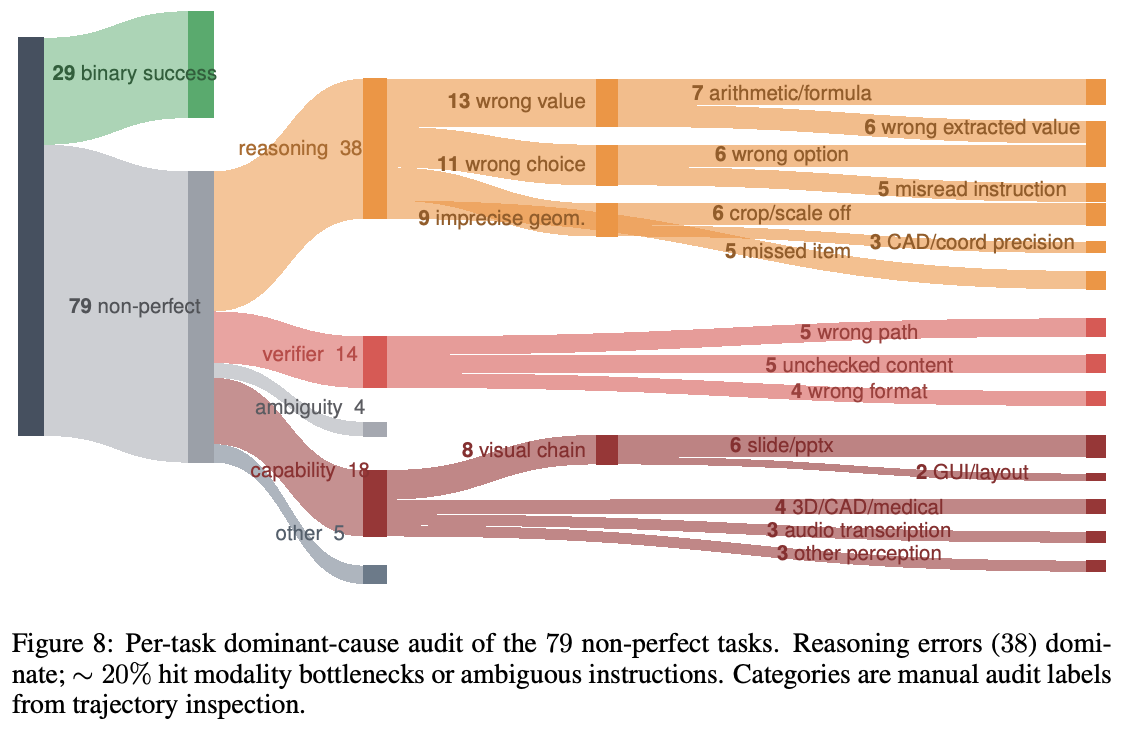
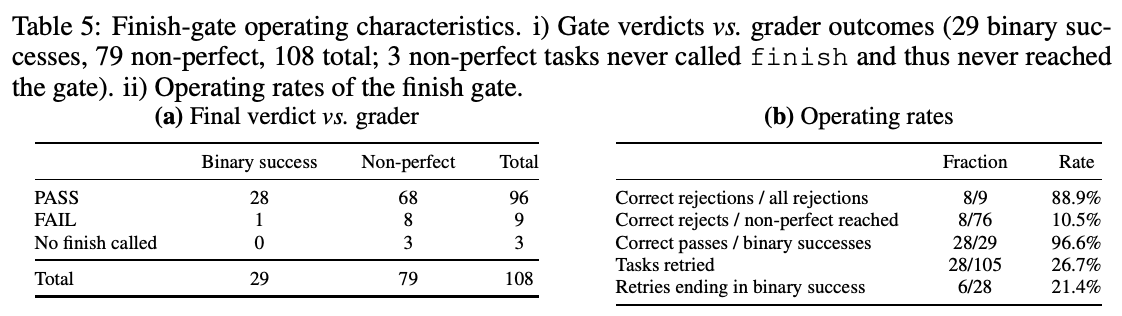
수동 감사는 완벽하지 않은 79개 과제 중 38개를 추론, 14개를 검증기 취약성 또는 잘못된 경로 종료, 18개를 능력 병목, 4개를 모호성, 5개를 기타 원인으로 분류한다. 게이트에 도달한 완벽하지 않은 76개 과제 중 8개는 올바르게 거부했고 68개는 잘못 통과시켰다. 이는 게이트가 구조적 검사에 한정되며, 공유된 값 해석 오류를 안정적으로 식별하지 못함을 보여 준다.
감사는 완벽하지 않은 79개 과제를 분류하며, 추론이 38개 과제로 가장 큰 범주다. 추론, 검증기, 모호성, 능력, 기타 원인을 분리하고, 잘못된 값, 시각 체인, 잘못된 경로 같은 세부 레이블도 제시한다.
게이트는 96개 과제를 통과시키고 9개를 실패시켰으며, 3개 과제는 종료를 호출하지 않았다. 게이트에 도달한 완벽하지 않은 76개 과제 중 8개를 올바르게 거부하고 68개를 잘못 통과시켰다. 따라서 8/9의 거부 정밀도는 도달한 완벽하지 않은 과제에서 10.5%에 불과한 올바른 거부율과 공존한다.
6.2 Is a strong GUI subagent necessary?
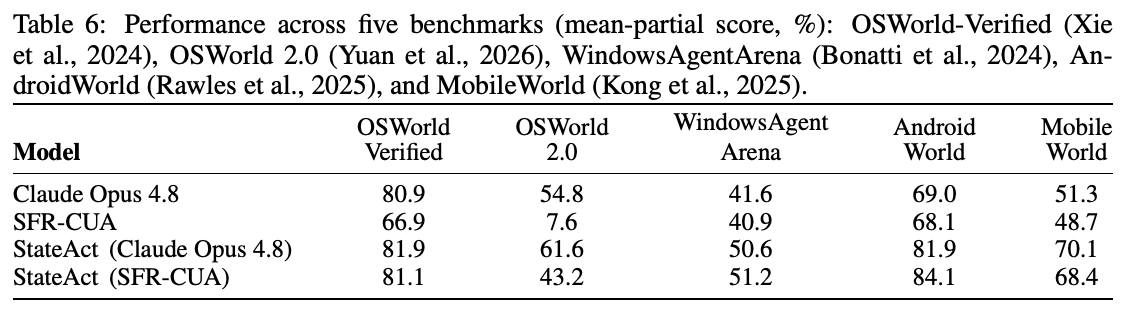
GUI 전문 에이전트를 소형 31B SFR-CUA로 교체해도 OSWorld-Verified, WindowsAgentArena, AndroidWorld, MobileWorld에서 종단 간 평균 부분 성능은 거의 변하지 않는다. 그러나 OSWorld 2.0에서 SFR-CUA를 사용한 StateAct는 이진 18.5%, 부분 43.2%에 도달하며 Claude Opus 4.8 GUI 전문 에이전트 구성보다 낮다. 따라서 어려운 시각적 fallback에서는 GUI 전문 에이전트의 성능이 여전히 중요하다.
SFR-CUA를 사용한 StateAct는 4개 벤치마크에서 Claude Opus 4.8 GUI 전문 에이전트 버전과 가깝지만, OSWorld 2.0에서는 평균 부분 점수 43.2% 대 61.6%로 크게 뒤처진다. 이는 가장 어려운 장기 지평 데스크톱 환경 밖에서는 소형 GUI fallback이 충분할 수 있다는 조건부 주장을 뒷받침한다.
7 Conclusion
저자들은 GUI 제어를 fallback으로 유지하면서도 프로그램 상태가 장기 지평 컴퓨터 사용 에이전트의 주 인터페이스가 될 수 있다고 결론짓는다. Ablation은 상태 기반 행동과 관측에 가장 큰 측정 기여를 귀속하며, 실패 분석은 값의 정확성과 추론을 남은 병목으로 지목한다.
부록
- 제공된 PDF는 결론 뒤에 참고문헌을 포함하며 별도의 기술 부록은 없다. 인용 문헌은 컴퓨터 사용 에이전트, 상태 검증, 혼합 행동 공간, 자기 개선, 평가한 벤치마크를 다룬다.
짧은 생각
동일 백본 비교는 하니스 개입의 실용적 정보를 제공하며, bash 전용 ablation은 코드 접근만으로 충분하지 않음을 유용하게 보여 준다. 다만 주된 결과는 108개 과제에 기반하며, 게이트에 도달한 완벽하지 않은 76개 과제 중 68개를 잘못 통과시킨 점은 구조적 검증을 신뢰할 수 있는 의미적 또는 값 검증으로 해석해서는 안 됨을 뜻한다.