


SWE-Bench ProMax: Benchmarking Agents on Large-Scale Multilingual Code Refactoring 요약 설명
10 Aug 2026 | Paper Review Code Refactoring AI Coding Agents BenchmarkContents
- 요약
- 1 Introduction
- 2 Related work
- 3 SWE-Bench ProMax
- 4 Experiments
- 5 Results and analysis
- 6 Conclusion
- 부록
- 짧은 생각
이번 글에서는 SWE-Bench ProMax: Benchmarking Agents on Large-Scale Multilingual Code Refactoring 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 8월 10일(Arxiv), COLM 2026
- Shi, Yuling, Xu, Jinghan, Fu, Kelin, Zeng, Wenhao, He, Shilin, Zhang, Lei, Liu, Yue, Zhao, Zelin, Zhuo, Terry Yue, Cao, Jialun, et al.
- Shanghai Jiao Tong University, Peking University, The Hong Kong University of Science and Technology, Douyin Group, University of Chinese Academy of Sciences, National University of Singapore, Monash University
- 논문 링크
- Project Page
요약
- SWE-Bench ProMax는 70개 저장소와 Python, Java, TypeScript, Go, C, C++, Rust의 7개 언어에서 실제 커밋을 수집해 전문가가 선별한 대규모 코드 리팩터링 과제 170개로 구성한 벤치마크다. 에이전트의 최종 저장소 상태가 전체 테스트 스위트를 통과하는지로 동작 보존형 다중 파일 변환을 평가하며, 보고된 최고 해결률은 41.2%다.
1 Introduction
논문은 기존 코딩 벤치마크가 포화되고 있으며, 테스트가 지나치게 좁거나 넓고 과제 명세가 모호하거나 공개 저장소 과제가 오염되면 평가 문제가 생길 수 있다고 주장한다. 리팩터링은 동작 불변성을 유지하면서 여러 파일의 변경을 조율해야 하는 장기 과제로 제시한다.
비교는 의도한 규모 차이를 정량화한다. ProMax 인스턴스의 30%는 10개보다 많은 파일을 수정하고 32%는 200 LOC보다 많이 변경하는 반면, SWE-bench Verified 인스턴스는 86%가 단일 파일이며 93%가 최대 20 LOC를 수정한다.

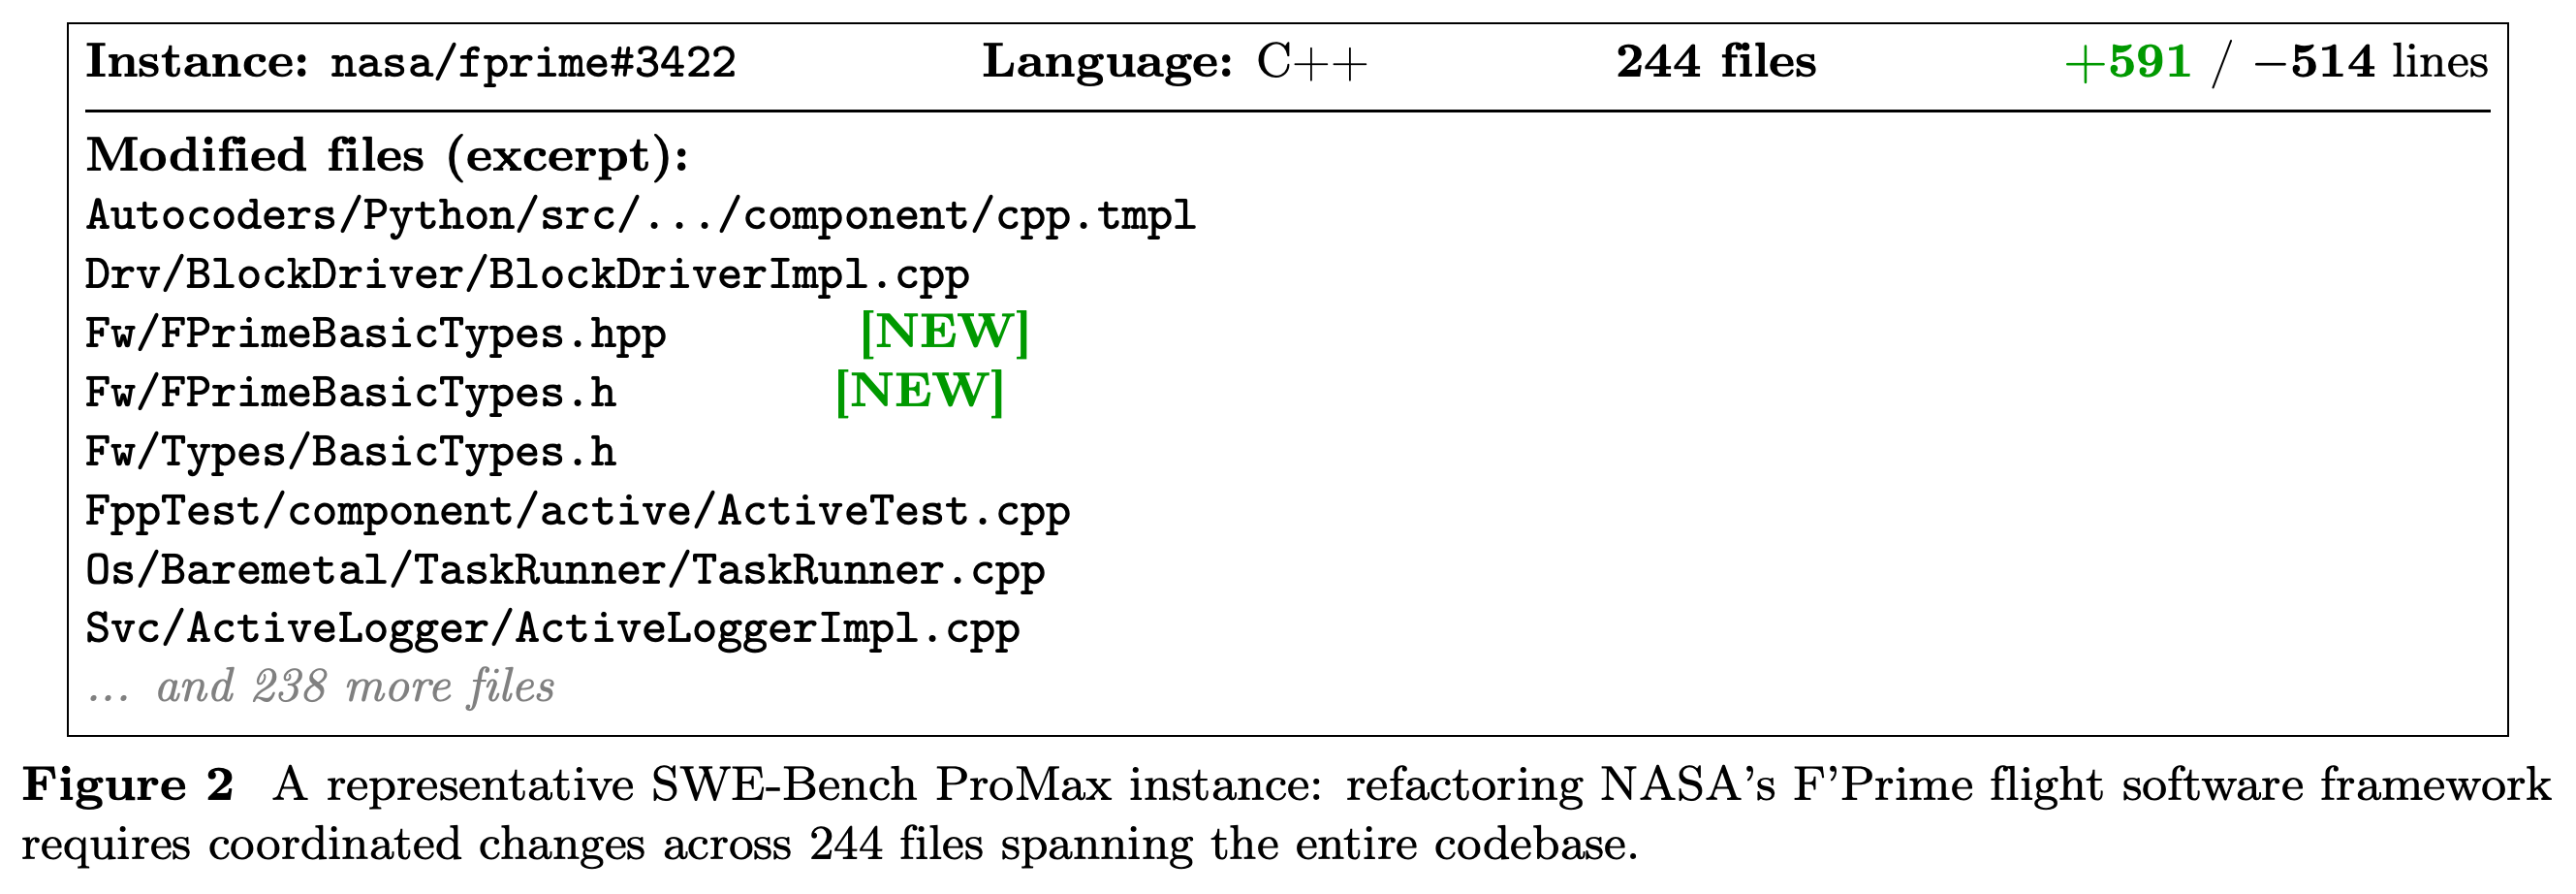
NASA F'Prime 사례는 다중 파일 요구 사항을 구체적으로 보여 준다. 이 리팩터링은 국소적 편집이 아니라 템플릿, 드라이버, OS 구성 요소, 서비스, 빌드 관련 코드를 아우르는 244개 파일에 걸친다.
2 Related work
관련 연구는 함수 수준 생성, 저장소 수준 이슈 해결, 다국어 평가, 장기 소프트웨어 과제, 벤치마크 구축을 다룬다. 저자들은 ProMax를 저장소 수준 실행 기반 평가, 다국어 리팩터링 과제, 대규모 패치, 명세와 테스트의 전문가 검토를 결합한 벤치마크로 제시한다.
2.1 Coding benchmarks
논문은 HumanEval과 MBPP를 포함한 초기 함수 수준 벤치마크를 SWE-bench, Multi-SWE-bench, SWE-bench Pro, SWE-EVO, Terminal-Bench 같은 저장소 수준 벤치마크와 대조한다. SWE-bench Verified에서 최전선 모델의 점수가 75%를 넘는다는 결과와 장기 과제에서 더 낮은 성공률을 보인다는 점을 더 까다로운 평가 환경의 근거로 든다.
2.2 Code refactoring
논문에서 다루는 리팩터링 특화 벤치마크 2개는 Python 또는 Java에만 한정되거나, 평균 변경 규모가 작거나, 테스트 품질을 사람이 검증하지 않았다는 한계가 있다. 전통적 리팩터링 도구는 주로 과거 변환을 탐지하며, LLM 리팩터링 연구는 코드 스멜 수, 컴파일 가능성, 정렬 점수처럼 서로 다른 측정치를 사용한다.
3 SWE-Bench ProMax
SWE-Bench ProMax는 대규모 동작 보존 리팩터링을 측정하는 다국어 실행 기반 벤치마크다. 각 과제는 리팩터링 전 저장소 상태, 다시 작성한 이슈 설명, 선별한 테스트, 원래 개발자의 정답 패치로 구성된다.
3.1 Task formulation
각 인스턴스에는 사전 구성한 Docker 환경, 정확한 자연어 명세, 테스트 스위트, 정답 패치가 포함된다. 에이전트는 환경과 명세를 받고, 최종 수정 사항이 모든 테스트를 통과할 때에만 인스턴스를 해결한 것으로 판정한다. 중간 명령은 평가하지 않는다.
3.2 Dataset construction and curation
3단계 파이프라인은 별이 500개 이상이고 승인된 라이선스를 사용하며 목표 언어가 코드베이스의 80% 이상을 차지하는 GitHub 저장소를 선택한다. 이후 테스트 파일과 비테스트 파일을 모두 수정한 2025년 1월 이후의 “refactor” 포함 커밋을 추출하고 “bug fix”는 제외한다. Docker 검증 뒤 전문가들은 단순하거나 다중 파일 범위가 부족한 과제를 제거하고 부적절한 테스트를 검토하며, LLM 지원으로 명세를 다시 작성하고 최종 일관성 검사를 수행한다. 후보 29,782개 중 170개가 남는다.
행렬은 ProMax만이 실행 기반, 저장소 수준, 다국어, 리팩터링 중심, 평균 수정 파일 5개 초과, 전문가 선별이라는 조건에 동시에 표시된 벤치마크임을 보여 준다.

파이프라인은 저장소 탐색과 커밋 추출부터 Docker 검증, 전문가 필터링, 문제 재작성, 검증까지의 선별 과정을 시각화한다. 공개된 세트가 초기 후보 풀보다 훨씬 작은 이유를 설명한다.

3.3 Dataset composition
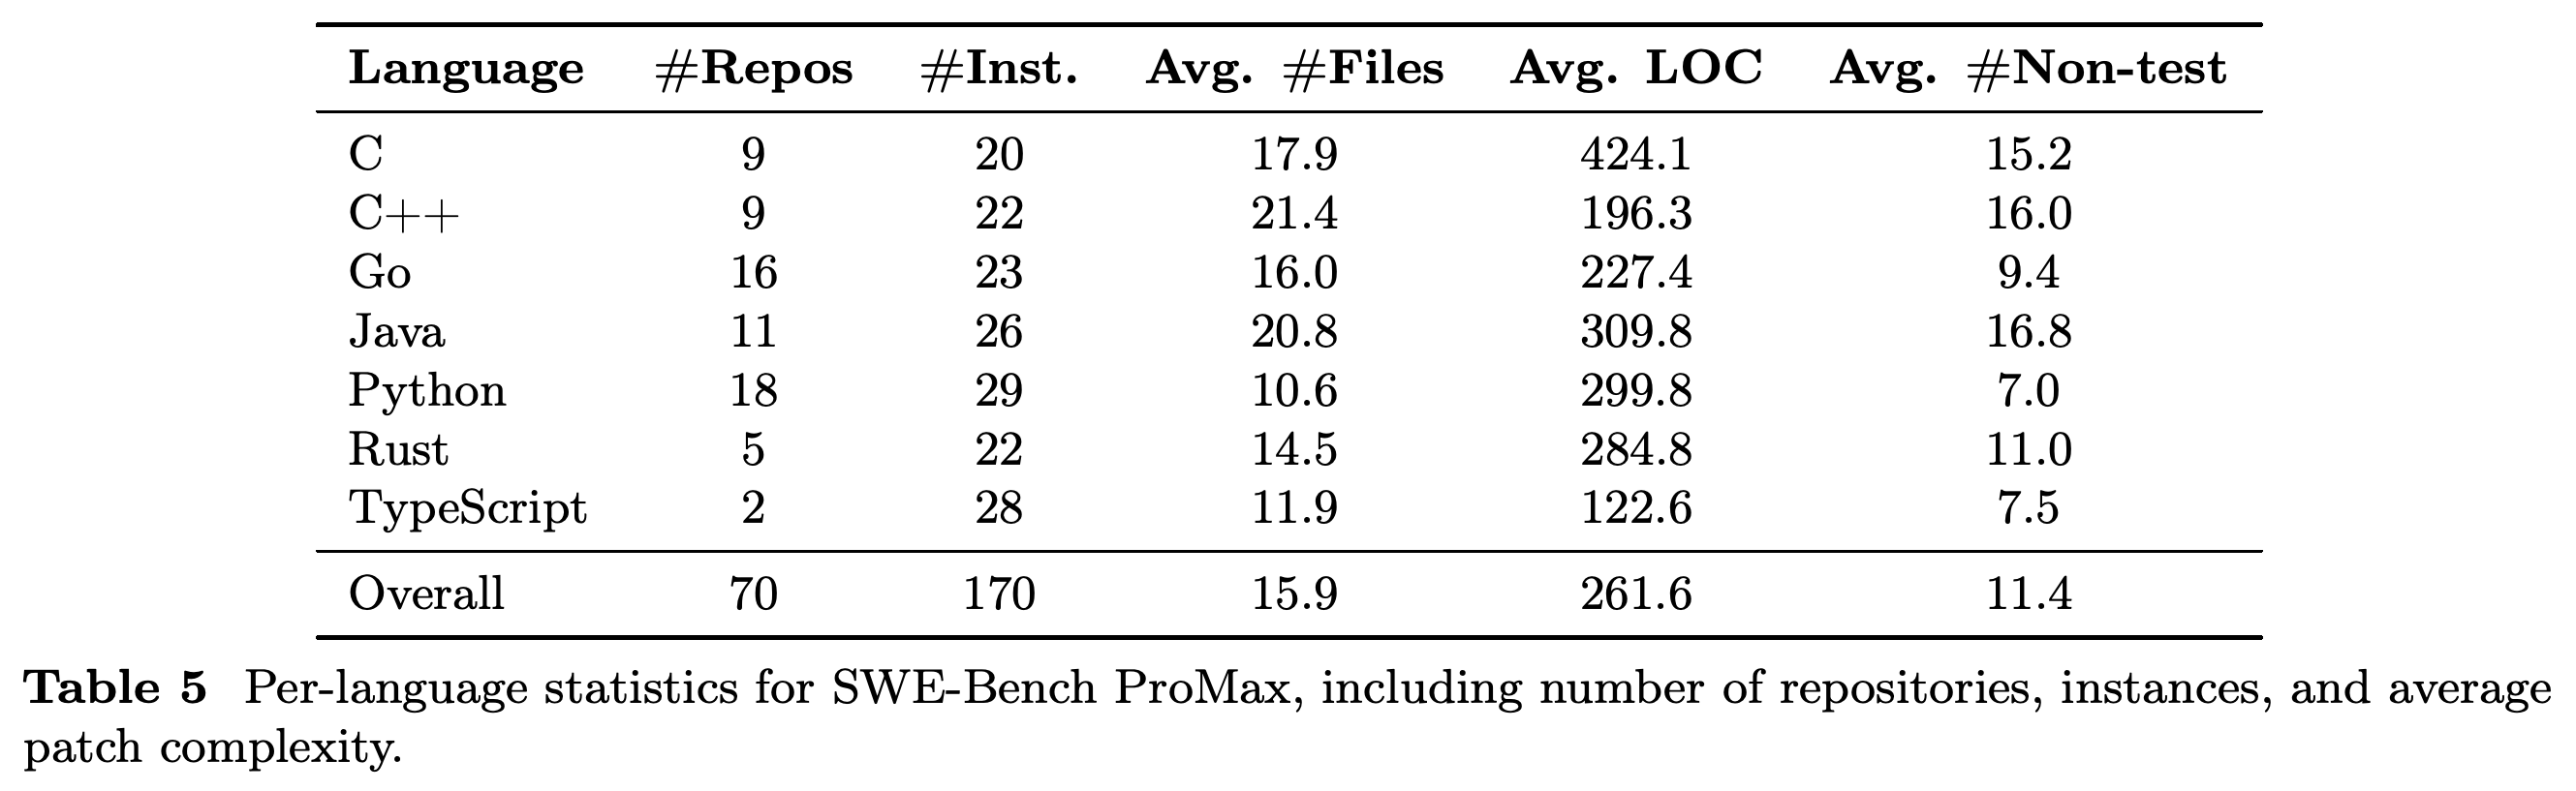
170개 과제의 소스 패치는 평균 11.4개 파일, 261.6 source LOC, 8,179.5 source-patch tokens로 구성되며, 테스트 패치는 평균 4.5개 파일과 185.5 LOC를 추가한다. 전체 수정 파일 수는 평균 15.9개이고, 이슈 설명은 평균 685.3 tokens이며, 가장 큰 소스 패치는 182개 파일을 수정한다.
4 Experiments
실험은 mini-swe-agent와 OpenHands에서 독점 모델과 오픈 웨이트 모델 6개를 비교한다. 평가는 170개 인스턴스 전체, 사전 구축한 격리 Docker 환경, 300단계 제한, 인스턴스당 $10 비용 제한, Pass@1 해결률, 언어별 해결률, 에이전트 단계 수, 평균 API 비용을 사용한다.
4.1 Experimental setup
mini-swe-agent는 반복적인 파일 열람, 편집, 검색, bash 실행을 제공하고, OpenHands는 샌드박스 명령 실행과 구조화된 파일 편집 도구를 제공한다. 모든 모델에 같은 스캐폴드와 제한을 적용해 모델과 런타임 도구의 효과를 통제된 방식으로 비교한다.
4.2 Models
독점 모델은 Gemini-3-Pro, Claude Sonnet 4.6, GPT-5.2이고, 오픈 웨이트 모델은 GLM-5, Kimi-K2.5, Qwen3.5다. 공통의 대규모 리팩터링 작업 부하에서 모델 계열, 아키텍처, 학습 패러다임을 아우르도록 선택했다.
5 Results and analysis
보고된 설정에서 ProMax는 여전히 어렵다. OpenHands를 사용한 GPT-5.2가 전체 최고 해결률 41.2%를 기록했으며, 이는 SWE-bench Verified에서 인용한 75%+ 최전선 성능보다 낮다. 결과는 에이전트 스캐폴드, 프로그래밍 언어, API 비용에 따라 크게 달라지며 모든 언어에서 선두인 모델은 없다.
5.1 Main results
OpenHands에서 GPT-5.2는 41.2%, Claude Sonnet 4.6은 38.8%, GLM-5와 Qwen3.5는 각각 36.5%에 도달한다. GPT-5.2는 mini-swe-agent에서 21.8%를 기록한 뒤 상승했다. 언어별 선두는 Python 48.3%와 C 75.0%의 GPT-5.2, TypeScript 53.6%와 Rust 63.6%의 Claude Sonnet 4.6, Java 34.6%의 GLM-5, Go 43.5%의 Kimi-K2.5, C++ 54.5%의 Qwen3.5다.
표는 스캐폴드 민감성, 언어별 차이, 비용 효율성에 관한 주장의 수치적 근거를 제공한다. OpenHands GPT-5.2의 전체 41.2%와 OpenHands GLM-5의 인스턴스당 $0.24에서 36.5%를 보고한다.

5.2 Agent behavior analysis
Claude Sonnet 4.6과 Kimi-K2.5의 에이전트 파일 수정 분포는 작은 과제에서는 정답 패치를 따르지만 더 큰 패치에서는 충분히 포괄하지 못한다. 에이전트는 수정 파일 약 10개에서 누적 범위 90%에 도달하는 반면, 정답 패치는 약 20개에서 도달한다. 실패한 실행은 상호작용 라운드도 더 많이 사용하며, 이는 불완전한 다중 파일 변경 전파와 비생산적인 편집·되돌리기 순환에 부합한다.
왼쪽 누적 분포는 Claude Sonnet 4.6과 Kimi-K2.5가 특히 큰 변경에서 정답 패치보다 적은 파일을 수정함을 보여 준다. 오른쪽 패널은 통과 실행과 실패 실행을 구분하며, 실패가 더 많은 상호작용 라운드를 요구하는 경향을 보인다.

5.3 Cost and efficiency analysis
비용은 해결률에 비례하지 않는다. OpenHands에서 Claude Sonnet 4.6은 인스턴스당 $4.77로 38.8%를 기록하고, GLM-5는 $0.24로 36.5%를 기록하며, GPT-5.2는 $3.60에서 41.2%에 도달한다. Qwen3.5는 두 스캐폴드에서 평균 단계 수가 각각 155.4와 141.2로 가장 많지만 전체 선두는 아니다. 논문은 저장소가 승인된 오픈소스 라이선스를 사용한다고 밝히고, 데이터 선별, 부록 분류, 논문 편집에 LLM 지원을 사용했음을 공개한다.
6 Conclusion
결론은 벤치마크의 난도가 대규모 다중 파일 범위와 품질을 통제한 명세 및 테스트에서 비롯된다고 설명한다. 영향을 받는 파일 전반에 변경을 완전하게 전파하지 못하는 문제가 현재 에이전트의 핵심 실증적 한계라고 지적하며, 오픈 웨이트 모델이 훨씬 낮은 API 비용으로 선도적인 독점 모델 성능에 근접할 수 있다고 보고한다.
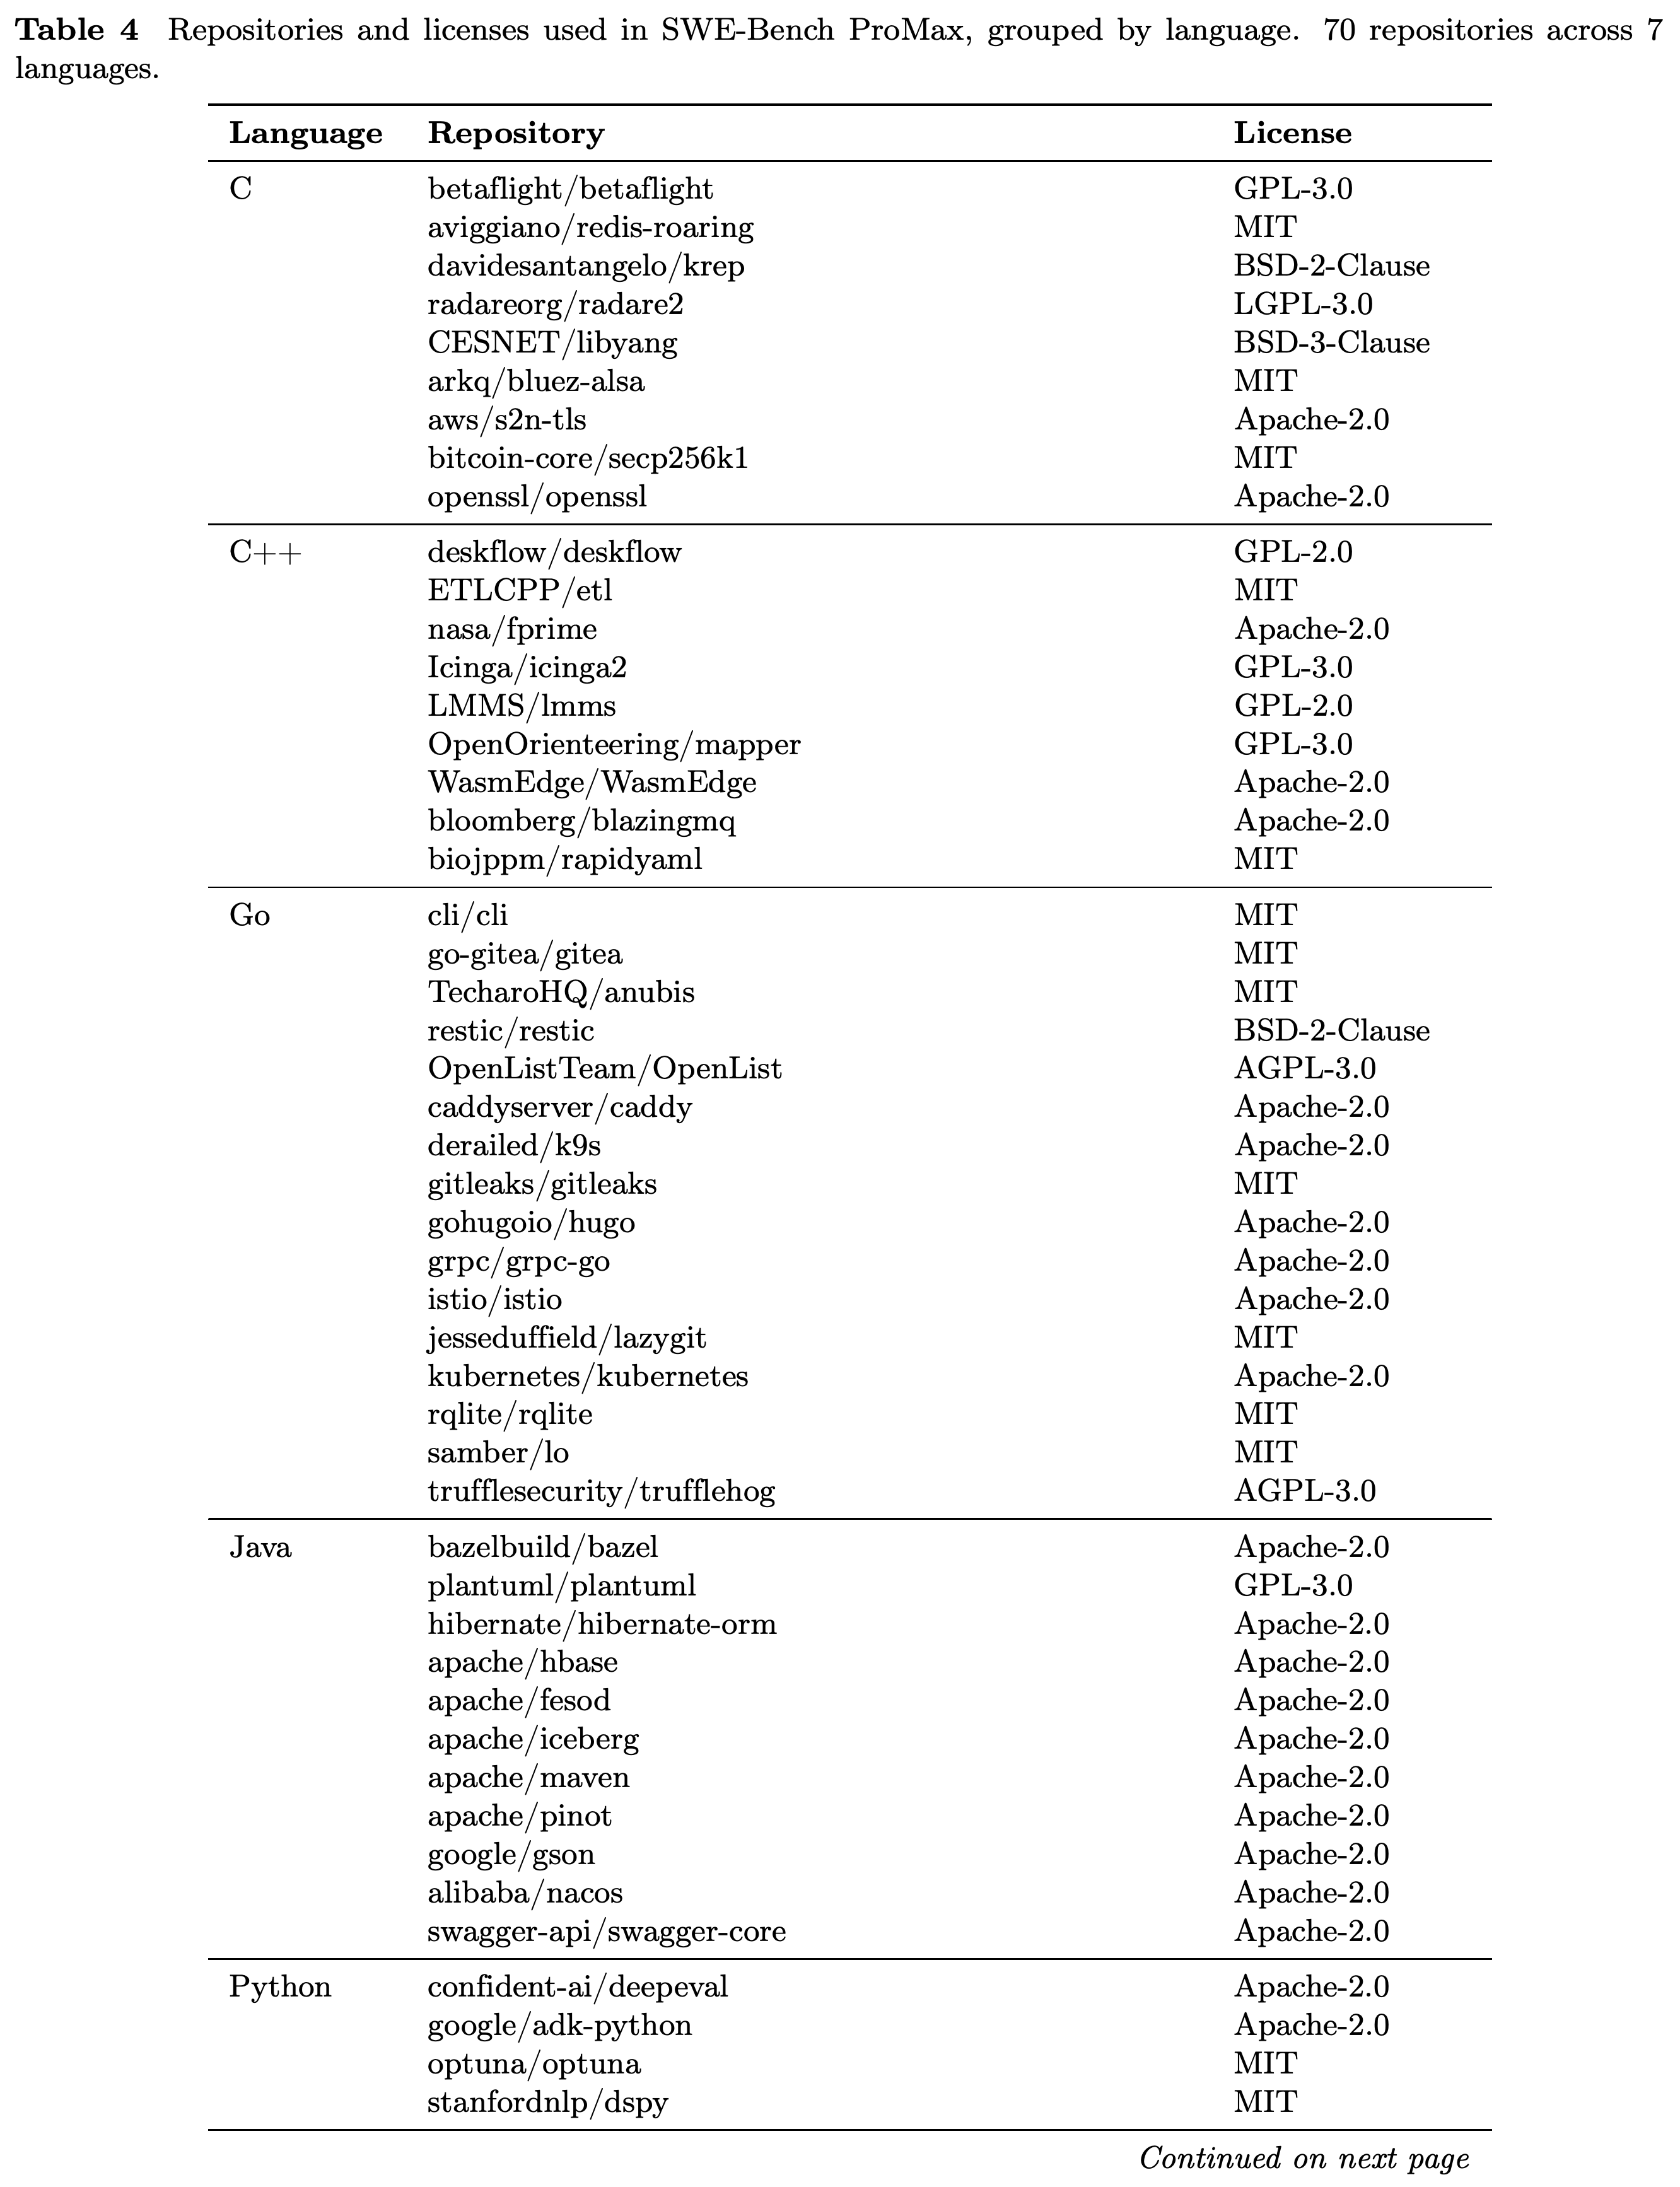
저장소 목록은 벤치마크에 사용한 공개 코드 원본과 라이선스를 기록하며, 7개 언어에 걸친 70개 저장소라는 폭을 뒷받침한다.
언어별 통계는 패치 복잡도가 고르지 않음을 보여 준다. C++와 Java는 평균 수정 파일 수가 각각 21.4개와 20.8개이고, C는 평균 LOC가 424.1로 가장 높다. TypeScript는 28개 인스턴스를 포함하지만 단 2개 저장소에서 가져와, 논문이 지적한 집중도 한계가 있다.
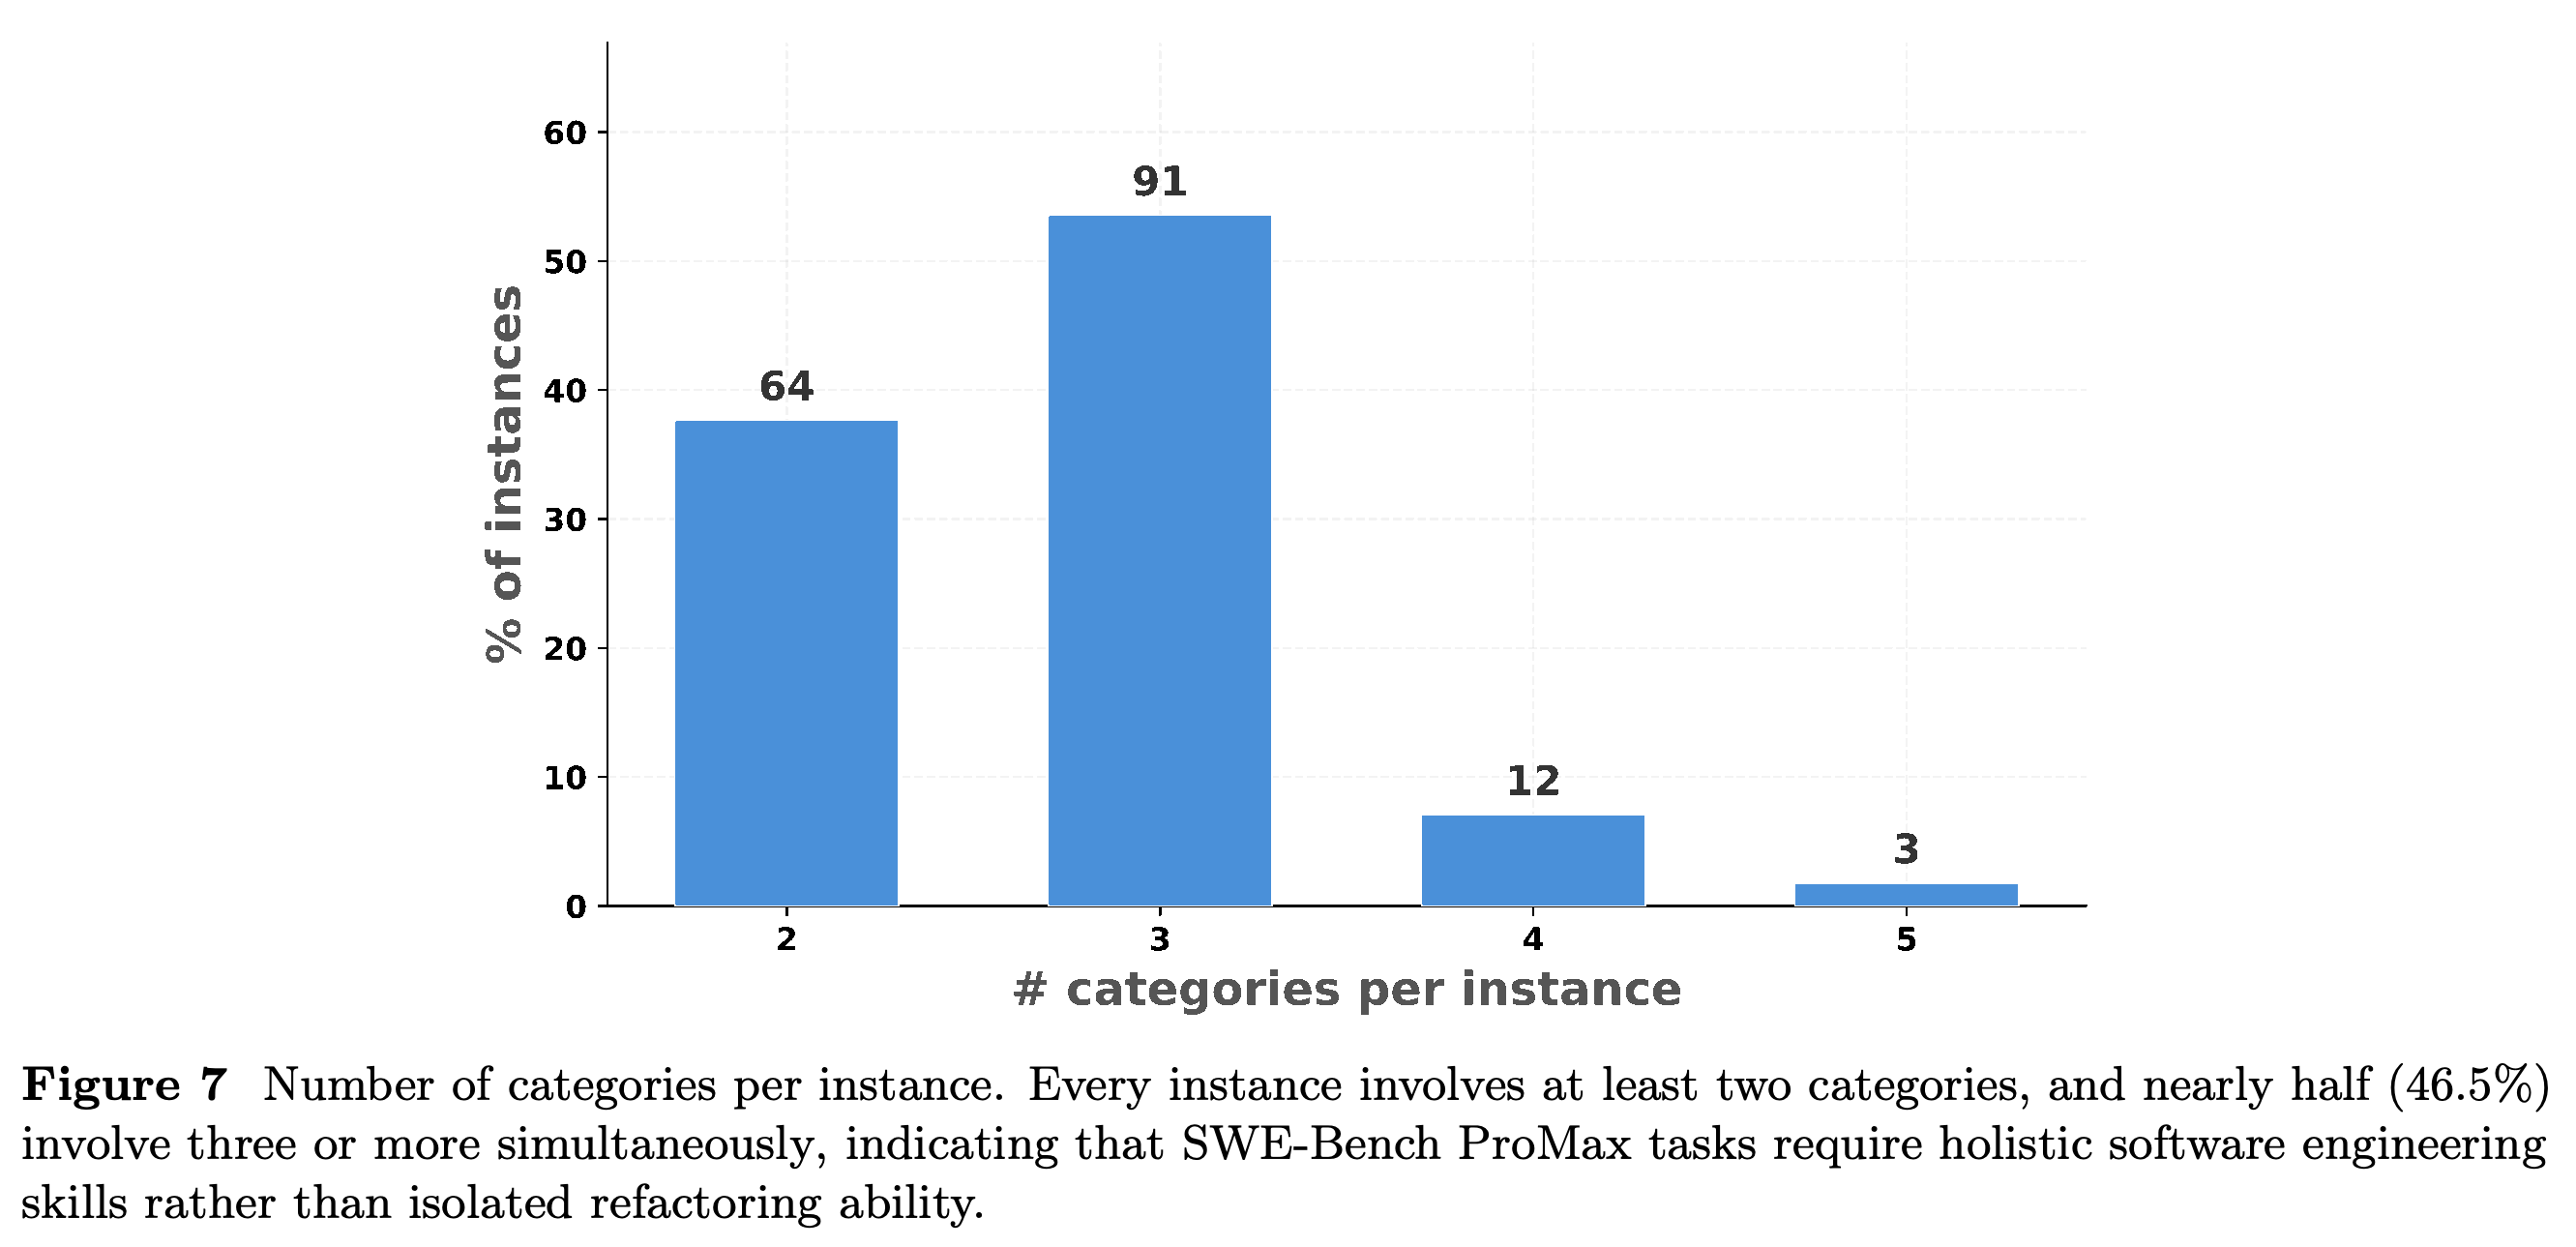
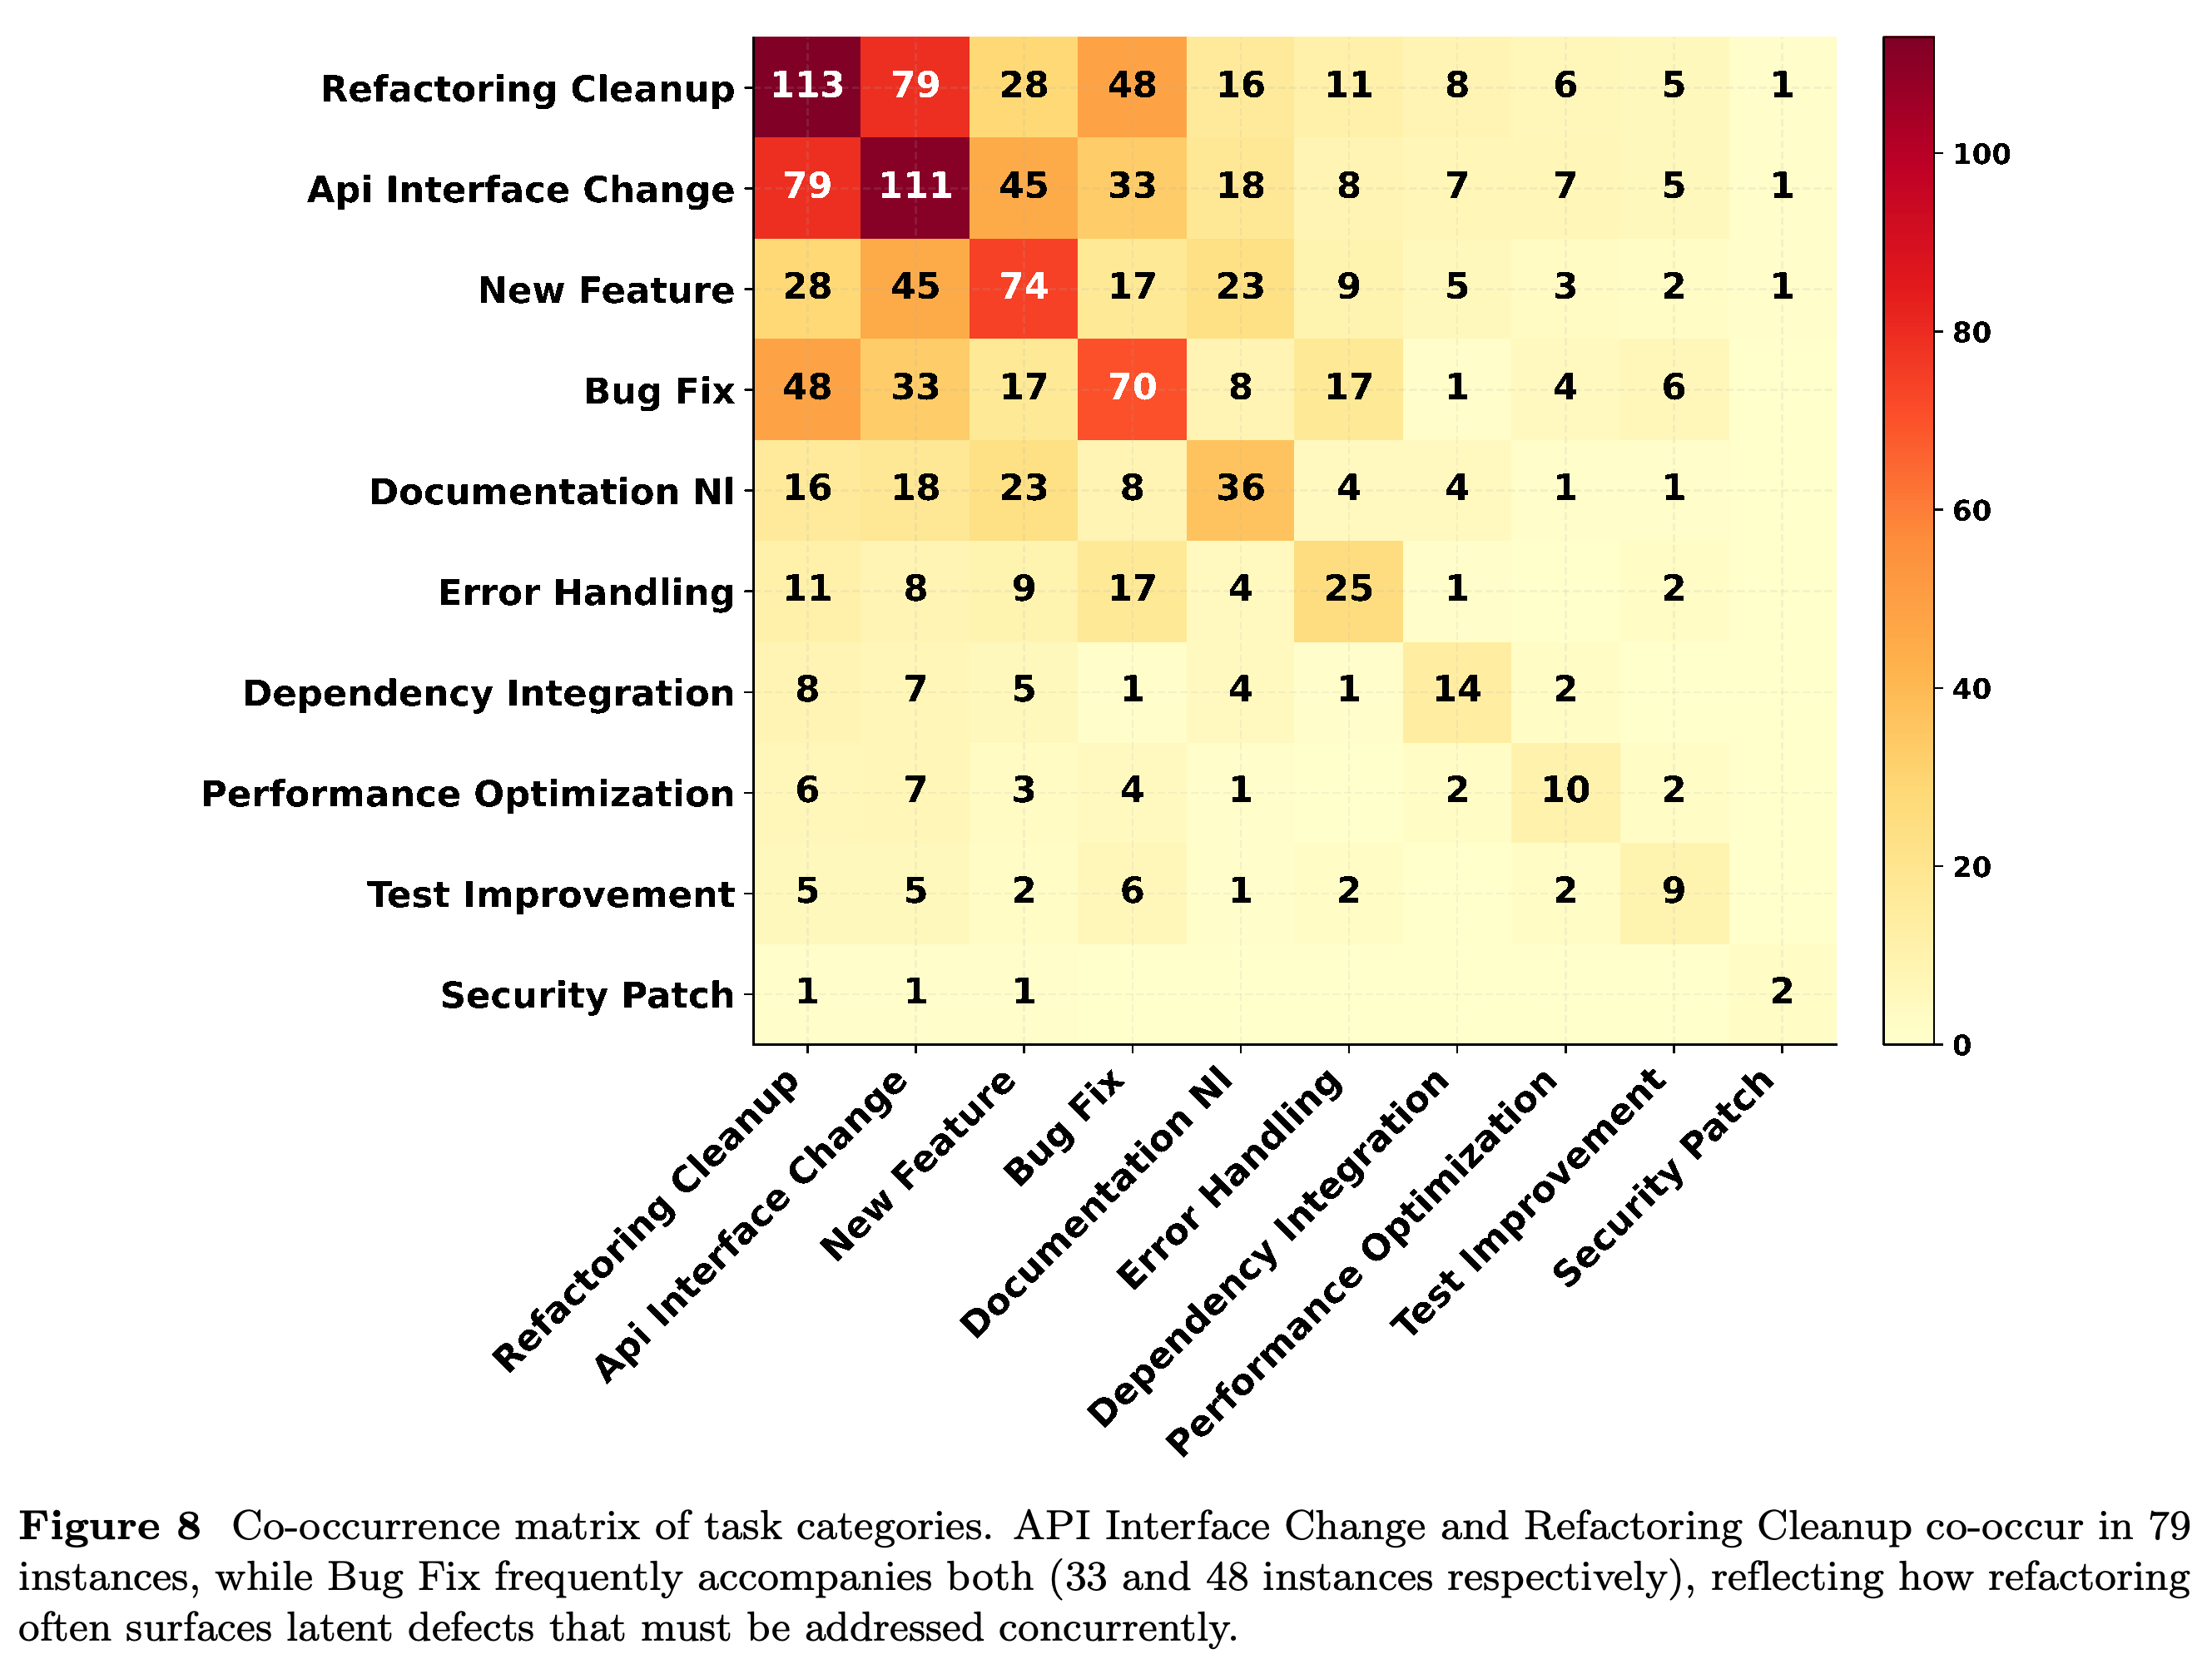
모든 과제에는 최소 2개 범주 라벨이 있고, 46.5%에는 3개 이상이 있다. 이는 벤치마크가 고립된 변환이 아니라 복합적인 소프트웨어 유지보수 변경을 포함함을 보여 준다.
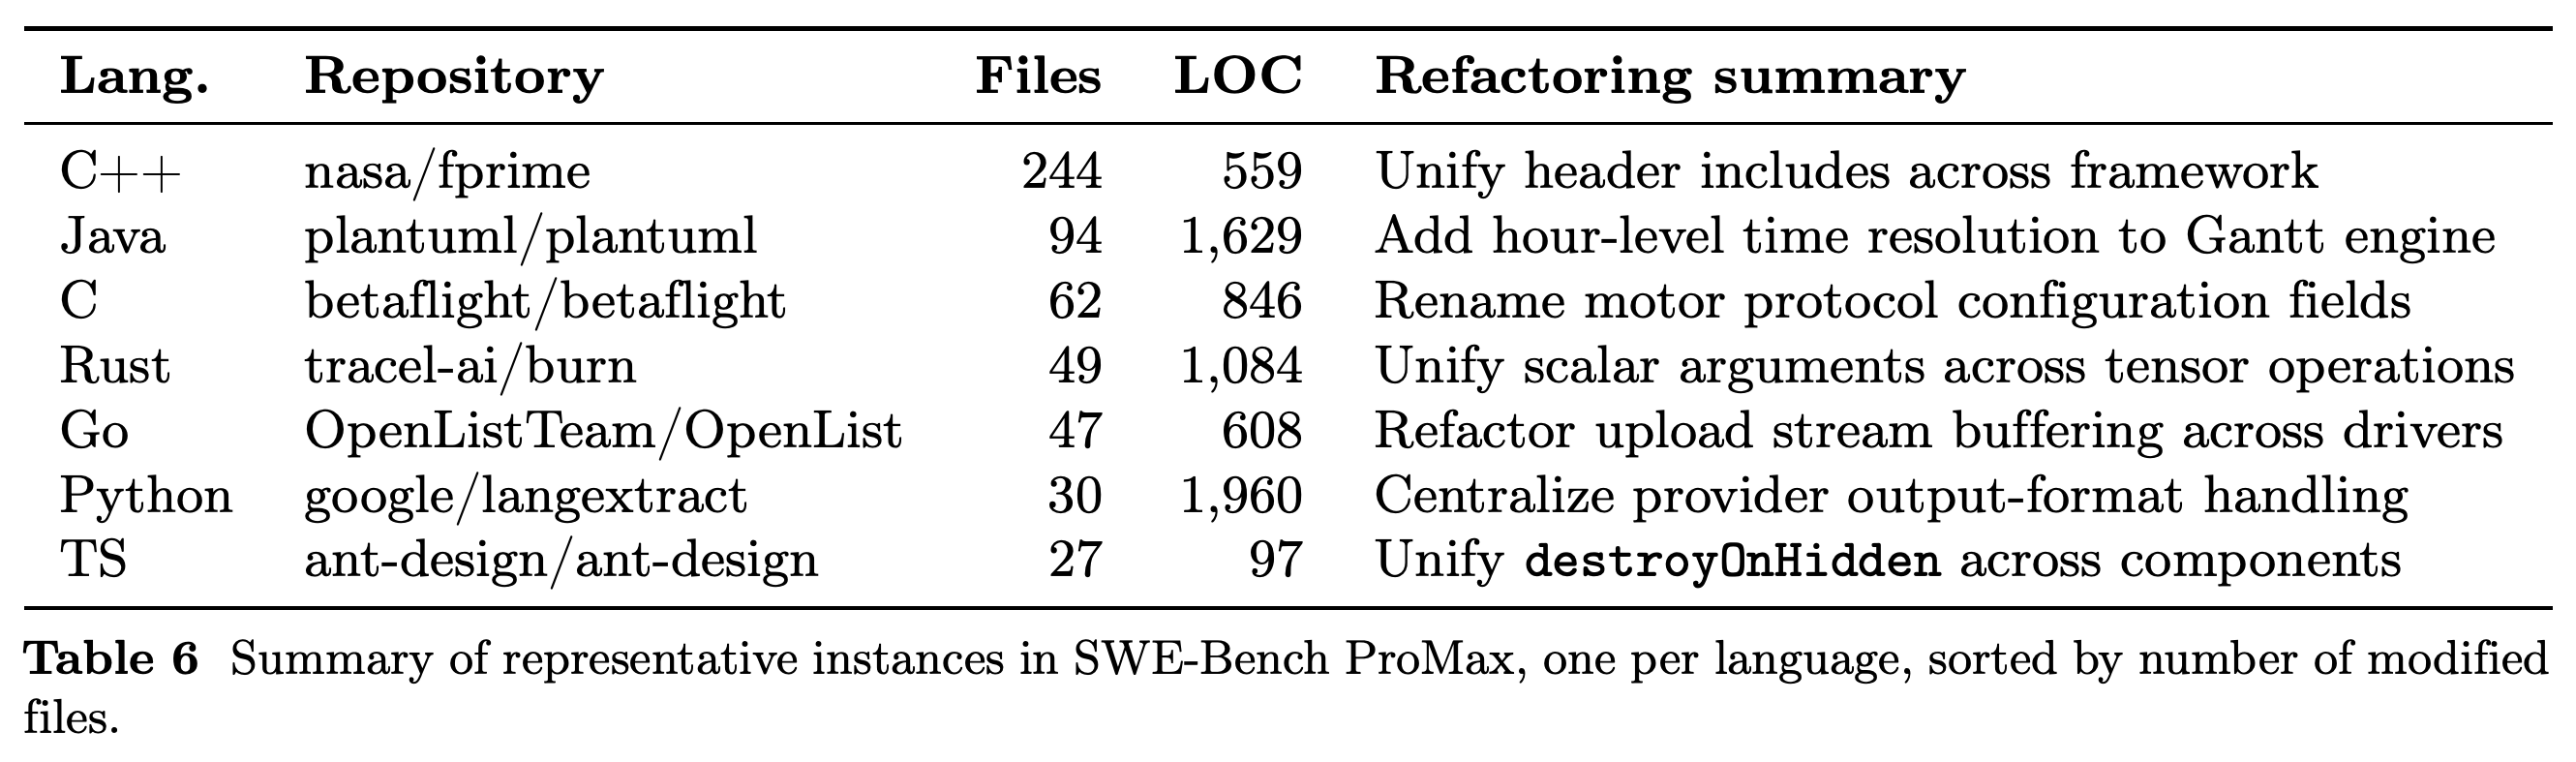
선별한 사례는 벤치마크의 범위를 보여 준다. 제시한 C++ 인스턴스는 244개 파일을, TypeScript 사례는 27개 파일을 변경한다. 요약에는 헤더 통합, 시간 해석, 설정 이름 변경, 텐서 API, 스트림 버퍼링, provider 포매팅, 컴포넌트 API가 포함된다.
동시 발생 행렬은 API Interface Change와 Refactoring Cleanup이 79개 인스턴스에서 겹침을 보여 준다. Bug Fix도 Refactoring Cleanup과 48개, API Interface Change와 33개에서 자주 동시 발생하며, 과제가 여러 유지보수 관심사를 흔히 결합함을 보여 준다.
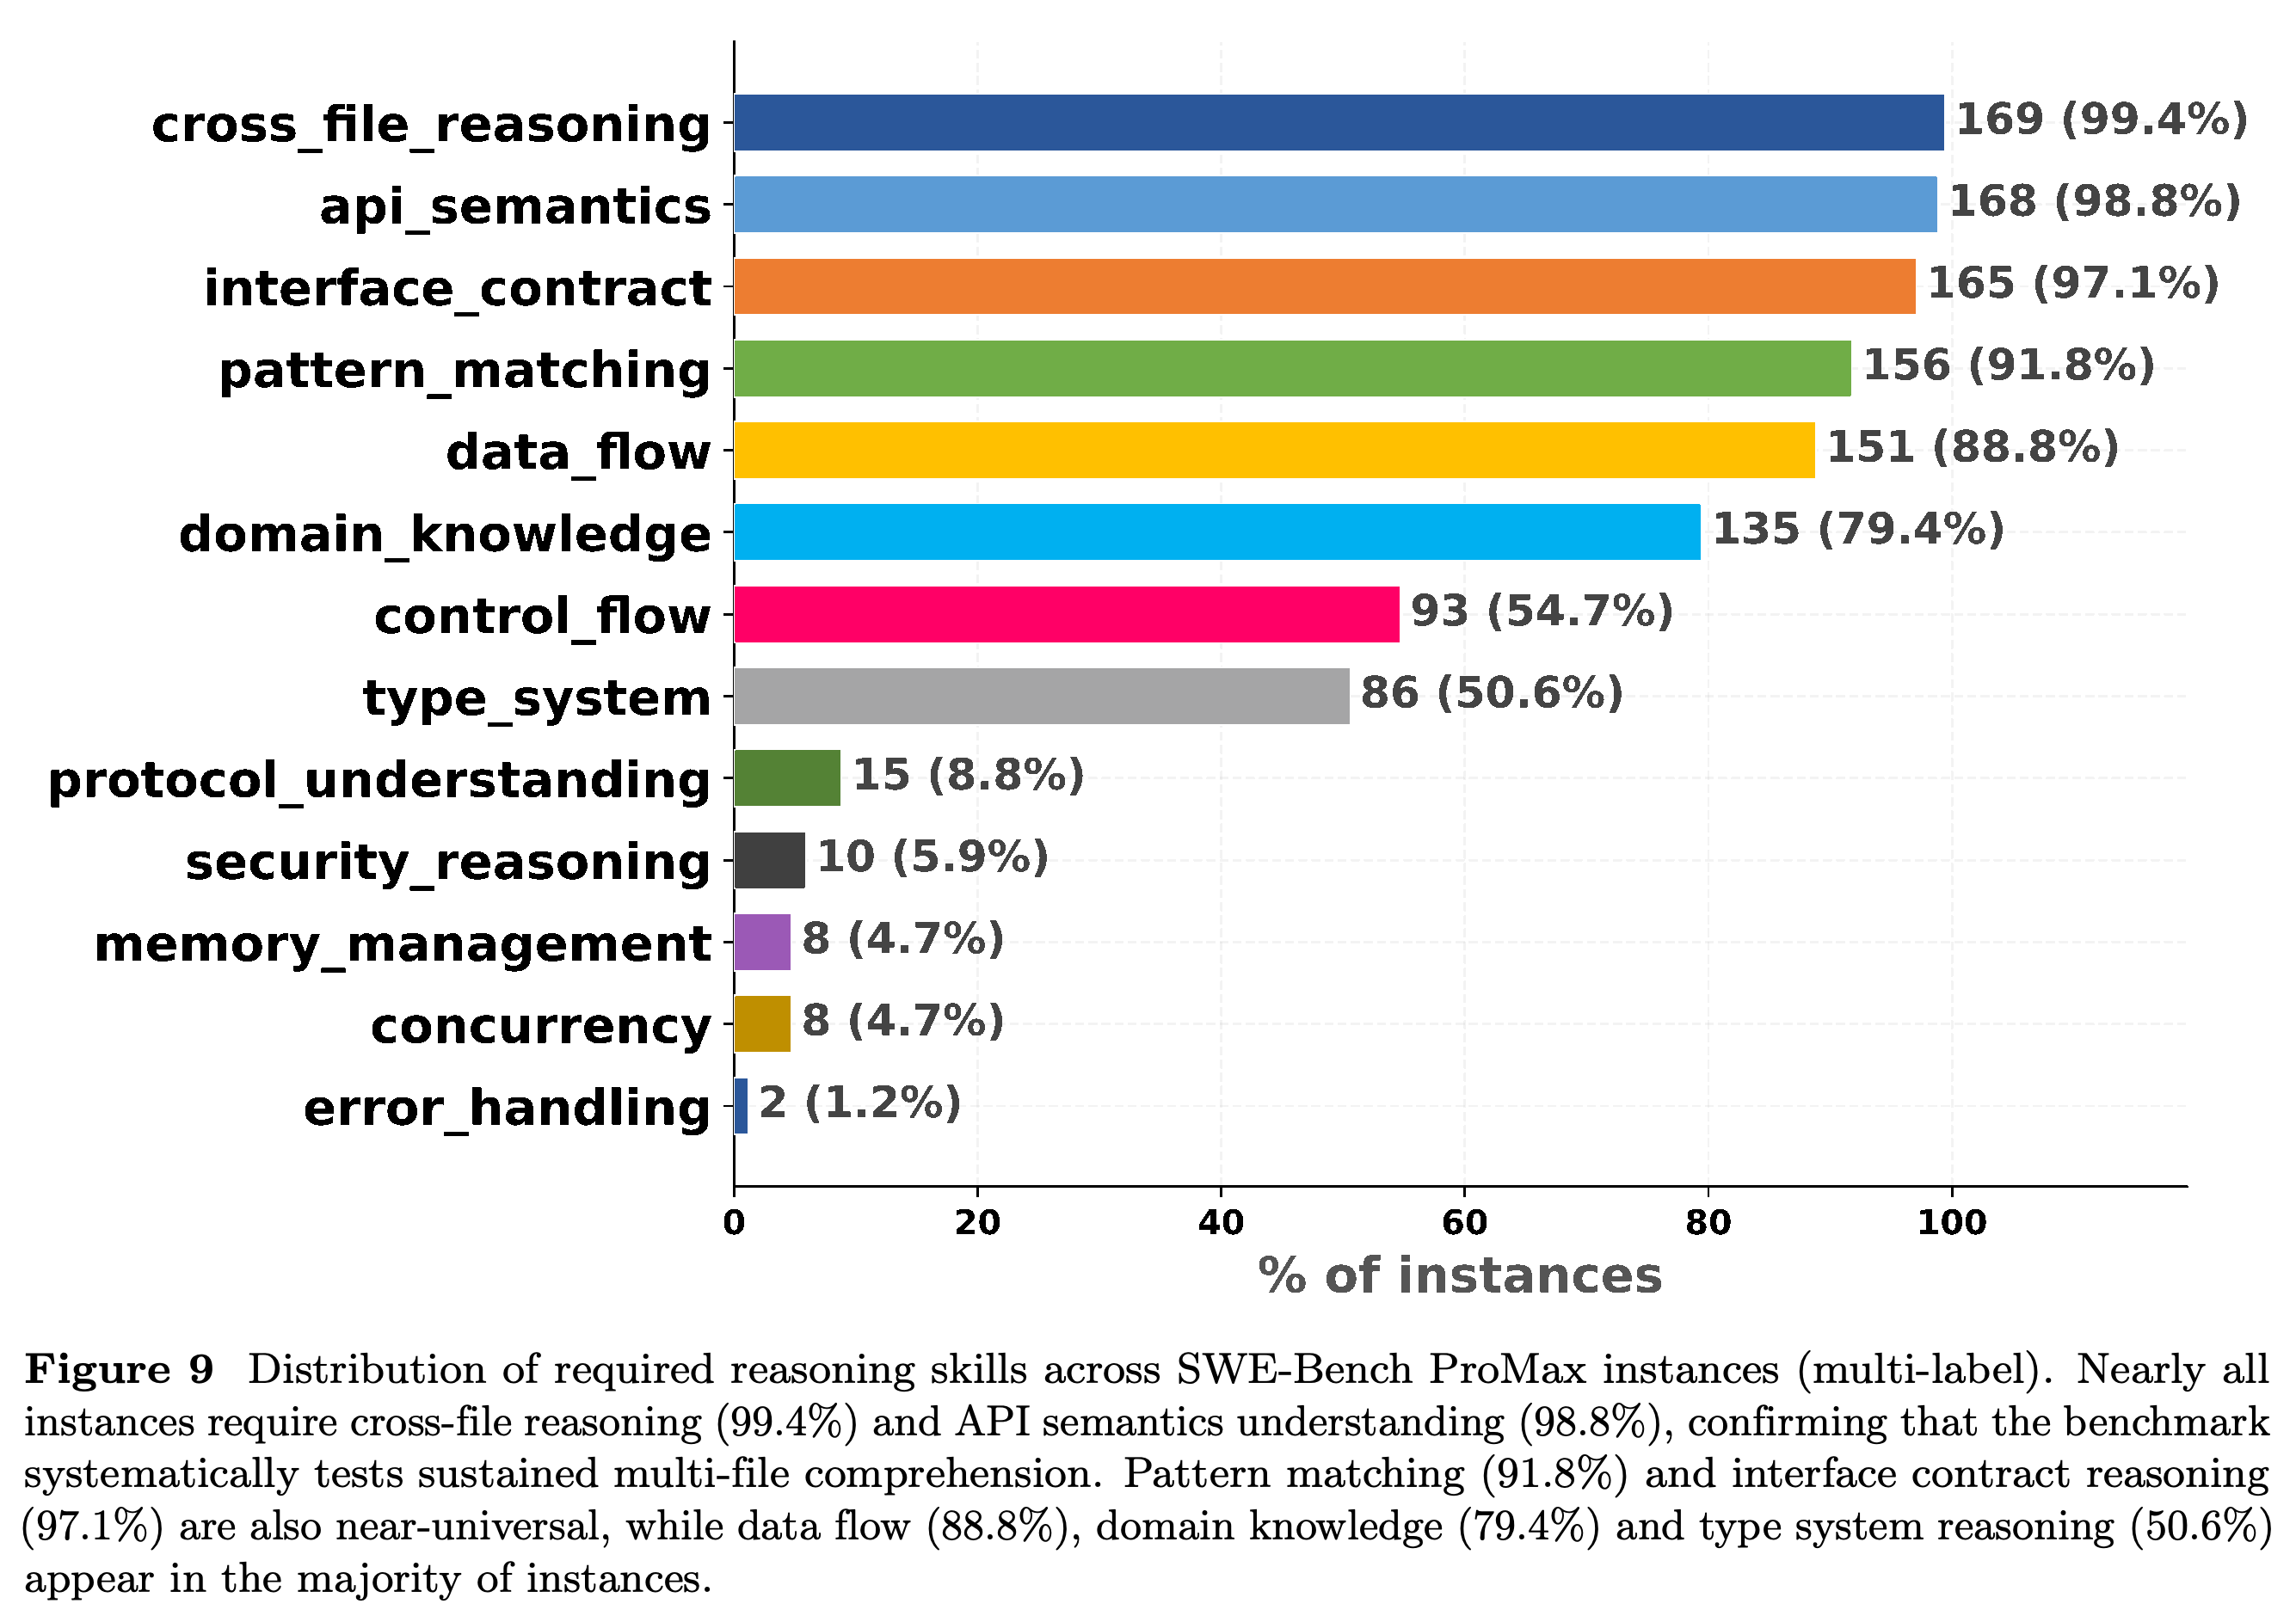
역량 라벨은 cross-file reasoning이 169개, API semantics가 168개 인스턴스에 필요하다고 식별한다. 그다음은 interface-contract reasoning 165개와 pattern matching 156개다. 이 주석은 벤치마크가 저장소 전반의 조정을 강조한다는 점을 뒷받침한다.
부록
- 부록은 70개 원본 저장소와 라이선스, 언어별 패치 통계, 과제 범주와 요구 역량 분석을 제시한다. Refactoring Cleanup과 API Interface Change는 각각 인스턴스의 66.5%와 65.3%에 나타나며, cross-file reasoning과 API semantics는 각각 99.4%와 98.8%에 표기된다. 대표 과제는 27개 파일을 수정하는 TypeScript API 통합부터 244개 파일을 수정하는 C++ 헤더 리팩터링까지 이른다.
짧은 생각
이 벤치마크의 기여는 대규모 다국어 리팩터링 과제에서 과제 명세, 테스트 스위트, 동작 보존 결과를 정렬하려는 시도다. 최고 결과 41.2%는 평가한 스캐폴드와 예산에 따라 달라지므로, 모든 소프트웨어 공학 역량의 직접적 척도라기보다 벤치마크 결과로 해석해야 한다. 데이터 선별 결정, 저장소 집중도, 테스트 충분성을 지속적으로 감사하는 일도 중요하다.