


Marigold V2: Revisiting Diffusion Transformers for Monocular Depth Estimation 요약 설명
08 Sep 2026 | Paper Review Monocular Depth Estimation Diffusion Transformers Parameter-Efficient Fine-Tuning Dense RegressionContents
이번 글에서는 Marigold V2: Revisiting Diffusion Transformers for Monocular Depth Estimation 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 9월 8일(Arxiv), ACM Transactions on Graphics
- Pavlovic, Igor, Wandel, Thiemo, Obukhov, Anton, Bartolomei, Luca, Davydov, Andrey, Tosi, Fabio, Poggi, Matteo, Süsstrunk, Sabine, Dai, Dengxin.
- EPFL, Switzerland, HUAWEI Bayer Lab, Switzerland, University of Bologna, Italy
- 논문 링크
- Github
- Project Page
요약
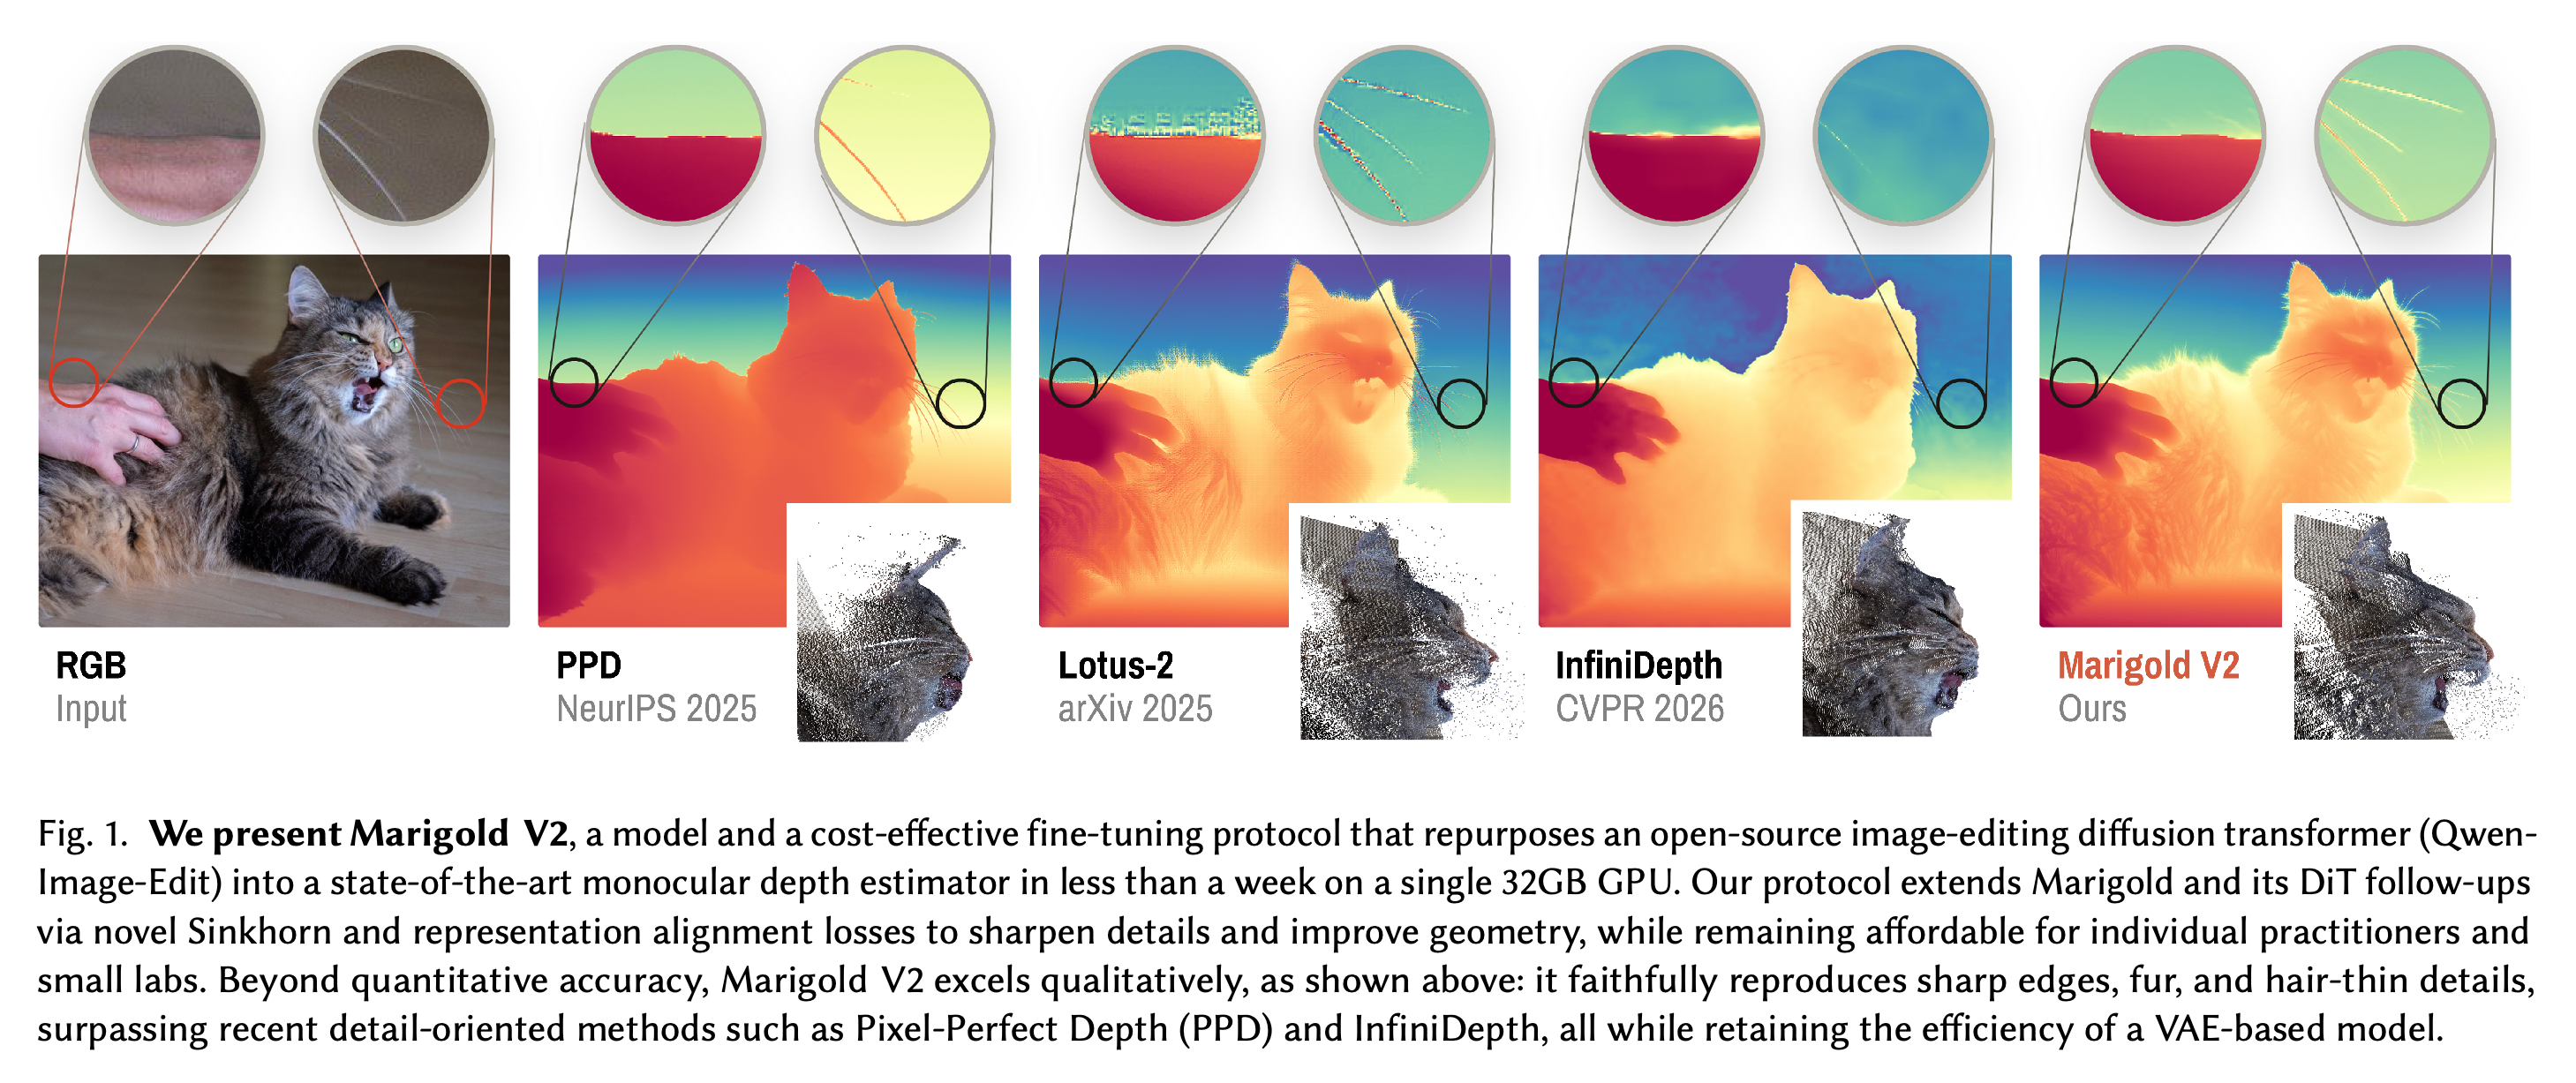
- Marigold V2는 이미지 편집용 diffusion transformer인 Qwen-Image-Edit-2509를 단일 패스의 affine-invariant monocular depth estimator로 재활용한다. 2단계 프로토콜은 4-bit QLoRA 적응, iREPA-depth 의미 정규화, SinkLoss 개선을 결합하며, 최종 Stage 1 학습은 74K개 이미지와 1개의 32GB GPU로 5일을 조금 넘겨 수행한다.
고양이 이미지와 PPD, Lotus-2, InfiniDepth, Marigold V2의 깊이 예측 확대 영역을 보여준다. 제시된 Marigold V2 출력은 다른 방법보다 털 질감과 좁은 경계를 더 선명하게 유지한다.
1 Introduction
단일 이미지 깊이 추정은 본질적으로 모호하며, 판별 모델은 주석이 달린 깊이 데이터의 범위와 품질에 제약받는다. 특히 비람베르시안, 투명, 반사 표면에서 그러하다. Diffusion 기반 추정기는 폭넓은 생성 사전지식을 활용하지만 경계를 흐리게 하고 고주파 구조를 잃기 쉽다. 이 논문은 단일 패스 추론을 유지하면서 이러한 아티팩트를 줄이고자 한다.
3 Method
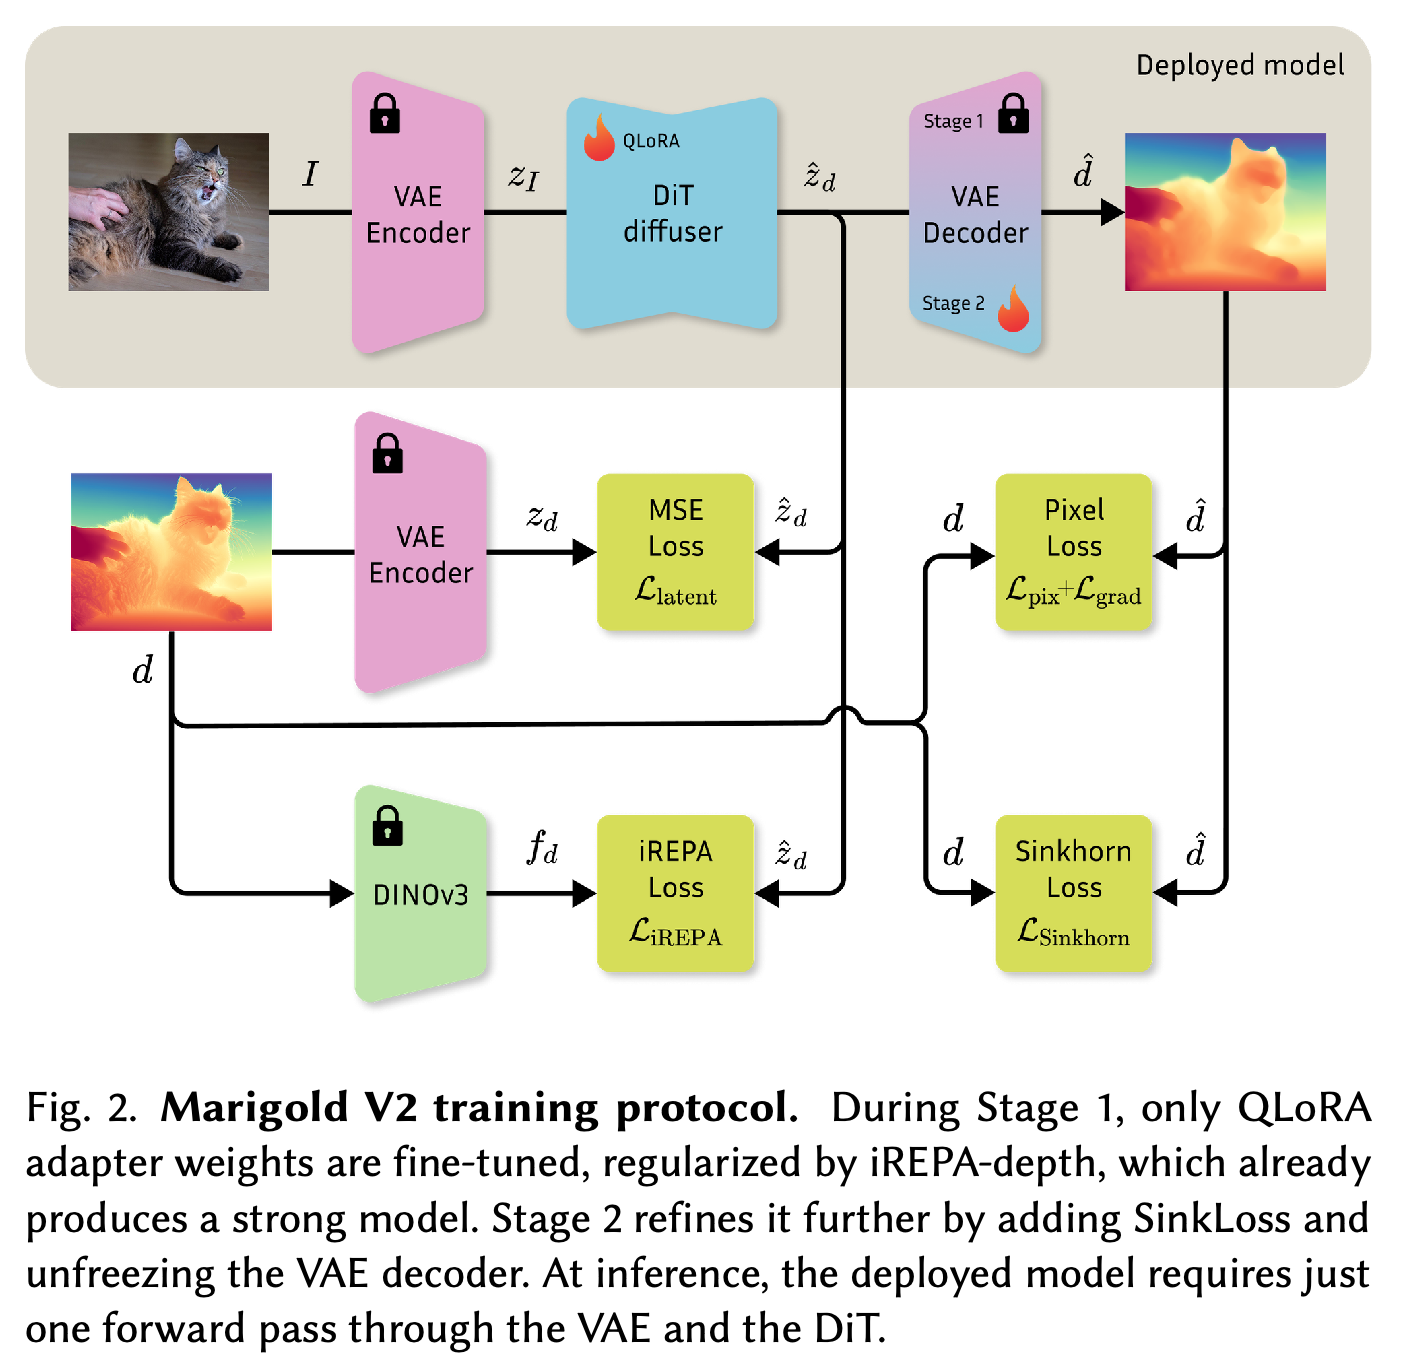
방법은 metric depth를 유효 픽셀의 2nd 및 98th percentile을 사용해 절단한 affine-invariant normalized log-depth target으로 변환한 뒤, 이미지 편집 backbone에 맞게 3개의 grayscale channel로 복제한다. Stage 1은 latent, pixel, gradient, semantic loss로 RGB latent에서 depth latent로의 rectified-flow regression을 학습한다. Stage 2는 얇거나 투명한 구조 주변의 국소적으로 모호한 supervision을 처리한다.
2단계 프로토콜을 보여준다. Stage 1은 latent, pixel, gradient, iREPA-depth loss로 QLoRA adapter를 학습하고, Stage 2는 SinkLoss를 추가하면서 VAE decoder를 unfreeze한다. 추론에서는 VAE와 DiT를 각각 1회 통과한다.
3.2 Diffusion Transformer Adaptation
저자들은 Qwen-Image-Edit-2509에서 시작해 사전학습된 DiT 가중치를 4-bit precision으로 양자화하고 rank-128 QLoRA adapter를 fine-tuning한다. 고정 timestep t = 0.5에서 DiT는 RGB와 normalized-depth VAE latent 사이의 velocity를 예측한다. 따라서 한 번의 forward pass로 depth latent를 복원하고 VAE로 decode할 수 있다.
3.3 Semantic Feature Regularization with iREPA
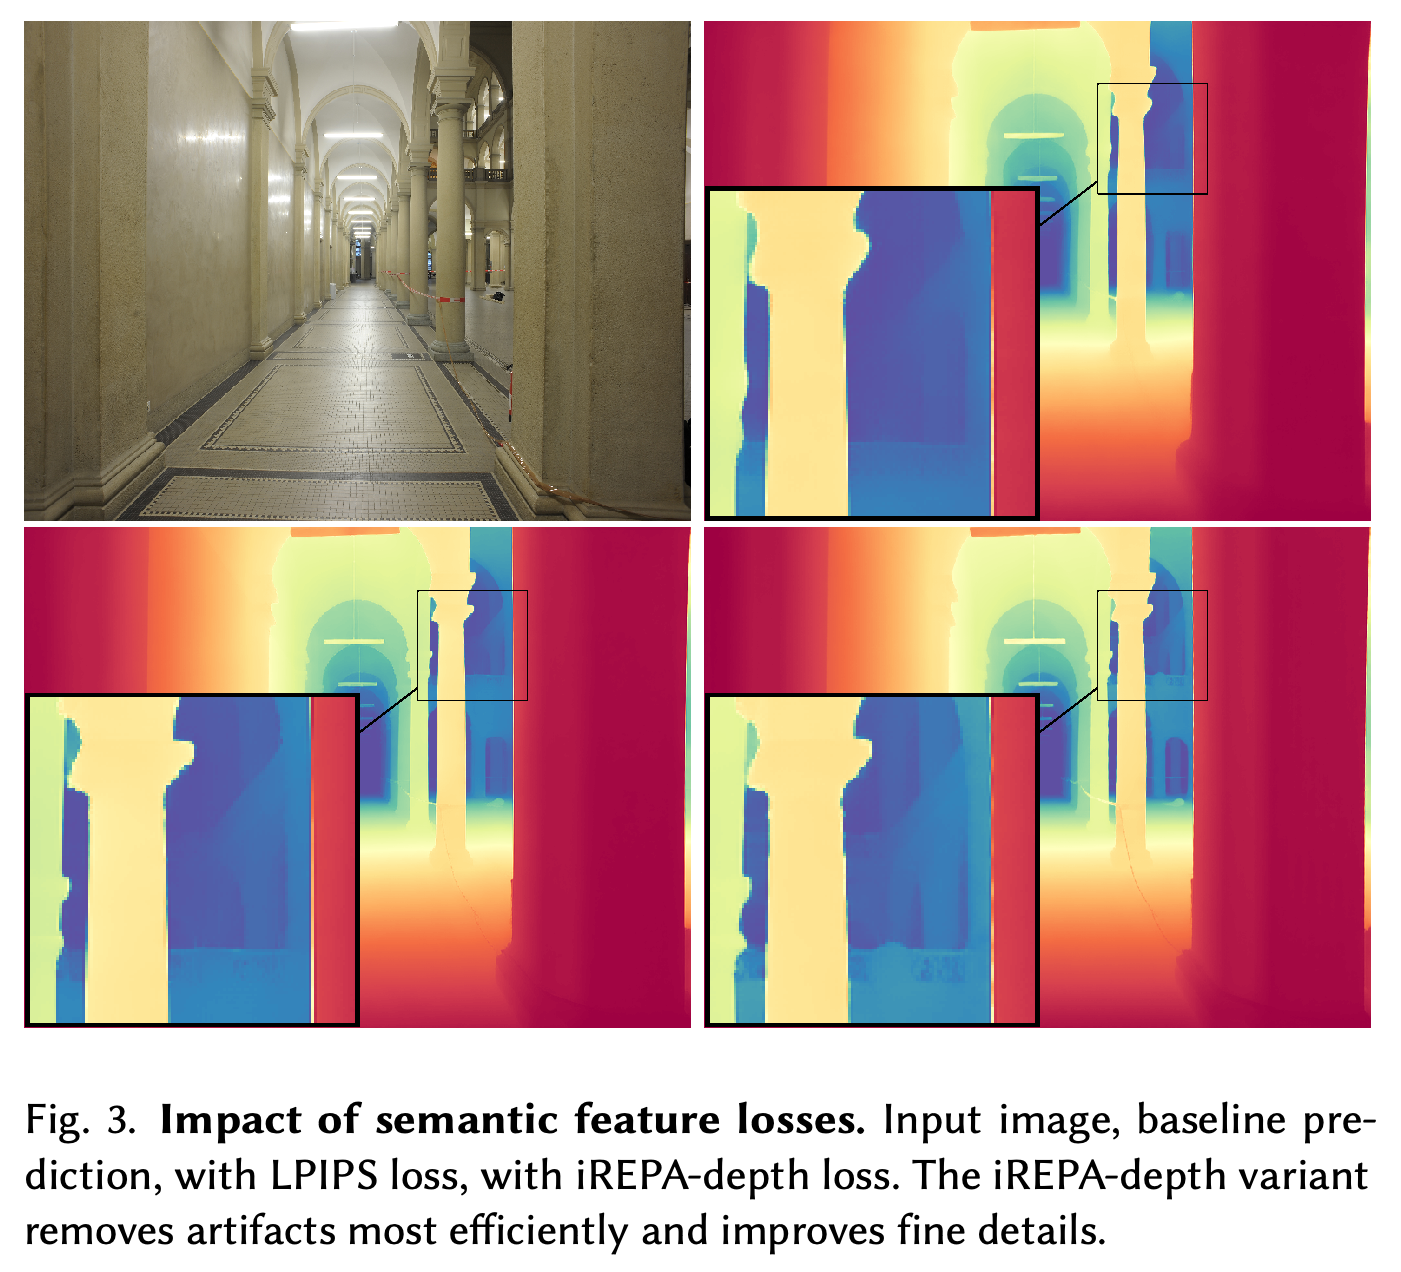
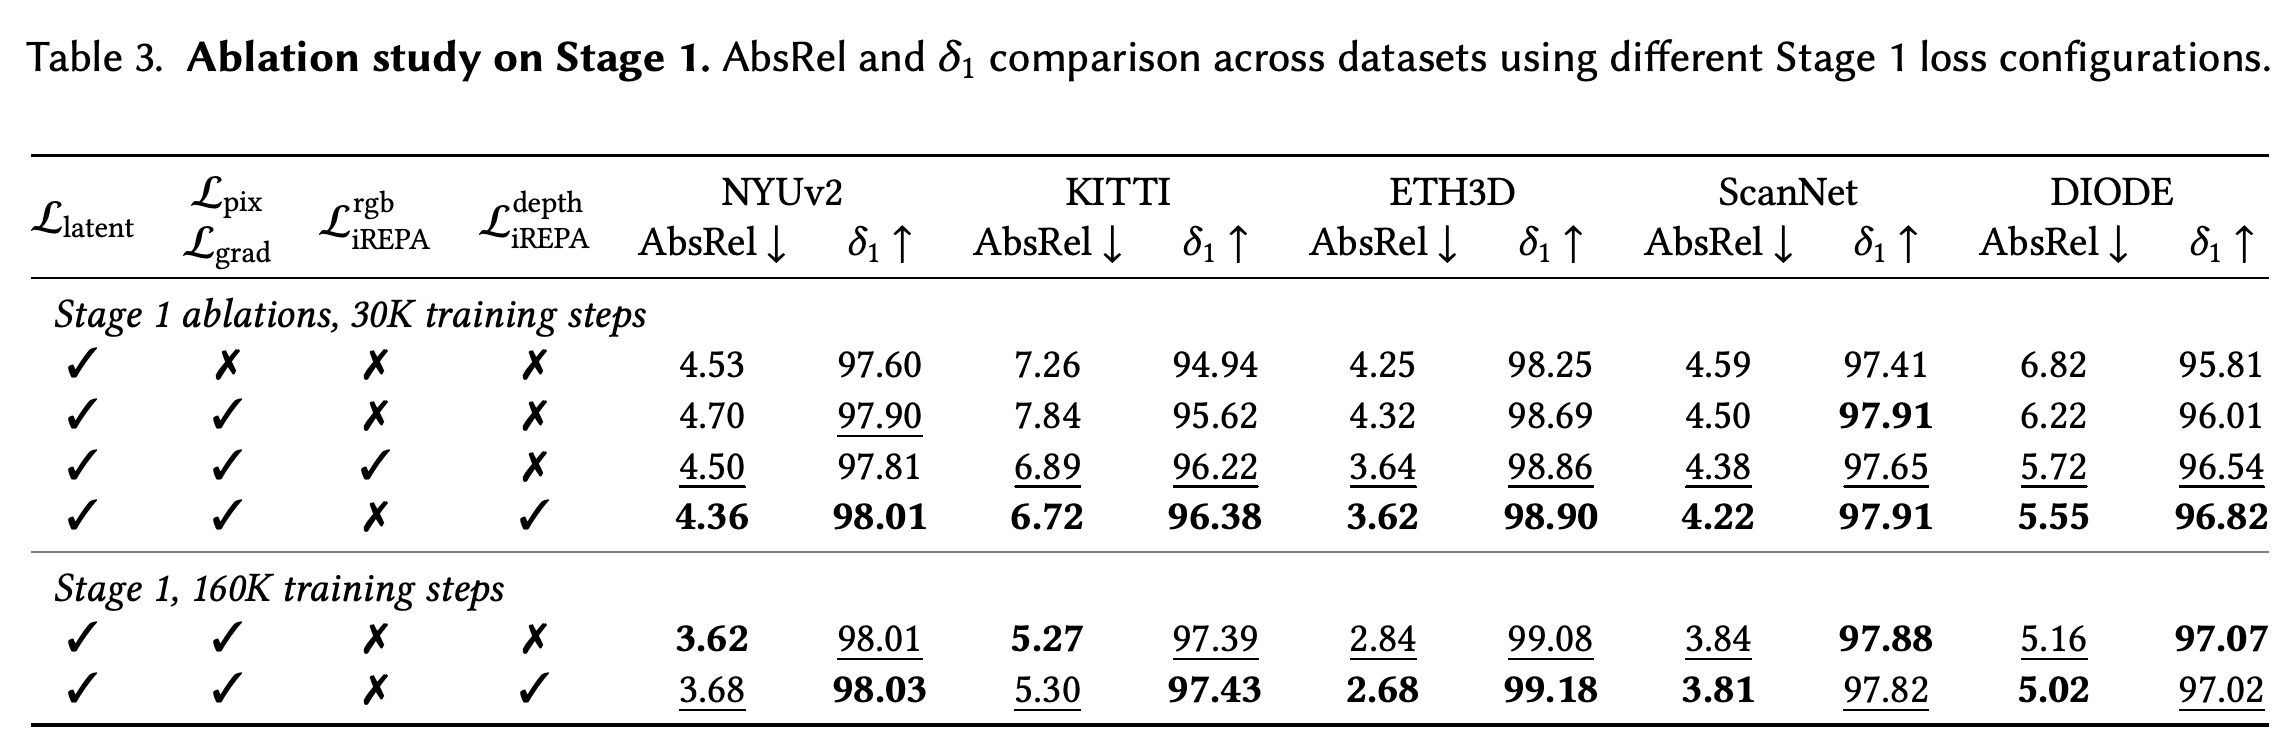
iREPA-depth는 입력 RGB 이미지가 아니라 ground-truth depth map에서 추출한 동결된 DINOv3 feature로 내부 DiT feature를 정규화한다. 30K-step ablation에서 depth-derived iREPA가 전체적으로 가장 강한 구성을 보인다. 160K step 뒤에는 수치상 우세가 작아지지만, 논문은 세부 영역에서 정성적 이점이 계속된다고 보고한다.
입력 이미지와 baseline, LPIPS-regularized, iREPA-depth 예측을 비교한다. iREPA-depth 결과는 복도 장면의 국소 아티팩트를 시각적으로 줄이고 구조를 더 잘 보존한다.
3.4 Stage-2 Refinement with SinkLoss
SinkLoss는 이미지를 겹치지 않는 K×K block으로 나누고, 각 block 안에서 예측 깊이값과 target 깊이값 사이에 entropy-regularized Sinkhorn matching을 적용한다. 이 방식은 label이 국소적으로 모호하거나 noisy할 때 정확한 픽셀 대응을 완화한다. 구현은 K = 5, τ = 0.1, B = 10^6, Sinkhorn iteration 5회를 사용하며, Stage 2에서는 VAE decoder도 unfreeze한다.
4 Experiments
학습은 HyperSim과 vKITTI를 각각 90%와 10% 확률로 sampling하며, 해상도는 각각 768 × 512와 1216 × 352이다. 모든 실험은 1개의 32GB GPU에서 수행한다. 최종 Stage 1은 160K step으로 학습하고 Stage 2는 30K step을 추가한다. 평가는 affine-depth metric을 계산하기 전에 예측을 metric ground truth에 RANSAC-align한다.
4.3 Zero-Shot Affine Depth Estimation
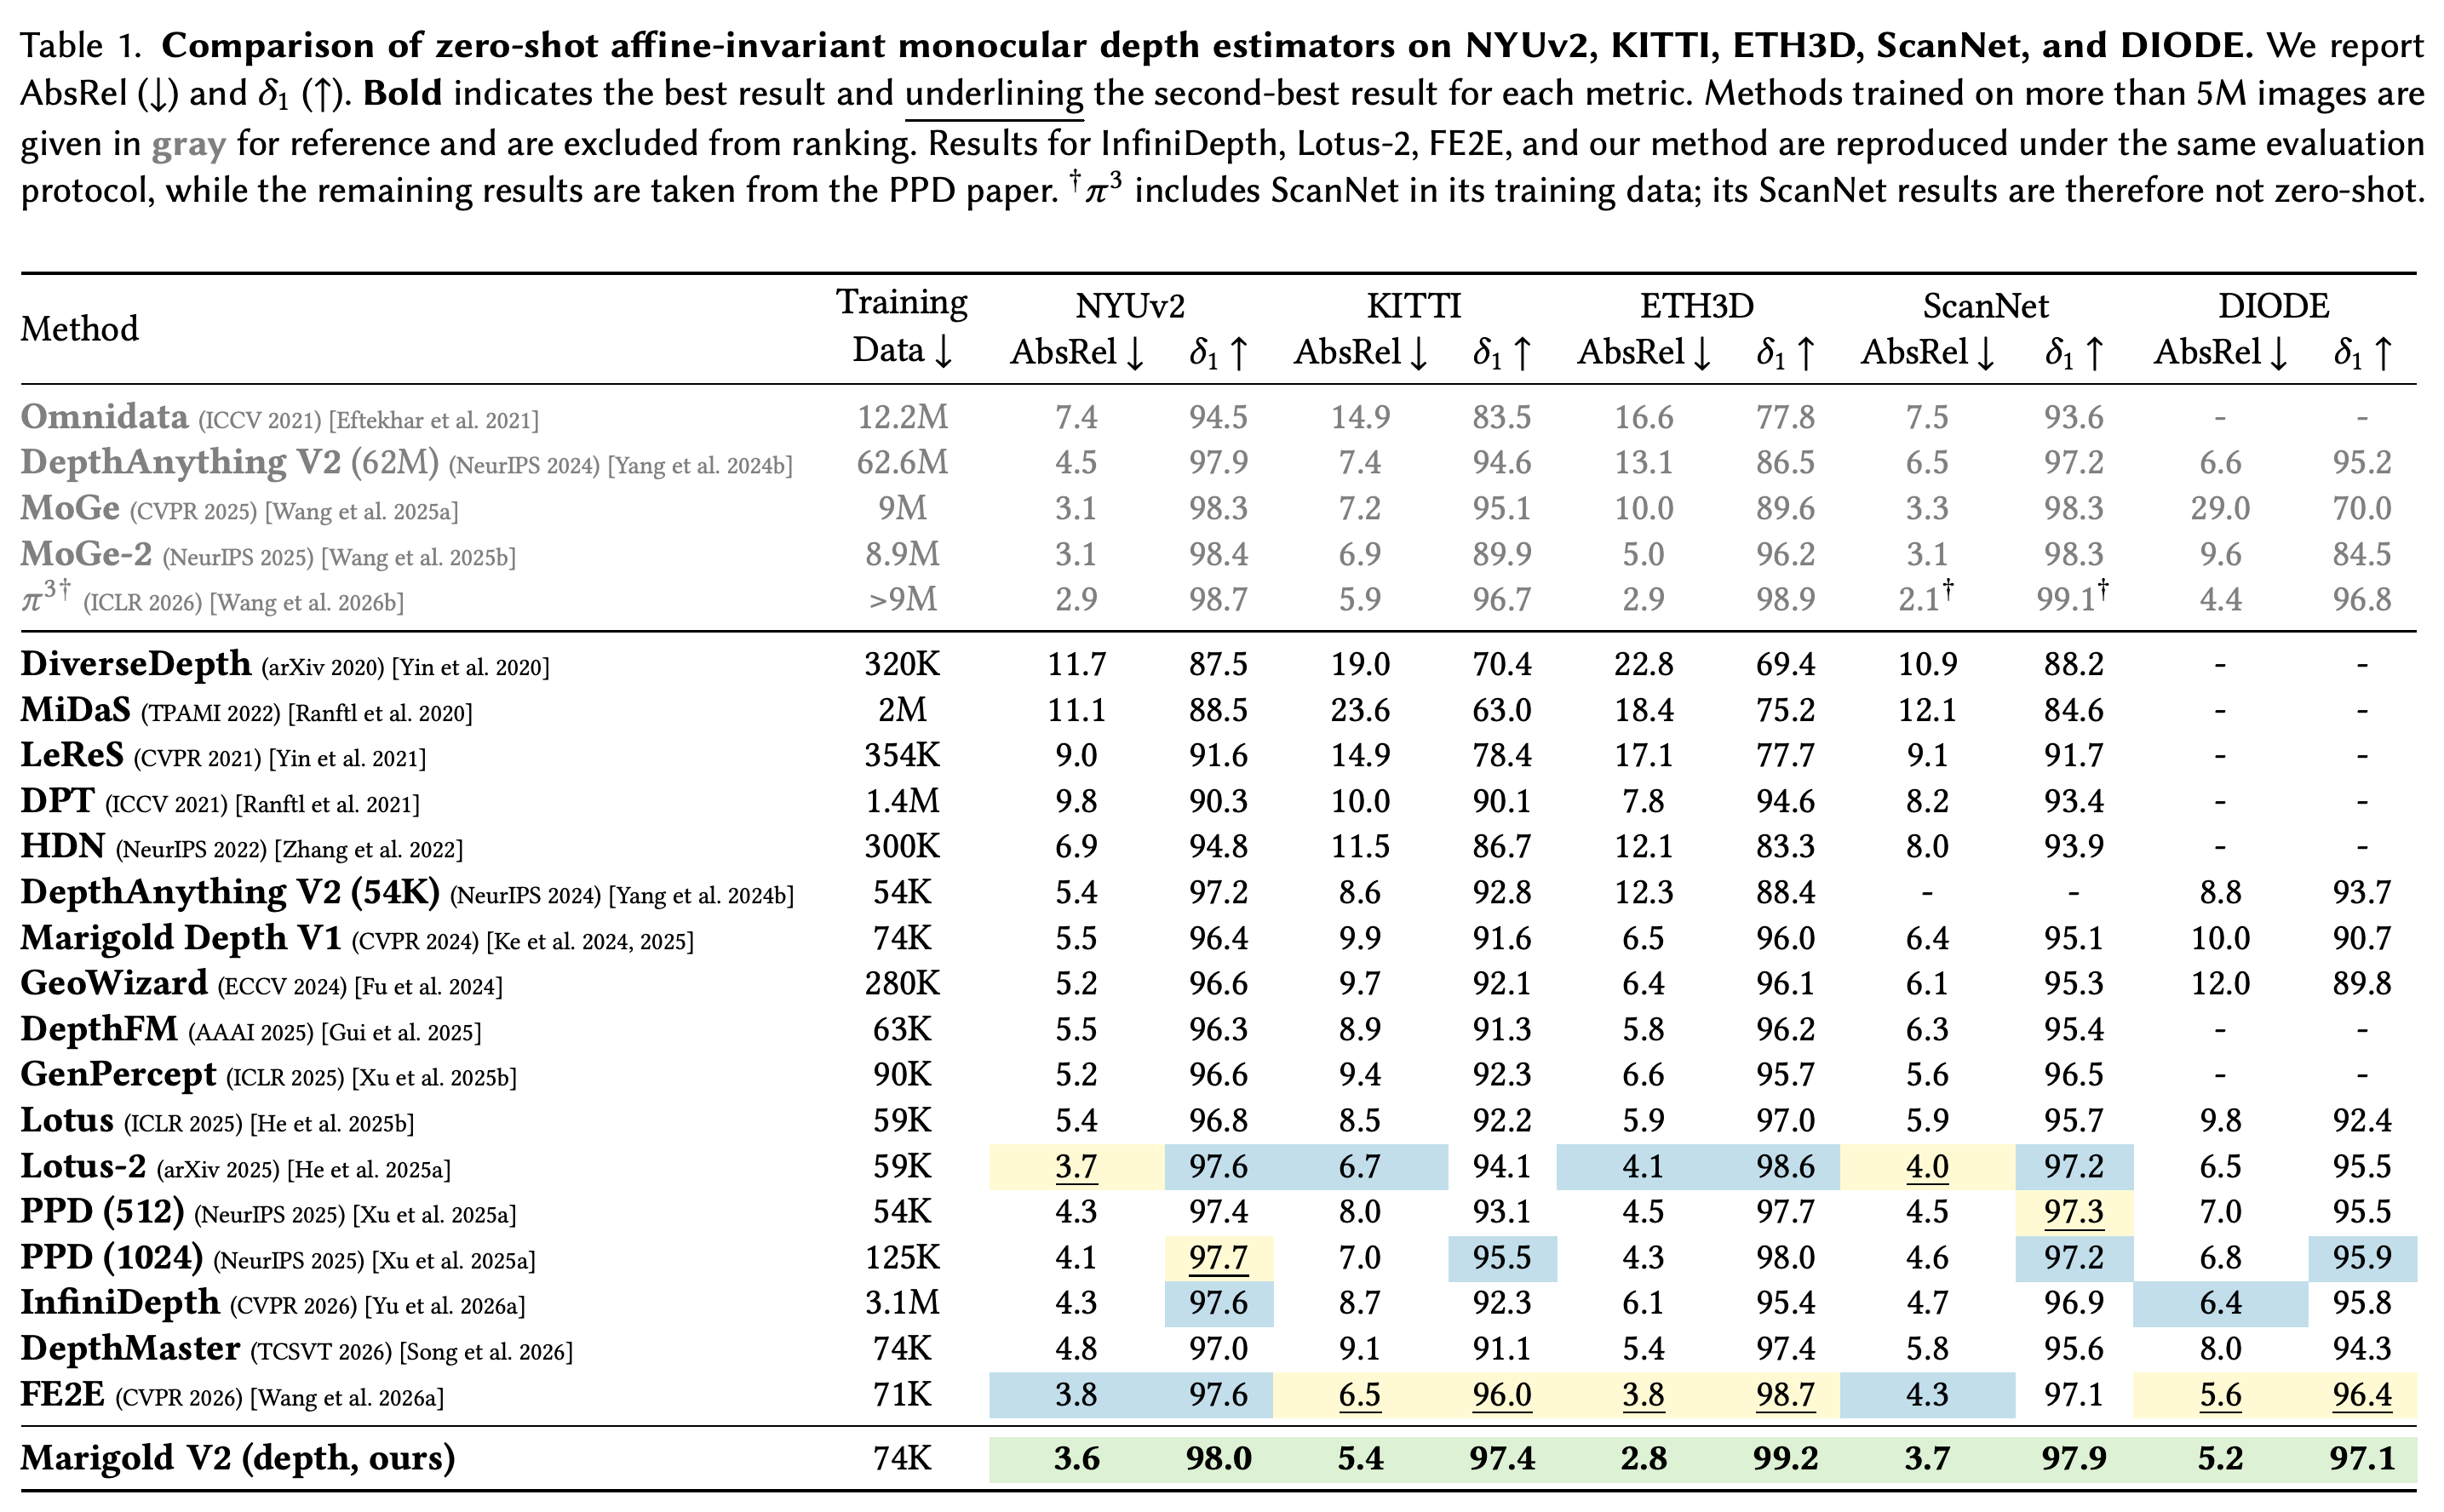
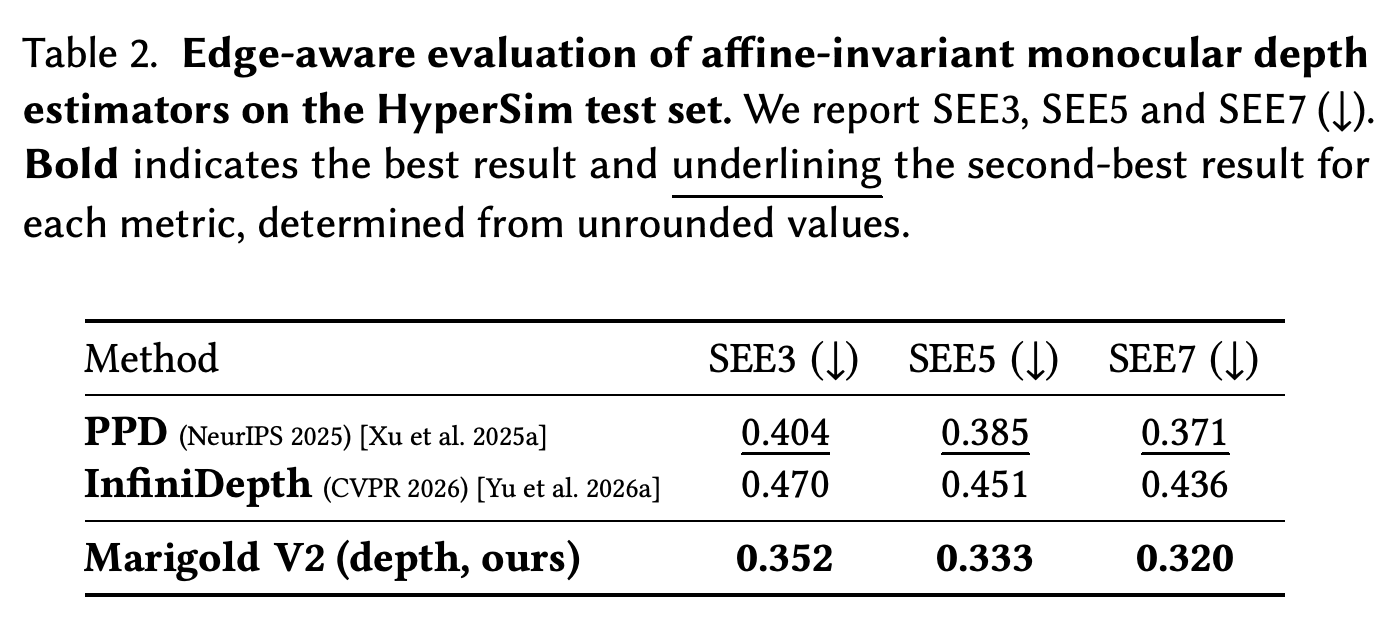
NYUv2, KITTI, ETH3D, ScanNet, DIODE에서 Stage-2 model은 각각 AbsRel/δ1 3.6/98.0, 5.4/97.4, 2.8/99.2, 3.7/97.9, 5.2/97.1을 보고한다. Table 1은 비교 가능한 규모의 데이터로 학습한 방법 가운데 이 모델을 해당 metric의 최고 성능으로 평가한다. HyperSim의 edge-aware evaluation에서는 SEE3/SEE5/SEE7 0.352/0.333/0.320을 보고한다.
5개 benchmark에서 zero-shot affine-depth AbsRel과 δ1을 보고한다. Marigold V2는 NYUv2에서 3.6/98.0, KITTI에서 5.4/97.4, ETH3D에서 2.8/99.2, ScanNet에서 3.7/97.9, DIODE에서 5.2/97.1을 기록한다. 이는 표에서 비교 가능한 규모의 데이터로 학습한 방법 가운데 최고 성능이다.
Soft Edge Error로 HyperSim의 boundary quality를 평가한다. Marigold V2는 나열된 3개 방법 가운데 가장 낮은 SEE3, SEE5, SEE7 값인 0.352, 0.333, 0.320을 기록한다.
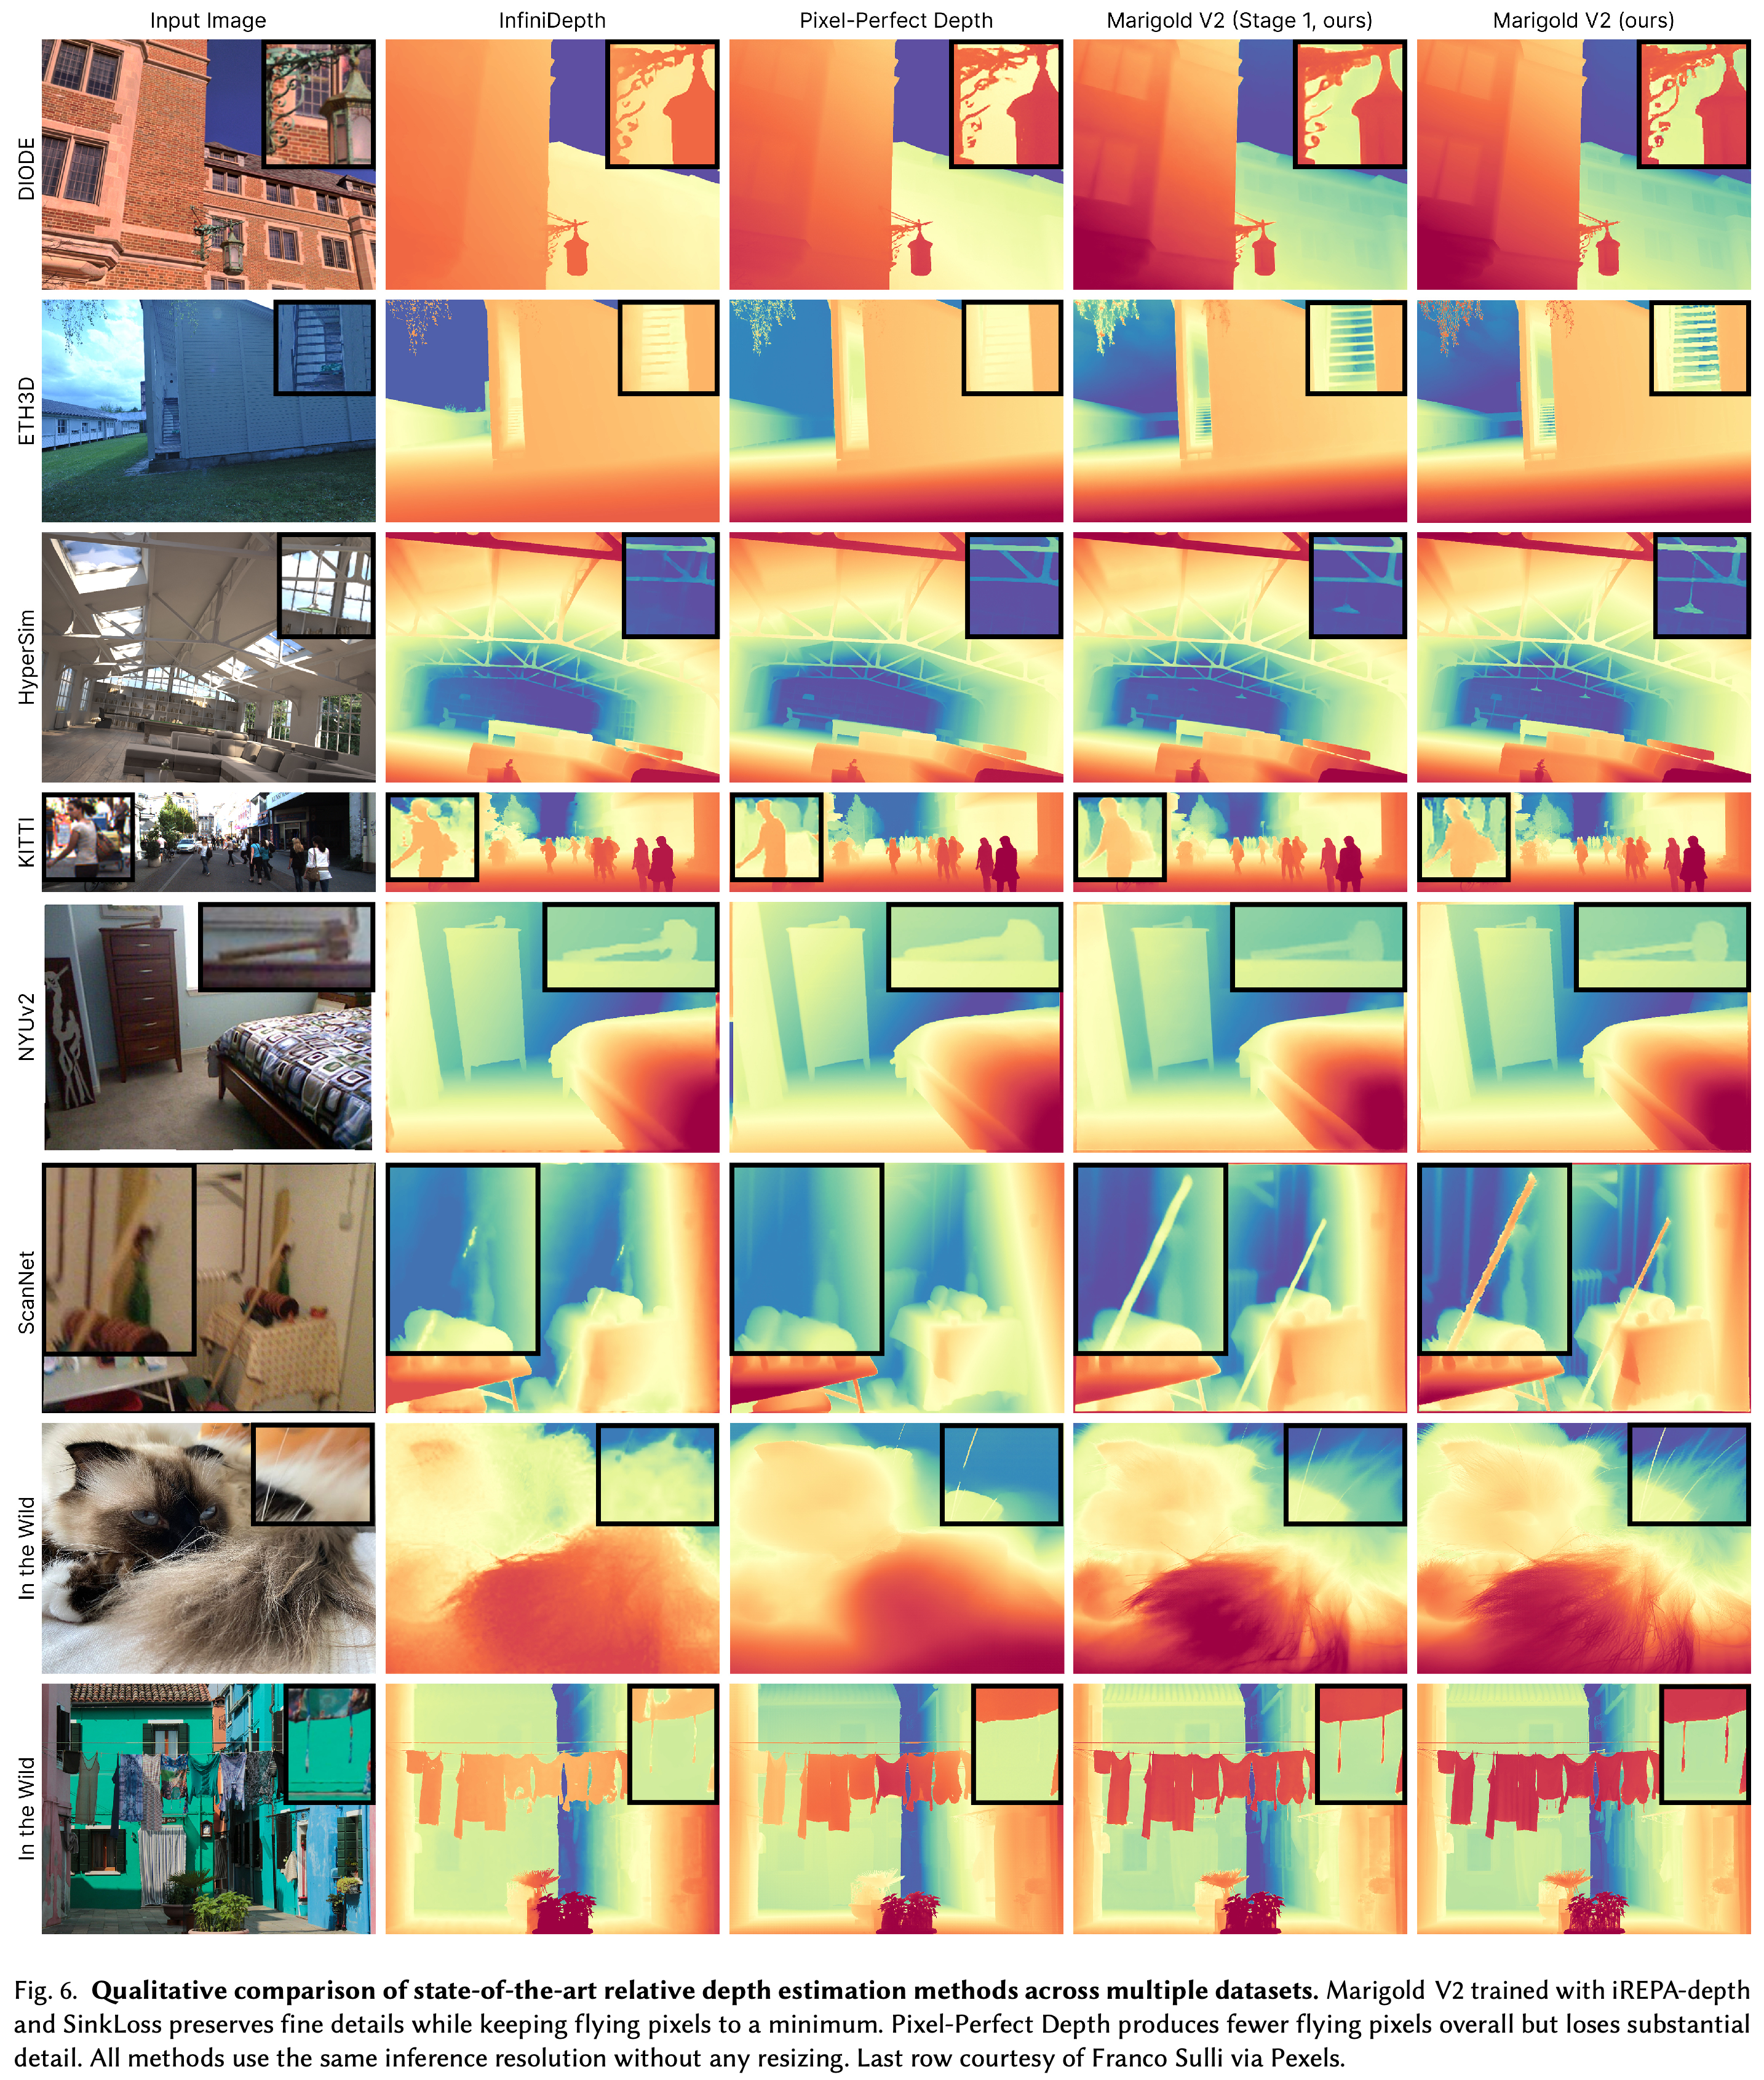
DIODE, ETH3D, HyperSim, KITTI, NYUv2, ScanNet, in-the-wild 이미지의 relative-depth prediction을 제시한다. 최종 Marigold V2 column은 Stage-1 output과 제시된 baseline보다 더 선명한 얇은 구조와 적은 flying pixel을 보인다.
4.5 Analysis and Ablation Studies
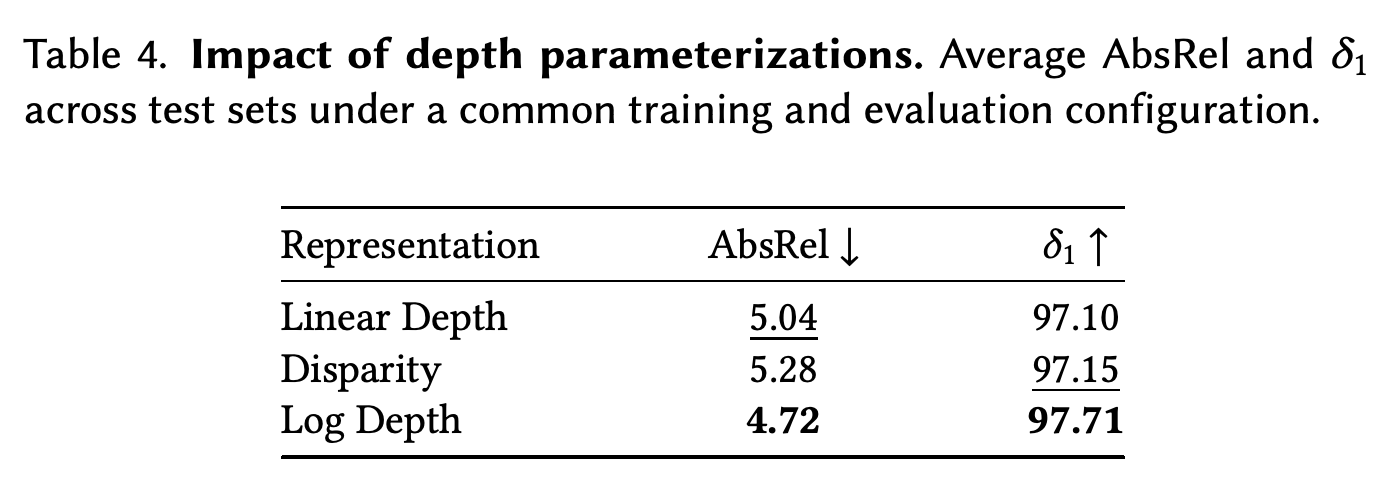
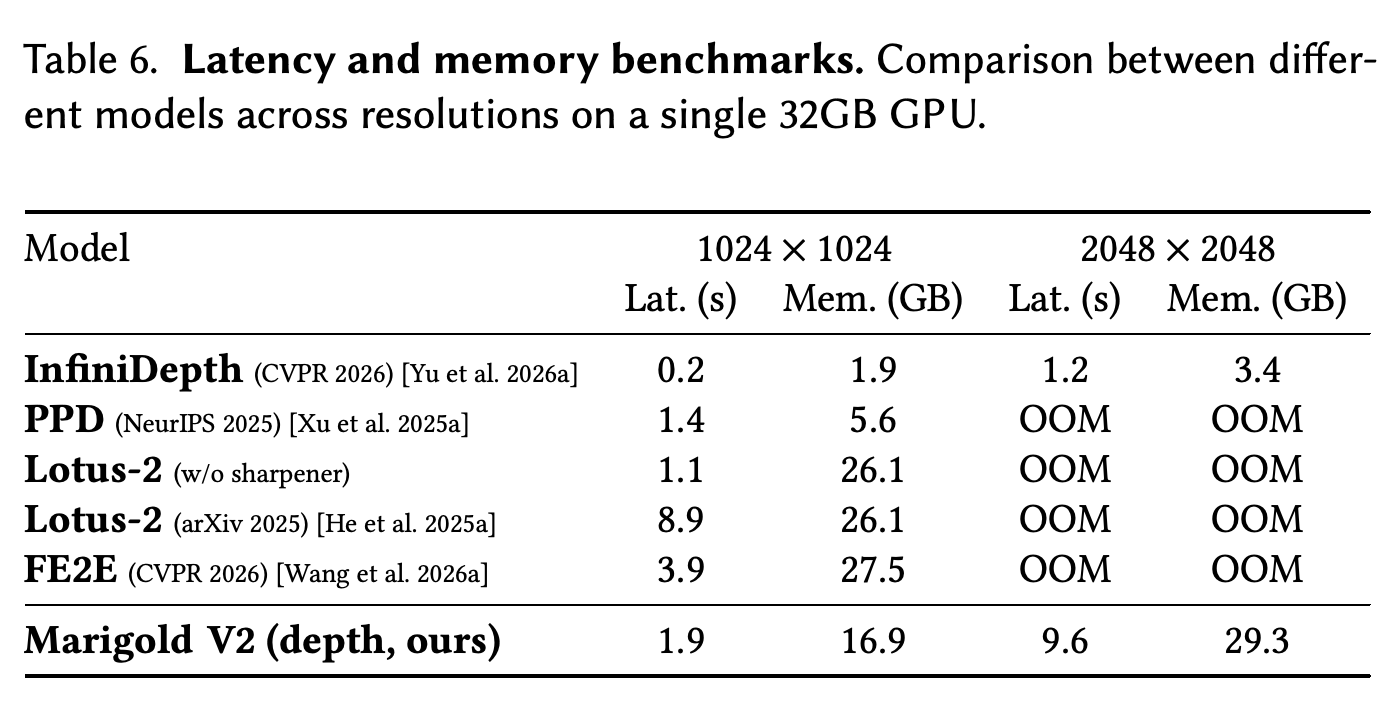
시험한 representation 가운데 normalized log-depth가 평균 AbsRel 4.72와 δ1 97.71로 가장 좋은 결과를 보인다. Linear depth는 5.04/97.10이고 disparity는 5.28/97.15이다. SinkLoss는 Stable Diffusion V1.5, FLUX.2 klein, Qwen-Image-Edit-2509에서 edge-sensitive SEE metric을 개선한다. Marigold V2는 2048 × 2048에서 단일 32GB GPU 기준 29.3 GB를 사용해 9.6 s에 실행된다.
30K 및 160K step에서 Stage-1 loss ablation을 보여준다. 30K step에서는 depth-derived iREPA가 전체적으로 가장 강하다. 160K step에서는 iREPA-depth와 iREPA를 사용하지 않은 구성의 차이가 작아진다.
공통 설정에서 linear-depth, disparity, log-depth parameterization을 비교한다. Normalized log-depth는 AbsRel 4.72 및 δ1 97.71로 가장 좋은 평균값을 보인다.
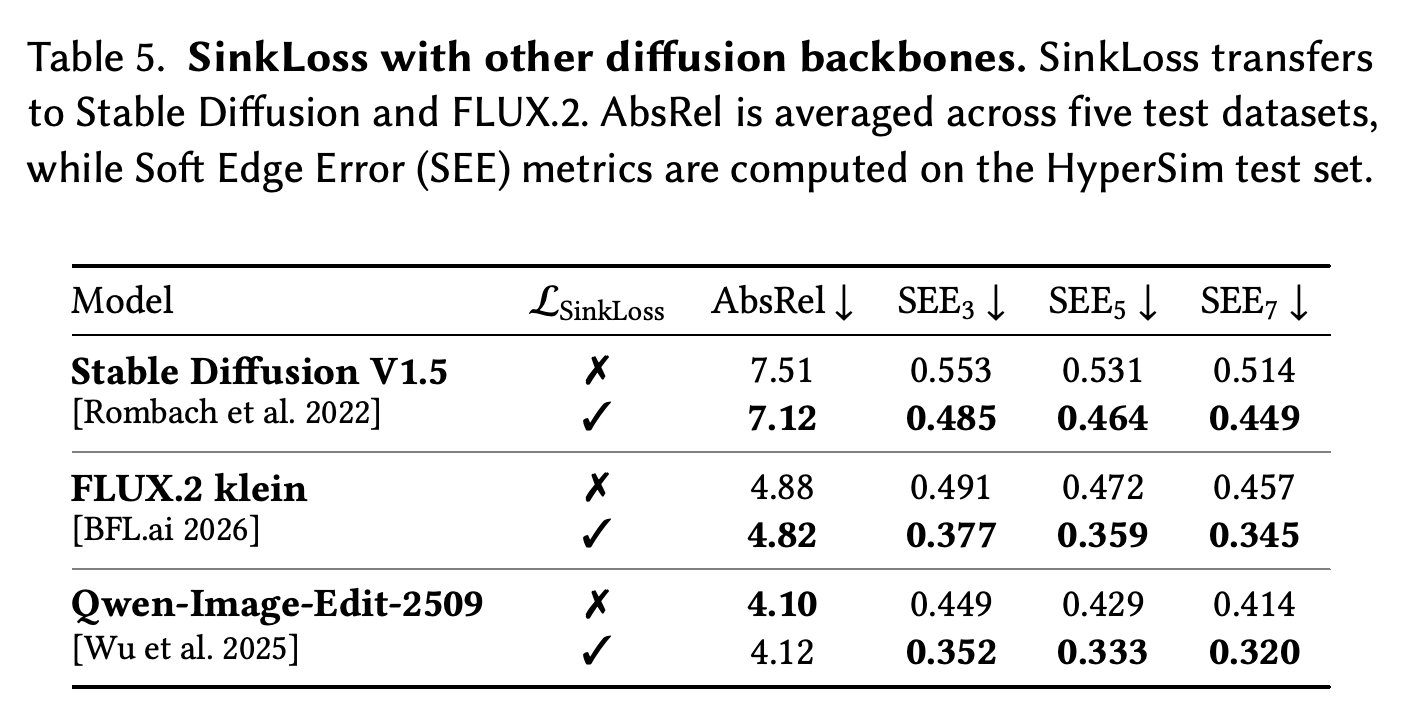
Stable Diffusion V1.5, FLUX.2 klein, Qwen-Image-Edit-2509에서 SinkLoss를 시험한다. 이를 활성화하면 3개 backbone 모두에서 보고된 모든 Soft Edge Error metric이 낮아지고, 평균 AbsRel 변화는 작다.
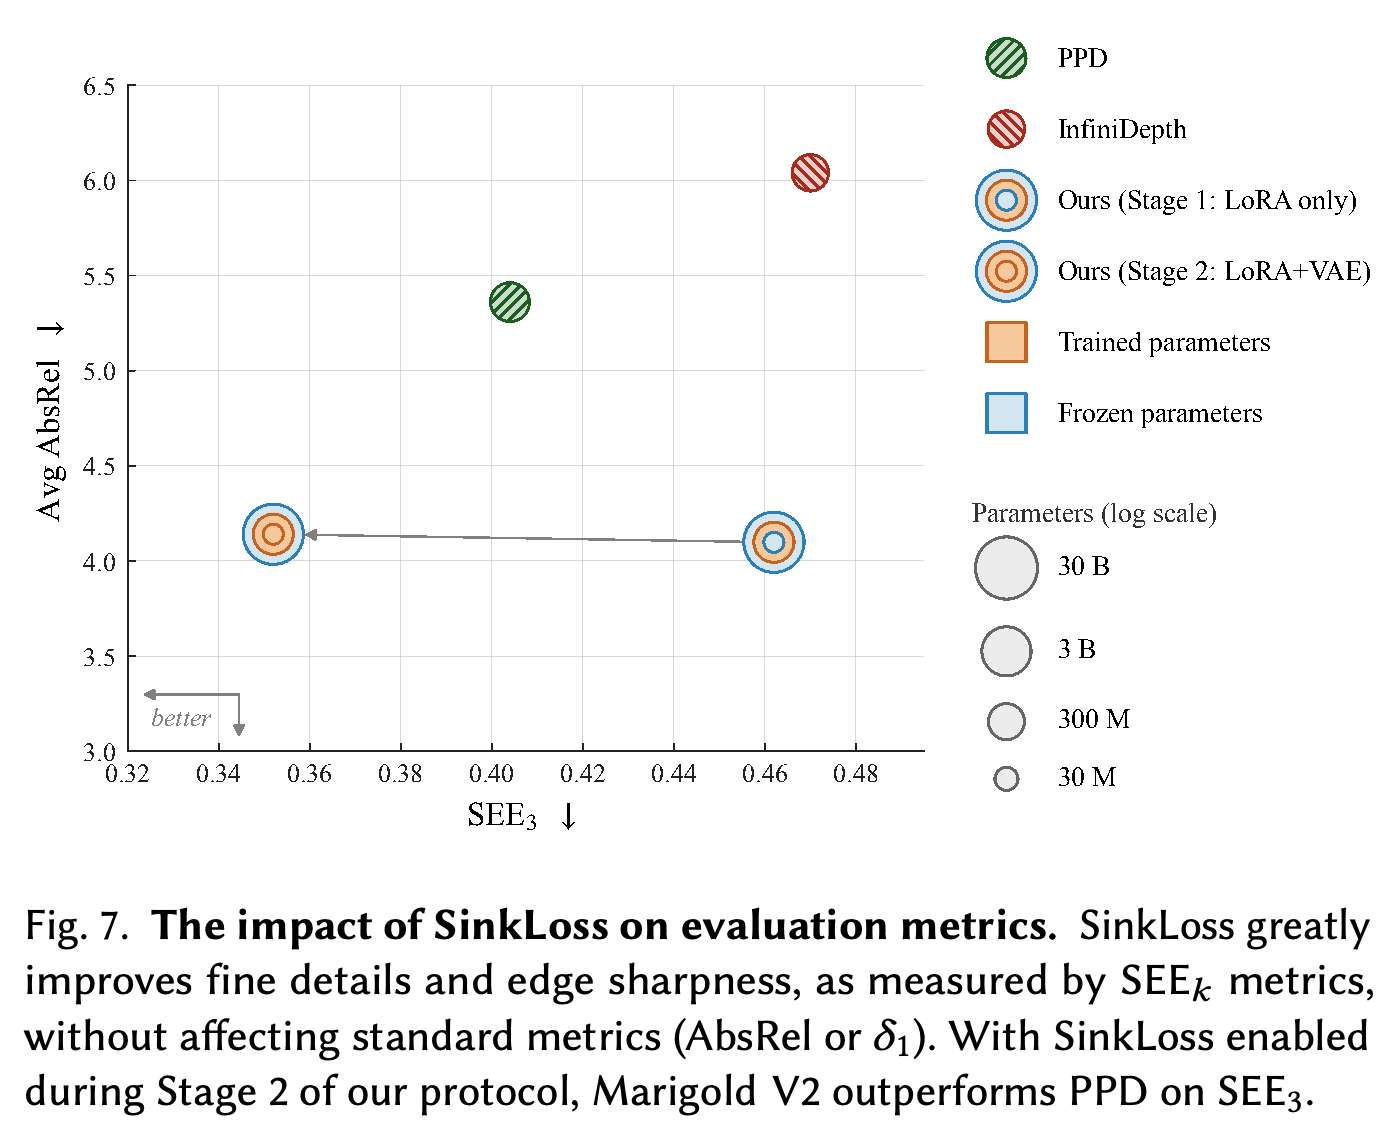
평균 AbsRel과 SEE3 및 parameter scale의 관계를 나타낸다. Stage-2 SinkLoss point는 Stage 1보다 edge error를 크게 개선하면서 유사한 평균 AbsRel을 유지한다.
단일 32GB GPU에서 inference를 benchmark한다. Marigold V2는 1024 × 1024에서 1.9 s와 16.9 GB, 2048 × 2048에서 9.6 s와 29.3 GB를 사용한다. 후자 해상도에서 PPD, Lotus-2, FE2E는 out of memory로 보고된다.
5 Other Dense Regression Tasks
저자들은 이 방법을 metric depth completion, see-through depth, surface-normal estimation, albedo estimation으로 확장한다. 실험은 같은 adaptation framework를 다른 dense regression output에도 적용할 수 있음을 보인다. 논문은 대형 이미지 편집 backbone이 real-time use에는 적합하지 않으며, reflection, motion, defocus blur는 여전히 모호하다고 지적한다.
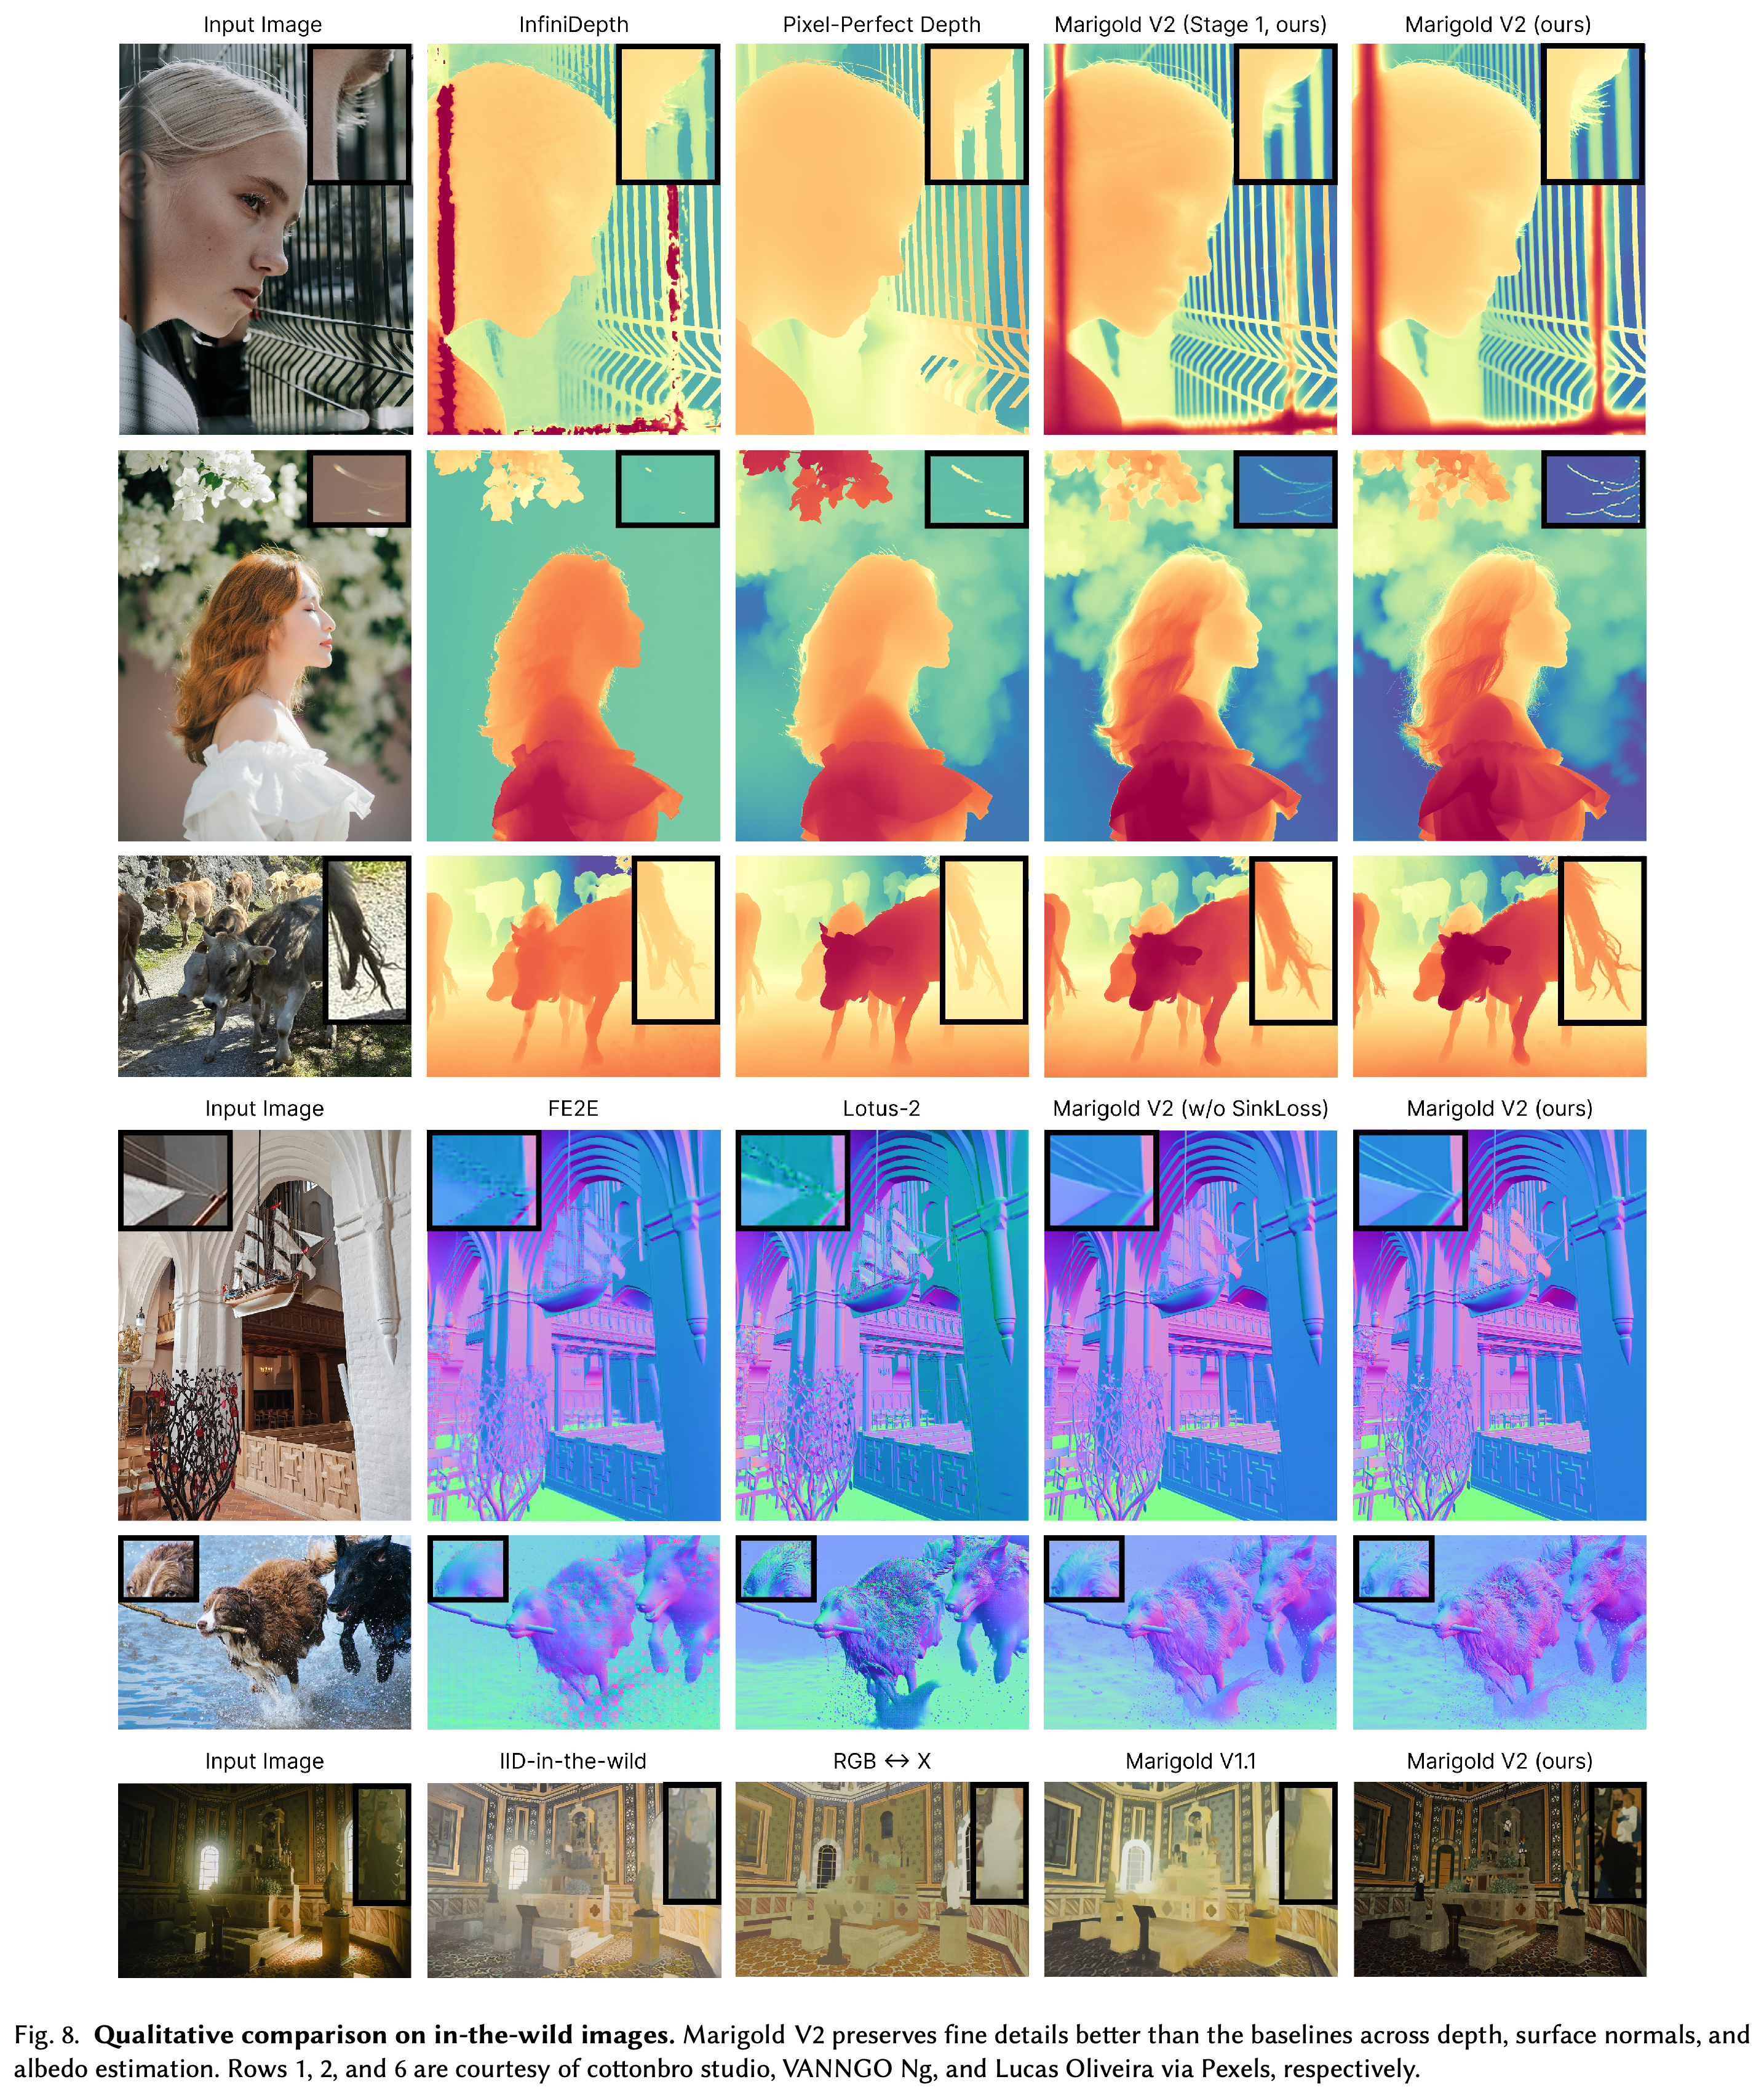
In-the-wild depth, surface-normal, albedo prediction을 비교한다. 이 그림은 adaptation된 model이 task 전반에서 머리카락, 건축 선, 털, intrinsic-image structure 같은 세부를 유지한다는 정성적 근거를 제공한다.
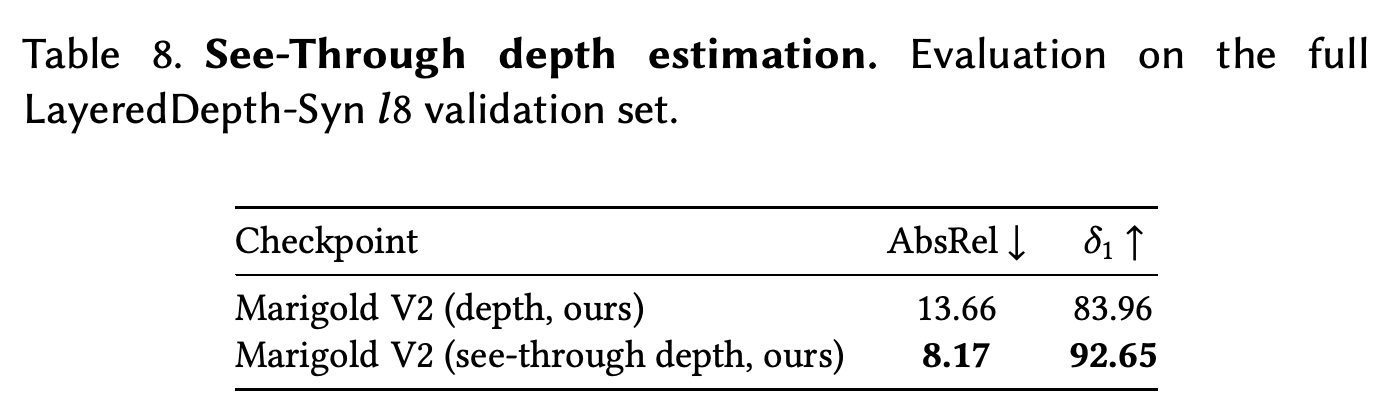
최종 LayeredDepth-Syn l8 layer에 대한 fine-tuning이 see-through depth를 개선함을 보인다. AbsRel은 13.66에서 8.17로 감소하고 δ1은 83.96에서 92.65로 증가한다.
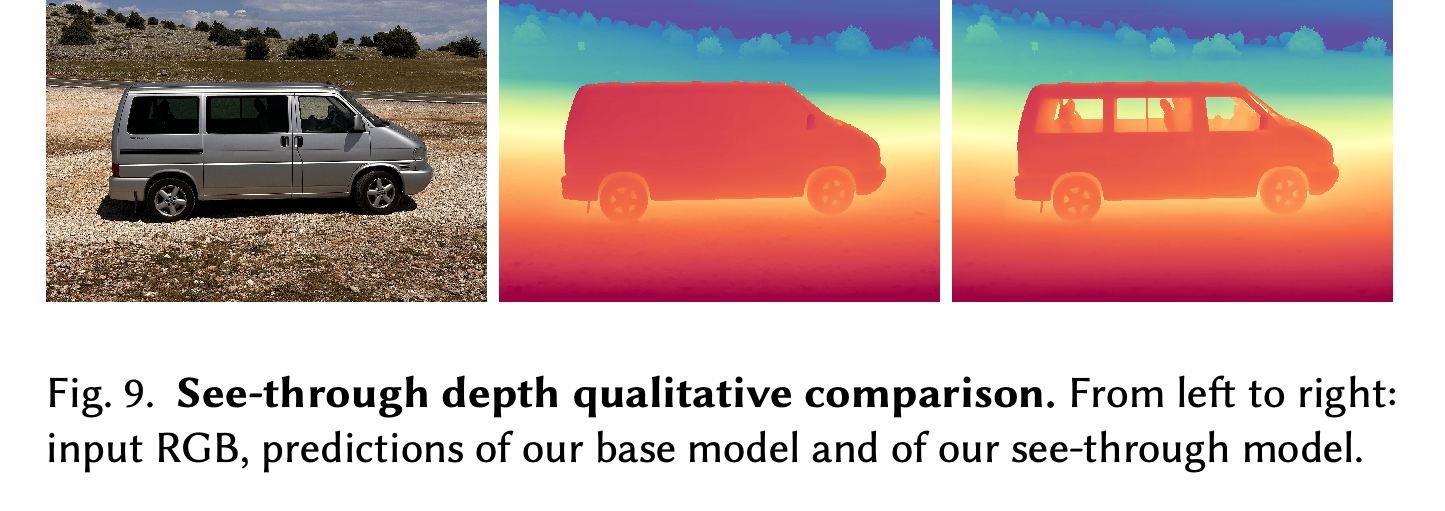
입력 이미지, base depth model, see-through checkpoint의 prediction을 대조한다. Specialized model은 가까운 유리 표면이 아니라 transparent surface 뒤의 geometry를 추정하도록 설계됐다.
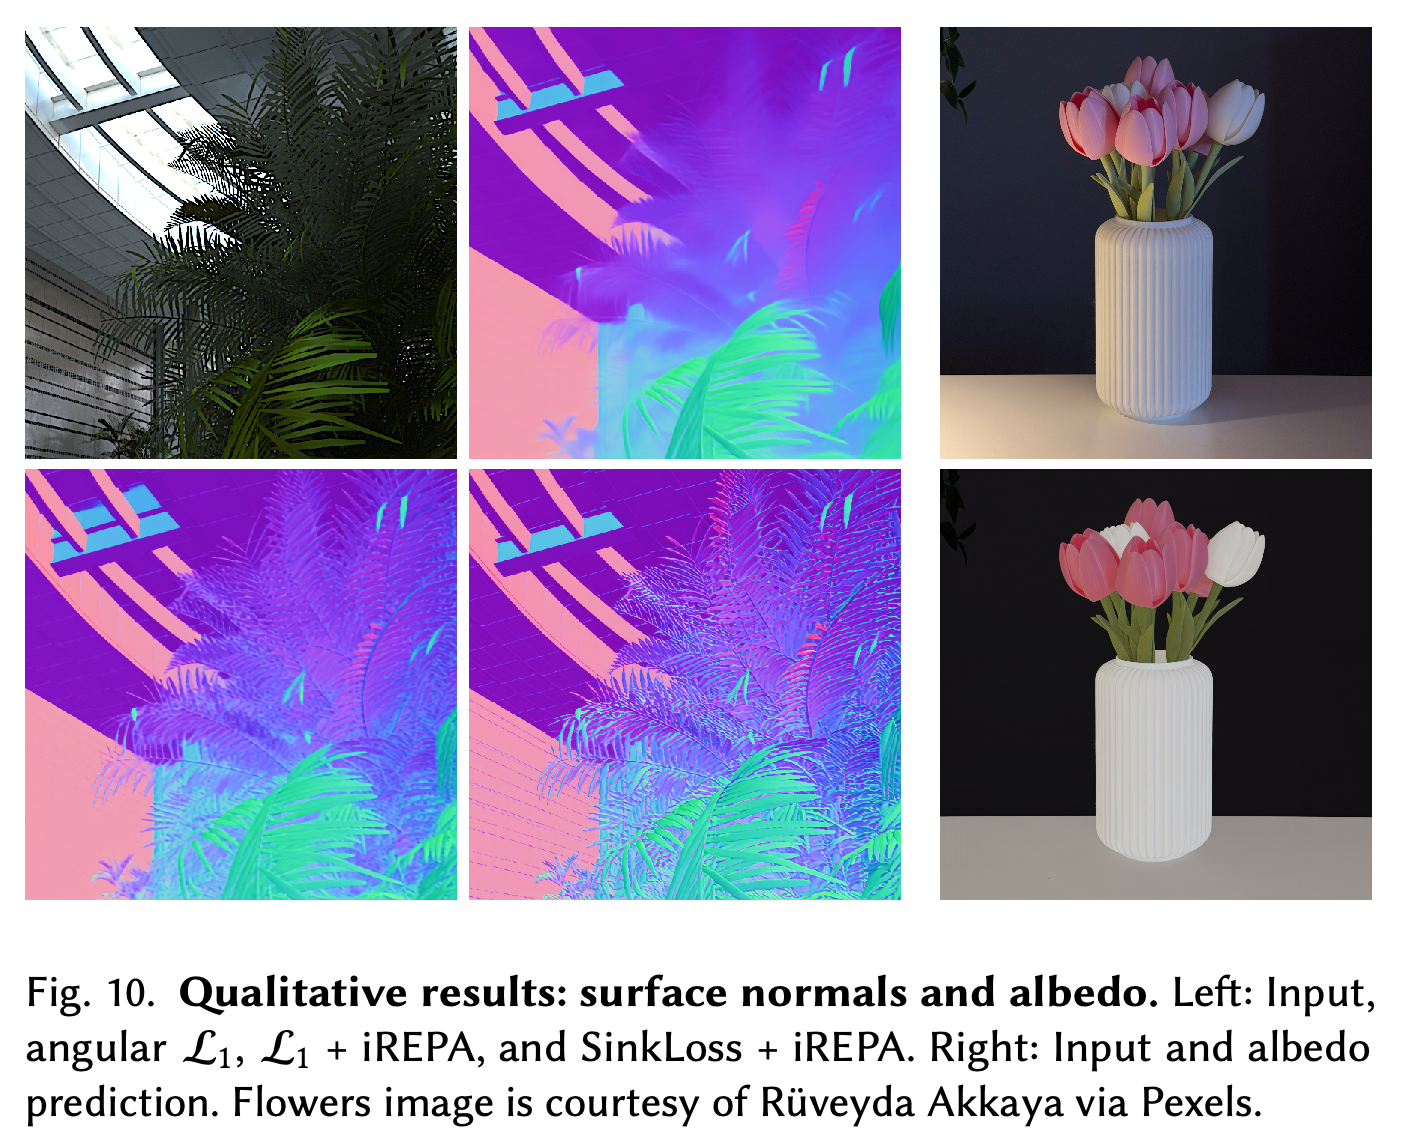
Angular L1, L1 + iREPA, SinkLoss + iREPA를 사용한 surface-normal estimation variant와 albedo example을 보여준다. 이는 semantic alignment와 local matching을 depth 외 task로 전이할 수 있음을 시각적으로 뒷받침한다.
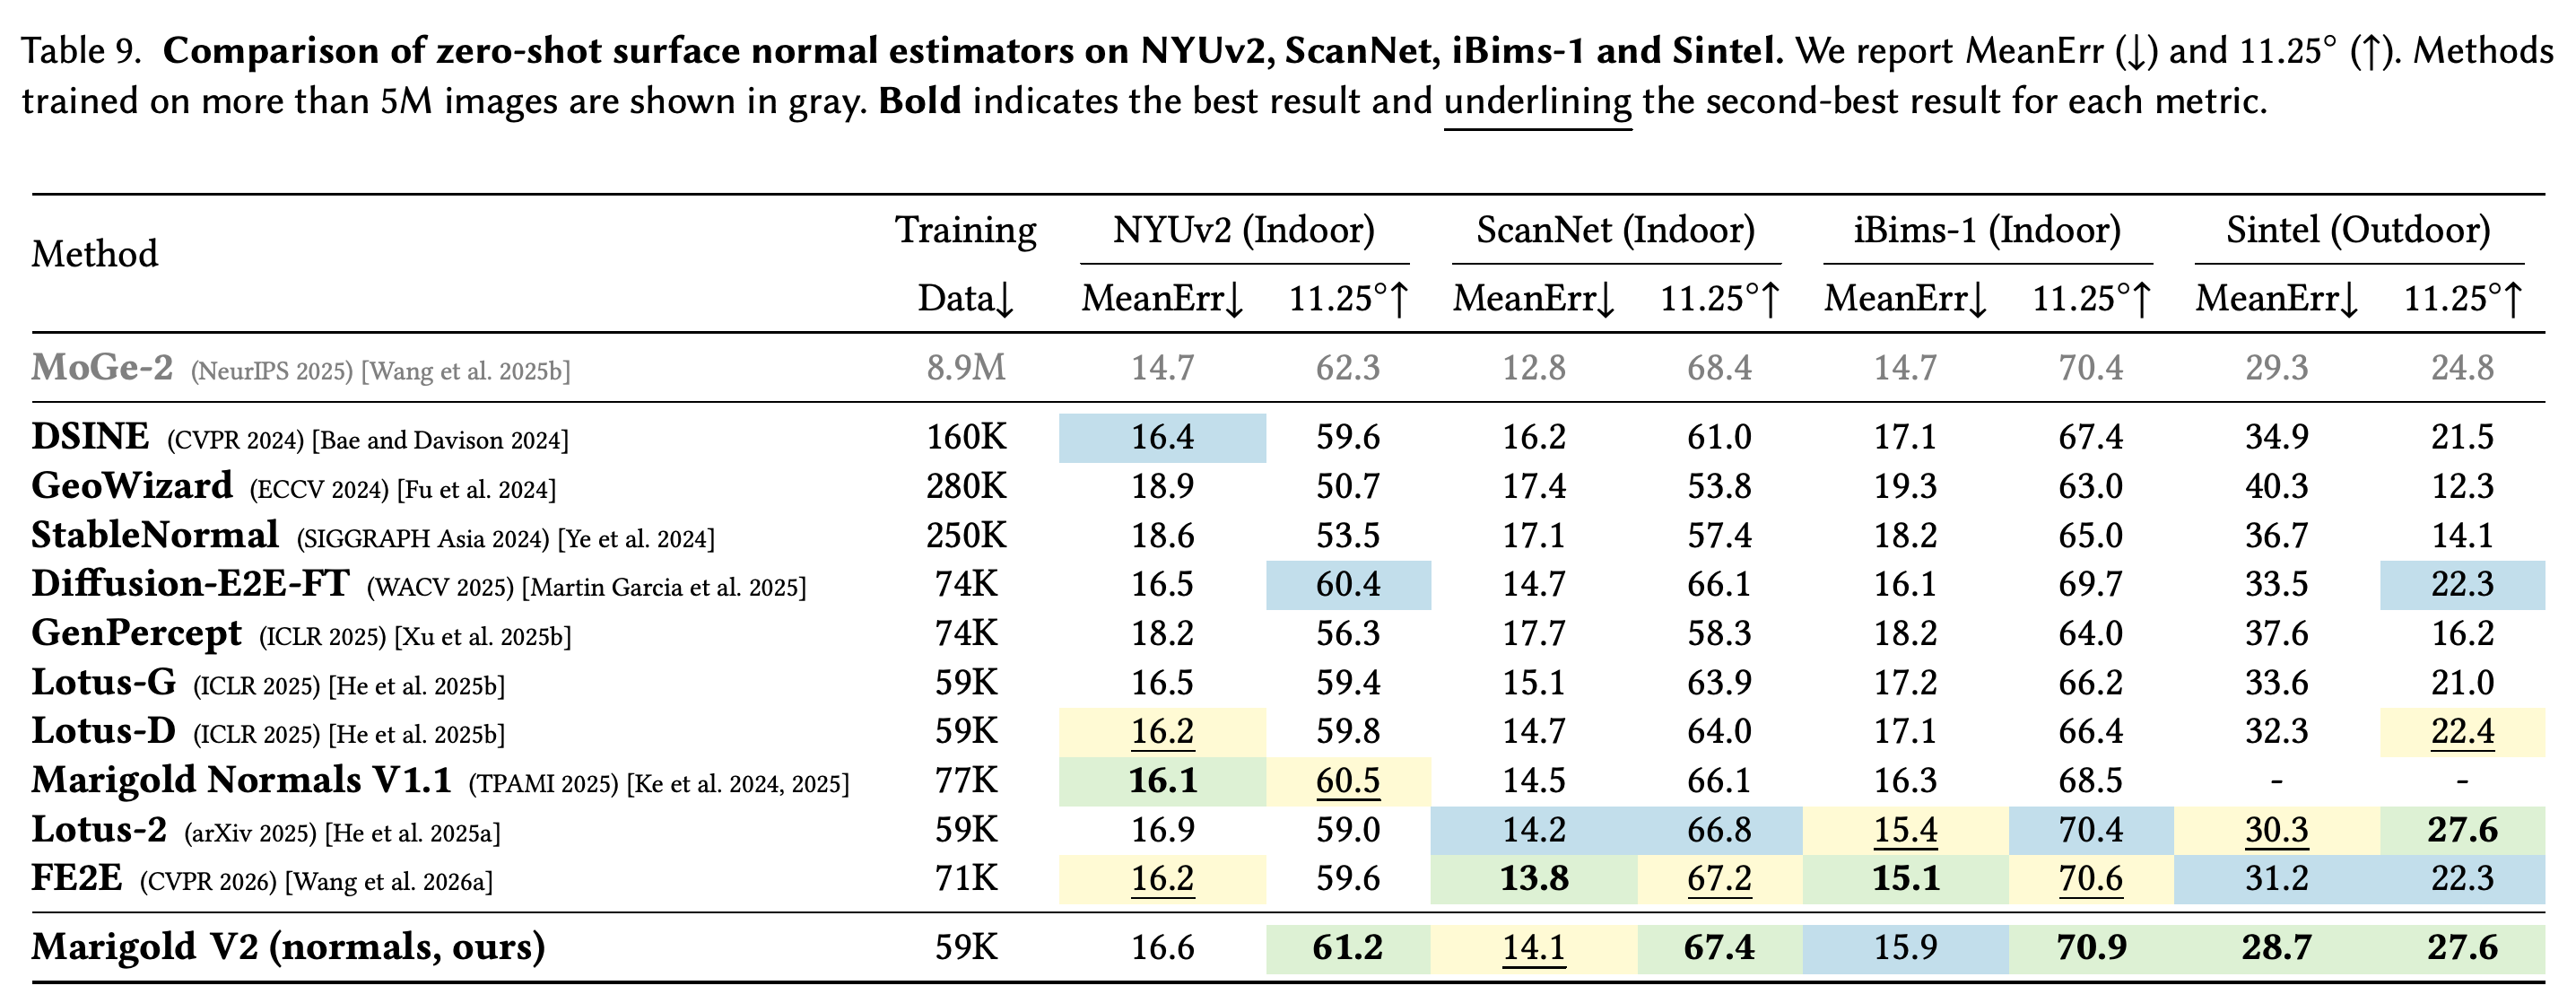
4개 dataset에서 zero-shot normal estimation을 비교한다. Marigold V2는 NYUv2, iBims-1, Sintel에서 가장 높은 11.25° rate를 보고한다. ScanNet 결과는 선두 값에 가깝지만 최고는 아니다.
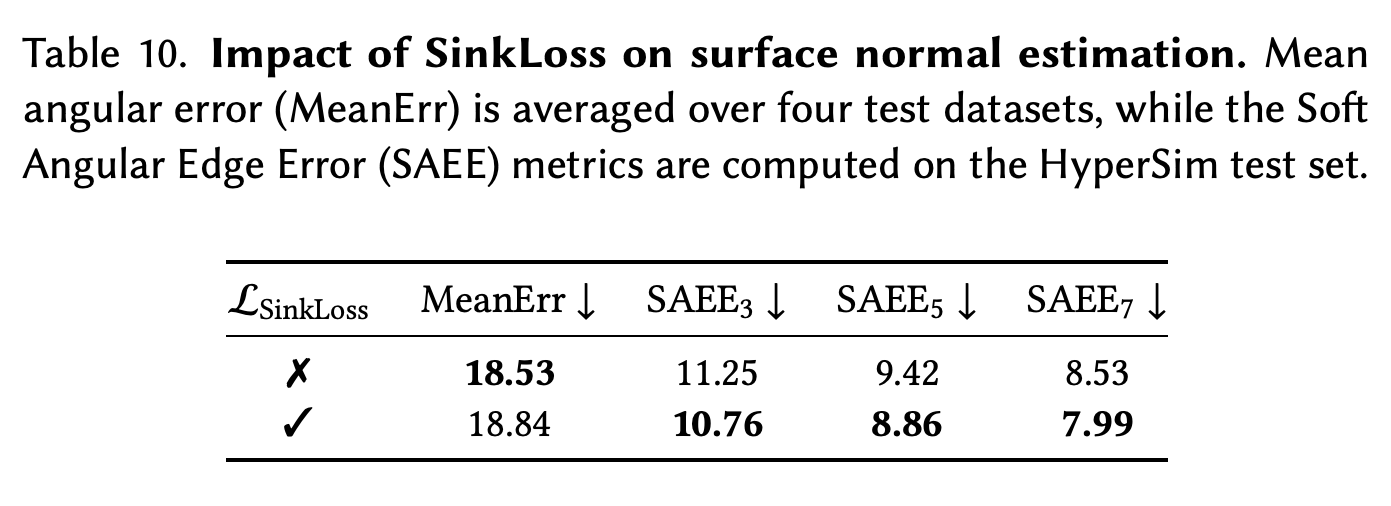
SinkLoss가 surface-normal estimation에서 보이는 trade-off를 나타낸다. 평균 MeanErr는 18.53에서 18.84로 상승하지만, 모든 boundary-specific SAEE metric은 11.25/9.42/8.53에서 10.76/8.86/7.99로 개선된다.
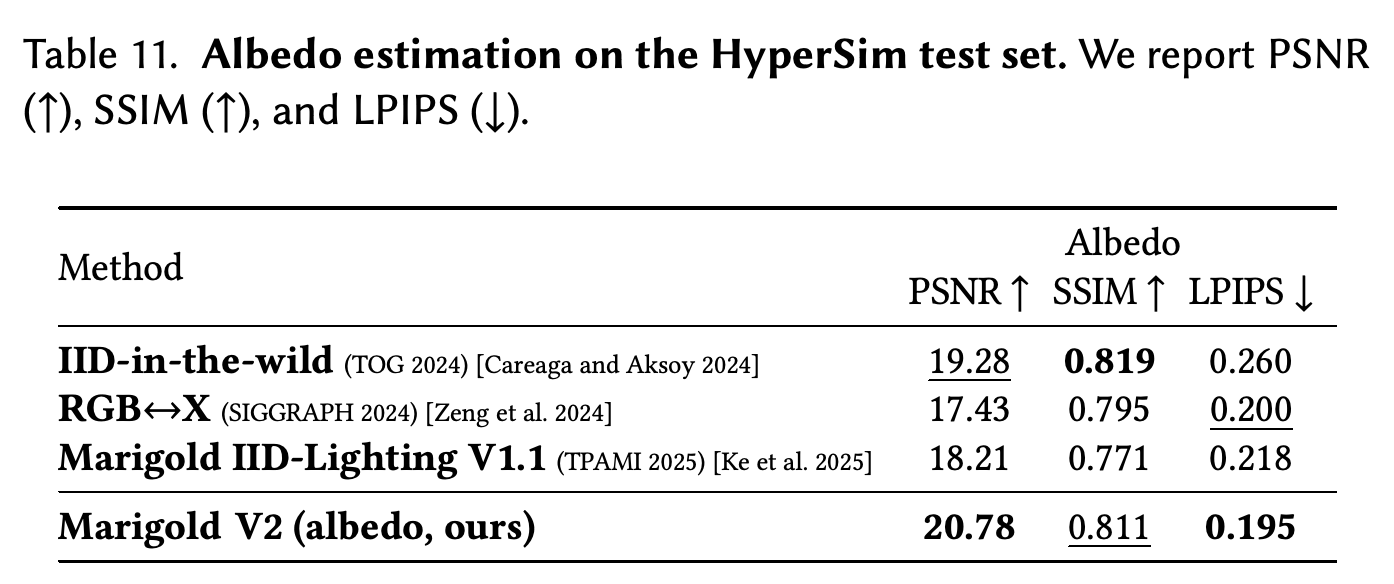
HyperSim albedo estimation에서 Marigold V2는 가장 높은 PSNR 20.78과 가장 낮은 LPIPS 0.195를 기록한다. SSIM 0.811은 IID-in-the-wild의 0.819보다 낮다.
5.1 Depth Completion
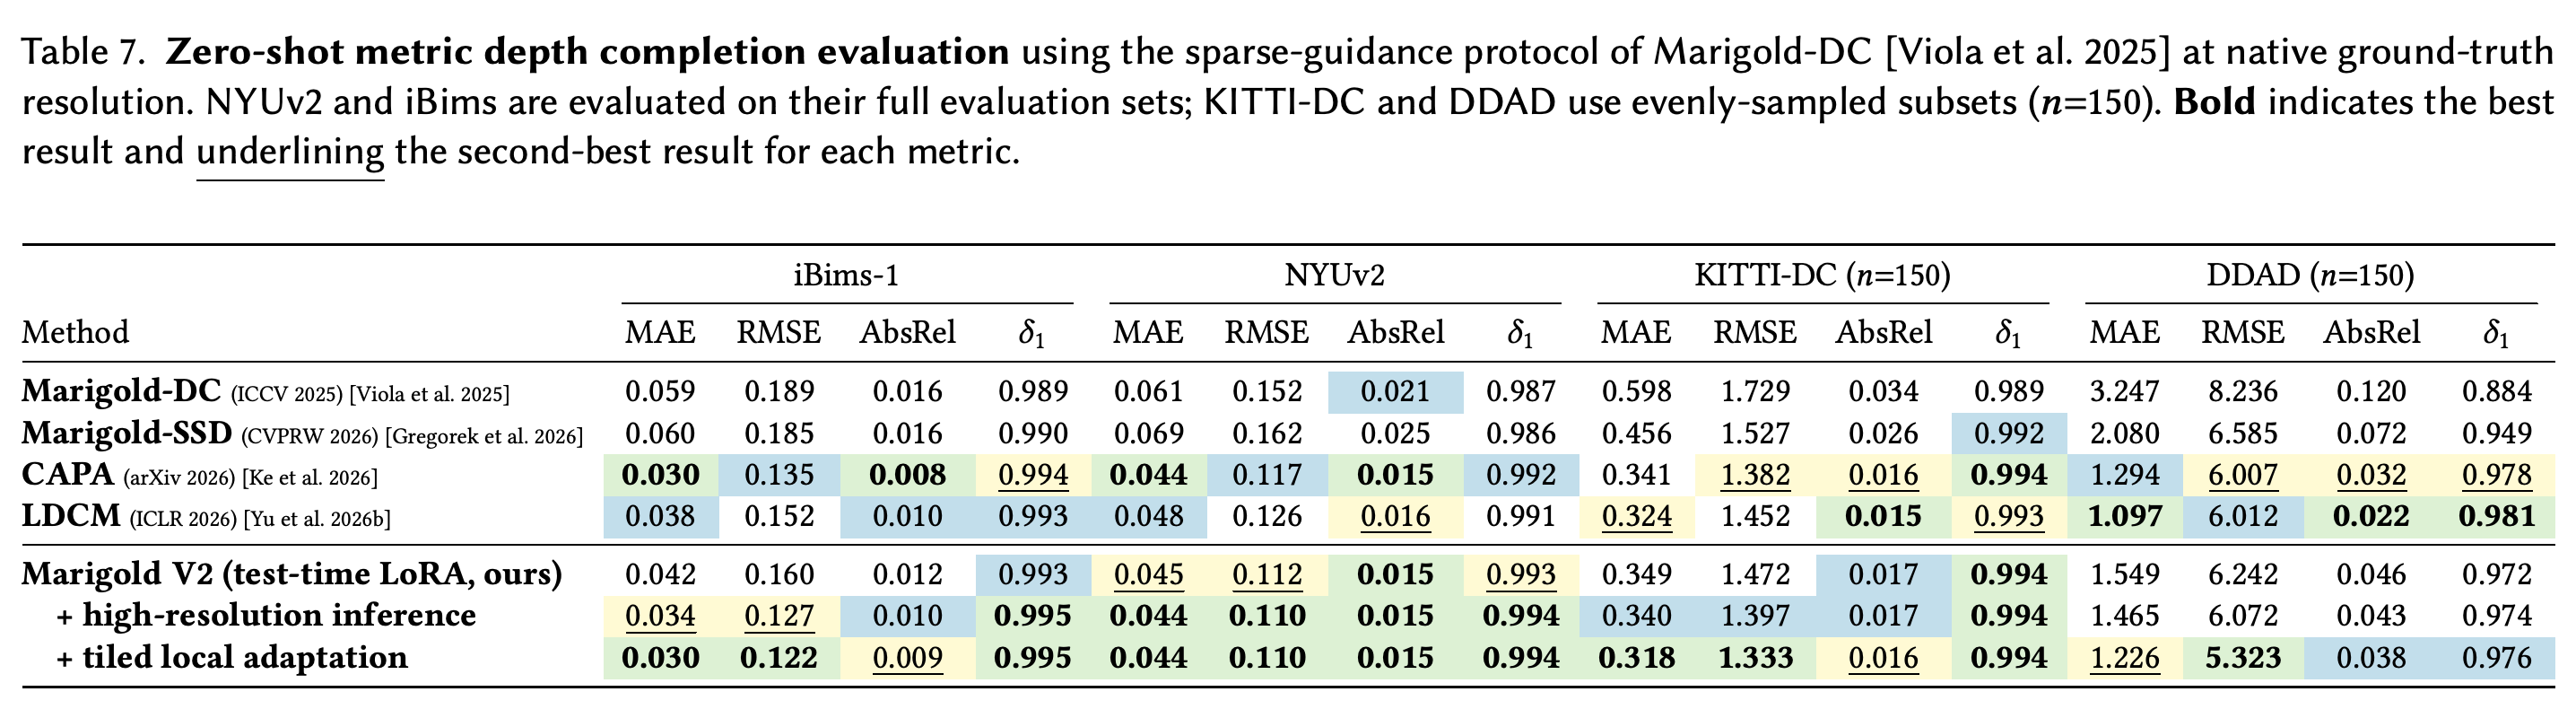
Metric depth completion에서는 affine-invariant prior를 고정하고, 60개 transformer block 중 마지막 12개에 두 번째 rank-16 LoRA를 적용한다. 또한 sparse measurement에서 추정한 scale과 shift를 함께 최적화한다. High-resolution inference와 tiled local adaptation으로 iBims-1에서 RMSE 0.122, NYUv2에서 0.110, KITTI-DC에서 1.333, DDAD에서 5.323을 얻는다. Tiling은 단일 패스 runtime의 4–14× 비용이 든다. LoRA에 대해서는 이 글을 참조하라.
Sparse-guided metric depth completion을 보고한다. Tiled local-adaptation variant는 4개 benchmark 모두에서 가장 낮은 RMSE를 기록하며, iBims-1에서 0.122, DDAD에서 5.323을 포함한다.
부록
- 제공된 PDF에는 별도의 appendix section이 없다. 마지막 페이지에는 main-body conclusion 뒤에 References가 수록되어 있다.
짧은 생각
핵심 기여는 전체 depth accuracy와 boundary fidelity를 명시적으로 분리한 점이다. SinkLoss는 평균 AbsRel을 거의 바꾸지 않으면서 Soft Edge Error를 크게 개선한다. 정량 깊이 비교는 RANSAC affine alignment와 논문의 comparable-training-data ranking rule에 의존한다. 실용적 trade-off는 real-time inference가 아니라 1개의 32GB GPU에서 고해상도 실행이 가능하다는 점이다.