


Rethinking the Evaluation of Harness Evolution for Agents 요약 설명
14 Jul 2026 | Paper Review Harness Optimization LLM Evaluation Test-Time Scaling목차
- 요약
- 1 Introduction
- 2 Related Work
- 3 Rethinking the Evaluation of Harness Evolution
- 4 Experiments
- 5 Discussion
- 6 Conclusions
- 부록
- 짧은 생각
이번 글에서는 Rethinking the Evaluation of Harness Evolution for Agents 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 7월 14일(Arxiv)
- Wang, Yike, Zhu, Huaisheng, Hu, Zhengyu, Yuan, Yige, Chen, Zhengyu, Senthil, Shakti, Hajishirzi, Hannaneh, Tsvetkov, Yulia, Dasigi, Pradeep, Xiao, Teng.
- Allen Institute for AI, University of Washington, Independent
- 논문 링크
- Github
- Project Page
요약
- 자동 harness evolution은 작업 피드백을 바탕으로 LLM 에이전트의 외부 실행 구조를 수정한다. 탐색과 최종 평가에 같은 벤치마크를 쓰면, 점수 상승은 재사용 가능한 harness 개선이 아니라 해당 작업에 대한 반복 탐색을 반영할 수 있다.
- 저자들은 동일한 rollout 예산 아래 Parallel Sampling, Sequential Refinement, 공유 Harness Evolution, 작업별 Harness Scaling을 비교하며, 단위 테스트 피드백이 있는 경우와 없는 경우를 모두 살펴본다. 학습 작업에서 harness를 진화시키고 검증 작업에서 선택한 뒤, 탐색에 사용하지 않은 Terminal-Bench 2.1 tasks에서 평가한다.
- Harness Evolution은 더 단순한 탐색 기준선보다 일관되게 우수하지 않다. Claude Opus 4.6과 GPT-5.4로 평가한 미사용 작업에서 평균 pass@1은 67.7에서 68.3으로 오르는 데 그친다. 이 결과는 탐색 작업과 평가 작업을 분리해야 할 이유를 보여준다.
1 Introduction
harness는 고정된 모델이 지시를 받고, 도구를 사용하고, 정보를 유지하고, 실행을 제어하는 방식을 정한다. harness 탐색 방법은 벤치마크 작업의 실행 궤적과 피드백을 살펴보므로, 논문은 보고된 성능 향상이 작업에 직접 추가 시도를 투입했을 때보다 큰지, 결과로 얻은 harness가 다른 작업에도 적용되는지 묻는다.
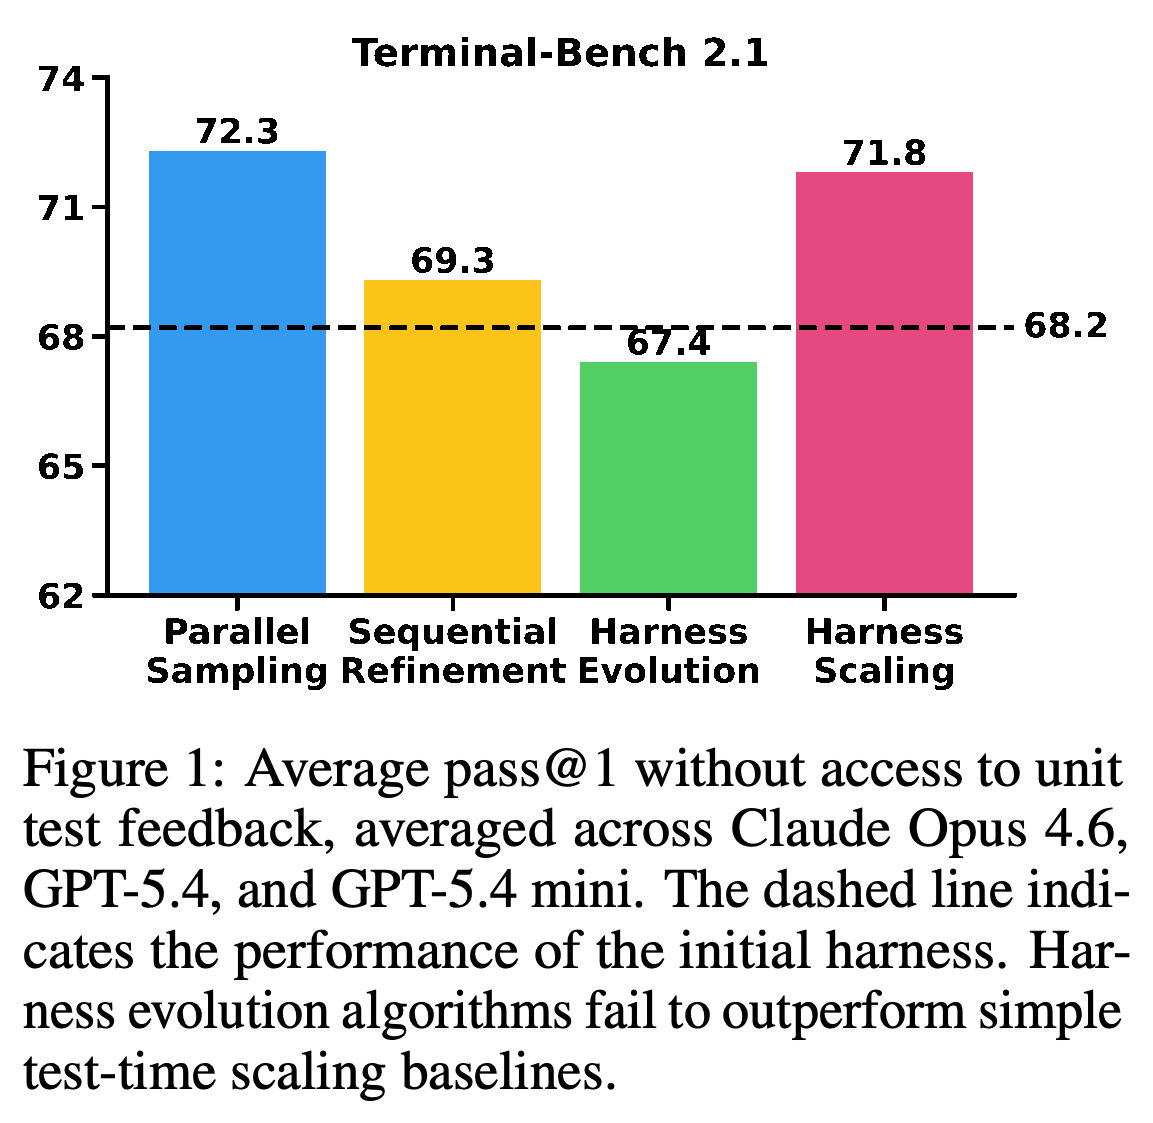
점선으로 표시된 초기 harness의 기준값은 68.2이다. 단위 테스트 피드백이 없을 때 Parallel Sampling이 72.3으로 가장 높고 Harness Scaling이 71.8, Sequential Refinement가 69.3으로 뒤따른다. 공유 Harness Evolution은 67.4로 기준값보다 낮다.
2 Related Work
test-time scaling은 모델 가중치를 바꾸지 않고 추론 계산량을 늘린다. Parallel Sampling은 독립적인 후보를 탐색하고, Sequential Refinement는 앞선 시도를 바탕으로 다음 시도를 만든다. 기존 최적화 방법은 프롬프트나 저장된 경험을 대상으로 했으며, Meta-Harness, Agentic Harness Engineering (AHE), AEVO는 더 넓은 범위의 에이전트 실행 구조를 수정한다. 이 논문은 범용 최적화 방법을 새로 제안하기보다 harness evolution을 평가한다.
3 Rethinking the Evaluation of Harness Evolution
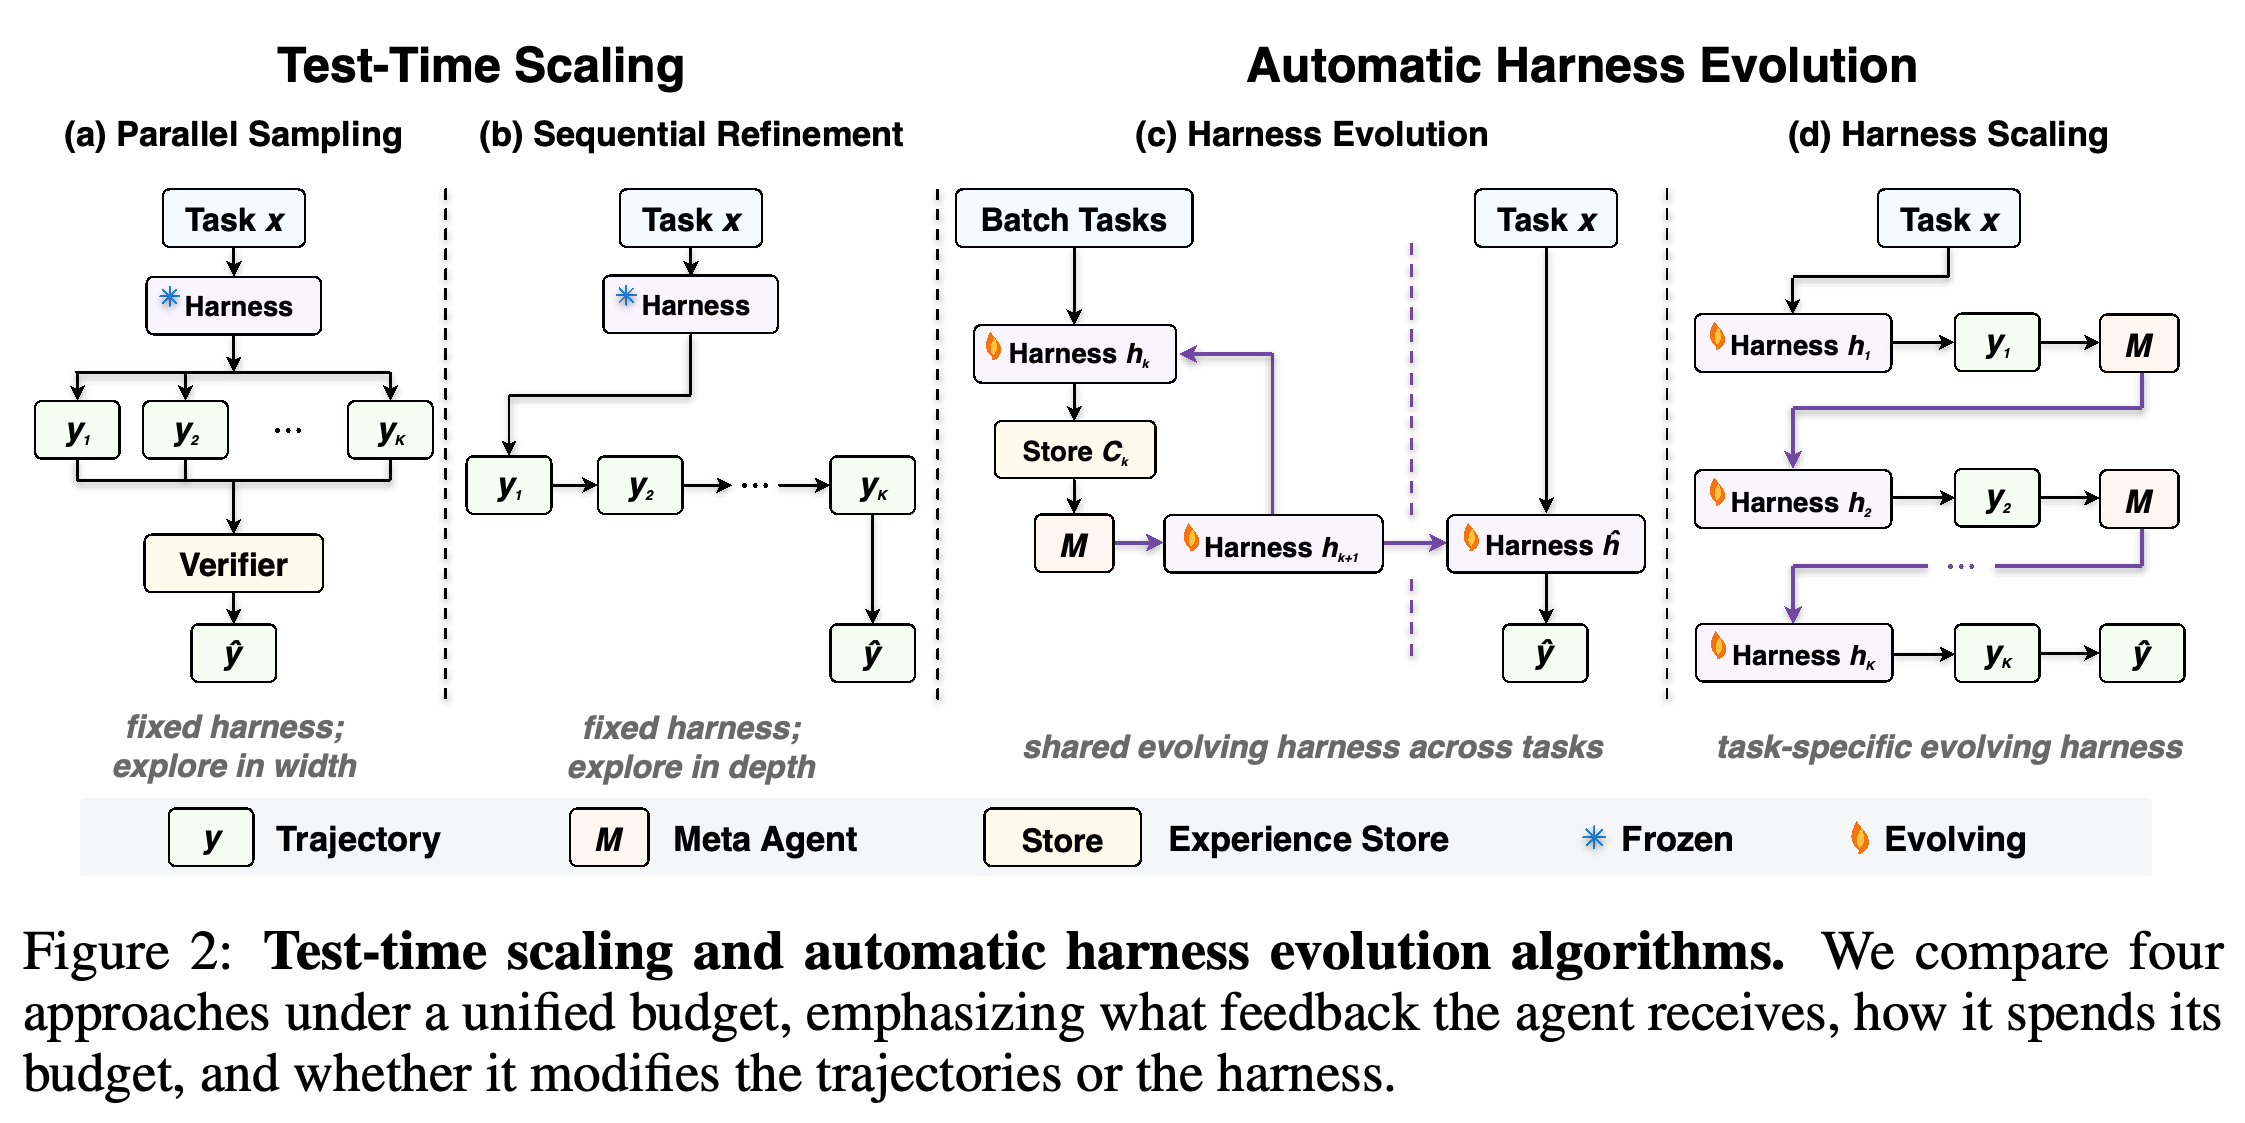
방법들은 추가 시도를 각각 독립적인 실행 궤적, 연속적인 수정, 여러 작업이 공유하는 harness, 1개 작업을 위해 수정하는 harness에 할당한다. 비교 체계는 고정된 harness와 진화하는 harness를 구분하고, 수정을 제안하는 메타 에이전트가 이용할 수 있는 실행 궤적, 요약된 경험, 피드백을 명시한다.
도식은 고정된 harness에서 독립적인 시도를 생성하거나 실행 궤적을 개선하는 방식과, 작업 묶음 전체에서 harness를 진화시키거나 작업마다 별도로 수정하는 방식을 구분한다. 뒤의 2가지 방법은 메타 에이전트를 사용하지만, 재사용 가능한 harness를 목표로 하는 것은 공유 Harness Evolution뿐이다.
3.1 Preliminary
작업 x에 대해 정책 πθ는 harness h 아래에서 실행 궤적 y를 생성한다. 단위 테스트 g를 사용할 수 있으면 R(y, g)가 성공 여부를 나타낸다. 각 방법에는 예산 K가 주어지며 최종 실행 궤적을 반환한다. 기반 모델이 수행하는 요약 함수 Φ는 저장된 시도와 결과를 이후의 수정이나 harness 편집에 활용할 수 있게 한다.
3.2 Parallel Sampling
Parallel Sampling은 같은 harness h로 독립적인 실행 궤적 K개를 생성한다. 단위 테스트가 없으면 에이전트의 자체 평가로 후보를 고르고, 테스트가 있으면 통과한 실행 궤적을 반환할 수 있다. 이 기준선은 harness를 수정하지 않고 시도 횟수만 늘렸을 때의 효과를 측정한다.
3.3 Sequential Refinement
Sequential Refinement는 h를 고정한 채 이전 실행 궤적의 요약을 반영해 다음 궤적을 생성한다. 단위 테스트를 사용할 수 있으면 이전 테스트 결과도 요약에 포함한다. 테스트가 없으면 마지막 시도를 반환하고, 테스트로 선택할 수 있으면 통과한 시도를 반환한다.
3.4 Harness Evolution
Harness Evolution은 공유 harness로 작업을 수행한 뒤 실행 궤적과, 가능한 경우 단위 테스트 결과를 저장한다. 이어서 메타 에이전트가 누적 경험의 요약을 이용해 harness를 수정한다. 목표 작업을 실행하기 전, 단위 테스트가 없으면 마지막 harness를 사용하고 테스트가 있으면 집계된 결과로 harness를 선택한다. AHE 구현에서는 외부에서 제공되는 벤치마크 전용 harness를 가져오지 못하도록 explore agent를 비활성화한다.
3.5 Harness Scaling
Harness Scaling은 평가 작업마다 harness를 별도로 수정한다. 메타 에이전트는 해당 작업, 이전 harness와 실행 궤적, 이용 가능한 단위 테스트 결과를 반영한다. 공유 Harness Evolution과 달리, 재사용할 harness를 만들기보다는 개별 작업에 맞추는 데 수정 기회를 쓴다.
4 Experiments
실험은 단위 테스트 피드백 없이 방법들을 비교하고, 피드백을 제공한 상태에서 비교를 반복한 뒤, 선택된 진화 harness를 탐색에서 제외한 작업에 적용한다. 앞의 설정들은 추가 시도를 활용하는 방식을 비교하고, 마지막 설정은 다른 작업으로의 전이를 측정한다.
4.1 Experimental Setup
Terminal-Bench 2.1은 터미널 작업 89개를 유지하며 버전 2.0의 작업 28개를 수정한다. 보고된 실험에는 Claude Opus 4.6, GPT-5.4, 명시된 경우 GPT-5.4 mini를 사용한다. 독립 실행 2회의 결과를 평균하고, 같은 초기 harness를 사용하며, K = 5로 설정하고, AHE에서는 harness마다 각 작업에 대해 rollout 1개를 수행한다(m = 1). 별도 언급이 없으면 모델의 추론 노력 수준은 high이며 최대 생성 예산은 128k tokens이다.
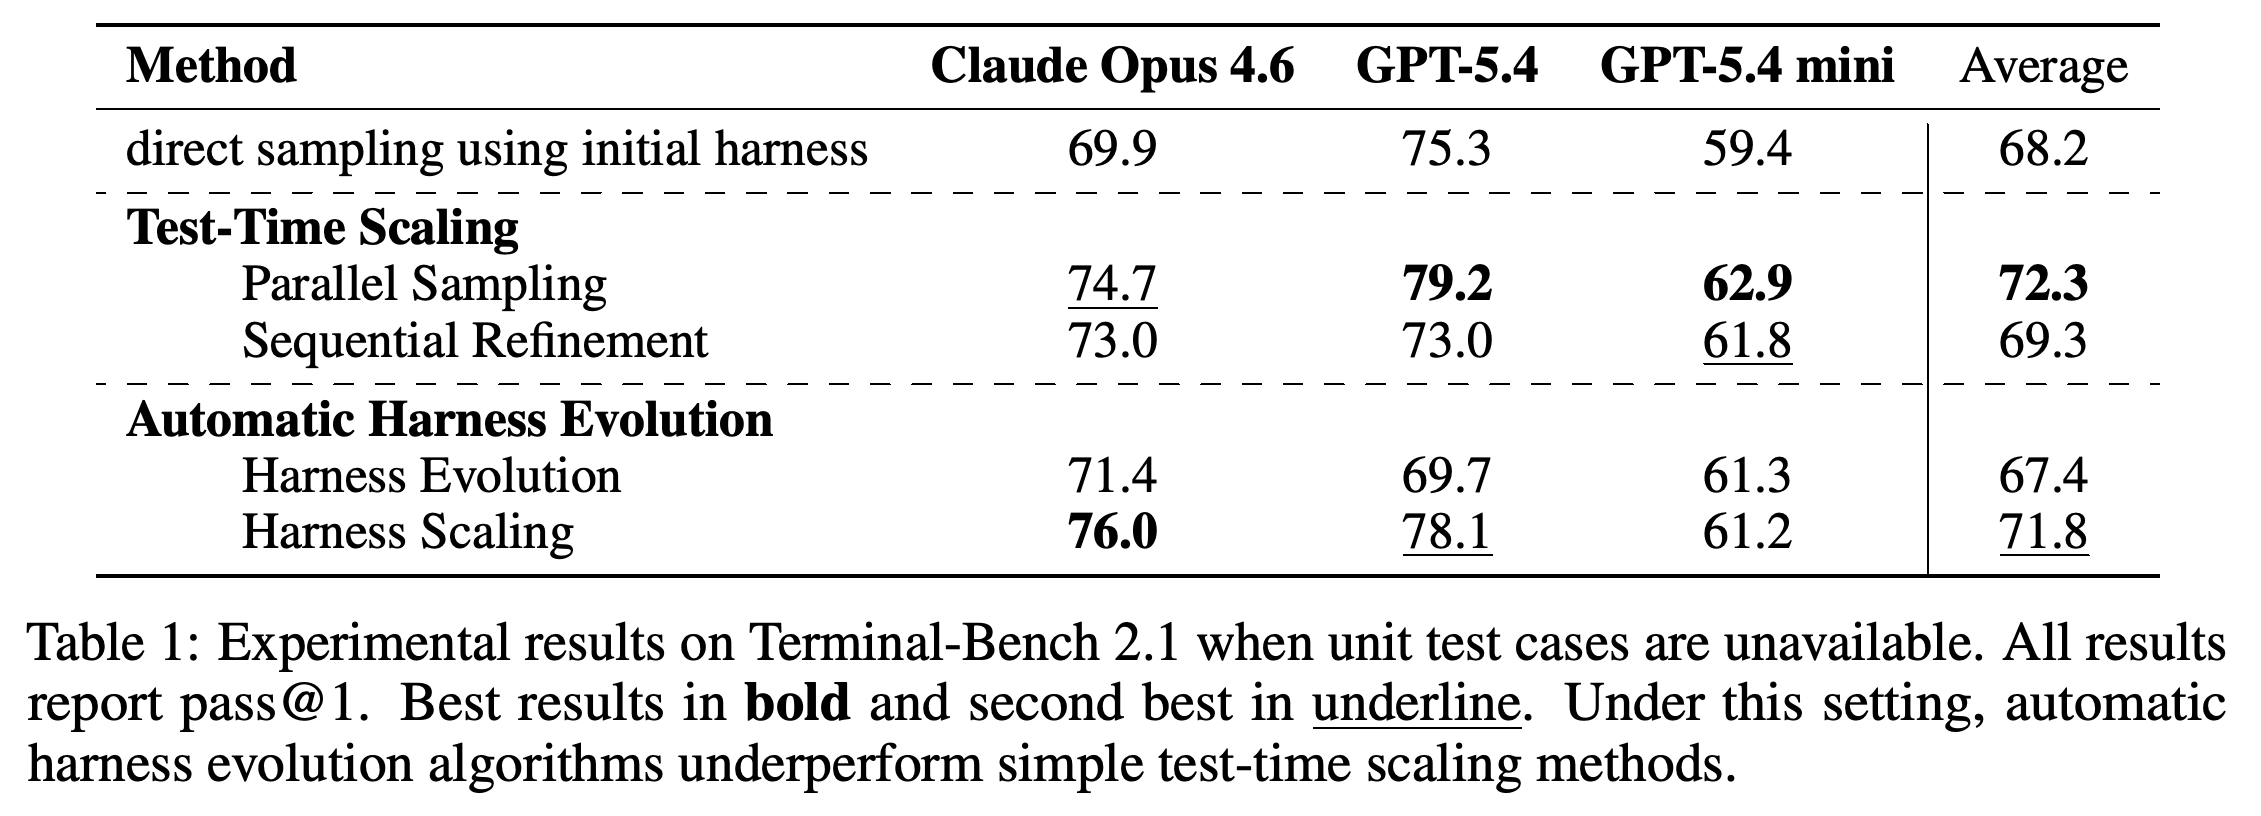
Parallel Sampling은 모델 3개 모두에서 직접 샘플링보다 성능이 높다. Harness Evolution의 평균은 67.4로 초기 harness의 68.2보다 낮으며, GPT-5.4에서는 75.3에서 69.7로 떨어진다. 작업별 Harness Scaling의 평균은 71.8이다.
4.2 Without Unit Test Cases, Automatic Harness Evolution Underperforms Test-Time Scaling
단위 테스트 피드백이 없을 때 모델 3개의 평균 pass@1은 초기 harness를 사용한 직접 샘플링에서 68.2, Parallel Sampling에서 72.3, Sequential Refinement에서 69.3, Harness Evolution에서 67.4, Harness Scaling에서 71.8이다. Harness Evolution을 적용하면 GPT-5.4의 성능은 75.3에서 69.7로 떨어진다. 반면 Harness Scaling은 Claude Opus 4.6에서 가장 높은 점수인 76.0을 기록한다. 이 비교에서 모델 3개 모두 직접 샘플링보다 성능이 나아진 방법은 Parallel Sampling뿐이다.
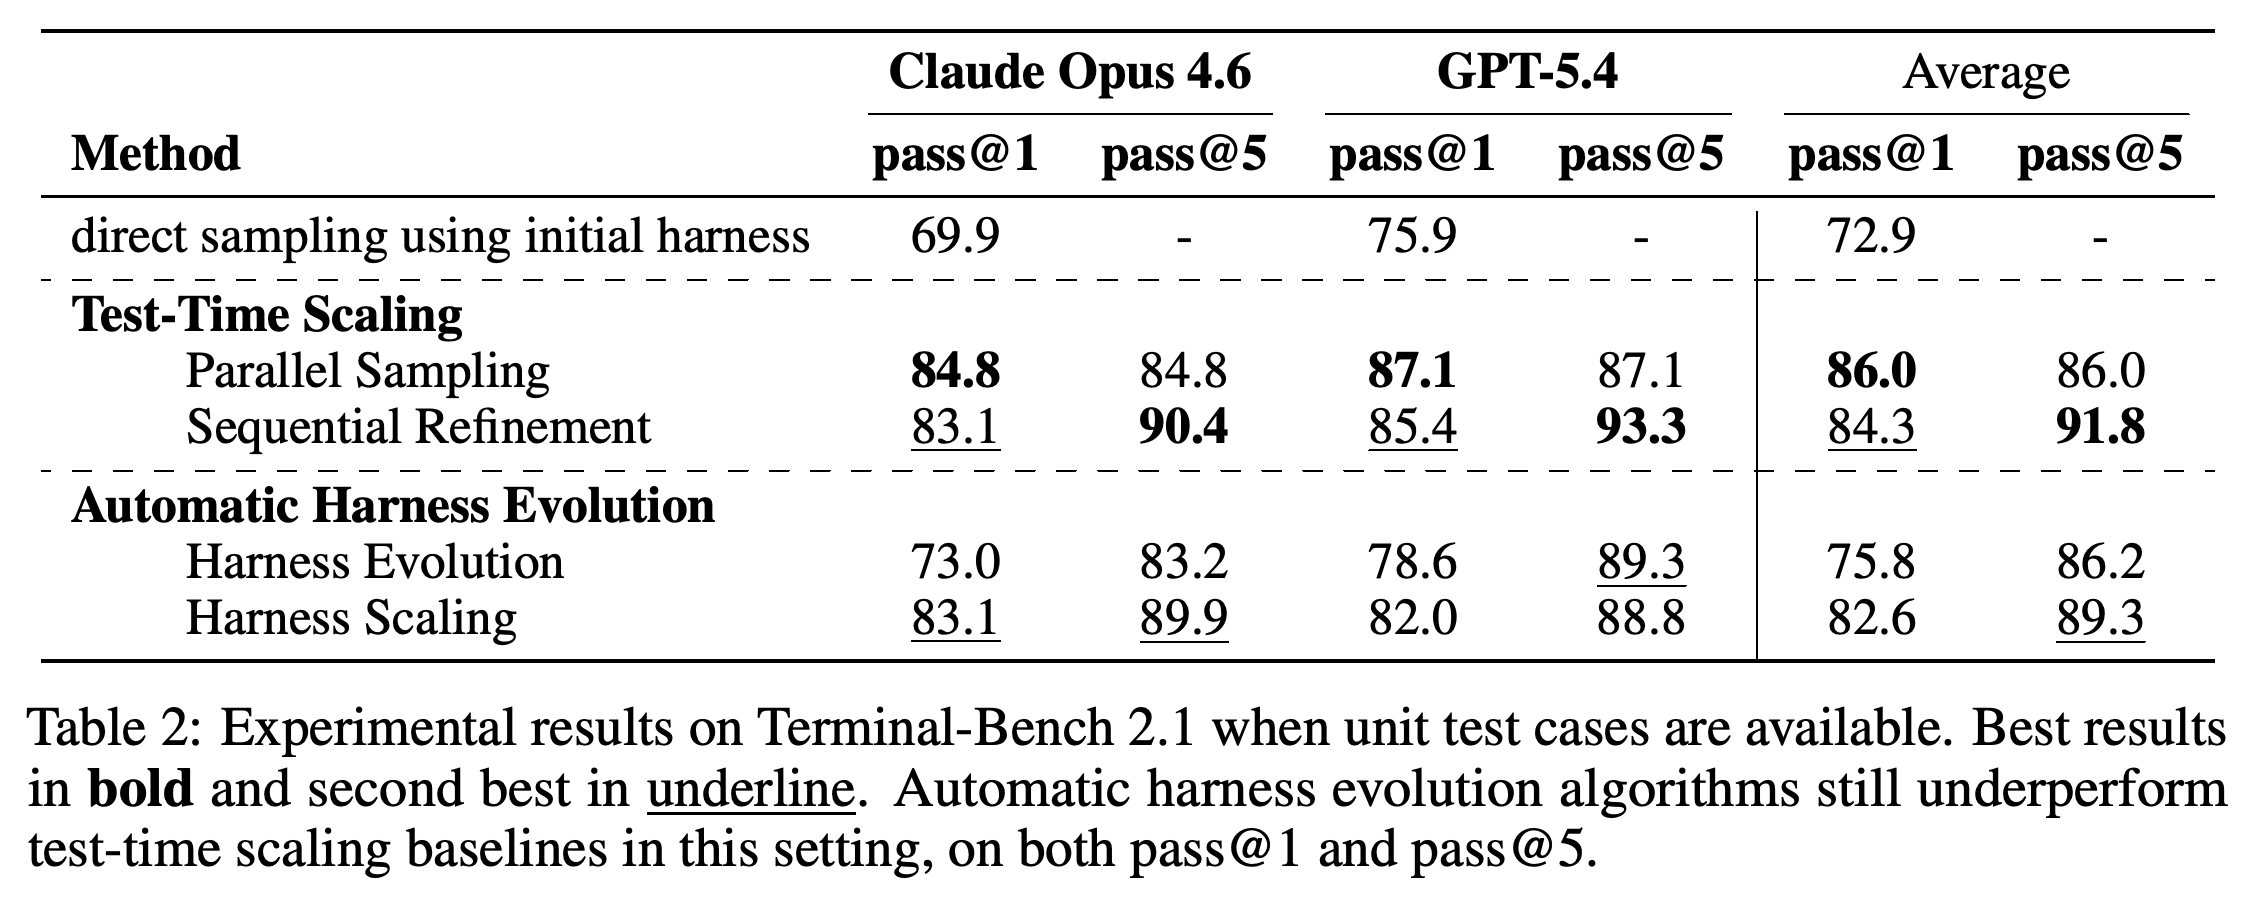
단위 테스트를 사용할 때 평균 pass@1은 Parallel Sampling이 86.0으로 가장 높고, 평균 pass@5는 Sequential Refinement가 91.8로 가장 높다. Harness Evolution의 점수는 각각 75.8과 86.2다. 이는 평균 rollout 성공률과 시도 5회 안에 성공을 적어도 1회 찾는 비율을 구분해 보여준다.
4.3 With Unit Test Cases, Automatic Harness Evolution Underperforms Test-Time Scaling
단위 테스트를 피드백과 선택에 사용할 때, Claude Opus 4.6과 GPT-5.4의 평균 pass@1은 Parallel Sampling이 86.0, Sequential Refinement가 84.3, Harness Evolution이 75.8, Harness Scaling이 82.6이며 직접 샘플링은 72.9이다. 평균 pass@5는 Sequential Refinement가 91.8로 가장 높고 Harness Evolution은 86.2이다. Harness Evolution에서 pass@1과 pass@5의 차이는 반복 시도 중 성공 사례를 찾았다는 사실이 평균 rollout 성공률의 비슷한 상승을 뜻하지는 않음을 보여준다.
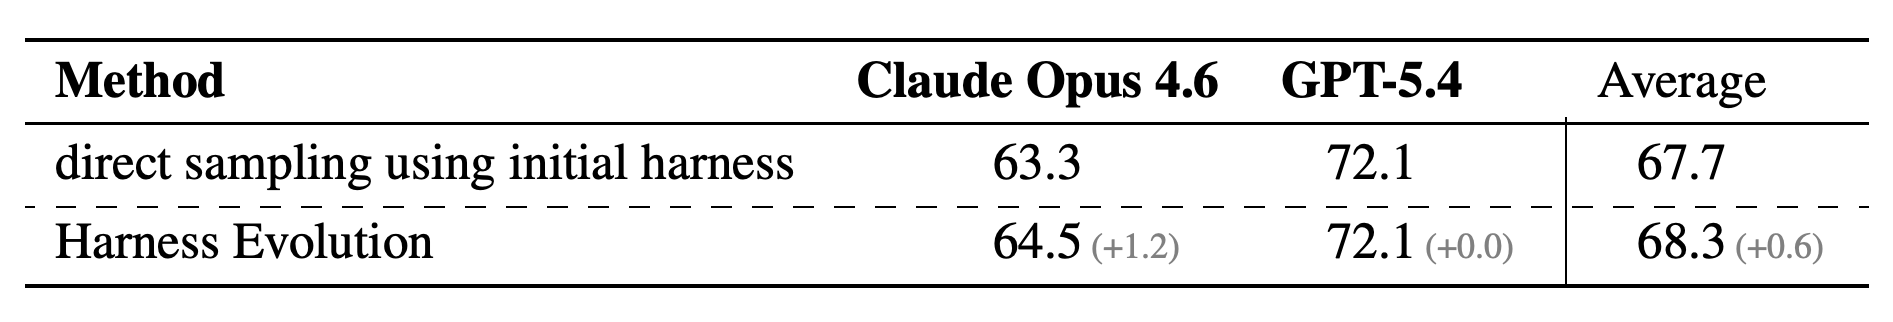
학습 작업에서 harness를 진화시키고 검증 작업에서 선택한 뒤, 미사용 작업의 pass@1은 Claude Opus 4.6에서 1.2포인트 상승하고 GPT-5.4에서는 0.0포인트 변한다. 평균은 초기 harness의 67.7에 비해 68.3으로, Terminal-Bench 2.1 안에서 분리된 작업으로의 전이를 측정한다.
4.4 Harness Evolution Fails to Generalize Beyond Training Tasks
저자들은 작업 89개를 학습 45개, 검증 10개, 미사용 테스트 34개로 나눈다. 학습 작업의 단위 테스트를 활용해 harness를 진화시키고 검증 성능으로 선택한다. 미사용 작업의 pass@1은 Claude Opus 4.6에서 63.3에서 64.5로 바뀌고, GPT-5.4에서는 72.1로 유지된다. 2개 모델의 평균은 67.7에서 68.3으로 변한다(+0.6). 이 결과는 벤치마크 내부에서 전이가 제한적임을 보여주지만, 어떤 개별 수정이 전이되는지는 밝히지 않는다.
5 Discussion
저자들은 프롬프트, 미들웨어, 도구의 수정이 타당해 보여도 전체 성능 향상은 작은 이유를 알아보기 위해 수정 과정을 살펴본다. 시간을 절약하거나 반복되는 설정 실패를 막는 수정과, 계속 어려운 작업을 풀 수 있게 하는 수정을 구분한다.
5.1 Rational Harness Edits but Marginal Gains
공유 Harness Evolution은 프롬프트와 메모리 지침을 추가하고, 이후 턴 예산 알림, 도구 출력 길이 제한, 최종 완료 절차, 도구 사용 지침을 도입하기도 한다. Harness Scaling은 이전 시도에서 관찰한 작업별 버그, 경로, 명령 계획, 점검 사항을 저장하는 경우가 더 많다. 저자들에 따르면 이런 수정은 피할 수 있는 실패를 막을 수 있지만, 특정 작업에만 해당하는 정보를 자주 보존하며 프롬프트가 길어지면 문맥 공간도 소모한다.
5.2 Task Difficulty and Harness Sensitivity as Factors
논의에서는 Terminal-Bench에서 성능 향상이 작은 이유로 2가지 설명을 제안한다. 기준 성능이 비교적 높아 남은 실패는 모델 자체의 능력에 달렸을 수 있고, 해결 가능한 작업 다수에는 기본 프롬프트와 shell 도구 이상의 구성이 필요하지 않을 수 있다. 어느 설명도 실험으로 분리해 검증하지 않았다. 저자들은 성능 개선 여지가 충분하면서 harness 구성 요소에도 실질적으로 의존하는 작업을 시험할 것을 제안한다.
6 Conclusions
결론은 harness 설계가 도움이 될 수 없는지보다 harness evolution의 효과를 뒷받침하는 증거에 관한 것이다. 벤치마크 작업을 탐색과 최종 측정에 재사용하면 재사용 가능한 개선과 작업별 발견을 혼동할 위험이 있다. 이 논문의 비교에서는 단순한 test-time 기준선도 경쟁력이 있으며, 미사용 작업에서의 성능 향상은 작다.
부록
- A Experimental Details의 A.1 Initial Harness는 4가지 방법에 모두 적용한 동일한 최소 구성의 코드 에이전트 harness를 명시한다. 여기에는 bash 도구 1개만 있으며 skills, 미들웨어, 영구 메모리는 없다. A.2 Summarization Map에서는 AHE의 Agent Debugger가 실행 기록을 파일로 정리하고 작업별 분석을 작성한 뒤 전체 개요로 합치며, 원본 기록에도 계속 접근할 수 있게 한다. A.3 Agentic Harness Engineering (AHE)은 explore agent를 비활성화해 외부에서 가져온 벤치마크 전용 harness 없이 제안 및 수정 과정을 유지한다.
- A.4 Configuration에 따르면 각 rollout은 새로운 E2B 원격 sandbox를 사용한다. Table 4에서는 코드 에이전트, debugger, 메타 에이전트에 high 추론 노력 수준, 최대 문맥 200,000 tokens, 턴당 최대 생성량 128,000 tokens를 지정하고, 최대 모델 턴 수를 각각 300, 25, 500으로 설정한다. A.5 Evaluation Metrics는 pass@1을 rollout의 이진 보상 평균으로, pass@k를 성공한 rollout이 적어도 1회 있는 작업의 비율로 정의한다. 인프라 예외는 실패로 계산한다.
- B Case Study는 작업별 Harness Scaling 수정 사례를 보여준다. Figure 3에서는 Coq 8.16.1, shell timeout, make install에 관한 지침을 추가한 뒤 compile-compcert가 통과하고, SQLite를 열기 전에 데이터베이스와 WAL 파일을 백업하도록 지시한 뒤 db-wal-recovery가 통과한다. mteb-retrieve는 query와 passage 임베딩의 프롬프트 유형을 구분한 뒤 반복 5회째에 통과한다. 이 사례들은 구체적인 실패 복구와 저장된 지침 중 일부의 작업별 특성을 함께 보여준다.
짧은 생각
고정 harness를 쓰는 탐색 기준선과 미사용 작업 분할은 서로 다른 평가 질문에 답한다. 추가 시도로 성능 향상을 설명할 수 있는지, 진화한 harness가 다른 작업에도 적용되는지를 각각 살핀다. 전이 결과는 벤치마크 1개와 모델 2개에 관한 것이며, 결과는 실행 2회의 평균이다. K와 AHE의 rollout 횟수를 맞추더라도, 다른 방법이 debugger나 메타 에이전트까지 호출한다면 총 token 사용량이 같다고 볼 수는 없다.