


Smarter and Cheaper at Once: Byte-Exact KV-Cache Grafting Turns a Frozen Small Model into a Verified-Knowledge Flywheel 요약 설명
15 Jul 2026 | Paper Review KV Cache Inference-Time Learning LLM Serving목차
- 요약
- 3 Methodology
- 4 Empirical Results
- Capability, recurrence, and transfer
- Scale and operational behavior
- 5 Discussion
- 부록
- 짧은 생각
이번 글에서는 Smarter and Cheaper at Once: Byte-Exact KV-Cache Grafting Turns a Frozen Small Model into a Verified-Knowledge Flywheel 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 7월 15일(Arxiv)
- Schelpe, Sietse.
- Corbenic AI
- 논문 링크
- Project Page
요약
- Taliesin은 검증된 풀이를 KV 상태로 저장하고 새 추론 문맥에 graft한다. Galahad는 모델 가중치를 바꾸지 않고 이 방식으로 문제를 풀고 결과를 검증·저장·검색한다. 논문은 저장된 지식을 활용할 때 고정된 모델의 답변 품질과 반복적인 prefill 또는 추론을 피할 때의 비용을 평가한다.
- 설정을 고정하고 결정적 연산을 사용한 실험에서, 캡처한 위치에 graft한 logit 바이트는 새로 계산한 결과와 SHA-256-equal이었다. AIME 2025에서는 검증된 라이브러리를 활용한 confidence-gated Gemma-4-12B 시스템의 점수가 80.0%에서 93.3%로 올랐다. 저장된 문제들이 다시 나오자 61 decode tokens로 모든 답을 반환한 반면, 기본 best-of-five 실행은 401,026 tokens를 쓰고도 문제를 풀지 못했다.
- 논문은 이 방법을 LMCache·CacheGen 같은 영속적 KV-cache 인프라, RadixAttention의 prefix 재사용, CacheBlend의 근사적 non-prefix 재사용, 검색 토큰이나 가중치 갱신을 통한 지식 추가와 구분한다. 핵심 주장은 저장된 상태를 재사용하면서도 블록을 캡처한 위치에서는 바이트 단위 일치가 실험으로 확인됐다는 것이다.
- 재출현 실험은 검증된 답을 읽어오는 것이므로 새로운 추론을 입증하지 않는다. 반면 held-out transfer는 새 문제에 대한 적응을 시험한다. 바이트 일치는 설정을 맞춘 상태에서 캡처한 위치에 단일 블록을 복원한 실험으로 확인됐으며, 임의의 위치 이동이나 단일 연결 입력을 기준으로 한 위치별 구성, 서로 다른 GPU 아키텍처 간 동일한 logit 바이트까지 입증한 것은 아니다.
3 Methodology
독점적인 상태 캡처·복원 엔진은 구현 방식이 아니라 입출력 동작으로 설명한다. 로컬 실험은 RTX 5090에서 Gemma-4-12B를 사용하고 CPU와 CUDA fixture도 검사한다. 규모 확장 실험은 H100과 B200 GPU에서 Gemma-4-31B를 사용한다. 보드 전력은 0.5~2 Hz로 샘플링한다. 공개된 Gemma 4와 Qwen의 AIME 2026 model-card 점수는 참고 기준이며, 논문의 AIME 2025 실행과 같은 벤치마크에서 측정한 baseline은 아니다.
3.2 The exactness guarantee, defined
대응하는 위치에서 SHA-256(bytes(ℓgraft)) = SHA-256(bytes(ℓfresh))이면 graft는 바이트 단위로 정확하다. logits가 같으면 분포 간 KL divergence는 0이고 argmax도 같다. 실험에서는 GGML_DETERMINISTIC=1과 CUBLAS_WORKSPACE_CONFIG=:4096:8을 설정하고, 블록을 [0, N)의 prefix로 복원한 다음 새 query를 [N, N + q)에서 계산한다. 이는 동일 설정과 동일 아키텍처 안에서의 보장이지, GPU 추론이 일반적으로 결정적이라는 주장이 아니다.
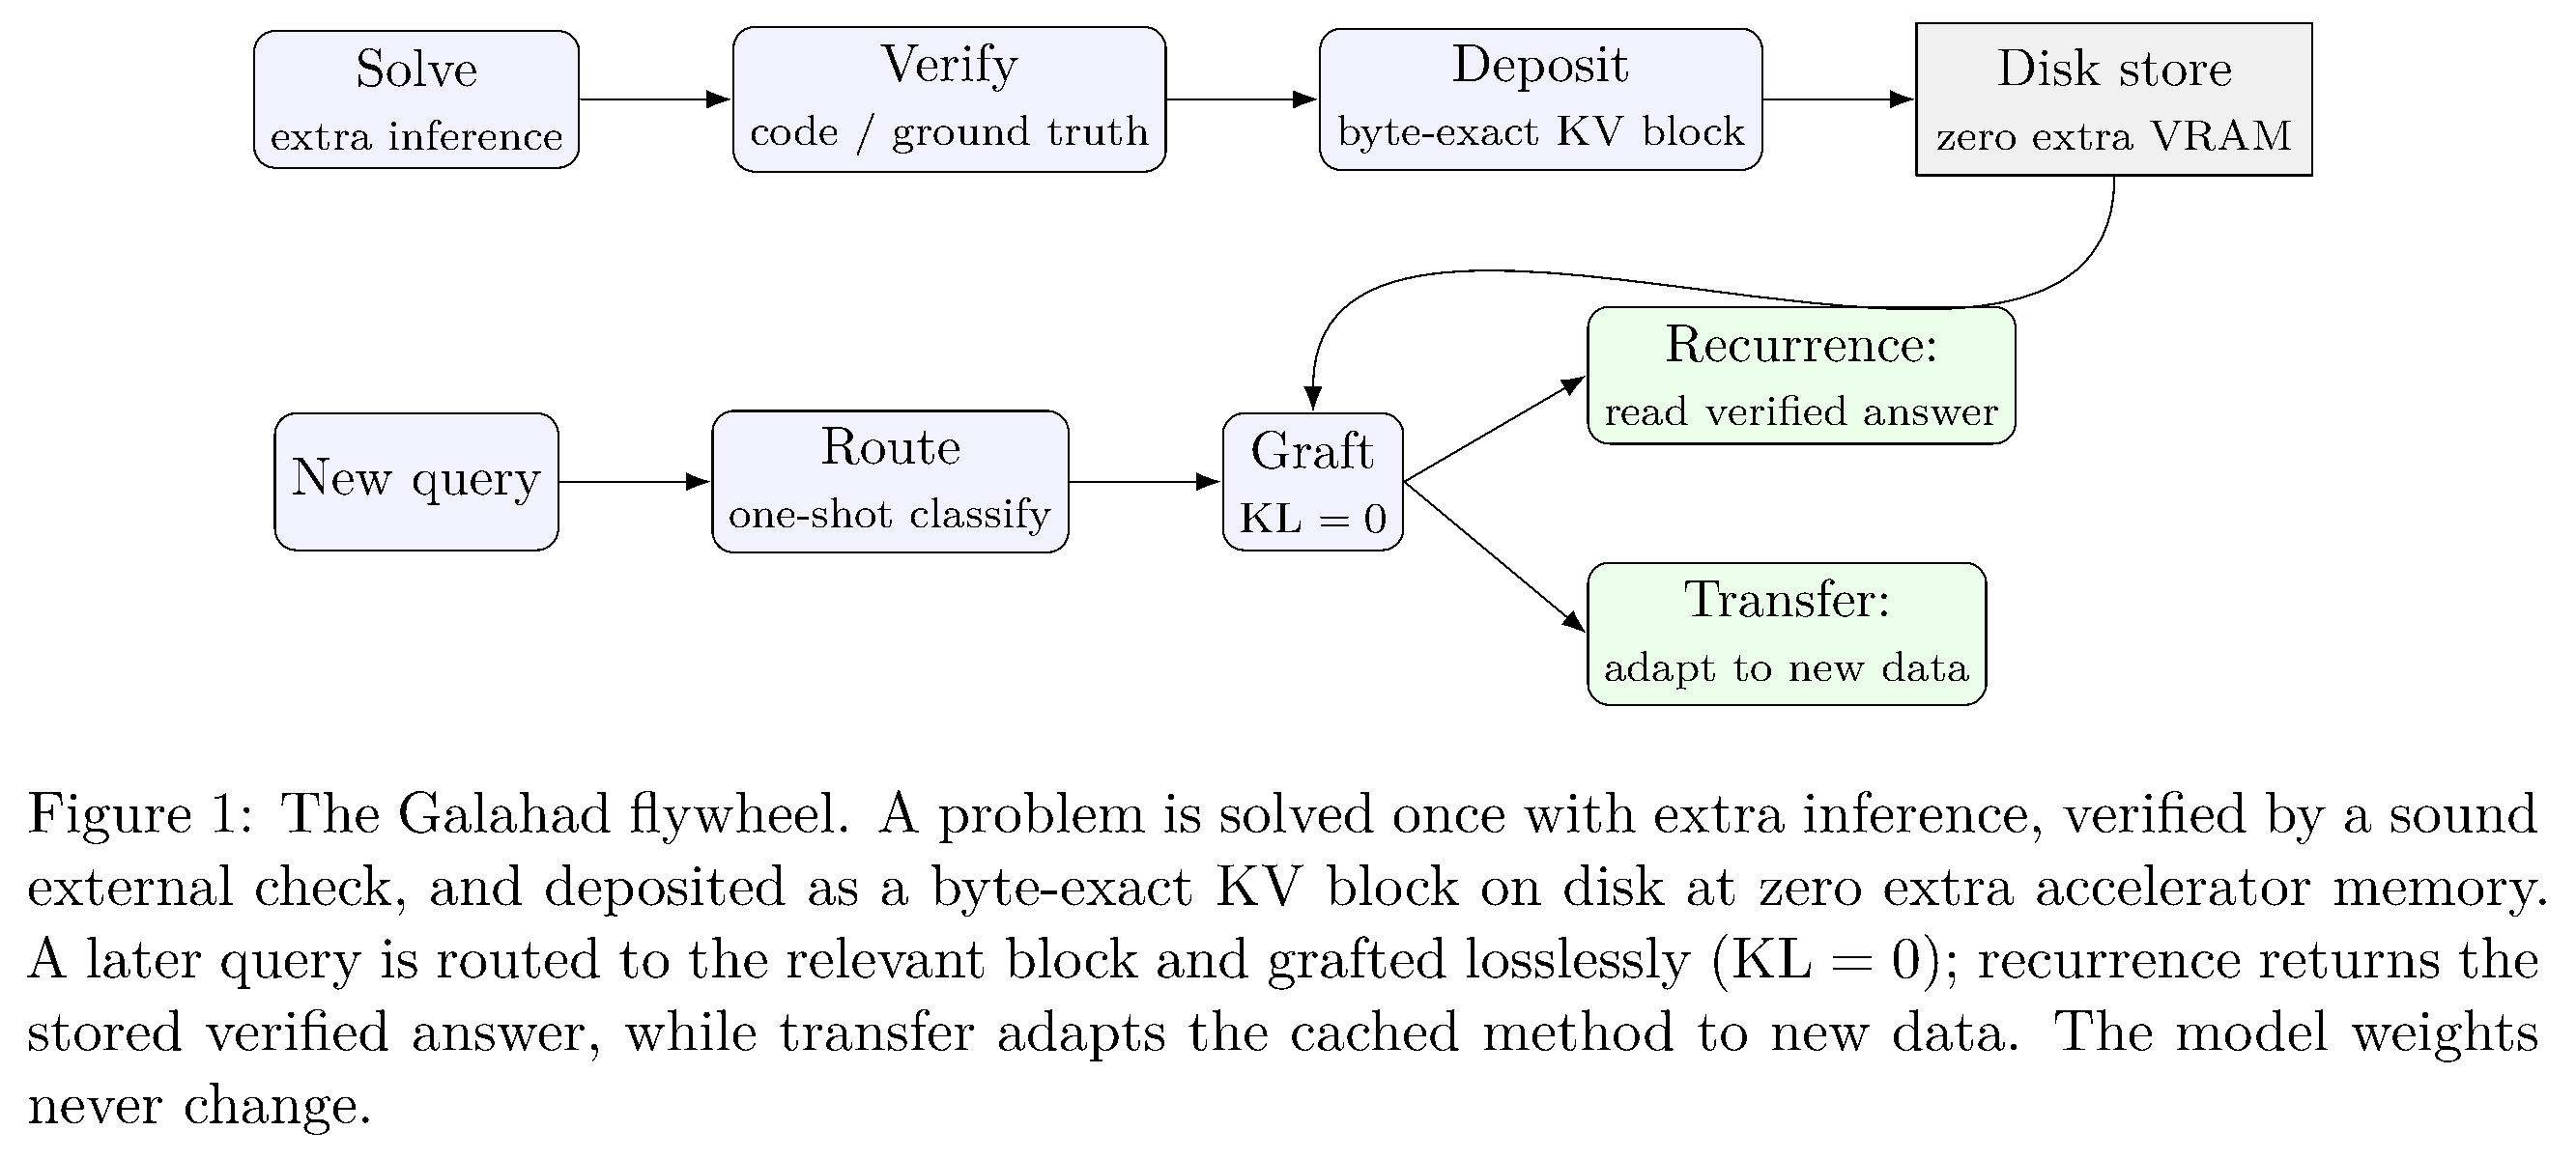
도표는 풀이를 저장하는 과정과 이후 사용하는 과정을 분리한다. 검증을 마친 뒤 상태를 저장하고, 새 query가 들어오면 관련 블록으로 routing한 다음 graft한다. 2갈래의 결과는 별도로 평가한 재출현 및 transfer 실험에 대응한다.
3.3 The flywheel protocol (Galahad)
Galahad는 고정된 모델이 안정적으로 풀지 못하는 문제에 추가 추론 자원을 쓰고, 결과를 외부에서 검증한 뒤 KV 상태를 저장한다. AIME에서는 생성한 코드를 실행해 출력 답이 알려진 정답과 같은지 확인하고, LiveBench에서는 ground truth와 대조한다. 재출현 문제는 정확한 조회로 저장된 답을 가져온다. Transfer에서는 새 문제를 분류하고 관련 블록 1개를 graft한 뒤 모델이 풀이법을 새 문제에 맞게 적용하도록 한다. 블록을 1개만 선택하는 이유는 flat prefix에서 관찰된 간섭을 피하기 위해서다.
4 Empirical Results
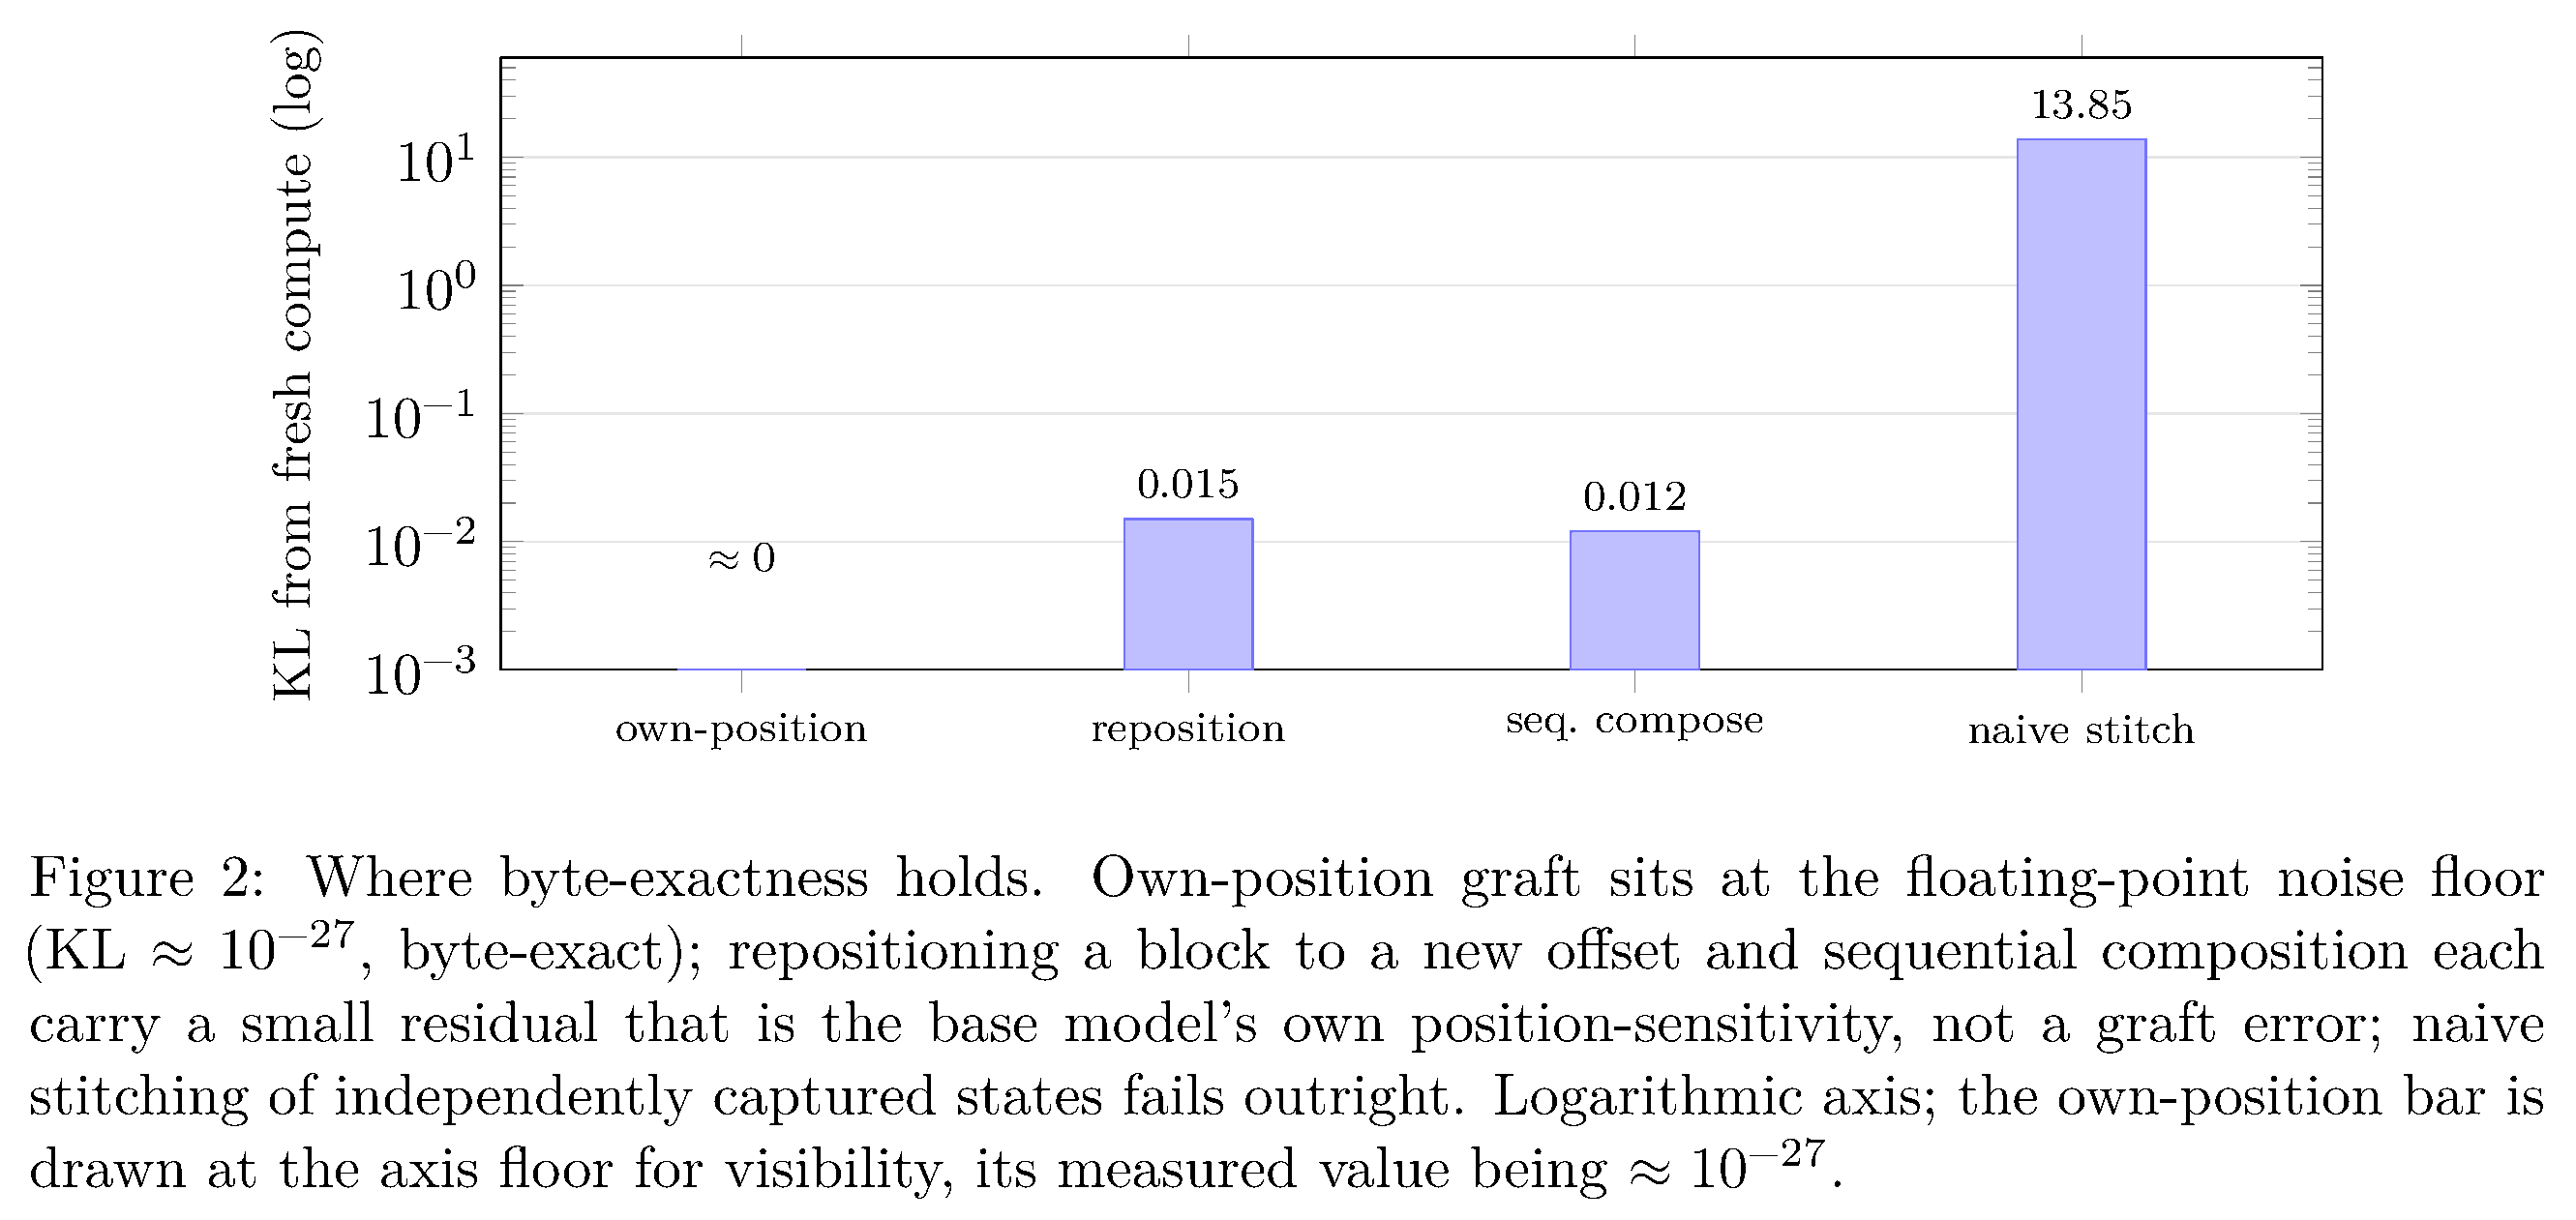
A를 복원한 뒤 B를 순차적으로 prefill하면 새로 계산한 단일 연결 입력과 비교한 KL 중앙값은 0.012이며, 50건 중 3건에서 argmax가 바뀐다. 독립적으로 캡처한 최종 상태를 이어 붙이면 B가 A에 attention하지 못하므로 KL은 13.85, argmax 변화는 50건 중 50건이다. 순차적 구성은 차이를 크게 줄이지만 단일 연결 입력을 새로 계산한 결과와 바이트 단위로 같지는 않다.
같은 아키텍처의 H100 pod 사이에 풀이 블록 8개를 복사했을 때 파일 SHA-256 digest가 일치했고, 다시 저장하지 않아도 8개 중 8개가 작동했다. 그러나 파일 hash 일치만으로는 머신 간 logit 바이트 일치를 입증할 수 없다. 부정적 결과로는 이미 216개 중 216개를 풀던 task family에서 효과가 없었던 사례, 품질이 낮은 캐시 절차로 인한 성능 저하, multi-exemplar block을 쓴 LiveBench 재출현 문제에서 20개 중 5개만 맞힌 사례가 있다.
4.1 The graft is bit-exact at its own position (KL = 0, SHA-equal)
두 층으로 된 fixture의 graft sample 50에서는 KL 중앙값과 p99가 모두 0이었고, graft 실패와 argmax 불일치도 없었다. logit 바이트 hash는 5개 중 5회에서 새로 계산한 결과와 일치했다. Gemma-4-12B의 sample 50개에서는 graft한 결과의 KL이 10^-27 수준의 fresh self-comparison 하한과 같았고, argmax 불일치가 없었으며, 보고된 SHA 일치 검사도 통과했다. 별도로 생성한 추론 문맥에 복원해도 시험한 조건에서 예상 logits가 재현됐다.
KL을 표시한 그래프에서 캡처한 위치로 복원한 경우는 측정된 self-comparison 하한에 놓인다. 위치를 옮기거나 순차적으로 구성한 경우는 약 0.01이며, 독립적인 이어 붙이기는 훨씬 큰 차이를 보인다. 바이트 일치가 보고된 경우는 캡처한 위치로 복원한 실험뿐이다.
4.2 The numerical regime of positional graft: own-position is the unique exact point
캡처한 블록을 다른 절대 위치로 옮기면 시험한 offset {8, 128, 1024, 4096}에서 graft와 fresh 계산 사이의 KL이 약 0.015다. Graft를 쓰지 않는 대조 실험에서도 같은 토큰을 위치 0과 128에서 새로 계산하면 KL이 약 0.014인 반면, fresh self-comparison은 0이다. 저자들은 이 잔차를 rotary encoding 아래에서의 부동소수점 위치 민감성으로 해석한다. 바이트 일치가 입증된 동작 조건은 캡처한 위치로의 복원이다.
4.3 The cost engine: an 85.6x prefill subsidy
Gemma-4-12B에서 11,994-token prompt를 처음부터 prefill하는 데는 1,547.3 ms가 걸린다. 캐시 상태를 복원하고 1 token을 진행하면 18.1 ms로 줄어 85.6배 빨라진다. 별도의 5,569-token continuation은 windowed layer에도 full-size KV를 활성화하고 요청을 캐시가 있는 slot에 고정한 뒤 1,087 ms에서 13 ms로 줄었다. 전자의 수정으로 명시된 64k-context 메모리 사용량은 19.7 GB에서 25.5 GB로 늘어난다.
4.4 Widening the usable context 87x at zero extra memory
디스크 저장소는 블록 88개에 2,854,766 tokens를 보관한다. 이는 설정된 32,768-token serving window의 87.1배이며, 해당 serving 설정 대비 추가 accelerator 메모리 없이 디스크 40.6 GB를 사용한다. 0~2.82M tokens의 표본 깊이에 심어 둔 needle은 7개 중 7개를 찾았다. 선택한 블록을 복원하는 데 약 0.29 s가 걸리고, 새 토큰 약 35개의 prefill이 추가된다. Window가 첫 블록에 남아 있을 때 마지막 needle을 물으면 잘못된 숫자를 반환하므로 저장소 전체가 현재의 attention 문맥에 올라와 있는 것은 아니다. 더 작은 실험에서는 464-token skill manual을 복원해 task 6개 중 6개를 올바르게 routing했다.
Capability, recurrence, and transfer
성능 실험은 전체 벤치마크의 시스템 점수, 다시 나온 문제의 정답 검색, 독립적으로 검증했거나 시간상 분리한 새 문제로의 적응을 구분한다. 마지막 유형만이 캐시된 방법을 새 문제에 적용하는 능력을 직접 평가한다.
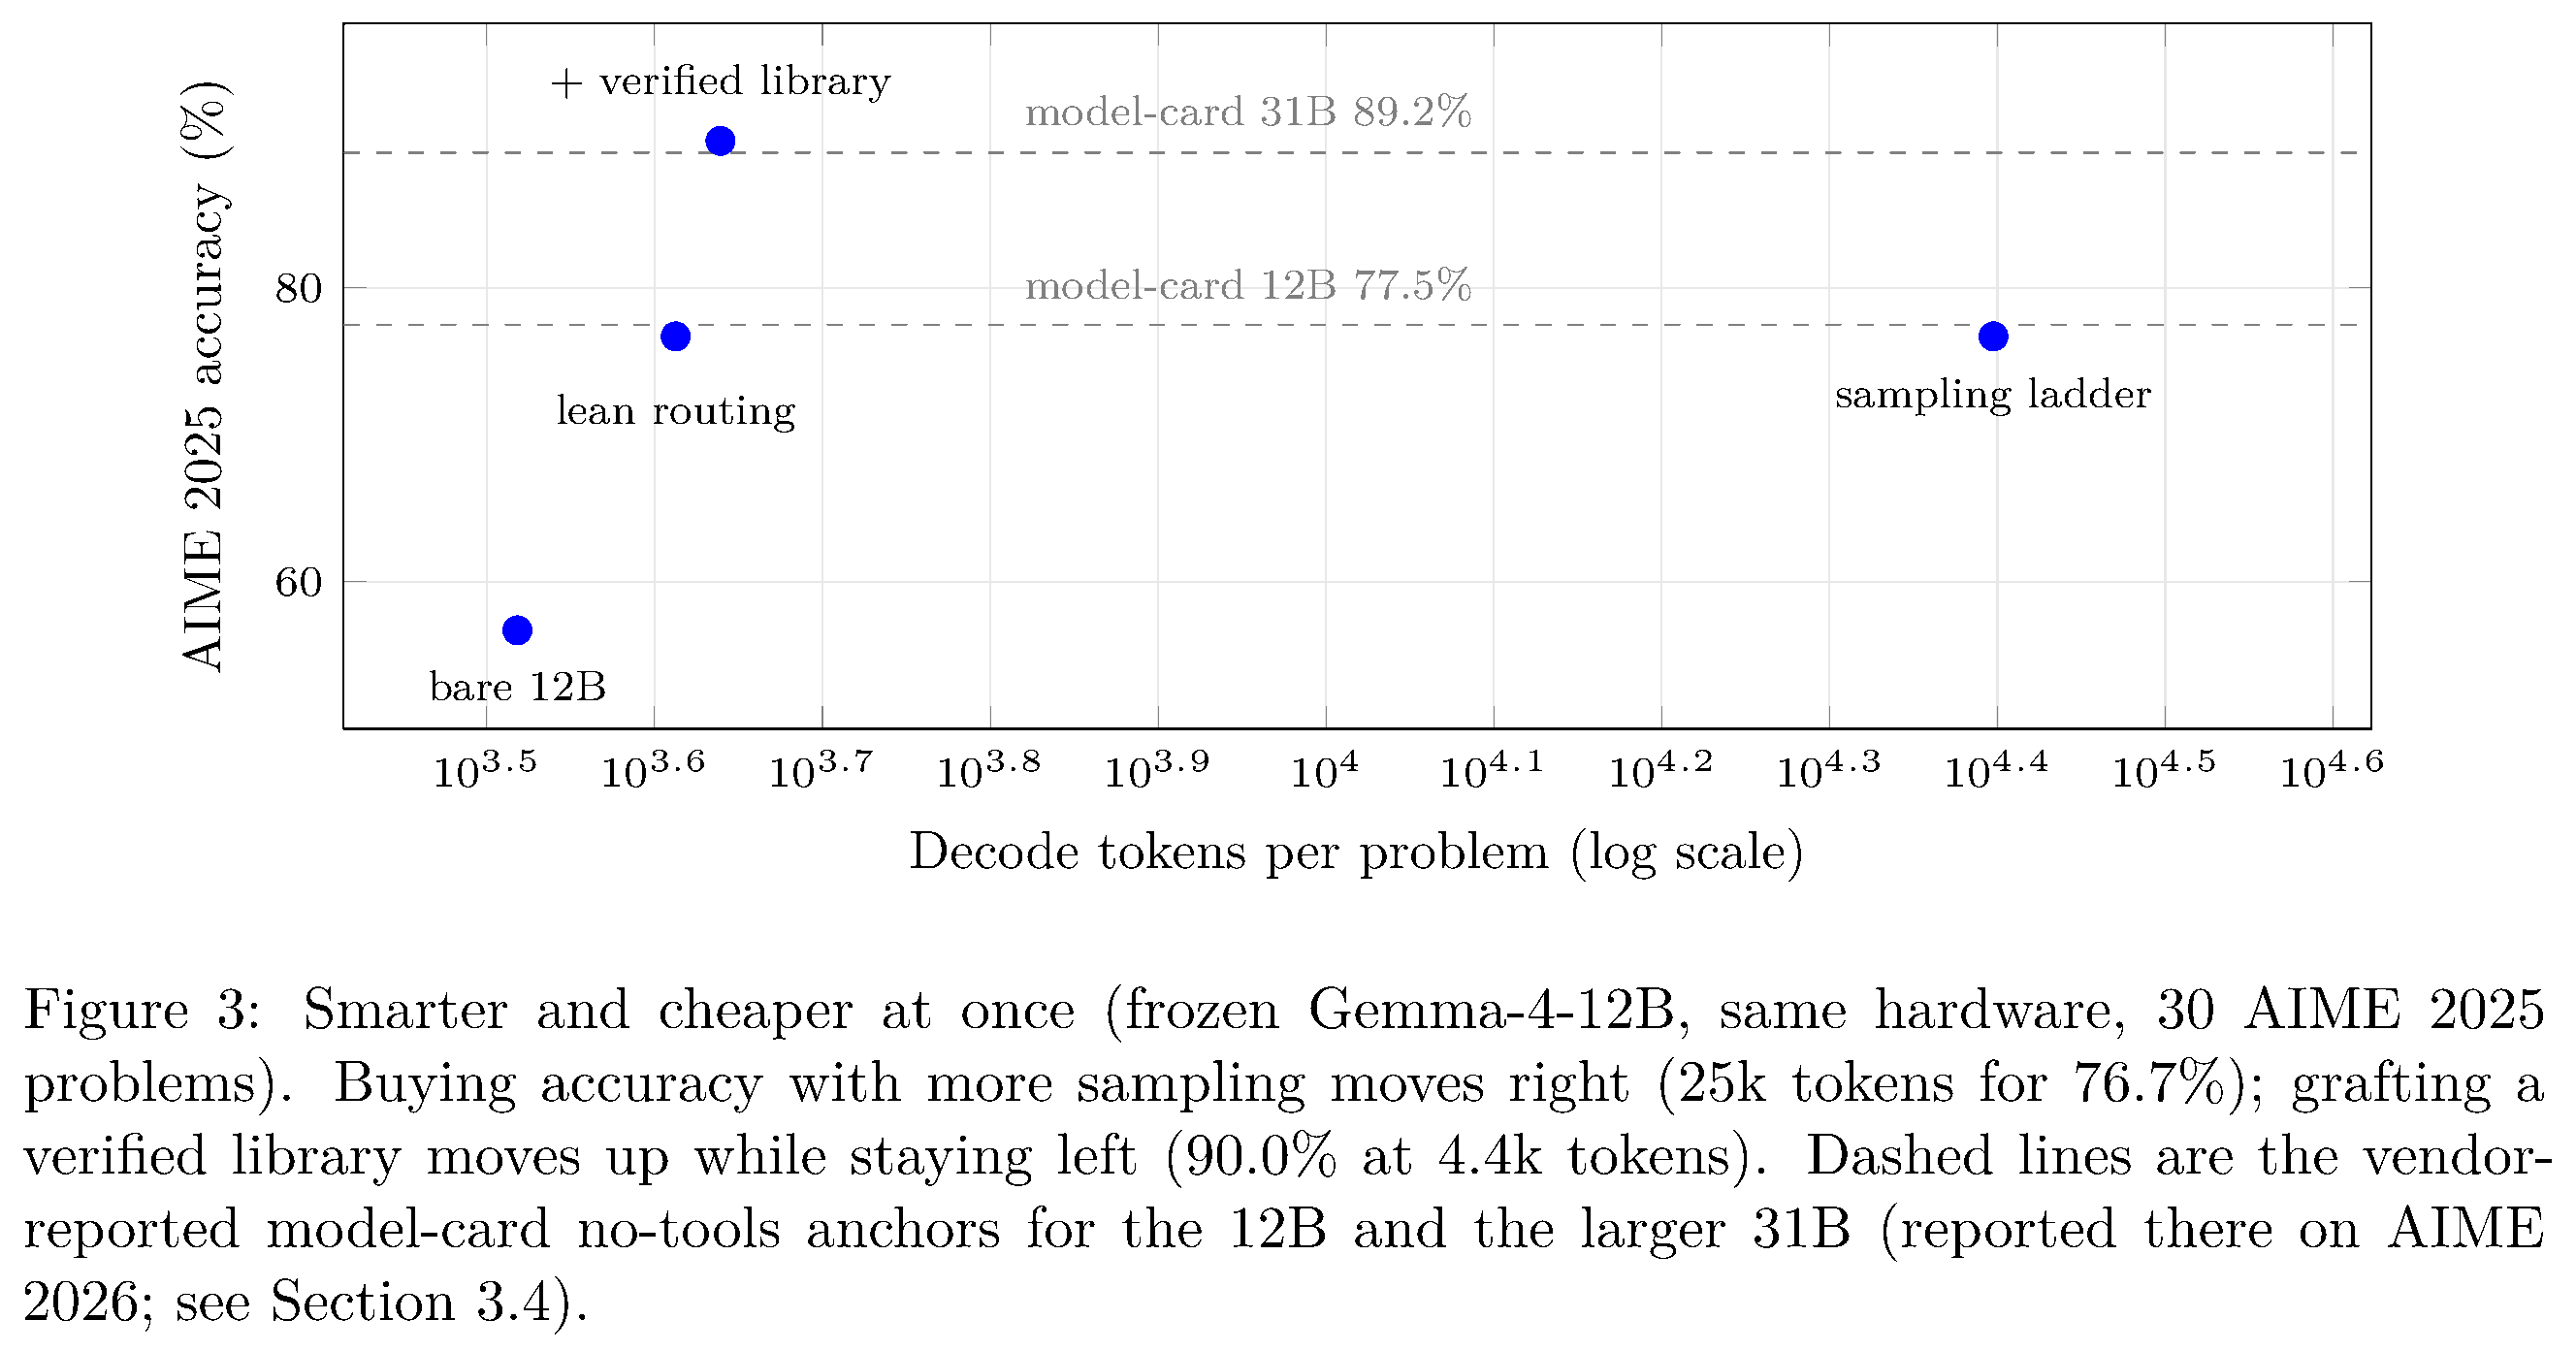
로컬 AIME 2025 평가에서는 검증된 라이브러리를 추가할 때 간소한 routing 설정의 정확도가 높아지며 decode tokens는 소폭 늘어난다. Sampling 설정은 훨씬 많은 tokens를 사용한다. 점선으로 표시한 model-card 기준점은 AIME 2026 결과이므로 같은 벤치마크의 비교 결과가 아니다.
4.5 The flywheel makes a 12B smarter: 80% to 93.3% on post-cutoff AIME
AIME 2025 문제 30개에서 고정된 12B의 가장 좋은 reasoning-plus-verification 설정은 30개 중 24개를 맞혀 80.0%를 기록한다. Confidence gate가 문제 8개를 불확실하다고 표시하고, graft한 라이브러리가 그중 6개를 해결한다. 그 결과 확신을 갖고 직접 맞힌 답 22개에 라이브러리 답 6개를 더해 30개 중 28개, 즉 93.3%가 된다. 별도의 간소한 code-routing 비교에서는 graft한 라이브러리가 문제당 4,360 decode tokens로 90.0%를 기록한다. 캐시 지식이 없으면 약 4,100 tokens에서 76.7%, sampling-and-voting을 쓰면 약 25,000 tokens에서 76.7%다. 이는 93.3% 실행과 설정이 다른 실험이다.
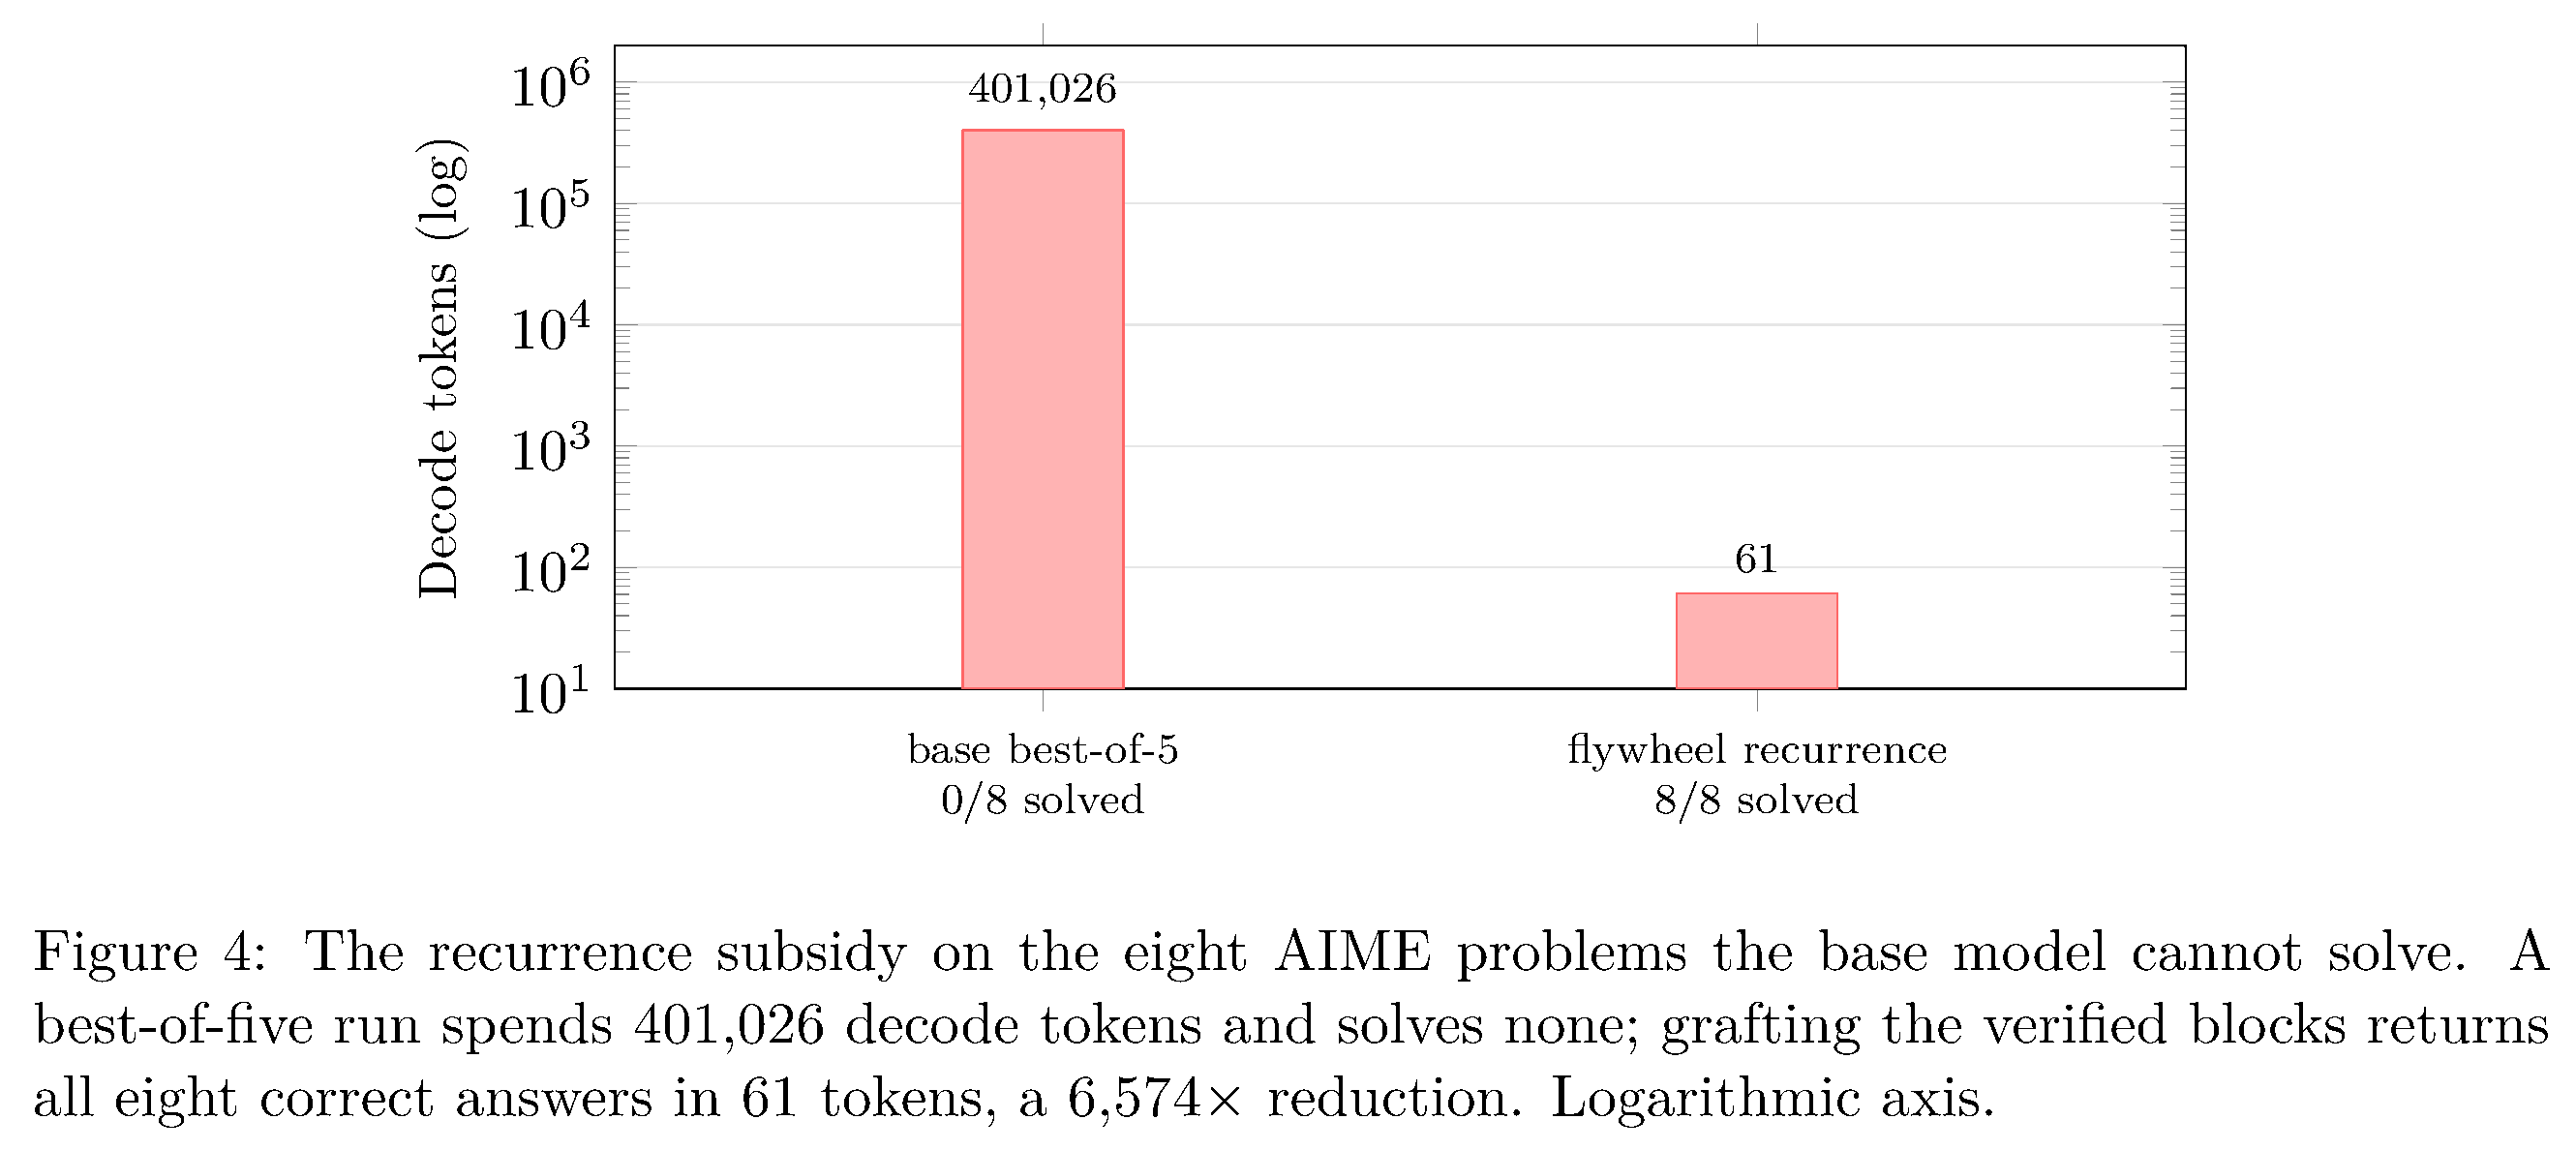
로그 척도 막대는 401,026 tokens를 사용하고도 문제를 풀지 못한 기본 sampling 실행과 검증·저장된 답 8개를 61 tokens로 반환한 실행을 대비한다. 이 비교는 재출현 문제의 비용 절감을 보여주며, 처음 보는 문제로의 transfer를 보여주지는 않는다.
4.6 The flywheel makes a 12B cheaper: 6,574x fewer tokens on recurrence
같은 AIME 문제 8개가 다시 나오면 검증된 개별 블록을 정확히 조회해 총 61 decode tokens로 8개 중 8개의 답을 반환하며, 문제당 평균은 7.6 tokens다. 기본 best-of-five 실행은 401,026 tokens를 쓰고도 8개 중 0개를 풀지 못해 보고된 토큰 절감률은 6,574배다. 이는 저장된 답의 검색 비용을 비교한 것이지 처음 보는 문제의 해결 능력을 비교한 것이 아니다. 2.8 s 실행의 적분 에너지 추정치는 0.053 Wh지만, 전력 샘플링 해상도가 제한되어 저자들은 보수적인 0.145 Wh 상한과 약 3,000배~8,700배의 에너지 절감 범위를 보고한다.
4.7 Transfer: the same store generalizes to new data, within a stated boundary
상수를 바꾸고 독립적으로 정답을 검증한 AIME 변형 문제 7개에서 12B는 7개 중 7개를 의도한 블록으로 routing하지만, 자율적으로는 7개 중 5개만 푼다. #11에서는 코드에 고정된 radical 때문에 시간 초과가 나고, #28에서는 구조적 상수를 과도하게 바꾼다. 의도한 literal을 기계적으로 치환하면 7개를 모두 푼다. #10에는 동일 구조를 유지하는 적절한 변형 문제가 없어 이 실험은 문제 8개가 아니라 7개를 다룬다.
Scale and operational behavior
규모 확장 실험은 Hopper에서 고정된 31B의 기능적 결과와 Blackwell에서 별도로 실시한 바이트 단위 재현 실험을 보고한다. 이식성·routing·paging 실험은 저장한 블록이 같은 아키텍처의 다른 서버에서도 작동하는지, 복원이 새 prefill보다 비용상 유리한지 확인한다.
4.9 Cross-architecture scale-up: a frozen 31B on an H100
임대한 H100에서 Taliesin을 사용한 고정된 Gemma-4-31B는 재출현 문제 8개 중 8개, held-out AIME 변형 문제 7개 중 7개를 맞혔다. 어려운 문제 8개에 대한 캐시 답을 포함한 전체 벤치마크 시스템 점수는 30개 중 30개이며, H100에서 bare model을 다시 실행한 결과는 보고하지 않는다. Transfer에는 25,361 decode tokens, 72.15 Wh, 8.4 min이 들고, full-30 run에는 56,189 tokens, 194.45 Wh, 21.9 min이 든다. 질문 식별자가 겹치지 않는 시간상 held-out LiveBench 분할에서는 단일 블록 routing이 60개 중 43개(71.7%)를 맞혀, 병합 블록의 56.7%를 웃돈다.
4.10 Cross-architecture byte-exactness: a pre-registered B200 replay
사전 등록된 B200 재현 실험에서 고정된 Gemma-4-31B는 graft 실패와 50회 실험의 argmax 불일치가 0이었다. Graft KL은 fresh self-comparison 하한과 같았고, 10개 중 10회에서 logit 바이트가 SHA 기준으로 일치했다. Graft를 쓰지 않은 채 서로 다른 위치에서 prefill하면 여전히 차이가 난다. 측정된 중앙값은 약 7 × 10^-4로 12B 결과보다 약 19 times 작다. 바이트 정확성은 RTX 5090과 B200에서 측정했지만 기능을 시험한 H100에서는 측정하지 않았다. 저자들은 위치 효과가 0이 아닐 것이라는 예측은 맞았으나 그 크기 예측은 틀렸다고 보고한다.
4.12 Systems behavior: router misrouting and disk paging, measured
라이브러리 내 one-shot transfer routing은 로컬 사례 15개 중 15개에서 정확했고, 보고된 Wilson 95% 구간은 약 79.6%~100%다. 분포 밖 prompt 4개 중 4개에는 블록을 선택하지 않았다. Graft와 답변 사이에 confidence gate가 없으므로 잘못된 블록을 확신하고 graft할 가능성은 남는다. 748~5,977 tokens 구간에서 다시 prefill하는 시간은 96.1~748.3 ms로 늘지만, 첫 접근 시 디스크 복원 시간은 57.7~85.8 ms로 늘어 측정된 복원 비용상의 이점이 1.7배에서 8.7배로 커진다. Page cache를 강제로 비우지 않았고 2-slot 실험이므로 높은 동시성에서의 성능을 주장하지 않는다.
5 Discussion
비용 절감 주장은 매 query마다 sampling을 반복하지 않고 외부에서 검증한 저장 상태를 재사용하는 데 달려 있다. 정확성 주장은 설정을 맞추고 캡처한 위치에 단일 블록을 복원한 경우에 적용된다. 위치를 옮기면 바이트가 일치하지 않고 독립적인 이어 붙이기는 실패한다. 순차적 구성은 작동하지만 단일 연결 입력의 prefill 결과와 차이가 난다. 논문은 실행 전 입력 hash와 실행 후 출력 hash를 보고하며, 생성 결과와 solver code를 보관해 점수를 확인할 수 있도록 했다. 생성을 재현하려면 비공개 Merlin/Taliesin suite가 필요하다.
5.3 Limitations
캐시된 코드에 문제별 상수가 고정돼 있으면 transfer에 실패할 수 있고, multi-exemplar block은 재출현 문제에서 성능이 낮다. 이미 알려진 절차를 캐시하면 오히려 성능이 떨어질 수도 있다. Router에는 graft 이후의 confidence gate가 없고, 바이트 일치에는 동일 아키텍처와 설정이 필요하다. Paging 근거는 단일 노드 실험이며 동시성 연구가 아니다. 결론의 AIME 93.3%와 100%는 시스템 점수로, 각각의 held-out transfer 결과인 7개 중 5개와 7개 중 7개와 구별해야 한다. 재현성 설명은 비공개 엔진 없이 확인할 수 있는 범위를 밝히고 Sietse Schelpe를 단독 저자이자 발명자로 명시한다.
부록
- 제공된 PDF에는 별도의 실험 appendix가 없다. 재현성 설명에 따르면 실행 전에는 dataset과 runner script의 hash를, 실행 후에는 결과와 원본 generation의 hash를 기록했다. 보관된 solver code로 독점 엔진 없이도 점수를 확인할 수 있지만, generation을 재현하려면 비공개 benchmark suite가 필요하다.
짧은 생각
가장 강한 수치 근거는 설정을 맞춘 fresh 계산과 graft의 logit 바이트 비교에 graft를 쓰지 않는 위치 대조 실험을 결합한 것이다. 시스템 근거는 prefill과 복원 비용을 별도로 측정한다. 해석할 때는 저장된 답을 저렴하게 검색하는 성능, 실시간 풀이와 캐시 답을 합친 벤치마크 점수, 새 문제로의 transfer를 구분해야 한다. Transfer는 문제별 상수를 다시 도출하지 않고 캐시된 방법을 적용할 수 있는지에도 좌우된다.