


Language Models Can Control Their Own Attention 요약 설명
02 Sep 2026 | Paper Review Sparse Attention Long-Context Language Models KV Cache목차
- 요약
- 2. Declarative Attention
- 3. When does DA pay off?
- 4. Experimental settings
- 5. Results
- 6. Analysis
- 8. Discussion, Limitations, and Future Work
- 부록
- 짧은 생각
이번 글에서는 Language Models Can Control Their Own Attention 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 9월 2일(Arxiv)
- Ho, Namgyu, Ahmad, Huzama, Koh, Woosung, Yun, Se-Young, Schuster, Tal, Santos, Cicero Nogueira dos.
- KAIST AI, Google DeepMind
- 논문 링크
요약
- Declarative Attention(DA)는 모델이 생성한 attention 선언을 디코딩 시점의 KV-cache mask로 바꾸는 long-context language model용 zero-shot 추론 프로토콜이다. 15개 long-context task에서 평균 attended token 감소는 Gemma-4-31B 52.0%, Qwen-3.6-27B 31.1%였고, 정확도 하락은 각각 1.27pp와 2.75pp였다. 모델은 <global>, <focus>, <local> 구간을 번갈아 사용하며, 15개 task에서 DA는 충분한 성능을 갖춘 모델의 평균 정확도를 소폭 낮추면서 attended token 수를 줄인다.
2. Declarative Attention
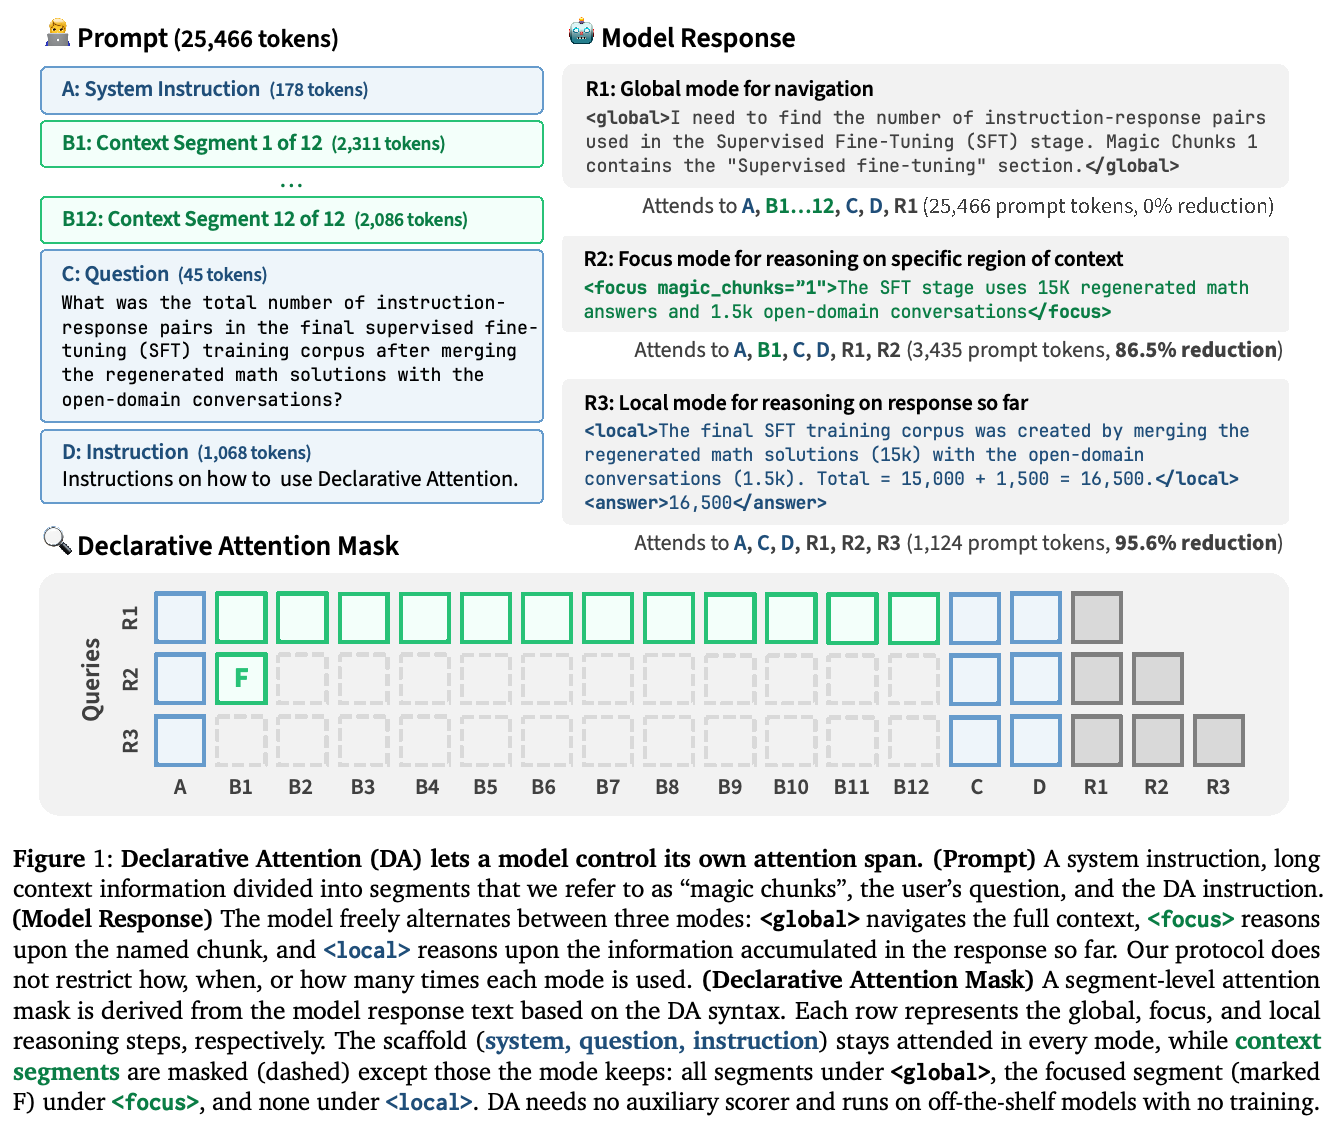
DA는 proxy score나 hidden activation으로 관련 token을 예측하지 않고, 생성한 reasoning trace에서 attention 범위를 명시한다. state machine은 선언을 파싱해 system scaffold, 질문, instruction, 생성 응답은 유지하면서 보이는 KV-cache block을 변경한다.
2.1. Prompt overview
프롬프트는 항상 보이는 scaffold와 긴 context를 분리한다. scaffold는 짧은 system instruction, 사용자 질문, DA instruction으로 구성되며, state machine은 context 영역을 선택적으로 노출한다.
2.2. Context delivery
DA는 context를 2048 token을 목표로 하는 주소 지정 가능한 magic chunk로 나눈다. segmenter는 paragraph, newline, sentence, clause, word 경계 순으로 선호하며, retrieval tool을 실행하지 않고 모의 tool-use transcript 안에 chunk를 제시한다.
2.3. Decode-time interventions
runtime은 global mode에서 시작한다. <focus magic_chunks=”K”> 또는 <local>을 열면 mask가 변경되고, 이에 대응하는 닫는 tag를 만나면 다시 global mode로 돌아간다. vLLM 통합은 매 decode step마다 요청의 KV-cache block table을 다시 작성하며, 기존 attention kernel을 그대로 실행할 수 있도록 전체 block을 유지한다.
예시는 global 탐색, Magic Chunk 1에서의 집중 추출, local 산술 계산을 거치는 응답을 보여 준다. mask는 보이는 prompt 내용을 전체 25,466 prompt token에서 scaffold와 1개 chunk로, 이후 scaffold와 생성 trace만으로 줄인다.
3. When does DA pay off?
DA는 추가 decoding step과 step당 global-attention memory read 감소를 맞바꾼다. 논문은 KV read가 memory-bound이며 context 길이에 따라 증가하는 반면, roofline 분석에서는 FFN 작업을 compute-bound로 가정하는 large-batch, long-context serving에서 이 절충이 유리하다고 주장한다.
4. Experimental settings
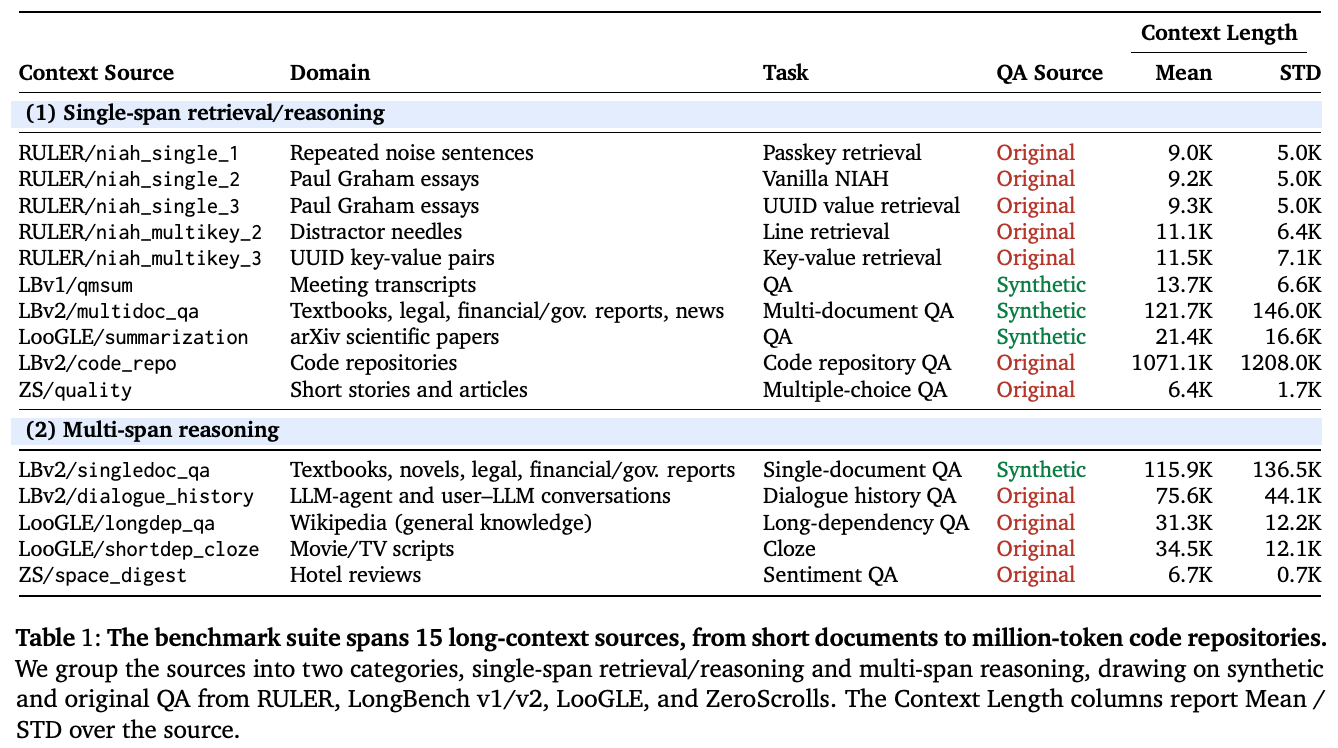
실험은 Gemma와 Qwen 모델 6개, RULER, LongBench, LooGLE, ZeroSCROLLS의 long-context task 15개를 다룬다. 244K token을 넘는 context와 Gemma-4-E4B의 경우 116K token을 넘는 context는 제외했다. 각 source에서는 fixed seed로 뽑은 예시를 최대 128개 사용하고, thinking은 비활성화했으며, generation은 8K token으로 제한했다.
benchmark suite는 single-span retrieval/reasoning과 multi-span reasoning으로 나뉜 15개 source를 포함한다. context는 약 6–14K token부터 시작하며, input-length filtering 전 LBv2/code_repo의 평균 context 길이는 1071.1K token이다.
5. Results
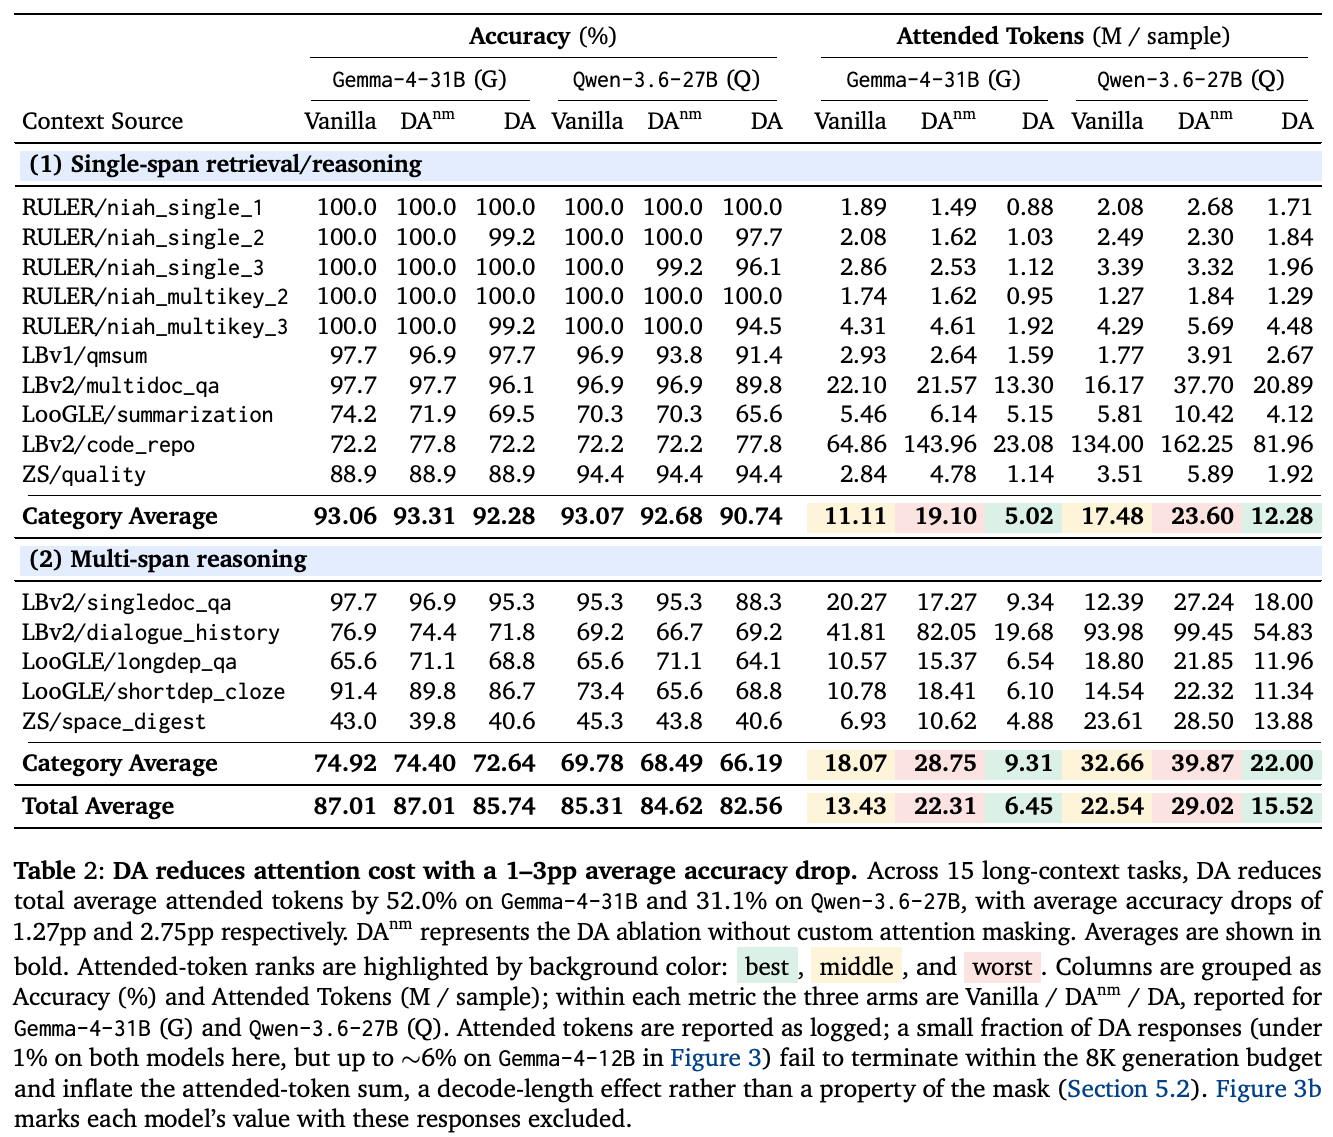
결과는 full causal attention을 사용하는 Vanilla, full attention으로 DA prompt를 사용하는 DA-no-mask(DAnm), dynamic masking을 사용하는 DA를 비교한다. 정확도는 생성한 acceptance rubric과 Qwen-3.5-4B로 판정하며, attended token은 decoding 동안 접근한 KV position을 합산한다. roofline 추정은 최적화된 B200 serving을 대상으로 한다.
5.1. Main results
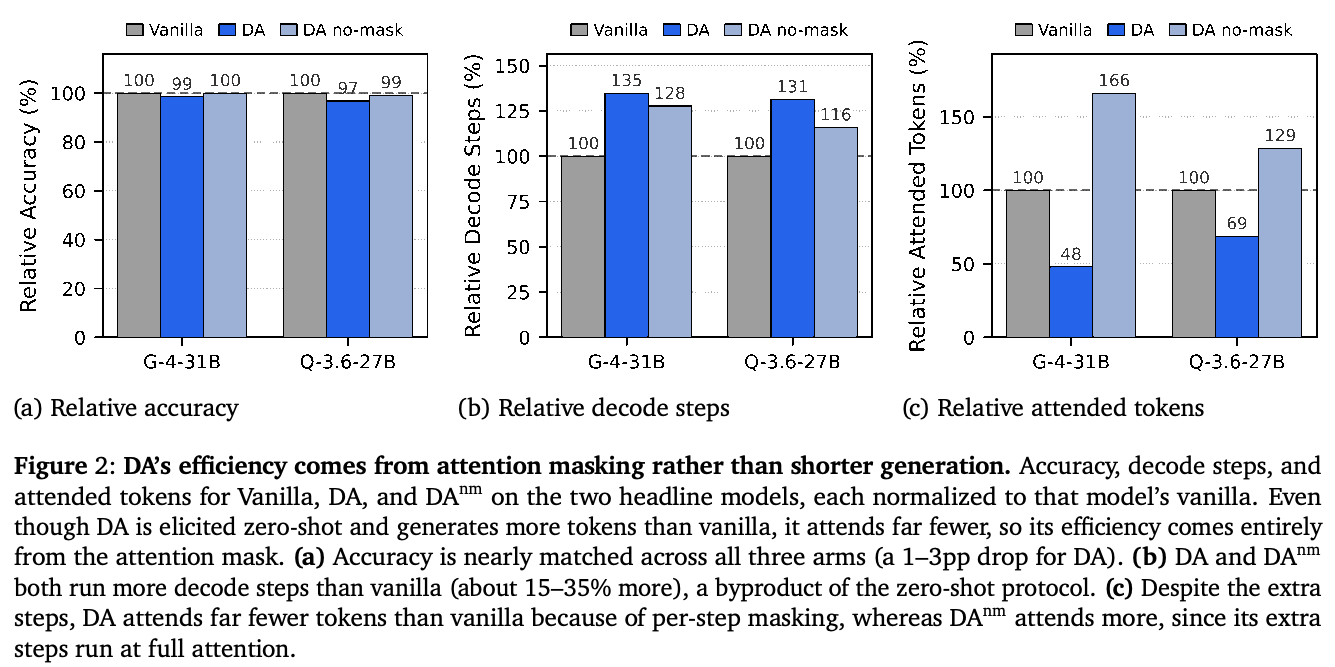
15개 task 전체에서 DA는 Gemma-4-31B의 정확도를 87.01%에서 85.74%로, Qwen-3.6-27B의 정확도를 85.31%에서 82.56%로 낮춘다. sample당 attended token은 각각 13.43M에서 6.45M으로, 22.54M에서 15.52M으로 줄인다. DAnm은 정확도를 거의 유지하지만 attended-token 총량을 22.31M과 29.02M으로 높인다. 이는 masking이 순효율 향상과 DA 정확도 비용 대부분을 만든다는 점을 보여 준다.
상세 task 결과는 DA가 대부분의 source에서 Vanilla보다 attended token을 줄이지만, task별 정확도와 절감량은 다름을 보여 준다. DAnm은 형식을 거의 손실 없이 유지하면서도 attended-token 총량을 크게 늘릴 수 있어 masking 효과를 분리해 보인다.
vanilla 대비 DA는 Gemma-4-31B에서 decode step의 135%, Qwen-3.6-27B에서 131%를 사용하지만, attention을 적용하는 token은 각각 48%와 69%에 불과하다. DAnm도 step을 추가하지만 vanilla token의 166%와 129%에 attention을 적용해 mask가 절감 효과의 원천임을 보여 준다.
5.2. Model capability scaling
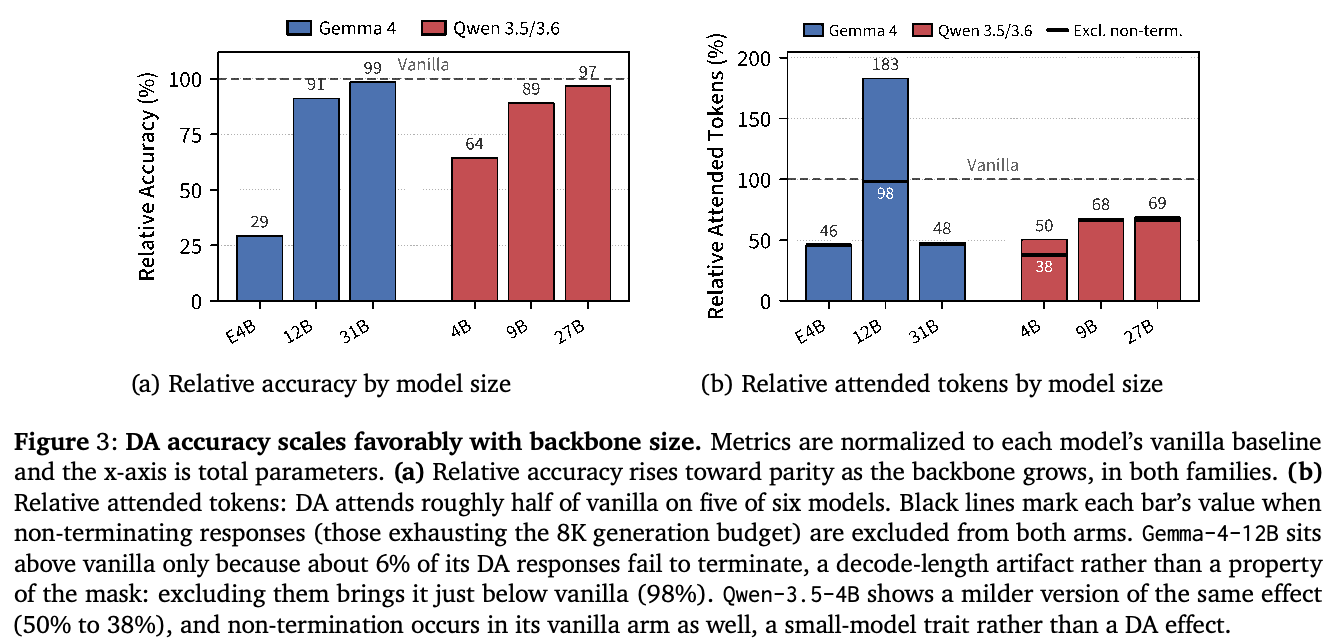
DA의 상대 정확도는 model scale에 따라 증가한다. Gemma 4에서는 vanilla의 29%에서 99%로, Qwen 3.5/3.6에서는 64%에서 97%로 높아진다. 6개 모델 중 5개는 vanilla보다 적은 token에 attention을 적용한다. Gemma-4-12B는 DA 응답의 약 6%가 8K 예산을 소진하기 때문에 예외이며, 종료하지 않는 응답을 제외하면 vanilla attended token의 98%까지 낮아진다.
두 model family 모두에서 model이 커질수록 상대 정확도는 vanilla에 근접한다. 종료하지 않는 응답이 총량을 부풀리는 경우를 제외하면 scale 전반에서 attended-token 감소는 대체로 비슷하며, Gemma-4-12B의 이상 현상도 종료하지 않는 응답을 제외하면 대부분 사라진다.
5.3. Context-length scaling
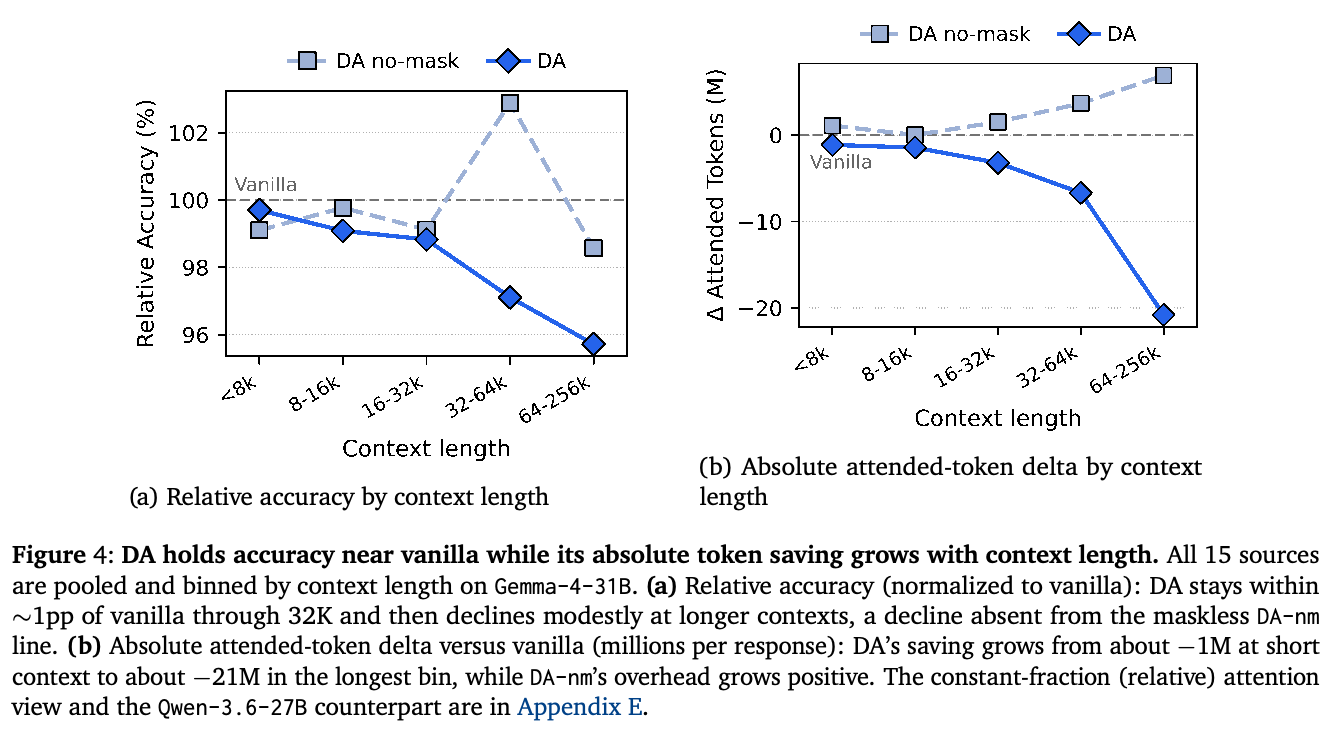
Gemma-4-31B에서 DA는 32K-token context까지 vanilla와 약 1 percentage point 이내의 차이를 유지한 뒤, 64–256K 구간에서 상대 정확도가 약 96%까지 낮아진다. masking은 context가 늘어도 대체로 일정한 비율의 감소를 유지하므로, 절대 절감량은 짧은 context의 약 1M attended token에서 가장 긴 구간의 약 21M으로 증가한다.
Gemma-4-31B 예시를 context 길이별로 모으면 DA는 긴 context에서 DAnm에는 없는 작은 정확도 차이를 보인다. DA의 attended-token 이점은 절대량 기준으로 가장 긴 구간에서 약 21M token 적게 사용하는 수준까지 증가한다.
5.4. Efficiency results
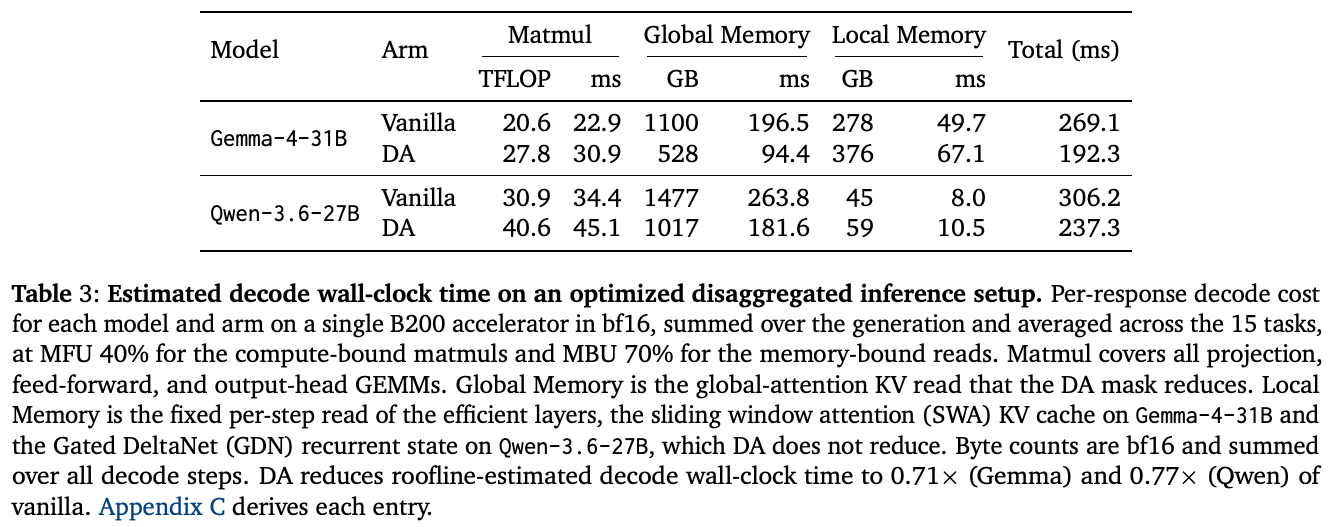
matrix multiply의 MFU를 40%, memory read의 MBU를 70%로 두고 bf16의 B200 accelerator 1개에 roofline 추정을 적용하면, DA는 Gemma-4-31B의 추정 decode 시간을 269.1 ms에서 192.3 ms로, Qwen-3.6-27B의 시간을 306.2 ms에서 237.3 ms로 줄인다. 이는 측정한 end-to-end latency가 아닌 이론적 decode-only 추정치이며, 최적화된 disaggregated large-batch serving을 가정한다.
분해 결과는 vanilla decode 시간 대부분이 global-memory read에 쓰임을 보여 준다. Gemma에서는 269.1 ms 중 196.5 ms, Qwen에서는 306.2 ms 중 263.8 ms다. DA는 이 항을 낮추지만 추가 decoding으로 matmul과 local-memory 비용이 증가하며, 추정 총시간은 192.3 ms와 237.3 ms가 된다.
6. Analysis
분석은 DA의 절감 효과를 focus와 local mode에 머문 시간으로 설명하고, 모델이 유효한 focus 선언을 생성하는지 측정한다. 또한 verbosity와 invalid reference를 포함한 zero-shot protocol의 한계와 block-masking mechanism을 구분한다.
6.1. Efficiency impact of DA modes
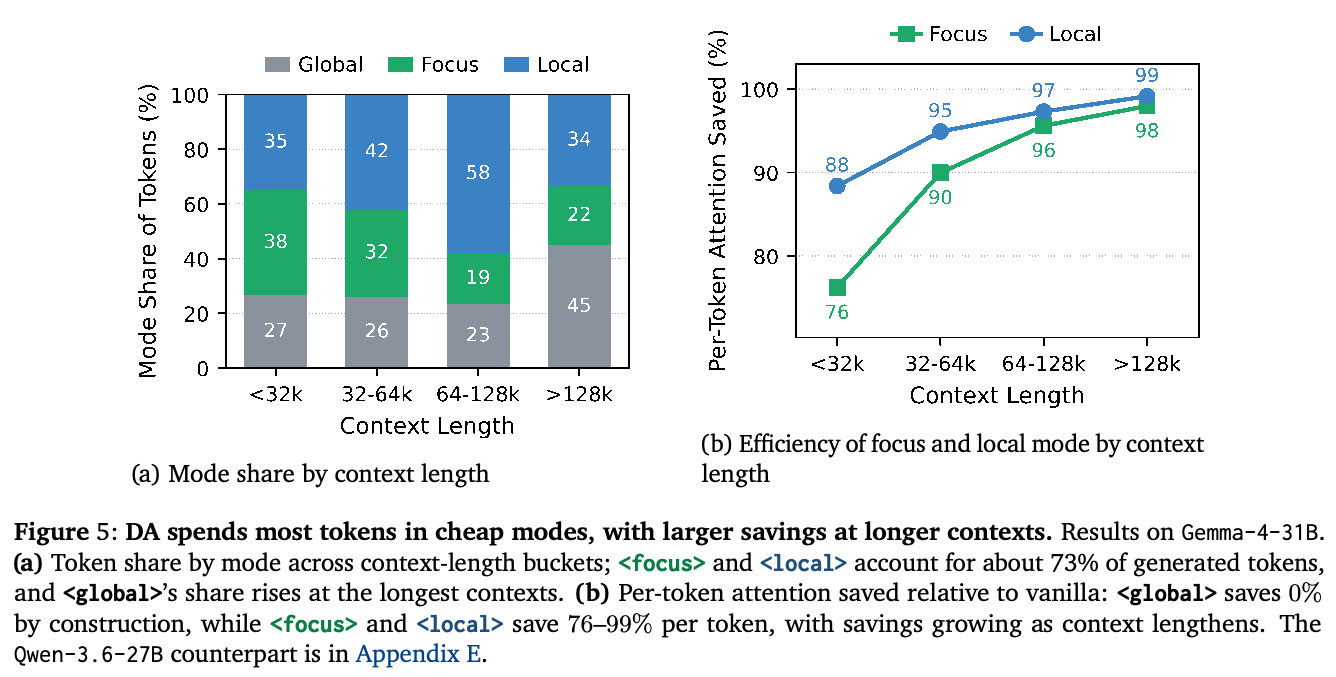
Gemma-4-31B에서 생성 token의 약 27%는 global mode에 속하고, focus와 local mode가 나머지 73%를 차지한다. focus와 local은 평균적으로 vanilla step token의 약 12%와 6%에 attention을 적용해 token당 76–99%를 절감한다. 다만 가장 긴 context bucket에서는 global 사용 비중이 약 45%까지 증가한다.
focus와 local mode는 generation에서 대부분을 차지하고 token당 read를 크게 줄여, output이 길어져도 절감 효과를 만든다. 긴 context에서 global-mode 비중이 증가하면 전체 절감 효과는 제한된다.
6.2. Protocol adherence
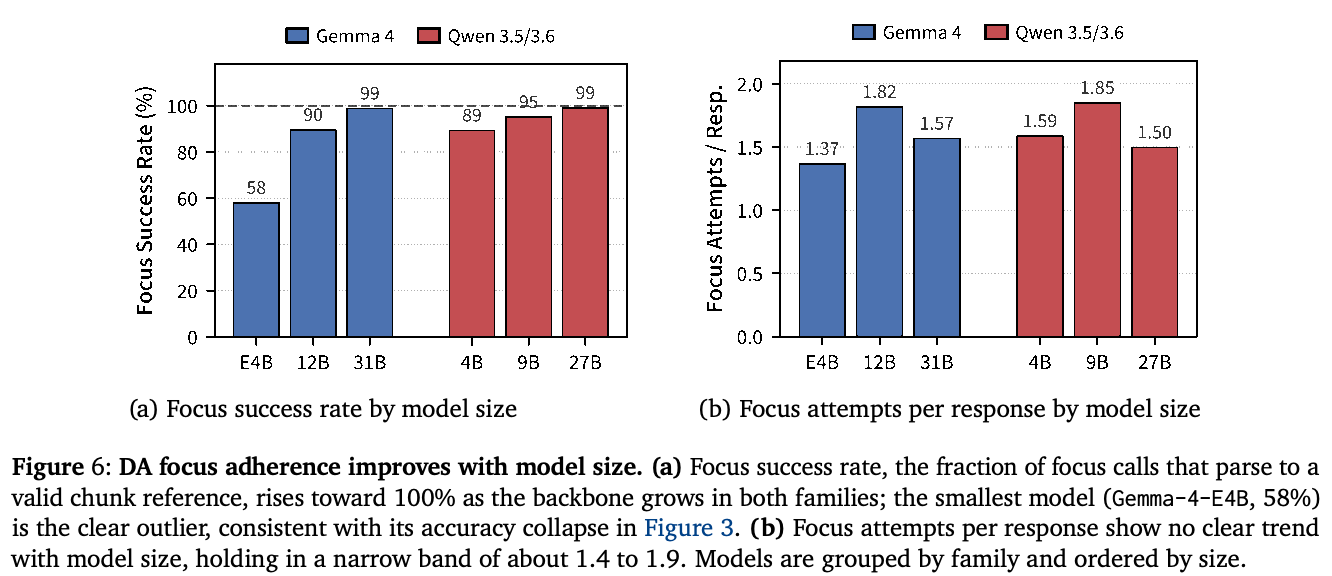
Focus-call 유효성은 model size에 따라 높아진다. Gemma-4-E4B에서는 58%에서 Gemma-4-31B에서는 99%로, Qwen-3.5-4B에서는 89%에서 Qwen-3.6-27B에서는 99%로 증가한다. Focus 시도는 응답당 약 1.4–1.9회 수준을 유지한다. 따라서 큰 모델은 focus call 수를 줄이기보다 유효한 chunk reference를 생성하면서 주로 개선된다.
가장 큰 모델에서는 유효한 focus reference가 거의 보편적으로 생성되지만, 시도 횟수는 scale에 따라 일관되게 줄지 않는다. 이는 focus retrieval 자체를 피하는 것이 아니라 protocol 준수가 개선된 결과임을 구분해 보여 준다.
8. Discussion, Limitations, and Future Work
논문은 DA를 latent sparse-attention selection의 가역적이고 명시적인 대안으로 제시한다. 전체 cache는 계속 상주하지만, 모델이 읽을 block을 제어한다. 한계로는 남아 있는 global-mode 비용, zero-shot 분해 품질, 인위적인 benchmark segmentation, non-thinking-mode 평가, 측정한 end-to-end latency가 아닌 roofline projection을 든다.
8.2. Further potential of DA with post-training and in agentic settings
저자들은 decoding step의 약 1/3 증가를 줄이고 task 구조에 더 잘 맞추기 위해 post-training DA policy를 제안한다. 또한 agentic system에는 tool output, user turn, retrieved passage처럼 자연스럽게 주소를 지정할 수 있는 단위가 있다고 제안하지만, 이 설정은 평가하지 않는다.
8.3. Synergy with modern efficient inference techniques
DA는 비용이 큰 global 구간에는 scan을 적용하고 focus 및 local 구간에는 선언을 사용하는 방식으로 경량 scan-based sparse attention과 결합할 수 있다. 또한 masking은 verification pass당 KV read를 낮추고 speculation은 순차적 decode pass를 줄이므로 speculative decoding을 보완할 수 있다.
부록
- appendix는 관련 sparse-attention 및 KV-cache 방법, vLLM 통합, roofline 유도, dataset, judge validation, prompt 구성, sampling, 추가 결과, 전체 prompt를 상세히 다룬다. 또한 2가지 구조적 실패 유형을 제시한다. segmentation은 필요한 evidence를 훼손할 수 있고, document 길이에 비례하는 output은 step당 attention이 줄어도 end-to-end 절감 효과를 없앨 수 있다.
짧은 생각
DA는 모델의 텍스트 계획이 attention mask를 직접 제어하므로 해석 가능한 sparse-decoding mechanism을 제공한다. 가장 강한 근거는 성능이 충분한 모델에서 attended-token을 줄인 결과다. 실용적 배포 주장을 뒷받침하려면 end-to-end latency 측정, thinking-mode 평가, global navigation과 구조적으로 어려운 task를 위한 개선된 policy가 여전히 필요하다.