


Paper2Video: Automatic Video Generation from Scientific Papers 요약 설명
06 Oct 2025 | Paper Review Presentation Video Generation Multi-Agent Coordination Benchmark목차
이번 글에서는 Paper2Video: Automatic Video Generation from Scientific Papers 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 10월 6일(Arxiv)
- Zhu, Zeyu, Lin, Kevin Qinghong, Shou, Mike Zheng.
- Show Lab, National University of Singapore
- 논문 링크
- Github
- Project Page
요약
- 연구 발표 영상을 만들려면 논문을 슬라이드, 내레이션, 자막, 발표자 애니메이션, 커서 안내로 변환하고 서로 맞춰야 한다. 논문 101편과 이에 대응하는 발표 영상으로 구성된 벤치마크 Paper2Video에서 영상 해석 모델이 논문 기반 세부 질문에 답할 때, PaperTalker로 생성한 영상의 정확도는 0.842로 저자가 녹화한 영상의 0.738보다 높다. 다만 사람의 선호도 평가에서는 저자가 녹화한 영상이 4.6으로 생성된 영상의 3.8보다 높다.
- PaperTalker는 역할별 빌더 4개를 조율하며 여러 슬라이드 레이아웃을 렌더링한 뒤 시각적으로 비교해 후보를 선택하는 Tree Search Visual Choice를 사용한다. 저자의 음성 샘플로 합성한 음성, 발표자 애니메이션, 내레이션과 정렬된 커서를 결합한다. 슬라이드별 병렬 생성은 직렬 PaperTalker 변형 대비 실행 시간을 287.2분에서 48.1분으로 줄인다.
- 벤치마크는 저자가 만든 자료와의 유사도, 영상 선호도, 논문 기반 퀴즈 정확도, 발표자와 연구의 연관성을 평가한다. 대부분의 평가는 모델을 청중 대신 사용하므로, 점수가 사람의 이해도나 지속적인 연구 영향력을 직접 입증하지는 않는다. 사람 대상 평가는 논문 10편과 참가자 10명을 대상으로 한다.
1 Introduction
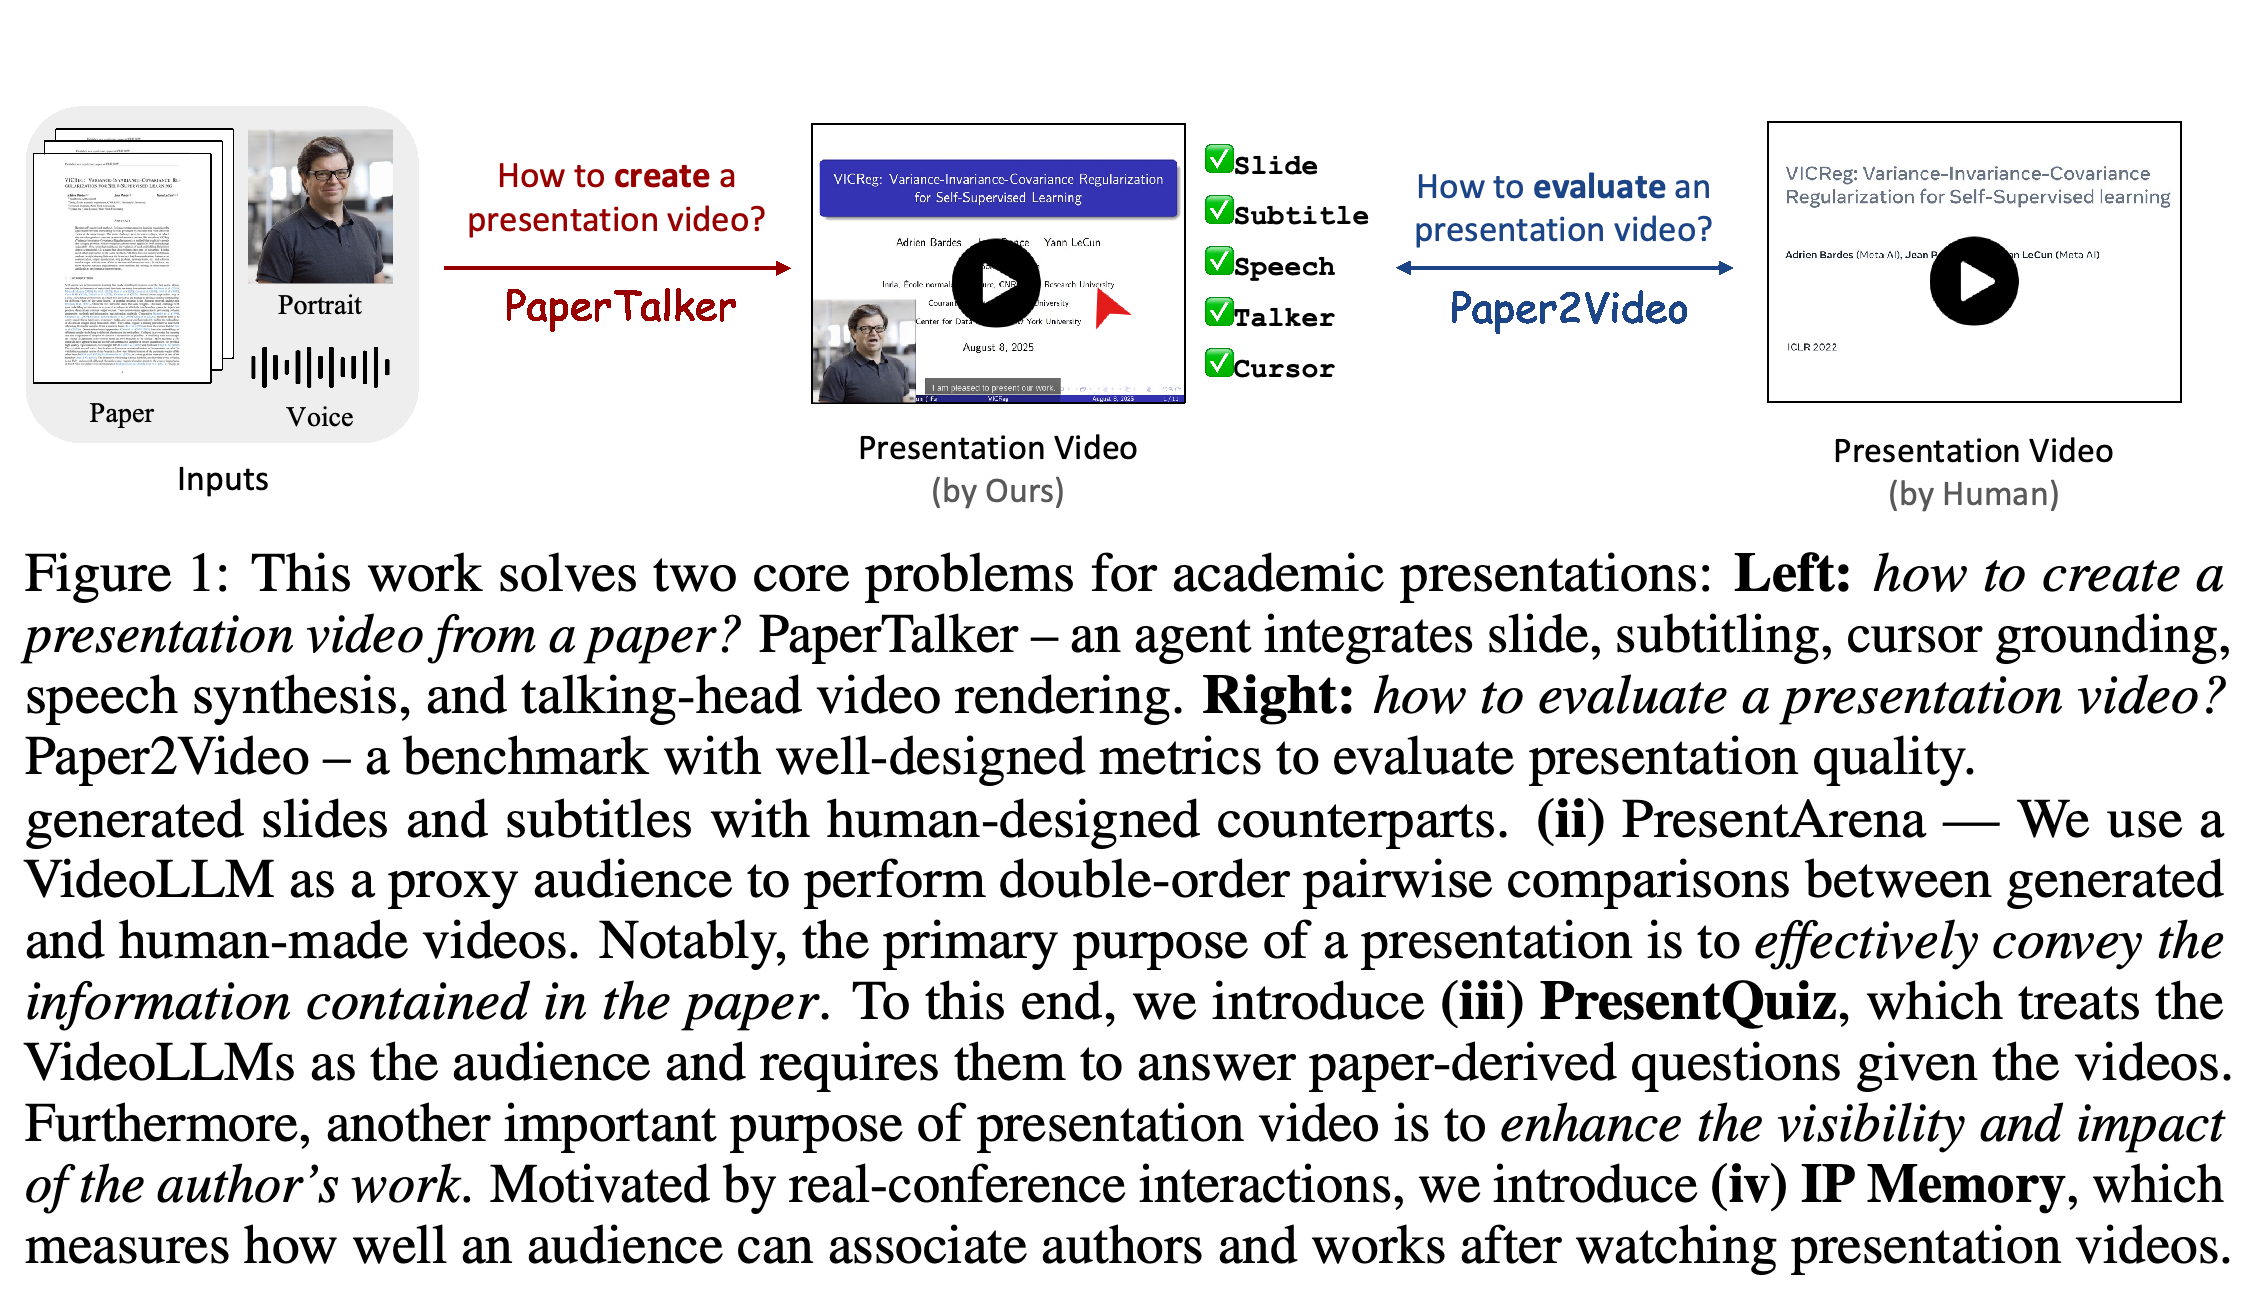
2~10분짜리 학술 발표를 제작하려면 슬라이드 디자인, 자막 작성, 녹화, 편집에 몇 시간이 걸릴 수 있다. 이 논문은 서로 연결된 문제 2개를 다룬다. 텍스트, 그림, 표를 포함하는 긴 문서에서 서로 정렬된 발표 구성 요소를 생성하고 완성된 영상이 연구 내용을 효과적으로 전달하는지 평가하는 문제다. Paper2Video는 논문과 발표가 짝지어진 참조 자료와 평가 지표를 제공하고 PaperTalker는 생성 파이프라인을 제공한다. 프로젝트 URL은 https://github.com/showlab/Paper2Video 이다.
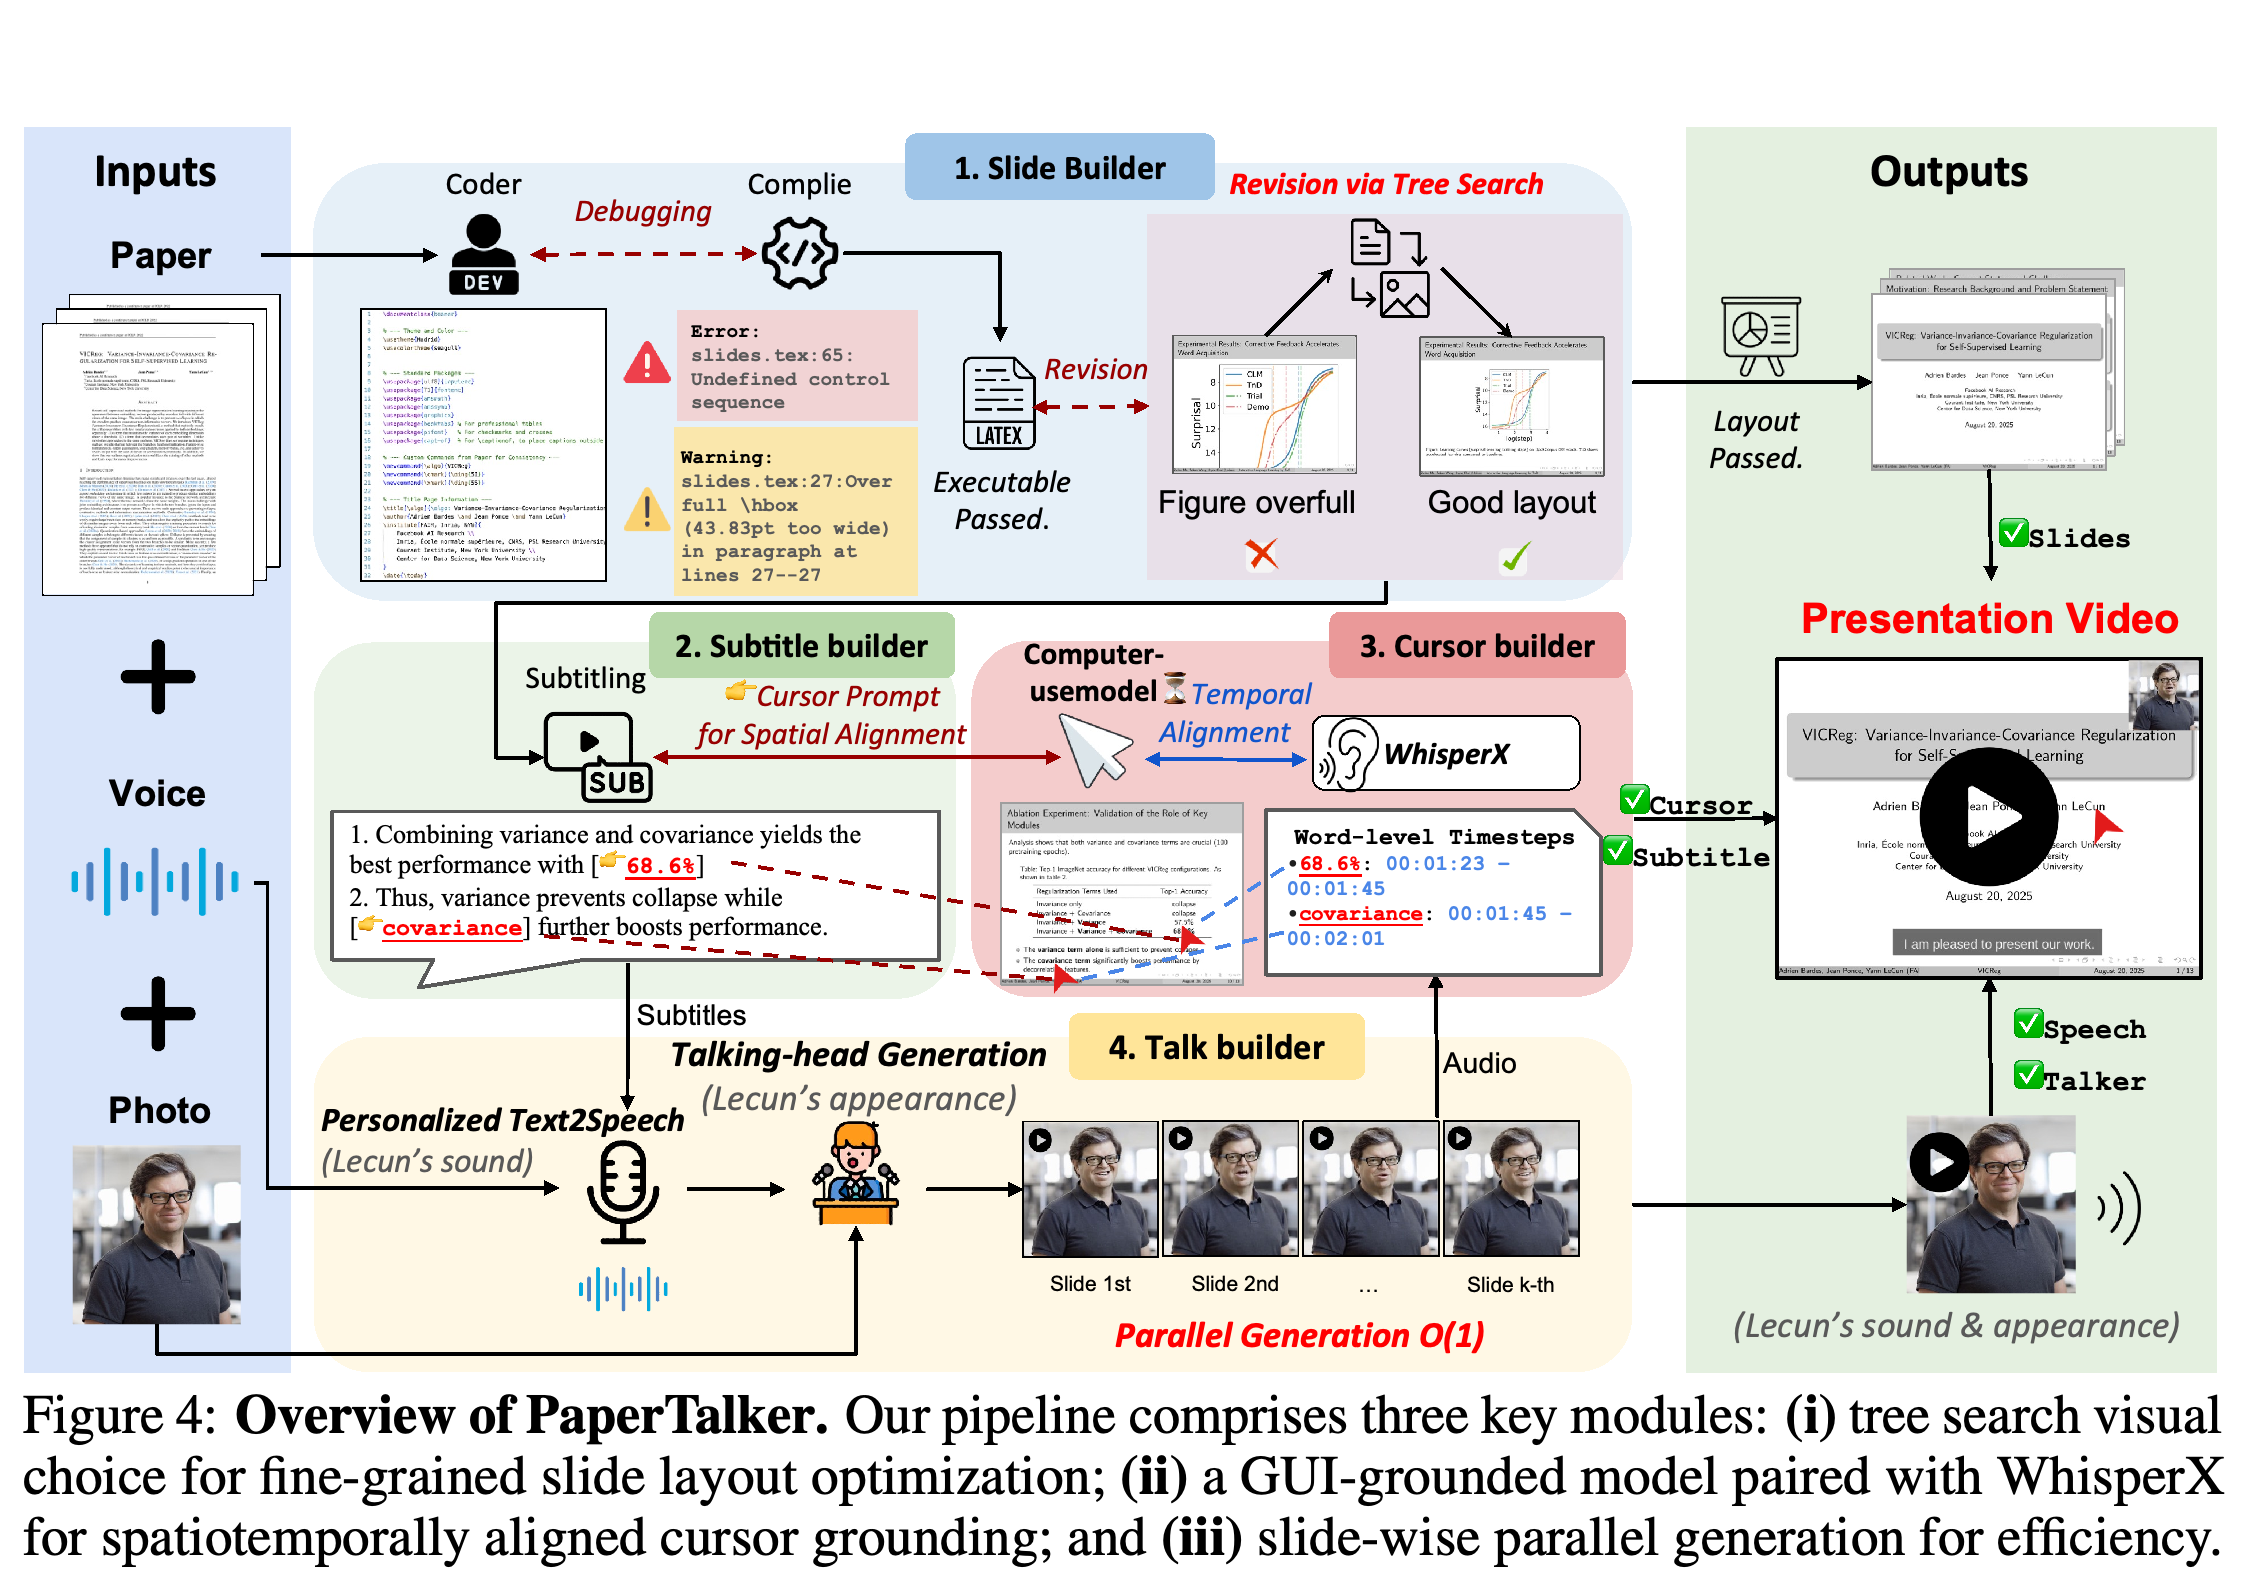
이 도식은 생성과 평가를 구분한다. PaperTalker는 논문, 인물 사진, 음성 샘플을 입력받고, Paper2Video는 저자가 만든 참조 자료를 사용하여 생성된 발표를 평가한다.
2 Related Works
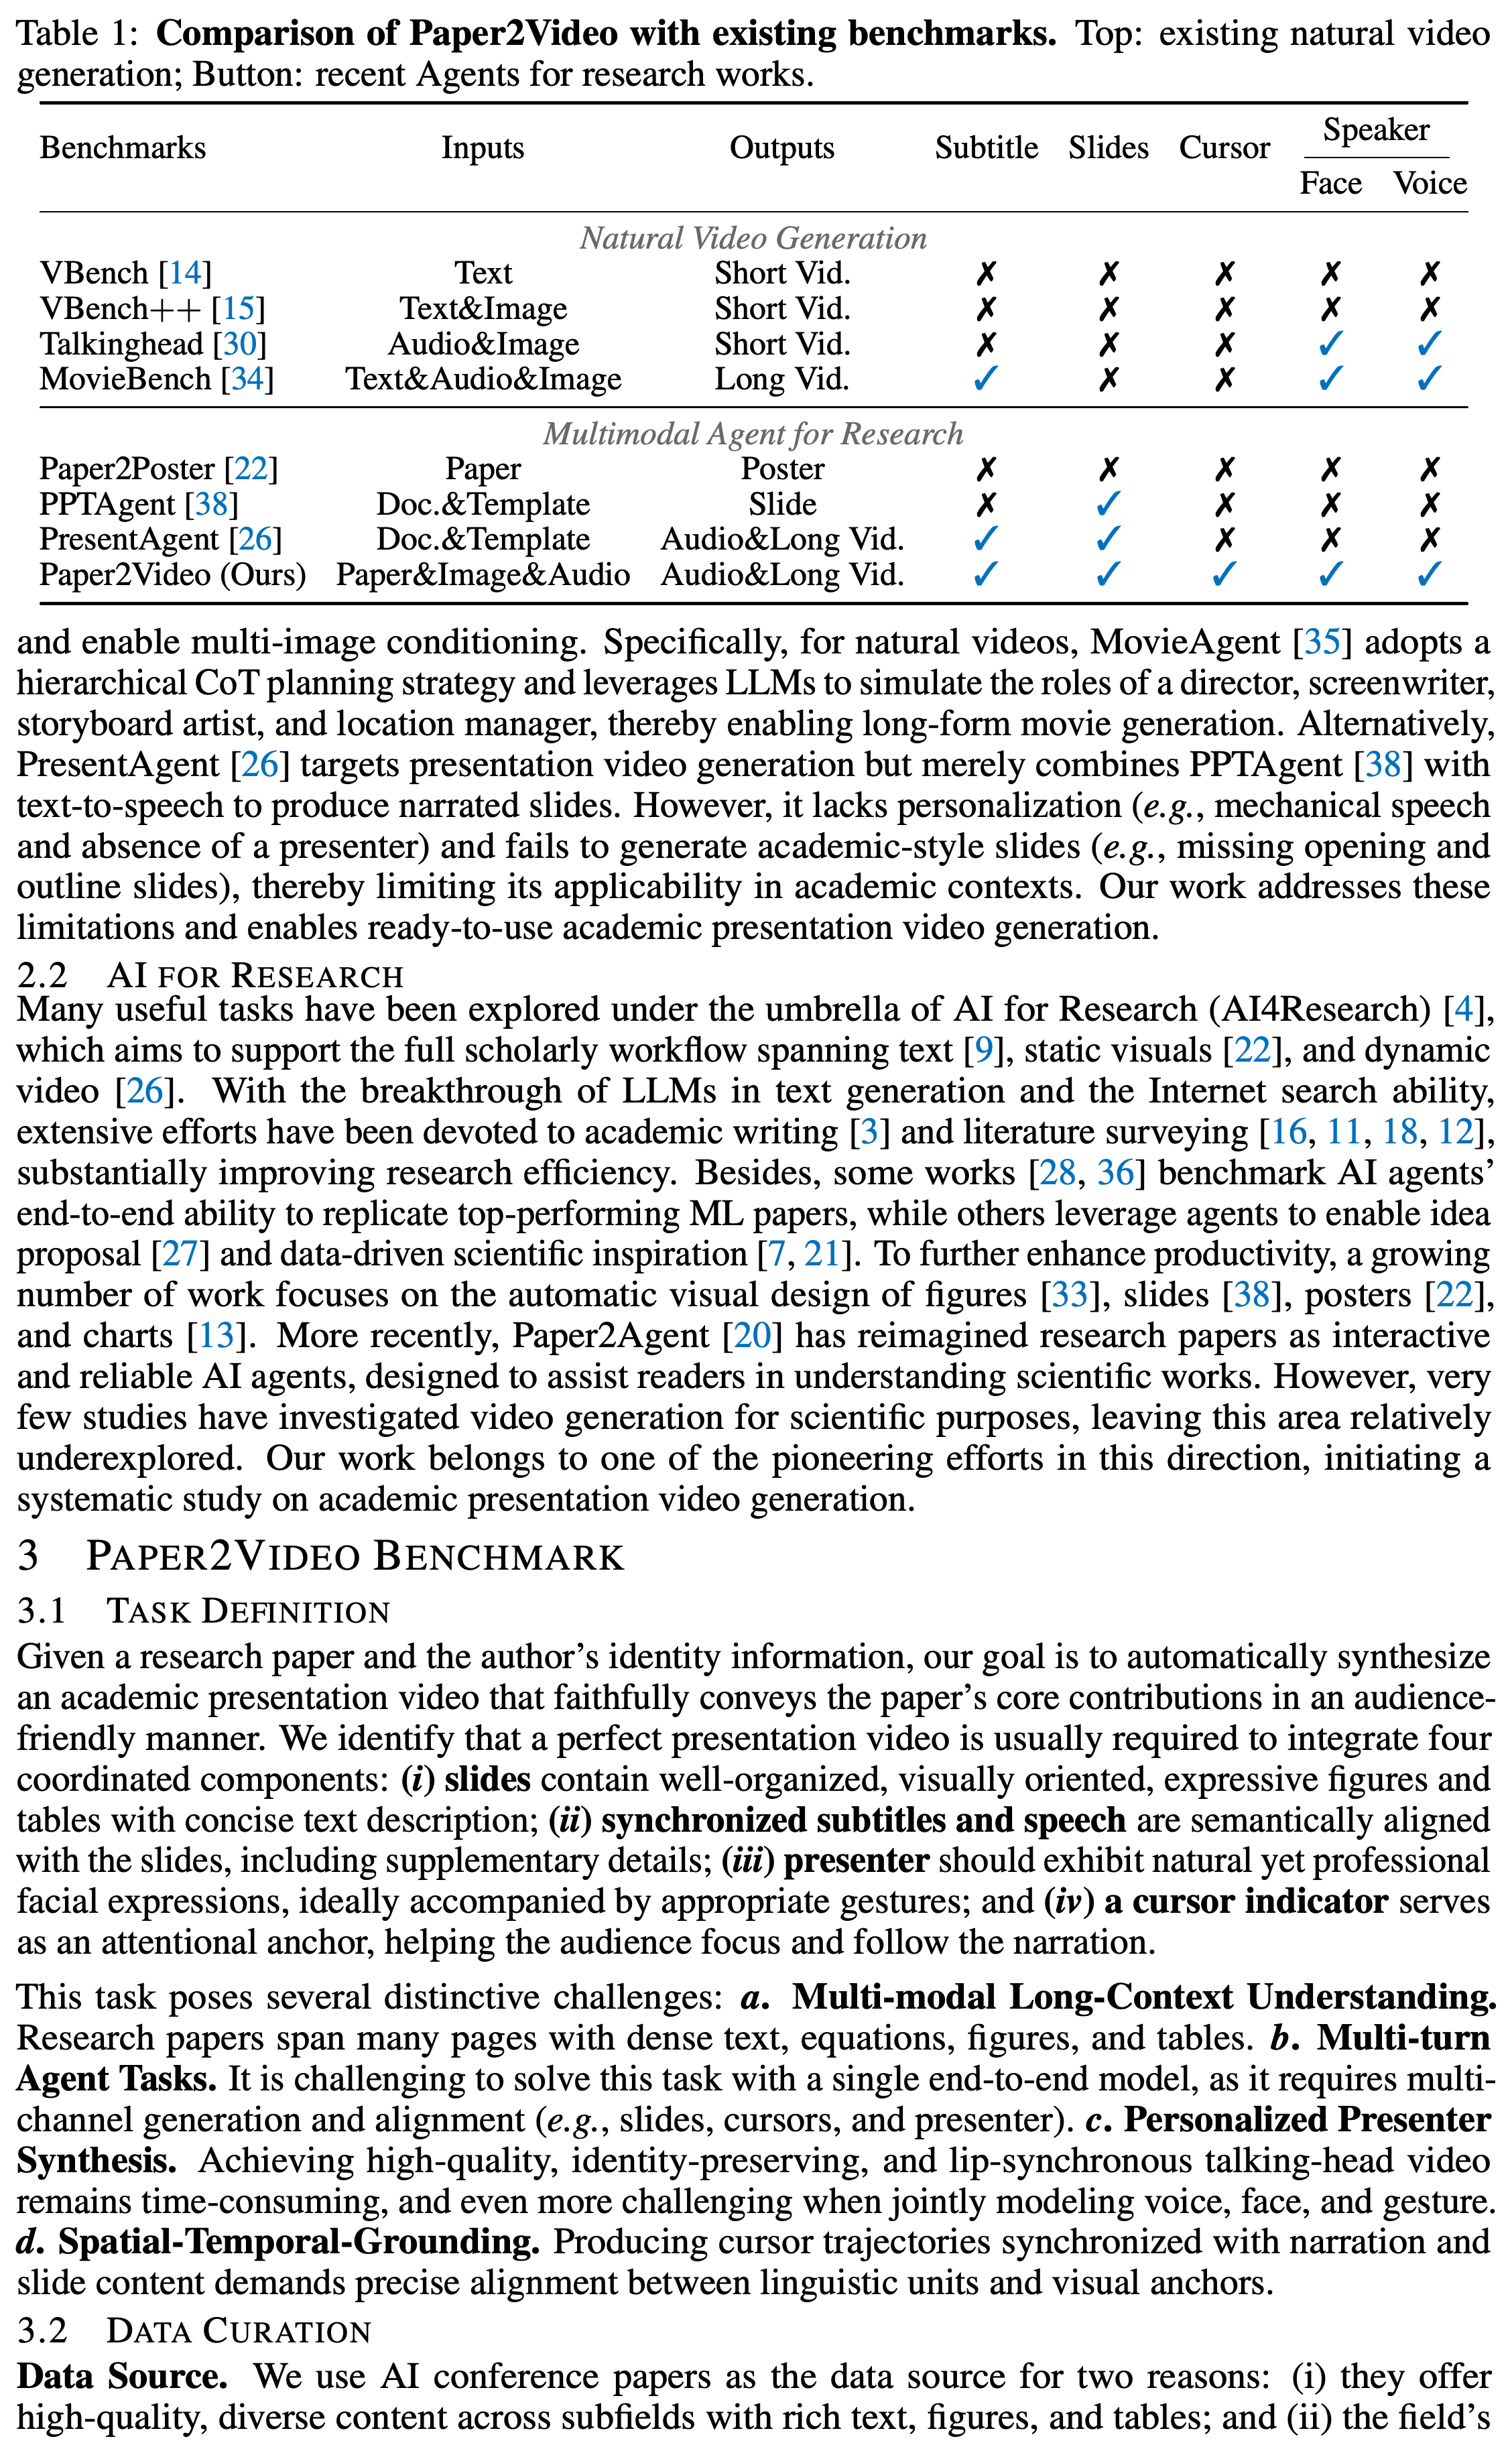
관련 연구는 학술 발표 생성과 일반 영상 합성, AI를 활용한 연구 작업을 연결한다. 비교에서는 시각 매체를 생성하는 방식과 슬라이드, 자막, 음성, 발표자, 커서를 함께 조율하는 시스템을 구분한다.
2.1 Video Generation
논문은 반복적인 노이즈 제거로 영상을 생성하는 기존 영상 확산 모델이 몇 분 길이의 출력, 여러 장면, 여러 조건 이미지, 영상과 정렬된 오디오를 처리하는 데 어려움을 겪는다고 주장한다. MovieAgent는 장편 영화 생성을 위해 기획 역할을 조율한다. PresentAgent는 슬라이드 생성 시스템 PPTAgent와 작성된 내레이션을 오디오로 변환하는 음성 합성(text-to-speech)을 결합한다. 저자들은 발표자 개인화와 학술 슬라이드 구조의 부재를 PresentAgent의 한계로 지적한다.
이 비교는 발표 구성 요소를 함께 조율하는 일을 이 과제의 특징적인 요구사항으로 제시한다. 목록에서 Paper2Video만 자막, 슬라이드, 커서, 발표자 얼굴, 발표자 음성을 모두 포함하는 것으로 표시된다. 표시는 구성 요소의 포함 여부를 나타내며 측정된 품질을 뜻하지 않는다.
2.2 AI for Research
AI for Research (AI4Research)는 AI로 학술 작업을 지원하는 것으로, 학술 글쓰기, 문헌 조사, 논문 재현, 아이디어 제안, 시각 디자인을 포함한다. 논문은 발표 영상 생성을 슬라이드와 포스터 자동화의 확장으로 설명하며 여러 매체의 출력을 함께 조율해야 한다고 본다. Paper2Agent는 논문을 대화형 연구 도우미로 바꾸는 상호 보완적인 접근법으로 소개한다.
3 Paper2Video Benchmark
Paper2Video는 연구 내용을 전달하기 위한 과제 정의, 선별된 논문과 발표 쌍, 평가 지표를 결합한다. 참조 자료에는 저자가 녹화한 영상과 발표자 신원 정보가 포함되어, 내용 전달과 발표 개인화를 평가할 수 있다.
3.1 Task Definition
이 과제는 연구 논문과 저자의 신원 정보를 입력받아 논문의 기여를 충실하게 전달하는 발표를 생성한다. 목표 구성 요소는 체계적인 슬라이드, 동기화된 자막과 음성, 자연스러운 발표자, 주의를 유도하는 커서다. 주요 과제는 텍스트와 이미지를 함께 고려한 긴 문서 이해, 생성 단계 조율, 발표자 신원 유지와 입 모양 및 음성의 동기화, 내레이션 grounding이다. 여기서 grounding은 내레이션 문장을 화면 위치 및 시간 구간과 정렬하는 것을 뜻한다.
3.2 Data Curation
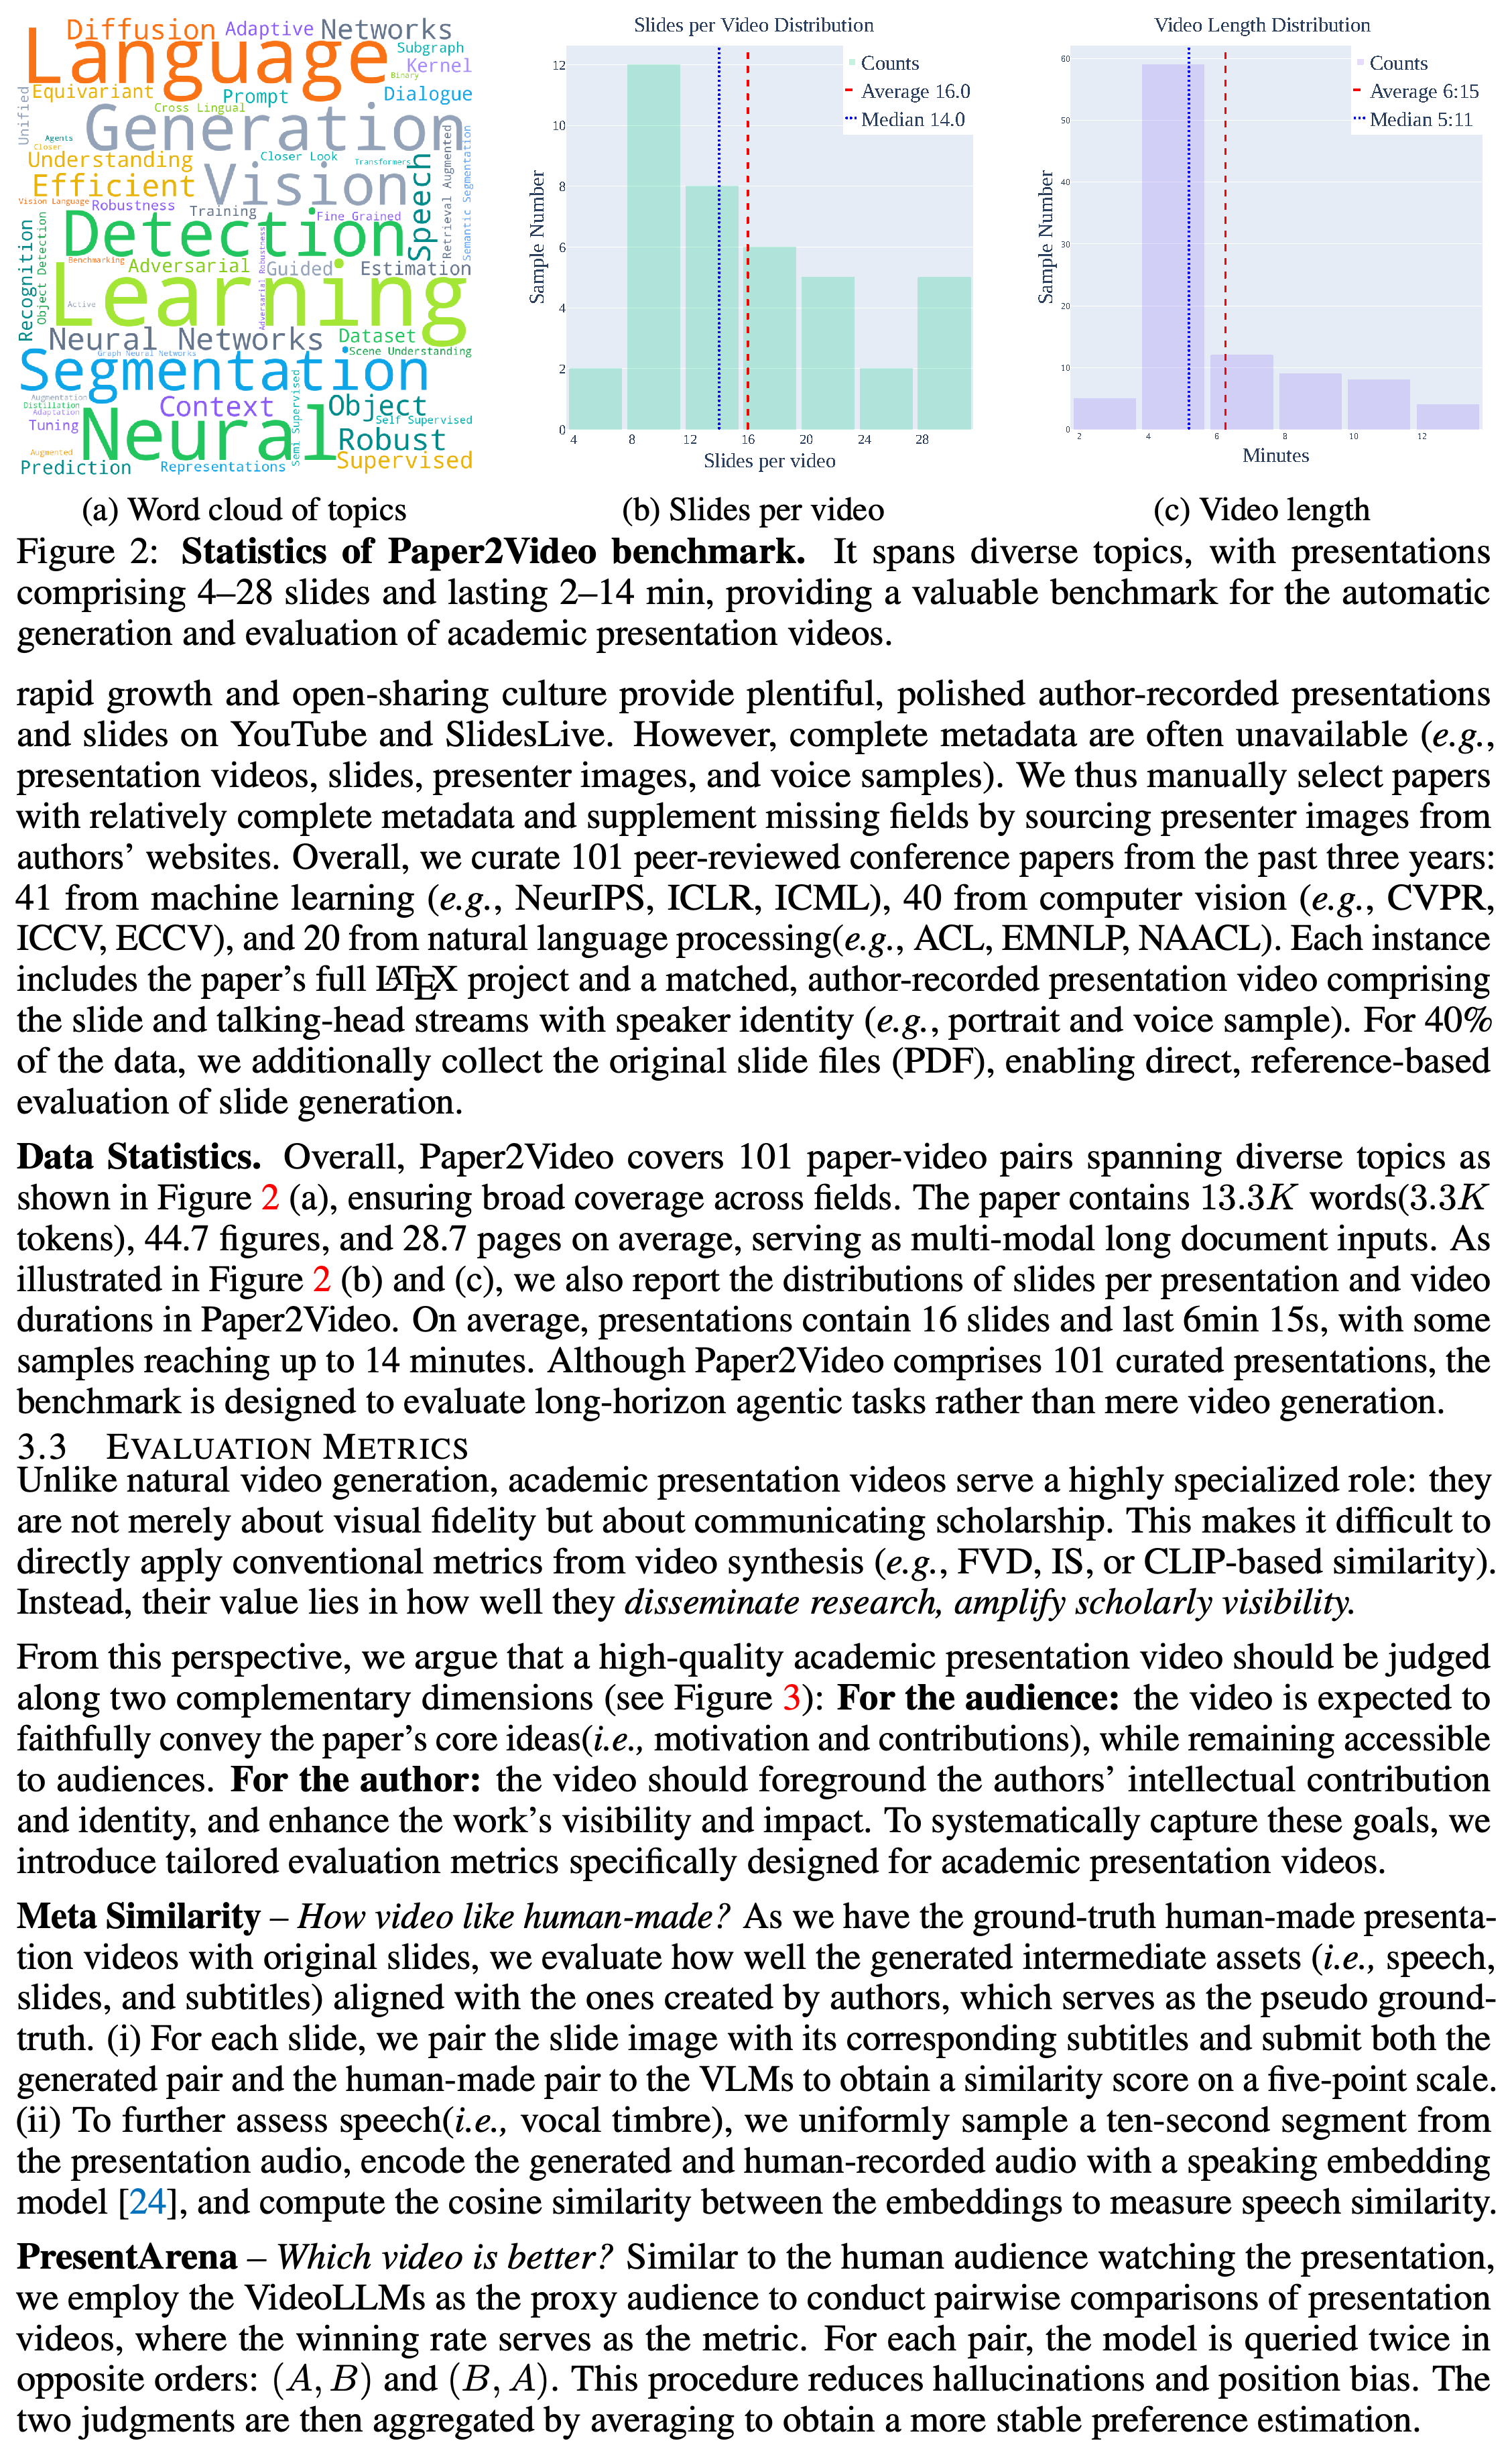
데이터셋에는 앞선 3년 동안 발표된 동료 심사를 거친 학회 논문 101편이 포함되며, 머신러닝 41편, 컴퓨터 비전 40편, 자연어 처리 20편으로 구성된다. 각 사례에는 논문 조판 소스인 전체 LaTeX 프로젝트, 저자가 녹화한 발표, 인물 사진과 음성 샘플 등의 발표자 정보가 포함된다. 원본 슬라이드 PDF는 사례의 40%에서 제공된다. 발표는 슬라이드 4~28장으로 구성되며 길이는 2~14분이다. 평균은 슬라이드 16장, 6분 15초다.
- 저자들은 YouTube와 SlidesLive 등의 출처에서 메타데이터가 비교적 완전한 논문을 선정하고 누락된 발표자 이미지는 저자 웹사이트에서 보충한다. 이러한 선별 과정만으로 선정된 AI 학회 논문을 넘어서는 대표성을 입증할 수는 없다.
- 원문은 논문당 평균 13.3K단어(3.3K토큰), 그림 44.7개, 28.7페이지를 보고한다. 토큰은 모델 입력에서 세는 텍스트 단위이며 보고된 단어 수와 토큰 수의 관계는 설명하지 않는다.
분포는 발표 길이와 슬라이드 수가 다양함을 보여준다. 슬라이드 수의 평균과 중앙값은 16.0과 14.0이고, 발표 길이의 평균과 중앙값은 6:15와 5:11이다. 평균은 각각 해당 중앙값보다 크다.
3.3 Evaluation Metrics
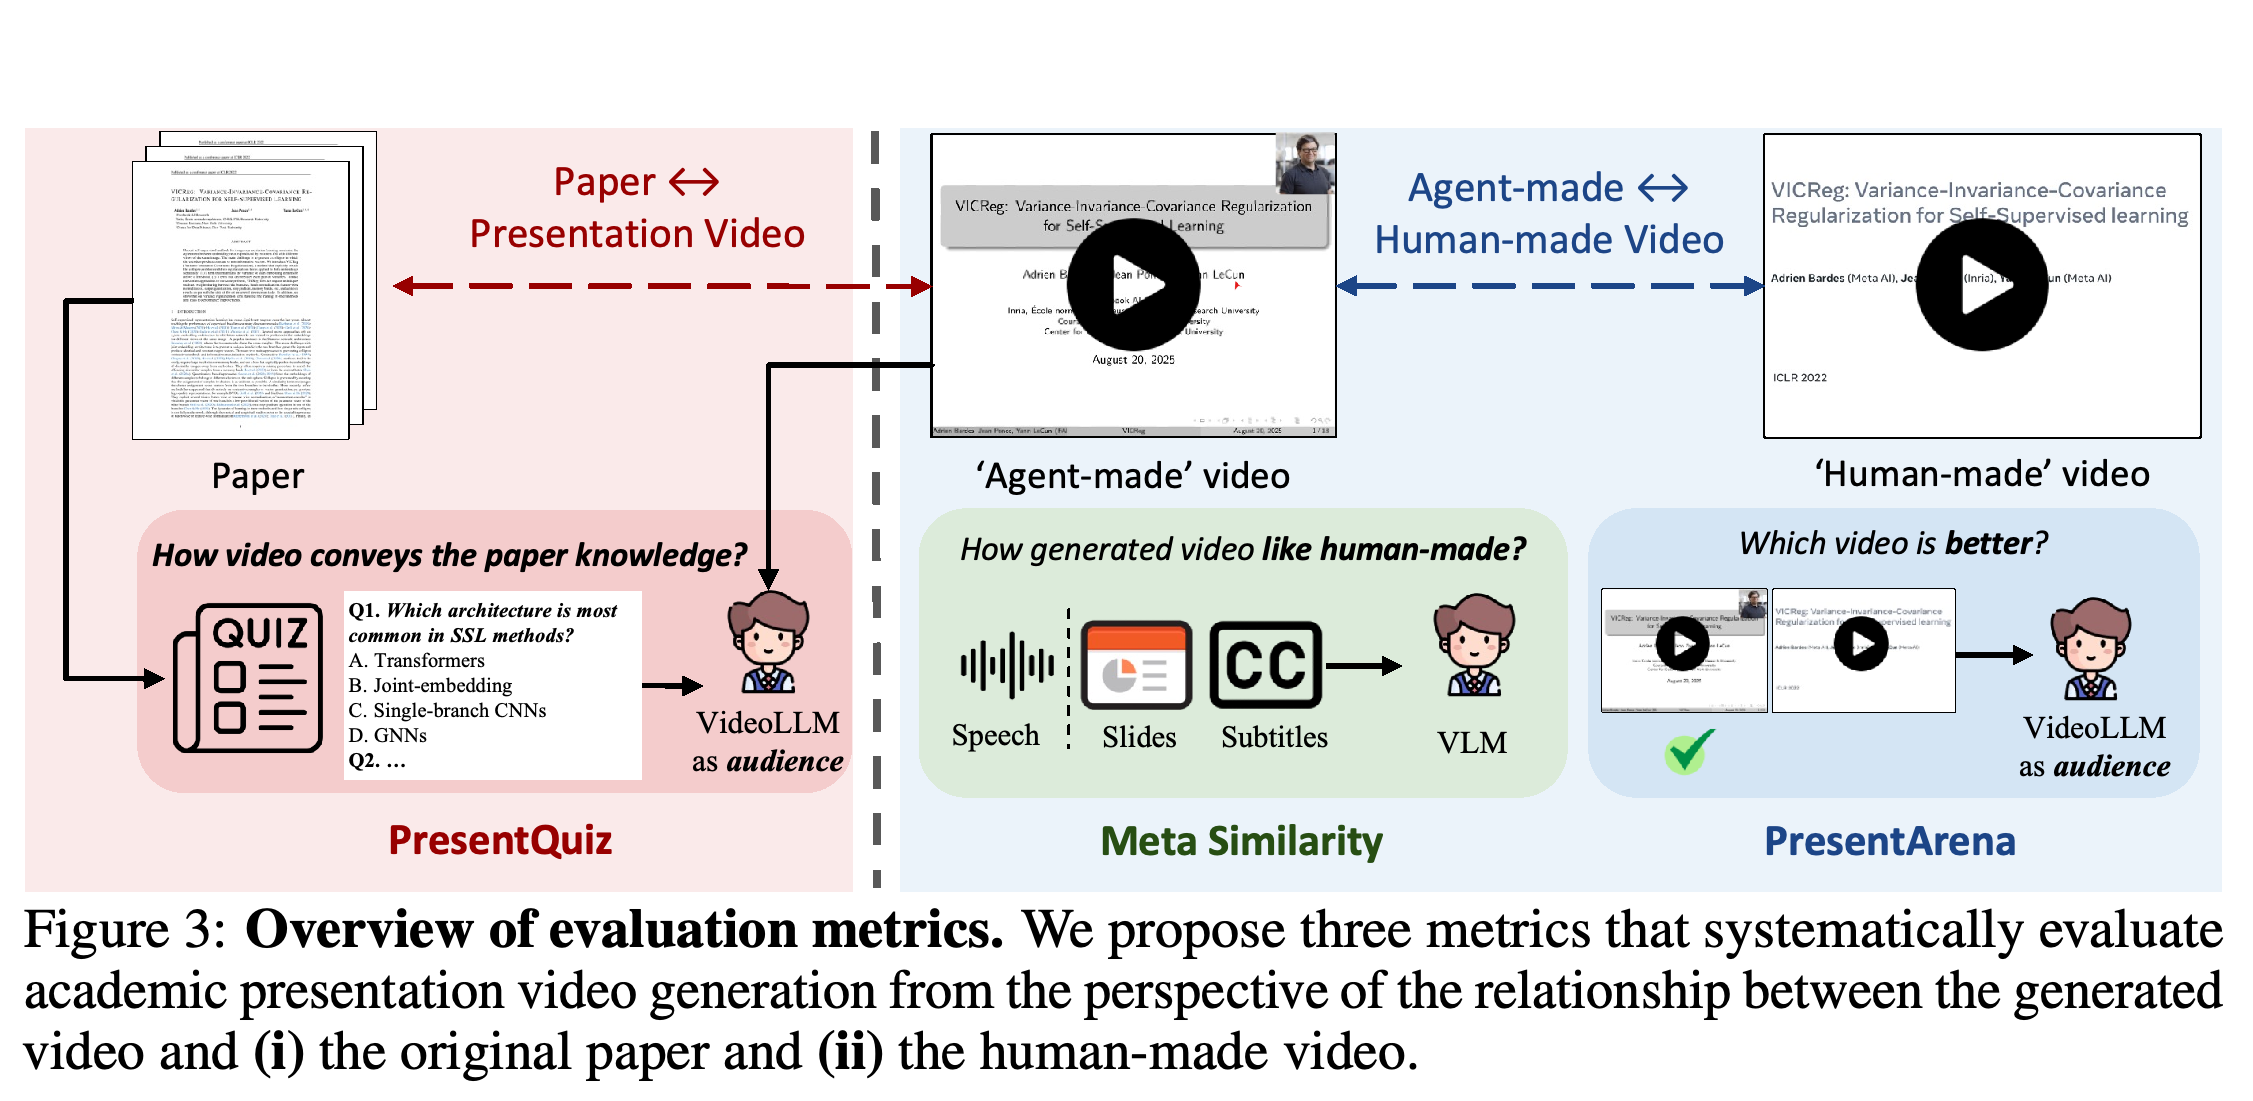
평가 지표 4개는 참조 자료와의 유사도, 전반적인 선호도, 정보 전달 범위, 발표자와 연구의 연관성을 측정한다. 이미지와 텍스트를 처리하는 비전 언어 모델(VLM)은 슬라이드와 자막의 유사도를 평가한다. 영상을 해석하는 영상 언어 모델(VideoLLM)은 선호도와 퀴즈 평가에서 청중 대신 사용된다. 이 지표들은 명시된 발표 특성을 평가하며 사람의 학습이나 학술적 영향력을 직접 측정하지는 않는다.
- Meta Similarity는 생성된 슬라이드와 자막을 저자가 만든 참조 자료와 비교한다. 별도로 10초 오디오 구간에서 추출한 음성 임베딩 사이의 코사인 유사도를 계산한다. 음성 임베딩은 음성 특성을 벡터로 표현한 것이고, 코사인 유사도는 벡터의 방향이 얼마나 일치하는지 측정한다. 본문은 내용 평가를 5점 척도로 설명하지만 부록 프롬프트는 0~5의 정수 점수를 지정한다.
- PresentArena는 생성된 영상과 사람이 만든 영상 사이의 선호도를 측정한다. 위치 편향을 줄이기 위해 각 쌍을 입력 순서를 뒤집어 2번 평가하고 판단을 평균한다.
- PresentQuiz는 선택지 4개가 있는 논문 기반 질문의 정확도를 측정하며 세부 정보와 상위 수준의 이해를 평가한다.
- IP Memory는 발표 영상 클립과 발표자 이미지를 바탕으로 관련 질문을 식별하게 하여 발표자와 연구의 연관성을 측정한다. 논문은 인지도와 영향력을 모사하는 일이 여전히 해결되지 않은 문제라고 인정한다.
이 그림은 원본 논문과의 비교와 사람이 만든 발표와의 비교를 구분한다. PresentQuiz는 논문에서 추출한 정보를 평가하고 Meta Similarity는 중간 산출물을 비교하며 PresentArena는 영상 선호도를 비교한다. IP Memory는 본문에서 별도로 설명한다.
4 PaperTalker Agent
PaperTalker는 생성을 Slide, Subtitle, Cursor, Talker 빌더로 나눈다. Slide 빌더는 LaTeX 슬라이드를 생성하고 수정한다. Subtitle 빌더는 내레이션과 시각적으로 주목할 영역의 설명을 생성한다. Cursor 빌더는 이 설명을 화면 위치와 시간 정보로 변환한다. Talker 빌더는 인물 사진과 음성 샘플로 개인화된 음성과 발표자 영상을 합성한다. 중간 산출물은 컴파일 검사, 시각적 개선, 정렬을 지원한다.
파이프라인은 컴파일 및 레이아웃 검사 이후에 대본 생성, 커서 정렬, 개인화된 발표자 합성이 진행됨을 보여준다. 독립적인 발표자 생성 분기는 병렬화 전략을 설명한다. O(1) 표기만으로 고정된 하드웨어 자원 아래에서 실행 시간이 일정하다고 입증할 수는 없다.
4.1 Slide Builder
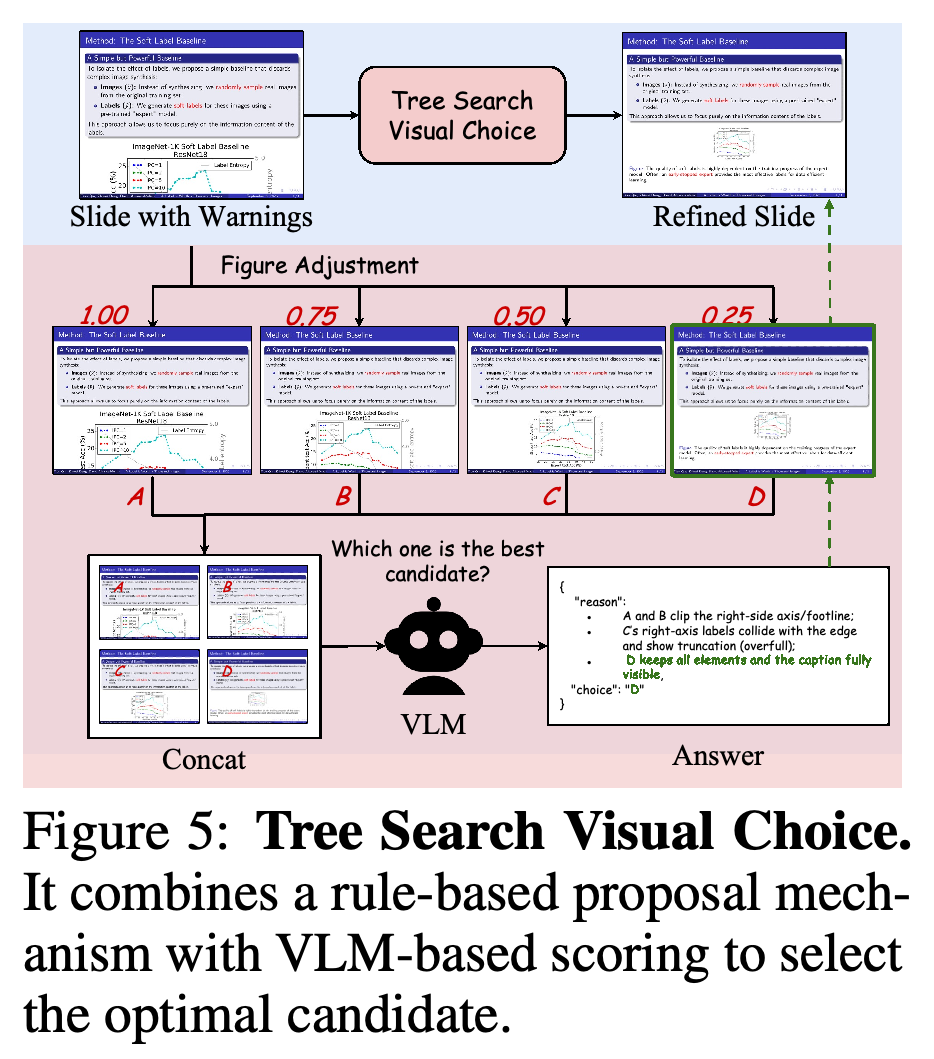
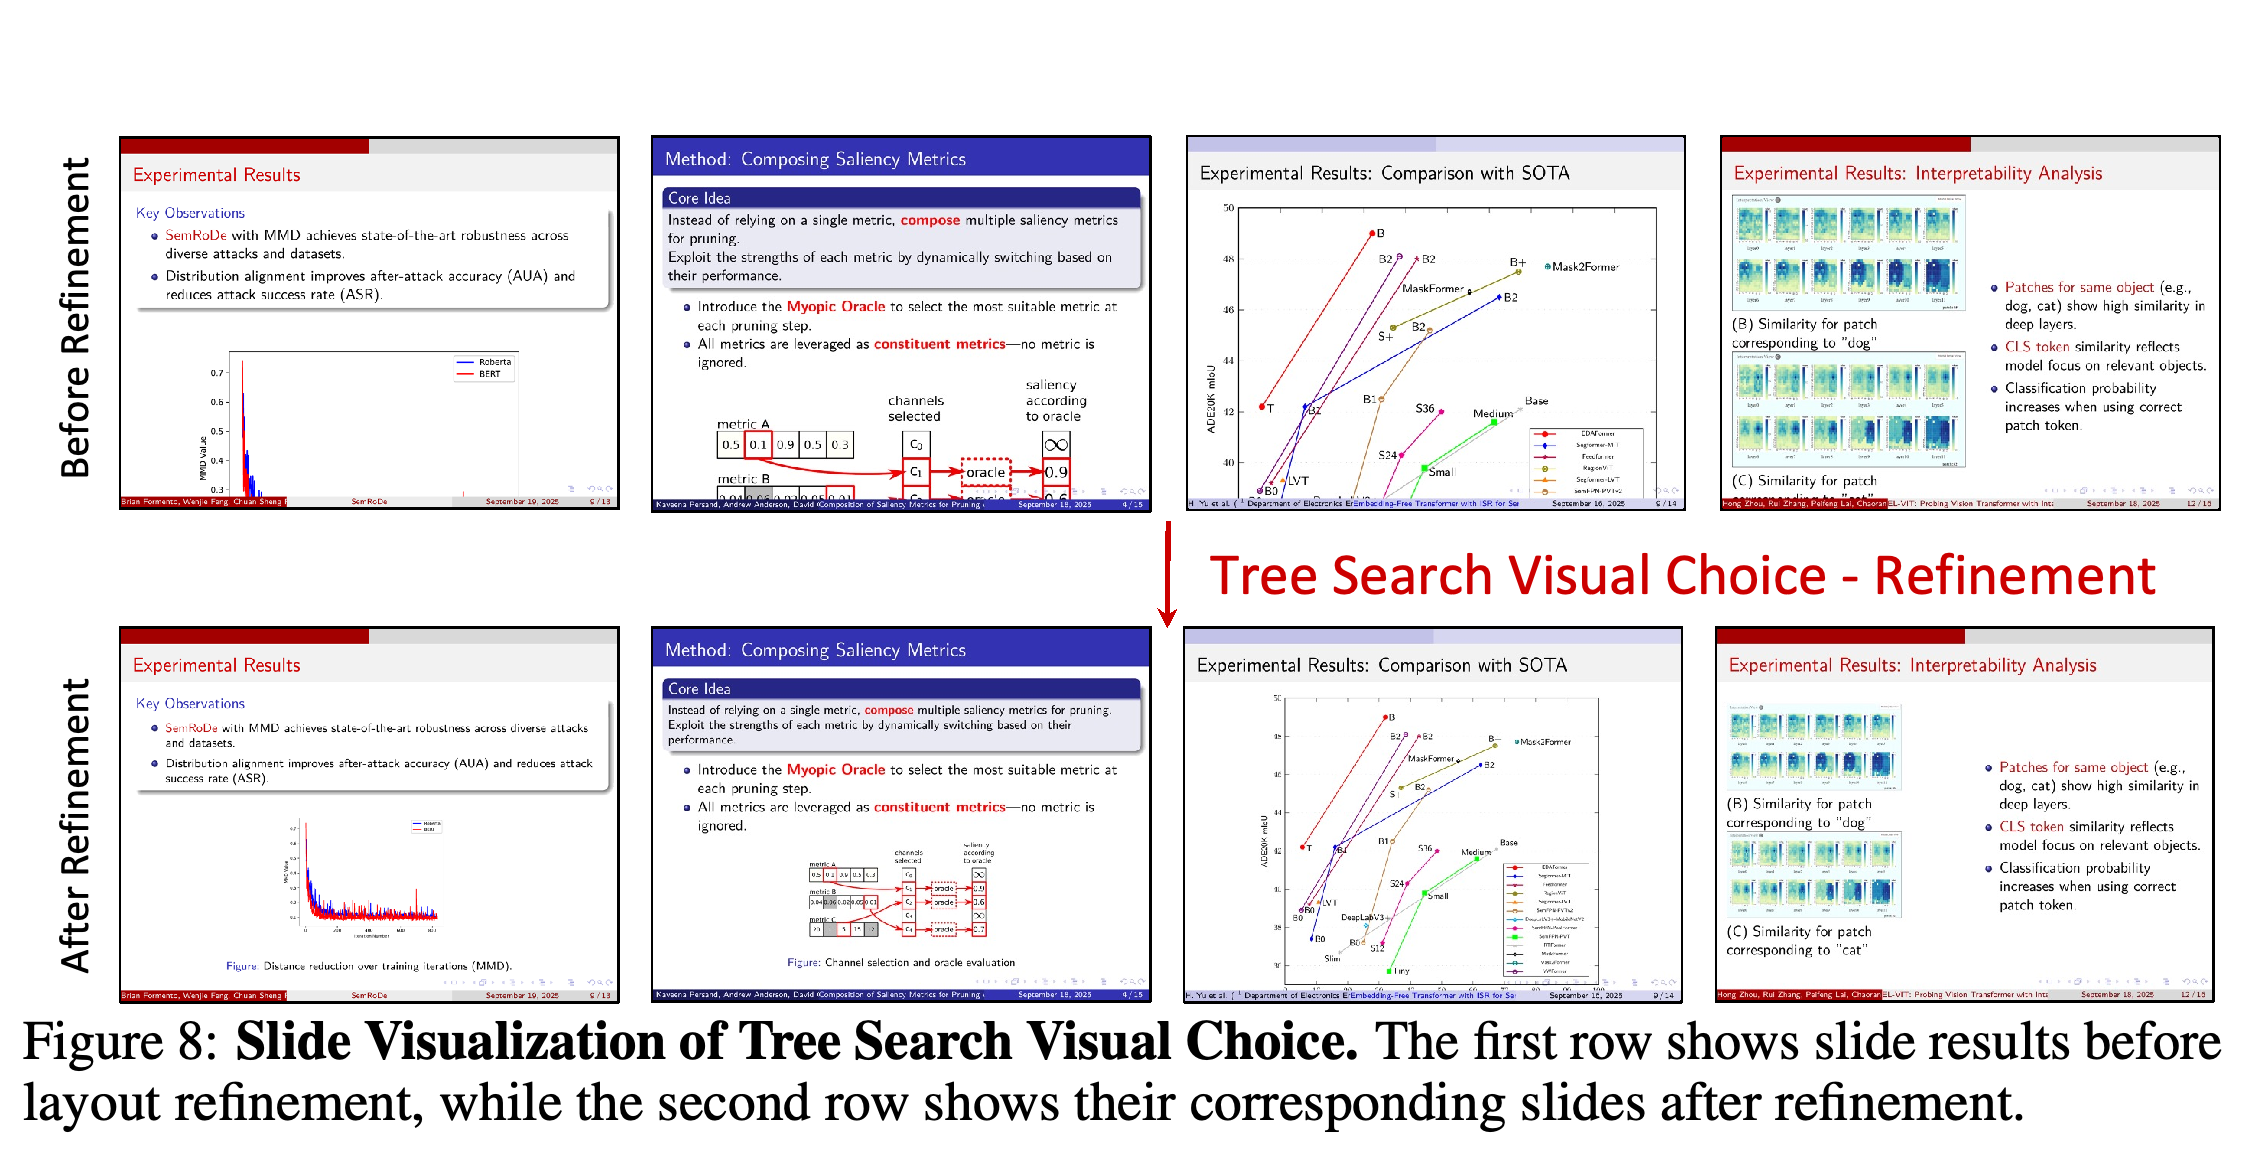
Slide 빌더는 논문의 LaTeX 프로젝트에서 발표 슬라이드용 LaTeX 형식인 Beamer 코드를 직접 생성한다. 컴파일 오류를 바탕으로 관련 코드를 집중적으로 수정하고 경고를 통해 레이아웃 개선이 필요할 수 있는 슬라이드를 찾는다. Tree Search Visual Choice는 규칙에 따라 그림 배율이나 글자 크기를 바꾼 후보들을 생성하고 렌더링한다. 이후 VLM에 내용이 슬라이드 밖으로 벗어나거나 잘리는 overflow를 피하면서 내용을 보이게 유지하는 레이아웃을 선택하도록 요청한다.
- Beamer는 자동 조판, 간결한 표현, 학술 발표 스타일을 제공한다. 저자들은 이러한 이유로 구조화된 마크업 표현인 XML 기반 형식의 템플릿을 편집하는 대신 Beamer를 사용한다.
- 텍스트만 있는 슬라이드에서는 글자 크기를 바꿔 가며 탐색한다. 그림이 있는 슬라이드에서는 글자 크기를 줄이기 전에 그림 배율을 조정한다. 본문은 배율 예시로 1.25, 0.75, 0.5, 0.25를 제시하지만 Figure 5에는 1.00, 0.75, 0.50, 0.25가 표시된다.
- 이 방법은 이산적인 레이아웃 변형과 의미에 기반한 생성을 분리하여, 언어 모델이 작은 수치 조정을 직접 수행하는 데 의존하지 않는다.
이 예시는 수치 기반 레이아웃 편집을 렌더링한 대안 가운데 시각적으로 선택하는 문제로 바꾼다. 그림 배율 후보는 1.00, 0.75, 0.50, 0.25이며, 평가자는 내용이 잘리지 않고 보이도록 유지하는 후보를 선택한다.
4.2 Subtitle Builder
Subtitle 빌더는 완성된 각 슬라이드를 래스터화하여 이미지로 변환하고 VLM으로 문장 단위 자막과 대응하는 visual-focus 프롬프트를 생성한다. 각 프롬프트는 해당 문장과 관련된 슬라이드 영역을 설명하여 내레이션과 커서 배치를 연결한다.
4.3 Talker Builder
Talker 빌더는 음성 합성 모델 F5-TTS를 사용하여 각 슬라이드의 자막과 저자의 음성 샘플로 오디오를 생성한다. Hallo2는 머리 부분만 보이는 발표자 애니메이션을 생성하고 FantasyTalking은 상반신 움직임을 지원한다. 발표자 클립은 슬라이드별로 독립적으로 생성하고 병렬 처리한다. 이는 슬라이드 전환 시 발표자 움직임이 연속적일 필요는 없다는 가정에 따른다.
4.4 Cursor Builder
Cursor 빌더는 커서가 각 문장 안에서는 정지하고 문장 사이에서만 이동한다고 가정한다. 스크린샷에서 인터페이스 대상을 찾는 모델 UI-TARS는 visual-focus 프롬프트를 슬라이드 좌표에 대응시킨다. 음성 전사 및 정렬 시스템 WhisperX는 단어 단위 타임스탬프를 제공하여 각 커서 구간의 시작과 끝을 결정한다. 이 방식은 커서 생성을 단순화하지만 문장 안에서의 연속적인 움직임은 모델링하지 않는다.
5 Experiments
실험은 논문을 바탕으로 만든 프롬프트로 영상을 직접 생성하는 end-to-end 영상 생성기, 발표 생성 프레임워크, PaperTalker 변형들을 비교한다. 참조 자료와의 유사도, 선호도, 정보 전달 범위, 발표자와 연구의 연관성, 사람의 평가, 생성 효율을 평가한다. 또한 구성 요소를 제거하여 그 기여를 확인하는 절제 실험(ablation)을 수행한다.
5.1 Baseline and Settings
베이스라인에는 직접 영상 생성을 위한 Wan2.2와 Veo3, 구성 요소를 조합한 발표 생성이나 슬라이드 평가를 위한 PresentAgent와 PPTAgent가 포함된다. GPT-4.1을 VLM으로, Gemini-2.5-Flash를 VideoLLM으로 사용하며 추론에는 NVIDIA RTX A6000 GPU 8개를 사용한다. 출력 길이는 크게 다르다. Wan2.2와 Veo3는 평균 길이가 각각 4.00초와 8.00초인 반면, PaperTalker는 234.36초다. 따라서 비교 결과에는 생성할 수 있는 영상 길이의 차이도 반영된다.
5.2 Main Results
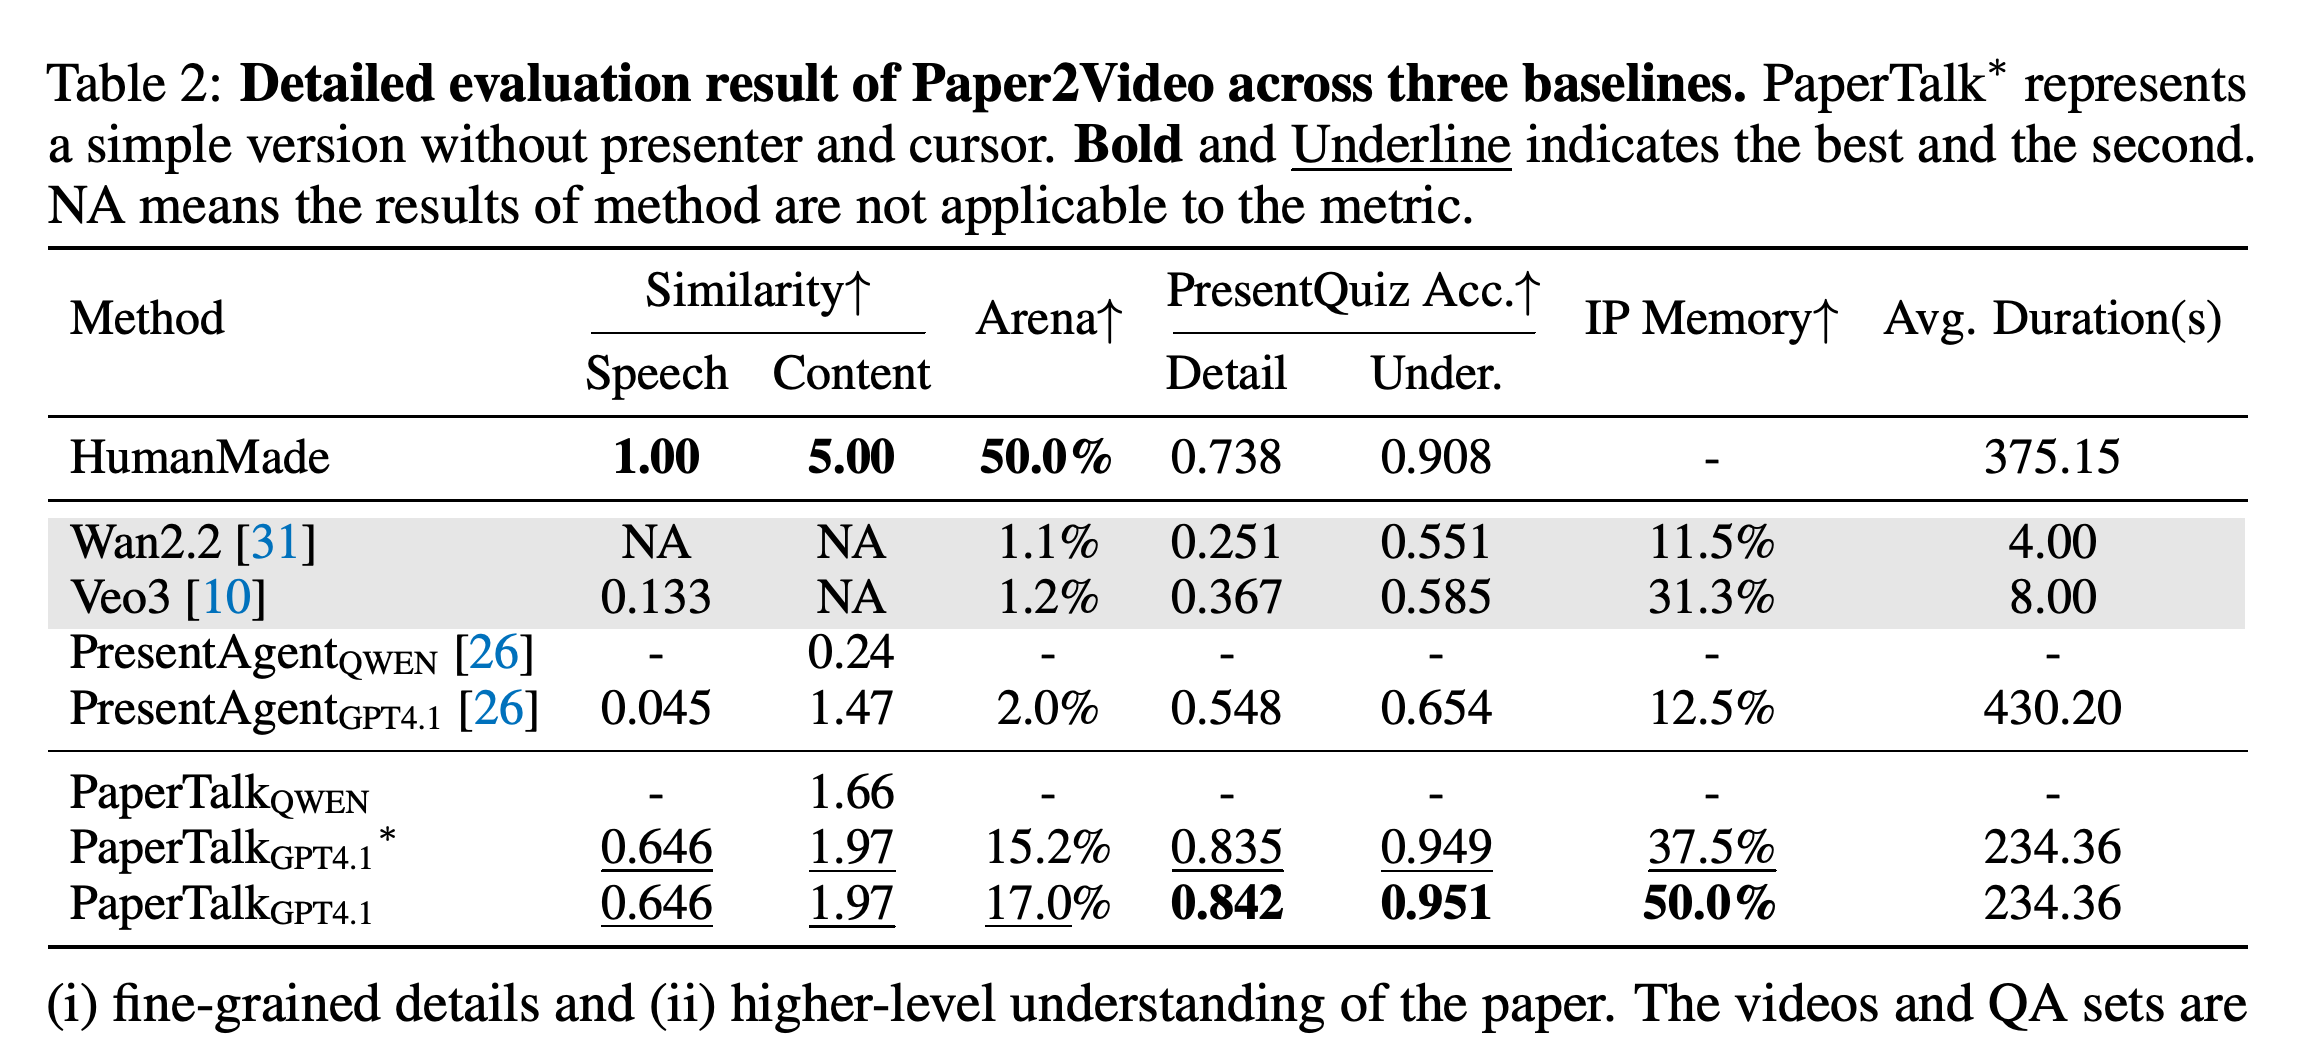
PaperTalker는 평가한 생성 영상 시스템 가운데 보고된 자동 평가 점수가 가장 높지만 저자가 녹화한 발표는 더 높은 선호도 점수를 받는다. PaperTalker의 세부 정보 및 이해 퀴즈 정확도는 0.842와 0.951로, 저자가 녹화한 참조 영상인 HumanMade의 0.738과 0.908보다 높다. 평균 영상 길이는 234.36초로 HumanMade의 375.15초보다 짧다. 사람이 만든 영상에 대한 PresentArena 승률은 17.0%이며, 사람 대상 평가에서는 PaperTalker가 3.8, HumanMade가 4.6을 받는다.
- PaperTalker의 음성 및 내용 유사도는 0.646과 1.97이며, GPT-4.1을 사용한 PresentAgent는 0.045와 1.47이다. PaperTalker의 점수들은 표에 있는 생성 시스템 가운데 가장 높지만 내용 유사도는 여전히 사람 참조값인 5.00보다 낮다.
- 발표자와 커서를 모두 제거하면 PresentArena는 17.0%에서 15.2%로, 세부 정보 퀴즈 정확도는 0.842에서 0.835로, 이해 정확도는 0.951에서 0.949로, IP Memory는 50.0%에서 37.5%로 낮아진다. 이 결합 절제 실험은 각 구성 요소의 기여를 개별적으로 분리하지 않는다.
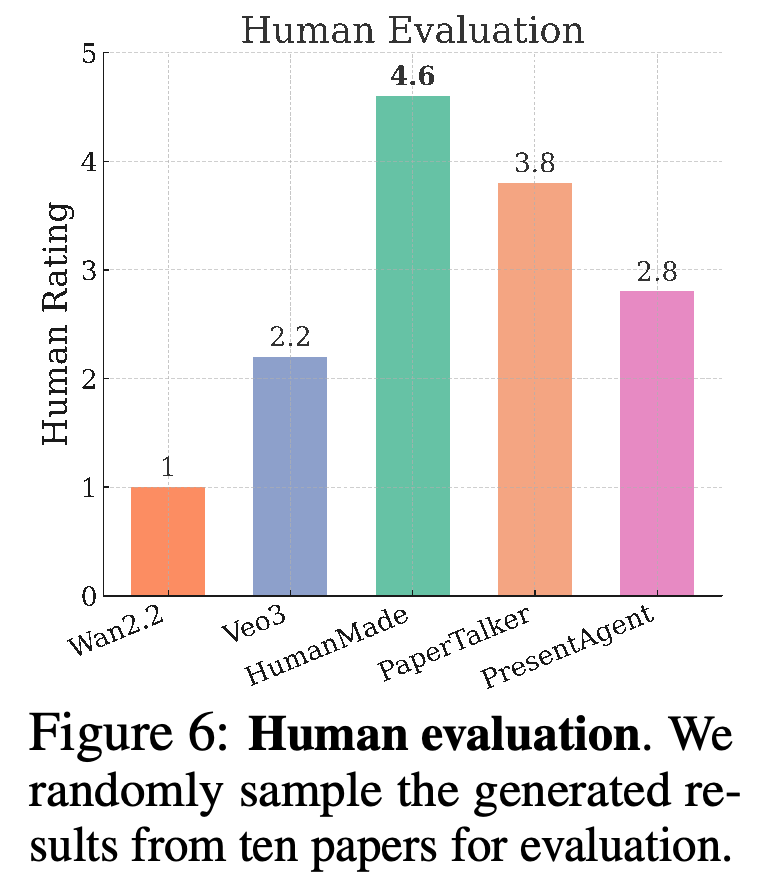
- 참가자 10명이 무작위로 표집한 논문 10편의 영상을 1~5 선호도 척도로 평가한다. 보고된 점수는 Wan2.2가 1, Veo3가 2.2, HumanMade가 4.6, PaperTalker가 3.8, PresentAgent가 2.8이다. 불확실성 추정치는 보고하지 않는다.
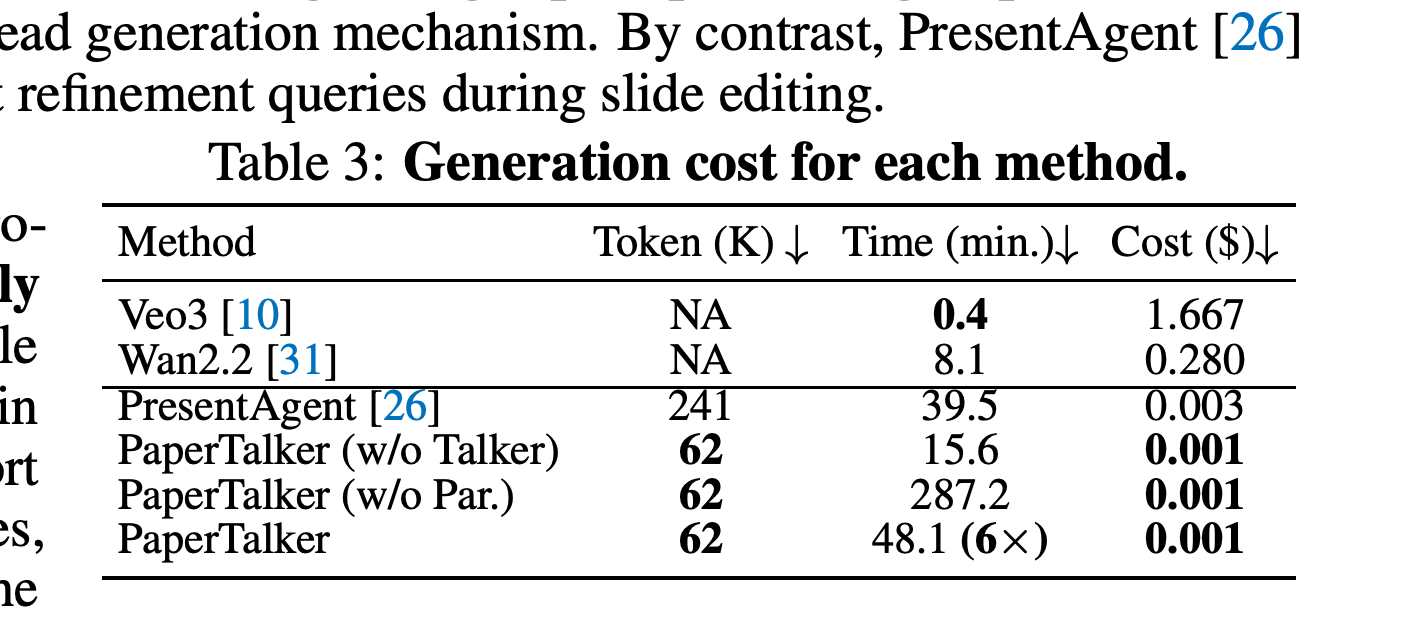
- PaperTalker는 62K토큰을 사용하며 PresentAgent는 241K토큰을 사용한다. 병렬화는 PaperTalker의 실행 시간을 287.2분에서 48.1분으로 줄여 약 6배의 속도 향상을 제공한다. 다만 전체 PaperTalker는 여전히 PresentAgent의 39.5분보다 오래 걸린다.
- Table 3은 PaperTalker의 비용을 $0.001, PresentAgent의 비용을 $0.003으로 보고한다. 하지만 GPU 연산을 포함한 전체 배포 비용으로 해석할 만큼 충분한 비용 산정 기준은 제시하지 않는다.
PaperTalker는 보고된 자동 평가 지표에서 생성 시스템 가운데 가장 높은 점수를 받으며 퀴즈의 2개 범주에서 HumanMade를 앞선다. 하지만 PresentArena 승률 17.0%와 내용 유사도 1.97은 높은 퀴즈 정확도가 저자가 녹화한 발표와 전반적으로 동등함을 입증하지는 않음을 보여준다. 서로 다른 영상 길이도 비교의 해석을 제한한다.
HumanMade는 4.6, PaperTalker는 3.8을 받으며 PaperTalker는 2.8인 PresentAgent, 2.2인 Veo3, 1인 Wan2.2보다 높다. 이 그래프는 비교한 생성 베이스라인보다 PaperTalker를 더 선호한다는 결과를 뒷받침하면서도, 사람이 만든 영상과의 격차를 보여준다.
병렬화는 토큰 사용량을 62K로 유지하면서 PaperTalker의 실행 시간을 287.2분에서 48.1분으로 줄인다. 발표자를 제거하면 실행 시간이 15.6분으로 줄어 발표자 생성의 연산 부담을 보여준다. 보고된 달러 비용에는 상세한 산정 기준이 없다.
5.3 Qualitative Analysis
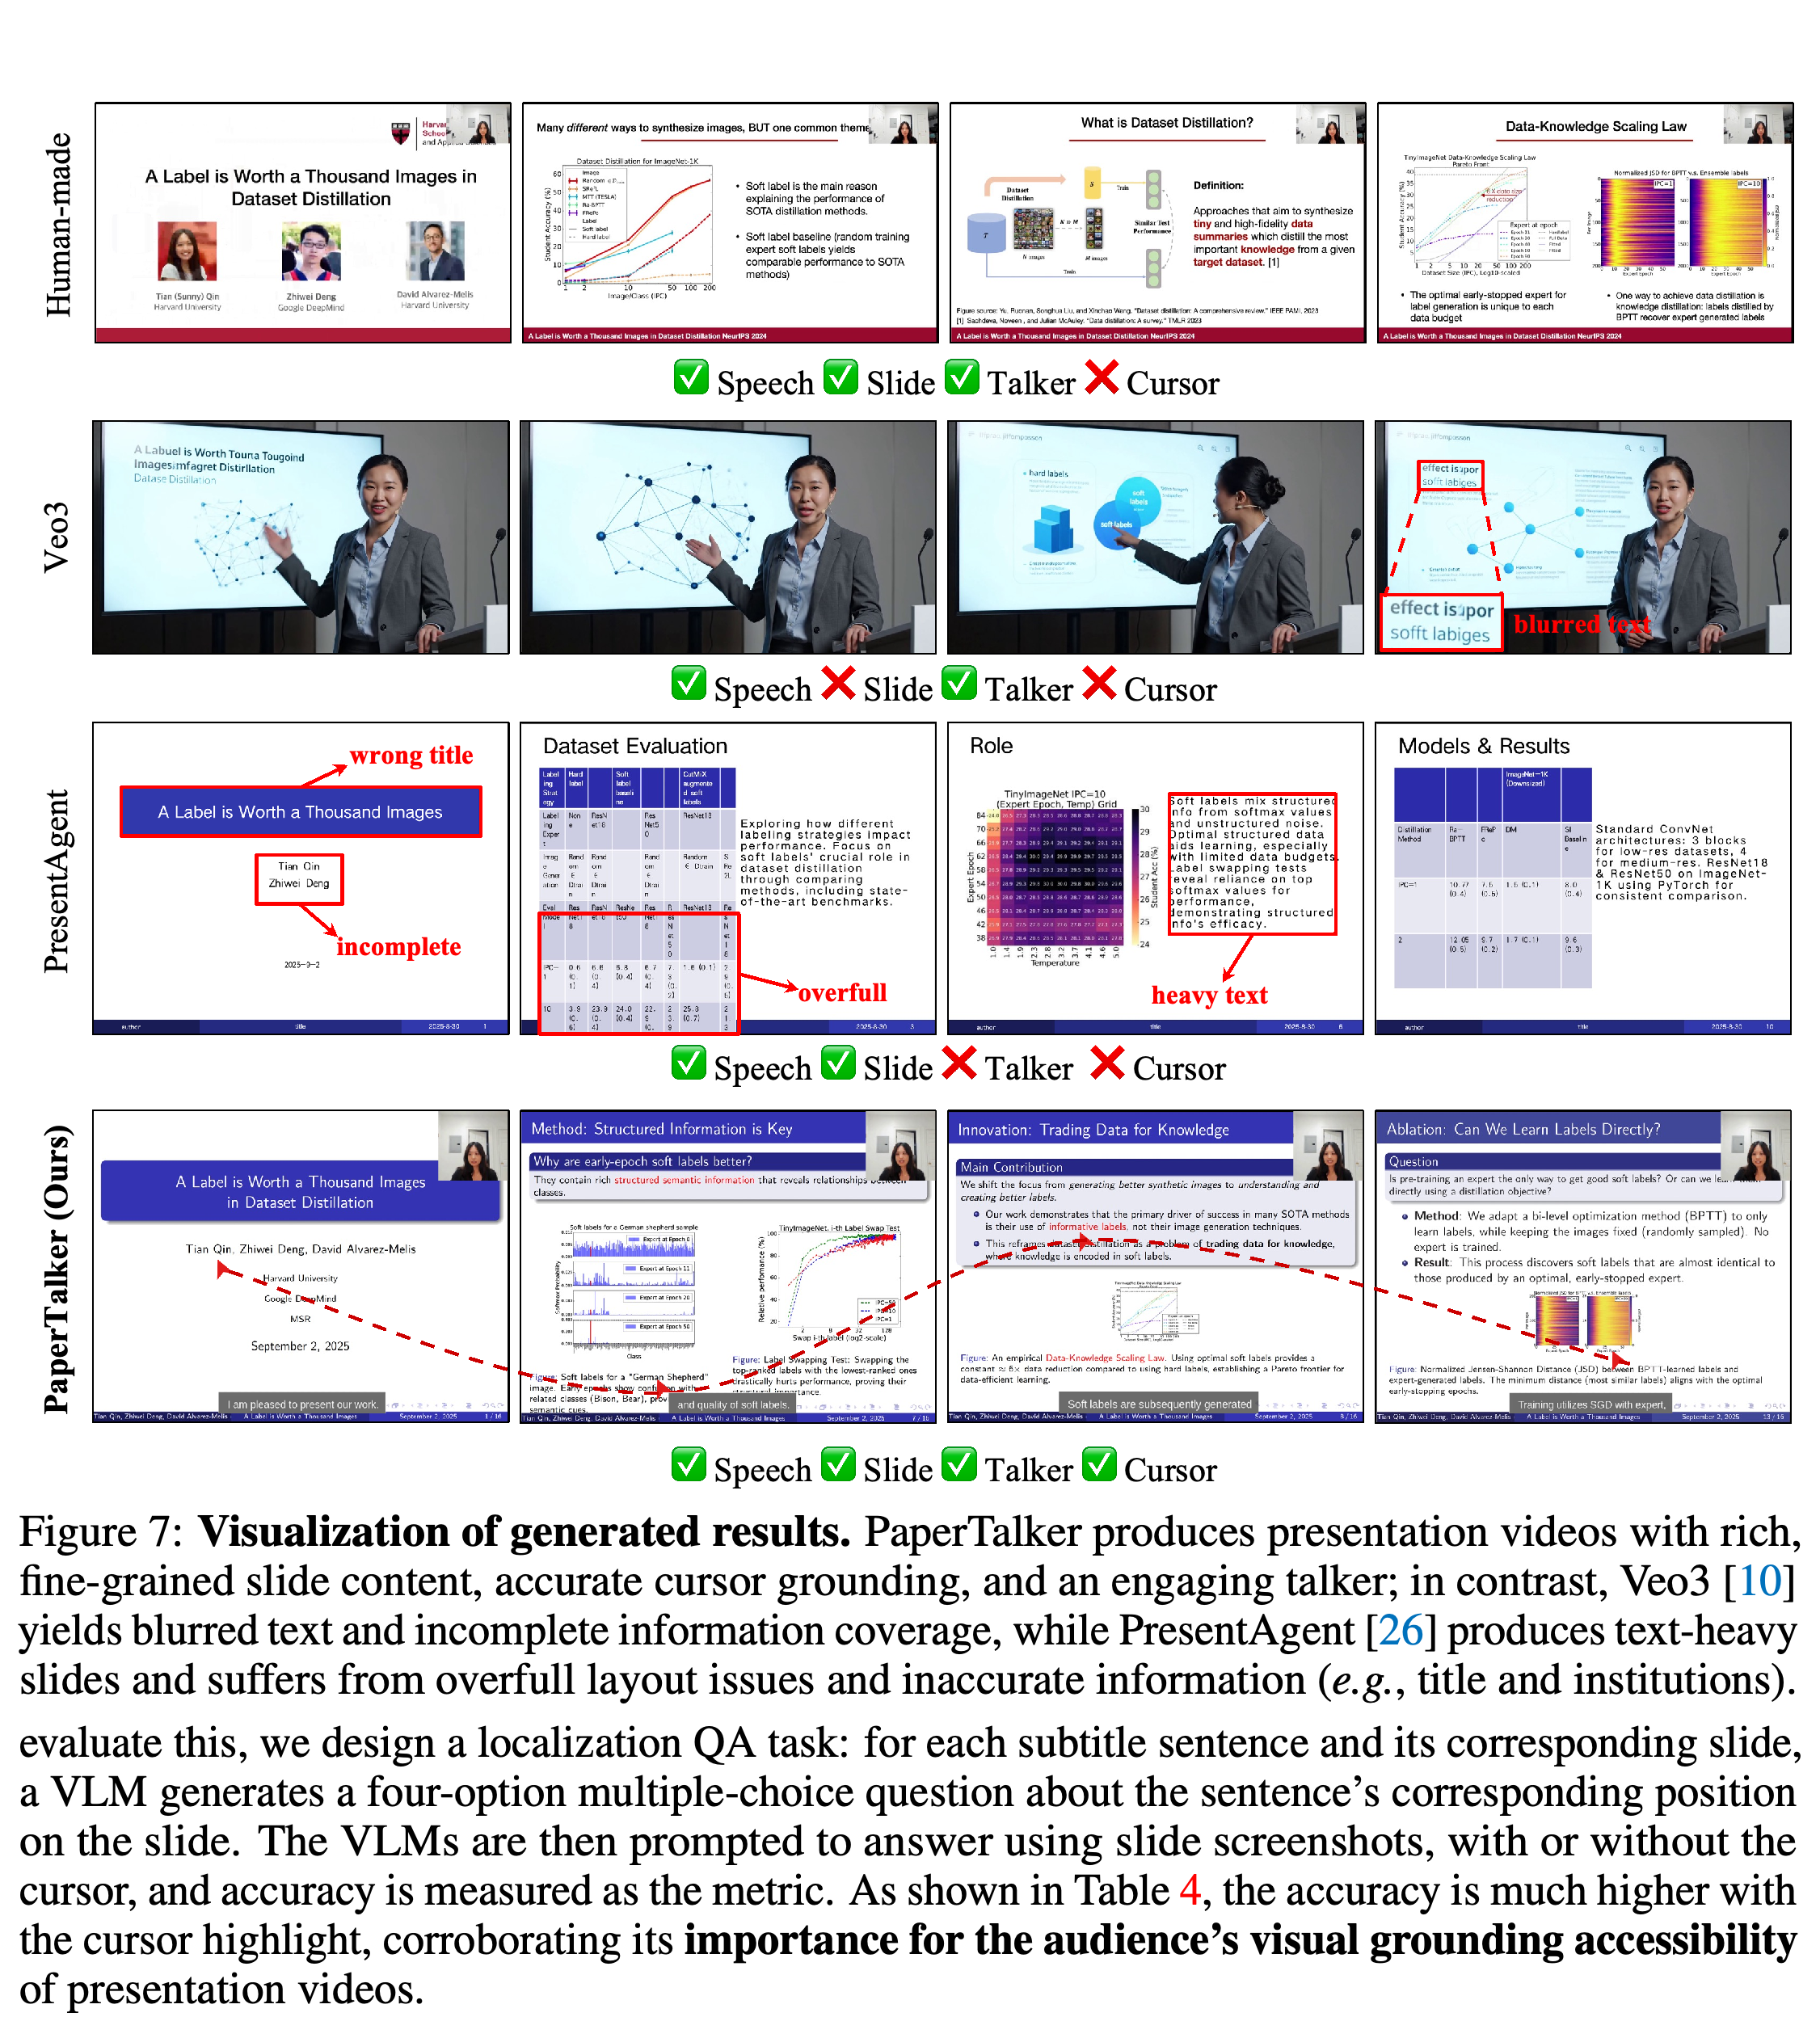
정성적 사례는 PaperTalker가 슬라이드 내용, 발표자, 음성, 커서 안내를 결합하는 모습을 보여준다. Veo3는 시각적으로 그럴듯한 발표자를 생성하지만 슬라이드 텍스트가 흐릿하다. PresentAgent 사례에는 잘못된 제목, 불완전한 저자 정보, 빽빽한 텍스트, 슬라이드 밖으로 벗어난 내용이 나타난다. 선정된 사례들은 실패 유형을 보여주지만 벤치마크 전체에서의 발생 빈도를 입증하지는 않는다.
선정된 사례는 Veo3의 흐릿한 텍스트와 PresentAgent의 잘못되거나 불완전하거나 슬라이드 밖으로 벗어난 내용을 보여준다. PaperTalker는 커서 안내를 포함해 서로 정렬된 구성 요소를 보여주지만 이 사례들로 벤치마크 전체의 실패율을 정량화할 수는 없다.
5.4 Key Ablations
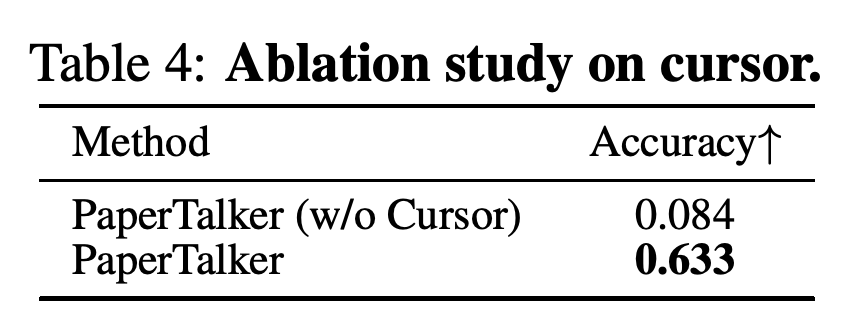
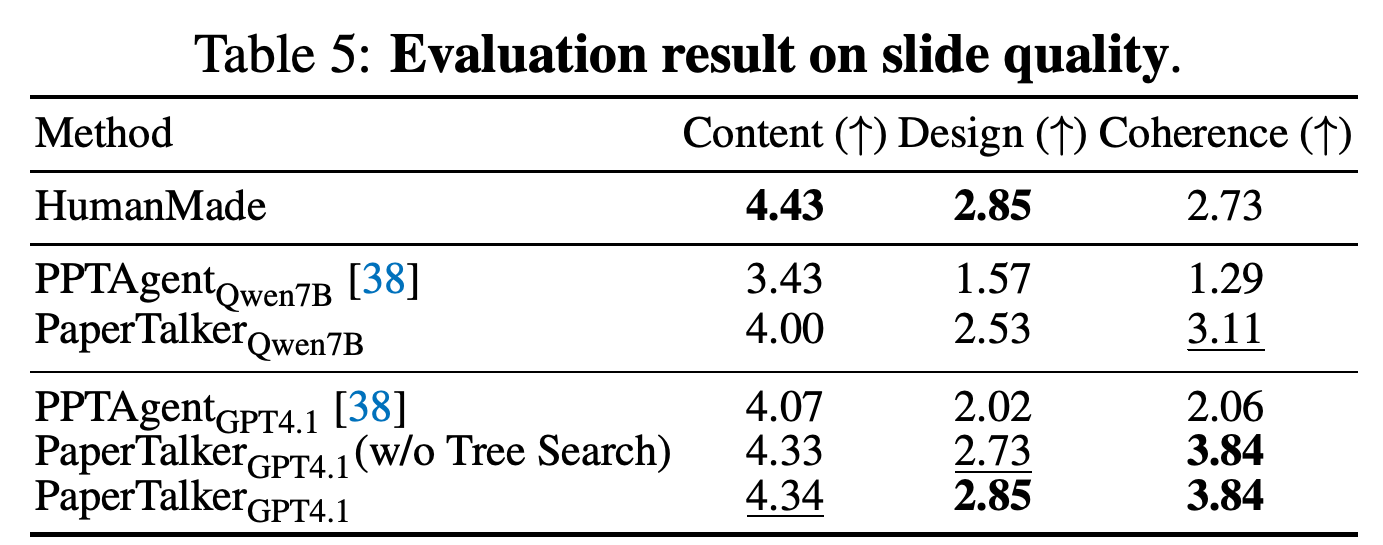
커서 절제 실험은 자막 문장과 관련된 슬라이드 영역을 찾는 선택지 4개의 위치 식별 질문을 사용한다. 모델 정확도는 커서가 없을 때 0.084에서 있을 때 0.633으로 높아진다. 슬라이드 레이아웃 절제 실험에서는 Tree Search Visual Choice가 1~5 척도의 디자인 점수를 2.73에서 2.85로 높인다. 내용 점수는 4.33에서 4.34로 바뀌고, 일관성 점수는 3.84로 유지된다. 이 결과는 모델의 위치 식별 능력 개선과 소폭의 디자인 점수 향상을 뒷받침하며 적용 전후 사례는 overflow가 수정된 모습을 보여준다.
커서를 추가하면 모델 기반 질의응답 과제의 위치 식별 정확도가 0.084에서 0.633으로 높아진다. 이는 평가자의 위치 식별 과제에서 명시적인 시각 안내가 유용함을 뒷받침하지만 사람의 이해도를 직접 측정하지는 않는다.
Tree Search Visual Choice는 GPT-4.1을 사용하는 PaperTalker의 디자인 점수를 2.73에서 2.85로 높여 HumanMade의 디자인 점수와 같게 만든다. 내용 점수는 4.33에서 4.34로 바뀌고, 일관성 점수는 3.84로 유지된다. 이는 측정된 개선 효과가 레이아웃 디자인에 집중됨을 나타낸다.
대응하는 사례들은 개선 전에 슬라이드 경계를 벗어났던 그림이 개선 후에는 레이아웃 안에 들어가는 모습을 보여준다. 이는 overflow 수정의 정성적 근거로, Table 5의 디자인 점수 향상을 보완한다.
6 Conclusions
논문은 역할별 생성 도구를 조율하면 학술 발표 제작을 자동화할 수 있으며 Paper2Video가 이 과제를 위한 벤치마크를 제공한다고 결론짓는다. 보고된 결과는 비교한 대안보다 높은 모델 기반 퀴즈 정확도와 직렬 PaperTalker보다 약 6배 빠른 생성을 뒷받침한다. PresentArena와 사람 대상 평가에서는 여전히 저자가 녹화한 영상을 선호한다.
부록
- A Evaluation Metrics와 A.1 IP Memory는 발표자와 연구의 연관성을 평가하는 과제를 명시한다. 평가자는 무작위로 표집한 영상과 질문 4쌍을 받으며 각 쌍에는 5초 발표 클립과 이해 수준의 PresentQuiz 질문이 포함된다. 영상과 질문은 순서를 섞어 발표자 이미지 1장과 함께 제시한다. 관련 질문을 선택하는 정확도로 IP Memory를 정의한다. 이는 지정된 프롬프트 아래에서 연관성을 평가하며 시간이 지난 뒤 사람의 기억을 측정하지는 않는다.
- B Experiment는 B.1 Video Results에서 보충 자료를 안내한다. B.2 Results of Tree Search Visual Choice는 Figure 8을 통해 overflow 수정과 레이아웃 개선의 정성적 근거를 제시한다.
- C Prompts는 슬라이드 생성, 컴파일 오류 수정, 시각적 레이아웃 판단, 커서 설명을 포함한 발표 대본 생성, 자동 평가의 프롬프트를 기록한다. 슬라이드 프롬프트는 약 10장을 요청한다. 대본 프롬프트는 슬라이드당 50단어 이하로 제한하고 script | cursor description 형식으로 각 문장에 커서 설명 1개를 대응시키며, ###로 슬라이드를 구분한다. 레이아웃 프롬프트에는 MSTS Judge라는 이름이 붙어 있지만 약어의 풀이는 제공하지 않는다. 이 프롬프트는 2×2 격자의 후보 4개 가운데 하나를 선택한다. Meta Similarity 프롬프트는 관대한 0~5 평가 기준을 사용하고 PresentArena는 무승부를 허용하며 마지막 퀴즈 프롬프트에는 PresentationQuiz라는 이름이 붙어 있다.
짧은 생각
공학적 기여는 중간 산출물에 있다. 컴파일 진단은 수정 대상을 찾고, 렌더링한 레이아웃 후보는 시각적 선택을 지원하며 문장 단위 프롬프트는 내레이션을 커서 좌표와 연결한다. 절제 실험은 이러한 설계를 뒷받침한다. 레이아웃 개선은 디자인 점수를 소폭 높이고, 커서 안내는 모델 기반 위치 식별에서 더 큰 향상을 제공한다.
높은 퀴즈 정확도는 선택한 VideoLLM이 영상에서 활용할 수 있는 정보를 측정하며 IP Memory는 짧은 클립에서 발표자와 연구의 연관성을 측정한다. 어느 지표도 사람의 이해도 향상이나 지속적인 영향력을 직접 입증하지는 않는다. AI 학회 논문 101편으로 구성된 데이터셋, 사례의 40%에서만 제공되는 원본 슬라이드, 소규모 사람 대상 평가, 서로 다른 영상 길이, 명시되지 않은 비용 산정 기준은 발표 품질과 제작 비용에 관한 결론을 더 넓게 일반화하는 데 한계가 된다.