


AutoScientists: Self-Organizing Agent Teams for Long-Running Scientific Experimentation 요약 설명
27 May 2026 | Paper Review AI Research Agents Multi-Agent Coordination Agent's Memory목차
- 요약
- 1 Introduction
- 2 Related Work
- 3 AUTOSCIENTISTS: Long-Running Self-Organizing Agent Teams
- 4 Experiments
- 5 Limitations and Future Work
- 6 Conclusion
- 부록
- 짧은 생각
이번 글에서는 AutoScientists: Self-Organizing Agent Teams for Long-Running Scientific Experimentation 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 5월 27일(Arxiv)
- Gao, Shanghua, Fang, Ada, Zitnik, Marinka.
- Harvard University
- 논문 링크
- Project Page
요약
- AUTOSCIENTISTS는 중앙 계획 에이전트 없이 장기간 계산 실험을 조율한다. 에이전트들은 제안을 비평하고 팀을 구성하거나 재편한다. 실험 근거가 쌓이면 현재 최선의 프로그램인 champion, 실험 결과, 실패한 연구 방향을 공유한다.
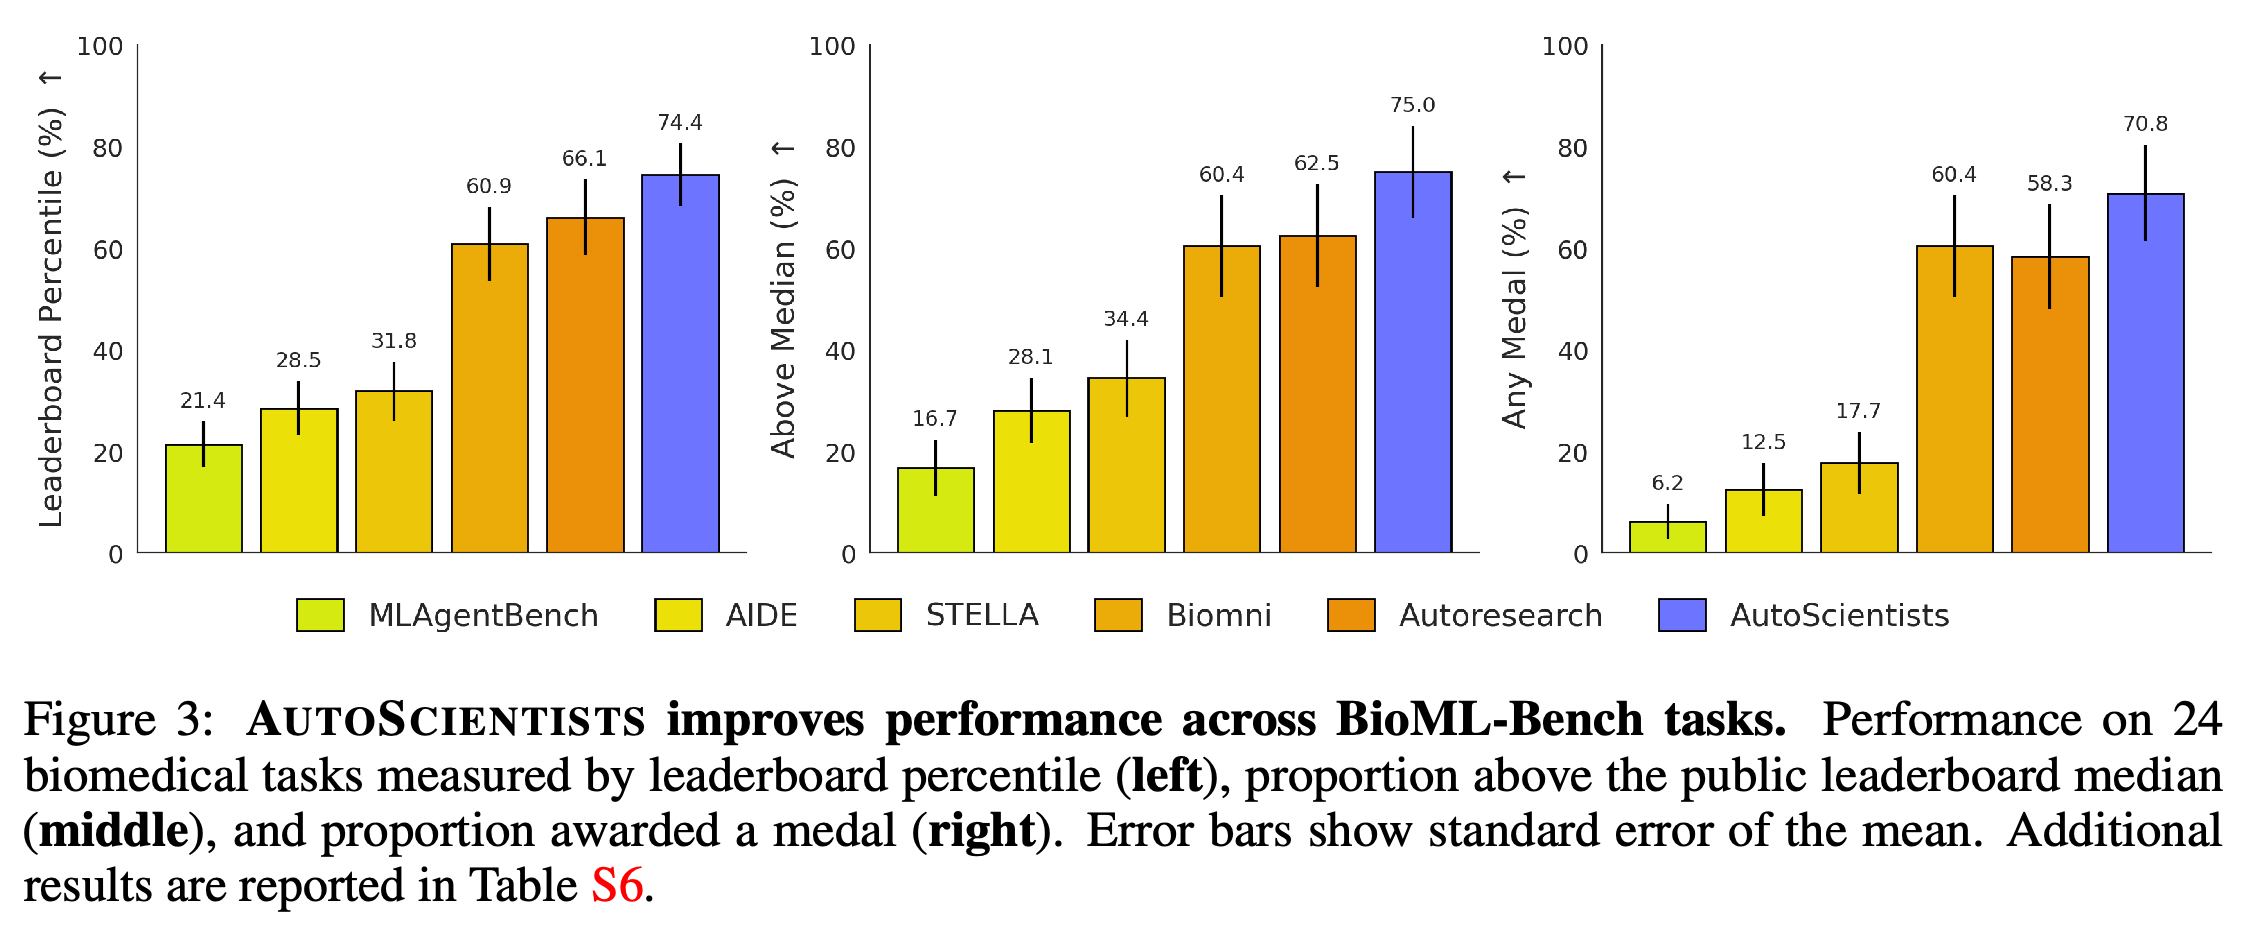
- 24개 BioML-Bench 과제에서 AUTOSCIENTISTS의 평균 리더보드 백분위는 74.40 (6.20)%이며, Autoresearch의 66.07 (7.38)%보다 8.33 백분위 포인트 높다. AUTOSCIENTISTS, Autoresearch, 재실행한 Biomni에는 동일한 실험 하드웨어와 시간 예산을 제공한다. 기존에 발표된 다른 기준 모델은 비영상 과제에서 다른 하드웨어 프로토콜을 사용한다.
- GPT nanochat 학습 최적화에서 AUTOSCIENTISTS는 34회 실험으로 val_bpb ≈ 0.978에 도달하고, Autoresearch는 65회가 필요했다고 보고한다. 이는 실험 효율을 측정한 결과이며, 실제 소요 시간이 1.9× 단축되었다는 뜻은 아니다. 동일한 강력한 champion과 실패 방향 기록에서 시작하면 AUTOSCIENTISTS는 93회 실험에서 7건의 갱신을 채택해 0.9730에 도달한다. 반면 Autoresearch는 100회 실험에서 갱신을 채택하지 못한다.
- ACE2–Spike 결합 과제에서 개발한 Kermut 확장 모델을 변경 없이 217개 ProteinGym assay에 적용하면 평균 Spearman’s ρ가 0.657에서 0.700으로 높아진다. 다만 MSE는 0.605에서 0.611로 조금 악화된다. 이 결과는 실험 탐색과 순위 예측 성능의 개선을 뒷받침하지만, 총비용 절감이나 임상적 타당성, 모든 조율 구성 요소의 통계적으로 신뢰할 만한 효과를 입증하지는 않는다.
1 Introduction
서론은 고정된 연구 절차가 장기간 실험에 적합하지 않은 이유를 설명한다. 경쟁 가설이 등장하고, 유망한 방향에서 더 이상 성과가 나오지 않으며, 실패 경험을 이후 결정에 반영해야 하기 때문이다. Present Work.는 중앙 조정 에이전트 없이 공유 상태로 협업하는 방식을 소개한다. 이를 통해 팀은 실험 근거가 바뀔 때 연구 노력을 다른 방향으로 전환할 수 있다.
- 논문의 기여는 생의학 ML, 언어 모델 학습, 단백질 적합도 예측을 위한 계산 실험에 있다. 자율적인 습식 실험실 연구는 평가하지 않는다.
- 웹사이트는 https://autoscientists.openscientist.ai 이며, 코드 저장소는 https://github.com/mims-harvard/AutoScientists 이다.
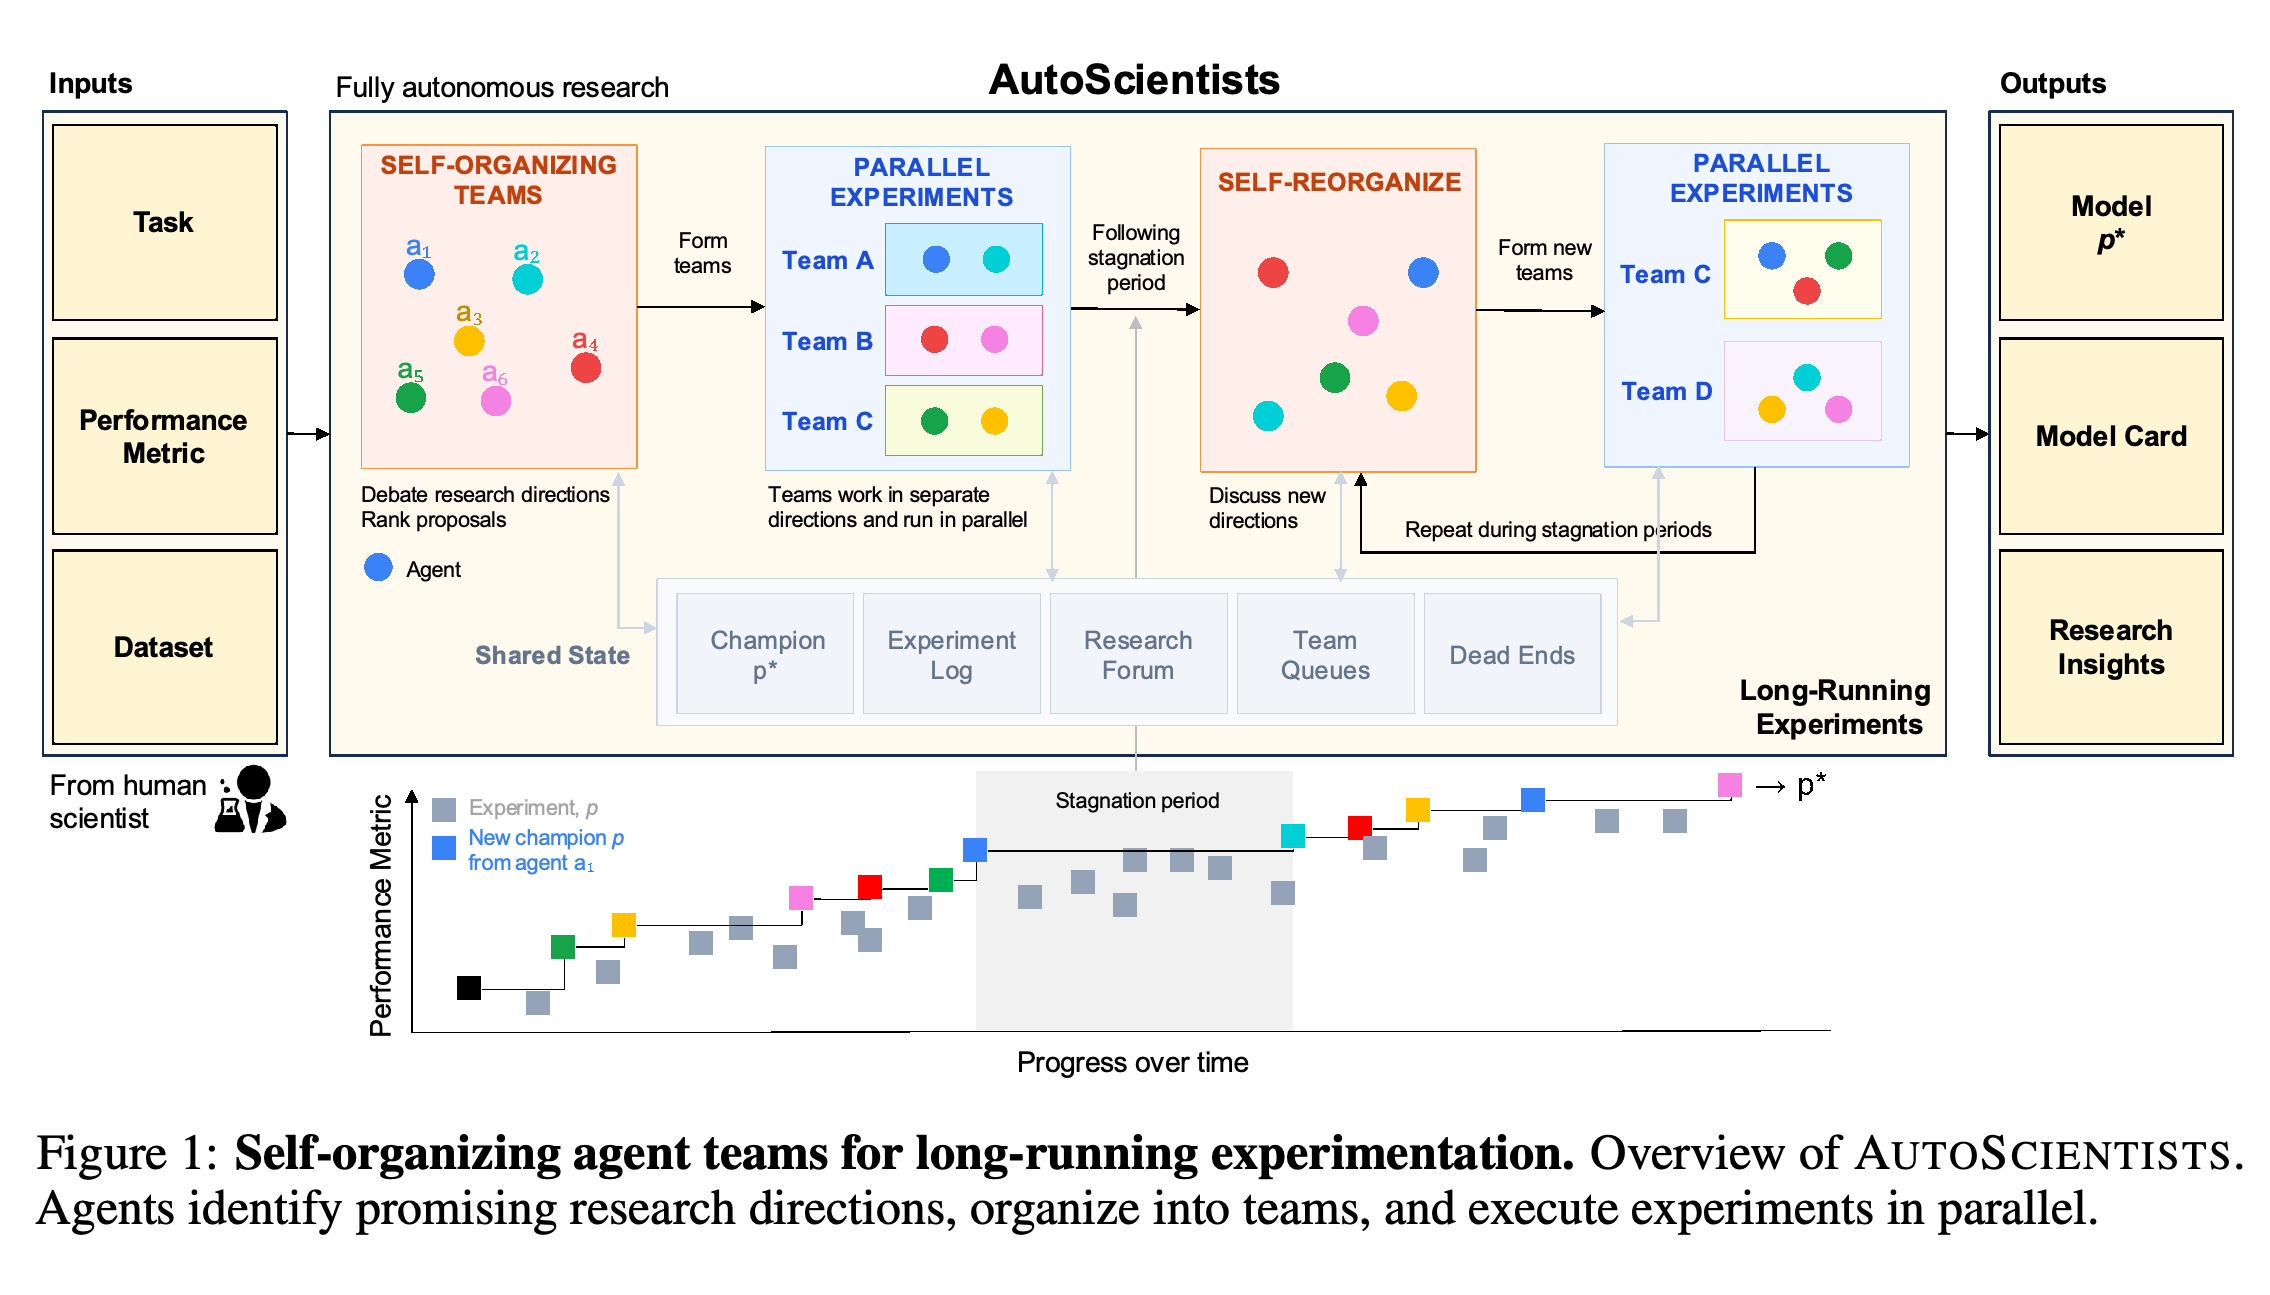
이 도식은 팀 구성과 재편을 공통 champion, 실험 로그, 포럼, 대기열, 실패 방향 기록과 연결한다. 정체가 발생하면 토론을 다시 시작한다. 다만 병렬 실험 블록은 시스템의 수행 가능성을 나타내며, GPU 1개를 사용하는 벤치마크에서 동시 GPU 학습을 입증하지는 않는다.
2 Related Work
관련 연구는 과학 연구 에이전트의 역량과 다중 에이전트 협업의 조직 방식을 구분한다. AUTOSCIENTISTS는 새로운 기반 언어 모델이나 과학 도구를 제안하기보다, 에이전트가 연구 방향을 선택하고 지속하는 방식에 초점을 맞춘다.
AI Agents for Scientific Research.
AI Agents for Scientific Research.는 문헌 종합, 가설 생성, 생의학 분석, 코드 실행, 반복적인 알고리즘 개발에 관한 연구를 검토한다. AUTOSCIENTISTS는 공유 토론을 통해 에이전트가 연구 방향을 결정한다는 점에서 고정된 PI–scientist–critic 구조나 관리자 주도 절차와 다르다.
- 실험 연산 자원을 쓰기 전에 토론으로 제안을 비평하고 선별한다. 단일 가설에 합의하도록 강제하지 않고 여러 연구 방향을 유지한다.
Coordination of Multi-Agent Systems.
Coordination of Multi-Agent Systems.는 에이전트나 소통을 추가한다고 성능이 자동으로 향상되지는 않는다는 점을 강조한다. 협업 구조, 다양성, 조율 비용, 문맥 관리에 관한 선행 연구를 바탕으로 단일 에이전트 비교와 조율 구성 요소의 제거 실험을 설계한다.
3 AUTOSCIENTISTS: Long-Running Self-Organizing Agent Teams
AUTOSCIENTISTS는 장기간 실험을 에이전트의 정체성과 축적된 지식을 유지하는 반복적 프로그램 탐색으로 정의한다. 동적으로 구성하는 연구팀, 역할별 제안 및 실행 루프, 호출 사이에 유지하는 공유 실험 근거를 결합한다.
3.1 Problem Formulation
입력은 과제 설명, 선택적인 초기 프로그램 p₀, 데이터셋 D, 평가 지표 ℓ로 구성된다. 목표는 p* = arg max over p ∈ P of ℓ_eval(p; D)이다. 여기서 P는 탐색한 프로그램 공간이며, 지표는 값이 클수록 좋도록 설정한다.
- 개발 과정의 피드백은 검증 세트나 학습 세트의 교차 검증에서 얻는다.
- 최종 성능은 별도로 보류한 테스트 지표가 있으면 이를 사용한다. 그렇지 않으면 개발 단계의 평가 프로토콜로 얻은 결과를 보고한다.
3.2 AUTOSCIENTISTS Approach
Overview.는 토론 단계와 실행 단계를 번갈아 수행한다. 에이전트는 실험 근거를 읽고 연구 방향별로 팀을 구성한 뒤 실험을 실행한다. 진전이 정체되면 토론을 다시 시작한다. 계획 에이전트 대신 공유 상태가 조율을 매개한다.
- 이 방법은 특정 LLM에 종속되지 않는다고 설명하지만, 보고된 실험은 단일 코딩 에이전트 백엔드를 사용한다.
Discussion and Self-Organization.은 팀 배정이나 탐색 공간의 사전 분할 없이 시작한다. 에이전트는 연구 방향을 제안하고 가설의 우선순위를 정하며 이전 게시물을 비평한다. 이후 토론을 정리해 팀별 연구 축과 구성원을 명시한 명단을 작성한다.
- [DISCUSS-DONE]에 과반수가 투표하면 토론을 종료한다. 참여한 analyst 중 알파벳순으로 마지막인 에이전트가 명단을 작성한다. 이는 결과를 결정적으로 정하기 위한 규칙이며, 해당 에이전트가 특별한 계획 권한을 갖는다는 뜻은 아니다.
- 팀 재편에서는 팀을 생성, 병합, 분할, 종료하거나 인력을 재배분할 수 있다. 본문의 설명은 영향을 받는 팀의 승인을 요구하며, 최근 10회 실험에서 개선이 없는 경우를 정체 감지의 예로 든다.
Long-Running Parallel Experiments.는 analyst 에이전트와 experiment 에이전트의 작업을 구분한다. Analyst는 아직 시험하지 않은 방향을 점검하고 제안을 대기열에 넣는다. Experiment 에이전트는 제안을 맡아 공유 champion을 수정하고, 후보를 학습·평가한 뒤 결과를 게시한다.
- 각 heartbeat는 공유 상태를 읽고 역할에 맞는 작업을 수행한 뒤 결과를 기록하며, 다음 세션에서 사용할 지식을 저장한다.
- 실험적으로 추정한 잡음 구간 안에 있는 개선은 다른 시드로 확인해야 champion으로 승격할 수 있다.
- 서로 읽을 수 있는 실패 방향 기록과 효과 크기 순위는 실패의 반복을 줄이고 탐색이 부족한 방향에 우선순위를 부여한다.
Shared State.에는 champion과 재현 지침, 전체 실험 로그, 구조화된 연구 포럼이 포함된다. 팀별 대기열, 실패 방향 기록, 가설 문서도 서로 읽을 수 있다. Output.은 최종 champion, 모델 카드, 성공한 방향과 기각한 방향을 추적하는 연구 결과 보고서로 구성된다.
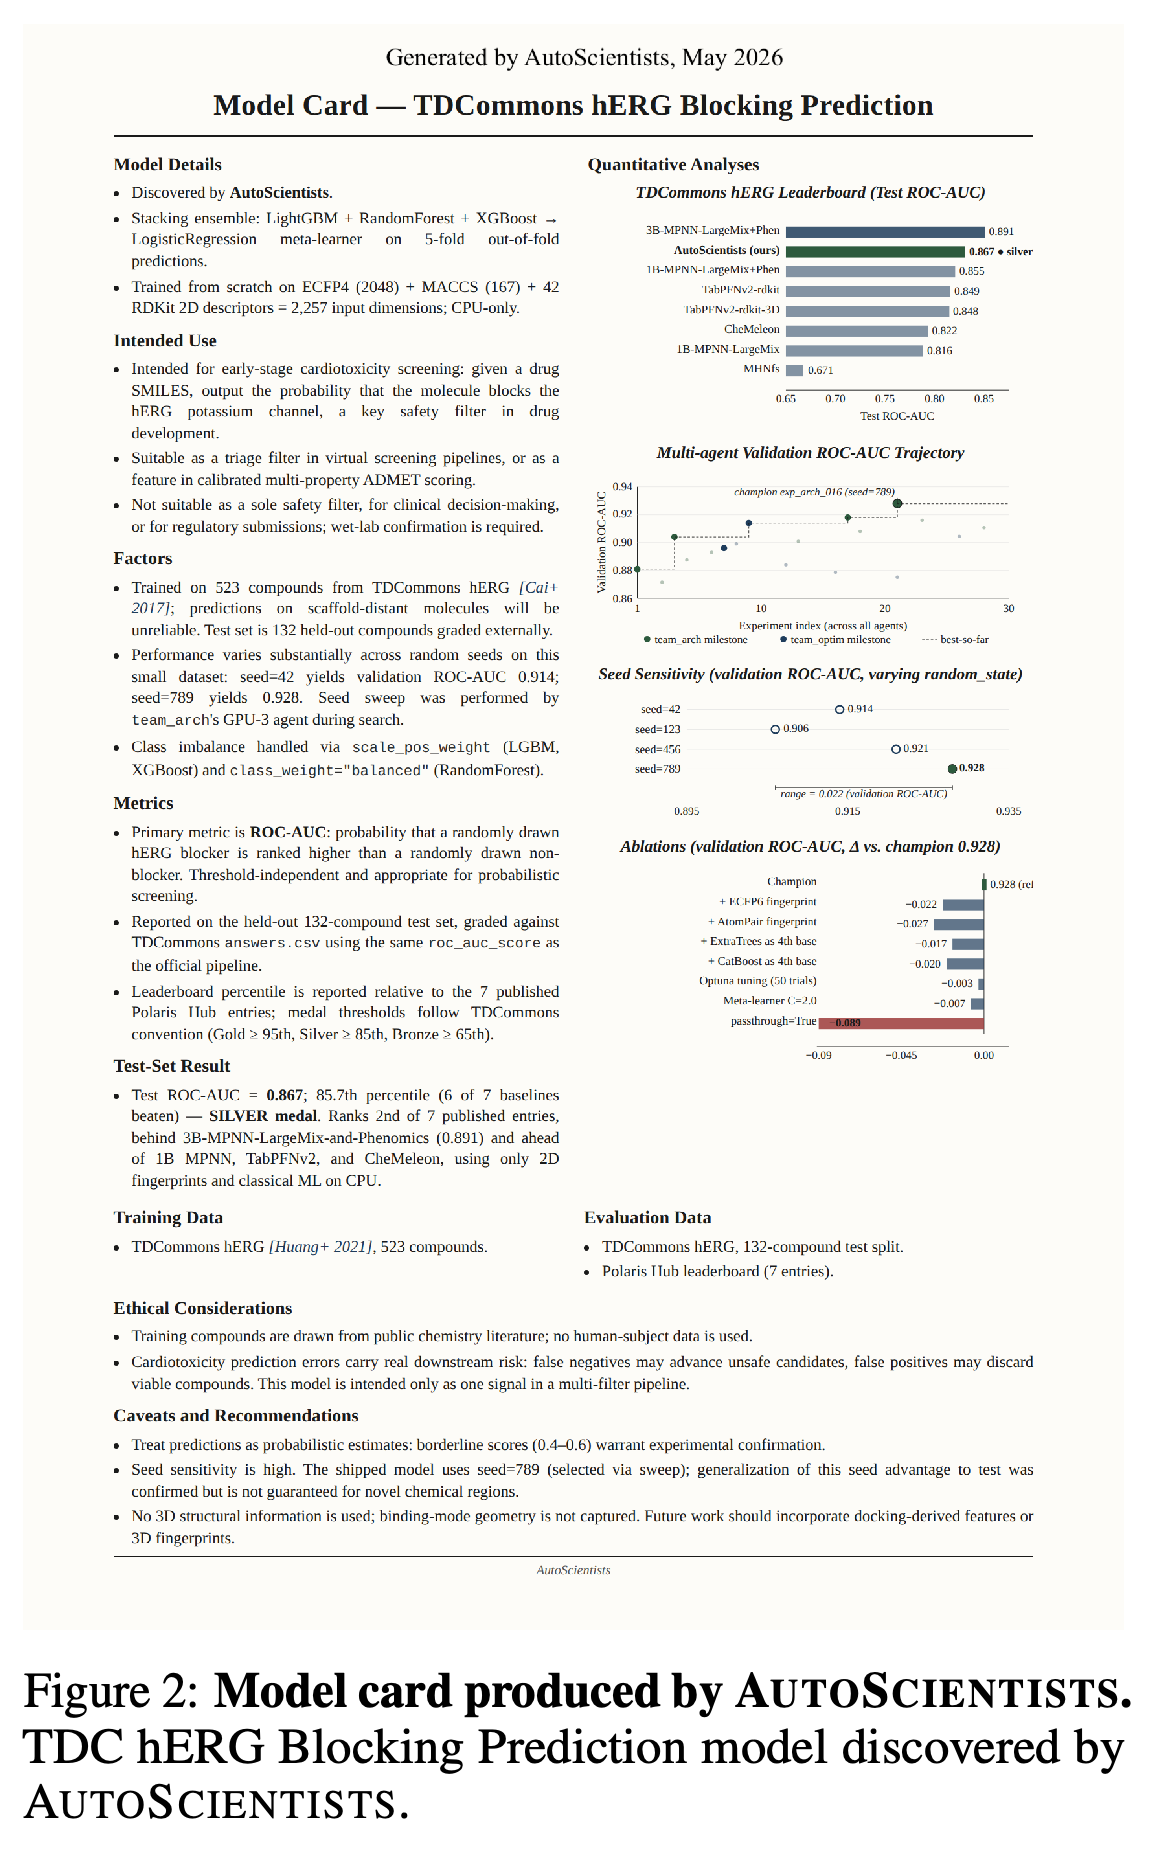
- Figure 2는 hERG 모델 카드를 보여주며, Appendix E는 GPT nanochat 산출물을 제공한다.
- Analyst가 기록한 설명은 탐색 과정을 문서화하지만, 인과적 기제를 독립적으로 입증하지는 않는다.
hERG 산출물은 모델 명세, 테스트 평가, 검증 성능의 변화, 시드 민감도, 제거 실험, 사용 한계를 함께 제시한다. 최종 점수 이상의 실험 문서화를 보여주지만, 임상적 타당성의 독립적인 근거는 아니다.
4 Experiments
실험은 과제 명세에서 출발하는 생의학 ML 파이프라인 개발, 짧은 학습 예산에서의 GPT 학습 코드 최적화, 강력한 단백질 적합도 예측기의 확장을 평가한다. 구성 요소 제거 실험은 일부 과제에서 조율 기제를 검토한다.
4.1 Implementation Details
모든 에이전트는 Claude Sonnet 4.6을 탑재한 Claude Code를 사용하며, Autoresearch도 같은 백엔드를 사용한다. 결정적으로 동작하는 모니터가 heartbeat 루프에서 에이전트를 반복 호출한다. 기본 구성은 analyst 에이전트 3개와 experiment 에이전트 6개이다.
- 실험에 H100 GPU를 사용할 수 있지만, BioML-Bench는 과제당 GPU 1개를 제공하므로 GPU를 사용하는 실험은 순차 실행해야 한다.
- 영속 상태가 연속된 LLM 세션을 연결한다. 장기간 조율을 위해 모델 문맥을 중단 없이 유지할 필요는 없다.
4.2 End-to-End Biomedical Machine Learning with AUTOSCIENTISTS
Setup.은 BioML-Bench 과제 24개를 평가한다. 생의학 영상 4개, 신약 개발 9개, 단백질 공학 6개, 단일 세포 오믹스 5개로 구성된다. 에이전트에는 과제 설명, 학습 데이터, 테스트 입력, 제출 예시, 검증 피드백을 제공한다. 비공개 테스트 레이블과 평가기는 작업 공간 밖에 둔다.
- AUTOSCIENTISTS의 토론 프롬프트에는 다양한 제안을 유도하기 위해 LLM이 생성한 과제군별 모델 패러다임 목록을 추가한다.
- AUTOSCIENTISTS, Autoresearch, 재실행한 Biomni에는 H100 GPU 1개, CPU 16개, 메모리 48 GB를 제공한다. 비영상 과제의 예산은 4시간, 영상 과제는 16시간이다. 기존에 발표된 비영상 기준 모델은 대신 8시간의 CPU 전용 프로토콜을 사용한다.
- 평가 항목은 리더보드 백분위, 중앙값을 넘는 제출 비율, 메달 획득률, 완료 여부이다. 평가한 에이전트는 웹 검색이나 fetch를 사용하지 않는다.
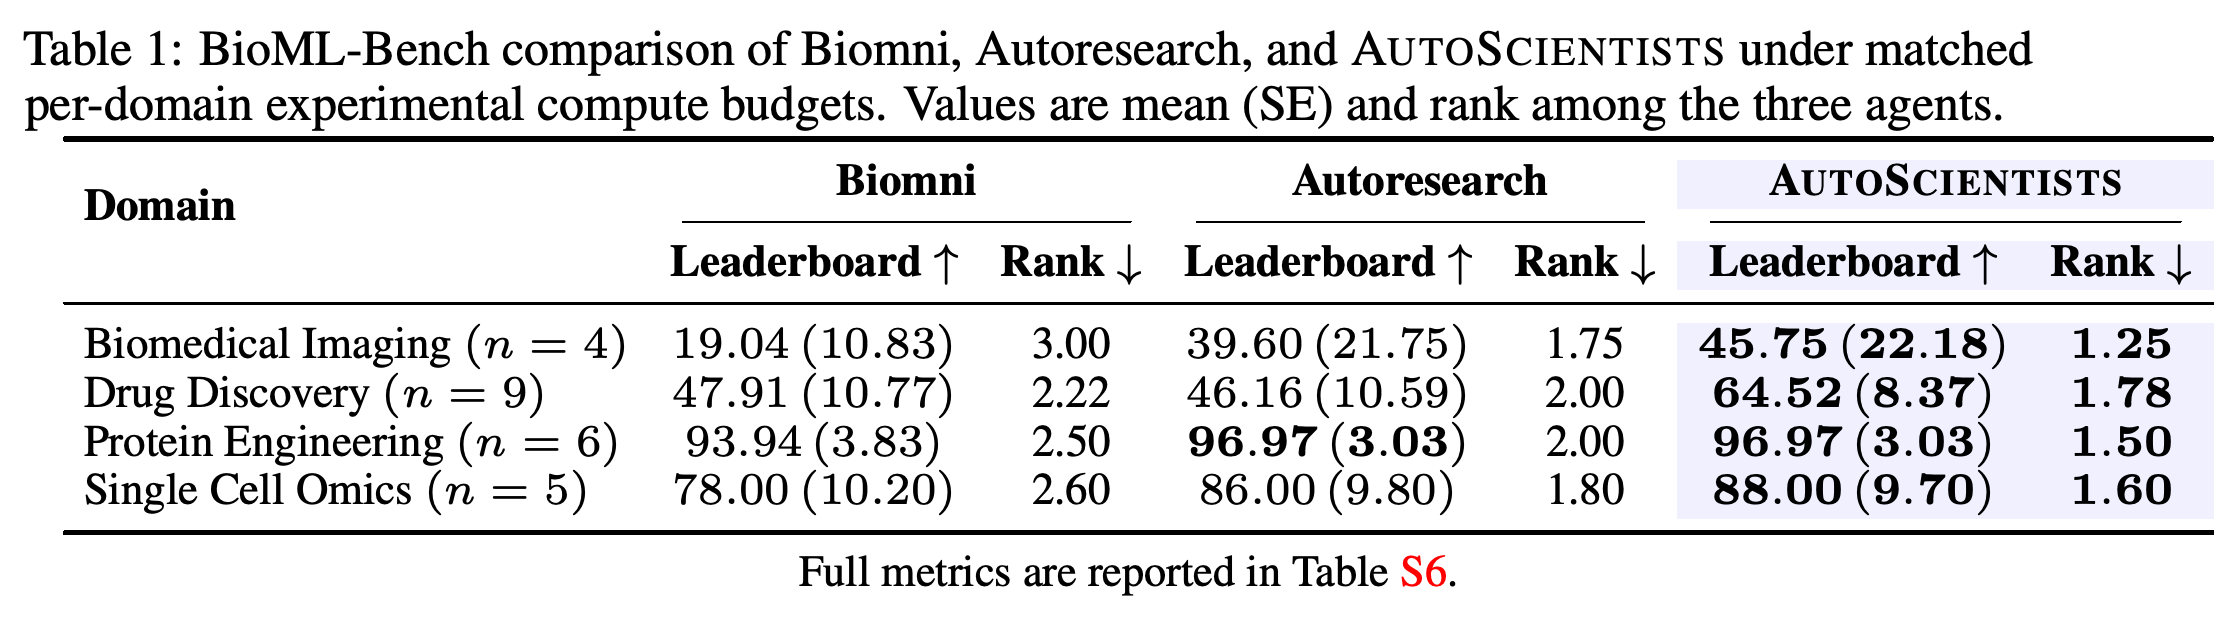
Results.에서 평균 리더보드 백분위는 74.40 (6.20)%이며, 24개 과제를 모두 완료한다. Autoresearch 대비 가장 큰 분야별 개선은 신약 개발에서 나타나며, 46.16 (10.59)%에서 64.52 (8.37)%로 높아진다. 영상 분야는 45.75 (22.18)%, 단일 세포 오믹스는 88.00 (9.70)%에 도달한다.
- 단백질 공학은 백분위 상한에 가깝다. AUTOSCIENTISTS와 Autoresearch 모두 96.97 (3.03)%를 얻지만, 평균 순위는 각각 1.50과 2.00으로 다르다.
- Figure 3은 공개 리더보드 중앙값을 넘는 비율을 75.0%, 메달을 획득한 비율을 70.8%로 보고한다.
- 전체 평균에서 우세하다고 모든 과제 지표에서 이기는 것은 아니다. Table S7에는 Biomni나 Autoresearch가 이긴 과제도 있다.
분야별 평균에서 Autoresearch 대비 가장 큰 백분위 우위는 신약 개발에 나타나며, 단백질 공학에서는 백분위 상한 근처에서 동률을 이룬다. 단백질 공학의 평균 순위는 여전히 다르므로, 세밀하지 않은 리더보드 백분위가 과제 점수의 차이를 가릴 수 있다. 영상 분야의 큰 표준오차도 분야 전체에 관한 결론을 제한한다.
AUTOSCIENTISTS는 도표의 집계 지표에서 평균 리더보드 백분위 74.4%, 중앙값을 넘는 제출 비율 75.0%, 메달 획득률 70.8%로 앞선다. 오차 막대는 시스템의 반복 실행이 아니라 과제 간 변동을 요약한다. 기존에 발표된 여러 기준 모델은 비영상 과제에서 다른 하드웨어 예산을 사용한다.
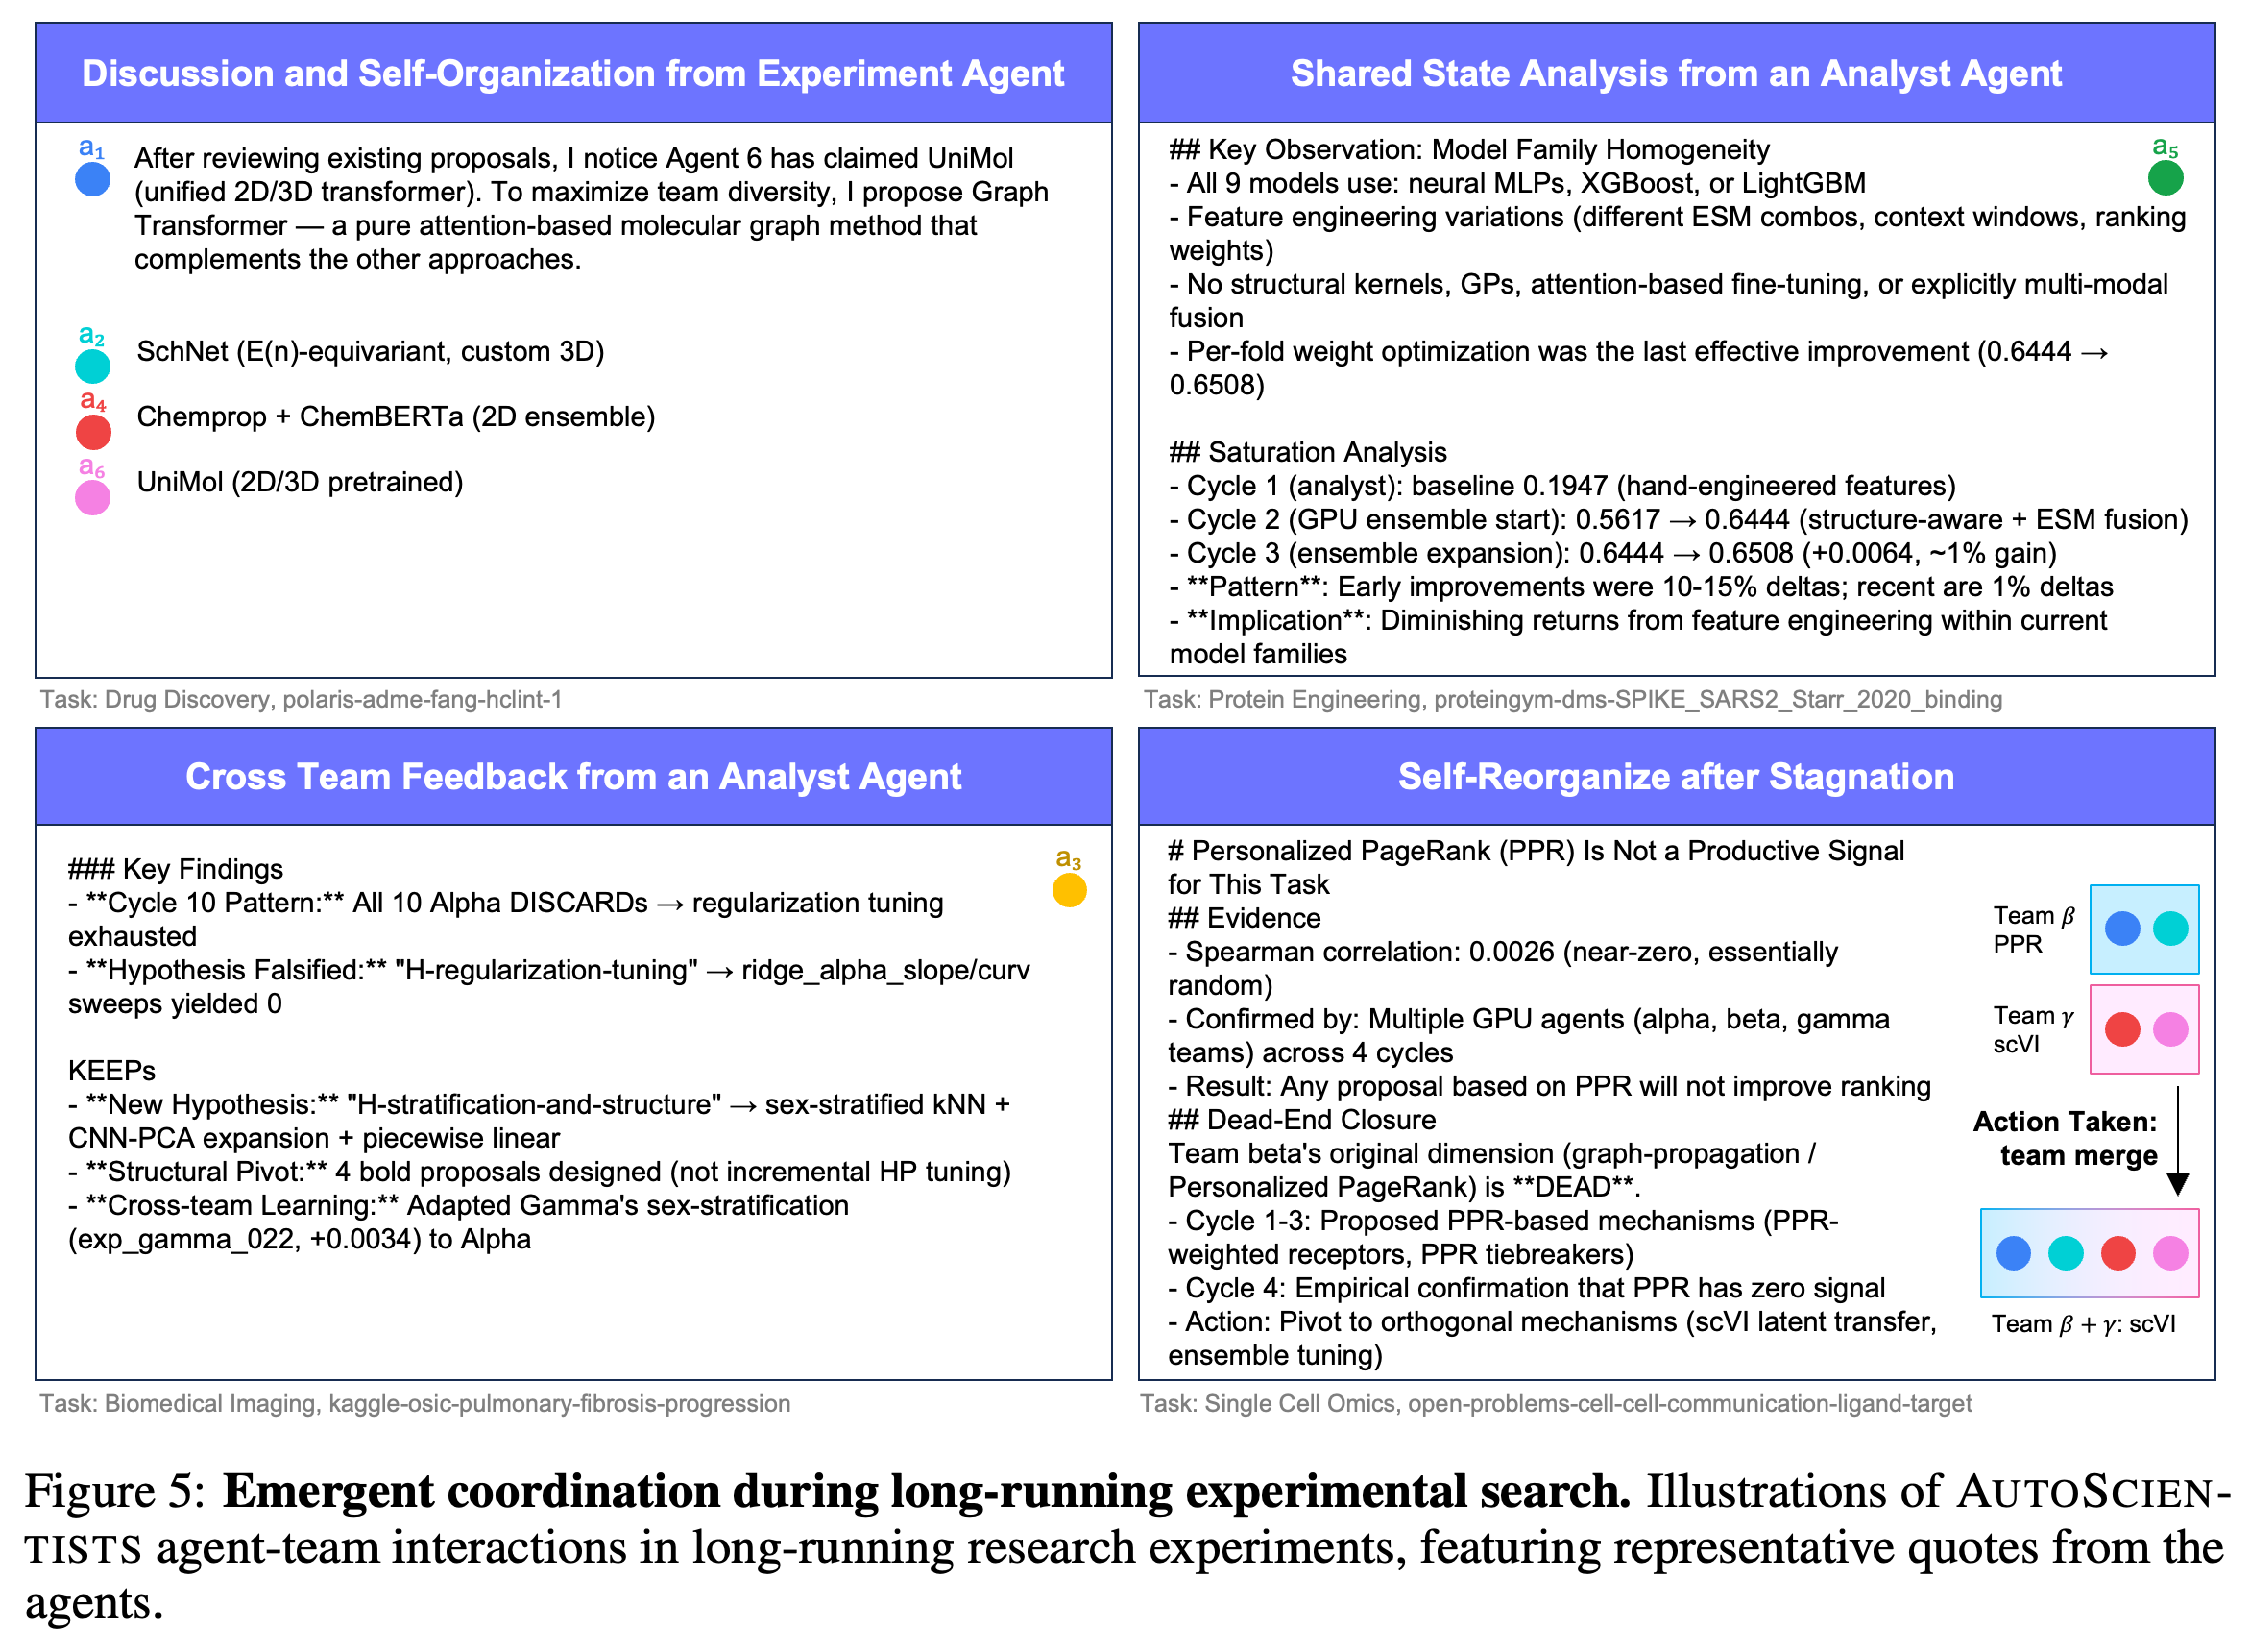
공유 상태 기록을 살펴보면 토론이 실험 선택을 바꾼다는 정성적 근거를 확인할 수 있다. Figure 5는 제안의 다양화, 성과가 포화된 방향의 인식, 팀 간 가설 전달, 정체 이후 실패 방향의 종료를 보여준다.
- 선별한 기록은 제안한 기제를 예시하지만, 그 기제가 얼마나 자주 나타나는지 정량화하거나 개별 상호작용의 인과적 효과를 분리하지는 않는다.
4.3 GPT Training Optimization with AUTOSCIENTISTS
Setup.은 GPT nanochat 실험마다 H100 GPU 하나에서 5분 동안 학습을 수행하고, 낮을수록 좋은 검증 bits-per-byte인 val_bpb를 평가한다. 2개 시스템은 같은 저장소와 백엔드를 사용하며, 실제 소요 시간 대신 실험 횟수로 진전을 비교한다.
- 기준 프로그램에서 시작하는 조건의 초기값은 val_bpb = 0.998이다.
- Champion에서 시작하는 조건의 초기값은 이전 AUTOSCIENTISTS 실험 50개 후의 val_bpb = 0.9777이다. 2개 시스템 모두 실패한 방향을 기록한 동일한 EXPLORED.md를 받는다.
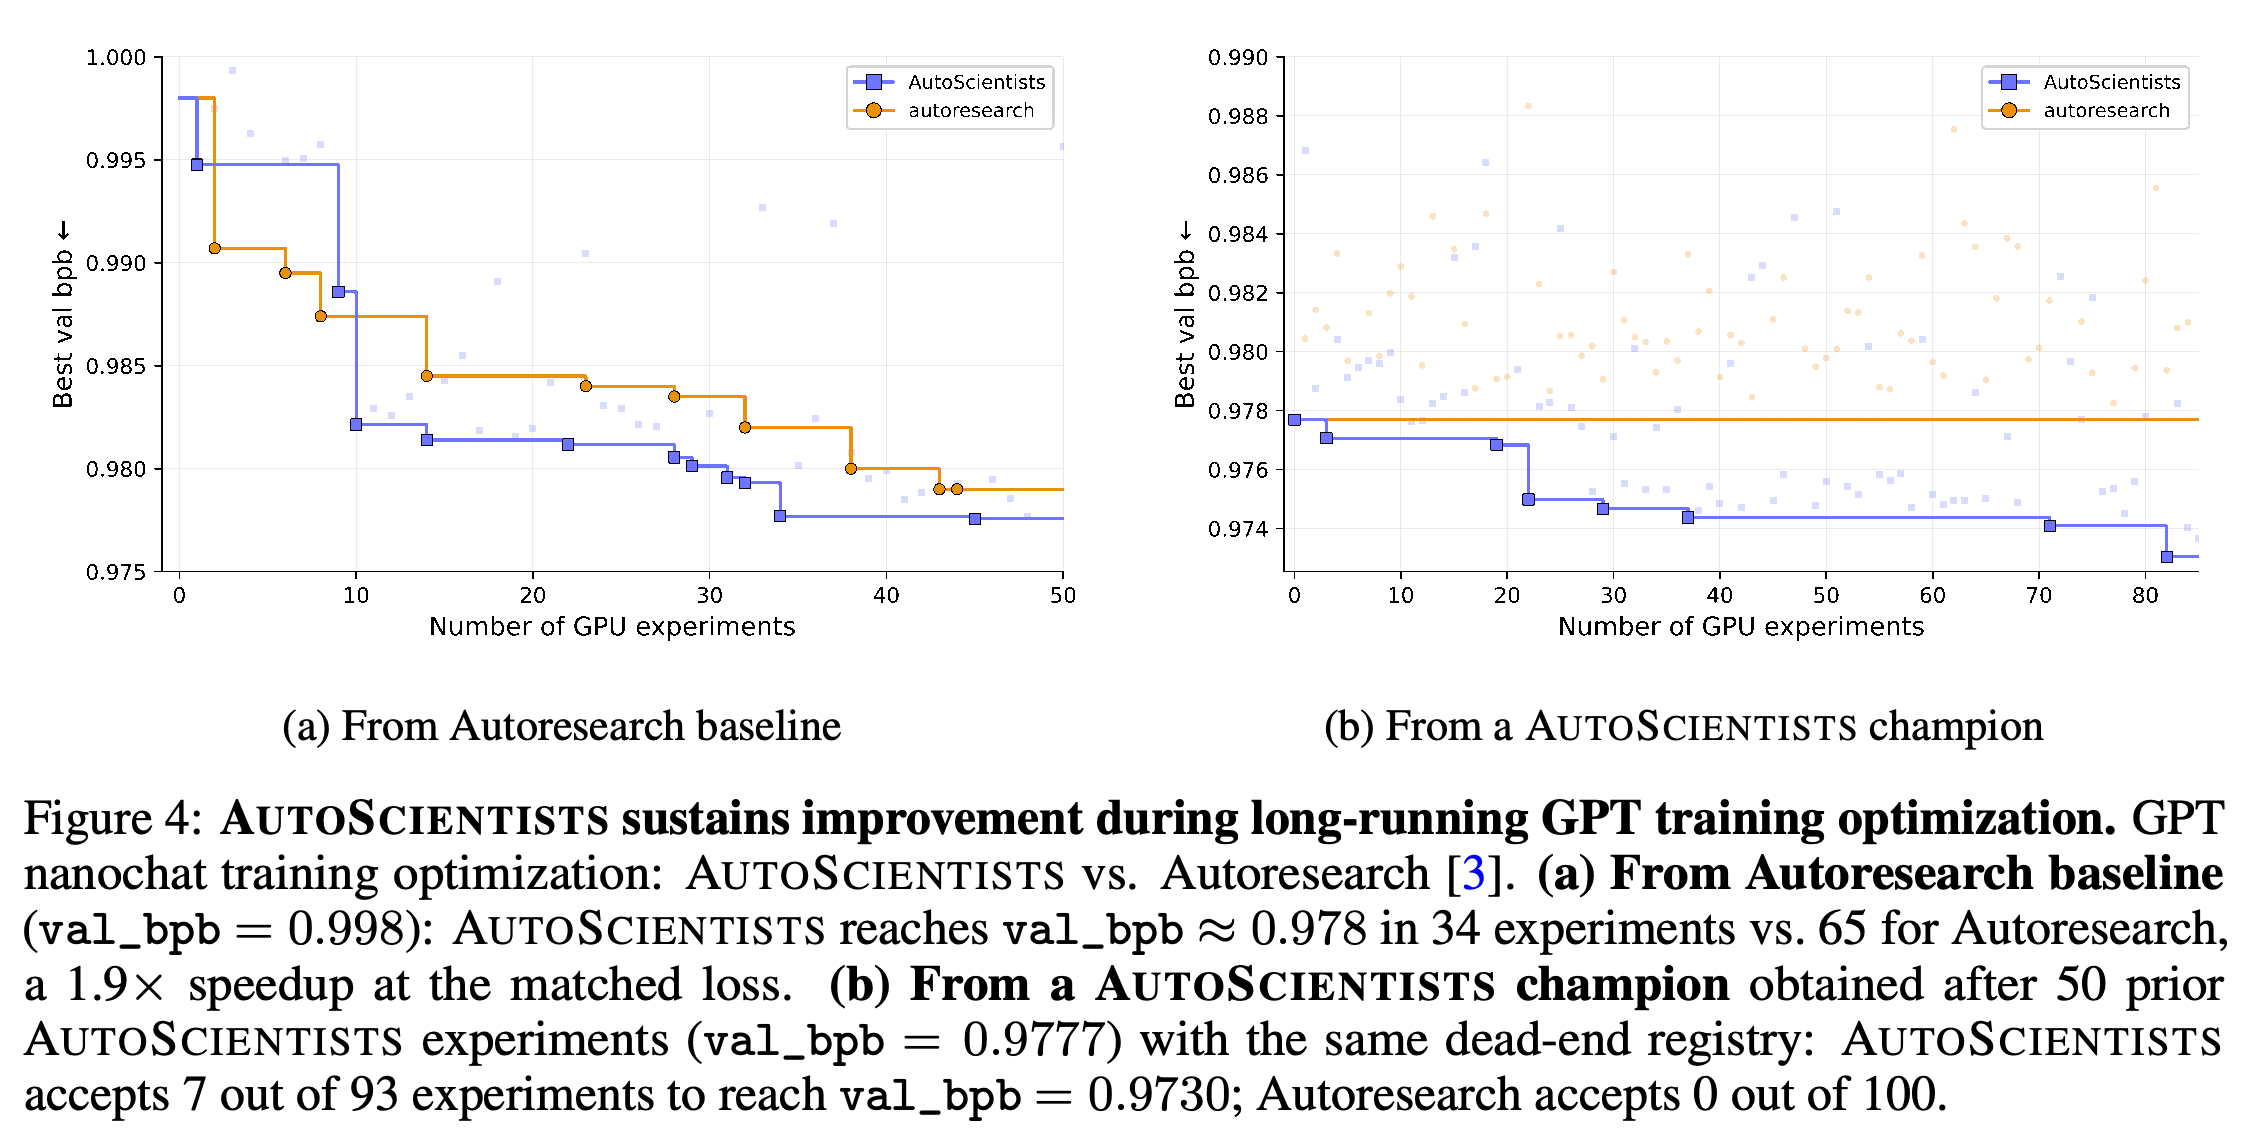
From Autoresearch Baseline.은 AUTOSCIENTISTS가 34회 실험으로 val_bpb ≈ 0.978에 도달하며, Autoresearch는 65회가 필요하다고 보고한다. Table S2에서 실험 횟수를 50회로 맞춘 종료 시점의 값은 각각 0.9777과 0.9790이다.
- 실행 중 architecture, schedule, optimizer 팀을 구성해 여러 연구 방향을 유지한다.
- 1.9× 비교는 목표 손실에 도달하는 데 필요한 실험 횟수에 관한 것이다. 하드웨어 병렬화로 실제 소요 시간이 단축되었다는 증거는 아니며, Figure 4a 자체는 처음 50회 실험만 표시한다.
From an AUTOSCIENTISTS Champion.은 93회 실험에서 갱신 7건을 채택해 val_bpb = 0.9730에 도달했다고 보고한다. Autoresearch는 100회 실험에서 갱신을 채택하지 못한다. 시도한 후보 중 최선의 값은 0.9783으로, 초기 champion보다 나쁘다.
- 채택한 방향에는 query-key 정규화 순서, 행렬 초기화, value-embedding 게이트 너비, 최종 학습률 비율, softcap 값, compile autotuning, 잡음 바닥 재보정이 포함된다.
- Autoresearch는 100회 시도 동안 query-key 정규화 순서를 제안하지 않는다. 이는 가설 탐색 범위가 다르다는 구체적인 예다.
- 채택한 갱신 중 1건은 모델을 바꾸지 않고 초기 champion을 재보정한다. Appendix B는 실험 예산을 100회로 설명하지만, 본문은 완료한 AUTOSCIENTISTS 실험을 93회로 보고한다.
기준 프로그램에서 시작한 패널은 표시된 실험 50개 구간의 후반부에서 AUTOSCIENTISTS의 누적 최저 손실이 더 낮음을 보여준다. Champion에서 시작한 패널에서는 이전 실패 지식에 동등하게 접근할 수 있는데도 Autoresearch의 champion은 그대로 유지되고 AUTOSCIENTISTS는 추가 개선을 채택한다. 실험 횟수에 따른 이 궤적은 실제 소요 시간의 병렬 단축을 측정하지 않는다. 원문 캡션의 실험 65개 기준 비교는 표시된 패널의 범위를 벗어난다.
4.4 Extending Kermut on ProteinGym Supervised Fitness Prediction
Setup.은 Gaussian process 기반 단백질 변이 효과 예측기인 Kermut에서 시작해 ACE2–Spike 결합 과제에서 수정안을 개발한다. 에이전트는 사람의 개입 없이 H100 GPU 1개에서 10 cycle 동안 random, modulo, contiguous 분할 방식의 평균 out-of-fold Spearman 상관계수를 최적화한다.
- Cycle은 각 experiment 에이전트가 대기열의 실험을 1회 완료하는 단위이다.
- 발견한 AUTOSCIENTISTS-Kermut 구성을 고정한 뒤, 217개 ProteinGym 지도 학습 치환 assay 전체에 적용한다.
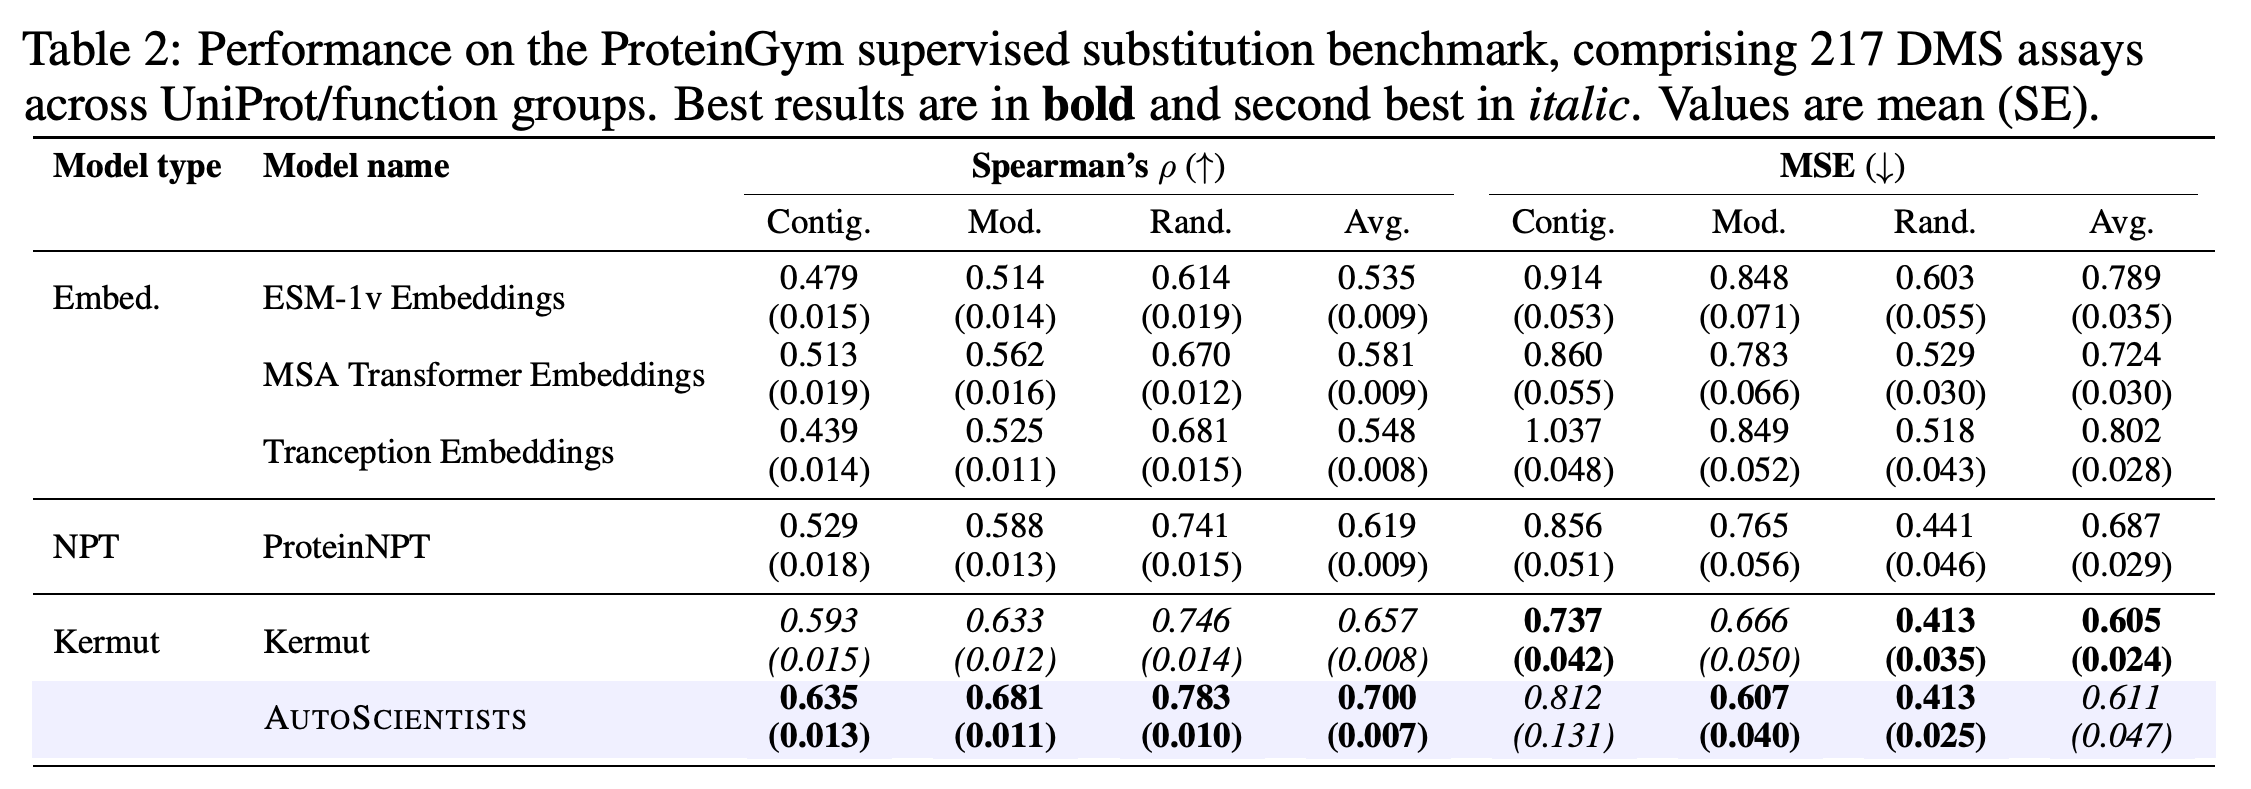
Results.는 개발 assay의 Spearman’s ρ를 0.747에서 0.840으로 높이며, 상대 개선율은 12.5%이다. 예측기는 GP 3개, Kermut의 구조 커널, 확장한 zero-shot 특징, 분위수 변환을 적용한 타깃을 결합한다. 본문은 다양성에 기반한 탐욕적 특징 선택도 설명한다.
- 217개 assay에서 평균 Spearman’s ρ는 0.657 (0.008)에서 0.700 (0.007)로 높아진다. 절대 개선 폭은 0.043이며, 상대 개선율은 6.5%이다.
- Contiguous, modulo, random CV에서 평균 상관계수는 모두 개선되지만, 평균 MSE는 0.605에서 0.611로 증가한다.
- 구성을 고정한 채 다른 assay에 적용한 결과는 개발 assay 밖에서도 재사용할 수 있음을 뒷받침한다. ProteinGym은 별도의 비공개 테스트 세트 대신 out-of-fold 예측을 평가하며, 217개 assay의 집계에는 개발 assay도 포함된다.
구성을 고정한 예측기는 217개 assay의 contiguous, modulo, random CV에서 평균 Spearman 상관계수를 높이며, 전체 ρ는 0.657에서 0.700으로 증가한다. 평균 MSE는 0.605에서 0.611로 높아진다. 이는 변이의 순서를 더 잘 예측해도 회귀 정확도가 개선되는 것은 아님을 보여준다.
4.5 Ablations of AUTOSCIENTISTS
Setup.은 TDC-hERG, Cell-Cell Communication, Human Plasma-Protein Binding, GPT 학습 최적화에서 analyst 역할, 에이전트 간 피드백, 자기 조직화, 또는 소통과 공유 상태를 함께 제거한다. 본문은 이를 동일한 백엔드, 과제 인터페이스, 초기 프로그램, 실험 예산을 사용하는 통제된 비교로 제시한다.
- Analyst를 제거하면 experiment 에이전트가 제안 생성과 지식 유지까지 맡는다.
- 에이전트 간 피드백을 제거하면 제안과 결과에 관한 토론이 사라진다. Appendix D에서는 정체 시 토론을 다시 시작하는 기능도 비활성화한다.
- 독립 에이전트는 champion과 지식을 각자 보관하므로, 다른 에이전트의 결과를 이어받거나 결합할 수 없다.
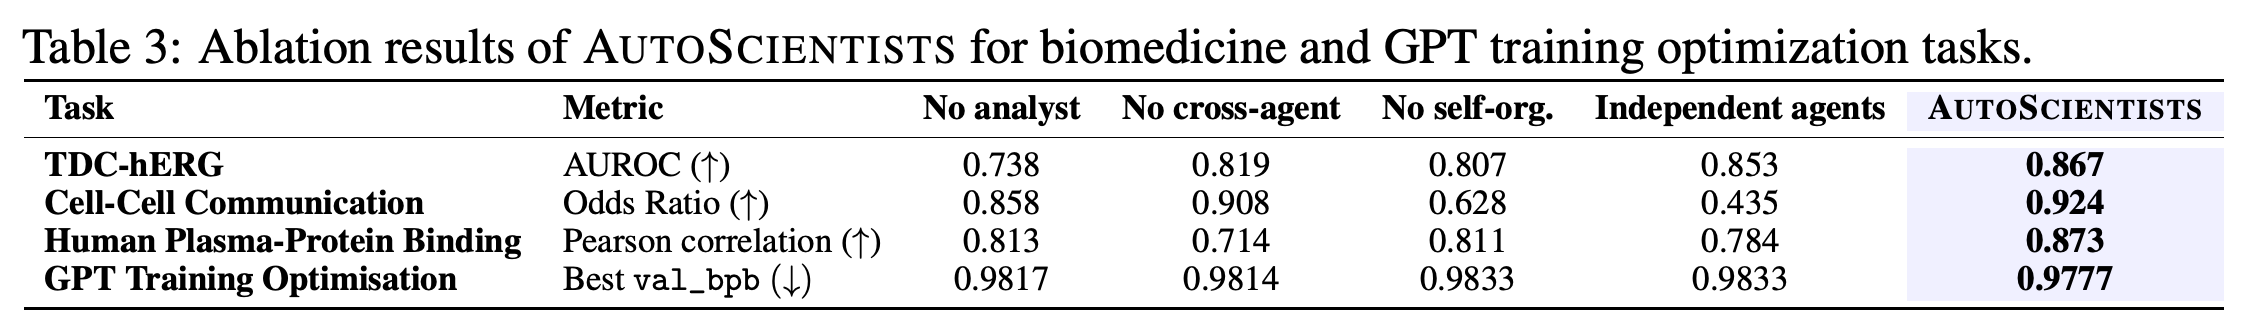
Results.에서 전체 시스템은 Table 3의 모든 주요 지표에서 가장 좋은 성능을 보이지만, 제거에 대한 민감도는 과제마다 다르다. Analyst를 제거하면 hERG AUROC가 0.867에서 0.738로 낮아진다. 피드백을 제거하면 혈장 단백질 결합의 Pearson 상관계수가 0.8729에서 0.7144로 낮아진다. 자기 조직화를 제거하면 GPT val_bpb가 0.9777에서 0.9833으로 높아진다.
- 독립 에이전트 조건에서는 Cell-Cell Communication 점수가 0.924에서 0.435로 낮아지고, GPT에서도 0.9833을 기록한다.
- 이 양상은 조율 기능이 상호 보완적이라는 해석과 부합한다. 다만 Appendix D는 조건마다 GPT 실행을 1회만 보고하며, 완료한 실험 횟수도 서로 다르다.
- 피드백 제거 조건에서는 재토론도 비활성화하므로, 효과 전체를 소통만의 영향으로 돌릴 수 없다.
전체 시스템은 과제 4개 모두에서 주요 점수가 가장 좋지만, 가장 큰 손실을 일으키는 제거 항목은 과제마다 다르다. 이 양상은 기능이 상호 보완적이라는 해석과 부합한다. 다만 조건별 단일 실행, 부록의 서로 다른 실험 횟수, 피드백 제거 조건에서의 재토론 비활성화가 인과적 해석을 제한한다.
선별한 상호작용 기록 4개는 제안의 다양화, 포화 분석, 팀 간 가설 전달, 성과가 없었던 Personalized PageRank 방향 이후의 팀 병합을 보여준다. 조율 설계를 기록된 탐색 결정과 연결하지만, 이러한 행동의 빈도나 평균적인 효과를 입증하지는 않는다.
5 Limitations and Future Work
AUTOSCIENTISTS는 고정된 실험 연산 자원에서 탐색을 개선하도록 설계했으며, LLM 호출 수나 총금전 비용의 최소화를 목표로 하지 않는다. Table S8은 GPU 연산 비용을 제외한 BioML-Bench LLM 비용을 AUTOSCIENTISTS $3984.7, Autoresearch $910.1로 추정한다.
- GPU 1개를 사용한 평가는 동시 GPU 실험을 충분히 검증하지 못한다. 더 큰 GPU 예산에서의 확장은 향후 과제로 남는다.
- 에이전트 수는 실행 전에 고정한다. 예비 탐색에서는 과제마다 최적 인원 구성이 다르고, 에이전트 14개에서 성능이 저하된다.
- 추가적인 평가 한계로는 불충분한 반복 실행, 단일 실행에 의존한 구성 요소 제거 실험, 단일 기반 LLM만 사용한 검증이 있다.
6 Conclusion
결론은 지속적인 탐색을 제안 비평, 성공 및 실패 실험의 공유, 유망한 방향의 변화에 따른 팀 재편과 연결한다. 비교 결과는 보편적인 우월성이나 전체 비용 절감보다, 실험 선택의 개선과 강력한 초기 프로그램에서의 지속적인 성능 향상을 더 직접적으로 뒷받침한다.
부록
- Reproducibility Statement는 https://github.com/mims-harvard/AutoScientists 에 실행 스크립트와 공개 자료를 제공한다. 공식 저장소에는 https://github.com/science-machine/biomlbench, https://github.com/OATML-Markslab/ProteinGym, https://github.com/karpathy/autoresearch, https://github.com/snap-stanford/biomni, https://github.com/petergroth/kermut 이 포함된다. Table S1은 버전, 커밋, 라이선스를 기록한다. 실행은 지정한 예산 동안 사람의 개입 없이 연속된 Claude Code 세션으로 진행한다. Impact Statement는 발견한 모델의 과도한 신뢰, 벤치마크 과적합, 잘못된 가설의 전파를 경고한다. 생의학 산출물에는 전문가 검토와 독립적인 검증이 필요하다.
- A Implementation Details and Algorithmic Protocols는 시작 절차, 팀 구성, 일반적인 실행 방식을 명시한다. A.1 Setup and Launch는 공유 상태와 미배정 에이전트를 초기화하고 토론 시작 신호를 게시한다. A.2 Heartbeat Protocol은 토론, 소속 팀이 없을 때의 종료, 미처리 결과 복구, 역할별 작업 중 수행할 절차를 결정한다. A.3 Self-Organized Team Formation에서는 에이전트가 방향을 제안하고 우선순위를 정하며 이전 기여를 비평한 뒤 [DISCUSS-MORE] 또는 [DISCUSS-DONE]에 투표한다. DONE 표가 과반수이면 참여한 analyst 중 알파벳순으로 마지막인 에이전트가 명단을 작성할 수 있다. 재편 과정은 팀을 생성, 병합, 분할, 종료하거나 인력을 재배분할 수 있으며, 이후 세션은 저장된 명단을 따른다. A.4 File Discovery는 list–decide–read 방식으로 파일에 접근한다. A.5 Queue and Claim Protocol은 버전 토큰 기반 낙관적 잠금으로 실험의 중복 배정을 막는다.
- A.6 Noise-Aware Champion Validation은 Δ > Mσ이면 개선을 바로 채택하며, M = 2로 설정한다. 0 < Δ ≤ Mσ이면 다른 시드에서도 champion보다 좋아야 하고, Δ ≤ 0이면 기각한다. 잡음 추정치는 σ = sqrt[(1/(2n)) Σᵢ(ℓ₁,ᵢ − ℓ₂,ᵢ)²]이다. 짝지은 실행을 최소 3회 수행한 뒤 추정을 시작하고, 5쌍 이후에는 값을 고정한다. 추정 전에는 보수적인 기본 잡음 구간을 사용한다. 이 규칙은 공유 기준 프로그램이 부정확한 champion 갱신으로 오염되는 것을 막지만, 다중 비교를 통제하는 유의성 검정이 아니라 휴리스틱 승격 규칙이다.
- A.7 Analyst Proposal Protocol은 수치 매개변수의 탐색 범위를 점검하고 경험적 평균 절대 효과 크기를 사용해 호출마다 제안 2개를 생성한다. 시도 횟수가 3회 미만인 방향에는 탐색 보너스를 주고, 효과가 잡음 바닥보다 작은 방향의 우선순위는 낮춘다. 최소 1개 제안은 과감한 변경 기준을 충족하거나 공개적인 [EXEMPT] 근거를 제시해야 한다. 기준의 예로는 매개변수 수 ≥10% 변경, 확인된 버그 수정, 미탐색 상태로 반복 지적된 축, 가설 간 충돌을 확인하는 실험이 있다. 제안은 서로 다른 방향을 대상으로 해야 한다. 새로운 근거 없이 같은 방향을 반복 실행하거나 기각된 범위를 다시 시험해서는 안 되며, champion 갱신 후에는 기제에 기반한 후속 실험을 포함해야 한다.
- B Extended Ablation Results의 B.1 Comparison Against Autoresearch at Matched and Extended Compute에서 Table S2는 기준 프로그램에서 시작한 50회 실험 후의 값을 0.9777과 0.9790으로 보고한다. 공유 champion에서 시작한 조건의 갱신 채택 수는 각각 7건과 0건이다. B.2 Team-Size Sensitivity: Parallelism Gain and Oversubscription은 작업 에이전트 2개, 4개, 9개, 14개인 구성을 비교하며, experiment/analyst 구성은 각각 1+1, 2+2, 6+3, 9+5이다. 최적 구성은 과제마다 다르고, 에이전트 14개는 각 과제의 최적 구성보다 성능이 낮다. 생산적인 소규모 구성은 서로 다른 실험 횟수로 비슷한 GPT 손실에 도달한다. 에이전트 9개가 2개보다 약 3.25× 빠르다는 값은 완전 병렬 실행을 가정하고 heartbeat 횟수로 계산한 예상치이다. 실제 에이전트는 완전 병렬이 아니라 반복적으로 호출했다.
- C Run-to-Run Stability는 독립적인 GPT cold start 3회의 최종 val_bpb를 0.9777, 0.9795, 0.9780으로 보고한다. 실험 횟수는 각각 75회, 64회, 62회이다. 보고된 평균은 0.9784, 표본 표준편차는 0.0010이며, 채택률은 9.7%에서 10.9% 사이이다. 서로 다른 중간 탐색 방향이 비슷한 성능 구간에 도달한다. 이는 전체 시스템에 대한 제한적인 반복 검증 근거이지만, Autoresearch와의 비교 분산을 밝히지는 않는다.
- D Per-Experiment Trajectories for Ablation Runs는 D.1 No Self-Organization (abl-no-self-org), D.2 No Cross-Agent Communication (abl-no-cross-agent), D.3 No Analyst Role (abl-no-analyst), D.4 Independent Agents (abl-independent)를 다룬다. 각 조건의 최종 GPT val_bpb는 0.9833, 0.9814, 0.9817, 0.9833이며, 실험 횟수는 각각 47회, 50회, 50회, 50회이다. 전체 시스템 기준 실행은 71회에서 0.9777을 기록한다. 자기 조직화 제거 실행은 예산 수정 후 중단했고, 소통 제거 조건은 재토론도 비활성화한다. Analyst 제거 실행에서도 공유 산출물과 제안을 통해 팀 간 개선이 발생한다. 독립 에이전트는 배치 크기 축소를 반복해서 다시 발견하며, 서로 다른 champion을 결합하지 못한다. 부록의 Autoresearch 기준 실행은 결국 83회 실험 후 0.9773에 도달한다. 이는 전체 시스템 종료값보다 조금 낮지만 더 많은 시도가 필요했다. 실행 길이가 다른 이러한 단일 실행 비교로는 통계적으로 신뢰할 만한 구성 요소 순위를 확정할 수 없다.
- E AUTOSCIENTISTS Output on GPT nanochat은 75회 실험의 cold-start 실행에서 val_bpb = 0.97769에 도달한 결과를 E.1 Model Card와 E.2 Research Insights로 제시한다. 모델 카드는 상위 저장소의 BPE-8192 tokenizer를 사용해 FineWeb shard로 학습한 영어용 87 M-parameter decoder-only transformer를 설명한다. 이 모델은 짧은 예산으로 만든 연구 산출물이며, 운영용 언어 모델이나 다운스트림 과제에서 검증된 시스템이 아니다. 원본 데이터의 편향도 이어받는다. 학습에는 DEPTH = 7, ASPECT_RATIO = 96, hybrid Muon/AdamW optimizer, bf16, torch.compile을 사용한다. H100 80 GB GPU 1개에서 300 s 동안 학습해 optimizer step 1,293회, 처리 토큰 339 M, 최대 VRAM 58 GB를 기록한다. 평가는 고정된 40 M-token 보류 FineWeb shard를 사용하며, 경험적 잡음 바닥 안에서 재현된다고 보고한다. Research Insights는 약 6.4시간의 탐색과 KEEPs 8건을 기록한다. 이는 기준 프로그램 고정과 개선 7건으로 구성된다. 개선 항목은 TOTAL_BATCH_SIZE 2¹⁹→2¹⁸, 너비 확장, Newton–Schulz 반복 수 축소, attention window 축소 2건, 정확한 Polar-Express 정규화, DEPTH 8→7이다. Analyst 기록은 이를 처리량, 학습률 조정과 결합된 모델 용량, optimizer 품질로 설명한다. Schedule 형태 변경과 다른 기각 실험은 성과를 낸 영역의 경계를 보여준다. short_window_ratio = 1/16은 다른 시드에서 확인에 실패해 승격하지 않는다. 팀 기록은 이전 개선의 팀 간 재사용을 보여주지만, 인과적 설명, 적용 순서의 효과, 일반화에 관한 결론은 단일 과제, 백엔드, 실행, 300 s 학습 조건에 제한된다.
- F Implementation Details of BioML-Bench는 F.1 Setup에서 연산 자원과 반복적인 검증 리더보드 평가를 정의한다. AUTOSCIENTISTS, Autoresearch, 재실행한 Biomni는 비영상 과제에 H100-backed 4시간 예산을, 영상 과제에 16시간 예산을 사용한다. 반면 기존에 발표된 비영상 기준 모델은 CPU 전용 8시간 예산을 사용한다. F.2 Task Datasets and Evaluation Metrics는 분야별 분할과 평가 방식을 명시한다. F.2.1 Biomedical Imaging은 kaggle-histopathologic-cancer-detection에서 ROC-AUC와 무작위 학습 분할을 사용한다. kaggle-osic-pulmonary-fibrosis-progression에서는 수정한 Laplace log-likelihood와 환자 단위 CV를, kaggle-rsna-miccai-brain-tumor-radiogenomic-classification에서는 ROC-AUC와 환자 단위 CV를 사용한다. kaggle-uw-madison-gi-tract-image-segmentation에서는 0.4 Dice + 0.6 (1 − HD3D)를 사용하며, 환자와 치료 날짜를 보류해 평가한다.
- F.2.2 Drug Discovery는 5배 교차 검증인 Murcko-scaffold CV와 레이블을 숨긴 보류 테스트를 사용한다. 원문의 순서에 따라 tdcommons-bbb-martins는 ROC-AUC로 BBB 투과성을, tdcommons-caco2-wang은 MAE로 세포 투과성을, tdcommons-cyp2d6-substrate-carbonmangels는 PR-AUC로 기질 활성을 평가한다. tdcommons-herg는 ROC-AUC로 채널 억제를, tdcommons-lipophilicity-astrazeneca는 MAE로 친유성을 평가한다. polaris-adme-fang-hclint-1, polaris-adme-fang-hppb-1, polaris-adme-fang-solu-1은 각각 청소율, 혈장 단백질 결합, 용해도를 Pearson 상관계수로 평가한다. polaris-pkis2-egfr-wt-c-1은 클래스가 불균형한 EGFR 억제를 PR-AUC로 평가한다.
- F.2.3 Single Cell Omics는 open-problems-predict-modality를 보류한 기관/공여자 배치의 RMSE로 평가한다. open-problems-single-cell-perturbations는 세포 유형 내 20% 검증 분할을 사용하고 MRRMSE로 평가한다. open-problems-cell-cell-communication-ligand-target은 레이블이 있는 쌍 81개와 레이블이 없는 테스트 쌍 731개를 포함한다. 무작위 80/20 검증 분할을 사용하고, 값의 범위가 제한된 score = 1 − 1/(1 + OR/2)를 보고한다. 따라서 본문 표의 Odds Ratio 표기는 변환된 점수를 간략히 나타낸 것이다. open-problems-label-projection은 보류한 배치에서 weighted F1을 사용한다. open-problems-spatially-variable-genes는 피질 유전자 210개의 Kendall’s τ를 사용한다. 기본적으로 비지도 방식인 공간 통계량을 확인하기 위해 소뇌 레이블도 제공한다.
- F.2.4 Protein Engineering은 별도의 보류 테스트 세트 없이 out-of-fold 예측을 평가한다. 치환 과제는 SPIKE_SARS2_Starr_2020_binding, SBI_STAAM_Tsuboyama_2023_2JVG, CBX4_HUMAN_Tsuboyama_2023_2K28, PSAE_PICP2_Tsuboyama_2023_1PSE에 fold_random_5, fold_modulo_5, fold_contiguous_5를 사용한다. Indel 과제인 Q8EG35_SHEON_Campbell_2022와 CSN4_MOUSE_Tsuboyama_2023_1UFM은 fold_random_5를 사용한다. 최종 지표는 원래 타깃 공간에서의 평균 Spearman 상관계수이다.
- F.3 Performance Across Independent Runs는 hERG AUROC를 0.867, 0.830, 0.862로 보고하며, 평균은 0.853, 표준편차는 0.020이다. 3회 모두 Table S7의 기준 모델을 능가했다는 주장은 Biomni의 0.85464와 맞지 않는다. F.4 Performance Across Wall-Clock Time은 4시간 예산에서 단백질 공학 과제 6개의 변화를 추적하며, 개발 CV와 최종 평가에 같은 프로토콜을 사용한다. F.5 Behavior of AUTOSCIENTISTS on BioML-Bench Tasks는 파이프라인을 중복을 허용하는 방법 범주 7개로 분류한다. 영상 분야는 과제 3개에서 사전 학습 CNN을 fine-tuning하고, OSIC에서는 고정된 CT 특징을 회귀 및 최근접 이웃과 결합한다. 신약 개발은 과제 6개에서 fingerprint 기반 boosting을 사용하며, 신경망, 커널, stacking 구성 요소도 활용한다. 단일 세포 오믹스는 학습이 필요 없는 휴리스틱 2개, 선형 모델 파이프라인 2개, residual MLP 1개를 사용한다. 단백질 공학은 과제 5개에서 고정된 ESM-2 특징을, 과제 2개에서 LoRA fine-tuning을 사용한다. 전체적으로 Linear/Ridge는 10/24개 과제, boosting은 8/24개, 고정된 foundation-model 특징은 7/24개, foundation-model fine-tuning은 6/24개에 등장한다. 이들은 대체로 서로 배타적인 전략이 아니라 더 넓은 파이프라인의 구성 요소이다.
- G AUTOSCIENTISTS-Kermut for ProteinGym ACE2-Spike binding DMS와 G.1 Setup은 고정된 GP 3개 구성을 명시한다. 입력에는 1280차원 ESM-2 embedding, ProteinMPNN log-probability, ESM-2 점수, 추가 zero-shot 예측기 15개, contact-map 특징 4개가 포함된다. 표준화, 결측값 대치, 타깃 분위수 정규화는 각 학습 fold 안에서 적합한다. Kermut 구조 커널은 ProteinMPNN 분포 거리와 스칼라 log-probability 거리를 Cα 거리와 결합한 뒤 각 모델의 서열 커널과 혼합한다. 서열 커널은 특징 1303개의 Matérn-3/2 ARD, 1280차원 embedding의 Matérn-5/2 ARD, 또는 스칼라 특징 18개의 선형 커널이다. 영역을 고려한 고정 잡음은 학습 fold와 보류 fold의 인덱스 간 거리에 따라 달라지며, 추가적인 등분산 잡음은 학습한다. 각 모델은 seed 2024로 AdamW 1000 step을 수행하고, 학습률을 10⁻¹에서 10⁻³으로 낮춘다. 전처리와 모델은 지정된 CV fold마다 다시 적합한다. 수렴한 모델의 예측은 평균하고 수치 계산에 실패한 모델은 제외한다. MSE는 z-score로 변환한 타깃을 기준으로 계산하며, 예측값은 [−10, 10]으로 제한한다.
- G.2 Ablations of AUTOSCIENTISTS-Kermut는 개발 assay의 평균 Spearman’s ρ를 전체 예측기 0.8407, ensembling 제거 0.8231, 분위수 정규화 제거 0.8070, 추가 zero-shot 점수 제거 0.8174로 보고한다. 따라서 Table S9에서 평균 순위 성능의 가장 큰 손실을 일으키는 것은 주변 본문의 설명과 달리 ensembling이 아니라 분위수 정규화의 제거이다. 분위수 정규화를 제거하면 MSE는 0.4527에서 0.3501로 개선된다. 이는 순위 최적화와 회귀 척도의 정확도가 다르다는 점을 다시 보여준다. 추가 zero-shot 점수를 제거하면 평균 상관계수와 MSE가 모두 악화된다. 이는 해당 assay에서 그 점수의 기여를 뒷받침하지만, 반복적인 발견 실행에서도 효과가 신뢰할 만하다는 점을 입증하지는 않는다.
짧은 생각
가장 분명한 기여는 실험 근거를 축적하고 재사용하는 운영 설계이다. 공통 champion, 기각한 방향의 기억, 실행 전 비평, 명시적인 재편 규칙이 여기에 해당한다. 강력한 공통 시작점에서 GPT 성능을 계속 개선한 결과와 구성을 고정한 AUTOSCIENTISTS-Kermut의 다른 assay 적용 결과는, 시스템이 고립된 국소 탐색의 반복을 넘어설 수 있다는 가장 강한 근거이다.
결과는 전체 자원 효율이나 실제로 측정한 대규모 병렬 속도 향상보다 실험 탐색의 개선을 보여준다. 더 높은 LLM 지출, 제한적인 반복 검증, 여러 기능을 함께 바꾸는 제거 실험, 부록의 서로 다른 실행 길이, 내부 보고의 불일치는 개별 구성 요소에 관한 인과적 주장을 제한한다. 실험 예산과 LLM 예산을 모두 맞춘 반복 비교가 이러한 주장을 더 잘 검증할 수 있다.