


Toward Autonomous Long-Horizon Engineering for ML Research 요약 설명
14 Apr 2026 | Paper Review AI Research Agents Multi-Agent Coordination Agent's Memory목차
- 요약
- 1. Introduction
- 2. Task Formulation
- 3. AiScientist
- 4. Experiments
- 5. Related Work
- 6. Conclusion
- 부록
- 짧은 생각
이번 글에서는 Toward Autonomous Long-Horizon Engineering for ML Research 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 4월 14일(Arxiv)
- Chen, Guoxin, Chen, Jie, Chen, Lei, Zhao, Jiale, Meng, Fanzhe, Zhao, Wayne Xin, Song, Ruihua, Chen, Cheng, Wen, Ji-Rong, Jia, Kai.
- Gaoling School of Artificial Intelligence, Renmin University of China, Independent Researcher, AweAI Team
- 논문 링크
- Github
요약
- Toward Autonomous Long-Horizon Engineering for ML Research는 에이전트가 불완전하게 명세된 연구 목표를 실행 가능하고 실험으로 검증된 ML 시스템으로 구현하는 방법을 연구한다. 핵심 문제는 일시적인 에이전트 호출이 반복되는 동안 의사결정에 필요한 프로젝트 근거를 보존하여 구현, 실험, 개선 결과가 누적되도록 하는 것이다.
- AiScientist는 계층적 전문가 위임과 스키마에 따라 관리되는 File-as-Bus 작업 공간을 결합한다. 작업당 24시간과 H20 GPU 1개를 사용하는 조건에서 PaperBench 평균 점수는 Gemini-3-Flash에서 30.52, GLM-5에서 33.73이다. MLE-Bench Lite의 Any Medal%는 두 backbone 모두 81.82 ±0.00이다.
- GLM-5에서 File-as-Bus를 제거하면 제출 유효성은 유지되지만, PaperBench 점수는 6.41점, MLE-Bench Lite Any Medal%는 31.82 %p 하락한다. 이 제거 실험은 영속 상태가 개선에 기여한다는 해석을 뒷받침한다. 다만 PaperBench의 반복 평가는 채점 비용으로 제한되며, Codex/GPT-5.5 xhigh와의 비교는 아키텍처 차이와 backbone 차이를 분리하지 못한다.
1. Introduction
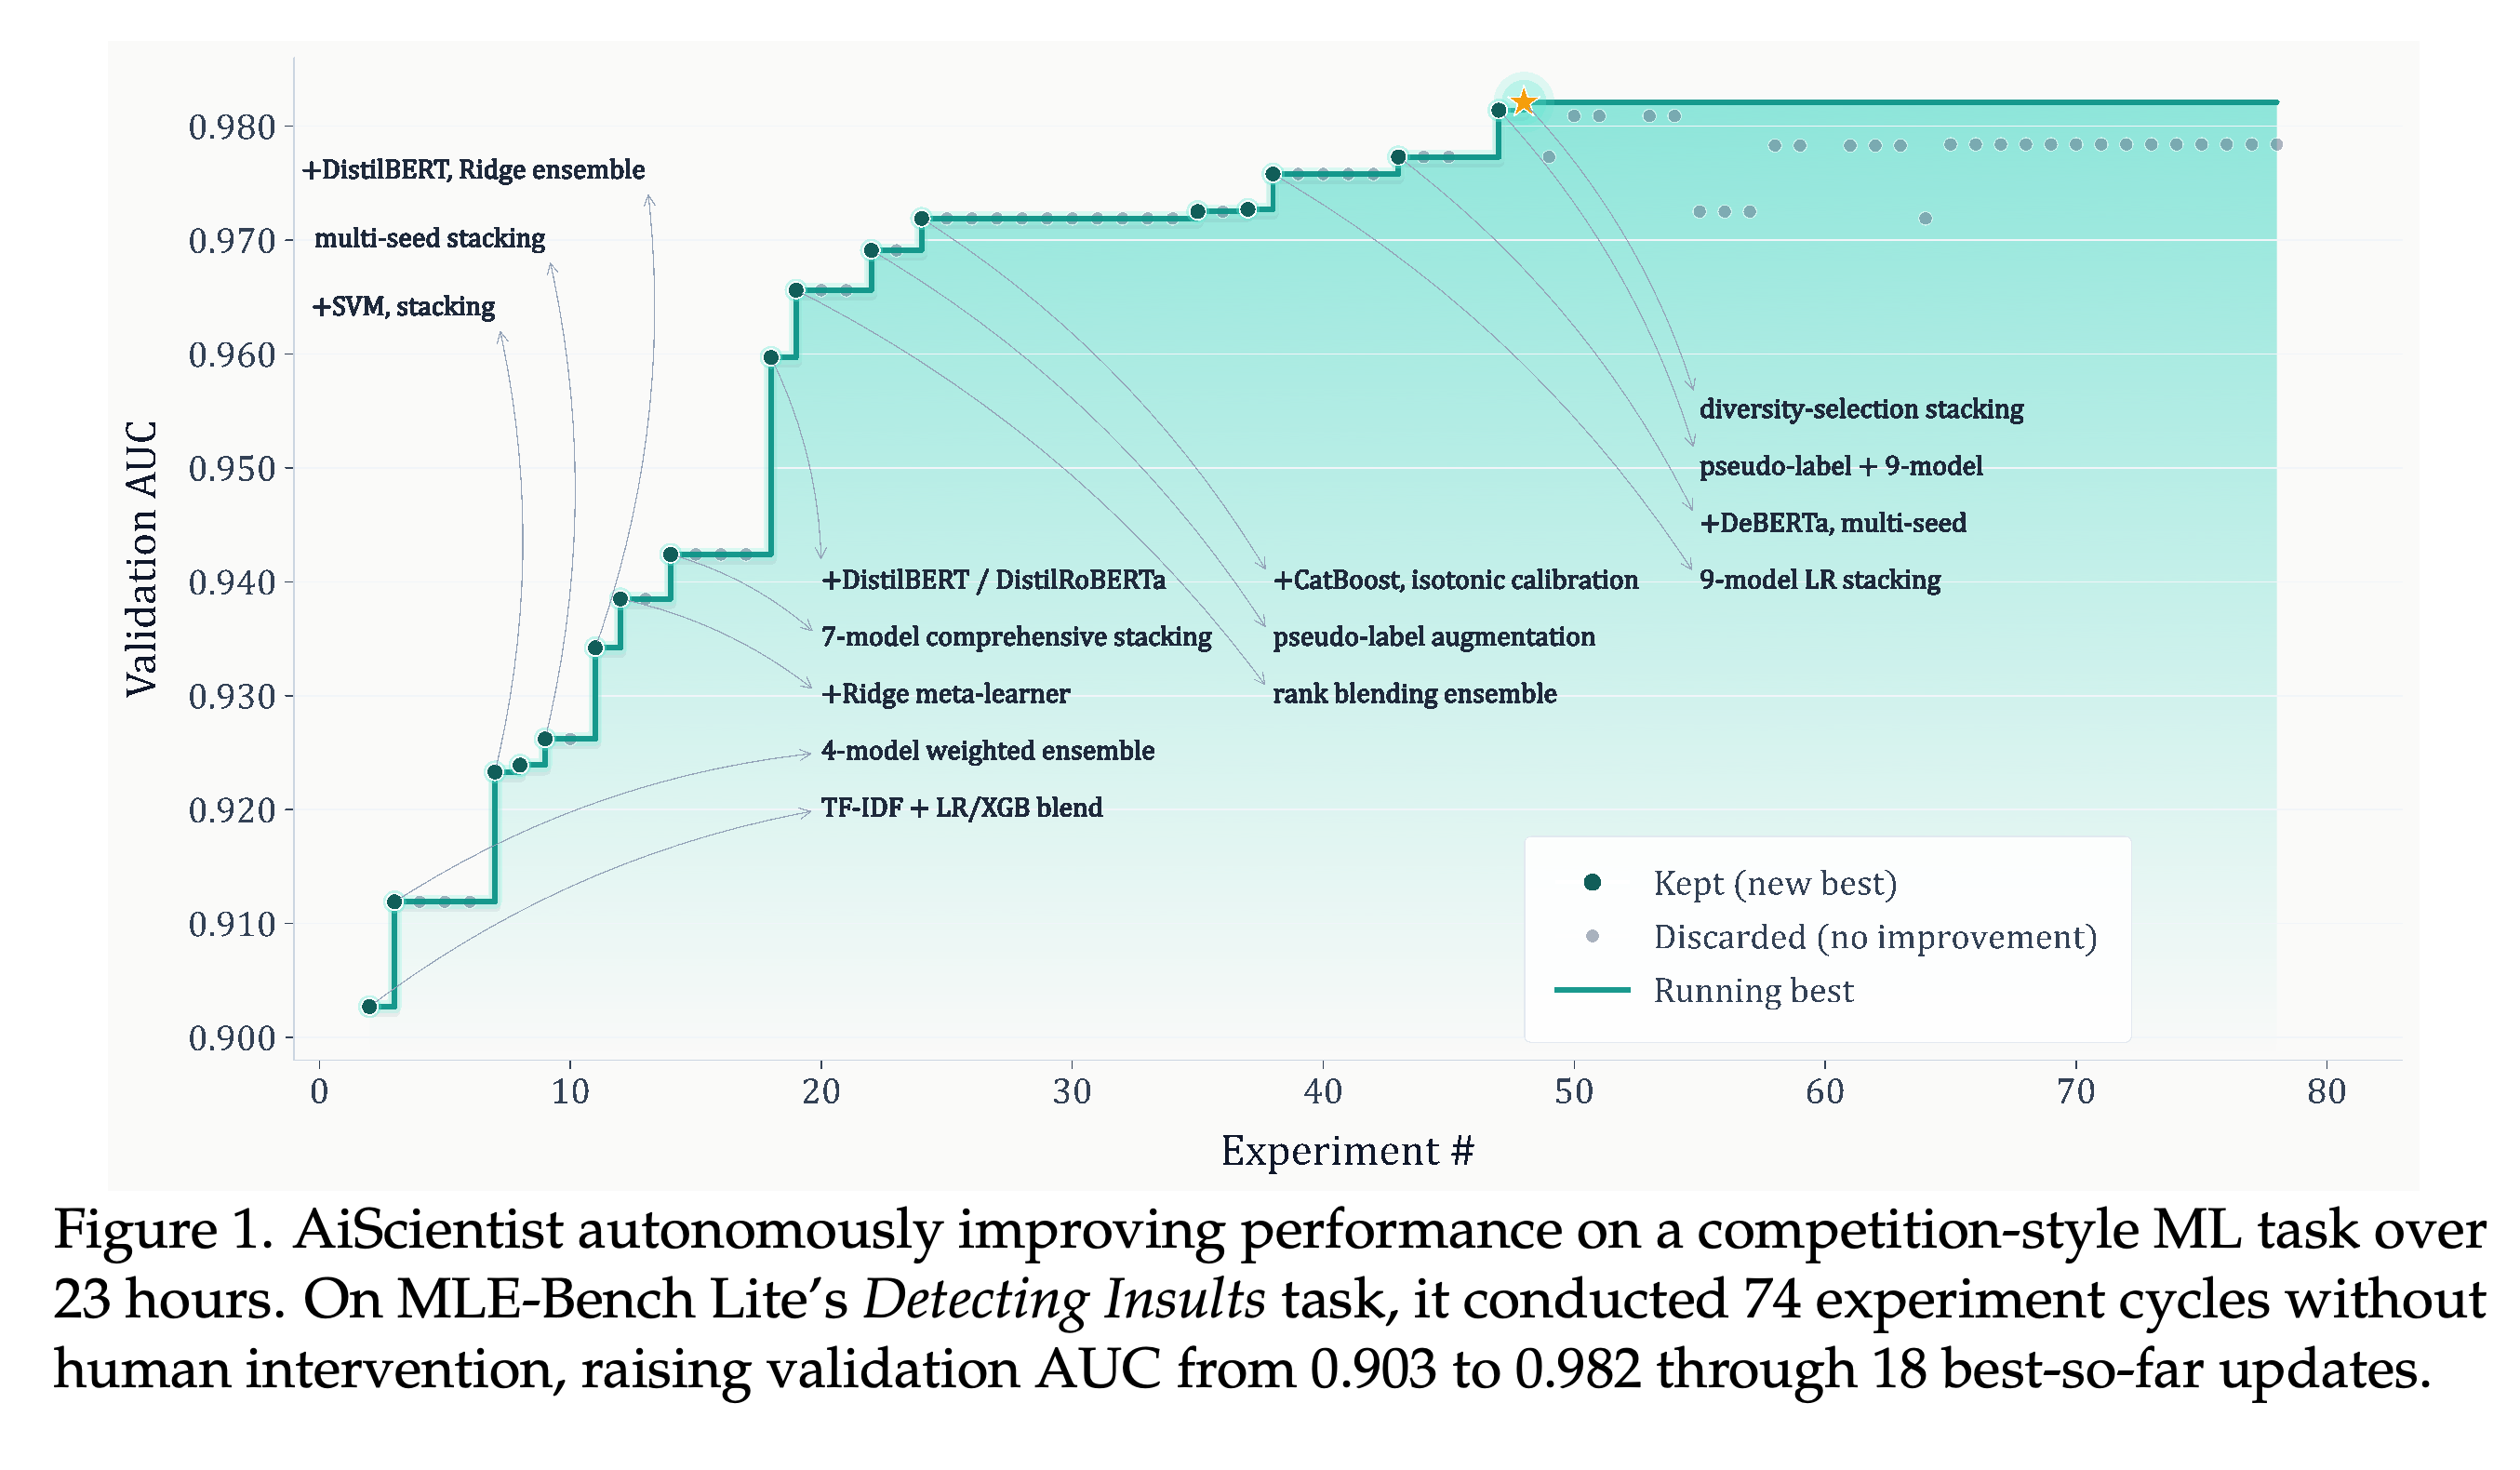
서론은 연구 엔지니어링을 개별적인 아이디어 생성, 코드 생성, 과학적 글쓰기와 구분한다. 구현물은 환경 설정, 자원 통합, 지연되는 실험, 여러 원인이 얽힌 실패의 진단을 거쳐서도 작동해야 한다. Figure 1은 Detecting Insults에서 이러한 반복 과정을 보여준다. AiScientist는 사람의 개입 없이 23시간 동안 74회의 실험 사이클을 완료하고, 최고 기록을 18회 갱신하며 검증 AUC를 0.903에서 0.982로 높인다.
- 역할 연속성은 다시 호출된 전문가가 이전의 가정, 시도한 수정, 실패, 미해결 질문을 복원할 수 있다는 뜻이다.
- 프로젝트 연속성은 서로 다른 전문가가 압축된 대화 인계 대신 공유된 근거를 통해 협업한다는 뜻이다.
- 이 사례는 1개 작업에서 검증 성능이 지속적으로 개선되는 모습을 보여주며, 일반화 성능이나 벤치마크 성능의 종합 추정치는 아니다.
누적 최고 점수 곡선은 모든 후보가 개선되는 대신 간헐적으로 성공한 실험을 통해 상승한다. 74회의 사이클 중 채택된 갱신은 18회이며, 이는 실패한 시도 사이에서도 개선을 반복하는 모습을 보여준다. 보고된 AUC는 1개 작업의 검증 지표이다.
2. Task Formulation
이 작업은 연구 명세, 실행 환경, 자원 접근 정책, 시간 예산을 입력으로 받고, 깨끗한 환경에서 새로 실행하여 평가할 제출물을 요구한다. 성공하려면 실행 가능성뿐 아니라 목표에 부합하는 실험 결과도 확보해야 한다.
- 불완전한 명세를 보완하려면 명세, 관련 문헌, 허용된 공개 자원에서 누락된 구현 결정을 찾아야 한다.
- System Setup Burden에는 의존성 설정, 데이터셋과 모델 확보, 실행 가능한 파이프라인으로의 통합이 포함된다.
- Delayed Feedback은 진단을 어렵게 한다. 결과 차이가 해석, 구현, 전처리, 인프라 중 어디에서 비롯되었는지 구분해야 하기 때문이다.
- State Continuity를 유지하려면 이후의 의사결정에서 코드, 설정, 로그, 결과, 진단 근거를 올바르게 재사용해야 한다.
3. AiScientist
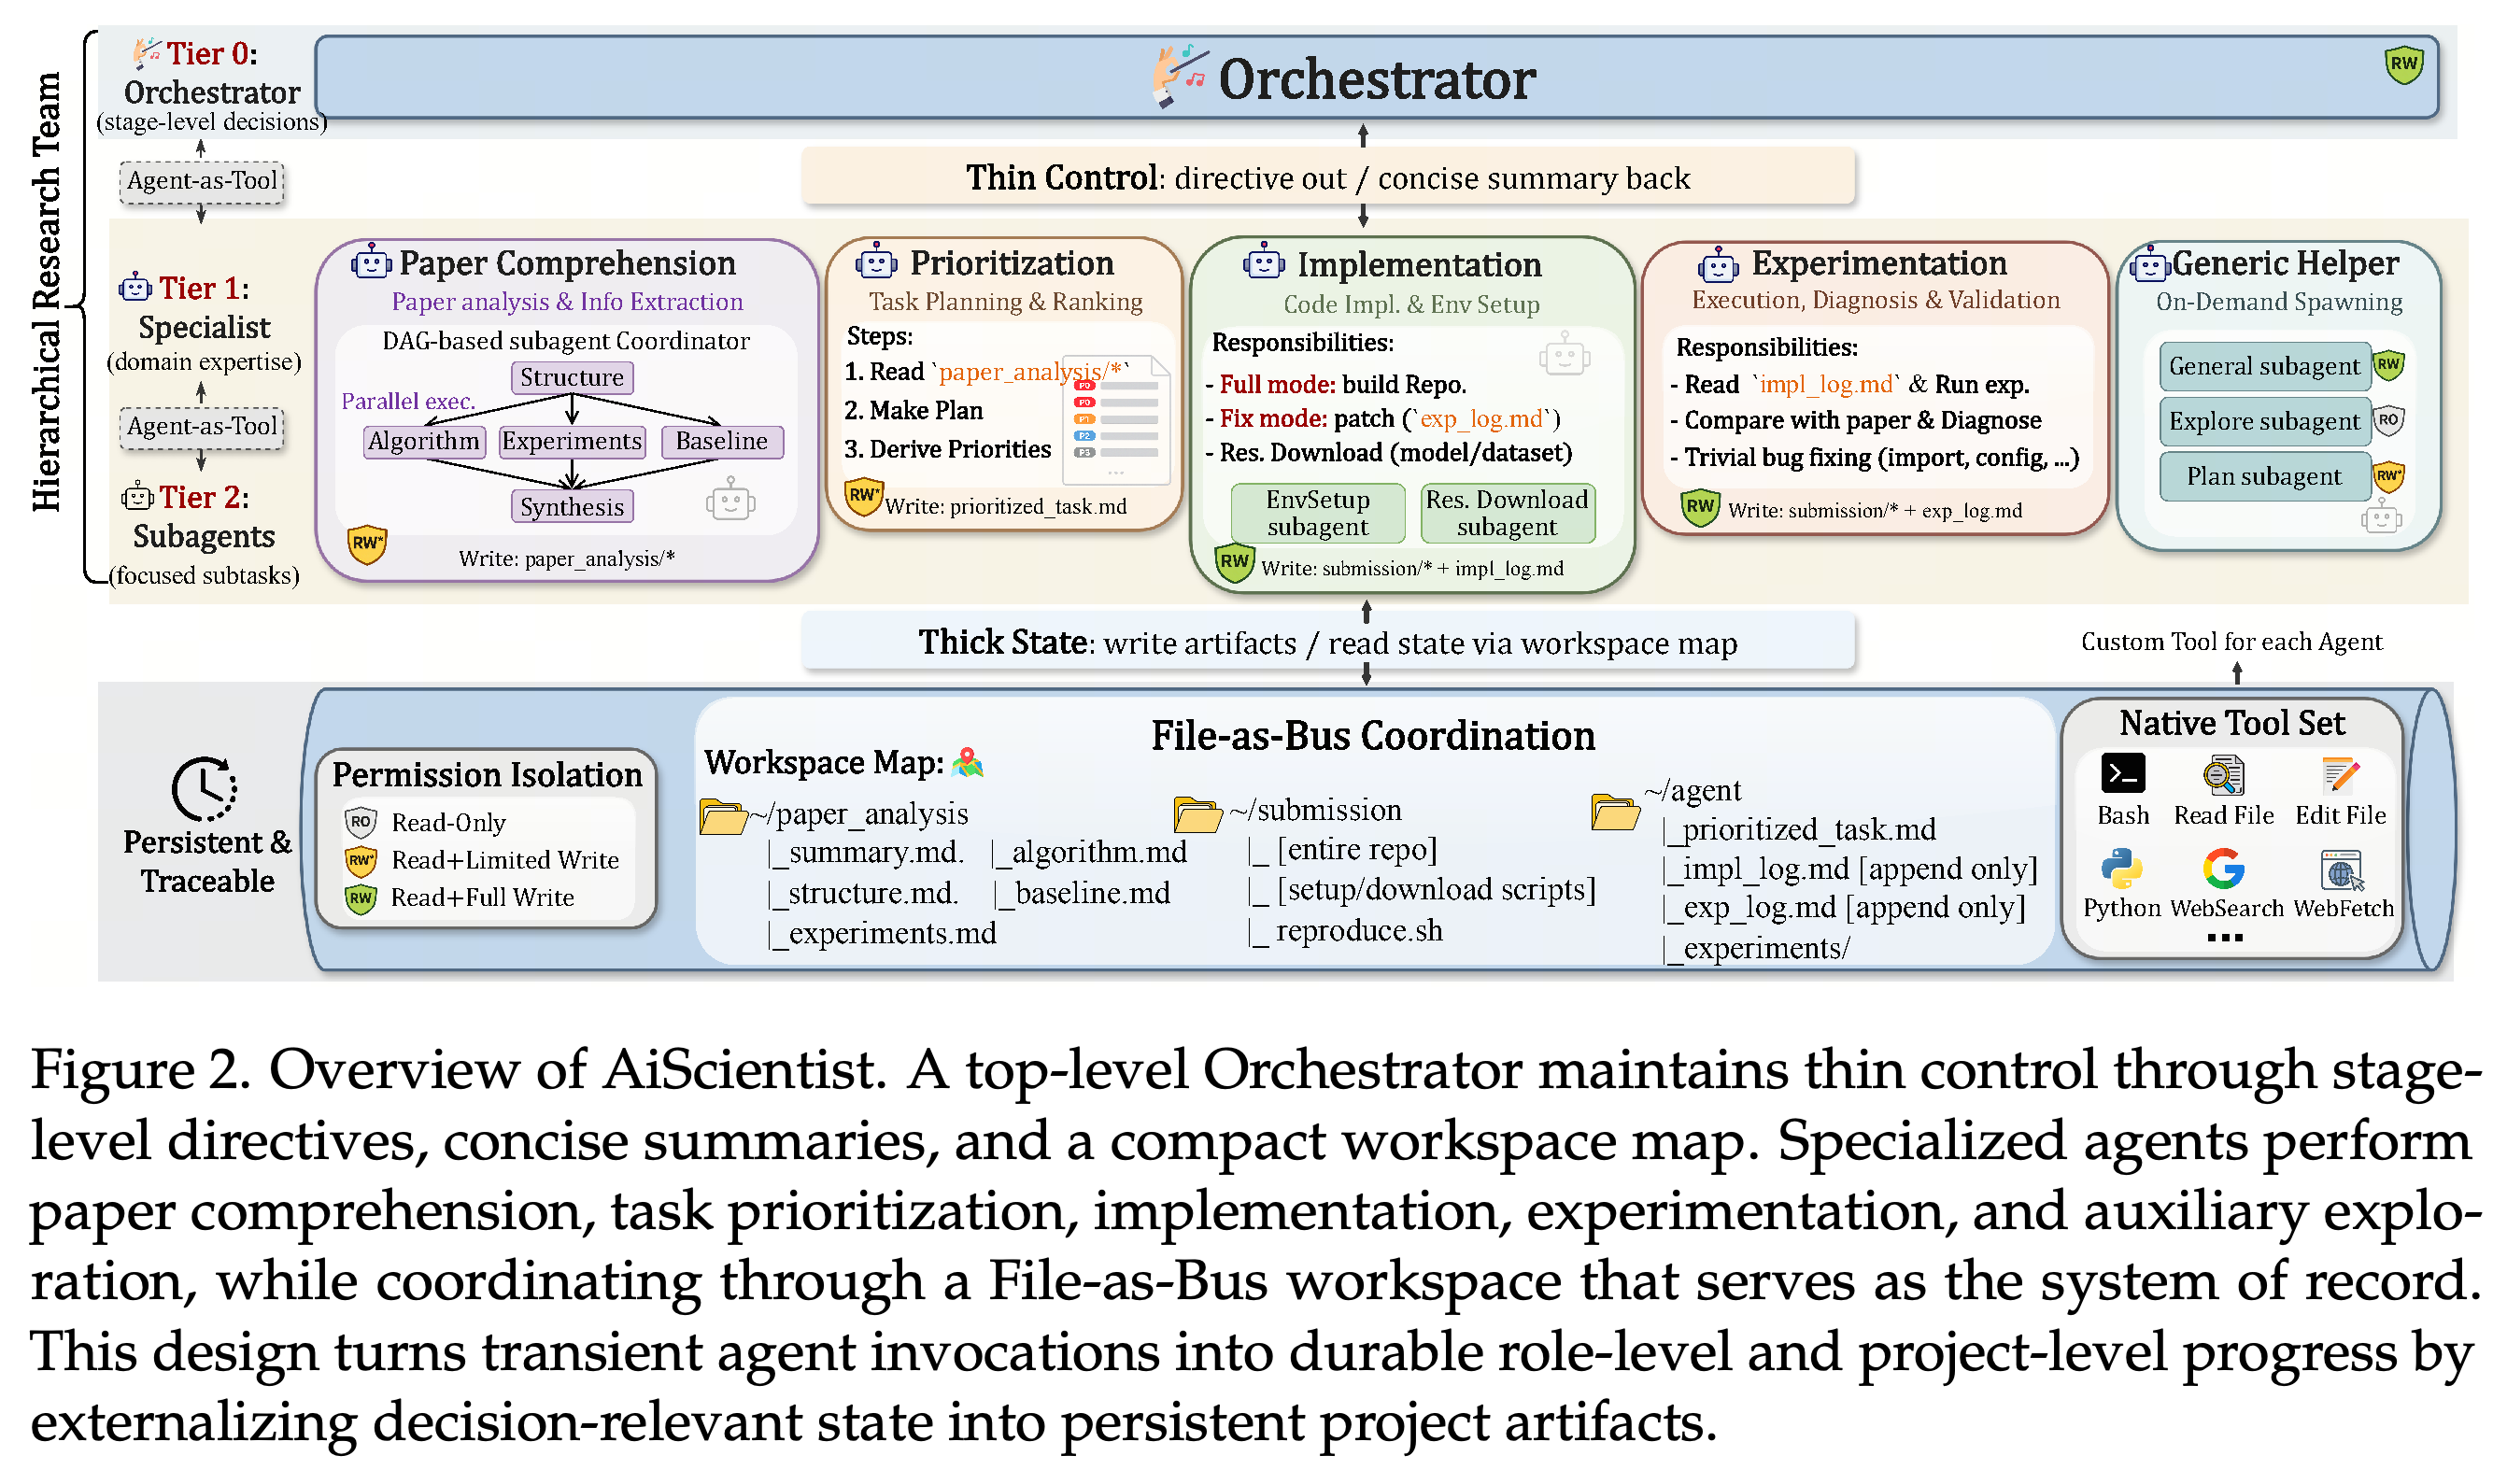
AiScientist는 산출물을 영속적으로 보존하는 프로토콜과 계층적 연구팀을 결합한다. 상세한 프로젝트 근거는 작업 공간에 남고, Orchestrator는 짧은 지시와 요약을 통해 작업을 배분한다.
3.1. Overview: Thin Control over Thick State
Thin control over thick state는 Orchestrator가 현재 제어에 사용하는 컨텍스트와 프로젝트의 영속 기록을 분리한다. Figure 2에서 Orchestrator는 단계별 지시를 내리고 간결한 요약을 받는다. 전문가는 간결한 작업 공간 맵을 통해 관련 산출물을 찾고 갱신한다.
- File-as-Bus는 상세한 근거를 보존하지만, 다음에 해결할 병목을 직접 결정하지는 않는다.
- 계층적 오케스트레이션은 매번 전체 프로젝트 이력을 제어 컨텍스트에 불러오지 않고도 다음 역할과 조치를 선택한다.
- 이 2가지 메커니즘은 전문가 호출이 반복되는 동안 역할 연속성과 프로젝트 연속성을 함께 유지하도록 설계되었다.
아키텍처는 간결한 제어 채널과 상세한 영속 상태를 분리한다. 전문가에게 보내는 지시와 전문가의 요약은 Orchestrator를 거치고, 분석, 계획, 실행 가능한 코드, 추가 전용 로그는 이후 호출과 역할 간 협업을 지원한다.
3.2. File-as-Bus Coordination
File-as-Bus는 단순한 공유 디렉터리가 아니라 산출물을 매개로 하는 협업 프로토콜이다. 영속 작업 공간 상태 W_t와 산출물 스키마 σ가 주어지면, 작업 공간 맵은 (m_t = \mathcal{M}(W_t; \sigma))로 정의된다. 이 맵은 사용 가능한 산출물, 각 산출물의 용도, 접근 규약을 결합한 간결한 색인이다.
- 추가 전용 로그는 구현 결정, 실험 결과, 실패, 진단을 시간순으로 보존한다.
- 버전 관리 산출물은 기준이 되는 현재 상태와 이전 개정본을 제공하도록 규정된다. 변경 가능한 상태는 같은 수준의 이력 보존이 필요하지 않은 정보를 다룬다. Appendix B는 구체적인 버전 관리 메커니즘 대신 개정본 보존을 개념적으로 설명한다.
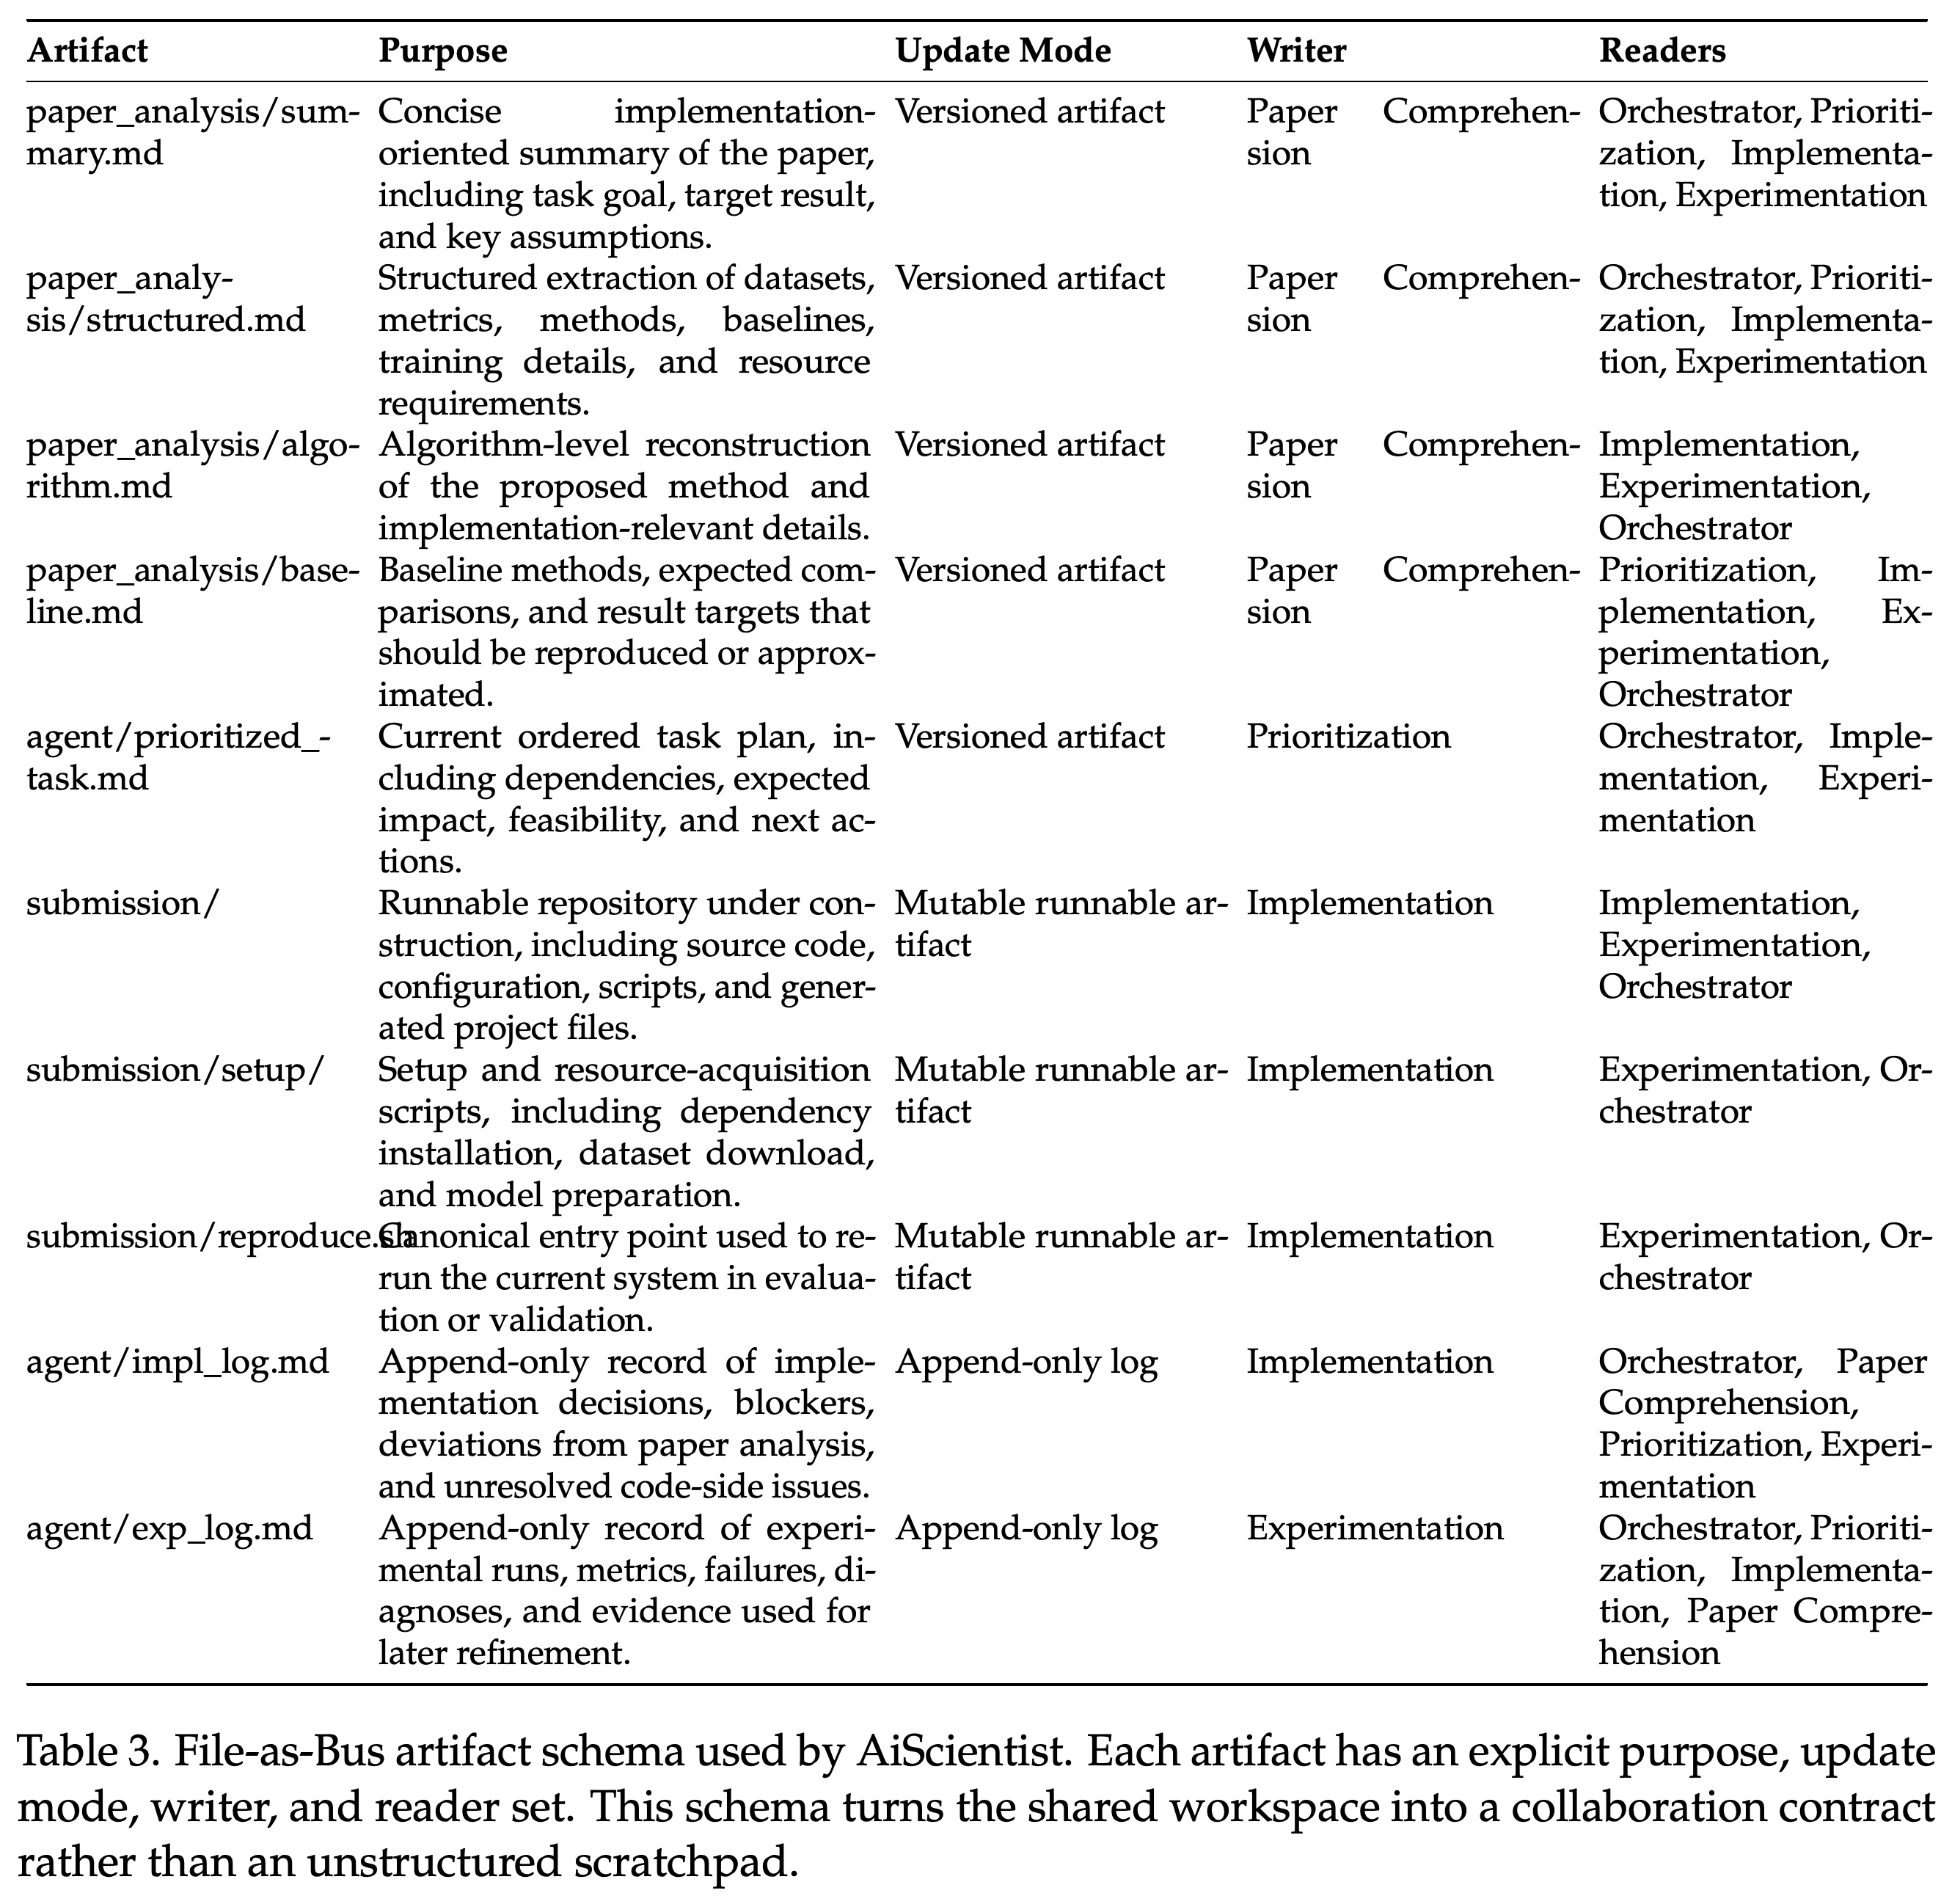
- Table 3은 산출물의 용도, 갱신 방식, 작성자, 열람자를 명시한다. 실행 가능한 저장소 파일은 직접 수정할 수 있으며, 모든 파일을 버전 관리하는 대신 결정 이력을 로그에 기록한다.
3.3. Hierarchical Research Team
Orchestrator는 위임을 Agent-as-Tool로 취급한다. (a_t = \pi_0(c_t, m_t))이며 (a_t \in \mathcal{T}0 \cup \mathcal{A}_1)이므로, 기본 도구를 사용하거나 Tier-1 전문가를 호출할 수 있다. 전문가는 ((s_t, \Delta W_t) = \pi_j(d_t, m_t; W_t))를 통해 간결한 요약과 영속 상태의 갱신 내용을 반환한다. 이후 (W{t+1} = \mathcal{U}(W_t, \Delta W_t))를 적용한다.
- Paper Comprehension은 방법, 목표 지표, baseline, 모호한 부분, 구현 가정을 추출한다. Prioritization은 의존성, 영향, 실현 가능성에 따라 작업 순서를 정한다.
- Implementation은 시스템을 구축하거나 수정하고 자원을 통합한다. Experimentation은 시스템을 실행하고 결과를 목표와 비교하며 진단을 기록한다.
- Generic Helper Interface는 범위가 제한된 보조 작업을 지원한다. Tier-2 subagent는 재귀적으로 위임하지 않는다. 조사 결과는 호출한 전문가에게 돌아가며, 관련성이 있으면 영속 산출물로 남는다.
3.4. Evidence-Driven Research-Engineering Loop
이 반복 과정은 먼저 코드, 설정, 환경 구성, 자원 확보, 진입점을 포함하는 실행 계획과 실행 가능한 기본 구조를 만든다. 이후 구현과 실험을 번갈아 수행하며, 기록된 실패, 부분적 성공, 지표 격차, 불일치를 근거로 다음 조치를 선택한다.
- 가능한 조치에는 코드 수정, 전처리나 설정 변경, 재실행, 가정이 무효화되었을 때의 논문 재분석이 포함된다.
- 실패는 영속적인 진단 근거로 남고, 성공한 변경은 실행 가능한 산출물과 결과 기록으로 보존된다.
4. Experiments
실험은 PaperBench에서 처음부터 연구 논문을 재현하는 작업과 MLE-Bench Lite에서 경진대회 방식으로 ML 성능을 반복 개선하는 작업을 평가한다. 최종 결과에 시간별 성능 추이, 제거 실험, 작업 과정 분석을 더하여 초기 실행 가능성 확보 이후에도 개선이 지속되는지 살펴본다.
4.1. Experimental Setup
각 작업에는 H20 GPU 1개와 24시간이 주어지며, AiScientist는 Gemini-3-Flash 또는 GLM-5를 사용한다. PaperBench는 20개의 재현 작업으로 구성되며, GPT-5.4로 채점하는 공식 전체 평가 프로토콜을 사용한다. MLE-Bench Lite는 22개 작업으로 구성되며, 3회 실행/시드에 대한 평균 ± SEM을 보고한다.
- PaperBench는 저자의 원본 코드와 그 밖의 금지 자원을 사용할 수 없도록 한다. 허용된 외부 자원은 새로운 구현을 만드는 데 사용할 수 있다.
- PaperBench에서 조건을 맞춘 baseline은 BasicAgent와 IterativeAgent이다. MLE-Bench Lite의 통제된 비교에는 보고된 backbone별 설정의 AIDE, LoongFlow, ML-Master 2.0을 사용한다.
- 공식 leaderboard 항목과 Codex/GPT-5.5 xhigh는 참고용 비교이며, backbone을 맞춘 비교가 아니다.
- PaperBench의 20개 작업 전체를 채점하는 비용은 약 $832이며, 이는 전체 벤치마크의 반복 평가를 상당히 제한한다.
4.2. Main Results on PaperBench
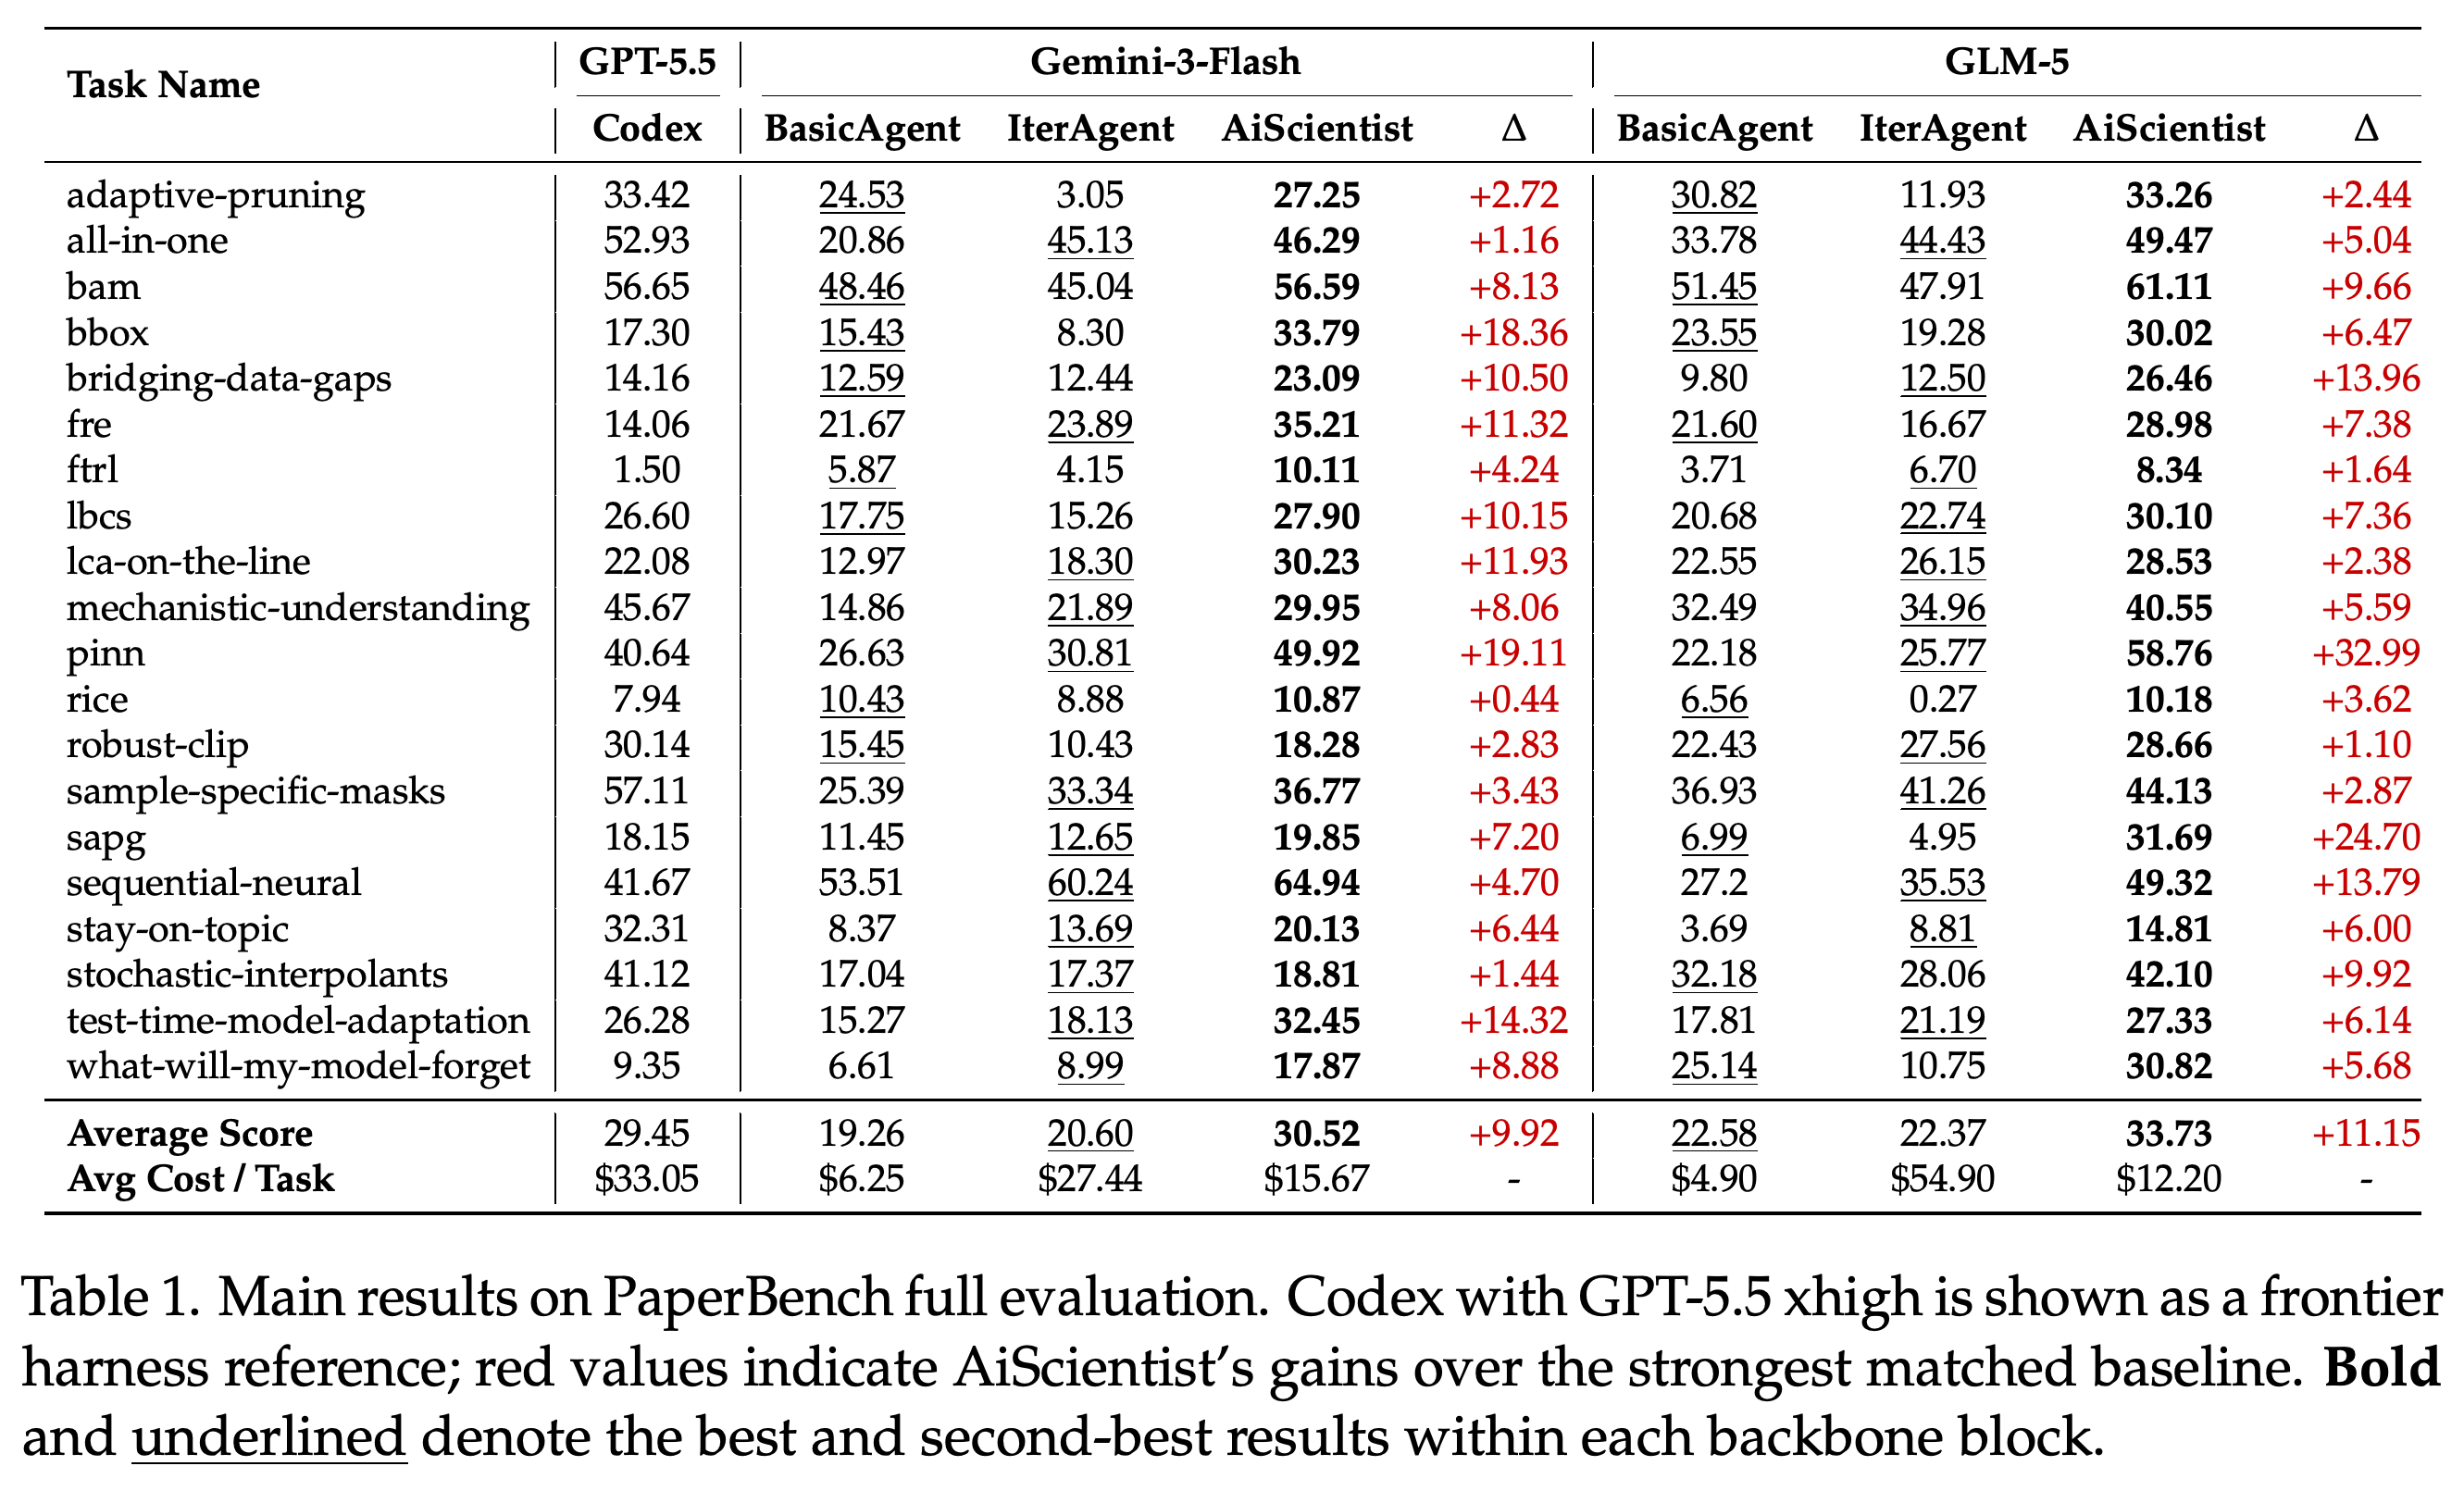
Table 1에서 PaperBench 평균 점수는 Gemini-3-Flash에서 30.52, GLM-5에서 33.73이다. 이는 조건을 맞춘 가장 강한 baseline보다 각각 9.92점, 11.15점 높다. 각 backbone 블록에 나열된 모든 작업에서 AiScientist는 조건을 맞춘 2개 baseline을 모두 앞서지만, 절대 점수와 개선 폭은 작업마다 크게 다르다.
- Gemini-3-Flash에서 작업당 평균 비용은 AiScientist가 $15.67, IterativeAgent가 $27.44이다. GLM-5에서는 각각 $12.20과 $54.90이다.
- AiScientist가 가장 저렴한 시스템은 아니다. BasicAgent의 비용은 두 backbone에서 각각 $6.25와 $4.90 per task이다.
- GLM-5 결과는 Codex/GPT-5.5 xhigh의 참고 점수 29.45보다 4.28점 높다. 이는 시스템 간 비교이지, 아키텍처 효과만을 분리한 비교가 아니다.
- IterativeAgent는 비용이 더 높지만 점수가 더 낮다. 이는 상호작용량만으로 성능 향상을 설명하기 어렵다는 근거이지만, 어떤 구성 요소가 향상을 일으키는지는 독립적으로 입증하지 못한다.
나열된 모든 작업에서 두 backbone 모두 조건을 맞춘 더 강한 baseline보다 높은 점수를 기록한다. 평균 점수는 30.52와 33.73이며, 비용은 IterativeAgent보다 낮지만 BasicAgent보다 높다. 따라서 일관되게 최소 비용을 달성한 결과가 아니라 성능과 비용의 절충을 보여준다.
4.3. Main Results on MLE-Bench Lite
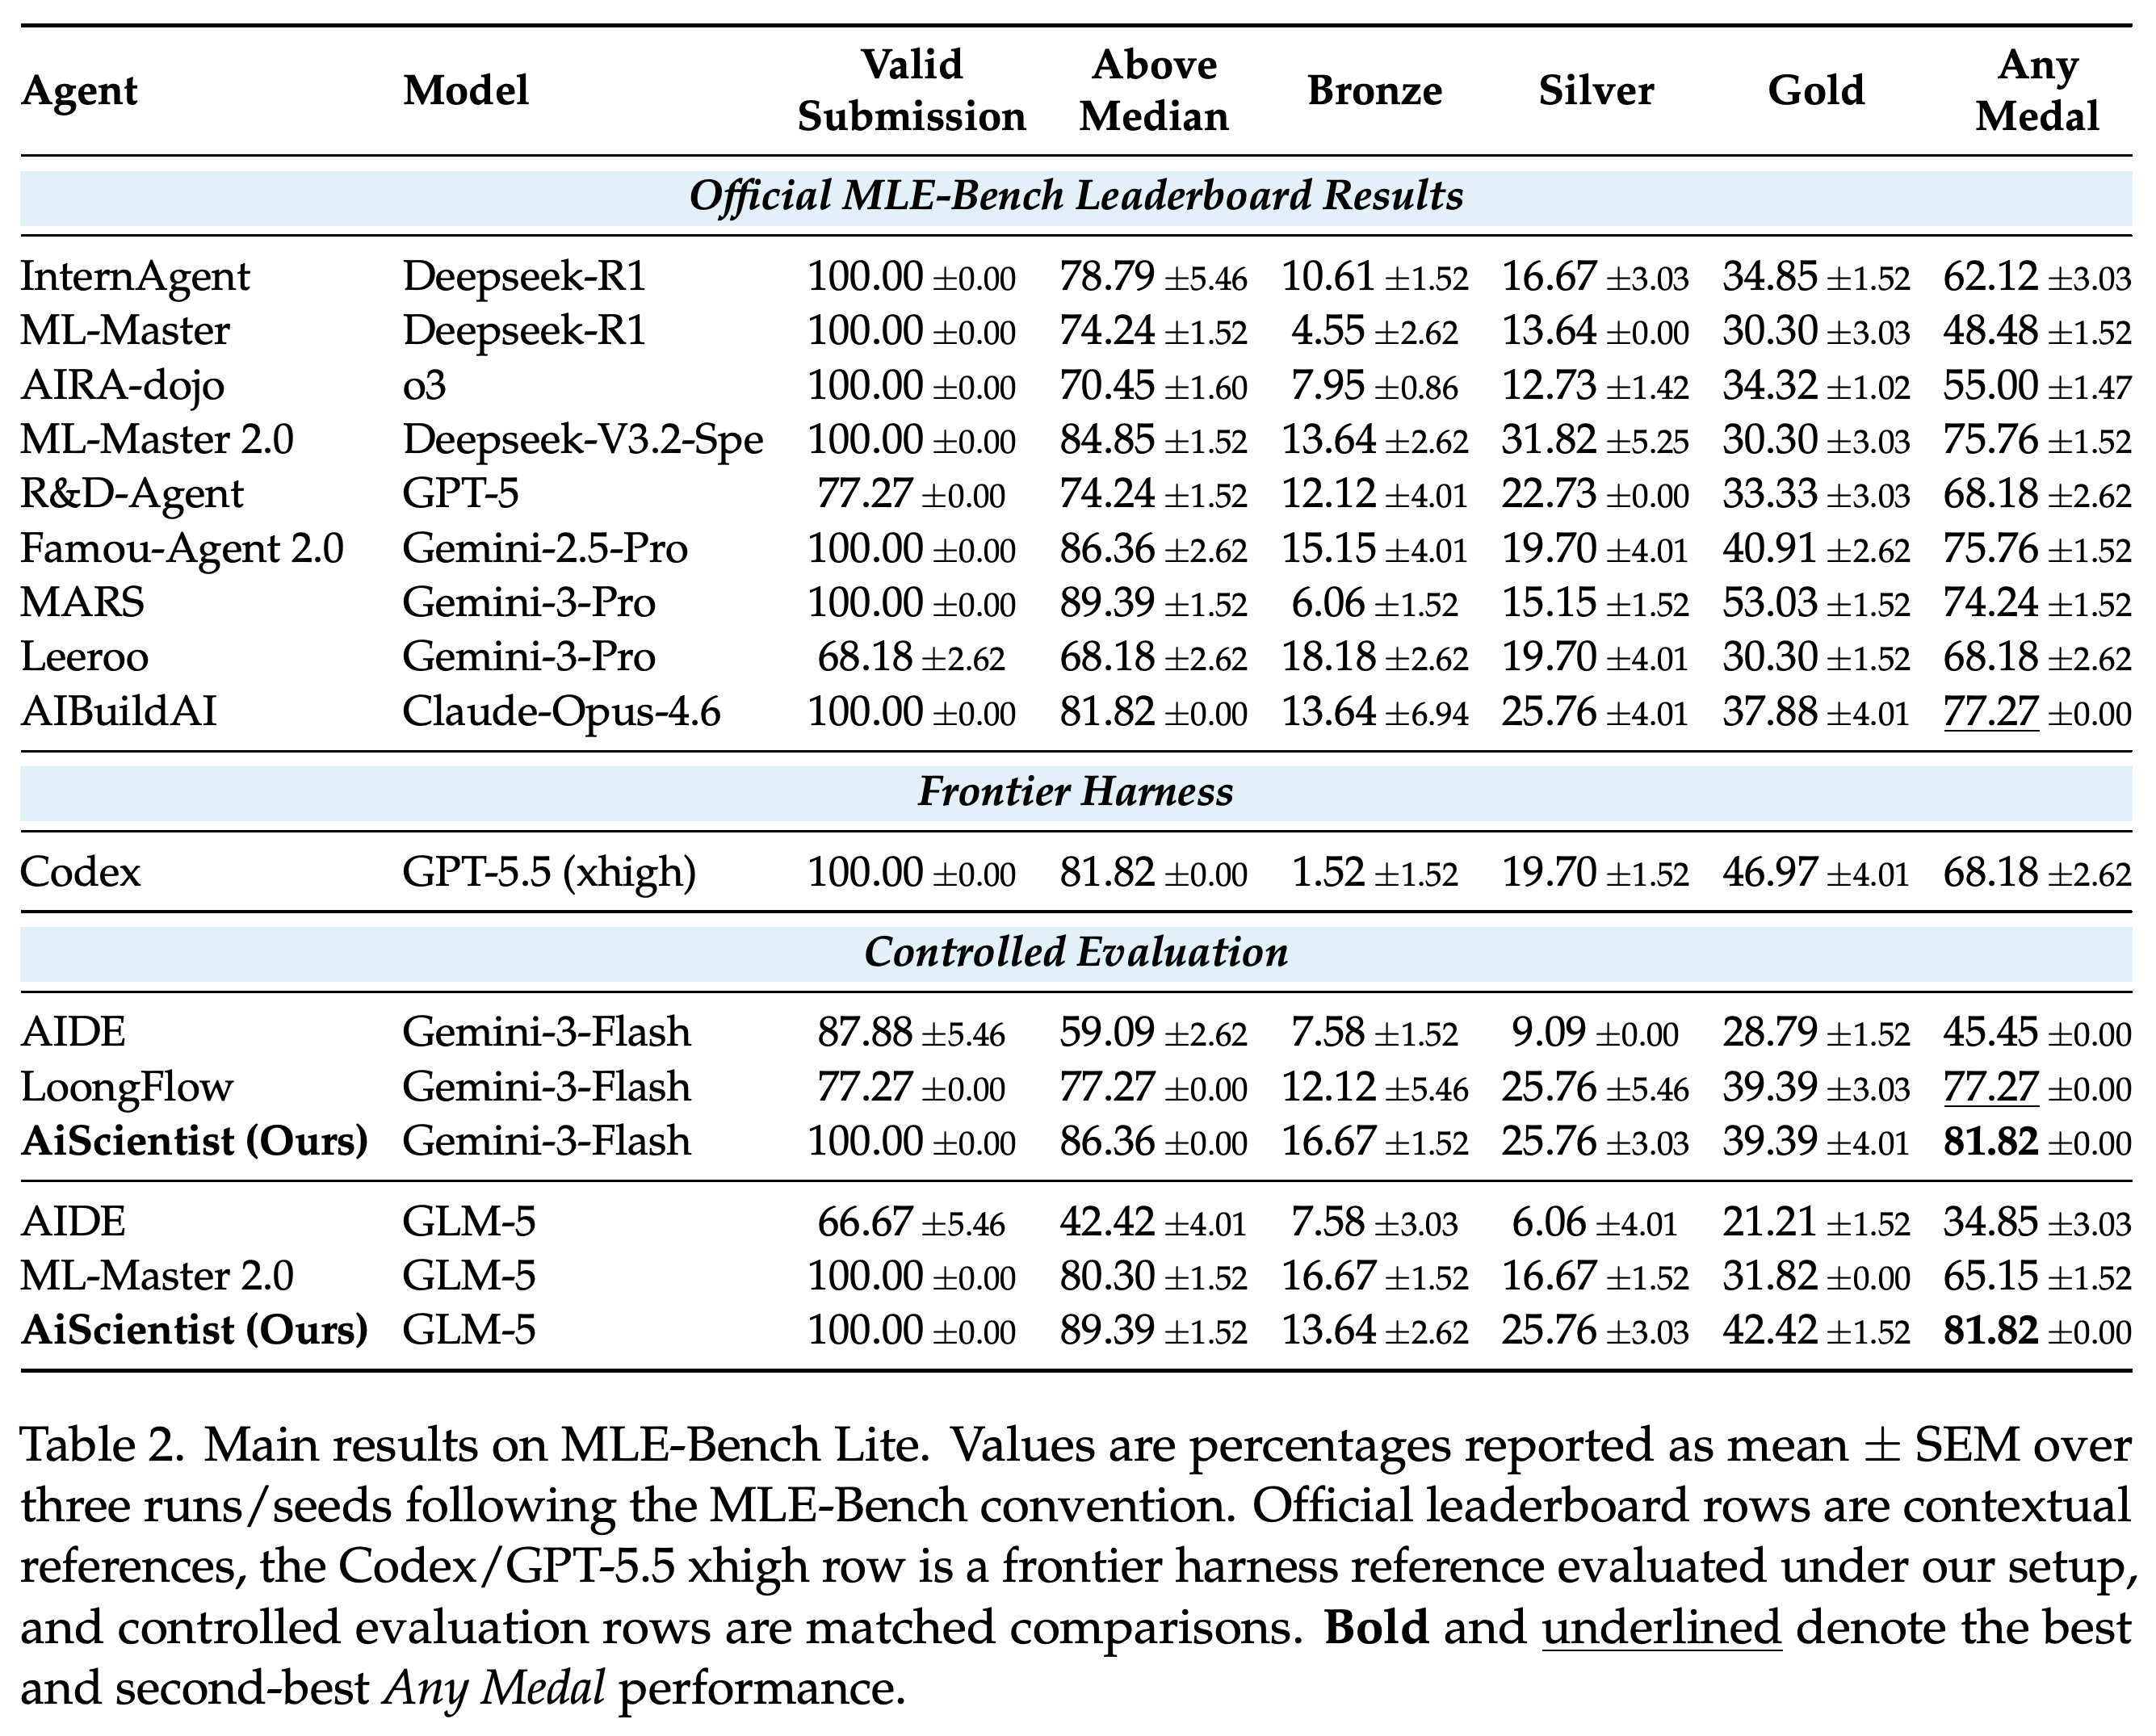
Table 2에서 AiScientist는 두 backbone 모두 Valid Submission% 100.00 ±0.00과 Any Medal% 81.82 ±0.00을 기록한다. Any Medal%는 Gemini-3-Flash를 사용하는 LoongFlow보다 4.55 %p, GLM-5를 사용하는 ML-Master 2.0보다 16.67 %p 높다.
- Above Median%는 Gemini-3-Flash에서 86.36 ±0.00, GLM-5에서 89.39 ±1.52이며, 각 조건에서 가장 강한 통제 baseline보다 9.09 %p 높다.
- Codex/GPT-5.5 xhigh의 Any Medal%는 68.18 ±2.62로, AiScientist보다 13.64 %p 낮다.
- AiScientist는 제시된 공식 leaderboard에서 가장 높은 AIBuildAI의 Any Medal% 77.27 ±0.00도 앞선다. 다만 이 외부 결과들은 backbone과 보고 조건이 다르다.
- 주요 평가 지표는 Any Medal%이다. AiScientist가 모든 메달 등급에서 우세한 것은 아니므로, 이 결과가 모든 경쟁 지표에서의 우위를 입증하지는 않는다.
표는 공식 leaderboard, frontier harness, 통제된 비교의 행을 구분한다. 각 구분이 뒷받침하는 비교가 다르기 때문이다. AiScientist는 두 backbone 모두 Any Medal% 81.82 ±0.00을 기록하고 모든 작업에서 유효한 제출물을 만들지만, 개별 메달 등급에서 항상 최고인 것은 아니다.
4.4. Long-Horizon Improvement Dynamics
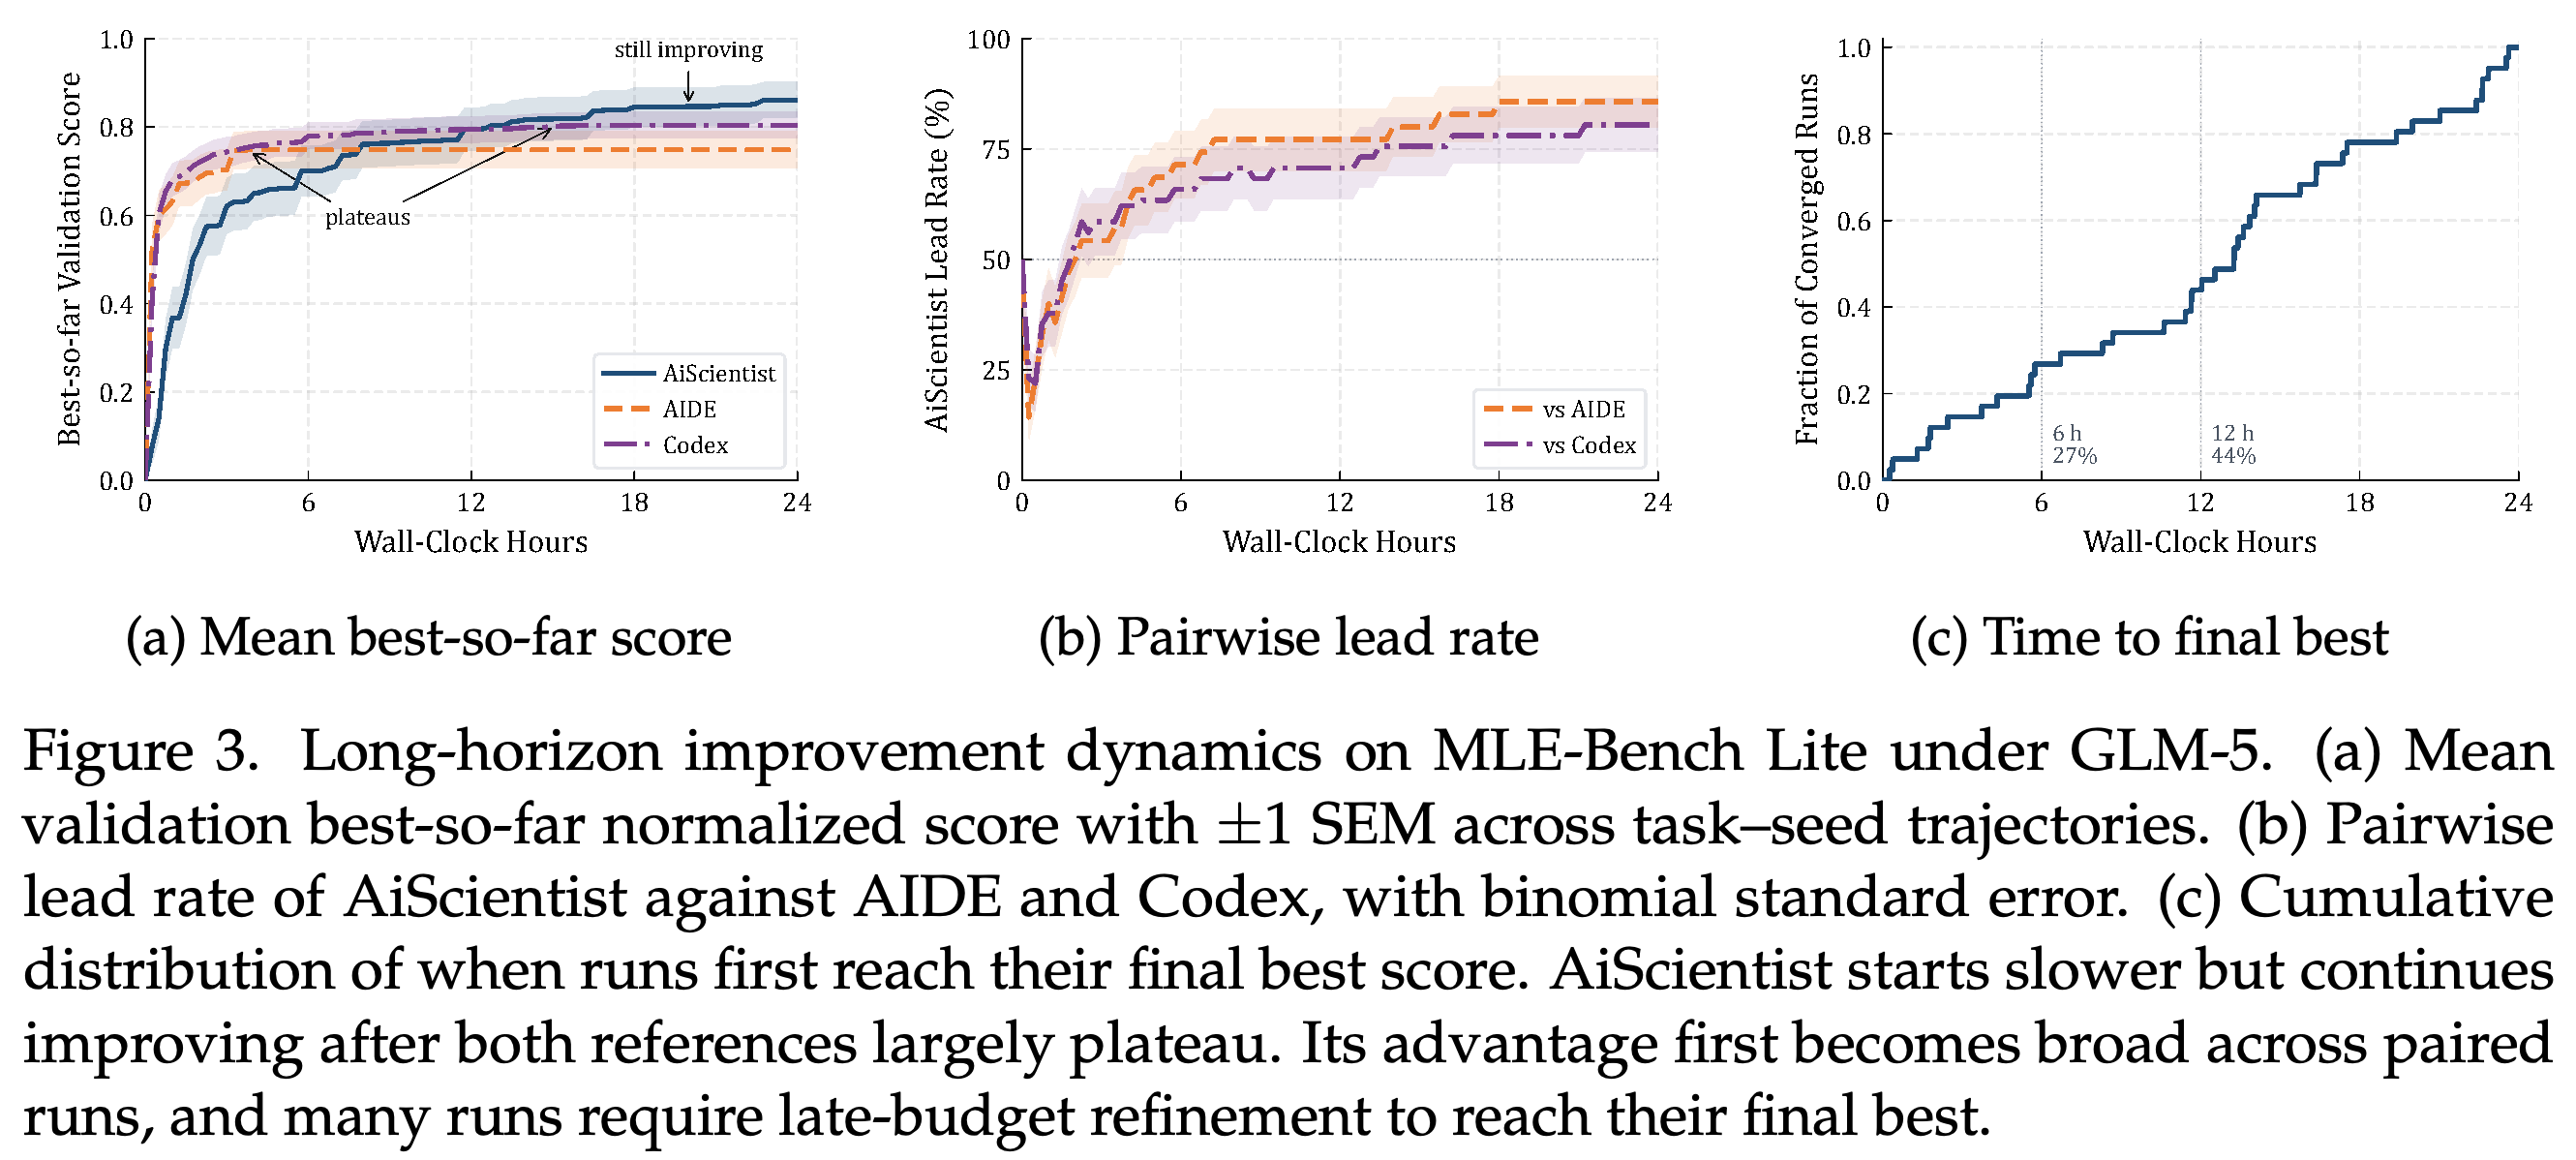
Figure 3은 GLM-5에서 개선의 크기, 우세한 작업의 범위, 개선 시점을 구분해 보여준다. AiScientist는 AIDE와 Codex보다 느리게 시작하지만, 이들의 평균 누적 최고 점수 곡선이 대체로 정체된 뒤에도 개선을 이어간다. 평균 점수가 참고 시스템을 완전히 추월하기 전부터 작업별 비교에서 우세한 범위가 넓어진다.
- 6시간까지 최종 최고 점수에 도달하는 실행은 27%뿐이며, 12시간까지는 44%이다. 이는 24시간 예산의 후반에 상당한 개선이 이루어진다는 점을 보여준다.
- 평균 정규화 검증 곡선은 유효한 작업–시드별 실행 궤적에 걸쳐 ±1 SEM을 사용한다. 작업별 비교의 우세 비율은 승리에 1, 동률에 0.5, 패배에 0을 부여하며, 이항 표준오차 근사를 사용한다.
- 수렴 곡선은 주어진 예산 안에서 관측된 최종 최고 점수까지 걸린 시간을 측정한다. 전역 최적해로의 수렴을 측정하는 것은 아니다.
- 초기 진행이 느린 모습은 이해, 계획, 기본 구조 구축에 먼저 투자한다는 해석과 부합한다. 다만 이 곡선들은 각 활동의 기여를 독립적으로 측정하지 않는다.
각 패널은 평균 개선, 작업별 비교에서 이기는 범위, 관측된 최종 최고 점수까지 걸린 시간을 구분한다. 6시간까지 최고 점수에 도달하는 실행은 27%뿐이며, 12시간까지는 44%이다. 따라서 초기 성능만으로는 최종적인 검증 성능 우위를 파악할 수 없다.
4.5. Mechanism Analysis
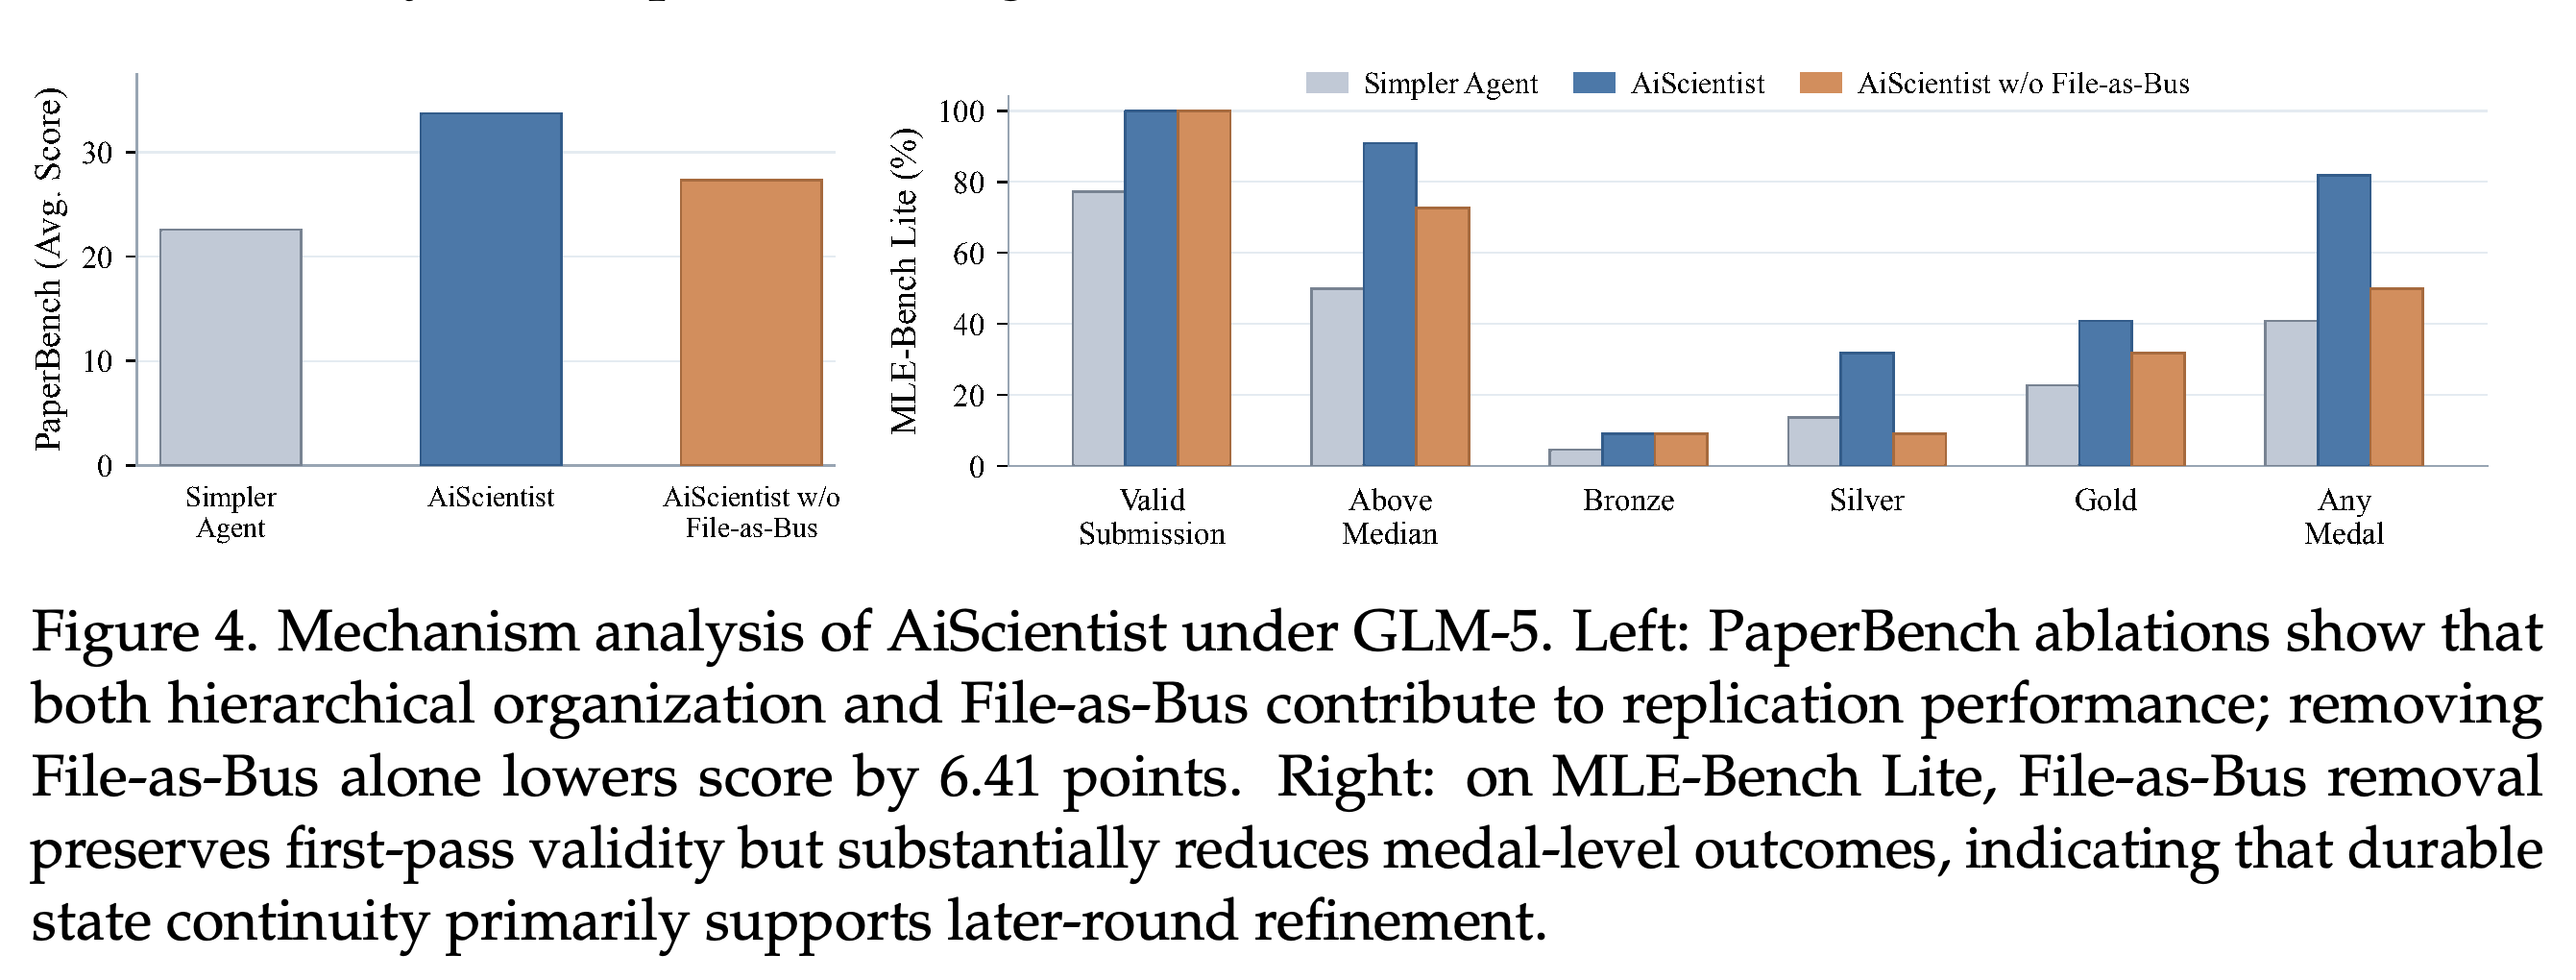
Figure 4는 GLM-5 제거 실험을 보고한다. File-as-Bus를 제거하면 PaperBench 평균 점수는 6.41점, MLE-Bench Lite Any Medal%는 31.82 %p 하락한다. Valid Submission과 Bronze 결과는 대체로 유지되지만, Above Median, Silver, Gold, Any Medal 결과는 더 크게 하락한다.
- 이 패턴은 유효한 제출물을 만드는 것 이상으로, 영속적인 근거가 진단과 개선에 기여한다는 해석을 뒷받침한다. 최종 유효성 지표만으로는 실행 가능한 최초 구현을 언제 확보했는지 알 수 없다.
- File-as-Bus가 없어도 계층적 변형은 단순한 에이전트보다 PaperBench에서 4.74점, Above Median에서 22.73퍼센트포인트, Any Medal에서 9.09퍼센트포인트 높다.
- 제거 실험은 상태 연속성과 역할 조직화가 모두 기여한다는 해석을 뒷받침하지만, 각 스키마 기능이나 전문가의 효과를 따로 정량화하지는 않는다.
File-as-Bus를 제거하면 제출 유효성은 유지되지만 더 높은 수준의 경쟁 성과는 줄어든다. PaperBench의 6.41점 하락과 Any Medal의 31.82퍼센트포인트 하락은 영속 상태가 개선에 기여한다는 해석을 뒷받침한다. 단순한 에이전트보다 여전히 높은 성능은 역할 조직화의 기여도 뒷받침하지만, 모든 구성 요소의 효과를 분리하지는 않는다.
4.6. Behavioral Analysis on PaperBench
Figure 5는 GLM-5에서 역할 구조가 다른 시스템을 비교하기 위해 PaperBench 활동을 작업 단계별로 묶는다. AiScientist는 평균 1112.2단계를 사용하며, IterativeAgent는 834.2단계를 사용한다. 특히 구현에는 573.5단계를 사용하여 IterativeAgent의 105.5단계보다 크게 늘지만, 보조 작업은 291.4단계에서 31.2단계로 줄어든다.
- Codex는 평균 148.4단계만 사용하면서도 경쟁력 있는 성능을 유지한다. 이는 실행 과정이 길다고 본질적으로 더 나은 것은 아니라는 점을 보여준다.
- AiScientist는 실험에 273.6단계, 검증에 129.6단계를 사용한다. IterativeAgent는 각각 217.9단계와 187.6단계를 사용한다. 논문의 포괄적인 서술과 달리, 이 비교에서 검증 단계 수는 늘지 않는다.
구현 단계 수는 AiScientist가 573.5단계, IterativeAgent가 105.5단계로 전자가 더 많지만, 보조 작업은 31.2단계 대 291.4단계로 더 적다. 검증 단계 수 역시 129.6단계 대 187.6단계로 적으므로, 모든 엔지니어링 단계가 늘어난 것은 아니다. Codex는 총 단계 수가 148.4단계여도 경쟁력 있는 성능을 유지한다. 따라서 실행 과정의 길이만 보는 것보다 작업 배분을 보는 편이 더 유용하다.
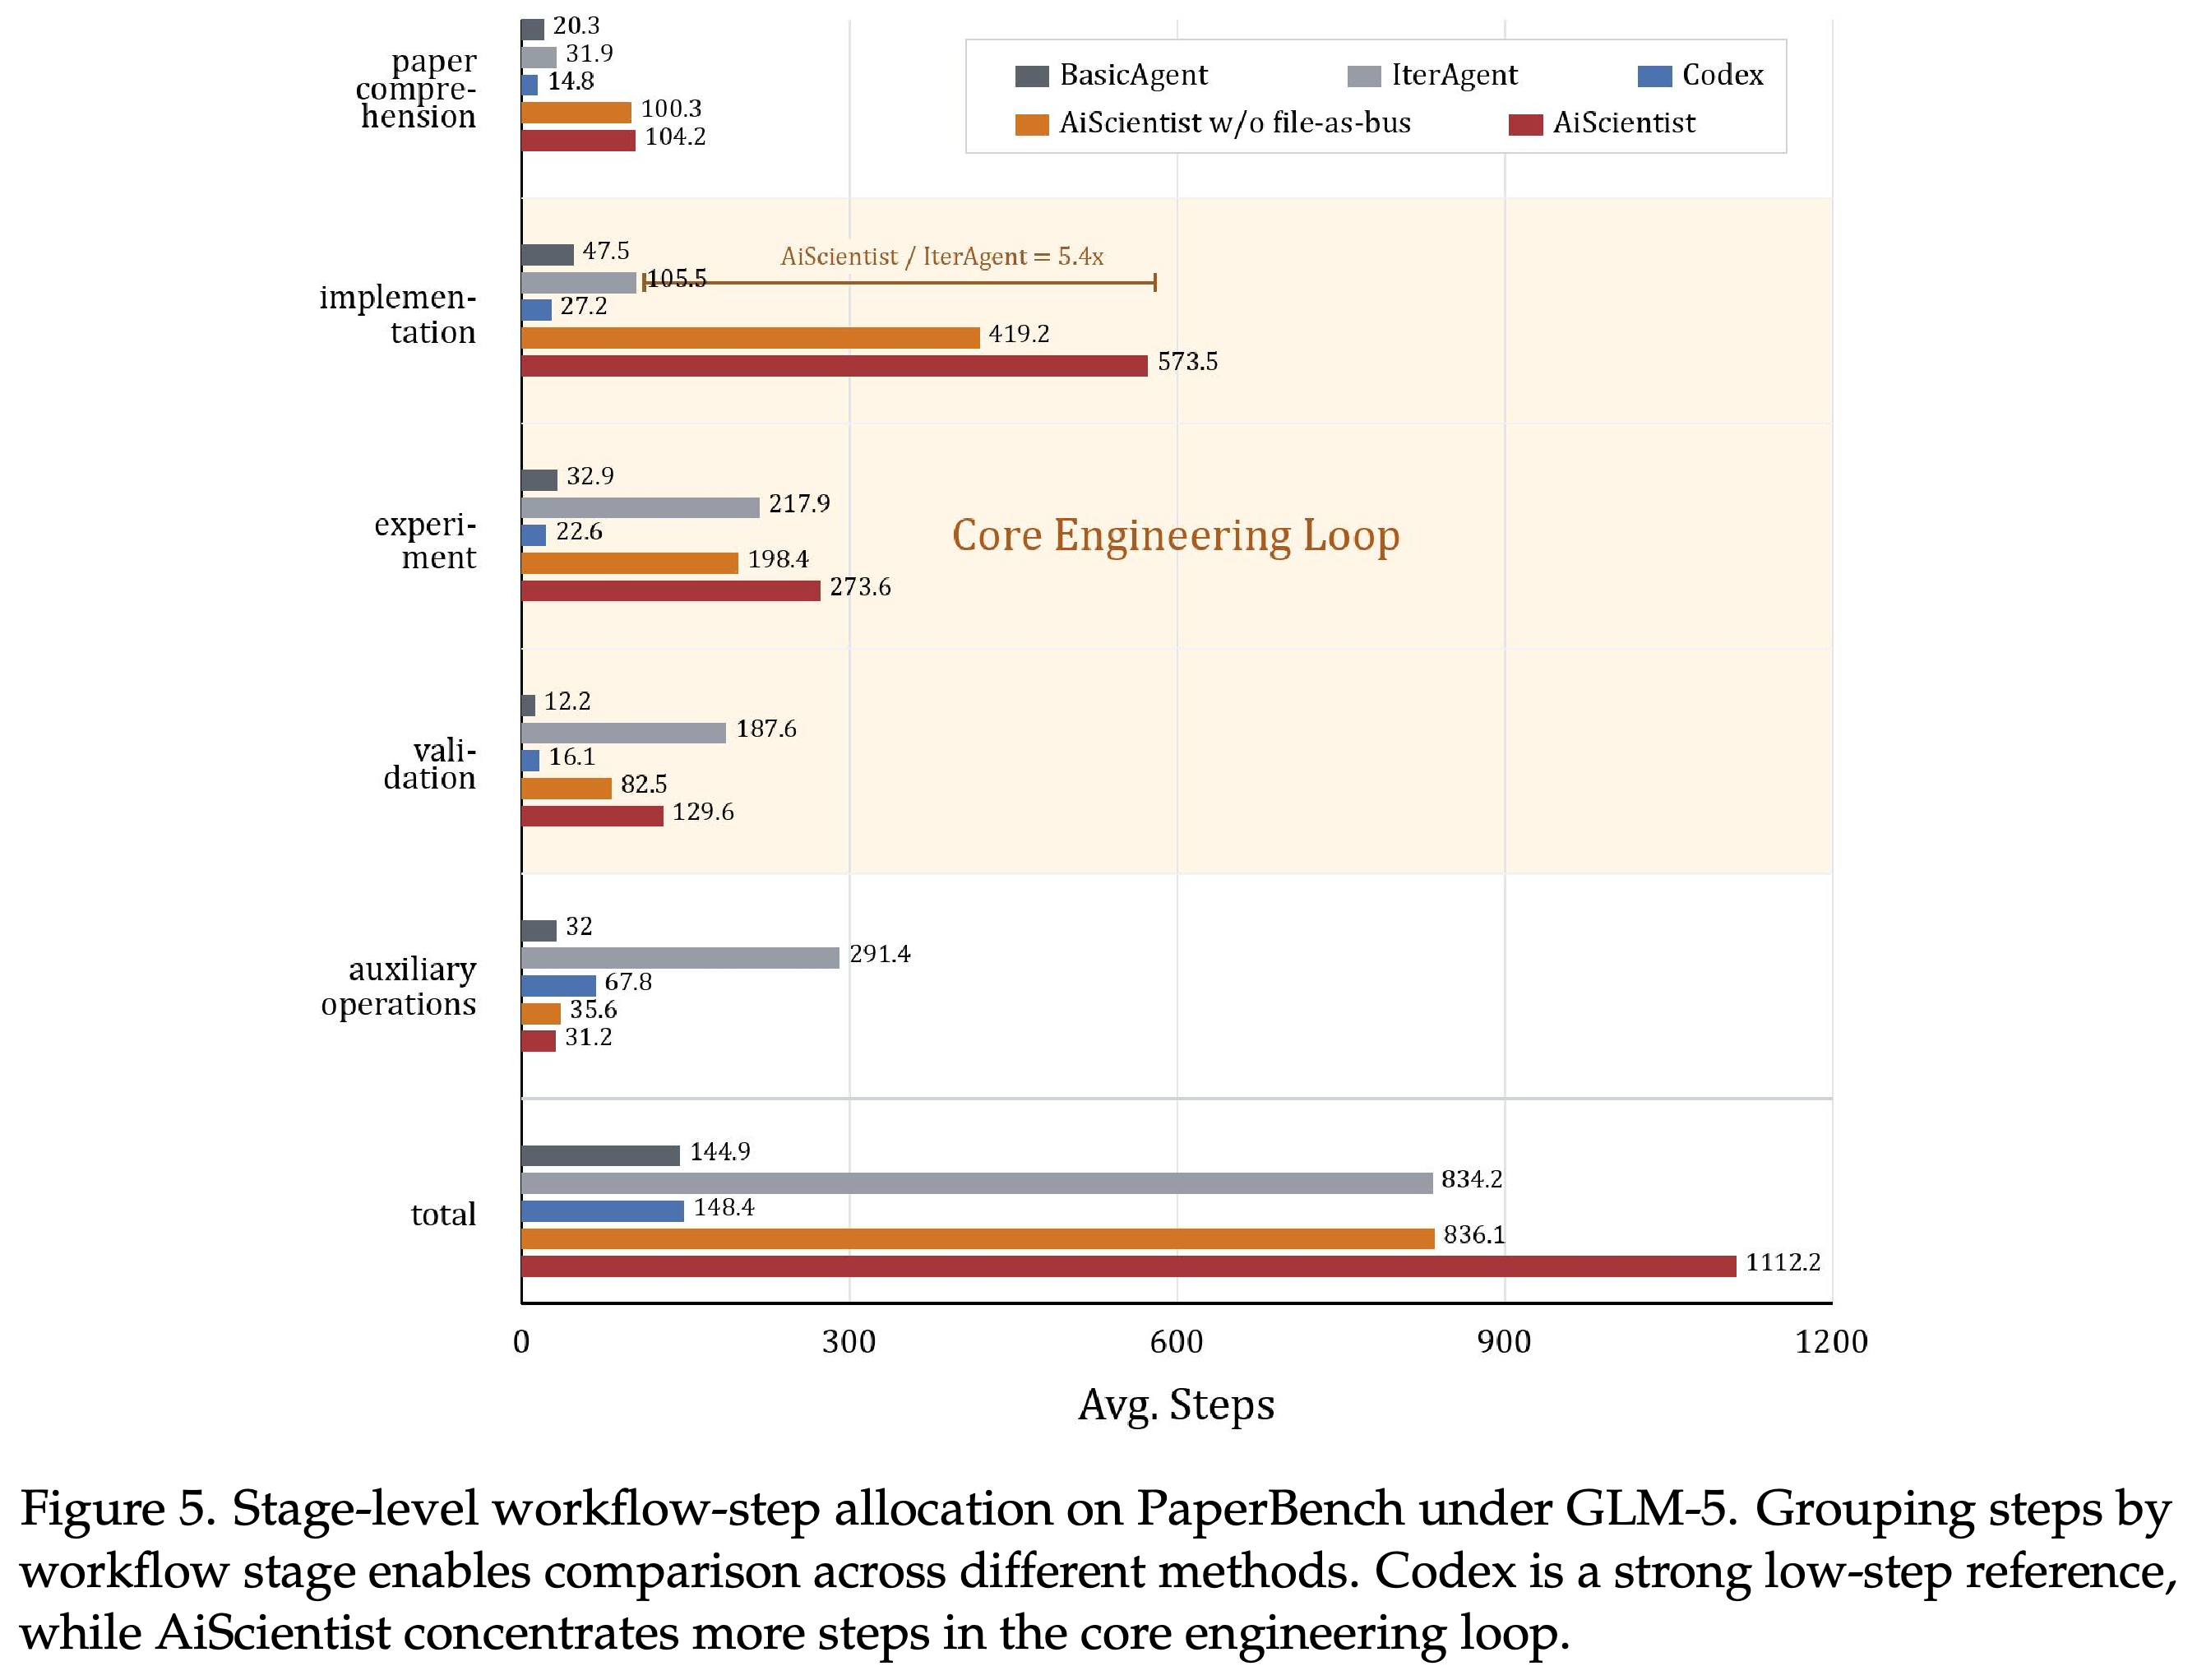
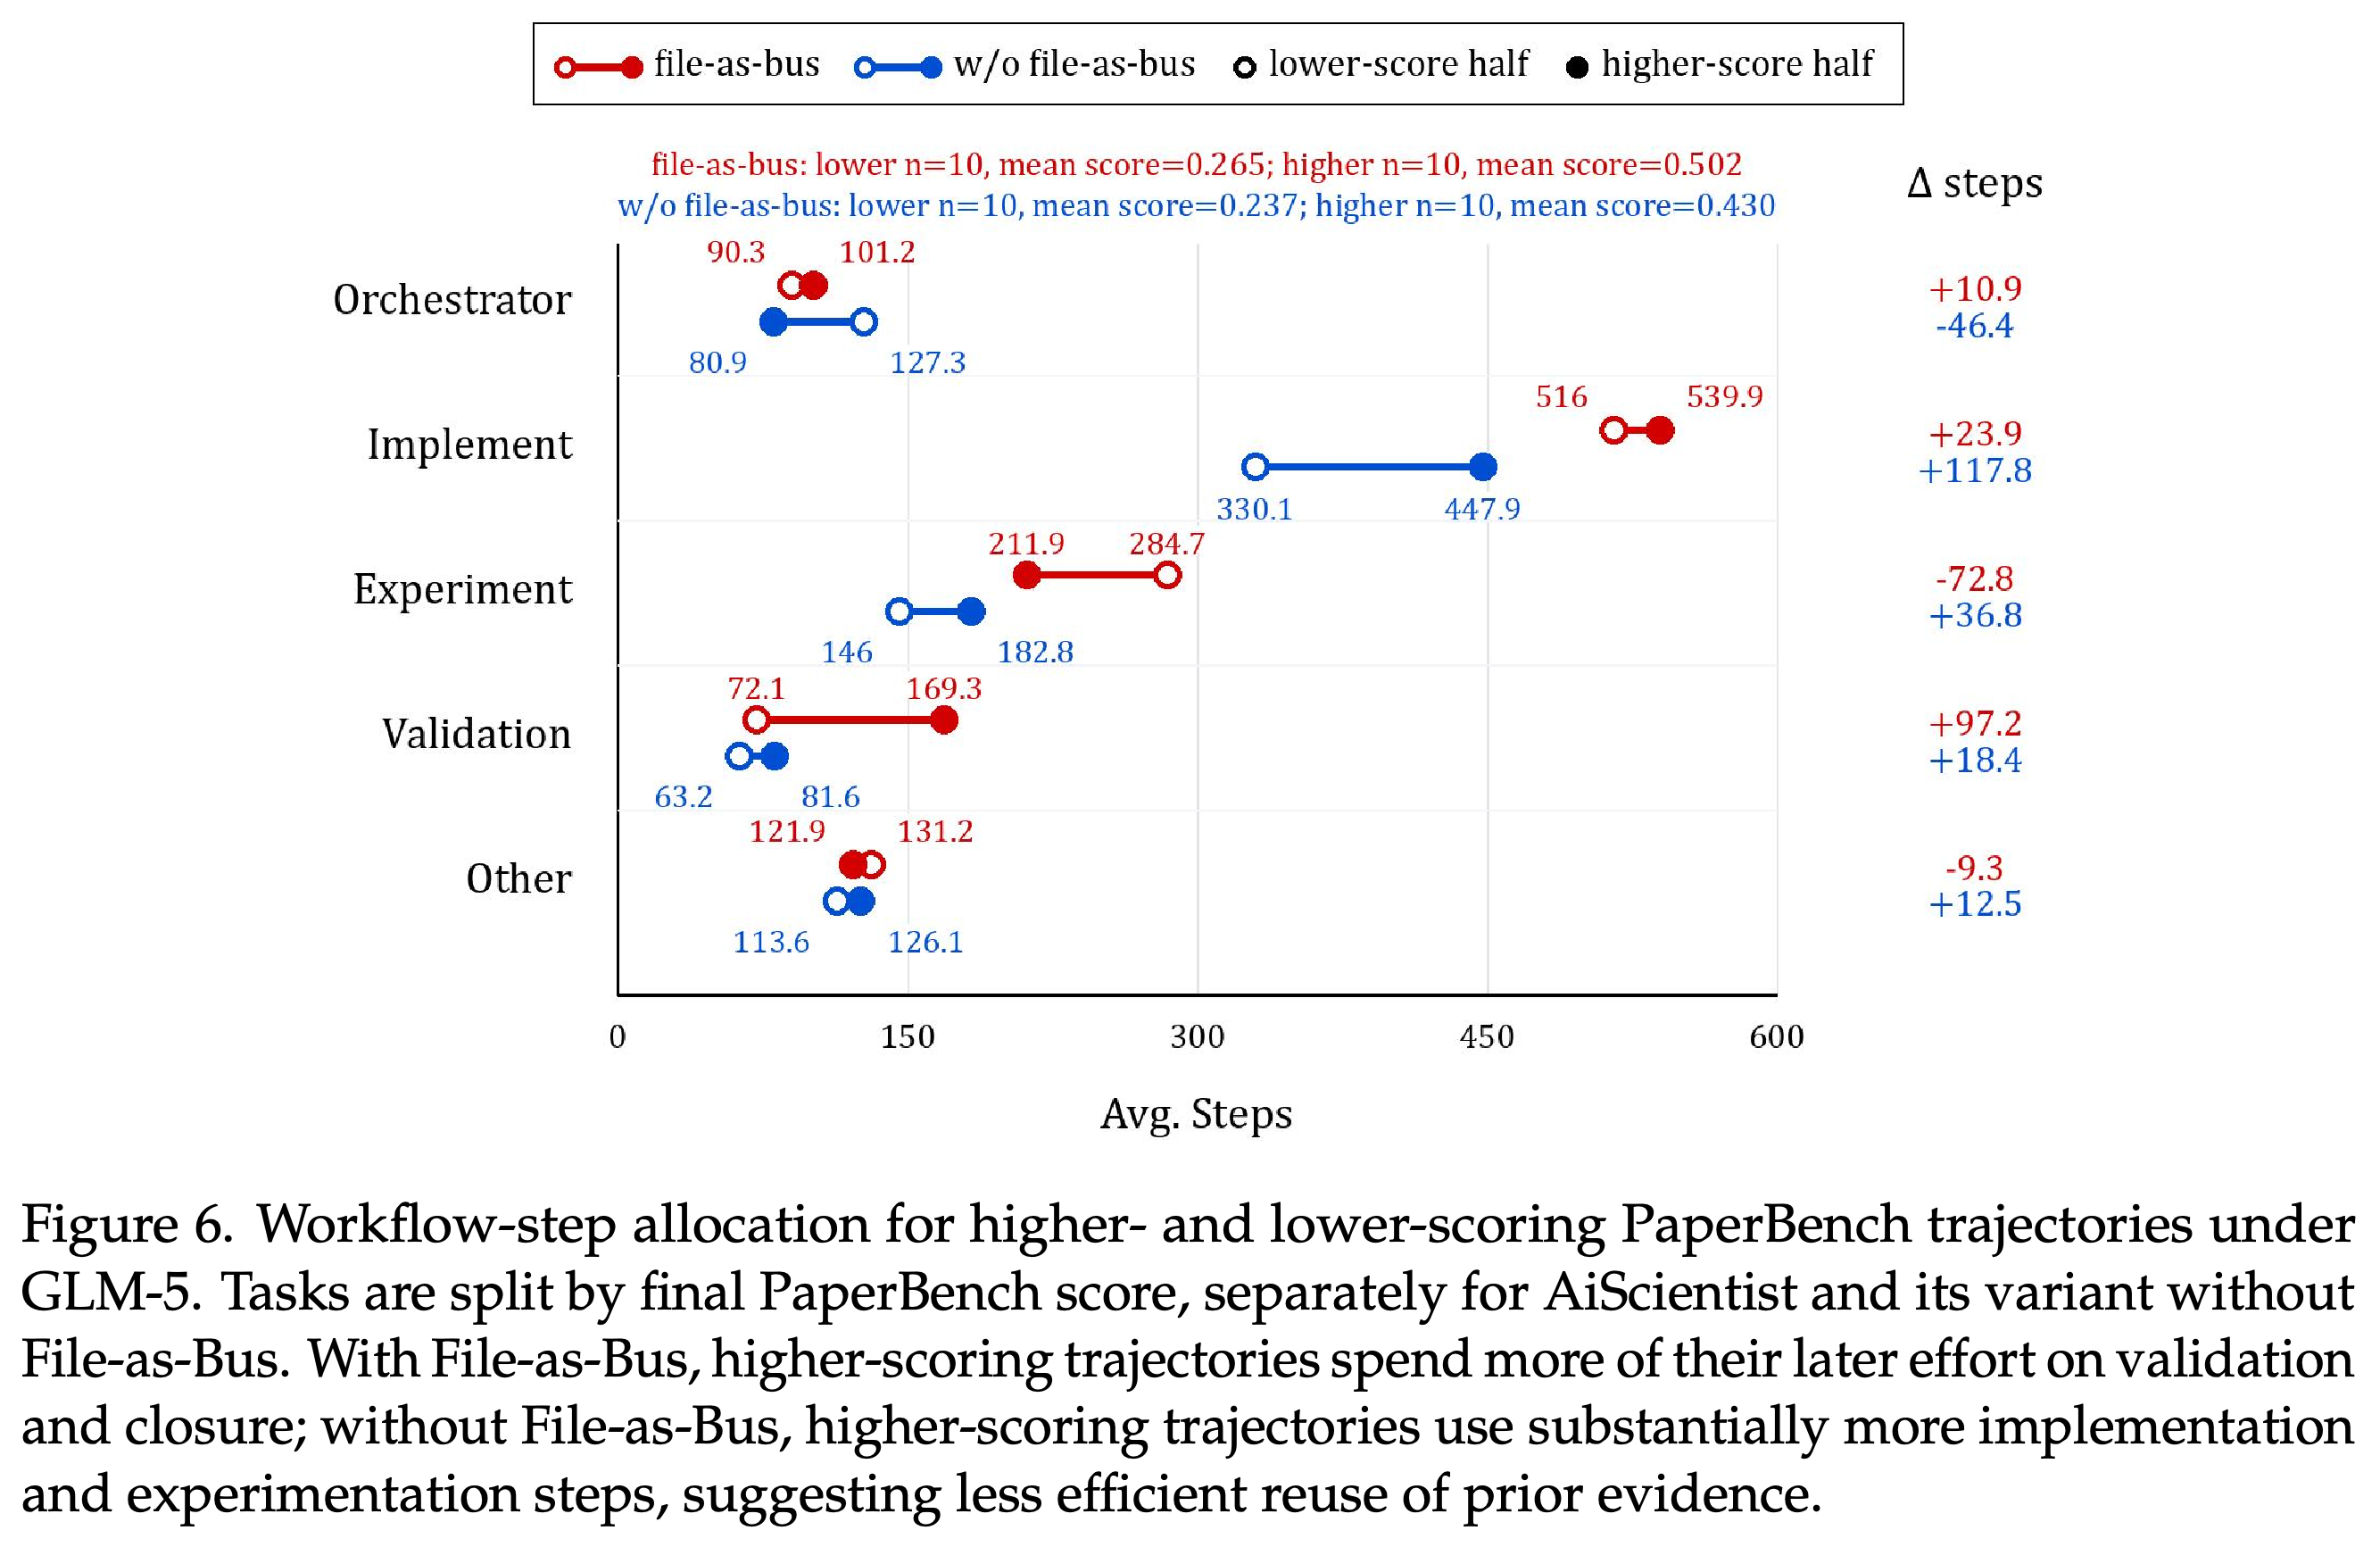
Figure 6은 GLM-5에서 AiScientist와 File-as-Bus 제거 변형 각각의 작업을 점수가 높은 절반과 낮은 절반으로 나눈다. File-as-Bus가 있을 때 고득점 실행 과정은 검증에 97.2단계를 더 사용하고 실험에 72.8단계를 덜 사용한다. File-as-Bus가 없을 때는 고득점 실행 과정이 구현에 117.8단계, 실험에 36.8단계를 더 사용한다.
- 이 패턴은 산출물을 매개로 한 성공적인 실행 과정이 구현 변형을 반복 탐색하기보다 검증에 더 집중한다는 해석과 부합한다.
- File-as-Bus를 사용한 고득점 그룹에서는 구현 단계도 23.9단계 늘어난다. 따라서 근거가 뒷받침하는 것은 추가 구현이 없다는 해석이 아니라 작업 비중이 달라진다는 해석이다.
- 이는 서로 다른 작업을 사후 비교한 연관성이며, 검증 노력에 대한 통제된 개입이 아니다. 작업 난도와 실행 과정의 다른 차이도 관측된 작업 배분에 영향을 줄 수 있다.
File-as-Bus가 있을 때 고득점 작업은 검증에 97.2단계를 더 사용하고 실험에 72.8단계를 덜 사용하며, 구현은 23.9단계 소폭 늘어난다. File-as-Bus가 없을 때는 구현과 실험 단계가 각각 117.8단계와 36.8단계 늘어난다. 이러한 작업 그룹 간 연관성은 서로 다른 작업 패턴과 부합하지만, 검증 노력이나 근거 재사용의 인과적 효과를 입증하지는 않는다.
5. Related Work
논문은 AiScientist를 자동화된 과학적 발견, 목표 지향적 ML 엔지니어링, 논문을 코드로 재현하는 시스템과 비교한다. 새로운 모델 학습 알고리즘을 제안하기보다, 계층적 오케스트레이션과 산출물을 통한 연속성으로 이 단계들에 걸쳐 일관된 엔지니어링 진전을 유지하는 데 초점을 둔다.
6. Conclusion
결론은 벤치마크 성능 향상과 File-as-Bus 제거 실험을 누적되고 점검 가능한 프로젝트 상태가 장기 연구 자동화에 기여한다는 근거로 해석한다. 입증된 범위는 제한된 예산에서 논문 재현과 경진대회 작업을 자율적으로 구현하고 개선하는 것이며, 제약 없는 자율적 과학 발견은 아니다.
부록
- A. Additional Related Work는 A.1. Automating AI Research와 A.2. Multi-Agent Coordination and Long-Horizon Continuity를 포함하며, 발견 시스템, 목표 지향적 엔지니어링 에이전트, 재현 도구와의 비교를 확장한다. CAMEL, MetaGPT, ChatDev의 역할 분해를 불안정한 작업 인계, 부족한 검증, 의사결정에 필요한 컨텍스트 손실이라는 문헌상의 문제와 연결한다.
- B. File-as-Bus Implementation Details는 역할별 산출물 소유권과 접근 범위를 명시한다. Table 3은 논문 분석, agent/prioritized_task.md, submission/, submission/setup/, submission/reproduce.sh, agent/impl_log.md, agent/exp_log.md를 나열한다. Tier-2 subagent는 기본적으로 읽기 전용 접근 권한을 가지며, 전문가 호출 후 작업 공간 맵을 갱신한다. 분석과 계획은 개정본 보존을 개념적으로 규정한 버전 관리 산출물이다. 실행 가능한 파일은 직접 수정할 수 있으며, 결정 이력은 추가 전용 로그에 기록한다.
- C. Evaluation and Metric Details는 익명화된 구현, 평가 스크립트, 실험 산출물이 제출한 보충 자료에 포함되어 있다고 명시한다. 유효한 실행 궤적에 대한 각 시점의 평균과 SEM, 동률을 반영한 작업별 비교 우세 비율, 그 비율의 이항 표준오차 근사를 정의한다. 또한 20개 작업으로 구성된 PaperBench와 22개 작업으로 구성된 MLE-Bench Lite의 설정을 명시한다.
- D. Baseline and Reference Details는 통제된 비교와 성능 수준을 가늠하기 위한 참고 비교를 구분한다. BasicAgent와 IterativeAgent는 PaperBench 작업 및 채점 설정을 공유하지만, Codex/GPT-5.5 xhigh는 harness와 backbone이 모두 다르다. 공식 MLE-Bench Lite leaderboard 항목 역시 모델과 보고 프로토콜이 다를 수 있다.
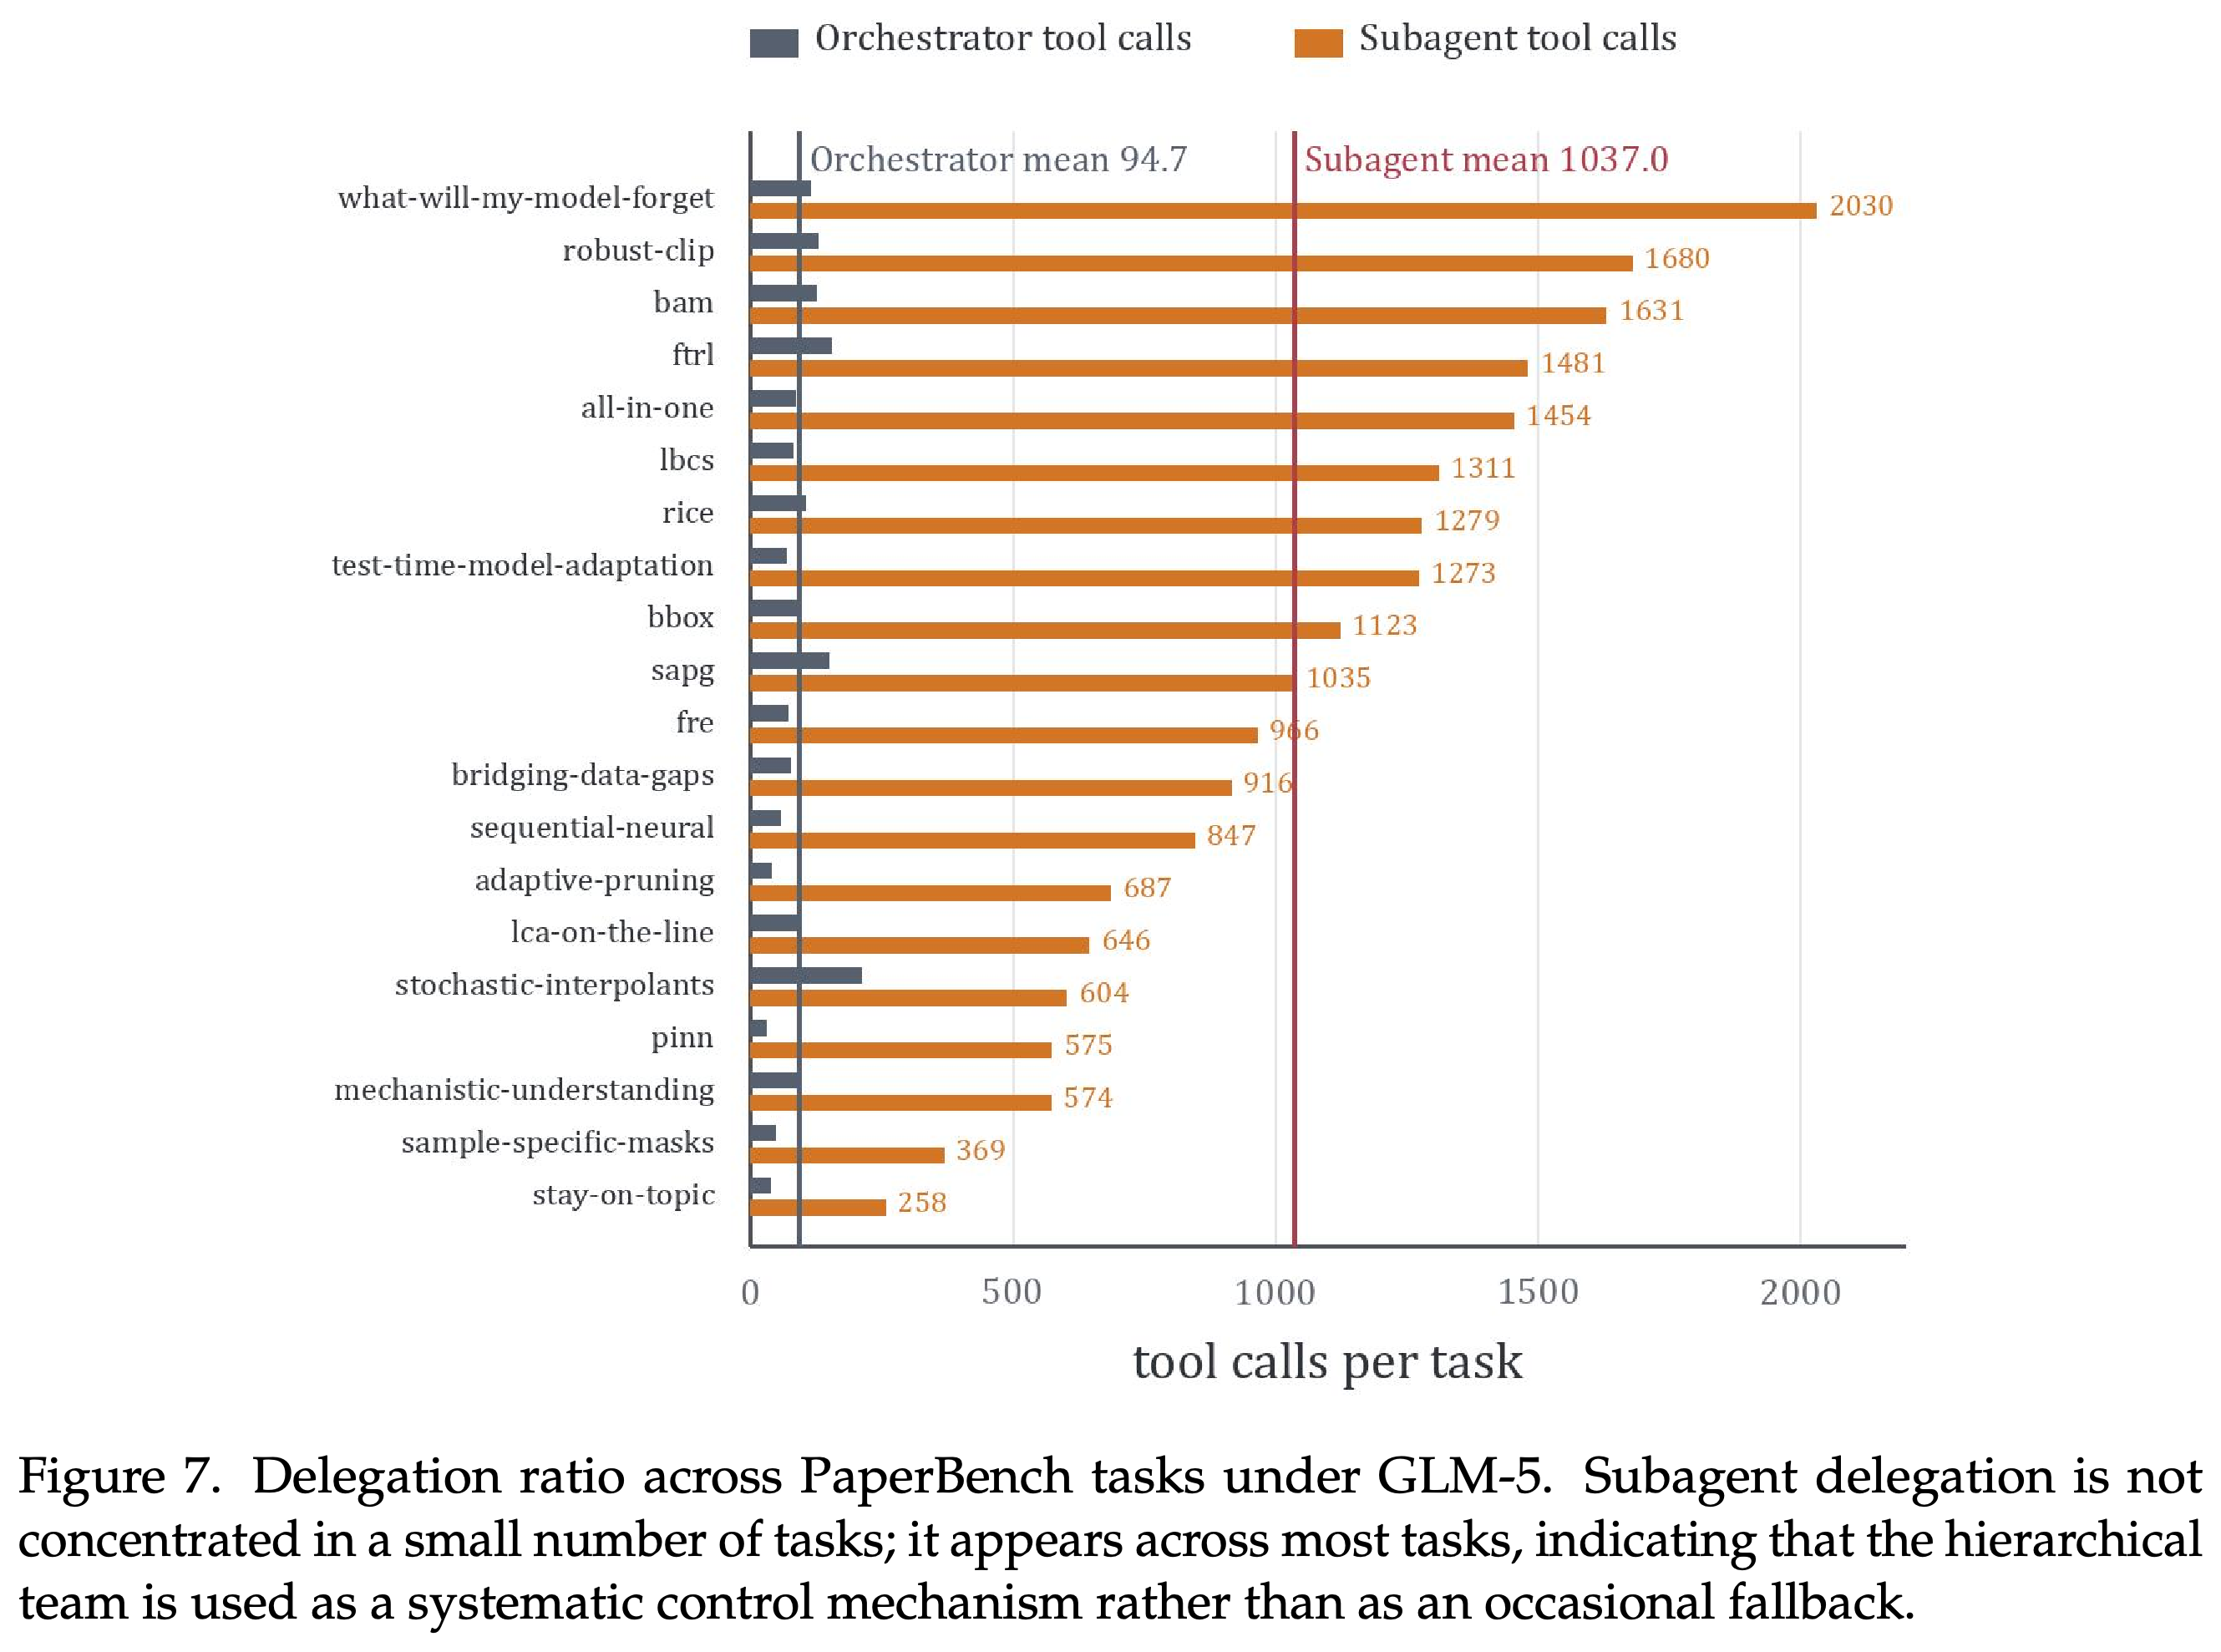
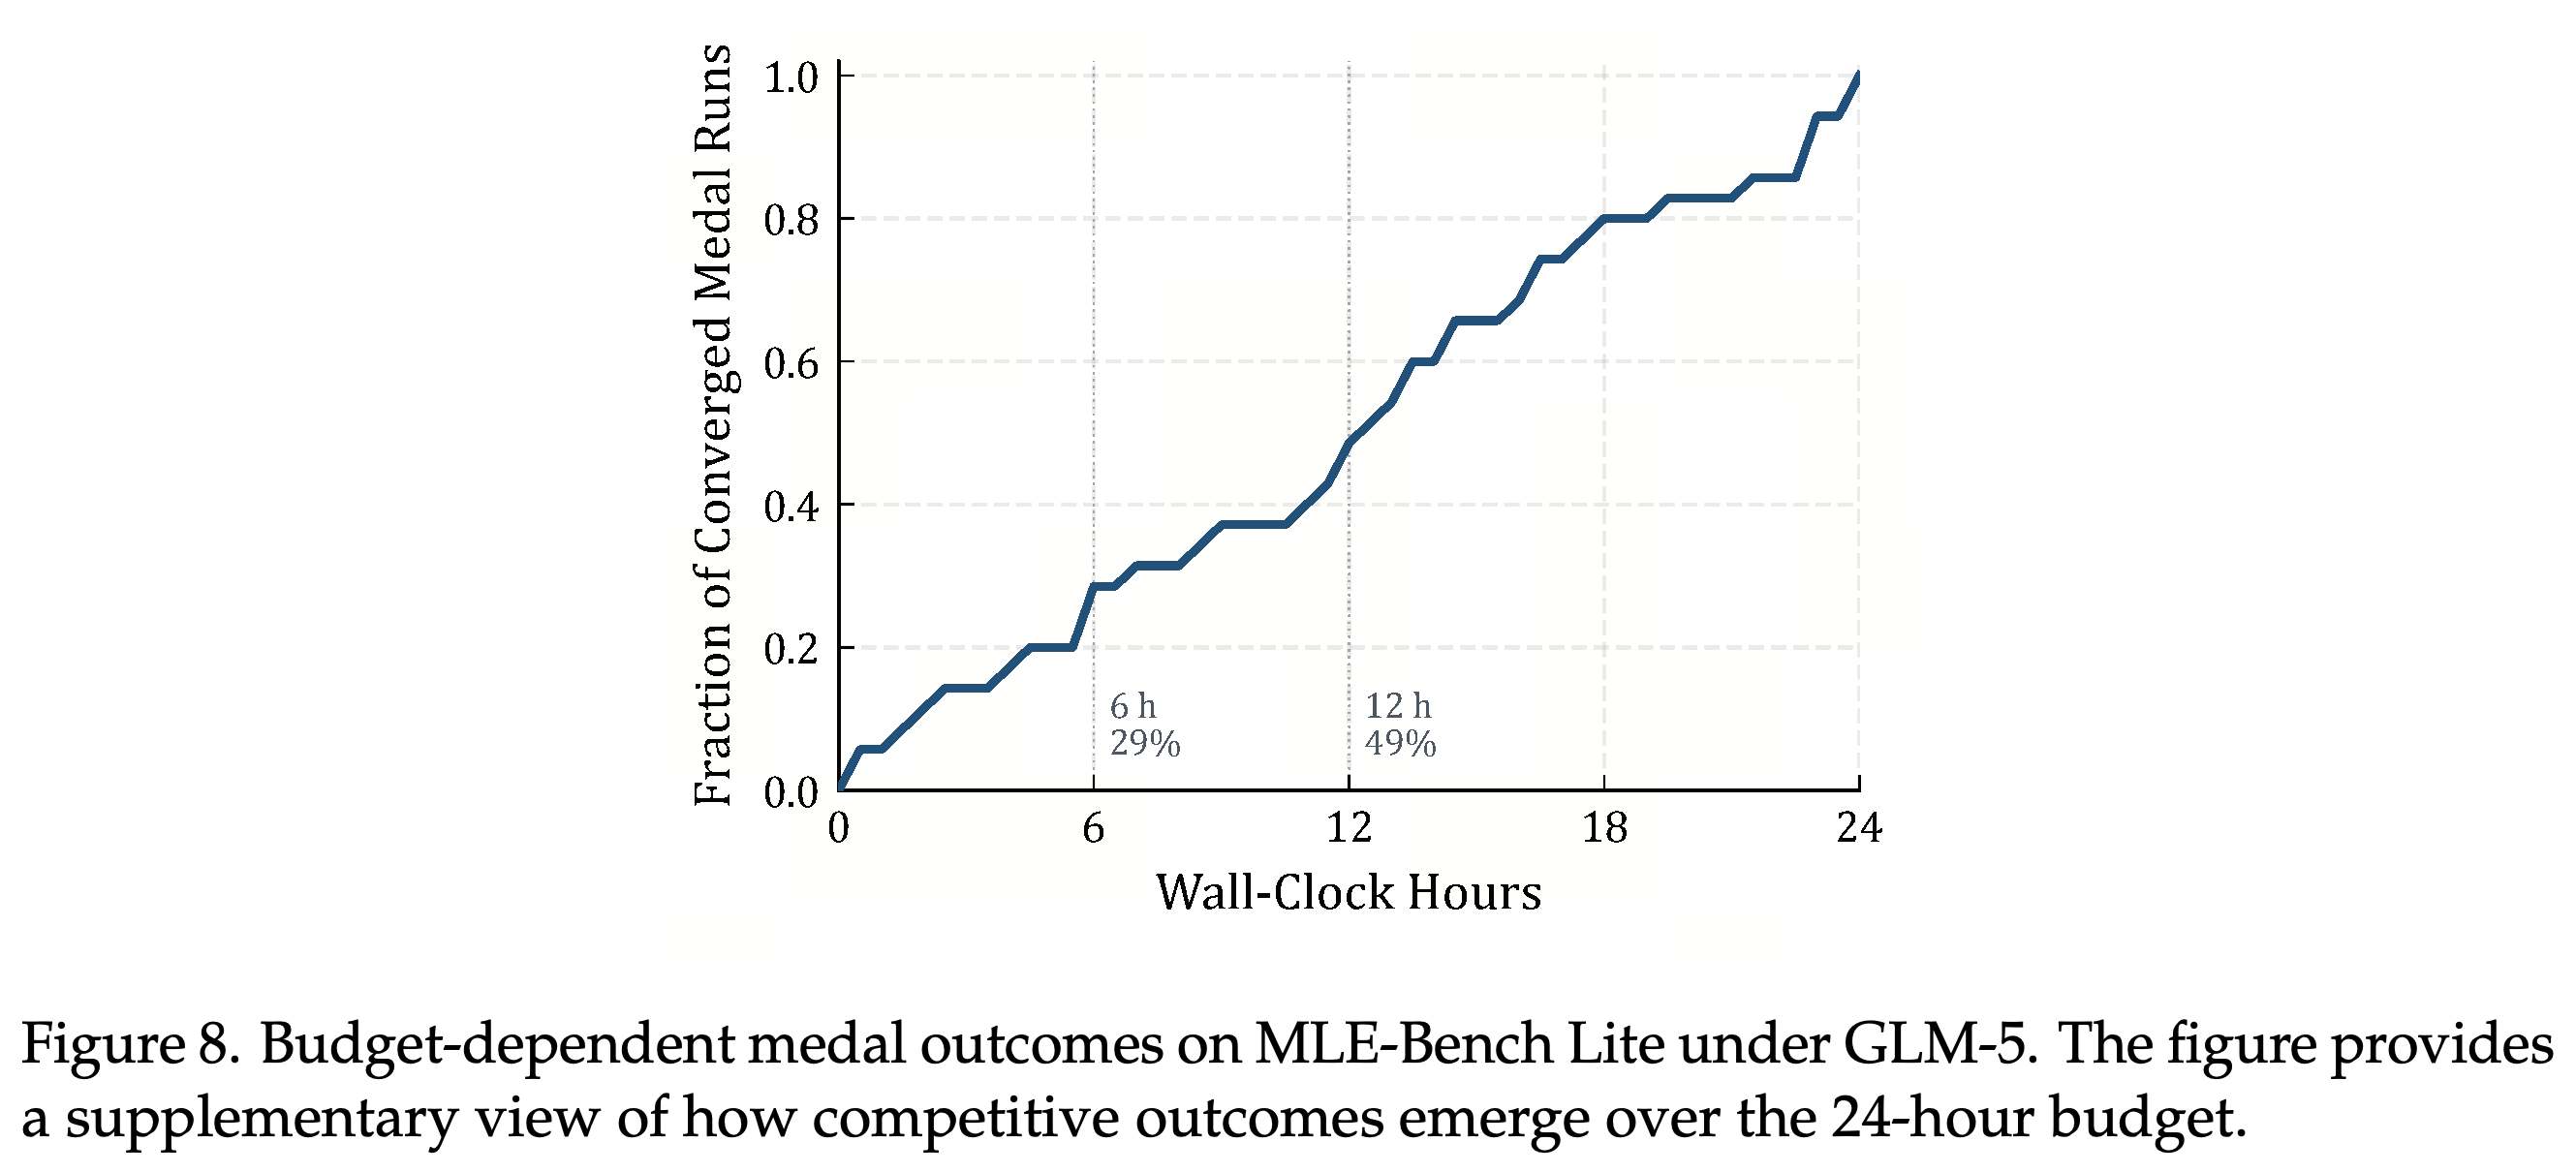
- E. Supplementary Analyses는 E.1. Delegation Patterns on PaperBench와 E.2. Budget and Medal Outcomes on MLE-Bench Lite를 포함한다. Figure 7은 작업 모음 전반의 위임을 보여주며, Orchestrator와 subagent의 평균 도구 호출 수는 각각 94.7회와 1037.0회이다. Figure 8에서 메달을 획득한 실행 중 6시간까지 수렴한 비율은 29%, 12시간까지는 49%이다. 이는 메달 획득 실행 내의 수렴을 설명하며, 각 시점에 전체 작업 중 메달을 획득한 비율을 뜻하지 않는다.
짧은 생각
가장 분명한 기여는 영속적인 근거를 위한 협업 규약이다. 제출 유효성은 유지되지만 경쟁 성과는 악화되는 제거 실험이 이를 뒷받침한다. Table 3은 책임과 산출물 수명주기를 정한다. Figures 7과 8은 위임이 일상적으로 사용되며, 메달을 획득한 많은 실행이 예산 후반에야 최종 최고 점수에 도달한다는 점을 보여준다.
작성자와 열람자를 지정하여 산출물을 단계 간 명시적인 인터페이스로 만든다. 분석과 계획은 버전 관리 산출물로 지정하고, 실행 가능한 파일은 직접 수정할 수 있게 두며, 진단 로그는 추가 전용으로 관리한다. 이 규약은 현재 실행 상태와 기록된 판단 근거를 분리한다. 다만 함께 제시된 설명은 구체적인 버전 관리 메커니즘을 명시하는 대신 개정본 보존을 개념적으로 설명한다.
위임된 도구 호출은 소수의 작업에만 나타나는 것이 아니라 PaperBench 작업 모음 전반에서 발생한다. subagent의 평균 도구 호출 수는 1037.0 calls per task이며, Orchestrator의 평균 호출 수는 94.7이다. 이는 상당한 양의 실행이 위임됨을 보여주지만, 그 자체로 위임이 높은 점수를 유발한다는 근거는 아니다.
메달을 획득한 실행 중 6시간까지 수렴한 비율은 29%, 12시간까지는 49%이다. 곡선은 이 부분집합 안에서 예산 후반에도 개선이 이루어진다는 해석을 뒷받침한다. 각 시점에 전체 작업 중 메달을 획득한 비율을 측정하거나, 더 짧은 예산을 별도로 적용했을 때의 결과를 직접 추정하는 것은 아니다.
근거는 시험한 엔지니어링 환경 안에서 이 설계를 뒷받침하지만, 몇 가지 한계가 남는다. PaperBench의 채점 비용은 약 $832로 반복 평가를 제한한다. 주요 결과에는 MLE-Bench Lite에서 사용하는 3회 실행 기반의 불확실성 보고가 없다. 작업 단계의 연관성으로는 인과관계를 입증할 수 없다. Codex 비교는 모델과 harness라는 2개 요소를 모두 바꾸므로, 점수 차이를 아키텍처 제거 실험으로 볼 수 없다.