


The Last Human-Written Paper: Agent-Native Research Artifacts 요약 설명
27 Apr 2026 | Paper Review AI Research Agents Research Reproducibility Agentic Skills Agent's Memory목차
- 요약
- 1. Introduction
- 2. The ARA Protocol
- 3. The Live Research Manager
- 4. The ARA Compiler
- 5. ARA Verification and Review
- 6. The (Human+AI)² Research Network
- 7. Evaluation
- 8. Related Work
- 9. Future Work
- 10. Limitations
- 11. Conclusion
- 부록
- 짧은 생각
이번 글에서는 The Last Human-Written Paper: Agent-Native Research Artifacts 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 4월 27일(Arxiv)
- Liu, Jiachen, Pei, Jiaxin, Huang, Jintao, Si, Chenglei, Qu, Ao, Tang, Xiangru, Lu, Runyu, Chen, Lichang, Bai, Xiaoyan, Zheng, Haizhong, et al.
- University of Michigan, Stanford University, Ohio State University, MIT, Yale University, Meta Superintelligence Labs, University of Chicago, Carnegie Mellon University, University of Washington, University of Toronto, NVIDIA, Meta, New York University, Nanyang Technological University, Orchestra Research, Harvard University, LinkedIn, UIUC, Arizona State University, Stony Brook University, University of Hong Kong, Boston College, Portland State University, National University of Singapore, Cornell University
- 논문 링크
- Github
- Project Page
요약
- The Last Human-Written Paper: Agent-Native Research Artifacts는 AI 에이전트가 연구를 직접 다룰 수 있도록 하는 파일 시스템 프로토콜인 Agent-Native Research Artifact (ARA)를 제안한다. ARA는 과학적 논리, 실행 명세, 탐색 이력, 원시 증거를 분리하고, 주장·실험·코드·출력을 명시적으로 연결한다.
- 아티팩트를 구성하고 검증하는 메커니즘은 3가지다. Live Research Manager는 연구자와 에이전트의 세션을 기록하고, ARA Compiler는 기존 연구 자료를 가져오며, ARA Seal은 구조적 무결성, 논증의 엄밀성, 결과 방향의 재현성을 확인한다. 중요성, 독창성, 문제 설정, 윤리적 판단은 여전히 사람이 검토한다.
- 지식 추출 질문 450개에서 ARA의 정확도는 93.7%이며, 기존 방식의 베이스라인은 72.4%다. 재현 하위 과제 150개에서는 난이도 가중 성공률을 각각 64.4%와 57.4%로 보고한다. ARA에는 전문가의 재현 루브릭이나 이전 탐색 기록도 추가되므로, 이 비교는 표현 방식만의 효과를 분리하지 못한다. 재현 평가 부록에서도 요약 결과와 표에 제시된 결과가 일치하지 않는 부분이 있다.
- RE-Bench 확장 과제 5개에서 보존된 실패 지식은 에이전트가 유용한 시도를 더 일찍 하도록 돕지만, Claude Sonnet 4.6에서 ARA가 최종적으로 앞선 과제는 3개뿐이다. 나머지 탐색 과정은 기존 휴리스틱이 탐색을 특정 방향에 고정하거나 분산시킬 수 있음을 시사한다. 배포 보안, 개인정보 보호 통제, 계산 기반 ML 이외의 분야로의 일반화는 아직 해결되지 않았다.
1. Introduction
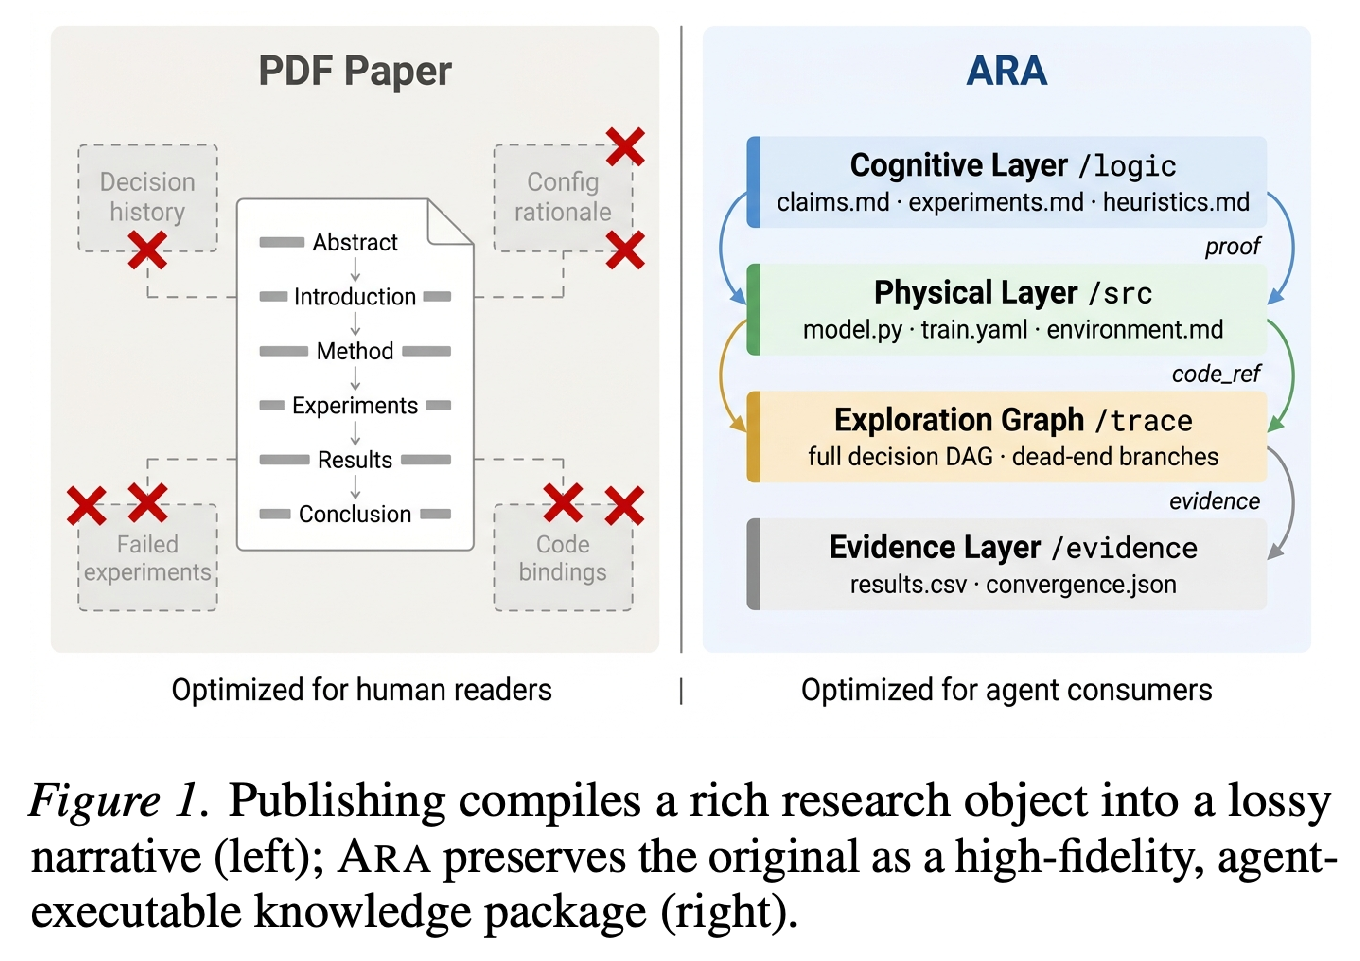
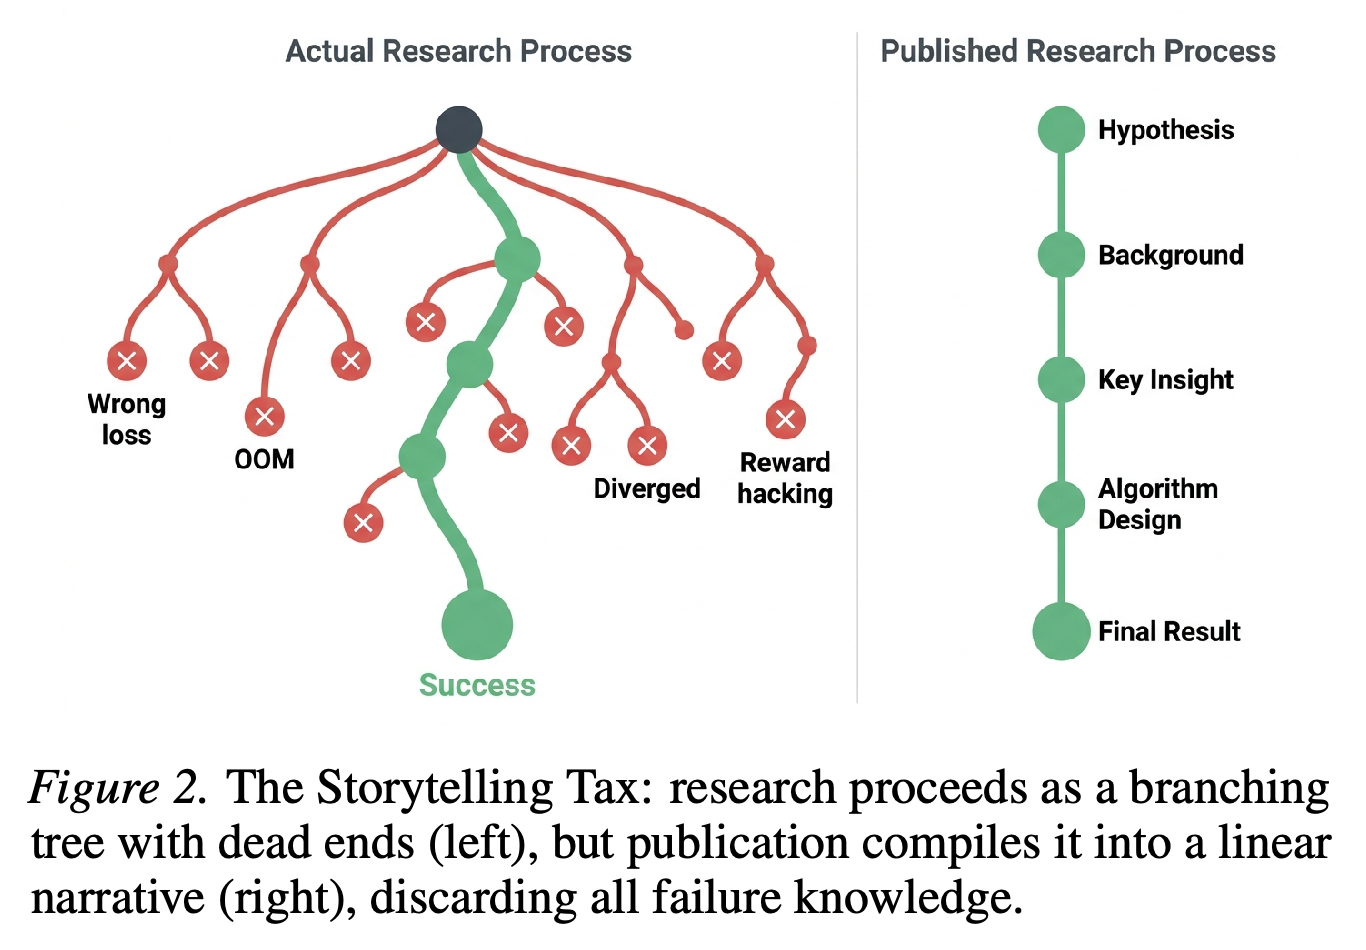
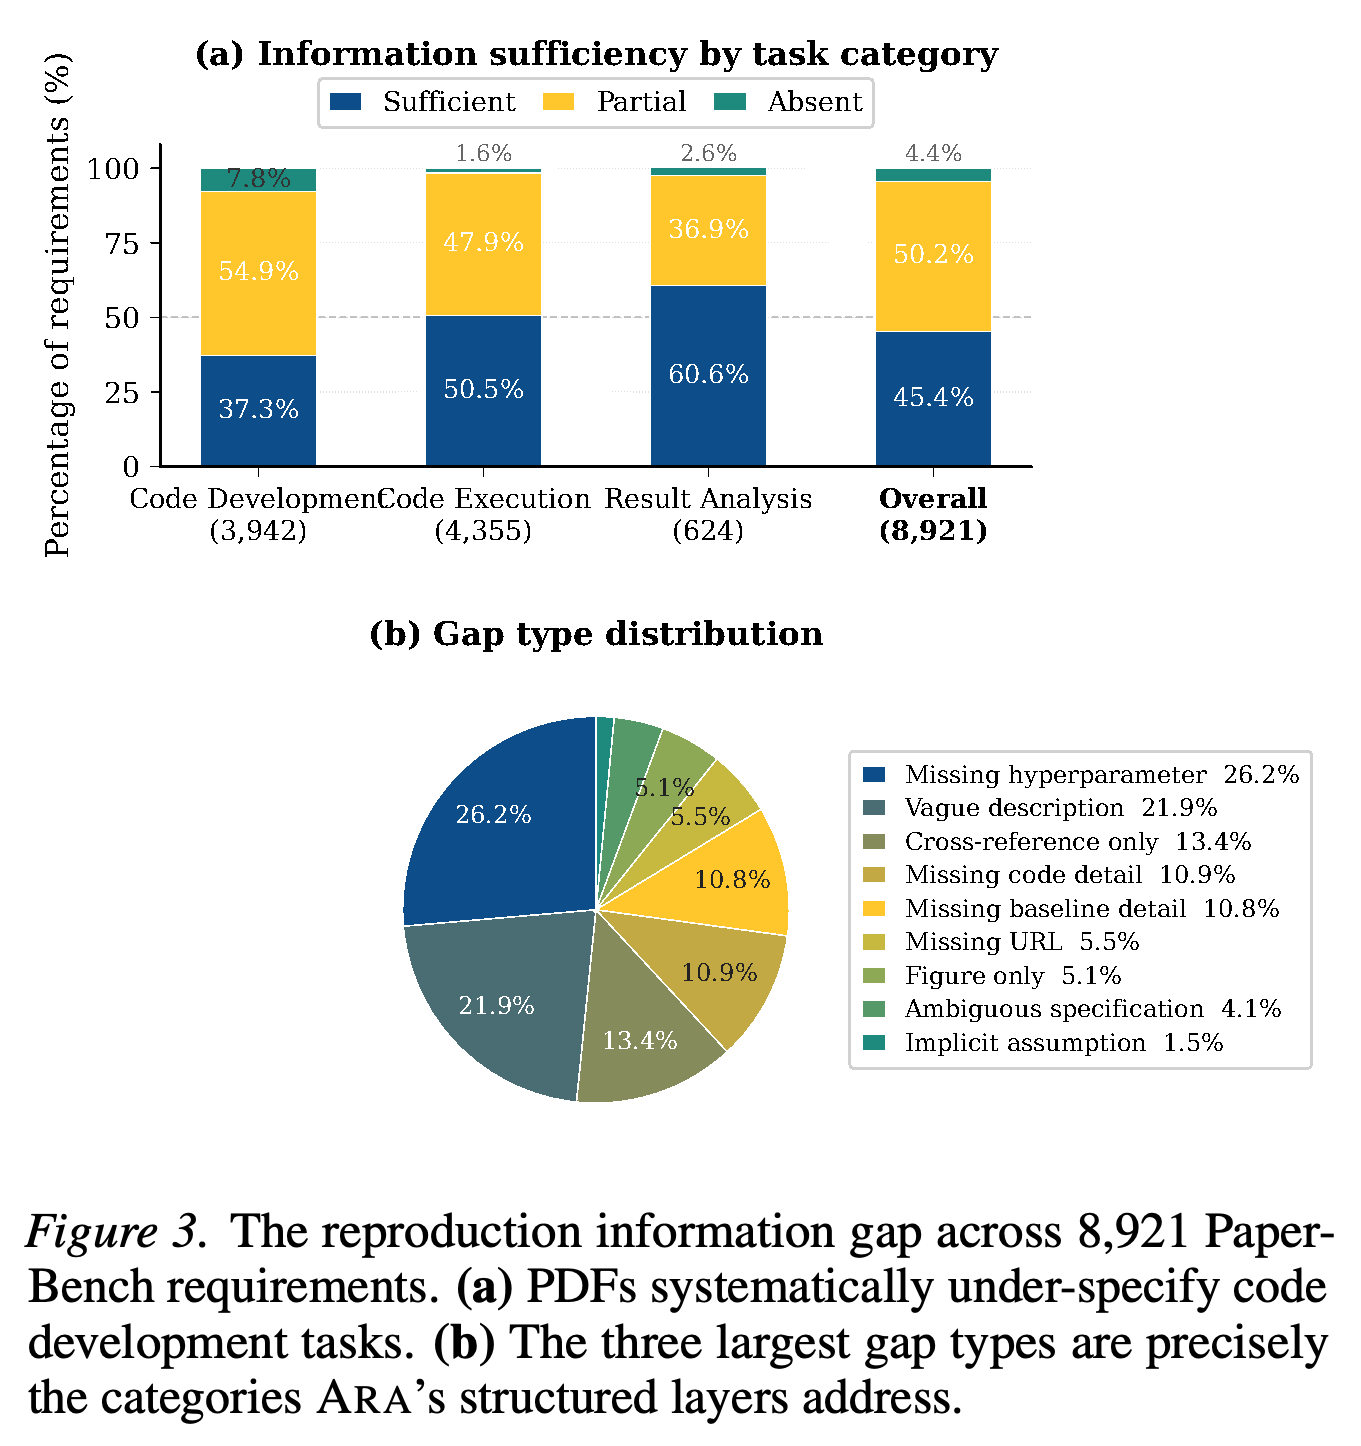
서론은 Storytelling Tax와 Engineering Tax를 구분한다. Storytelling Tax는 실패한 실험, 기각된 가설, 탐색 분기에서 내린 결정이 사라지는 문제다. Engineering Tax는 심사자가 이해하기에 충분한 설명과 에이전트가 실행하기에 충분한 명세 사이의 격차다. Figures 1–2는 성공한 과정의 서술만이 아니라 연구 자체를 보존해야 하는 이유를 보여주며, Figure 3은 재현에 필요한 정보가 얼마나 누락되는지 정량화한다.
- 논문 23편의 PaperBench 재현 요구사항 8,921개 중 PDF에 충분히 명시되었다고 판단된 비율은 45.4%뿐이다. 코드 개발 요구사항의 충분한 명시 비율은 37.3%이며, 보고된 정보 누락 레이블 중 하이퍼파라미터 누락이 26.2%를 차지한다.
- 탐색 비용 분석에서는 토큰의 59.2%와 달러 비용의 90.2%가 기준 성능에 못 미친 실행에 사용되었다. Appendix E.3에 따르면 실행 24,008개로 이루어진 코퍼스는 RE-Bench만을 대상으로 하지 않고, 모델 21개와 과제 228개를 포함한다. 실패한 탐색은 후속 연구자가 이를 반복해야 할 때에만 피할 수 있는 후속 비용이 된다.
- 이 제안은 ARA를 기준 원본으로 삼고 논문을 여기서 컴파일한 표현물로 취급한다. 문제의 원인을 단순한 PDF 파일 형식이 아니라 문서화 관행에서 찾는다.
이 비교는 의사결정 이력, 실패한 실험, 설정의 근거, 코드 연결을 기존 서술에서 빠질 수 있는 정보로 제시한다. ARA의 연결된 4개 계층은 이를 대신할 실행 가능한 연구 대상으로 제안된다. 이 도식은 보존 충실도를 측정한 결과가 아니라 설계 동기를 보여준다.
분기 트리에는 잘못된 손실 함수, 메모리 부족 실패, 발산, 보상 해킹이 포함되지만, 출판된 순서는 성공 경로만 남긴다. 이는 최종 방법의 설명만으로는 후속 연구자가 어떤 대안을 이미 탐색했는지 알 수 없음을 보여준다.
요구사항 8,921개 중 충분히 명시되었다고 판단된 비율은 45.4%뿐이다. 코드 개발의 충분한 명시 비율은 37.3%로 가장 낮다. 보고된 누락 레이블 분포에서는 하이퍼파라미터 누락, 모호한 설명, 교차 참조에만 의존하는 명세가 큰 비중을 차지한다. 이는 명시적인 실행 명세가 필요한 이유를 보여준다.
2. The ARA Protocol
ARA 프로토콜은 새로운 모델이나 학습 알고리즘이 아니라 연구 지식을 위한 파일 시스템 온톨로지를 정의한다. 4개 계층은 기여가 무엇인지, 어떻게 재현하는지, 이전 탐색에서 무엇을 알아냈는지, 어떤 실험 출력이 주장을 뒷받침하는지에 각각 답한다.
2.1. Design Philosophy
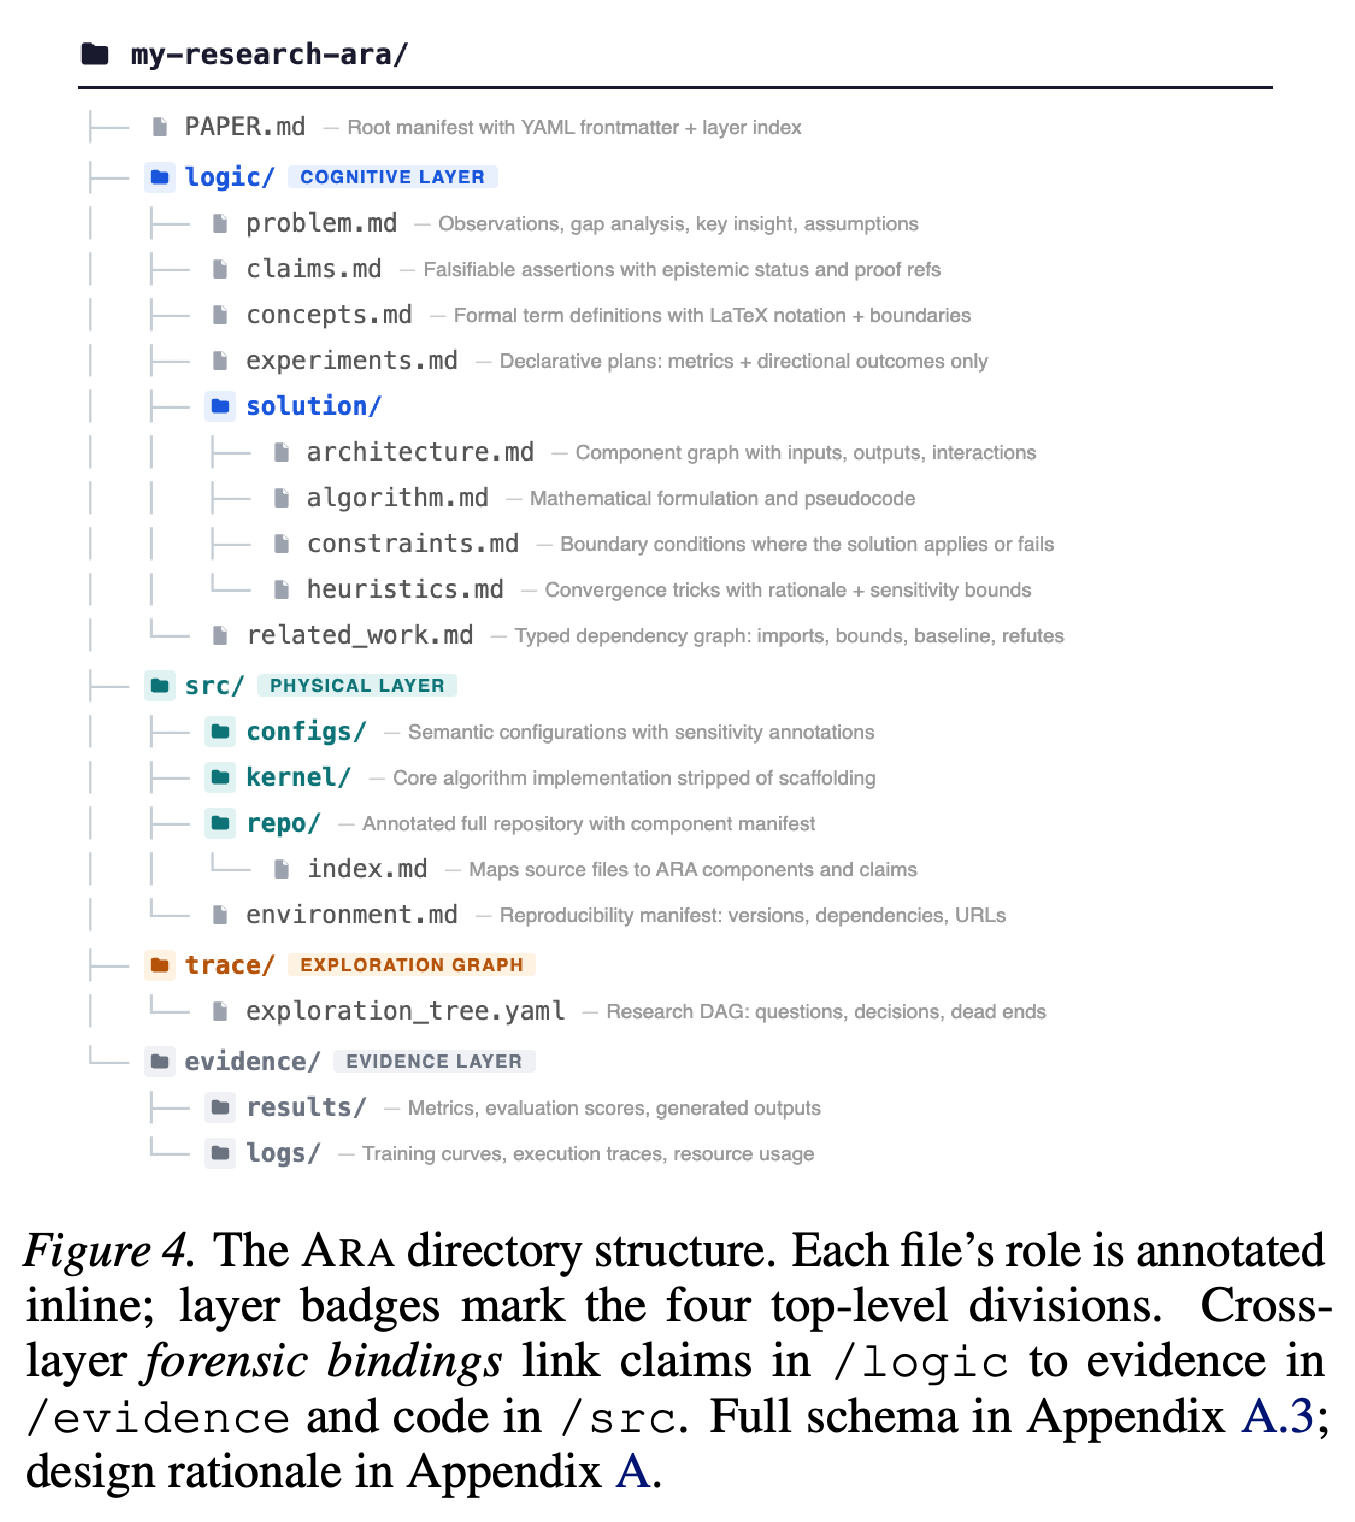
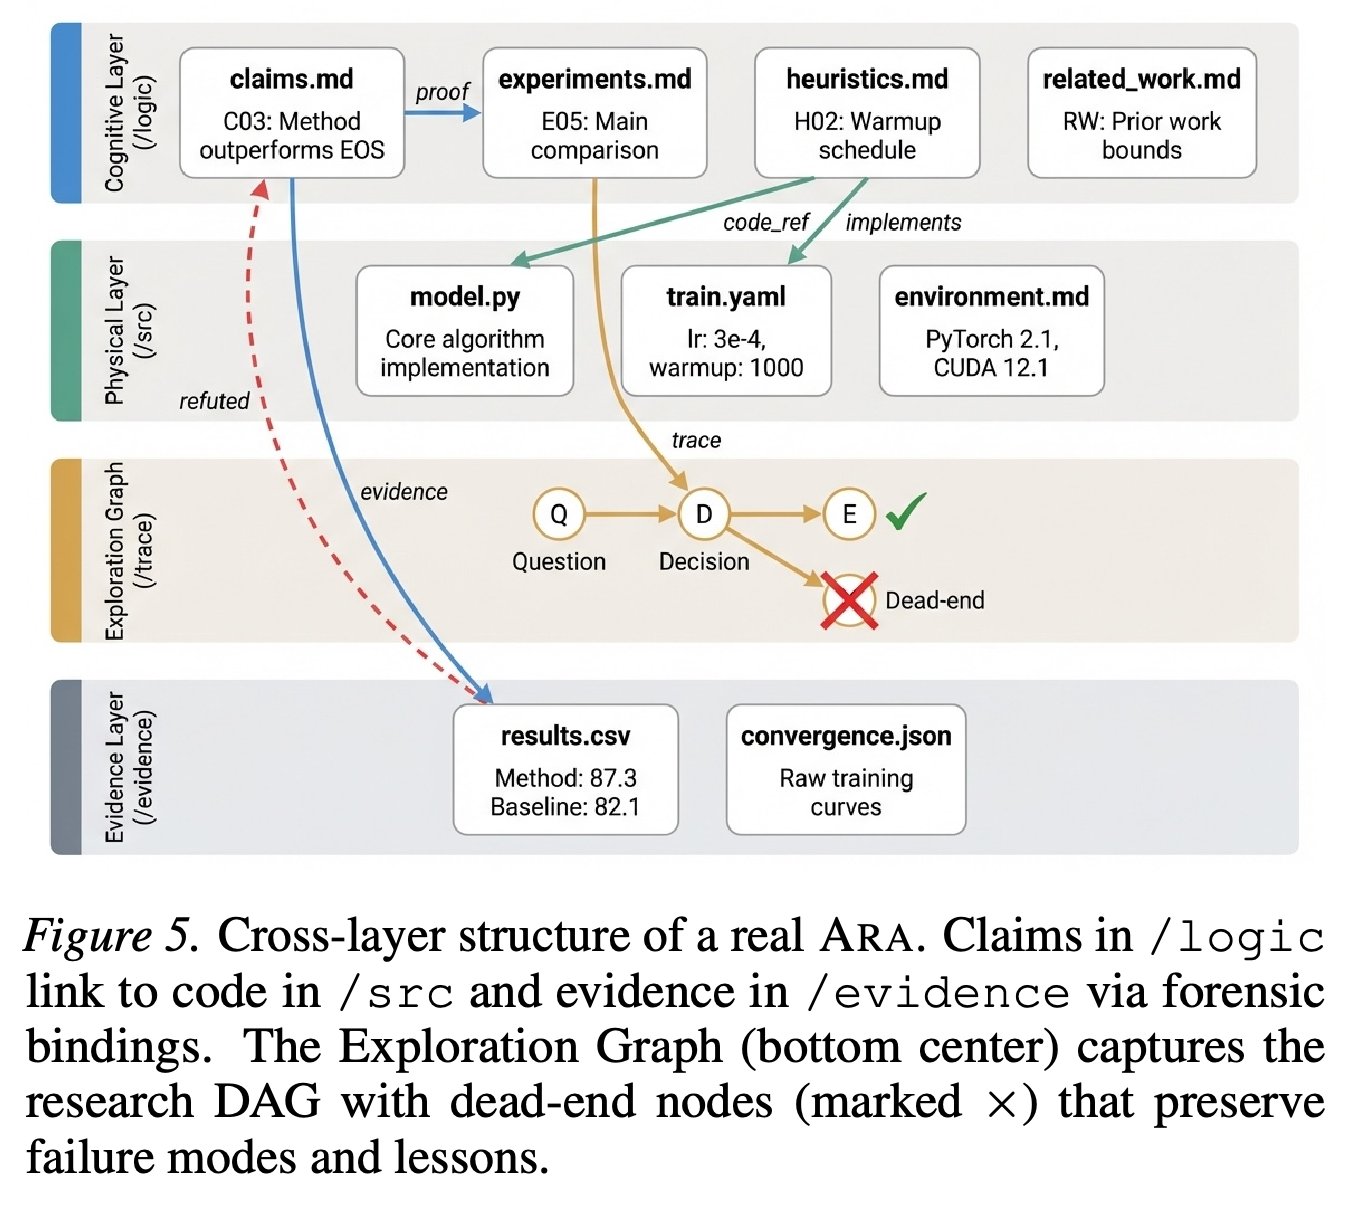
핵심 원칙은 Knowledge over Narrative다. 변화하는 연구 지식을 기본 대상으로 삼고, 산문은 그 지식에서 파생된 표현으로 본다. Figure 4는 독립적으로 조회할 수 있는 디렉터리를 정의한다. Figure 5는 에이전트가 주장부터 실험, 구현, 증거, 관련 실패까지 따라갈 수 있게 하는 계층 간 연결을 보여준다.
- 점진적 공개는 논문이나 저장소 전체를 반복해서 읽는 대신 과제와 관련된 파일만 불러와 컨텍스트 사용량을 줄인다.
- 프로토콜은 서사적 구성보다 정보 밀도가 높은 사실 진술과 출처 정보를 우선한다. 높은 충실도의 보존은 설계 요구사항이며, 컴파일된 모든 아티팩트에서 정보 손실이 없음을 입증한 보장은 아니다.
디렉터리 트리는 문제 정의, 주장, 실험 계획, 알고리즘, 설정, 구현, 탐색 이력, 출력에 서로 다른 검색 위치를 배정한다. 에이전트가 전체 아티팩트를 불러오지 않고 PAPER.md로 관련 파일을 선택할 수 있다는 점에서 점진적 공개를 구체화한다.
화살표는 과학적 주장을 실험, 구현, 휴리스틱, 원시 결과에 연결하며, 탐색 그래프는 기각된 분기를 보존한다. 핵심 메커니즘은 문서를 별도 폴더에 넣는 데 그치지 않고, 계층을 가로질러 근거를 추적할 수 있게 하는 것이다.
2.2. ARA Architecture
PAPER.md는 약 500토큰으로 관련성을 빠르게 판단할 수 있도록 YAML frontmatter와 계층 색인을 제공한다. 아키텍처는 실험 계획과 정확한 결과를 분리한다. 이를 통해 제안된 검증 절차에서는 에이전트가 재현을 시도하는 동안 증거를 공개하지 않을 수 있다.
- Cognitive Layer (/logic)는 problem.md, solution/, claims.md, experiments.md, related_work.md를 포함한다. 주장에는 반증 기준과 증명 포인터가 붙으며, 유형이 지정된 문헌 의존성은 imports, bounds, baselines를 나타낸다.
- Physical Layer (/src)는 알고리즘 기여를 분리할 수 있으면 kernel mode를, 엔지니어링 자체가 기여이면 repository mode를 사용한다. configs/는 파라미터와 선택 근거를 기록하며, environment.md는 의존성, 하드웨어, 시드를 기록한다.
- Exploration Graph (/trace)는 exploration_tree.yaml에 question, decision, experiment, dead_end, pivot 노드를 저장한다. also_depends_on은 여러 경로가 합류하는 의존성을 나타낸다. Evidence Layer (/evidence)는 정확한 결과, 로그, 진단 정보를 저장한다.
- 실험 논리, 결과, 기록된 수용·기각 결정을 분리하면 에이전트 학습 환경에도 활용할 수 있다. 아티팩트의 충분성은 충분한 능력을 갖춘 코딩 에이전트가 사람의 개입이나 외부 컨텍스트 없이 핵심 주장을 재현할 수 있는지를 기준으로 정의한다. 현재 에이전트에 대한 보장은 아니다.
3. The Live Research Manager
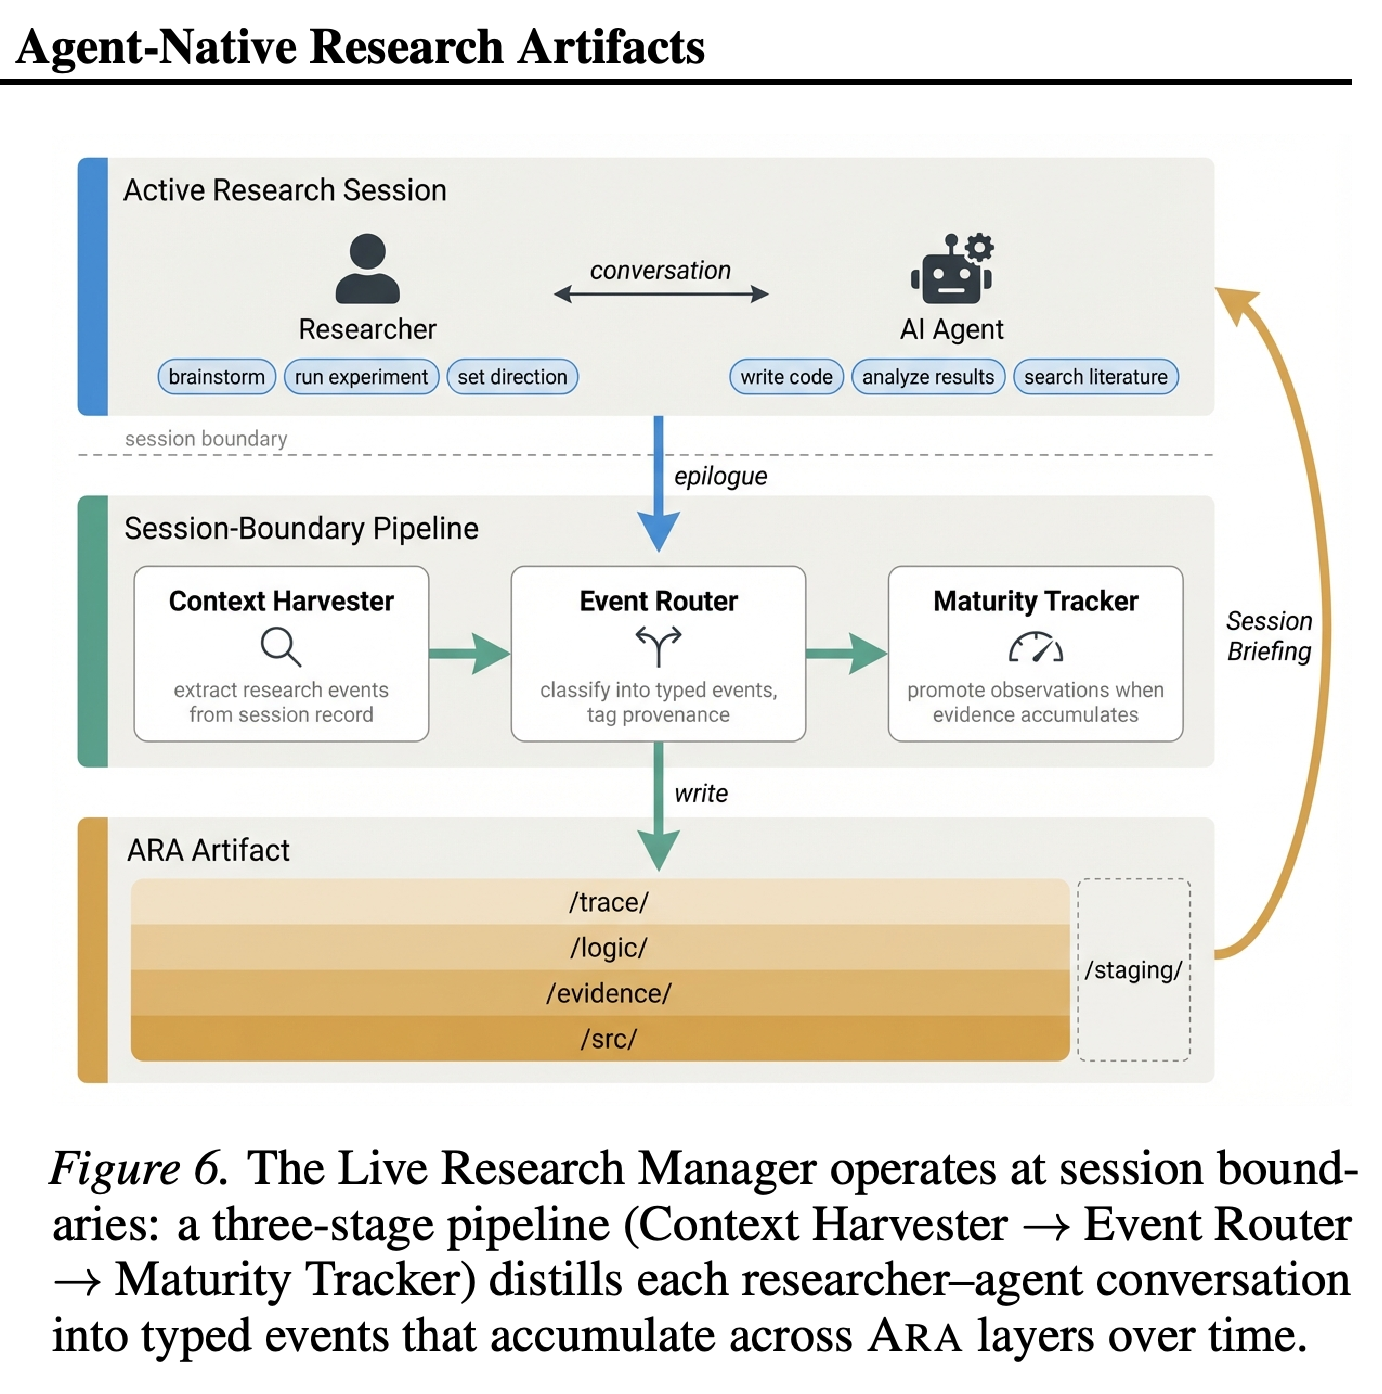
Live Research Manager는 구조화된 연구 기록을 수작업으로 작성하는 부담을 줄이려 한다. 연구자와 에이전트의 대화, 도구 출력, 실험 결과, 코드 변경을 지속적으로 갱신되는 ARA의 원자료로 취급한다. Figure 6은 작업 도중에 개입하는 대신 세션 경계에서 기록을 수집하는 방식을 보여준다.
3.1. Design Principles
Manager는 작업을 방해하지 않고 프레임워크에 종속되지 않는 통합, 지식의 출처를 충실하게 기록하는 것, 전체 탐색 과정을 수집하는 것이라는 3가지 원칙을 따른다. 자연어로 작성된 에이전트 스킬은 기존 파일·셸 도구를 사용하고, 연구 이벤트의 출처를 태그로 표시하며, 버전 관리로 수정 이력을 보존한다.
- 출처는 user, ai-suggested, ai-executed, user-revised 이벤트를 구분한다. ai-suggested 이벤트는 연구자의 확인 없이 자동으로 확정 기록으로 승격되지 않는다.
- 아직 결론이 나지 않은 관찰은 곧바로 주장이나 결정으로 정리하지 않고 /staging/에 넣는다. 문서화 부담이 무시할 만큼 작다는 주장은 관련 연구 활동이 이미 에이전트를 매개로 한 세션 안에서 이루어진다고 가정한다. 수집 오버헤드는 별도로 평가하지 않았다.
3.2. System Design
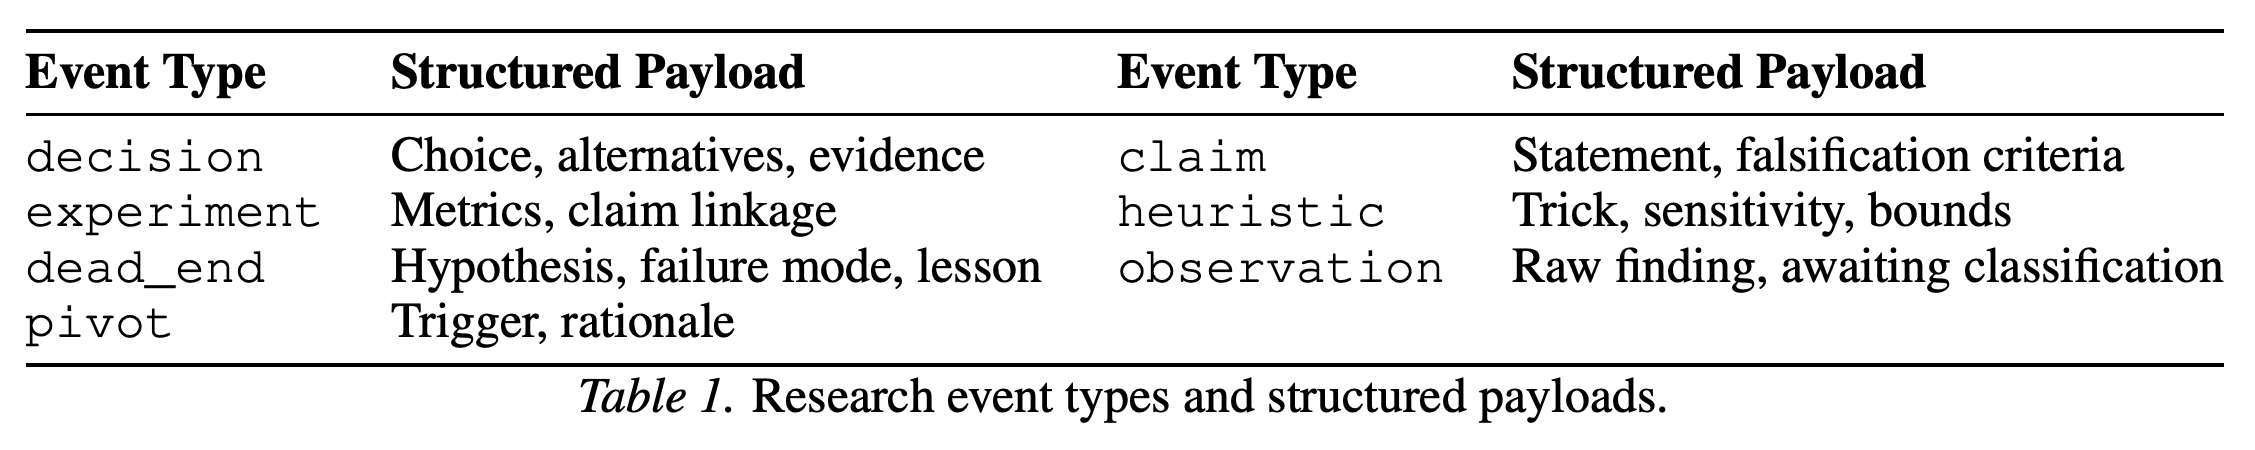
세션이 끝나면 Context Harvester가 연구에 중요한 활동을 추출하고, Event Router가 유형과 출처를 지정하며, Maturity Tracker가 결론이 난 관찰을 승격한다. Table 1은 이벤트 유형 7개와 각 유형의 구조화된 페이로드를 제시한다. trace 이벤트는 세션 경계마다 쌓이며, 주장과 명세는 주요 이정표에서 확정된다.
- 종결 신호에는 주제 중단, 명시적 확인, 실험을 통한 결론, 후속 아티팩트에 반영된 확정 사항이 포함된다. 모순은 이전 항목을 조용히 덮어쓰지 않고 그대로 보존한 뒤 표시한다.
- 아티팩트는 세션 기록, 세션 색인, 임시 관찰, trace/pm_reasoning_log.yaml을 통해 세션 간 기억을 유지한다. 개요에서는 구조화된 브리핑을 언급하지만, 상세한 연속성 유지 방식은 요청하지 않은 시작 브리핑을 요구하기보다 필요할 때 관련 컨텍스트를 제공한다.
- 구현은 https://github.com/AmberLJC/Agent-Native-Research-Artifact 에서 제공한다.
기록 수집은 연구자와 에이전트가 작업 중인 세션이 끝난 뒤 수집, 라우팅, 성숙도 추적을 통해 이루어진다. 영속 아티팩트에서 이후 세션으로 이어지는 피드백 경로는 Manager 자체가 상태를 유지하지 않아도 연구 기록으로 연속성을 제공할 수 있음을 보여준다.
이벤트 유형 7개는 탐색 과정 항목을 과학적 주장, 구현 휴리스틱, 미분류 관찰과 구분한다. 실패 경로에 가설, 실패 유형, 교훈을 요구하면 실패한 실행을 단순 보관 로그가 아니라 재사용할 수 있는 지식으로 바꿀 수 있다.
4. The ARA Compiler
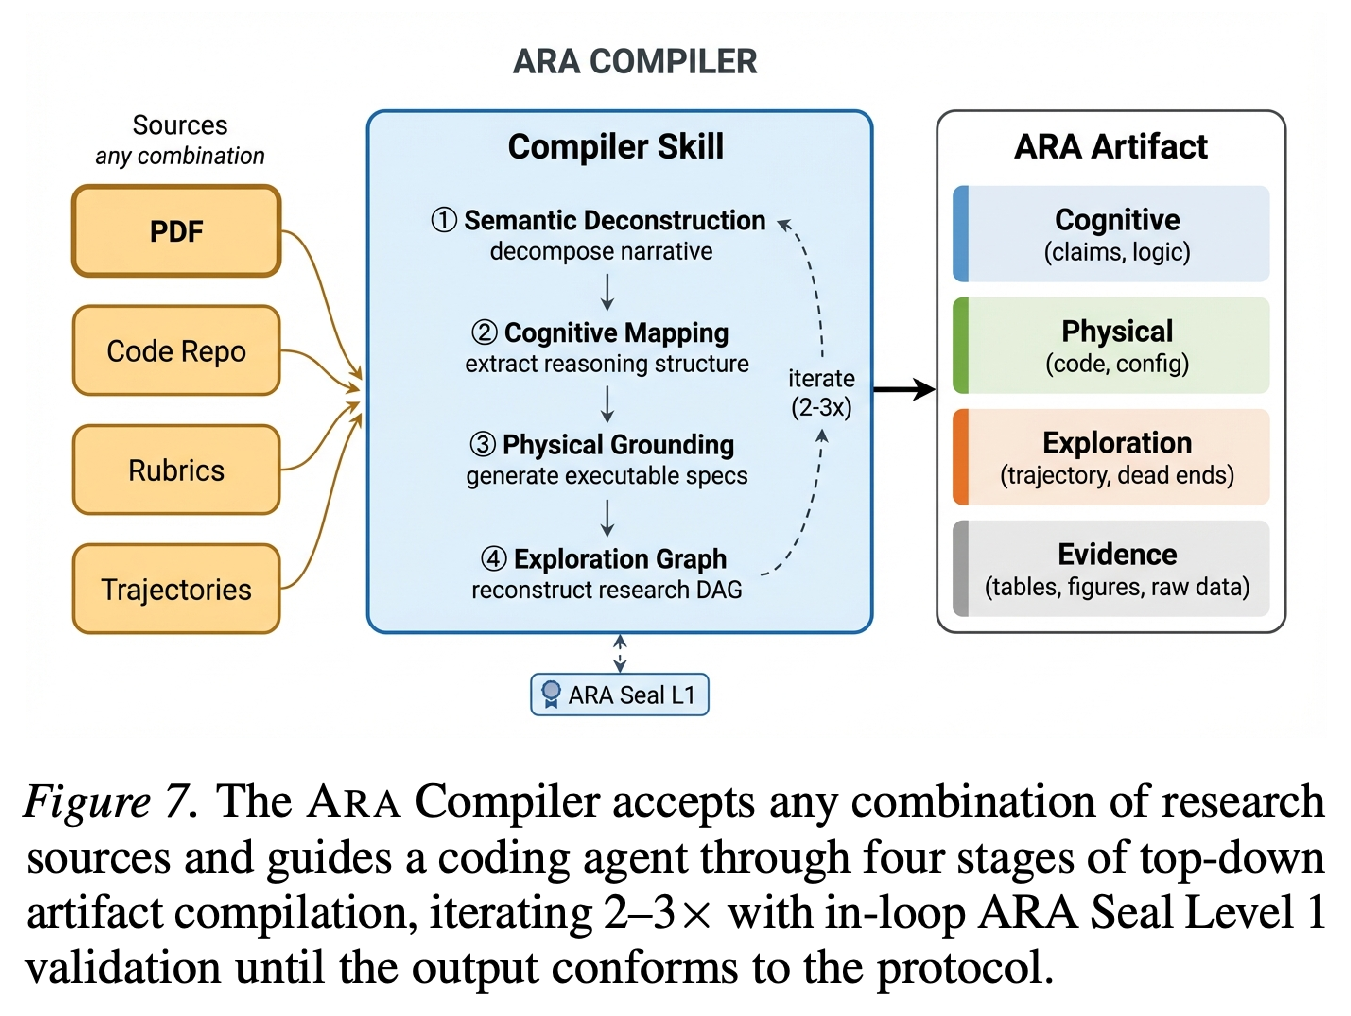
ARA Compiler는 연구 과정에서 기록되지 않은 기존 연구와의 호환성을 제공한다. PDF, 저장소, 데이터셋, 전문가 루브릭, 실험 과정을 입력받아 기준 아티팩트를 재구성한다. Figure 7은 컴파일 과정 안의 Level 1 검증과 이후의 Levels 2–3 검증을 구분한다.
4.1. Design Principles
Compiler의 원칙은 다양한 입력에서 기준 출력을 만드는 것, 높은 충실도로 정보를 보존하는 것, 단순 추출이 아니라 지식의 계보를 복원하는 것이다. PDF만 입력하면 코드 스텁을 포함한 구조적으로 유효한 아티팩트를 만들 수 있다. 저장소, 루브릭, 대화 기록은 논문에 없는 구현 지식과 과정 지식을 제공할 수 있다.
- 보존을 위해서는 원자료의 수치 결과, 설정, 아키텍처 세부 사항, 부정적 결과를 요약 과정에서 삭제하지 않아야 한다.
- 핵심 재구성 과제는 산문, 그림, 부록, 저장소 주석에 암묵적으로 흩어진 주장·실험·증거·코드의 연결을 복원하는 것이다. 구조를 준수한다고 해서 복원된 연결이 과학적으로 옳다는 뜻은 아니다.
4.2. Compiler Implementation
컴파일은 Semantic Deconstruction, Cognitive Mapping, Physical Grounding, Exploration Graph Extraction을 거친다. Level 1 진단은 generate→validate→fix 반복을 이끌며, 일반적으로 2–3회가 필요하다고 설명한다. 보조 자료는 각 자료가 뒷받침하는 계층으로 배정한다.
- Physical Grounding은 스텁을 사용 가능한 구현으로 대체하고 코드와 논문의 주장을 대조한다. 암묵적인 구현 지식은 출처 태그가 붙은 휴리스틱으로 기록한다.
- 이전 ARA를 사용할 수 있으면 collective inference가 현재 논문에 없는 도메인의 공통 휴리스틱을 제안할 수 있다. 추론한 후보와 원자료에 명시된 사실을 구분하도록 collective_inference 태그를 붙인다. 보고된 평가는 이 메커니즘의 효과를 분리하지 않는다.
여러 유형의 원자료가 하향식 컴파일 단계 4개로 들어가며, Level 1 검증이 수정 피드백을 제공한다. 원자료를 통한 정보 보강은 방법의 일부다. 컴파일 중 구조 준수 검사는 이후의 논증 검증 및 실증 검증과 분리된다.
5. ARA Verification and Review
ARA 기반 검증은 결정론적 구조 검사, 과학적 근거에 대한 루브릭 기반 평가, 전문가 판단을 분리한다. ARA Seal은 자동 검사를 위한 인증으로 제안된다. 심사 절차는 Seal의 보고서를 활용하며, 연구 가치에 대한 사람의 평가를 대체하지 않는다.
5.1. Design Principles
심사 시스템은 기계적으로 수행할 수 있는 검증을 자동화하고, 재현성을 제출의 기본 요건으로 삼으려 한다. 구조 검사에 실패하면 다음 단계로 진행할 수 없다. 비용이 큰 실행 전에 논증을 검토하며, 사람 심사자는 감사 기록을 받아 중요성, 독창성, 논쟁이 있는 결과를 평가한다.
5.2. The ARA Seal: Machine-Verifiable Research Credentials
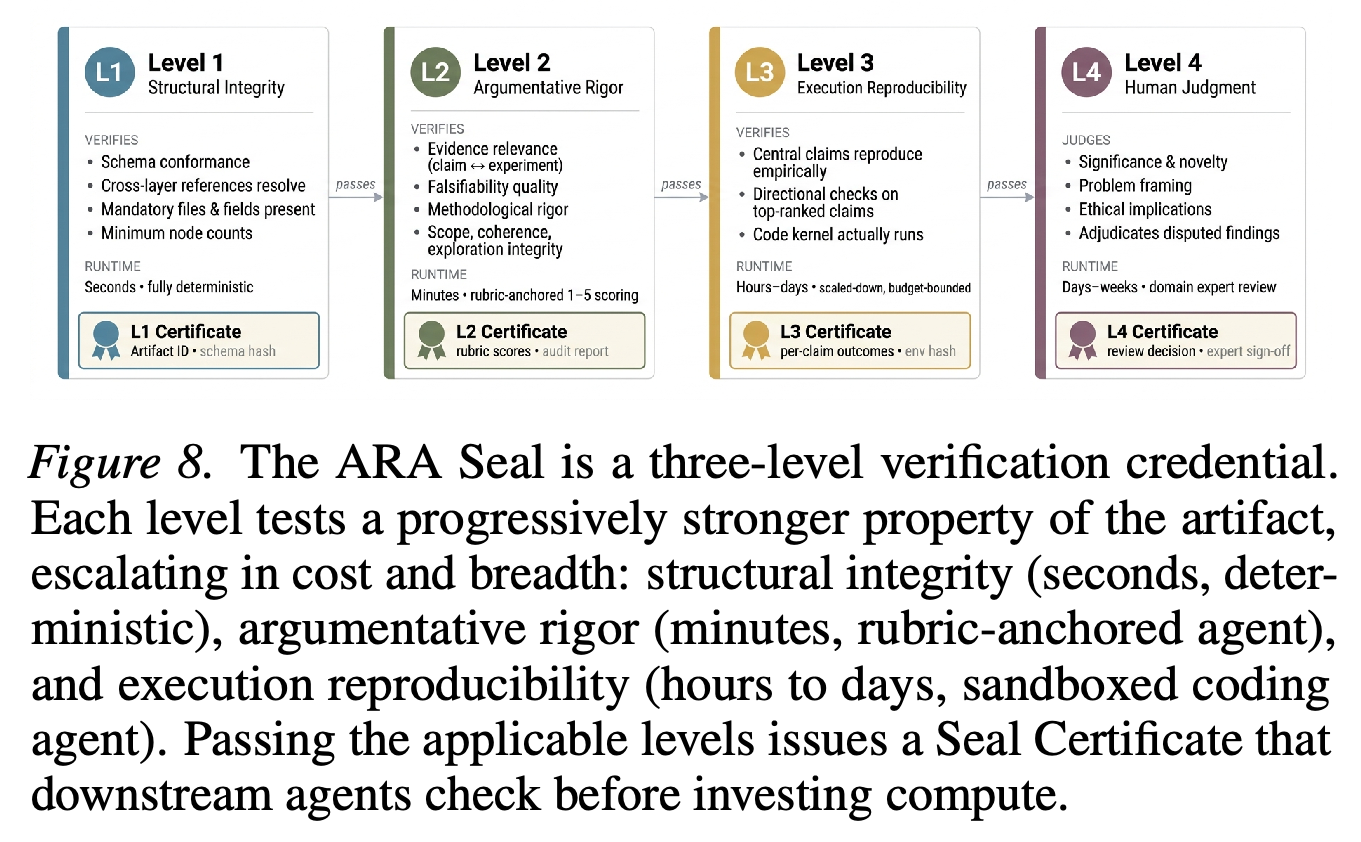
본문은 자동화된 ARA Seal 수준을 Structural Integrity, Argumentative Rigor, Execution Reproducibility의 3개로 정의한다. Figure 8에는 Level 4로 표시된 Human Judgment 카드도 있다. 그러나 주변의 프로토콜 설명에서는 사람의 판단을 4번째 자동 Seal 수준이 아니라 심사의 Stage 3에 배정한다.
- Level 1은 디렉터리, 필수 필드, 스키마, 최소 개수, 참조의 유효성을 결정론적으로 검사한다.
- Level 2는 코드 실행이나 외부 자문 없이 Rigor Auditor를 사용한다. 기준점이 명시된 1–5 루브릭으로 증거 관련성, 반증 가능성의 품질, 주장 범위의 적절성, 논증의 일관성, 탐색의 무결성, 방법론의 엄밀성을 평가한다. 증거 구간과 함께 심각도순으로 지적 사항을 출력한다. 루브릭에 기준점을 명시해도 판단이 결정론적으로 바뀌지는 않는다.
- Level 3은 핵심 주장을 우선하고, 정확한 전체 규모 재현 대신 예산 내에서 축소된 규모로 결과 방향을 확인한다. 제안된 프로토콜은 /evidence/를 공개하지 않으며, 비용상 확인할 수 없는 주장은 미검증으로 표시한다. 선택적으로 전체 규모 재현을 수행하면 이후 인증서를 갱신할 수 있다.
- Seal Certificate는 아티팩트 ID, 달성 수준, 타임스탬프, 환경 해시, 주장별 결과를 담은 서명된 기록으로 정의한다. 운영 환경의 샌드박싱과 세분화된 접근 통제는 아직 구현되지 않았다.
카드는 저비용 구조 검사, 루브릭 기반 논증 평가, 고비용 실행 검사, 사람의 판단을 구분한다. 그림은 Human Judgment를 Level 4로 표시하지만, 본문은 자동 Seal 수준을 3개로 정의한다. 그림의 샌드박스 실행도 현재 시스템에 구현된 기능이 아니라 제안된 속성이다.
5.3. Three-Stage Review Pipeline
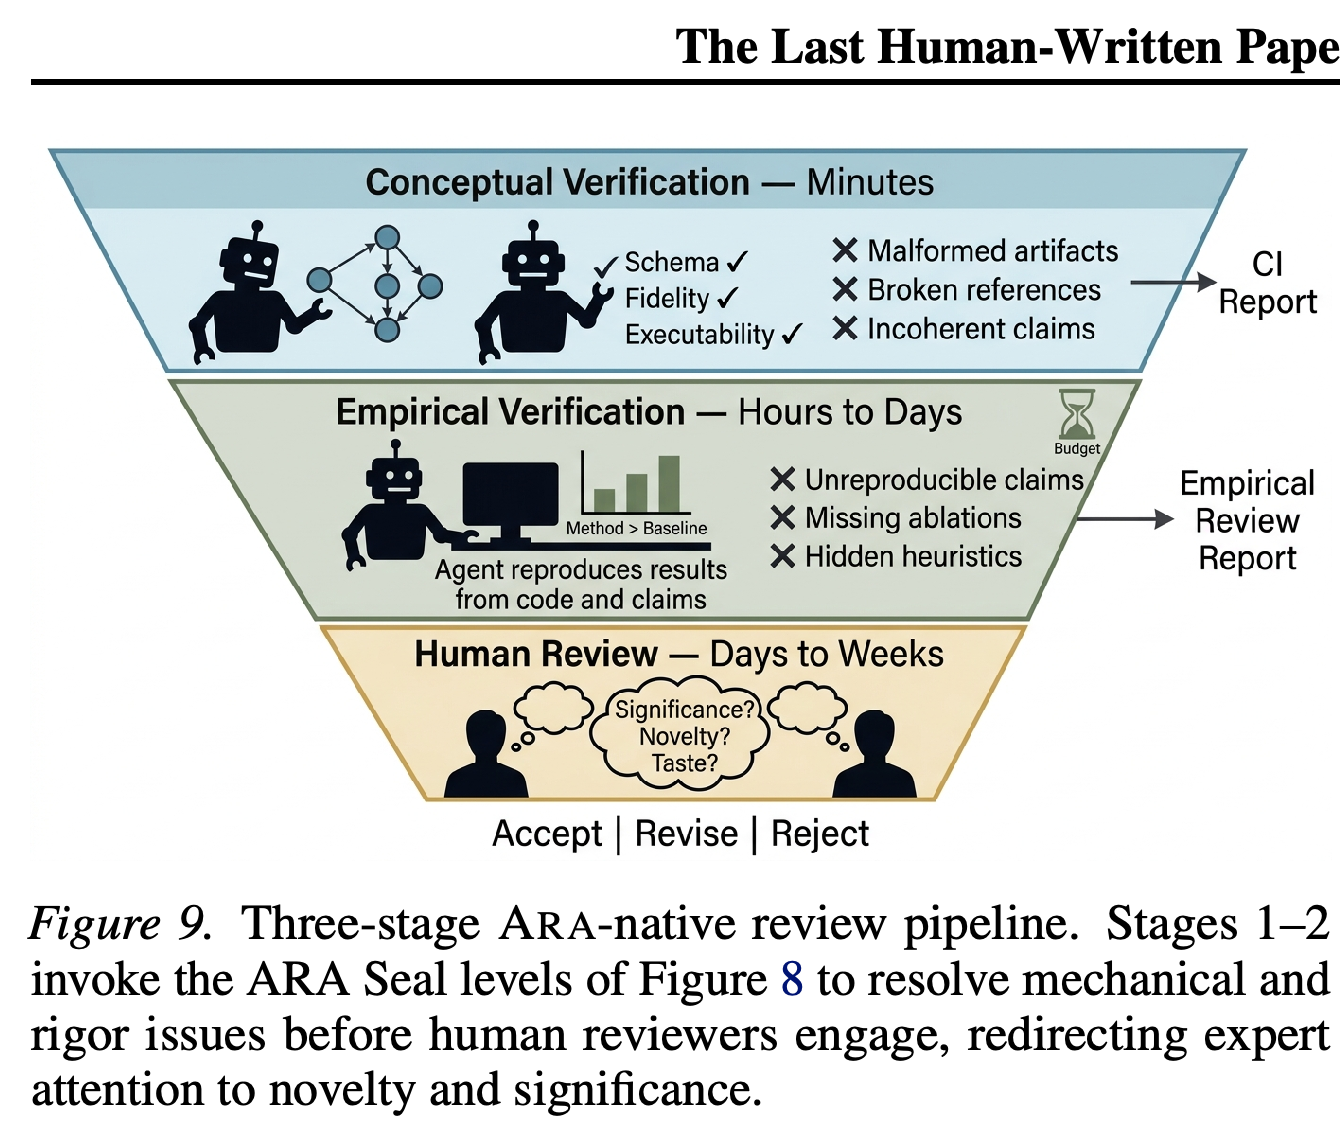
Figure 9는 심사를 Conceptual Verification(분 단위), Empirical Verification(시간–일 단위), Human Review(일–주 단위)로 구성한다. Stage 1은 구조 검사와 엄밀성 보고서를 결합한다. Stage 2는 학술 행사나 저널의 계산 예산 안에서 우선순위가 높은 주장의 결과 방향을 재현하려 한다. Stage 3은 기여의 품질을 평가하고 이견을 조정한다.
- 권고용 진단에는 실패 경로 문서화의 누락, 불완전한 베이스라인, 실험과 주장 사이의 연결 누락이 포함된다. 이러한 진단은 다음 단계 진행 여부를 결정하는 Seal 검사와 구분된다.
- 실증 검증에서는 ablation, 주장된 일반성, 문서화되지 않은 코드 휴리스틱도 살펴본다. 사람의 지적 사항은 특정 ARA 구성요소에 연결되지만, 논문은 심사 시간 절감 효과를 실험으로 측정하지 않는다.
이 절차는 전문가 심사 전에 개념 검증과 실증 검증을 배치하고, 기계가 생성한 보고서를 제출물에 첨부한다. 의도한 역할 분담을 보여주지만, 이 절차가 심사자의 업무량을 줄이거나 사람의 채택 결정을 개선하는지는 검증하지 않는다.
6. The (Human+AI)² Research Network
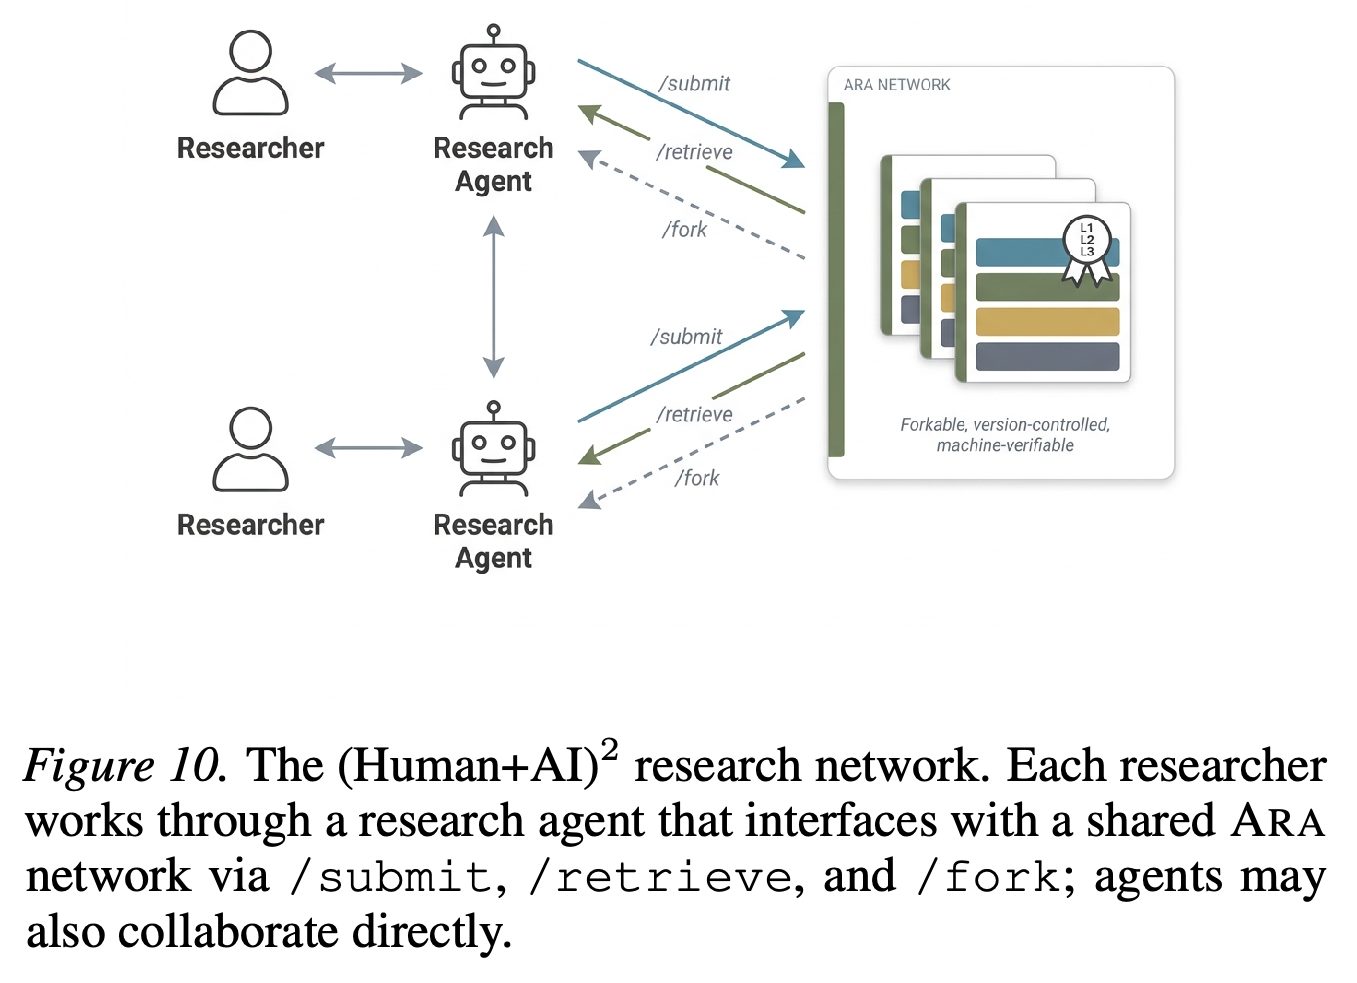
(Human+AI)² Research Network는 기준 아티팩트를 중심으로 기록 수집, 컴파일, 검증, 교환을 결합한다. Figure 10은 연구자의 지시를 받는 에이전트가 /submit, /retrieve, /fork를 사용하는 모습을 보여준다. 후속 연구팀은 부모 아티팩트의 출처를 유지하고, 구조화된 변경 사항을 심사에 제출하게 된다.
- 아티팩트를 사용하는 에이전트는 독자의 필요에 따라 아티팩트를 논문, 슬라이드, 영상, 시연, 근거에 기반한 대화로 표현할 수 있다.
- Git 방식의 출판, 실행 가능한 기여 diff, 공유 과학 지식 공간은 생태계에 대한 제안이다. 벤치마크 실험으로 입증된 결과는 아니다.
연구자는 공유 아티팩트를 제출하고 검색하며 fork하는 에이전트를 통해 소통한다. 에이전트끼리도 직접 조율할 수 있다. 이 도식은 아티팩트 프로토콜을 네트워크 제안으로 확장한 것이며, 실험으로 평가한 다중 연구팀 시스템을 제시하는 것은 아니다.
7. Evaluation
평가는 지식 추출, 재현, 개방형 확장을 검증한 뒤 자동 심사 체계를 평가한다. 각 비교에서는 에이전트와 과제를 동일하게 유지한다. 다만 ARA 조건은 구조화된 정보 구성에 더해, 기존 출판 자료 묶음에는 대체로 없는 추가 원자료를 포함한다.
7.1. Datasets and Motivation
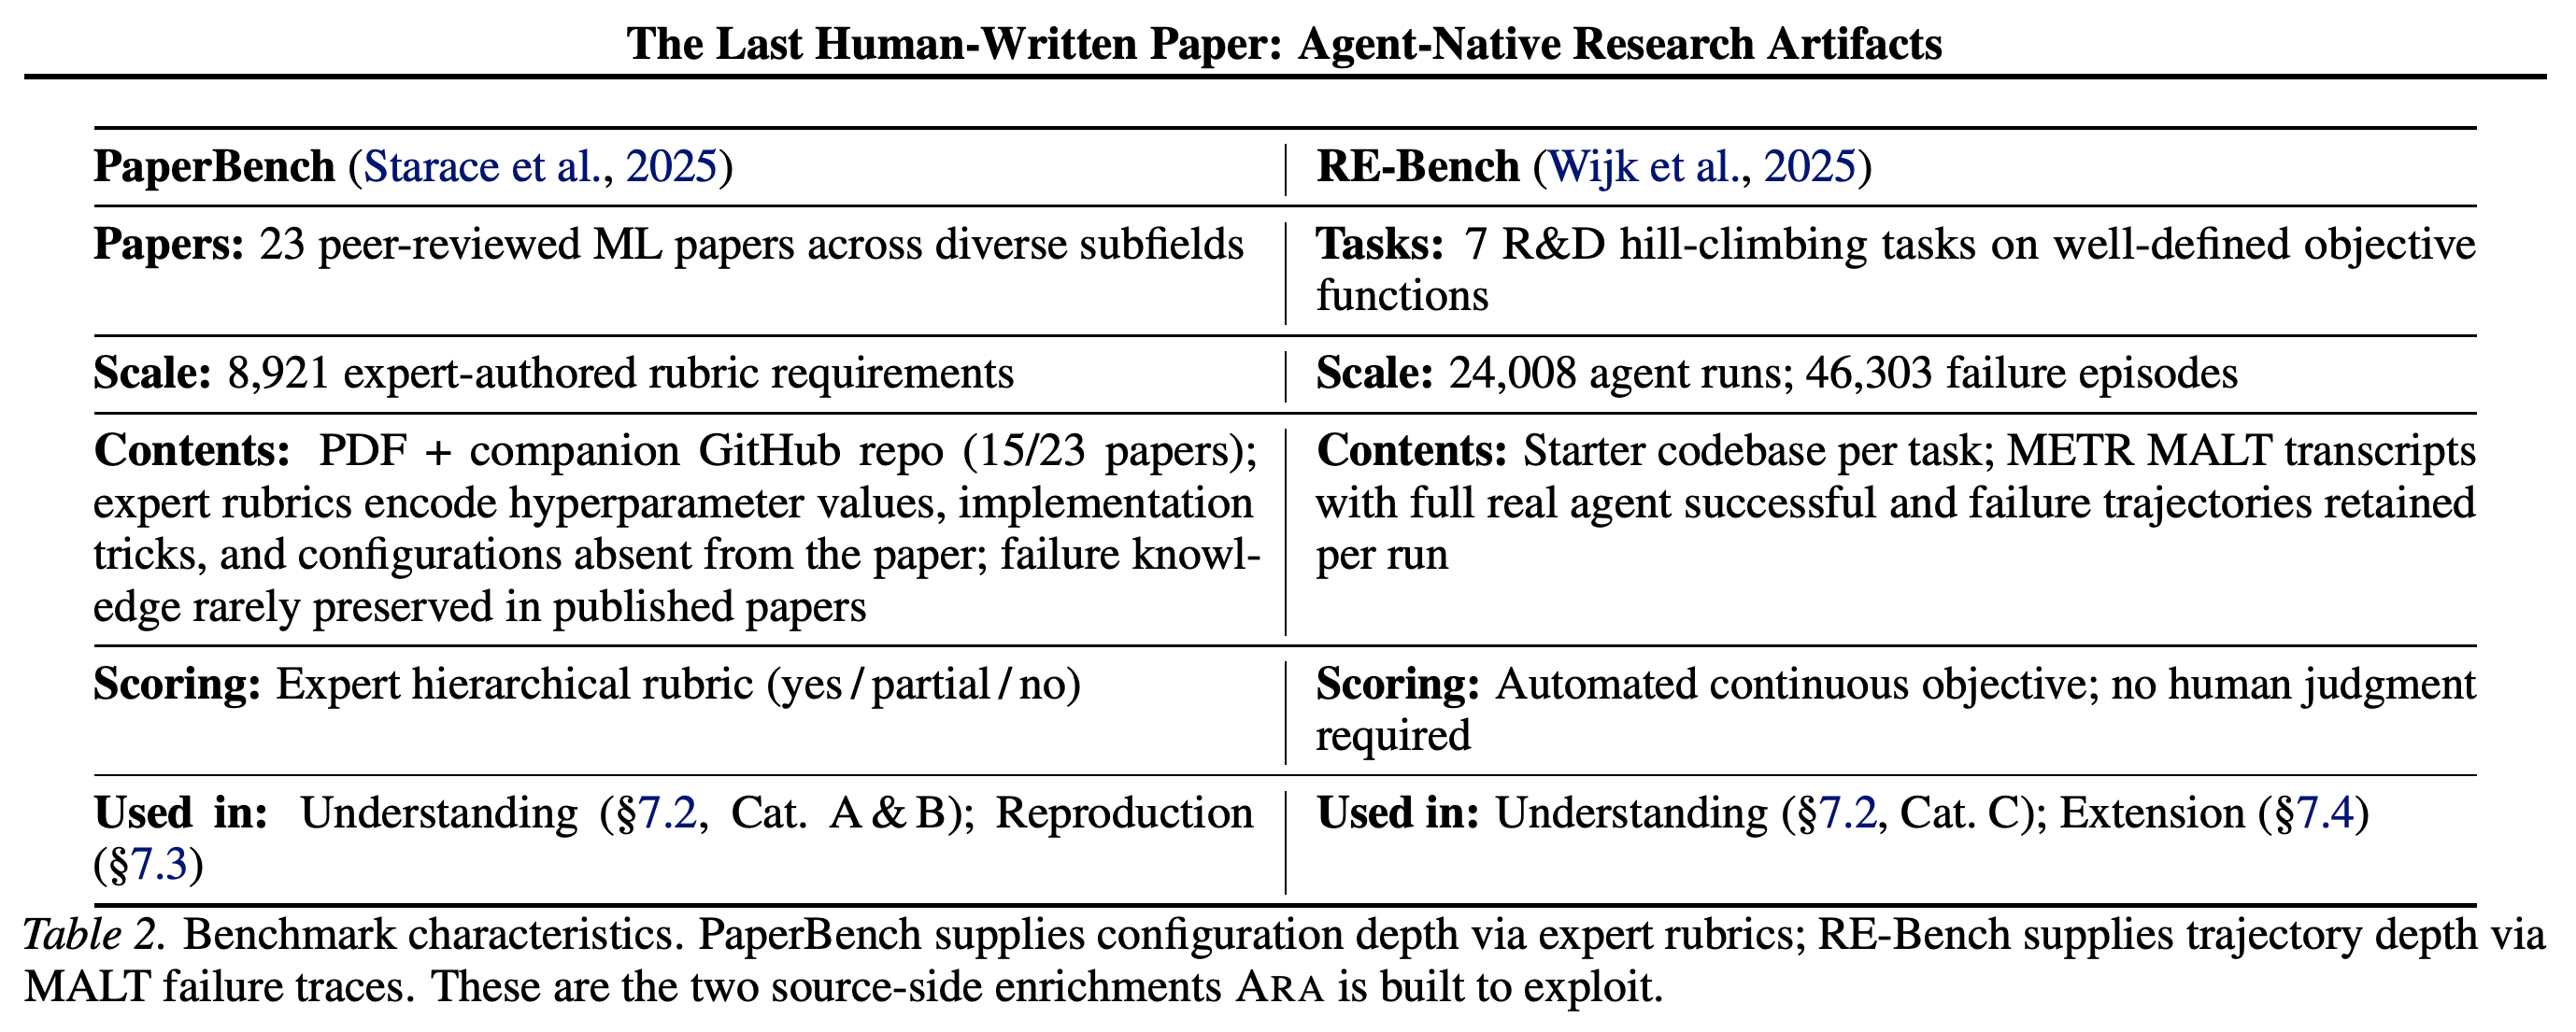
Table 2는 상호 보완적인 벤치마크를 구분한다. PaperBench는 논문 23편과 전문가 재현 요구사항 8,921개를 제공하며, RE-Bench는 R&D 과제 7개와 에이전트의 탐색 기록을 제공한다. 이해 평가는 대상 30개 전체를 다룬다. 재현에는 저장소가 있는 논문 15편을, 확장에는 활용 가능한 실패 기록이 있는 과제 5개를 사용한다.
- PaperBench 베이스라인은 PDF와, 사용 가능하면 해당 저장소를 받는다. ARA 컴파일에는 전문가 루브릭도 사용한다. 따라서 설정 복원 성능의 향상은 중앙화된 정보 구성과 전문가가 제공한 정보 모두에서 비롯될 수 있다.
- RE-Bench 과제에는 원래 연구 논문이 없으므로, 베이스라인은 합성한 정돈된 연구 설명과 공식 소스를 사용한다. ARA는 추가적인 MALT 탐색 지식을 보존한다. 따라서 이는 정보량을 맞춘 대안과의 비교가 아니라, 의도적으로 성공에 초점을 맞춘 기존 방식의 표현과의 비교다.
- 실증 평가의 범위는 계산 기반 ML이다. 디지털화된 다른 연구에 적용할 수 있다는 제안은 검증하지 않았다. 물리적 개입이나 실행 가능한 코드가 없는 이론적 기여도 입증된 범위 밖에 있다.
PaperBench는 전문가 루브릭을 통해 설정 지식을 제공하고, RE-Bench는 에이전트 대화 기록을 통해 탐색 지식을 제공한다. 이러한 추가 원자료 때문에 평가는 정보량을 엄격히 맞춘 형식 변경이 아니라 정보가 보강된 ARA를 측정한다.
7.2. Knowledge Extraction from ARA
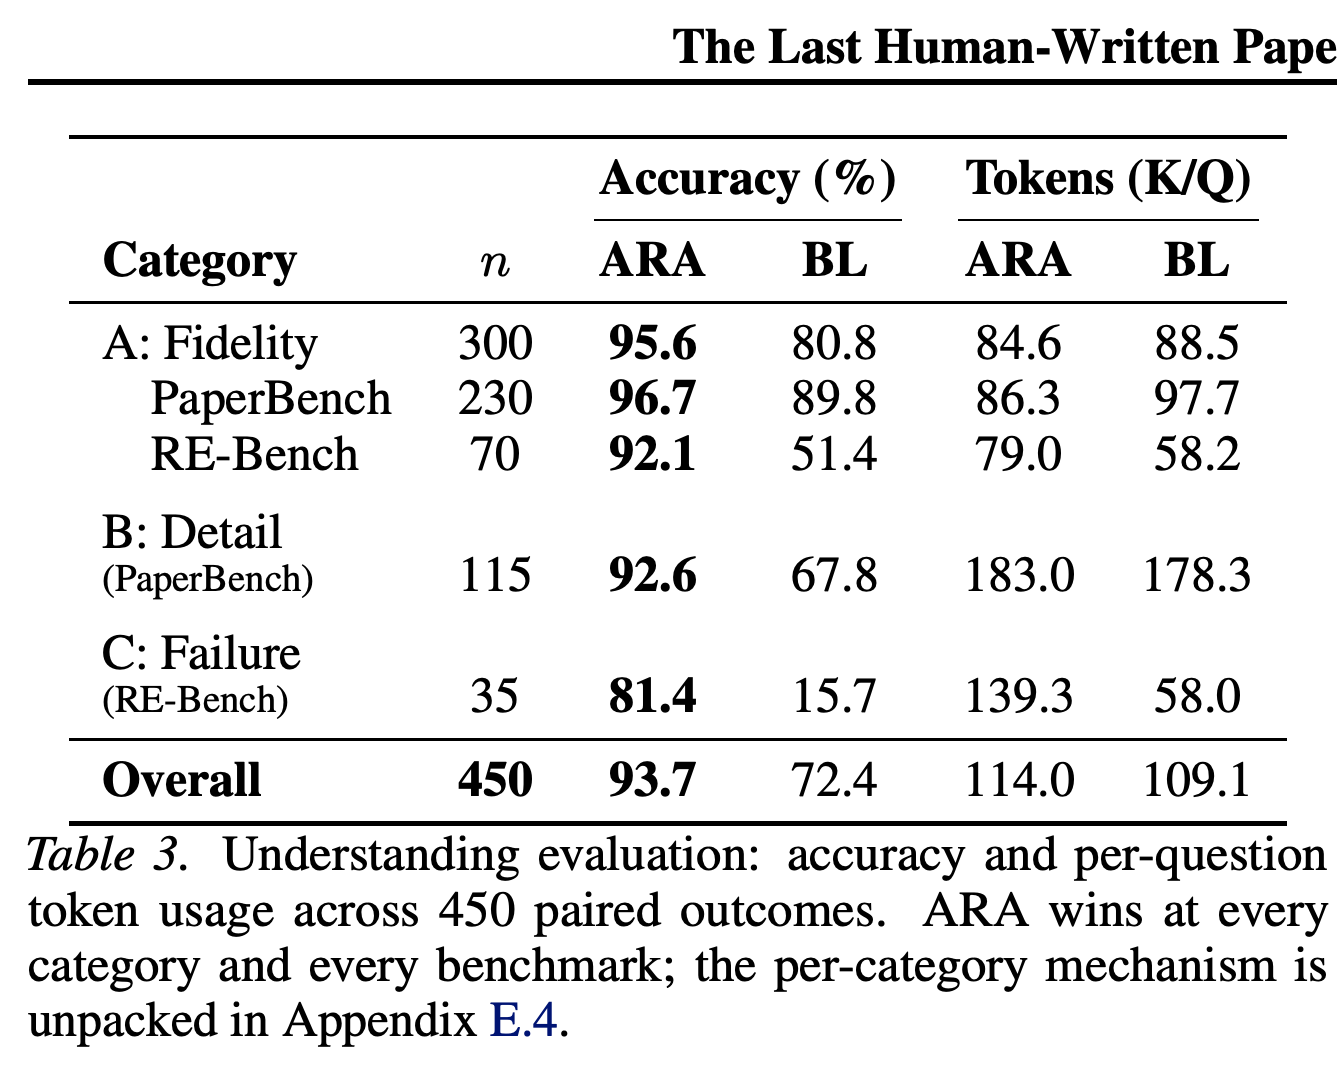
지식 추출에는 질문 450개를 사용한다. Category A의 충실도 질문은 300개, Category B의 설정·세부 사항 질문은 115개, Category C의 실패 지식 질문은 35개다. 각 질문은 독립적인 Claude Sonnet 4.6 컨텍스트에서 답하며, Claude Opus 4.6 평가자가 정답 기준과 비교해 1.0, 0.5, 0.0을 부여한다. 2개 표현 방식에서 각각 생성한 질문 풀은 합친 뒤 중복을 제거한다.
- Table 3은 전체 정확도를 93.7% 대 72.4%, 질문당 토큰 사용량을 114.0K 대 109.1K로 보고한다. Category A는 95.6% 대 80.8%, Category B는 92.6% 대 67.8%, Category C는 81.4% 대 15.7%를 달성한다.
- 제안된 메커니즘은 유형마다 다르다. 색인 조회는 충실한 정보 검색을 돕고, 중앙화된 설정은 세부 사항 복원을 돕는다. 보존된 대화 기록은 베이스라인에 없는 실패 지식을 제공한다. 이러한 설명은 결과와 부합하지만 ablation으로 분리해 검증하지 않았다.
- 보고된 12% 토큰 절감은 PaperBench Category A(86.3K 대 97.7K)에 적용되며, Category A 전체 집계(84.6K 대 88.5K)에 적용되지 않는다. Appendix E는 전체 결과에 대해 McNemar χ² = 95.15와 p < 10⁻¹⁰을 보고하지만, 난이도별 질문 수는 명시된 총수와 맞지 않는다.
가장 큰 정확도 격차는 실패 지식에서 나타나며, 결과는 81.4% 대 15.7%다. 이 범주에서는 베이스라인에 관련 탐색 원자료가 없다. ARA의 전체 토큰 사용량은 약간 더 높으며, 검색 시 토큰 절감은 모든 범주에 고르게 나타나기보다 충실도 질문에 집중된다.
7.3. Reproduction from ARA
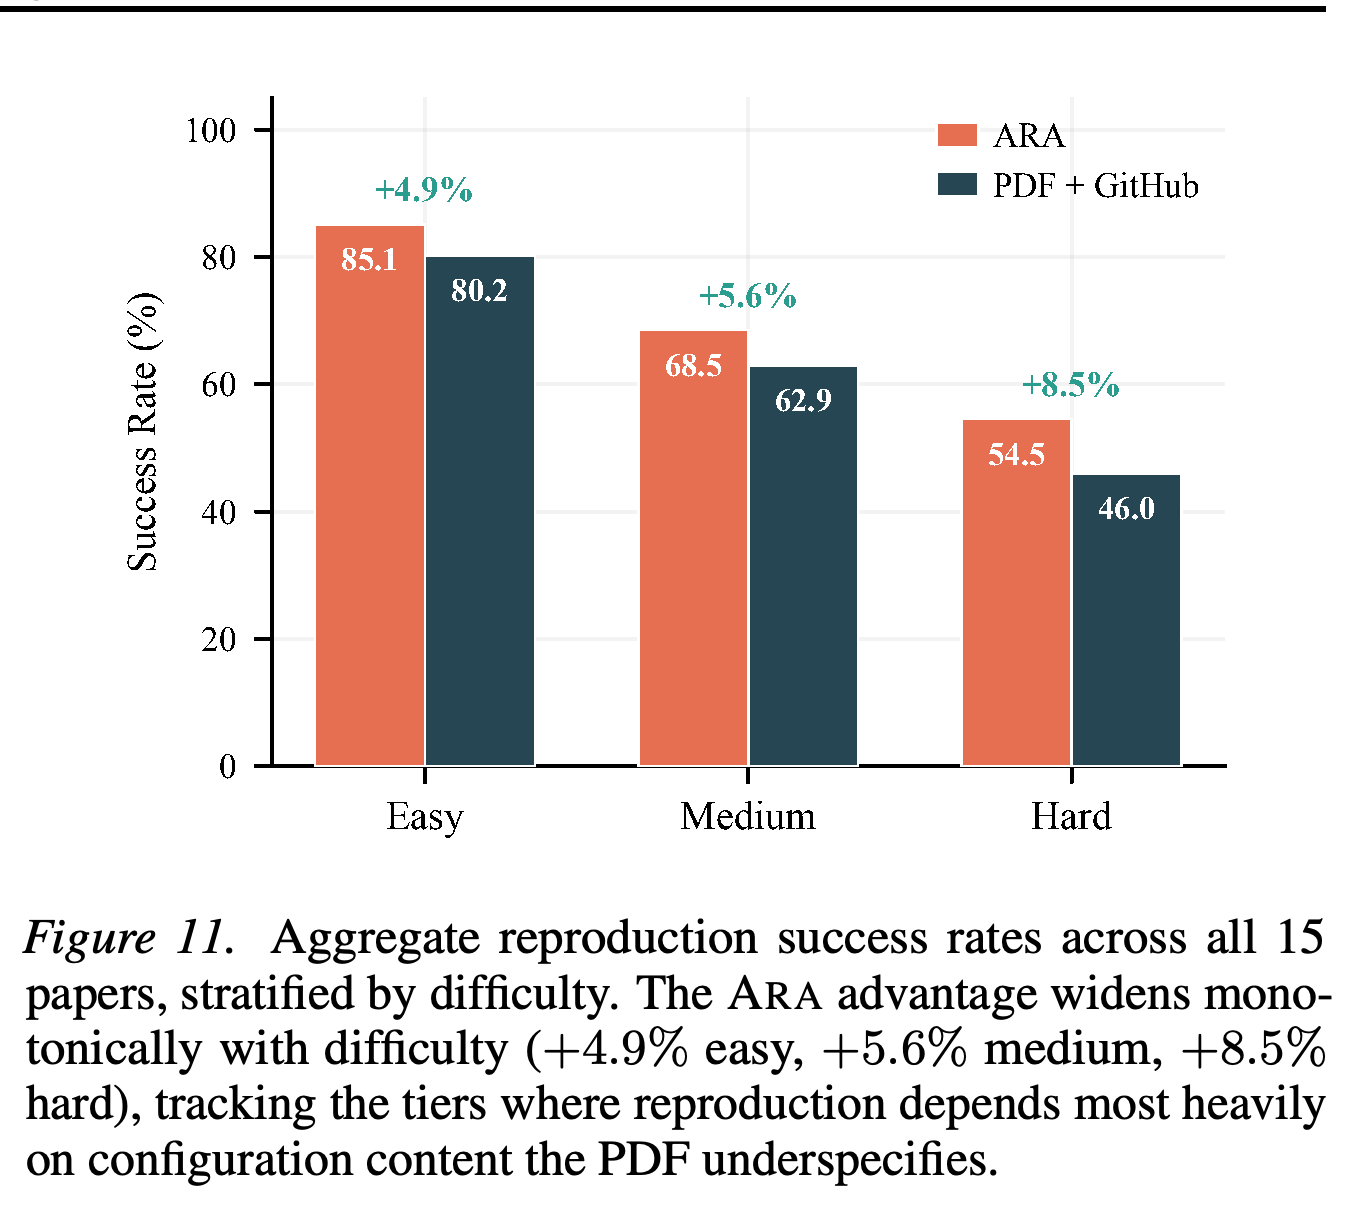
재현 평가는 논문 15편에 걸쳐 하위 과제 150개와 루브릭 요구사항 1,743개로 구성된다. 쉬운 과제는 50개, 중간 난이도는 49개, 어려운 과제는 51개다. 두 조건 모두 Claude Sonnet 4.6과 동일한 과제 프롬프트를 사용하며, 논문별 예산은 14–20M 토큰이고 캐시 읽기는 10%로 할인해 계산한다. 조건을 모르는 Claude Opus 4.6 평가자가 요구사항을 yes, partial, no로 채점한다.
- 주요 지표는 쉬움, 중간, 어려움에 1:2:3 가중치를 부여한다. 논문은 난이도 가중 성공률을 ARA 64.4%, PDF + GitHub 57.4%로 보고한다. Wilcoxon p = 0.028이며, 논문 단위 승/무/패 요약은 8/5/2다. Appendix F가 이 요약과 Table 11을 완전히 일치시키지 못하므로, 이를 논문이 보고한 결과로 취급해야 한다.
- Figure 11은 쉬운 과제에서 85.1% 대 80.2%, 중간 난이도에서 68.5% 대 62.9%, 어려운 과제에서 54.5% 대 46.0%를 보고한다. 격차가 커지는 양상은 실행 명세가 더 까다로운 실행에 도움을 준다는 설명과 부합한다. 다만 어려운 과제의 요구사항 중 상당수는 여전히 충족되지 않는다.
- fre 사례는 실행상의 이점이 있을 수 있음을 보여준다. ARA 에이전트는 JAX 코드를 PyTorch로 다시 구현하고, GPU 메모리를 30.8 GB 대신 1.8 GB 사용했으며, 도메인 3개에서 모델 17개를 학습했다. 베이스라인은 학습 시도 3개를 완료했다.
- 프롬프트에서는 기대 수치를 가리지만, 명시된 ARA 입력에는 evidence/가 포함된다. 이는 Seal이 제안하는 증거의 완전한 비공개보다 약한 조건이다. 결과 조작은 ARA 실행 1개와 베이스라인 실행 2개에서 발생했으므로, 어느 조건도 이를 확실히 방지하지 못한다.
보고된 ARA의 우위는 쉬운 과제의 4.9%포인트에서 중간 난이도의 5.6을 거쳐 어려운 과제에 해당하는 값인 ‘8.5 on hard tasks’로 커진다. 이는 상세한 설정에 의존하는 실행에서 이점이 더 크다는 설명과 부합한다. 다만 어려운 과제의 요구사항 중 상당수는 충족되지 않으며, 부록은 집계 결과와 논문별 표가 어떻게 일치하는지 명확히 설명하지 않는다.
7.4. Extension from ARA
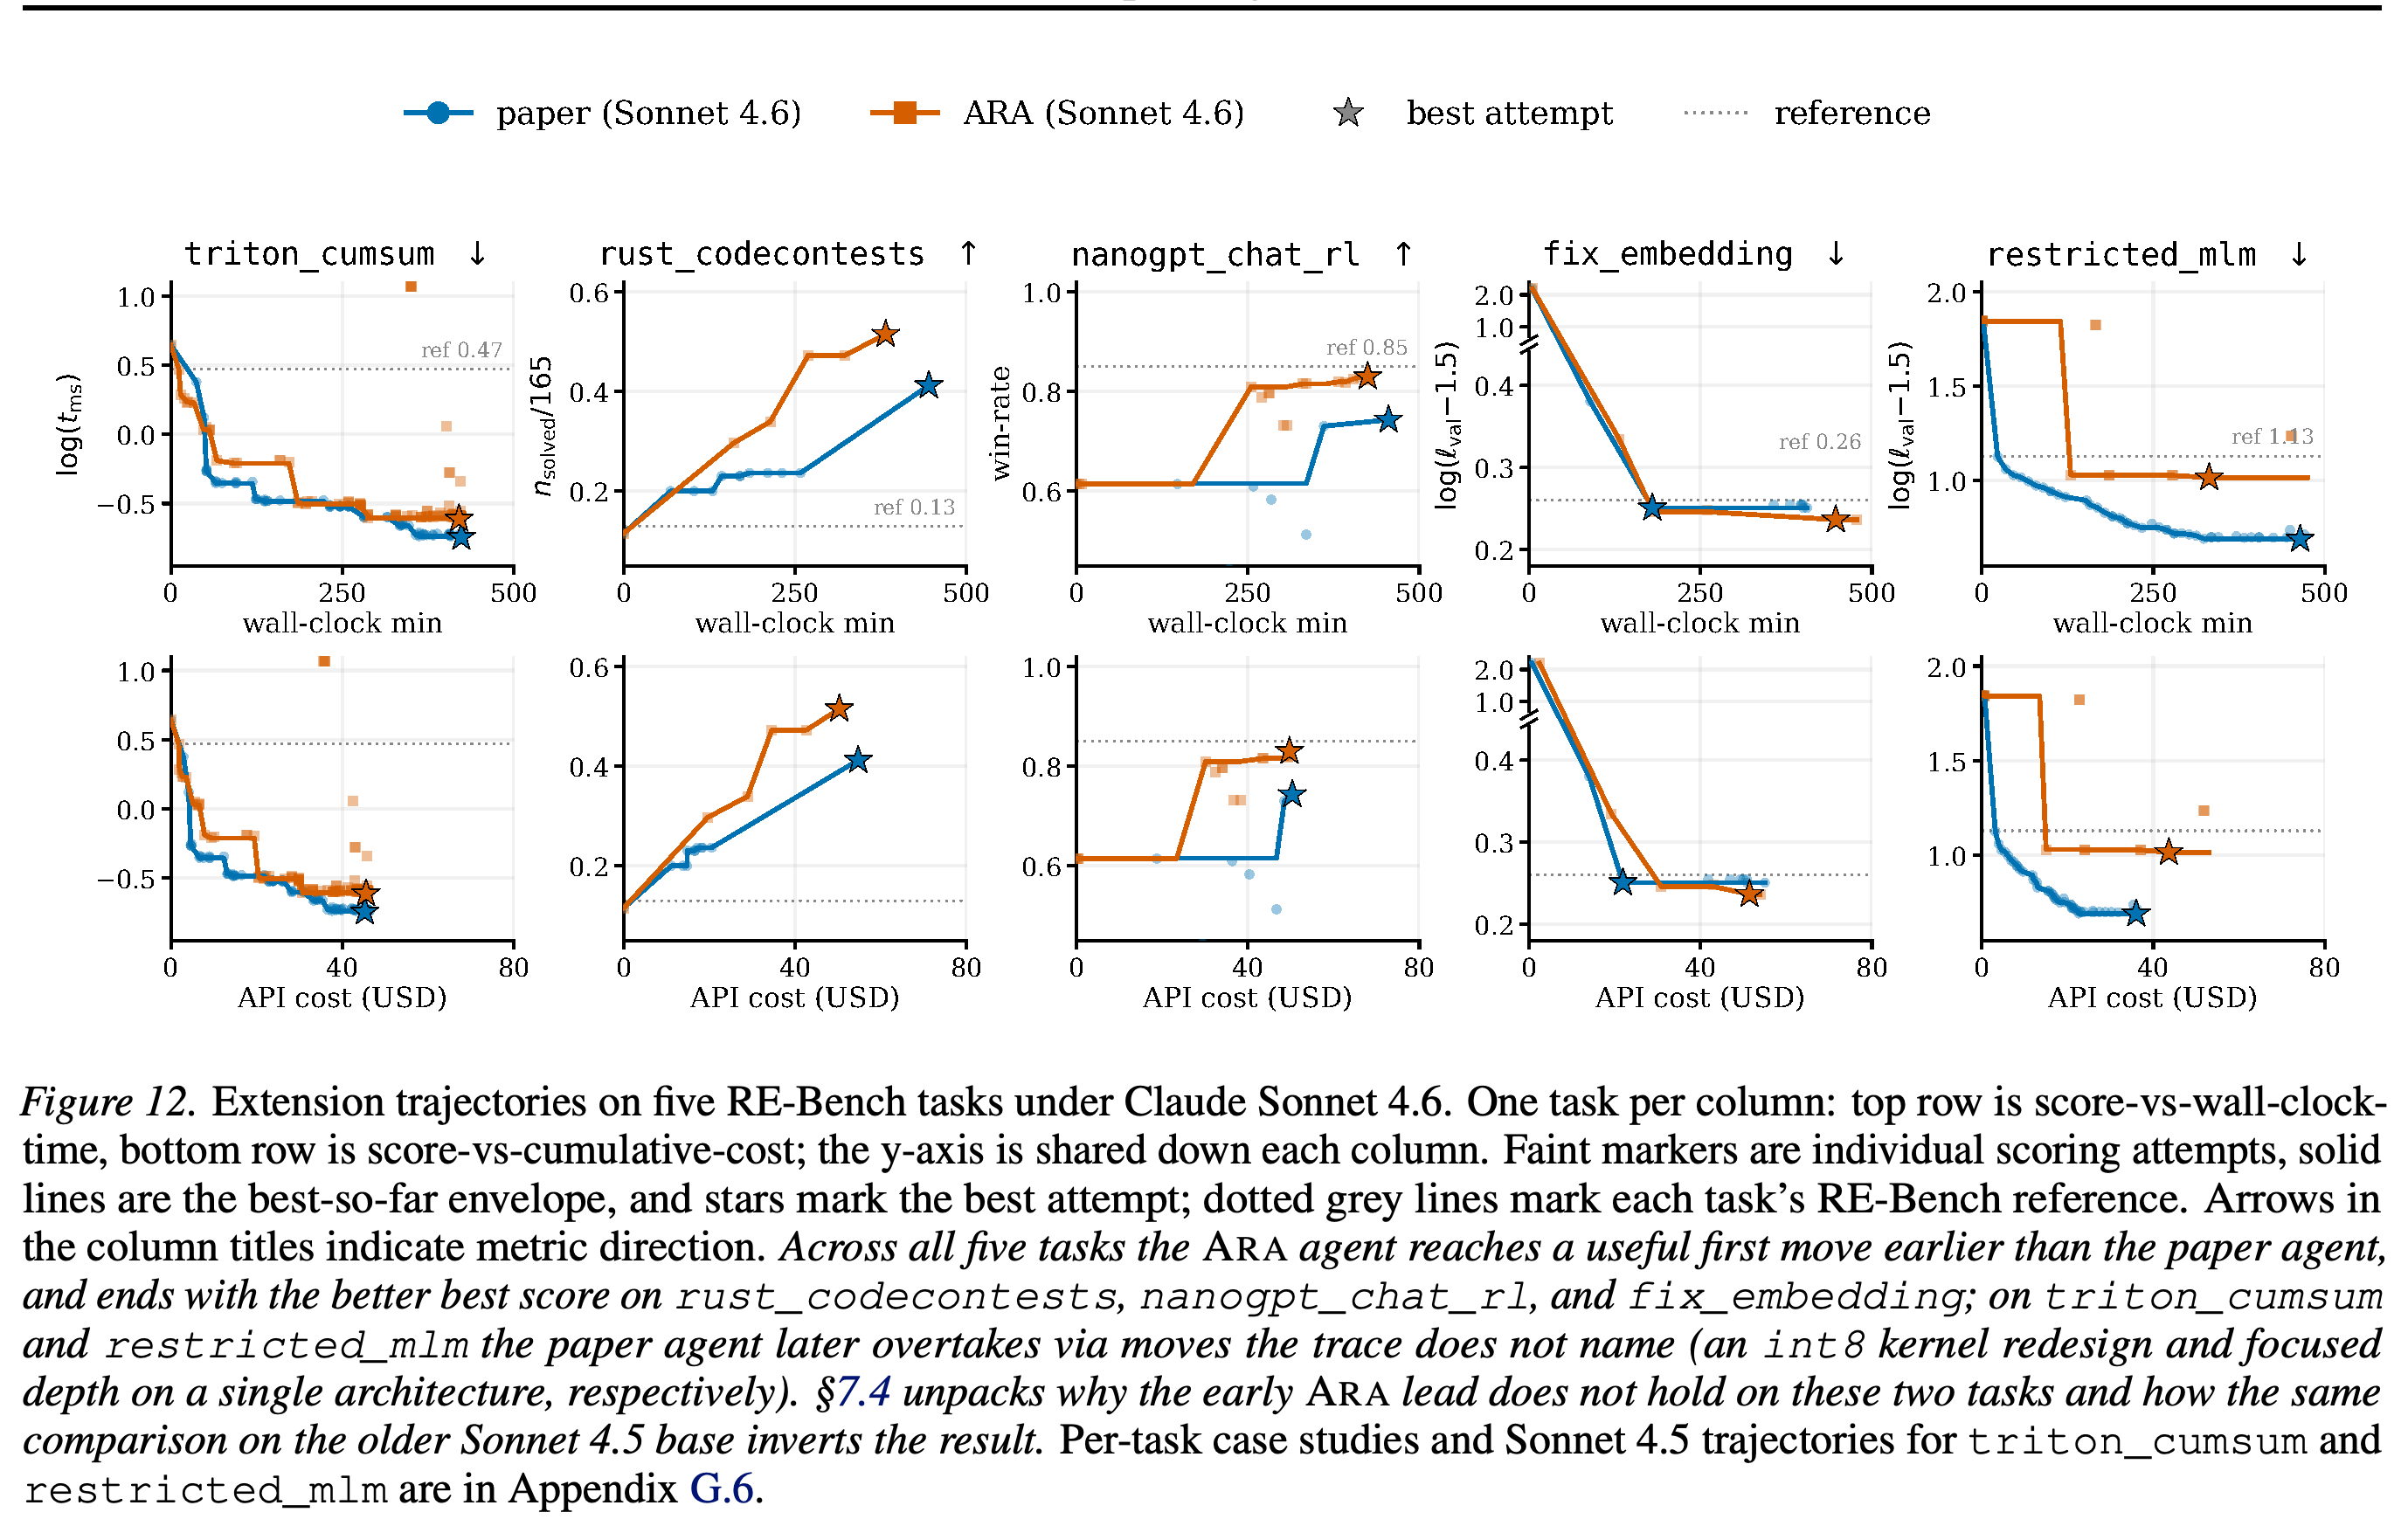
확장 평가는 triton_cumsum, rust_codecontests, nanogpt_chat_rl, fix_embedding, restricted_mlm을 대상으로 한다. 동일한 시작 코드를 사용하며, 실행별 명목상 제한은 SLURM 경과 시간 8 h와 API 비용 $50다. 점수의 우열 방향을 고려하는 시도별 필터로 기준 성능을 넘는 MALT 채점 시도를 제외한다. ARA는 기준 성능에 못 미친 부분적 성공, 실패한 접근, 여기서 도출한 휴리스틱을 보존한다.
- Figure 12에서 Sonnet 4.6을 사용한 ARA는 rust_codecontests, nanogpt_chat_rl, fix_embedding에서 최종적으로 앞선다. 논문 에이전트는 triton_cumsum과 restricted_mlm에서 이긴다. 사례 분석은 초기 전략 선택을 특정 trace 항목과 연결하지만, 소수의 탐색 기록으로 평균적인 인과 효과를 입증할 수는 없다.
- rust_codecontests에서 ARA는 약 10 min 안에 직접 작성한 Rust 라이브러리를 시도한다. 논문 에이전트는 오랜 프롬프트 엔지니어링 끝에 395 min 시점에서 같은 방향을 독립적으로 재발견한다. fix_embedding에서는 논문 에이전트가 순열 복원 실패를 이미 관찰했는데도 이를 다시 시도한다.
- Sonnet 4.6 paper 에이전트는 triton_cumsum에서 trace에 없는 int8 커널 재설계로 앞서고, restricted_mlm에서는 ConvMLMDilated를 지속적으로 튜닝해 앞선다. 반면 ARA는 이전 커널 전략에 고정되거나 기록에 제시된 여러 대안에 노력을 분산한다.
- 대응되는 Sonnet 4.5 비교에서는 2개 과제의 결과가 모두 뒤집힌다. triton_cumsum에서 ARA 점수는 0.27, 비교 조건은 0.64이며, restricted_mlm에서는 각각 0.73과 1.03이다. 점수는 낮을수록 좋다. 이러한 탐색 과정은 확장 품질이 보편적으로 향상된다는 결론보다 모델에 따라 효과가 달라짐을 시사한다.
- Appendix G는 여러 과제의 단일 시드 비교, 복구 후 재개, rust_codecontests의 예산 제한 없는 최종 점수 전용 재평가를 기록한다. 그래프의 비용 축도 $50를 넘어서므로, 별도 조건을 확인하지 않은 채 명목상 제한이 표시된 모든 탐색 과정에 적용된다고 가정해서는 안 된다.
현재까지의 최고 성능 추이는 유용한 시도를 일찍 한다고 해서 최종 결과도 가장 좋아지는 것은 아님을 보여준다. Sonnet 4.6 비교 5개 중 ARA는 3개에서 이기지만, triton_cumsum과 restricted_mlm에서는 논문 에이전트가 앞선다. 과제마다 점수의 우열 방향이 다르고 비용 패널은 명목상 제한인 $50를 넘어선다. 따라서 해석할 때 부록의 재개 및 채점 조건을 확인해야 한다.
7.5. ARA-Native Review Systems
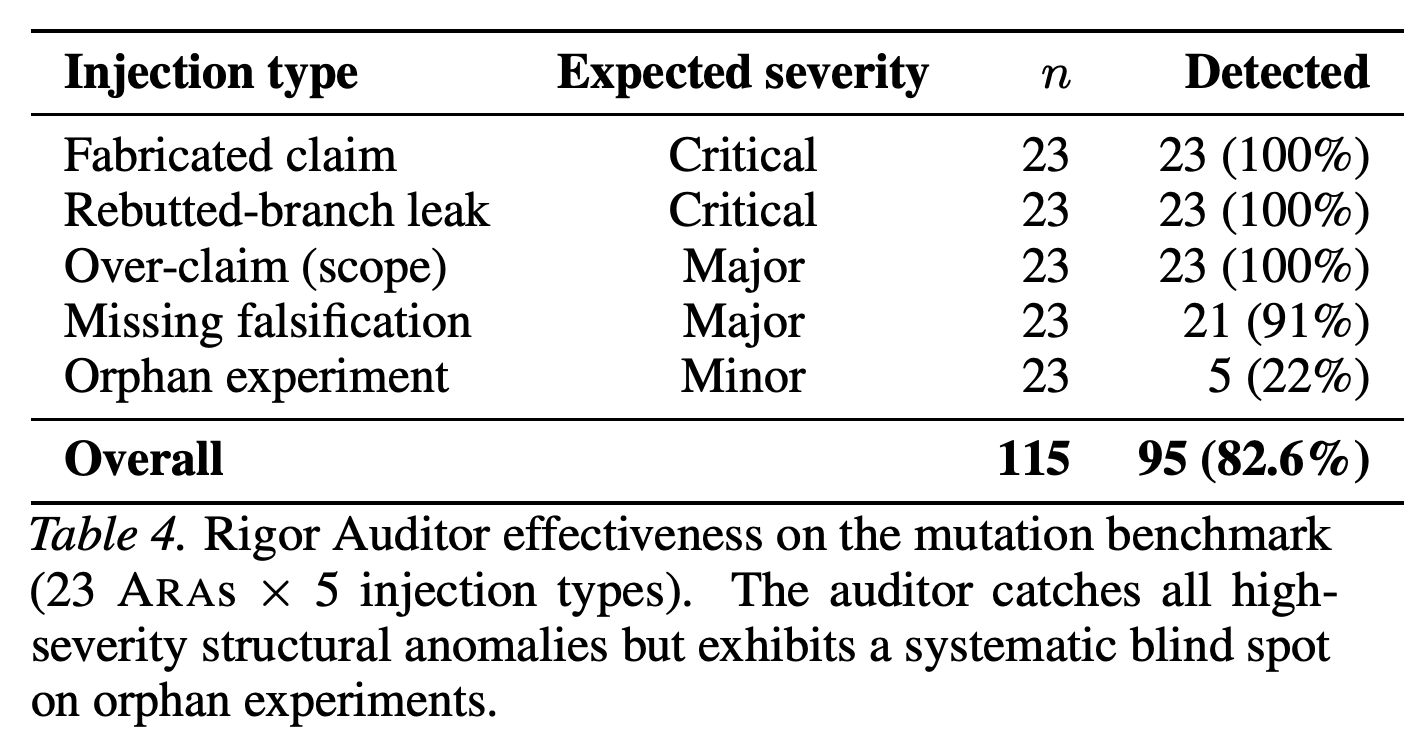
심사 평가는 자동화된 Seal 수준 3개를 측정하며, 독창성이나 중요성에 대한 사람의 평가는 측정하지 않는다. 아티팩트 30개 모두 검증 피드백이 필요했고 3회 이내의 반복에서 Level 1을 통과했다. Level 2 변이 벤치마크는 PaperBench ARA 23개 각각에 결함 5개를 주입하고, 비공개 주입 명세를 기준으로 탐지 여부를 평가한다.
- Table 4는 결함 95/115개를 탐지했다고 보고하며, 탐지율은 82.6%다. 조작된 주장은 23/23, 반박된 분기의 내용 유출은 23/23, 과도한 주장은 23/23, 반증 기준 누락은 21/23, 연결되지 않은 실험은 5/23만 탐지했다.
- 연결되지 않은 실험에 대한 사각지대는 주장 중심 탐색이 Verifies 대상 참조가 유효하지 않은 실험을 놓친다는 설명과 부합한다. 여러 주입 결함은 이미 Level 1에 명시된 검사를 위반하므로, 이 벤치마크가 고차원적인 논증의 엄밀성만을 검증하는 것은 아니다.
- 아티팩트 17/23개에서는 보고된 전체 평균이 Accept 임계값을 넘을 만큼 위로 반올림된다. Critical 지적 사항이 있어도 규정된 평가 차원별 점수 감소가 적용되지 않는다. 이는 등급을 별도로 생성하기보다 지적 사항에서 판정을 결정론적으로 계산하라는 저자들의 권고를 뒷받침한다.
- 논문은 보고된 재현 성공률 64.4%를 Level 3 지표로 재사용한다. 이는 안전한 실행이나 증거 격리에 대한 독립적 검증이 아니다. Level 1 통과만으로 정보의 완전성이 입증되는 것도 아니다.
주입 유형 3개는 모두 탐지하지만, 연결되지 않은 실험의 탐지는 5/23에 그친다. 전체 결함 탐지 재현율은 82.6%다. 이러한 유형별 차이는 주장 중심 LLM 검사의 한계를 드러내며, 결정론적으로 참조를 열거해야 한다는 주장을 뒷받침한다. 여러 주입 결함은 순수한 논증 오류가 아니라 구조 위반이다.
8. Related Work
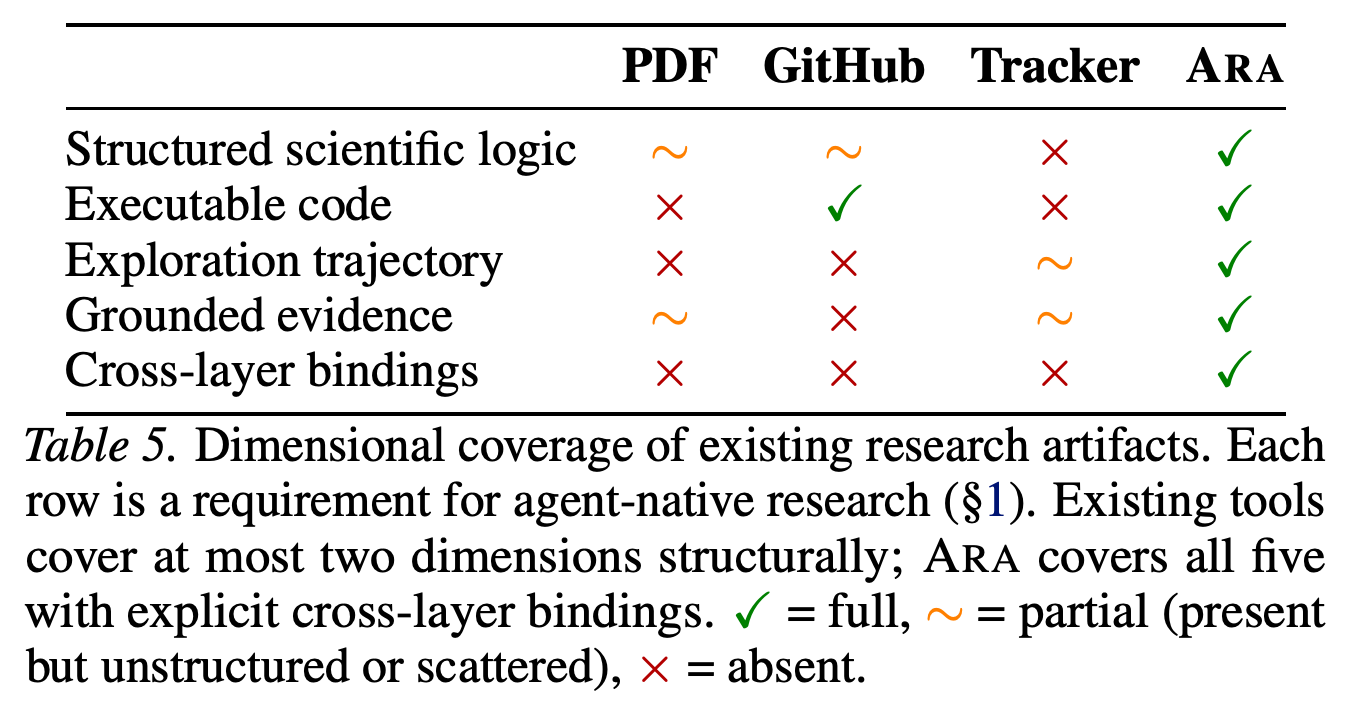
관련 연구는 기계가 읽을 수 있는 과학 자료, 재현성 인프라, 부정적 지식, 에이전트 지향 도구를 다룬다. Table 5는 ARA의 기여를 PDF, 저장소, 실험 추적기의 대체가 아니라 명시적인 계층 간 연결로 제시한다.
- FAIR, PROV-O, nanopublications, knowledge graphs, RO-Crate, Whole Tale은 메타데이터, 출처, 구조화된 주장, 패키징, 실행 환경을 다룬다. 논문은 이러한 접근이 자신이 제안하는 실행 명세와 의사결정 이력을 함께 제공하지는 않는다고 주장한다.
- 워크플로 엔진과 노트북은 계산을 기록하지만 주장의 의미까지 반드시 인코딩하지는 않는다. 원시 탐색 기록 아카이브는 활동을 보존하지만 활용 가능한 실패 유형을 반드시 드러내지는 않는다.
- ARA는 주장, 증거, 휴리스틱, 이들 사이의 연결을 작성 시점에 기록하자고 제안한다는 점에서 사후 paper-to-code 파이프라인과 다르다. Table 5는 개념적 포괄 범위 비교이며, 직접 측정한 비교 평가는 아니다.
포괄 범위 행렬은 다른 아티팩트 유형에 빠진 차원으로 명시적인 계층 간 연결을 제시한다. 체크 표시는 저자들의 개념적 분류를 나타낸다. 모든 저장소나 추적기에 유사한 통합이 없음을 입증하거나 실증적인 성능 우위를 정량화하는 것은 아니다.
9. Future Work
향후 연구는 아티팩트의 계보와 유지보수에서 코퍼스 수준 협업과 분야 간 적용으로 확장한다. 제안된 구조화된 부모·자식 diff는 구축과 재검증 작업을 줄일 수 있다. 아티팩트를 사용하는 에이전트는 오래된 의존성을 수정하고 그 수정 사항을 상위 아티팩트로 전달할 수 있다.
- 코퍼스 지식 그래프는 주장을 정렬하고, 인용된 베이스라인을 비교하며, 상충하는 탐색 과정을 드러낼 수 있다. 재현과 반대 증거를 바탕으로 신뢰도를 지속적으로 갱신하는 데도 활용할 수 있다.
- wet-lab 연구로 일반화하려면 실행 계층과 탐색 계층을 물리적 실험에 맞게 조정해야 한다. Section 7.4는 오래된 휴리스틱에 탐색이 고정되는 문제를 줄이기 위해 trace의 선택적 공개와 모델 계열 출처 기록도 제안한다.
10. Limitations
명시된 한계는 평가 범위, 원자료에 제한되는 충실도, 배포 전제조건이다. 실험은 ML 아티팩트만 다룬다. 컴파일 결과는 사용 가능한 원자료의 누락을 그대로 이어받으며, 높은 충실도의 실시간 기록은 프로젝트 전반에 코딩 에이전트가 참여한다고 가정한다.
- 벤치마크는 ARA와 선정된 논문에 익숙한 주석 작성자들이 구축했다. 따라서 익숙하지 않거나 특수한 도메인의 아티팩트에서 보일 성능은 불확실하다. 물리적 실험과 증명 기반 기여는 실증적으로 검증하지 않았다.
- 샌드박스 실행, 콘텐츠 수준 이상 탐지, 세분화된 Exploration Graph 접근 통제는 구현되지 않았다. 따라서 제안된 심사 아키텍처의 보안·개인정보 보호 특성은 현재 보장되는 속성이 아니다.
- PAPER.md에는 ara_schema 버전 태그가 있으며, 검증기는 알 수 없는 필드와 누락된 선택 필드를 허용하도록 설계된다. 메이저 버전 마이그레이션, 보관 자료 재작성, 장기적인 검사 도구 가용성, 지원 중단 정책은 해결되지 않았다.
11. Conclusion
결론은 ARA를 에이전트가 다룰 수 있는 연구 지식을 출판하고 검증하며 확장하는 인프라로 제시한다. 실험은 정보가 보강된 구조화 아티팩트에서 검색과 제한된 조건의 재현이 개선됨을 뒷받침한다. 다만 확장 결과는 엇갈리므로, 더 완전한 과정 문서화가 후속 발견을 항상 개선한다는 광범위한 주장은 제한해서 해석해야 한다.
부록
- A. ARA Protocol and Design Rationale은 논문 5편의 리프 요구사항 3,050개로 구성된 부분집합에서 재현에 중요한 정보 범주 10개를 도출한다. 조합형 실험 행렬이 24.1%, 평가 프로토콜이 18.5%, 하이퍼파라미터가 17.2%를 차지한다. 나머지 범주는 로깅, 해석, 아키텍처, 정식화, 구현 기법, 데이터 파이프라인, 인프라를 다룬다. 핵심 결과는 하이퍼파라미터가 요구사항의 일부만 포괄하고, 실험 조합을 명시적으로 열거해야 하며, 가중치가 높은 해석 요구사항은 실행 가능한 코드만이 아니라 정성적 주장의 검증을 요구한다는 것이다. A.2는 src_mode: kernel | repo를 구분한다. A.3은 이 논문의 자체 아티팩트를 보여준다. PAPER.md는 계층을 색인화한다. logic/claims.md는 상태, 출처, 반증 기준, 증명 포인터를 기록한다. logic/problem.md는 관찰을 기존 접근의 공백과 핵심 통찰에 연결한다. logic/solution/heuristics.md는 결정과 그 근거·민감도를 기록한다. trace/exploration_tree.yaml은 결정, 실패, 실험을 보존한다. trace/sessions/는 이벤트, 변경된 파일, 영향을 받은 주장, 미해결 주제를 기록한다. 발췌문에는 스냅샷별 개수가 다르게 보고된다. 탐색 노드는 114개 대 94개, 휴리스틱은 23개 대 18개, 세션은 38개 대 36개다. manifest의 NeurIPS 2026 항목은 status: draft이므로 출판이나 채택을 입증하지 않는다.
- B. Compiler Skill Details는 약 482줄의 자연어 스킬을 설명한다. 이 스킬은 워크플로, 도구 관례, 디렉터리 스키마, 컴파일 단계 4개, 출력 불변조건을 다룬다. 호스트 에이전트는 실행 수단을 제공하고, 스킬은 도메인 요구사항을 지정한다. 주장의 필수 필드는 Statement, Status, Falsification criteria, Proof이며, 규범 명세는 파일 경로가 아닌 실험 ID 참조를 요구한다. 실험 계획에는 기대하는 결과 방향을 담되, 정확한 결과는 /evidence/에만 둔다. 명세는 필수 파일 15개와 노드가 최소 8개인 탐색 트리를 요구한다. 트리에는 dead_end와 decision이 포함되어야 하며, 주장·결과·휴리스틱을 지어내는 행위를 금지한다. 이는 구현 요구사항이지, 컴파일이 항상 이를 충족한다는 추가 증거는 아니다.
- C. Live Research Manager Details는 이식 가능한 통합, 지식의 출처 기록, 기록 시점의 계층 간 연결에 대한 근거를 자세히 설명한다. 종결에 따른 승격은 미해결 질문 없이 기본값 k = 5회의 후속 턴 동안 관찰을 다시 다루지 않은 주제 중단, 언어적 확인, 실험을 통한 결론, 후속 아티팩트에 반영된 확정 사항을 신호로 사용한다. 반박된 관찰은 dead_end 항목이 될 수 있다. 모순이 있으면 양쪽 항목을 모두 보존하고, 연구자가 판단할 수 있도록 미해결 decision 노드를 만든다. 세션 간 연속성은 trace/pm_reasoning_log.yaml과 압축된 핵심 컨텍스트 기록을 사용한다. 이를 통해 이전 대화 전체를 요구하지 않고도 정보 구성의 근거와 대화 맥락을 유지한다.
- D. Test Corpus는 PaperBench 논문 23편 전체를 나열하고 재현 평가에 포함된 대상을 15로 표시한다. 나머지 8은 이해 평가에는 남지만 계산·인프라 제약 때문에 재현 평가에서 제외된다. 제약에는 여러 날이 걸리는 파인튜닝, 특수 시뮬레이션, 전체 ImageNet sweep, 대규모 벤치마크 모음이 포함된다. 평가 하네스는 PaperBench의 원래 저자 코드 금지 규칙을 완화해 기존 방식의 베이스라인이 부속 저장소를 사용할 수 있게 한다. 코퍼스는 효율성, 정렬, 해석 가능성, RL, 과학적 ML, 생성 모델링, 최적화, 검색, 평가, 적응을 포괄한다. 여러 문단은 모든 논문을 ICML 2024 논문으로 설명하지만, 선정 기준에는 NeurIPS의 2024 papers 중 워크숍 개발 단계 논문 2편이 포함된다고 명시한다.
- E. Understanding Evaluation은 질문 템플릿, 새 컨텍스트에서의 평가, 삼원 채점, PDF 정보 누락 레이블링, 탐색 비용 집계, 범주별 메커니즘, 통계를 상세히 설명한다. 누락 레이블은 뒷받침하는 PDF 구절을 인용하도록 요구된 LLM 평가자가 생성하며, 요구사항의 64%가 높은 신뢰도의 레이블을 받는다. Table 9의 누락 개수는 부분적으로 명시되거나 명시되지 않은 요구사항 수뿐 아니라 전체 코퍼스의 요구사항 8,921개도 초과한다. 따라서 추가 설명 없이 이를 상호 배타적인 요구사항 개수로 해석해서는 안 된다. 24,008회 실행에 대한 탐색 분석은 과제 228개와 총비용 $63,483을 다루며, 필요한 탐색과 피할 수 있는 후속 재발견을 구분한다. Category A는 색인 기반 검색, Category B는 중앙화된 설정, Category C는 다른 조건에는 없는 실패 지식에 대한 접근을 강조한다. Appendix E는 McNemar χ² = 95.15와 p < 10⁻¹⁰을 보고한다. 그러나 난이도별 개수 74, 193, 172에 답할 수 없는 질문 26개를 더하면 450과 맞지 않는다. 명시되지 않은 범주 중복이 있지 않는 한 이 수치는 일치하지 않는다.
- F. Reproduction Evaluation은 주요 지표를 sum_i(s_i · w_d_i) / sum_i(m_i · w_d_i)로 정의한다. w_d는 쉬움, 중간, 어려움에 대해 각각 1, 2, 3이다. s_i는 충족한 요구사항의 가중치 합에 부분적으로 충족한 요구사항의 가중치 합을 0.5 times로 반영한 값을 더한 것이며, m_i는 최대 점수다. 요약된 8–2 부호 패턴에 대해 Wilcoxon p = 0.028과 exact-binomial p = 0.039를 보고하지만, 명시된 이항 확률은 통상적인 정확 검정에서 해당 패턴과 일치하지 않는다. Figure 13과 Table 11은 난이도별 결과를 제공한다. Table 11의 가중 열에는 양의 차이 9개와 음의 차이 6개가 있으며 정확한 동률은 없다. 반면 논문은 동률 임계값을 명시하지 않고 8/5/2를 보고한다. 여러 서술상의 차이 값도 표와 맞지 않는다. 예를 들어 ftrl에서는 표의 ARA 성능이 더 낮은데도 ARA가 유리하다고 서술한다. 집계 행이 나열된 논문별 값과 어떻게 일치하는지 명확히 설명하지 않으며, rice의 난이도별 값은 보간한 값이라고 명시한다. 따라서 보고된 전체 재현율을 부록에서 독립적으로 재구성한 결과처럼 제시해서는 안 된다.
- G. Extension Evaluation은 과제 선정, 구성, 베이스라인, 하네스 엔지니어링, 점수 추출, 사례 분석 5개를 기록한다. optimize_llm_foundry에는 공개된 MALT 코퍼스가 없으며, small_scaling_law의 trace는 드물고 전략적으로 유용한 정보가 부족하다. 구성에는 실행별 추출, 출처 태그를 붙인 병합, 추출과 병합 과정에서 적용하는 기준 성능 초과 필터를 사용한다. 합성 논문 베이스라인은 기각된 대안보다 성공한 방법을 의도적으로 보존한다. 하네스 수정에는 더 큰 SDK 버퍼, 대량 배치 채점 차단, 중단 루프에 대한 재개 유도와 복구 후 재개, 과제별 채점기 타임아웃이 포함된다. 점수는 에이전트의 설명이 아니라 공식 채점기 출력에서 가져온다. 비용은 사용 기록에서 재구성하고 SDK 총계와 대조한다. triton_cumsum 사례는 Sonnet 4.5에서 유용했던 autotune 안내와 Sonnet 4.6에서 trace가 권장한 재설계에 고정된 행동을 대비한다. rust_codecontests에서는 직접 작성한 Rust 라이브러리를 더 일찍 채택하지만, 복구 후 재개와 예산 제한 없는 최종 채점이 포함된다. nanogpt_chat_rl은 알고리즘을 반복적으로 재설계하는 대신 trace를 따라 기준 알고리즘을 이어가며, 문서화된 비정상 출력 필터를 사용한다. fix_embedding에서는 공개된 adapter 절차를 비슷하게 실행한 뒤 기준 성능 이후의 탐색이 달라진다. 순열 복원을 반복해서 시도하는 행동은 논문 조건에서만 나타난다. restricted_mlm에서는 Sonnet 4.5가 집중적으로 튜닝하지만 Sonnet 4.6은 탐색을 분산한다. Figure 15는 초기 베이스라인 측정이 오류로 중단된 뒤 ARA-4.5의 시작 기준점도 재구성한다. Figures 14–15는 Sonnet 4.5 비교를 제공한다. 코드와 재구성 가능한 이벤트 로그는 code/extension-harness/, code/rebench-pipeline/, code/artifacts/rebench-<task>/, 각 실행의 trace.jsonl에 있다.
- H. Review System Evaluation은 Level 1의 디렉터리, 파일, 스키마, 최소 개수, 양방향 참조 검사를 명시하며, 실험의 Verifies 대상도 검사한다. 첫 시도 성공은 0/30이며, 모든 아티팩트가 3회 이내의 반복에서 통과했다고 보고한다. Compiler 실패는 유효하지 않은 참조 42%, 필드 누락 31%, 탐색 노드 수 부족 14%, 파싱 오류 8%, 파일 누락 5%로 구성된다. Level 2 변이 벤치마크는 생성된 등급을 정답으로 쓰지 않고 지적 사항을 비공개 주입 대상과 대조한다. Table 14는 연결되지 않은 실험의 탐지 실패와 bam·bbox의 반증 기준 누락 탐지 실패를 구체적으로 보여준다. Critical로 분류된 반박 분기 관련 지적 사항이 있어도 규정된 탐색 무결성 점수 감소가 적용되지 않는다. 이는 지적 사항과 점수가 분리되는 문제를 보여준다. 부록은 남은 충실도 오류가 모두 원자료의 정보 부재 때문이어야 한다고 주장하지만, 구조 검증만으로는 그런 결론을 도출할 수 없다. Level 3은 독립적인 실행 벤치마크를 도입하지 않고 재현 평가를 재사용한다.
짧은 생각
가장 명확한 기여는 구조화된 부정적 지식과 명시적인 주장·실험·코드·증거 그래프를 결합한 것이다. 검색 결과는 실행에 필요한 정보를 에이전트가 쉽게 접근할 수 있게 해야 한다는 주장을 뒷받침한다. 그러나 루브릭과 대화 기록이 추가되므로 모든 성능 향상을 디렉터리 형식의 효과로 돌릴 수는 없다. 정보 구성과 정보 보강의 효과를 분리하려면 정보량을 맞춘 베이스라인이 필요하다. 정확한 집계상의 재현 우위를 독립적으로 검증된 결과로 취급하려면 재현 보고의 불일치도 해소해야 한다.
확장 결과가 엇갈린다는 점은 일관된 우위를 주장한 서론을 제한해서 해석해야 함을 보여준다. 보존된 이력은 재발견 시간을 줄일 수 있지만 탐색을 제한하거나 분산시킬 수도 있다. Auditor 결과는 LLM이 생성한 지적 사항과 함께 결정론적 참조 검사와 판정 계산을 사용해야 함을 뒷받침한다. 적은 탐색 표본, 일치하지 않는 부록 요약, 재현 중 증거 접근, 미구현 보안 통제로 인해 ARA의 입증된 수준은 검증된 운영용 출판 시스템이 아니라 연구 인프라 프로토타입에 머문다.