


DeepSeek-OCR: Contexts Optical Compression 요약 설명
21 Oct 2025 | Paper Review Optical Character Recognition Context Compression Vision-Language Models목차
이번 글에서는 DeepSeek-OCR: Contexts Optical Compression 논문의 핵심 포인트만 간단히 정리한다.
요약
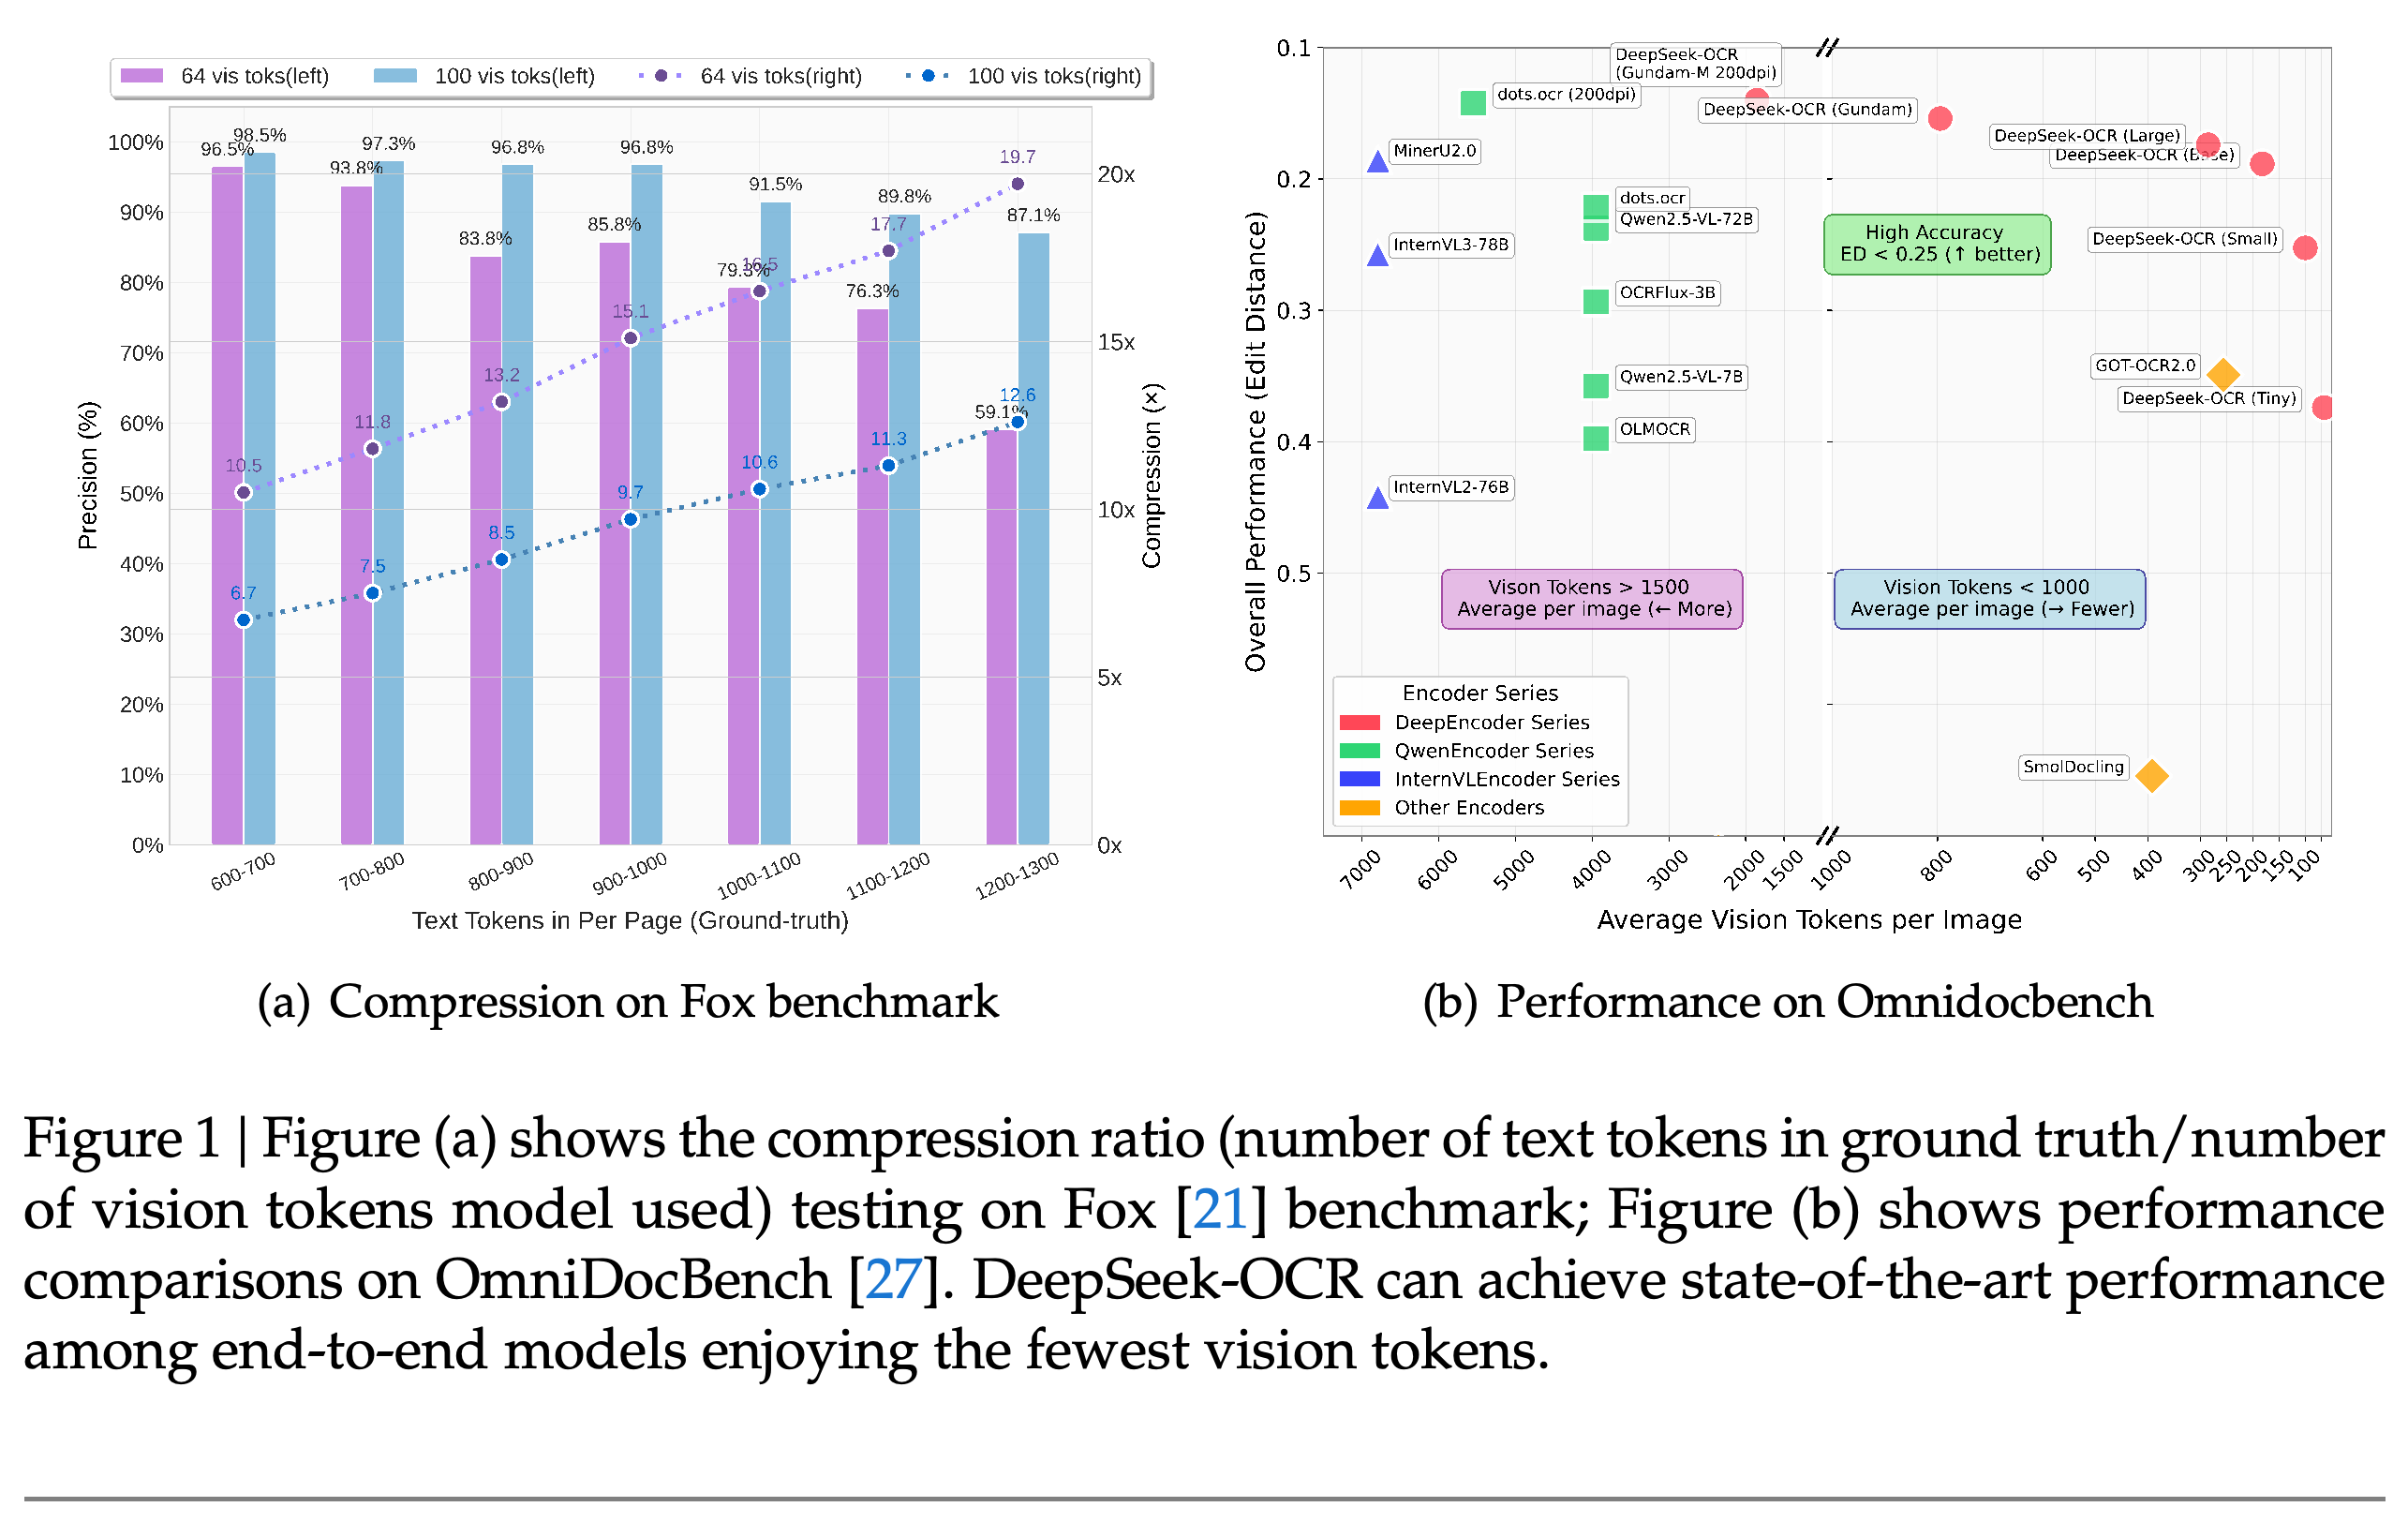
- DeepSeek-OCR은 문서 이미지에 긴 텍스트를 더 적은 vision token으로 담으면서 광학 문자 인식(OCR)에 필요한 정보를 유지할 수 있는지 살펴본다. Vision token은 언어 디코더에 입력되는 이미지 표현이며 OCR은 이미지에서 텍스트를 복원하는 작업이다. 문서 파싱 벤치마크인 OmniDocBench에서 Gundam 모드는 페이지당 평균 795 vision token을 사용하며 영어/중국어 종합 편집 거리는 0.127/0.181이다. MinerU2.0은 6790토큰을 사용하며 편집 거리는 0.133/0.238이다. 편집 거리가 낮을수록 정답 출력과의 차이가 적다.
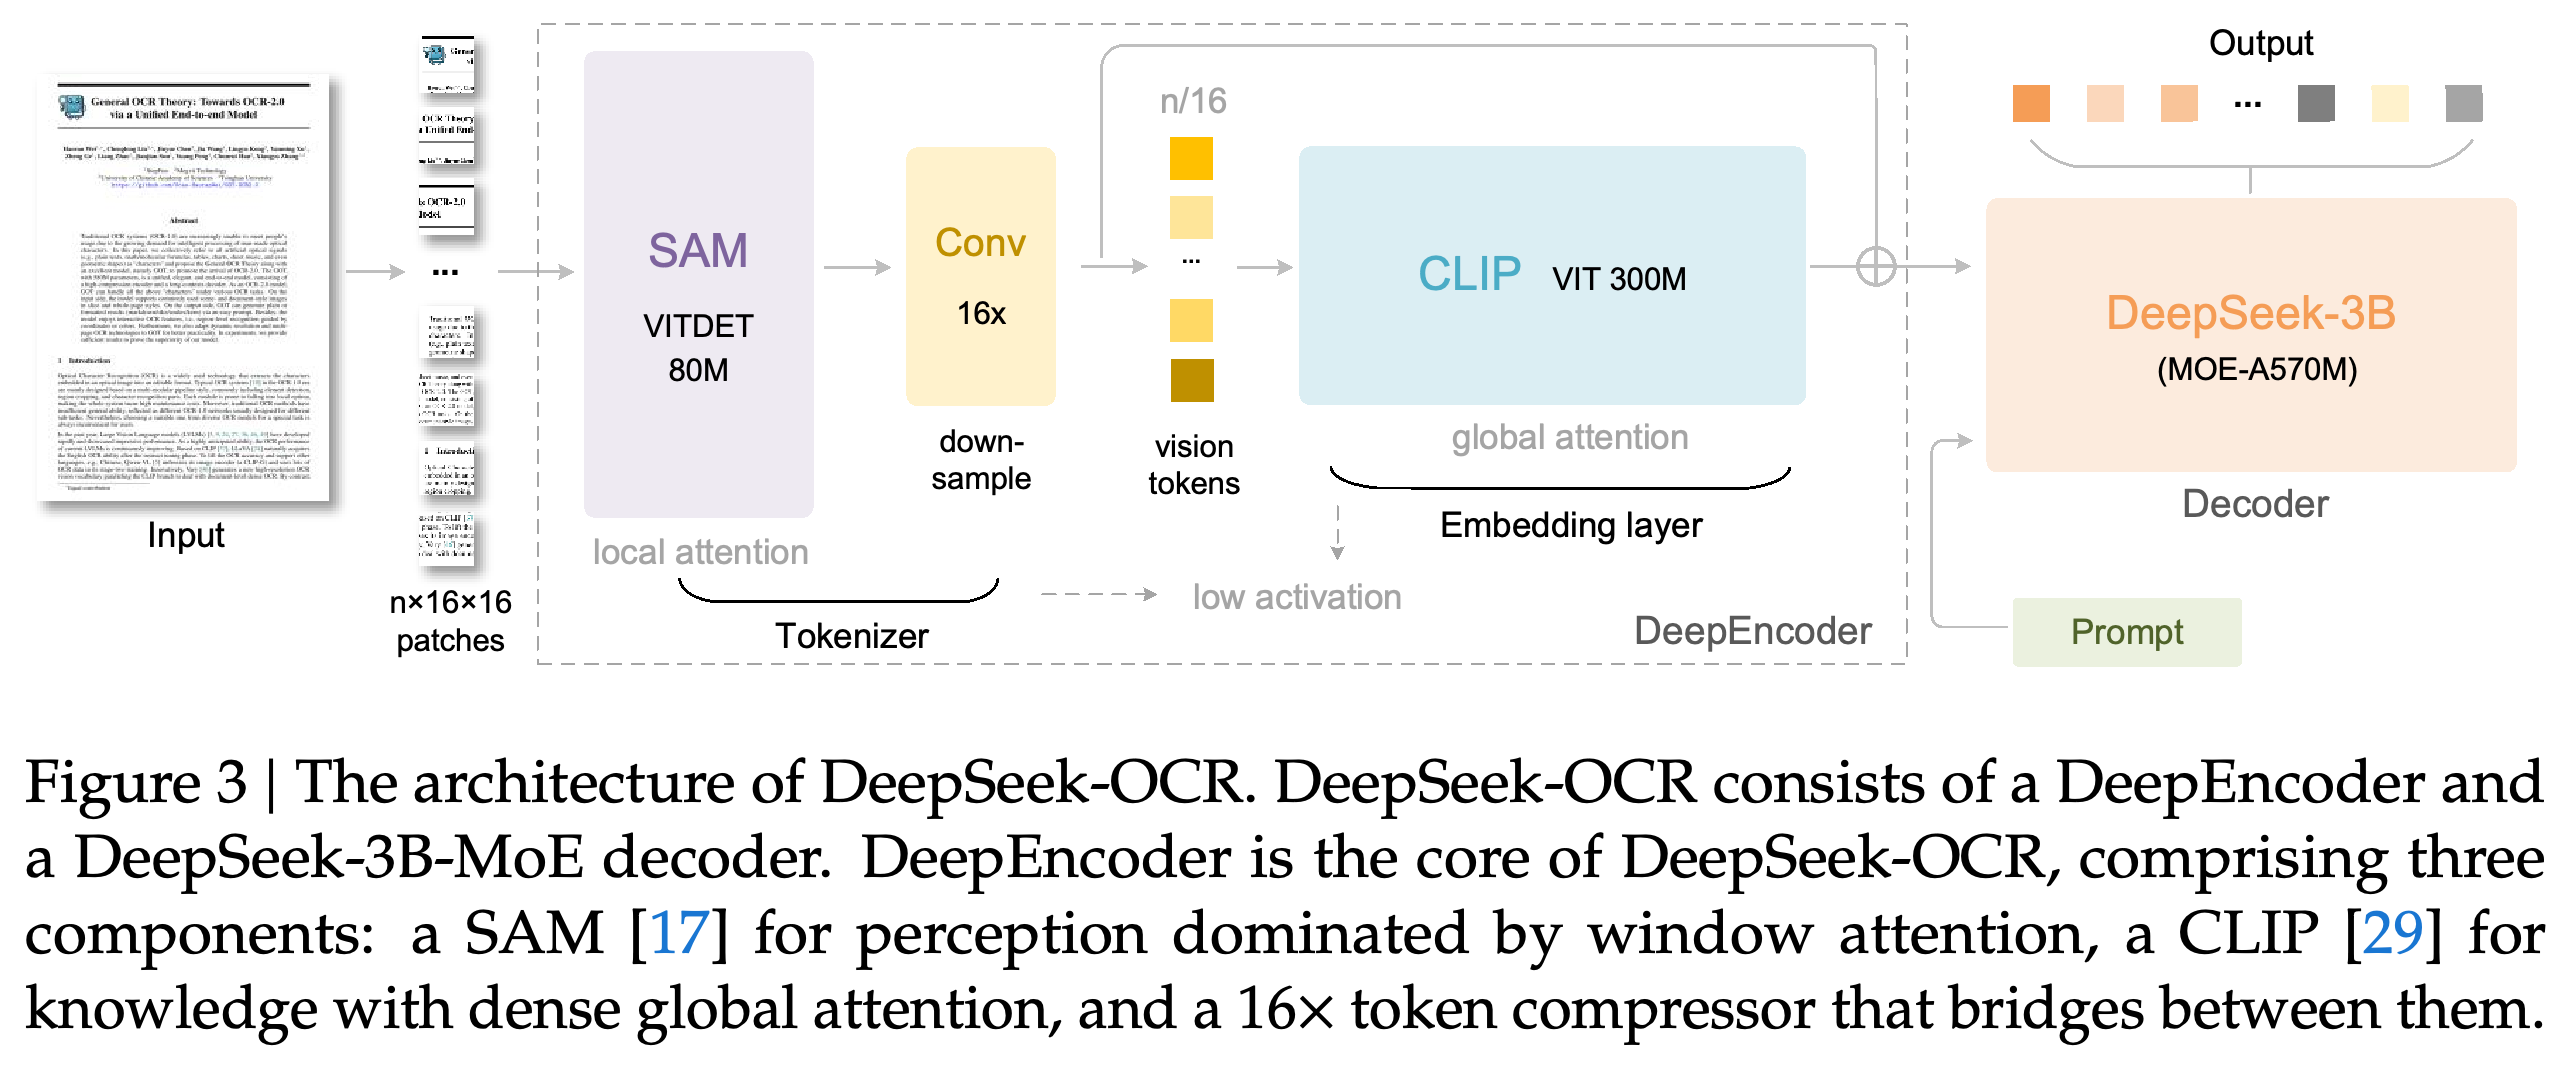
- DeepEncoder는 국소 이미지 처리, 16× 토큰 다운샘플링, 전역 이미지 처리를 거쳐 3B mixture-of-experts(MoE) 디코더에 입력을 전달한다. 이 디코더는 전문가 네트워크 중 일부와 약 570M 파라미터를 활성화한다. 문서 이해 벤치마크인 Fox의 영어 100페이지에서 압축률이 10× 미만일 때 OCR 정밀도는 약 97%다. 압축률은 정답 텍스트 토큰 수를 vision token 수로 나눈 값이다. 압축률이 가장 높은 구간에서는 19.7× 압축률에서 정밀도 59.1%를 기록한다.
- 실험은 효율적인 문서 전사와 파싱을 뒷받침하지만 압축된 이미지가 긴 문맥의 추론이나 검색 능력을 보존하는지는 입증하지 않는다. 저자들은 디지털 텍스트와 이미지로 렌더링한 텍스트를 교차 배치해 학습하는 디지털/광학 혼합 사전학습과 긴 문맥에서 목표 정보를 찾는 needle-in-a-haystack 평가를 후속 과제로 남긴다. 오래된 대화 기록을 점진적으로 압축하는 방식도 제안된 활용 방안이다.
1. Introduction
논문은 텍스트를 처리하고 생성하는 대규모 언어 모델(LLM)에서 긴 시퀀스에 드는 계산 비용을 광학 압축의 동기로 제시한다. OCR을 측정 가능한 압축과 복원 작업으로 보고, 문서 이미지를 비교적 적은 토큰으로 인코딩한 뒤 텍스트를 복원한다. 주요 기여는 압축 실험, DeepEncoder 아키텍처, 구조화된 이미지 파싱 기능을 갖춘 OCR 시스템이다.
- 이미지와 텍스트를 함께 처리하는 vision-language model(VLM)이 이 접근법의 기반이다. 서론은 VLM이 텍스트 정보를 효율적으로 표현하는 능력에 초점을 맞춘다.
- 저자들은 운영 환경에서 A100-40G 그래픽 처리 장치(GPU) 1개로 하루 200k+페이지, A100-40G GPU가 각각 8개인 20개 노드로 하루 33 million페이지의 데이터를 생성한다고 보고한다. 이는 운영 환경에서 보고한 수치이며 평가에는 조건을 통제한 처리량 비교가 없다.
Fox 패널은 vision token 예산을 64개 또는 100개로 고정했을 때 페이지의 텍스트 길이에 따라 전사 정밀도가 어떻게 달라지는지 보여준다. OmniDocBench 패널은 평균 토큰 사용량과 파싱 오류를 비교한다. 이를 통해 압축률에 따른 복원 성능 변화와 다른 OCR 시스템과의 성능 비교를 구분해 보여준다.
2. Related Works
관련 연구는 vision encoder가 고해상도 이미지를 처리하는 방식과 end-to-end OCR 시스템이 문서 내용을 복원하는 방식을 다룬다. 텍스트를 안정적으로 복원하는 데 필요한 vision token 수가 이 2개 분야를 연결한다.
2.1. Typical Vision Encoders in VLMs
저자들은 dual-tower, 타일 기반, 적응형 해상도 인코더를 비교한다. 이 분석은 고해상도 세부 정보를 국소적으로 처리한 뒤 토큰 시퀀스를 줄이고, 전체 시퀀스의 토큰들이 상호작용하는 전역 어텐션을 적용하는 설계의 근거가 된다.
- Vary와 같은 dual-tower 시스템은 병렬 인코더로 이미지를 처리한다. 논문은 인코더마다 전처리 경로가 따로 있어 배포가 복잡해지고, 순차적인 모델 단계를 여러 장치에 나누는 파이프라인 병렬화가 어려워진다고 설명한다.
- InternVL2.0과 같은 타일 기반 시스템은 이미지를 작은 조각으로 나눈다. 중간 계산 결과를 저장하는 활성화 메모리는 줄지만 기본 해상도가 낮으면 큰 문서가 지나치게 잘게 나뉘고 vision token이 많아질 수 있다.
- Qwen2-VL과 같은 적응형 해상도 시스템은 다양한 이미지 크기와 종횡비를 지원하는 인코더 설계인 NaViT를 사용한다. 논문은 전체 이미지의 패치를 처리하면 활성화 메모리와 시퀀스 길이가 커져 학습 및 추론 비용이 증가할 수 있다고 주장한다.
2.2. End-to-end OCR Models
End-to-end OCR은 별도의 검출과 인식 단계를 통합된 이미지-텍스트 모델로 대체한다. 논문은 학술 문서 전사용 Nougat, 합성 시각 구조 파싱용 GOT-OCR2.0, 문서 처리 기능을 갖춘 범용 VLM을 소개한다. 이를 바탕으로 1000단어가 담긴 문서를 디코딩하는 데 vision token이 얼마나 필요한지 묻는다.
3. Methodology
이 방법은 이미지 인코더와 텍스트 디코더를 결합하고 전사, 레이아웃 추출, 구조화된 시각 정보 파싱, 일반 시각 처리, 언어 모델링 데이터를 학습에 사용한다. 먼저 DeepEncoder를 독립적으로 학습한 뒤, 이를 결합한 DeepSeek-OCR 모델을 학습한다.
3.1. Architecture
DeepEncoder는 약 380M 파라미터로 구성된다. 이미지 분할 모델인 Segment Anything에 기반한 80M SAM-base 구성 요소 뒤에, 자연어를 감독 신호로 사전학습한 vision encoder인 300M CLIP-large 구성 요소를 배치한다. 합성곱 압축기가 둘을 연결하며 디코더는 압축된 이미지 토큰과 작업 프롬프트를 받아 출력을 생성한다. CLIP-large에 대해서는 CLIP 논문 리뷰(Learning Transferable Visual Models From Natural Language Supervision) 글을 참조하라.
- 디코더는 DeepSeek-3B-MoE이며, 전체 파라미터는 3B, 활성화되는 파라미터는 약 570M이다. 이 디코더 수치는 DeepEncoder의 약 380M 파라미터와 별개다.
압축 모듈은 전역 어텐션 앞에 배치되어 패치 시퀀스가 CLIP에 들어가기 전에 길이를 줄인다. 디코더는 그 결과로 얻은 시각 특징과 작업 프롬프트를 함께 입력받는다.
3.2. DeepEncoder
3.2.1. Architecture of DeepEncoder는 주로 국소 이미지 영역에 한정되는 window attention과 압축 이후의 dense global attention을 결합한다. SAM-base는 16×16 패치를 사용한다. 2개 합성곱 계층이 토큰 수를 16× 줄인 뒤 CLIP-large가 해당 시퀀스를 처리한다. 1024×1024 이미지는 4096개 패치 토큰을 만들며, 이 토큰은 전역 어텐션에 들어가기 전에 256개로 줄어든다.
- 각 합성곱 계층은 커널 크기 3, 스트라이드 2, 패딩 1을 사용하며 채널 수는 256에서 1024로 늘어난다.
- CLIP은 앞선 구성 요소에서 토큰을 받으므로, 이미지 패치를 입력 표현으로 변환하는 기존 패치 임베딩 계층은 제거한다.
- DeepEncoder는 고해상도, 적은 활성화 메모리, 적은 출력 토큰, 다양한 입력 해상도, 적정한 파라미터 수를 목표로 한다. 논문에는 구성 요소를 개별적으로 제거해 비교하는 ablation 실험이 없어 각 설계 선택의 효과를 분리해 확인할 수 없다.
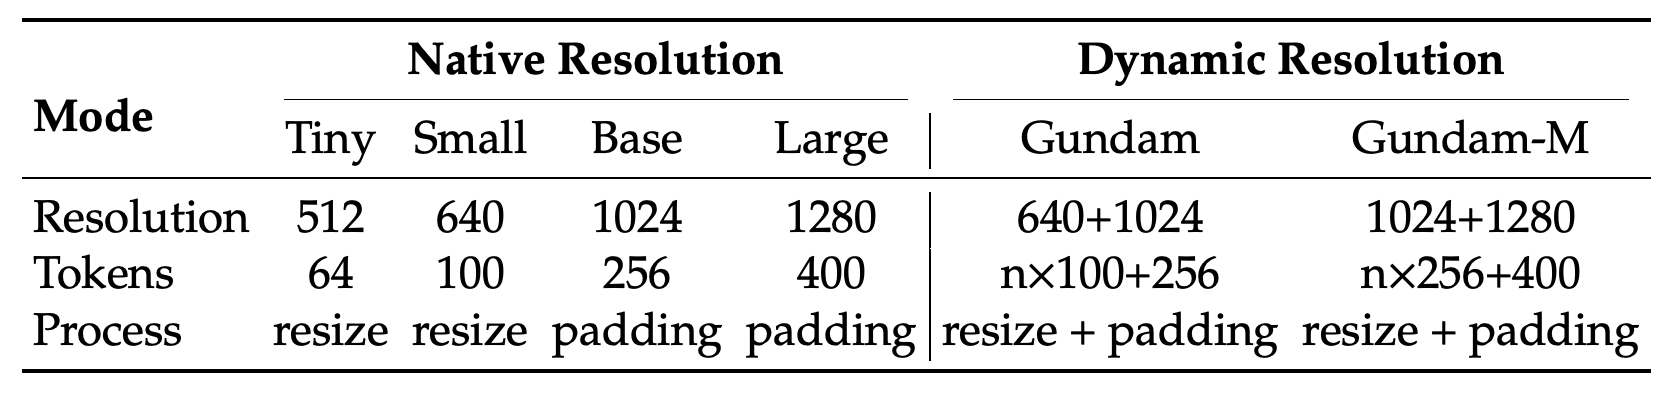
3.2.2. Multiple resolution support는 토큰 위치를 나타내는 위치 인코딩을 보간해 Tiny, Small, Base, Large 모드를 지원한다. 각 모드의 해상도는 512×512, 640×640, 1024×1024, 1280×1280이며, 각각 64, 100, 256, 400토큰을 출력한다. Tiny와 Small은 이미지 크기를 바로 조정하고 Base와 Large는 패딩으로 종횡비를 유지한다. Gundam은 국소 이미지 조각과 전역 뷰를 결합하며 Gundam-master는 추가 학습으로 얻는다.
- 식 (1)은 유효 토큰 수를 N_valid = ⌈N_actual × [1 − ((max(w,h) − min(w,h))/max(w,h))]⌉로 계산한다. 여기서 w와 h는 원본 이미지의 너비와 높이다. 이 계산은 패딩을 제외한 이미지 내용에 해당하는 토큰 수를 추정하며 시퀀스 예산은 여전히 실제 토큰 수로 결정된다.
- Gundam은 n개의 640×640 views를 국소 뷰로, 1024×1024 views를 전역 뷰로 사용해 n×100+256토큰을 생성한다. 타일 수는 2–9 범위로 제한한다. 이미지의 너비와 높이가 모두 640보다 작으면 n=0이 되어 Base 모드와 같아진다.
- Gundam-master는 1024×1024 views를 국소 뷰로, 1280×1280 views를 전역 뷰로 사용해 n×256+400토큰을 생성한다. 더 작은 모드들의 공동 학습을 늦추지 않도록 별도로 학습한다.
도식은 직접 크기 조정, 종횡비를 유지하는 패딩, 국소 뷰와 전역 뷰의 결합을 구분한다. 모드를 바꾸면 토큰 수뿐 아니라 시각적 세부 정보와 전처리도 달라진다. 따라서 압축 실험에서는 원본 이미지의 정보 보존 정도와 시퀀스 예산이 함께 변한다.
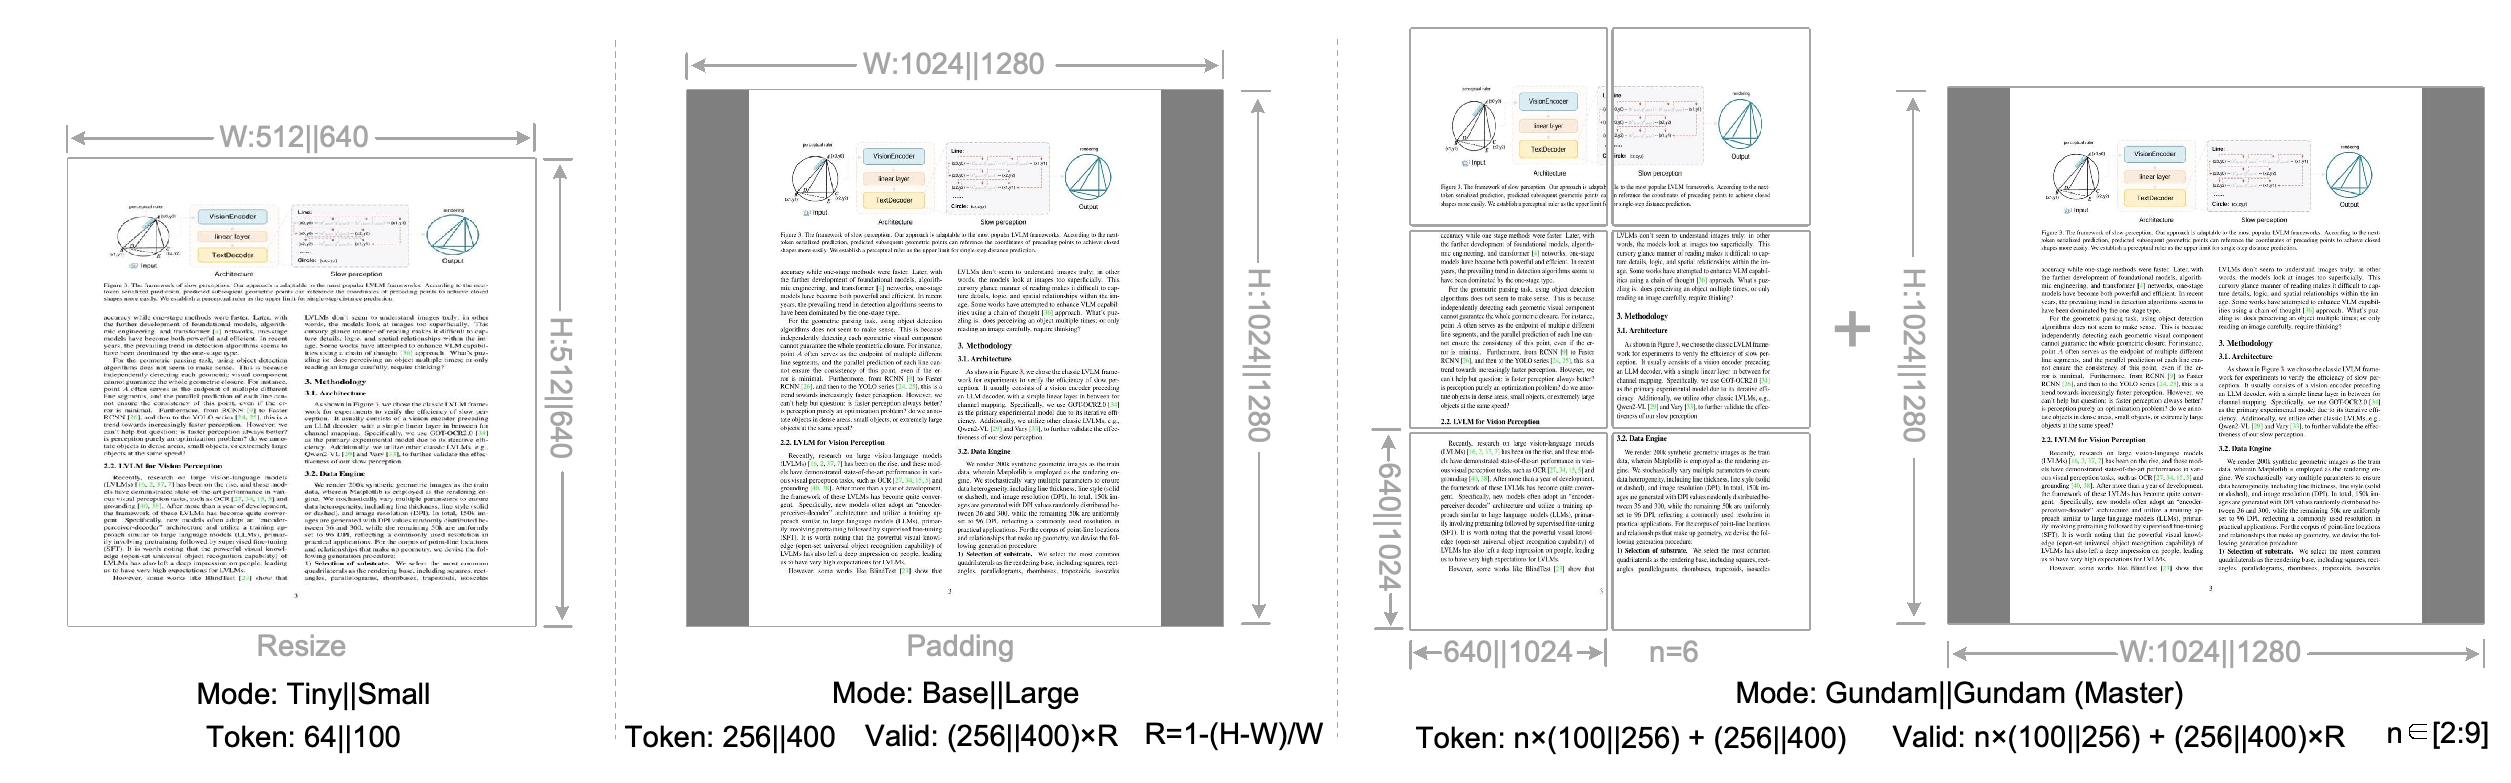
기본 해상도 모드는 64–400토큰을 사용한다. 동적 모드는 전역 뷰의 256개 또는 400개 토큰에 국소 뷰당 100개 또는 256개 토큰을 더하므로, 전체 토큰 수는 이미지 조각 수에 따라 달라진다.
3.3. The MoE Decoder
DeepSeek-3B-MoE는 추론 시 입력에 따라 선택되는 routed expert 64개 중 6개와 shared expert 2개를 활성화한다. 디코더는 압축된 시각 표현을 복원된 텍스트로 변환하는 비선형 매핑을 학습한다. 논문의 수식에서는 시각 시퀀스 길이가 텍스트 시퀀스 길이보다 짧거나 같을 수 있다. 더 큰 LLM도 특화된 사전학습을 통해 비슷한 디코딩 능력을 얻을 수 있다는 제안은 추측이다.
3.4. Data Engine
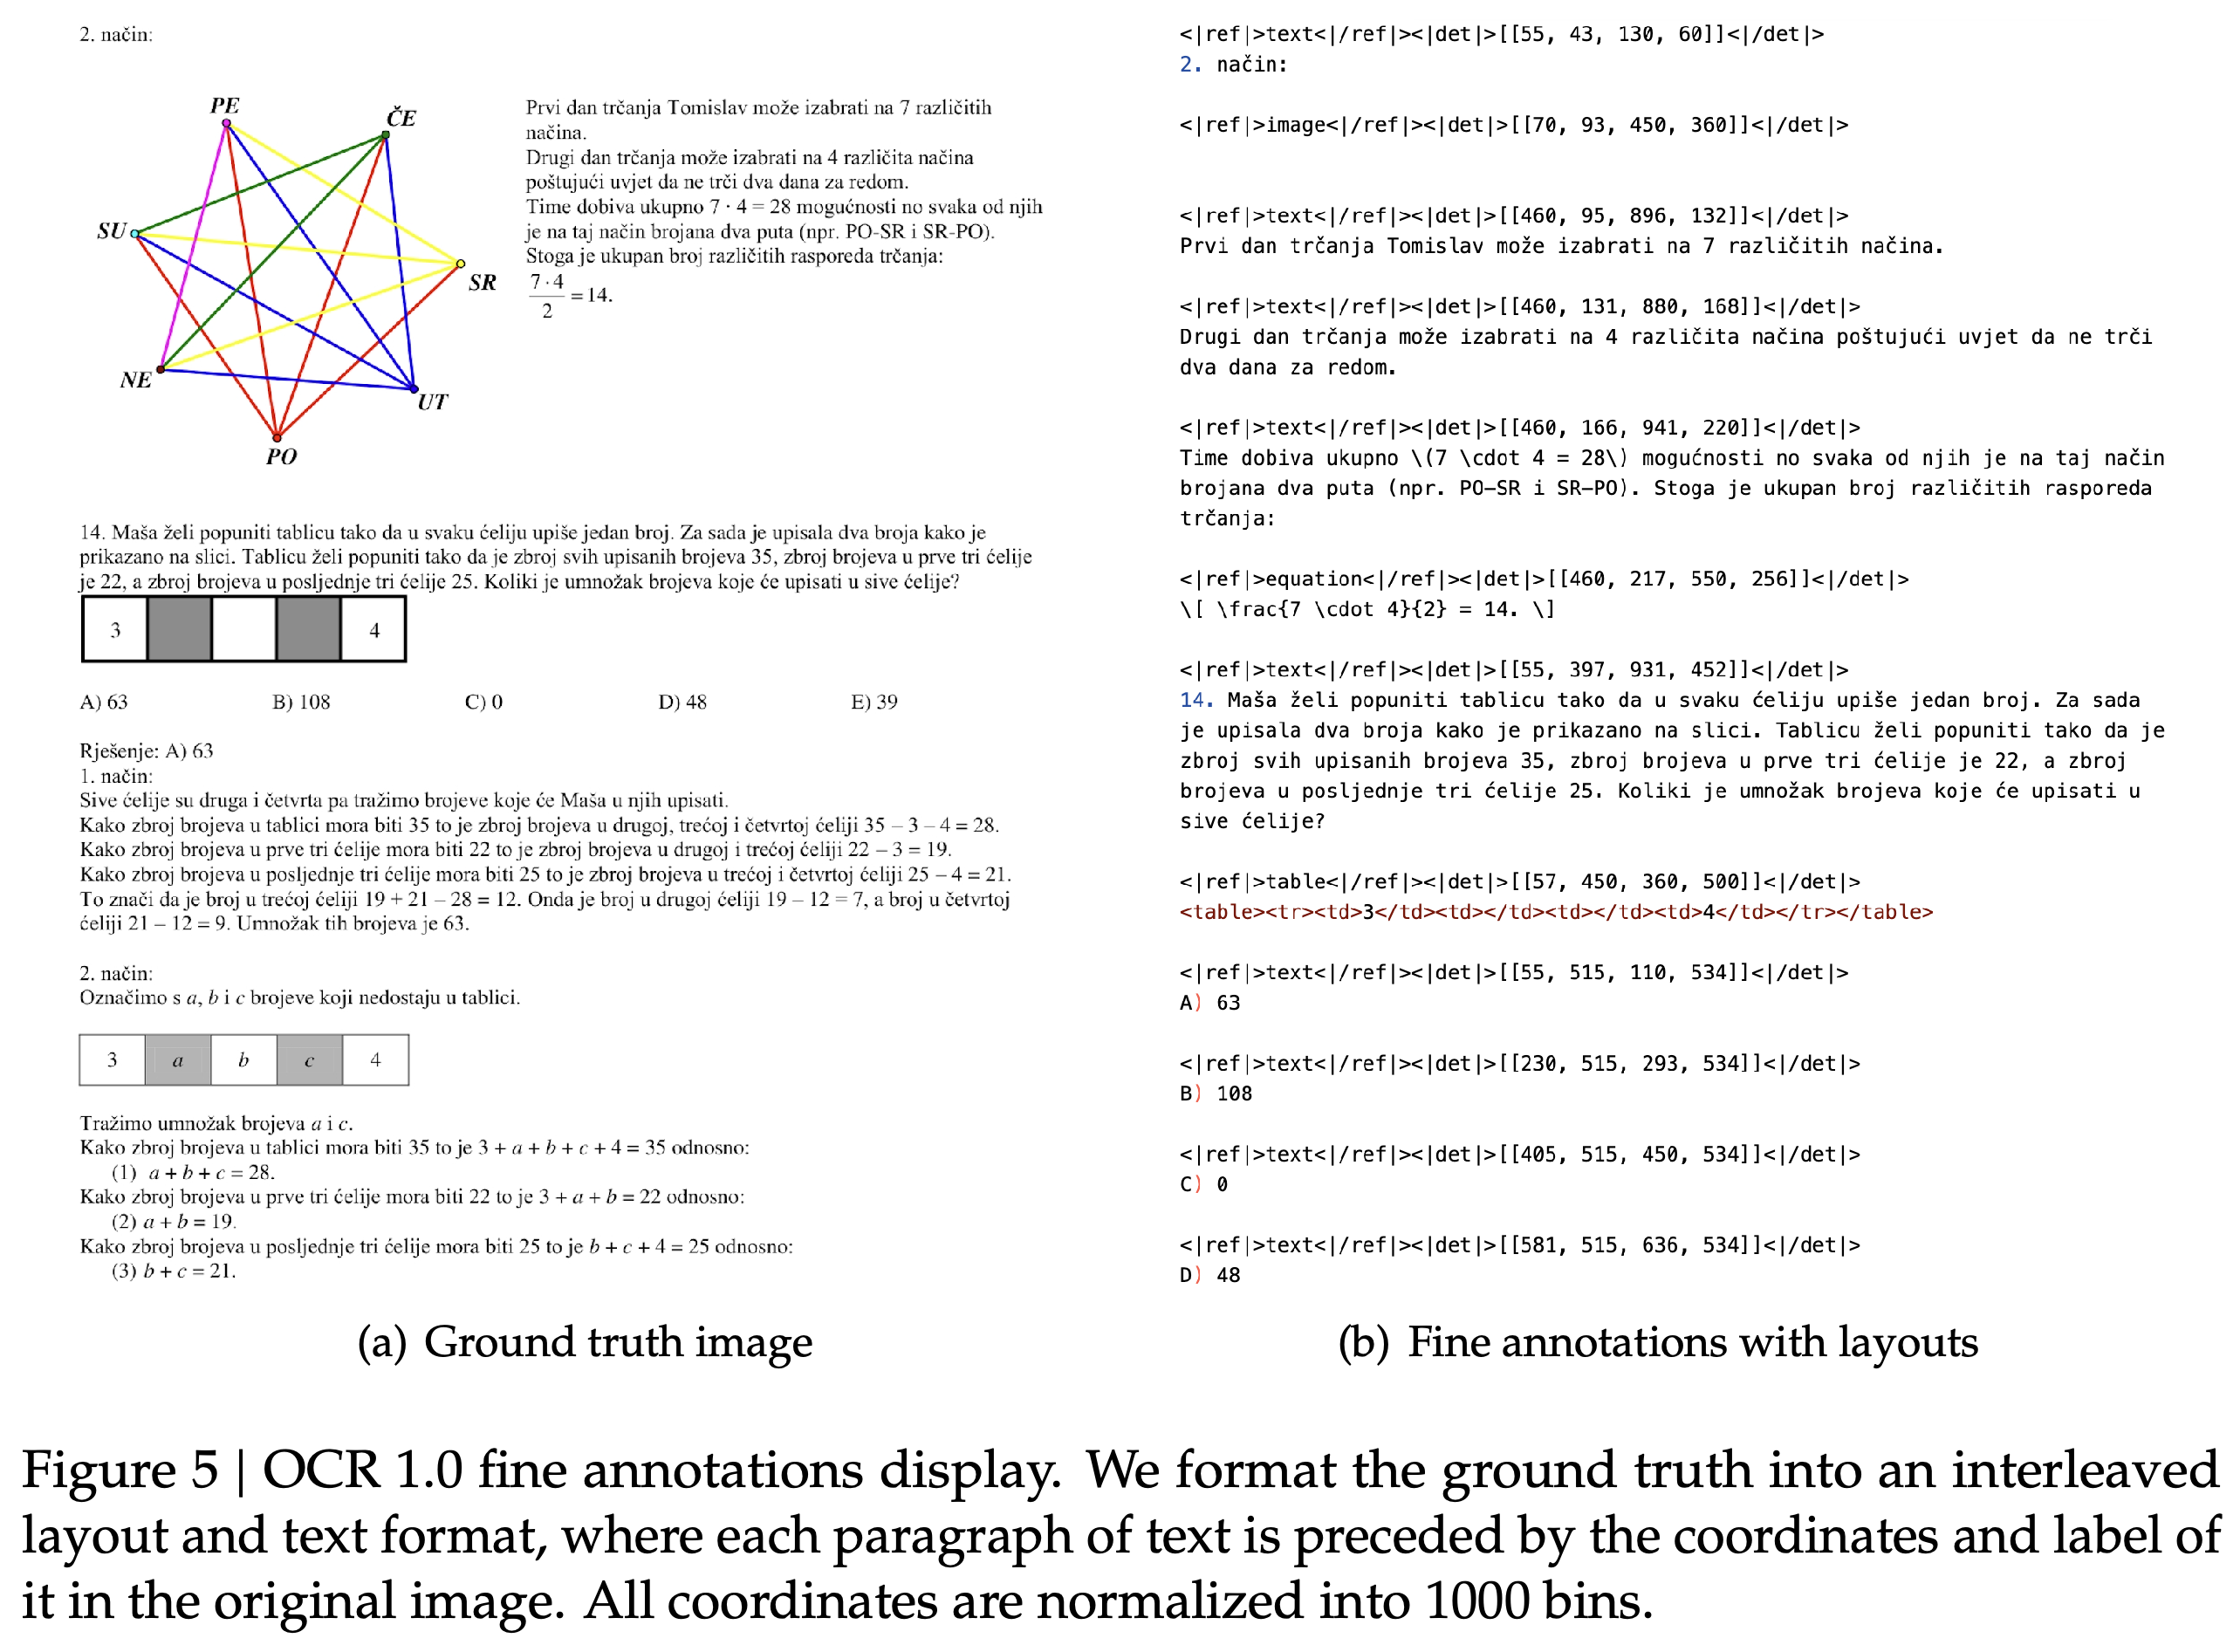
데이터 엔진은 전통적인 전사 데이터를 OCR 1.0 데이터로, 구조화된 인공 이미지 파싱 데이터를 OCR 2.0 데이터로 구분한다. 3.4.1. OCR 1.0 data에서 저자들은 약 100개 언어를 포함하는 PDF 30M페이지를 수집한다. 약 25M페이지는 중국어/영어이며 5M페이지는 다른 언어다. 거친 라벨은 PDF 처리 도구인 fitz로 만들고, 세밀한 라벨은 영역 유형, 좌표, 인식한 내용을 교차 배치한다.
- 세밀한 주석에는 레이아웃 및 OCR 모델로 라벨링한 중국어와 영어 각 2M페이지가 포함된다. 소수 언어는 추출한 텍스트 패치로 학습한 GOT-OCR2.0 모델이 레이아웃 처리 이후 각 영역에 라벨을 부여해 600K개 샘플을 만든다. 서로 다른 프롬프트로 거친 라벨과 세밀한 라벨을 이용한 학습을 구분한다.
- 저자들은 이미지-텍스트 쌍을 만들기 위해 Word 문서 3M개도 수집한다. 이 데이터는 특히 수식과 HTML 형식의 표에 도움이 되며, HTML은 표 출력에 사용하는 마크업 언어다.
- 자연 장면 인식에는 이미지-텍스트 데이터 소스인 LAION과 Wukong에서 가져온 중국어 10M개, 영어 10M개 샘플을 사용하며 PaddleOCR 인식 시스템으로 라벨링한다. 검출 상자의 포함 여부는 프롬프트로 제어한다.
- 세밀한 레이아웃 주석은 좌표를 1000개 구간으로 정규화한다. Figure 5는 문서 영역과 해당 영역의 텍스트 또는 구조화된 내용을 교차 배치하는 방식을 보여준다.
주석이 달린 각 영역에는 내용 앞에 유형 라벨과 정규화된 상자 좌표가 붙는다. 정답은 공간적 레이아웃, 전사 텍스트, 구조화된 내용을 1개 출력 시퀀스로 결합한다.
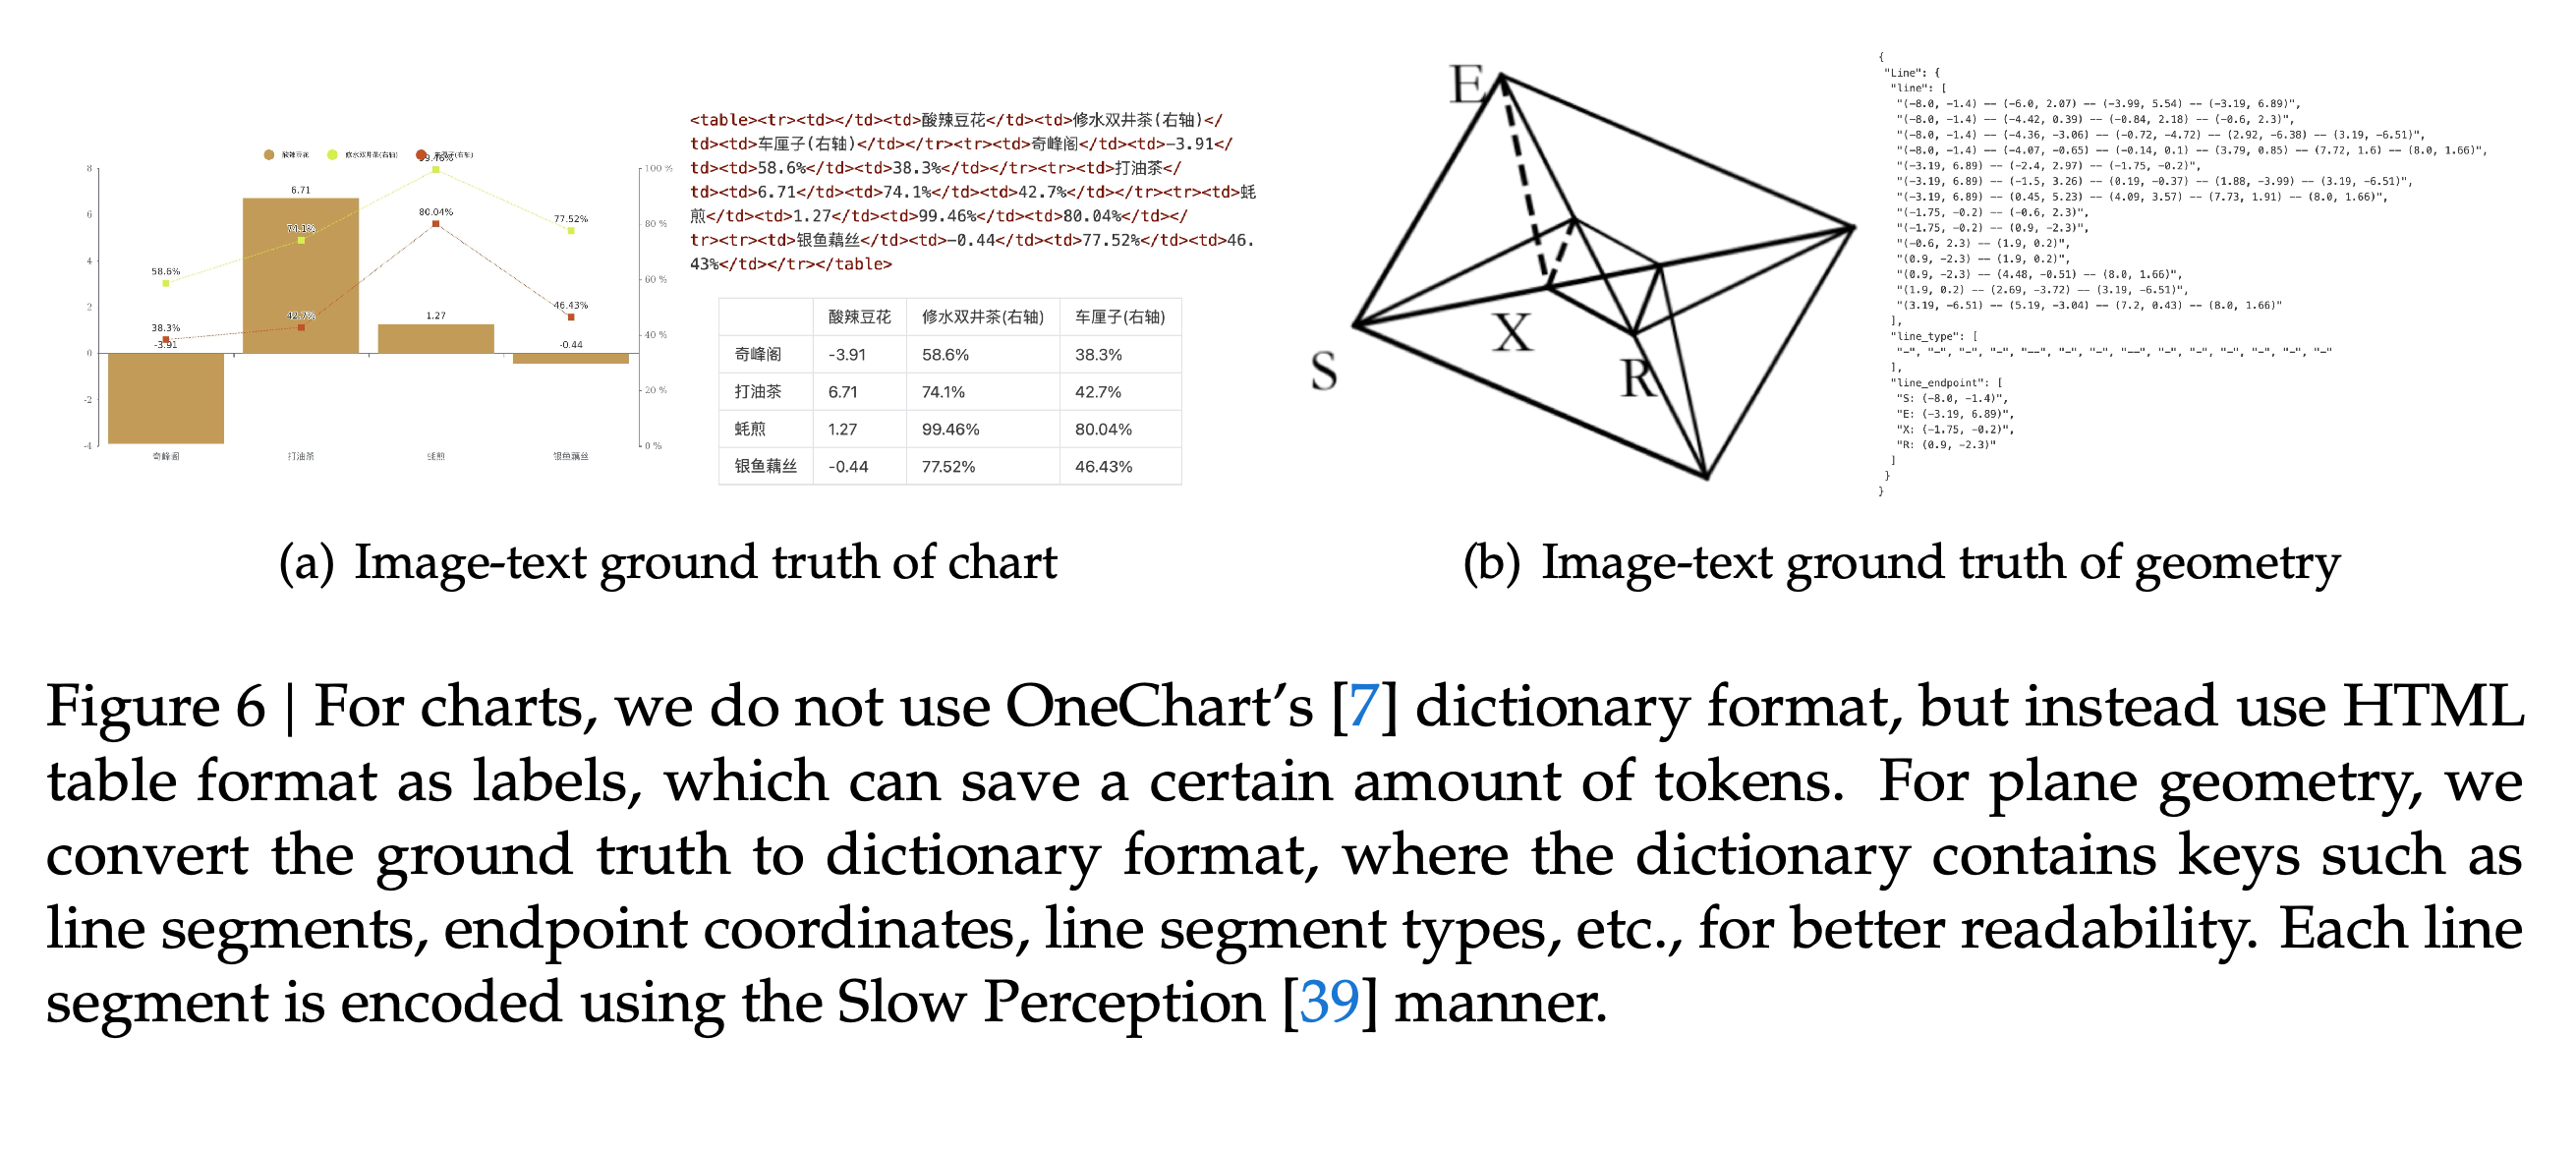
3.4.2. OCR 2.0 data는 렌더링한 차트 이미지 10M개, 화학 이미지-텍스트 쌍 5M개, 평면 기하 예제 1M개를 포함한다. 차트는 HTML 표로, 화학 구조는 분자 구조의 텍스트 표현인 SMILES로, 기하 도형은 선분과 좌표를 기술하는 딕셔너리로 변환한다.
- 차트는 시각화 라이브러리인 pyecharts와 matplotlib으로 렌더링하며 선, 막대, 원형, 복합 차트를 포함한다. 출력 토큰을 줄이기 위해 차트 파싱 방법인 OneChart의 딕셔너리 형식 대신 HTML 표를 학습 정답으로 사용한다.
- 화학 데이터는 화학 데이터베이스인 PubChem의 SMILES에서 시작하며 화학 구조 도구인 RDKit으로 렌더링한다.
- 기하 데이터는 선분 인코딩 방법인 Slow Perception을 따르며, perception-ruler 크기는 4다. 평행 이동 증강은 이미지를 이동하면서도 정답 구조가 좌표계의 중심에 놓이도록 유지한다.
차트 정답은 차트에 담긴 값을 HTML 표로 표현하며 기하 정답은 구조 요소와 좌표를 딕셔너리에 기록한다. 두 작업 모두 보이는 텍스트를 전사하는 것에 더해 시각적 구조도 복원해야 한다.
3.4.3. General vision data는 일반적인 시각 처리 기능을 유지하기 위해 캡셔닝, 검출, 텍스트 설명을 이미지 영역과 연결하는 grounding을 포함한다. 3.4.4. Text-only data에서는 언어 능력을 보존하기 위해 자체 사전학습 텍스트를 포함한다. 최종 데이터 혼합 비율은 OCR 70%, 일반 시각 데이터 20%, 텍스트 전용 데이터 10%다. 텍스트 전용 샘플은 8192토큰으로 처리하며 이는 DeepSeek-OCR의 시퀀스 길이와 같다.
- 저자들은 DeepSeek-OCR을 범용 VLM이 아닌 OCR 특화 모델로 설명한다.
- 보고서에는 3개 데이터 구성 요소의 개별 효과를 측정하는 ablation 실험이 없다.
3.5. Training Pipelines
3.5.1. Training DeepEncoder에서는 소형 언어 모델과 next-token prediction을 사용해 다음 출력 토큰을 예측하도록 학습한다. 설명된 OCR 1.0/2.0 데이터 전체와 LAION의 일반 샘플 100M개를 사용한다. 배치 크기 1280, 시퀀스 길이 4096, 학습률 5e-5로 2 epochs 동안 학습한다. 가중치 감쇠를 분리한 옵티마이저인 AdamW와 학습률을 코사인 곡선에 따라 조정하는 cosine annealing 스케줄을 사용한다. 3.5.2. Training DeepSeek-OCR에서는 SAM과 압축기를 고정하고 CLIP과 디코더를 학습한다.
- 학습 플랫폼인 HAI-LLM은 모델을 4개 파이프라인 병렬(PP) 단계로 나눈다. SAM/압축기는 PP0, CLIP은 PP1에 배치하고 디코더의 12개 계층 중 6개씩을 PP2와 PP3에 배치한다.
- 결합 모델 학습에는 A100-40G GPU가 각각 8개인 20개 노드를 사용한다. 복제된 모델이 서로 다른 데이터 배치를 학습하는 데이터 병렬도는 40이며, 전역 배치 크기는 640이다. AdamW, 스텝 기반 스케줄러, 초기 학습률 3e-5를 사용한다.
- 보고된 학습 속도는 텍스트 전용 데이터에서 90B tokens/day, 멀티모달 데이터에서 70B tokens/day다.
- Gundam-master는 샘플링한 예제 6M개로 추가 학습한다. 다른 모드와 같은 절차를 따르므로 논문은 상세한 학습 절차를 생략한다.
4. Evaluation
평가는 제한된 토큰 예산에서의 텍스트 복원, 실용적인 문서 파싱, 정성적 시연을 다룬다. Fox는 압축률과 정밀도의 관계를 측정한다. OmniDocBench는 영어와 중국어 문서에서 작업별, 문서 유형별 파싱 오류를 비교한다.
4.1. Vision-text Compression Study
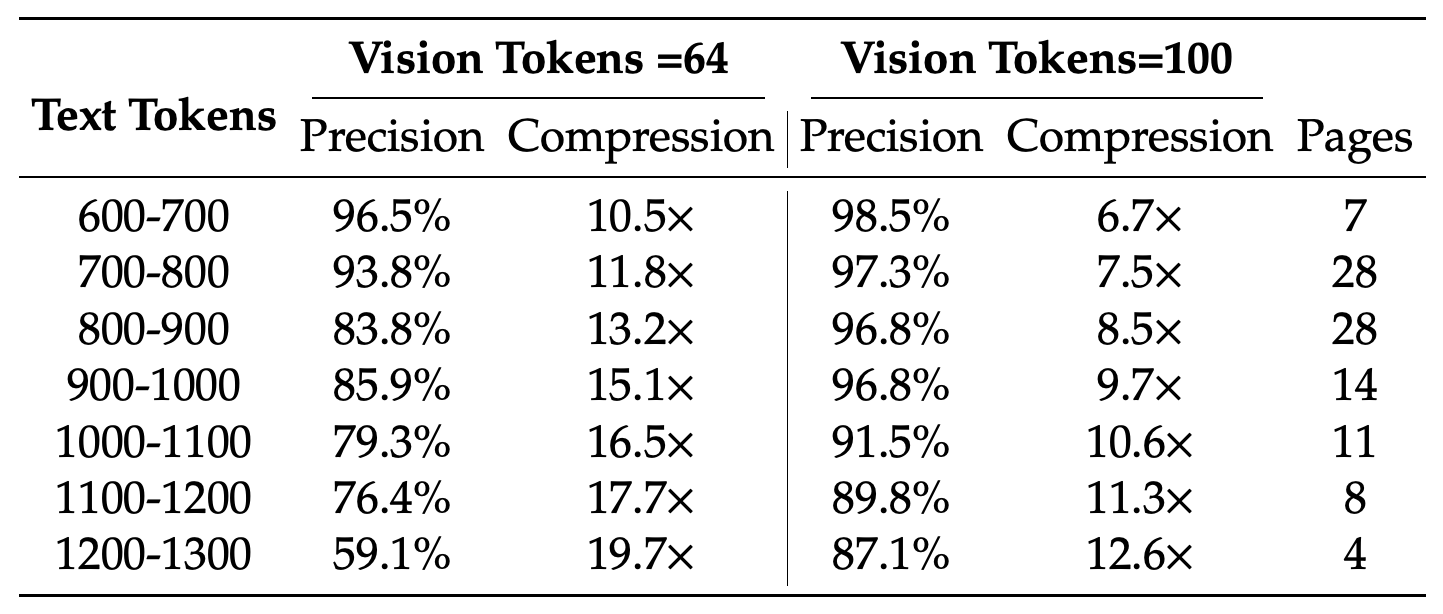
압축 실험은 DeepSeek-OCR 토크나이저 기준으로 정답 토큰이 600–1300개인 Fox 영어 100페이지 전체를 사용한다. 이 토크나이저의 어휘 크기는 약 129k다. Tiny와 Small은 크기를 조정한 페이지를 각각 64개와 100개 vision token으로 인코딩하며 프롬프트 “<image>\nFree OCR.”을 사용한다. 압축률은 정답 텍스트 토큰 수를 vision token 수로 나눈 값이다.
- 100 vision token을 사용하면 텍스트 토큰 600–1000개 범위의 4개 구간에서 압축률 6.7×, 7.5×, 8.5×, 9.7×에 각각 정밀도 98.5%, 97.3%, 96.8%, 96.8%를 기록한다.
- 텍스트 토큰 1000–1300개 범위에서 Small은 압축률 10.6×, 11.3×, 12.6×에 각각 정밀도 91.5%, 89.8%, 87.1%를 기록한다. Tiny는 1200–1300 tokens 구간에서 압축률 19.7×에 정밀도 59.1%를 기록하며 이 구간에는 4페이지만 포함된다.
- 저자들은 약 10×를 넘어설 때 복잡한 레이아웃과 흐려진 텍스트가 성능 저하에 영향을 준다고 추정한다. 이 설명들의 효과를 분리한 실험은 없다.
- 출력 형식은 Fox의 정답 형식과 완전히 일치하지 않는다. 저자들은 이 차이가 측정 성능을 낮춘다고 주장하지만 보정된 점수나 무손실 복원의 근거는 제시하지 않는다.
Small은 900–1000토큰 구간에서 압축률 9.7×에 정밀도 96.8%를 유지한다. Tiny는 1200–1300 tokens 구간에서 압축률 19.7×에 정밀도 59.1%를 기록한다. 각 구간에는 4–28페이지가 포함되며, 압축률이 가장 높은 결과는 4페이지만으로 뒷받침된다.
4.2. OCR Practical Performance
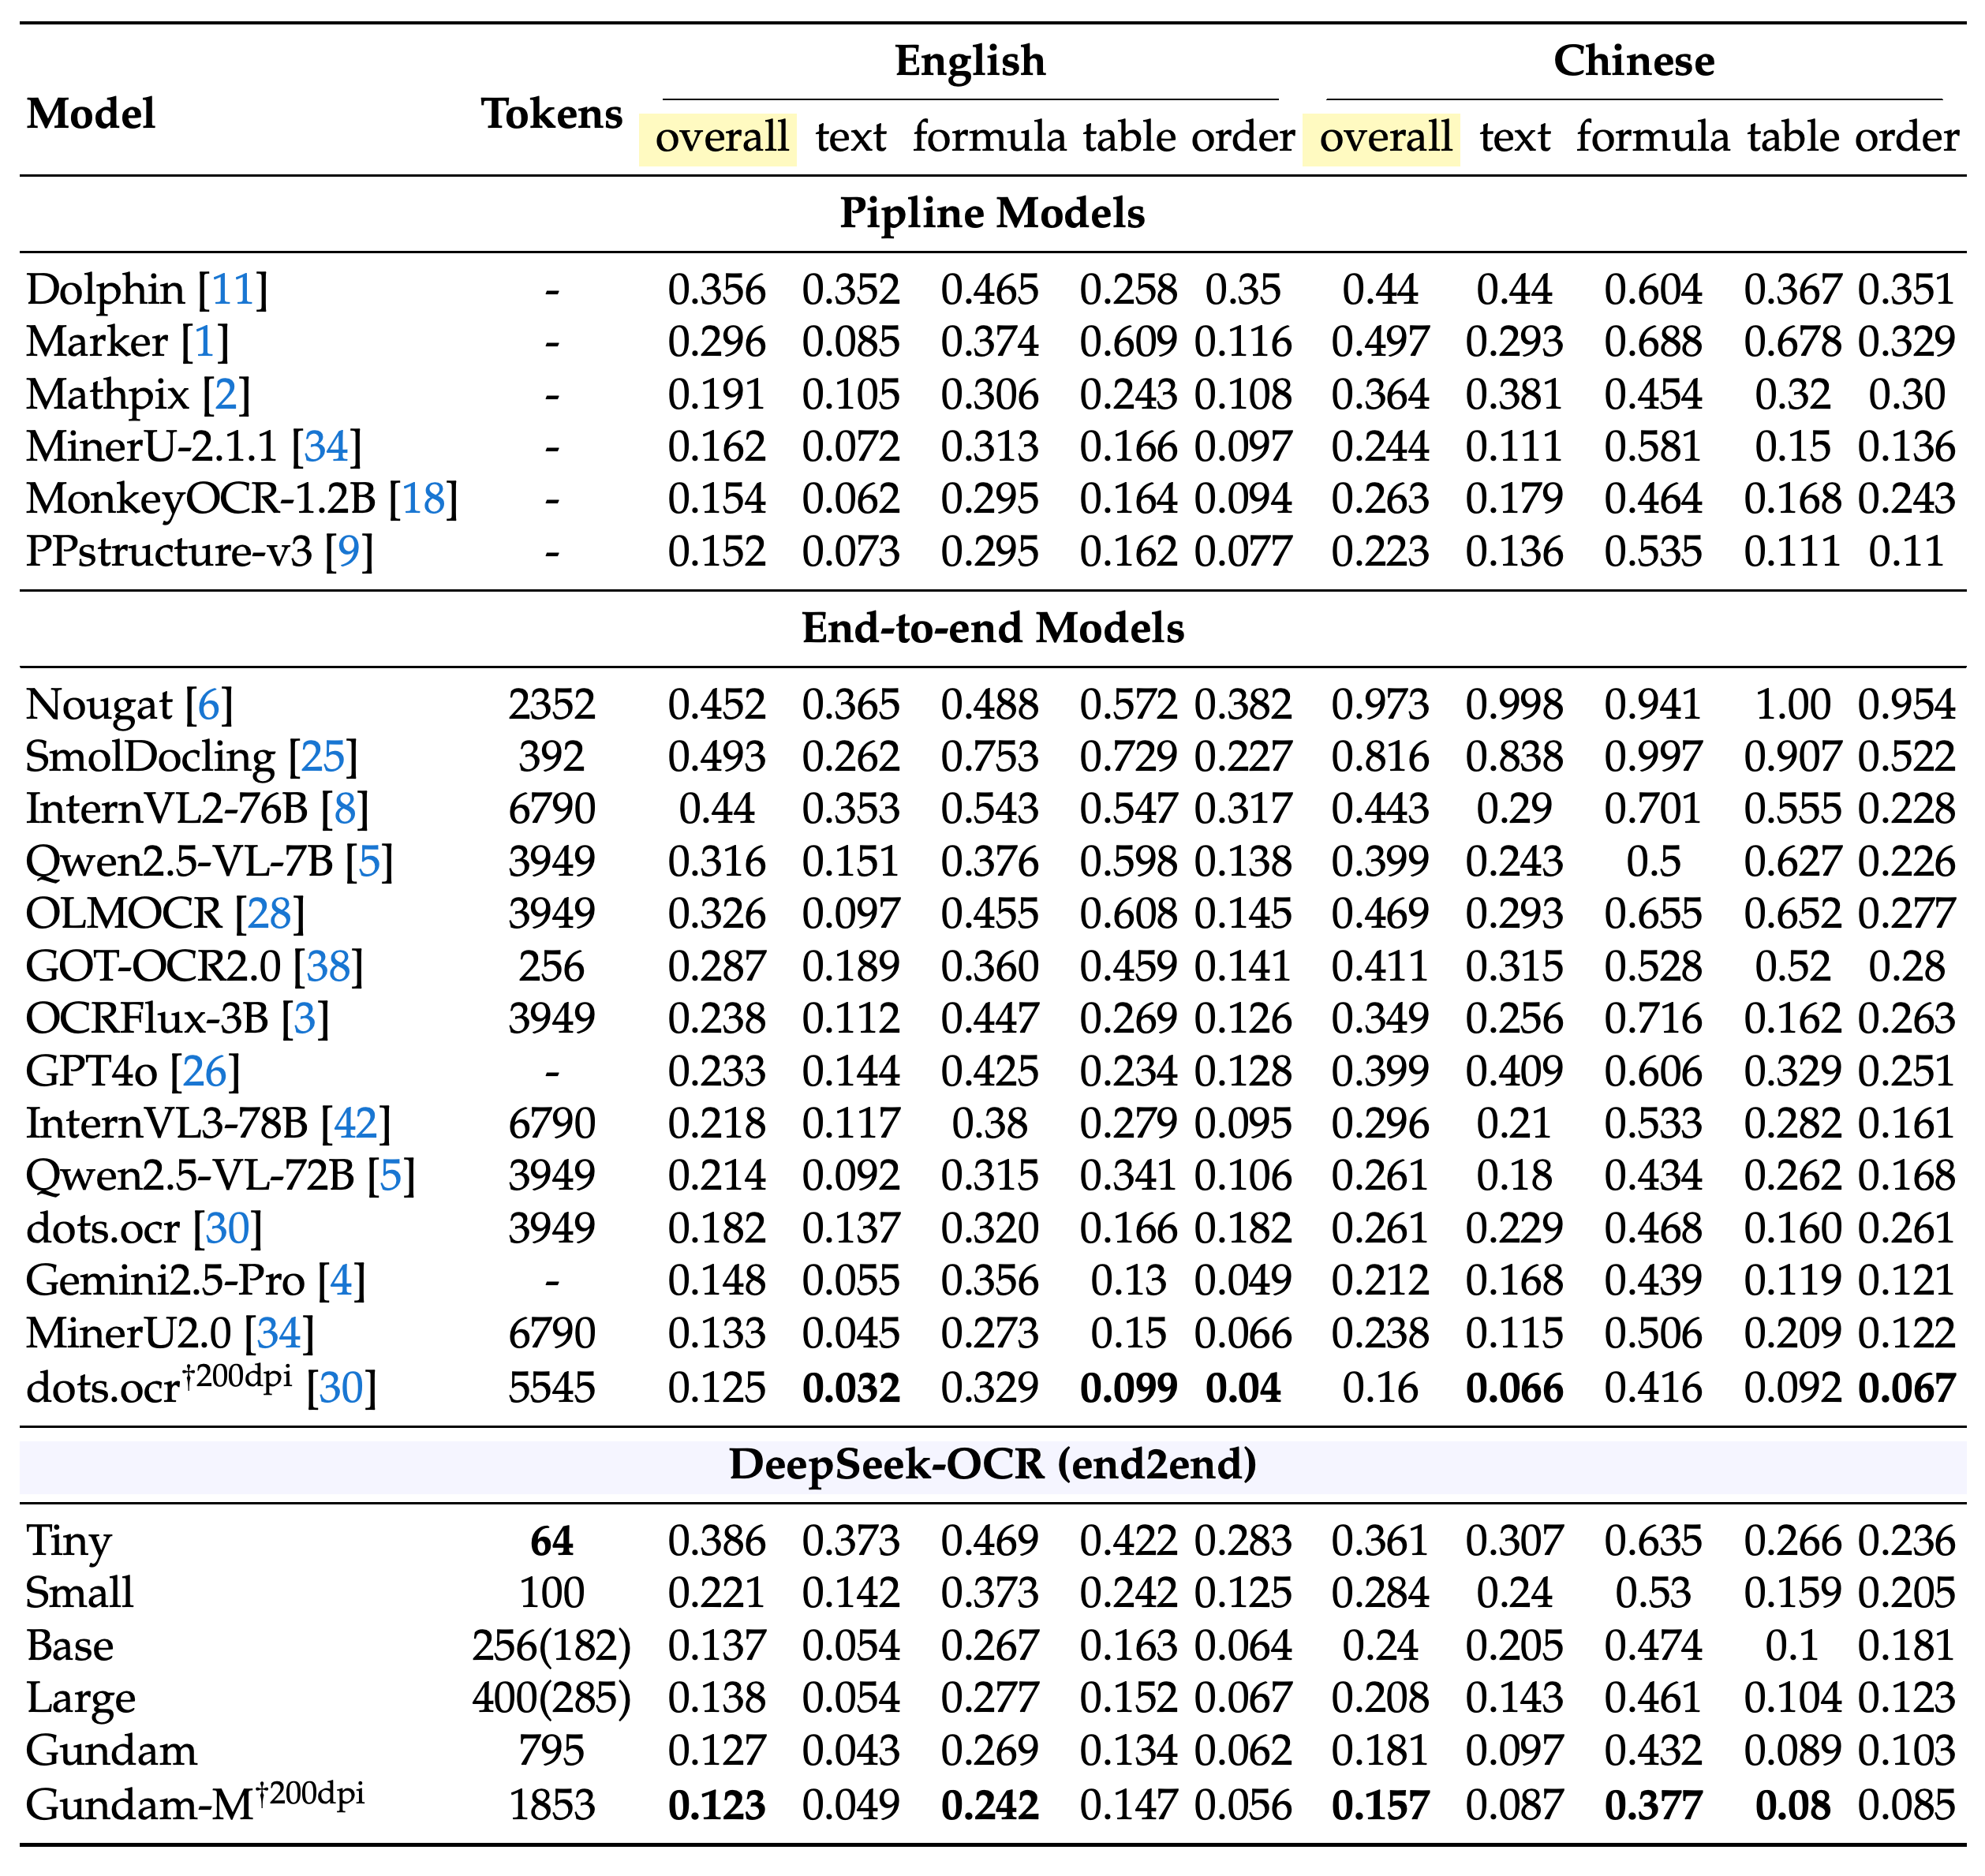
OmniDocBench에서 Small은 100토큰을 사용하며 영어/중국어 종합 편집 거리는 0.221/0.284다. GOT-OCR2.0은 256토큰을 사용하며 편집 거리는 0.287/0.411이다. Gundam은 평균 795토큰을 사용해 0.127/0.181을 기록하며 MinerU2.0은 6790토큰을 사용해 0.133/0.238을 기록한다. Gundam-M†200dpi는 1853토큰으로 0.123/0.157을 기록한다. †200dpi는 fitz로 입력 이미지를 인치당 200도트로 보간했음을 뜻한다.
- Table 3은 텍스트, 수식, 표, 읽기 순서의 편집 거리와 종합 값을 보고한다. DeepSeek-OCR이 모든 세부 지표에서 앞서지는 않는다. dots.ocr†200dpi의 영어 텍스트 및 표 편집 거리는 Gundam-M†200dpi보다 낮다.
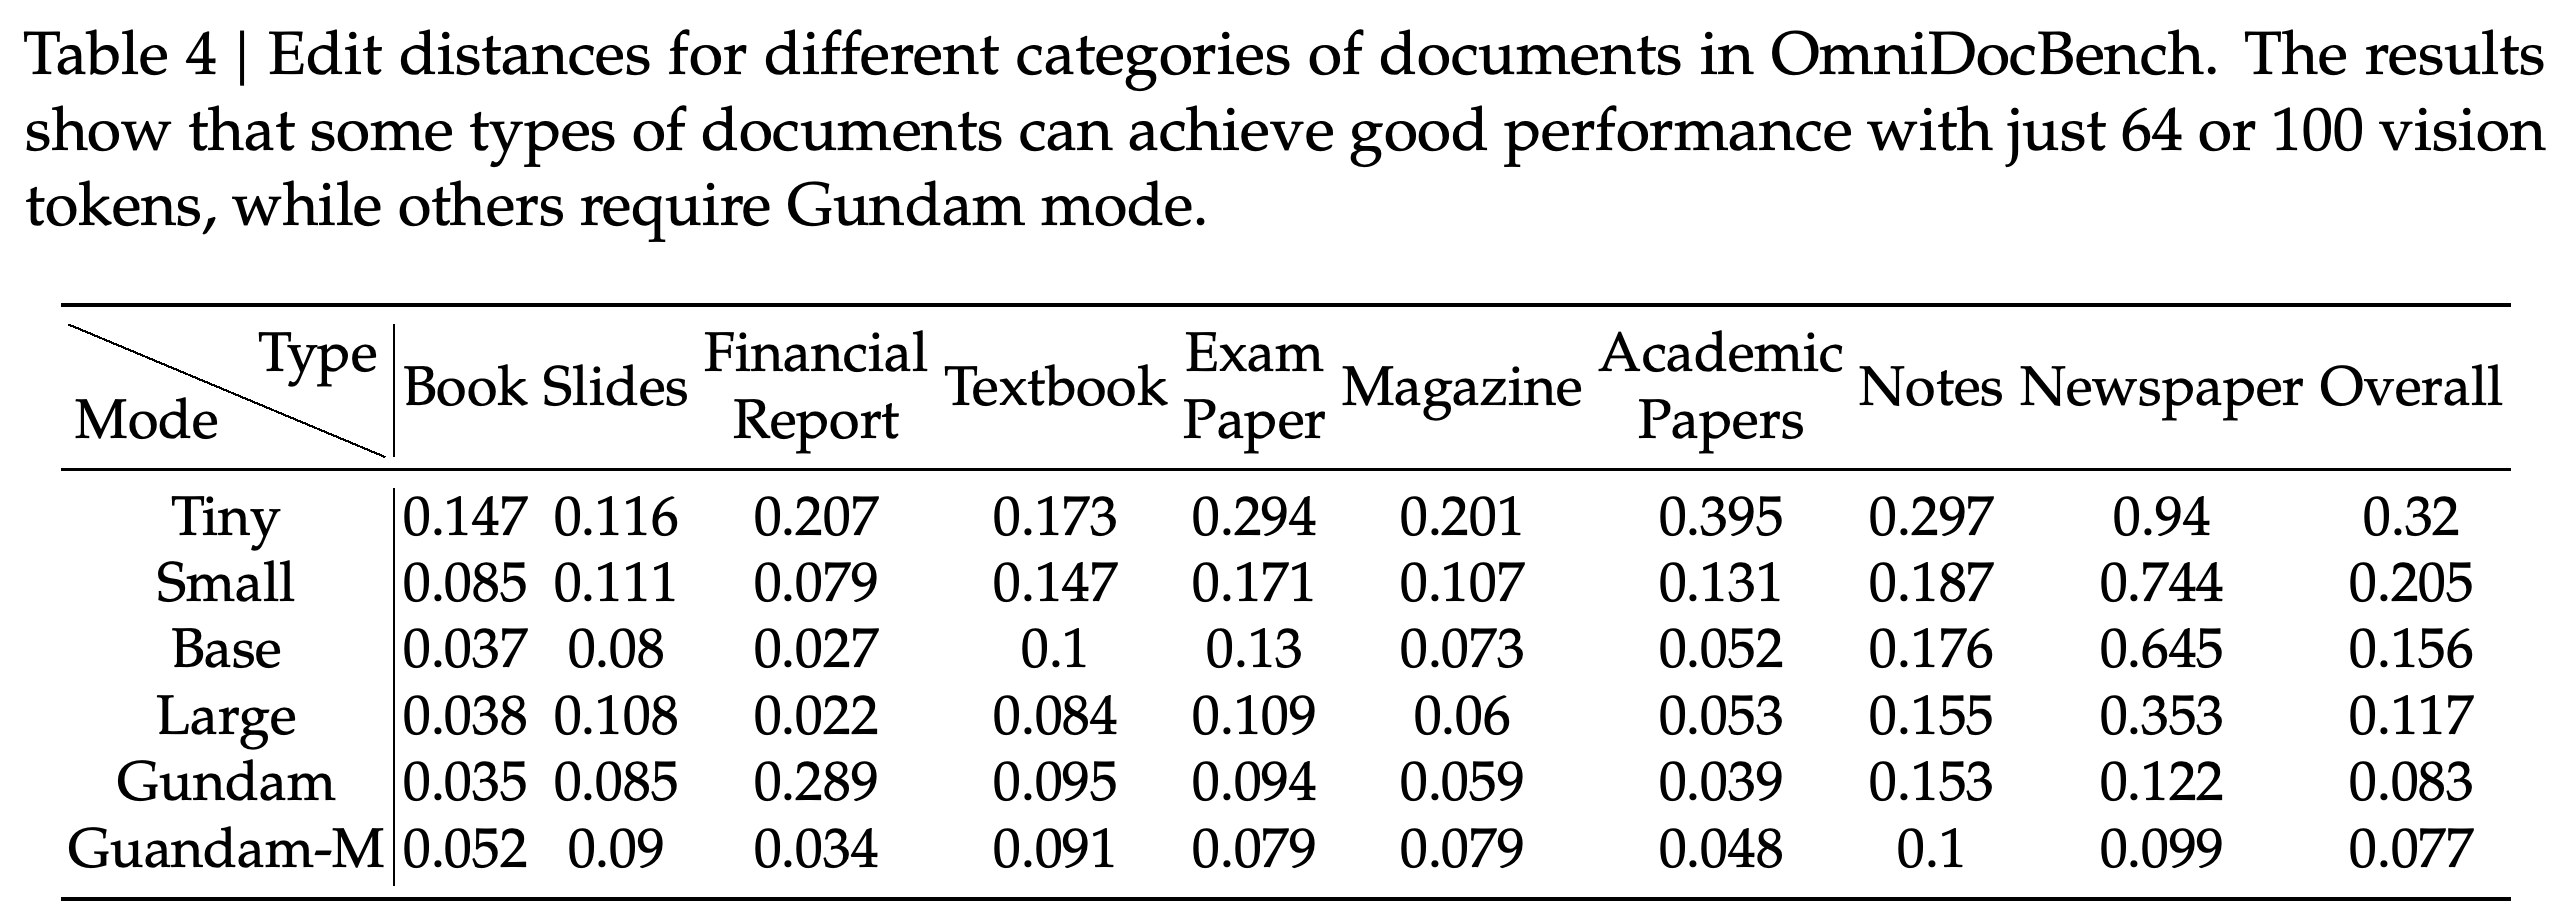
- Table 4는 필요한 해상도가 문서 유형에 따라 달라짐을 보여준다. 신문 편집 거리는 Tiny의 0.94, Small의 0.744에서 Gundam의 0.122, Gundam-M의 0.099로 낮아진다.
- 해상도를 높여도 모든 유형의 성능이 계속 개선되지는 않는다. Table 4에서 보고한 재무 보고서 편집 거리는 Large에서 0.022지만 Gundam에서는 0.289다.
- 저자들은 신문에 더 높은 해상도가 필요한 이유를 약 4,000–5,000개 텍스트 토큰과 연관 짓는다. 이는 문서 유형별 결과에 대한 저자들의 해석이며 토큰 밀도만 분리해 검증한 실험은 아니다.
Gundam은 평균 토큰 795개로 6790개를 사용하는 MinerU2.0보다 영어/중국어 종합 편집 거리가 낮다. 개별 작업 열에서는 종합 성능이 가장 좋은 DeepSeek-OCR 설정도 모든 지표에서 앞서지는 않음을 확인할 수 있다. †200dpi가 표시된 행은 이미지 전처리 조건도 명시적으로 다르다.
동적 해상도에서는 신문 오류가 크게 줄어들며, 책과 슬라이드는 작은 토큰 예산에서도 오류가 낮다. 개선이 모든 유형에서 일관되지는 않는다. 보고된 재무 보고서 편집 거리는 Gundam에서 0.289이며, Large에서는 0.022다.
4.3. Qualitative Study
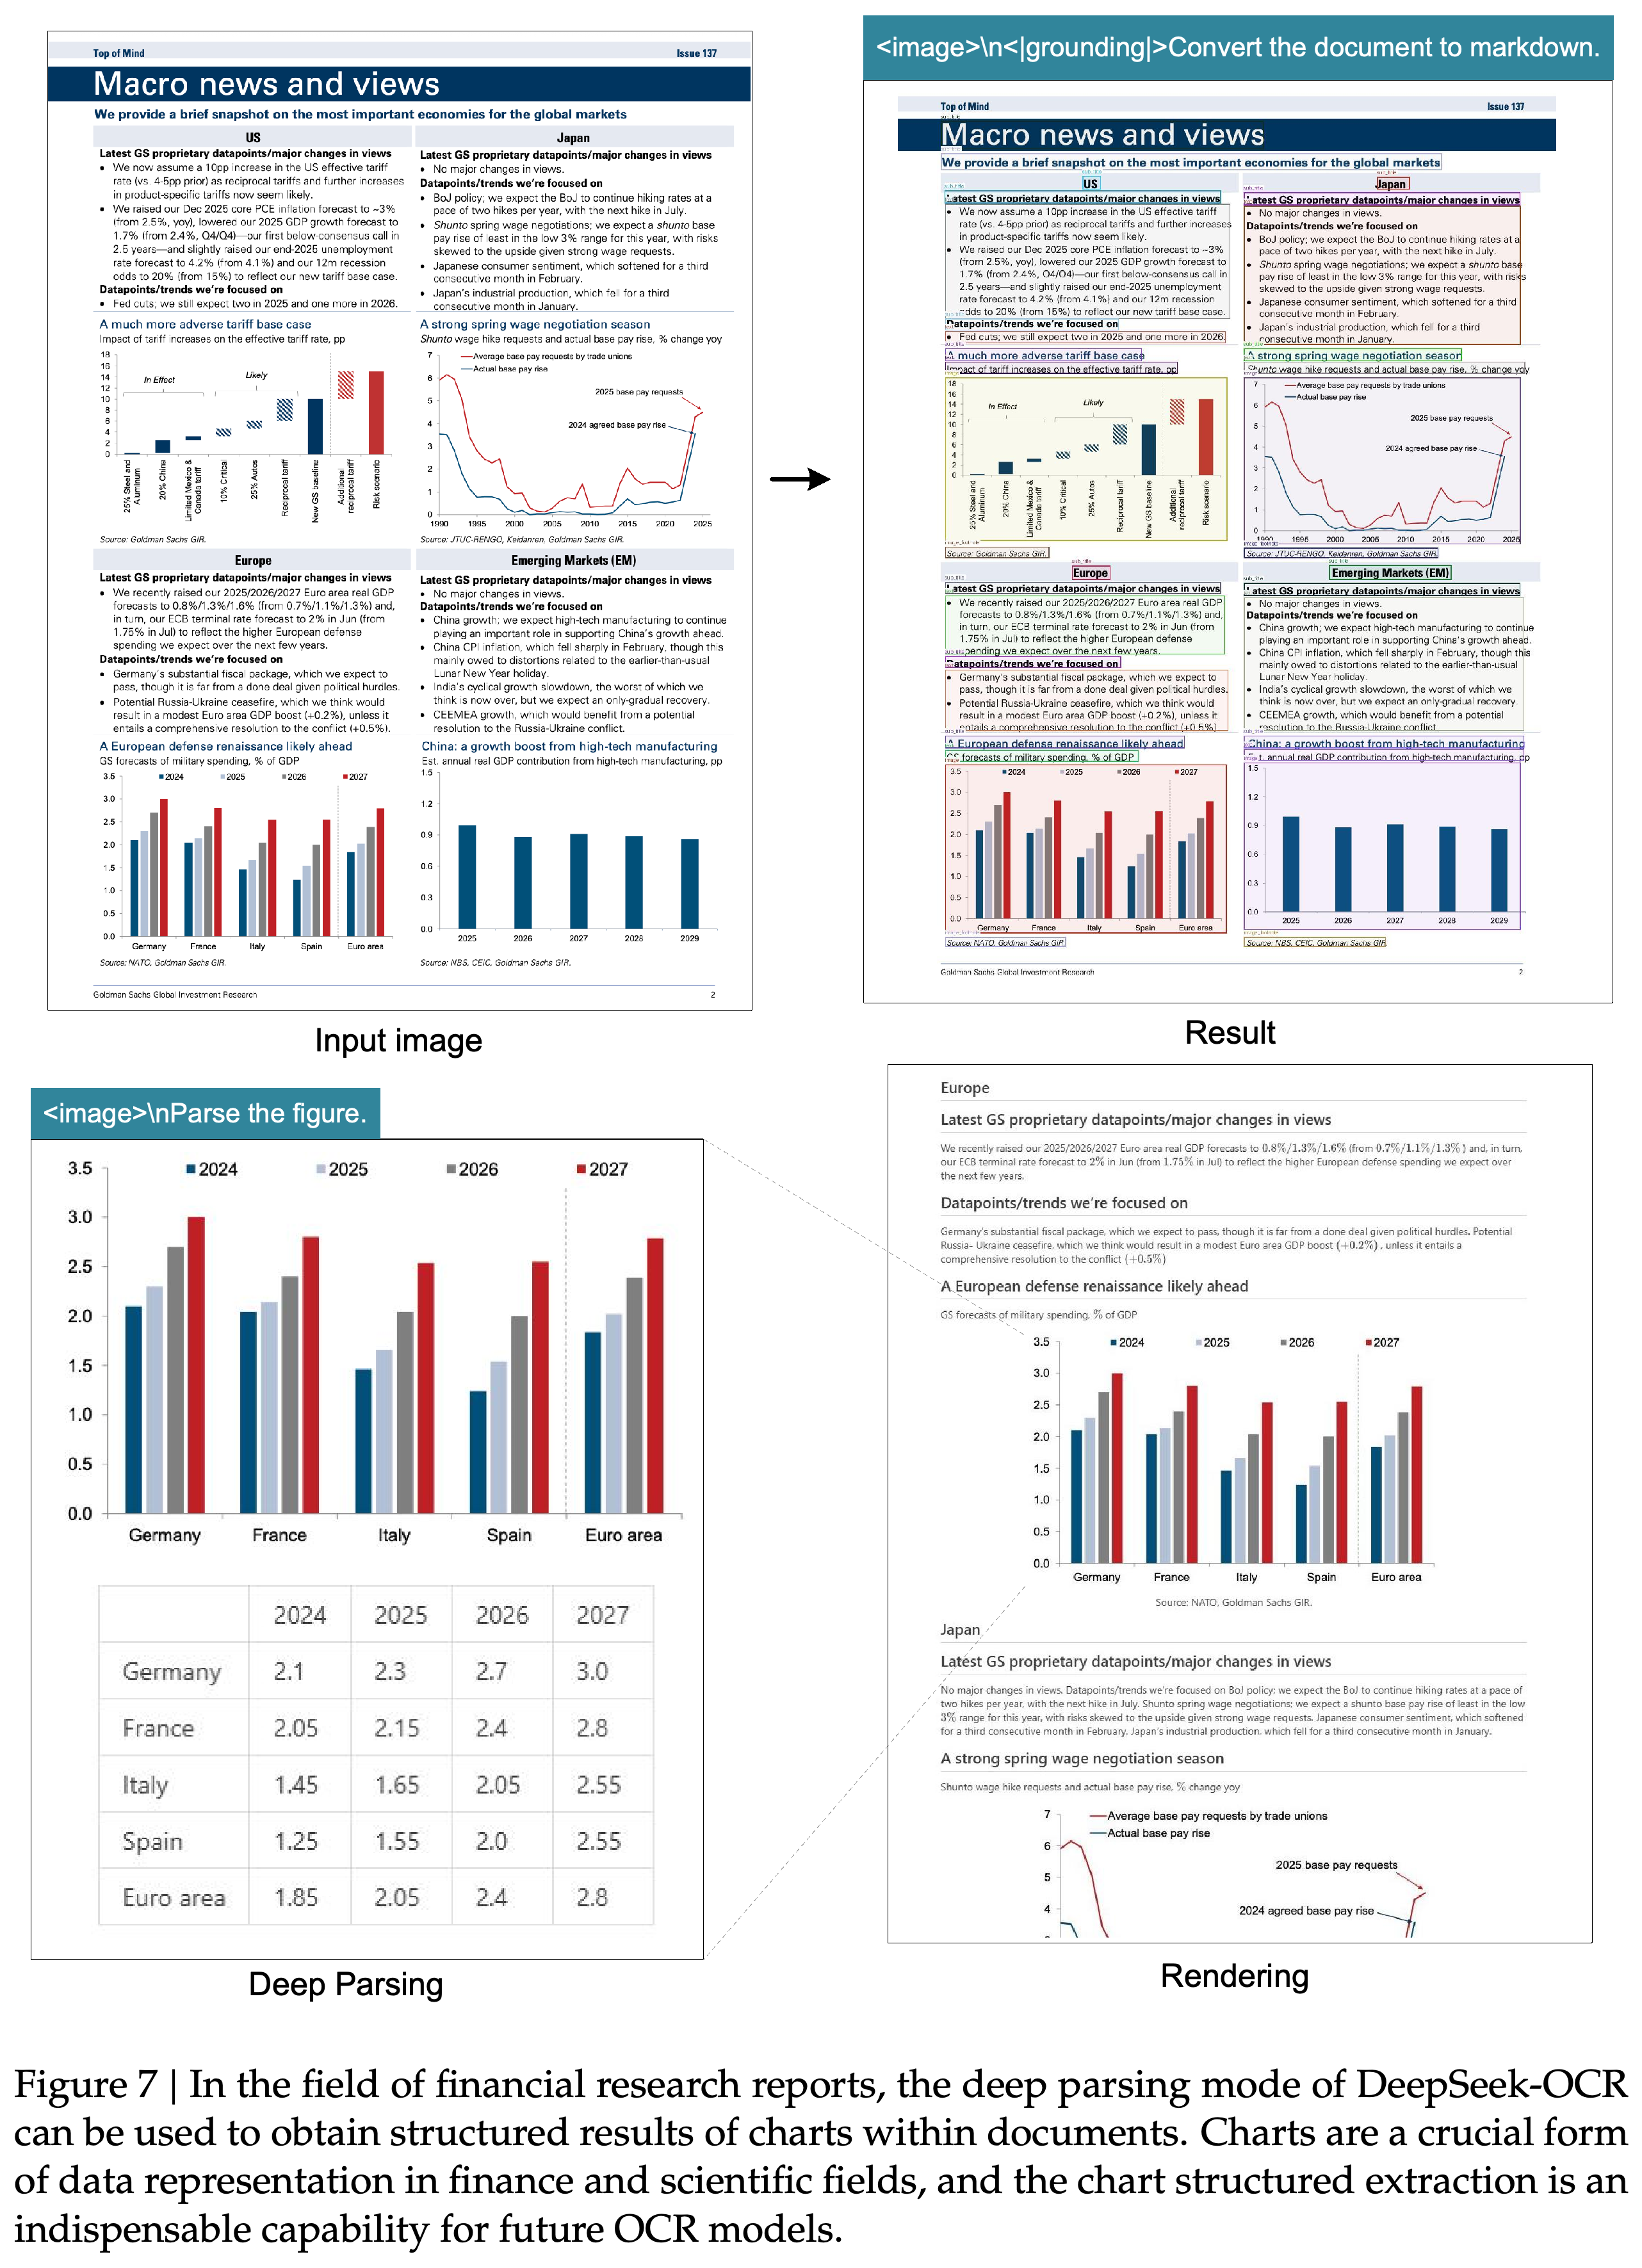
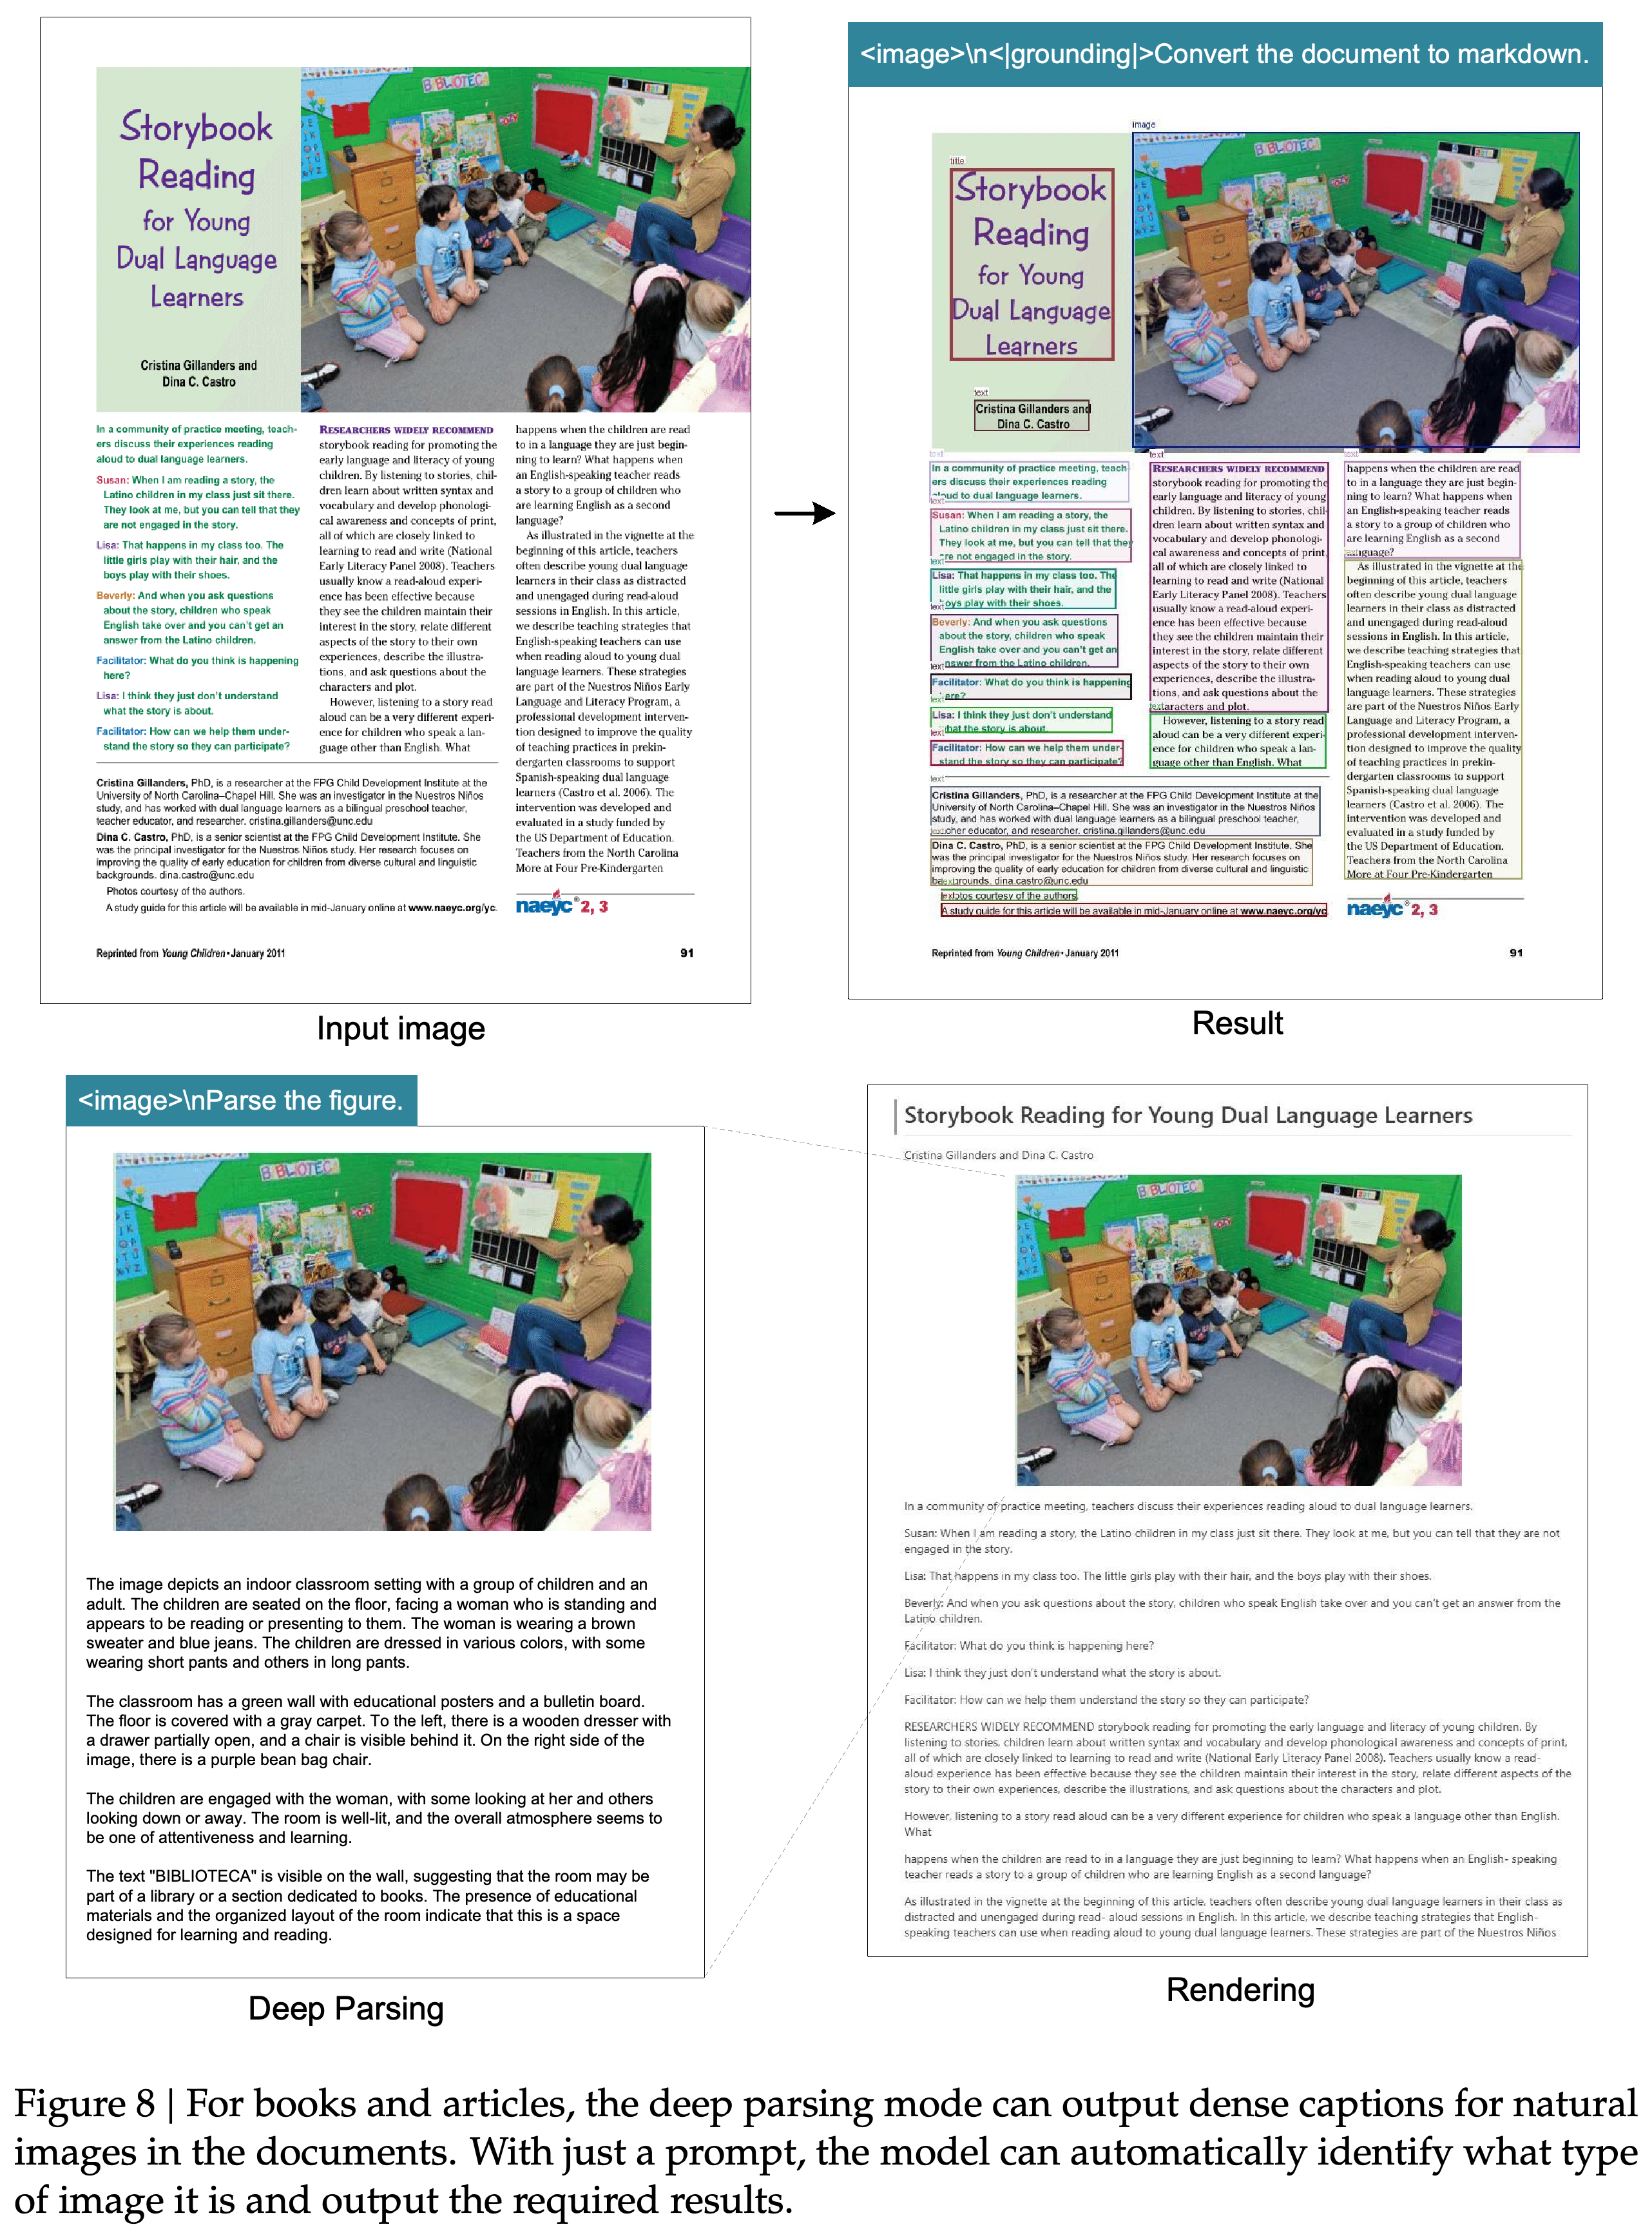
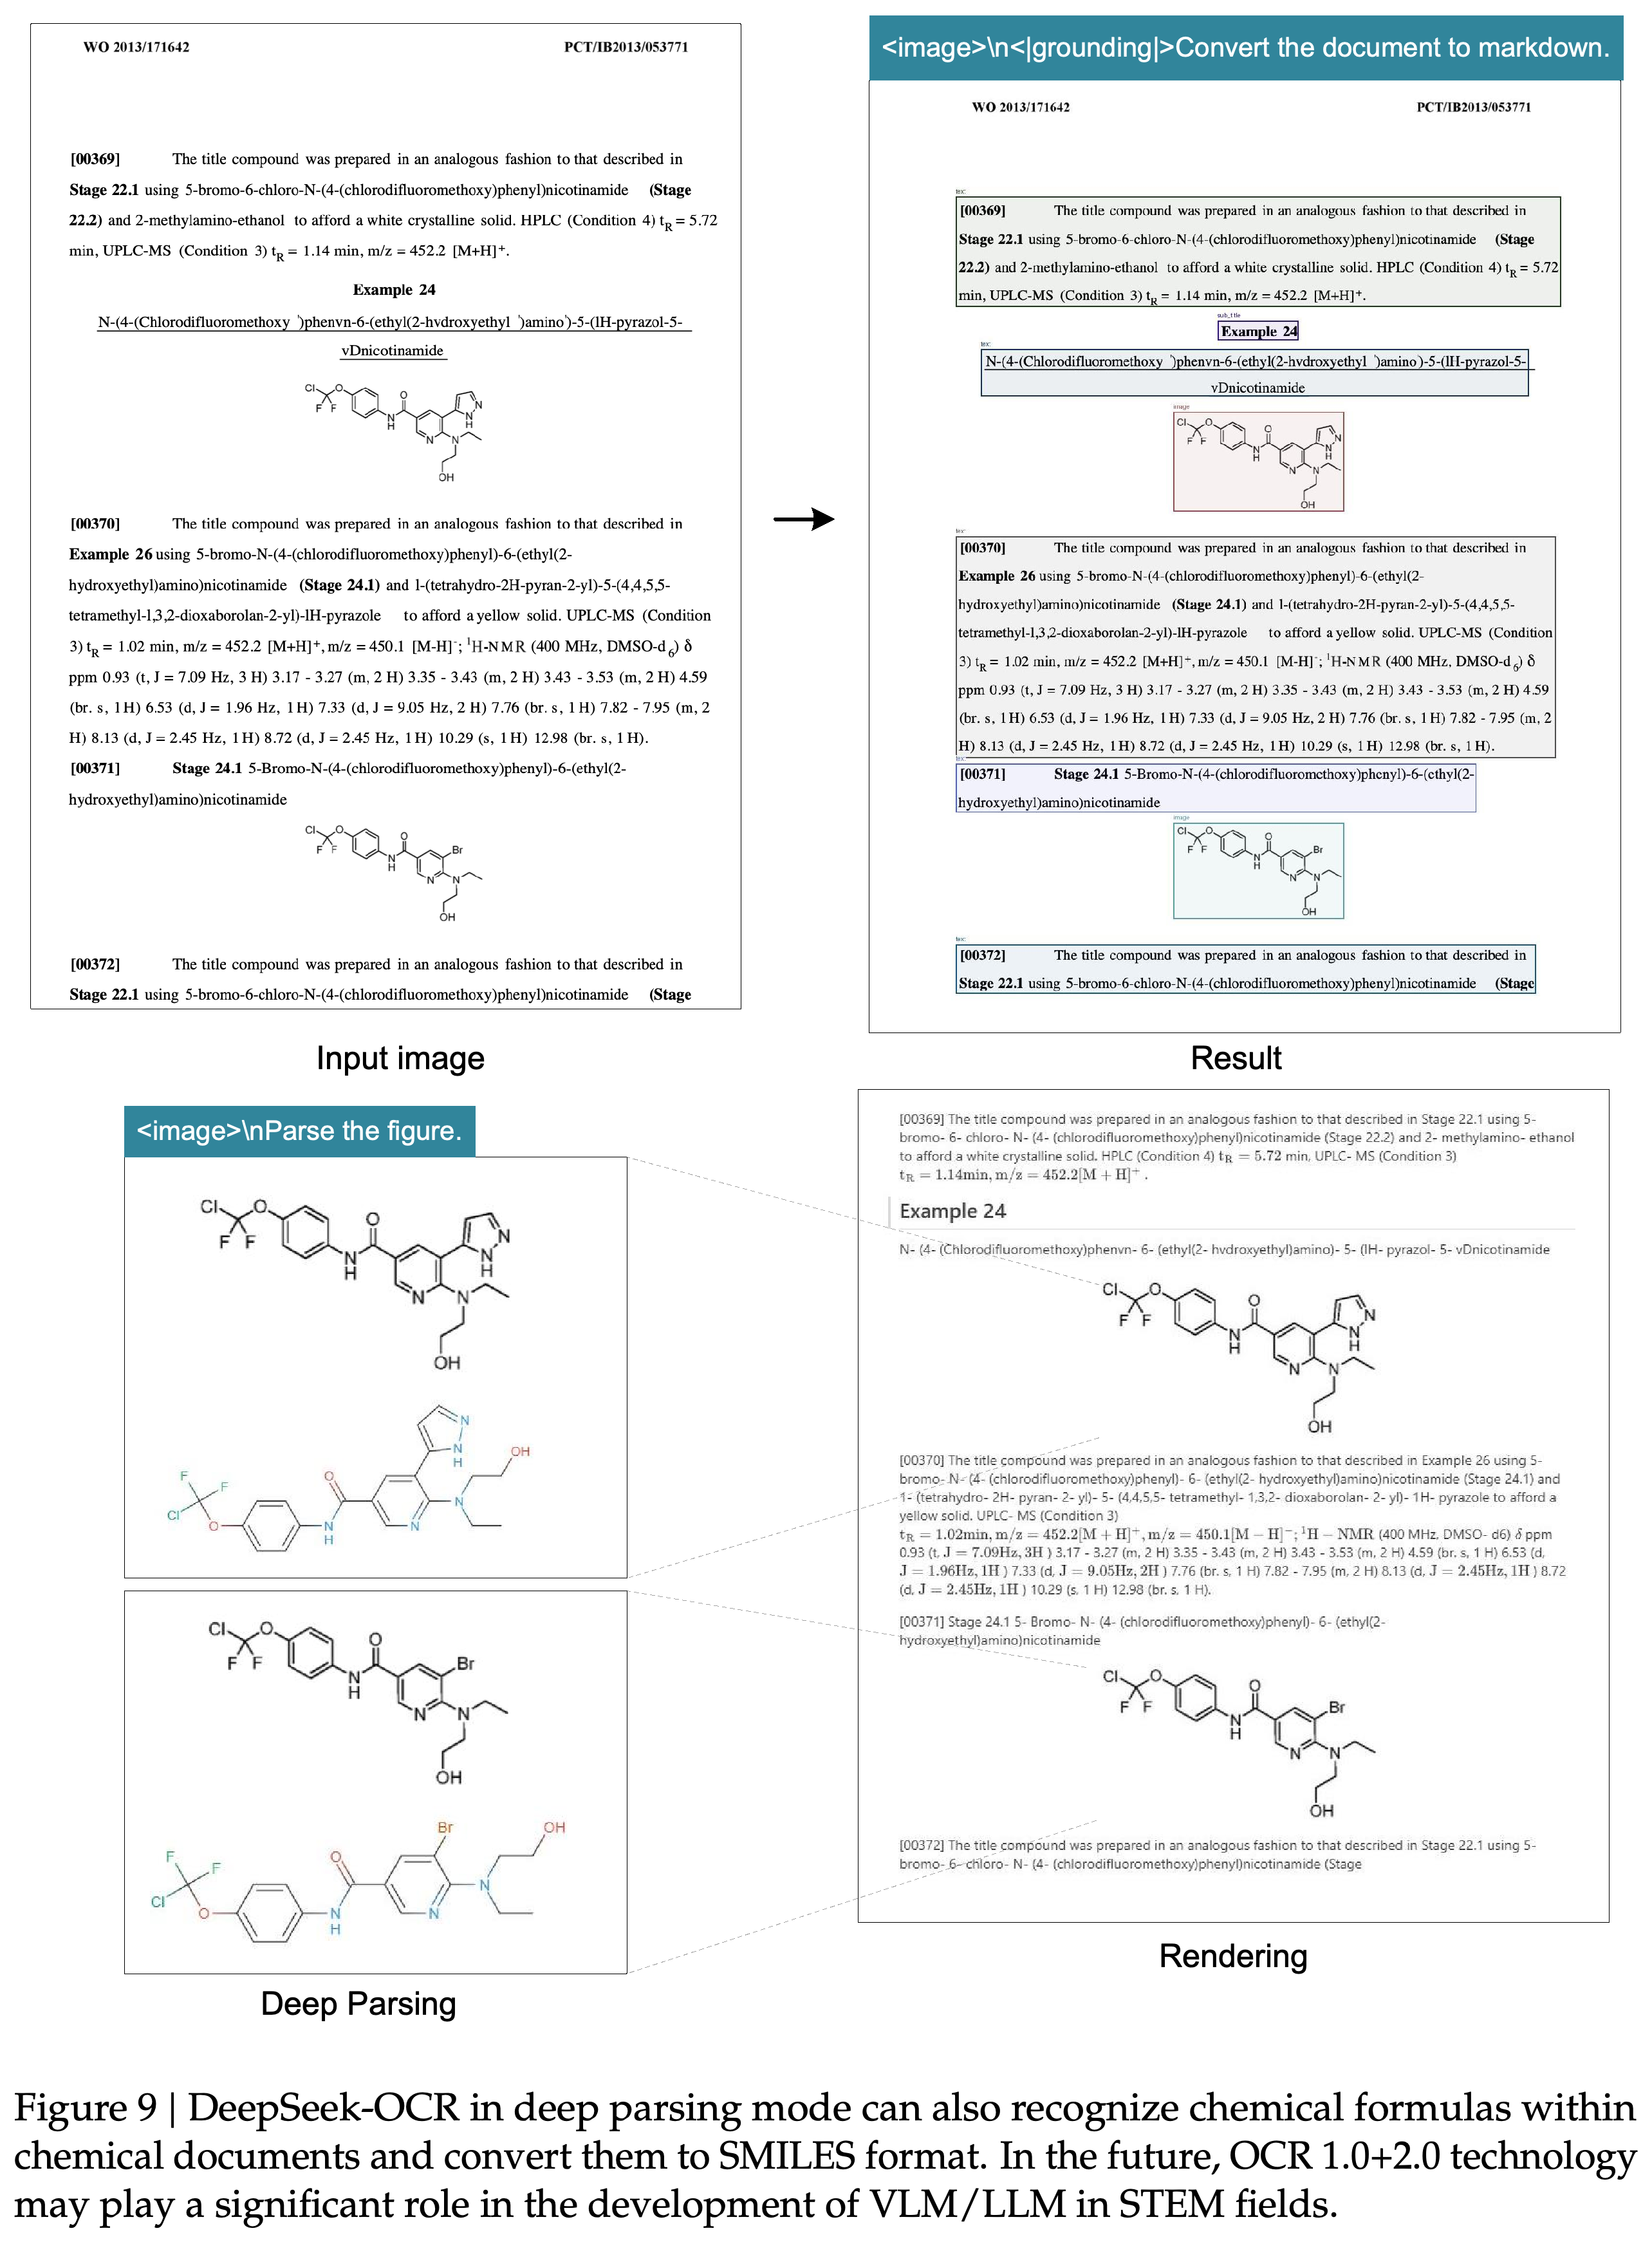
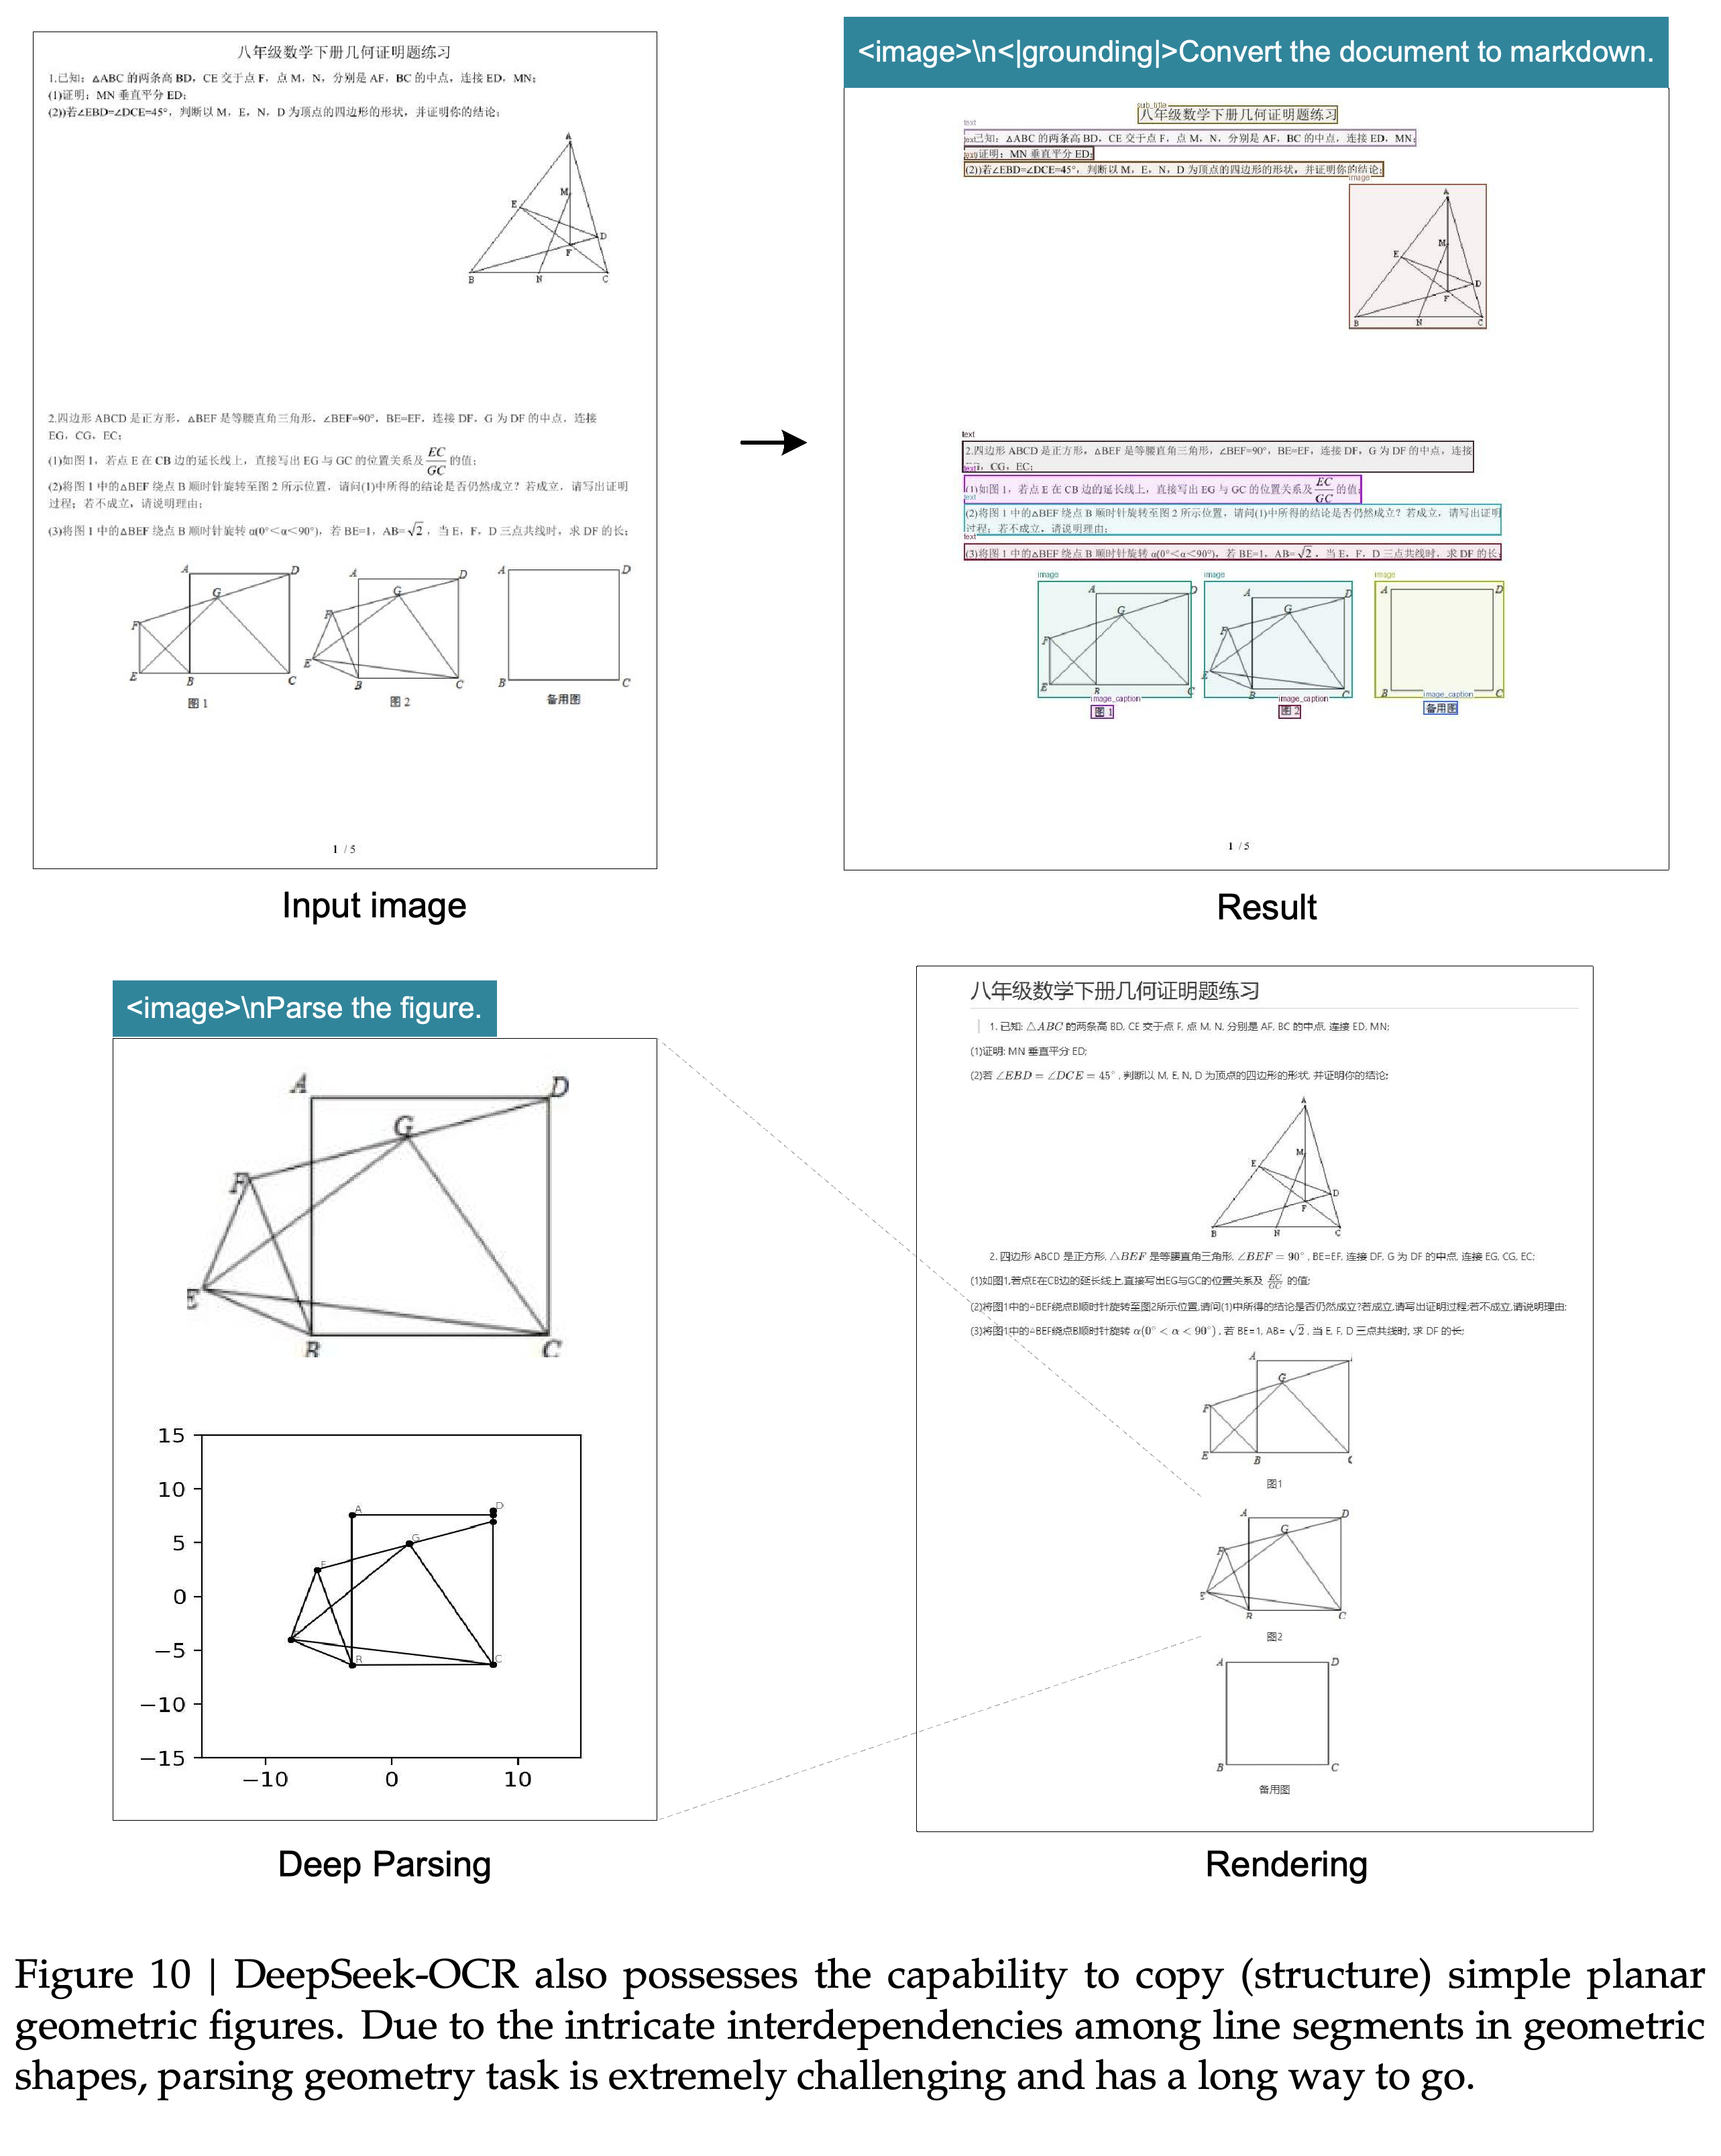
4.3.1. Deep parsing은 문서에서 검출한 이미지에 모델을 추가로 호출하는 방식이다. Figures 7–10은 차트의 표 변환, 자연 이미지 설명, 화학 구조 변환, 단순 평면 기하 도형 복원을 보여준다. “<image>\n<|grounding|>Convert the document to markdown.”으로 문서를 파싱한 뒤, 공통 그림 프롬프트 “<image>\nParse the figure.”을 사용한다.
- 차트 예제는 표로 렌더링할 수 있는 구조화된 값을 생성한다. 화학 예제는 분자 그림을 SMILES로 변환하고 추출한 구조를 렌더링한다.
- 기하 예제는 선분과 그 배치를 복원한다. 저자들은 선분 사이의 의존 관계를 남은 과제로 제시한다.
- 이 시연은 예제 출력을 보여주지만 추가 파싱 작업의 종합 정확도 측정치는 제시하지 않는다.
재무 보고서 페이지에서 레이아웃을 파싱한 뒤, 추출한 차트를 다시 처리해 표의 값을 얻는다. 이 예제는 추가 모델 호출을 보여주지만 테스트 세트 전반의 차트 추출 정확도를 측정하지는 않는다.
모델은 기사 안의 사진을 식별하고 그림 파싱 프롬프트로 상세한 설명을 생성한다. 이 출력은 같은 프롬프트가 사진에 대해서는 구조화된 차트 값 대신 자연어 설명을 생성할 수 있음을 보여준다.
화학 문서에서 분자 그림을 추출하고 SMILES로 변환한 뒤 복원된 구조로 렌더링한다. 이 예제는 작업 절차를 보여주지만 종합적인 화학 인식 정확도는 제시하지 않는다.
문서에 포함된 기하 도형을 좌표 기반으로 복원하고 렌더링된 문서 내용에 반영한다. 저자들은 선분 사이의 의존 관계를 복원하는 작업이 여전히 어렵다고 인정한다.
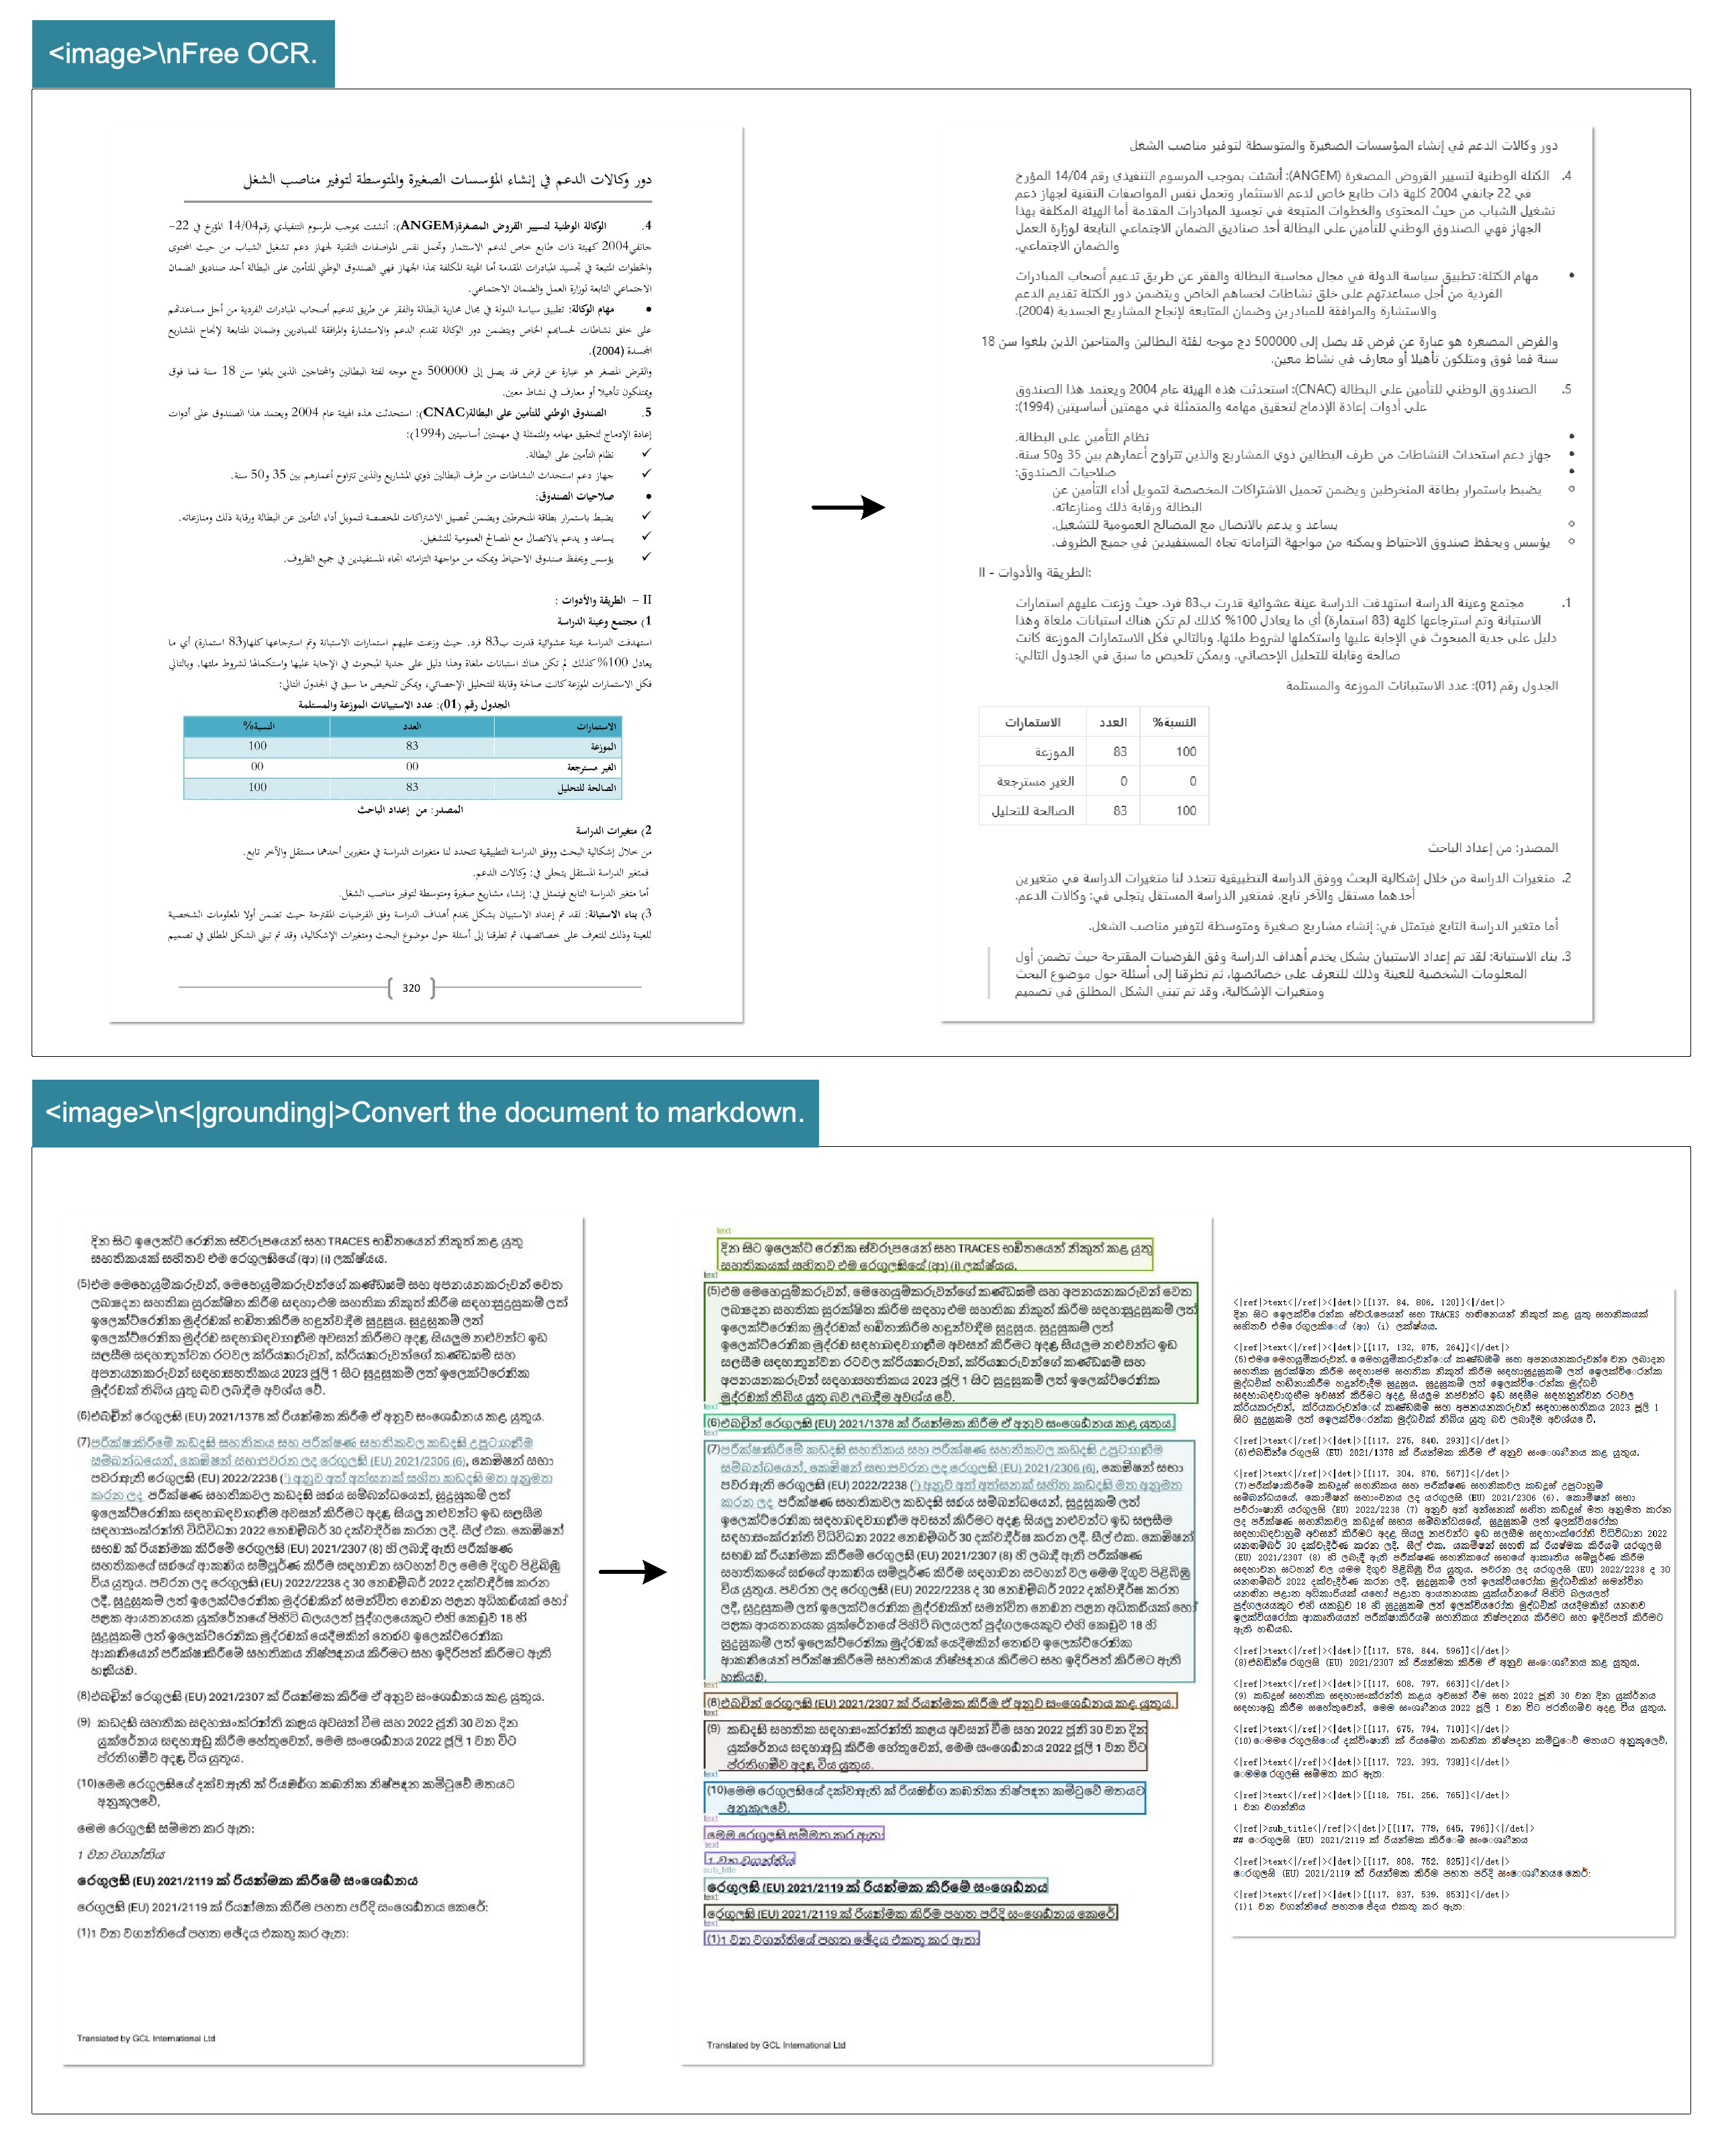
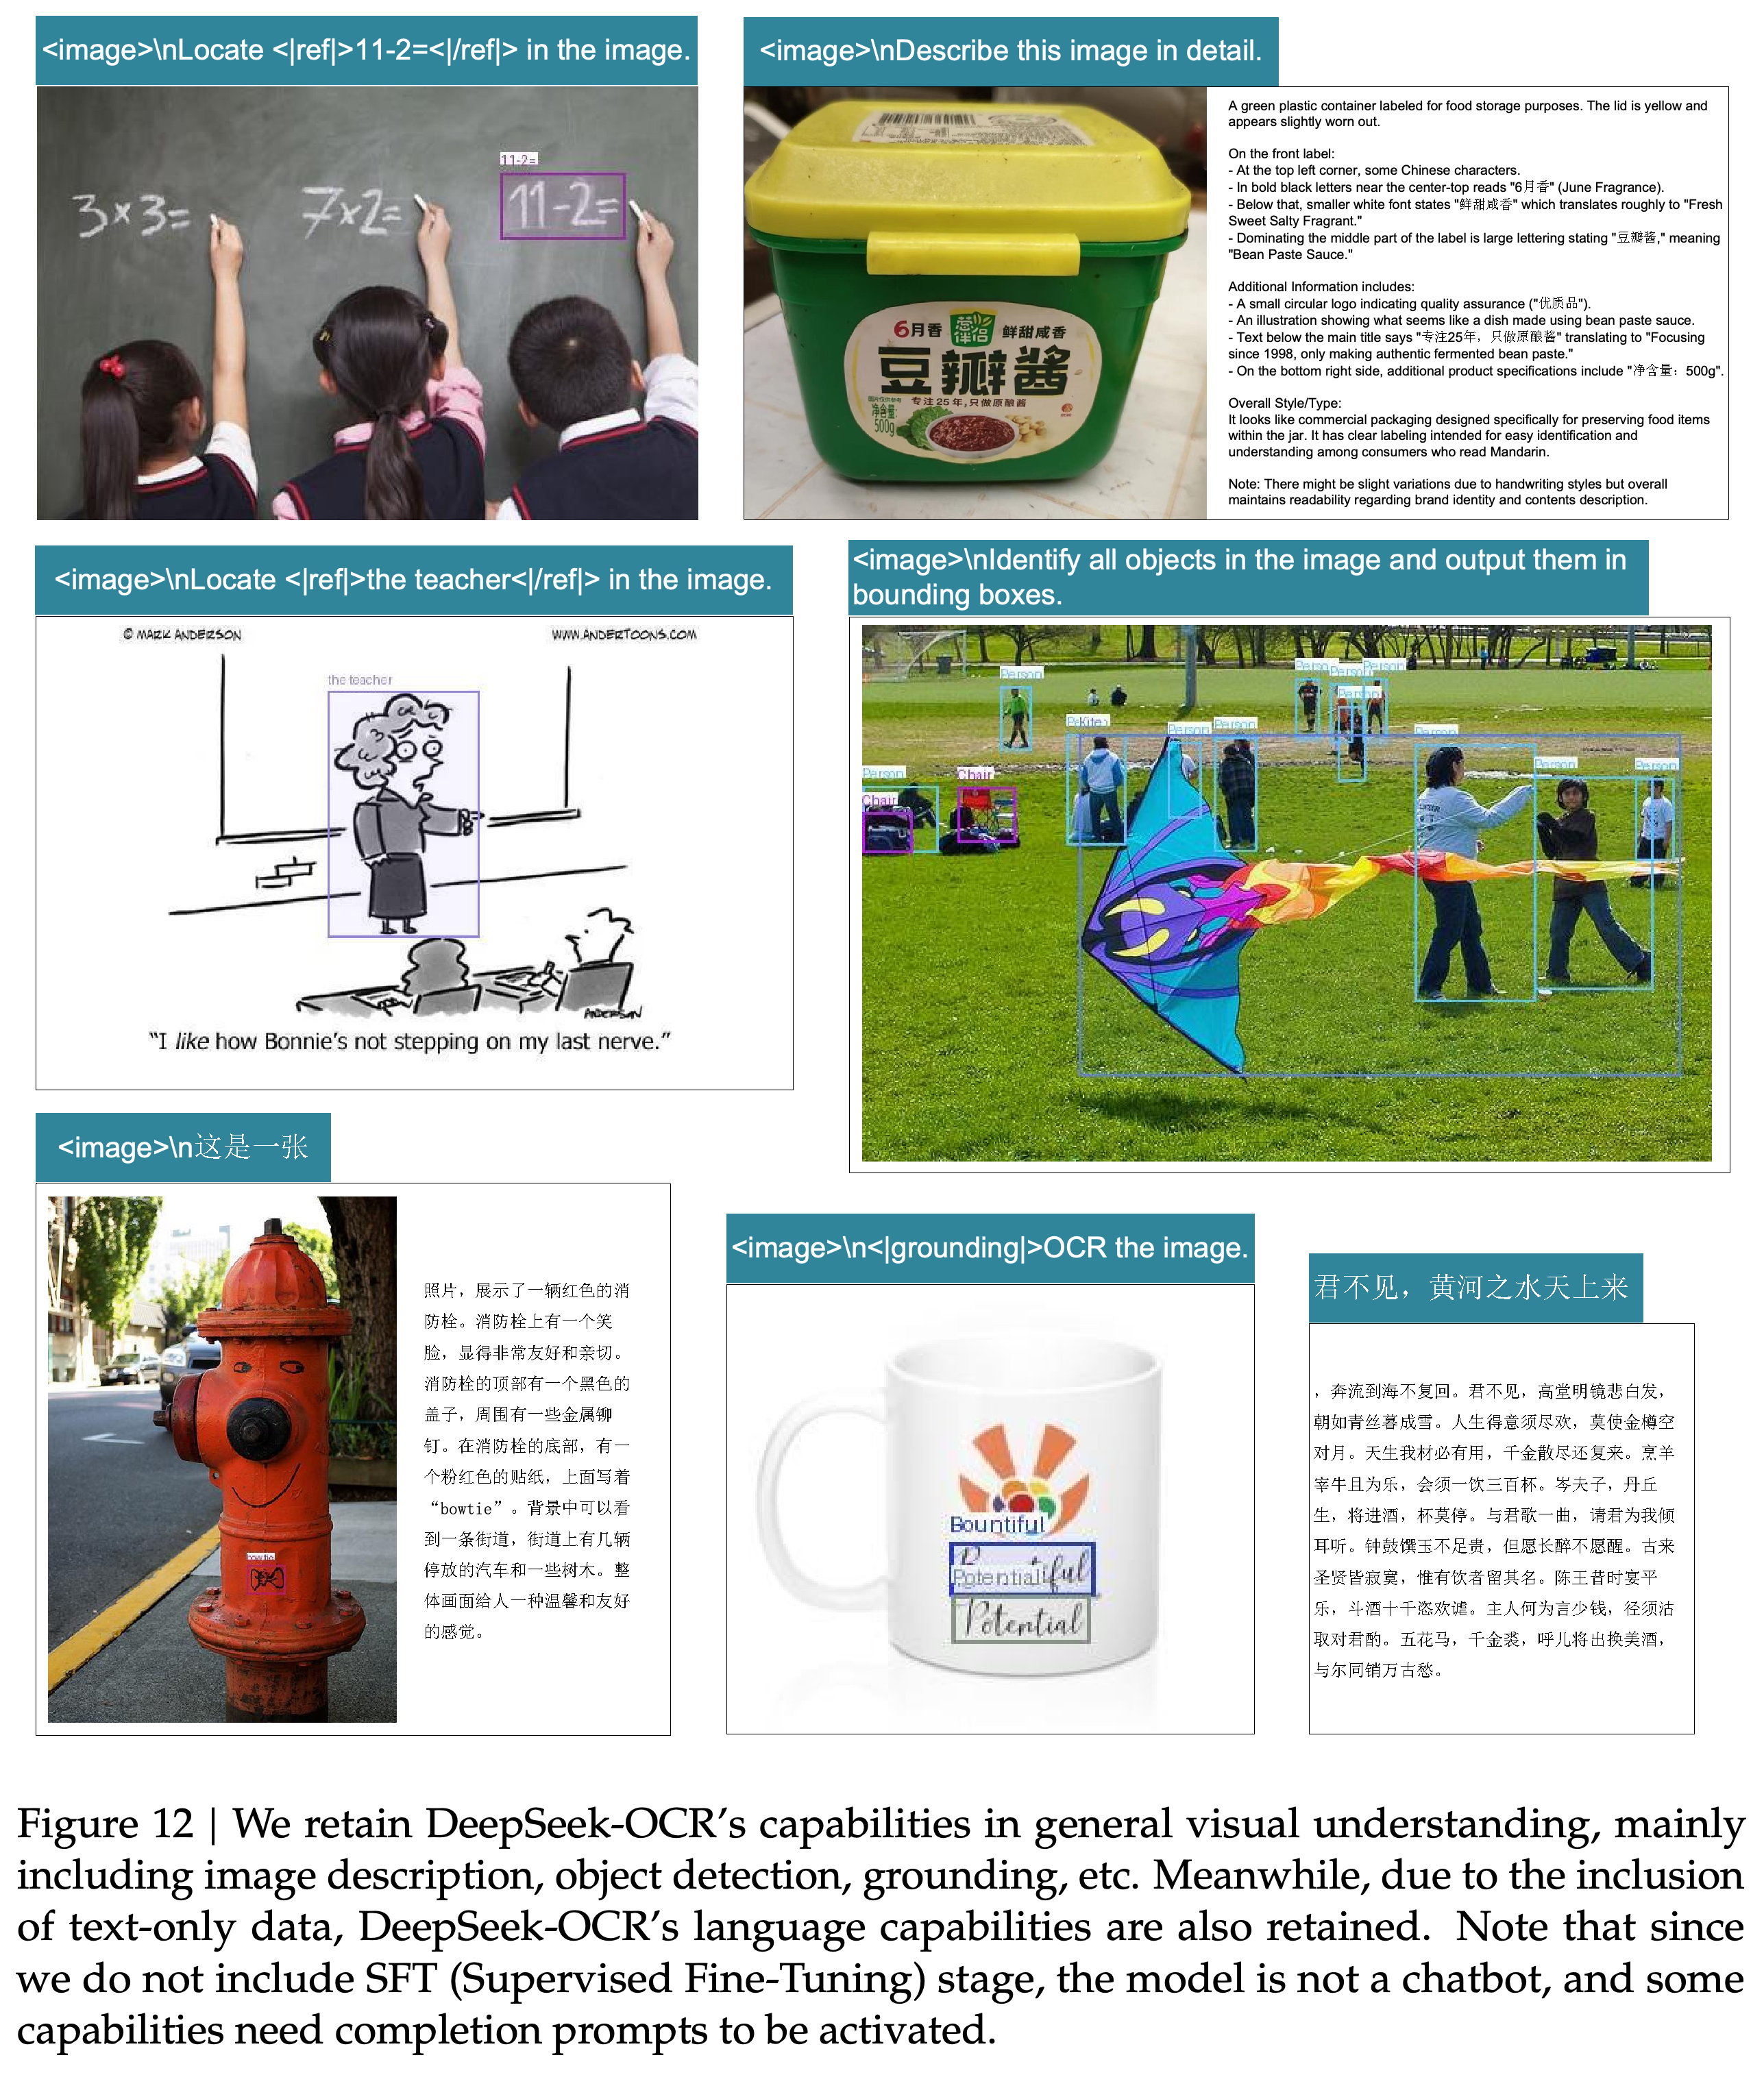
4.3.2. Multilingual recognition은 거의 100개 언어를 지원한다고 보고하며 아랍어 전사와 레이아웃 정보를 포함한 싱할라어 추출을 보여준다. 4.3.3. General vision understanding은 이미지 설명, 객체 검출, grounding, 언어 완성을 보여준다. 보고서는 정량적인 다국어 또는 일반 시각 벤치마크 대신 예제를 제시한다.
- 다국어 문서에서 서로 다른 프롬프트로 일반 전사 출력과 레이아웃 정보를 포함한 출력을 선택한다.
- 저자들은 별도의 supervised fine-tuning(SFT) 단계를 생략하며 모델이 챗봇이 아니라고 명시한다. 일부 기능에는 모델이 입력에 이어서 출력을 생성하는 완성형 프롬프트가 필요하다. 이것이 OCR 학습에 감독용 정답이 없다는 뜻은 아니다.
아랍어 예제는 일반 전사를 보여주며, 싱할라어 예제는 영역 주석과 추출한 내용을 포함한다. 이 예제들은 프롬프트로 출력 형식을 제어할 수 있음을 보여주지만 지원한다고 보고한 거의 100개 언어 전반의 정확도를 입증하지는 않는다.
예제에는 텍스트와 객체의 위치 찾기, 이미지 설명, 객체 검출, 장면 텍스트 읽기, 언어 완성이 포함된다. 일반 시각 능력의 정량 평가 없이 유지된 작업 인터페이스와 입력에 이어서 출력을 생성하는 동작을 보여준다.
5. Discussion
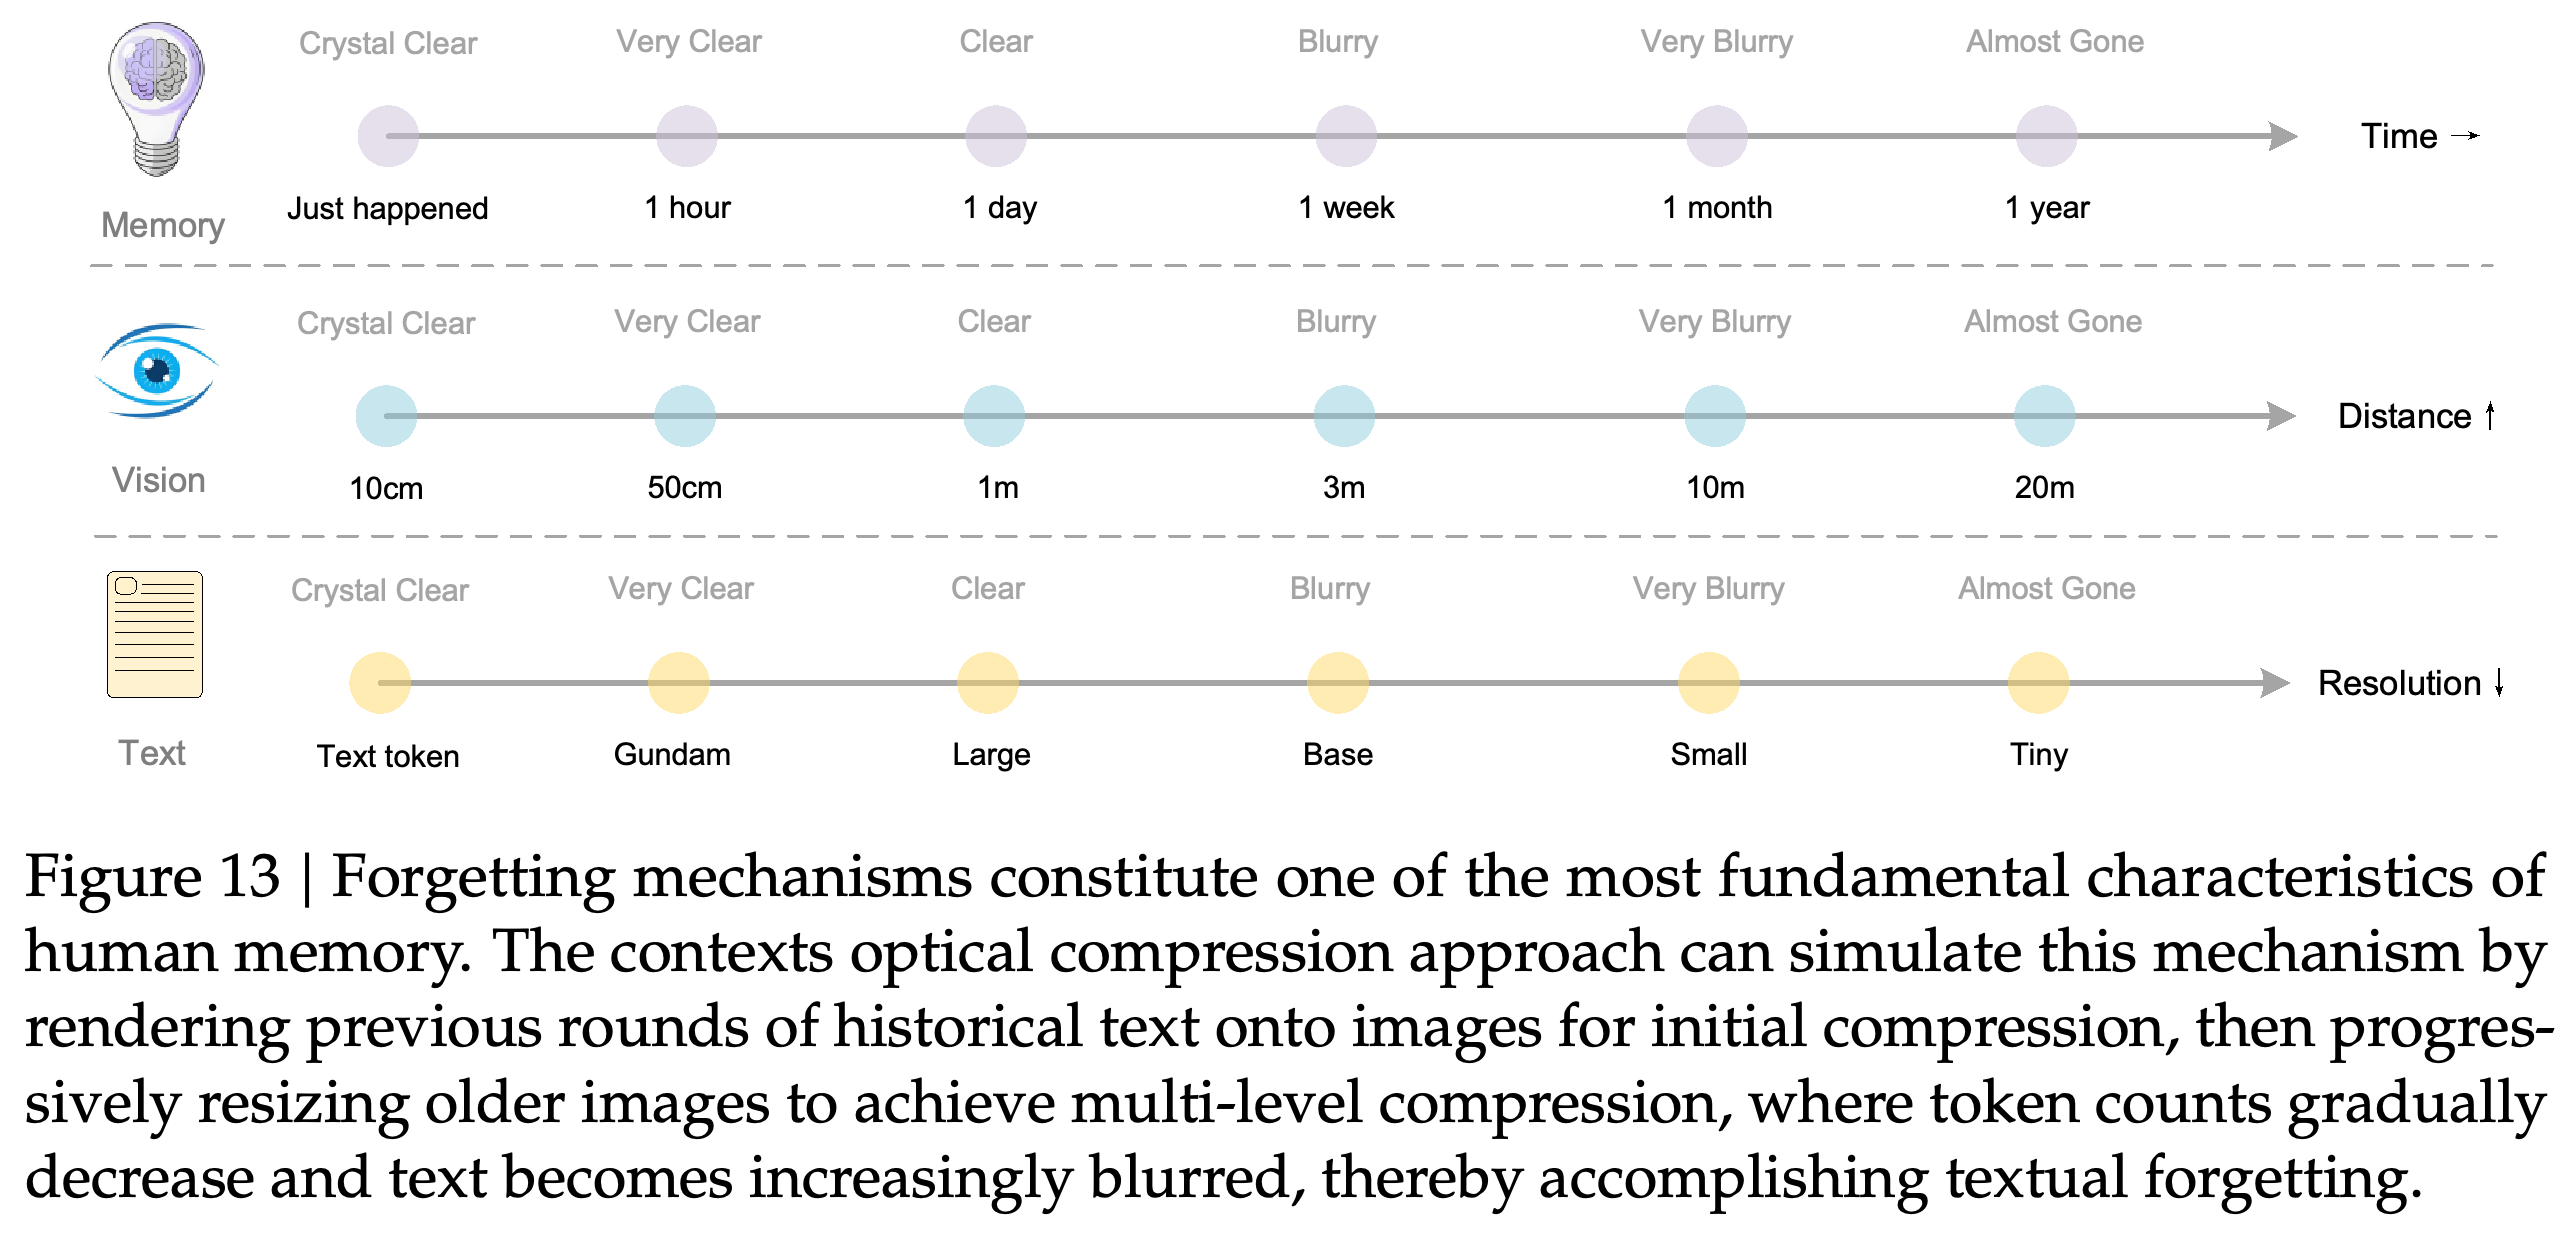
논의에서는 k차례보다 오래된 대화 기록을 이미지로 렌더링하고 더 오래된 이미지를 점진적으로 축소해 토큰 사용량을 줄이는 방식을 제안한다. k는 구체적인 값이 명시되지 않은 대화 경과 기준이다. Figure 13은 이 제안을 인간 기억의 감퇴 및 거리가 멀어질수록 낮아지는 시각적 선명도와 연결한다. 저자들은 초장문 문맥을 처리하는 이 접근법이 추가 연구가 필요한 초기 단계라고 설명한다.
- OCR 실험은 압축률이 높아질 때 복원 성능이 달라지는 관계를 보여준다. 점진적인 정보 손실이 유용한 대화 정보, 검색 정확도, 후속 추론을 보존하는지는 평가하지 않는다.
- 보고서는 대화 기록을 렌더링하고 인코딩한 뒤 압축된 기록을 사용하는 대화 시스템의 전체 지연 시간이나 메모리 절감량을 측정하지 않는다.
나란히 배치한 척도는 기억의 경과 시간, 관찰 거리, 낮은 해상도의 문서 표현 사이의 유사성을 보여준다. 오래된 대화 기록의 토큰 예산을 줄이는 제안은 개념적이며 이 비유를 검증하는 대화 기억 실험은 없다.
6. Conclusion
결론은 DeepSeek-OCR을 소형 디코더가 적은 vision token 예산으로 텍스트를 복원할 수 있다는 예비 근거로 제시하며 사전학습 데이터 생성에 실용적으로 활용할 수 있다고 설명한다. OCR만으로는 진정한 문맥 광학 압축을 검증하기에 충분하지 않다고 명시한다. 후속 연구 계획에는 디지털 텍스트와 광학 텍스트를 교차 배치한 사전학습, needle-in-a-haystack 평가, 기타 평가가 포함된다.
부록
- 제공된 22페이지 보고서에는 원문 부록이 없으며 페이지 20–22에는 References가 있다. 초록에는 코드와 모델 가중치 링크 http://github.com/deepseek-ai/DeepSeek-OCR가 있다. 제공된 버전은 arXiv:2510.18234v1이며, 날짜는 21 Oct 2025다.
짧은 생각
Gundam은 페이지당 vision token 795개를 사용하면서 6790개를 사용하는 MinerU2.0보다 영어와 중국어 종합 편집 거리가 낮다는 구체적인 문서 파싱 결과를 보여준다. 더 넓은 문맥 압축 주장은 아직 검증되지 않았다. 복원 실험은 영어 100페이지를 다루고, 압축률이 가장 높은 구간에는 4페이지만 있으며 보고서에는 긴 문맥을 활용한 후속 검색이나 추론 실험이 없다. 동적 해상도는 신문에 도움이 되지만 모든 문서 유형을 개선하지 않으므로, 문서 유형별 결과는 실제 대상 문서 분포에서 해상도 선택을 검증할 필요성을 뒷받침한다.