


LiveFigure: Generating Editable Scientific Illustration with VLM Agents 요약 설명
22 May 2026 | Paper Review Scientific Illustration Generation Vision-Language Models Agent Learning목차
이번 글에서는 LiveFigure: Generating Editable Scientific Illustration with VLM Agents 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 5월 22일(Arxiv), Proceedings of the 43rd International Conference on Machine Learning, Seoul, South Korea. PMLR 306, 2026.
- Shao, Chenyang, Liu, Jiahe, Xu, Fengli, Li, Yong.
- Department of Electronic Engineering, BNRist, Tsinghua University, Beijing, China, Zhongguancun Academy
- 논문 링크
요약
- LiveFigure는 생성 후 텍스트, 기하 구조, 연결선, 레이아웃을 국소적으로 수정해야 하는 과학 도해 생성 문제를 다룬다. Cognition-Inspired Procedural Construction 프레임워크는 VLM 에이전트로 도식을 계획하고, 실행 가능한 코드로 네이티브 PowerPoint 소스를 생성하며, 탐지한 시각적 결함을 수정한다. 저자들은 https://github.com/tsinghua-fib-lab/LiveFigure.git에서 코드를 제공한다. 논문은 전문가가 생성한 PPTX를 출판 가능한 상태라고 판단할 때까지 필요한 원자적 수동 편집 횟수로 편집 가능성을 평가한다. VLM에 대해서는 이 글을 참조하라. VLM에 대해서는 이 글을 참조하라. VLM에 대해서는 이 글을 참조하라.
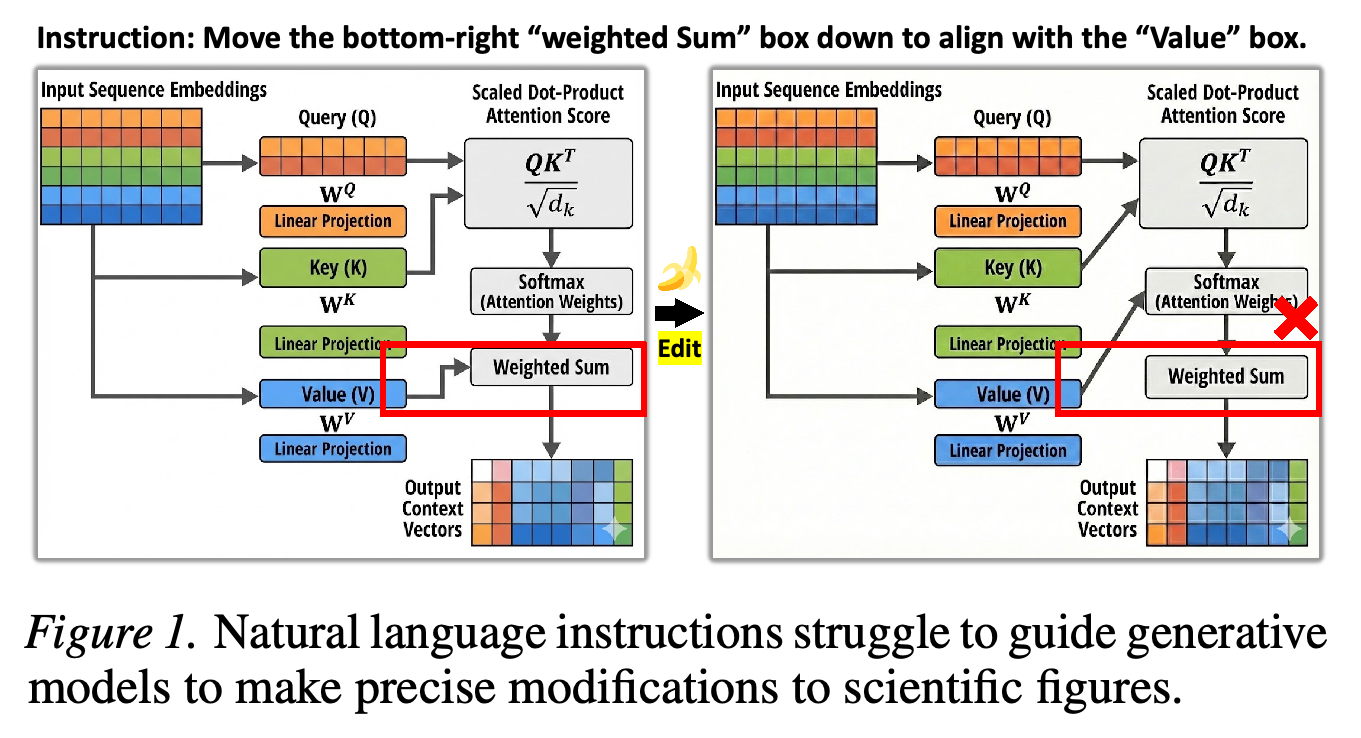
이 예시는 단일 “weighted Sum” 상자를 옮기라는 지시와 요청한 국소 정렬 변경을 구현하지 못한 래스터 모델의 응답을 보여 준다. 이는 도해를 단일 이미지가 아니라 독립적으로 편집 가능한 객체로 표현해야 하는 이유를 설명한다.
3. Methodology
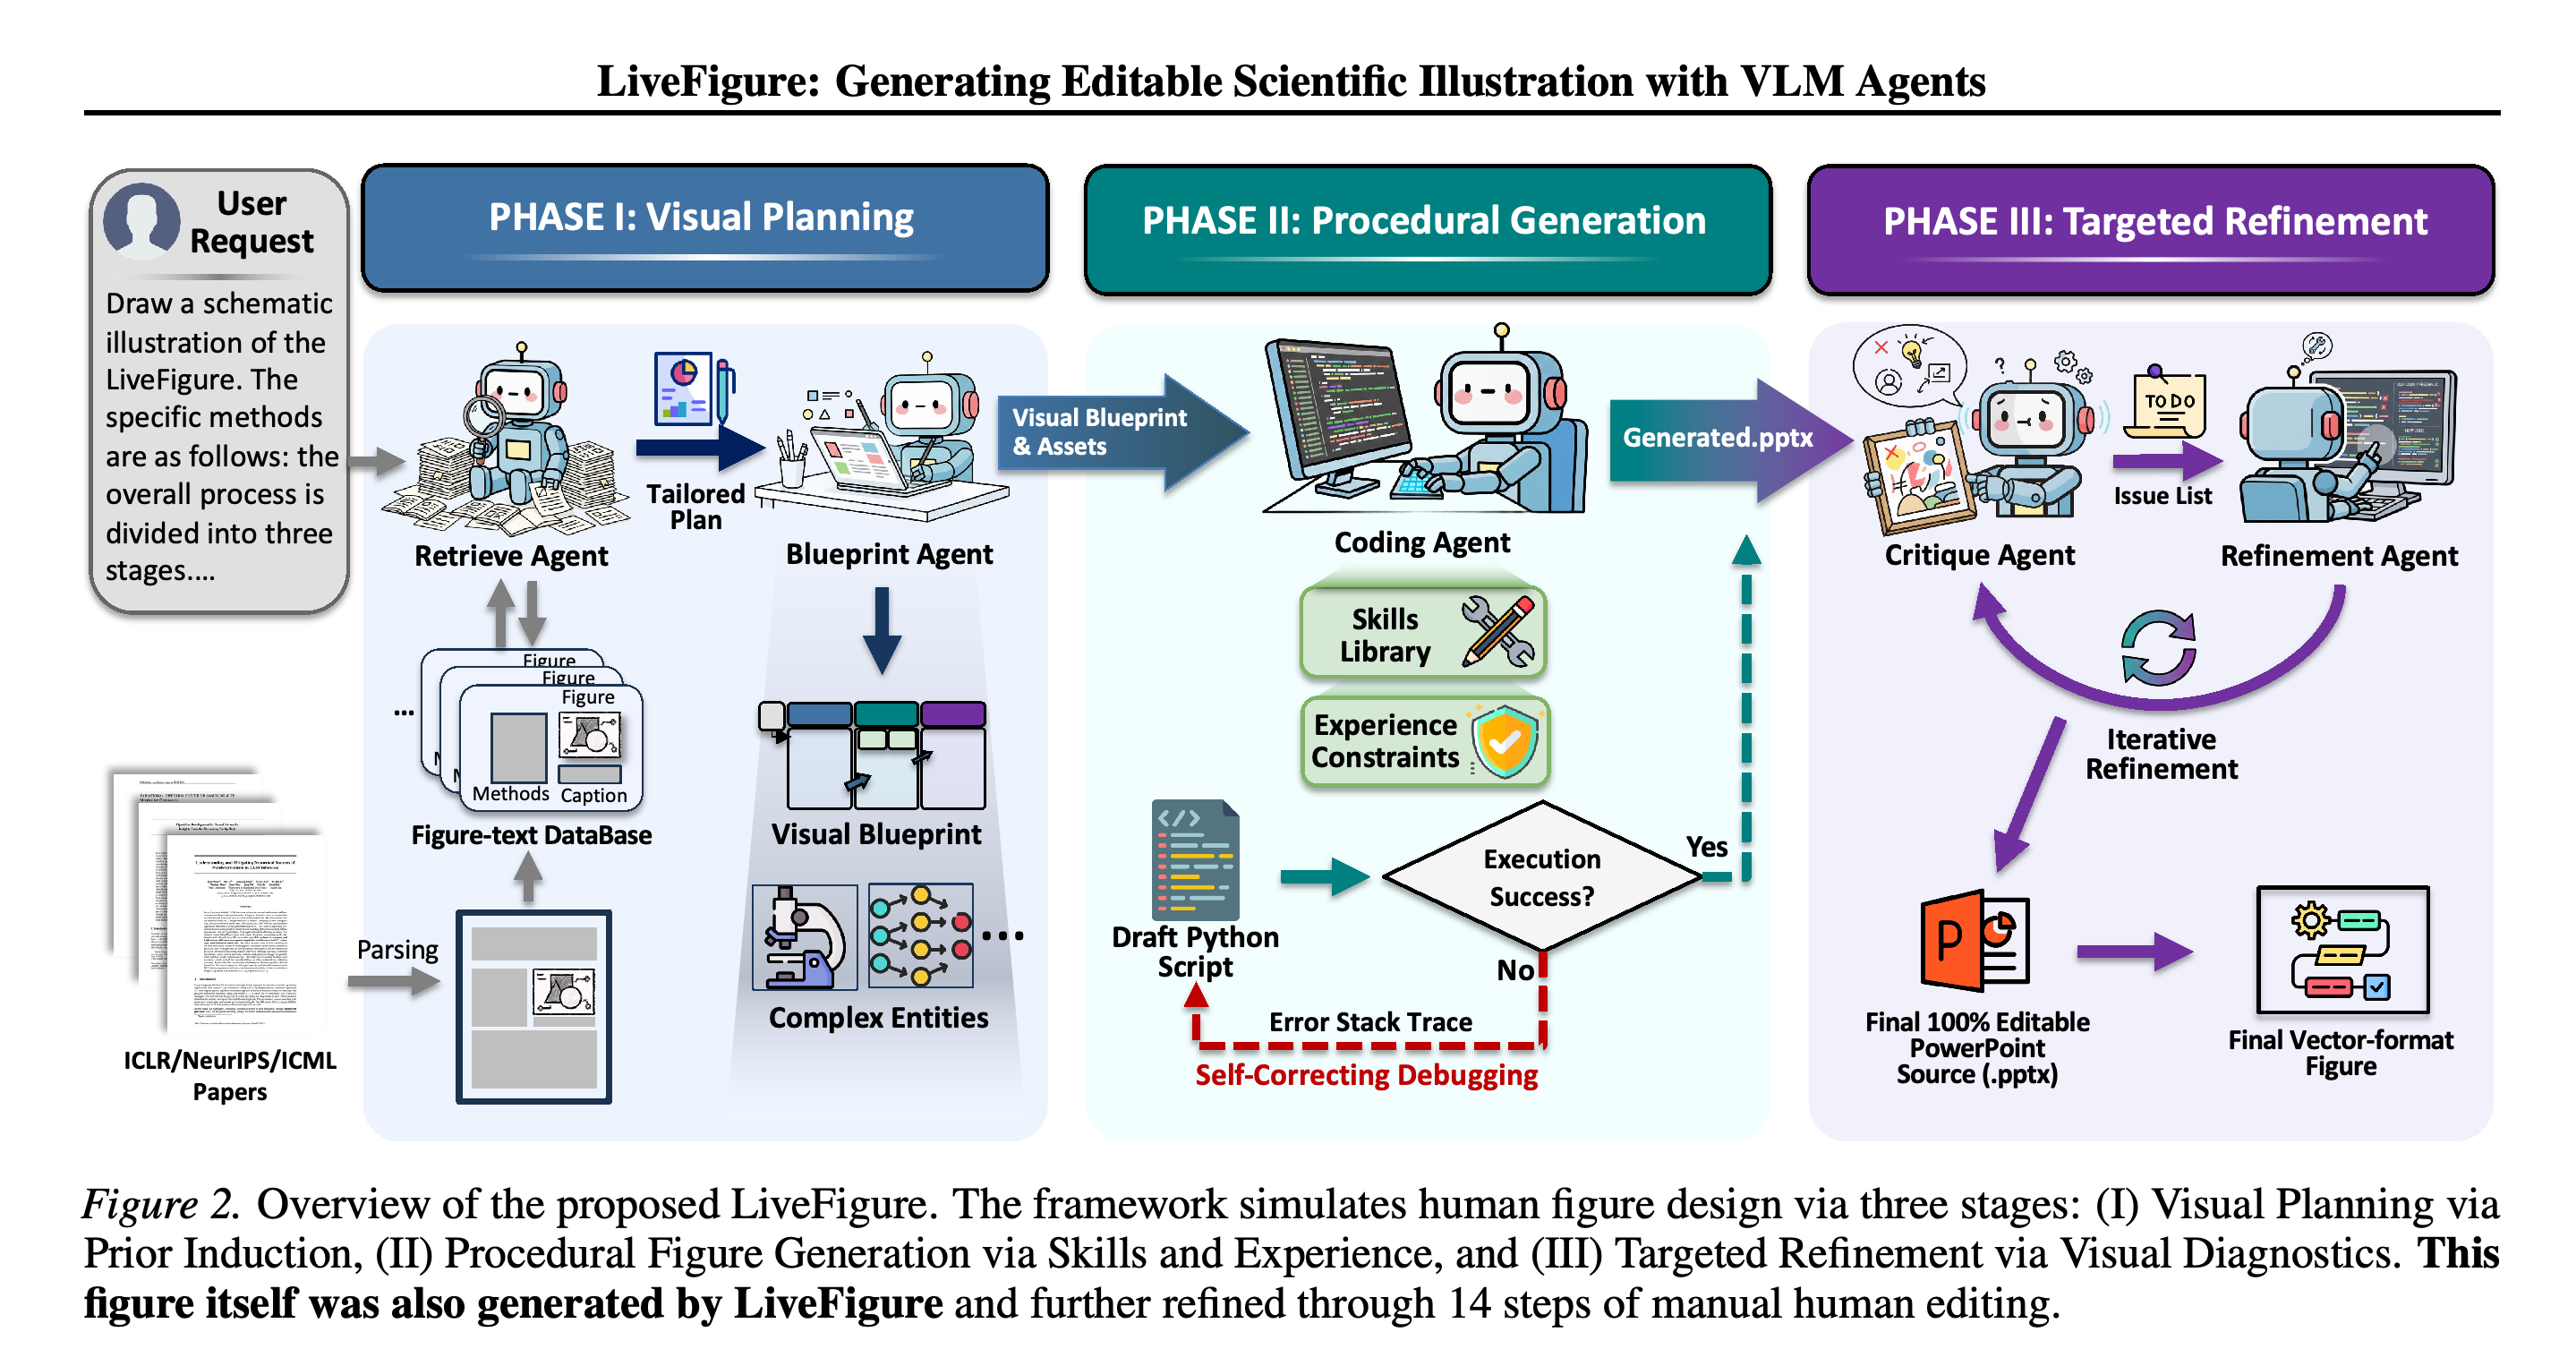
이 프레임워크는 방법론 텍스트 T_in을 시각 계획, 절차적 조립, 시각 정제의 3개 순차 단계로 처리해 편집 가능한 최종 도해로 변환한다. Stage I은 계획과 에셋을 만들고, Stage II는 실행 가능한 PowerPoint 생성 스크립트를 만들며, Stage III는 도해 전체를 다시 생성하지 않고 렌더링 이미지의 진단 결과로 스크립트를 갱신한다.
3.1. Visual Planning via Prior Induction (Stage I)
Stage I은 필터링한 방법론 도식, 캡션, 밀도 높은 기술 설명으로 구성한 figure–text knowledge base K = {(v_i, c_i, d_i)}_{i=1}^N를 구축한다. 검색 에이전트가 의미적으로 관련된 예시를 선택하고, VLM이 구조 계획을 도출하며, blueprint 에이전트가 시각 청사진을 생성한다. 복잡한 domain-specific entity에는 스타일 조건부 M × N 아이콘 격자를 생성한 뒤 이를 자르고 배경을 제거해 에셋 라이브러리를 구성한다.
이 도식은 참조 검색과 청사진 생성에서 skill 및 experience 제약을 적용한 코드 생성, 실행 디버깅, 비평가 기반 정제까지 3개 단계를 보여 준다. 벡터 형식으로 내보내기 전 네이티브 .pptx 파일을 편집 가능한 중간 출력으로 제시한다.
3.2. Procedural Figure Generation via Skills and Experience (Stage II)
Stage II는 Python과 python-pptx로 청사진과 에셋을 편집 가능한 PowerPoint 도해로 변환한다. 사전 검증한 skill library는 연결선 경로 설정과 중첩 텍스트-도형 구성 같은 작업을 캡슐화하고, 축적한 디버깅 경험은 알려진 API 오류를 막는 음성 제약으로 주입된다. 실행에 실패하면 에이전트는 최대 반복 횟수까지 스택 트레이스를 활용하는 반복 복구 루프를 수행한다.
3.3. Targeted Refinement via Visual Diagnostics (Stage III)
Stage III는 현재 스크립트를 렌더링하고 VLM 비평가에게 실행 가능한 문제 목록을 생성하게 해 코드-지각 루프를 완성한다. 정제 에이전트는 겹침, 잘림, 정렬 불량, 일관되지 않은 스타일 같은 국소 문제에 맞춰 점진적으로 코드를 변경한다. 이 과정은 문제 목록이 비거나 절차가 수렴할 때까지 계속된다.
4. Experiments
실험은 LiveFigure를 래스터 생성기인 Nano Banana, GPT-Image-1.5, Imagen-4.0-Ultra, Qwen-Image, Grok-2-Image와 Mermaid, Graphviz, Matplotlib, TikZ-V1, HTML/CSS를 포함한 프로그래밍 기반 기준선과 비교한다. 300개 사례 벤치마크는 ICLR 2024, NeurIPS 2024, ICML 2024에서 각각 100개의 과학 도식–텍스트 쌍을 추출한다. 평가는 XML 기반 Edit Distance, 9개 VLM 채점 차원, 이중 맹검 전문가 선호도, 보충 정성 사례 연구를 결합한다.
4.1. Experimental Setup
Edit Distance는 생성한 PPTX와 전문가가 편집한 PPTX의 XML 트리 사이에서 고유한 Modify, Add, Delete 작업을 세며, 같은 요소에 반복 적용한 변경은 하나로 집계한다. 시각 평가 프로토콜은 캡션만 입력하는 V1과 캡션에 방법 설명을 더하는 V2에서 Aesthetic Quality, Visual Expressiveness, Professional Polish, Clarity, Logical Flow, Text Legibility, Accuracy, Completeness, Appropriateness를 채점한다. 인간 평가 패널은 최상위 AI 학회 또는 저널에 논문을 최소 3편 게재한 PhD AI 연구자 7명으로 구성됐다.
4.2. Main Results
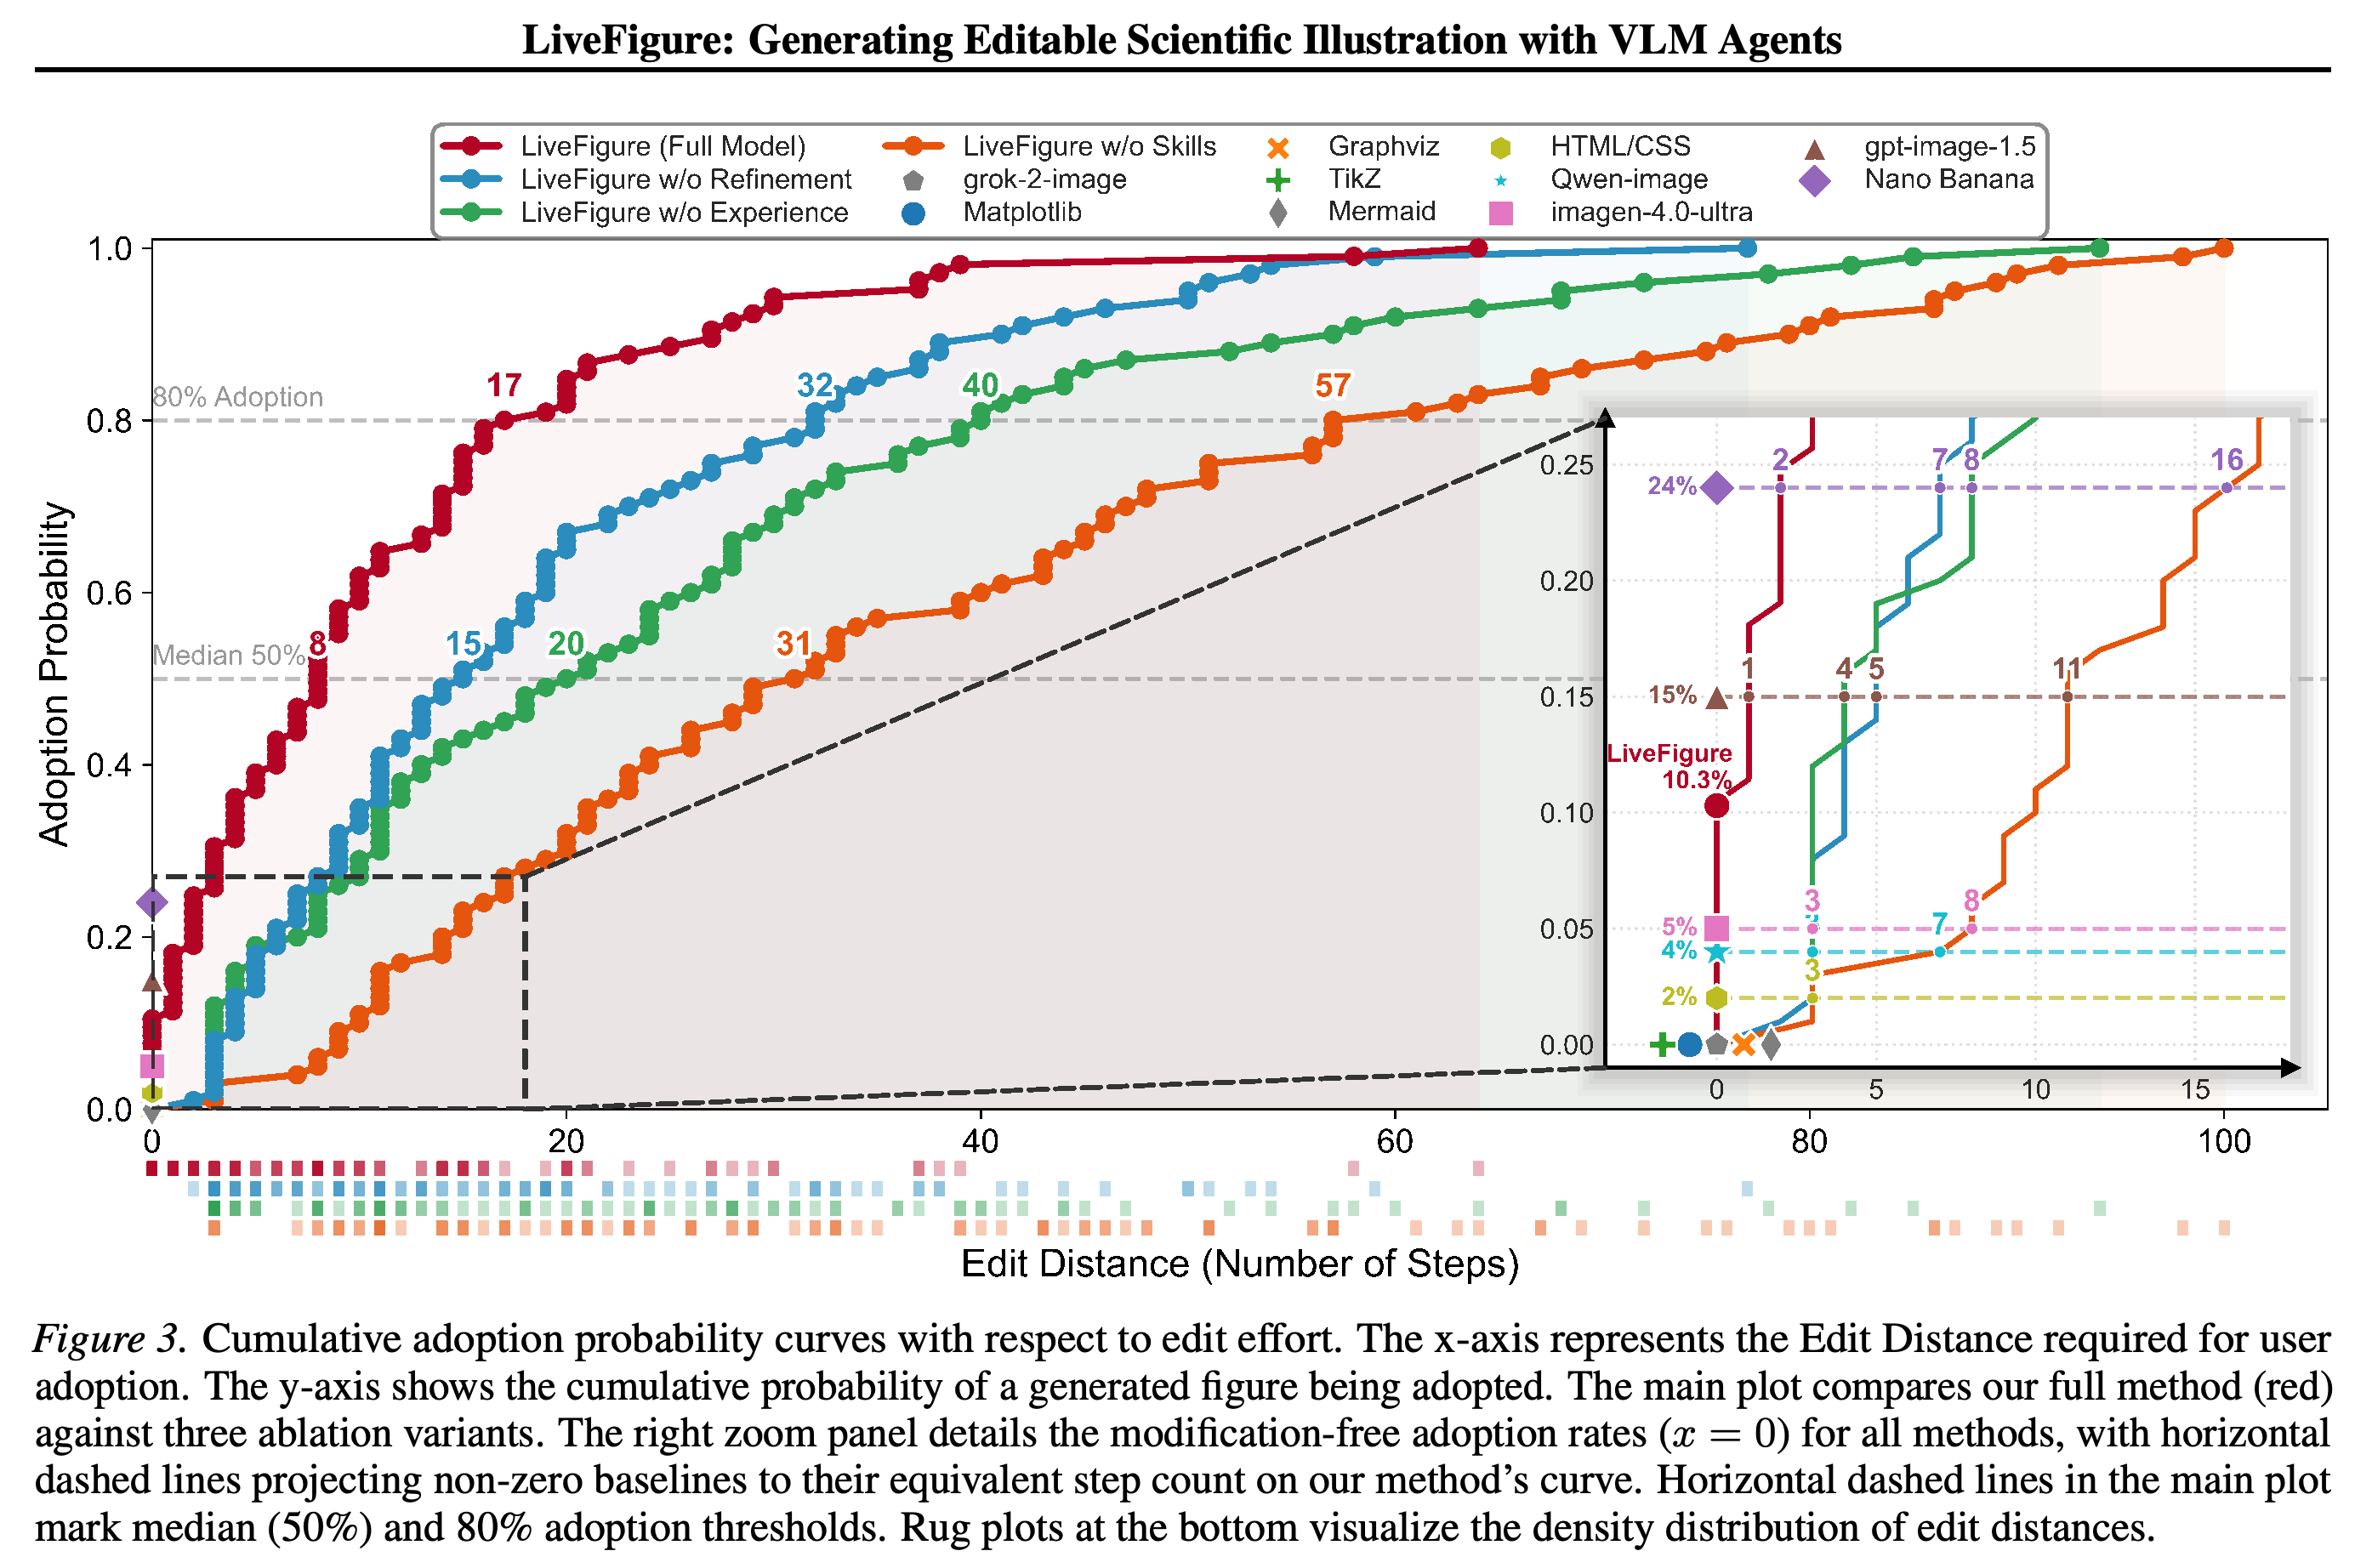
전체 시스템은 8 edits에서 50% adoption, 17 edits에서 80% adoption에 도달한다. Nano Banana와 GPT-Image-1.5의 modification-free adoption rate는 각각 24%와 15%이지만, 이 수치는 전체 모델의 17-edit 80% threshold와 직접 동등하지 않다. Skills를 제거하면 median adoption effort는 31 edits로 증가하고, Experience를 제거하면 median adoption은 20 edits로 늦어진다.
누적 곡선은 Edit Distance의 함수로 채택을 정의하고, 전체 시스템의 50%와 80% 임계값을 8회와 17회 편집에 표시한다. 제거 실험 곡선은 refinement, experience, skills를 생략했을 때 추가로 필요한 편집 노력을 보여 주며, 삽입 그림은 모든 방법의 수정 없는 채택률을 보고한다.
4.3. Visual Quality and Content Fidelity Evaluation
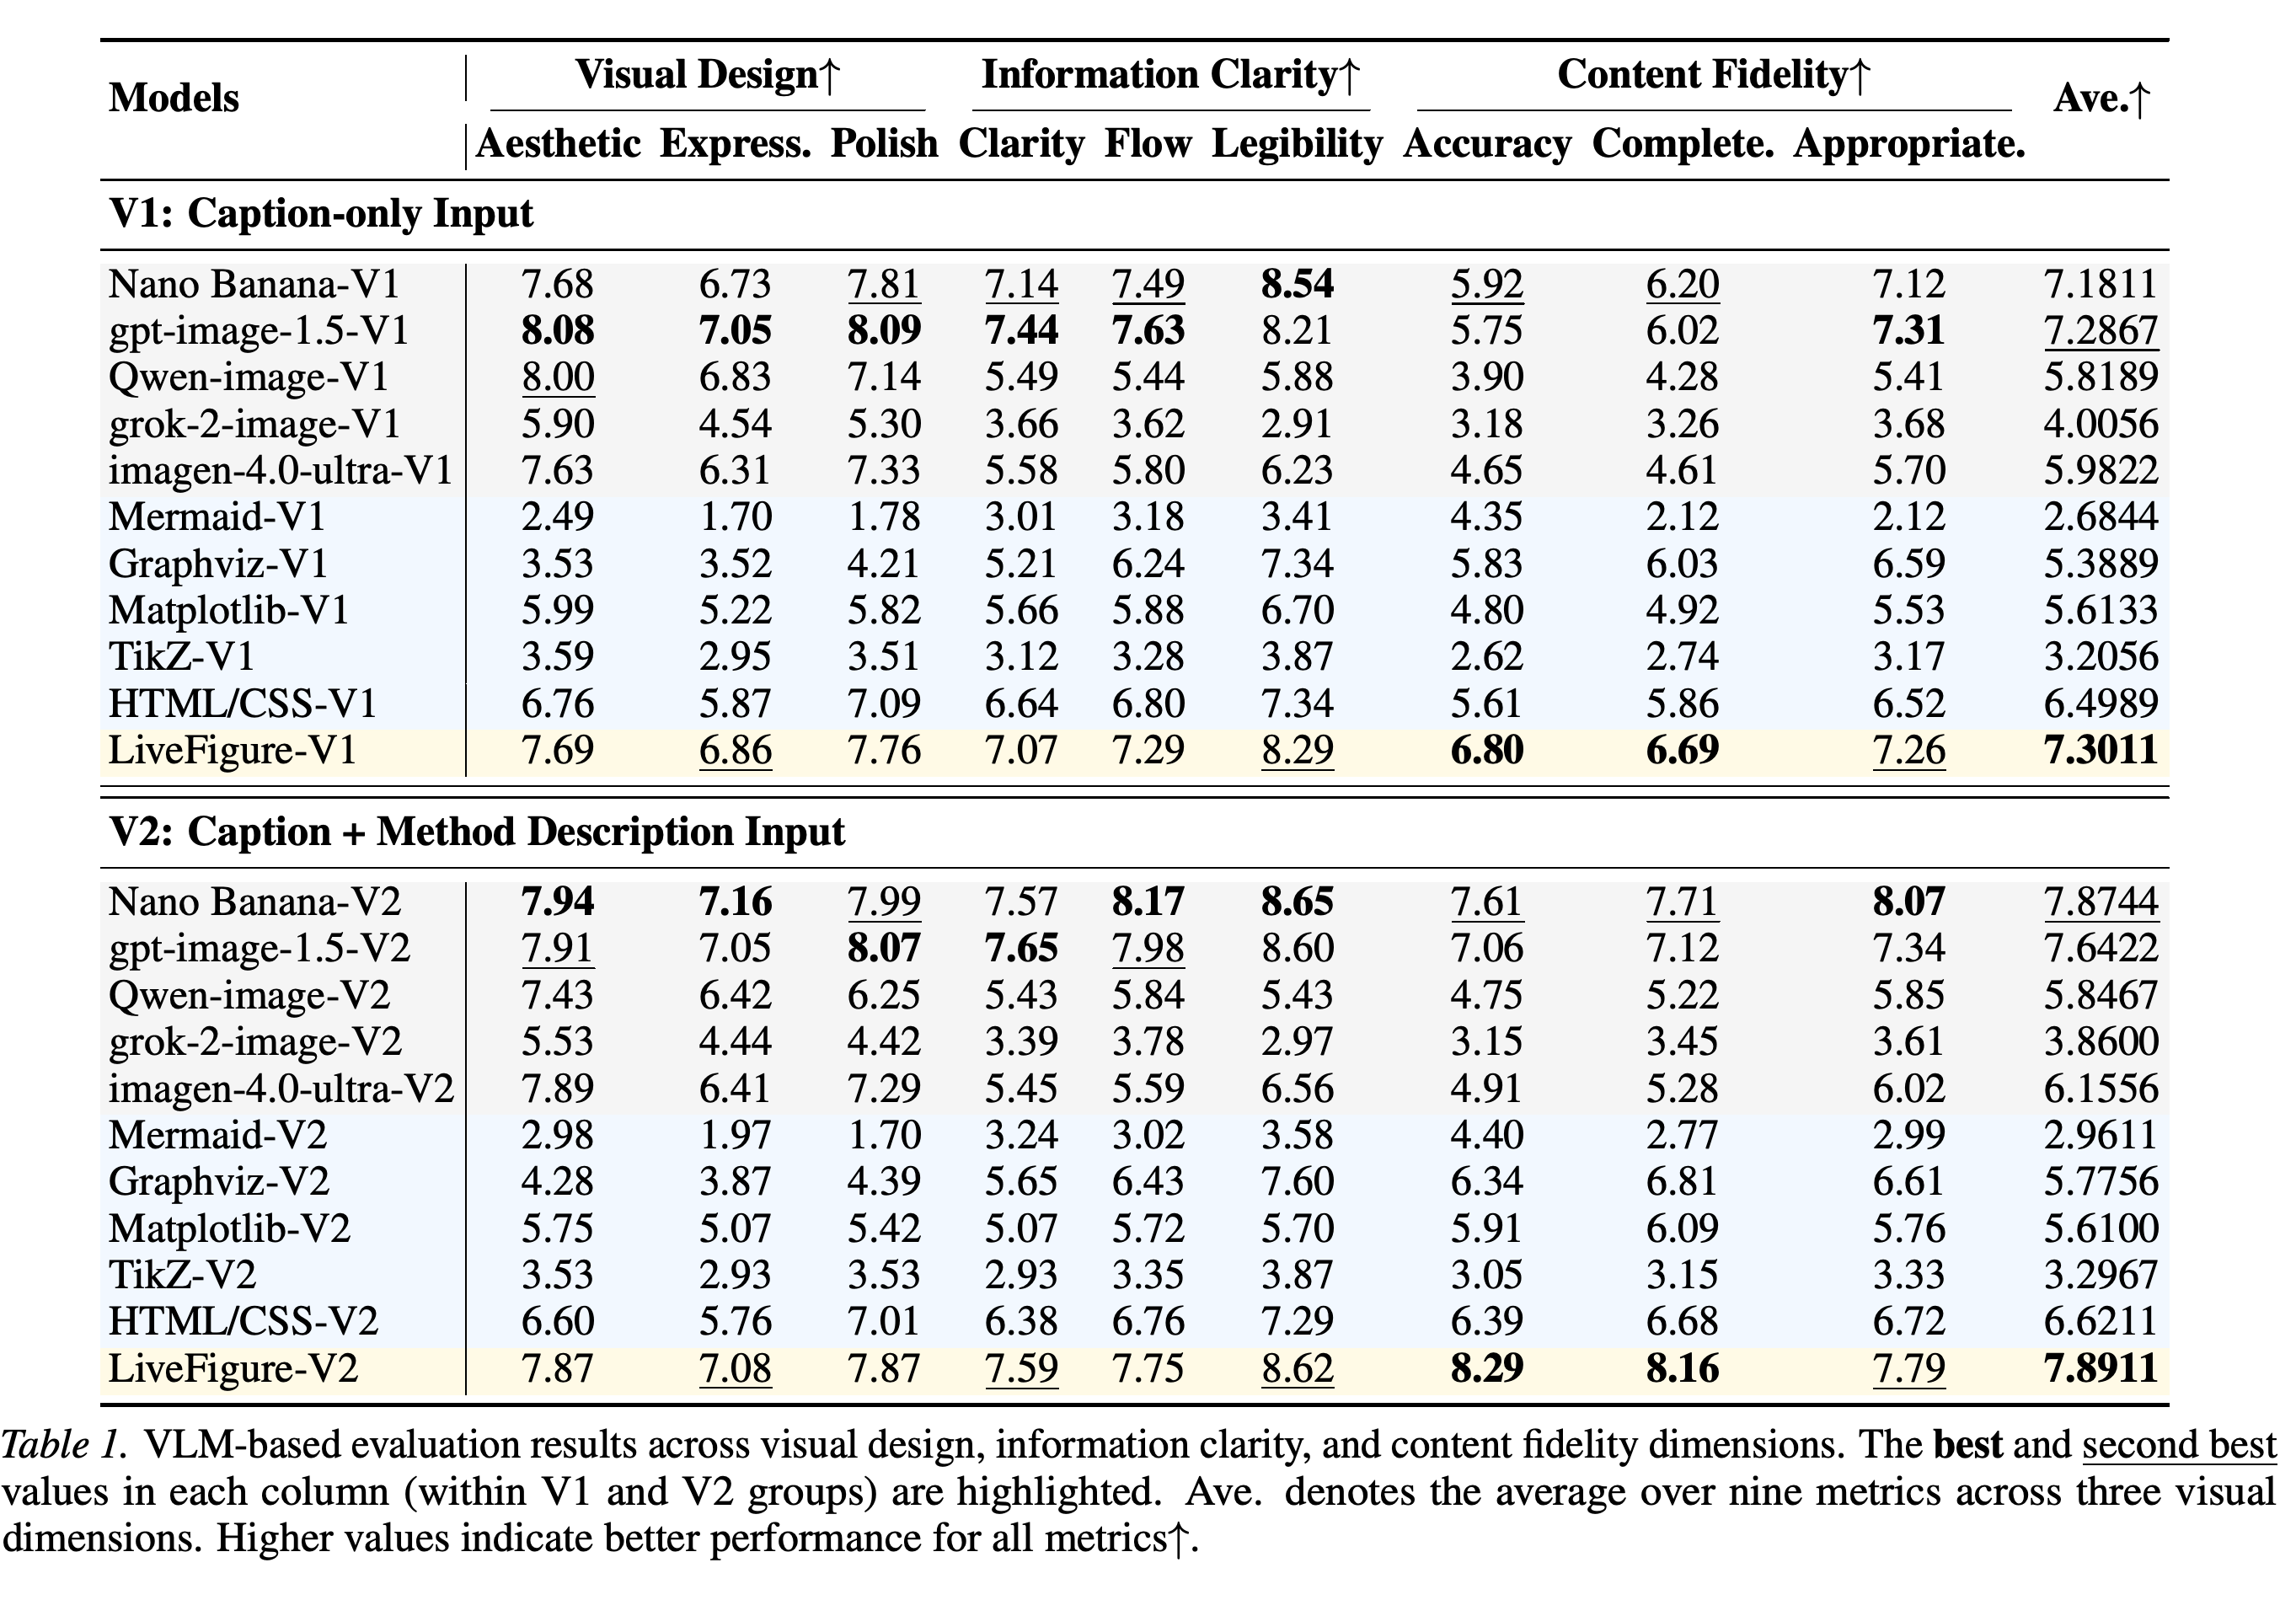
9개 지표 VLM 평가에서 LiveFigure-V2의 평균은 7.8911로, Graphviz-V2의 5.7756과 Matplotlib-V2의 5.6100보다 높고 Nano Banana-V2의 7.8744와 가깝다. V2 Content Fidelity 점수는 Accuracy 8.29, Completeness 8.16이며, GPT-Image-1.5-V2의 7.06과 7.12보다 높다. 점수는 V1의 7.3011에서 V2의 7.8911로 상승하며, 캡션에 더해 방법 설명을 제공하는 이점을 보여 준다.
이 표는 캡션만 입력하는 조건과 캡션 및 방법 설명을 함께 입력하는 조건에서 visual design, information clarity, content fidelity를 구분한다. LiveFigure-V2는 제시한 평균 중 가장 높은 7.8911을 기록하며, Nano Banana는 여러 visual-design 측정치에서 경쟁력을 유지한다.
4.4. Ablation Study
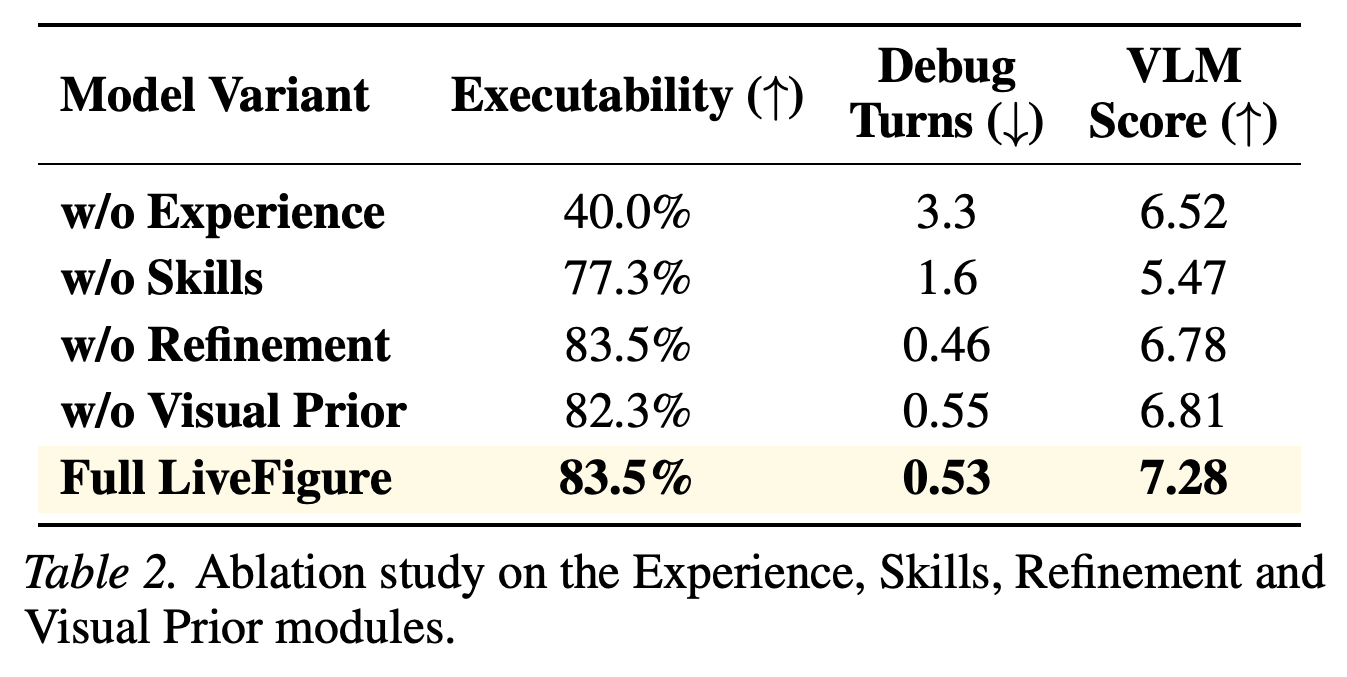
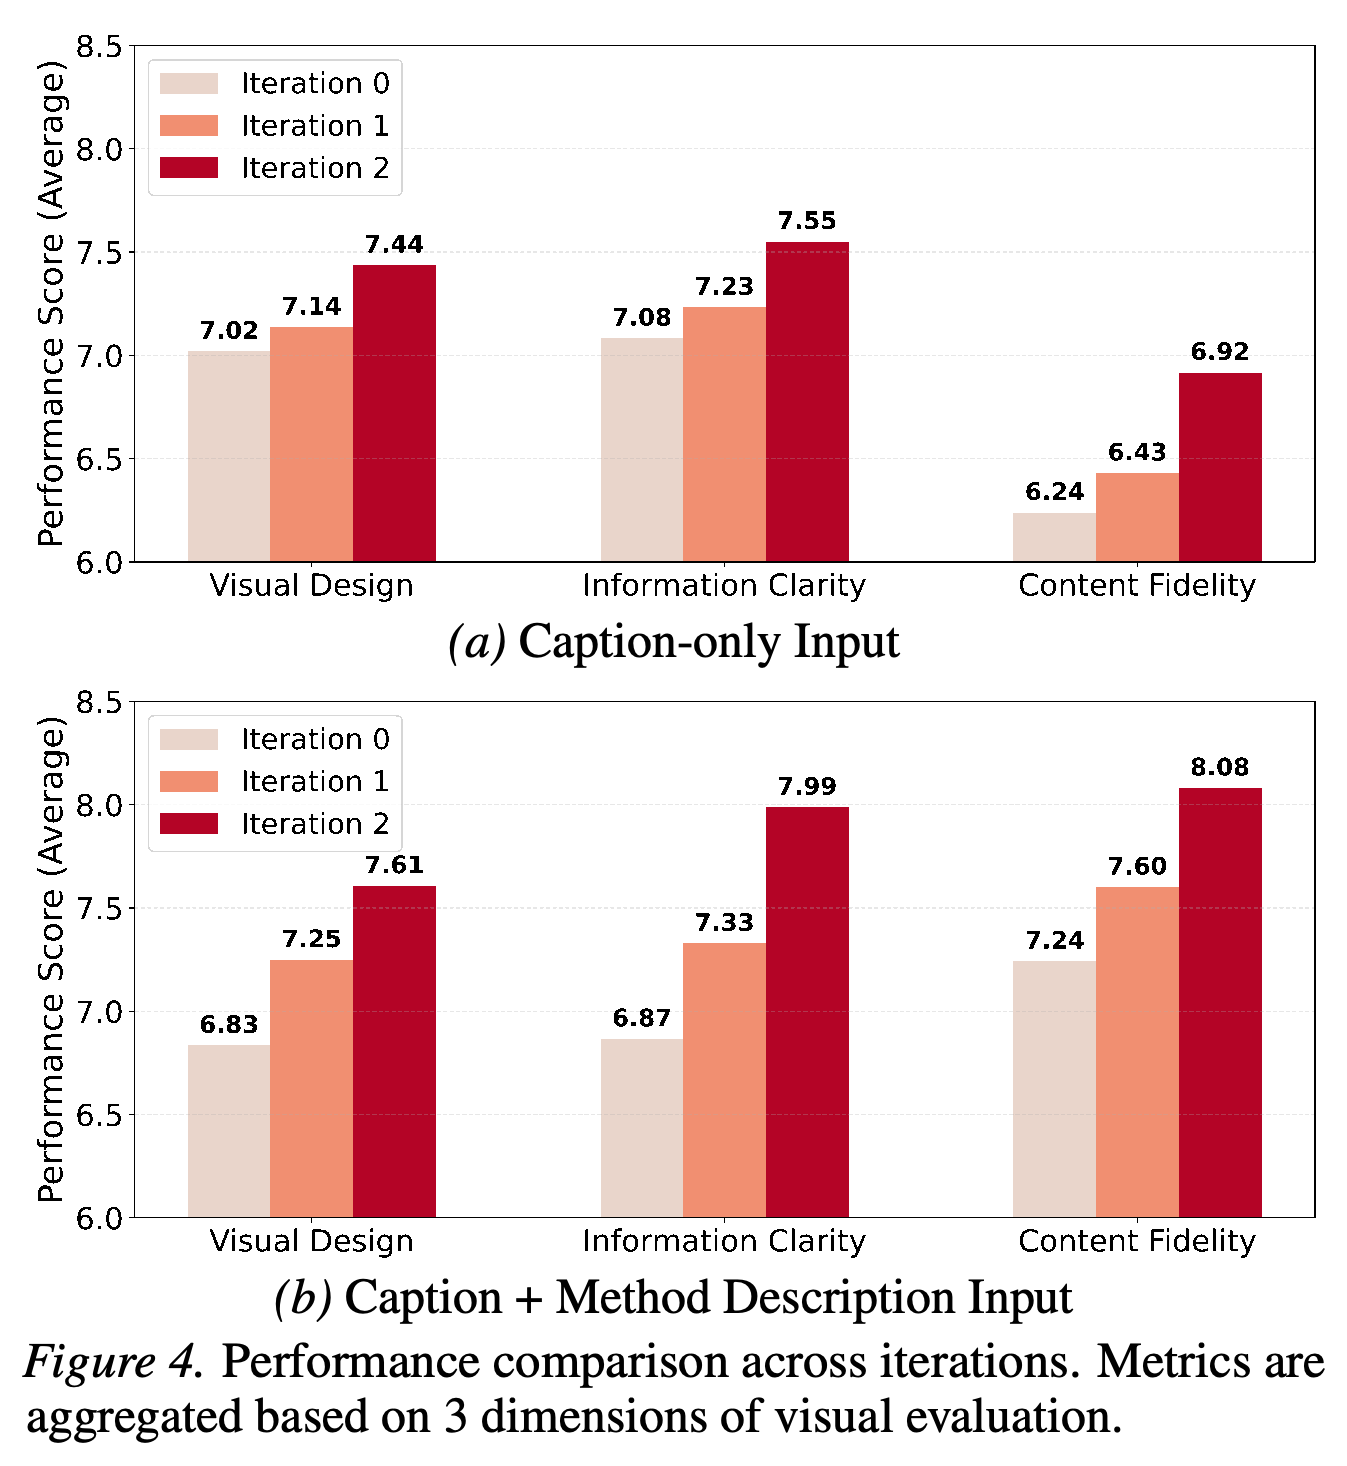
Ablation table은 각 구성 요소의 역할을 구분한다. Experience가 없으면 실행 가능성은 40.0%, 디버그 횟수는 3.3이고, Skills가 없으면 VLM 점수는 5.47이다. 전체 시스템은 실행 가능성 83.5%, 디버그 횟수 0.53, VLM 점수 7.28을 보고한다. 2회 정제 반복에 걸쳐 V2 Information Clarity는 6.87에서 7.99로, V2 Content Fidelity는 7.25에서 8.08로 상승한다. 보충 단계별 결과는 Skills와 Experience를 추가하면 시각 계획 뒤 32.5%였던 실행 가능성이 83.5%로 상승함을 보여 준다.
이 제거 실험은 실행 신뢰성, 디버깅 부담, VLM 점수를 분리한다. Experience를 제거했을 때 실행 가능성이 가장 크게 하락하고, Skills를 제거했을 때 VLM 점수가 가장 낮으며, 전체 모델은 보고한 점수 중 가장 높다.
묶음 막대는 3회 정제 반복 동안 두 입력 조건에서 visual design, information clarity, content fidelity가 향상되는 모습을 보여 준다. V2 설정에서 Information Clarity는 6.87에서 7.99로, Content Fidelity는 7.25에서 8.08로 상승한다.
4.5. Human Evaluation
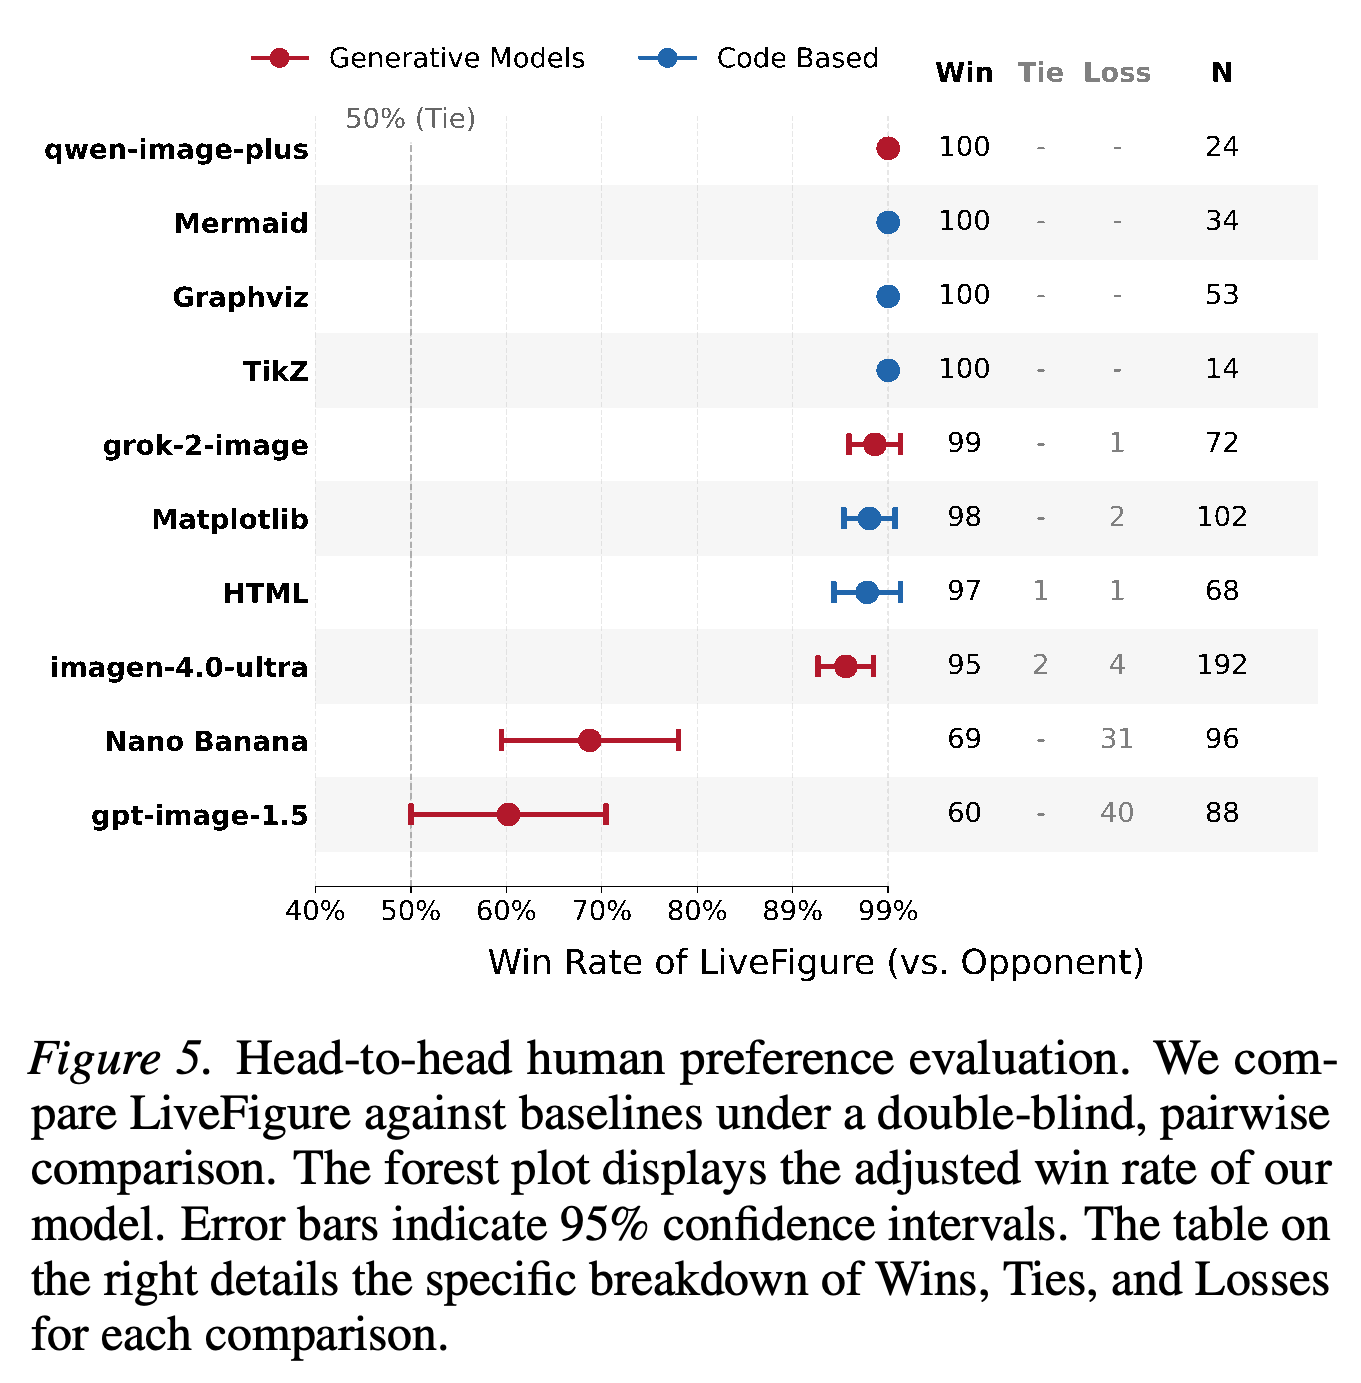
이중 맹검 쌍대 비교에서 LiveFigure의 보정 승률은 Nano Banana 대비 96개 판단에서 69%, GPT-Image-1.5 대비 88개 판단에서 60%다. 여러 코드 기반 방법에 대해서는 97%를 넘는 보정 승률을 보고하며, 보고한 95% 신뢰구간은 50%를 넘는다. 이 결과는 정보 정확성과 시각 명료성에 관한 전문가 판단을 다루며, 자동 시각 평가는 여전히 VLM 기반이다.
포리스트 플롯과 승–무–패 표는 맹검 인간 선호도 근거를 제시한다. 보정 승률은 Nano Banana 대비 69%, GPT-Image-1.5 대비 60%이며, 표시한 코드 기반 기준선에 대해서는 더 큰 보고 격차를 보인다.
부록
- Appendix는 도해당 평균 종단 간 비용이 약 $0.80이고 약 3분이 든다고 보고한다. 이 가운데 이미지 생성 호출 2회는 $0.38, VLM 호출 12회는 $0.42를 차지한다. 또한 knowledge base와 테스트 세트 구성, PowerPoint 형식 선택 근거, 평가 프롬프트, 단계별 결과, 객체 수준 편집 가능성, 생물학 및 대화형 편집 사례, 약 44개의 텍스트 노드와 거의 30개의 논리적 연결을 포함한 밀집 도해 실패 사례를 문서화한다. 저자들은 지나치게 복잡한 시각화와 제한된 세밀한 스타일 제어를 한계로 지적하고, RLHF와 venue-annotated style data를 향후 방향으로 제안한다.
짧은 생각
이 논문은 구조화한 PPTX 객체를 생성하고 생성 후 필요한 수동 개입을 측정함으로써 편집 가능성을 주요 출력 기준으로 삼는다. 제시한 근거는 더 낮은 보고 편집 횟수, 모듈 제거 실험, VLM 기반 시각 점수, 맹검 선호도 판단을 결합한다. 다만 출판 가능성은 전문가 판단과 VLM 채점으로 조작적으로 정의됐고, 벤치마크는 AI 학회 논문의 도식으로 제한됐으며, 복잡한 연결선 경로 설정은 여전히 명시적인 실패 양상이다.