


NVIDIA Nemotron Parse 1.1 요약 설명
25 Nov 2025 | Paper Review Document Parsing Optical Character Recognition Token Compression목차
이번 글에서는 NVIDIA Nemotron Parse 1.1 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 11월 25일(Arxiv)
- Chumachenko, Kateryna, Deshmukh, Amala Sanjay, Seppanen, Jarno, Karmanov, Ilia, Chen, Chia-Chih, Voegtle, Lukas, Fischer, Philipp, Wawrzos, Marek, Motiian, Saeid, Ageev, Roman, et al.
- NVIDIA
- 논문 링크
- Project Page
요약
- NVIDIA Nemotron-Parse 1.1은 페이지 이미지에서 텍스트를 추출하면서 서식, 표 구조, 요소 위치, 읽기 순서를 보존하는 문서 파싱을 다룬다. GOT 문서 인식 벤치마크에서 885M-parameter 모델의 광학 문자 인식(OCR, 이미지 속 텍스트 인식) F1 점수는 0.9785다. 텍스트 인식 결과를 비교하는 이 점수는 Gemini Flash 2.0의 0.9915보다 낮고, Table 3에 나열된 나머지 추출기보다 높다.
- 이미지 인코더와 텍스트 디코더는 페이지 이미지를 서식이 있는 텍스트, 경계 상자, 의미 클래스로 변환한다. 경계 상자는 페이지 요소의 위치를 나타내는 사각형이고, 의미 클래스는 제목과 캡션 같은 역할을 나타내는 레이블이다. 토큰 압축(TC) 변형은 디코더에 전달하는 특징 단위인 이미지 토큰을 3201개에서 833개로 줄이고, 표와 캡션 같은 부유 요소를 페이지의 자연스러운 읽기 순서에 포함한다.
- 학습에는 합성 문서, 공개 데이터셋, 사람이 작성한 주석을 함께 사용하며 각 샘플에서 제공하는 주석에 맞춰 프롬프트를 지정한다. LaTeX 문서 컴파일과 구조화된 주석 추출을 결합한 NVpdftex 파이프라인은 서로 정렬된 텍스트, 문자 위치, 의미 레이블, 읽기 순서를 제공한다.
- 문서 파싱 벤치마크인 OmniDocBench v1.0의 영어 부분집합에서 TC는 전체 오류 지표를 0.131에서 0.129로, 읽기 순서 지표를 0.066에서 0.048로 개선한다. 반면 텍스트, 수식, 표 지표는 소폭 악화된다. 16비트 수치 형식인 bf16을 사용하고 H100 그래픽 처리 장치(GPU) 1개에서 페이지당 1000토큰인 10,000페이지를 처리할 때, 처리량은 3800 tokens/second에서 4500 tokens/second로 증가한다.
- 보고된 정확도와 처리량을 보면 작업에 따라 유리한 변형이 달라진다. 다국어 평가는 생성한 과학 문서를 사용하며 과학 문서와 표준 PDF 환경을 벗어난 이미지 및 문서에서는 중국어, 일본어, 한국어 지원이 제한적이다. 논문은 디코더 위치 임베딩이나 다중 토큰 학습의 효과를 개별적으로 측정한 수치 기반 ablation 실험을 제공하지 않는다.
1. Introduction
언어 모델, 검색, 질의응답에 사용할 문서 정보를 추출하려면 일반 텍스트뿐 아니라 레이아웃, 읽기 순서, 수식, 표, 요소의 역할도 필요하다. 논문은 실무상의 어려움 2가지를 제시한다. 다단계 파이프라인은 처리량이 낮아지고, 이미지를 처리해 언어를 생성하는 종단 간 비전 언어 모델은 추출 하위 작업마다 성능이 고르지 않을 수 있다.
- Nemotron Parse 1.1은 Nemoretriever-Parse 1.0과 Eclair의 후속 모델로, 1개 모델에서 서식이 있는 텍스트와 블록 단위 레이아웃 정보를 보존한다. 텍스트 서식에는 Markdown을, 수식과 표 내용에는 LaTeX를 사용한다.
- TC는 핵심 추출 기능을 유지하면서 표와 캡션을 비롯한 부유 요소를 페이지의 자연스러운 순서에 배치한다.
2. Nemotron-Parse
Nemotron-Parse는 인코더-디코더 구조와 조건부 출력 인터페이스를 결합해, 프롬프트로 원하는 주석을 선택할 수 있게 한다. 2가지 변형은 이미지 토큰 압축과 읽기 순서 처리 방식이 다르며, 모두 텍스트 추출, 요소 위치 식별, 의미 분류를 지원한다.
2.1. Model Architecture
비전 인코더는 논문에서 인용한 비전 파운데이션 모델인 RADIO로 초기화하며 657M 파라미터의 비전 트랜스포머 구조인 ViT-H/16을 사용한다. 인코더 특징을 디코더에 연결하는 비전 넥은 크기 1 × 4, 스트라이드 1 × 4의 수평 합성곱 커널을 사용한다. 1648 × 2048 이미지에서 RADIO의 요약 토큰을 추가하기 전에 3200토큰을 생성한다.
- TC는 이미지 특징을 추가로 재배열해 시퀀스를 줄이는 pixel-shuffle을 적용하여 833토큰으로 압축한다. 논문은 인코더 표현 대비 총 ×16 감소라고 설명한다.
- 텍스트 디코더는 논문에서 인용한 다국어 인코더-디코더 모델인 mBART를 10개 레이어로 줄이고 가중치를 공유한다. 초록은 언어 디코더가 256M-parameter 모델이며 전체 모델은 885M 파라미터라고 보고한다.
- 각 출력 토큰은 압축된 이미지 표현과 입력 프롬프트를 포함한 앞선 텍스트 토큰을 조건으로 생성된다.
2.1.1. Positional embeddings: 디코더는 토큰 위치 정보를 제공하는 명시적 위치 임베딩 없이 학습하고 평가한다. 저자들은 위치 임베딩을 사용한 모델과 비슷한 정확도를 유지하면서 더 긴 문맥에서 추론할 수 있다고 보고한다. 앞선 토큰만 참조하는 인과적 어텐션과 이미지 특징의 공간 정보가 이미 위치 단서를 제공한다고 설명한다.
- 저자들은 추가적인 1차원 위치 신호를 제거하면 이미지 특징에 담긴 2차원 공간 정보와의 간섭을 피할 수 있다고도 설명한다.
- 논문은 실험한 문맥 길이의 한계를 명시하지 않으며 위치 임베딩을 사용하는 디코더와의 수치 비교도 제공하지 않는다.
2.1.2. Multi-token inference: 추가 선형 레이어는 현재 은닉 상태와 앞선 예측의 임베딩을 바탕으로 여러 미래 토큰을 예측한다. 학습에는 추가 예측에 정답 토큰 임베딩을 제공하는 teacher forcing을 사용한다. 추론에는 가장 높은 점수의 토큰을 선택하는 greedy decoding을 사용하며 토큰 검증은 수행하지 않는다.
- 추가 예측 헤드는 l_head(l_1(h_n + l_2(e_{n+1})))를 계산한다. 여기서 h_n은 현재 은닉 상태이고 e_{n+1}은 다음 토큰의 임베딩이다.
- 저자들은 다중 토큰 학습 후 일반적인 단일 토큰 추론을 수행해도 정확도가 개선된다고 보고하지만 수치 기반 ablation 실험이나 별도의 다중 토큰 처리량 측정값은 제공하지 않는다.
2.2. Prompts and Output Format
2.2.1. Input prompts: 프롬프트 선택 항목 3가지가 텍스트 형식, 경계 상자, 의미 클래스를 제어하며 유효한 조합은 8가지다. 학습에서는 각 샘플의 주석이 지원하는 조합을 지정한다. 경계 상자 없이 클래스만 요청하는 조합과 출력을 전혀 요청하지 않는 조합은 제외한다.
- 텍스트 옵션은 <output_markdown>, <output_plain>, <output_no_text>다. Markdown 출력은 표와 LaTeX 구문이 필요한 수식을 LaTeX로 표현하며 간단한 인라인 수식은 Markdown으로 유지한다.
- 위치 옵션은 <predict_bbox>와 <no_bbox>이며, 클래스 옵션은 <predict_classes>와 <no_classes>다.
- 서식이 있는 텍스트, 위치, 클래스를 함께 요청하는 maximal-information prompt(MIP)는 <output_markdown><predict_bbox><predict_classes>다.
2.2.2. Output format: 각 의미 블록에는 왼쪽 위 좌표, 텍스트, 오른쪽 아래 좌표, 클래스 레이블이 들어간다. 논문은 1024 × 1280 척도의 상대 좌표를 설명하고 매칭 패턴으로 <x_(\d+)><y_(\d+)>(.*?)<x_(\d+)><y_(\d+)><class_([^>]+)>를 제시한다.
- 기본 모델은 Page-Header 요소를 먼저 출력한 뒤 Text, Section-Header, List-Item, Title, Formula 요소를 읽기 순서대로 출력한다. 이어서 Footnotes, Page-Footers, Tables, Pictures, Captions를 출력한다.
- TC는 이러한 부유 요소를 페이지의 자연스러운 순서에 통합한다.
- 원문의 예시는 <x_0.1152><y_0.2586># NVIDIA Nemotron-Parse 1.1<x_0.8799><y_0.2797> <class_Title>다. 이 예시의 소수 좌표는 논문에 기재된 정수 매칭 패턴과 다르다.
3. Training and Data
학습에는 제공하는 출력 레이블이 서로 다른 합성 데이터, 공개 데이터, 사람이 주석을 작성한 데이터를 함께 사용한다. 이 절은 데이터 출처와 주석 구성 방법을 설명하지만 전체 최적화 일정, 학습 연산 예산, 샘플링 비율은 명시하지 않는다.
3.1. Datasets
NVpdftex는 LaTeX 컴파일과 구조화된 출력 추출을 1회 처리 과정에서 함께 수행하며 렌더링된 페이지와 텍스트 사이의 정렬을 문자 단위 경계 상자까지 보존한다. TeX Live 컴파일 도구 체인을 확장하여 문자와 노드 생성, 상자 할당, 토큰 읽기, 페이지 출력 이벤트를 가로채 주석을 추출한다.
- LaTeX를 HTML을 거쳐 Markdown으로 변환하는 인용된 Nougat 파이프라인과 달리, NVpdftex는 컴파일 중에 주석을 추출한다. 파이프라인은 https://github.com/NVIDIA-NeMo/Curator/tree/experimental/experimental/nvpdftex 에 공개되어 있다.
- 기계 번역으로 6개 언어의 데이터를 추가하고 LaTeX 수준에서 글꼴, 색상, 레이아웃을 바꿔 렌더링을 다양화한다.
공개 레이아웃 분석 데이터셋인 DocLayNet에는 읽기 순서, 이미지 속 텍스트, Markdown 서식, 표, 수식에 대한 자동 레이블을 추가한다. Common Crawl 샘플에는 사람이 제공한 일반 텍스트, 경계 상자, 클래스가 있으며 이미지 속 텍스트와 서식에 대한 자동 레이블을 추가한다.
- Common Crawl에서는 stage-1 trained model이 개별 경계 상자 영역을 잘라낸 이미지를 처리한다. 예측에서 서식을 제거한 텍스트와 정답 일반 텍스트 사이의 편집 거리, 즉 텍스트 변경량을 기준으로 예측을 필터링한다.
- 품질이 낮은 영역은 이미지에서 지운다. 전체 페이지 예측으로 얻은 제목 서식은 휴리스틱을 사용해 개별 블록과 정렬한다.
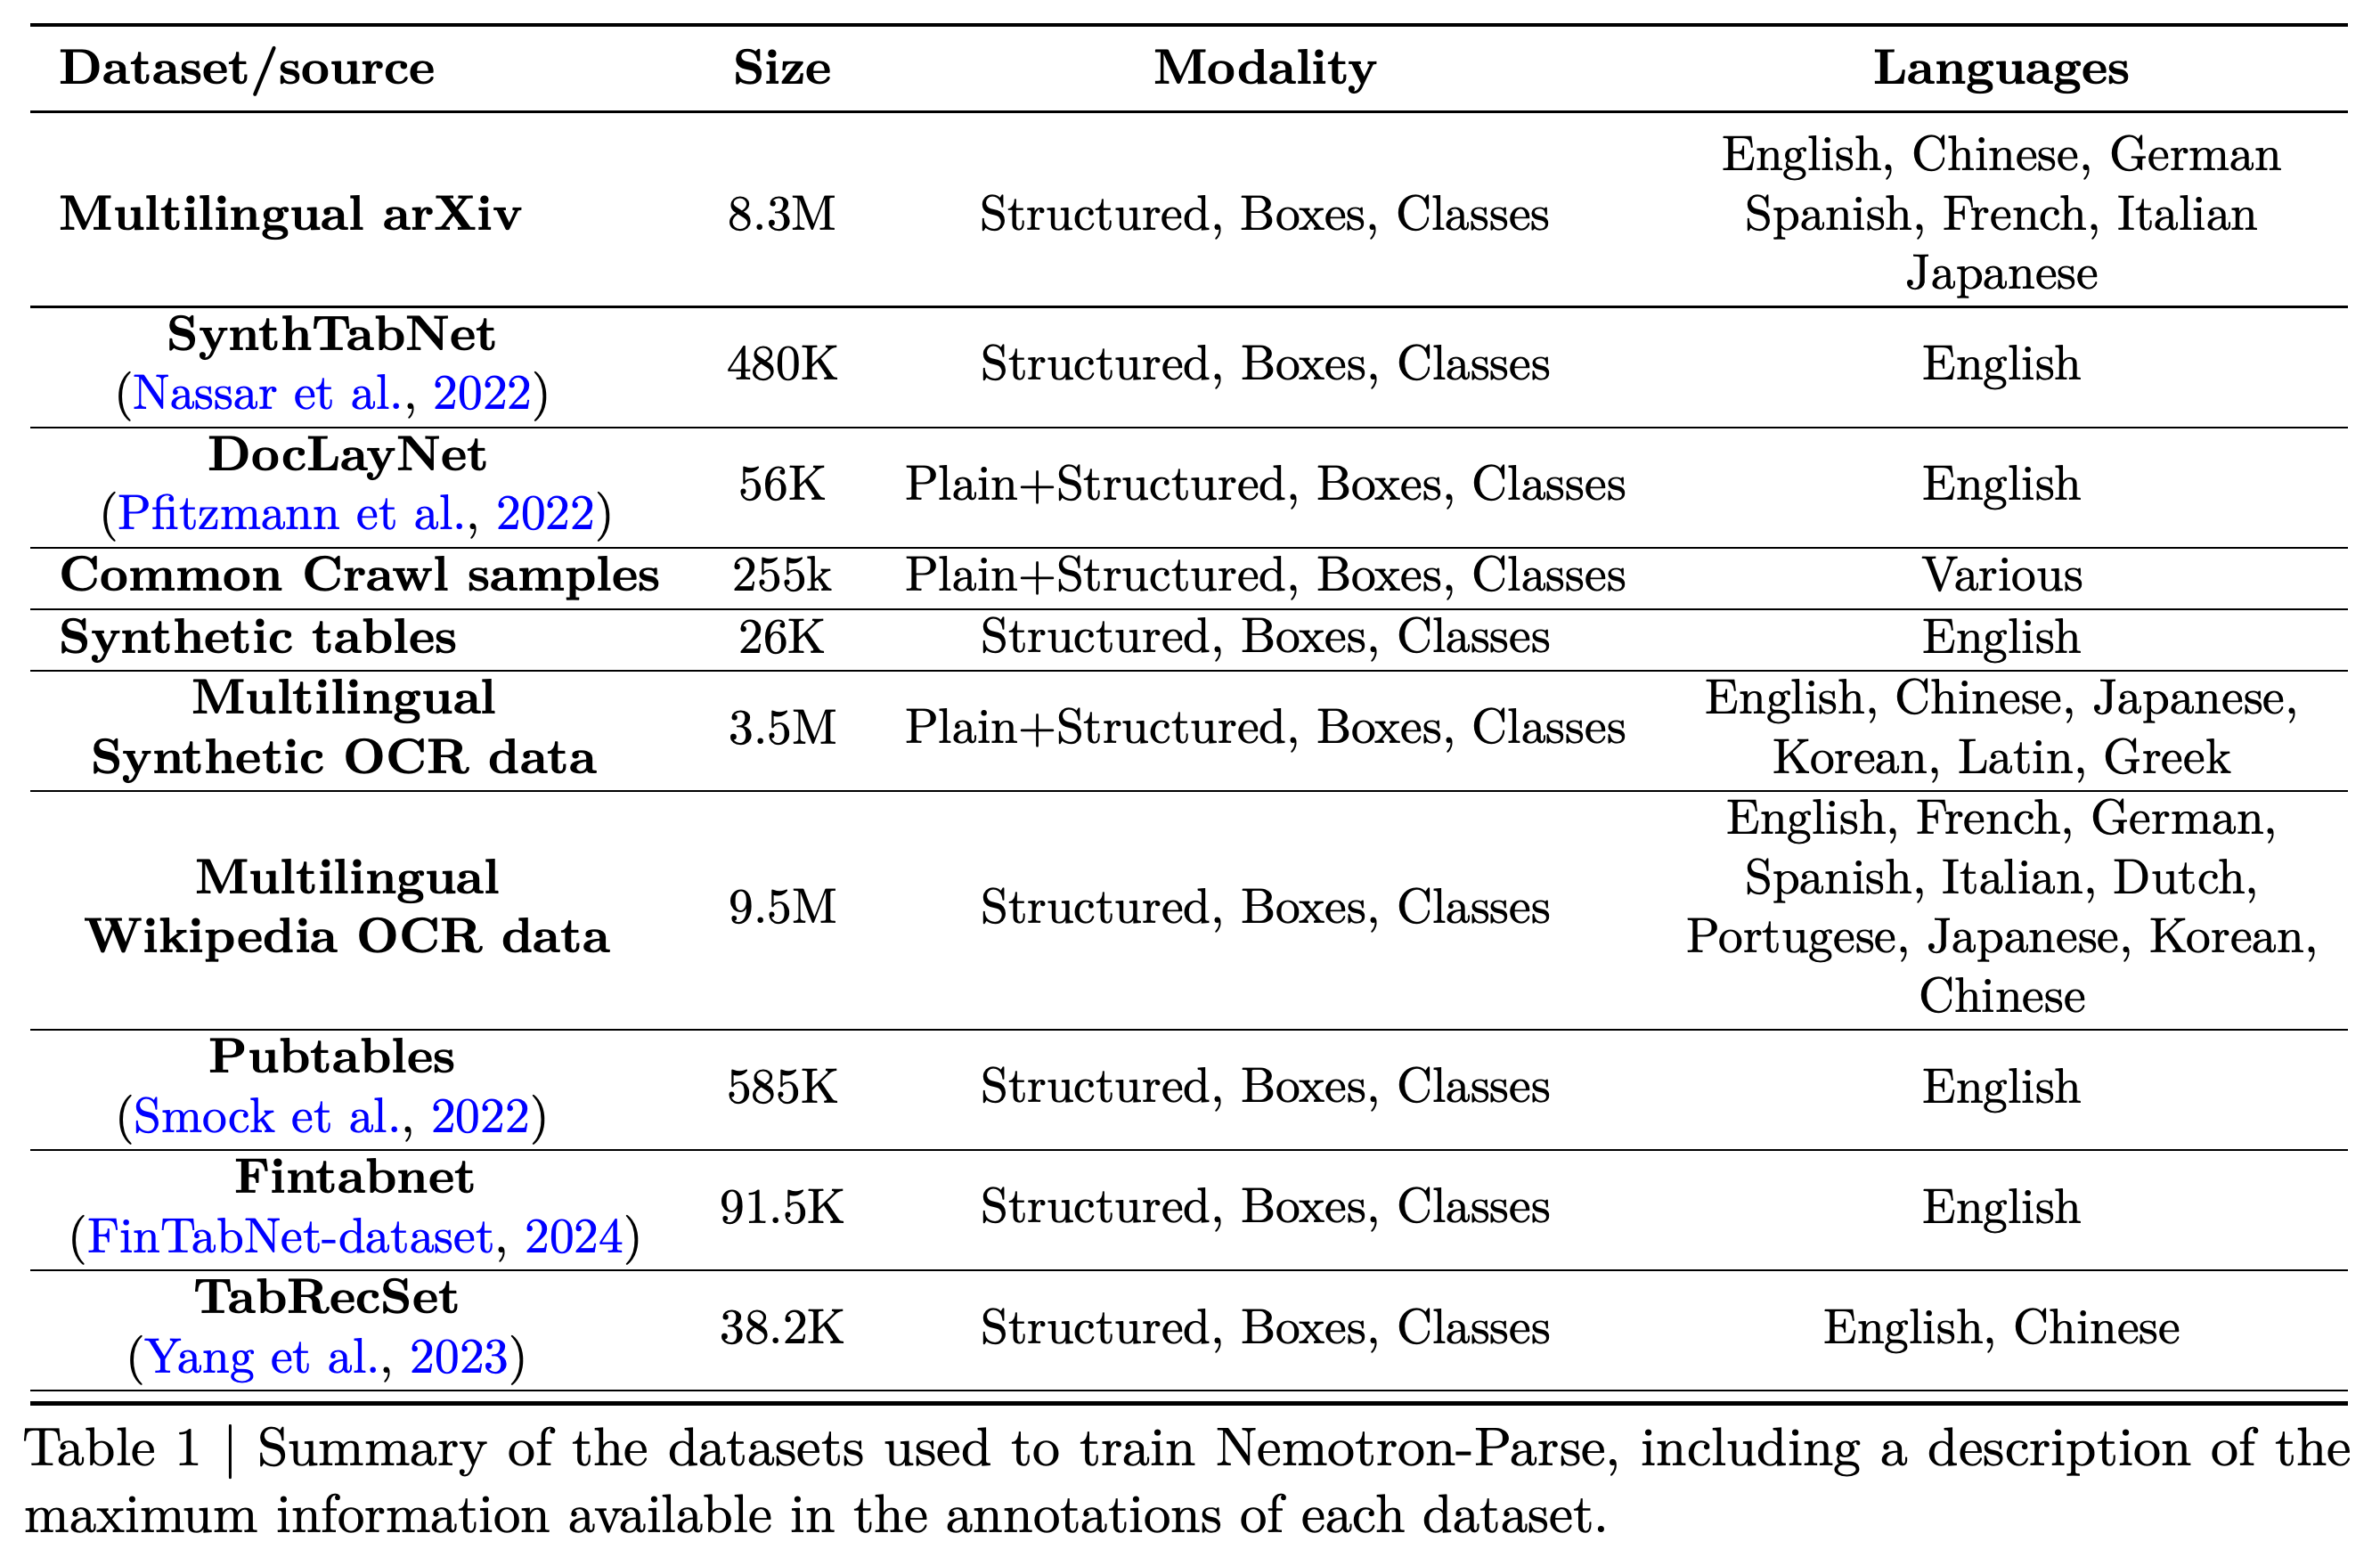
Table 1에서 가장 큰 데이터 출처는 Multilingual arXiv 8.3M, Multilingual Synthetic OCR data 3.5M, Multilingual Wikipedia OCR data 9.5M이다. 규모가 더 작은 출처는 다양한 레이아웃과 표를 제공하며 SynthTabNet 480K, DocLayNet 56K, Common Crawl samples 255k, Synthetic tables 26K, Pubtables 585K, Fintabnet 91.5K, TabRecSet 38.2K로 구성된다.
- 합성 표는 구조화된 콘텐츠를 표현하는 마크업 형식인 HTML로 생성한 뒤 LaTeX로 변환한다. 레이아웃, 서식, 희소성, 체크박스를 다양하게 바꿔 렌더링한다.
- 고밀도 OCR 데이터에는 6개 언어의 무작위 단어, 문자, 기호가 포함된다. Wikipedia 텍스트에는 글꼴, 배경, 색상 증강을 적용해 렌더링한다.
- 공개 표 데이터셋은 HTML에서 LaTeX로 변환하고 나머지 페이지 요소에는 자동으로 레이블을 부여한다. 공개 학습 데이터는 https://huggingface.co/datasets/nvidia/Nemotron-VLM-Dataset-v2 에서 이용할 수 있다.
학습 데이터는 규모가 큰 다국어 렌더링 코퍼스와 규모가 작은 레이아웃 및 표 데이터셋을 혼합한다. 주석 유형을 보면 주석에 맞춘 프롬프트를 사용하는 이유를 알 수 있다. 일부 출처는 일반 텍스트와 구조화된 텍스트를 제공하고 다른 출처는 경계 상자와 클래스가 포함된 구조화된 텍스트를 제공한다.
4. Experimental results
실험은 텍스트 인식과 읽기 순서, 구조화된 표 추출, 다국어 OCR을 평가한다. 언어 범위, 정규화 규칙, 필요한 출력 변환 등 평가 조건은 데이터셋마다 다르다.
4.1. OCR and reading order evaluation
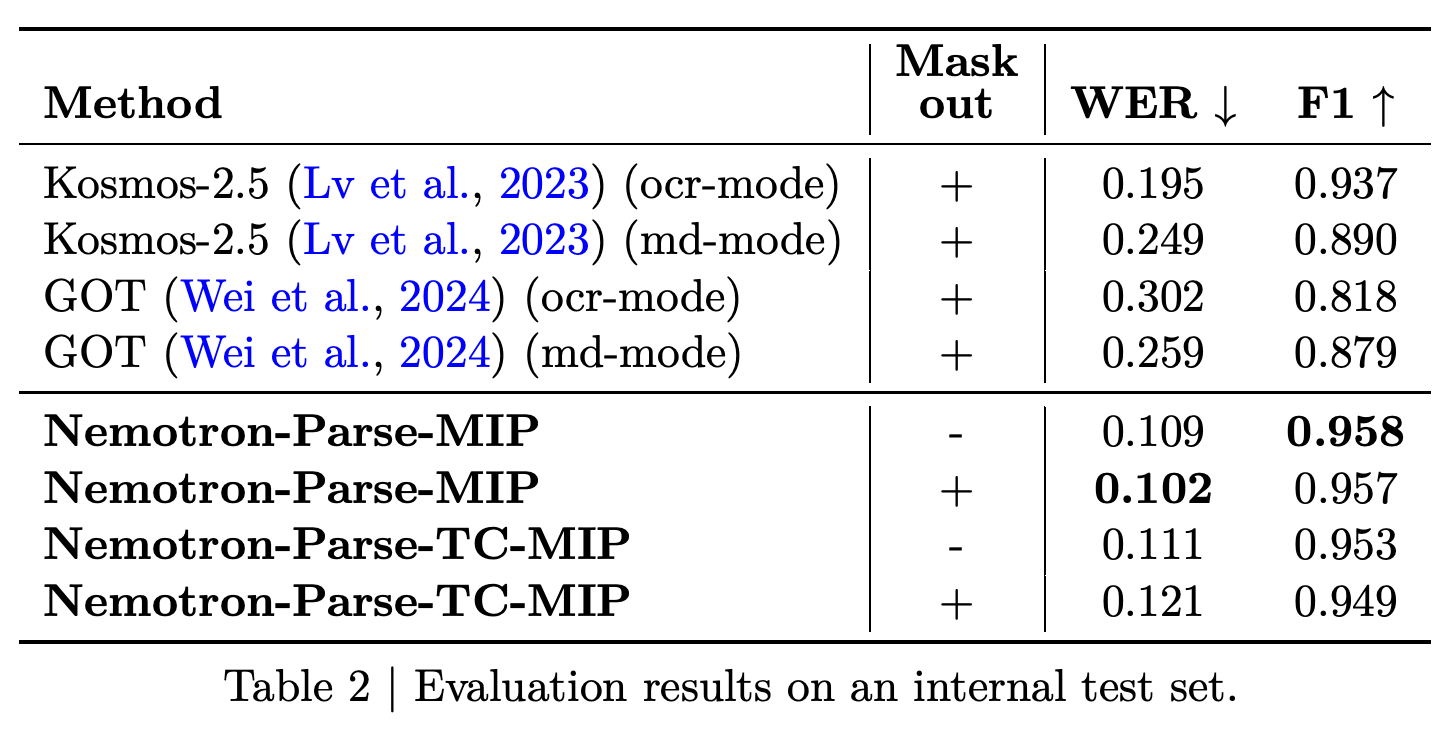
내부 평가는 잡지, 책, Common Crawl에서 수집하고 사람이 레이블을 작성한 PDF 페이지 789개를 사용하며 명시적인 읽기 순서 주석을 포함한다. 출력을 정규화하고 표, 방정식, TeX 명령을 제외한다. GOT의 Markdown 모드에서는 머리글과 바닥글도 마스킹한다.
- 마스킹하지 않은 조건에서 Nemotron-Parse-MIP의 단어 오류율(WER, 논문에서 보고한 단어 단위 오류 지표)은 0.109이고 F1은 0.958이다. TC는 각각 0.111과 0.953이다.
- 마스킹한 조건에서 기본 모델의 WER은 0.102이고 F1은 0.957이며, Kosmos-2.5 OCR 모드는 각각 0.195와 0.937이다. TC는 각각 0.121과 0.949다.
- Table 2는 모든 기준 모델 행을 마스킹된 조건으로 표시하지만 본문은 GOT Markdown 모드의 마스킹을 구체적으로 설명한다. 이 불일치로 인해 기준 모델의 전처리 설명이 불완전하다.
기본 모델은 마스킹 조건에서 보고된 최저 WER인 0.102를 달성하고 마스킹하지 않은 조건에서 최고 F1인 0.958을 달성한다. TC는 마스킹하지 않은 조건에서 비슷한 성능을 유지한다. 마스킹은 기본 모델의 WER을 개선하지만 TC의 WER은 악화시킨다.
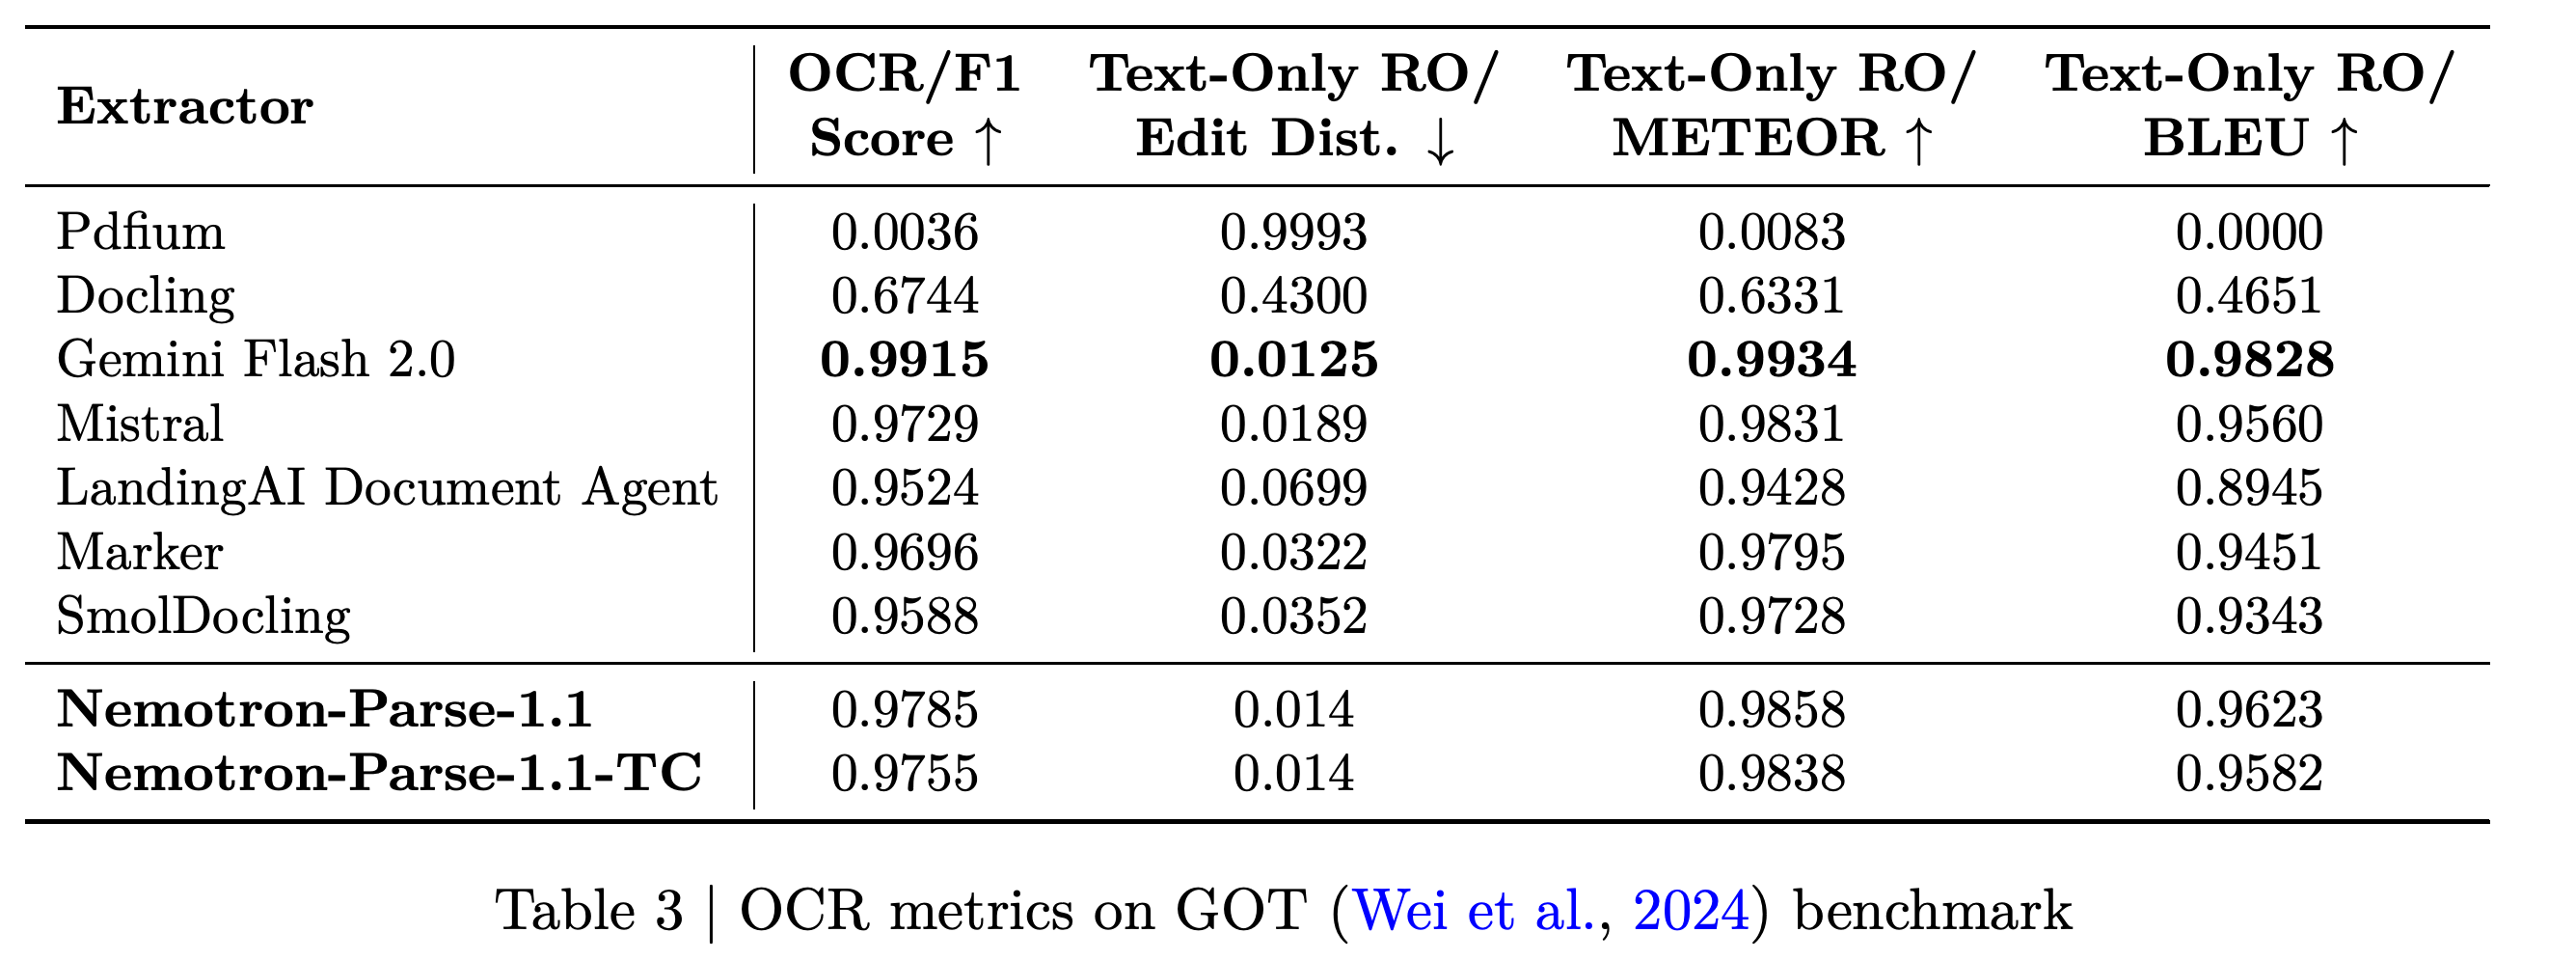
GOT에서 기본 모델의 OCR/F1은 0.9785이고 TC는 0.9755이며, Gemini Flash 2.0은 0.9915다. 텍스트만을 대상으로 한 읽기 순서 편집 거리는 기본 모델과 TC 모두 0.014이며, Gemini Flash 2.0은 0.0125다.
- METEOR와 BLEU는 추출한 읽기 순서 시퀀스에 적용한 텍스트 비교 점수다. 기본 모델의 읽기 순서 METEOR와 BLEU는 각각 0.9858과 0.9623이고, TC는 각각 0.9838과 0.9582다.
- 기본 모델은 보고된 4개 지표 모두에서 Gemini Flash 2.0을 제외한 모든 추출기보다 높은 성능을 보인다.
기본 모델은 4개 지표 모두에서 Gemini Flash 2.0보다 낮고, 나머지 추출기보다 높은 성능을 보인다. 압축은 OCR/F1, METEOR, BLEU를 소폭 낮추지만 보고된 읽기 순서 편집 거리 0.014는 유지한다.
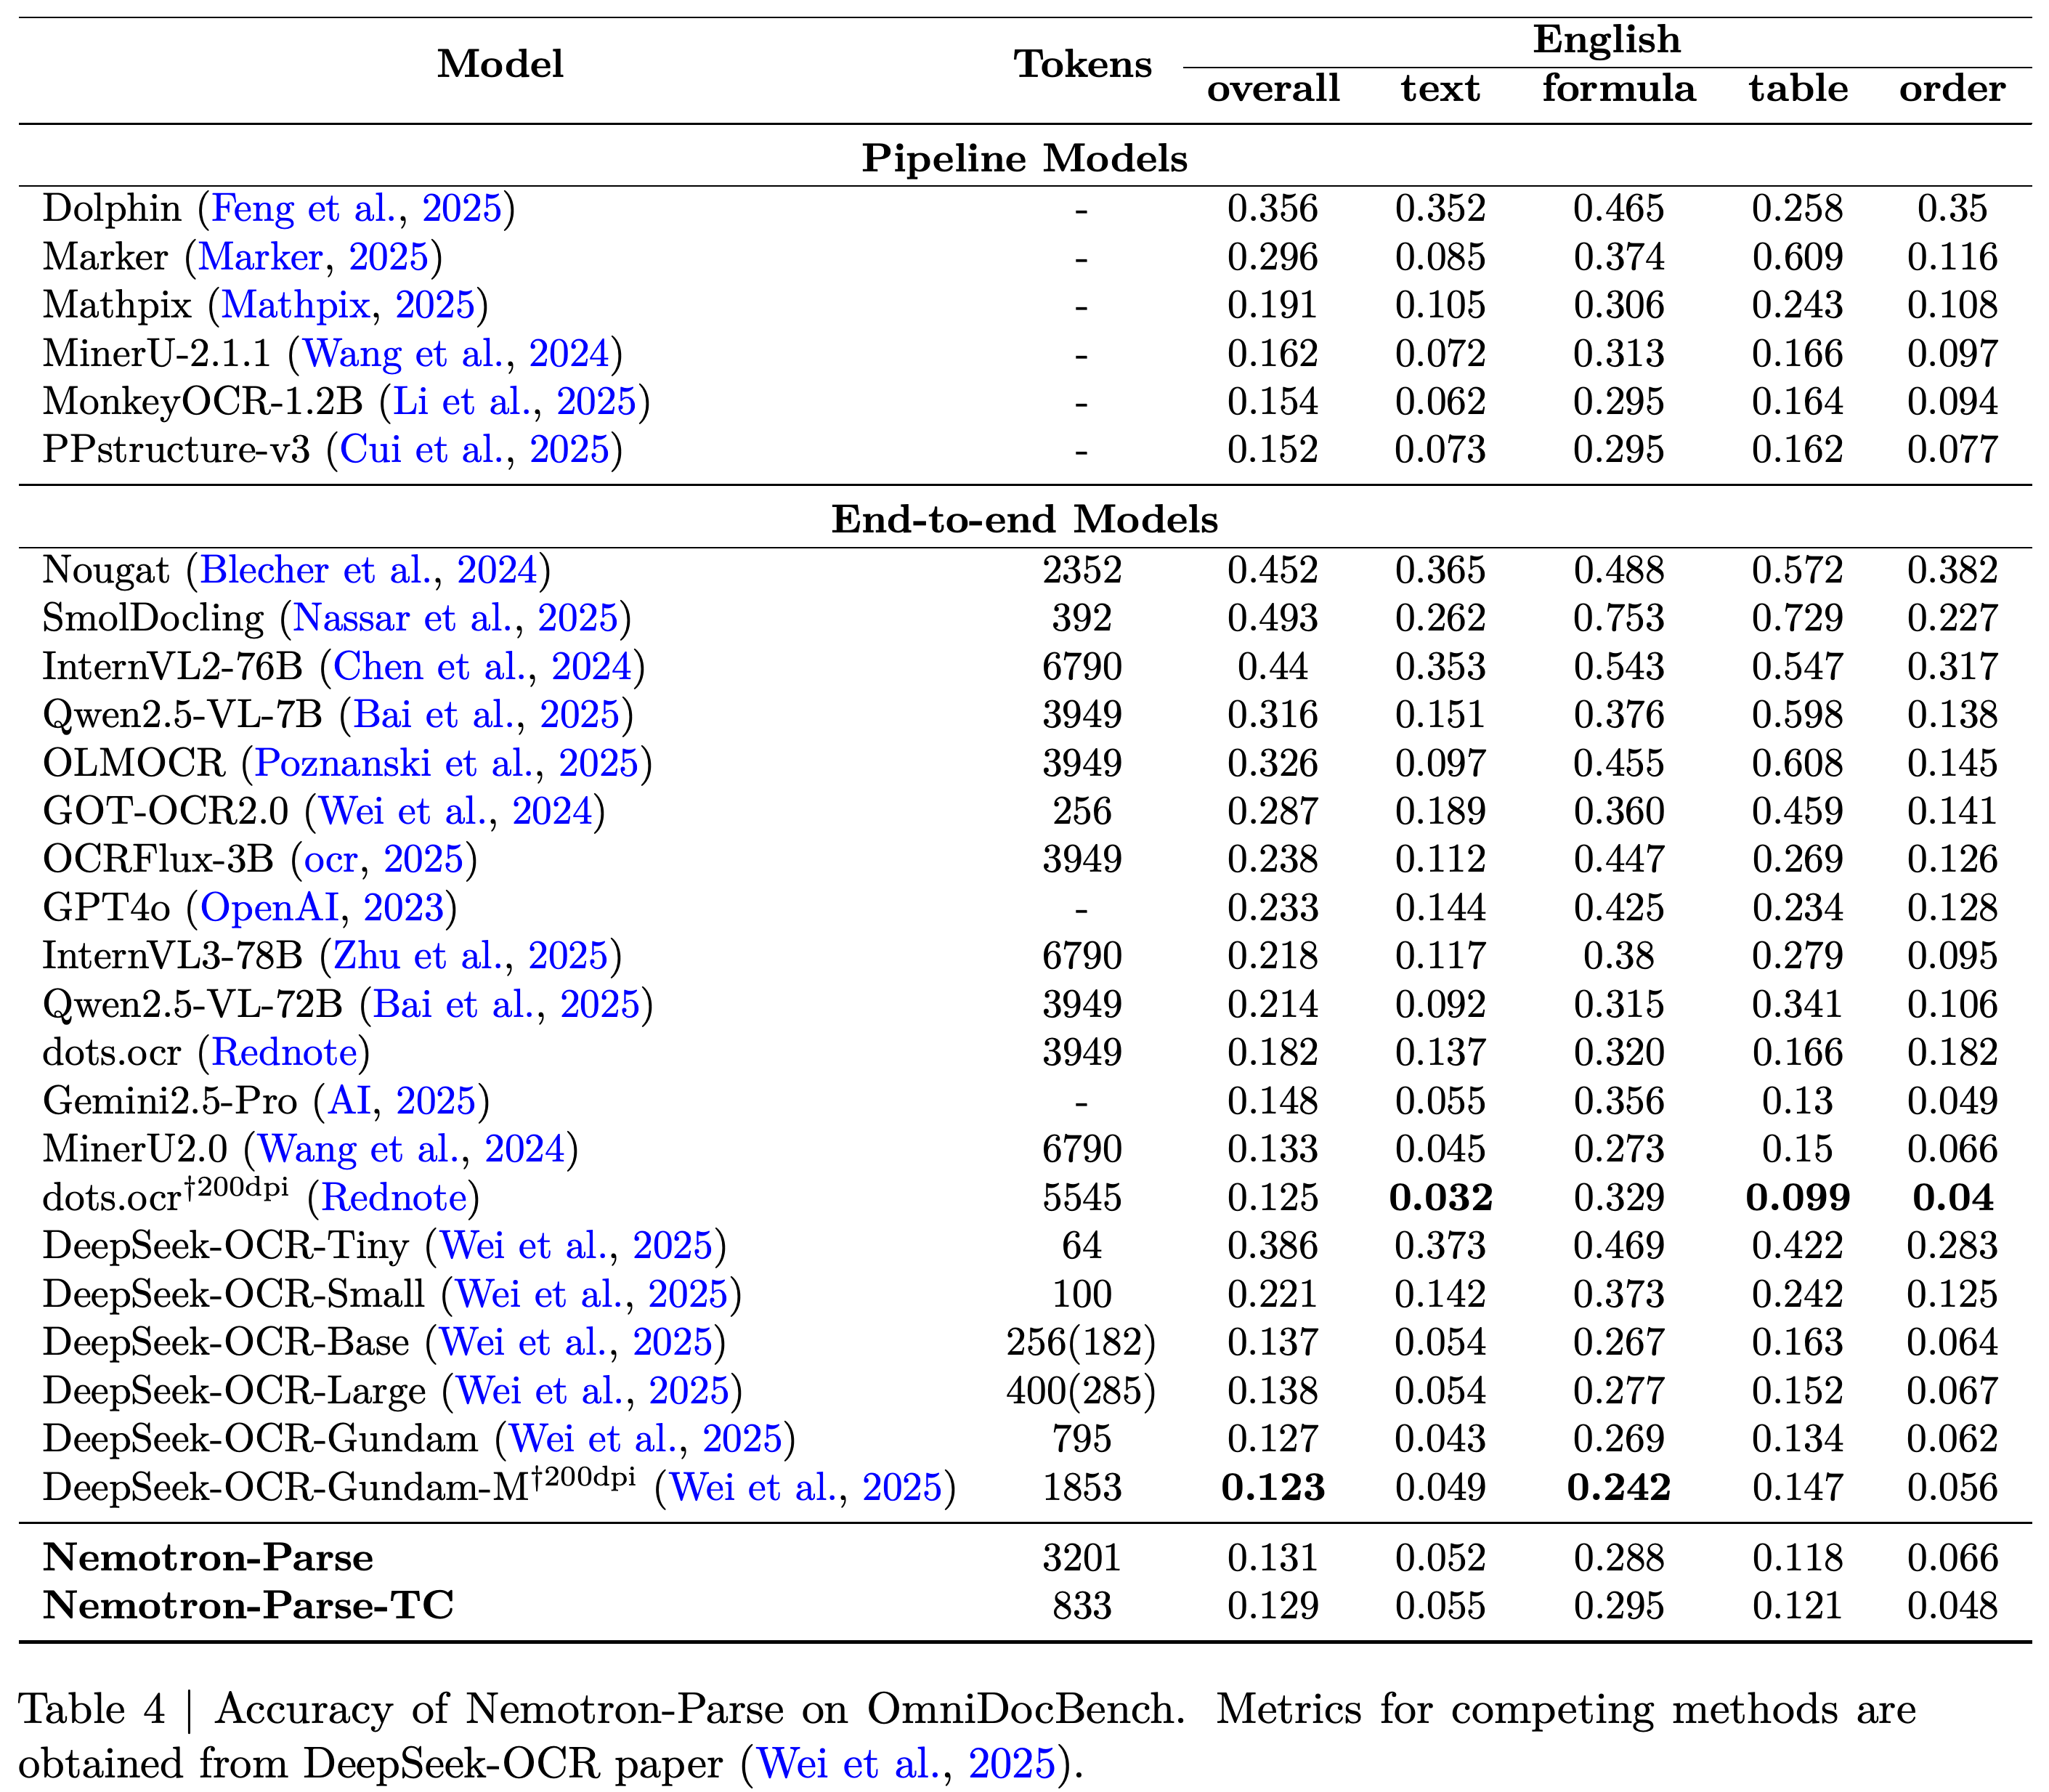
OmniDocBench v1.0의 영어 부분집합에서 기본 모델의 전체, 텍스트, 수식, 표, 순서 지표는 각각 0.131, 0.052, 0.288, 0.118, 0.066이다. TC는 각각 0.129, 0.055, 0.295, 0.121, 0.048이며, 값이 낮을수록 성능이 좋다.
- TC는 읽기 순서가 개선되면서 전체 지표가 좋아지지만 텍스트, 수식, 표 지표는 소폭 악화된다.
- 저자들은 간단한 수식을 올바르게 표현해도 Markdown 출력에 평가기가 요구하는 LaTeX 수학 구분자가 없으면 불이익을 받을 수 있다고 설명한다.
- 경쟁 모델 결과는 DeepSeek-OCR 논문에서 가져왔다. DeepSeek-OCR-Gundam-M†200dpi의 전체 지표는 0.123이며, dots.ocr†200dpi의 표 지표는 0.099, 순서 지표는 0.04다. 표시된 변형은 표에 명시된 200dpi 이미지 해상도 조건을 사용한다.
TC는 기본 모델의 3201토큰 대신 833토큰을 사용하며 전체 지표를 0.131에서 0.129로 낮춘다. 읽기 순서는 개선되지만 텍스트, 수식, 표 지표는 악화된다. 일부 다른 모델은 전체 점수가 더 좋으며 경쟁 모델 점수는 DeepSeek-OCR 논문에서 가져왔다.
4.2. Table extraction
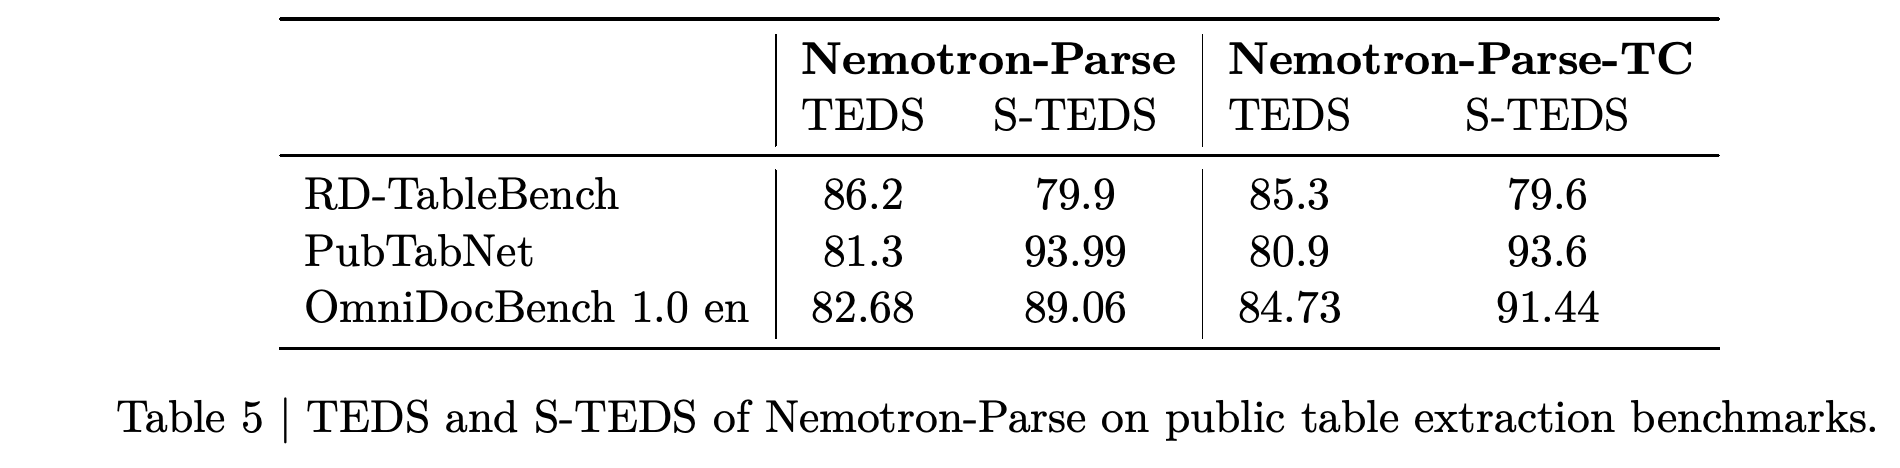
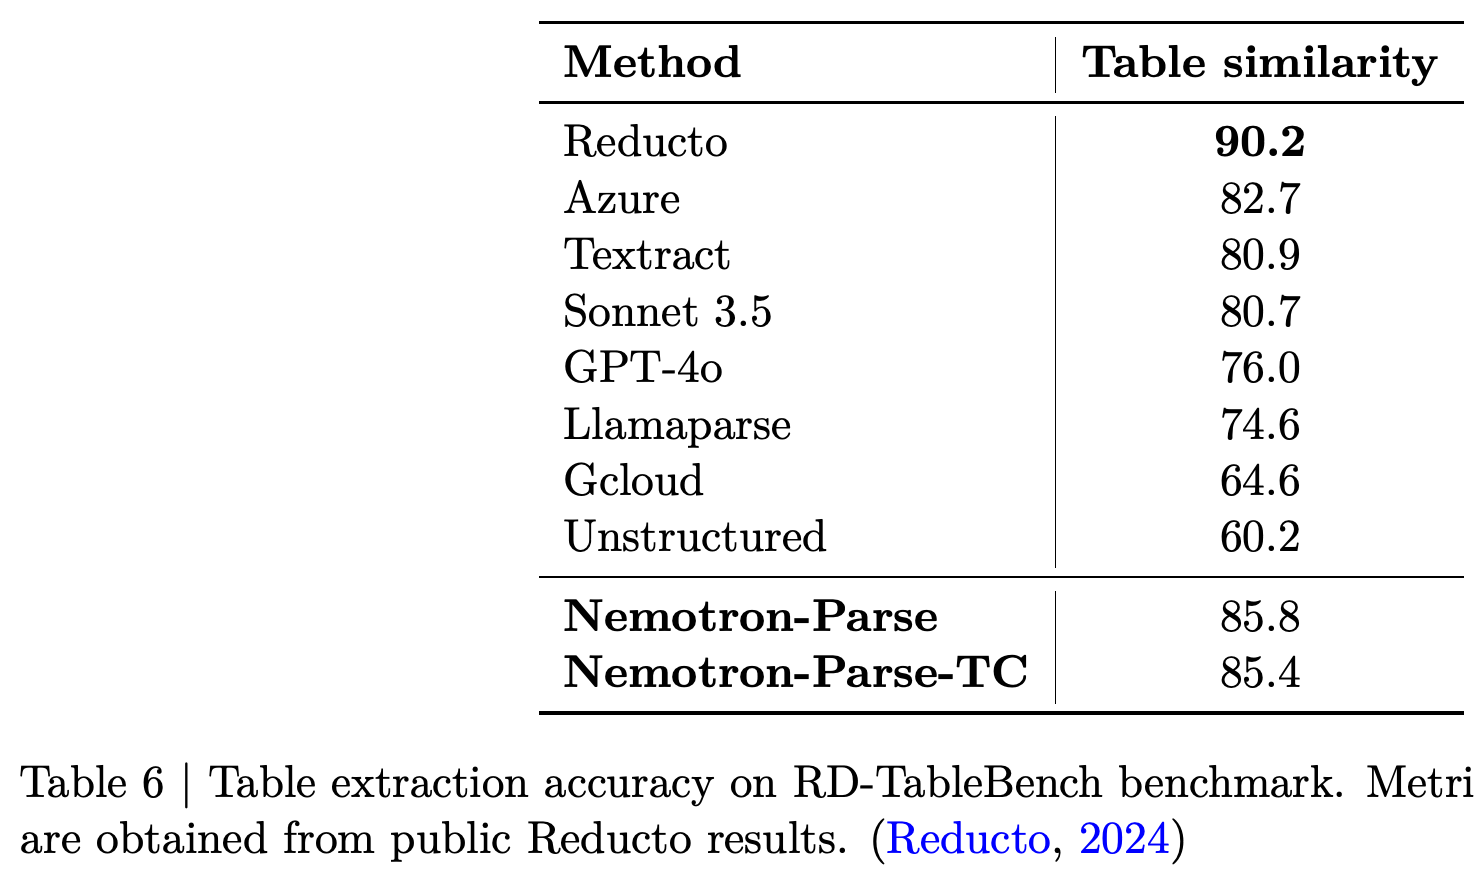
표는 LaTeX로 예측하며 평가에 필요하면 HTML이나 Markdown으로 변환한다. Table 5는 논문에서 정의를 제시하지 않은 표 추출 비교 점수 2가지인 TEDS와 S-TEDS를 보고한다. Table 6은 다양한 실제 표로 구성된 RD-TableBench에서 별도의 표 유사도 점수를 보고한다.
- 기본 모델/TC의 TEDS 값은 RD-TableBench에서 86.2/85.3, PubTabNet에서 81.3/80.9, OmniDocBench 1.0 en에서 82.68/84.73이다. 이에 대응하는 S-TEDS 값은 각각 79.9/79.6, 93.99/93.6, 89.06/91.44다.
- RD-TableBench의 표 유사도는 기본 모델이 85.8, TC가 85.4로, Reducto의 90.2보다 낮고 Azure의 82.7보다 높다.
- Table 6은 공개된 Reducto 결과에서 경쟁 모델 점수를 가져왔다. 이 표의 표 유사도 값은 Table 5의 TEDS 값과 구별된다.
압축은 RD-TableBench와 PubTabNet에서 보고된 표 지표 모두를 소폭 낮추지만 OmniDocBench 1.0 en에서는 모두 개선한다. 따라서 구조화된 표 추출에 미치는 효과는 보고된 평가셋마다 다르다.
기본 모델과 TC의 점수는 각각 85.8과 85.4로, Reducto의 90.2보다 낮고 나머지 방법보다 높다. 경쟁 모델 점수는 공개된 Reducto 결과에서 가져왔으며 이 지표는 TEDS 평가와 다르다.
4.3. Multilingual OCR
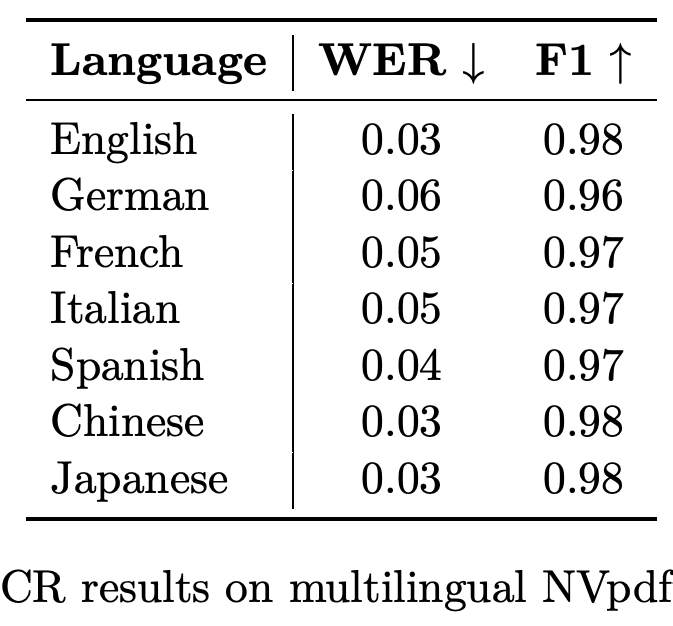
다국어 평가는 NVpdftex로 생성하고 글꼴과 색상 증강을 적용한 고밀도 과학 문서를 언어별로 10,000개씩 사용한다. Table 7의 WER/F1은 영어 0.03/0.98, 독일어 0.06/0.96, 프랑스어와 이탈리아어 0.05/0.97, 스페인어 0.04/0.97, 중국어와 일본어 0.03/0.98이다.
- 본문은 모든 언어에서 F1 > 0.96이라고 서술하지만 표에 보고된 독일어 값은 0.96이다.
- 저자들은 과학 문서와 표준 PDF 환경에서는 중국어, 일본어, 한국어를 효과적으로 지원하지만 실제 환경의 이미지와 문서에서는 지원이 제한적이라고 설명한다. Table 7에는 한국어 결과가 없다.
보고된 7개 언어는 생성된 과학 문서에서 F1이 0.96에서 0.98 사이에 있다. 독일어는 정확히 0.96으로 보고되며, 한국어는 학습 데이터와 지원 설명에 등장하지만 평가 결과에는 없다.
5. Implementation
두 변형은 모두 32비트 부동소수점 형식인 fp32와 bf16으로 공개되며, https://huggingface.co/nvidia/NVIDIA-Nemotron-Parse-v1.1 및 https://huggingface.co/nvidia/NVIDIA-Nemotron-Parse-v1.1-TC 에서 VLLM 추론을 지원한다. 모델 서빙용으로 패키징하고 최적화한 NIM 배포 컨테이너는 https://build.nvidia.com/nvidia/nemotron-parse 에서 제공한다.
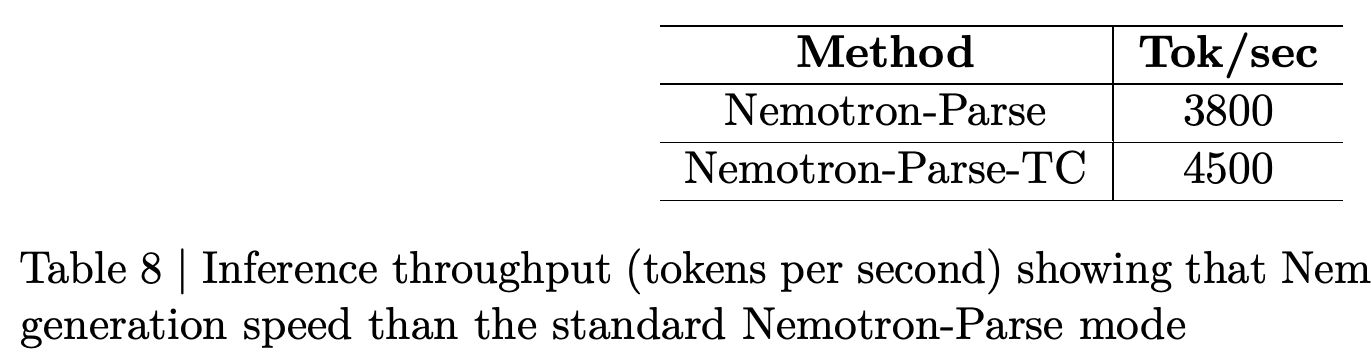
- H100 GPU 1개에서 bf16 모델을 사용하고 페이지당 1000토큰인 10,000페이지에 걸쳐 평균을 낸 종단 간 처리량은 기본 모델이 3800 tokens/second, TC가 4500 tokens/second다.
- 초록은 속도가 20% 개선되었다고 설명하며 표의 반올림된 값으로 계산하면 처리량 증가는 약 18.4%다. 구현 절의 본문은 이 속도를 각각 약 4 pages/second와 5 pages/second로 표현한다.
- 배치 크기, 동시 처리 수, 지연 시간 분포는 보고하지 않아, 이 처리량 결과를 대화형 서빙에 직접 적용하는 데 한계가 있다.
처리량은 3800 tokens/second에서 4500 tokens/second로 증가하며 반올림된 값으로 계산하면 약 18.4% 증가한다. 측정에는 H100 GPU 1개, bf16 정밀도, 페이지당 1000토큰인 10,000페이지를 사용한다. 요청별 지연 시간은 제공하지 않는다.
6. Contributors
Core Model Development의 기여자로 Kateryna Chumachenko, Amala Sanjay Deshmukh, Jarno Seppänen, Ilia Karmanov, Chia-Chih Chen, Lukas Vögtle, Philipp Fischer, Marek Wawrzos, Timo Roman, Karan Sapra, Andrew Tao, Bryan Catanzaro를 명시한다.
Infrastructure, Data, Benchmarking, and Product
Infrastructure, Data, Benchmarking, and Product의 기여자로 Saeid Motiian, Roman Ageev, Kedi Wu, Alexandre Milesi, Maryam Moosaei, Krzysztof Pawelec, Padmavathy Subramanian, Mehrzad Samadi, Xin Yu, Celina Dear, Sarah Stoddard, Jenna Diamond, Jesse Oliver, Leanna Chraghchian, Patrick Skelly, Tom Balough, Yao Xu, Jane Polak Scowcroft, Daniel Korzekwa, Darragh Hanley, Sandip Bhaskar를 명시한다.
8. Examples
예시는 페이지 요소의 위치와 클래스, 서식이 있는 수학 텍스트, 예측한 LaTeX로 복원한 복잡한 표라는 3가지 출력을 보여준다. 이 선별된 예시는 출력 표현을 설명하며 전체 정확도나 실패 빈도를 측정하지 않는다.
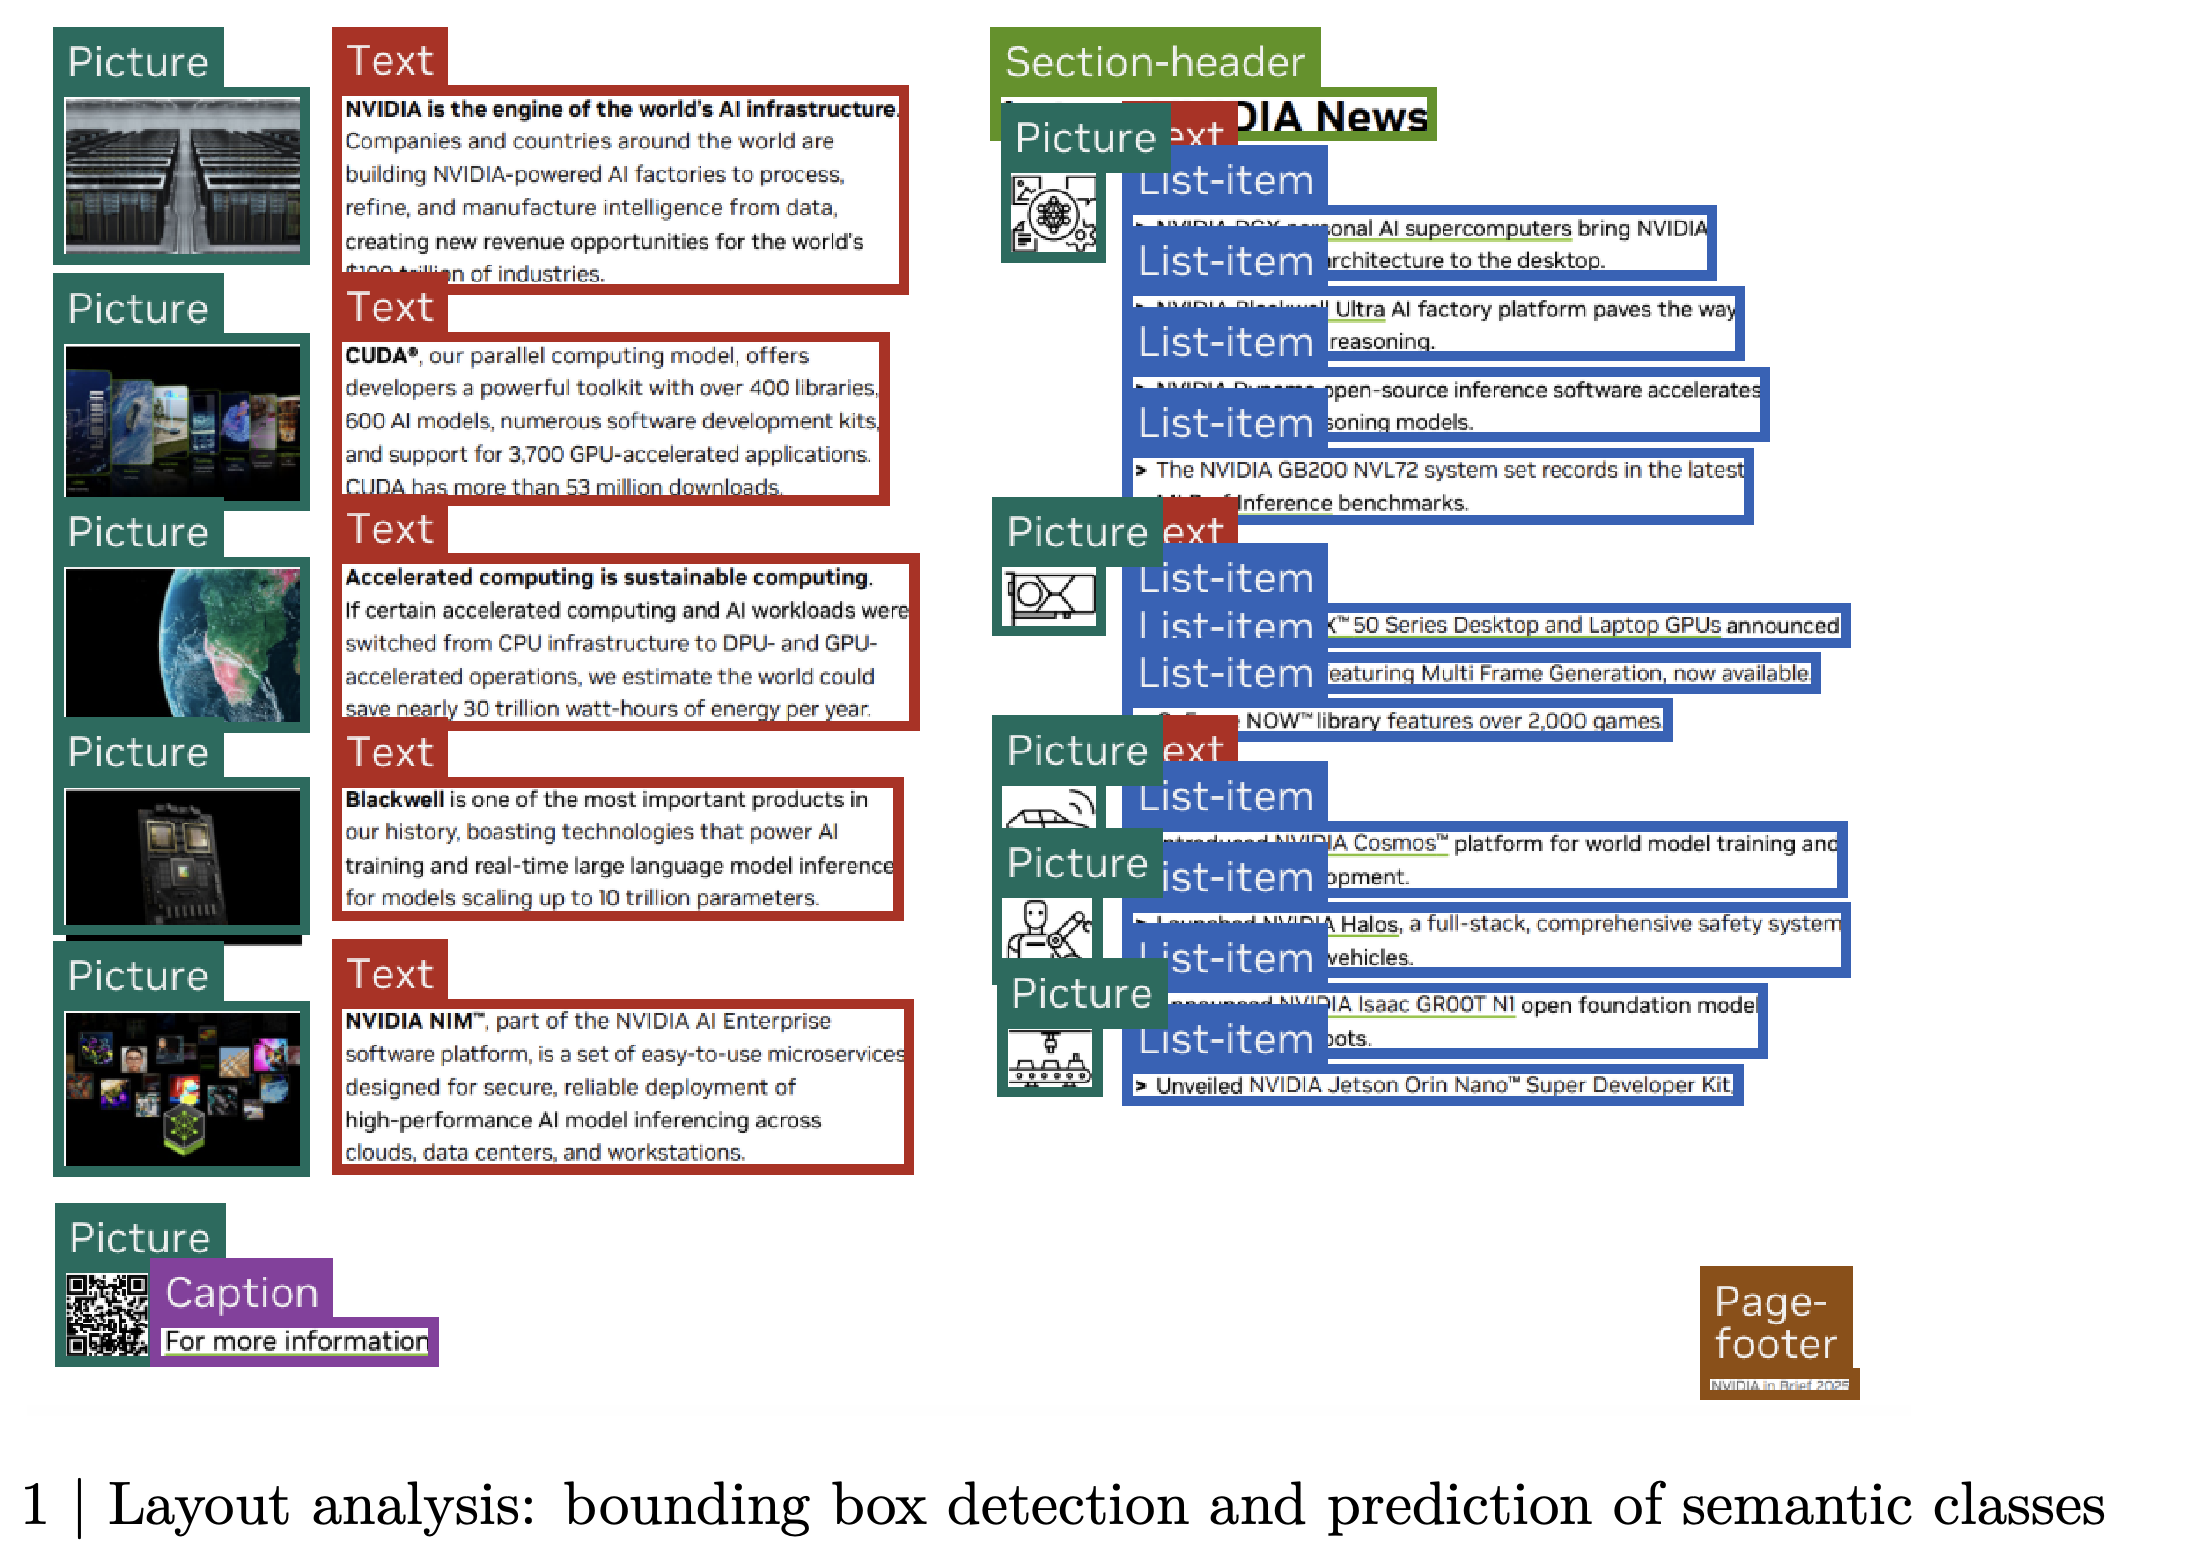
- Figure 1은 시각적 구성이 다양한 페이지에서 그림, 텍스트, 절 제목, 목록 항목, 캡션, 페이지 바닥글에 레이블을 표시한다.
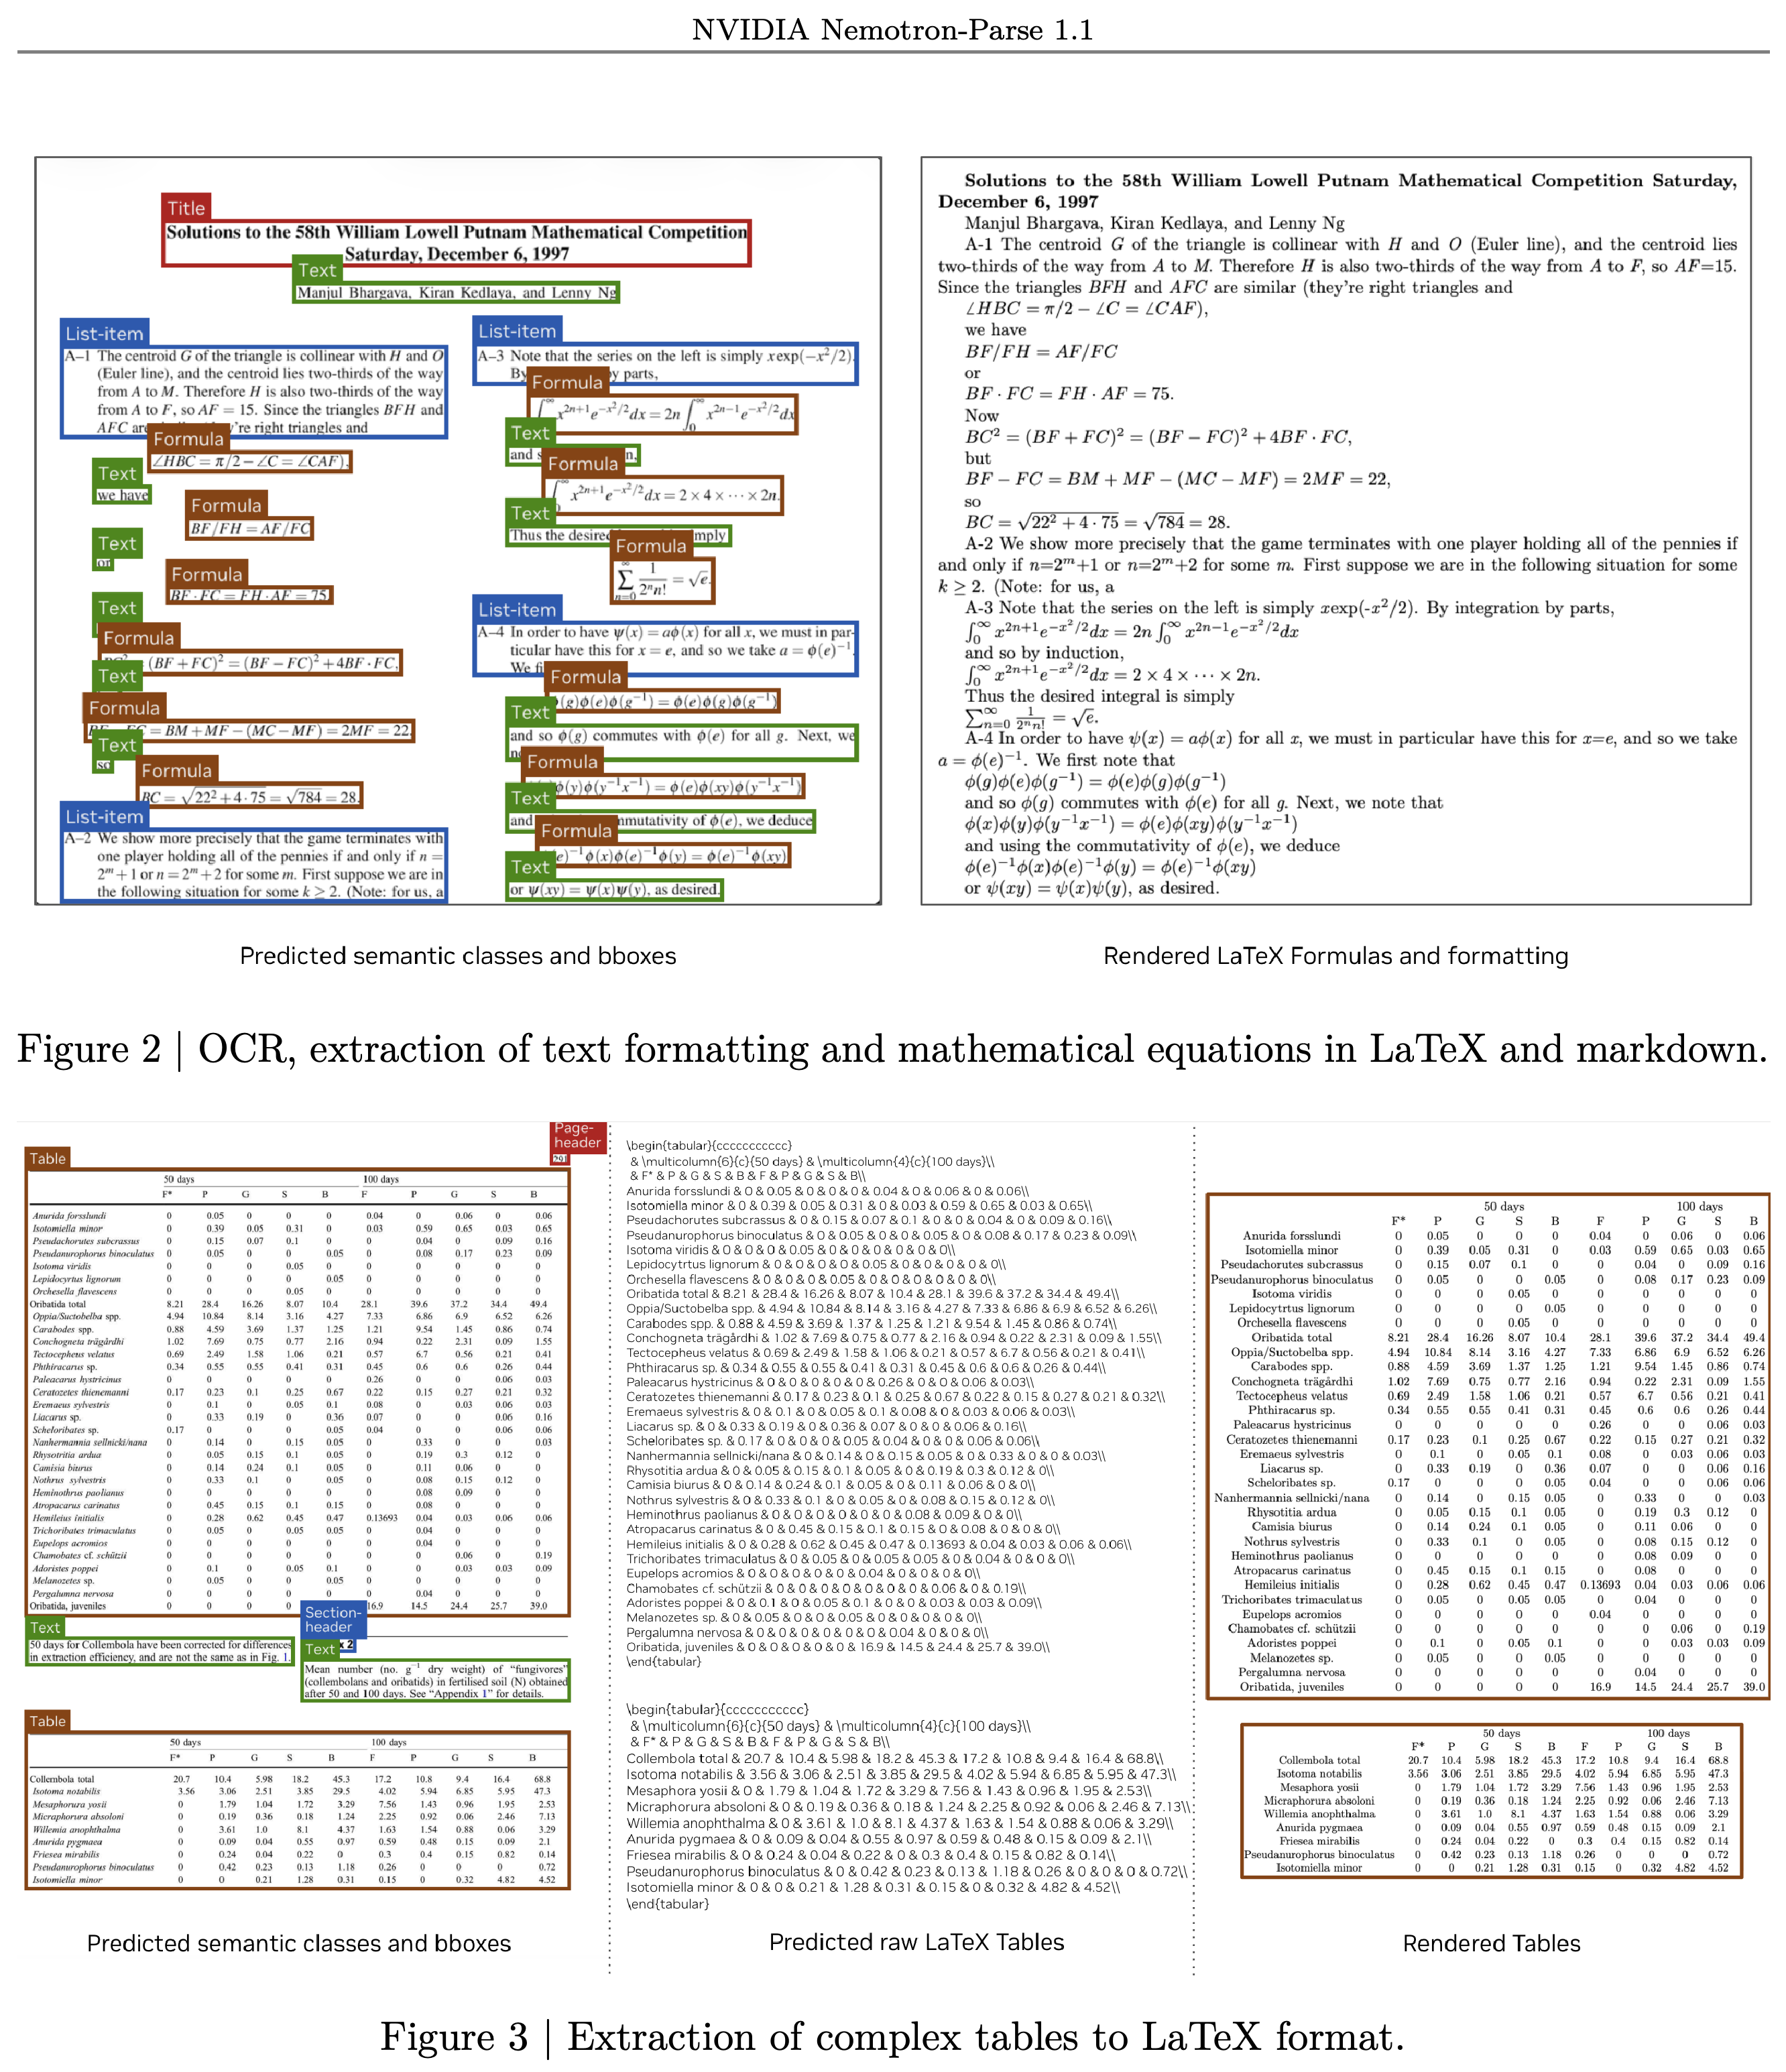
- Figure 2는 2단 문서에서 예측한 클래스와 경계 상자를 렌더링된 수학 콘텐츠와 함께 보여준다.
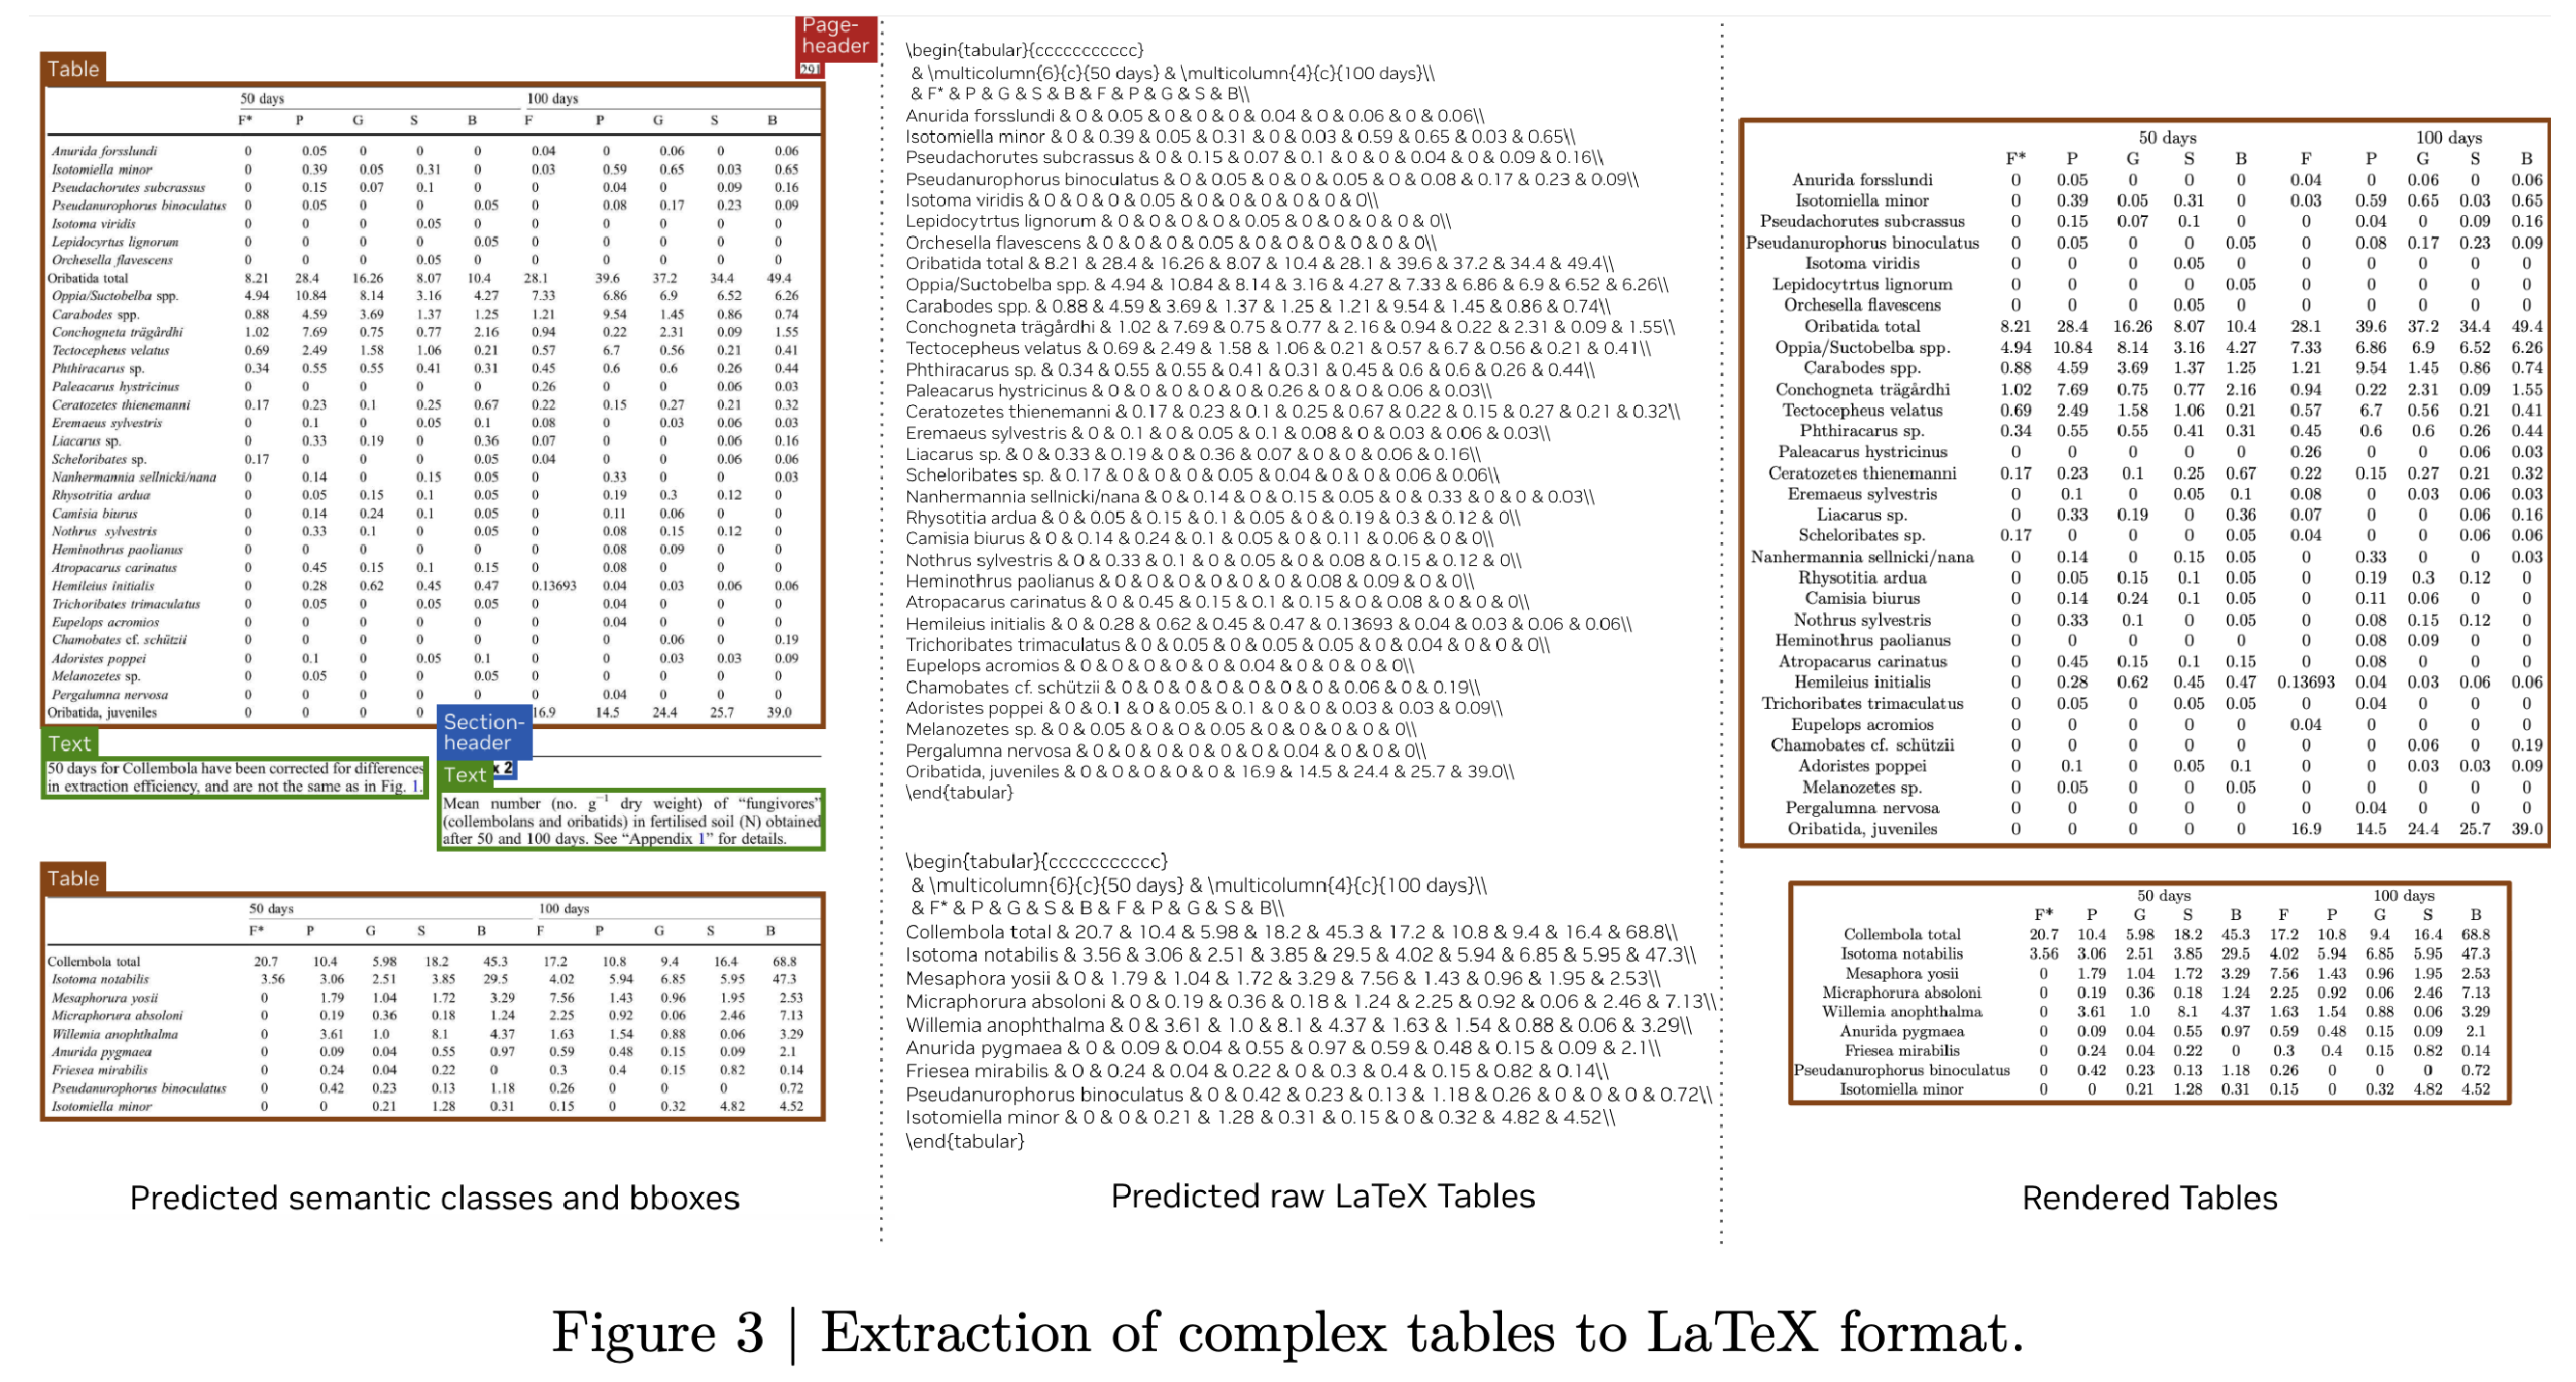
- Figure 3은 검출한 표 영역, 예측한 LaTeX 원문, 렌더링한 표를 보여준다.
색상으로 표시한 영역은 왼쪽의 그림과 텍스트, 오른쪽의 절 제목과 목록 항목을 구별하며 캡션과 페이지 바닥글 레이블도 포함한다. 이 예시는 서로 다른 요소가 섞인 페이지에서 예측한 위치와 의미적 역할을 보여준다.
왼쪽 패널은 2단 수학 문서의 제목, 텍스트, 목록 항목, 수식을 식별하며 오른쪽 패널은 추출한 콘텐츠를 렌더링한다. 패널을 함께 보면 페이지 영역이 서식이 있는 수학 출력에 어떻게 대응하는지 알 수 있다.
3개 패널은 검출한 페이지 영역, 예측한 LaTeX 표 원문, 렌더링한 표를 보여준다. 고밀도 표 콘텐츠를 렌더링 가능한 표현으로 변환하지만 이 예시는 복원 충실도를 정량적으로 측정한 값을 제공하지 않는다.
부록
- 제공된 14페이지 논문에는 별도 부록이 없다. 예시 뒤에 참고문헌이 이어지며, 추가 실험 부록이나 보충 ablation 실험 표는 포함되어 있지 않다.
짧은 생각
처리량과 통합된 읽기 순서를 우선하는 작업에서는 TC를 평가할 만하다. TC는 이미지 토큰 833개를 사용하고 OmniDocBench의 순서 지표를 0.048로 개선하며 보고된 H100 조건에서 4500 tokens/second를 달성한다. OCR과 표 성능이 저하되는 경우가 있어 작업에 따라 선택해야 하며, 표 결과는 벤치마크와 지표마다 다르다. 공개된 가중치, 학습 데이터, NVpdftex 파이프라인은 검토와 재사용을 지원한다. 다만 논문은 전체 학습 실행을 재현하기에 충분한 최적화 설정이나 데이터 혼합 비율을 제공하지 않는다. 위치 임베딩 제거와 다중 토큰 학습 각각의 효과는 수치로 측정되지 않았다. 실제 사용하려는 문서 도메인에서 다국어 평가를 수행하면 생성된 과학 문서 테스트 페이지와 배포 데이터 사이의 차이를 확인할 수 있다.