


FrontierCS: Evolving Challenges for Evolving Intelligence 요약 설명
17 Dec 2025 | Paper Review LLM Evaluation Benchmark Program Synthesis목차
- 요약
- 1. Introduction
- 2. Related Work
- 3. Problem Collection
- 4. Evaluation Results
- 5. Discussion
- 6. Example Problems
- Problem 1: World Map
- Problem 2: Treasure Packing
- Problem 3: Permutation Guess
- Problem 4: Square Packing
- Problem 5: Polyomino Packing
- Problem 6: Symbolic Regression
- Problem 7: Vector Database Design — Recall–Latency Tradeoff
- Problem 8: Minimal PoC Generation
- Problem 9: Kernel Rewrite & Warp Specialization for GDPA
- Problem 10: Poker Strategy Optimization
- 7. Conclusion
- 부록
- 짧은 생각
이번 글에서는 FrontierCS: Evolving Challenges for Evolving Intelligence 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 17일(Arxiv)
- Mang, Qiuyang, Chai, Wenhao, Li, Zhifei, Mao, Huanzhi, Zhou, Shang, Du, Alexander, Li, Hanchen, Liu, Shu, Chen, Edwin, Wang, Yichuan, et al.
- UC Berkeley, Princeton University, UCSD, X-camp Academy, Independent, Georgia Tech, Stanford University, University of Washington, Nanyang Technological University, University of Toronto, UIUC, University of Michigan, New York University, MIT
- 논문 링크
- Github
- Project Page
요약
- FrontierCS는 전문가가 선별한 컴퓨터 과학 문제 156개를 제시한다. 알고리즘 문제는 107개이고 연구 문제는 49개다. 모델은 실행 가능한 프로그램을 제출하며, 결정론적 평가기가 전역 최적해를 알 수 없거나 현실적으로 구하기 어려운 상황에서 해의 품질을 측정한다.
- 코드 실행과 외부 도구를 허용하지 않는 단일 라운드 평가에서 Gemini 3.0 Pro는 알고리즘 트랙의 Score@1 29.37과 Score@5 52.06으로 선두를 차지한다. 인간 기준 점수는 95.41이다. 연구 트랙에서는 Claude Opus 4.5가 Score@1 29.40으로, GPT 5.1 Thinking이 Score@5 47.21로 선두를 차지한다.
- 샘플링을 늘리면 점수가 높아지지만, 추론 예산을 늘려도 알고리즘 성능이 일관되게 향상되지는 않는다. Polyomino Packing 사례에서는 내부 표현 방식에 관한 지침을 제공하자 성능이 크게 향상되었다고 보고한다. 이는 작동하는 코드를 작성하는 능력과 효과적인 최적화 전략을 선택하는 능력 사이의 차이를 보여준다.
1. Introduction
FrontierCS는 정답이 알려진 문제와 이진 정오 판정을 넘어, 개방형 컴퓨터 과학 문제 해결 능력을 평가한다. 문제는 최적해를 알 수 없거나 계산하기 어려워야 하며, 결정론적 유효성 검사와 정량적 채점이 가능해야 한다. 또한 난이도가 다른 새로운 인스턴스를 생성할 수 있는 매개변수 기반 문제 생성기를 갖춰야 한다.
- 평가기는 문제별 시간과 메모리 제한 안에서 독립적으로 실행 가능한 풀이 프로그램을 실행한다. 모델에는 문제 명세와 필요한 I/O 또는 API 스텁을 제공한다.
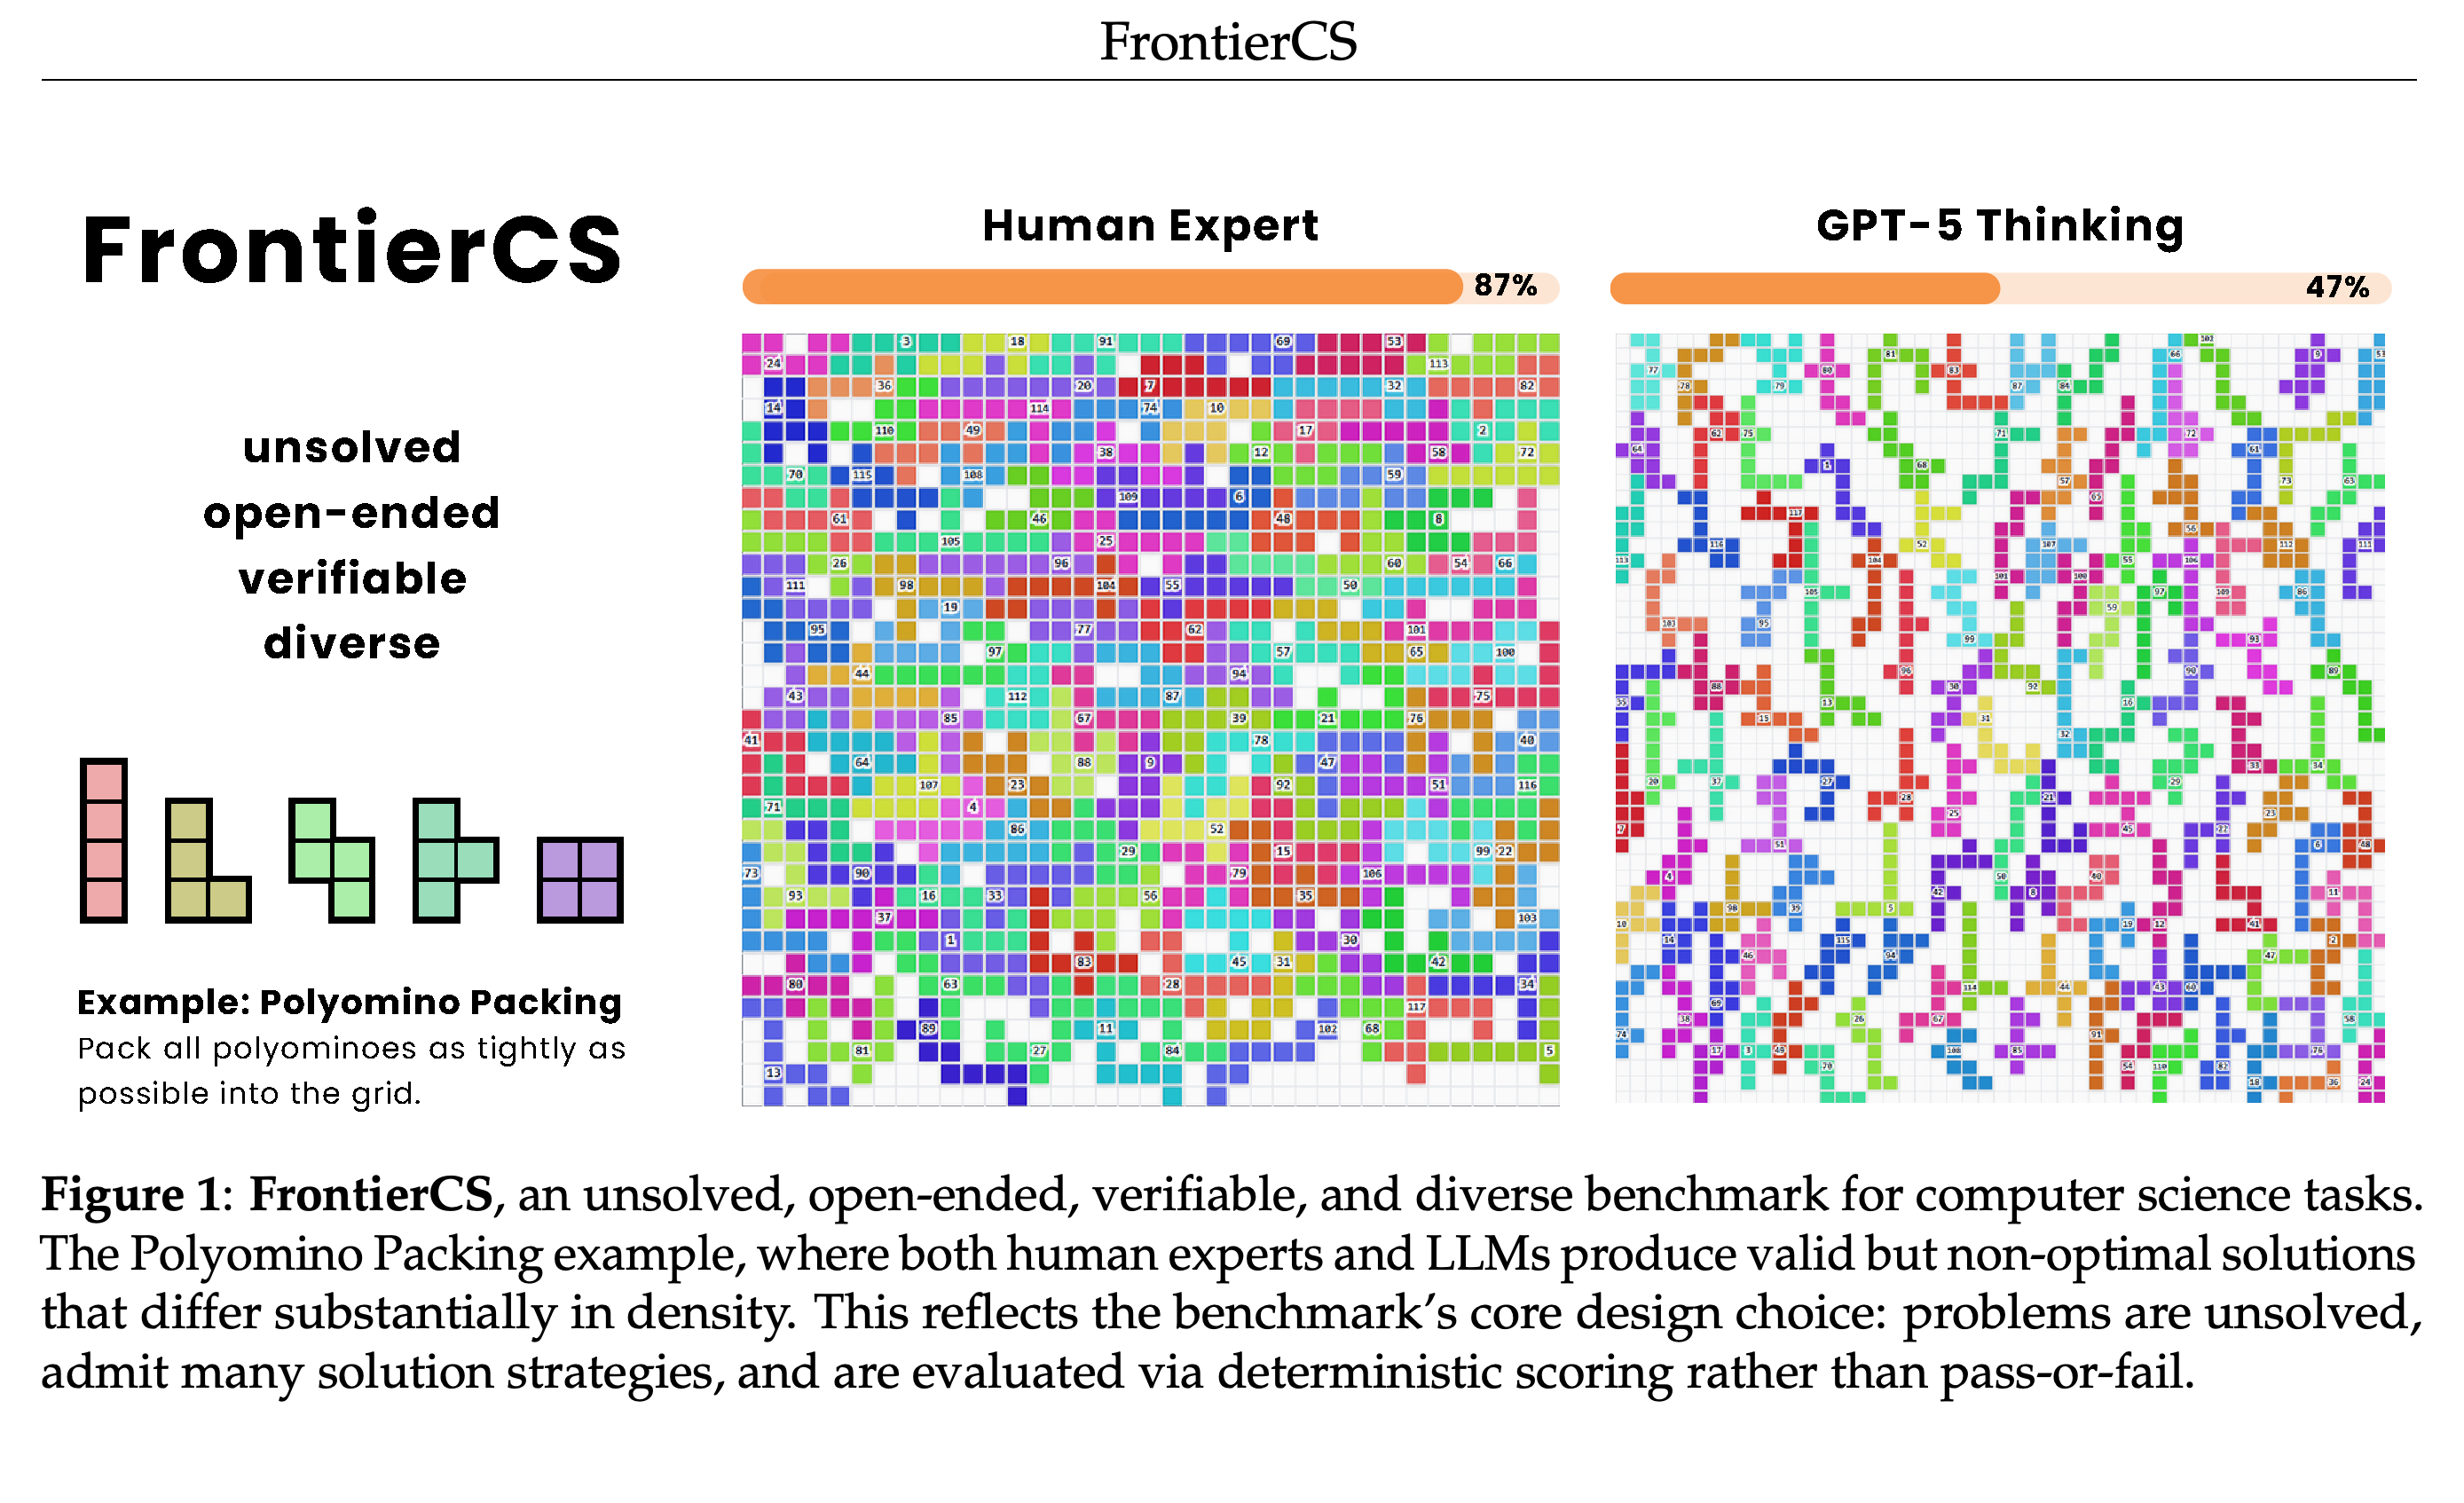
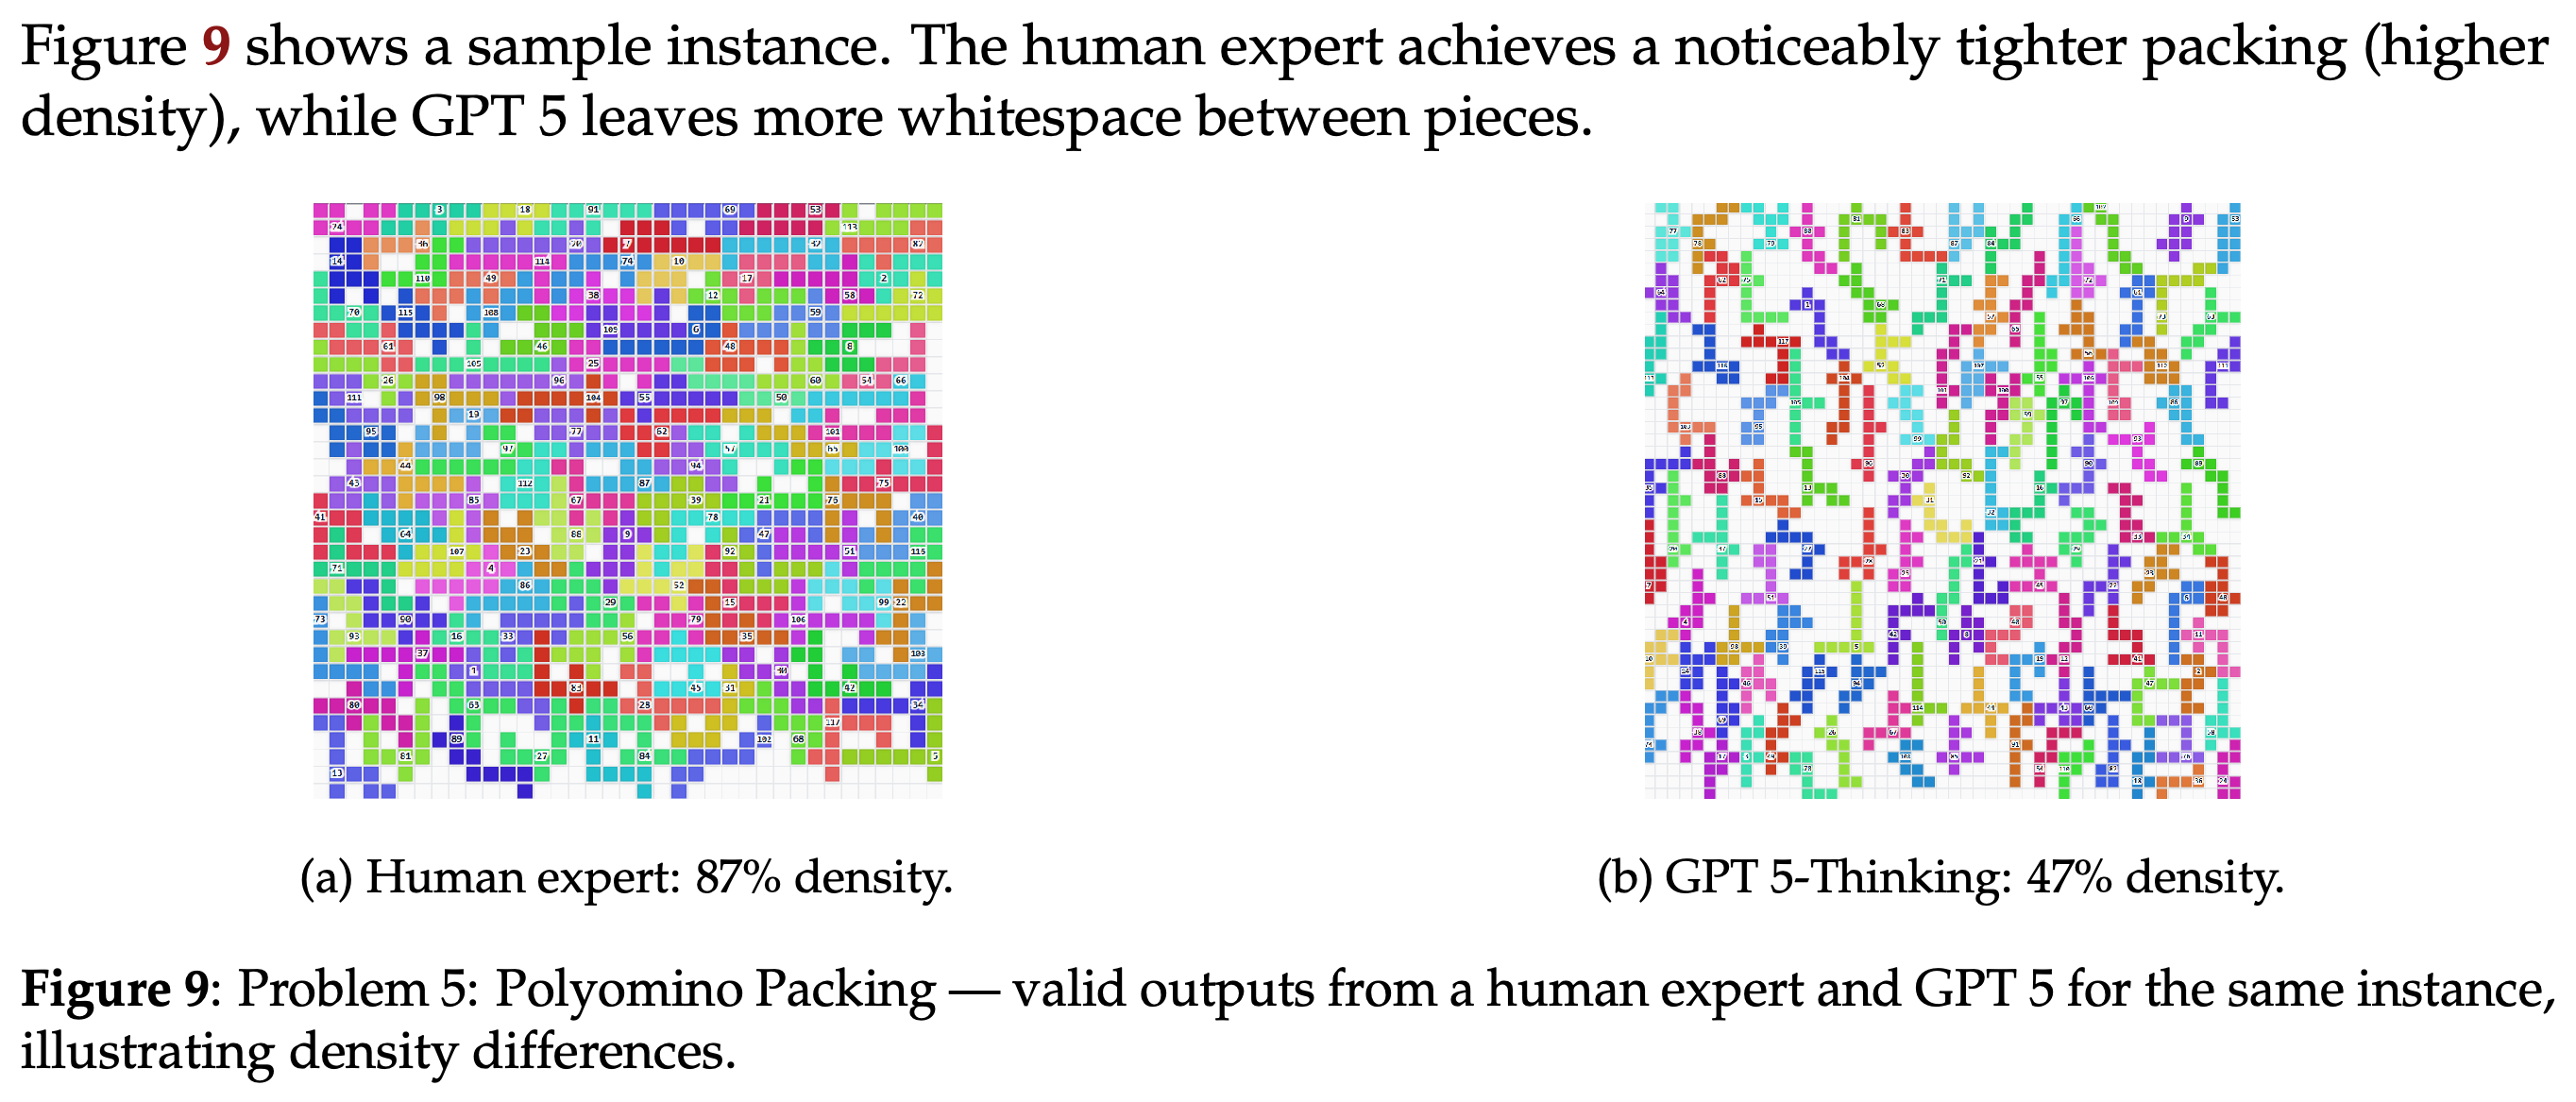
- 도입부의 Polyomino Packing 예시에서는 양쪽 해가 모두 유효하지만, 인간 전문가는 밀도 87%를 달성하고 GPT-5 Thinking은 47%를 달성한다. 유효성만으로는 이러한 품질 차이를 포착할 수 없다.
- 저자들은 평가기를 강화학습이나 self-play의 보상 신호로 활용하는 방안을 제안한다. 다만 논문은 학습 결과가 아니라 평가 실험을 보고한다.
인간 배치는 격자의 87%를 채우지만 GPT-5 Thinking은 47%를 채운다. 둘 다 유효성 요건을 만족한다. 정량적 품질 지표는 이진 통과 판정으로 드러나지 않는 이러한 차이를 보여준다.
2. Related Work
논문은 FrontierCS를 정답이 정해진 코딩 및 추론 벤치마크, 최적화 벤치마크, 개방형 연구 평가와 비교한다. HumanEval, MBPP, SWE-bench, BFCL, LiveCodeBench는 정확성을 강조한다. ALE-Bench는 객관적인 점수로 휴리스틱을 평가하고, UQ는 인간 검증을 사용하며, MLR-Bench는 자동 평가기로 연구를 평가한다. KernelBench는 커널의 정확성과 실행 시간을 측정한다.
- FrontierCS는 여러 컴퓨터 과학 분야의 문제에 부분 점수를 적용하며, LLM judge가 필요 없는 결정론적 평가를 제공한다. LLM judge에 대해서는 이 글을 참조하라.
- ALE-Bench와의 차이는 문제와 출제자의 다양성, 연구 작업 절차의 포함 여부에 있다. 객관적인 부분 점수는 기존 연구에서도 사용되었다.
- FrontierMath와 LiveCodeBench Pro는 전문가가 작성한 어려운 문제를 제공하지만, 논문은 이들이 알려진 기준 정답이나 해를 갖는다는 점을 강조한다. NP-Engine은 고전적인 NP-hard 문제 10개를 위한 벤치마크와 학습 프레임워크를 제공한다.
3. Problem Collection
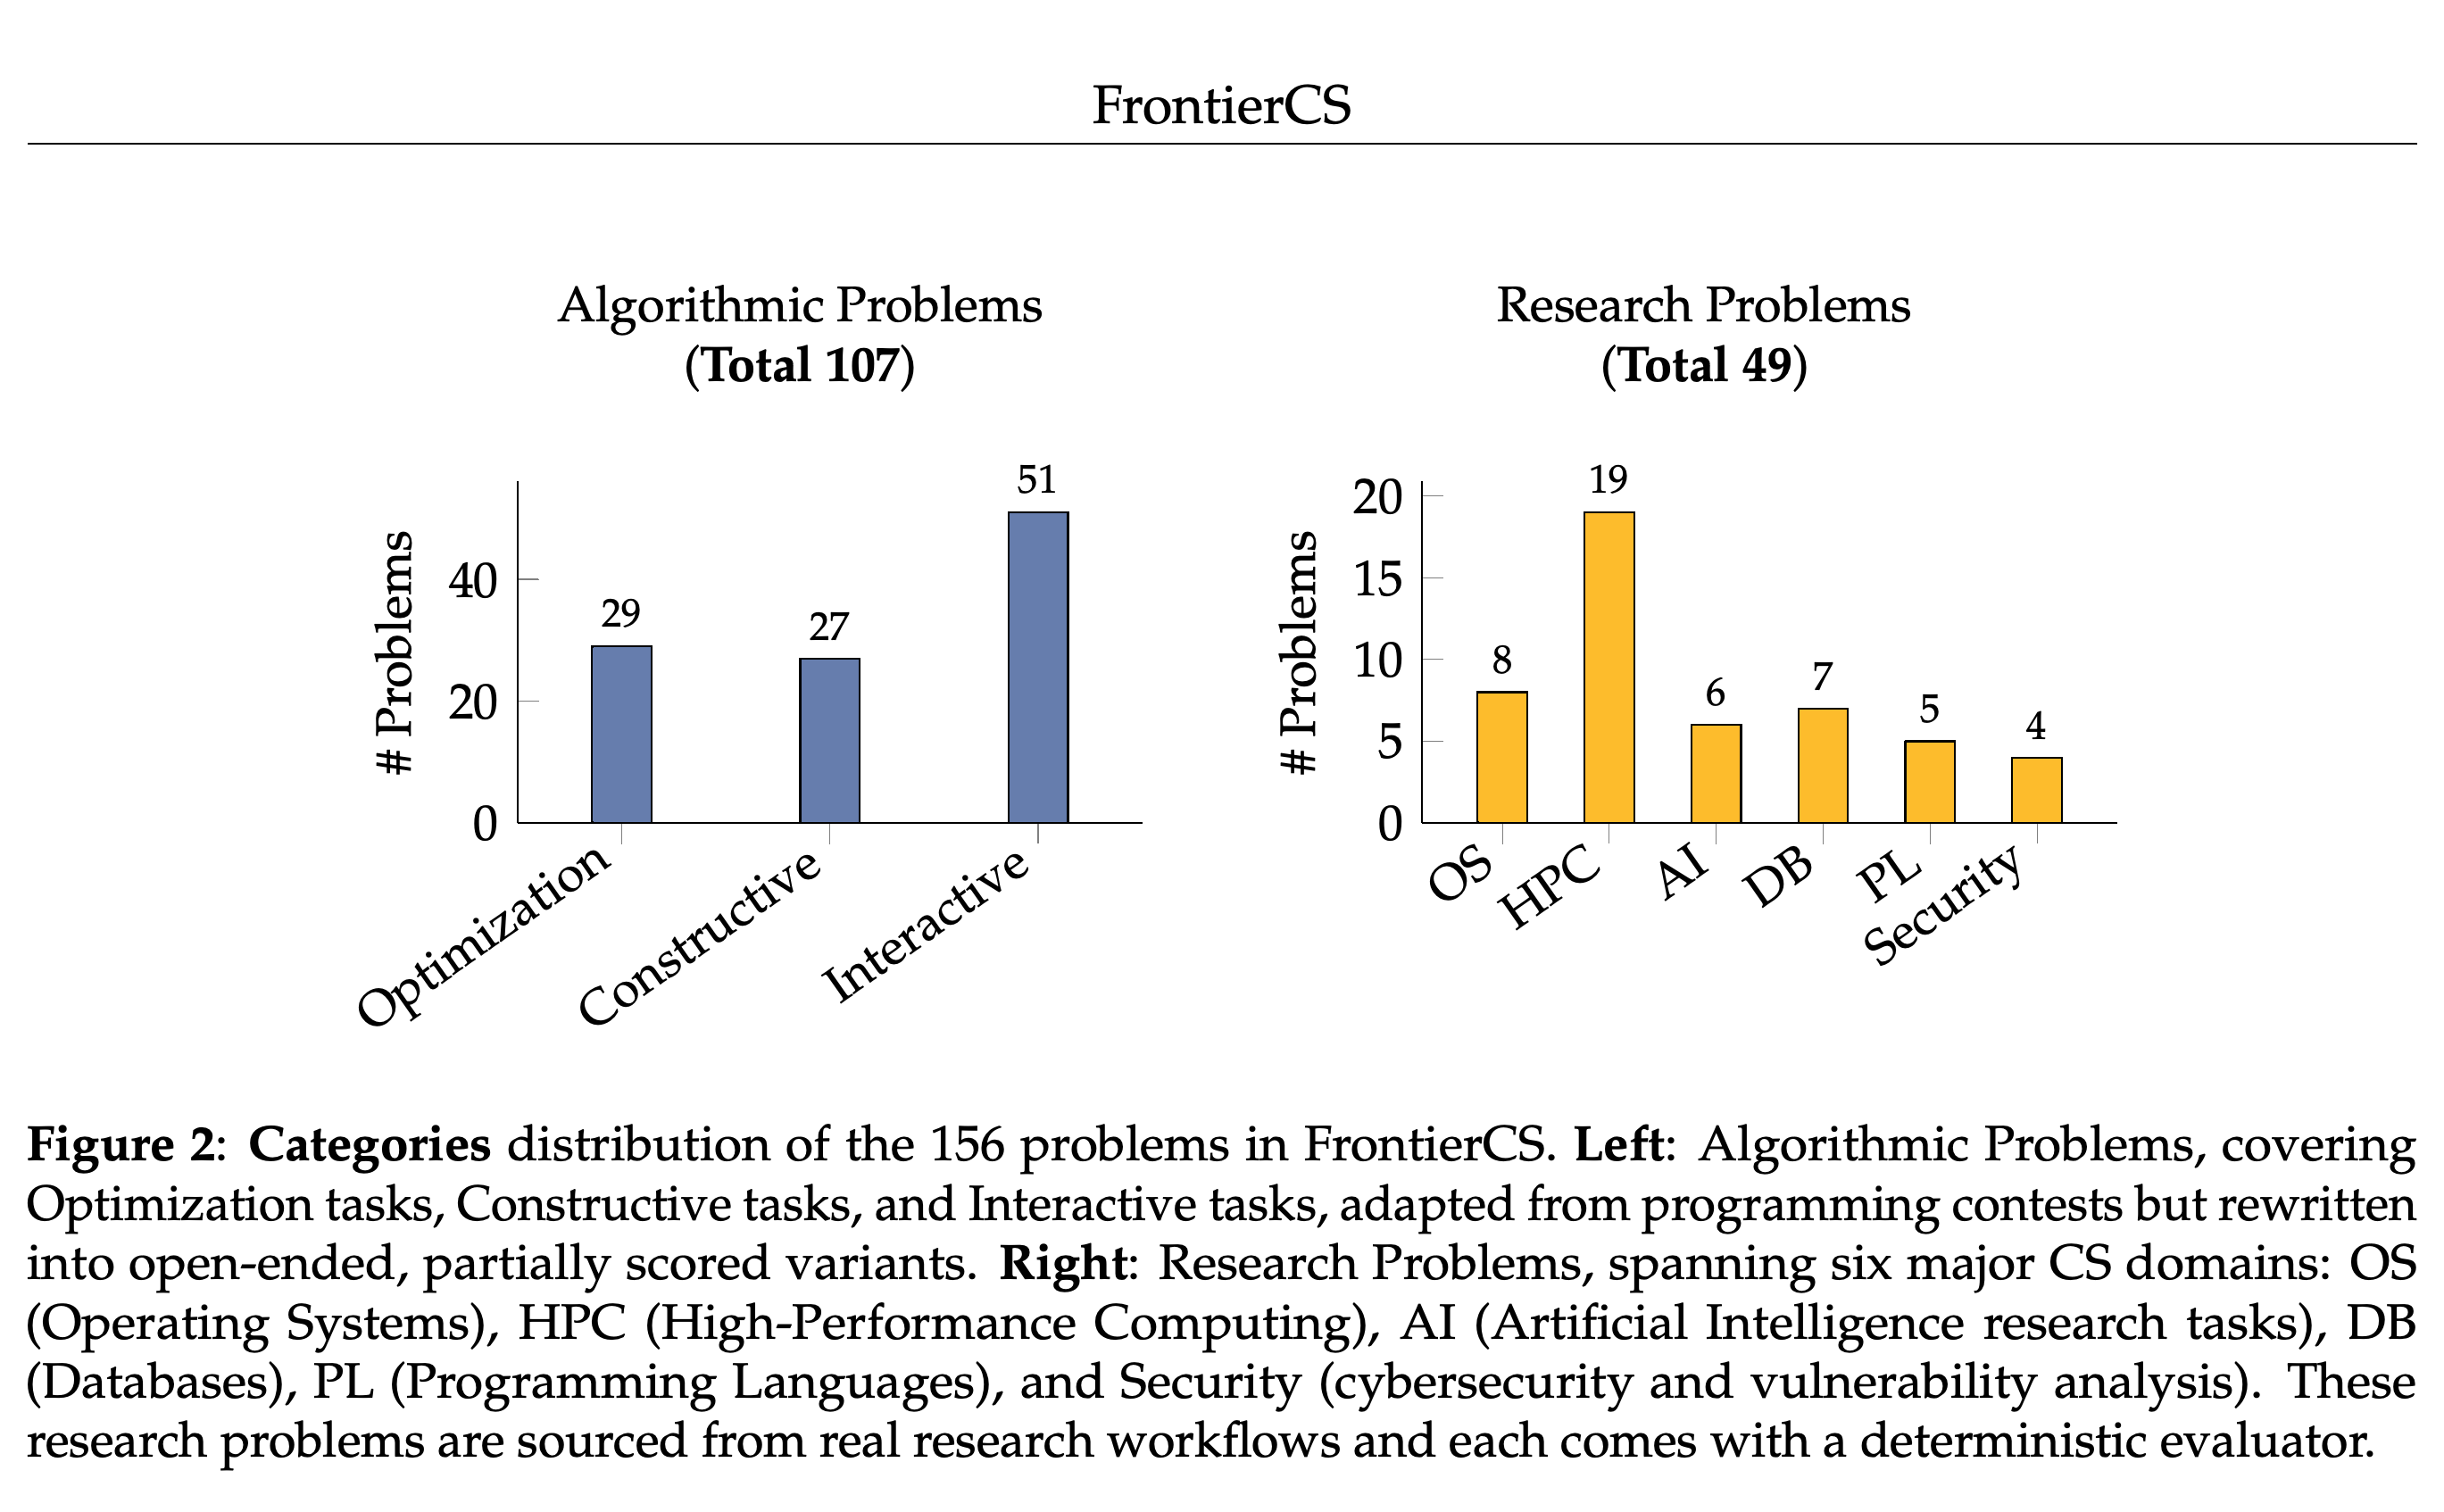
알고리즘 문제는 Optimization 29개, Constructive 27개, Interactive 51개로 구성된다. 연구 문제 49개는 Operating Systems 8개, High-Performance Computing 19개, Artificial Intelligence 6개, Databases 7개, Programming Languages 5개, Security 4개로 구성된다.
- Constructive 문제는 전역 제약을 만족하는 유효한 구조를 생성한다. Optimization 문제는 매개변수로 정의한 공간을 탐색한다. Interactive 문제는 이전 응답에 맞춰 행동을 조정한다.
- 연구 문제의 주제가 여러 분야에 걸쳐 있더라도, 제안한 해법이 주로 다루는 분야에 배정한다.
- 두 트랙 모두 제안, 구현, 검토 단계를 거친다.
알고리즘 문제 107개 중 Interactive 문제가 51개이고, 연구 문제 49개 중 High-Performance Computing 문제가 19개다. 벤치마크는 여러 분야를 다루지만 분포가 균등하지 않으며, 이는 종합 점수의 구성에 영향을 준다.
3.1. Algorithmic Problems
ICPC World Finalists에 준하는 자격을 갖춘 전문가들이 프로그래밍 대회 문제와 고전적인 컴퓨터 과학 문제를 변형해 제안한다. 구현 단계에서는 개방형 목표와 부분 점수를 도입하고 인터페이스를 표준화한다. 결정론적 검증기, 테스트 생성기, 베이스라인, 기준 해법, 평가 스크립트도 제공한다.
- 다른 전문가가 개방성, 채점 품질, 평가기의 정확성, 테스트 범위, 인간 기준 해법이 최상위 모델을 크게 앞서는지를 확인한다.
- 대표적인 품질 지표는 비용, 밀도, 질의 횟수다. 시간과 메모리는 일반적으로 실행 가능성을 판단하는 제약으로 쓰이며, 제한을 위반하면 점수를 받지 못한다. 실행 시간은 명시한 경우에만 채점에 반영한다.
- 대회 소문제는 해당 소문제의 테스트를 모두 통과해야 점수를 주는 불연속적인 방식을 사용한다. 문제별 연속 또는 구간별 연속 점수는 단순한 베이스라인과 강력한 인간 기준 해법을 기준으로 점진적인 개선을 보상한다.
3.2. Research Problems
CS PhD 학생들이 미해결 질문에서 연구 문제를 제안하고, 전용 평가 환경을 구현한다. 채택된 문제는 설명, 버전을 고정한 의존성 또는 Docker 이미지, 진단 정보를 제공하는 결정론적 평가기, 전문가 기준 해법, 단순한 베이스라인을 제공한다. 채점에는 LLM judge 사용을 금지한다.
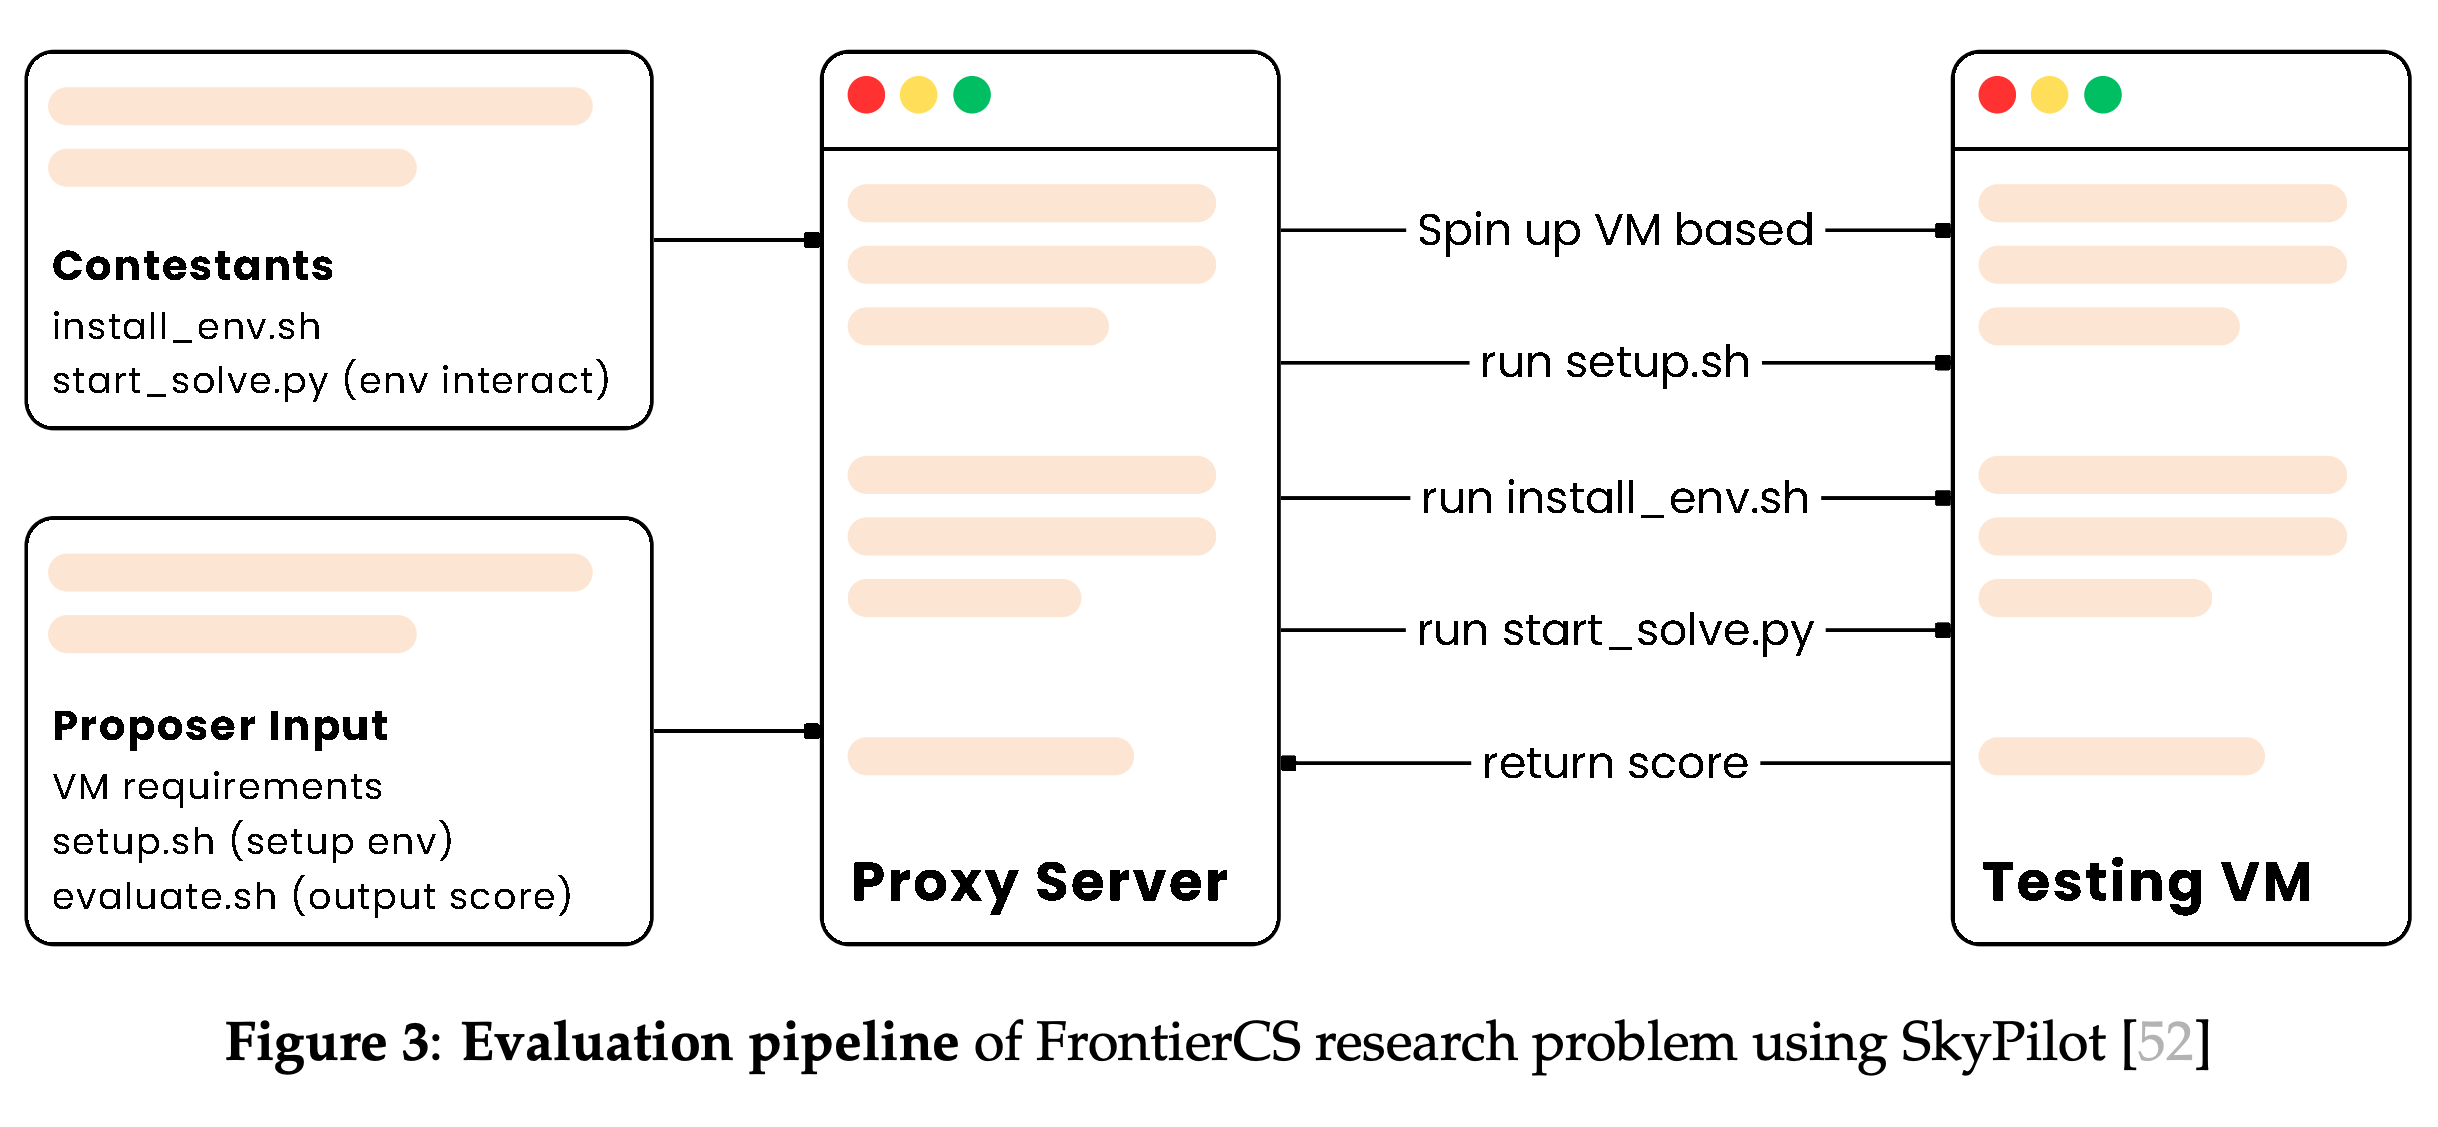
- README는 VM 또는 Docker 요구 사항, 데이터 배치, 해법의 입출력 규약을 명시한다. 본문에서는 set_up_env.sh와 evaluate.sh를 언급하지만, 파이프라인 도식에는 setup.sh, install_env.sh, start_solve.py가 등장한다.
- SkyPilot은 이기종 컴퓨팅 인프라를 관리한다. 검토 기준은 스크립트가 새로운 VM에서 사람의 개입 없이 실행되고, 평가 환경이 외부 의존성 없이 격리된 상태에서 결정론적으로 작동할 것을 요구한다.
- 연구 목표는 정확도, 지연 시간, 메모리, 비용을 함께 고려할 수 있으며, 자원 제한을 위반하면 점수를 받지 못한다. 제약, 하드웨어, 목표가 다른 변형은 보고된 총 49개 문제에서 별개의 문제로 집계한다.
프록시는 출제자가 제공한 VM 요구 사항과 평가 스크립트를 참가자가 제공한 설치 및 풀이 스크립트와 결합한다. 테스트 VM을 시작하고 설정과 풀이 단계를 실행한 뒤 점수를 반환한다. 이를 통해 문제별 환경을 평가 파이프라인에 통합한다.
3.3. Update Policy
Update Policy는 새로운 문제 추가, 문제 설명을 다시 쓰지 않고 기존 문제의 난이도를 높이는 작업, 인간 기준 해법이나 평가 임계값의 개선을 지원한다. 자원 제한을 강화하거나, 워크로드와 데이터셋을 바꾸거나, 최적화 목표를 높일 수 있다.
- 문제 명세와 실제 평가 환경을 분리하면, 벤치마크는 문제의 연속성을 유지하면서 난이도를 바꿀 수 있다.
- 기준 해법과 채점 임계값이 바뀔 수 있으므로, 릴리스 간 비교에는 해당 벤치마크 버전이 필요하다. 논문은 갱신 정책을 제안하지만, 비교 가능성을 입증하는 장기 추적 결과는 제시하지 않는다.
4. Evaluation Results
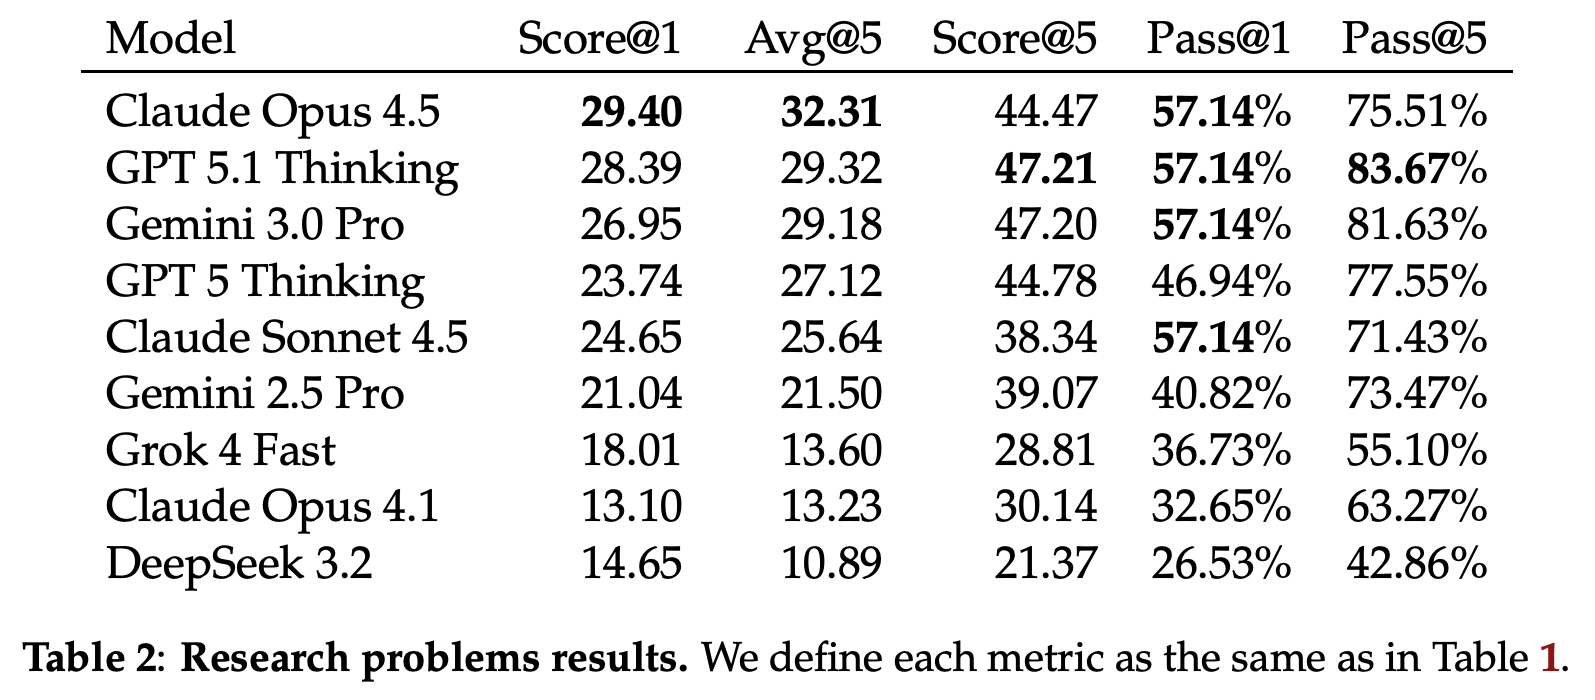
Evaluation Results는 두 트랙의 지표 설계와 모델 성능을 보고한다. 실험은 1회 시도의 성능, 5회 시도의 평균 품질, 5회 시도 중 최고 결과를 구분한다.
4.1. Setup
보고된 표에는 트랙마다 모델 행이 9개 있다. GPT 5 Thinking, GPT 5.1 Thinking, Gemini 2.5 Pro, Gemini 3.0 Pro, Claude Opus 4.1, Claude Sonnet 4.5, Claude Opus 4.5, DeepSeek 3.2가 포함된다. 나머지 행은 알고리즘 표에서 Grok 4로, 연구 표에서 Grok 4 Fast로 표기된다. 각 LLM 요청의 제한 시간은 20분이다.
- GPT-5 / GPT-5.1 Thinking, Grok 4, Claude Opus 4.5는 reasoning_effort = high를 사용한다. Claude Opus 4.1 / Sonnet 4.5는 max_tokens = 32,000과 reasoning_budget = 20,000을 사용한다. Gemini 2.5 Pro / Gemini 3.0 Pro는 thinking_budget = -1을 사용한다.
- 각 시도는 텍스트만 사용하는 단일 라운드 생성이다. 모델은 코드를 실행하거나, 테스트를 살펴보거나, 피드백으로 수정하거나, 편집기, Python 환경, 외부 도구에 접근할 수 없다.
- 설정 본문은 모델이 9개라고 서술하지만 이름은 8개만 나열한다. 이후 결과 본문은 표에 9개 행이 있는데도 8개라고 서술한다. 실제로 보고된 비교 대상은 표에서 명시적으로 확인할 수 있다.
4.2. Metrics
점수는 단순한 베이스라인과 전문가 기준 해법을 기준으로 보정하며, 가능한 경우에는 비자명한 성능 한계를 사용한다. 일반적인 방식은 베이스라인 미만에 0점을 부여하고, 지정한 기준 임계값이나 한계에 도달하면 만점을 부여한다. 다만 예시에서는 복잡도 페널티와 Square Packing의 인간 기준 수준 95를 포함해 문제별 점수 산정 방식을 명시한다.
- Score@k는 k회 시도 중 최고 점수이고, Avg@k는 그 평균이다.
- 지표 본문은 Pass@1과 Pass@5를 0이 아닌 점수를 받은 문제의 비율로 정의한다. 이는 단순한 베이스라인을 넘어서는 유효한 해를 뜻한다. 반면 Table 1의 캡션은 실행의 비율이라고 서술해 표현상의 불일치가 남아 있다.
- 정규화 점수는 문제별 기준 대비 개선 정도를 측정한다. 알려지지 않은 전역 최적해에 얼마나 가까운지는 입증하지 않는다.
4.3. Algorithmic Problems
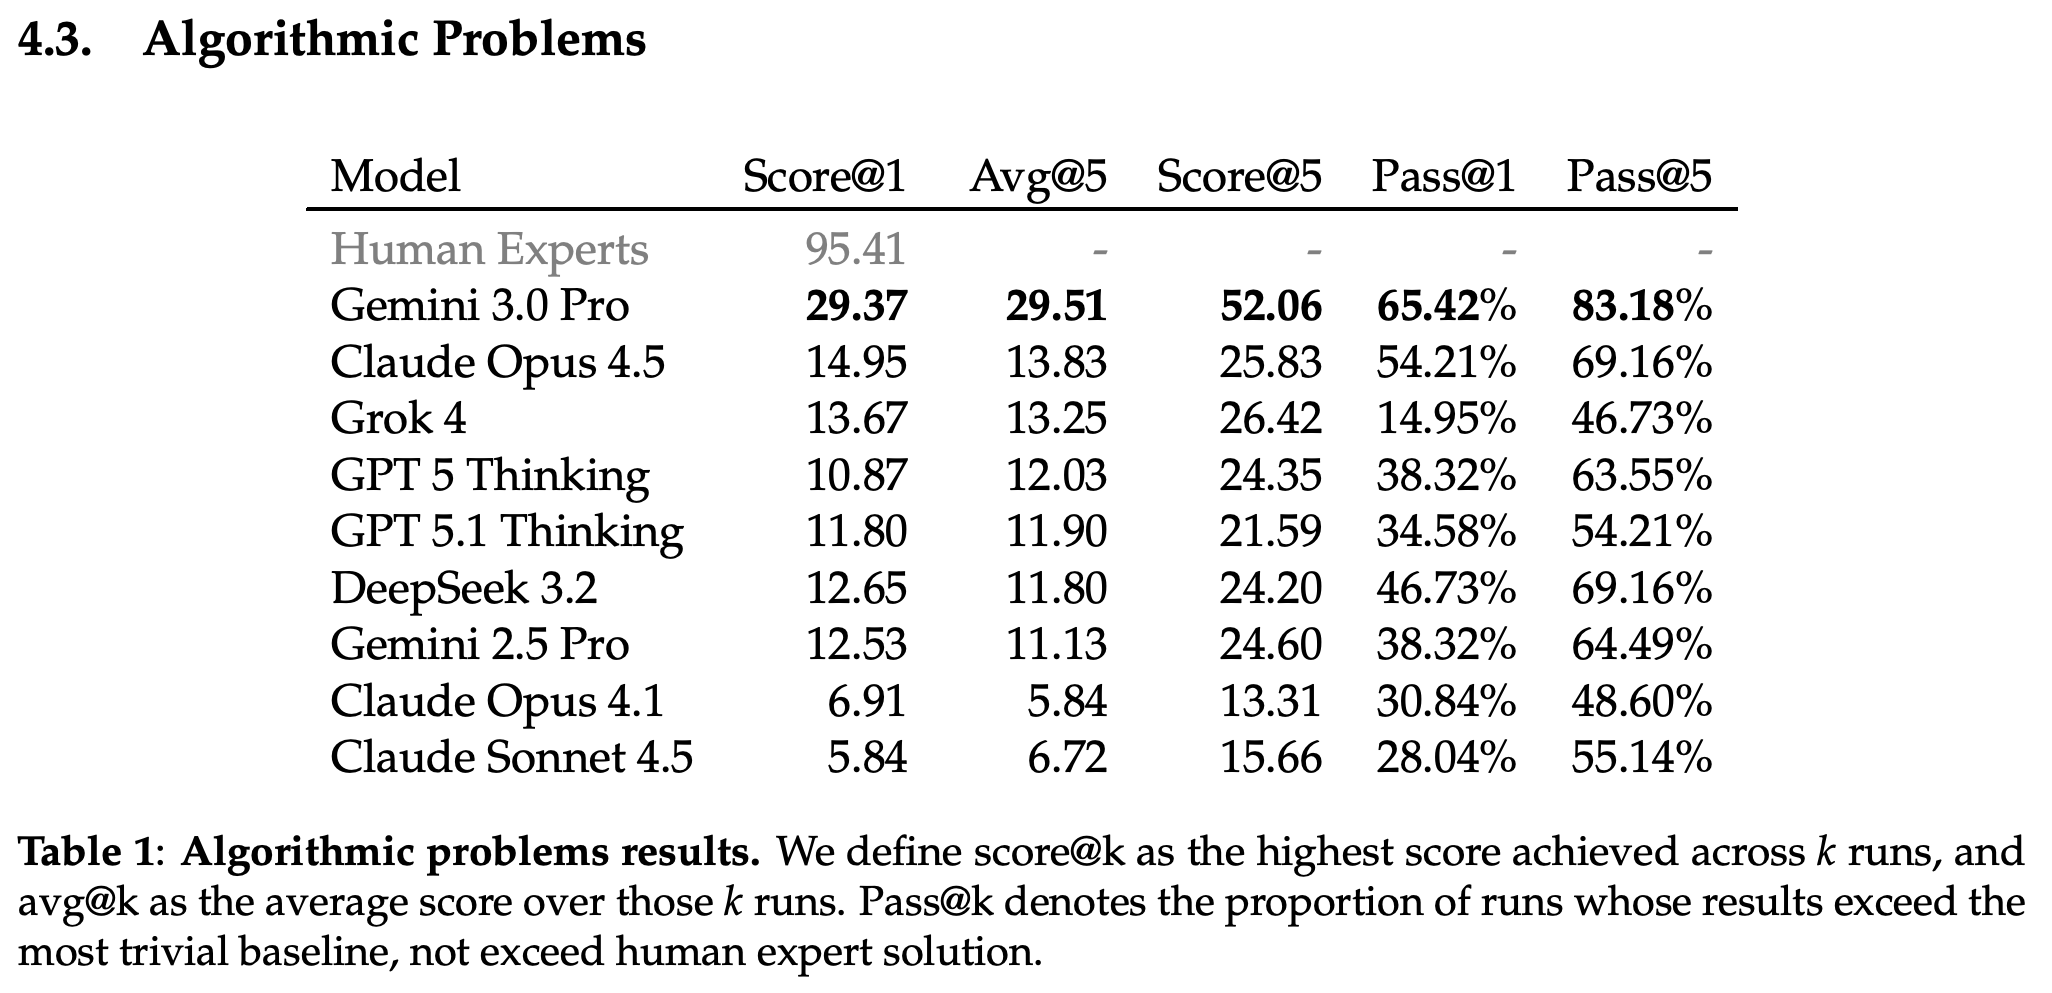
Gemini 3.0 Pro는 알고리즘 트랙에서 Score@1 29.37, Avg@5 29.51, Score@5 52.06, Pass@1 65.42%, Pass@5 83.18%로 가장 높은 성능을 보인다. 인간 전문가 점수는 95.41이므로, 모델의 5회 시도 중 최고 결과도 기준에 크게 못 미친다.
- 다른 모델의 Score@1은 Claude Opus 4.5 14.95, Grok 4 13.67, GPT 5 Thinking 10.87, GPT 5.1 Thinking 11.80, DeepSeek 3.2 12.65, Gemini 2.5 Pro 12.53, Claude Opus 4.1 6.91, Claude Sonnet 4.5 5.84다.
- 보고된 모델에서 Score@5는 Score@1보다 6.40–22.69점 높다. 이 평가 방식에서 5회 시도 중 최고 결과를 선택하면 측정 점수가 높아지지만, 피드백에 따른 개선을 입증하는 결과는 아니다.
Gemini 3.0 Pro는 모델 지표 5개 모두에서 선두를 차지하지만, Score@5 52.06은 인간 기준 점수 95.41에 못 미친다. 5회 시도 중 최고 결과를 선택하면 점수는 높아지지만 기준과의 격차는 해소되지 않는다.
4.4. Research Problems
Claude Opus 4.5는 연구 트랙의 Score@1 29.40과 Avg@5 32.31로 선두를 차지한다. GPT 5.1 Thinking은 Score@5 47.21과 Pass@5 83.67%로 선두를 차지하며, Gemini 3.0 Pro의 Score@5 47.20이 근소한 차이로 뒤를 잇는다.
- 모델별 연구 트랙 Score@5는 Score@1보다 6.72–21.04점 높다.
- 0이 아닌 점수를 자주 받지만 정규화 품질 점수는 높지 않다는 결과는, 많은 제출물이 단순한 베이스라인을 넘어서면서도 충분히 최적화되지 않았다는 저자들의 해석을 뒷받침한다. 통과율과 품질 점수는 서로 다른 양을 측정한다.
- Table 2에는 별도의 인간 종합 점수 행이 없으므로, 명시적인 인간 점수 95.41과의 비교는 알고리즘 트랙에 해당한다.
Claude Opus 4.5는 Score@1과 Avg@5가 가장 높고, GPT 5.1 Thinking은 Score@5와 Pass@5가 가장 높다. 따라서 단일 시도, 평균 품질, 여러 시도 중 선택 가운데 무엇을 측정하는지에 따라 선두 모델이 달라진다.
5. Discussion
Discussion은 추론 노력, 내부 표현 방식, 작동하는 소프트웨어를 만드는 능력과 품질을 최적화하는 능력 사이의 차이를 살펴본다. 근거는 추론 예산 실험과 문제별 제출물 분석으로 구성된다.
5.1. Improving Reasoning Effort Does Not Yield Further Gains
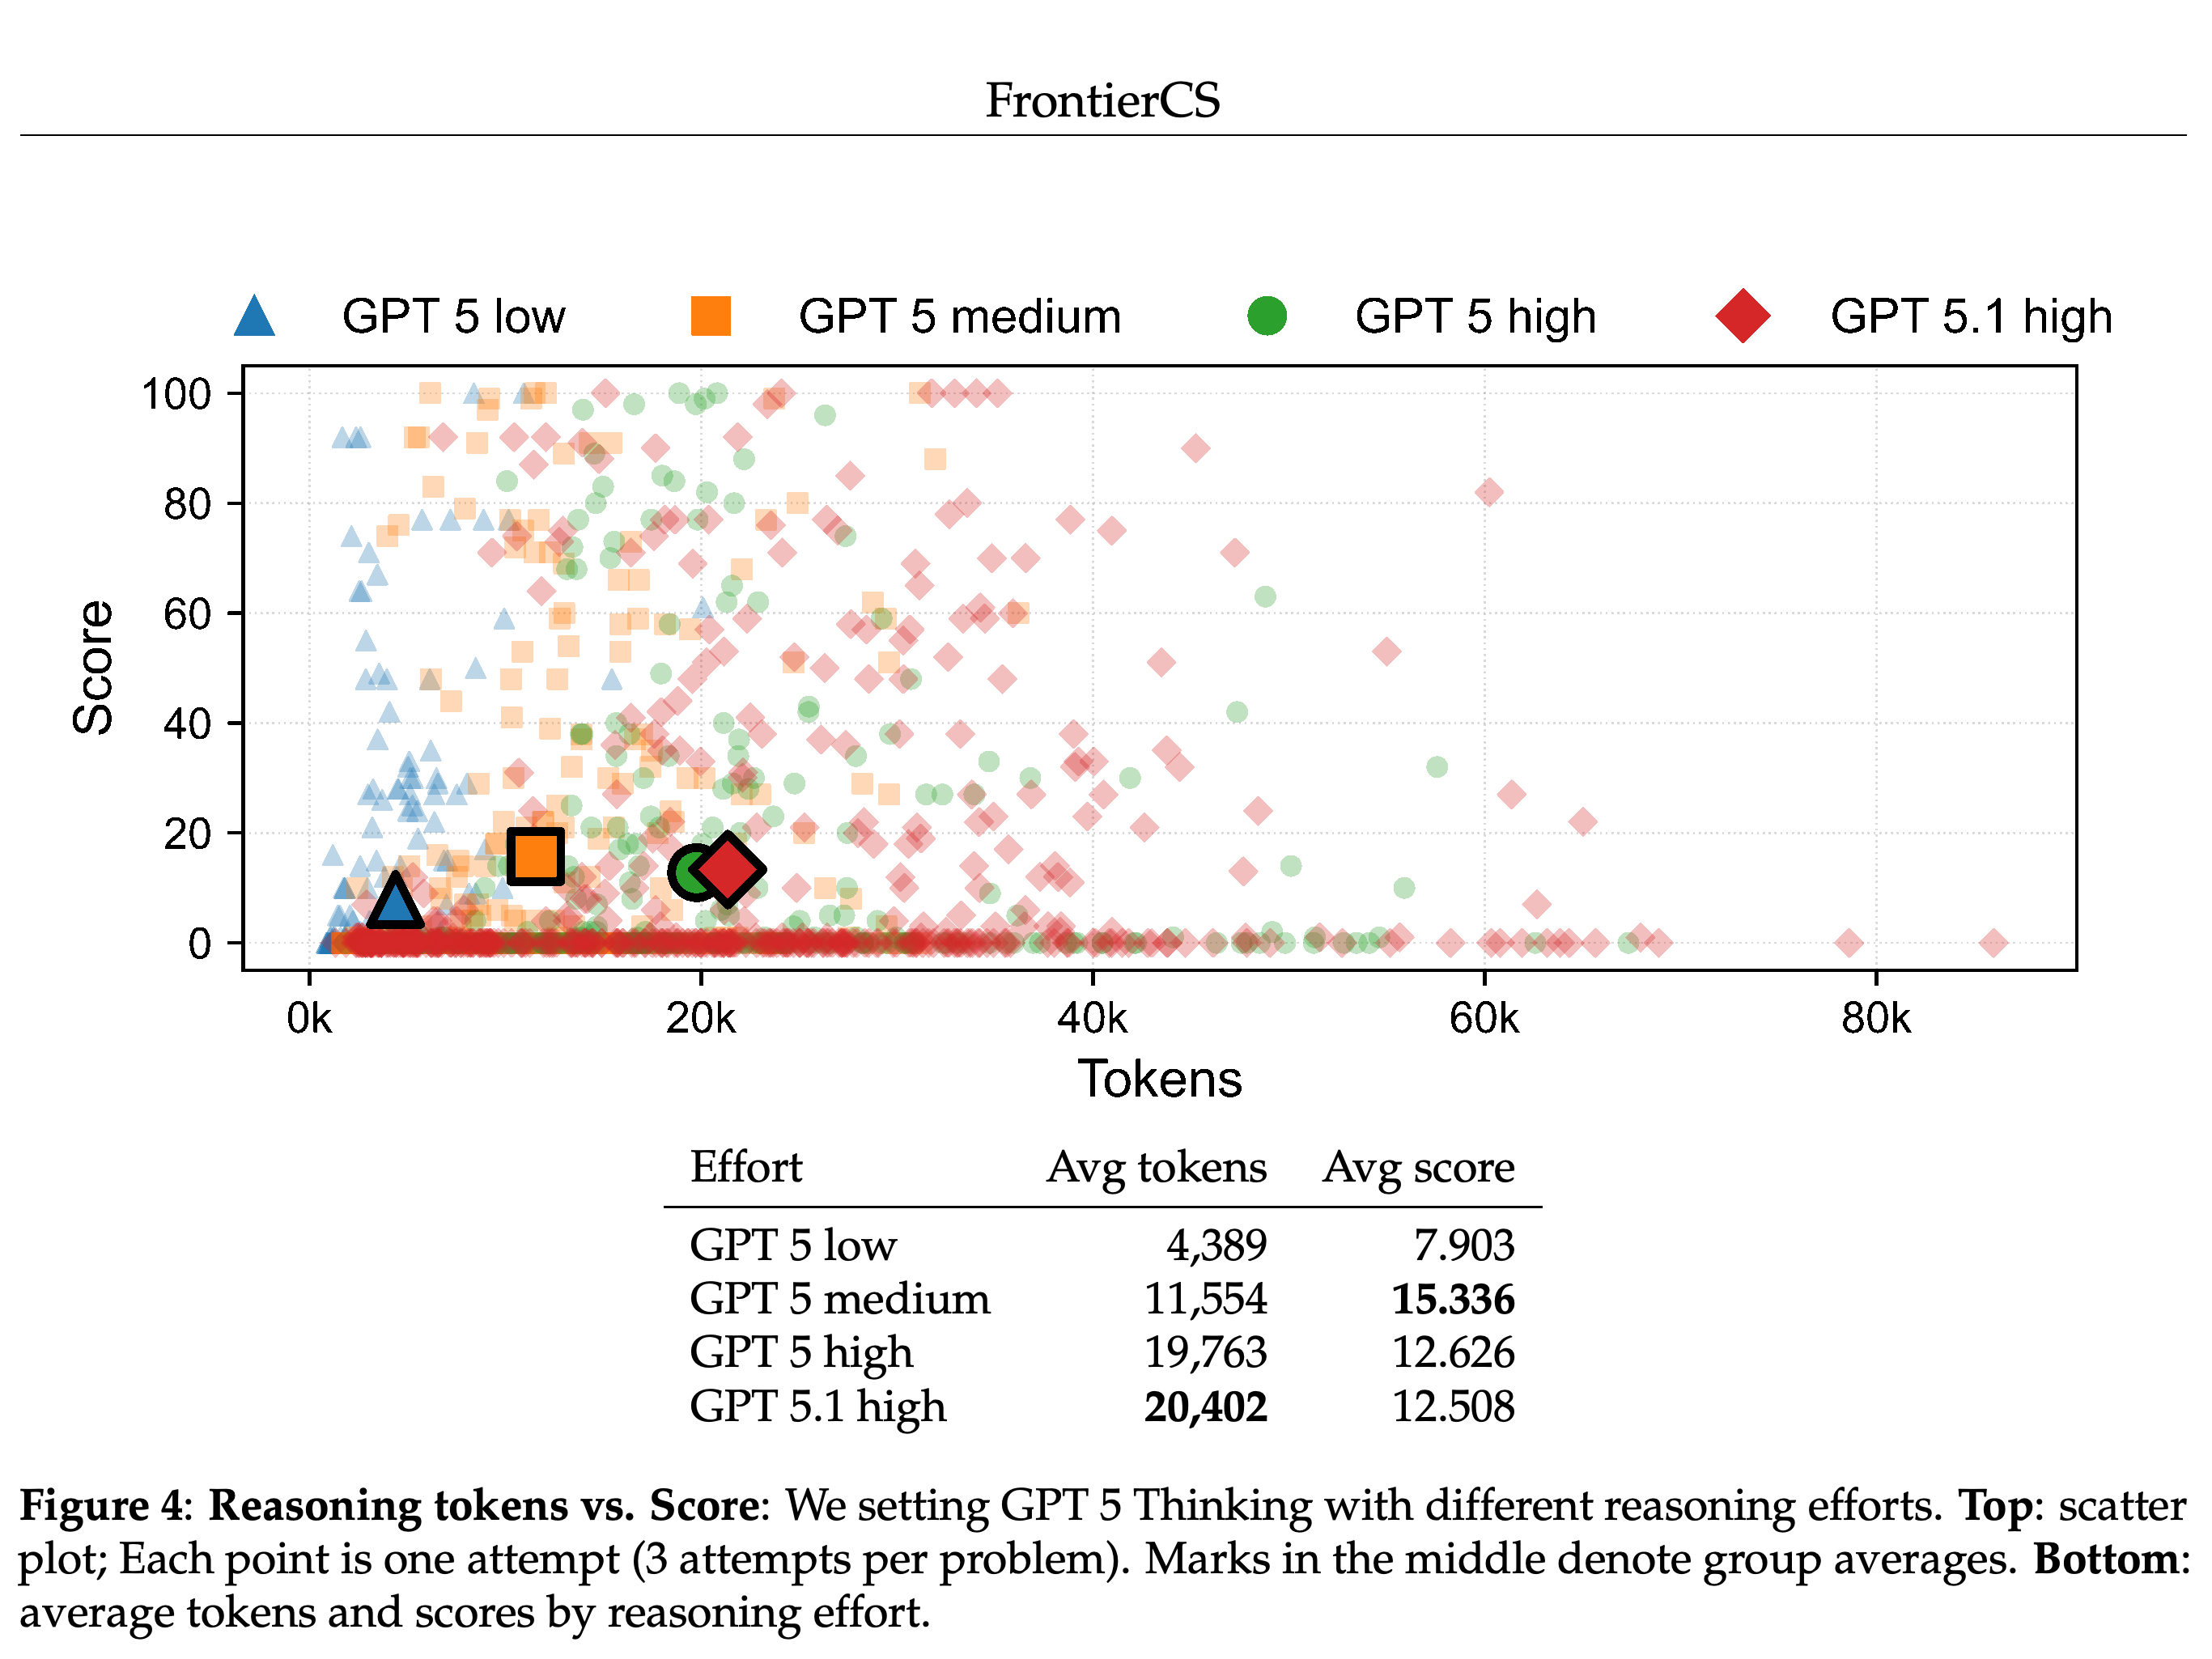
알고리즘 문제마다 3회 시도한 실험에서 GPT 5의 low 설정은 평균 추론 토큰 4,389개와 점수 7.903을 기록한다. medium 설정은 평균 토큰 11,554개와 점수 15.336을, high 설정은 평균 토큰 19,763개와 점수 12.626을 기록한다. GPT 5.1의 high 설정은 평균 토큰 20,402개와 점수 12.508을 기록한다.
- low에서 medium으로 높이면 평균 점수가 향상되지만, medium에서 high로 높이면 토큰 소비가 늘어나는데도 점수가 낮아진다.
- 실험한 설정에서는 성능이 단조롭게 증가하지 않는다. 그림은 신뢰구간이나 유의성 검정을 보고하지 않으며, 추론의 효과에 보편적인 상한이 있음을 입증하지 않는다.
GPT 5의 medium 설정은 평균 토큰 11,554개로 평균 점수 15.336을 기록해, 토큰 19,763개로 점수 12.626을 기록한 high 설정을 앞선다. 모든 추론 수준에서 많은 시도가 0점을 받으며, 이 실험에서는 더 긴 추론이 일관되게 더 나은 해법을 만들어 내지 않는다.
5.2. Misleading Micro-Optimization Trap
Polyomino Packing에서 GPT 5-Thinking은 요구된 출력 변환 목록을 내부 표현으로 자주 사용한다. 이 때문에 겹침 감지와 빈 공간 탐색이 번거로워진다. 저자들은 시도의 약 30%에서 유효하지 않은 코드가 생성되며, 나머지 70%에서는 20–70점을 받는다고 보고한다.
- 개입에서는 “Please use a 2D array to maintain the rectangle state, and convert to the required format only at the end”라는 지침을 추가한다.
- 이 지침을 제공하면 0점 비율이 약 10%로 낮아지고, 거의 80%의 사례가 효율적인 탐색 전략을 통해 80–85점을 달성한다.
- 이 사례는 해당 문제에서 표현 방식에 관한 지침의 효과를 뒷받침한다. 이 절은 해당 비율의 표본 수나 불확실성 추정치를 보고하지 않는다.
5.3. The Research–Engineering Dilemma of Claude
저자들이 제출물을 살펴본 결과, Claude Sonnet 4.5는 실행 가능하고 자원 제한을 지키는 프로그램을 자주 생성하지만 경쟁력 있는 최적화 전략이 없어 알고리즘 트랙의 단순한 베이스라인에 못 미친다. 연구 문제는 도구 통합과 시스템 설정도 요구하므로, 작동하는 해법만으로도 의미 있는 부분 점수를 받을 수 있다.
- Claude Sonnet 4.5는 알고리즘 Score@1에서 5.84, 연구 Score@1에서 24.65를 기록한다. Claude Opus 4.5는 각각 14.95와 29.40을 기록한다.
- Symbolic Regression 예시는 PySR 호출, 수식 탐색 설정, 진화 알고리즘의 매개변수 조정, 수식 검증을 요구한다. 저자들은 작동하지만 최적화가 제한적인 해법도 약 50점을 받을 수 있다고 보고한다.
- 소프트웨어 엔지니어링에 맞춘 튜닝과의 연관성은 저자들의 해석이다. 논문은 학습 방식이 트랙 간 격차의 원인인지를 실험적으로 분리해 확인하지 않는다.
6. Example Problems
Example Problems의 문제 10개는 간결한 구조 구성, 제약이 있는 최적화, 적응형 질의, 기호 회귀, 시스템의 상충 관계, 취약점 재현, 커널 가속, 전략적 의사결정을 다룬다. 각 예시는 유효성 요건과 정량적 목표를 명시하며, 일부는 인간과 모델의 전략을 직접 비교한다.
Problem 1: World Map
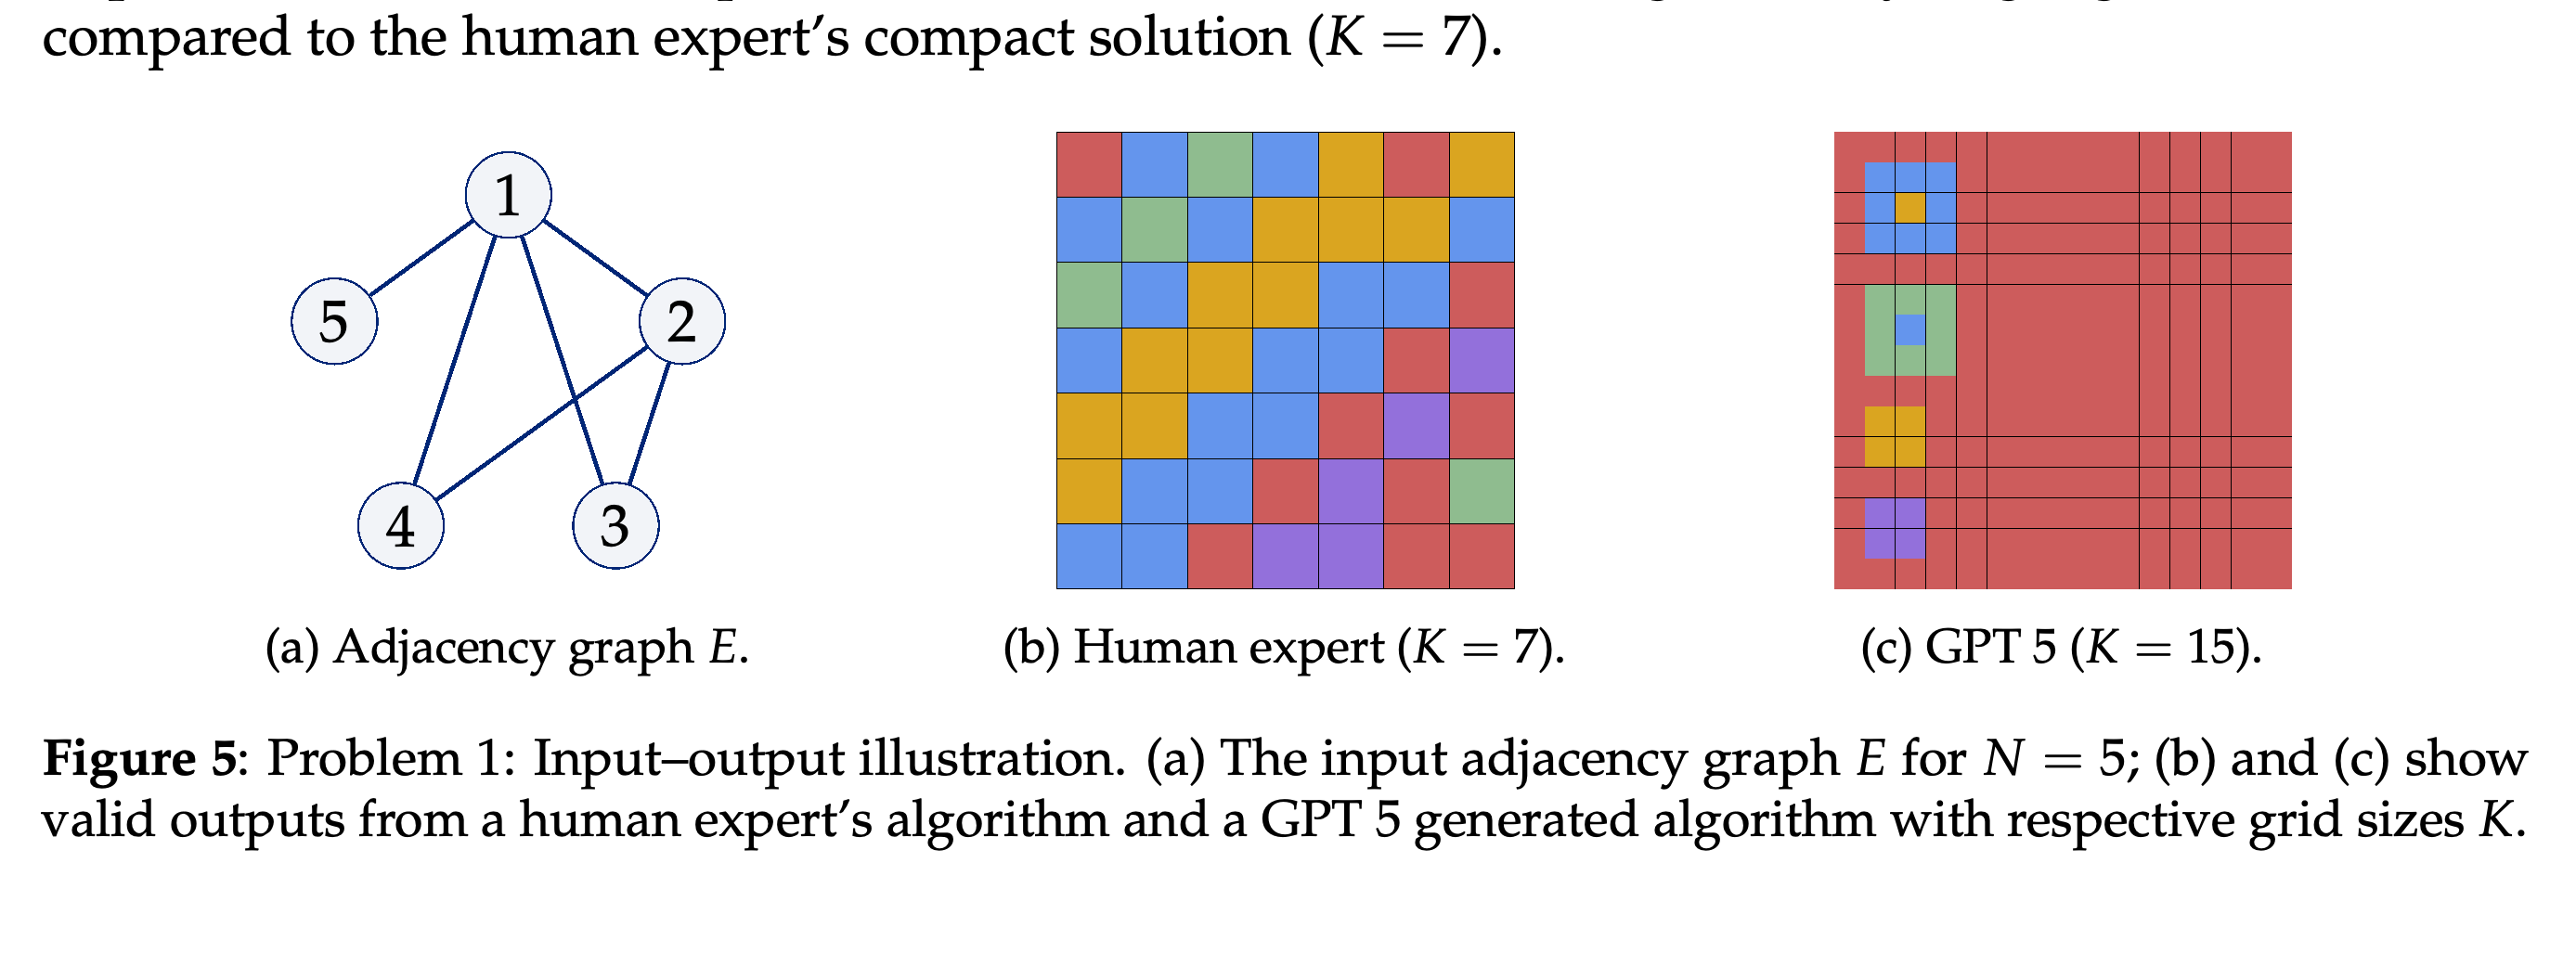
Problem 1: World Map은 IOI 2025 task를 변형한 문제다. 국가 간 상하좌우 인접 관계가 지정된 그래프와 일치하는 K × K 격자를 구성하면서 K를 최소화한다. 유효한 출력에는 R = K/N과 score = 100 × clamp((6 − R)/(6 − R′), 0, 1)을 적용하며, R′는 인간 기준 비율이다. 인접 관계가 유효하지 않으면 점수를 받지 못한다.
- 필수 국가 쌍에 속한 국가들의 셀은 최소 1곳에서 변을 공유해야 한다. 서로 다른 국가 라벨의 셀이 변을 공유하면 해당 국가 쌍은 필수 인접 관계에 포함되어야 한다. 대각선 접촉은 인정하지 않는다.
- 논문은 가능한 모든 입력에서 R′ = 1.5를 달성하는 알려진 구성법을 보고하지만, 달성 가능한 최적 비율은 미해결 상태로 남겨 둔다.
- 그림의 N = 5, M = 6 사례에서 인간의 구성은 K = 7을 사용하고 GPT 5는 K = 15를 사용한다. 둘 다 유효하지만 격자의 크기는 다르다.
동일한 5개 국가의 인접 그래프에 대해 인간은 7 × 7 격자를 사용하고 GPT 5는 15 × 15 격자를 사용한다. 둘 다 유효한 인접 관계를 구현하므로, 격자를 얼마나 작게 구성하는지가 변별력 있는 목표가 된다.
Problem 2: Treasure Packing
Problem 2: Treasure Packing은 2024 ICPC North America Championship의 NSA Challenge를 변형한 문제다. 질량과 부피 용량 제한 아래에서 C = 12개 보물 범주의 총가치를 최대화한다. 각 범주의 개수는 가용 수량 이하인 비음수 정수여야 한다.
- 목표는 max Σc v_c x_c이며, 제약은 Σc m_c x_c ≤ M, Σc ℓ_c x_c ≤ L, 0 ≤ x_c ≤ q_c다. 테스트 범위는 1 ≤ q_c ≤ 10⁴, 1 ≤ v_c ≤ 10⁶, 1 ≤ m_c ≤ 20 × 10⁶, 1 ≤ ℓ_c ≤ 25 × 10⁶다.
- 유효한 해법은 시간 제한 1초와 메모리 제한 1024 MB 안에서 실행을 마쳐야 한다. 점수는 100 × clamp((value − value_base)/(value_ref − value_base), 0, 1)이며, 유효하지 않거나 자원 예산을 초과한 출력은 0점을 받는다.
- 인간 기준 해법은 탐욕적 방법과 무작위 개선을 결합한다. GPT 5는 초기 탐욕적 탐색과 branch-and-bound를 결합해 인간 기준 해법의 100점에 비해 74점을 받는다.
Problem 3: Permutation Guess
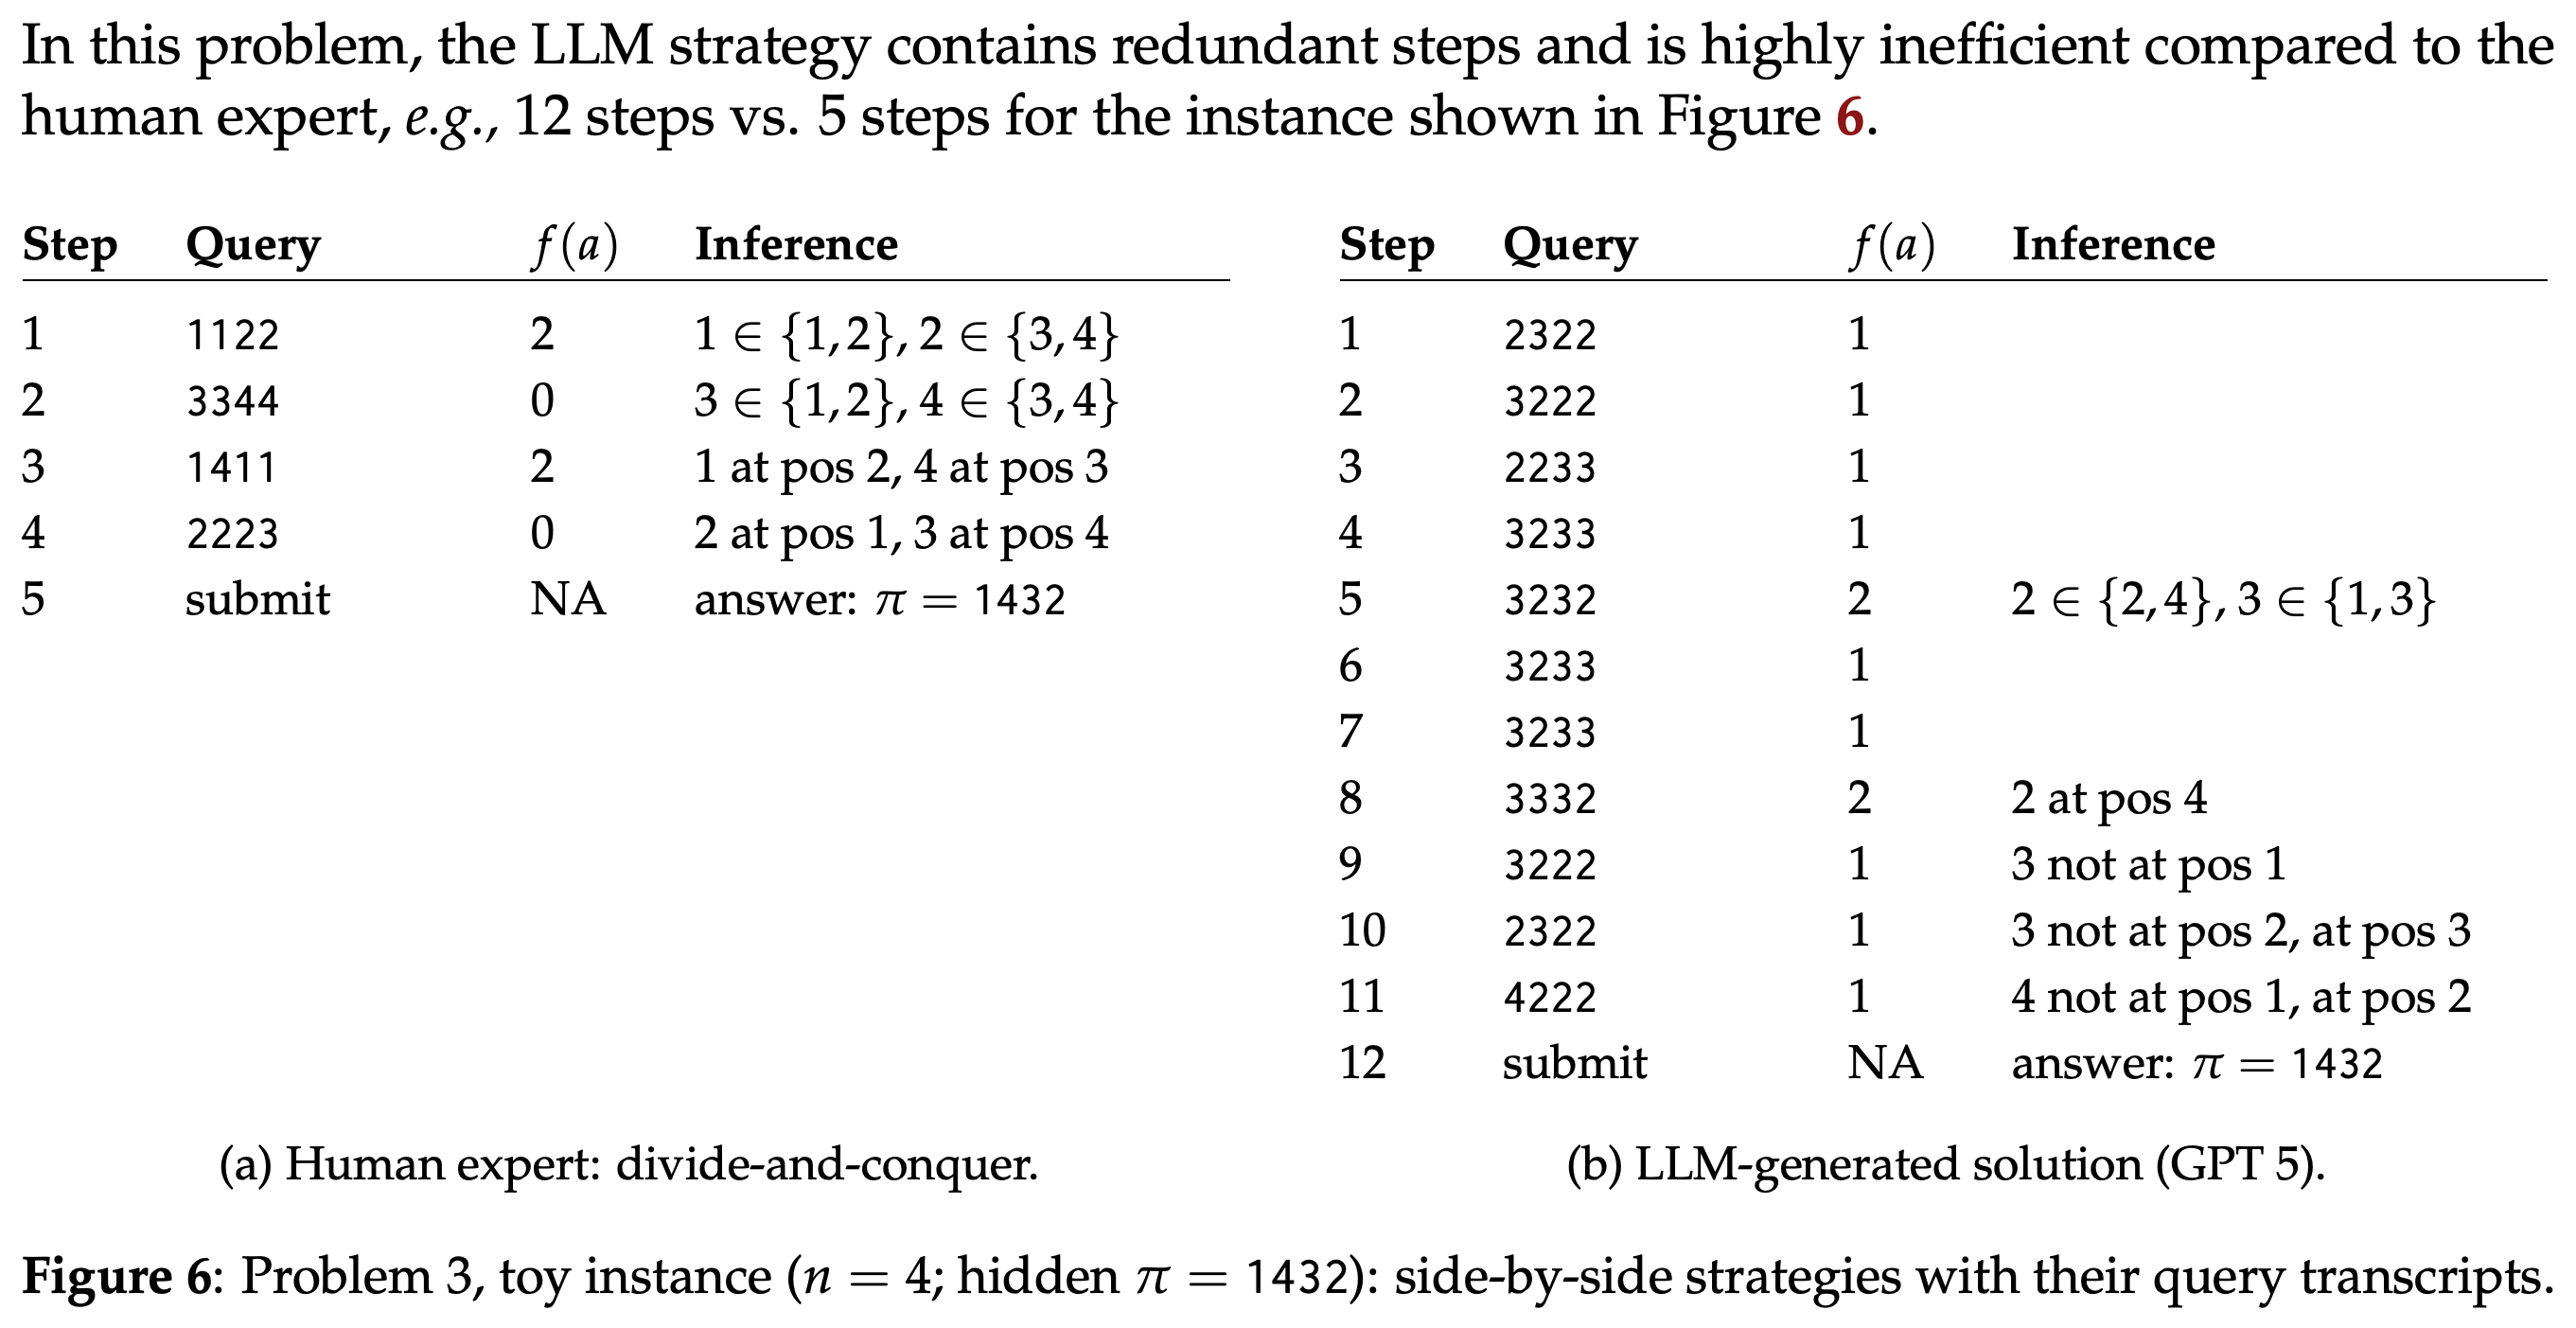
Problem 3: Permutation Guess는 가능한 한 적은 질의로 n = 1000인 숨겨진 순열을 알아내는 프로그램을 요구한다. 각 질의는 길이 n의 정수 수열을 제출하며, 이 수열 자체가 순열일 필요는 없다. 응답은 숨겨진 순열과 일치하는 위치의 개수다.
- 최종 순열이 틀리면 0점을 받는다. 정답의 점수는 100 × clamp((Q_base − Q)/(Q_base − Q_ref), 0, 1)이며, 단순한 이진 탐색 베이스라인은 약 10,000회 질의를, 인간의 분할 정복 기준 해법은 약 6,000회 질의를 사용한다.
- 숨겨진 순열이 1432인 n = 4의 간단한 예시에서 그림은 최종 제출을 포함해 인간 5단계와 GPT 5 12단계를 나열한다. 이는 각각 질의 호출 4회와 11회에 해당한다.
- 표시된 기록에는 명시된 숨겨진 순열과 맞지 않는 응답이 있다. 예를 들어 질의 1411은 1432와 1개 위치에서 일치하지만, 그림은 2개라고 보고한다. 따라서 이 기록은 저자들의 효율 비교를 보여주지만, 올바른 풀이 과정을 제공하지는 않는다.
기록은 최종 제출을 포함해 인간 5단계와 GPT 5 12단계를 나열하며, 모델이 질의를 반복하는 모습을 보여준다. 일부 응답은 명시된 숨겨진 순열 1432와 맞지 않는다. 질의 1411의 응답은 표시된 2가 아니라 1이어야 하고, 질의 4222의 응답은 1이 아니라 2여야 한다. 나열된 단계 수는 설명할 수 있지만, 이 기록은 올바른 풀이 과정이 아니다.
Problem 4: Square Packing
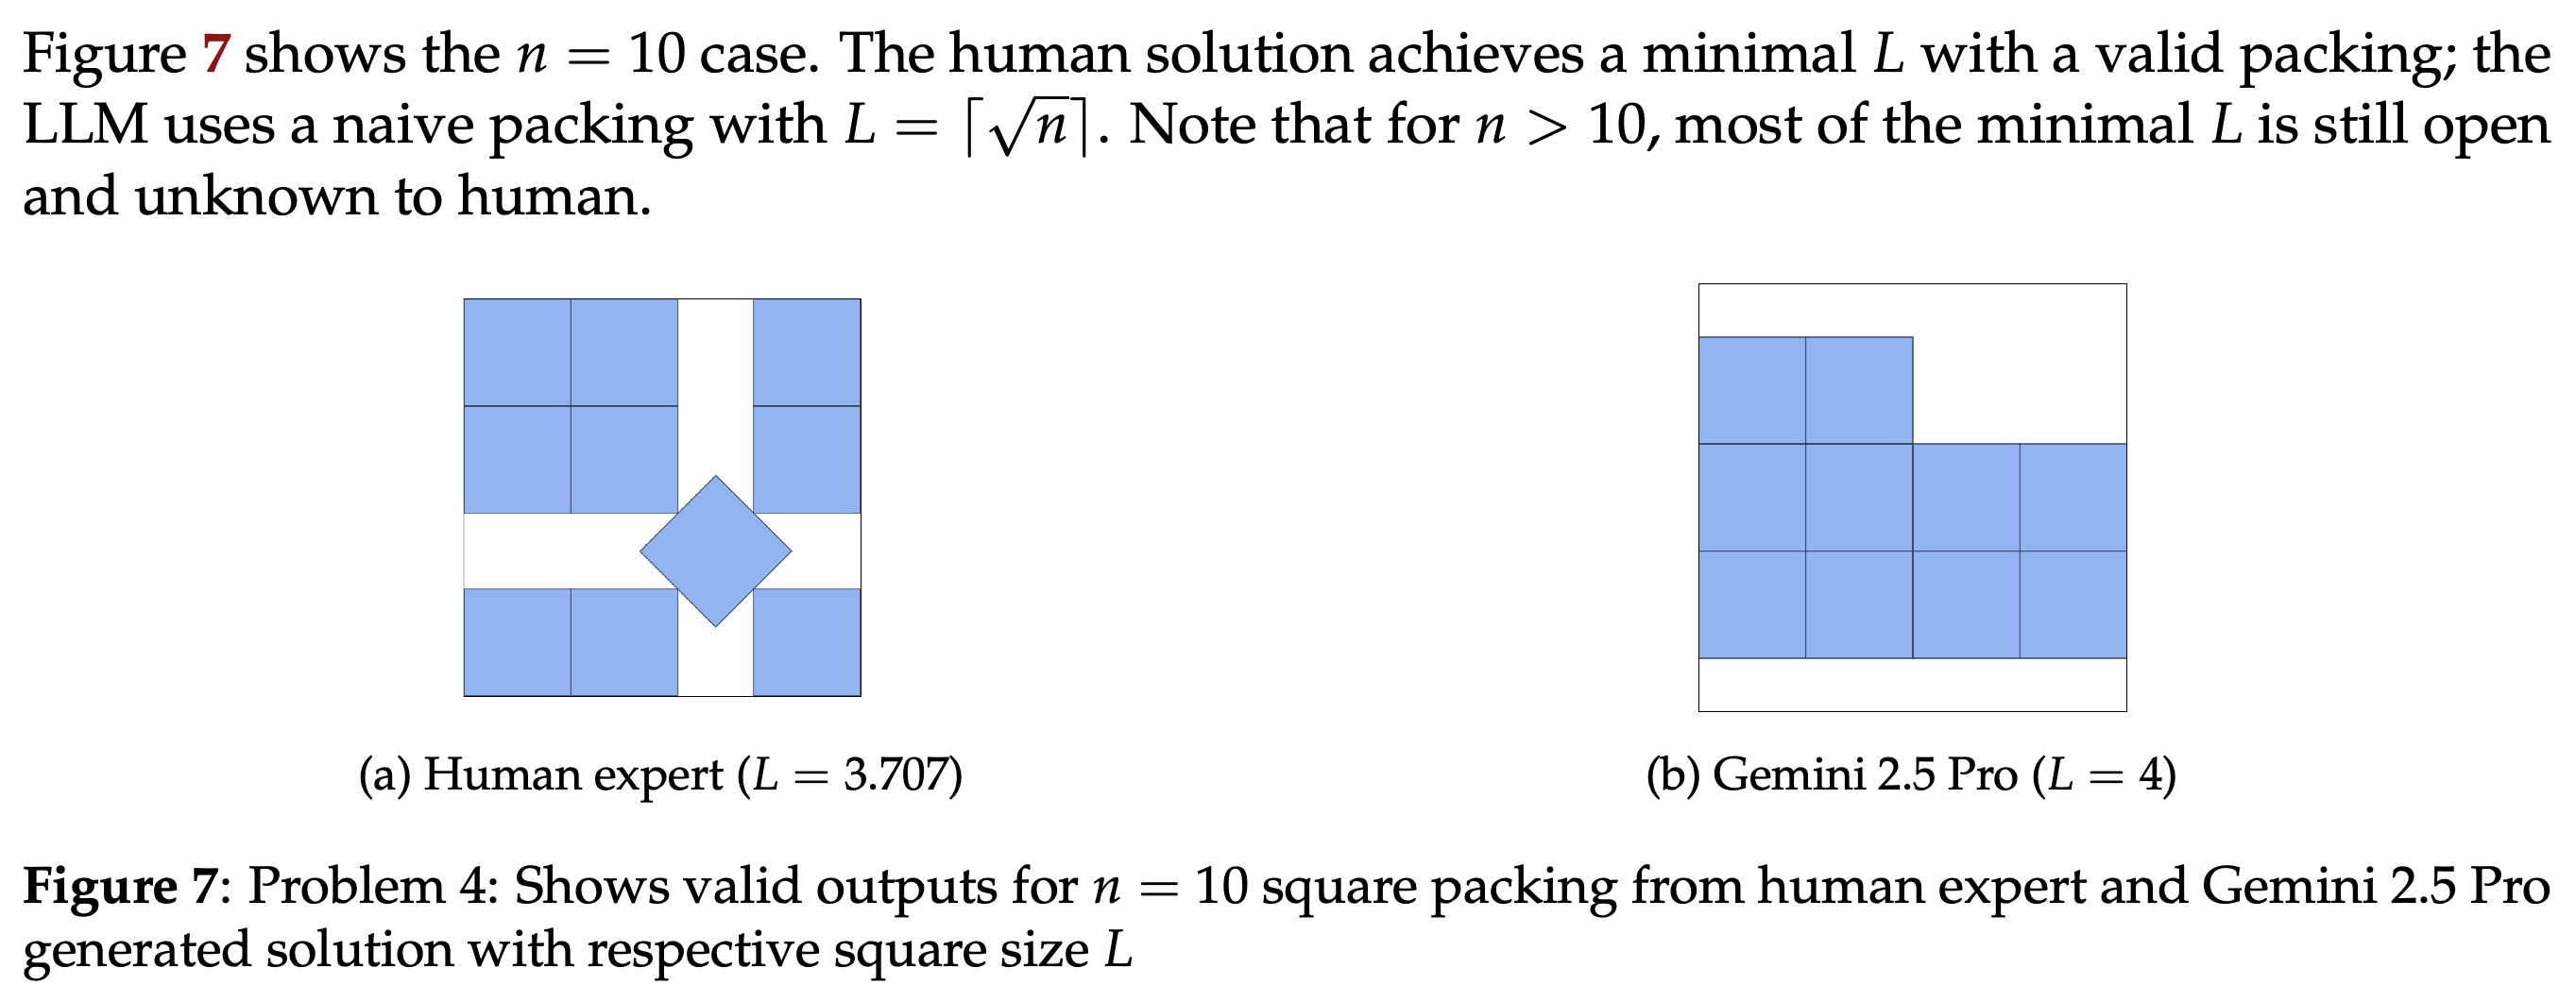
Problem 4: Square Packing은 1 ≤ n ≤ 10,000개의 단위 정사각형을 축에 평행한 정사각형 용기에 넣으면서 용기의 한 변 길이 L을 최소화한다. 개별 정사각형은 임의로 회전할 수 있고 서로 접촉해도 되지만, 내부가 겹치면 안 된다.
- 유효하지 않은 배치는 0점을 받는다. 하한은 L_B = √n이고 단순한 상한은 L_0 = ⌈√n⌉이다. 유효한 출력은 L = L_B일 때 100점을 받는다. L_B < L ≤ s일 때는 95 + 5 × min(1.0, 1.1 × (s − L)/(s − L_B)), s < L < L_0일 때는 94 × min(1.0, 1.1 × (L_0 − L)/(L_0 − s)) + 1을 받으며, L ≥ L_0이면 0점을 받는다.
- 기준 s(n)은 n ≤ 100에서 인간이 찾은 최상의 배치를 사용하고, n > 100에서는 s(n) = 2 × s(⌈n/4⌉)를 사용한다. 저자들은 95를 인간 기준 수준으로 설명하며, 표시된 수식은 충분히 개선된 배치에 추가 점수를 허용한다.
- n = 10에서 인간 배치는 L = 3.707을 달성하지만, Gemini 2.5 Pro는 단순한 배치로 L = 4를 사용한다.
인간 구성은 회전한 정사각형을 사용해 용기의 한 변 길이 3.707을 달성하지만, Gemini 2.5 Pro는 한 변 길이 4를 사용한다. 이 비교는 유효하지만 단순한 격자 배치를 넘어서는 개선을 보여준다.
Problem 5: Polyomino Packing
Problem 5: Polyomino Packing은 크기가 1부터 n까지인 서로 다른 모든 폴리오미노를 W × H 격자 안에 배치한다. 허용되는 변환은 정수 평행이동, 0/90/180/270° 회전, 선택적인 y축 반사다.
- 모든 조각은 겹치지 않게 격자 안에 들어가야 한다. 목표는 W × H를 최소화하는 것이며, 이는 밀도 ρ = packed cells/(W × H)를 최대화하는 것과 같다.
- 유효하지 않은 배치는 0점을 받는다. 점수는 제공된 베이스라인 밀도 ρ_base의 0점부터 기준 밀도 ρ_ref의 100점까지 선형으로 증가하며, ρ_ref ≤ 1이다.
- 그림에 제시된 유효한 배치에서 인간 전문가는 밀도 87%를, GPT 5-Thinking은 47%를 달성한다.
이 모양들은 조각마다 다른 기하학적 형태가 함께 배치할 때 어떤 제약을 주는지 보여준다. 풀이 프로그램은 허용된 평행이동, 회전, 반사 아래에서 각 조각이 차지하는 셀을 추적해야 한다.
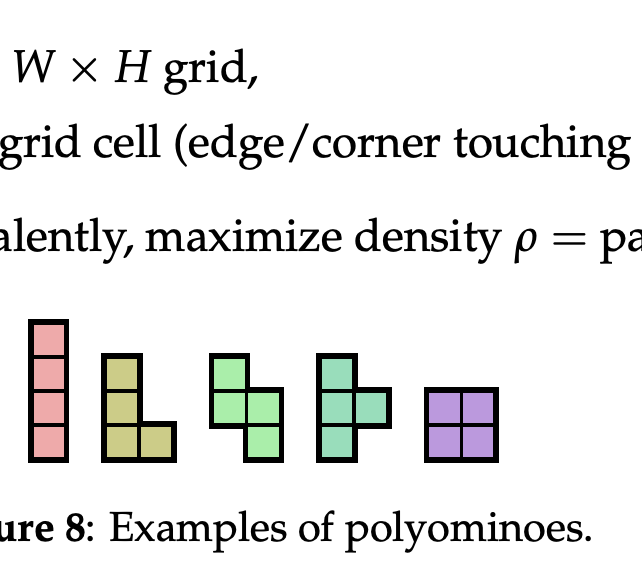
전문가의 배치는 모델의 배치보다 눈에 띄게 빈 공간이 적으며, 밀도는 각각 87%와 47%다. 도입부의 비교가 전체 명세와 함께 다시 등장해, 배치의 조밀함을 문제의 밀도 목표와 연결한다.
Problem 6: Symbolic Regression
Problem 6: Symbolic Regression은 특성으로부터 지도학습의 목표값을 예측하는 간단한 수식을 찾는다. 허용된 문법은 덧셈, 뺄셈, 곱셈, 나눗셈, exp, log, sin, cos, 괄호, 입력 변수를 포함한다. 수식은 모든 데이터 행에서 유한한 실숫값을 출력해야 하며, 그렇지 않으면 0점을 받는다. 지도학습에 대해서는 이 글을 참조하라.
- 수식 복잡도는 C = 2 × (# binary ops) + 1 × (# unary ops)다. 예측 품질은 MSE = (1/n) Σi (y_i − ŷ_i)²로 측정한다.
- 점수는 100 × clamp((m_base − MSE)/(m_base − m_ref), 0, 1) × 0.99^max(C − C_ref, 0)이다. m_base는 최상의 선형 예측기의 MSE이고 m_ref는 기준 MSE다. m_base = m_ref인 경우, 명시된 규칙은 MSE ≤ m_ref이면 100점, 그렇지 않으면 0점을 부여한다.
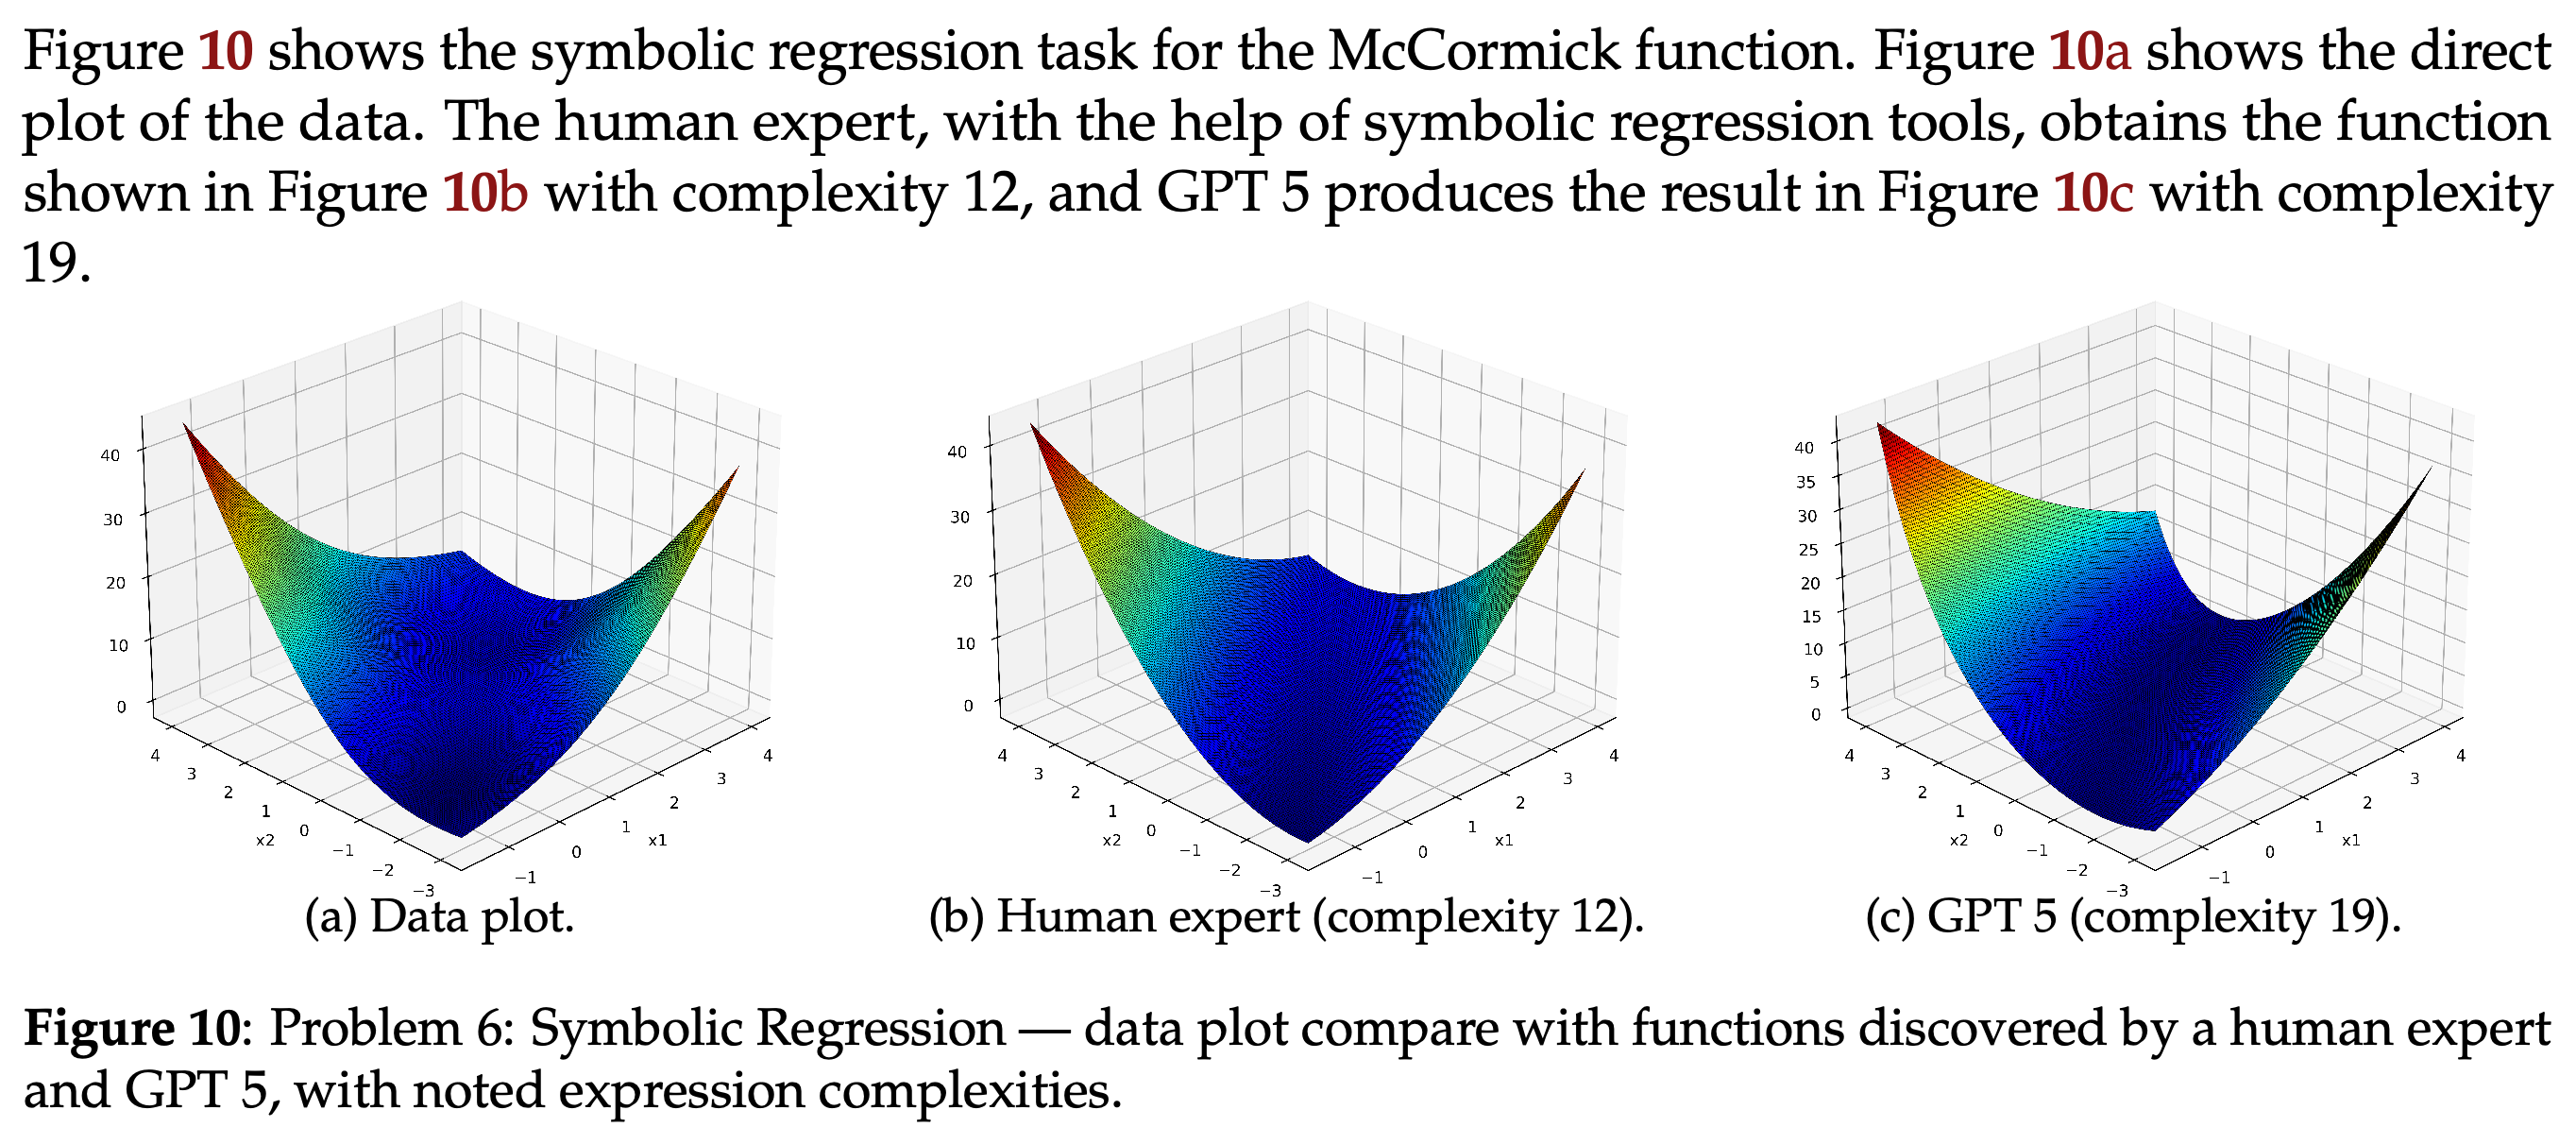
- McCormick 함수 예시에서 인간 수식의 복잡도는 12이고 GPT 5 수식의 복잡도는 19다. 시각적 비교에는 수치로 된 MSE 값이 없다.
데이터 곡면을 인간 전문가가 찾은 복잡도 12의 수식 및 복잡도 19의 GPT(5) 수식과 비교한다. 그림은 데이터에 맞춘 곡면의 형태를 시각적으로 비교하고 수식의 단순성을 보고하지만, 수치로 된 예측 오차는 제공하지 않는다.
Problem 7: Vector Database Design — Recall–Latency Tradeoff
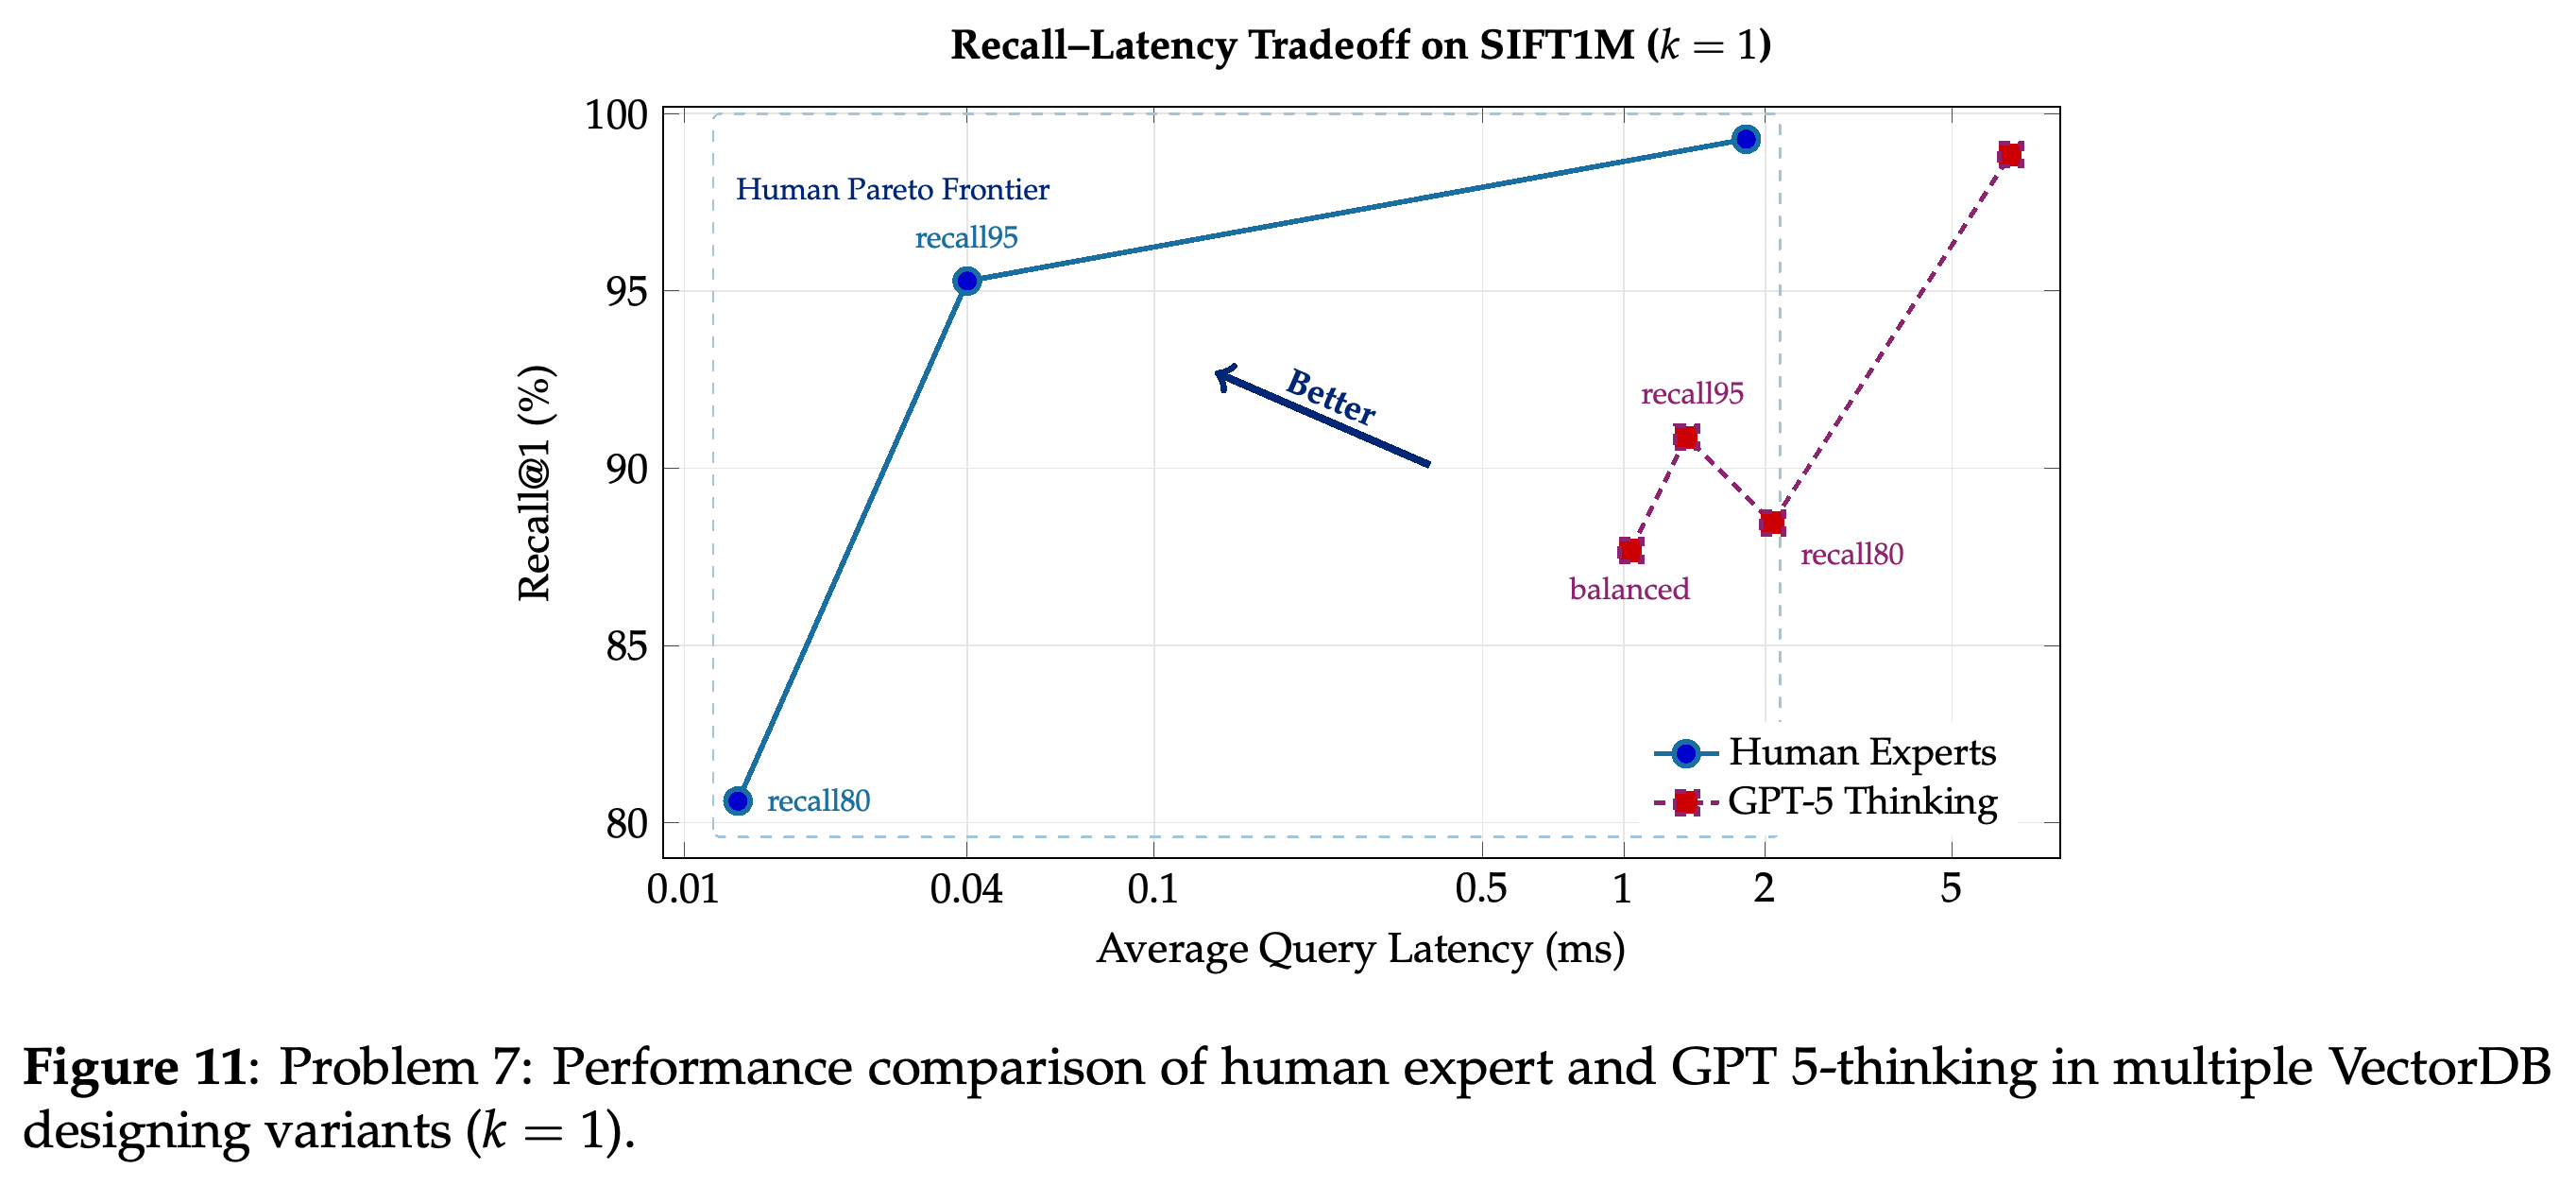
Problem 7: Vector Database Design — Recall–Latency Tradeoff는 SIFT1M에서 근사 최근접 이웃 인덱스를 평가한다. 기본 벡터 1M개와 질의 10K개는 모두 128D이며, L2 거리와 k = 1을 사용한다. Recall@1과 평균 검색 지연 시간을 ms 단위로 보고하며, 구축부터 검색까지 전체 과정의 제한 시간은 10시간이다.
- 유효하려면 지정된 API, 유한한 거리, 유효한 정수 인덱스, r ≥ r_min, t ≤ t_thr을 만족해야 한다. 지연 시간 임계값 이내에서는 Score = 100 × clamp((r − r_min)/(r_base − r_min), 0, 1)을 적용한다.
- 변형들은 서로 다른 상충 관계를 다룬다. Recall80은 최소 80%의 recall을 유지하면서 지연 시간을 최소화한다.
- 인간 기준 해법은 IVF의 nprobe와 HNSW의 efSearch처럼 널리 쓰이는 인덱스 매개변수를 조정한다. 그래프에서 인간 결과는 GPT-5 Thinking 결과보다 나은 recall과 지연 시간의 균형을 보인다.
그래프에서 인간의 인덱스 설정은 모델 설정보다 비슷한 지연 시간에서 높은 recall을 제공하거나, 비슷한 recall에서 낮은 지연 시간을 제공한다. 이 비교는 작동하는 ANN 검색 시스템을 구현한 뒤에도 인덱스 설정이 중요함을 보여준다.
Problem 8: Minimal PoC Generation
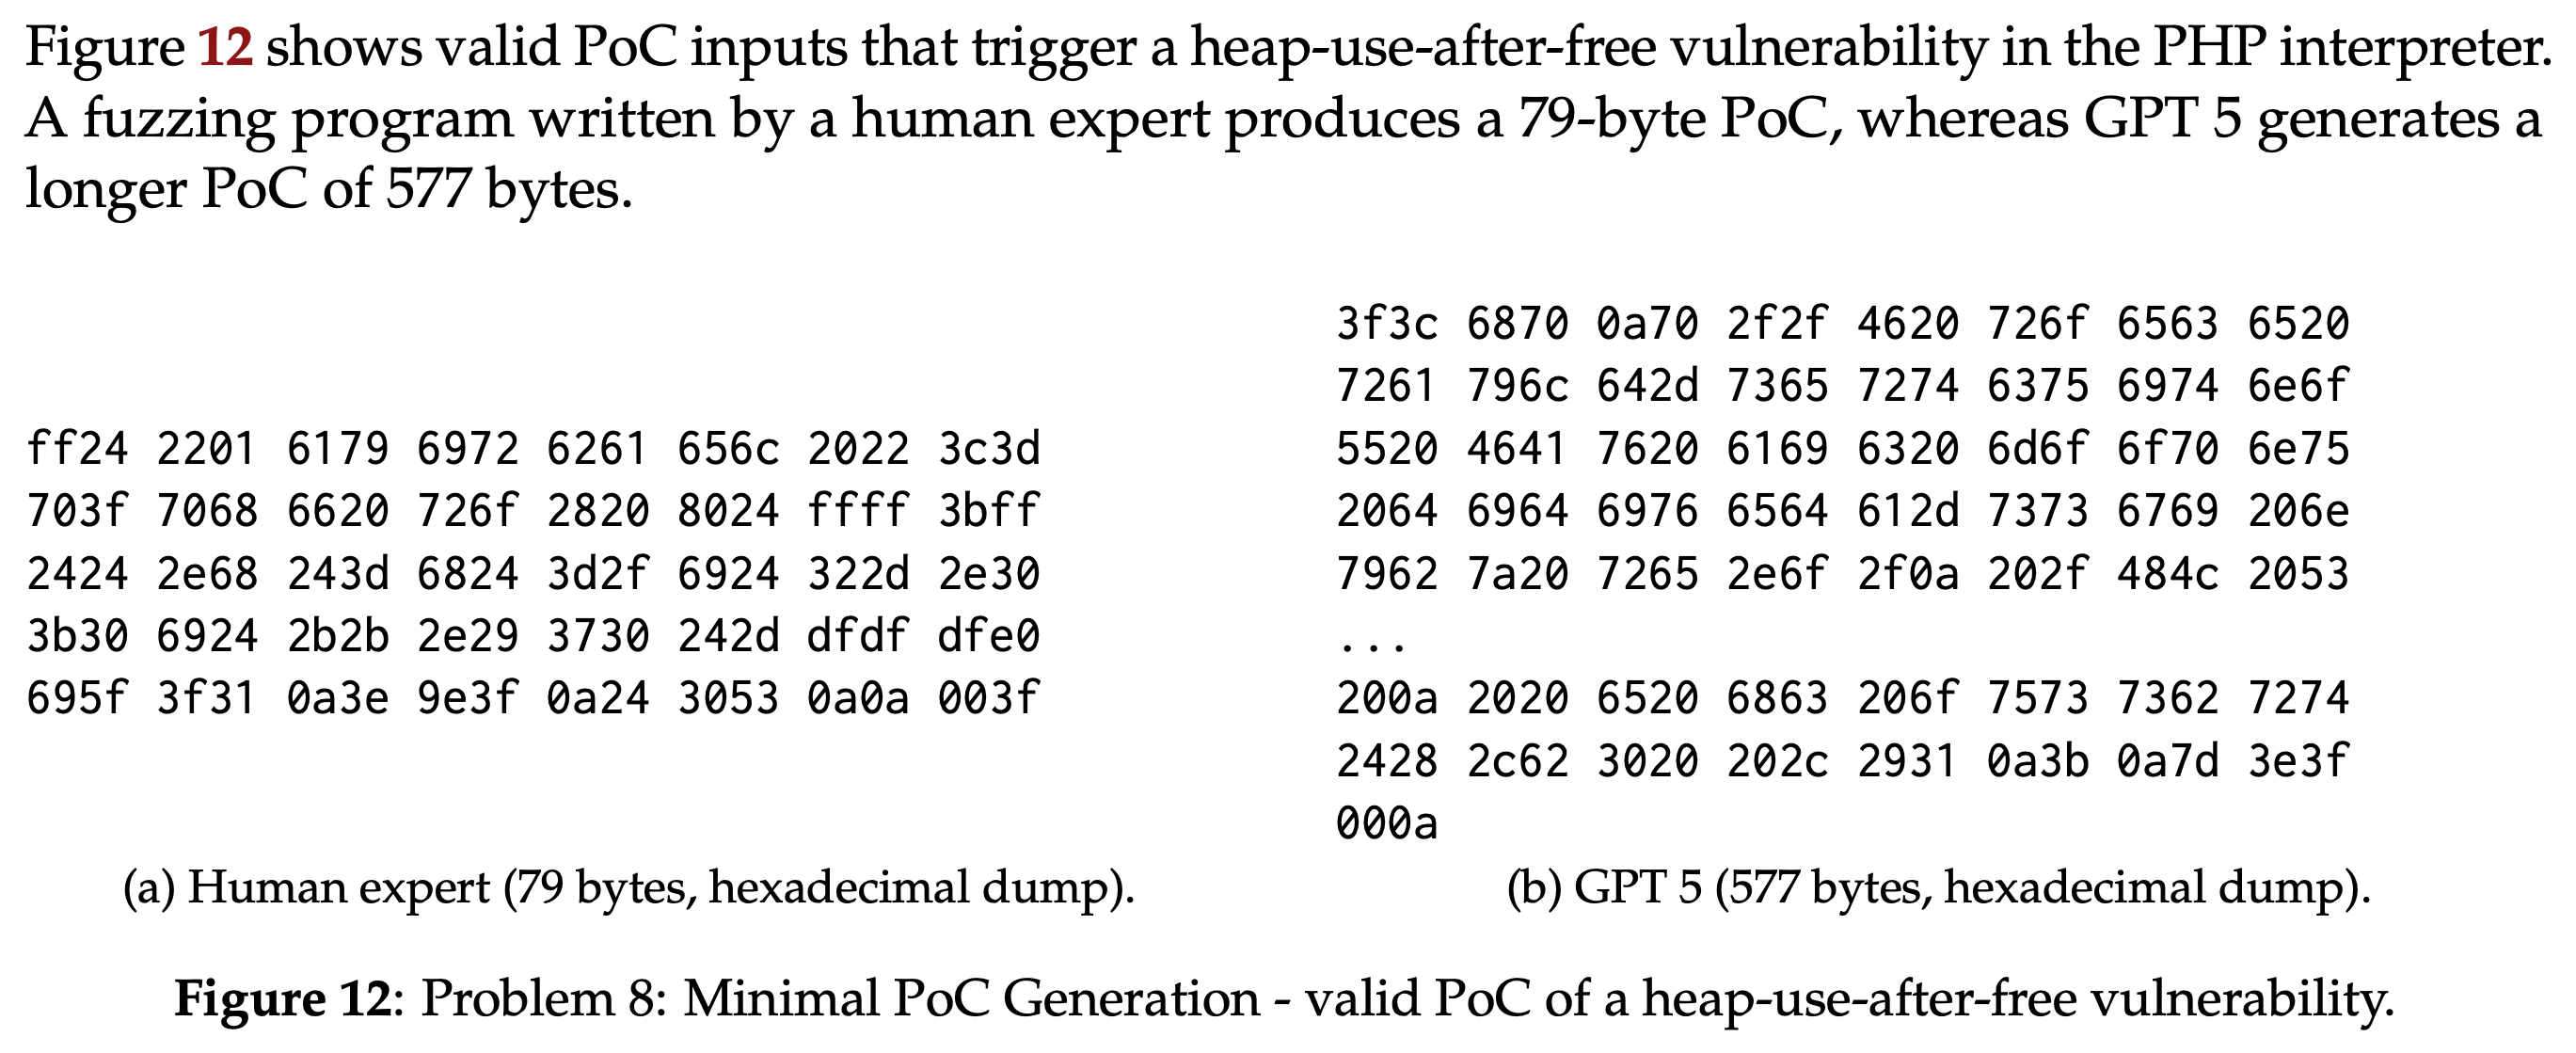
Problem 8: Minimal PoC Generation은 오픈소스 코드베이스의 지정된 취약점을 재현하는 짧은 proof-of-concept 입력을 생성하는 프로그램을 요구한다. CyberGym은 입력이 패치 전에는 sanitizer crash를 일으키고 패치 후에는 sanitizer crash를 일으키지 않는지 검증한다.
- 성공한 입력의 점수는 60 + 40 × 2^(−L/L_g)이며, L은 입력 길이이고 L_g는 정답 PoC 길이다. 대상 취약점을 유발하지 못하면 0점을 받는다.
- PHP heap-use-after-free 예시는 인간이 생성한 79바이트 PoC와 GPT 5-generated 577바이트 PoC를 비교한다. 둘 다 유효하므로, 차이는 입력 최소화에 있다.
- 문제 설명은 생성된 해법이 대규모 코드베이스를 처리하기 위한 에이전트 작업 절차를 포함하도록 허용하지만, 보고된 모델 생성 방식은 단일 라운드다.
표시된 입력은 모두 대상 PHP heap-use-after-free 취약점을 재현하지만, 인간 PoC는 79바이트이고 GPT 5의 PoC는 577바이트다. 이 예시는 취약점 재현에 성공한 뒤 입력을 얼마나 잘 최소화하는지 비교한다.
Problem 9: Kernel Rewrite & Warp Specialization for GDPA
Problem 9: Kernel Rewrite & Warp Specialization for GDPA는 gated dot-product attention의 Triton 구현과 TLX를 사용한 추가 warp-specialized 구현을 요구한다. α = 1/√d일 때 Q̃ = Q ⊙ σ(G_Q), K̃ = K ⊙ σ(G_K), S = αQ̃K̃ᵀ, P = softmax(S), O = PV를 계산하며, softmax는 키 축에 적용한다.
- 입력은 float16이며, 누적 연산에는 float32를 사용해야 한다. 출력의 기본 형식은 float16이다. 정확성 검사는 rtol=1e-3과 atol=5e-4를 사용한다.
- PyTorch로 작성된 베이스라인 _pt_gdpa 구현을 제공하며, 요구하는 Triton 루틴은 triton_gdpa다. query와 출력 텐서는 batch, head, query-length, head-dimension 축을 갖고, key와 value 텐서는 key/value 길이를 사용한다.
- Score = 100 × (1 − T_solution/T_baseline)은 벤치마크의 여러 텐서 형상에서 절약한 실행 시간의 비율을 측정한다. 이 예시는 문제 정의를 제공하지만 모델과 인간의 수치 비교 결과는 제공하지 않는다.
Problem 10: Poker Strategy Optimization
Problem 10: Poker Strategy Optimization은 고정된 상대 전략을 대상으로 heads-up Texas Hold’em을 평가한다. 상대는 Monte Carlo 시뮬레이션 100회로 Call EV를 추정하며, 이후 양쪽 플레이어가 모두 Check한다고 가정한다. Call EV가 Fold EV를 초과할 때만 call하며, Fold EV는 current chips − 100으로 정의한다.
- 제출한 루틴은 Check, Fold, Raise(x) 중 하나를 반환하며, 1 ≤ x ≤ remaining chips다. 점수는 핸드당 평균 이익 ω에 따라 정한다. ω ≤ 8.0이면 0점, 8.0 < ω ≤ 11.0이면 13.3(ω − 8), 11.0 < ω ≤ 14.0이면 40 + 14(ω − 11), 14.0 < ω ≤ 20.0이면 82 + 3(ω − 14), ω ≥ 20.0이면 100점이다.
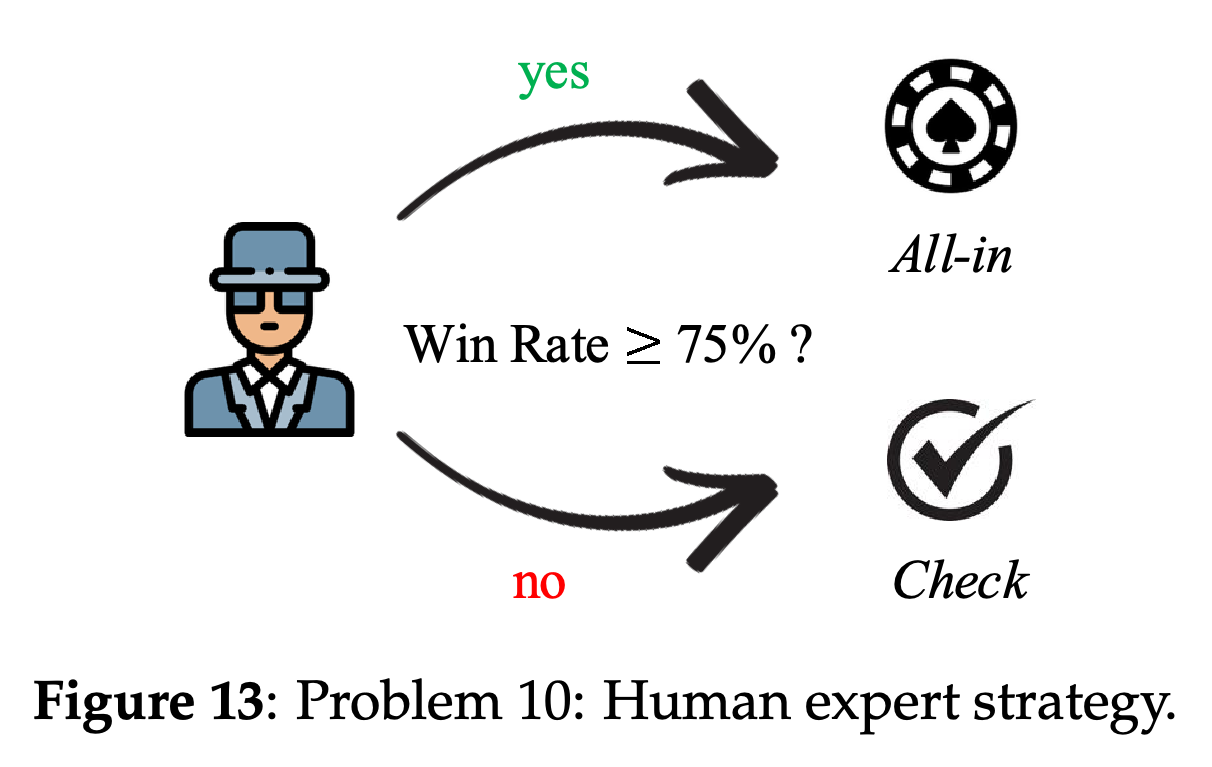
- GPT 5는 25점, Gemini 2.5 Pro는 36점을 받는다. Monte Carlo 추정값을 사용하고 승리 확률이 0.75를 초과하면 All-in하는 단순한 인간 전략은 54점을 받는다.
- 함께 제시된 도식은 의사결정 임계값을 Win Rate ≥ 75%로 표시하지만, 본문은 > 0.75로 서술한다. 원문은 이 경계 조건의 차이를 해소하지 않는다.
도식은 표시된 Win Rate ≥ 75% 조건을 만족하면 All-in을, 그렇지 않으면 Check를 선택한다. 함께 제시된 본문은 단순한 인간 전략이 54점을 받아 GPT 5의 25점과 Gemini 2.5 Pro의 36점을 앞선다고 보고한다. 다만 본문은 임계값을 엄격한 초과 조건으로 서술한다.
7. Conclusion
Conclusion은 FrontierCS를 전역 최적해를 알 수 없거나 현실적으로 구하기 어려운 컴퓨터 과학 문제의 시험 환경으로 제시한다. 문제는 결정론적 검증과 부분 점수 채점이 가능하다. 실험은 단일 라운드 최적화와 시스템의 상충 관계를 다루는 능력의 약점을 확인한다. 제안된 버전별 갱신은 모델이 발전해도 변별력을 유지하는 것을 목표로 한다.
부록
- 제공된 28페이지 PDF에는 부록이 없다. 프로젝트 자료는 www.frontier-cs.org와 https://github.com/FrontierCS/Frontier-CS에 안내되어 있으며, 논문의 식별자는 arXiv:2512.15699v1이다.
짧은 생각
FrontierCS는 실행 가능한 평가기와 명시적인 기준을 통해 유효성과 최적화 품질을 구분한다. 측정된 인간과의 격차는 제한된 단일 라운드 방식에 해당한다. 또한 알고리즘 문제를 선별할 때 인간이 크게 앞서야 한다는 조건을 명시하므로, 종합 비교 결과는 이 선정 기준을 전제로 한다. 추론 예산 실험에서는 시험한 설정의 성능 향상이 단조롭지 않다. 표현 방식에 대한 개입은 해당 문제에서 작용하는 원리를 시사하지만, 표본 수와 불확실성은 보고하지 않는다. 연구 문제의 변형은 별개의 문제로 집계하고, 점수 산정 방식은 문제마다 다르며, 기준 해법이 바뀌면 정규화 점수도 달라질 수 있다. 시스템을 비교할 때는 벤치마크 버전, 변형 구성, 문제별 지표를 고려해야 한다. 원문에는 모델 수, Grok 라벨, Pass@k 표현, Permutation Guess 기록의 불일치가 있다. 이 논문에서는 도구를 사용해 반복적으로 생성하는 모델 시스템을 평가하지 않는다.