


Agentic Rubrics as Contextual Verifiers for SWE Agents 요약 설명
07 Jan 2026 | Paper Review AI Coding Agents Rubric-Based Evaluation Test-Time Scaling Knowledge Distillation목차
- 요약
- 1. Introduction
- 2. Preliminaries
- 3. Experimental Design
- 4. Results
- 5. Ablations
- 6. Related Work
- 7. Conclusion
- 8. Limitations
- 부록
- 짧은 생각
이번 글에서는 Agentic Rubrics as Contextual Verifiers for SWE Agents 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 1월 7일(Arxiv)
- Raghavendra, Mohit, Gunjal, Anisha, Liu, Bing, He, Yunzhong.
- Scale AI
- 논문 링크
- Project Page
요약
- Agentic Rubrics는 저장소 맥락에 근거한 검증을 2단계로 나눈다. 전문가 에이전트가 저장소를 탐색해 명시적인 평가 기준을 작성한 뒤, LLM judge가 후보 패치를 실행하지 않고 점수를 매긴다. 실행 기반 검증의 반복 비용과 직접 패치 분류기의 부족한 저장소 맥락 및 낮은 해석 가능성을 개선하려는 방법이다.
- SWE-Bench Verified의 전체 500개 문제에서 문제당 독립적으로 생성한 후보 16개를 평가했을 때, Agentic Rubrics의 BEST@16 해결률은 Qwen3-32B에서 40.6%, Qwen3-Coder-30B-A3B에서 54.2%다. 이는 비교한 기준선 중 성능이 가장 높은 Patch Classifier보다 각각 3.5%포인트와 4.0%포인트 높다.
- 루브릭 점수는 정답 테스트 결과를 ROC-AUC 0.886, PR-AUC 0.722로 구분하며, 기준별 진단을 제공한다. 저장소 접근은 패치 선택 성능을 높이고, 지도 증류는 오픈 웨이트 루브릭 생성기를 개선한다. 다만 모델 기반 유용성 분석에서는 구현 방식을 지나치게 제한하는 기준과 루브릭·테스트 간 불일치도 발견한다. 루브릭 보상을 이용한 강화학습은 아직 검증하지 않았다.
1. Introduction
검증은 소프트웨어 패치가 정확하고 완전하며 안전한지, 의도한 동작과 일치하는지를 판단해야 한다. 단위 테스트는 실행 환경을 반영한 근거를 제공하지만 환경 설정이 필요하고, 신호가 희소하거나 불안정할 수 있다. 실행 없는 분류기와 유사도 지표는 반복 실행 비용을 줄이지만, 저장소에서 지켜야 할 규약을 놓치거나 피상적인 단서에 의존할 수 있다.
- Agentic Rubrics는 judge가 이슈와 패치만으로 모든 관련 제약을 추론하도록 하지 않는다. 대신 저장소를 탐색해 작업별 수용 기준을 작성한다.
- 실험으로 입증한 기여는 best-of-K 패치 선택, 정합성과 유용성 분석, 루브릭 생성의 지도 증류다. 서론에서는 사후 학습용 보상도 논의하지만, 루브릭 보상을 이용한 강화학습을 입증하지는 않는다.
- 논문은 연구 페이지로 https://scale.com/research/agenticrubrics 주소를 제시한다.
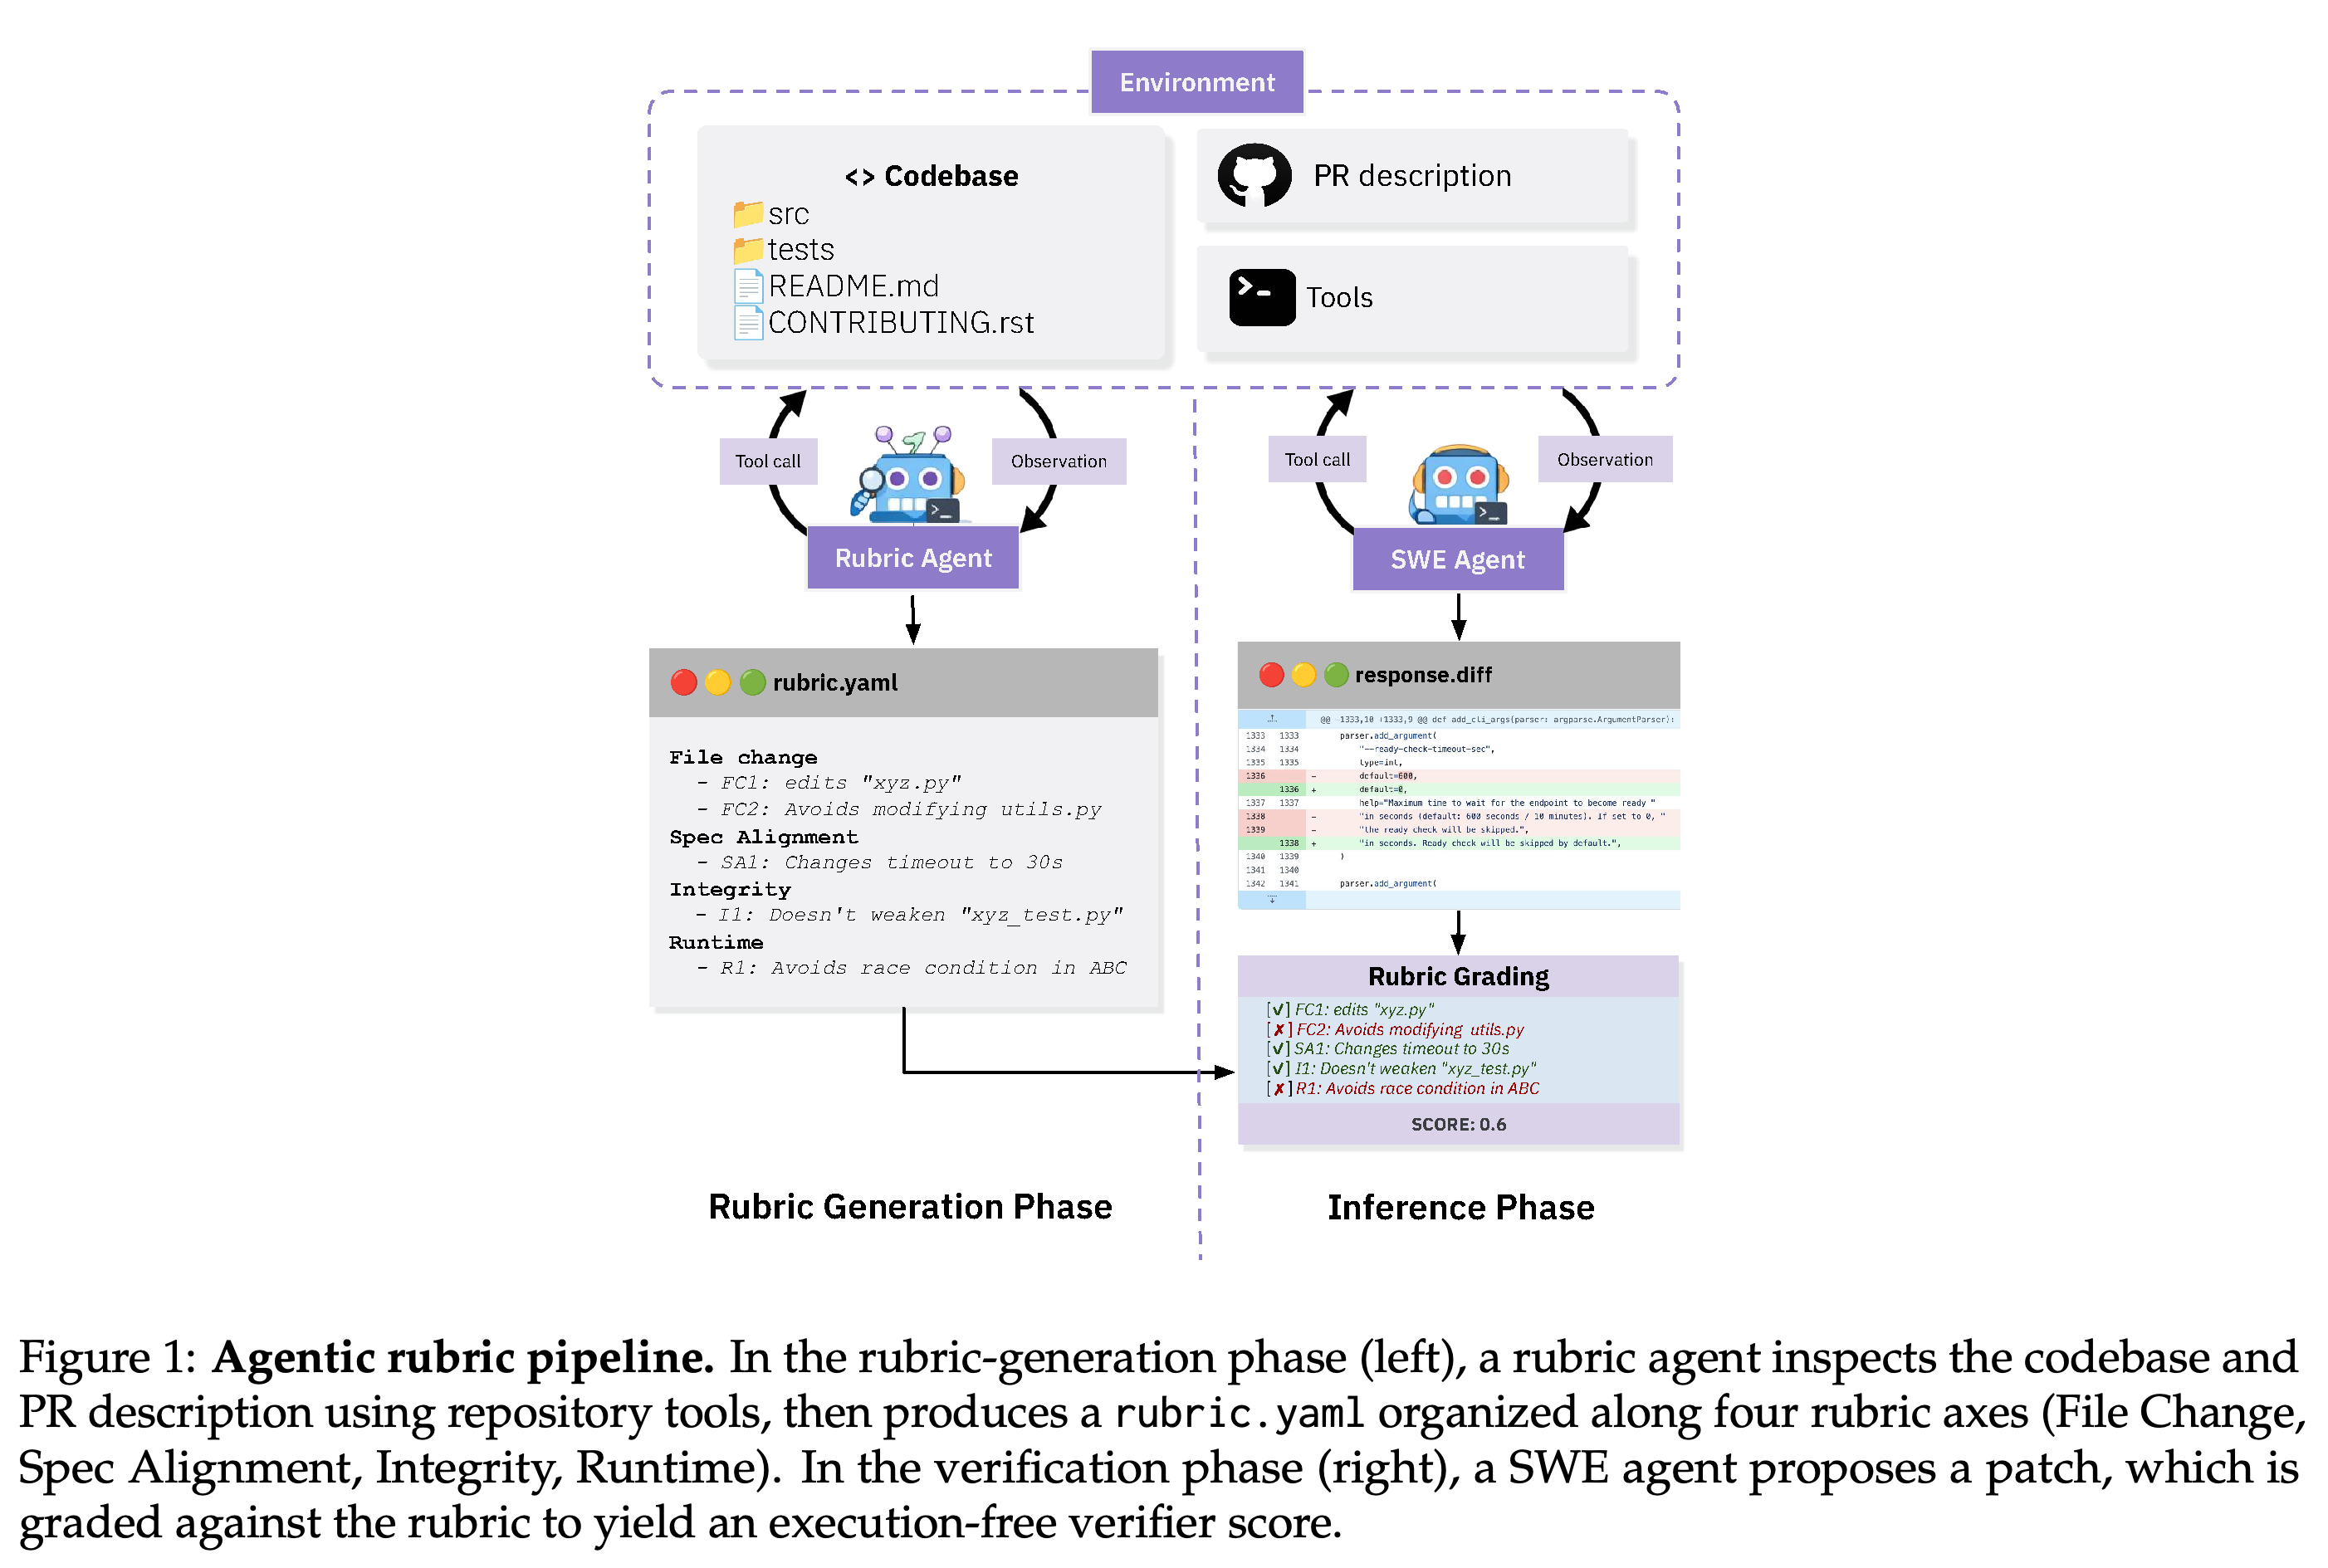
저장소 탐색으로 생성한 루브릭을 여러 후보 패치의 채점에 재사용할 수 있다. 루브릭 에이전트와 SWE 에이전트는 모두 환경과 상호작용하지만, 최종 채점 단계에서는 후보 코드를 실행하지 않고 제출된 diff를 명시적인 기준으로 평가한다.
2. Preliminaries
배경 절에서는 패치 검증과 루브릭 기반 채점을 정의한다. 저장소 맥락을 활용하면 작업별 제약을 유지하면서도 반복적인 후보 채점의 부담을 낮출 수 있다고 설명한다.
2.1 Verification for SWE Agents
검증기는 주어진 이슈에 대한 후보 패치에 점수를 부여한다. 실행 기반 방법은 코드를 실행하며, 보통 사람이 작성하거나 자동 생성한 테스트를 사용한다. 실행 없는 방법은 저장소를 실행하지 않고 분류기, 유사도 지표, LLM 판단으로 패치의 순위를 매긴다.
- 실행 기반 검증에는 샌드박스 설정 비용이 들 수 있다. 또한 후보를 충분히 구분하지 못하거나 test toxicity가 발생하는 등 신호가 희소하거나 불안정할 수 있다.
- 실행 없는 검증은 운영 부담을 줄이는 대신 저장소 맥락 반영, 신뢰성, 해석 가능성이 약해질 수 있다. 코드 스타일이나 의미와 무관한 요소에도 민감할 수 있다.
2.2 Rubric-based Verification
루브릭은 정확성을 명시적인 자연어 기준으로 나누고, 필요에 따라 기준을 평가 축으로 묶으며, 중요도 가중치와 집계 규칙을 정한다. Judge는 각 기준을 평가하고 판단을 종합해 선택이나 학습에 사용할 점수를 만든다. 이슈 설명만으로 만든 기준은 저장소에 고유한 인터페이스, 제약, 관례를 빠뜨릴 수 있다.
3. Experimental Design
실험에서는 후보 생성 정책을 고정하고, 병렬 테스트 시점 선택에 사용하는 검증기를 바꾼다. 산출물 없이 점수를 매기는 방법과, 먼저 저장소와 상호작용해 테스트·대리 패치·루브릭을 생성하는 방법을 비교한다.
3.1 Agentic Rubrics
루브릭 생성 에이전트는 SWE-Agent 프레임워크로 저장소 탐색, 파일 확인, 편집, 셸 명령 실행을 수행하고 rubrics.yaml을 산출물로 제출한다. 각 기준에는 짧은 설명과 중요도 가중치 1, 2, 3 중 하나를 부여한다. 각각 있으면 좋은 조건, 중요한 조건, 필수 조건에 해당한다. 산출물을 파싱할 수 없으면 해당 생성 시도는 무효로 처리한다.
- File Change는 수정이 최소한이고 국소적이며 충분한지를 평가하는 4–8개 항목으로 구성된다.
- Spec Alignment는 이슈 요구사항을 평가하는 3–6개 항목으로 구성된다.
- Integrity는 테스트 약화, 불필요한 리팩터링, 대량 이름 변경, 불필요한 의존성 변경과 관련 코드 관리 제약을 다루는 3–6개 항목으로 구성된다.
- Runtime은 의도한 동작과 명백한 실행 시점 위험을 기술하는 3–6개 항목으로 구성된다. 실행한 테스트가 아니라 텍스트 근거로 평가한다.
- 생성 템플릿은 원자적이고 독립적으로 이해할 수 있으며 개별 문제에 맞는 기준을 요구한다. 중복 집계도 피하도록 한다. Figure 1의 예시 산출물 이름은 rubric.yaml이지만, 실제 구현은 rubrics.yaml을 사용한다.
채점할 때 LLM judge는 각 기준의 충족 여부를 이진 점수로 부여한다. 가중 집계식은 (S=\frac{\sum_i w_i s_i}{\sum_i w_i})이며, (s_i\in{0,1})이고 (w_i\in{1,2,3})이다. 이 식으로 [0, 1] 범위의 검증 점수를 산출한다.
- 저장소와의 상호작용은 산출물을 만드는 동안 이루어진다. 후보 채점에는 문제 설명, 루브릭, 패치를 사용하며 후보 코드는 실행하지 않는다.
3.2 Test-time Scaling with Agentic Rubrics
저자들은 SWE-Bench Verified의 500개 문제 각각에 대해 temperature 1.0으로 독립적인 SWE-Agent rollout 16개를 샘플링한다. Qwen3-32B는 Instruct 버전을 사용하고 최대 30턴을 부여한다. Qwen3-Coder-30B-A3B에는 최대 50턴을 부여한다.
BEST@K는 점수가 가장 높아 선택된 패치가 정답 Fail-To-Pass와 Pass-to-Pass 테스트를 모두 통과하는지를 측정한다. K < 16에서는 후보 부분집합 샘플링을 100회 반복한다. ORACLE PASS@K는 정답 테스트로 패치를 선택하는 상한선이며, RANDOM@K는 균등하게 무작위 선택한다.
- 이 평가 절차는 생성 정책의 개선이 아니라 고정된 후보 집합에서의 선택을 평가한다.
- 숨겨진 평가 테스트는 벤치마크 해결 여부를 결정하지만 검증 에이전트는 접근할 수 없다.
3.3 Baselines
Non-agentic Verifiers는 산출물을 생성하지 않는다. Self-Consistency는 unified-diff 문자열에 difflib의 SequenceMatcher.ratio()를 적용해 다른 K−1개 후보와의 평균 유사도가 가장 높은 diff를 선택한다. Patch Classifier는 LLM judge에게 [0, 1] 범위의 연속 점수로 정확성을 예측하도록 한다.
Agentic Verifiers는 산출물을 활용한다. Agentic Tests는 test_issue.py를 생성하고 후보 패치에 대해 테스트 케이스를 실행한다. Agentic Patch Similarity는 저장소 맥락에 근거한 대리 참조 패치를 생성한 뒤 LLM judge로 유사도를 1–5 척도로 평가한다. Agentic Rubrics는 대신 명시적인 기준을 생성하고 이에 따라 후보를 채점한다.
주요 비교에서는 산출물 생성에 Claude Sonnet-4.5와 30턴 예산을 사용하고, LLM 기반 채점에는 GPT-5의 low reasoning을 사용한다. 저장소는 PR 이전 스냅샷으로 초기화한다. 에이전트는 기존 코드와 테스트를 확인할 수 있지만, 숨겨진 평가 테스트, 참조 패치, git 이력에는 접근할 수 없다.
- 산출물이 없거나 유효하지 않으면 점수는 0이다.
- LLM 채점에서는 rollout 궤적과 도구 실행 기록을 제외한다. 이슈, 해당하는 경우 산출물, 최종 패치만 사용해 실행 기록에 따른 편향과 검증기 해킹을 줄인다.
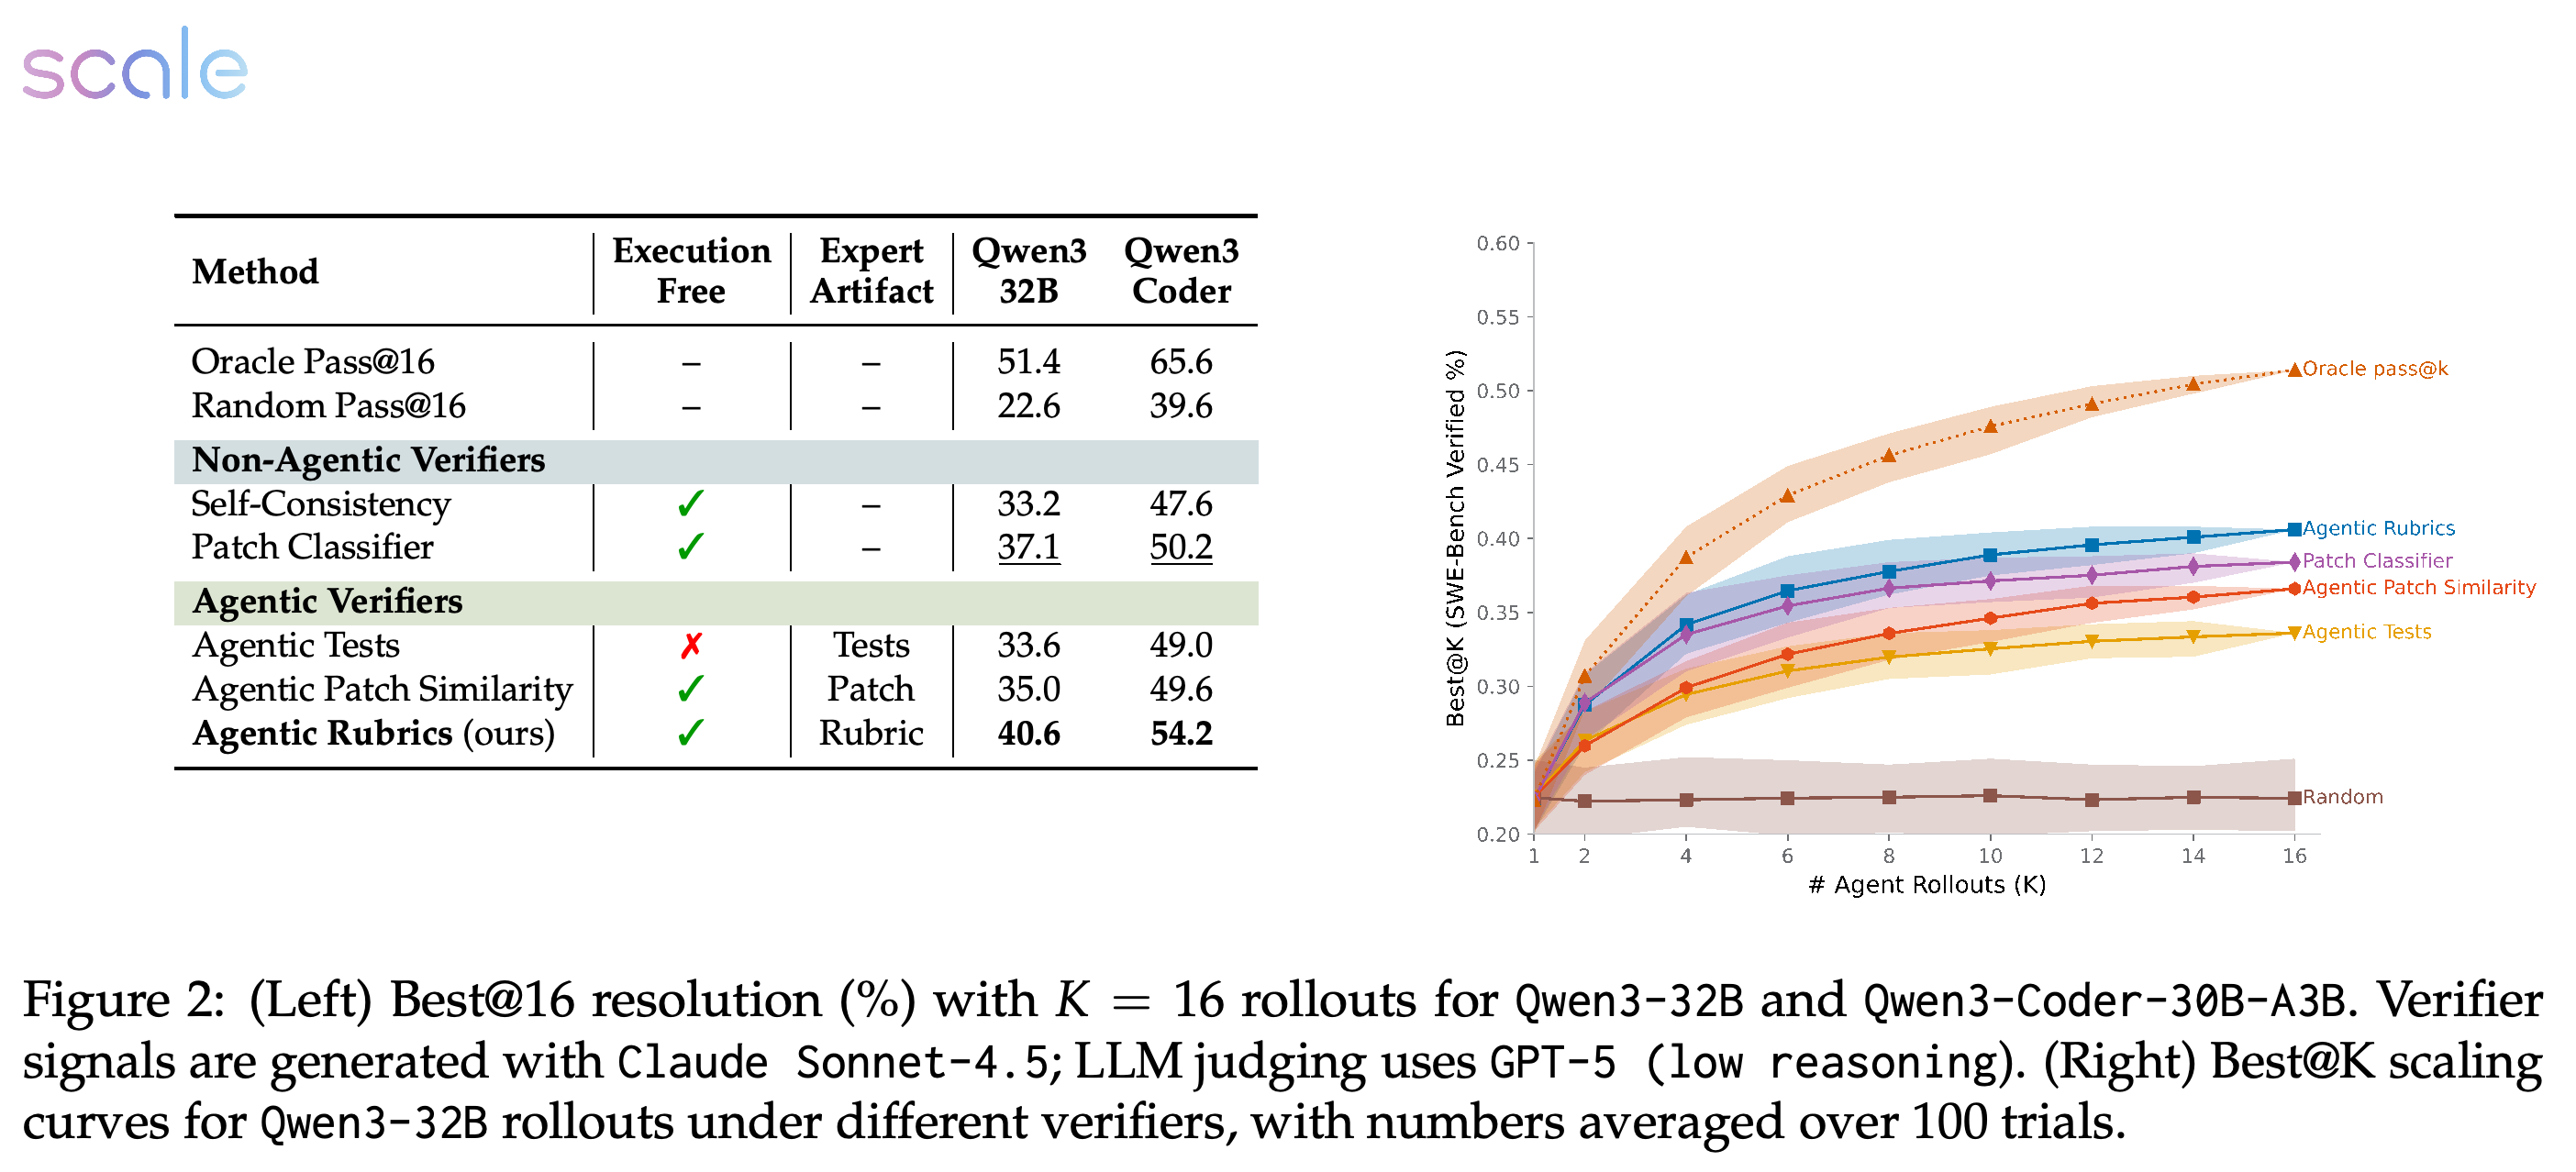
- Figure 2는 BEST@16과 후보 수에 따른 성능을 비교한다.
왼쪽 패널에서 Agentic Rubrics의 BEST@16은 40.6%와 54.2%로, Patch Classifier보다 3.5%포인트와 4.0%포인트 높다. 오른쪽 패널에서는 Qwen3-32B의 후보 수가 1개보다 많아지면서 루브릭의 우위가 나타난다. Oracle 곡선은 선택 성능을 더 높일 여지를 보여준다. 표 형식의 패널은 이 그림의 일부이며 별도 번호가 있는 표가 아니다.
4. Results
결과에서는 패치 선택 정확도, 정답 테스트 및 참조 패치와의 일치, 기준별 판단의 진단적 유용성을 평가한다. 유용성 분석은 별도의 모델 기반 검토이며, 실행 기반 정확성 평가를 추가로 수행한 것은 아니다.
4.1 Test Time scaling with Agentic Rubrics
Agentic Rubrics는 생성기 2개 모두에서 비교한 검증기 중 가장 높은 BEST@16을 달성한다. Qwen3-32B에서는 40.6%로, Patch Classifier의 37.1%와 Agentic Patch Similarity의 35.0%보다 높다. Qwen3-Coder-30B-A3B에서는 54.2%로, 각각 50.2%와 49.6%보다 높다.
- Patch Classifier 대비 향상은 +3.5%포인트와 +4.0%포인트다. Agentic Patch Similarity 대비 향상은 두 설정 모두 +4.6%포인트다.
- Agentic Tests는 33.6%와 49.0%, Self-Consistency는 33.2%와 47.6%를 달성한다.
- Oracle 선택은 51.4%와 65.6%를 달성하므로 선택 성능을 더 개선할 여지가 상당하다.
- Qwen3-32B의 확장 곡선에서는 K = 16에서만이 아니라 후보 집합이 K = 1보다 커지면서 루브릭의 우위가 나타난다.
저자들은 실행 가능한 테스트를 만들거나 1개의 대리 구현과 일치시키는 대신, 충족해야 할 속성을 명시한 것이 성능 우위의 이유라고 설명한다. 생성된 테스트는 성공적인 실행과 후보 구분 능력에 의존하고, 대리 패치 유사도는 의미상 올바른 대안에도 불이익을 줄 수 있다. 다만 이는 제안한 설명이며, 원인을 따로 분리해 검증한 결과는 아니다.
4.2 Analysis of Agentic Rubrics
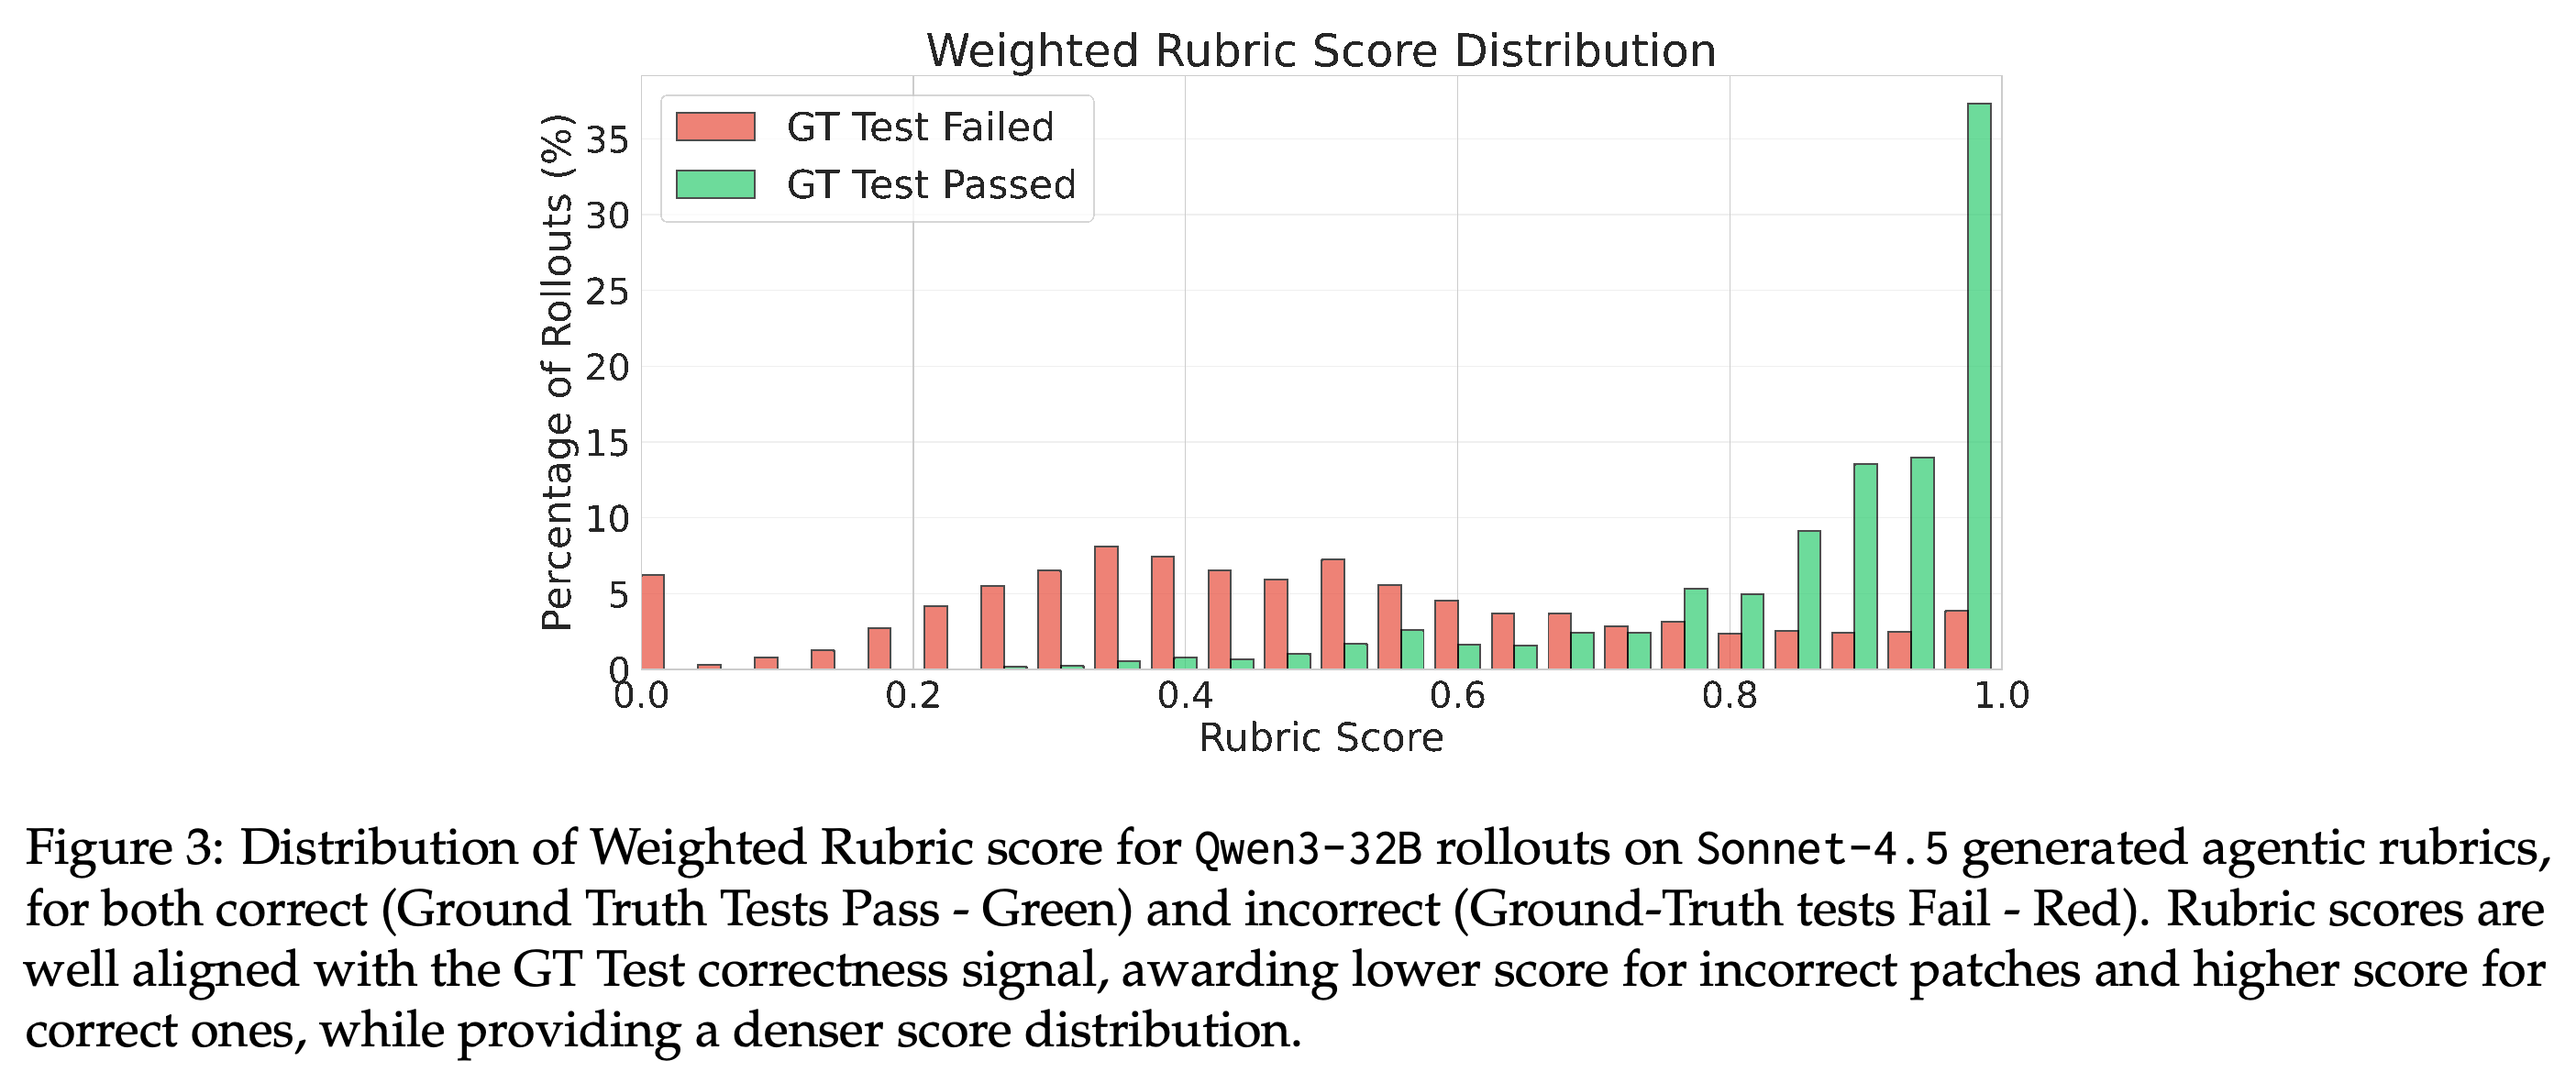
4.2.1 Rubric Score Alignment Analysis에서는 Sonnet-4.5 루브릭으로 채점한 Qwen3-32B 후보를 분석한다. 테스트를 통과한 패치는 대체로 0.85–1.0에 집중되고, 실패한 패치는 더 낮고 넓게 분산되며 흔히 0.4–0.5 부근에 분포한다. 루브릭 점수로 정답 테스트의 통과·실패를 예측하면 ROC-AUC 0.886, PR-AUC 0.722를 얻는다.
- Figure 3에서는 분포가 뚜렷이 구분되지만 겹치는 부분도 나타난다. 높은 루브릭 점수가 테스트 통과를 보장하지는 않는다.
- 사람이 작성한 참조 패치는 프런티어 모델이 생성한 루브릭에서 대체로 높은 점수를 받는다. File Change는 반복적으로 예외를 보인다. 정확한 수정 위치를 요구하는 기준이 참조 구현보다 더 엄격하게 구현 방식을 제한할 수 있기 때문이다.
테스트를 통과한 후보는 가중 점수 범위의 상단에 집중되고, 실패한 후보는 낮은 점수와 중간 점수에 걸쳐 분포한다. 분포가 겹친다는 점은 검증기가 유용한 정보를 제공하지만 완벽하지 않음을 보여준다. 이는 보고된 ROC-AUC 0.886, PR-AUC 0.722와도 일관된다.
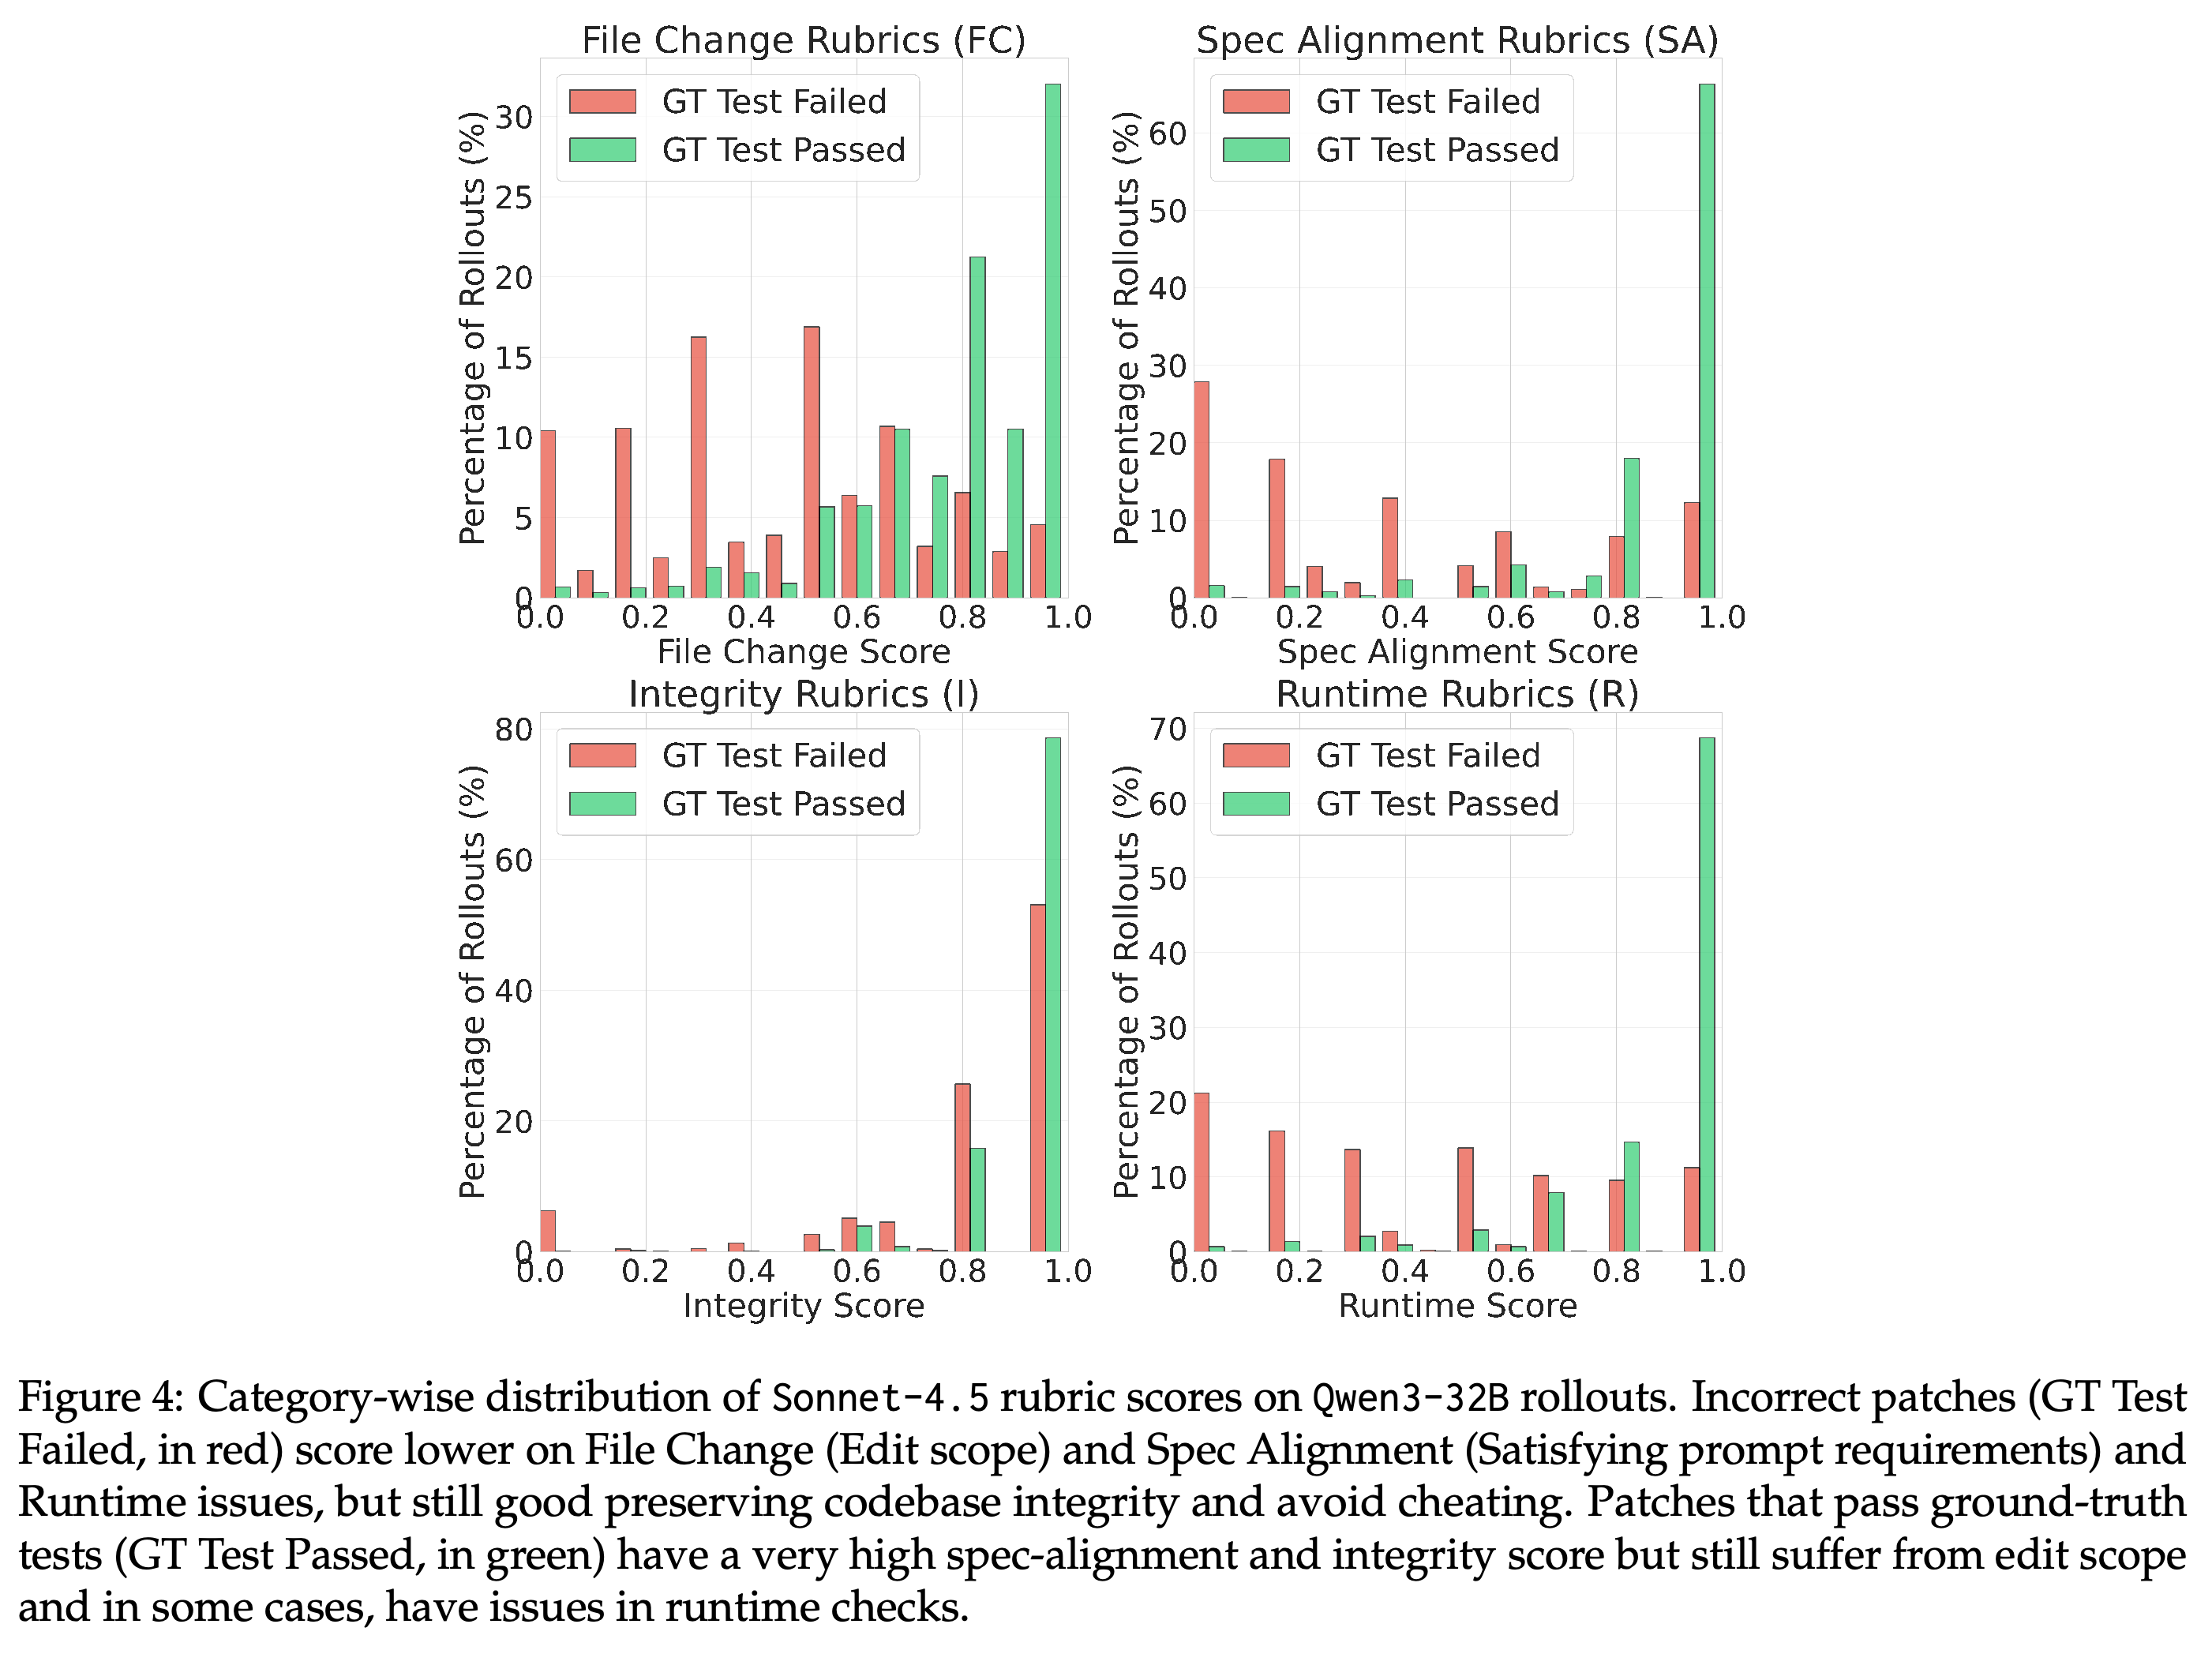
평가 축별 분포에서는 채점 양상이 다르게 나타난다. 테스트에 실패한 패치는 File Change, Spec Alignment, Runtime에서 낮은 점수를 받지만, Integrity 점수는 높은 경우가 많다. 테스트를 통과한 패치는 Spec Alignment와 Integrity에서 거의 만점을 받으면서도 수정 범위와 실행 동작에 대해서는 일부 감점을 받는다.
- Figure 4는 코드 관리 기준을 충족하는 것만으로 기능적 정확성이 입증되지 않으며, 평가 축별 판단이 단일 통과·실패 결과보다 더 자세한 정보를 제공한다는 점을 보여준다.
- 중간 수준의 루브릭 점수는 정도에 따른 구분 능력을 보여준다. 다만 이 분석은 해당 점수가 부분적인 기능적 정확성을 측정하는 보정된 척도인지 별도로 검증하지 않는다.
많은 오답 패치에서도 Integrity 점수는 높게 유지된다. 따라서 코드 관리 기준 충족만으로 기능적 정확성을 입증할 수는 없다. File Change, Spec Alignment, Runtime은 더 뚜렷한 구분을 보이며, 테스트를 통과한 후보에서도 수정 범위에 따른 감점이 나타난다.
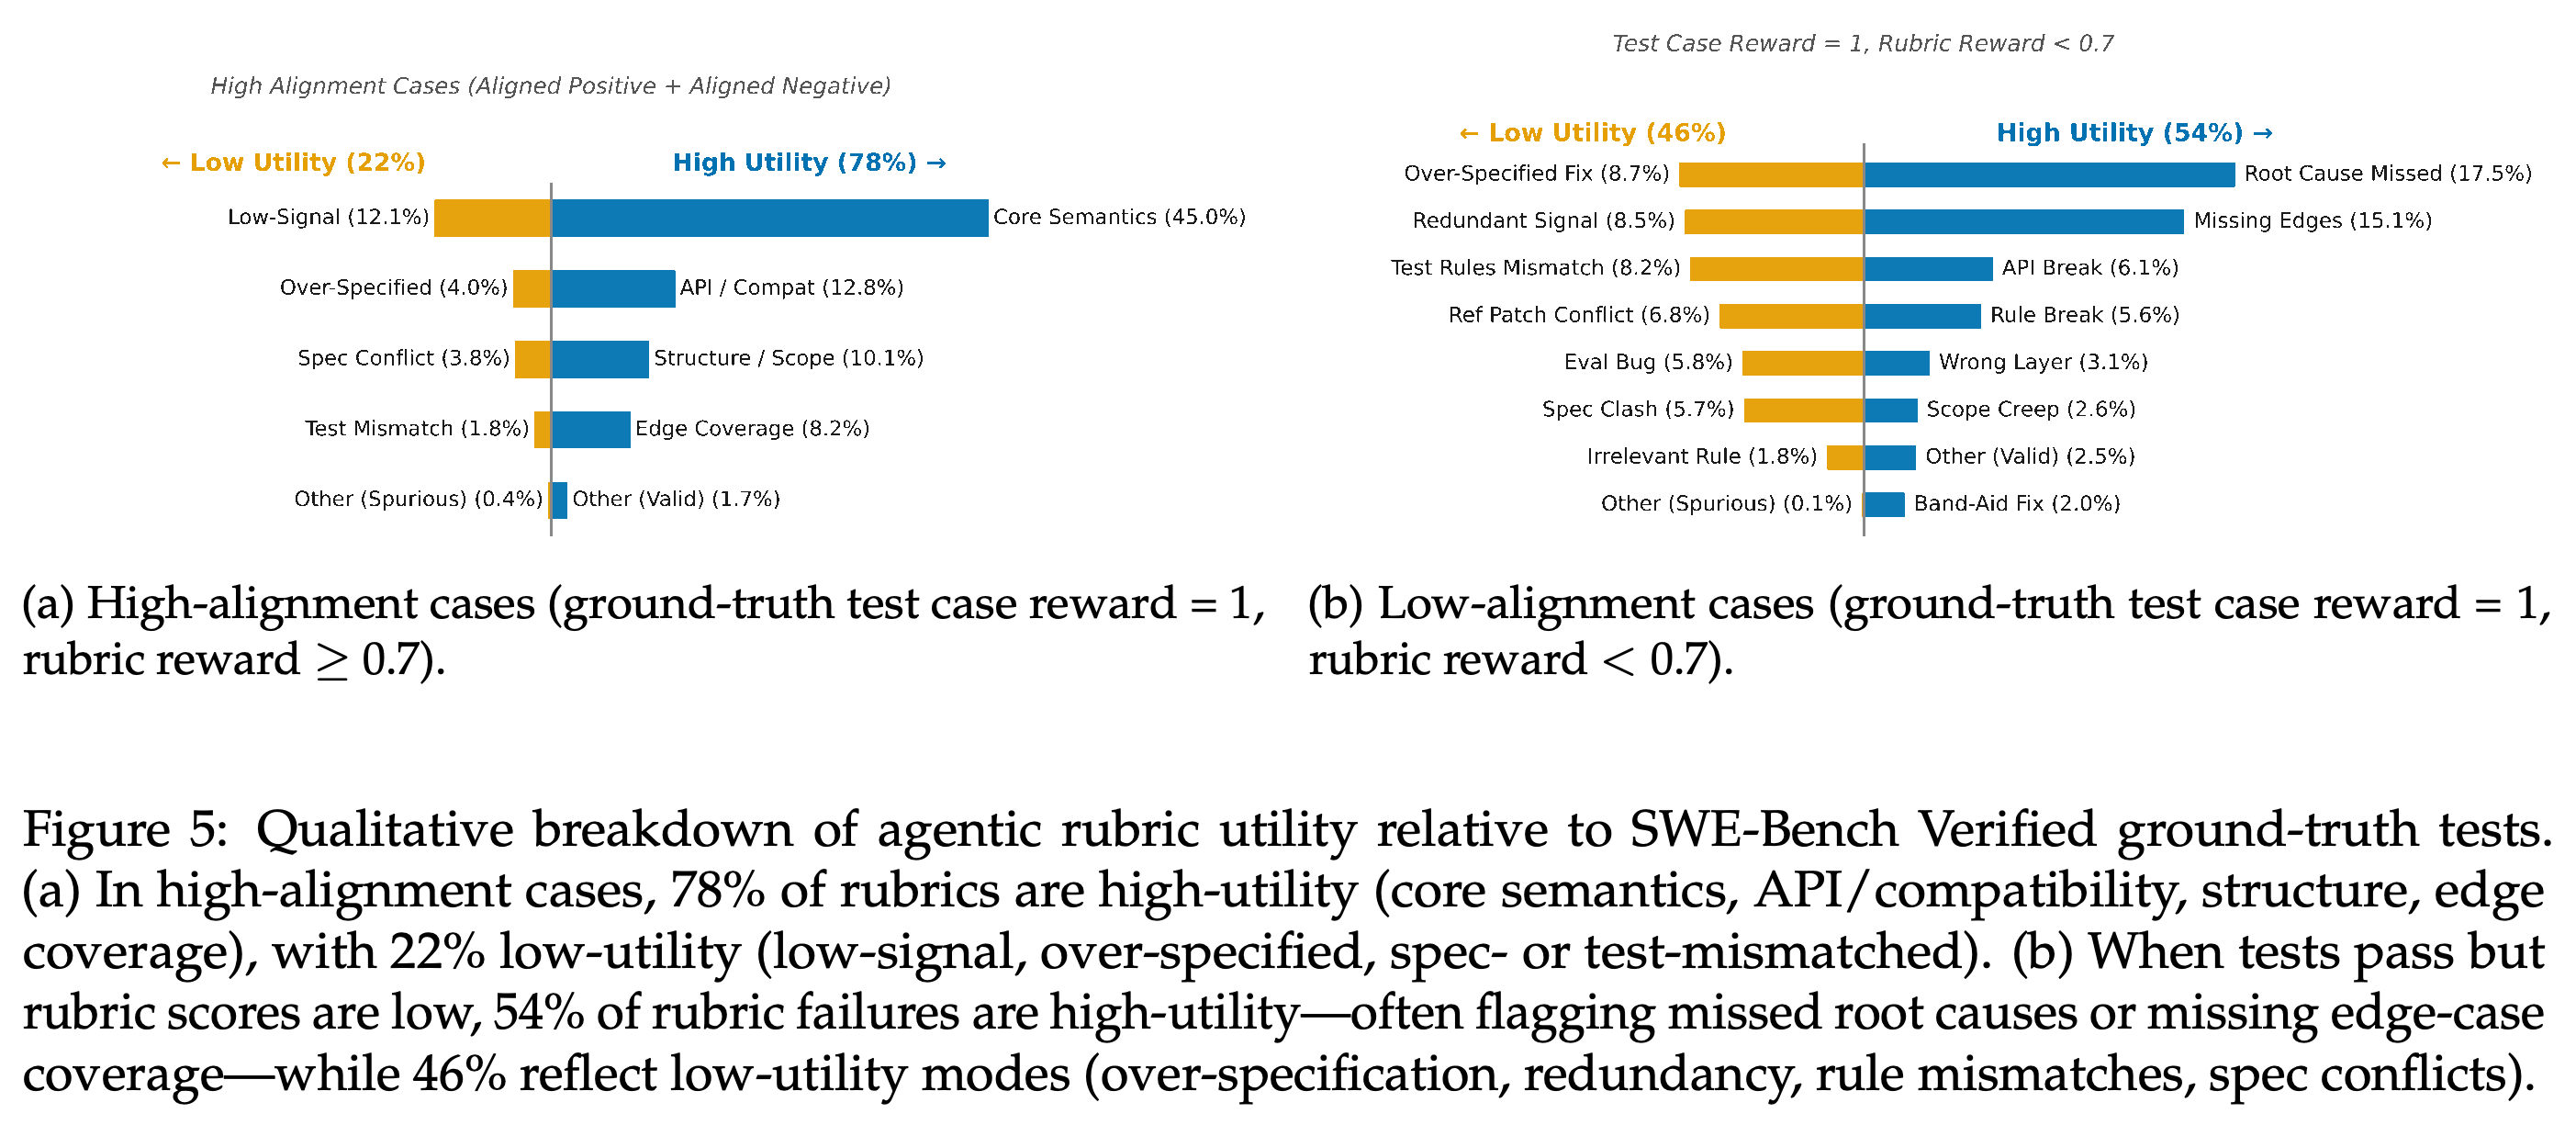
4.2.2 Rubric Utility Analysis에서는 인스턴스 100개로 이루어진 부분집합을 분석한다. GPT-5의 medium reasoning이 이슈, 정답 테스트, 참조 패치를 명세로 사용해 판단을 분류한다. 루브릭 수용 임계값을 0.7로 설정했을 때, 보고된 일치 조건에서 판단의 78%가 높은 유용성으로 분류된다. 테스트는 통과하지만 루브릭 점수가 0.7 미만인 경우에는 루브릭의 불충족 판단 중 54%가 높은 유용성, 46%가 낮은 유용성으로 분류된다.
- 결과가 일치하면서 유용한 판단은 주로 Core Semantics, API/Compatibility, Structure/Scope, Edge Coverage와 관련된다.
- 테스트보다 엄격하면서 유용한 판단은 흔히 Root Cause Missed나 Missing Edges를 지적한다. 유용성이 낮은 사례에는 지나치게 구체적인 수정 요구, 중복 신호, 평가 오류, 명세 또는 테스트와의 불일치가 포함된다.
- 이 비율은 LLM 기반 검토 결과다. 독립적인 인간 판정이나 실행으로 확인한 추가 버그 발견 결과는 아니다.
- Figure 5(a)의 하위 캡션은 test reward = 1과 rubric reward ≥ 0.7을 명시한다. 반면 패널 제목과 본문은 수용과 거부 모두에서의 일치를 설명한다. 따라서 보고된 일치 조건의 정확한 구성은 불명확하다.
모델 기반 검토는 결과가 일치한 판단의 78%, 테스트를 통과한 패치에 대한 루브릭 불충족 판단의 54%를 높은 유용성으로 분류한다. 유용한 불일치에서는 Root Cause Missed와 Missing Edges가 주를 이룬다. 다만 낮은 유용성이 46%이므로, 엄격한 채점이 곧 더 나은 정확성의 증거라고 해석할 수는 없다. 첫 번째 패널의 하위 캡션은 수용한 패치만 설명하지만, 제목과 본문은 결과가 일치한 거부 판단도 포함한다.
5. Ablations
Ablation 실험에서는 루브릭 생성 모델, 저장소 접근, 채점 모델을 바꾼다. 생성 능력, 저장소 맥락 반영, judge의 능력이 최종 패치 선택에 미치는 영향을 평가한다.
5.1 Rubric-Agent Model Choice
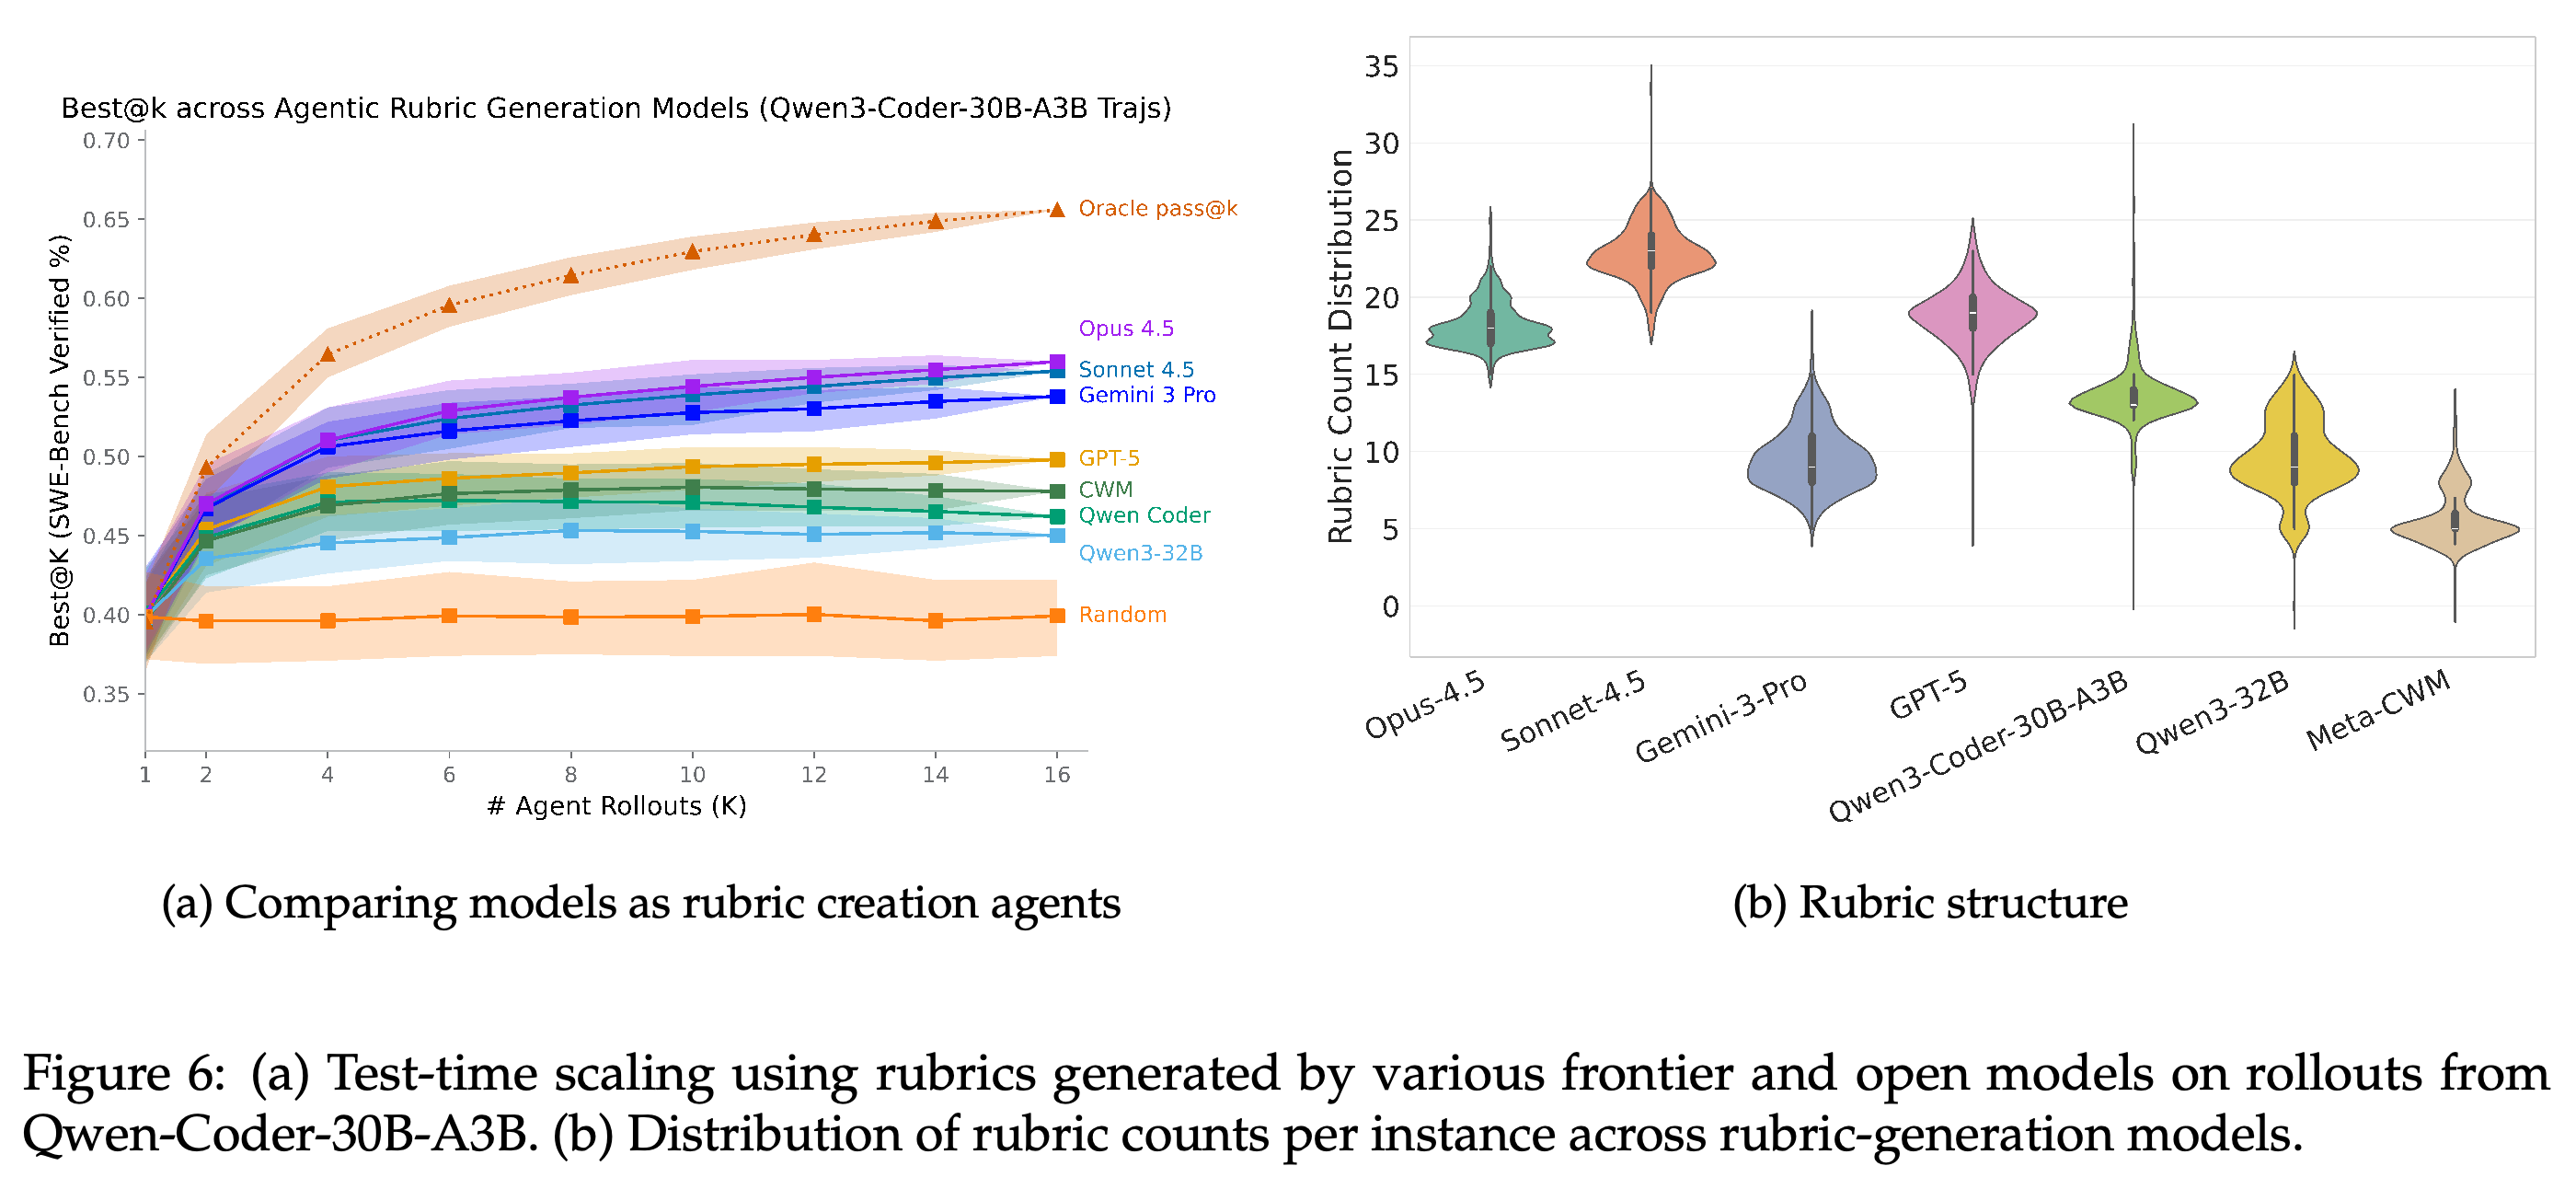
Qwen3-Coder-30B-A3B 후보와 GPT-5 low-reasoning 채점을 고정했을 때, 프런티어 루브릭 생성기는 평가한 오픈 웨이트 생성기보다 성능이 높다. Figure 6에서는 기준 수에도 상당한 차이가 나타난다. Sonnet-4.5는 보통 20개가 넘는 항목을 생성하지만, Qwen3-32B와 Meta-CWM은 더 적은 항목을 생성한다.
- 해당하는 경우 루브릭 생성기는 기본 reasoning effort를 사용한다.
- 기준 수는 선택 성능과 관련이 있지만 성능을 단독으로 설명하지는 못한다. Gemini-3-Pro는 기준을 더 적게 생성하면서도 높은 성능을 유지한다.
- 이 절의 본문은 프런티어 모델 성능을 54%, 오픈 웨이트 코딩 모델을 약 45%, Qwen3-32B를 약 43%로 요약한다. Figure 6에서는 여러 모델의 대략적인 곡선 끝값이 이와 다르므로, 본문의 요약값을 모델별 정확한 측정값으로 읽어서는 안 된다.
- 형식이 잘못되었거나 누락된 산출물에는 0점이 부여되므로 생성 실패도 선택 성능에 영향을 준다.
후보 생성기와 judge를 고정해도 루브릭 생성 모델에 따라 선택 곡선과 기준 수 분포가 달라진다. Gemini-3-Pro는 기준을 더 적게 생성하면서도 높은 성능을 보여, 기준 수만으로 순위를 설명할 수 없음을 드러낸다. 여러 곡선의 끝값이 이 절 본문에서 반올림해 요약한 수치와 다르다. 따라서 그림은 정확한 요약 수치보다 상대적인 성능 양상을 더 분명하게 뒷받침한다.
5.1.1 Training Open-Weight Rubric Agents에서는 Sonnet-4.5의 루브릭 생성 궤적 2,000개로 Qwen3-32B를 미세 조정한다. 온폴리시 루브릭 샘플은 사용하지 않는다. 비교용 분류기에는 R2E-Gym 프롬프트 2,000개와 Sonnet-4.5 및 Qwen3-32B rollout에서 얻은 테스트 라벨 예시 4,696개를 사용한다. 예시의 라벨은 대략 균형을 이루며, 채점에는 YES/NO 토큰 확률을 사용한다.
- 학습에는 AdamW를 사용하며 2 epochs 동안 학습한다. 학습률은 1.0e−5이고 cosine scheduling을 적용한다. batch size는 32이며, 8xH100 GPUs를 갖춘 노드 4개를 사용한다.
- 데이터셋의 감독 신호와 궤적 내용이 다르므로, 정보 예산을 맞춘 비교가 아니라 실용적인 학습 방식의 비교다.
Figure 7에서는 미세 조정한 루브릭 생성기가 기본 버전과 기본·미세 조정 패치 분류기 모두보다 선택 성능이 높다. 미세 조정한 분류기의 곡선은 K가 커지면 평탄해진 뒤 약간 하락한다. 반면 미세 조정한 루브릭의 곡선은 상승한 뒤 대체로 정체된다. 정확한 끝값은 표로 제시하지 않는다.
- 부록 Figure 10에서는 미세 조정 후 유효한 산출물 생성이 개선되고, 기준 수 분포가 교사 모델에 가까워진다.
- 이는 루브릭 생성을 학습으로 개선할 수 있음을 보여준다. 패치 생성 에이전트가 강화학습으로 개선되었음을 보여주는 결과는 아니다.
5.2 Impact of Repository Grounding
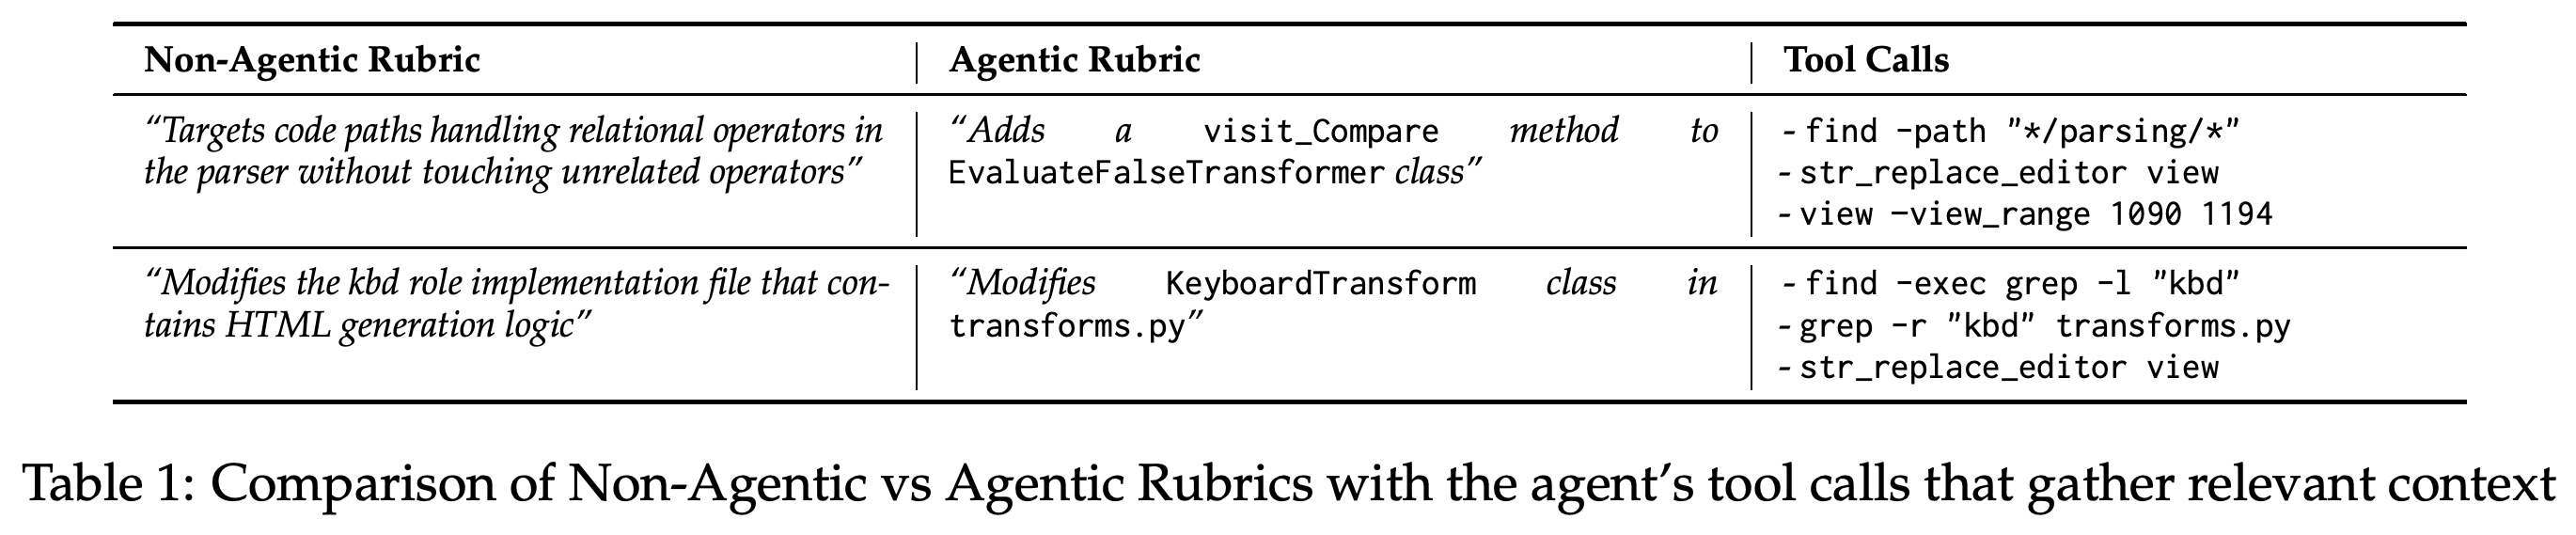
Sonnet-4.5의 루브릭 생성에서 저장소 접근을 제거하면 BEST@16이 Qwen3-32B 후보에서 4.0%포인트, Qwen3-Coder-30B-A3B 후보에서 1.4%포인트 감소한다. Table 1은 저장소 맥락을 활용하면 일반적인 설명이 EvaluateFalseTransformer의 visit_Compare, transforms.py의 KeyboardTransform 같은 구체적인 심볼과 연결된 확인 항목으로 바뀐다는 점을 보여준다.
- 검색과 파일 확인 호출을 통해 이슈만으로 만든 루브릭에는 없는 구현 요소의 이름을 파악한다.
- 이 ablation 실험은 맥락 수집의 이점을 뒷받침한다. 다만 구체적인 수정 위치 요구는 유용성 분석에서 발견한 지나친 구현 제약을 유발할 수도 있다.
저장소 검색과 파일 확인은 일반적인 기준을 EvaluateFalseTransformer의 visit_Compare와 transforms.py의 KeyboardTransform을 명시하는 확인 항목으로 바꾼다. 이 예시는 저장소 맥락을 기준에 반영하는 방식을 설명한다. 선택 성능 개선의 정량적 근거는 저장소 접근 ablation 실험에서 제공한다.
5.3 Sensitivity to Judge Model Choice
Table 2의 BEST@16은 GPT-5-mini에서 52.6 ± 2.20, GPT-5 Low Reasoning에서 54.2 ± 2.22, GPT-5 Medium Reasoning에서 54.3 ± 2.25, GPT-5 High Reasoning에서 55.0 ± 2.21이다. 차이가 크지 않다는 점은 이 실험에서 low reasoning이 실용적인 채점 선택임을 뒷받침한다. 다만 통계적으로 유의한 순위를 입증하지는 않는다.
- 이 절의 본문은 Qwen3-32B 후보를 명시하지만, Table 2의 캡션은 Qwen3-Coder-30B-A3B를 명시한다. 여기서는 표에 명시된 조건에 따른 수치로 다룬다.
- 논문은 이 표의 ± 값이 무엇을 뜻하는지 정의하지 않는다.
- Appendix A.4에서는 반복 채점의 결정성을 별도로 평가한다.
6. Related Work
관련 연구에서는 저장소 기반 코딩 벤치마크와 에이전트 프레임워크를 테스트 시점 확장, 학습된 패치 검증기, 생성된 테스트와 연결한다. 또한 루브릭 기반 LLM 평가와 루브릭 보상 연구 속에서 이 방법의 위치를 설명한다. 저장소를 고려한 기준 생성을 SWE 패치 선택으로 평가한다는 점을 이번 연구의 차별점으로 제시한다.
7. Conclusion
결론은 병렬 테스트 시점 선택에서 가장 직접적으로 뒷받침된다. 저장소 맥락에 근거한 루브릭은 평가한 검증기보다 성능이 높고, 검토 가능한 기준별 판단을 제공한다. 정합성 분석과 예시는 보완적인 진단 가치를 시사하며, 지도 증류는 오픈 웨이트 루브릭 생성기를 개선한다. 루브릭 보상을 사후 학습에 통합하는 일은 향후 과제로 남는다.
8. Limitations
논문은 루브릭 신호를 강화학습 사후 학습에 통합하지 않는다. 보상 해킹, 정책이 개선되면서 발생하는 비정상성, 다단계 에이전트 행동에 대한 기여도 할당은 향후 과제로 남긴다.
- 자동 생성한 루브릭은 중복되거나 구현 방식을 지나치게 제한할 수 있고, 테스트 및 의도한 동작과 불일치할 수 있다. 인간 검토, 편집, 템플릿 재사용, 특정 문제를 겨냥한 개선을 제안하지만 평가하지는 않는다.
- 실험 범위는 SWE-Bench Verified와 고정된 후보 생성기 2개다. 더 폭넓은 저장소나 개방형 소프트웨어 작업으로의 일반화는 입증하지 않는다.
- 실행 없는 채점도 산출물을 만드는 데 필요한 초기 저장소 샌드박스와 전문가 모델 비용을 없애지는 않는다.
부록
- A.1 Analyzing agentic rubric scores against Ground-Truth patch의 Table 3은 사람이 작성한 패치의 평균 가중 점수를 보고한다. Opus-4.5는 0.8658, GPT-5는 0.8413, Sonnet-4.5는 0.8233, Gemini-3-Pro는 0.8082, Meta-CWM은 0.8015, Qwen3-Coder-30B-A3B는 0.8037, Qwen3-32B는 0.6729다. Figure 8은 대표적인 부분집합의 점수를 평가 축별로 나누며, 특히 File Change의 정합성이 고르지 않음을 보여준다.
- A.2 Agentic abilities of rubric generation models의 Figure 9에서 파싱 가능한 파일의 비율은 Opus-4.5 97.6%, Sonnet-4.5 99.4%, Gemini-3-Pro 96.8%, GPT-5 86.2%, Qwen3-Coder-30B-A3B 88.2%, Qwen3-32B 74.6%, Meta-CWM 69.4%다. 반면 함께 제시된 본문은 Sonnet-4.5를 97.8%로 보고한다. Figure 10에서는 Qwen3-32B를 미세 조정하면 파싱 가능 비율이 88.8%로 높아지고 파싱 오류가 18.2%에서 3.6%로 감소한다. 기준 수 분포도 교사 모델의 분포에 가까워진다.
- A.3 Cost analysis for agentic verification methods의 Table 4는 산출물 비용, 후보당 채점 비용, 평균 API 호출 수를 보고한다. Patch Similarity는 $0.640/$0.006/48.5, Tests는 $0.499/$0.001/29.2, Rubrics는 $0.245/$0.003/22.9다. 전체 BEST@16 검증 비용은 각각 $0.736, $0.515, $0.293 per instance로 보고한다. 테스트 채점에는 Modal에서의 샌드박스 실행이 포함된다. 이 비교에서는 대리 패치 생성에 50단계를 부여하며, 주요 비교의 30보다 많다. Qwen3-32B 선택 결과는 36.6%로 보고하며, 주요 비교의 35.0%와 다르다. 따라서 주요 기준선 설정과 조건이 다르다.
- A.4 Rubric Flakiness Study에서는 Sonnet-4.5와 Qwen3-32B 각각에서 인스턴스 20개와 인스턴스당 기준 5개를 샘플링한다. 이어서 기준 100개 각각을 GPT-5 low reasoning으로 독립적으로 5회 채점한다. 채점 결과에 불일치가 있으면 해당 항목을 불안정한 것으로 표시한다. 이 비율은 Sonnet-4.5 기준에서 2%, Qwen3-32B 기준에서 9%다. 이는 정확성보다는 채점 안정성에 대한 소규모 표본 근거다.
- A.5 Hybrid verifiers using rubrics v/s classifier의 Figure 11에서는 Agentic Rubrics와 Agentic Tests를 결합한 방법이 각각의 단독 사용과 분류기·테스트 결합보다 높은 성능을 보인다. 부록은 정확한 향상 폭을 표로 제시하지 않고 집계식도 명시하지 않아, 하이브리드 결과의 재현에 한계가 있다.
- A.6 Categories of rubric utility classification의 Table 5는 검토한 rollout과 실패 유형을 바탕으로 수작업으로 만든 분류 체계를 제시한다. 높은 유용성 범주는 Rule Break, Band-Aid Fix, Wrong Layer, Root Cause Missed, Missing Edges, Scope Creep, Perf Risk, API Break, Security Risk다. 낮은 유용성 범주는 Test Rules Mismatch, Over-Specified Fix, API Over-Strict, Style Nit, Spec Clash, Ref Patch Conflict, Redundant Signal, Eval Bug, Irrelevant Rule다.
- A.7 SWE Agent Setup에서 모든 에이전트 기반 방법은 SWE-Agent를 사용하고, 5턴마다 남은 턴 수를 알려준다. 저자들은 응답 파싱을 수정해 도구 사용과 함께 턴별로 짧은 계획 요약을 요구한다. 이는 루브릭 생성 궤적의 수집과 증류를 돕는다.
- A.8 Rubric and their grading - Illustrative Examples의 matplotlib__matplotlib-26291 후보는 renderer=None이거나 특정 렌더링 오류가 발생하면 크기가 0인 bounding box를 반환한다. 이를 통해 보고된 실행 오류를 피하고 정답 테스트를 통과한다. 논문은 이 우회 방식 때문에 tight layout이 inset을 무시하게 된다고 주장한다. 이는 R4의 위치 요구사항, SA4의 절대·상대 크기 요구사항, SA5의 bbox_inches=”tight” 요구사항, R3의 하위 호환성 요구사항과 충돌한다.
- A.9 Rubric Examples and grading에서는 테스트를 통과했지만 루브릭 점수가 낮은 패치 3개의 diff와 기준별 결과를 제시한다. matplotlib__matplotlib-26291의 크기 0 bounding box 우회 방식은 동작 관련 감점과 self.figure를 설정하지 않았다는 구현 방식 관련 감점을 모두 받는다. matplotlib__matplotlib-25332에서 Grouper의 pickle 메서드를 추가한 패치는 Grouper 동작, 반복적인 레이블 정렬, 가비지 컬렉션으로 회수된 axes 관련 감점을 받는다. 이와 함께 figure.py를 수정하고 테스트를 추가하라는 구현 방식 지정도 받는다. django__django-13417의 반복적인 clear_ordering(True) 호출은 기존 정렬 동작 유지와 상태 변경에 대한 감점을 받으며, 지정된 위치에서 QuerySet.ordered를 수정하라는 요구도 받는다.
- A.10 Prompts - Baselines and Agentic Rubrics는 Agentic Patch Similarity (Rollout Generation), Agentic Patch Similarity (Judge), Agentic Rubrics, Agentic Tests, Patch Classifier, Non-Agentic Rubrics를 문서화한다. 각각 최소한의 대리 수정, 1–5 유사도 채점, 파싱 가능한 rubrics.yaml 기준, 독립 실행 가능한 test_issue.py 생성, YES/NO 분류, 이슈만을 이용한 루브릭 생성을 명시한다. 루브릭 생성 문서는 원자성, 독립적인 이해 가능성, 저장소별 구체성, 중복 집계 방지를 명시적인 설계 요구사항으로 둔다.
- A.11 Rubric Judge Prompt의 채점 인터페이스는 PR_DESCRIPTION, PATCH, RUBRIC을 제공하고, 기준 식별자마다 이진 충족 점수 1개를 요구한다. 채점기가 실행 결과나 전체 에이전트 궤적이 아니라 패치 텍스트를 받는다는 점을 확인할 수 있다.
- A.12 Rubric Utility Analysis Prompt의 유용성 분류기는 이슈, 정답 패치, 후보 패치, 정답 테스트, 테스트 보상, 루브릭 설명, 선택된 기준 식별자를 받는다. 판단을 Valid 또는 Spurious로 분류하고 하위 범주와 근거에 기반한 설명을 제공한다. 제시된 템플릿은 결과가 일치하는 긍정·부정 판단에 초점을 맞춘다. 따라서 본문에서 설명한, 테스트보다 엄격한 판단을 별도로 검토하는 절차를 완전히 문서화하지는 않는다.
짧은 생각
핵심 기여는 저장소 맥락과 관련된 근거 수집을 반복적인 패치 채점과 분리한 것이다. 저장소 접근 ablation 실험, 후보 생성기 2개에서의 선택 성능 향상, 측정한 검증 비용은 best-of-K 선택에 이 설계를 사용하는 것을 뒷받침한다. 명시적인 기준은 단일 분류기 점수와 달리 패치가 감점된 이유도 드러낸다.
루브릭은 보완적인 근거를 제공하지만 실행으로 정확성을 보장하지는 않는다. 테스트보다 엄격하게 거부한 판단 중 낮은 유용성의 비율이 46%라는 점, 유용성 라벨이 모델 기반이라는 점, 여러 조건의 보고가 일관되지 않다는 점에 유의해야 한다. 하이브리드 검증기 결과는 루브릭을 테스트의 완전한 대체재로 보기보다 테스트와 결합하는 접근을 뒷받침한다.