


Two-Level Meta-Rubrics for Evaluating Open-Ended Generation: GAMUT, a Benchmark for Factual Completeness 요약 설명
21 Jul 2026 | Paper Review LLM Evaluation Factual Completeness Multimodal Learning Rubric-Based Evaluation목차
- 요약
- 3 A Two-Level Meta-Rubric Framework for Evaluating Open-Ended Generation
- 4 Dataset Construction
- 5 Evaluating Models on Gamut
- 6 Dataset Analysis
- 부록
- 짧은 생각
이번 글에서는 Two-Level Meta-Rubrics for Evaluating Open-Ended Generation: GAMUT, a Benchmark for Factual Completeness 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 7월 21일(Arxiv)
- Chen, Xilun, Feizollahi, Zhaleh, Goodwin, Ross, Moon, Seungwhan, Yih, Scott, Donmez, Pinar, Damavandi, Babak, Dong, Luna.
- Meta AI
- 논문 링크
- Github
요약
- GAMUT는 답변에 포함된 주장 정확도만이 아니라 개방형 장문 답변의 사실적 완전성을 평가한다. 이 벤치마크는 10개 도메인의 이미지 기반 일상 심층 조사 질문 1,813개와 전문가가 검증한 근거 기반 루브릭으로 구성된다. 평가한 14개 모델 중 Gemini 3.1 Pro가 58.7%로 최고 점수를 기록한다.
3 A Two-Level Meta-Rubric Framework for Evaluating Open-Ended Generation
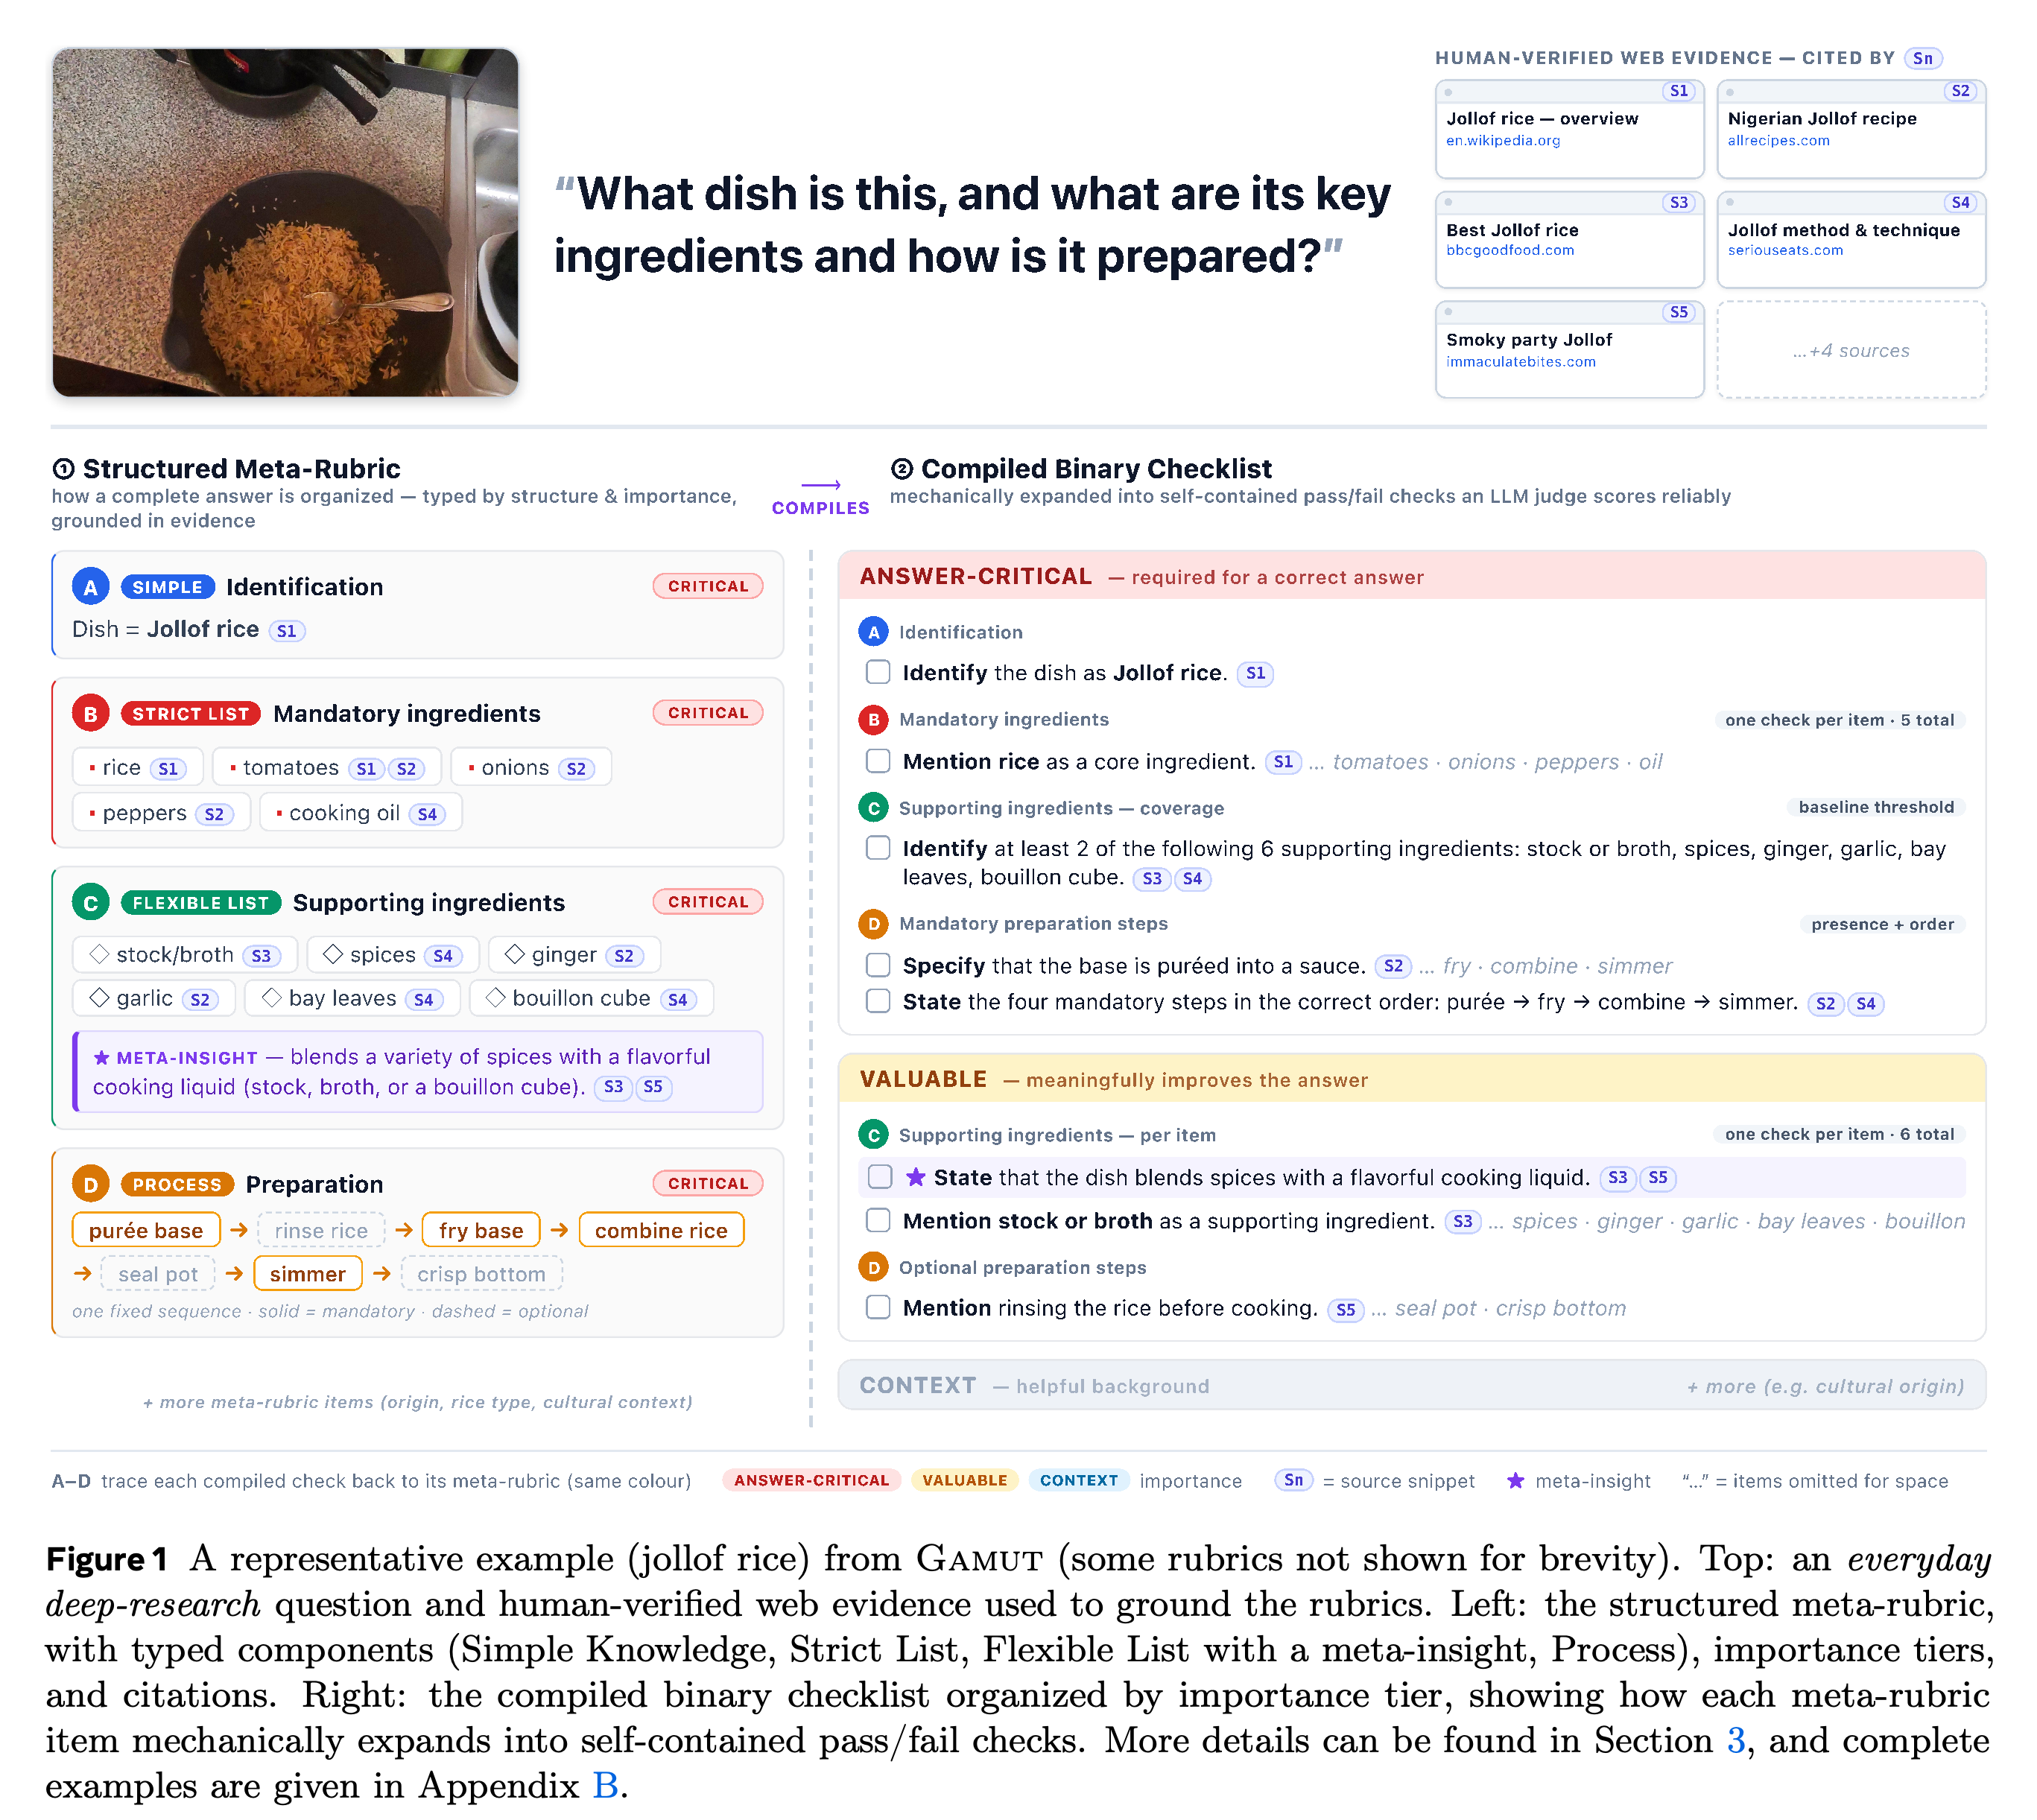
이 프레임워크는 표현력 있는 루브릭 작성과 신뢰할 수 있는 자동 채점을 분리한다. 구조화된 메타 루브릭은 완전한 답변의 구성을 기록하고, 고정된 기계적 규칙은 이를 LLM 심사자가 사용할 수 있는 독립적인 이진 점검 항목으로 변환한다.
3.1 Meta-Rubrics
각 메타 루브릭 항목에는 Answer-Critical, Valuable, Context 중 하나의 중요도 등급과 Simple Knowledge, Strict List, Flexible List, Process, Relationship 중 하나의 5가지 유형이 있다. 목록과 과정에는 개별 사실로 환원할 수 없는 항목 간 종합인 메타 인사이트도 포함될 수 있다.
3.2 From Meta-Rubrics to Binary Rubrics
Simple Knowledge는 1개 점검 항목이 되고, Strict List는 필수 항목마다 1개 점검 항목이 된다. Flexible List에는 독립적인 포괄성 임곗값과 더 폭넓은 포괄성에 대한 하위 등급 점수를 부여한다. Process에서는 단계 존재 여부와 순서 점검 항목을 만들고, Relationship과 메타 인사이트는 원자적 점검 항목으로 분해한다.
Jollof rice 사례는 사람이 검증한 발췌문이 유형화된 메타 루브릭과 등급별 이진 점검 항목으로 이어지는 과정을 보여 준다. 필수 재료는 개별 critical 점검 항목이 되고, 보조 재료는 포괄성 임곗값과 하위 등급의 항목별 점수가 되며, 조리 과정은 2단계 점검 항목과 순서 점검 항목이 된다.
3.3 Scoring
각 이진 점검 항목에서 심사자는 meets, partially meets, missing, contradicts 중 하나를 반환한다. 등급별 점수는 부분 충족에 λ = 0.5, 모순에 µ = −2를 적용한 뒤 Answer-Critical, Valuable, Context 등급을 각각 0.6, 0.3, 0.1의 가중치로 결합한다. 없는 등급의 가중치는 남은 등급에 재분배한다.
4 Dataset Construction
데이터셋 구축은 프런티어 LLM의 제안과 여러 차례의 전문가 인간 검토를 결합한다. 실제 웨어러블 이미지에서 질문을 만들고, 루브릭을 조사·구조화·변환·개선한 뒤 인용한 웹 근거와 대조해 검토하고 공개한다.
4.1 Question Creation
저자들은 10개 일상 도메인에 걸친 CRAG-MM 이미지 1,938개로 시작하며, 이 가운데 약 80%는 자아중심 시점의 스마트 글래스 사진이다. Gemini 3.1 Pro는 조사가 많이 필요하고 이미지에 의존하는 질문을 제안한다. 2명의 주석자가 각 후보를 검토하고, 3번째 주석자가 이견을 조정하며, 자동 단계가 채택한 질문을 필터링·순위화·다양화한다.
4.2 Rubric Creation
각 채택 질문에 대해 Gemini 3.1 Pro는 웹을 조사하고 근거 발췌문을 포함한 메타 루브릭 초안을 작성한 뒤 이를 이진 점검 항목으로 변환한다. 자기 개선 단계는 출처를 다시 검증하고 누락된 근거를 독립적으로 검색한다. 이후 사내 주석자들이 2차례의 인간 검토를 거쳐 루브릭과 인용을 수정한다. 12개 예시를 수정하고 타당하지 않은 사례를 제거해 1,813개 질문이 남는다.
5 Evaluating Models on Gamut
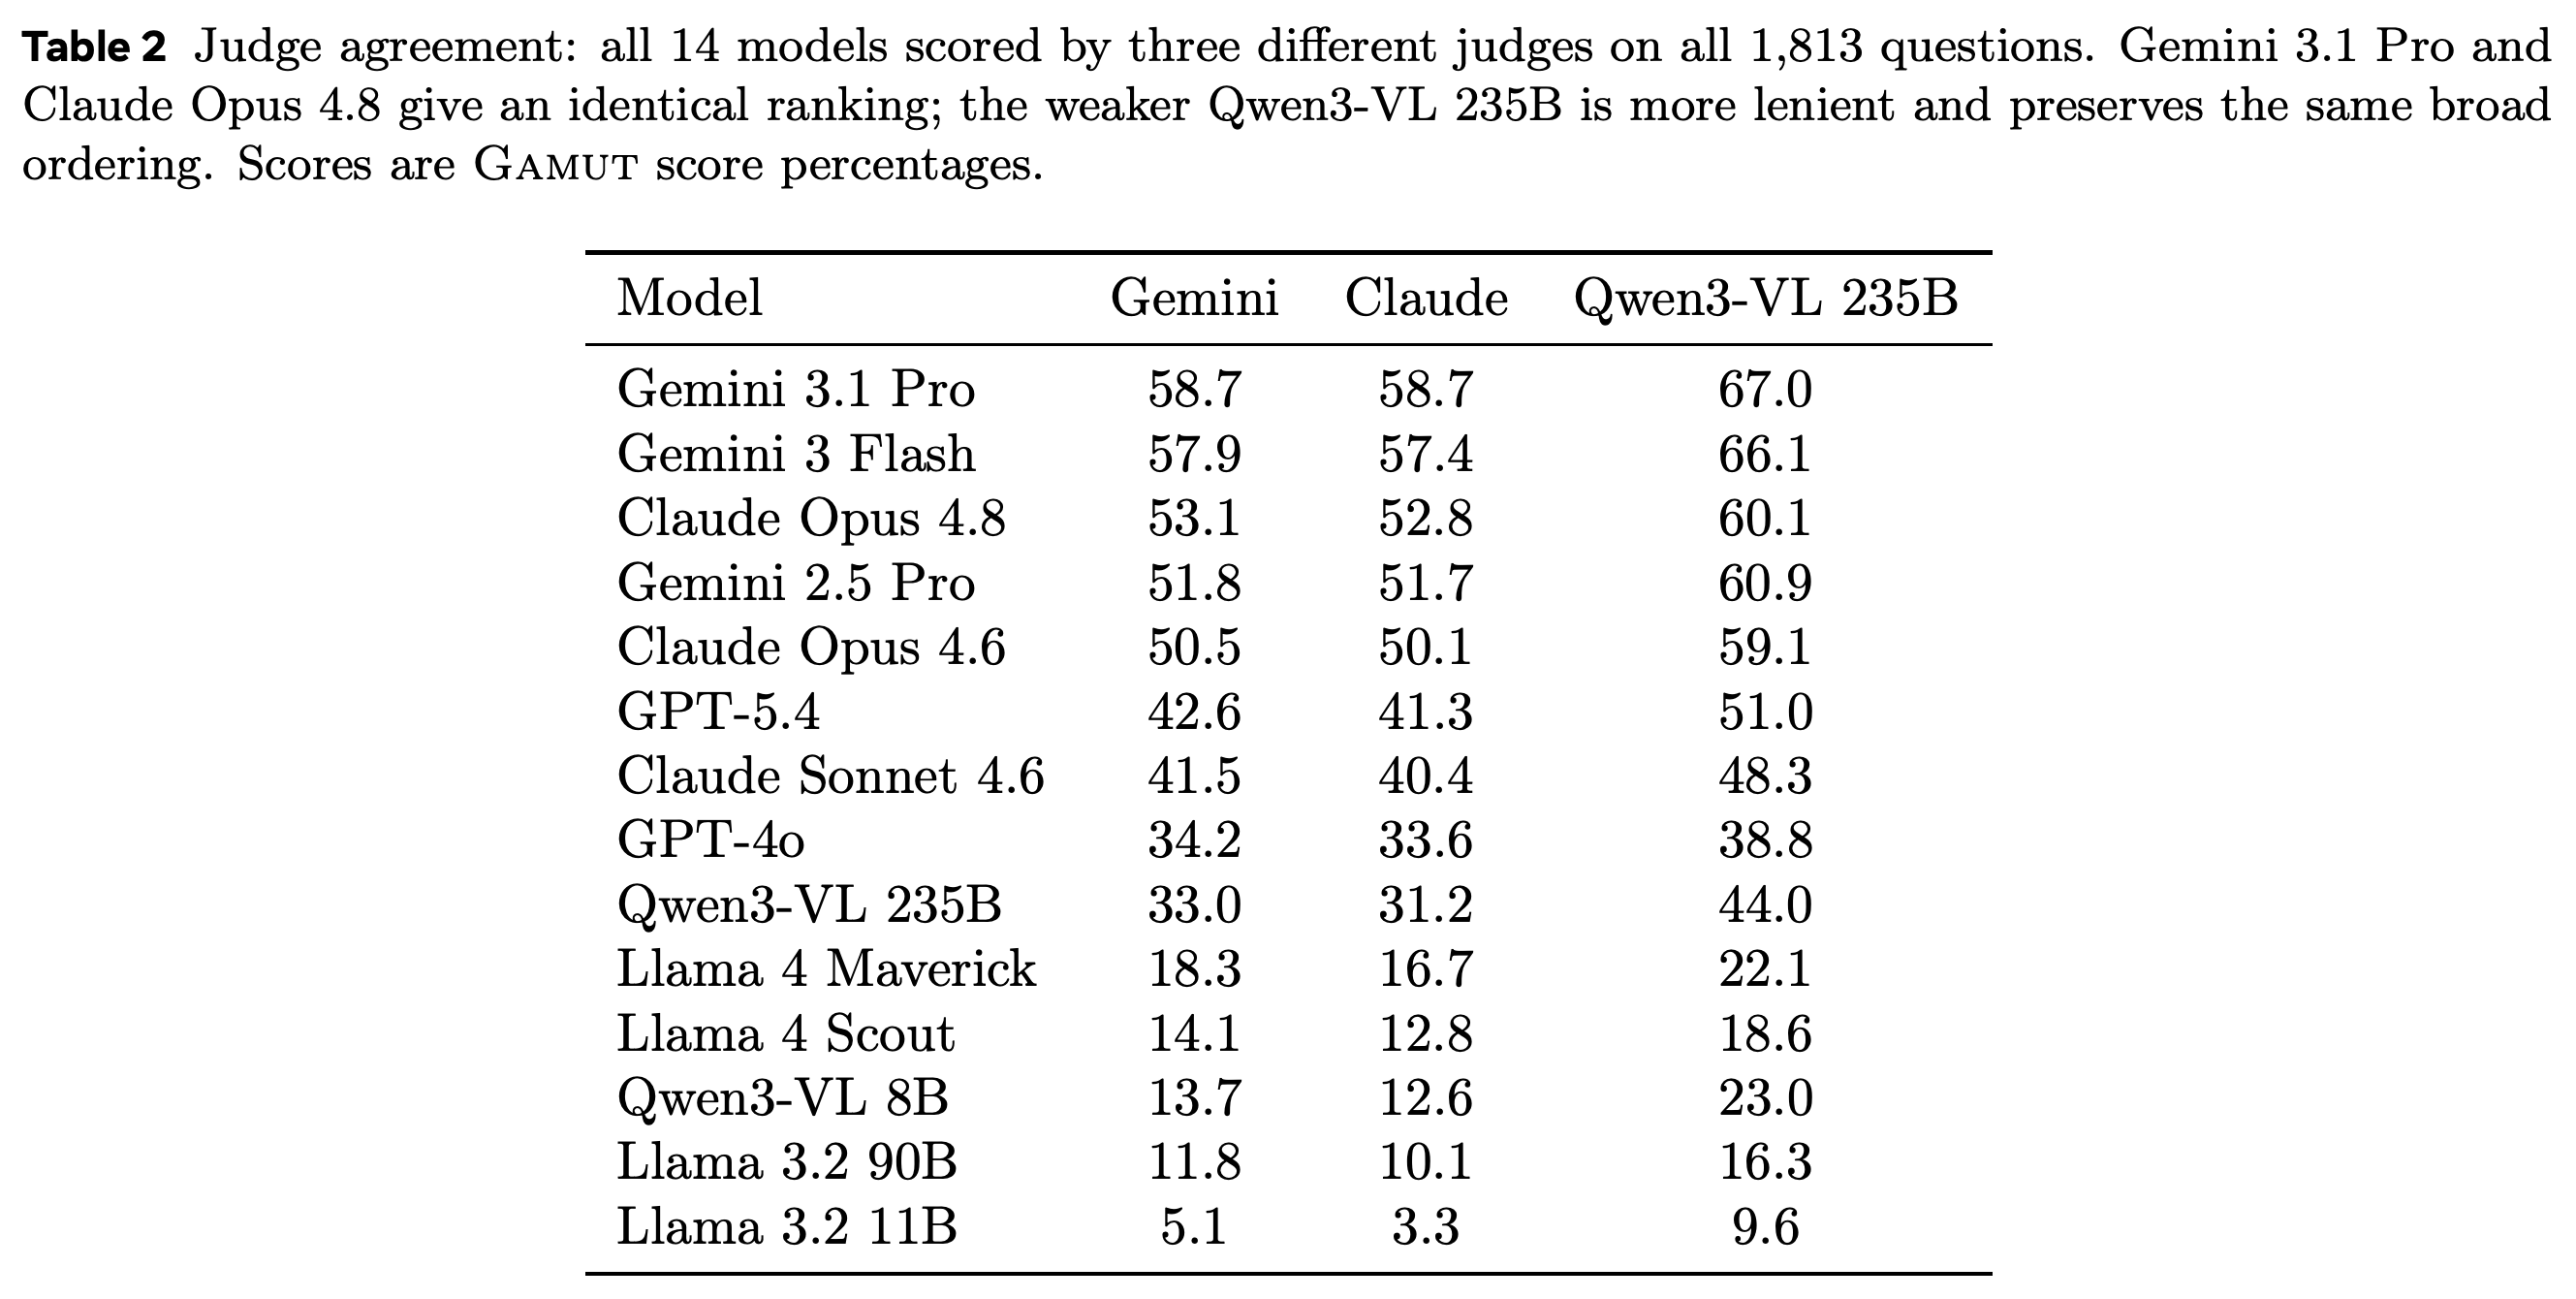
모델은 이미지와 질문을 바탕으로 답변하고, Gemini 3.1 Pro는 정의된 채점 절차로 변환된 각 점검 항목을 심사한다. 저자들은 모델 순위가 평가자에 의존하는지 확인하기 위해 Claude Opus 4.8과 Qwen3-VL 235B도 심사자로 사용한다. 이미지와 질문을 바탕으로 답변에 대해서는 이 글을 참조하라.
5.1 Main Results
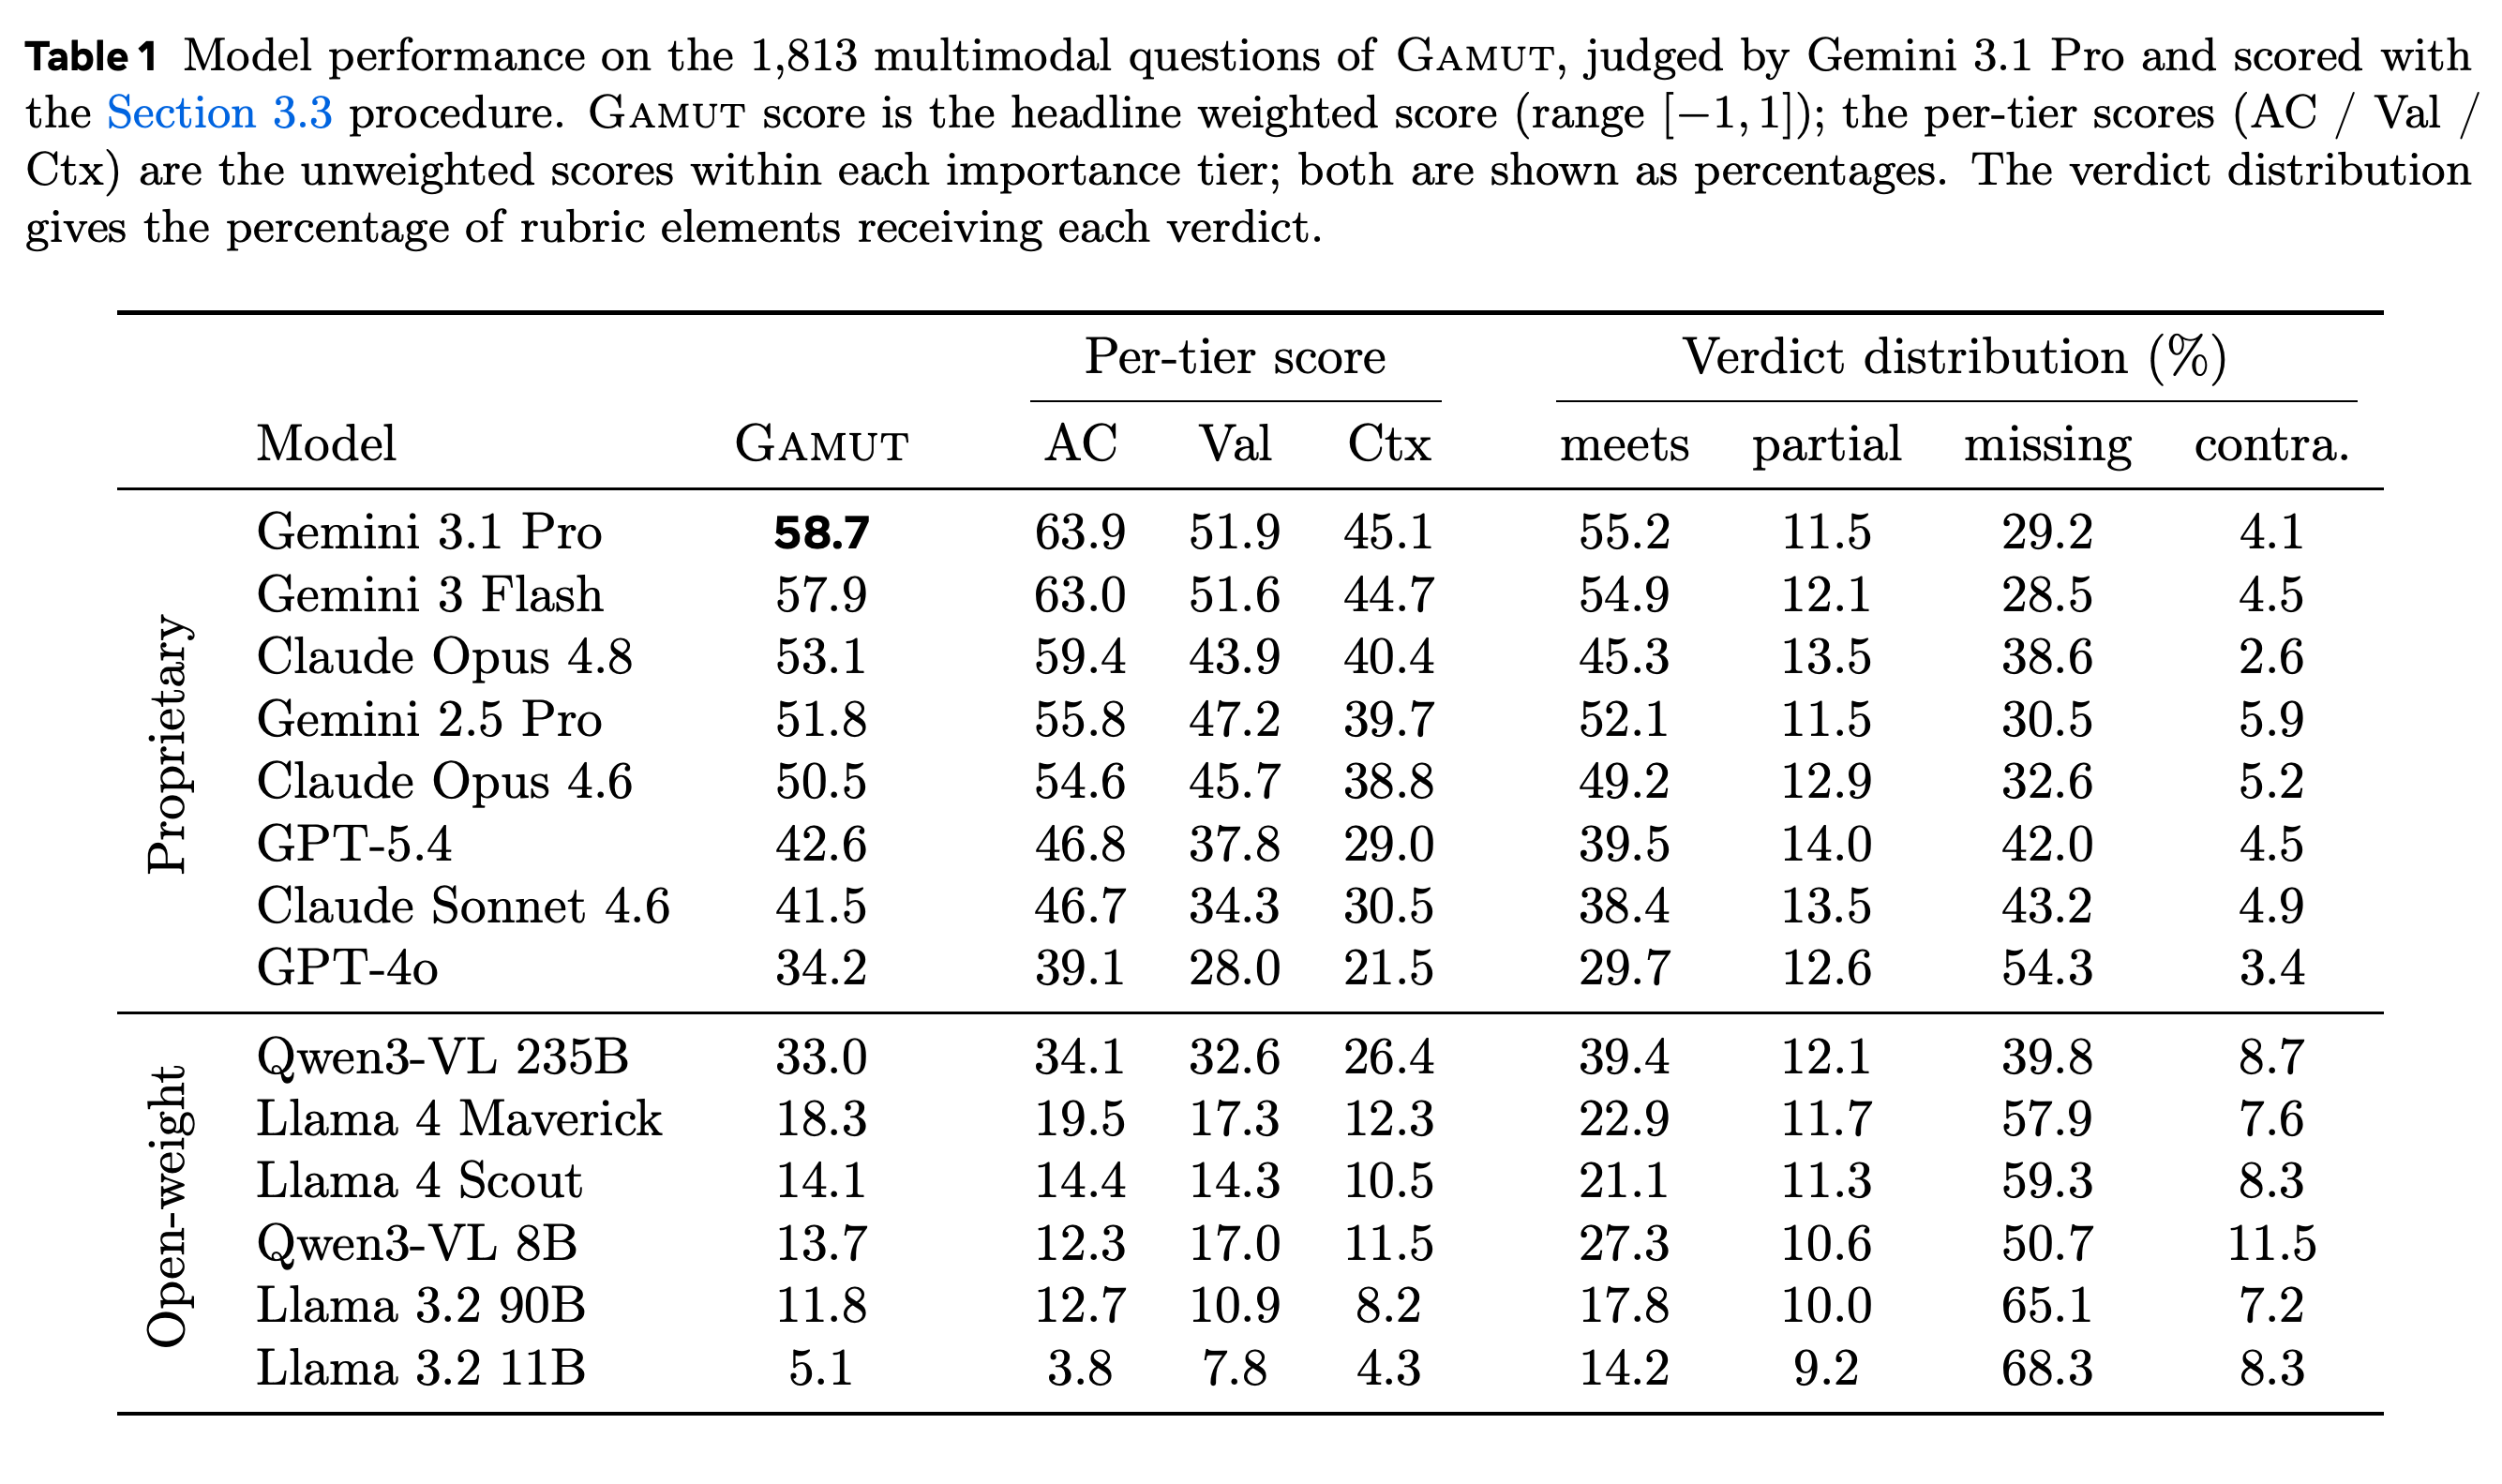
GAMUT는 어렵고 변별력이 높다. Gemini 3.1 Pro가 58.7%로 선두이며, 이 모델도 루브릭 요소의 55.2%만 완전히 충족한 것으로 판정된다. Gemini 3.1 Pro와 Claude Opus 4.8은 동일한 순위를 만들고 모델별 점수 차이는 1.8점 이내다. Qwen3-VL 235B는 4–11점 더 관대하지만 전반적인 순위를 유지한다. 누락이 실패의 대부분을 차지하며, 성능이 낮은 모델은 모순 비율도 더 높다.
이 표는 주요 멀티모달 벤치마크 순위와 등급별 성능, 판정 분포를 제시한다. Gemini 3.1 Pro는 58.7%로 가장 높고 Llama 3.2 11B는 5.1%를 기록하며, 모든 모델에서 누락 점검 항목이 널리 나타난다.
3명의 심사자를 비교한 결과는 주요 순위가 하나의 평가자만으로 생긴 결과가 아님을 보여 준다. Gemini 3.1 Pro와 Claude Opus 4.8은 같은 순위를 부여하며, Qwen3-VL 235B는 절대 점수를 더 높게 부여하지만 전반적인 순위를 유지한다.
5.2 A Text-Only Variant
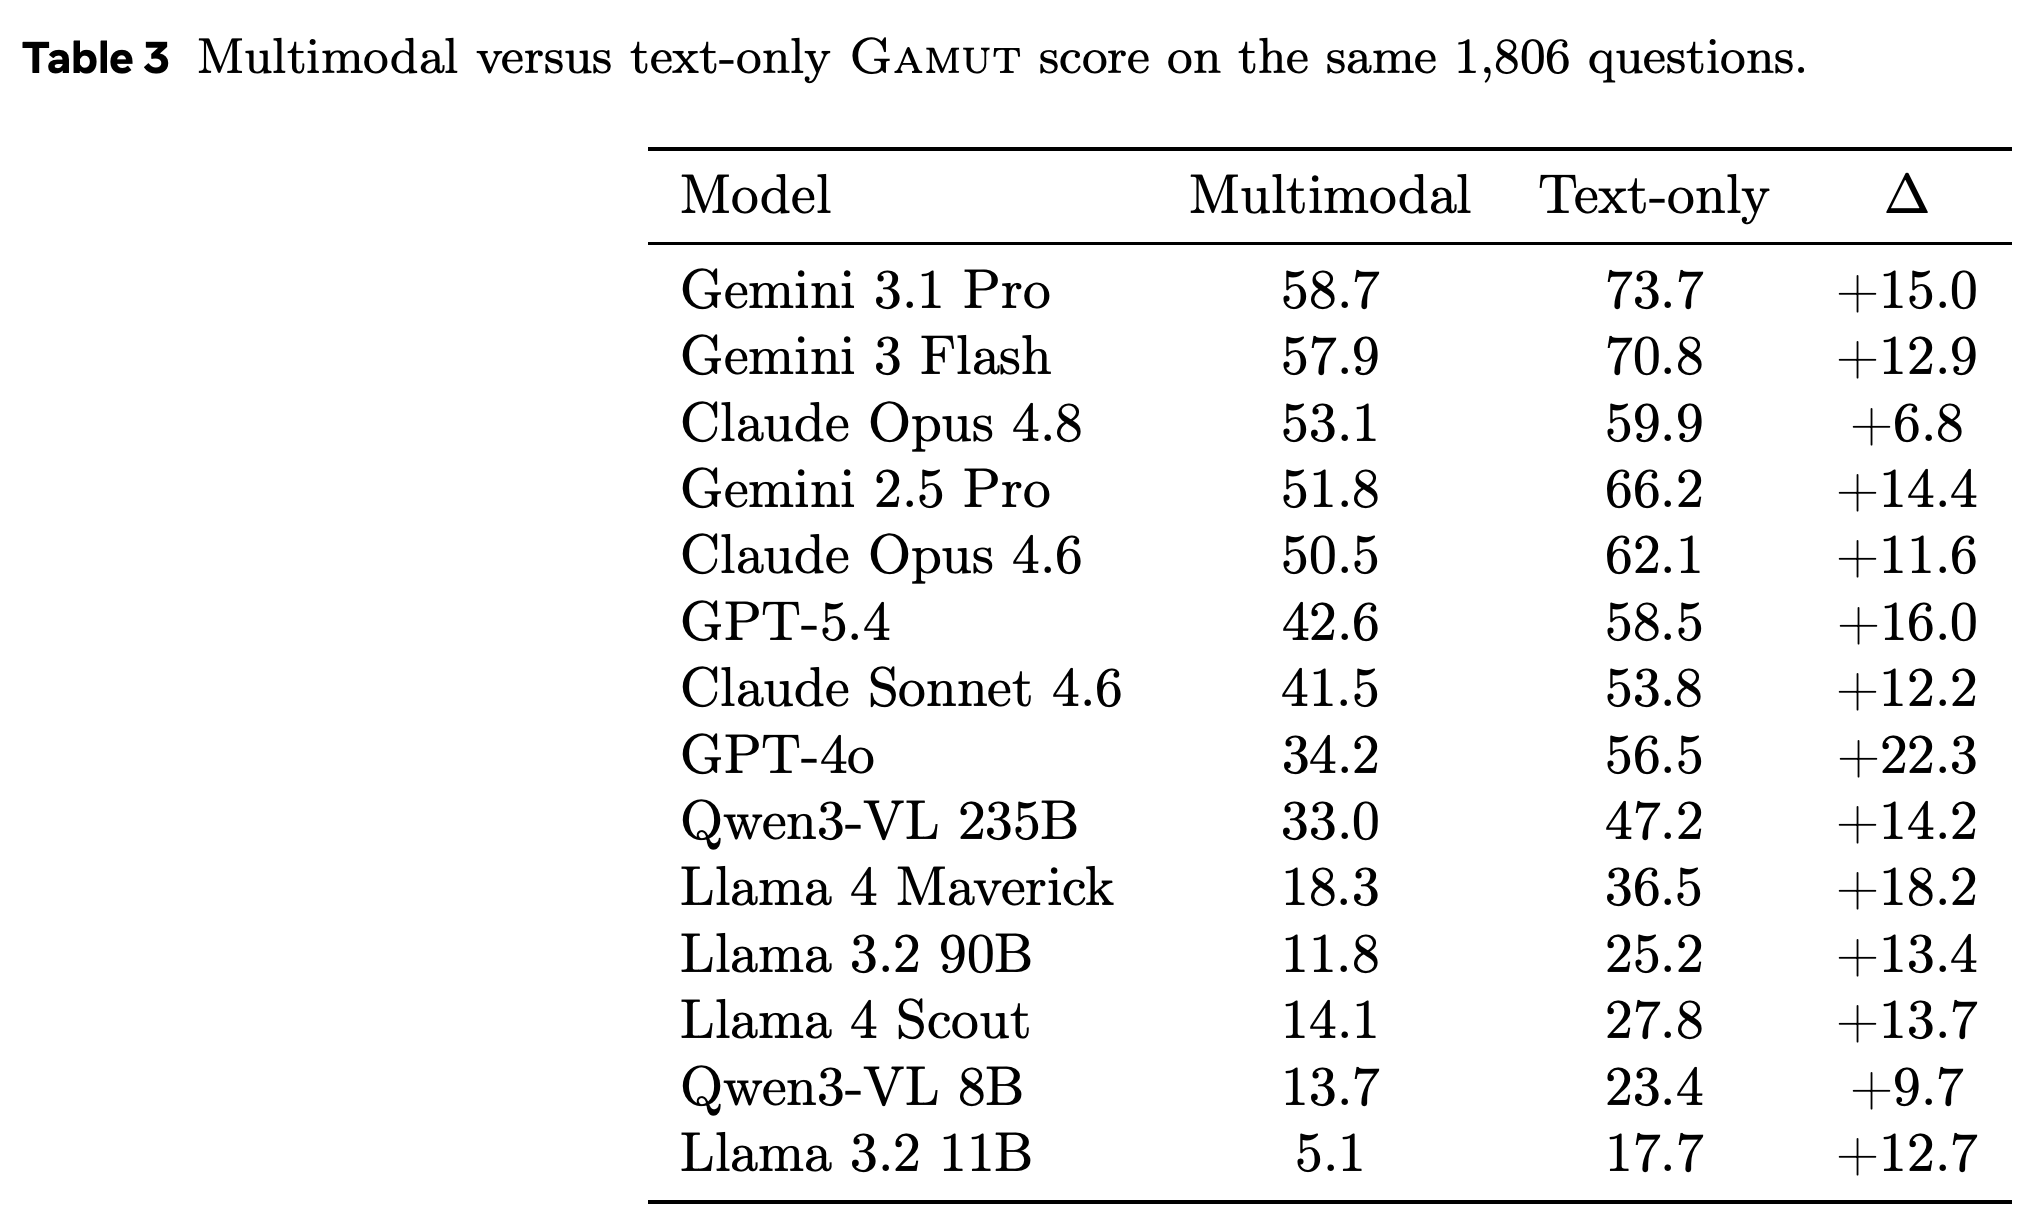
텍스트 전용 변형은 각 개체를 명시하고 자명해지는 식별 기준을 제거한다. 이미지 의존적인 질문 7개를 제외해 1,806개 질문이 남는다. 모든 모델의 성능이 대체로 약 10–20점 향상하며, 전반적인 순위는 유지된다.
텍스트 전용 조건에서 대상을 명시하면 모든 모델의 점수가 상승한다. 상승폭은 Claude Opus 4.8의 +6.8부터 GPT-4o의 +22.3까지다. 전반적으로 유지된 순위는 시각적 식별이 모델 차이를 만드는 주된 원인이라기보다 추가 비용이라는 논문의 해석을 뒷받침한다.
6 Dataset Analysis
데이터셋 분석은 질문이 다양한지와 구조화된 표현이 경험적으로 필요한지를 검토한다. 질문은 짧지만 템플릿화되지 않았고 도메인별 주제 다양성이 있으며, 루브릭의 구조·규모·근거 지원은 평면적인 사실 목록을 넘어선다고 보고한다.
6.1 Question Diversity
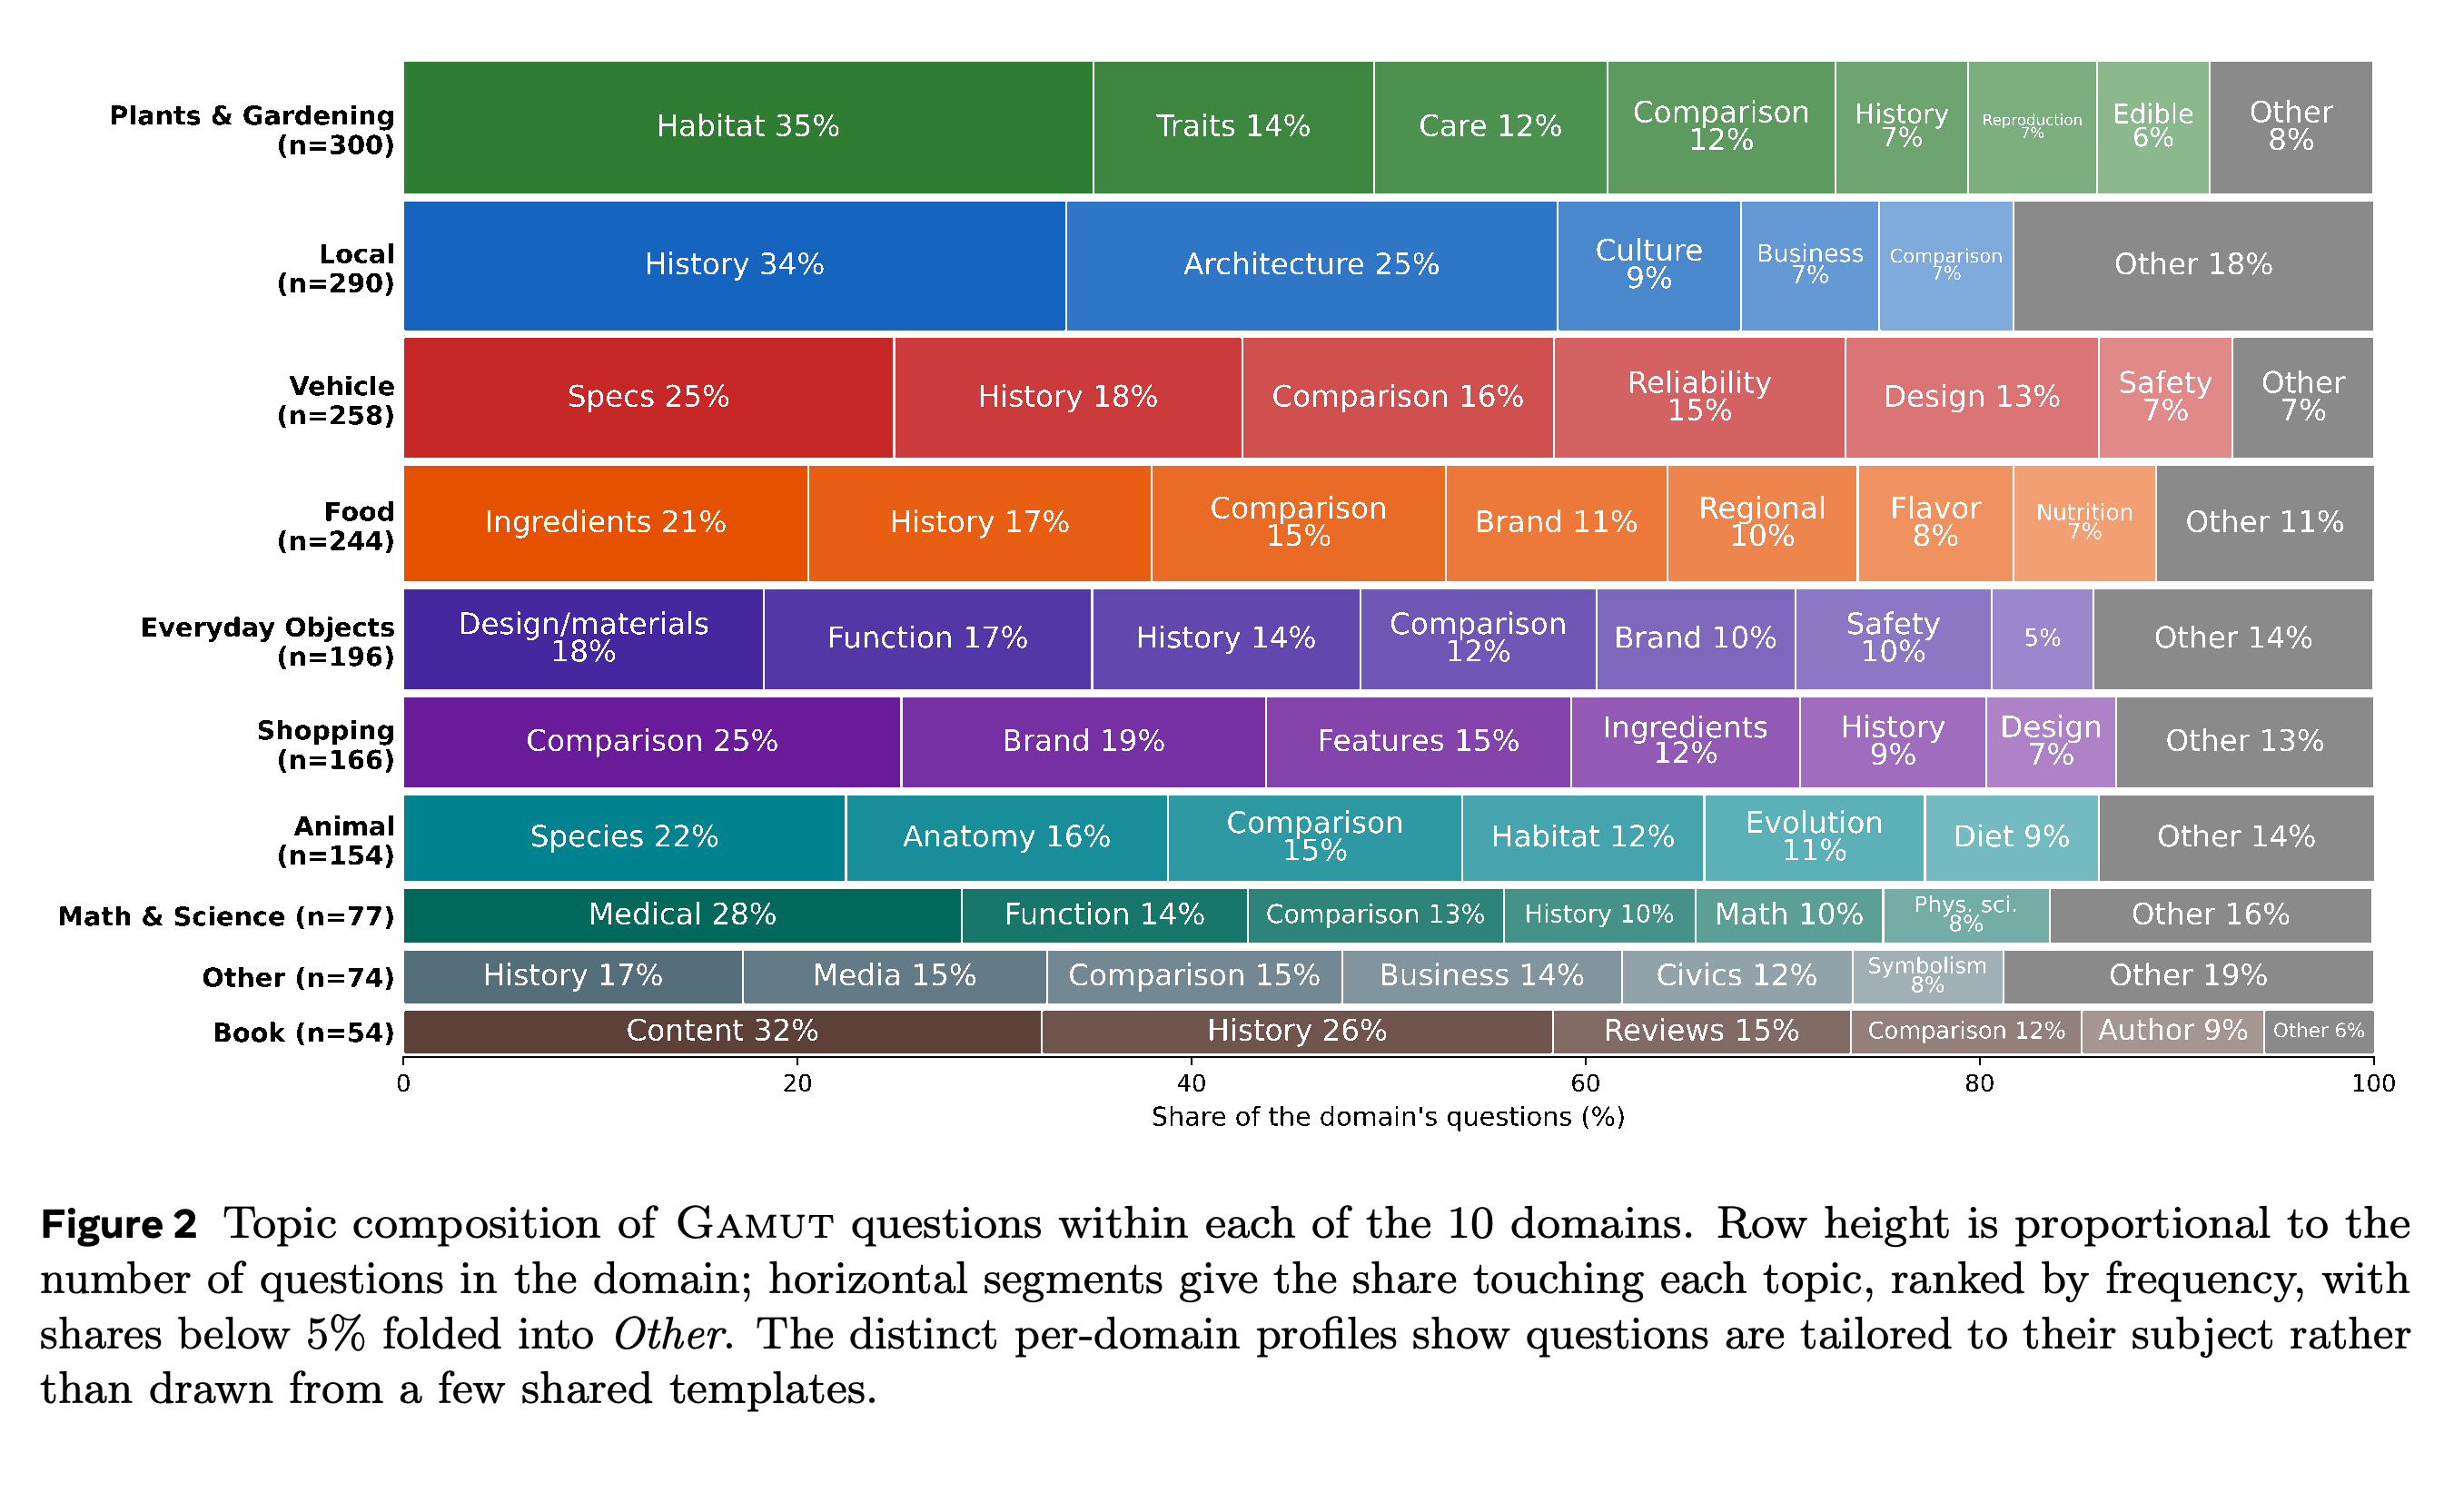
질문의 중앙 길이는 23단어이며, 가장 흔한 25개 시작 구문이 전체의 60% 미만을 차지한다. 각 도메인에는 하나의 템플릿이 아니라 여러 반복 주제가 있다. 식물 질문은 서식지, 특성, 관리, 비교를 다루며, 차량 질문은 제원, 역사, 비교, 신뢰성을 다룬다.
누적 막대는 10개 도메인에서 공통 질문 템플릿을 반복한 것이 아니라 서로 다른 주제 조합을 사용했음을 보여 준다. 예를 들어 지역 질문은 역사와 건축을 강조하고, 음식 질문은 재료, 역사, 비교, 브랜드, 지역적 변이를 두루 다룬다.
6.2 Rubric Statistics
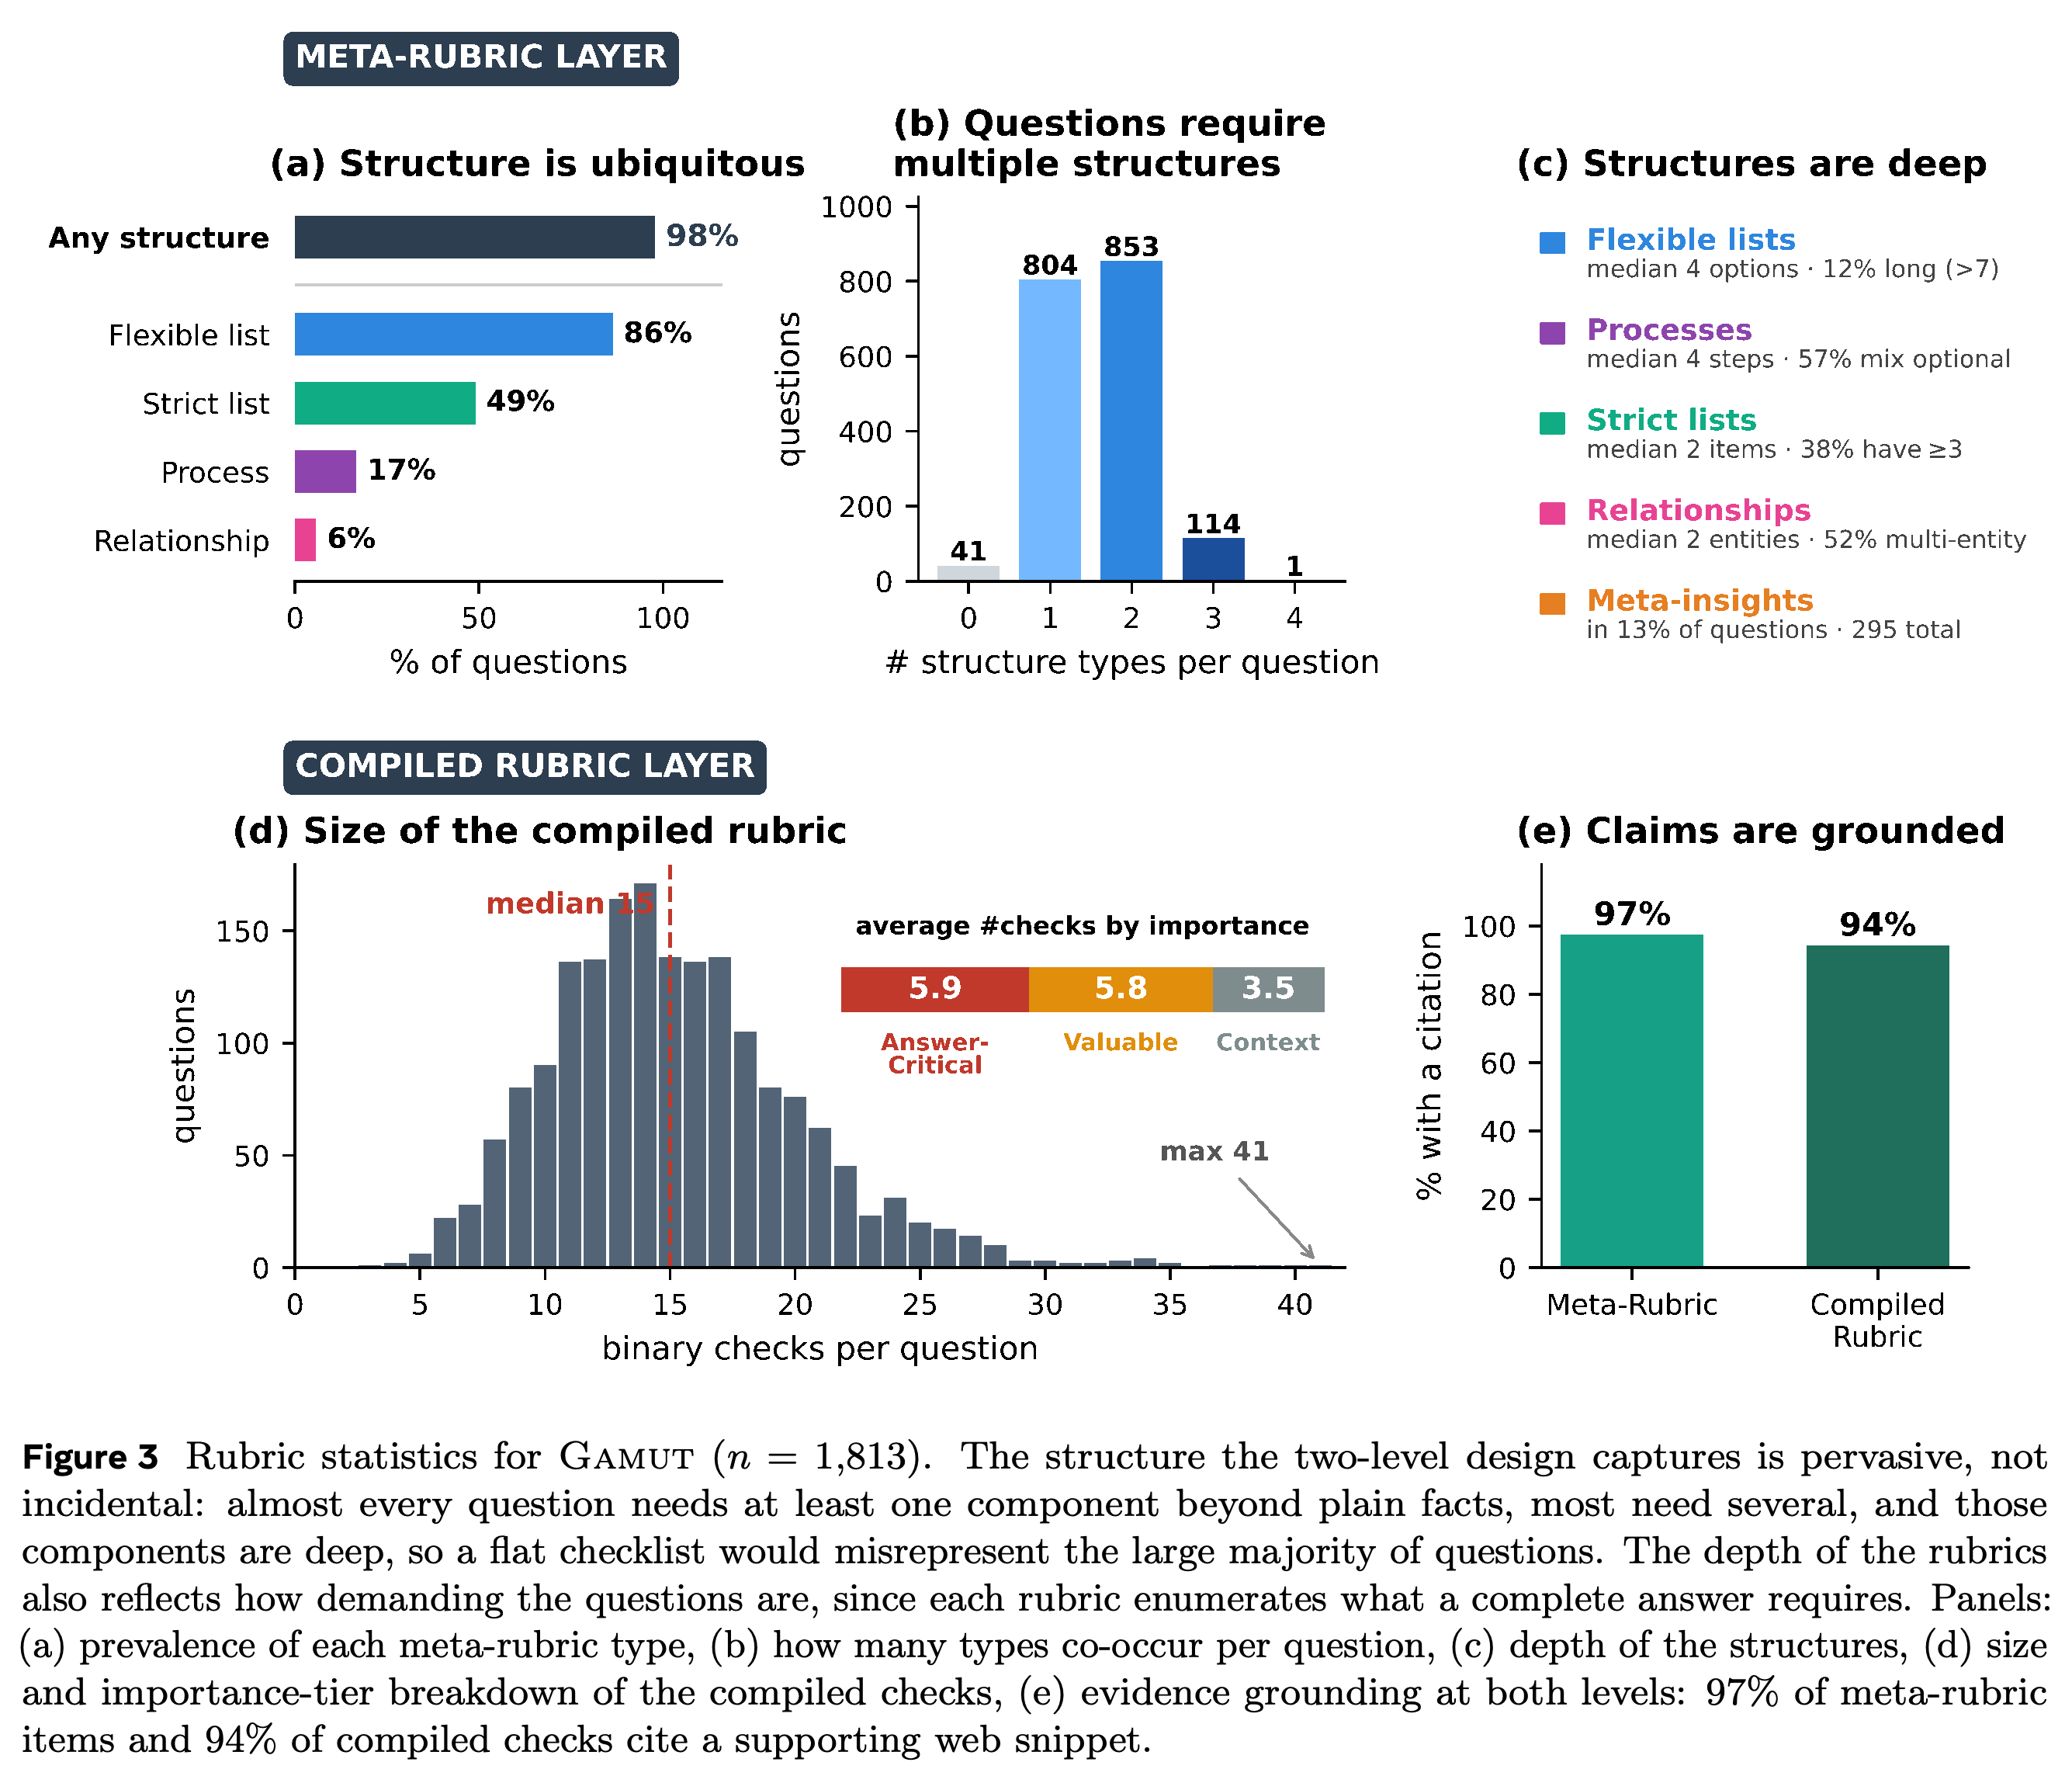
질문당 변환된 점검 항목은 평균 15.2개이고 중앙값은 15개다. 이 중 Answer-Critical은 5.9개, Valuable은 5.8개, Context는 3.5개다. 루브릭은 질문당 약 10개의 웹 발췌문을 활용하고 9,400개가 넘는 서로 다른 웹 페이지를 인용한다. 메타 루브릭 항목의 97%와 변환된 점검 항목의 94%에는 인용이 있다.
6.3 The Structure Behind the Rubrics
구조화된 내용은 널리 존재한다. 질문의 98%는 Simple Knowledge 외에 최소 1개의 구성 요소를 요구하며, 86%는 Flexible List, 49%는 Strict List, 17%는 Process, 6%는 Relationship을 사용한다. Flexible List는 임곗값 점검 항목을 만들고 Process는 순서 점검 항목을 만들어, 심사자가 원래 구조를 전체적으로 채점하지 않아도 개방 집합의 포괄성과 순서를 평가할 수 있게 한다.
이 그림은 거의 모든 질문에 자명하지 않은 구조가 있고, 대부분은 1개 또는 2개의 구조 유형을 포함하며, 변환된 루브릭이 상당한 규모와 근거성을 갖는다는 점을 정량화한다. 이진 점검 항목 중앙값은 15개이며, 메타 루브릭의 인용 비율은 97%, 변환된 점검 항목의 인용 비율은 94%라고 보고한다.
부록
- 부록은 질문 생성, 선택, 루브릭 생성과 개선, LLM 심사, 텍스트 전용 변환에 사용한 전체 프롬프트를 제공한다. 또한 완전한 Jollof rice와 Tang sancai 사례, 주석자 자격 기준, 각각 45분인 루브릭 교육 2회, 작업의 10% 감사도 포함한다.
짧은 생각
2단계 설계는 구체적인 평가 불일치를 해결한다. 풍부한 답변 요건은 평면적 사실로 작성하기 어렵지만 전체적으로 심사하기도 어렵다. 비평면 구조의 광범위한 사용과 심사자 간 안정적인 순위는 이 설계를 뒷받침한다. 다만 공개된 루브릭은 여전히 웹 기반 근거, 전문가 수정, LLM 기반 최종 판정에 의존한다.