


Gaia2: Benchmarking LLM Agents on Dynamic and Asynchronous Environments 요약 설명
12 Feb 2026 | Paper Review LLM Evaluation Synthetic Environments Multi-Agent Coordination목차
- 요약
- 1 Introduction
- 2 Related Work
- 3 ARE: Scaling Up AGENT Environments and Evaluations
- 4 GAIA2: Expanding General AGENT Evaluation
- 5 EXPERIMENTS
- 6 Conclusion & Discussion
- 부록
- 짧은 생각
이번 글에서는 Gaia2: Benchmarking LLM Agents on Dynamic and Asynchronous Environments 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 2월 12일(Arxiv), ICLR 2026
- Froger, Romain, Andrews, Pierre, Bettini, Matteo, Budhiraja, Amar, Cabral, Ricardo Silveira, Do, Virginie, Garreau, Emilien, Gaya, Jean-Baptiste, Laurençon, Hugo, Lecanu, Maxime, et al.
- Meta SuperIntelligence Labs
- 논문 링크
요약
- Gaia2는 모델이 추론하는 동안에도 에이전트의 행동과 독립적으로 변화하는 시뮬레이션에서 LLM 에이전트를 평가한다. Agents Research Environments (ARE)를 기반으로 구축했으며, 사람이 작성한 800개 시나리오로 5가지 핵심 역량을 평가한다. 여기에 노이즈 강건성과 Agent2Agent 협업을 평가하는 320개 증강 시나리오를 포함한다.
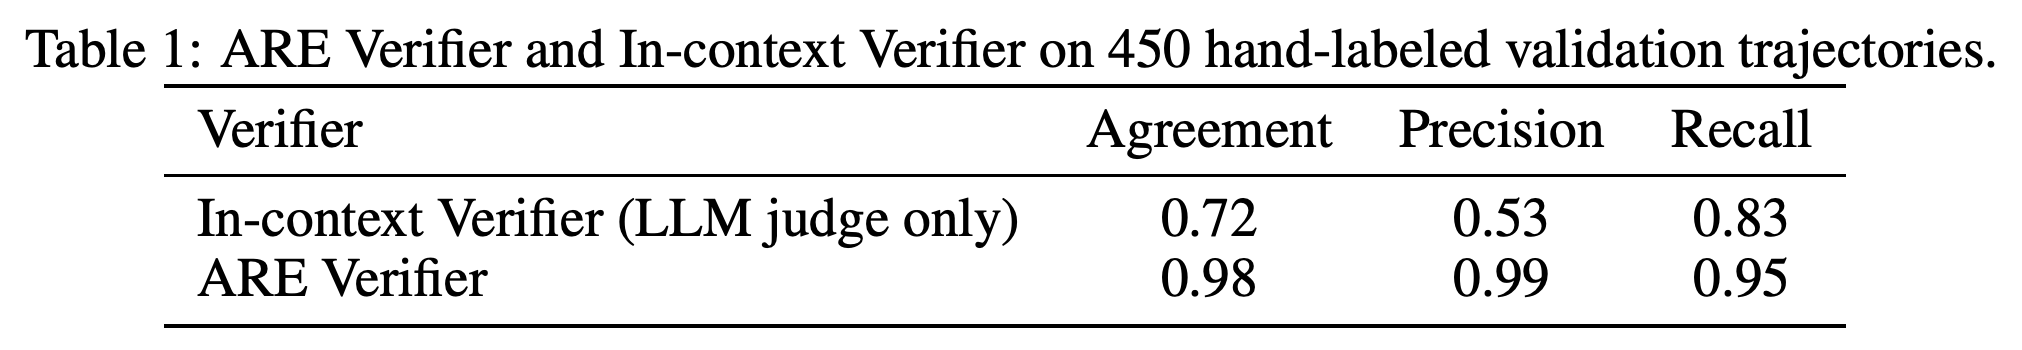
- ARE Verifier는 필수 쓰기 행동의 인자 일관성, 인과적 순서, 실행 시점, 완결성을 검사한다. 탐색적 읽기 행동은 오라클 매칭에서 제외한다. 사람이 라벨링한 450개 실행 궤적에서 일치도 0.98, 정밀도 0.99, 재현율 0.95를 달성하며, 평가와 검증 가능한 보상 기반 강화학습(RLVR)을 지원한다.
- 공통 ReAct 실행 구조에서 GPT-5 (high)는 전체 pass@1이 42.1%로 가장 높지만, Time 점수는 0.0%다. 생성 지연을 제거하면 Time 점수가 34.4%로 상승한다. 협업은 Llama 4 Maverick에서 토큰 사용량을 기준으로 비교한 반복 샘플링 성능을 개선하지만, Claude 4 Sonnet에서는 그렇지 않다. 이는 정확도, 지연, 조율 사이의 상충 관계가 모델에 따라 달라짐을 보여준다.
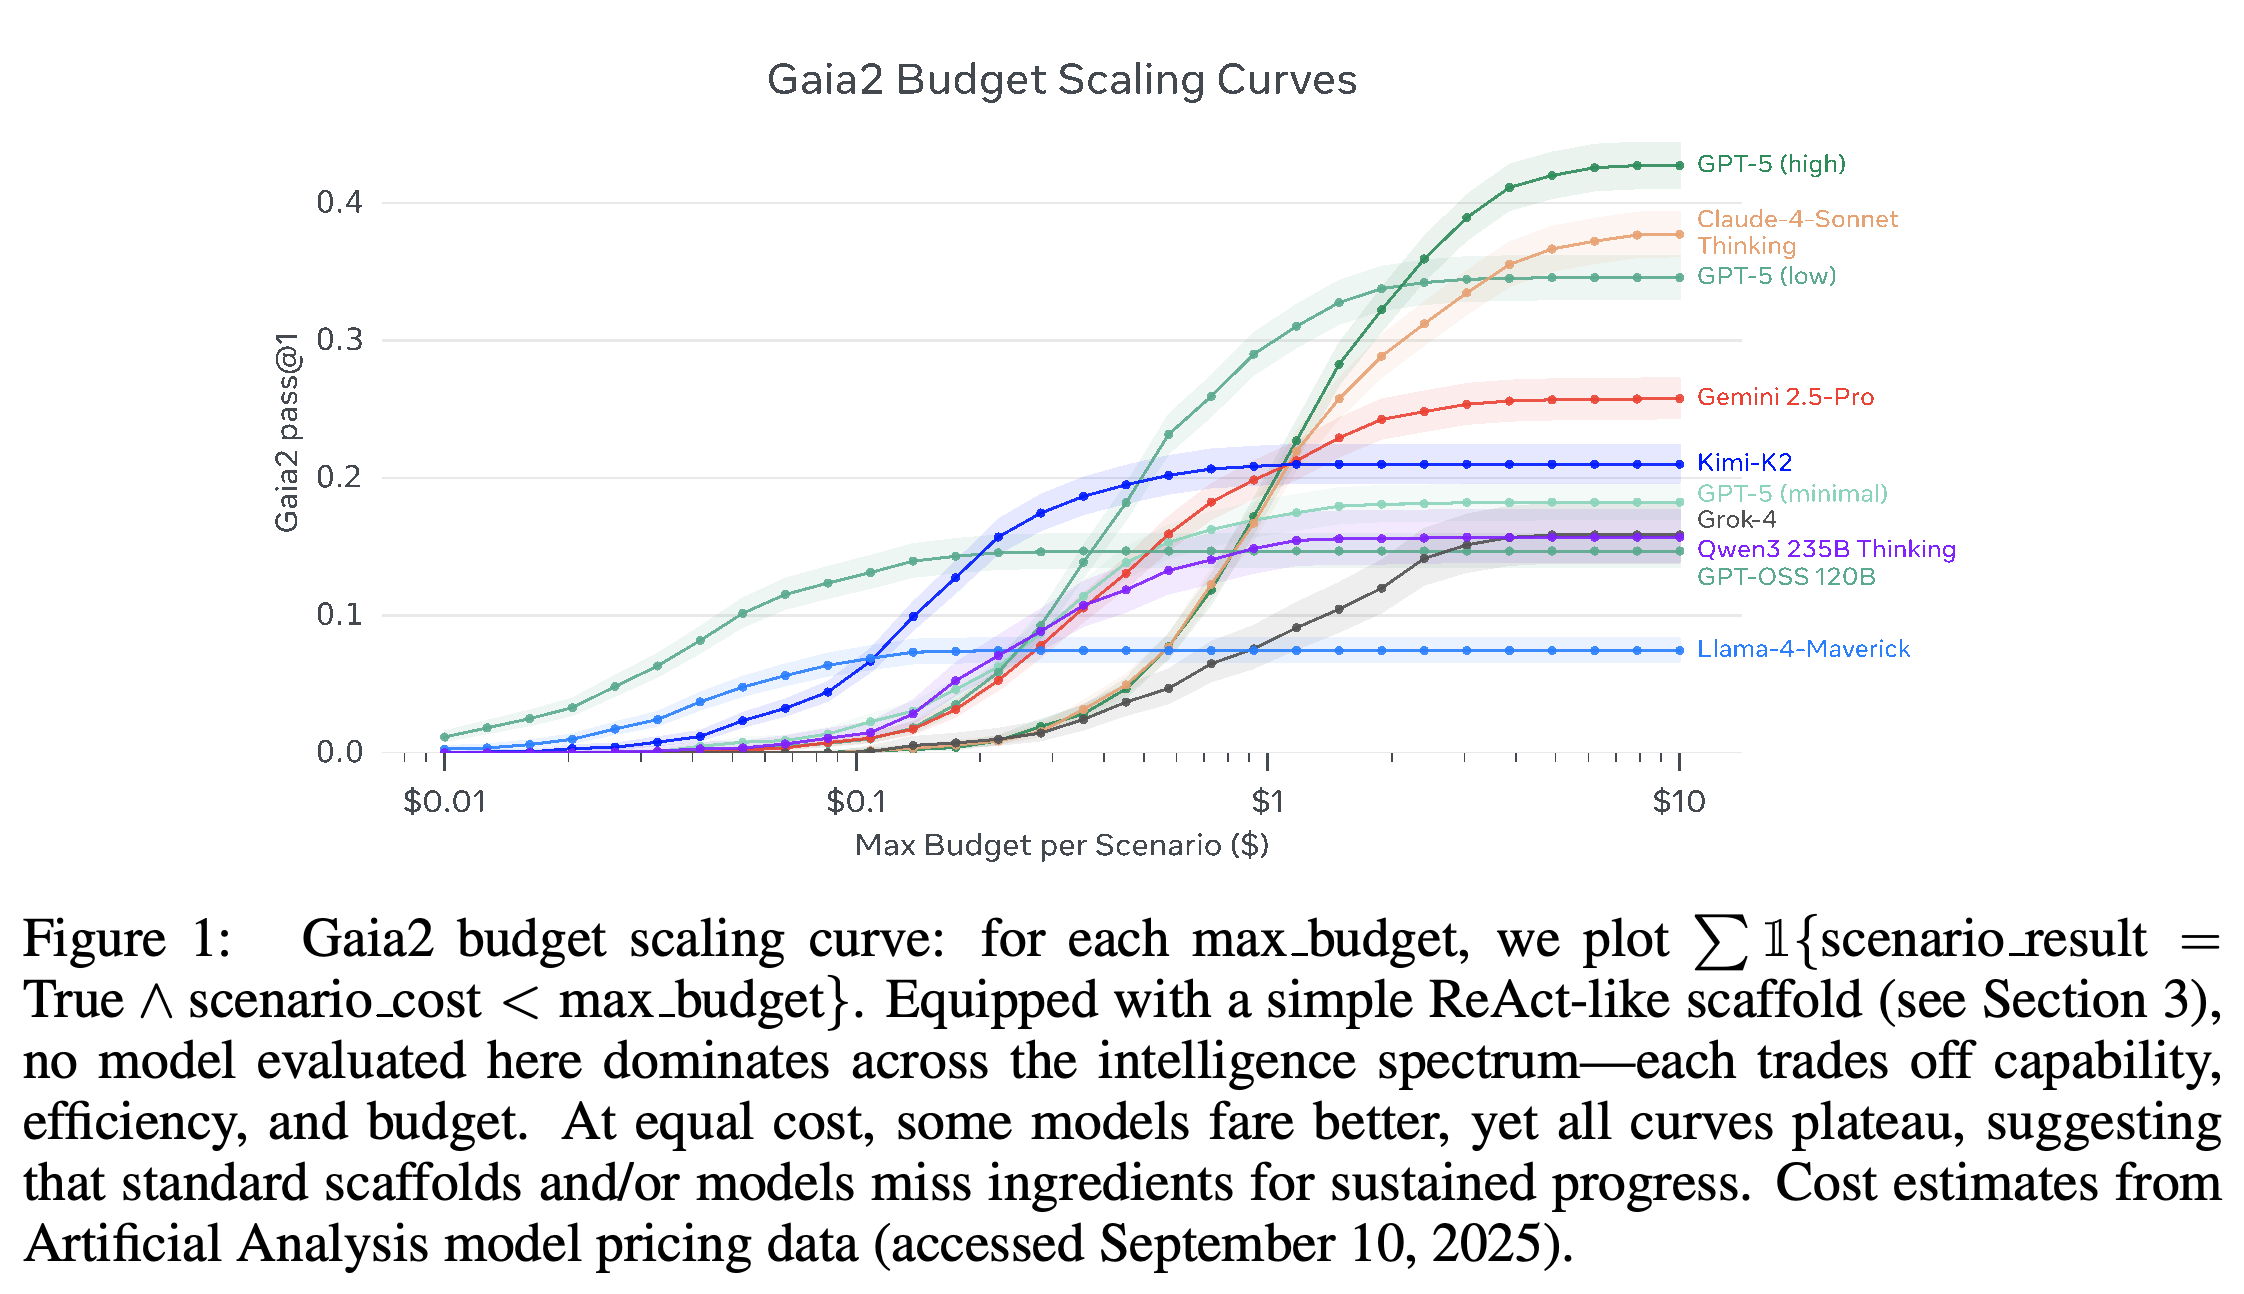
곡선은 기록된 실행 중 비용이 각 임계값 미만이면서 성공한 실행을 세므로, 허용 예산에 따라 모델 순위가 달라진다. GPT-5 (high)는 가장 높은 수준에서 포화되며, 예산 임계값이 낮을 때는 저렴한 설정도 경쟁력이 있다. 포화 구간은 기록된 평가에서 남은 실패를 반영한다. 각 실행에 점점 더 많은 추론 연산을 허용한 실험은 아니다.
1 Introduction
이 논문은 동기식 벤치마크와 실제 배포된 에이전트 사이의 차이를 다룬다. 배포된 에이전트는 지연된 메시지, 변화하는 조건, 마감 시점, 다른 에이전트에 대응해야 한다. 기여는 3가지다. ARE 시뮬레이션 프레임워크와 Gaia2 벤치마크를 제시하고, 독점 모델과 오픈소스 모델의 정확도, 비용, 실행 시간을 실험으로 비교한다.
- Gaia2는 정보 탐색을 웹 작업에 한정하지 않고, 이메일, 메시지, 캘린더, 연락처 등의 앱이 있는 통제된 스마트폰 유사 환경으로 확장한다.
- 쓰기 행동 주석은 최종 답변이나 최종 상태만 평가할 때 놓칠 수 있는 중간 단계의 오류를 드러낸다.
2 Related Work
관련 연구에서는 에이전트 벤치마크가 다루는 역량과 검증 방법을 함께 살펴본다. Gaia2는 비동기적으로 변화하는 환경과 행동 단위 검증을 결합한다.
Benchmarking LLM agents
논문은 Gaia2를 ALFWorld, WebShop, WebArena, WorkArena 같은 환경 내 실행 벤치마크, AppWorld와 ToolSandbox 같은 앱 기반 환경, 함수 호출·시간·멀티 에이전트 평가와 비교한다. Gaia2에서는 외부 이벤트가 에이전트의 행동과 독립적으로 발생하며, 하나의 통제된 환경에서 실행 시점, 모호성, 강건성, 조율을 평가한다.
- GAIA, SWE-bench, BrowseComp는 최종 결과에 중점을 둔 평가로 소개한다.
- 이 비교는 더 폭넓은 평가가 필요한 이유를 설명한다. 다만 인용한 모든 벤치마크에 중간 단계 검증이나 시간에 따른 상호작용이 전혀 없다는 사실을 입증하지는 않는다.
Verification in agentic benchmarks
GAIA는 최종 출력의 정확한 일치 여부를 검사하고, ToolSandbox는 milestones와 minefields로 실행 궤적에 제약을 부여한다. 평가 기준표를 사용하는 접근은 정확히 일치하는 답변만으로는 판단하기 어려운 경우를 다룬다. ARE Verifier는 정확한 인자 검사, 도구별 LLM 판단, 인과적·시간적 제약을 결합해 모든 필수 쓰기 행동을 평가한다.
- 이 혼합 설계는 메시지 내용에 유연성을 허용하면서도 전체 실행 궤적의 판단을 LLM에 맡기지 않는다.
- 검증기는 Gaia2-specific 채점 코드에 그치지 않고 다른 ARE 환경에서도 재사용할 수 있는 기반 구성요소로 제시된다.
3 ARE: Scaling Up AGENT Environments and Evaluations
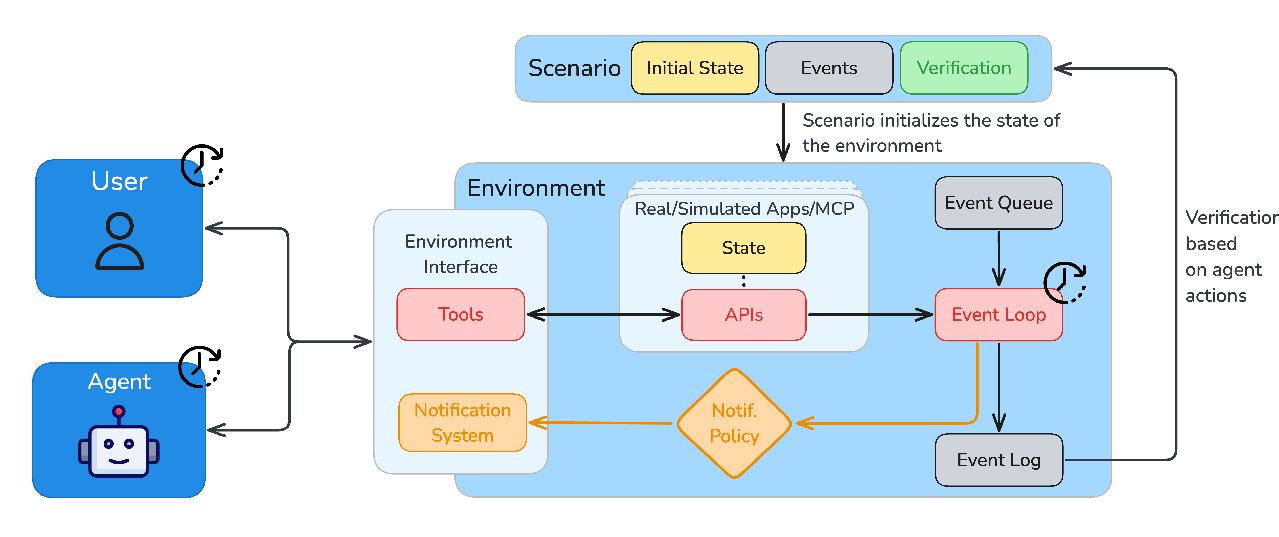
ARE는 환경 루프와 에이전트 루프를 분리한다. 에이전트가 추론하는 동안에도 시뮬레이션 시간이 흐르고 예약된 이벤트가 실행된다. 플랫폼은 상호작용과 상태 변화를 기록하므로, 연구자는 시나리오를 재현하고 실행 궤적을 살펴보며 실패를 분석할 수 있다.
Core concepts
ARE는 서로 상호작용하는 5가지 추상화인 앱, 환경, 이벤트, 알림, 시나리오를 정의한다. 시나리오는 초기 상태와 함께 요청, 외부 변화, 검증 로직을 담은 이벤트 DAG를 지정한다. 독립적인 분기 사이에는 전체 순서를 정할 필요가 없다.
- 앱은 상태를 유지하는 API를 제공하며, 도구는 읽기 전용 또는 쓰기로 구분한다. 환경은 앱에 시간 관리와 동작 규칙을 결합한다.
- 이벤트에는 타임스탬프를 붙여 기록한다. 절대 시점이나 상대 시점으로 예약하고 의존성을 명시할 수 있다. 알림 정책은 어떤 이벤트를 에이전트에 보여줄지 결정한다.
- 검증은 실행 중 주요 단계에서 온라인으로 수행하거나, 실행 후 오프라인으로 수행할 수 있다. 저자들은 τ-bench, τ²-bench, GAIA, BFCL-v3, VendingBench도 ARE에서 재구현했다고 보고한다.
이벤트 큐와 이벤트 루프는 사용자 및 에이전트의 상호작용과 분리되어 동작한다. 기록된 이벤트는 알림 정책과 검증에 전달된다. 이를 통해 비동기 관측과 검토 가능한 채점을 연결한다.
Asynchronicity and time
모델이 출력을 생성하는 동안 시뮬레이션 시간도 흐르므로, 응답이 느리면 마감 시점을 놓치거나 환경이 바뀐 뒤에 도착할 수 있다. 따라서 응답 속도가 작업 성공에 직접 영향을 준다.
Mobile environment
Mobile은 12개 앱과 101개 도구로 ARE를 구현한다. 사용자 중심의 각 universe에는 파일시스템 내용을 제외하고 400K–800K 토큰의 정형·비정형 콘텐츠가 들어 있다. 이 콘텐츠는 PersonaHub에서 가져온 페르소나와 앱 간 의존성을 바탕으로 생성한다.
- 턴은 사용자 메시지나 알림 이벤트로 시작하고, 에이전트가 사용자에게 답하면 끝난다. 시나리오는 작업 완료, 한도 도달, 검증 실패로도 종료된다.
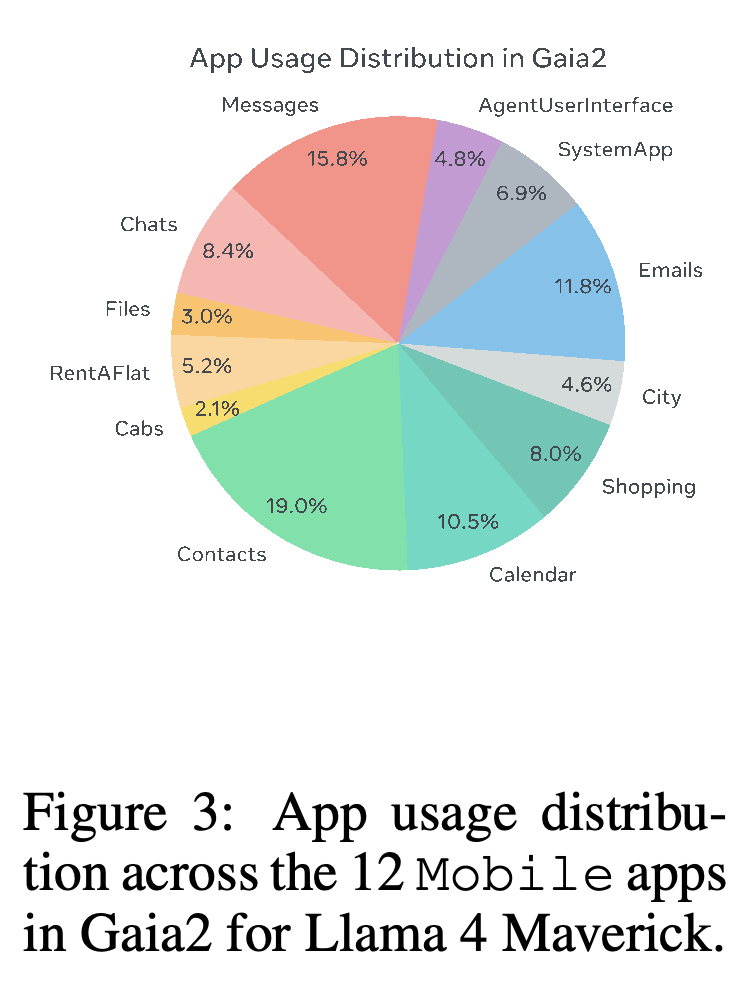
- Figure 3에서 Llama 4 Maverick은 다양한 앱을 사용한다. Contacts가 19.0%, Messages가 15.8%, Emails가 11.8%를 차지한다.
- Mobile은 API 기반 환경이며, 터치스크린이나 시각적 인터페이스 제어를 평가하지 않는다. 부록은 의존성을 반영해 콘텐츠를 생성하더라도 앱 간 일관성 문제가 여전히 남아 있다고 설명한다.
Llama 4 Maverick은 단일 서비스에 집중하지 않고 Mobile의 12개 앱 모두와 상호작용한다. Contacts가 19.0%로 가장 큰 비중을 차지하고 Messages가 15.8%로 뒤를 잇는다. 이는 앱 간 정보 수집이 필요한 작업의 특성과 부합한다.
Agent orchestration
기본 실행 구조는 모델에 종속되지 않는 ReAct 루프를 사용하며, 단계마다 구조화된 JSON 도구 호출 1개를 출력한다. 단계 전 훅은 대기 중인 알림을 컨텍스트에 넣고, 단계 후 훅은 종료 조건을 검사한다. 이를 통해 비동기 및 멀티턴 시나리오와 상호작용한다.
- Parallel Tool Calling 비교 실험은 일부 설정에서 효율을 높이지만, pass@1을 일관되게 개선하지는 않는다.
- 이 결과는 순차적 도구 호출만으로 낮은 점수를 설명하기 어렵다는 점을 보여준다. 다만 모델 역량이 유일한 병목이라고 입증하거나 더 나은 실행 조율의 가능성을 배제하지는 않는다.
4 GAIA2: Expanding General AGENT Evaluation
Gaia2에는 10개 Mobile universe에 걸쳐 사람이 작성한 고유 시나리오 800개가 있으며, 핵심 역량마다 160개 시나리오를 배정한다. Gaia2-mini는 160개 시나리오로 구성된 부분집합이다. 이 부분집합에 Noise와 Agent2Agent 증강을 적용해 320개 시나리오를 추가하며, 총 1,120개가 된다.
4.1 Capabilities Evaluated
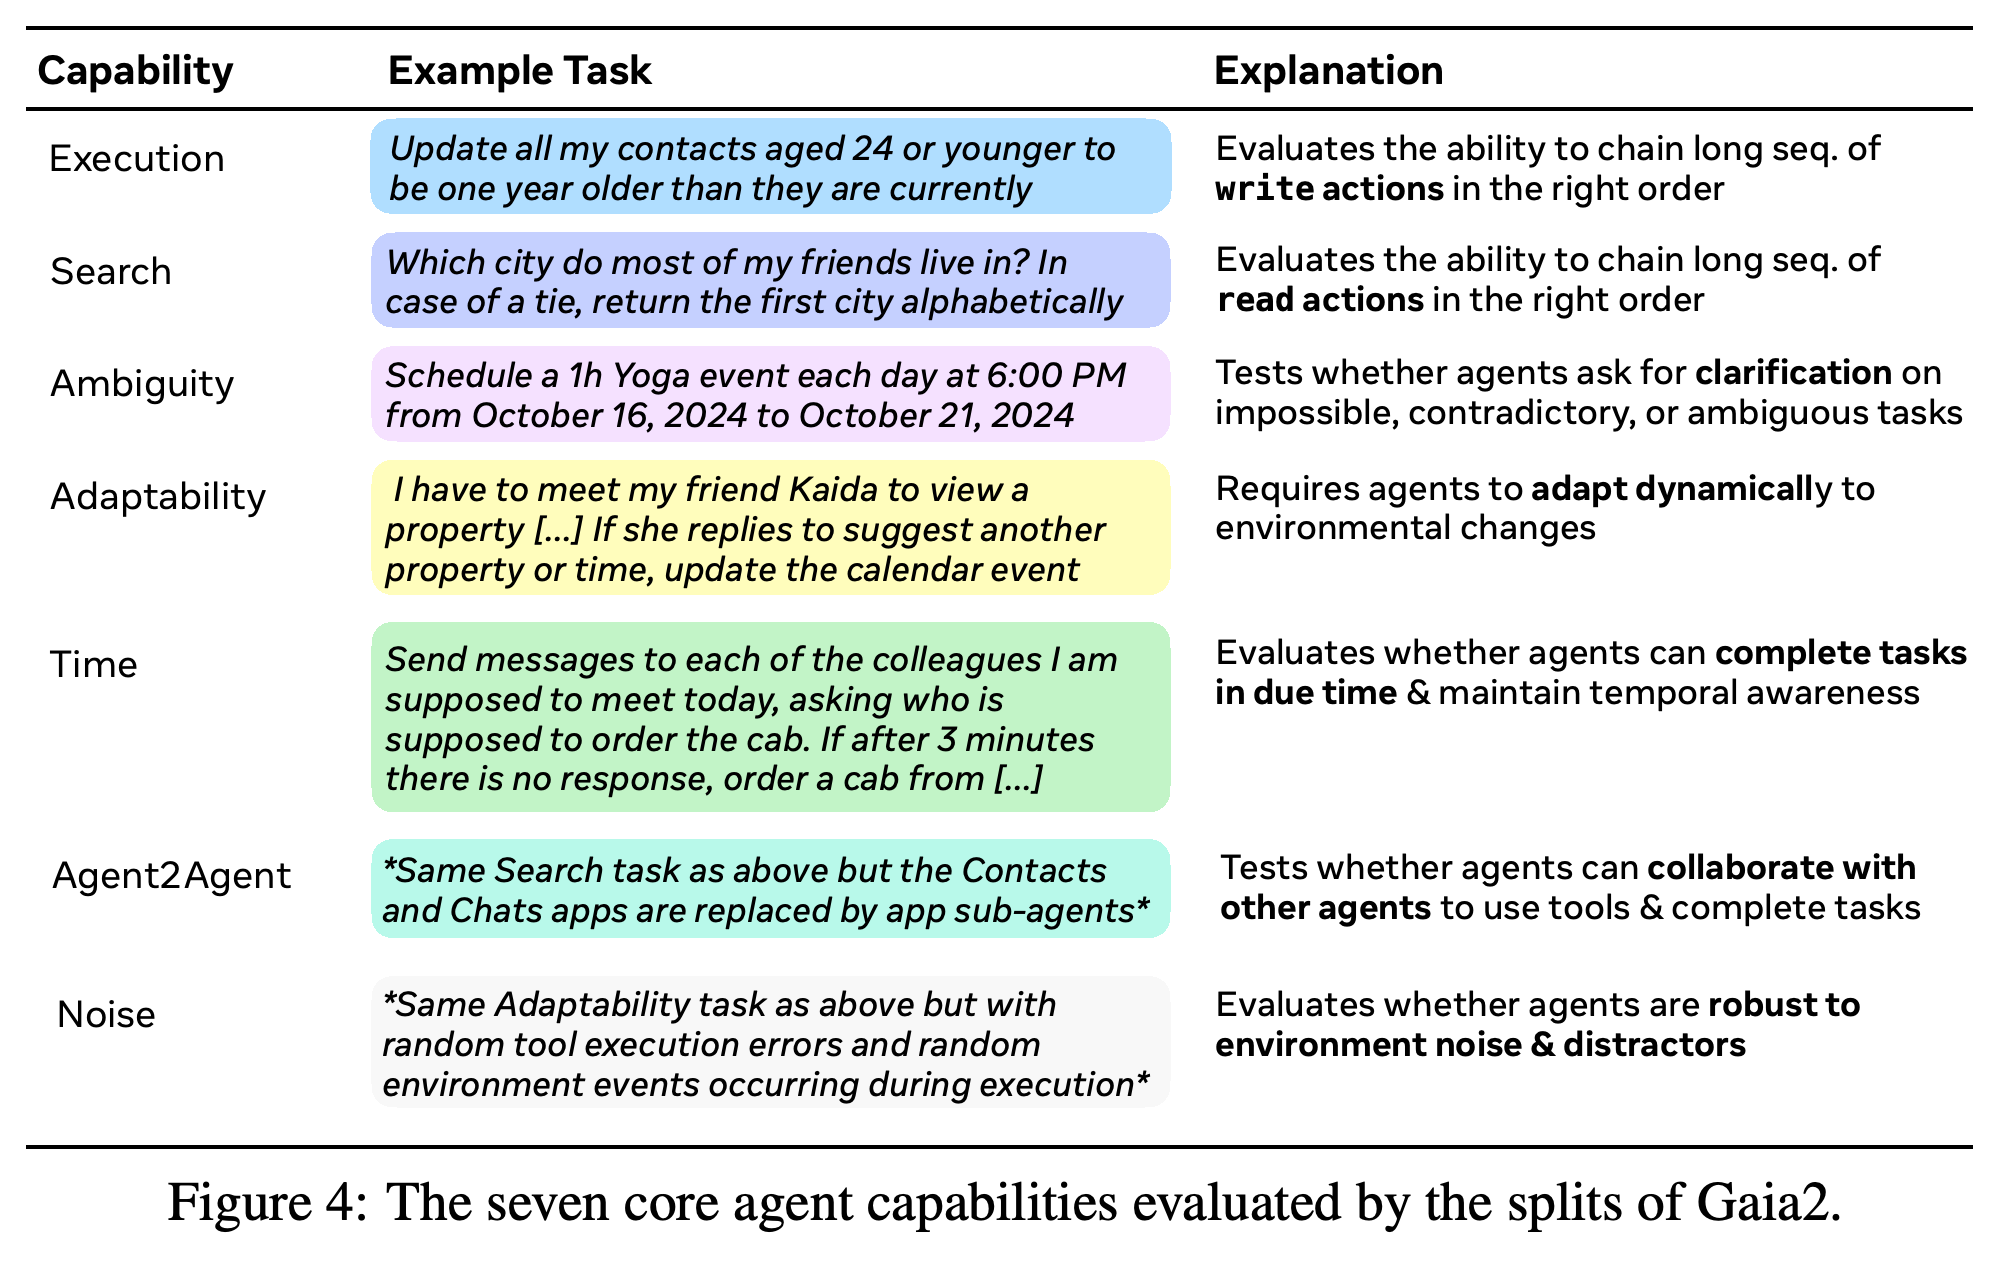
5가지 핵심 역량은 Execution, Search, Ambiguity, Adaptability, Time이다. 이들은 서로 독립적인 평가 축이 아니라 작업의 주된 특성을 나타낸다. 시간 제약이 있는 작업에도 상당한 탐색과 실행이 필요할 수 있다.
- Execution은 쓰기 행동의 연속 실행에, Search는 여러 앱에서 정보를 모으는 데 중점을 둔다. Ambiguity는 불가능하거나 모순되거나 정보가 부족한 요청을 보고하는 능력을 평가한다.
- Adaptability는 환경이 바뀐 뒤 행동을 수정해야 하며, Time은 지정된 시간 제약 안에서 행동해야 한다. 초기 실험에서 부자연스럽고 평가 신호가 불명확한 작업이 나왔기 때문에, 3가지 이상 역량을 인위적으로 결합한 작업은 제외했다.
- Noise는 도구 실패, 시그니처 변경, 방해 이벤트를 추가한다. Agent2Agent는 직접적인 앱 접근을 필요할 때 호출하는 app-agent로 대체해, 부분 관측 조건에서 작업 분해와 조율을 평가한다. 기본 설정에서는 main-agent와 app-agent가 같은 모델을 사용한다.
예시는 5가지 핵심 작업 유형과 2가지 환경 증강을 구분한다. Noise는 실행 조건을 바꾸고, Agent2Agent는 앱 접근 방식을 바꾼다. 모두 기존 작업 주석을 재사용할 수 있다.
4.2 Scenario Design and ANNOTATION Protocol
주석 작업자는 생성된 universe를 탐색하고, ARE 주석 인터페이스로 필수 쓰기 행동과 환경 이벤트의 정답 DAG를 만든다. 독립적인 검증 절차, 일관성 검사, 구조적 제약, 기본 에이전트를 이용한 난도 보정을 통해 주석 오류를 줄인다.
- 작업은 주된 역량에 초점을 맞추되, 읽기와 쓰기, 환경 상호작용을 자연스럽게 결합한다.
- 오라클은 필수 쓰기 행동을 지정하며, 탐색적 읽기의 순서를 미리 정하지 않는다.
4.3 Verifier
검증기는 먼저 쓰기 도구의 이름과 호출 횟수가 일치하는지 확인한다. 이어서 오라클 행동을 에이전트 행동에 대응시키며 인자, 의존성, 실행 시점을 검사한다. 성공하려면 모든 오라클 쓰기 행동을 매칭해야 한다. 독립적인 목표는 어느 순서로 완료해도 된다.
- ID처럼 엄격한 필드는 정확한 일치를 요구하고, 이메일 본문처럼 유연한 필드는 도구별 LLM 평가 기준과 해킹 방지 검사로 판단한다.
- Table 1에서 ARE는 일치도 0.98, 정밀도 0.99, 재현율 0.95를 기록한다. 같은 450개 실행 궤적에서 LLM만 사용하는 in-context 검증기는 각각 0.72, 0.53, 0.83을 기록한다.
- 읽기 행동은 오라클 매칭에서 제외하지만, 실험의 단계 수, 컨텍스트, 시간 한도는 그대로 적용한다.
구조화된 검증기는 LLM만 사용하는 실행 궤적 판정기보다 정밀도를 0.53에서 0.99로, 일치도를 0.72에서 0.98로 높인다. 재현율도 0.83에서 0.95로 상승하므로, 거의 모든 실행 궤적을 거부해서 정밀도를 높인 결과는 아니다.
5 EXPERIMENTS
실험은 전체 7개 분할에서 모델을 비교하고, Time의 지연, Agent2Agent 협업, 일부 실행 설정을 별도로 분석한다. 전체 pass@1은 분할별 점수의 산술평균이며, 5가지 핵심 역량만을 대상으로 한 점수가 아니다.
Experimental setup
주요 실험은 최소 128K 토큰인 모델의 전체 컨텍스트 길이를 사용한다. 명시된 temperature는 0.5이며, 턴마다 생성 한도는 16K 토큰이고 시나리오마다 3회 실행한다. 200단계 도달, 컨텍스트 초과, 검증 완료 또는 실패, 시간 초과 시 실행을 중단한다. 기본 알림 정책은 medium이다.
- Appendix B.4는 GPT-5의 예외를 명시한다. API 제약 때문에 temperature와 top-p를 1로 설정한다.
- 배포 과정의 문제에 대응하기 위해 응답을 생성하는 동안 평가를 일시 정지한다. 이후 생성 시간에 맞는 시뮬레이션 시간 오프셋을 적용해 재개하므로, 생성 지연은 시뮬레이션에 반영된다.
- 검증기는 temperature 0의 Llama-3.3-70B-Instruct를 사용한다. 단계 사이에는 중간 추론 출력을 버린다. 저자들은 추론과 도구 사용을 교차하는 모델에 이 방식이 최적이 아닐 수 있다고 인정한다.
5.1 Core Results
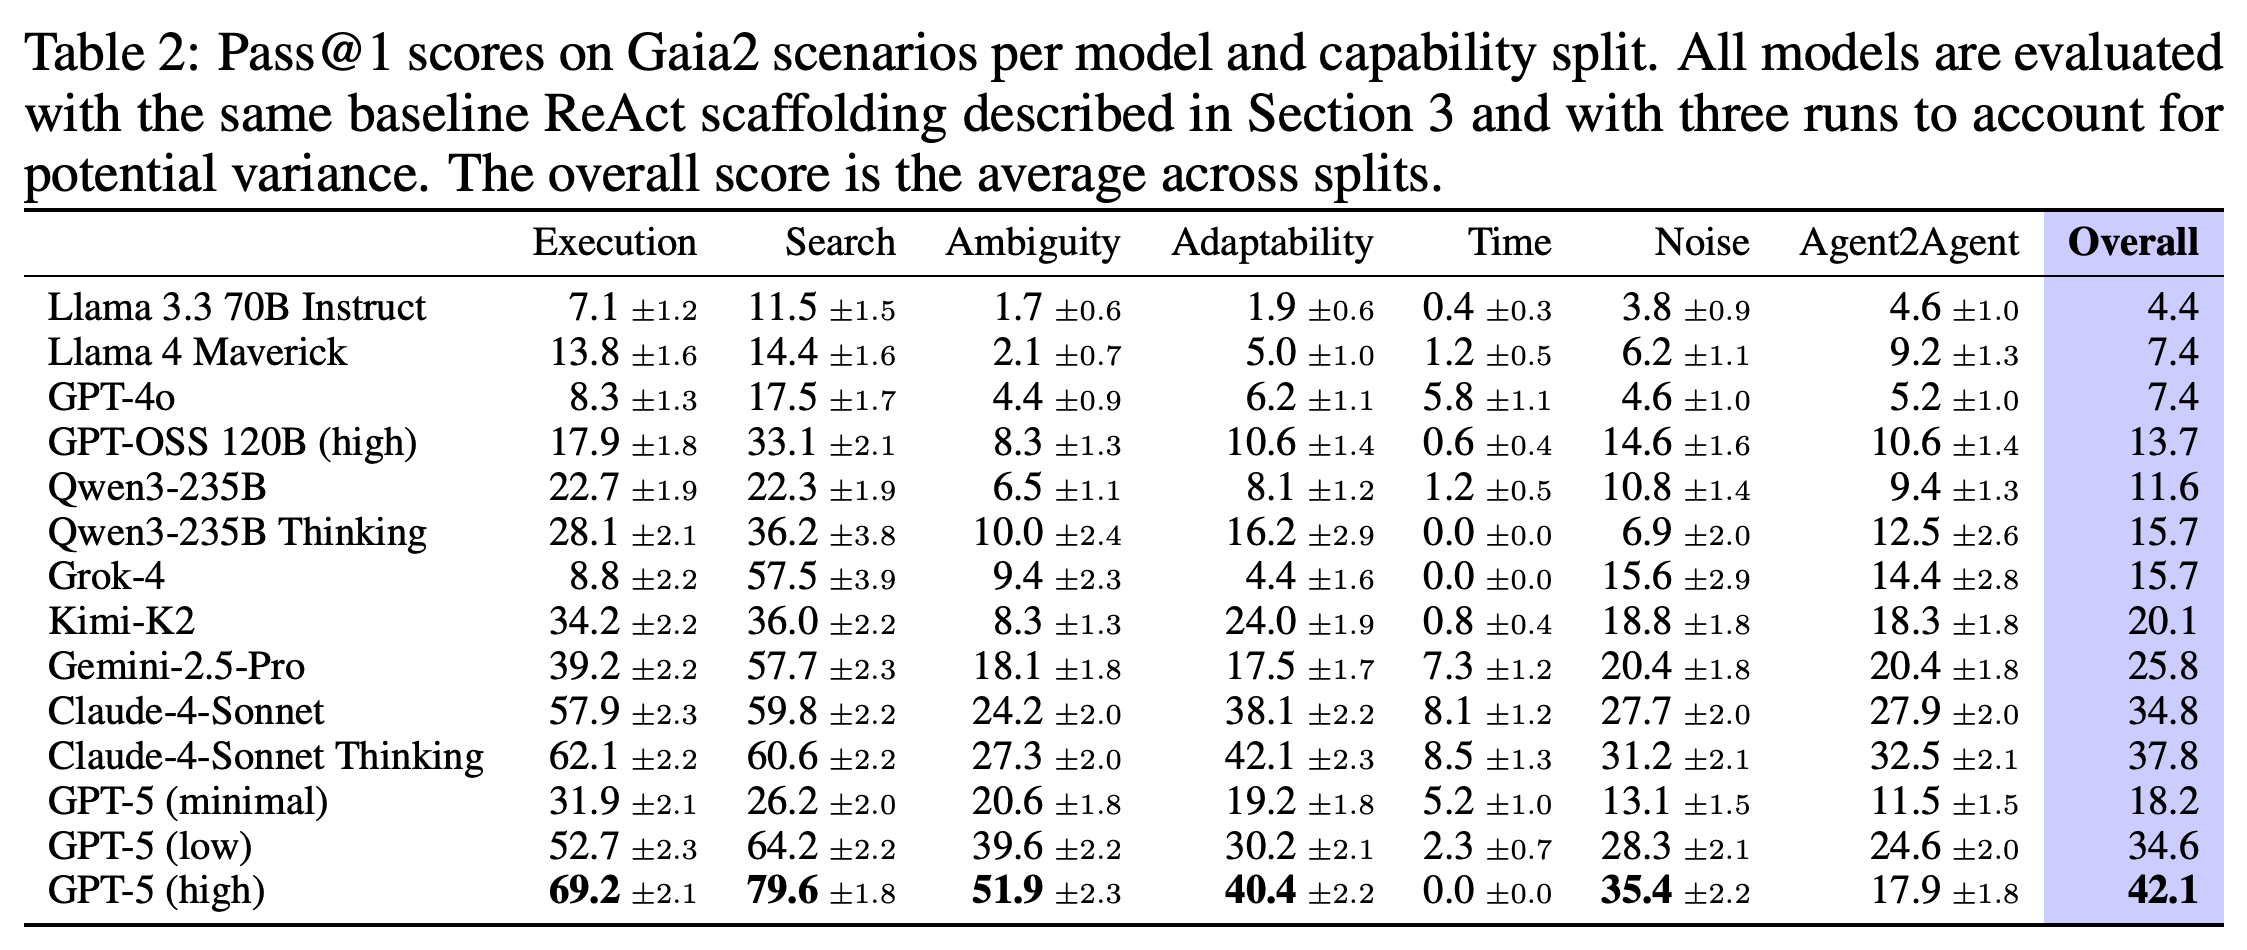
Table 2에서 GPT-5 (high)는 전체 점수 42.1%로 가장 높고, Claude-4-Sonnet Thinking이 37.8%, Claude-4-Sonnet이 34.8%로 뒤를 잇는다. Kimi-K2는 20.1%로 평가한 오픈소스 모델 중 가장 높다. 다만 초록과 일부 논의에서는 이 점수를 약 21%로 설명한다.
- GPT-5 (high)는 Execution에서 69.2%, Search에서 79.6%, Ambiguity에서 51.9%, Noise에서 35.4%를 기록하지만, Time에서는 0.0%, Agent2Agent에서는 17.9%를 기록한다.
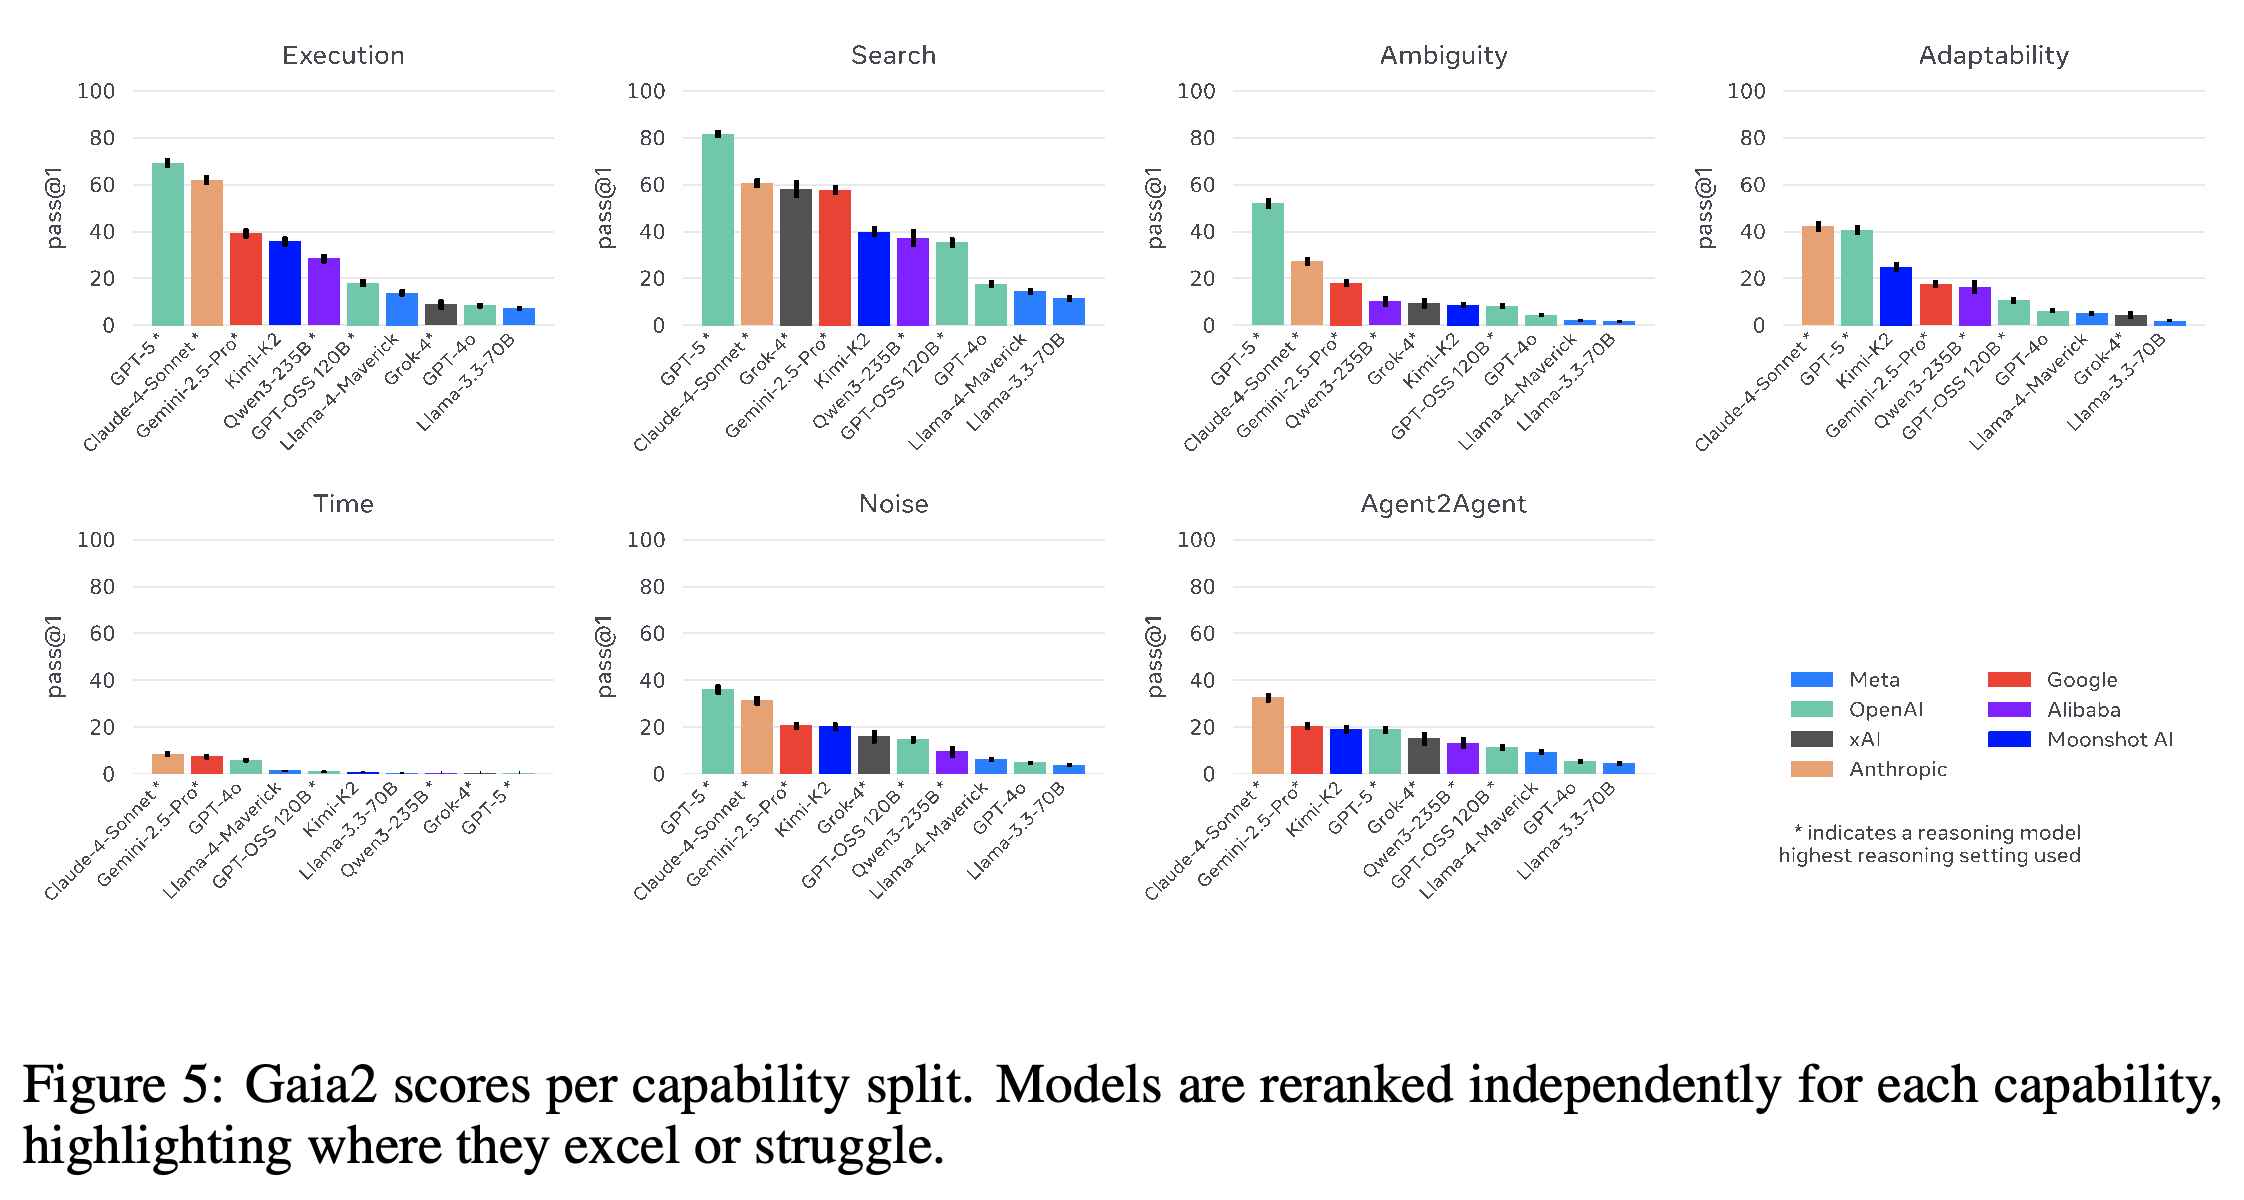
- Claude-4-Sonnet Thinking은 Adaptability에서 42.1%, Time에서 8.5%, Agent2Agent에서 32.5%를 기록한다. 이는 Figure 5의 역량별 순위 차이를 보여준다.
- 이 벤치마크에서는 Execution과 Search가 상대적으로 쉽지만, 최고 점수만으로 해당 작업을 완전히 해결했다고 볼 수는 없다.
전체 점수가 가장 높은 모델이 모든 분할에서도 최고인 것은 아니다. GPT-5 (high)는 전체 42.1%를 달성하지만 Time에서는 0.0%다. 반면 Claude-4-Sonnet Thinking은 Time에서 8.5%, Agent2Agent에서 32.5%를 기록한다. Kimi-K2의 정확한 전체 점수는 20.1%다.
역량별로 순위를 다시 매기면 모델 순서가 어떻게 바뀌는지 확인할 수 있다. 낮은 Time 점수는 더 높은 Execution 및 Search 점수와 대비된다. Claude의 Thinking 설정은 표시된 Adaptability와 Agent2Agent 비교에서 가장 높다.
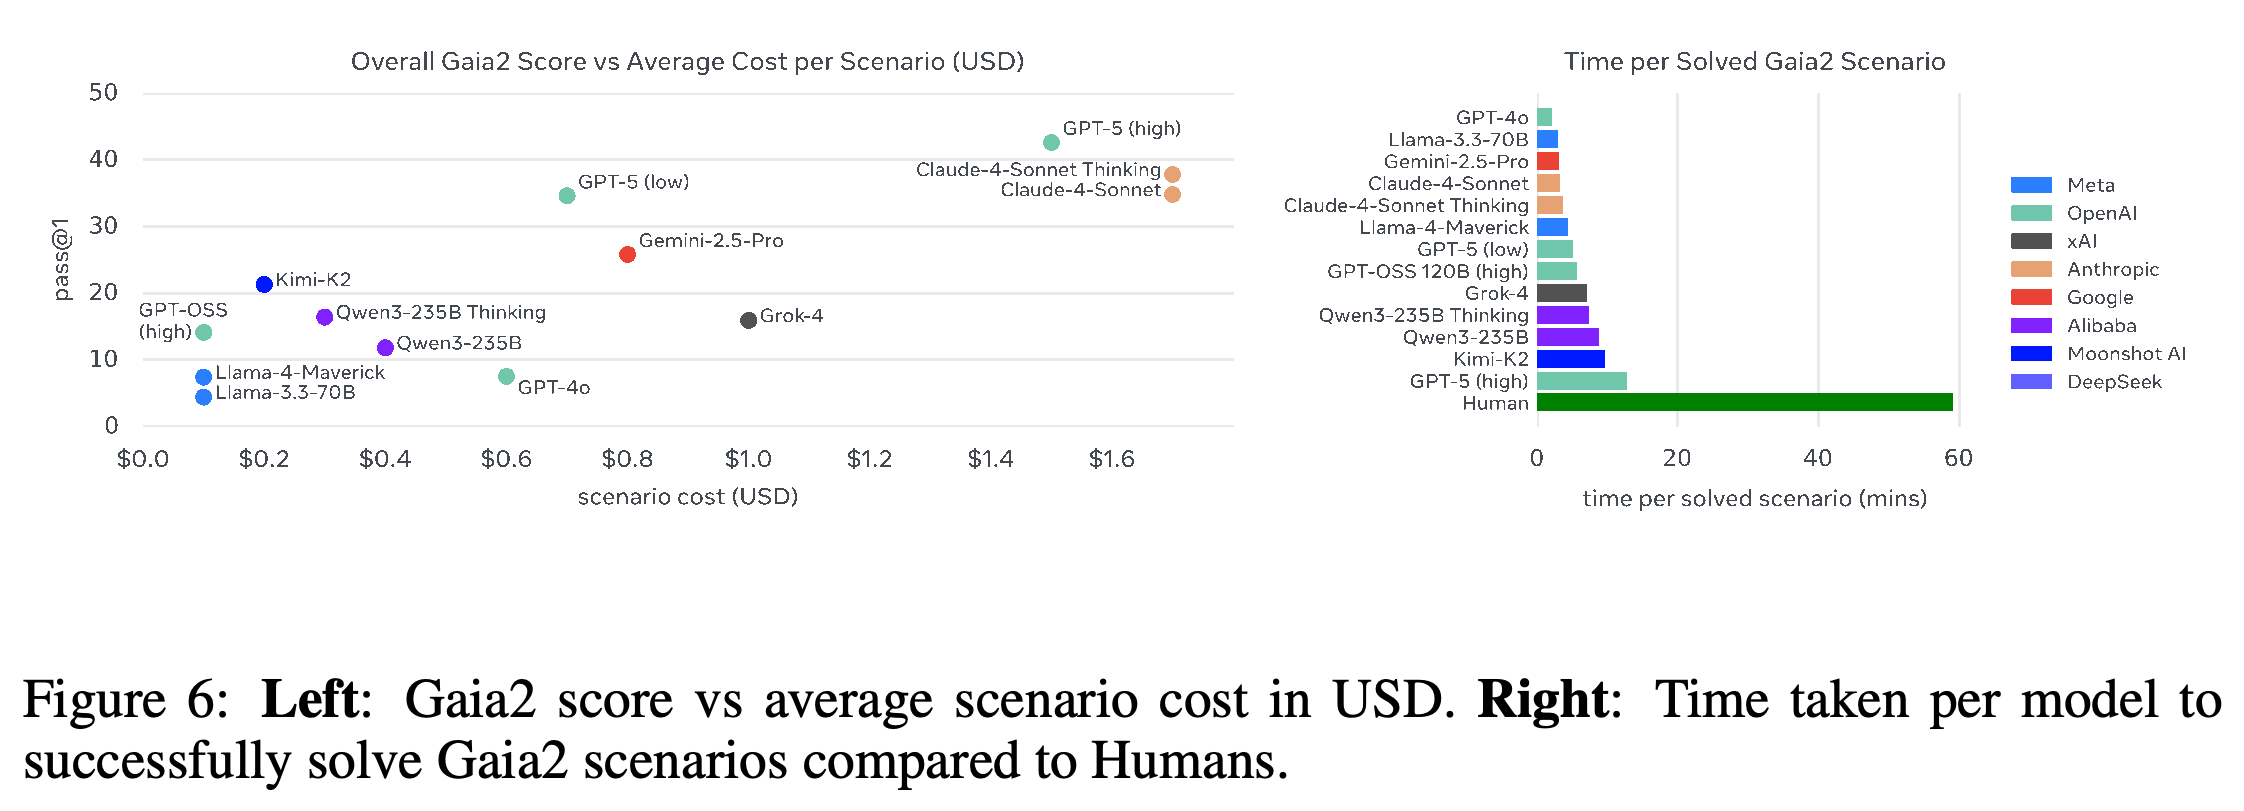
GPT-5의 reasoning effort를 높이면 전체 정확도가 높아지는 대신 해결 시간이 길어진다. Claude 4 Sonnet은 비슷한 정확도에서 GPT-5 (low)보다 비용이 약 3배 들지만, 실행 속도는 훨씬 빠르다. 비용 추정에는 2025년 9월 10일에 조회한 Artificial Analysis 데이터를 사용한다.
- Figure 1은 기록된 실행 중 비용이 각 예산 임계값 미만이면서 성공한 실행을 센다. 같은 모델에 점점 더 큰 추론 예산을 배정하는 실험은 아니다.
- Figure 6에서 Kimi-K2는 비용 효율적인 모델에 속하고, Grok-4는 효율이 낮은 설정에 속한다.
- 사람 주석 작업자는 모든 작업을 해결하지만 ARE GUI를 사용하므로 시간이 더 오래 걸린다고 보고한다. 따라서 사람과 모델의 시간 비교에는 인터페이스 차이도 반영된다.
정확도, 금전적 비용, 완료 시간을 기준으로 삼으면 모델 순위가 서로 달라진다. Claude 4 Sonnet은 GPT-5 (low)보다 비용이 높지만 성공한 시나리오의 실행 시간은 짧다. 사람의 시간 기준값은 모델과 동일한 인터페이스가 아니라 ARE GUI를 통한 상호작용을 반영한다.
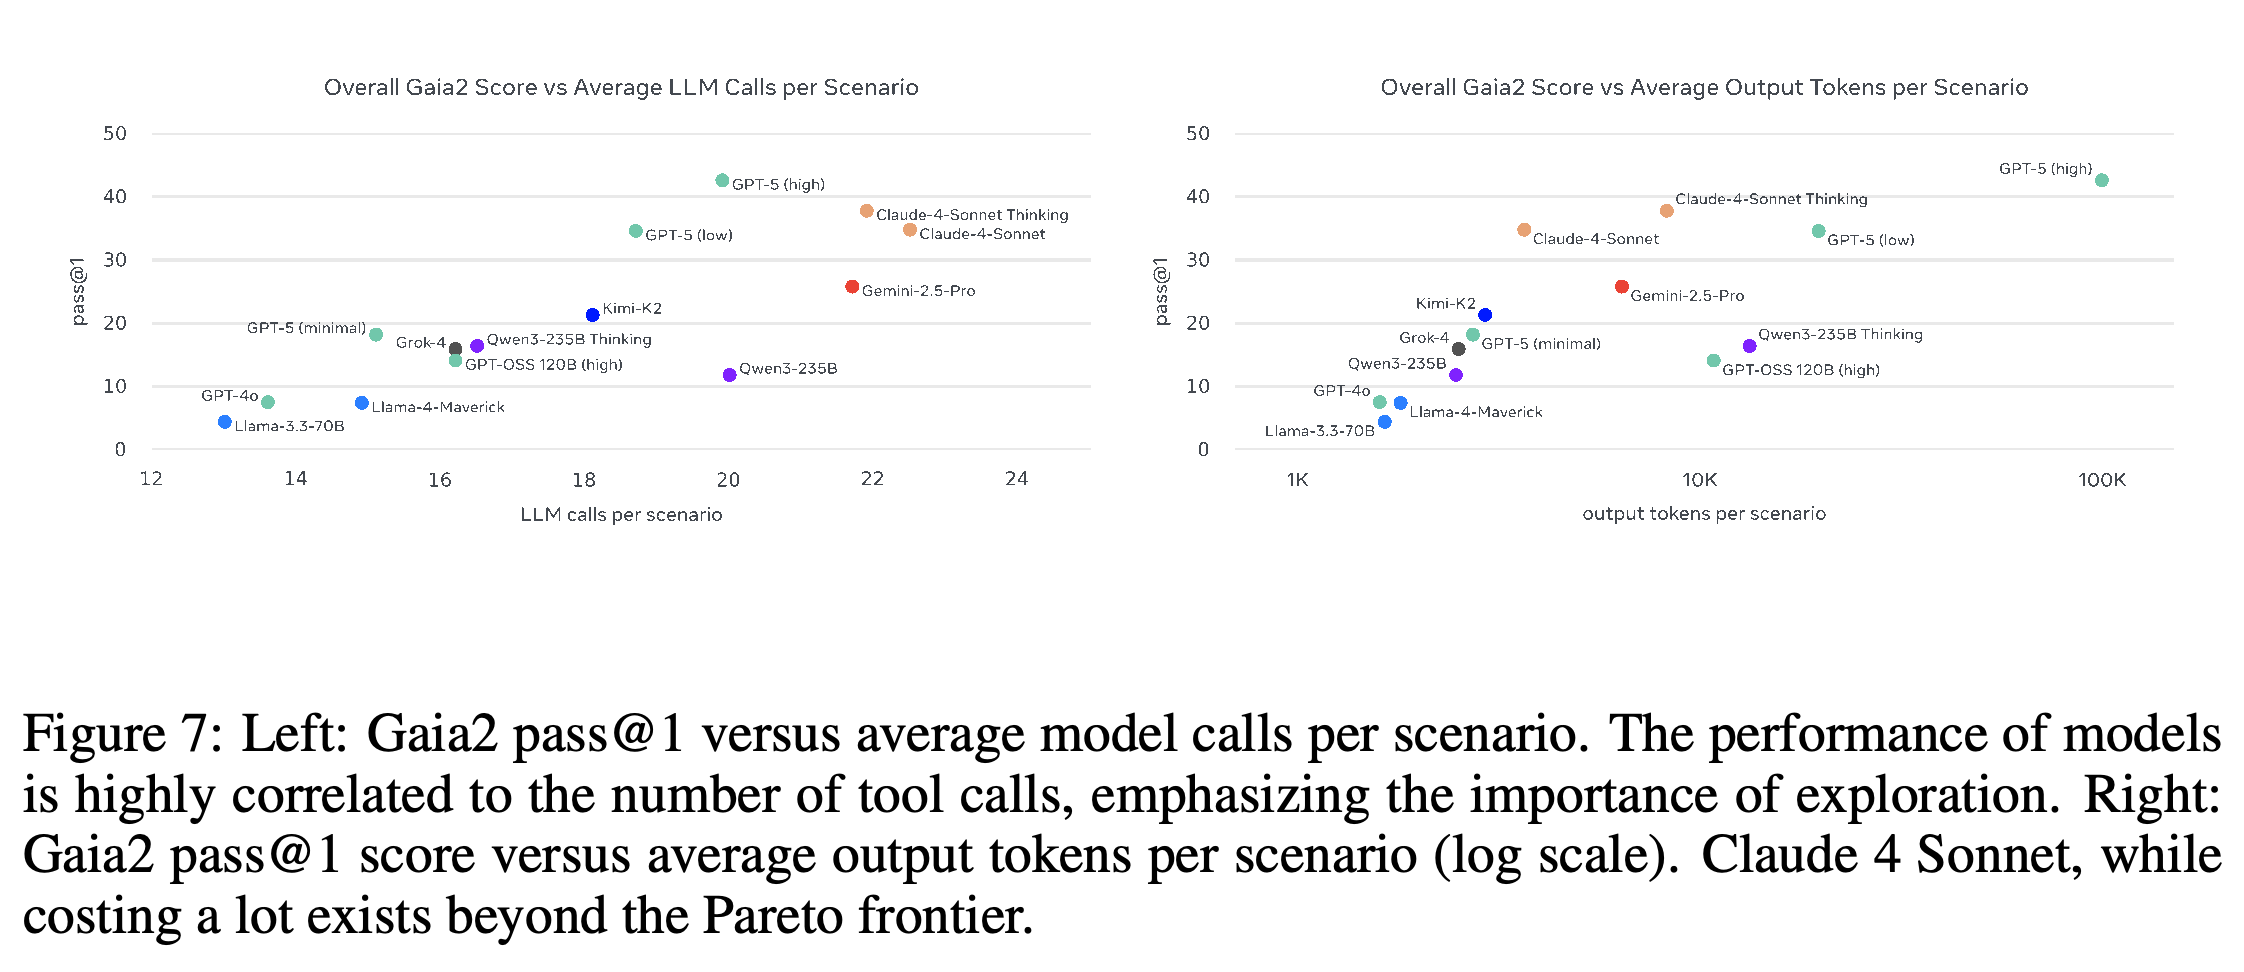
평가한 모델 전체에서 pass@1은 평균 모델 호출 수 및 생성한 출력 토큰 수와 양의 상관관계를 보인다. Figure 7이 이를 보여준다. Claude-4 Sonnet과 Kimi-K2는 상대적으로 적은 출력 토큰으로 비교적 높은 점수를 얻는다. Claude와 Qwen의 Thinking 버전은 단계당 더 많은 토큰을 쓰지만 전체 단계 수는 더 적다.
- 이는 모델 간 상관관계이며, 도구 호출이나 토큰을 늘리는 것 자체가 성공률을 높인다는 통제된 증거는 아니다.
- 저자들은 모델 간 앱 사용 패턴이 거의 같다고 보고한다. 토큰 효율을 설명하기 위해 제안한 아키텍처상의 원인은 직접 검증하지 않는다.
일반적으로 모델 호출 수와 출력 토큰 수가 많을수록 점수가 높다. 다만 Claude 4 Sonnet과 Kimi-K2는 더 적은 생성 토큰으로 상대적으로 높은 정확도를 달성한다. 이 산점도는 상관관계와 효율이 두드러지는 모델을 보여주며, 연산량 증가의 인과적 효과를 입증하지는 않는다.
5.2 TIME REVEALS THE IMPACT OF INFERENCE SPEED—AND SYSTEM RELIABILITY
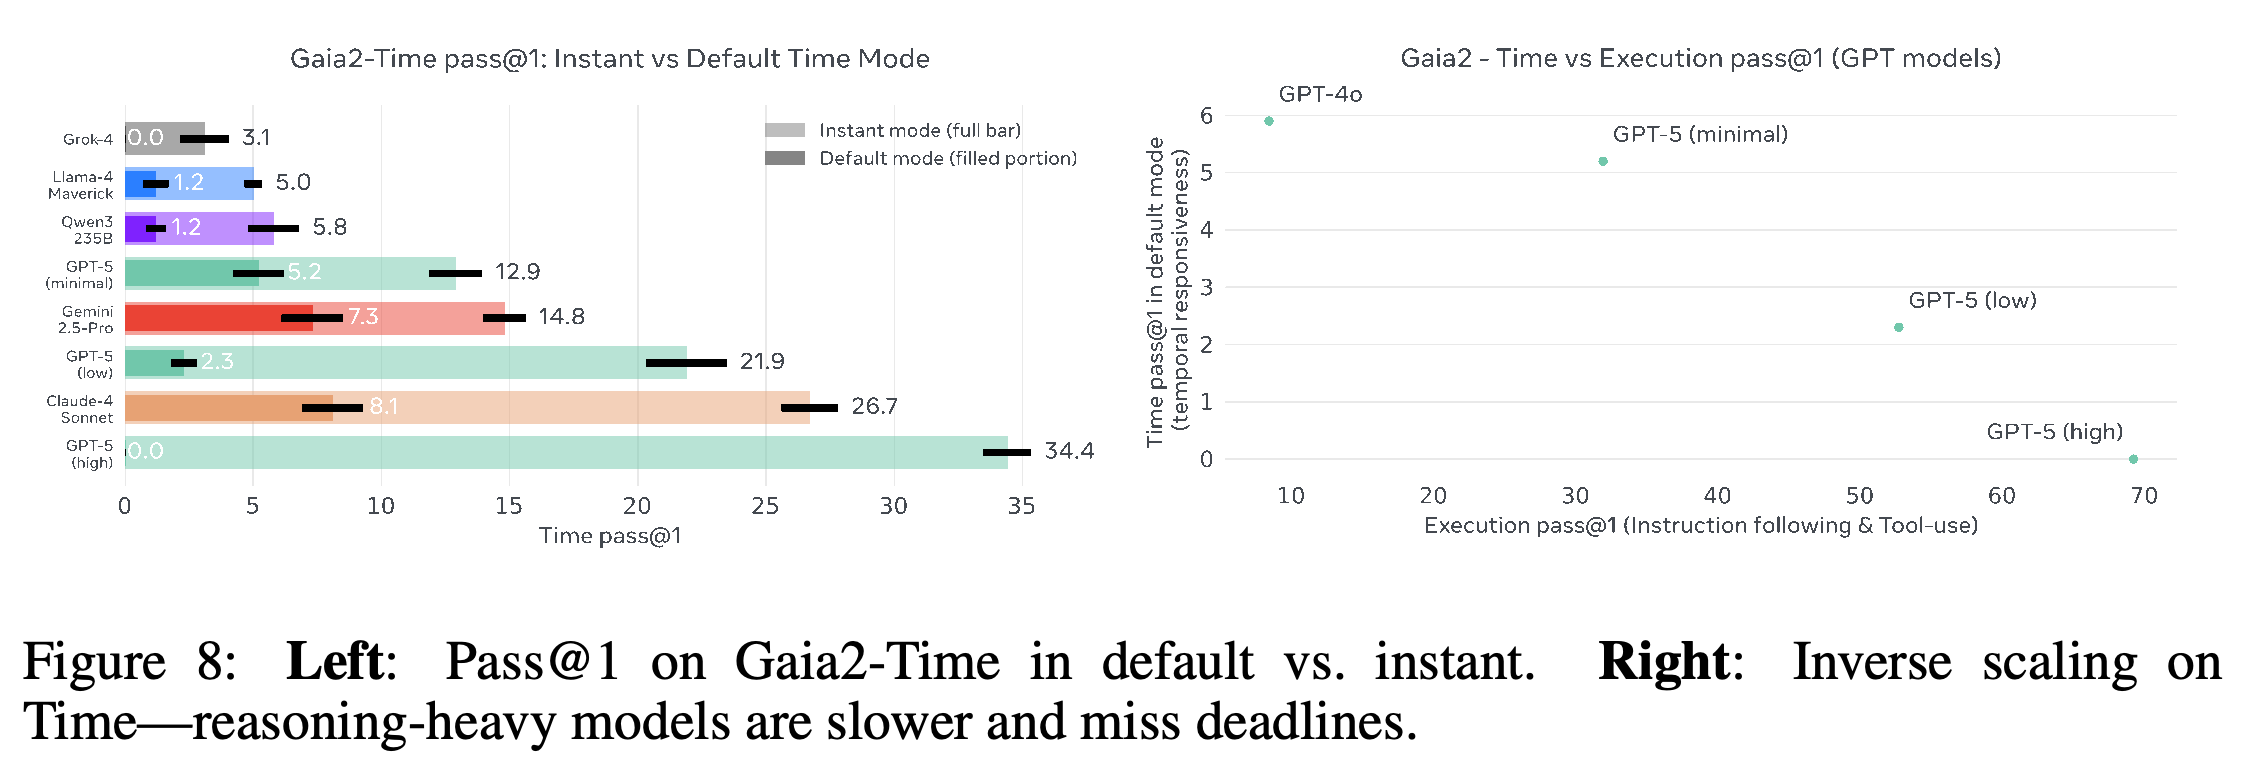
instant 모드에서 생성 지연을 제거하면 Time 점수가 GPT-5 (high)는 0.0%에서 34.4%로, Claude-4 Sonnet은 8.1%에서 26.7%로, Gemini 2.5 Pro는 7.3%에서 14.8%로 상승한다. 기본 모드에서는 GPT-5의 reasoning effort를 높일수록 Execution 성능이 개선되지만 시간 제약에 대한 대응력은 낮아진다.
- 지연 제거 실험은 해당 설정에서 생성 시간이 Time 실패에 크게 기여함을 보여준다. 다만 instant 모드 점수도 완전한 성공에는 크게 못 미친다.
- 적응적 연산 배분과 안정적인 서빙 인프라를 향후 방향으로 제안한다. 그러나 적응적 정책이나 서빙 안정성을 바꾸는 통제된 개입은 평가하지 않는다.
- 일부 작업은 좁은 시간 구간에서 동시 행동을 요구하며, 기본 단일 스레드 실행 구조로는 이를 충분히 표현할 수 없다.
생성 지연을 제거하면 Time 성능이 크게 높아진다. 특히 GPT-5 (high)의 점수는 0.0%에서 34.4%로 상승한다. GPT 계열 비교는 Execution 점수가 높아져도 마감 시점에 민감한 작업의 성능은 낮아질 수 있음을 보여준다.
5.3 A Closer Look at Multi-AGENT Collaboration on GAIA2 with Agent2Agent
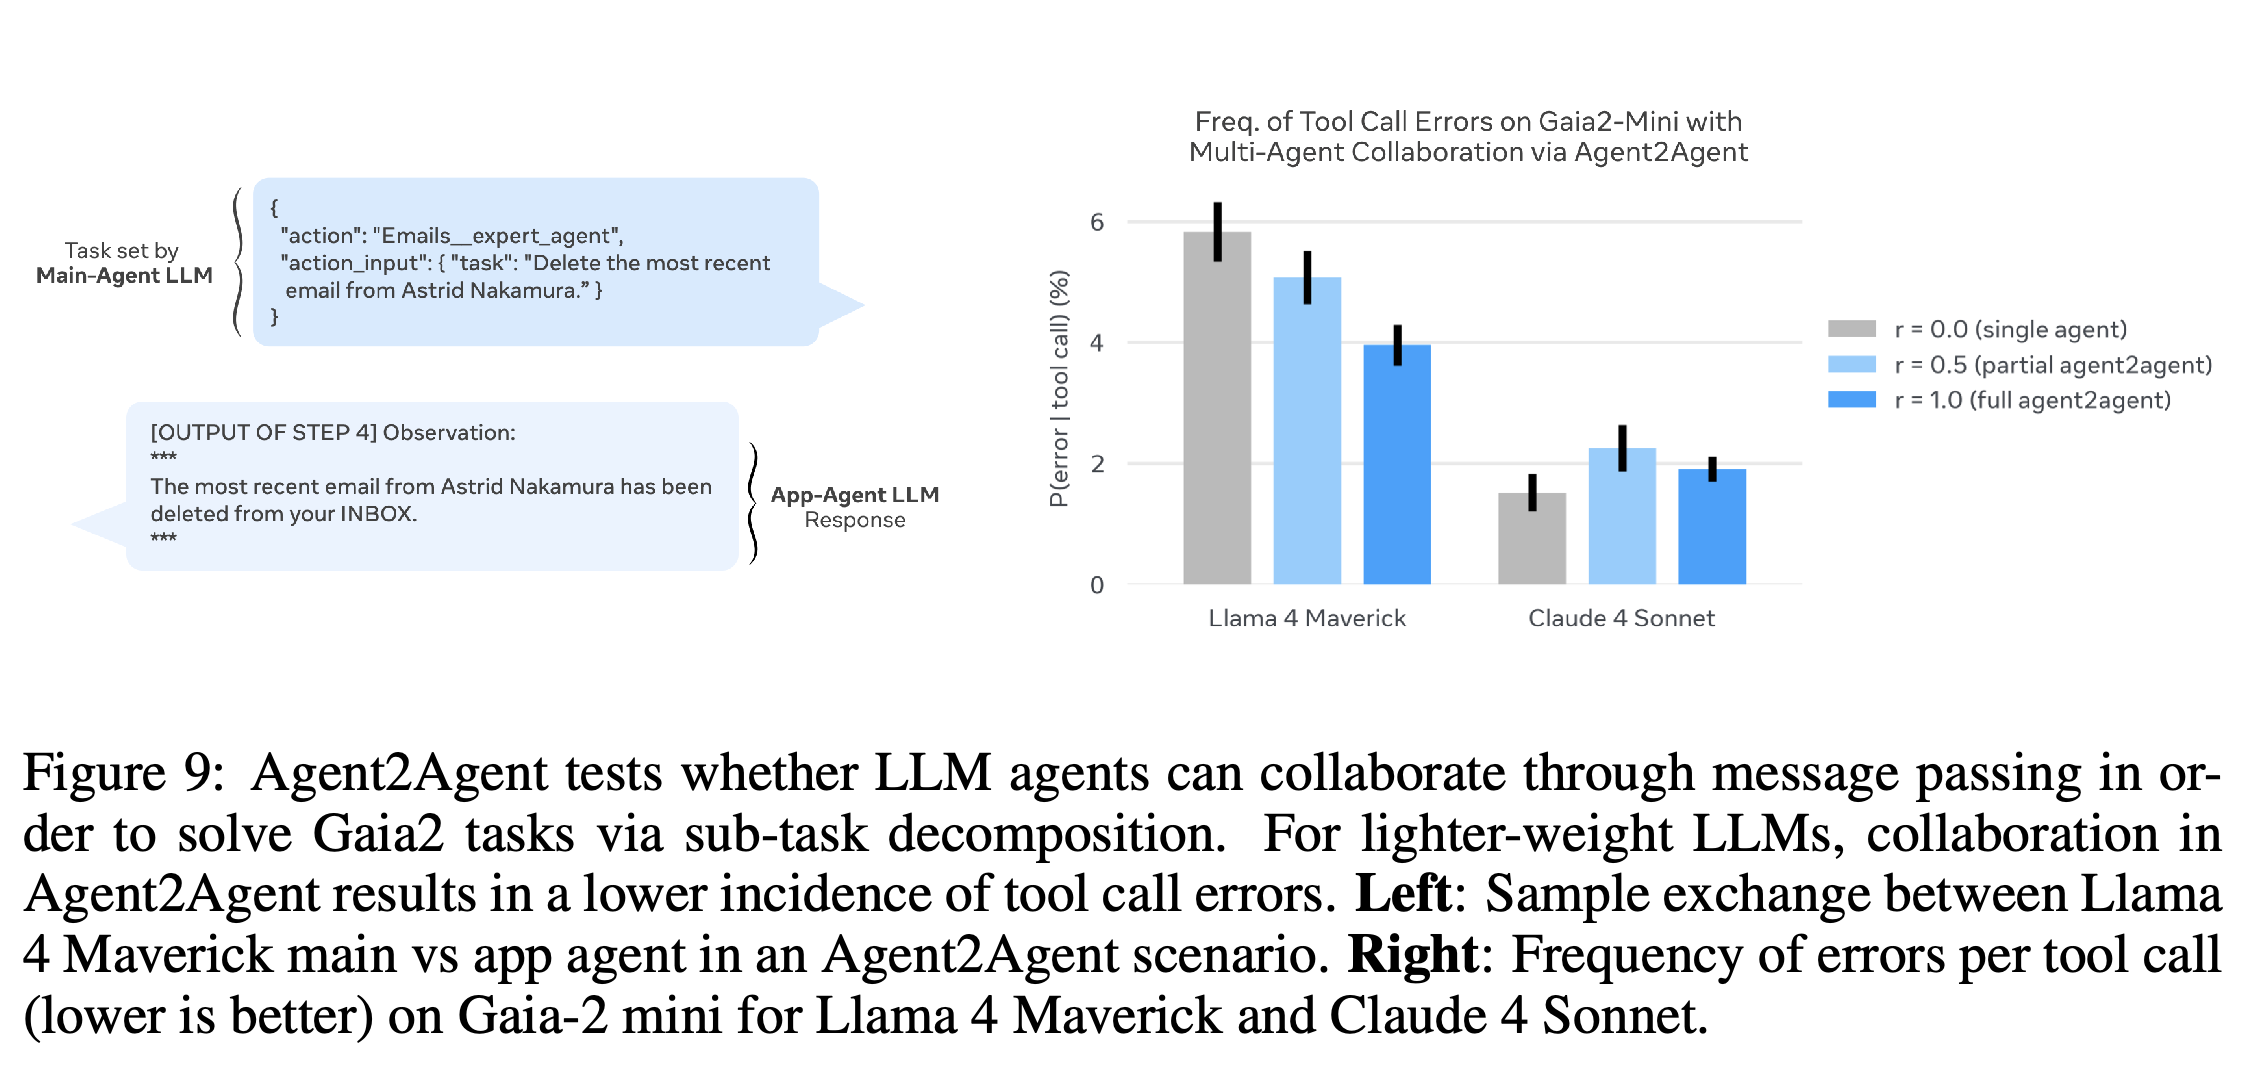
Gaia2-mini에서 Agent2Agent 비율 r을 높이면 Llama 4 Maverick의 반복 샘플링 pass@k와 총 토큰 사용량 사이의 상충 관계가 개선되고 도구 호출 오류가 줄어든다. Claude 4 Sonnet은 토큰 사용량을 기준으로 비교했을 때 이에 상응하는 이점을 얻지 못한다. 협업 설정의 도구 호출 오류율도 단일 에이전트 설정보다 높다.
- main-agent는 일정 시간 동안 수행해야 하는 하위 작업을 app-agent에 위임한다. 이 과정에서 계층적 작업 분해와 메시지 전달에 따른 추가 비용이 발생한다.
- Figures 9와 10은 협업의 효과가 모델에 따라 다름을 뒷받침한다. 협업자가 많을수록 모든 에이전트가 개선된다는 일반적인 주장을 뒷받침하지는 않는다.
- 작업 분해의 이점이 조율 비용을 넘을 때 위임이 도움이 된다는 설명을 제안하지만, 이를 별도의 인과 실험으로 분리해 검증하지는 않는다.
위임 예시는 main-agent가 하위 작업을 지정하고 app-agent의 보고를 받는 과정을 보여준다. 위임을 늘리면 Llama 4 Maverick의 도구 호출 오류는 줄어든다. 반면 Claude 4 Sonnet은 협업 설정 모두에서 단일 에이전트 설정보다 오류율이 높으며, 비율이 높아질수록 일관되게 개선되지 않는다.
총 토큰 사용량이 비슷할 때 협업은 Llama 4 Maverick의 반복 샘플링 성공 곡선을 개선한다. Claude 4 Sonnet에서는 토큰 사용량을 기준으로 비교했을 때 이에 상응하는 이점이 나타나지 않는다. 따라서 결과는 특정 모델과 실행 조율 방식의 조합에 한정된다.
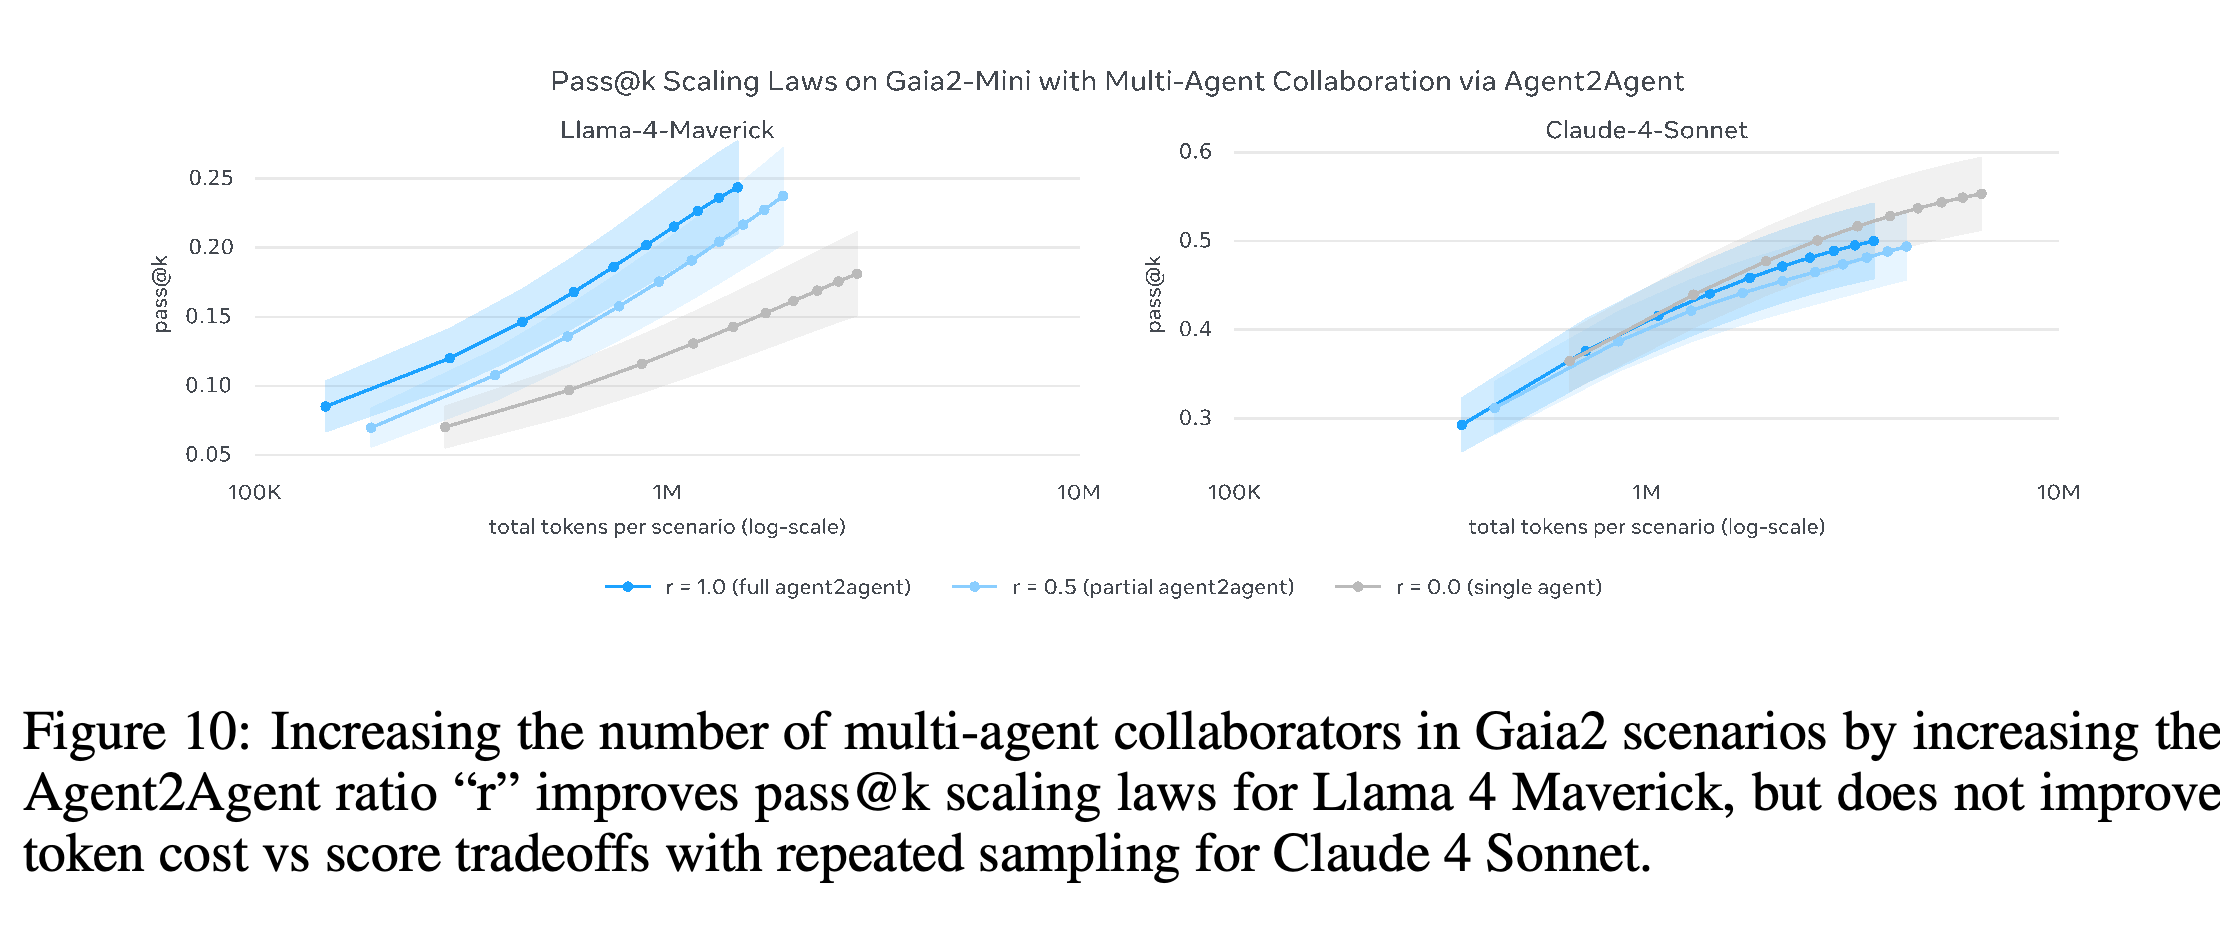
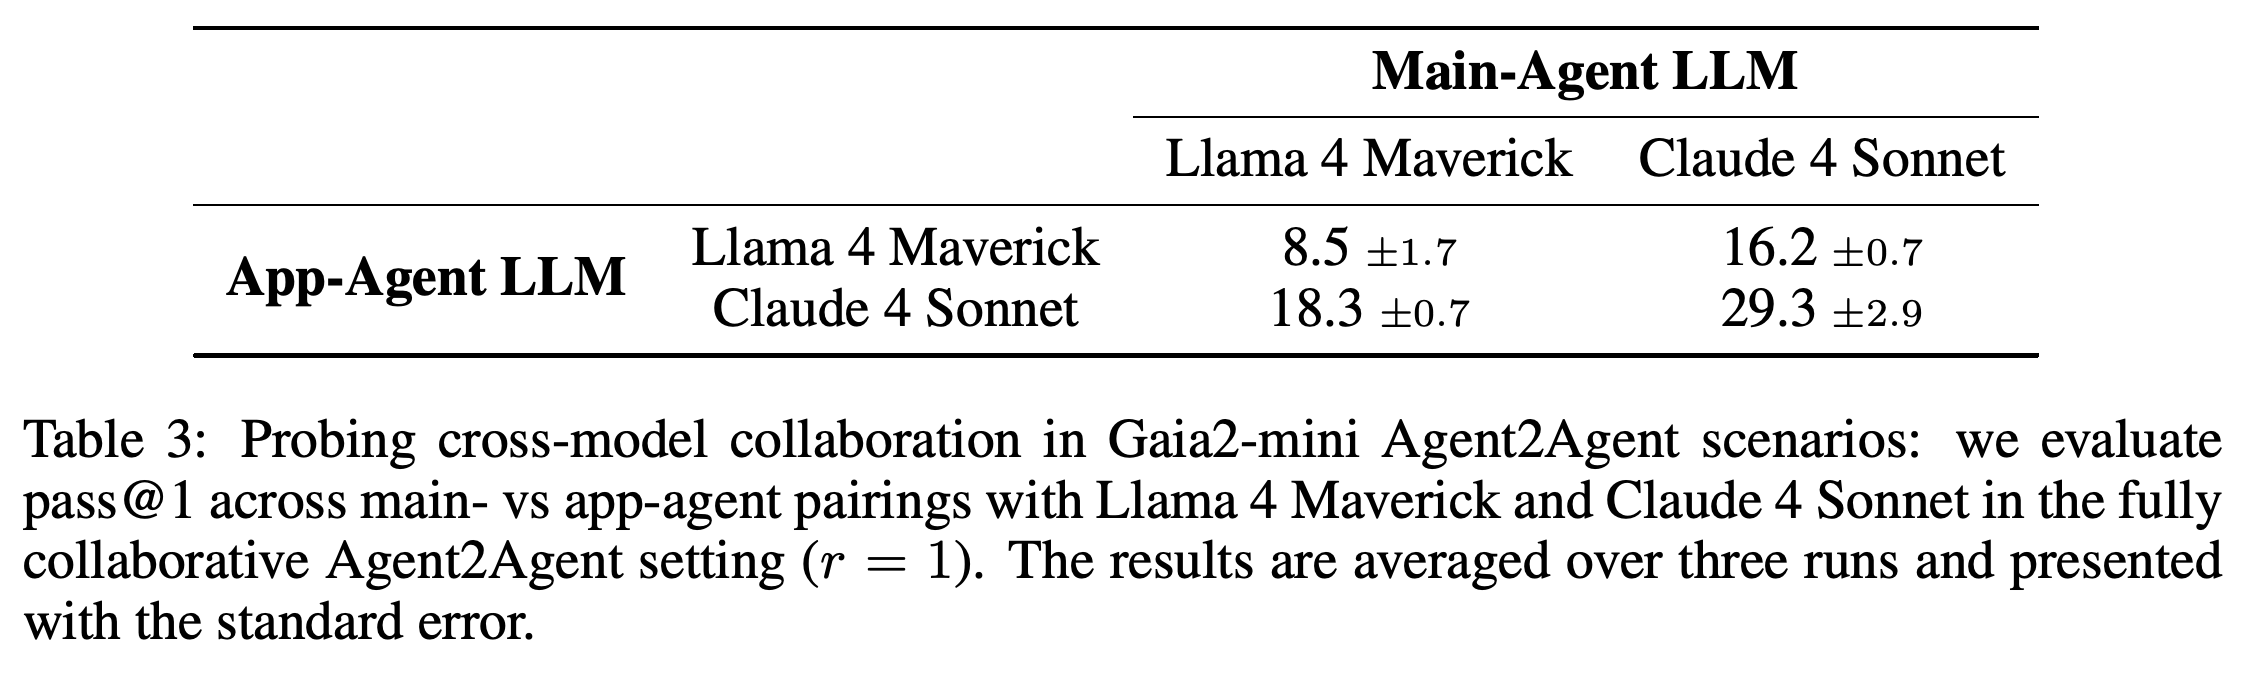
Table 3은 r = 1에서 서로 다른 모델의 main-agent/app-agent 조합을 평가하며, 3회 실행의 평균과 표준오차를 제시한다. 표의 라벨에 따르면 all-Llama는 8.5 ±1.7, Llama-main과 Claude-app은 18.3 ±0.7, Claude-main과 Llama-app은 16.2 ±0.7, all-Claude는 29.3 ±2.9다.
- 어느 역할이든 Claude로 바꾸면 all-Llama 설정보다 개선된다. 평가한 팀 중 가장 강한 구성은 main-agent와 app-agent 모두 Claude를 사용하는 팀이다.
- 주변 본문은 2개 혼합 팀의 점수를 서로 바꿔 서술한다. 여기서는 표의 main-agent 열과 app-agent 행에 따른 값을 사용한다.
- 이 결과는 이질적인 팀이 가장 강한 동질적 팀보다 우수하거나, 금전적 비용을 기준으로 보정한 뒤에도 최적임을 입증하지 않는다.
표의 라벨에 따르면 Llama-main/Claude-app은 18.3 ±0.7이고, Claude-main/Llama-app은 16.2 ±0.7이다. 주변 본문에서는 이 값이 서로 바뀌어 있다. 혼합 설정 모두 all-Llama의 8.5 ±1.7보다 높지만, all-Claude가 29.3 ±2.9로 가장 높다.
6 Conclusion & Discussion
논문은 비동기 평가가 정적인 작업 점수에 가려진 정확도·비용·지연 사이의 상충 관계를 드러낸다고 결론짓는다. ARE는 평가와 RLVR에 재사용할 수 있는 행동 단위 검증을 제공한다. Time과 Agent2Agent 실험은 작업 정확도와 함께 응답 속도와 위임을 평가하는 일이 중요함을 보여준다.
- 측정된 검증기의 정밀도와 재현율은 실용성을 뒷받침한다. 다만 관찰된 보상 해킹 사례는 검증과 적대적 검사가 계속 필요한 이유를 보여준다.
- 적응적 연산 배분, 혼합 보상 신호, 개선된 위임은 제안한 연구 방향이며, 입증된 해결책은 아니다.
부록
- A ARE APPENDIX와 A.1 ARE FOUNDATIONS는 앱, 환경, 이벤트, 알림, 시나리오를 설명한다. 앱은 내부 상태를 유지한다. Python App 메서드는 도구 설명으로 변환되고, 데코레이터는 읽기 도구와 쓰기 도구를 구분한다. 역할별 범위는 에이전트, 사용자, 환경의 행동을 분리한다. MCP 호환성과 교체 가능한 저장소 백엔드는 확장을 지원한다. AgentUserInterface는 블로킹 및 논블로킹 통신을 제공하고, System은 시간 조회와 대기 도구를 제공한다. 대기 중에는 이벤트 사이를 건너뛰며 시뮬레이션을 빠르게 실행한다. A.1.2 ENVIRONMENT는 앱, 시간 관리, 알림을 상태에 포함하는 Markov Decision Process를 정의한다. 초기 상태와 시드가 고정되면 실행은 결정적이다.
- A.1.3 EVENTS는 이벤트 생성, EventQueue의 의존성 기반 예약, EventLoop의 실행, EventLog의 기록을 설명한다. 도구 호출 이벤트는 에이전트, 사용자, 환경의 활동을 나타낸다. 조건부 이벤트는 조건을 감시하고, 검증 이벤트는 주요 단계나 제약을 검사하며, 오라클 이벤트는 정답을 표현한다. A.1.4 NOTIFICATION SYSTEM과 A.2 NOTIFICATION POLICIES IN ARE는 low, medium, high 정책으로 관측 범위를 바꾼다. 사용자 메시지는 항상 알리며, 에이전트는 알림 없이도 앱 내용을 능동적으로 확인할 수 있다. medium 정책은 일부 이메일, 메시지, 쇼핑, 차량 호출, 캘린더 변경을 알린다. A.1.5 SCENARIOS는 scenario.py에서 초기 상태, 예약 이벤트, 검증을 구현하며, 보통 send_message_to_agent로 시작한다. 2턴 예시는 Chats 탐색에서 비동기적으로 받은 이메일 처리로 전환하며, 턴 경계에서 검증한다.
- A.3 UNIVERSE GENERATION은 의존성을 처리할 때 Contacts 같은 기반 앱을 우선한다. PersonaHub 시드에 위치 정보를 추가하고, 샘플링한 사용자 페르소나를 각 universe의 기준으로 삼는다. Chats와 Messages는 최소 10개의 메시지가 번갈아 오가는 그룹 및 개인 대화를 포함한다. Emails는 사용자와 연락처 페르소나를 바탕으로 받은 편지함과 보낸 편지함의 콘텐츠를 생성한다. Calendar는 주간 일정과 요약을 반복적으로 생성하고, RentAFlat은 매물을 제공한다. City는 우편번호별 범죄 수치를 1–100 범위로 지정하며, Cabs는 국가에 맞는 탑승 기록을 생성한다. Shopping은 공개 Amazon 데이터셋에서 universe마다 500개 상품을 샘플링한다. Files는 개인정보가 없는 공개 콘텐츠와 파일을 universe 간에 공유한다. 해결되지 않은 시간적 일관성, 통신 채널 간 관계 일관성, 모달리티 간 참조 문제가 합성 세계의 일관성을 제한한다.
- A.4 ARE GRAPHICAL USER INTERFACE는 환경 탐색, 이벤트 DAG 시각화, 타임스탬프가 있는 실행 기록 확인, 과거 단계 수정 후 재실행을 결합한다. 앱 화면은 자동으로 생성한다. 시나리오 화면은 의존성, 트리거, 시간 제약, 실행 상태를 보여주며, 긴 시나리오에서는 시간을 건너뛸 수 있다. 실행 기록만 주석 처리하는 도구와 달리, 이 인터페이스에서는 재현 가능한 시뮬레이션 안에서 시나리오를 구성할 수 있다. 그래프 기반 주석 편집기는 구조와 실행 시점의 불일치를 검사한다. 수동 방식과 비교해 Mobile 주석 작업 시간 측면의 효율을 약 5 times 높였다고 보고한다. 논문 작성 시점에는 주석 인터페이스를 공개하지 않았다고 명시한다.
- B.1 DETAILS OF GAIA2 ANNOTATION은 send_message_to_agent를 루트로 하는 연결된 이벤트 DAG와 단일 대화 분기를 요구한다. 턴은 send_message_to_user로 끝나야 하며, 그 뒤에는 사용자 메시지나 환경 이벤트만 올 수 있다. 예시에는 24세 이하 연락처 갱신, Contacts와 Chats에서 친구들의 도시 집계 및 동률 시 알파벳순 선택, 일정 충돌 탐지, 친구의 답변에 따른 매물 방문 변경, 3분 동안 응답이 없을 때 차량 호출이 포함된다. Search는 최종 답변만 쓰기 행동으로 허용하며, 복잡한 계산 없이 간결하게 답해야 한다. Ambiguity는 단일 턴이며 모호성을 보고하라고 명시적으로 요청한다. 불가능한 요청, 모순, 정보 부족, 여러 유효한 해석을 포함한다. Adaptability는 행동, 보고, 의존적 환경 이벤트, 적응의 순서를 따르며 방해 요소를 추가할 수 있다. 이벤트 분류는 초기 요청에 연결된 독립 이벤트와 에이전트 보고 뒤의 의존 이벤트를 구분하고, 방해 요소에는 구조적 예외를 허용한다. Time은 시계나 이벤트가 촉발하는 일회성 및 반복 작업을 5분 범위 안에서 다룬다. 오라클의 상대 지연이 1초를 초과하면 시간 검사를 적용하며, ([\Delta t-5\,\mathrm{sec},\;\Delta t+25\,\mathrm{sec}]) 안의 행동을 허용한다. 이벤트 직후 수행해야 하는 행동에는 +2 sec 지연을 주석으로 지정한다.
- B.2 VERIFICATION DETAILS는 쓰기 도구 호출 횟수를 검사하고, 오라클 행동을 위상 정렬한 뒤 인자, 선행 부모 행동, 상대적 실행 시점을 매칭한다. 동등한 대체 쓰기 행동은 없다고 가정하므로, 오라클의 Chats 도구 대신 Messages를 사용하면 실패한다. 멀티턴 검증은 온라인이든 오프라인이든 모든 턴이 통과해야 실행 궤적을 승인한다. 실행 중에는 검증 성공을 이후 턴의 진행 조건으로 삼을 수 있다. 접근 가능한 오라클이 없는 테스트 시나리오는 send_message_to_user 뒤에 다음 턴으로 진행한다. RL 실험에서는 코드와 유사한 답변 내용으로 판정기를 해킹하는 사례가 나타났으며, 작업에 종속되지 않는 문체 검사를 추가해 관찰된 취약점에 대응했다. 합성 단위 테스트가 실제 행동을 모두 다룰 수 없으므로, 검증기 검증에는 유효성을 유지하거나 깨뜨리는 오라클 변형과 사람이 라벨링한 모델 실행 궤적 450개를 함께 사용한다. 구조화된 검증기와 in-context 기준선 모두 Llama 3.3 70B Instruct를 사용한다. 대체 검증기 모델인 Gemini 2.5 pro와 Claude Sonnet 3.7은 같은 검증 세트에서 각각 일치도 0.96, 정밀도 0.98, 재현율 0.89를 달성한다.
- B.3 AGENT ORCHESTRATION은 각 ReAct 단계를 Thought, Action, Observation으로 정의하고, 그 전후에 설정 가능한 메서드를 배치한다. 보고된 Execution 및 Time 비교 실험에서 Parallel Tool Calling에 따른 pass@1 변화는 −6.3에서 +3.0 %p다. Execution의 GPT-5 (low)는 435 s와 출력 토큰 5109개를 절약하지만 점수는 1.0 %p 낮아진다. 일부 설정에서는 시간이나 토큰을 더 많이 사용한다. B.4 EXPERIMENTAL SETUP AND IMPLEMENTATION DETAILS는 Claude, Kimi, Qwen에 맞춤 stop sequence를 사용하고, Gemini의 dynamic reasoning을 활성화한다. Grok-4의 추론은 16K 토큰으로 제한하며, GPT-5의 temperature와 top-p는 1로 설정한다. 잦은 Grok-4 Empty Response 오류, 비용과 지연에 따른 모델 제외, 중간 추론 폐기 때문에 이 점수가 각 모델의 최적 에이전트 성능을 충분히 반영하지 못할 수 있다.
- B.5 ADDITIONAL EXPERIMENTS는 모델 계열 간 하위 에이전트 생성 행동이 대체로 비슷하다고 보고한다. Agent2Agent 성능이 높은 모델은 더 많은 협업자를 생성하는 경향이 있다. 시나리오 시간 초과 전까지 협업자 수에 명시적인 한도는 없다. 노이즈 수준 비교 실험은 도구 오류 확률과 방해 이벤트 빈도를 바꾼다. Claude-4 Sonnet 점수는 노이즈가 없을 때 31.2, low 노이즈에서 35.0, 기본 medium 노이즈에서 23.8, high 노이즈에서 8.1이다. 제시한 표는 1개 모델만 다루고 불확실성 추정치를 제공하지 않는다. 따라서 해당 모델에서 강한 노이즈에 따른 성능 저하를 뒷받침하지만, 보편적 경향의 크기를 정량화하거나 낮은 노이즈의 이점을 통계적으로 입증하지는 않는다.
짧은 생각
지연 제거 실험은 특히 유용하다. 전체 점수가 가장 높은 모델도 기본 Time 시나리오에서는 모두 실패하지만, 생성 시간을 제거하면 성능이 크게 회복된다. Gaia2는 작업 정확도와 제때 실행하는 능력을 구분한다. 다만 합성 API 환경, 구조화된 프롬프트, 5분 범위의 Time 평가는 일반적인 배포 안정성에 관한 주장을 제한한다. 행동 단위 검증은 잘못된 중간 쓰기를 탐지한다. 그러나 쓰기 도구의 정확한 호출 횟수와 도구 일치 조건은 사용자의 더 넓은 목표를 달성할 수 있는 대체 전략이나 수정 전략도 거부한다. 협업 결과는 에이전트 수를 보편적인 확장 변수로 다루기보다, 모델별 역할과 자원 사용량을 기준으로 보정한 결과를 보고해야 함을 뒷받침한다. RLVR 호환성은 기반 구성요소 측면의 기여다. 보고한 RL 실험은 검증기 해킹을 드러내지만, 학습된 에이전트가 벤치마크의 성능 격차를 줄였음을 보여주지는 않는다.