


Online Experiential Learning for Language Models 요약 설명
17 Mar 2026 | Paper Review Online Learning On-Policy Distillation Agent Learning목차
- 요약
- 1 Introduction
- 2 Preliminary: Online Learning
- 3 Online Experiential Learning
- 4 Experiments
- 5 Related Work
- 6 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Online Experiential Learning for Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 3월 17일(Arxiv)
- Ye, Tianzhu, Dong, Li, Dong, Qingxiu, Wu, Xun, Huang, Shaohan, Wei, Furu.
- Microsoft Research
- 논문 링크
- Project Page
요약
- Online Experiential Learning (OEL)은 보상 감독 없이 배포 중 수집한 궤적을 모델 업데이트에 활용한다. 텍스트 상호작용 기록에서 다른 상황에도 적용할 수 있는 경험 지식을 추출하고, on-policy context distillation으로 모델에 내재화한다. 이 과정에서 서버는 상호작용 환경에 접근할 필요가 없다.
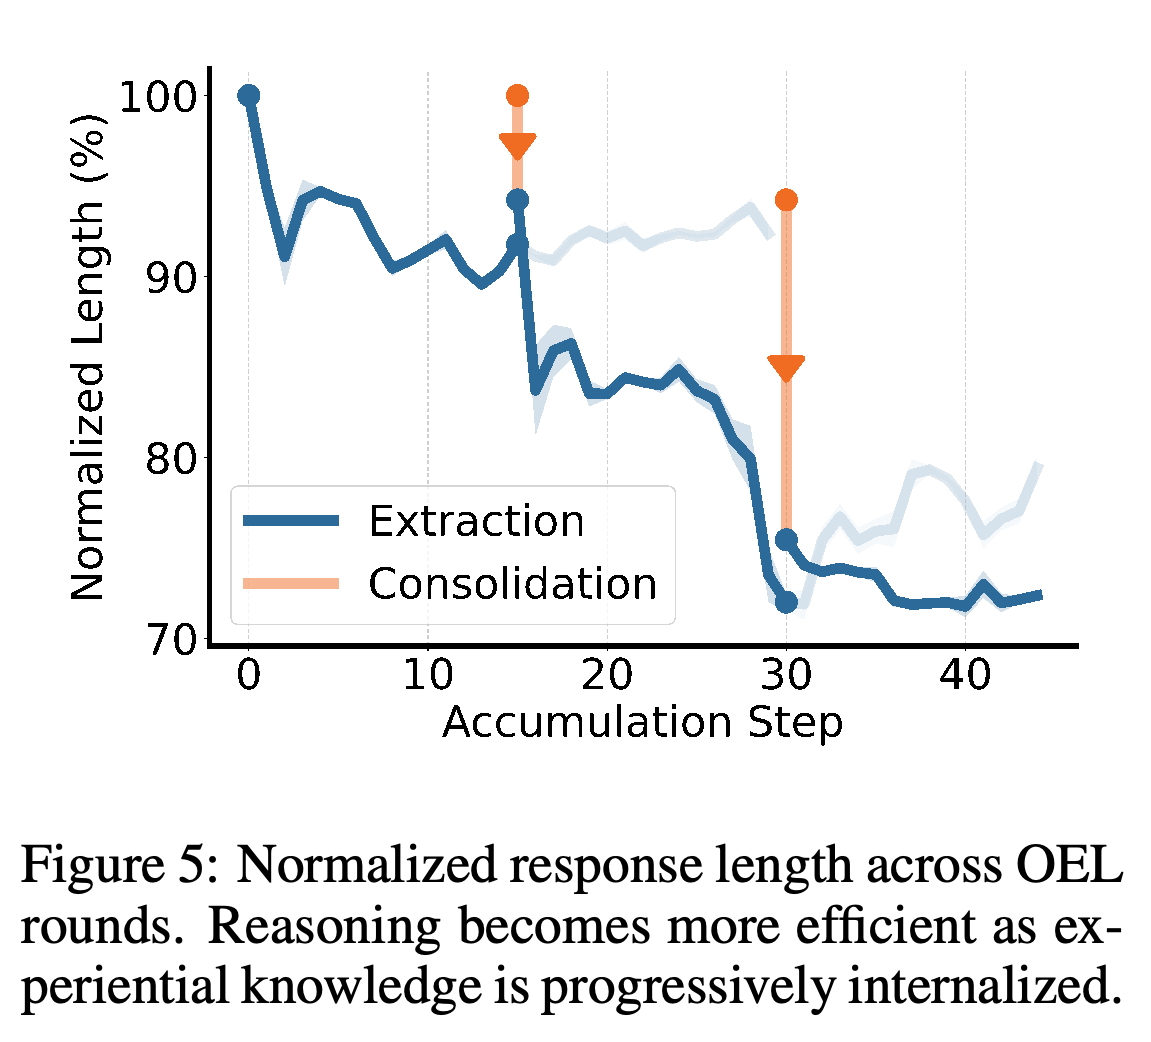
- 실험은 TextArena의 Frozen Lake와 Sokoban에서 수행한다. 모델은 파라미터가 1.7B, 4B, 8B인 Qwen3 thinking 모델과 Qwen3-4B-Instruct-2507을 사용한다. 라운드를 거듭할수록 게임 성공률이 높아진다. Frozen Lake의 Qwen3-1.7B는 3번째 반복까지 턴당 평균 응답 길이가 초기값의 약 70%로 줄어든다.
함께 제시된 그래프는 추출과 통합을 번갈아 수행하면서 성공률이 높아지고 정규화된 응답 길이가 줄어드는 모습을 보여준다. 통합 화살표는 파라미터 업데이트 후 지식 문맥 없는 모델의 변화를 나타내며, 추출 곡선은 문맥에 지식을 누적하는 효과를 보여준다.
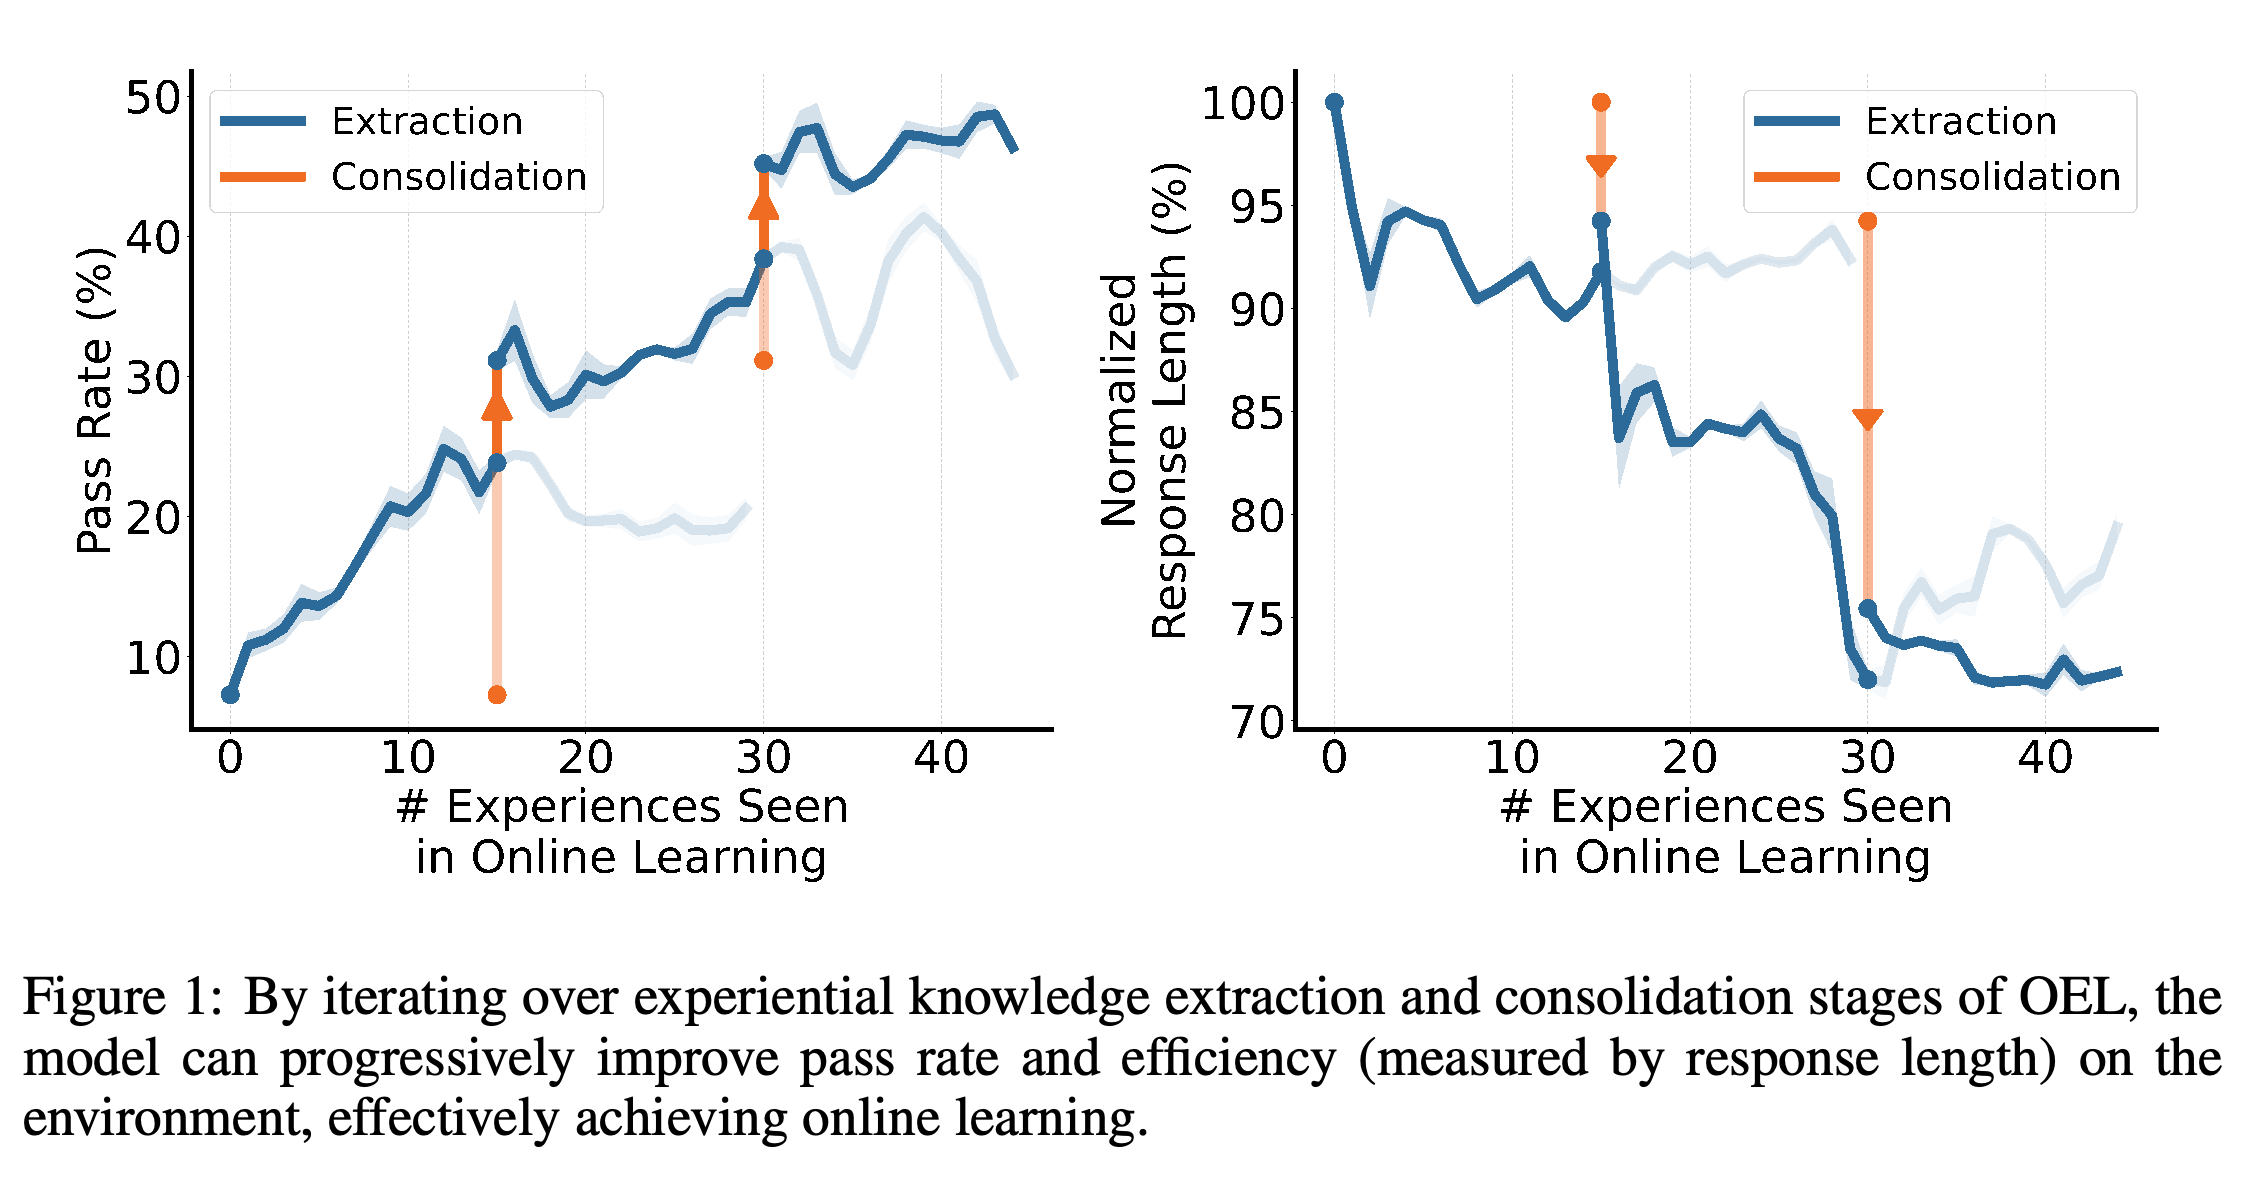
- Ablation에서는 원본 궤적보다 추출한 지식이, 더 큰 모델에서 가져온 지식보다 자체 추출한 지식이 더 효과적이다. On-policy 통합은 off-policy 대안보다 IF-Eval 정확도도 더 잘 유지한다. 다만 평가는 소규모 게임 환경 2개와 out-of-distribution 벤치마크 1개에 한정된다.
1 Introduction
이 논문은 학습 서버가 사용자 측 환경에 접근할 수 없고, 상호작용에서 스칼라 보상 대신 텍스트 피드백을 받는 상황에서 배포 경험을 학습하는 문제를 다룬다. OEL은 환경마다 사람이 단 주석이나 보상 함수를 요구하는 대신, 상호작용 기록으로 학습 신호를 구성한다.
- 사용자 측에서 상호작용 궤적을 수집하고, 서버에서 지식 추출과 파라미터 업데이트를 수행한다.
- 이 절차에는 사람이 단 주석, 보상 모델, 검증 가능한 보상 함수가 필요하지 않다. 게임 성공 여부는 평가 지표이며 학습 보상이 아니다.
- 이 논문은 On-Policy Context Distillation for Language Models에 이은 Experiential Learning 시리즈의 Part II다. 코드 주소는 aka.ms/oel-code다.
2 Preliminary: Online Learning
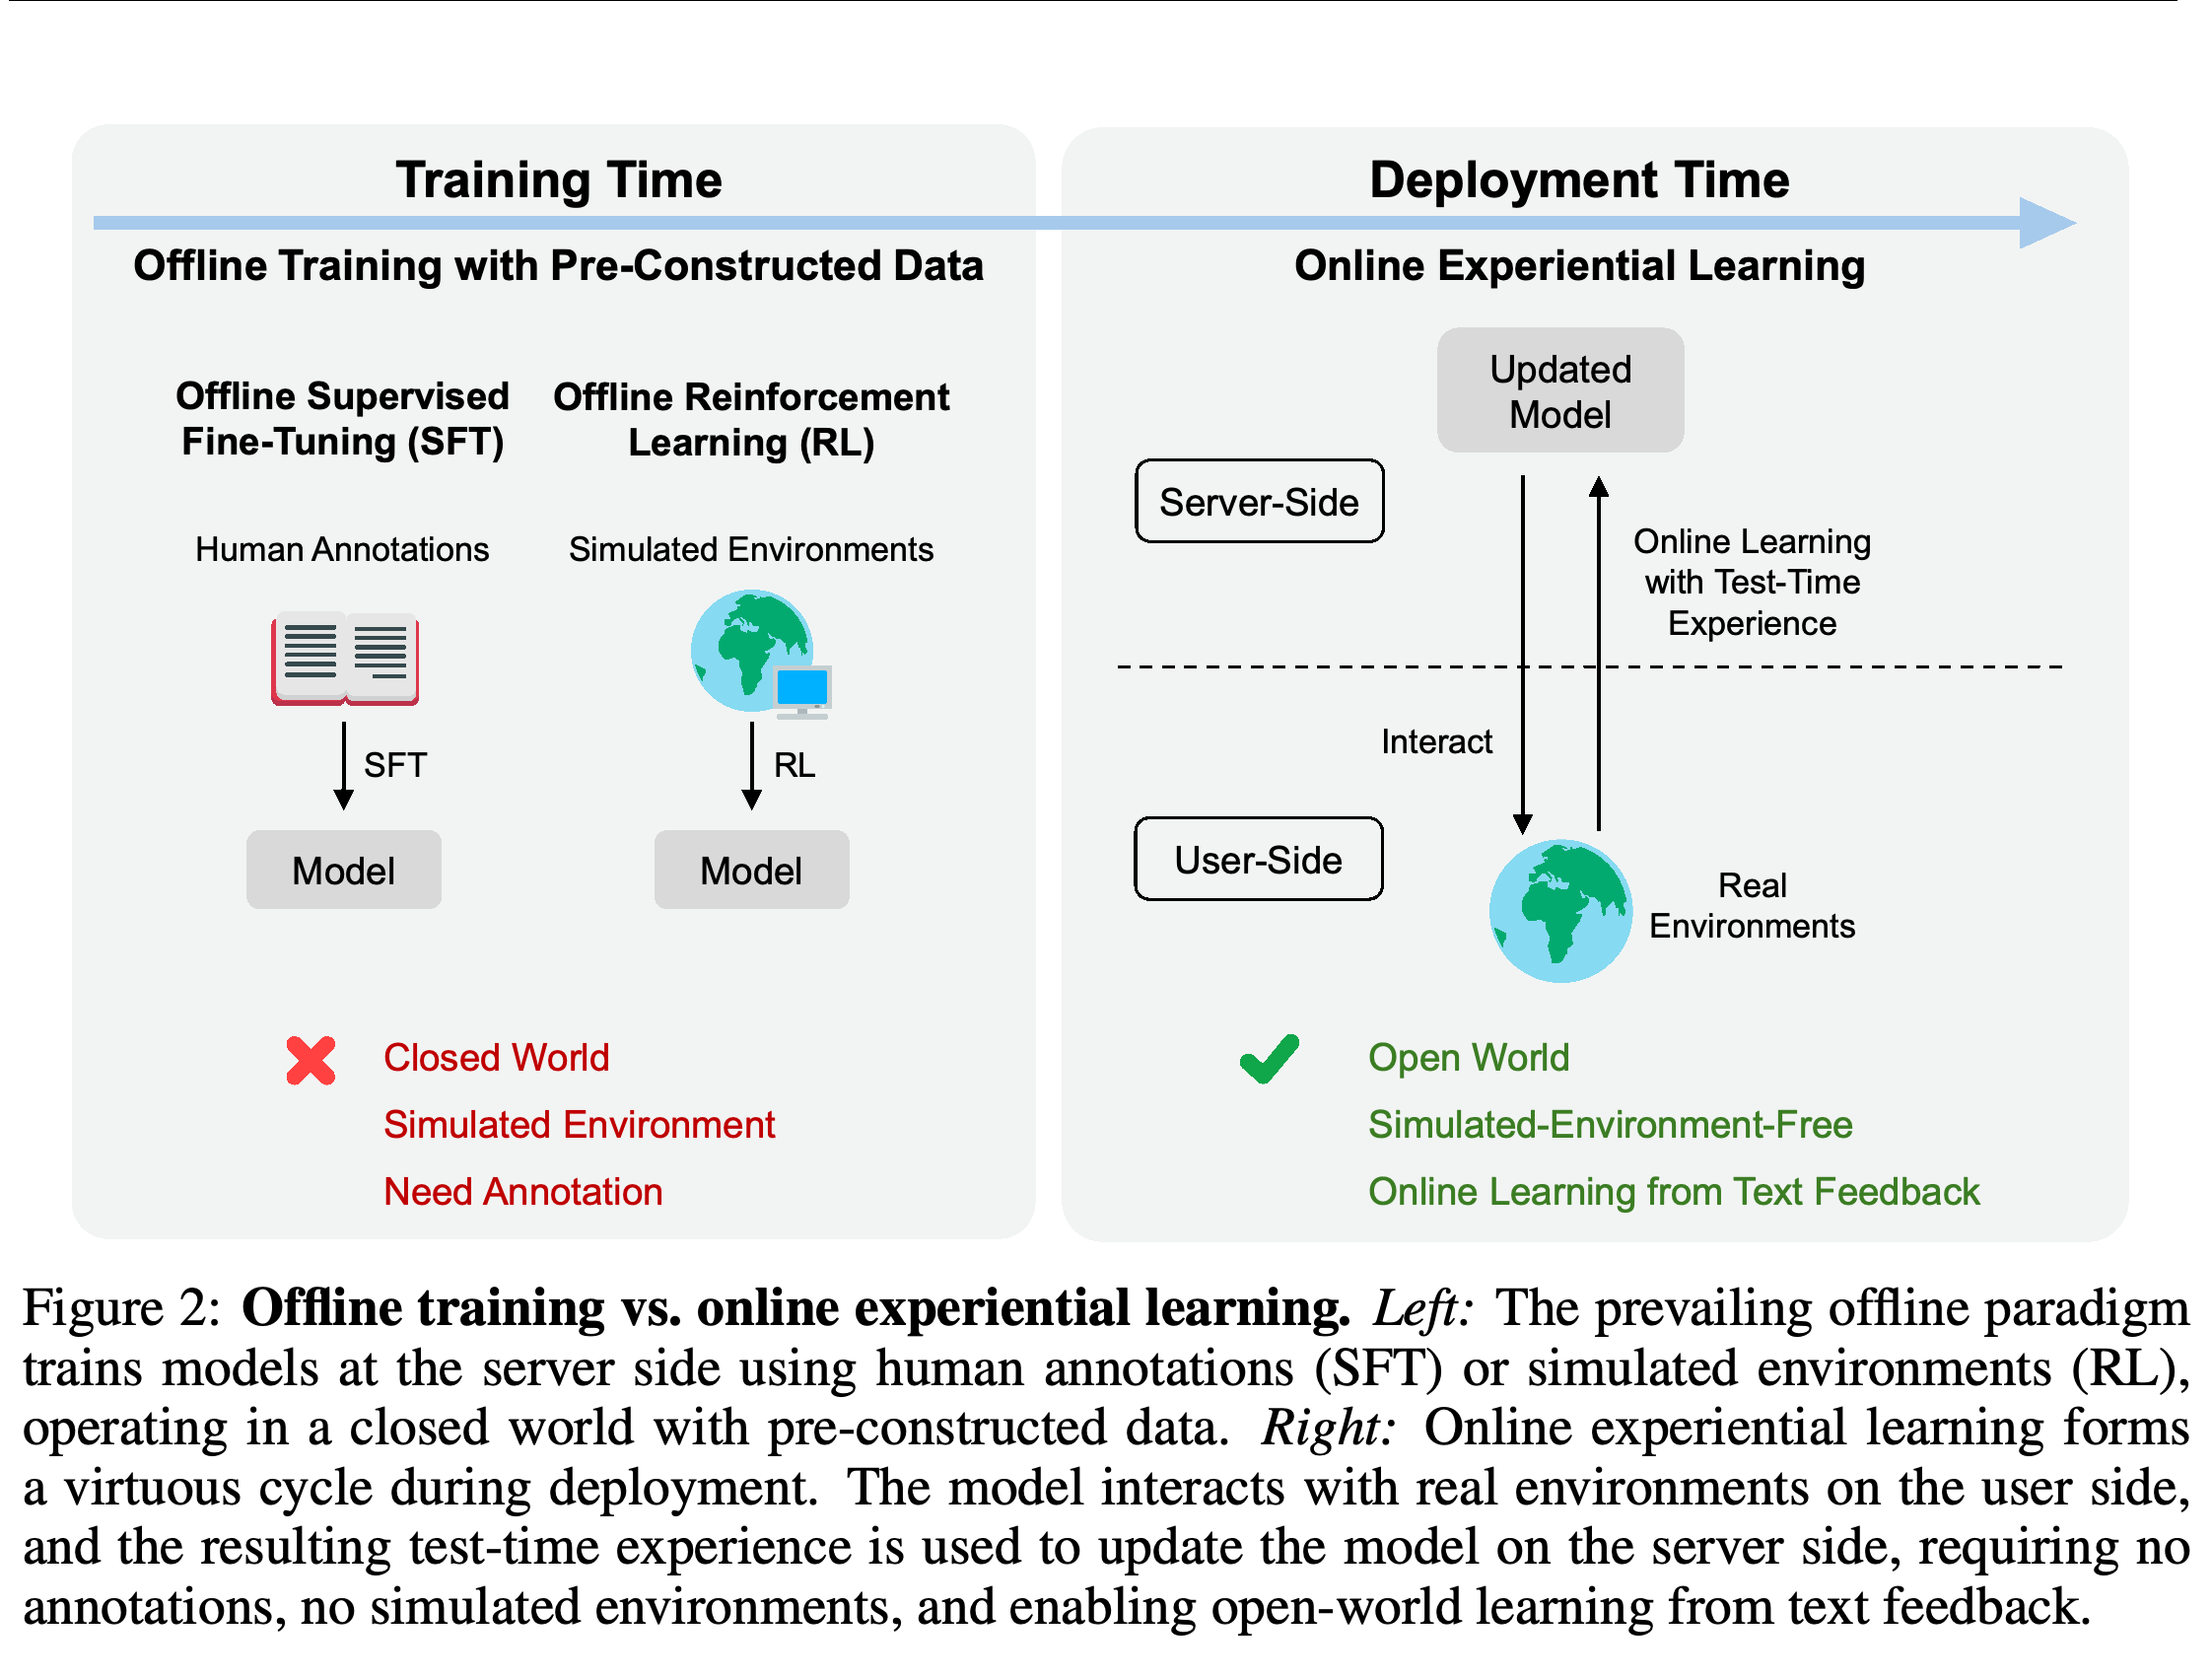
논문은 online learning을 미리 구성한 데이터셋만으로 학습하는 방식이 아니라, 배포와 경험 수집, 서버 측 업데이트를 반복하는 과정으로 설명한다. Figure 2는 사용자 측 상호작용과 서버 측 학습을 구분한다. 그림의 open-world 표현은 제안하는 배포 방식을 설명하며, 실험에서 직접 검증한 환경을 뜻하지는 않는다.
- 서버가 환경에 접근하지 않는다고 해서 환경 상호작용 자체가 없어지는 것은 아니다. 배포된 모델은 여전히 궤적을 수집해야 한다.
- 실험은 실제 사용자 배포가 아니라 통제된 TextArena 게임으로 이 구조를 구현한다.
도식은 사용자 측 상호작용과 수집한 경험을 활용하는 서버 측 업데이트를 구분한다. Open-world 표기는 제안하는 배포 방식을 설명한다. 실험이 통제된 게임 대신 실제 환경을 사용했다는 근거로 해석해서는 안 된다.
3 Online Experiential Learning
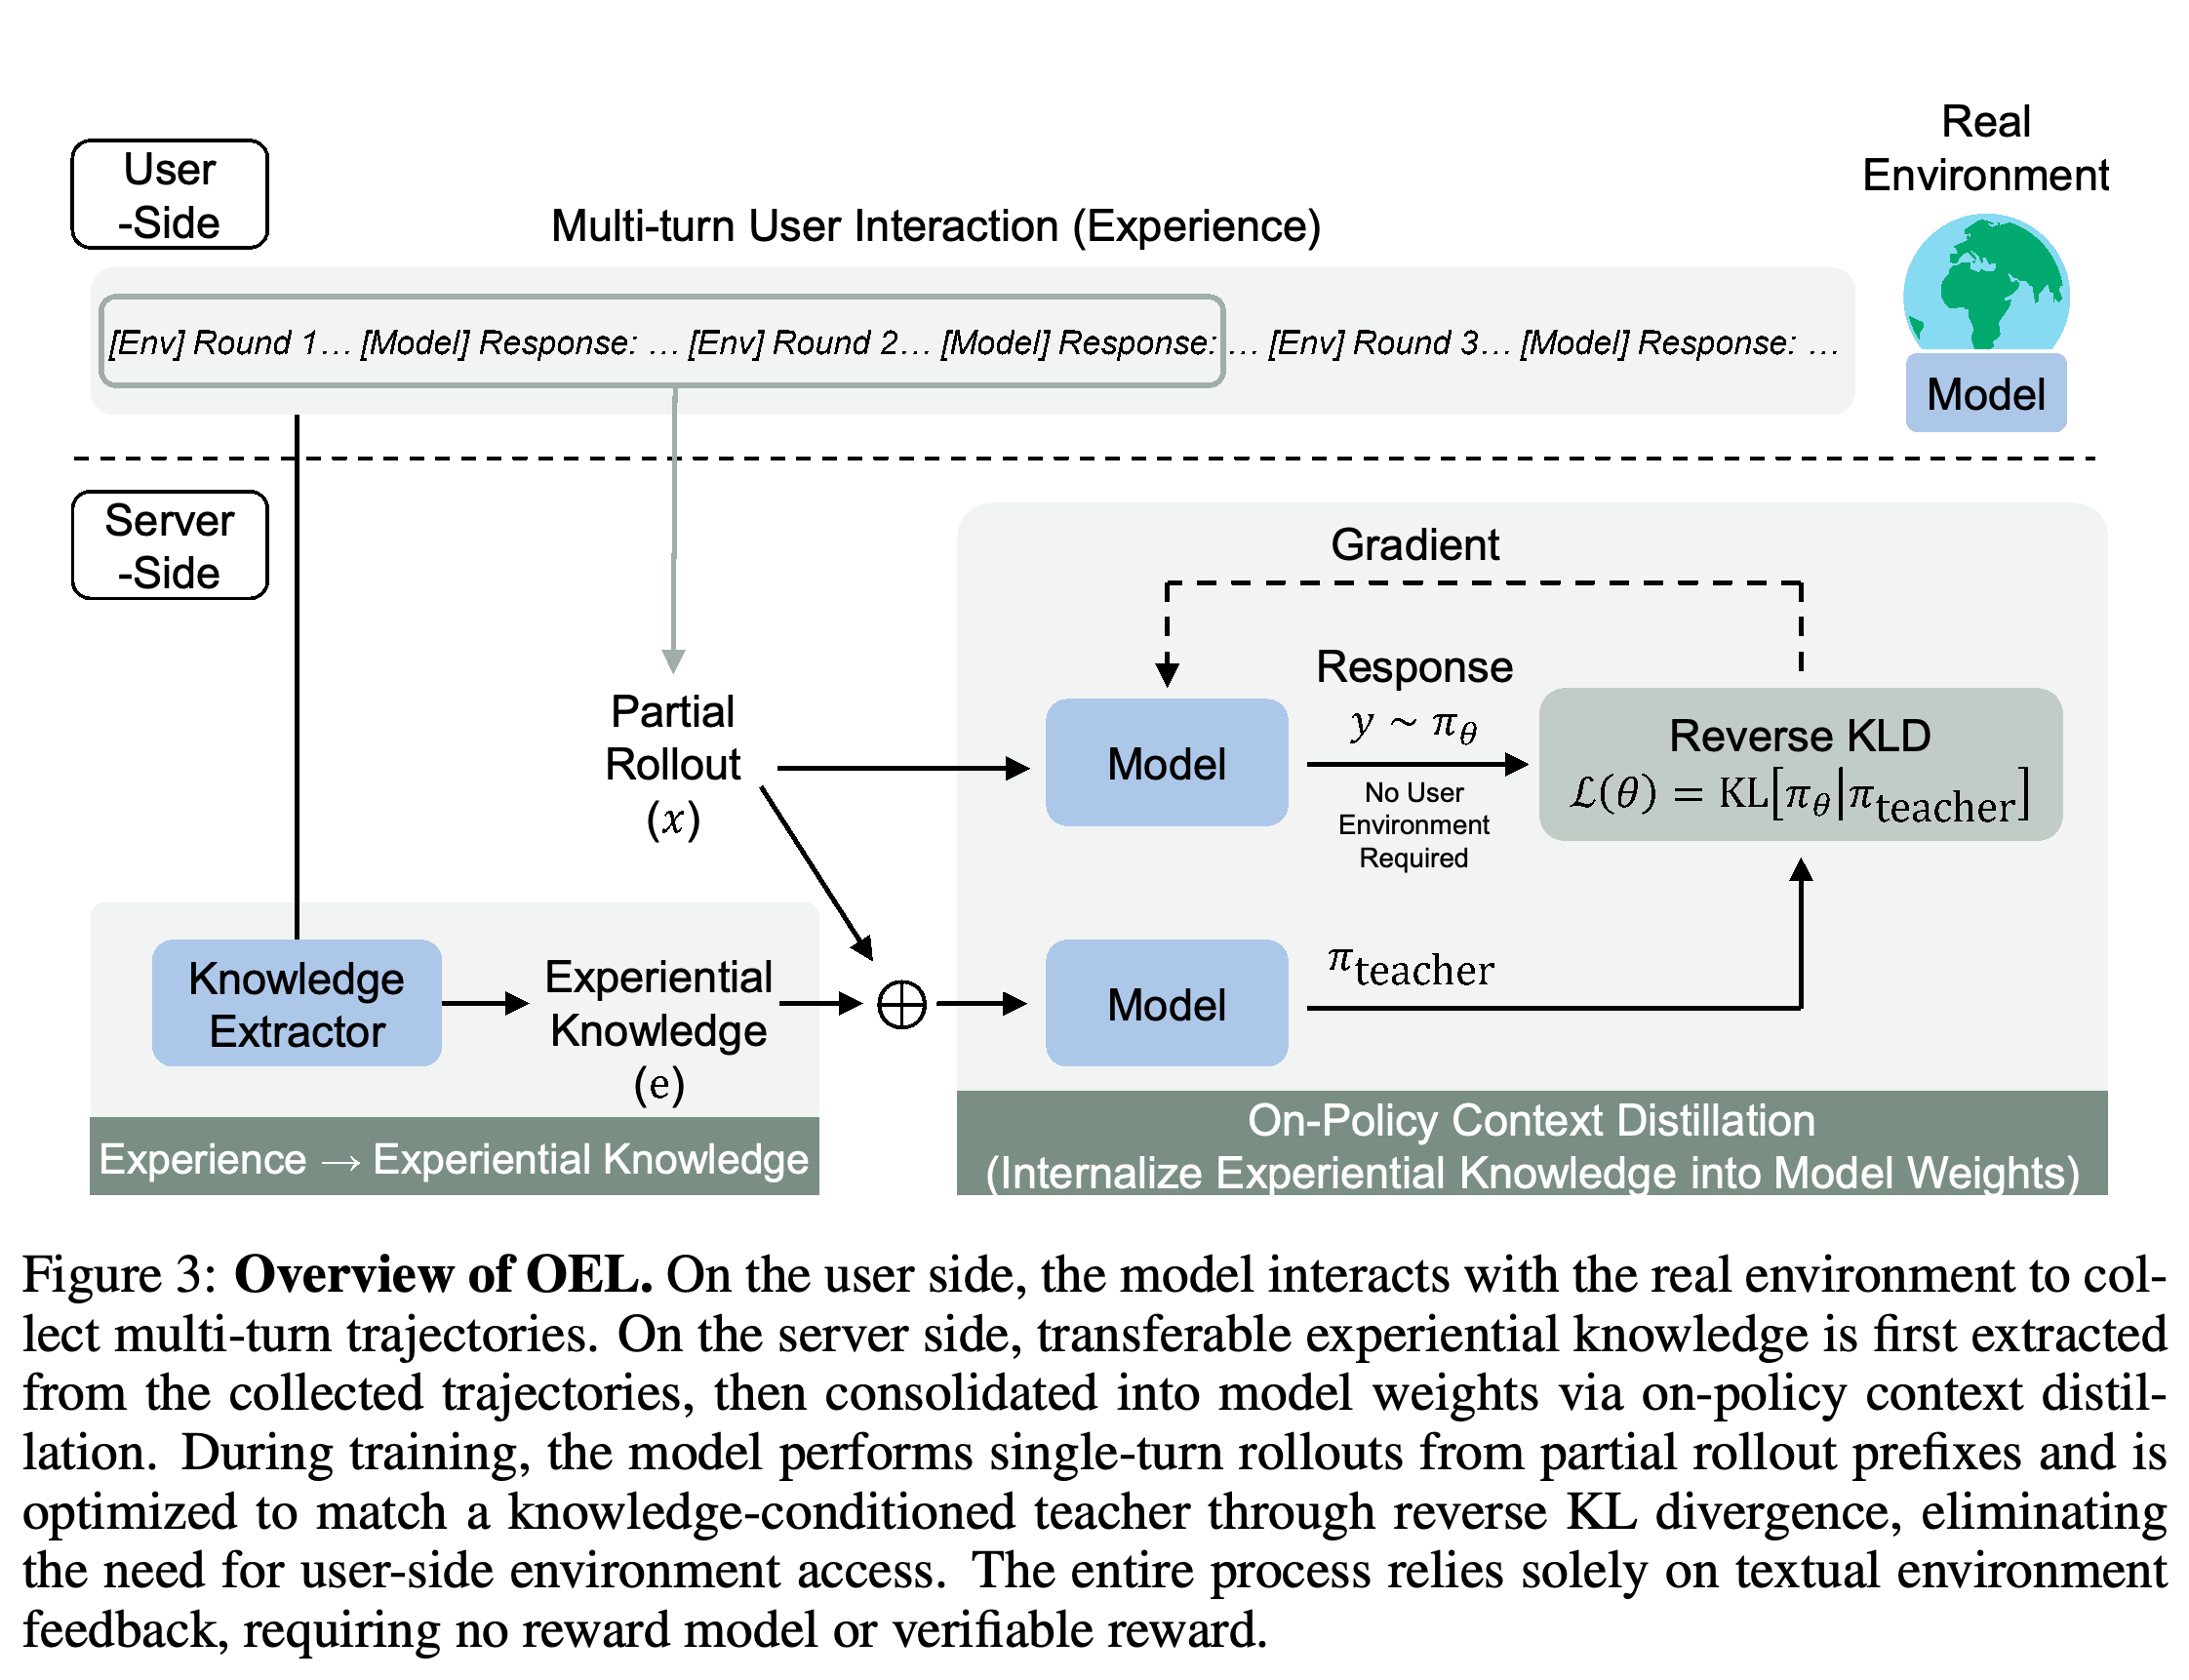
OEL은 경험 처리 과정을 지식 추출과 가중치 통합으로 나눈다. Figure 3는 수집한 궤적에서 teacher에 제공할 경험 지식을 얻고, 부분 상호작용 기록에서 student가 새로운 단일 턴 응답을 생성하는 과정을 보여준다.
- Teacher는 문맥에 경험 지식을 제공받고, student는 상호작용 prefix만 제공받는다.
- Reverse KL divergence는 student가 생성한 응답에 토큰 단위 감독 신호를 제공한다. 따라서 통합 과정에는 추가 환경 상호작용이 필요하지 않다.
3.1 Extract Experiential Knowledge from User Trajectories
배포된 모델은 환경의 텍스트 피드백과 모델 행동이 번갈아 나타나는 궤적을 수집한다. 기본 설정에서는 같은 모델이 누적 지식을 조건으로 각 궤적에서 새 지식을 추출한다. 추출과 누적은 e′ᵢ ∼ πextract(· | τᵢ, eᵢ₋₁), eᵢ = [eᵢ₋₁; e′ᵢ]로 표현하며, 초기 지식은 e₀ = ∅다.
- 기존 지식과 새로 추출한 내용을 이어 붙여 지식을 누적하며, 추출에는 정답 레이블을 사용하지 않는다.
- 프롬프트는 특정 보드에만 해당하는 설명 대신 다른 상황에도 적용할 수 있는 규칙과 전략을 요구한다.
- Qwen3-1.7B는 추출 문맥에 이전 누적 지식을 넣지 않는다. 저자들은 이 작은 모델이 긴 문맥 정보를 활용하는 데 어려움을 겪는다고 관찰했다.
3.2 Consolidate Experiential Knowledge into Model Weights
실험은 Cross-Trajectory 변형을 사용한다. 한 궤적 집합에서 누적 지식을 얻고, 별도 집합에서 통합 학습 예제를 얻는다. 각 학습 예제는 다음 모델 응답 직전의 환경 관측에서 끝나는 부분 rollout prefix다.
- 서로 다른 random seed로 추출을 반복해 여러 지식 문맥을 구성한다.
- 각 학습 단계에서 prefix와 지식 문맥을 따로 샘플링한다. 따라서 지식을 추출한 원래 궤적 외의 상황에도 그 지식을 적용할 수 있다.
- 서버는 새 단일 턴 응답을 생성하지만, 그 응답을 환경에서 실행하지는 않는다.
Student는 경험 지식 없이 응답을 샘플링하고, 지식을 조건으로 받는 teacher와의 평균 토큰 단위 reverse KL divergence를 최소화한다. 손실은 L(θ) = Eₓ∼D,e∼C,y∼πθ(·|x)[|y|⁻¹ Σₜ₌₁^{|y|} DKL(πθ(· | x, y<t) ∥ πteacher(· | e, x, y<t))]다. Teacher는 통합 라운드 시작 시점의 모델을 복사한 뒤 고정한 모델이다.
- 2개 모델 모두 student가 생성한 동일한 응답 prefix에서 평가하지만, 지식 문맥은 teacher에만 제공한다.
- 새로 생성하는 응답 토큰에 대해서는 on-policy 학습이며, 상호작용 기록은 미리 수집한다.
- 구현에서는 student 확률이 높은 상위 256개 토큰으로 어휘 전체의 reverse KL을 근사한다.
수집한 기록에서 추출 지식과 부분 rollout prefix를 얻는다. Student는 prefix만으로 응답을 생성하고, teacher는 지식과 prefix를 함께 제공받는다. Reverse KL은 서버가 환경에서 새 행동을 실행하지 않아도 teacher의 문맥 정보를 전달한다.
3.3 Online Learning Process
통합 후에는 업데이트한 모델을 다시 배포해 추출용 궤적과 학습용 궤적을 새로 수집한다. Algorithm 1은 수집, 추출, 통합, 재배포를 반복하며, 매 라운드의 현재 모델을 추출기와 고정 teacher로 설정한다.
- 저자들은 개선된 행동이 이후 업데이트에 더 유익한 경험을 제공할 수 있다고 설명한다.
- 통합을 거치면 배포된 모델의 추론 문맥에 추출 지식을 계속 넣어 둘 필요가 없다.
4 Experiments
실험은 반복 학습에 따른 개선, 응답 토큰 효율, out-of-distribution instruction-following 능력의 유지, 모델 크기의 영향, 경험 지식의 출처와 표현 방식을 살펴본다. 주요 과제 지표는 게임 성공률이다. On-policy와 off-policy를 비교할 때는 IF-Eval로 능력 유지 정도를 측정한다.
4.1 Setup
데이터셋과 모델: Frozen Lake는 구멍 2개가 있는 3 × 3 격자를, Sokoban은 상자 1개가 있는 6 × 6 격자를 사용한다. 모델은 thinking 모드의 Qwen3-1.7B, Qwen3-4B, Qwen3-8B와 non-thinking 모델인 Qwen3-4B-Instruct-2507이다.
- 초기 프롬프트에서는 명시적인 게임 규칙을 제거하고, 일반적인 목표, 플레이어 식별자, 이동 행동, 필수 행동 문법을 제공한다.
- TextArena는 행동 결과와 갱신된 지도를 텍스트로 계속 반환하므로, 모델은 피드백에서 게임 규칙을 추론할 수 있다.
- 평가는 따로 분리해 둔 게임 지도 128개를 사용하며, random seed 10개에서 얻은 성공률을 평균한다.
추출 단계: 구조화된 지식은 “– EXPERIENCE ITEM:”으로 시작하는 항목을 유지하며, n = 25 또는 n = 50개의 궤적에 걸쳐 누적한다. 최대 길이는 8192 토큰이다. 비구조화된 지식은 n = 15를 사용하며 최대 길이는 2048 토큰이다. 두 형식 모두 서로 다른 random seed로 누적 과정을 K = 10회 반복한다.
- 누적 내용이 해당 길이 제한을 넘으면 초과 부분을 잘라 낸다.
- Thinking 추출기는 답변 부분만 지식으로 유지하고 추론 부분은 제거한다.
- 보상이나 관측된 최고 성능으로 지식을 선택하지 않고, 라운드마다 고정된 누적 단계에서 지식을 가져온다.
통합 단계: 각 라운드는 학습 20 또는 100단계로 구성되며, 단계당 게임 샘플 64개를 사용한다. 이는 궤적 샘플 1280 또는 6400개에 해당한다. 수집하는 상호작용은 최대 5턴이며, 턴당 최대 응답 길이는 1024 토큰이다. 평가에는 체크포인트 선택 없이 마지막 단계의 체크포인트를 사용한다.
- 학습률은 {1e−6, 5e−6}에서 선택하고, 샘플링 온도는 0.7로 설정한다. 각 모델-과제 조합의 하이퍼파라미터는 모든 라운드에서 고정한다.
- Frozen Lake의 Qwen3-1.7B는 비구조화된 지식, n = 15, 2048 토큰, 학습률 5e−6, 학습 20단계를 사용한다.
- Frozen Lake의 Qwen3-4B와 Qwen3-8B는 구조화된 지식을 사용하며, 각각 n = 25와 n = 50, 학습 20단계와 100단계를 적용한다. Sokoban의 Qwen3-4B-Instruct-2507은 구조화된 지식, n = 50, 학습 100단계를 사용한다. 이 3개 설정은 모두 지식 길이 제한 8192 토큰과 학습률 1e−6을 사용한다.
4.2 OEL Enables Online Learning
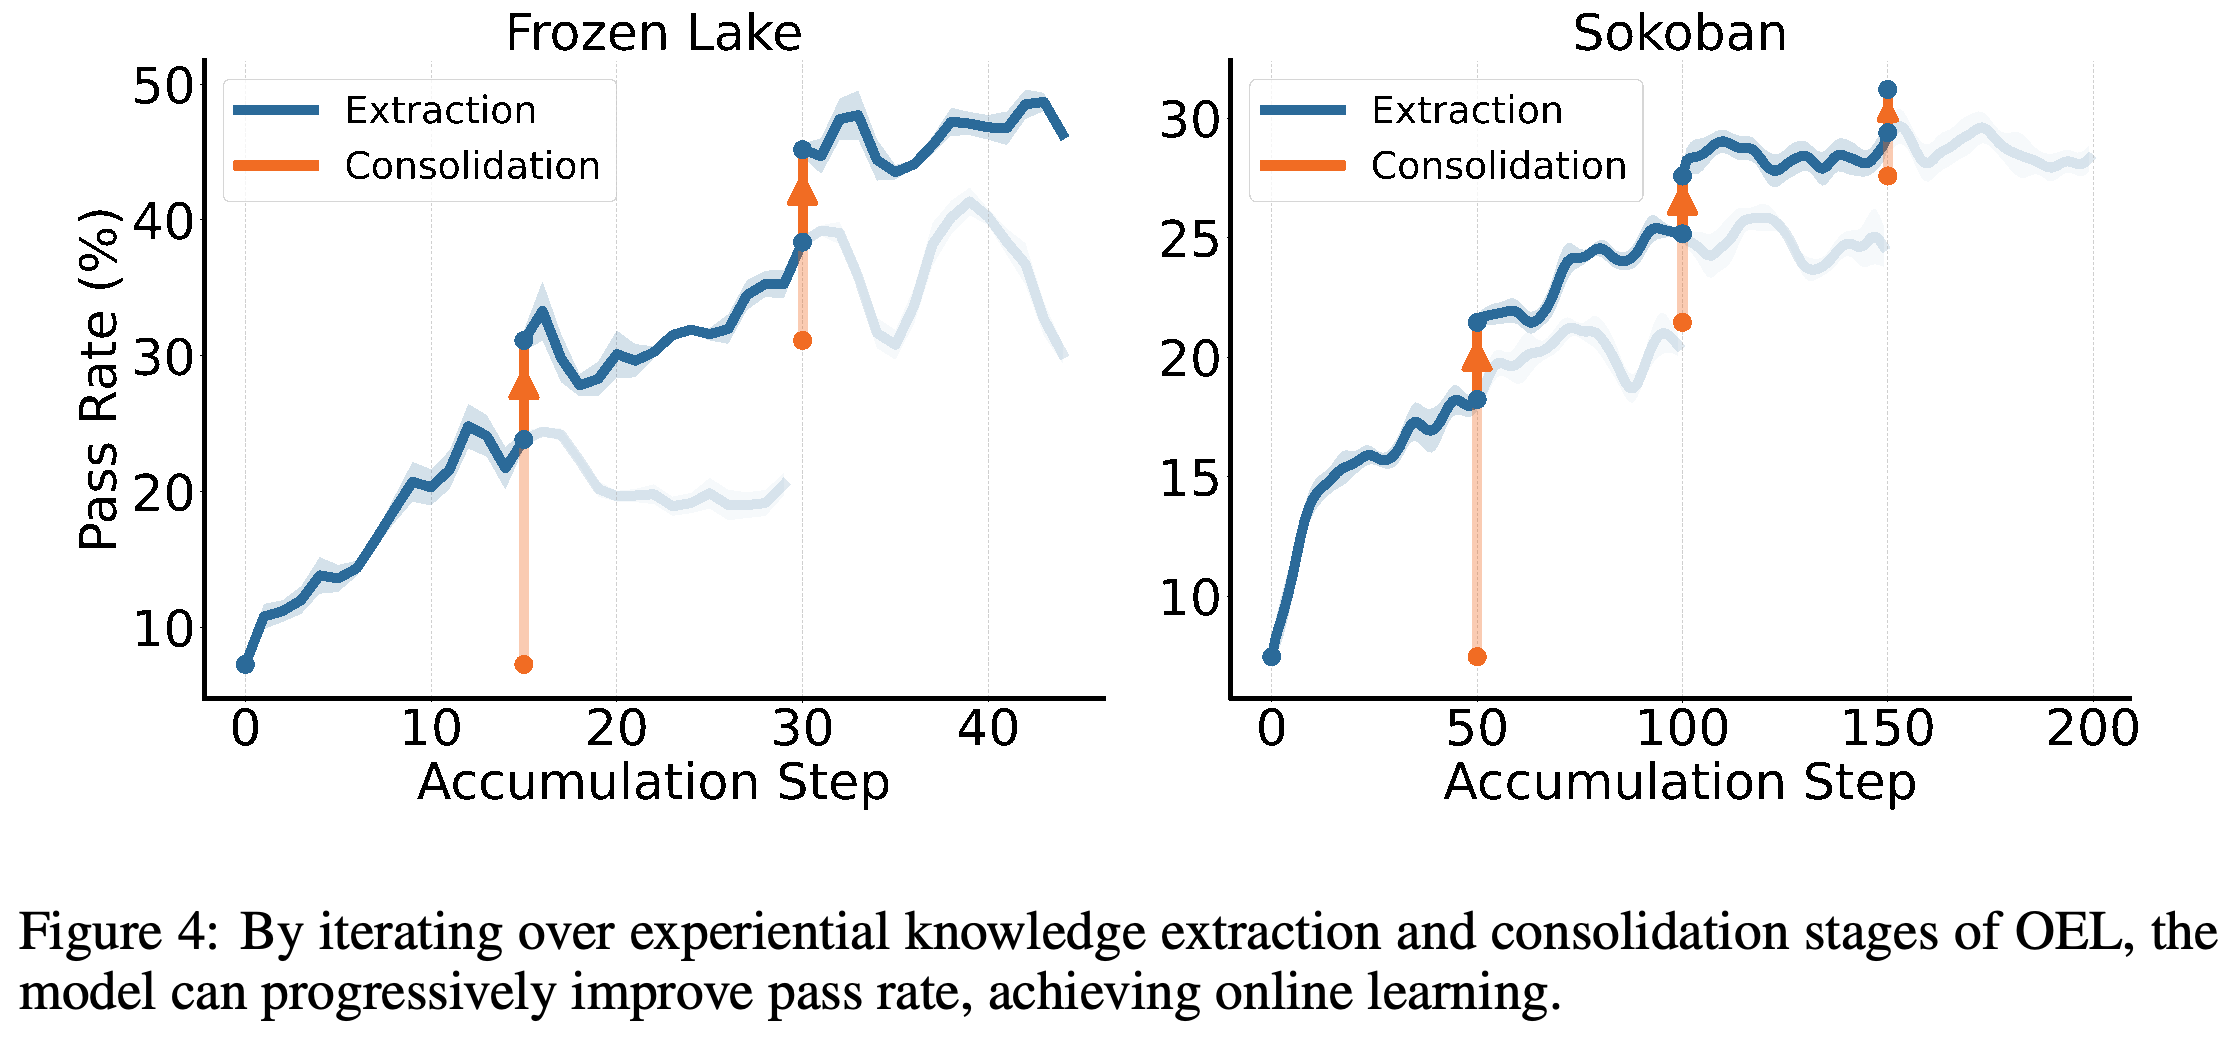
Figure 4는 Frozen Lake의 Qwen3-1.7B와 Sokoban의 Qwen3-4B-Instruct-2507이 반복적으로 개선되는 모습을 보여준다. 지식 누적은 in-context 성능을 높이지만 결국 포화된다. 통합은 지식 문맥 없이도 성능을 높이고, 다음 라운드를 더 높은 성능의 모델로 시작하게 한다.
- 저자들은 teacher의 조밀한 토큰 단위 감독 신호를 활용해 통합 데이터에서 일반화가 일어나므로, teacher에서 측정한 in-context 성능을 넘어설 수 있다고 설명한다.
- 반투명 연장 곡선은 통합 업데이트 없이 문맥 누적만 계속할 때의 한계를 보여준다.
- 결과는 그림에 제시된 라운드 동안의 개선을 뒷받침하며, 임의의 배포 조건에서 무한히 개선된다는 뜻은 아니다.
두 게임의 그래프 모두 통합 후 지식 문맥 없는 시작 정책의 성능이 높아지고, 이후 추출 과정에서 추가로 개선되는 모습을 보여준다. 반투명 연장 곡선은 문맥 누적만 계속하면 성능이 정체되거나 하락할 수 있음을 보여준다. 반면 문맥 누적과 가중치 업데이트를 번갈아 수행하면 제시된 라운드 동안 개선이 이어진다.
4.3 OEL Improves Token Efficiency
Figure 5에서 Frozen Lake의 Qwen3-1.7B는 3번째 반복까지 턴당 평균 응답 길이가 초기값의 약 70%로 줄어든다. 응답이 짧아지는 동시에 성공률은 높아진다. 통합 후에도 이 감소가 유지되며, 추론 시 경험 지식을 제공할 필요가 없다.
- 효율 지표는 생성된 응답 길이를 측정하며, end-to-end 지연 시간이나 전체 학습 비용을 측정하지 않는다.
- 정규화된 응답 길이 지표에는 추출과 통합에 필요한 추가 연산이 포함되지 않는다.
Frozen Lake의 Qwen3-1.7B는 3번째 반복까지 턴당 평균 응답 길이가 초기값의 약 70%에 가까워진다. 업데이트한 모델은 지식 문맥 없이도 더 짧은 응답을 유지한다. 이 그래프는 생성 토큰 길이를 측정하며, 지연 시간이나 전체 학습 비용을 측정하지 않는다.
4.4 OEL Mitigates Catastrophic Forgetting
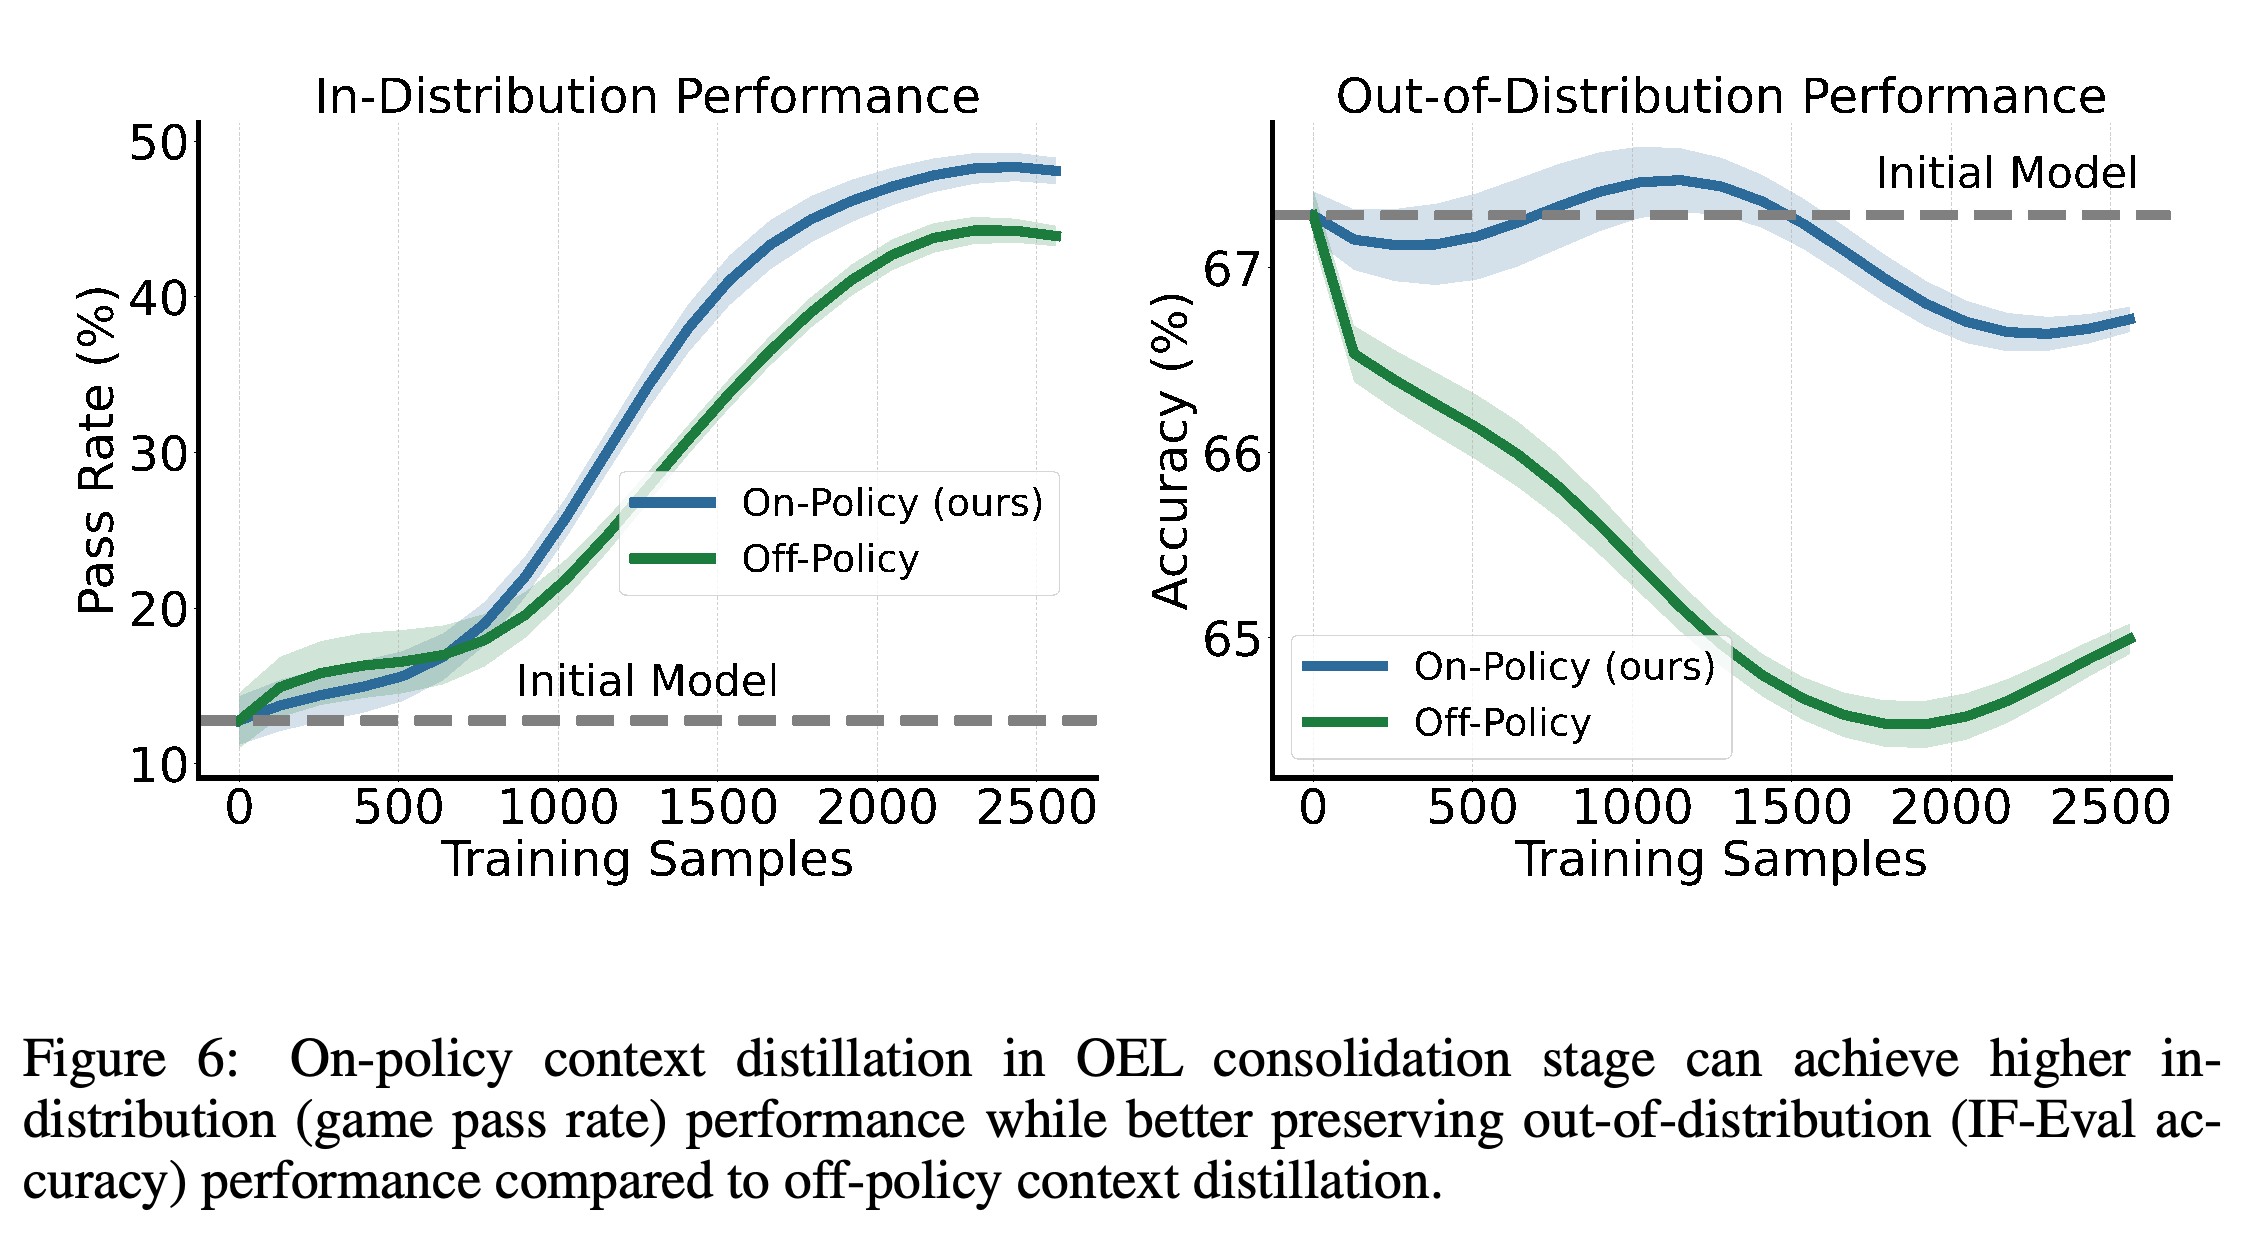
Figure 6는 Frozen Lake의 Qwen3-1.7B에서 on-policy와 off-policy context distillation을 비교한다. On-policy 학습은 더 높은 게임 성공률을 달성하고, IF-Eval의 prompt-level strict accuracy를 초기 모델에 더 가깝게 유지한다. 반면 off-policy 대안에서는 정확도가 더 크게 하락한다.
- Off-policy 기준선은 지식을 조건으로 받는 teacher로 응답을 생성하고, forward KL divergence로 지식 문맥 없는 student를 학습한다.
- 비교에서는 Round 1과 Round 2의 통합 단계를 이어 붙인다. 각 단계는 gradient step 20회와 batch size 64를 사용한다. 포화 구간은 생략하고, 이어 붙인 곡선에는 평활화를 적용한다.
- 이 결과는 해당 비교에서 IF-Eval 정확도를 더 잘 유지한다는 점을 보여주며, 언어 모델의 모든 일반 능력을 보존한다는 뜻은 아니다.
On-policy 통합은 off-policy 통합보다 더 높은 게임 성공률을 달성하고 IF-Eval 정확도의 하락 폭도 작다. 곡선은 학습 단계 2개를 이어 붙이고, 포화 구간을 생략한 뒤 평활화를 적용한 결과다. 따라서 가로축에 따른 변화는 단일 실행의 기록을 그대로 나타낸 것이 아니다.
4.5 Effect of Model Size
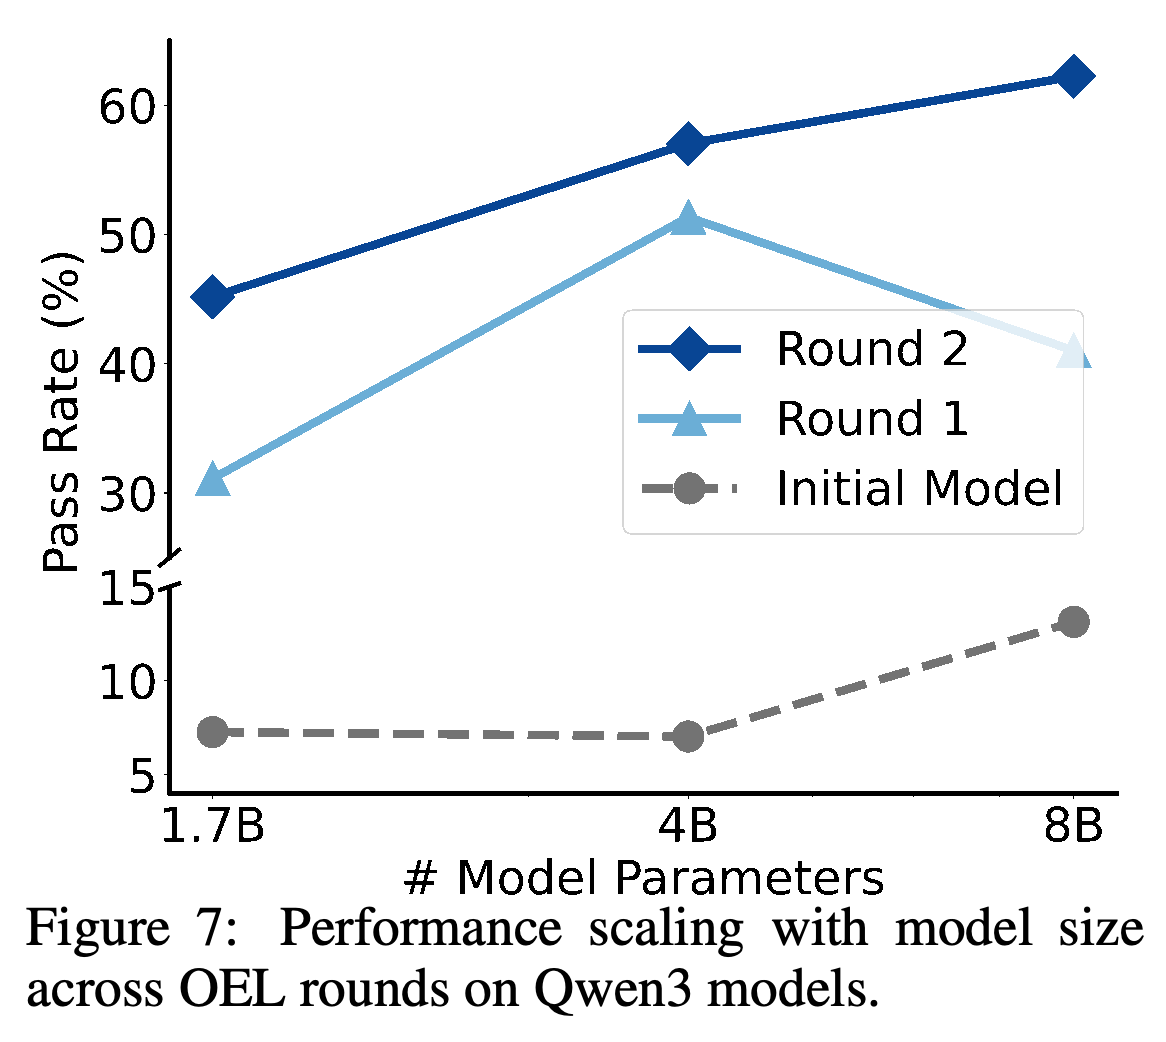
Figure 7은 Qwen3-1.7B, Qwen3-4B, Qwen3-8B의 학습 전과 OEL 2라운드 후 Frozen Lake 성능을 보여준다. 3개 모델 모두 개선되며, 모든 크기에서 Round 2가 Round 1보다 높다. Round 2 성공률은 모델이 클수록 높지만, Round 1 결과는 단조롭게 증가하지 않는다.
- 저자들은 후반 라운드의 더 높은 성능을 더 좋은 궤적과 더 효과적인 추출 지식으로 설명한다. 다만 이 그래프만으로 그 메커니즘이 입증되지는 않는다.
- 연산량을 맞춘 비교가 아니다. Qwen3-8B는 통합 100단계를 사용하지만 Qwen3-1.7B와 Qwen3-4B는 20단계를 사용하며, 추출 설정도 다르다.
- 세로축의 중간 구간을 생략했으므로 초기 성능과 학습 후 성능의 시각적 간격을 해석할 때 주의해야 한다.
3개 크기의 모델 모두 OEL 후 개선되며, 2번째 라운드 결과가 1번째 라운드보다 높다. 2번째 라운드 성능은 모델 크기에 따라 높아지지만, 1번째 라운드 성능은 단조롭게 증가하지 않는다. 추출 설정과 학습 예산이 달라 이러한 차이를 모델 용량만으로 설명할 수는 없다.
4.6 Analysis
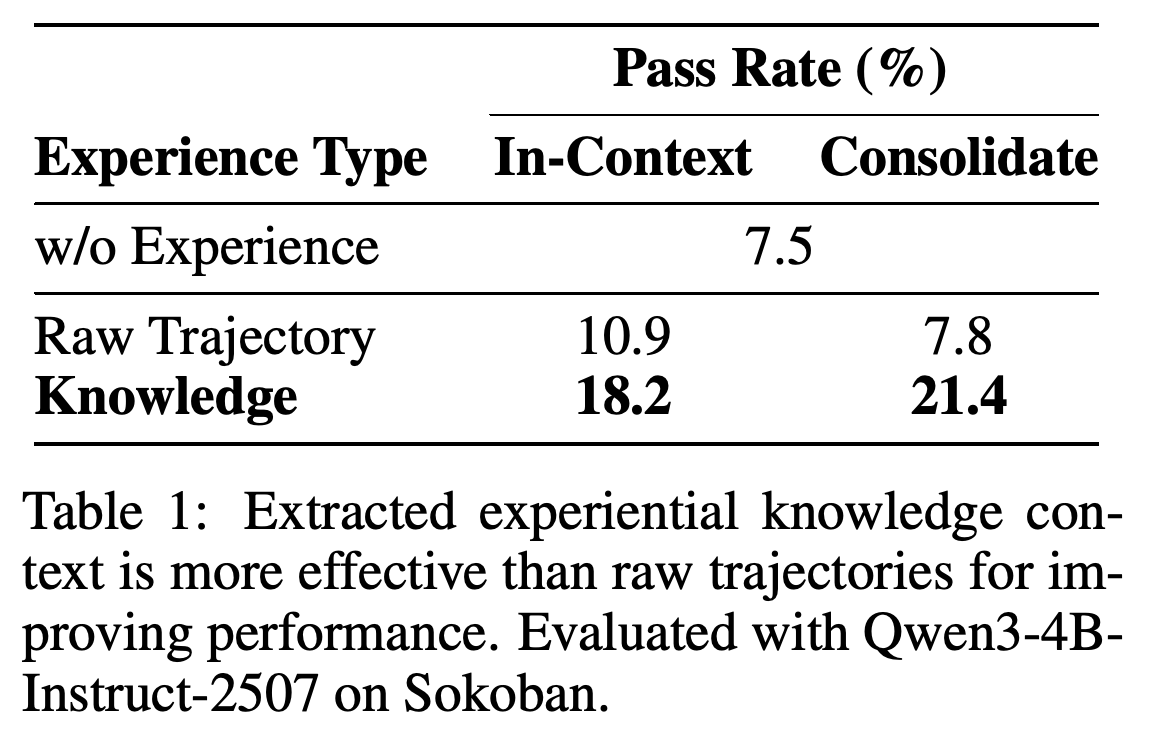
4.6.1 Learning from Experiential Knowledge over Raw Experience: Table 1은 Qwen3-4B-Instruct-2507의 1번째 라운드 Sokoban 성능을 평가한다. 경험을 제공하지 않은 기준선은 7.5%다. 원본 궤적을 사용하면 in-context 성능은 10.9%, 통합 후 성능은 7.8%다. 추출 지식을 사용하면 in-context 성능은 18.2%, 통합 후 성능은 21.4%다.
- 지식 통합은 기준선보다 13.9 percentage points 개선되지만, 원본 궤적 통합은 0.3 percentage points 개선된다.
- 이 ablation은 검증한 설정에서 추출의 효과를 뒷받침한다. 모든 원본 궤적 학습 방법이 효과가 없다는 뜻은 아니다.
추출 지식은 Sokoban 성공률을 7.5%에서 in-context 18.2%, 통합 후 21.4%로 높인다. 원본 궤적은 in-context에서 10.9%에 도달하지만 통합 후에는 7.8%에 그친다. 이 결과는 해당 설정에서 추출 단계의 효과를 직접 뒷받침한다.
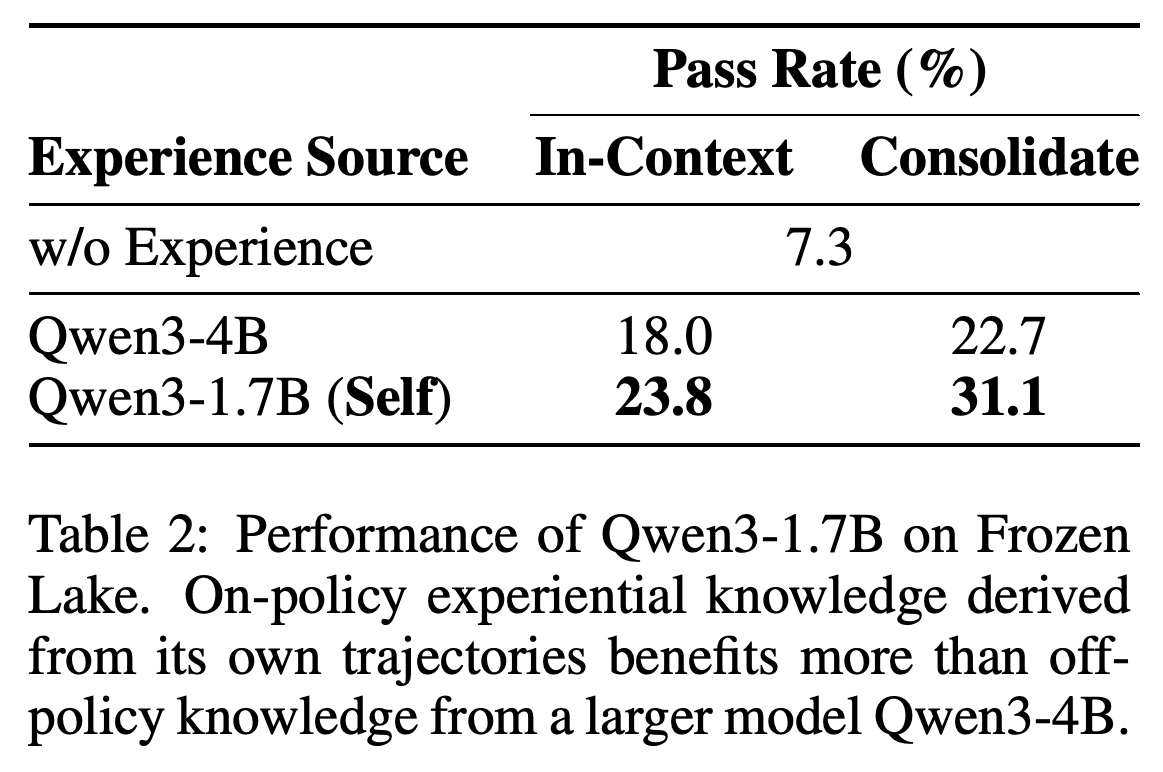
4.6.2 On-Policy Consistency Between Experiential Knowledge and Policy Model: Table 2는 기준선이 7.3%인 Frozen Lake의 Qwen3-1.7B를 평가한다. Qwen3-4B에서 얻은 지식을 사용하면 in-context 성능은 18.0%, 통합 후 성능은 22.7%다. 자체 추출한 지식을 사용하면 각각 23.8%와 31.1%다.
- 자체 추출한 지식은 더 큰 모델에서 얻은 지식보다 in-context 성능이 5.8 percentage points, 통합 후 성능이 8.4 percentage points 높다.
- 저자들은 더 큰 모델의 지식에 작은 모델이 효과적으로 실행하지 못하는 전략이 포함될 수 있다고 설명한다.
- 이 비교는 해당 모델 조합에서 자체 추출 지식이 더 효과적임을 보여주지만, 지식 전달 성능에 차이가 생긴 원인을 분리해 밝히지는 않는다.
Qwen3-1.7B에서는 자체 추출한 지식이 Qwen3-4B에서 얻은 지식보다 in-context와 통합 후 모두 더 높은 성능을 보인다. 통합 후 성공률은 각각 31.1%와 22.7%다. 이 결과는 해당 지식 제공 모델과 학습 모델의 조합에서 자체 추출 지식이 더 효과적임을 보여주지만, 차이의 정확한 원인은 밝히지 않는다.
5 Related Work
관련 연구에서는 OEL을 on-policy distillation, context distillation, 상호작용 경험 학습과 연결한다. OEL은 배포를 반복하는 과정에서 궤적으로부터 지식을 추출하고 그 지식을 파라미터에 통합한다.
On-Policy Distillation
On-policy distillation은 teacher가 생성한 예제 대신 student가 생성한 응답으로 학습한다. 이를 통해 학습 응답과 student의 추론 분포 사이의 불일치를 줄인다. OEL은 이 메커니즘과 reverse KL divergence를 사용해 지식을 조건으로 받는 teacher의 행동을 내재화한다.
- 논문은 reverse KL을 mode-seeking 특성과 연결하고, on-policy distillation과 망각 감소에 관한 선행 연구를 인용한다.
- OEL의 능력 유지에 관한 직접적인 실험 근거는 Frozen Lake와 IF-Eval 비교다.
Context Distillation
Context distillation은 teacher의 문맥에 제공한 정보를 student 파라미터로 옮겨, 추론 시 해당 문맥이 필요하지 않게 한다. OEL은 context distillation 자체를 처음 제안한 것이 아니라, On-Policy Context Distillation for Language Models를 바탕으로 한다.
- 논문은 student 생성 응답과 reverse KL을 사용하는 학습을, teacher 생성 응답과 forward KL을 사용하는 기존 context distillation과 대비한다.
- OEL은 배포 궤적에서 모델을 안내할 문맥을 얻고, 라운드마다 추출과 distillation을 반복한다.
Learning from Experience
논문은 OEL을 경험 기반 agent 학습, 실패에 대한 성찰, 통찰을 추출해 외부 메모리에 저장하는 방법과 연결한다. 통찰을 추론 문맥이나 검색된 메모리로만 유지하는 접근과 달리, OEL은 추출 지식을 모델 가중치에 통합한다.
- 상호작용 기록에서 학습하는 사례로 Reflexion과 ExpeL을 다룬다.
- 초기 상호작용 경험과 추론, self-play, 성찰을 통한 전략 발견도 다룬다.
6 Conclusion
결론에서는 OEL을 보상 없이 추출과 통합을 반복하는 과정으로 제시한다. 서버가 사용자 환경에 접근할 필요도 없다. 실험은 검증한 설정에서 반복적인 성능 개선, 더 짧은 응답, off-policy 통합보다 더 나은 IF-Eval 정확도 유지를 뒷받침한다.
- 실제 배포 경험을 지속 학습에 활용하는 것이 더 넓은 목표지만, 입증된 결과는 텍스트 기반 게임에서 얻었다.
부록
- A Implementation of On-Policy Context Distillation은 손실을 student가 생성한 토큰 기록에서 평가하는 어휘 단위 reverse KL 항으로 전개한다. 전체 어휘 합은 student 확률이 높은 top-k 토큰으로 근사하며, 모든 실험에서 k = 256을 사용한다.
- B Self-Trajectory Variant는 각 궤적에서 지식을 독립적으로 추출하고, 그 궤적의 prefix에만 해당 지식을 연결한다. Algorithm 2는 이 대안을 설명한다. 실제 실험에서는 추출용 궤적 집합과 통합용 궤적 집합을 분리한 Cross-Trajectory 변형을 사용한다.
- C Details of Experiments와 C.1 Dataset Details는 구멍 2개가 있는 3 × 3 Frozen Lake 격자와 상자 1개가 있는 6 × 6 Sokoban 격자를 명시한다. 초기 프롬프트는 명시적인 게임 규칙을 제거하지만 일반적인 목표와 이동 인터페이스는 유지한다. 이후 관측은 행동 결과와 갱신된 지도를 설명한다.
- C.2 Prompt Templates는 latest_experience와 previous_experience를 사용하는 구조화 및 비구조화 추출 래퍼와, 누적 경험을 새 문제에 적용하는 래퍼를 제공한다. 추출 프롬프트는 특정 보드에만 해당하는 설명 대신 폭넓게 적용할 수 있는 규칙과 전략을 요구한다. 적용 래퍼는 추론한 경험이 불완전하거나 틀릴 수 있다고 경고한다.
- C.3 Extraction Stage와 C.4 Consolidation Stage는 고정된 누적 단계, K = 10개의 지식 샘플, 길이를 초과한 내용의 절단, 모델별 설정, 샘플링 온도 0.7, 마지막 체크포인트 평가를 설명한다. 또한 다른 설정과 달리 Qwen3-1.7B는 추출 과정에서 이전 누적 지식을 제공받지 않는다고 명시한다.
- D Experiential Knowledge Examples는 Qwen3-4B-Instruct-2507이 생성한 Sokoban 지식을 보여준다. 여기에는 현재 상태 검증, 목표 추적, Manhattan distance 감소에 관한 조언이 포함된다. 일부 항목은 목표를 향해 직접 이동하는 전략이 언제나 유효하다고 주장하며, 상자를 목표에 밀어 넣는 대신 목표에 도달하는 행동을 설명한다. 이는 모델이 생성한 가설이지 검증된 게임 규칙이 아니다.
짧은 생각
OEL의 핵심 기여는 환경에 의존하는 수집 과정과 환경에 의존하지 않는 on-policy 통합 과정을 분리한 데 있다. 원본 궤적 ablation은 중간 지식 표현의 가치를 뒷받침한다. 자체 추출 지식 비교는 이 절차에서 지식을 제공하는 모델이 더 크다고 해서 자동으로 더 좋은 teacher가 되는 것은 아님을 보여준다.
주요 한계는 배포 경험으로 학습한다는 목표와 평가 범위 사이의 차이다. 평가는 작은 게임 2개, 짧은 상호작용, 소수의 학습 라운드에 한정되며, out-of-distribution 테스트는 IF-Eval뿐이다. 학습 예산이 달라 모델 크기 비교도 해석하기 어렵다. 지식 예제에 포함된 잘못된 규칙은 성공률 개선만으로 추출 지식의 정확성을 입증할 수 없음을 보여준다. 논문은 장기적인 분포 변화, 더 폭넓은 능력의 유지, 반복 추출과 통합의 총 연산 비용을 평가하지 않는다. 결과는 통제된 조건에서 학습 구조가 작동함을 보여주며, 제한 없는 실제 환경의 지속 학습을 입증하지는 않는다.