


Voxtral TTS 요약 설명
26 Mar 2026 | Paper Review Speech Generation Voice Cloning Flow Matching Direct Preference Optimization목차
- 요약
- 1 Introduction
- 2 Modeling
- 3 Training
- 4 Results
- 5 Analysis
- 6 Inference and Serving in vLLM-Omni
- 7 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Voxtral TTS 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 3월 26일(Arxiv)
- Mistral-AI, :, Liu, Alexander H., Tacnet, Alexis, Ehrenberg, Andy, Lo, Andy, Sun, Chen-Yo, Lample, Guillaume, Lagarde, Henry, Delignon, Jean-Malo, et al.
- 논문 링크
- Project Page
요약
- Voxtral TTS는 지원 언어 9개에서 새 화자에 대한 추가 학습 예시 0개로 동작하는 다국어 제로샷 text-to-speech 모델이며, 3초 길이의 참조 오디오로도 음성을 생성한다. 하이브리드 구조를 통해 의미 음성 토큰은 자기회귀 방식으로 생성하고, 음향 토큰은 프레임별 조건을 받는 경량 flow-matching transformer로 생성한다.
- Voxtral Codec은 24 kHz 모노 음성을 12.5 Hz로 표현하며, 프레임마다 ASR 증류로 학습한 의미 VQ 토큰 1개와 음향 FSQ 토큰 36개를 사용한다. 비트레이트는 약 2.14 kbps다. 의미 토큰의 교차 엔트로피와 음향 flow matching을 함께 학습한 뒤, 이산 출력과 연속 출력 모두에 맞게 수정한 Direct Preference Optimization을 적용한다.
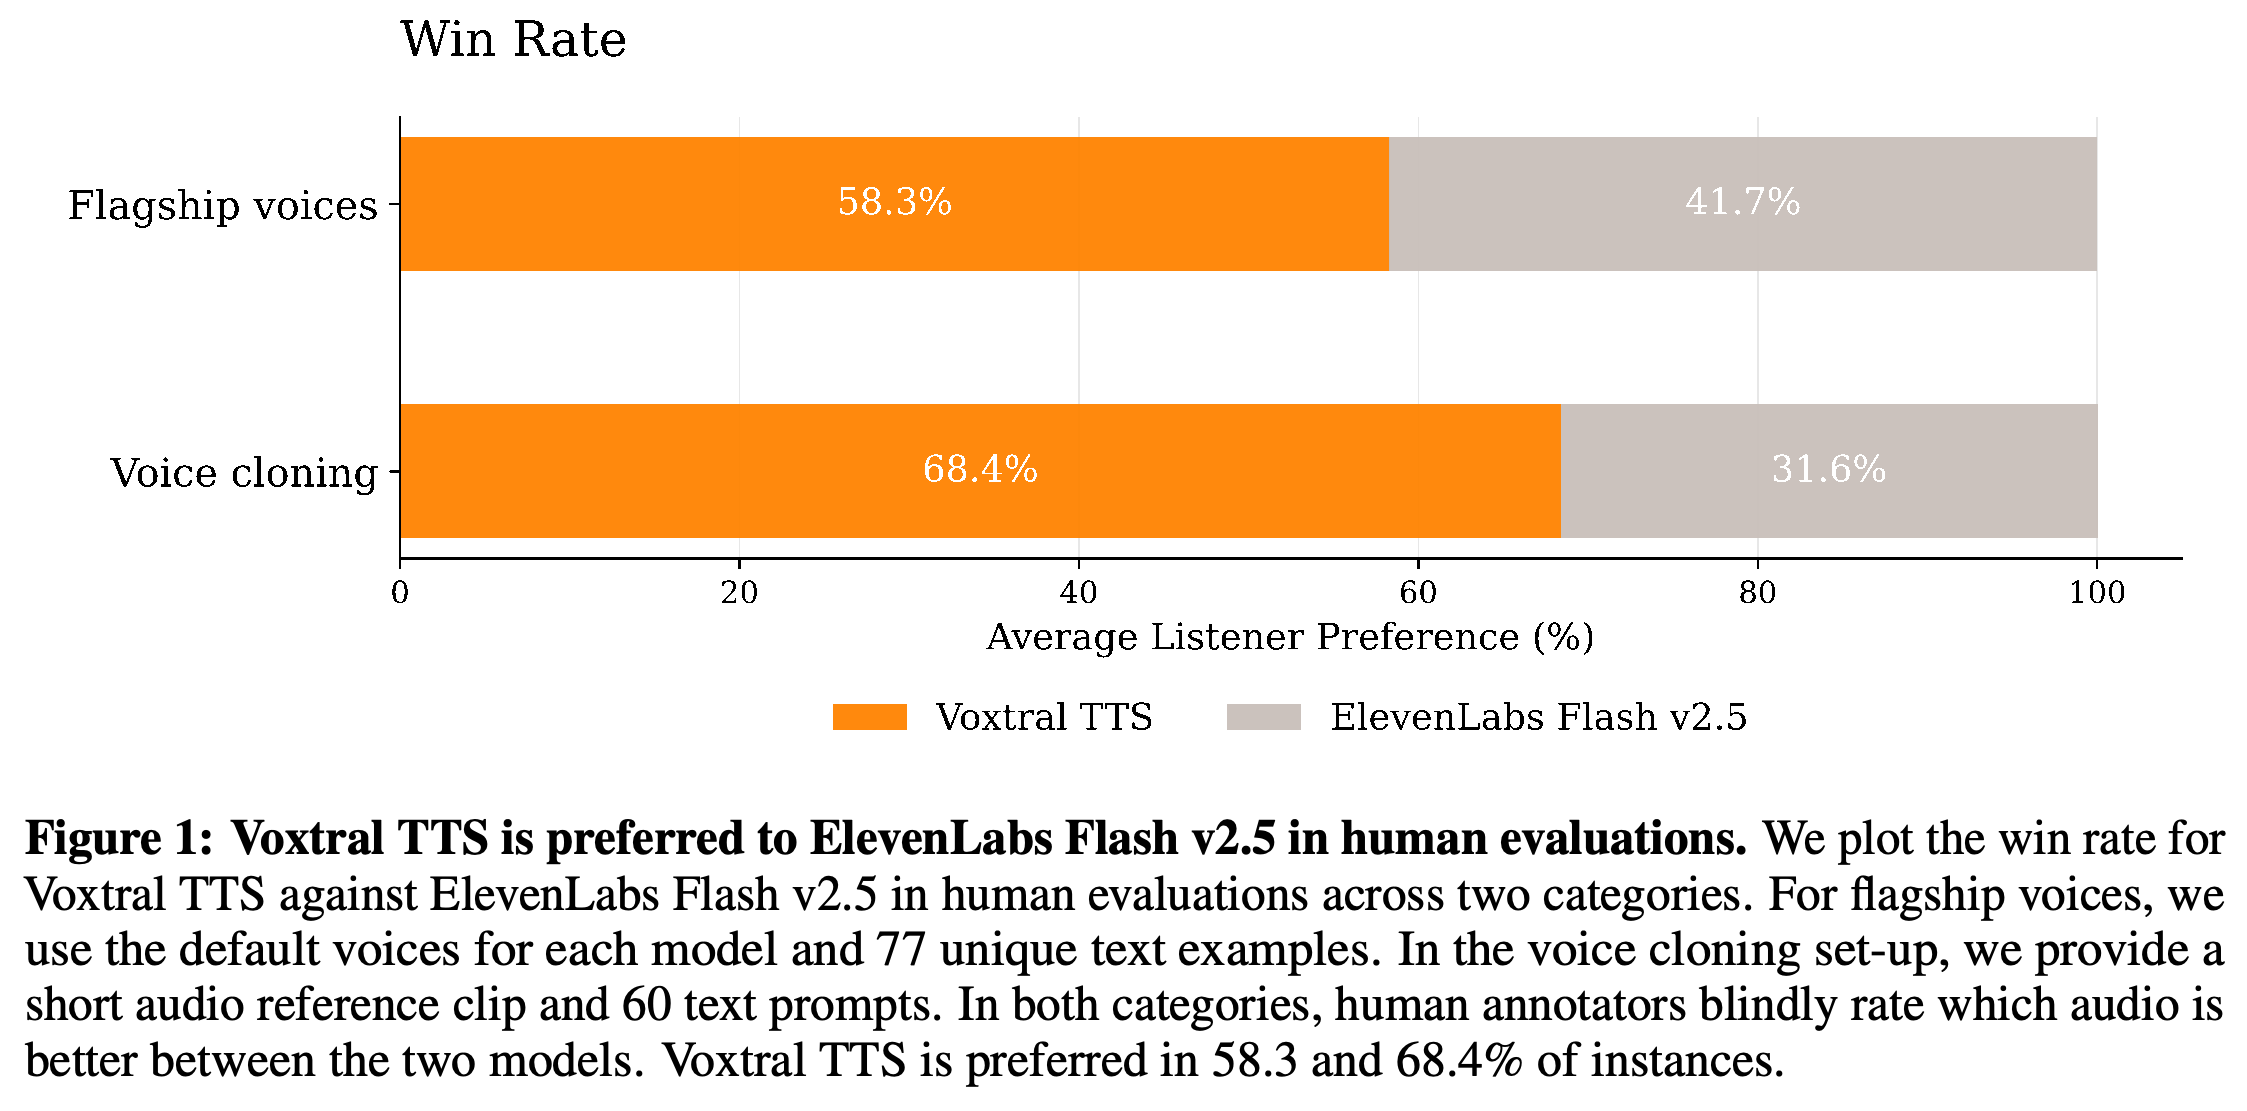
- 블라인드 청취 평가에서 ElevenLabs Flash v2.5 대비 음성 복제 승률은 68.4%, 암묵적 감정 제어를 적용한 대표 음성 승률은 58.3%다. 자동 평가에서 Voxtral TTS는 보고된 모든 벤치마크 행에서 평가 대상 ElevenLabs 모델 2개 모두보다 화자 유사도가 높다. 그러나 WER이 일관되게 낮지는 않으며, 대표 음성 비교에서는 Gemini 2.5 Flash TTS에 뒤진다.
- vLLM-Omni에서 CUDA graphs와 비동기 스트리밍을 적용하면, 단일 NVIDIA H200으로 동시 요청 32개를 처리할 때 첫 오디오 도착 시간이 552 ms, RTF가 0.302, 처리량이 1430.78 char/s/GPU다. 이는 500자 입력과 10초 참조 오디오 조건에서 측정한 결과다. 가중치는 CC BY-NC로 공개되며, 이 서빙 결과만으로 다른 하드웨어나 워크로드의 성능을 판단할 수는 없다.
전체 비교에서 Voxtral TTS는 대표 음성보다 음성 복제에서 더 큰 우위를 보인다. ElevenLabs Flash v2.5 대비 승률은 음성 복제 68.4%, 대표 음성 58.3%다. 대표 음성 설정은 텍스트 예시 77개를 사용하고, 복제 설정은 짧은 참조 음성과 프롬프트 60개를 사용한다. 이는 서로 다른 평가 조건이며, 일반화를 검증하는 통제 실험은 아니다.
1 Introduction
연구 목표는 모든 음향 코드북을 자기회귀 방식으로 생성하지 않으면서도 제로샷 TTS의 화자 정체성, 자연스러움, 표현력을 유지하는 것이다. Voxtral TTS는 의미 정보와 음향 정보를 분리하는 코덱을 바탕으로, 시간축 시퀀스 모델링은 자기회귀 백본에 맡기고 세밀한 음향 생성은 조건부 연속 모델에 맡긴다.
- ASR 증류로 학습한 의미 토큰은 장기 의존성을 모델링하는 이산 시퀀스를 제공한다. FSQ 음향 차원에는 연속 flow matching을 적용한 뒤 이산화한다.
- 논문은 이 하이브리드 출력 공간에 맞게 DPO를 수정하고, 명료도, 예측된 자연스러움, 화자 유사도, 사람의 선호도, 스트리밍 성능을 평가한다.
2 Modeling
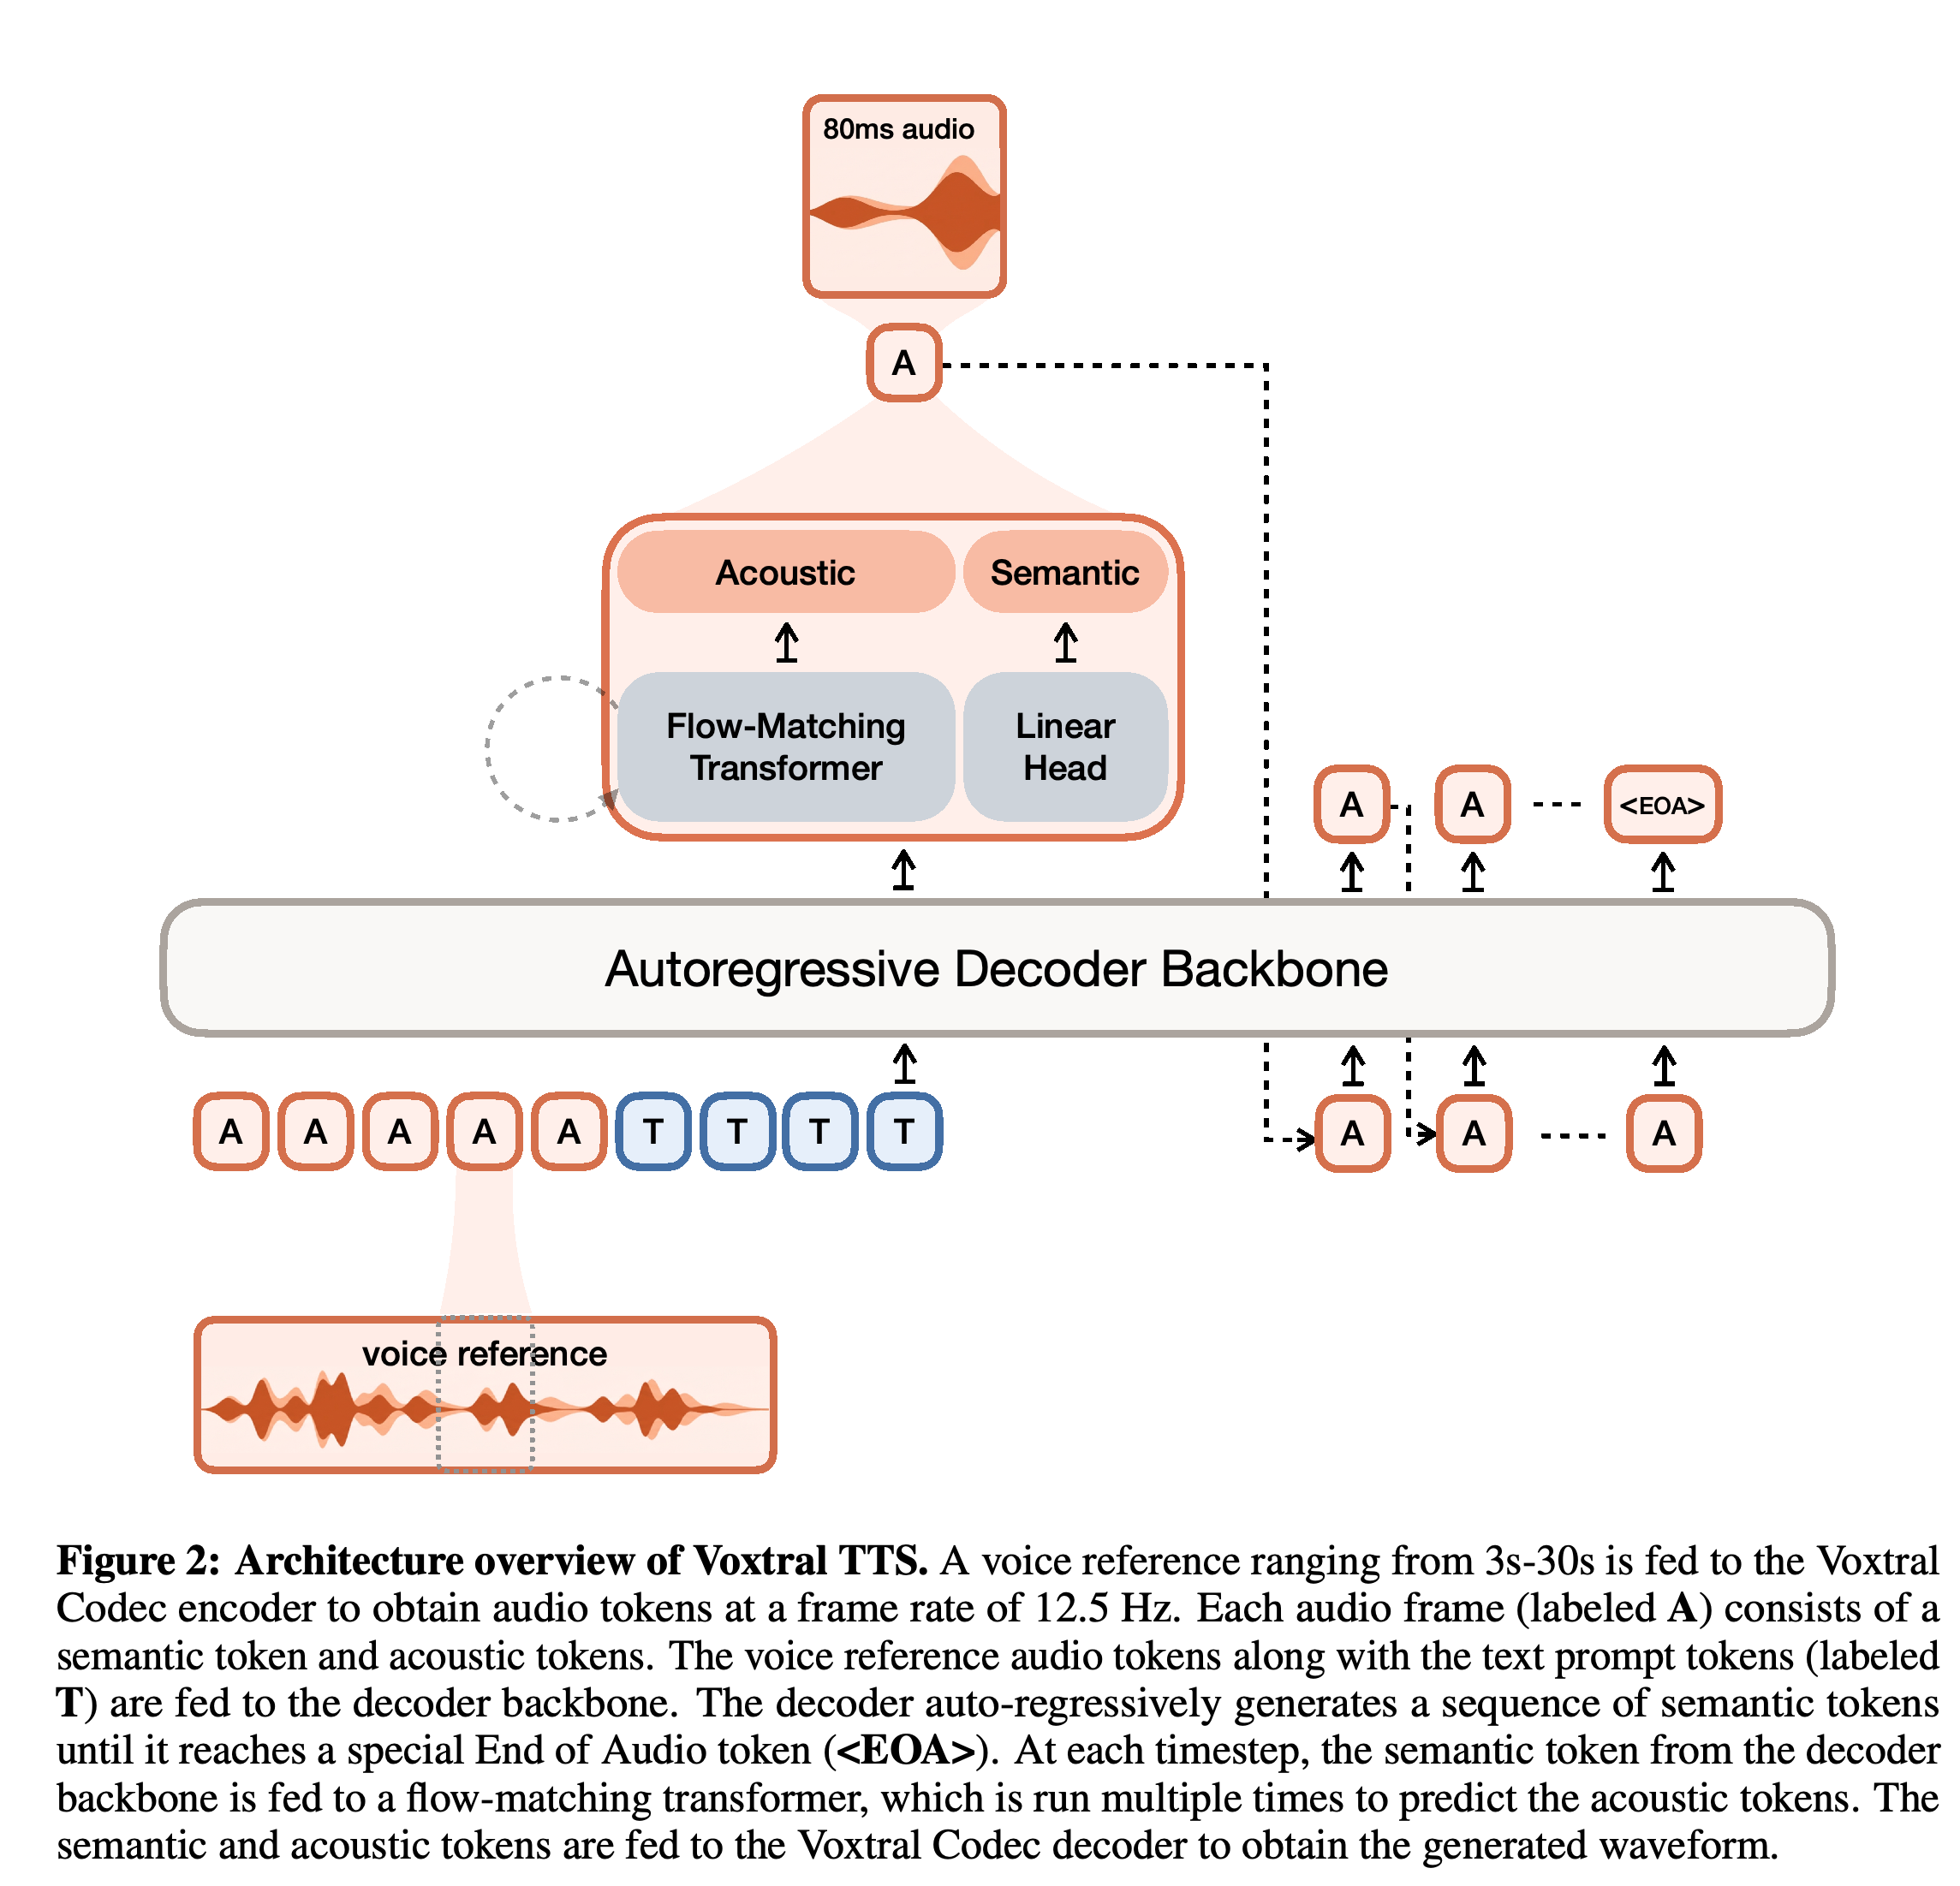
참조 음성을 Voxtral Codec으로 인코딩한 뒤 텍스트 토큰과 연결해 디코더 백본에 입력한다. 생성할 각 프레임에서 선형 헤드는 의미 토큰을 예측하고, flow-matching transformer는 백본의 은닉 상태를 조건으로 음향 값을 예측한다. 이렇게 얻은 이산 토큰은 백본에 다시 입력되며, 파형으로 디코딩된다.
- Figure 2는 3s–30s 참조 오디오, 12.5 Hz 오디오 프레임률, 특수 토큰 <EOA>에서 끝나는 생성 과정을 보여준다.
- 각 프레임은 80 ms 오디오에 해당하며, 의미 토큰 1개와 음향 토큰 36개로 구성된다.
도식은 시간축 생성과 세밀한 음향 생성을 분리해 보여준다. 참조 오디오 프레임과 텍스트가 자기회귀 백본에 입력되고, 백본의 은닉 상태를 사용해 의미 예측과 반복적인 음향 flow 평가를 수행한다. 완성된 오디오 프레임은 <EOA>에 도달할 때까지 시퀀스에 다시 입력된다. 따라서 이 구조는 시간축에서는 자기회귀적이지만, 음향 코드북 사이에서는 그렇지 않다.
2.1 Voxtral Codec
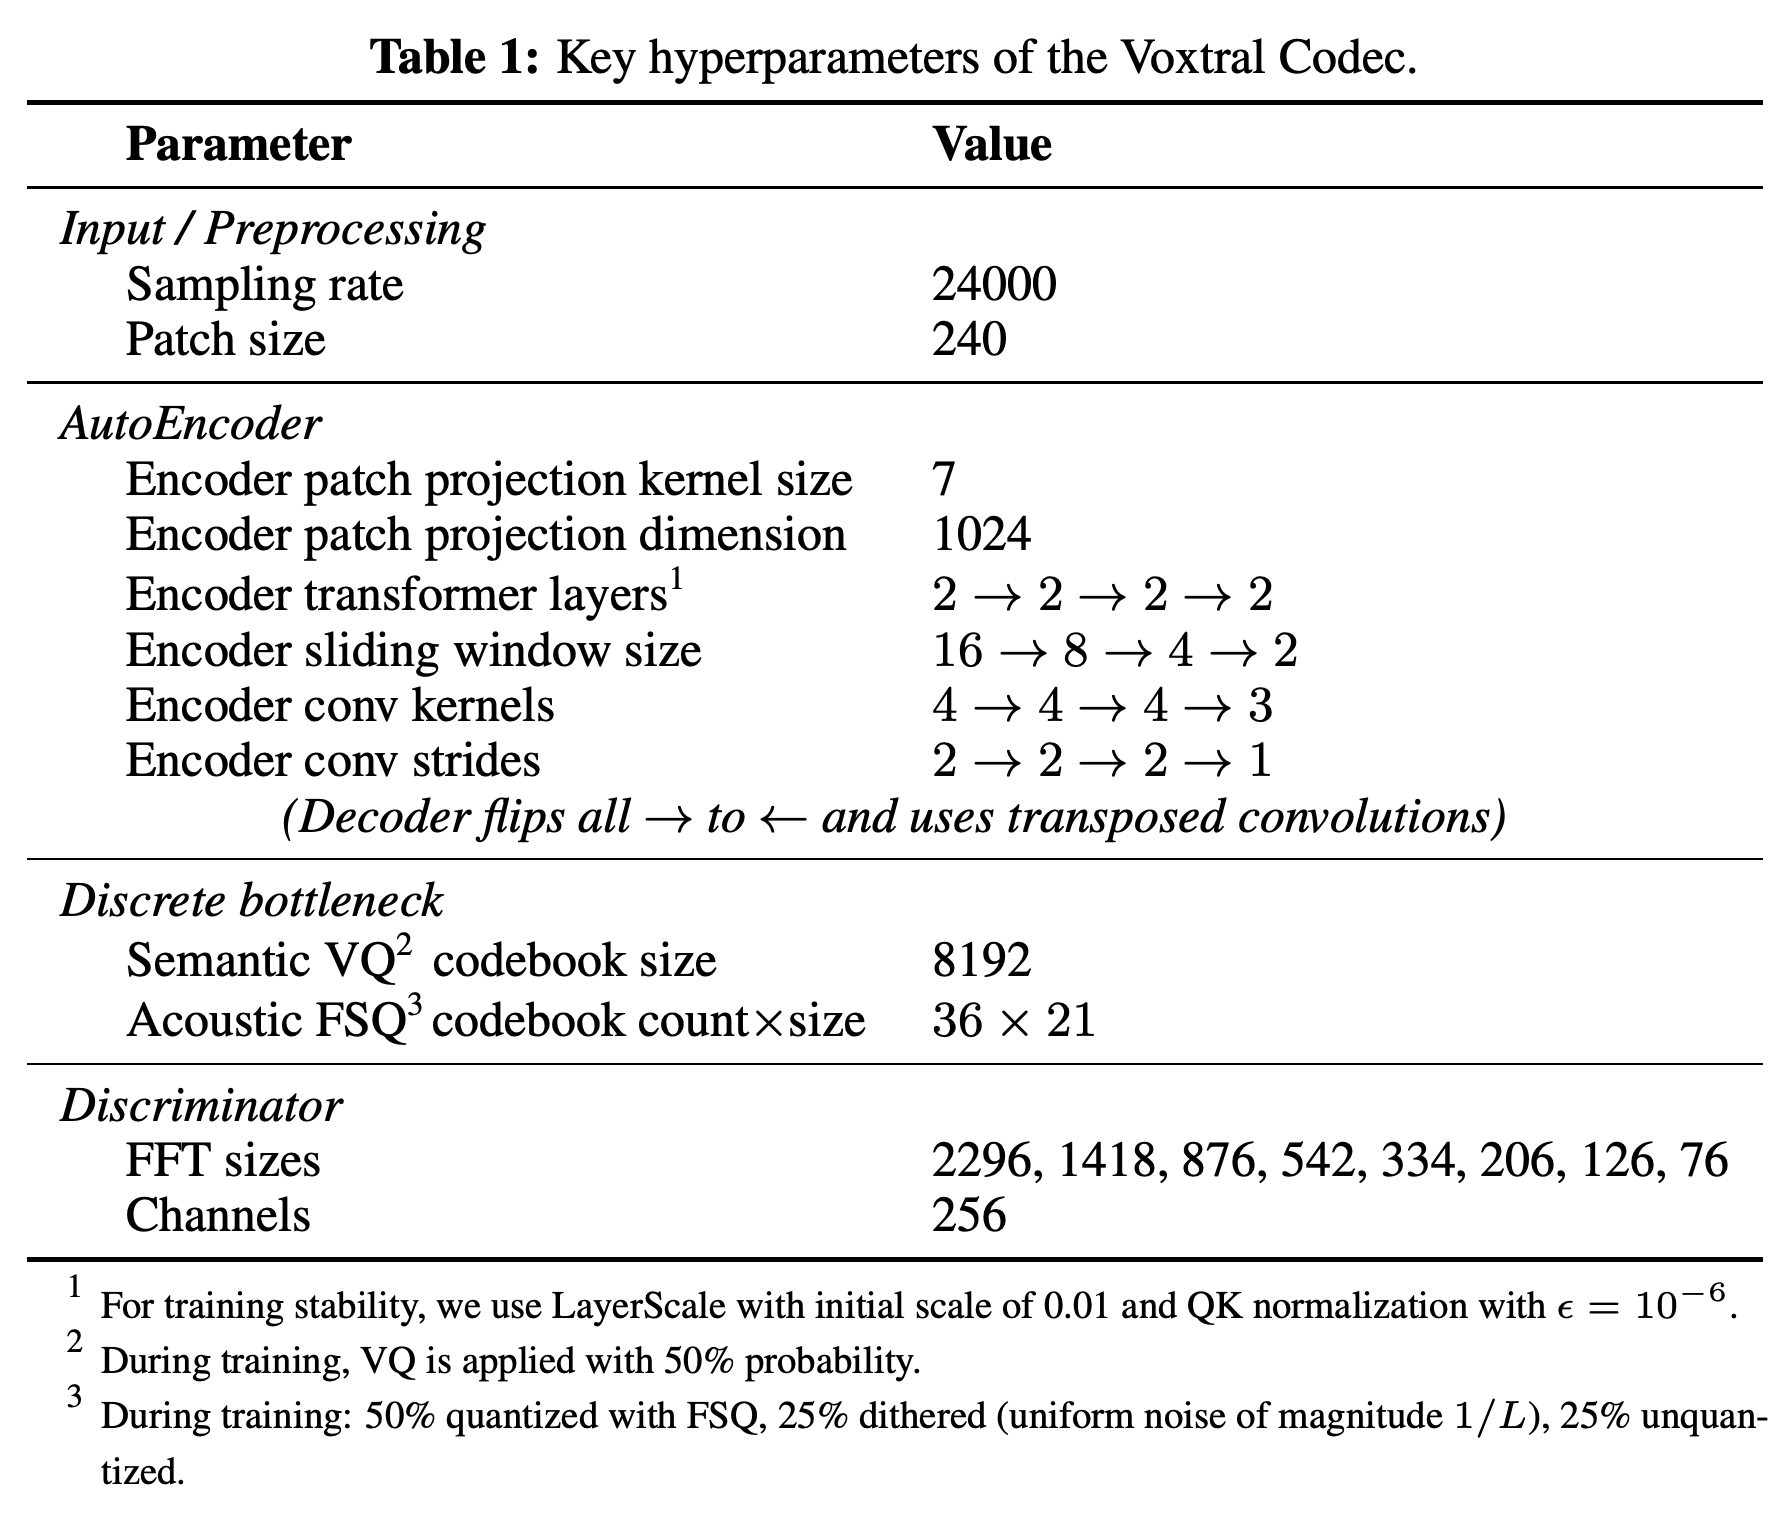
파형 오토인코더를 살펴본다. Voxtral Codec은 파라미터가 약 300M인 인과적 합성곱–트랜스포머 오토인코더다. 24 kHz 모노 오디오를 샘플 240개로 구성된 겹치지 않는 패치로 나누고, 그 결과인 100 Hz 시퀀스를 1024차원 임베딩으로 투영한 뒤 12.5 Hz의 292차원 잠재 표현으로 압축한다.
- 인코더 블록 4개는 각각 2층 인과적 트랜스포머와 인과적 CNN으로 구성된다. 앞의 CNN 3개는 2배씩 다운샘플링하고, 마지막 CNN은 스트라이드 1로 잠재 공간에 투영한다.
- 어텐션 윈도 크기는 16 → 8 → 4 → 2로 줄어든다. 트랜스포머에는 ALiBi, QK-norm, 초기값이 0.01인 LayerScale을 사용한다.
- 디코더는 인과적 투영, 전치 합성곱, 인과적 트랜스포머로 압축을 되돌린 뒤 샘플 240개로 구성된 파형 패치를 복원한다. Table 1은 디코더가 인코더의 스트라이드 순서를 역순으로 적용한다고 명시한다. 전치 합성곱에 대해서는 이 글을 참조하라.
표현 양자화에서는 잠재 표현을 256차원 의미 성분과 36차원 음향 성분으로 나눈다. 의미 성분에는 항목이 8192개인 학습형 VQ 코드북을 사용한다. 각 음향 차원에는 tanh 활성화 뒤 균일한 FSQ 레벨 21개로 독립적인 양자화를 적용한다.
- 학습 샘플의 50%에 의미 VQ를 적용하고, 나머지는 양자화하지 않는다.
- 음향 학습에서는 샘플의 50%에 FSQ 양자화를 적용하고, 25%에는 L=21일 때 크기가 1/L인 균일 잡음을 더하며, 25%는 양자화하지 않는다.
- 보고된 비트레이트는 (12.5\times(\log_2 8192+36\times\log_2 21)\approx 2.14\,\mathrm{kbps})다.
의미 토큰 학습에는 지도학습된 Whisper 모델을 고정해 사용한다. 이 모델의 디코더 은닉 상태와 교차 어텐션 가중치를 보조 ASR 증류 손실에 사용한다. VQ를 거친 의미 임베딩을 투영해 Whisper 디코더의 마지막 층 상태와 소프트 정렬하고, 코사인 거리로 학습한다.
- 정렬에는 DTW를 통해 단어 타임스탬프와 연결된 교차 어텐션 헤드를 사용한다. 이후 디코더 토큰 축에 따른 정규화, 중앙값 필터링, 헤드 평균, 코덱의 12.5 Hz 프레임률에 맞춘 보간을 적용한다.
- 이 절차는 사전에 지도학습된 ASR 모델에 의존하지만, 코덱 학습에는 외부 강제 정렬기나 오디오와 짝지어진 전사문이 필요하지 않다.
- 저자들은 연속 은닉 상태가 신뢰도와 음성학적 유사성까지 담으므로, 확정적인 전사 레이블보다 풍부한 학습 신호를 제공한다고 설명한다.
적대적 학습에서는 다중 해상도 STFT 판별기 8개가 힌지 손실로 원본 오디오와 복원 오디오를 구분한다. 코덱에는 일반적인 GAN 생성기 손실 대신, 판별기 활성값에 대한 L1 특징 매칭 손실을 적용한다.
- STFT 크기는 2296, 1418, 876, 542, 334, 206, 126, 76이다. Table 1에 기재된 판별기 채널 수는 256이다.
- 저자들은 학습 중 변하는 판별기 특징이 점차 더 구분력 있는 복원 신호를 제공한다고 설명한다.
코덱 학습 목적함수는 αLfeature + βLASR + γLL1 + γLSTFT + δLcommit이며, α=1.0, β=1.0, (\gamma=0.9999^t), δ=0.1이다. 여기서 t는 학습 스텝이다. 따라서 파형과 STFT 크기의 복원 손실 가중치는 함께 감소하고, 특징 매칭, ASR 증류, VQ commitment의 가중치는 고정된다.
- commitment 항은 Lcommit = ||ze − sg(zq)||²₂이며, sg는 stop-gradient를 뜻한다.
- Table 1은 구조와 양자화 설정을 정리한다. 논문은 설계 선택에 대해 제거 실험을 수행했다고 밝히지만, 해당 코덱 실험 결과는 제시하지 않는다.
의미 분기와 음향 분기는 파형 인코더와 디코더를 공유하지만, 서로 다른 양자화기와 학습 신호를 사용한다. ASR 증류는 의미 분기에만 적용된다. 적대적 특징 매칭과 복원 신호는 양쪽 분기로부터 복원한 파형을 통해 코덱을 학습한다.
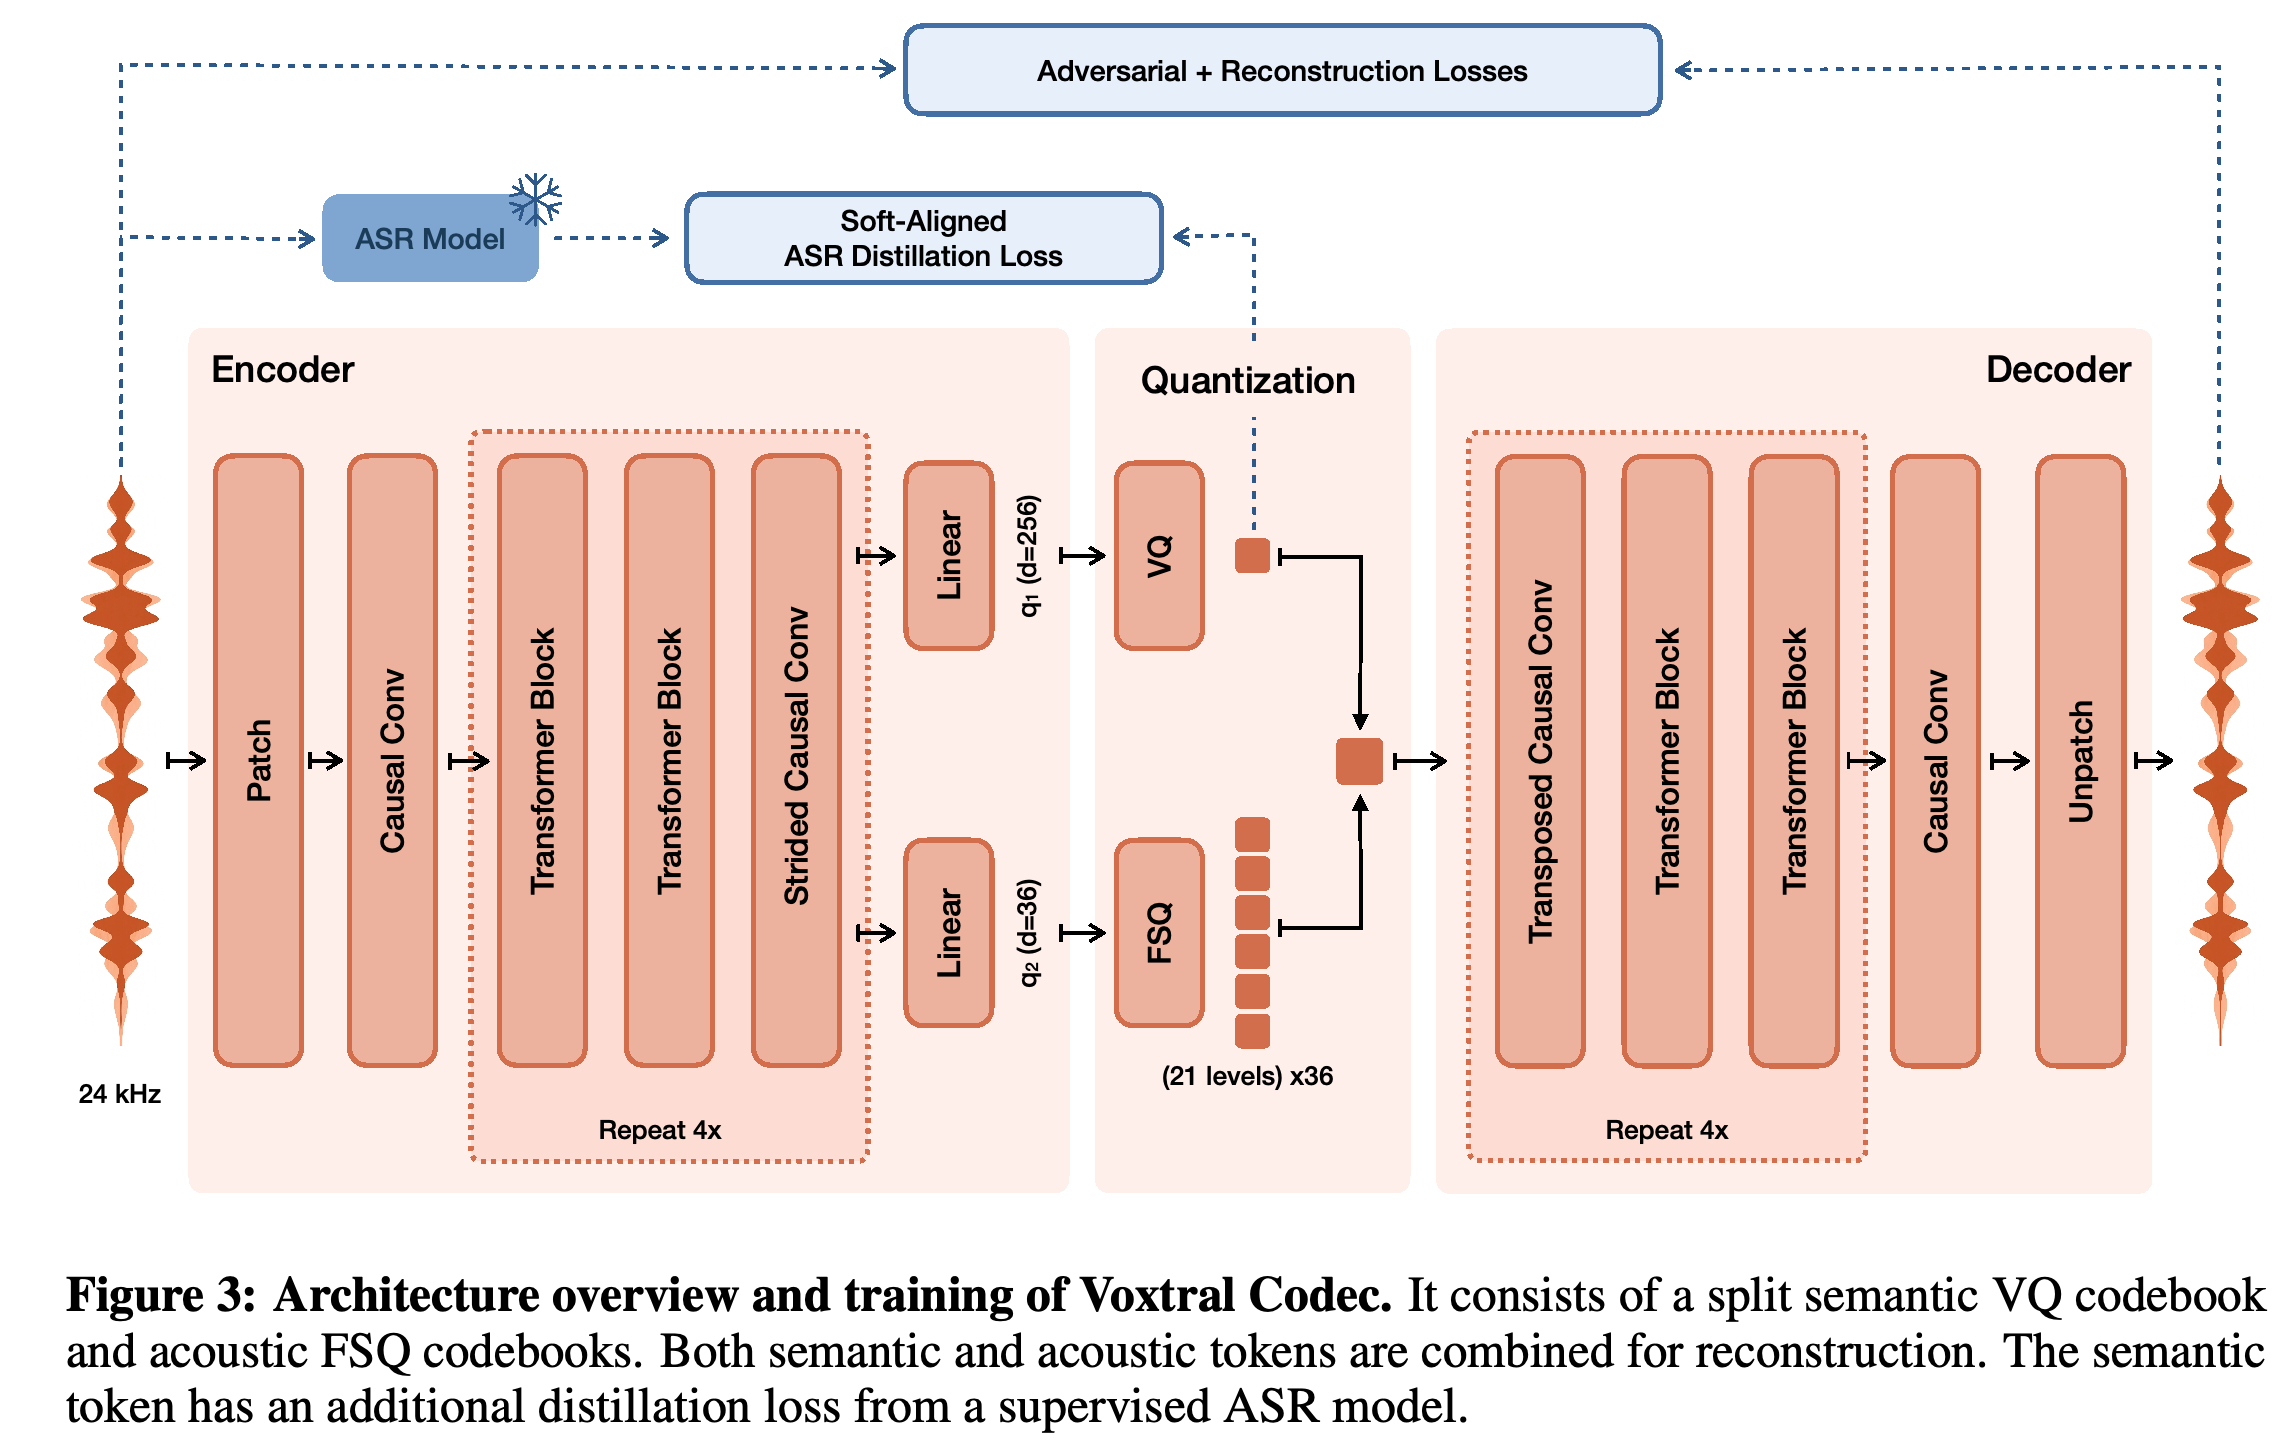
샘플 240개로 구성된 패치와 스트라이드 2의 축소 연산 3회를 결합해 100 Hz 패치 시퀀스를 12.5 Hz 병목 표현으로 바꾼다. 항목 8192개의 의미 코드북과 36 × 21 음향 양자화 구조가 생성기의 이산 인터페이스를 정의한다. 각주는 확률적 양자화와 학습 안정화 설정을 명시한다.
2.2 Decoder Backbone
디코더 전용 백본은 Ministral 3B의 구조를 따른다. 각 오디오 프레임은 코드북별 임베딩 조회 벡터 37개를 합산해 표현한다. 각 출력 은닉 상태는 의미 항목 8192개와 <EOA>에 대한 로짓으로 투영된다.
- 의미 예측에는 교차 엔트로피를 사용하며, 같은 은닉 상태가 음향 flow matching의 조건이 된다.
- flow로 생성한 음향 값은 다음 자기회귀 단계 전에 양자화하므로, 입력 인터페이스는 완전히 이산적인 형태를 유지한다.
2.3 Flow-Matching Transformer
음향 생성기는 백본과 같은 폭을 가진 양방향 3층 트랜스포머다. 각 프레임에서 입력 3개인 백본 은닉 상태 h, 정현파 임베딩을 적용한 적분 시간 t, 36차원 음향 상태 xt를 각각 별도로 투영해 처리한다.
- 학습 중에는 10% 확률로 조건을 제거한다. 추론에는 함수 평가 8회, Δt=1/8, CFG α=1.2인 Euler 적분을 사용한다.
- 가이던스를 적용한 속도는 vt = αvθ(xt,t,h) + (1−α)vθ(xt,t,∅)이며, 적분 갱신식은 (x_{t+\Delta t}=x_t+v_t\cdot\Delta t)다. 무조건 분기에서는 h 대신 영벡터를 사용한다.
- CFG는 전체 백본이 아니라 작은 음향 트랜스포머만 2번 실행한다. 출력은 다시 입력하기 전에 FSQ 레벨 21개로 양자화한다.
- 논문은 AdaLN 조건화보다 결과가 좋고 MaskGIT 및 Depth Transformer 대안보다 표현력이 높다고 보고하지만, 수치 비교는 제공하지 않는다. 프레임당 계산량은 MaskGIT의 시퀀스 길이 38, Depth Transformer의 자기회귀 단계 36회, flow matching의 입력 위치 3개와 NFE 8회로 설명한다. 이 수치는 실제 실행 시간을 측정한 비교가 아니다.
3 Training
학습은 2단계로 진행한다. 먼저 오디오–텍스트 쌍으로 의미 및 음향 생성을 사전학습하고, 이어서 생성한 승자–패자 쌍으로 선호 최적화를 수행한다. 사후학습 단계에서도 고품질 음성에 대한 사전학습 목적함수를 유지한다. 저자들은 합성 선호 데이터로 더 오래 학습하면 음성이 더 기계적으로 변했다고 보고한다.
3.1 Pretraining
사전학습 샘플은 (A1, T2, A2) 형태다. A1은 같은 화자의 참조 음성이고, T2는 목표 오디오 A2의 의사 레이블 전사문이다. 각 구간은 <next>와 <repeat>로 구분한다. 손실은 A2에만 적용하며, 의미 토큰 교차 엔트로피와 제곱 오차 기반 조건부 flow-matching 목적함수를 결합한다.
- 전사문은 Voxtral Mini Transcribe로 생성한다. A1과 A2가 시간상 인접할 필요는 없다. A1과 A2 모두 최대 길이는 180초이며, A1은 최소 1초여야 한다. 논문은 3초에서 25초 사이의 참조 프롬프트에서 가장 잘 작동했다고 보고한다.
- 백본은 Ministral 3B로 초기화하고, 음향 flow matching, 오디오 임베딩, 출력 투영은 무작위로 초기화한다. 드물게 나타나는 전사 토큰에 대한 강건성을 높이기 위해 텍스트 임베딩은 고정한다.
- VAD 기반 가중치로 비음성 프레임의 영향을 줄이고, 매우 긴 무음 구간에는 가중치 0을 부여한다. LLM으로 전사문을 다시 작성해 “5 - 4”와 “five minus four”처럼 정규화 여부가 다른 표현에 대한 강건성을 높인다.
- Equations (6)–(7)은 속도 목표를 x1 − x0으로 정의하고 x0을 데이터, x1을 가우시안 잡음으로 표시한다. 이는 Section 2.3에서 사용한 끝점 표기와 반대다.
3.2 Direct Preference Optimization
DPO는 표준 의미 토큰 선호 목적함수와 flow 기반 음향 선호 목적함수를 결합한다. 음향 목적함수는 시퀀스 위치마다 적분 시간을 독립적으로 샘플링하고, 참조 모델을 기준으로 승자와 패자의 속도 예측 오차 합을 비교한다.
- 정책 모델과 참조 모델은 대응하는 시퀀스 위치에서 동일하게 샘플링한 시간과 x0 값을 사용한다. 승자 길이로 정규화하면 학습이 불안정해지는 것으로 확인됐다.
- 의미 손실과 음향 손실을 합할 때 가중치는 동일하게 부여하며, βsemantic=0.1, βacoustic=0.5, 학습률은 8e−8이다.
- 별도로 확보한 단일 화자 참조 음성과 Mistral Small Creative 1이 생성한 텍스트를 거절 샘플링에 사용한다. 쌍 선택에는 WER, 화자 유사도, 음량 일관성, UTMOS-v2, 기타 LM-judge 지표를 사용한다.
- 사후학습은 고품질 음성에 대한 사전학습 목적함수를 함께 적용하며 1 epoch 동안 진행한다. 저자들은 합성 데이터로 더 오래 학습하면 음성이 더 기계적으로 변했다고 관찰한다.
4 Results
결과는 코덱 복원 품질과 종단 간 TTS 품질을 나누어 제시한다. 코덱에는 Expresso를 사용하고, 자동 TTS 평가에는 SEED-TTS와 지원 언어 9개에 해당하는 MiniMax-TTS 데이터를 사용한다. 블라인드 청취 평가에서는 대표 음성의 감정 제어와 제로샷 음성 복제를 살펴본다.
4.1 Voxtral Codec
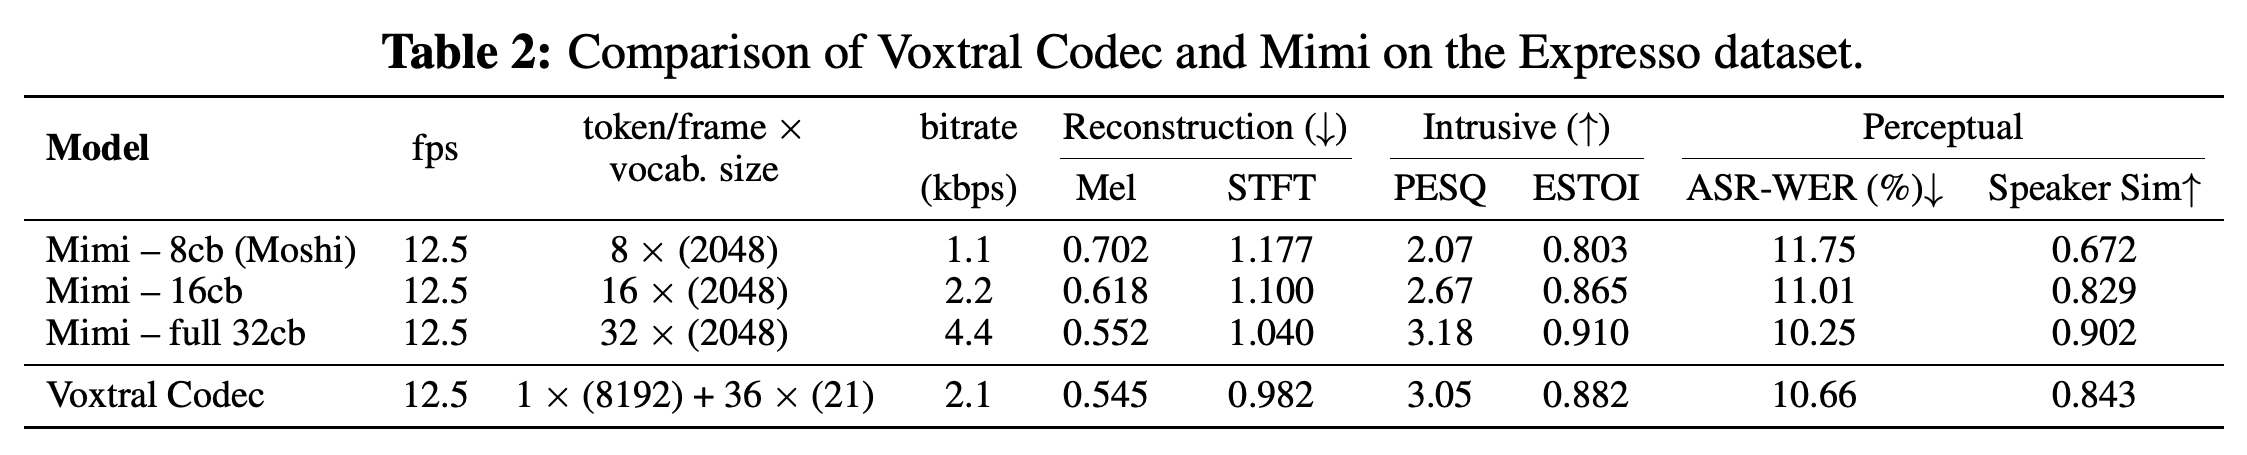
Expresso에서 Voxtral Codec은 비슷한 비트레이트의 Mimi–16cb보다 보고된 모든 객관적 품질 지표에서 우수하다. Table 2에서 비트레이트는 2.1 대 2.2 kbps, PESQ는 3.05 대 2.67, ASR-WER은 10.66% 대 11.01%, 화자 유사도는 0.843 대 0.829다. 이는 비교한 비트레이트에서 복원 품질이 더 좋다는 근거이며, 모든 Mimi 설정보다 우수하다는 뜻은 아니다.
- Voxtral Codec은 Mimi–full 32cb보다 Mel 및 STFT 거리도 낮다. 그러나 비트레이트가 4.4 kbps인 해당 설정은 PESQ, ESTOI, 화자 유사도가 더 높고 ASR-WER이 더 낮다. 비교한 모든 설정은 12.5 fps로 동작한다.
- 여기서 ASR-WER은 원본과 복원 오디오의 ASR 전사문을 비교한다. 생성한 TTS가 요청 텍스트와 얼마나 일치하는지를 측정하는 지표는 아니다.
- 논문은 내부 주관 평가에서 Mimi–16cb와 비슷하거나 더 좋은 음성 품질을 보였다고 보고하지만, 청취자 수나 선호도 통계는 제공하지 않는다.
비슷한 비트레이트에서 Voxtral Codec은 Mimi–16cb보다 나열된 모든 품질 지표를 개선한다. PESQ는 2.67에서 3.05로, 화자 유사도는 0.829에서 0.843으로 높아진다. 코드북 32개를 모두 사용하는 Mimi 설정은 약 2배의 비트레이트에서 여러 지각 품질 및 명료도 지표의 우위를 유지한다. 따라서 이 결과의 핵심은 비트레이트가 비슷한 설정 간 비교다.
4.2 Automatic Evaluations
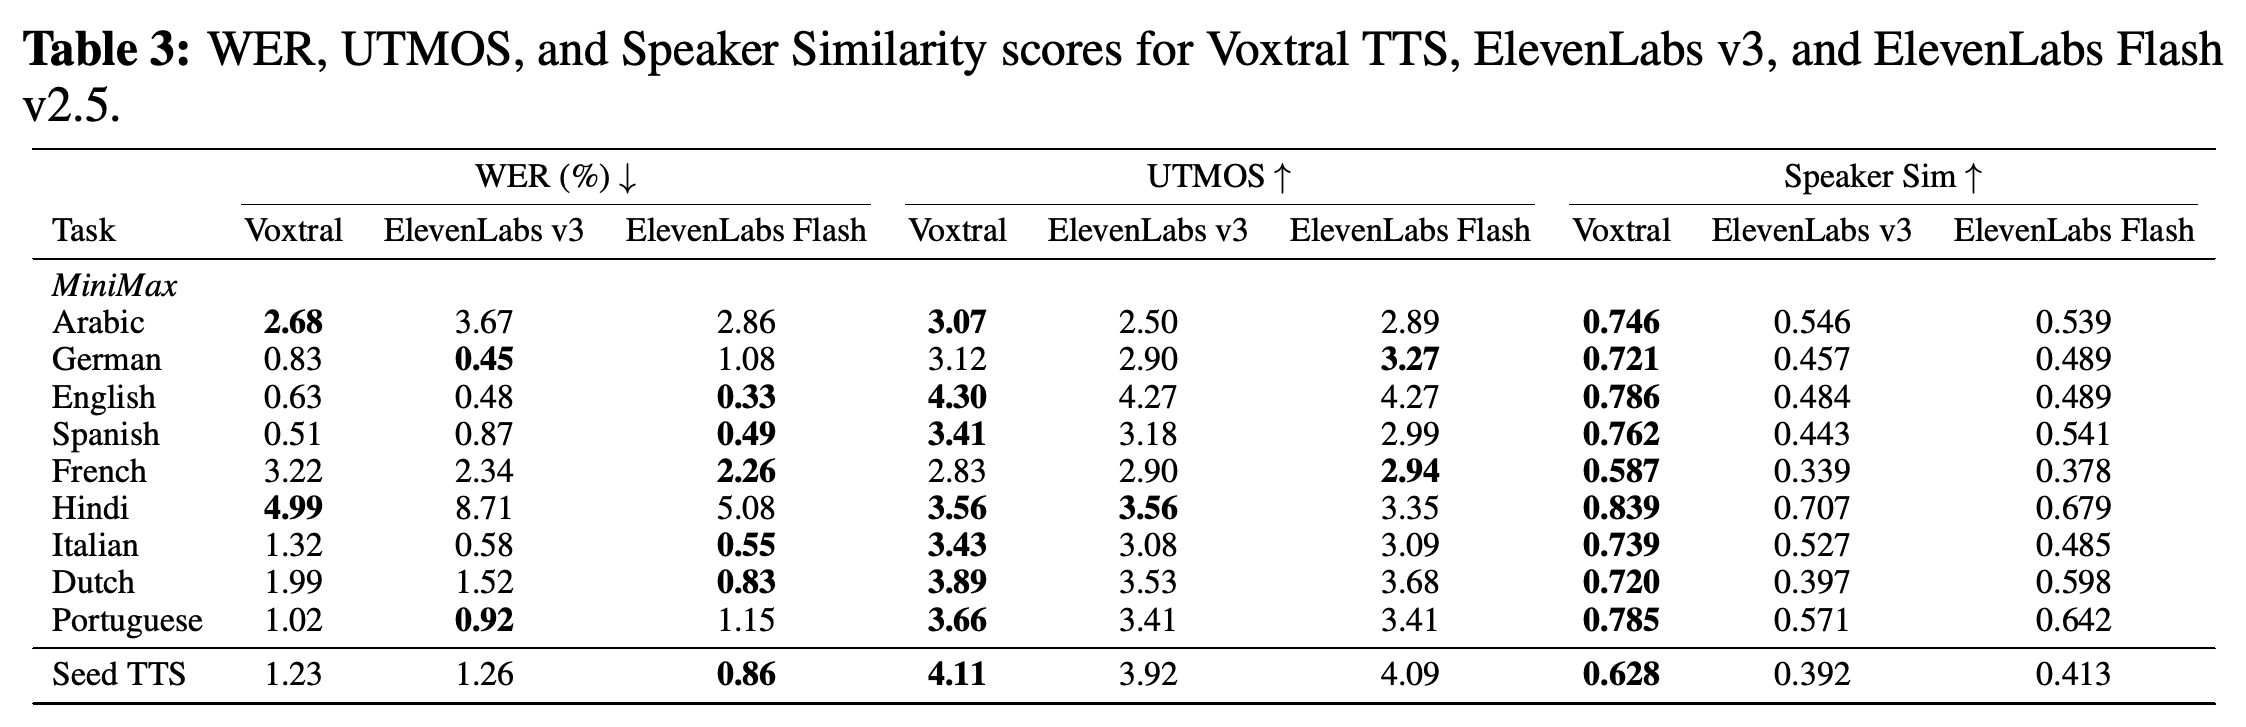
자동 평가에서는 Voxtral Mini Transcribe v2로 WER을, UTMOS-v2로 예측 MOS를, ECAPA-TDNN 화자 임베딩으로 참조 음성과 생성 음성 사이의 코사인 유사도를 측정한다. Table 3에서 Voxtral TTS는 MiniMax-TTS의 9개 언어와 SEED-TTS 모두에서 화자 유사도가 가장 높다. 반면 WER에서 가장 좋은 모델은 언어와 비교 대상에 따라 달라진다.
- MiniMax 영어에서 Voxtral의 WER은 0.63%, UTMOS는 4.30, 화자 유사도는 0.786이다. ElevenLabs v3는 0.48%, 4.27, 0.484이며, ElevenLabs Flash v2.5는 0.33%, 4.27, 0.489다.
- SEED-TTS에서 Voxtral은 1.23%, 4.11, 0.628이다. ElevenLabs v3는 1.26%, 3.92, 0.392이며, Flash v2.5는 0.86%, 4.09, 0.413이다.
- 논문은 Flash v2.5가 자동 평가에서 ElevenLabs v3보다 좋은 점수를 얻는 경우가 많지만, 사람의 감정 제어 평가에서는 v3가 더 좋은 결과를 보인다고 관찰한다. 또한 UTMOS는 선호도와의 상관관계가 약하고, 언어 간 점수 보정도 잘 되어 있지 않다고 설명한다.
Voxtral은 보고된 모든 과제에서 화자 유사도가 가장 높지만, WER 순위는 달라지며 UTMOS도 항상 우세하지는 않다. 예를 들어 영어 화자 유사도는 0.786으로 비교 모델의 0.484와 0.489보다 높지만, 영어 WER은 ElevenLabs 기준 모델 2개 모두보다 높다. 화자 정체성 보존과 명료도는 별개의 결과다.
4.3 Human Evaluations
청취 평가에서는 모델의 정체를 공개하지 않은 출력을 비교하고, “약간 더 좋음”, “훨씬 더 좋음”, “둘 다 좋음”, “둘 다 나쁨” 중에서 판단한다. 형식에 따른 편향을 줄이기 위해 참조 음성을 포함한 모든 오디오를 24 kHz WAV로 리샘플링한다.
- 대표 음성 평가에는 프롬프트 77개를 사용한다. 이 중 11개는 중립적이며, 66개는 기대되는 감정과 연결된다.
- Figure 1은 음성 복제 비교에 텍스트 프롬프트 60개를 사용했다고 명시한다. 전체 선호도 막대에서 ElevenLabs Flash v2.5 대비 승률은 대표 음성 58.3%, 음성 복제 68.4%다.
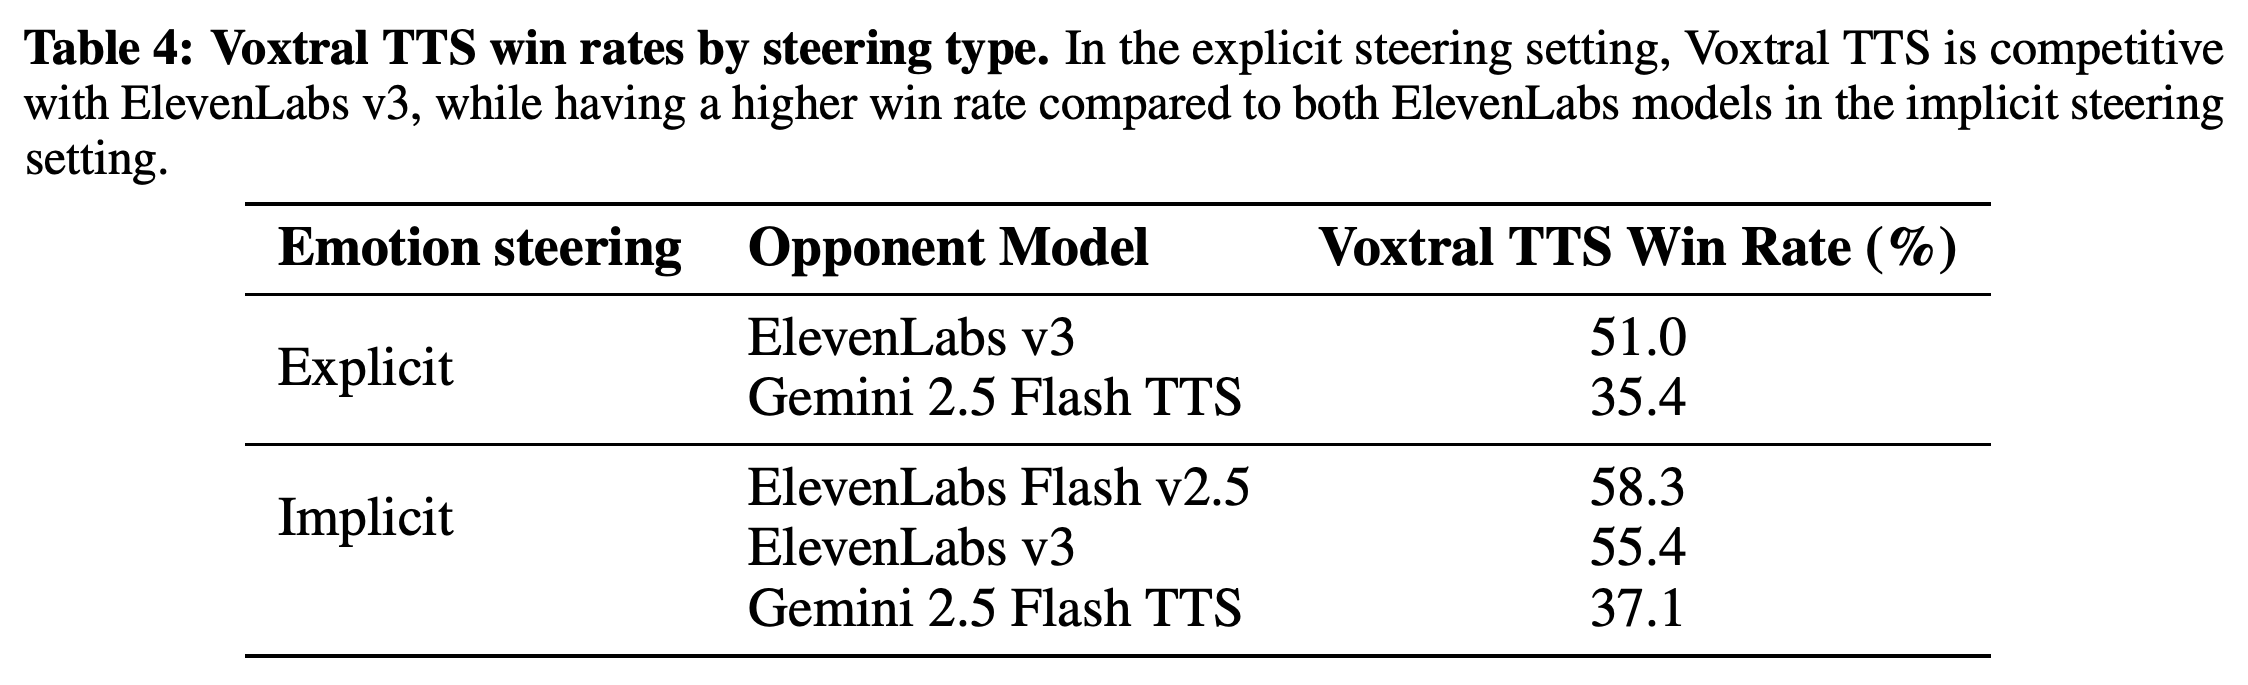
4.3.1에서는 대표 음성을 평가한다. Voxtral의 British-Female, British-Male, American-Male, French-Female 음성을 성별과 억양이 일치하는 경쟁 모델 음성과 비교한다. 같은 방언을 사용하는 원어민 3명이 각 쌍을 평가하며, Table 4는 무승부를 제외한 승률을 보고한다.
- 명시적 감정 제어에서는 Gemini 2.5 Flash TTS에 자유 형식 감정 지시를, ElevenLabs v3에 대괄호 감정 태그를 제공한다. 감정 태그나 텍스트 지시를 지원하지 않는 Voxtral TTS에는 같은 화자의 감정이 담긴 참조 음성을 제공한다.
- 명시적 제어에서 Voxtral의 승률은 ElevenLabs v3 대비 51.0%, Gemini 2.5 Flash TTS 대비 35.4%다.
- 암묵적 제어에서는 감정 레이블을 제공하지 않으며, Voxtral은 중립적인 참조 음성을 사용한다. 승률은 Flash v2.5 대비 58.3%, ElevenLabs v3 대비 55.4%, Gemini 2.5 Flash TTS 대비 37.1%다.
무승부를 제외하면 명시적 제어에서 Voxtral과 ElevenLabs v3는 대체로 비슷하며, 암묵적 제어에서는 Voxtral이 ElevenLabs의 2개 시스템 모두보다 더 자주 이긴다. Gemini 대비 승률은 35.4%와 37.1%이므로, 대표 음성 결과로 사람의 선호도에서 전반적인 우위를 입증할 수는 없다.
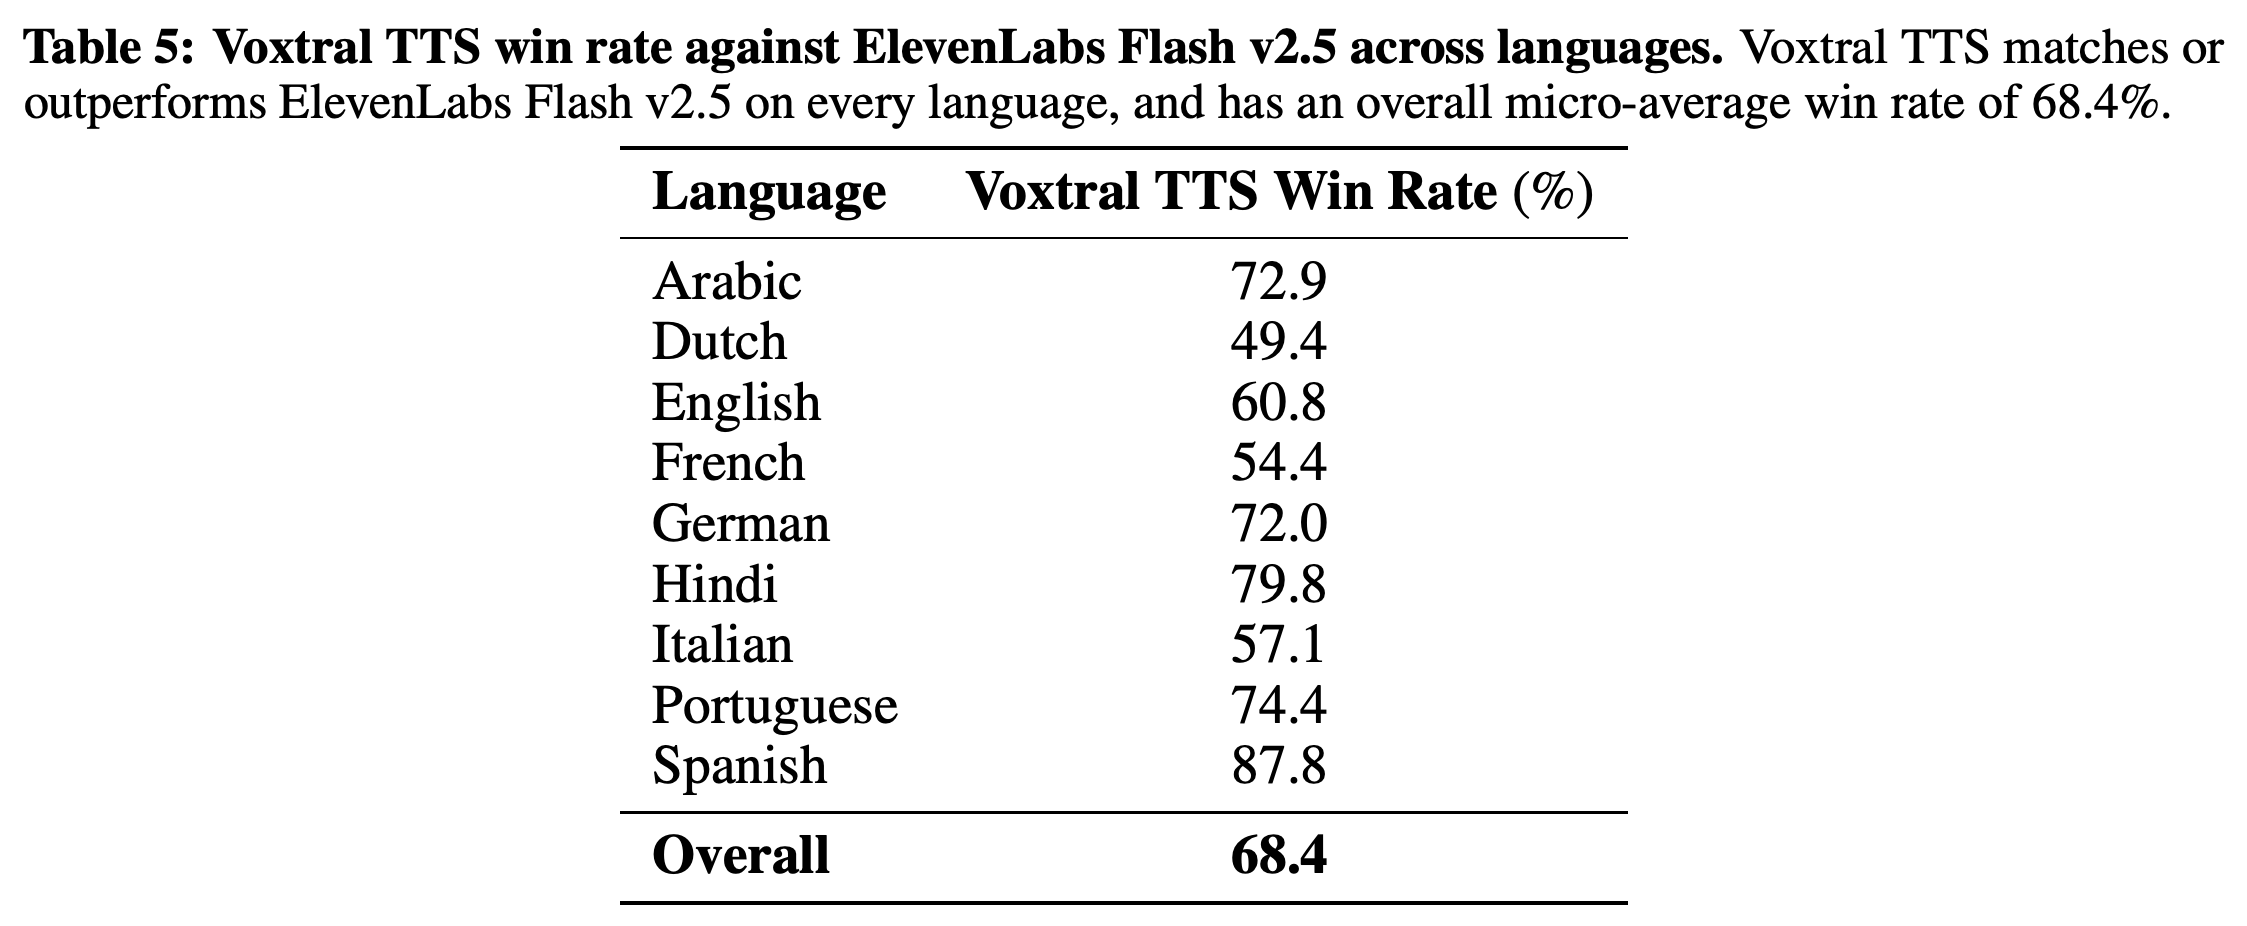
4.3.2에서는 제로샷 음성 복제를 평가한다. 평가에는 언어별로 알려진 화자 2명의 고품질 녹음을 사용하며, 청취자는 참조 음성과의 유사성, 자연스러움, 표현력을 판단한다. ElevenLabs Flash v2.5 대비 Voxtral TTS의 전체 마이크로 평균 승률은 68.4%다.
- Table 5의 승률은 아랍어 72.9%, 네덜란드어 49.4%, 영어 60.8%, 프랑스어 54.4%, 독일어 72.0%, 힌디어 79.8%, 이탈리아어 57.1%, 포르투갈어 74.4%, 스페인어 87.8%다.
- 8개 언어의 승률이 50%를 넘고, 네덜란드어는 그보다 조금 낮다. 불확실성 추정치가 없으므로 네덜란드어 결과로 명확한 우위나 통계적 동등성을 입증할 수는 없다.
- 전체 음성 복제 승률이 대표 음성 승률보다 높다는 결과는 이 복제 설정에서 상대적인 성능이 더 좋다는 뜻이다. 그러나 평가 조건이 다르므로 사용자 녹음 전반에 대한 일반화가 입증된 것은 아니다.
전체 음성 복제 승률 68.4%에는 네덜란드어 49.4%부터 스페인어 87.8%까지 큰 언어별 차이가 포함된다. 보고된 9개 언어 중 8개가 50%를 넘는다. 불확실성 추정치가 없으므로 네덜란드어 수치로 명확한 우위나 동등성을 입증할 수는 없다.
5 Analysis
분석에서는 사전학습 체크포인트와 DPO 체크포인트를 비교한 뒤, 음향 솔버의 함수 평가 횟수와 CFG 스케일을 바꾼다. 자동 지표로 변화를 정량화하고, 환각, 음량 일관성, 텍스트에 암묵적으로 담긴 감정에 대한 반응은 정성적 관찰로 다룬다.
5.1 DPO improvements
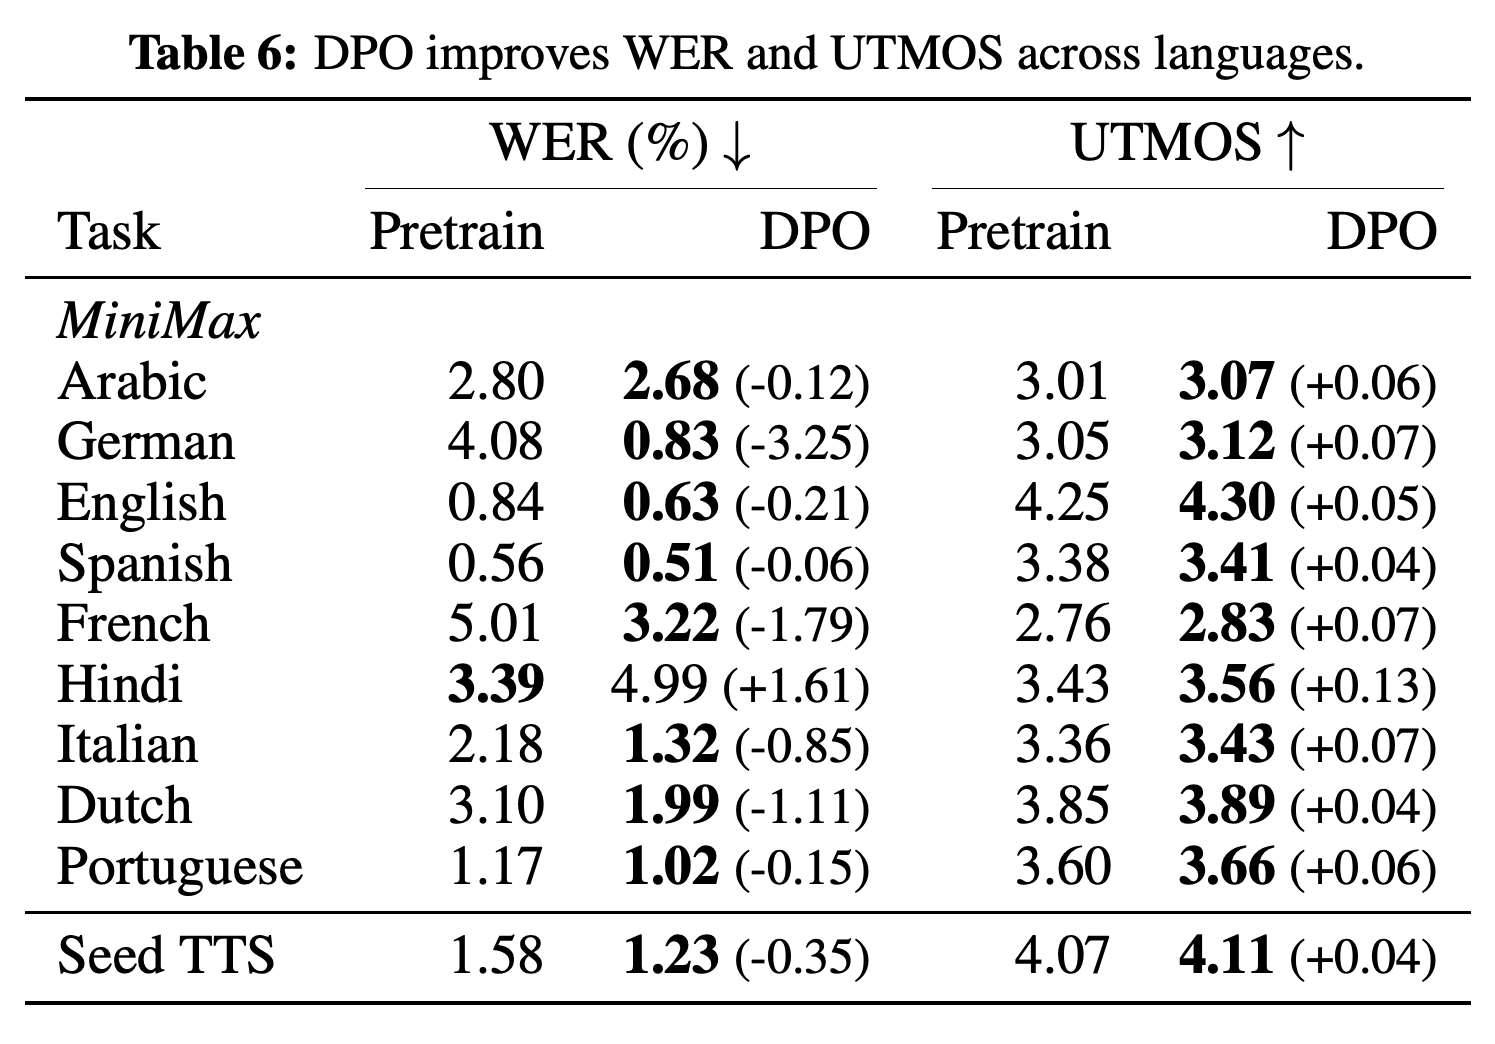
Table 6에서 DPO는 MiniMax-TTS의 8개 언어와 SEED-TTS에서 WER을 낮추고, 보고된 모든 행에서 UTMOS를 높인다. WER 개선 폭은 독일어의 4.08%에서 0.83%, 프랑스어의 5.01%에서 3.22%가 가장 크다. 반면 힌디어는 3.39%에서 4.99%로 악화된다.
- 그럼에도 힌디어 UTMOS는 3.43에서 3.56으로 높아진다. 이는 예측된 자연스러움과 명료도가 서로 다른 방향으로 변할 수 있음을 보여준다.
- 저자들은 DPO 이후 환각과 누락된 단어가 줄고, 음량이 점차 작아지는 현상도 감소했다고 정성적으로 보고한다.
- 본문에 따르면 화자 유사도 변화는 사전학습 체크포인트 대비 ±0.01 이내다. 해당 점수는 표에 제시되지 않는다.
DPO는 힌디어를 제외한 모든 보고 과제에서 WER을 개선하고, 모든 과제에서 UTMOS를 높인다. 독일어 WER은 4.08%에서 0.83%로 낮아지는 반면, 힌디어는 UTMOS가 개선되어도 WER이 3.39%에서 4.99%로 높아진다. 이는 선호 최적화에 언어별 상충 관계가 있음을 보여준다.
5.2 Inference Parameters
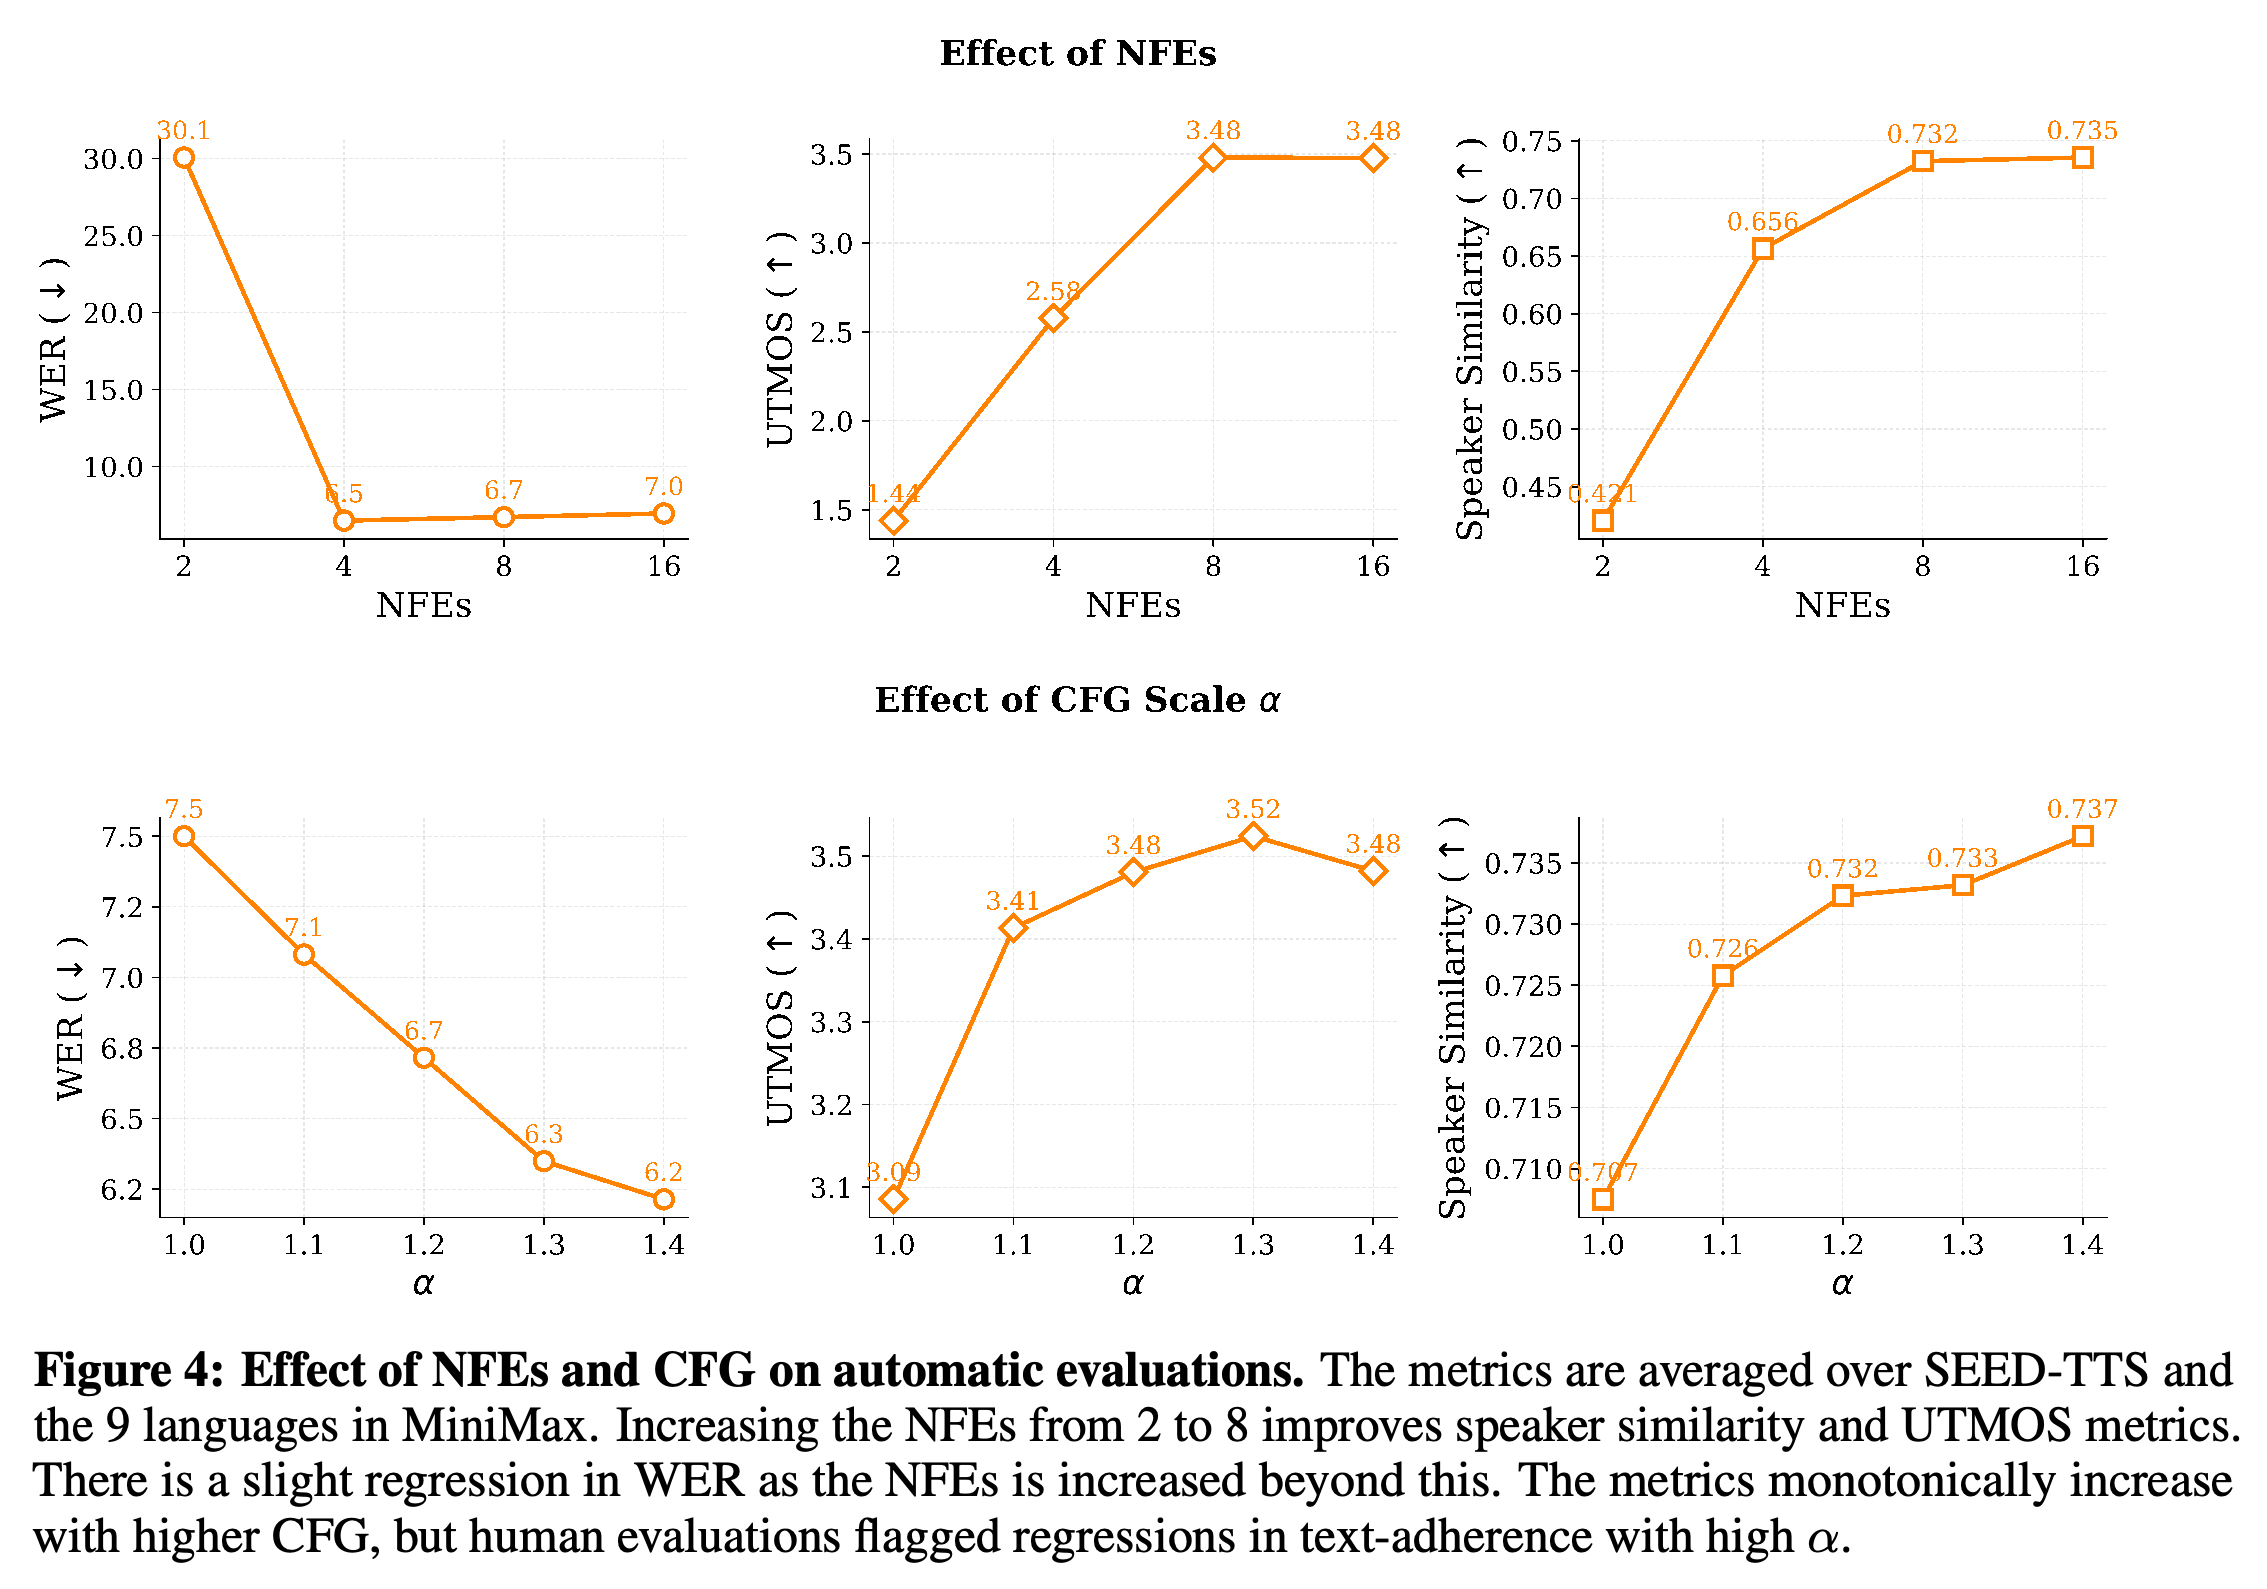
Figure 4는 NFE 8회가 품질과 비용의 절충점임을 뒷받침한다. UTMOS는 NFE 2회에서 1.44, 8회에서 3.48로 높아지고, 화자 유사도는 0.421에서 0.732로 높아진다. 16회로 늘리면 UTMOS는 3.48에 머물고 유사도는 0.735로 소폭 높아지지만, WER은 6.7에서 7.0으로 악화된다.
- WER은 NFE 2회에서 30.1, 4회에서 6.5로 크게 개선되지만, 8회에서는 6.7이다. 평가 횟수를 늘린다고 WER이 단조롭게 개선되지는 않는다.
- CFG α를 1.0에서 1.4로 높이면 그래프의 WER은 7.5에서 6.2로 낮아지고, 화자 유사도는 0.707에서 0.737로 높아진다. UTMOS는 α=1.3에서 3.52로 정점에 이른 뒤, α=1.4에서 3.48로 낮아진다.
- 내부 청취 평가에서는 가이던스가 높을수록 참조 음성을 지나치게 따르면서 텍스트에 암묵적으로 담긴 감정에 덜 반응했다. 기본값 α=1.2는 고품질 녹음에 맞춘 선택이며, 논문은 실제 환경에서 수집한 녹음에는 더 강한 가이던스가 도움이 될 수 있다고 제안한다.
NFE 그래프에서 UTMOS와 화자 유사도는 평가 8회까지 크게 개선되고, 이후에는 추가 이득이 작아진다. WER은 8회가 아니라 4회에서 가장 낮다. CFG를 높이면 그래프의 WER과 유사도는 개선되지만 UTMOS는 단조롭게 개선되지 않는다. 내부 청취 결과는 텍스트에 내포된 감정 변화를 유지하기 위해 더 낮은 기본 가이던스를 사용하는 근거가 된다.
6 Inference and Serving in vLLM-Omni
vLLM-Omni는 Voxtral TTS를 의미·음향 토큰 생성과 코덱 파형 디코딩으로 이루어진 2단계 파이프라인으로 서빙한다. 공유 메모리를 통한 비동기 청크 전송 덕분에 전체 파형 합성이 끝나기 전에 재생을 시작할 수 있다.
6.1 CUDA Graph Acceleration for Flow-Matching Transformer
논문에 따르면 flow-matching transformer가 생성 단계의 계산 병목이다. CFG를 적용한 적분 평가 N회에는 프레임마다 순전파 2 × N회가 필요하기 때문이다. ODE 솔버 전체를 CUDA graphs로 캡처하면 Python 오버헤드와 커널 실행 지연을 줄일 수 있다.
- 시작할 때 배치 크기 버킷별로 워밍업하고 그래프를 캡처한다. 추론에서는 실제 배치 크기 이상인 가장 가까운 버킷에 맞춰 패딩하고 그래프를 재실행한 뒤, 출력을 실제 배치 크기로 잘라낸다. 최대 버킷보다 큰 배치는 eager 실행으로 처리한다.
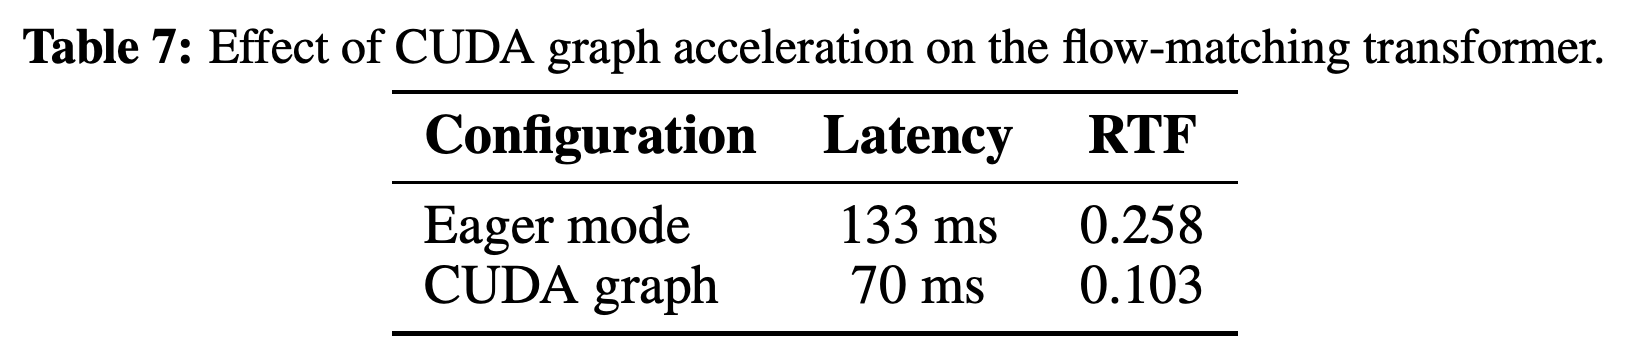
- 500자 입력, 10초 참조 음성, 동시 요청 1개, H200 1개 조건에서 Table 7의 지연 시간은 133 ms에서 70 ms로, RTF는 0.258에서 0.103으로 낮아진다.
- 논문은 이를 지연 시간 47% 개선과 RTF 2.5배 감소로 설명한다.
H200 1개에서 500자 입력, 10초 참조 음성, 동시 요청 1개 조건으로 CUDA graph 실행을 적용하면 지연 시간은 133 ms에서 70 ms로, RTF는 0.258에서 0.103으로 낮아진다. 이는 명시된 서빙 조건에서 반복 실행되는 음향 솔버를 캡처해 얻은 구현상의 이점을 측정한 결과다.
6.2 Asynchronous Chunked Streaming
생성과 코덱 디코딩은 별도의 스케줄링 루프를 사용한다. 전송 관리자는 요청별 오디오 토큰을 모으고, 미리 정한 버퍼 길이에 도달하면 청크를 내보낸다. 따라서 자기회귀 생성과 파형 합성을 동시에 진행할 수 있다.
- 각 청크에는 새 프레임뿐 아니라 앞선 프레임도 포함한다. 이를 통해 코덱 디코더의 인과적 슬라이딩 윈도 어텐션이 청크 경계를 넘어 시간적 문맥을 참조할 수 있다.
- PDF는 청크 길이나 겹치는 구간의 길이를 명시하지 않는다.
6.3 Inference Throughput
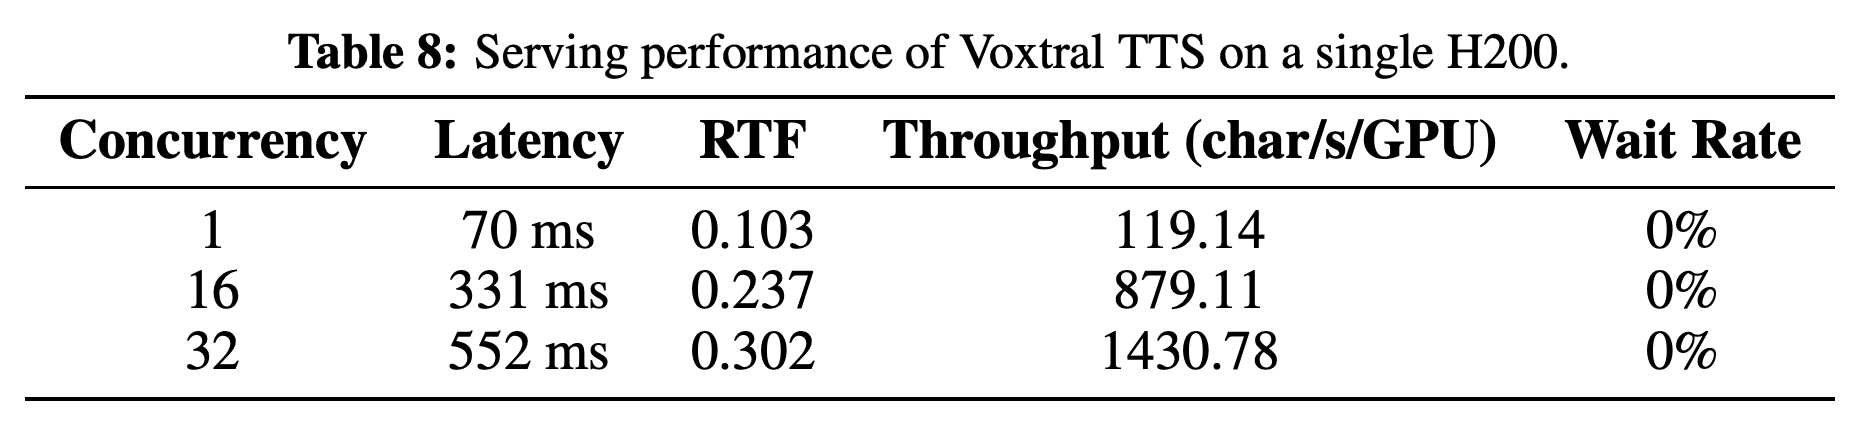
Table 8은 500자 텍스트 입력과 10초 음성 참조 조건에서 NVIDIA H200 1개를 동시 요청 1개, 16개, 32개로 평가한다. 처리량은 119.14에서 879.11, 1430.78 char/s/GPU로 증가한다. 첫 오디오 도착 시간은 70에서 331, 552 ms로, RTF는 0.103에서 0.237, 0.302로 증가한다.
- 클라이언트가 재생을 멈추고 기다려야 하는 오디오 청크의 비율인 클라이언트 대기율은 동시 요청 수준 3개 모두에서 0%다.
- 이 측정은 시험한 워크로드에서 끊김 없는 실시간 스트리밍이 가능함을 보여준다. 동시 요청 32개일 때의 전체 처리량은 1개일 때보다 약 12배 높다.
- 보고된 조건에서는 더 긴 입력, 다른 참조 길이, 다양한 요청 분포, 다른 GPU를 시험하지 않는다.
동시 요청을 1개에서 32개로 늘리면 처리량은 119.14에서 1430.78 char/s/GPU로 높아지며, 첫 오디오 도착 시간은 1초 미만이고 대기율은 0%를 유지한다. 요청별 RTF는 0.302로 높아진다. 이는 고정된 워크로드에서 실시간 동작을 계속 유지한다는 뜻이지, 요청별 속도가 그대로라는 뜻은 아니다.
7 Conclusion
논문은 자기회귀 의미 생성, flow matching 기반 음향 생성, ASR 증류 VQ–FSQ 코덱을 결합해 짧은 참조 음성으로 표현력 있는 다국어 음성 복제가 가능하다고 결론짓는다. Voxtral TTS는 제한 없는 상업적 이용 라이선스가 아니라 CC BY-NC에 따른 공개 가중치로 배포된다.
- 웹페이지 주소는 https://mistral.ai/news/voxtral-tts 이다.
- 모델 가중치는 https://huggingface.co/mistralai/Voxtral-4B-TTS-2603 에 공개된다.
부록
- 16페이지 PDF에는 부록이 없다. 논문은 arXiv:2603.25551v2 [cs.AI]로 식별되며, 날짜는 6 Apr 2026이다. 문서는 기여자 목록, 감사의 글, 참고문헌으로 끝난다. 구현에 영향을 줄 수 있는 표기 불일치가 남아 있다. Section 2.3은 x0을 가우시안 잡음, x1을 음향 데이터로 정의하지만, Equations (6)–(7)과 그 설명은 x0을 데이터, x1을 가우시안 잡음으로 정의한다.
짧은 생각
핵심 방법론적 기여는 코덱 표현과 생성 방식의 대응 관계에 있다. 이산 의미 예측은 낮은 프레임률의 시간축 인터페이스를 유지하고, 연속 음향 생성은 깊이 방향의 자기회귀 단계 36회를 피한다. 실험은 시험한 조건에서 경쟁력 있는 음성 복제와 저지연 스트리밍을 뒷받침한다. 그러나 각 구조적 선택의 기여를 분리하거나 다양한 배포 워크로드의 성능을 입증하지는 않는다. 사람의 선호도 평가는 자동 평가를 보완한다. 화자 유사도는 일관되게 Voxtral에 유리하지만 WER 순위는 달라지며, 대표 음성 비교에서는 Gemini가 이긴다. 명시적 감정 제어도 서로 다른 제어 인터페이스를 사용하므로, 동일한 조건화 기법이 아니라 전체 시스템을 비교한 결과다. PDF는 전체 학습 데이터 규모, 상세한 데이터 구성, 사람의 선호도 신뢰구간, 대체 음향 구조 및 코덱 제거 실험의 수치 결과를 보고하지 않는다. 이 정보가 없어 재현성과 불확실성 평가에 한계가 있다. 음성 복제 평가에는 언어별로 알려진 화자 2명과 고품질 참조 녹음을 사용한다. 잡음이 있는 마이크, 더 큰 화자 집단, 서로 다른 언어의 참조–목표 조합에 대한 일반화는 정량화하지 않는다. DPO는 대부분의 명료도 결과를 개선하지만 힌디어 WER을 악화시키며, 화자 유사도는 거의 바꾸지 않는다. 따라서 이점은 보편적이지 않고 지표와 언어에 따라 달라진다.