


How Well Do Agentic Skills Work in the Wild: Benchmarking LLM Skill Usage in Realistic Settings 요약 설명
06 Apr 2026 | Paper Review Agentic Skills LLM Evaluation Test-Time Adaptation목차
- 요약
- 1 Introduction
- 2 Related Work
- 3 Skill Usage in Realistic Settings
- 4 Narrowing the Gap with Skill Refinement
- 5 Conclusion
- Ethics Statement
- LLM Usage Disclosure
- 부록
- 짧은 생각
이번 글에서는 How Well Do Agentic Skills Work in the Wild: Benchmarking LLM Skill Usage in Realistic Settings 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 4월 6일(Arxiv), Preprint. Under review.
- Liu, Yujian, Ji, Jiabao, An, Li, Jaakkola, Tommi, Zhang, Yang, Chang, Shiyu.
- UC Santa Barbara, MIT CSAIL, MIT-IBM Watson AI Lab
- 논문 링크
- Github
- Project Page
요약
- 이 논문은 에이전트가 스킬을 선택하고 검색하며 과제에 맞게 수정해야 할 때 재사용 가능한 스킬 문서가 도움이 되는지 평가한다. 스킬 34,198개를 수집하고, 모델–하네스 3 pairs를 SKILLSBENCH 84 tasks와 89개의 TERMINAL-BENCH 2.0 tasks에서 평가한다. 각 과제는 3회 실행한다.
- 과제에 맞게 선별한 스킬에 접근하기 어려워지거나 해당 스킬이 제거되면 스킬의 효과는 대체로 줄어든다. SKILLSBENCH에서 Claude Opus 4.6의 통과율은 선별 스킬을 강제로 로드할 때 55.4%, 선별 스킬을 제외하고 검색할 때 38.4%, 스킬을 사용하지 않을 때 35.4%다. 선별 스킬을 제외하면 Kimi와 Qwen은 스킬 미사용 기준선보다 성능이 조금 낮아진다.
- 질의별 정제는 탐색적 과제 수행과 자체 평가를 통해 과제에 맞는 스킬을 구성한다. 이 방식은 평가한 모델–설정 조합 9개 중 7개에서 통과율을 높인다. TERMINAL-BENCH 2.0에서 검색 후 정제를 수행하면 Claude의 통과율은 스킬 미사용 기준선인 57.7%에서 65.5%로 높아지지만, 추론 시점에 추가 탐색이 필요하다. 초기 스킬이 과제 요구를 충족하는 범위가 좁은 설정에서는 개선 폭이 대체로 작다.
1 Introduction
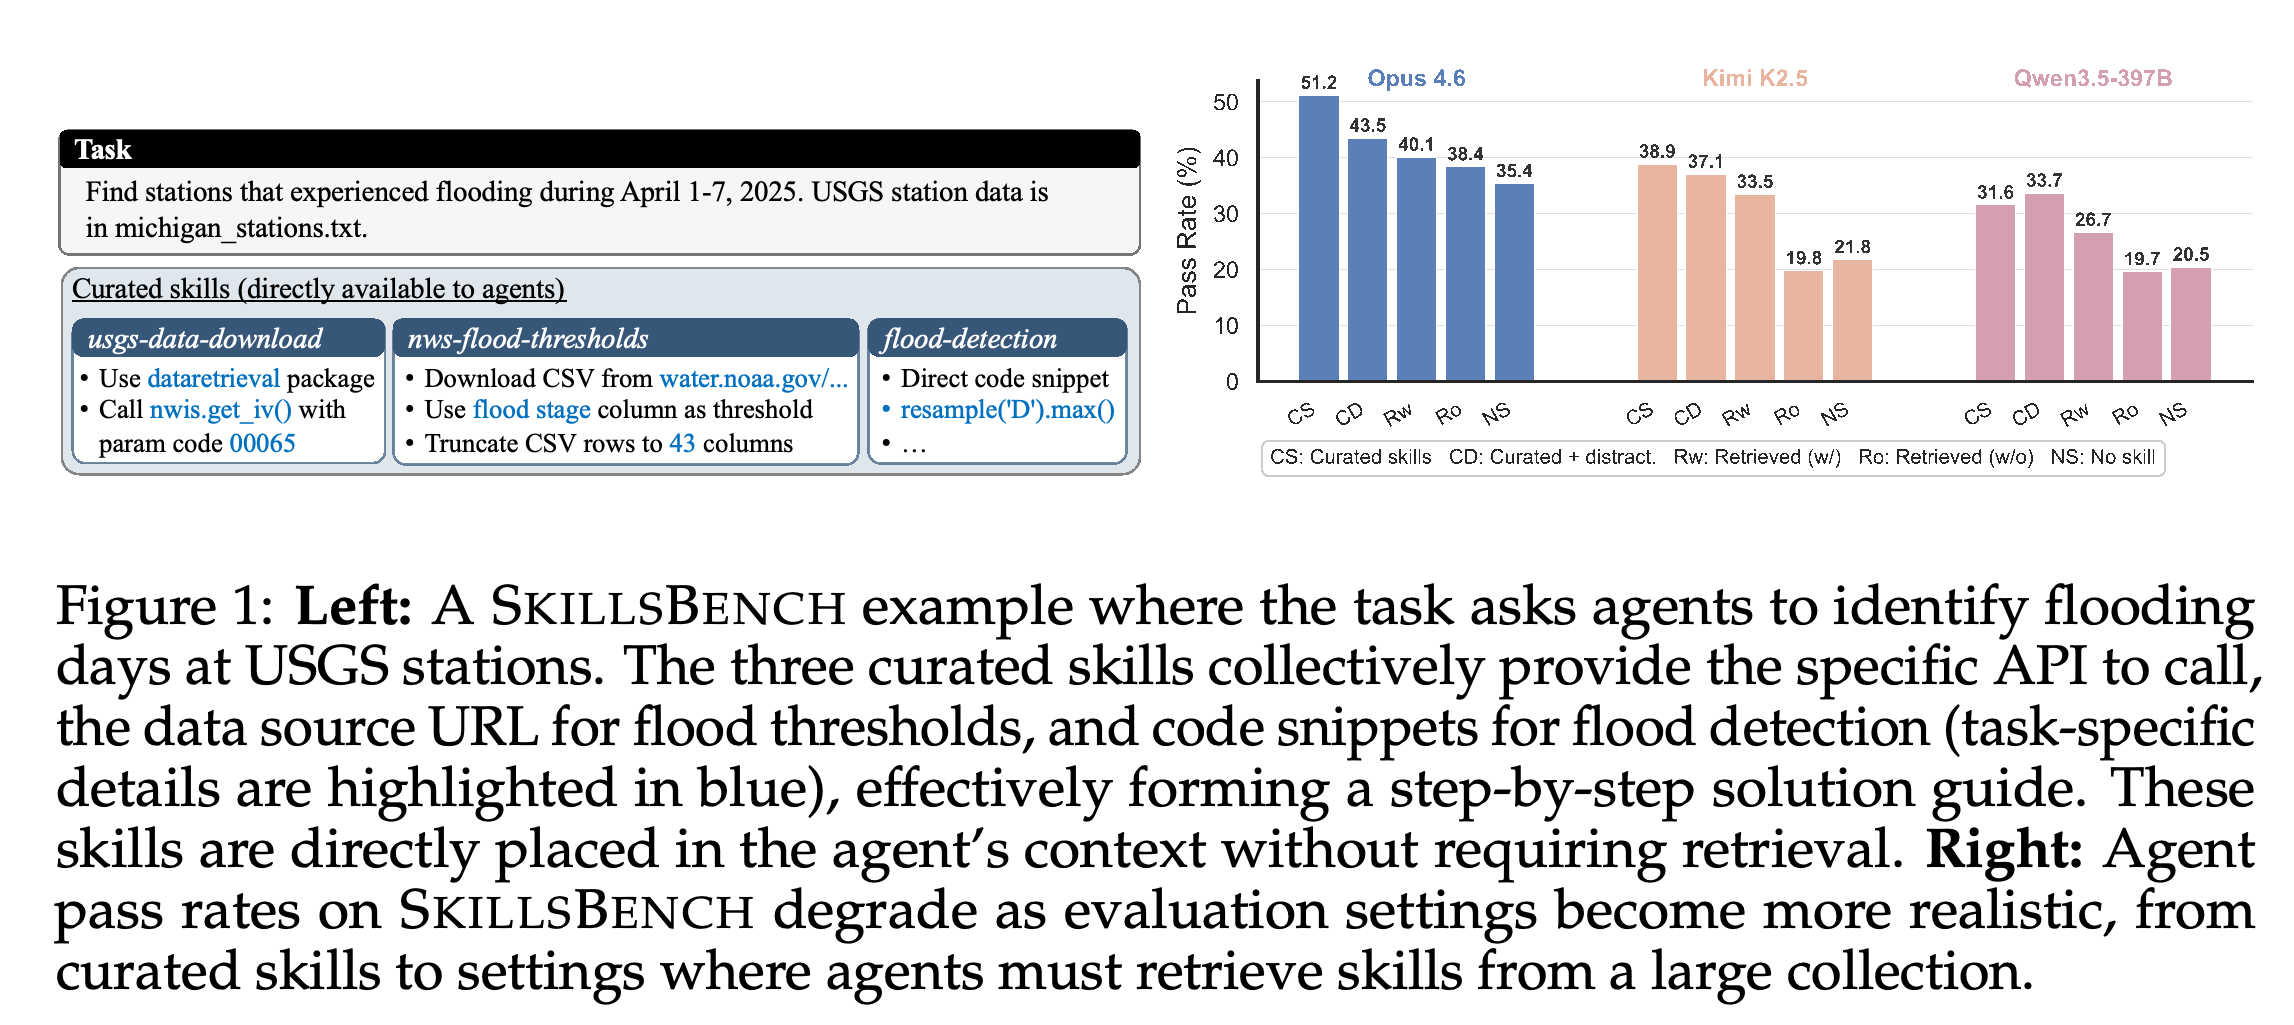
이 논문은 과제에 특화해 수작업으로 만든 스킬을 직접 제공하는 평가 방식에 의문을 제기한다. 이러한 조건에서는 대규모 저장소에서 유용한 지식을 찾는 과정이 생략되기 때문이다. Figure 1은 홍수 관련 과제로 이 문제를 보여준다. usgs-data-download, nws-flood-thresholds, flood-detection은 데이터 API, 임계값 출처, 탐지 절차를 함께 명시하므로, 제공된 스킬은 풀이 안내서에 가깝다.
- 예시 과제는 michigan_stations.txt를 사용해 2025년 4월 1–7 사이에 홍수가 발생한 관측소를 찾도록 요구한다. 스킬은 nwis.get_iv(), 매개변수 코드 00065, 각 행을 43개 열로 자르기, resample(‘D’).max() 같은 세부 사항을 제공한다.
- 연구는 사용 가능한 스킬의 선택, 대규모 스킬 모음에서의 검색, 일부만 관련된 내용의 적용을 각각 평가한다.
- 코드는 https://github.com/UCSB-NLP-Chang/Skill-Usage 에 공개되어 있다.
홍수 과제 예시는 선별 스킬이 폭넓게 재사용할 수 있는 지식보다 과제 절차 거의 전체를 담을 수 있음을 보여준다. 옆의 그래프는 유용한 스킬을 찾아내고 과제에 맞게 적용하는 능력을 평가할 필요성을 제시한다. Claude는 선별 스킬을 제공받을 때 51.2%에서 선별 스킬을 제외하고 검색할 때 38.4%로 낮아지며, Kimi와 Qwen은 스킬 미사용 기준선보다 조금 낮은 성능을 기록한다. 전체 추세가 모든 모델에서 엄밀하게 단조 감소하는 것은 아니다.
2 Related Work
기존 연구는 LLM 에이전트가 재사용할 지식을 도구, 체화된 환경의 스킬 라이브러리, 지침서, 워크플로, 절차적 메모리, 지속적 메모리로 표현한다. 이 논문은 표준화된 스킬 형식으로 검색한 지식의 효용을 평가하며, 지식 생성이나 발전에 초점을 맞춘 연구를 보완한다.
표준화된 agentic skills는 구조화된 메타데이터와 내용을 담은 SKILL.md 파일로 구성되며, 보조 파일을 포함할 수도 있다. 논문은 스킬 인프라, 발견, 라우팅, 메모리, 보안, 선별 스킬을 직접 제공하는 벤치마크 관련 연구와 비교해 이번 평가의 위치를 설명한다.
스킬 정제는 에이전트의 자체 개선과 테스트 시점 적응에 관한 연구와 연결된다. 관련 접근법에는 언어적 자기 성찰, 피드백 기반 정책 개선, 메모리 기반 학습, 추론 시점의 재사용 가능한 지식 축적이 있다. 평가한 정제 절차는 벤치마크의 정답 검증기에 접근하지 않고 탐색과 자체 평가를 사용한다.
3 Skill Usage in Realistic Settings
평가는 3가지 어려움을 단계적으로 도입한다. 사용 가능한 스킬 중 로드할 스킬을 선택하고, 대규모 저장소에서 후보를 검색하며, 과제와 일부만 맞는 범용 스킬을 과제에 맞게 수정해야 한다. 실험은 먼저 스킬 모음과 검색 시스템을 구축한 뒤, SKILLSBENCH에서 이러한 조건을 바꾸어 평가한다.
3.1 Skill Collection
스킬 메타데이터는 skillhub.club과 skills.sh에서 수집하고, 전체 스킬 폴더는 원래 GitHub 저장소에서 내려받는다. MIT 또는 Apache 2.0 라이선스가 적용된 스킬만 남기고, 이름이나 설명이 비어 있는 항목을 제거하며, 파일 내용을 기준으로 중복을 제거한다. 그 결과 웹 개발, 데이터 엔지니어링, 개발 운영, 과학 계산 등 여러 분야에 걸쳐 스킬 34,198개를 확보한다.
- 수집한 자료에는 메타데이터 설명뿐 아니라 SKILL.md와 함께 제공되는 보조 파일도 포함된다.
- 수집에 사용한 플랫폼은 https://www.skillhub.club/ 과 https://skills.sh/ 다.
3.2 Skill Search Engine
스킬 인덱스에는 각 스킬의 이름과 설명으로 만든 메타데이터 표현과 SKILL.md에서 얻은 전체 내용 표현을 저장한다. Qwen3-Embedding-4B는 밀집 임베딩을 제공하고, BM25는 희소 키워드 매칭을 제공한다.
직접 검색은 과제 설명을 1회 임베딩하고 메타데이터 인덱스에서 top-k 후보를 검색한다. 에이전트 기반 검색은 질의 작성, 후보 검토, 선택을 반복할 수 있으며, 키워드 전용, 의미 검색 전용, 메타데이터 전용 하이브리드, 메타데이터와 전체 내용을 사용하는 하이브리드 방식으로 나뉜다.
- 하이브리드 방식은 에이전트에 키워드 검색, 의미 검색, 결합 검색 도구를 제공한다.
- 전체 내용을 사용하는 방식은 메타데이터에 더해 스킬 전체 내용을 반영하므로, 이름과 설명에 없는 정보도 검색에 활용할 수 있다.
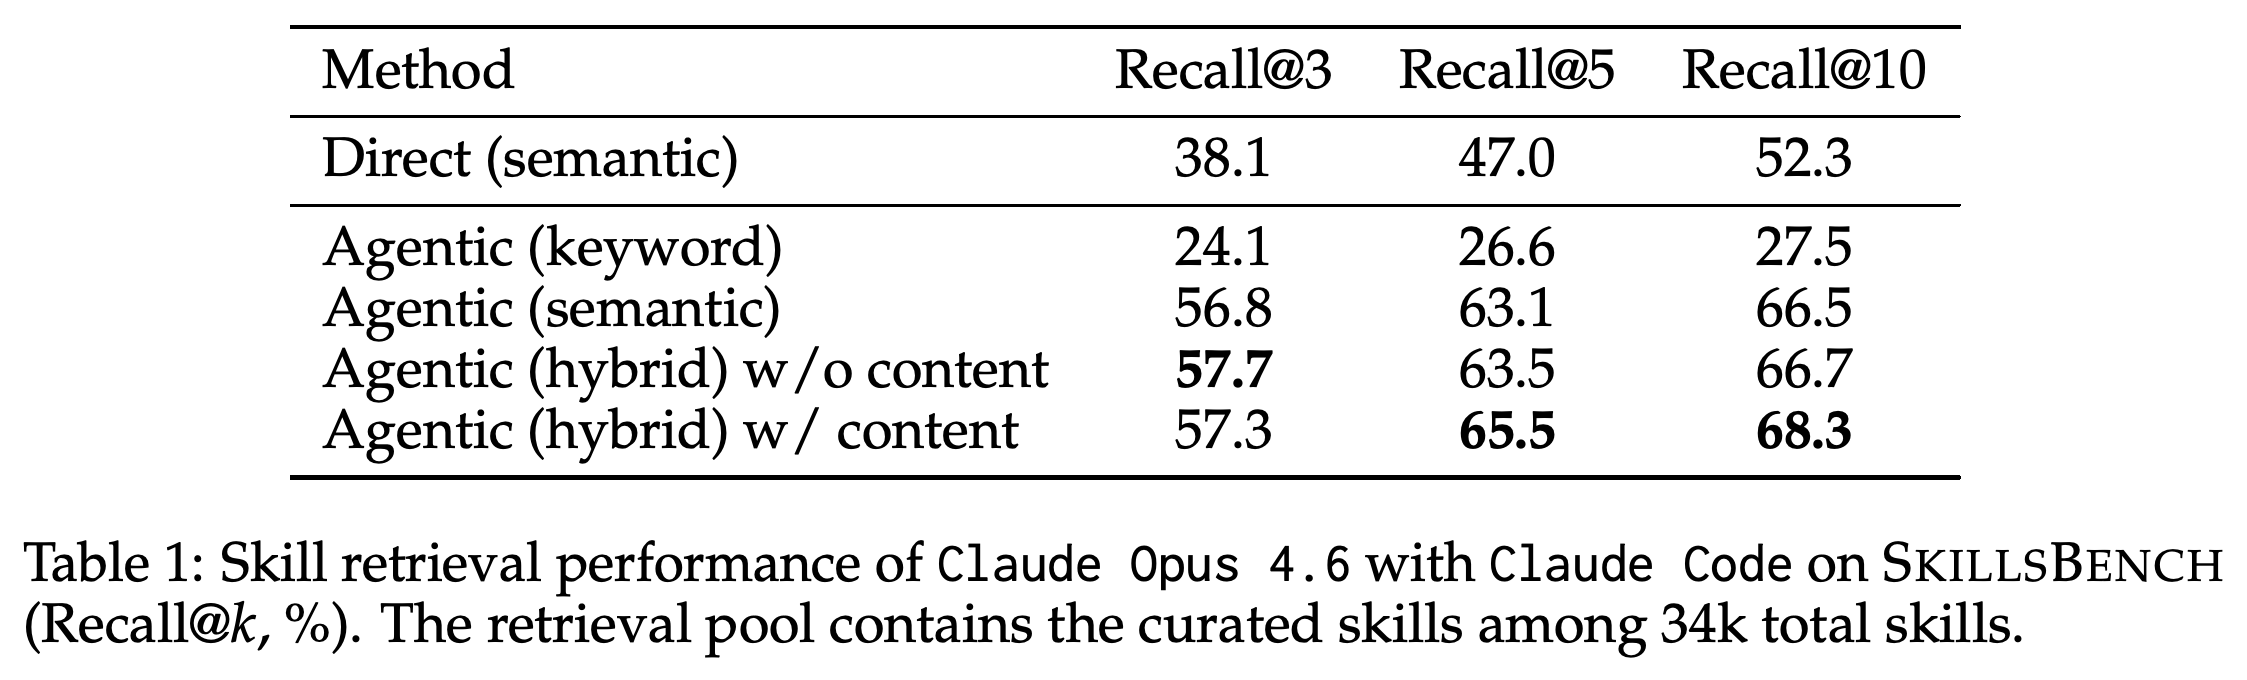
검색 성능은 SKILLSBENCH에서 수작업으로 선별한 스킬을 기준으로 과제별 Recall@k를 평균해 평가한다. Claude Opus 4.6과 Claude Code가 에이전트 기반 검색을 수행한다. 에이전트 기반 의미 검색은 직접 의미 검색 대비 Recall@3를 38.1%에서 56.8%로 높인다. 전체 내용을 사용하는 에이전트 기반 하이브리드 검색은 Recall@5 65.5%, Recall@10 68.3%를 기록하며 기본 검색 방법으로 채택된다.
- 에이전트 기반 키워드 검색의 Recall@5는 26.6%에 그치지만, 에이전트 기반 의미 검색은 63.1%를 기록한다.
- 전체 내용을 추가하면 하이브리드 검색의 Recall@5는 63.5%에서 65.5%로, Recall@10은 66.7%에서 68.3%로 높아진다. 다만 Recall@3는 57.7%에서 57.3%로 바뀐다.
- 이 재현율은 선별 스킬을 다시 찾아내는 능력을 평가한다. 검색한 다른 스킬도 과제 해결에 도움이 되는지는 직접 측정하지 않는다.
반복적인 에이전트 기반 검색이 검색 성능을 가장 크게 개선한다. 에이전트가 의미 검색을 수행하면 Recall@3가 38.1%에서 56.8%로 높아진다. 전체 내용을 사용하는 하이브리드 검색은 Recall@5와 Recall@10에서 각각 65.5%와 68.3%로 가장 좋은 결과를 보인다. 다만 Recall@3는 메타데이터만 사용하는 하이브리드 검색이 조금 더 높다. 이 지표는 후속 과제의 성공 여부가 아니라 알려진 선별 스킬을 다시 찾아내는 능력을 측정한다.
3.3 Progressive Evaluation Settings
6가지 평가 조건에서 로드를 강제할지 에이전트가 결정할지, 스킬을 제공할지 검색할지, 과제별 선별 스킬을 사용할 수 있는지를 바꾼다.
- Curated + forced load는 원래 선별 스킬을 모두 로드하도록 명시적으로 요구한다. Curated는 로드 여부를 에이전트가 결정하게 한다.
- Curated + distractors는 선별 스킬을 유지하면서 검색한 방해 스킬을 추가해 전체 스킬 수를 5개로 맞춘다.
- Retrieved (w/ curated)는 선별 스킬을 추가한 모음에서 top-5 스킬을 선택한다. Retrieved (w/o curated)는 해당 스킬 없이 top-5를 선택한다. No skills는 기준선이다.
Claude Opus 4.6은 Claude Code를, Kimi K2.5는 Terminus-2를, Qwen3.5-397B-A17B는 Qwen-Code를 사용한다. 각 모델–하네스 조합은 검색, 과제 수행, 정제를 독립적으로 수행한다. 알려진 문제가 있는 과제를 제외한 SKILLSBENCH 과제 84개를 평가하며, 각 조건을 과제마다 3회 반복한다.
- 결과는 공통 하네스에서 모델 역량을 측정한 것이 아니라 모델–하네스 조합의 종단 간 성능을 측정한 것이다.
- 통과율은 벤치마크의 자동 검증기로 측정한다. 스킬 사용 여부는 실행 과정에서 스킬을 하나라도 로드했는지, 선별 스킬을 모두 로드했는지를 추적한다.
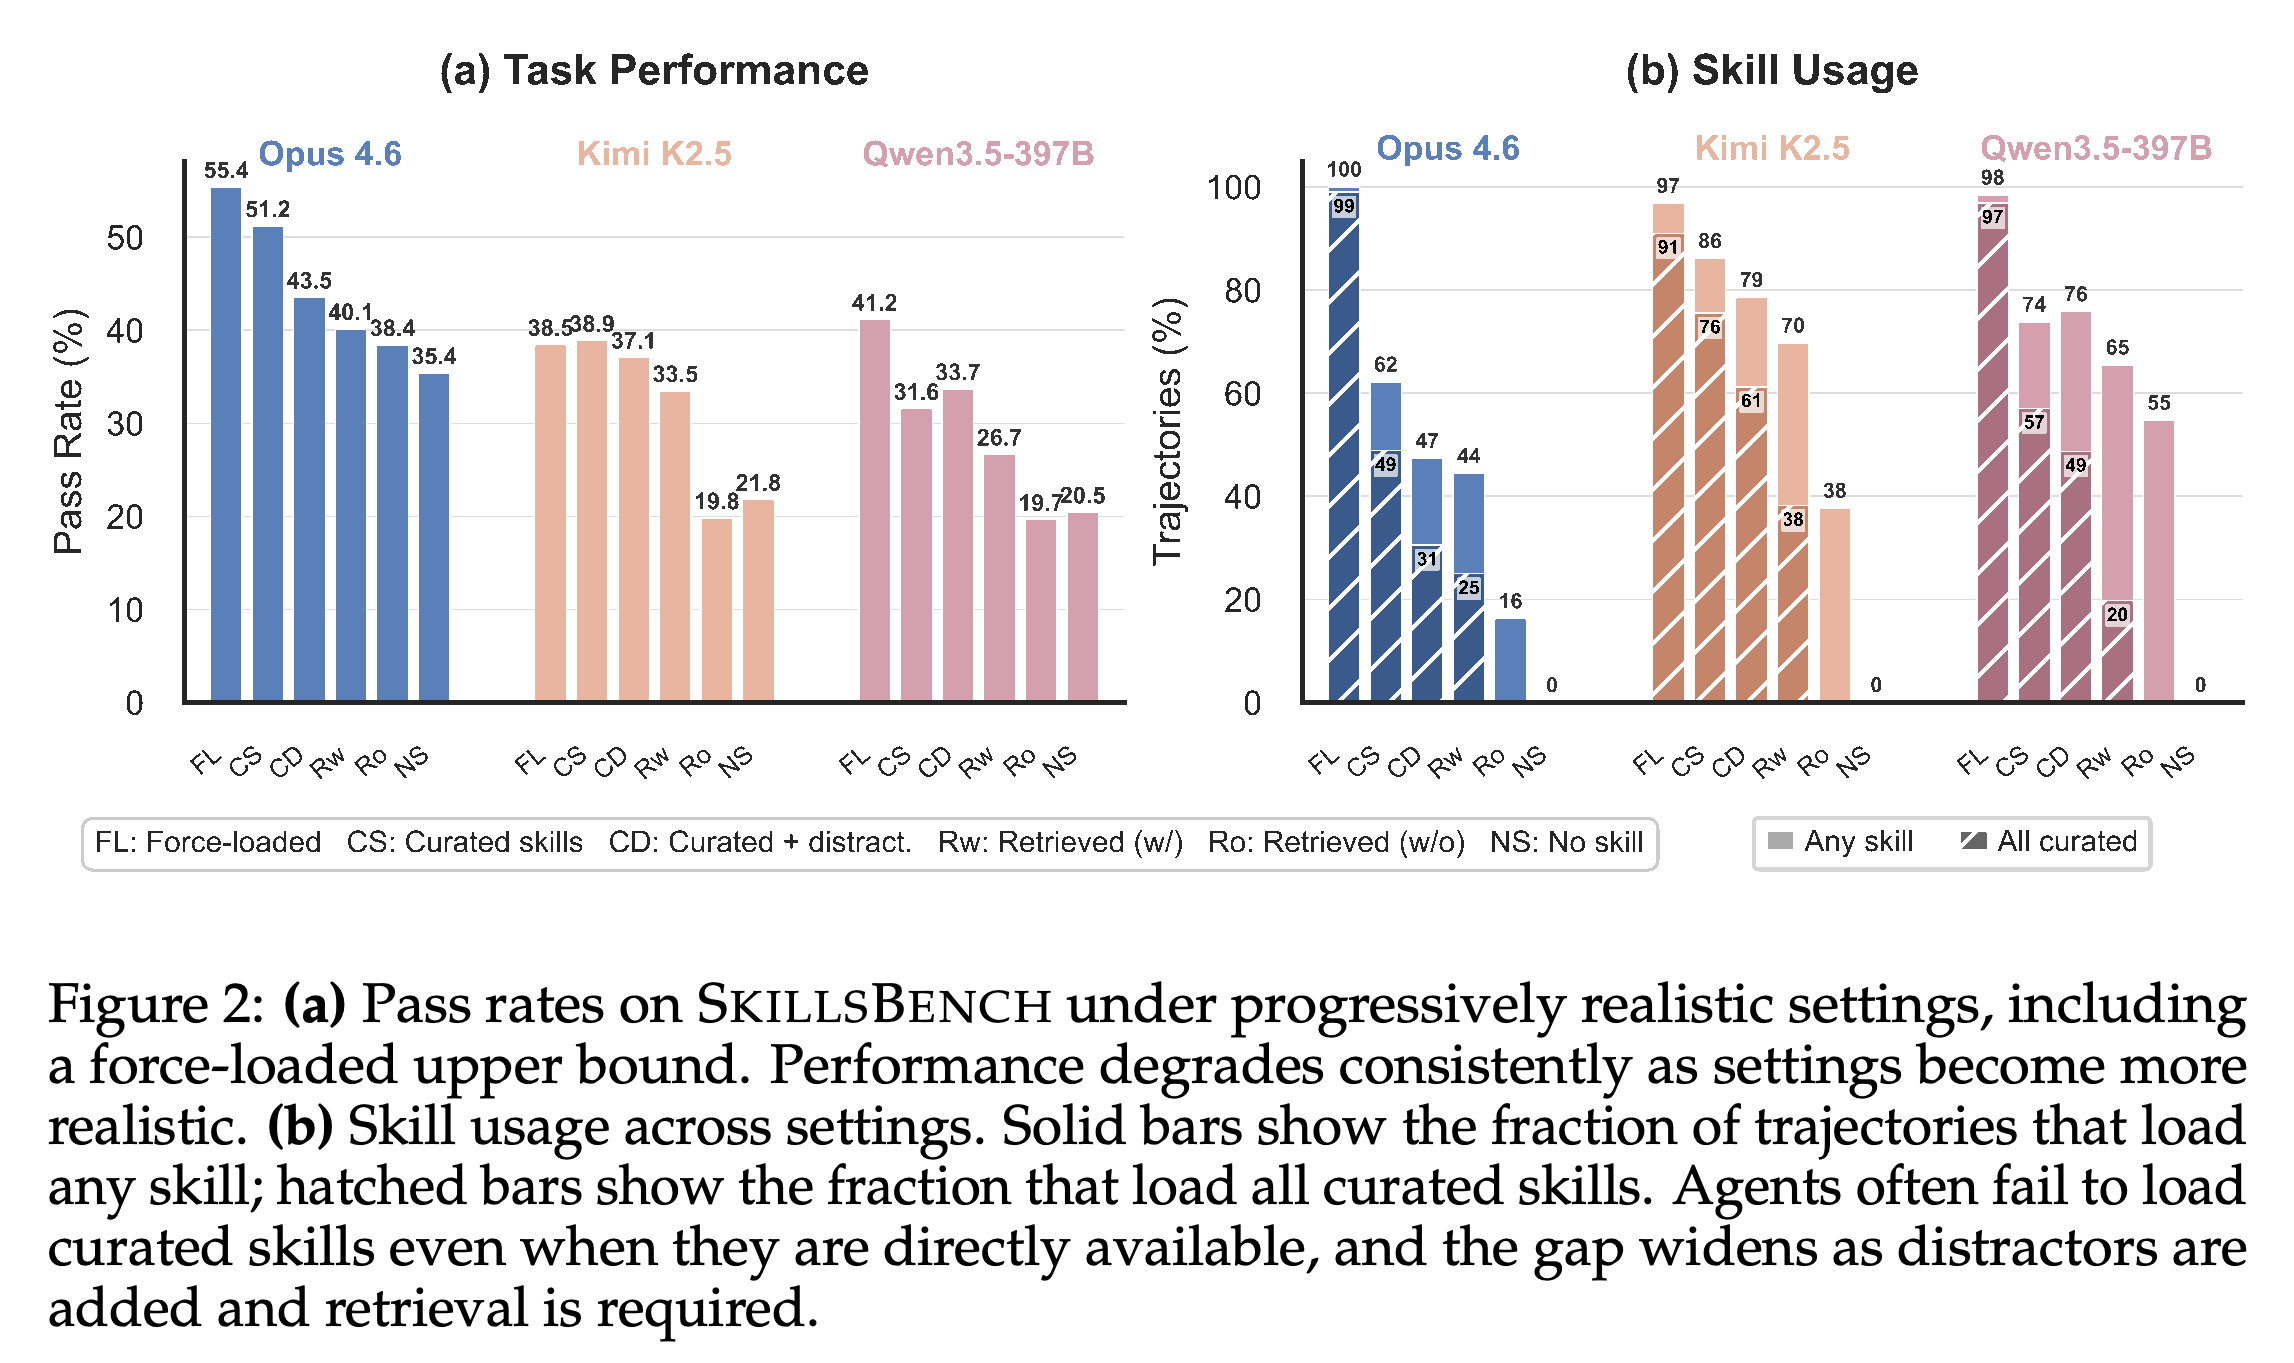
스킬 선택 결과를 보면 에이전트는 적절한 스킬이 직접 제공되어도 이를 선택하지 못한다. Claude의 통과율은 강제 로드 시 55.4%에서 선별 스킬을 자율적으로 로드할 때 51.2%로, 방해 스킬을 추가하면 43.5%로 낮아진다. 선별 스킬을 모두 로드한 비율은 Curated의 49%에서 방해 스킬이 있는 조건의 31%로 낮아진다.
- Qwen은 이 3가지 조건에서 각각 41.2%, 31.6%, 33.7%를 기록한다. 강제 로드와 나머지 조건 사이에는 전반적인 성능 차이가 있지만, 성능이 엄밀하게 단조 감소하지는 않는다.
- Kimi는 선별 스킬 조건의 실행 과정 중 86.1%에서 스킬을 하나 이상 로드하며, Claude는 62.2%에서 로드한다. 그러나 Kimi의 선별 스킬 조건 통과율 38.9%는 강제 로드 결과인 38.5%와 비슷하다.
- 로드 측정치는 선택 과정에 병목이 있음을 뒷받침하지만, 스킬을 더 많이 로드했다는 사실만으로 내용을 효과적으로 사용했다고 볼 수는 없다.
에이전트가 스킬을 검색해야 하면 성능이 더 낮아진다. 검색 대상에 선별 스킬이 남아 있어도 통과율은 Claude 40.1%, Kimi 33.5%, Qwen 26.7%로 낮아진다. 검색은 추가적인 실패 요인이 된다. 평가한 검색 설정 중 가장 좋은 설정도 Recall@5에서 선별 스킬의 65.5%만 찾아낸다.
- Claude가 스킬을 하나 이상 로드하는 비율은 선별 스킬을 제공받을 때 62.2%에서 검색한 스킬을 사용할 때 44.4%로 낮아진다.
- 검색 대상에 과제별 지식을 유지했는데도 성능이 낮아진다. 이는 저장소에 지식이 존재하는 것과 에이전트가 그 지식을 찾아낼 수 있는 것이 다름을 보여준다.
선별 스킬이 없으면 에이전트는 범용 스킬을 과제에 맞게 적용하는 데 어려움을 겪으며, 성능은 스킬 미사용 기준선에 가까워진다. Claude는 38.4%를 기록해 기준선 35.4%보다 3.0%p 높은 데 그치며, 스킬을 하나 이상 로드하는 비율은 16.3%로 낮아진다. Kimi는 스킬이 없을 때 21.8%인 데 비해 19.8%를 기록하고, Qwen은 20.5%에 비해 19.7%를 기록한다.
- 저자들은 기준선보다 낮은 결과를 관련 없는 스킬 지침이 에이전트의 노력을 다른 곳으로 돌리거나 잘못된 방향으로 이끌 수 있다는 근거로 해석한다.
- 종합 결과는 이 설정에서 스킬의 효용이 제한적임을 보여준다. 다만 개별 실행의 실패 원인을 분리해 밝히거나 모델 역량에 따른 일반적인 효과를 입증하지는 않는다.
평가 결과는 스킬 메타데이터와 내용을 모두 정제할 필요성을 제시한다. 메타데이터를 정제하면 유용한 스킬을 더 쉽게 식별할 수 있고, 내용을 정제하면 불필요한 정보를 제거해 일부만 관련된 지식을 더 쉽게 적용할 수 있다.
함께 제시한 패널은 6가지 조건의 과제 성능과 로드 행동을 보여준다. Claude는 강제 로드에서 55.4%, 선별 스킬을 제외한 검색에서 38.4%를 기록하며, 후자의 실행 과정 중 16%만 스킬을 하나 이상 로드한다. Kimi의 비교적 높은 로드 비율은 더 좋은 성능을 보장하지 않으며, Qwen의 방해 스킬 조건 결과는 선별 스킬 조건보다 높다. 따라서 성능이 모든 모델에서 엄밀하게 단조 감소하는 것은 아니다.
4 Narrowing the Gap with Skill Refinement
정제 실험은 최종 과제 수행 전에 검색한 스킬을 변환하면 저하된 성능을 회복할 수 있는지 살펴본다. SKILLSBENCH의 선별 스킬 포함·제외 검색 조건과 선별 스킬 집합이 없는 TERMINAL-BENCH 2.0에서 질의와 무관한 정제와 질의별 정제를 비교한다.
4.1 Refinement Strategies
질의와 무관한 정제는 대상 과제나 검색한 다른 스킬을 보지 않고 각 스킬을 독립적으로 개선한다. 전체 스킬 34,198개를 처리하지 않고도 오프라인에서 정제한 스킬 모음을 근사한다. Anthropic의 skill-creator는 합성 질의 생성, 스킬 사용 여부에 따른 에이전트 출력 비교, 자체 평가, 수정을 안내한다.
- 이 절차는 오프라인 전처리에 적합하지만, 대상 과제에 맞게 내용을 조정하거나 검색한 스킬 간 지식을 결합할 수는 없다.
- 실험은 검색한 스킬만 정제한다. 전체 모음을 정제해 다시 구축하고 검색하지는 않는다.
- 정제를 안내하는 메타 스킬은 https://github.com/anthropics/skills/tree/main/skills/skill-creator 에 공개되어 있다.
질의별 정제에서는 에이전트가 대상 지시문과 검색한 모든 스킬을 읽고 초기 풀이를 시도한다. 이후 정답 검증기 없이 자체 평가를 수행하고, 과제에 맞게 정제한 스킬 집합을 만든다. 상호 보완적인 정보를 합치고, 관련 없는 지침을 버리며, 탐색 과정에서 얻은 지식을 포함할 수 있다.
- skill-creator 메타 스킬은 메타데이터와 내용 작성을 안내한다.
- 정제는 추론 시점에 전체 탐색 단계를 수행해야 하므로, 검색한 스킬을 로드하는 것보다 추가 연산이 필요하다.
- 부록에서는 정제를 1회 반복으로 제한한다. 결과 스킬 집합은 원래 검색한 집합보다 스킬 수가 많거나 적을 수 있다.
4.2 Results
질의별 정제는 대체로 효과적이다. Table 2에서는 9개 모델–설정 조합 중 7개에서 성능이 개선된다. 선별 스킬이 검색 대상에 포함된 SKILLSBENCH에서 Claude는 40.1%에서 48.2%로, Qwen은 26.7%에서 30.8%로 높아진다. 전체 89개의 TERMINAL-BENCH 2.0 tasks에서는 통과율이 Claude 61.4%에서 65.5%로, Kimi 50.6%에서 56.2%로, Qwen 44.2%에서 49.1%로 높아진다.
- 이에 대응하는 TERMINAL-BENCH 2.0 baselines의 스킬 미사용 통과율은 각각 57.7%, 46.6%, 44.7%다.
- 예외는 검색 대상에 선별 스킬이 포함된 SKILLSBENCH에서 33.5%에서 26.7%로 낮아지는 Kimi와, 선별 스킬이 없을 때 38.4%에서 37.9%로 바뀌는 Claude다.
- 이 예외에서도 로드 비율은 높아진다. 선별 스킬이 있는 조건에서 Kimi의 로드 비율은 69.7%에서 95.2%로, 선별 스킬이 없는 조건에서 Claude의 로드 비율은 16.3%에서 61.1%로 높아진다. 따라서 스킬 사용 증가만으로 정답률 개선이 보장되지는 않는다.
Pass와 Load 열은 정답 여부와 스킬 사용을 구분한다. 질의별 정제는 TERMINAL-BENCH 2.0에서 3개 모델 모두의 통과율을 높인다. 그러나 선별 스킬이 있는 SKILLSBENCH에서 Kimi의 통과율은 33.5%에서 26.7%로 낮아지는 반면, 로드 비율은 69.7%에서 95.2%로 높아진다. 질의와 무관한 정제 결과는 엇갈리며, Kimi의 하네스는 필요한 하위 에이전트 기능을 지원하지 않아 해당 결과가 없다.
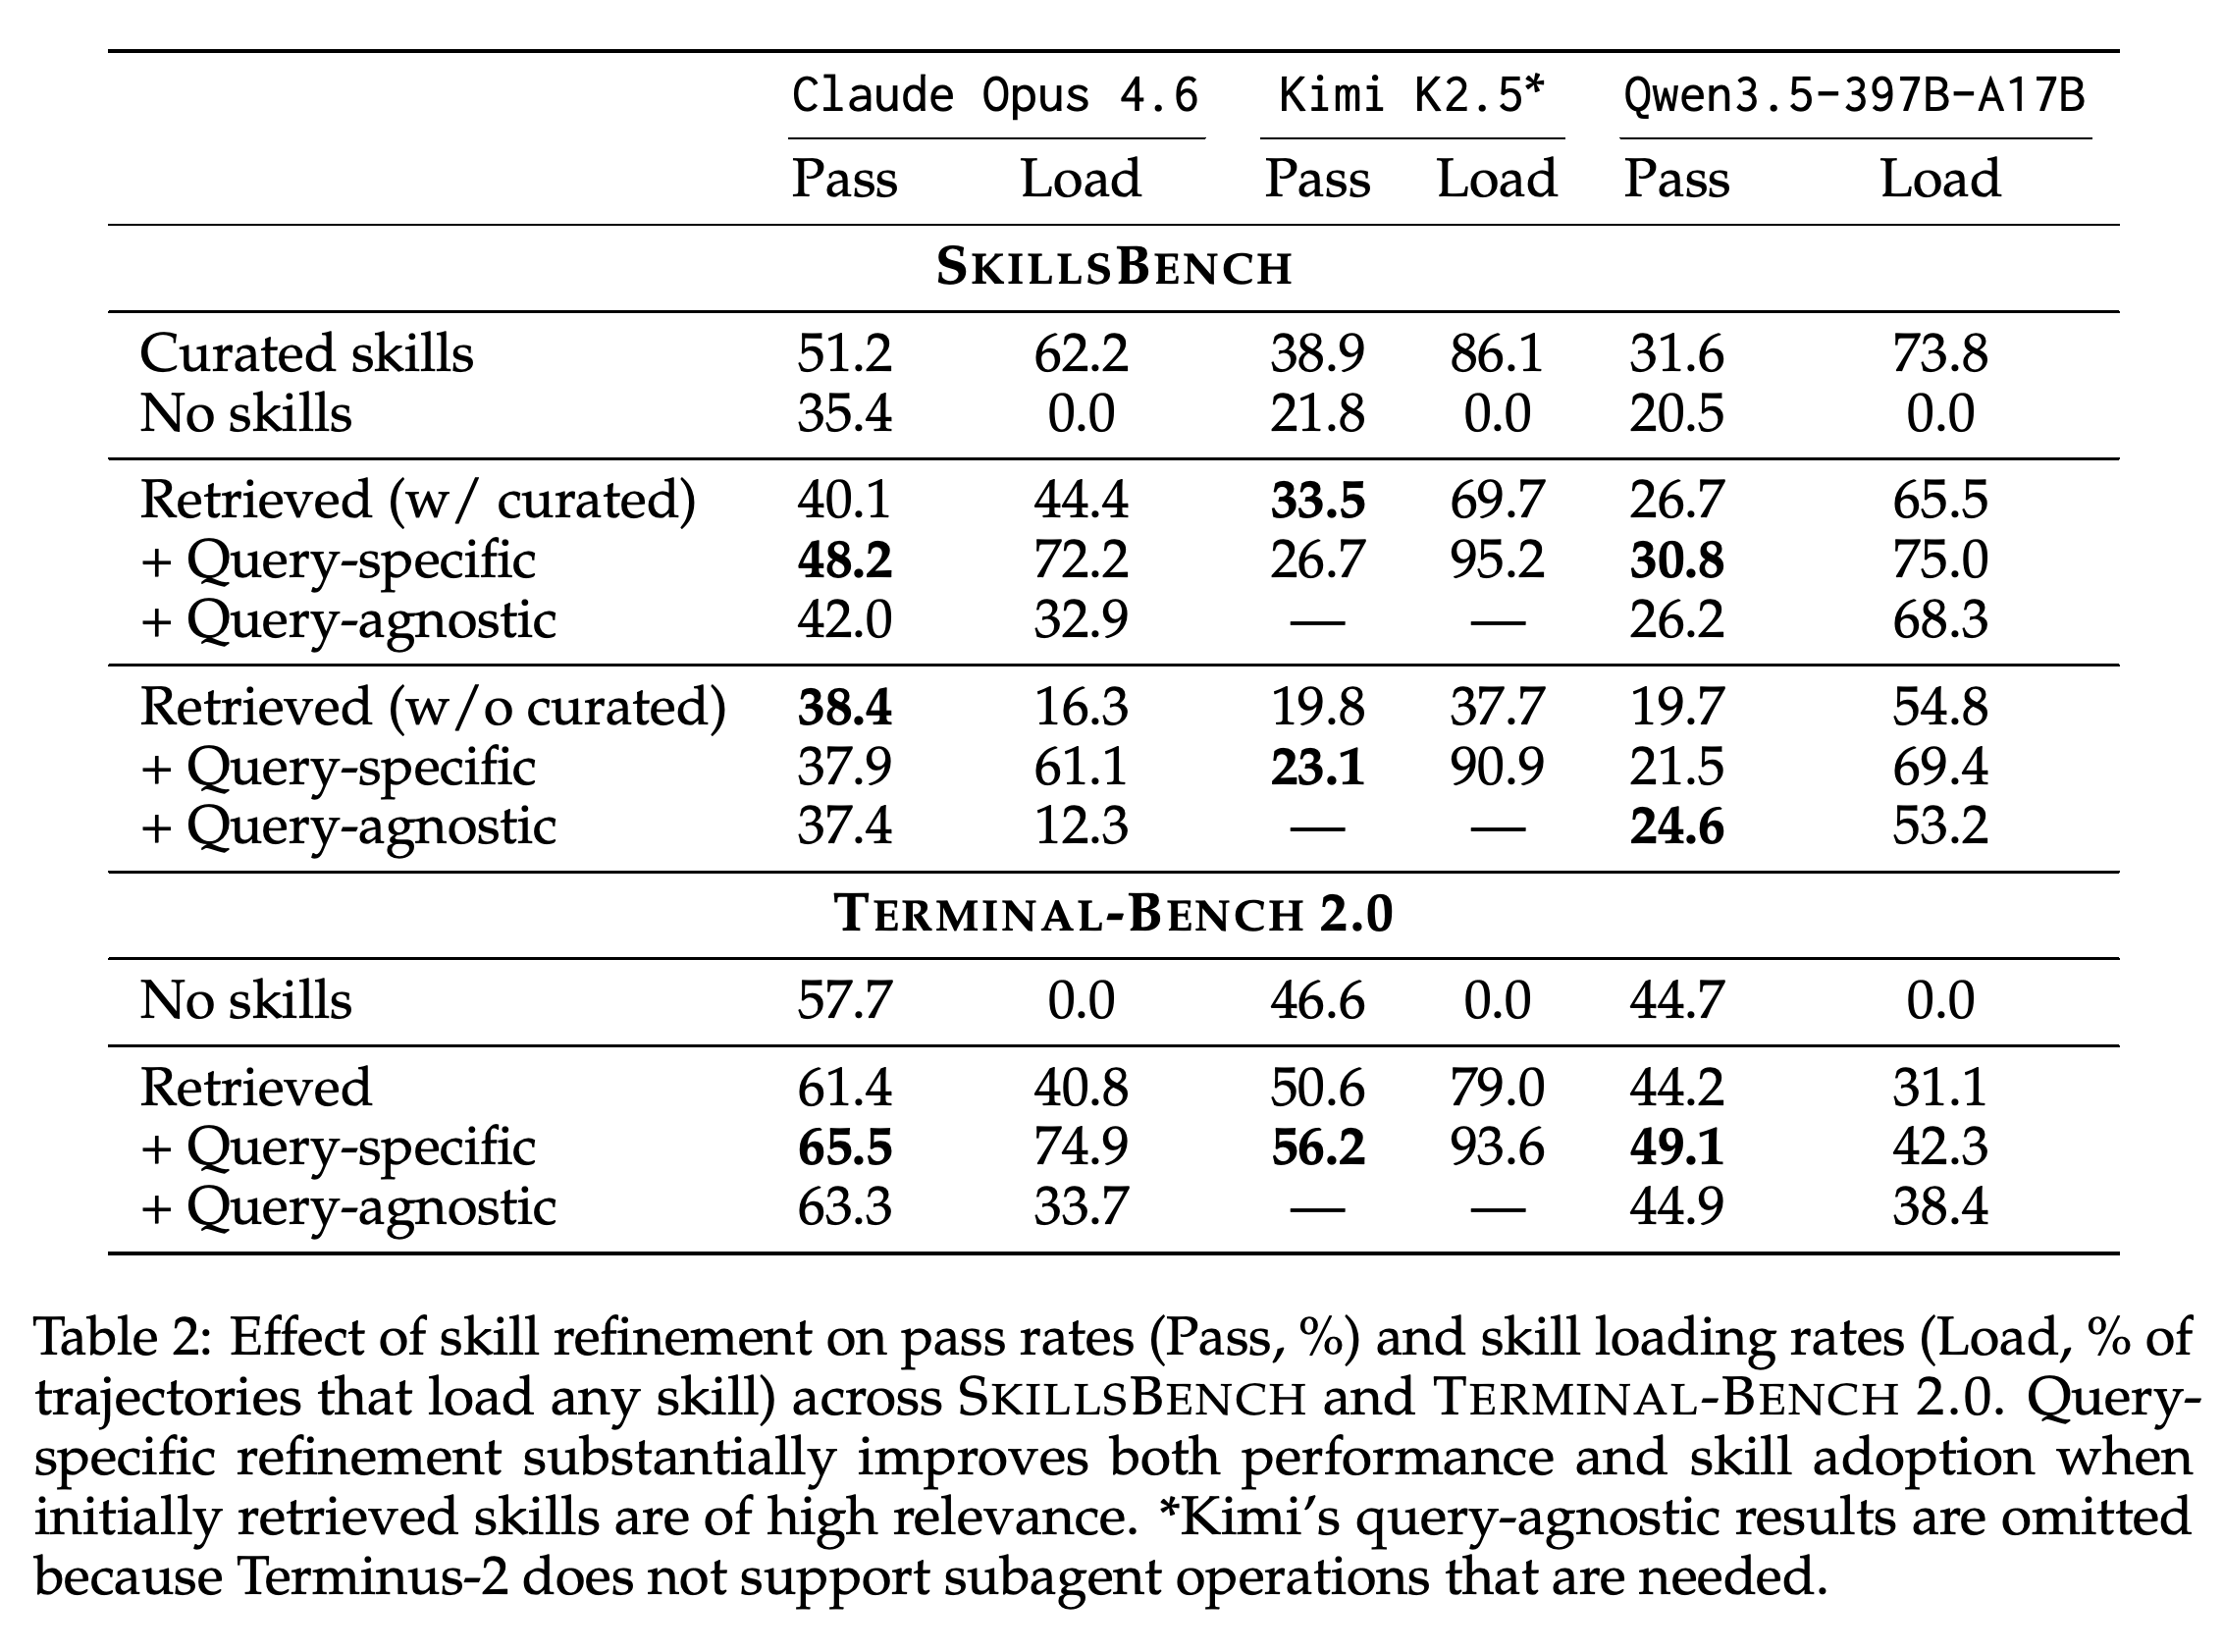
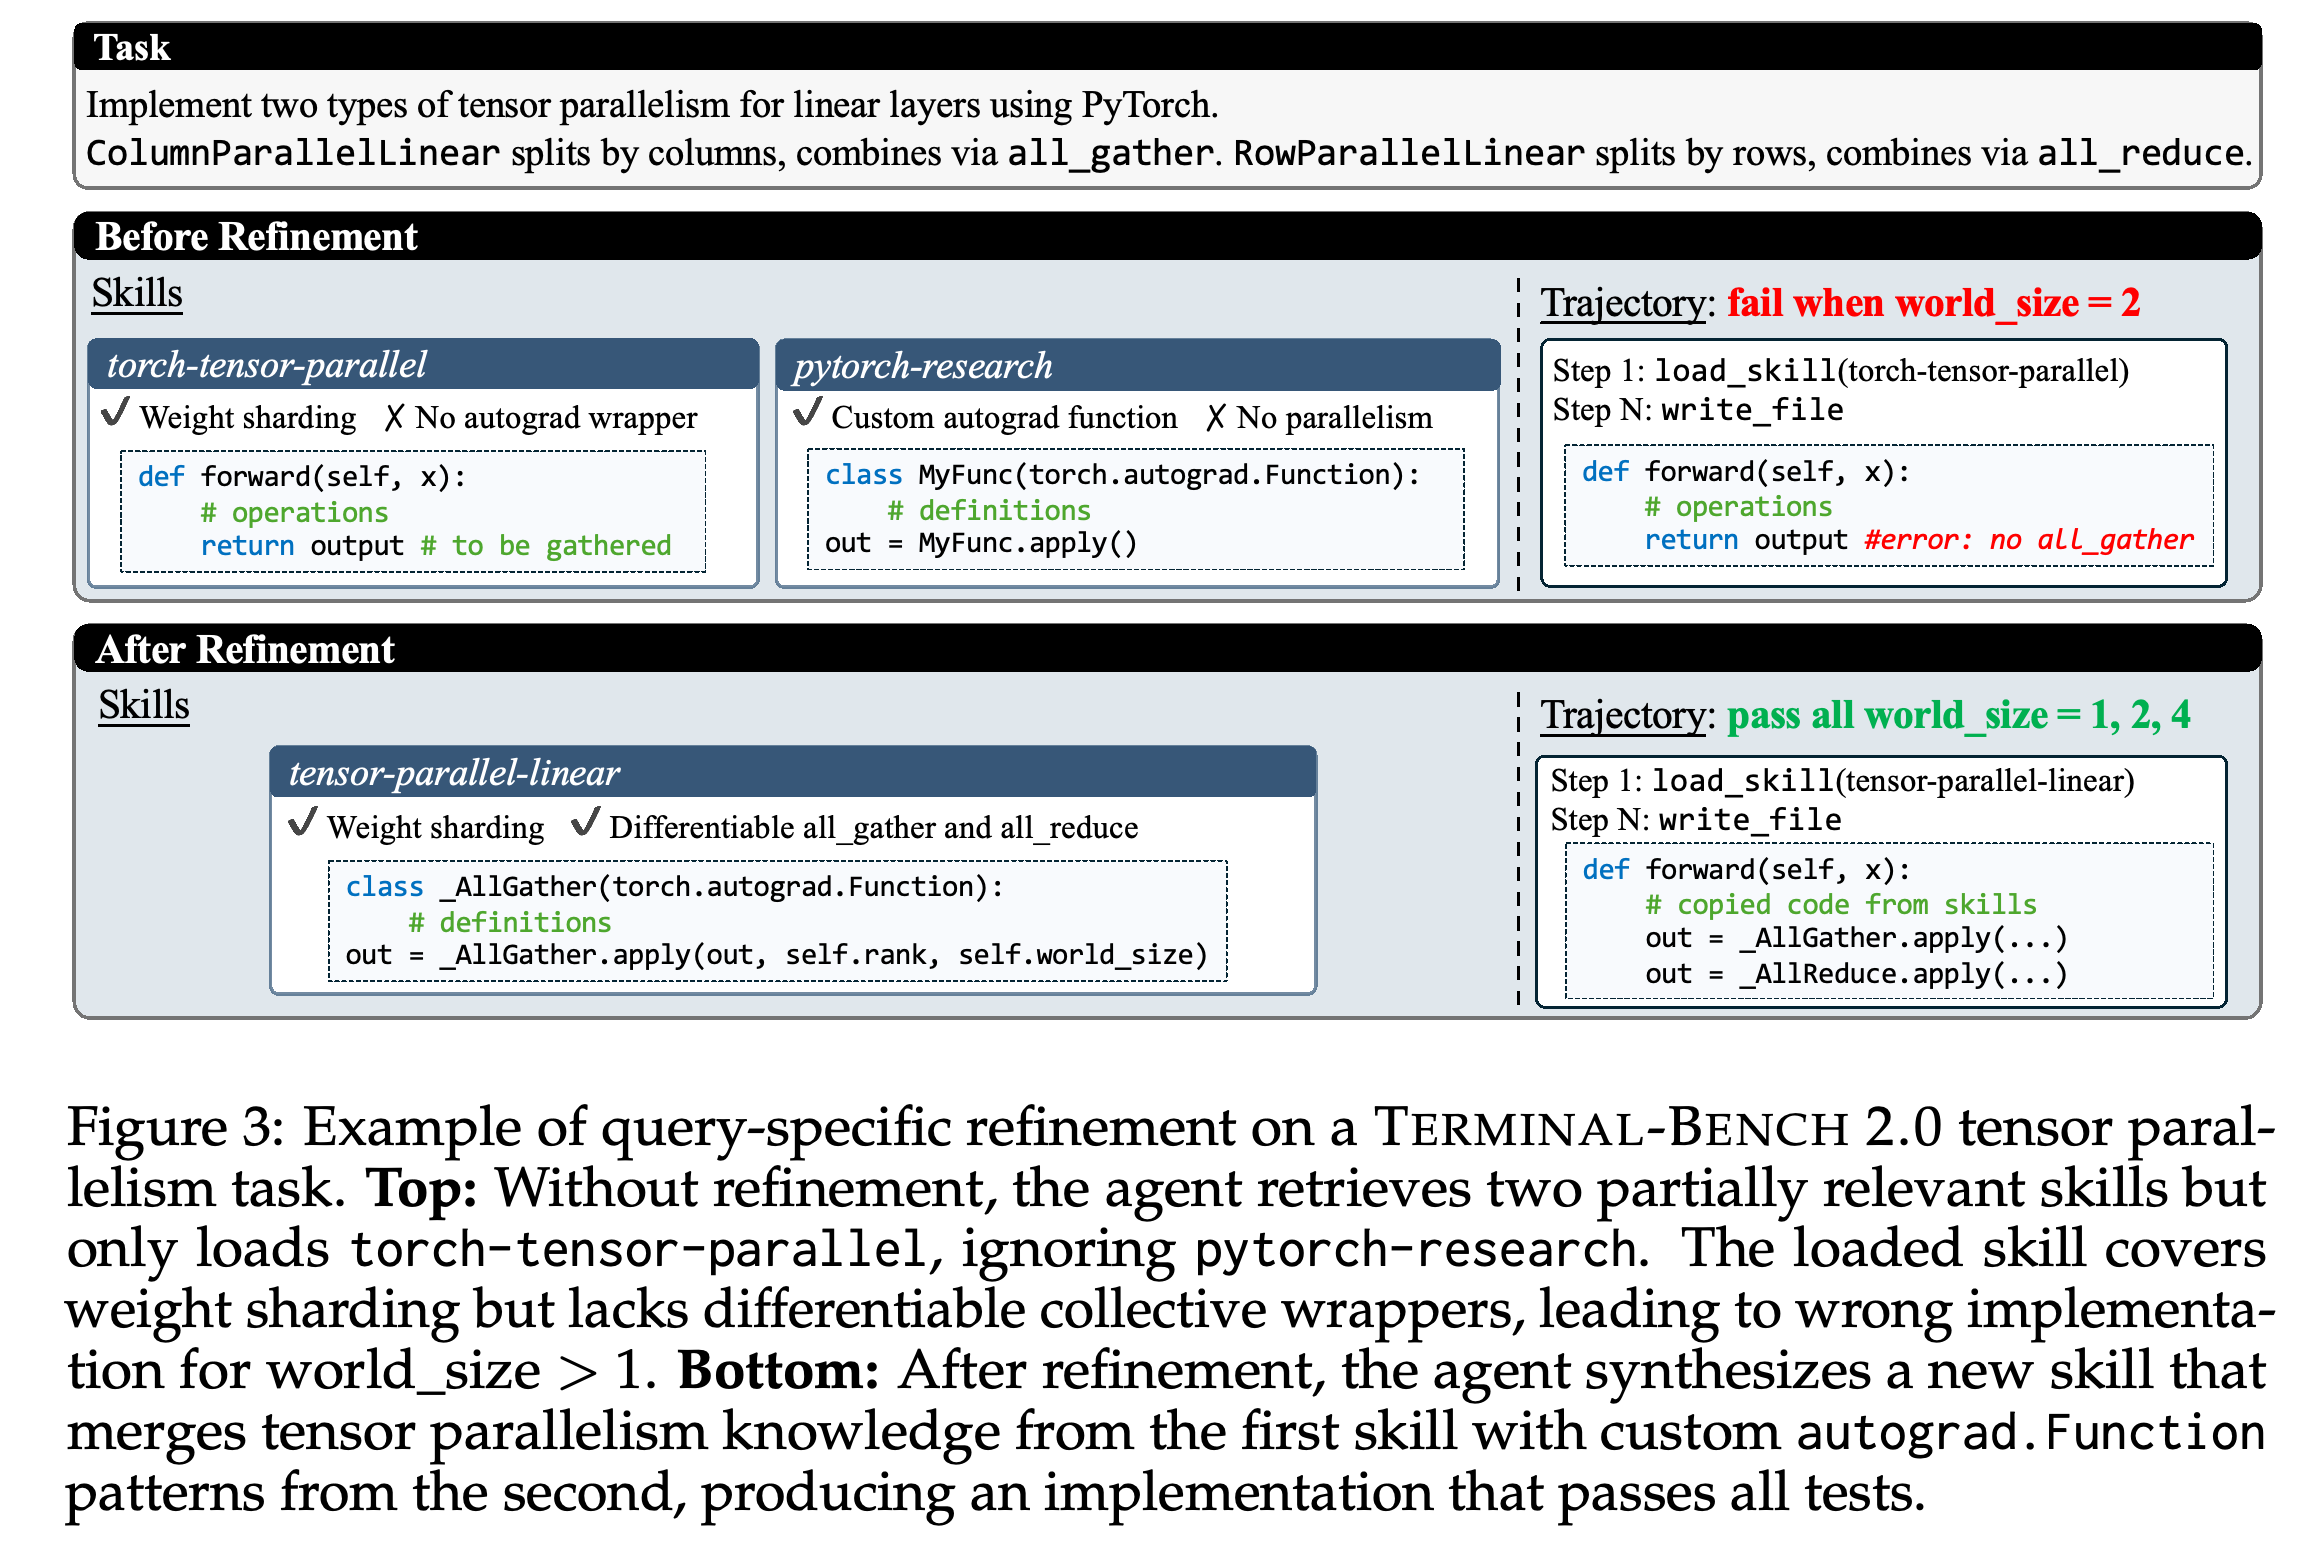
Figure 3은 TERMINAL-BENCH 2.0 PyTorch tensor-parallelism task에서 스킬 간 지식 결합을 보여준다. 정제 전 에이전트는 torch-tensor-parallel을 로드하지만 pytorch-research는 사용하지 않으며, world_size = 2에서 실패하는 풀이를 만든다. 정제는 가중치 샤딩 지침과 사용자 정의 autograd.Function 패턴을 tensor-parallel-linear로 결합한다. 이를 통해 미분 가능한 all_gather와 all_reduce를 지원하고 world_size = 1, 2, 4에서 통과한다.
- 과제는 ColumnParallelLinear가 열 단위로 분할한 뒤 all_gather로 결합하고, RowParallelLinear가 행 단위로 분할한 뒤 all_reduce로 결합하도록 요구한다.
- 이 예시는 상호 보완적인 자료를 성공적으로 결합한 사례를 보여주지만, 이러한 방식이 정제 효과를 얼마나 자주 설명하는지는 추정하지 않는다.
정제 전에는 로드한 torch-tensor-parallel 스킬이 가중치 샤딩 지식을 제공하지만 미분 가능한 집합 연산 래퍼가 없으며, 실행은 world_size = 2에서 실패한다. 정제는 pytorch-research의 사용자 정의 autograd.Function 패턴을 tensor-parallel-linear에 통합한다. 이를 통해 미분 가능한 all_gather와 all_reduce를 지원하고 world_size = 1, 2, 4에서 통과한다. 이는 스킬 간 지식을 결합한 성공 사례 1개를 보여준다.
질의와 무관한 정제는 개선 폭이 더 작다. Claude는 선별 스킬이 검색 대상에 포함된 SKILLSBENCH에서 40.1%에서 42.0%로, TERMINAL-BENCH 2.0에서 61.4%에서 63.3%로 높아지지만, 선별 스킬이 없을 때는 38.4%에서 37.4%로 바뀐다. Qwen의 결과도 엇갈린다. 선별 스킬이 있으면 26.7%에서 26.2%로, 없으면 19.7%에서 24.6%로, TERMINAL-BENCH 2.0에서는 44.2%에서 44.9%로 바뀐다.
- Terminus-2가 이 절차에 필요한 하위 에이전트 작업을 지원하지 않으므로 Kimi의 질의와 무관한 정제 결과는 생략한다.
- 질의별 정제가 항상 더 좋지는 않다. 선별 스킬이 없는 조건에서 Qwen은 질의와 무관한 정제의 결과가 질의별 정제의 21.5%보다 높다.
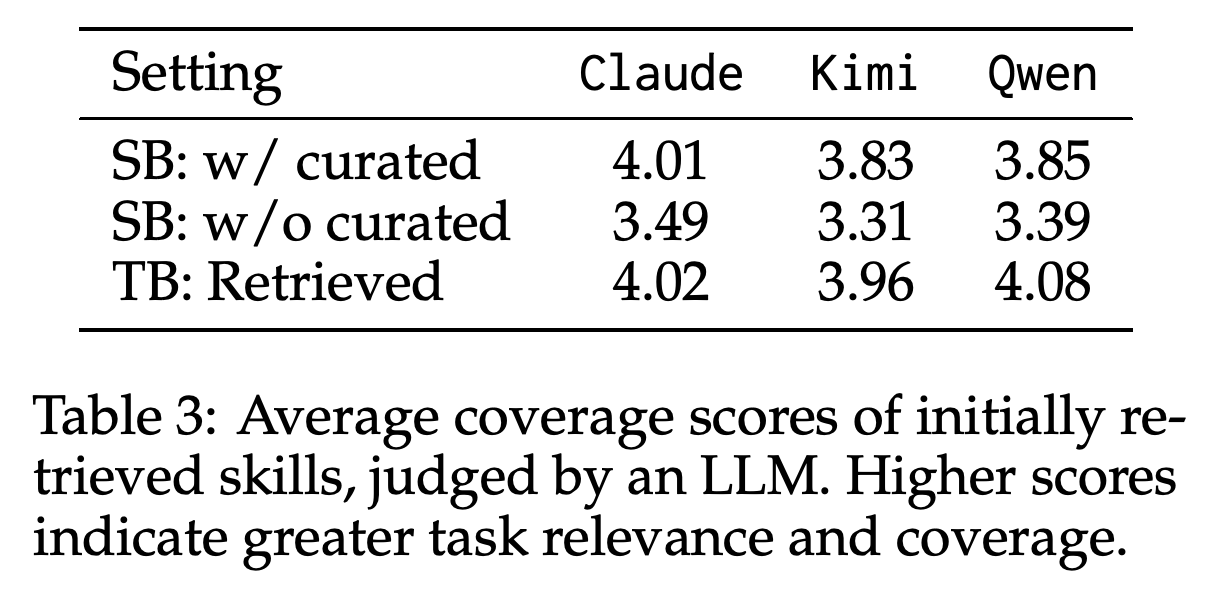
정제 효과는 초기 스킬 품질에 따라 달라진다. GPT-5.4는 처음 검색한 스킬 집합의 관련성과 과제 요구 충족 범위를 1–5 척도로 평가한다. 선별 스킬이 있는 SKILLSBENCH에서 Claude, Kimi, Qwen의 점수는 각각 4.01, 3.83, 3.85다. 선별 스킬이 없으면 3.49, 3.31, 3.39이며, TERMINAL-BENCH 2.0에서는 4.02, 3.96, 4.08이다.
- 스킬이 과제 요구를 더 넓게 충족하는 설정에서는 질의별 정제의 개선 폭이 대체로 더 크다. 이는 정제가 검색 자료에서 유용한 정보를 추출하고 결합한다는 해석과 일치한다.
- 이는 LLM 평가자의 판단에 근거한 설정 수준의 연관성이다. 정제가 새 지식을 생성할 수 없다거나 과제 요구 충족 범위만으로 성공 여부가 결정된다는 증거는 아니다. 정제 프롬프트는 탐색 중 발견한 지식을 추가하도록 명시적으로 허용한다.
- 과제 요구 충족 범위가 넓은 선별 스킬 포함 조건에서 Kimi의 성능이 낮아진다는 점은 이 범위만으로 설명하는 단순한 해석의 예외다.
선별 스킬이 없는 SKILLSBENCH의 초기 과제 요구 충족 점수는 3.31–3.49로, 선별 스킬 포함 조건과 TERMINAL-BENCH 설정의 3.83–4.08보다 낮다. 이 패턴은 관련 있는 원자료가 정제에 도움이 된다는 해석과 일치한다. 다만 점수는 LLM의 판단이며, 선별 스킬 포함 조건에서 Kimi의 성능이 낮아지는 사례를 비롯한 모든 예외를 설명하지는 못한다.
5 Conclusion
논문은 스킬의 효용이 저장소에 존재하는지에만 달린 것이 아니라, 에이전트가 관련 내용을 발견하고 로드하며 사용하는 데 달려 있다고 결론짓는다. 질의별 정제는 관련 지식을 검색한 여러 설정에서 성능을 회복하지만, 선별 스킬이 없어 과제 요구 충족 범위가 좁은 SKILLSBENCH 설정에서는 개선이 제한적이다. 저자들은 검색, 오프라인 정제, 서로 다른 모델 역량과의 호환성을 향후 연구 과제로 제시한다.
Ethics Statement
Ethics Statement는 공개 벤치마크와 MIT 또는 Apache 2.0 라이선스로 필터링한 공개 GitHub 스킬을 사용하며, 비공개 데이터나 민감한 데이터는 사용하지 않는다고 밝힌다. 평가는 격리된 Docker 컨테이너에서 실행하며, 저자들은 이를 통해 외부 시스템에 대한 위험을 피한다고 설명한다.
LLM Usage Disclosure
LLM Usage Disclosure는 COLM 정책을 인용하며, 평가 인프라 수정, 디버깅, 실행 과정 분석에 LLM의 도움을 받았다고 밝힌다. 글쓰기 지원에는 저자가 작성한 초안 수정, 교정, 시각화 스크립트 작성, LaTeX 서식 작업이 포함된다. 저자들은 연구 아이디어, 실험 설계, 분석을 직접 수행했다고 밝힌다.
부록
- A Skill Search Engine Details는 검색 엔진의 세부 사항을 설명한다. SQLite FTS5로 BM25 검색을 구현하며, 필드 가중치는 이름 10, 설명 5, 전체 내용을 포함하는 경우 해당 내용 5다. 밀집 검색 질의에는 Qwen3-Embedding-4B와 접두사 “Find skills matching this query:”를 사용한다. /keyword, /semantic, /hybrid 엔드포인트는 검색을 제공하고, /detail은 SKILL.md 전체 내용을 가져온다. 하이브리드 검색은 RRF 점수 (\sum_s \frac{w_s}{k+r_s})를 사용하며, 기본 방법 가중치는 0.5이고 k = 60이다. 의미 검색에서 메타데이터와 내용을 결합할 때는 (1 − w) · simmeta + w · simcontent를 사용하며, 합성 질의의 Recall@5를 비교해 w = 0.05를 선택한다. finding-skills 프로토콜은 과제를 분해하고, 검색을 반복하며, 후보를 검토한 뒤 검색 평가를 위해 선택한 스킬 10개를 기록한다. 후속 과제 수행 조건에서는 top-5 스킬을 사용한다.
- B Experiment Details는 실험의 세부 사항을 설명한다. SKILLSBENCH는 mhc-layer-impl, scheduling-email-assistant, fix-visual-stability를 제외해 과제 84개를 사용하고, TERMINAL-BENCH 2.0은 전체 과제 89개를 사용한다. Claude는 Claude Code v2.1.19를 사용한다. Kimi는 최대 입력이 253,952토큰인 Terminus-2와 로컬 SGLang 서빙을 사용한다. Qwen/Qwen3.5-397B-A17B-FP8는 Qwen-Code v0.12.3과 로컬 SGLang 서빙을 사용한다. Harbor는 격리된 Docker 컨테이너에서 각 과제를 3회 실행하고 자동 검증기로 출력을 평가한다. SKILLSBENCH는 모든 모델에 시간 제한 배수 1.5×를 적용한다. TERMINAL-BENCH 2.0은 Kimi와 Qwen에 2×를, Claude에 1×를 적용한다.
- C Skill Refinement Details는 스킬 정제의 세부 사항을 설명한다. C.1 Query-Specific Refinement는 과제의 데이터, 라이브러리, 도구가 있는 해당 과제의 Docker 환경에서 동작하지만 정답 검증기는 사용하지 않으며, 탐색과 수정을 1회 반복하도록 허용한다. 검색한 모든 스킬을 읽고, 과제 수행 중 지침을 시험하며, 유용하거나 잘못된 방향으로 이끄는 내용을 검토한다. 이후 탐색 중 발견한 지식을 포함해 과제에 적합한 스킬을 결합하여 작성한다. C.2 Query-Agnostic Refinement는 Python이 설치된 Ubuntu 24.04에서 각 스킬을 독립적으로 처리하고, skill-creator가 안내하는 합성 질의와 A/B 테스트를 사용하며, 마찬가지로 개선을 1회 반복하도록 제한한다.
- D LLM-as-Judge for Skill Coverage는 스킬의 과제 요구 충족 범위를 평가하는 방법을 설명한다. GPT-5.4는 과제 지시문과 보조 파일을 포함한 검색 스킬의 전체 자료를 입력받는다. 자료는 스킬당 400K자, 전체 2M자로 제한한다. 관련 요구를 전혀 충족하지 못하는 1부터 완전히 충족하는 5까지 스킬 집합을 평가하며, 중간 단계는 충족 범위가 낮은 수준, 중간 수준, 높은 수준을 구분한다. 출력에는 점수, 충족하는 내용, 남은 부족 사항을 기록한다. 이 판단은 Table 3에 사용되며, 벤치마크의 통과·실패 결과를 결정하지는 않는다. LLM-as-Judge에 대해서는 이 글을 참조하라.
짧은 생각
이 논문의 핵심 기여는 단계적 평가 설계다. 선별 스킬을 유지한 채 방해 스킬을 추가하거나 검색을 요구하면, 선별 지식을 완전히 제거하기 전에 서로 다른 실패 지점을 드러낼 수 있다. 검증기 기반 통과율과 로드 행동을 함께 보고하면 스킬 사용이 늘어도 과제 성능이 낮아지는 사례를 확인할 수 있다. 선별 스킬 포함 조건에서 질의별 정제를 수행한 Kimi가 그 예다.
질의별 정제는 전체 탐색 시도를 추가하지만, 논문은 연산량을 맞춘 추가 시도 기준선, 상세 실행 시간이나 토큰 비용, 통과율의 불확실성 구간을 보고하지 않는다. 하네스와 시간 제한 설정이 달라 모델 자체만 비교하는 데 한계가 있으며, LLM이 평가한 과제 요구 충족 범위는 인과적 설명이 아닌 연관성을 뒷받침한다. 실험은 평가한 코딩 및 터미널 과제에서 검색 스킬의 한계를 보여주며, 재사용 가능한 스킬이 보편적으로 실패한다는 것을 입증하지는 않는다.