


Length Value Model: Scalable Value Pretraining for Token-Level Length Modeling 요약 설명
29 Apr 2026 | Paper Review Length-Controlled Generation Value Pretraining Output Length Prediction목차
- 요약
- 1. Introduction
- 2. Related Work
- 3. Length Value Model
- 4. Experiments: Validating LenVM as a Token-Level Length Signal
- 5. Qualitative Case Study: Length Tokens as Markers of Length Shifts
- 6. Ablations
- 7. Conclusion
- 부록
- 짧은 생각
이번 글에서는 Length Value Model: Scalable Value Pretraining for Token-Level Length Modeling 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 4월 29일(Arxiv)
- Zhang, Zhen, Yang, Changyi, Xia, Zijie, Yang, Zhen, Liu, Chengzhi, Weng, Zhaotiao, Liu, Yepeng, Chen, Haobo, Pan, Jin, Zhao, Chenyang, et al.
- University of California, Santa Barbara, Carnegie Mellon University, University of Wisconsin–Madison, LMSYS Org, Apple Inc.
- 논문 링크
- Github
- Project Page
요약
- Length Value Model: Scalable Value Pretraining for Token-Level Length Modeling은 접두사를 조건으로 할인된 잔여 생성 길이를 추정하는 LenVM을 제안한다. 샘플링한 완성문에서 Monte Carlo 타깃을 자동으로 구성하고, 모든 비종료 토큰 위치에서 스칼라 가치 헤드를 학습한다. 추가적인 사람의 주석이나 보상 모델은 사용하지 않는다.
- LenVM은 LIFEBench-token에서 Qwen2.5-7B-Instruct의 Equal-To Length Score를 30.9에서 64.8로 높인다. 8회 호출하는 LCG와 결합하면 점수가 71.3에서 83.6으로 높아지고, 평균 절대 상대 편차는 14.0%에서 5.8%로 줄어든다. 모델과 데이터 규모가 커질수록 예측 정확도와 검증 손실이 개선되며, 유도 디코딩은 평균 출력 길이가 비슷할 때 강제 절단보다 높은 과제 정확도를 달성한다.
- LenVM이 추정하는 값은 정책에 조건화된 할인 잔여 길이이지, 실제 토큰 수의 조건부 평균이 아니다. 최적화한 유도 디코딩에서도 측정된 지연 시간은 1.90×다. 논문에 제시된 지수 틸팅 식은 β < 0일 때 더 작은 음수 값을 선호하지만, 논문의 리턴 정의에서 이 값은 더 짧은 후속 생성이 아니라 더 긴 후속 생성에 해당한다. 따라서 구현에서 사용한 부호 규약을 명확히 밝혀야 한다.
1. Introduction
생성 길이는 디코딩 연산량, KV-cache 증가량, 지연 시간, 추론에 사용할 수 있는 분량에 영향을 준다. 논문은 시퀀스 수준 페널티, 프롬프트 지시, 디코딩 전 예측에만 의존하지 않고, 각 토큰을 선택할 때마다 갱신되는 접두사별 잔여 길이 추정기가 필요하다고 설명한다.
- LenVM은 과제의 유용성 대신 생성 종료까지의 거리를 평가하며, 폭넓게 분포하는 완성문 길이를 유계 가치 공간으로 변환한다.
- 주석 없이 촘촘한 학습 신호를 얻으며, 고정된 롤아웃 정책 아래에서는 조건부 할인 리턴 타깃에 대한 비편향 추정치를 제공한다. 이는 실제 길이 예측이 비편향이거나 임의의 정책 변경에도 보정이 유지된다는 뜻은 아니다.
- 실험은 추론 시점의 응용을 평가한다. PPO 방식의 활용은 개념적으로 논의하며, RL 미세 조정의 실증 평가는 후속 연구로 남긴다.
2. Related Work
관련 연구에서는 길이 제약 생성, 정적·점진적 출력 길이 예측, 생성 비용의 가치 기반 정식화를 다룬다. LenVM은 실현된 완성문 길이에서 할인 리턴 타깃을 구성하고, 이를 이용해 토큰 수준 추정기를 별도로 학습한다.
2.1. Length-Controlled Generation
기존 길이 제어 방법에는 countdown prompting, Plan-and-Write 구조, 반복적인 Metropolis–Hastings 샘플링, 길이 차이 위치 인코딩, 숨겨진 길이 추적 토큰이 있다. 반면 LenVM은 디코딩 중 다음 상태 후보를 평가한다. 기본 생성기의 파라미터를 바꾸지 않으며, LCG 같은 외부 반복 제어기와도 결합할 수 있다.
2.2. Output Length Prediction
논문은 프롬프트 경계에서의 길이 예측과 생성 도중의 점진적 잔여 길이 예측을 구분한다. entropy-guided token pooling(EGTP), progressive length prediction(PLP)과 비교하며, 고정된 모델의 층별 표현을 이용한 예측과 코드 infilling의 잔여 길이 예측도 다룬다.
- 길이 예측은 스케줄링, 배치 구성, 메모리 계획에 활용할 수 있지만, 논문은 스케줄러 전체의 개선 대신 예측 지표를 평가한다.
- 실제 토큰 수를 직접 학습하는 예측기와 달리, LenVM은 유계 할인 잔여 길이 타깃을 학습한다.
2.3. RL Framing and Reward Shaping of Generation Length
토큰마다 일정한 비용을 부과하면 잔여 생성 길이를 가치 함수로 표현할 수 있다. 논문은 이 정식화를 PPO, GAE, 가치 사전학습, 적응형 길이 페널티와 연결한다. 또한 품질과 효율을 직접 최적화하는 방법과, 고정 포텐셜 가정 아래에서 원래 목적을 보존하는 포텐셜 기반 보상 셰이핑을 구분한다.
3. Length Value Model
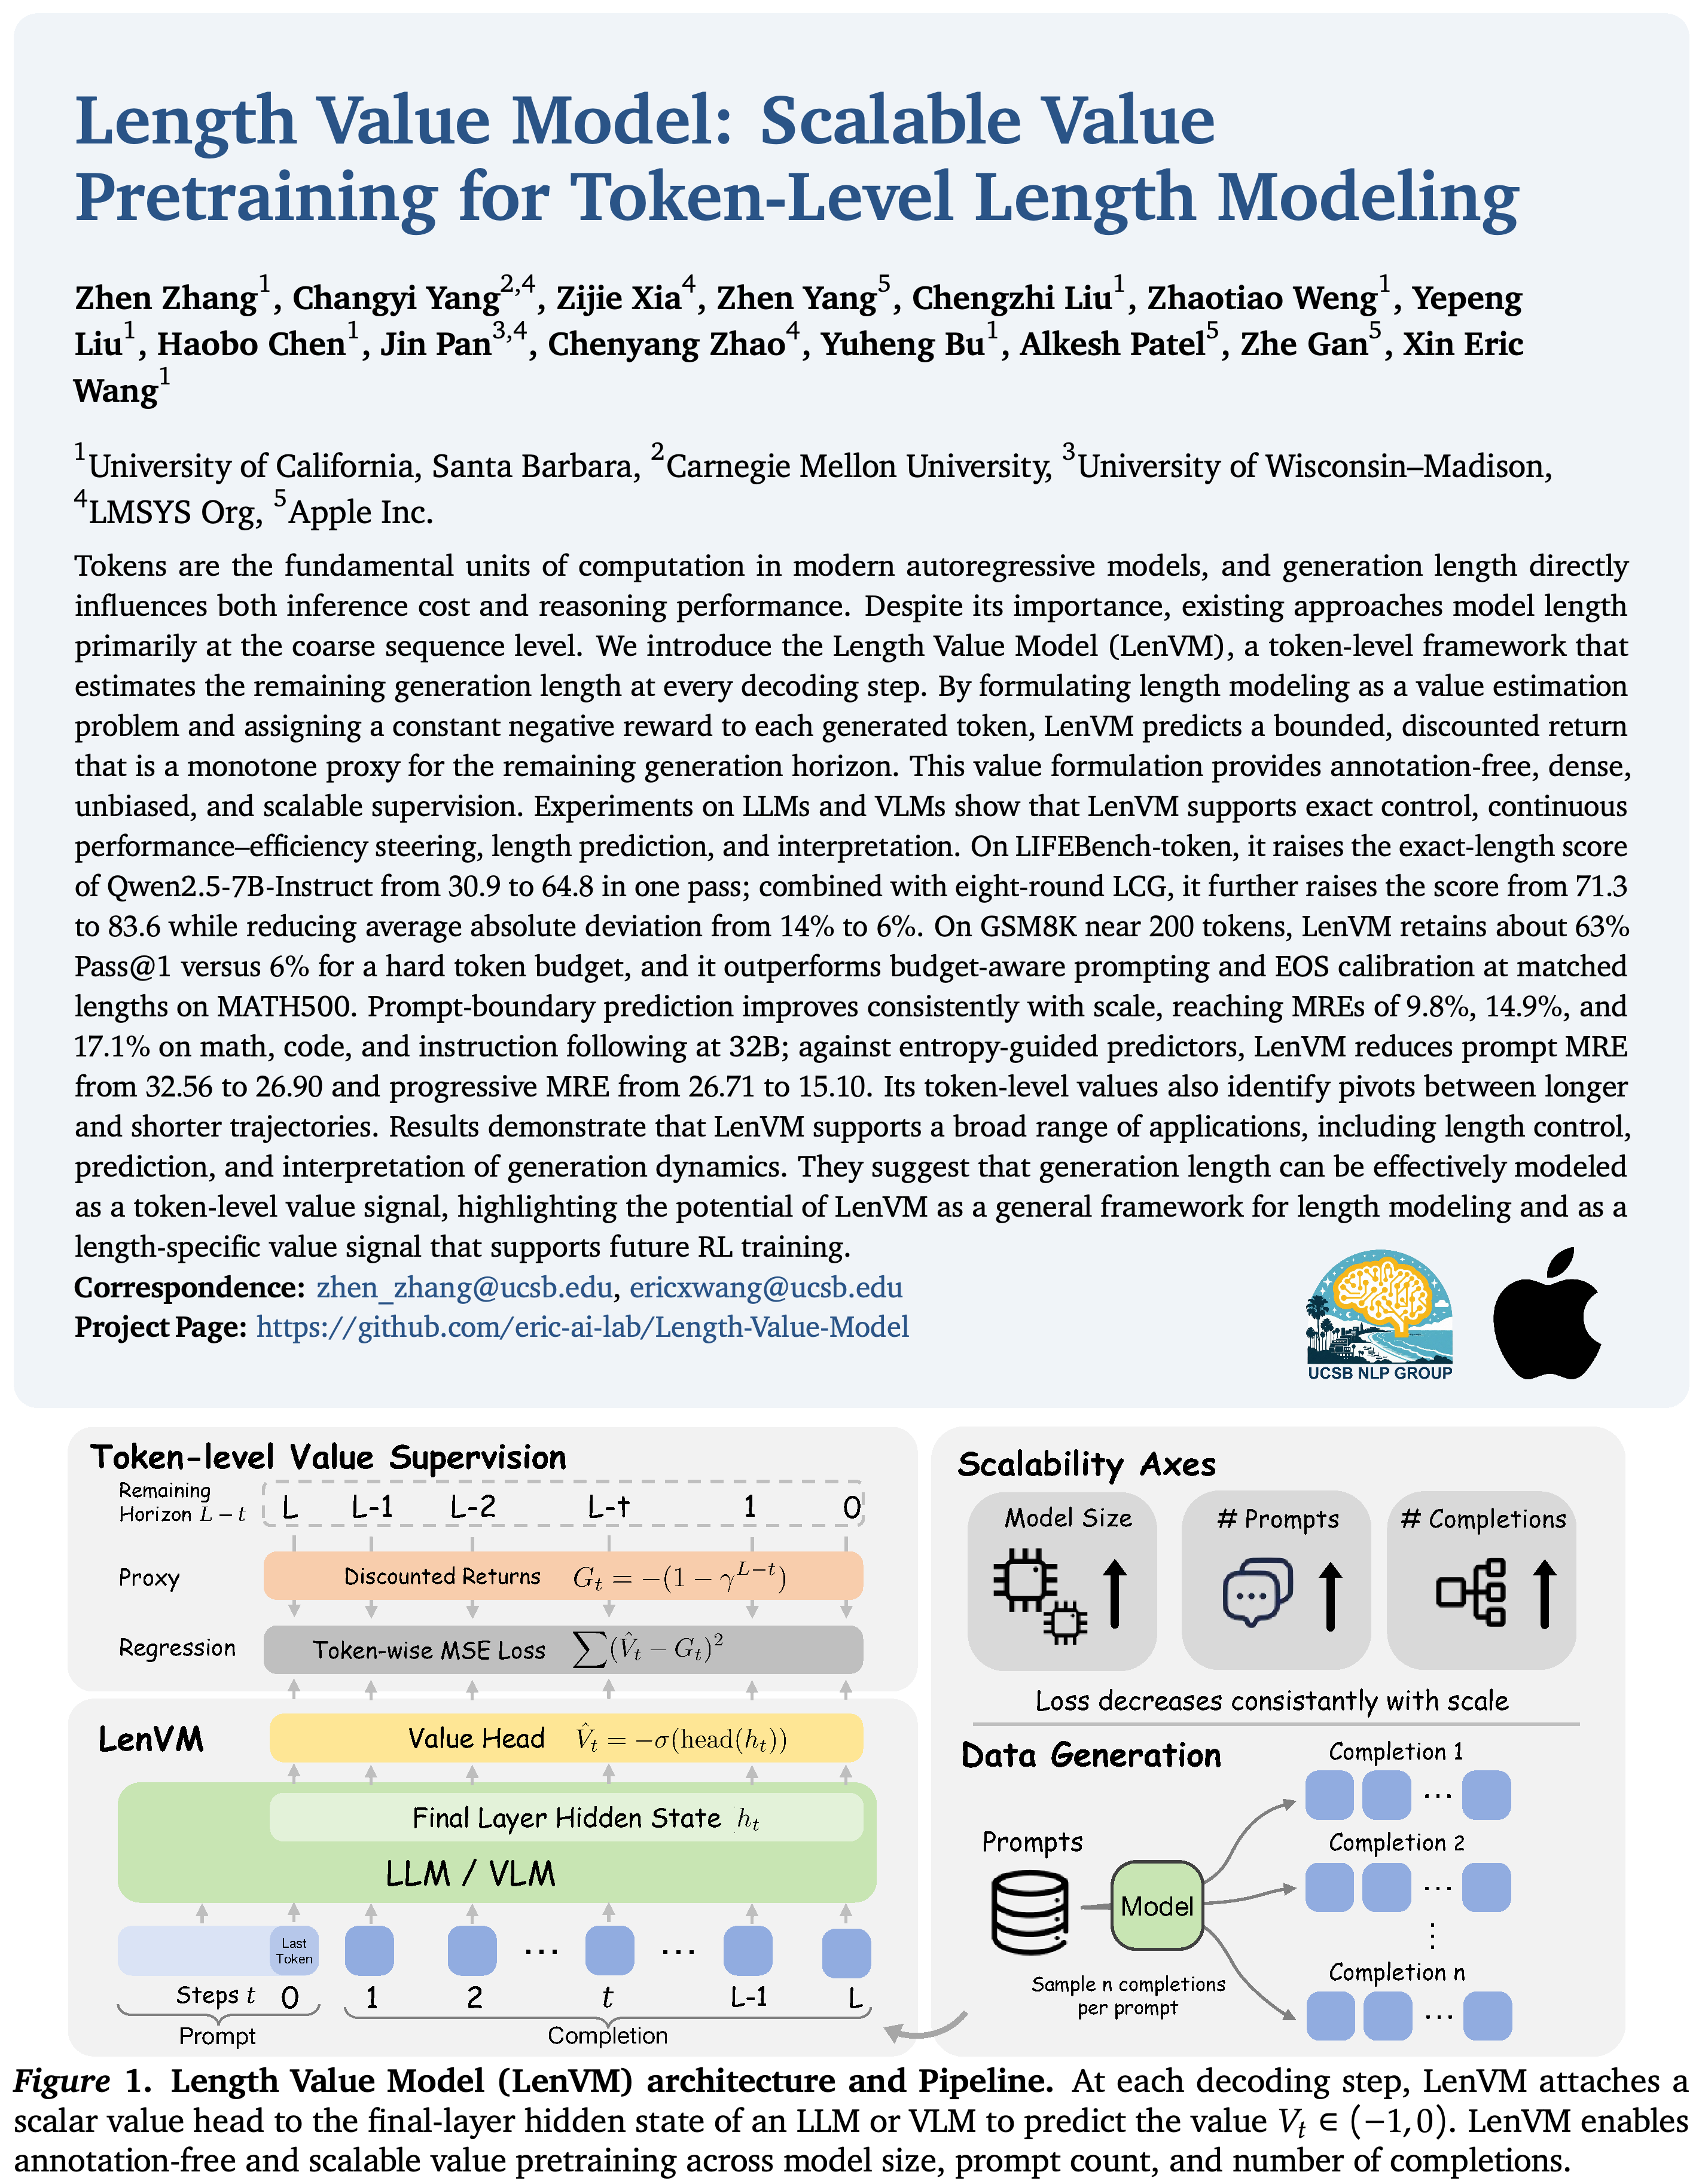
LenVM은 자기회귀 디코딩을 에피소드 과정으로 보고, 마지막 프롬프트 토큰부터 각 접두사에 대한 스칼라 추정값을 출력한다. Figure 1은 샘플링한 완성문, 자동으로 계산한 할인 리턴, 마지막 층 표현, 토큰별 회귀가 어떻게 연결되는지 보여 준다.
- 프롬프트와 완성문을 추가하면 별도의 레이블링 없이 학습 데이터를 늘릴 수 있다.
- 프로젝트 페이지는 https://github.com/eric-ai-lab/Length-Value-Model 이다.
샘플링한 각 완성문은 모든 비종료 접두사에서 잔여 길이 타깃을 제공한다. 가치 헤드는 마지막 층 표현을 유계 예측값으로 변환한다. 모델 규모, 프롬프트 수, 프롬프트당 완성문 수는 별개의 규모 확장 축이다.
3.1. Modeling Length as a Discounted Return
길이가 L인 완성문에서 t개 토큰을 생성한 뒤의 상태를 생각하면, 비종료 보상은 r_t = −(1 − γ)이고 r_L = 0이다. 타깃은 (G_t=-(1-\gamma^{L-t}))이며, G_t = r_t + γG_(t+1)을 만족한다. 잔여 길이가 짧을수록 0에 가까워지고, 길수록 −1에 가까워진다.
- 고정된 롤아웃 정책 π에 대한 가치는 V^π(s_t) = E_π[G_t | s_t]이다. 실현된 리턴은 l = log(1 + G_t) / log γ로 정확히 역변환할 수 있다.
- 조건부 평균 리턴을 역변환해도 일반적으로 조건부 평균 토큰 수를 복원할 수는 없다. Appendix G는 잔여 길이가 확률적일 때 과소 추정이 발생함을 증명한다.
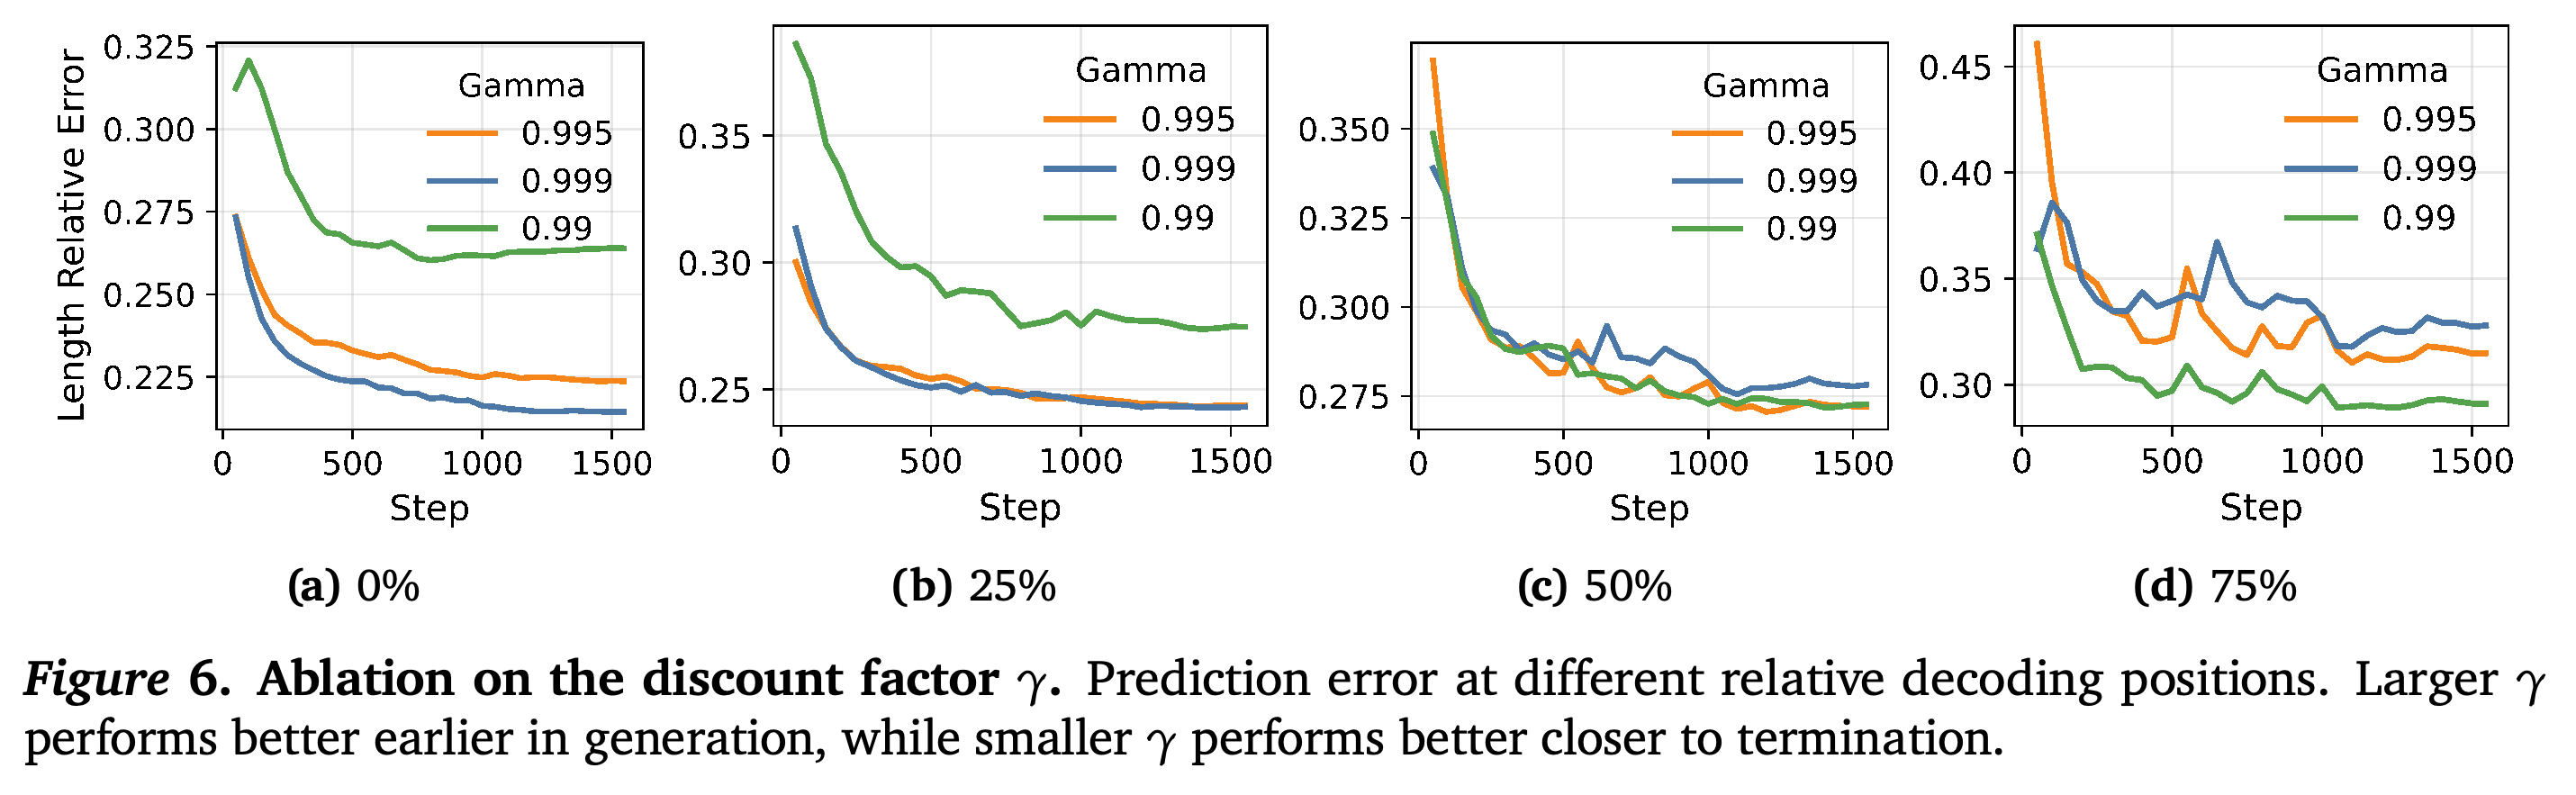
- γ가 크면 긴 잔여 길이에서도 해상도를 유지하고, γ가 작으면 종료에 가까운 구간에 해상도가 집중된다.
3.2. LenVM Head
LenVM 헤드는 마지막 층의 은닉 상태 h_t를 입력으로 받고 SiLU 활성화를 사용하는 2층 MLP다. 출력은 (V_\theta(s_t)=-\sigma!\left(W_2\operatorname{SiLU}(W_1h_t+b_1)+b_2\right))이며, 예측값을 (−1, 0) 범위로 제한한다.
3.3. Training Objective
학습에서는 미니배치의 모든 비종료 상태에서 예측 오차의 제곱을 합산한 뒤, 생성된 전체 토큰 수로 나눈 값을 최소화한다. 완성문은 고정된 생성기 체크포인트와 디코딩 정책으로 얻으며, 각 타깃은 실현된 잔여 길이에서 정확히 계산한다.
- 토큰에 동일한 가중치를 주어 평균하면 상태에 조건화된 리턴 타깃이 보존된다. 각 시퀀스 안에서 토큰 손실을 먼저 평균한 뒤 시퀀스 간 평균을 구하면 1/L에 비례하는 가중치가 생겨 일반적으로 타깃이 바뀐다.
- GAE를 이용한 부트스트래핑 변형도 가능하지만, 보고된 실험에서는 λ = 1의 성능이 가장 좋다. 완전한 궤적만으로도 모든 비종료 토큰 위치의 전체 리턴 타깃을 얻을 수 있다.
4. Experiments: Validating LenVM as a Token-Level Length Signal
실험은 명시적 길이 제어, 정확도와 길이의 연속적 조절, 프롬프트 경계 및 점진적 예측, 가치 학습 목적의 규모 확장을 평가한다. 출력 토큰이 줄면 추론도 빨라진다고 가정하지 않고, 별도의 지연 시간 측정으로 추가 순전파 비용을 정량화한다.
4.1. Experimental Setup
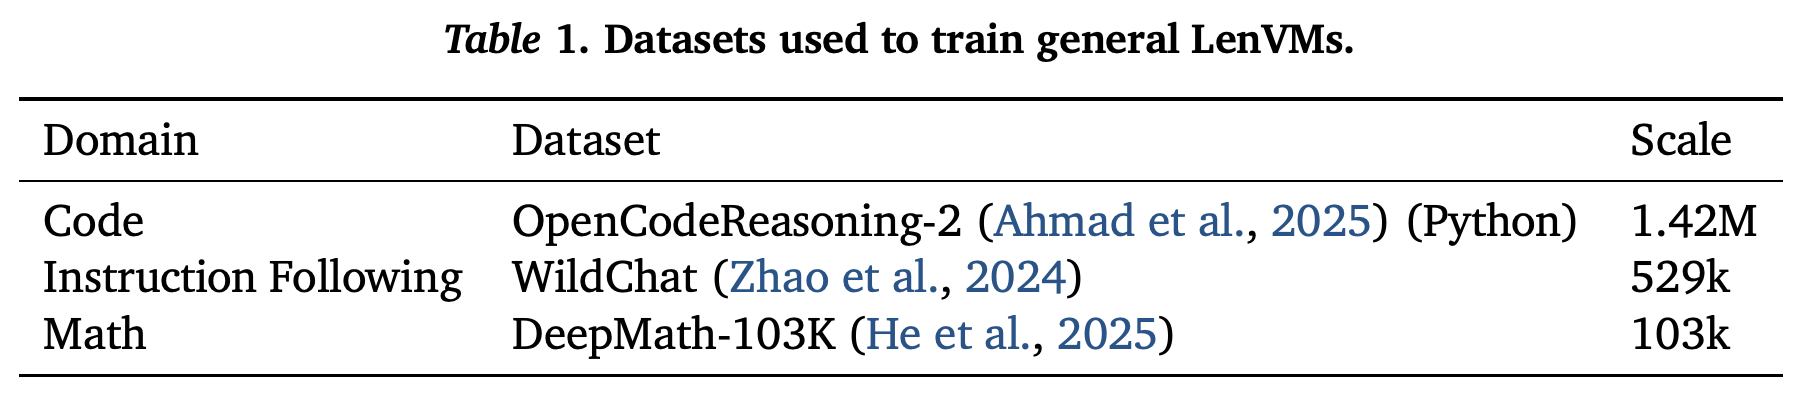
범용 LenVMs는 Table 1에 제시된 OpenCodeReasoning-2(Python; 1.42M), WildChat(529k), DeepMath-103K(103k)를 혼합해 학습한다. Qwen2.5 실험은 비전-언어 체크포인트를 포함한 Qwen2.5-Instruct 계열로 LenVM을 초기화하고, Qwen3 실험은 Qwen3-Base로 초기화한다.
- Appendix B는 별도 언급이 없으면 2 epochs, 학습률 2 × 10^−5, 배치 크기 1024, BF16을 사용하고, temperature 1.0과 top-p 1.0으로 프롬프트당 최대 16개 완성문을 샘플링한다고 명시한다.
- 보고된 할인 계수는 Qwen2.5-Instruct와 Qwen2.5-VL-Instruct에서 0.997, Qwen3-Instruct에서 0.9998이다. 후자의 모델명은 본문에서 Qwen3-Base로 초기화한다고 설명한 내용과 다르다.
- 어블레이션과 규모 확장 실험은 데이터셋당 100k개 예제를 사용하되, 수학에서는 사용 가능한 95k개 예제를 모두 사용한다. 제어 및 효율 실험은 전체 학습 세트를 사용한다. 학습 검증에는 무작위로 추출한 8k개 예제를 사용한다.
학습 데이터는 코드, 지시 따르기, 수학을 포함하며, 기재된 코퍼스 크기는 서로 다르다. 이 원본 데이터 규모만으로 도메인별 가중치가 같거나 모든 실험의 샘플 수가 같다고 판단할 수는 없다.
4.2. Application 1: Length-Controlled Generation
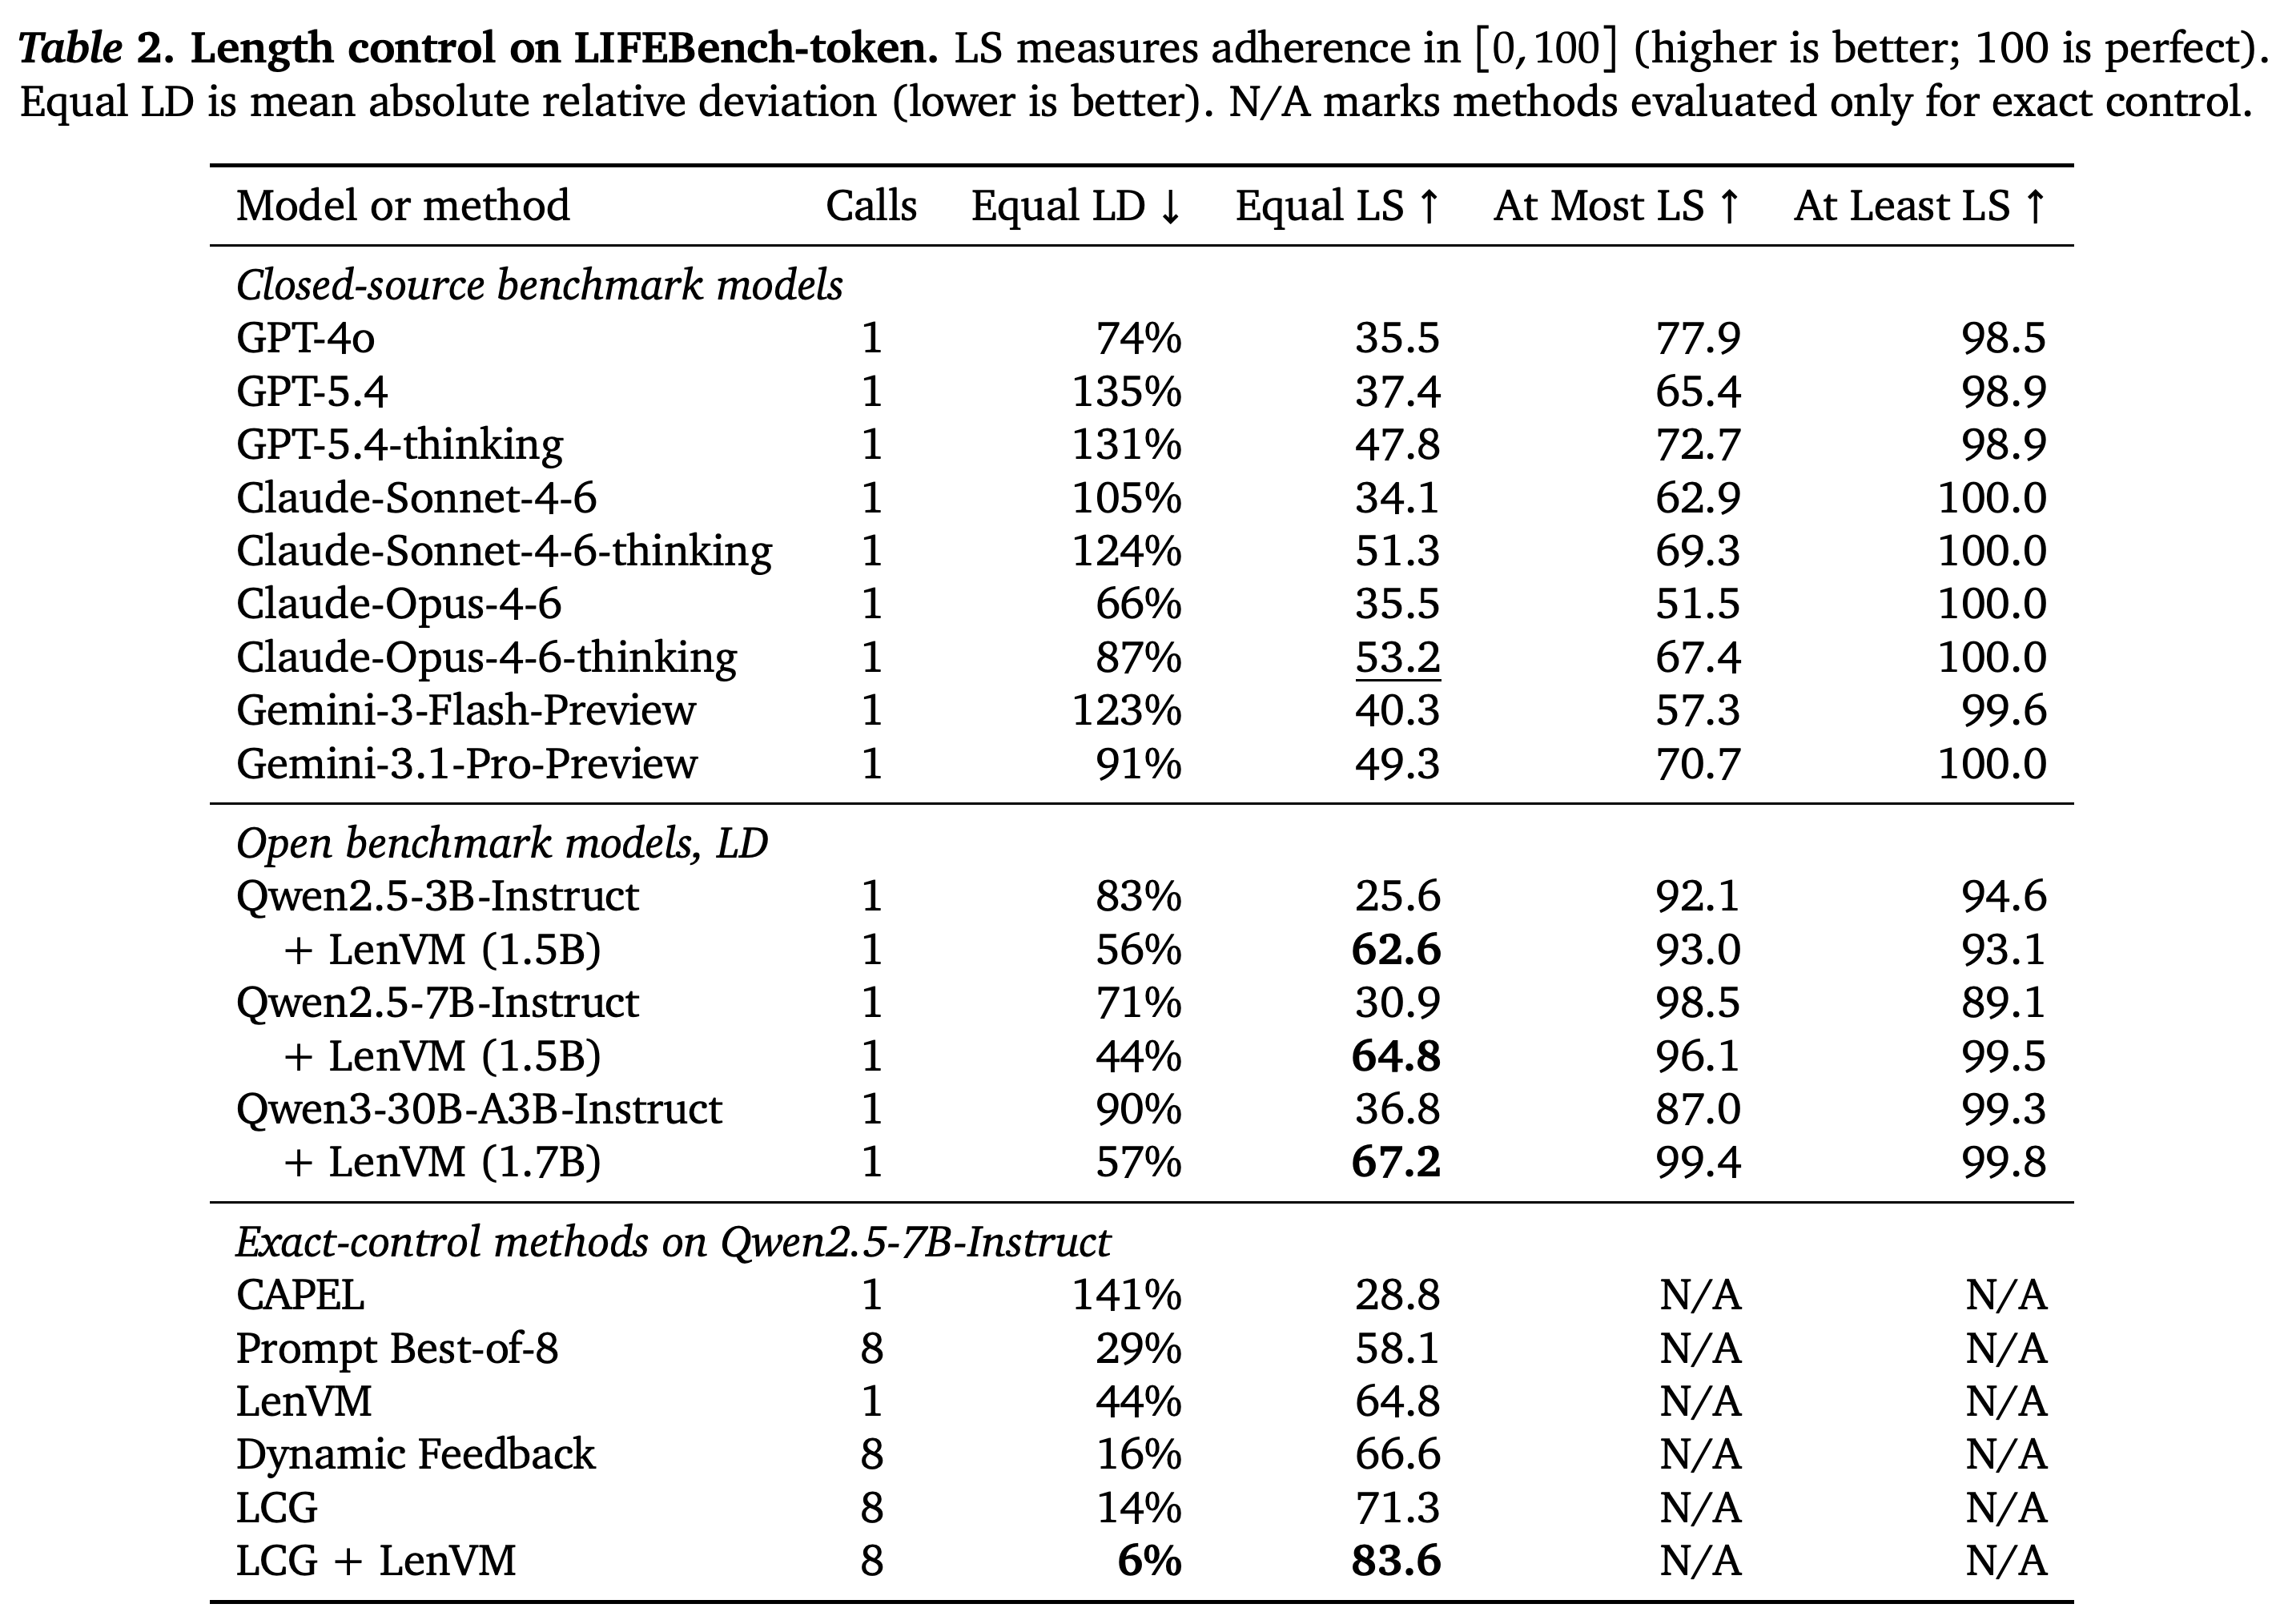
LIFEBench-token은 이중 언어 기본 사례 360개에서 Equal To, At Most, At Least 토큰 수 제약을 평가한다. Section 4.2는 목표 길이가 32~1024 tokens라고 보고한다. LenVM은 다음 상태 후보를 평가한 뒤, Equal To에서는 목표 가치에 가장 가까운 값, At Least에서는 가장 작은 음수 값, At Most에서는 0에 가장 가까운 값을 선택한다.
- temperature 1.0, top-p 0.999, top-k 15에서 Qwen2.5-7B-Instruct의 Equal-To LS는 30.9에서 64.8로 높아지고, Equal-To LD는 71%에서 44%로 줄어든다. At-Most LS는 98.5에서 96.1로 낮아지므로 모든 제약에서 개선되는 것은 아니다.
- Table 2는 1회 패스 방법과 여러 번 호출하는 제어기를 비교한다. LenVM의 1회 패스는 LS에서 Prompt Best-of-8을 넘지만, LenVM은 후보 평가를 추가하므로 생성 호출 횟수가 같다고 연산량까지 같은 것은 아니다.
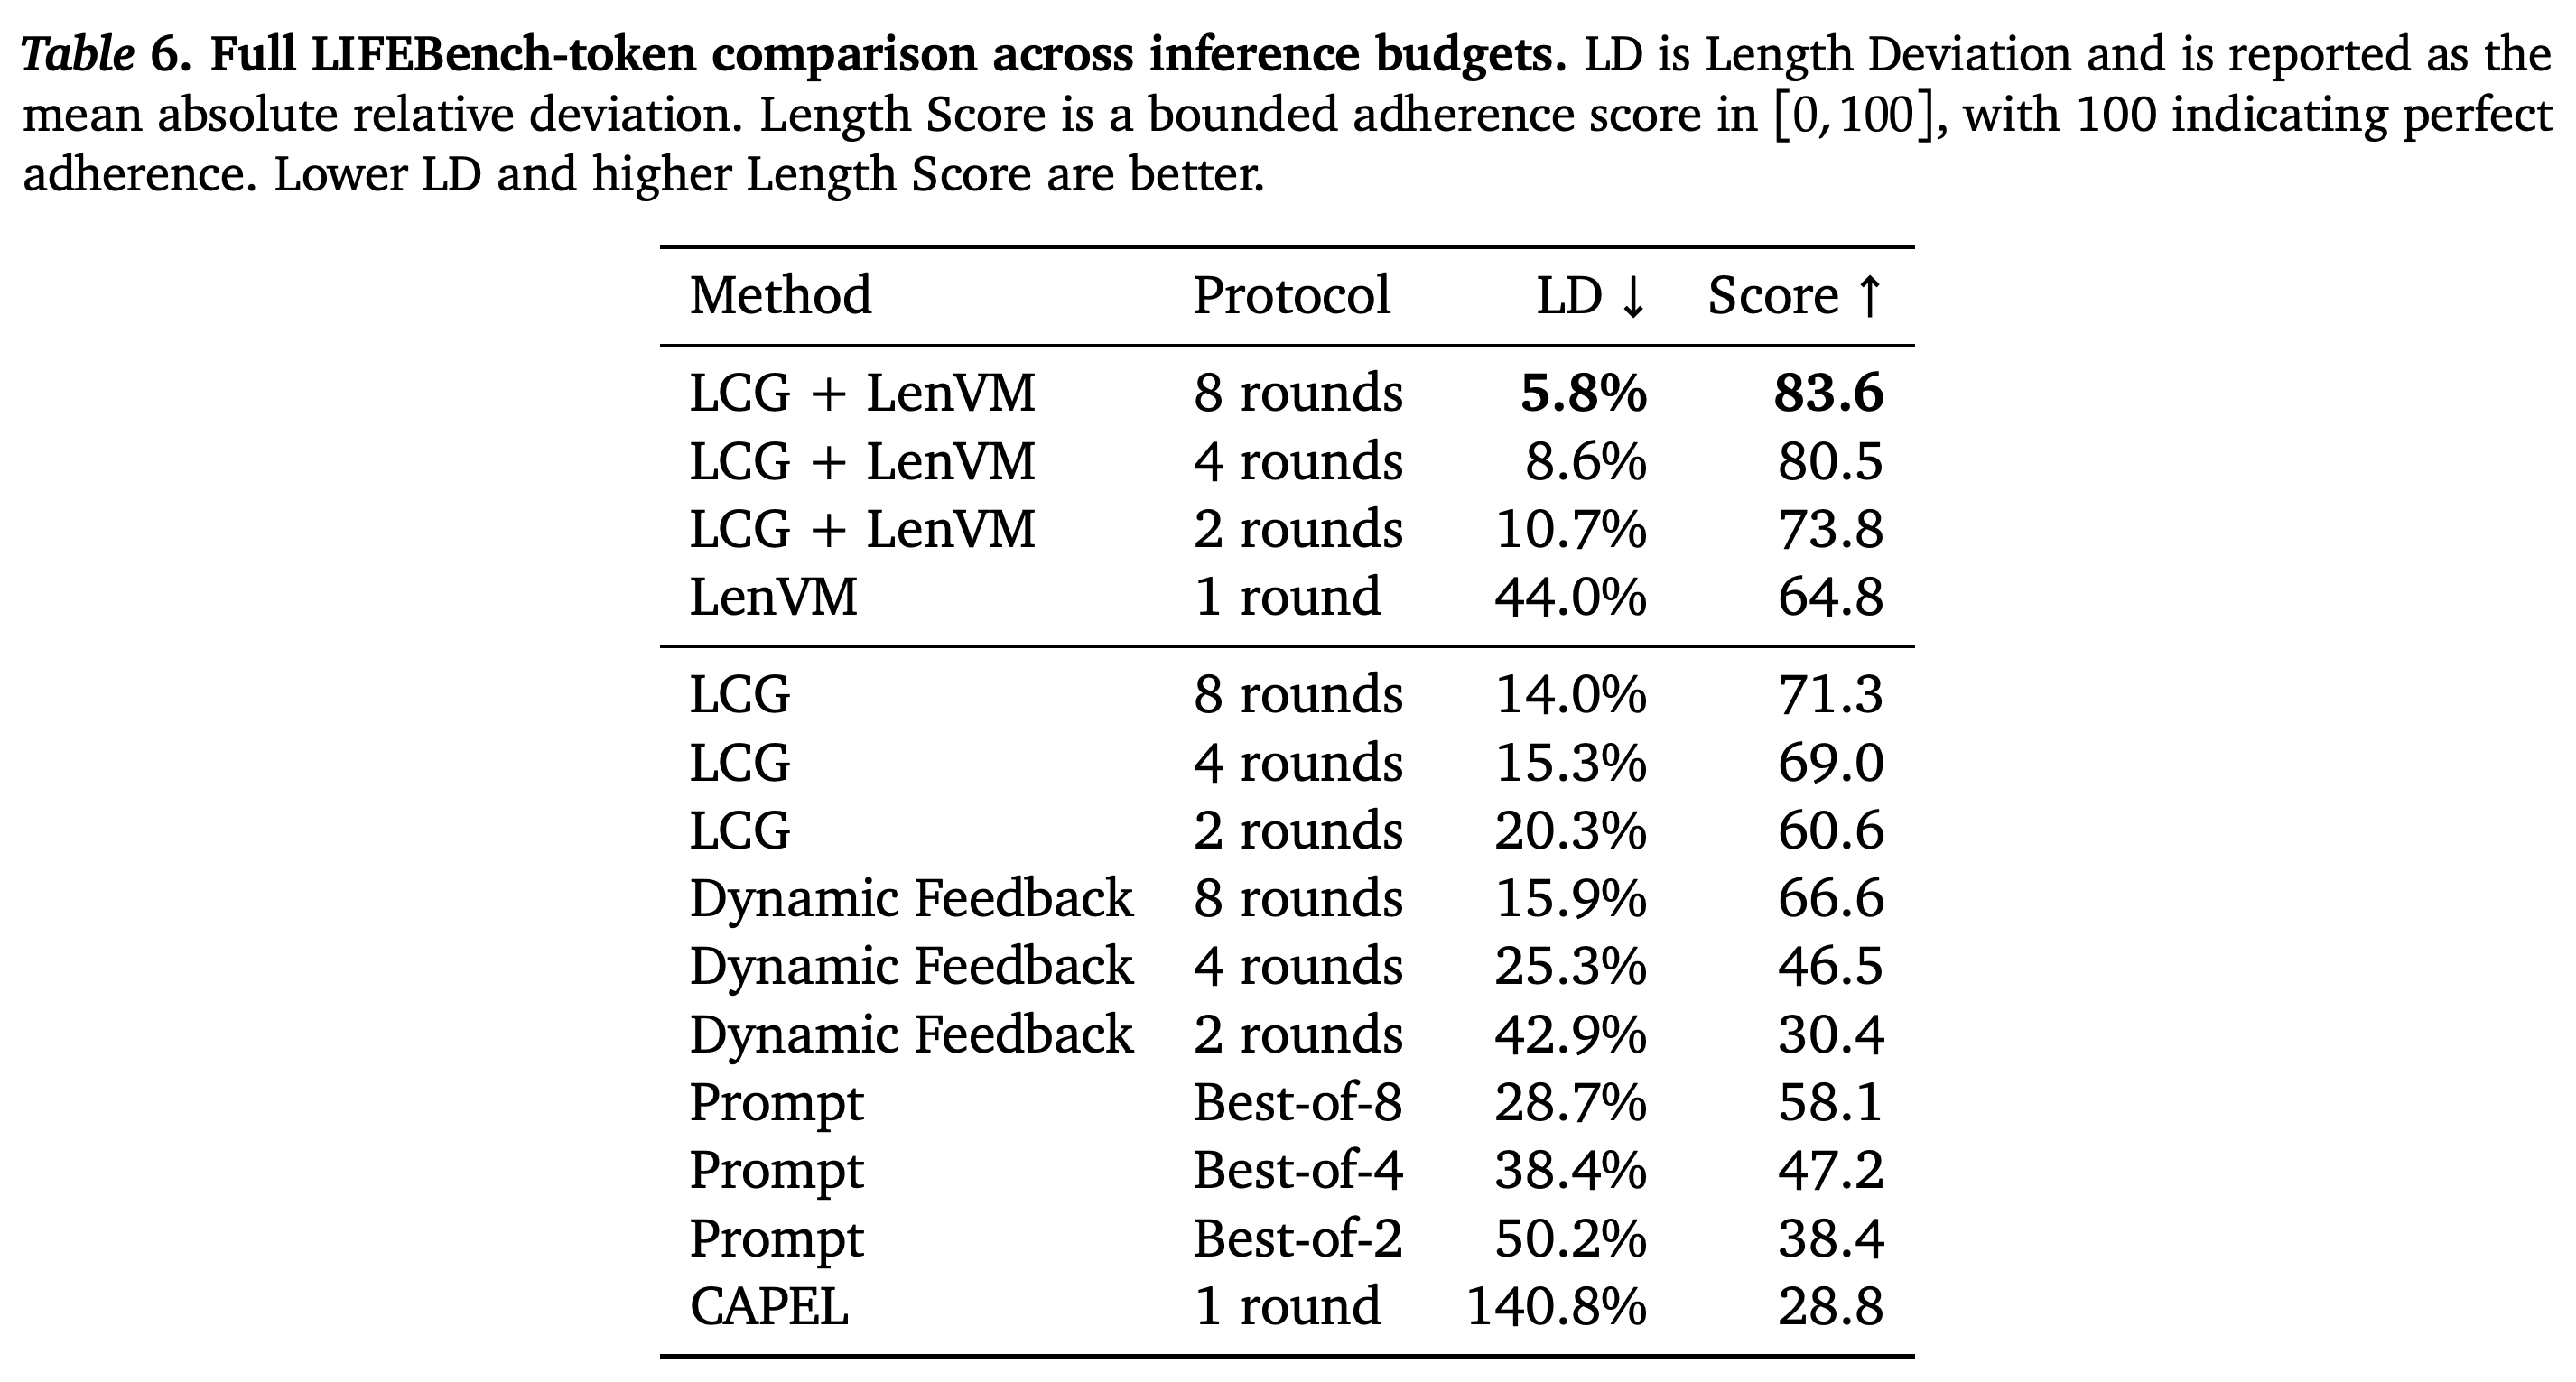
- Table 6은 LCG의 제안 생성 과정에 LenVM을 넣으면 추가 개선이 발생함을 보여 준다. 호출 횟수가 2, 4, 8일 때 LS는 각각 60.6, 69.0, 71.3에서 73.8, 80.5, 83.6으로 높아진다.
- Appendix A는 16~8192 범위의 원래 목표값 10개를 설명하고 이를 유지한다고 명시하므로, 실제 평가한 목표 범위가 불명확하다. 토큰 기반 점수는 원래 단어·문자 기반 리더보드와 직접 비교할 수 없다.
Equal-To 제약 준수가 크게 개선되며, Qwen2.5-7B-Instruct의 LS도 30.9에서 64.8로 높아진다. 반면 At-Most 점수는 낮아지고 호출 예산도 서로 다르므로, 이 표를 모든 경우의 개선이나 동일 연산량 기준 순위로 해석해서는 안 된다.
LenVM을 추가하면 시험한 모든 외부 호출 예산에서 LCG가 개선되며, 8회 호출 조합은 LD 5.8%와 LS 83.6에 도달한다. 반복 횟수를 맞추면 수정 예산은 통제할 수 있지만, LenVM이 각 호출 안에서 후보 평가를 추가하므로 전체 추론 연산량까지 같아지는 것은 아니다.
4.3. Application 2: Performance–Efficiency Trade-off
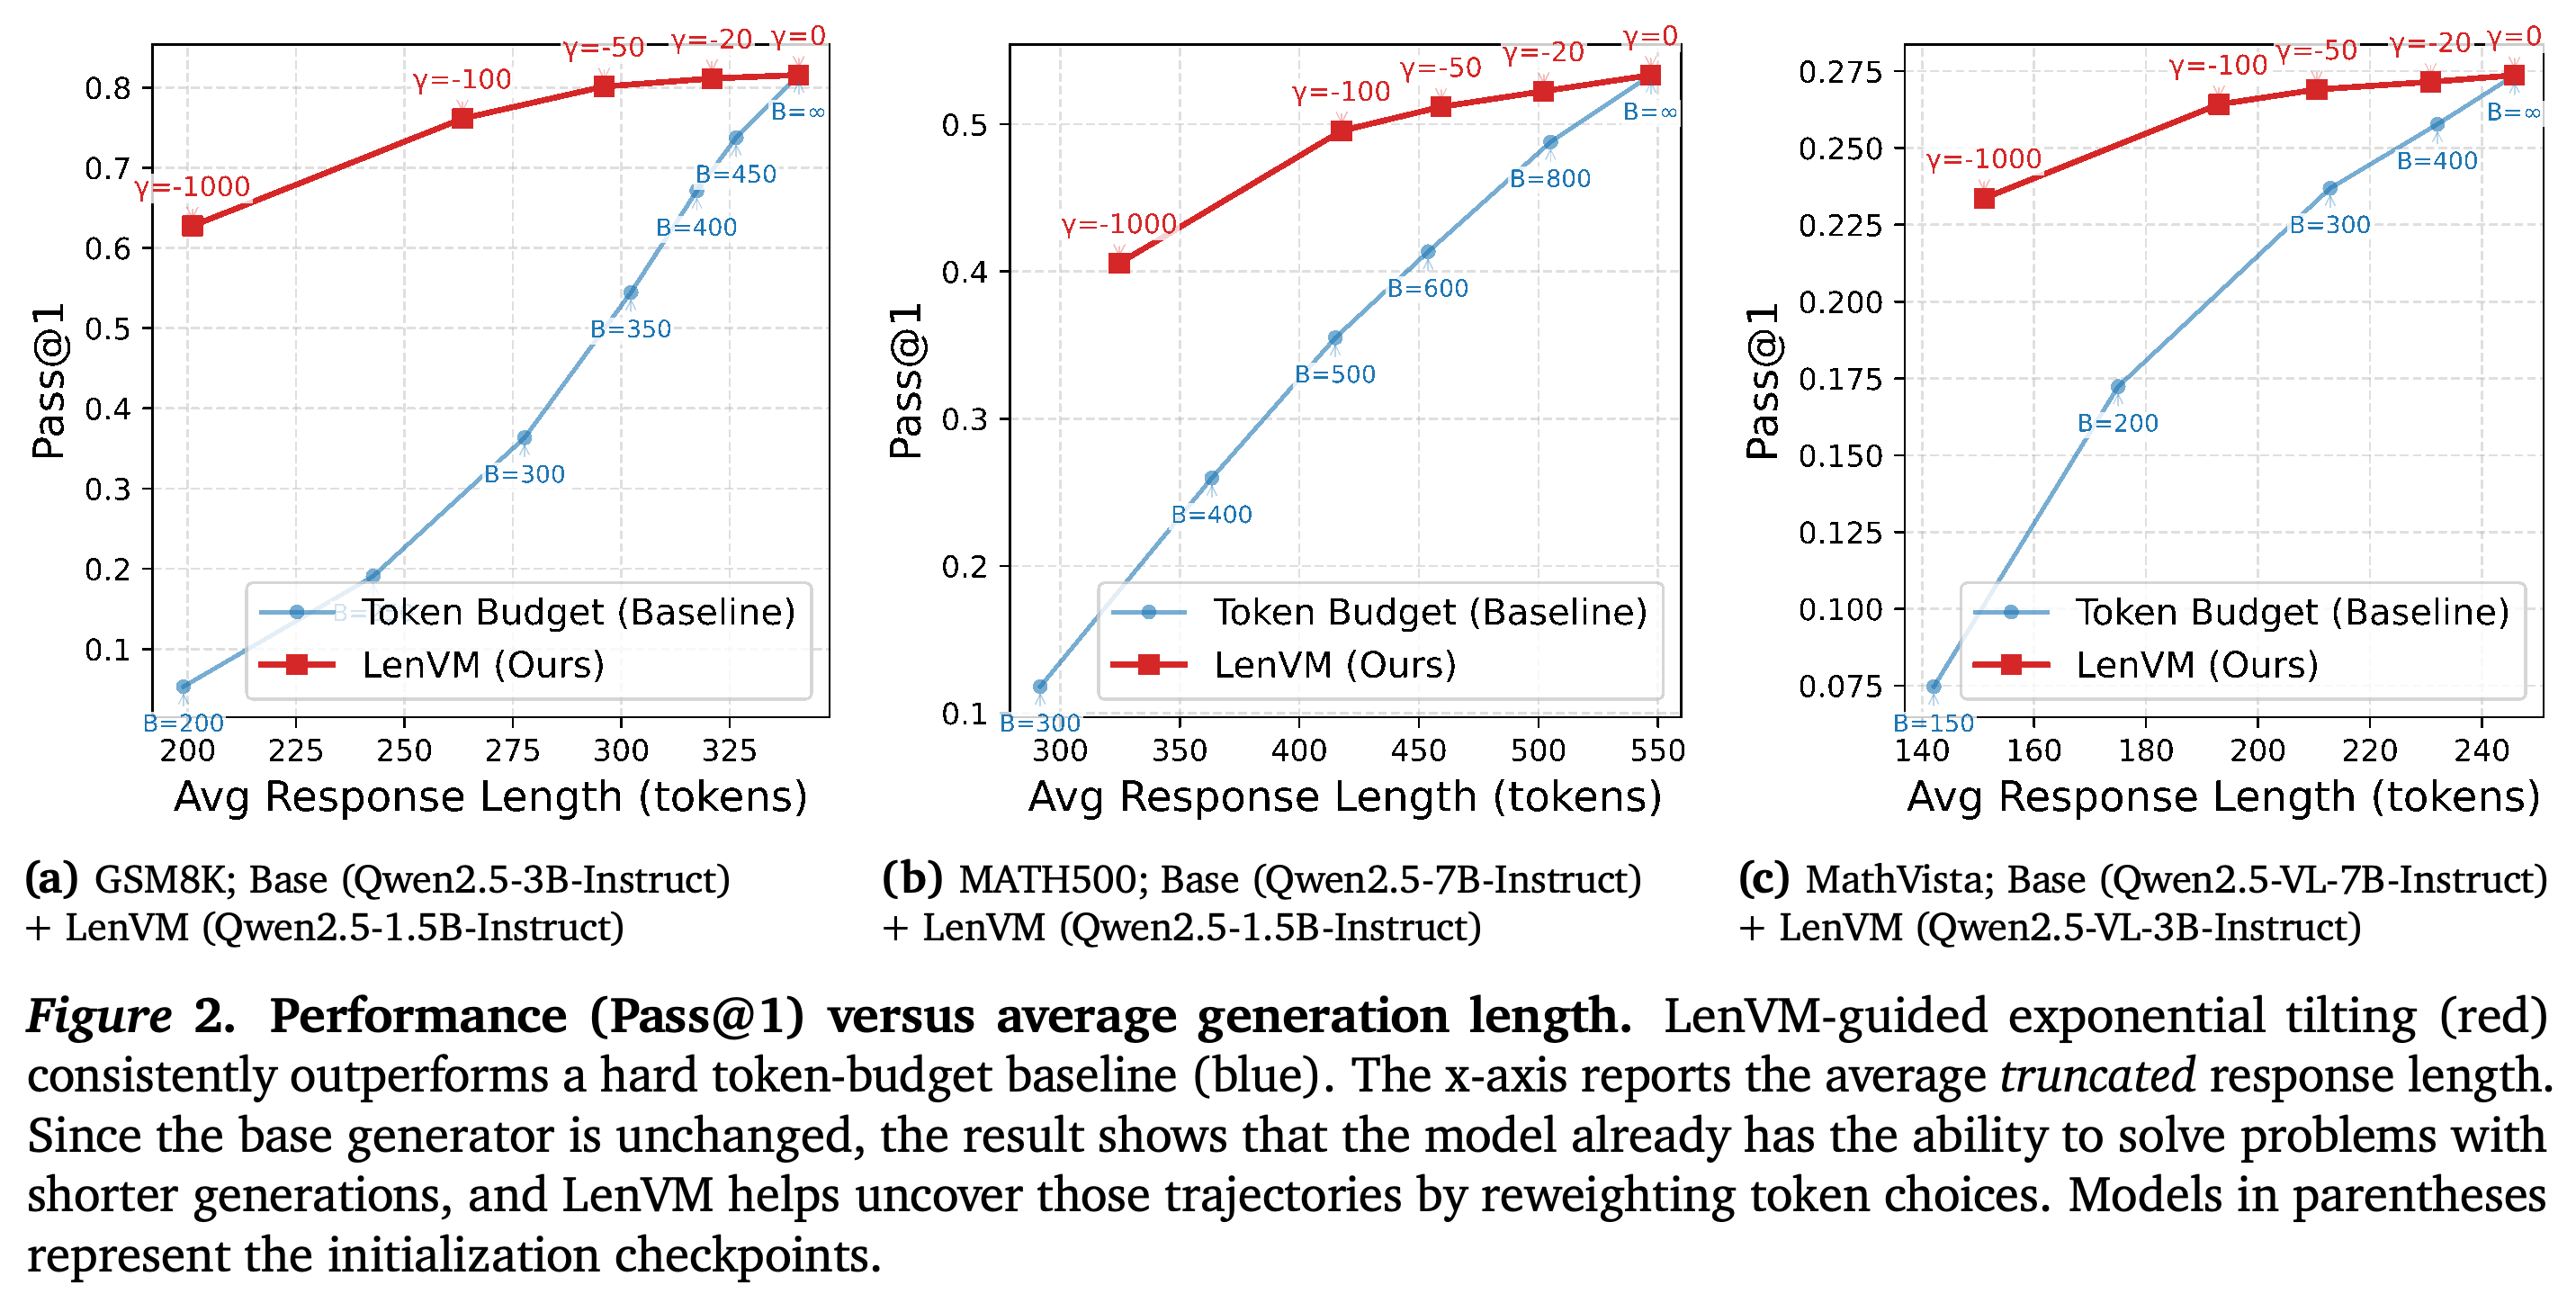
논문은 가치 기반 지수 틸팅을 (p’(x)=\frac{p(x)\exp(\beta\hat v(x))}{\sum_{x’}p(x’)\exp(\beta\hat v(x’))})로 정의하며, β < 0을 사용한다. Figure 2는 GSM8K, MATH500, MathVista에서 강제 절단보다 우수한 Pass@1–길이 프런티어를 보고한다. Qwen2.5-3B-Instruct로 GSM8K에서 약 200 tokens를 생성할 때, 보고된 Pass@1은 약 63% 대 6%다.
- 이 실험은 temperature 1.0과 top-p 1.0으로 질문당 64개 완성문을 샘플링한다. 유도 디코딩은 후보 배치 크기를 제한하기 위해 min-p 0.01을 사용한다. 길이 예산 B를 넘는 출력은 절단하고 오답으로 처리한다.
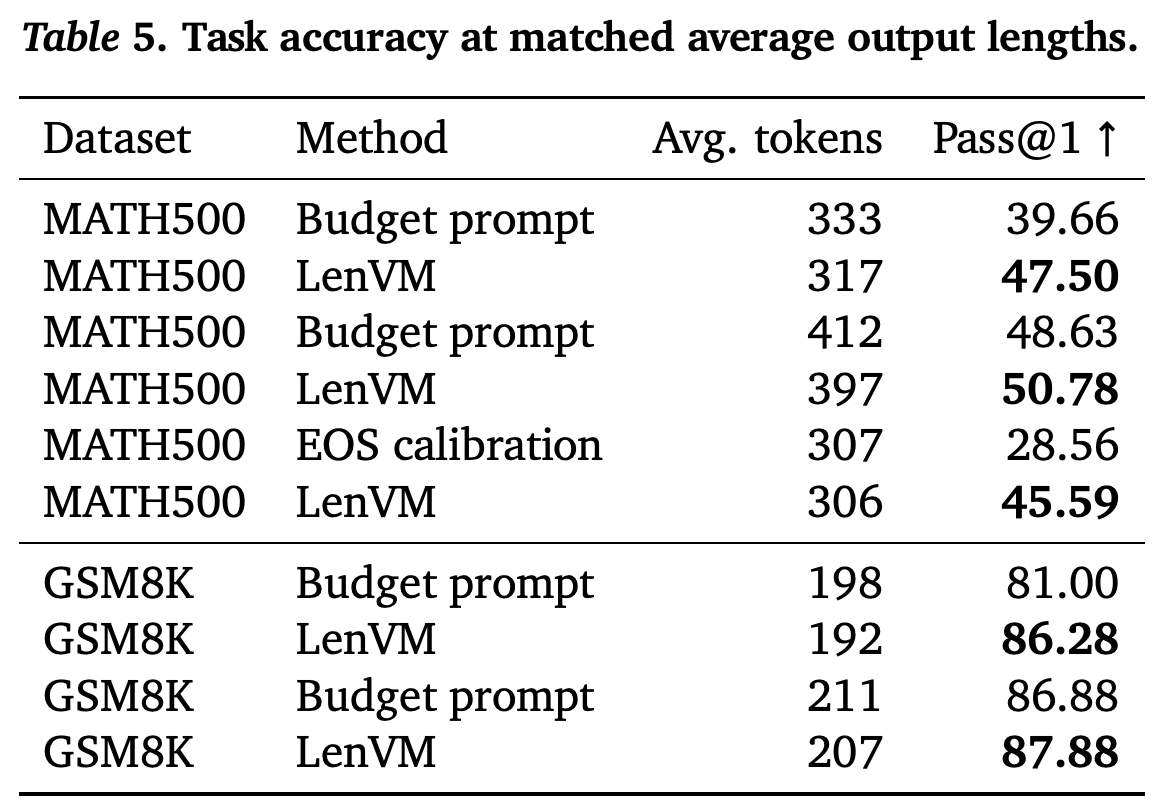
- Table 5의 가장 가까운 평균 길이 비교는 Qwen2.5-7B-Instruct를 사용한다. MATH500에서 LenVM은 306 tokens로 Pass@1 45.59를 얻고, EOS calibration은 307 tokens로 28.56을 얻는다. 또 LenVM은 317 tokens로 47.50을 얻고, budget prompting은 333 tokens로 39.66을 얻는다.
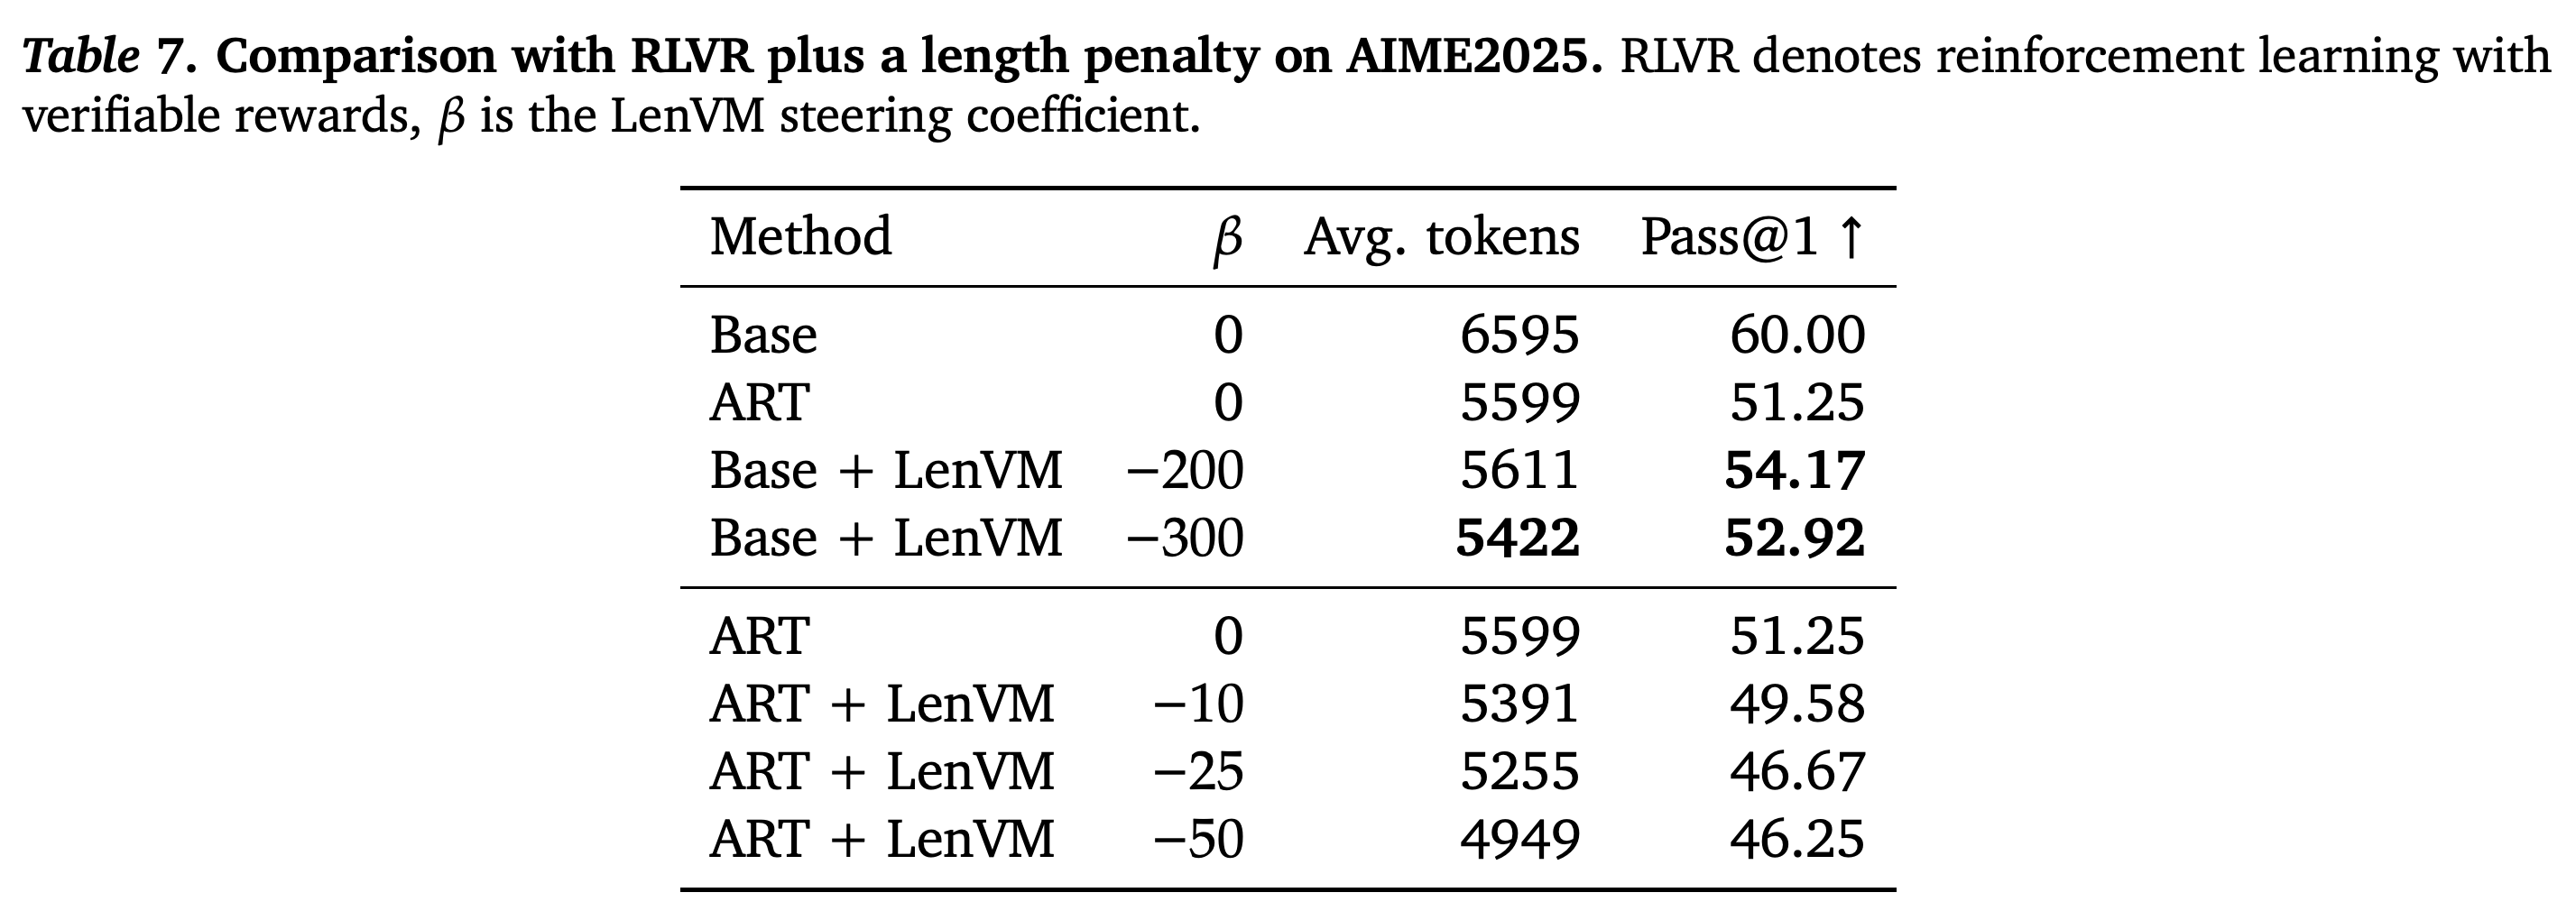
- Table 7은 AIME2025에서 Base + LenVM이 5611 tokens로 Pass@1 54.17을 얻고, ART는 5599 tokens로 51.25를 얻는다고 보고한다. ART에 추가 조절을 적용하면 정확도가 낮아지는 대신 길이가 더 줄어든다. 이는 RLVR 학습보다 항상 우수하다는 결과가 아니라 함께 사용할 수 있음을 보여 주는 결과다.
- 제시된 식은 길이를 줄인다는 설명과 충돌한다. β < 0이면 더 작은 음수 v̂의 상대 확률이 높아지지만, Section 3에서는 이 값을 더 긴 잔여 길이에 대응시킨다. 보고된 곡선만으로는 구현에서 어떤 부호나 가치 규약을 사용했는지 알 수 없다.
보고된 유도 디코딩 곡선은 3개 벤치마크 모두에서 평균 길이가 비슷할 때 강제 절단보다 높은 정확도를 유지한다. GSM8K의 약 63% 대 6% 차이는 크지만, 강제 절단은 제약이 강한 베이스라인이며 제시된 조절 규약에는 해결되지 않은 부호 불일치가 있다.
가장 가까운 평균 길이에서의 비교는 강제 절단과의 비교보다 근거를 강화한다. MATH500에서 LenVM은 306 tokens로 Pass@1 45.59를 얻어, 307 tokens로 28.56을 얻는 EOS calibration을 넘는다. budget prompting과의 비교도 LenVM에 유리하지만, 비교 대상의 평균 길이가 항상 같지는 않다.
Base + LenVM은 5611 tokens로 Pass@1 54.17을 얻고, ART는 5599 tokens로 51.25를 얻는다. ART에 LenVM을 적용하면 정확도가 낮아지는 대신 응답이 더 짧아진다. 이는 학습 절차나 운용 지점 전반에서 우세하다는 뜻이 아니라, 디코딩 시점 제어를 함께 사용할 수 있음을 보여 준다.
4.4. Application 3: Generation Length Prediction
규모와 도메인에 따른 프롬프트 경계 평가에서는 각 홀드아웃 프롬프트마다 N = 64개 완성문을 생성한다. 기준 잔여 길이는 u(L) = 1 − γ^L을 평균한 뒤 그 평균을 역변환해 구한다. 따라서 보고된 MRE는 실제 완성문 길이의 평균이 아니라 리턴과 일관된 잔여 길이에 대한 오차다.
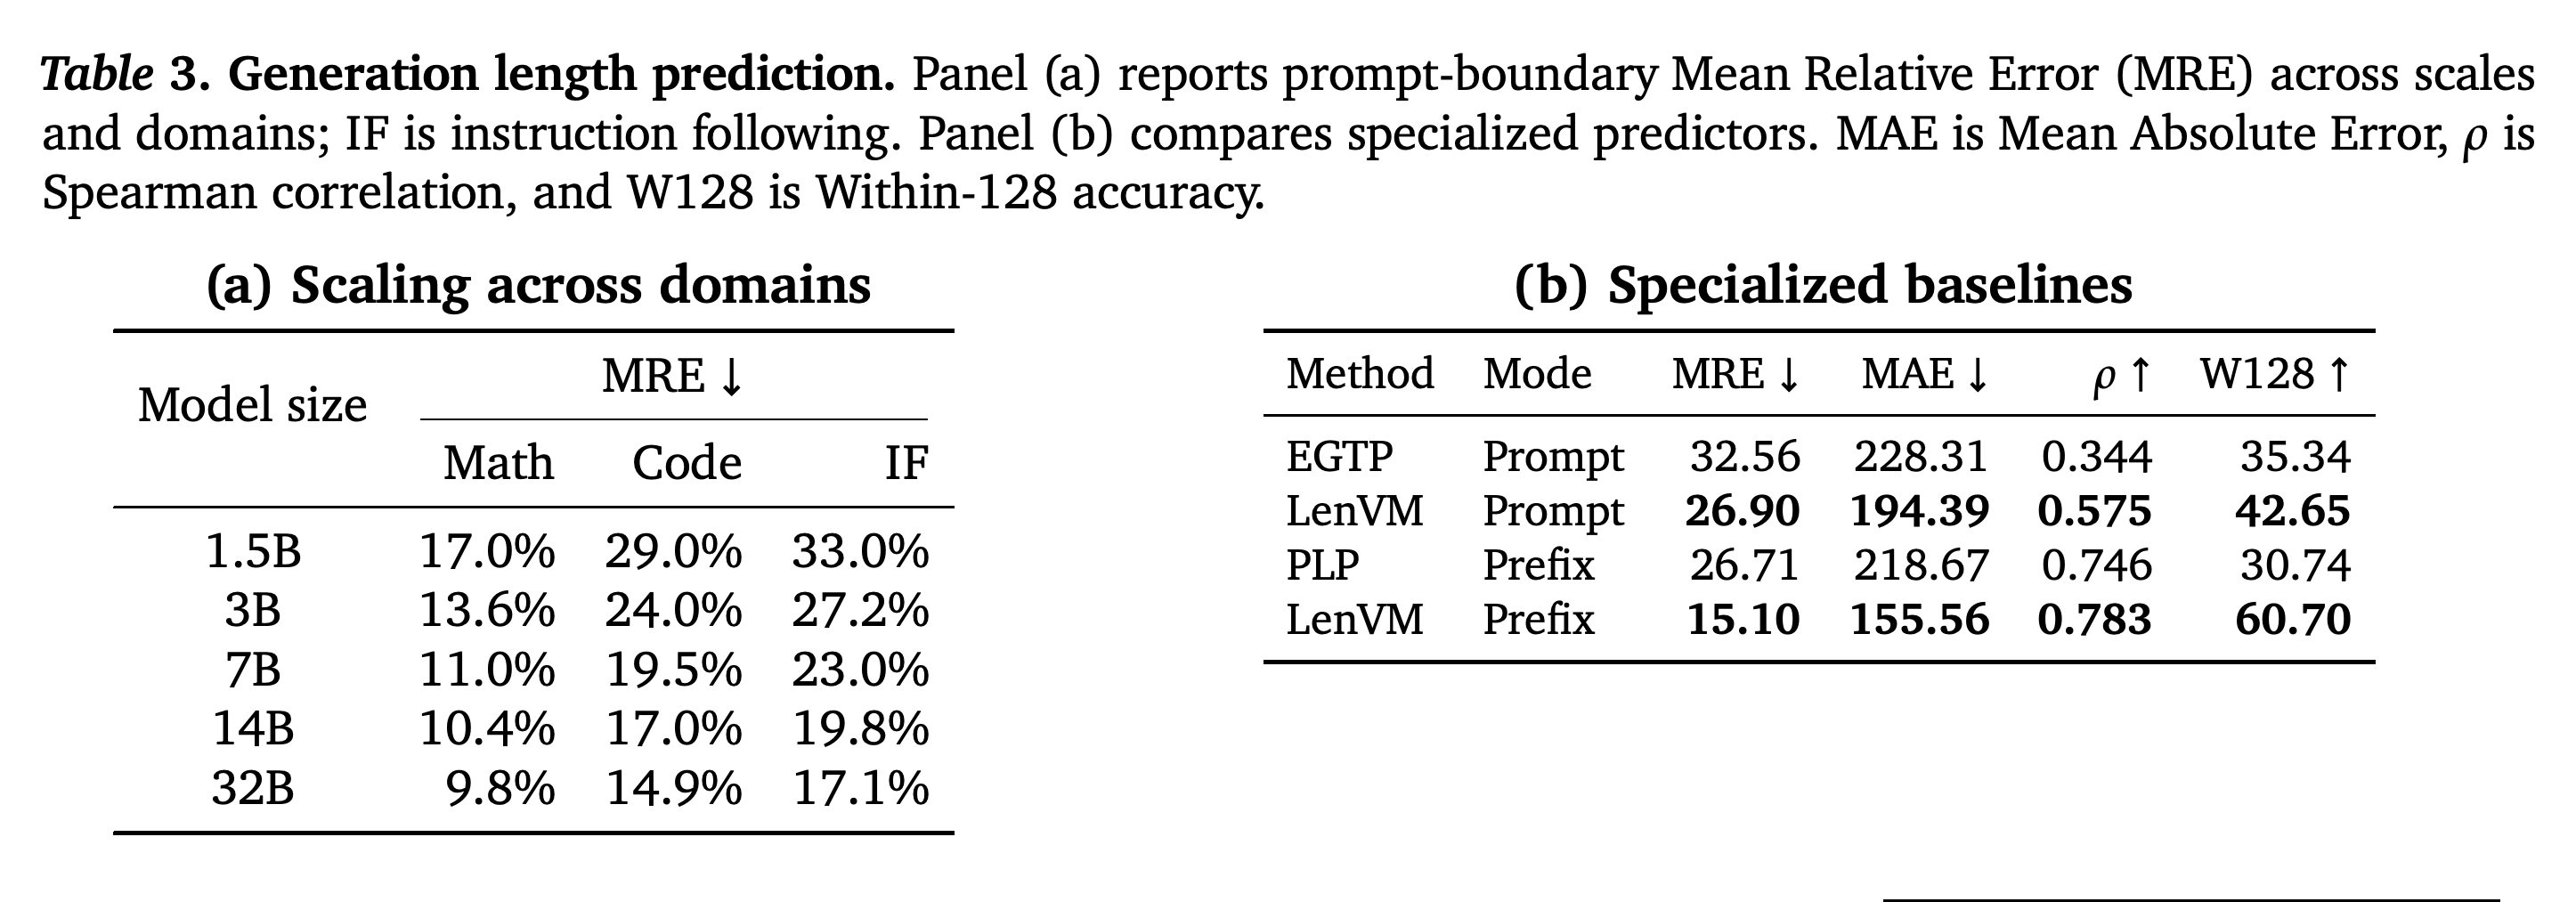
- Table 3(a)는 모델 규모가 1.5B에서 32B로 커질 때 수학, 코드, 지시 따르기의 MRE가 각각 17.0%, 29.0%, 33.0%에서 9.8%, 14.9%, 17.1%로 줄어든다고 보고한다.
- Table 3(b)는 고정된 Qwen2.5-7B-Instruct 생성기를 사용해 홀드아웃 DeepMath-103K 프롬프트 8192개와 약 108,000개 접두사 상태에서 예측기를 비교한다. LenVM은 프롬프트 MRE를 32.56에서 26.90으로, 점진적 MRE를 26.71에서 15.10으로 줄인다.
- 점진적 예측의 Within-128 정확도는 PLP의 30.74에서 LenVM의 60.70으로 높아진다. Appendix B는 이 특화 비교에서 실현된 완성문 길이를 공통 타깃으로 사용한다고 명시한다. 이는 규모 확장 평가에서 64개 샘플을 변환해 얻은 기준값과 다르다.
모델 규모가 커질수록 3개 도메인 모두에서 프롬프트 경계 MRE가 낮아진다. 별도의 특화 베이스라인 패널에서는 오차, 순위 상관, Within-128 정확도가 개선되며, 특히 점진적 예측에서 개선이 크다. 이 패널의 실현된 길이 평가 타깃은 규모 확장 패널의 변환된 기준값과 다르다.
4.5. Scalability of LenVM
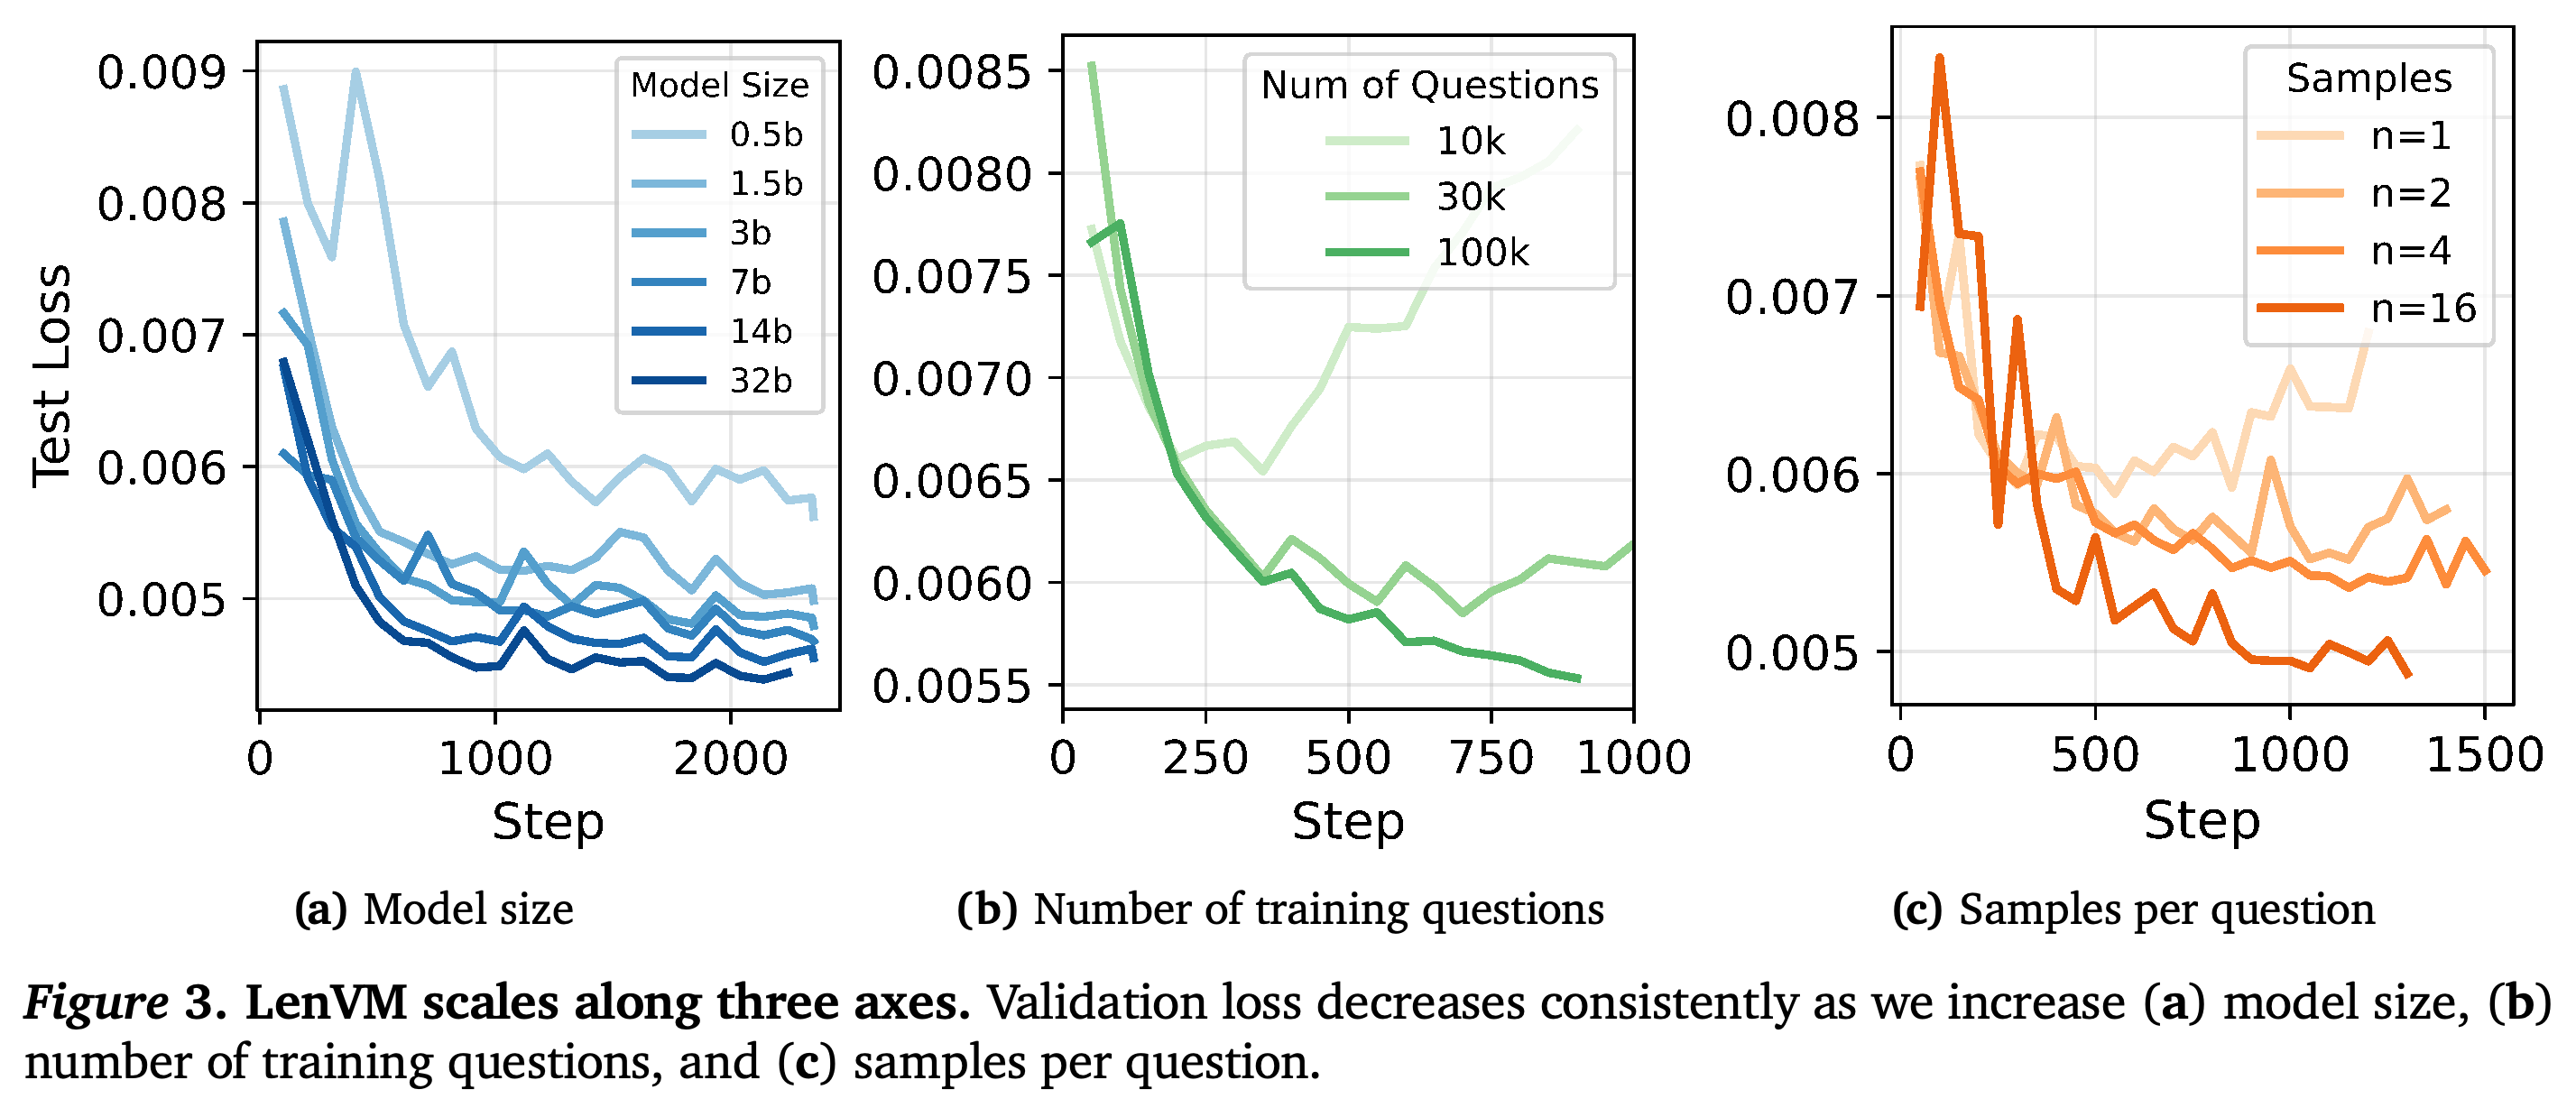
Figure 3은 모델 규모를 0.5B~32B, 학습 질문 수를 10k, 30k, 100k, 질문당 샘플 수를 1, 2, 4, 16으로 바꾸어 평가한다. 시험한 범위에서는 모델이 크고 프롬프트와 샘플링 궤적이 많을수록 대체로 검증 손실이 낮아진다.
- 곡선은 경험적인 규모 확장 추세를 보여 줄 뿐, 데이터에 맞춘 스케일링 법칙이나 모델 규모·프롬프트 범위·반복 샘플링 사이의 연산량 최적 배분을 제시하지는 않는다.
모델이 크고 프롬프트 범위가 넓으며 프롬프트당 완성문이 많을수록 대체로 더 낮은 검증 손실에 도달한다. 이 비교는 연산량의 최적 배분이나 각 규모 확장 방향의 비용 대비 이익을 정량화하지는 않는다.
4.6. Inference Cost
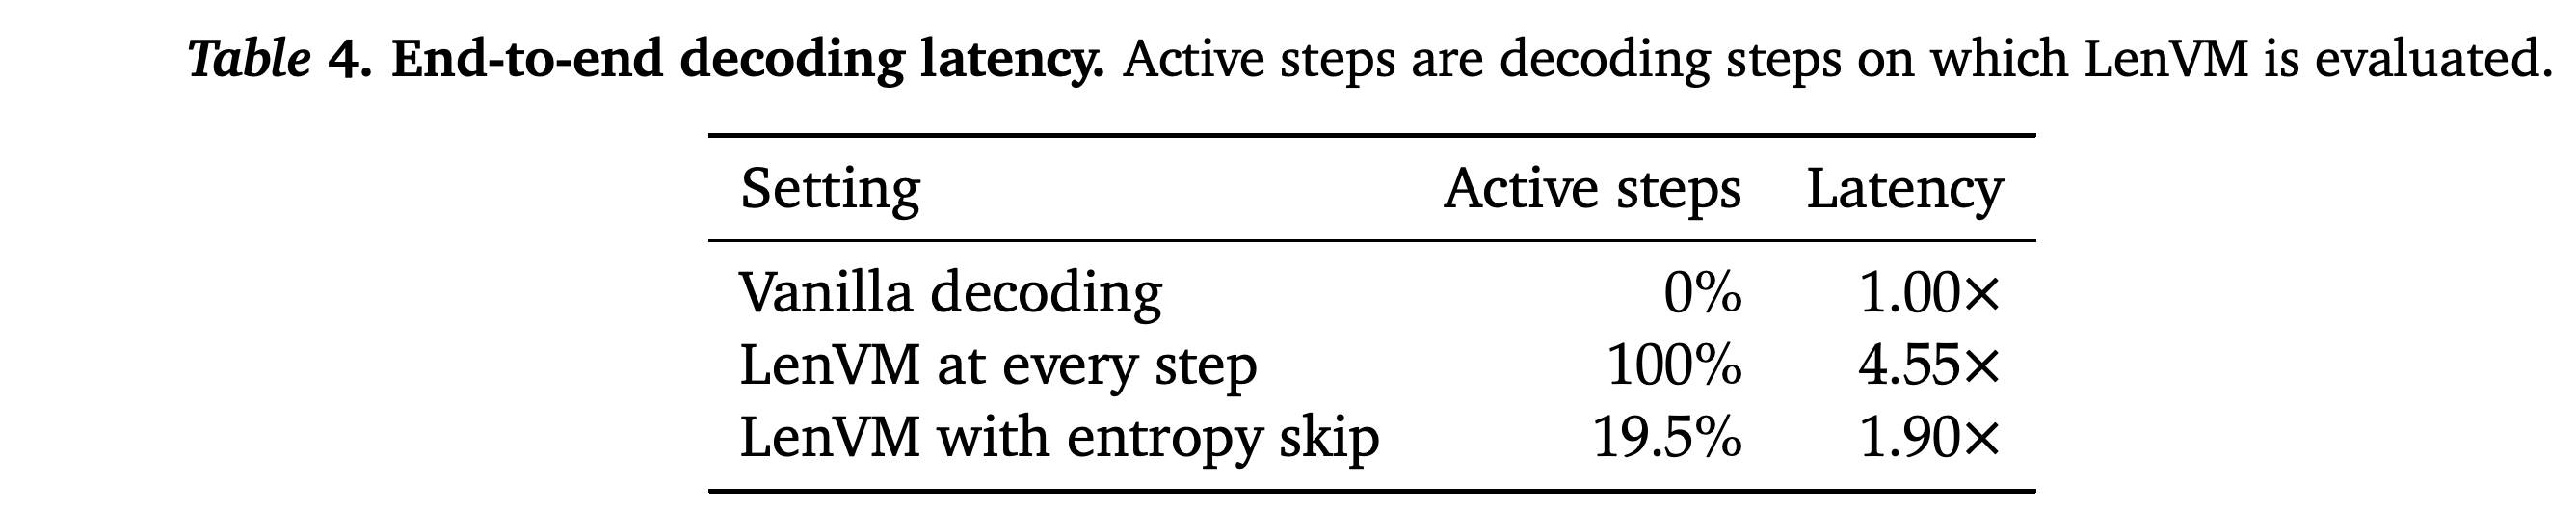
다음 상태 후보는 공유 접두사 어텐션과 캐시된 LenVM KV 상태를 활용해 1회의 묶음 SGLang 호출로 평가한다. Table 4에 따르면 생성기 엔트로피가 0.5 미만일 때 가치 평가를 생략하면 활성 단계 비율이 19.5%로 줄고, 측정된 전체 지연 시간은 일반 디코딩 대비 4.55×에서 1.90×로 줄어든다.
- 지연 시간 측정에서는 Qwen2.5-7B-Instruct를 생성기로 사용하고, LenVM은 Qwen2.5-1.5B-Instruct로 초기화한다. 남은 추가 비용은 하드웨어와 서빙 부하에 따라 달라진다.
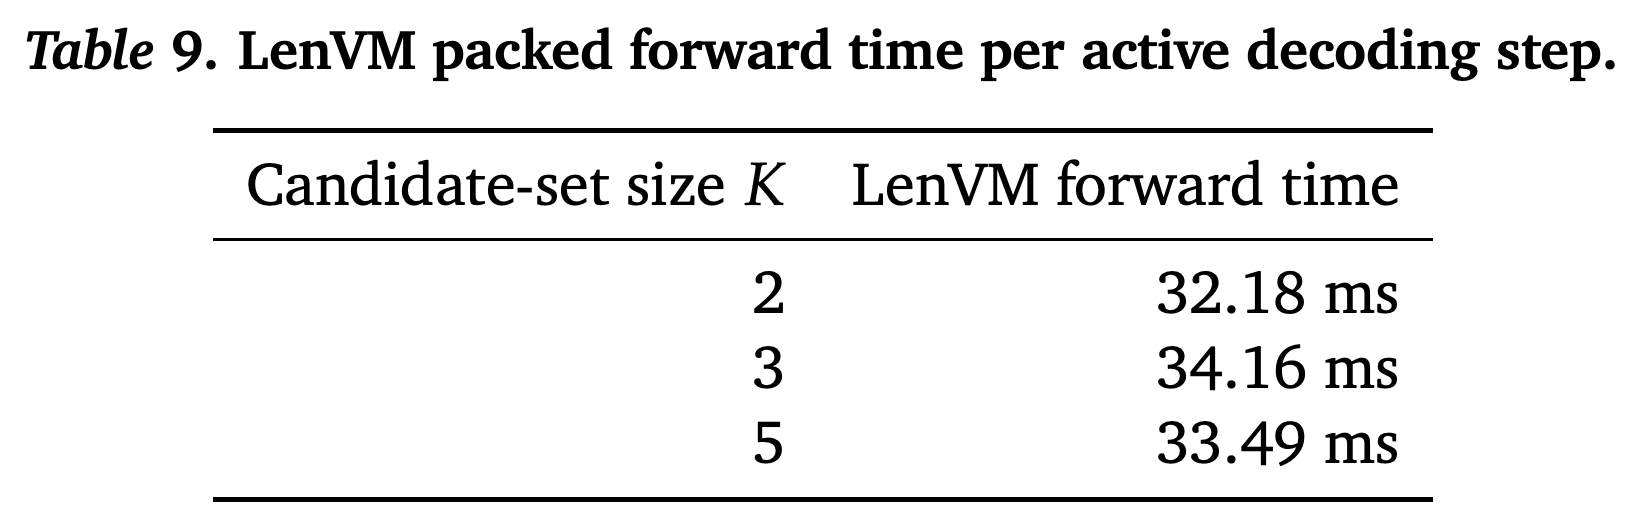
- Table 9는 K = 2, 3, 5에서 묶음 순전파 시간이 각각 32.18 ms, 34.16 ms, 33.49 ms라고 보고한다. 이는 K번의 직렬 호출 대신 묶음 평가를 사용할 근거가 되지만, 이 좁은 범위 밖에서도 실행 시간이 K와 무관하다는 뜻은 아니다.
- 논문은 응답이 짧아져 실제 실행 시간이 절약되는지 입증하지 않는다.
엔트로피 기반 생략은 모든 디코딩 단계에서 활성화되던 가치 모델을 19.5%의 단계에서만 활성화하도록 줄이고, 상대 지연 시간을 4.55×에서 1.90×로 낮춘다. 따라서 이 설정에서는 최적화한 구성도 일반 디코딩 대비 1.90 times의 시간이 걸린다.
묶음 평가는 K = 2, 3, 5에서 32.18~34.16 ms가 걸리며, K번의 독립 호출 대신 공유 접두사 배치를 사용할 근거를 제공한다. 시험한 범위가 좁으므로 더 큰 후보 집합에서도 비용이 일정하다고 판단할 수는 없다.
5. Qualitative Case Study: Length Tokens as Markers of Length Shifts
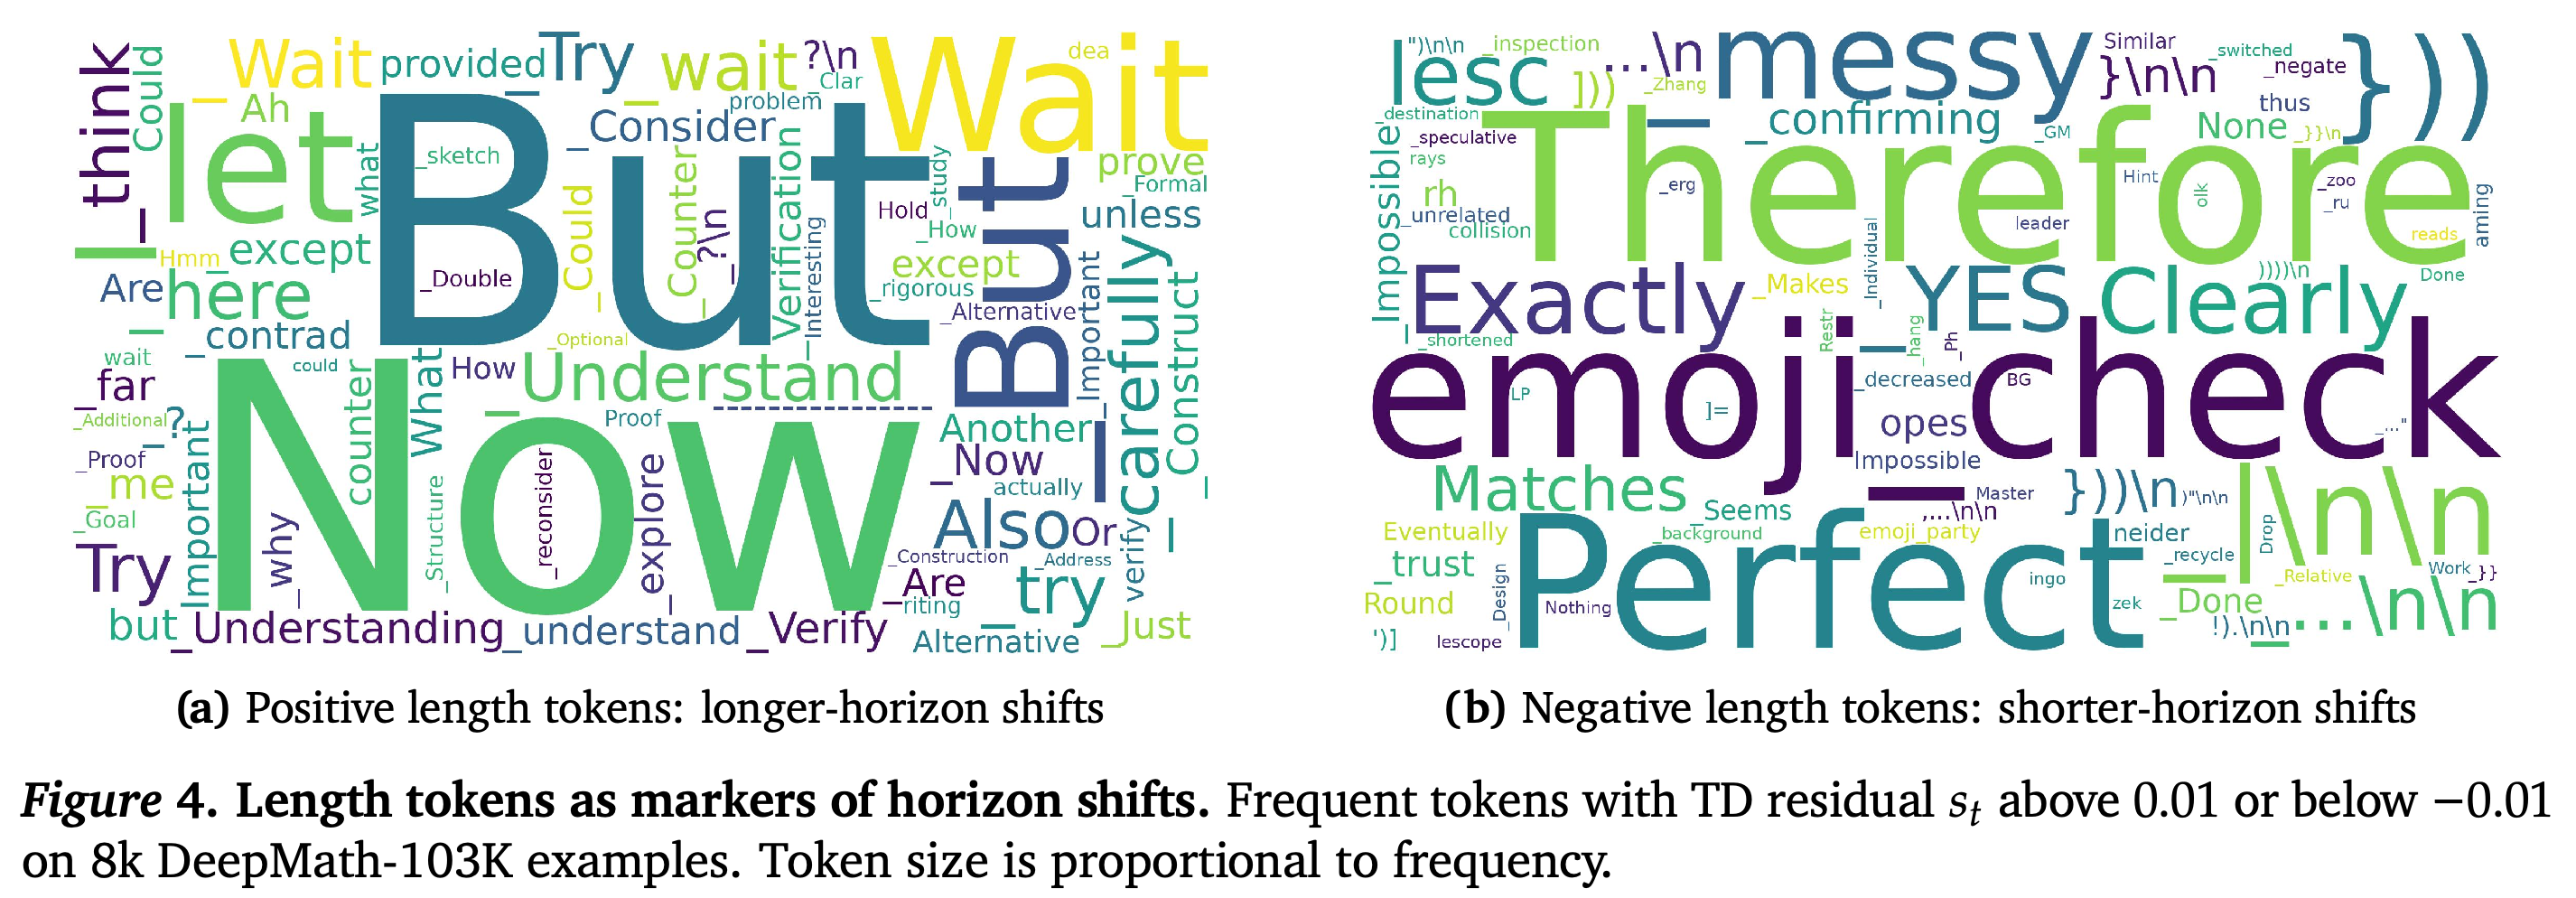
사례 연구는 DeepMath-103K 예제 8k개에서 잔차 s_t = r_(t−1) + γV_t − V_(t−1)을 계산하고, 0.01보다 크거나 −0.01보다 작은 잔차를 가진 빈번한 토큰을 묶는다. Figure 4는 wait, think, try 같은 추론 전환 토큰과 therefore, clearly, perfect 같은 마무리 관련 토큰을 대비한다.
- 이 그룹은 예측된 잔여 길이 변화와의 연관성을 나타내며, 개별 토큰의 인과 효과를 나타내지는 않는다.
- 논문은 양의 잔차를 잔여 길이가 늘어나는 변화로, 음의 잔차를 줄어드는 변화로 표시한다. 그러나 음의 비용 규약에서 양의 잔차는 다음 상태 가치가 Bellman 예측값보다 높다는 뜻이며, 이는 해당 예측보다 대리 잔여 길이가 짧다는 뜻이다.
워드 클라우드는 수학 궤적에서 양·음의 잔차 임계값으로 선택한 빈번한 토큰을 보여 준다. 추론 전환 표현과 마무리 표현이 서로 다른 그룹에 나타나지만, 이 연관성이 인과성을 입증하지는 않는다. 잔여 길이 방향 레이블도 음의 비용 잔차 규약과 충돌한다.
6. Ablations
어블레이션은 타깃 표현, 배치 구성, 할인 계수, 수치 정밀도, 후보 집합 크기를 살펴본다. 별도 언급이 없으면 모델, 옵티마이저, 평가 절차는 고정한다.
6.1. Length-Space Representation
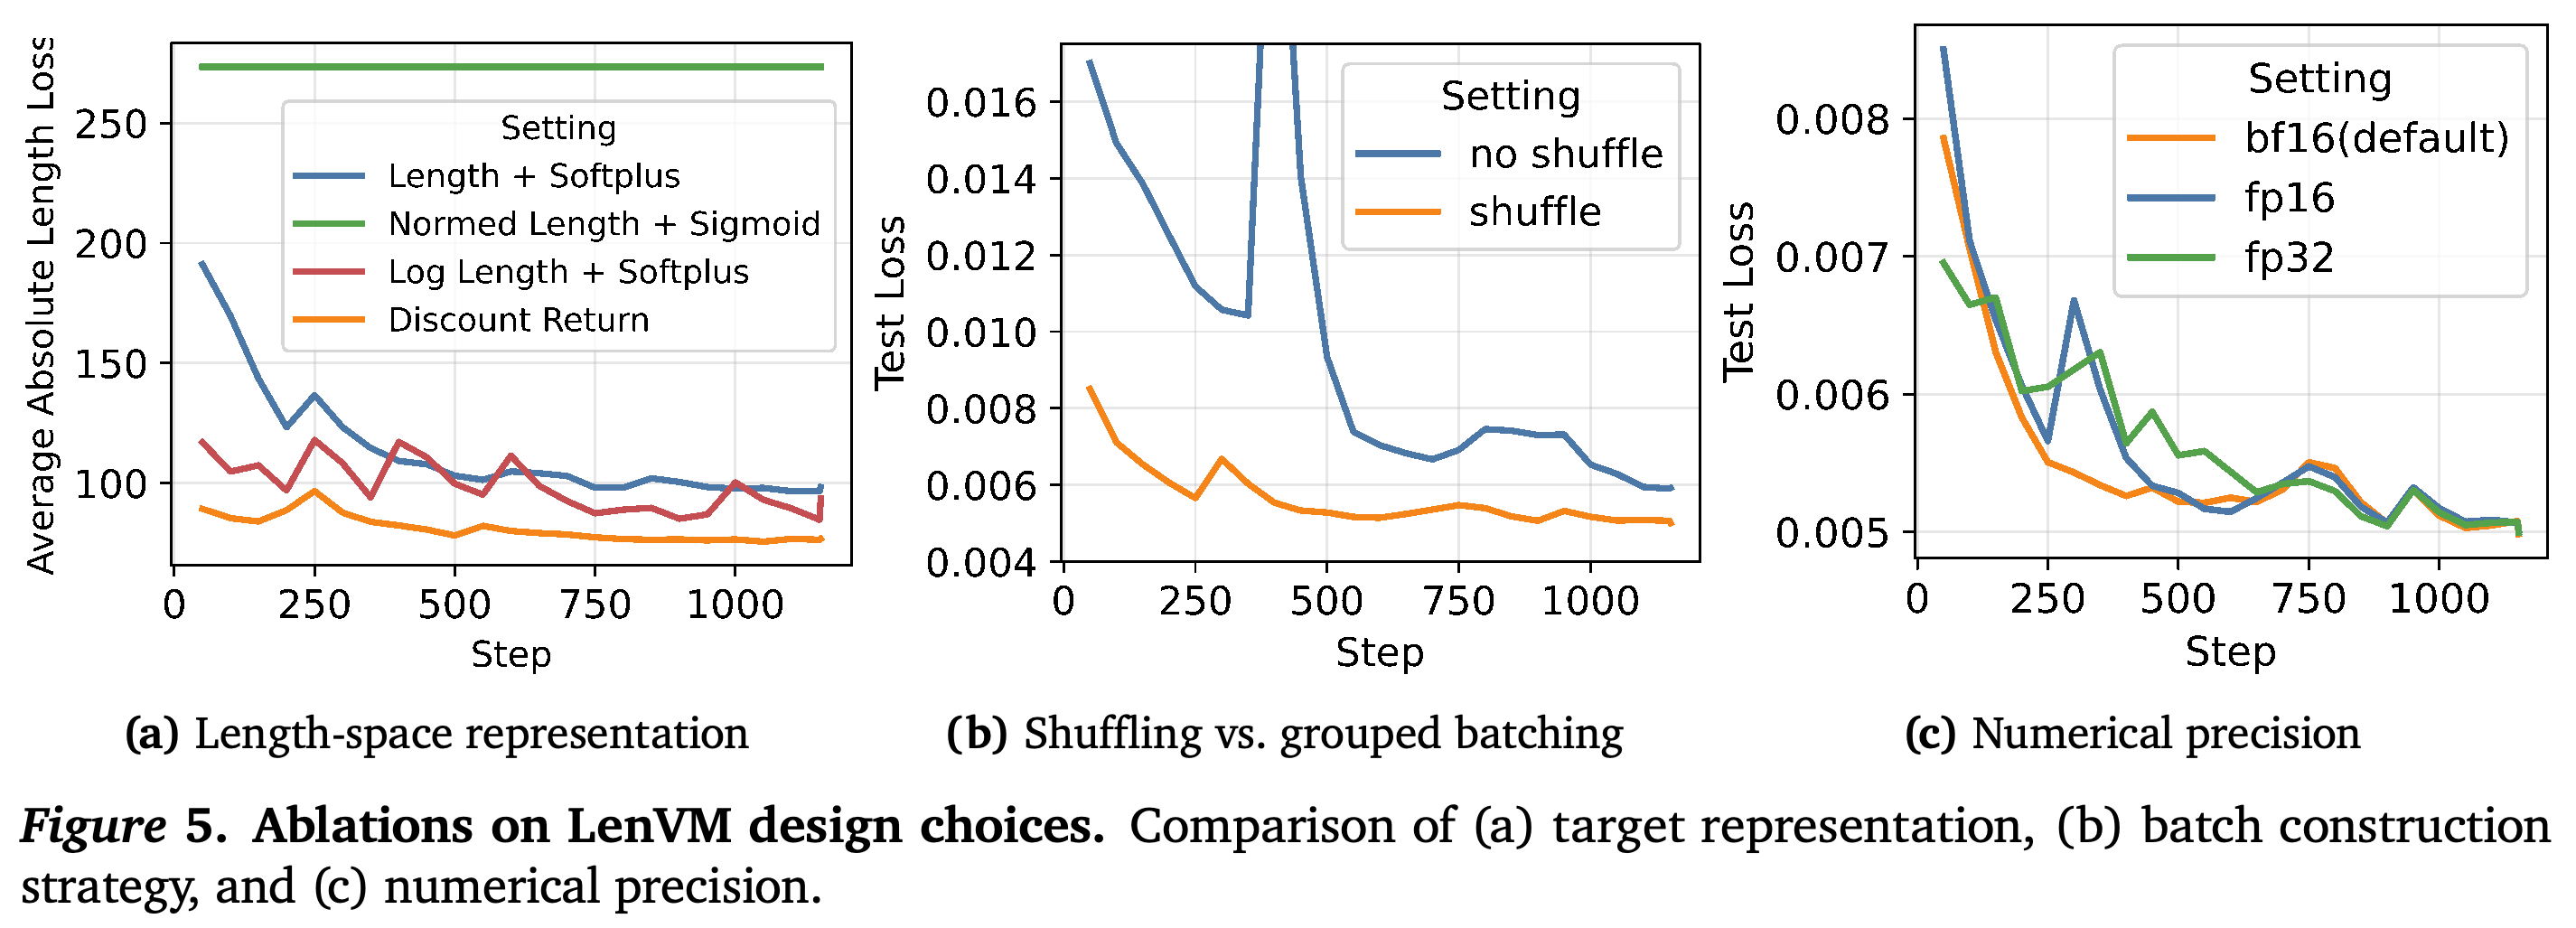
Figure 5(a)는 Length + Softplus, Normalized Length + Sigmoid, Log Length + Softplus, Discount Return + Sigmoid를 비교한다. 할인 리턴은 그래프에서 가장 낮은 평균 절대 길이 오차를 달성한다. 로그 길이 회귀는 최대값으로 정규화한 길이보다 크게 개선되지만, 할인 리턴에는 미치지 못한다.
- 논문은 정규화 길이의 낮은 성능을 흔한 짧은 길이가 좁은 구간으로 압축되기 때문이라고 설명하며, 할인 타깃은 단계별 Bellman 재귀식을 만족한다고 지적한다.
- 이 비교만으로는 이점의 원인이 Bellman 정합성인지 수치적 조건 개선인지 분리할 수 없다. 학습 후반에는 로그 길이와 실제 길이의 오차도 비슷하므로, 이 2개 대안의 우열을 일괄적으로 정하기는 어렵다.
6.2. Batch Construction Strategy
Figure 5(b)는 업데이트당 데이터 양을 고정하고, 데이터를 완전히 섞는 학습과 같은 프롬프트에서 얻은 여러 완성문을 한 배치에 묶는 학습을 비교한다. 시험한 설정에서는 데이터를 섞을 때 평가 손실이 더 낮다.
6.3. Discount Factor γ
Figure 6은 생성 진행률 0%, 25%, 50%, 75%에서 γ = 0.99, 0.995, 0.999를 비교한다. 초반에는 큰 γ가 더 좋고, 종료에 가까워지면 작은 γ가 더 좋다. 제안된 선택 규칙은 생성 길이의 99th-percentile을 사용해 1 − γ^L_0.99 = 0.99가 되도록 설정한다.
- Section 6.3은 γ가 클수록 긴 잔여 길이를 더 강하게 압축한다고 설명하지만, Section 3.1은 긴 잔여 길이에서 더 높은 해상도를 유지한다고 설명한다. 이 모순된 설명을 받아들이지 않고도 위치에 따른 실험 결과는 보고할 수 있다.
패널은 위치에 따른 상충 관계를 보여 준다. 프롬프트 경계 근처에서는 γ = 0.999가 가장 좋고, 생성 후반에는 γ = 0.99가 더 좋다. 중간 위치에서는 차이가 작으므로, 보편적인 순위보다는 조건에 따른 추세로 해석하는 편이 타당하다.
6.4. Numerical Precision
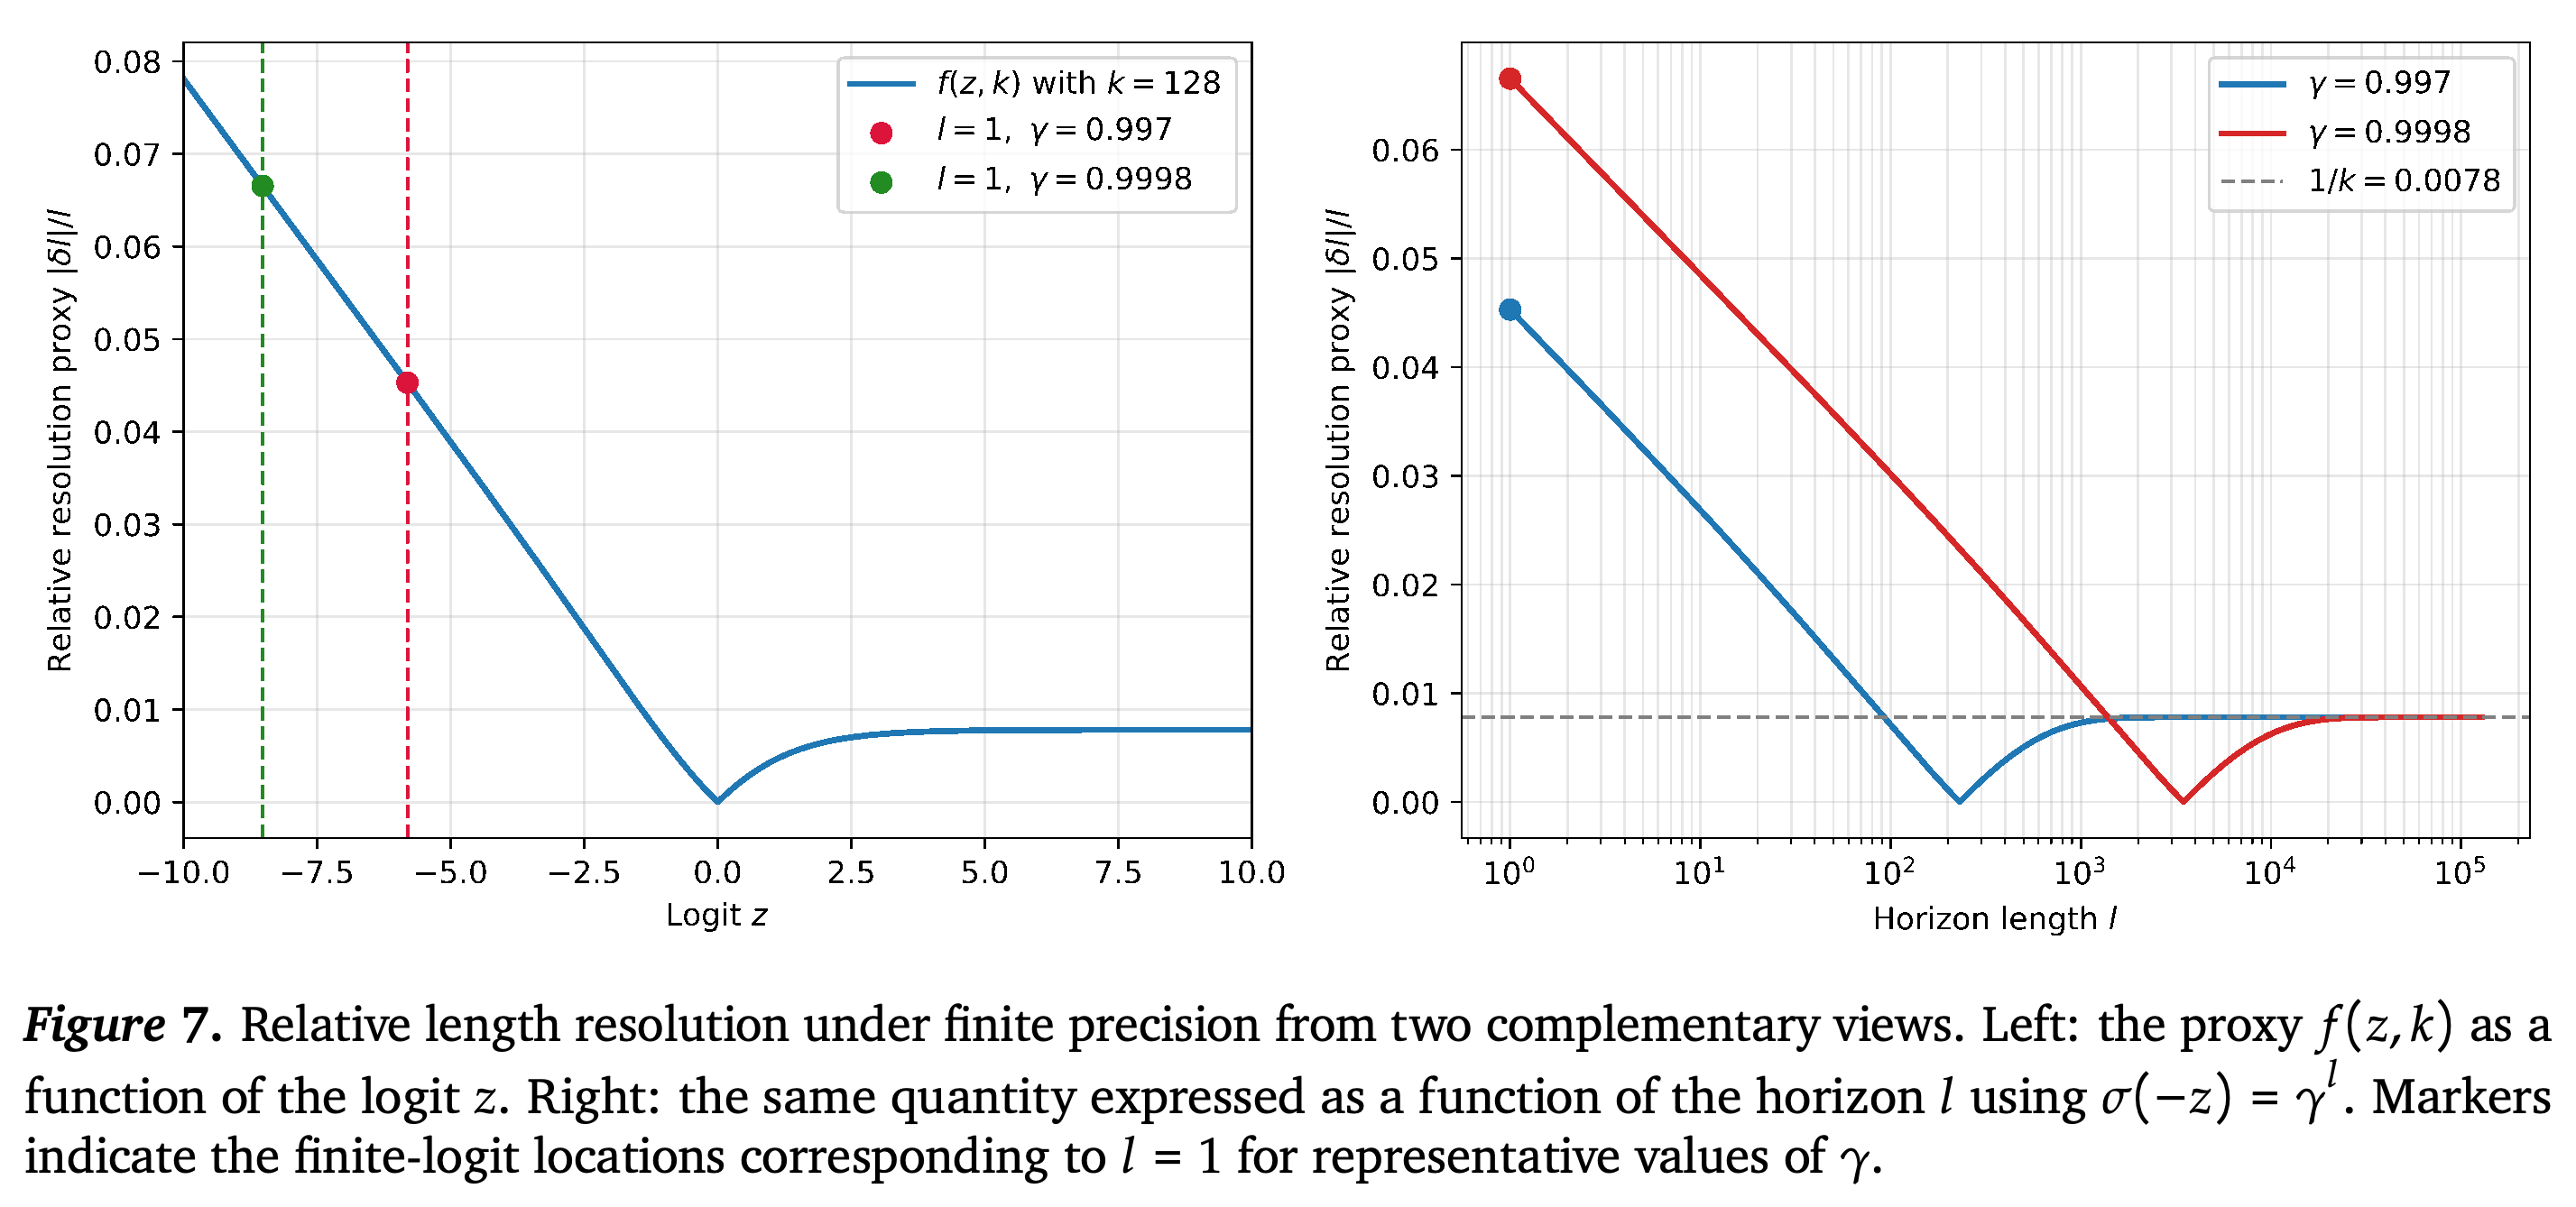
Figure 5(c)는 학습 초반의 차이에도 불구하고 fp16, bf16, fp32의 최종 손실이 비슷함을 보여 준다. Appendix E와 Figure 7은 긴 잔여 길이에서 1/k에 수렴하고 1토큰 잔여 길이 근처에서는 상대 영향이 더 큰 국소 logit 섭동 대리 지표를 분석한다.
- 분석에서는 bfloat16에 k = 128, fp16에 1024, fp32에 8388608을 사용한다. 이는 표현 해상도를 나타내는 1차 대리 지표이며, 모든 추론·학습 오차의 상한은 아니다.
타깃 표현 패널에서는 할인 리턴이, 배치 구성 패널에서는 데이터 섞기가 더 좋다. 정밀도 패널은 초반 차이에도 불구하고 최종 손실이 비슷한 수준으로 수렴한다. 첫 패널은 절대 길이 오차를 측정하고, 나머지 패널은 테스트 손실을 보고한다.
2개 좌표 표현은 국소 logit 섭동 대리 지표를 잔여 길이에 따른 상대 해상도로 변환해 보여 준다. 그림의 bfloat16 대리 지표에서 긴 잔여 길이의 민감도는 1/k = 0.0078에 수렴하고, 1토큰 잔여 길이에서는 상대 민감도가 더 크다. 이 곡선은 측정된 예측 오차가 아니라 해석적 근사다.
6.5. Candidate-Set Size
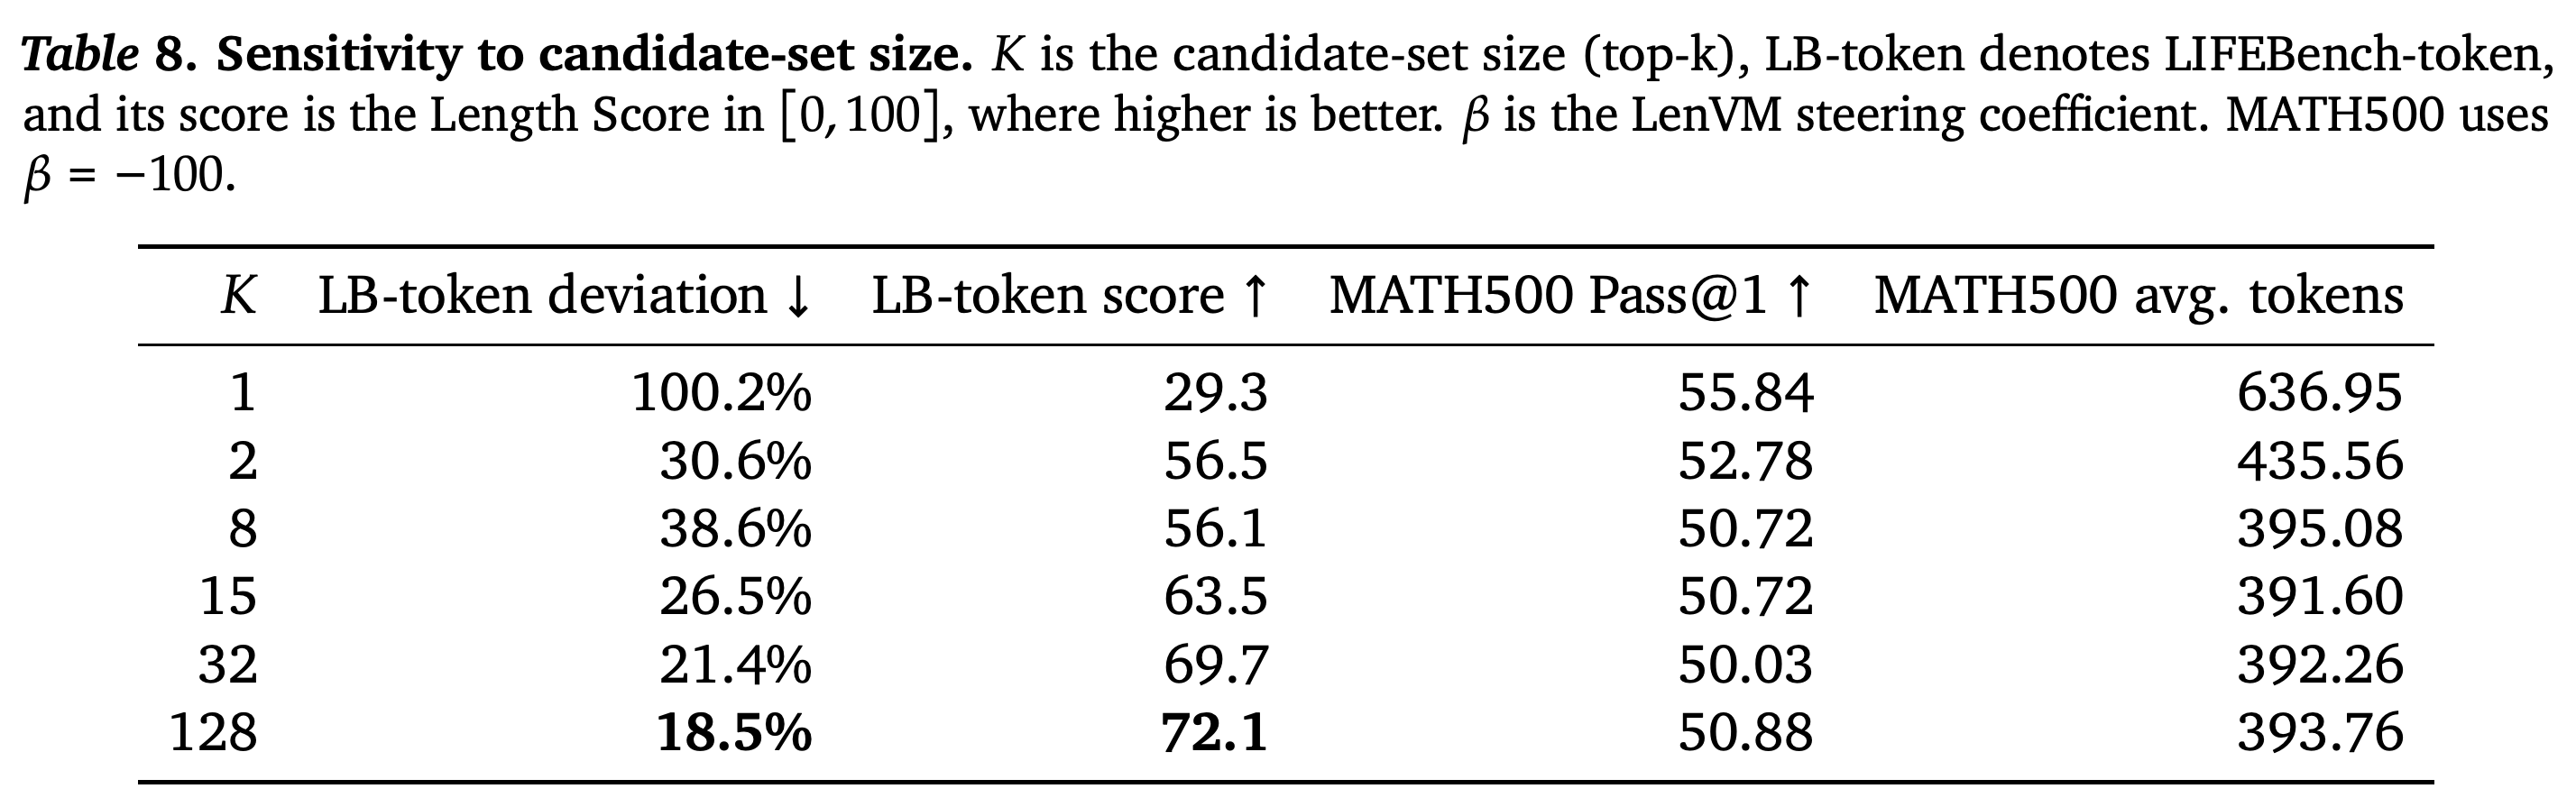
Table 8은 K를 1에서 128로 늘리면 LIFEBench-token LS가 29.3에서 72.1로 높아지고 LD가 100.2%에서 18.5%로 줄어든다고 보여 준다. 다만 중간 결과가 엄격히 단조롭지는 않다. β = −100인 MATH500에서는 K = 1에서 K = 2로 늘릴 때 길이가 가장 크게 줄고, 시험한 더 큰 집합에서는 정확도와 평균 길이의 변화가 작다.
- 목표 길이에 직접 맞추는 방식은 후보 풀이 커지면 선택지가 늘어나는 반면, 지수 틸팅은 생성기의 확률 가중치를 유지한다.
- 이 K 변화 실험은 별도의 어블레이션이므로 Table 2의 제어 결과를 대신해서는 안 된다.
목표 길이에 직접 맞추는 방식은 전반적으로 후보 풀이 커지면 좋아지지만, K = 2에서 K = 8로 늘릴 때는 제어 성능이 나빠진다. MATH500 조절에서는 K = 1에서 K = 2로 늘릴 때 길이 변화가 가장 크고, 이후 시험한 설정에서는 변화가 작다.
7. Conclusion
제어, 예측, 규모 확장 실험은 할인된 잔여 길이가 유용한 토큰 수준 회귀 타깃임을 뒷받침한다. 근거는 추론 시점의 유용성과 주석 없는 학습 신호에 관한 것이다. 실증적인 RL 개선, 관련 없는 생성기에서의 보정 성능, 추가 비용까지 고려한 서빙 효율 개선은 아직 입증되지 않았다.
부록
- A. LIFEBench-token Evaluation Details는 영어·중국어의 QA, 요약, 추론, 창작 생성을 설명한다. 기본 사례 360개와 원래 목표값 10개를 사용해 제약 사례 10,800개를 구성한다. LD는 예제별 부호가 있는 상대 길이 오차이며, Equal To에서는 절대 LD의 평균으로 집계한다. LS는 [0, 100] 범위다. 제약을 위반할 때는 부족한 생성에 k_1 = 5, 과도한 생성에 k_2 = 2를 사용하는 지수 페널티를 적용하고, 제약을 만족하면 100을 부여한다. 프롬프트는 과제 지시와 자연어 토큰 수 요구사항을 결합한다.
- B. Additional Experimental Details는 학습, 샘플링, 토크나이저, 베이스라인 조정을 명시한다. 여기에는 CAPEL의 countdown 마크업 제거, 구간별 Dynamic Feedback, LCG 제안 수락이 포함된다. LCG + LenVM은 외부 제어기를 유지하면서 각 제안 안에 K = 15인 Equal-To 유도를 적용한다. 예측 베이스라인은 실현된 길이 타깃을 공유한다. 정책 의존성과 지연 시간 측정 절차는 생성기에 기반한 후보가 off-policy 불일치를 줄이지만 제거하지는 못함을 명확히 한다.
- C. Additional Experimental Results는 묶음 처리한 전체 디코딩 지연 시간, 가장 가까운 평균 길이에서의 품질 비교, 2·4·8회 호출을 모두 포함한 제어 비교를 보고한다. 또한 AIME2025에서 기본 모델과 ART를 비교하고, 정확도가 낮아지는 대신 ART의 길이를 더 줄일 수 있음을 보여 준다. 후보 크기 민감도와 묶음 평가 시간도 제공한다. 생성 호출 예산, 출력 토큰 수, 측정된 지연 시간은 서로 다른 비용이므로 같은 것으로 취급해서는 안 된다.
- D. LenVM as a Length-Specific Value Function in RL은 할인 길이 목적, 별도의 과제·길이 critic, 각 GAE advantage의 가산 결합을 정의한다. 길이 advantage를 추가하면 최적화 목적이 바뀐다. 반면 LenVM을 고정 포텐셜로 사용하고 할인 계수를 맞추며 종료 포텐셜을 0으로 설정하면, 셰이핑 항이 망원합으로 소거되어 같은 초기 상태에서 리턴 순서를 보존한다. 이 부록은 종료 시점의 길이 페널티보다 촘촘한 credit assignment, 목적에 맞는 베이스라인, 품질과 효율의 분리가 유리하다고 주장한다. 그러나 실증적인 RL 개선은 보고하지 않으며, 이 활용은 후속 연구로 남긴다.
- E. Finite-Precision Analysis of Relative Length Resolution은 역변환한 잔여 길이를 l̂ = ln(σ(−z)) / ln γ로 다시 쓰고, 국소 logit 섭동을 |δz| ≈ |z|/k로 모델링한다. 이 섭동 모델에서 상대 길이 민감도는 긴 잔여 길이에서 1/k에 수렴한다. 분석은 1~32k 범위 잔여 길이의 표현 해상도를 다루며, 전체 수치 오차의 상한을 제시하기보다는 정밀도 어블레이션을 보완한다.
- F. Future-Dependent Weighting Changes the Regression Target은 조건부 가중치 기댓값이 양수일 때 가중 최적해 V*_w(s) = E[wG | s] / E[w | s]를 유도한다. 상수 가중치나 현재 상태에만 의존하는 양의 가중치는 상태별 조건부 평균을 보존하지만, 미래에 의존하는 가중치는 일반적으로 이를 바꾼다. 궤적별 평균은 w = 1/L의 사례로, 긴 완성문의 가중치를 낮추므로 토큰에 동일한 가중치를 주는 회귀를 사용할 근거가 된다.
- G. Why Inverting the Transformed Horizon Underestimates Expected Remaining Length는 기댓값이 존재한다는 가정 아래, u(L) = 1 − γ^L의 엄격한 오목성과 Jensen 부등식을 사용해 u^−1(E[u(L)]) ≤ E[L]을 보인다. 등호가 성립하려면 잔여 길이가 결정적이어야 한다. 따라서 가치 공간에서 조건부 평균을 정확히 예측하더라도, 역변환한 평균 토큰 수 예측이 일반적으로 비편향인 것은 아니다.
- H. Derivation of the Exponential Tilting Solution in the Performance–Efficiency Trade-off Experiment는 β < 0인 KL 정규화 목적에서 제시된 Gibbs 분포를 유도한다. 대수적 유도는 그 목적과 일치하지만, 낮은 가치를 짧은 잔여 길이로 해석하는 것은 Section 3의 음의 비용 규약과 충돌한다. β > 0이면 목적 함수에 하한이 없다는 추가 주장도 기본 확률이 양수인 유한 후보 집합의 확률 단체에서는 틀리다. 이 경우 볼록 최소화 논증은 더 이상 적용되지 않지만, 목적 함수는 여전히 유계다.
짧은 생각
핵심 기여는 재사용할 수 있는 학습 신호 구성법이다. 완성문 길이만으로 주석 없이 촘촘한 정책 조건부 가치 타깃을 얻고, 1개의 추정기로 여러 추론 시점 응용을 지원한다. 가장 가까운 평균 길이에서의 MATH500 비교와 예측 성능 개선은 강제 절단과의 비교만 할 때보다 유용성에 대한 더 강한 근거를 제공한다. 조절 부호의 불일치는 재현성에서 가장 큰 우려다. 식을 실행 가능한 디코딩 명세로 사용하려면 TD 잔차 레이블과 할인 계수 설명도 명확히 해야 한다. Length Score는 제약 준수 정도를 평가하며, 정확히 일치한 성공률은 아니다. Qwen2.5-7B 비교에서 1회 패스 LenVM의 평균 절대 상대 편차는 여전히 44%다. 1.90× 지연 시간 결과는 전반적인 속도 향상을 주장할 수 없음을 보여 준다. 정책 변화에 따른 보정 성능, 명확한 벤치마크 목표 범위, 실증적인 RL 평가가 추가되면 방법의 적용 범위가 더 분명해진다.