


$\delta$-mem: Efficient Online Memory for Large Language Models 요약 설명
12 May 2026 | Paper Review Agent's Memory Fast Weights Parameter-Efficient Fine-Tuning목차
- 요약
- 1 Introduction
- 2 Preliminaries
- 3 δ-mem
- 4 Experiments
- 5 Ablative Study
- 6 Related Work
- 7 Conclusion
- 부록
- 짧은 생각
이번 글에서는 $\delta$-mem: Efficient Online Memory for Large Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 5월 12일(Arxiv), 40th Conference on Neural Information Processing Systems (NeurIPS 2026)
- Lei, Jingdi, Zhang, Di, Li, Junxian, Wang, Weida, Fan, Kaixuan, Liu, Xiang, Liu, Qihan, Ma, Xiaoteng, Chen, Baian, Poria, Soujanya.
- Nanyang Technological University, Fudan University, Shanghai Jiao Tong University, The Chinese University of Hong Kong, The Hong Kong University of Science and Technology (Guangzhou), Mind Lab
- 논문 링크
- Github
요약
- δ-mem은 동결된 full-attention Transformer에 온라인 연관 메모리 상태(OSAM)를 추가한다. 저장한 이력을 텍스트로 다시 입력하는 대신, 작은 순환 행렬을 읽고 그 결과를 query 측과 output 측 attention 보정값으로 변환한다. 행렬은 게이트가 적용된 delta rule로 갱신한다.
- rank r = 8일 때 단일 상태 변형은 각 삽입 계층에서 8 × 8 메모리 행렬을 사용하며, 학습 가능한 파라미터는 4.87M이다. Qwen3-4B-Instruct에서 Token-State Write (TSW)는 5개 벤치마크 평균을 46.79에서 51.66으로 높인다. Multi-State Write (MSW)는 MemoryAgentBench와 LoCoMo에서 각각 38.85와 49.12로 가장 높은 평균을 기록한다.
- 실험은 압축된 이력이 유용한 정보를 보존하며, 3개 backbone 모두에서 종합 점수가 개선됨을 보여준다. 다만 문맥을 정확히 복원하거나 모든 과제에서 성능을 높이지는 못한다. TSW의 디코딩은 수정하지 않은 backbone보다 느리며, 문맥을 제거한 실험의 LoCoMo 수치는 본문과 Figure 2가 서로 다르다.
1 Introduction
장기적으로 사용하는 assistant와 agent는 상호작용을 거치며 정보를 축적하고 수정하며 재사용해야 한다. 서론에서는 context window를 늘리는 것만으로는 충분하지 않다고 주장한다. full attention의 비용이 증가하고, 토큰을 추가해도 문맥을 효과적으로 활용한다는 보장이 없기 때문이다.
- 논문은 메모리 메커니즘을 이력의 저장 방식을 결정하는 memory state와, 이력이 backbone에 영향을 주는 방식을 결정하는 memory steering으로 나눈다.
- 텍스트 메모리는 검색 품질과 문맥 예산의 제약을 받는다. 별도 채널을 통한 메모리는 검색과 통합 장치를 추가로 요구하며, 파라미터 메모리는 대체로 추론 중에 계속 변화하는 상태를 갖지 않는다.
- δ-mem은 작은 상태를 지속적으로 유지하며, 이 상태를 읽은 결과가 attention에 직접 영향을 준다. 사전 학습된 backbone 파라미터는 동결된 상태로 유지한다. 공개 코드 URL은 https://github.com/declare-lab/delta-Mem이다.
2 Preliminaries
기초 정식화에서는 메모리 행렬을 온라인 key–value 회귀 모델로 다룬다. key에 대한 예측값은 이전 상태에 해당 key를 곱한 결과다. 제곱 예측 오차에 SGD를 적용하면 delta 갱신식 S_t = S_{t−1} + β_t(v_t − S_{t−1}k_t)k_tᵀ을 얻는다. 여기에 retention gate를 추가해 망각을 제어한다.
- 잔차항은 새 key–value 외적을 모두 단순히 누적하는 대신, 기존 상태가 잘못 예측하는 연관 관계를 보정한다.
- 게이트를 적용한 기초 갱신식은 S_t = λ_tS_{t−1} + β_t(v_t − S_{t−1}k_t)k_tᵀ이다. 이후 제안 방법에서는 차원별 게이트를 구현한다.
3 δ-mem
δ-mem은 각 위치에서 read–steer–write 순서로 동작한다. 이전 메모리 상태를 조회하고, 얻은 신호로 attention을 보정한 뒤, 현재 정보를 반영한다. Figure 1은 동결된 Transformer 옆에 메모리 분기를 표시하고, 토큰 단위 쓰기와 구간 단위 쓰기, 다중 상태 쓰기를 구분한다.
- 현재 위치의 정보를 쓰기 전에 이전 상태를 읽으므로, steering 신호는 앞서 축적한 정보에 의존한다.
- backbone은 표준 full attention을 유지한다. δ-mem은 토큰 혼합 구조를 대체하지 않고 보완한다.
그림은 동결된 attention 경로와 학습 가능한 메모리 인터페이스를 분리해 보여준다. 이전 상태의 읽기 결과는 query 구성과 attention output에 영향을 주며, 이후 현재 key, value, gate가 상태를 갱신한다. 오른쪽 패널은 갱신 빈도와 다중 상태 구성을 구분한다.
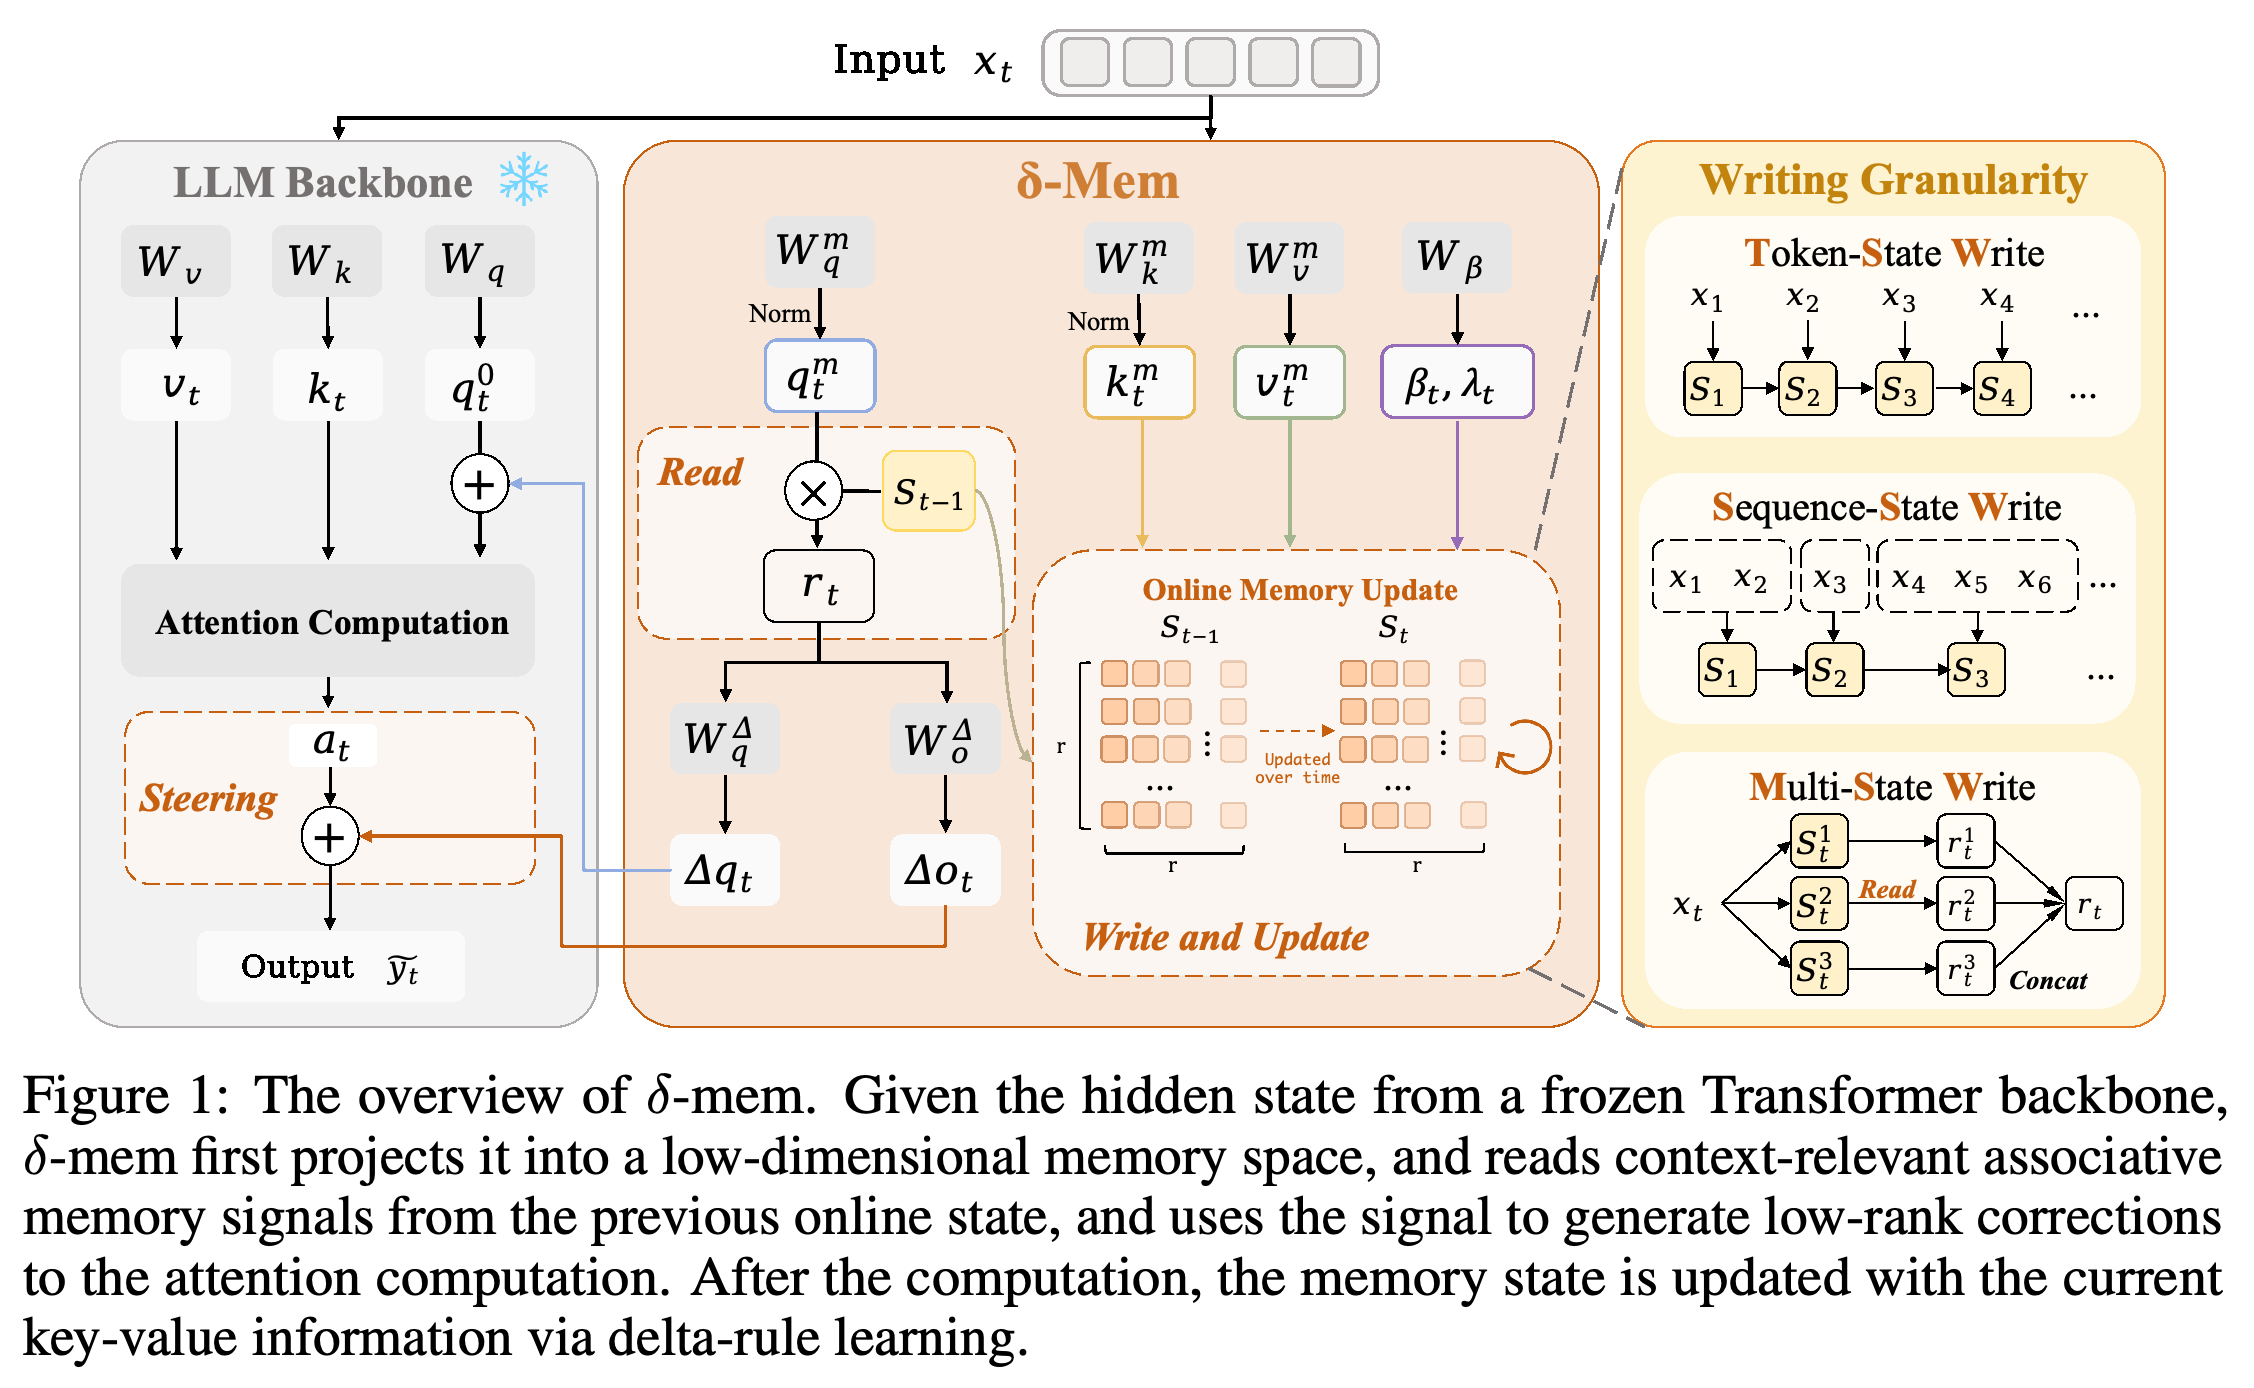
3.1 Memory Projections
학습된 projection은 현재 hidden state를 차원이 r인 메모리 query, key, value로 변환한다. query와 key에는 tanh 다음에 L2 정규화를 적용하고, value에는 선형 projection을 사용한다. 정규화는 순환 갱신 중 값의 스케일이 변하는 것을 억제하기 위한 것이다.
- 쓰기 게이트는 (\beta_t=\sigma(W_\beta x_t+b))이며, retention gate는 (\lambda_t=1-\beta_t)로 쓰기 게이트와 연결된다.
- 2개 게이트는 모두 r차원 벡터다. 따라서 메모리의 각 행은 서로 다른 비율로 이전 정보를 유지하거나 새 잔차를 쓸 수 있다.
3.2 Reading from Online State of Associative Memory
읽기 연산은 (r_t=S_{t-1}q_t^m)이며, 이전 상태에서 연속적인 연관 메모리 신호를 얻는다. 상태의 차원이 고정되어 있으므로 비용은 축적된 이력의 길이에 좌우되지 않는다.
- 명시적인 key를 대상으로 하는 표준 attention과 달리, 이 연산은 과거의 모든 토큰 표현을 검색하지 않는다.
- 읽기 결과는 검색한 텍스트나 추가 문맥 토큰이 아니라, 이력에 따라 달라지는 steering 신호를 제공한다.
3.3 Steering Attention through Low-Rank Corrections
2개의 선형 매핑이 메모리 읽기 결과를 보정값 Δq_t와 Δo_t로 변환한다. query 보정값은 attention 전에, output 보정값은 attention 후에 더하며, 둘 다 α/r로 스케일링한다. 기본 설정에서는 backbone의 key와 value를 변경하지 않는다.
- 보정된 query는 q̃_t = W_Qx_t + (α/r)Δq_t이며, 보정된 output은 ỹ_t = Attn(q̃_t, K_≤t, V_≤t) + (α/r)Δo_t이다.
- 보정 projection은 학습 후 고정되지만, 입력은 변화하는 메모리 상태에 의존한다. 이 점에서 정적인 low-rank adapter와 구별된다.
3.4 Writing into Online State of Associative Memory
쓰기에는 차원별 게이트를 적용한 delta rule S_t = Diag(λ_t)S_{t−1} + Diag(β_t)(v_t^m − S_{t−1}k_t^m)(k_t^m)ᵀ을 사용한다. 이 식은 이전 상태의 유지와 현재 key 방향의 잔차 보정을 결합한다.
- 갱신식을 전개하면 3가지 연산으로 나뉜다. 이전 상태를 유지하고, 현재 key 방향의 예측 성분을 빼고, 같은 방향으로 새 value를 쓴다.
- 각 행에는 독립적인 게이트가 있다. 이를 통해 안정적인 연관 관계와 새로 들어오는 정보 사이의 균형을 조절한다.
3.5 Writing Granularity of Online State
논문은 갱신 단위나 메모리 구성을 바꾸는 3가지 쓰기 전략을 평가한다. TSW는 매 토큰 뒤에 갱신한다. Sequence-State Write (SSW)는 메시지의 평균 hidden representation을 사용해 메시지당 1회 갱신한다. MSW는 병렬 하위 상태를 유지하고 각 읽기 결과를 연결한다.
- TSW는 세밀한 변화를 보존하지만, 반복되는 표현이나 서식 토큰, 단기적인 잡음에도 상태가 노출될 수 있다.
- SSW는 중복된 쓰기를 줄이고 갱신을 완만하게 만들지만, 평균을 내는 과정에서 토큰 단위의 세부 정보가 사라질 수 있다.
- MSW는 서로 다른 종류의 정보 사이에서 간섭을 줄이기 위한 방식이다. 구현에서는 각각 8 × 8 행렬을 갖는 4개의 하위 상태를 사용한다.
3.6 Training Objective
학습은 응답 토큰에 대한 자기회귀 교차 엔트로피를 사용하는 supervised fine-tuning으로 진행한다. 과거 문맥을 먼저 상태 S_C에 기록하지만, 예측할 때 backbone의 명시적인 입력으로 다시 제공하지는 않는다. 동결된 backbone은 질의와 응답 시퀀스를 입력받고, δ-mem은 메모리 상태에 따라 달라지는 steering을 제공한다.
- 목적 함수는 L_SFT = −Σ_j log p_{ϕ,θ}(y_j | Q, y_<j, S_C)이다. ϕ는 동결된 backbone 파라미터를, θ는 학습 가능한 δ-mem 파라미터를 나타낸다.
- 이 학습 설정에서는 메모리 경로가 과거 정보를 응답 생성에 전달해야 한다.
4 Experiments
실험은 메모리 활용이 중요한 과제와 일반적인 능력을 평가한다. 동일한 Qwen3-4B-Instruct backbone에서 메모리 메커니즘을 비교하고, Qwen3-8B와 SmolLM3-3B에서도 설계를 평가한다.
4.1 Experimental Setup
평가에는 HotpotQA, GPQA-Diamond, IFEval, LoCoMo, MemoryAgentBench를 사용하며, LoCoMo의 adversarial 질문 범주는 제외한다. baseline에는 BM25 RAG, LLMLingua-2, MemoryBank, Context2LoRA, MemGen, MLP Memory가 포함된다.
- 보고된 학습 설정에서는 QASPER에서 시퀀스가 가장 짧은 2,219개 샘플로 구성된 split을 사용해 1 epoch 동안 학습한다. 이 split의 최대 시퀀스 길이는 8,269 tokens다. backbone 학습 입력은 512 tokens로 제한하며, 메모리 쓰기 예산은 8,192 tokens다.
- 기본 설정은 r = 8, α = 16, query/output 보정이며, MSW는 4개의 상태를 사용한다. 학습에는 8 × A800 GPUs, bfloat16, DeepSpeed ZeRO-2, fused AdamW를 사용한다.
- 평가 지표는 IFEval의 prompt-level strict accuracy, HotpotQA의 EM/F1, GPQA의 accuracy, LoCoMo의 F1이다. MemoryAgentBench는 데이터셋별 지표를 샘플 수로 가중해 종합한다.
4.2 Main Results across Memory Mechanisms
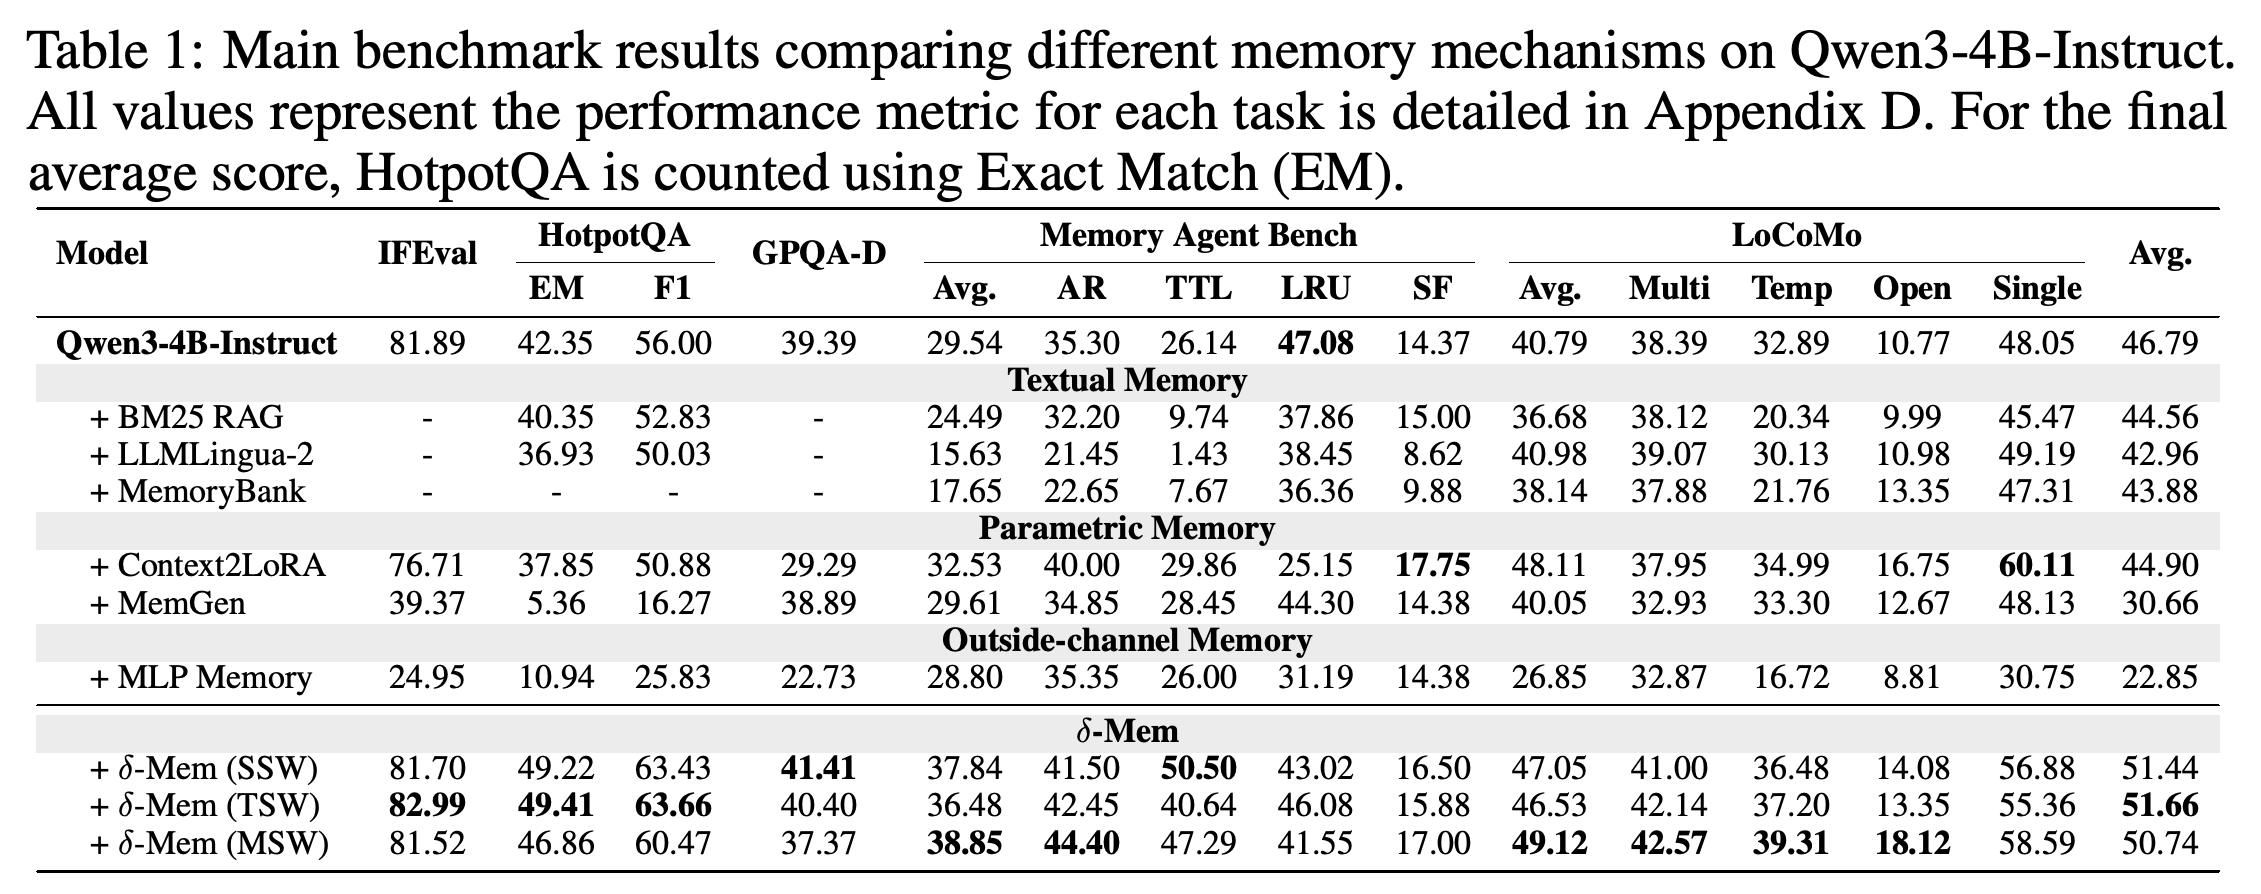
Table 1에서 TSW의 전체 평균은 51.66으로 가장 높다. 동결된 backbone의 46.79보다 4.87 points, Context2LoRA의 44.90보다 6.76 points 높다. SSW는 51.44, MSW는 50.74를 기록한다. 최종 평균에는 HotpotQA의 F1이 아니라 EM을 반영한다.
- MSW는 MemoryAgentBench를 29.54에서 38.85로, LoCoMo를 40.79에서 49.12로 높인다. SSW는 Test-time Learning (TTL)에서 가장 높은 점수를 기록하며, 26.14에서 50.50으로 높인다.
- TSW는 HotpotQA EM/F1을 42.35/56.00에서 49.41/63.66으로, IFEval을 81.89에서 82.99로 높인다.
- 개선은 일관되지 않다. 3개 변형 모두 MemoryAgentBench의 Long Range Understanding (LRU)에서 backbone의 47.08보다 낮은 점수를 기록하며, MSW는 GPQA-Diamond를 39.39에서 37.37로 낮춘다. baseline의 검색 잡음이나 과적합을 원인으로 제시한 저자들의 설명은 별도로 검증하지 않았다.
TSW는 전체 평균에서 51.66으로 가장 높지만, 메모리 활용이 중요한 2개 벤치마크의 평균은 MSW가, TTL 하위 과제는 SSW가 가장 높다. 효과는 일관되지 않다. 모든 δ-mem 변형은 backbone보다 LRU 점수가 낮고, MSW는 GPQA-Diamond accuracy도 낮다. 일부 baseline 결과는 보고되지 않았으며, 원문 캡션은 최종 평균에서 누락된 항목을 어떻게 처리했는지 설명하지 않는다.
4.3 Main Results Across Different Backbone Models
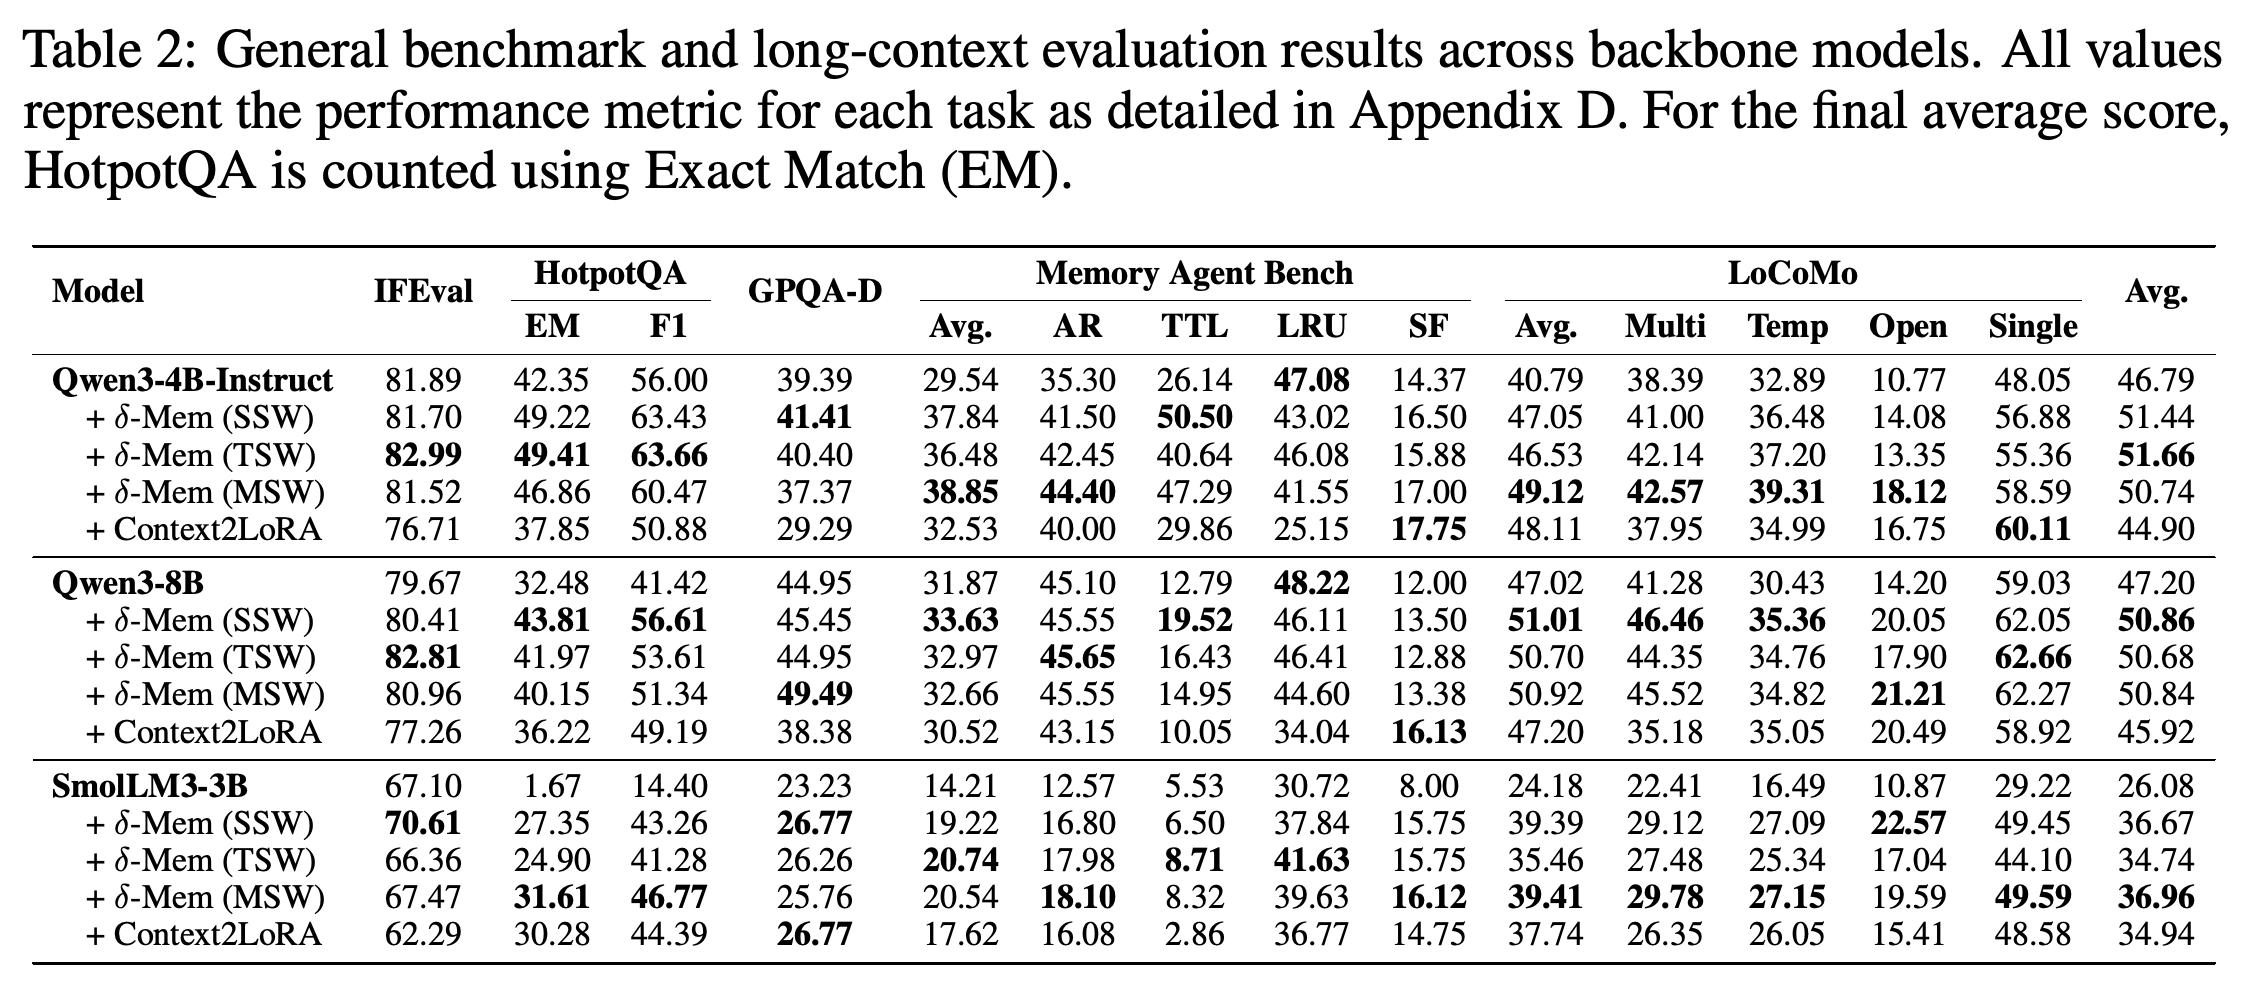
Table 2에서는 3개 backbone 모두 δ-mem의 종합 점수가 더 높다. 가장 좋은 변형을 기준으로 Qwen3-4B-Instruct는 46.79에서 51.66으로, Qwen3-8B는 47.20에서 50.86으로, SmolLM3-3B는 26.08에서 36.96으로 높아진다.
- Qwen3-4B-Instruct에서는 TSW가, Qwen3-8B에서는 SSW가, SmolLM3-3B에서는 MSW가 가장 좋다. 평가한 backbone 전체에서 우세한 쓰기 전략은 없다.
- SmolLM3-3B에서는 HotpotQA 성능이 특히 크게 개선된다. MSW는 EM을 1.67에서 31.61로, F1을 14.40에서 46.77로 높인다.
- 저자들은 더 강한 backbone에는 완만한 구간 단위 갱신이, 더 작은 backbone에는 상태 간 간섭 감소가 유리하다고 설명한다. 다만 이 비교는 모델 용량을 원인으로 분리해 검증하지 않는다.
3개 backbone 모두 종합 점수가 개선되지만, 가장 좋은 쓰기 전략은 달라진다. Qwen3-4B-Instruct에서는 TSW, Qwen3-8B에서는 SSW, SmolLM3-3B에서는 MSW가 가장 좋다. SmolLM3-3B의 종합 점수 증가가 가장 크며, 26.08에서 36.96으로 높아진다. 이 비교만으로 모델 크기와 메모리 효과 사이에 일관된 스케일링 관계가 있다고 볼 수는 없다.
5 Ablative Study
ablation에서는 명시적인 이력 없이 정보를 보존하는 능력, 보정값을 받는 attention 분기, 모듈 삽입 깊이를 살펴본다. 이 실험은 Qwen3-4B-Instruct를 사용하며 HotpotQA와 LoCoMo에 초점을 맞춘다.
5.1 Context Recovery
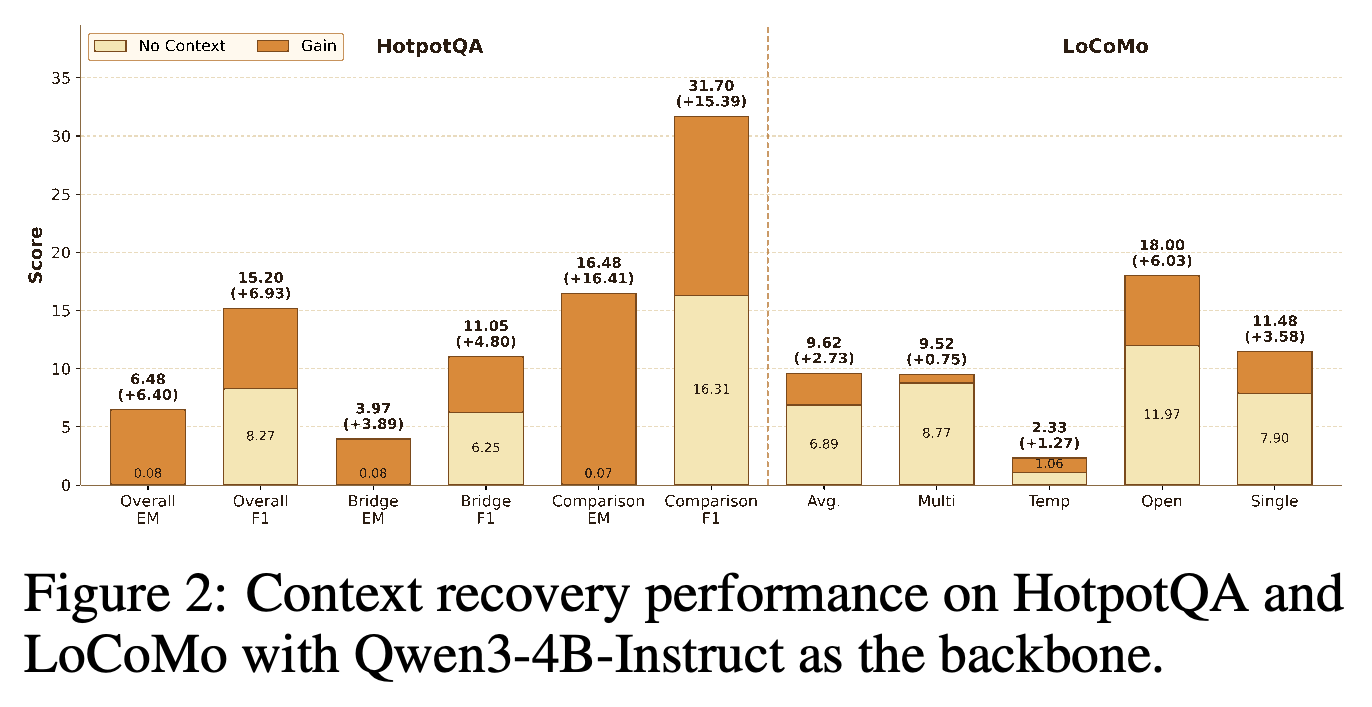
과거 문맥을 제거한 Figure 2에서 HotpotQA 전체 EM은 0.08에서 6.48로, F1은 8.27에서 15.20으로 높아진다. 이 결과는 유용한 근거를 일부 보존함을 뒷받침하지만, 전체 문맥을 사용하는 추론과 동등함을 입증하지는 않는다.
- Bridge EM/F1은 0.08/6.25에서 3.97/11.05로, Comparison EM/F1은 0.07/16.31에서 16.48/31.70으로 높아진다.
- LoCoMo의 평균은 그림에서 6.89에서 9.62로 증가하지만, 함께 제시된 본문은 3.49에서 8.05로 증가한다고 보고한다. PDF는 이 차이를 해명하지 않는다.
- 그림에서는 Multi, Temp, Open, Single 범주 모두 개선된다. 표시된 LoCoMo 범주 중 증가 폭이 가장 큰 것은 Open으로, 11.97에서 18.00으로 높아진다.
누적 막대는 명시적인 과거 문맥을 제거한 뒤에도 유용한 정보를 일부 복원함을 보여준다. HotpotQA 전체 EM은 0.08에서 6.48로, 그림의 LoCoMo 평균은 6.89에서 9.62로 높아진다. 후자는 본문의 3.49와 8.05에 어긋나므로, LoCoMo 복원 성능의 추정치는 확정하기 어렵다.
5.2 Heads Ablation
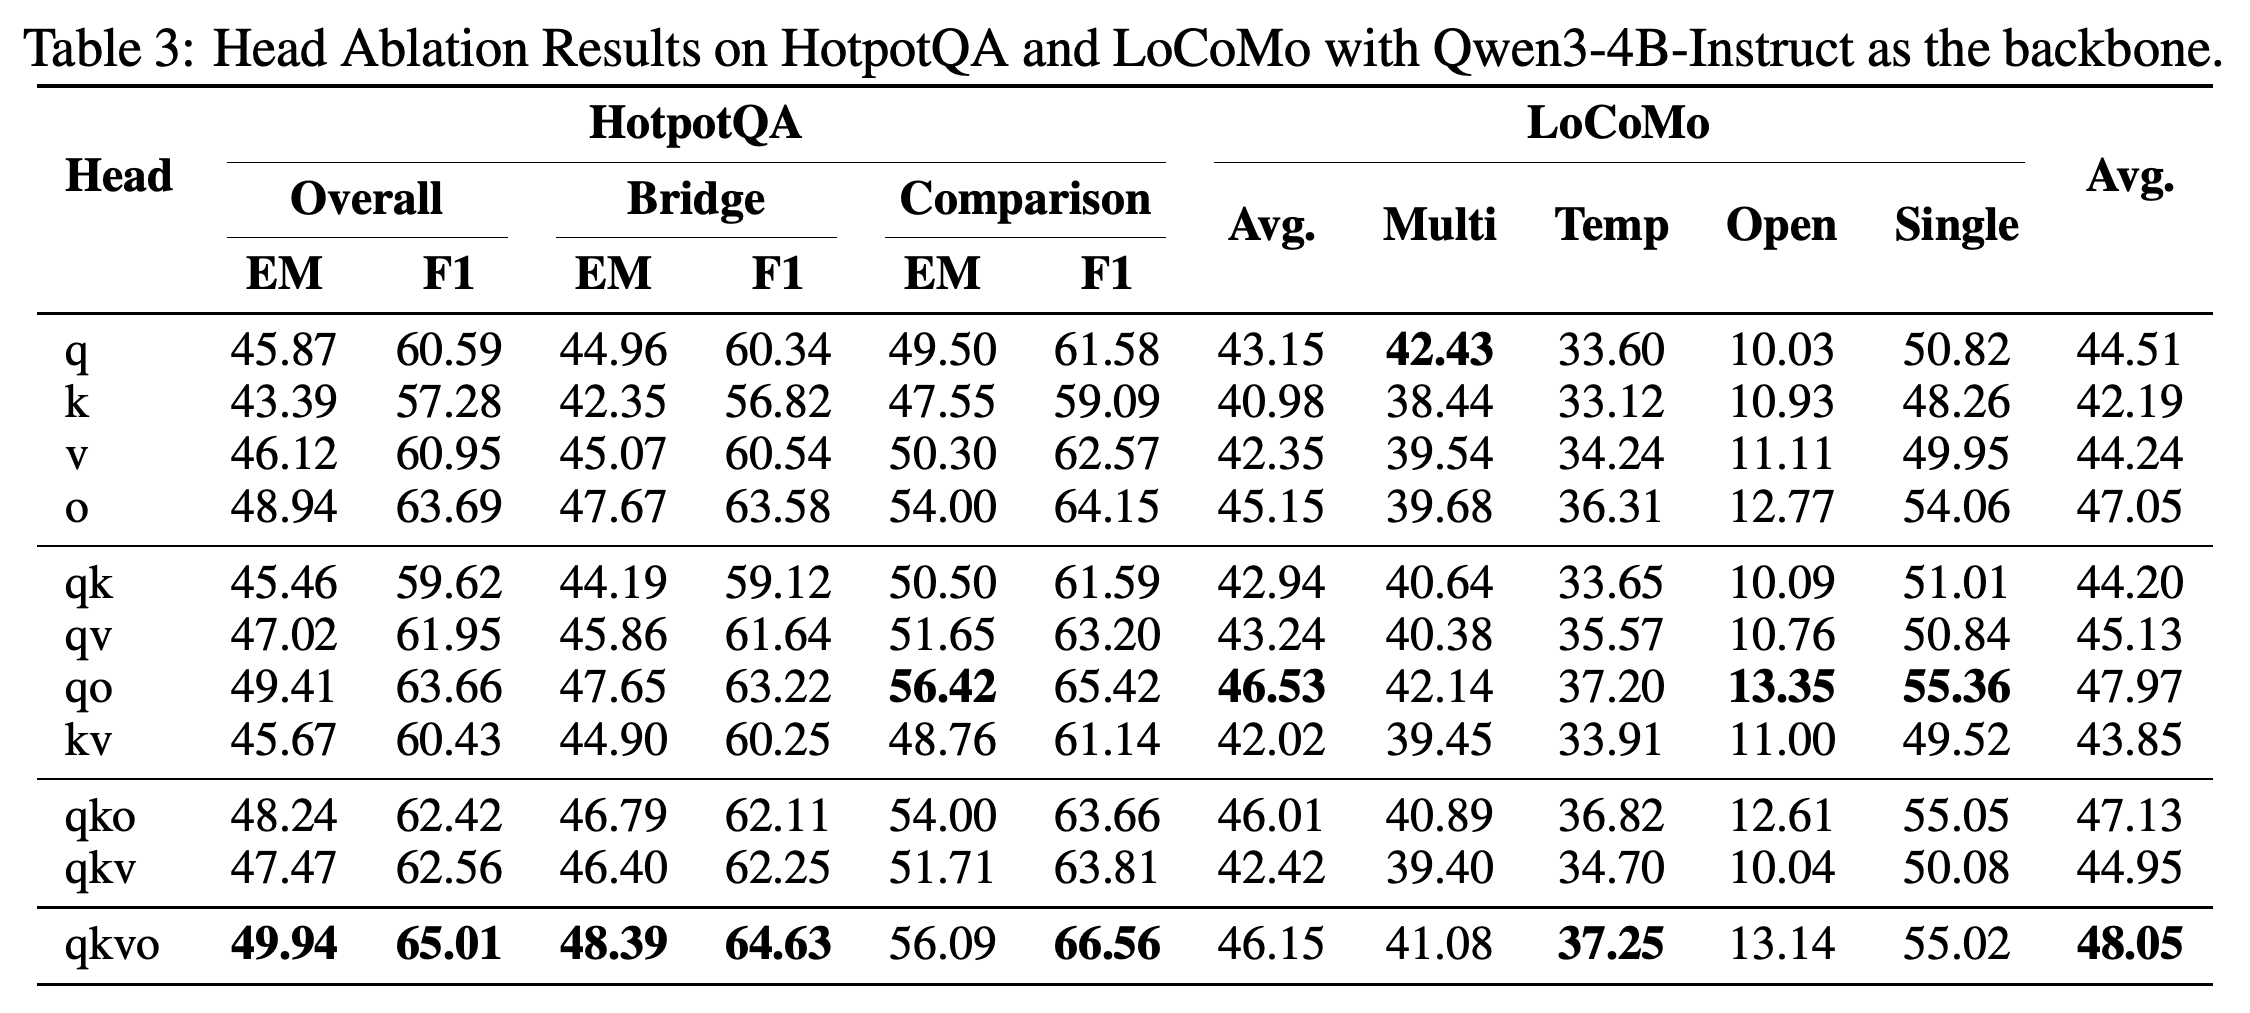
Table 3은 query, key, value, output 분기와 그 조합에 대한 보정을 비교한다. 기본 qo 설정의 평균은 47.97로, 전체 qkvo 설정의 48.05에 가깝다. 저자들은 종합 점수의 0.08-point 개선을 위해 보정 분기를 추가하는 대신 qo를 선택한다.
- 단일 분기 변형 중에서는 output 보정이 47.05로 가장 좋다. q는 44.51, k는 42.19, v는 44.24다.
- qkvo는 HotpotQA 전체 EM/F1에서 가장 높은 49.94/65.01을 기록한다. qo는 LoCoMo 평균에서 가장 높은 46.53을 기록하며, qkvo는 46.15다.
- 이 실험은 attention 내부에서 보정을 적용하는 위치를 비교한 ablation이며, 일반적인 attention head의 개수를 비교한 실험이 아니다.
단일 분기 중에서는 output만 보정하는 방식이 가장 좋다. query와 output을 함께 보정하면 종합 점수가 47.97로 전체 qkvo 설정의 48.05에 거의 도달하며, LoCoMo 평균은 더 높다. 이는 qo가 오버헤드를 줄이는 선택임을 뒷받침하지만, 모든 지표에서 가장 높은 점수를 얻는 설정이라는 뜻은 아니다.
5.3 Insertion Depth Ablation
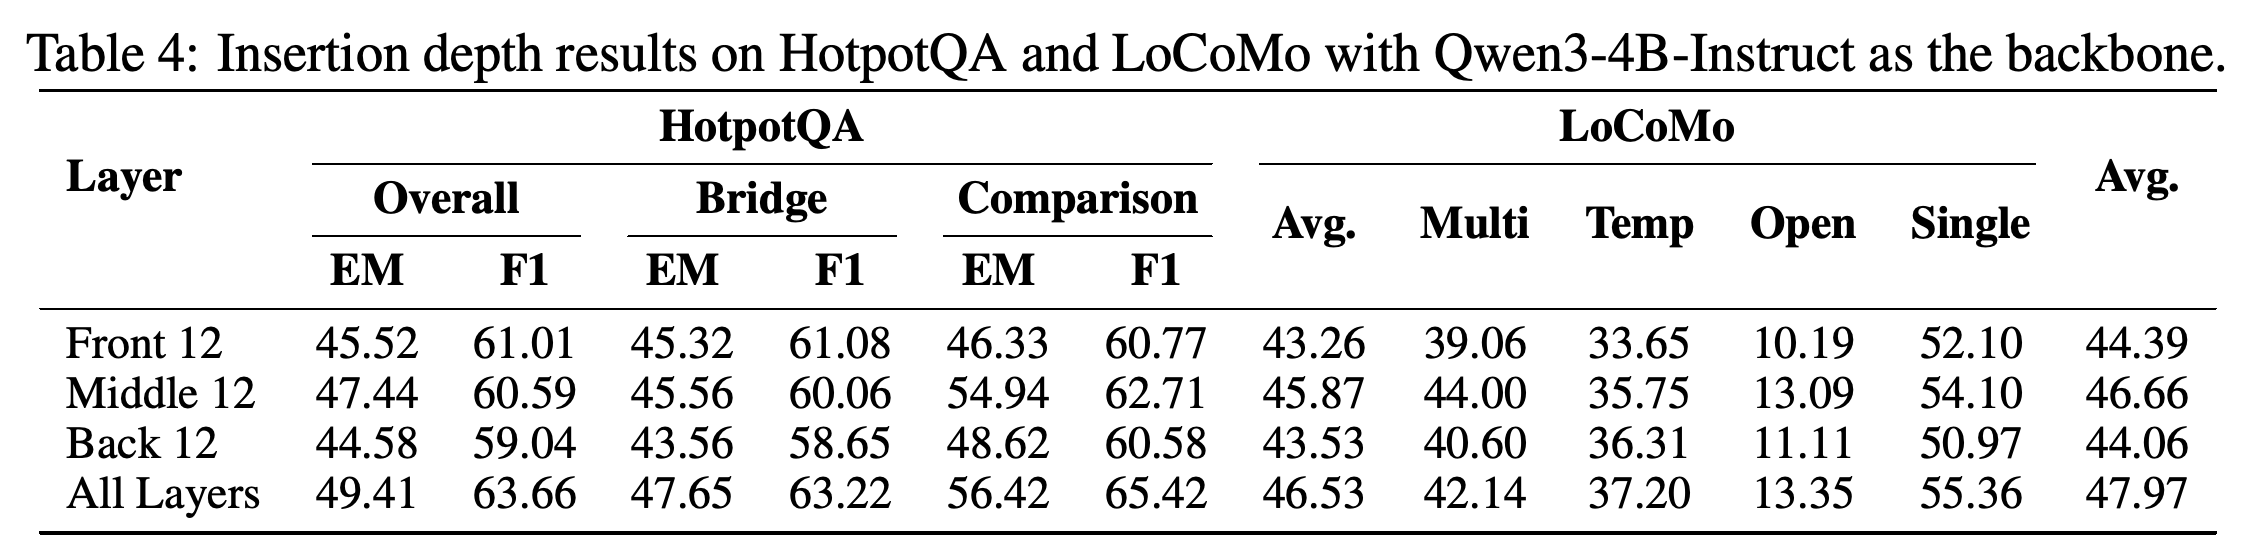
Table 4는 앞쪽 12개, 중간 12개, 뒤쪽 12개 또는 전체 backbone 계층에 모듈을 삽입한 결과를 비교한다. 전체 계층 삽입이 평균 47.97로 가장 좋다. 그다음은 중간 계층 삽입 46.66, 앞쪽 계층 삽입 44.39, 뒤쪽 계층 삽입 44.06이다.
- 전체 계층 삽입은 HotpotQA EM/F1에서 49.41/63.66, LoCoMo 평균에서 46.53을 기록한다.
- 일부 깊이에만 삽입하는 방식 중에서는 중간 계층 삽입이 가장 좋으며, LoCoMo Multi에서도 가장 높은 44.00을 기록한다.
- 저자들은 중간 단계의 의미 표현과 깊이에 따른 보정 전파로 이 패턴을 설명한다. 전체 계층 삽입은 모듈도 더 많이 추가하므로, 파라미터 수를 맞춰 삽입 위치의 효과만 분리한 비교는 아니다.
전체 계층 삽입은 가장 높은 종합 점수와 가장 좋은 HotpotQA 및 LoCoMo 전체 결과를 기록한다. 12개 계층에 삽입하는 3가지 대안 중에서는 중간 계층 삽입이 가장 좋다. 전체 계층 삽입은 모듈을 더 많이 사용하므로, 이 비교에는 삽입 위치와 적응에 사용하는 파라미터 예산의 효과가 함께 반영된다.
6 Related Work
관련 연구 절에서는 δ-mem을 텍스트 저장소, 외부 latent-memory bank, 파라미터 적응 및 편집, hybrid attention 또는 순환 구조와 비교한다. δ-mem은 동결된 full-attention backbone, 상호작용 간에 유지되는 연관 상태, 게이트가 적용된 delta 쓰기, 메모리 상태에 따라 달라지는 attention 보정을 결합한다는 점에서 구별된다.
- 텍스트 방식과 달리 δ-mem은 메모리를 토큰 공간을 통해 다시 삽입하지 않는다. Memorizing Transformers나 LongMem과 달리 별도의 reader 경로로 외부 bank를 검색하지 않는다.
- low-rank 인터페이스는 LoRA와 비슷하지만, 실행 중 steering은 정적인 가중치 갱신이 아니라 변화하는 상태에 의존한다. LoRA에 대해서는 이 글을 참조하라.
- Infini-attention도 압축 메모리를 사용하며 delta-rule 갱신을 고려한다. Titans는 테스트 시점에 neural-memory 파라미터를 갱신한다. δ-mem의 기여는 지속 상태와 query/output 보정을 연결하는 구체적인 인터페이스이며, 연관 메모리의 순환 갱신이나 delta 학습 자체를 처음 제안한 것은 아니다.
7 Conclusion
결론에서는 작은 온라인 상태로도 전체 fine-tuning이나 구조 교체, 명시적인 이력 재입력 없이 동결된 Transformer에 유용한 메모리를 제공할 수 있다고 주장한다. 벤치마크 평균과 문맥 제거 후 복원 결과는 평가한 모델에서 메모리 보강이 유용함을 뒷받침한다. 다만 정보 보존은 근사적이며 디코딩 오버헤드가 따른다.
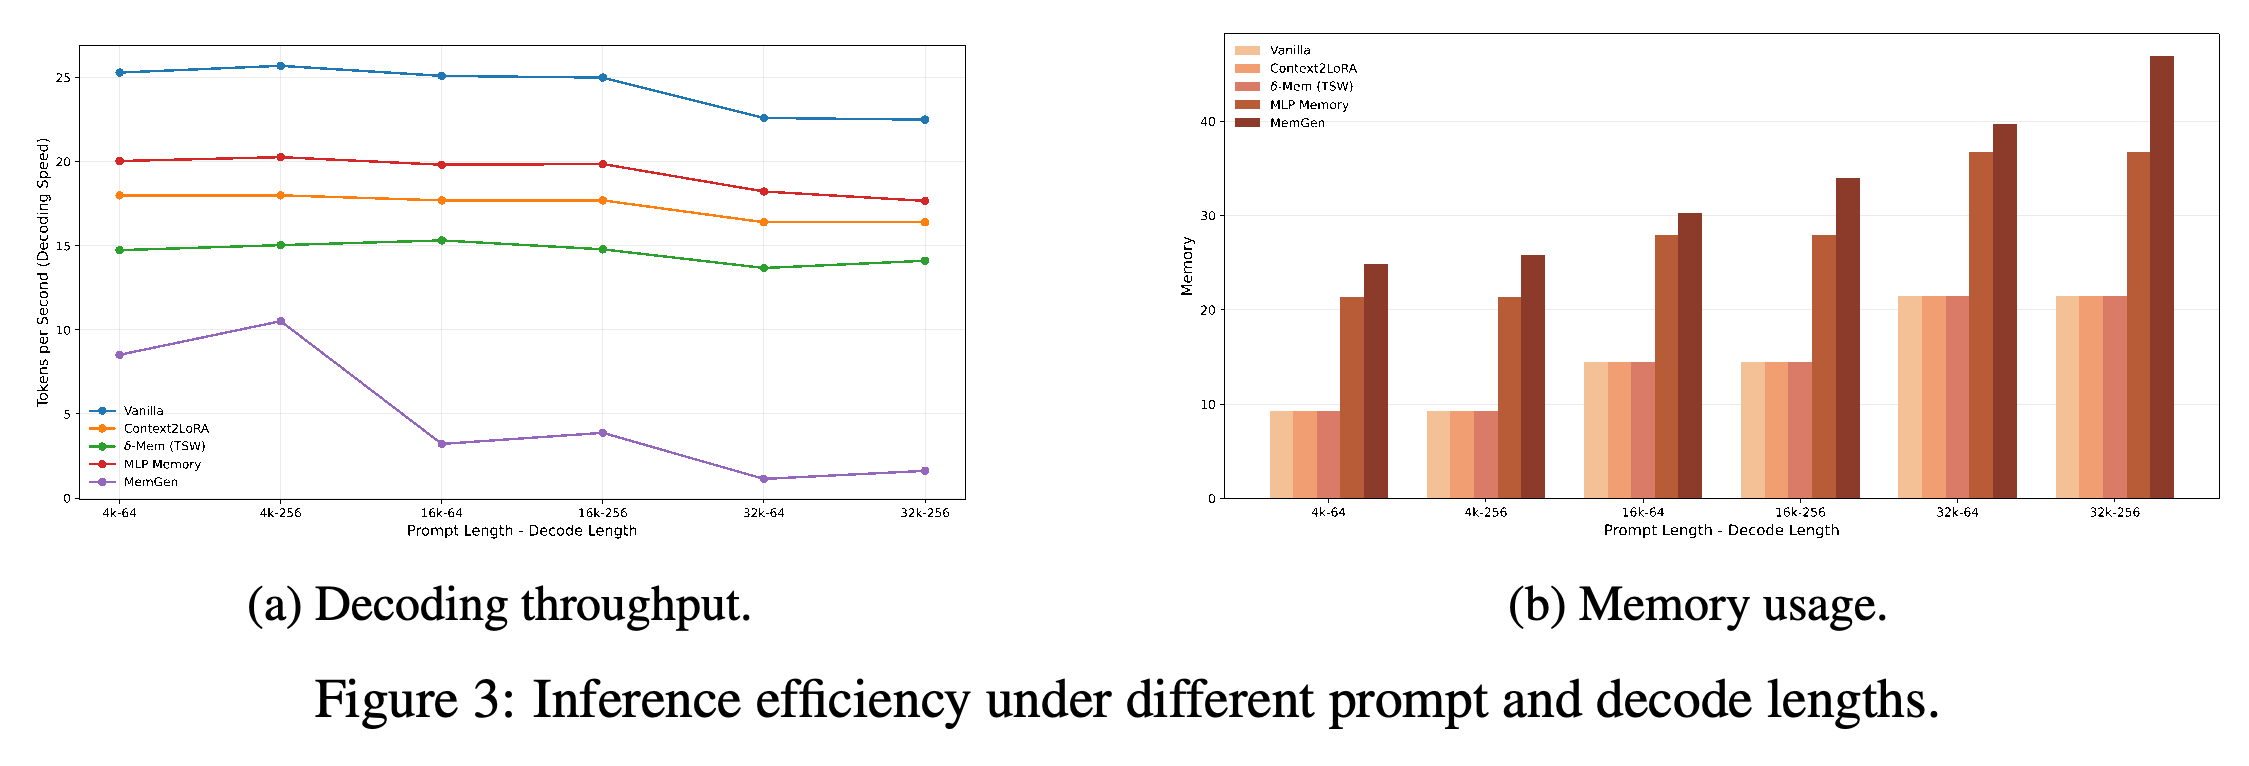
- Figures 3와 4는 효율성과 파라미터 오버헤드를 보여준다. TSW의 관측된 GPU 메모리 증가는 작지만, 디코딩 처리량은 Vanilla와 Context2LoRA보다 낮다. 학습 가능한 모듈의 파라미터 수는 backbone에 비해 작다.
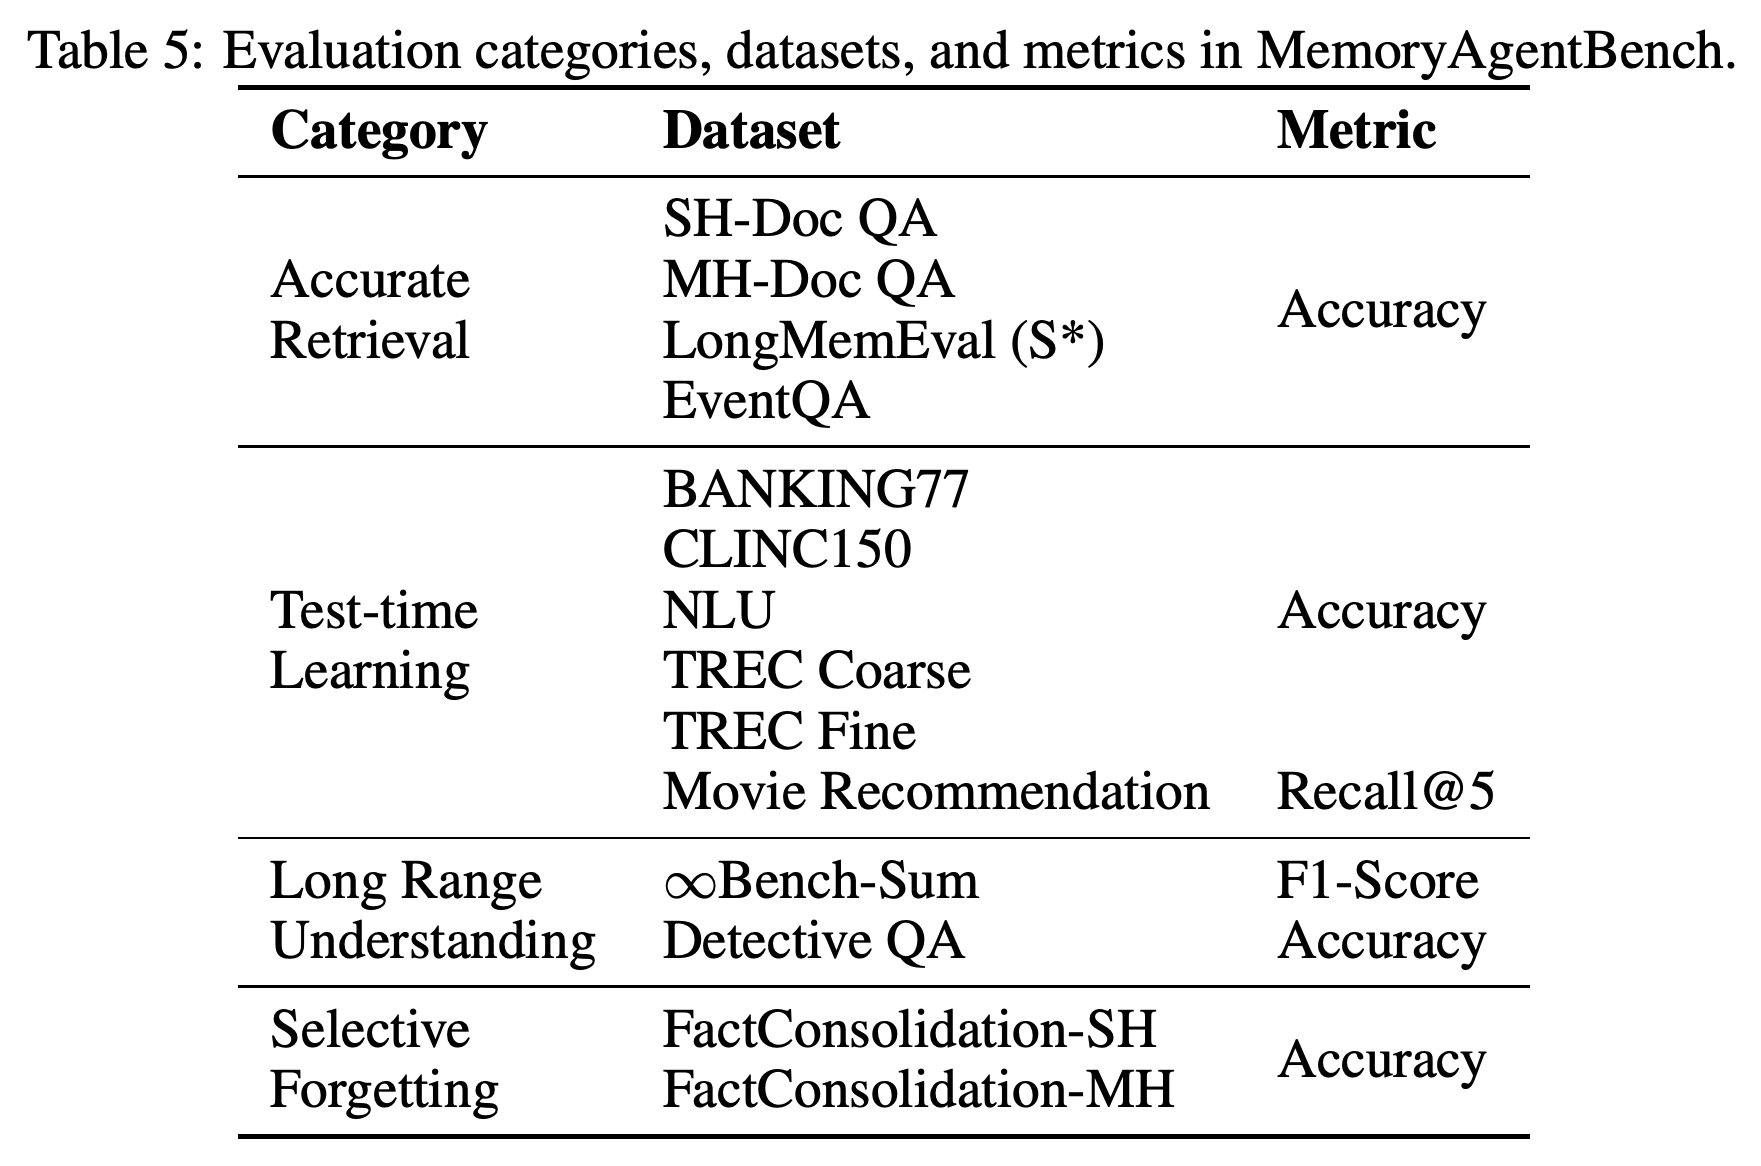
- Table 5는 MemoryAgentBench에 사용된 서로 다른 데이터셋 지표를 정리한다. 이 차이는 종합 점수를 해석할 때 중요하다.
6개 prompt/디코딩 길이 조합에서 TSW의 메모리 막대는 Vanilla와 Context2LoRA에 가깝지만, 디코딩 처리량은 더 낮다. 이 그림은 추가 GPU 메모리 사용량이 작음을 뒷받침한다. 추론 속도가 같거나 모든 쓰기 변형이 효율적이라는 주장을 뒷받침하지는 않는다. 메모리 축에는 물리적 단위가 명시되어 있지 않다.
MemoryAgentBench는 Accurate Retrieval, Test-time Learning, Long Range Understanding, Selective Forgetting을 결합한다. 대부분의 데이터셋은 accuracy를 사용하지만, Movie Recommendation은 Recall@5를, ∞Bench-Sum은 F1-Score를 사용한다. 따라서 샘플 수로 가중한 최종 점수는 단일한 공통 지표가 아니라 서로 다른 종류의 측정값을 종합한다.
부록
- A Limitations: 작은 상태는 명시적인 문맥을 근사한다. 저자들은 전체 문맥을 사용하는 정확한 추론에 더 가깝게 맞추는 것을 향후 과제로 제시한다. 또한 디코딩 연산이 추가됨을 인정하며, 시스템 수준의 최적화는 후속 과제로 남긴다. GPU 메모리 오버헤드가 작아도 측정된 처리량 손실이 사라지는 것은 아니다.
- B Broader Impacts: 지속적으로 유지하는 압축 메모리는 제한된 연산 예산에서 assistant와 agent의 동작을 도울 수 있다. 반면 민감한 정보의 보존, 오래되거나 잘못된 기억, 사용자 프로파일링의 위험도 생긴다. 논문은 동의, 투명한 제어, 삭제 기능, 필터링 또는 감사를 권고하지만, 이러한 보호 조치를 실험으로 평가하지는 않는다.
- C Inference Efficiency and Memory Use: Figure 3은 prompt 길이 4k, 16k, 32k 각각에 대해 디코딩 길이 64와 256으로 TSW를 평가한다. 표시된 GPU 메모리 사용량은 Vanilla 및 Context2LoRA와 거의 같다. 디코딩은 Vanilla와 Context2LoRA보다 느리지만 MemGen보다는 빠르다. 메모리 축에는 물리적 단위가 명시되어 있지 않다.
- D Implementation Details: 학습에는 최대 learning rate 2 × 10⁻⁴와 cosine decay, warmup 비율 0.1, 장치당 batch size 1, gradient accumulation 4 steps, 유효 global batch size 32, random seed 42를 사용한다. 평가는 공식 prompt와 디코딩 설정을 따른다. Table 5에서는 대부분의 MemoryAgentBench 데이터셋에 accuracy를, Movie Recommendation에 Recall@5를, ∞Bench-Sum에 F1-Score를 적용한 뒤 샘플 수로 가중해 종합한다.
- E Parameter Overhead: Figure 4에서 SSW와 TSW의 학습 가능한 파라미터는 각각 4.87M이며, 각각 backbone의 0.12%다. MSW는 19.47M으로 0.48%다. Context2LoRA는 5.90M (0.15%), MemGen은 46.20M (1.13%), MLP Memory는 3078.00M (76.40%)을 사용한다. 이 수치는 학습된 모듈의 파라미터 수이며, 실행 중 사용하는 연관 상태 행렬과는 구별된다.
짧은 생각
핵심 기여는 학습된 메모리 인터페이스와 동적으로 갱신되는 메모리 내용을 분리한 데 있다. qo ablation, 여러 backbone에서의 종합 점수 개선, 적은 파라미터 수는 제한된 attention 인터페이스만으로도 backbone 파라미터를 동결한 채 순환 상태를 활용할 수 있음을 보여준다.
장기 정보를 충실하게 저장하는 능력과 end-to-end 효율성에 대한 근거는 상대적으로 부족하다. 문맥을 제거했을 때의 복원은 부분적이며, 주 비교에 사용한 backbone의 LRU 점수는 낮아지고 TSW 디코딩은 느려진다. 학습 seed도 1개만 보고되었고, LoCoMo 복원 수치도 일치하지 않는다. 따라서 결론은 평가한 종합 점수의 개선으로 한정된다. 이력을 무손실로 압축하거나 메모리 동작을 일관되게 개선했다고 볼 수는 없다.