


Nemotron-Labs-Diffusion: A Tri-Mode Language Model Unifying Autoregressive, Diffusion, and Self-Speculation Decoding 요약 설명
07 Jul 2026 | Paper Review Diffusion Language Models Speculative Decoding Autoregressive Language Models Parallel Decoding목차
- 요약
- 2. Tri-Mode LM Training
- 3. Tri-Mode LM Inference
- 4. Speed-of-Light Analysis
- 5. Nemotron-Labs-Diffusion Family
- 6. Evaluation and Analysis
- 8. Insights and Future Directions
- 부록
- 짧은 생각
이번 글에서는 Nemotron-Labs-Diffusion: A Tri-Mode Language Model Unifying Autoregressive, Diffusion, and Self-Speculation Decoding 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 7월 7일(Arxiv)
- Fu, Yonggan, Whalen, Lexington, Garg, Abhinav, Wu, Chengyue, Khadkevich, Maksim, Oswald, Nicolai, Xie, Enze, Egert, Daniel, Sreenivas, Sharath Turuvekere, Diao, Shizhe, et al.
- NVIDIA, Georgia Tech, HKU, University of Chicago, MIT
- 논문 링크
요약
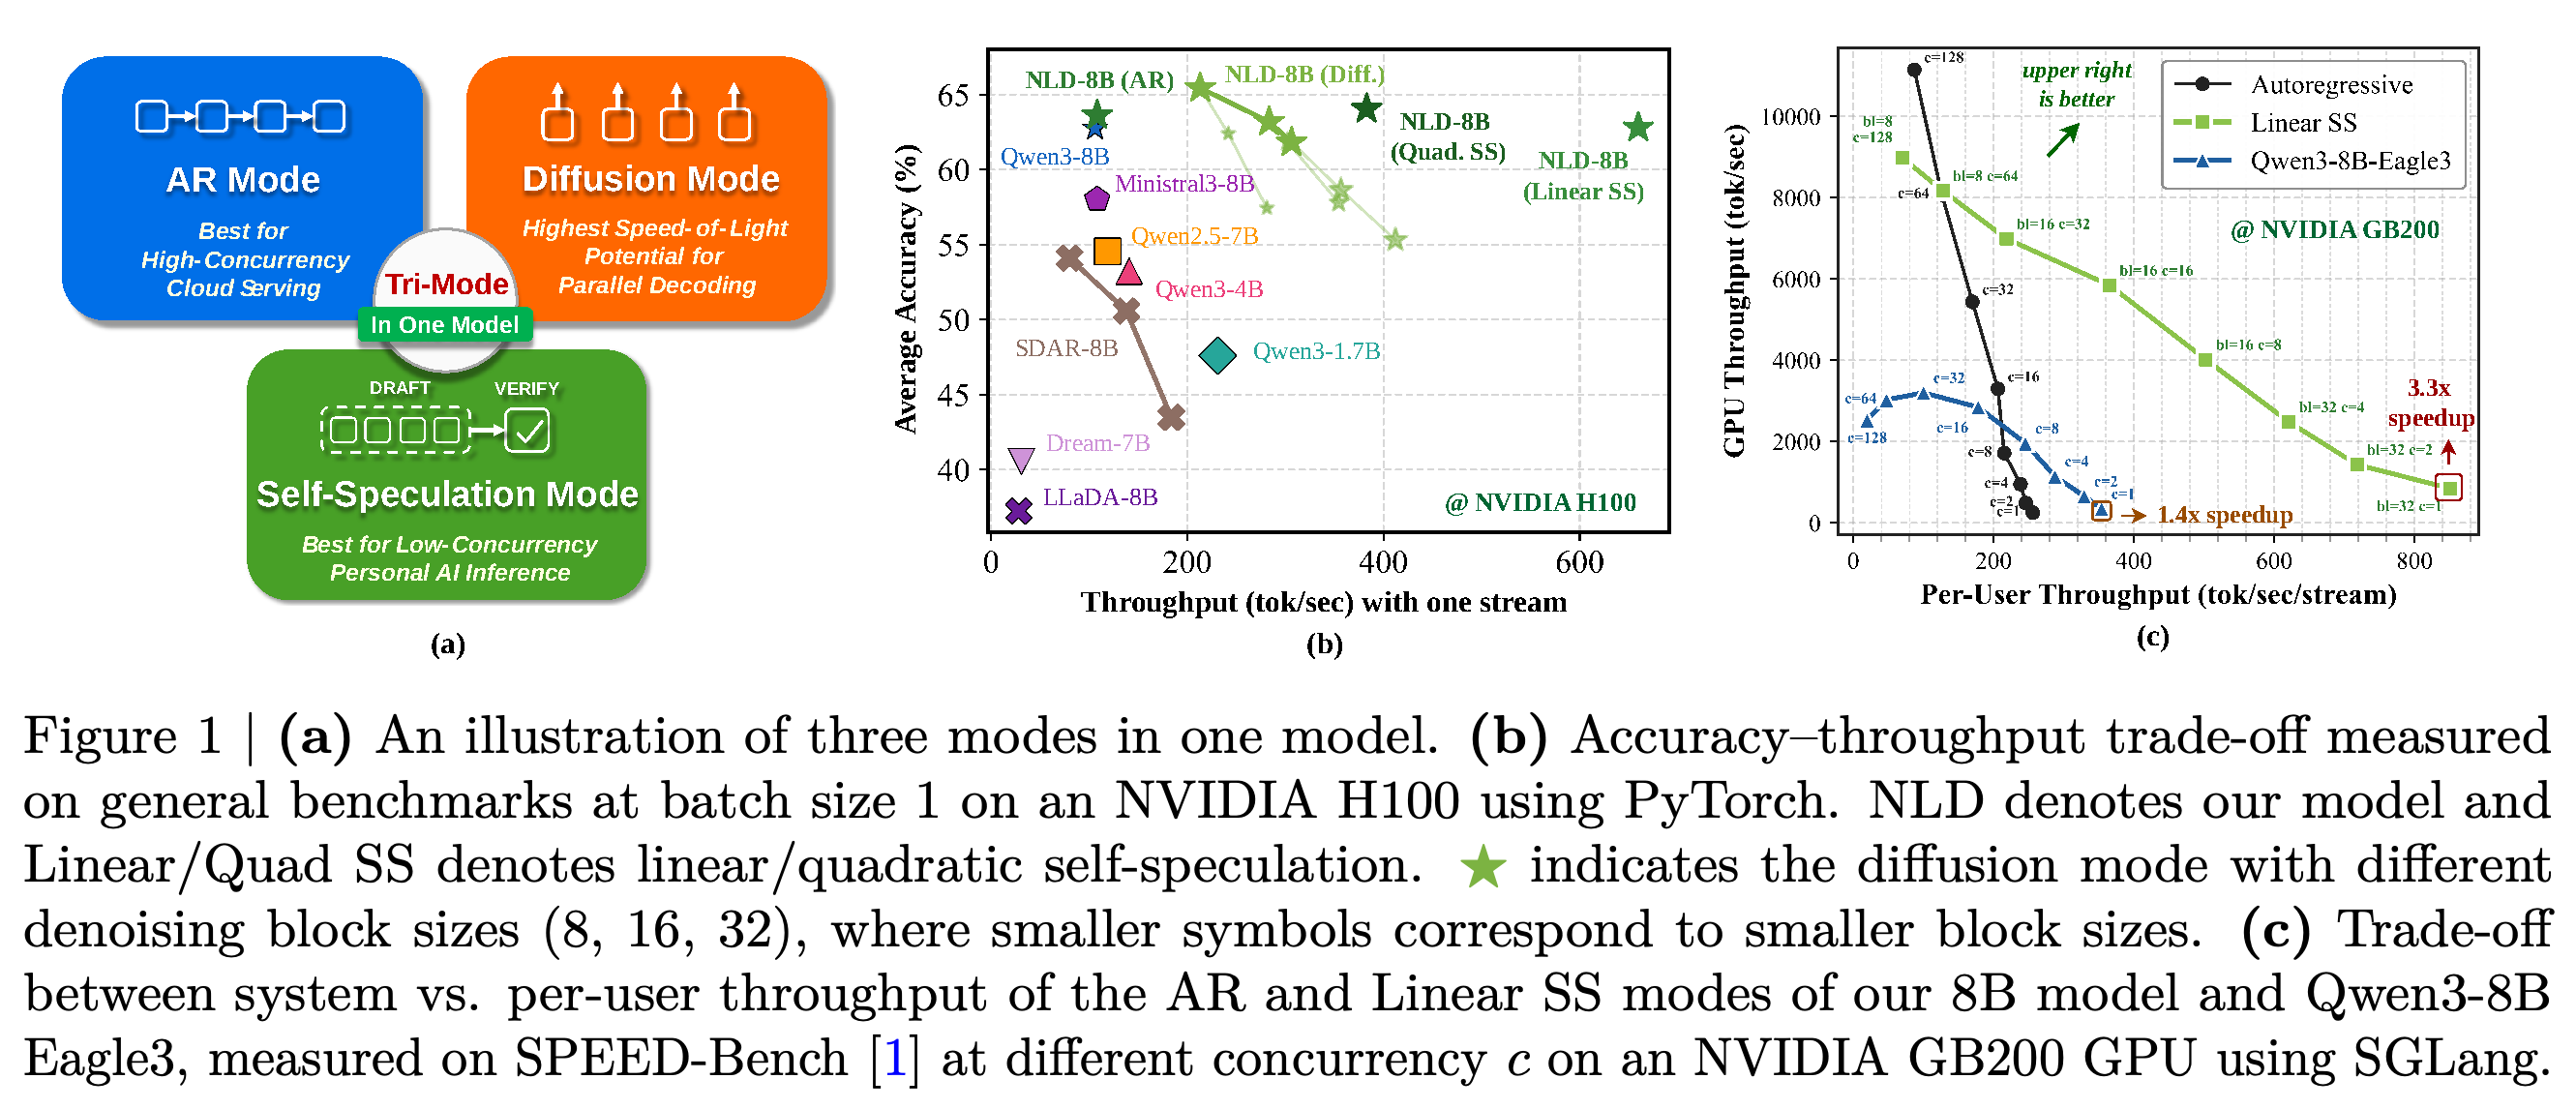
- 자기회귀(AR) 디코딩은 토큰을 순차적으로 생성한다. 확산 디코딩은 여러 위치를 병렬로 예측할 수 있지만 정확도와 효율 사이에 상충 관계가 있다. Nemotron-Labs-Diffusion은 하나의 백본에서 AR 다음 토큰 예측과 블록 단위 확산 노이즈 제거를 공동 학습한다. 별도의 예측 헤드 없이 AR, 확산, 자기 추측 디코딩을 지원한다.
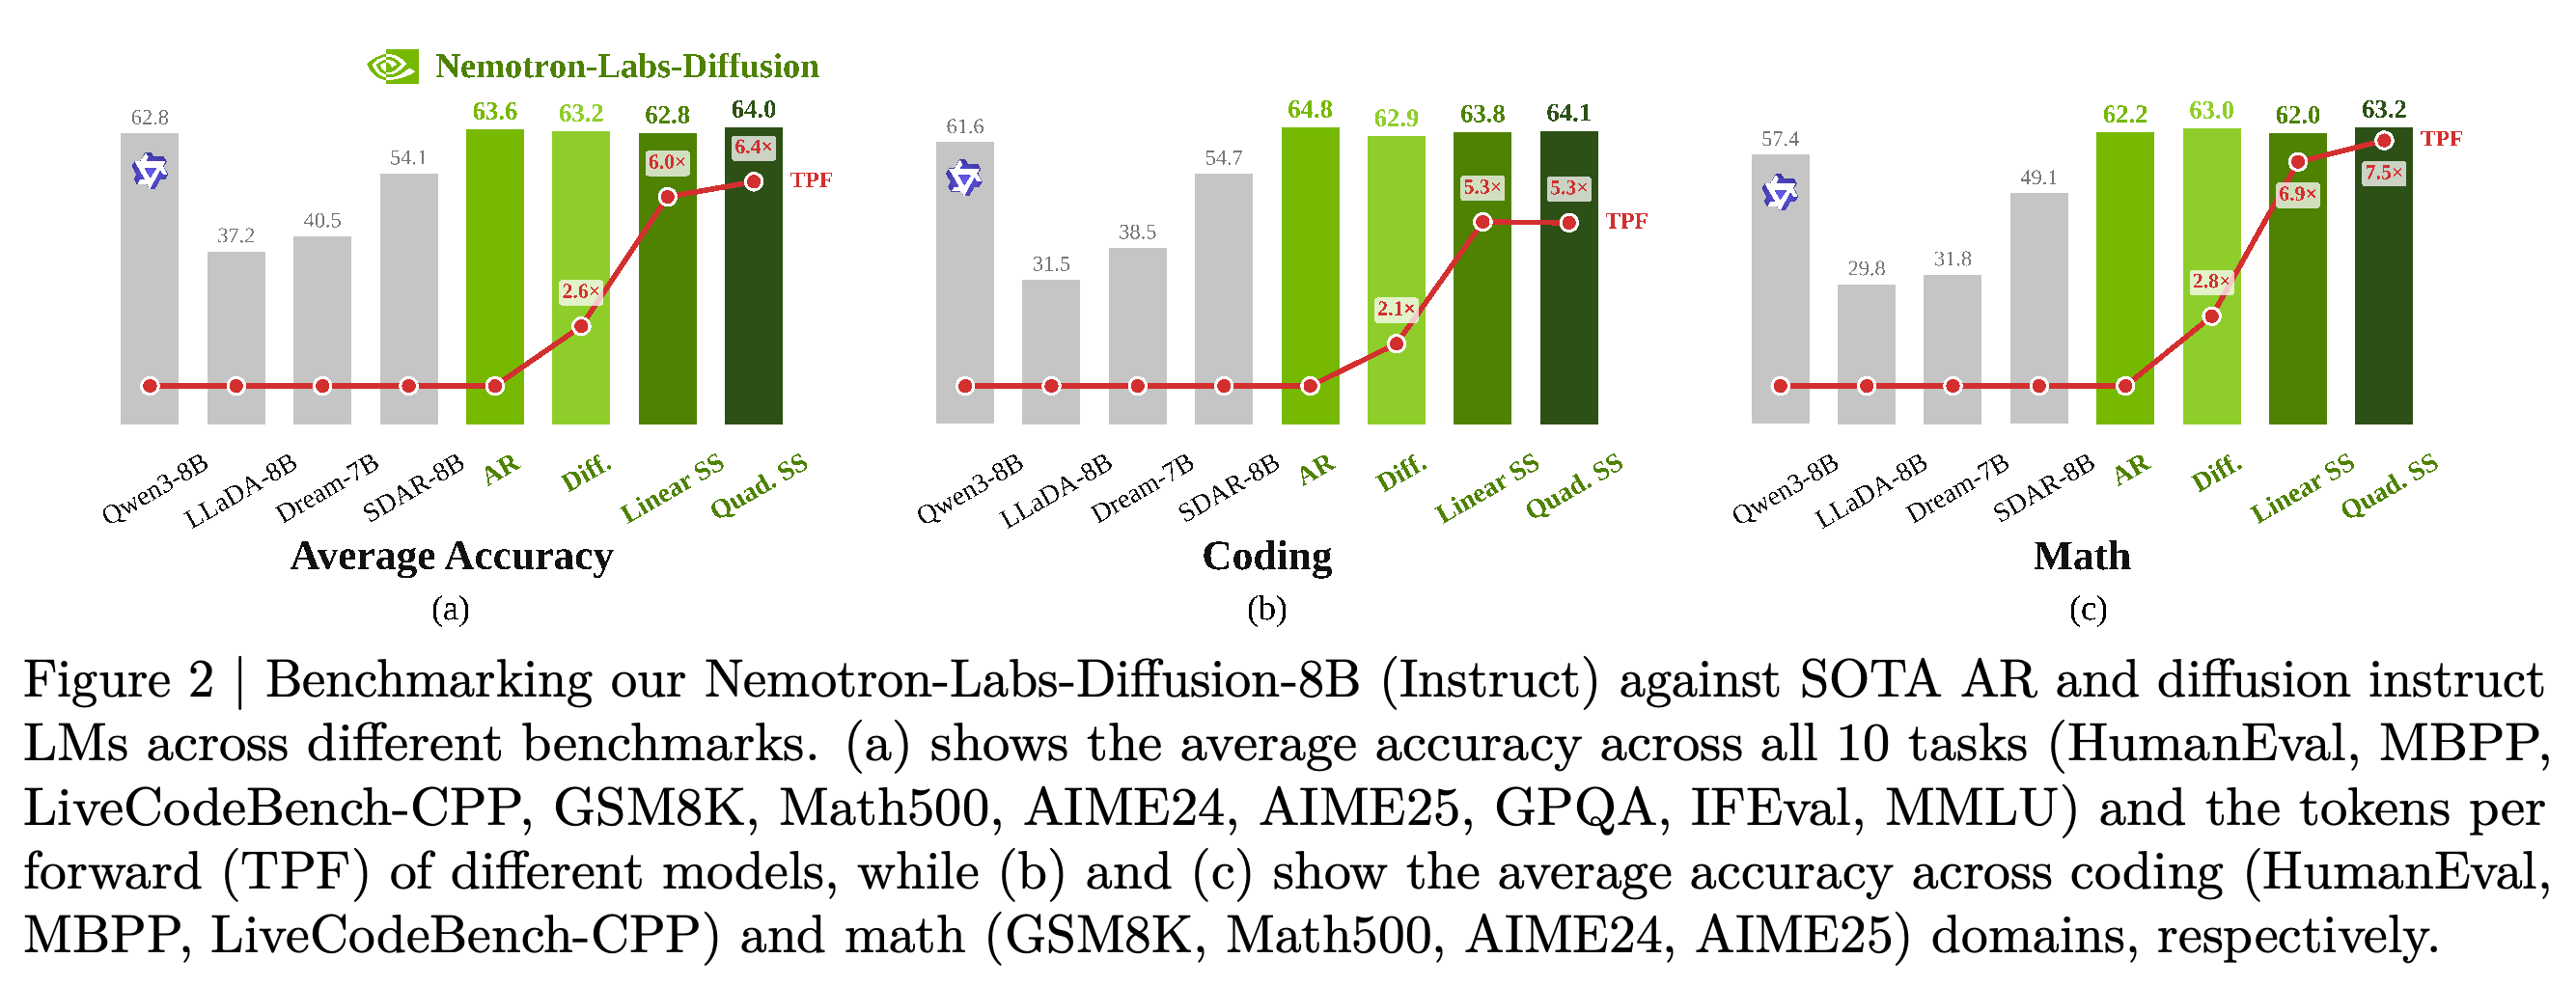
- 자기 추측 디코딩에서는 확산 경로가 토큰 초안을 만들고 같은 모델의 AR 경로가 이를 검증한다. instruct 과제 10개에서 8B 모델의 평균 정확도는 AR 모드 63.61, 확산 모드 63.18이다. LoRA로 개선한 선형 자기 추측 디코딩은 평균 정확도 62.81과 순전파당 5.99토큰(TPF)을 기록한다. Qwen3-8B는 각각 62.75와 1.00 TPF를 기록한다.
- 오라클의 안내를 받는 확산은 SPEED-Bench에서 6.02 TPF에 도달하며, 선형 자기 추측 디코딩은 3.41 TPF를 기록한다. 다만 오라클 결과는 실제로 배포된 샘플러의 측정치가 아니다. 모델 계열에는 3B/8B/14B base 및 instruct 모델과 8B 비전·언어 모델이 포함된다. 별도의 SGLang 시험에서는 GB200, RTX Pro 6000, DGX Spark에서 낮은 동시성의 처리량을 측정한다.
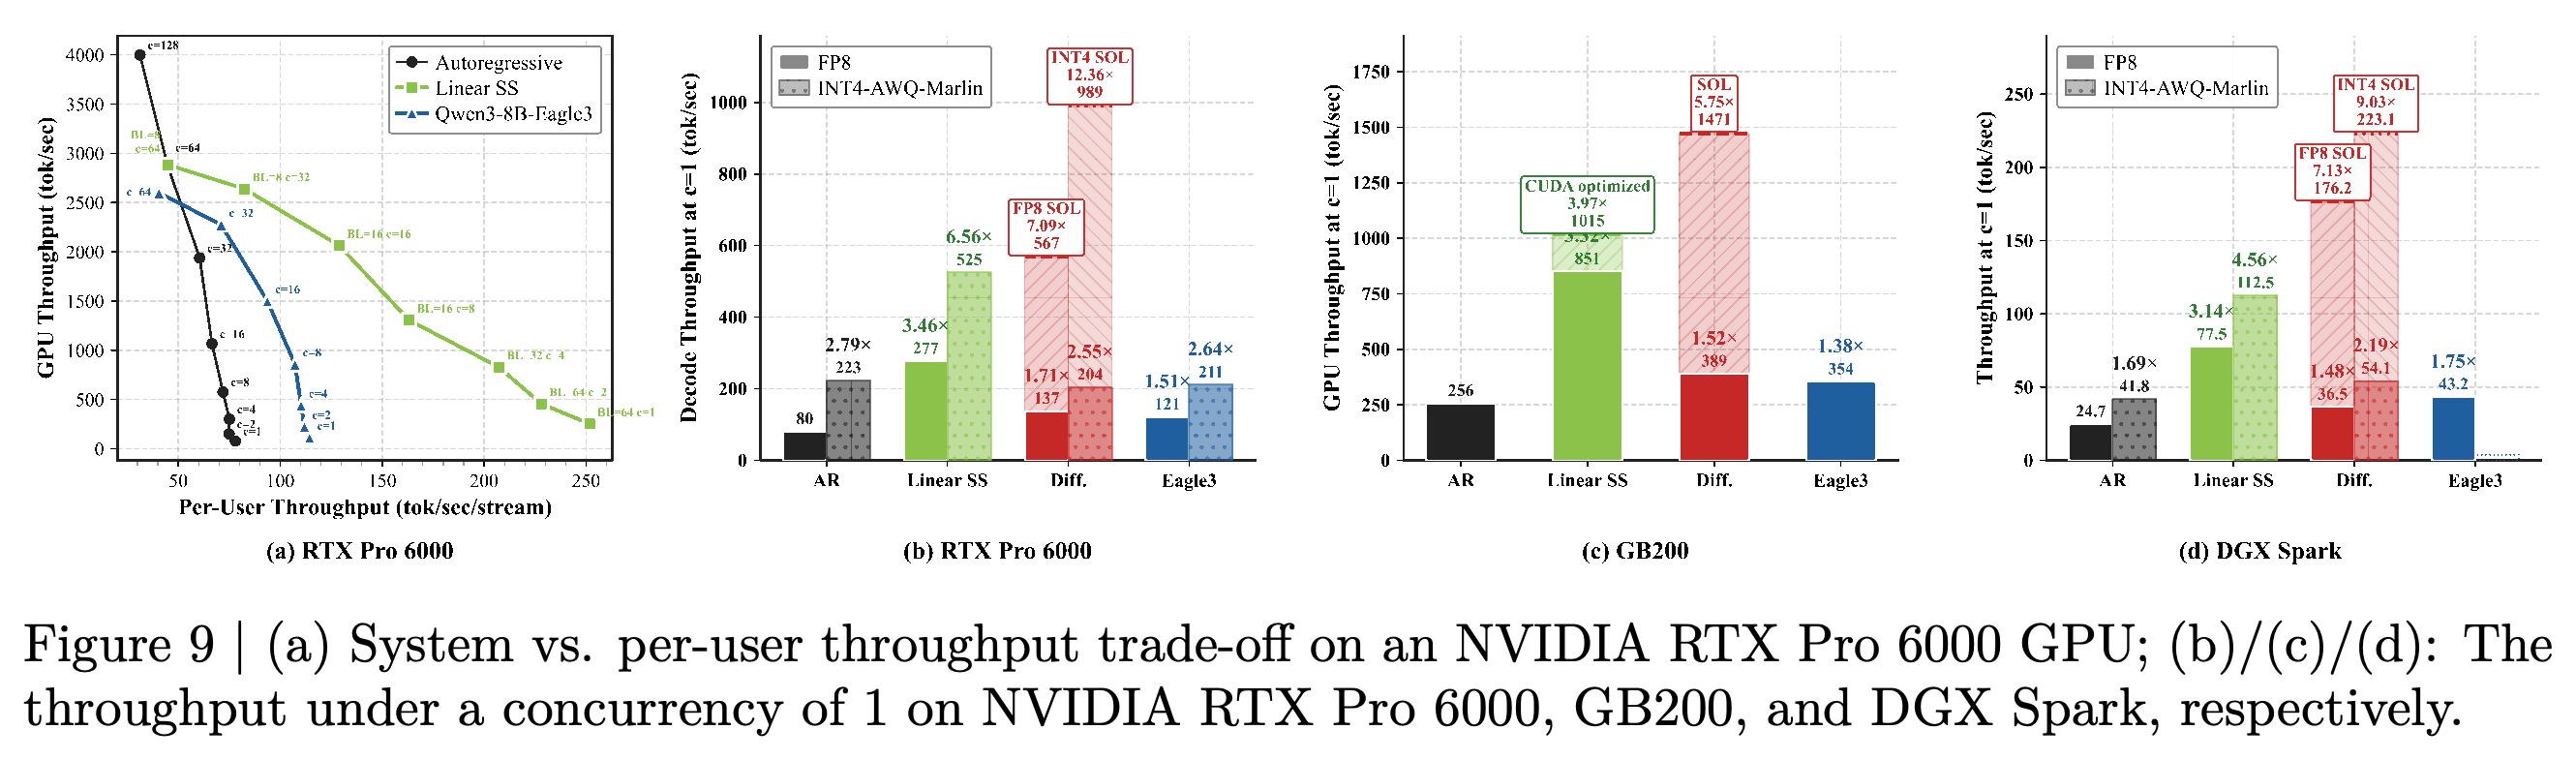
각 패널은 디코딩 모드와 적합한 운영 조건을 연결한다. 보고된 측정에서는 동시성이 높을 때 AR을 제시하고, 단일 스트림에서는 자기 추측 디코딩의 처리량 향상을 보여준다. GB200 곡선은 배치 크기 1에서 얻은 이점을 높은 동시성의 서비스 환경에 그대로 적용할 수 없는 이유도 보여준다.
8B instruct 모델과 기준 모델의 전체, 코딩, 수학 정확도를 TPF와 함께 보여준다. 과제 점수를 순전파당 생성 토큰 수의 증가와 나란히 비교할 수 있다.
2. Tri-Mode LM Training
학습에서는 깨끗한 인과적 스트림과 손상된 스트림을 결합해 공유 백본에 AR 및 블록 내부 노이즈 제거 학습 신호를 제공한다. 먼저 AR만 학습한 다음 공동 학습을 진행하며, 마스킹 비율이 달라지는 경우를 위해 배치 전체 토큰에 대한 손실 평균을 제안한다.
- 어텐션 설계는 앞선 AR·확산 공동 학습 연구 [14]를 따른다. 이 논문은 이에 더해 다중 모드 추론, 학습 후 개선 방법, 모델 계열, 오라클 기반 확산 분석을 다룬다.
2.1. Training Objectives
AR 목적함수는 앞선 토큰을 바탕으로 각 토큰을 예측한다. 블록 단위 확산은 앞선 깨끗한 블록을 조건으로 손상된 위치의 노이즈를 제거한다. 공동 목적함수는 L(θ) = L_AR(θ) + αL_diff(θ)이다. Stage 1에서는 α = 0, Stage 2에서는 α = 0.3을 사용한다.
- 저자들은 확산 손실에 1/t 인자가 포함되므로 시퀀스별 평균을 내면 마스킹된 토큰이 적은 예제에 과도한 가중치가 부여될 수 있다고 주장한다. 그러나 제시한 식 4–5는 모두 고정 길이 토큰 합을 NL로 나누므로, 활성 토큰에 대한 별도의 정규화가 없다면 대수적으로 같다.
2.2. Attention Pattern
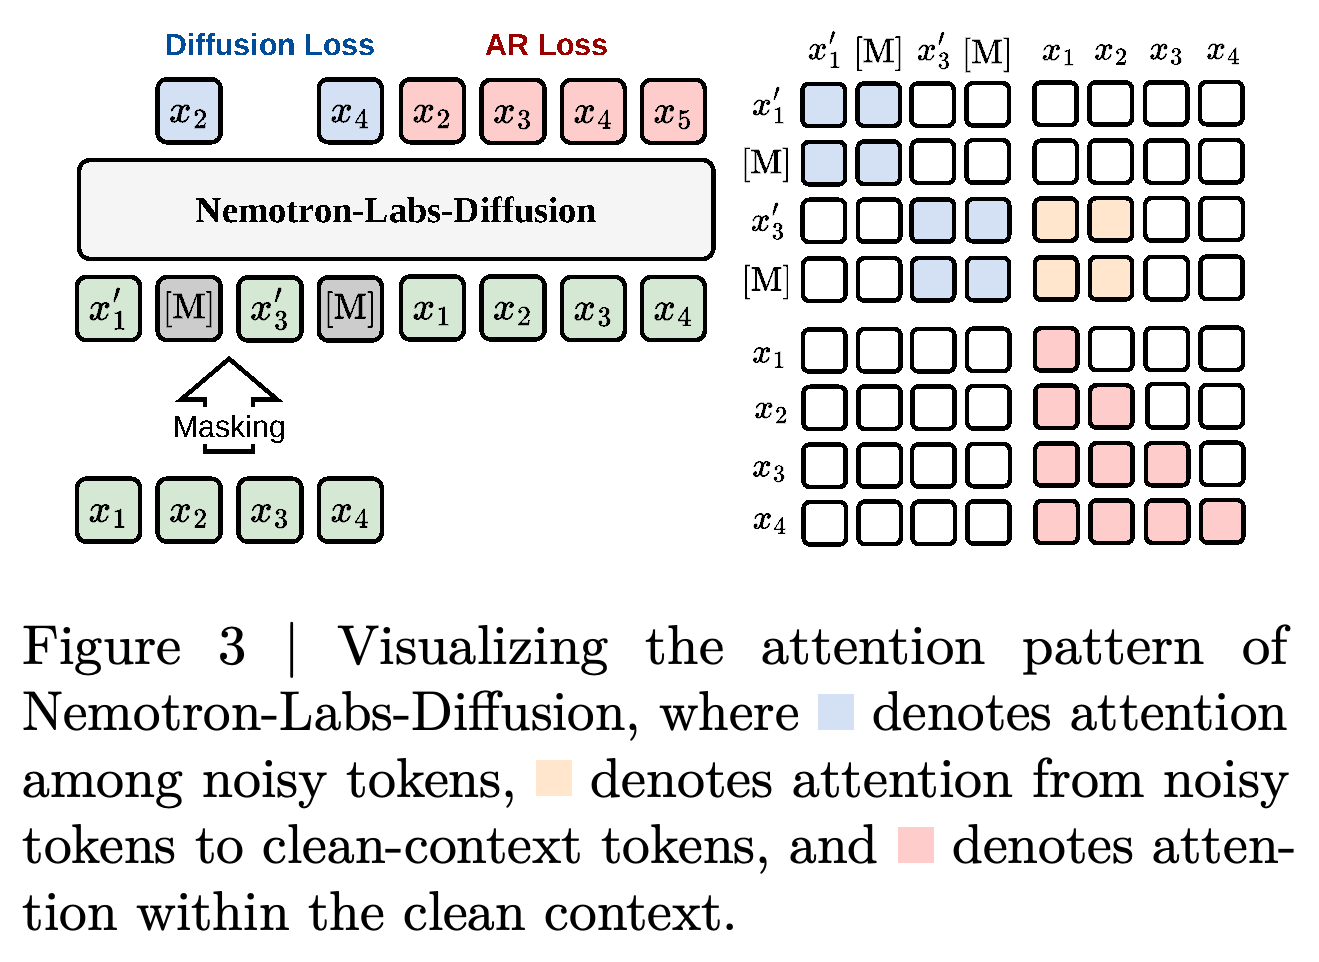
노이즈가 있는 토큰은 블록 안에서 양방향으로 어텐션하고, 앞선 깨끗한 블록의 토큰도 참조한다. 깨끗한 스트림은 엄격한 인과적 어텐션을 사용한다. 깨끗한 토큰끼리의 어텐션을 제한하므로, AR 예측에 미래 토큰을 노출하지 않으면서 순전파·역전파 1회로 AR과 확산 손실을 계산할 수 있다.
어텐션 마스크는 노이즈 토큰 사이, 노이즈 토큰에서 앞선 깨끗한 토큰으로, 깨끗한 토큰 사이의 인과적 어텐션을 구분한다. 마지막 제한은 같은 학습 과정에서 계산하는 AR 학습 신호에 미래 토큰이 유입되는 것을 막는다.
2.3. Ablation Study on Training Techniques
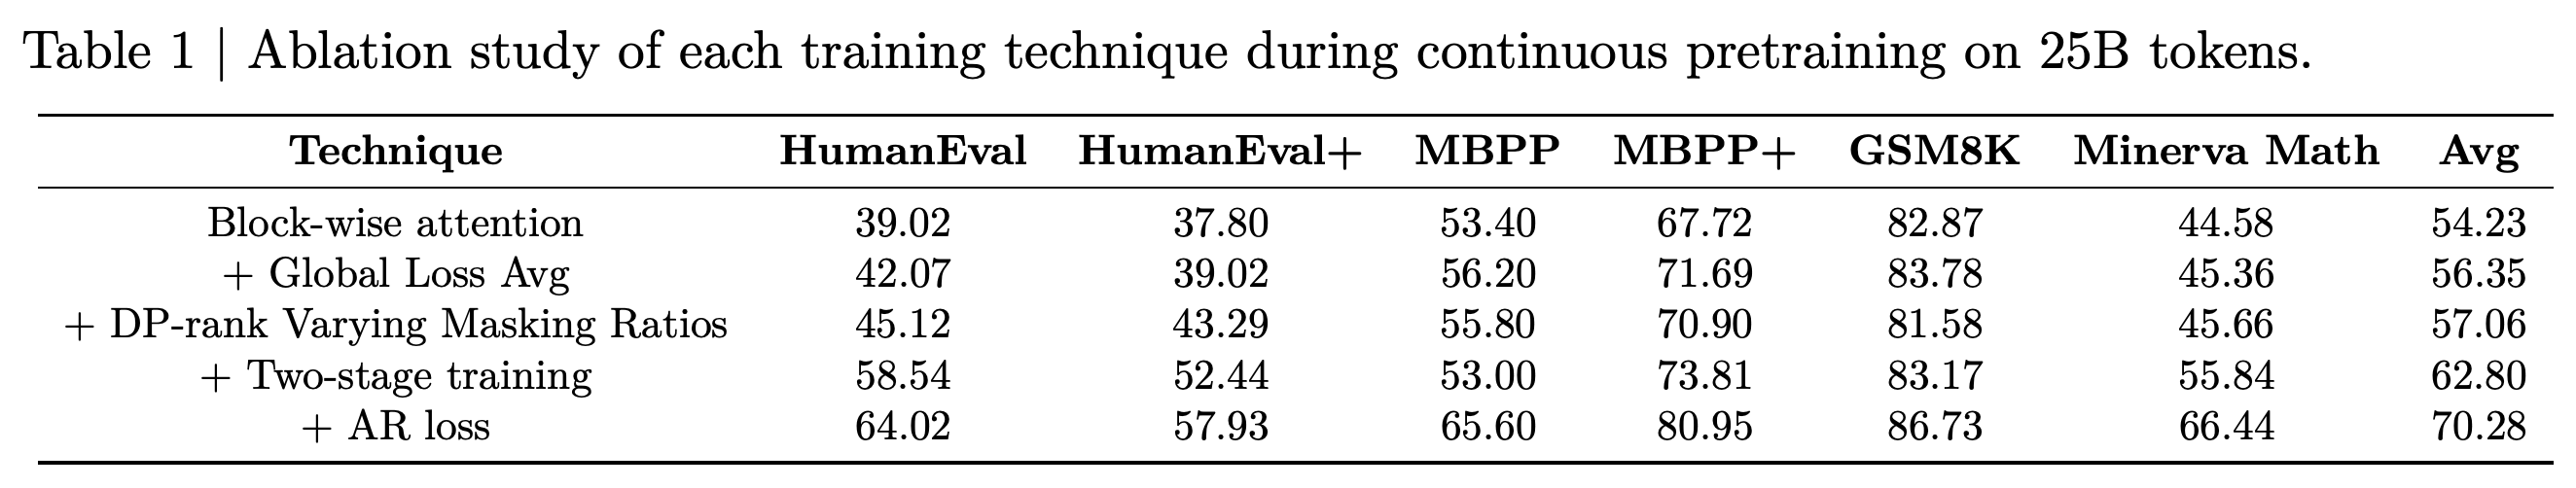
Ministral3-8B에서 시작한 점진적 절제 실험에서 확산 모드의 평균 정확도는 블록 단위 어텐션을 적용했을 때 54.23이다. 배치 전체 손실 평균을 추가하면 56.35, DP-rank마다 다른 마스킹 비율을 적용하면 57.06, 단계별 학습을 적용하면 62.80, AR 손실까지 추가하면 70.28로 높아진다. 이는 요소별 효과를 분리한 실험이 아니라 변경 사항을 누적한 비교다. 단계별 학습 설정에는 보고된 25B 토큰 연속 사전학습 비교에 앞서 1T-token AR 초기 학습도 추가된다.
변경 사항을 차례로 추가하면서 확산 모드의 평균 정확도가 54.23에서 70.28로 높아진다. 변경 사항이 누적되고 2단계 설정에는 추가 AR 초기 학습이 포함되므로, 증가분은 동일한 전체 학습 예산에서 측정한 개별 효과가 아니다.
2.4. Mutual Impact of AR/Diffusion Losses
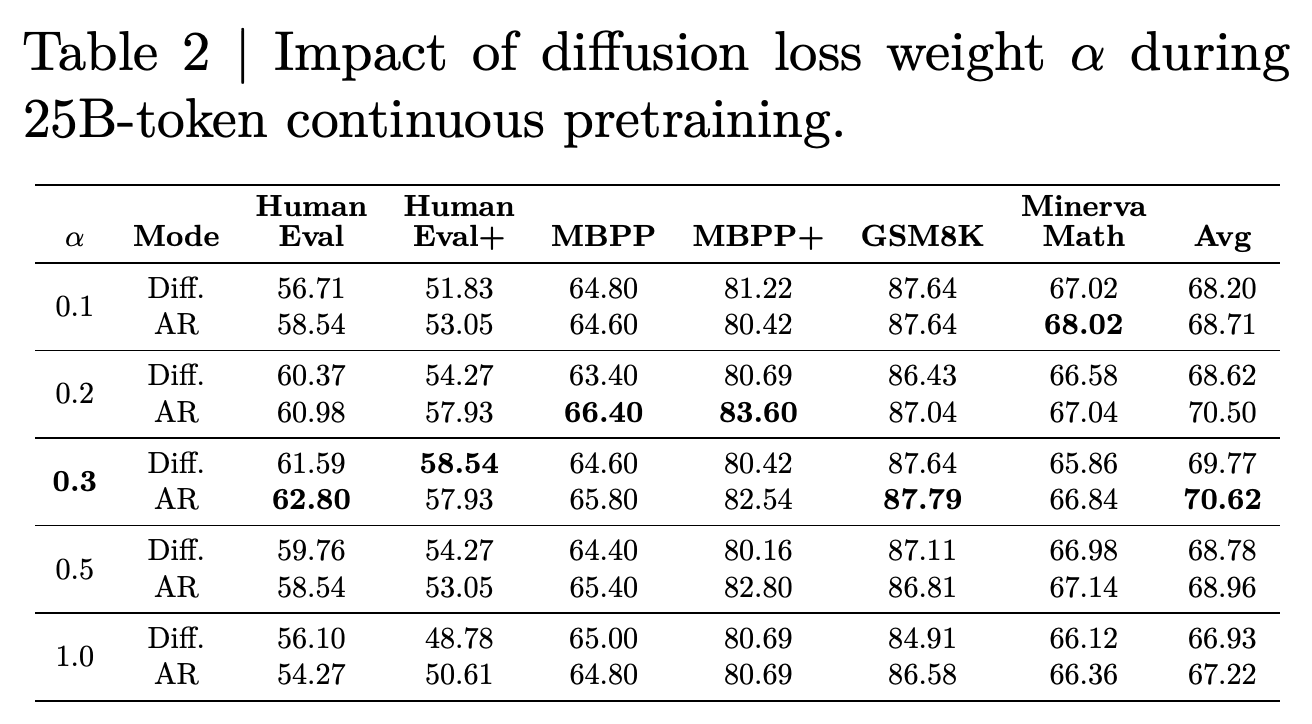
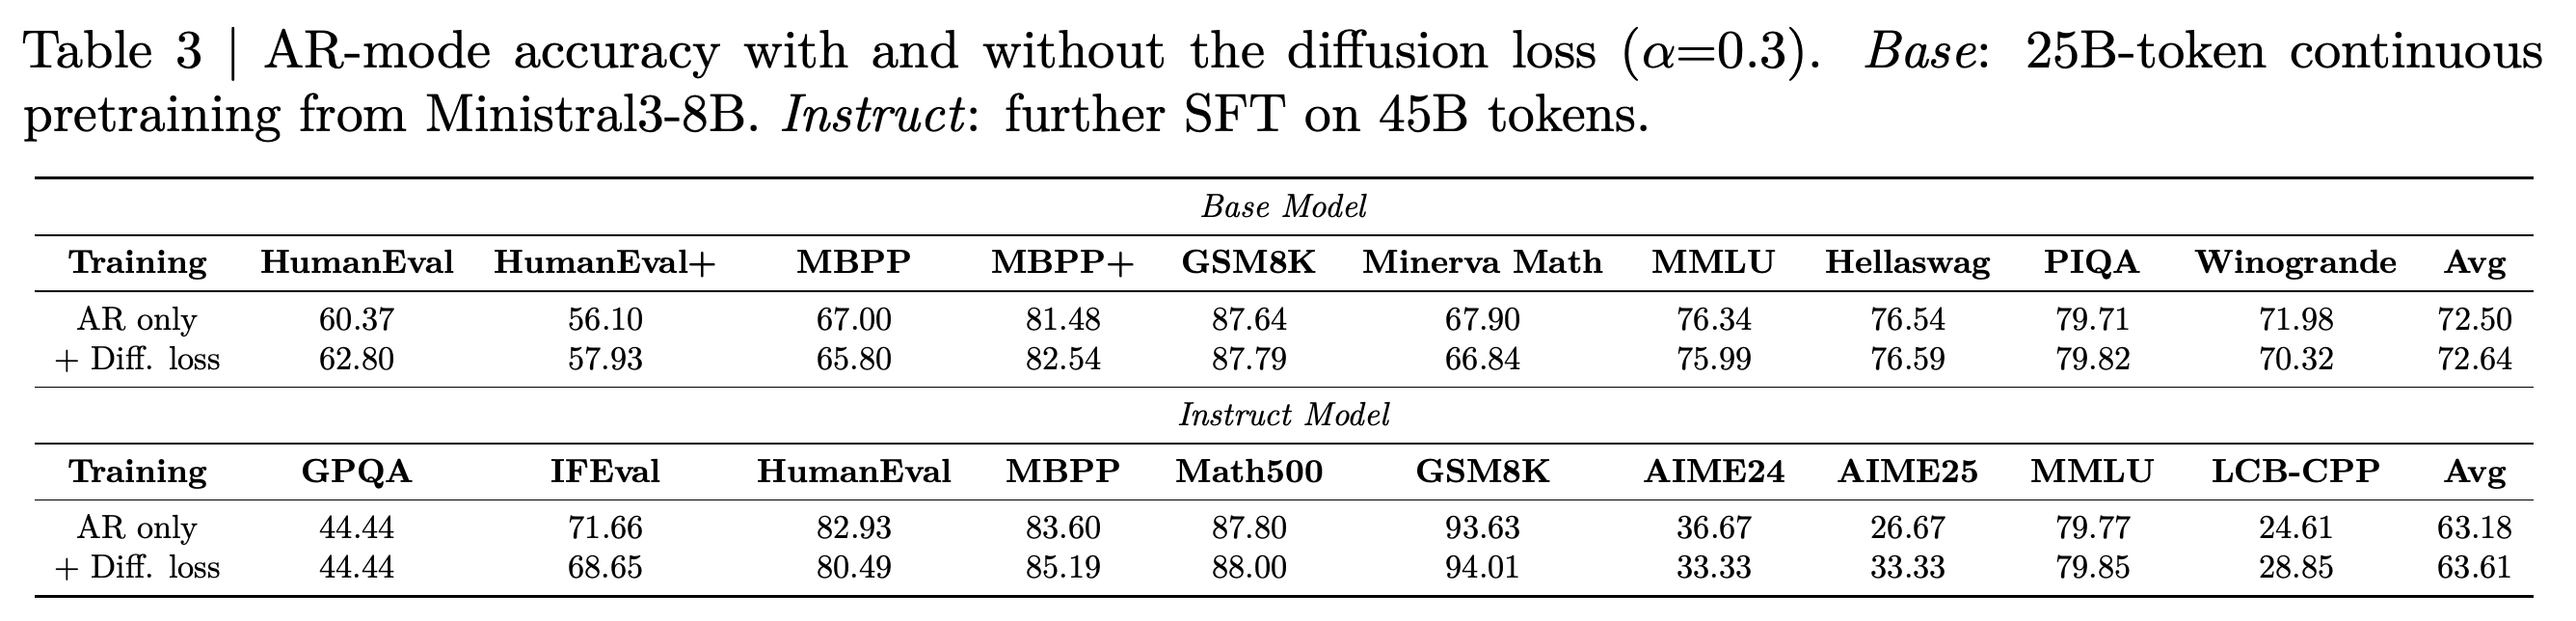
25B 토큰으로 진행한 계수 실험에서 α = 0.3은 확산 모드와 AR 모드 모두에서 보고된 평균 정확도가 가장 높으며, 각각 69.77과 70.62다. 학습 토큰 수를 맞춘 비교에서 확산 손실을 추가하면 base 모델의 AR 평균은 72.50에서 72.64로, instruct 모델은 63.18에서 63.61로 바뀐다. 다만 instruct IFEval은 71.66에서 68.65로 떨어진다.
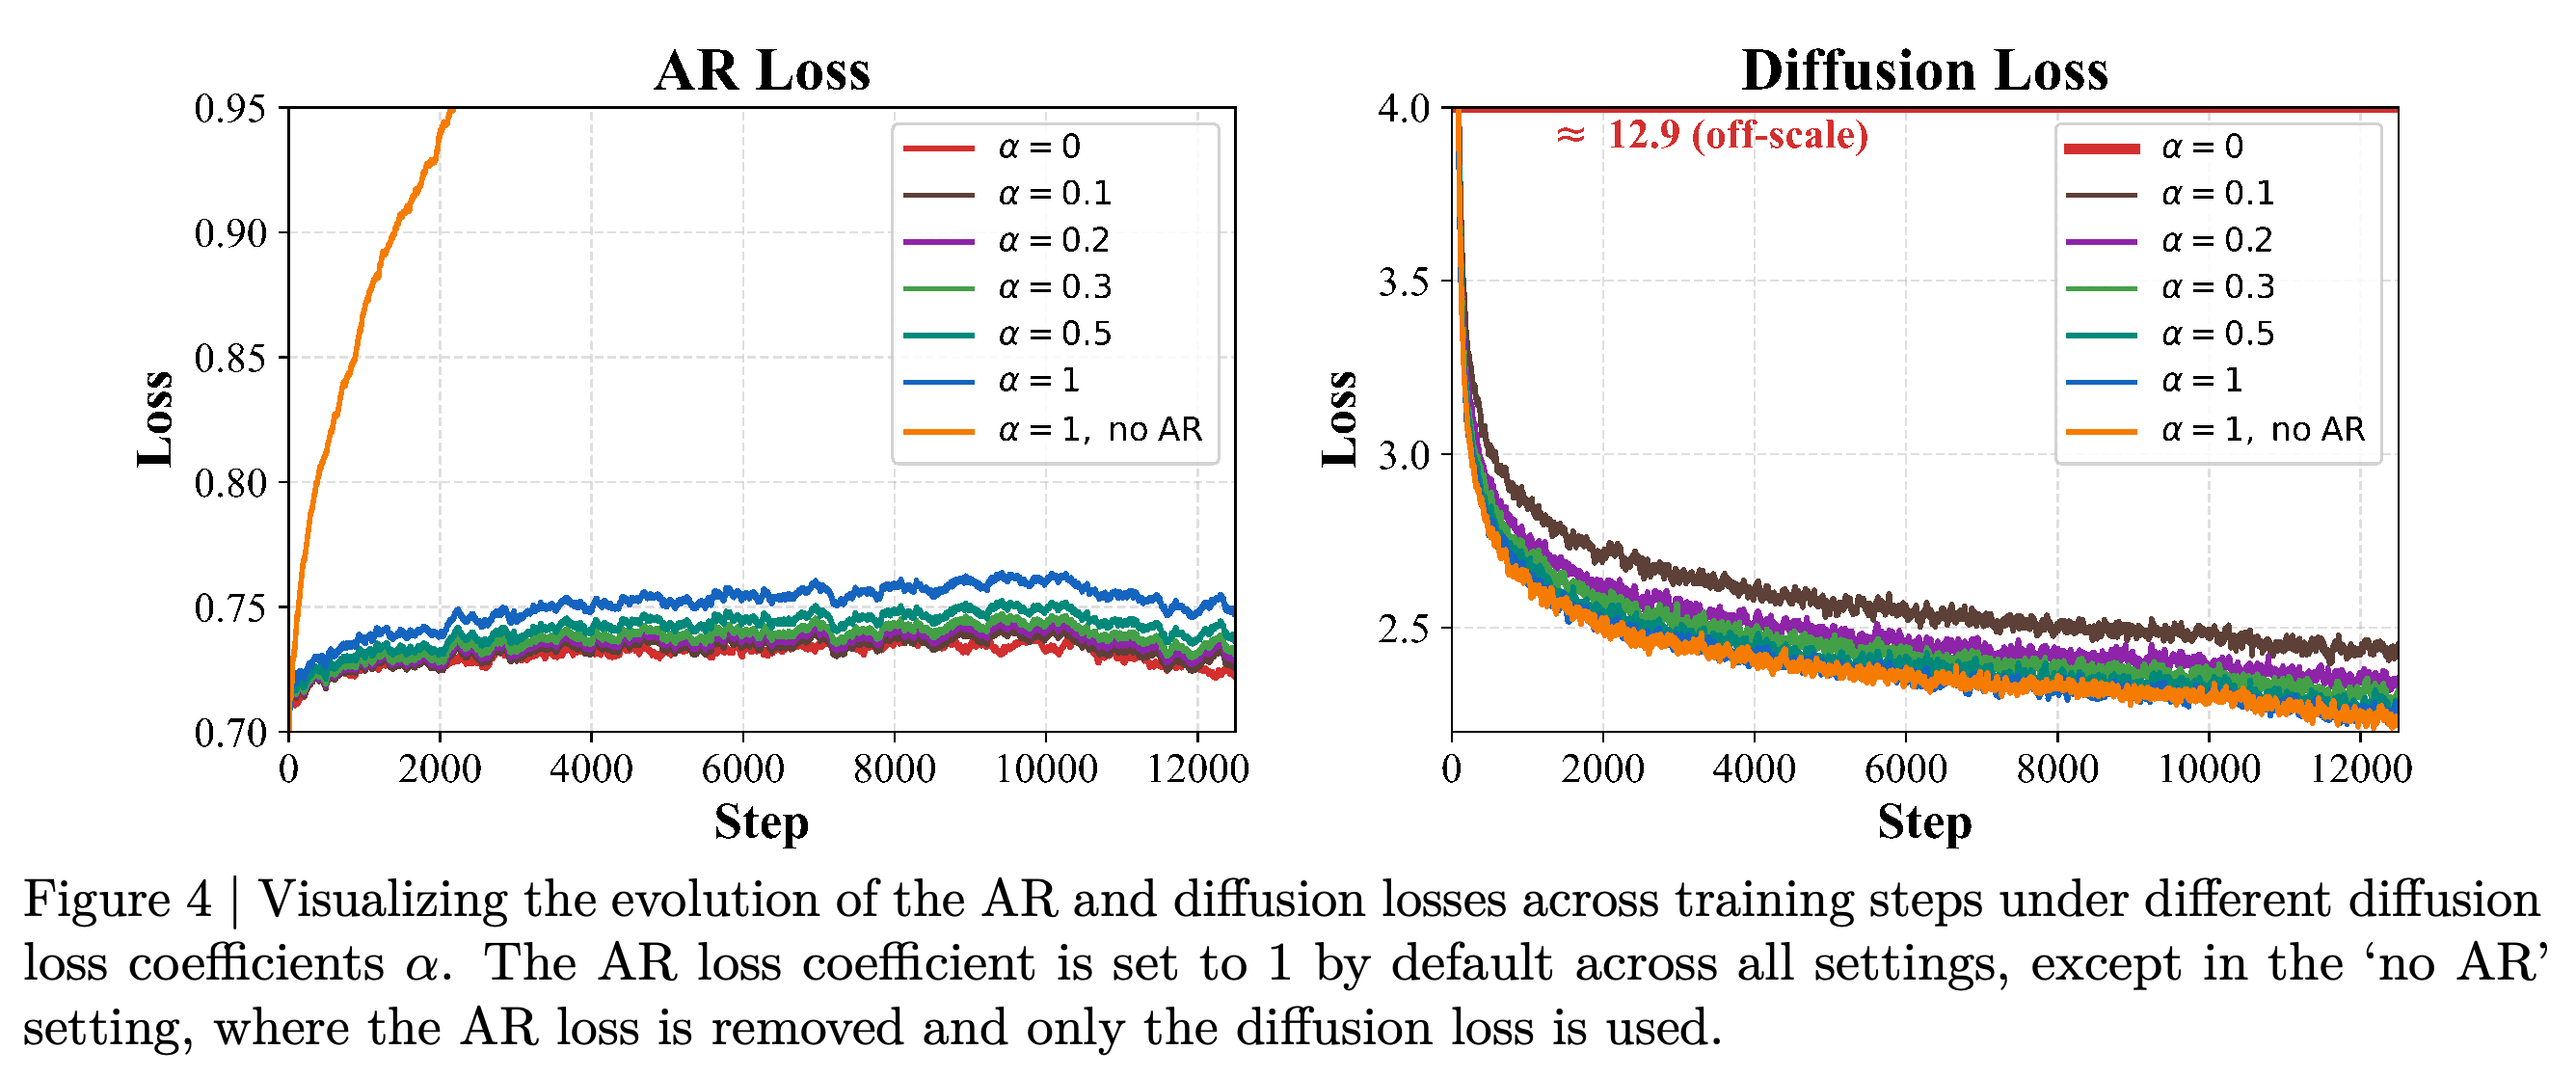
- Figure 4에서 α = 0일 때의 확산 손실은 그래프 범위를 벗어난 약 12.9로 표시된다. 학습 손실 곡선만으로 벤치마크에 최적인 계수를 판단할 수는 없다.
AR 학습 신호가 없으면 그래프의 AR 손실이 급격히 높아진다. α = 0에서의 확산 손실은 확산 패널의 범위 밖인 약 12.9로 표시된다. α = 0.3을 선택하는 근거는 이 손실 곡선만이 아니라 벤치마크 계수 실험이다.
6개 벤치마크를 사용한 이 실험에서 AR과 확산의 평균은 모두 α = 0.3에서 각각 70.62와 69.77로 가장 높다. 확산 손실의 가중치를 이보다 높인다고 일관되게 도움이 되지는 않는다.
학습 토큰 수를 맞춘 base 및 instruct 비교에서 확산 손실을 추가해도 평균 AR 점수는 조금만 변하지만, 과제별 점수는 오르거나 내린다. instruct IFEval이 71.66에서 68.65로 낮아져 모든 성능이 개선된다고 볼 수는 없다.
3. Tri-Mode LM Inference
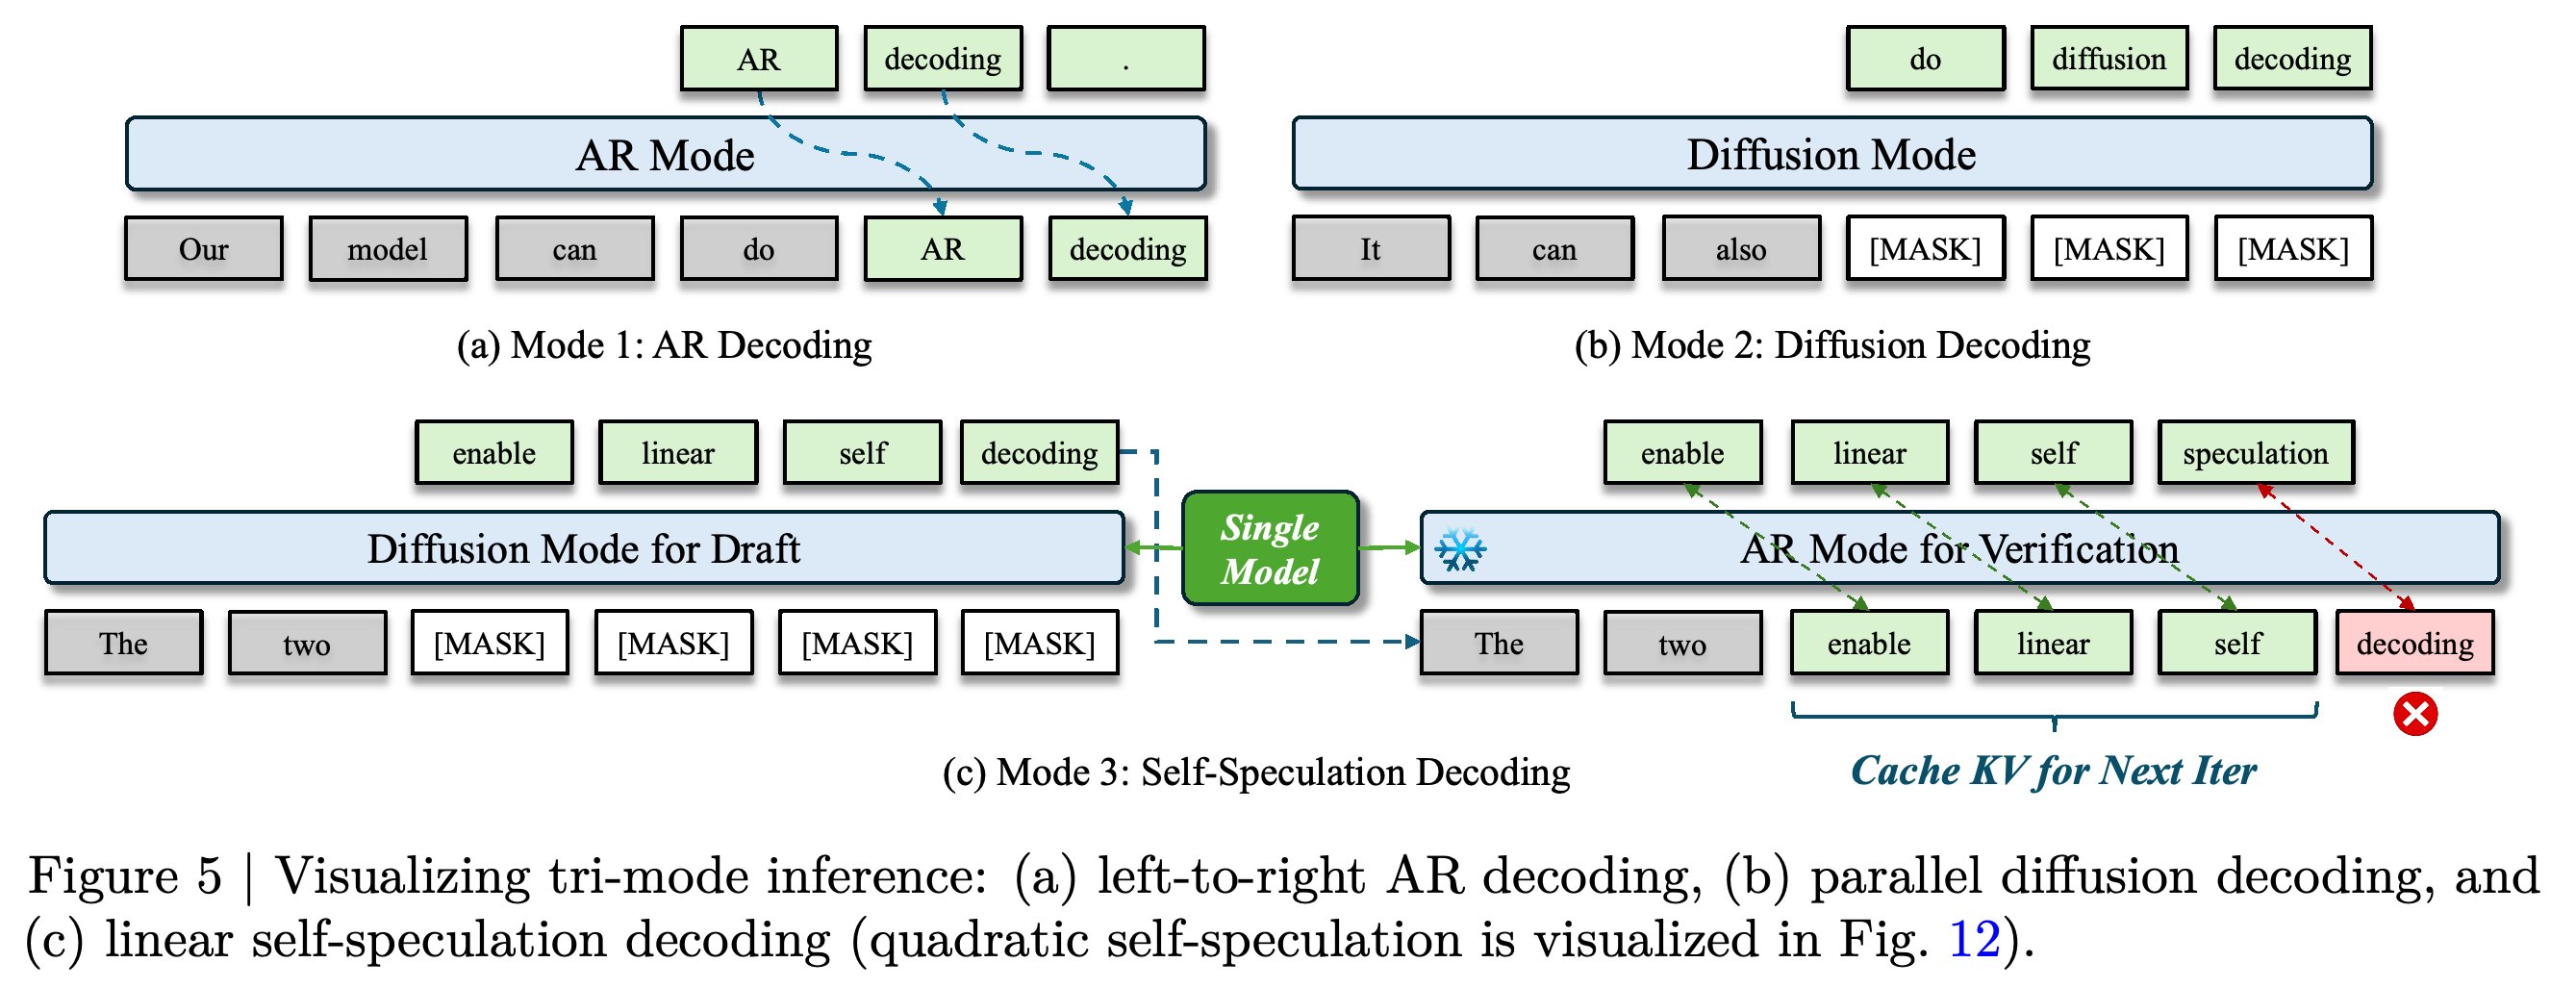
추론은 표준 인과적 AR 생성, 반복적인 블록 단위 확산, 확산 초안 작성과 AR 검증을 지원한다. 이차 자기 추측 방식은 제곱 규모의 배치와 구조화된 어텐션을 사용해 순전파 1회로 초안 작성과 검증을 결합한다. TPF는 더 높지만, 평가에 사용한 커널에서는 실제 기기 효율이 선형 자기 추측 방식보다 낮다.
3.2. Mode 2: Block-wise Diffusion Denoising
확산은 각 블록을 마스크로 시작하고, 신뢰도 임계값으로 고른 위치를 반복적으로 확정하며, 블록이 완성되면 KV 캐시를 갱신한다. 별도로 학습한 샘플러는 현재 한 위치의 top-1 토큰이 기준 노이즈 제거 경로에서 최종 확정되는 토큰과 일치할지를 추정한다. 예측값에 임계값을 적용해 정확도와 TPF 사이의 균형을 조정한다.
3.3. Mode 3: Self-Speculation Decoding
선형 자기 추측 디코딩은 검증된 접두부에 k개의 마스크를 붙이고 병렬로 토큰 초안을 만든다. 이어 두 번째 인과적 순전파를 통해 조건을 충족하는 가장 긴 접두부를 수락한다. 처음 거절된 위치에서는 AR 토큰을 추가로 얻는다. 두 순전파 모두 검증된 접두부의 KV 캐시를 재사용할 수 있지만, 거절된 위치 뒤의 초안은 버린다.
- 어텐션의 o_proj에 적용한 확산 경로 전용 LoRA 어댑터(rank 128, α = 512; 학습 가능 매개변수 약 36M개)는 초안을 고정된 AR 검증기와 일치시키도록 학습한다. LK-hybrid 손실과 교차 엔트로피 손실은 수락된 접두부와 처음 거절된 위치를 사용하며, 추론 과정에서 버리는 후속 내용에 조건화된 로짓은 제외한다.
자기 추측 디코딩 패널은 병렬 확산 초안 작성, 인과적 검증, 거절, 수락된 접두부의 캐싱을 보여준다. 별도의 AR·확산 모드와 달리 선형 자기 추측 디코딩은 한 주기마다 모델 순전파 2개가 필요하다.
4. Speed-of-Light Analysis
speed-of-light(SOL) 분석은 확산이 자신의 순차적 노이즈 제거 결과를 재현하면서 순전파마다 안전하게 확정할 수 있는 위치 수를 추정한다. AR 검증기를 사용하지 않으며 기준 시퀀스도 독립적인 정답이 아니다. 따라서 SOL TPF는 오라클 기반 비교치이지 실제 서비스 처리량 측정치가 아니다.
4.1. Diffusion SOL Construction
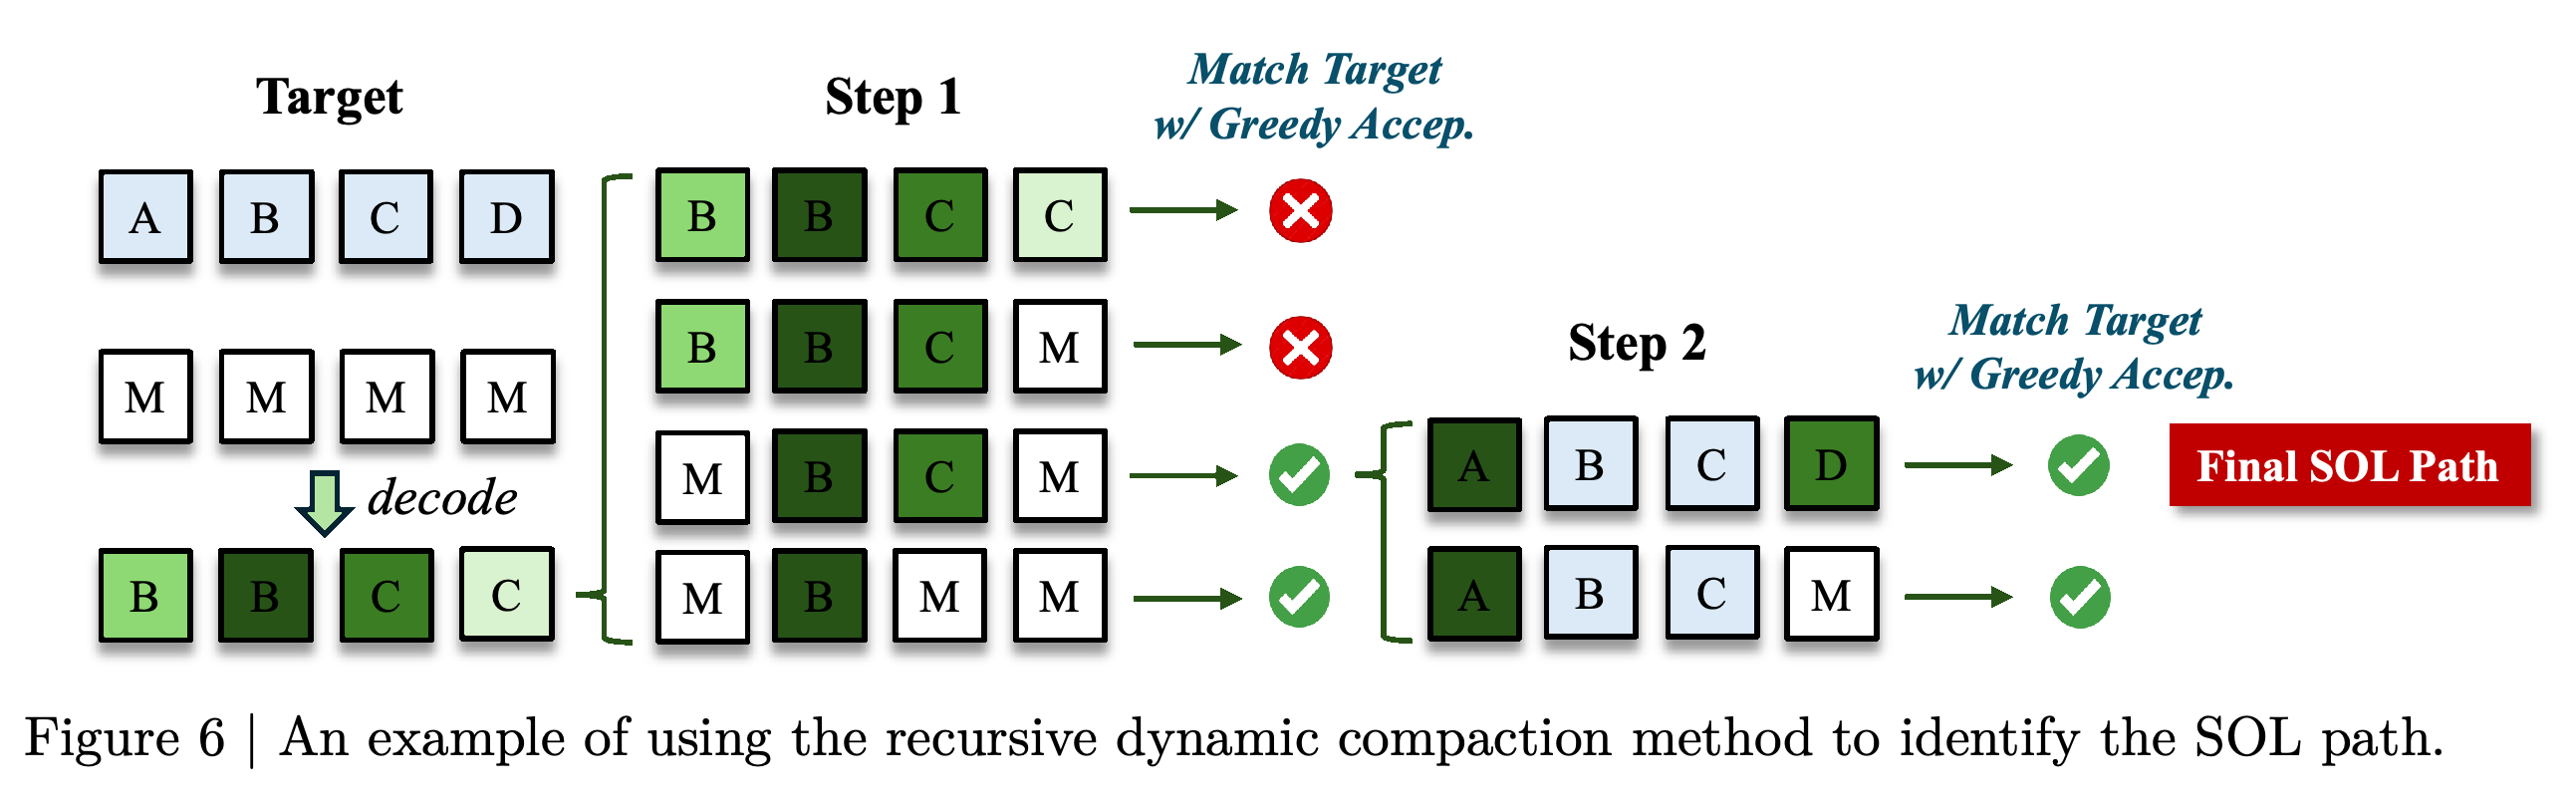
순차적 노이즈 제거는 순전파마다 신뢰도가 가장 높은 위치를 확정해 길이 B인 블록의 목표 결과를 정한다. 재귀적 동적 압축은 신뢰도 순으로 정렬된 일치 위치에서 큰 부분집합을 찾아, 이를 확정한 뒤 시뮬레이션을 계속하면 목표에 도달하는지 확인한다. 블록당 순전파 5000회의 시뮬레이션 예산을 넘는 후보는 안전하지 않은 것으로 취급한다. 현재 일치하는 위치를 모두 확정하면 목표 결과가 보존되지 않을 수 있다.
예시에서는 개별적으로 일치하는 토큰 여러 개를 확정하면 나머지 예측이 순차적 목표에서 벗어날 수 있다. 따라서 탐색 과정은 선택한 확정 위치의 집합에서 출발해 그 목표에 도달할 수 있는지 확인한다.
4.2. SOL Evaluation on SPEED-Bench
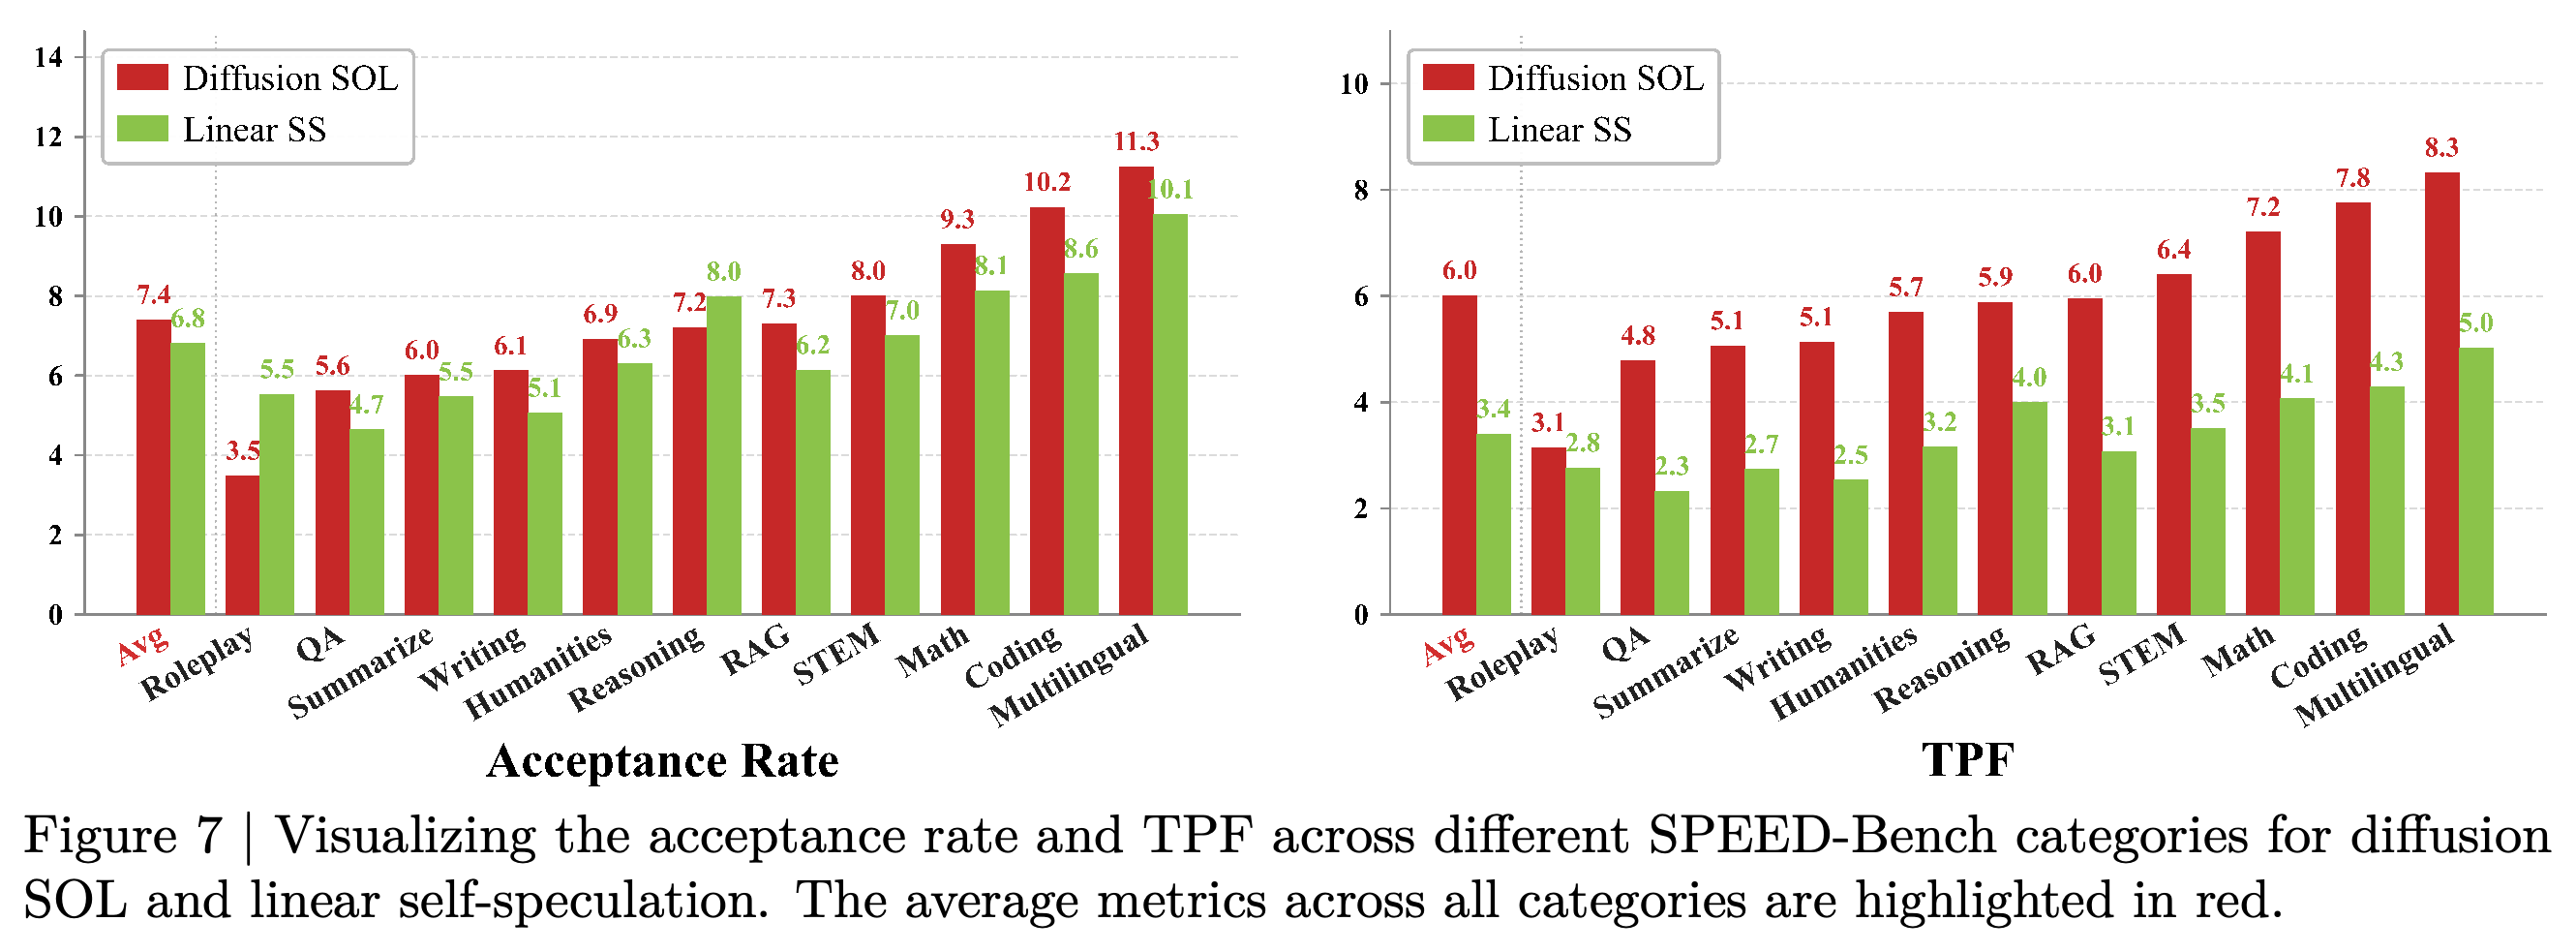
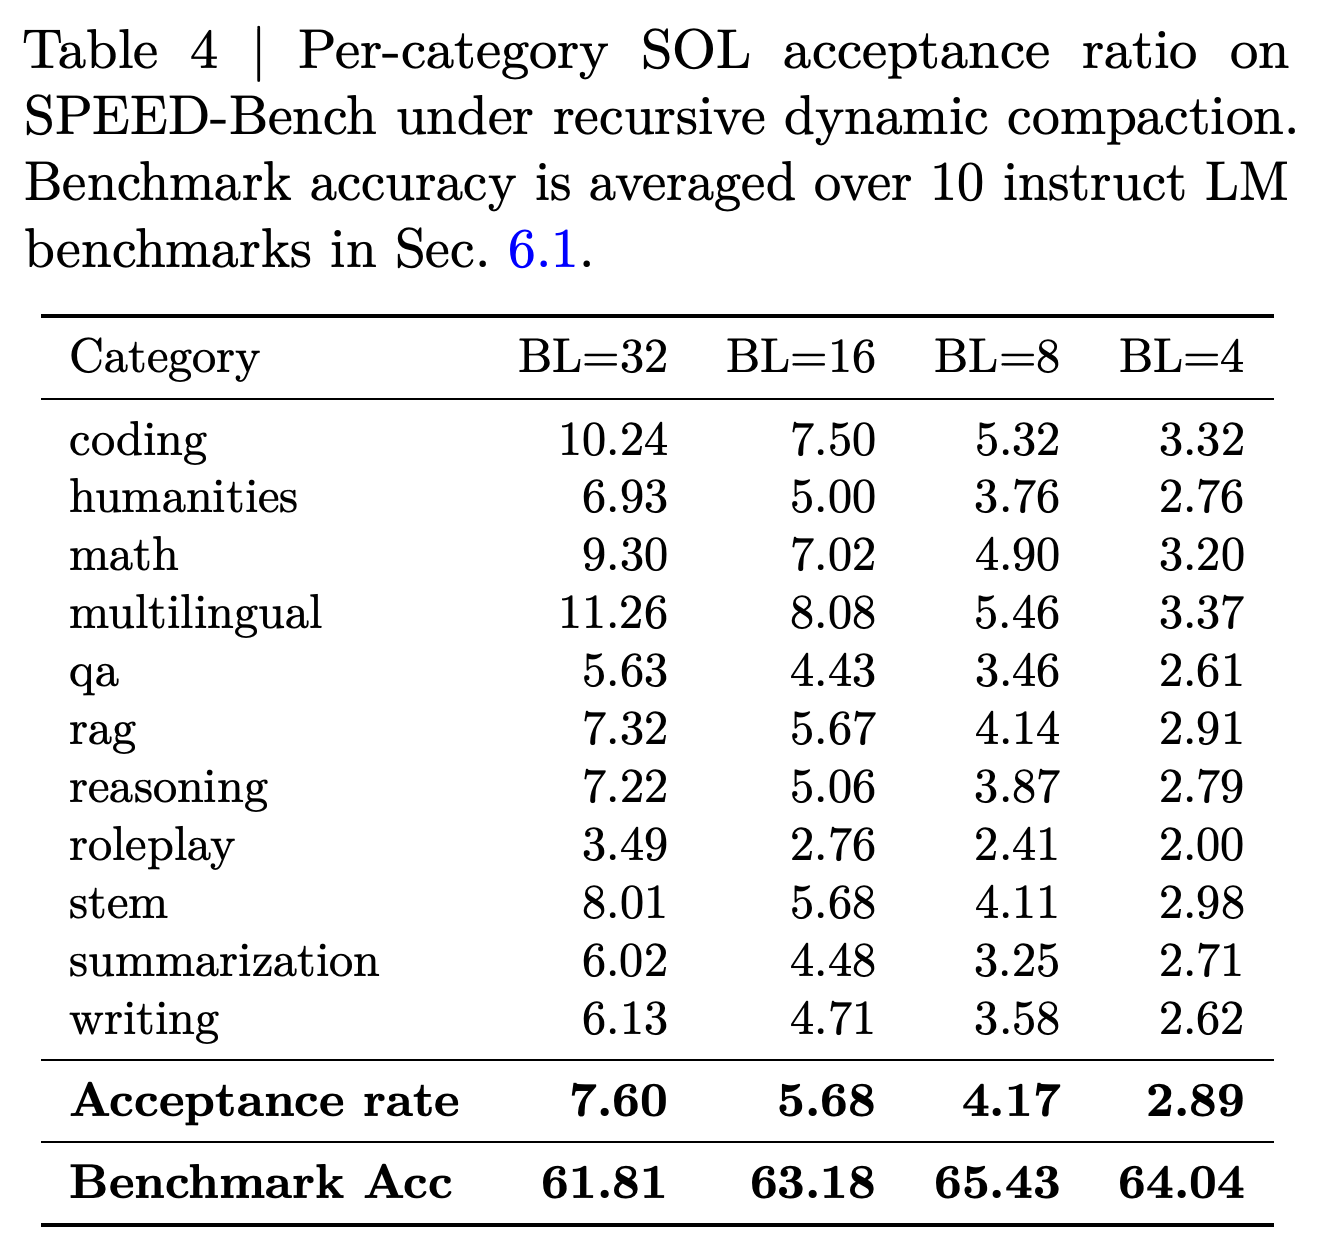
11개 범주의 SPEED-Bench 샘플 713개에서 SOL 수락 길이는 블록 길이 4일 때 2.89, 길이 32일 때 7.60으로 증가한다. 길이 32에서 범주별 수치는 STEM 8.01, roleplay 3.49, multilingual 11.26이다. 별도의 10개 과제 instruct 평가에서 평균 정확도는 길이 32의 61.81이 아니라 길이 8의 65.43에서 가장 높다.
- 길이 32에서 SOL과 선형 자기 추측 디코딩의 수락 길이는 각각 7.60과 6.82이지만 실제 TPF는 6.02와 3.41이다. 두 방식은 정답 여부를 판단하는 기준이 다르며, SOL의 TPF 우위 76.5%는 실제 샘플러에서 실현된 속도 향상이 아니다.
패널은 단계당 수락 토큰과 모델 순전파당 토큰을 구별한다. 전체 수락 길이는 SOL 7.60, 선형 SS 6.82인 반면 실제 TPF는 각각 6.02와 3.41이다. 선형 SS에는 별도의 초안 작성과 검증 순전파 비용이 든다.
블록을 길게 하면 오라클 기반 수락 길이가 늘어나며, STEM은 블록 길이 32에서 8.01에 도달한다. 그러나 별도의 instruct 벤치마크 모음에서 평균 정확도는 길이 8일 때 가장 높다. 범주별 차이는 잠재적 병렬성의 측정치가 콘텐츠에 따라 달라진다는 점도 보여준다.
5. Nemotron-Labs-Diffusion Family
3B/8B/14B base 모델은 사전학습된 Ministral3 모델에서 출발한다. NVIDIA H100 GPU 256개에서 시퀀스 길이 4096으로 AR 학습 1T 토큰을 거친 뒤, α = 0.3으로 공동 학습 300B 토큰을 진행한다. instruct 모델은 시퀀스 길이 16k에서 45B 토큰으로 공동 목적함수를 사용해 지도 미세조정한다. 프롬프트 토큰은 마스킹하지 않으며 손실은 답변 토큰에 대해서만 계산한다.
5.3. Vision-Language Models
8B 비전·언어 모델은 확산을 고려해 학습한 instruct LM 백본에 Ministral3-8B-Instruct-2512의 비전 인코더와 2층 MLP 프로젝터를 결합한 뒤 함께 미세조정한다. 비대칭 이중 스트림은 마스킹되지 않은 비전 토큰을 노이즈가 있는 쪽에서 제외하고 깨끗한 쪽에는 유지한다. 이에 따라 전체 입력 길이는 2L에서 L_text + L로 바뀌며, L_text = L − N_vis이다.
6. Evaluation and Analysis
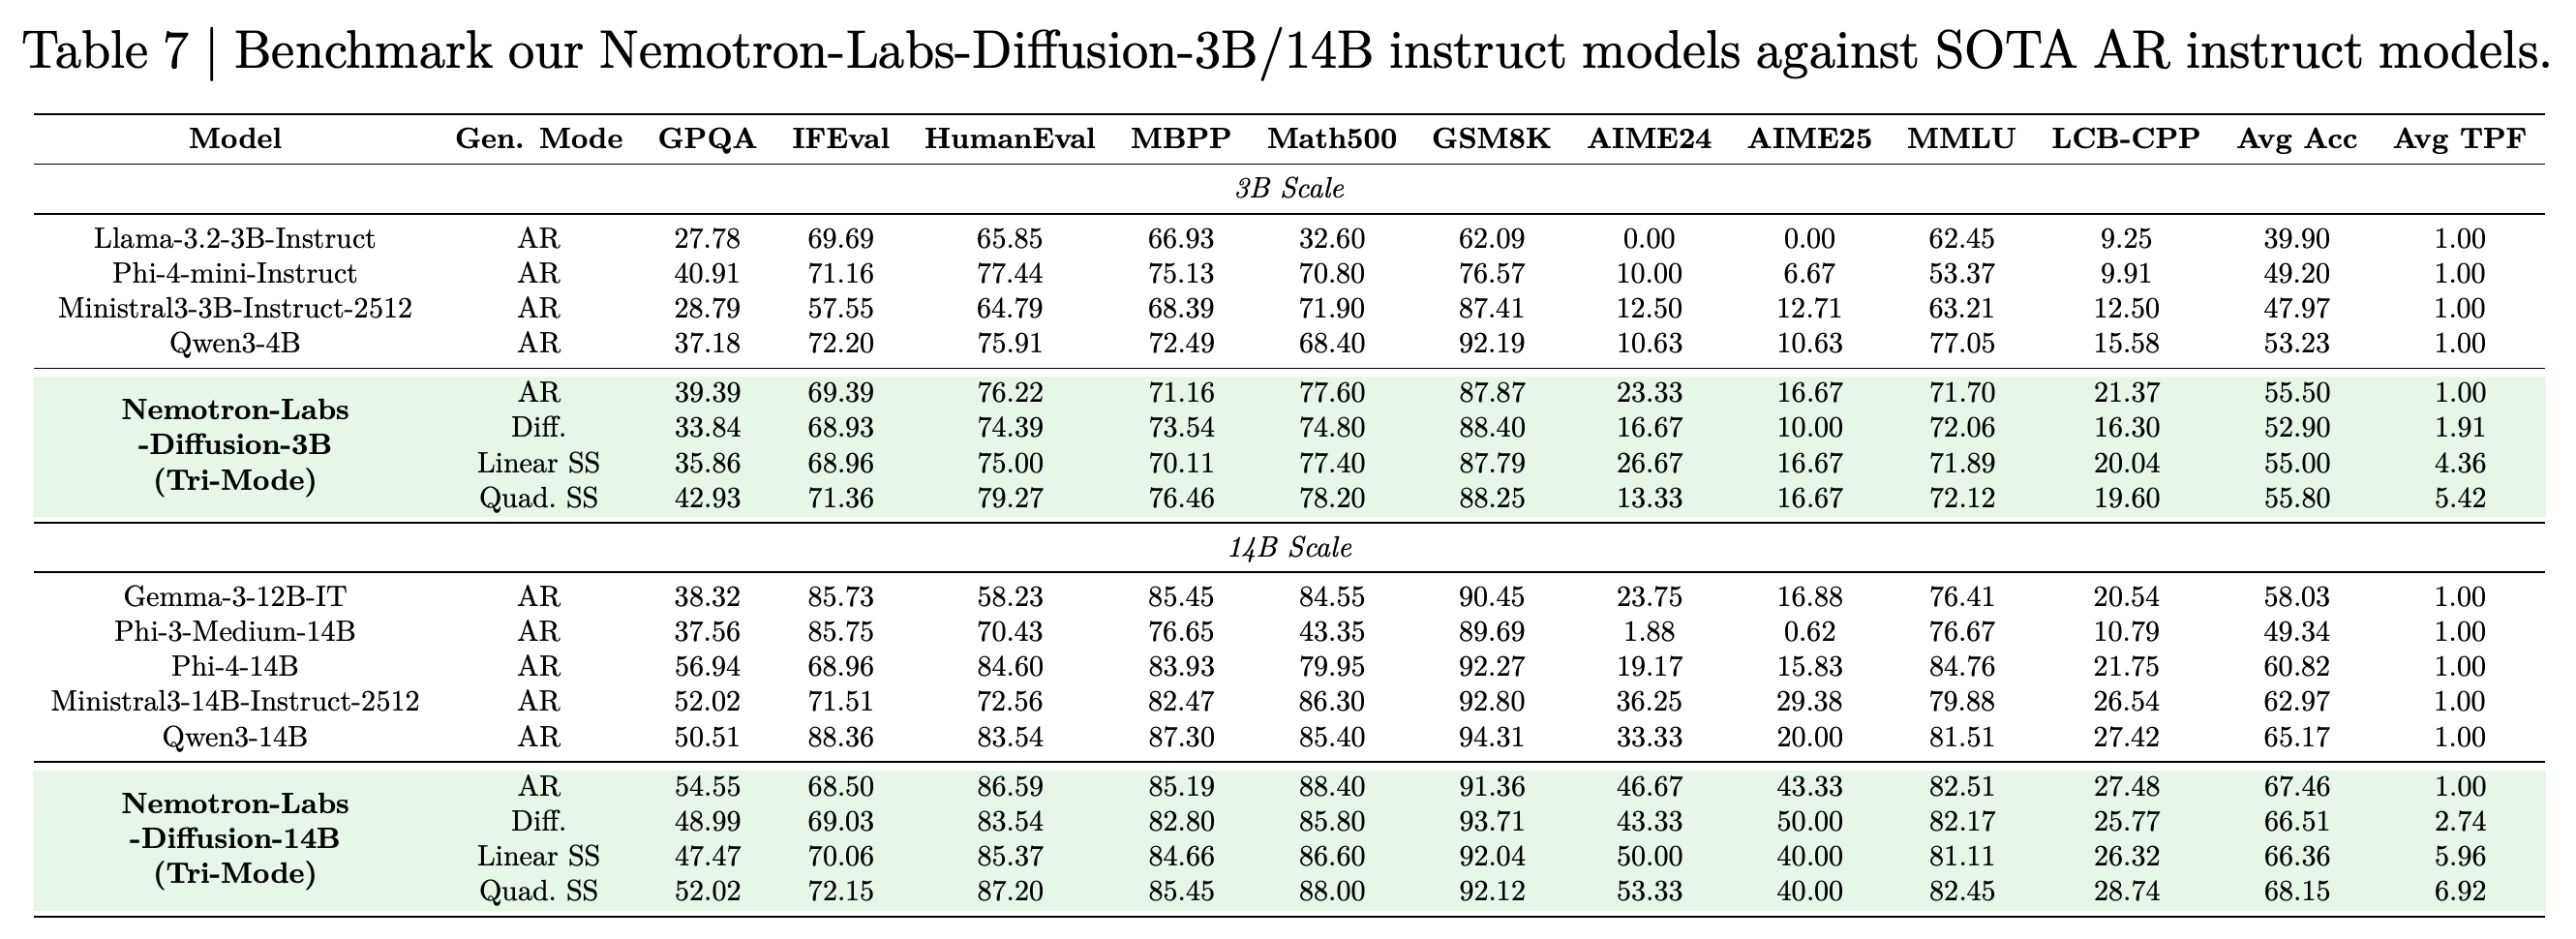
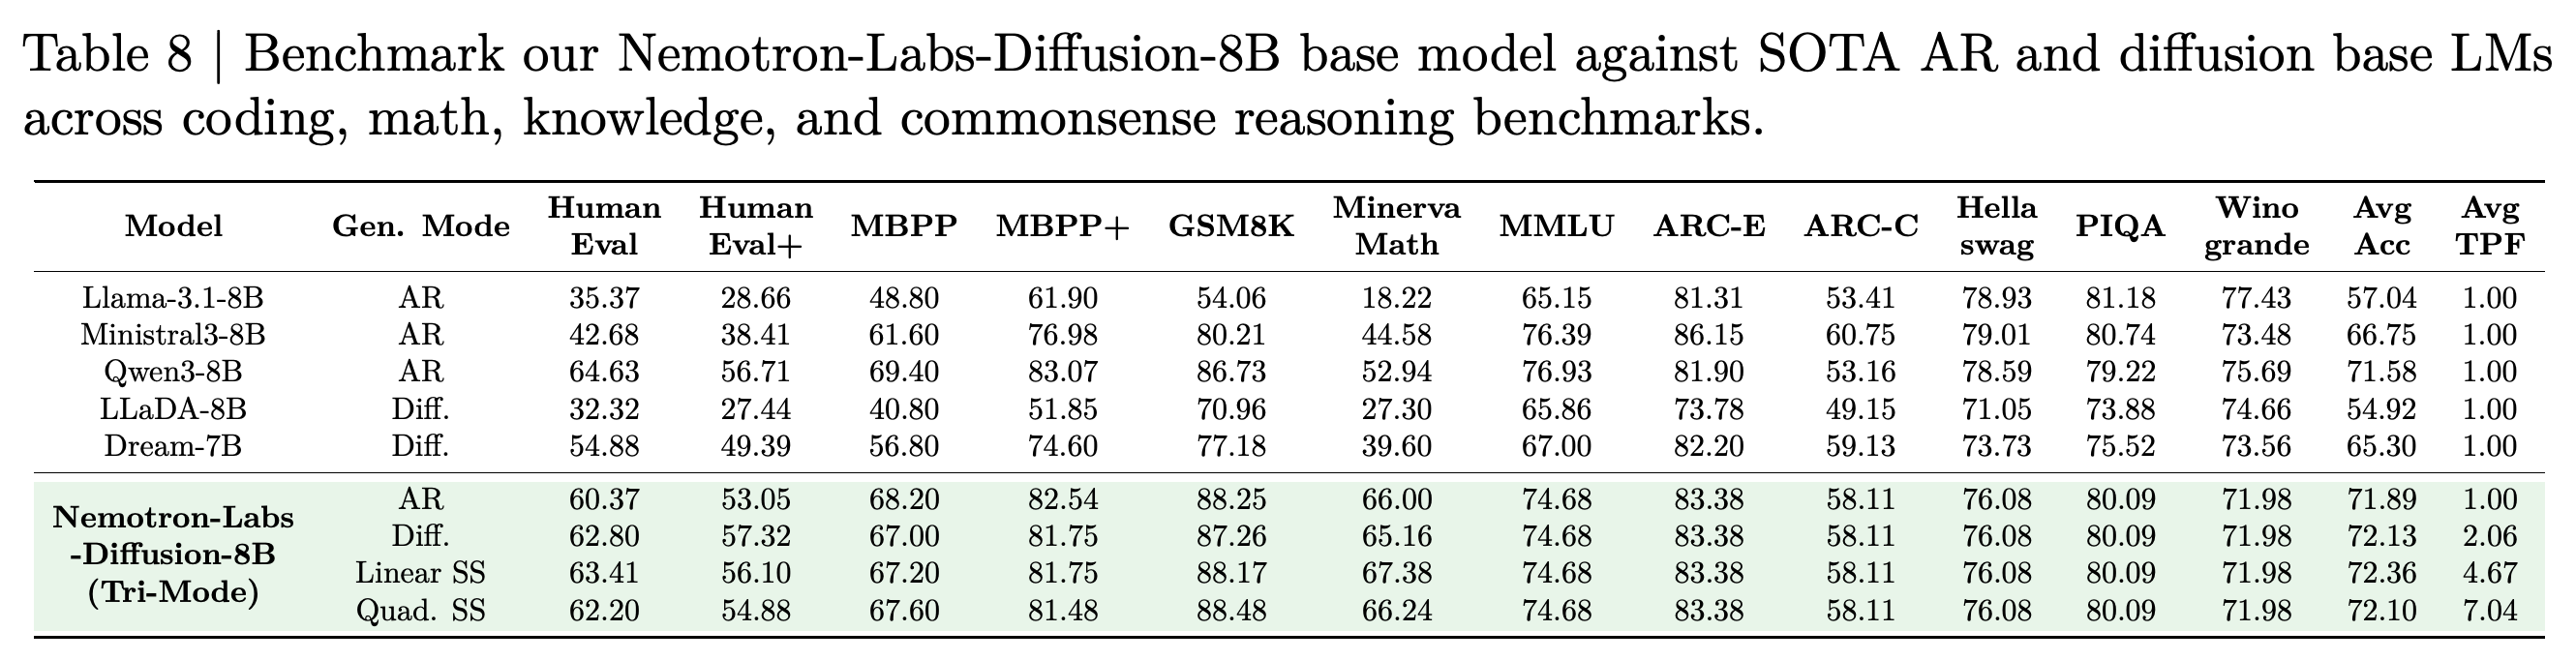
평가 대상은 비사고형 instruct 모델, base 모델, VLM이며 TPF와 기기 처리량을 별도로 보고한다. 3B와 14B에서 LoRA로 조정한 선형 자기 추측 디코딩은 각각 4.36, 5.96 TPF와 평균 정확도 55.00, 66.36을 기록한다. 8B base 모델은 정확도 72.36과 4.67 TPF를 기록하며, Qwen3-8B base는 71.58과 1.00 TPF를 기록한다.
- 3B instruct 비교에는 매개변수 수가 같은 3B 모델 대신 Qwen3-4B가 포함된다. 이 결과에서는 모델 규모가 커질수록 TPF가 증가하지만, 표만으로는 저자들이 제시한 미래 예측 능력이라는 설명을 분리해 검증할 수 없다.
6.1. Benchmark Instruct Models
GPQA, IFEval, MMLU, 코딩 과제 3개, 수학 과제 4개에서 8B instruct 모델의 AR/확산/선형 SS/이차 SS 모드 평균 정확도는 63.61/63.18/62.81/64.04이며, TPF는 1.00/2.57/5.99/6.38이다. 블록 길이 32에서 학습된 샘플러는 그래프에 나타난 확산 정확도·TPF 경계를 개선한다. 정확도를 맞추면 TPF가 1.3배이고, TPF를 맞추면 정확도가 10.6%p 높다. LoRA는 평균 정확도를 비슷하게 유지하면서 8B 선형 SS의 TPF를 4.52에서 5.99로 높인다.
- AR 기준 모델과 제안 모델은 NeMo-Skills [26]로 평가하지만, 확산 기준 모델은 각각의 기존 평가 파이프라인을 사용한다. 따라서 모델 간 결과가 모두 동일한 평가 구현에 기반하지는 않는다.
선형 SS는 10개 instruct 과제에서 평균 정확도 62.81과 5.99 TPF를 기록하며, 평균 정확도는 제안 모델의 AR 및 확산 모드와 비슷하다. 과제별 비교 결과는 상당히 다르며, IFEval 점수는 Qwen3-8B보다 낮다.
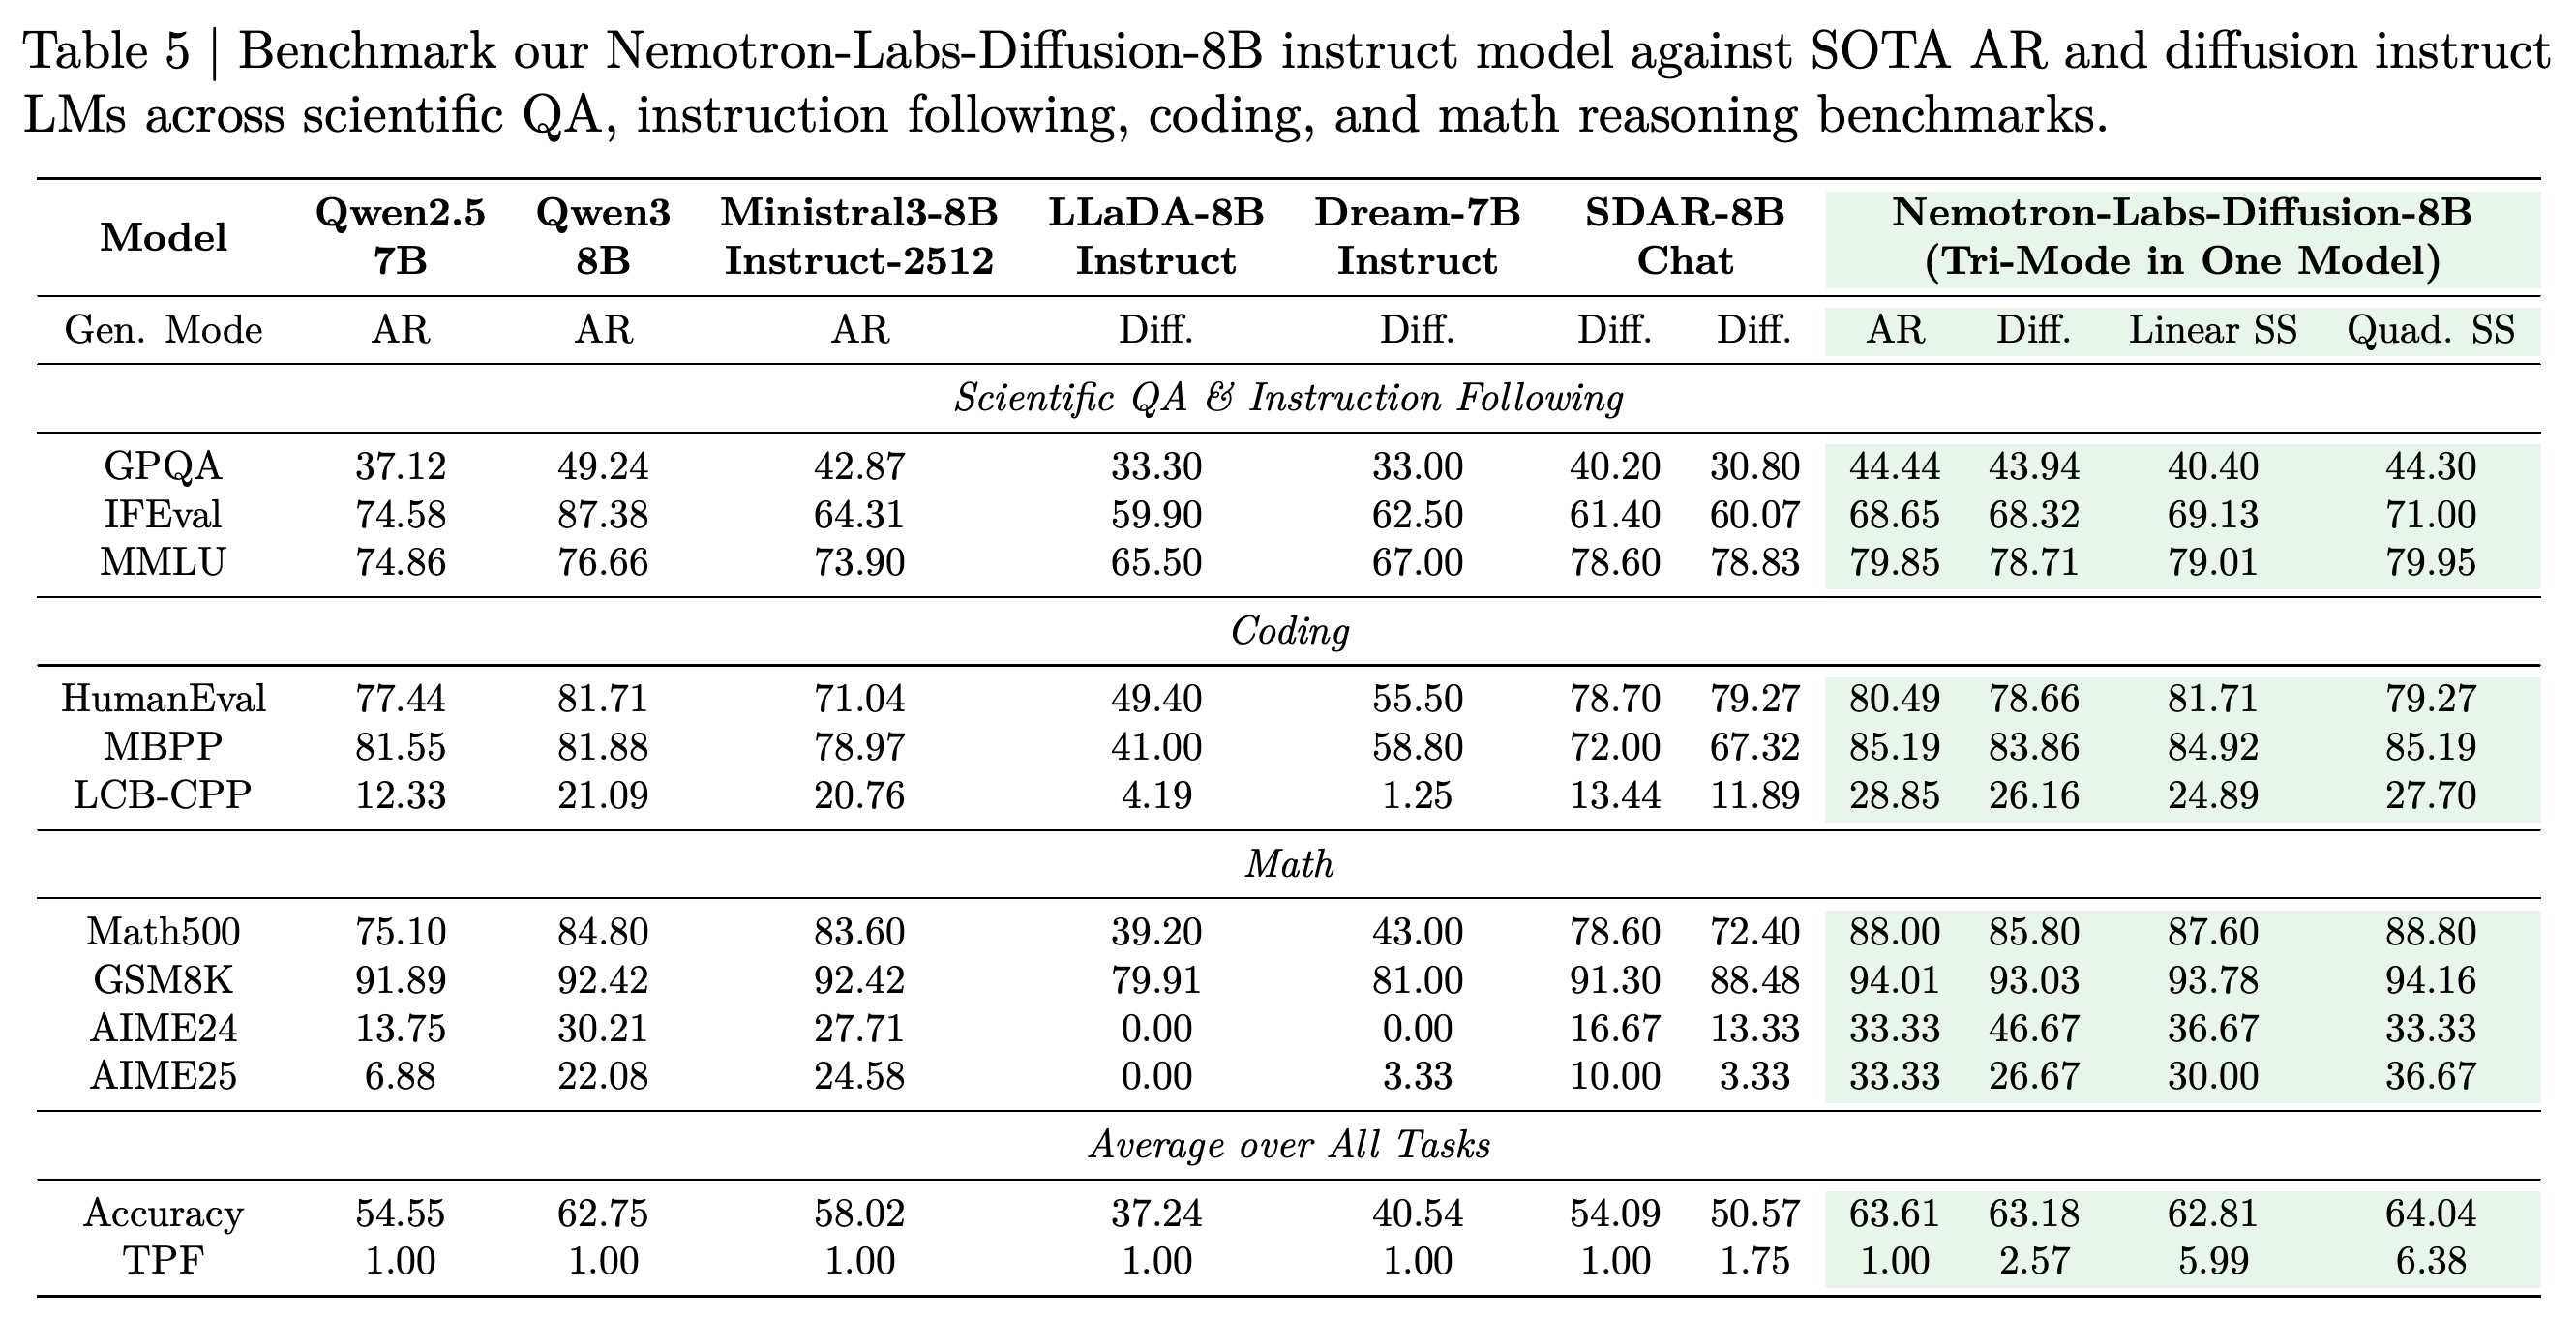
LoRA는 3B, 8B, 14B 규모 모두에서 제시된 평균 정확도를 거의 바꾸지 않으면서 선형 SS의 TPF를 높인다. 8B의 TPF는 4.52에서 5.99로 높아져 초안 모델 조정의 효과를 직접 보여준다.
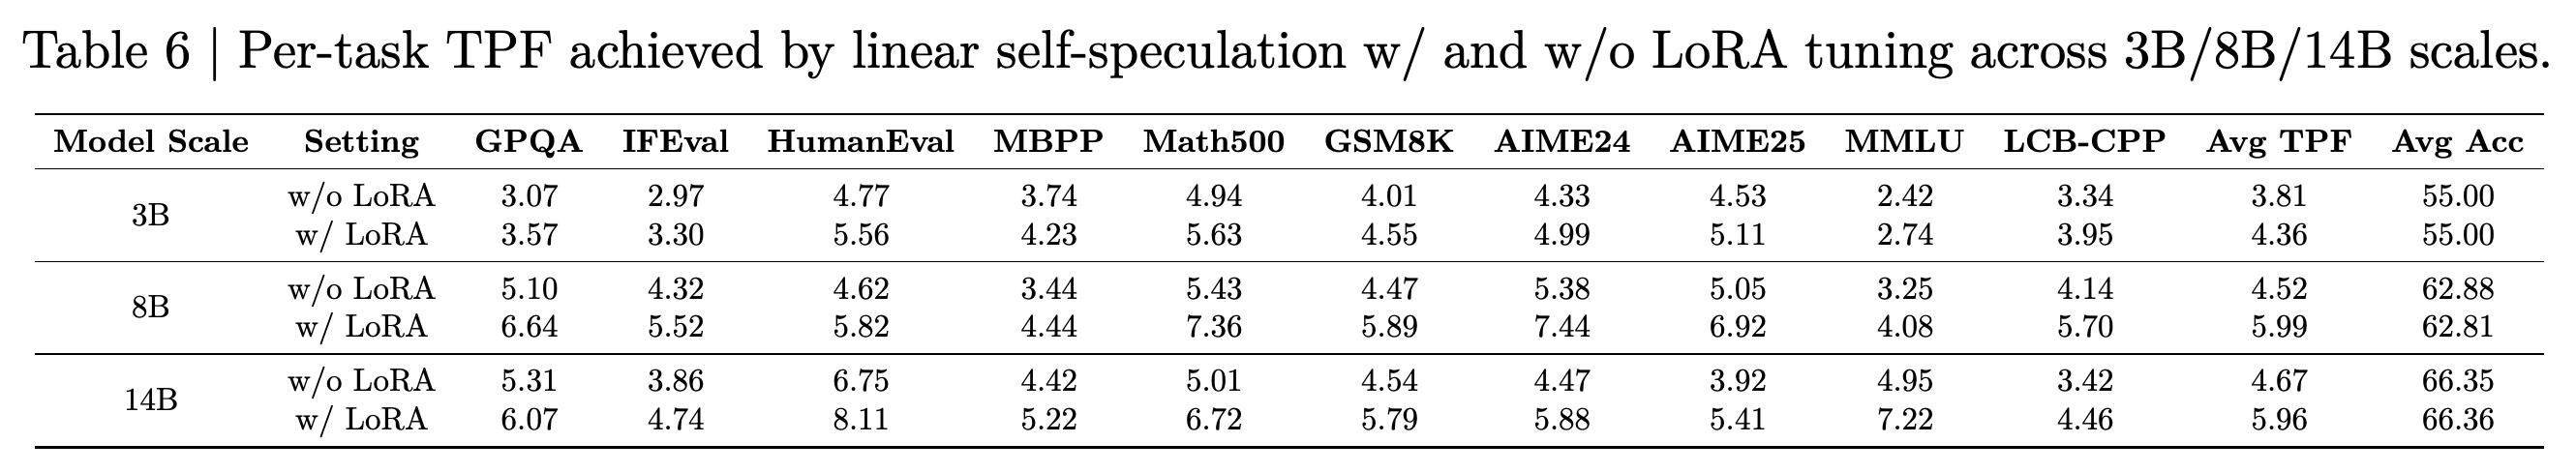
블록 길이 32에서 학습된 샘플러는 신뢰도 임계값만 사용했을 때보다 그래프의 정확도·TPF 균형을 개선한다. 표시된 비교에서는 정확도를 맞추면 TPF가 1.3배, TPF를 맞추면 정확도가 10.6%p 높다.
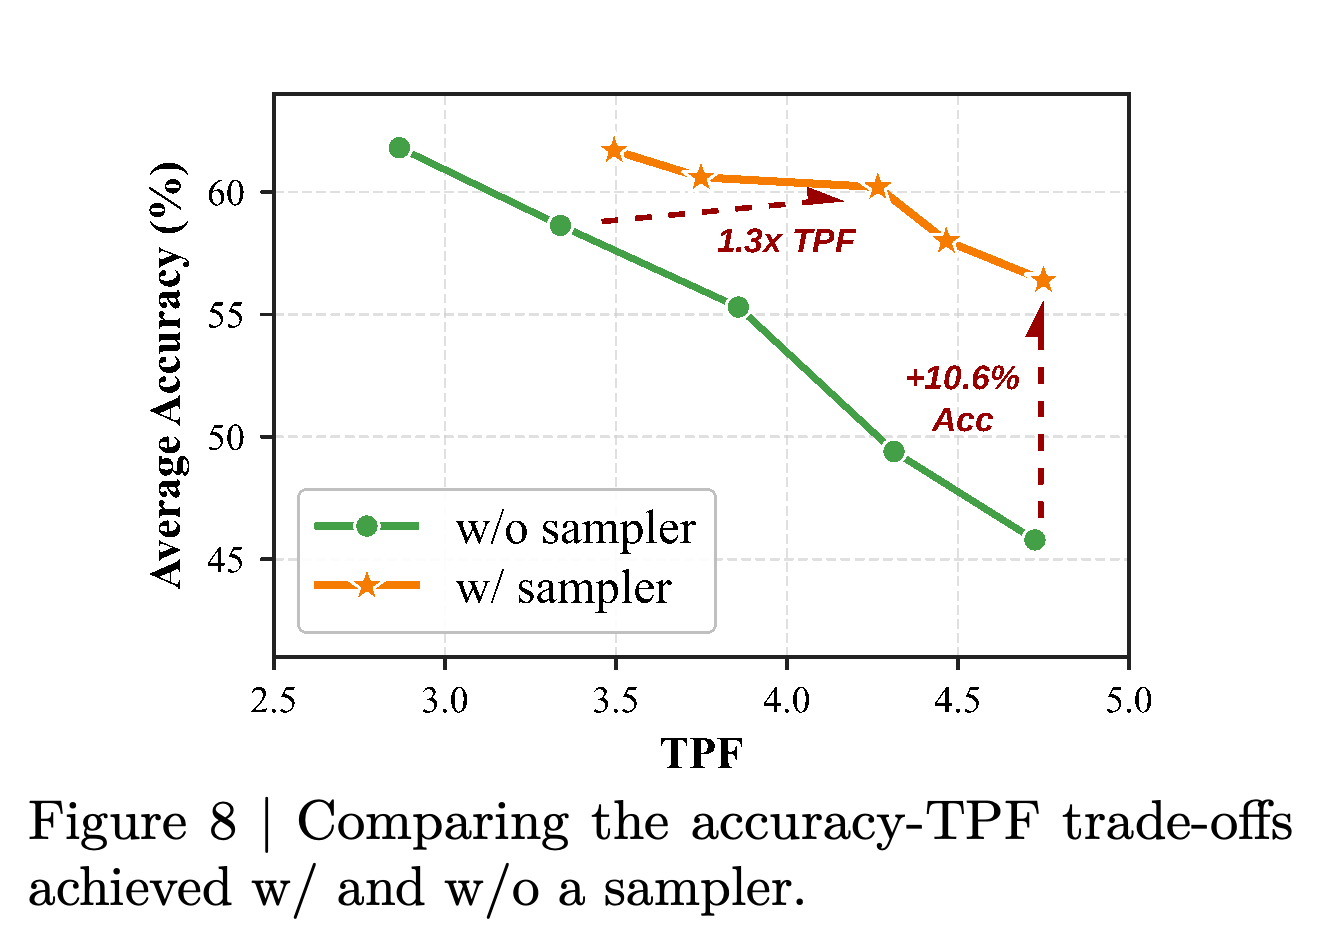
3B와 14B instruct 모델의 선형 SS는 각각 4.36과 5.96 TPF, 평균 정확도 55.00과 66.36을 기록한다. 3B 비교에는 Qwen3-4B가 포함되므로, 매개변수 수를 맞춘 3B 비교는 아니다.
제안한 8B base 모델의 선형 SS는 평균 정확도 72.36과 4.67 TPF를 기록하며, Qwen3-8B base는 71.58과 1.00을 기록한다. 이 모델의 4가지 모드 결과는 디코딩 방식에 따라 정확도와 TPF가 같은 양상으로 변하지 않음을 보여준다.
6.4. Benchmark VLMs
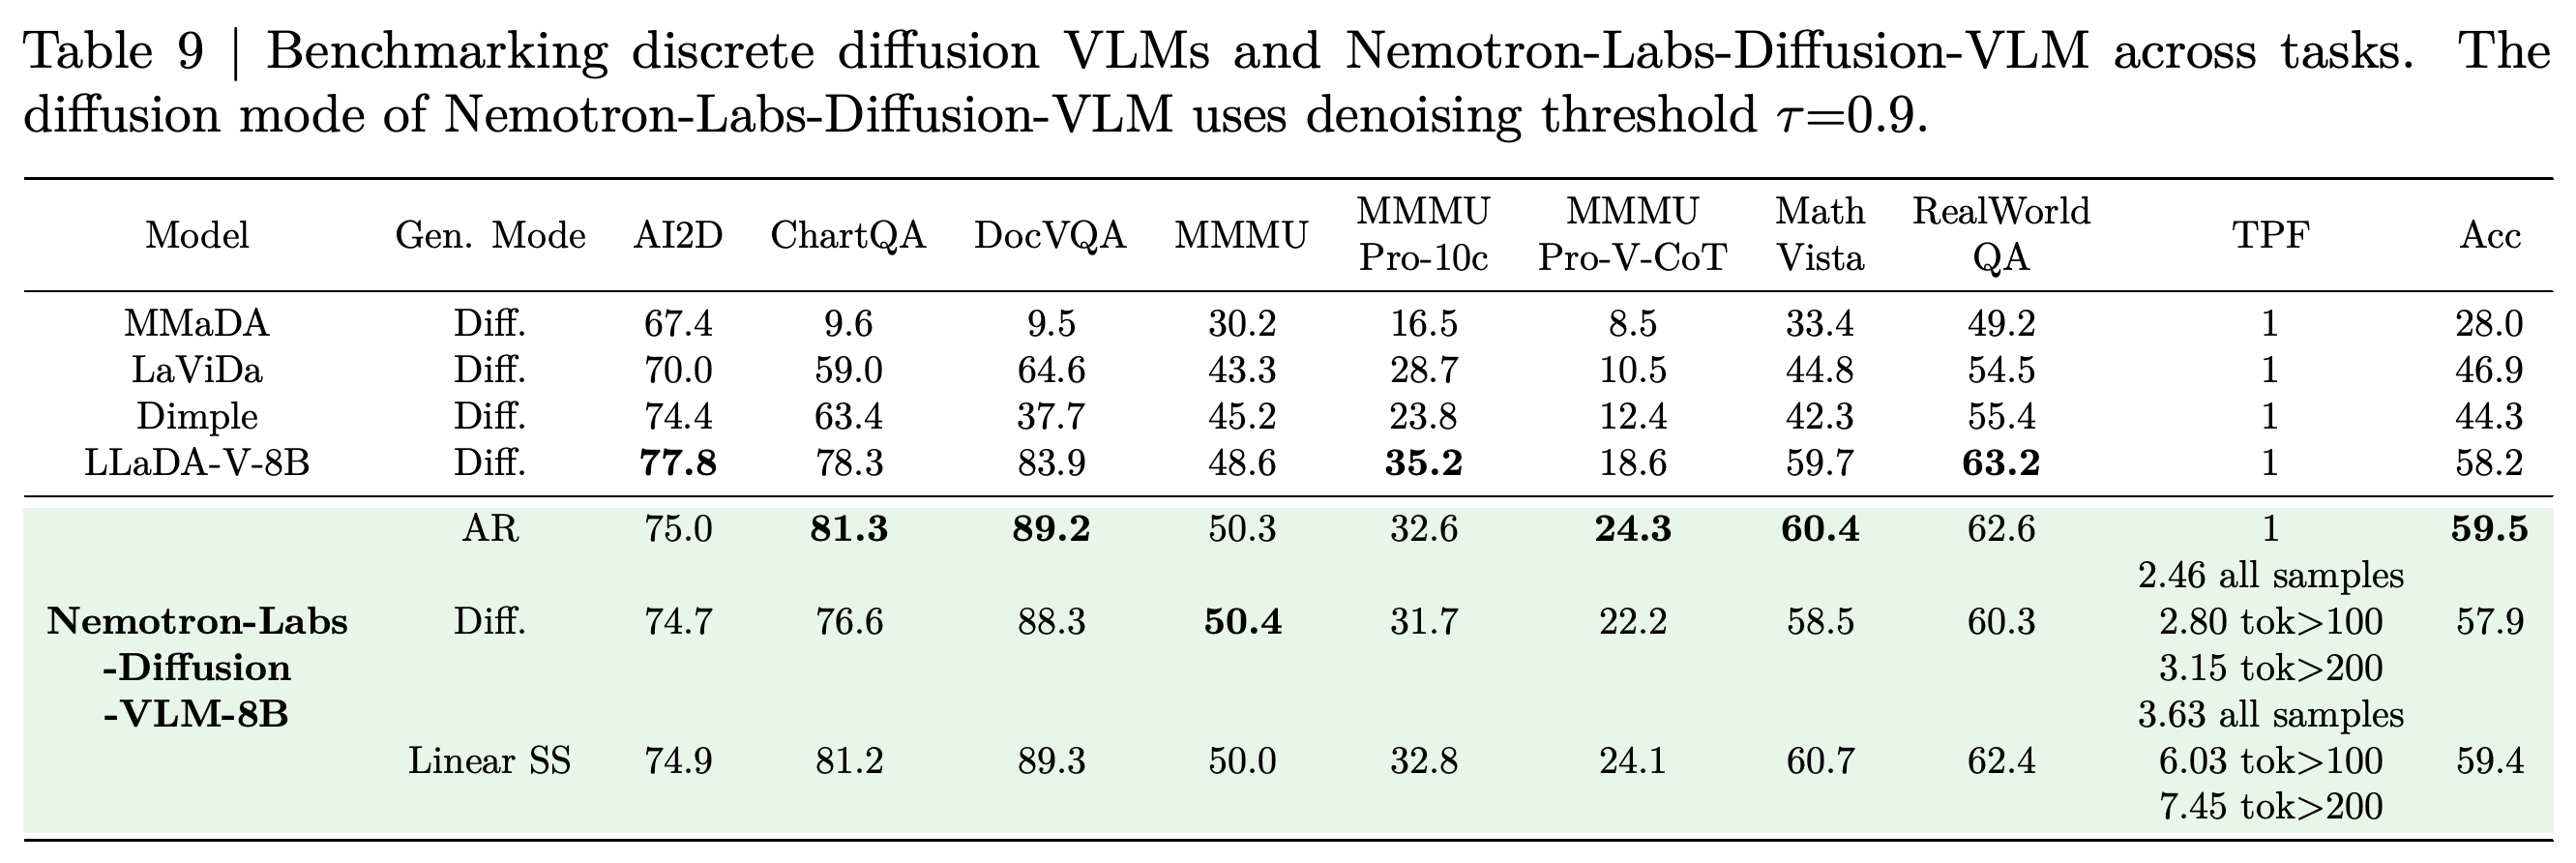
VLM 벤치마크의 8개 열에서 AR과 선형 SS 모드의 평균 정확도는 59.5와 59.4이며, 노이즈 제거 임계값 τ = 0.9를 사용한 확산 모드는 57.9다. 선형 SS의 TPF는 전체 샘플에서 3.63, 응답 길이가 200토큰을 넘는 경우 7.45다. 후자는 길이로 선별한 TPF이지 전체 샘플의 처리량이 아니다.
VLM 선형 SS의 평균 정확도는 59.4로 AR의 59.5와 비슷하다. 7.45 TPF는 응답이 200토큰을 넘는 경우에만 적용되며, 전체 샘플의 선형 SS 수치는 3.63 TPF다.
6.5. Inference Efficiency
SGLang 시험은 SPEED-Bench의 수학, 코딩, 추론, 다국어 프롬프트에서 8B 모델과 Qwen3-8B-Eagle3을 비교하며, 생성은 최대 1024토큰으로 제한한다. GB200에서 동시성 1일 때 선형 SS는 851 tok/sec, AR은 256 tok/sec, Eagle3은 354 tok/sec를 기록한다. 최적화된 커널은 1015 tok/sec에 도달하지만, SOL의 1471 tok/sec는 추정치다.
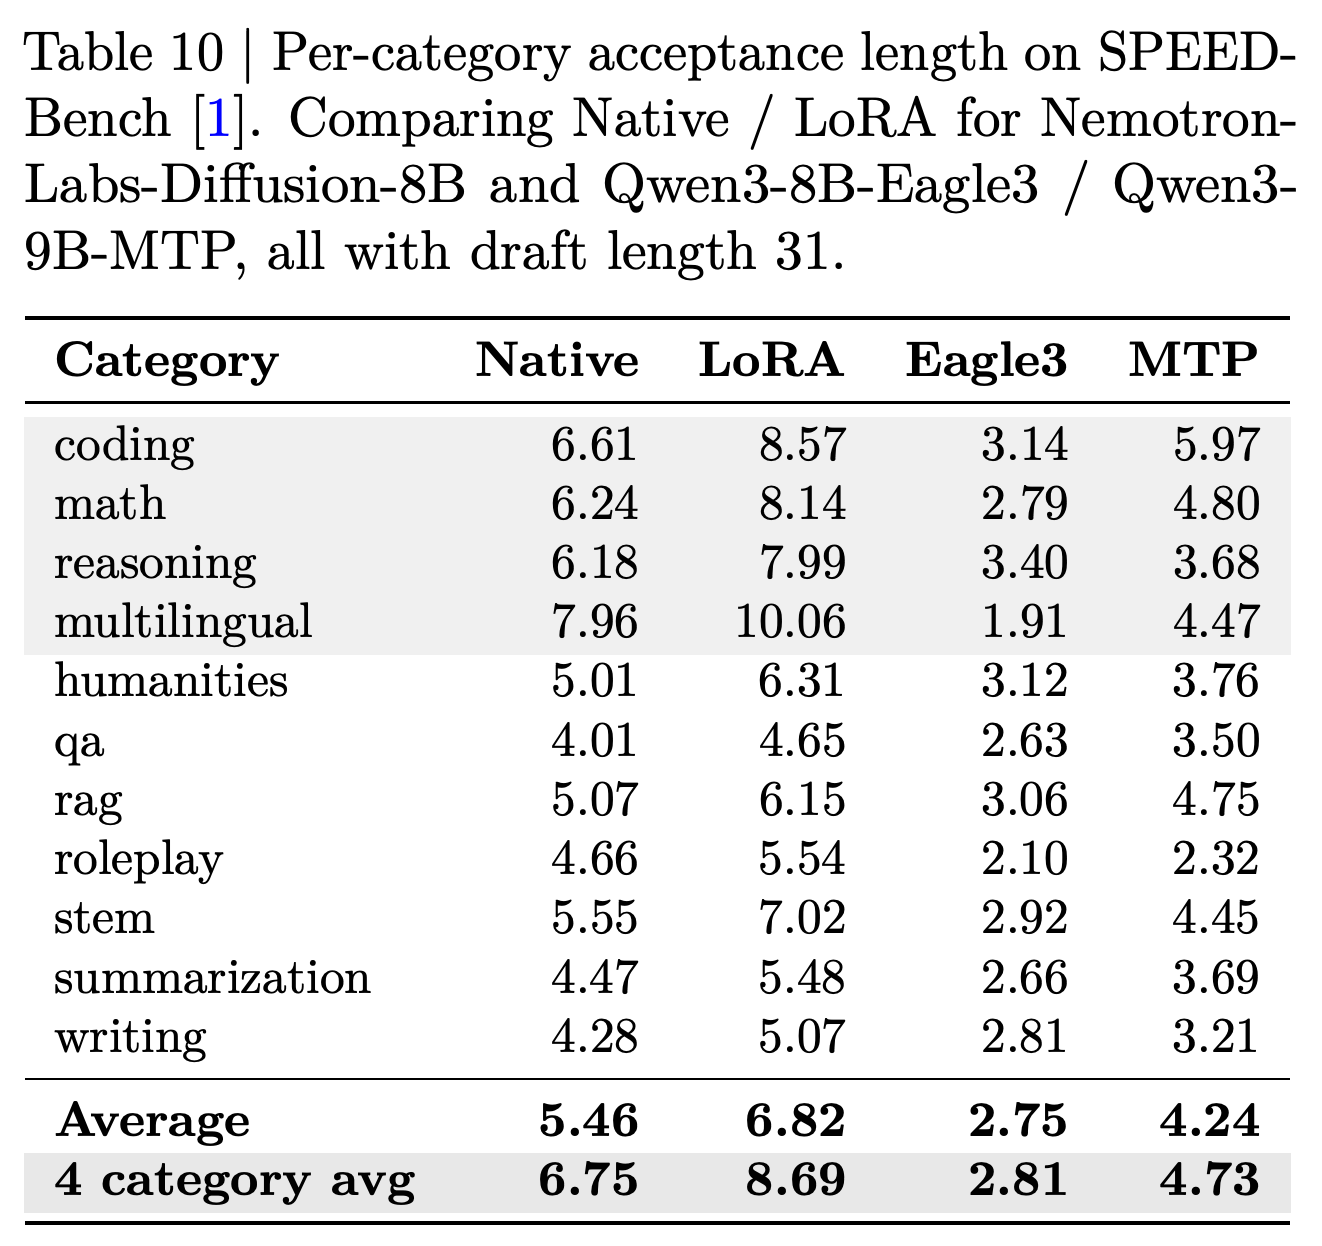
- 초안 길이 31에서 11개 범주의 LoRA 자기 추측 디코딩은 평균 6.82토큰을 수락한다. Eagle3은 2.75토큰, Qwen3-9B-MTP는 4.24토큰을 수락한다. 범주 4개의 LoRA 평균은 8.69다. DGX Spark에서 선형 SS는 FP8로 77.5 tok/sec(AR 대비 3.14배), INT4로 112.5 tok/sec(AR 대비 2.69배)를 기록한다. 보고된 동시성 곡선에서는 부하가 높아질수록 전체 시스템 처리량과 사용자별 처리량 사이의 균형이 달라진다.
기기별 패널은 동시성 1에서 측정한 처리량과 빗금으로 표시한 SOL 추정치를 구별한다. GB200에서 측정한 선형 SS 처리량은 851 tok/sec이고, 최적화된 커널을 적용하면 1015 tok/sec다. AR은 256 tok/sec이며, 다른 패널에는 RTX Pro 6000과 DGX Spark의 결과를 별도로 제시한다.
초안 길이 31에서 LoRA 자기 추측 디코딩은 11개 범주에 걸쳐 평균 6.82토큰을 수락한다. Eagle3은 2.75토큰, MTP는 4.24토큰을 수락한다. LoRA의 4개 범주 평균 8.69는 전체 벤치마크가 아닌 코딩, 수학, 추론, 다국어 부분집합의 결과다.
8. Insights and Future Directions
공동 학습으로 모드별 구조 변경 없이 3가지 추론 모드를 지원한다. 계수 실험과 학습 토큰 수를 맞춘 절제 실험은 평균 AR 정확도가 유지됨을 보여준다. LoRA 절제 실험과 기기 측정은 평가된 Eagle3 및 MTP 비교 모델에 비해 선형 자기 추측 디코딩이 낮은 동시성에서 실용적 이점이 있음을 뒷받침한다. 배치 전체 손실 평균과 AR 초기 학습은 보고된 학습 방법에 포함되지만, 누적형 절제 실험은 동일한 총학습 예산에서 각각의 효과를 분리하지 않는다.
- 오라클과 샘플러 사이의 격차 축소, 초안 모델과 검증기의 정렬 개선, 연속된 AR 접두부를 넘어선 검증, 세그먼트 수준 병렬성 확보를 향후 방향으로 제시한다. SOL은 모델 자신의 순차적 출력을 기준으로 비용이 많이 드는 시뮬레이션을 수행하므로, TPF 차이 76.5%가 실제 배포 환경의 속도 향상을 입증하지는 않는다.
부록
- Appendix A는 4개 층, 은닉 차원 384, 매개변수 4.8M개, 위치별 특성 차원 144인 샘플러를 설명한다. 이 샘플러는 약 20M개의 노이즈 제거 경로로 학습되며, MLP만 사용한 절제 실험에서는 정확도·TPF AUC가 10%p 낮아진다. Appendix B는 확산 초안 모델의 LoRA 학습을 보여준다. Appendix C는 k²개의 마스크를 삽입하는 제곱 규모의 배치와 AR 및 확산 예측 분포를 보간하는 선택적 검증기를 명시한다.
짧은 생각
통제된 AR 손실 비교와 낮은 동시성에서 측정한 처리량 결과는 공유 AR·확산 모델을 주장하는 논문의 서로 다른 근거가 된다. SOL 구성은 잠재적인 수락 길이와 순전파 비용을 구분하는 데 유용하다. 그러나 오라클 탐색, 별도의 정답 판단 기준, 블록이 커질 때 나타나는 정확도 하락 때문에 실제 확산 샘플러의 성능을 입증하는 근거로는 한계가 있다.