


DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation 요약 설명
06 Jul 2026 | Paper Review Speculative Decoding Semi-Autoregressive Generation Hardware-Aware Scheduling Confidence Calibration목차
- 요약
- 3. Architecture
- 4.1. Experimental Setup
- 4.2. Experimental Results
- 4.3. Experimental Analysis
- 5. Real-World Deployment of DSpark
- 부록
- 짧은 생각
이번 글에서는 DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 7월 6일(Arxiv)
- Cheng, Xin, Yu, Xingkai, Shao, Chenze, Li, Jiashi, Xiong, Yunfan, Qian, Yi, Zhu, Jiaqi, Ma, Shirong, Zhang, Xiaokang, Ye, Jiasheng, et al.
- Peking University, DeepSeek-AI
- 논문 링크
요약
- Speculative decoding은 draft model이 토큰 블록을 제안하고 target model이 rejection sampling으로 수락할 접두부를 검증해 target distribution을 보존한다. Autoregressive drafter에는 순차 생성 지연이 발생한다. 병렬 drafter는 한 번에 더 긴 블록을 제안할 수 있지만 샘플링한 토큰 사이의 의존성을 반영하지 못한다. 부하가 높을 때 수락 가능성이 낮은 접미부까지 검증하면 배치 용량이 낭비된다.
- DSpark는 병렬 draft backbone에 가벼운 순차 보정 단계를 결합해 토큰마다 국소적으로 정규화된 확률을 산출한다. Confidence head는 조건부 수락 확률을 예측하고, scheduler는 보정된 접두부 생존 확률과 측정된 엔진 step-rate 곡선을 사용해 검증 길이를 정한다. 관련 연구에서 논의한 전역 정규화 방식이나 잠재 출력 방식과 달리, 국소 보정을 통해 표준 rejection sampling을 사용할 수 있다.
- Confidence scheduling을 끈 오프라인 실험에서 DSpark의 macro-average accepted length는 Eagle3보다 Qwen3-4B에서 30.9%, 8B에서 26.7%, 14B에서 30.0% 높다. 측정된 실제 DeepSeek-V4 트래픽에서는 총처리량을 맞췄을 때 사용자당 생성 속도가 이전 운영 기준인 MTP-1보다 V4-Flash에서 60%–85%, V4-Pro에서 57%–78% 높다. 이 비교 결과는 해당 설정과 트래픽에 한정된다.
3. Architecture
DSpark는 생성 토큰당 지연 L = (T_draft + T_verify)/τ를 줄이는 것을 목표로 한다. 여기서 τ는 target model이 생성한 보너스 토큰을 포함한 디코딩 라운드당 수락 길이다. 병렬 backbone은 draft 생성 패스 수를 줄이고, 순차 head는 접미부의 수락률을 높인다. Confidence에 따라 검증 길이를 정해 생존 가능성이 낮다고 판단한 접미부에 target model의 처리 용량을 쓰지 않는다.
3.1. Semi-Autoregressive Generation
DSpark는 DFlash backbone을 수정해 anchor와 γ−1개의 mask로 이루어진 γ개 입력에서 γ개 draft 위치를 병렬 패스 한 번으로 생성한다. 위치 k에서는 가벼운 순차 단계가 접두부에 따라 달라지는 bias B_k를 backbone logits U_k에 더하고 분포를 국소 정규화한다. 왼쪽에서 오른쪽으로 샘플링해 rejection sampling에 필요한 조건부 확률을 얻는다.
- 기본 Markov head는 전이 행렬을 B = W₁W₂로 분해하며, 기본 rank는 r = 256이다. 바로 앞 토큰을 조건으로 사용한다.
- 대안인 RNN head는 블록 전반에 걸쳐 상태를 유지하고 backbone hidden state도 반영한다. 기본 설정은 Markov head다.
이 보정은 다봉 분포에서 발생하는 충돌을 완화한다. 각 위치에서 독립적으로 토큰을 고르면 서로 다른 그럴듯한 후속 문장의 일부가 섞일 수 있지만, 앞에서 샘플링한 토큰을 조건으로 삼으면 그에 맞는 다음 토큰을 우선할 수 있다. Draft 생성 지연을 낮게 유지하려면 순차 계산량이 병렬 패스에 비해 작아야 한다.
3.2.1. Confidence Head
Confidence head는 backbone state h_k와 직전 토큰의 Markov embedding을 사용해 c_k를 예측한다. 앞선 위치가 수락됐을 때 위치 k도 수락될 조건부 확률을 예측하도록 학습하며, 단계별 수락률의 해석적 값 c*_k = 1 − ½‖p^d_k − p^t_k‖₁을 soft label로 사용한다.
- Sequential Temperature Scaling (STS)은 별도로 확보한 데이터에서 누적 접두부 생존 확률을 보정한다. 왼쪽에서 오른쪽으로 진행하는 1차원 grid search가 이전 위치의 보정값을 고정한 채 각 위치의 Expected Calibration Error (ECE)를 최소화한다.
3.2.2. Hardware-Aware Prefix Scheduler
요청 r의 위치 j에서 추정한 접두부 생존 확률은 a_r,j = ∏_{i≤j} c_r,i이다. 요청 수가 R이고 각 검증 길이가 ℓ_r일 때 scheduler는 배치 크기 B = Σ_r(1 + ℓ_r), 수락 토큰 수 τ = Σ_r(1 + Σ_{j=1}^{ℓ_r} a_r,j), 처리량 Θ = τ · SPS(B)를 추정한다. 이때 초기화 시 측정한 엔진 step-rate 곡선을 사용하며, step rate가 문맥 길이의 차이보다 주로 검증 배치 크기에 좌우된다고 가정한다.
- Algorithm 1은 접두부를 확장할 후보를 생존 확률순으로 정렬한다. 요청마다 생존 확률이 증가하지 않으므로 이 순서는 접두부 제약을 지키며, 배치 크기가 고정됐을 때 기대 수락 토큰 수를 최대화한다.
- 제안한 인과적 탐색은 추정 처리량이 개선되지 않으면 멈춘다. 따라서 이전 토큰의 포함 여부를 소급해 결정할 때 그 토큰의 샘플링 값이 후속 위치의 confidence를 통해 영향을 주지 않는다. 확장 경로에서 Θ가 단봉형이면 단계별 중단으로 전체 처리량의 최댓값을 찾는다.
3.3. Training
학습에서는 target sequence마다 여러 anchor를 샘플링하고 target model, 공유 embedding, language-modeling head를 고정한다. 갱신하는 backbone, 순차 모듈, confidence head에는 위치 가중 cross-entropy, draft–target total-variation matching, soft acceptance label에 대한 binary cross-entropy를 적용한다. 가중치는 w_k = exp(−(k−1)/γ)이고 기본 계수는 α_ce = 0.1, α_tv = 0.9, α_conf = 1.0이다.
4.1. Experimental Setup
오프라인 평가는 Qwen3-{4B, 8B, 14B}와 Gemma4-12B를 target model로 사용한다. Eagle3, DFlash, DSpark를 동일한 프레임워크에서 재학습하며, 1.3 million개 샘플로 구성된 Open-PerfectBlend 데이터셋의 프롬프트에 대해 target model이 다시 생성한 응답을 사용한다. 비교에서는 Eagle3의 TTT horizon과 DFlash/DSpark의 블록 크기를 7로 맞추고, drafter layer 수는 각각 1과 5로 설정한다. Math, code, chat 벤치마크에서 sampling temperature 1.0의 non-thinking 생성을 평가하며 AIME25 (Zhang and Math-AI, 2025)도 포함한다.
- 보고한 accepted length에는 target model이 생성한 보너스 토큰이 포함된다. 비교 대상인 모든 drafter는 chain-based drafting을 사용한다.
4.2. Experimental Results
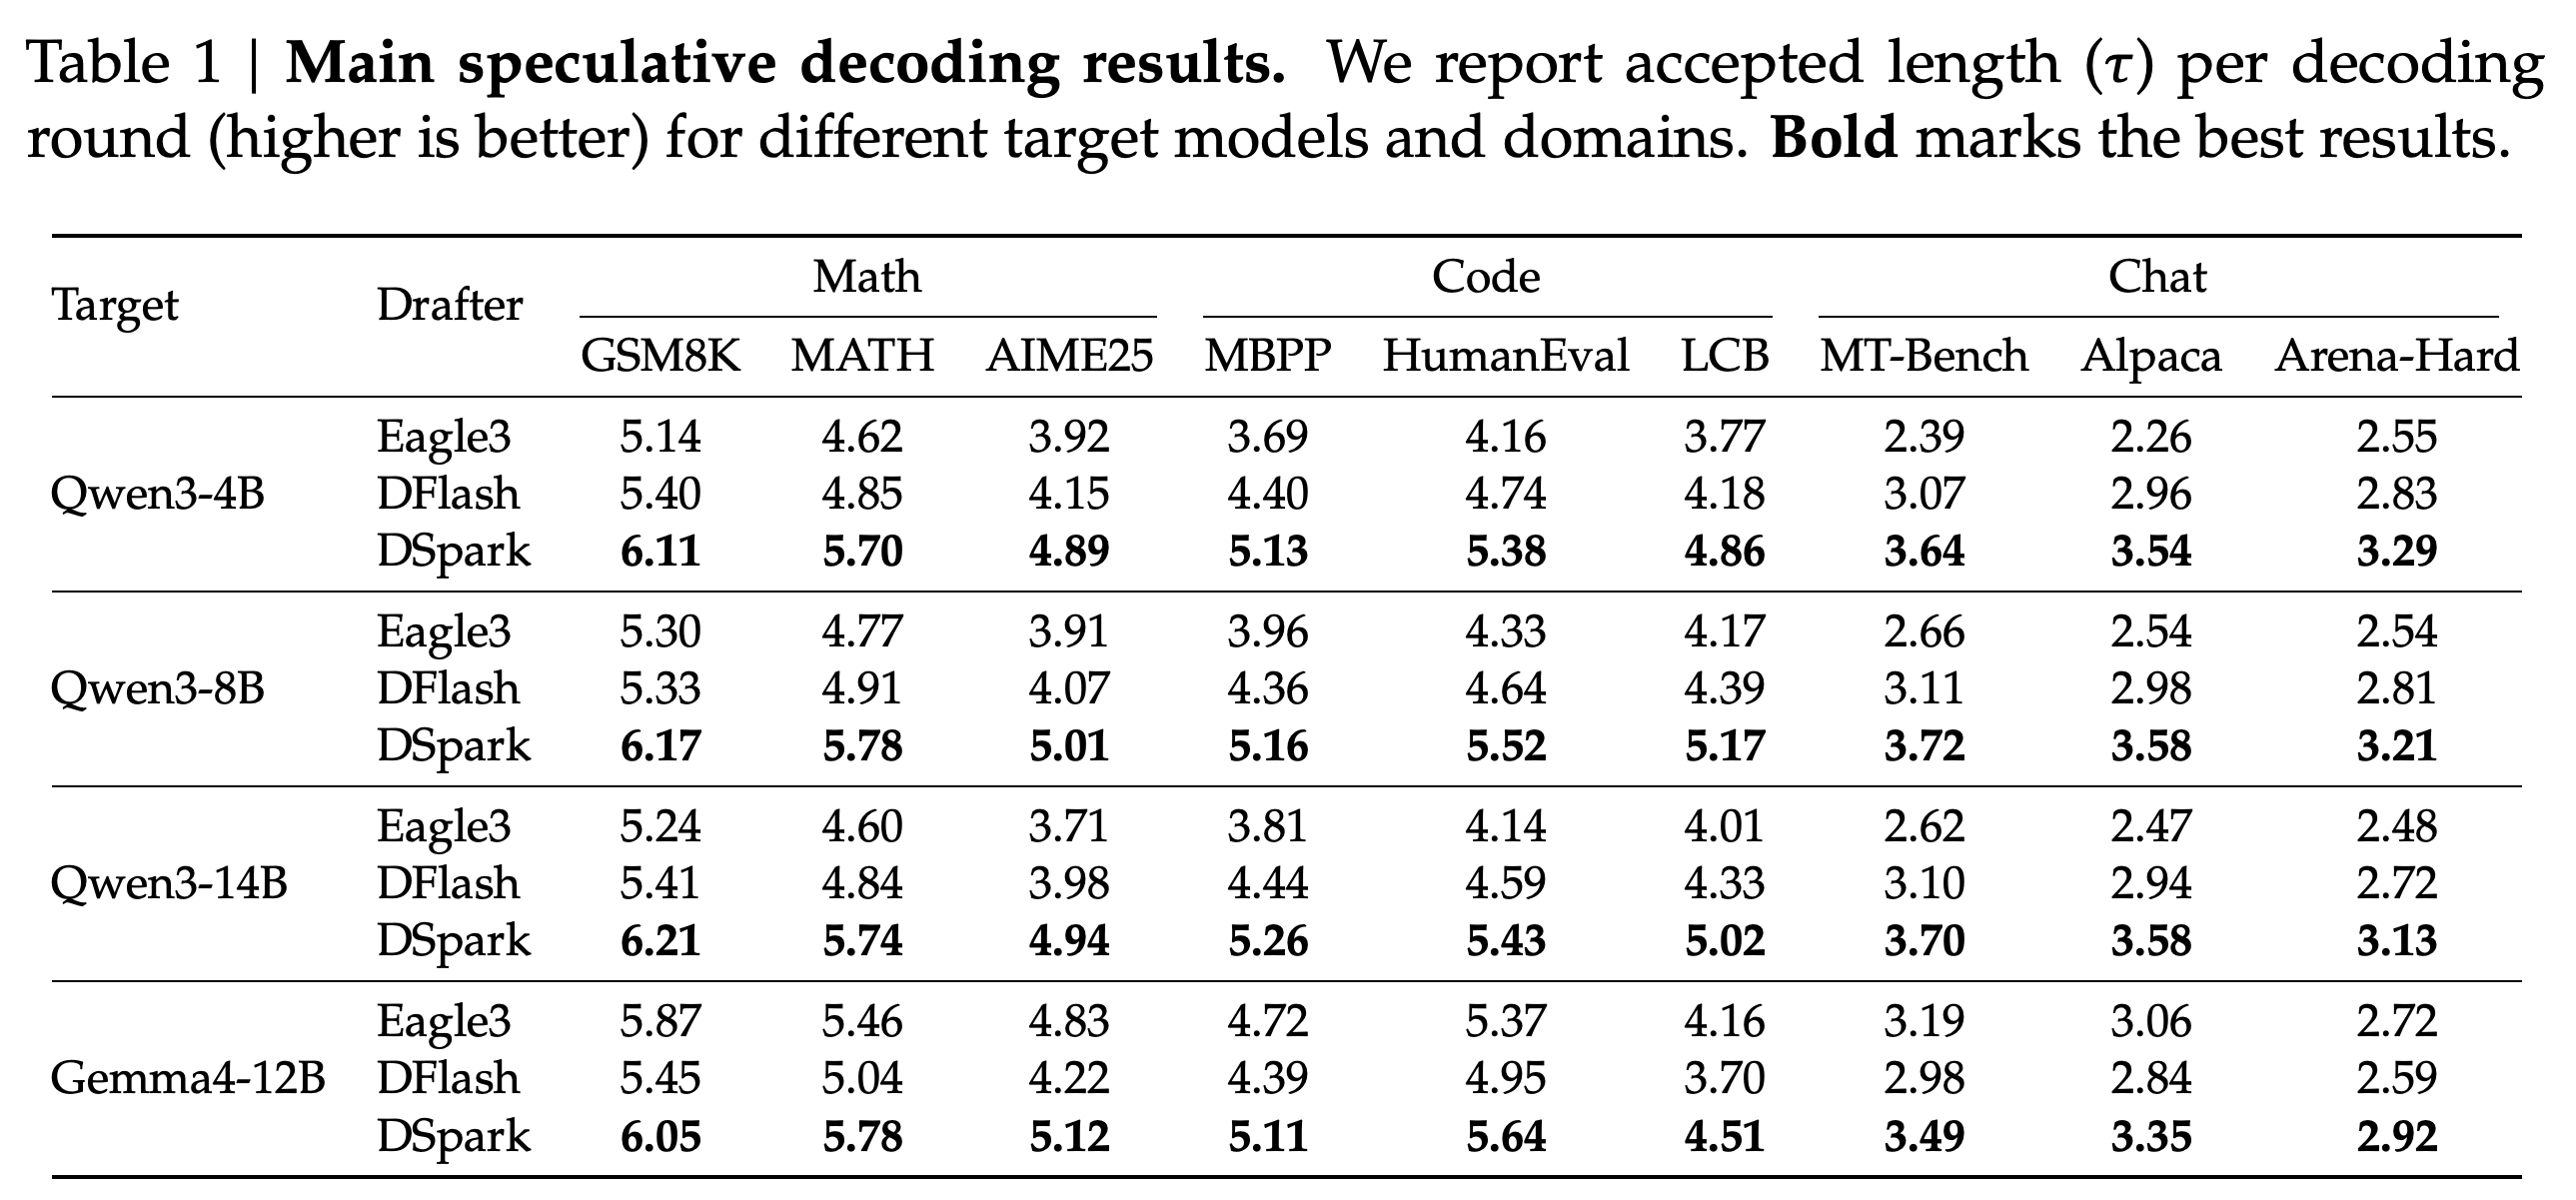
오프라인 비교에서는 draft 품질만 분리해 보기 위해 confidence scheduling을 끈다. Table 1에서 DSpark는 나열된 모든 target–benchmark 조합에서 accepted length가 가장 길다. Qwen3-4B의 GSM8K 결과는 DSpark 6.11, DFlash 5.40, Eagle3 5.14이며, MT-Bench 결과는 각각 3.64, 3.07, 2.39다.
- DFlash와 비교한 DSpark의 macro-average accepted-length 증가율은 Qwen3-4B에서 16.3%, 8B에서 18.4%, 14B에서 18.3%다. Gemma4-12B에서도 증가하지만 accepted length만으로 서빙 속도를 판단할 수는 없다.
모든 DSpark 값이 4개 target model과 9개 벤치마크의 해당 Eagle3, DFlash accepted length보다 높다. 이 비교에서는 scheduling을 껐으므로 표만으로 운영 처리량을 알 수는 없다.
4.3. Experimental Analysis
분석에서는 draft 위치별 조건부 수락률, drafter 깊이와 제안 길이, 순차 루프 지연, confidence 기반 가지치기와 보정을 살펴본다. 이러한 분석은 draft 품질과 scheduler가 처리량에 미치는 효과를 구분한다. 처리량 효과는 배포 환경에서 평가한다.
4.3.1. Why Can Parallel Generation Outperform Autoregression?
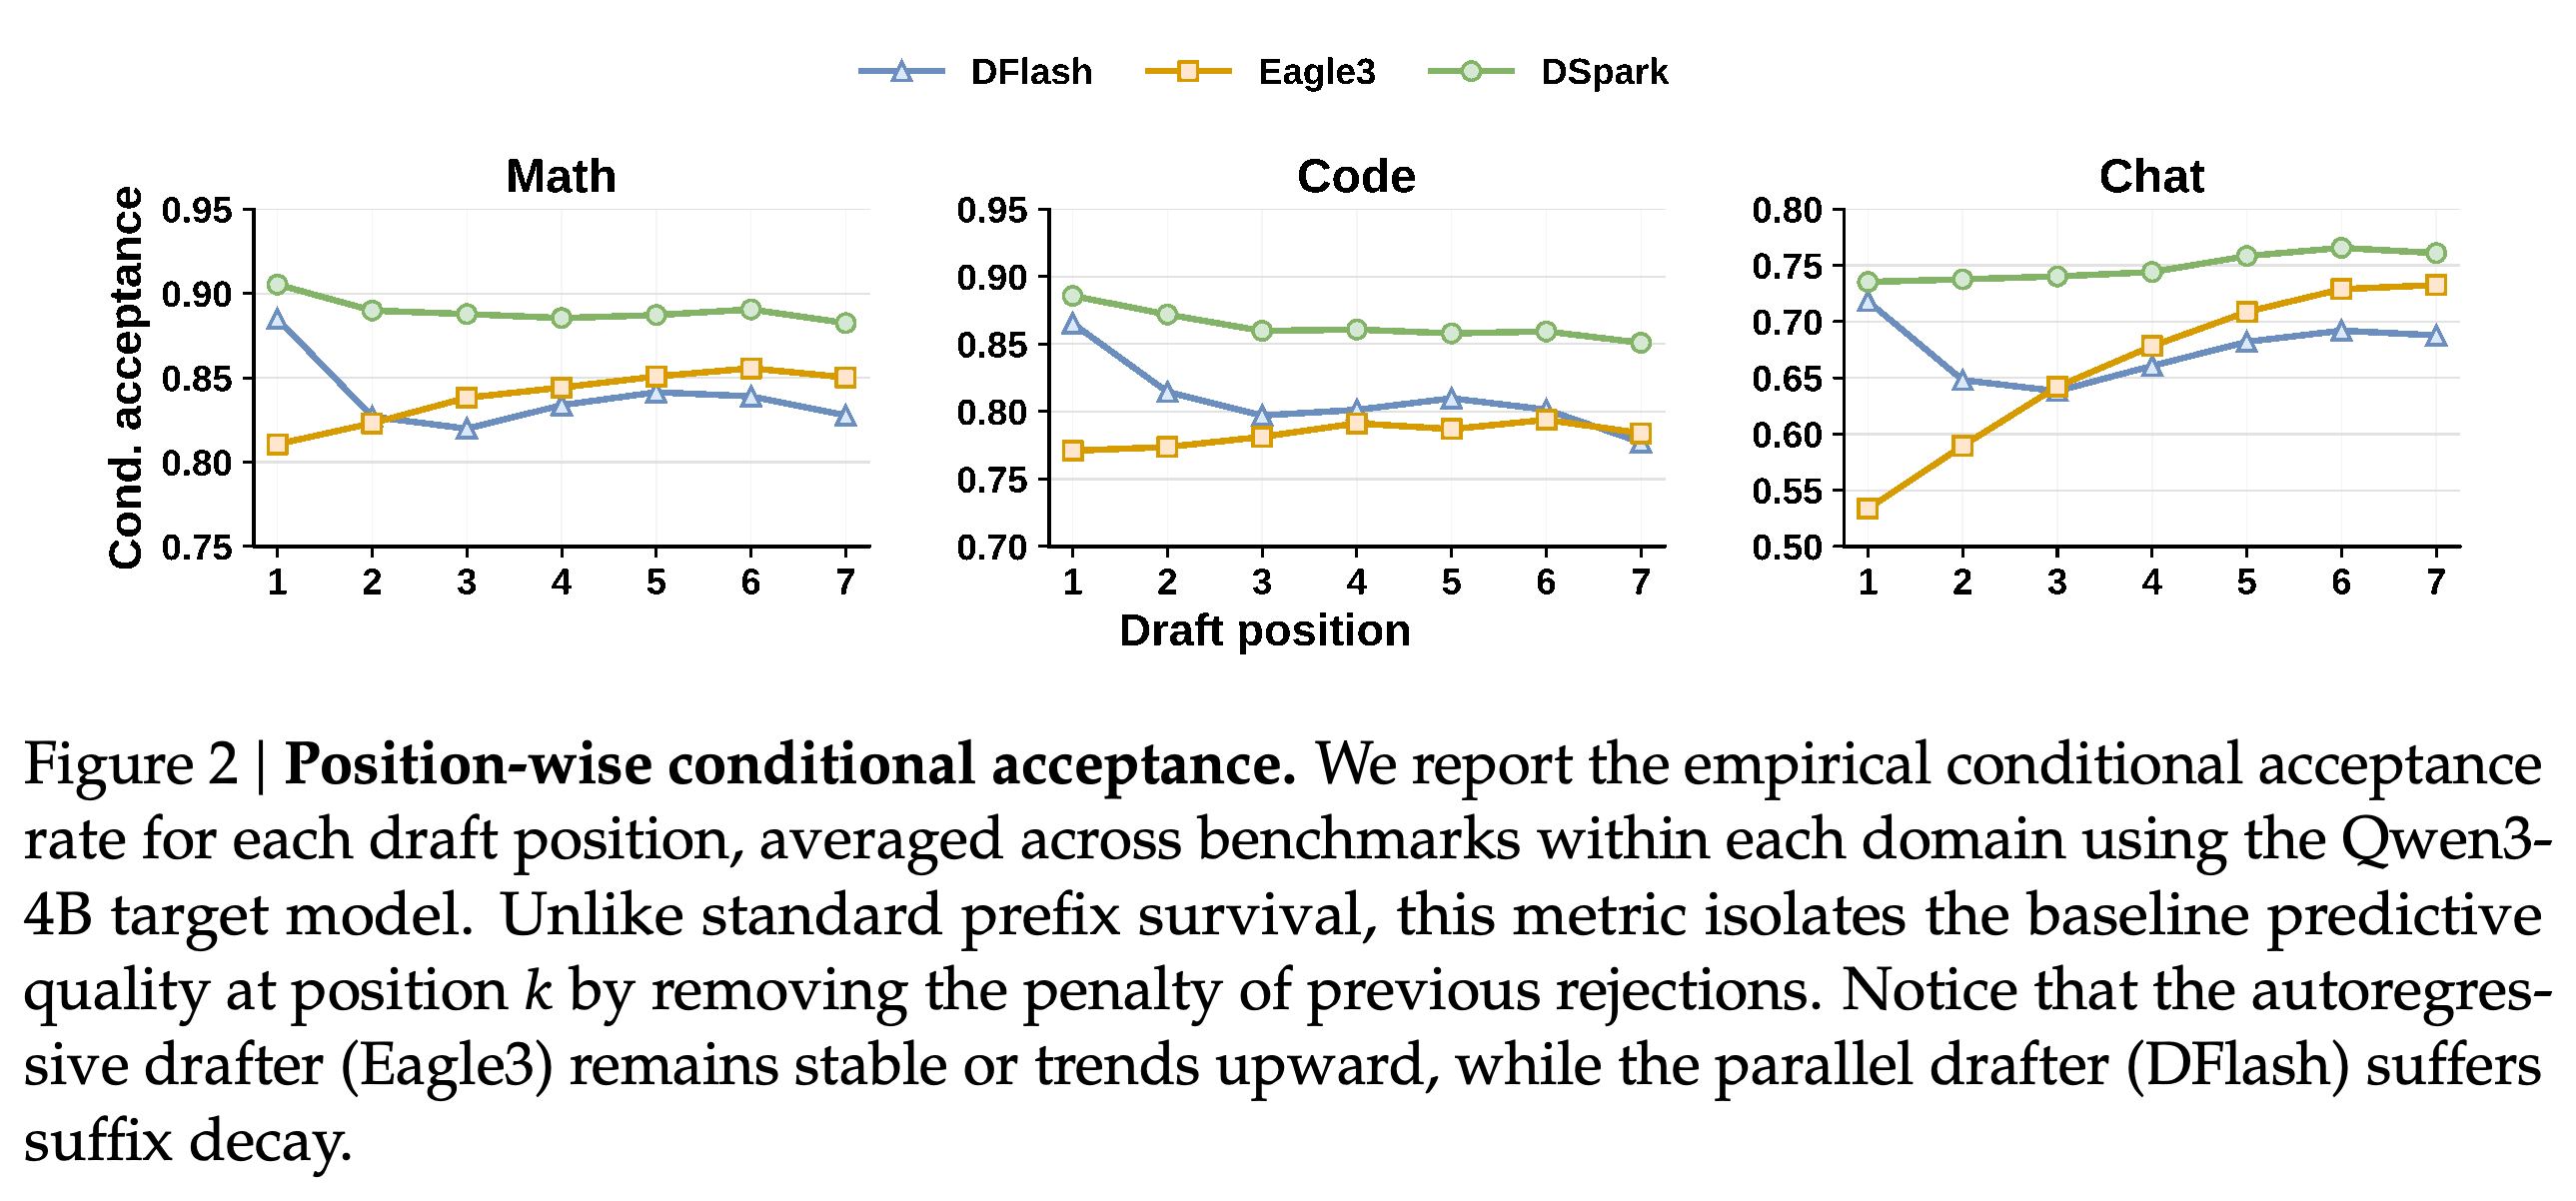
Figure 2에서는 이전 draft 토큰이 모두 수락된 경우에만 위치 k의 수락 여부를 집계한다. Qwen3-4B에서 DFlash의 초기 수락률은 math에서 약 0.88로 Eagle3의 0.81보다 높고, chat에서도 0.72로 Eagle3의 0.53보다 높다. 그러나 DFlash의 후반부 조건부 수락률은 하락하는 반면, Eagle3의 chat 수락률은 약 0.53에서 0.74로 올라간다.
- 이 측정에서 DSpark는 초기 조건부 수락률이 높고 접미부의 수락률 하락도 더 작다. 이 곡선은 깊은 병렬 backbone이 앞쪽 위치에, 순차 보정이 뒤쪽 위치에 도움이 된다는 설명을 뒷받침하지만, backbone 깊이만을 유일한 원인으로 분리해 입증하지는 않는다.
조건부 수락률을 구할 때 그래프에 표시한 각 위치보다 앞에서 거절된 rollout은 제외한다. DFlash는 초반 수락률이 높지만 접미부로 갈수록 낮아지고, Eagle3는 더 안정적이거나 상승한다. DSpark는 블록 전반에서 비교적 높은 수락률을 유지한다.
4.3.2. A Little Autoregression Goes a Long Way
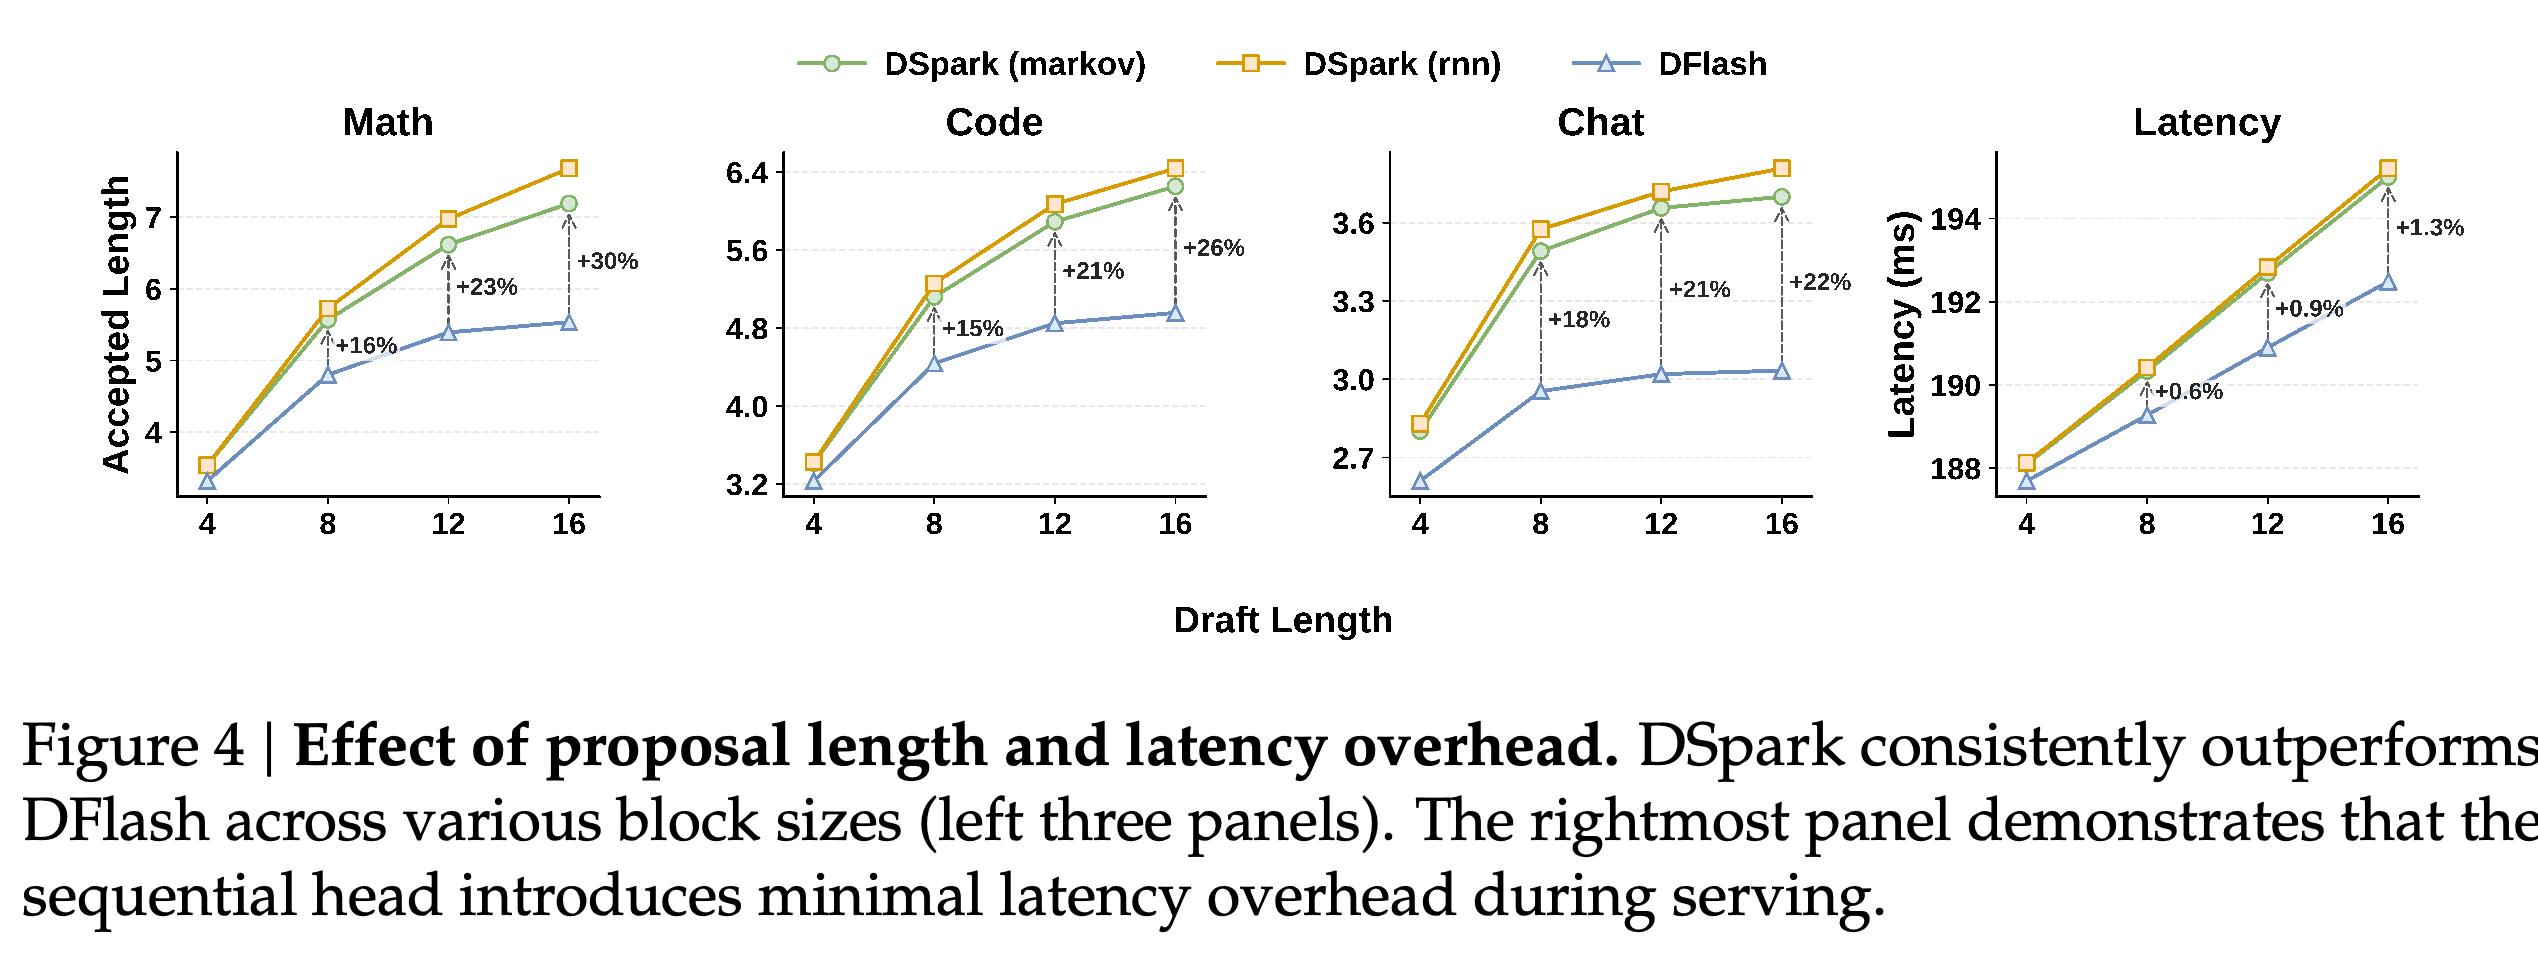
Qwen3-4B에서 블록 크기를 7로 고정하면 DSpark backbone을 1 layer에서 5 layer로 늘릴수록 accepted length가 증가하며, 그래프의 2-layer 모델도 5-layer DFlash보다 높은 결과를 보인다. Backbone이 5 layer일 때 DFlash 대비 DSpark의 accepted-length 증가율은 γ = 7에서 math 16%, code 15%, chat 18%이고, γ = 15에서는 각각 30%, 26%, 22%로 커진다.
- RNN head의 추가 이득은 작으며 주로 제안 길이가 길 때 나타난다. 배치 크기 128에서 문맥 토큰 수 512, 1024, 2048, 4096에 걸쳐 지연을 평균하면, 제안 길이가 4에서 16으로 증가할 때 순차 head로 인한 전체 라운드 지연 증가는 0.2%–1.3%다.
Math, code, chat 패널에서는 제안 길이가 늘수록 DSpark와 DFlash의 차이가 커진다. 지연 패널은 배치 크기 128에서 전체 라운드에 추가되는 지연이 작음을 보여준다. RNN head가 Markov head보다 늘리는 accepted length는 제한적이다.
4.3.3. Verify Smarter, Not Longer: The Role of Confidence Head
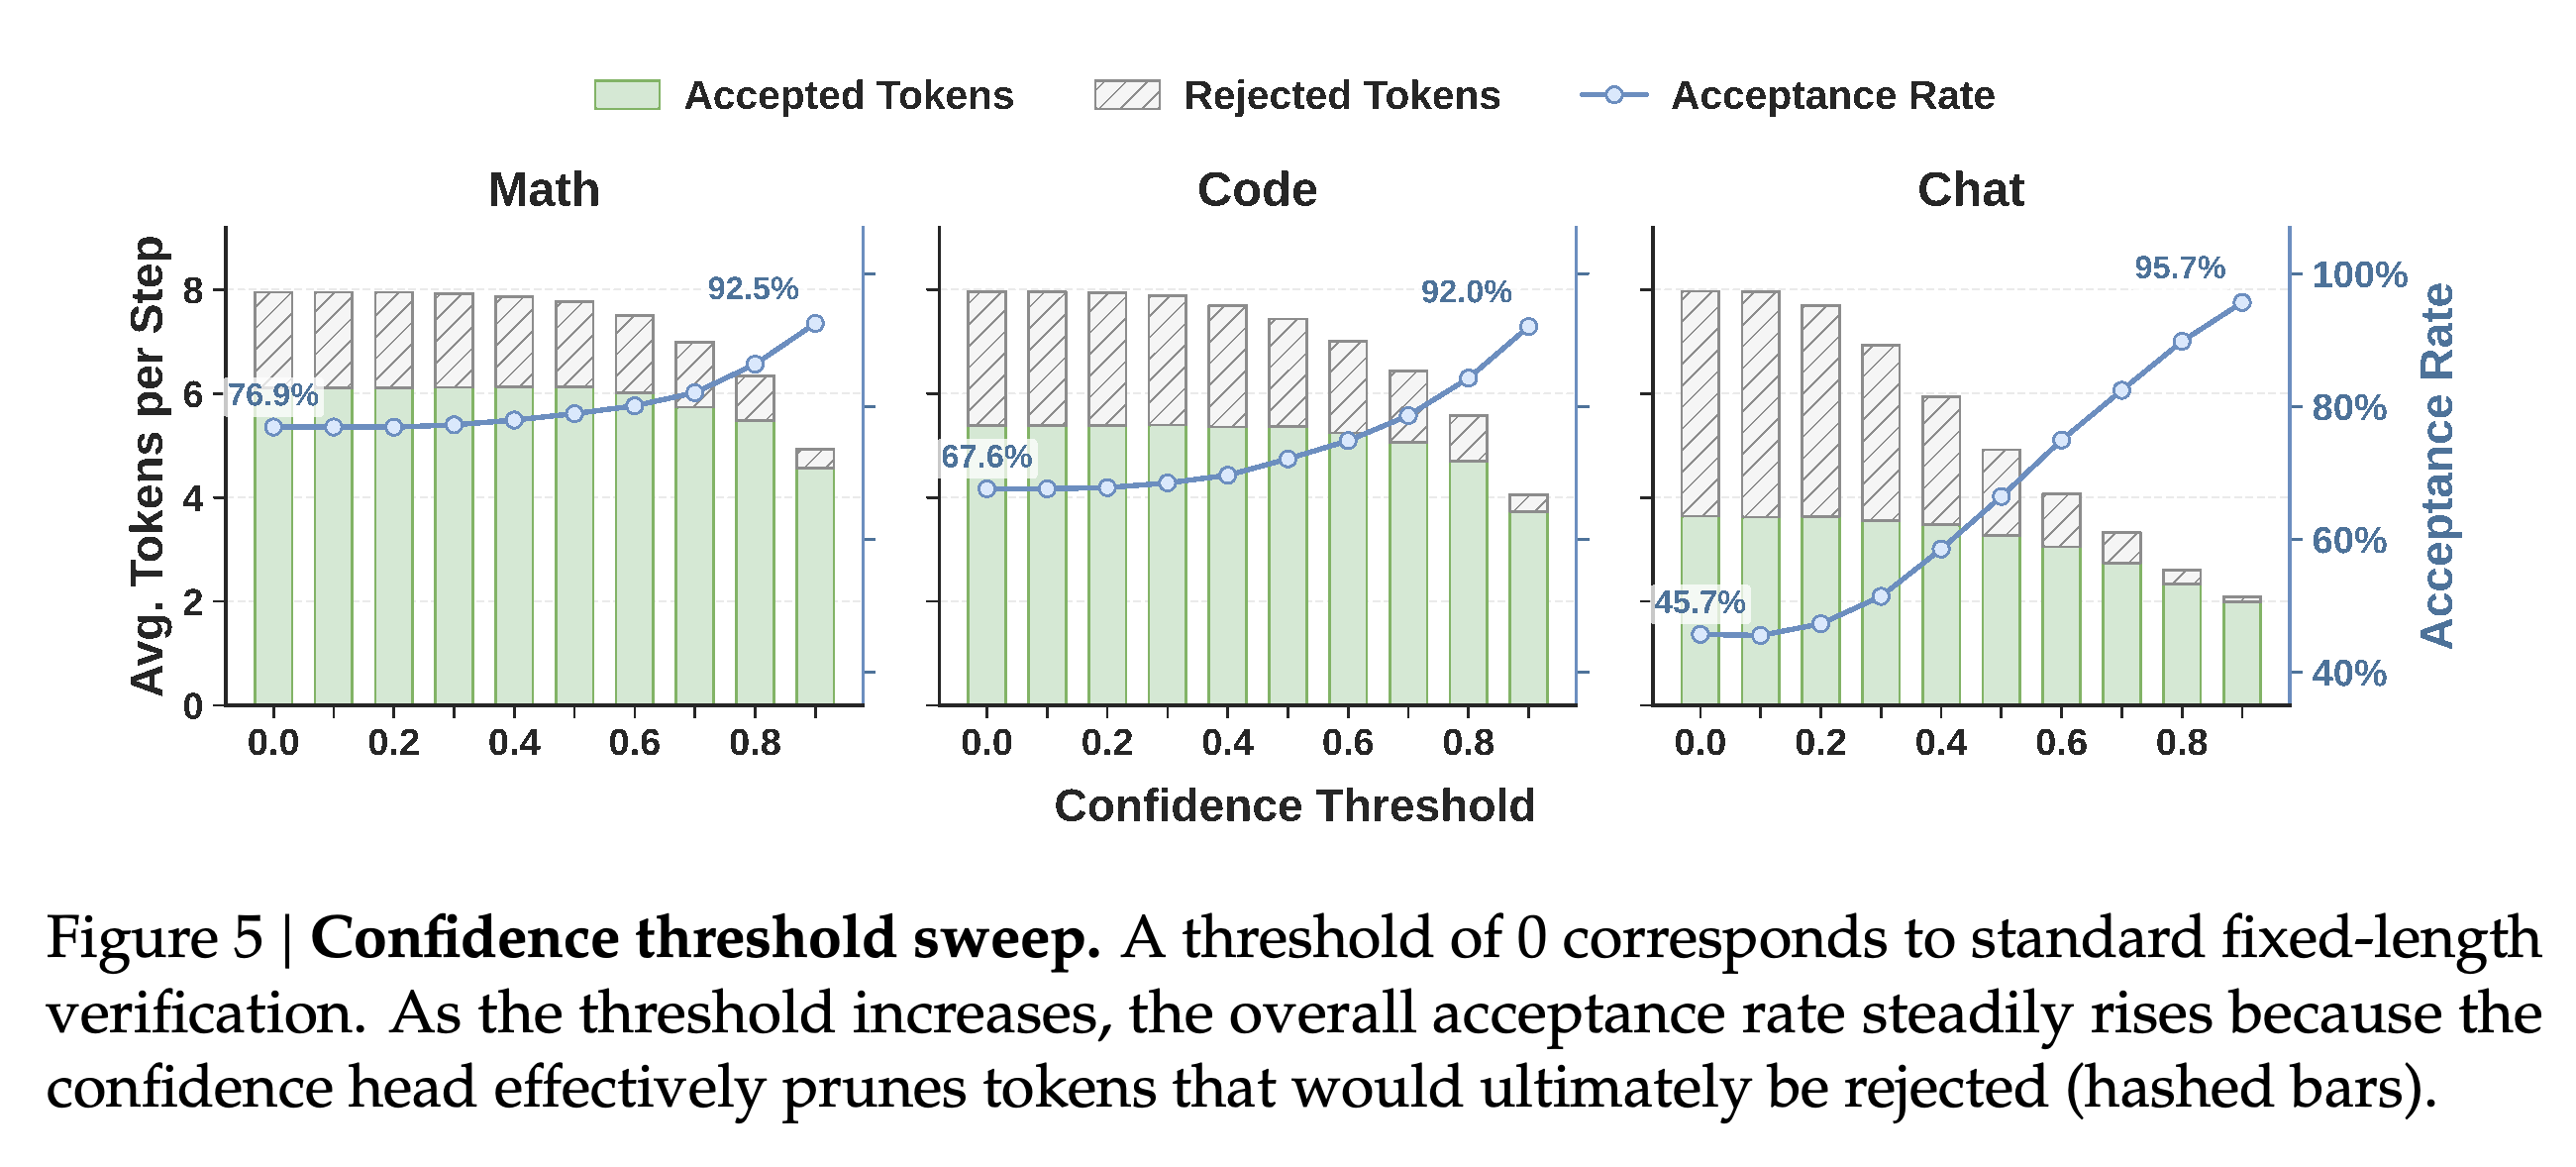
Qwen3-4B에서 static threshold를 바꾸는 실험은 confidence head를 운영 scheduler와 별도로 시험한다. 임곗값이 높을수록 거절될 토큰을 더 많이 걸러내며, 보고된 수락률은 chat에서 45.7%에서 95.7%, math에서 76.9%에서 92.5%, code에서 67.6%에서 92.0%로 높아진다. 동시에 검증하는 접두부도 짧아지므로 수락률만으로 처리량이 최적인지는 알 수 없다.
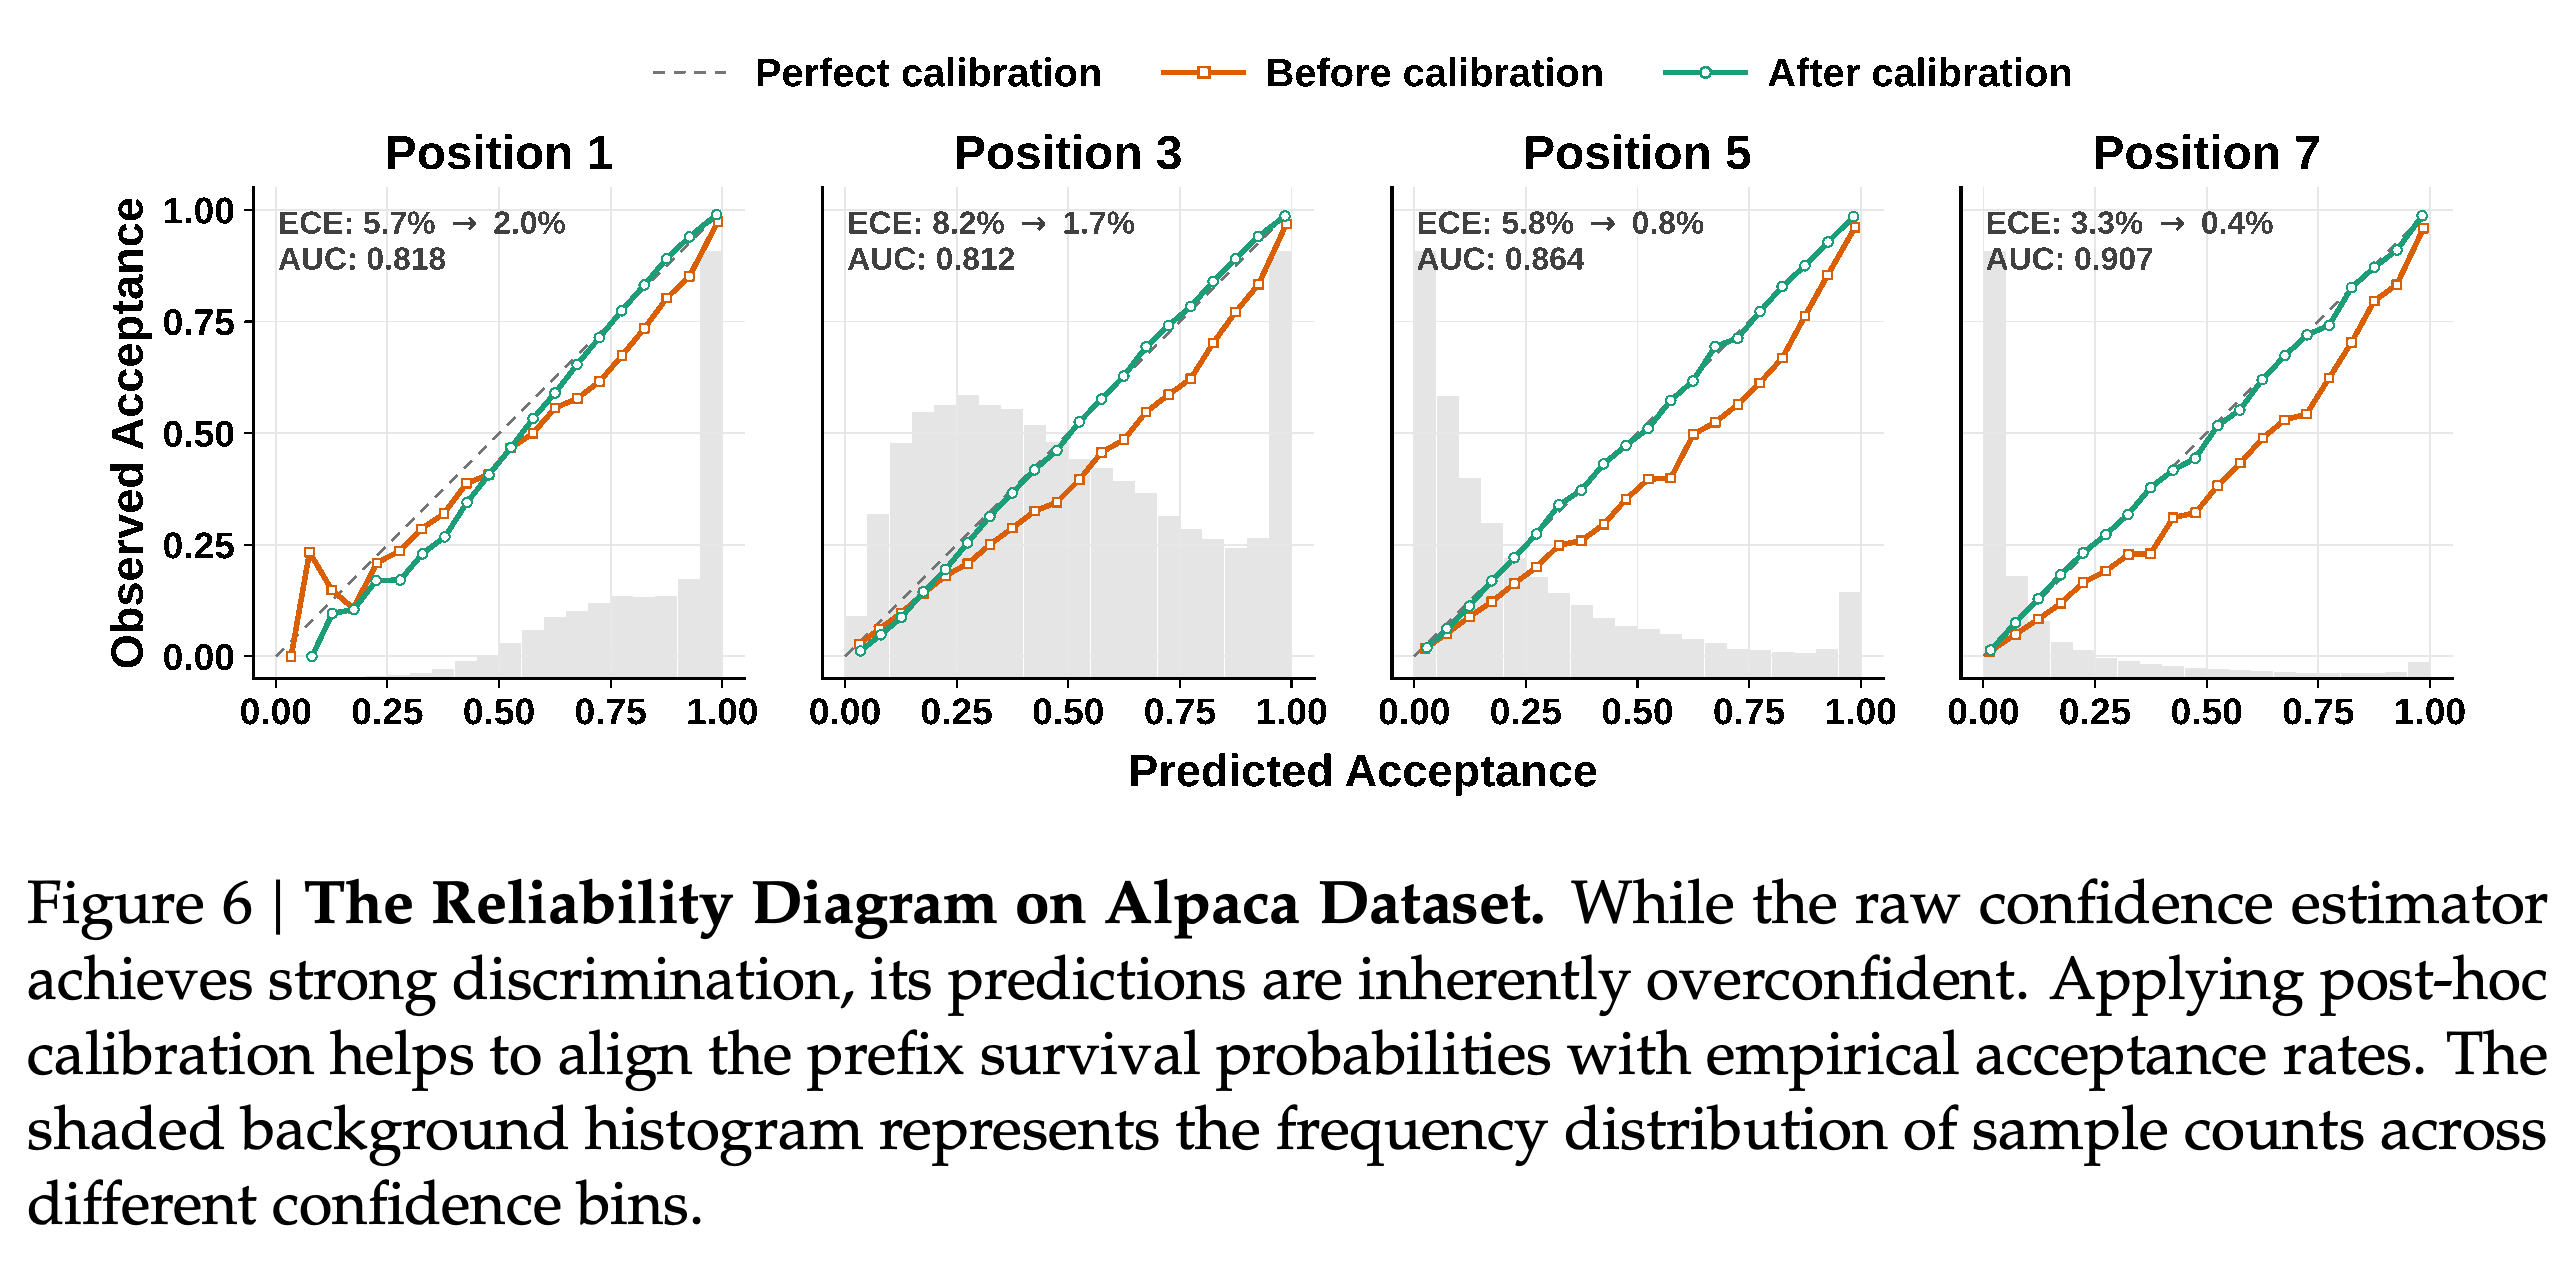
- Alpaca의 Figure 6은 위치 1, 3, 5, 7에서 ROC-AUC를 각각 0.818, 0.812, 0.864, 0.907로 보고한다. STS 적용 후 해당 위치의 ECE는 각각 5.7%, 8.2%, 5.8%, 3.3%에서 2.0%, 1.7%, 0.8%, 0.4%로 낮아진다.
임곗값을 높이면 특히 chat에서 빗금으로 표시된 거절 토큰 부분이 줄고, 검증한 토큰 중 수락한 비율이 높아진다. 동시에 검증 토큰 수도 줄어들기 때문에 이 실험은 가지치기 동작을 보여줄 뿐 최적의 서빙 처리량을 입증하지 않는다.
Alpaca의 위치 1, 3, 5, 7에서 보정 후 reliability curve는 원래 예측보다 이상적인 대각선에 가까워지며 보고된 ECE도 낮아진다. 그래프에 표시된 ROC-AUC는 calibration과 별개인 판별 성능을 측정한다.
5. Real-World Deployment of DSpark
DSpark는 DeepSeek-V4-Flash (preview)와 DeepSeek-V4-Pro (preview)에 배포된다. 이 환경에서는 부하에 맞춰 검증 길이를 조정하고 비동기 서빙 파이프라인에도 맞춰야 한다. 실제 트래픽 평가는 draft architecture의 효과만 분리하지 않고 전체 구현을 이전 운영 설정인 단일 토큰 MTP-1과 비교한다.
5.1. Scalable and Flexible Training
배포한 병렬 backbone은 mHC와 128의 sliding window attention을 적용한 3개 MoE layer로 구성된다. 최대 draft 블록 크기는 γ = 5이며 Markov head와 후속 STS 보정을 사용한다. 학습 중 통신량을 줄이기 위해 작업자들이 전체 vocabulary logits 대신 target hidden state를 전송하고, 샘플링한 위치에서 language-modeling head를 로컬로 적용한다. Anchor 경계를 기준으로 한 sequence packing은 문서 전체 문맥에 따른 draft 측 계산량을 줄인다.
- 논문은 target vocabulary가 약 10⁵개이며 토큰당 hidden-state 통신 복잡도가 O(d)라고 명시한다. 여기서 d는 hidden dimension이다.
5.2. Hardware-Aware Prefix Scheduler in Practice
운영 scheduler는 Algorithm 1을 불규칙하고 불연속적인 SPS(B) 곡선과 Zero-Overhead Scheduling (ZOS)에 맞게 조정한다. 2단계 이전의 confidence 정보로 다음 용량 한도 K를 정하고, 현재 후보 토큰은 현재의 누적 confidence로 정렬한다. 이로써 GPU 파이프라인의 스케줄링을 기다리지 않고 동적으로 top-K를 선택한다.
- 구현에서는 과거 정보를 바탕으로 용량을 예측할 때 hardware throughput cliff의 국소 최적점에 빠지지 않도록 early-stopping break를 생략한다. 논문은 이 용량 선택이 현재 샘플링한 토큰이 아니라 과거 정보에 기반하므로, target distribution의 정확한 복원에 필요한 비예지 조건을 유지한다고 설명한다.
5.3. High-Throughput and Low-Latency Inference
보고된 배포 환경에서는 KV-cache 한계나 가용 트래픽 때문에 유효 배치가 GPU 연산 포화 수준에 미치지 못하는 경우가 많다. 따라서 총처리량과 사용자당 속도가 함께 개선될 수 있다. 검증 길이가 요청마다 다른 경우에는 요청 간 토큰을 펼쳐 배치하고 sparse attention의 marker tensor로 sequence 경계를 전달한다. 또한 과도한 padding을 피하도록 DeepSeek-V4의 index-attention과 compress kernel을 수정한다.
5.4. Performance under Live User Traffic
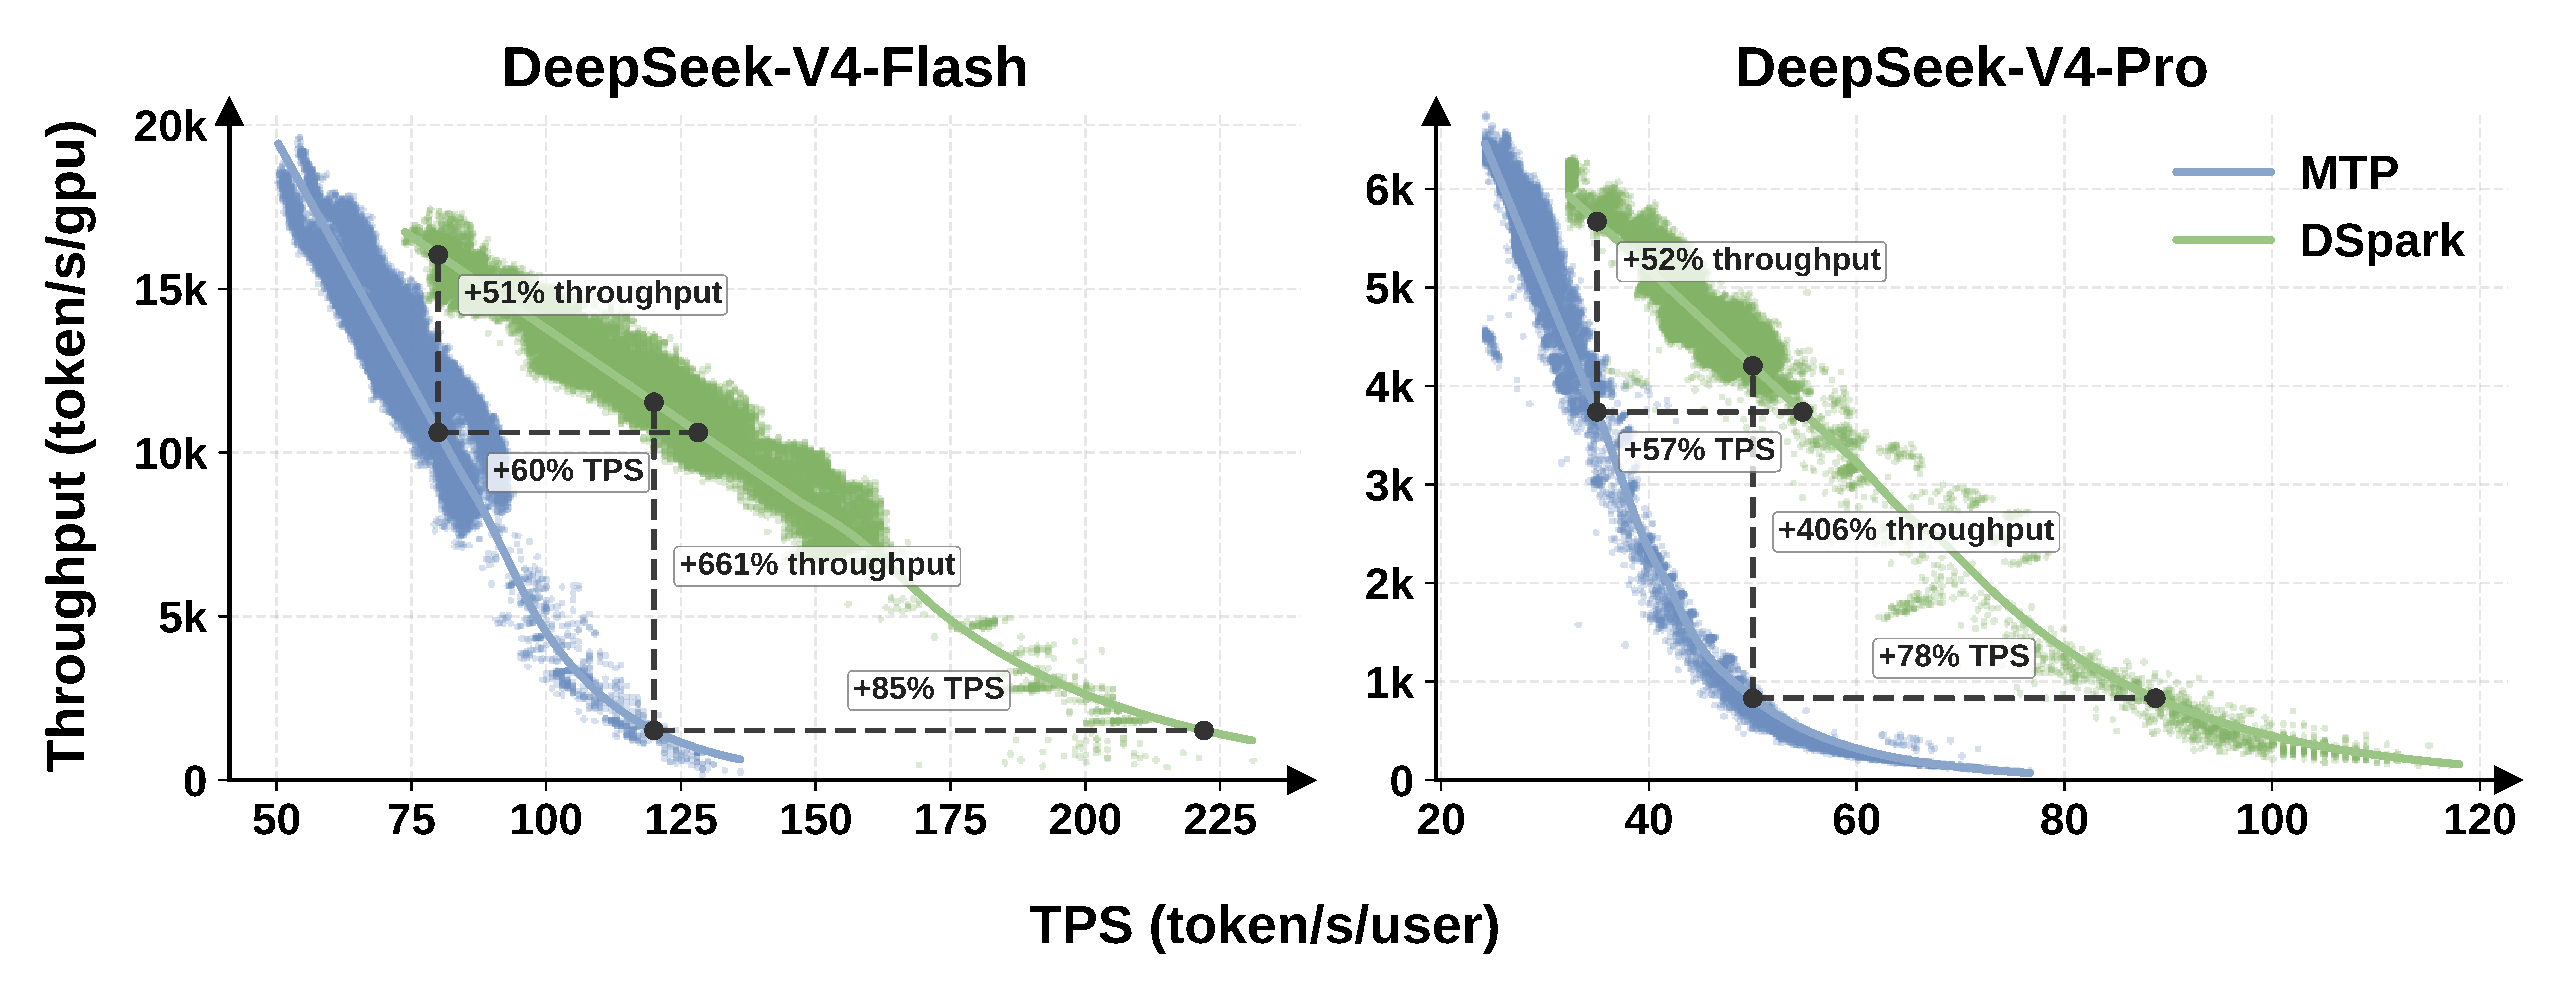
측정된 실제 트래픽에서 DSpark-5는 MTP-1보다 처리량과 응답 속도의 절충 관계를 개선한다. 사용자당 80 tok/s일 때 V4-Flash의 총처리량은 51% 증가하고, 사용자당 35 tok/s일 때 V4-Pro에서는 52% 증가한다. 총처리량을 맞추면 사용자당 속도는 각각 60%–85%, 57%–78% 높다.
- Flash의 사용자당 120 tok/s에서 나타나는 명목상 661% 증가와 Pro의 사용자당 50 tok/s에서 나타나는 406% 증가는 MTP-1이 낮은 동시 요청 수만 처리할 수 있는 지점에서 측정됐다. 따라서 활용도가 높은 기준 설정과 비교한 대표적인 증가율이라기보다 실현 가능한 성능 범위가 넓어졌다는 근거다.
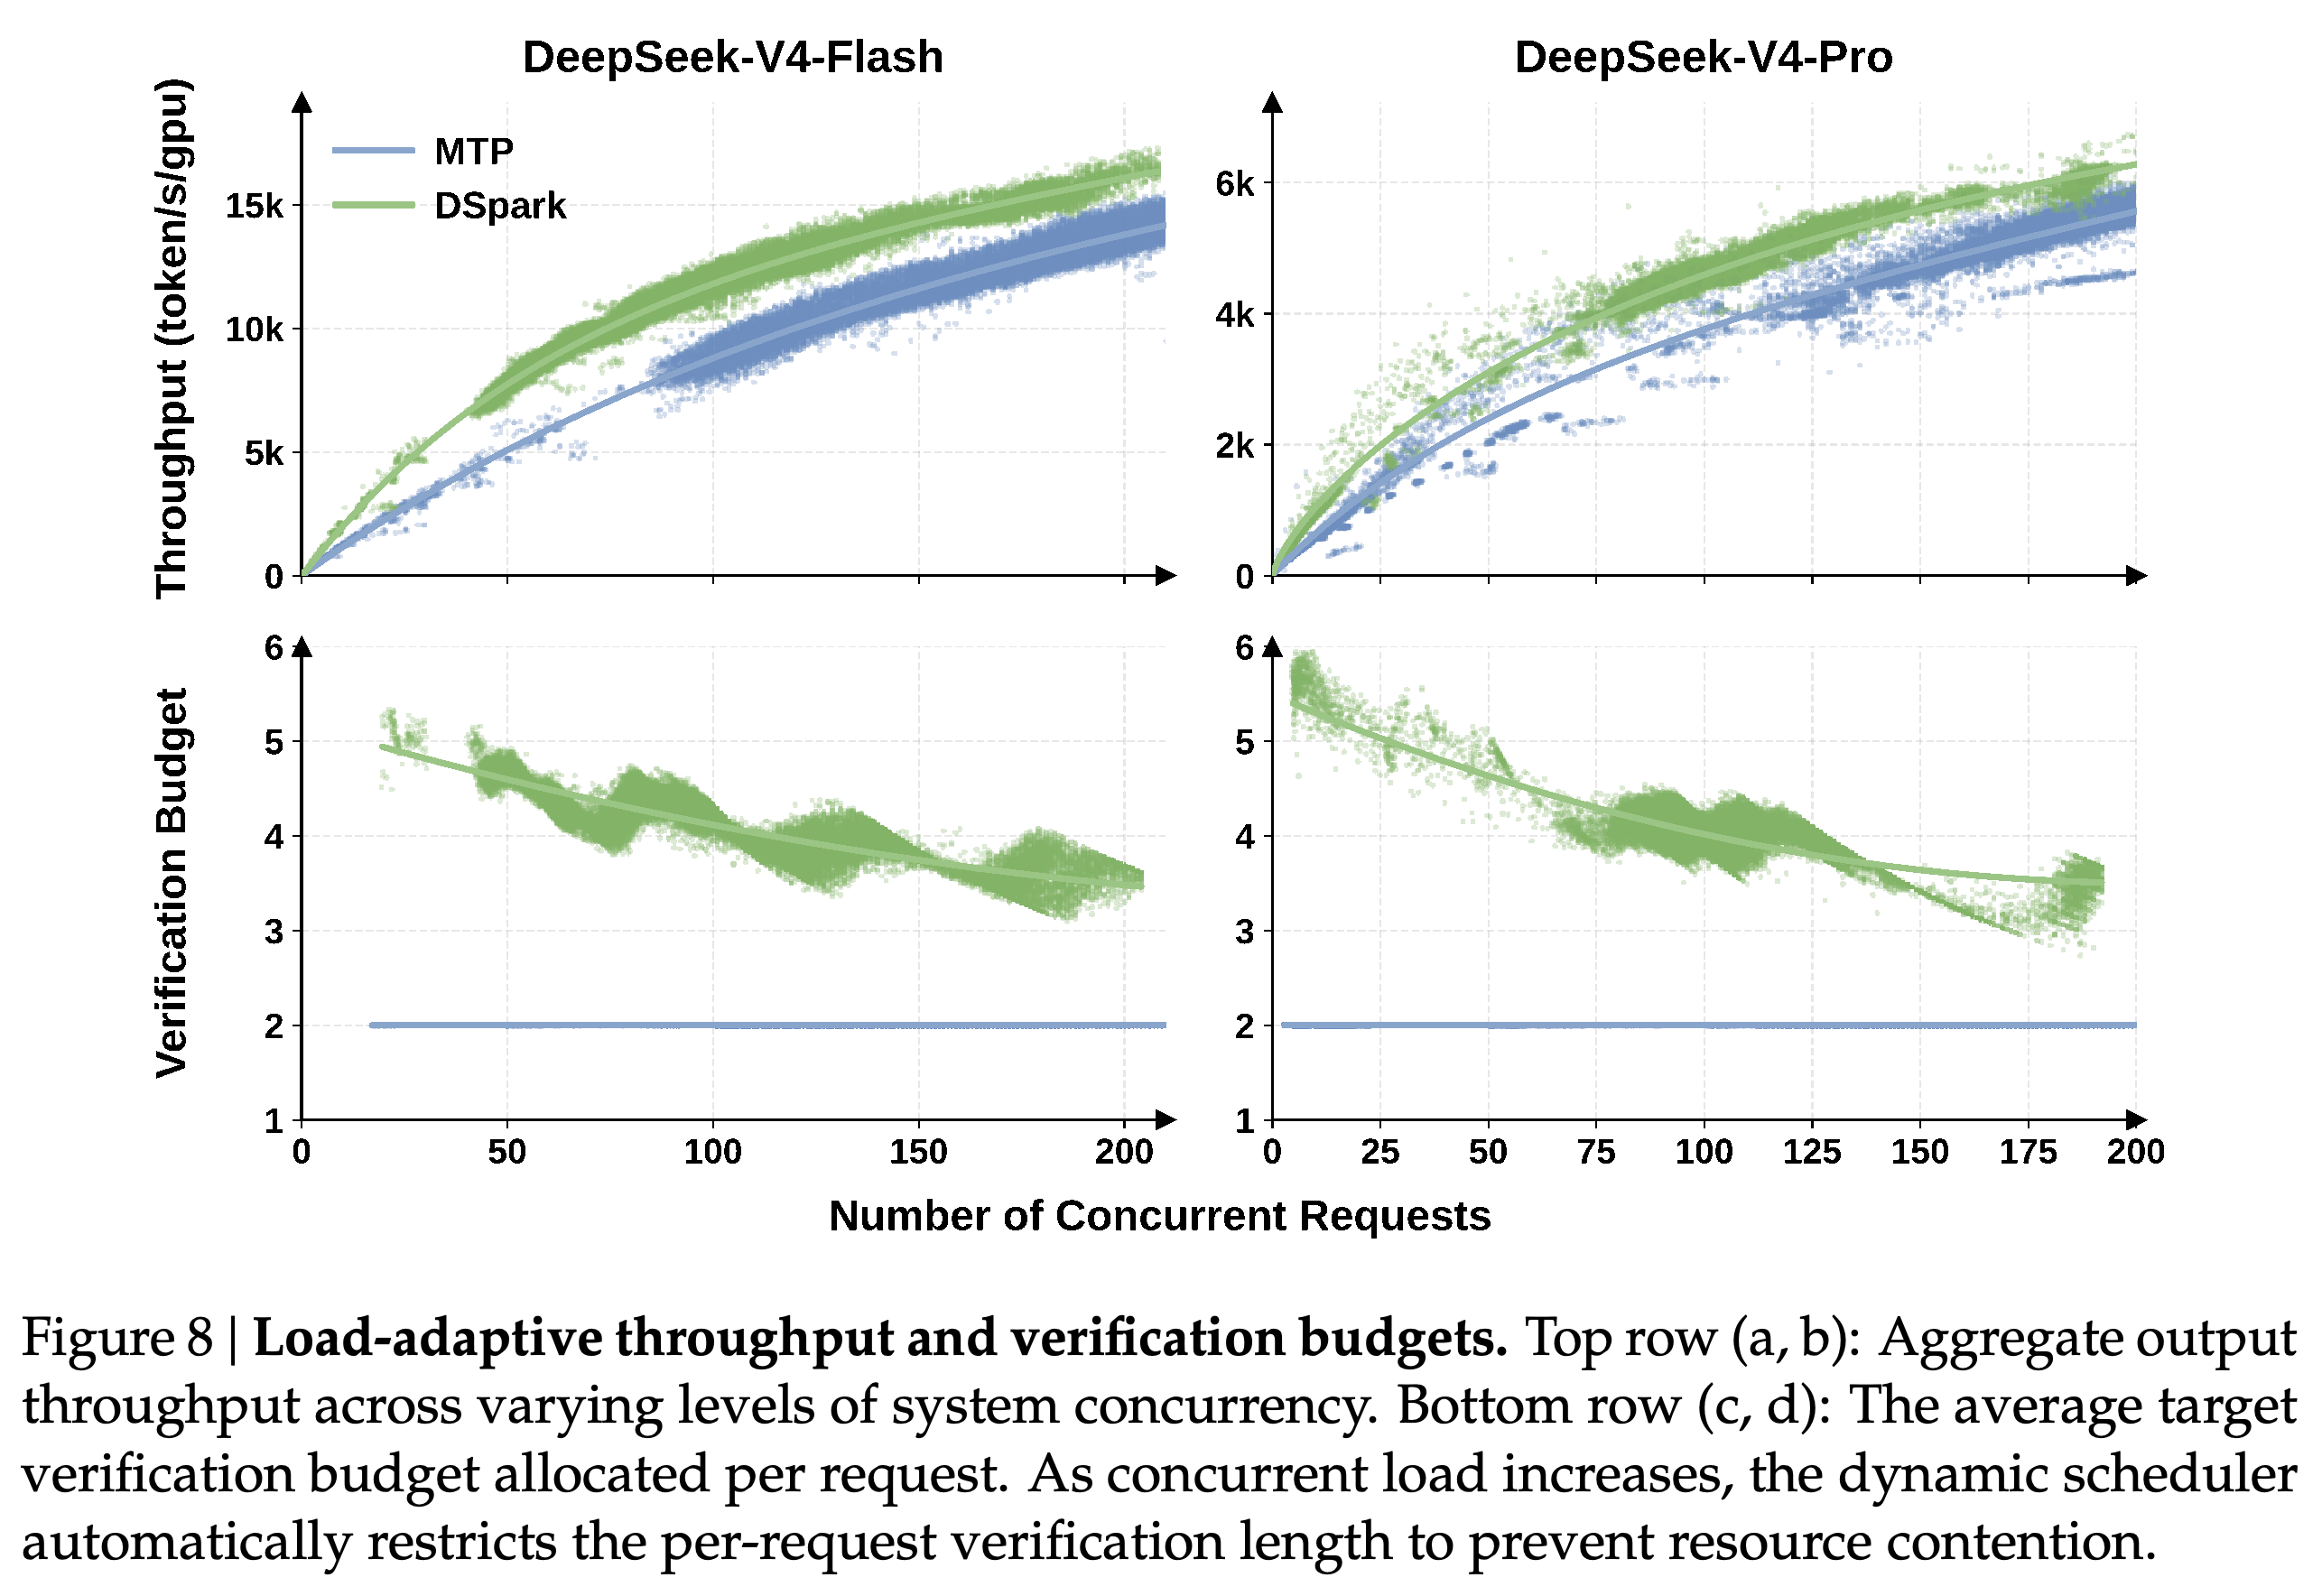
- Figure 8은 중간 수준의 부하에서 요청당 검증 토큰 예산이 약 4–6개임을 보여준다. MTP-1은 고정된 2개를 사용하며, DSpark의 예산은 동시 요청 수가 늘수록 감소한다. 수락률이 낮은 요청에서도 초기 전체 draft 블록을 생성하는 비용은 발생한다.
실제 트래픽에서 수집한 지표와 적합 곡선에 따르면 사용자당 속도가 비슷할 때 DSpark가 두 엔진 모두에서 더 높은 총 출력 처리량을 보인다. 비율 차이가 가장 큰 지점은 MTP-1의 낮은 동시 요청 수 경계 부근이며, 총처리량을 맞춘 비교는 더 실용적인 운영 지점에서의 사용자당 속도 개선을 보여준다.
위쪽 패널은 동시 요청 수에 따른 총처리량을 비교한다. 아래쪽 패널에서는 MTP-1이 2개 토큰으로 일정한 반면 DSpark의 요청당 검증 예산은 부하가 증가할수록 줄어든다. 이 그래프는 측정된 처리량 이점과 부하에 따른 검증 용량 배분의 관계를 보여준다.
부록
- Appendix A는 early stopping 없이 이전 결정을 소급하는 scheduler의 반례를 제시한다. 요청이 1개이고 γ = 2, a₁ = 0.8이며 SPS(1), SPS(2), SPS(3)이 각각 1.0, 0.5, 0.45일 때 초기 처리량 추정치는 Θ₀ = 1.0, Θ₁ = 0.9다. 첫 토큰을 샘플링한 결과로 후속 위치를 평가하면 c₂ = 0.9에서는 길이 2를, c₂ = 0에서는 길이 0을 선택한다.
- {A, B}에 대한 첫 위치의 draft 확률이 (0.5, 0.5)이고 target 확률이 (0.7, 0.3)일 때, 부록의 소급 선택 규칙으로 얻는 출력 확률은 target distribution이 아닌 (0.85, 0.15)다. 반면 early stopping은 후속 위치의 confidence를 평가하기 전에 Θ₁이 Θ₀보다 낮아지는 순간 중단한다.
짧은 생각
Scheduler를 끈 비교는 DSpark가 더 긴 접두부를 수락한다는 점을 보여주고, 위치별 수락률 분석은 기준 모델과 차이가 나는 위치를 파악하게 해준다. 운영 환경의 측정치는 보고된 DeepSeek-V4 엔진과 트래픽에서 MTP-1 대비 성능 향상을 보여주지만, 완성된 시스템을 적응적으로 다중 토큰을 스케줄링하는 다른 운영 기준과 비교하지는 않는다. 수락률이 낮은 요청은 초기 draft 블록 생성 비용도 그대로 부담한다.