DropoutNet(Addressing Cold Start in Recommender Systems) 요약 설명
19 Aug 2022 | Paper Review DropoutNet목차
DropoutNet: Addressing Cold Start in Recommender Systems는 기존 추천 모델이 학습한 preference 표현과 content를 함께 받아, 상호작용 이력이 없는 사용자·아이템도 추천할 수 있도록 학습하는 모델입니다.
요약
- Cold start는 새로운 사용자나 아이템의 상호작용 이력이 없어 collaborative filtering의 latent vector를 충분히 추정할 수 없는 상황입니다. DropoutNet은 이 상황을 preference 입력이 누락된 문제로 다룹니다.
- 학습 중 무작위로 선택한 사용자 또는 아이템의 preference latent vector 전체를 제거합니다. Content feature는 유지하고, 남은 입력으로 기존 모델의 추천 점수를 복원하도록 학습합니다.
- 사용자와 아이템에 각각 DNN을 적용하고, 출력 벡터의 내적으로 점수를 계산합니다. 손실은 기존 latent 모델의 내적 점수와 새 모델의 내적 점수 사이의 제곱 오차입니다.
- CiteULike의 item cold start에서 DN-WMF는 recall@100 0.636을 기록했으며, 비교한 DeepMusic은 0.601이었습니다. Warm start에서는 각각 0.593과 0.371이었고, 원래 WMF는 0.592였습니다.
- 새 사용자의 상호작용이 조금씩 쌓일 때는 반응한 아이템의 기존 latent vector 평균을 preference 입력으로 사용합니다. 이 근사도 학습 중에 노출하여 전체 모델을 다시 학습하기 전까지 표현을 갱신합니다.
Introduction
Matrix factorization과 같은 latent 추천 모델은 사용자와 아이템을 짧은 벡터로 표현하므로 저장과 검색이 효율적입니다. 다만 추천 이력이 전혀 없는 대상에는 그 벡터를 학습할 근거가 없습니다. 아이템의 제목·본문·이미지, 사용자의 프로필처럼 상호작용과 별개로 관측할 수 있는 content가 이때 필요합니다.
기존 hybrid 모델은 추천 손실에 content 복원 등의 목적을 추가하는 경우가 많았습니다. DropoutNet은 content 자체를 잘 복원하도록 요구하는 대신, content와 preference를 입력받아 추천 점수를 재현하도록 합니다. 학습 시 preference의 일부를 의도적으로 누락시키면, 하나의 모델을 warm start와 cold start 양쪽에 사용할 수 있다는 접근입니다.
Framework
사용자 수를 $N$, 아이템 수를 $M$이라고 하면 상호작용 행렬은 $R\in\mathbb{R}^{N\times M}$입니다. 명시적인 평점이나 클릭·저장 같은 implicit feedback을 표현할 수 있으며, 논문의 주요 실험에서는 상호작용 유무를 이진 값으로 다룹니다. 이 경우 0은 관측된 선호가 없다는 뜻이지, 반드시 싫어한다는 뜻은 아닙니다.
사용자 $u$가 반응한 아이템 집합을 $\mathcal V(u)$, 아이템 $v$에 반응한 사용자 집합을 $\mathcal U(v)$라고 하면 다음처럼 구분할 수 있습니다.
| 상황 | 사용 가능한 정보 | DropoutNet의 입력 |
|---|---|---|
| Warm start | 상호작용으로 얻은 preference와 content가 있습니다. | 두 입력을 함께 사용합니다. |
| User cold start | $\mathcal V(u)=\varnothing$이며 사용자 preference가 없습니다. | 사용자 preference를 0으로 두고 사용자 content를 사용합니다. |
| Item cold start | $\mathcal U(v)=\varnothing$이며 아이템 preference가 없습니다. | 아이템 preference를 0으로 두고 아이템 content를 사용합니다. |
사용자 content를 $\phi_u^U\in\mathbb{R}^{C_U}$, 아이템 content를 $\phi_v^V\in\mathbb{R}^{C_V}$로 표시하겠습니다. Content까지 없는 cold start 대상은 이 모델에도 개인화 근거가 부족합니다. 따라서 어떤 쪽에 content가 있는지에 따라 해결할 수 있는 cold start의 범위가 달라집니다.
Relevant Work
CTR은 topic model과 weighted matrix factorization(WMF)을 결합하고, CDL은 content를 처리하는 stacked denoising autoencoder를 결합합니다. 이런 모델은 preference와 content를 함께 활용하지만 복수의 손실과 결합 가중치를 조정해야 합니다.
DeepMusic은 content에서 latent 표현을 예측하는 DNN을 사용합니다. 반면 DropoutNet은 content와 함께 기존 preference 표현도 입력합니다. Warm start에서 풍부한 이력을 활용하면서, 입력을 누락시킨 학습 사례를 통해 cold start에도 대응하려는 차이입니다. 비교 실험의 DeepMusic에는 원래 손실 대신 DropoutNet과 같은 점수 복원 손실을 사용했으므로, 원형을 그대로 실행한 결과와 구분해야 합니다.
Our Approach
Model Architecture
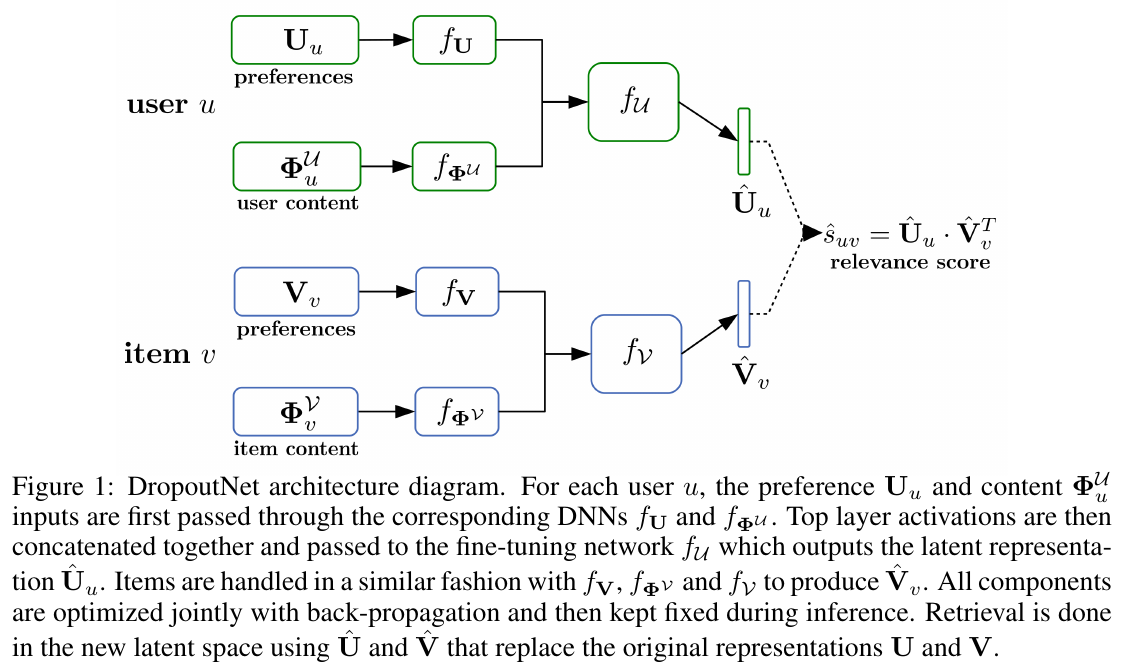
기존 latent 모델로 얻은 사용자 행렬 $U\in\mathbb{R}^{N\times D}$와 아이템 행렬 $V\in\mathbb{R}^{M\times D}$를 준비합니다. 기존 모델의 점수는 다음과 같습니다.
\[s_{uv}=U_uV_v^\top.\]전체 상호작용 행렬의 행·열을 DNN에 넣으면 입력이 너무 커지므로, 각각 $D$차원인 latent vector를 preference feature로 사용합니다. 사용자·아이템 DNN의 출력 차원을 $D’$라고 하면 새 표현과 추천 점수는 다음과 같습니다.
\[\widehat U_u=f_U(U_u,\phi_u^U)\in\mathbb{R}^{D'},\qquad \widehat V_v=f_V(V_v,\phi_v^V)\in\mathbb{R}^{D'},\] \[\widehat s_{uv}=\widehat U_u\widehat V_v^\top.\]이미지처럼 원시 입력을 바로 이어 붙이기 어려운 content에는 별도의 encoder를 적용합니다. Preference와 content의 표현을 연결한 뒤 최종 DNN에 전달하며, 이미 고정 길이 feature로 정리된 경우에는 입력 벡터를 바로 연결할 수 있습니다. 학습 후에는 새 아이템 벡터를 미리 계산해 두고 사용자 벡터와 내적 검색을 수행할 수 있습니다.
Training For Cold Start
기본 목적은 다음 점수 복원 손실을 최소화하는 것입니다.
\[\mathcal L=\sum_{u,v} \left(U_uV_v^\top-f_U(U_u,\phi_u^U)f_V(V_v,\phi_v^V)^\top\right)^2.\]학습 목표는 기존 latent 모델이 낸 점수 $U_uV_v^\top$이며, 관측 행렬 $R_{uv}$를 직접 복원하는 손실과는 구분됩니다. 기존 모델을 먼저 학습하고, 그 점수를 고정한 목표로 사용하여 새 DNN을 최적화합니다. 새 벡터를 원래 벡터와 좌표별로 같게 만들 필요는 없으므로, 추천 점수를 보존하는 새로운 latent 공간을 학습할 수 있습니다.
모든 preference 입력을 항상 제공하면 DNN은 content를 무시하고 기존 벡터를 그대로 전달하는 쉬운 해를 학습할 수 있습니다. 이를 막기 위해 mini-batch에서 무작위로 고른 사용자·아이템의 preference 입력 전체를 0으로 만듭니다. 사용자 cold start를 모사한 손실은 다음과 같습니다.
\[\mathcal L_{uv}^{\mathrm{user\ cold}} =\left(U_uV_v^\top-f_U(0,\phi_u^U)f_V(V_v,\phi_v^V)^\top\right)^2.\]Item cold start에서는 $f_V$의 첫 입력을 0으로 바꿉니다. 입력을 지운 사례에도 목표 점수 $U_uV_v^\top$를 유지하므로, 모델은 content를 이용해 기존의 선호 신호를 예측하도록 학습합니다.
일반적인 원소별 dropout과도 구분해야 합니다. 이 방법은 preference vector의 좌표 일부를 무작위로 지우는 것이 아니라, 선택한 사용자의 $U_u$ 또는 아이템의 $V_v$ 전체를 지워 실제 cold start 조건을 만듭니다. Preference를 남긴 사례는 warm start 성능을, 지운 사례는 content에 의존하는 능력을 학습합니다.
Inference
완전한 cold start 사용자는 $\widehat U_u=f_U(0,\phi_u^U)$로 표현합니다. 이후 상호작용이 생기면 기존 latent 모델을 즉시 재학습하는 대신, 반응한 아이템의 벡터를 평균하여 임시 preference를 구성합니다.
\[\widetilde U_u=\frac{1}{|\mathcal V(u)|}\sum_{v\in\mathcal V(u)}V_v, \qquad \widehat U_u=f_U(\widetilde U_u,\phi_u^U).\]아이템도 반응한 사용자 벡터의 평균으로 처리합니다. 평균을 쓰는 식은 상호작용이 하나 이상 있을 때 적용하며, 이력이 없는 경우에는 0 입력을 사용합니다.
평균 벡터의 분포는 기존 모델이 직접 학습한 벡터와 다를 수 있습니다. 이 분포 차이에 대응하도록 학습 중에도 일부 preference를 평균 벡터로 치환합니다. 논문의 실험에서는 mini-batch마다 dropout과 평균 치환을 번갈아 적용했습니다.
Experiments
실험은 CiteULike와 XING 기반 ACM RecSys 2017 Challenge 데이터로 수행했습니다. WMF, CTR, DeepMusic, CDL과 비교했으며, 모든 DNN은 batch size 100, 고정 learning rate, momentum 0.9를 사용했습니다. DropoutNet과 DeepMusic은 비교를 위해 동일한 DNN 구조와 점수 복원 목적을 사용했습니다.
CiteULike
사용자 5,551명, 논문 16,980개, 관측된 사용자·논문 쌍 204,986개로 구성됩니다. 논문 제목과 초록에서 선택한 8,000개 단어로 아이템 content를 만들었습니다. 사용자 content는 없으므로 이 실험의 dropout은 아이템 preference에만 적용했습니다.
Warm start에서는 학습에서 관측한 상호작용을 제외한 전체 논문 집합에서 추천했습니다. Item cold start에서는 3,396개 논문에 대한 학습 상호작용을 제거하고, 평가 때 이 논문들을 후보로 사용했습니다. 두 평가의 후보 집합이 다르므로 cold start의 숫자가 더 높다는 이유로 과제가 더 쉽거나 모델이 더 우수하다고 직접 비교할 수는 없습니다.
Rank는 $D=200$이고, DropoutNet은 tanh를 사용하는 500-unit hidden layer 한 개를 사용했습니다. 아래 표의 DN-WMF와 DN-CDL은 각각 WMF와 CDL의 latent vector를 입력으로 사용한 모델이며, preference dropout rate는 0.5입니다.
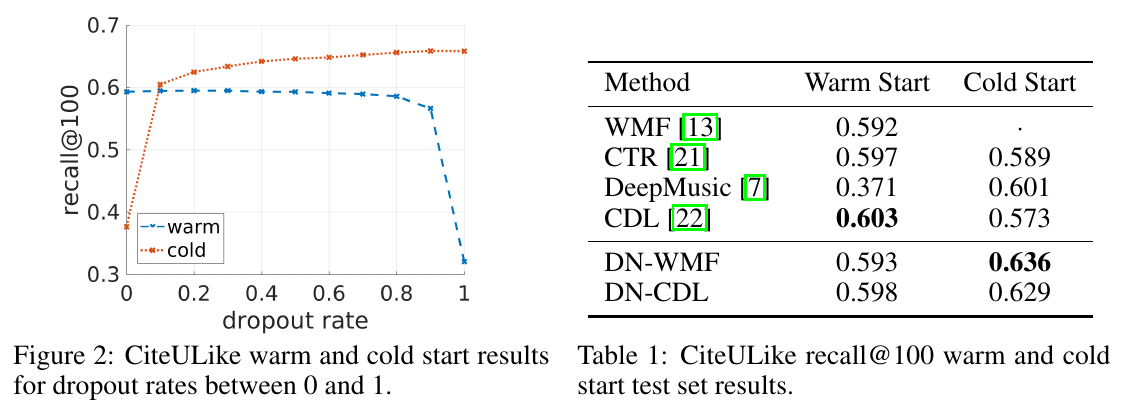
| 모델 | Warm start recall@100 | Item cold start recall@100 |
|---|---|---|
| WMF | 0.592 | 적용 불가 |
| CTR | 0.597 | 0.589 |
| DeepMusic | 0.371 | 0.601 |
| CDL | 0.603 | 0.573 |
| DN-WMF | 0.593 | 0.636 |
| DN-CDL | 0.598 | 0.629 |
DN-WMF의 cold start 개선은 DeepMusic 대비 0.035의 절대 차이이며, 상대적으로 약 5.8%입니다. DN-CDL은 CDL 대비 0.056, 상대적으로 약 9.8% 개선됐습니다. Warm start에서는 CDL의 0.603이 가장 높았으며, DN-WMF와 DN-CDL은 각각 입력 모델인 WMF와 CDL에 가까운 성능을 유지했습니다.
Dropout 비율을 바꾼 실험에서는 0일 때 cold start 성능이 낮았고, 0.1만 적용해도 크게 개선됐습니다. 비율을 지나치게 높이면 warm start 성능이 떨어졌으므로 dropout rate는 실제 서비스의 평가 조건에 맞춰 선택해야 합니다.
RecSys
원 데이터는 약 150만 사용자, 130만 일자리, 3억 건 이상의 상호작용을 포함합니다. 논문은 중복과 delete를 제거한 뒤 상호작용을 이진 행렬로 만들고, 마지막 2주를 test로 나눴습니다. 학습에는 1,870만 건을 사용했습니다. Cold start 평가를 위해 무작위로 선택한 사용자·아이템의 학습 이력을 제거했으므로, 자연적으로 유입된 신규 대상만으로 만든 test는 아닙니다.
사용자 feature는 831차원, 아이템 feature는 2,738차원입니다. Test는 warm start 약 426,000건, user cold start 약 159,000건, item cold start 약 184,000건으로 구분했고, cold start 사용자는 42,153명, 아이템은 49,975개였습니다.
WMF를 입력 모델로 사용하고, preference dropout과 평균 치환 비율을 0.5로 설정했습니다. DNN에는 tanh와 batch normalization을 사용했으며, hidden layer를 늘린 결과는 다음과 같습니다.
| Hidden layer 크기 | Warm start recall@100 | User cold start recall@100 | Item cold start recall@100 |
|---|---|---|---|
| 400 | 0.421 | 0.211 | 0.234 |
| 800 → 400 | 0.420 | 0.229 | 0.255 |
| 800 → 800 → 400 | 0.412 | 0.231 | 0.265 |
입력 WMF의 warm start 값은 0.426입니다. 더 깊은 모델은 cold start를 개선했지만 warm start가 0.412로 낮아졌으므로 성능 간 절충이 있습니다. 논문은 이후 비교에서 세 개의 hidden layer를 사용했습니다.
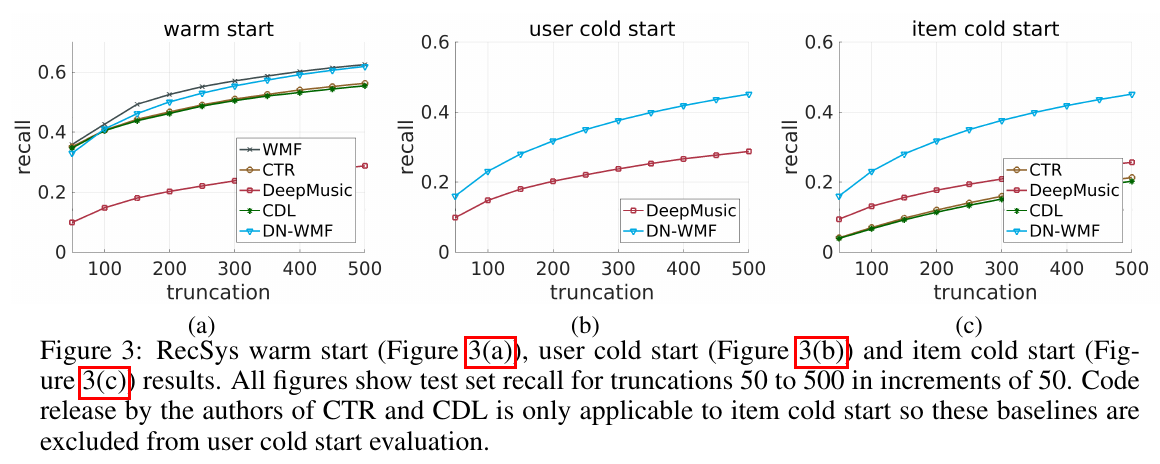
Top-50부터 top-500까지 비교한 곡선에서 DN-WMF는 user/item cold start 모두 DeepMusic보다 높은 recall을 보였습니다. CTR과 CDL의 저자 공개 코드는 user cold start를 지원하지 않아, 두 모델은 warm start와 item cold start에서만 비교했습니다.
추가 실험에서는 원래 이력이 다섯 건 이상인 cold start 사용자 10,000명을 골라, 학습에서 숨겨 둔 상호작용을 시간순으로 하나씩 다시 제공했습니다. 상호작용이 0건에서 5건으로 늘어날 때 평균 벡터를 사용하는 추론 절차로 recall@100이 개선됐습니다. 이는 새 이력이 생겼을 때 전체 재학습 없이 표현을 갱신하는 방법의 효과를 확인한 실험입니다.
Conclusion
DropoutNet은 기존 latent 모델의 점수를 복원하는 단일 목적을 사용하면서, preference 입력을 통째로 제거하는 학습으로 cold start에 대응합니다. 사용자와 아이템에 같은 원리를 적용할 수 있고, 상호작용 평균을 사용하는 근사 입력도 학습하여 초기 이력이 쌓이는 단계까지 연결합니다.
짧은 생각
RecSys에서 DNN 구조와 점수 복원 손실을 맞춘 DeepMusic보다 DropoutNet의 cold start recall이 높았다는 비교가 설계의 효과를 판단하는 근거가 됩니다. 평가 시 preference가 없는 대상에서도, 학습 중에는 preference를 제공한 사례를 함께 사용하는 편이 유리했습니다. Content만으로 점수를 복원하는 학습과 preference를 함께 활용하는 학습을 섞은 결과로 읽을 수 있지만, 어떤 학습 사례에서 이득이 생기는지는 이 비교만으로 구분하기 어렵습니다.
이를 더 확인하려면 학습 때 이력이 많았던 사용자·아이템과 적었던 사용자·아이템을 나누고, 각 집단의 preference를 평가 시 모두 숨긴 뒤 DeepMusic과의 격차를 비교할 수 있습니다. DropoutNet의 목표 점수도 기존 latent 모델에서 오므로, 이력이 풍부한 집단에 개선이 집중된다면 그 모델이 만든 점수의 신뢰도가 cold start 학습에도 영향을 준다는 해석을 뒷받침할 것입니다. 이력이 적은 집단에서도 비슷한 개선이 유지되는지는 별도로 확인할 가치가 있습니다.