


Sekai: A Video Dataset towards World Exploration 요약 설명
18 Jun 2025 | Paper Review Datasets Video Generation Camera Control목차
이번 글에서는 Sekai: A Video Dataset towards World Exploration 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 6월 18일(Arxiv), 39th Conference on Neural Information Processing Systems (NeurIPS 2025)
- Li, Zhen, Li, Chuanhao, Mao, Xiaofeng, Lin, Shaoheng, Li, Ming, Zhao, Shitian, Xu, Zhaopan, Li, Xinyue, Feng, Yukang, Sun, Jianwen, et al.
- Shanghai AI Laboratory, Beijing Institute of Technology, Shanghai Innovation Institute, Shenzhen MSU-BIT University, The University of Tokyo
- 논문 링크
- Github
- Project Page
요약
- 탐색 가능한 환경을 생성하는 비디오 모델을 학습하려면 길고 다양한 1인칭 영상과 카메라 궤적 주석이 필요하다. 카메라 궤적은 시간에 따른 카메라의 위치와 방향을 나타낸다. Sekai-Real 드론 영상으로 미세 조정하면 기준 카메라 제어 비디오 모델에 비해 이동 오차가 28.32에서 17.19로, 회전 오차가 27.2에서 19.89로 감소한다.
- Sekai는 101개 국가와 지역, 750개가 넘는 도시에서 수집한 5,000시간이 넘는 실제 도보 및 드론 영상과 Lushfoil Photography Sim 게임 영상을 결합한다. 수집, 필터링, 주석 작성, 샘플링 파이프라인을 통해 위치, 장면, 날씨, 시간대, 군중 밀도, 캡션, 카메라 궤적을 제공한다.
- 주석 검증에서는 표본 영상 500개 중 위치 관련 문제가 있는 비율이 5% 미만이며, 사례 500개에서 범주 주석 일치율이 90%를 넘는다고 보고한다. 범주 분석에서는 실내 장면을 제외한다. 생성 실험에서는 카메라 궤적 추종 성능이 개선되고 학습 후반 체크포인트의 종합 점수가 높아진다. 다만 선정된 테스트 클립 50개로 평가하며, 장시간 상호작용 탐색을 입증하지는 않는다. 일반 비디오 생성 실험은 미세 조정하지 않은 기준 모델 없이 미세 조정 체크포인트끼리 비교한다.
1 Introduction
논문은 세계 탐색을 이미지, 텍스트 또는 비디오로 동적이고 사실적인 환경을 구성하고 그 안에서 상호작용하며 이동하는 것으로 정의한다. 키보드와 마우스 입력을 카메라 움직임으로 변환할 수 있으므로 카메라 제어 비디오 생성은 이 목표를 실현할 방법이 될 수 있다. 그러나 기존 데이터셋은 이러한 동작을 학습하는 데 필요한 영상 길이, 지리적 다양성, 주석이 부족한 경우가 많다.
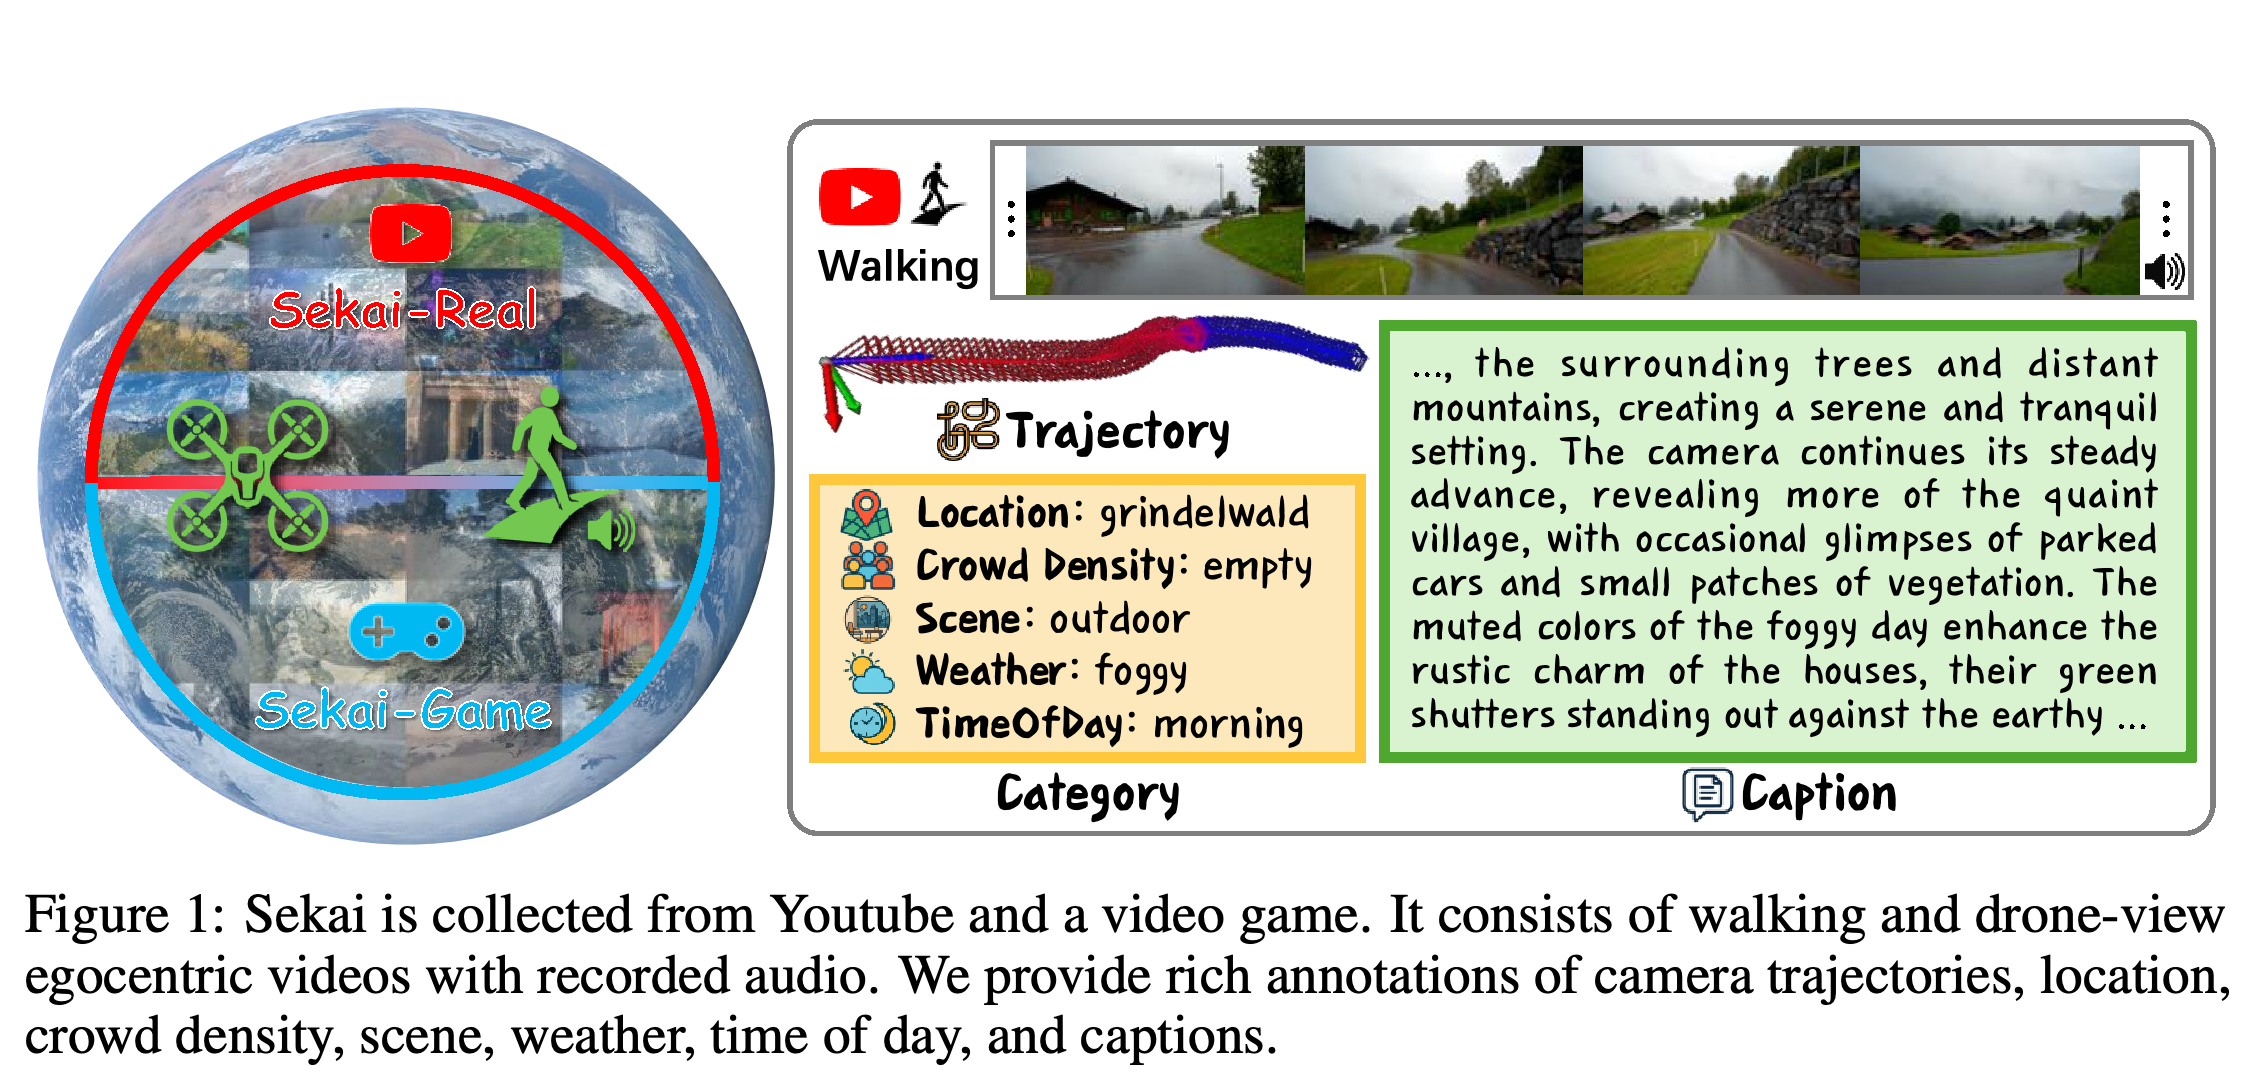
- Sekai-Real은 YouTube 영상으로 구성되며, Sekai-Game은 카메라 포즈를 직접 기록한 게임 플레이 영상으로 구성된다. 각 포즈는 카메라의 위치와 방향을 나타낸다. 도보 영상은 오디오를 유지한다.
- 논문의 기여는 데이터셋, 데이터 정제 파이프라인, 통계와 주석 검증 및 생성 실험을 통한 검증이다. 프로젝트 URL은 https://lixsp11.github.io/sekai-project/ 이다.
예시는 도보 영상에 카메라 경로, 위치, 환경 레이블, 상세 캡션을 연결한다. 움직임 학습 정보와 환경 설명을 어떻게 결합하는지 보여준다.
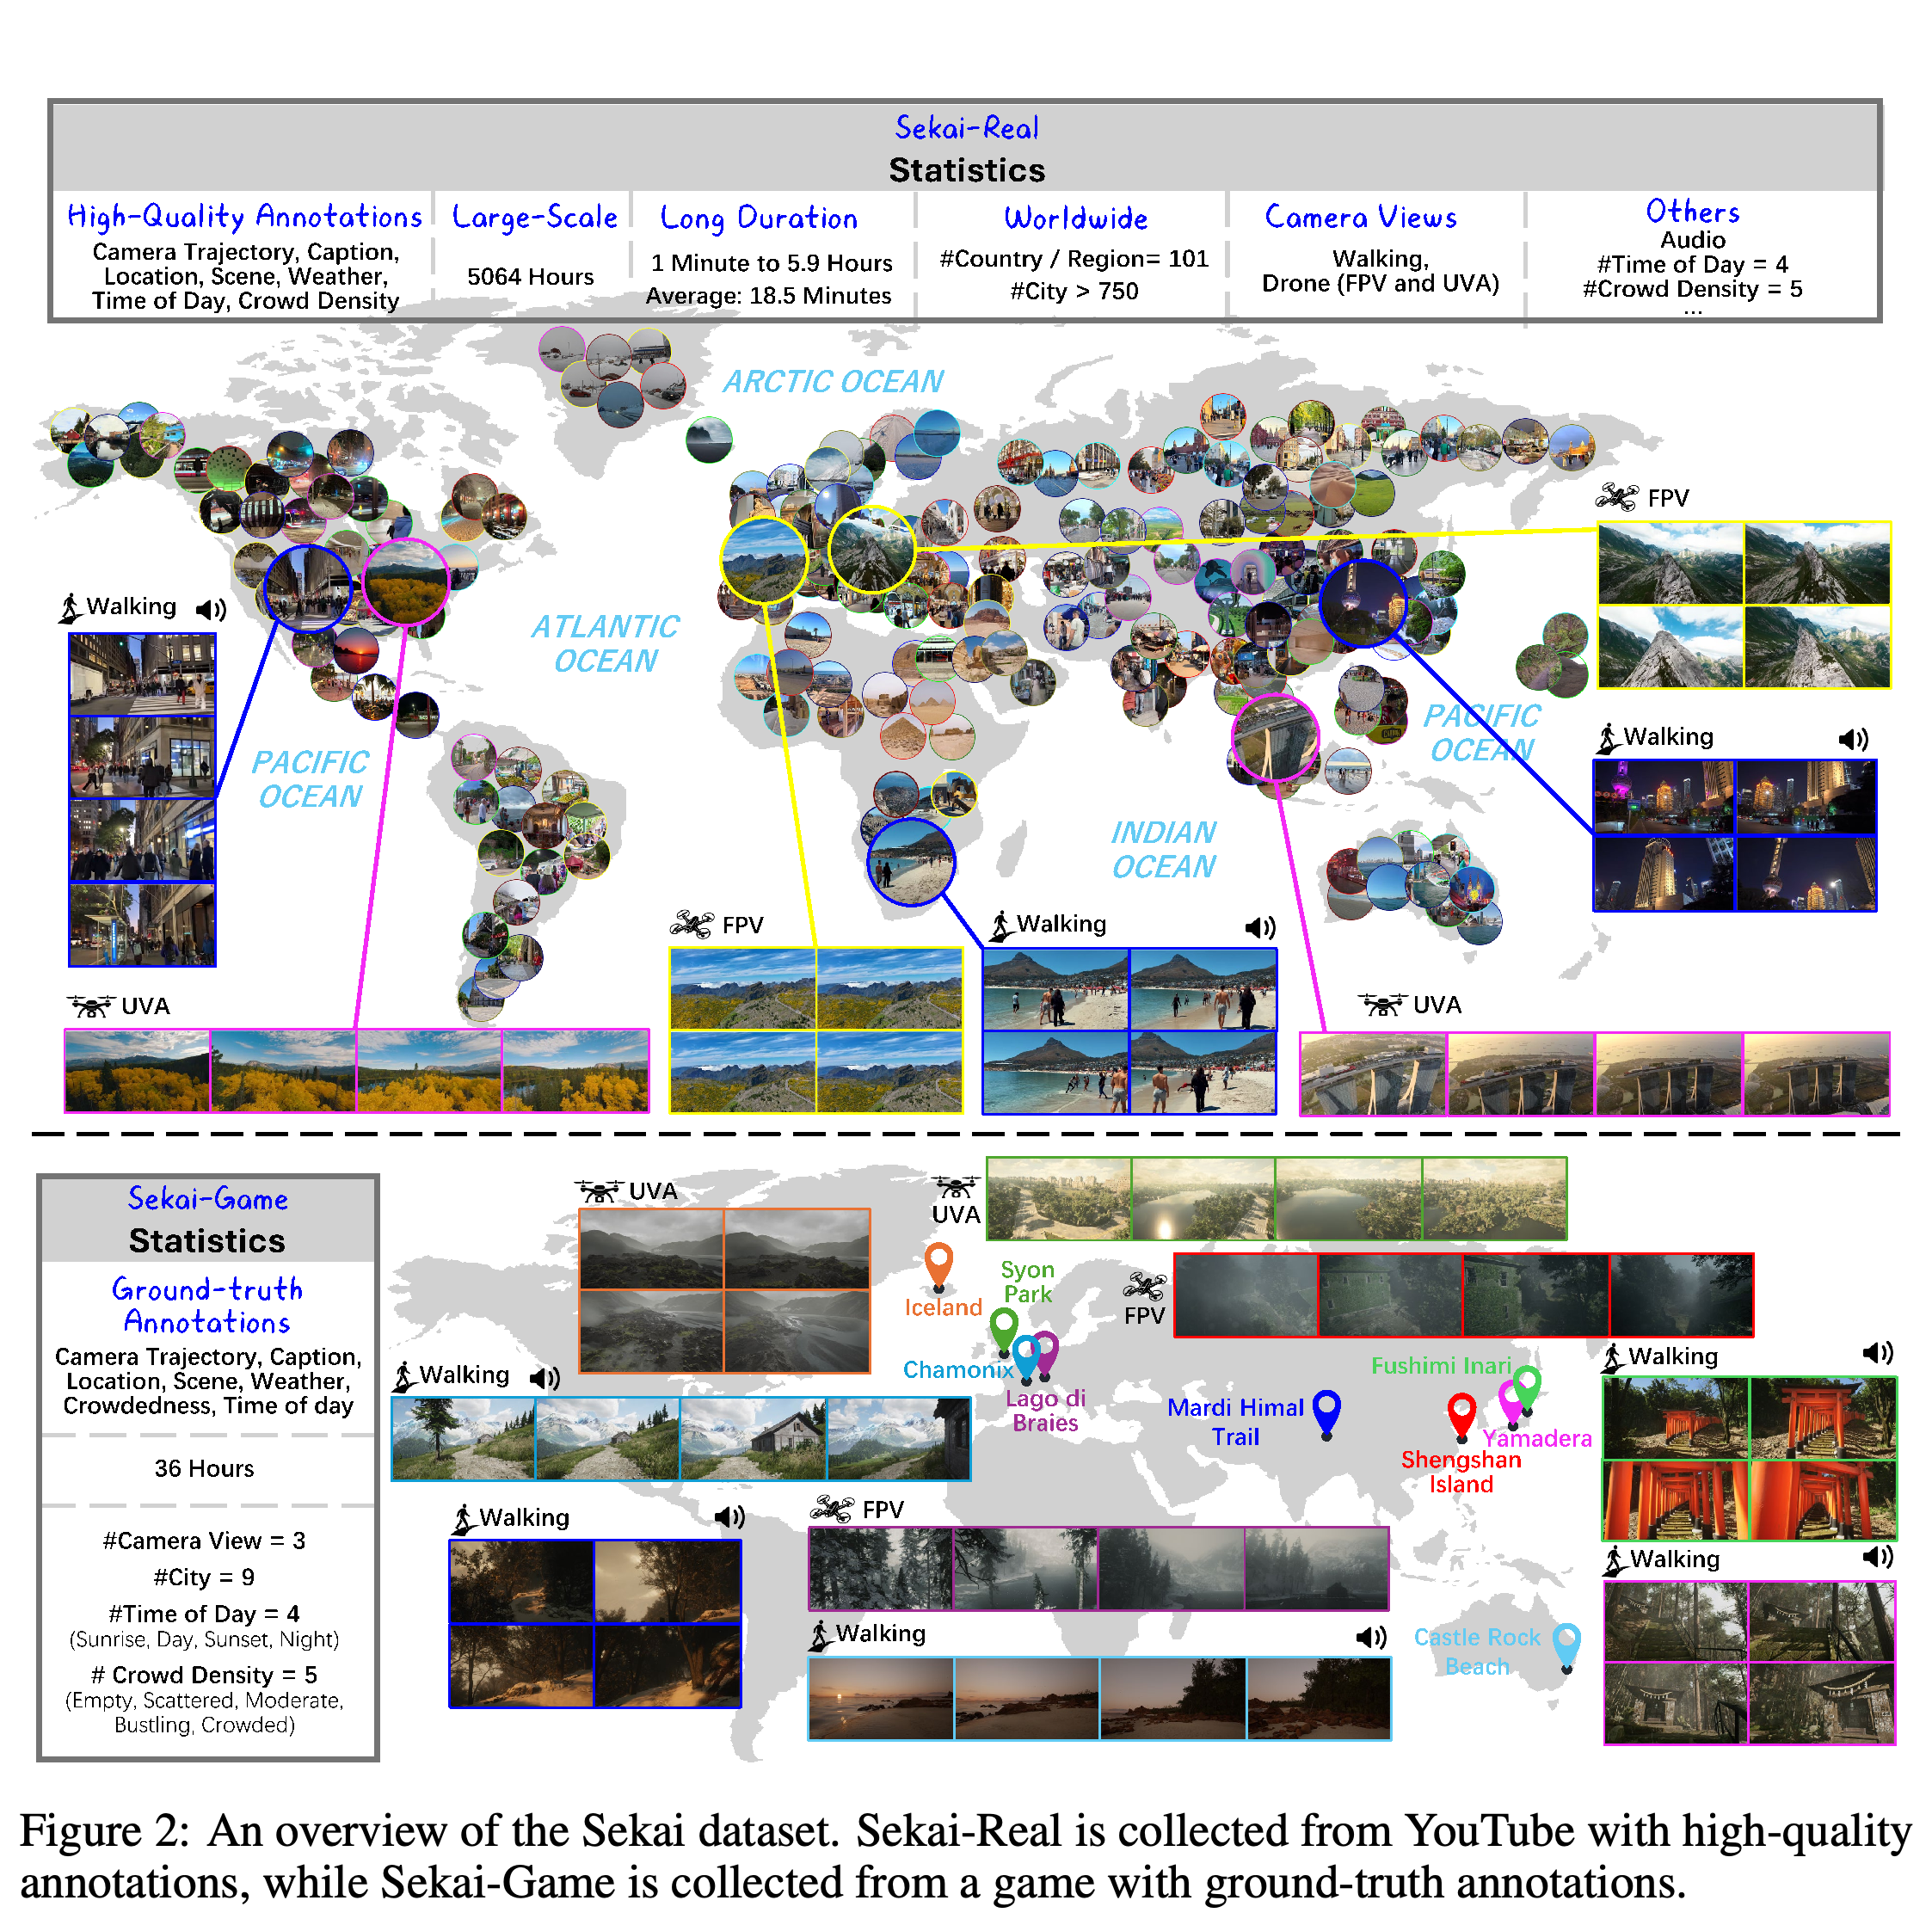
지도는 도보 및 드론 예시를 통해 전 세계의 수집 범위를 보여주며, 하단 패널은 규모가 더 작은 게임 영상 모음을 별도로 제시한다. Sekai-Real 5064시간과 Sekai-Game 36시간이라는 수치는 규모 차이를 보여준다.
2 Related Work
관련 연구는 탐색 가능한 세계를 생성하는 모델과 비디오 생성 모델 학습에 사용하는 데이터셋을 다룬다. Sekai는 긴 1인칭 이동 영상에 환경과 카메라 움직임을 설명하는 주석을 결합한다.
2.1 World Generation Model
세계 생성 연구에는 비디오 생성, 3차원 장면 생성, 시간에 따라 변하는 3차원 장면을 뜻하는 4차원 생성이 포함된다. 논문은 깊이를 추정해 이미지를 3차원 표현으로 확장하는 방법과 시간에 따라 변화하는 환경을 생성하는 방법을 살펴본 뒤, 상호작용 비디오 생성을 위한 데이터에 초점을 맞춘다.
2.2 Video Generation Dataset
논문은 특정 시나리오에 한정된 데이터셋과 다양한 시나리오를 포괄하는 데이터셋을 구분한다. 열거한 특정 시나리오 데이터셋은 총길이가 800시간 미만이고 영상당 평균 길이가 20초 미만이라고 설명한다. 더 큰 규모로 다양한 시나리오를 다루는 데이터셋도 긴 시퀀스, 카메라 포즈, 환경 레이블을 함께 갖추지는 못한다.
- OpenSoraPlan-V1.0은 상세한 캡션을 갖춘 274시간의 영상을 포함한다. OpenVid-1M은 2100시간을 포함하지만 영상당 평균 길이가 25초 이하이다. MiraData는 평균 길이가 72.1초이며, 이 논문이 강조하는 탐색 및 세계 관련 주석이 없다.
- 이 절에서는 Sekai 영상의 길이가 1~39분이고 평균은 2분이라고 설명한다. Figure 2는 다른 길이 통계를 제시하며, PDF는 이 설명들이 어떻게 연결되는지 명확히 밝히지 않는다.
3 Dataset Curation
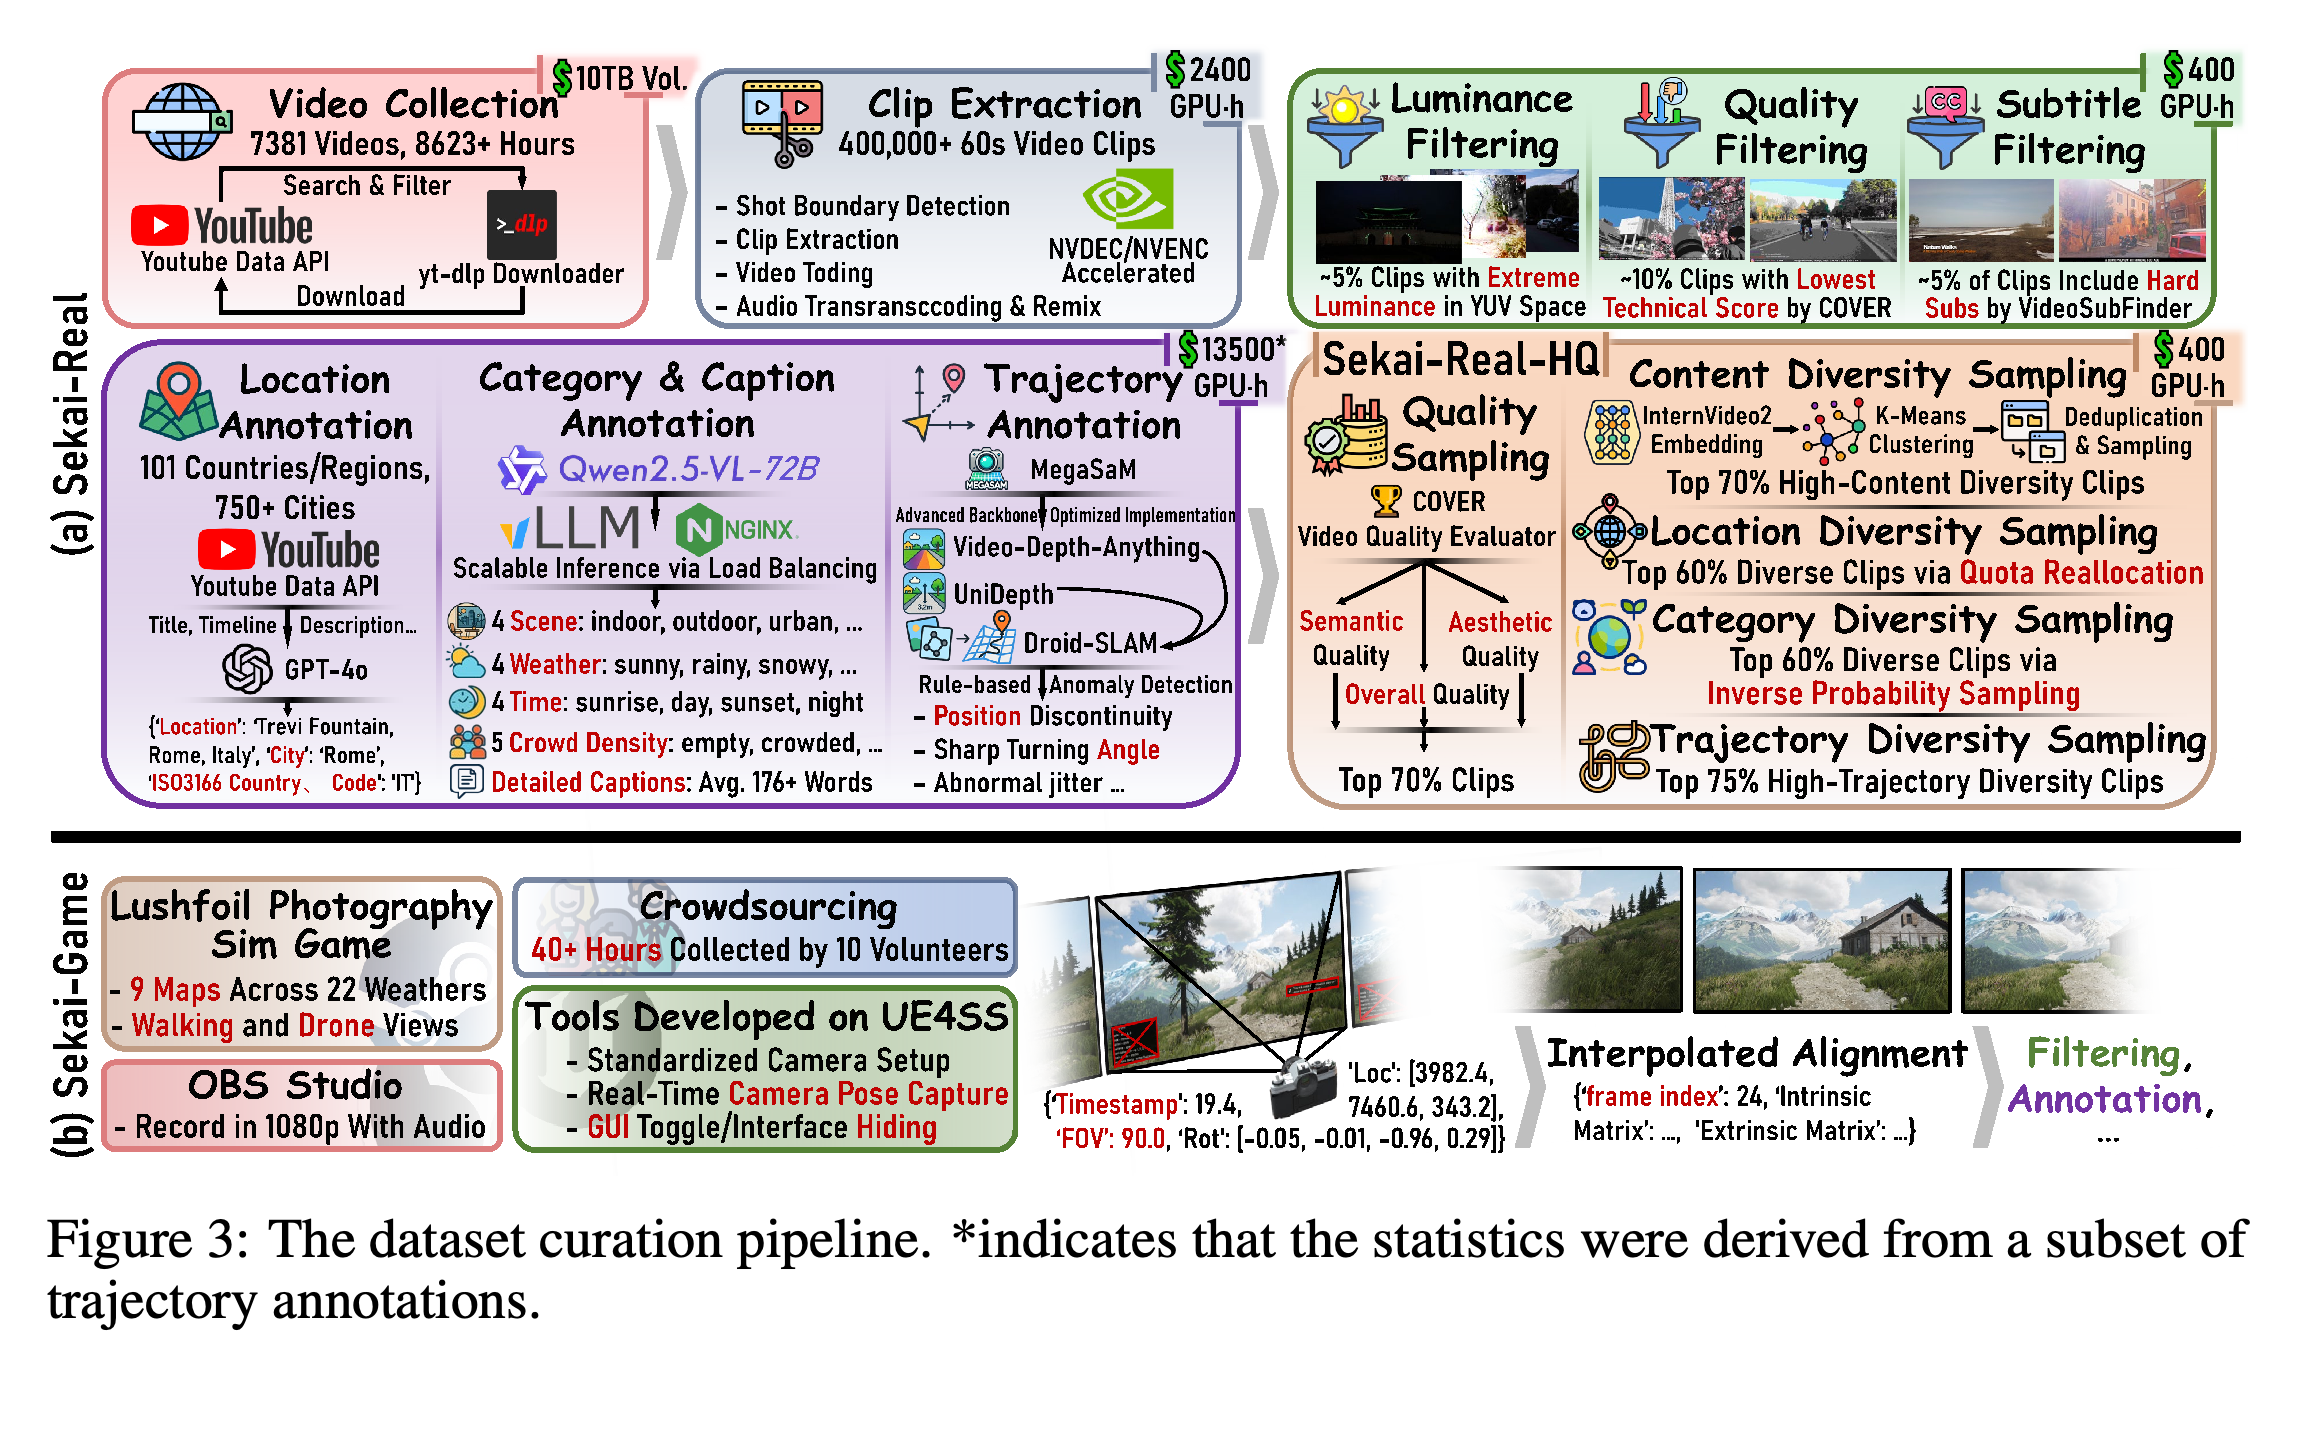
데이터셋 정제는 영상 수집, 전처리, 주석 작성, 샘플링으로 구성된다. 실제 영상의 주석은 추론해야 하지만, 게임 파이프라인은 카메라 포즈를 직접 기록하고 게임 맵 설명에서 환경 정보를 얻을 수 있다.
2개 분기는 YouTube 영상에서 주석을 추론하는 방식과 게임 플레이 중 카메라 포즈를 직접 기록하는 방식을 구분한다. 품질 및 다양성 샘플링은 실제 영상의 학습 부분집합을 추가로 선정한다. 별표가 붙은 궤적 통계는 주석의 일부에만 해당한다.
3.1 Video Collection
저자들은 수작업 수집과 키워드 검색을 통해 YouTube에서 도보 영상 10471시간과 드론 영상 628시간을 찾는다. 다운로드 실패와 손상된 영상을 제외하고 실제로 다운로드한 자료는 도보 영상 8409시간과 드론 영상 214시간으로, 총 8623시간이다.
- 원본 영상은 수집 시점 이전 3년 동안 공개되었으며, 길이는 30분~12시간이고 해상도는 최소 1080P, 프레임률은 초당 30~60프레임이다. 파이프라인은 초당 인코딩 데이터양을 뜻하는 비트레이트가 가장 높은 1080P 버전을 다운로드한다.
- Lushfoil Photography Sim은 풍경 속 도보 탐색과 1인칭 드론 탐색을 지원한다. 저자들은 영상 녹화 소프트웨어인 OBS Studio로 장소와 날씨를 다양하게 바꾸며 40시간을 녹화한다. 녹화 설정은 1080P, 초당 30프레임, 비트레이트 8~12 Mbps이다.
3.2 Video Pre-processing
전처리는 도입부와 끝부분, 불연속 구간, 저품질 영상, 자막, 추정된 카메라 움직임 중 비현실적인 부분을 제거한다. 감지된 전환 사이의 연속 영상인 샷을 1분 클립으로 나누고 더 짧은 조각은 버린다. 연속된 클립은 이후 학습을 위해 다시 이어 붙일 수 있다.
- 파이프라인은 각 YouTube 영상의 양 끝에서 2분씩 잘라낸다. 이어서 샷 전환 감지 모델인 TransNetV2를 임계값 0.4로 사용해 샷 경계를 찾고, 각 샷의 양 끝에서 5초씩 잘라낸다. 디코딩에 PyNVideoCodec을, 프레임 처리에 CVCUDA를 사용하고 그래픽 처리 장치인 GPU로 가속하면 샷 감지 속도가 원래 구현 대비 5 times로 높아진다고 보고한다.
- 클립은 720p, 초당 30프레임, 4 Mbps 설정으로 H.265 비디오 압축을 사용해 MP4 파일로 인코딩한다. 보고된 트랜스코딩 평가에서는 재구성 충실도를 측정하는 최대 신호 대 잡음비가 35를 넘는다. 도보 영상의 오디오는 48 kHz로 AAC 압축을 적용한다.
- 휘도 필터링은 평균 밝기가 극단적으로 높거나 낮은 프레임이 15프레임을 초과해 연속되는 클립을 제거하며, 이 과정에서 300시간을 제외한다. 비디오 품질 평가기인 COVER는 기술적 품질 점수가 가장 낮은 10%를 제거한다. 자막 감지기인 VideoSubFinder는 프레임 하단 3분의 1 영역에 자막이 0.75초 넘게 나타나는 클립을 제거하며, 제거 비율은 약 5%이다.
- 궤적 주석이 있는 선정 부분집합에서는 10초 안에 150도를 넘는 방향 반전이 여러 차례 발생하거나, 연속 프레임 사이의 시점 변화가 60도를 넘거나, 위치 변위가 해당 프레임을 포함한 30프레임 구간 평균 변위의 5 times를 초과하는 클립을 제외한다.
3.3 Video Annotation of Sekai-Real
Sekai-Real 주석은 원본 메타데이터, 시각 정보 해석, 추정된 카메라 기하 정보를 결합한다. 위치 추출에는 언어 모델인 GPT-4o를 사용해 YouTube 챕터 설명을 ISO 3166 표준 국가 또는 지역 코드와 함께 구조화한다. 타임스탬프를 대조해 클립을 챕터에 배정하며, 유일한 챕터에 대응시킬 수 없는 약 8%의 클립은 버린다.
- 시각 및 텍스트 입력을 처리하는 모델인 Qwen2.5-VL-72B는 먼저 장면, 날씨, 시간대, 군중 밀도를 분류하며, 확실하지 않으면 판단을 보류한다. 이어서 이 레이블과 위치 정보, 2초마다 샘플링한 프레임을 사용해 시간순 캡션을 생성한다. 캡션의 평균 길이는 176단어를 넘는다.
- 저자들은 카메라 움직임 추정 방법을 비교하고, 비디오에서 장면 구조와 카메라 움직임을 추정하는 MegaSaM을 선택한다. 시간적 일관성을 높이기 위해 단일 이미지 깊이 추정기를 비디오 깊이 추정 모델인 Video Depth Anything으로 교체하고, 여러 머신과 GPU에서 추론하도록 조정한다.
3.4 Video Annotation of Sekai-Game
Sekai-Game 파이프라인은 Unreal Engine 객체에 접근하는 스크립팅 시스템인 RE-UE4SS와 OBS Studio를 함께 사용해 영상과 주석을 기록한다. 도구는 카메라 설정을 표준화하고, 카메라 포즈를 실시간으로 기록하며, 그래픽 사용자 인터페이스를 숨긴다.
- 위치와 범주 정보는 게임 맵 설명에서 얻으며, 캡션 프롬프트는 게임 플레이에 맞게 조정한다. 기록된 포즈는 지연을 보정하고 보간해 비디오 프레임과 정렬한다. 이렇게 기록한 포즈와 게임에서 얻은 메타데이터는 실제 영상에서 추론한 주석보다 직접적인 근거를 갖는다.
3.5 Video Sampling
Video Sampling은 가용 학습 예산에 맞춰 Sekai-Real-HQ라는 400시간 부분집합을 만든다. 먼저 품질을 기준으로 선택한 뒤 콘텐츠, 위치, 범주, 카메라 움직임의 다양성을 순서대로 고려해 샘플링한다.
- 3.5.1 Quality Sampling은 시각적 조화와 콘텐츠의 완전성 또는 일관성을 측정하는 COVER의 미적 품질 점수와 의미적 품질 점수를 합산하고, 점수가 높은 상위 70%의 클립을 유지한다.
- 3.5.2 Diversity Sampling은 비디오 표현 모델인 InternVideo2로 클립 콘텐츠를 수치로 표현한 임베딩을 추출한다. 클러스터링 방법인 Mini-batch K-Means로 각 국가 또는 지역 안에서 이 표현들을 묶는다. 콘텐츠 단계에서는 품질 순위에 따른 선택과 유사 클립 제거를 거쳐 70%를 유지한다. 위치 샘플링은 60%를 유지하며, 특정 도시의 클립이 부족하면 할당량을 재배분한다.
- 범주 샘플링은 날씨, 장면, 시간대, 군중 밀도의 레이블 빈도에 반비례하는 확률을 사용해 60%를 유지한다. 범주들이 독립적이라고 가정하고 범주별 확률을 곱한 뒤 정규화하여 비복원 추출한다.
- 카메라 샘플링은 시작점에서 끝점까지의 이동 방향과 지터를 함께 기준으로 클립을 묶고 75%를 유지한다. 지터는 30프레임마다 계산한 위치 분산의 유클리드 노름으로 정의한다. 이 그룹들에서 샘플링해 카메라 움직임을 다양하게 구성한다.
4 Dataset Statistics
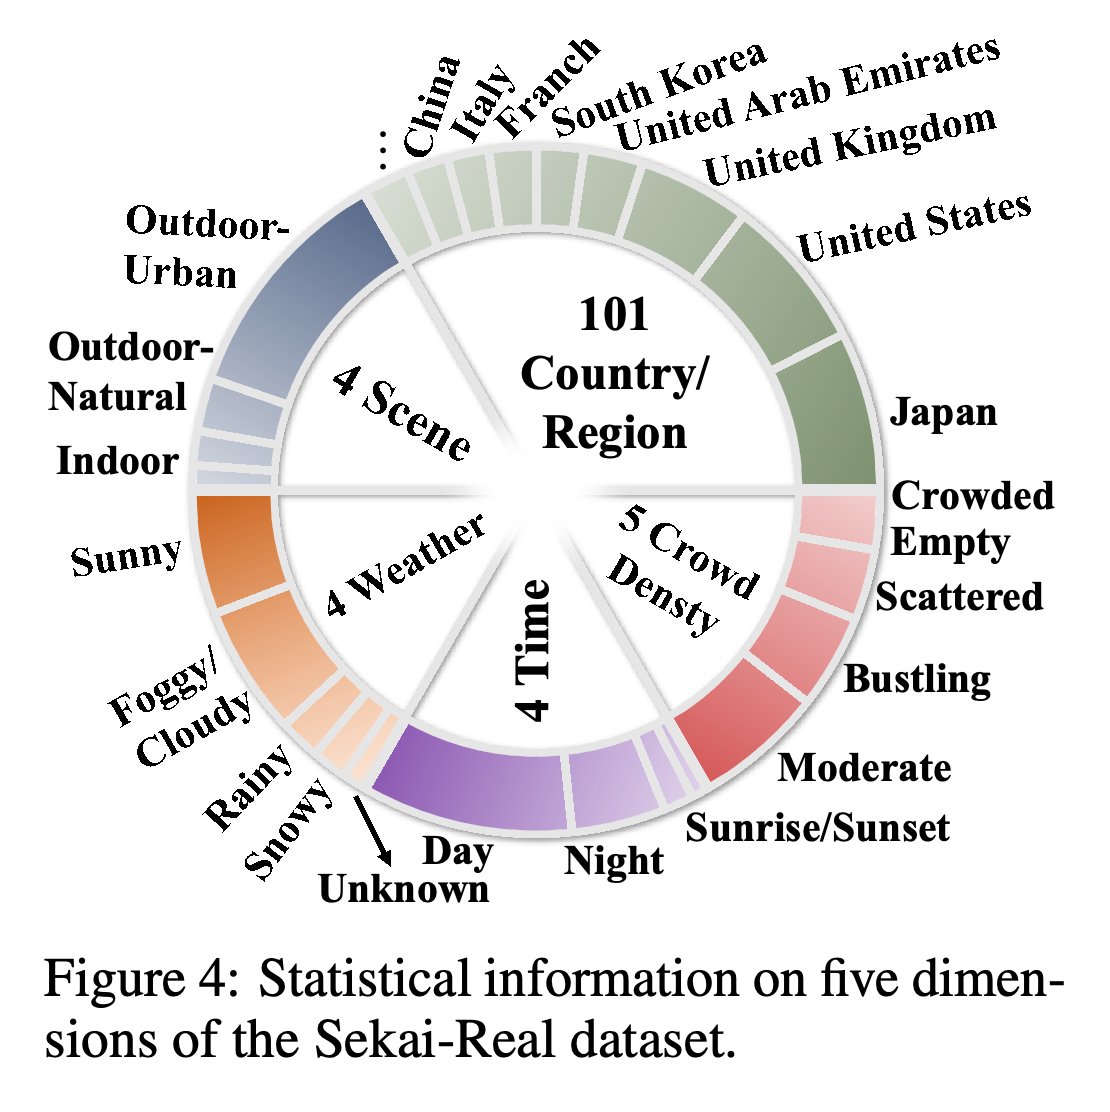
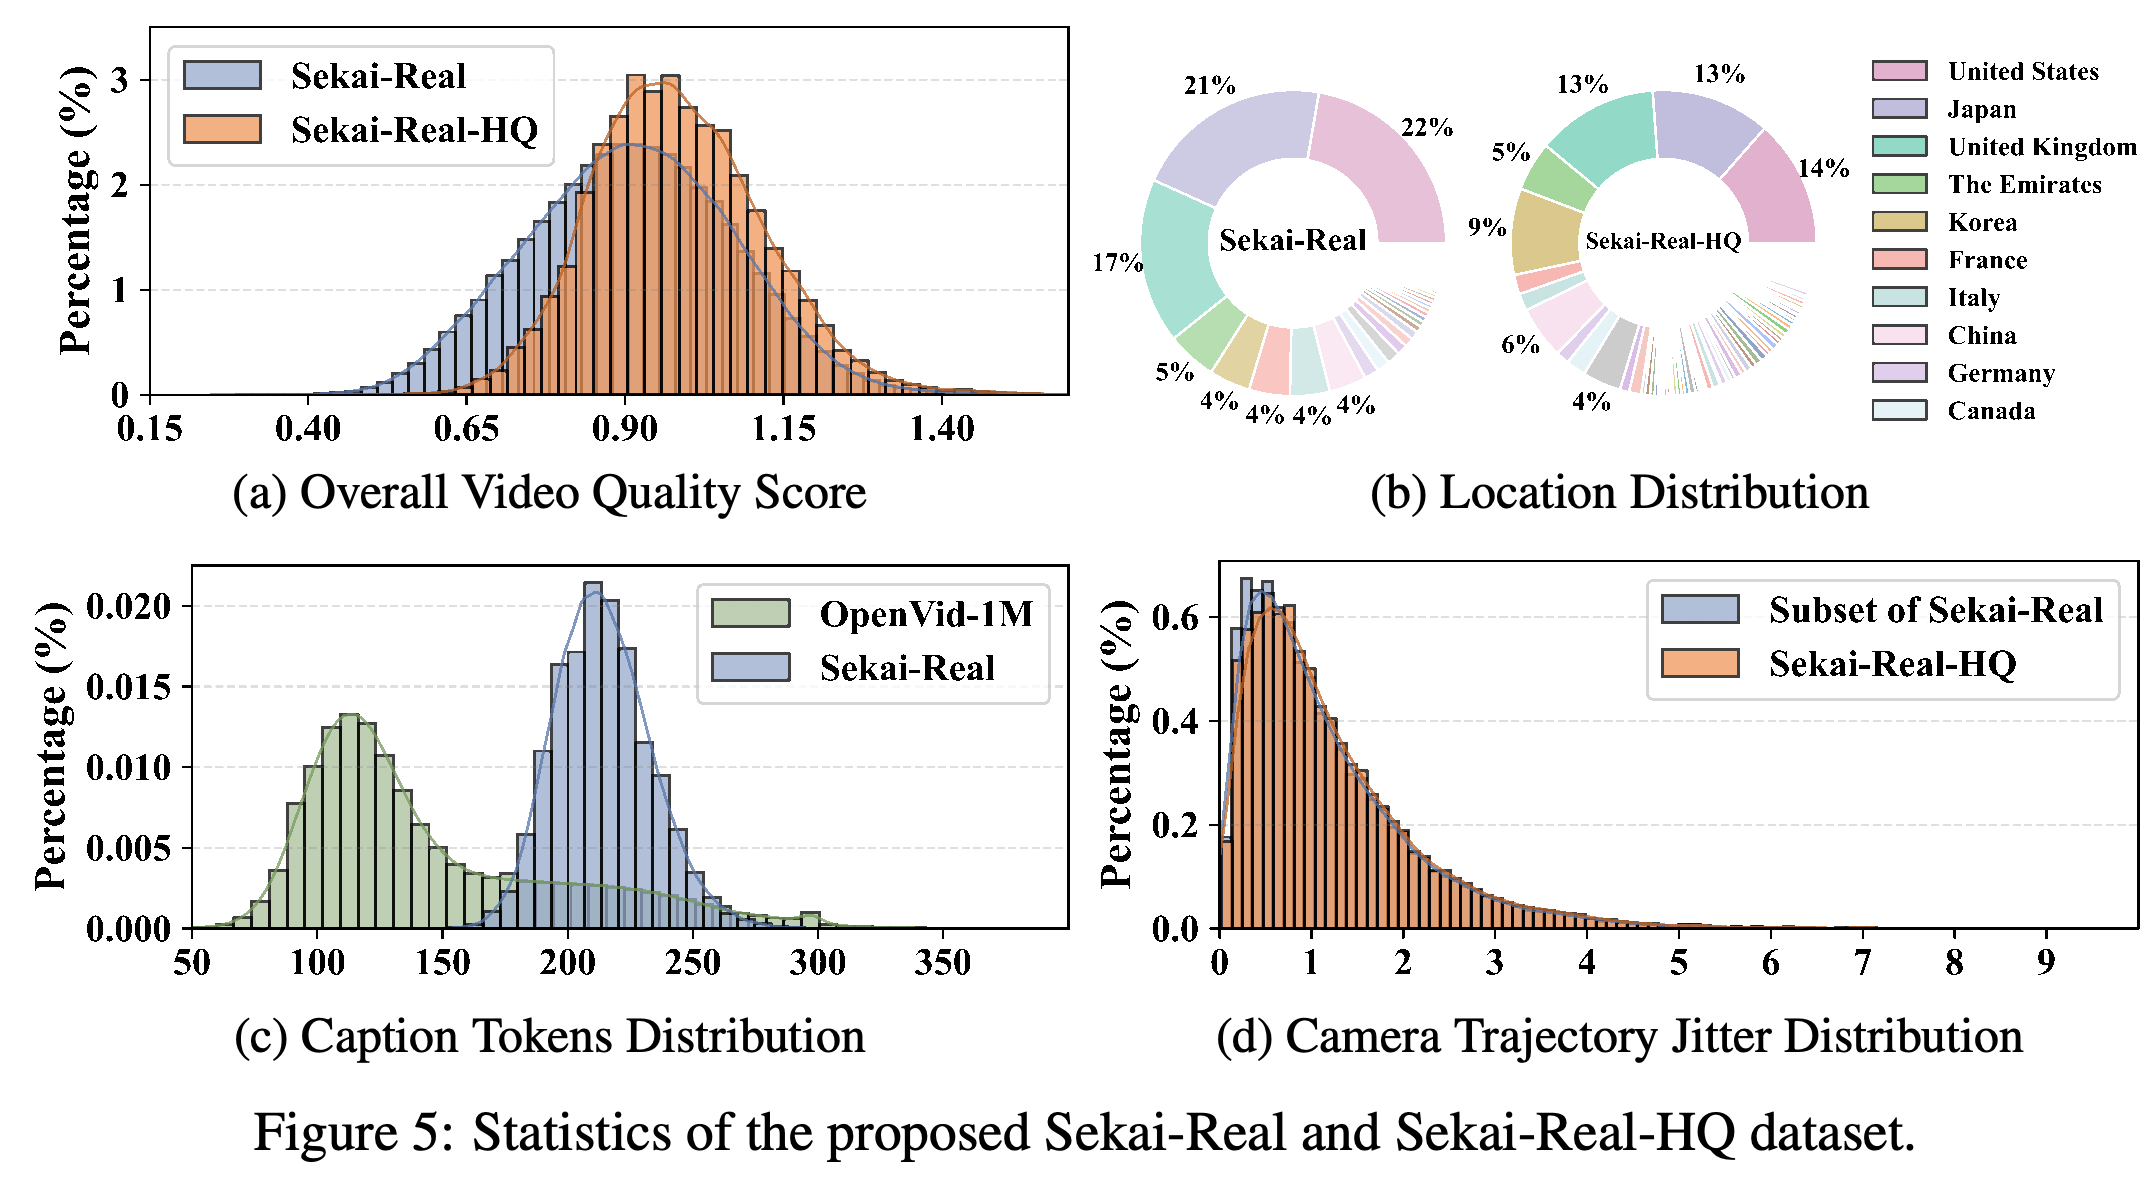
Sekai-Real은 101개 국가와 지역을 포함하지만, 지리적 분포는 여전히 편중되어 있다. 상위 8개 국가가 전체 영상 길이의 약 60%를 차지한다. 야외 영상과 낮 장면이 대부분이며, 군중 밀도 레이블은 사람이 드문 환경부터 붐비는 거리까지 포괄한다.
- Figure 2는 Sekai-Real이 5064시간이며, Sekai-Game은 게임 내 9개 장소에서 수집한 36시간이라고 보고한다. Sekai-Real 영상 길이는 1분~5.9시간, 평균은 18.5분으로 제시한다. 이 수치가 전처리의 1분 클립 및 Section 2.2의 길이 통계와 어떤 관계인지는 불분명하다.
- Sekai-Real 영상의 절반 이상은 보고된 종합 품질 지표에서 0.9를 넘는다. Sekai-Real-HQ는 평균 품질이 더 높고 분산이 더 낮으며, 지리적 분포가 더 균형 잡혀 있고 카메라 지터 분포도 더 완만하다.
- Sekai 캡션의 평균 토큰 수는 OpenVid-1M 캡션보다 많다. 여기서 토큰은 비교에 사용한 텍스트 단위이다. 이 결과는 캡션이 더 길다는 점을 보여주지만, 그래프만으로 캡션 정확도가 더 높다고 판단할 수는 없다.
항목별 분포는 지리적 범위가 넓으면서도 소수 국가와 특정 장면 또는 조명 조건에 집중되어 있음을 보여준다. 군중 밀도 레이블은 사람이 나타나는 정도를 다양하게 포괄한다.
품질 및 위치 패널은 Sekai-Real-HQ를 선정한 뒤 품질 점수가 높아지고 지리적 분포가 더 균형 잡혔음을 보여준다. 캡션 패널은 OpenVid-1M보다 캡션이 길다는 점을 보여준다. 지터 패널은 기하 정확성이 아니라 카메라 움직임 분포의 변화를 설명한다.
5 Experiments
실험은 주석 품질, Sekai-Real-HQ를 사용한 텍스트 및 이미지 조건부 비디오 생성, 카메라 주석을 사용한 카메라 제어 생성을 평가한다. 일반 생성 실험은 사전 학습된 비디오 생성 모델인 SkyReels-V2를 미세 조정한다. 상호작용 생성 실험은 카메라 조건부 비디오 생성 모델인 Wan2.1-Fun-V1.1-1.3B-Control-Camera를 미세 조정한다.
5.1 Evaluation of Annotation Quality
주석 검증은 위치, 카메라 궤적, 범주 레이블을 확인한다. 수치 근거는 표본에서 발견한 위치 문제와 범주 일치율에 관한 것이다. 궤적 비교는 상대적인 매끄러움과 주석 품질을 보고하지만, 알려진 카메라 포즈를 기준으로 한 수치 오차 표는 제시하지 않는다.
- 공동 저자들은 무작위로 뽑은 영상 500개를 온라인 지도와 대조하며 누락되거나 잘못 합쳐진 구간, 타임스탬프 불일치, 명시적인 원본 근거 없이 추론한 위치를 확인한다. 논문은 이러한 문제가 5% 미만에서 발견되었다고 보고한다.
- MegaSaM과 이미지에서 3차원 정보를 예측하는 모델인 VGGT를 도보 시점 클립 100개와 드론 시점 클립 100개에서 비교한다. 저자들은 MegaSaM의 궤적이 더 매끄럽고 VGGT의 추론이 더 빠르다고 보고하며, 이를 바탕으로 MegaSaM을 선택한다.
- 범주 다양성을 유지하도록 뽑은 사례 500개에서 Qwen2.5-VL과 공동 저자의 레이블 일치율은 90%를 넘는다. 실내 장면은 분석에서 제외한다. 날씨 오류는 주로 흐리거나 안개 낀 조건과 비가 오는 조건을 혼동하는 경우이며, 비를 확인하려면 연속 프레임이 필요할 수 있다.
5.2 Video Generation
5.2.1 Settings에서는 텍스트에서 비디오를 생성하는 T2V에 SkyReels-V2-T2V-14B-540P를, 이미지에서 비디오를 생성하는 I2V에 SkyReels-V2-I2V-14B-540P를 사용한다. 학습 설정은 비디오 크기 544×960×49, 초당 16프레임, 배치 크기 1, 학습률 1e-5, 적응형 경사 최적화 알고리즘인 Adam, NVIDIA H100 GPU 8개이며, 총 20,000회 반복한다고 명시한다. 추론은 같은 크기와 프레임률로 50단계를 사용한다.
- Sekai-Real-HQ를 무작위로 10개 폴드로 나누고 마지막 2개 폴드를 학습에서 제외한다. 독립적인 주석 작업자들은 학습에서 제외한 이 폴드에서 다양한 클립 50개를 골라 평가에 사용한다.
- 비디오 생성 평가 지표 모음인 VBench는 피사체 외형의 일관성, 배경 안정성, 움직임의 매끄러움, Dynamic Degree를 통한 움직임 정도, Aesthetic Quality를 통한 시각적 매력, Imaging Quality를 통한 왜곡을 측정한다. 확장 평가 도구인 VBench++는 입력 이미지와의 대응을 평가하는 I2V Subject와 I2V Background를 추가한다.
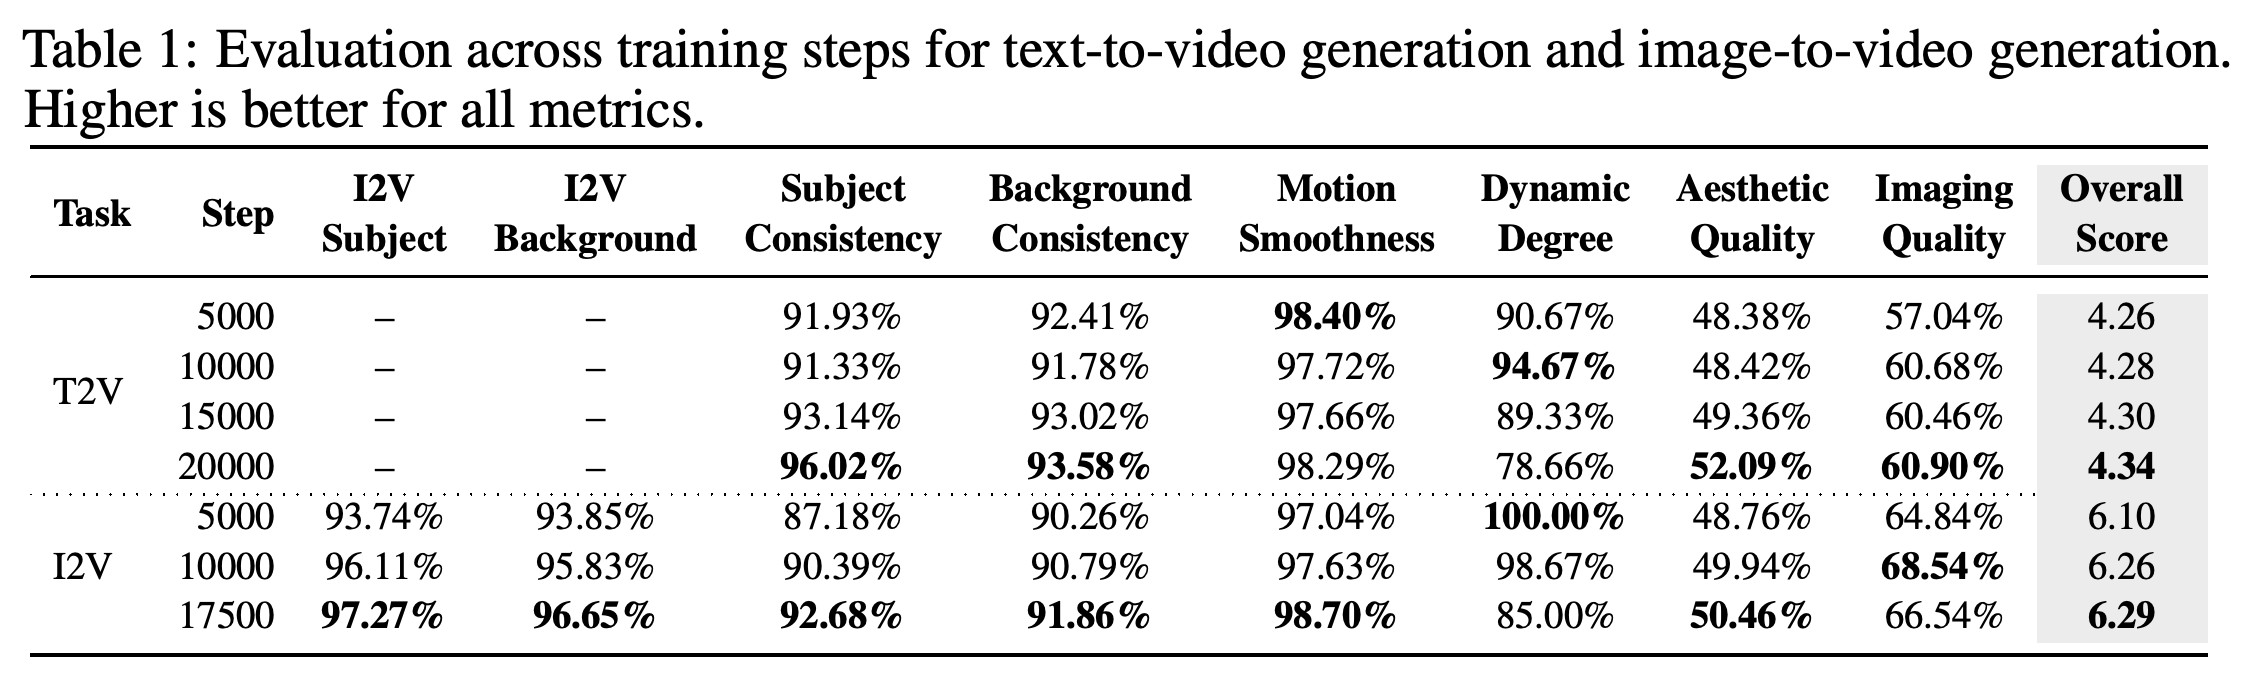
5.2.2 Quantitative Results에서는 제시한 학습 체크포인트에서 Overall Score가 상승한다고 보고한다. T2V는 5000단계의 4.26에서 20000단계의 4.34로, I2V는 5000단계의 6.10에서 17500단계의 6.29로 증가한다. Table 1은 이전 미세 조정 체크포인트 대비 개선을 보여주지만, 미세 조정하지 않은 원래 모델 대비 개선량은 제시하지 않는다.
- T2V의 피사체 일관성은 91.93%에서 96.02%로, 미적 품질은 48.38%에서 52.09%로, 영상 품질은 57.04%에서 60.90%로 상승한다. Dynamic Degree는 10000단계에서 최고치인 94.67%를 기록한 뒤 20000단계에서 78.66%로 하락한다.
- I2V Subject는 93.74%에서 97.27%로, I2V Background는 93.85%에서 96.65%로 증가한다. 영상 품질은 10000단계에서 최고치인 68.54%를 기록한 뒤 17500단계에서 66.54%로 하락하며, Dynamic Degree는 100.00%에서 85.00%로 감소한다.
- 저자들은 움직임 감소를 더 깨끗한 프레임과 선명한 세부 묘사를 지향하는 변화로 해석한다. 표는 움직임 정도가 감소하는 동시에 일부 품질 지표가 상승함을 보여주지만, 그 원인을 분리해 확인하지는 않는다.
제시한 미세 조정 체크포인트에서 2개 과제 모두 Overall Score가 상승하지만, 후반에는 Dynamic Degree가 감소한다. I2V 영상 품질은 중간 최고점 이후 하락하므로 개선 양상은 지표마다 다르다. 표에는 0단계 비교가 없다.
5.3 Interactive Video Generation
5.3.1 Settings에서는 초기 이미지, 텍스트 프롬프트, 카메라 궤적을 사용해 Wan2.1-Fun-V1.1-1.3B-Control-Camera를 미세 조정한다. Sekai-Real 드론 영상과 전체 Sekai-Game 데이터셋으로 각각 별도의 학습을 수행하며, 전체 학습 데이터를 반복해서 순회하며 2 epochs 동안 학습한다. 평가는 앞서 설명한 절차로 선정한 테스트 영상 50개를 사용한다.
- 기준 모델은 이산적인 카메라 동작을 포즈로 변환한 뒤, 모델에 프레임별 카메라 표현으로 제공하는 Plücker 임베딩으로 변환한다. 미세 조정에는 대신 Sekai의 프레임별 포즈 주석을 사용한다.
- TransErr와 RotErr는 입력 궤적과 MegaSaM으로 생성 영상에서 추정한 궤적 사이의 이동 및 회전 차이를 측정한다. 값이 낮을수록 카메라 궤적을 더 가깝게 따른다는 뜻이며, 표에는 물리 단위가 명시되어 있지 않다.
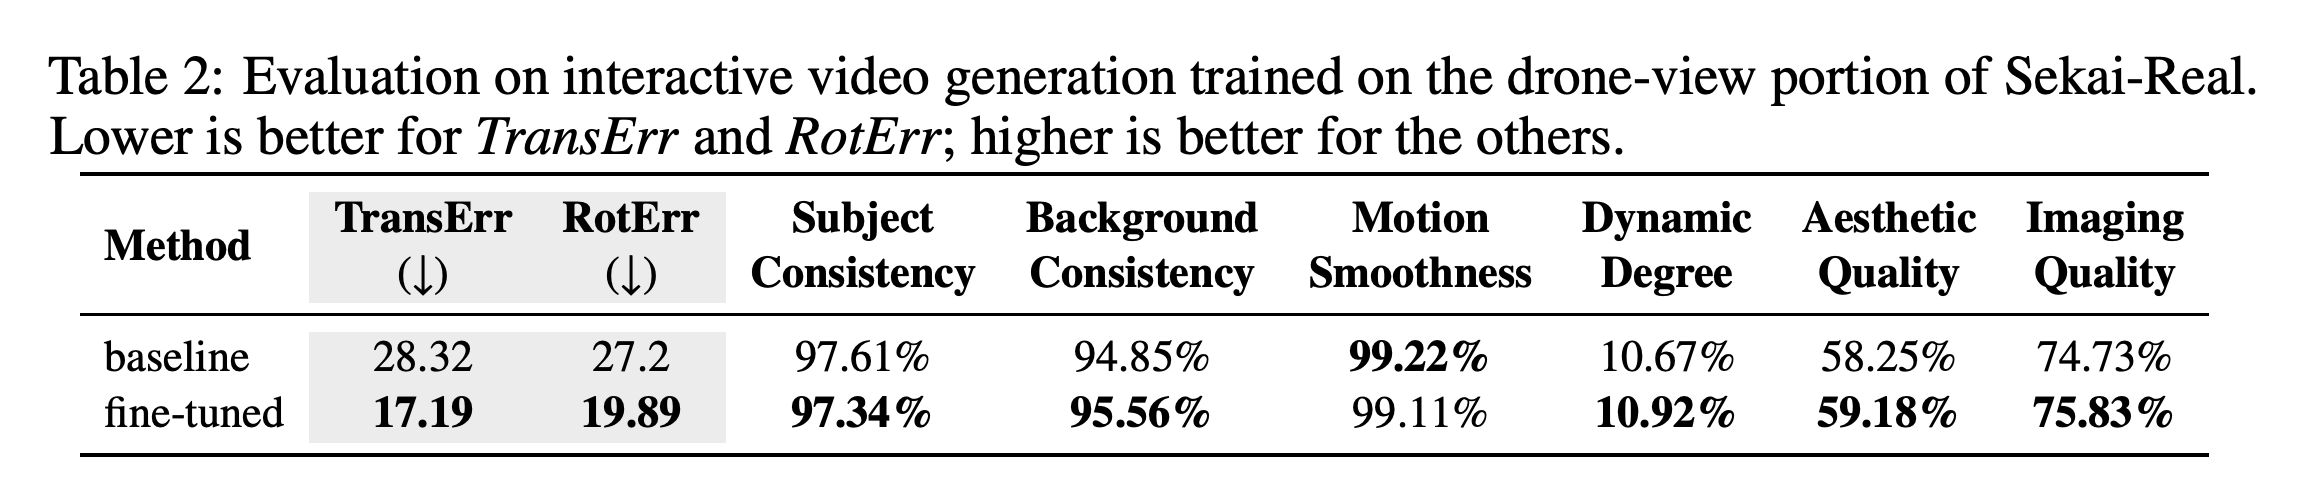
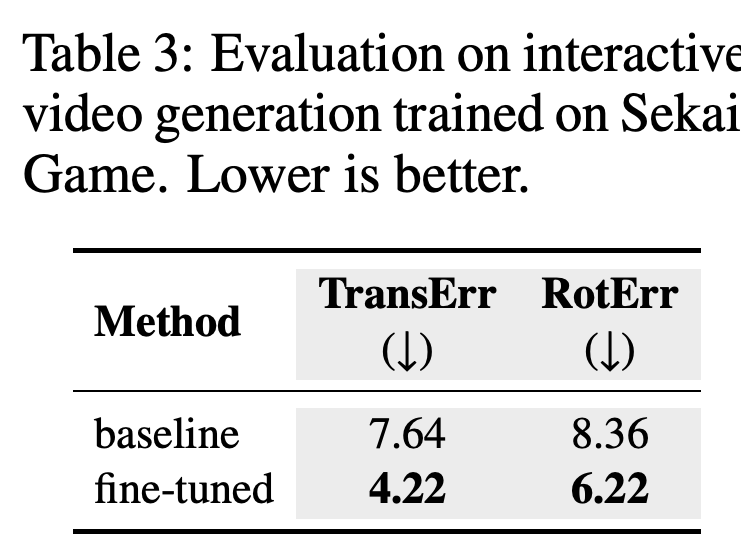
5.3.2 Quantitative Results에서는 Sekai-Real 드론 영상으로 미세 조정하면 TransErr가 28.32에서 17.19로, RotErr가 27.2에서 19.89로 감소한다고 보고한다. 절대 감소량은 각각 11.13과 7.31이다. Sekai-Game으로 미세 조정하면 이 오차들이 각각 7.64에서 4.22로, 8.36에서 6.22로 감소한다.
- 실제 드론 영상 생성에서는 배경 일관성이 94.85%에서 95.56%로, 미적 품질이 58.25%에서 59.18%로, 영상 품질이 74.73%에서 75.83%로 개선된다. 피사체 일관성은 97.61%에서 97.34%로, 움직임의 매끄러움은 99.22%에서 99.11%로 낮아지므로 모든 지표가 고르게 개선되지는 않는다.
- 카메라 오차 감소는 실험 조건에서 궤적 추종 성능이 개선되었음을 뒷받침한다. MegaSaM은 실제 영상의 학습 주석과 생성 영상의 궤적 추정을 모두 제공하므로, 이 평가가 절대적인 기하 정확도를 독립적으로 입증하지는 않는다.
Sekai-Real 드론 영상으로 미세 조정하면 카메라 궤적 오차가 모두 감소한다. 배경 일관성, Dynamic Degree, 미적 품질, 영상 품질은 개선되지만, 피사체 일관성과 움직임의 매끄러움은 조금 낮아진다.
게임 데이터 실험에서도 카메라 궤적 추종 성능이 개선된다. 이동 오차는 7.64에서 4.22로, 회전 오차는 8.36에서 6.22로 감소한다. 이 표는 이 2개 오차만 보고하므로 함께 발생한 시각적 품질 변화는 측정하지 않는다.
6 Conclusion
논문은 환경 및 카메라 주석을 갖춘 도보와 드론 영상 데이터셋 Sekai와, 연산 예산에 맞춰 학습 데이터를 선택하는 샘플링 절차를 제시한다. 실험은 평가한 비디오 생성 및 카메라 궤적 추종 과제에서 유용성을 보여준다. 제약 없는 세계 탐색은 여전히 더 넓은 목표로 남아 있다.
부록
- 제공된 14페이지 PDF에는 부록이 없다. 11~14페이지에는 감사의 글과 참고문헌이 있다.
짧은 생각
Sekai는 지리적으로 다양한 1인칭 영상에 카메라 및 환경 학습 정보를 결합한다. 카메라 제어 실험은 기준 모델과 직접 비교하지만, 일반 생성 실험은 미세 조정하지 않은 기준 모델이나 대체 학습 데이터셋 없이 미세 조정 체크포인트끼리 비교한다. 긴 녹화 영상만으로 장시간 생성을 입증할 수는 없다. SkyReels-V2 실험은 초당 16프레임의 49프레임 클립을 사용한다. 지속적인 이동, 장소 재방문, 장시간 장면 일관성은 평가하지 않는다. 수작업으로 선정한 50개 클립 평가 세트와 불확실성 추정의 부재는 일반화에 관한 해석을 제한한다. 논문은 무작위 폴드 분할을 설명하지만, 같은 원본 녹화에서 나온 모든 클립을 동일한 폴드에 두는지는 밝히지 않는다. 본문과 그림의 영상 길이 통계 및 중간 단계 게임 데이터 총량이 서로 달라 데이터셋 집계가 불분명하다. 캡션 길이와 카메라 경로의 매끄러움은 주석의 특성을 설명하지만, 의미적 정확성이나 기하 정확도를 직접 입증하지는 않는다.