


Freeing the Law with LOCUS: A Local Ordinance Corpus for the United States 요약 설명
17 Jun 2026 | Paper Review Legal NLP Datasets LLM-as-a-Judge목차
- 요약
- 1 What it means to “free the law”
- 2 Related Work
- 3 Properties of LOCUS
- 4 Constructing LOCUS
- 5 A Dimensional Analysis of Local Laws
- 6 Discussion, Limitations, and Future Work
- 부록
- 짧은 생각
이번 글에서는 Freeing the Law with LOCUS: A Local Ordinance Corpus for the United States 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 6월 17일(Arxiv)
- Peskoff, Denis, Barrow, Joe, Vu, Christopher, Davenport, Diag.
- UC Berkeley, School of Information, Independent
- 논문 링크
요약
- Freeing the Law with LOCUS: A Local Ordinance Corpus for the United States는 9,239개 시와 카운티의 법전 코퍼스를 소개한다. 지방 조례가 대규모 연구용 접근보다 개별 열람에 맞춰진 여러 플랫폼에 흩어져 있다는 문제를 다룬다. LOCUS-v1은 미국 3,144개 카운티 중 2,309개를 포괄하는 2,211,516개 텍스트 청크를 카운티 단위로 통합해 공개한다. 해당 카운티에는 전체 인구의 94%가 거주하지만, 선택된 법전이 그 안의 모든 주민에게 반드시 적용되는 것은 아니다.
- 파이프라인은 약 7M페이지의 PDF를 Markdown으로 변환하고, 서식 잔여물을 제거한 뒤 개별 법규로 분할한다. 이어서 LLM이 생성한 주석으로 학습한 ModernBERT 분류기를 적용한다. 별도의 회귀 모델은 쌍대 비교 판단을 TrueSkill로 집계한 점수에서 집행 재량, 불투명성, 온정주의, 문제 중요도를 학습한다.
- 회귀 모델은 차원별 홀드아웃 조례 1,000개에서 정규화된 TrueSkill 목표 점수와 0.822–0.936의 Pearson 상관계수를 보인다. 이 결과는 LLM에서 도출한 점수와의 일치도를 측정한 것이며, 법적 타당성을 독립적으로 검증한 결과는 아니다. 공개 자료는 사안별 관할권 위계와 우선 적용할 법적 근거를 판단하는 문제를 해결하지 않는다. 데이터셋과 파생 모델은 https://huggingface.co/datasets/LocalLaws/LOCUS-v1 에서 제공한다.
1 What it means to “free the law”
지방 조례는 구역 지정, 주거, 인허가, 소음, 동물 관리 등 일상 활동을 규율하지만, 기존 법률 AI 자원은 이러한 법규에 체계적으로 접근할 수단을 제공하지 않는다. LOCUS는 전국 단위 코퍼스를 제공하되, 검색만으로는 주법, 카운티 조례, 시 법전, 자치 헌장, 자치권 조항, 상위법 우선 원칙 사이의 관계를 해결할 수 없다는 점을 인정한다.
- 업체별 탐색 방식, 동적으로 생성되는 PDF, 일관되지 않은 관할권 목록, 중앙 호스팅 등록부의 부재 때문에 전국 단위 수집에는 단일 스크래핑 작업을 넘어 자료를 발견하고 추출하는 과정이 필요하다.
- 카운티 단위 통합 접근 계층은 문서 길이를 기준으로 대표 법전을 선택한다. 이를 통해 검색과 Census 및 정책 데이터 연계에 공통 지리 단위를 제공하지만, 특정 법적 질문에서 어느 기관의 법규가 우선하는지는 결정하지 않는다. 검색, 규제 정보의 구조화된 추출, 관할권을 고려하는 추론 벤치마크는 제안된 활용 사례이며, 평가를 마친 시스템이 아니다.
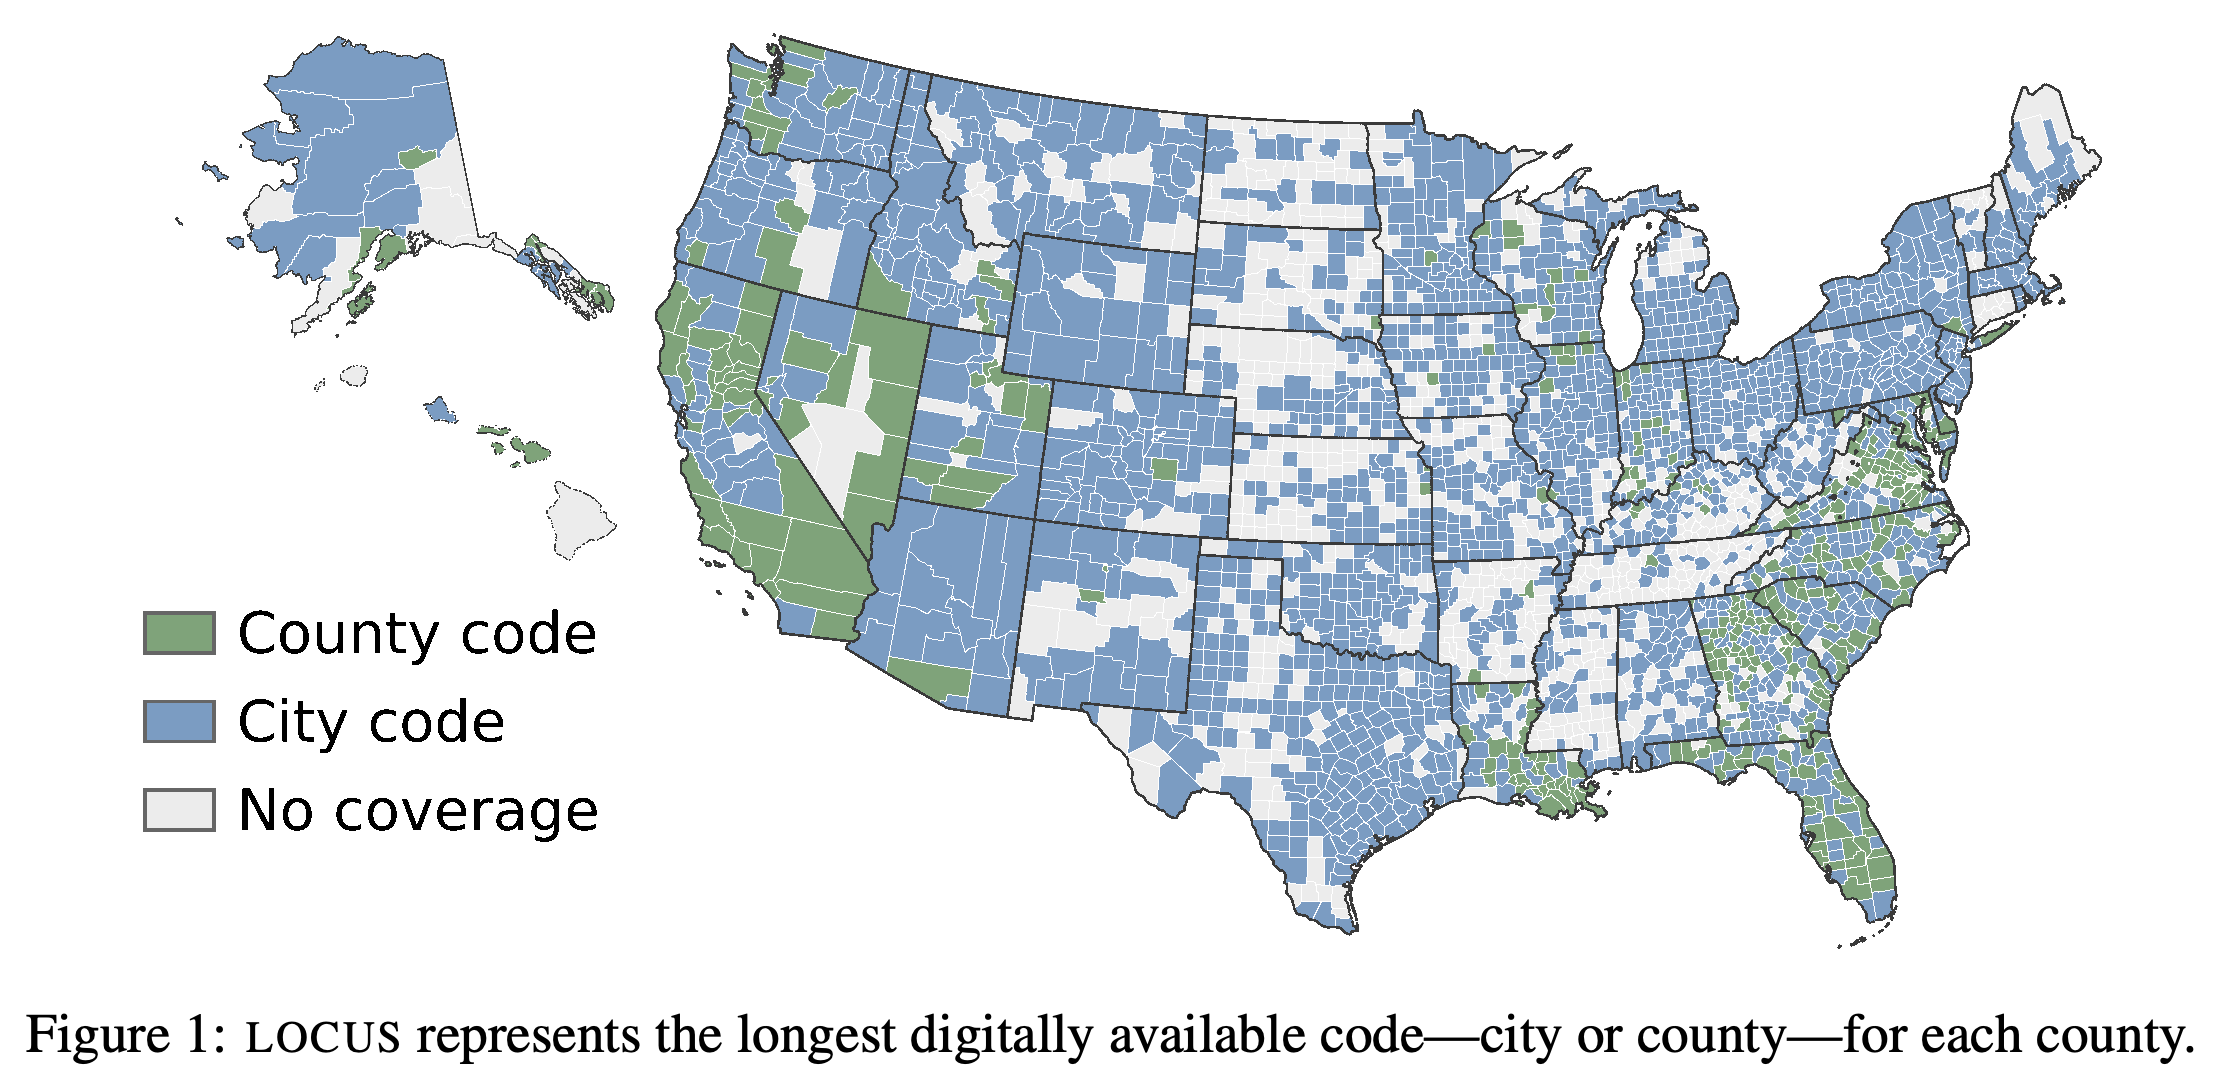
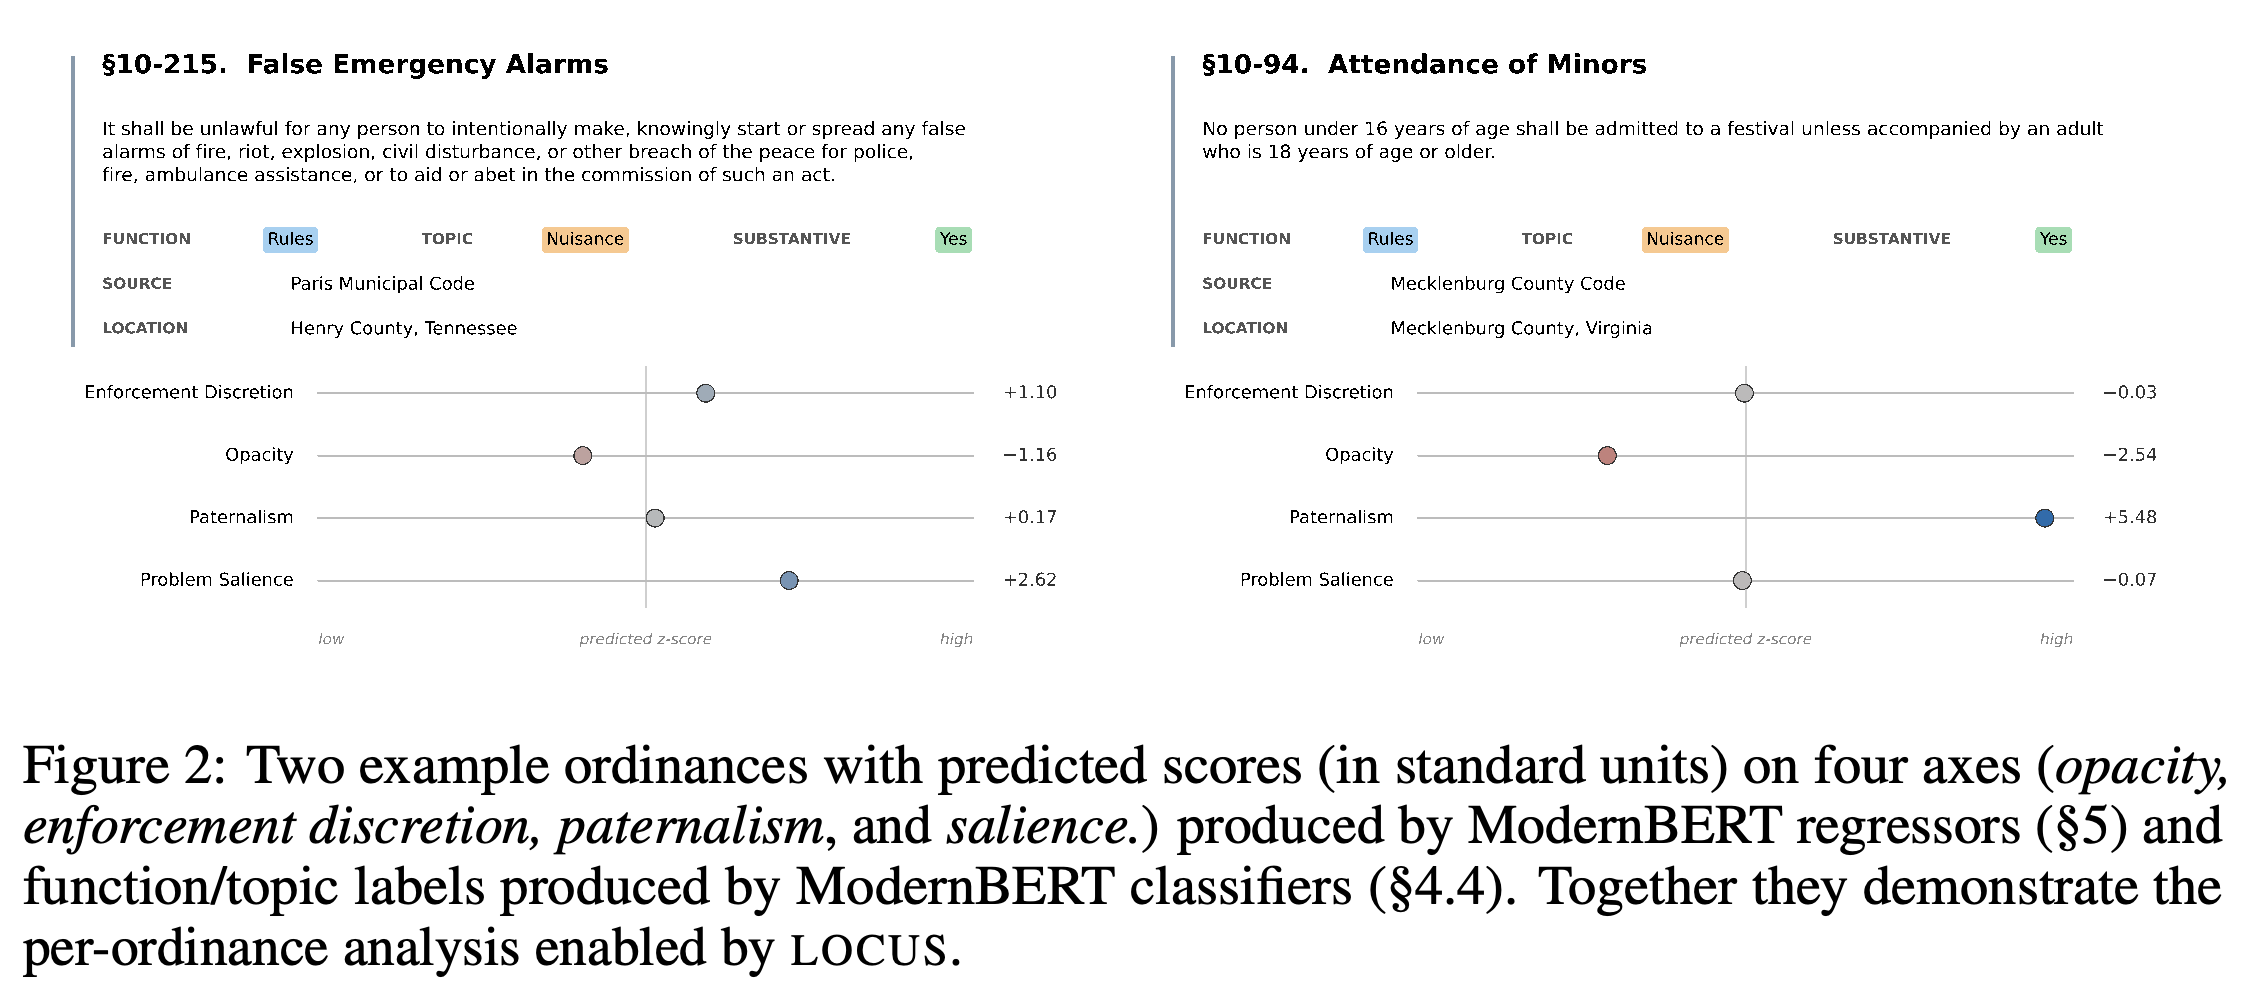
- Figure 1은 카운티 법전이 선택된 지역, 시 법전이 선택된 지역, 자료가 없는 카운티를 구분한다. Figure 2는 조례별 메타데이터를 보여준다. 미성년자의 축제 참석 규정은 예측 온정주의 점수(+5.48)가 높고 불투명성 점수(−2.54)가 낮으며, 허위 비상경보 금지 규정은 문제 중요도 점수(+2.62)가 더 높다.
지도는 자료가 있는 각 카운티에서 선택한 출처가 카운티 법전인지 시 법전인지 구분하며, 자료가 없는 지역도 별도 범주로 표시한다. 이는 출처 선택과 지리적 공백을 시각화한 것이지, 선택된 모든 조례의 지역적 적용 범위를 나타낸 것이 아니다. 보고된 인구 비중 94%를 해석할 때 이 구분이 필요하다.
Paris Municipal Code의 허위 비상경보 금지 규정과 Mecklenburg County Code의 축제 참석 규정은 모두 Rules와 Nuisance 레이블을 받지만, 차원별 점수 양상은 다르다. 축제 규정의 예측 온정주의 점수는 +5.48, 불투명성 점수는 −2.54이며, 허위 경보 규정의 문제 중요도 점수는 +2.62다. 따라서 같은 범주 레이블을 가진 법규도 연속 점수에서는 상당히 다를 수 있다.
2 Related Work
논문은 LOCUS를 ECHR과 Pile of Law를 비롯해 판례, 법원 의견, 계약, 법령을 다루는 법률 NLP 코퍼스와 함께 설명한다. LegalBench의 162개 태스크 중 지방 조례를 다루는 태스크가 없다는 점을 지적하며, 코퍼스 구축과 향후 지방 법규 추론 벤치마크 개발을 구분한다.
- 2020년 4월 27일에 판결된 Georgia v. Public.Resource.Org, Inc., No. 18-1150은 논문이 다루는 법률 접근성의 법적 배경을 제공한다. 퍼블릭 도메인이라는 사실만으로 지방 법전을 수집하고 표준화하는 기술적 장벽이 사라지지는 않는다.
3 Properties of LOCUS
LOCUS는 광범위한 원시 수집 자료와 검색 및 비교 분석을 위해 카운티 단위로 통합한 더 작은 공개 자료를 구분한다. 구조화된 주석은 텍스트 청크의 기능과 주제를 기술하며, 추가 문서는 접근 조건을 관리하면서 연구자에게 제공할 계획이다.
3.1 A County-Harmonized Access Layer
공개 접근 계층에는 2,211,516개 청크가 포함된다. Rules와 Enforcement는 실질적인 법규로 분류하고, Context와 Process는 비실질적 텍스트로 유지한다. 구조적 잔여물은 제거한다. 실질적인 청크에는 Buildings, Business, Zoning, Nuisance, Other라는 5개 통합 주제 레이블 중 하나를 부여한다.
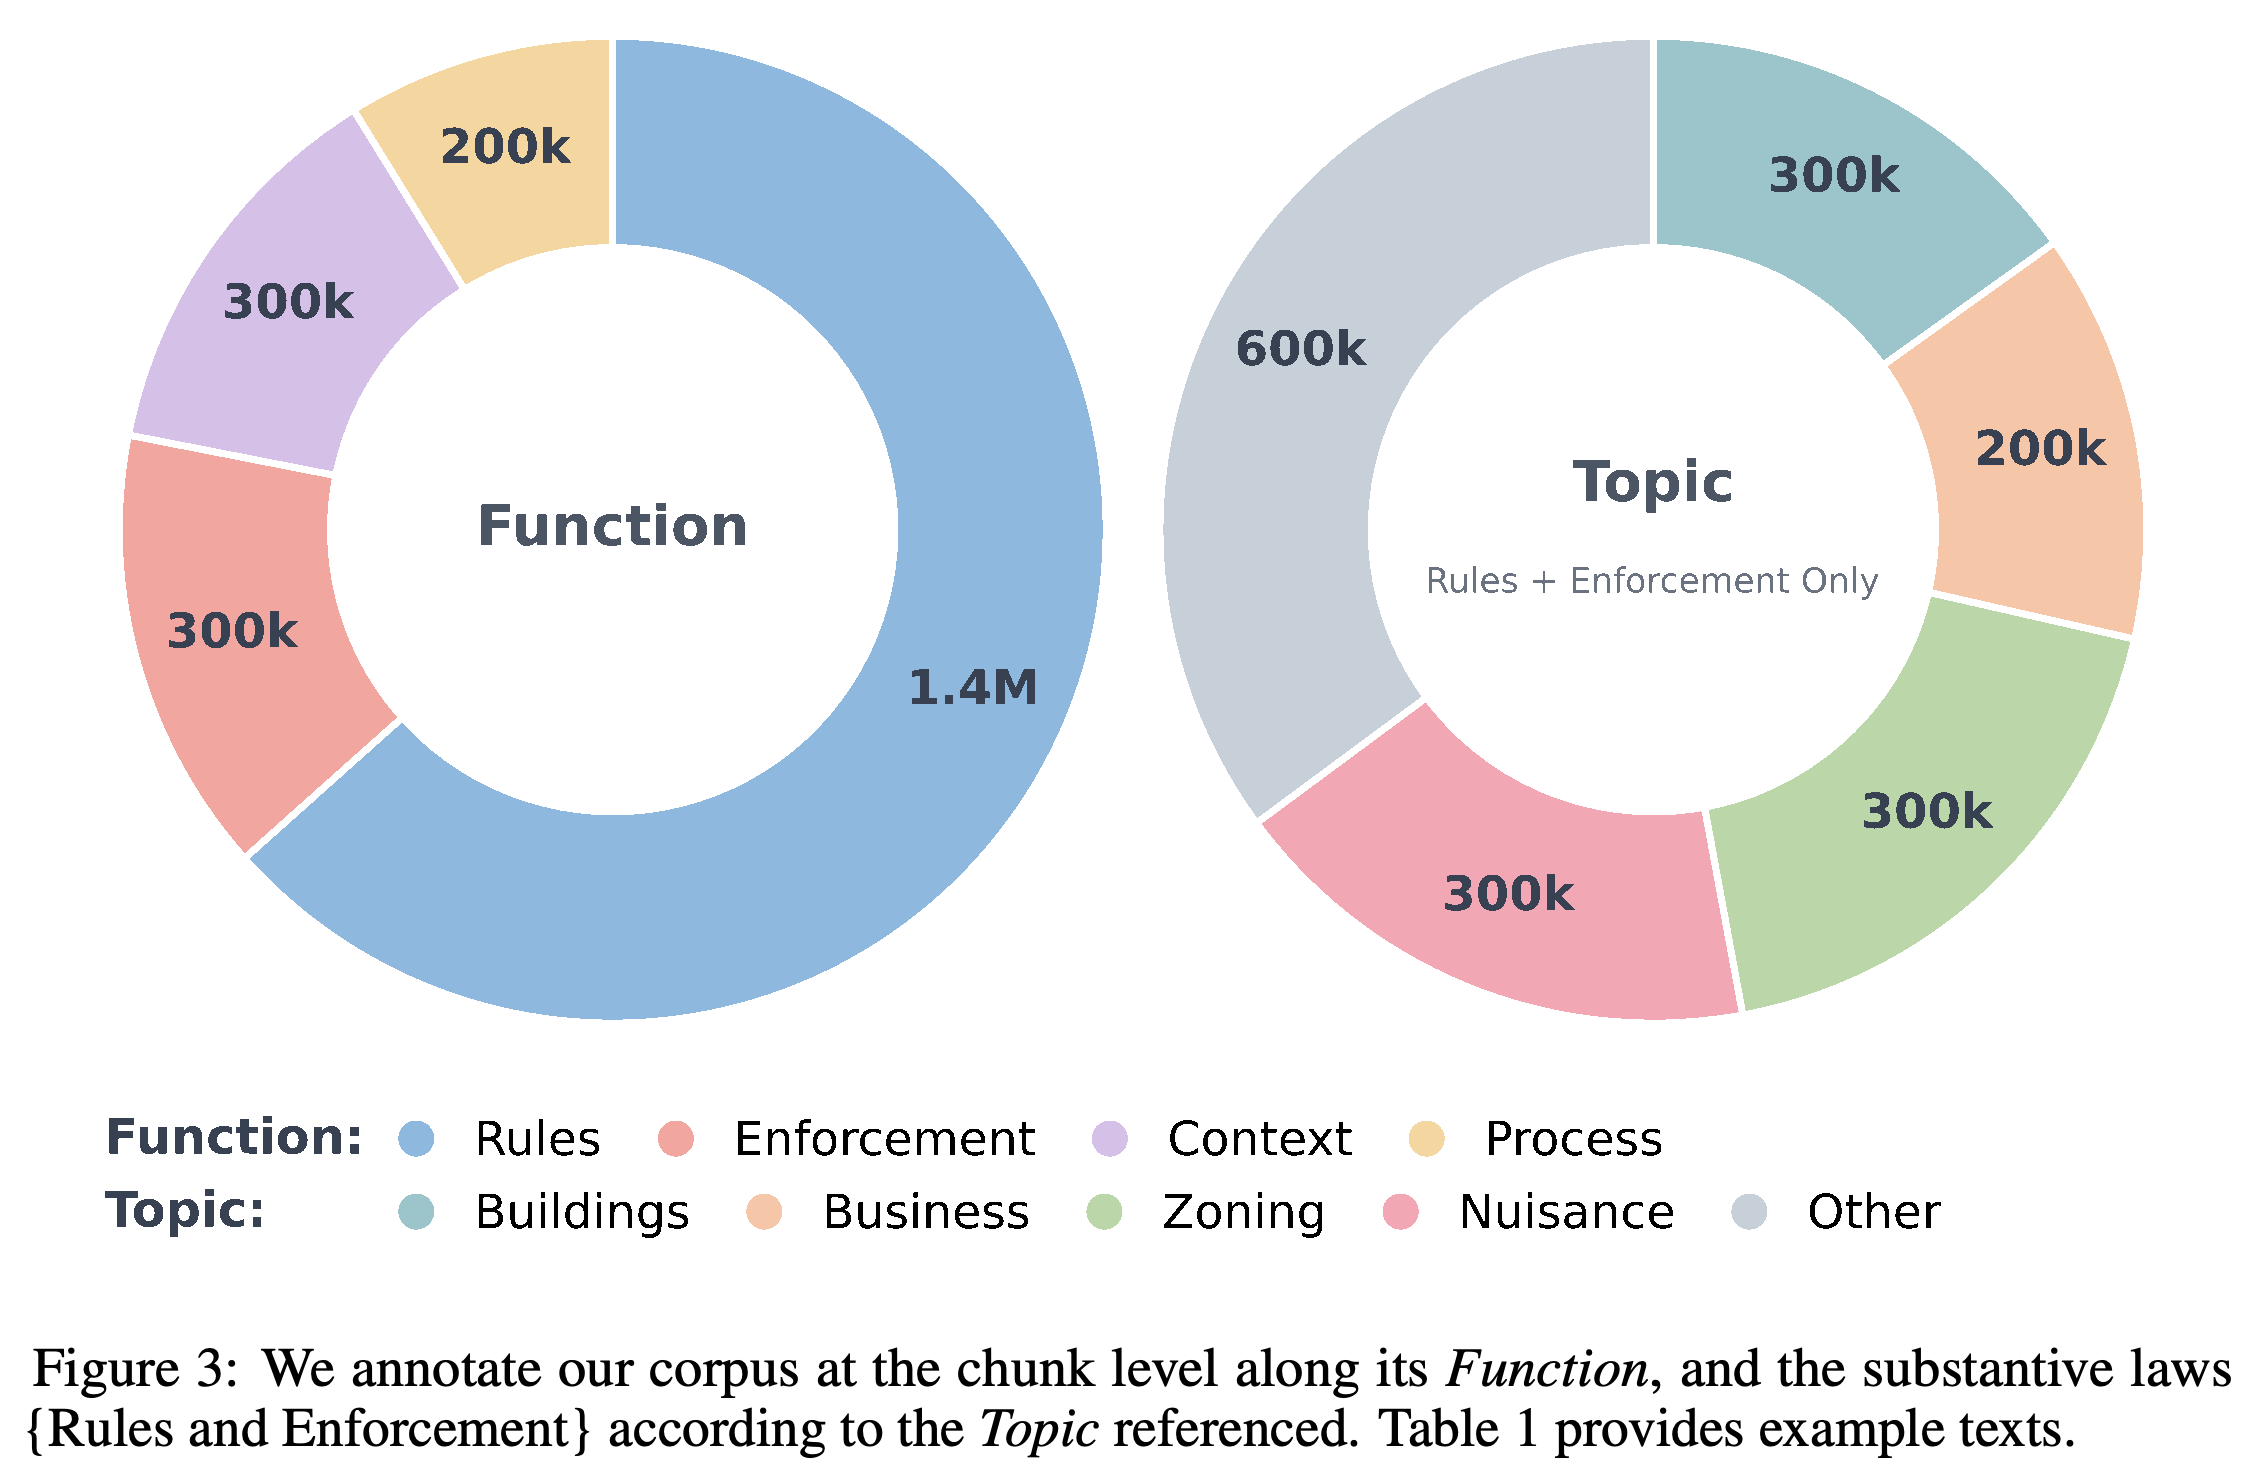
- Figure 3에서 가장 큰 기능 범주는 Rules다. 그림에 표시된 반올림 수치를 공개 데이터의 정확한 총계로 해석해서는 안 된다.
- 실질적인 법규의 약 삼분의 일은 Other에 속하며, 저자들은 이 범주를 식별하는 정밀도가 90%에 가깝다고 보고한다. 제목을 검토한 결과 이 범주는 정부, 고용 문제, 동물 규제와 관련된다. 동물 규제는 Alaska에서 Other 청크 비중이 비교적 큰 이유 중 하나다.
- 카운티를 대표하는 법전으로는 카운티 법전과 지방자치단체 법전 중 더 긴 문서를 선택하며, 가능하면 해당 카운티에서 가장 큰 도시의 법전을 후보로 사용한다. 이는 재현 가능한 접근 규칙이지, 선택한 텍스트가 카운티 전체를 규율한다는 법적 판단이 아니다.
기능 차트에서는 Rules가 유지된 코퍼스의 가장 큰 비중을 차지하며, 반올림한 수치는 Rules 1.4M개, Enforcement 300k개, Context 300k개, Process 200k개다. 주제 차트는 Rules와 Enforcement만 포함하며, 가장 큰 범주인 Other는 600k개다. 이 반올림 수치는 분포를 요약한 것이며, 전체 청크 2,211,516개의 정확한 집계를 제공하지 않는다.
3.2 Additional Data for Researchers
저자들은 공개 자료 외에도 다른 시와 카운티에서 문서 7,000개를 추가로 수집했다. MIMIC과 유사하게 서명한 이용 동의서를 통해 연구자에게 접근 권한을 제공할 계획이다. 이를 통해 향후 기반 모델의 지방 법규 포괄 범위를 평가할 때 평가 자료가 모델 학습 데이터에 유입되는 오염을 방지하고자 한다.
4 Constructing LOCUS
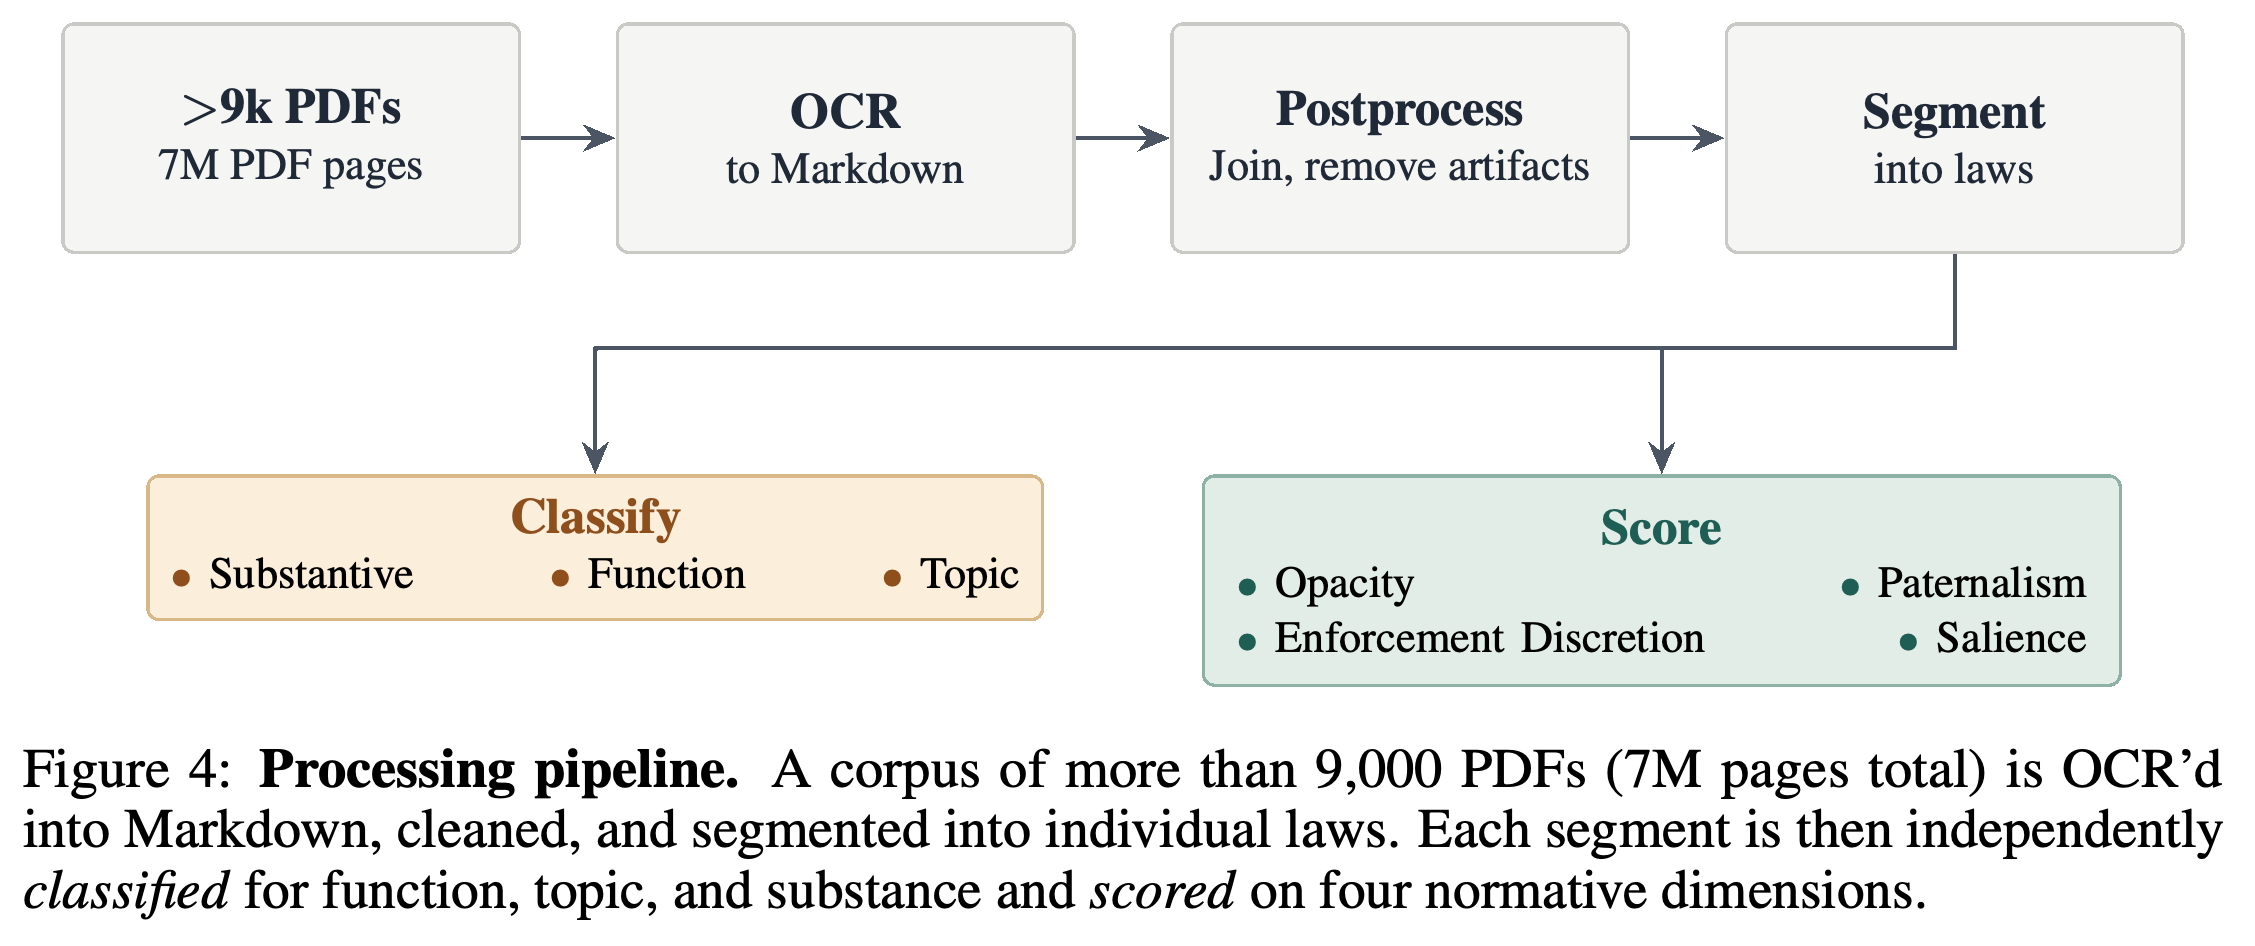
Figure 4는 PDF 수집, OCR을 통한 Markdown 변환, 페이지별 출력의 병합과 정제, 법규 분할, 각 조각의 분류와 점수 산정으로 이어지는 구축 과정을 요약한다. 마지막 2개 분기는 법률 텍스트를 범주별로 정리하고 4개 규범적 차원을 연속 점수로 측정한다.
이 과정은 9,000개가 넘는 PDF와 7M페이지를 OCR, 정제, 분할을 거쳐 표준화한다. 이후 범주 분류와 4차원 점수 산정으로 나뉘며, 같은 추출 법규가 정리용 메타데이터와 비교 측정에 모두 쓰인다는 점을 보여준다.
4.1 Collecting the data
원시 수집 자료에는 유효한 PDF 9,239개가 포함되며, 총용량은 약 80 GB다. 수집 과정은 브라우저 자동화와 업체별 다운로드 로직을 결합한다. 자동화로 처리하지 못하는 자체 호스팅 법전이나 PDF 다운로드가 제한된 법전은 수작업으로 확보한다.
- 관찰된 실패 사례에는 서버 측 PDF 조립 한계, 이름이 같은 지방자치단체 사이의 파일명 충돌, 인터페이스에 드러나지 않은 한도, 15초의 크롤링 지연, 봇 차단 조치, 여러 카운티에 걸친 통합 시가 포함된다.
- 이러한 실패에는 범용 스크래퍼가 아니라 사례별 복구가 필요했다. 따라서 수집 엔지니어링 자체가 이 연구의 주요 기여에 해당한다.
4.2 Identifying salient laws
초기 레이블링은 zero-shot LLM 분류로 실질적인 법규와 구조적·절차적 내용을 구분한다. 저자들은 500개 표본 평가에서 GPT-5.4 mini와 nano를 비교한 뒤 비용이 낮은 nano를 주석 모델로 선택한다. 가장 어렵다고 판단한 주석 5.5%는 GPT-5.4로 검토한다.
- 더 강력한 모델은 검토한 예측 108,889개 중 64,977개에 동의한다. 불일치 사례에서는 Rules 레이블이 Process나 Enforcement로 바뀌는 경우가 많으며, 이는 주석 체계의 기능 범주 경계가 불확실하다는 점을 보여준다.
- 저자들은 구조적 내용을 일관되게 인식하고 제거했다고 보고한다. 또한 LLM-as-a-Judge의 한계를 넘어서기 위한 방법으로 변호사와 판사의 평가를 제시한다.
4.3 OCR and Processing
LightOnOCR-2-1B는 스캔 문서, 디지털 원본 문서, 단일 열 문서, 이중 열 문서를 처리하기 위해 모든 페이지 이미지를 Markdown으로 변환한다. 후처리는 반복되는 머리말, 꼬리말, 페이지 번호를 제거하고, 페이지에 걸쳐 나뉜 문단과 표를 병합한다. 또한 절과 하위 절 제목을 식별해 텍스트를 분할한다.
- 저자들은 LightOnOCR-2-1B를 16MM페이지의 PDF로 미세 조정한 공개 1B 파라미터 비전-언어 모델로 설명한다. 다양한 조례 형식에서 읽기 순서를 안정적으로 처리한다고 보고하지만, 이 코퍼스에 대한 정량적 OCR 정확도 평가는 제시하지 않는다.
- 약 7M-page 규모의 작업은 Modal, https://modal.com 에서 실행하며, 보고된 처리 요금은 1,000페이지당 약 $0.30이다. 이는 처리 요금이며, 수집·주석·모델 학습을 모두 포함한 전체 예산이 아니다.
- 이후 ModernBERT-base 분류기가 추출한 조각의 실질성, 기능, 주제를 추론한다. 순수하게 Structural로 분류된 조각은 제외한다.
4.4 Annotating the Law
3개 분류기가 실질성, 기능, 주제에 따라 조례를 정리한다. GPT-5.4-nano가 법규 표본 100,000개에 주석을 달며, 이를 학습용 80,000개, 파라미터 탐색용 10,000개, 최종 평가용 10,000개로 나눈다.
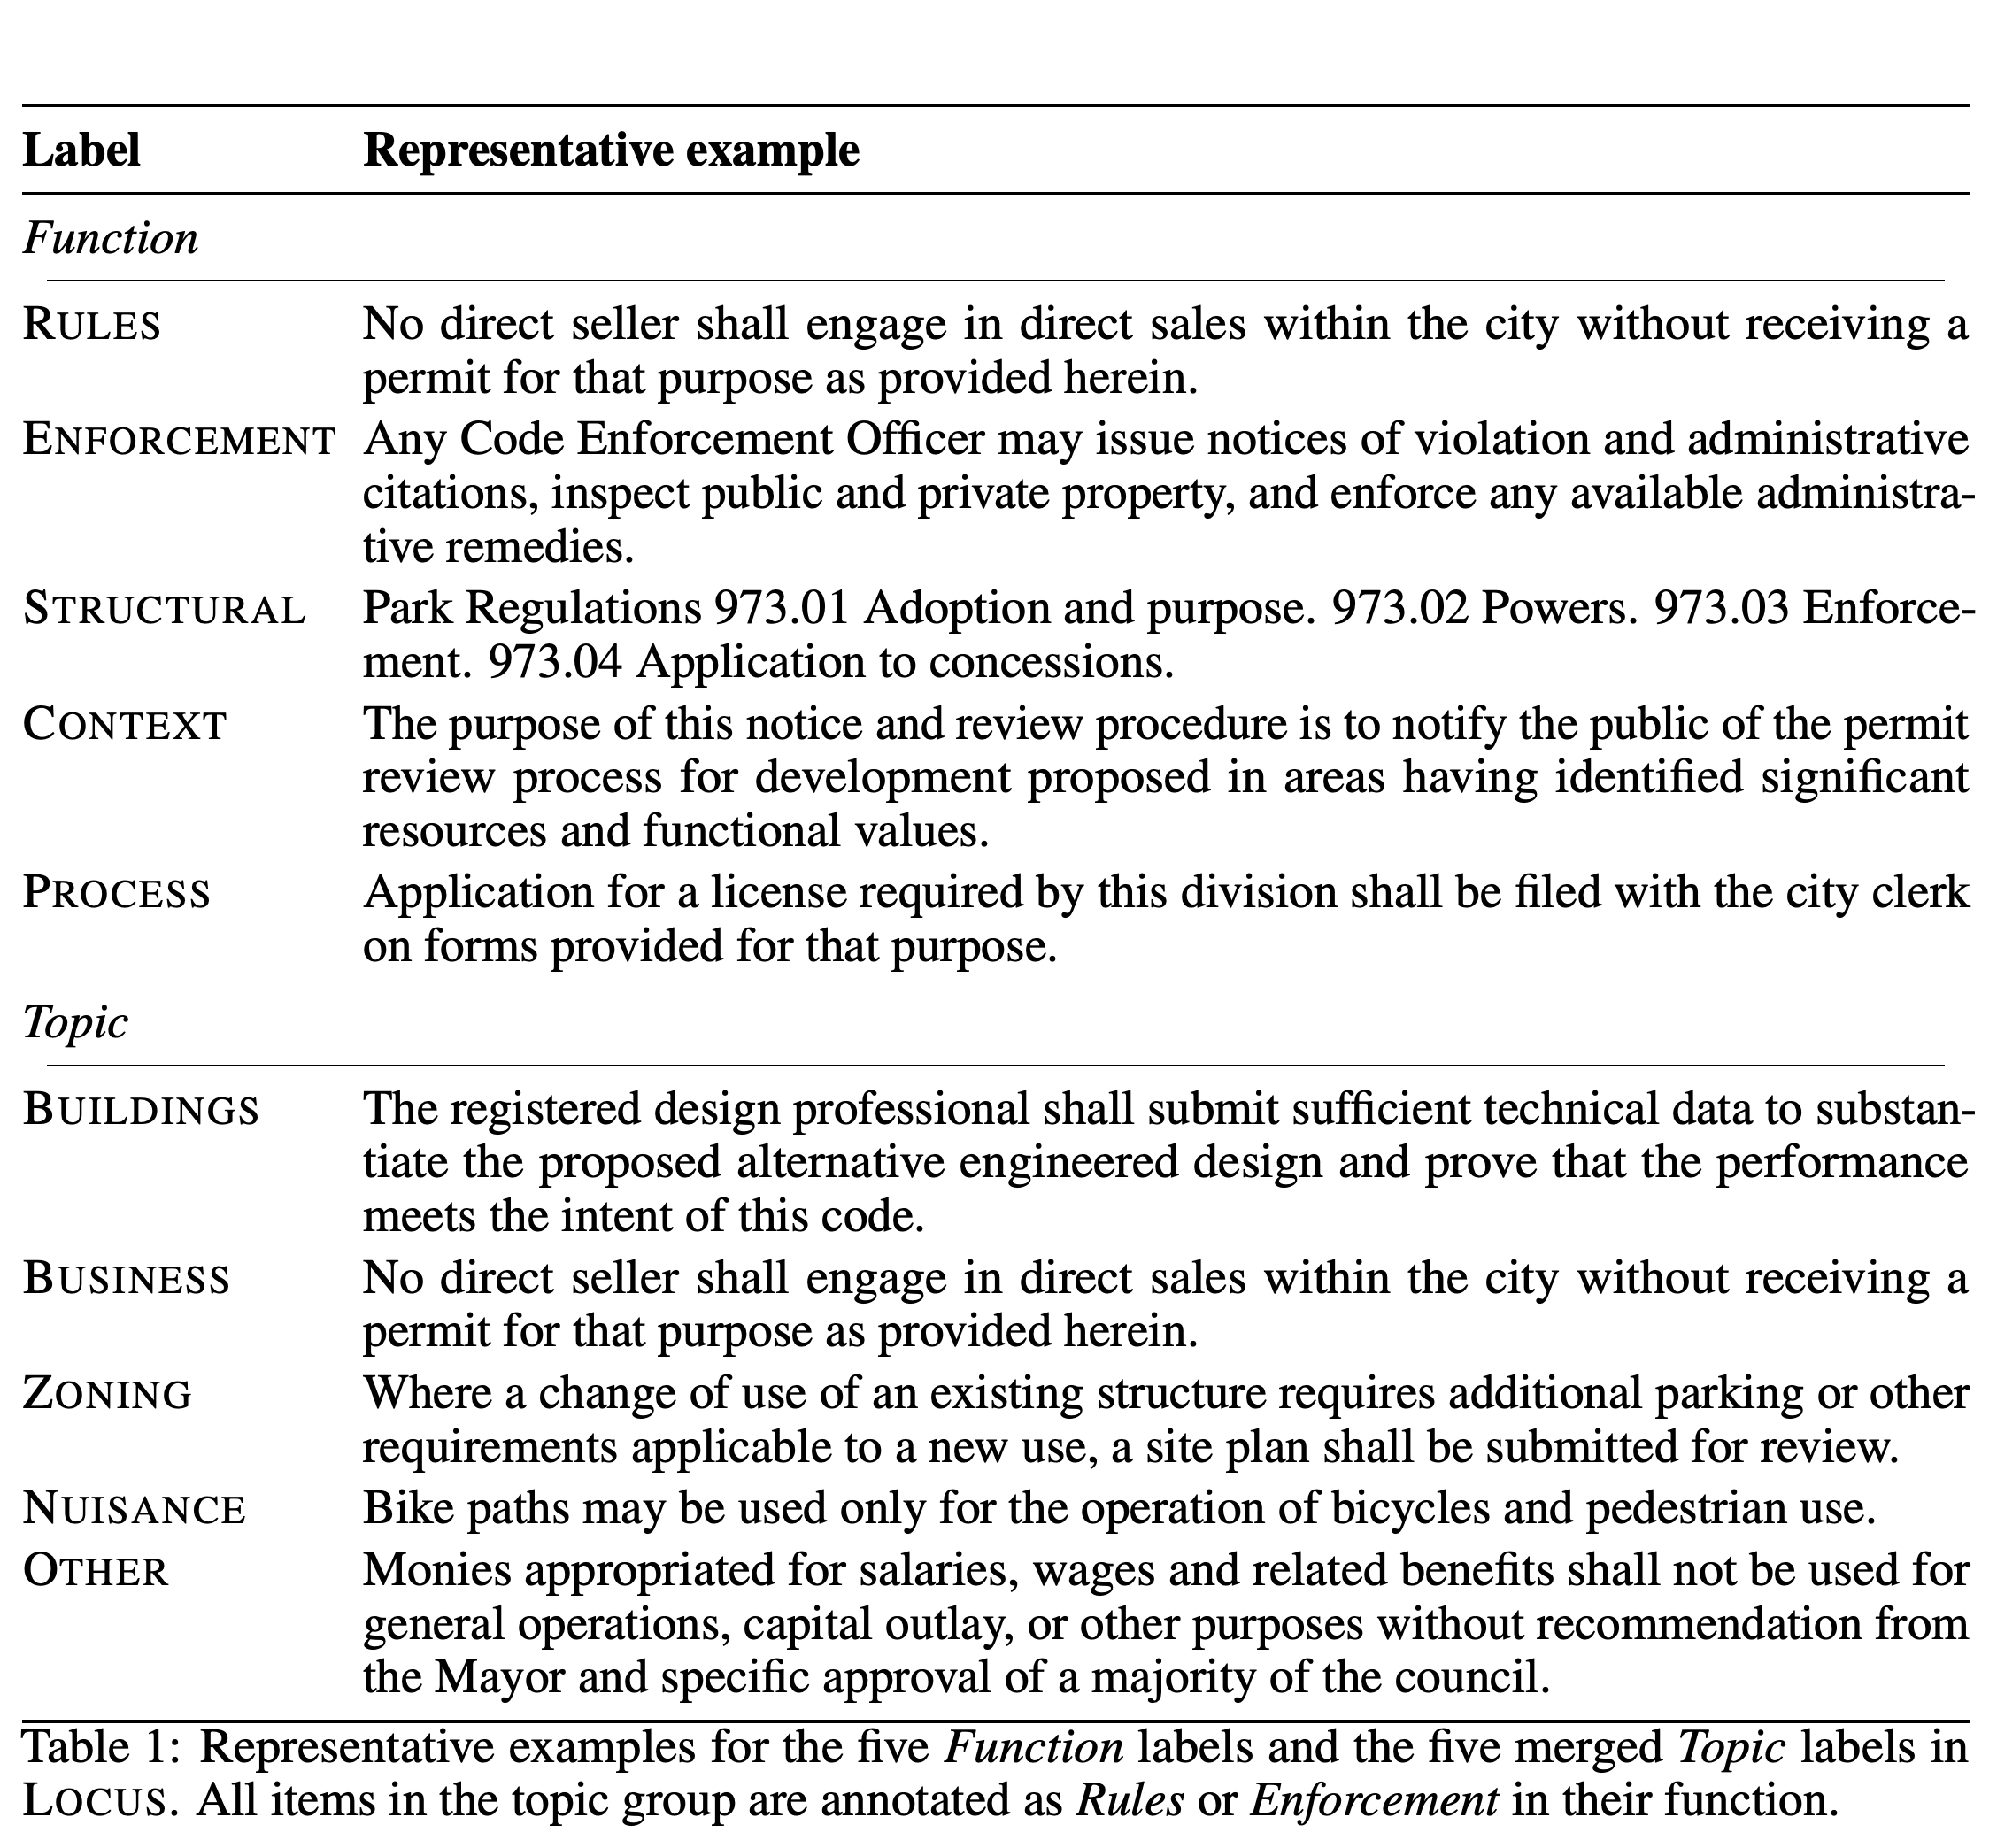
- Table 1은 실제 규율을 담은 Rules, 집행 조항인 Enforcement, 설명을 담은 Context, 행정 절차인 Process, 규율 효력이 없는 구조적 잔여물인 Structural을 구분한다. 주제 예시는 Rules 또는 Enforcement로 분류된 텍스트로 한정한다.
- 5개 통합 주제 레이블 중 Other에는 성격이 서로 다른 나머지 내용이 포함된다. 부록의 초기 주석 프롬프트는 더 세분화된 7개 주제 범주를 사용하므로, 이를 공개 데이터의 5개 통합 레이블과 혼동해서는 안 된다.
- 논문은 평가 데이터 분할을 명시하지만, 3개 분류기에 대한 전체 홀드아웃 성능 지표를 보고하지는 않는다.
예시는 레이블의 경계를 명확히 보여준다. 직접 판매 허가 요건은 Rules, 공무원의 권한은 Enforcement, 절 목록은 Structural, 절차의 목적을 설명하는 문구는 Context, 면허 신청 단계는 Process다. 주제 예시는 Other에 속하는 예산 배분 제한을 포함해 5개 통합 범주를 보여준다. 이 잔여 범주는 단순히 분류되지 않은 잡음이 아니라 실제 효력이 있는 법률 내용을 포함한다.
4.5 Creating a Harmonized Access Layer
통합 알고리즘은 각 카운티에서 카운티 법전과 이용 가능한 시 법전을 확인하며, 가능하면 가장 큰 도시의 법전을 후보로 사용한다. 둘 다 있으면 페이지 수가 더 많은 문서를 선택한다. 자료가 있는 카운티에는 미국 인구의 94%가 거주하지만, 저자들은 이 지리적 통계와 선택된 법전이 실제로 규율하는 더 작은 인구를 구분한다.
- 페이지 수는 해석과 재현이 쉽다는 이유로 선택한다. 법전 길이와 관할 지역 인구 사이에서 관찰된 연관성도 이 선택을 뒷받침한다.
- 카운티 법전은 평균적으로 시 법전보다 약간 짧지만, 알고리즘은 관할권별 가중치를 적용하지 않는다. 다른 지방자치단체와 선택된 도시 밖의 주민은 접근 계층에 충분히 반영되지 않는다.
5 A Dimensional Analysis of Local Laws
LOCUS는 Enforcement Discretion, Opacity, Paternalism, Problem Salience에 연속 점수를 부여해 같은 법전 안에서나 관할권 사이에서 비교할 수 있게 한다. 각 차원은 공무원의 집행 재량, 의무를 이해하기 어려운 정도, 타인 보호 대비 행위자 본인 보호의 정도, 사안의 중요성이나 위협을 텍스트가 강조하는 정도를 다룬다.
- 연속 점수는 법규를 개별 규범 범주에 배정하기보다 순서를 매기기 위한 것이다. Figure 2는 조례별로 이 점수와 기능·주제 레이블을 함께 보여준다.
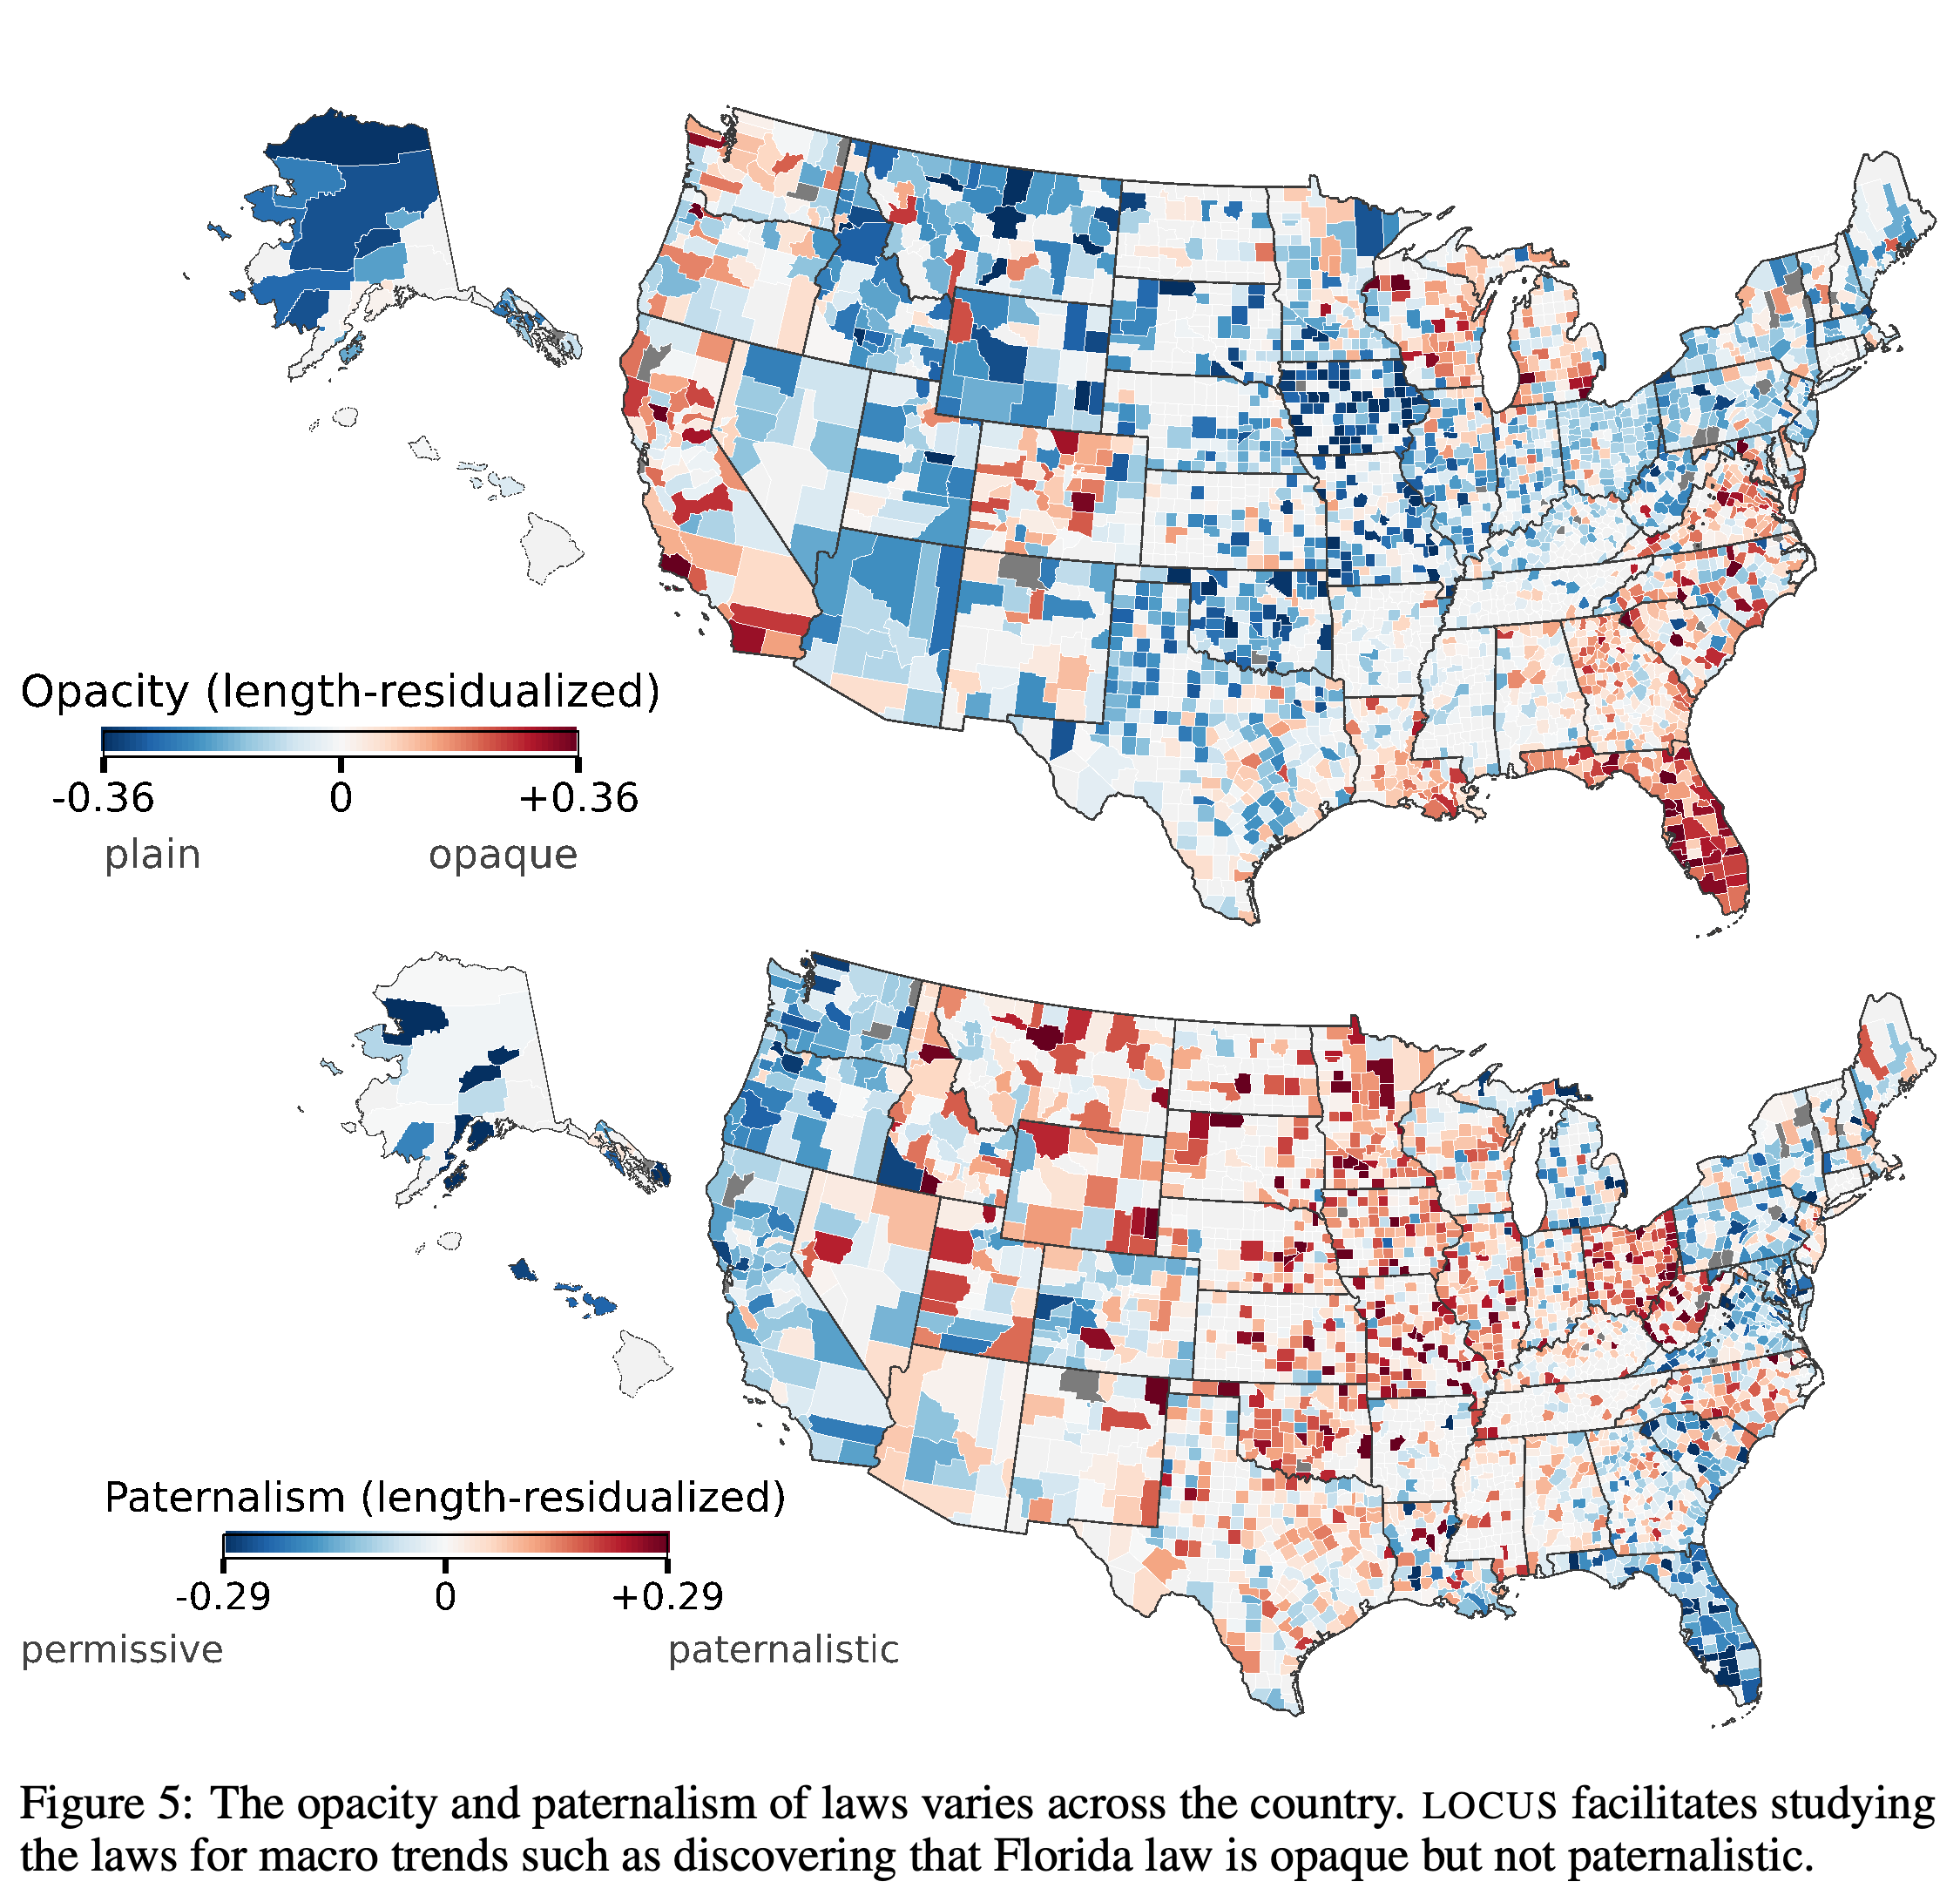
- Figure 5는 길이 효과를 제거한 불투명성과 온정주의를 지도에 나타낸다. 2개 축을 하나의 규제 척도로 취급하지 않고 각각의 지리적 패턴을 구분한다.
지도는 길이 효과를 제거한 불투명성과 온정주의를 별도 척도로 표시한다. 불투명성 척도의 양 끝값은 −0.36과 +0.36이며, 온정주의는 −0.29와 +0.29다. Florida는 비교적 불투명하지만 상대적으로 온정주의적이지 않은 지역으로 나타나며, 이는 2개 축을 하나의 규제 점수로 합쳐서는 안 되는 이유를 보여준다. 지도는 모델에서 도출한 텍스트 차이를 보여주며, 법적 권한이나 집행 결과를 나타내지는 않는다.
5.1 Building LOCUS Scorers
각 차원에서 GPT-5.4-nano는 고정된 조례 표본 10,000개를 대상으로 쌍대 비교 200,000개를 수행하고 A, B, Tie 중 하나를 선택한다. 위치 편향을 줄이기 위해 각 비교 쌍을 역순으로도 평가하며, TrueSkill은 비교 이력을 잠재 점수로 집계한다.
- TrueSkill 점수는 해당 차원의 평균을 뺀 뒤 표준편차로 나누어 정규화한다.
- 각 차원은 학습용 조례 8,000개, 검증용 1,000개, 테스트용 1,000개를 사용한다. 선형 회귀 헤드를 갖춘 별도의 ModernBERT-base 모델이 평균제곱오차를 사용해 정규화된 점수를 학습한다.
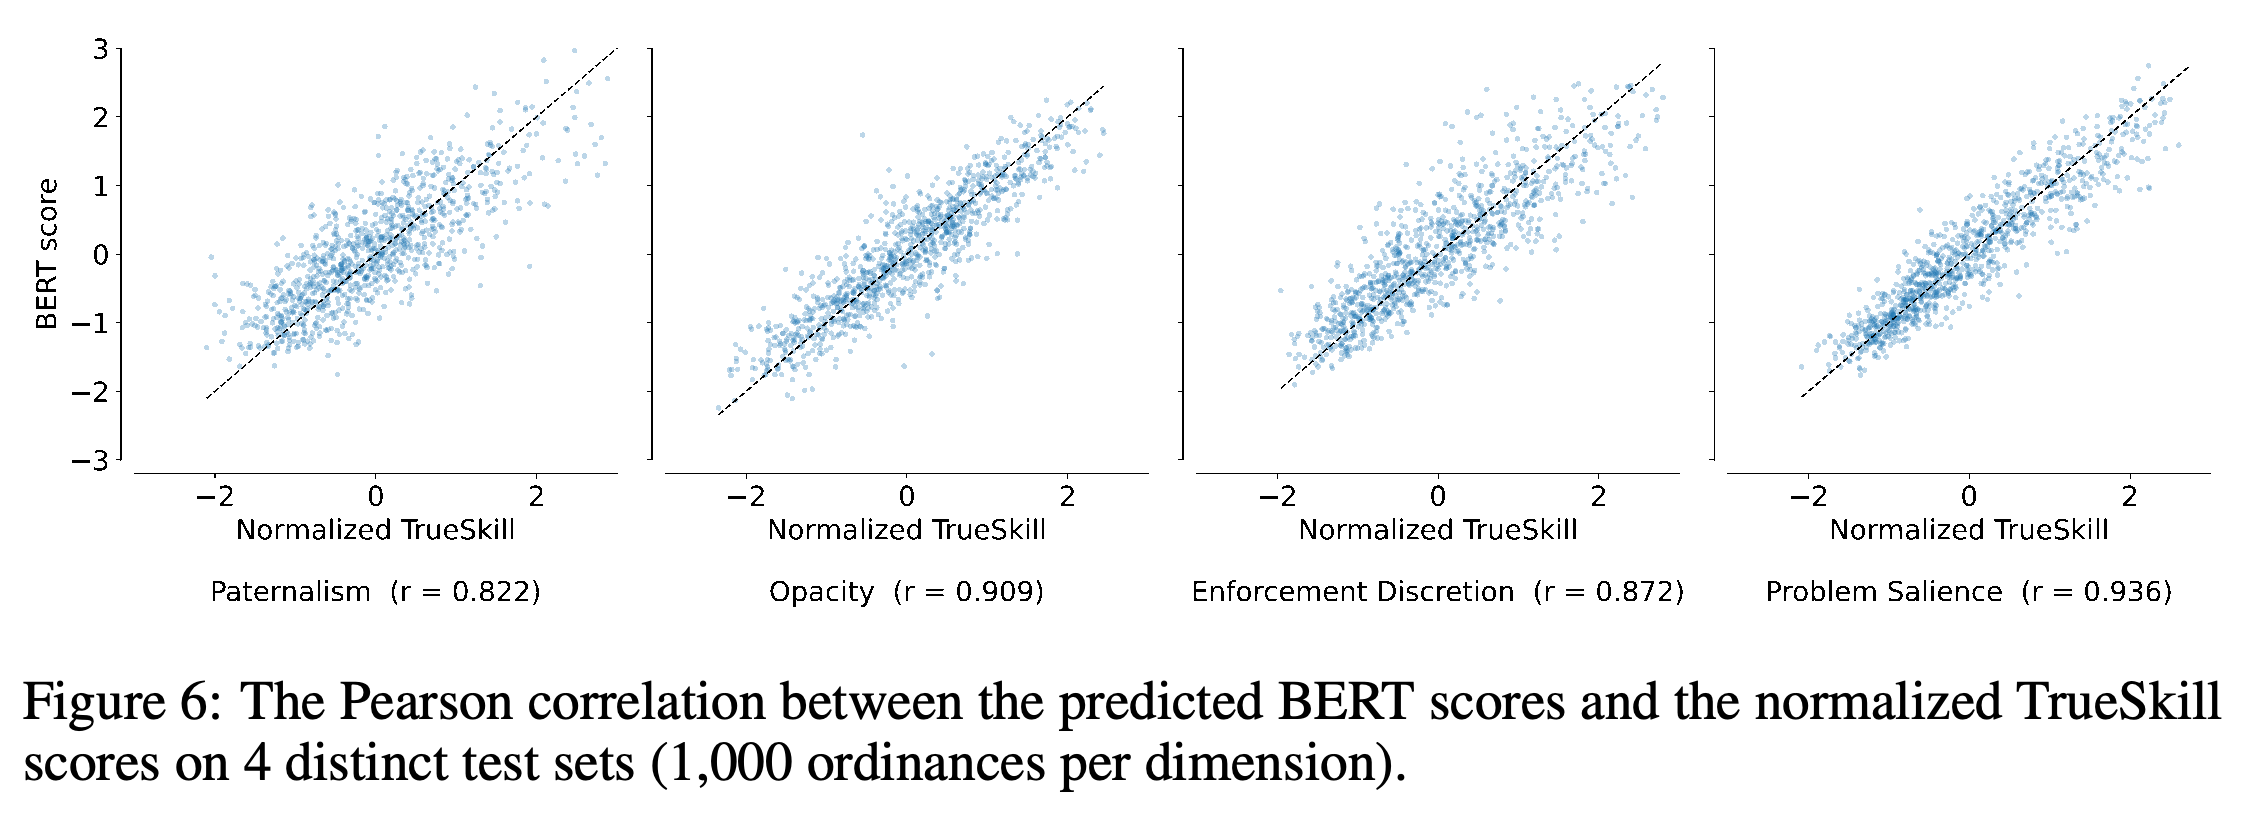
Figure 6은 테스트 세트의 Pearson 상관계수를 온정주의 0.822, 불투명성 0.909, 집행 재량 0.872, 문제 중요도 0.936으로 보고한다. 회귀 모델은 LLM에서 도출한 TrueSkill 목표 점수의 변동을 상당 부분 재현하며, 온정주의가 가장 낮은 재현도를 보인다.
- 각 상관계수는 해당 차원의 홀드아웃 조례 1,000개로 측정한다. 목표 점수는 독립적으로 확립된 사람의 점수가 아니라 LLM 쌍대 비교 판단의 결과다.
- 논문의 점수 조회 웹사이트는 https://locallaws–locus-leaderboards-web.modal.run 이다.
산점도는 차원별 테스트 조례 1,000개에서 ModernBERT 예측과 정규화된 TrueSkill 목표 점수를 비교한다. 상관계수는 온정주의 0.822, 불투명성 0.909, 집행 재량 0.872, 문제 중요도 0.936이다. 이 일치도는 회귀 모델이 쌍대 비교 판단 파이프라인을 근사한다는 점을 뒷받침하지만, 그 기반이 되는 규범적 판단을 독립적으로 검증하지는 않는다.
5.2 Analysis
저자들은 카운티 법전이 평균적으로 시 법전보다 불투명하며, Florida의 불투명성이 다른 어느 주와 비교해도 2배를 넘는다고 보고한다. 2,211,516개 절에서 불투명성과 온정주의는 Pearson r=0.11로 약한 상관관계를 보인다.
- Figure 5의 길이 효과를 제거한 지도에서 Florida는 비교적 불투명하지만 온정주의적이지 않은 지역으로 나타난다. 이는 모델에 기반한 현황 비교이며, 인과 효과나 실제 집행 행태에 대한 근거가 아니다. 표준화된 불투명성 점수만으로 법률 이해의 어려움을 비율척도로 측정할 수 있는 것도 아니다.
- 높은 온정주의 점수는 통행금지 규정이나 제목에 ‘possession’ 또는 ‘alcoholic’이 포함된 절을 찾는 데 도움이 된다. ‘definitions’와 ‘variances’는 불투명성과 연관된다.
6 Discussion, Limitations, and Future Work
LOCUS-v1은 법적 권한을 완전하게 표현한 자료가 아니라 접근 계층이다. 대표 법전만으로는 사람, 필지, 사업체, 사안에 우선 적용할 규칙을 확정할 수 없다. 논의에서는 시와 카운티 법전의 실질적 내용이 다르고 그 차이가 지역마다 달라지므로, 관할권 유형과 문서 구조를 유지해야 한다고 강조한다.
- 저자들은 카운티 법전에 구역 지정 자료가 더 많고, 시 법전에는 생활 방해와 공공질서 규제가 더 많다고 보고한다. Northeast에서는 카운티 법전이 구역 지정에 덜 치중하고 집행에 더 집중하는 것으로 나타나므로, 카운티 단위 통합을 일률적으로 해석하기 어렵다.
- 법전에서는 일반 조항과 정부 조직, 사업 규제, 생활 방해와 공공질서, 구역 지정, 건축 규제로 이어지는 주제 순서가 반복된다. 논의에서는 이를 검색과 벤치마크 설계에서 법전 내 위치를 유지해야 하는 이유로 제시하지만, 해당 순서에 대한 상세한 정량 평가는 제공하지 않는다.
- 향후 벤치마크는 관련 정부 계층을 식별하고, 주법의 맥락을 반영하며, 중첩되는 자료를 처리하고, 우선 적용할 법적 근거를 판단해야 한다. 이는 LOCUS의 제안된 활용 방식이지, 입증된 시스템 결과가 아니다.
부록
- A Scoring Prompts는 Pairwise Comparison System Prompt와 4개 축의 평가 기준을 제공한다. Axis Rubric: Problem Salience는 긴급성, 심각성, 사안의 중대성을 나타내는 강화된 처벌을 다룬다. Axis Rubric: Paternalism vs. Externality Orientation은 자신에게 미치는 피해와 타인에게 미치는 피해를 구분한다. Axis Rubric: Opacity / Intelligibility는 전문용어, 상호 참조, 정의되지 않은 용어, 복잡한 구조에 초점을 맞춘다. Axis Rubric: Enforcement Discretion은 시민이 집행 대상이 되는 범위와 문구상 공무원에게 허용되는 재량을 함께 고려하며, 사인에게 적용되지 않는 조항에만 최저점을 부여한다. 비교 템플릿은 A, B, Tie 중 비교 결과와 1문장 설명을 요청한다.
- B Annotation Prompt는 초기 GPT-5.4-nano 분류와 GPT-5.4 검토를 위한 Annotation Prompt, 검토 지침, CLASSIFICATION_SCHEMA를 포함한다. 스키마는 is_substantive, primary_function, sub_category, logic을 요구한다. is_substantive는 Rules 또는 Enforcement일 때만 1이며, 그렇지 않으면 sub_category는 null이다. 초기 주제 어휘는 Land use, Noise/Nuisance, Housing, Business licensing, Public space, Building/Safety, Other다. 검토 지침은 실제 효력이 있는 내부 운영 절차를 Process로, 효력이 없는 잔여물을 Structural로 구분한다. 또한 review_logic과 함께 confirm, override, fresh 결과를 요청하지만, 인쇄된 스키마에는 이 검토 필드가 없다.
짧은 생각
핵심 기여는 흩어진 지방 법전을 검색할 수 있고 지리적으로 정리된 인프라로 전환한 데 있다. 그 규모는 PDF 9,239개와 공개 청크 2,211,516개로 명시되어 있다. 이 자료의 가치를 유지하려면 지리적 포괄 범위와 법규의 적용 권한을 구분해야 한다. 점수 모델의 상관계수는 LLM에서 도출한 순위를 효율적으로 재현할 수 있음을 뒷받침하지만, 법률 전문가의 판단과 일치함을 입증하지는 않는다. 어려운 기능 레이블에서 상당한 불일치가 나타난다는 점도 사람의 검토가 필요함을 보여준다. 비교 분석에서는 자료가 시 법전인지 카운티 법전인지 유지하고, 가장 긴 법전을 선택하는 규칙을 고려해야 한다. 해당 코퍼스에 대한 OCR 검증, 더 완전한 분류기 성능 지표, 전문가 평가는 세부적인 법률 결론의 신뢰도를 높이는 데 도움이 된다.