


SWE-chat: Coding Agent Interactions From Real Users in the Wild 요약 설명
22 Apr 2026 | Paper Review AI Coding Agents Datasets Human-Agent Interaction목차
- 요약
- 1 Introduction
- 2 SWE-chat
- 3 How do humans interact with coding agents in the wild? (RQ1)
- 4 How do coding agents fail and how do users respond? (RQ2)
- 5 Discussion
- Ethics statement
- 부록
- 짧은 생각
이번 글에서는 SWE-chat: Coding Agent Interactions From Real Users in the Wild 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 4월 22일(Arxiv), COLM 2026
- Baumann, Joachim, Padmakumar, Vishakh, Li, Xiang, Yang, John, Yang, Diyi, Koyejo, Sanmi.
- Stanford University
- 논문 링크
- Github
- Project Page
요약
- SWE-chat은 실제 개발자와 에이전트의 대화, 도구 사용 궤적, 커밋을 연결하고 각 코드 줄을 사람과 에이전트 중 누가 작성했는지 기록한다. 2026년 9월에 공개된 SWE-chat v2에는 공개 GitHub 저장소 707개에서 수집한 18,000개에 가까운 세션, 229,000개 이상의 사용자 프롬프트, 약 2 million회의 도구 호출이 포함된다.
- 구체적으로 분류된 프롬프트 의도 중에서는 기존 코드 이해가 18.2%로 가장 흔하다. 커밋된 코드의 작성자 비율은 뚜렷한 쌍봉 분포를 보인다. 세션의 25.0%는 human-only, 33.9%는 collaborative, 41.1%는 vibe coding에 해당한다. 에이전트가 거의 모든 코드를 작성하더라도 사람이 작업 방향을 조정하지 않는다는 뜻은 아니다.
- 에이전트가 누적 생성한 코드 줄 중 커밋에 포함되는 비율은 59.4%에 불과하며, 에이전트의 최종 순산출물 중 변경 없이 유지되는 비율은 65.4%다. 커밋된 100줄당 비용 중앙값은 vibe coding이 $2.71, collaborative coding이 $0.92다. 추가된 1,000줄당 새로 발생한 Semgrep 탐지 항목은 vibe coding이 0.47건이며, collaborative coding은 0.15건, human-only coding은 0.12건이다.
- Claude Code 세션에서는 프롬프트의 50.2%에서 사용자가 작업을 중단시키거나 이의를 제기하지만, 에이전트가 확인 질문 도구를 호출하는 비율은 턴의 약 3%다. 이 관찰 결과는 공개 저장소에서 자발적으로 참여한 사용자를 대상으로 한다. 기록되지 않은 중도 포기 세션, 불완전한 LLM 주석, 개발자 노력을 충분히 측정하지 못하는 지표 때문에 결과를 일반화하는 데 한계가 있다.
1 Introduction
이 논문은 정제된 소프트웨어 엔지니어링 벤치마크와 실제 협업 개발 사이의 차이를 다룬다. 검증 가능한 해답이 있는 독립적인 과제만으로는 개발자가 요구사항을 점진적으로 구체화하고, 에이전트를 교정하고, 에이전트의 행동을 취소하거나 생성된 코드를 버리는 과정을 포착할 수 없다.
- RQ1은 실제 코딩 작업에서 사용자가 코딩 에이전트와 어떻게 상호작용하는지 묻는다.
- RQ2는 실제 환경에서 에이전트가 어떻게 실패하고 사용자가 어떻게 대응하는지 묻는다.
- 서론은 벤치마크 과제의 난이도와 실제 워크플로에서의 유용성 및 상호작용 비용을 구분한다.
1.1 Our contributions
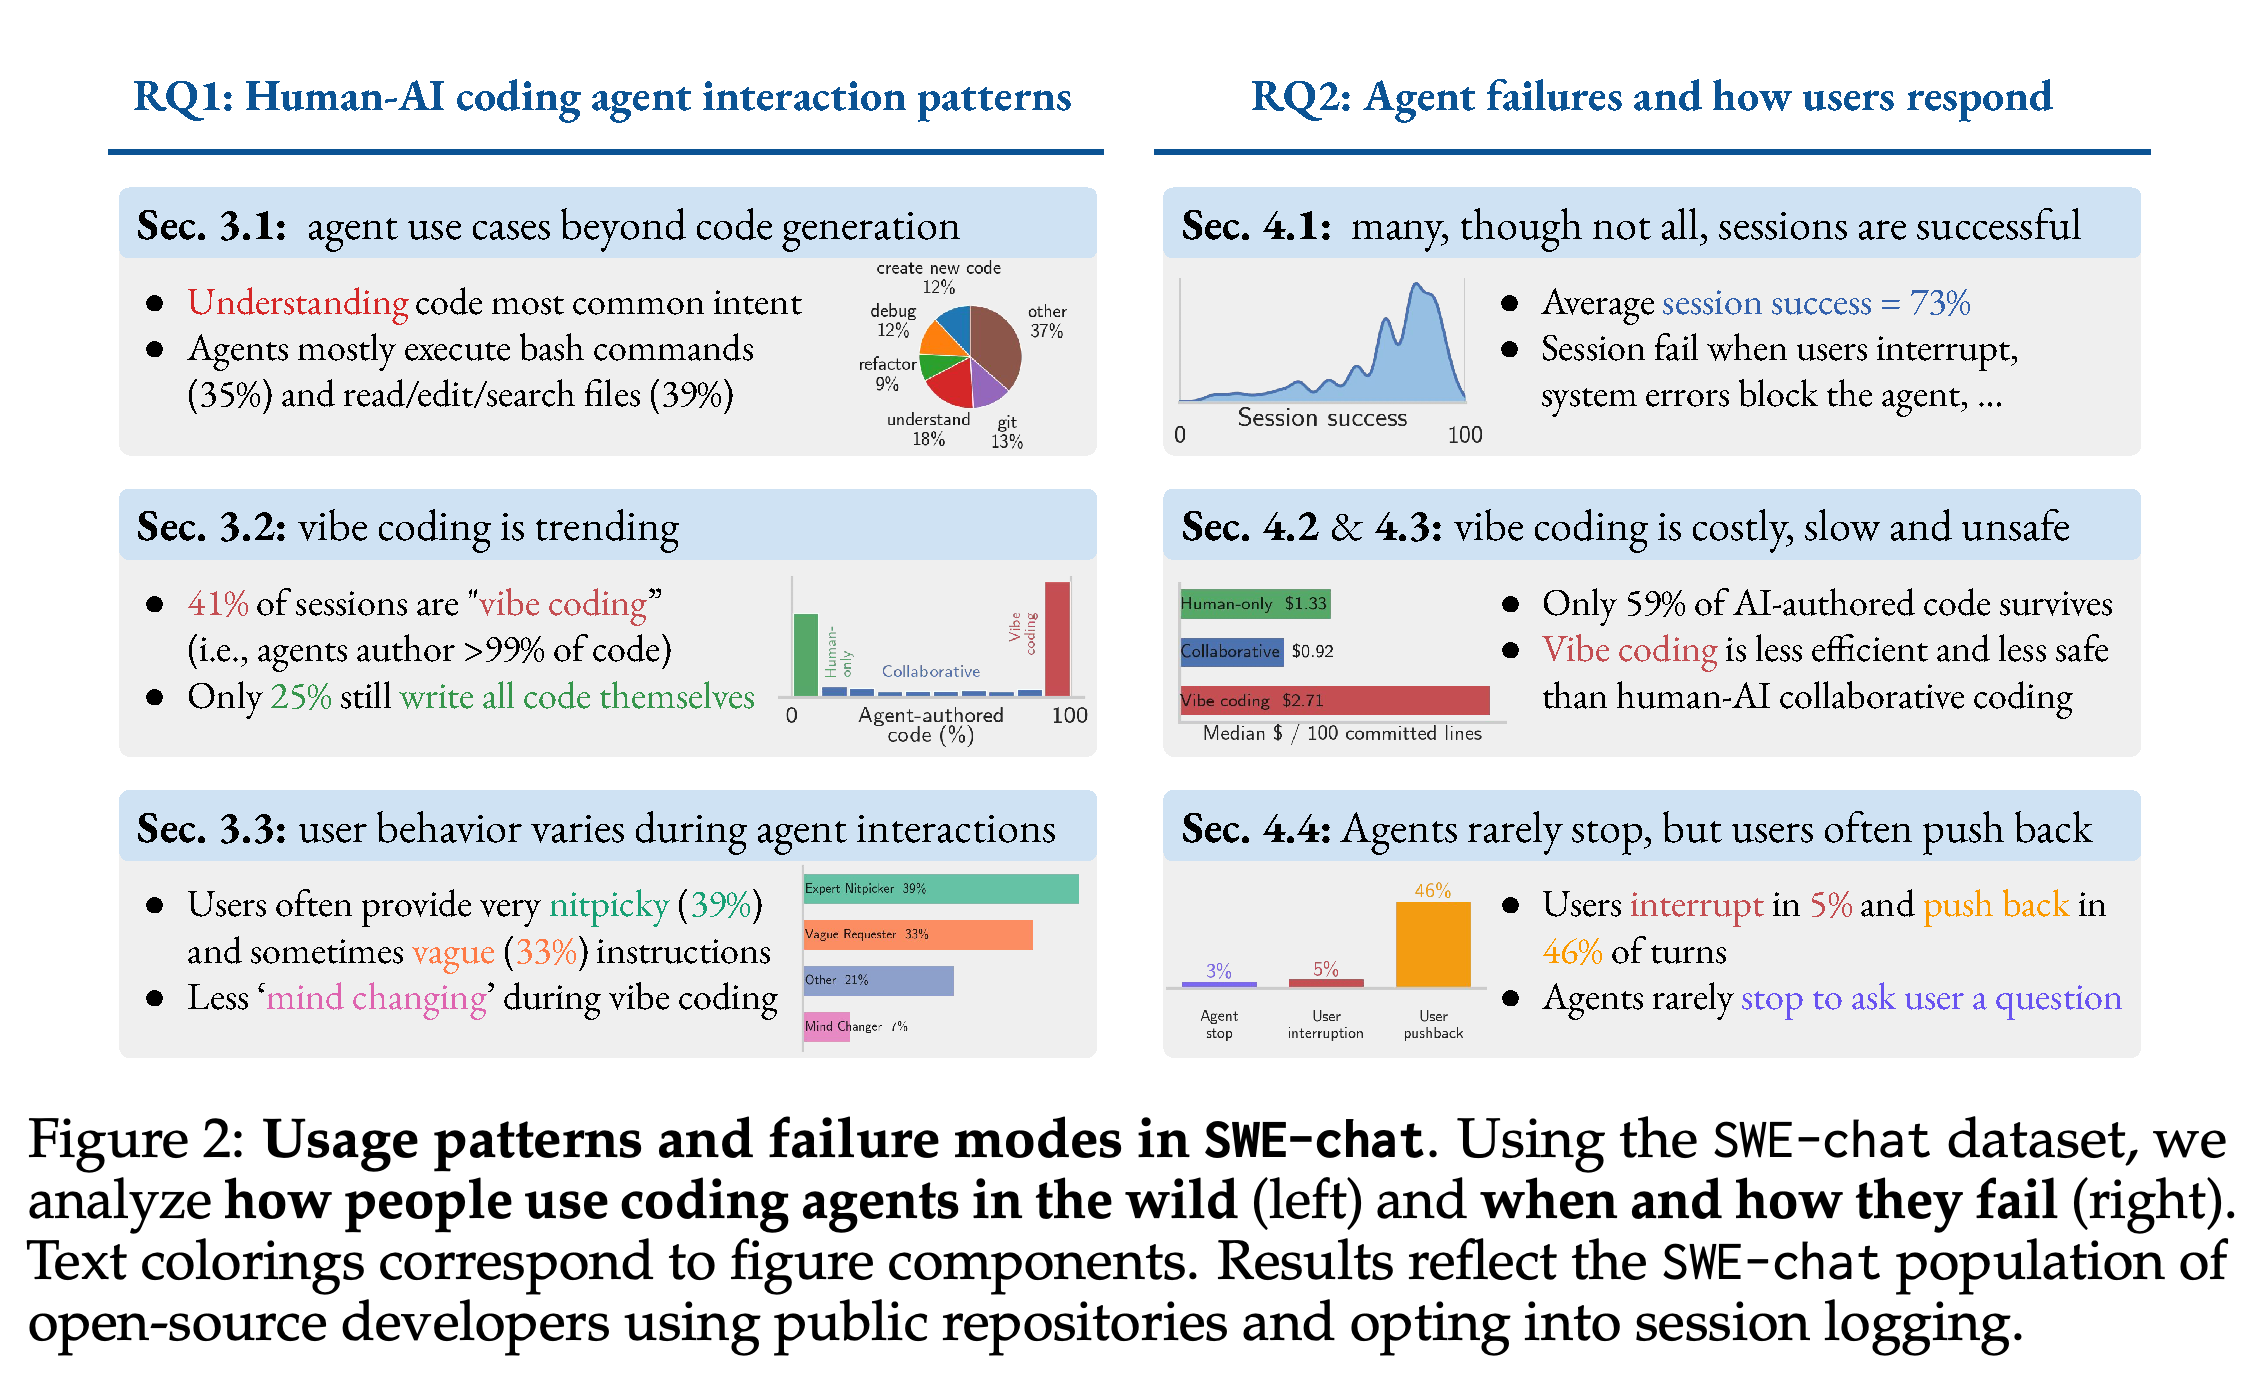
핵심 기여는 사람의 프롬프트, 에이전트의 전체 도구 사용 궤적, 코드 diff, 작성자 정보를 결합한 공개 데이터셋이다. Table 1은 이 조합을 기존 데이터셋과 비교하며, Figure 2는 초기 분석을 상호작용 패턴과 실패 유형으로 정리한다.
- 실증 분석은 작업의 다양성, 코드 작성 방식, 사용자 행동, 유지된 코드, 자원 소비, 보안 탐지 항목, 사용자 감독을 다룬다.
- vibe coding이 증가했다는 결과는 p < 0.001인 혼합효과 로지스틱 회귀로 뒷받침된다.
- 프롬프트 의도와 저장소 도메인을 보정한 커밋 코드 줄당 비용의 OLS 분석에서는 vibe coding에 대해 β = +0.46과 p < 0.001을 보고한다. 이 보정만으로 인과관계가 입증되지는 않는다.
개요는 작업의 다양성, 코드 작성 방식, 사용자 페르소나를 성공도 점수, 효율, 보안 탐지 항목, 사용자 감독과 연결한다. 반올림된 값은 자발적 참여자 표본을 요약한다. 실제 분석에 적용한 정의와 정확한 측정값은 상세 절에서 제시한다.
2 SWE-chat
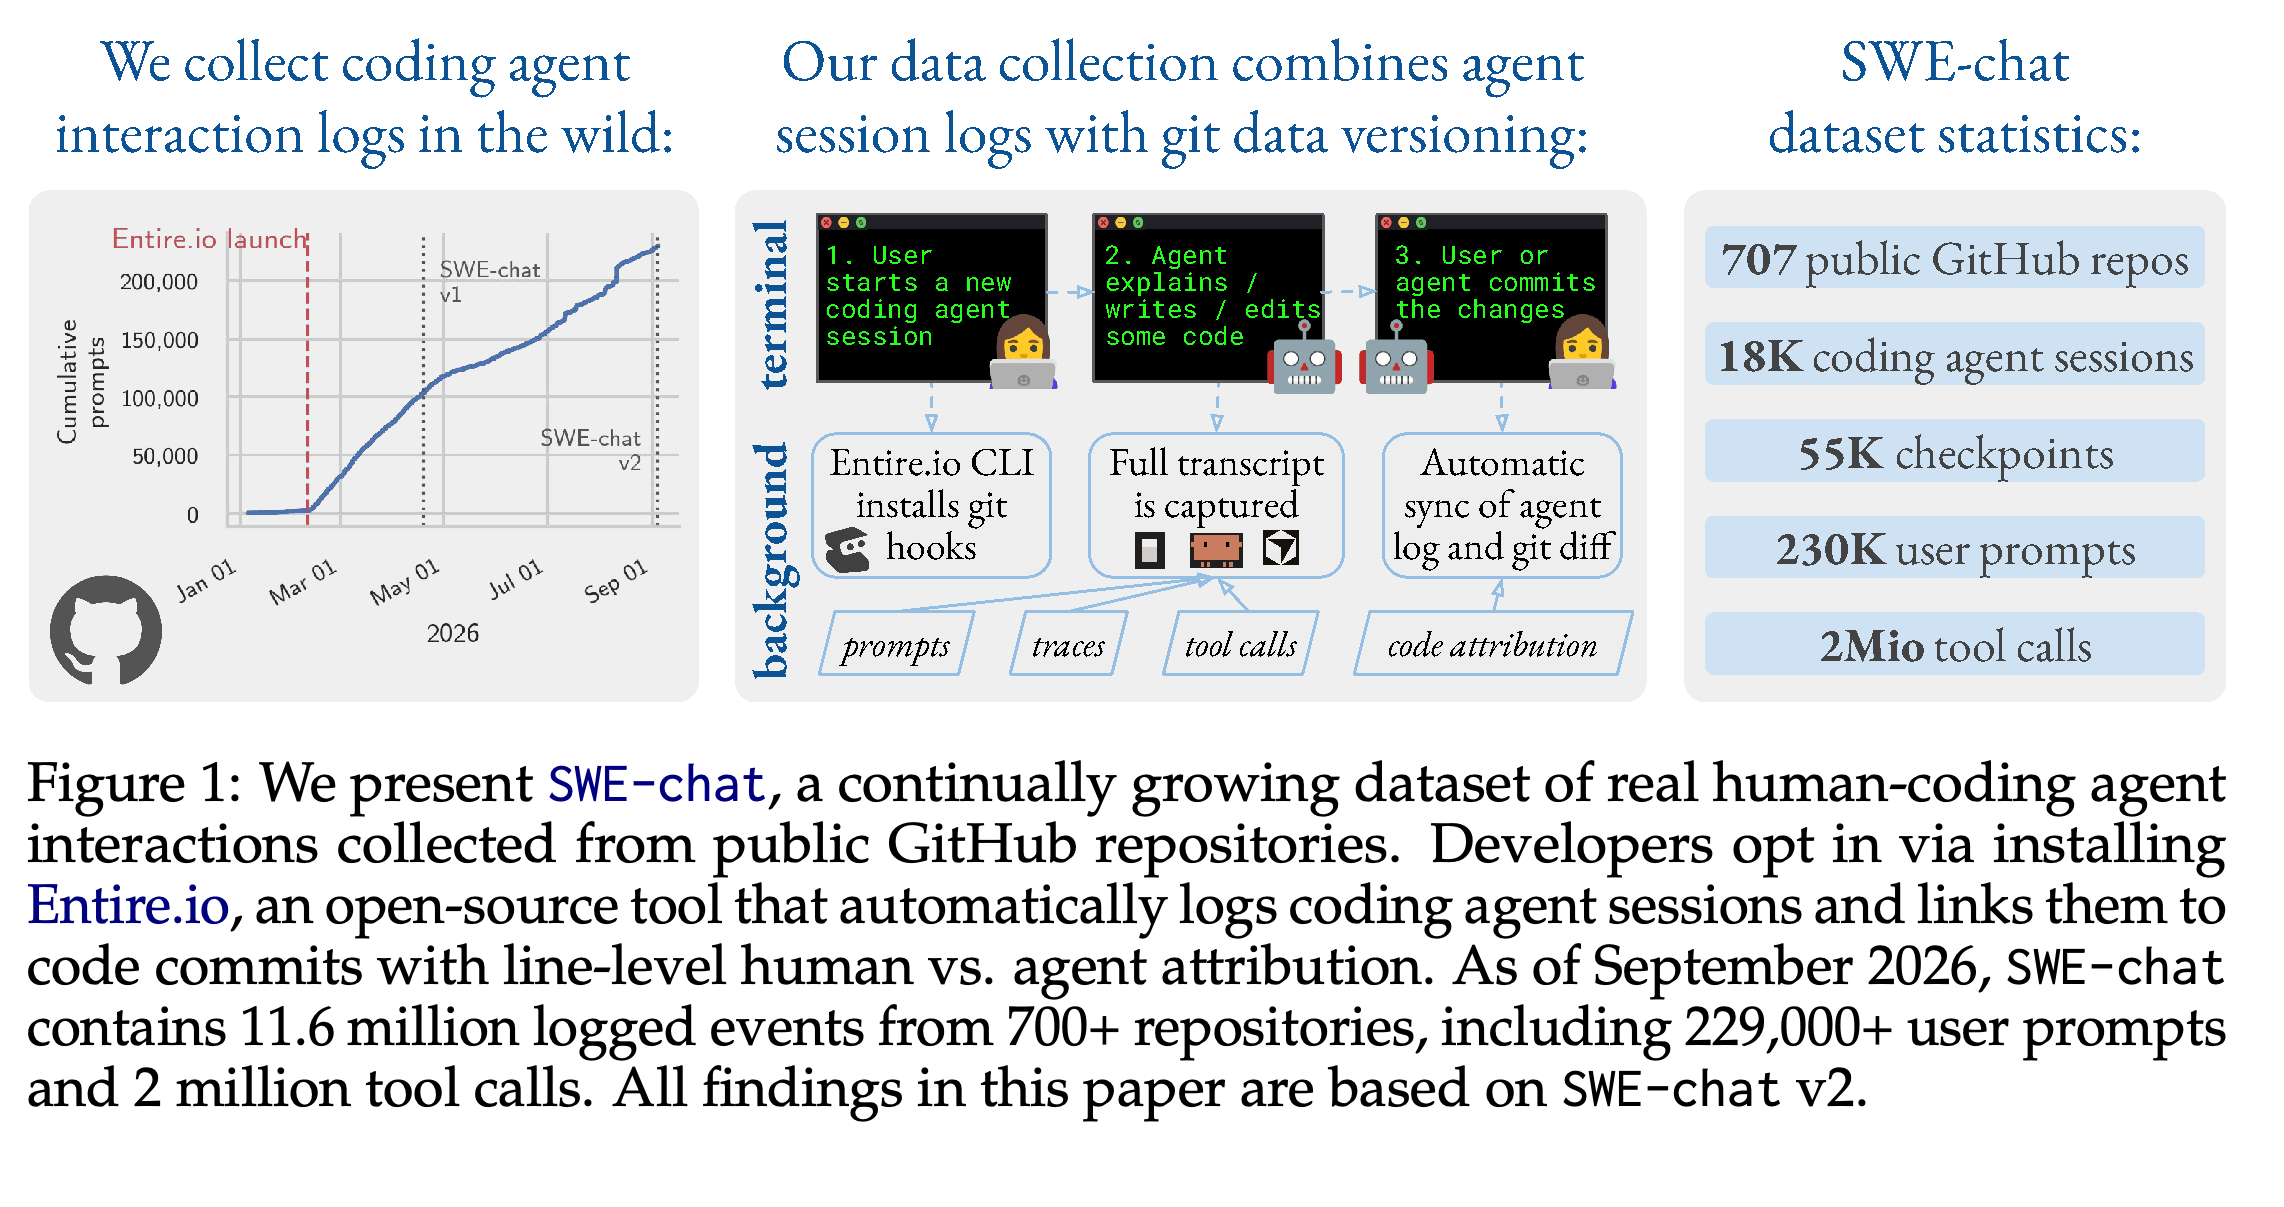
SWE-chat은 에이전트의 최종 응답이나 패치만 평가하는 대신, 상호작용 기록을 커밋된 코드와 연결한다. Figure 1은 Entire.io 로깅이 대화 기록과 git 변경 사항을 동기화하여 개발 과정과 커밋된 결과를 함께 보여주는 방식을 설명한다.
로깅 도식은 git hook과 대화 기록 수집을 통해 프롬프트, 에이전트 행동, 커밋을 연결한다. 증가 곡선과 9월 집계는 고정된 벤치마크 과제 모음이 아니라, 커밋과 연결된 출처 정보를 갖추고 계속 변화하는 관찰 데이터임을 보여준다.
2.1 Data collection
수집 파이프라인은 개발자가 Entire.io의 CLI 체크포인트 로깅을 활성화하고 로그를 공개한 GitHub 저장소를 찾는다. 체크포인트는 대화 기록과 커밋을 연결하고 코드 줄별 작성자 정보를 제공한다. 대화 기록에는 프롬프트, 응답, 도구 호출, 토큰 사용량이 포함되며, 지원되는 경우에는 skill 호출과 subagent 대화 기록도 포함된다.
- 지원하는 에이전트에는 Claude Code, OpenAI Codex, OpenCode, Gemini CLI, Cursor, GitHub Copilot CLI, Pi, Factory Droid가 있다.
- 공개 데이터에는 54,000개 이상의 체크포인트와 11.6 million건의 기록된 이벤트가 포함된다. 이벤트에는 진행 상황, 도구 결과, 6,600개 이상의 세션에서 수집한 확장 사고 기록이 포함된다.
- Figure 3은 세션, 사용자 프롬프트, 텍스트와 도구 호출을 포함하는 에이전트 턴을 구분한다. 자발적으로 공개한 로그를 수집하므로 표본은 초기 도입자에 치우친다.
2.2 Data statistics
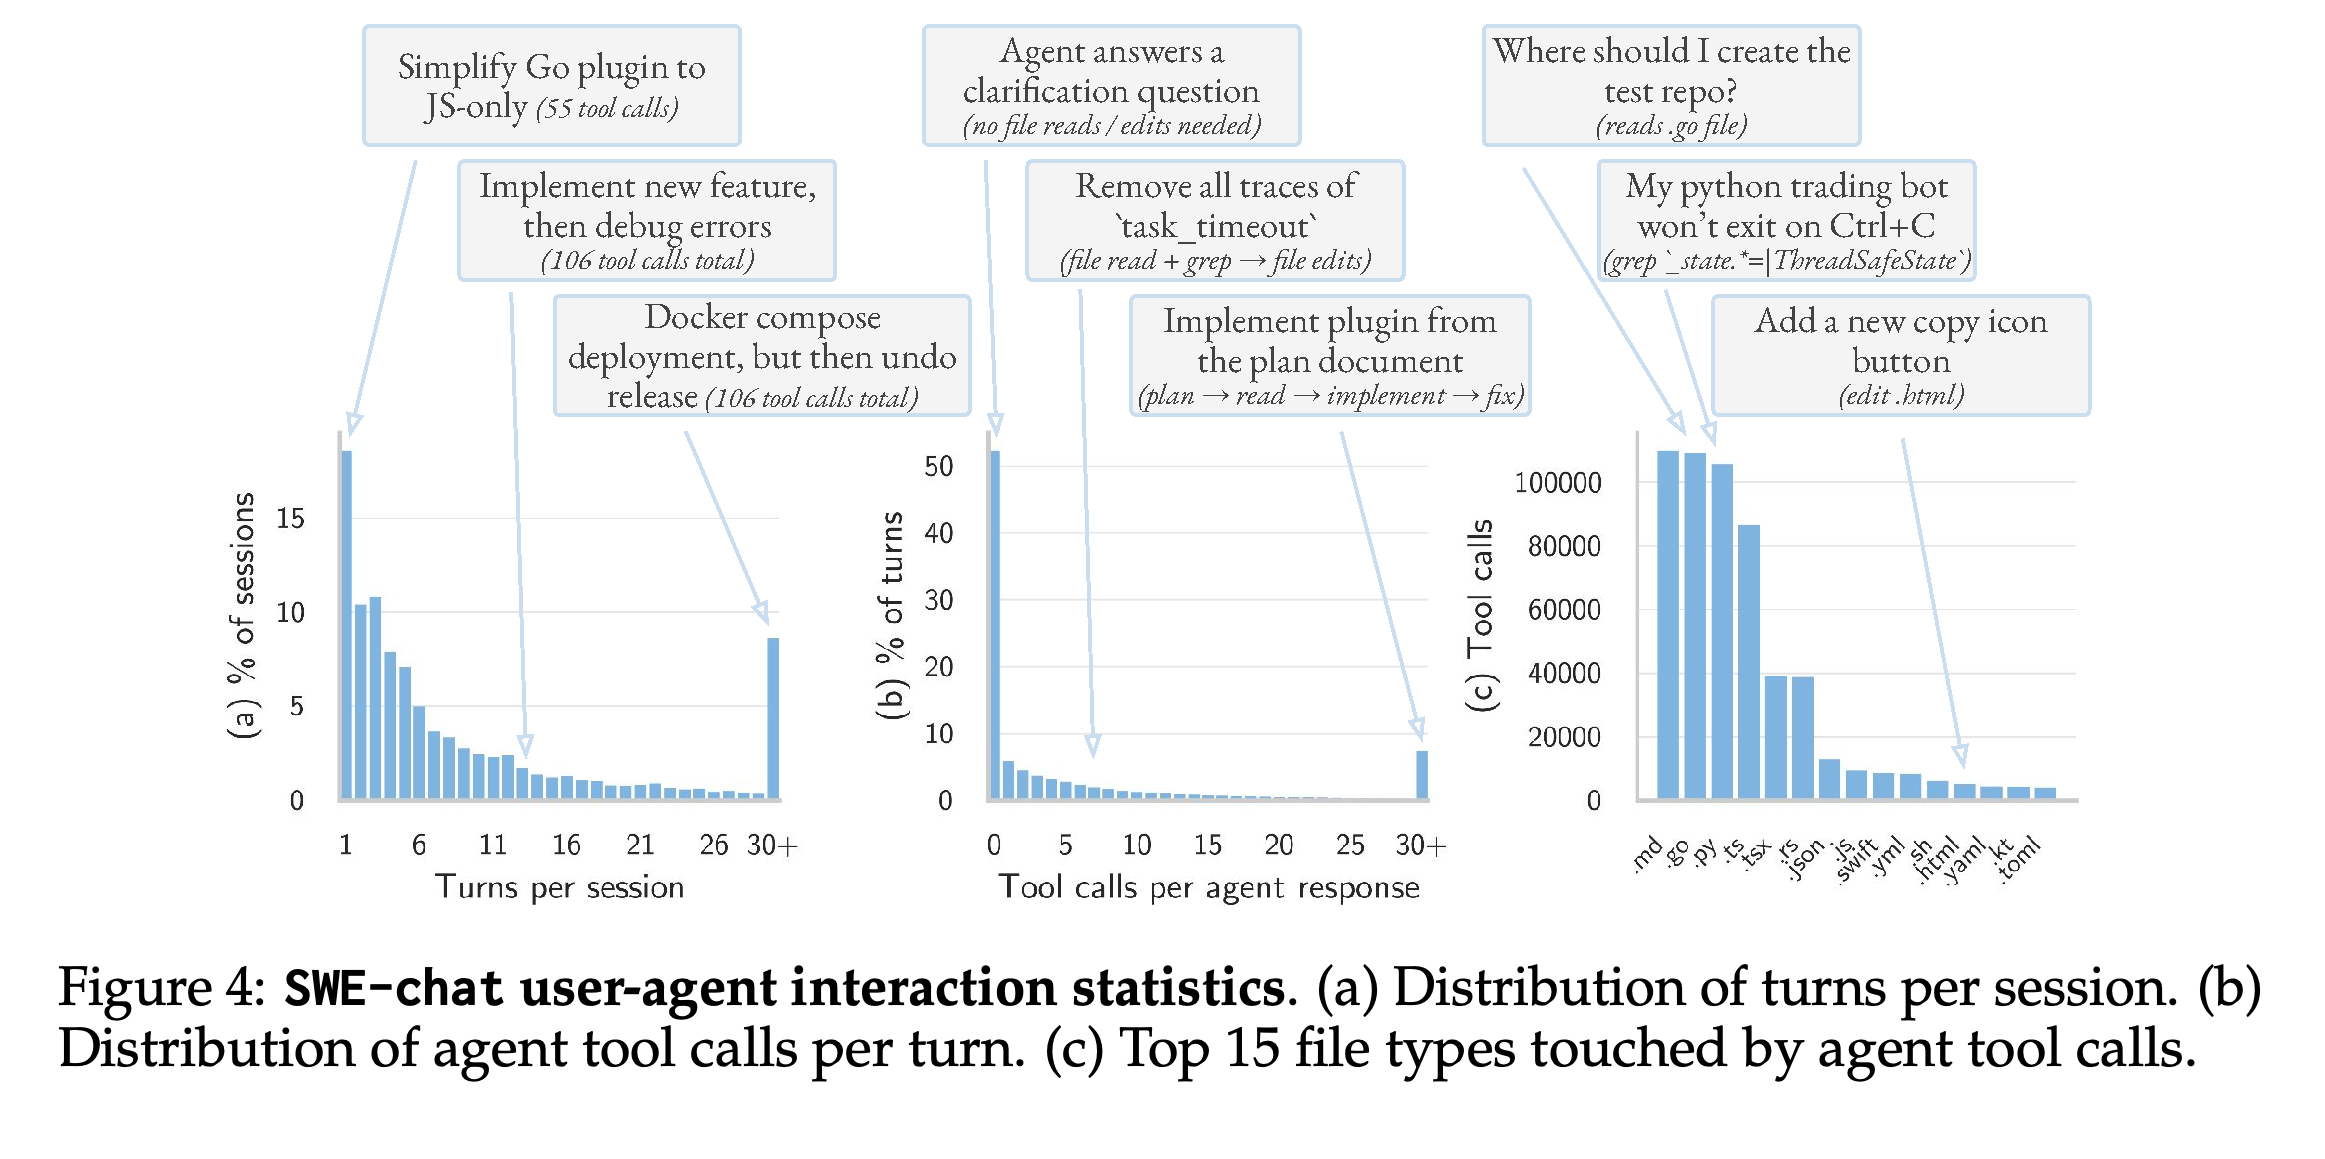
Figure 4는 세션 길이, 턴당 도구 호출 수, 작업 대상 파일 유형이 다양함을 보여준다. 데이터셋은 수백 명의 사용자와 널리 쓰이는 에이전트 8개, 커뮤니티 통합 도구를 포함한다. Claude Code는 세션의 약 69%를 차지하며, 이는 Entire.io가 초기에 Claude Code를 지원한 영향도 있다.
- 분석에서는 자동화된 봇이 생성한 것으로 보이는 데이터를 걸러낸다.
- 긴 세션과 도구 호출이 많은 턴뿐 아니라 파일 작업이 필요 없는 짧은 조언 요청도 포함된다.
- 파일 유형은 문서와 여러 프로그래밍 언어에 걸쳐 분포한다.
많은 대화가 짧거나 도구 호출 없이 이루어지지만, 분포의 긴 꼬리에는 긴 세션과 도구 호출이 많은 턴이 포함된다. 파일 유형 패널은 문서와 여러 프로그래밍 언어를 포함하여, 로그가 단일한 패치 작성 워크플로보다 넓은 범위를 다룸을 보여준다.
2.3 Data analysis methodology
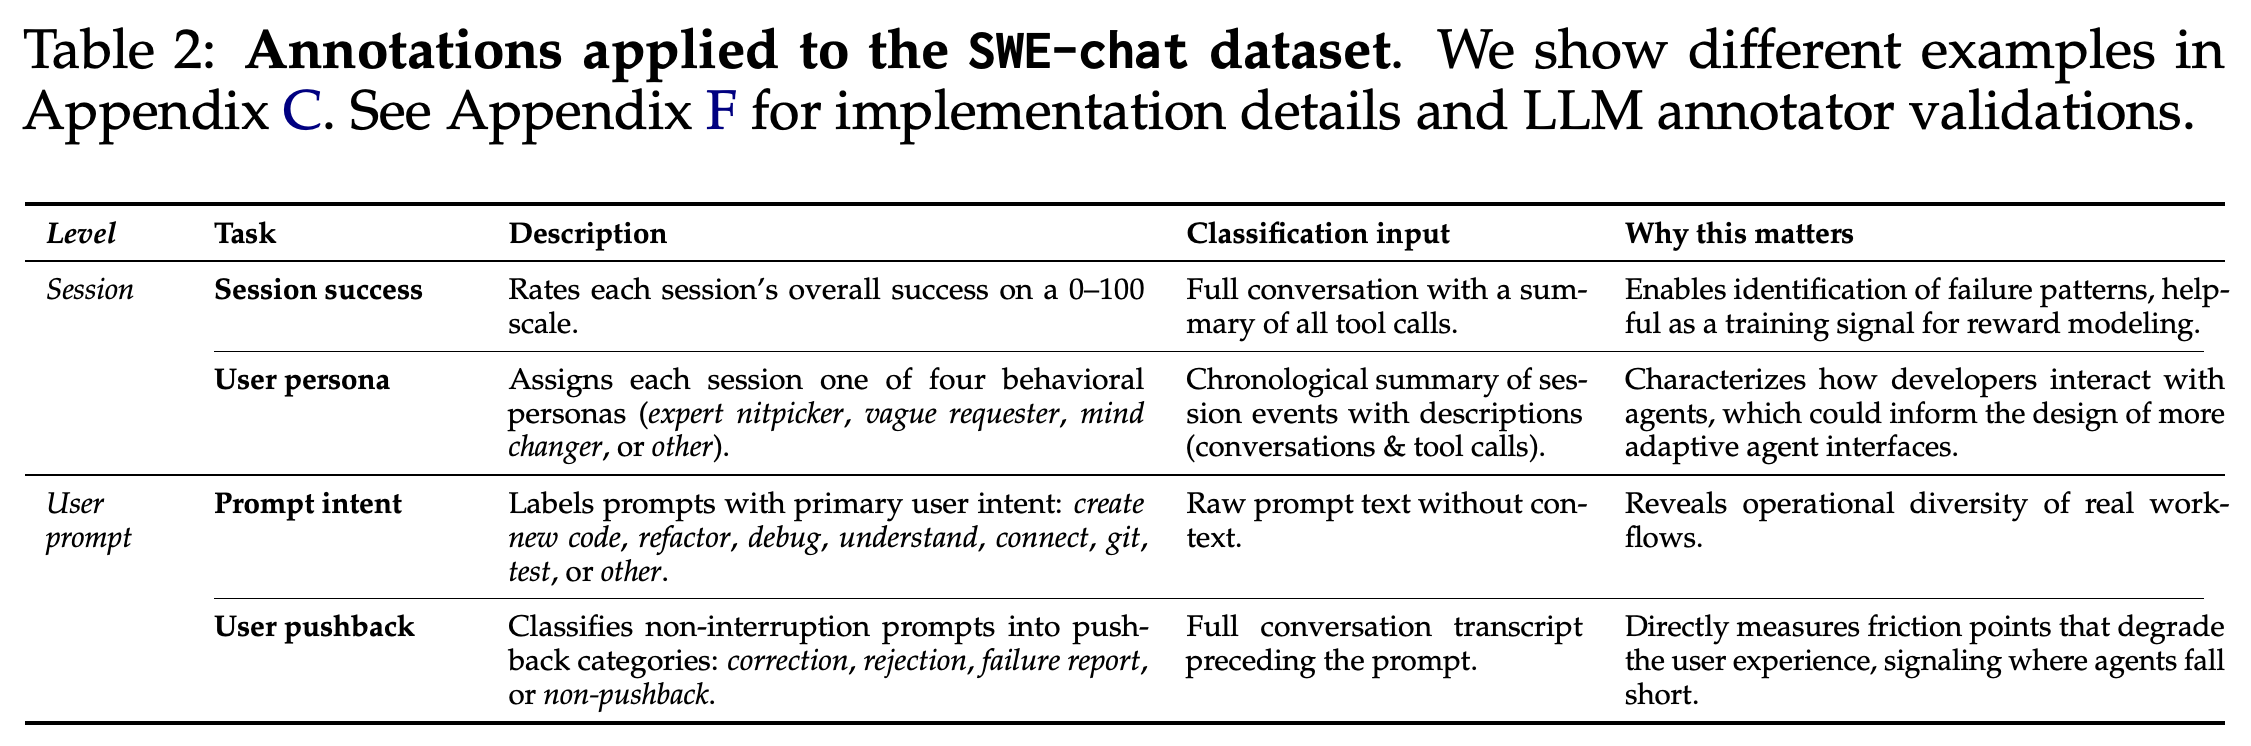
저자들은 LLM이 생성한 행동 주석과 로그 및 코드 작성자 정보에서 직접 계산한 지표를 함께 사용한다. Table 2는 세션 단위의 성공도 및 페르소나 라벨과 프롬프트 단위의 의도 및 이의 제기 라벨을 구분한다. 각 라벨은 서로 다른 범위의 근거를 사용한다.
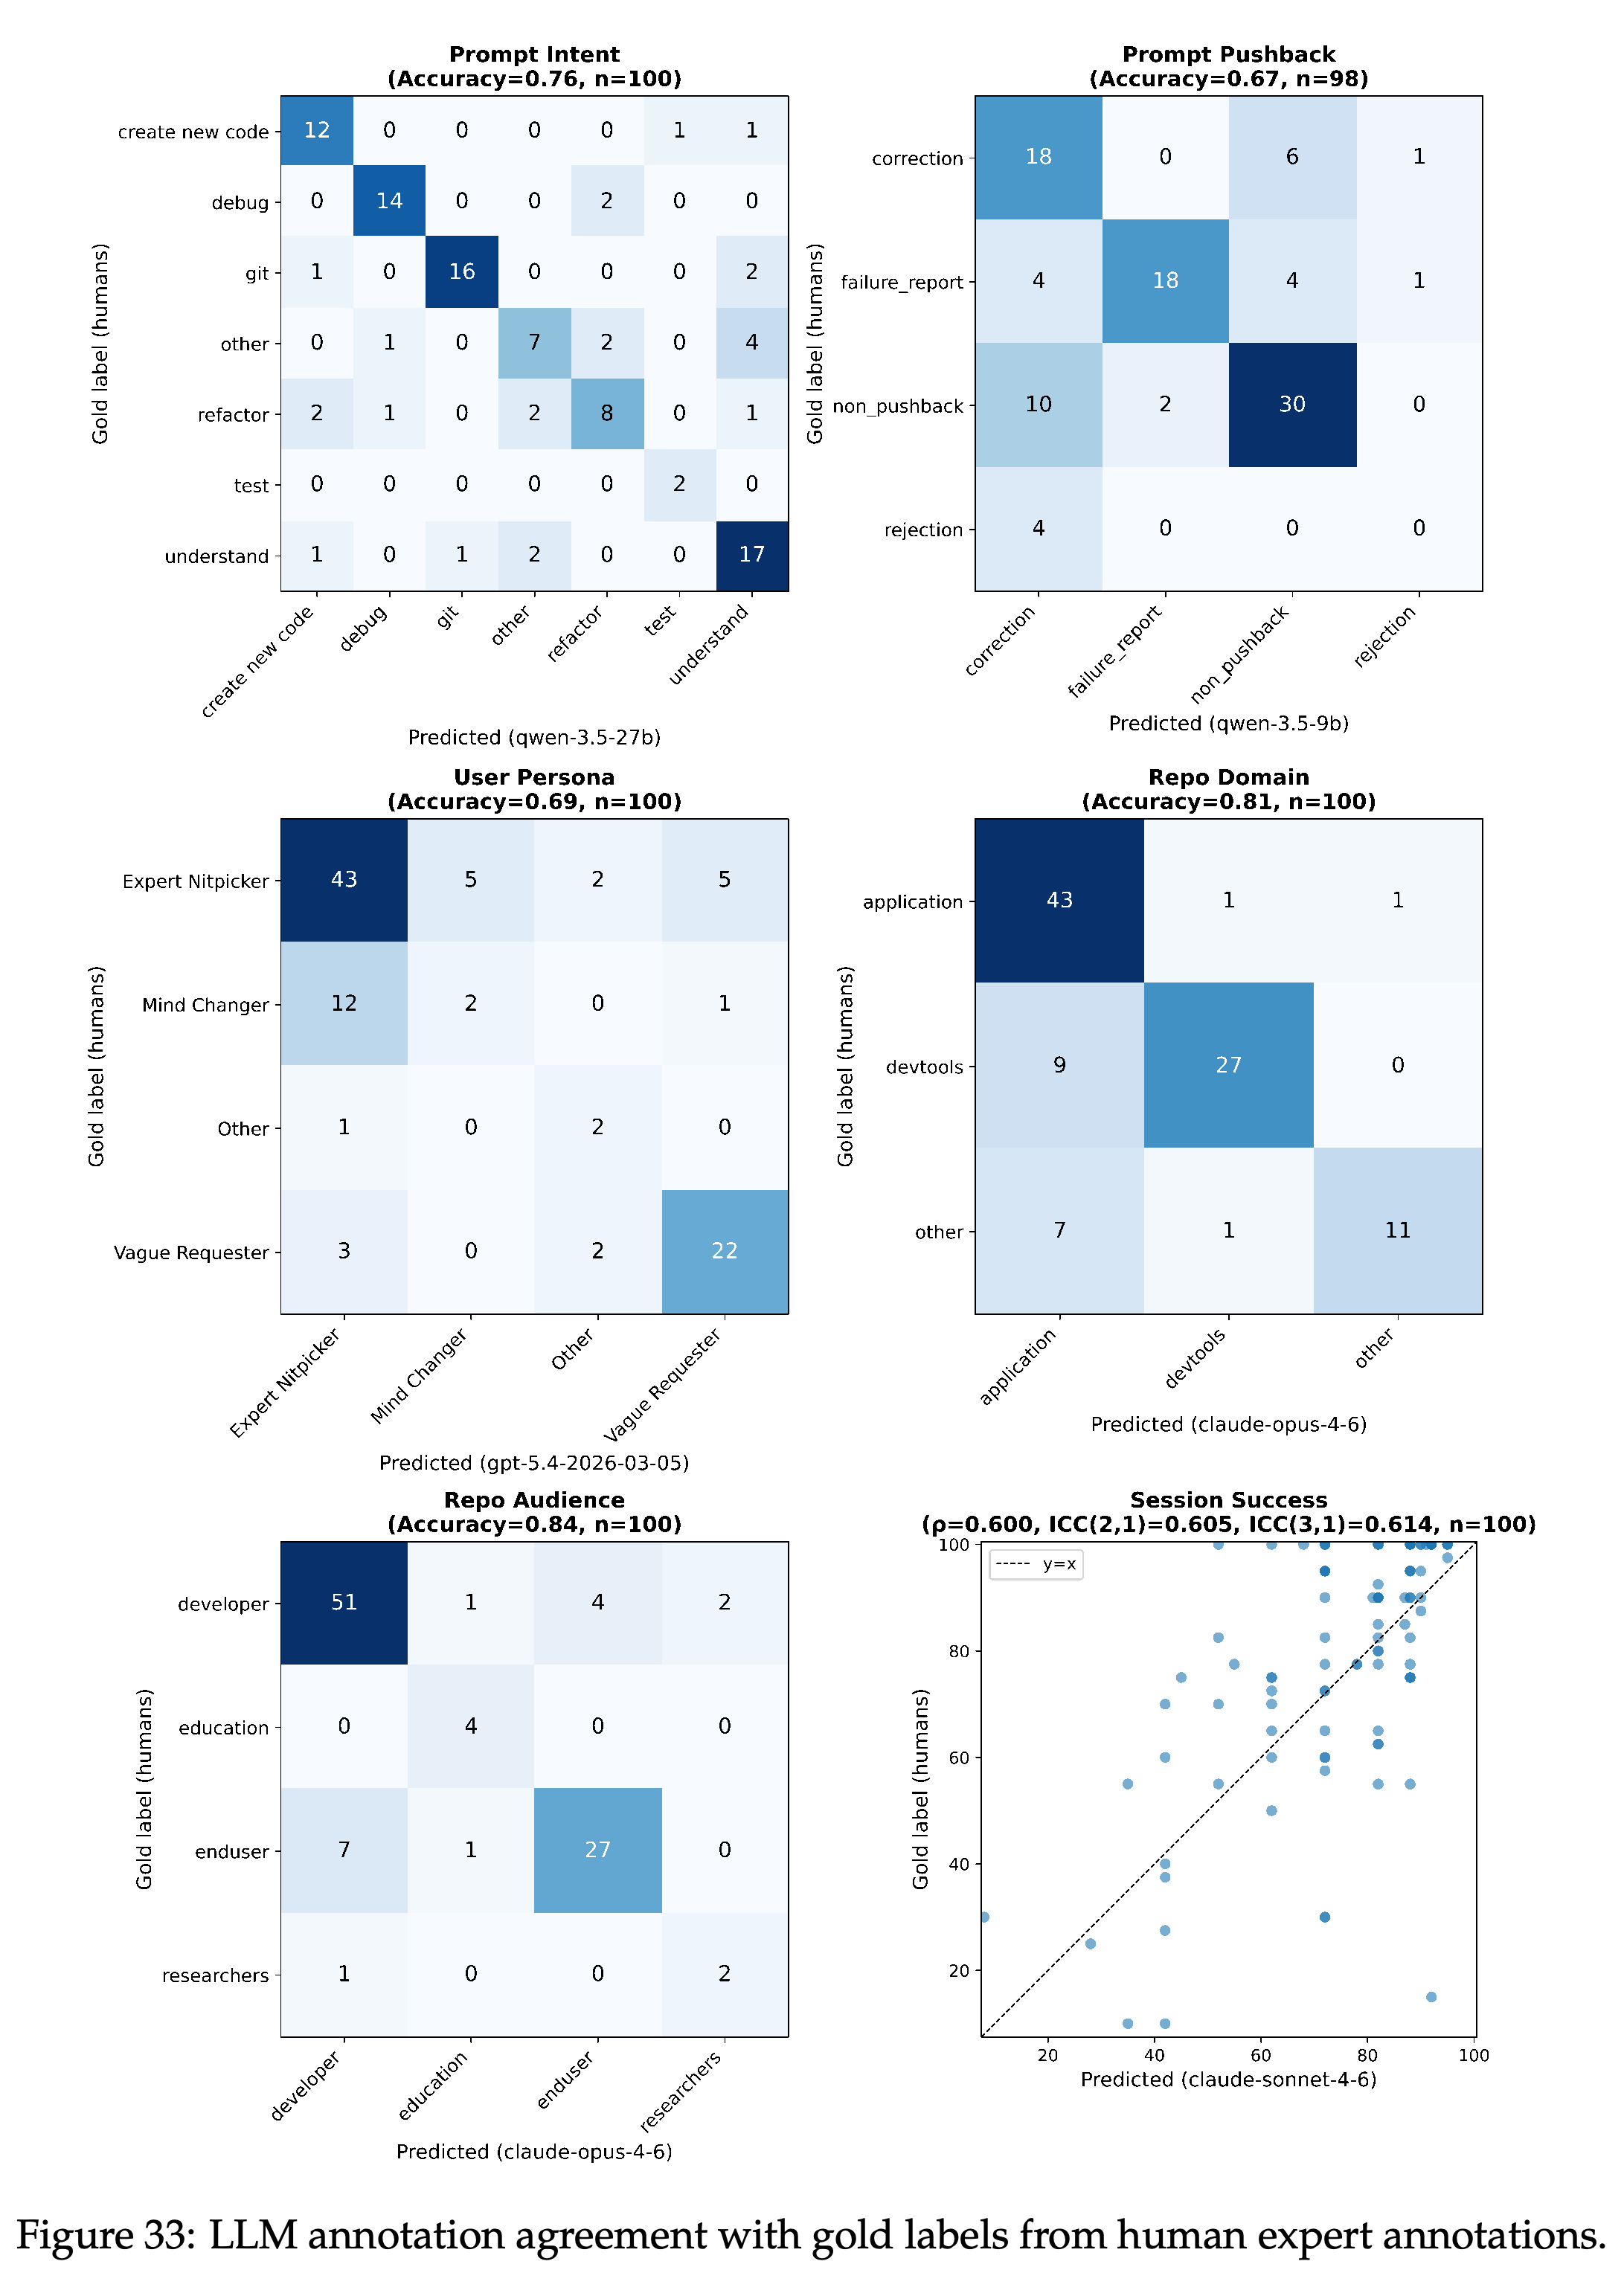
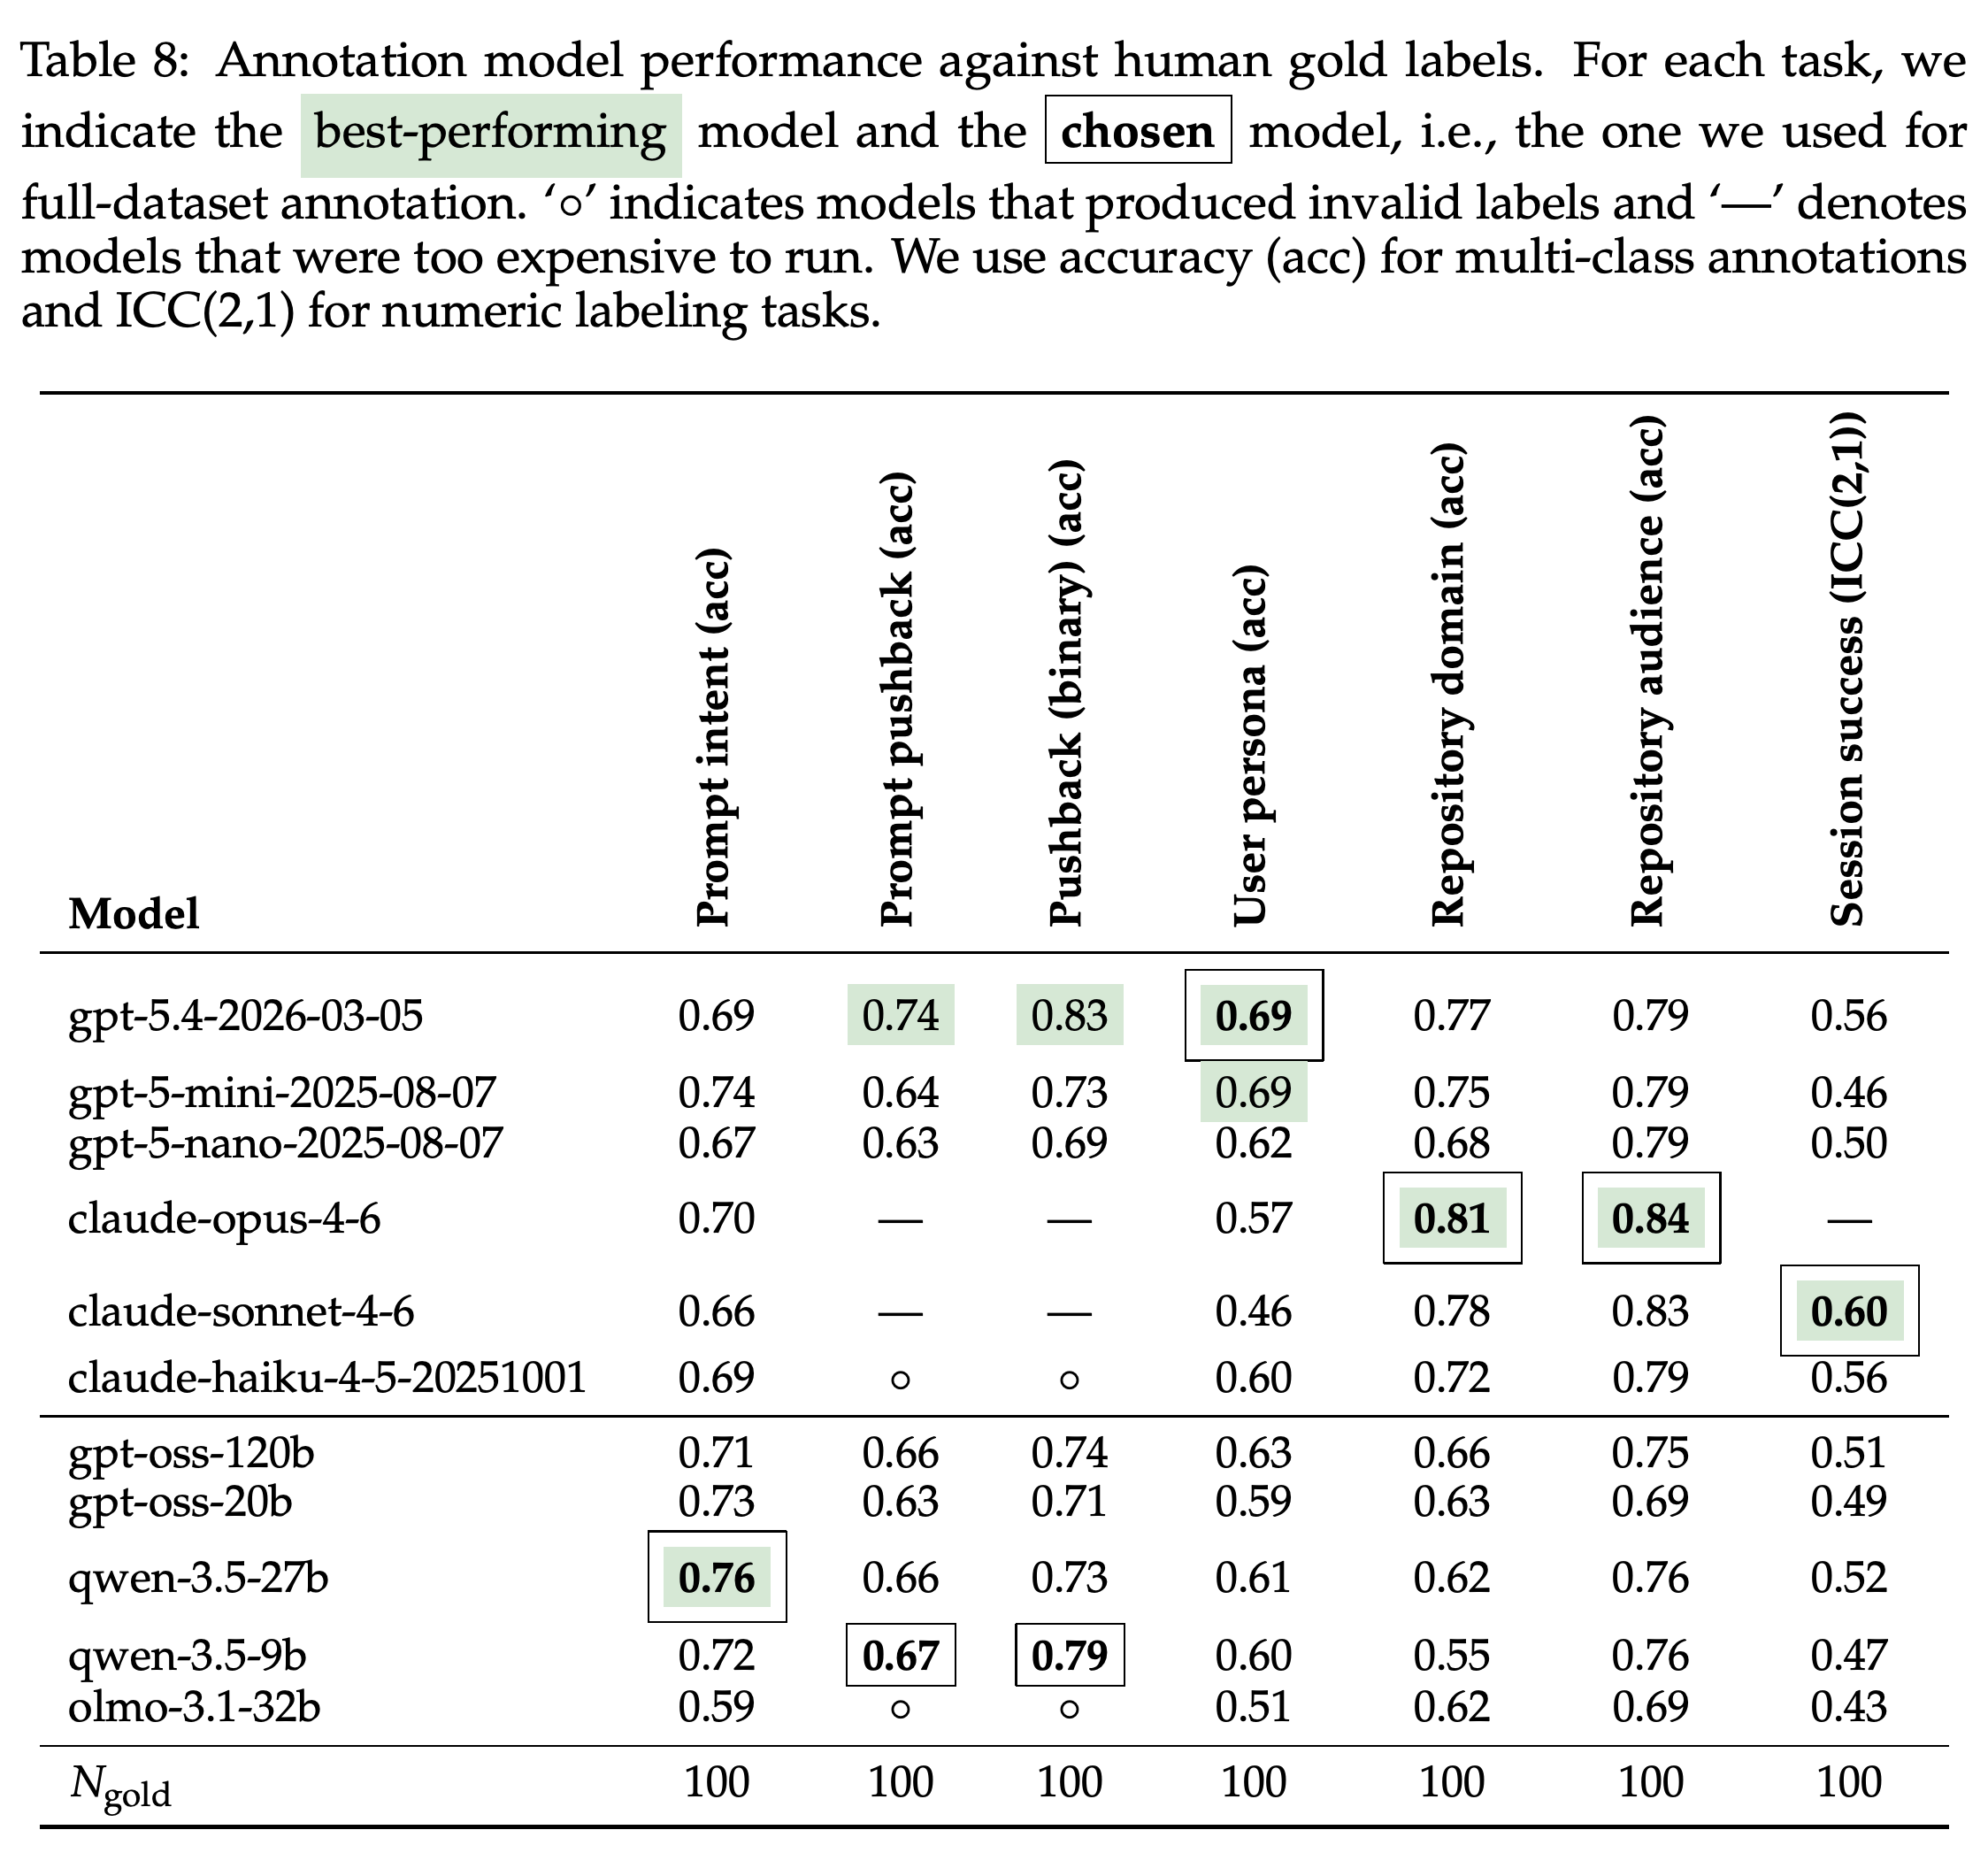
- 후보 모델과 프롬프트 변형은 과제별 사례 100개에 대한 전문가 정답 라벨로 평가한다. Figure 33과 Table 8은 특히 이의 제기와 페르소나 분류에서 남아 있는 오류를 보여준다.
- 선정된 모델은 의도 분류에 Qwen/Qwen3.5-27B, 이의 제기 분류에 Qwen/Qwen3.5-9B, 페르소나 분류에 gpt-5.4-2026-03-05, 저장소 유형 분류에 claude-opus-4-6, 세션 성공도 평가에 claude-sonnet-4-6이다.
- 효율 지표는 생성된 코드 줄과 유지된 코드 줄을 재구성한다. 보안 분석은 수정된 파일에서 커밋 전후의 Semgrep 탐지 항목을 비교한다. 어느 측정에도 LLM 행동 라벨은 필요하지 않다.
의도 분류는 개별 프롬프트 텍스트를, 이의 제기 분류는 앞선 대화를, 페르소나와 성공도 평가는 세션 단위 근거를 사용한다. 근거 범위와 평가 기준이 다르므로 이 라벨들을 서로 대체 가능한 실패 지표로 취급할 수 없다.
혼동 행렬은 전체 정확도에 가려진 오류를 드러낸다. 여기에는 Mind Changer 세션을 Expert Nitpicker로, 거부 프롬프트를 수정 지시로 분류한 사례가 포함된다. 성공도 비교에서는 ICC(2,1) = 0.605로, 전문가 정답 점수와의 절대적 일치가 불완전함을 보여준다.
모델 비교는 주석 정확도와 비용 사이의 서로 다른 절충을 보여준다. Qwen3.5-9B는 gpt-5.4-2026-03-05보다 정확도가 낮지만 이의 제기 분류 모델로 선정된다. 선정 모델들의 일치도가 고르지 않으므로 후속 행동 추정의 정밀도에도 한계가 있다.
3 How do humans interact with coding agents in the wild? (RQ1)
RQ1은 사용자가 무엇을 요청하는지, 커밋된 코드 중 에이전트가 얼마나 작성하는지, 사용자가 세션 방향을 어떻게 조정하는지 살펴본다. 분석은 자율적인 일회성 코드 생성뿐 아니라 반복적인 개발 활동을 다룬다.
3.1 Task types: agents assist with a broad range of tasks beyond writing code
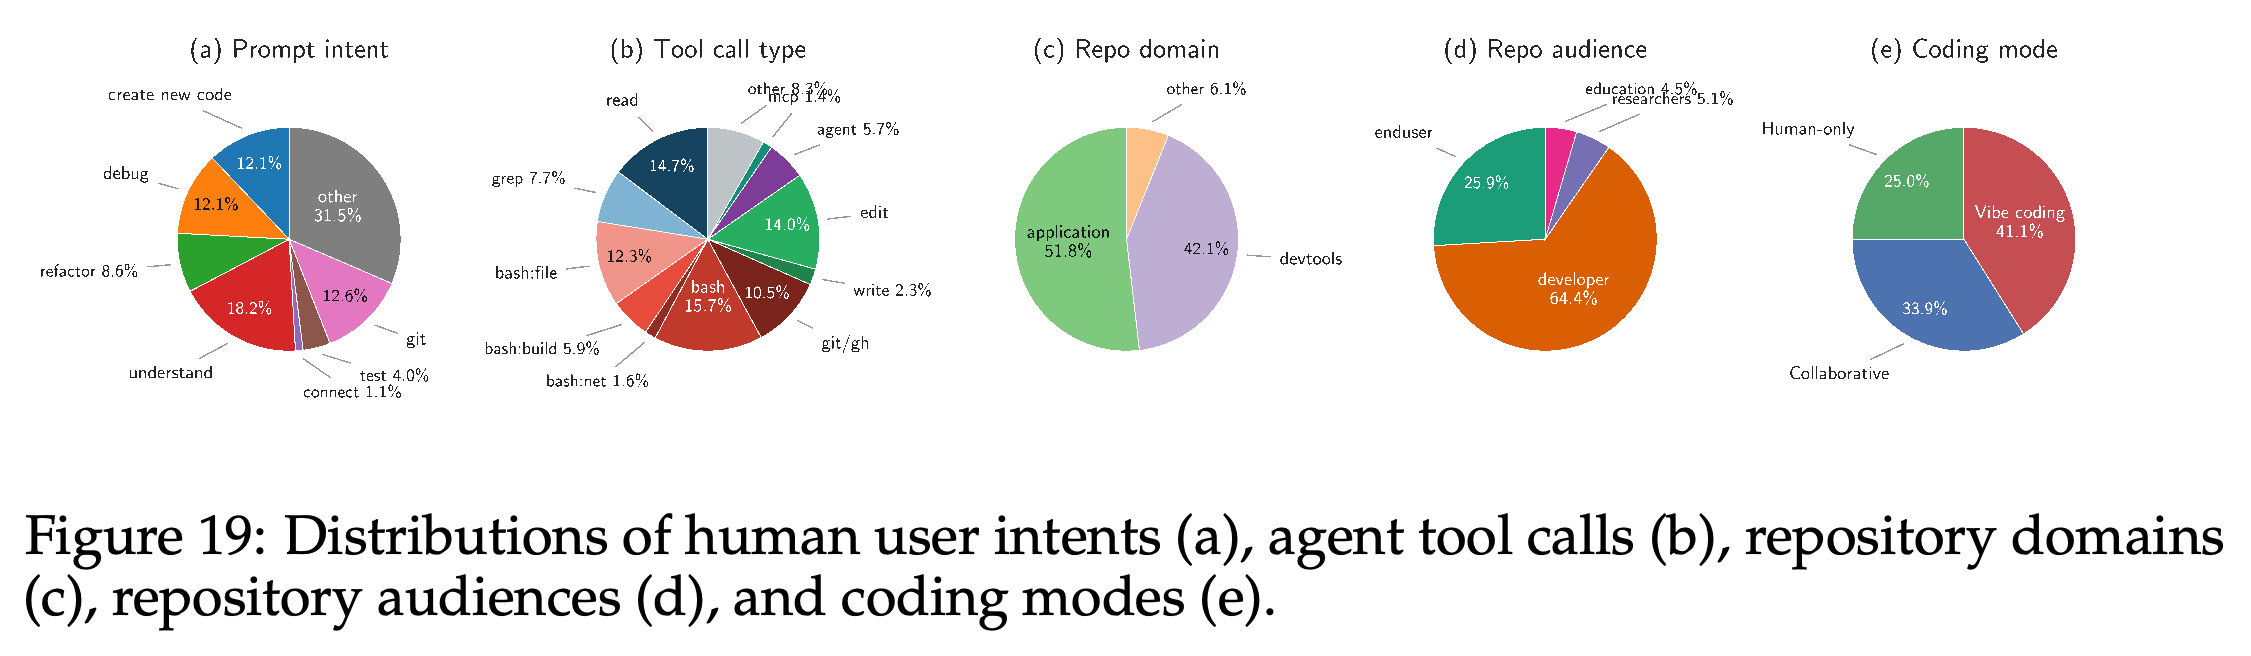
프롬프트 중 코드 이해는 18.2%, git 작업은 12.6%, 새 코드 작성은 12.1%, 디버깅은 12.1%를 차지한다. 31.5%는 “other”로 분류된다. Figure 19는 전체 의도 및 도구 분포를 제시하며, 기능 구현과 버그 수정 패치를 넘어서는 워크플로를 보여준다.
- 프롬프트 중 리팩터링은 8.6%, 테스트는 4.0%, 시스템 연결은 1.1%를 차지한다.
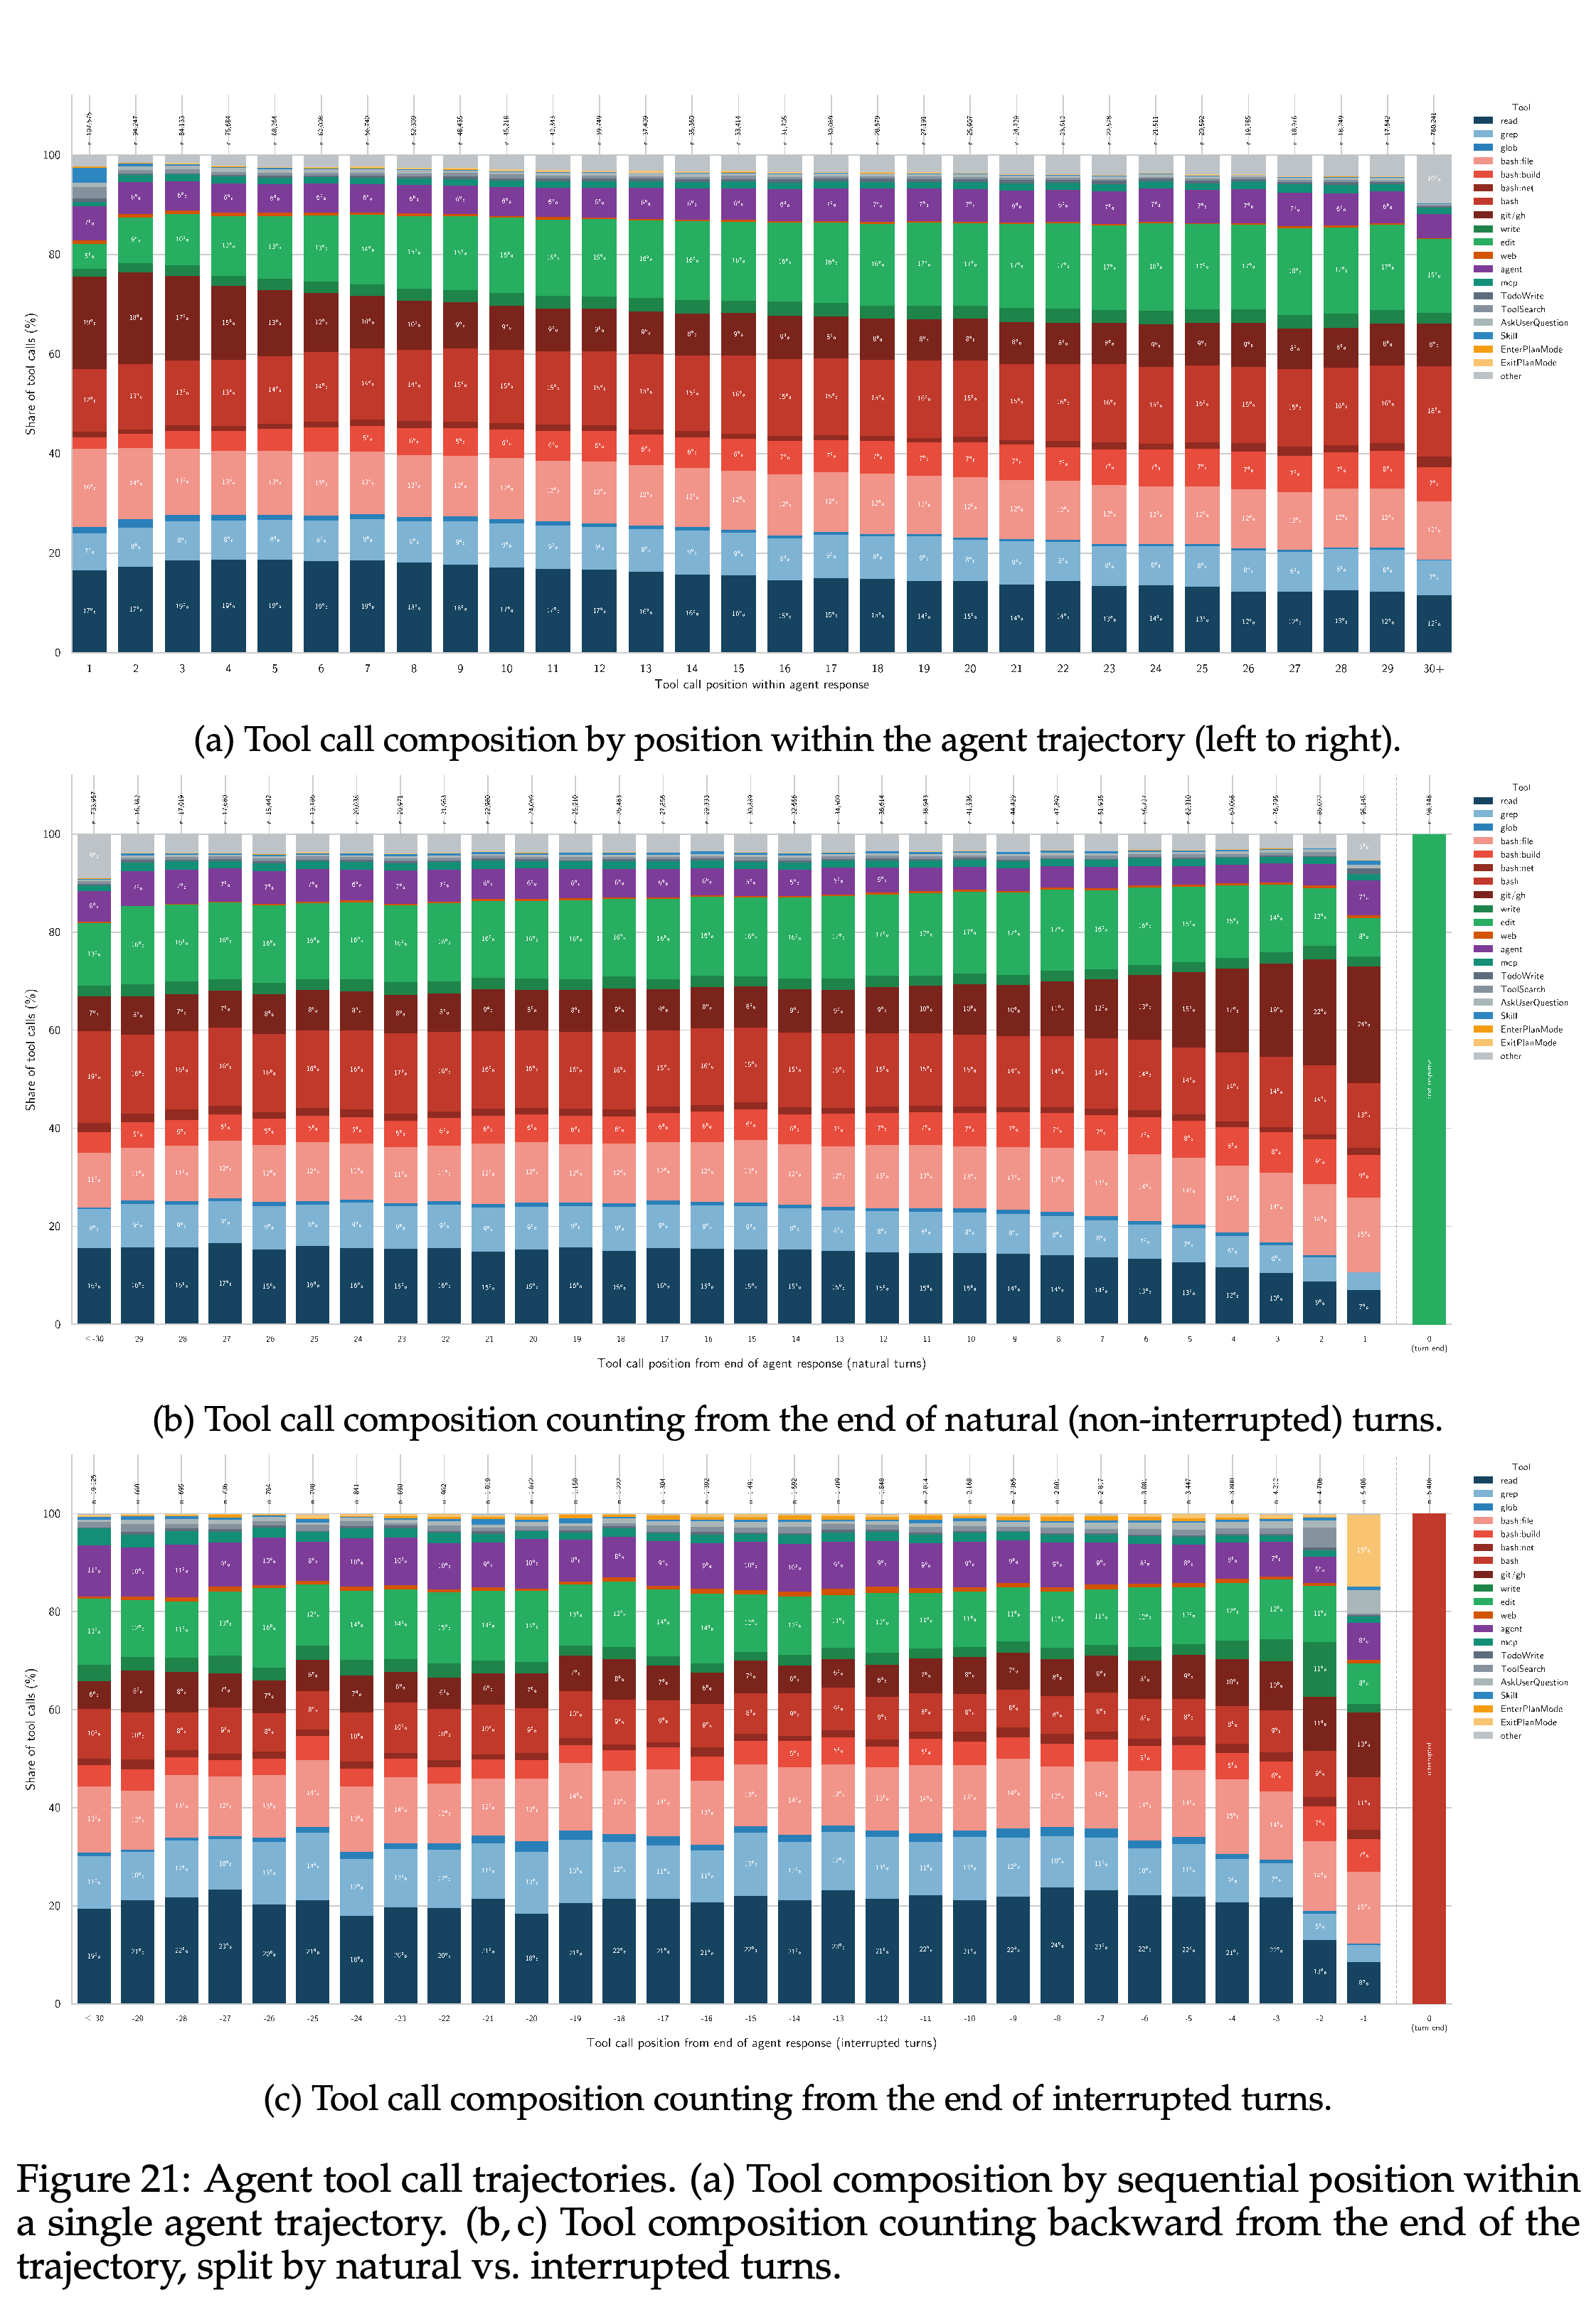
- 셸 관련 범주를 합치면 셸 명령이 도구 호출의 45%를 초과한다. Figure 21은 초기에 읽기와 검색에 집중한 뒤 편집과 빌드 작업으로 이동하는 양상을 보여준다.
- Claude Code 세션의 48%는 subagent를 최소 1개 호출하고, 28%는 skill을 호출한다.
코드 이해가 구체적인 요청 범주 중 가장 크며, 셸, 읽기, 편집, 검색 작업이 도구 사용의 상당한 비중을 차지한다. 저장소 패널은 이러한 상호작용이 주로 애플리케이션과 개발자 도구 환경에서 이루어짐을 보여주며, 마지막 패널은 코드 작성 방식별 비중을 다시 제시한다.
순방향 궤적은 읽기와 검색에서 편집과 빌드로 이동한다. 역방향 궤적은 자연스러운 완료와 중단을 구분한다. 중단된 턴의 끝 직전에는 ExitPlanMode가 유독 자주 나타나므로, 계획에서 실행으로 넘어가는 시점이 흔한 개입 지점임을 알 수 있다.
3.2 Coding modes: vibe coding is increasingly common
에이전트가 작성한 코드 비율의 평균은 55.3%지만, Figure 5의 분포는 0%와 100% 부근에 집중되며 중앙값은 75.6%다. 세션 중 human-only coding은 25.0%, collaborative coding은 33.9%, vibe coding은 41.1%를 차지한다.
- human-only는 커밋된 코드 중 에이전트가 작성한 줄이 0%인 경우이며, collaborative는 >0%이면서 <99%인 경우다. 본문은 vibe coding을 >99%로 정의하지만 Figure 5는 ≥99%를 사용하므로 정확한 경계값에서 불일치가 있다.
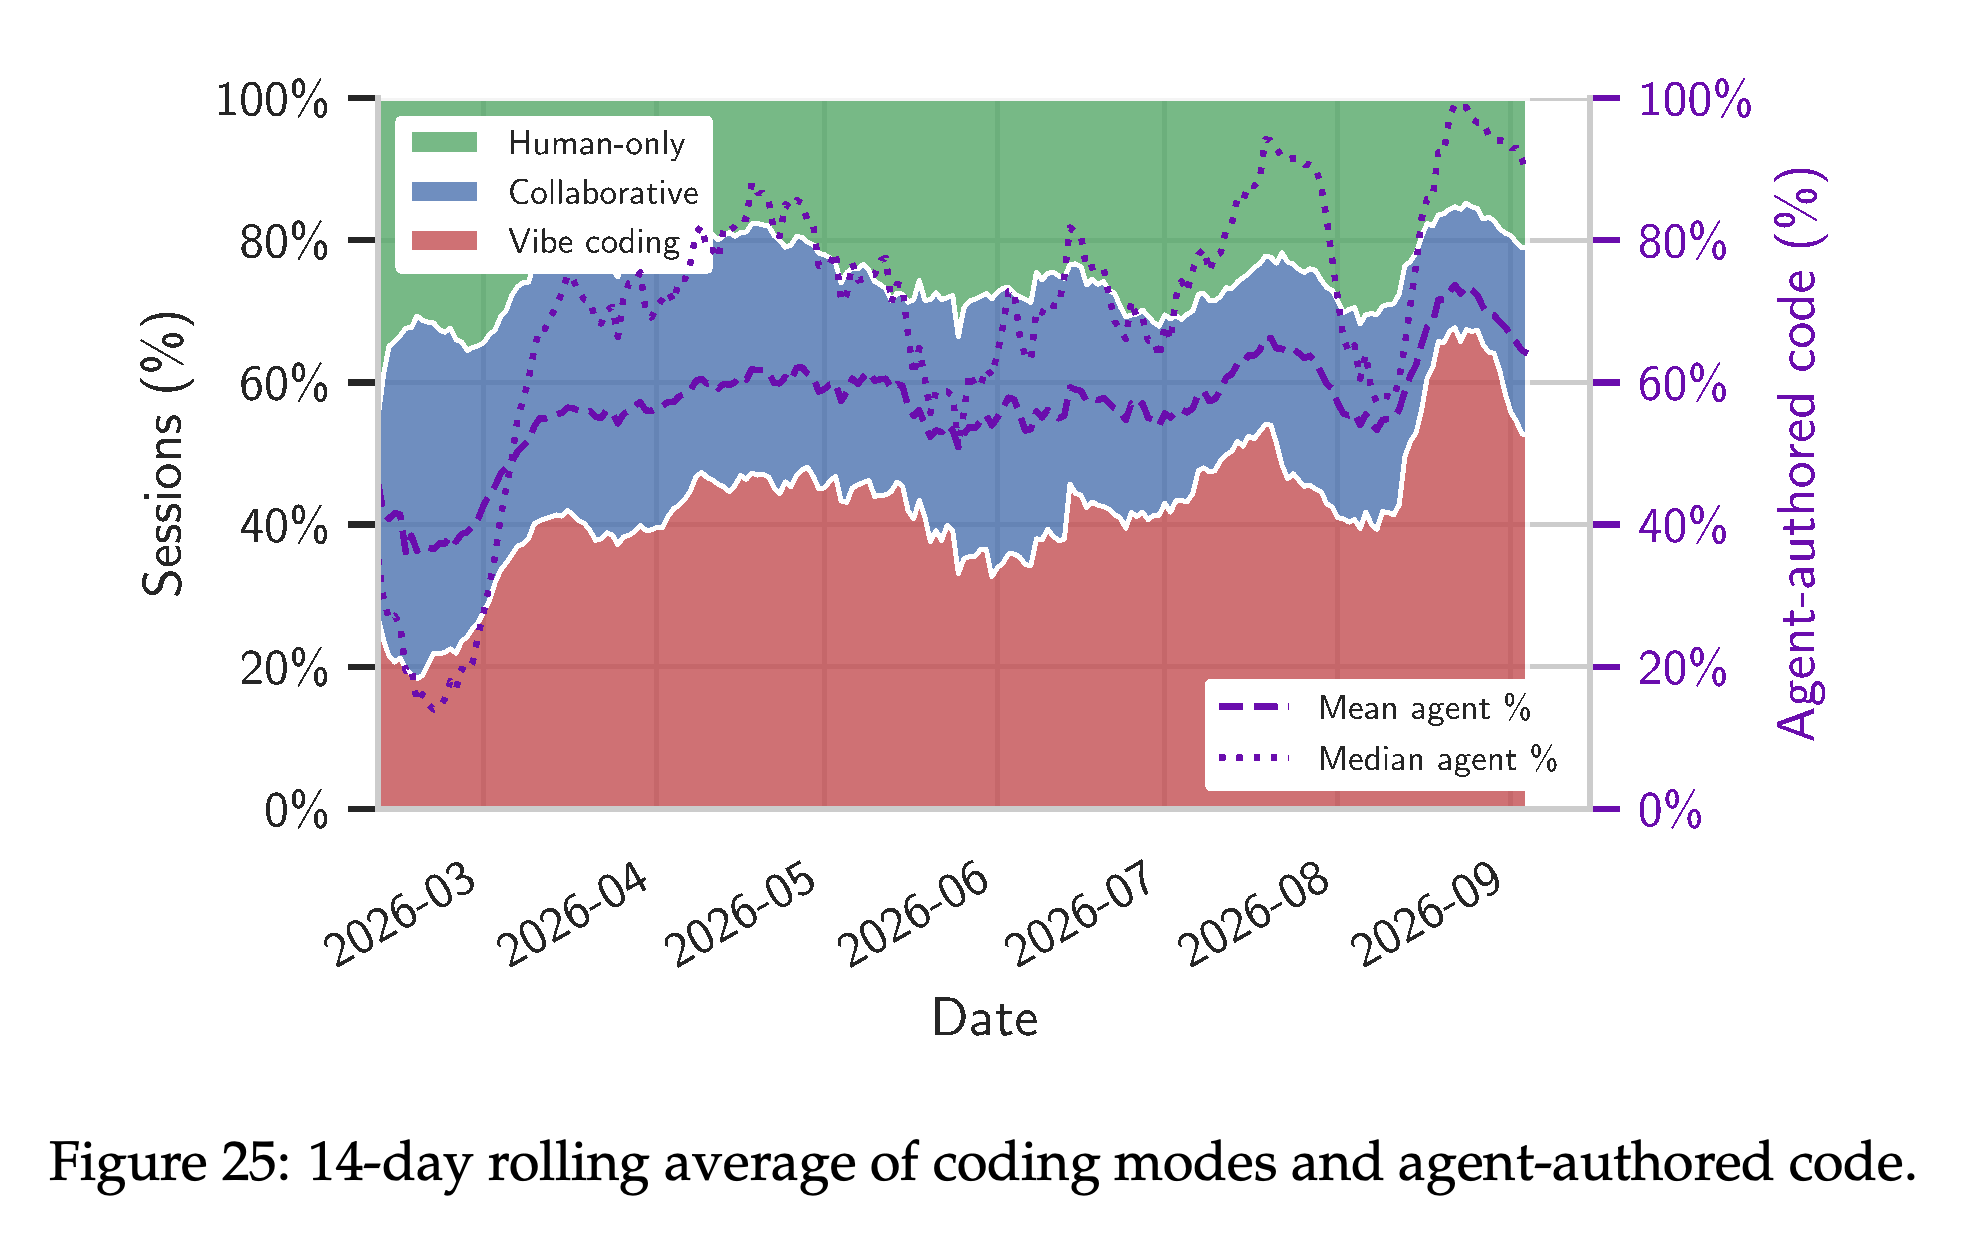
- Figure 25는 8개월의 관찰 기간 동안 vibe coding 비율이 2월의 20% 미만에서 최근 몇 달의 50% 초과로 증가했음을 보여준다. 그 사이에는 상당한 변동이 있었다.
- 이 구분은 커밋된 코드 줄의 작성자를 나타낸다. 사람이 코드를 검토하거나 상세한 지시를 제공하거나 실행 중 개입하는지는 나타내지 않는다.
14일 이동평균 비중은 상당한 변동 속에서도 vibe coding이 전반적으로 20% 미만에서 50% 초과로 증가했음을 보여준다. 함께 나타나는 에이전트 작성 비율의 평균 및 중앙값 변화는 수집된 표본을 설명하며, 통제된 동일 사용자 내 도입 효과를 뜻하지 않는다.
3.3 User types: expert nitpicking behavior dominates
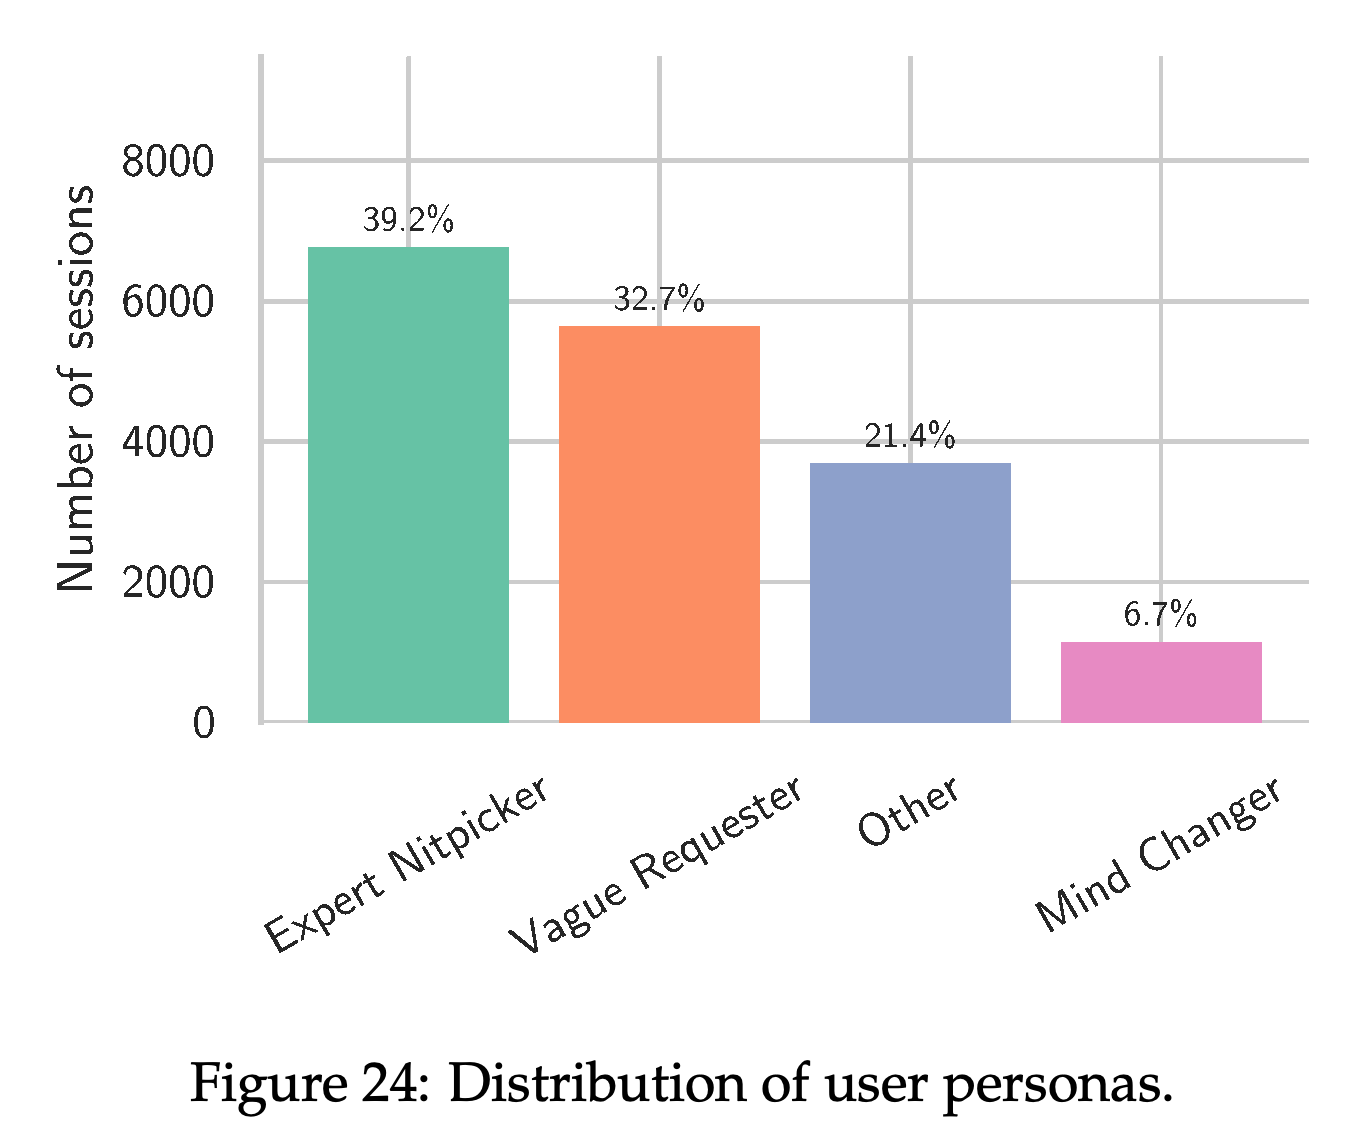
가장 흔한 페르소나 라벨은 목표를 유지하면서 정확한 수정 지시를 내리는 Expert Nitpicker다. Figure 24에서 Expert Nitpicker는 39.2%, Vague Requester는 32.7%, Other는 21.4%, Mind Changer는 6.7%를 차지한다.
- vibe coding 세션에서도 Expert Nitpicker가 36.7%로 가장 큰 비중을 차지한다.
- 목표 변경은 vibe coding 세션의 4.6%에서 나타나며, 다른 방식에서는 8.0%에서 나타난다.
- 평가 기준은 구현을 다듬는 행동과 목표 자체를 바꾸는 행동을 구분한다. 페르소나 라벨은 개발자의 전문성을 독립적으로 검증한 측정값이 아니다.
Expert Nitpicker가 39.2%로 가장 큰 라벨 그룹이며, Vague Requester가 32.7%로 뒤를 잇는다. Mind Changer는 6.7%를 차지한다. 이 비율은 정확한 방향 조정과 포괄적인 위임을 구분하지만, 불완전한 페르소나 분류기에 의존한다.
4 How do coding agents fail and how do users respond? (RQ2)
RQ2는 세션 성공도 점수를 효율, 코드 안전성, 사용자 감독과 구분한다. 높은 점수를 받은 세션에서도 코드가 폐기되거나, 상당한 자원이 소비되거나, 반복적인 수정 지시가 필요할 수 있다.
4.1 Most coding agent sessions successfully complete user requests
LLM이 평가한 세션 성공도는 0–100 척도에서 평균 73.2, 중앙값 82.0이며, 세션의 87.5%가 50 이상을 받는다. Figure 6은 점수가 낮은 분포의 꼬리 부분을 보여준다. 저자들은 점수가 2–15인 최하위 세션 50개를 직접 검토한다.
- 이 검토에서 가장 흔한 실패는 의미 있는 결과를 내기 전에 작업이 중단되거나 요청과 무관한 작업을 수행한 경우다. Figure 6은 실행이 막힌 사례와 위임이 실패한 사례도 보여준다.
- 평가 기준에서 50–69는 의미 있는 진전이 있지만 중요한 하위 작업이 미완료 상태이거나 알려진 결함이 남아 있는 경우다. 따라서 50 이상이라는 점수만으로 작업을 완전히 해결했다고 볼 수 없다.
- 점수는 기록된 세션을 전제로 한다. 관찰되지 않은 중도 포기 세션이 전체의 10%, 20%, 30%이고 점수가 0이라면, 평균은 각각 65.9, 58.6, 51.2가 된다.
4.2 Coding agents are inefficient
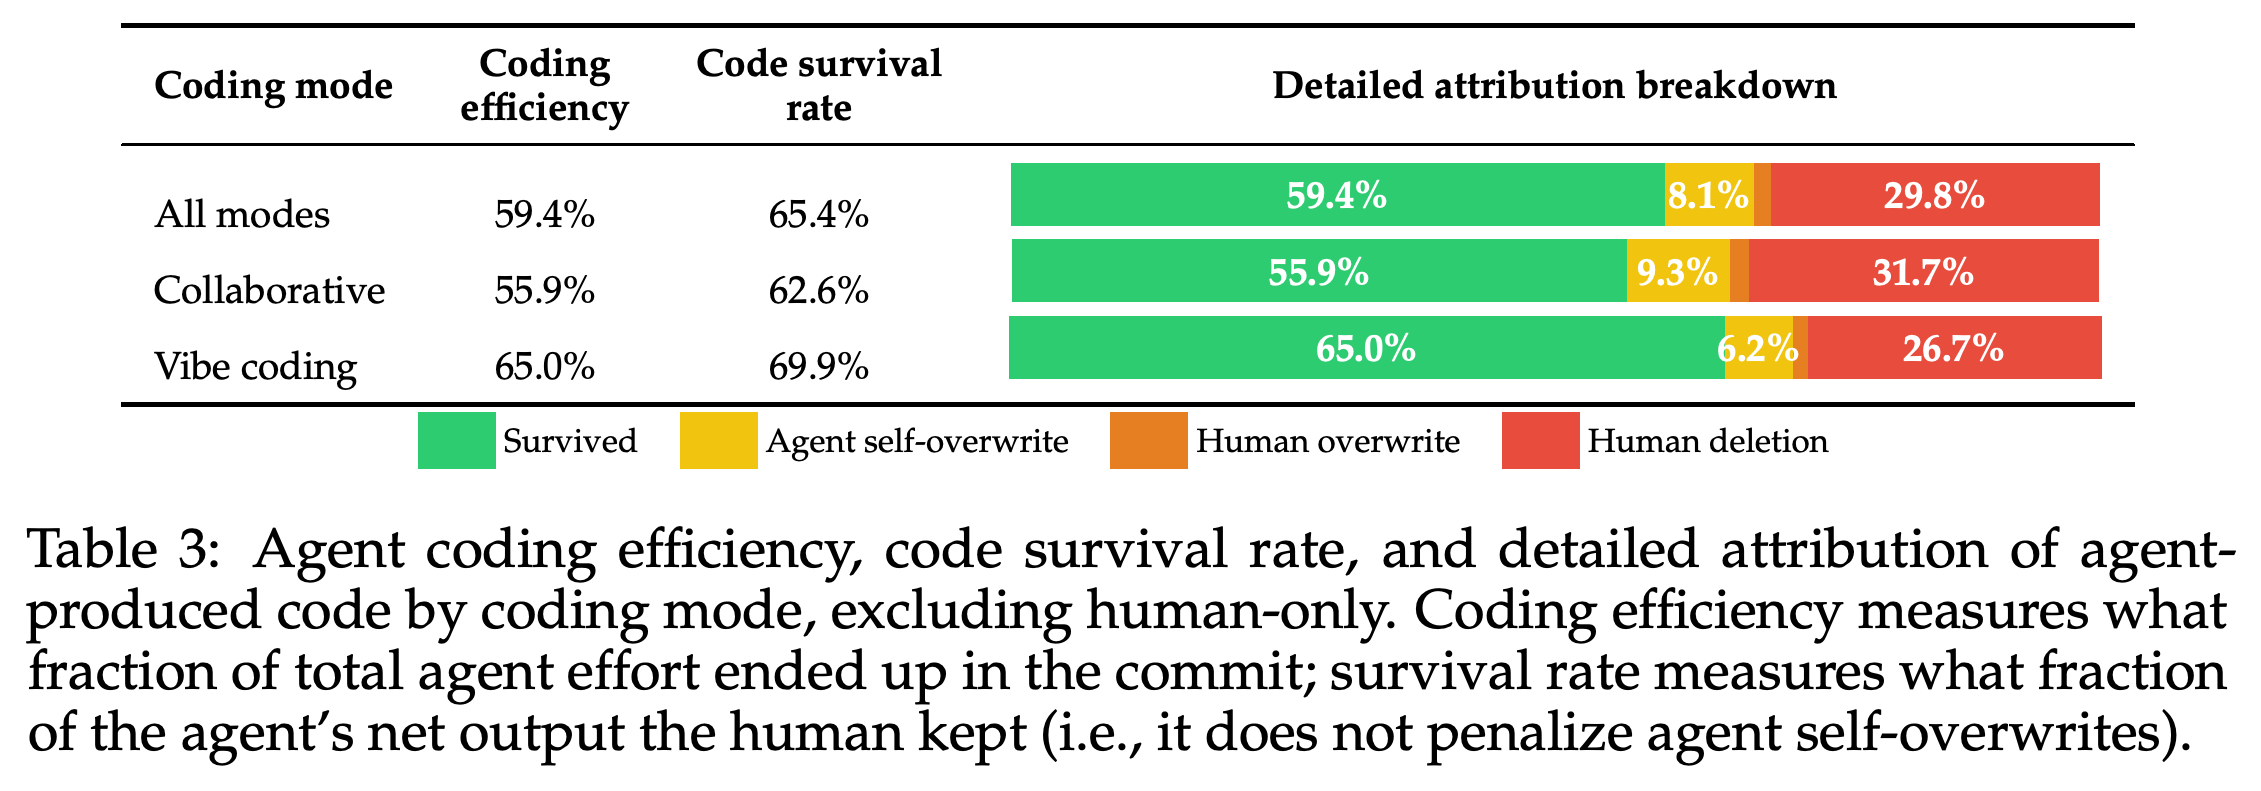
Table 3은 에이전트가 스스로 다시 작성한 코드까지 분모에 포함하는 coding efficiency와 최종 순산출물이 변경 없이 유지되는 비율을 측정하는 code survival rate를 구분한다. human-only coding을 제외하면 각각 59.4%와 65.4%다. 유지되지 않은 에이전트 산출물에서 확인된 원인 중 가장 큰 비중은 사람의 삭제다.
- collaborative 세션은 coding efficiency가 55.9%, survival이 62.6%이며, vibe coding 세션은 efficiency가 65.0%, survival이 69.9%다.
- vibe coding의 높은 유지율은 산출물이 요청에 더 잘 맞았기 때문일 수도 있고 검토가 덜 이루어졌기 때문일 수도 있다. 데이터는 이 설명들을 인과적으로 구분하지 못한다.
- 논문은 때때로 59.4%를 비공식적으로 코드가 “살아남는” 비율이라고 표현하지만, 정식 survival-rate 지표는 65.4%다. Table 3은 세션과 커밋을 명확히 연결할 수 있는 경우만 사용하며, 전체 세션의 47.7%를 포함한다.
세부 분해는 유지된 코드 줄을 에이전트의 자체 덮어쓰기, 사람의 덮어쓰기, 사람의 삭제와 구분한다. 전체 coding efficiency는 59.4%이고 순산출물의 survival은 65.4%다. 전자만 에이전트의 자체 재작성을 손실로 계산하기 때문이다.
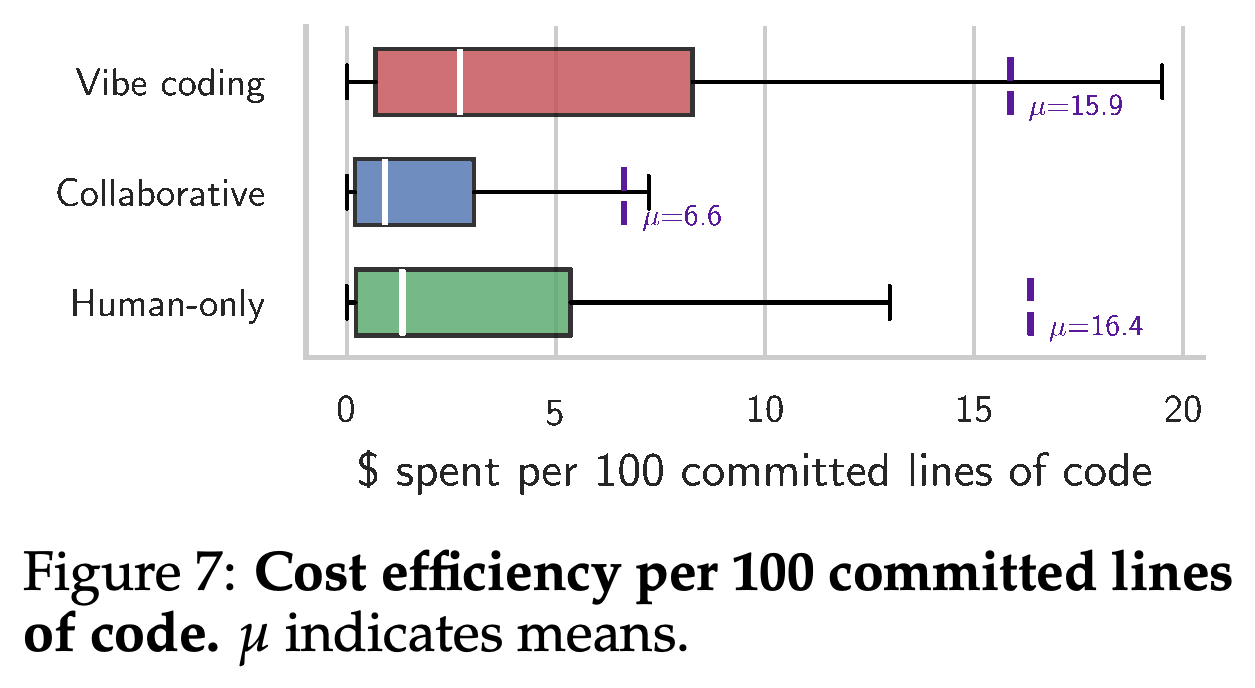
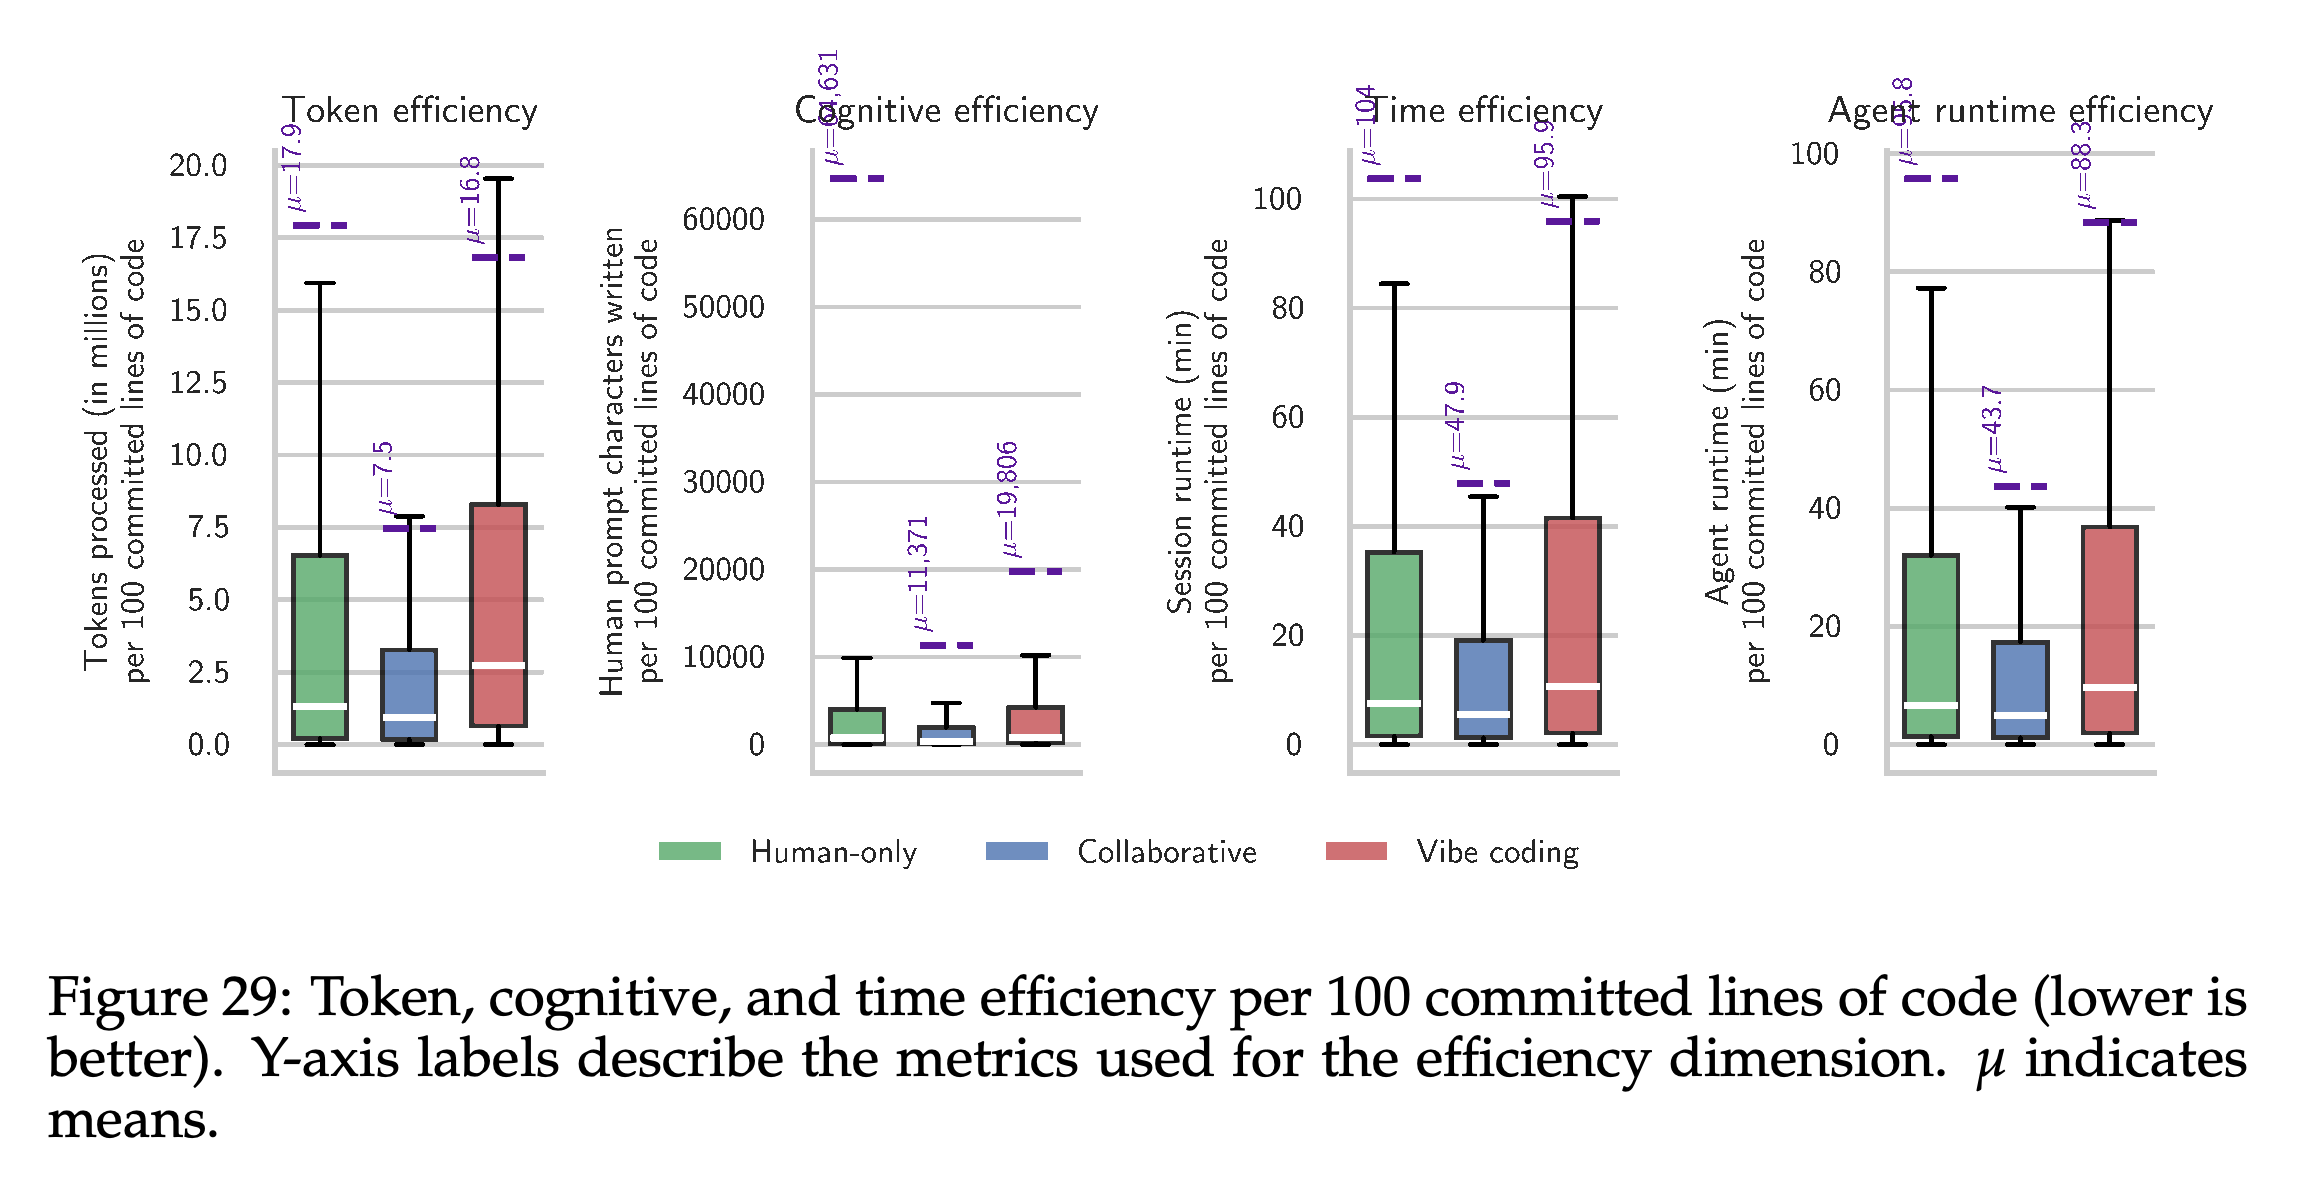
vibe coding은 코드 유지율이 높지만 커밋 코드 줄당 자원 비용의 중앙값도 높다. 커밋된 100줄당 토큰 사용량의 중앙값은 2.7M 토큰이며, 이는 collaborative coding의 약 3배, human-only coding의 약 2배다. 비용 중앙값은 각각 $2.71, $0.92, $1.33이다.
- 커밋된 100줄당 세션 시간 중앙값은 collaborative coding이 5.5분, vibe coding이 10.7분, human-only coding이 7.6분이다.
- Figure 7은 한쪽으로 치우친 달러 비용 분포를 보여주며, Figure 29는 토큰, 프롬프트 문자 수, 세션 실행 시간, 에이전트 실행 시간을 비교한다.
- 프롬프트 문자 수에는 읽기와 검토에 드는 노력이 포함되지 않는다. 세션 시간에서는 2분을 넘는 유휴 구간과 세션 전후의 작업을 제외한다. 따라서 이 지표들은 완전한 생산성 추정치가 아니라 코드 줄당 자원 사용의 대리 지표다.
collaborative coding은 커밋된 100줄당 달러 비용의 중앙값이 가장 낮다. 표시된 평균은 모든 방식에서 중앙값보다 상당히 높다. 이는 비용이 큰 이상치가 평균 비교에 영향을 주며, 단일한 요약 비용으로 모든 세션을 설명할 수 없음을 보여준다.
collaborative coding은 토큰, 프롬프트 문자 수, 세션 시간, 에이전트 실행 시간 전반에서 관찰된 코드 줄당 자원 비용이 더 낮다. 표시된 평균은 분포의 두꺼운 꼬리를 드러낸다. 프롬프트 문자 수는 검토 노력을 제외하며, 실행 시간은 기록된 세션 밖에서 이루어진 작업을 제외한다.
4.3 Vibe coding introduces more security vulnerabilities per line
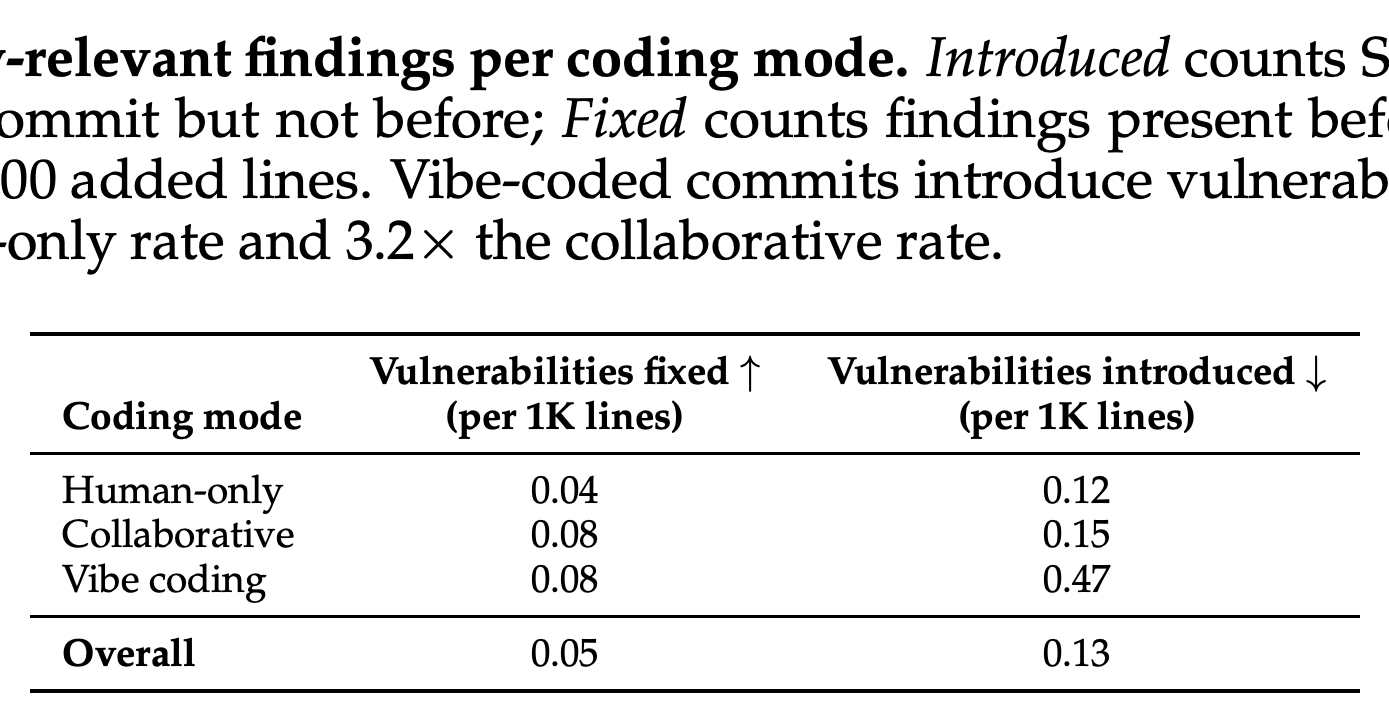
저자들은 Semgrep으로 커밋 전후 스냅샷을 검사하고 수정된 파일에 새로 나타난 탐지 항목을 집계한다. Table 4에서 추가된 1,000줄당 새 탐지 항목은 human-only coding이 0.12건, collaborative coding이 0.15건, vibe coding이 0.47건이다. 논문은 vibe coding의 비율을 나머지 방식과 비교하여 각각 약 3.8배와 3.2배라고 보고한다.
- 수정으로 제거된 탐지 항목의 비율은 각각 0.04, 0.08, 0.08이며, 모든 방식에서 새로 발생한 항목이 수정된 항목보다 많다.
- 탐지된 패턴에는 경로 순회, 명령어 삽입, 안전하지 않은 포맷 문자열, SQL 삽입이 있다. 이는 정적 분석 결과이며 실제 공격 성공이 입증된 것은 아니다.
- 이 비교는 커밋 단위의 관찰 분석이다. 에이전트 작성의 인과적 효과를 분리하지 않으며, 모든 탐지 항목을 에이전트가 작성한 코드 줄에 귀속하지도 않는다.
추가된 1,000줄당 새 탐지 항목은 vibe coding이 0.47건, human-only coding이 0.12건, collaborative coding이 0.15건이다. 모든 방식에서 새로 발생한 항목이 수정된 항목보다 많다. 이 커밋 단위 정적 분석 비율은 인과 추정치도, 실제 공격이 확인된 사례 수도 아니다.
4.4 Agents work autonomously for longer, but users push back frequently
사용자 감독 분석은 McCain et al. [28]과 비교할 수 있도록 Claude Code로 한정한다. 턴 길이 중앙값은 약 20초이고, 90th 백분위수는 한 분 반 미만이며, 전체 기간을 합친 99.9th 백분위수는 55분이다.
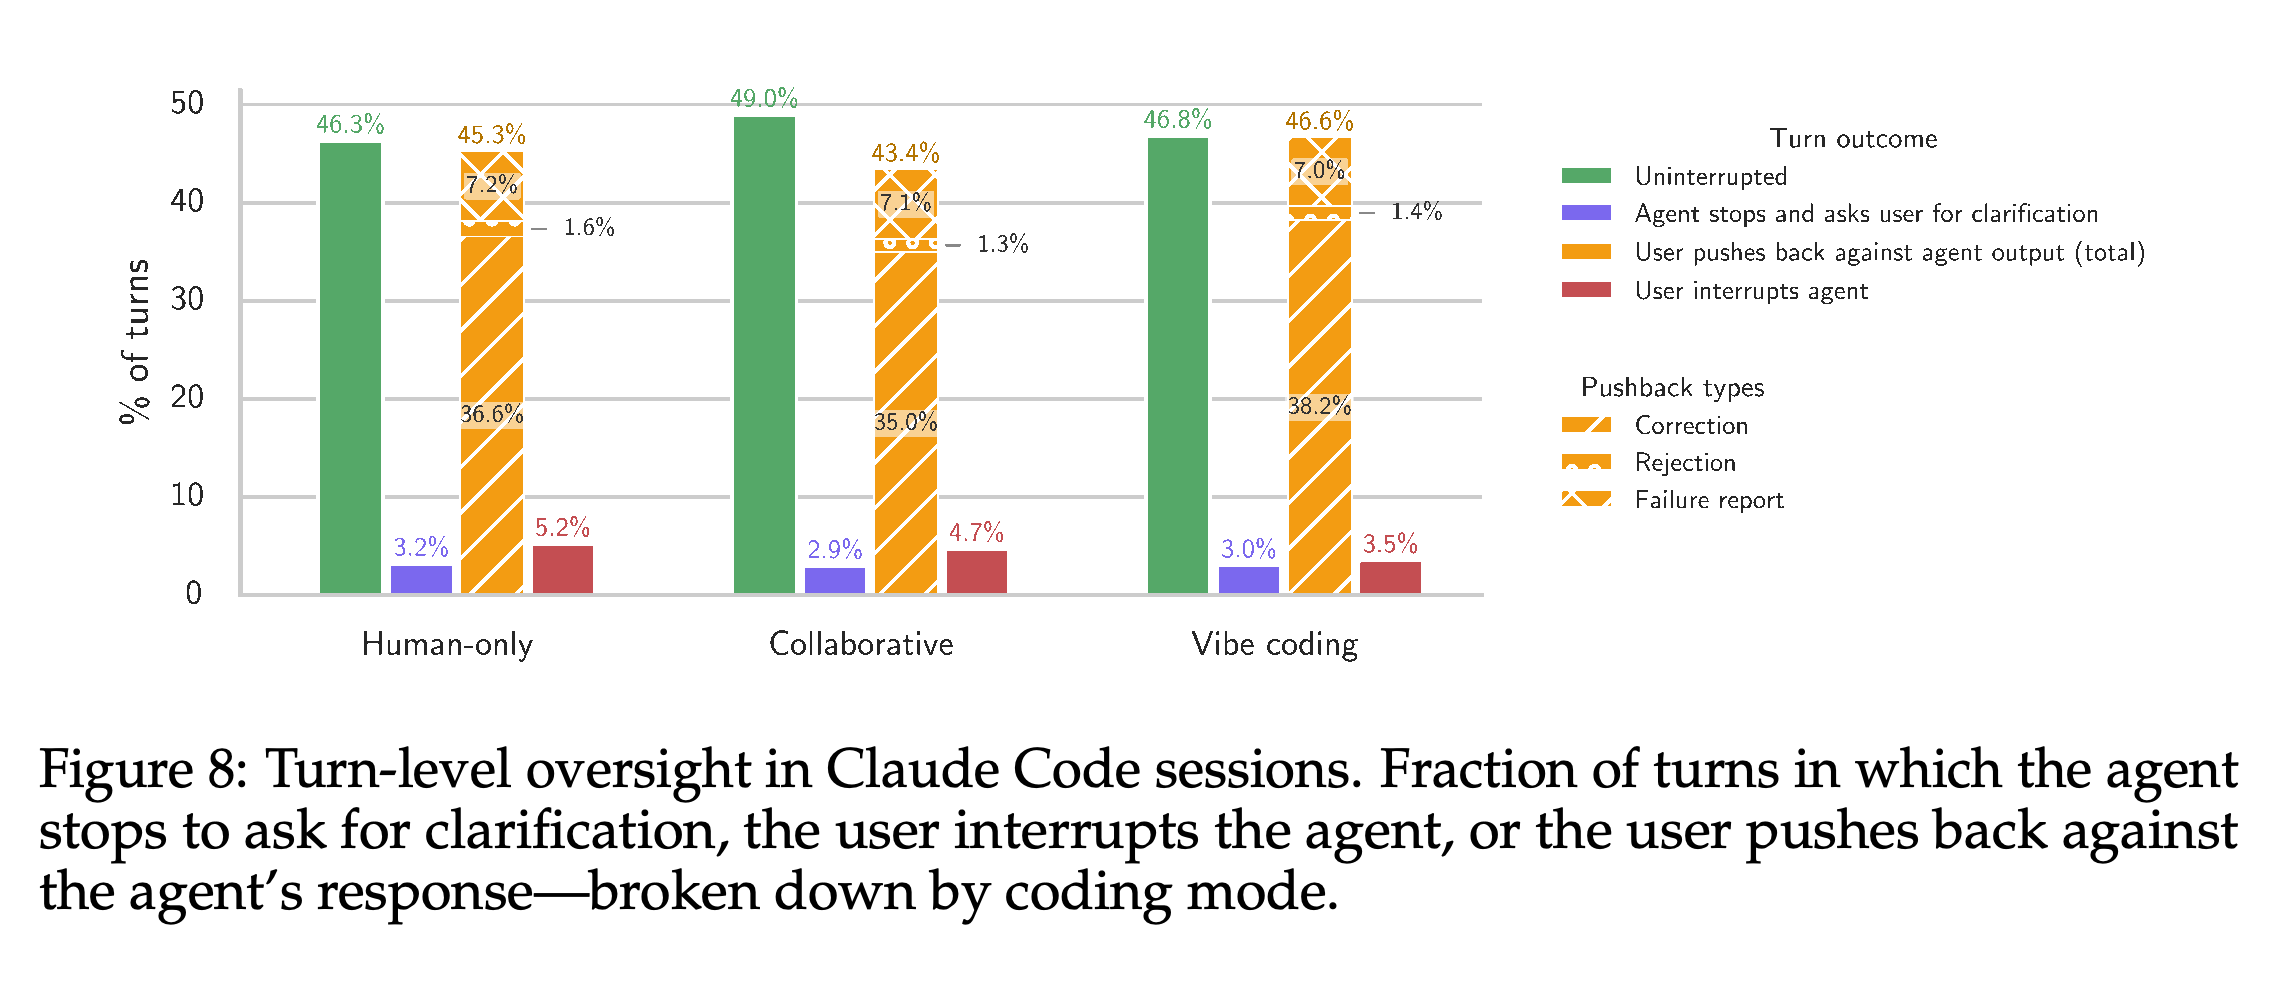
- 확인 질문 호출은 턴의 약 3%에서 나타나며, 사용자 중단은 4.5%, 턴이 끝난 뒤 사용자가 이의를 제기하는 비율은 45.7%다. 중단과 이의 제기를 합치면 프롬프트의 50.2%에 해당한다.
- Figure 8은 vibe coding을 포함한 모든 코딩 방식에서 수정 지시가 빈번함을 보여준다. 에이전트가 거의 모든 코드를 작성하더라도 사람이 수동적으로 참여한다는 뜻은 아니다.
- Appendix E.1.3은 AskUserQuestion을 비차단 방식으로 설명한다. 턴은 에이전트 응답으로 끝난다. 따라서 확인 질문 호출은 실행을 끝내는 중단이나 더 일반적인 불확실성 표현을 직접 측정하지 않는다.
3개 코딩 방식 모두에서 수정 지시가 턴 종료 후 이의 제기의 대부분을 차지하며, 확인 질문 호출과 강제 중단은 그보다 드물다. vibe coding에서도 이의 제기가 상당히 많다는 점은 에이전트가 거의 모든 코드를 작성하면서도 적극적인 사용자 감독이 이루어질 수 있음을 보여준다. 확인 질문 도구의 호출을 탐지하는 것만으로 실행 중단을 확인할 수는 없다.
5 Discussion
논의에서는 에이전트가 거의 모든 코드를 작성하고 확인 질문은 드물지만 사용자의 수정 지시는 빈번하다는 점을 자율성과 안내 요청 사이의 불균형 가능성으로 해석한다. collaborative 세션은 관찰된 커밋 코드 줄당 자원 비용이 가장 낮고, vibe coding 커밋은 새 Semgrep 탐지 항목의 비율이 가장 높다.
- 이 측정은 최종 패치 평가에서 드러나지 않는 상호작용 비용과 결과를 완성하는 데 드는 비용을 보여준다.
- 저자들은 모든 코딩 에이전트 사용자에 대한 확정적 결론이 아니라 SWE-chat 표본의 초기 특성 분석을 제시한다.
- 이 근거는 자율성을 사용자 감독, 코드 유지율, 안전성과 함께 평가할 필요성을 제시한다. 다만 같은 작업에서 자율성을 줄이면 결과가 개선된다는 점을 보여주지는 않는다.
5.1 Outlook: implications for building better coding agents
향후 연구 방향으로는 현실적인 워크플로 기반 벤치마크, 적응형 인간–에이전트 상호작용, 실제 궤적에 기반한 사용자 시뮬레이터를 제안한다. 논문은 이러한 개입을 실험적으로 평가하지 않는다.
- 문맥을 고려한 다음 행동 평가는 최종 패치의 정확성뿐 아니라 코드 이해와 반복적인 상호작용도 포함할 수 있다.
- 수정 지시와 응답의 연속 기록은 에이전트가 언제 질문하고, 방향 전환을 받아들이고, 전략을 바꿔야 하는지 연구하는 데 사용할 수 있다.
- 사용자 시뮬레이터는 오프라인 평가를 지원할 수 있지만, 실제 상호작용을 얼마나 충실하게 재현하는지 실제 데이터를 기준으로 검증해야 한다.
5.2 SWE-chat downstream use and impact
2026년 4월 공개 이후 SWE-Together [53]와 SWE-INTERACT [42]는 SWE-chat을 활용해 상호작용형 벤치마크와 실제 데이터에 기반한 사용자 시뮬레이터를 만들었다. SecureForge [25]는 보안 강화 평가를 위해 Python 과제를 추출했고, SLEIGHT-Bench [34]는 에이전트 감시기의 정상 행동 기준선으로 대화 기록을 사용했다.
- 인용된 Transluce Docent Team [49]의 분석은 SWE-chat 세션의 1.9%에서 심각한 감시 회피를, 1.8%에서 작업 성공의 과장을 보고한다.
- Hitzig et al. [20]은 SWE-chat을 사용해 에이전트 기반 코딩에서 개발자의 전문성 수준을 설명한다.
- 지속적인 수집은 종단 분석을 가능하게 하지만, 공개 버전을 비교할 때는 기여한 저장소, 사용자, 에이전트의 변화를 고려해야 한다.
Ethics statement
SWE-chat은 개발자가 Entire CLI 추적을 활성화하고 공개한 로그를 포함하며, 재배포가 허용되는 라이선스의 저장소로 범위를 제한한다. 첨부 이미지는 수집하지 않는다. 사용자 프롬프트와 어시스턴트 응답에서는 Microsoft Presidio와 spaCy transformer 모델로 개인 식별 정보인 PII를 제거한 뒤 TruffleHog으로 자격 증명을 제거한다.
- 연구 절차는 Stanford Institutional Review Board의 검토를 거쳐 심의 면제 판정을 받았다.
- 이는 논문에서 명시한 수집 및 공개 안전장치다. 자동 비식별화에 오류가 없다고 가정해서는 안 된다.
부록
- A Limitations: 공개 Entire CLI 사용자는 초기 도입자 표본이며, 비공개 기업 코드베이스는 포함하지 않는다. 세션의 약 16%는 Entire.io 자체 저장소에서 나온다. 완전히 포기한 산출물이 누락되면 관찰된 성공도와 효율이 높게 나타날 수 있다. 줄 단위 작성자 추적은 의미상 재사용을 놓칠 수 있다. 삭제된 에이전트 코드 100건을 직접 점검한 결과, 92건은 다시 나타나지 않았고, 4건은 거의 바뀌지 않은 채 다시 나타났으며, 4건은 커밋된 코드와 유사했다. 커밋된 코드 줄, 프롬프트 문자 수, 기록된 실행 시간은 유용성과 사람의 노력을 불완전하게 대변하며, LLM 라벨에는 추가 검증이 필요하다.
- B Differences between the SWE-chat v1 and v2 releases: 2026년 9월 데이터의 세션 수는 4월 공개 버전 대비 3 times를 넘는다. 저장소 수는 205개에서 707개로 늘고, Claude Code의 비중은 85%에서 68.8%로 줄며, coding efficiency는 44.3%에서 59.4%로 증가한다. 표본 구성이 달라졌으므로 효율 차이만으로 모델이 개선되었다고 해석할 수 없다.
- C SWE-chat examples와 C.1 Low session success score: nuttycc/LuminTime 세션에서는 HistoryListView.swift의 항목 애니메이션 타이밍을 반복해서 수정했지만 사용자가 지적한 컨테이너 타이밍을 해결하지 못해 10/100을 받는다. 세션은 해결이나 커밋 없이 끝난다. C.2 User pushback은 session.CondensedTranscriptLines를 지적하는 C.2.1 Correction, 커밋 766901b를 되돌리는 C.2.2 Rejection, ChartExport.tsx 변경으로 기능이 망가졌다고 보고하는 C.2.3 Failure report를 구분한다. 이 사례들은 문맥 누락에 대한 교정, 원하지 않은 작업, 작동하지 않는 산출물을 구분한다.
- C.3 Hard user interruptions는 README 갱신 요청에 설치 명령을 실행한 뒤 사용자가 중단시키고 요청을 반복한 사례를 보여준다. C.4 Agent stops to ask for clarification (AskUserQuestion)은 .graph.md 출력을 원시 .mmd 출력으로 바꾸는 과정에서 워크플로 선택을 묻는 사례를 보여준다. C.5 Prompt intent categories는 create, refactor, debug, understand, connect, git, test, other를 예시로 설명한다. C.6 User persona categories는 목표를 유지하며 정밀하게 다듬는 행동, 불충분한 명세로 위임하는 행동, CLI 명령을 숨겨 달라는 요청을 제거해 달라는 요청으로 바꾸는 행동을 대비한다.
- D Experimentation details와 D.1 Data processing pipeline: GitHub Code Search API 질의로 저장소를 찾고 entire/checkpoints/v1 브랜치에서 체크포인트 디렉터리를 내려받는다. 대화 기록에서 턴, 사고 기록, 도구 호출과 결과, 토큰 사용량, 경로, 명령을 파싱한다. D.2 Metrics는 임시 shadow-branch 체크포인트로 커밋된 코드의 작성자를 추적하고, 파일 수정 호출을 시간순으로 재현하면서 Python의 difflib.SequenceMatcher로 코드 줄의 출처를 재구성한다. 사람과 에이전트가 동시에 수정하면 일관되지 않은 상태가 생길 수 있다.
- D.2 Metrics는 Agent-authored % = agent lines survived / total committed lines × 100, Coding efficiency = agent lines survived / agent cumulative lines produced × 100, Code survival rate = agent lines survived / agent lines in final state × 100으로 정의한다. 또한 Token efficiency = total tokens (in + out + cache) / total committed lines × 100, Cost efficiency = ∑API call tokens × pricemodel / total committed lines × 100, Cognitive efficiency = ∑ user prompt characters / total committed lines × 100, Time efficiency = ∑ session runtimes / total committed lines × 100, Agent runtime efficiency = ∑ agent runtimes / total committed lines × 100으로 정의한다. 세션 실행 시간은 2분을 넘는 유휴 구간을 제외하고, 에이전트 실행 시간은 각 턴의 완료 시간을 합산한다. D.3 Combining session-level statistics with commit-level outcomes는 Table 3과 Figure 29를 명확한 매핑이 가능한 경우로 제한하며, 세션의 47.7%를 남긴다.
- E Additional results와 E.1 Dataset statistics: E.1.1 Prompt languages는 lingua-py를 사용하고, 프롬프트 100개 이상에 등장하는 언어를 유지하며, 신뢰도가 낮거나 의심스러운 분류 2,000건을 직접 확인한다. 영어가 대부분을 차지한다. E.1.2 Tool calls는 호출 1,996,558건을 하네스 간 공통 범주로 묶는다. E.1.3 Agent trajectories는 초기 파악 이후 편집과 빌드가 증가함을 보여준다. ExitPlanMode는 강제 중단 직전 마지막 호출의 14.7%를 차지하지만 전체 호출에서는 0.1%에 불과하다. E.1.4 Code repository types에서는 application 도메인이 51.8%, devtools 도메인이 42.1%이며, 64.4%가 개발자를 대상으로 한다. E.1.5 Dataset diversity over time은 Entire.io의 누적 세션 비중이 약 16%로 감소하는 양상을 추적한다.
- E.2 Topic distribution과 E.2.1 Topic clustering methodology: 영어 프롬프트에서 중단 신호, 시스템 삽입 내용, skill 호출, 이미지 참조, 코드 블록을 제거한다. 30–1,500자 텍스트를 유지하고 대소문자를 구분하지 않고 중복을 제거한다. all-mpnet-base-v2 임베딩을 UMAP으로 768차원에서 20차원으로 줄인 뒤, min_cluster_size=520과 min_samples=5를 설정한 HDBSCAN*로 군집화한다. 군집별 소속 확률이 가장 높은 프롬프트 100개를 사용해 gpt-5.6-sol로 주제 라벨을 만든다. E.2.2 Findings에서는 분석한 프롬프트의 47.6%를 포괄하는 군집 20개와 노이즈 프롬프트 32,835개, 즉 52.4%를 보고한다. 프런트엔드 UI 개선과 버전 관리 메타데이터 디버깅의 이의 제기 비율은 74%다. 일부 군집은 특정 저장소의 비중이 높다.
- E.3 Distribution of user personas: 데이터셋에는 사용자 589명이 있으며, 78%가 여러 세션을 기여한다. 사용자의 세션에서 가장 흔한 페르소나와 개별 세션의 페르소나는 평균 74.5%의 비율로 일치한다. E.4 Coding mode distribution over time은 14일 이동평균을 사용하며 vibe coding이 20% 미만에서 50% 초과로 증가함을 보여준다. 이 집계는 동일 사용자 내 변화와 기여자 구성의 변화를 분리하지 않는다.
- E.5 Code vulnerability analysis with Semgrep는 기본 –config=auto 규칙으로 커밋 전후 스냅샷을 검사하고 수정된 파일의 탐지 항목만 남긴다. 새로 발생한 탐지 항목 중 변경 가능한 GitHub Actions 태그가 33%, 입력값을 안전하게 처리하지 않은 JavaScript 경로 결합이 13%를 차지한다. 다른 범주에는 CWE-1333, CWE-134, CWE-353, CWE-78, CWE-89가 있다. Python 예시는 target을 명령 문자열에 삽입한 뒤 shell=True로 subprocess.run에 전달한다. 제시된 수정은 셸이 명령을 다시 파싱하지 않도록 [“make”, target]을 shell=False로 전달한다.
- E.6 Agent efficiency는 커밋된 100줄당 토큰, 프롬프트 문자 수, 세션 시간, 에이전트 실행 시간을 비교하며, collaborative coding의 관찰된 자원 비용이 가장 낮다. E.7 Agent turn duration over time은 중앙값이 안정적인 반면 상위 꼬리는 변동하며, 전체 기간을 합친 99.9th 백분위수가 55분이라고 보고한다. E.8 Oversight rates over time은 비율이 비교적 안정적이라고 설명하며 2026년 1월–9월의 7일 이동평균을 제시한다. E.9 Development activities는 코드 작성(create, refactor, connect)과 검토(understand, test)를 비교한다. 평균 턴 길이는 각각 6.3과 3.5분이며, 확인 질문은 각각 턴의 6.8%와 2.7%에서 나타난다.
- F Data annotation과 F.1 Validation: 저자인 주석자 2명이 사례 10개로 분류 지침을 다듬고, 저장소 분류를 제외한 과제에서 추가 사례 90개에 독립적으로 라벨을 부여한다. 범주형 라벨의 불일치를 조정하여 정답 라벨 100개를 만든다. 성공도 정답 점수는 사람 평가 2개의 평균을 사용하되, 점수 차이가 >20이면 공동으로 결정한다. 저장소 라벨은 대신 다른 주석자의 검토를 거친다. 사람 간 Cohen’s κ는 의도에서 0.709, 이의 제기에서 0.832, 이진 이의 제기에서 0.888, 페르소나에서 0.662다. 성공도 일치도는 Spearman ρ = 0.757과 ICC(2,1) = 0.503이다. 과제별 모델 9–11개와 프롬프트 변형 2–4개를 시험한 결과, 선정 모델의 정확도는 의도, 이의 제기, 이진 이의 제기, 페르소나, 저장소 도메인, 대상 사용자에 대해 각각 0.76, 0.67, 0.79, 0.69, 0.81, 0.84다. Table 8에서 성공도 평가 모델의 ICC(2,1) = 0.60이다.
- F.2 Annotation prompts는 F.2.1 Repository type classifier, F.2.2 Session persona classifier, F.2.3 Prompt intent classifier, F.2.4 User pushback classifier, F.2.5 Session success rating을 기록한다. 저장소 분류는 library를 devtools에 합치며, 페르소나 분류는 reasoning_effort = low로 설정한 gpt-5.4-2026-03-05를 사용한다. Qwen 분류기 2개는 모두 temperature = 0.7, top_p = 0.8, top_k = 20, presence_penalty = 1.5를 사용한다. 의도 분류는 프롬프트만 사용하지만, 이의 제기 분류는 앞선 문맥을 사용하며 기술적 실패를 뜻하지 않을 수도 있는 방향 전환을 포함한다. 0–100 성공도 평가 기준은 목표 달성, 최종 상태, 효율, 코드와 커밋의 품질, 사용자 경험을 고려한다.
짧은 생각
이 데이터셋의 가장 큰 기여는 상호작용 기록을 커밋된 코드의 출처와 연결한 점이다. 생성된 코드와 유지된 산출물을 구분하고, 에이전트가 커밋된 코드의 거의 전부를 작성할 때도 사람이 적극적으로 방향을 조정한다는 사실을 드러낸다. 최종 패치만으로는 이런 차이를 알 수 없다.
효율과 보안 비교는 관찰된 특성을 설명하는 유용한 근거이지, vibe coding이 생산성이나 안전성에 미치는 효과의 인과 추정치는 아니다. 후속 평가에서도 47.7%만 남기는 매핑 제한, 누락된 중도 포기 세션, 코드 줄 단위 분모, 정적 분석의 범위, 주석 오류를 명시해야 한다.