


Back to Basics: Let Denoising Generative Models Denoise 요약 설명
17 Nov 2025 | Paper Review Diffusion Transformers Denoising Flow Matching목차
이번 글에서는 Back to Basics: Let Denoising Generative Models Denoise 논문의 핵심 포인트만 간단히 정리한다.
요약
- 노이즈를 점진적으로 제거하는 이미지 생성 모델은 Transformer가 큰 원시 픽셀 패치를 처리할 때 실패할 수 있다. ImageNet 256×256에서 깨끗한 이미지를 직접 예측하면 생성 이미지 50,000장으로 측정한 Fréchet Inception Distance(FID-50K, 낮을수록 좋다)가 8.62다. 노이즈 예측은 372.38, 노이즈가 섞인 샘플의 변화율을 예측하는 flow velocity 예측은 96.53이다. 이 비교는 모두 16×16 패치를 사용하는 기본 크기의 Just image Transformers 모델(JiT-B/16), velocity 공간의 손실, 200 epochs 학습, 샘플링 중 클래스 조건의 강도를 조절하는 classifier-free guidance(CFG)를 사용한다.
- JiT는 이미지 패치를 처리하는 Transformer인 Vision Transformer(ViT)로 깨끗한 이미지를 직접 예측한다. 픽셀을 생성용 표현으로 변환하는 인코더인 학습된 latent tokenizer, 사전 학습, 보조 손실을 사용하지 않는다. 보고된 비교에서는 guidance 설정과 exponential moving average(EMA)의 감쇠율을 모델마다 별도로 선택한다. EMA 감쇠율은 학습 중 모델 파라미터를 평균하는 방식을 결정한다.
- 논문의 설명은 manifold 가정에 기반한다. 자연 이미지는 픽셀 공간 안의 저차원 구조에 대략 분포하지만 노이즈와 flow velocity는 그 주변의 고차원 공간에 분포한다는 가정이다. 통제된 합성 데이터 실험과 ImageNet의 구성 요소별 비교 실험은 네트워크가 입력을 압축해도 깨끗한 이미지 예측이 효과적이라는 주장을 뒷받침한다.
- 가장 큰 JiT 모델은 256×256에서 FID 1.82, 512×512에서 1.78을 달성한다. 해상도에 맞춰 패치 크기를 늘리므로 순전파당 연산량은 거의 변하지 않는다. 비교 대상 중 일부 방법은 더 낮은 FID를 달성하며 제안한 방법을 다른 자연 데이터 분야로 확장하는 실험은 수행하지 않았다.
1. Introduction
서론은 깨끗한 이미지를 직접 예측하는 x-prediction, 노이즈를 예측하는 ε-prediction, 깨끗한 데이터와 노이즈의 혼합을 예측하는 v-prediction을 구분한다. 이 값들은 대수적으로 서로 변환할 수 있지만 용량이 제한된 네트워크에서는 예측 과제의 난도가 다를 수 있다. 고차원 노이즈를 보존하려면 denoising에서 버릴 수 있는 정보까지 유지해야 하기 때문이다.
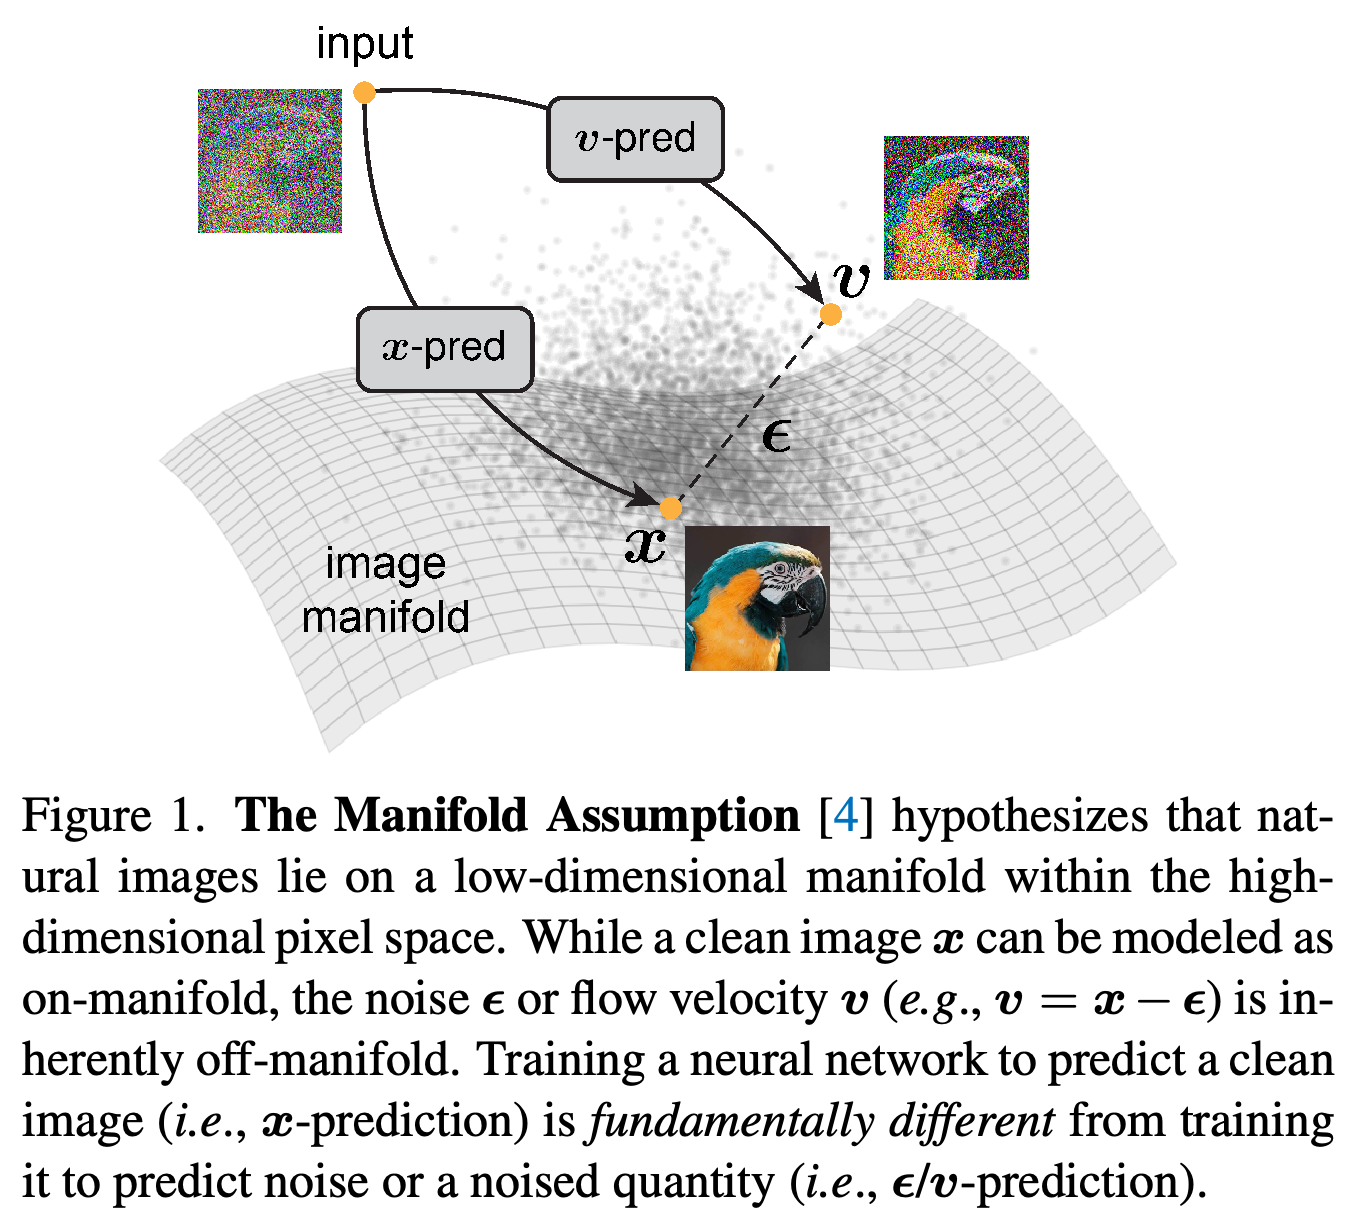
- Figure 1은 저차원 manifold 위의 깨끗한 이미지와 그 바깥에 있는 노이즈 포함 예측 대상의 차이를 보여준다.
- JiT는 latent tokenizer, discriminator의 adversarial loss, 사전 학습된 분류기의 특징을 사용하는 perceptual loss, 사전 학습된 모델과의 representation alignment를 사용하지 않는다.
- 단백질, 분자, 날씨에 대한 활용 가능성은 연구의 동기이며 보고된 실험은 ImageNet을 사용한다.
이 도식은 네트워크 용량에 관한 설명의 동기를 제시한다. 깨끗한 이미지라는 예측 대상은 저차원 데이터 구조 위에 있을 수 있지만 velocity 예측 대상은 그 구조 바깥의 노이즈를 유지한다. 이미지 차원을 측정한 결과가 아니라 manifold 가정을 시각적으로 설명한 그림이다.
2. Related Work
관련 연구에서는 diffusion의 예측 대상을 고전적인 denoising, 관측값에서 저차원 표현을 학습하는 manifold learning과 연결한다. 손상된 입력에서 깨끗한 입력을 복원하도록 학습하는 네트워크인 Denoising Autoencoders(DAEs)가 이 연결의 근거를 제공한다. Autoencoder의 표현 공간에서 diffusion을 수행하는 Latent Diffusion Models(LDMs)는 생성 전에 관측 차원을 줄인다.
- 기존 픽셀 공간 방법은 조밀한 convolution, 채널 확장, 멀리 떨어진 레이어 사이에서 특징을 전달하는 skip connection, 작은 초기 패치로 정보를 보존하는 경우가 많다. 저자들은 이런 설계가 노이즈를 포함한 예측 대상을 처리하려는 요구에서 비롯됐을 수 있다고 제안한다.
- Elucidating the design space of diffusion-based generative models(EDM)는 네트워크 출력을 노이즈가 섞인 입력과 정해진 방식으로 결합하는 pre-conditioner로 감싼다. 따라서 네트워크 자체가 깨끗한 이미지를 직접 출력하지 않는다.
- 깨끗한 이미지 예측은 JiT 이전에도 사용됐다. 이 논문의 기여는 고차원 환경에서 네트워크가 직접 출력하는 값의 매개변수화가 중요하다는 근거를 제시한 데 있다.
3. On Prediction Outputs of Diffusion Models
논문은 네트워크가 직접 출력하는 값을 정하는 예측 공간과 학습 오차를 계산할 값을 정하는 손실 공간을 구분한다. 각각 깨끗한 이미지, 노이즈, velocity 중에서 선택하면 9가지 정식화가 나온다. 같은 대수적 변환을 사용하더라도 실제 동작은 서로 다를 수 있다.
3.1. Background: Diffusion and Flows
학습에서는 \(z_t = t x + (1-t)\epsilon\)로 깨끗한 이미지와 노이즈를 보간하며 t의 범위는 [0, 1]이다. 이에 대응하는 velocity는 \(v=x-\epsilon\)다. 시간은 logit(t)가 정규분포를 따르는 logit-normal 분포에서 뽑는다. 생성 과정에서는 노이즈에 해당하는 t = 0부터 데이터에 해당하는 t = 1까지 \(\frac{dz_t}{dt}=v_\theta(z_t,t)\)를 적분한다.
- 시간에 따른 연속적인 변화를 규정하는 ordinary differential equation(ODE)이 샘플링 경로를 정의한다.
- 기본 수치 샘플러는 ODE 수치 해법인 50-step Heun이다. 샘플링 전에 네트워크 출력을 velocity로 변환할 수 있다.
3.2. Prediction Space and Loss Space
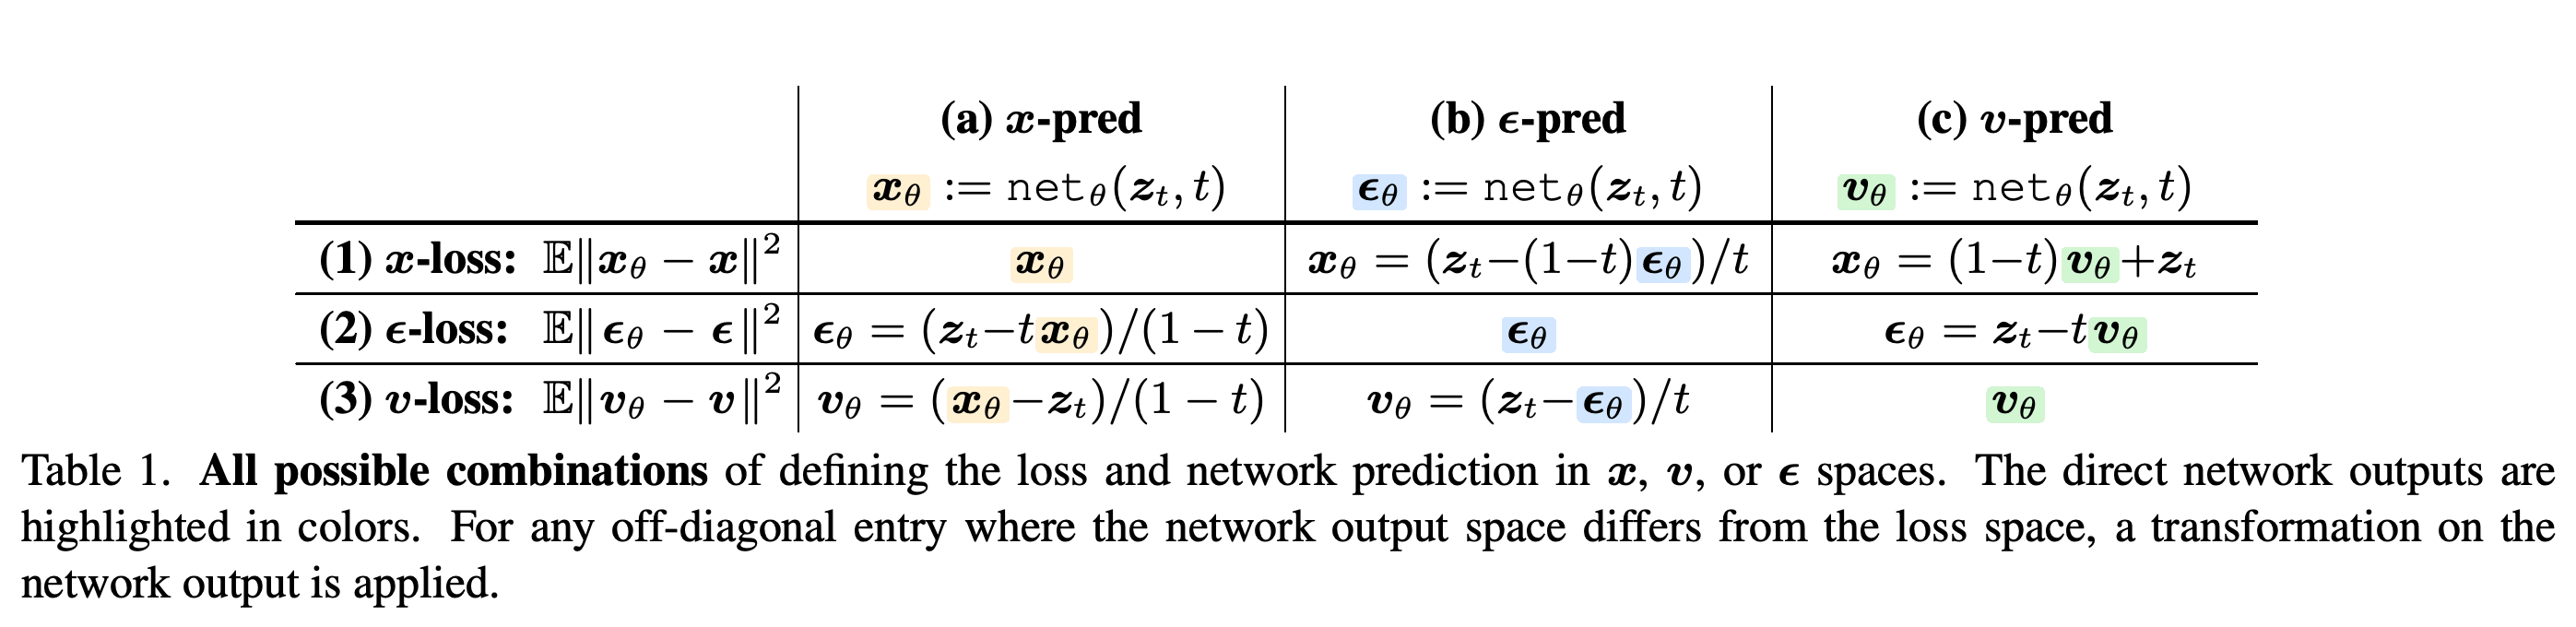
Table 1은 네트워크의 직접 출력과 손실 공간을 조합한 9가지 경우를 정리한다. x-prediction에서는 \(\epsilon_\theta=\frac{z_t-tx_\theta}{1-t}\)와 \(v_\theta=\frac{x_\theta-z_t}{1-t}\)로 노이즈와 velocity를 복원한다. 따라서 깨끗한 이미지를 출력하는 모델도 velocity 공간의 손실로 학습할 수 있다.
- x-prediction에서 v-loss는 \(\mathbb{E}\left[\frac{\|x_\theta-x\|^2}{(1-t)^2}\right]\)가 된다. 이는 시간에 따라 가중치를 부여한 깨끗한 이미지 복원 손실이다.
- 손실 공간을 바꾸면 실질적인 시간 가중치가 바뀐다. 직접 출력을 바꾸면 네트워크가 수행할 과제도 바뀐다.
- 9가지 정식화 모두 velocity로 변환한 뒤 샘플을 생성할 수 있다. 하지만 가중치가 없는 손실과 직접 출력을 조합한 9가지 경우가 수학적으로 동등한 것은 아니다.
9개의 셀은 네트워크가 직접 예측하는 값과 손실이 평가하는 값을 구분한다. 대각선 밖의 변환을 사용하면 동일한 손실에서 출력 매개변수화를 비교할 수 있다. 이는 실험 논거의 기반이 된다.
3.3. Toy Experiment
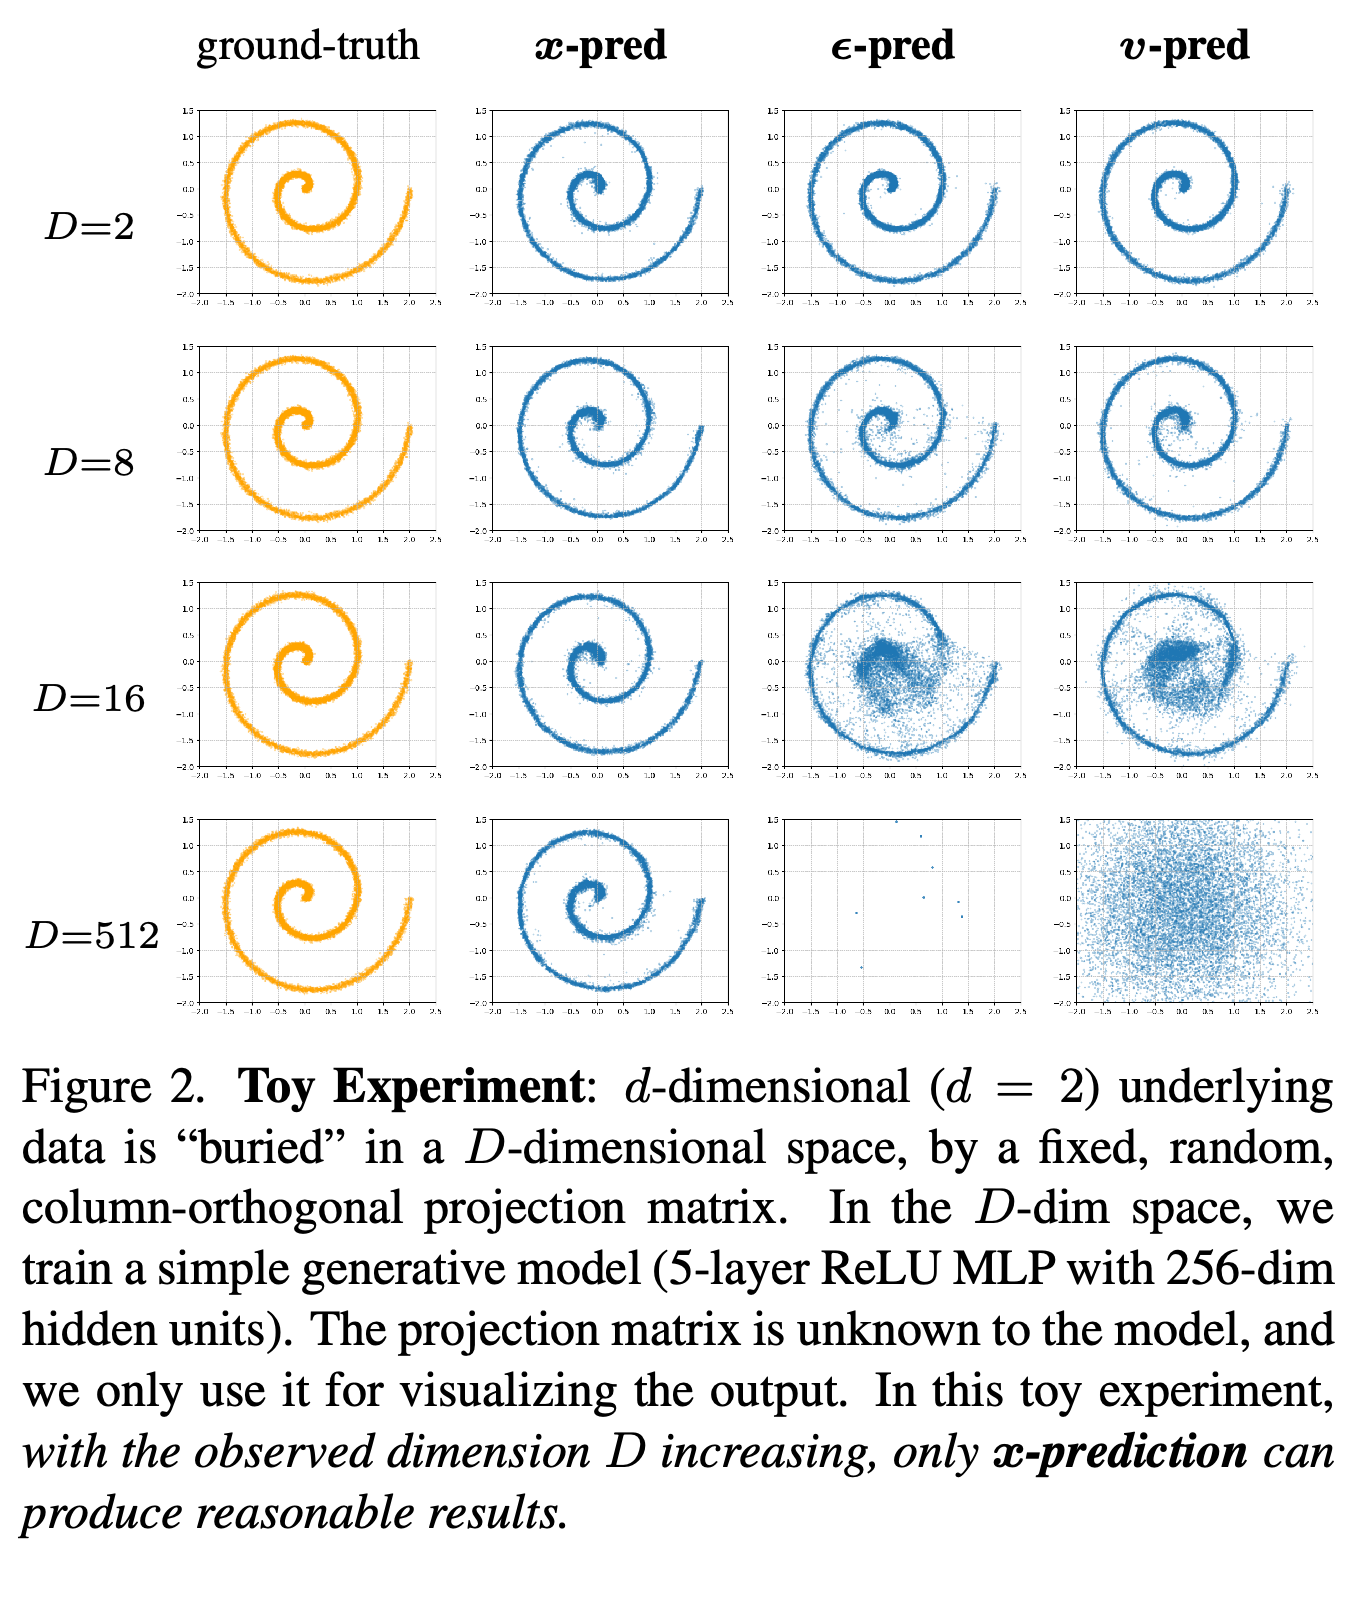
간단한 실험에서는 2차원 나선 데이터를 관측 차원 D ∈ {2, 8, 16, 512}에 삽입한다. 열벡터들이 서로 정규직교하는 고정된 무작위 투영을 사용하며 모델에는 이 투영을 알려주지 않는다. 완전연결 레이어를 쌓은 5층 multilayer perceptron(MLP)에 rectified linear unit(ReLU) 활성화와 256차원 은닉층을 사용한다. 각 예측 대상에 동일한 v-loss를 적용해 생성을 학습한다.
- Figure 2는 생성 샘플을 2차원으로 다시 투영해 확인한다. ε-prediction과 v-prediction은 D = 16에서 악화되고 D = 512에서 실패한다.
- x-prediction은 은닉층 너비가 관측 차원보다 작은 D = 512에서도 나선 구조를 보존한다. 이는 통제된 합성 데이터 환경에서 네트워크 용량에 관한 설명을 뒷받침한다.
관측 차원이 커질수록 노이즈 예측과 velocity 예측은 투영된 나선을 점점 더 왜곡하지만 깨끗한 이미지 예측은 구조를 보존한다. D = 512에서 모델의 은닉 유닛은 256개뿐이다.
4. “Just Image Transformers” for Diffusion
이미지 생성 실험은 합성 데이터 실험의 결과가 원시 픽셀을 처리하는 일반적인 Transformer에서도 성립하는지 확인한다. 핵심 제안은 표준 패치 기반 구조를 유지하면서 깨끗한 이미지를 직접 출력하도록 하는 것이다.
4.1. Just Image Transformers
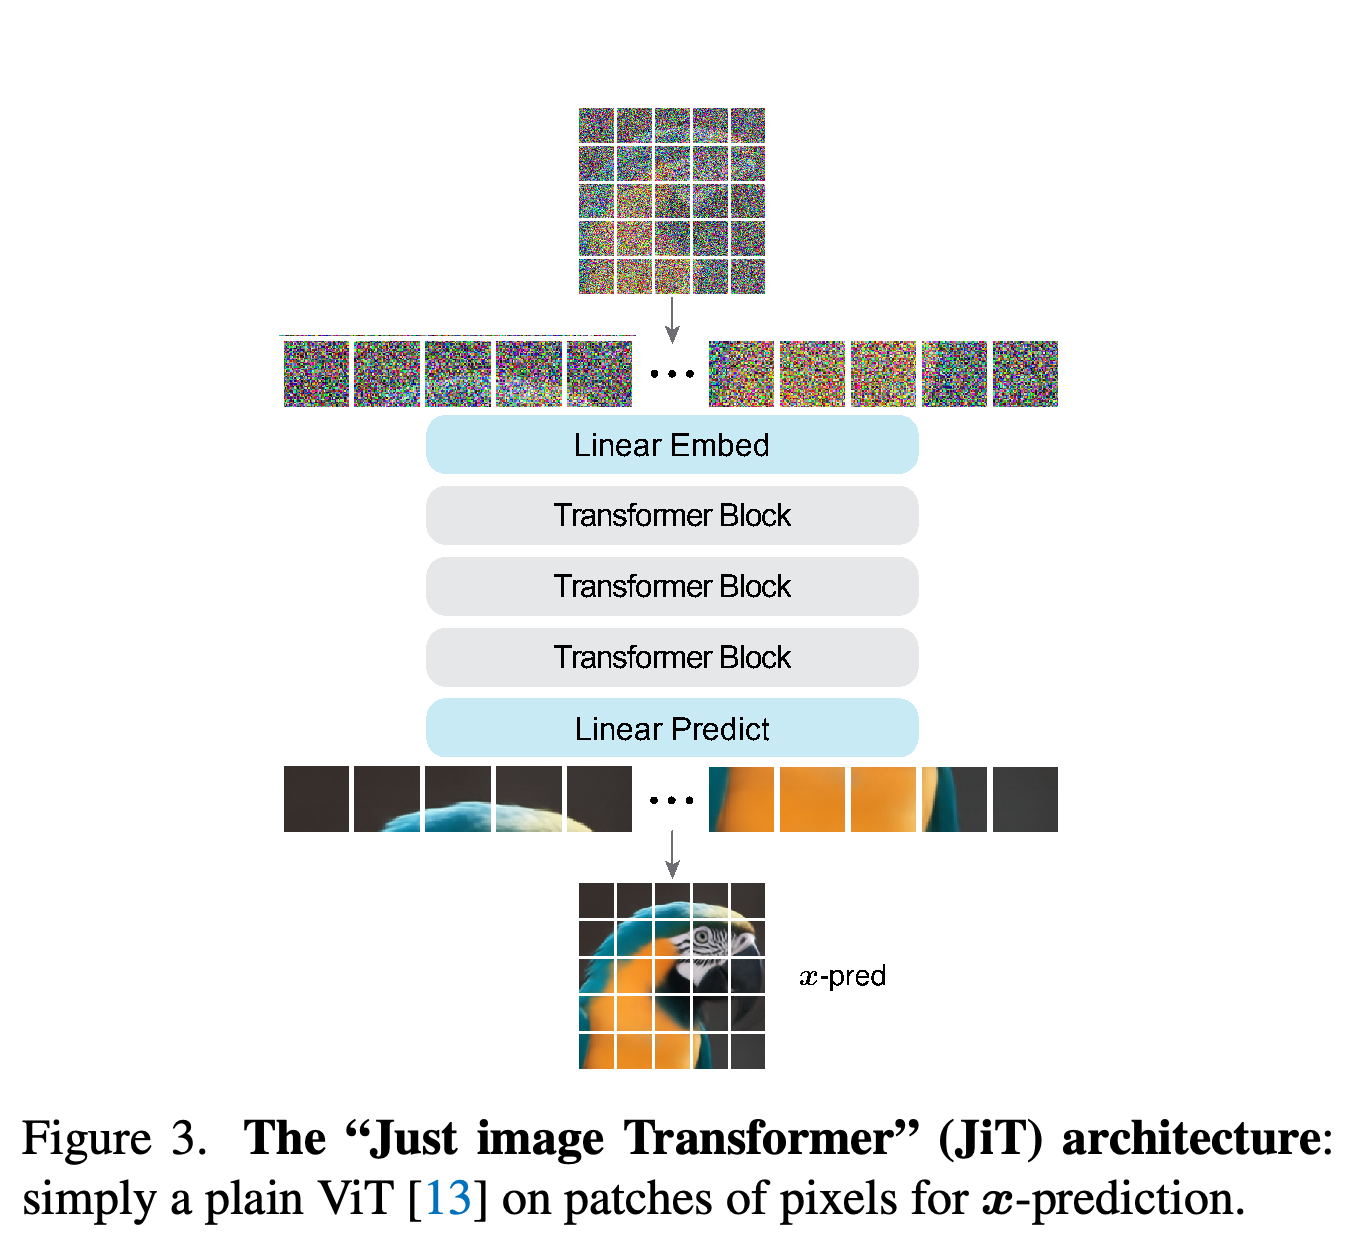
JiT는 red-green-blue(RGB) 이미지를 겹치지 않는 p×p 패치로 나눈다. 각 패치를 선형 임베딩하고 위치 정보를 더한 뒤, Transformer 블록으로 시퀀스를 처리하고 선형 변환으로 깨끗한 출력 패치를 예측한다. 시간과 클래스 레이블은 Diffusion Transformer(DiT)에서 채택한 적응형 레이어 정규화 기반 조건 부여 방식인 adaLN-Zero를 통해 네트워크에 전달한다.
- Figure 3은 선형 입력, 출력 투영을 사용하는 패치 간 변환 구조를 보여준다.
- 256×256의 JiT/16은 패치당 값이 768개이고, 512×512의 JiT/32는 3072개다. 두 모델 모두 16×16 패치 격자를 사용하므로 이미지 토큰 시퀀스 길이가 같다.
네트워크는 노이즈가 섞인 픽셀 패치를 선형 임베딩과 Transformer 블록으로 처리해 깨끗한 패치로 직접 변환한다. 따라서 핵심 생성 모델에는 별도의 latent encoder나 decoder가 필요하지 않다.
4.2. What to Predict by the Network?
Table 2는 은닉층 너비 768의 JiT-B를 200 epochs 동안 학습하고 CFG를 적용해 예측 공간과 손실 공간의 9가지 조합을 검증한다. Guidance와 EMA 설정은 모델마다 별도로 선택한다. 256×256에서 16×16 패치를 사용하면 x-prediction의 FID는 x-loss, ε-loss, v-loss에서 각각 10.14, 10.45, 8.62다. ε-prediction은 372.38~394.58, v-prediction은 96.53~126.88이다.
- 64×64에서 4×4 패치를 사용하면 패치 차원은 48로 줄고 은닉층 너비와 이미지 토큰 시퀀스 길이는 그대로 유지된다. 9가지 조합 모두 FID 3.46~6.20을 달성한다.
- 이 비교는 성능이 패치별 차원과 직접 예측 대상에 민감하다는 설명을 뒷받침한다. 손실 공간만 바꿔서는 실험에서 나타난 고차원 환경의 실패를 해결하지 못한다.
256×256에서는 3가지 손실 모두 깨끗한 이미지 출력에서 작동하고 노이즈 또는 velocity 출력에서 실패한다. 64×64에서는 모든 조합이 양호한 성능을 보인다. 은닉층 너비와 시퀀스 길이를 고정하고 패치 차원을 바꾼 결과는 차원에 관한 설명을 뒷받침한다. Guidance와 EMA 설정은 모델마다 선택한다.
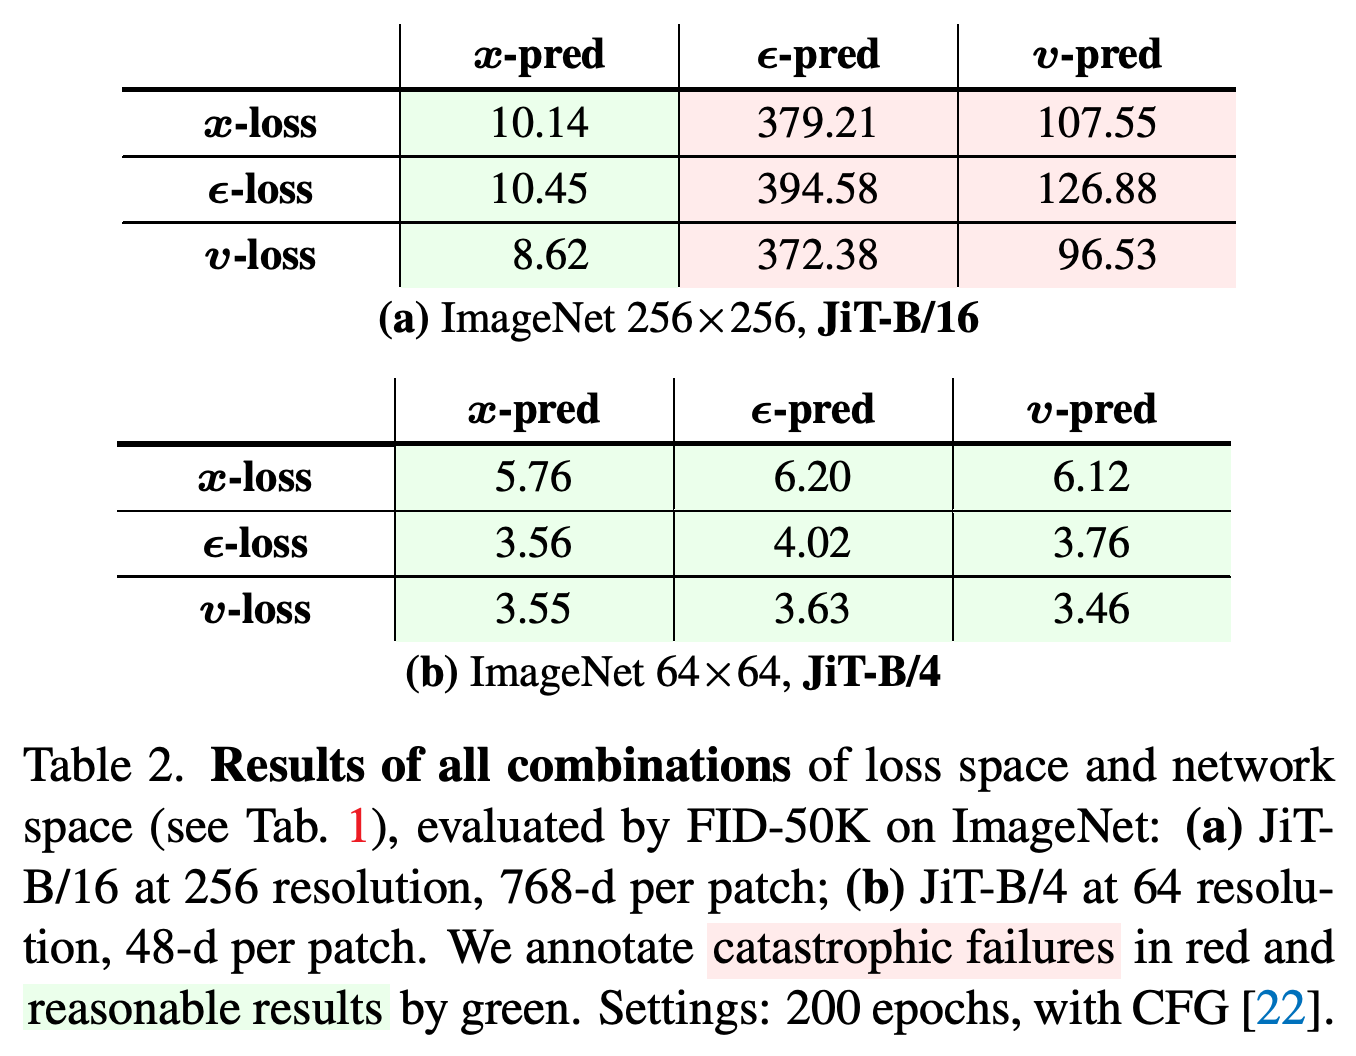
Table 3은 시간 분포의 평균 μ를 바꿔 학습 중 노이즈 수준을 조절한다. x-prediction의 FID는 μ = 0.0에서 14.44, μ = −0.8에서 8.62로 개선된 뒤 μ = −1.2에서 8.99로 증가한다. ε-prediction과 v-prediction은 실험한 모든 평균에서 성능이 낮다.
- 저자들은 이후 실험에 μ = −0.8을 선택한다.
- 선형 보간 스케줄에서 μ가 작아지면 더 작은 시간값을 뽑게 되며 노이즈가 많아진다. 이 조정은 x-prediction을 개선하지만 실험에서 나타난 노이즈 포함 출력의 실패를 해결하지 못한다.
시간 샘플링 평균을 바꾸면 깨끗한 이미지 예측은 μ = −0.8에서 가장 좋은 결과를 얻는다. 하지만 실험한 어떤 평균에서도 노이즈 예측이나 velocity 예측은 경쟁력 있는 성능을 보이지 않는다. 이 표는 해당 평균에서 노이즈 예측의 FID를 372.36으로 보고하며 Table 2의 372.38과 약간 다르다.
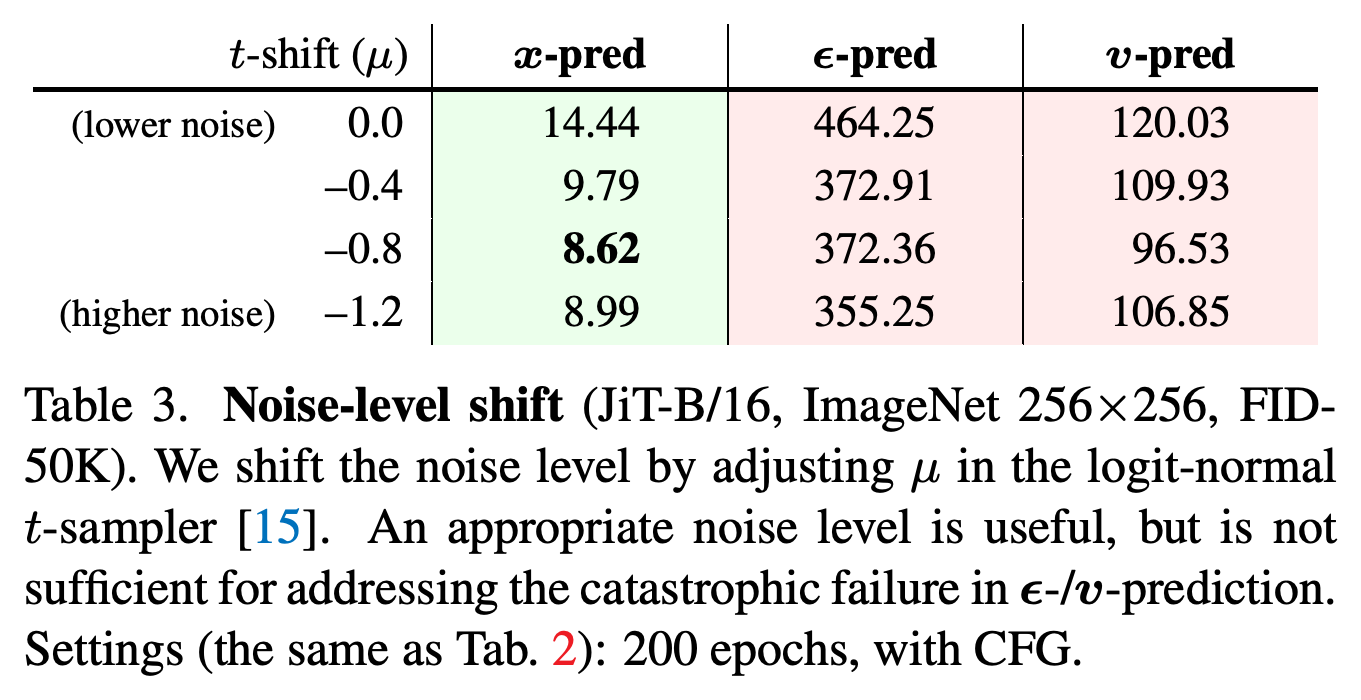
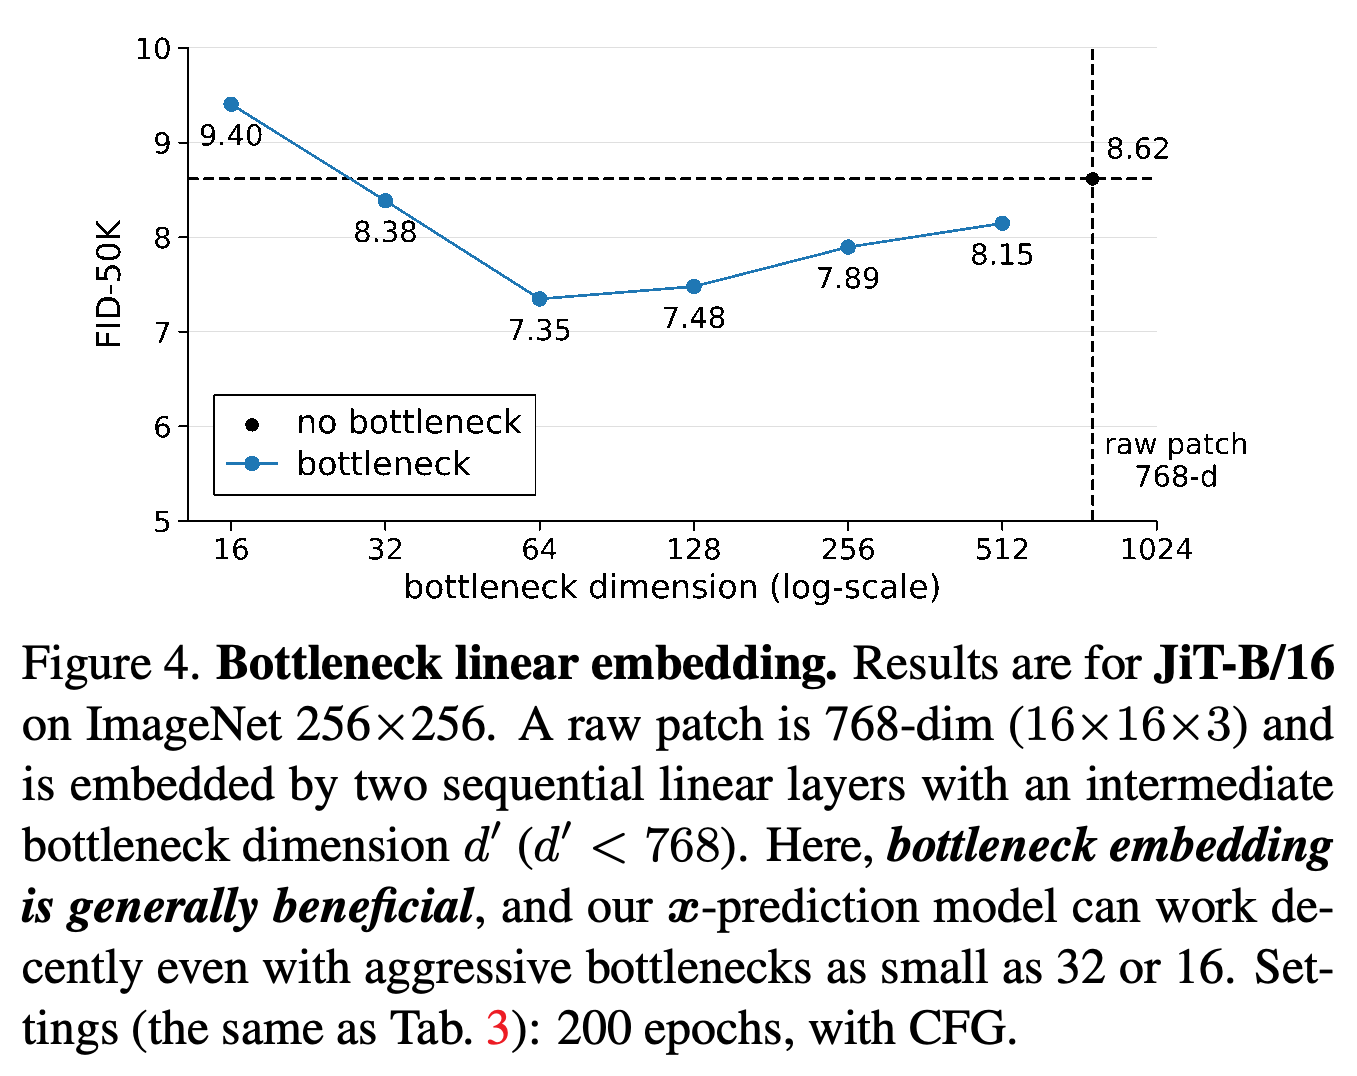
Figure 4는 입력 투영을 2개의 선형 레이어로 대체한다. 중간 차원이 원시 패치보다 좁은 표현인 bottleneck을 형성한다. JiT-B/16에서 64차원 bottleneck을 사용하면 FID가 bottleneck이 없을 때의 8.62에서 7.35로 개선된다. 16차원 bottleneck에서도 FID는 9.40이며, 심각한 실패는 발생하지 않는다.
- 중간 차원이 32, 128, 256, 512일 때 FID는 각각 8.38, 7.48, 7.89, 8.15다.
- 이 실험은 x-prediction에 원시 패치의 모든 차원을 보존할 필요가 없음을 보여준다. 자연 이미지의 내재 차원을 직접 측정한 실험은 아니다.
그래프에서 가장 좋은 결과는 768차원 원시 패치에 64차원 중간 표현을 사용했을 때다. 압축은 생성 성능을 개선할 수 있으며 16차원 bottleneck에서도 노이즈를 포함한 예측 대상에서 관찰된 심각한 실패가 발생하지 않는다.
4.3. Our Algorithm
최종 알고리즘은 \(x_\theta=\operatorname{net}_\theta(z_t,t)\)를 직접 예측하고 이를 \(v_\theta=\frac{x_\theta-z_t}{1-t}\)로 변환한 뒤 velocity 제곱 오차의 기댓값을 최소화한다. Algorithm 1은 이 학습 단계를 제시한다. Algorithm 2는 예측 velocity를 따라 수치적으로 이동하는 Euler 적분을 사용해 z_next = z + (t_next − t) * v_pred로 샘플을 갱신한다.
- 이 나눗셈을 계산할 때마다 분모 1 − t의 최솟값을 0.05로 제한한다.
- 의사 코드는 간결하게 제시하기 위해 클래스 조건과 CFG를 생략한다. 보고된 기본 샘플러는 예시의 Euler 단계 대신 Heun을 사용한다.
4.4. “Just Advanced” Transformers
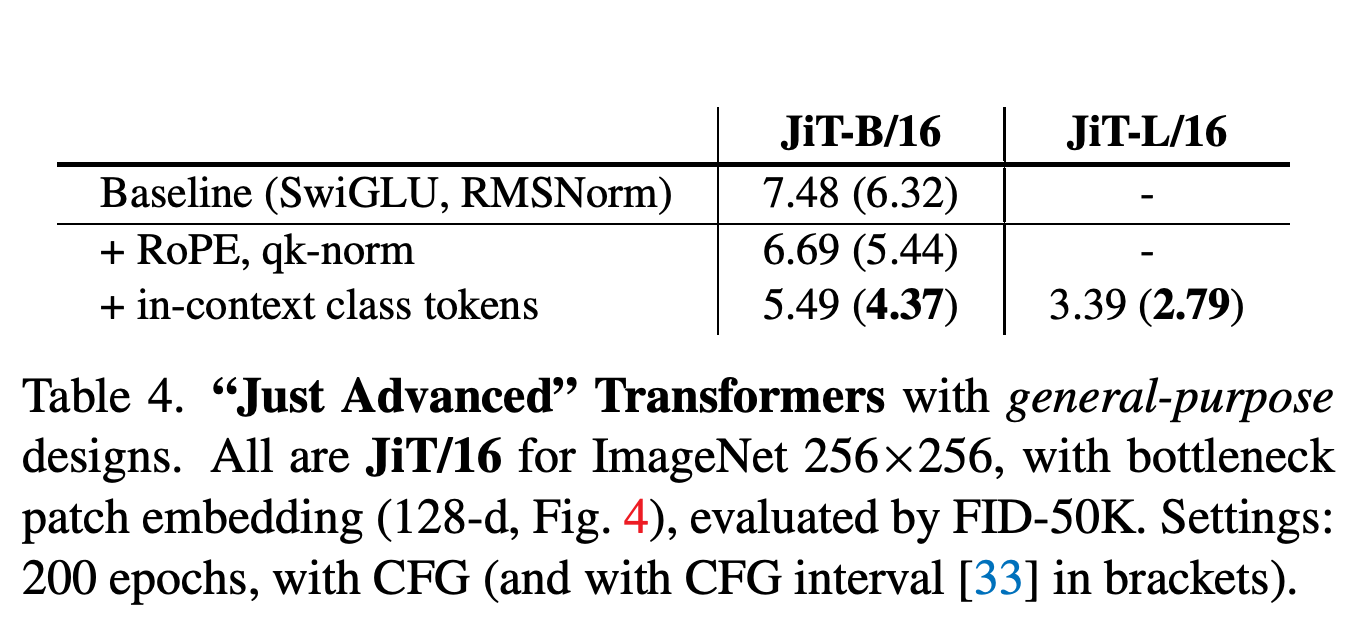
개선된 구조는 게이트를 사용하는 Transformer 구성 요소인 SwiGLU, root mean square layer normalization인 RMSNorm, rotary position embedding인 RoPE, query-key normalization인 qk-norm을 사용한다. 또한 서로 다른 위치 임베딩을 부여한 32개의 반복 클래스 토큰을 in-context conditioning에 사용한다. 기본 adaLN-Zero 조건 부여와 함께 토큰 시퀀스에도 클래스 정보를 넣는다.
- Table 4는 128차원 입력 bottleneck과 200 epochs를 사용한다. JiT-B/16의 FID는 SwiGLU와 RMSNorm을 사용할 때 7.48, RoPE와 qk-norm을 더하면 6.69, 클래스 토큰을 더하면 5.49로 개선된다.
- CFG를 샘플링 시간의 특정 구간으로 제한하면 대응하는 FID는 6.32, 5.44, 4.37이다. JiT-L/16은 전체 설계와 구간 제한을 적용해 2.79를 달성한다.
- 앞선 구성 요소별 비교 실험에도 이미 SwiGLU와 RMSNorm이 포함돼 있다. 따라서 Table 4는 기본 x-prediction 모델에서 구조와 guidance를 추가로 개선한 효과를 측정한다.
범용 Transformer 구성 요소와 추가 클래스 토큰이 깨끗한 이미지를 예측하는 기본 모델을 개선한다. 대괄호 안의 값은 CFG를 특정 구간으로 제한할 때 추가 개선이 있음을 보여준다. 따라서 guidance 정책도 최종 점수에 영향을 준다.
5. Comparisons
Table 5는 해상도에 비례해 패치 크기를 늘리면서 이미지 토큰 256개와 JiT-B의 은닉층 너비 768을 유지한다. 256×256, 512×512, 1024×1024에서 패치 차원은 각각 768, 3072, 12288이며, FID는 4.37, 4.64, 4.82다. 모델 크기는 131M, 133M, 141M 파라미터이며 순전파당 연산량은 25, 26, 30 Gflops다. Gflops는 부동소수점 연산량을 십억 단위로 나타낸 값이다.
- 노이즈 크기는 해상도 512에서 2×, 1024에서 4×로 증가한다. 나머지 학습 설정은 유지한다.
- 비슷한 비용은 서로 다른 패치 크기를 사용하는 모델 사이의 비교에 해당한다. 고정된 패치 크기의 구조에 점점 길어지는 이미지 시퀀스를 입력한 결과가 아니다.
이미지 해상도와 함께 패치 크기를 늘리면 이미지 토큰 시퀀스 길이를 유지하고 순전파 비용을 비슷하게 유지할 수 있다. 패치 차원이 은닉층 너비보다 훨씬 커져도 마찬가지다. 패치 크기를 비례해 늘리는 설정에서 해상도가 256×256에서 1024×1024로 커지면 FID는 4.37에서 4.82로 증가한다.
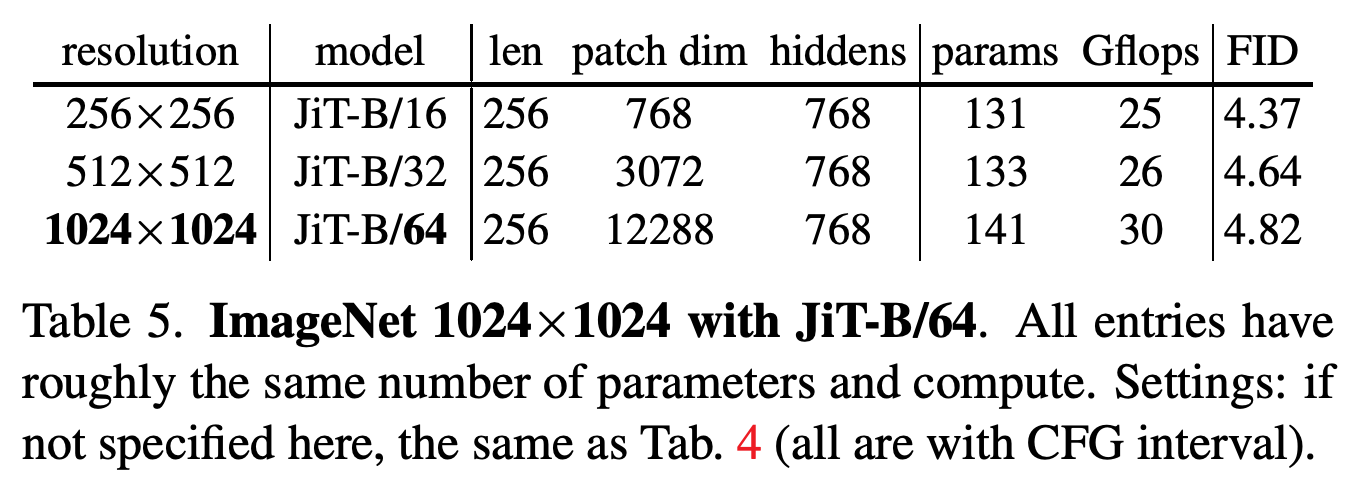
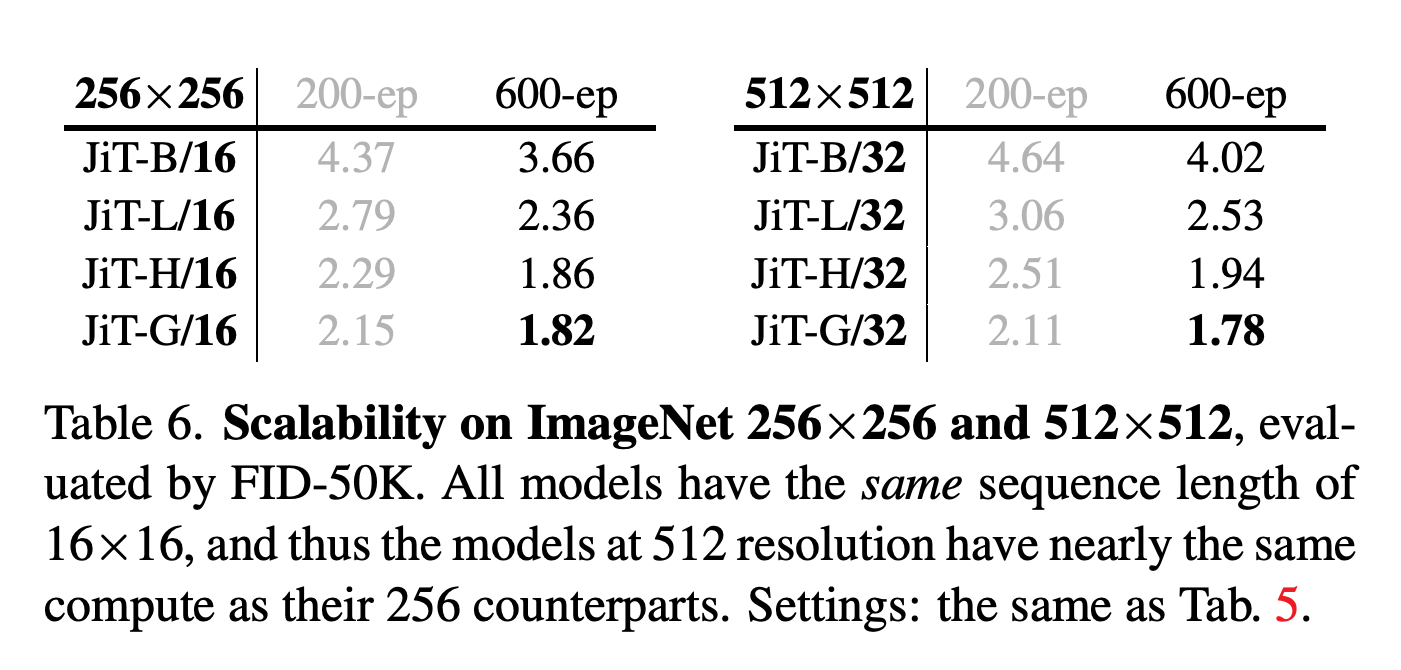
Table 6은 모델 규모와 학습 기간을 늘릴 때의 개선을 보여준다. 600 epochs로 표시된 열에서 JiT-B/L/H/G의 FID는 256×256에서 3.66/2.36/1.86/1.82, 512×512에서 4.02/2.53/1.94/1.78이다.
- 부록은 학습 기간 표기에 단서를 제시한다. JiT-G 모델은 모니터링한 FID가 악화되기 시작하는 약 320 epochs에서 학습을 중단한다.
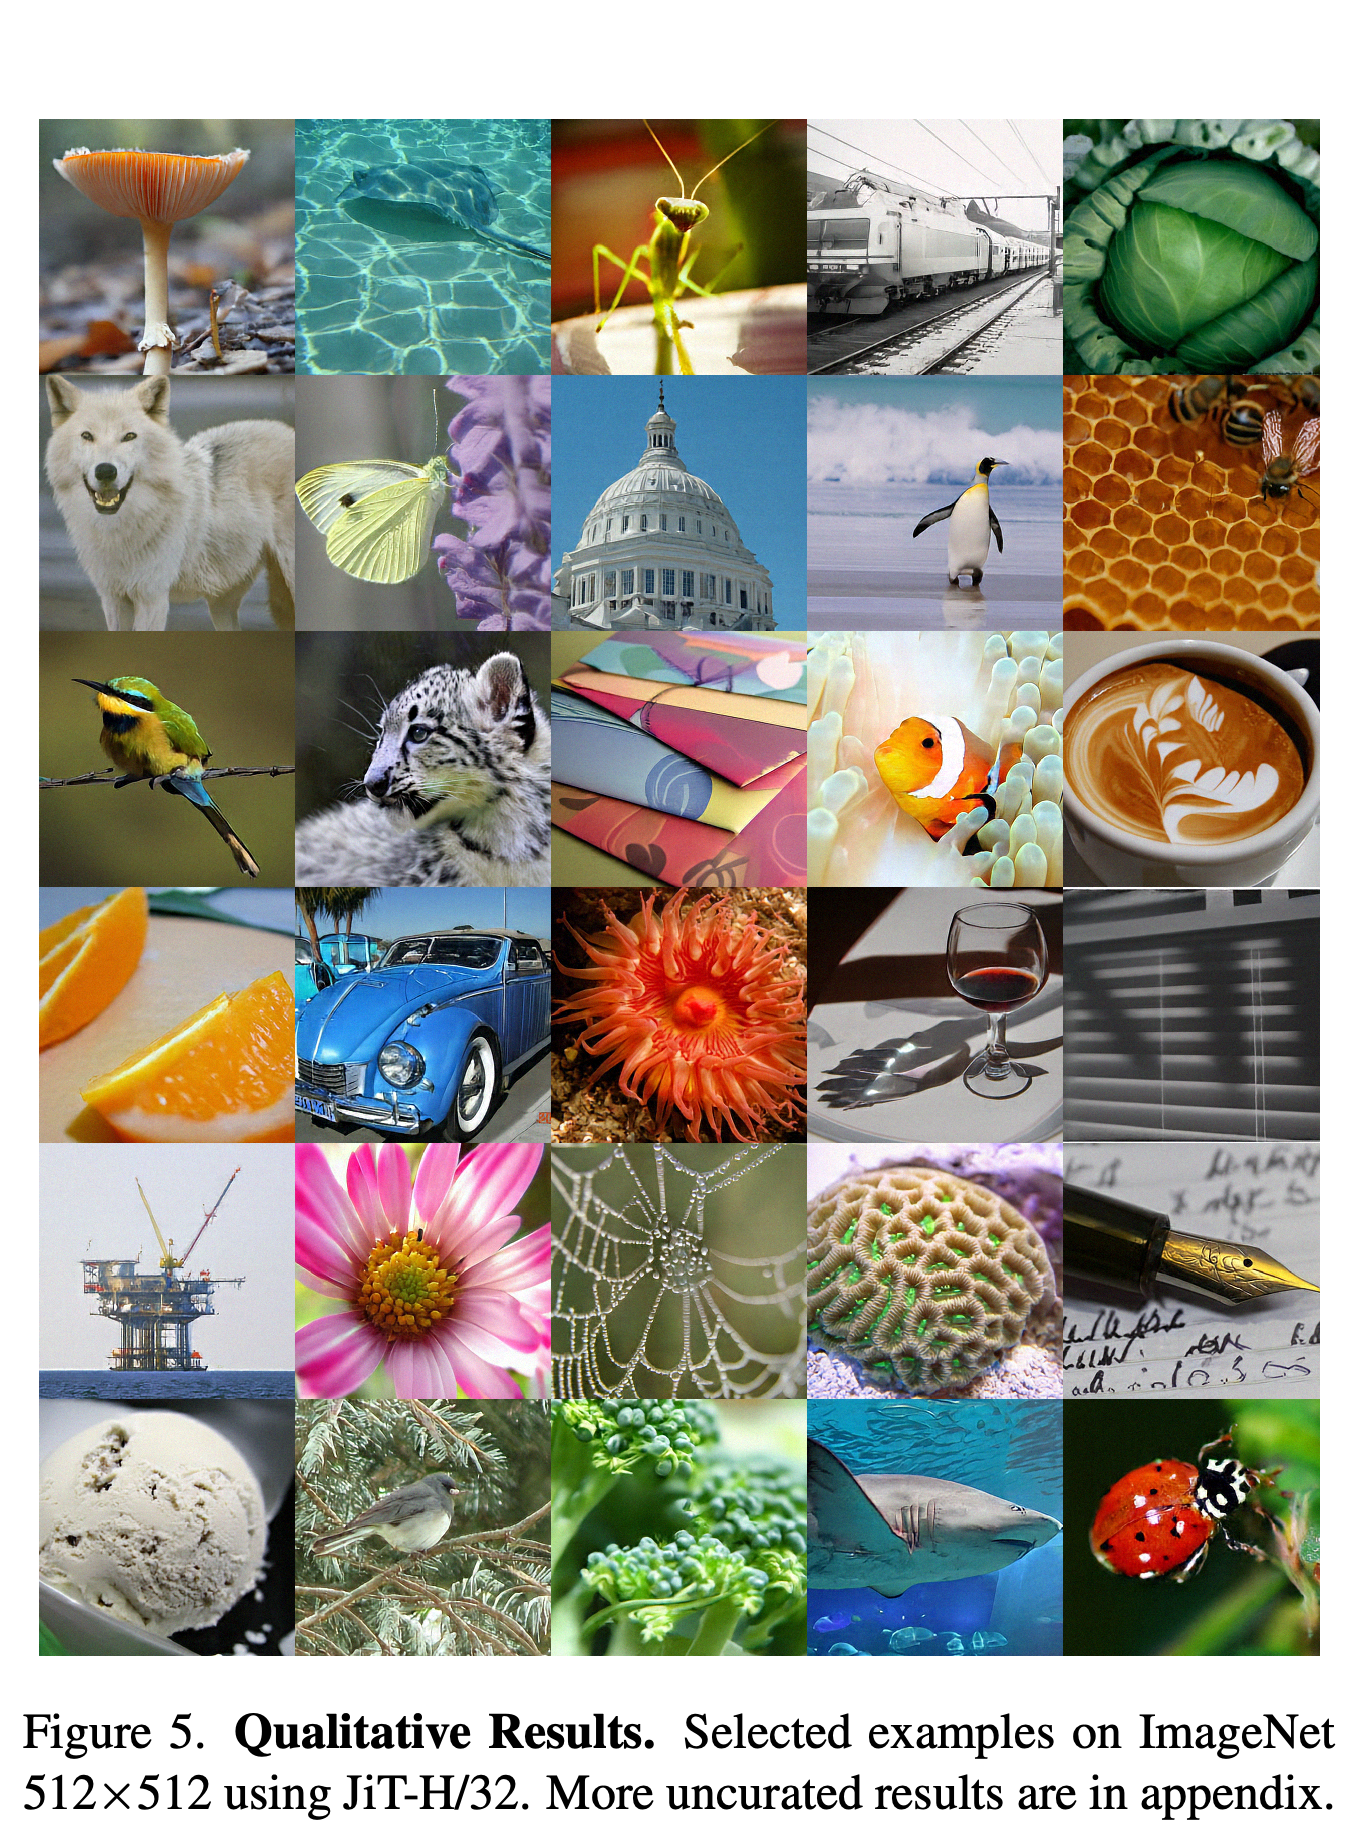
- Figure 5는 512×512 해상도의 JiT-H/32 samples를 선별해 다양한 사물, 질감, 장면을 보여준다. 선별된 모음만으로 일반적인 샘플 품질을 판단할 수는 없다.
더 큰 모델과 더 긴 학습 설정은 두 해상도에서 모두 FID를 개선한다. 가장 큰 512 모델은 대응하는 256 모델보다 약간 좋은 성능을 보인다. 다만 부록은 G 크기 모델을 약 320 epochs에서 조기 종료했다고 명시한다.
선별된 512×512 samples는 알아볼 수 있는 사물, 세밀한 질감, 다양한 장면을 보여준다. 달성 가능한 시각적 품질을 예시하지만 실패한 샘플의 빈도를 정량화하지는 않는다.
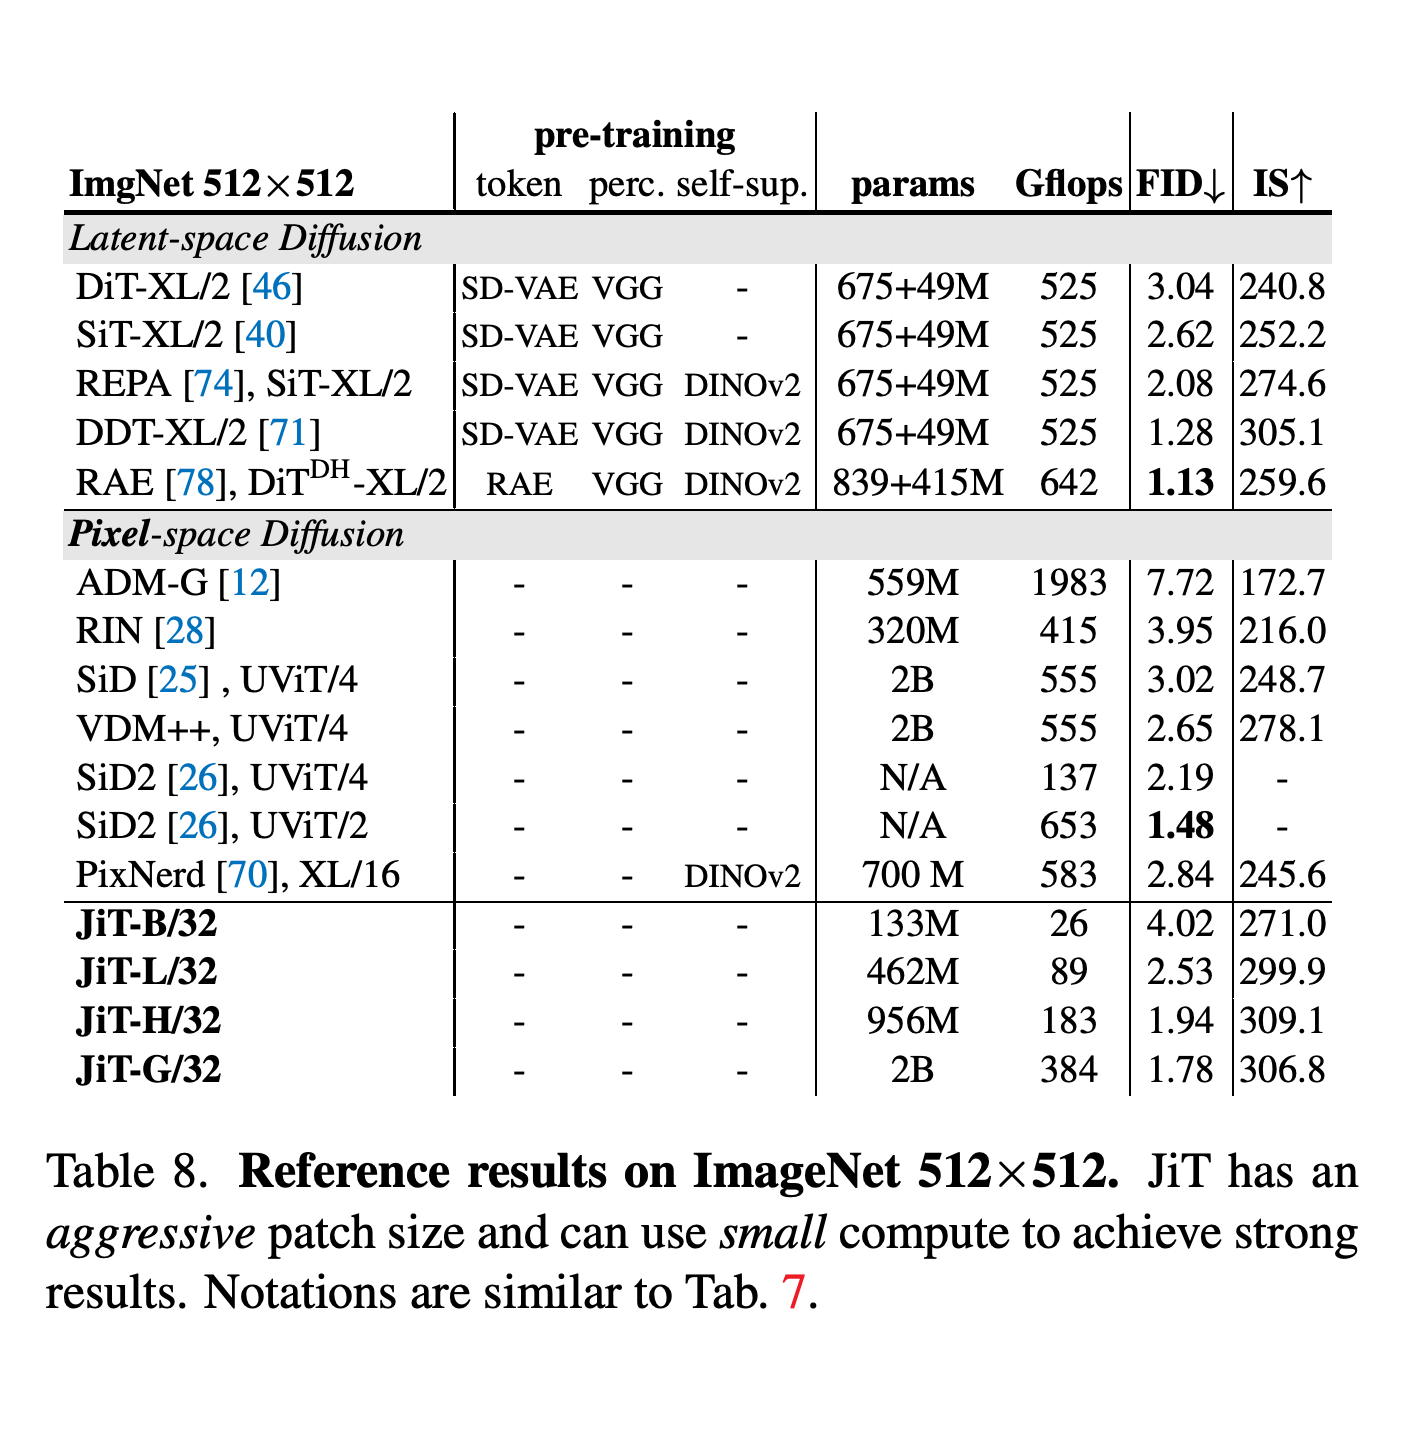
Tables 7과 8은 비교 방법이 사용하는 사전 학습된 tokenizer, perceptual loss, self-supervised 구성 요소를 명시한다. Self-supervised 구성 요소는 지도 학습용 레이블 없이 학습한 요소다. 512×512에서 JiT-L/32는 89 Gflops로 FID 2.53을 달성한다. 비교 대상인 scalable interpolant Transformer, SiT-XL/2는 FID 2.62와 525 Gflops를 기록하며 JiT-G/32는 384 Gflops로 1.78에 도달한다. Self-supervised에 대해서는 Self-Supervised Learning(자기지도 학습 설명) 글을 참조하라.
- JiT의 FID가 비교 대상 중 가장 낮지는 않다. 512×512에서 Simpler Diffusion(SiD2) UViT/2는 653 Gflops로 1.48을 보고한다. 인코딩된 표현에서 생성하는 representation autoencoder(RAE) 방법은 642 Gflops로 1.13을 보고한다.
- 256×256에서 JiT-G/16은 383 Gflops로 1.82를 달성하고 SiD2 UViT/2는 137 Gflops로 1.73을 보고한다. 따라서 비교 표가 모든 경우의 연산량 우위를 입증하지는 않는다.
- Gflops는 순전파 1회를 측정하며 tokenizer 연산은 제외한다. 비교에서는 총 학습 비용을 맞추지 않는다. 표는 동일한 생성 이미지 50K장으로 평가한 추가 샘플 품질 지표인 Inception Score(IS)도 보고한다.
256×256 비교 결과는 JiT의 FID를 모델 크기, 순전파 비용, 외부 사전 학습 요건과 함께 제시한다. JiT는 이런 의존 요소 없이 경쟁력 있는 성능을 보인다. 하지만 SiD2 UViT/2는 JiT-G/16보다 FID와 순전파 비용이 모두 낮다.
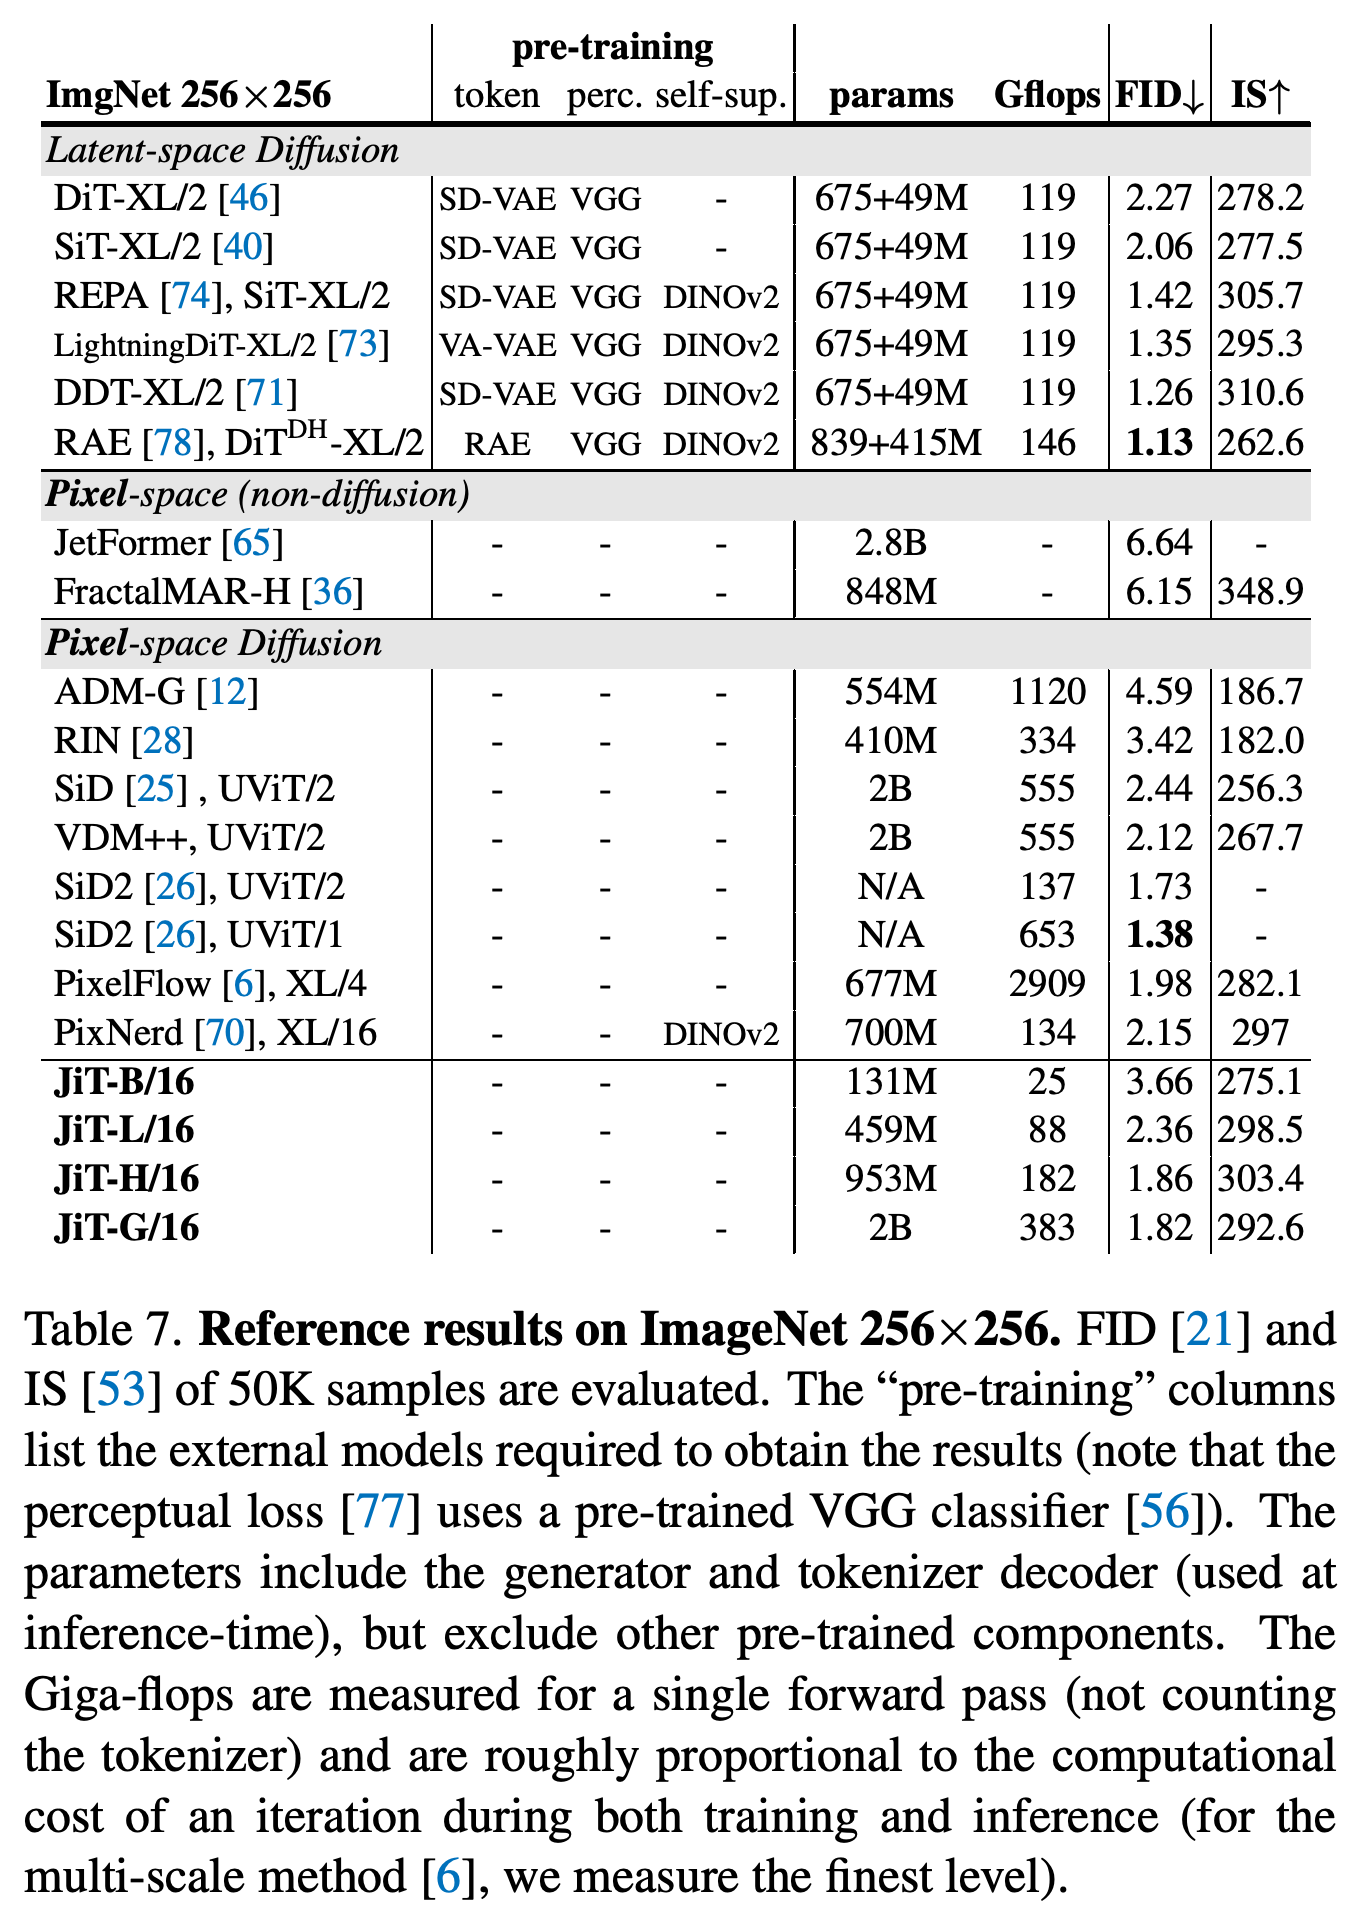
JiT는 512×512에서 더 큰 패치를 사용해 순전파 비용을 256×256과 거의 같게 유지한다. 비교 결과는 효율성의 절충 관계를 보여준다. SiD2와 RAE의 FID가 더 낮으므로 전반적인 품질 우위를 주장할 수는 없다.
6. Discussion and Conclusion
결론은 신경망 용량이 예측 매개변수화를 제약한다는 점을 강조한다. 깨끗한 자연 데이터와 노이즈는 예측하기가 똑같이 쉬운 대상이 아닐 수 있다. JiT는 외부의 사전 학습된 구성 요소 없이 원시 이미지에서 diffusion과 Transformer를 결합하는 설계의 근거를 제시한다. 다른 고차원 자연 데이터에 대한 활용 가능성은 아직 검증하지 않았다.
부록
- A. Implementation Details에서 JiT-B/L/H/G의 깊이는 12/24/32/40, 은닉 차원은 768/1024/1280/1664다. 학습에는 β₁ = 0.9, β₂ = 0.95인 Adam optimizer, 배치 크기 1024, 학습률 2e-4, warmup 5 epochs, 고정 학습률 스케줄, weight decay 0을 사용한다. 시간 샘플러는 μ = −0.8과 σ = 0.8을 사용한다. B/L의 bottleneck 너비는 128, H/G는 256이다. H/G는 블록 가운데 절반에 학습 중 과적합을 줄이는 기법인 dropout 0.2를 적용한다. G 모델은 모니터링한 FID가 악화되는 약 320 epochs에서 학습을 중단한다.
- A. Implementation Details는 평가 설정의 선택 방식도 명시한다. CFG scale은 1.0부터 4.0까지 0.1 간격으로 탐색하고 EMA 감쇠율 후보는 0.9996, 0.9998, 0.9999다. 저자들은 각 구성 요소별 비교 실험을 포함한 모든 모델에서 생성 샘플 8K개로 설정을 선택한다. 이후 1000개 클래스마다 50개씩 생성한 이미지 50K장을 ImageNet 학습 세트와 비교해 평가한다. 샘플링에는 Heun 50 steps를 사용하며 구간 제한을 활성화하면 CFG interval은 [0.1, 1]이다. Figure 6에서 JiT-L/16의 최적 FID는 구간 제한이 없을 때 2.88, 적용할 때 2.36으로 개선된다.
- B. Additional Experiments는 학습 오차, 출력 pre-conditioning, 보조 분류 목적함수, 해상도 전환, 추가 품질 지표를 다룬다. B.1. Training Loss and Denoised Images는 동일한 v-loss에서 x-prediction과 v-prediction을 비교한다. v-prediction의 손실은 약 25% 더 높으며 Figure 7의 단일 단계 복원 이미지에는 눈에 띄는 아티팩트가 있다. 본문은 ε-prediction의 손실이 약 3× 더 높고 불안정하다고 보고하며 복원 오차가 여러 단계의 샘플링 과정에서 누적될 수 있다고 설명한다.
- B.2. Pre-conditioner는 정해진 계수로 노이즈가 섞인 입력과 네트워크 출력을 결합하는 x_θ = c_skip z_t + c_out net_θ(z_t, t)를 검증한다. Table 10에서 x-loss/ε-loss/v-loss에 따른 FID는 변형한 EDM 방식이 28.94/72.05/35.49, 선형 pre-conditioner가 39.50/67.56/46.25다. 직접 x-prediction의 결과는 10.14/10.45/8.62다. 저자들은 사용한 노이즈 스케줄이 EDM과 다르므로 이 변형이 원래 EDM 정식화와 완전히 동등하지 않다고 명시한다.
- B.3. Exploration: Classification Loss는 JiT-B의 블록 4 또는 JiT-L의 블록 8 뒤에 pooling을 적용한 선형 분류기를 연결한다. ImageNet의 1000개 클래스에 대한 분류 손실로 가중 cross-entropy를 추가한다. 분류기가 조건 정보를 통해 정답 레이블에 접근하는 label leakage를 방지하기 위해 분류기 이전에는 클래스 조건을 비활성화한다. CFG interval을 사용해 200 epochs 동안 학습한 Table 11에서 JiT-B/16의 FID는 4.37에서 4.14로, JiT-L/16은 2.79에서 2.50으로 개선된다. 다른 실험에서는 이 손실을 사용하지 않는다.
- B.4. Cross-resolution Generation은 모델의 기본 생성 해상도를 바꾸지 않고 생성된 이미지의 크기를 조절한다. JiT-G/32 출력을 512에서 256으로 다운샘플링하면 FID는 1.84이며, 기본 해상도의 JiT-G/16이 기록한 1.82와 가깝다. JiT-G/16 출력을 512로 업샘플링하면 2.45로, 기본 해상도의 JiT-G/32가 기록한 1.78보다 나쁘다. 저자들은 후자의 성능 저하를 고주파 세부 정보의 부족으로 설명한다.
- B.5. Additional Metrics는 IS와 함께 샘플의 충실도와 데이터 분포를 얼마나 폭넓게 재현하는지 측정하는 generative precision과 recall을 보고한다. 256×256에서 JiT-G/16은 IS 292.6, precision 0.79, recall 0.62다. SiT-XL/2는 277.5, 0.82, 0.59이며, RAE는 262.6, 0.78, 0.67이다. 이 결과에서는 모든 지표에 걸친 일관된 우위가 나타나지 않으며 샘플 충실도와 분포 재현 범위가 모델마다 다르다.
- C. Qualitative Results는 Figures 8–11에서 지정된 동물, 사물, 건축, 자연 클래스에 대한 256×256 해상도의 JiT-G/16 samples를 선별 없이 제공한다. 이미지 모음 모두 시각화를 위해 별도로 선택한 더 높은 guidance 값 대신, 보고된 FID 1.82에 대응하는 CFG 2.2를 사용한다. 이 이미지들은 클래스 내부의 다양성을 보여주는 예시로 종합 지표를 보완한다.
짧은 생각
가장 강한 근거는 예측 대상과 손실 공간을 분리한 실험이다. Table 2는 9가지 조합에서 구조와 평가 절차를 고정하면서 모델마다 guidance와 EMA 설정을 선택한다. Figure 4는 입력을 크게 압축해도 깨끗한 이미지 예측이 효과적일 수 있음을 보여준다. 합성 데이터 투영 실험과 함께 보면, 이 결과들은 실험에서 나타난 실패를 네트워크 용량과 연결하는 설명을 뒷받침한다. 이 근거가 모든 고차원 diffusion 모델에 x-prediction을 사용해야 한다는 점을 입증하지는 않는다. 논문의 저차원 설정에서는 3가지 예측 대상이 모두 작동한다. JiT는 외부의 사전 학습된 구성 요소 없이 학습한다. 패치 크기를 해상도에 비례해 늘리면 실험한 해상도에서 순전파 비용도 거의 일정하다. 더 강한 비교 방법과의 FID 격차, guidance와 EMA 설정 선택, 조기 종료, ImageNet 이외의 실험 부재는 더 넓은 주장을 제한한다.