


Motion Attribution for Video Generation 요약 설명
13 Jan 2026 | Paper Review Data Attribution Video Diffusion Models Data Curation목차
이번 글에서는 Motion Attribution for Video Generation 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 1월 13일(Arxiv)
- Wu, Xindi, Paschalidou, Despoina, Gao, Jun, Torralba, Antonio, Leal-Taixé, Laura, Russakovsky, Olga, Fidler, Sanja, Lorraine, Jonathan.
- NVIDIA, Princeton University, MIT, University of Michigan, University of Toronto, Vector Institute
- 논문 링크
- Project Page
요약
- Motion Attribution for Video Generation은 지정한 움직임 패턴과 관련된 파인튜닝 클립을 찾는 그래디언트 기반 프레임워크 Motive(MOTIon attribution for Video gEneration)를 제안한다. 쿼리 영상과 객체, 질감, 배경이 비슷한 클립을 찾는 데 그치지 않고, 생성 영상의 시간적 움직임을 개선할 수 있는 학습 후보 클립을 찾는다.
- Motive는 optical flow 크기로 잠재 공간의 예측 오차에 가중치를 부여하고, 동일한 timestep과 노이즈 샘플로 학습 데이터와 쿼리의 그래디언트를 계산한다. 이어서 Fastfood로 투영하고 정규화한 그래디언트를 비교한다. 백분위수 기반 투표로 여러 쿼리의 순위를 집계해 파인튜닝 부분집합을 선택한다.
- Motive는 학습 후보 데이터의 10%만 사용해 Wan2.1-T2V-1.3B와 Wan2.2-TI2V-5B에서 VBench dynamic degree 점수 47.6%와 48.3%를 달성한다. 전체 후보 집합으로 파인튜닝한 점수는 각각 42.0%와 45.3%다. 사람 평가자는 사전 학습된 기본 모델과의 비교 중 74.1%에서 Motive의 움직임을 선호한다. Wan 모델의 motion smoothness는 거의 달라지지 않으며, 시각적 품질 지표가 모두 개선되는 것은 아니다.
- 실험은 평가한 파인튜닝 조건에서 목표 움직임에 맞춘 부분집합 선택의 효과를 뒷받침하지만, 개별 클립의 정확한 인과적 기여도를 입증하지는 않는다. 제약으로는 A100 1대에서 Wan2.1-T2V-1.3B로 10k개 클립의 그래디언트를 미리 계산하는 데 약 150시간이 걸린다는 점, 평가가 10개 움직임 범주에 한정된다는 점, 카메라 움직임과 객체 움직임을 완전히 분리하지 못한다는 점, classifier-free guidance를 모델링하지 않는다는 점이 있다.
1. Introduction
서론은 궤적, 변형, 카메라 움직임, 상호작용을 형성하는 데이터를 이해하고 선별하는 도구로 데이터 기여도 분석을 제시한다. 대규모 사전 학습 데이터에는 접근하기 어려울 수 있지만, 선택한 클립으로 사전 학습된 생성 모델의 움직임을 바꿀 수 있으므로 파인튜닝에 초점을 맞춘다.
- 이미지 중심의 기여도 분석을 영상에 그대로 적용하면 정적인 외형에 치우칠 수 있다. 논문은 움직임 위치 파악, 시퀀스 단위의 계산 비용, 시간적 관계를 주요 과제로 제시한다.
- 논문의 주요 기여는 확장 가능한 그래디언트 기여도 분석, 영상 길이 효과의 처리, 움직임 가중 기여도 분석, 선택한 부분집합의 후속 평가다.
- 프로젝트 URL은 https://research.nvidia.com/labs/sil/projects/MOTIVE/ 이다.
2. Background
배경 절은 잠재 공간 기반 영상 생성과 그래디언트 기반 데이터 기여도 분석을 연결한다. Diffusion과 flow matching은 모두 timestep에 따라 달라지는 그래디언트를 만들며, 영상에서는 가변 길이와 움직임 특유의 실패 양상까지 고려해야 한다.
2.1. Video Generation with Diffusion and Flow-Matching Models
영상은 VAE 잠재 표현으로 인코딩되며, 스케줄러가 제어하는 신호와 노이즈 스케일에 따라 노이즈가 추가된다. Diffusion은 주입한 노이즈를 예측하고, flow matching은 잠재 공간 보간 경로의 속도를 예측한다. 두 목적함수 모두 timestep과 노이즈 샘플에 걸쳐 예측 오차를 적분한다.
- 개별 프레임이 선명하더라도 영상 모델은 일관되지 않은 궤적, 깜빡임, 객체 정체성의 변화, 부자연스러운 움직임을 해결해야 한다.
- 논문은 연속 프레임 사이의 변위로 움직임을 표현한다. Optical flow 크기는 Motive의 손실 마스크에 사용하는 공간적·시간적 중요도를 제공한다.
2.2. Data Attribution
고전적인 influence function은 학습 데이터와 쿼리의 그래디언트, 역 Hessian을 사용해 학습 예제의 가중치를 높였을 때 쿼리 손실이 얼마나 변하는지 근사한다. 현대 모델 규모에서는 곡률 계산이 비현실적이므로, TracIn과 TRAK 같은 방법은 그래디언트 유사도나 투영된 그래디언트 특징을 사용한다.
- Diffusion의 그래디언트 노름은 timestep마다 달라서, 노름이 큰 평가 결과에 기여도가 치우칠 수 있다. Diffusion-ReTrac은 그래디언트 정규화와 timestep·노이즈 부분 샘플링의 근거를 제공한다.
- 영상 전체의 그래디언트 유사도에는 여전히 움직임과 외형이 섞여 있다. 계산 비용은 샘플링한 timestep 수, 노이즈 샘플 수, 시퀀스 길이, 그래디언트 차원에 따라 증가한다.
3. Method
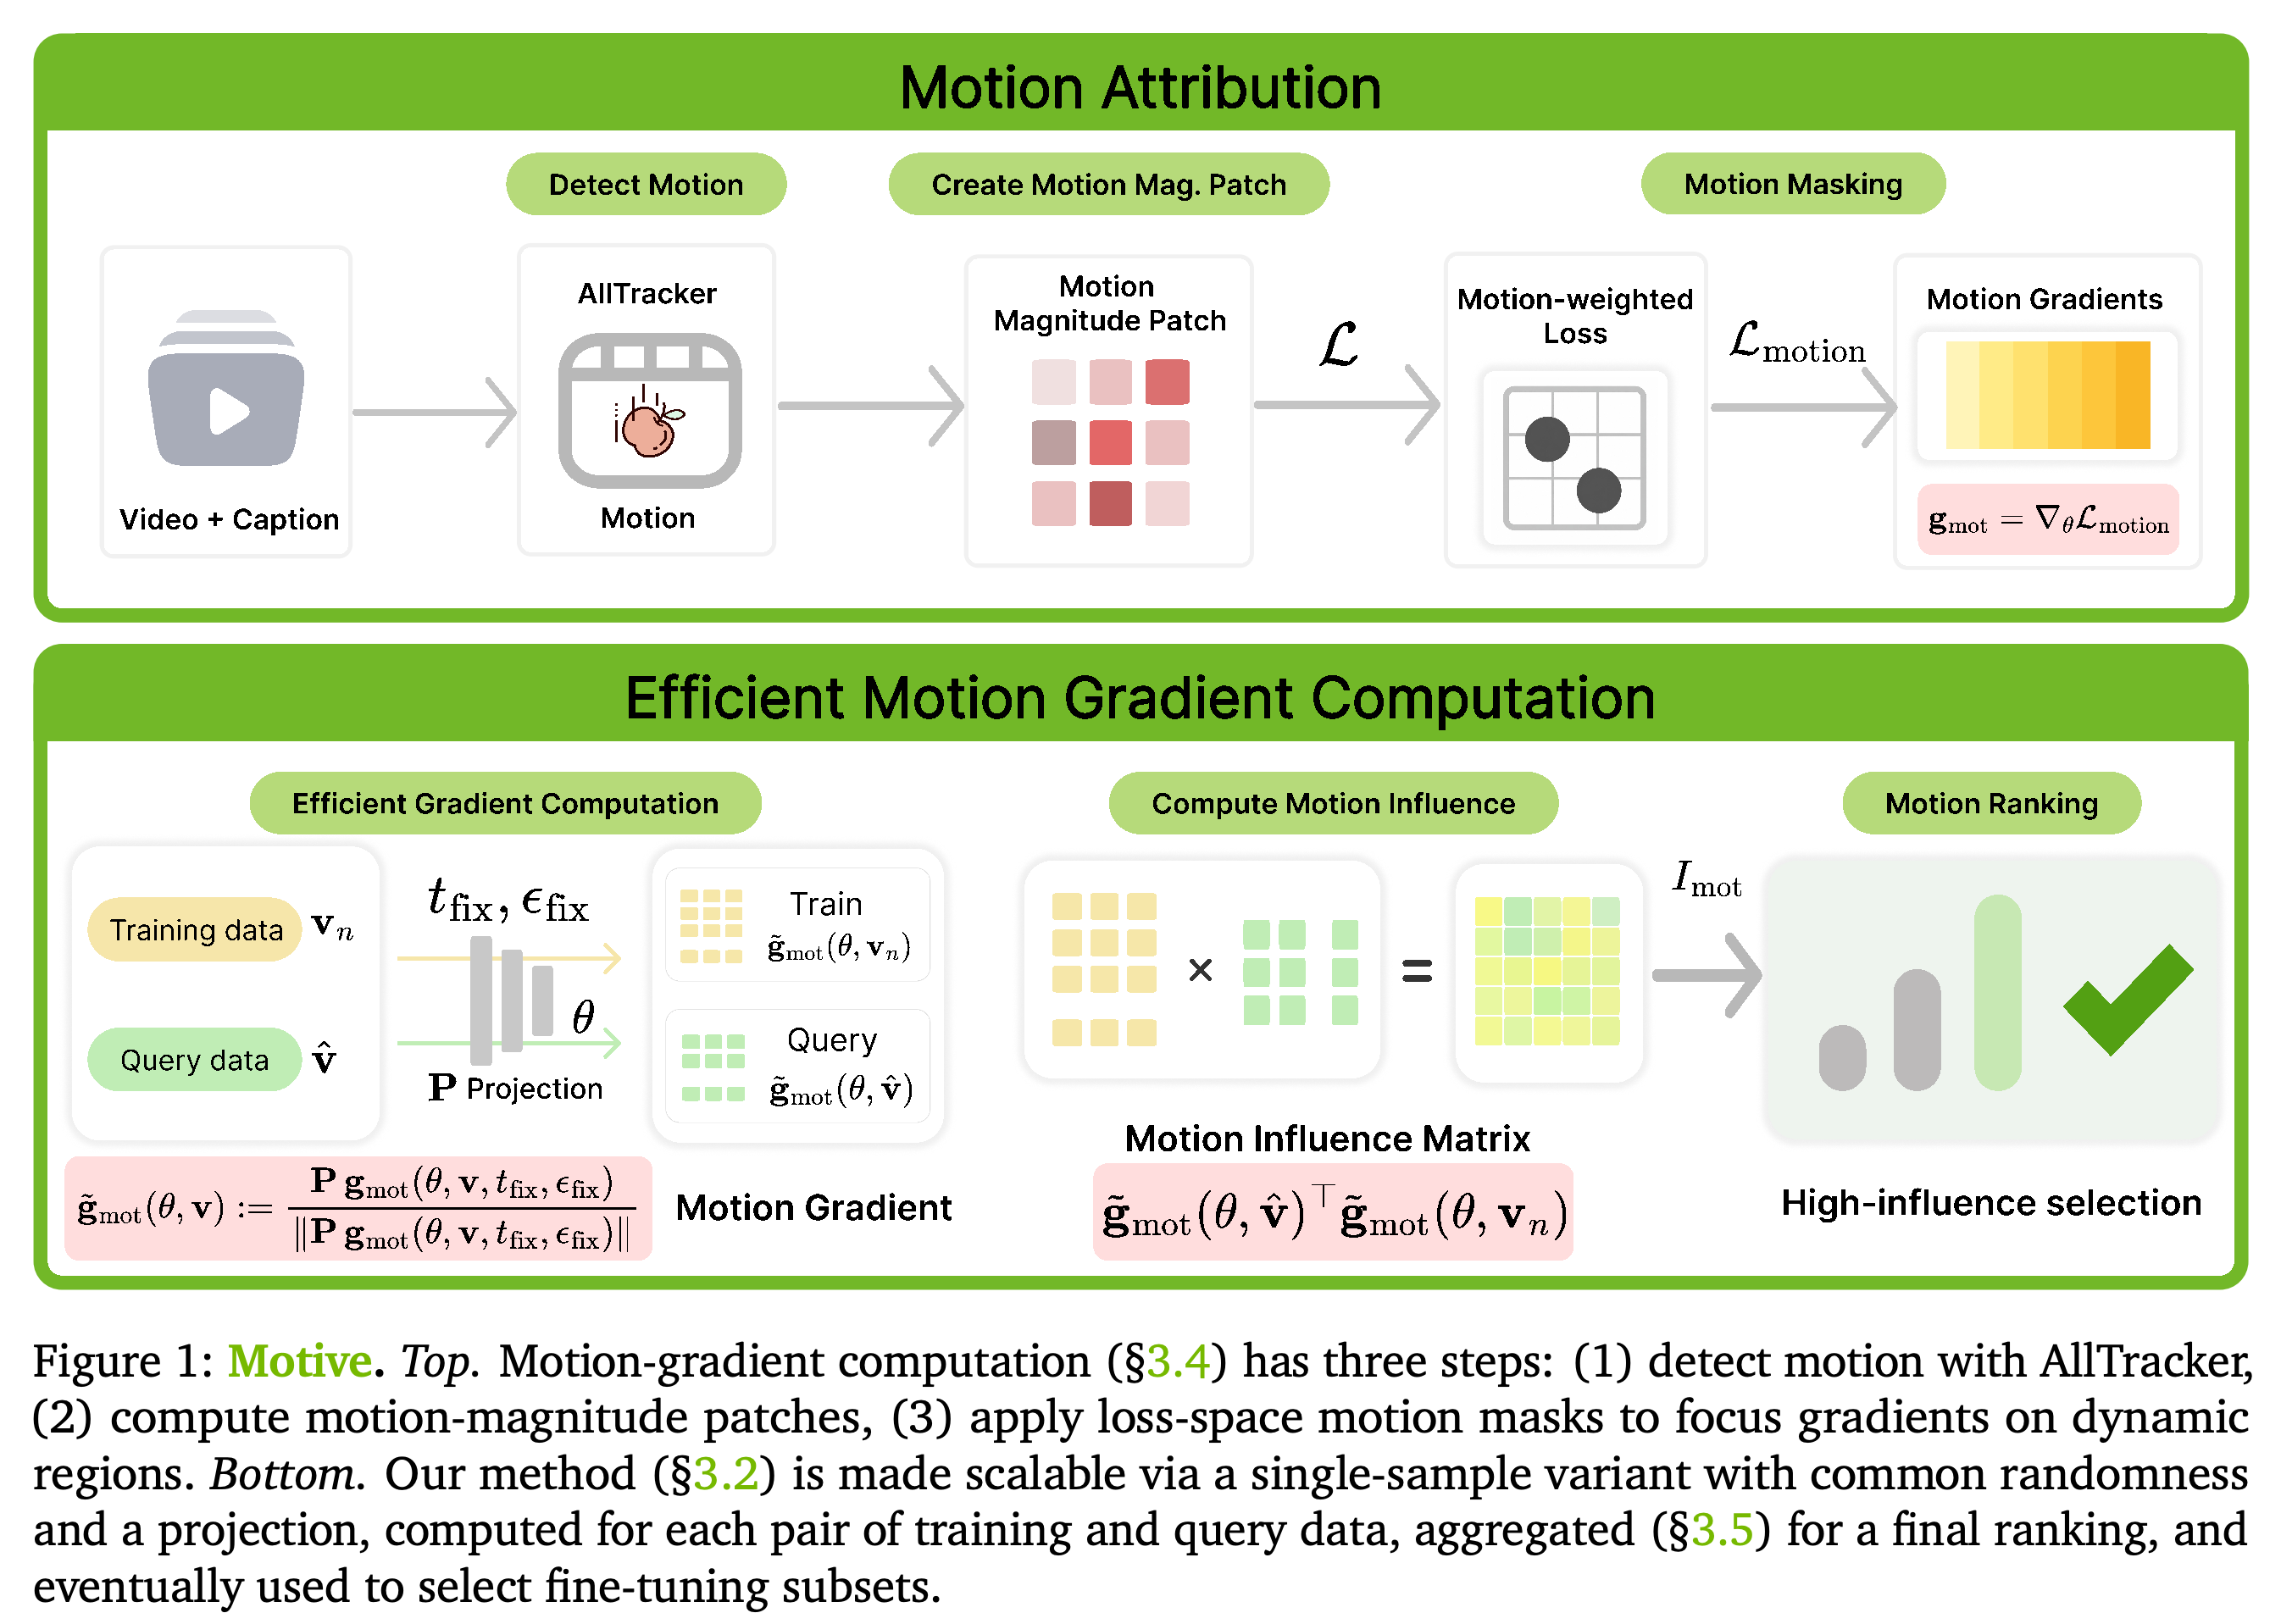
Motive는 확장 가능한 그래디언트 계산, 프레임 길이 편향 처리, 움직임을 고려한 손실 가중, 기여도 기반 부분집합 선택을 결합한다. Figure 1은 순방향 노이즈 주입을 바꾸지 않고 움직임 추출과 그래디언트 투영으로 쿼리에 따른 순위를 만드는 과정을 보여준다.
도식은 움직임 가중과 계산 근사를 구분한다. Optical flow에서 얻은 마스크는 어떤 예측 오차가 그래디언트에 기여할지 결정한다. 공유 timestep·노이즈 샘플과 저차원 투영은 쿼리 점수 계산과 부분집합 선택에 재사용할 수 있는 학습 벡터를 만든다.
3.1. Problem Formulation
파인튜닝 데이터와 조건 정보가 포함된 쿼리 영상이 주어지면, 각 후보 클립에 움직임을 고려한 기여도 점수를 부여한다. 목표는 선택한 부분집합의 파인튜닝으로 평가할 수 있는 예측력 있는 순위를 얻고, 명시적인 Hessian 역행렬 계산이나 광범위한 예제별 적분 없이 계산을 수행하는 것이다.
- 예산 K가 데이터 크기 N보다 훨씬 작을 때, 단일 쿼리는 점수가 높은 상위 K개 클립을 선택한다. 여러 쿼리를 사용할 때는 최종 부분집합을 선택하기 전에 결과를 집계해야 한다.
- 실제 점수는 클립의 정확한 반사실적 기여도가 아니라 그래디언트 정렬 정도를 측정한다.
3.2. Scalable Gradient-based Attribution
확장 가능한 추정기는 역 Hessian 계산 대신 항등 전처리 행렬을 사용하며, 동일한 timestep·노이즈 쌍으로 학습 데이터와 쿼리의 그래디언트를 평가한다. 단일 샘플 방식은 timestep 1개와 공유 Gaussian 노이즈 샘플 1개를 고정해, 예제마다 순전파·역전파 계산을 1회만 수행한다.
- 공통 난수를 사용해 독립적인 확률적 평가보다 상대 순위를 안정화하려 한다.
- 단일 timestep 근사는 Section 4.4에서 10개 timestep을 사용하는 기준과 비교한다. 전체 적분 기여도를 재현한다고 보장하지는 않는다.
Fastfood는 Walsh–Hadamard 변환, 무작위 부호, 순열, Gaussian 스케일링, 재스케일링으로 구조화된 Johnson–Lindenstrauss 투영을 구현한다. 각 투영 그래디언트를 정규화한 뒤, 투영된 쿼리 그래디언트와의 코사인 유사도를 기여도로 사용한다.
- 보고된 Wan2.1 구현은 그래디언트를 D = 1,418,996,800에서 D′ = 512차원으로 투영한다.
- 논문은 투영 복잡도를 O(D′ log D′), 내적 복잡도를 O(D′), 투영 벡터 저장 공간을 O(|𝒟| D′)로 제시한다. 여기서 |𝒟|는 데이터셋 크기다.
3.3. Video-specific Frame-length Bias Fix
Section 3.3은 영상 길이 편향의 원인을 원본 그래디언트 크기로 보고, 투영과 L2 정규화 전에 각 클립의 그래디언트를 프레임 수로 나누는 방법을 제안한다. Section 4.4의 ablation 실험은 입력을 16 fps의 81프레임으로 표준화하는 방법을 평가하며, 이는 그래디언트에 스칼라를 곱해 크기를 조절하는 것과 다르다.
- 시간축 입력 표준화는 그래디언트 방향을 바꿀 수 있다. 반면, 명시된 선형 투영과 L2 정규화에서는 투영 그래디언트가 0이 아닌 경우 양의 스칼라 재스케일링 효과가 상쇄된다.
- Figure 4는 길이에 따른 정성적 비교를 제공하고, Section 4.4는 길이 상관관계의 수치 분석을 제시한다.
3.4. Motion Attribution
AllTracker는 픽셀별 변위, 가시성, 신뢰도 정보를 추출한다. Motive는 변위 크기로 가중치를 만들고, ζ = 10⁻⁶을 사용해 모든 프레임과 픽셀에 걸쳐 [0, 1]로 min–max 정규화한 뒤, 쌍선형 보간으로 VAE 잠재 격자에 매핑한다.
- Wan2.1에 대한 정식화에서는 공간 다운샘플링 s = 8과 잠재 채널 C = 16을 명시한다.
- 상대 크기 가중은 클립의 절대적인 움직임 양으로 클립 간 순위를 정하는 대신, 각 클립 내부에서 움직이는 위치를 강조한다.
- 추적기는 가시성과 신뢰도 채널도 제공하지만, 명시된 가중식은 변위 크기를 사용한다.
움직임 가중 목적함수는 각 잠재 위치의 제곱 예측 오차에 움직임 가중치를 곱하고, 가중 오차의 평균을 구하며, 1/Fv 인자를 포함한다. 움직임 기여도는 이 목적함수로 계산한 학습 데이터와 쿼리의 그래디언트를 투영·정규화한 뒤 얻는 내적이다.
- 모든 값이 1인 마스크를 사용하면 명시된 프레임 수 인자가 포함된 비마스킹 목적함수가 복원된다.
- 마스킹은 기여도 계산에 쓰는 손실을 바꾸며, 순방향 노이즈 주입이나 생성 절차는 바꾸지 않는다.
- 가중치는 정적인 영역의 기여를 억제하지만, 움직이는 영역의 외형 오차는 시간적 정보와 여전히 섞일 수 있다.
3.5. Most Influential Fine-tuning Subset Selection
단일 쿼리는 점수가 가장 높은 클립을 선택하며, 선택 예산은 데이터셋의 백분위수로 표현한다. 여러 쿼리를 사용할 때는 각 쿼리가 자신의 백분위수 기준을 넘는 클립에 투표한다. 후보를 총득표수로 정렬하고 ICONS 집계 방식으로 상위 K개를 선택한다.
- 투표 방식은 쿼리 사이에서 원시 기여도 점수의 척도를 맞출 필요가 없으며, 서로 다른 목표에서 반복적으로 선택되는 클립을 우선한다.
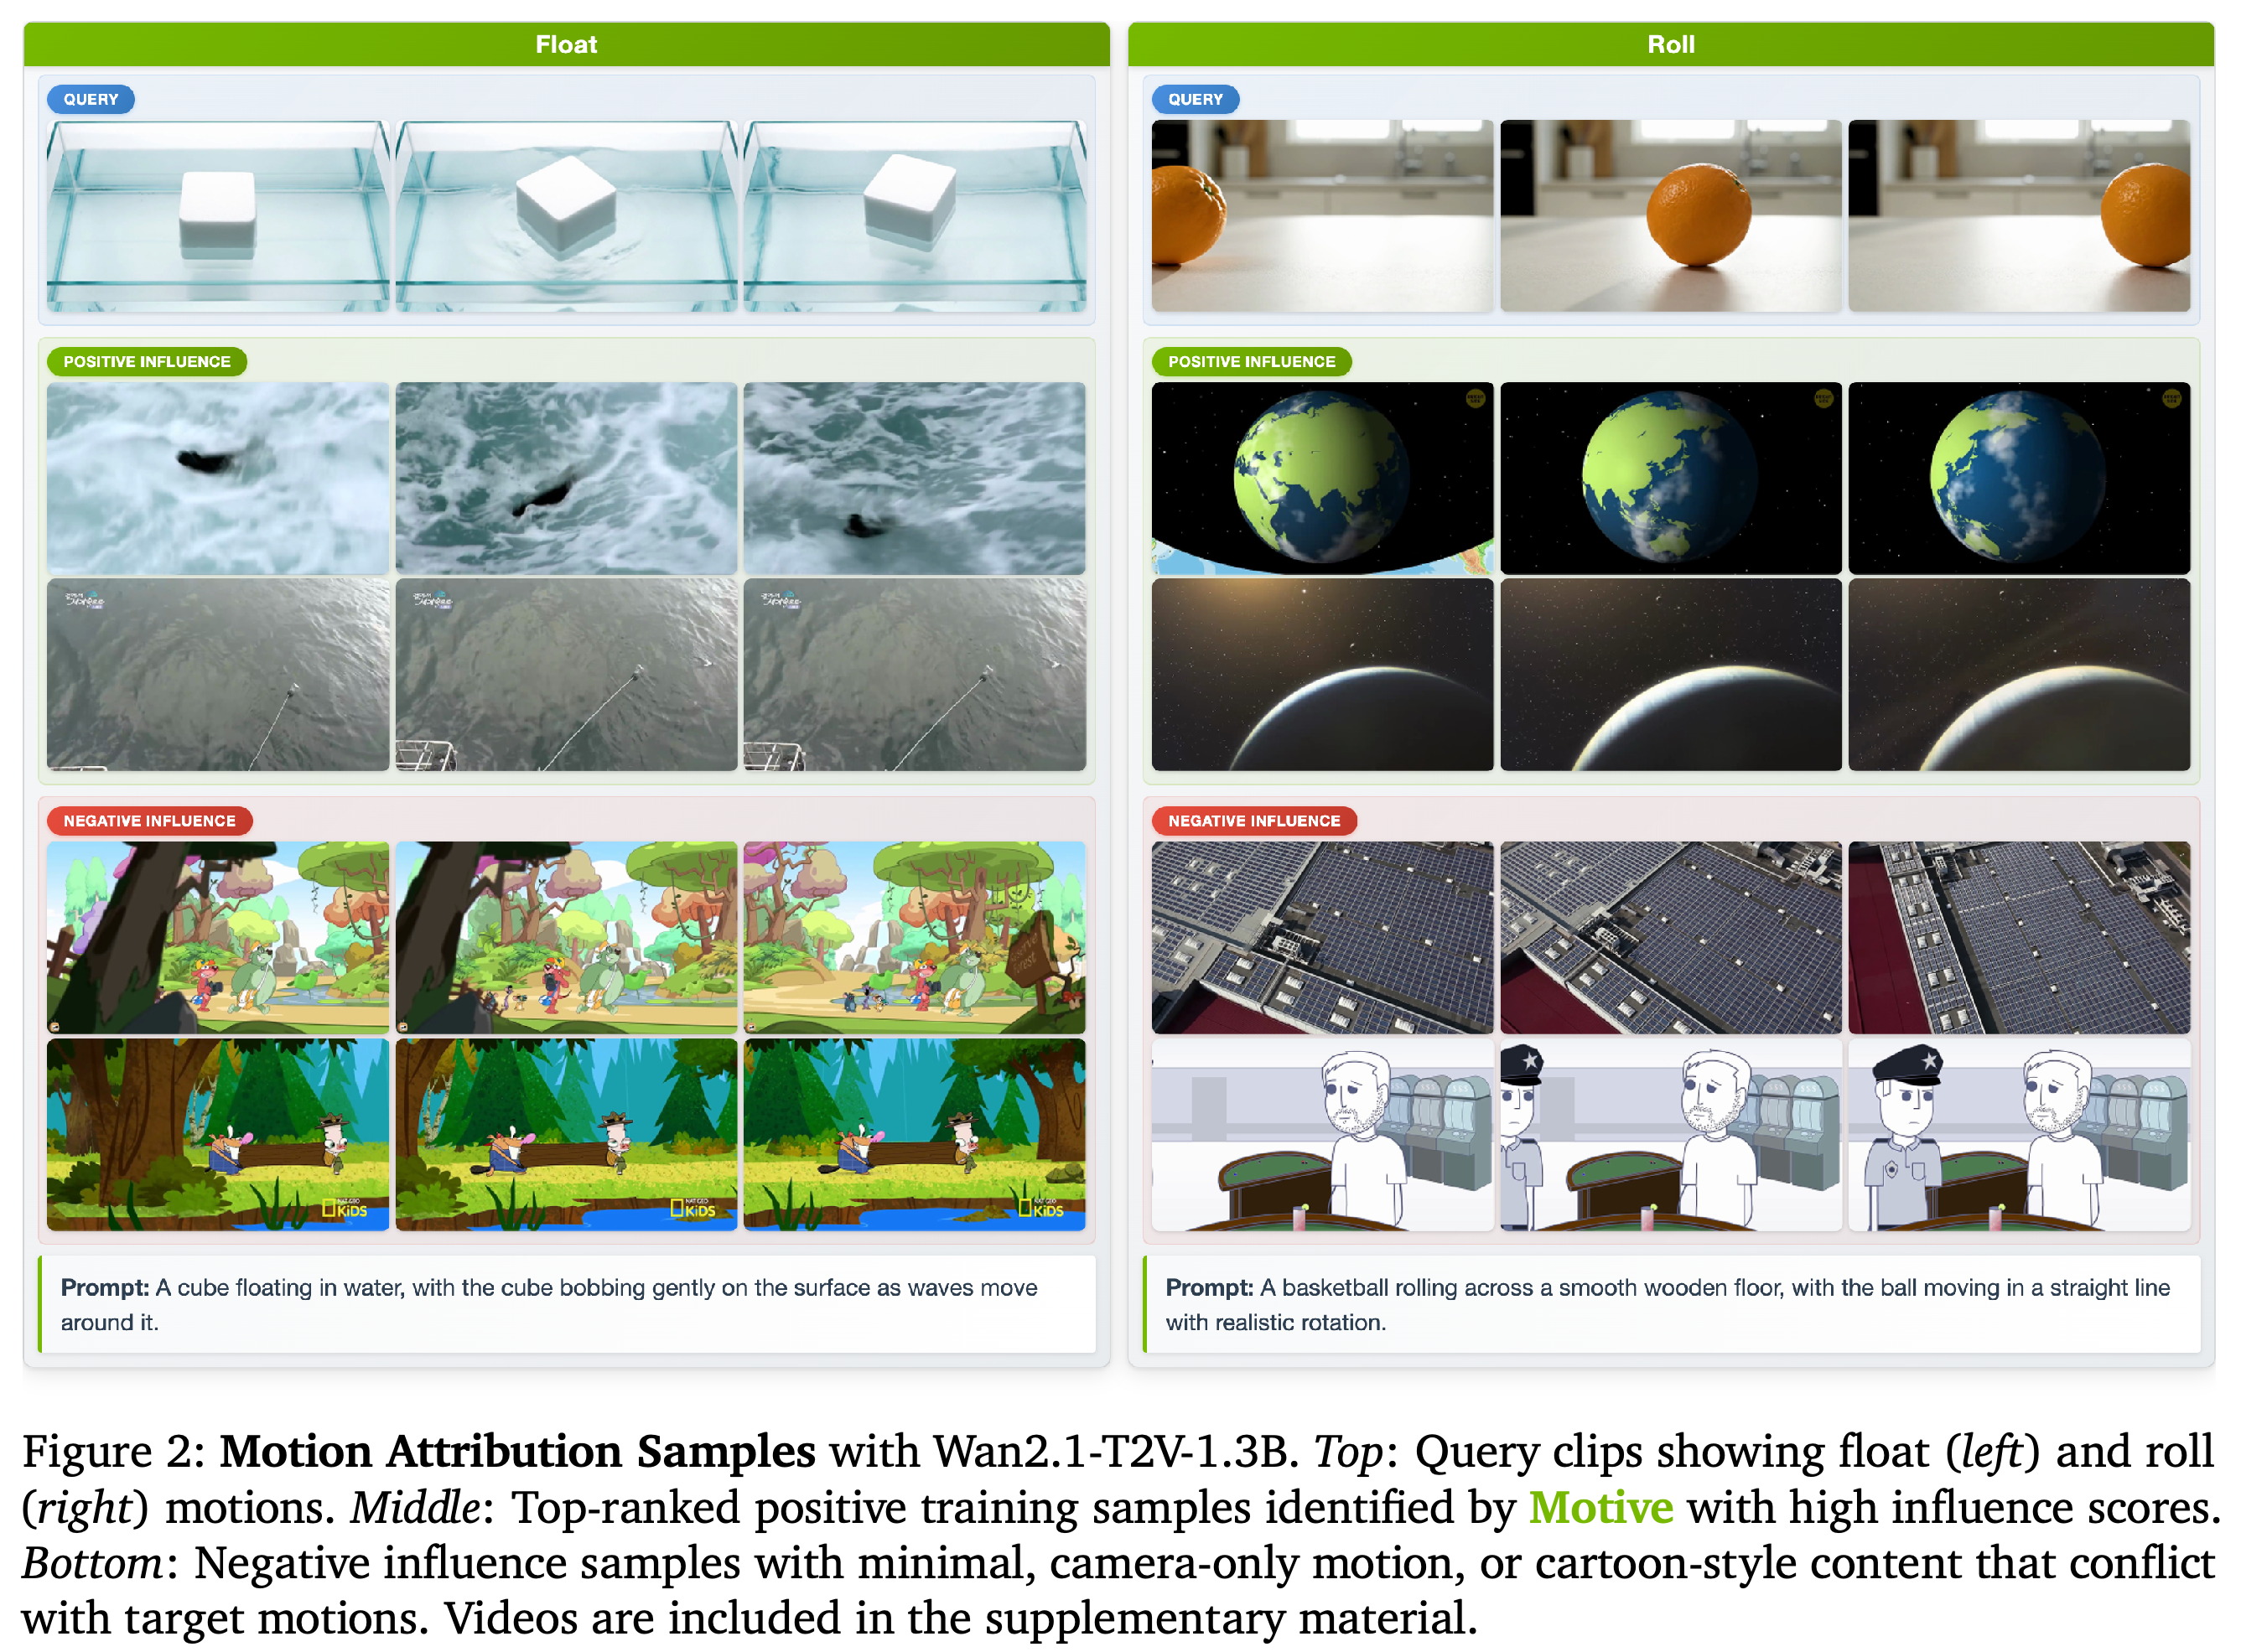
- Figure 2는 floating과 rolling 쿼리를 보여준다. 양의 기여도 예제에는 물의 움직임과 행성 회전이, 음의 기여도 예제에는 만화와 카메라 움직임이 지배적인 영상이 포함된다. 이는 순위 예시이며 개별 재학습 실험은 아니다.
상위 예제는 외형이 다른 클립을 쿼리와 관련된 움직임으로 연결한다. Floating 쿼리에는 물 장면이, rolling 쿼리에는 행성 회전이 연결된다. 음의 기여도 예제에는 만화와 카메라 움직임이 지배적인 영상이 포함된다. 이는 그래디언트 정렬이 전반적인 시각적 유사도와 다름을 보여주지만, 음의 점수를 받은 각 클립이 단독으로 생성 품질을 떨어뜨린다고 입증하지는 않는다.
3.6. Computational Efficiency Analysis
timestep·노이즈 쌍 1개를 고정하면 그래디언트 계산량은 O(N |𝒯| B)에서 O(N B)로 줄어든다. |𝒯|는 샘플링한 쌍의 수이고 B는 순전파·역전파 1회의 비용이다. 투영 벡터 저장 공간은 O(N D) 대신 O(N D′)이며, 쿼리 1개의 점수 계산 비용은 O(N D′), 정렬 비용은 O(N log N)이다.
- 구조화된 Fastfood 상태를 저장하려면 추가로 O(D) 공간이 필요하다.
- 움직임 마스크는 1회 추출한 뒤 캐시한다. 논문이 제시한 추출 복잡도는 O(N H W F)다.
- 고정된 모델 체크포인트에서 후보 그래디언트 계산 비용은 여러 쿼리에 걸쳐 분산되지만, 새 쿼리마다 별도의 역전파가 필요하다.
4. Experiment
실험은 자동 지표, 정성적 비교, 사람의 판단, 근사 방식의 ablation 실험으로 기여도 기반 부분집합이 생성 영상의 움직임을 개선하는지 평가한다. 선택 데이터로 파인튜닝한 모델을 사전 학습 모델, 전체 후보 집합으로 파인튜닝한 모델, 다른 선택 방법과 비교한다.
4.1. Setup
실험은 VIDGEN-1M과 4DNeX-10M에서 가져온 10k-video 후보 집합을 사용한다. 기여도 분석의 목표는 쿼리 클립 50개이며, compress, bounce, roll, explode, float, free fall, slide, spin, stretch, swing에 예제를 동일하게 배정한다.
- 부록에 따르면 쿼리는 Veo-3-generated 영상이며, 명확성, 사실성, 물리적 개연성을 기준으로 수동 선별했다. 쿼리는 기여도 분석의 목표를 지정하며 파인튜닝 데이터로 쓰이지 않는다.
- 테스트 프롬프트는 동일한 10개 움직임 범주를 다른 외형으로 다루며, 범주마다 평가 프롬프트 5개를 사용한다.
주요 모델은 Wan2.1-T2V-1.3B와 Wan2.2-TI2V-5B이며, 부록에서는 LTX-2B도 평가한다. 선택 기준선은 균등 무작위 샘플링, 평균 움직임 크기가 가장 큰 클립 선택, V-JEPA 기반 선택, 움직임 마스킹을 제거한 Motive다. 부분집합 방법은 후보 데이터의 10%를 사용한다.
- 파인튜닝은 T5 텍스트 인코더와 VAE를 고정하고 DiT 백본을 업데이트하며, 해상도 480 × 832와 학습률 1 × 10⁻⁵를 사용한다.
- Specialist는 움직임 범주 1개의 선택 결과를 사용하고, generalist는 집계한 선택 결과를 사용한다.
- VBench는 subject consistency, background consistency, motion smoothness, dynamic degree, aesthetic quality, imaging quality를 측정한다. 주요 시간적 평가 대상은 motion smoothness와 dynamic degree다.
4.2. Main Results
Table 1에서 가장 뚜렷한 우위는 dynamic degree에 나타난다. Motive는 2개 Wan 모델에서 47.6%와 48.3%를 기록한다. 무작위 선택은 41.3%와 41.6%, 비마스킹 기여도 분석은 두 모델 모두 43.8%, 전체 파인튜닝은 42.0%와 45.3%다. Aesthetic quality 점수 46.0%와 45.6%도 보고된 방법 중 가장 높다.
- Motion smoothness는 Wan2.1에서 96.3%로 기본 모델 및 전체 파인튜닝과 같고, Wan2.2에서는 97.6%로 두 비교 대상의 97.5%보다 높다.
- 정량적 근거는 이미 높은 smoothness를 개선한다는 주장보다 움직임의 활동성을 높인다는 주장을 더 강하게 뒷받침한다. Dynamic degree가 물리적 개연성을 직접 입증하지는 않는다.
- 시각적 품질의 절충은 남아 있다. Wan2.1의 background consistency는 96.1%로 Base의 96.4%보다 낮고, imaging quality는 64.6%로 65.7%보다 낮다. Wan2.2의 imaging quality는 65.5%로 Full FT의 66.2%보다 낮다.
다른 부분집합 방법과 동일한 10% 선택 예산에서 Motive는 두 Wan 모델 모두 가장 높은 dynamic degree를 기록하며, 이 지표에서 전체 후보 집합 파인튜닝보다 높다. Motion smoothness는 Wan2.1에서 Base와 같고 Wan2.2에서는 소폭만 증가한다. Background consistency와 imaging quality 점수는 모든 품질 측면에서 개선되는 것은 아님을 보여준다.
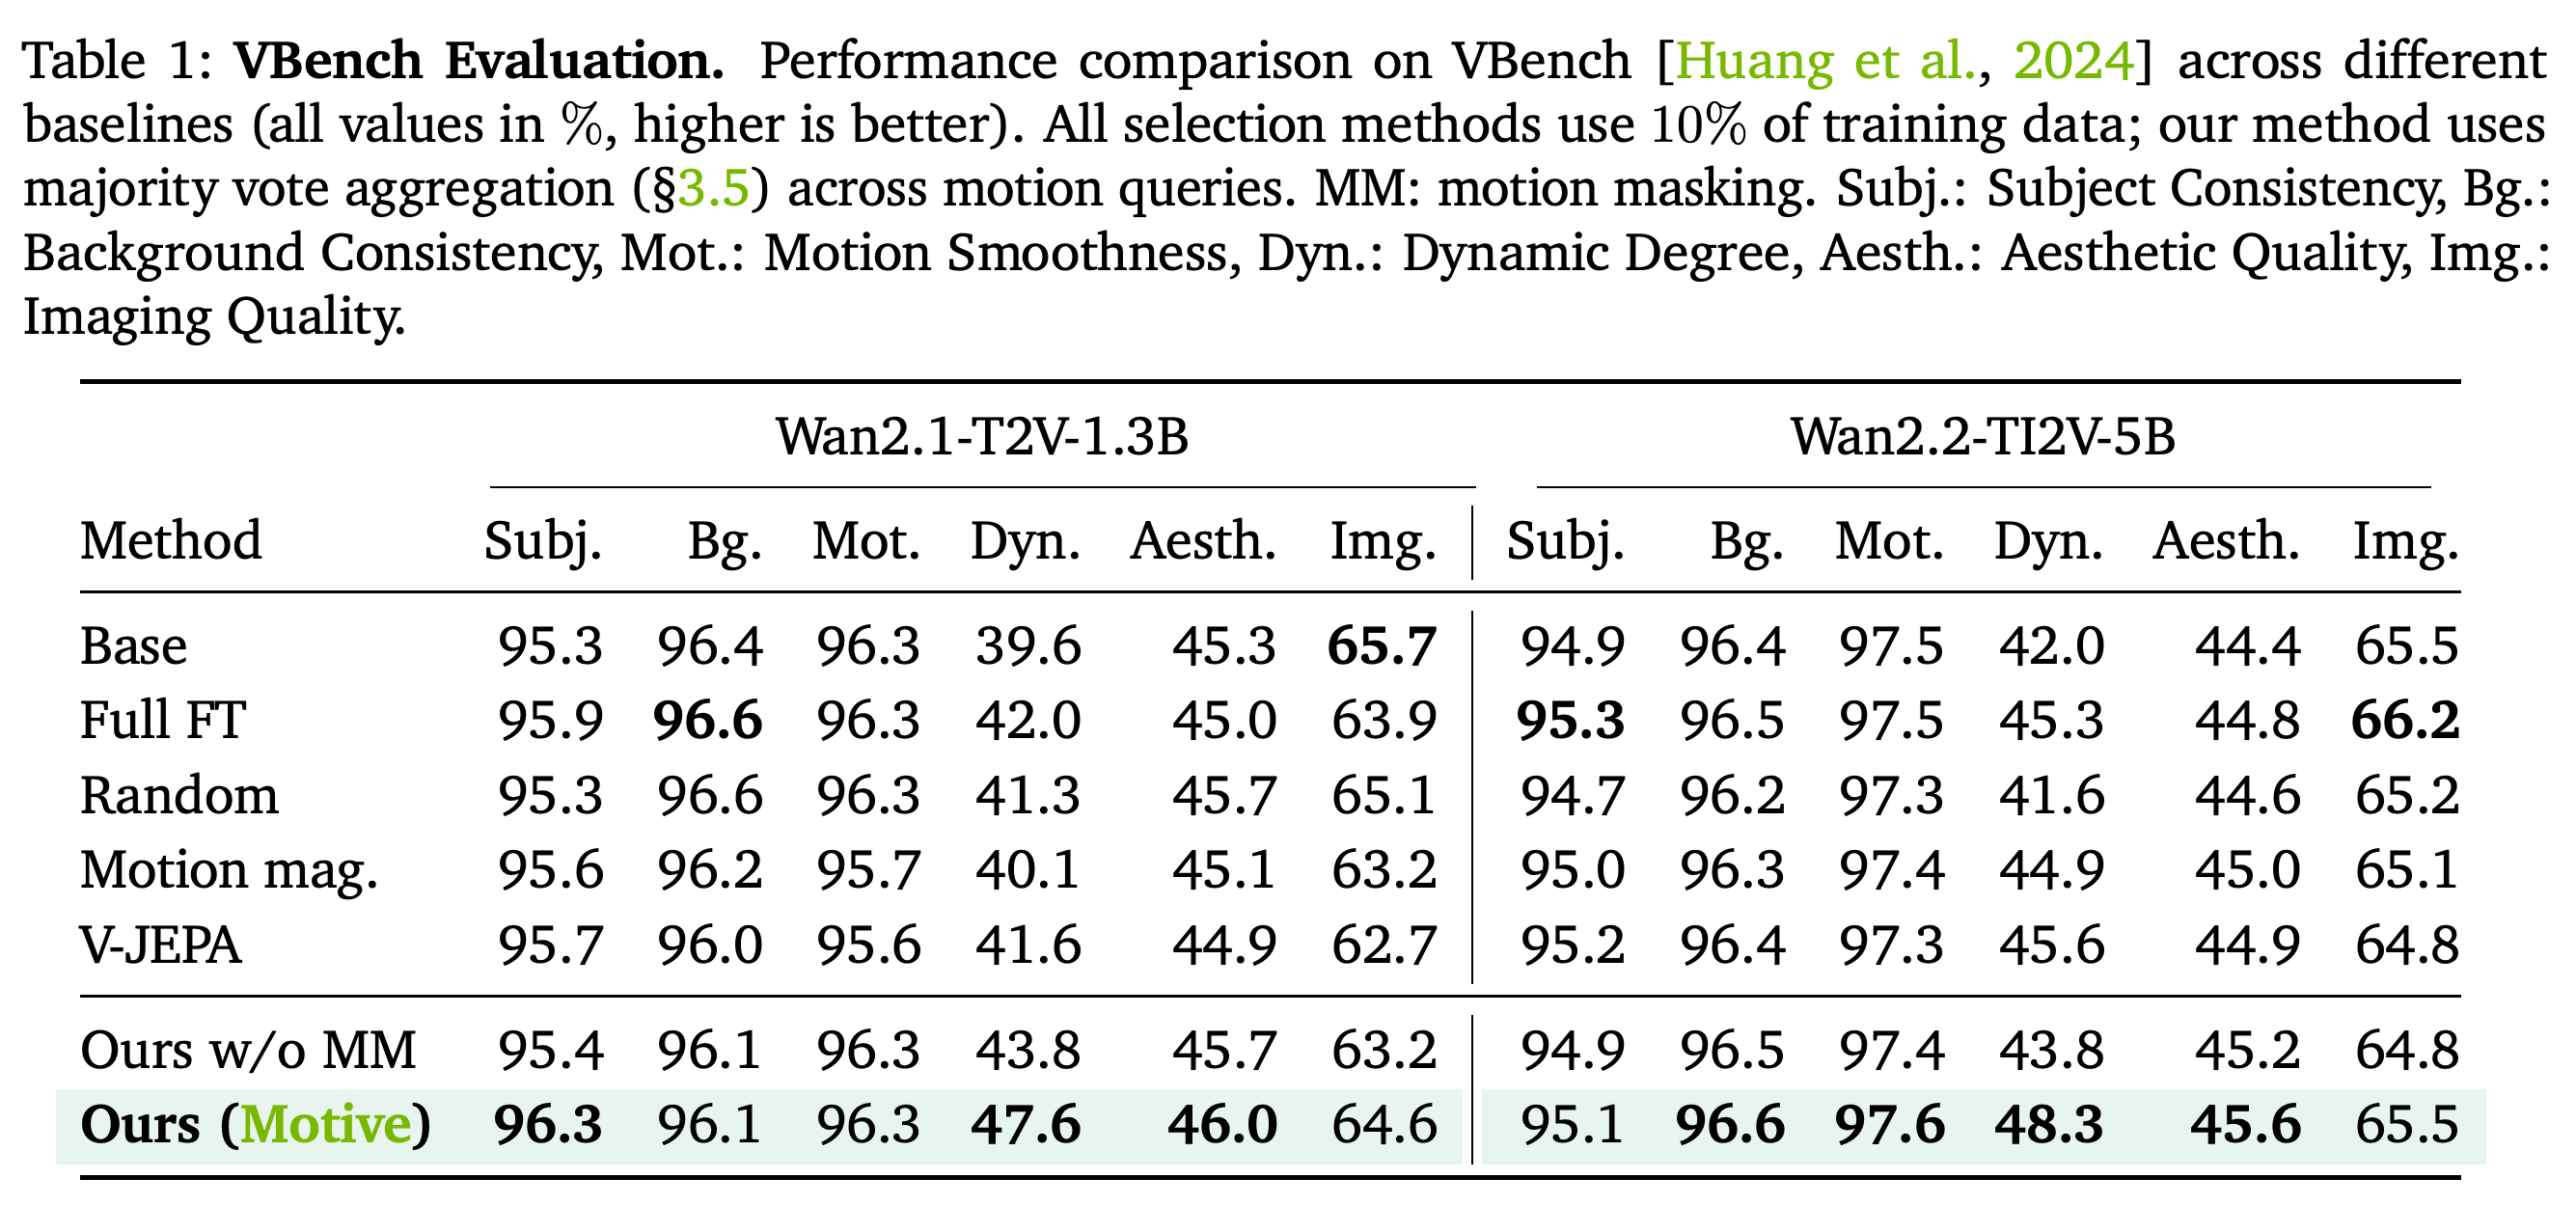
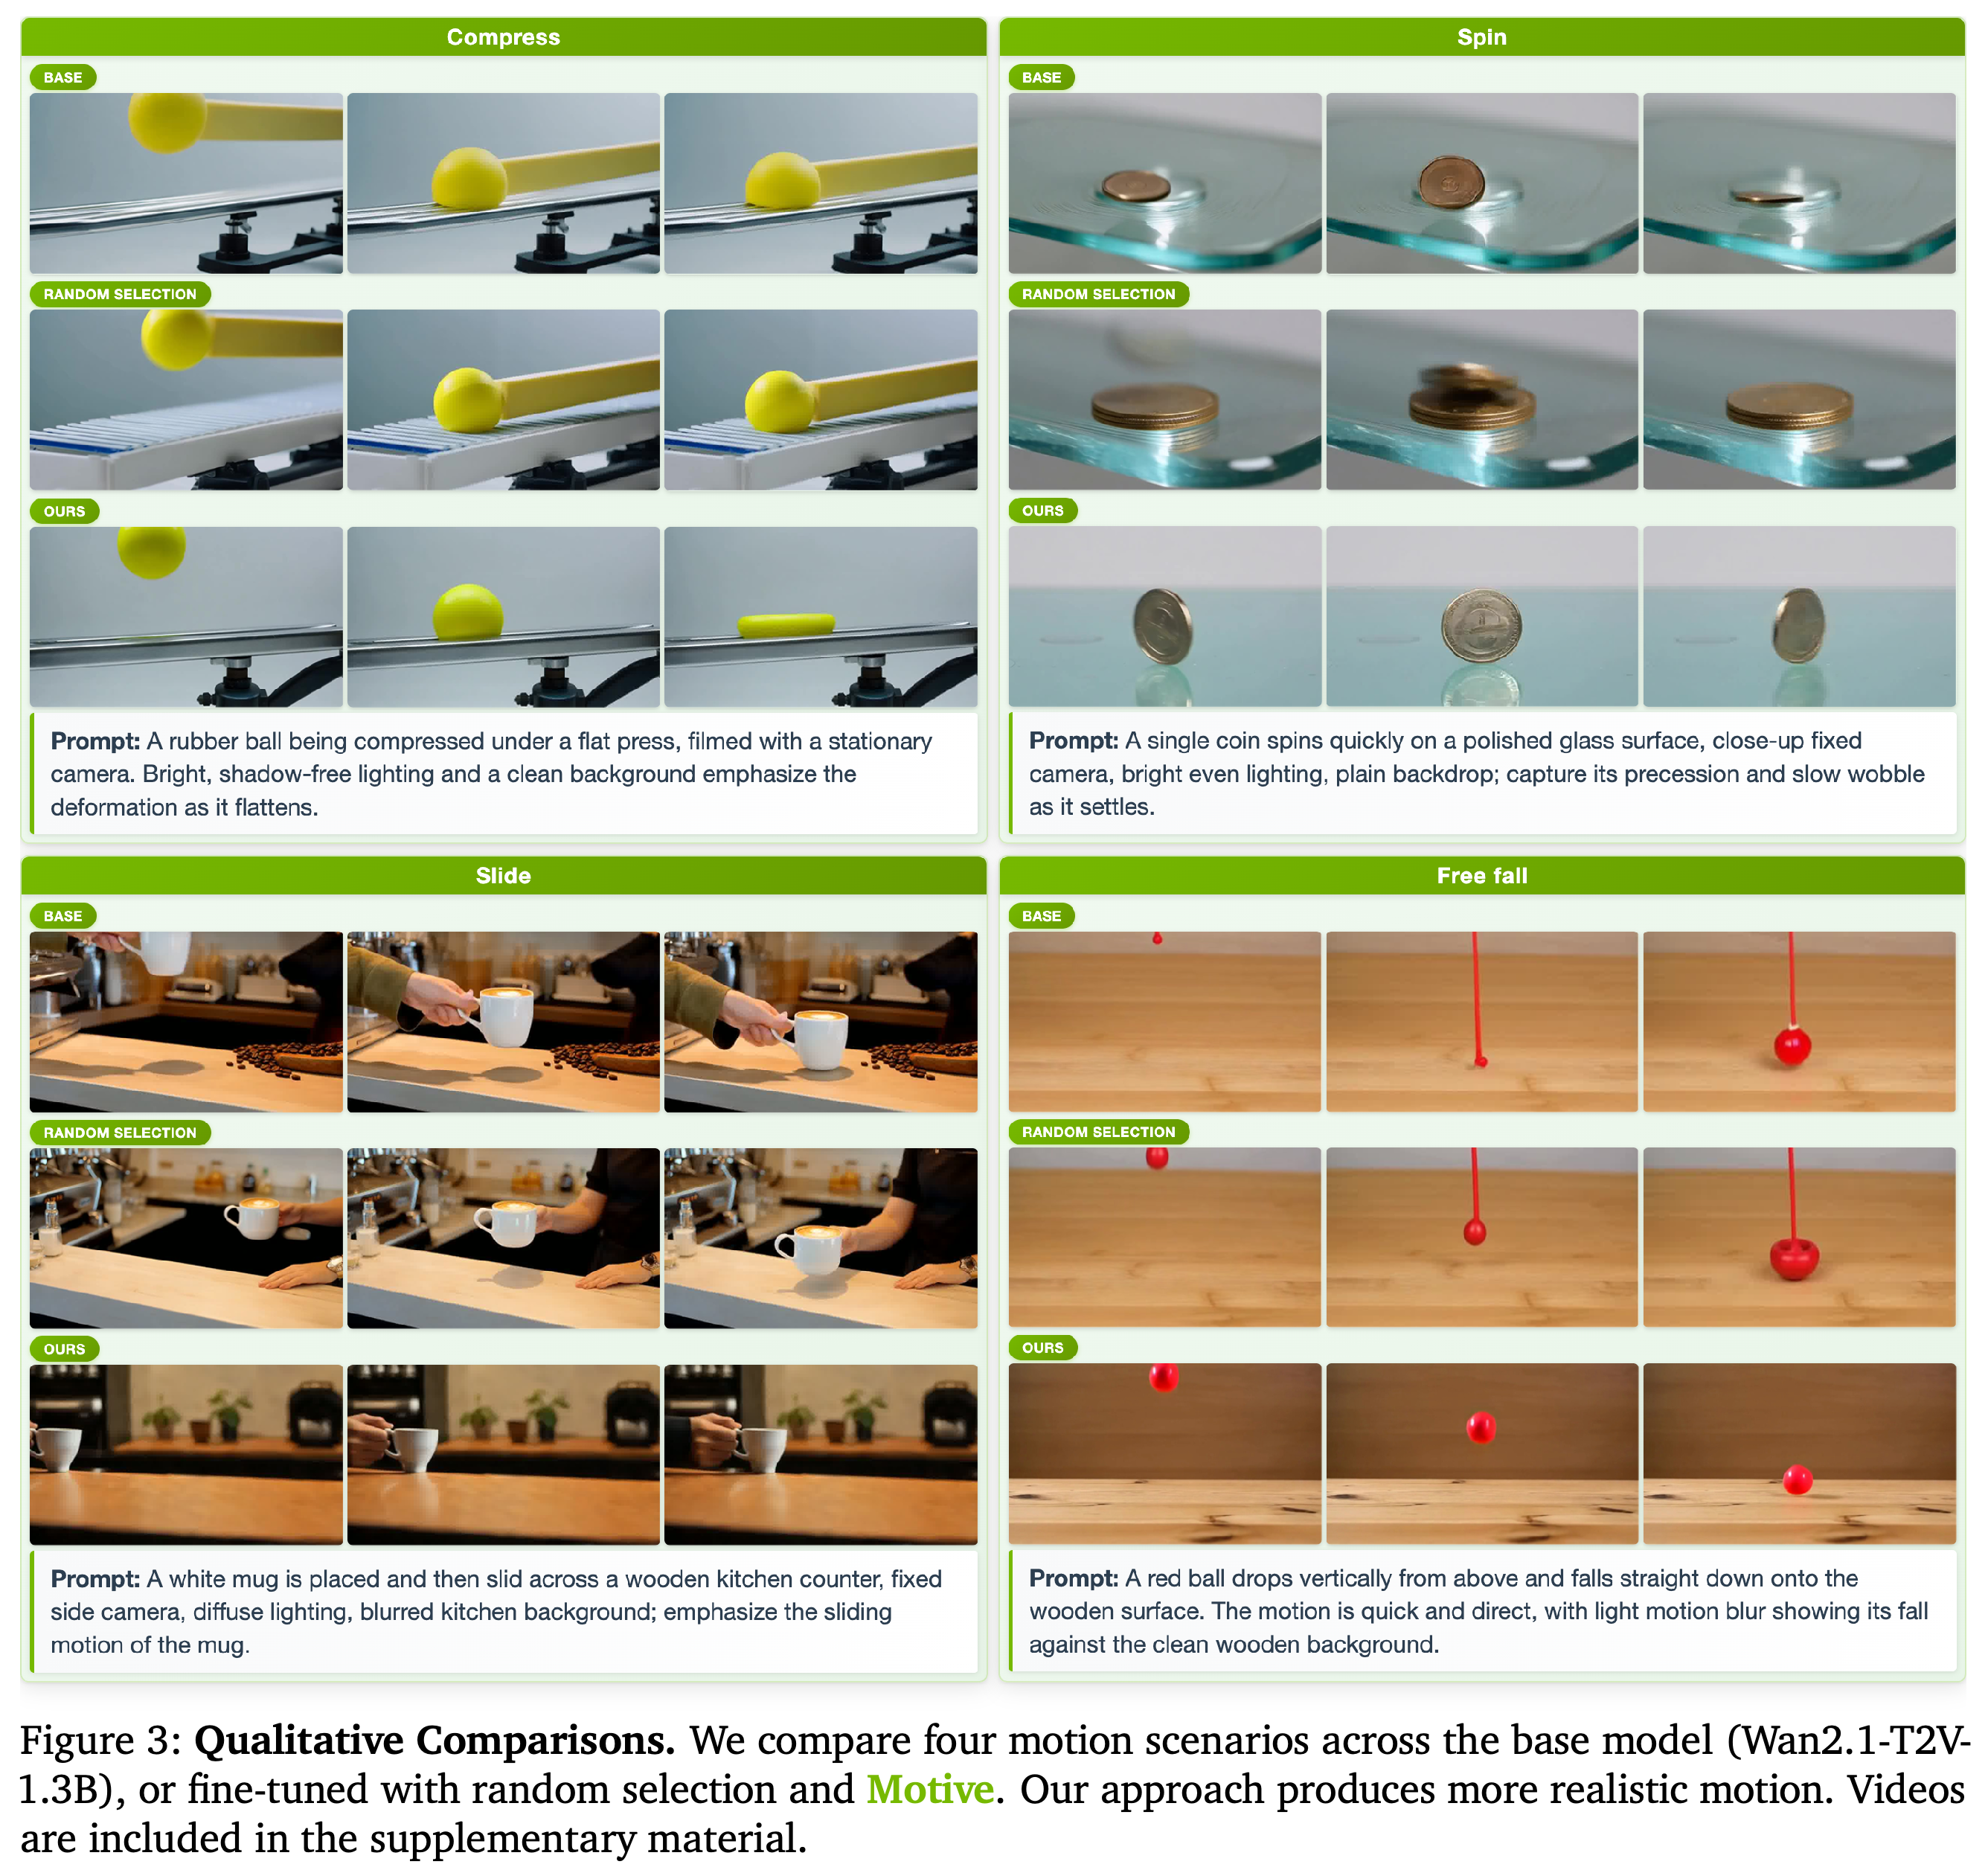
Figure 3은 기본 모델, 무작위 선택 파인튜닝, Motive 선택 파인튜닝의 compression, spinning, sliding, free fall을 비교한다. 제시된 시퀀스에서 Motive 예제는 더 명확한 변형과 프롬프트에 더 잘 맞는 객체 움직임을 보여준다.
- Figure 2는 상위 후보 클립이 쿼리와 동일한 객체를 포함할 필요가 없다는 점도 보여준다.
- 선택된 예제는 집계 지표를 보완하지만, 개선이 얼마나 자주 나타나는지 정량화하거나 물리 법칙 준수 여부를 직접 검증하지는 않는다.
Motive 행에서는 눈에 띄게 납작해진 공, 제시된 회전 시점에 똑바로 선 동전, 조리대 위에 놓인 머그잔, 서로 다른 하강 위치의 공이 보인다. 이 프레임은 선택된 예제 4개에서 프롬프트에 더 잘 맞는 움직임을 보여주지만, 궤적의 부드러움이나 개선 빈도를 정량화하지는 못한다.
4.3. Human Evaluation
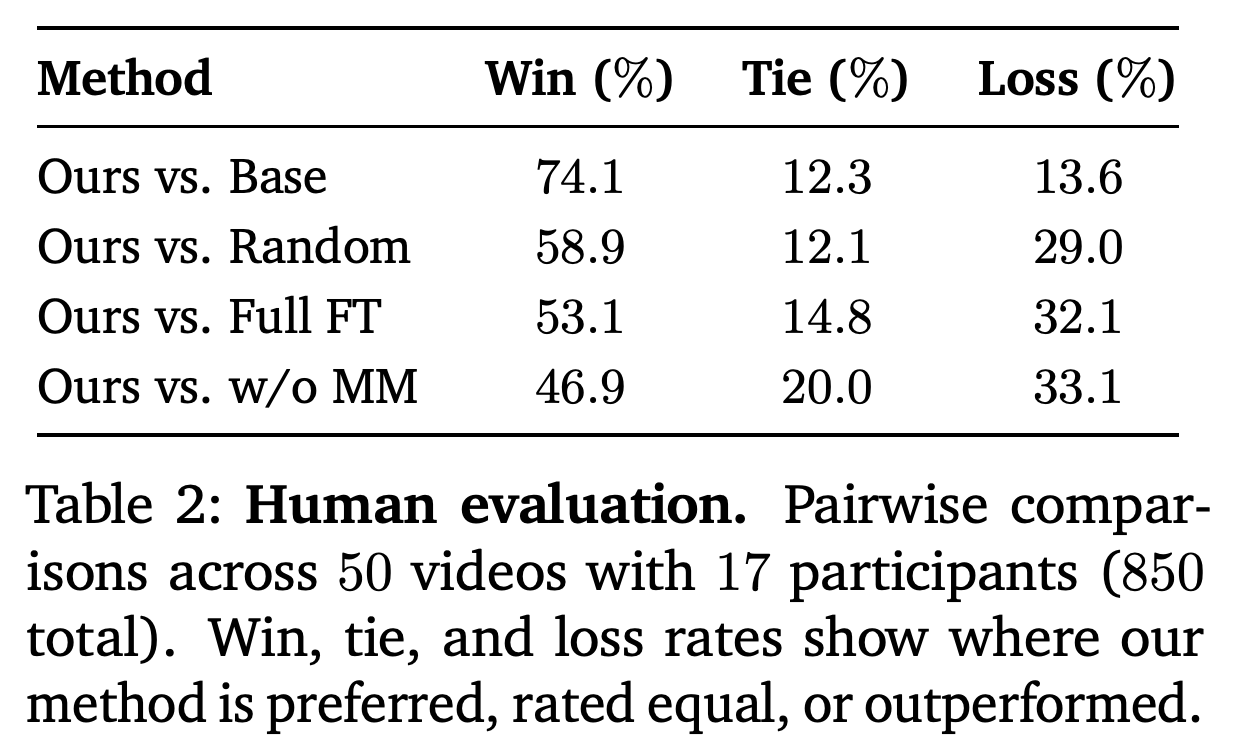
참가자 17명이 영상 쌍을 비교해 움직임을 판단하며, 제시 순서는 무작위로 정하고 무승부를 허용한다. Table 2는 영상 50개와 총 판단 850건을 명시한다. Motive의 승리/무승부/패배 비율은 Base 대비 74.1%/12.3%/13.6%, Random 대비 58.9%/12.1%/29.0%, Full FT 대비 53.1%/14.8%/32.1%, 움직임 마스킹을 제거한 버전 대비 46.9%/20.0%/33.1%다.
- 비마스킹 기여도 분석과의 비교에서는 승리가 패배보다 많지만, 무승부를 분모에 포함하면 승률은 50% 미만이다.
- 평가 절차 본문은 비교 조합 3개를 언급하지만 표에는 기준선 비교 4개가 있다. PDF는 이 수치와 명시된 총횟수의 관계를 설명하지 않는다.
- 선호 비율에는 신뢰구간이나 통계적 유의성 검정이 제시되지 않는다.
선호 차이는 사전 학습된 기본 모델과 비교할 때 가장 크며, 전체 파인튜닝이나 비마스킹 기여도 분석과 비교할 때는 더 작다. 비마스킹 방법 대비 승리 46.9%는 패배 33.1%보다 많고, 무승부는 20.0%다. 무승부를 포함하면 승률이 50%를 넘는 것은 아니다.
4.4. Ablations
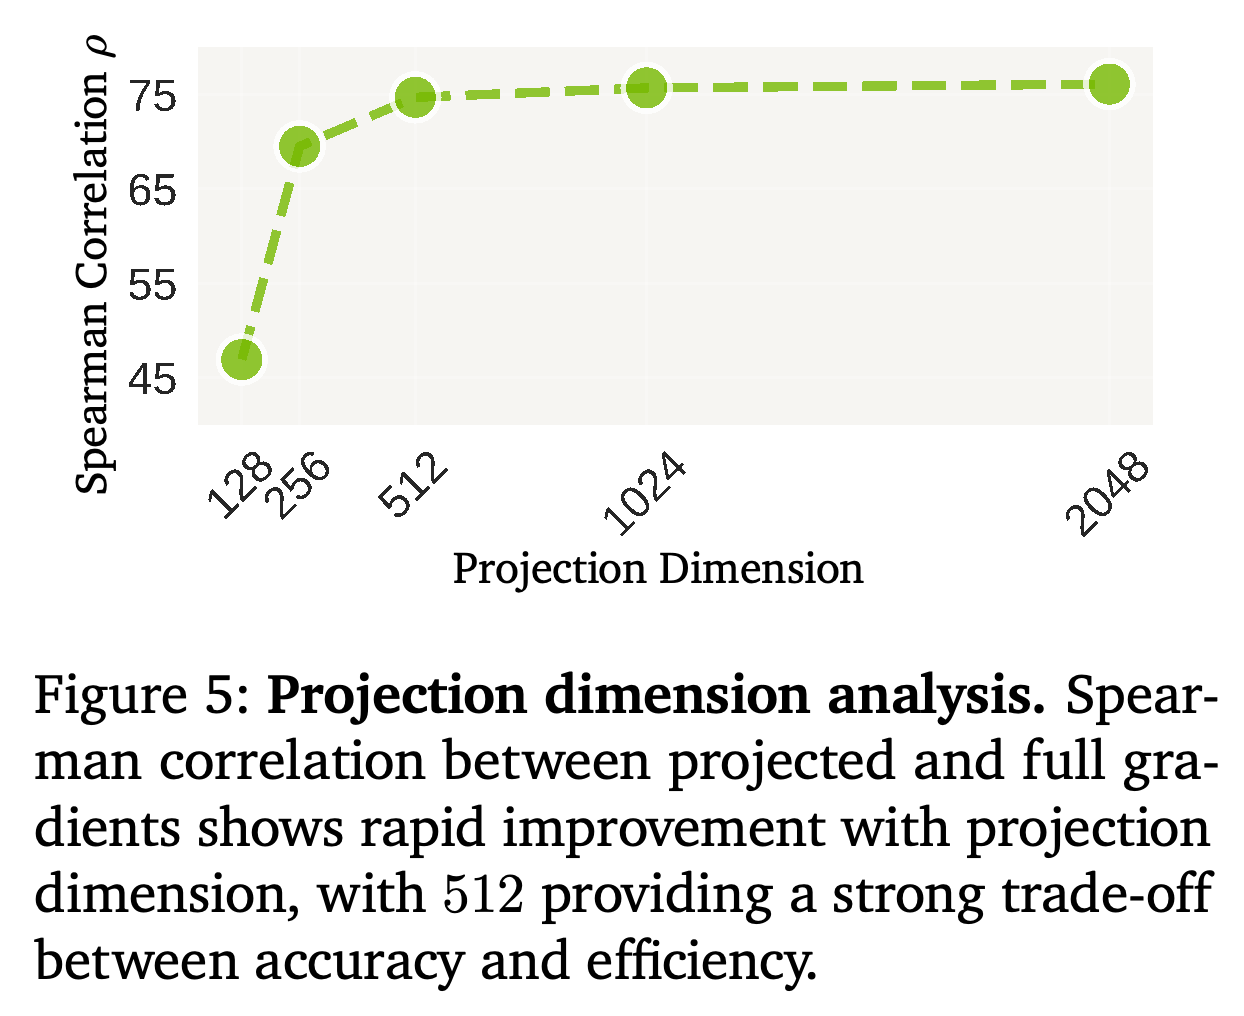
투영 ablation 실험은 투영된 그래디언트와 전체 그래디언트로 구한 기여도 순위 사이의 Spearman 상관계수를 측정한다. 상관계수는 D′ = 128에서 46.9%, D′ = 512에서 74.7%로 상승하지만, 1024에서는 75.7%, 2048에서는 76.1%로 소폭 증가한다. Figure 5의 결과는 512차원 설정을 선택한 근거다.
- 이 상관계수는 저차원 근사의 타당성을 뒷받침하지만, 해당 비율만큼의 순위가 정확히 보존된다는 뜻은 아니다.
Spearman 상관계수는 투영 차원 512까지 빠르게 상승한 뒤 대체로 정체된다. 512차원의 74.7%에서 2048차원의 76.1%로 증가하는 결과는 효율을 위해 더 작은 표현을 선택할 근거가 된다. 동시에 투영 그래디언트와 전체 그래디언트의 순위가 동일하지 않다는 점도 보여준다.
고정 timestep t = 751에서 단일 timestep 기여도는 flow-matching 스케줄의 등간격 timestep 10개를 사용하는 기준과 Spearman 상관계수 ρ = 66%를 보인다. 저자들은 노이즈가 많은 초기 노이즈 제거 단계와 세부 묘사가 지배하는 후기 단계 사이의 절충으로 이 설정을 설명한다.
- 기준은 여러 timestep의 그래디언트 추정치이며, 개별 예제의 기여도에 대한 재학습 기반 정답은 아니다.
- 논문은 t = 751을 1000단계 경로의 중간점이라고 부르지만, 그 이유는 설명하지 않는다.
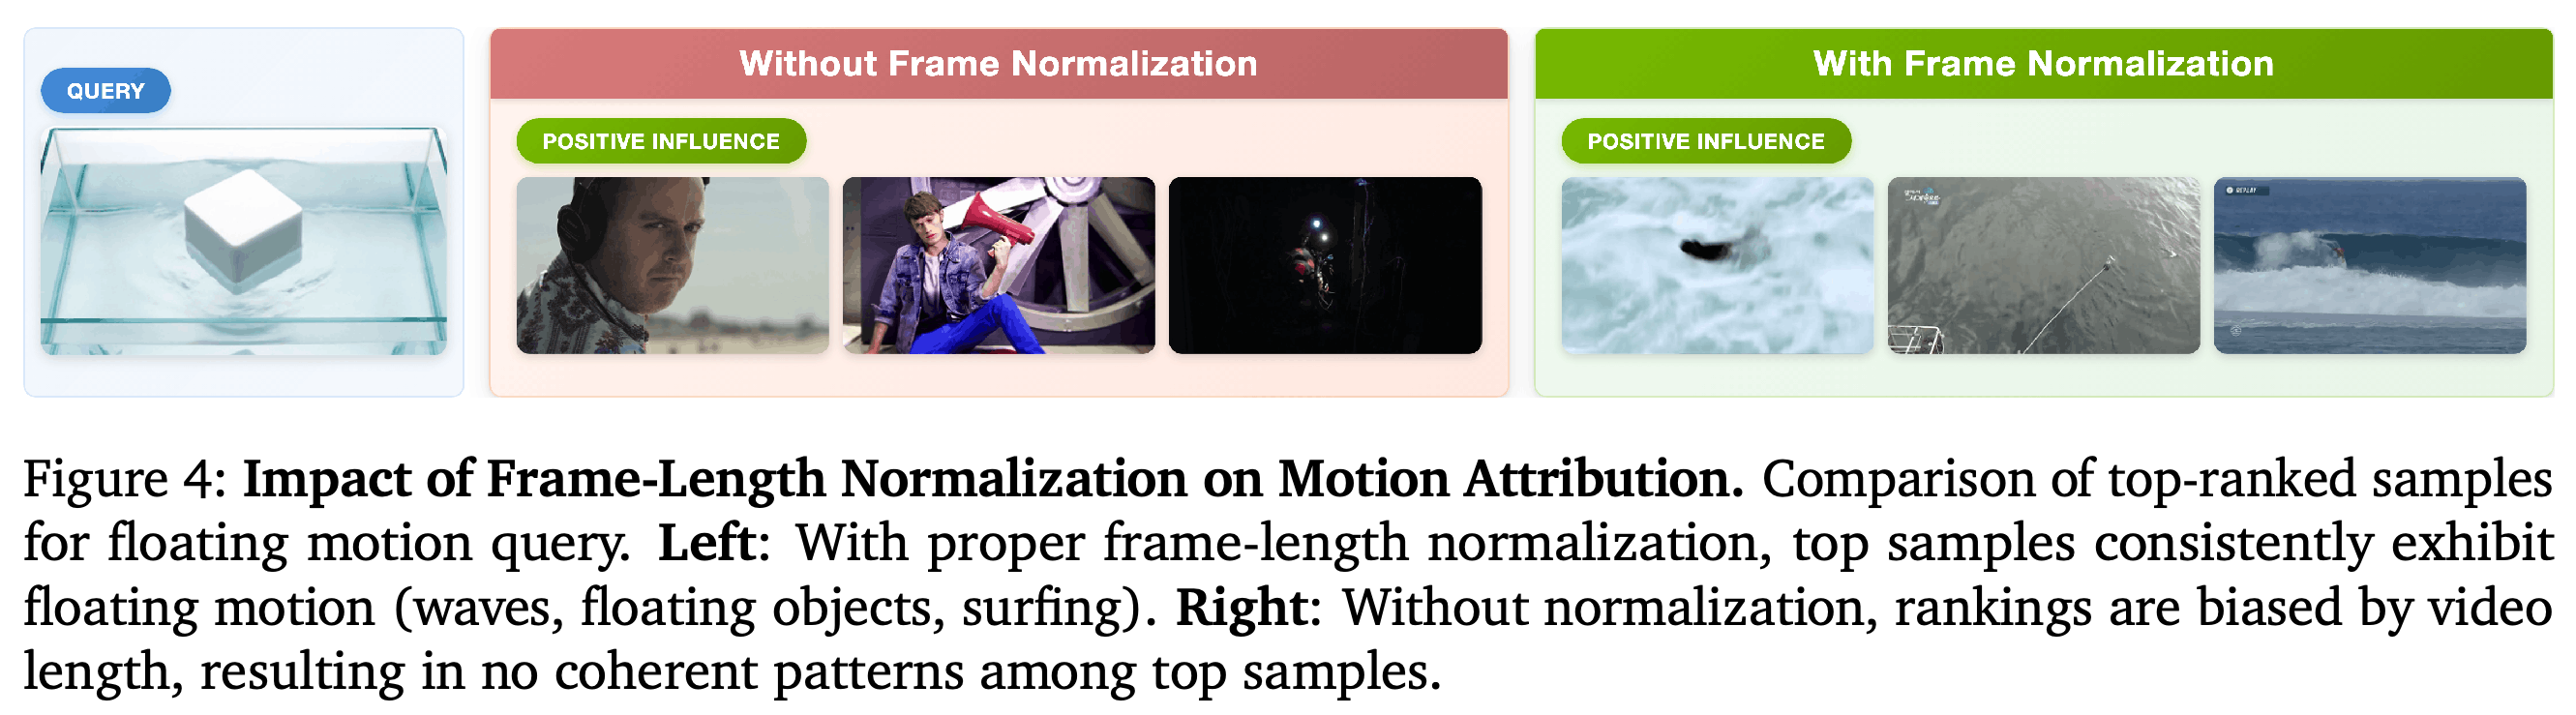
길이 ablation 실험은 영상을 16 fps의 81프레임으로 표준화해 4n+1 제약을 만족시킨다. 표준화하지 않으면 기여도 점수와 영상 길이의 상관계수는 ρ = 78.0%라고 보고한다. 표준화는 길이와의 허위 상관을 54.0% 줄이며, Figure 4는 floating 쿼리의 움직임과 더 관련된 선택 결과를 보여준다.
- Figure 4의 순위 패널에서 “Without Frame Normalization”은 왼쪽, “With Frame Normalization”은 오른쪽에 있으며, 캡션과 Section 4.4 본문의 설명과 반대다.
- 실험은 시간축 입력 표준화의 효과를 뒷받침하지만, 코사인 정규화 전에 그래디언트를 스칼라로 나누는 효과를 따로 분리하지는 않는다.
오른쪽의 “With Frame Normalization” 순위 패널에는 물 관련 영상이 포함되어 있다. 반면 “Without Frame Normalization” 패널에는 floating 쿼리의 움직임과 덜 일치하는 선택 결과가 담겨 있다. 캡션과 Section 4.4는 이 패널 위치를 반대로 설명한다. 이 예제는 보고된 시간축 표준화의 이점을 보여주지만, 스칼라 그래디언트 재스케일링의 효과를 분리하지는 않는다.
5. Conclusion
결론은 움직임을 고려한 기여도 분석을, 목표에 맞춘 파인튜닝으로 영상의 움직임을 개선하는 데이터 선택 방법으로 제시한다. 실험은 규모가 작으면서 움직임과 관련된 부분집합의 효과를 뒷받침한다. 더 폭넓은 진단과 제어 가능성은 제안된 활용 방향이며, 별도로 검증한 결과는 아니다.
부록
- A. Notation: Tables 3과 4는 영상, 조건 정보, 잠재 공간, 데이터셋, 움직임, 손실, 투영, 기여도의 기호를 정의한다. 전체 그래디언트와 투영 그래디언트를 구분하고, 기여도 계산에 사용하는 고정 timestep·노이즈 쌍을 명시한다.
- B. Extended Related Work, B.1. Data Attribution, B.2. Motion in Video Generation: 부록은 재학습 기반 기여도 분석과 그래디언트 기반 근사를 구분하고, timestep에 따라 달라지는 diffusion 기여도 분석을 검토한다. 또한 시간적 모델링 및 optical flow 방법과 Motive의 관계를 설명한다. Motive는 생성 모델 구조를 바꾸거나 움직임 제어 신호를 제공하는 대신, 움직임 가중 그래디언트로 학습 후보 클립을 선택한다.
- C. Additional Experiments, C.1. Results on Additional Video Generation Models: Table 5는 평가를 LTX-2B로 확장한다. Motive의 dynamic degree는 45.1%이며, Base는 36.5%, Full FT는 38.9%, 움직임 마스킹을 제거한 버전은 41.8%다. Motion smoothness는 95.5%이며, 비교 대상은 각각 94.6%, 94.8%, 95.3%다. Imaging quality 48.6%는 Full FT의 49.1%보다 낮고, aesthetic quality 32.7%는 무작위 선택과 비마스킹 기여도 분석에서 보고한 32.8%보다 낮다.
- D. Analysis, D.1. Motion Distribution Analysis, D.2. Cross-Motion Influence Patterns: Figure 6은 VIDGEN 클립 10k개를 분석한다. 상위 10%의 평균 움직임 크기는 3.85, 하위 10%는 3.69로, 상대 차이는 4.3%다. 두 집단 모두 움직임이 작은 구간과 큰 구간에 걸쳐 분포한다. Figure 7의 범주 간 기여 클립 집합의 평균 중복률은 4DNEX에서 24.0%, VIDGEN에서 24.3%다. Bounce에서 float로의 중복률은 44.4%/46.3%, free fall에서 stretch로의 중복률은 12.8%/12.7%다. 논문은 각 범주의 쿼리 5개에서 집계한 고유 기여 클립 수가 달라 방향별 비대칭이 생긴다고 설명한다. 이 분석은 선택 결과가 단순히 움직임이 가장 큰 클립을 고르는 필터와 다름을 보여주지만, 선택 클립의 중복이 공통된 내부 움직임 메커니즘을 입증하지는 않는다.
- E. Additional Method Details: Algorithm 1은 움직임 마스크 추출, 움직임 가중 그래디언트 계산, 투영, 코사인 점수 계산, 부분집합 선택을 요약한다. 저자들은 추적기를 교체 가능한 중요도 정보원으로 설명하며, 기여도 계산 절차가 diffusion과 flow-matching 목적함수 모두에 적용된다고 설명한다. Algorithm 1은 이미 프레임 수 인자를 포함한 손실을 평가한 뒤 그래디언트를 프레임 길이로 다시 나눈다. PDF는 두 스케일링을 함께 명시한 이유를 설명하지 않는다.
- F. Additional Experiment Details, F.1. Hyperparameter Settings, Samples from Query Set, Samples from Test Set, F.2. Details on Motion Query Data: 부록은 bfloat16 기여도 계산, 512차원 투영, AdamW 파인튜닝, 상위 10% 선택, 데이터셋을 50회 반복하면서 1 epoch 학습하는 설정을 명시한다. Wan 모델의 기본 설정은 DiffSynth-Studio와 공식 Wan 저장소를, LTX 모델은 Diffusion-Pipe를 따른다. 쿼리와 테스트 예제는 같은 움직임 범주 안에서 외형을 바꾼다. Compression에는 샌드위치 빵과 고무공을, floating에는 폼 큐브와 잎을 사용한다. Figure 8은 배경과 카메라 움직임의 교란을 줄이도록 설계하고 수동 선별한 Veo-3 쿼리를 보여준다. 이 쿼리는 기여도 분석의 목표를 지정하며 파인튜닝에는 사용하지 않는다.
- G. Discussion, G.1. Runtime, G.2. Limitations, G.3. Future Directions: Tables 6과 7에 따르면 A100 1대에서 Wan2.1-T2V-1.3B로 클립 10k개의 후보 그래디언트를 계산하는 데 약 150시간이 걸린다. V-JEPA 선택은 약 3시간, 움직임 크기 기반 선택은 5.5시간이 걸린다. 고정 체크포인트에서 후보 그래디언트는 여러 쿼리에 재사용할 수 있다. 새 쿼리는 그래디언트 계산에 약 54초, 유사도 계산에 46밀리초가 필요하다. 투영은 샘플당 약 1.97초, 쿼리 50개의 집계는 약 139밀리초가 걸린다. 한계로는 유용한 움직임 구간의 정보가 평균 과정에서 희석된다는 점, 카메라 움직임에 대한 민감성, 모델링하지 않은 classifier-free guidance, 더 폭넓은 생성 능력과의 절충이 있다. 저자들은 공간적으로 균일한 움직임 마스크가 카메라만 움직이는 클립을 식별하고 가중치를 낮추는 데 도움이 된다고 하지만, 구체적인 규칙은 명시하지 않는다. 제안하는 확장 방향은 구간 단위 기여도 분석, 신뢰도를 고려한 마스크, 자체 생성 쿼리, 반복적 데이터 선별, 학습된 쿼리 가중치, 다른 모달리티, 안전성 중심 필터링과 감사다.
- H. Visualization, H.1. Motion Visualization: Figure 9는 클립 7개의 초기, 중간, 후기 시점에서 원본 프레임과 움직임 오버레이를 함께 보여준다. 오버레이는 정적인 영역을 회색에 가깝게 약화한다. 이는 모델의 내부 표현이 아니라 손실 가중치를 시각화한 것이며, 움직이는 영역에는 외형 정보가 여전히 보인다.
짧은 생각
비마스킹 기여도 분석 및 움직임 크기 기반 선택과의 비교는 움직임 조건에 맞춘 데이터 선별을 가장 강하게 뒷받침한다. Motive는 평가한 3개 모델 모두에서 dynamic degree를 개선하며, 분포 분석은 선택된 클립이 단순히 움직임이 가장 많은 클립이 아님을 보여준다. 결과는 평가한 움직임 범주 안에서 목표에 맞춘 선택의 효과를 뒷받침하지만, 일반적인 물리적 사실성이나 모든 측면에서 더 나은 생성 품질을 입증하지는 않는다.
그래디언트 코사인 유사도는 부분집합 파인튜닝으로 검증한 기여도의 대리 지표이며, 개별 클립의 정확한 인과적 설명은 아니다. 명시된 선형 투영과 L2 정규화에서는 투영 그래디언트가 0이 아닌 경우 양의 프레임 수 재스케일링 효과가 상쇄된다. 따라서 별도의 효과를 입증하는 추가 구현 근거가 없다면, 길이 실험 결과는 시간축 입력 표준화의 효과로 해석해야 한다.