


NVIDIA OmniDreams: Real-Time Generative World Model for Closed-Loop Autonomous Vehicle Simulation 요약 설명
02 Jun 2026 | Paper Review Interactive World Models Video Diffusion Models Autonomous Driving Simulation Self-Distillation목차
- 요약
- 1. Introduction
- 2. Data
- 3. Model Architecture
- 4. Training
- 5. Training-free Model Inference Optimization
- 6. Closed-Loop Simulation Integration
- 7. Post-training OmniDreams as a World-Action Model (WAM)
- 8. Post-Training OmniDreams as a Diffusion Fixer
- 9. Experiments and Results
- 10. Related Work
- 11. Conclusion
- 부록
- 짧은 생각
이번 글에서는 NVIDIA OmniDreams: Real-Time Generative World Model for Closed-Loop Autonomous Vehicle Simulation 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 6월 2일(Arxiv)
- Basant, Aarti, Kar, Amlan, Paschalidou, Despoina, Wei, Fangyin, Ferroni, Francesco, Cobo, Guillermo Garcia, Turki, Haithem, Ling, Huan, Seo, Jaewoo, Lucas, James, et al.
- 논문 링크
- Github
- Project Page
요약
- OmniDreams는 Cosmos-Predict 2.5를 폐루프 자율주행 평가를 위한 행동 조건부 카메라 시뮬레이터로 적응시킨다. 첫 프레임 RGB 시드, 텍스트, 구조화된 시뮬레이터 상태, 캐시된 시각 이력으로 짧은 영상 청크를 생성한다. 이를 통해 장면별 재구성 범위를 벗어나는 시각 조건과 시점을 지원한다.
- 학습에는 주행 도메인 및 다중 시점 적응, 인과적 Diffusion Forcing, Distribution Matching Distillation (DMD)을 적용한 노이즈 제거 2단계 Self Forcing을 결합한다. 추론 최적화를 통해 704 × 1280 해상도에서 GB300 1개로 카메라 1대의 유효 처리량 68 FPS를, GB300 GPU 16개로 카메라 4대의 카메라당 유효 처리량 105 FPS를 달성한다. 이 수치는 청크 생성 처리량이며, 정책의 재계획 빈도가 아니다.
- 홀드아웃 클립 1,000개에서 Self Forcing은 단일 시점 FVD를 인과적 Diffusion Forcing 모델의 31.7에서 24.8로 개선하지만, Temporal Sampson은 1.87에서 1.90으로 악화된다. 점진적 장문맥 증류는 20초 롤아웃의 평균 구간별 FVD를 240.0에서 179.4로 낮추지만, 뒤쪽 구간으로 갈수록 품질은 여전히 저하된다.
- 조건을 통제한 501개 장면 비교에서는 NuRec과 OmniDreams 사이에 절대 사고율 차이가 있지만, 4개 정책 구성의 전체 사고율 순위는 유지된다. 별도의 예비 실험에서는 574개 장면에서 충돌률이 Alpamayo 1.5의 6.9%에서 약 2 B개 파라미터를 가진 OmniDreams World-Action Model의 4.2%로 감소한다. 어느 실험도 실제 환경에서의 안전성 동등성을 입증하지는 않는다.
1. Introduction
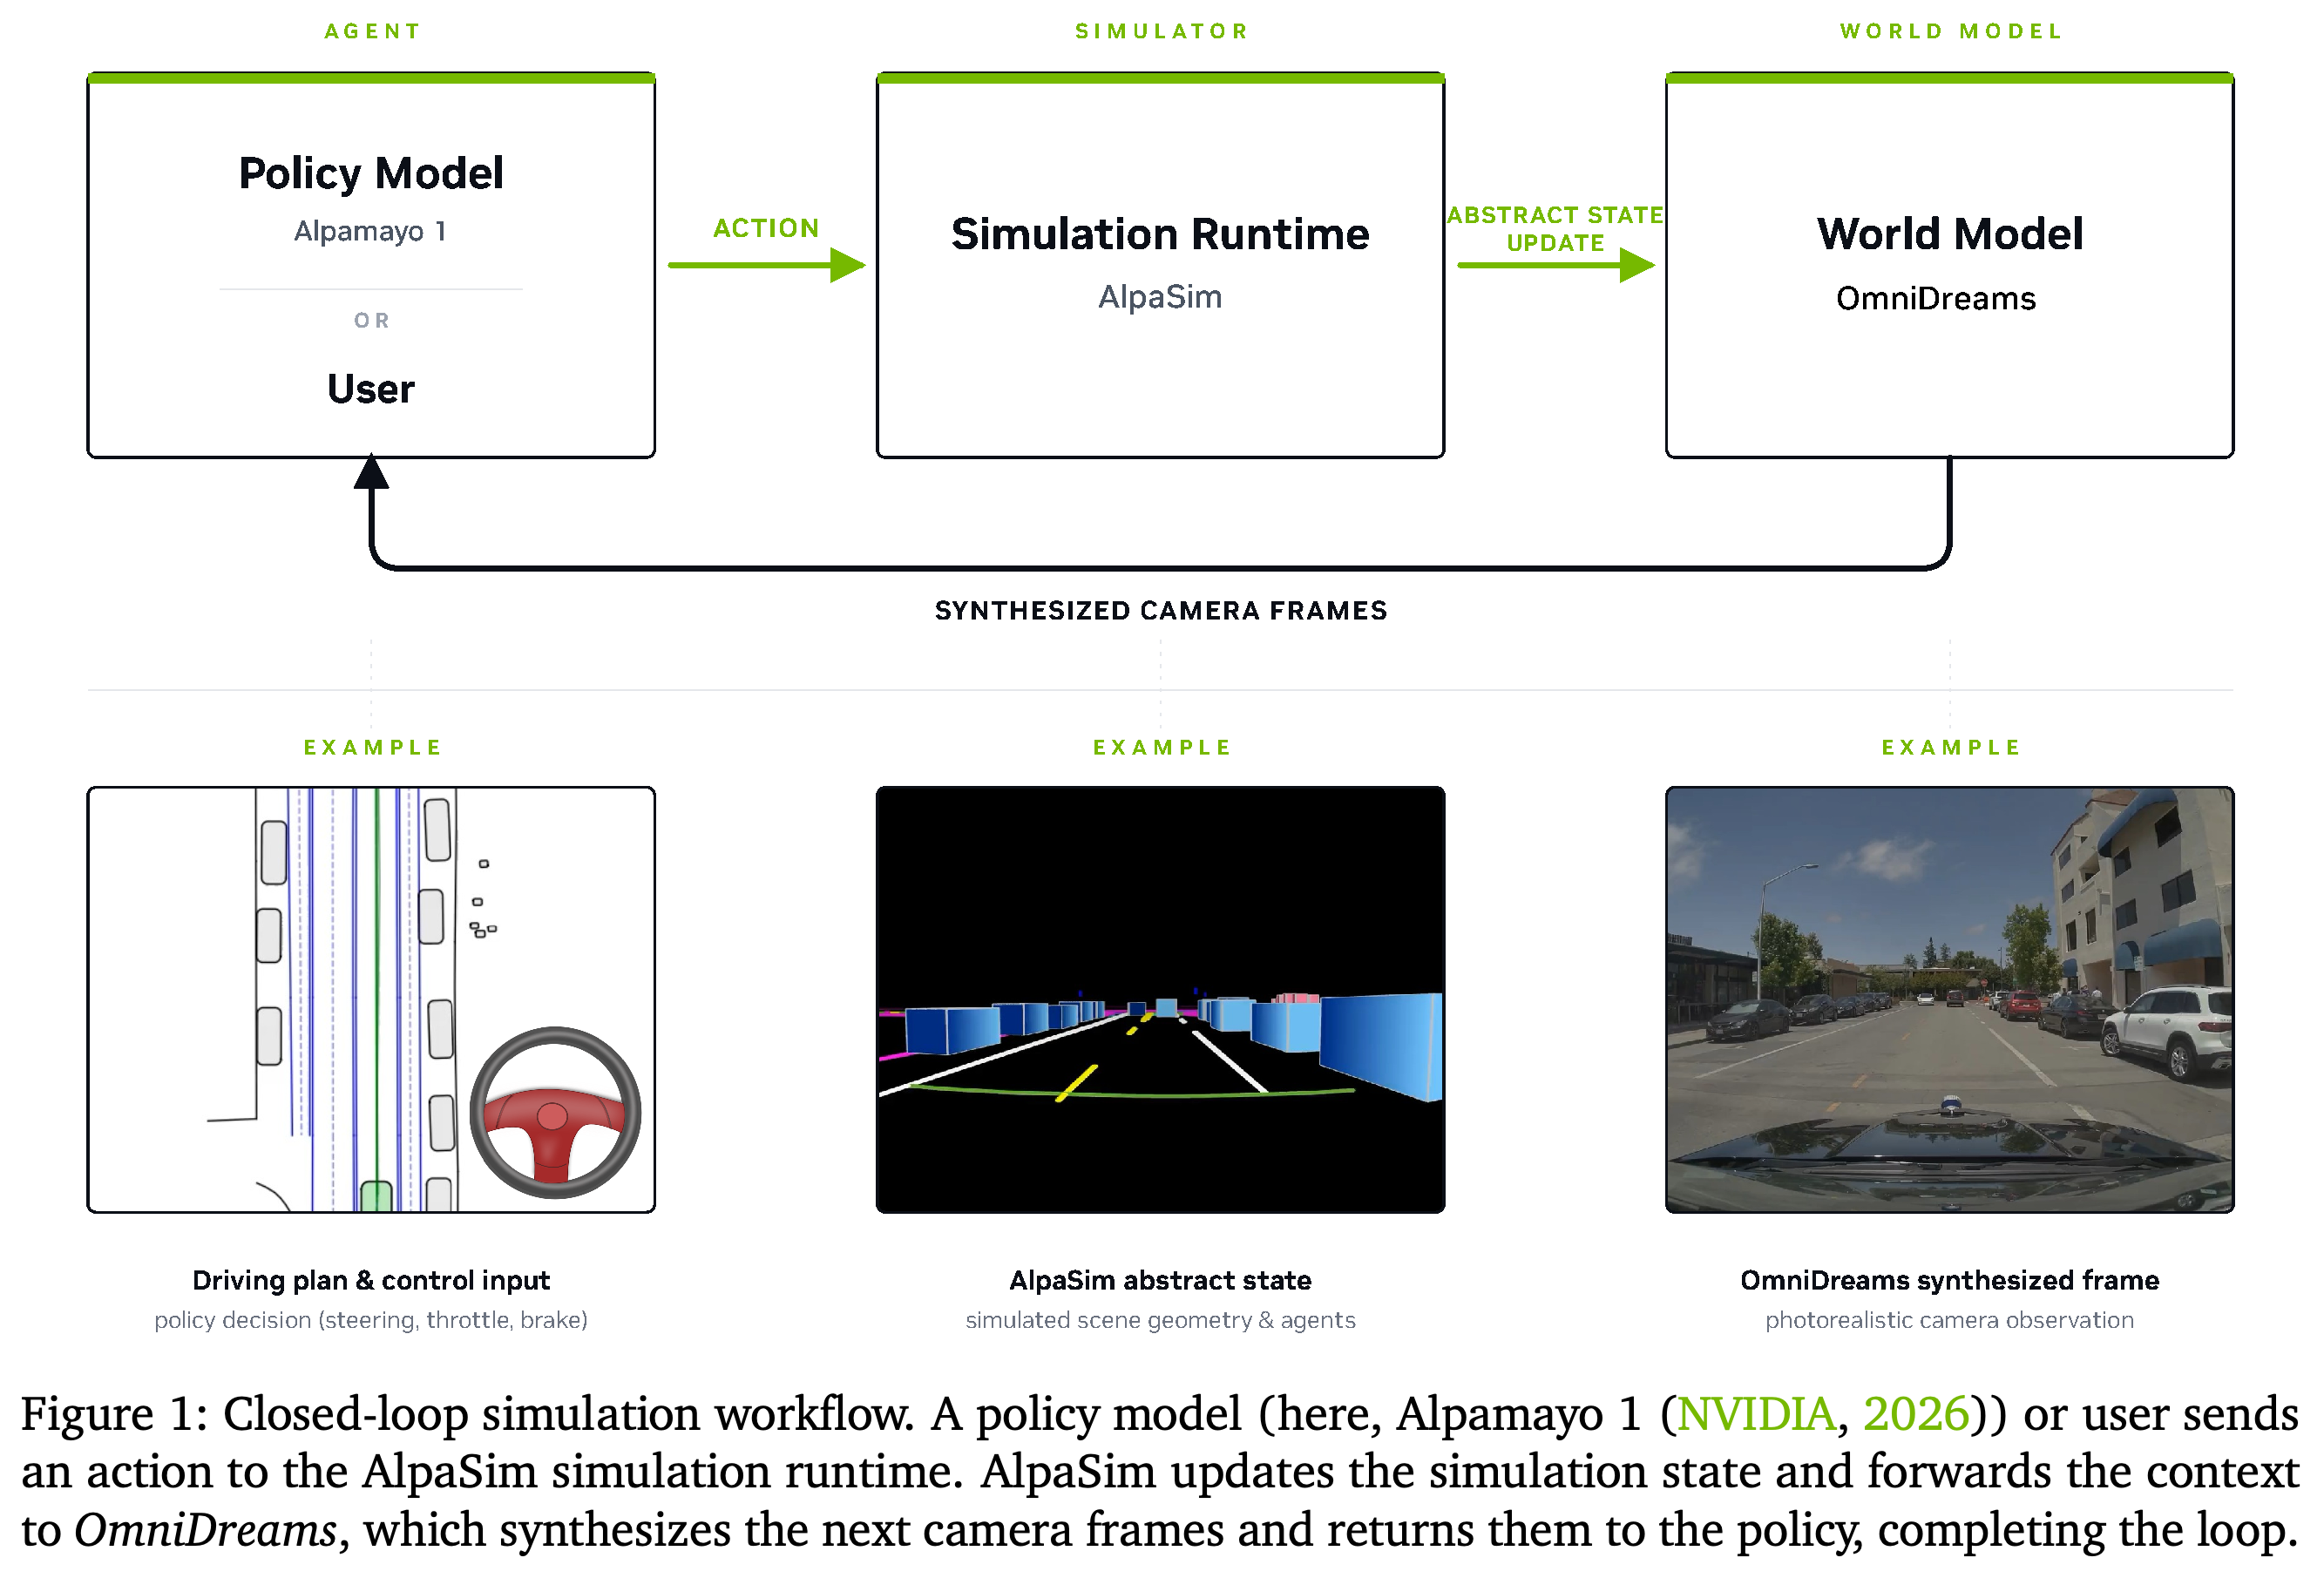
폐루프 평가에서는 고정된 녹화 영상을 재생하는 대신 정책의 행동에 따라 관측이 달라져야 한다. 재구성 기반 신경망 시뮬레이터는 촬영된 장면 안에서 통제된 변형을 지원하지만, 새로운 시점, 날씨, 관절이 있는 객체, 장면 내용은 재구성 범위를 벗어날 수 있다. OmniDreams는 생성 모델의 시각 사전 지식으로 센서 영상을 합성하고, 상태 갱신과 실행 조율은 AlpaSim에 맡긴다.
- Figure 1은 정책, 시뮬레이션 런타임, 센서 생성기를 구분한다. 행동이 AlpaSim의 추상 상태를 갱신하면 OmniDreams가 다음 정책 결정에 사용할 카메라 관측을 반환한다.
- 이 보고서는 학습된 백본의 2가지 활용을 살펴본다. 실시간 카메라 렌더러와 후속 학습을 거친 궤적 예측 정책이다.
피드백 화살표는 인과적 의존 관계를 명확히 보여준다. 정책이 시뮬레이터 상태를 바꾼 뒤 새로운 카메라 관측이 합성된다. OmniDreams는 센서 이미지를 제공하며, 런타임의 상태·교통·물리 처리 역할을 대체하지 않는다.
2. Data
데이터 파이프라인은 주행 영상에 구조화된 장면 표현, 자차 궤적, 텍스트 설명을 연결한다. 모델은 이 입력으로 시뮬레이터가 제어하는 기하 구조와 움직임에 맞춰 시간적으로 일관된 관측을 생성하도록 학습한다.
2.1. Data Sources
중간 학습에는 20s 클립 3M개로 구성된 Real Driving Scene (RDS)을 사용한다. 파인튜닝과 후속 학습에는 품질을 중시해 확장한 데이터셋 RDS-HQ-1M을 사용하며, 약 1.14M개의 10s/20s 클립을 포함한다. 두 데이터셋은 모두 15개국의 주행 로그에서 수집되었으며, 동기화된 카메라 7대의 1080p, 30 FPS 영상을 포함한다. 카메라는 front-wide, front-telescope, front-left, front-right, rear-left, rear-right, rear-tele로 구성된다.
- RDS는 도로 환경, 주간·야간 조건, 주행 속도를 균형 있게 구성하며, Cosmos-Predict 2.5-AV 사전 학습에도 포함된다.
- RDS-HQ-1M은 시각적 품질과 정확한 world-scenario 주석에 중점을 둔다.
2.2. Conditioning Signal Extraction
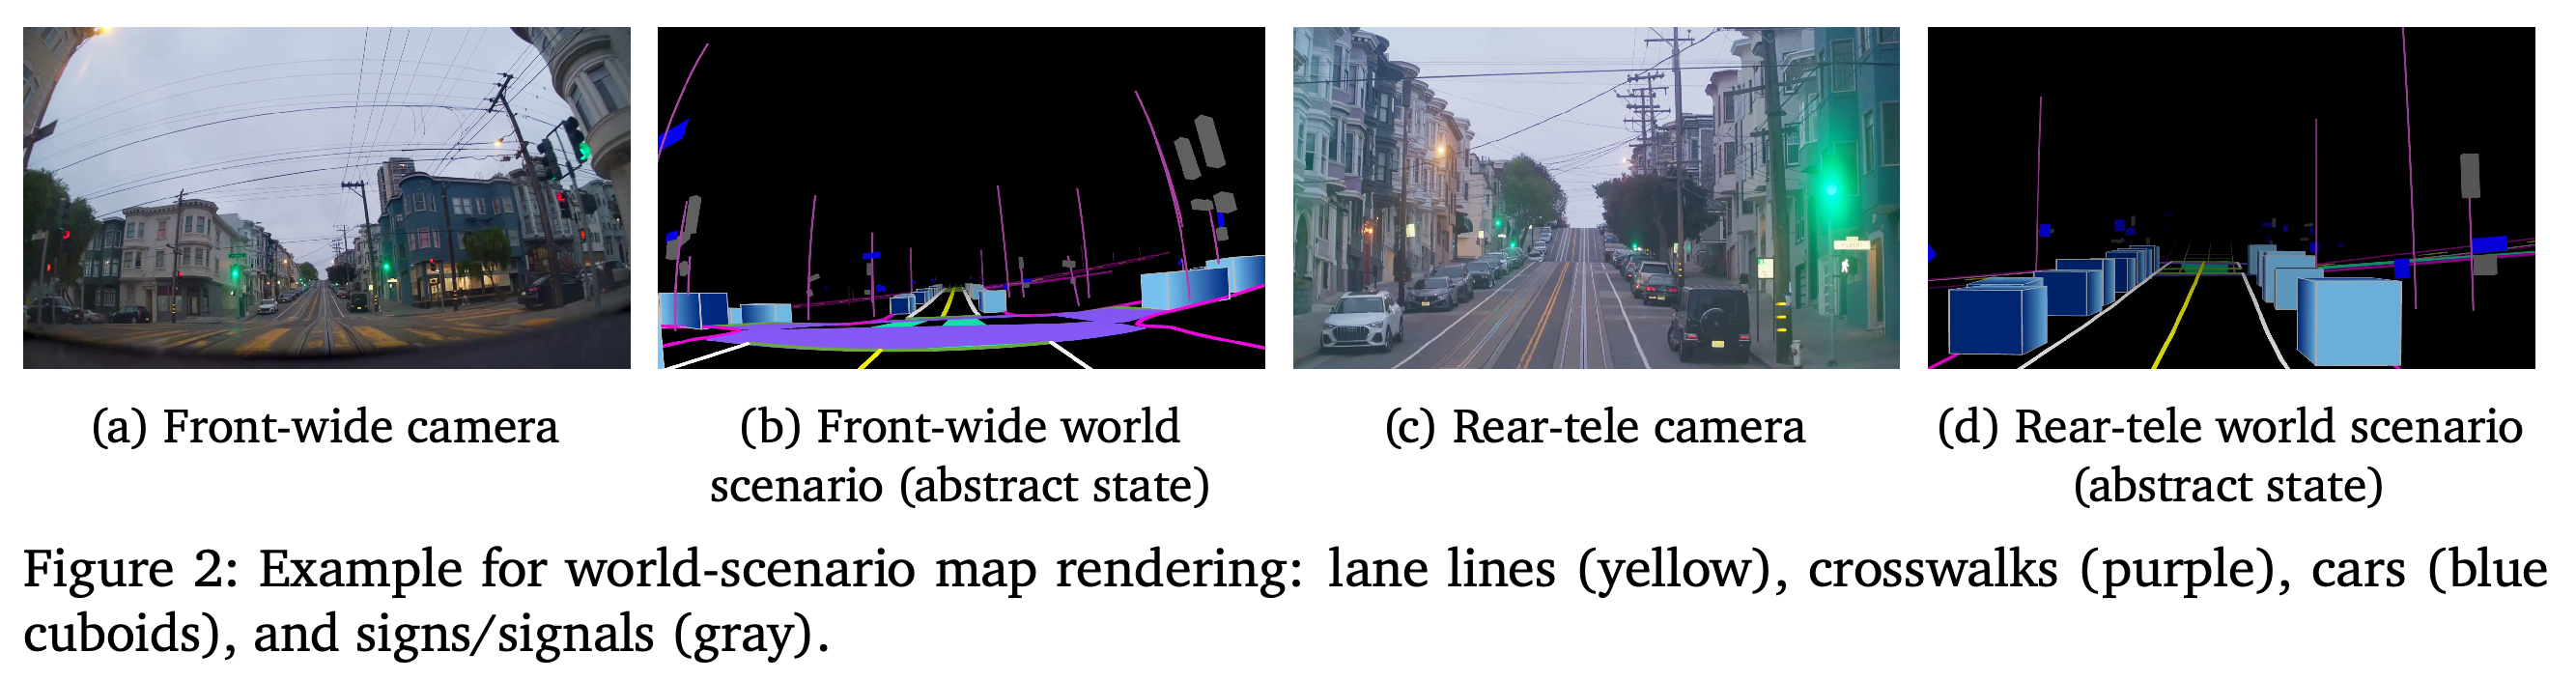
World-scenario map은 정적 HD map 요소와 추적된 동적 행위자를 각 카메라의 보정 정보로 투영해 픽셀에 정렬된 선, 면, 음영 처리된 직육면체를 생성한다. 텍스트 프롬프트는 Qwen2.5-VL-7B가 카메라별로 10s 구간의 풍경, 날씨, 주행 행동, 교통 상황을 독립적으로 설명해 만든다. 이 프롬프트는 기하학적 제어 입력과 별개로 외관 조건을 제공한다.
- 도시 단위 HD map은 차선, 도로 경계, 정지선, 기둥, 횡단보도, 노면 표시, 신호등, 교통 표지판을 제공한다. 3D 검출과 추적은 10 FPS로 수행한 뒤 30 FPS로 보간한다.
- World-scenario 렌더링은 카메라 궤적을 통해 자차 행동을 반영한다. 따라서 행동 조건은 시뮬레이터가 렌더링한 상태를 거쳐 전달된다.
- 짧은 캡션, 중간 캡션, 긴 캡션은 각각 약 40, 80, 200개 단어로 구성되며, 학습 중 0.1/0.2/0.7의 확률로 샘플링된다.
짝지어진 RGB와 추상 상태 렌더링은 카메라 보정으로 희소한 기하 조건을 목표 이미지에 정렬하는 방식을 보여준다. 색으로 표시된 차선, 횡단보도, 직육면체, 표지판은 완전한 사실적 외관을 지정하지 않고 구조를 제약한다.
2.3. Data Curation and Quality Filtering
학습 전에 신뢰하기 어려운 센서 시퀀스, 불확실한 주석, 예측 결과가 불일치하는 데이터를 필터링한다. VLM은 색수차 같은 아티팩트가 있는 카메라 영상을 걸러낸다. 자차 궤적과 시각 특징을 이용한 중복 제거는 고속도로 직진 주행처럼 반복적인 시퀀스의 비중을 줄인다.
2.4. Dataset Composition
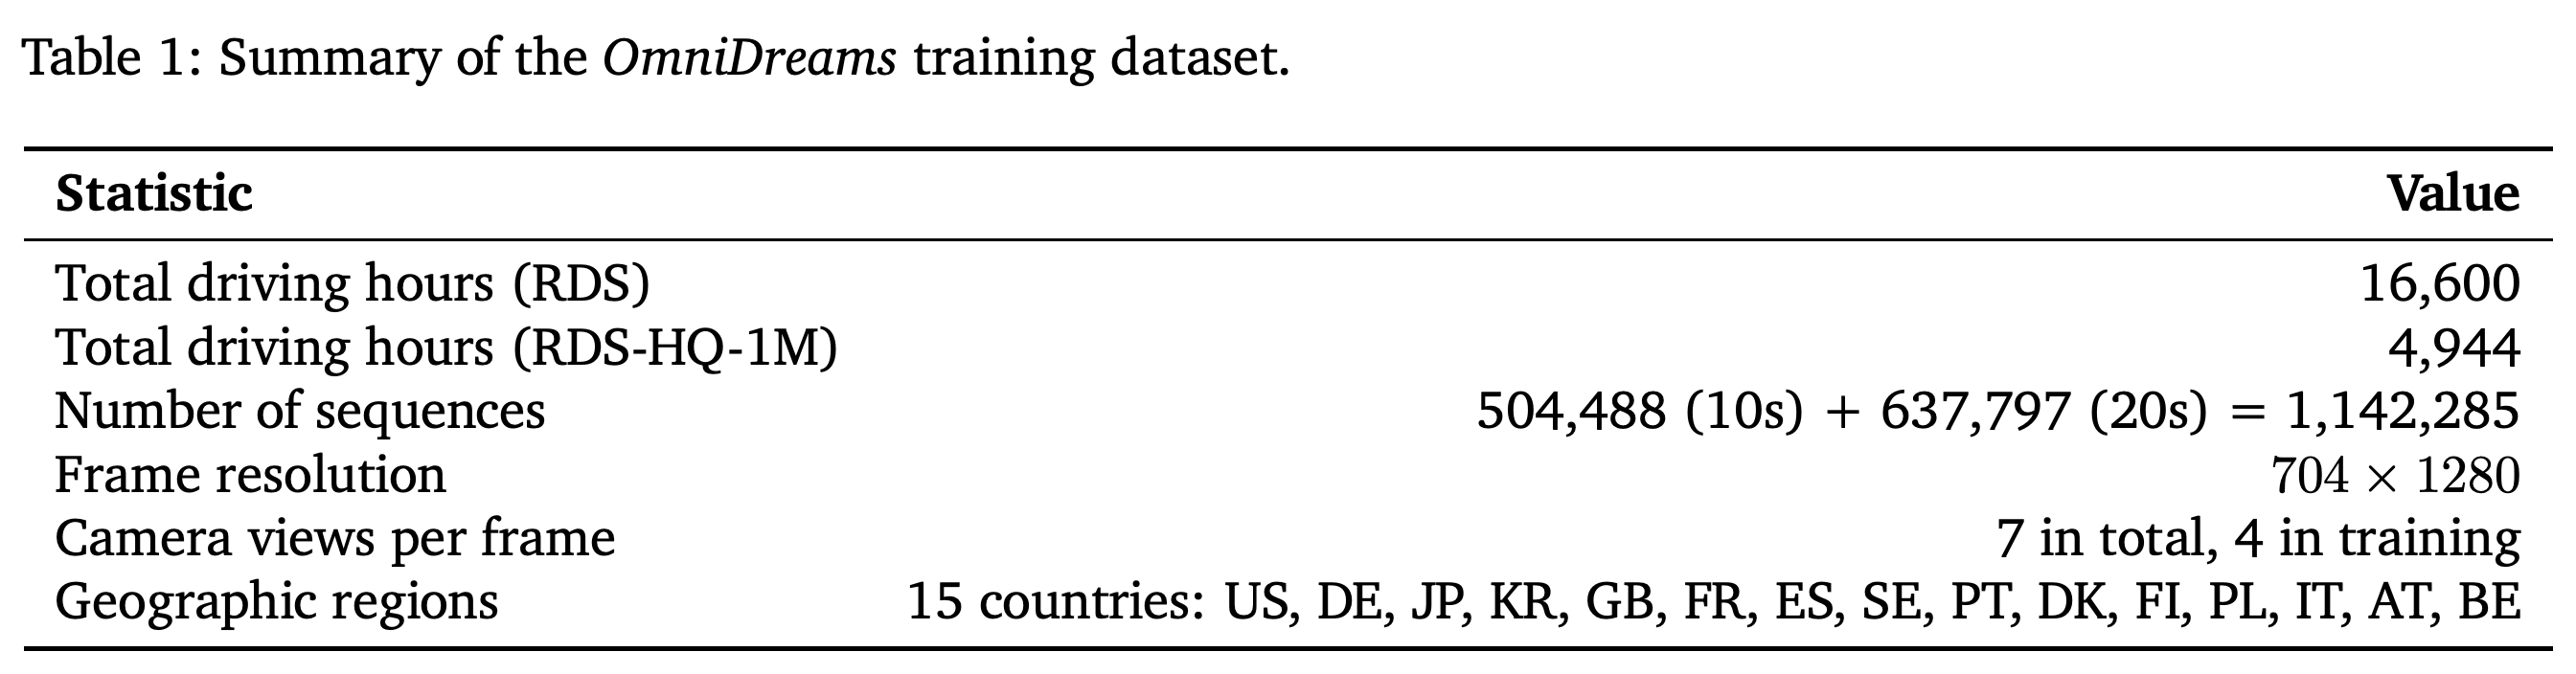
RDS는 16,600 h를 제공한다. RDS-HQ-1M은 4,944 h와 클립 1,142,285개를 제공하며, 10 s 클립 504,488개와 20 s 클립 637,797개로 구성된다. 학습 해상도는 704 × 1280이며, 사용 가능한 카메라 시점 7개 중 4개를 사용한다. 저자들은 시나리오별 균형을 맞춘 클립 5,000개를 홀드아웃하고, 장기 일관성 평가를 위해 그중 300개의 60 s 버전을 확보한다.
- 홀드아웃 범주에는 교통약자, 대형 차량, 비, 눈, 안개, 야간, 터널, 철도 건널목, 공사 구간, 사고 장면이 포함된다.
- Table 1에 기재된 국가 범위는 US, DE, JP, KR, GB, FR, ES, SE, PT, DK, FI, PL, IT, AT, BE다.
표는 중간 학습 데이터셋 16,600 h와 후속 학습 데이터셋 4,944 h를 구분하고, 정확한 10s/20s 클립 구성을 기록한다. 녹화된 시점 7개를 사용할 수 있지만 학습에는 4개를 사용한다.
2.5. Curation and Inspection with SIL-Wheel
SIL-Wheel은 기반 데이터셋 전반에서 클립 단위 검색과 검수를 지원한다. 캡션 검색, 의미 및 시각 검색, 자차 궤적 질의, 분류기 점수, 인지 필터를 결합해 학습 데이터 혼합과 홀드아웃 시나리오 부분집합을 구성한다.
- 파인튜닝용 부분집합을 구성할 때는 드문 날씨, 공사, 교통약자, 관절 움직임, 복잡한 상호작용처럼 부족한 조건을 검색하고 가중치를 높인다.
- 평가용 부분집합도 같은 인터페이스로 구성하며, 시나리오별 그룹을 만든다.
- 데이터 검수에서는 자동 주석 품질을 확인하고, 필터링에서 표시된 클립을 검토하며, 검색된 부분집합이 의도한 조건에 맞는지 확인한다.
3. Model Architecture
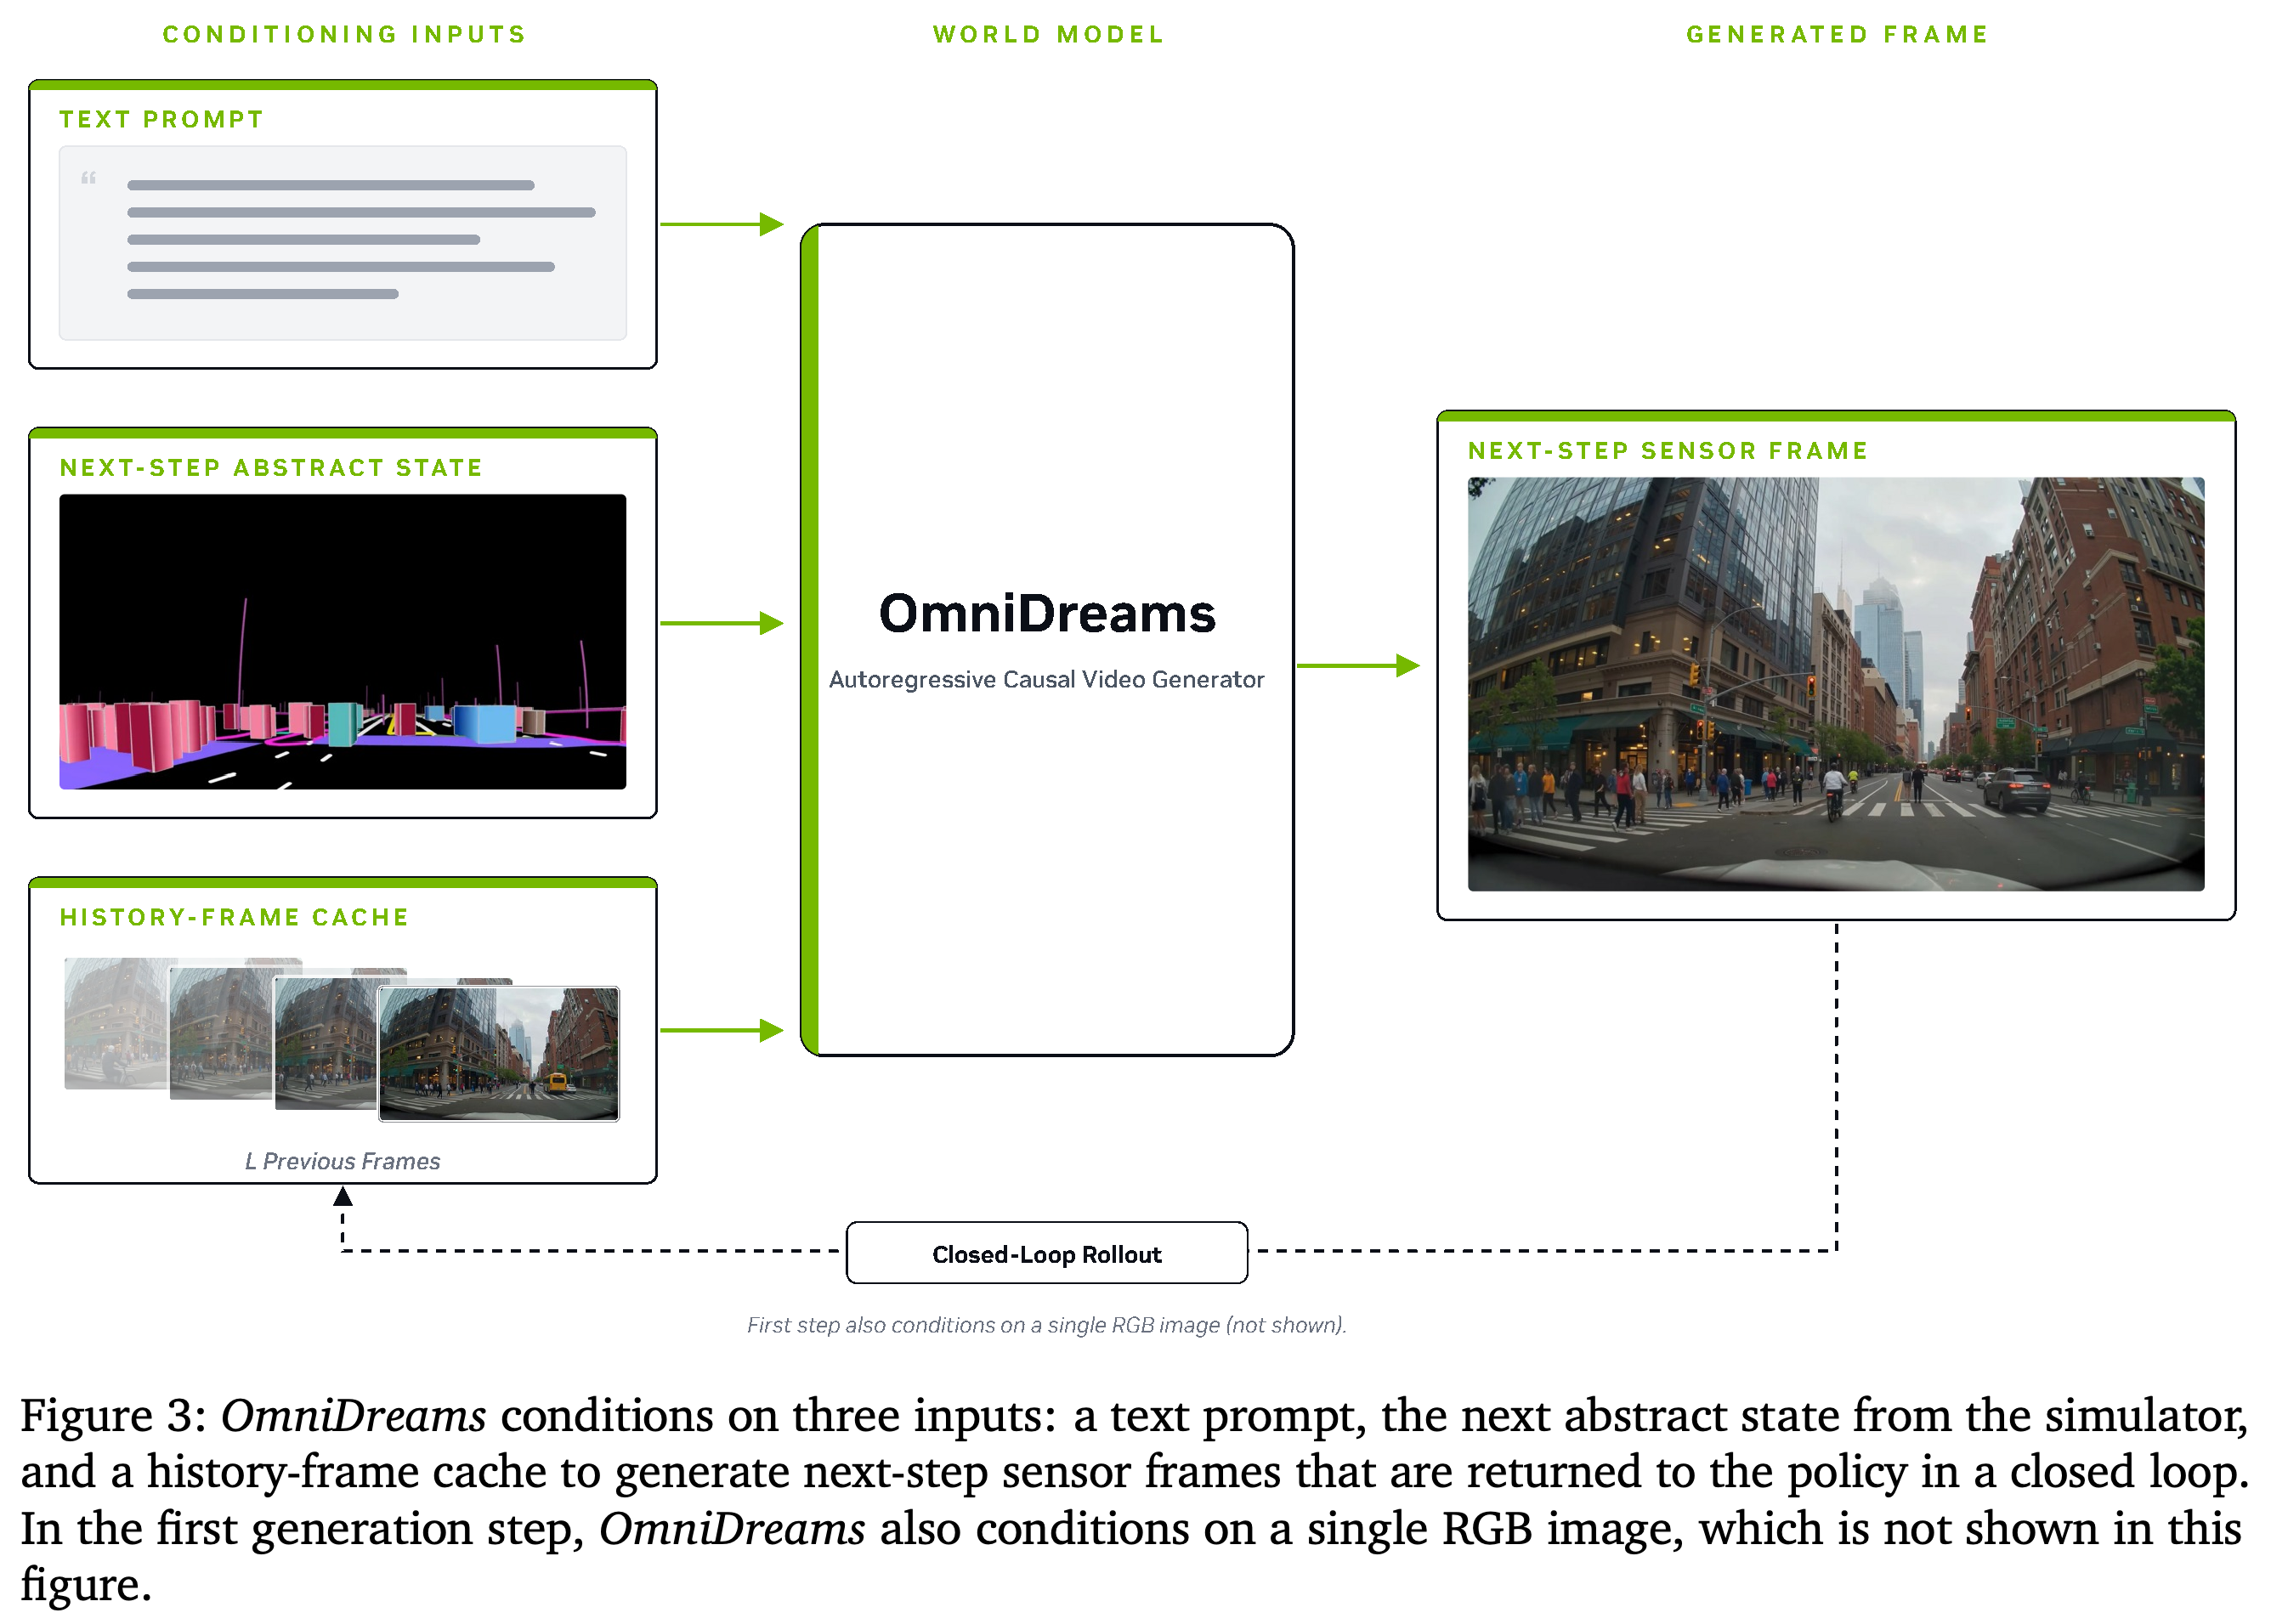
OmniDreams는 인과적 블록 자기회귀 확산으로 시뮬레이터 상태가 갱신될 때마다 관측을 생성한다. OmniDreams-SV는 단계마다 잠재 프레임 2개에 해당하는 RGB 프레임 8개를 생성한다. OmniDreams-MV는 동기화된 시점 4개에 대해 카메라당 잠재 프레임 4개에 해당하는 RGB 프레임 16개를 공동 생성한다. 스트리밍 KV cache는 전체 롤아웃을 다시 계산하지 않고 과거 attention 표현을 재사용한다.
3.1. Network Architecture
인과적 Transformer는 노이즈가 추가된 시각 잠재 표현에 깨끗한 첫 프레임 잠재 표현, Cosmos 텍스트 인코더로 인코딩한 텍스트, world-scenario 조건, 캐시된 이력을 결합한다. 경량 MLP는 구조화된 제어 입력을 시각 표현에 정렬된 압축 토큰으로 변환하고 시각 토큰과 이어 붙인다. 따라서 별도의 ControlNet 형태 네트워크가 필요하지 않다.
- 첫 RGB 이미지는 시뮬레이션 세션을 초기화한다. 이후 청크는 갱신된 구조화 조건과 계속 갱신되는 메모리 캐시를 사용한다.
- 텍스트는 cross-attention을 통해 조명, 날씨, 시간대의 조건을 제공하고, 투영된 지도와 행위자 박스는 주행에 중요한 구조를 제약한다.
- Figure 3은 생성된 관측이 이후 생성에 사용할 이력으로 바뀌는 과정을 보여준다.
도식은 텍스트를 통한 외관 조건, 추상 상태를 통한 기하·움직임 조건, 캐시된 이력을 통한 시간 문맥을 구분한다. 초기 RGB 시드는 초기화 조건이며, 매 단계 새로 필요한 이미지가 아니다.
3.2. Consistent Multi-View Generation
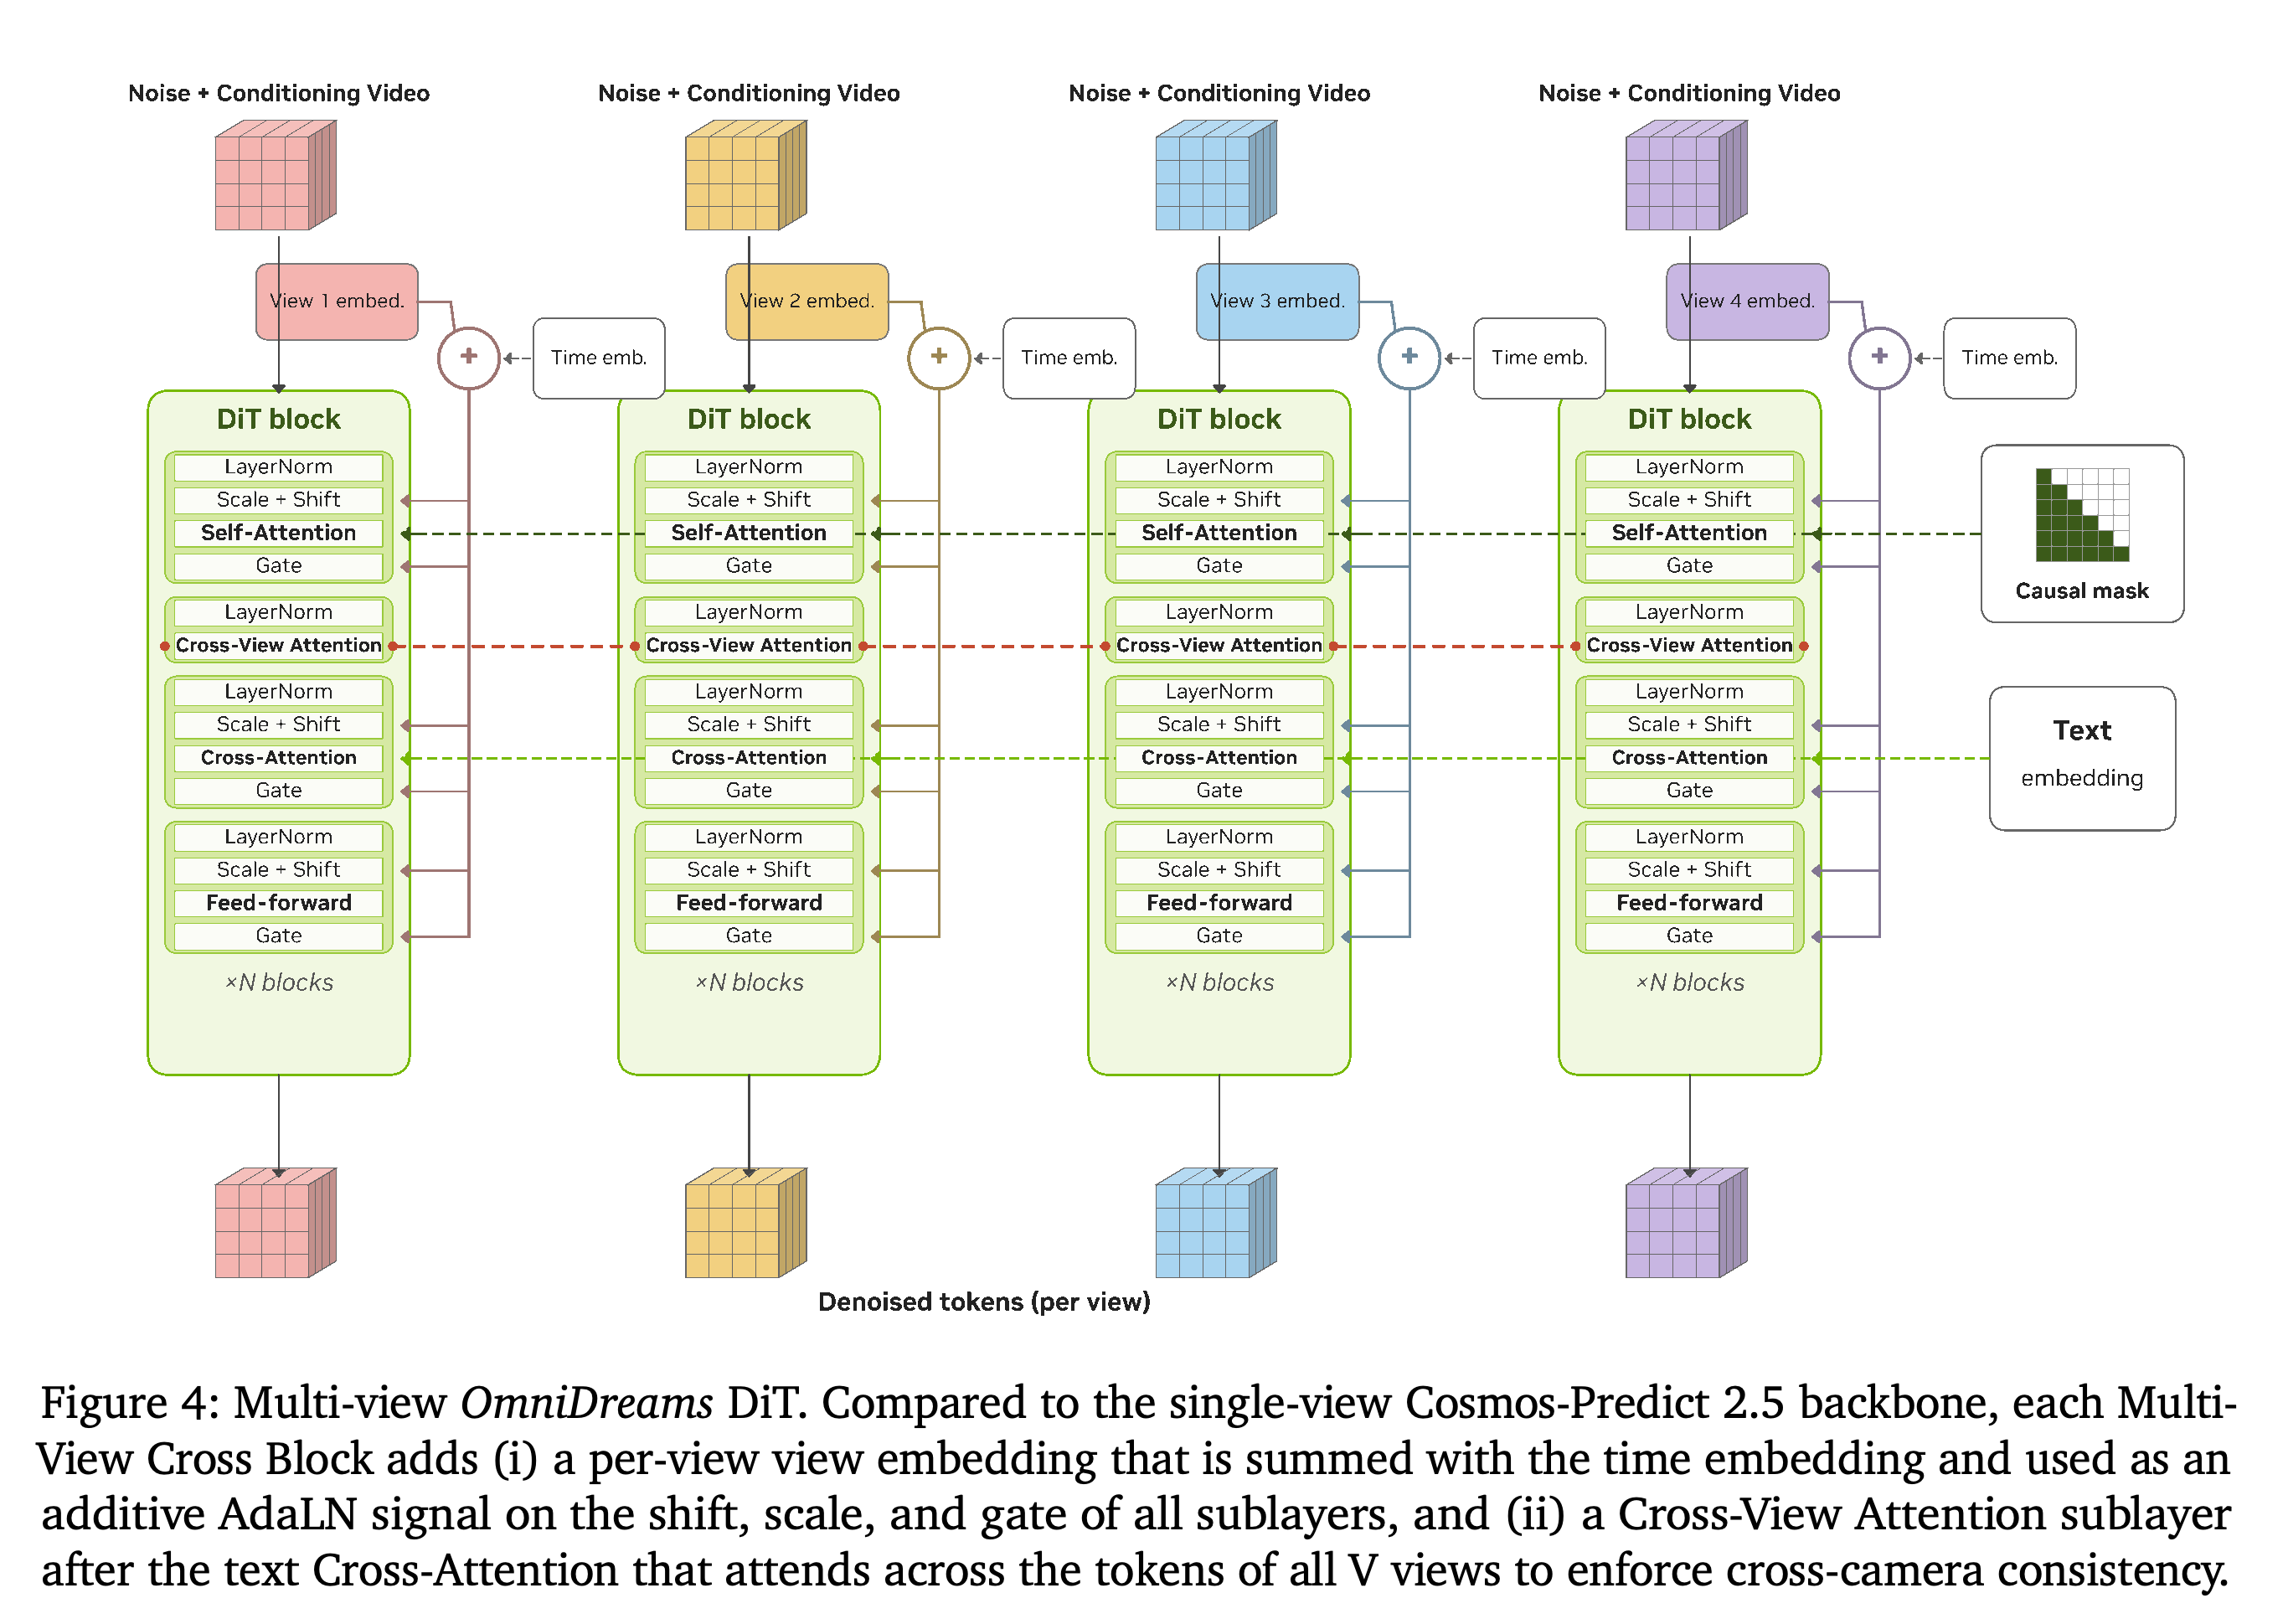
다중 시점 생성에서는 각 카메라에 학습 가능한 시점 임베딩과 개별 텍스트, 시드 이미지, 카메라에 정렬된 세계 상태 입력을 할당한다. Temporal attention은 각 시점 안에서 독립적으로 작동하고, cross-view attention은 같은 시간 단계의 카메라 사이에서 정보를 교환한다. 논문은 attention 복잡도를 O(N²T²)에서 O(NT²) + O(N²)로 낮춘다고 보고한다. 여기서 N은 시점 수, T는 시간 길이다.
- 이 분해는 모든 시점·시간 토큰에 제약 없는 공동 attention을 적용하는 대신 시간 모델링과 카메라 간 대응 관계를 분리한다.
- 아키텍처는 동기화된 시점 최대 7개를 지원한다고 설명하지만, 보고된 실시간 다중 시점 배포에서는 4개를 사용한다.
- Figure 4에 그려진 하위 계층 순서는 cross-view attention을 텍스트 cross-attention 뒤에 배치하는 캡션 및 Section 4.1과 다르다.
병렬 카메라 스트림은 각 시점의 구분과 인과적 시간 처리를 유지하면서 cross-view attention으로 정보를 교환한다. 그림은 cross-view attention을 텍스트 cross-attention 앞에 배치하지만, 캡션과 Section 4.1은 뒤에 배치한다.
4. Training
학습은 Cosmos-Predict 2.5의 주행 도메인 적응에서 시작해 OmniDreams-MV를 위한 다중 시점 적응, Diffusion Forcing을 통한 인과적 변환, 양방향 교사와 인과적 학생을 위한 world-scenario 제어 학습으로 이어진다. 이후 Self Forcing DMD는 인과적 생성기를 적은 단계로 추론하도록 증류하면서, 모델이 직접 생성한 문맥으로 학습한다.
4.1. World-Scenario Control and Multi-view adaptation
기본 학습 방식은 rectified flow다. x_t = (1 − t)x + tε, 목표 속도 v_t = ε − x, L = E_{x,t}[‖u_θ(x_t, t) − v_t‖²]를 사용하며, 텍스트, 첫 프레임 이미지, 제어를 위한 보조 조건 c를 함께 제공한다. 다중 시점 적응은 먼저 시점 4개를 균등하게 혼합해 카메라별 임베딩을 학습한 뒤, cross-view attention을 추가하고 동기화된 영상으로 공동 학습한다. World-scenario map 제어는 0으로 초기화한 제어 분기를 추가하고, 학습 클립을 93프레임에서 189프레임으로 늘린다.
- Rectified-flow 정식화에서는 ε를 N(0, I)에서 샘플링하고, t ∈ [0, 1]을 logit-normal 분포에서 샘플링한다.
- 시점 임베딩은 adaptive layer normalization을 통해 입력된다. 임베딩과 cross-view 출력 투영은 모두 0으로 초기화한다.
- Text-to-video와 image-to-video 과제를 1:1로 혼합해 첫 프레임 조건을 학습하면서도 새로운 콘텐츠 생성 능력을 유지한다. 제어 조건을 사용하는 양방향 모델은 증류 교사로 사용한다.
4.2. Mid-training for Autoregressive Generation
Causal Masking은 영상을 p(x^{1:T}) = ∏_{i=1}^{T} p(x^i | x^{<i})로 분해하고 attention을 현재 및 이전 프레임으로 제한한다. 블록 자기회귀 확장은 Flex-Attention으로 구현한다. Diffusion Forcing은 프레임마다 독립적으로 샘플링한 노이즈 수준을 할당하고, 병렬 순전파 1회로 흐름 속도를 예측하도록 인과적 모델을 학습한다. 먼저 지도 제어 없이 RDS로 학습한 뒤 제어 분기를 추가하고 RDS-HQ-1M에서 학습을 이어간다. 인과적 변환에는 제어 주석 데이터셋이 제공하는 것보다 더 많은 데이터가 유리하기 때문이다.
- 프레임별 timestep 벡터 t에 대해 노이즈 시퀀스는 x_t^{1:T} = (I − t) · x^{1:T} + t · ε이며, 목표 속도는 v_t = ε − x^{1:T}다.
- Equation (1)은 L_DF = E_{x^{1:T},ε}[‖u_θ(x_t^{1:T}, t) − v_t‖²]다. 이 절은 timestep에 log-normal 분포를 명시하지만, Section 4.1은 logit-normal 샘플링을 명시한다.
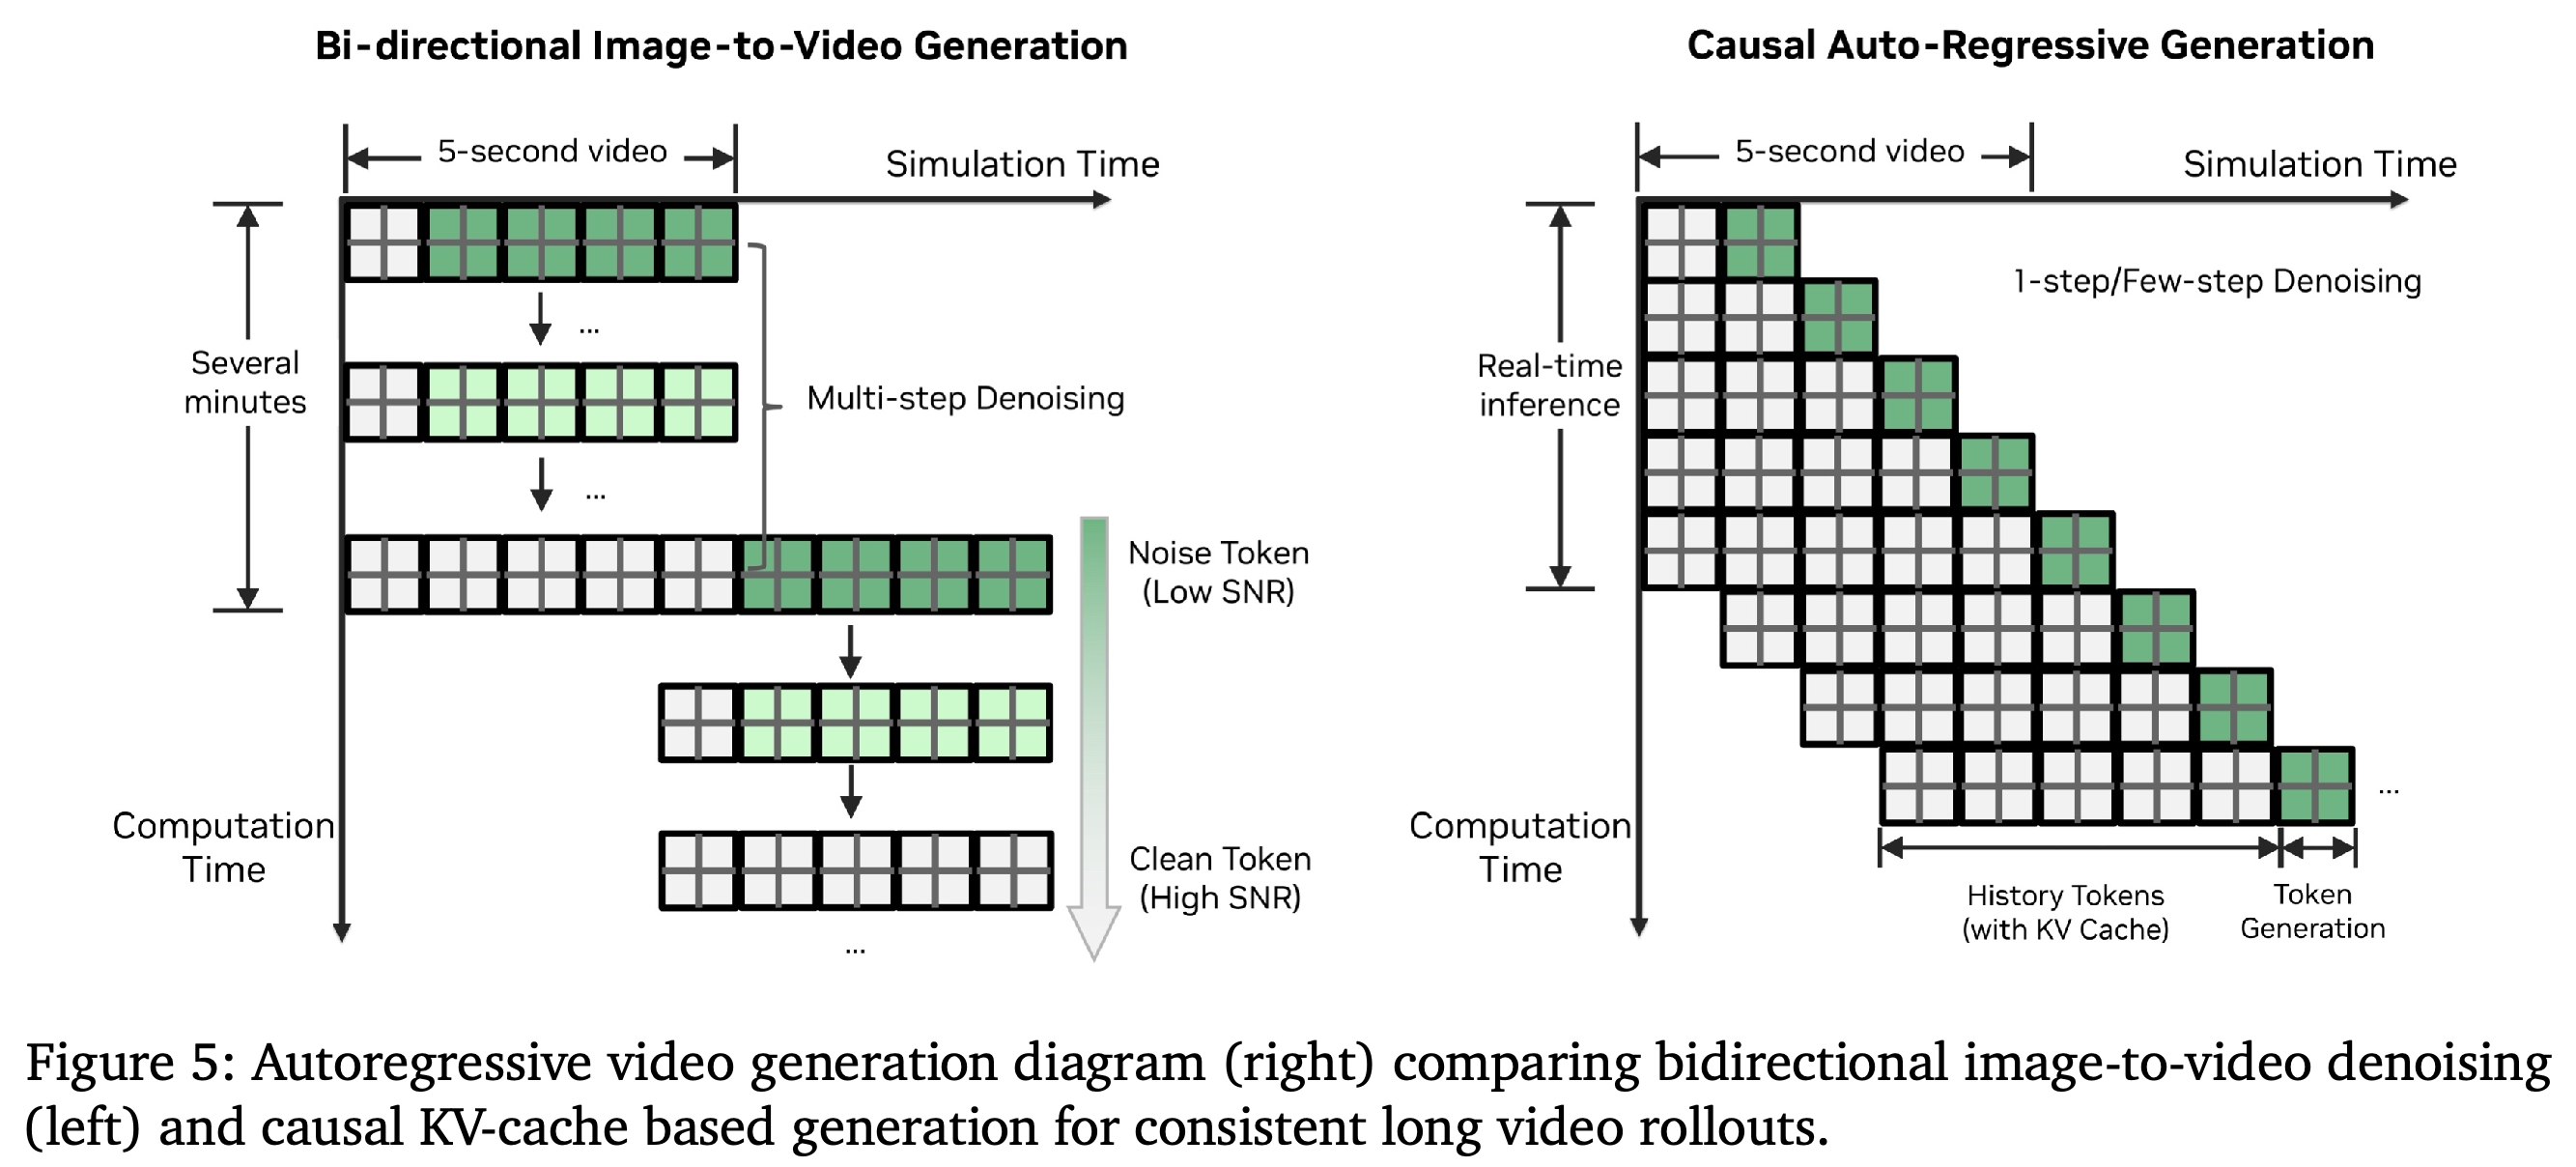
- Figure 5는 양방향 클립 노이즈 제거와, 이전에 계산한 이력을 KV cache에 유지하는 인과적 생성을 대비한다.
인과적 설계는 과거 토큰을 캐시된 문맥으로 재사용하고 짧은 미래 블록만 생성한다. 양방향 방식은 더 큰 클립의 노이즈를 제거한 뒤에야 관측을 제공한다. 이 차이는 지연을 줄이기 위해 인과적 생성을 채택한 이유를 보여준다.
4.3. Distillation
Self Forcing Training via Self-Rollout은 깨끗한 정답 이력 대신 이전 모델 출력을 조건으로 각 프레임을 생성하도록 학습한다. 노이즈 제거는 K=2단계이며 스케줄은 [1000, 450]이다. Holistic Distribution Matching via DMD에서는 고정된 real score network와 학습되는 fake score network가 짝지어진 픽셀 복원 대신 영상 단위 분포 매칭 감독 신호를 제공한다. Progressive Training with a Longer Teacher에서는 더 긴 문맥을 가진 양방향 교사로 증류를 이어가, 짧은 문맥 증류 후에도 남는 외관 변화 아티팩트를 줄인다.
- 역전파는 무작위로 샘플링한 노이즈 제거 단계로 제한한다. 이전 프레임 KV 임베딩으로는 기울기를 전달하지 않고, 학습 attention은 추론 시 이동 윈도와 일치시킨다.
- Equation (2)는 L_DMD(θ) = E[½‖x̂ − sg[x̂ − (f_ψ(x̂_t, t) − f_φ(x̂_t, t))]‖²]를 사용한다. f_φ는 고정되어 있고, f_ψ는 생성 분포의 score를 추정하며, sg는 stop-gradient를 뜻한다. 목적함수는 생성 분포와 실제 데이터 분포 사이의 reverse KL divergence를 목표로 한다.
- 증류에는 까다로운 도시 장면을 중심으로 선별한 58k-video 부분집합을 사용한다. 더 긴 문맥의 교사는 장기 품질을 개선하지만, 구간별 FVD 결과에서 품질 저하를 완전히 없애지는 못한다.
5. Training-free Model Inference Optimization
배포 최적화는 증류된 확산 모델의 가중치를 바꾸지 않는다. 보고된 시스템은 GB300 1개에서 단일 시점 8프레임 청크를 118 ms에, GB300 GPU 16개에서 4개 시점의 16프레임 청크를 151 ms에 생성한다. 두 구성 모두 해상도는 704 × 1280이다.
5.1. Model Optimization
Local temporal attention은 OmniDreams-SV에서 잠재 프레임 6개, 즉 RGB 프레임 24개의 윈도를 유지하고, OmniDreams-MV에서는 잠재 프레임 8개, 즉 RGB 프레임 32개의 윈도를 유지한다. Streaming static-shape KV cache는 미리 할당한 캐시 텐서의 shape을 고정하고 갱신 작업을 별도 스레드로 옮긴다. Compile and CUDA Graphs에서는 고정 shape을 이용해 torch.compile을 적용하고 CUDA Graph를 필요할 때 캡처한다. 이후 같은 shape의 청크와 롤아웃에서 이를 재실행한다.
- 경량 인코더와 디코더를 사용한다. OmniDreams-SV는 조건 인코딩에 LightVAE를 사용하고, OmniDreams-MV는 인코딩 지연이 미미한 pixel shuffle을 사용한다. 둘 다 RGB 디코딩에는 LightTAE를 사용한다.
- 단계마다 변하지 않는 연산을 반복 실행에서 분리한다. RoPE 주파수는 청크마다 1회 계산하고, patchify/unpatchify는 노이즈 제거 단계마다 수행하지 않고 청크의 시작과 끝에서 수행한다.
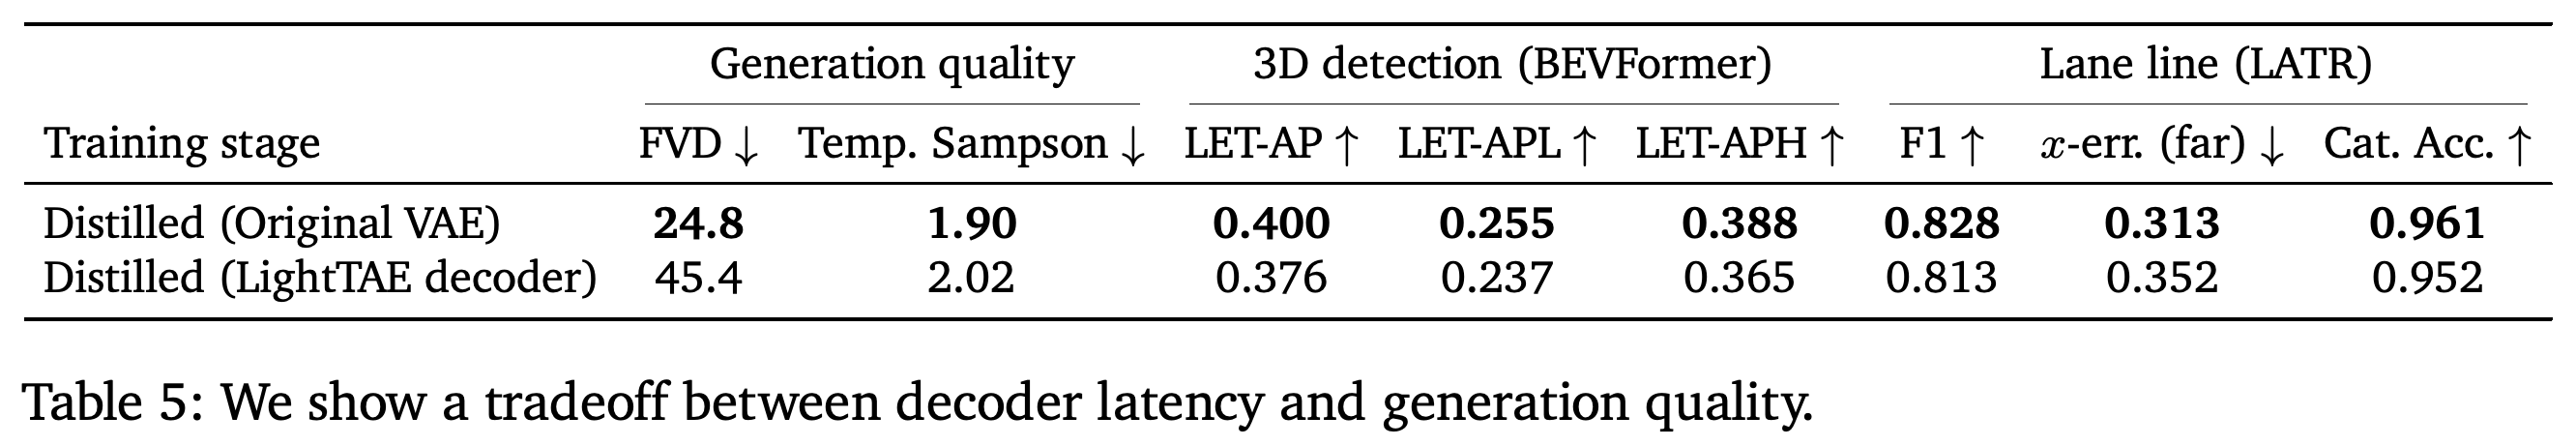
- Table 5는 저지연 구성에 사용한 LightTAE 디코더의 품질 손실을 측정한다.
5.2. Multi-GPU Inference
계층적 context parallelism은 DiT를 카메라 시점 V, 시간 T, 공간 HW 축으로 분할하며 V → T → HW 순으로 우선한다. 16-GPU 기반 4개 시점 배포는 V=4, T=4, HW=1로 구성해 공간 분할 전에 시점 및 청크 내부 시간 병렬성을 모두 활용한다. 자체 ring-attention 구현은 KV shard 통신과 로컬 attention 계산을 겹쳐 수행한다.
- 시점 분할은 카메라별 self-attention 호출을 유지하며, 카메라 4대 축의 병렬성을 모두 사용할 때까지 거의 선형으로 확장된다.
- 그다음에는 시간 단계별 cross-view attention 블록을 유지하는 시간 분할을 우선한다. 공간 분할은 self-attention과 cross-view attention을 모두 나누기 때문이다.
5.3. End-to-End Performance
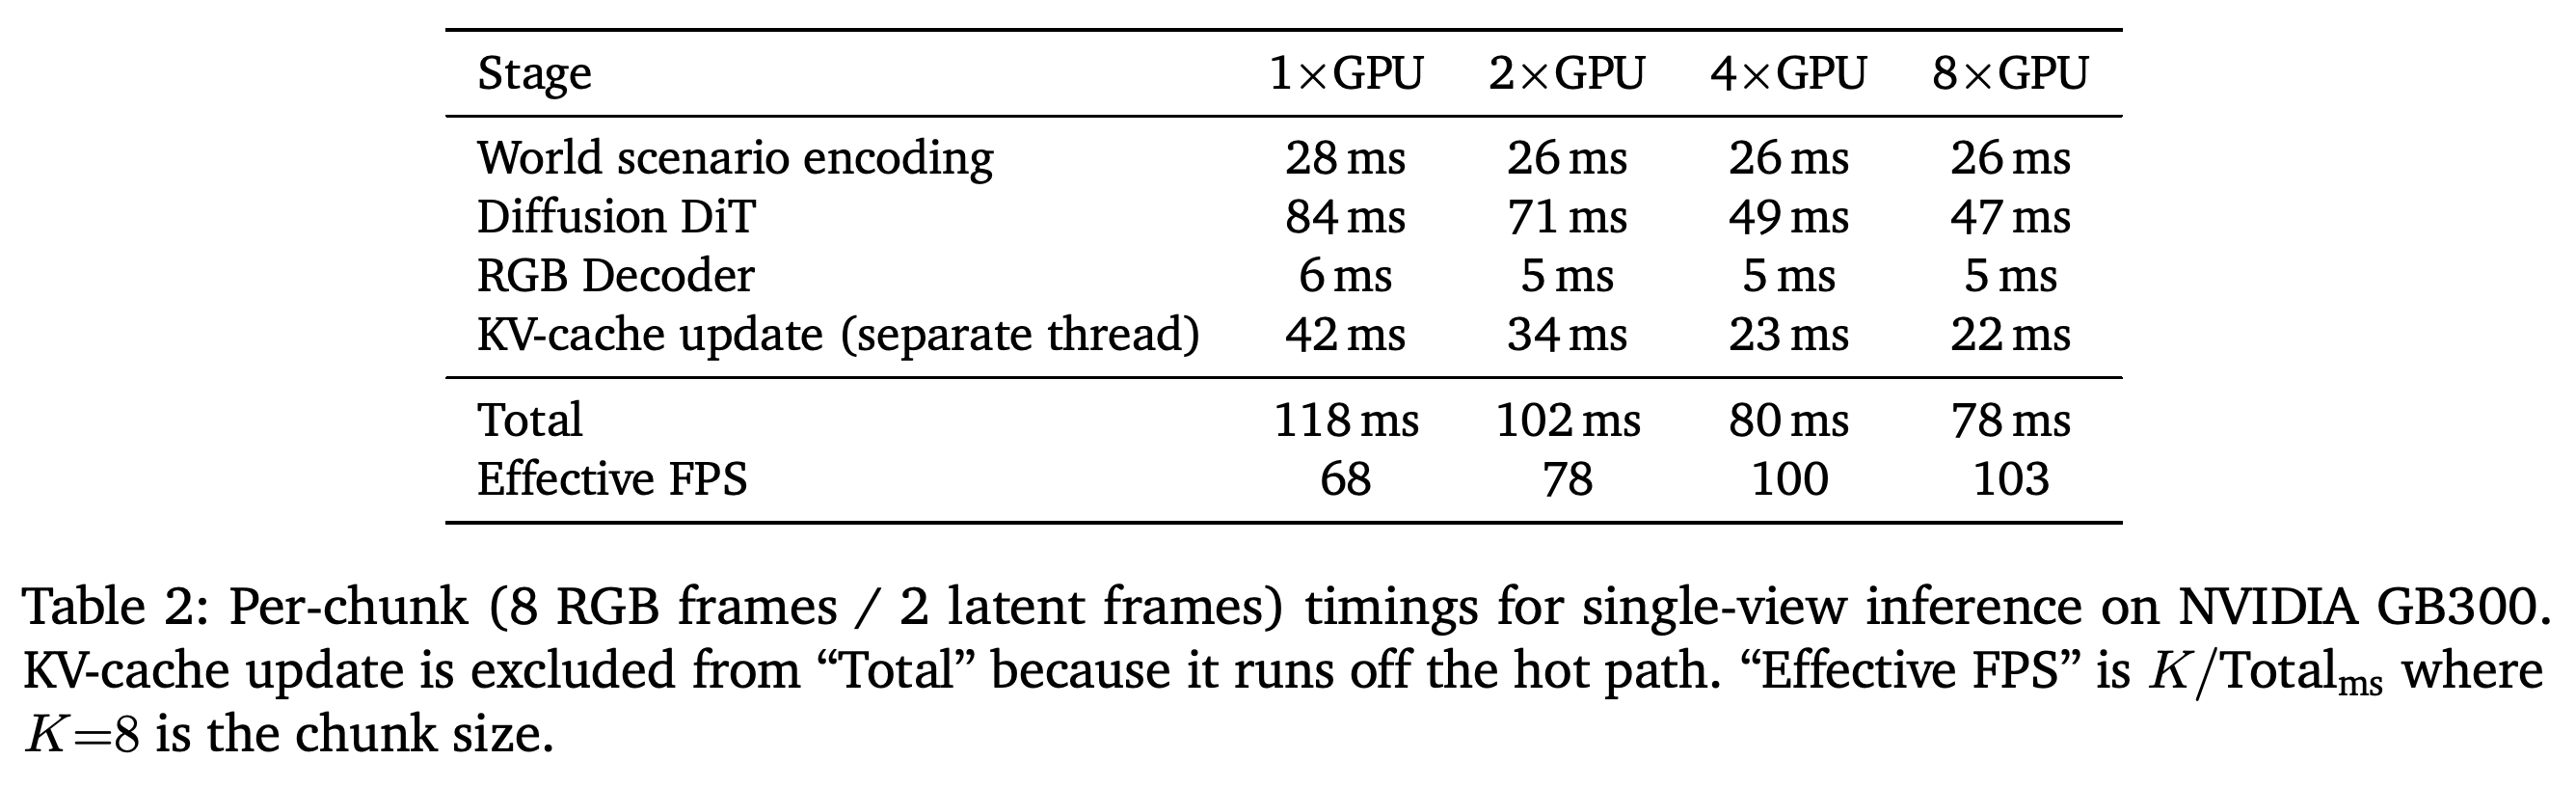
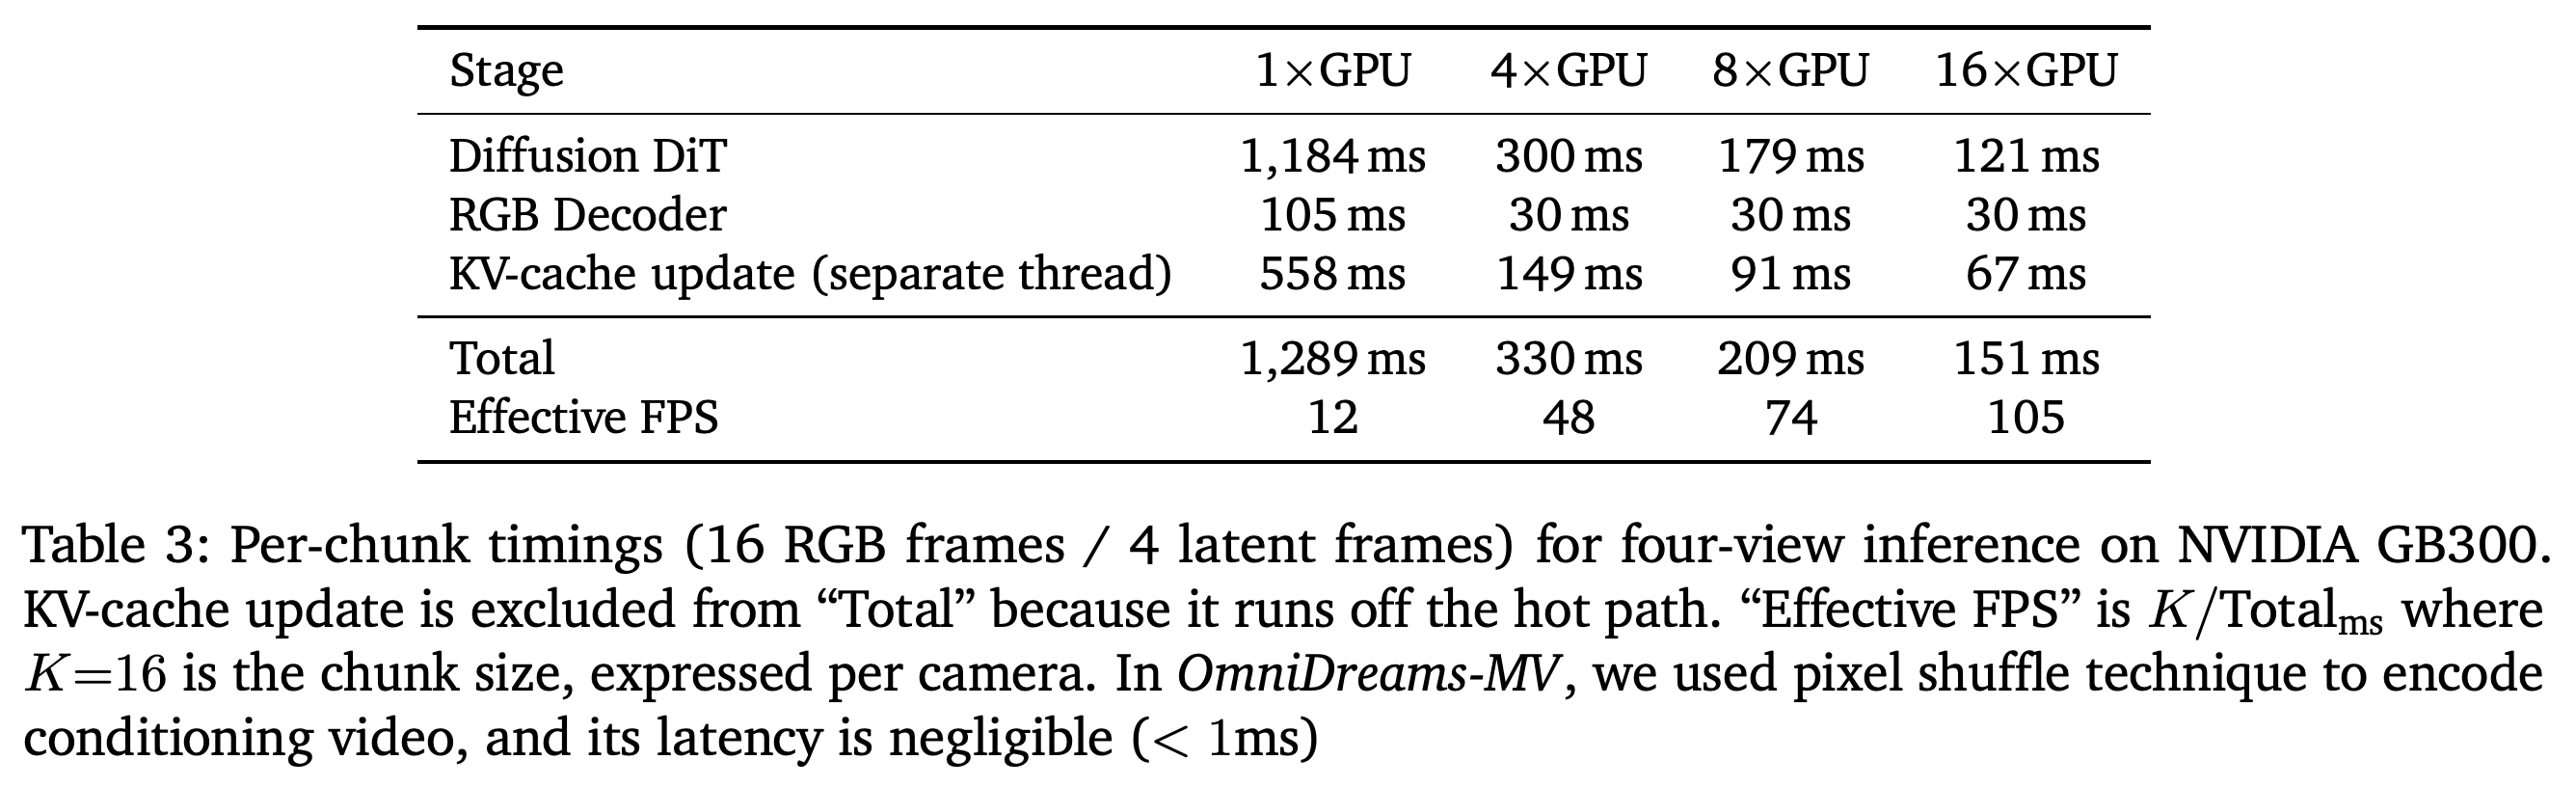
Tables 2와 3은 704 × 1280에서 노이즈 제거 2단계 모델을 벤치마크하며, 주 실행 경로 밖에서 수행하는 KV cache 갱신은 총 지연에서 제외한다. 단일 시점 추론은 GPU 1, 2, 4, 8개에서 각각 유효 처리량 68, 78, 100, 103 FPS를 달성한다. 4개 시점 추론은 GPU 1, 4, 8, 16개에서 각각 카메라당 유효 처리량 12, 48, 74, 105 FPS를 달성한다. 논문은 실시간 렌더링을 30 FPS로 정의한다.
- 단일 시점의 총 청크 지연은 118, 102, 80, 78 ms다. GPU 4개를 넘으면 조건 인코딩이 상당한 고정 비용이 되어 추가 GPU의 효과가 줄어든다.
- 4개 시점의 총 청크 지연은 1,289, 330, 209, 151 ms다. GPU 1개에서 16개로 늘리면 DiT 지연은 1,184 ms에서 121 ms로 감소한다.
- 유효 FPS는 생성한 프레임 수를 청크 생성 시간으로 나눈 값이다. 폐루프 비교에서는 533 ms마다 재계획하므로 렌더링 처리량은 피드백 제어 빈도가 아니다.
단일 시점 처리량은 GB300 1개의 68 FPS에서 8개의 103 FPS로 증가하지만, GPU 4개에서 8개로 늘릴 때 총 청크 지연은 80 ms에서 78 ms로만 줄어든다. 해당 구성에서 world-scenario 인코딩은 26 ms를 유지한다. 캐시 갱신은 주 실행 경로 밖에서 수행되므로 제외된다.
4개 시점의 총 지연은 GPU 1개의 1,289 ms에서 16개의 151 ms로 감소하며, 카메라당 유효 처리량은 105 FPS에 도달한다. GPU 1개 구성에서는 DiT가 대부분의 시간을 차지하고, pixel-shuffle 조건 인코딩 지연은 1 ms 미만이다.
5.4. FlashDreams: Generalized Inference and Serving Infra
FlashDreams는 로컬 윈도 attention, 고정 shape 스트리밍 캐시, CUDA Graph 실행, 네트워크 서빙을 오픈소스 추론 스택으로 제공한다. OmniDreams 외에도 저자들은 GB200 1개에서 Wan2.1 기반 Self Forcing의 최대 1.95× 속도 향상과 H100 4개에서 Lingbot-World의 최대 2.49× 속도 향상을 보고한다.
- 서빙 스택은 제어 입력을 서버로, RGB 프레임을 클라이언트로 스트리밍하기 위해 gRPC와 webRTC 프로토콜을 제공한다.
- 저장소 주소는 https://github.com/NVIDIA/flashdreams 이다. 보고된 속도 향상은 구성별 최대값이다.
6. Closed-Loop Simulation Integration
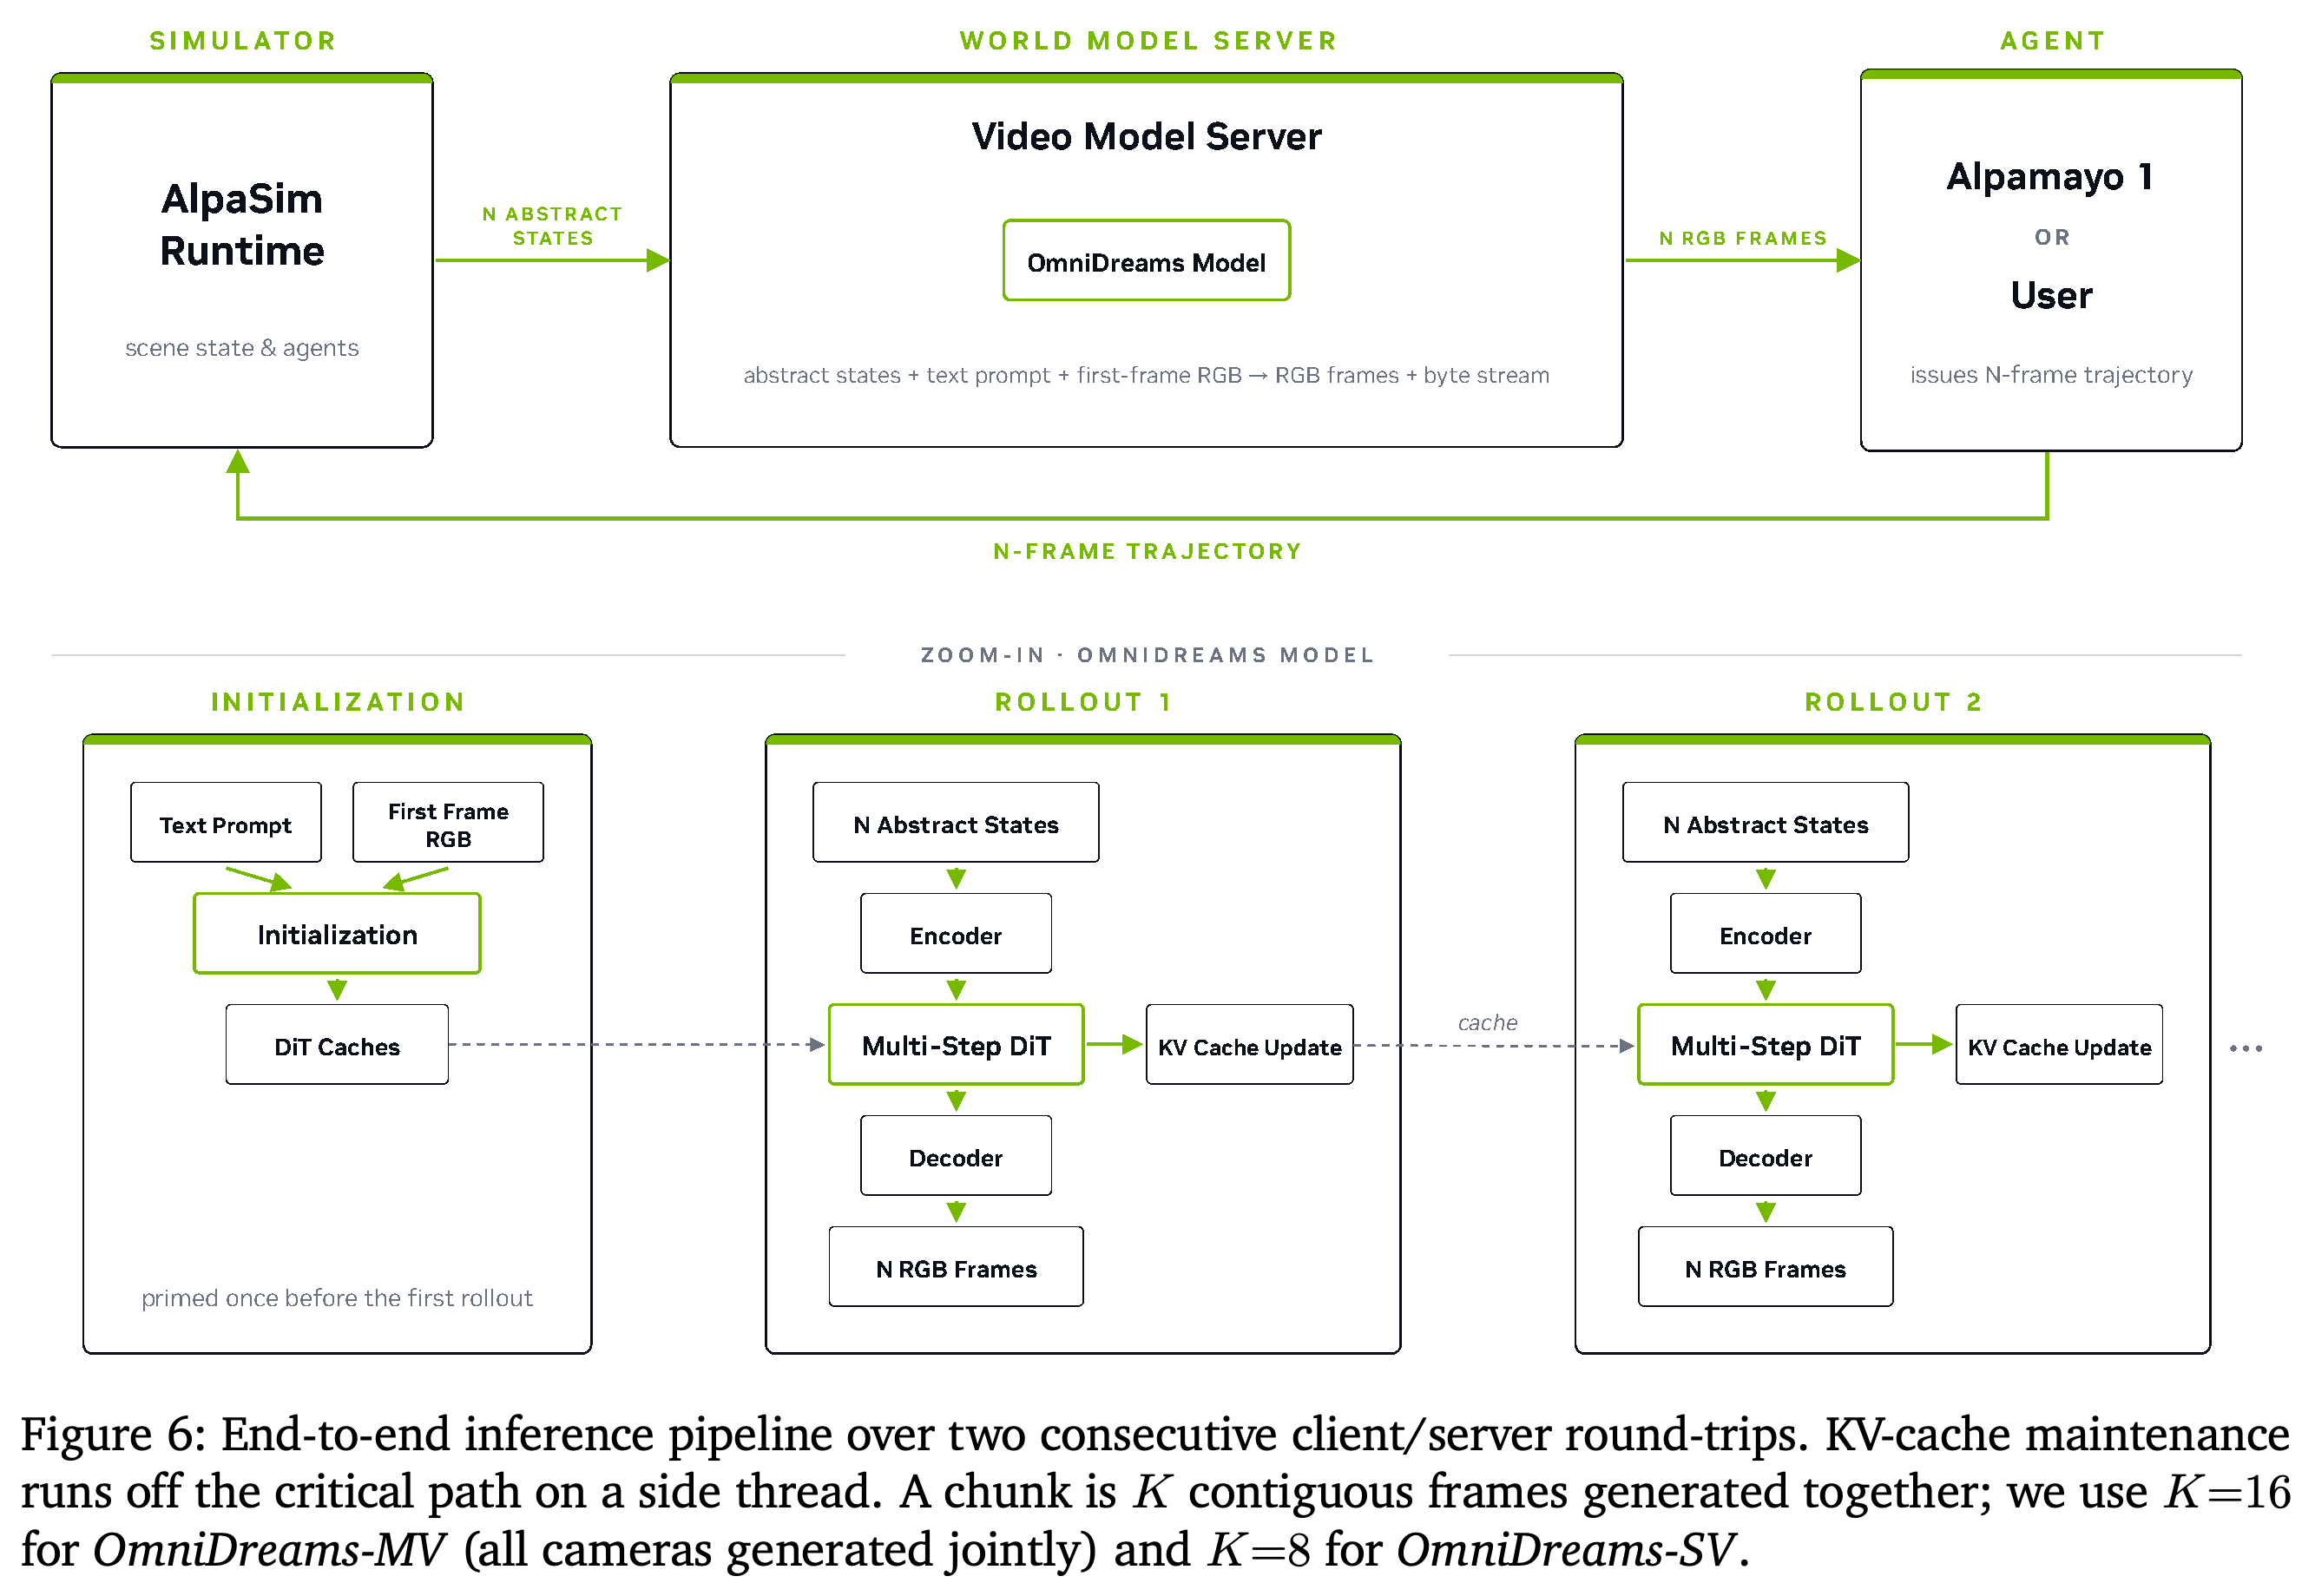
상태를 유지하는 영상 모델 서버가 gRPC를 통해 시뮬레이터에 연결된다. 요청에는 궤적과 프롬프트를 포함하며, 초기 RGB 시드는 세션 초기화 때만 보낸다. 서버는 조건을 렌더링하고 인과적 노이즈 제거를 2단계 수행한 뒤 JPEG로 인코딩한 프레임을 반환한다. KV cache, 캡처된 CUDA Graph, 렌더러 상태는 청크 사이에 유지된다.
- Figure 6은 초기화와 연속된 2회의 왕복 요청을 보여준다. 캐시 유지 작업은 핵심 렌더링 경로와 분리된다.
- 이 통합은 분산 추론, 순서를 유지하는 자기회귀 상태, 생성 청크 전체에 대해 확정된 궤적을 지원한다.
초기화는 유지할 상태를 1회 준비한다. 이후 요청은 새 추상 상태 청크를 인코딩하고 DiT를 실행한 뒤 RGB를 디코딩하며, 캐시 유지 작업은 보조 스레드에서 수행한다. 모델 측 상태는 네트워크 왕복 요청 사이에 유지되어 시드 이미지를 반복 전송할 필요가 없다.
6.1. AlpaSim
AlpaSim은 Docker로 배포된 마이크로서비스가 gRPC로 통신하는 연구용 AV 시뮬레이터다. 비동기 런타임은 전문화된 서비스에 걸쳐 동시 롤아웃을 파이프라인으로 실행한다. OmniDreams 통합은 NuRec 카메라 렌더러를 교체하고, 상태를 유지하는 청크 생성을 지원하도록 런타임과 프로토콜을 확장한다.
- 서비스는 동시에 들어오거나 순서가 뒤바뀔 수 있는 요청에서 각 롤아웃의 상태를 구분해야 한다.
- 오픈소스 시뮬레이터는 https://github.com/NVlabs/alpasim 에서 제공한다.
6.2. Networked integration in AlpaSim
rank 0의 gRPC 서버는 시뮬레이터 요청을 받고 NCCL 이벤트를 통해 나머지 분산 rank에 렌더링 작업을 전달한다. 생성된 프레임은 rank 0에 모아 직렬화한 뒤 AlpaSim에 반환한다. 이 방식은 모델 의존성과 rank 병렬 실행을 다른 시뮬레이터 구성 요소에서 분리한다.
- RDMA 기반 gRPC 또는 gRPC로 조율하는 NCCL 대용량 프레임 전송은 향후 과제로 제안되며, 현재 통합에서 검증된 방식은 아니다.
- 이러한 전송 방식 변경은 기존 프레임 인코딩·디코딩의 복잡성과 손실 문제를 해결하기 위한 것이다.
6.3. Session-based state
각 롤아웃은 시드 프레임, 세계 지도 표현, 미리 할당한 KV cache를 포함하는 세션을 생성한다. 서버는 새 세션 ID를 반환하고, AlpaSim은 이후 요청에 이 ID를 첨부해 올바른 자기회귀 이력을 선택한다.
6.4. Supporting chunked generation
청크 생성은 렌더링 시작 전에 모든 프레임의 자차와 행위자 pose를 요구한다. 따라서 청크를 무효화하지 않고서는 청크 중간에 정책이나 교통 궤적을 바꿀 수 없다. 6.4.1. Post-fetch generation은 오래된 시각 입력으로 정책과 교통을 진행한 뒤 생성 관측을 삽입한다. AlpaSim에 구현된 6.4.2. Pre-fetch generation은 청크 경계에서 다단계 궤적을 예측하고 확정한 뒤 영상을 요청한다.
- Post-fetch는 시각 관측이 자차 움직임보다 늦게 도착해도 작동하는 정책을 요구하며, 시뮬레이션 이벤트의 순서가 뒤바뀌게 한다.
- Pre-fetch는 확정된 궤적을 프레임 타임스탬프에 맞춰 보간하고, 반환된 프레임을 타임스탬프가 있는 이벤트로 삽입해 이벤트 순서를 유지한다.
- 더 작은 청크와 궁극적인 프레임 단위 생성은 향후 목표다. 현재의 청크 처리 방식은 청크 내부에서 변화에 대응하는 능력을 제한한다.
7. Post-training OmniDreams as a World-Action Model (WAM)
World-Action Model (WAM) 실험은 생성형 주행 표현이 정책 예측에도 도움이 되는지 시험한다. World-scenario 제어 파인튜닝 전의 약 2 B개 파라미터를 가진 OmniDreams-SV 인과적 체크포인트로 초기화하고, 10 Hz에서 64개 waypoint로 구성된 6.4초 궤적을 예측한다.
- 백본의 front-wide 시점은 120° 시야각을 가진다.
- 센서 시뮬레이션과 달리 궤적 예측에는 world-scenario map 제어가 필요하지 않다.
7.1. Architecture and training
WAM은 DINOv2 (dinov2_vitb14)로 초기화한 인코더의 투영된 패치 특징과 30° front-telescope 카메라를 추가하고, 자차 움직임 1.6 s를 인코딩한 이력 토큰을 사용한다. 이력 토큰은 현재와 과거 영상 토큰을 참조하지만 다른 이력 토큰은 참조하지 않는다. 이 출력은 R^{64×3}의 궤적 잠재 표현을 다루는 12층 U-Net 형태 MLP flow 모델의 조건이 된다. 공동 학습은 노이즈 시간을 독립적으로 샘플링해 영상과 궤적의 flow-matching 손실을 더한다.
- Attention mask는 인과적 video-to-video attention을 유지하면서 이력 토큰으로 향하는 단방향 정보 흐름을 추가한다.
- 추론에서는 노이즈가 낮은 영상 잠재 프레임 4개와 이력 토큰 1개로 DiT를 1회 실행한 뒤, 경량 궤적 MLP에서 flow-matching 4단계를 수행한다.
- 미래 궤적만 요청할 때는 영상 노이즈 제거 롤아웃이 필요하지 않다.
7.2. Closed-loop comparison to Alpamayo 1.5
기존 Alpamayo 1.5 평가 프로토콜에 따라 WAM 학습 장면을 제외한 Physical AI Autonomous Vehicles NuRec 장면 574개에서 WAM을 평가한다. 재계획은 10 Hz로 수행하고 롤아웃은 20초다. 파라미터 수가 약 2 B 대 10 B로 더 적음에도 충돌률은 6.9%에서 4.2%로 감소한다. Front는 1.0%에서 0.9%로, Lateral은 0.6%에서 0.4%로, Rear는 5.3%에서 3.0%로 감소한다.
- 보고된 방향별 감소 폭은 후방 충돌에서 가장 크다.
- 이 예비 결과는 백본이 정책 예측에 유용함을 뒷받침하지만, 표현 학습의 효과를 아키텍처, 학습, 조건 입력의 차이와 분리하지는 못한다.
- 이 574개 장면, 10 Hz 프로토콜은 Section 9.4의 501개 장면, 533 ms 재계획 시뮬레이터 비교와 별개다.
8. Post-Training OmniDreams as a Diffusion Fixer
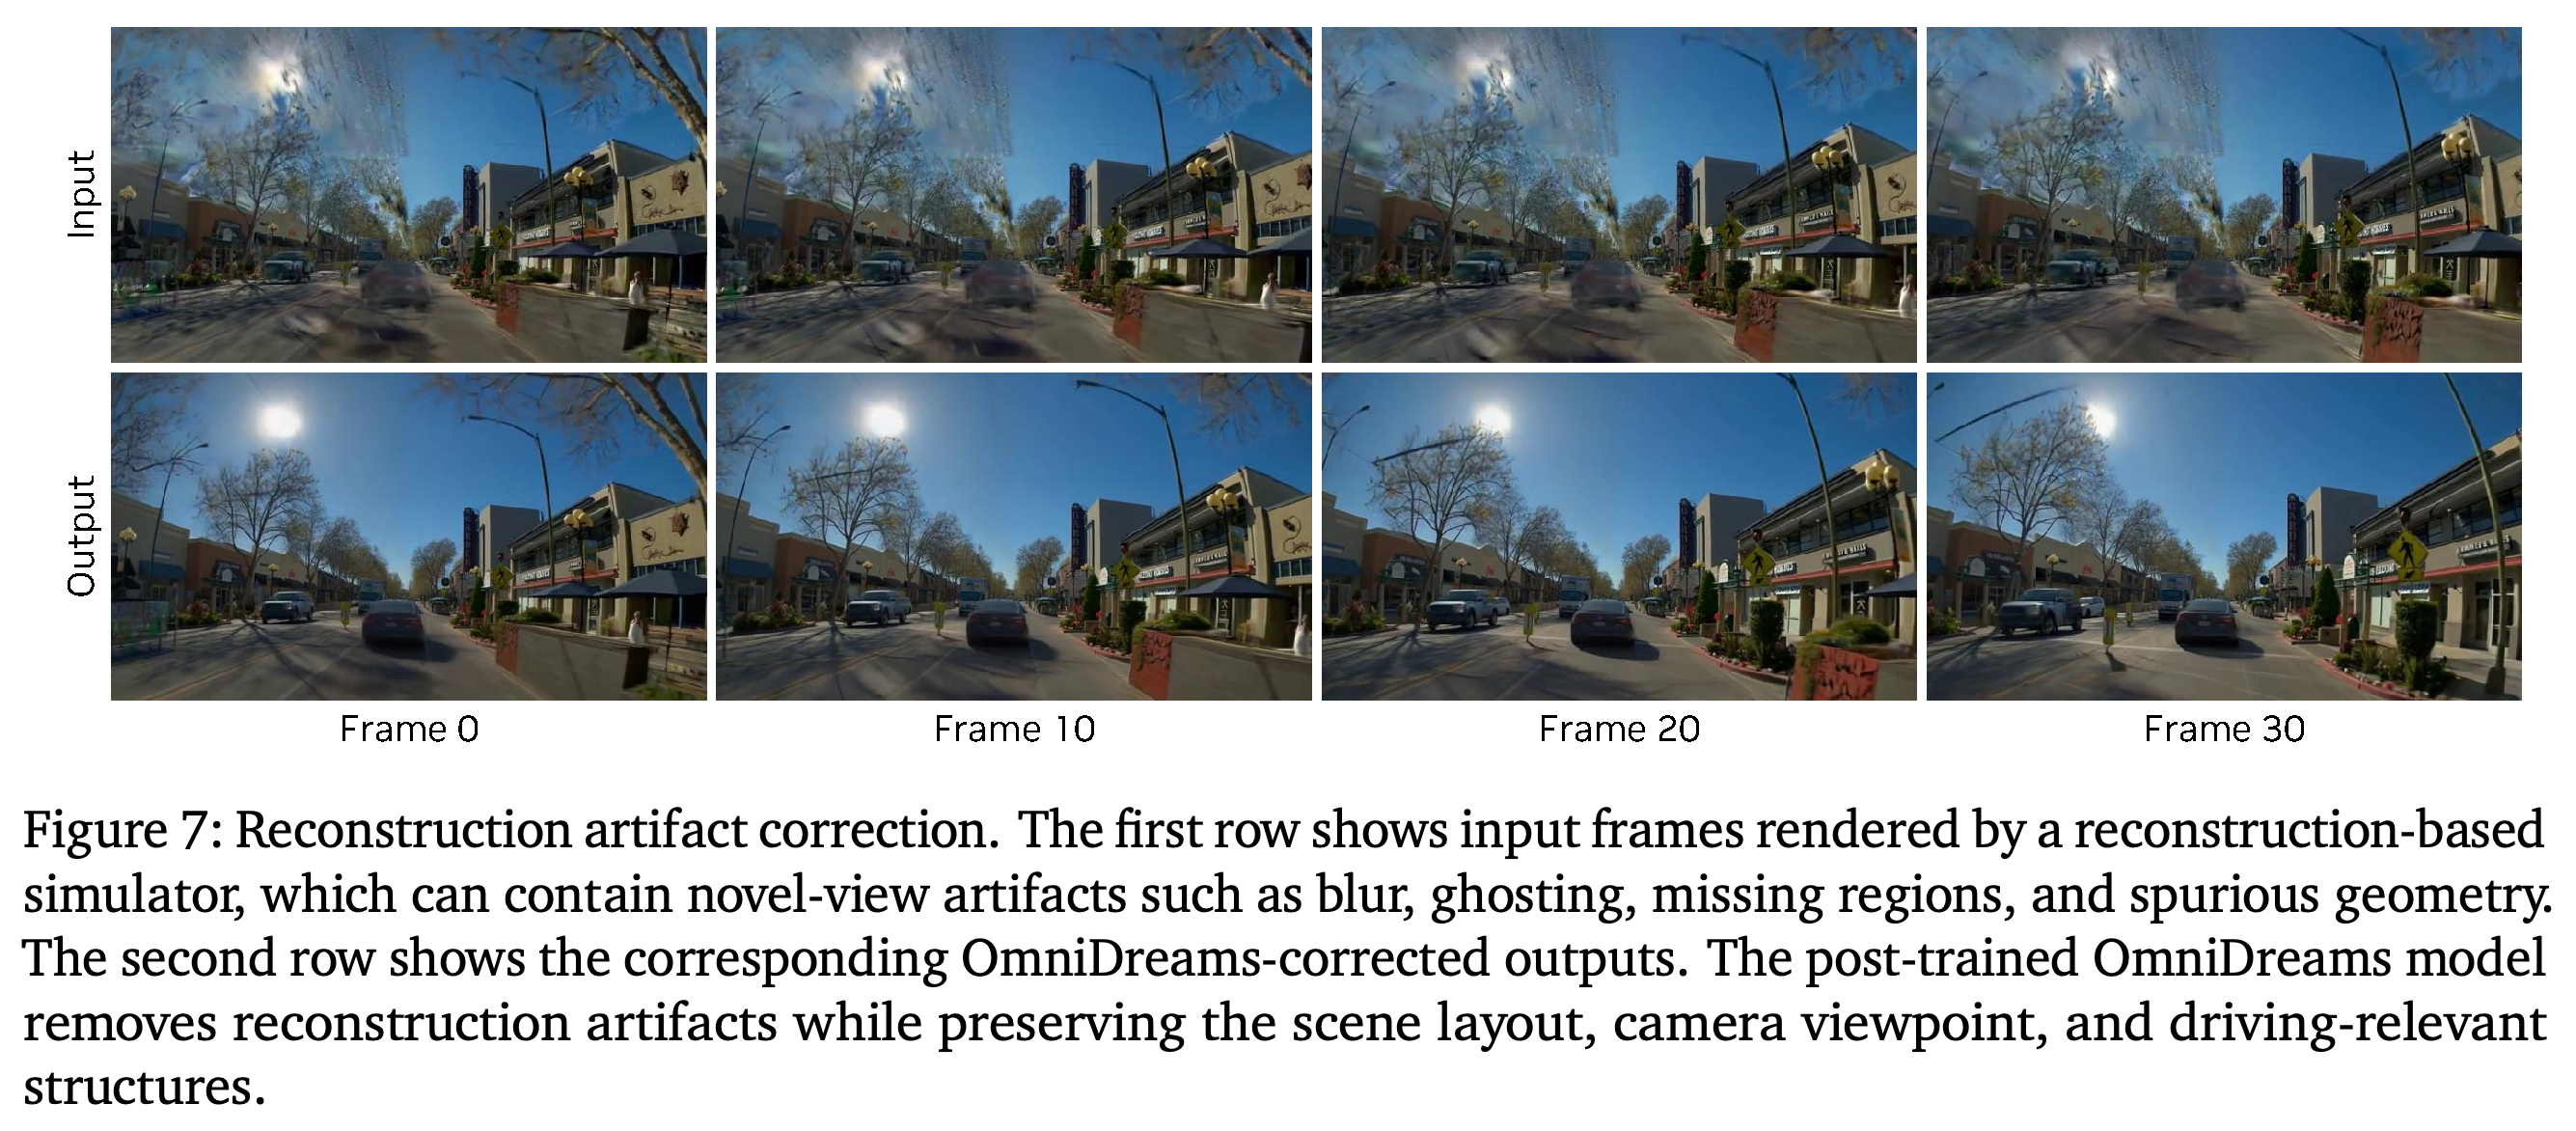
OmniDreams는 품질이 저하된 재구성 렌더링과 깨끗한 목표 이미지를 짝지어 diffusion fixer로도 후속 학습한다. 노이즈 제거는 무작위 Gaussian 노이즈가 아니라 품질이 저하된 렌더링에서 시작한다. 장면 배치와 시점을 보존하는 것을 목표로 더 깨끗한 이미지로 향하는 흐름을 학습한다. 추론에서는 인과적 이력과 KV cache가 연속된 보정의 조건이 된다.
- Figure 7은 재구성 아티팩트가 있는 입력과 보정된 프레임을 정성적으로 비교한다.
- 이 혼합 방식은 재구성에 기반한 장면의 기하학적 기반을 유지하지만, 해당 절은 정량적 보정 지표나 후속 사고 감소 결과를 보고하지 않는다.
프레임 0, 10, 20, 30의 입력과 보정 출력은 도로와 장면 배치를 알아볼 수 있게 유지하면서 렌더링이 눈에 띄게 깨끗해짐을 보여준다. 이 예시는 아티팩트 보정을 정성적으로 뒷받침하지만, 기하 구조 보존이나 정책의 이점을 정량화하지는 않는다.
9. Experiments and Results
실험은 외관과 동역학, 장기 안정성, 제어 가능한 롱테일 시나리오, 폐루프 정책 평가를 다룬다. 정량적 품질 지표와 시뮬레이터 비교에 더해 다중 시점 생성, 시나리오 편집, 특이한 객체, 재구성 보정의 정성적 예시를 제시한다.
9.1. Simulation Quality
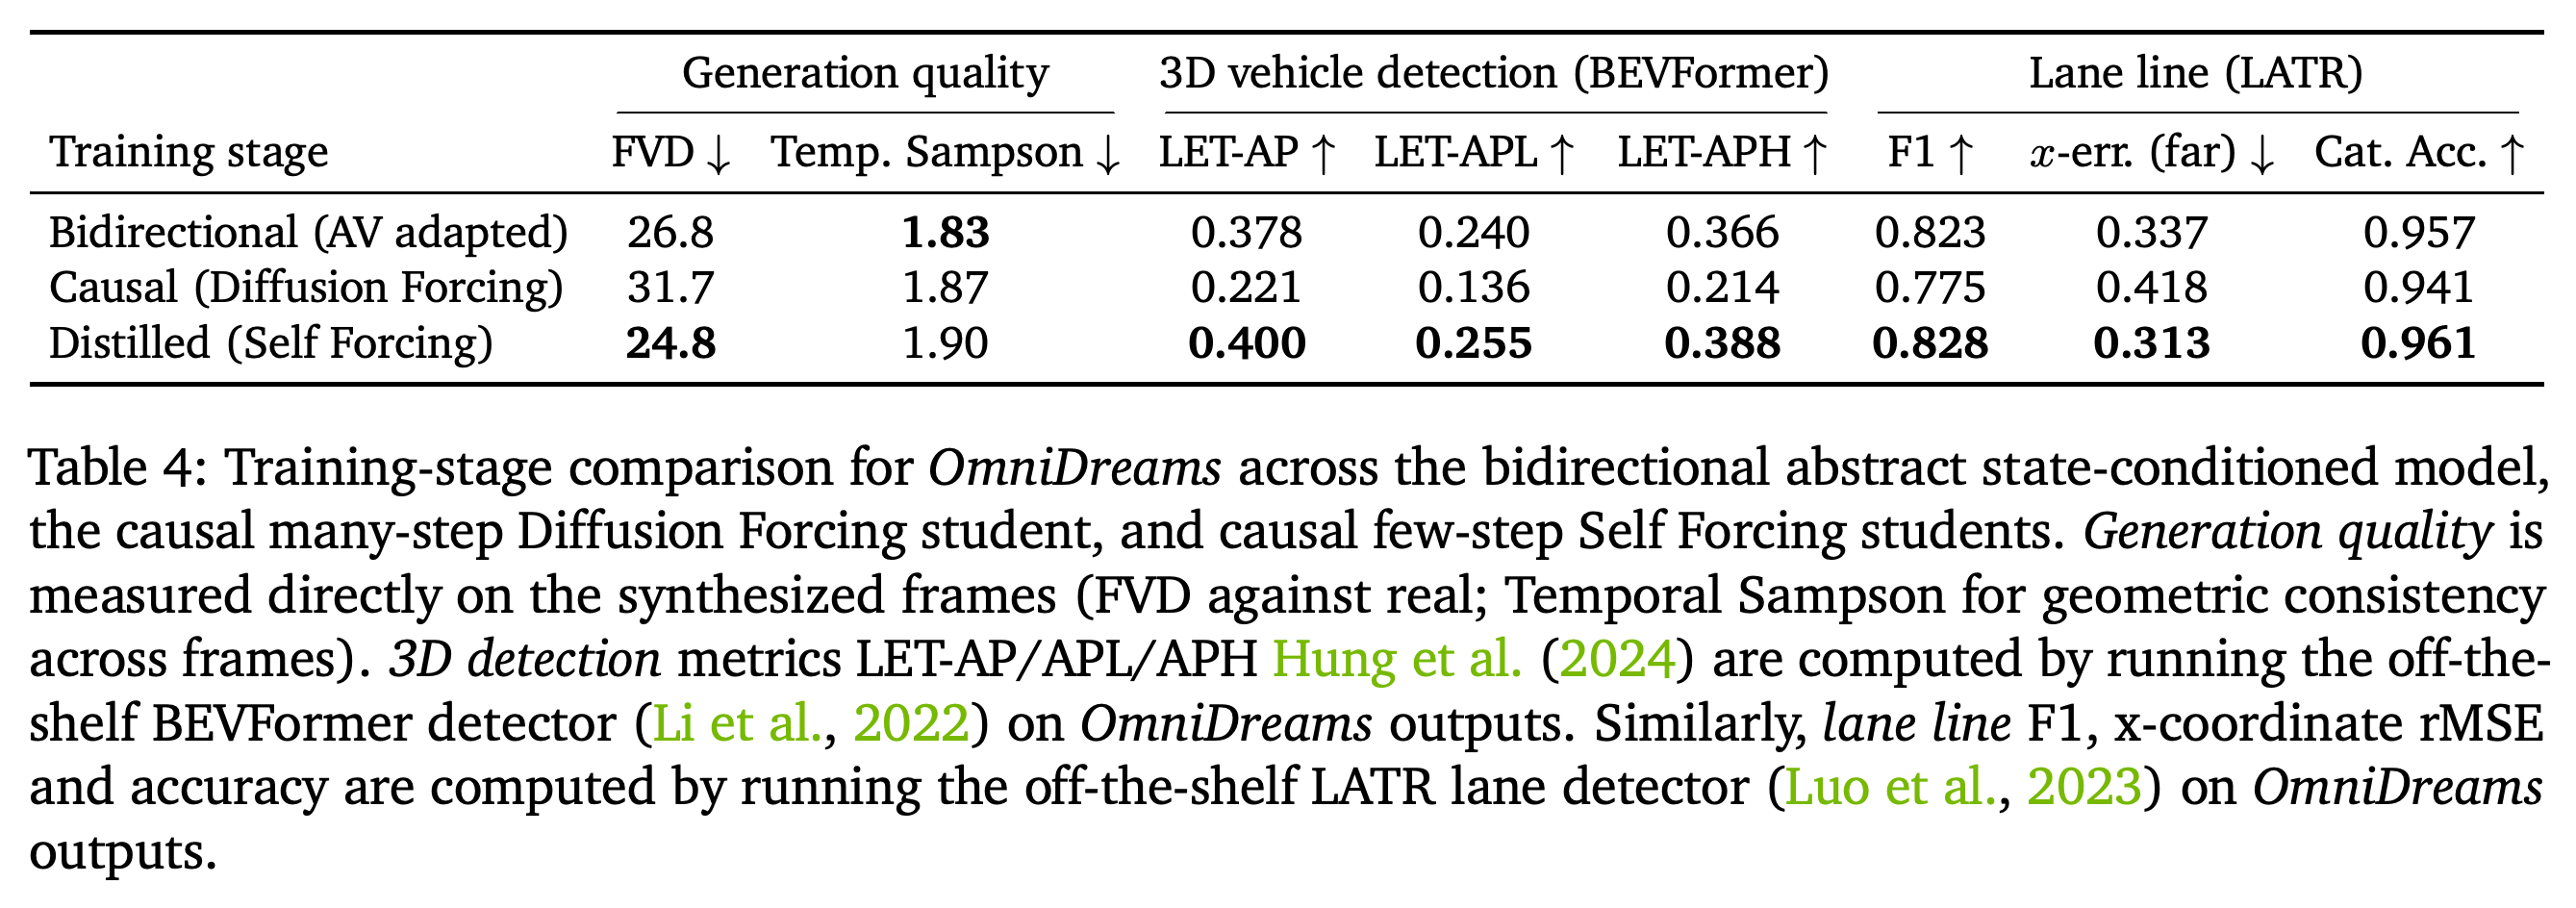
시뮬레이션 품질 지표는 RDS-HQ-1M의 5,000개 클립 홀드아웃 분할에서 샘플링한 클립 1,000개로 측정한다. Table 4에서 Self Forcing은 인과적 Diffusion Forcing보다 FVD와 보고된 모든 차량 검출·차선 지표를 개선하지만, Temporal Sampson은 개선하지 못한다. Table 5는 저지연 LightTAE 디코더의 품질 손실을 보여준다.
- 양방향, 인과적, 증류 모델 순으로 FVD는 26.8/31.7/24.8, LET-AP는 0.378/0.221/0.400, 차선 F1은 0.823/0.775/0.828이다. Temporal Sampson은 1.83/1.87/1.90이며 낮을수록 좋다.
- 원래 디코더를 LightTAE로 교체하면 FVD는 24.8에서 45.4로, LET-AP는 0.400에서 0.376으로, 차선 F1은 0.828에서 0.813으로, Temporal Sampson은 1.90에서 2.02로 바뀐다. Section 9.1은 이를 LightVAE라고 부르지만, Table 5와 Section 5.1은 디코더를 LightTAE로 명시한다.
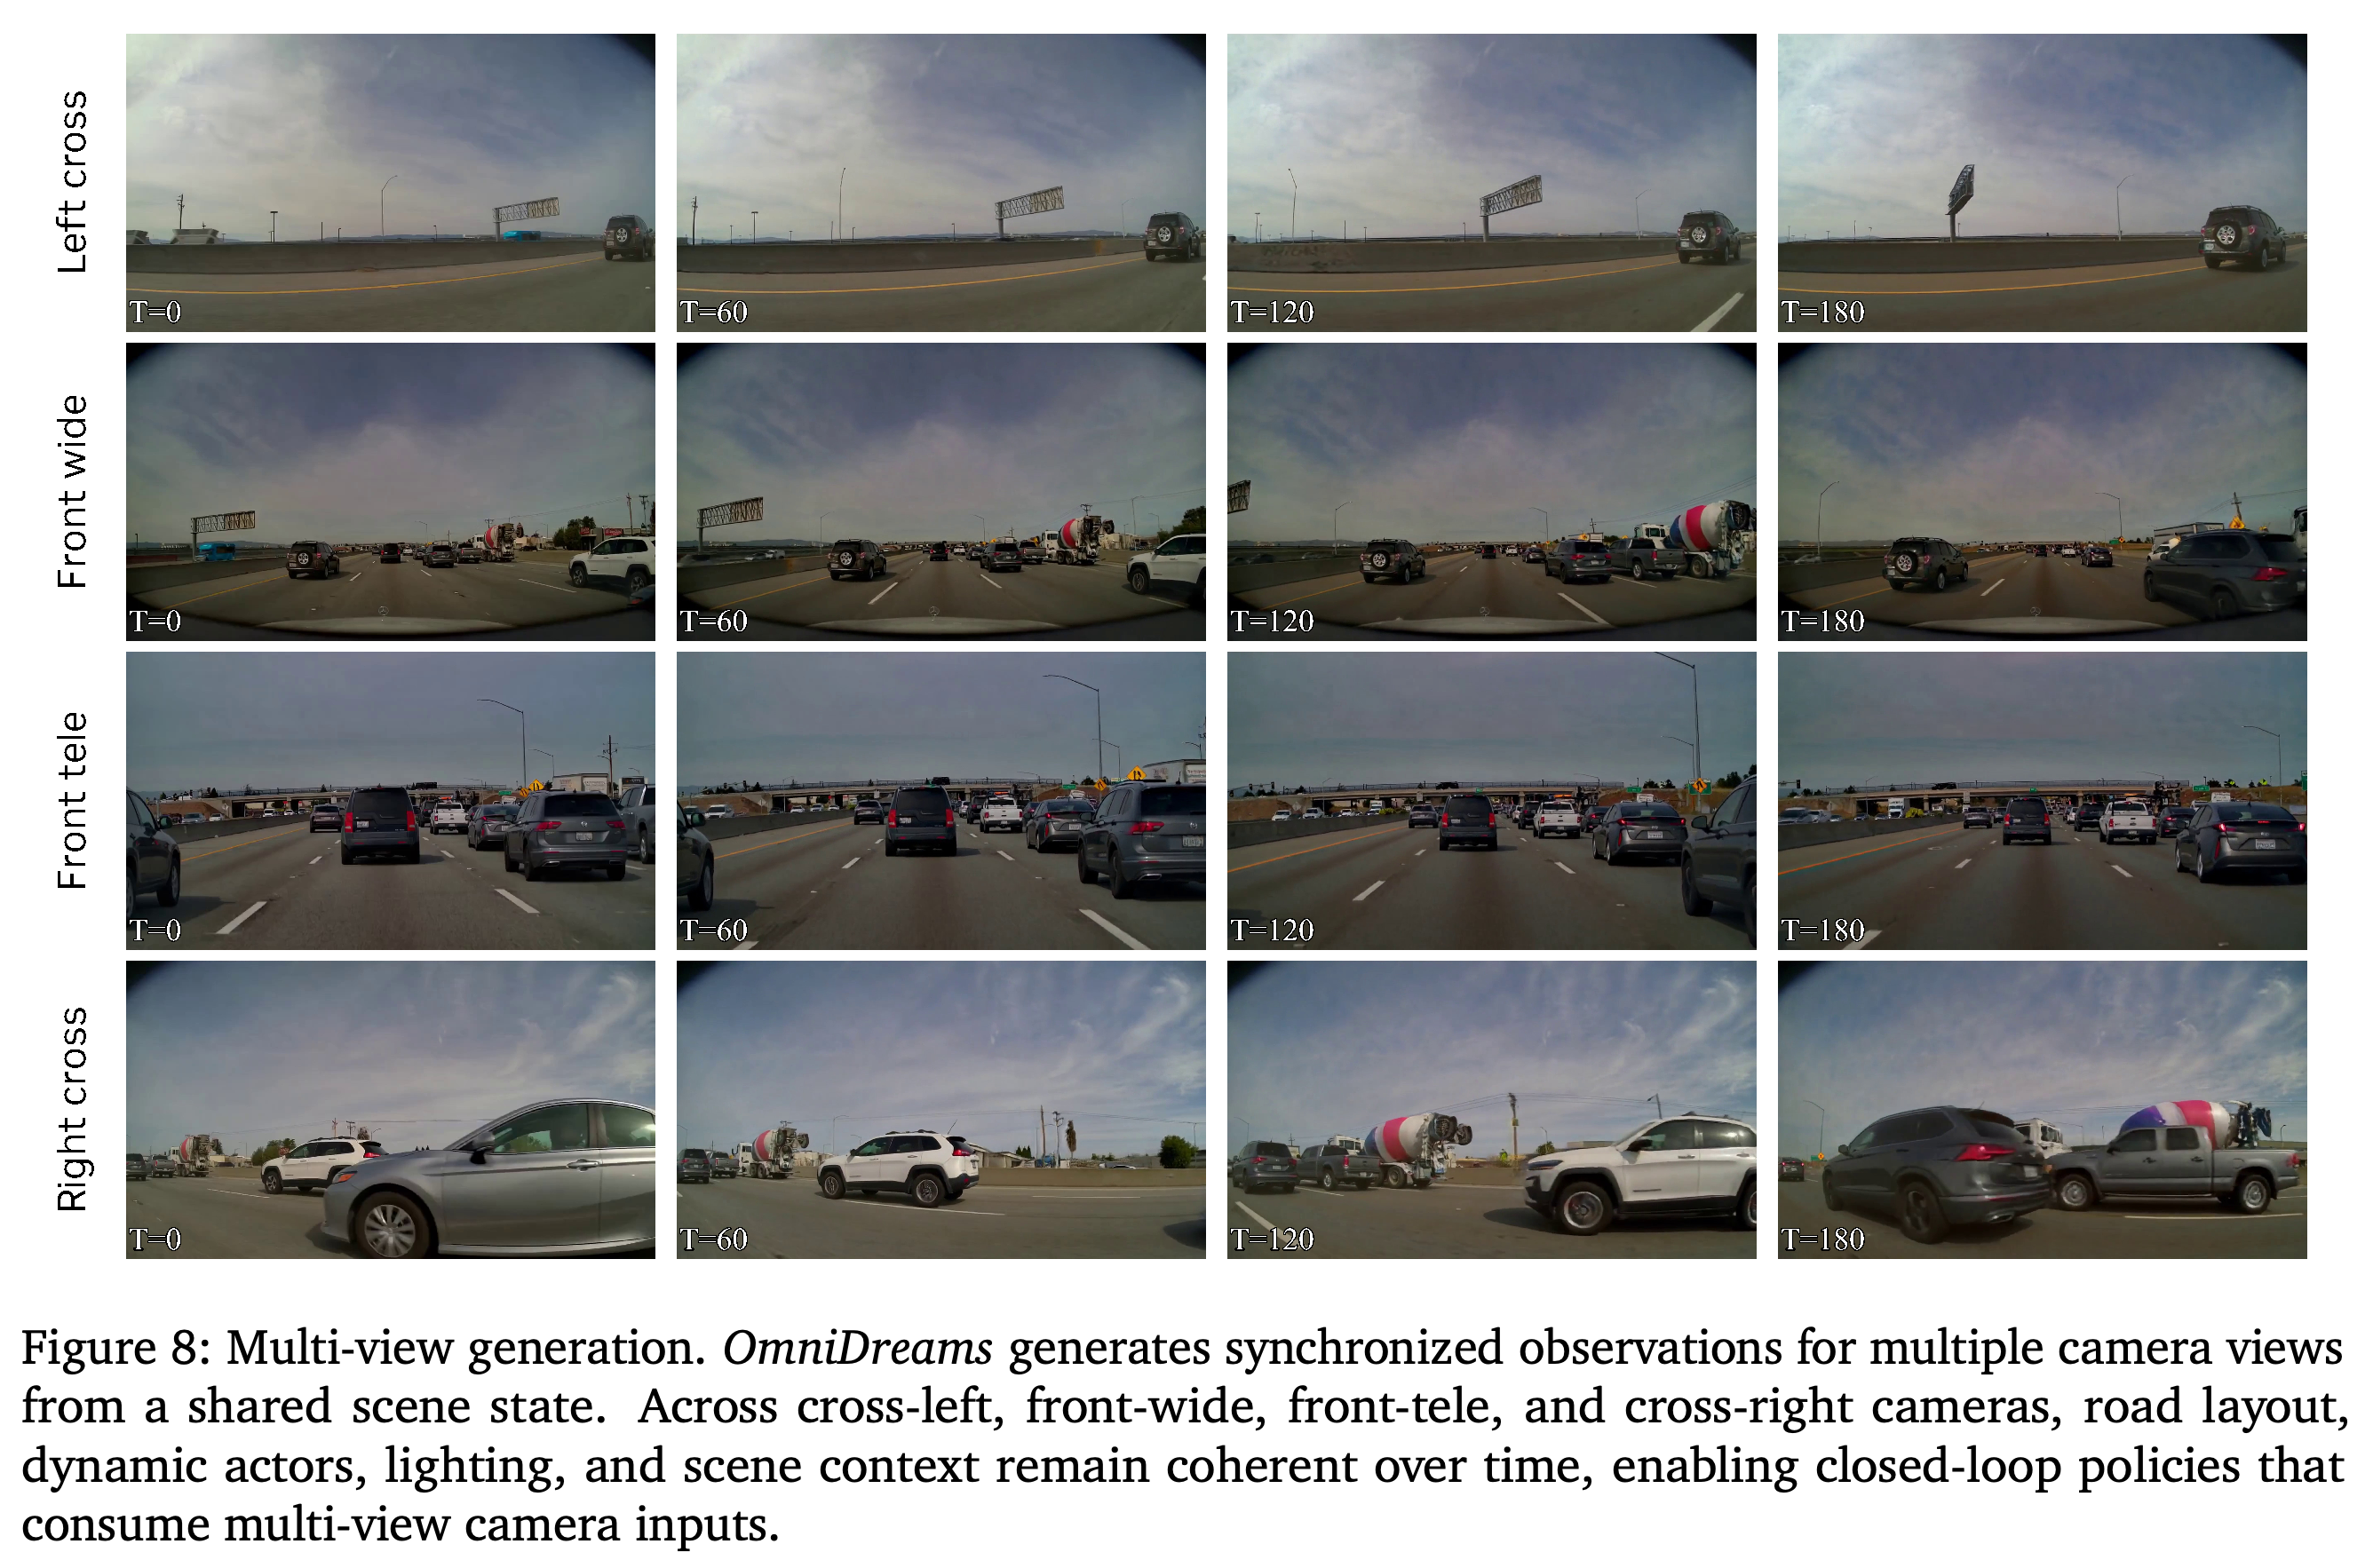
- BEVFormer와 LATR는 주행에 중요한 충실도를 간접적으로 시험한다. Figure 8은 4개 카메라의 정성적 일관성을 보여주지만, 해당 절은 별도의 수치적 cross-view 일관성 지표를 제공하지 않는다.
카메라 4개의 영상 행은 같은 시각에 변화하는 교통 장면을 보여주며, 겹치는 시점 사이에 차량과 도로 맥락을 공유한다. 이는 카메라 간 일관성의 정성적 근거이며, 수치적 일관성 벤치마크는 아니다.
Self Forcing은 3개 단계 중 가장 좋은 FVD, 차량 검출 점수, 차선 지표를 달성한다. 반면 Temporal Sampson은 증류 모델의 1.90보다 양방향 모델의 1.83이 더 좋으므로, 모든 지표가 고르게 개선되는 것은 아니다.
LightTAE는 원래 디코더보다 표시된 모든 품질 지표를 악화시킨다. FVD는 24.8에서 45.4로, 차선 F1은 0.828에서 0.813으로 바뀐다. 따라서 가장 빠른 배포 구성은 원래 VAE로 평가한 품질을 유지하지 못한다.
9.2. Long Rollouts
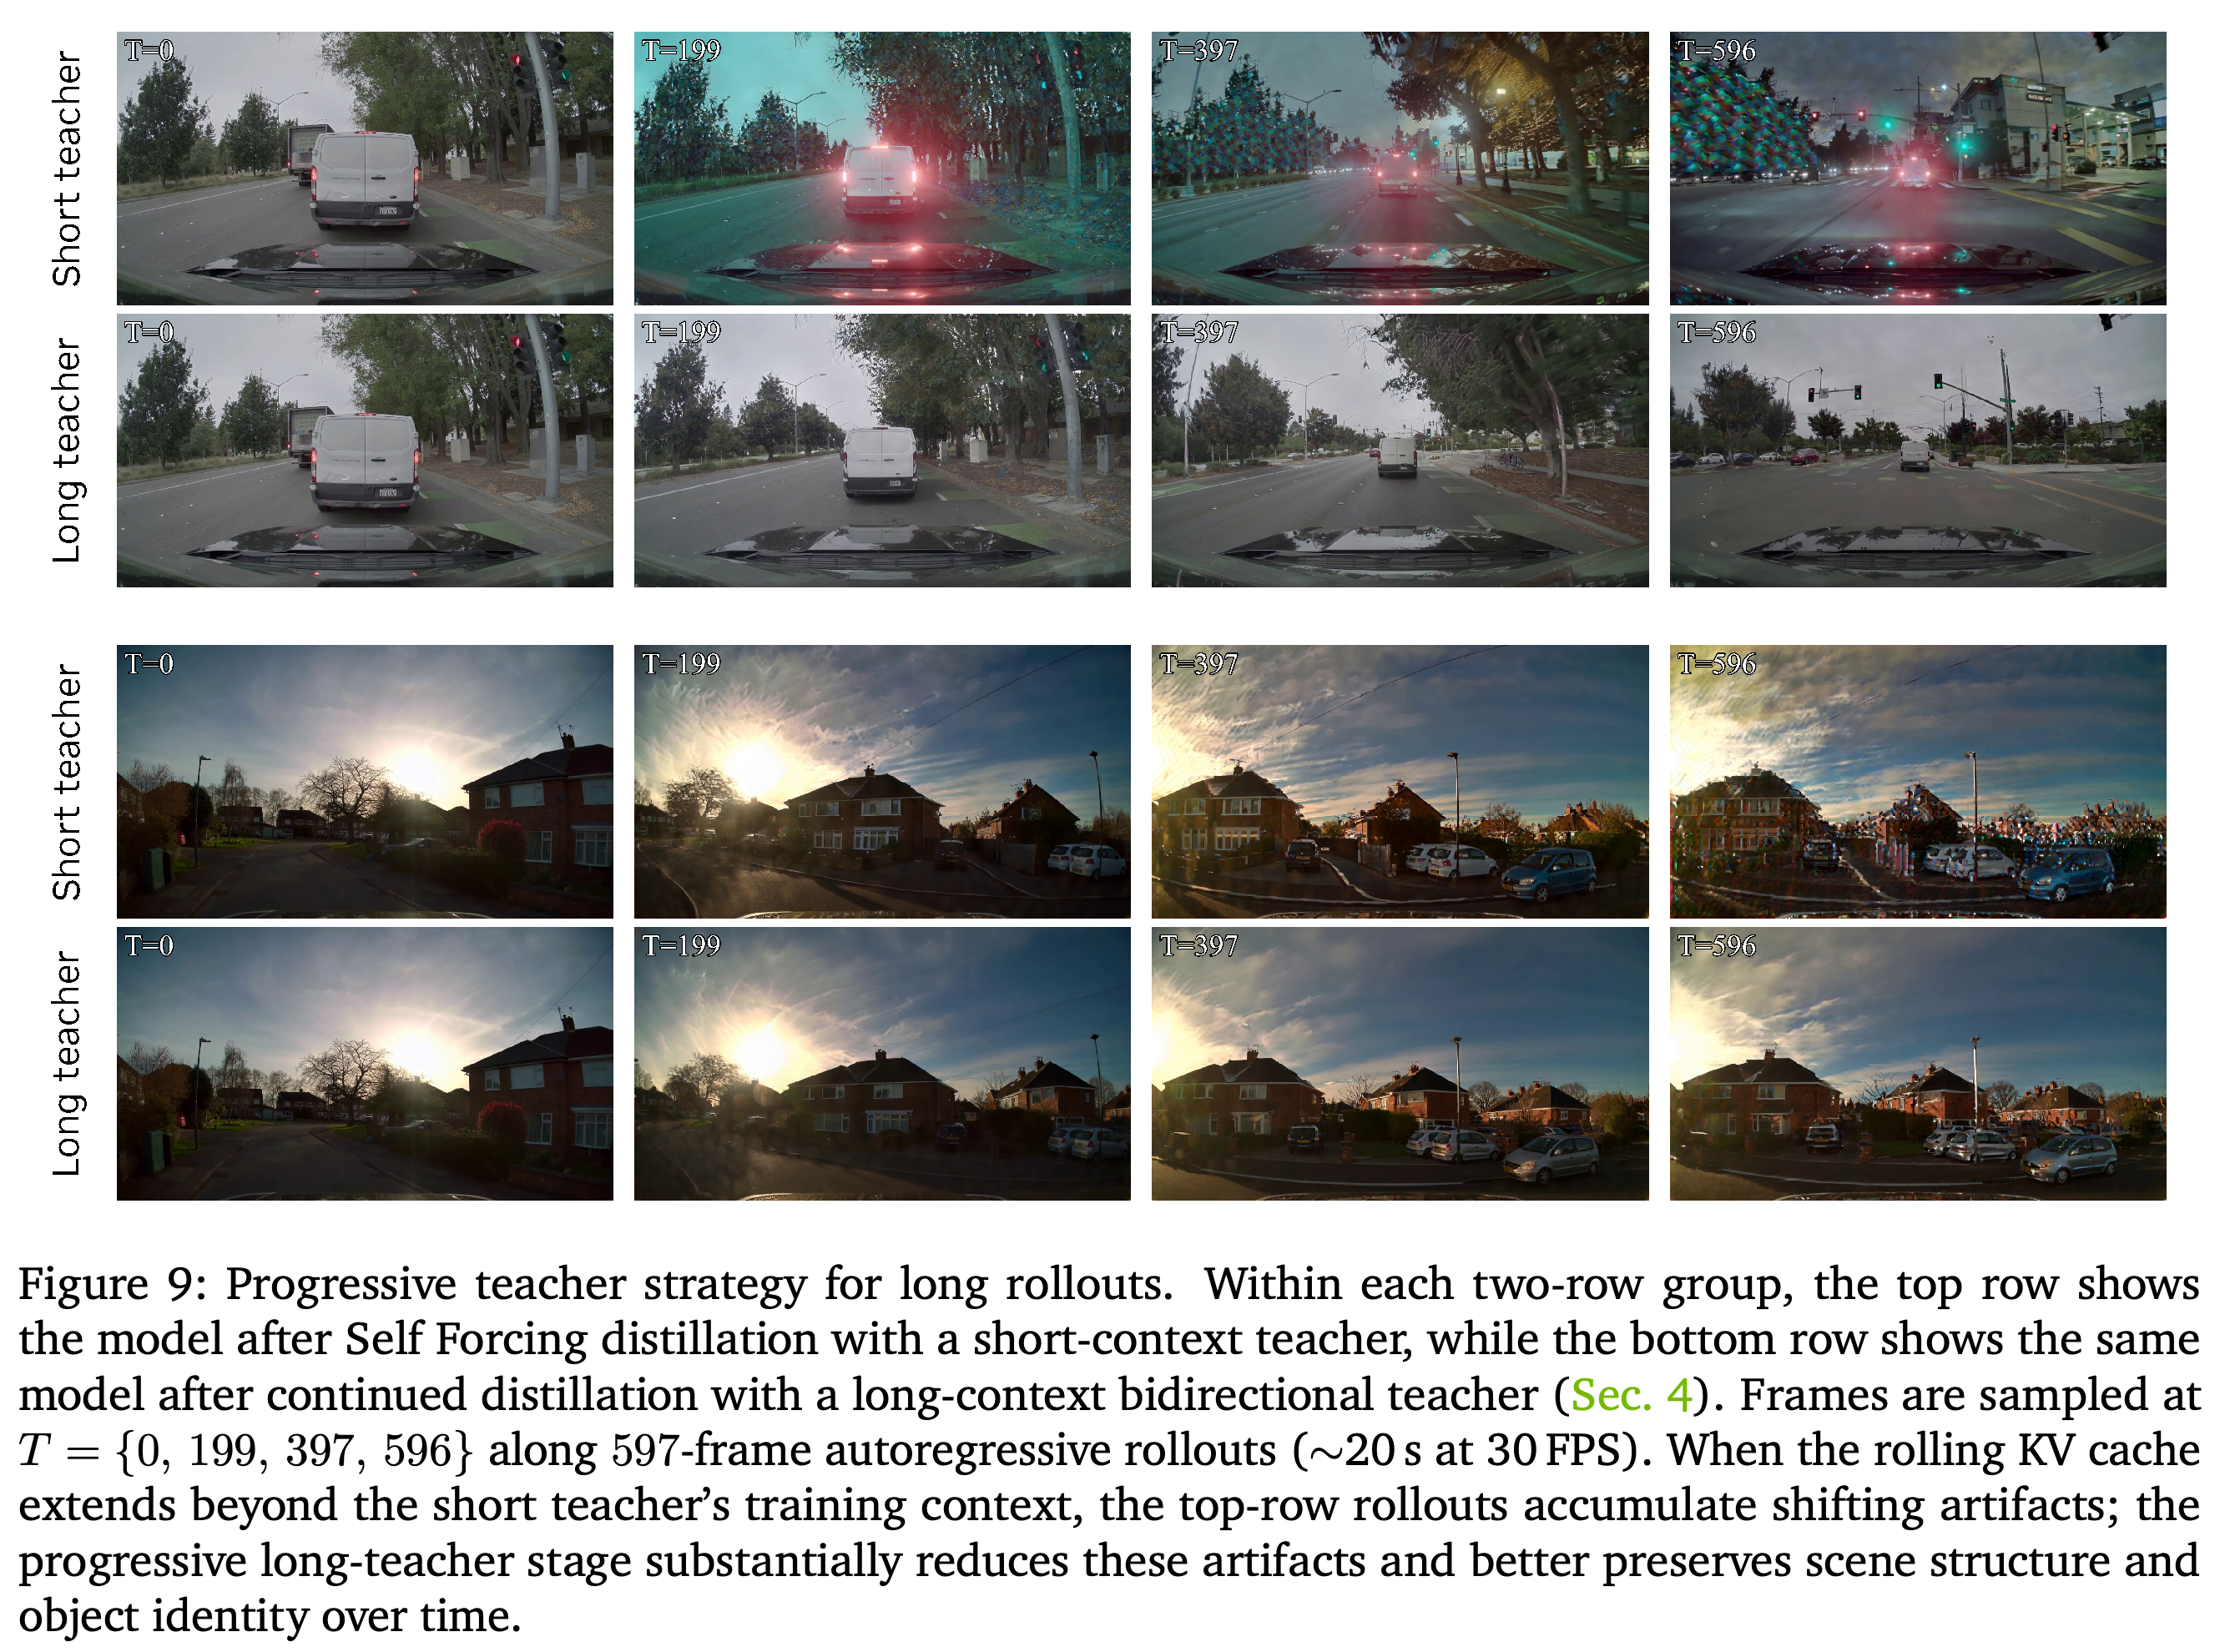
장기 롤아웃 안정화는 인과적 KV cache, 점진적 장문맥 Self Forcing, 범위를 제한한 temporal attention, 첫 RGB 프레임의 attention-sink 토큰을 결합한다. Figure 9는 597프레임 롤아웃을 T = {0, 199, 397, 596} 프레임에서 비교한다. 이는 30 FPS에서 약 20 s에 해당한다. Table 6은 동일한 실제 front-wide 영상 기준 분포를 사용해 5초 구간 4개에서 품질 저하가 줄어들지만 여전히 남아 있음을 측정한다.
- 짧은 문맥 교사의 연속 구간별 FVD는 109.3, 183.0, 258.3, 409.2이고, 점진적 교사는 95.5, 151.0, 202.5, 268.4다.
- 평균 FVD는 240.0에서 179.4로 감소하고, 마지막 구간과 첫 구간의 차이 Δ는 299.9에서 172.9로 감소한다.
- 저자들은 실제 사용에서 수분 동안 양호한 품질을 얻는다고 보고하지만, 제시된 정량적 근거는 20초 롤아웃을 다룬다.
T = {0, 199, 397, 596}에서 짧은 문맥 교사와 긴 문맥 교사의 대응 예시를 비교하면 점진적 증류 후 외관 변화가 줄어든다. 예시는 597프레임, 즉 30 FPS에서 약 20 s를 다루며, 장면 구조가 더 잘 유지됨을 보여준다.
9.3. Long-tail Coverage and Counterfactual Variations
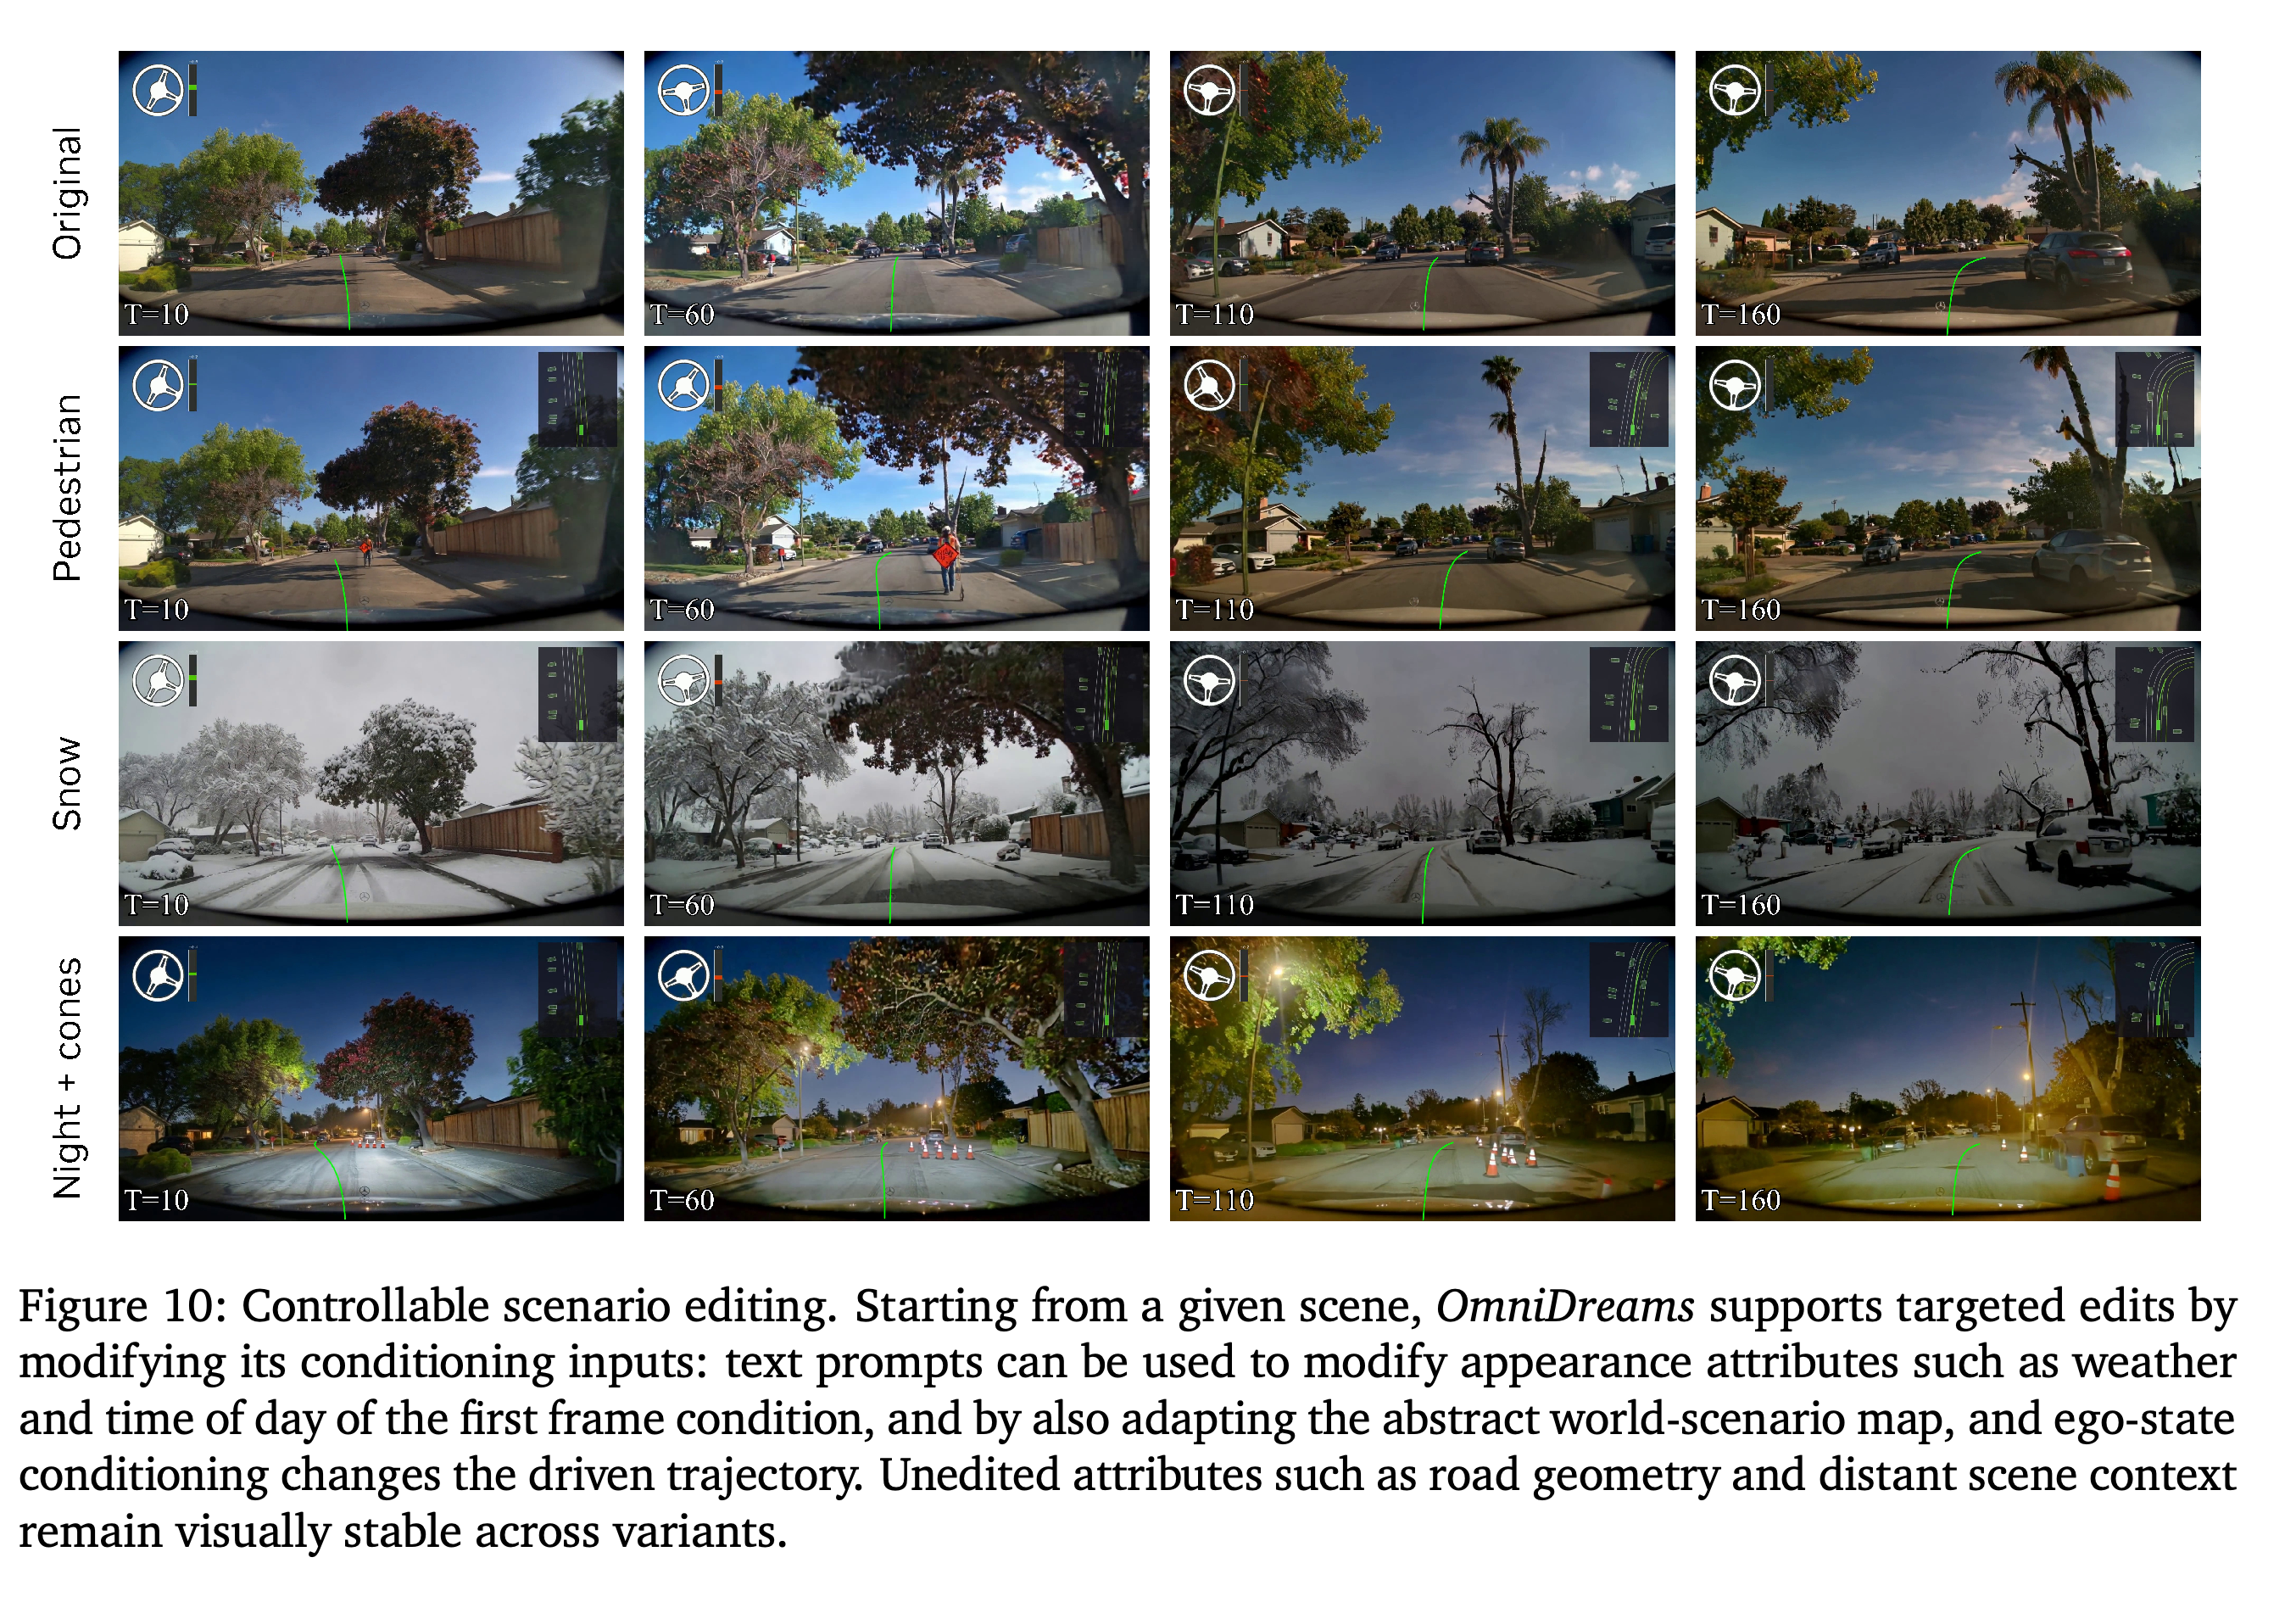
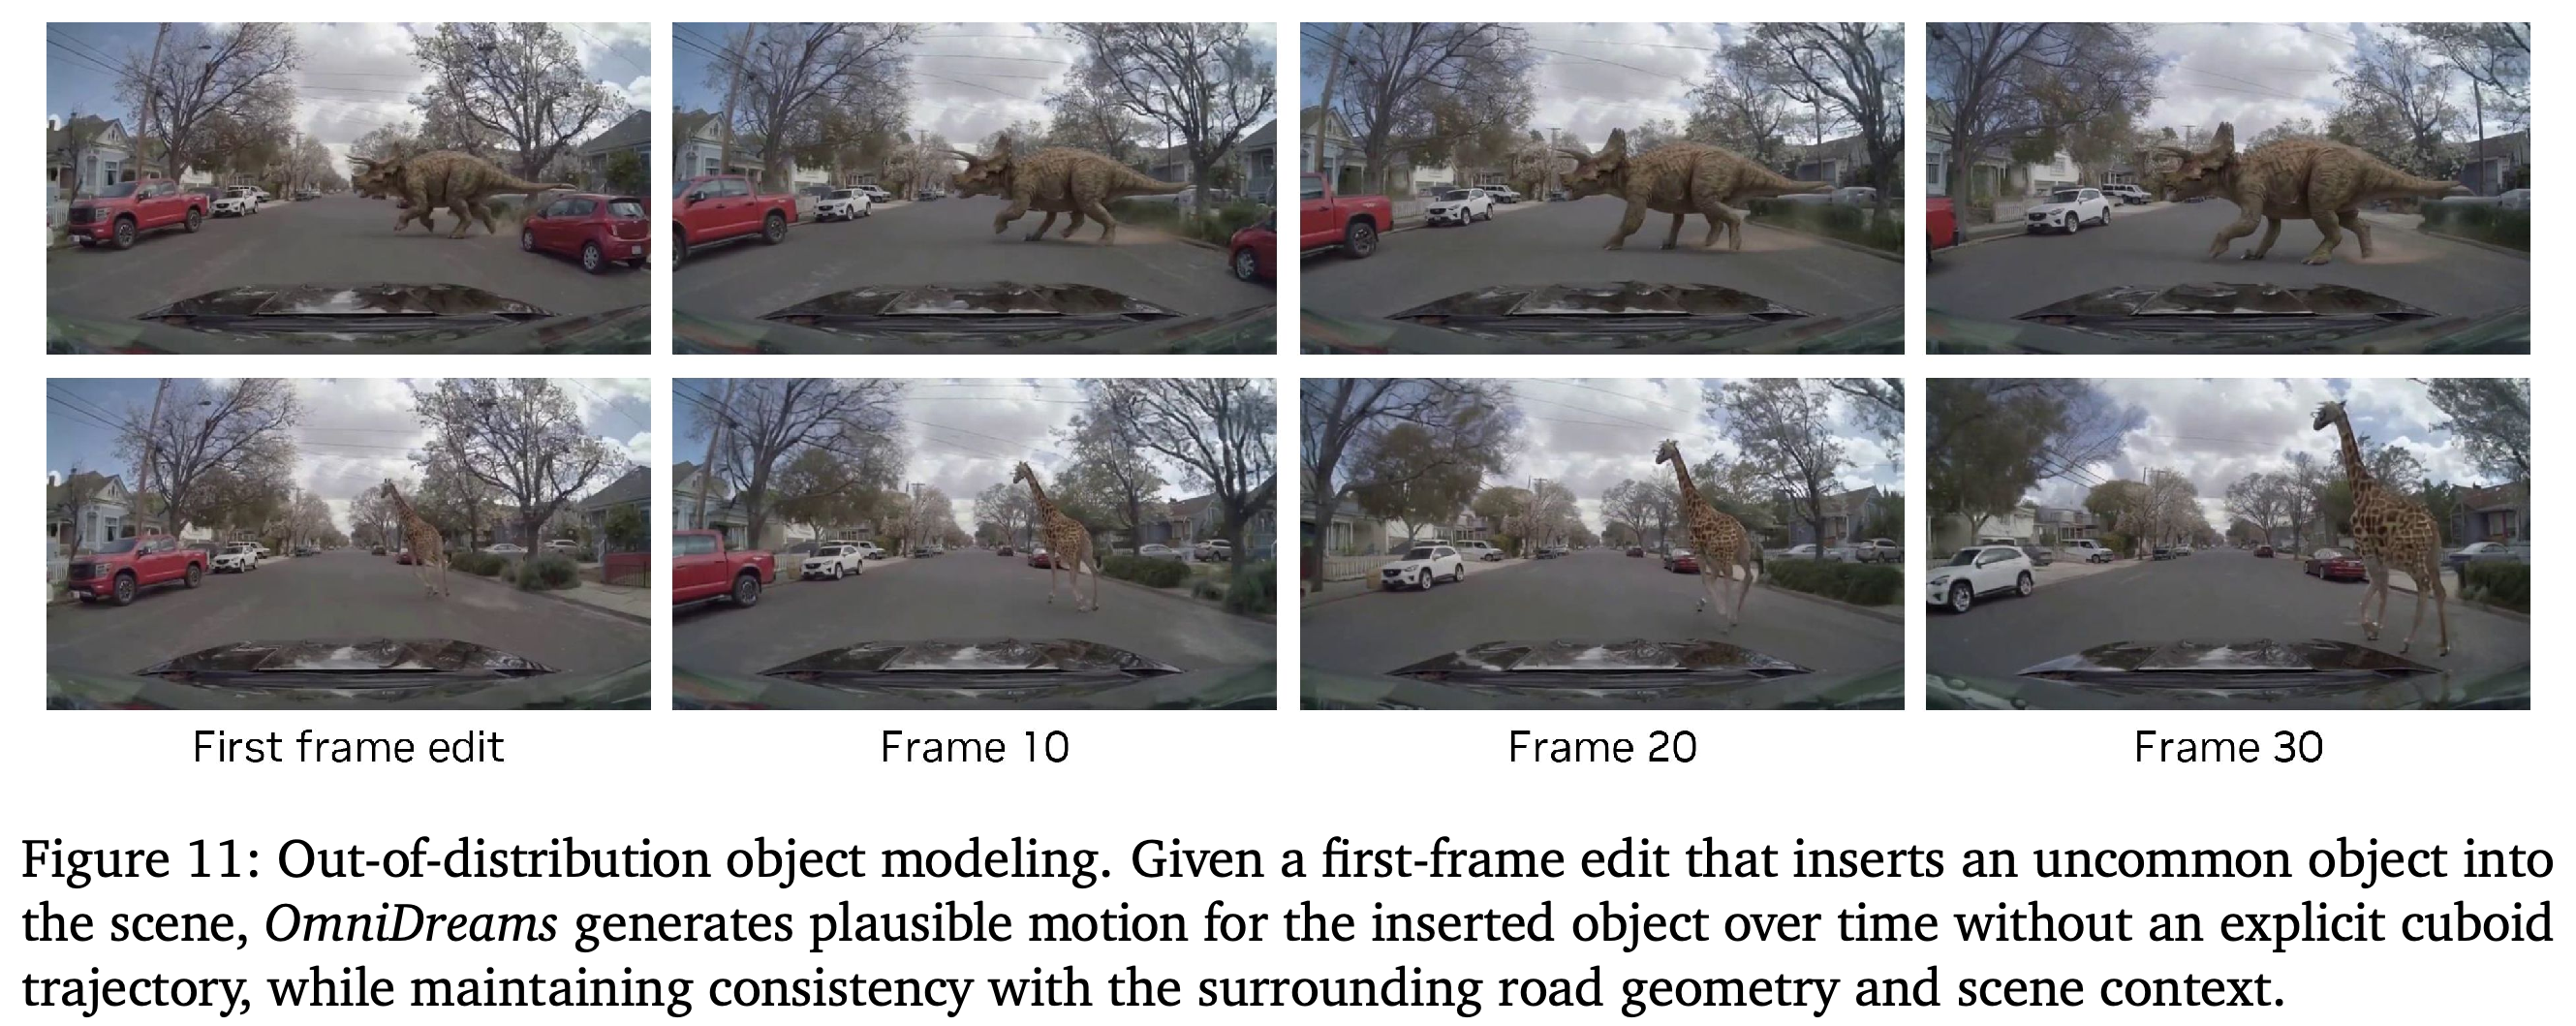
9.3.1. Controllable Scenario Editing은 텍스트, 첫 프레임 RGB, 추상 world-scenario map으로 환경 외관, 장면 구조, 행위자, 자차 움직임을 바꾼다. 9.3.2. Out-of-Distribution Object Modeling은 동적 직육면체를 무작위로 dropout하는 후속 학습 변형을 도입한다. 이를 통해 첫 프레임에 삽입한 특이한 객체가 명시적인 직육면체 궤적 없이도 유지된다. 이 시연은 정성적 예시이며, 롱테일 안전성 평가 범위를 측정한 결과가 아니다.
- Figure 10은 식별 가능한 도로 기하 구조와 장면 맥락을 유지하면서 Original, Pedestrian, Snow, Night + cones 변형을 비교한다.
- 첫 프레임의 객체 삽입은 구조화 조건과 충돌할 수 있다. 동적 직육면체 dropout은 시각 이력과 문맥에 더 의존하도록 학습하며, 주차 차량 같은 정적 직육면체는 바꾸지 않는다.
- Figure 11은 첫 프레임 편집에서 이어진 공룡과 기린을 보여준다. 생성된 움직임은 명시적인 시뮬레이터 제어나 검증된 물리적 행동의 근거가 아니다.
Original, Pedestrian, Snow, Night + cones 행은 알아볼 수 있는 시드 장면에 목표한 변형을 적용한 결과를 보여준다. 유지된 도로와 배경 맥락은 시각적 편집을 보여주지만, 이 예시만으로 기하 구조 불변성이나 체계적인 안전성 시험 범위를 입증하지는 못한다.
초기 프레임에 삽입한 공룡과 기린은 명시적인 직육면체 궤적 없이도 이후 생성 프레임에 계속 나타난다. 이 예시는 dropout 변형의 유연성을 보여주지만, 해당 객체의 물리적 움직임이나 명시적인 시뮬레이터 제어를 검증하지는 않는다.
9.4. Closed-Loop Evaluation
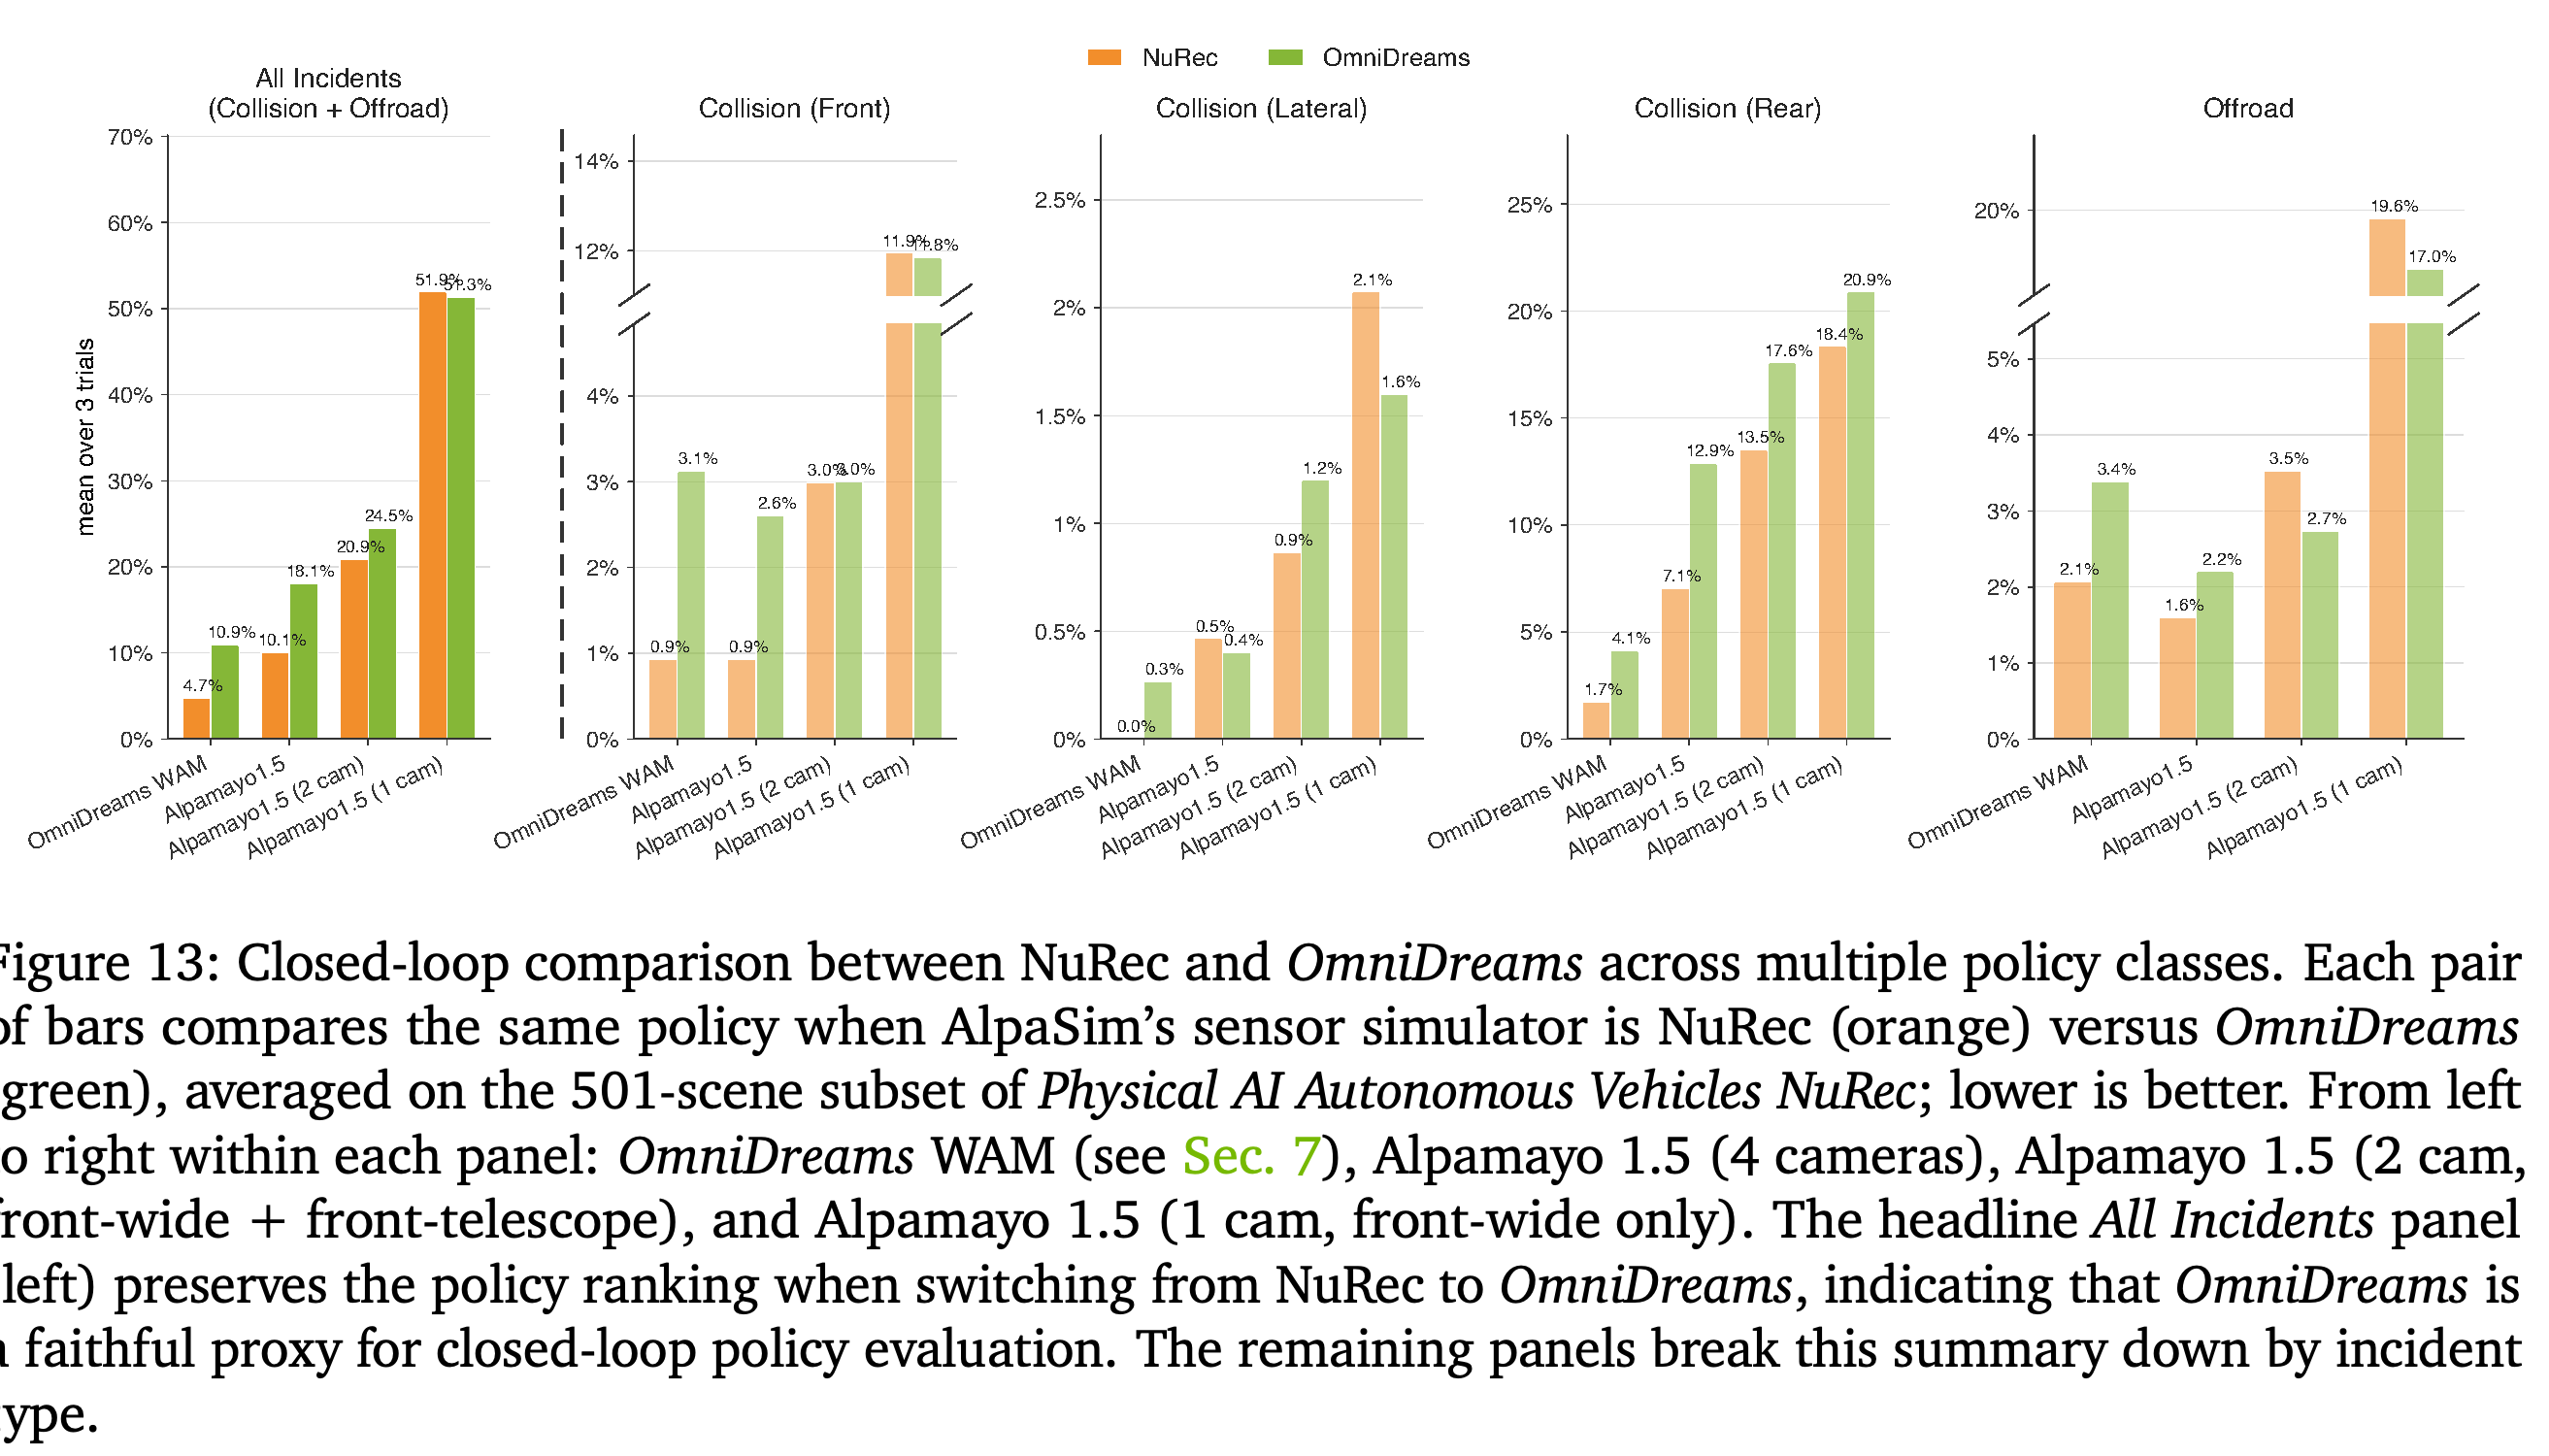
9.4.1. Closed-Loop Comparison to Reconstruction-based NuRec Simulator는 AlpaSim, 교통, 물리, 장면별 초기화를 고정하고 센서 백엔드만 교체한다. 평가에 쓰인 장면 501개는 재구성과 OmniDreams 호환 조건을 모두 제공하며, WAM 학습 장면은 제외한다. 각 롤아웃은 20초이며 533 ms마다 재계획한다. 자차가 기록된 궤적에서 4 m 이내에 있을 때만 사고를 집계한다. 보고 지표는 All Incidents (Collision + Offroad), Collision (Front), Collision (Lateral), Collision (Rear), Offroad다.
- 비교하는 정책 구성은 OmniDreams WAM과 카메라 4, 2, 1대를 사용하는 Alpamayo 1.5다. 카메라 2대 구성은 front-wide와 front-telescope를 사용하고, 카메라 1대 구성은 front-wide를 사용한다. 3회 시행의 평균 All Incidents 비율은 NuRec/OmniDreams 순으로 4.7%/10.9%, 10.1%/18.1%, 20.9%/24.5%, 51.9%/51.3%다. 전체 순위는 유지되지만 절대 비율은 다르다.
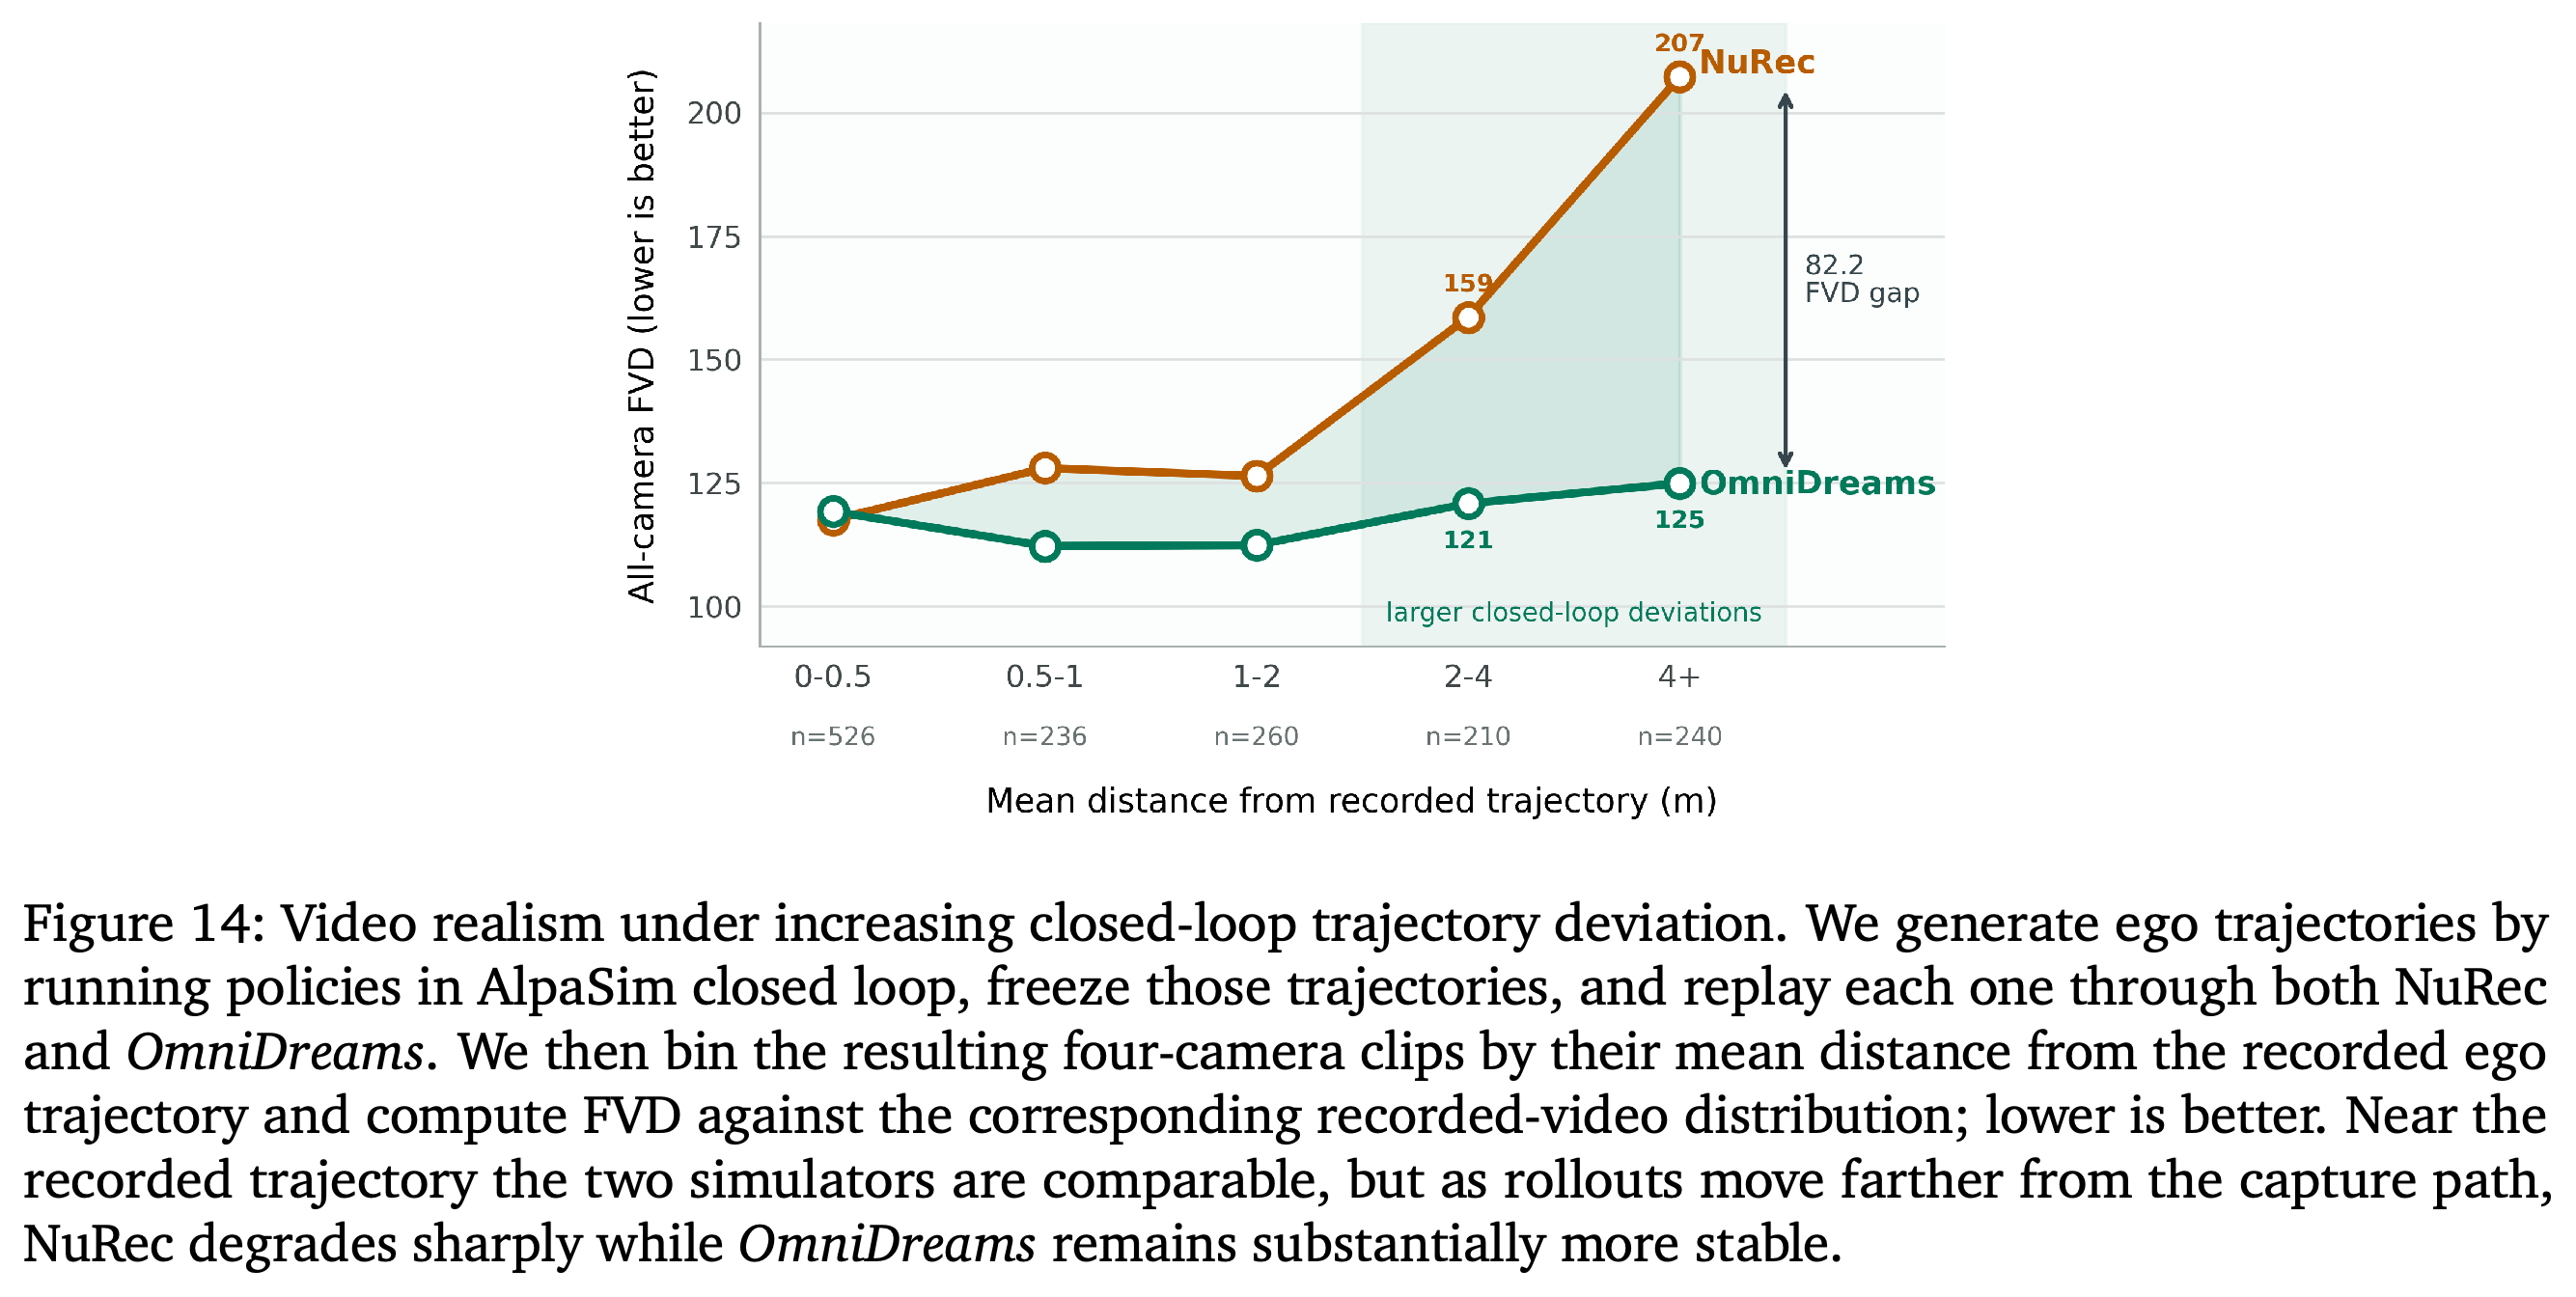
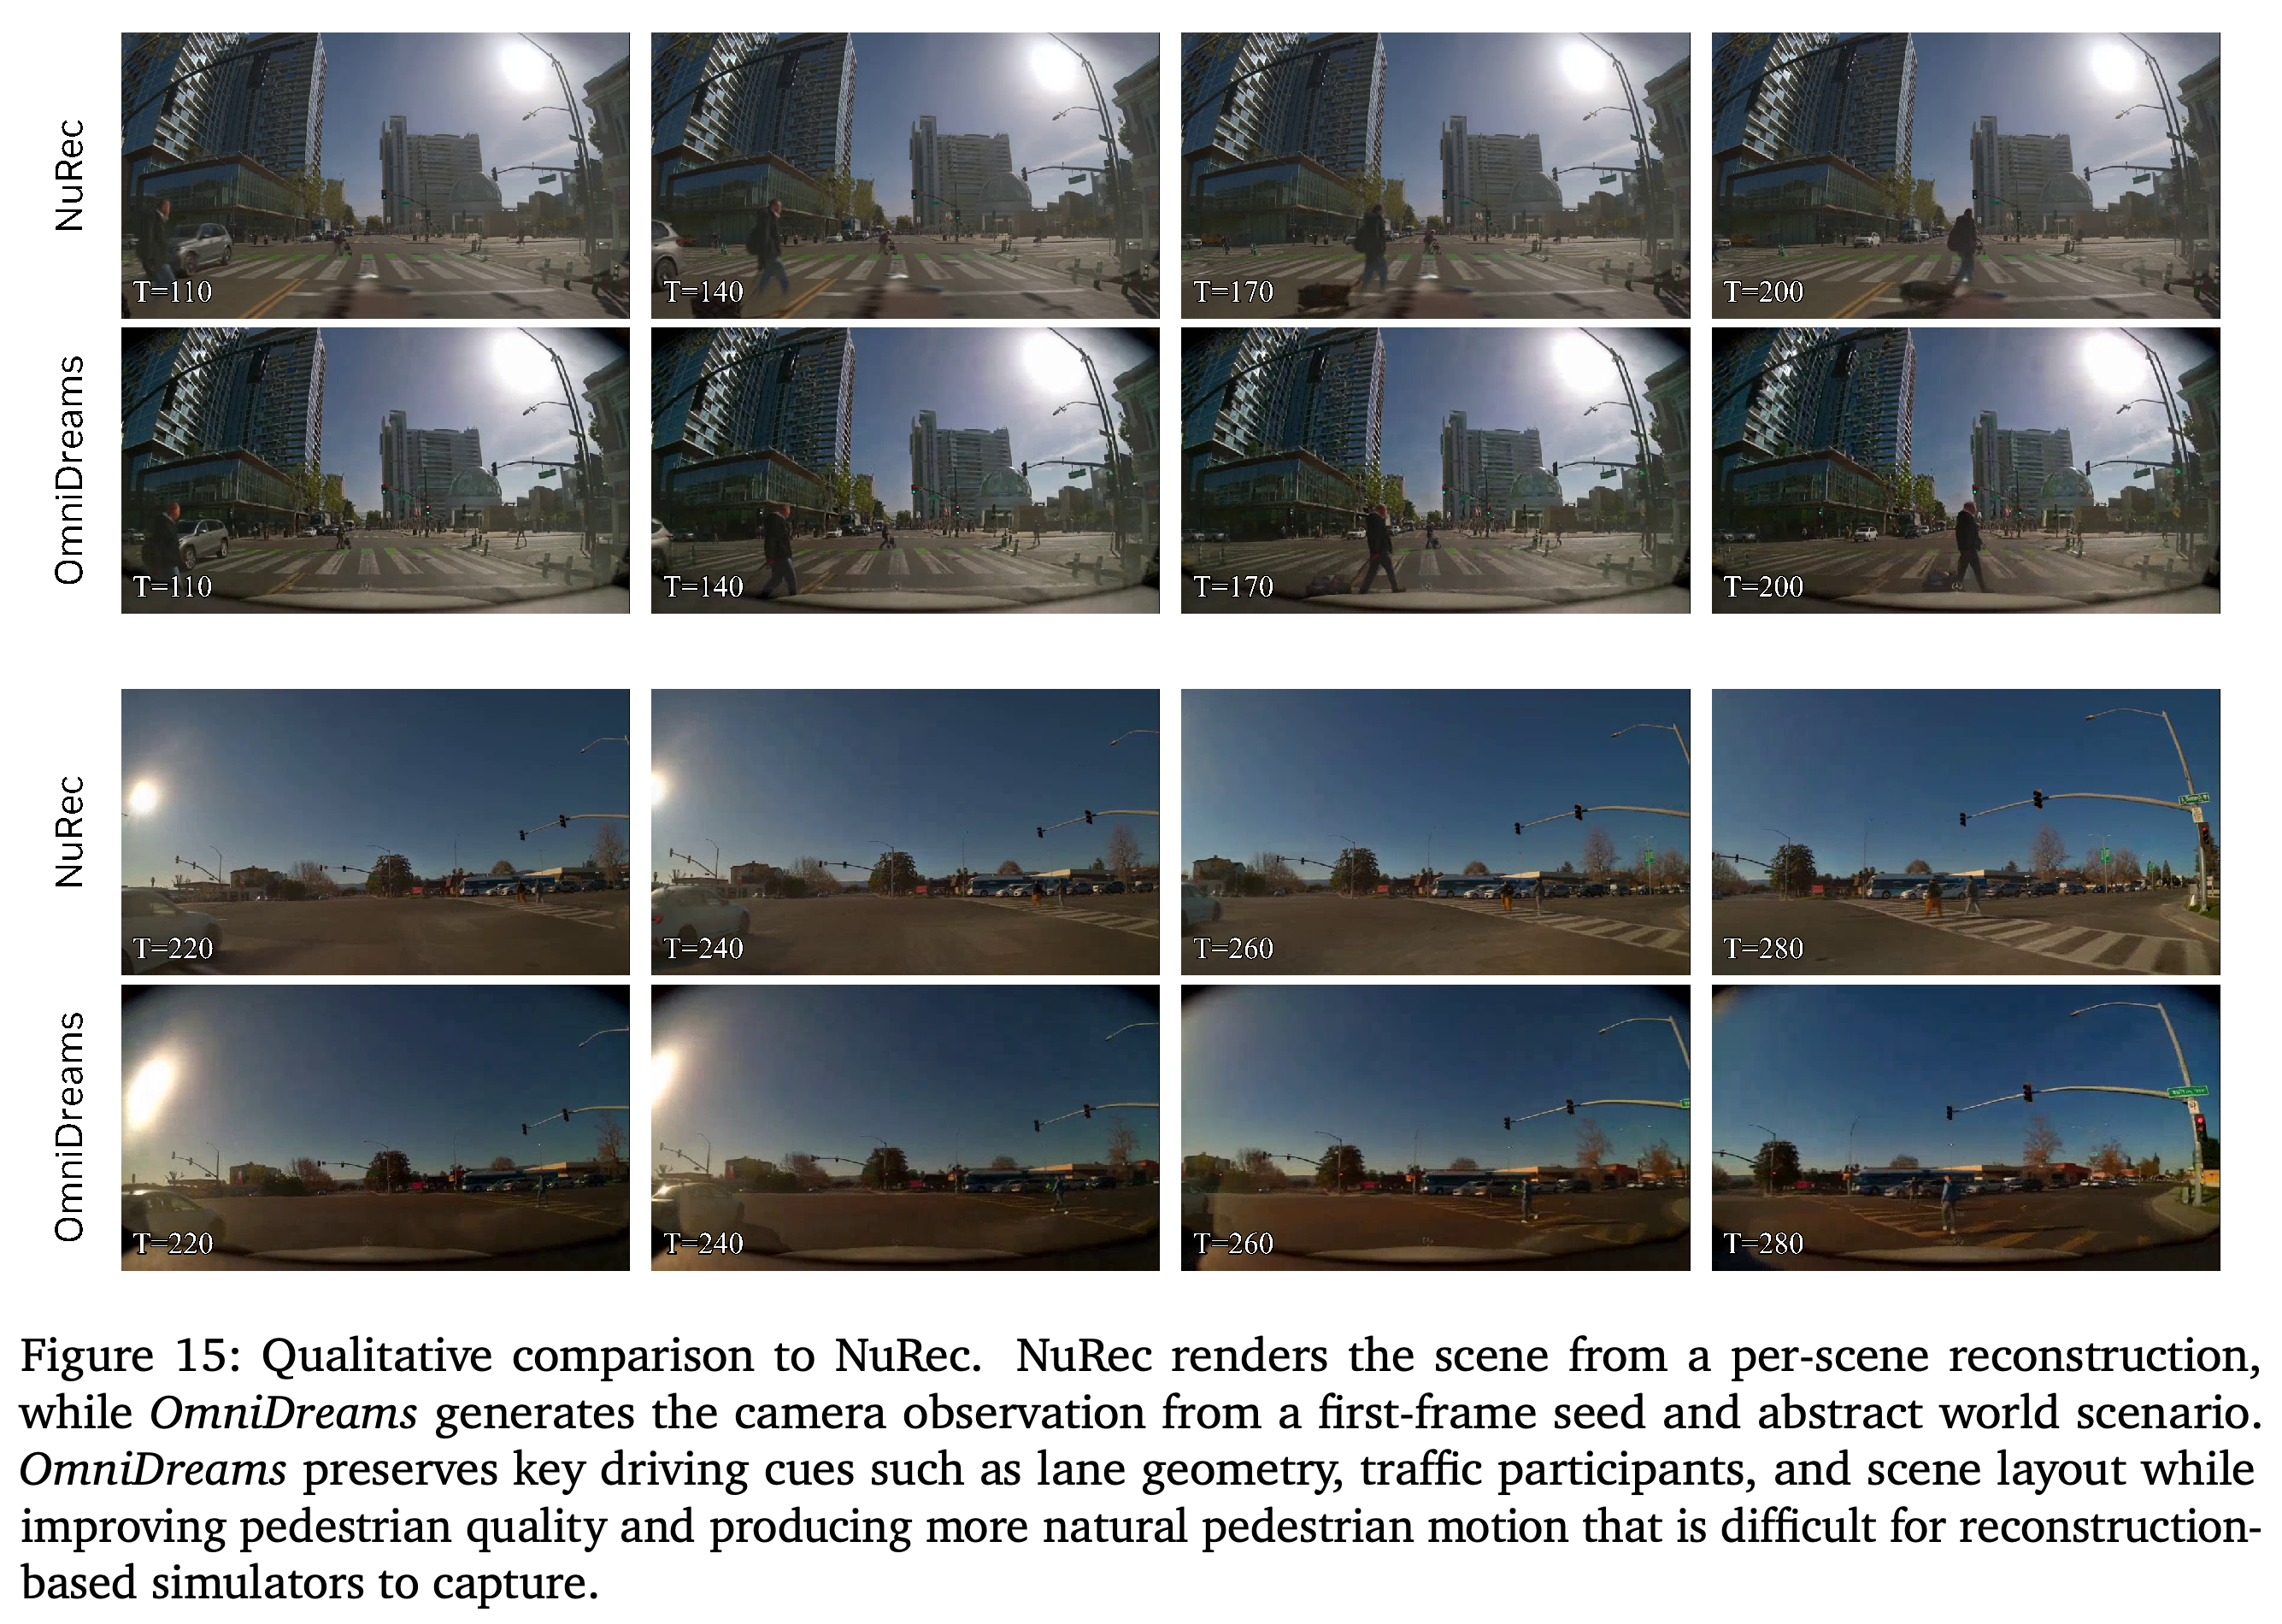
- 시각적 사실성을 비교하기 위해 양쪽 백엔드의 폐루프 궤적을 고정하고 양쪽 렌더러에서 재생한다. Figure 14는 촬영 경로 근처에서 비슷한 FVD를 보이며, 이탈이 커질수록 OmniDreams의 이점이 커짐을 보여준다. 4+ m에서 그래프의 값은 NuRec 207, OmniDreams 125이며, FVD 차이는 82.2로 표기된다. Figures 12와 15는 롤아웃과 보행자의 정성적 예시를 제공한다.
- 제어 가능성과 계산 비용 측면에서 OmniDreams는 장면별 오프라인 3DGS 재구성 대신 보정된 첫 프레임 시드와 구조화된 세계 조건을 사용하지만, 추론에 훨씬 더 많은 계산이 필요하다. 순위 일치는 시험한 조건에서 비교 평가를 뒷받침할 뿐, 실제 환경의 사고 확률을 정확히 추정한다는 주장이나 안전성 동등성을 뒷받침하지는 않는다.
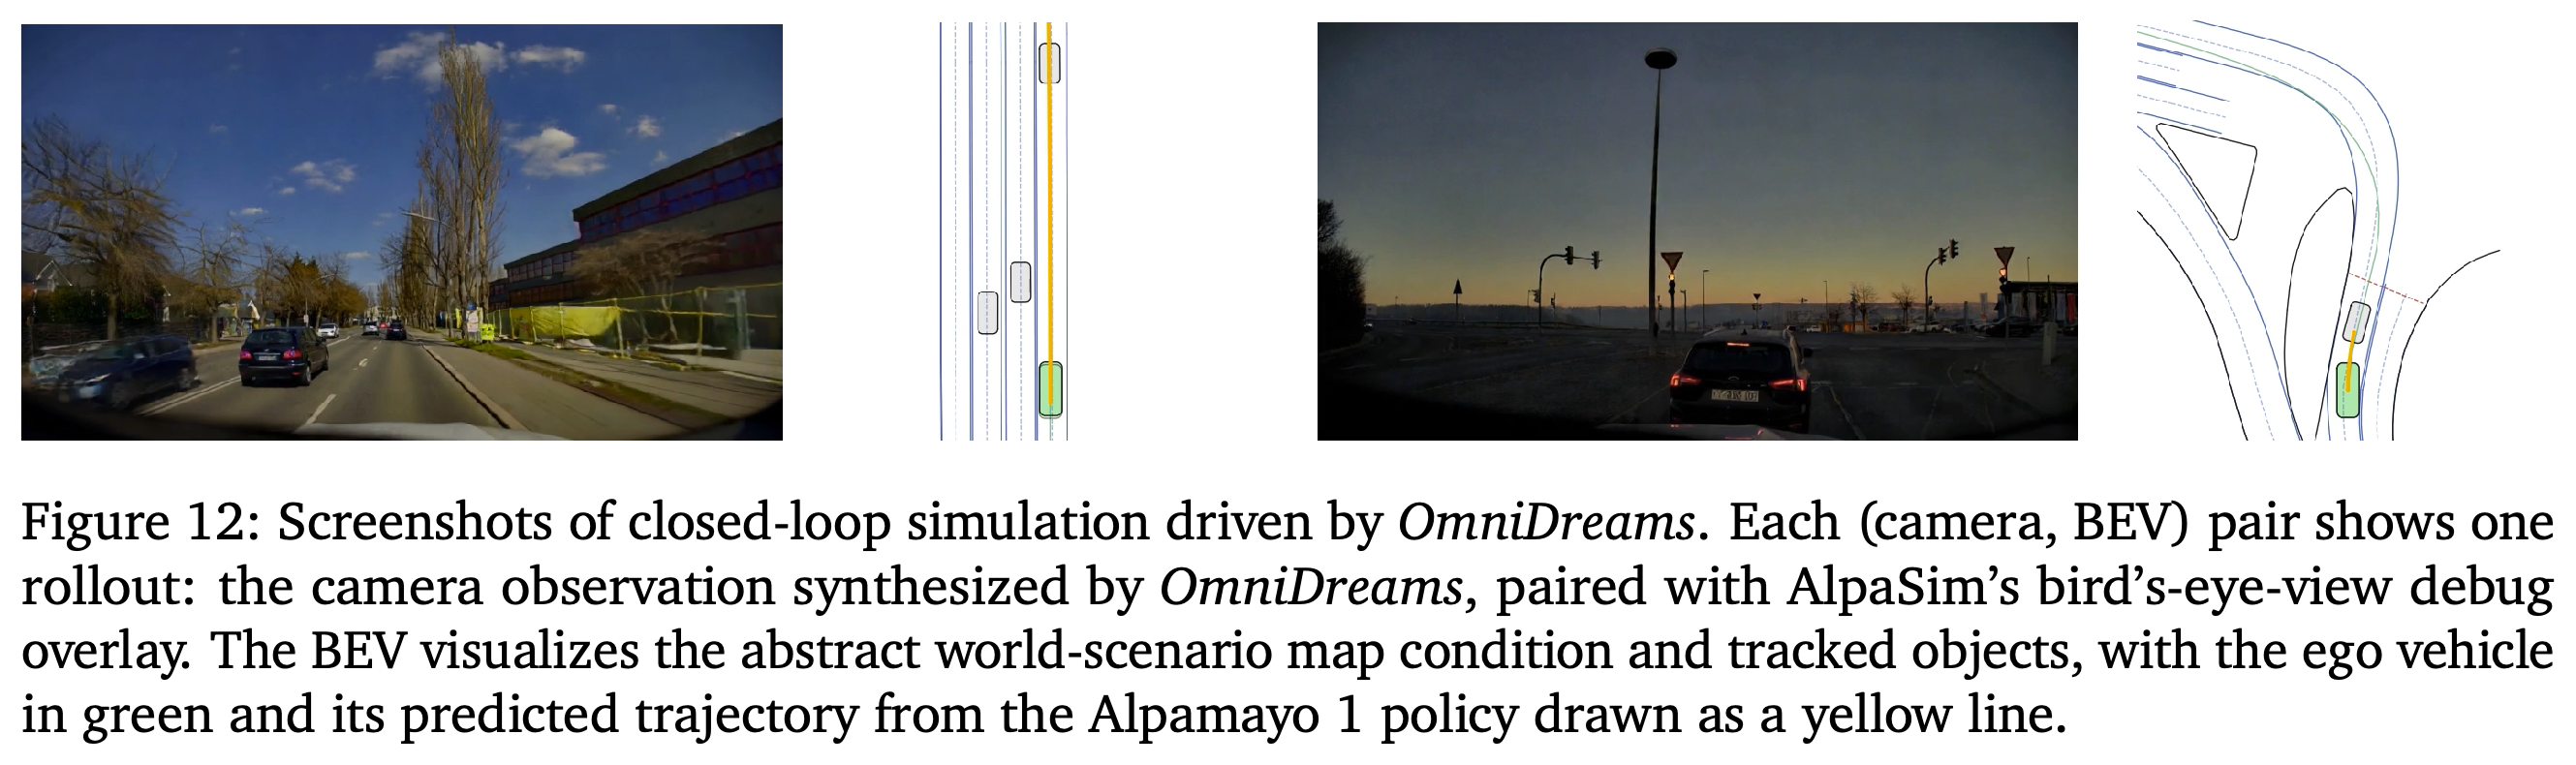
생성된 카메라 관측은 자차와 계획 궤적을 보여주는 AlpaSim BEV 오버레이와 짝지어진다. 이는 센서 합성이 독립적인 오프라인 생성이 아니라 시뮬레이터 상태 및 정책에 따른 롤아웃과 연결됨을 보여준다.
501개 장면의 3회 시행 평균은 All Incidents 순위를 유지한다. 두 렌더러 모두에서 WAM이 가장 좋고 카메라 1대의 Alpamayo가 가장 나쁘다. 절대 비율은 달라서 WAM은 4.7% 대 10.9%, 카메라 4대의 Alpamayo는 10.1% 대 18.1%다. 사고 유형별 패널은 동일한 순위나 정확한 사고율 추정을 입증하지 않는다.
동일하게 고정한 궤적을 두 렌더러에서 재생해 영상 분포 비교 시 요청된 움직임을 통제한다. 평균 이탈 2–4 m에서 FVD는 NuRec 159, OmniDreams 121이며, 4+ m에서는 각각 207, 125다. 이는 촬영 경로 밖에서 더 사실적인 영상을 생성함을 뒷받침하지만, 기하학적 정확성을 입증하지는 않는다.
대응하는 횡단 시퀀스에서 OmniDreams 출력의 보행자는 NuRec 프레임보다 더 알아보기 쉽다. 이 비교는 관절 움직임이 있는 동적 콘텐츠에서 보고된 이점을 보여주지만, 별도의 수치적 보행자 움직임 지표를 제공하지는 않는다.
10. Related Work
관련 연구는 센서를 생성하는 세계 모델과 이를 정책에 연결하는 인프라로 나누어 정리한다. 이는 OmniDreams의 인과적 생성 및 시각 사전 지식과, 상태 유지·분산 실행·청크 처리를 고려한 AlpaSim 통합을 구분한다.
10.1. World models for closed-loop AV Simulation
10.1.1. Reconstruction-based World Models는 촬영 장면을 렌더링하는 NeRF와 3D Gaussian Splatting 시스템을 다룬다. 이 시스템은 관측되지 않은 시점과 조건을 다루는 범위가 제한적이다. 10.1.2. Video models as world simulator는 Sora, Movie Gen, Wan, Veo 3, Genie, Cosmos를 검토한다. OmniDreams는 이 중 Cosmos를 행동 조건부 AV 시뮬레이션에 특화한다. 10.1.3. Generative AV World Models는 주행 영상 생성기와 이 보고서의 폐루프 배포 중심 접근을 비교한다.
- 재구성 사례에는 NeuRAD, EmerNeRF, SiMUli, NuRec이 포함된다. 장면의 기하학적 기반을 제공하는 데 유용하지만, 외삽은 여전히 촬영 범위에 제한된다.
- 주행 생성 사례에는 DriveGAN, DriveDreamer, GAIA-1/GAIA-2, Vista, MagicDrive, Drive-WM, GenAD, Cosmos-Drive-Dreams, Waymo World Model이 포함된다. OmniDreams는 스트리밍 캐시, 적은 단계의 추론, 공개된 시뮬레이터 및 정책 스택과의 통합을 강조한다.
- 10.1.4. Real-time and streaming video diffusion은 이 접근을 Self Forcing, CausVid, Diffusion Forcing, StreamingT2V, FIFO-Diffusion, StreamingLLM attention sink, ring attention과 연결한다. 희소 temporal attention과 경량 초해상도는 향후 확장 과제다.
10.2. Closed-loop AV simulation infrastructure
인프라 논의는 Waymax와 PufferDrive 같은 추상적 또는 비시각적 시뮬레이터, CARLA와 MetaDrive 같은 아티스트 제작 에셋 기반 시뮬레이터, DriveArena, HUGSIM, WorldEngine, AlpaSim 같은 신경망 재구성 기반 시스템을 구분한다. 저자들은 생성형 세계 모델을 센서 사실성을 높이는 또 다른 접근으로 제안하고, 원격 분산 렌더링과 청크 기반 상태를 지원하도록 AlpaSim의 마이크로서비스 아키텍처를 확장한다.
11. Conclusion
보고서는 생성형 카메라 시뮬레이션을 정책 및 시뮬레이션 실행 조율 계층과 통합하면 재구성만 사용하는 작업 방식보다 시험 조건을 넓힐 수 있다고 결론 내린다. 실험은 명시된 하드웨어의 실시간 렌더링, 제어 가능한 시각적 변형, 촬영 경로 밖에서 개선된 FVD, 평가 조건에서의 전체 정책 순위 일치를 보여준다. 그러나 결론에서 언급한 안전한 실제 배포와의 더 넓은 연관성은 이 실험으로 입증되지 않는다.
부록
- B. Glossary는 개념과 약어, NVIDIA SIL 플랫폼 구성 요소, 데이터셋과 벤치마크, 수학 표기를 정리한다. AV, VLA, WAM, BEV, HD map, VRU, DiT, VAE, AdaLN, RoPE, 스트리밍 KV cache, attention sink, local-window 및 cross-view attention, context parallelism, Diffusion Forcing, Self Forcing, DMD, 평가 지표를 정의한다. 플랫폼과 데이터셋 항목은 Cosmos, OmniDreams-SV/MV, Cosmos-Drive-Dreams, AlpaSim, Alpamayo, NuRec, SIL-Wheel, GB300, RDS, RDS-HQ-1M을 설명한다. 수학 표기의 Latent variables., Noise, conditioning, and parameters., Distributions and operators., Model functions and distributions. 항목은 잠재 시퀀스, Gaussian 노이즈, 조건, 모델 파라미터, 기댓값, stop-gradient, 속도 예측기, real/fake score network를 설명한다. Sizes and parallelism axes. 항목은 여러 의미로 쓰이는 기호를 구분한다. K는 학습에서는 노이즈 제거 단계 수, 추론에서는 청크당 프레임 수를 뜻하고, T는 시퀀스 길이 또는 시간 병렬성, L은 손실 또는 이동 윈도 크기를 뜻한다. Symbols in tables and prose. 항목은 ↑/↓, →, ×를 설명한다.
짧은 생각
핵심 기여는 인과적 영상 생성을 실제로 작동하는 폐루프 시스템에 통합하고, 하드웨어, 청크 크기, 정책 실행 시간의 측정값을 명시한 데 있다. 평가는 절대 사고율의 충실도보다 상대적인 정책 순위를 더 직접적으로 뒷받침한다. WAM의 All Incidents 비율은 NuRec의 4.7%에서 OmniDreams의 10.9%로 바뀐다. 디코더 품질 손실, 장기 롤아웃에서 증가하는 FVD, 다중 카메라의 계산 요구량, 청크 내부 궤적 확정은 실시간 시뮬레이션이라는 주장의 범위를 제한한다. 점진적 교사 학습은 명확한 수치 근거와 함께 시간에 따른 품질 저하를 줄이지만, 완전히 없애지는 못한다. 예비 WAM 충돌 결과는 렌더러 비교와 다른 장면 부분집합 및 재계획 프로토콜을 사용하므로 별도로 다뤄야 한다. 측정된 처리량은 명시된 하드웨어에서의 실현 가능성을 보여줄 뿐, 저비용 확장성이나 실제 환경의 안전성 검증을 보여주지는 않는다.