


VibeThinker-3B: Exploring the Frontier of Verifiable Reasoning in Small Language Models 요약 설명
15 Jun 2026 | Paper Review Reasoning Reinforcement Learning Self-Distillation Test-Time Scaling목차
이번 글에서는 VibeThinker-3B: Exploring the Frontier of Verifiable Reasoning in Small Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 6월 15일(Arxiv)
- Xu, Sen, Liu, Shixi, Wang, Wei, Min, Jixin, Dai, Yingwei, Yin, Zhibin, Chen, Yirong, Zhou, Xin, Zhang, Junlin.
- Sina Weibo Inc.
- 논문 링크
- Github
- Project Page
요약
- VibeThinker-3B: Exploring the Frontier of Verifiable Reasoning in Small Language Models는 3B-parameter dense 모델이 수학과 실행으로 검증하는 코딩 과제에서 선도적인 추론 시스템에 근접할 수 있는지 살펴본다. Qwen2.5-Coder-3B base를 바탕으로 커리큘럼 기반 지도 미세조정, 다중 도메인 강화학습, 오프라인 자기 증류, 지시 이행 중심 강화학습을 결합한다.
- 파이프라인은 Spectrum-to-Signal Principle을 따른다. 지도학습은 다양한 유효 풀이 경로를 보존하고, MaxEnt-Guided Policy Optimization은 모델의 현재 능력 경계에 가까운 검증 가능한 문제에 집중한다. 추론 RL은 단일 64K 컨텍스트 윈도우를 사용하며, Long2Short Math RL은 정답 궤적 사이에서 보상을 재분배해 간결한 추론을 선호하도록 한다. 지도학습에 대해서는 이 글을 참조하라.
- VibeThinker-3B는 AIME26에서 94.3, LiveCodeBench v6에서 Pass@1 80.2, IFEval에서 93.4를 보고한다. 추론 시 샘플링과 자기 검증을 수행하는 Claim-Level Reliability Assessment(CLR)를 적용하면 AIME26은 97.1로, IMO-AnswerBench는 76.4에서 80.6으로 오른다. 최근 LeetCode 대회에서는 최초 시도 Python 제출 128건 중 96.1%가 통과했다.
6개 패널은 벤치마크에 따라 경쟁력이 달라짐을 보여준다. CLR은 AIME26을 94.3에서 97.1로 높이지만, 기본 LiveCodeBench v6 점수 80.2는 표시된 모든 대표 최상위 비교 모델보다 낮다. IFBench 74.5는 표시된 비교 모델 5개 중 4개보다 높지만 GLM-5의 76.5보다 낮다. 이는 전반적인 우위보다 과제별 강점을 뒷받침한다.
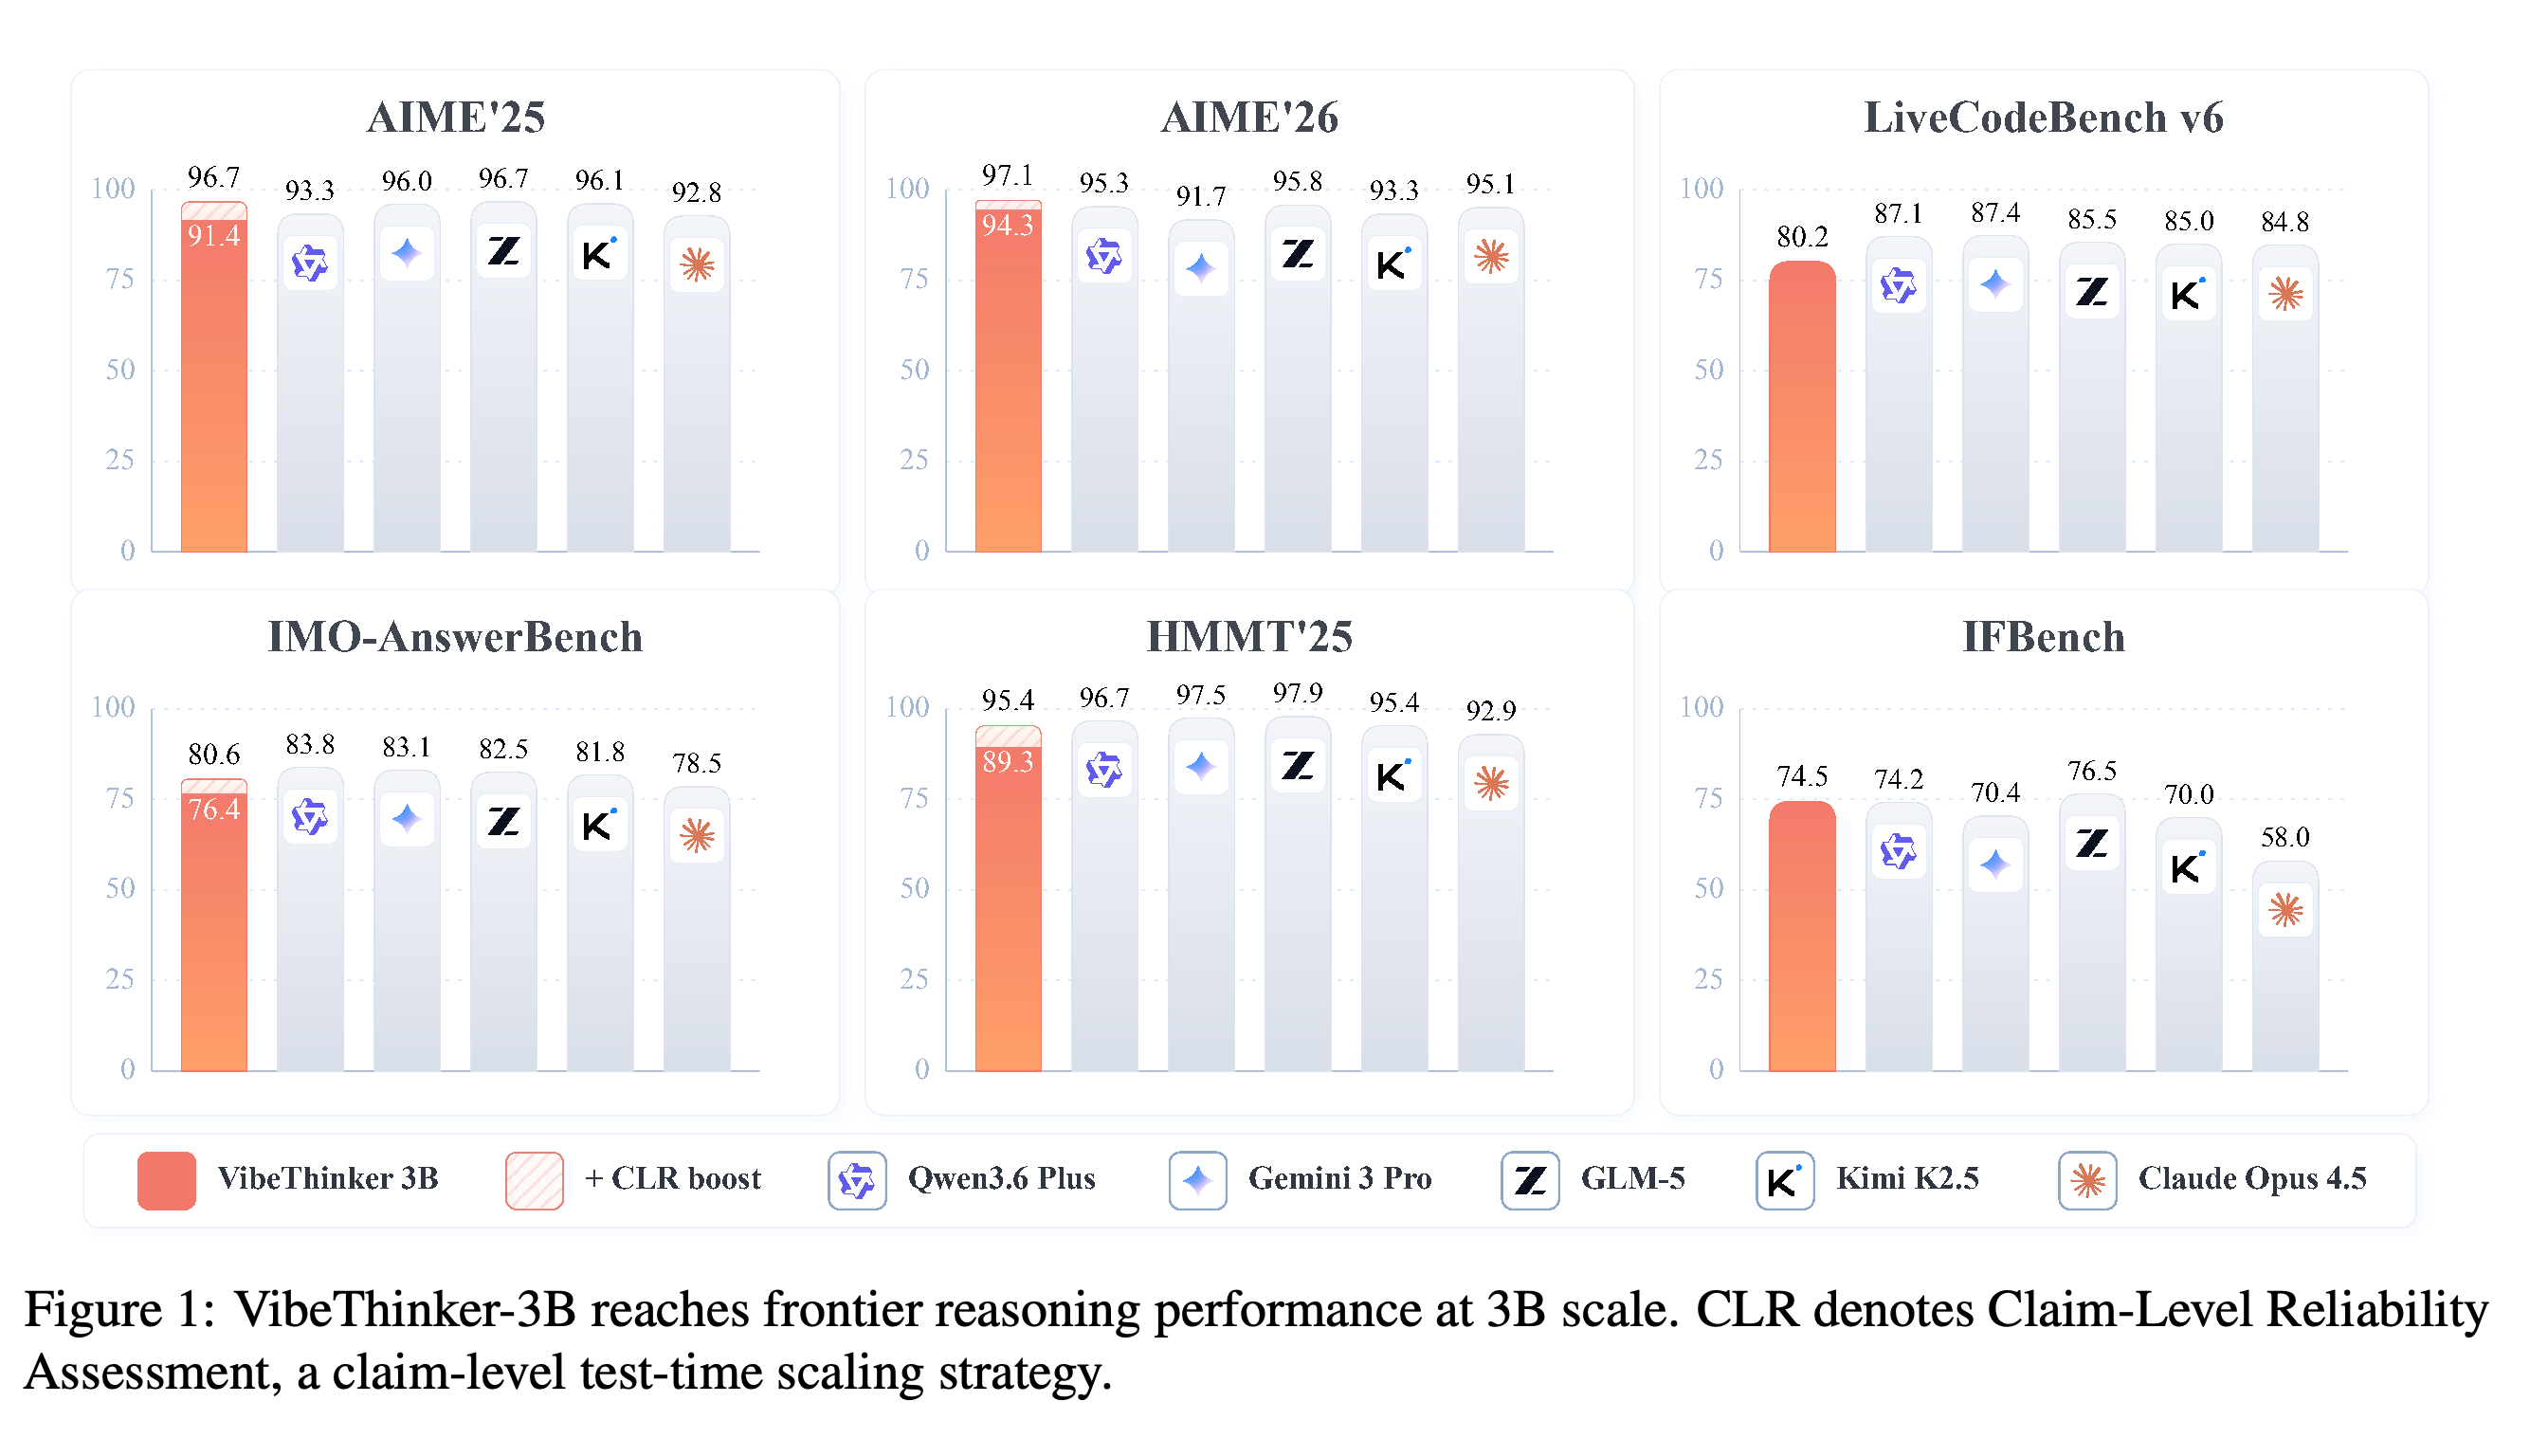
- 이 결과는 구조화되고 검증 가능한 과제에서 파라미터 수 대비 성능이 높다는 근거이지, 선도적인 범용 모델과 동등하다는 근거는 아니다. GPQA-Diamond는 CLR 없이 70.2, CLR 적용 시 72.9에 머문다. 보고서에는 어떤 파이프라인 변경이 성능 향상을 일으켰는지 확인할 구성 요소별 ablation 실험이나 연산량을 맞춘 비교가 없다.
1 Introduction
이 연구는 소형 모델의 추론 가능성을 보인 VibeThinker-1.5B에서 나아가, 엄격한 3B 파라미터 예산에서 성능의 한계를 살펴본다. 저자들은 결과를 신뢰성 있게 검증할 수 있는 어려운 수학적 유도와 프로그래밍 과제에 집중한다.
- 3B 버전은 파라미터 규모와 사후학습을 모두 바꾼다. 더 엄격한 데이터 필터링, 2단계 SFT 커리큘럼, 다중 도메인 RL, 긴 컨텍스트 학습, 효율성 중심 Math RL, 자기 증류, 지시 이행을 위한 정렬을 적용한다.
- 따라서 기존 1.5B 모델과의 비교만으로는 파라미터 수를 2배로 늘린 효과를 분리할 수 없다.
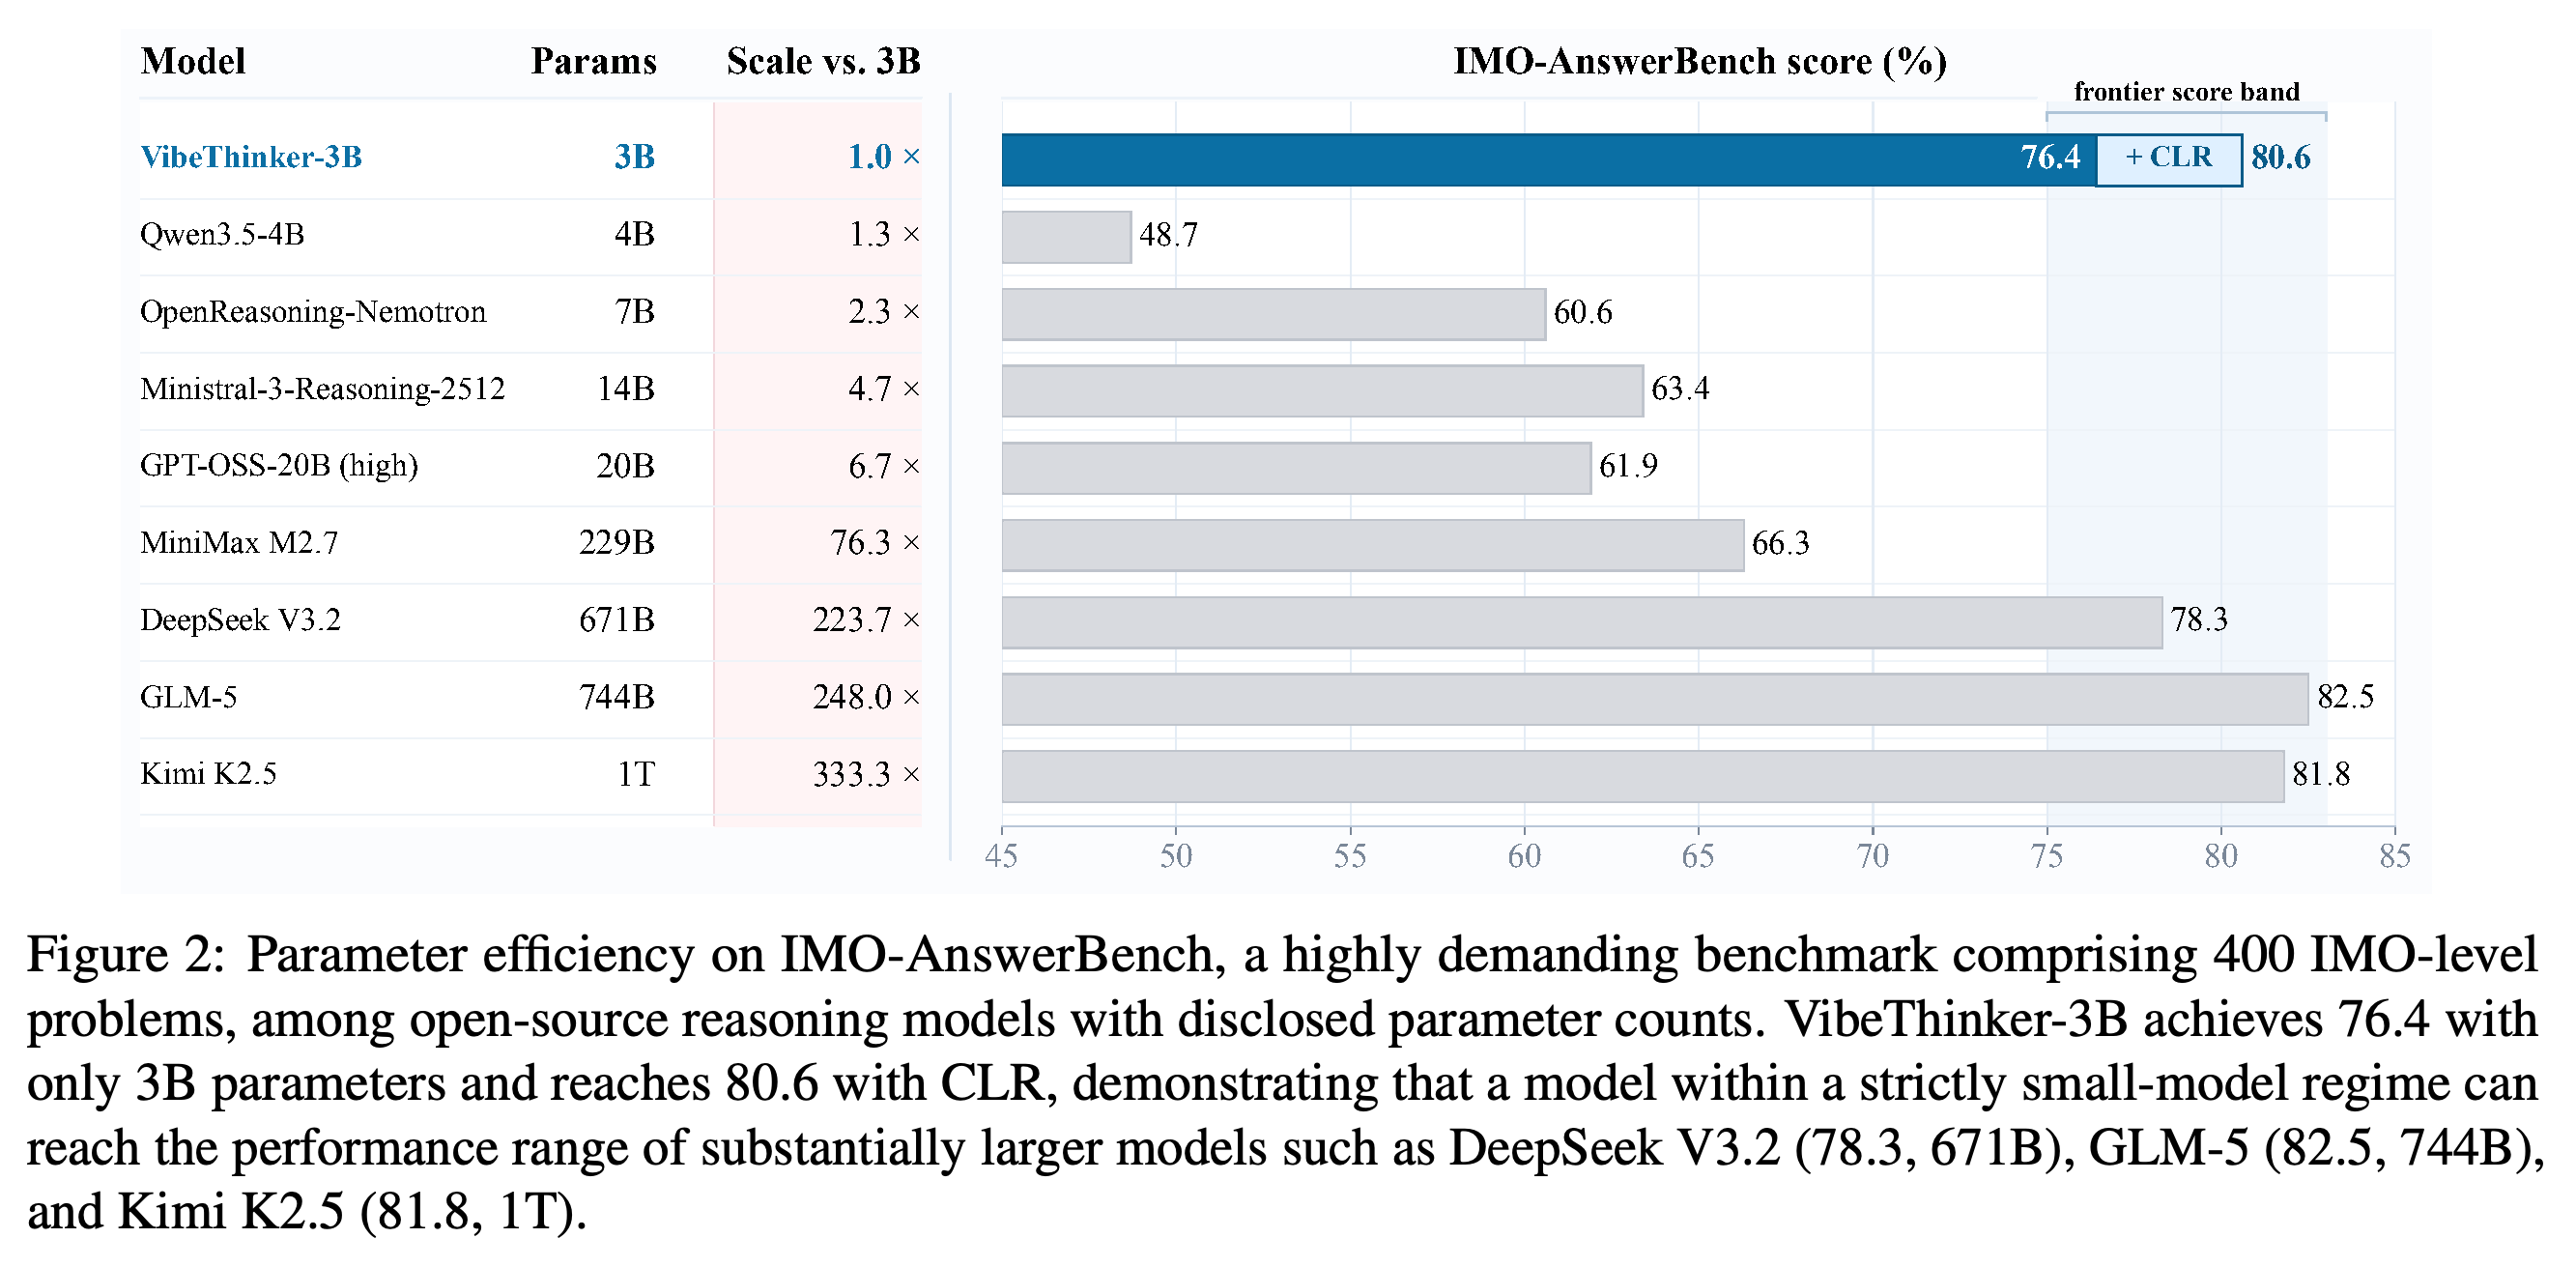
Parametric Compression-Coverage Hypothesis는 재사용 가능한 탐색 및 제약 해결 절차처럼 적은 파라미터에 압축할 수 있는 능력과, 폭넓은 사실 지식과 의미를 포괄하기 위해 많은 파라미터가 필요한 능력을 구분한다. 관련된 Reasoning-Knowledge Decoupling Paradigm은 소형 추론 모델이 대형 범용 모델을 보완한다고 본다. Figure 2는 이 관점의 동기가 된 파라미터 수와 성능 비교를 보여주지만, 이러한 능력이 파라미터에 어떻게 인코딩되는지는 입증하지 않는다.
- 400문제로 구성된 IMO-AnswerBench에서 VibeThinker-3B는 76.4, CLR 적용 시 80.6을 기록한다. 비교 모델은 671B 파라미터의 DeepSeek V3.2가 78.3, 744B의 GLM-5가 82.5, 1T의 Kimi K2.5가 81.8을 기록한다.
- GPQA-Diamond의 격차는 이 가설과 부합하지만, 모델 간 벤치마크 비교로는 지식의 포괄 범위와 추론 능력을 분리할 수 없다.
VibeThinker-3B는 400문제로 구성된 IMO-AnswerBench에서 76.4를 기록하고, CLR 적용 시 80.6으로 오른다. 이는 DeepSeek V3.2의 78.3보다 높지만 GLM-5의 82.5와 Kimi K2.5의 81.8보다 낮다. 공개된 파라미터 수는 모델이 작다는 점을 보여주지만, CLR 확장에 필요한 추가 추론 작업량은 이 그래프에서 정량화하지 않는다.
2 Methods
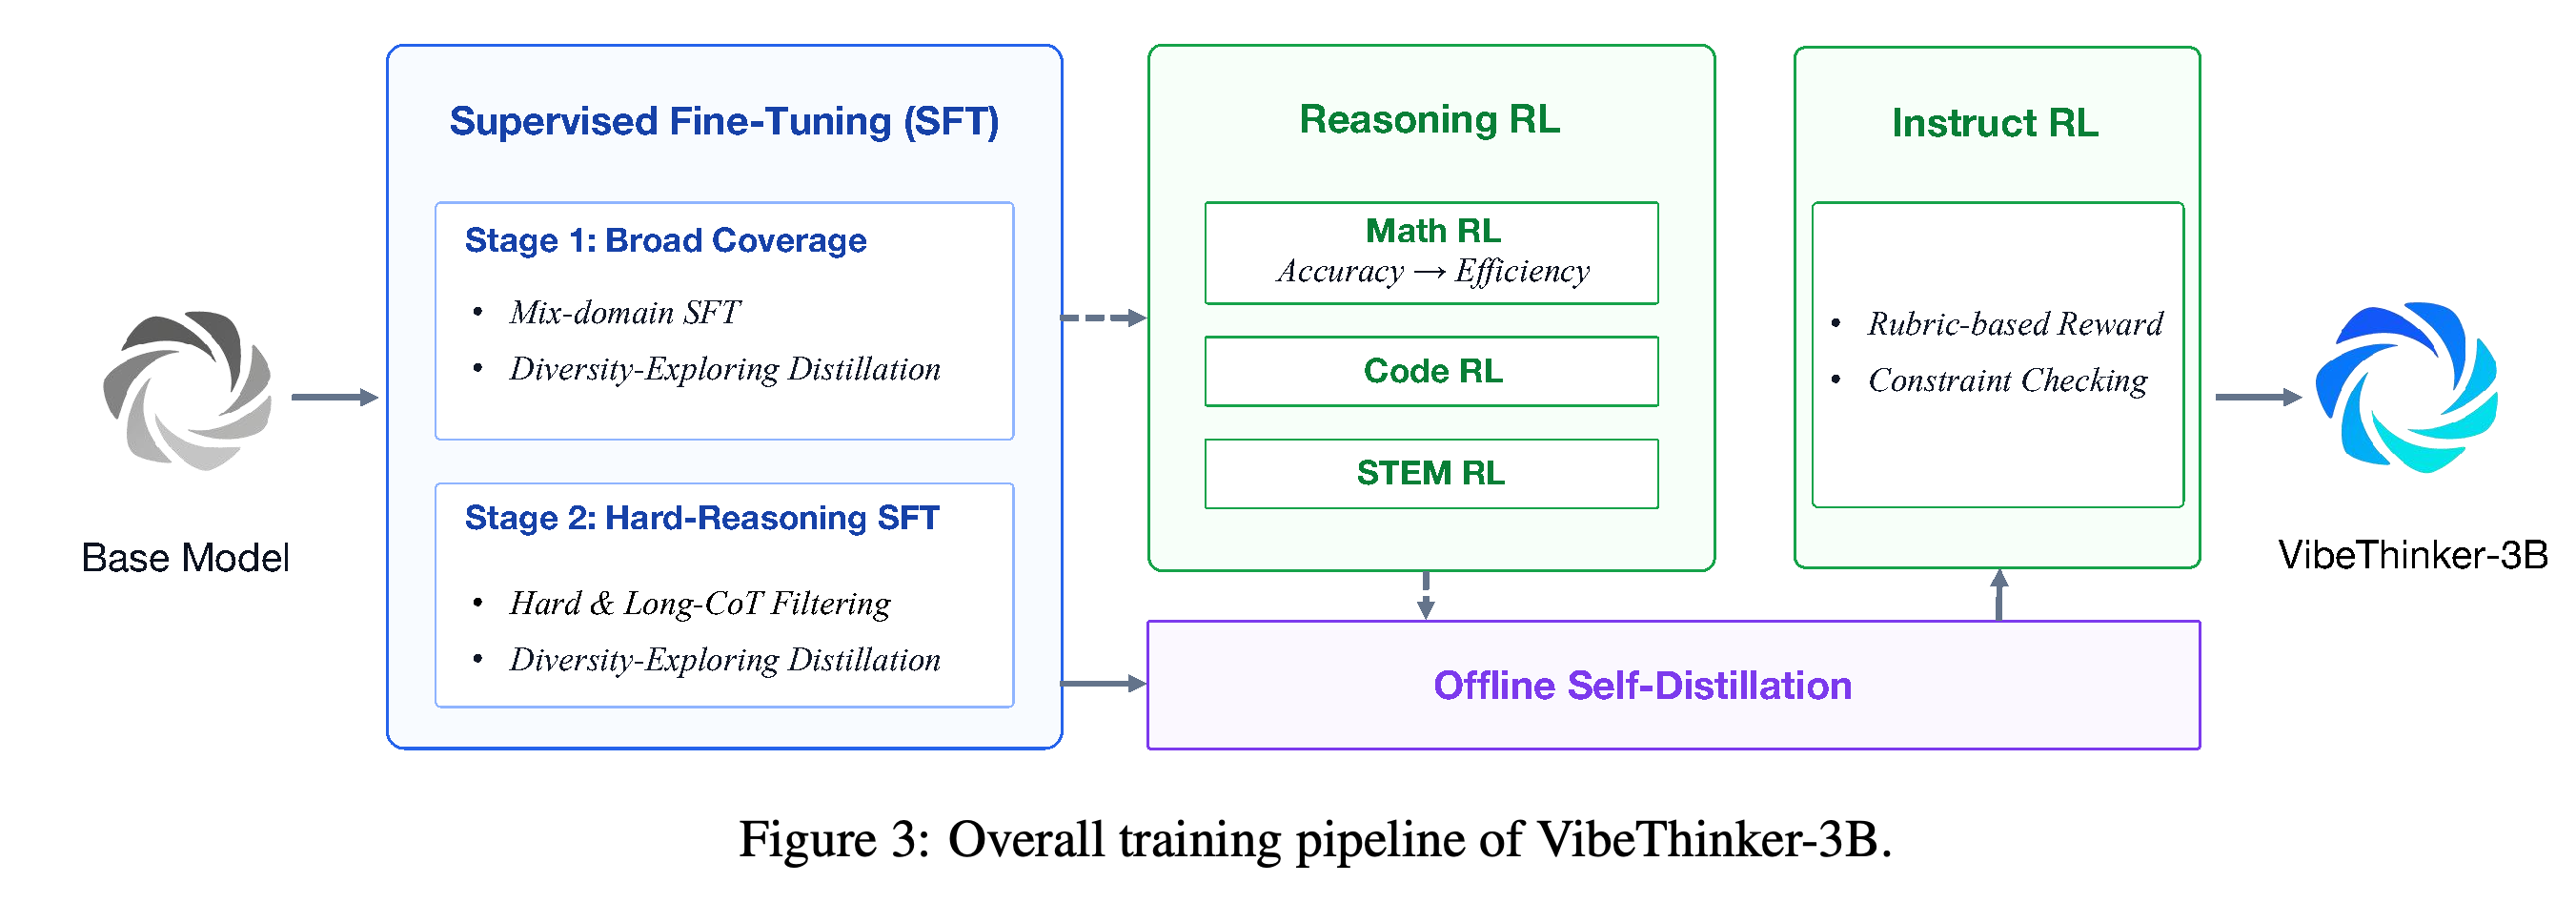
Figure 3은 Qwen2.5-Coder-3B base를 바탕으로 한 전체 사후학습 파이프라인을 보여준다. Diversity-Exploring Distillation은 2단계 SFT에서 다양한 풀이를 확보한다. 이어지는 Math, Code, STEM RL은 검증 가능한 추론을 강화하고, 오프라인 자기 증류는 단계별 능력을 통합한다. 마지막 Instruct RL은 지시 이행을 중심으로 정렬한다.
- 수학 RL 단계는 정확도 최적화에서 Long2Short 효율성 최적화로 전환한다.
- 도메인별 RL 단계의 체크포인트는 이후 통합 학생 모델에 검증된 궤적을 제공한다.
도식은 폭넓은 범위를 다루는 SFT와 어려운 추론을 위한 SFT를 구분하며, 두 단계 모두에 Diversity-Exploring Distillation을 적용한다. 추론 RL은 Math, Code, STEM 순서로 진행하고, 각 체크포인트는 제약 및 평가 기준 기반 Instruct RL에 앞서 오프라인 자기 증류에 사용된다. Math RL 블록은 정확도에서 효율성으로의 전환을 표시한다.
2.1 Supervised Fine-tuning
2.1.1 데이터 구성에서 SFT 데이터는 수학, 코드, STEM 추론, 일반 대화, 지시 이행을 포함한다. 데이터 합성과 질의 확장에 사용할 수학 시드 질의에는 신뢰할 만한 답이나 풀이 근거가 필요하고, 프로그래밍 시드에는 신뢰할 만한 테스트나 실행 가능한 평가 규칙이 필요하다. 확장 과정에서는 개념 조합, 풀이의 기본 구조, 제약 조건, 평가 목표를 바꾼다.
- 강력한 교사 모델들이 초기 필터링을 거친 합성 질의에 대해 독립적으로 응답을 샘플링하고, 다수결로 의사 레이블을 생성한다.
- Multi-path Reasoning Distillation은 각 문제를 1개의 표준 풀이로 축소하지 않고, 여러 후보 추론 과정의 완전한 중간 단계와 다양한 유효 풀이법을 보존한다.
다층 품질 관리에서는 N-gram 필터링으로 반복적이거나 퇴화한 생성 결과와 평가 세트에 겹치는 데이터를 제거한다. LLM 기반 질의 필터링은 불완전하거나 불합리하거나 논리적으로 타당하지 않은 문제를 제외한다. 추론 과정의 정확성 필터링에는 답 검증, 샌드박스 실행, LLM 다수결을 함께 사용한다. 이후 데이터를 추론 길이와 난도에 따라 나눈다.
- 파이프라인에는 벤치마크 오염 제거와 감독 신호 검사가 명시적으로 포함되지만, 보고서는 데이터셋 규모, 교사 모델 이름, 세부 오염 판정 임계값을 제시하지 않는다.
2.1.2 학습 과정은 커리큘럼 기반 2단계 SFT 전략을 사용한다. 첫 단계는 품질 필터링을 거친 전체 데이터셋으로 학습하며, 시퀀스 패킹, 전역 배치 크기 128, 초기 학습률 5 × 10⁻⁵, 8 × 10⁻⁸까지의 코사인 감쇠, 5 epochs, 5% 선형 워밍업을 적용한다. 다음 단계는 같은 하이퍼파라미터로 2 epochs 동안 추가 학습한다. 이때 길이가 최소 5K 토큰인 추론 과정과 VibeThinker-1.5B의 8회 롤아웃에서 오류율이 최소 0.75인 문제를 유지한다.
- Diversity-Exploring Distillation은 SFT의 두 단계 모두에서 중간 체크포인트를 도메인별 Pass@K로 평가한다. 검증 손실이 가장 낮거나 Pass@1이 가장 높은 모델이 아니라, 유효한 풀이를 생성하는 능력을 기준으로 전문 모델을 선택한다.
- 전문 모델들을 파라미터 수준에서 병합해 통합 SFT 모델을 만든다. 보고서는 병합 규칙이나 평가용 세트의 K를 명시하지 않는다.
2.2 Reinforcement Learning
2.2.1 알고리즘 기반으로 사용하는 MaxEnt-Guided Policy Optimization(MGPO)은 샘플링한 G개 응답 그룹의 경험적 정답률에 따라 각 프롬프트에 가중치를 부여한다. 정답률은 (p(q)=\frac{1}{G}\sum_{i=1}^{G}\mathbb{I}(r_i=1))이다. 프롬프트 가중치는 w(q) = exp(−γ DME(p(q) ∥ p₀))이며, p₀ = 0.5와 γ > 0을 사용해 정답과 오답 궤적이 함께 있는 그룹을 선호한다.
- 이 가중치는 GRPO 방식의 클리핑된 토큰 수준 확률비 목적함수 안에서 그룹 상대 advantage에 곱해진다.
- 저자들은 DME를 최대 엔트로피 지점 0.5에서의 편차로 설명하지만, 이 보고서에는 명시적인 수식을 제시하지 않는다.
- 모든 RL 단계는 학습과 추론 사이의 확률 불일치를 줄이기 위해 on-policy 방식으로 진행한다. 저자들은 이 불일치가 학습을 불안정하게 만들거나 붕괴시킬 수 있음을 관찰했다.
2.2.2 다중 도메인 추론 RL에서는 각 도메인의 학습 데이터로 벤치마크 오염을 제거하고 신뢰할 만한 감독 신호를 갖춘 샘플을 사용한다. 시작 체크포인트의 정확도가 정확히 0.0 또는 1.0인 프롬프트는 제외한다. 수학 보상은 주로 최종 답을 검증하고, 코드 보상은 샌드박스 테스트를 실행하며, STEM 보상은 답 일치 확인과 선택지 검증을 결합한다.
VibeThinker-3B는 기존 1.5B system과 달리 추론 RL 전체에서 단일 64K 컨텍스트 윈도우를 사용한다. 저자들은 초기에 추론 과정이 많이 잘리는 설정으로 학습하면 긴 추론을 하는 행동이 약화되고, 이후 컨텍스트를 확장해도 완전히 회복되지 않았다고 보고한다.
- 저자들은 더 강한 SFT 초기 모델에 이미 유용한 장기 추론 과정이 포함되어 있어, 잘림이 주로 잡음이 많은 추론을 억제하기보다 유효한 행동을 훼손한다고 가정한다. 다만 컨텍스트 길이 조정 일정에 대한 정량적 ablation 실험은 제공하지 않는다.
- RL 학습은 Math, Code, STEM 순서로 진행한다. 각 단계는 각각 기호적 유도와 탐색, 실행 가능한 논리와 경계 사례, 여러 분야에 걸친 과학 추론을 목표로 한다.
- 최종 순차 학습 체크포인트에만 의존하지 않고, 각 도메인 단계의 체크포인트를 오프라인 자기 증류에 사용하도록 보존한다.
Long2Short Math RL은 정확도 중심 MGPO 이후에 수행하는 2번째 수학 RL 단계다. 오답 보상은 그대로 두고 더 짧은 정답 응답을 선호하도록 한다. 정답 궤적 C에서 sᵢ = 1/Lᵢ이고 평균 간결성 점수가 s̄일 때, 보상은 r′ᵢ = rᵢ + λ(sᵢ − s̄)/maxⱼ∈C|sⱼ − s̄|가 되며 λ = 0.2를 사용한다.
- 모든 정답 궤적의 길이가 같으면 보상은 바뀌지 않는다.
- 평균을 중심으로 계산한 보상 변화량의 합은 C에서 0이다. 따라서 정답 부분집합과 전체 그룹의 평균 보상을 모두 보존하면서 정답 경로 사이의 상대적 선호를 바꾼다.
- 목표는 검증 성능을 유지하면서 불필요한 추론을 제거하는 것이다. 다만 보고서는 실제 토큰 감소량이나 정확도와 길이 사이의 절충 관계를 제시하지 않는다.
2.3 Offline Self-Distillation
오프라인 자기 증류는 Math, Code, STEM RL 체크포인트에서 얻은 검증된 궤적을 SFT로 1개의 학생 모델에 전달한다. Learning-potential Filtering은 검증기 기반 rejection sampling 이후 학생 모델의 길이 정규화 음의 로그우도로 추론 과정을 평가한다. 점수는 SLP(q, y) = −(1/|y|) ∑ₜ₌₁^|y| log πθstu(yₜ | q, y<t)이며, 학생 모델이 아직 잘 모델링하지 못하는 정답 추론 과정을 우선한다.
- 선택은 전체 순위가 아니라 도메인별 길이 구간 안에서 이루어진다.
- 극도로 짧은 추론 과정과 점수가 지나치게 높은 이상치를 제거한 뒤, 검증된 중상위 점수의 추론 과정을 여러 도메인에 걸쳐 혼합한다.
- 필터링은 비정상 토큰에 대한 민감도, 형식 오류, 분포 변화, 잡음이 있는 샘플에 대응하지만, 구간 경계와 선택 비율은 명시하지 않는다.
2.4 Instruct RL
Instruct RL은 추론 능력을 강화한 체크포인트를 형식에 민감한 프롬프트, 긴 컨텍스트 지시, 일반 정렬 예제로 학습한다. 명시적 제약에는 형식, 순서, 항목 수, 키워드, 완성 여부에 대한 규칙 기반 보상을 부여한다. 개방형 프롬프트에는 유용성, 일관성, 지시 준수, 중복 정도에 대한 평가 기준 기반 보상을 부여한다.
- 두 보상 체계는 같은 on-policy RL 프레임워크 안에서 작동한다.
- 최종 IFEval과 IFBench 결과는 높은 제약 준수 성능을 보여준다. 하지만 Instruct RL의 기여를 분리하거나 이전 능력이 바뀌지 않았음을 입증하는 전후 비교는 없다.
3 Evaluation
평가는 최종 3B 모델을 수학, 실행으로 검증하는 코딩, 과학 지식, 지시 이행 영역에서 살펴본다. 표준 벤치마크 결과에 최근 대회 코딩 결과와 별도의 CLR 적용 추론 설정을 추가한다.
3.1 Evaluation Setup
수학 벤치마크는 AIME25, AIME26, HMMT25, BruMO25, IMO-AnswerBench이고, 코딩 벤치마크는 LiveCodeBench v6와 OJBench다. GPQA-Diamond는 대학원 수준의 과학 추론을 측정하고, IFEval과 IFBench는 명시적인 지시 제약을 평가한다.
- 별도로 명시하지 않는 한 VibeThinker-3B는 vLLM에서 temperature 1.0, top-p = 0.95, top-k = −1로 실행한다. 모델의 최대 생성 길이 외에 추가적인 출력 길이 제한은 두지 않는다.
- 수학 채점에는 math verify와 LLM-as-judge를 함께 사용한다. 코딩의 정확성은 생성한 풀이를 테스트에 실행해 판정한다.
- 수학 점수는 독립적인 생성 64회의 Pass@1 평균을 보고하며, 예외인 IMO-AnswerBench는 16회를 사용한다. 지식 벤치마크는 생성 16회, 코딩 벤치마크는 8회를 사용한다. 비교 모델 점수는 동일 조건의 재평가가 아니라 공개 보고서, 공개 리더보드, 공식 평가 기록에서 가져온다.
CLR은 주장 수준의 신뢰도 평가로 테스트 시점의 추론을 확장한다. 표준 샘플링 설정으로 K = 32개의 후보 궤적을 생성하고, 각 최종 답과 함께 판단에 중요한 주장 M = 5개를 추출한다. 모델은 이 주장들을 이진 판정 vₖ,ₘ으로 자기 검증하고, 신뢰도 (r_k=\left(\frac{1}{M}\sum_{m=1}^{M}v_{k,m}\right)^M)를 부여한다. 이후 Score(G) = ∑{k | yₖ∈G} rₖ를 최대화하는 동치 답 클러스터를 선택한다.
- 비선형 신뢰도 점수는 샘플링한 모든 답에 같은 가중치를 부여하는 대신, 기각된 중간 주장이 있는 궤적에 불이익을 준다.
- 전체 절차를 독립적으로 8회 반복하고, 최종 답의 평균 Pass@1을 “+ CLR”로 보고한다. 이는 단일 생성 궤적이 아니라 여러 샘플을 이용하는 선택 절차를 측정한다.
- 저자들은 전체 추론 과정을 자기 검증하는 방식보다 토큰 소비가 적다고 주장하지만, 비교 토큰 수, 지연 시간 측정값, 검증 정확도 분석은 제공하지 않는다.
3.2 Evaluation Results
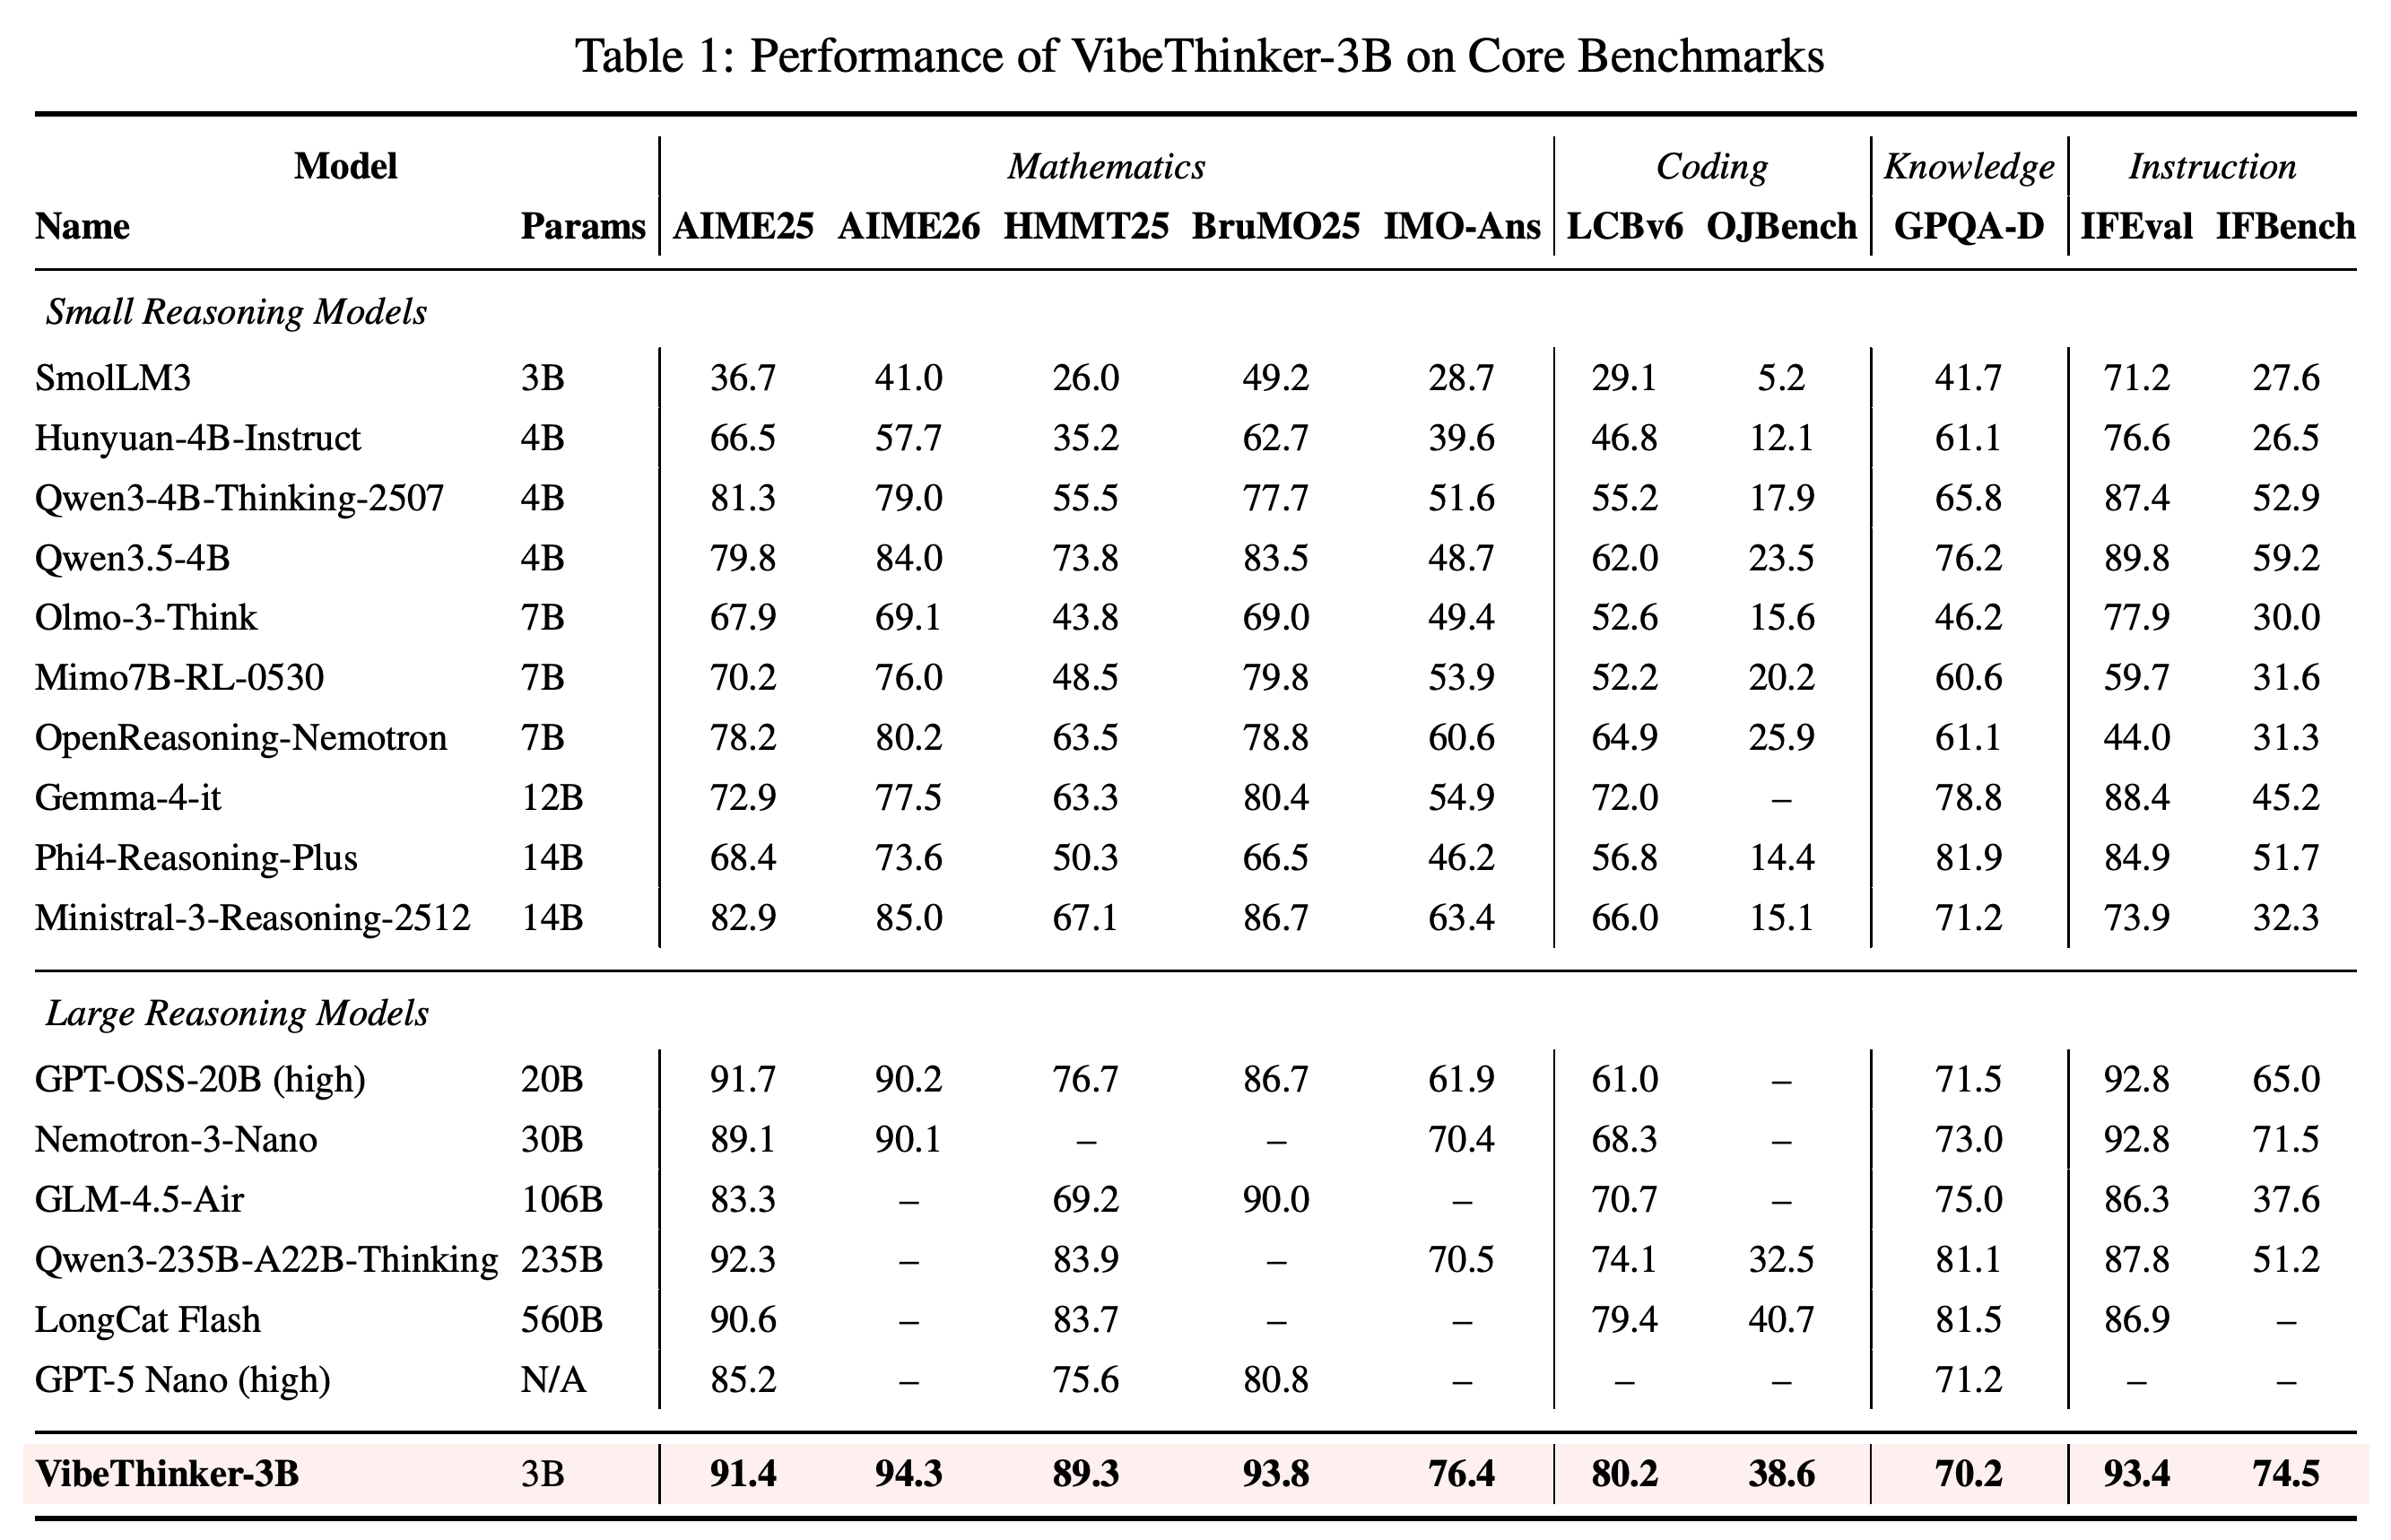
결과는 파라미터 수를 늘리는 것만으로 이러한 성능에 도달하는지가 아니라, 완성된 3B 시스템이 선도적인 추론 모델에 근접할 수 있는지를 다룬다. 핵심 벤치마크 성능을 정리한 Table 1에서 AIME25는 91.4, AIME26은 94.3, HMMT25는 89.3, BruMO25는 93.8, IMO-AnswerBench는 76.4를 기록한다. 이 수학 벤치마크 전체에서 14B 모델을 포함해 표에 나열된 모든 소형 모델 기준선을 넘는다.
- LiveCodeBench v6는 80.2로 Table 1에서 보고한 가장 높은 값이다. 반면 OJBench는 38.6으로 LongCat Flash의 40.7보다 낮다.
- IFEval 93.4와 IFBench 74.5는 Table 1에서 보고한 가장 높은 값이다. 이는 최종 모델의 높은 지시 이행 성능을 보여주지만, 이전 학습 단계 대비 능력 보존을 입증하지는 않는다.
Table 1은 우위가 모든 평가 영역에 걸쳐 나타나지는 않는다는 점도 보여준다. GPQA-Diamond는 70.2로, Qwen3.5-4B의 76.2와 Phi4-Reasoning-Plus의 81.9보다 낮다.
- 이 양상은 압축 가능한 추론 절차와 폭넓은 지식 범위를 구분하는 저자들의 관점과 부합한다. 하지만 학습 데이터, 초기 모델, 평가 조건의 차이 때문에 인과적으로 해석할 수는 없다.
VibeThinker-3B는 수학 벤치마크 전체에서 표에 나열된 소형 추론 모델을 앞서며, 이 비교에서 보고된 LiveCodeBench v6, IFEval, IFBench 점수도 가장 높다. OJBench는 LongCat Flash보다 낮고, GPQA-Diamond는 Qwen3.5-4B를 포함한 여러 모델보다 낮아 우위가 모든 영역에 걸쳐 나타나지는 않음을 보여준다.
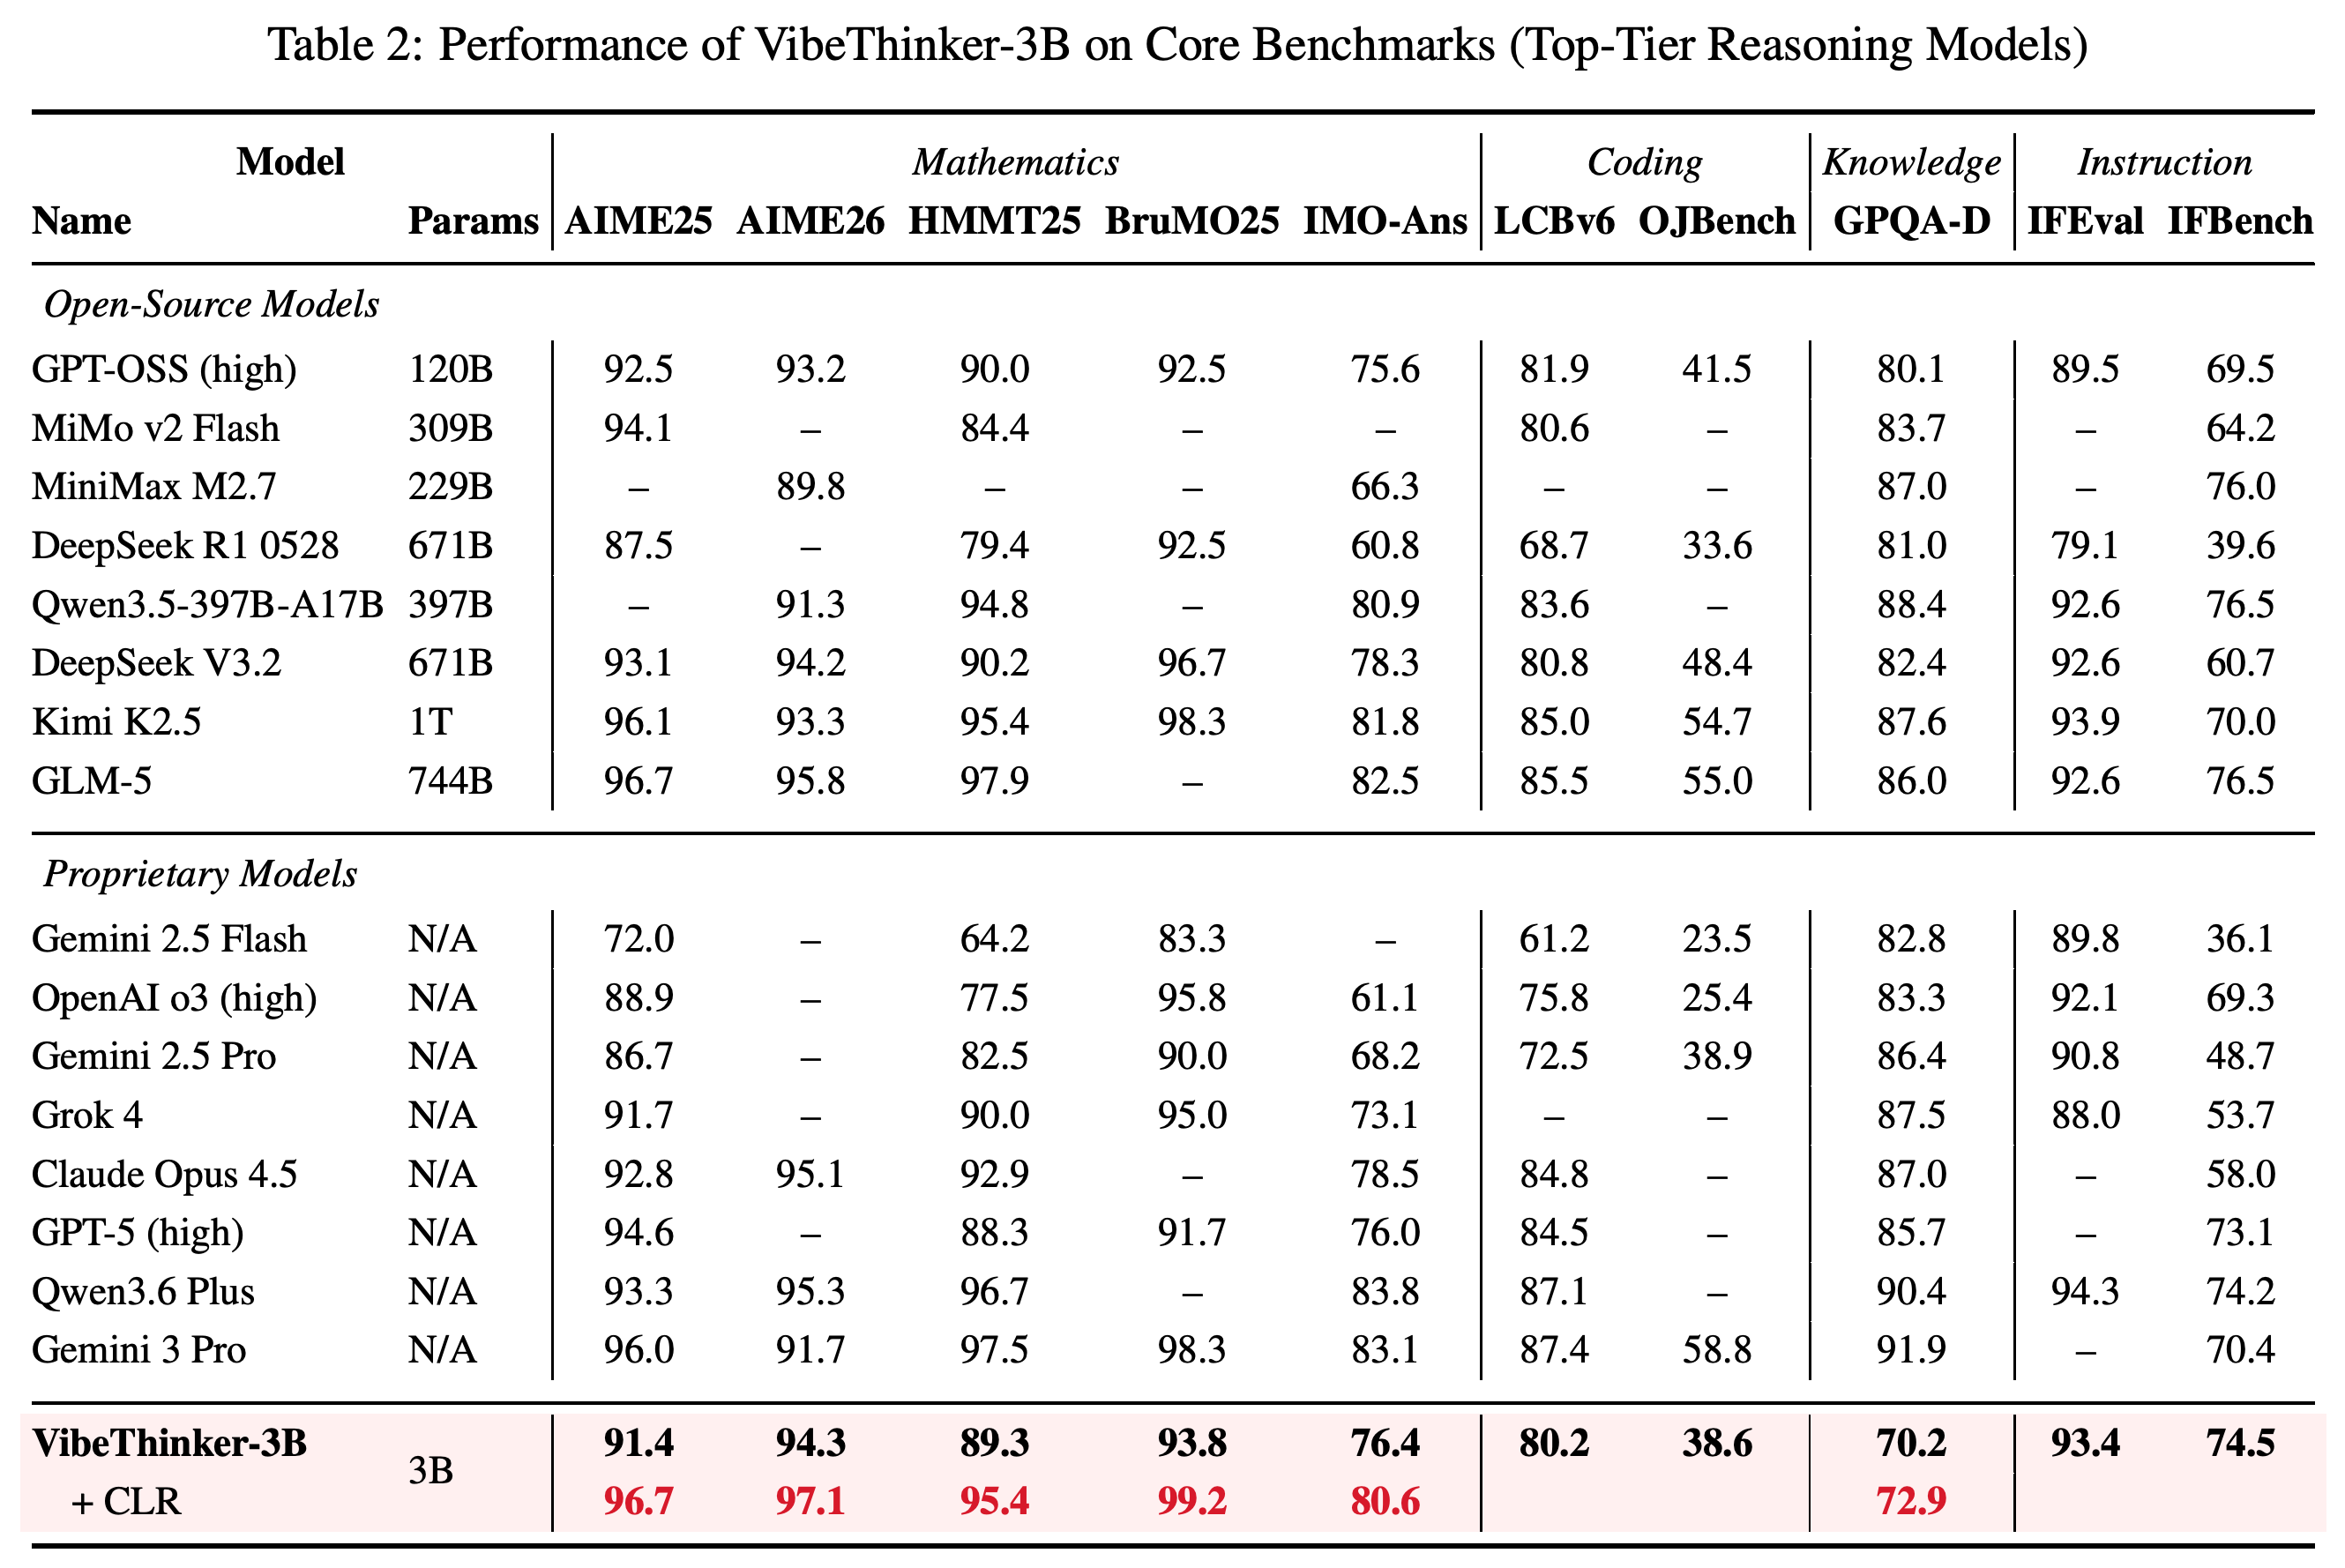
최상위 추론 모델과 비교한 Table 2에서 기본 AIME26 점수는 94.3으로, DeepSeek V3.2의 94.2와 Kimi K2.5의 93.3에 근접한다. CLR은 수학 점수를 AIME25 96.7, AIME26 97.1, HMMT25 95.4, BruMO25 99.2, IMO-AnswerBench 80.6으로 높인다.
- CLR을 적용한 AIME26과 BruMO25는 Table 2에 보고된 모든 비교값을 넘지만, IMO-AnswerBench는 GLM-5의 82.5와 Qwen3.6 Plus의 83.8보다 낮다.
- 기본 LiveCodeBench v6 점수 80.2는 DeepSeek V3.2의 80.8에 가깝지만 Gemini 3 Pro의 87.4보다 낮다. OJBench 38.6도 Gemini 3 Pro의 58.8보다 낮다.
- GPQA-Diamond는 CLR을 적용하면 70.2에서 72.9로 오르지만, Gemini 3 Pro는 91.9를 기록한다. 결과는 벤치마크별 경쟁력을 뒷받침할 뿐, 대표적인 최상위 시스템과의 전반적인 동등성을 뒷받침하지는 않는다.
기본 설정과 “+ CLR”을 분리한 행은 가장 높은 수학 점수를 얻는 데 추가 샘플링과 자기 검증이 필요함을 보여준다. CLR 적용 시 AIME26은 97.1, BruMO25는 99.2를 기록하지만, GPQA-Diamond는 72.9에 머물며 CLR을 적용한 코딩 결과는 보고하지 않는다. 따라서 수학에서의 경쟁력이 대표 최상위 모델과의 전반적인 동등성을 뜻하지는 않는다.
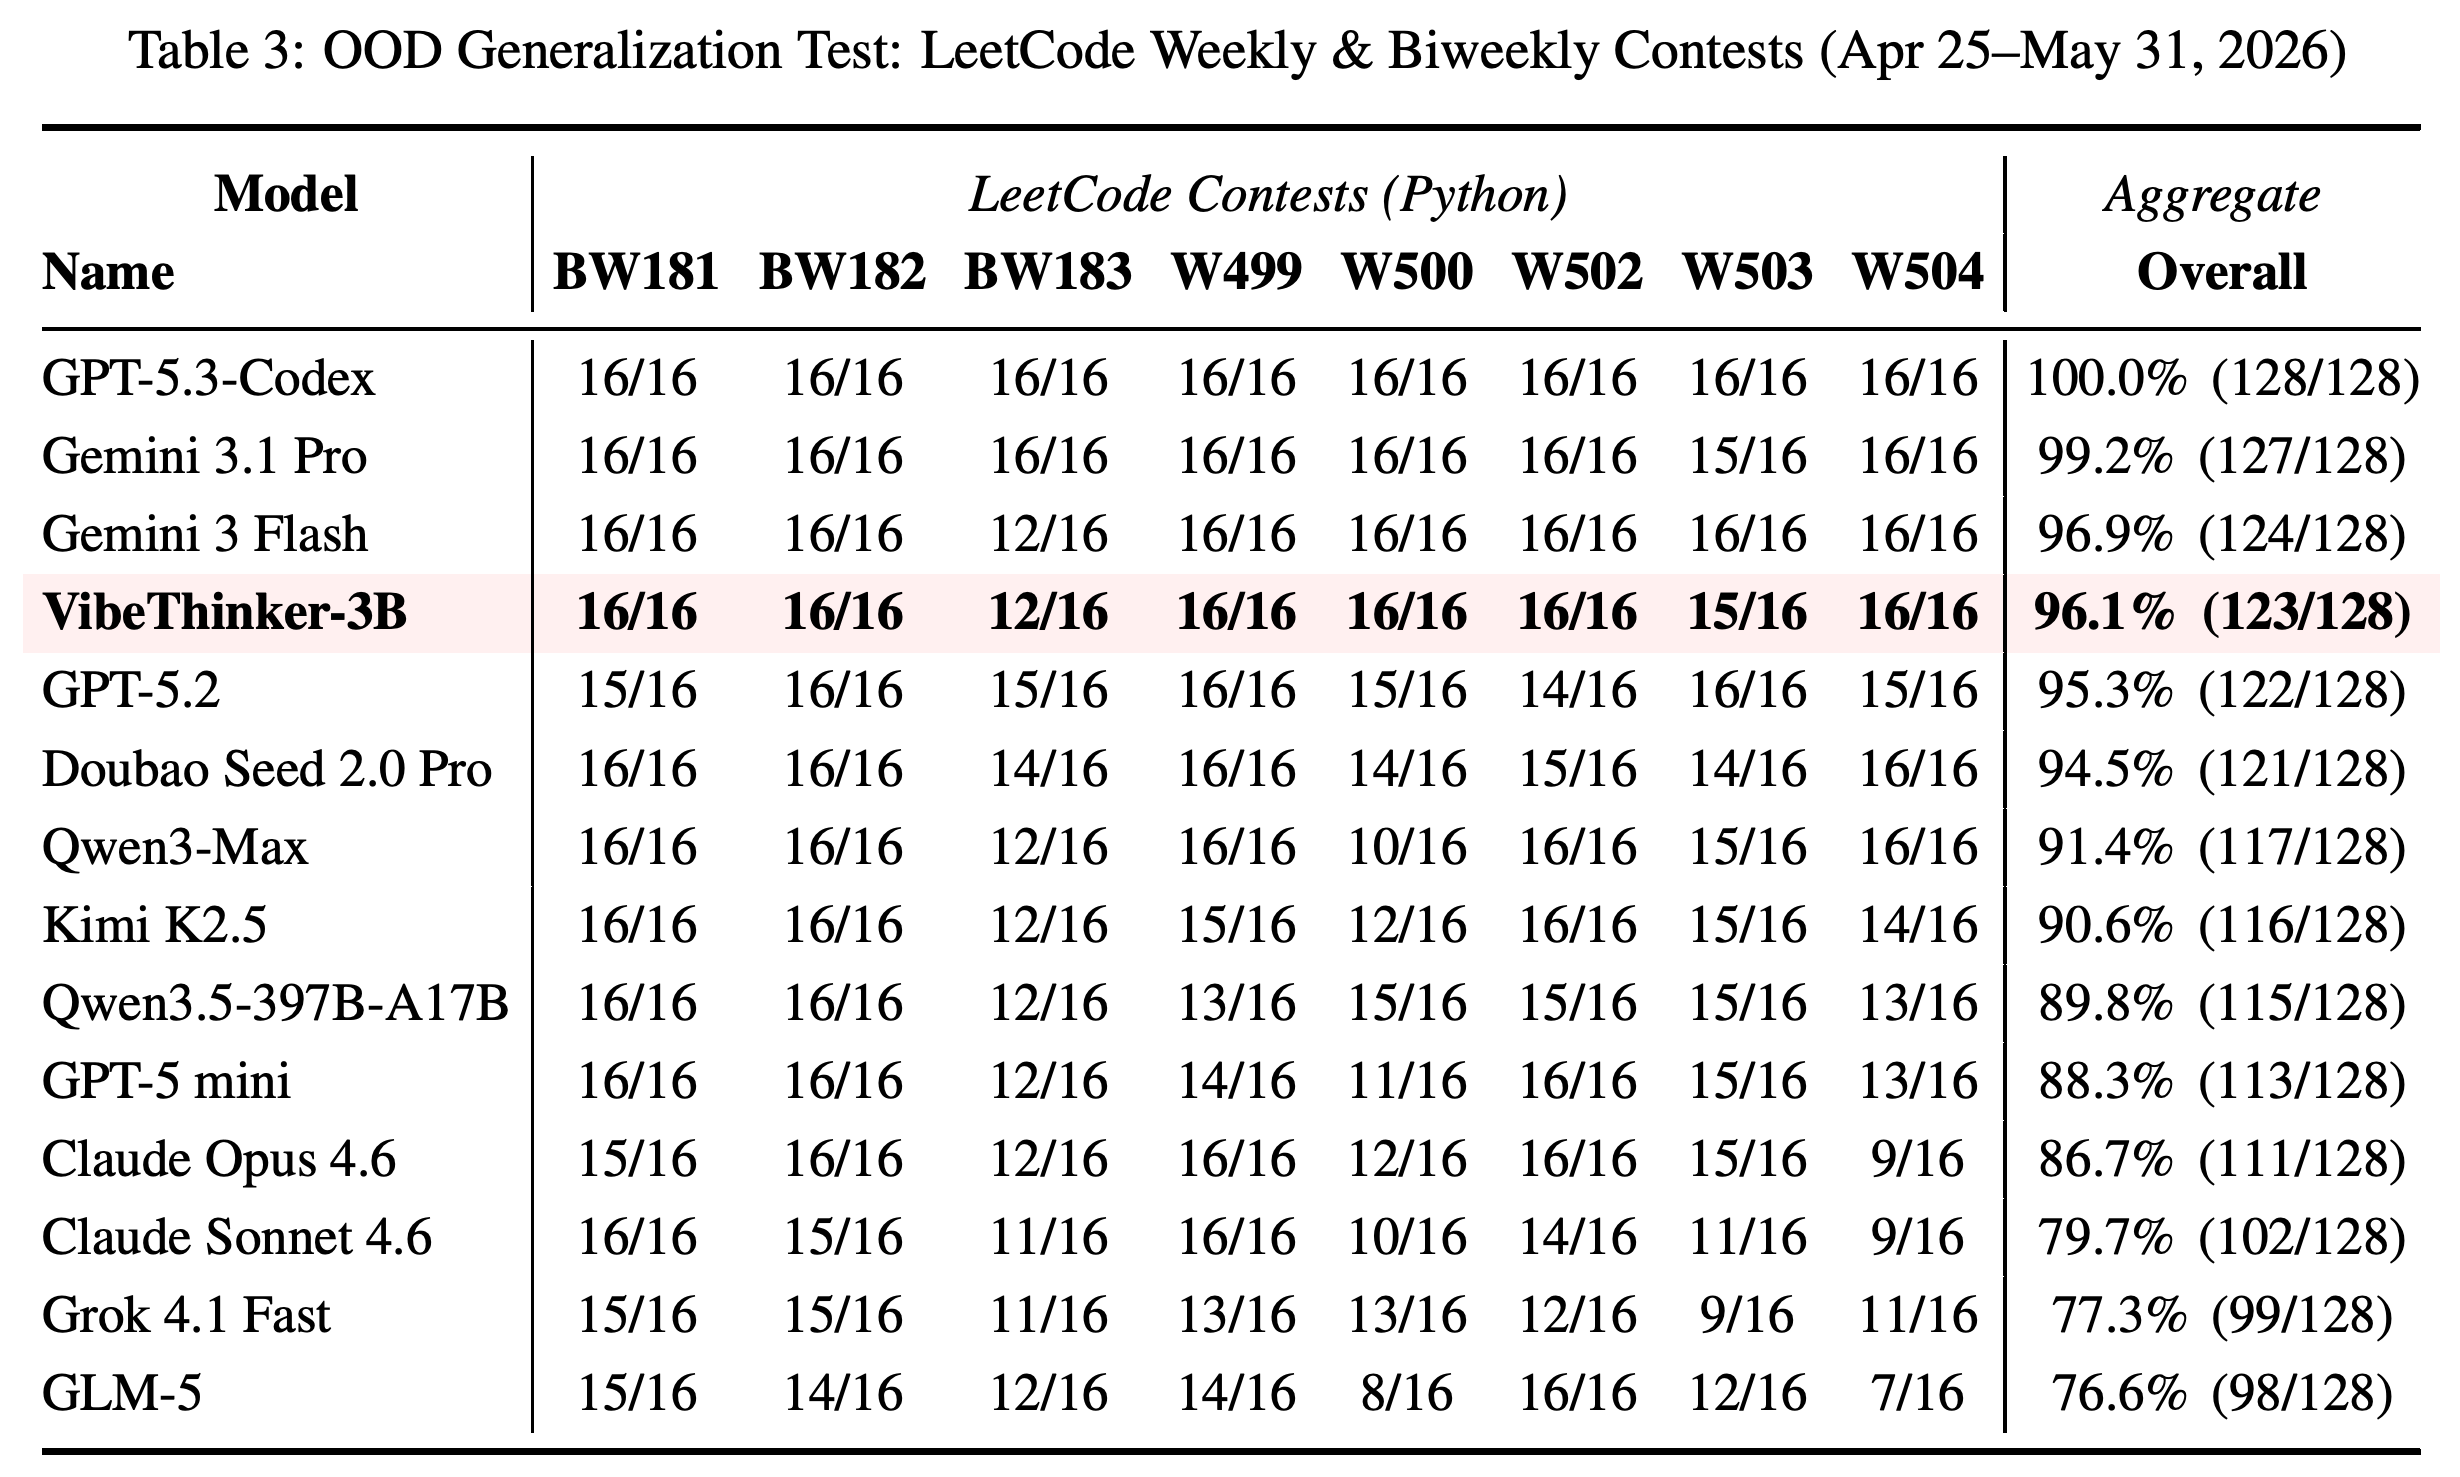
최근 LeetCode 대회 일반화 시험을 정리한 Table 3은 Apr. 25–May 31, 2026 대회를 대상으로 Python만 사용하는 one-shot 생성을 평가한다. 대회당 4문제와 문제당 4회의 독립 롤아웃으로 대회당 최초 시도 제출 수는 16건이 된다. BW181, BW182, BW183, W499, W500, W502, W503, W504 전체에서 VibeThinker-3B의 통과 비율은 123/128이며, 96.1%를 기록한다.
- 실패가 발생한 대회는 12/16을 기록한 BW183과 15/16을 기록한 W503이다. 나머지 6개 대회는 16/16이다.
- 총 통과 수는 Gemini 3 Flash의 124/128과 GPT-5.2의 122/128 사이이며, GPT-5.3-Codex의 128/128과 Gemini 3.1 Pro의 127/128보다 낮다.
- W501은 공개 LeetCode LLM 순위 데이터가 없어 제외한다. 평가 대상은 서로 다른 128개 과제가 아니라 32개 문제다. 저자들은 학습에서 보지 않은 대회라고 설명하지만, 이를 독립적으로 확인할 학습 데이터 마감 시점은 제시하지 않는다.
VibeThinker-3B는 8개 대회에서 서로 다른 32개 문제마다 4회 롤아웃을 수행해, 독립적인 최초 시도 Python 제출 128건 중 123건을 통과한다. 총 통과 수는 Gemini 3 Flash보다 1건 적고 GPT-5.2보다 1건 많다. 실패 5건 중 4건은 BW183에서 발생한다. 서로 다른 과제 수가 제한적이라는 점을 고려해 이러한 작은 차이를 해석해야 한다.
4 Conclusion
결론은 VibeThinker-3B를 특화된 사후학습을 통해 소형 모델도 복잡하고 검증 가능한 여러 과제에서 대표적인 최첨단 시스템의 성능 범위에 진입할 수 있다는 근거로 제시한다. 수학, 코딩, 최근 대회 결과를 Parametric Compression-Coverage Hypothesis로 해석하고, 소형 추론 모델이 대형 범용 모델을 보완한다고 본다.
- 평가는 이 특정 3B 시스템의 높은 성능을 입증하지만, 비슷한 추론 성능에 필요한 최소 파라미터 수를 확정하지는 않는다.
- 재사용 가능한 추론 핵심 절차가 폭넓은 지식보다 쉽게 압축된다는 설명은 여전히 파라미터 표현에 관한 가설이다.
부록
- 제공된 PDF에는 부록이 없으며, 11–14페이지에는 결론과 참고문헌이 있다. 보고서는 2026년 6월 15일자 arXiv:2606.16140v1이며, 프로젝트 자료를 https://github.com/WeiboAI/VibeThinker 및 https://huggingface.co/WeiboAI/VibeThinker-3B에서 제공한다.
짧은 생각
가장 강한 근거는 서로 다른 채점 방식에서 나온 결과다. AIME26은 94.3, 실행으로 검증하는 LiveCodeBench v6는 80.2, 제약 기반 IFEval은 93.4를 기록한다. 상대적으로 약한 GPQA-Diamond와 OJBench 비교는 최첨단 수준의 추론이라는 포괄적 주장보다 모델의 강점과 한계를 더 명확하게 보여준다.
주요 미해결 문제는 성능 향상의 원인과 전체 효율성이다. 보고서는 SFT 하이퍼파라미터와 보상 수식을 제공하지만, 구성 요소별 ablation 실험, 완전한 학습 데이터 명세, 연산 예산, 실제 Long2Short 절감량, 연산량을 맞춘 CLR 기준선은 제시하지 않는다. 파라미터 수 대비 성능을 입증된 종단 간 효율성과 동일시해서는 안 된다. 비교 점수를 공개 자료에서 가져왔고 불확실성 구간도 없으므로, 작은 점수 차이만으로 우위를 입증하기는 어렵다. 학습 단계별 평가와 동일한 토큰 예산에서 CLR을 일반적인 답 다수결과 비교하는 실험이 있다면 학습과 추론의 기여를 더 명확히 구분할 수 있다.